
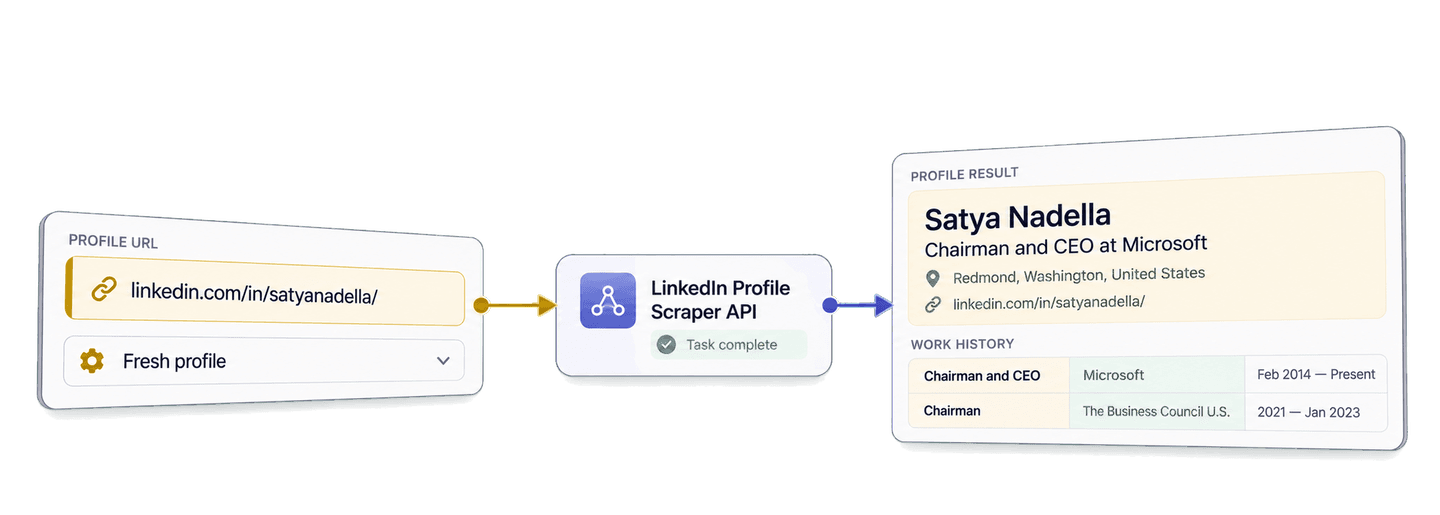
Puoi fare scraping dei profili LinkedIn in Python inviando URL pubblici già noti alla LinkedIn Profile Scraper API di Datablist tramite la libreria Requests. L’API restituisce campi strutturati relativi a identità, località, esperienze lavorative, formazione e azienda, utili per creare liste di lead e personalizzare l’outreach con informazioni pertinenti sul ruolo e sull’azienda.
Questa guida usa l’URL del profilo pubblico di Satya Nadella come esempio compatto. Eseguirai un task completo di scraping del profilo, interpreterai il ruolo in Microsoft e le esperienze lavorative con relative date, quindi assocerai il risultato al lead di origine prima di preparare l’outreach.
🔑 Riepilogo per chi va di fretta: Invia a Datablist gli URL noti di profili LinkedIn personali e recupera i dati disponibili su profilo, località, esperienze lavorative, formazione e aziende in formato JSON strutturato. L’esempio Python qui sotto mantiene queste informazioni associate a ogni lead di origine, così puoi qualificare la lista e preparare un outreach più pertinente.
- Input: URL noti di profili LinkedIn personali.
- Output: Dati strutturati del profilo associati a ogni contatto di origine.
💡 Preferisci una soluzione no-code? Usa LinkedIn Profile Scraper di Datablist per estrarre i dati da URL di profili noti senza scrivere codice.
Configurare l’API Datablist e l’ambiente Python
L’accesso alla REST API di Datablist è incluso nel piano Growth. Il recupero dei profili consuma anche crediti di enrichment, che analizzerò nella sezione dedicata ai costi.
Crea una Personal API Key dalla pagina API del tuo account Datablist. Questo esempio mostra il formato della Personal API Key:
exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2🔑 Hai già una API key? Le chiavi meno recenti usano il formato
auth0|<userId>:<accountId>:<secret>:1e continuano a essere supportate. Usa la chiave esistente esattamente come è stata generata: non devi sostituirla né modificarne il formato.
Lo script legge la chiave dalla variabile d’ambiente DATABLIST_API_KEY e la invia nell’header X-API-Key.
Per questo esempio Python uso il package requests. I comandi di configurazione seguenti sono pensati per una shell macOS o Linux. Crea una cartella per il progetto, aprila nel terminale ed esegui:
python -m venv .venv
source .venv/bin/activate
python -m pip install requestsOra crea un file chiamato scrape_linkedin_profiles.py ed esporta la chiave:
export DATABLIST_API_KEY="your-personal-api-key"Eseguire lo scraping completo di un profilo LinkedIn in Python
Il record di origine usato in questa guida contiene un ID contatto stabile e un URL di profilo noto:
{
  "contact_id": "contact-satya-nadella",
  "profile_url": "https://www.linkedin.com/in/satyanadella/"
}
Lo script invia contact_id come inputId dell’API. I risultati non arrivano necessariamente nello stesso ordine degli input, quindi questo ID permette di associare in modo affidabile ogni risultato al relativo contatto di origine.
Incolla lo script completo seguente in scrape_linkedin_profiles.py:
import json
import os
import time
import uuid
import requests
def scrape_profiles(source_contacts, api_key):
"""Submit one task, wait for completion, and return every result page."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": contact["contact_id"],
"data": {"profileUrl": contact["profile_url"]},
}
for contact in source_contacts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "linkedin-profile-scraper",
"uniqueId": unique_id,
"settings": {
"experiencesNb": "5",
"educationsNb": "3",
"acceptCachedProfiles": False,
"includeUrn": False,
"includePictures": False,
},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
source_contacts = [
{
"contact_id": "contact-satya-nadella",
"profile_url": "https://www.linkedin.com/in/satyanadella/",
}
]
profile_results = scrape_profiles(source_contacts, api_key)
print(json.dumps(profile_results, indent=2))Eseguilo con:
python scrape_linkedin_profiles.pyLe impostazioni richiedono cinque esperienze lavorative e tre percorsi di formazione. L’API si aspetta che questi valori siano stringhe. acceptCachedProfiles: false richiede un recupero aggiornato, mentre le opzioni relative alle immagini e agli ID interni restano disattivate perché questo workflow utilizza campi testuali e URL persistenti.
Per ogni input, usa un URL pubblico standard di tipo /in/ oppure l’URL di un lead in Sales Navigator. Il nome di una persona, una pagina di ricerca LinkedIn e una pagina aziendale corrispondono a operazioni diverse e non sono input validi per questo scraper. Se la fonte contiene link di Sales Navigator, il profileUrl restituito può essere l’URL pubblico normalizzato del profilo. Per liste più grandi, mantieni ogni inputId univoco e stabile, invece di ricavarlo dalla posizione della riga.
I valori relativi allo storico determinano quanti campi numerati e non nidificati l’API può restituire per esperienze lavorative e formazione. Non modificano il costo in crediti per profilo. Richiedi uno storico sufficiente per la tua analisi, ma evita di selezionare dieci esperienze se prevedi di esaminare soltanto gli ultimi ruoli.
Come funzionano le tre chiamate API
La richiesta POST invia le impostazioni selezionate e gli input dei profili. Datablist accetta l’elaborazione come task in background e ne restituisce l’@id. Lo script mostra sia il uniqueId generato sia l’ID del task restituito, fornendoti i valori necessari per controllarlo in seguito.
La prima chiamata GET verifica lo stato del task ogni tre secondi. Il client Python rimane in attesa, mentre il task API continua a essere eseguito in background. Il loop termina quando lo stato diventa completed, failed o stopped.
La seconda chiamata GET recupera i risultati in pagine contenenti fino a 100 record. Se nextCursor contiene un valore, lo script carica la pagina successiva. Si ferma quando nextCursor è null.
Leggere il risultato e scegliere le impostazioni corrette
L’URL inviato determina quale profilo verrà recuperato dallo scraper. Datablist accetta URL pubblici di profili personali e URL di lead in Sales Navigator, normalizza l’URL del profilo quando necessario e mappa i dati pubblici disponibili in campi non nidificati relativi a profilo, lavoro, formazione e azienda.
La ricerca aggiornata usata in questa guida è stata completata correttamente e ha consumato 25 crediti. Ecco il risultato completo:
{
  "inputId": "contact-satya-nadella",
  "status": "success",
  "outputs": {
    "profileUrl": "https://www.linkedin.com/in/satyanadella/",
    "fullName": "Satya Nadella",
    "firstName": "Satya",
    "lastName": "Nadella",
    "linkedInHeadline": "Chairman and CEO at Microsoft",
    "linkedInSummary": "As chairman and CEO of Microsoft, I define my mission and that of my company as empowering every person and every organization on the planet to achieve more.",
    "linkedInProfilePicture": "https://media.licdn.com/dms/image/v2/C5603AQHHUuOSlRVA1w/profile-displayphoto-shrink_800_800/profile-displayphoto-shrink_800_800/0/1579726625483?e=1794441600&v=beta&t=I1sL---bTuvjxqb1vdbNsNy-fAsLCpBj3-WtJjOGbOc",
    "linkedInInternalIdentifier": "ACoAAAEkwwAB9KEc2TrQgOLEQ-vzRyZeCDyc6DQ",
    "linkedInLocation": "Redmond, Washington, United States",
    "linkedInCity": "Redmond",
    "linkedInState": "Washington",
    "linkedInCountryName": "United States",
    "linkedInCountryCode": "US",
    "linkedInLanguages": "",
    "linkedInConnections": 832,
    "linkedInlastExpTitle": "Chairman and CEO",
    "linkedInlastExpCompany": "Microsoft",
    "linkedInlastExpEmploymentType": null,
    "linkedInlastExpLocation": "Greater Seattle Area",
    "linkedInlastExpStartsAt": "2014-02-01",
    "linkedInlastExpEndsAt": null,
    "linkedInlastExpDescription": null,
    "linkedInlastExpCompanyWebsite": "https://news.microsoft.com/",
    "linkedInlastExpCompanyPage": "https://www.linkedin.com/company/microsoft/",
    "linkedInlastExpCompanyIndustry": "Software Development",
    "linkedInlastExpCompanyRange": "10001+",
    "linkedInlastExpCompanyDescription": "Every company has a mission. What's ours? To empower every person and every organization to achieve more. We believe technology can and should be a force for good and that meaningful innovation contributes to a brighter world in the future and today. Our culture doesn’t just encourage curiosity; it embraces it. Each day we make progress together by showing up as our authentic selves. We show up with a learn-it-all mentality. We show up cheering on others, knowing their success doesn't diminish our own. We show up every day open to learning our own biases, changing our behavior, and inviting in differences. Because impact matters. \n\nMicrosoft operates in 190 countries and is made up of approximately 228,000 passionate employees worldwide.",
    "linkedInlastExpCompanyLogo": "https://media.licdn.com/dms/image/v2/D560BAQH32RJQCl3dDQ/company-logo_200_200/B56ZYQ0mrGGoAM-/0/1744038948046/microsoft_logo?e=1793836800&v=beta&t=4wXD40LQU4IfLY4DiEvT2bwvjUoPQPGgi5_T-vPsbQ8",
    "linkedIn2ExpTitle": "Chairman",
    "linkedIn2ExpCompanyName": "The Business Council U.S.",
    "linkedIn2ExpEmploymentType": null,
    "linkedIn2ExpStartsAt": "2021-01-01",
    "linkedIn2ExpEndsAt": "2023-01-01",
    "linkedIn2ExpDescription": null,
    "linkedIn2ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQGcnaZNpjMvrw/company-logo_200_200/company-logo_200_200/0/1630557702704/the_business_council_us_logo?e=1793836800&v=beta&t=Ejb0D8lV5sMTFwcz_-FKdfQvIvq-mKx_Nl8vRMib53k",
    "linkedIn3ExpTitle": "Member Board Of Trustees",
    "linkedIn3ExpCompanyName": "University of Chicago",
    "linkedIn3ExpEmploymentType": null,
    "linkedIn3ExpStartsAt": "2018-01-01",
    "linkedIn3ExpEndsAt": null,
    "linkedIn3ExpDescription": null,
    "linkedIn3ExpLogo": "https://media.licdn.com/dms/image/v2/D4E0BAQGDP-PXY3u8dw/company-logo_200_200/B4EaENqZTQGoAM-/0/1791230580227/uchicago_logo?e=1793836800&v=beta&t=NJGoETr0tY868Z2pvlyXeh939iXwW0WbSFwRctabEVU",
    "linkedIn4ExpTitle": "Board Member",
    "linkedIn4ExpCompanyName": "Starbucks",
    "linkedIn4ExpEmploymentType": null,
    "linkedIn4ExpStartsAt": "2017-01-01",
    "linkedIn4ExpEndsAt": "2024-01-01",
    "linkedIn4ExpDescription": null,
    "linkedIn4ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQEQxk9y2rk7Hw/company-logo_200_200/company-logo_200_200/0/1631316692275?e=1793836800&v=beta&t=NVjljhe0oI5KzvJHodAJjss5EdvxaOIzQQ2rAGyh_AQ",
    "linkedIn5ExpTitle": "Board Member",
    "linkedIn5ExpCompanyName": "Fred Hutch",
    "linkedIn5ExpEmploymentType": null,
    "linkedIn5ExpStartsAt": "2016-01-01",
    "linkedIn5ExpEndsAt": "2022-01-01",
    "linkedIn5ExpDescription": null,
    "linkedIn5ExpLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQGF4eOou62nvQ/company-logo_200_200/company-logo_200_200/0/1664795263764/fredhutch_logo?e=1793836800&v=beta&t=dJWSO-KkuBPd6I6aRYBoIcQVzcSEmGLwqYy-VMFXJQc",
    "linkedInlastEduSchool": "The University of Chicago Booth School of Business",
    "linkedInlastEduDegree": null,
    "linkedInlastEduField": null,
    "linkedInlastEduStartsAt": "1994-01-01",
    "linkedInlastEduEndsAt": "1996-01-01",
    "linkedInlastEduPage": "https://www.linkedin.com/school/universityofchicagoboothschoolofbusiness/",
    "linkedInlastEduLogo": "https://media.licdn.com/dms/image/v2/D560BAQFZO05jhYKSkw/company-logo_200_200/company-logo_200_200/0/1692627816910/universityofchicagoboothschoolofbusiness_logo?e=2147483647&v=beta&t=BTjFA4UVU5iKIIyicg8d44rhoiuMbetNDB97BmqpwhQ",
    "linkedIn2EduSchool": "Manipal Institute of Technology",
    "linkedIn2EduDegree": "Bachelor’s Degree",
    "linkedIn2EduField": "Electrical Engineering",
    "linkedIn2EduStartsAt": null,
    "linkedIn2EduEndsAt": null,
    "linkedIn2EduPage": "https://www.linkedin.com/school/manipal-institute-of-technology/",
    "linkedIn2EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQHodG_7cUqs6w/company-logo_200_200/B4DZ8hC8AUJQAE-/0/1782965846314/manipal_institute_of_technology_logo?e=2147483647&v=beta&t=jqJK15_r7lxUNgWdbbzdMq47aLa_PqnkDYxg4Jun4Zo",
    "linkedIn3EduSchool": "University of Wisconsin-Milwaukee",
    "linkedIn3EduDegree": "Master’s Degree",
    "linkedIn3EduField": "Computer Science",
    "linkedIn3EduStartsAt": null,
    "linkedIn3EduEndsAt": null,
    "linkedIn3EduPage": "https://www.linkedin.com/school/uwmilwaukee/",
    "linkedIn3EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQE47QlO_LG8SQ/company-logo_200_200/company-logo_200_200/0/1729615751602/uwmilwaukee_logo?e=2147483647&v=beta&t=l-w3ttd1mZRc-_j5aCPXEzNiYJzl1iJjMGw7q8B3eRI"
  },
  "creditsUsed": "25",
  "error": null
}
Leggi insieme il ruolo, il datore di lavoro e le date di inizio e fine. L’esperienza in Microsoft inizia a febbraio 2014 e non ha una data di fine. Quella presso The Business Council U.S. va dal 2021 a gennaio 2023. Queste date permettono di distinguere un’esperienza ancora in corso da una conclusa e mostrano anche come più ruoli possano sovrapporsi.
linkedInlastExpTitle e linkedInlastExpCompany contengono l’esperienza attuale o l’ultima esperienza mappata. Questa prima voce può includere informazioni più dettagliate sull’azienda, come pagina aziendale, sito web, settore, descrizione e fascia di dipendenti. Le voci numerate aggiungono ruoli, datori di lavoro e date precedenti. In questa risposta, il sito Microsoft restituito è https://news.microsoft.com/. Questo URL offre al record del lead una fonte aziendale utile, insieme allo storico professionale della persona.
I campi linkedInlastEduSchool, linkedIn2EduSchool e linkedIn3EduSchool indicano The University of Chicago Booth School of Business, Manipal Institute of Technology e University of Wisconsin-Milwaukee. La voce relativa a Manipal include un Bachelor’s Degree in Electrical Engineering, mentre quella di Wisconsin-Milwaukee include un Master’s Degree in Computer Science. Per Chicago, i valori relativi al titolo di studio e all’ambito sono vuoti.
Usa i valori "3", "5" o "10" per experiencesNb e "1", "3" o "5" per educationsNb, in base alla quantità di storico necessaria. Quando sono utili alla tua ricerca, leggi questi campi direttamente da outputs. Un valore opzionale vuoto non rende non valido l’intero risultato.
La modalità fresh è adatta alla preparazione di liste di lead quando vuoi recuperare nuovamente i dati pubblici disponibili del profilo. La modalità cached può restituire un profilo già archiviato a un costo inferiore in crediti e, se non è disponibile nella cache, passare a un nuovo recupero. Scegli in base al livello di aggiornamento desiderato e al budget di crediti.
Preparare i record dei lead per l’outreach
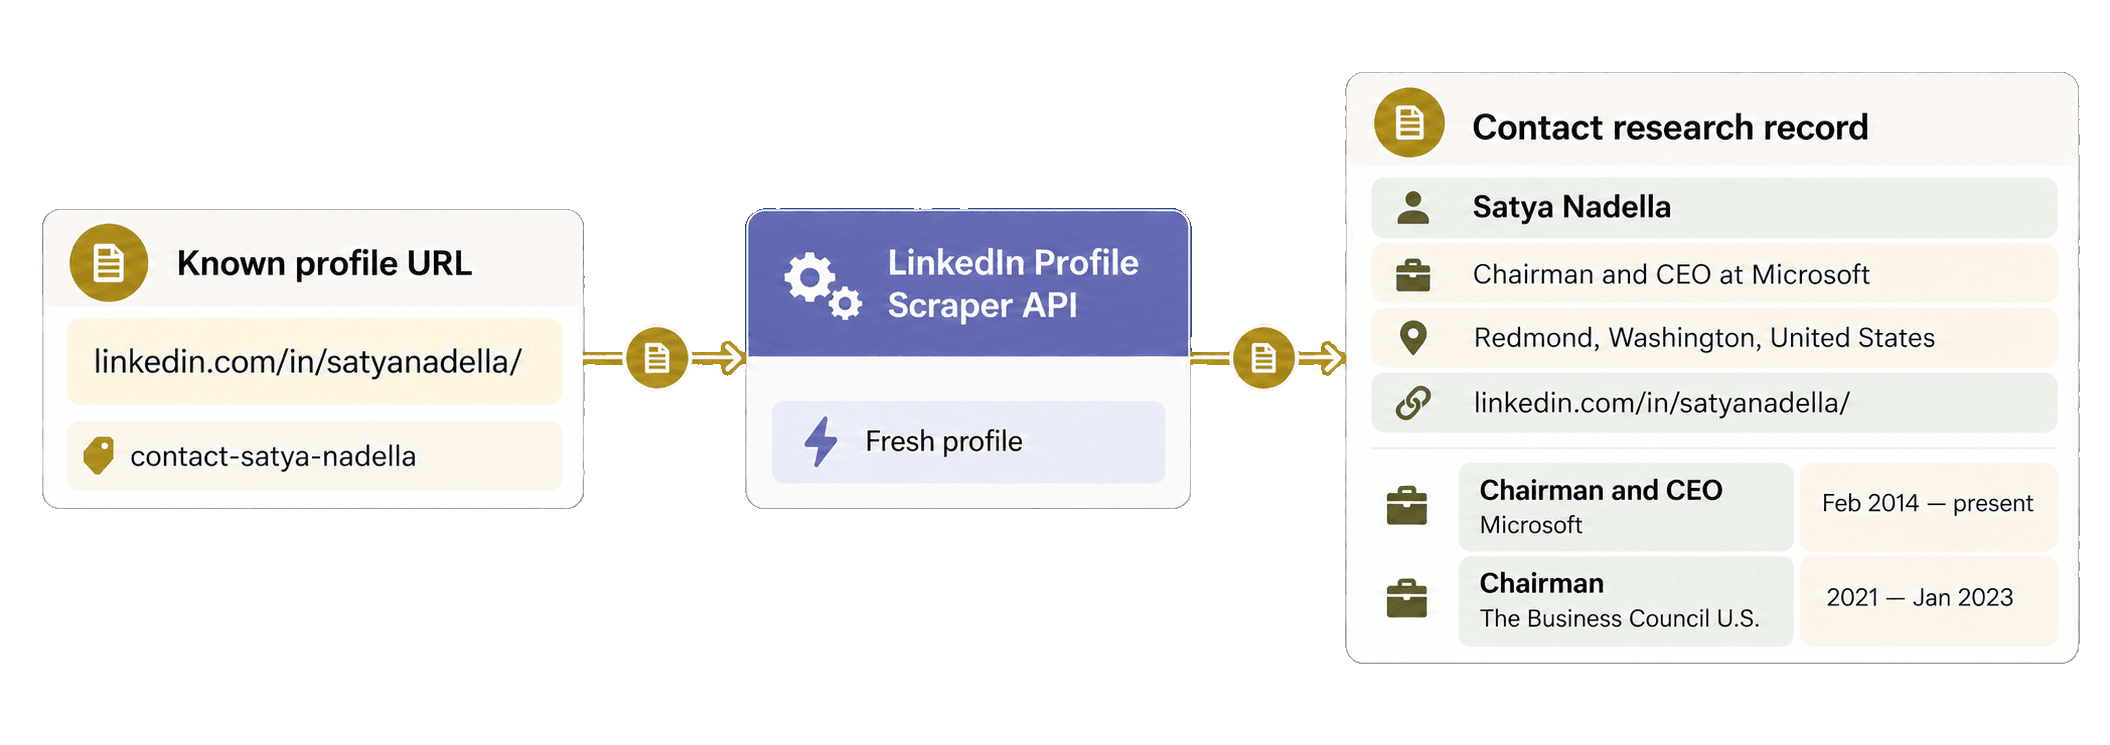
Quando profile_results è disponibile, puoi associare ogni risposta al relativo contatto di origine senza inviare un altro task. Il blocco seguente riutilizza le variabili create dallo script completo:
results_by_input_id = {
result["inputId"]: result
for result in profile_results
}
contact_research = []
for contact in source_contacts:
result = results_by_input_id[contact["contact_id"]]
contact_research.append(
{
"contact_id": contact["contact_id"],
"source_profile_url": contact["profile_url"],
"result_status": result["status"],
"profile": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
research_record = contact_research[0]
profile = research_record["profile"]
print("Contact:", profile.get("fullName"))
print("Headline:", profile.get("linkedInHeadline"))
print("Location:", profile.get("linkedInLocation"))
print(
"First work entry:",
profile.get("linkedInlastExpTitle"),
"at",
profile.get("linkedInlastExpCompany"),
)Il dizionario indicizzato per inputId gestisce le risposte ricevute in ordine diverso dagli input. contact-satya-nadella resta sia l’ID di origine sia l’ID API, l’URL LinkedIn noto rimane in source_profile_url e profile conserva l’oggetto outputs originale senza modifiche.
Questo wrapper mantiene il profilo completo restituito insieme all’URL di origine, allo stato API e ai crediti utilizzati. Puoi usare headline, località e prima esperienza lavorativa mostrate in output per qualificare il lead e aggiungere all’outreach informazioni pertinenti sul ruolo o sull’azienda. Le righe API non riuscite mantengono lo stato e l’errore restituiti, così restano visibili nella lista di lead.
Puoi scaricare l’esempio con Requests in modalità bloccante oppure usare l’alternativa asincrona con HTTPX dopo aver compreso il flusso bloccante.
Calcolare il costo dello scraping dei profili LinkedIn
Un recupero fresh consuma 25 crediti per profilo. Quando i profili cached sono abilitati, un risultato disponibile nella cache consuma 20 crediti; se invece manca, il sistema può comunque eseguire un recupero fresh da 25 crediti. L’esempio fresh di Satya Nadella ha utilizzato 25 crediti.
Per 1.000 profili, il recupero richiede quindi 20.000 crediti se tutti i profili richiesti sono disponibili nella cache, oppure fino a 25.000 crediti con il recupero fresh. L’accesso alla REST API di Datablist richiede il piano Growth. L’abbonamento, i crediti inclusi e gli eventuali top-up sono componenti di costo separate. Consulta la pagina dei prezzi per il listino aggiornato.
Usando come riferimento per la pianificazione l’attuale top-up base di 20 USD per 20.000 crediti, i crediti consumati corrispondono a un costo stimato di 20 USD per elaborare 1.000 profili tutti disponibili nella cache, oppure 25 USD per un’elaborazione fresh. Queste stime non includono il costo dell’abbonamento Growth.
Risolvere gli errori comuni e recuperare un task
DATABLIST_API_KEYnon è presente: lo script si interrompe prima di effettuare una richiesta. Esporta la variabile, quindi esegui nuovamente il file.- L’API rifiuta la chiave: controlla la Personal API Key e invia soltanto la credenziale
X-API-Keyusata in questo esempio. - L’URL del profilo è assente o non valido: usa un URL pubblico di un profilo personale LinkedIn oppure un URL di lead Sales Navigator supportato. Il nome di una persona, una pagina di ricerca o una pagina aziendale non sono input di profilo validi.
- I crediti non sono sufficienti: controlla il saldo, quindi usa i crediti inclusi o aggiungi un top-up prima di creare un altro task.
- Il task è
failedostopped: controlla l’errore, i risultati disponibili e i crediti utilizzati prima di decidere se sia necessario un nuovo invio a pagamento. - Un risultato contiene pochi dati oppure ha stato
no_resultoerror: controlla lo stato e l’errore pubblico, quindi verifica URL e impostazioni. I campi disponibili possono variare in base al profilo, alla sua visibilità e al recupero.
Se la connessione si interrompe durante la richiesta POST, usa il uniqueId mostrato prima dell’invio. Elenca i task recenti dello scraper e confronta i relativi valori prima di crearne un altro:
response = requests.get(
"https://api.datablist.com/v1/enrichments/tasks",
headers={"X-API-Key": api_key},
params={"enrichmentId": "linkedin-profile-scraper", "limit": 100},
)
response.raise_for_status()
printed_unique_id = "paste-the-printed-unique-id"
tasks = response.json()["tasks"]
matching_task = None
for task in tasks:
if task["uniqueId"] == printed_unique_id:
matching_task = task
break
if matching_task:
print("Task ID:", matching_task["@id"])La lista dei task può essere filtrata per enrichmentId, ma non per uniqueId. Segui il relativo nextCursor se il task non compare nella prima pagina. Una volta ottenuto l’ID del task, continua usando gli stessi URL di stato e risultati impiegati dalla funzione principale. La documentazione della task API spiega più nel dettaglio il ciclo di vita, la paginazione e il comportamento in caso di interruzione.
Prossimi passi
Ora hai una funzione Python Requests riutilizzabile che trasforma URL noti di profili LinkedIn in risultati strutturati, oltre a record di lead associati tramite un ID stabile. Sostituisci l’esempio con un piccolo gruppo di URL già verificati, scegli tra recupero fresh e cached in base al livello di aggiornamento e al costo in crediti che ti servono, quindi usa le informazioni restituite su ruolo e azienda per qualificare i lead o personalizzare l’outreach.
Se i tuoi input sono URL di pagine aziendali, segui invece la guida Python allo scraping dei dati aziendali di LinkedIn.
Se devi ancora trovare gli URL dei profili partendo da nomi e keyword relative ad aziende o istituti, consulta prima la guida separata per trovare profili LinkedIn in Python con una API, quindi esegui questo scraper.