
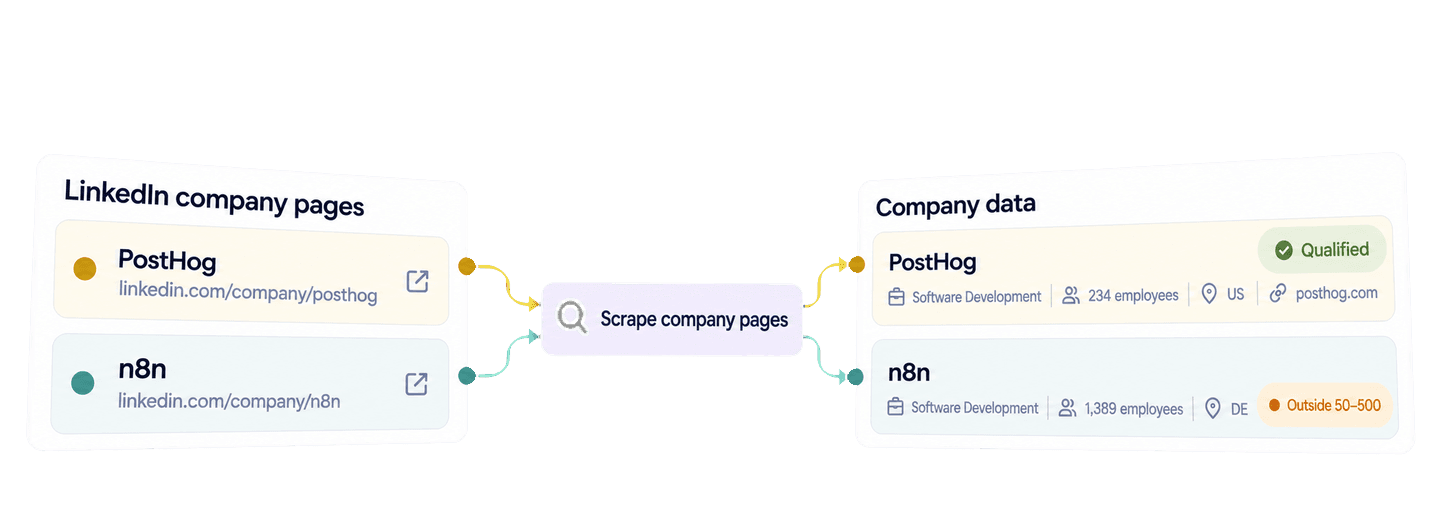
Puoi estrarre i dati aziendali da LinkedIn con Python inviando un elenco di URL di pagine aziendali all'API di Datablist tramite la libreria Requests. L'API restituisce record aziendali strutturati con dati come settore, numero di dipendenti, sede centrale, sito web e descrizione, quando disponibili sulla pagina aziendale pubblica.
In questa guida utilizzo un'unica funzione Python facile da leggere per recuperare i record di n8n, PostHog, Back Market e Datablist. Riutilizzo poi i risultati per qualificare le aziende software con 50-500 dipendenti e sede negli Stati Uniti o in Germania. Ogni record qualificato mantiene il sito web e la descrizione, utili per approfondire la sales research.
🔑 In breve, per chi ha fretta
Datablist trasforma URL verificati di pagine aziendali LinkedIn in record strutturati, pronti per un workflow di sales research. L'esempio Python qui sotto recupera tutte le pagine dei risultati e applica poi un filtro locale per qualificare gli account, senza effettuare una seconda chiamata API.
- Input: URL delle pagine aziendali LinkedIn.
- Output: dati aziendali disponibili e decisione di qualificazione locale, mantenendo insieme l'URL originale e l'output aziendale completo.
💡 Preferisci una soluzione no-code? Usa il LinkedIn Company Page Scraper di Datablist per estrarre i dati aziendali da URL noti di pagine LinkedIn senza scrivere codice.
Configura Python e la chiave API Datablist
Per questo esempio Python utilizzo il pacchetto requests. La REST API di Datablist è disponibile con il piano Growth e ogni ricerca su una pagina aziendale consuma crediti di enrichment.
Crea una Personal API Key dalla pagina API del tuo account Datablist.
Crea un file chiamato scrape_linkedin_companies.py, quindi prepara un ambiente virtuale e installa Requests:
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
export DATABLIST_API_KEY="your-api-key"Lo script legge la chiave da DATABLIST_API_KEY e la invia nell'header X-API-Key.
Estrai pagine aziendali LinkedIn con una funzione Python
L'elenco di partenza qui sotto include aziende con settori, dimensioni e Paesi della sede centrale differenti. Ogni account_id diventa l'inputId dell'API. I risultati non vengono associati in base alla loro posizione nella risposta: è quindi questo ID stabile a collegare ogni risultato al giusto URL di origine.
Incolla questo script completo in scrape_linkedin_companies.py:
import json
import os
import time
import uuid
import requests
accounts = [
{
"account_id": "account-n8n",
"linkedin_company_url": "https://www.linkedin.com/company/n8n/",
},
{
"account_id": "account-posthog",
"linkedin_company_url": "https://www.linkedin.com/company/posthog/",
},
{
"account_id": "account-back-market",
"linkedin_company_url": "https://www.linkedin.com/company/back-market/",
},
{
"account_id": "account-datablist",
"linkedin_company_url": "https://www.linkedin.com/company/datablist/",
},
]
def scrape_companies(accounts, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"companyLinkedInUrl": account["linkedin_company_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Request ID: {unique_id}")
payload = {
"enrichmentId": "linkedin-company-enrichment",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
company_results = scrape_companies(accounts, api_key)
print(json.dumps(company_results, indent=2, ensure_ascii=False))Eseguilo con:
python scrape_linkedin_companies.pyI valori principali da modificare sono i record in accounts. Mantieni ogni account_id stabile e univoco, quindi sostituisci linkedin_company_url con una pagina aziendale LinkedIn verificata. La funzione converte questi record nel formato inputs dell'API e invia l'URL aziendale come companyLinkedInUrl. settings rimane vuoto perché questo enrichment non prevede impostazioni pubbliche.
La richiesta POST crea un task di enrichment in background. L'API risponde con 202 Accepted e un task ID, mentre il client Requests attende interrogando periodicamente l'URL di stato. Questo codice Python bloccante è pratico per uno script di piccole dimensioni, ma il task viene comunque eseguito in modo asincrono lato Datablist.
La prima richiesta GET controlla il task. Un task può terminare con lo stato completed, failed o stopped. Lo script prosegue solo dopo completed; negli altri casi genera un errore che include il task ID e l'errore restituito dall'API. Conserva questo ID durante le verifiche, perché anche un task non riuscito o interrotto può avere risultati e consumi di crediti da esaminare.
Una volta completato il task, il ciclo finale recupera le pagine dei risultati con un limite di 100. Continua a scaricare la pagina successiva finché nextCursor non è null. Ogni risultato conserva l'inputId fornito: per questo il successivo ciclo di qualificazione può associare correttamente i risultati anche quando l'ordine della risposta è diverso da quello degli input.
Leggi il risultato aziendale e il metodo di recupero
L'URL LinkedIn identifica direttamente l'azienda. Datablist normalizza l'URL dell'organizzazione e recupera i dati pubblici disponibili dalla pagina aziendale, invece di cercare e valutare diverse aziende possibili. Partendo dall'URL di un'azienda specifica, consulta la pagina pubblica e può completare i campi mancanti tramite fonti di fallback gestite, conservando i dati utili già trovati.
Questa distinzione è importante quando analizzi il risultato. I campi facoltativi dipendono dalle informazioni disponibili pubblicamente. Un indirizzo della sede centrale impostato su null o una specializzazione assente non significa che l'intera ricerca aziendale sia fallita.
Ecco la pagina completa dei risultati restituita per i quattro URL:
{
  "taskId": "69516a973dc34481920f41ade748e917",
  "results": [
    {
      "inputId": "account-n8n",
      "status": "success",
      "outputs": {
        "companyName": "n8n",
        "companyHQPostalCode": "10115",
        "companyDescription": "n8n is a workflow automation platform that uniquely combines AI capabilities with business process automation. The platform enables connection to any app or API while maintaining the flexibility of code with the speed of no-code.\n\nReleased under a fair-code license, n8n can be self-hosted and is supported by a vibrant community of developers and builders. Users can start simple and layer complexity as needed - utilizing the visual builder for quick wins, and adding custom Javascript or Python code where more control is required, enabling the connection of anything to everything.\n\nn8n is privately held, with funding from Sequoia, Felicis Ventures, Firstminute Capital, Harpoon Ventures, and others. Individual investors include Eventbrite's Kevin Hartz and Supercell's IIkka Paananen. n8n was founded in 2019 and is headquartered in Berlin.",
        "companyTagline": "Flexible AI workflow automation for technical teams.",
        "companyIndustry": "Software Development",
        "companySpecialities": "AI, SOAR, Workflow Automation, and AI agents",
        "companyWebsite": "https://n8n.io",
        "companyHQCity": "Berlin",
        "linkedInCompanyId": "28491094",
        "companyType": "Privately Held",
        "companyHQCountry": "DE",
        "companySize": 1389,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4D0BAQEgEphZqatXwA/company-logo_200_200/B4DaFY.Sa2JcAE-/0/1792494086070/n8n_logo?e=2147483647&v=beta&t=NTL4C6f5QAd_o9nXd15PO8pOMSSEoms_tJdDHEo6eLk",
        "companyHQAddress": "Novalisstraße 10",
        "companyFoundedYear": 2019,
        "companyFollowerCount": 442229
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-posthog",
      "status": "success",
      "outputs": {
        "companyName": "PostHog",
        "companyHQPostalCode": null,
        "companyDescription": "At PostHog, we're working to increase the number of successful products in the world.\n\nUntil now, tools for building products have been fragmented. Product analytics, heatmaps, session recording, web analytics, feature flags, and A/B testing are all helpful, but no one wants to buy, send data to, and integrate multiple products.\n\nPostHog offers these tools (and more) in an integrated, open source platform which can be hosted in either the US or EU. Both versions are SOC2 certified, GDPR-ready, and HIPAA compliant. \n\nWe started PostHog during Y Combinator's W20 cohort and had the most successful B2B software launch on Hacker News since 2012 - with a product that was just 4 weeks old.\n\nWith over 100,000 users, we're default alive, growing 97% through word of mouth, and we are in the top 0.01% most popular repos on GitHub.",
        "companyTagline": "Your product's context layer. Get started with npx @posthog/wizard",
        "companyIndustry": "Software Development",
        "companySpecialities": "analytics, open source, product analytics, product, data, engineering, self-driving product, session replay, context warehouse, AI, product context, and error tracking",
        "companyWebsite": "https://posthog.com/",
        "companyHQCity": "San Francisco",
        "linkedInCompanyId": "37415928",
        "companyType": "Privately Held",
        "companyHQCountry": "US",
        "companySize": 234,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D560BAQGQUyE_CXUxIw/company-logo_200_200/B56aCMWEgaJAAE-/0/1789060991251/posthog_logo?e=2147483647&v=beta&t=WfTGRSqp5UfYL33sBXx3tZ1zmFUECfUPf7JtEGPAvbA",
        "companyHQAddress": null,
        "companyFoundedYear": 2020,
        "companyFollowerCount": 59696
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-back-market",
      "status": "success",
      "outputs": {
        "companyName": "Back Market",
        "companyHQPostalCode": null,
        "companyDescription": "The world is waking up to what fast tech costs. Back Market is where the revolution shops. \nWe make refurbished tech the smart, confident choice by building trust in quality, repair and circularity. New is not always better. Smarter is.\n\nAs a certified B Corp, our mission is to create a world that does more with what we already have by prolonging the lifespan of electronic devices through circularity and repair. We have grown by double digits year over year and now serve 18 million customers across 17 markets, avoiding more than 2 million tons of CO2 emissions*\n*Back Market calculation based on ADEME 2022 methodology.\n\nFounded in Paris in 2014 by Thibaud Hug de Larauze, Quentin Le Brouster and Vianney Vaute, Back Market is a leading global marketplace where people can buy professionally refurbished technology or trade in their devices.\n\nAre you ready to join us?",
        "companyTagline": "Where the world shops refurbished tech.",
        "companyIndustry": "Internet Marketplace Platforms",
        "companySpecialities": "refurbished tech, marketplace, sustainability, circularity, Right to Repair, sustainable solutions, refurbished marketplace, circular economy, and sustainable alternatives",
        "companyWebsite": "http://www.backmarket.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "4793443",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 1054,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4E0BAQHRv6UClt5D2g/company-logo_200_200/B4EZnoUG3tKgAI-/0/1760539209613/back_market_logo?e=2147483647&v=beta&t=Pywpeu1Qs3h0Cl8kgvYurmBfXbImm5QIIc-aQog1MqM",
        "companyHQAddress": null,
        "companyFoundedYear": 2014,
        "companyFollowerCount": 101878
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-datablist",
      "status": "success",
      "outputs": {
        "companyName": "Datablist",
        "companyHQPostalCode": null,
        "companyDescription": "When people hear \"data,\" they think of something complicated. We will change this.\n\nDatablist is an AI-powered spreadsheet that helps you: get, manipulate, or clean data and create workflows that run automatically while you focus on what matters most.\n\nIf you want to separate Datablist.com into its main parts, you can say we have:\n\n- Deduplicating, grouping, and labeling data\n- Cleaning and editing data\n- Managing data and automated workflows\n- 50+ B2B data sources and scrapers\n- 3 AI agents:\n    - Editing assistant\n    - AI Research agent\n    - Deduplication assistant\n\nThe top 3 reasons why companies choose Datablist.com are:\n\n1. Simplicity: you don't need to have technical knowledge or experience with formulas to get everything out of it.\n2. Flexibility that allows you to do (almost) everything with your data and AI while keeping everything under your control.\n3. Scalability that no other solution can match. Up to 2 million rows—forget Excel.\n\nGo on try it for free!\n\nhttps://www.Datablist.com",
        "companyTagline": "Let your tasks become workflows: automated workflows.",
        "companyIndustry": "Information Technology & Services",
        "companyWebsite": "https://www.datablist.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "69842428",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 3,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/C4E0BAQFNFlMb8KEPRQ/company-logo_200_200/company-logo_200_200/0/1630622803412?e=2147483647&v=beta&t=UVkk7BOerChiWgS9Y06zOpT08SlK4kpAWGDYiVvUEVU",
        "companyFollowerCount": 134,
        "companyFoundedYear": 2020,
        "companyHQAddress": null
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
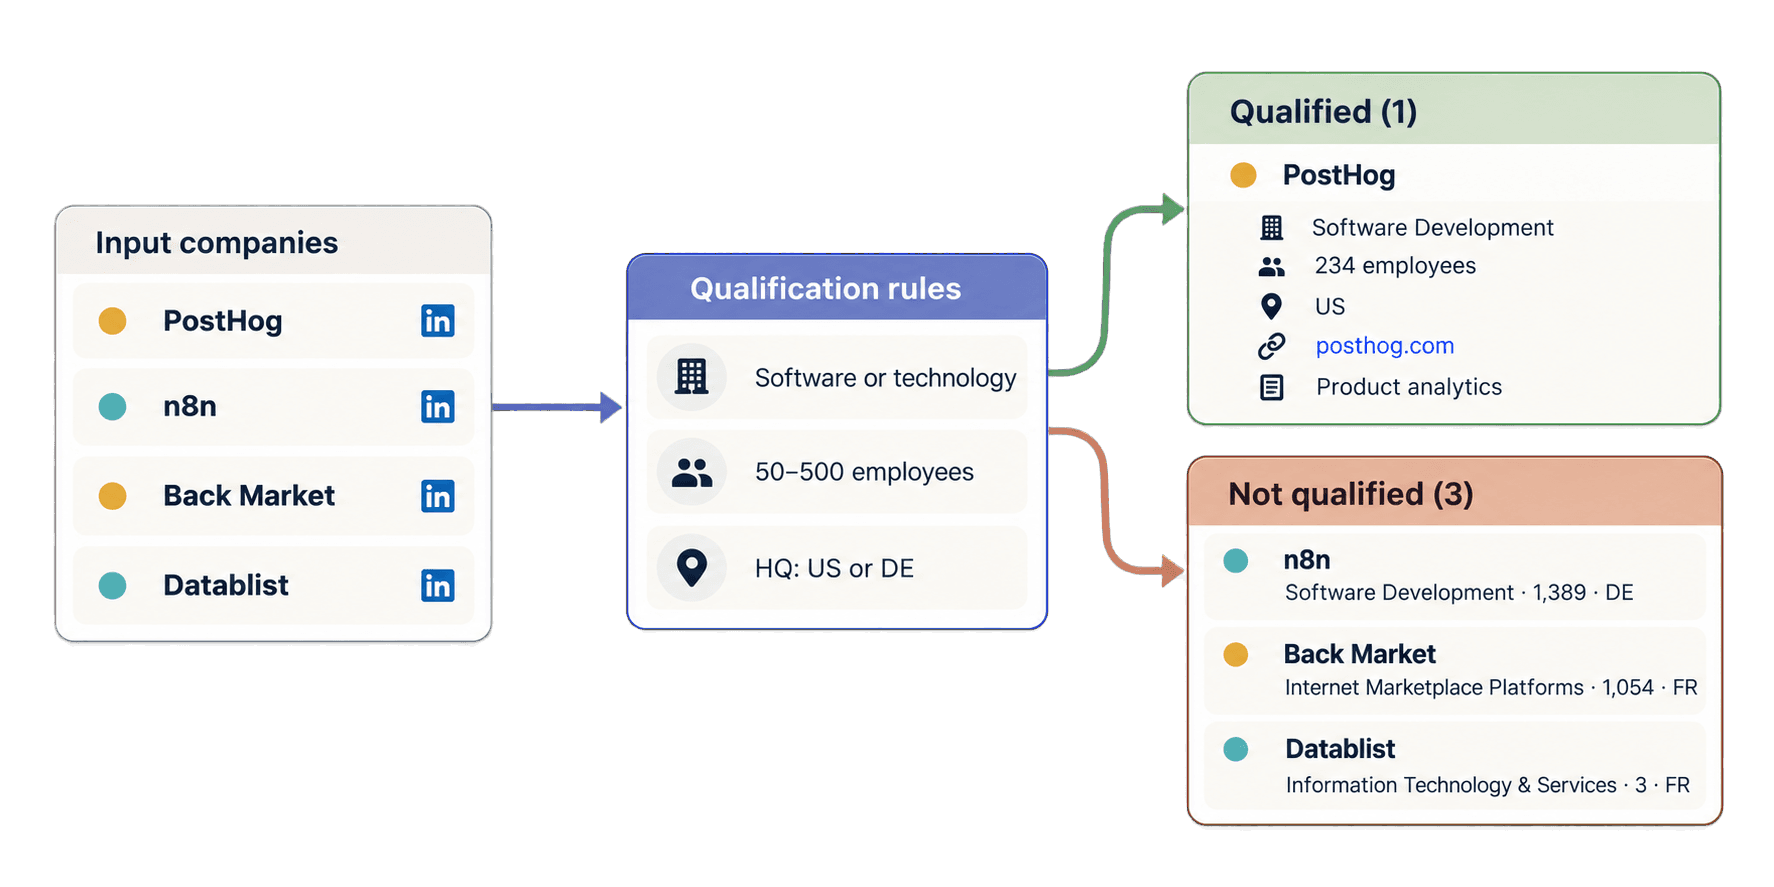
Tutti e quattro i record sono stati recuperati correttamente e hanno consumato 25 crediti ciascuno. Per PostHog sono stati restituiti Software Development, 234 dipendenti, sede centrale negli Stati Uniti, sito web e descrizione. Anche n8n è un'azienda software con sede in uno dei Paesi selezionati, ma il numero di dipendenti restituito è 1.389. Per Back Market sono stati restituiti Internet Marketplace Platforms, 1.054 dipendenti e sede centrale in Francia. Per Datablist, invece, Information Technology & Services, 3 dipendenti e sede centrale in Francia.
L'oggetto completo è utile perché la ricerca su un account raramente si ferma a un solo campo. Puoi qualificare le aziende in base a settore, numero di dipendenti e Paese, conservando al tempo stesso il sito web e la descrizione esatti restituiti dall'API per la fase di ricerca successiva.
In questa risposta, companySize indica il numero di dipendenti restituito, non una fascia dimensionale di LinkedIn. companyHQCountry rappresenta il Paese della sede centrale, non tutti i Paesi in cui opera l'azienda. Sono distinzioni importanti quando adatti i filtri per dimensione e Paese al tuo ideal customer profile.
Non è necessario che tutti i campi facoltativi siano presenti per qualificare un'azienda. Un indirizzo o una specializzazione mancante può rimanere vuoto se sono disponibili settore, numero di dipendenti e Paese della sede centrale. Conserva companyWebsite così come viene restituito, senza presupporre che l'API lo converta in un dominio semplice. La descrizione può aiutare chi si occupa di sales research a comprendere il prodotto dell'azienda e a preparare una ricerca specifica sull'account prima dell'outreach. Quando esamini o salvi il record, mantieni status, creditsUsed ed error accanto ai dati aziendali.
Qualifica gli account per la sales research
Supponiamo che il tuo target sia un'azienda software o tecnologica con 50-500 dipendenti e sede centrale negli Stati Uniti o in Germania. Aggiungi questo ciclo sotto lo script completo. Riutilizza company_results, quindi non invia un altro task:
accounts_by_id = {account["account_id"]: account for account in accounts}
qualified_accounts = []
other_accounts = []
for result in company_results:
account = accounts_by_id.get(result["inputId"])
qualification = "needs_review"
if result["status"] == "success":
outputs = result["outputs"]
industry = outputs.get("companyIndustry")
company_size = outputs.get("companySize")
country = outputs.get("companyHQCountry")
if industry and isinstance(company_size, (int, float)) and country:
industry_matches = any(
keyword in industry.lower()
for keyword in ("software", "technology")
)
size_matches = 50 <= company_size <= 500
country_matches = country in {"US", "DE"}
if industry_matches and size_matches and country_matches:
qualification = "qualified"
else:
qualification = "not_qualified"
source_url = None
if account is not None:
source_url = account["linkedin_company_url"]
reviewed_account = dict(result)
reviewed_account["sourceLinkedInUrl"] = source_url
reviewed_account["qualification"] = qualification
if qualification == "qualified":
qualified_accounts.append(reviewed_account)
else:
other_accounts.append(reviewed_account)
print(json.dumps(qualified_accounts, indent=2, ensure_ascii=False))PostHog viene associata correttamente a account-posthog anche se l'API restituisce i record in un ordine diverso. È qualificata perché Software Development, 234 dipendenti e US superano tutti e tre i controlli. Il ciclo copia il risultato originale con gli outputs completi, il sito web restituito https://posthog.com/, la descrizione, creditsUsed ed error. Aggiunge soltanto l'URL di origine e l'etichetta di qualificazione locale.
n8n viene associata a account-n8n e non è qualificata perché 1.389 dipendenti superano il limite massimo. Back Market non soddisfa i criteri relativi a settore, dimensioni e Paese, mentre Datablist è al di sotto della fascia dimensionale e ha sede fuori dai Paesi selezionati. Eventuali record futuri non riusciti o incompleti ricevono l'etichetta needs_review, invece di essere eliminati senza alcuna segnalazione.
Puoi scaricare l'esempio sincrono con Requests, mantenuto e aggiornato, oppure utilizzare l'alternativa asincrona con HTTPX disponibile nel repository quando ti serve codice applicativo non bloccante.
Calcola i crediti per lo scraping di aziende LinkedIn
Una pagina aziendale LinkedIn standard con nome nell'URL utilizza 25 crediti. Un URL aziendale con ID numerico può utilizzare 75 crediti quando è necessario l'ultimo fallback, ma questo non significa che ogni URL numerico costi 75 crediti. Anche le ricerche non riuscite o senza corrispondenze possono consumare crediti: considera quindi il totale del task e il valore creditsUsed di ogni risultato come riferimento per il consumo effettivo.
I quattro URL con nome utilizzati in questa guida hanno consumato complessivamente 100 crediti. Alla tariffa standard, 1.000 pagine aziendali utilizzano 25.000 crediti. Se gli input includono molti URL con ID numerico, occorre prevedere un margine maggiore per il possibile percorso da 75 crediti.
L'accesso alla REST API richiede il piano Growth. Il piano mensile include 20.000 crediti, mentre i crediti top-up devono essere acquistati separatamente. Con l'attuale top-up base in USD da 20 $ per 20.000 crediti, ogni credito costa 0,001 $. A questa tariffa, 25.000 crediti equivalgono a 25 $. Consulta i prezzi di Datablist per verificare il piano e il catalogo crediti aggiornati.
Risolvi i problemi di input, task e risultati
DATABLIST_API_KEYè assente: lo script si interrompe prima di inviare una richiesta. Esporta la variabile ed esegui nuovamente il file.- L'API rifiuta la chiave: verifica la tua Personal API Key e mantienila nell'header
X-API-Keyutilizzato nell'esempio. - L'URL di origine non è valido: sostituisci un profilo personale, un sito non pertinente, un valore vuoto o un URL non valido con un URL pubblico supportato di un'azienda LinkedIn, una scuola, una pagina showcase, un'azienda con ID numerico o un'azienda in Sales Navigator.
- I crediti non sono sufficienti: controlla il saldo, quindi usa i crediti inclusi o acquista un top-up prima di creare un altro task.
- Il task è
failedostopped: esamina l'errore, i risultati esistenti e il consumo di crediti prima di decidere se inviare un altro task a pagamento. - Un risultato contiene pochi dati oppure è
no_resultoerror: conserva l'URL di origine, lo stato, i crediti e l'errore per poterli verificare. Prima di inviare di nuovo il task, accertati che l'input sia una pagina aziendale pubblica, senza formulare ipotesi sul motivo per cui i dati non erano disponibili.
Se perdi la risposta alla richiesta di creazione, usa il request ID stampato dallo script prima della POST. Elenca innanzitutto i task e cerca il valore corrispondente in uniqueId:
curl "https://api.datablist.com/v1/enrichments/tasks?limit=100" \
-H "X-API-Key: $DATABLIST_API_KEY"L'@id del task corrispondente è il task ID. Usalo per continuare a controllare /v1/enrichments/tasks/{taskId} o per recuperare /v1/enrichments/tasks/{taskId}/results, invece di creare automaticamente un altro task. Una singola richiesta può contenere fino a 10.000 input e 10 MiB; consulta la documentazione sui task per i dettagli relativi alla conservazione e alle altre fasi del ciclo di vita.
Prossimi passi
Ora hai una funzione Python Requests riutilizzabile che trasforma un elenco di URL di pagine aziendali LinkedIn in record strutturati, oltre a un ciclo di qualificazione locale che conserva l'output completo dell'API per la sales research.
Sostituisci i quattro esempi con un piccolo elenco verificato di account, mantieni gli ID stabili e adatta le regole su settore, numero di dipendenti e Paese al tuo ideal customer profile. Se parti da persone anziché da aziende, consulta la guida all'API per lo scraping dei profili LinkedIn. Se disponi soltanto dei nomi delle aziende, inizia trovando i siti web aziendali con Python.