
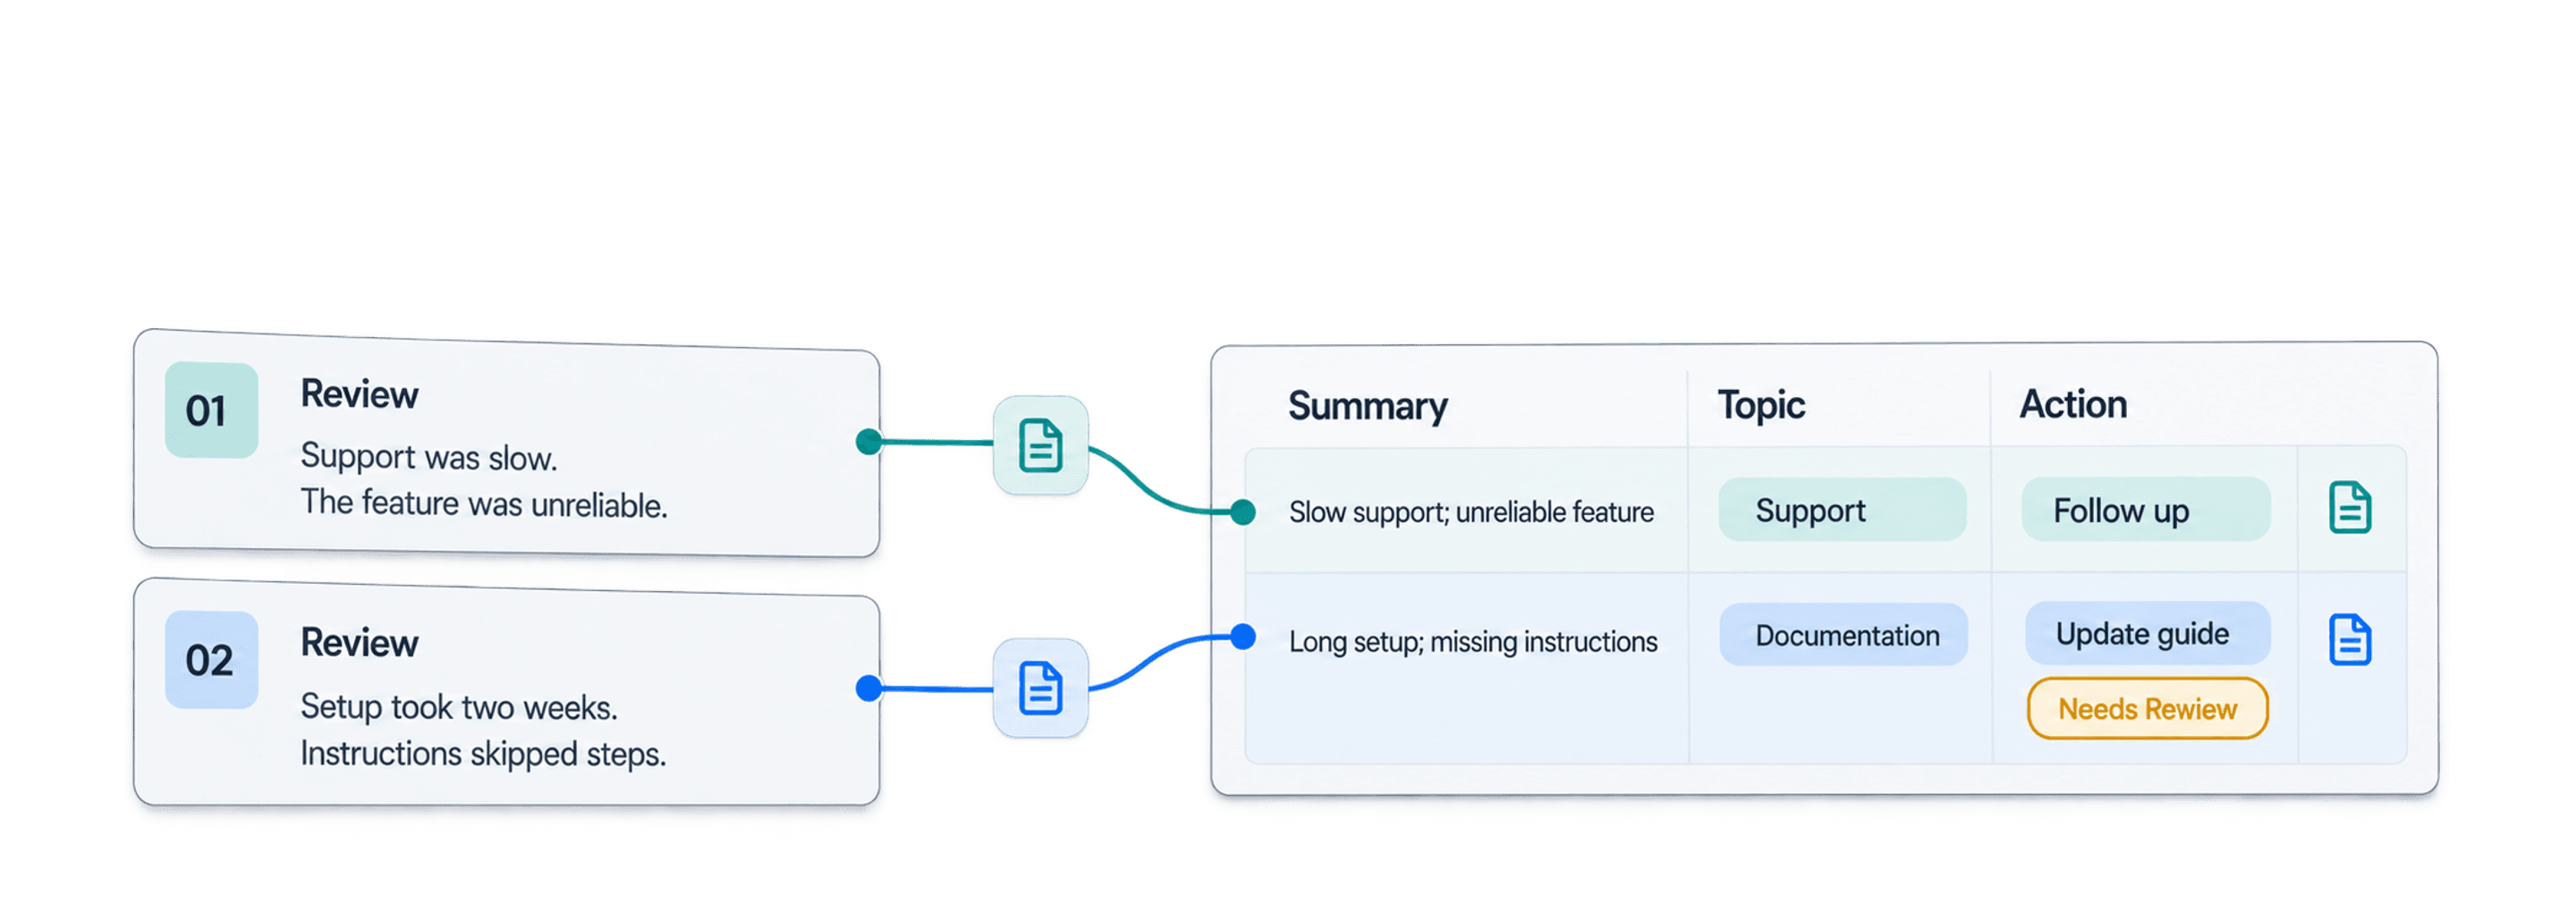
何百件ものレビューを読むには時間がかかります。数千件、ましてや数十万件を人の手で継続的に確認するのは現実的ではありません。星評価を見ればスコアは分かりますが、具体的な不満や繰り返し発生している製品上の問題、チームが次に取るべき対応までは、ほとんど見えてきません。
Datablistなら、CSVやExcelからエクスポートしたファイル全体を対象に、AIで顧客レビューを要約できます。1つの構造化プロンプトで各レビューを分析し、Review Summary、Sentiment、Main Topic、Issue Type、Urgency、Recommended Action、Needs Reviewの各列を追加します。一部のコメントだけをサンプリングするのではなく、チームで絞り込み、確認し、具体的なアクションにつなげられるレビューデータセットを作成できます。
本ガイドでは、手順を再現できるよう100行のファイルを使用します。数千件、数十万件のレビューを含むエクスポートでも、流れは同じです。まず多様なサンプルでプロンプトをテストし、残りの行を処理した後、判断が不確かな結果を確認し、元のフィールドと生成されたフィールドをまとめてエクスポートします。
本当に役立つ成果物は、1つの長い要約ではありません。絞り込み、確認し、アクションにつなげられるレビュー表です。 最初の工程では、レビューを1行ずつ分析します。ファイル全体のテーマ別集計や経営層向けサマリーは、ラベルを確認した後の工程で作成します。
AIによるレビュー要約で得られるもの
レビュー分析を3つの工程に分けます。
最初に、モデルが各レビューの短い要約を作成します。優れた要約は、すべての詳細をそのまま書き写すことなく、投稿者の意図と感情を保ちます。次に、Sentiment、トピック、Issue Type、Urgencyなど、あらかじめ定義したフィールドを返します。これにより、異なるレビューを同じ基準で比較できます。最後に、レビューの内容に基づくアクションを提案し、曖昧な行を目視確認の対象としてマークします。
フィールドを列ごとに分けることが重要です。AIが生成した1つの文章は読みやすくても、絞り込みには向きません。AIの構造化出力を利用すれば、レスポンスを再解析せずに、Urgencyの高い不満だけを抽出したり、星評価とSentimentを比較したり、レビューをトピック別に分類したりできます。
🔑 集計前に各レビューを分析する
生成された各判断を元のレビューと並べて保存しておけば、サンプリングや修正を無理なく行えます。一貫した行単位のラベルは後の集計に役立ちますが、それだけで統計的に妥当なレポートになるわけではありません。
必要なのが1つの定義済みラベルと信頼度だけであれば、より用途を絞ったClassification with ChatGPT/OpenAIが適しています。ここでは、1回のリクエストで7つのフィールドを入力するため、Ask ChatGPT/OpenAIを使用します。
顧客レビューCSVのサンプル
合成データで作成した100行の顧客レビューサンプルを使用しました。ファイルにはIndex、Review ID、Product Name、Rating、Review Textが含まれています。各行に1件のレビューが入っていれば、お手元のCSVやExcelエクスポートでも同じ手順を実行できます。
| Review ID | Product Name | Rating | Review Textの抜粋 |
|---|---|---|---|
7wQDdSKxrw | Smart Clock Lock | 3 | 機能は果たすものの、リモートチームではスムーズに使えず、サポートへ2回問い合わせた。 |
9xSyNNTkPZ | Mini Phone Scooter | 2 | サポートの対応が遅く、必要な機能も安定して動作しなかった。 |
b3RFuoVRvJ | Mixer Grill | 4 | 開封後すぐ問題なく動作したが、初期設定には1週間かかった。 |
ZjmazxYl87 | Advanced Microphone Lamp Speaker Smart | 1 | サポートが遅く、説明書には手順の抜けがあり、設定に2週間かかった。 |
必須の入力項目はReview Textです。RatingとProduct Nameはモデルに有用なコンテキストを与え、Review IDがあれば各出力を元データまで追跡できます。最終エクスポートには、この4列をすべて残します。
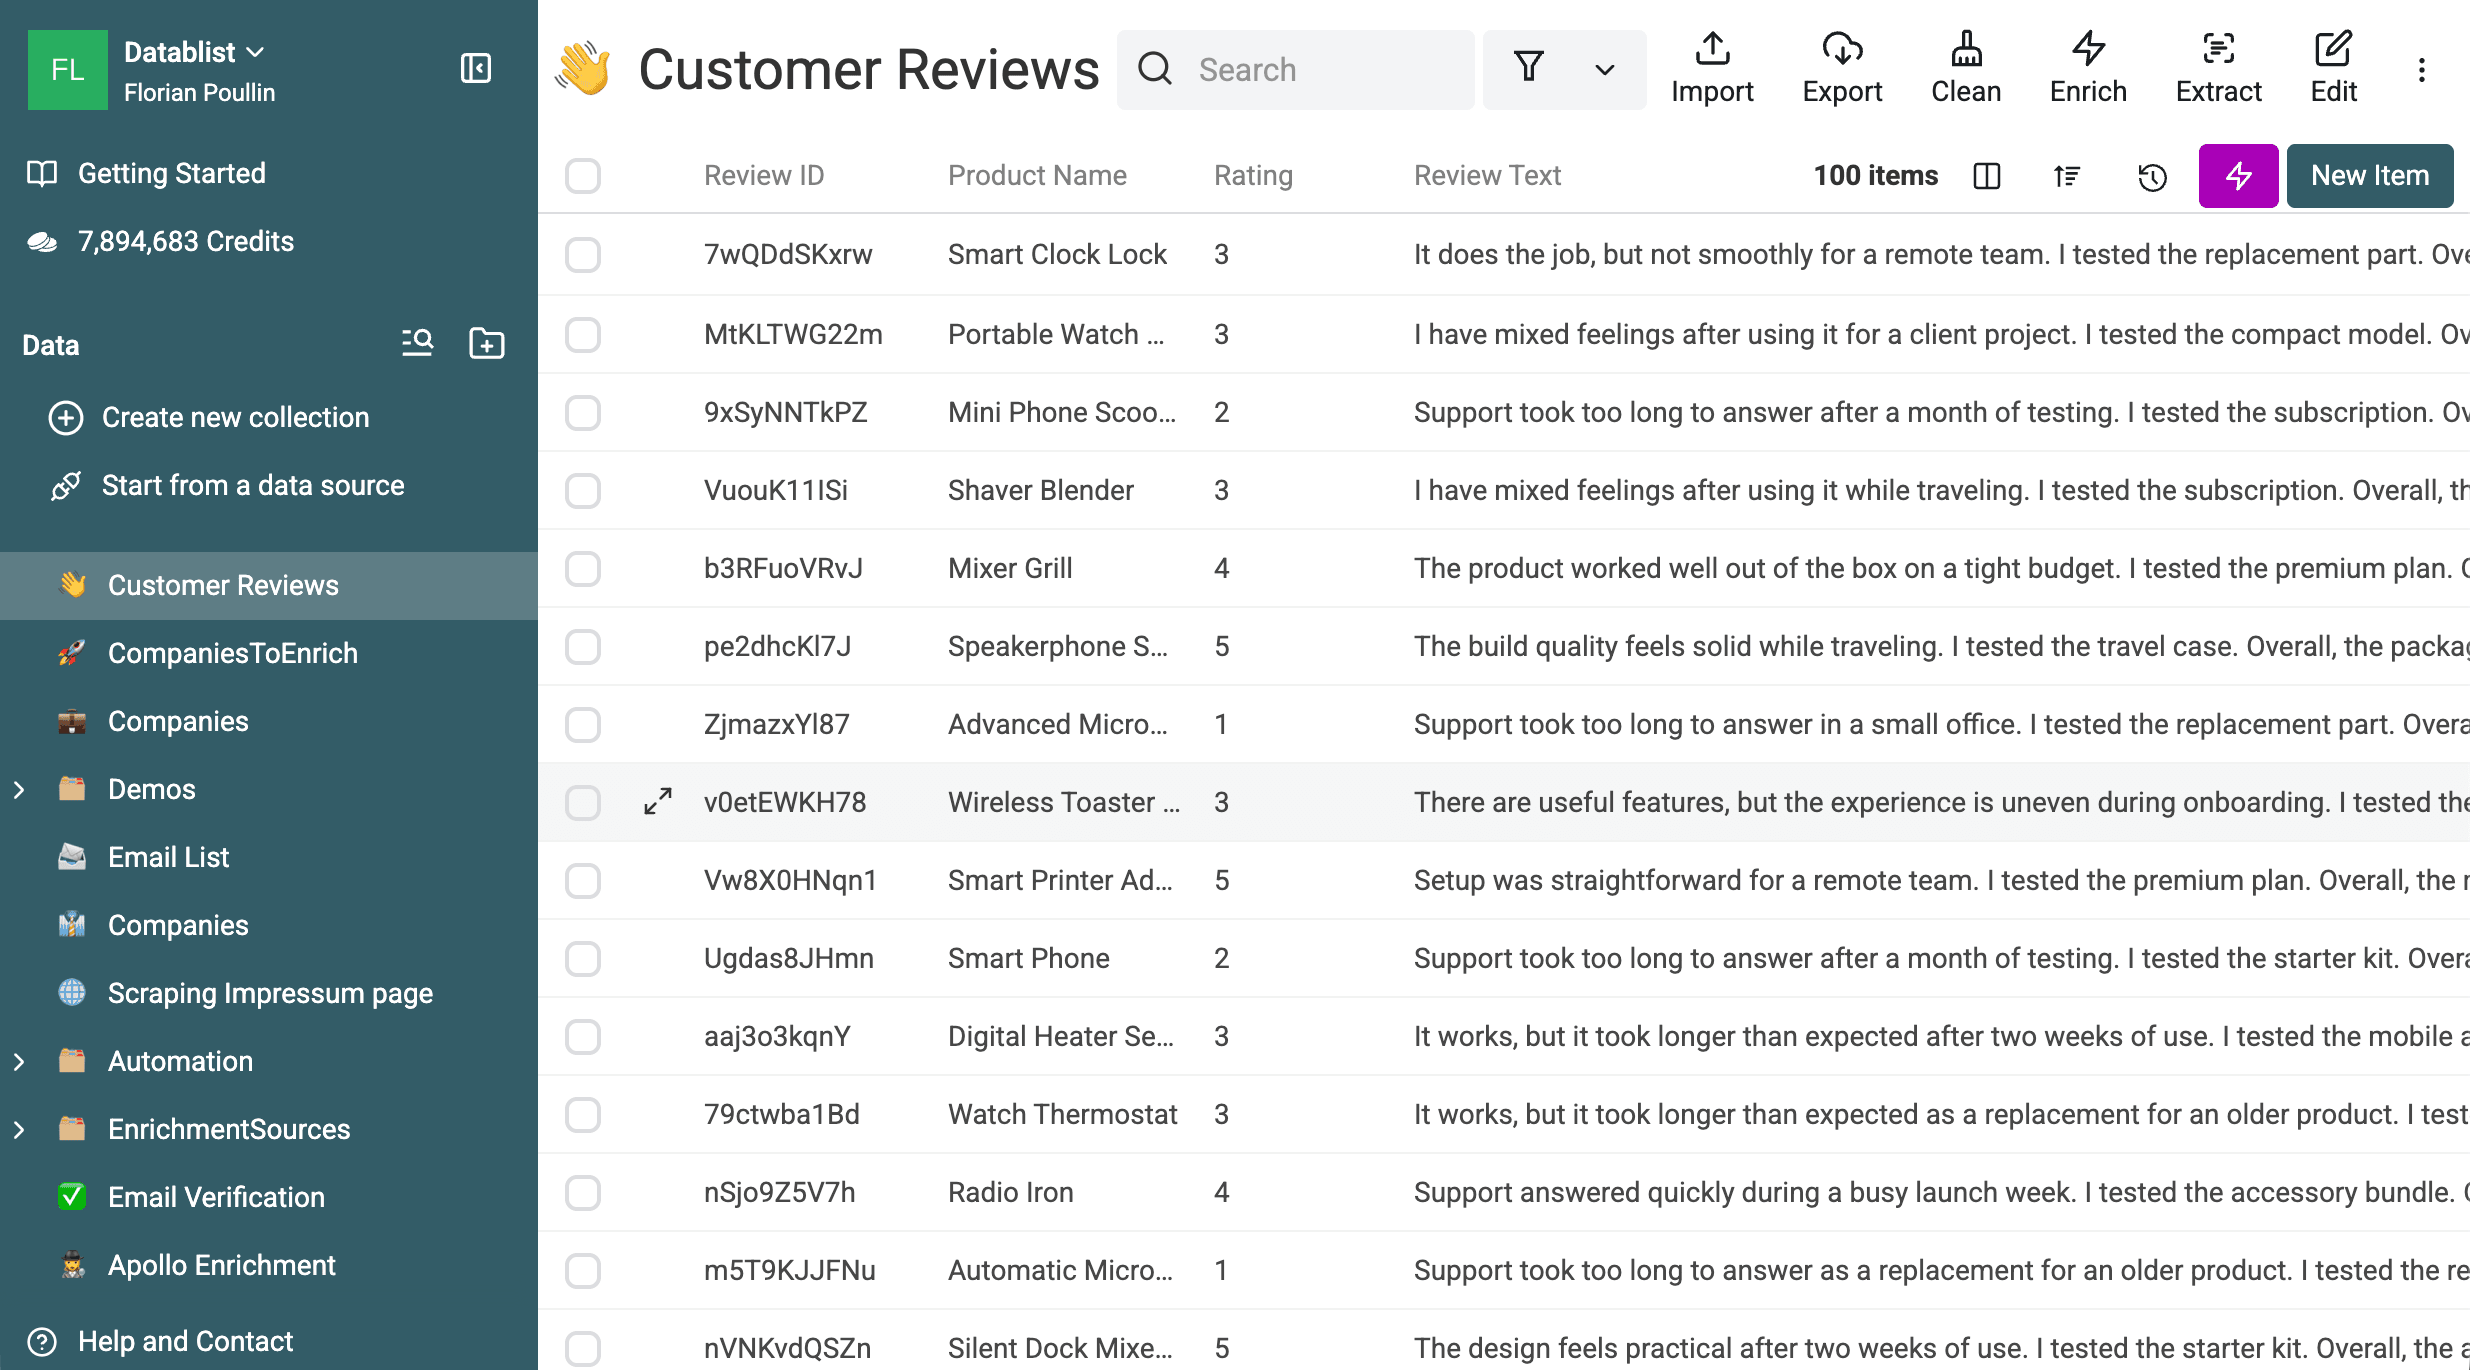
このワークフローでは、7つの分析フィールドに加えて、処理済みフラグと実行ステータスも追加します。元データをまだ収集していない場合は、別ガイドのTrustpilotレビューを収集する方法またはTrusted Shopsレビューを収集する方法をご覧ください。本チュートリアルは、レビューをファイルにまとめた段階から始めます。
AI分析前にレビューを整える
Enrichmentを開く前に、まずファイル自体を確認します。
Review Textが空の行を絞り込みます。テキストがなければ、信頼できる要約や分類はできません。- 重複を確認します。同一のリクエストにはキャッシュが有効な場合もありますが、傾向分析の前に意図しない重複は削除しておくことをおすすめします。
Ratingを1〜5など、1つの評価尺度に統一します。正解データではなく、診断用のシグナルとして扱ってください。- 極端に長いレビューや多言語のレビューを見つけます。出力上限の引き上げ、言語指定、別バッチでの処理が必要になる場合があります。
- 内容に幅を持たせた10〜20件のプレビューセットを作ります。低・中・高評価、短文・長文、複数トピックを含むフィードバックを選んでください。
💡 難しい行から先にテストする
先頭10行よりも、多様なレビューを含むプレビューのほうが多くのことを確認できます。ファイル全体の処理に費用をかける前に、曖昧なラベル、評価との矛盾、弱いレビューフラグのルールを洗い出せます。
レビュー分析プロンプトと出力を理解する
プロンプトには4つの役割があります。1行の内容を要約すること、定義済みラベルを選ぶこと、レビューに基づいて1つのアクションを提案すること、そして人による確認が必要な根拠を検出することです。使用する情報は、製品名、評価、レビューテキストだけです。製品の詳細や顧客の意図を推測で補ってはいけません。
無理に断定するより、Needs Reviewフィールドを設ける方法をおすすめします。複数のトピックを含むレビューでは、2つの分類がどちらも妥当なことがあります。自信ありげなラベルで曖昧さを隠すより、確認対象として振り分けるほうが安全です。
ルールを調整する場合は、データ分析用の信頼できるプロンプトの書き方とスプレッドシートの値をプロンプトへ挿入する方法をご覧ください。定義済みラベルによって行同士を比較でき、Needs Reviewによって不確かな判断を見える状態に保てます。
Analyze customer reviewsテンプレートには、このプロンプトがあらかじめ設定されています。以下の完全版は、分類体系を確認または変更したい場合に役立ちます。
あなたは製品チームのために顧客レビューを分析します。各フィールドは、提供されたレビュー、評価、製品名だけに基づいて作成してください。要約は事実に即して記述してください。許可されたラベルだけを使用してください。テキストが空、矛盾している、曖昧すぎる、またはフィールドの判断に必要な根拠がない場合は、フォールバック値を使用し、その行を要確認としてマークしてください。製品の詳細や顧客の意図を推測で補わないでください。
タスク
1件の顧客レビューを分析してください。25語以内の1文で要約を返してください。製品、サポート、マーケティングのいずれかのチームが次に行うべき短いアクションを1つ提案してください。アクションは、提供されたレビューの内容に基づいていなければなりません。
出力ルール
Review Summary:事実に基づく1文、25語以内。
Sentiment:Positive、Neutral、Negative、Mixedのいずれか。
Main Topic:Product quality、Setup and onboarding、Ease of use、Performance and reliability、Support、Pricing and value、Documentation、Features、Delivery and packaging、Otherのいずれか。
Issue Type:Praise、Complaint、Feature request、Question、No clear issueのいずれか。
Urgency:High、Medium、Low、Noneのいずれか。
Recommended Action:レビューに基づく短いアクションを1つ。アクションを裏付ける情報がない場合は、中立的なフォールバックを使用すること。
Needs Review:テキストが曖昧、矛盾している、同程度に重要なトピックが複数ある、評価と大きく食い違う、または信頼できる分類に必要な根拠がない場合はYes。それ以外はNo。
この行の入力
Product Name:{{Product Name}}
Rating:5段階中{{Rating}}
Review Text:{{Review Text}}
固定の指示を先に、行ごとの変数を最後に配置します。これにより、選択したモデルとリクエストがプロンプトキャッシュに対応している場合、繰り返されるプレフィックスを一定に保てます。ただし、キャッシュヒットを保証するものではありません。
確認すべき出力プロパティ
| プロパティ | 型 | 許可される値またはルール |
|---|---|---|
Review Summary | Long text | 事実に基づく1文、25語以内 |
Sentiment | Textまたはselect | Positive、Neutral、Negative、Mixed |
Main Topic | Textまたはselect | プロンプトで指定した10トピックのいずれか |
Issue Type | Textまたはselect | Praise、Complaint、Feature request、Question、No clear issue |
Urgency | Textまたはselect | High、Medium、Low、None |
Recommended Action | Long text | レビューに基づく短いアクションを1つ |
Needs Review | Checkbox | 判断が曖昧、または根拠が不足している場合はYes、それ以外はNo |
プロンプトと出力の説明には、同じラベルセットを明記してください。このわずかな重複により、指示とスキーマのずれを防げます。
Analyze customer reviewsテンプレートを選ぶ
レビューファイルをインポートする
CSVまたはExcelファイルをDatablistにインポートします。Review Text、Rating、Product Name、Review IDが想定どおりのプロパティに入っていることを確認してください。全体的な設定方法が必要な場合は、CSV・Excelの各行でChatGPTプロンプトを実行する方法をご覧ください。
Ask ChatGPT/OpenAIを開いてテンプレートを選ぶ
Enrichを開き、Ask ChatGPT/OpenAI enrichmentを選択します。
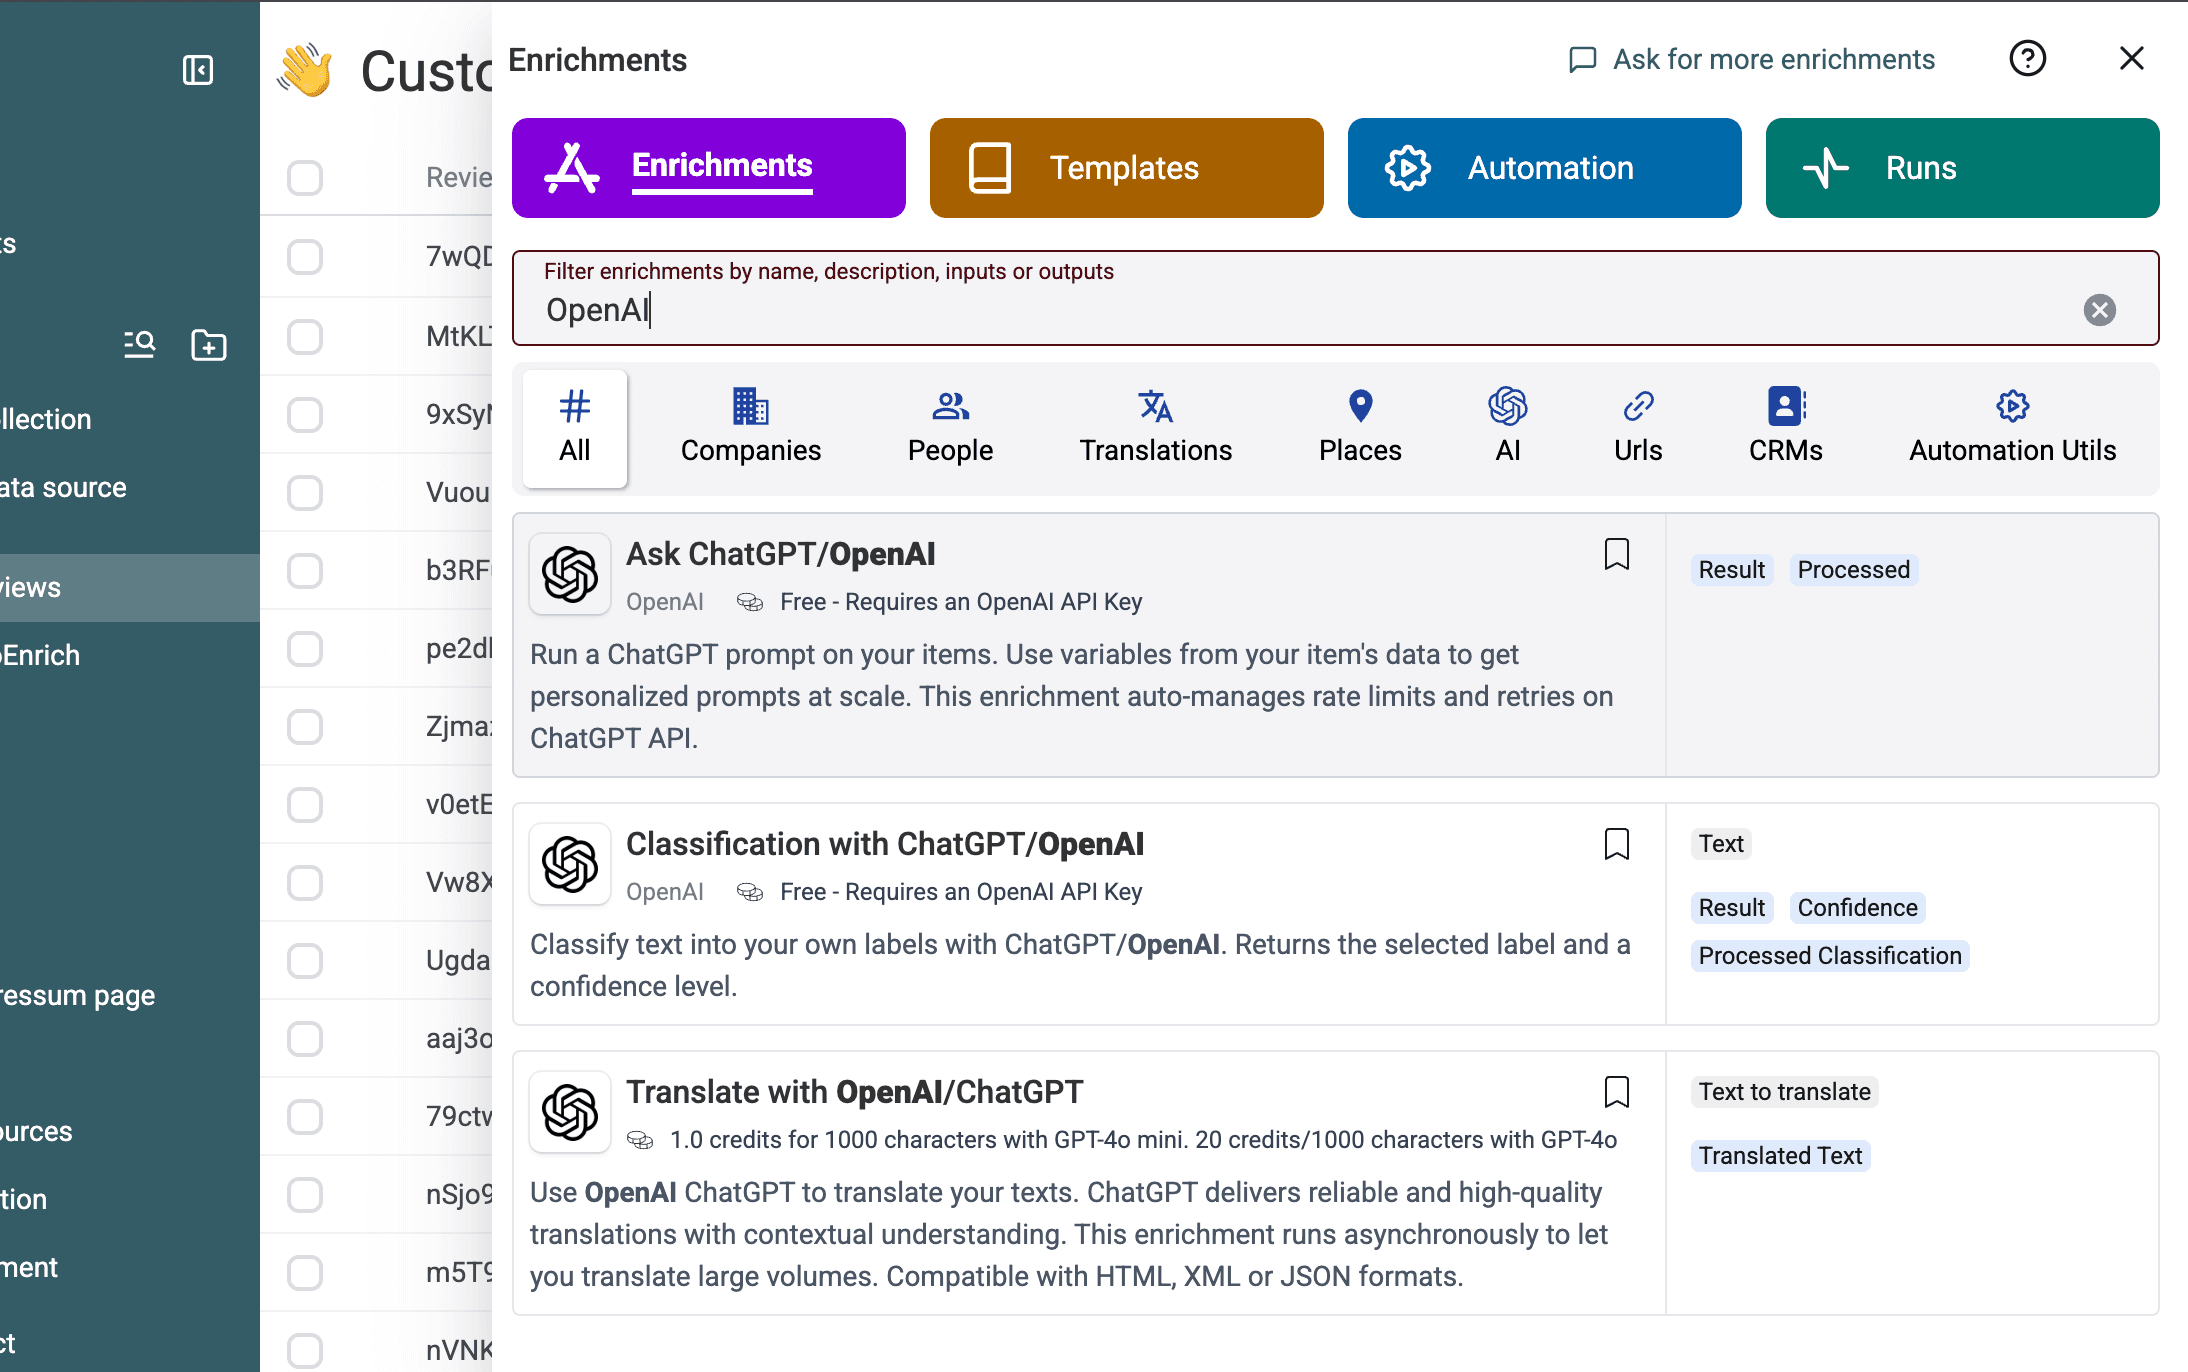
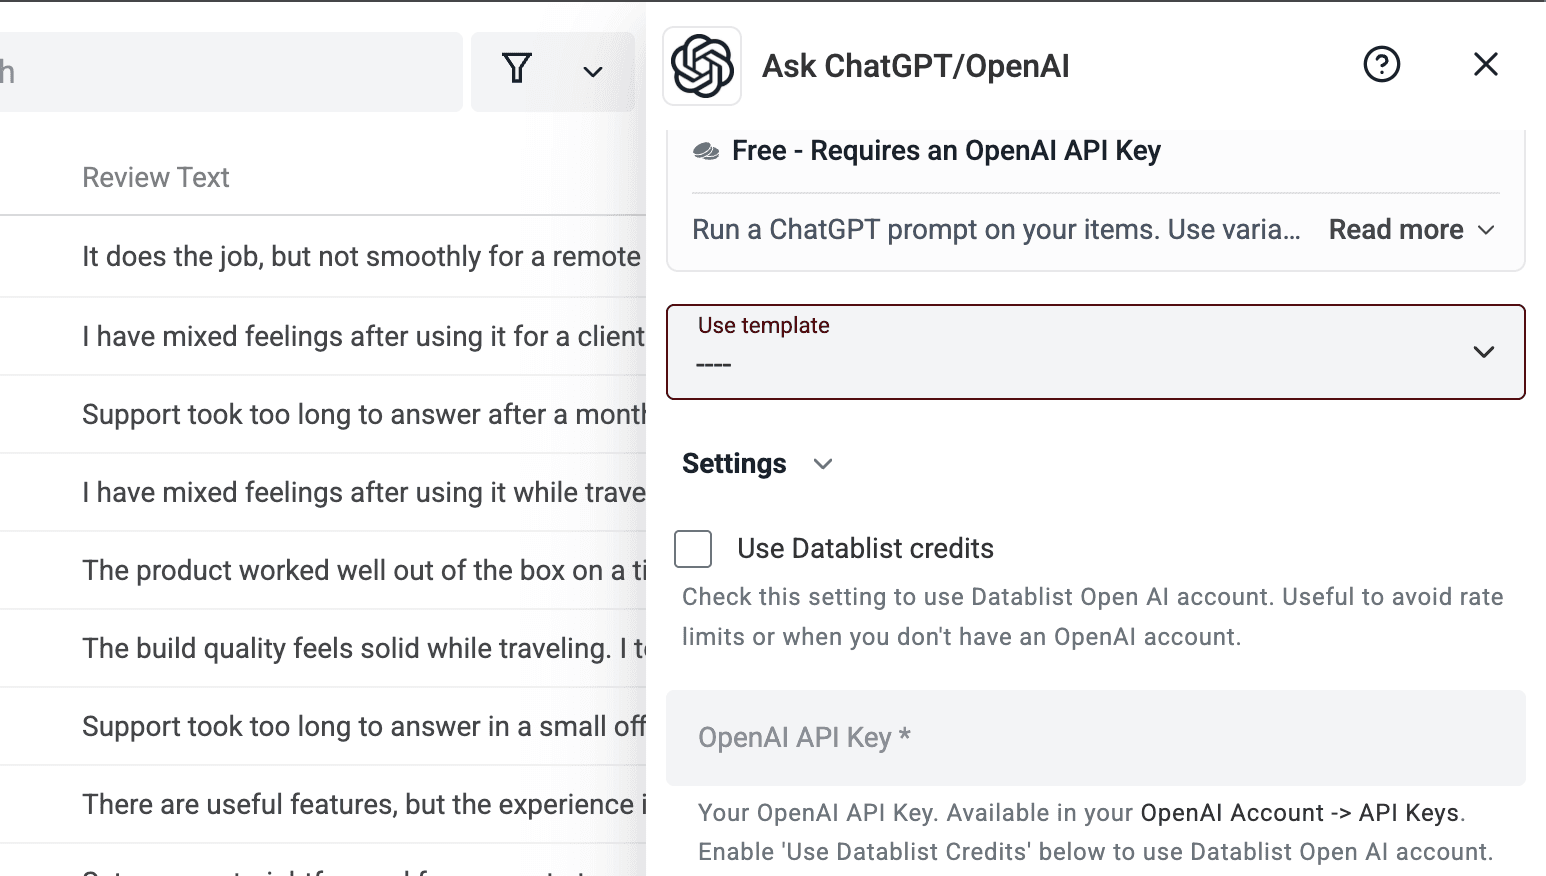
Use templateを開きます。テンプレートを選択する前は、空のセレクターが表示されます。
Analyze customer reviewsを選択します。Datablistがプロンプトと構造化出力を自動入力するため、7つの出力定義を最初から作り直す必要はありません。
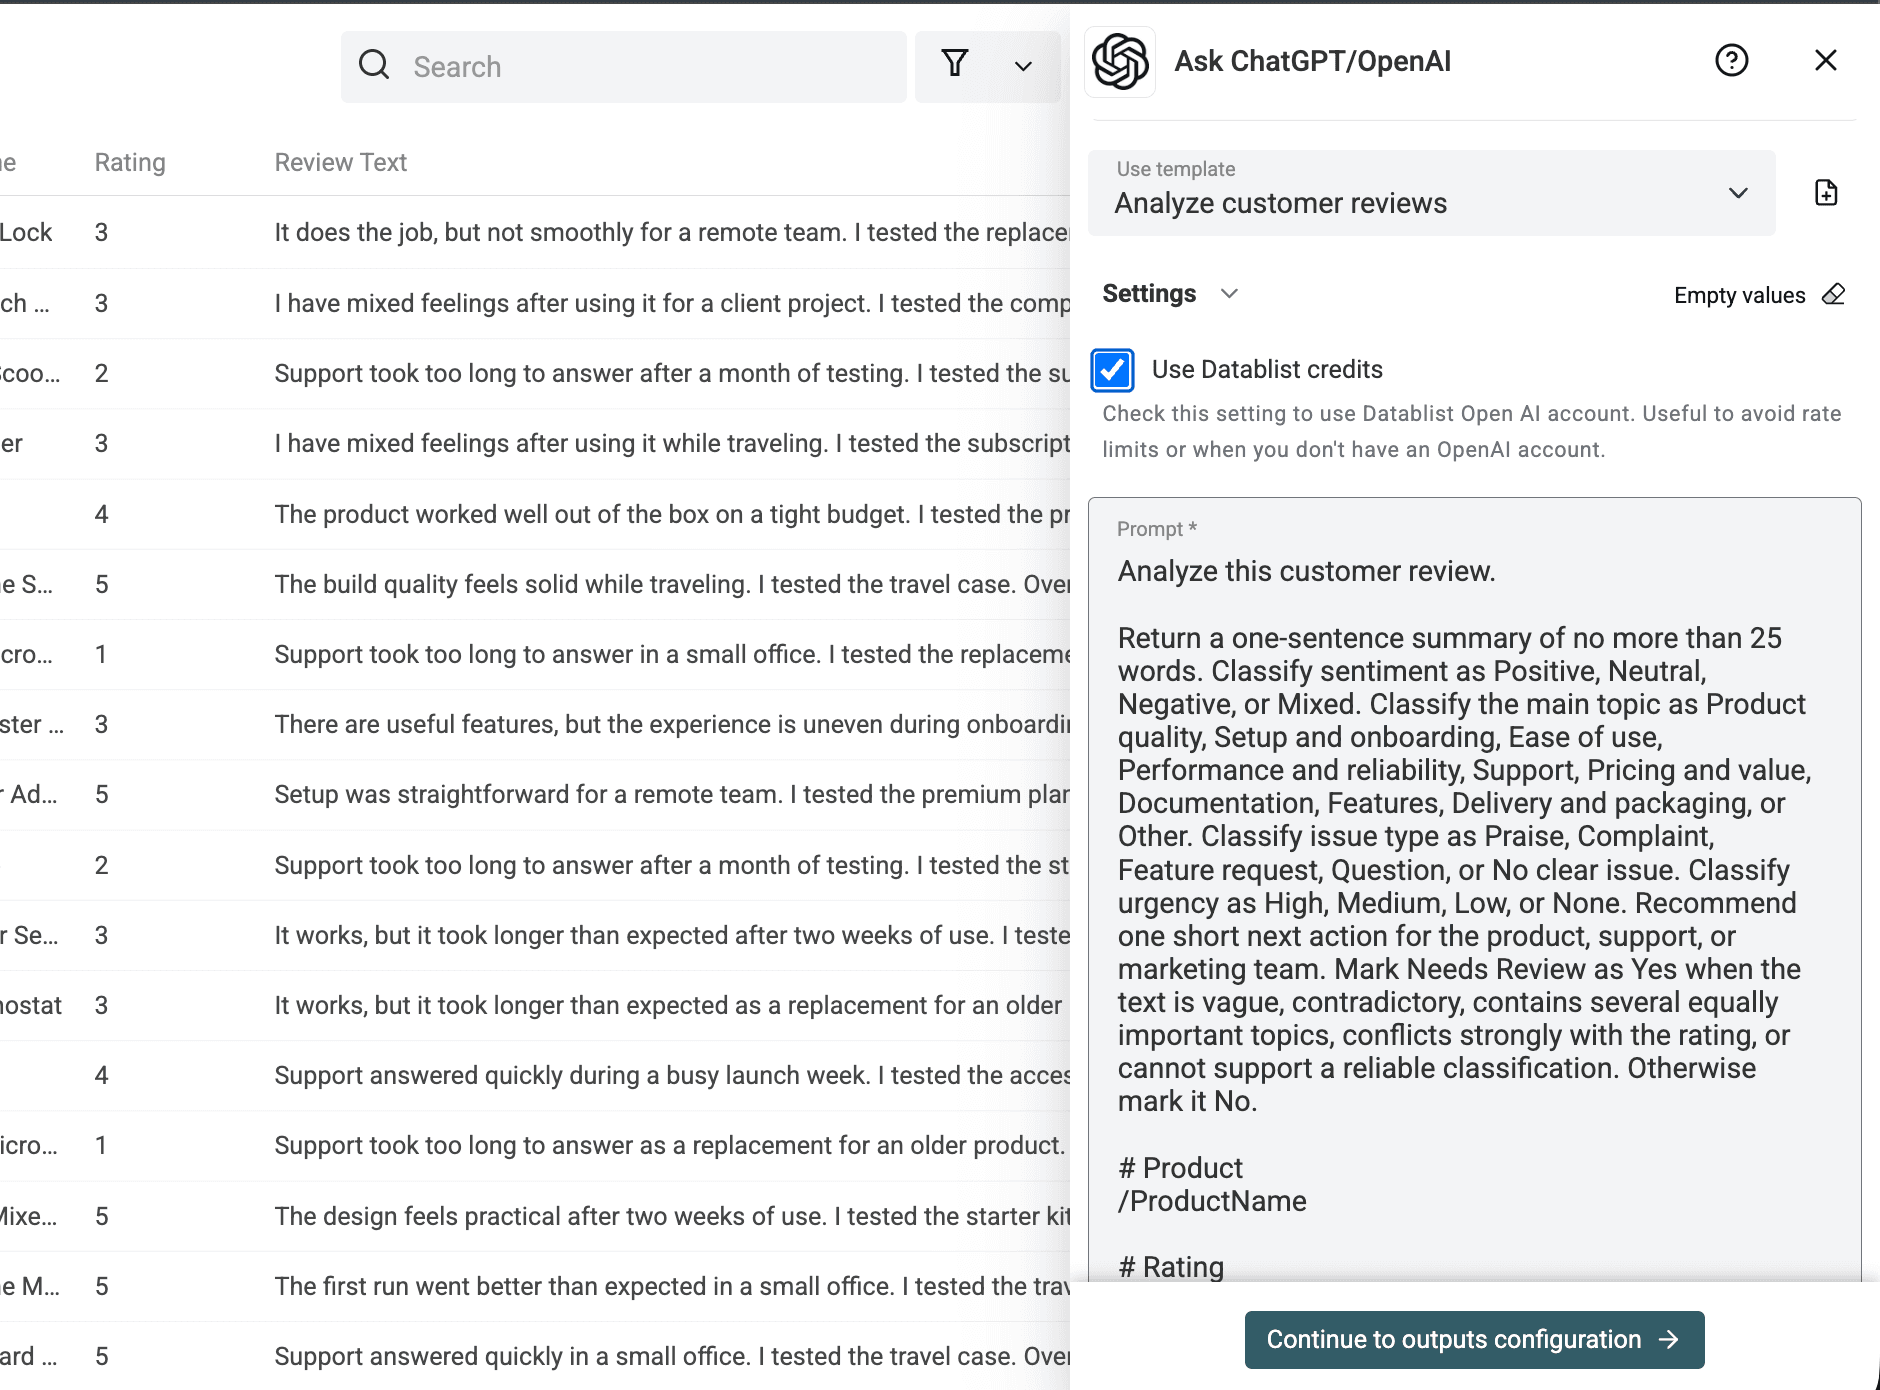
プロンプト変数を置き換えて出力を確認する
3つのプレースホルダーを、コレクション内のProduct Name、Rating、Review Textプロパティに置き換えます。誤ったテキスト列を割り当ててもプロンプト自体は正常に実行される可能性があるため、変数チップは必ず1つずつ確認しています。
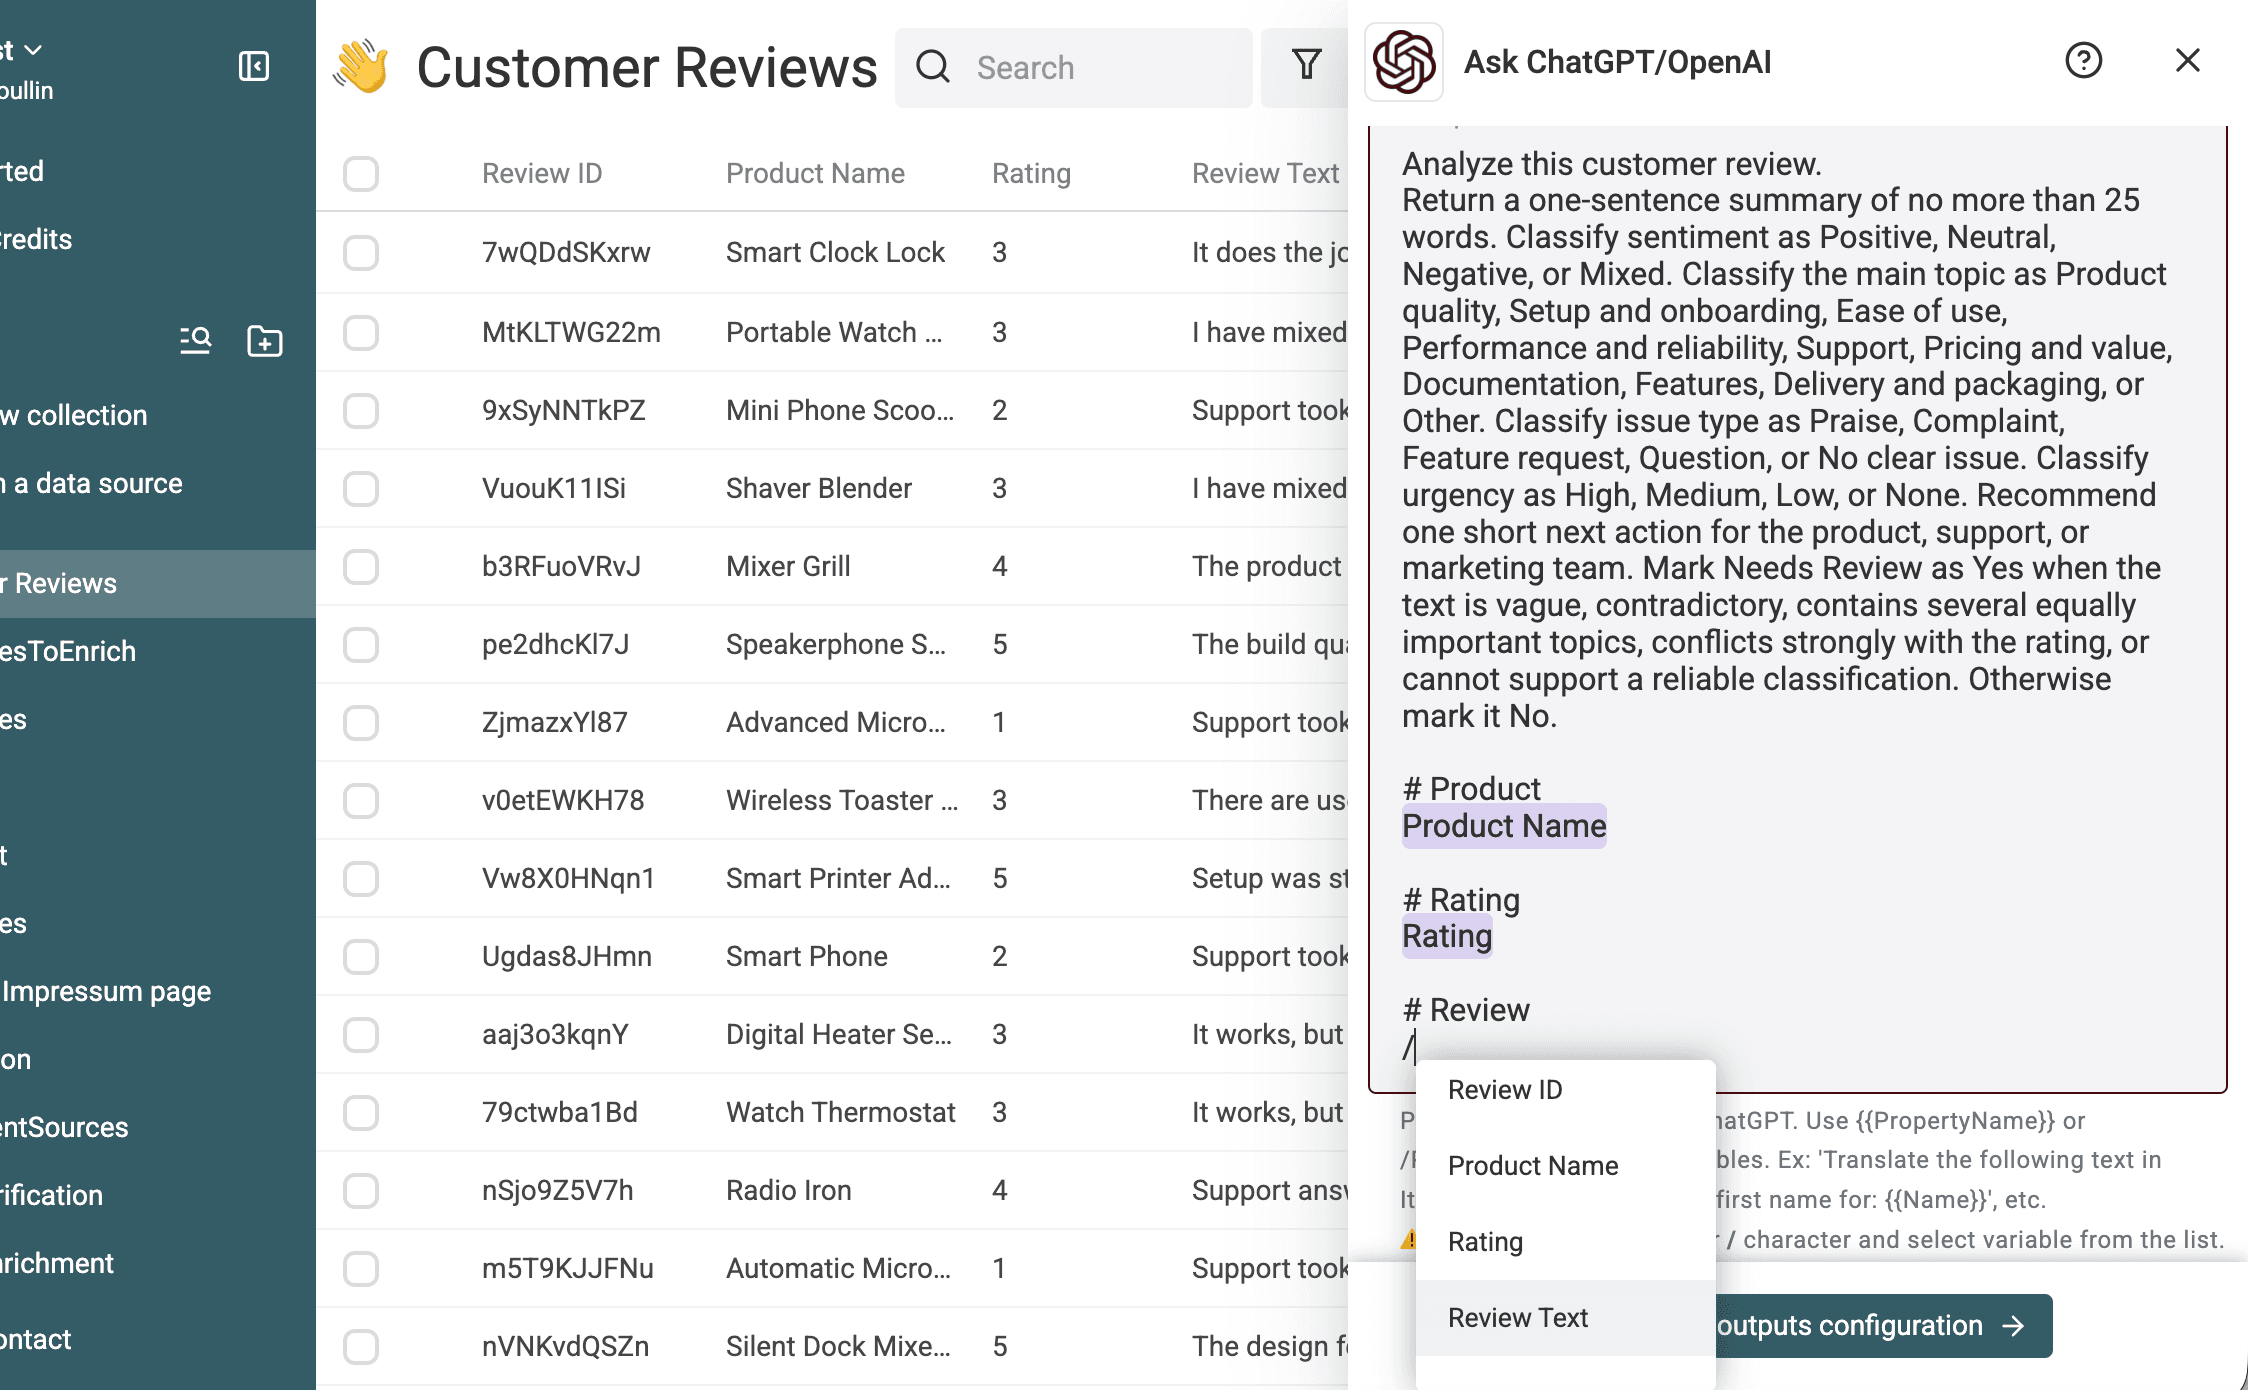
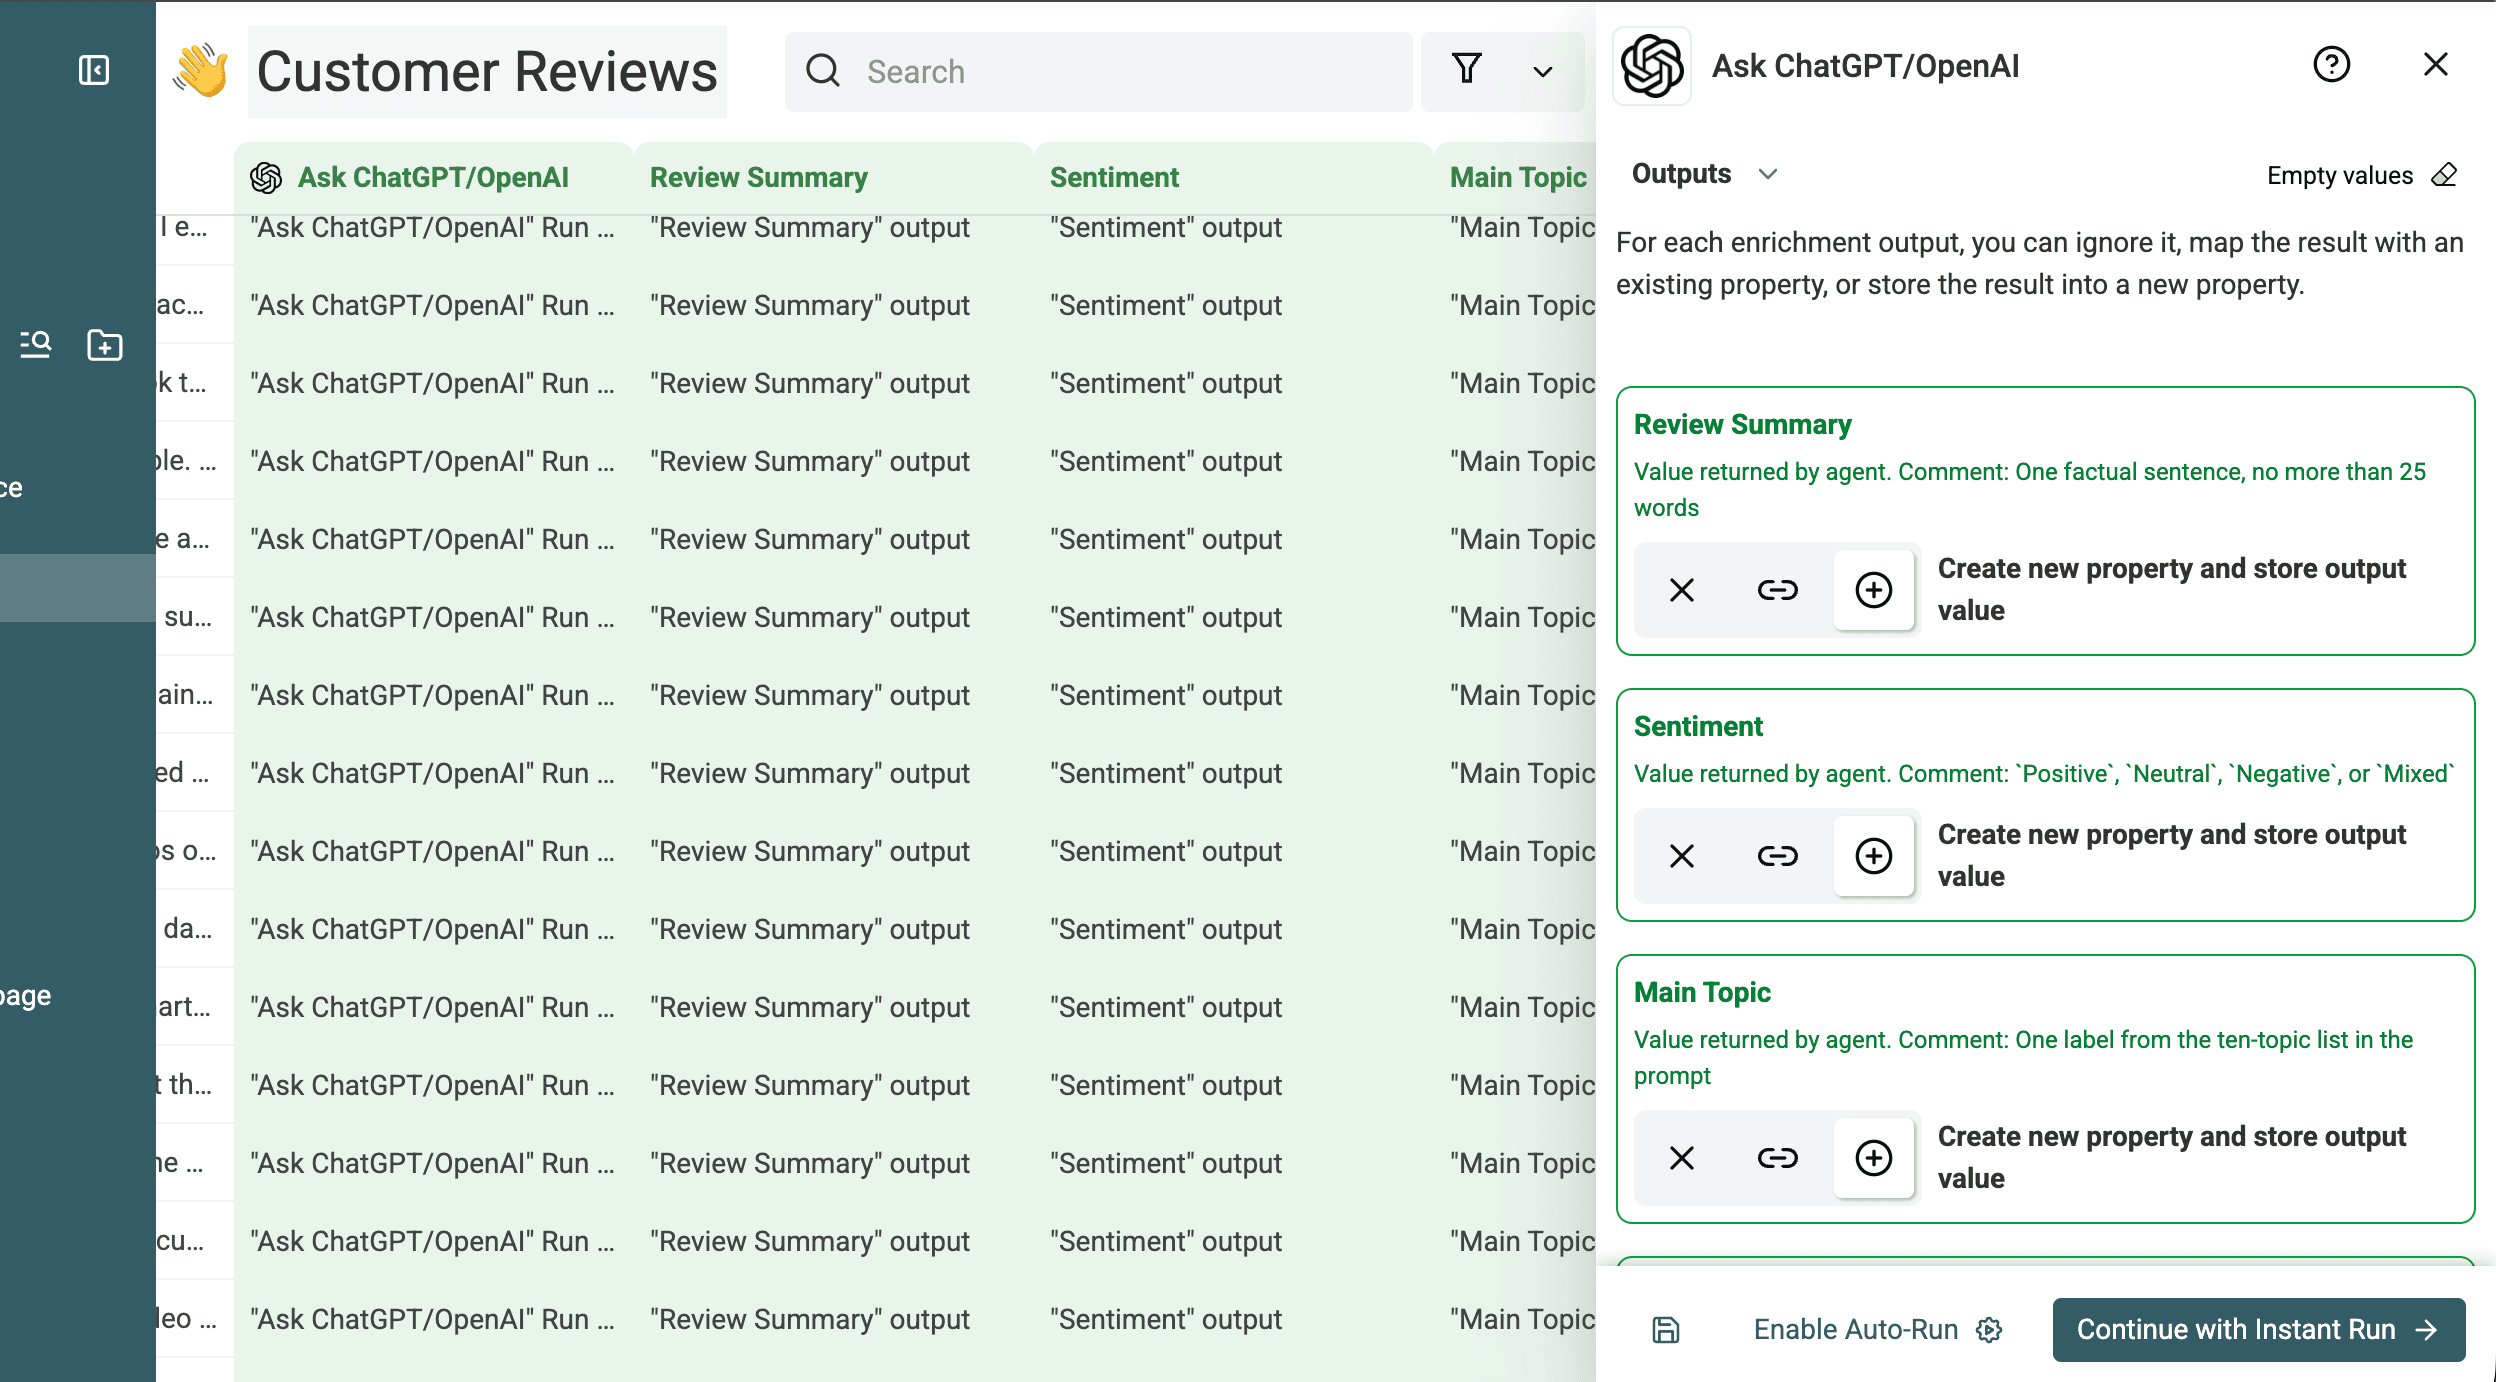
次に、構造化出力を確認します。以下のスクリーンショットでは、設定済みの要約、Sentiment、Main Topic、Issue Type、レビューフラグを確認できます。また、テストで使用した型と定義済み値の説明も記録されています。
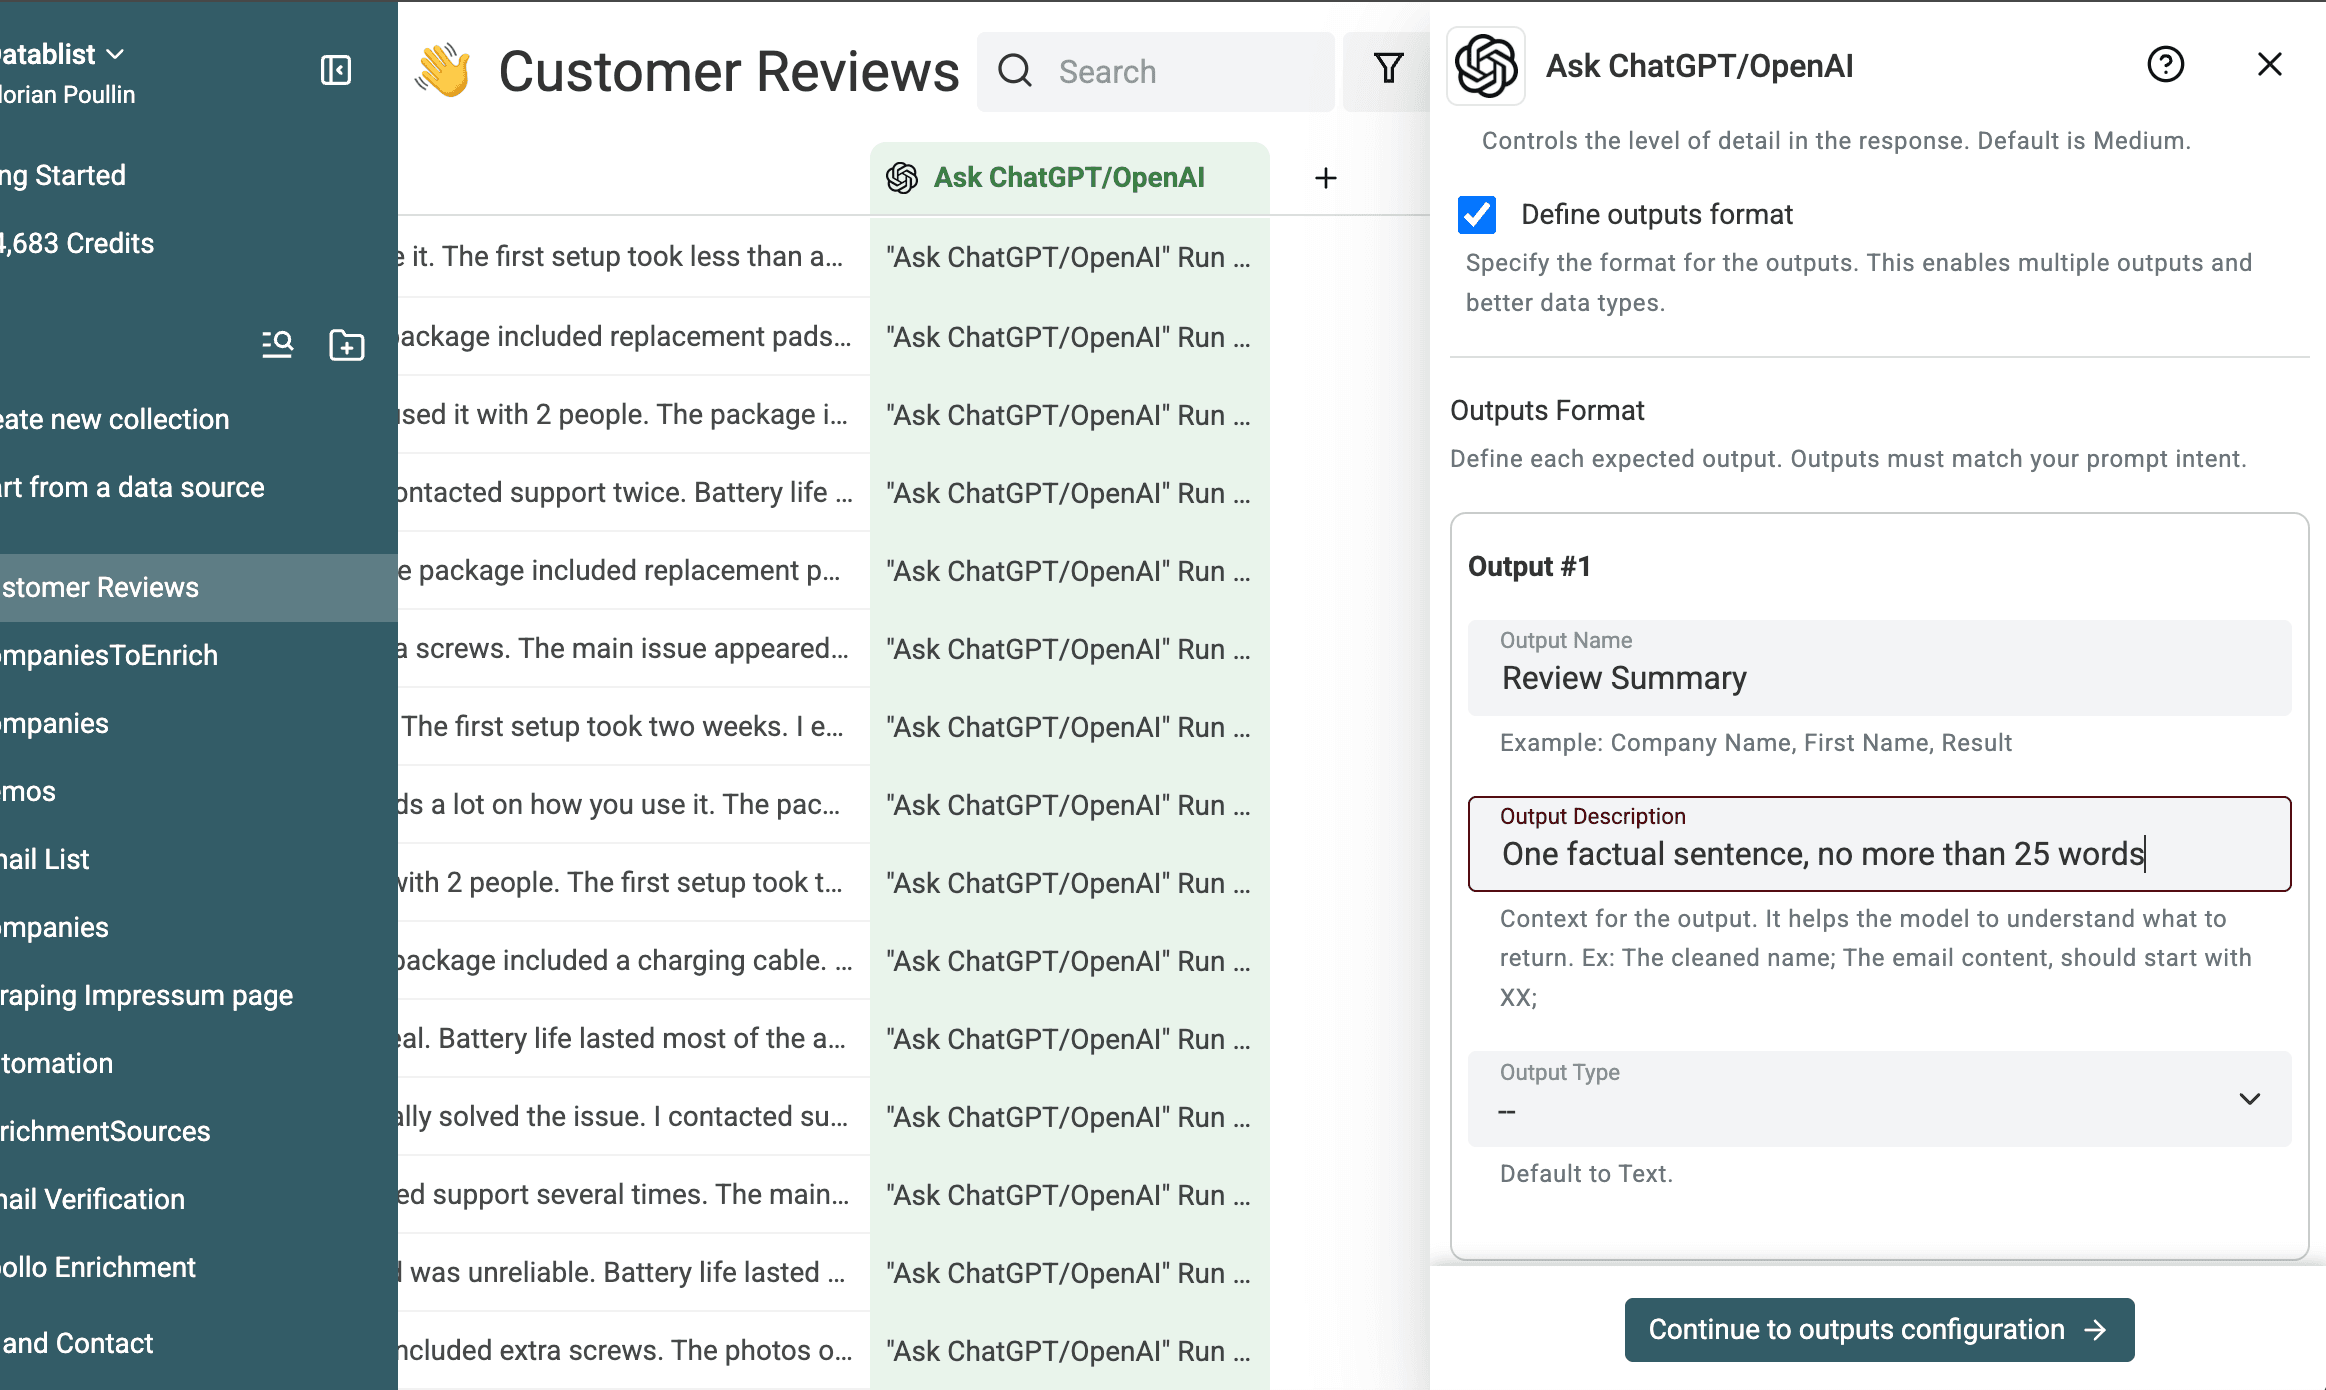
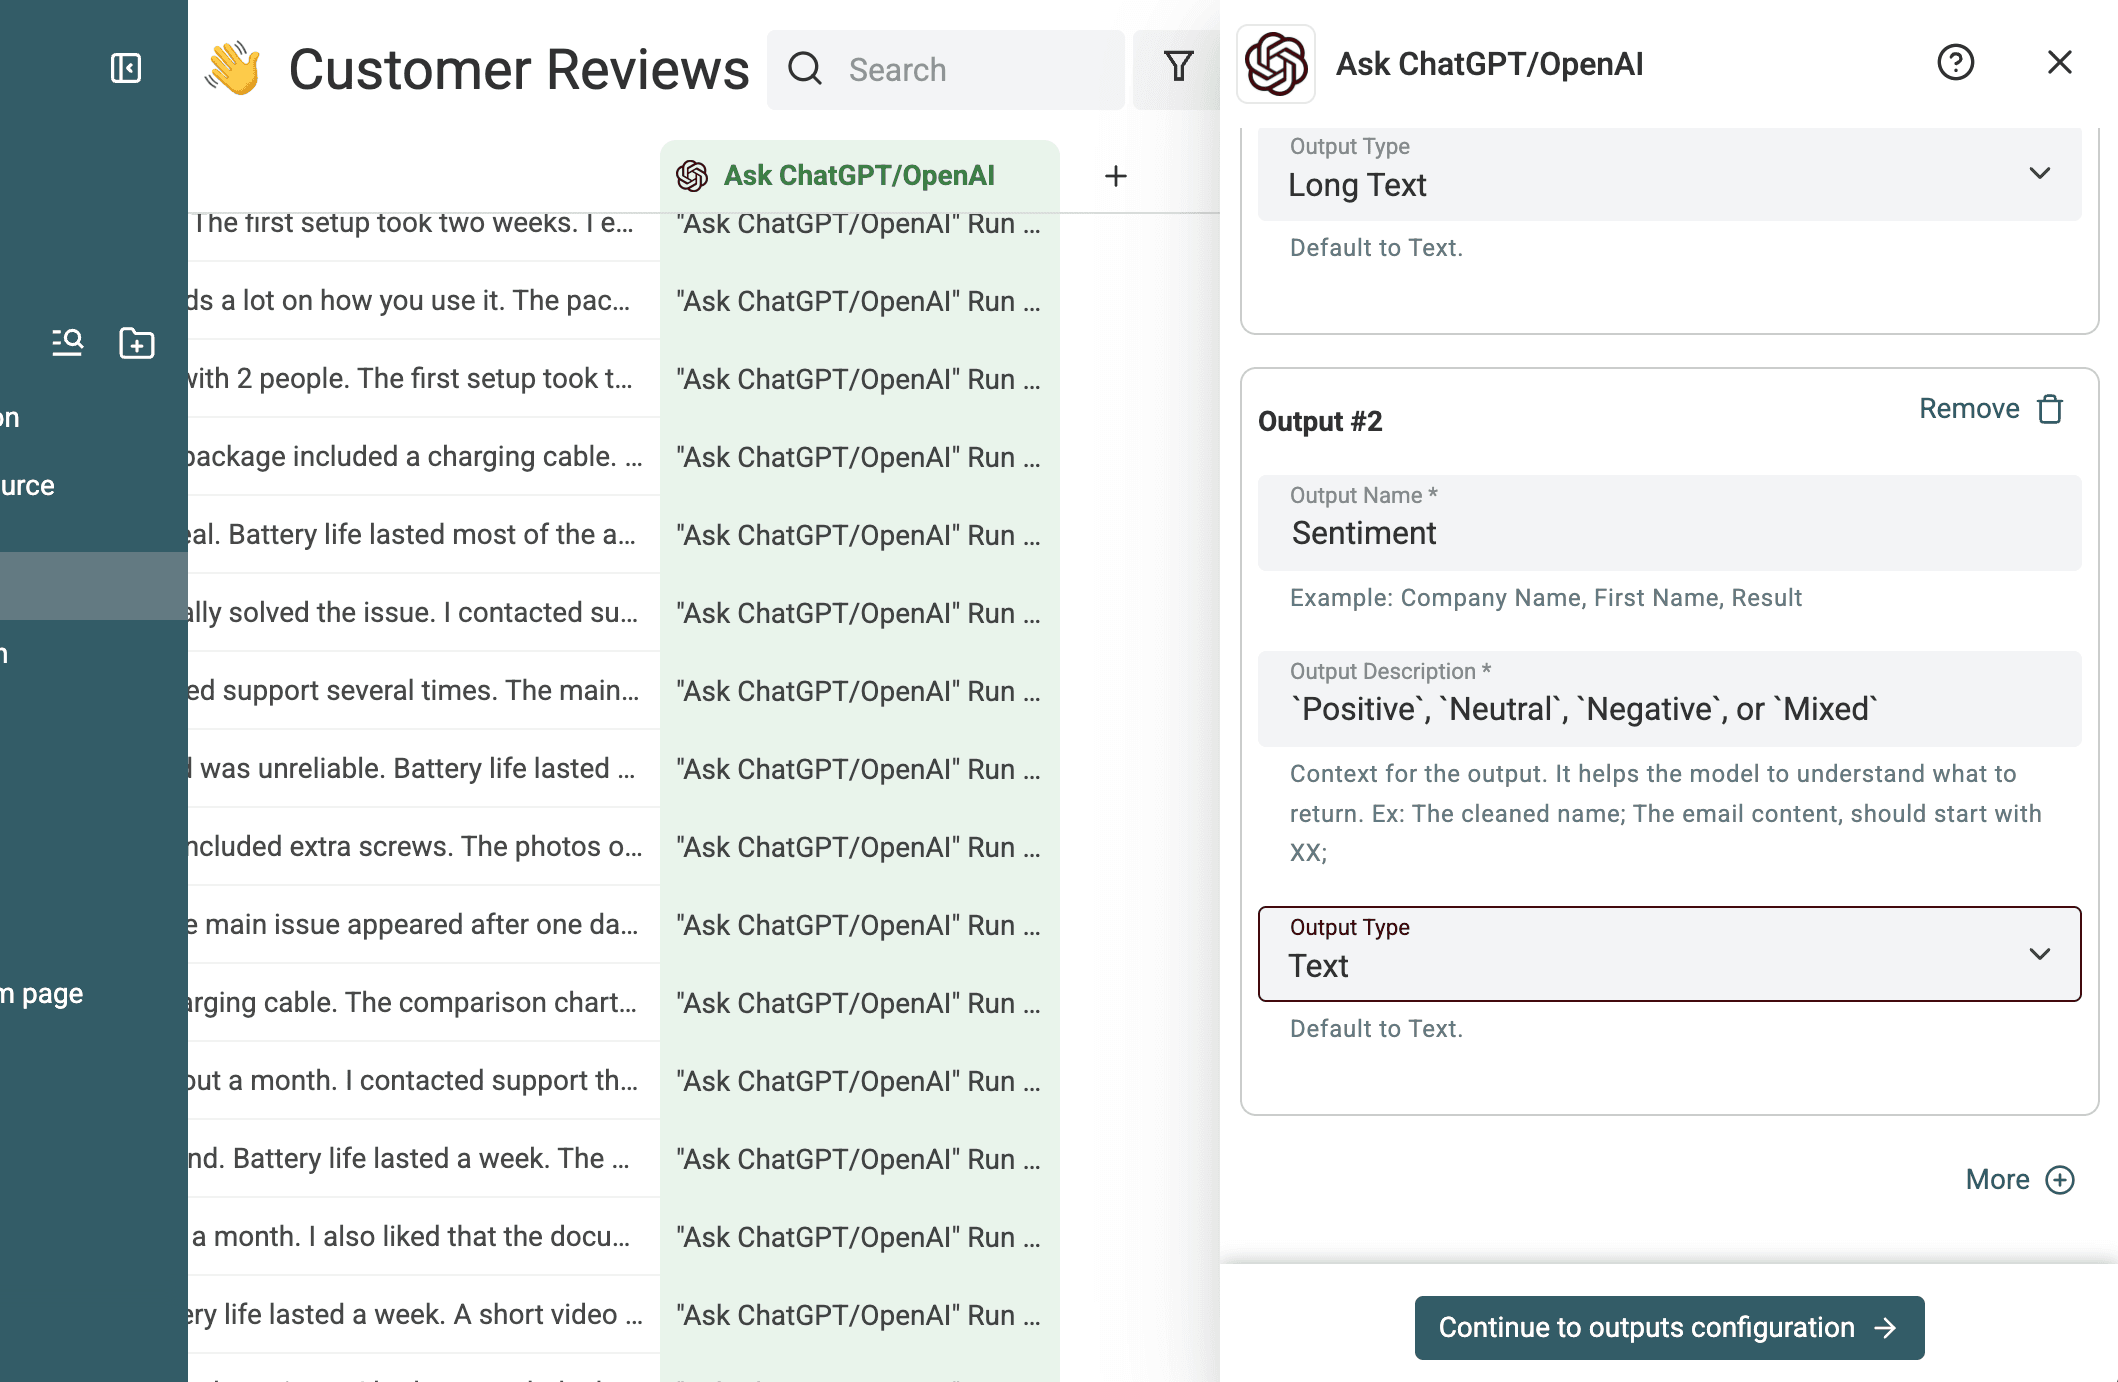
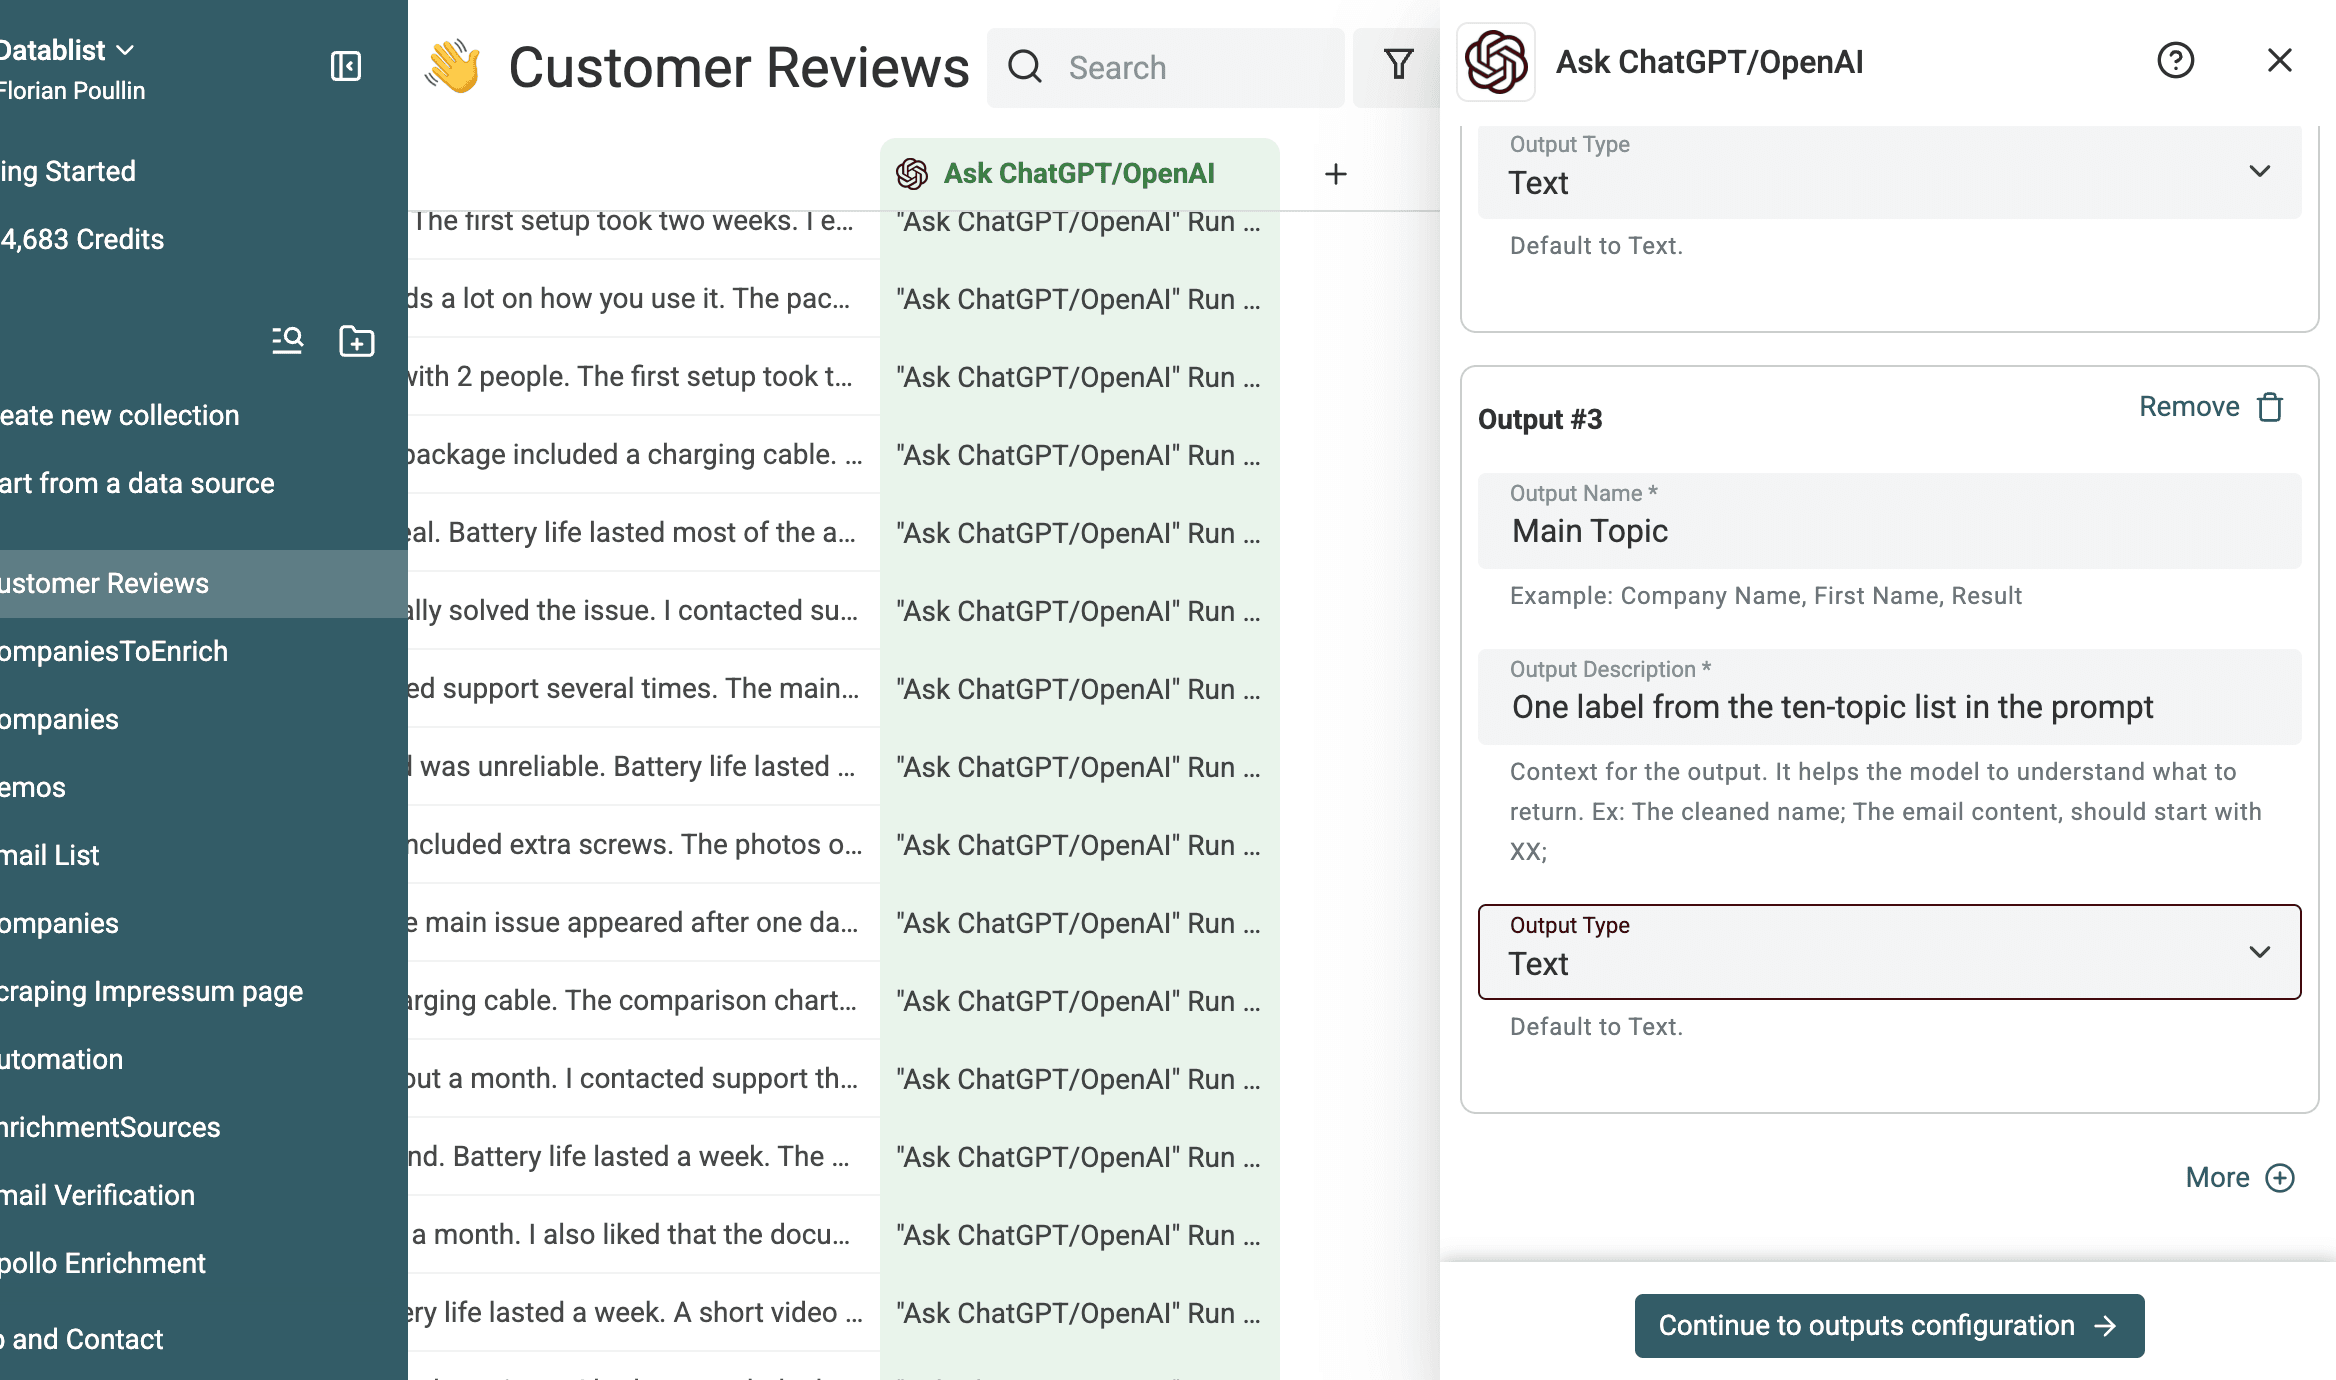
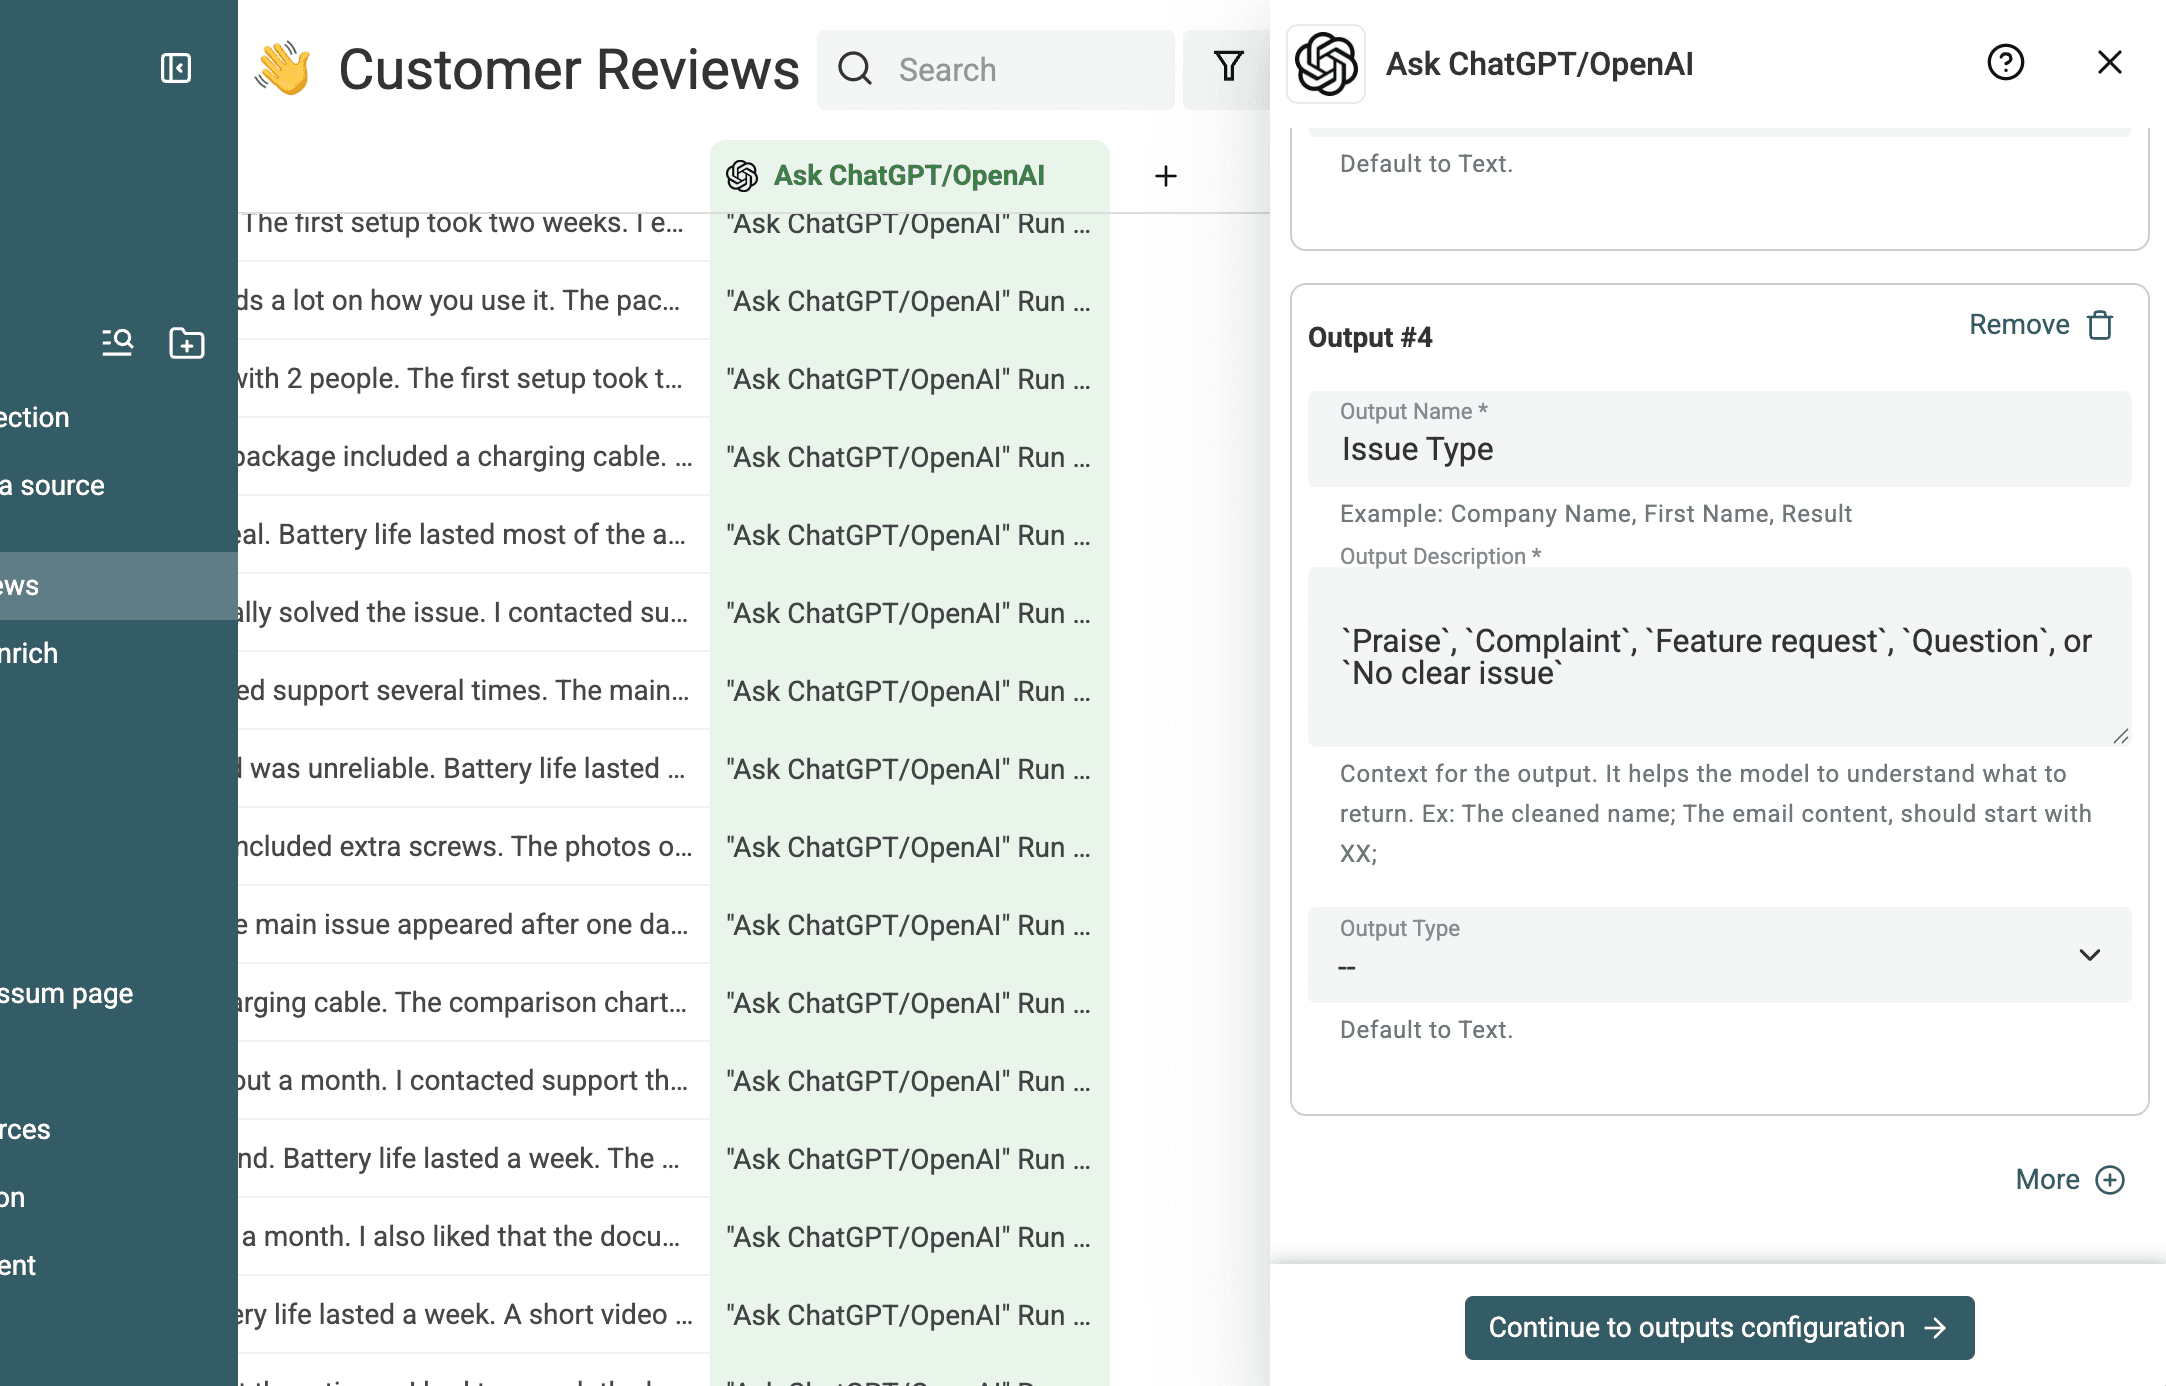
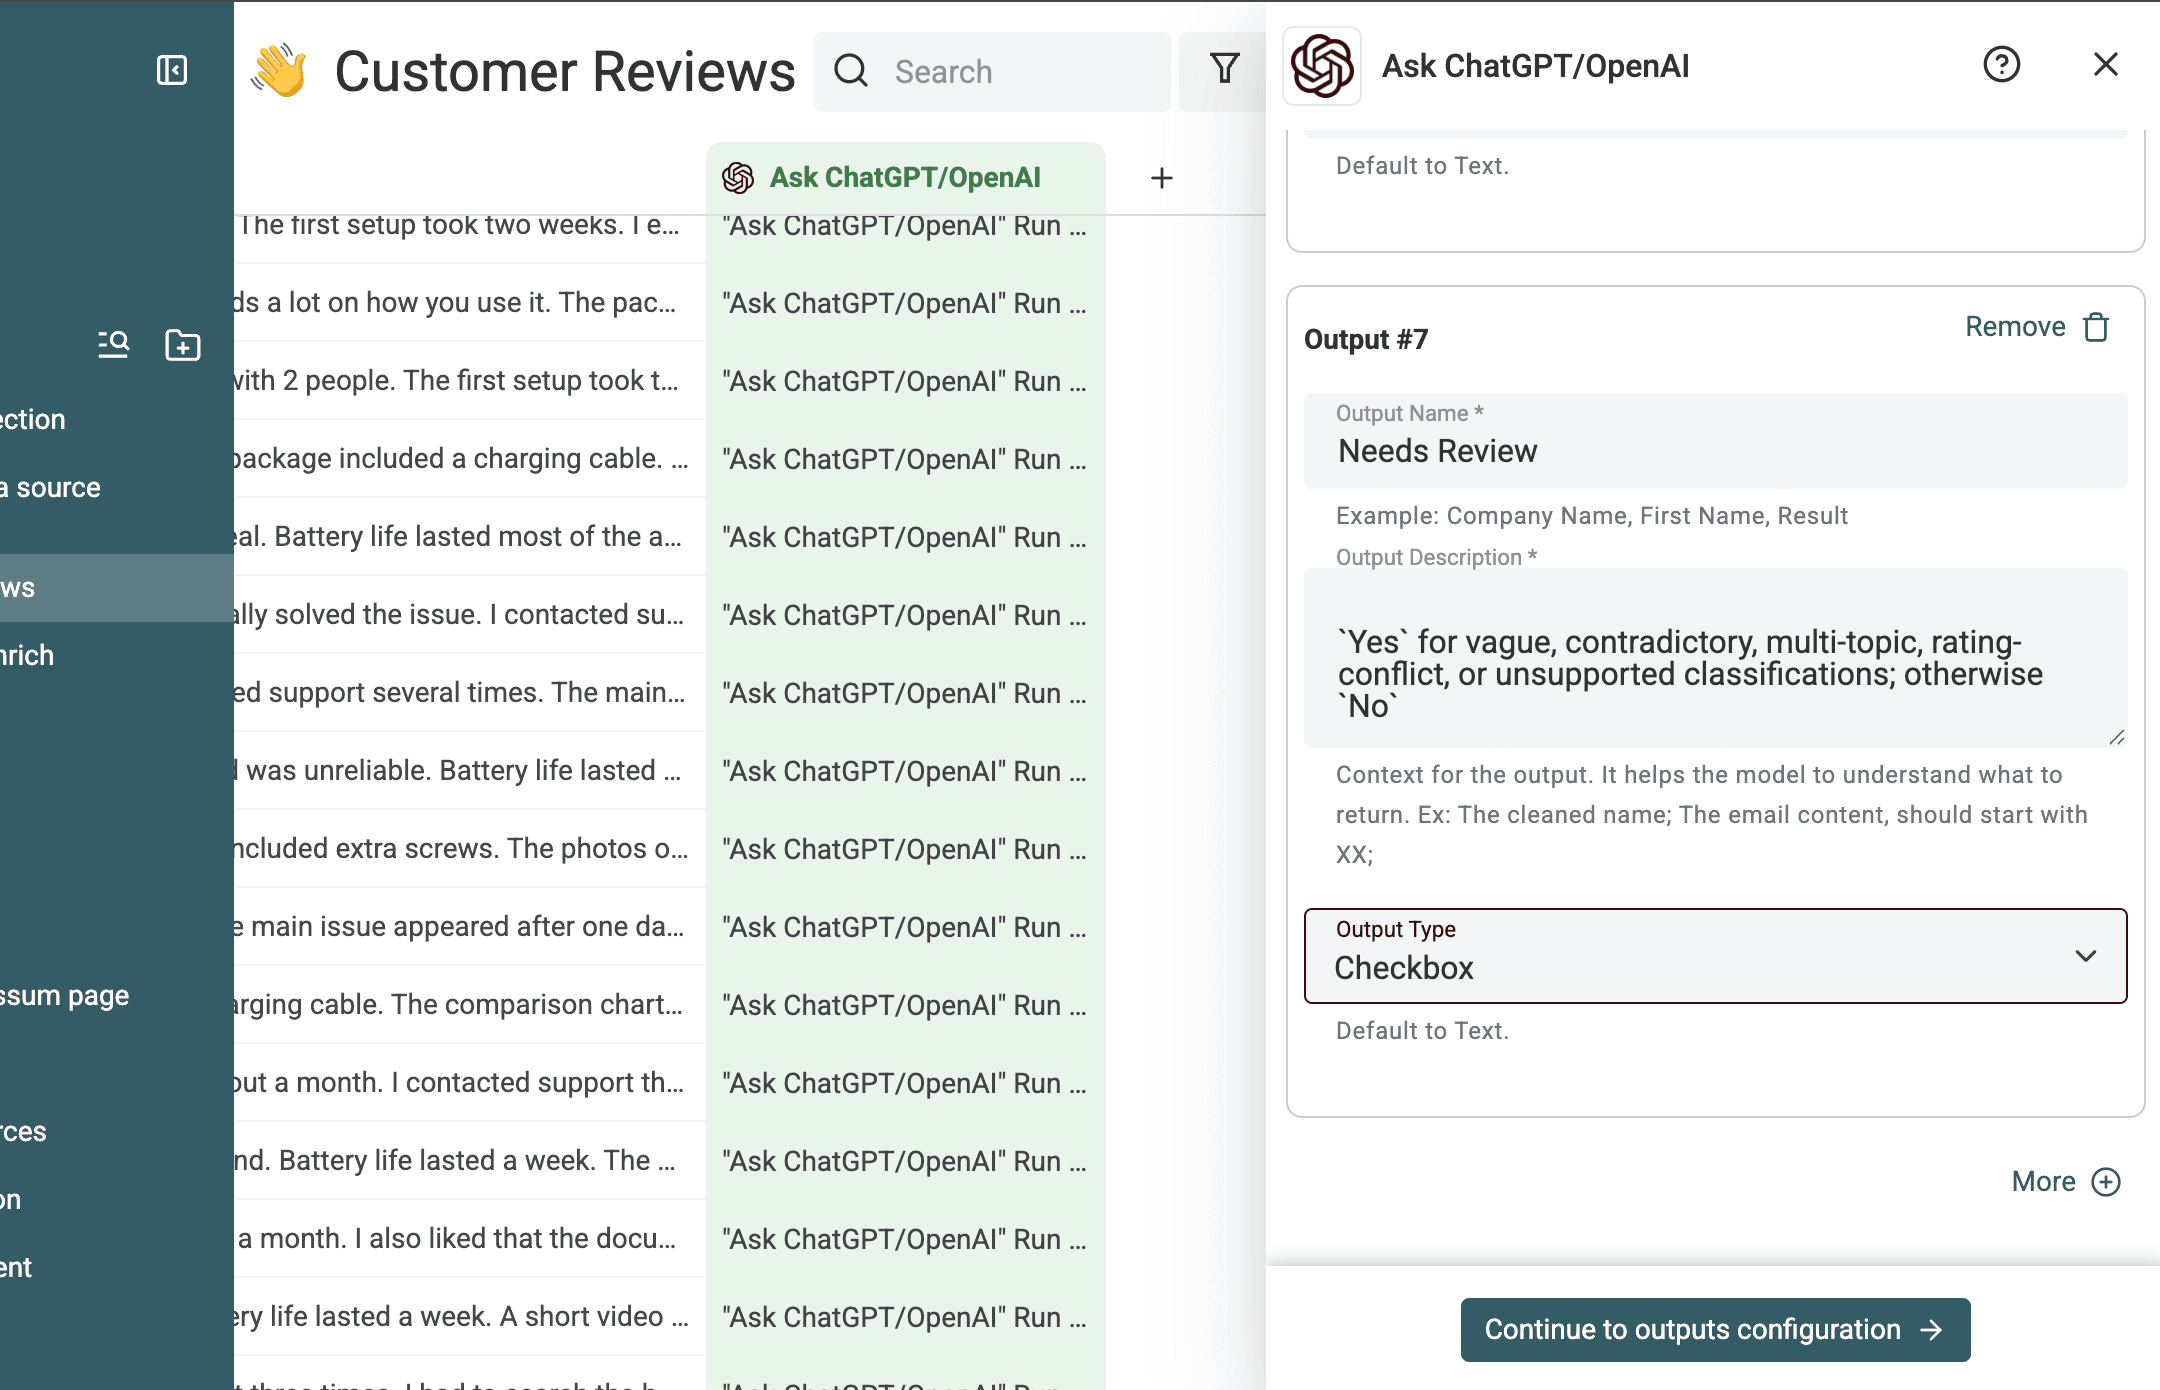
返される各値を既存のプロパティにマッピングするか、新しい出力先プロパティを作成します。
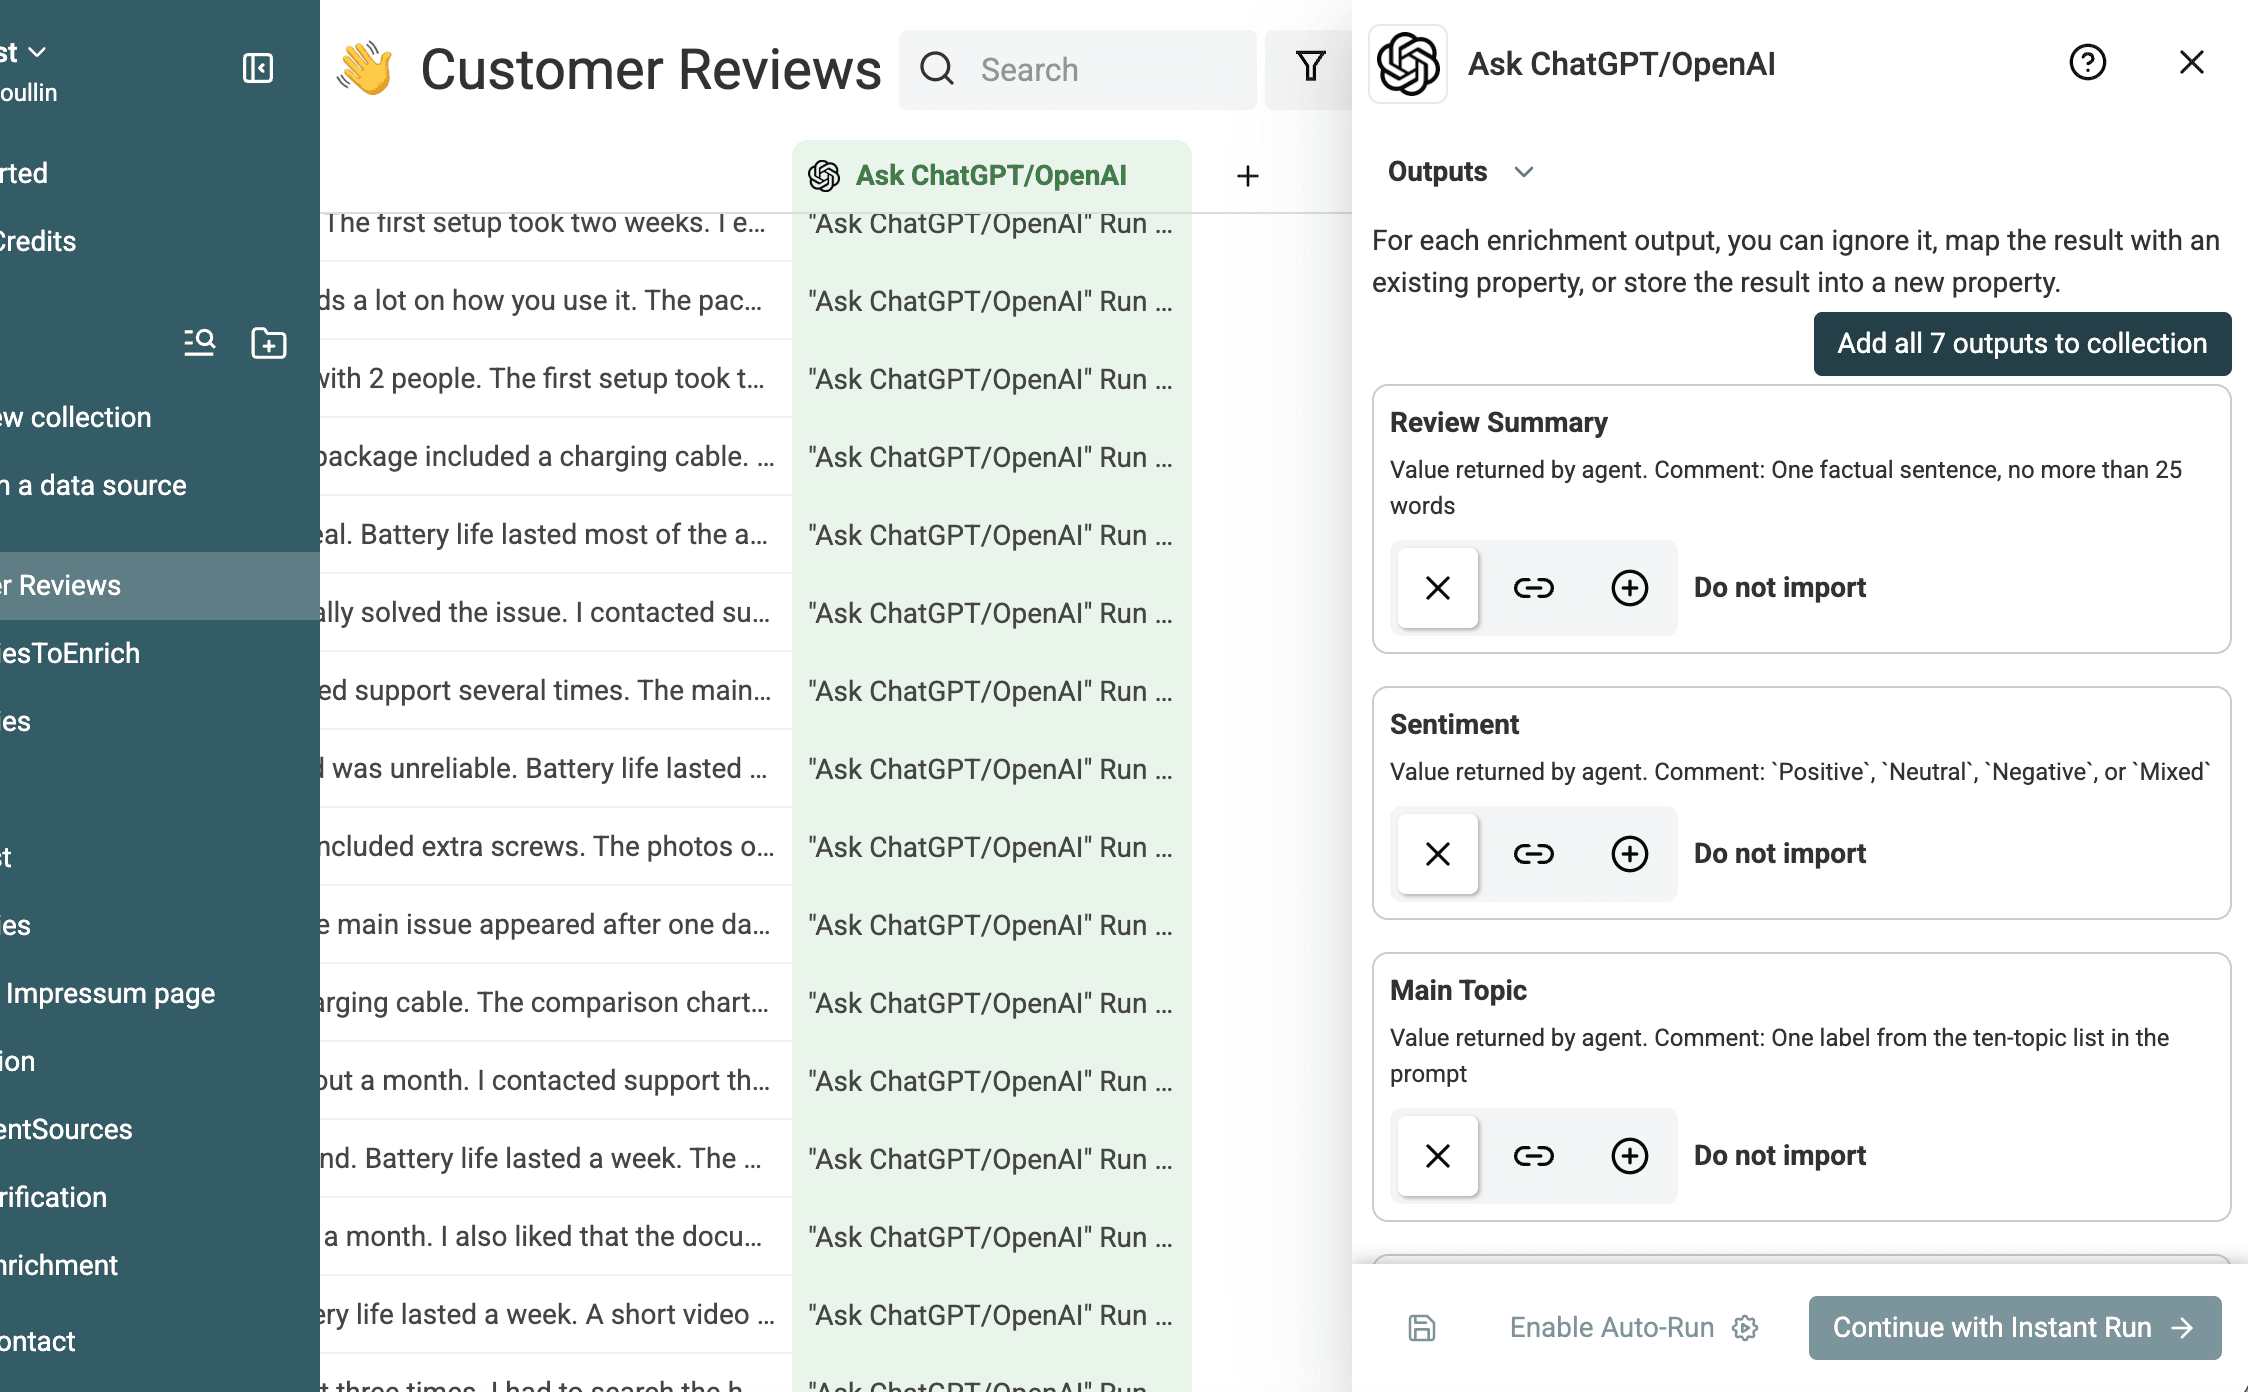
実行設定を記録する
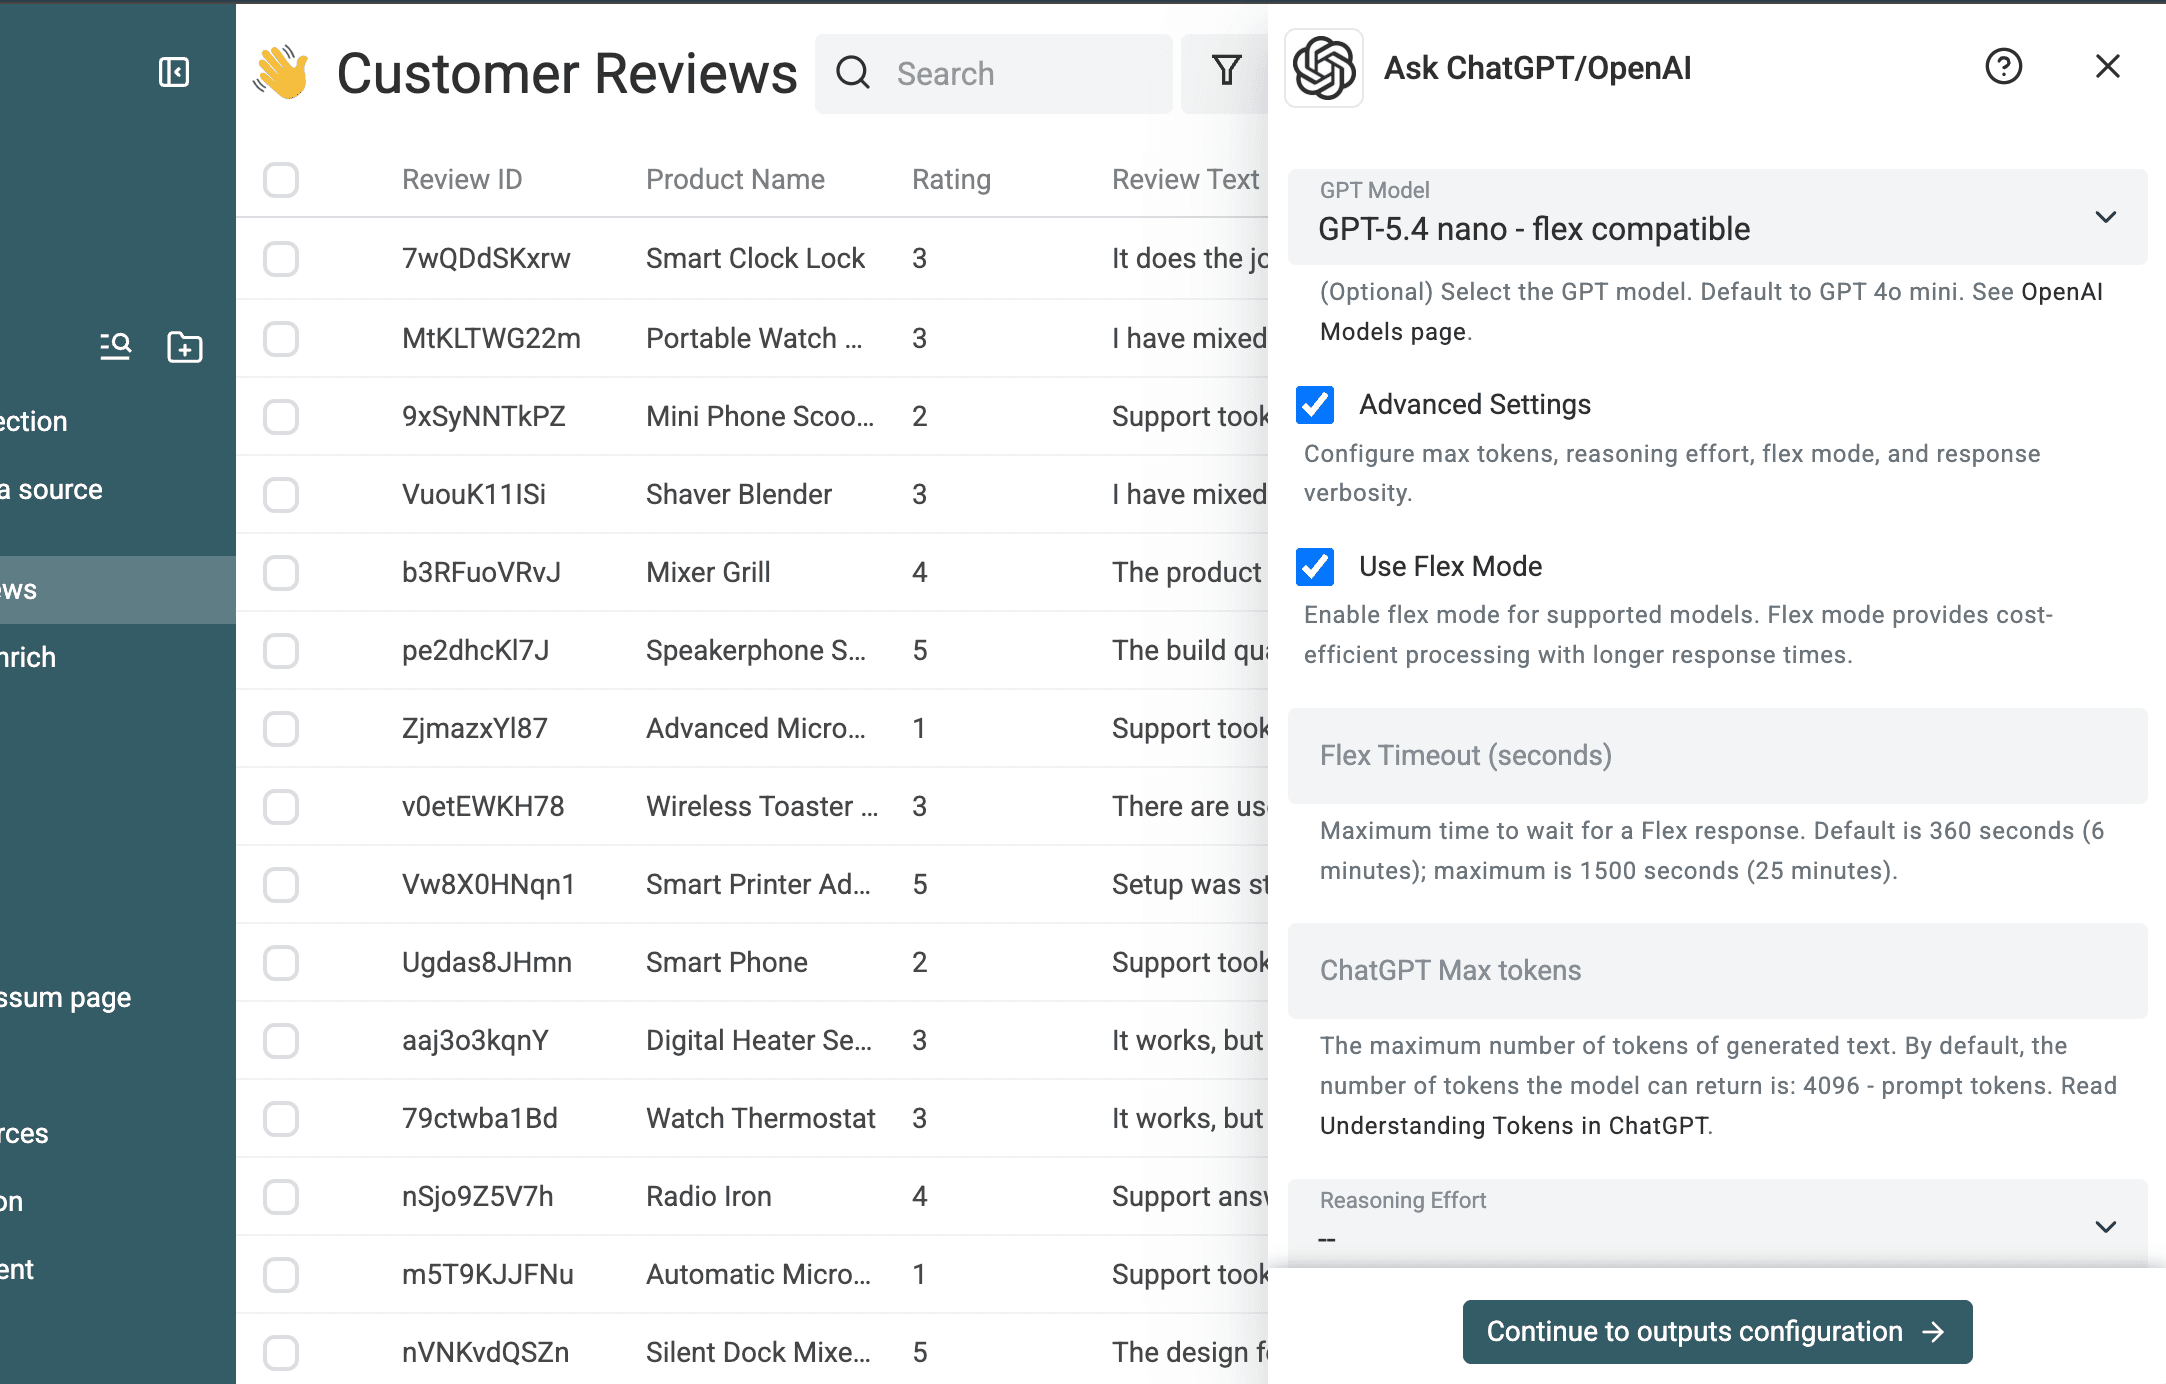
検証に使用した設定は、GPT 5.4 nano、Flex mode、Datablist Creditsです。これは今回のテスト設定であり、あらゆるケースに共通する推奨設定ではありません。Ask ChatGPT/OpenAIでは、ほかのモデル、最大出力トークン数、キャッシュ、ご自身のOpenAI API keyによる課金も選択できます。
Flex modeを利用できることは、このワークフローをDatablistで実行するメリットの1つです。レスポンスが遅く、所要時間を予測しにくい処理でも問題ない場合、対応するOpenAIモデルではStandard modeと比べて処理料金を半分に抑えられます。DatablistのEnrichment画面から設定できるため、別途APIワークフローを構築せずに低料金の処理モードを利用できます。対応モデルの確認、料金比較、タイムアウトに関する注意点は、OpenAI Flex modeガイドをご覧ください。
少量をプレビューしてから全件を処理する
多様なレビューを10〜20件プレビューする
Run on first 10 itemsを使用するか、代表的な行をご自身で選択します。今回のテストでは、最初のバッチに10件のレビューを含めました。要約が元の内容に忠実か、許可されたラベルが使われているか、Urgency、推奨アクション、曖昧なレビューへのフラグ付けを確認しました。
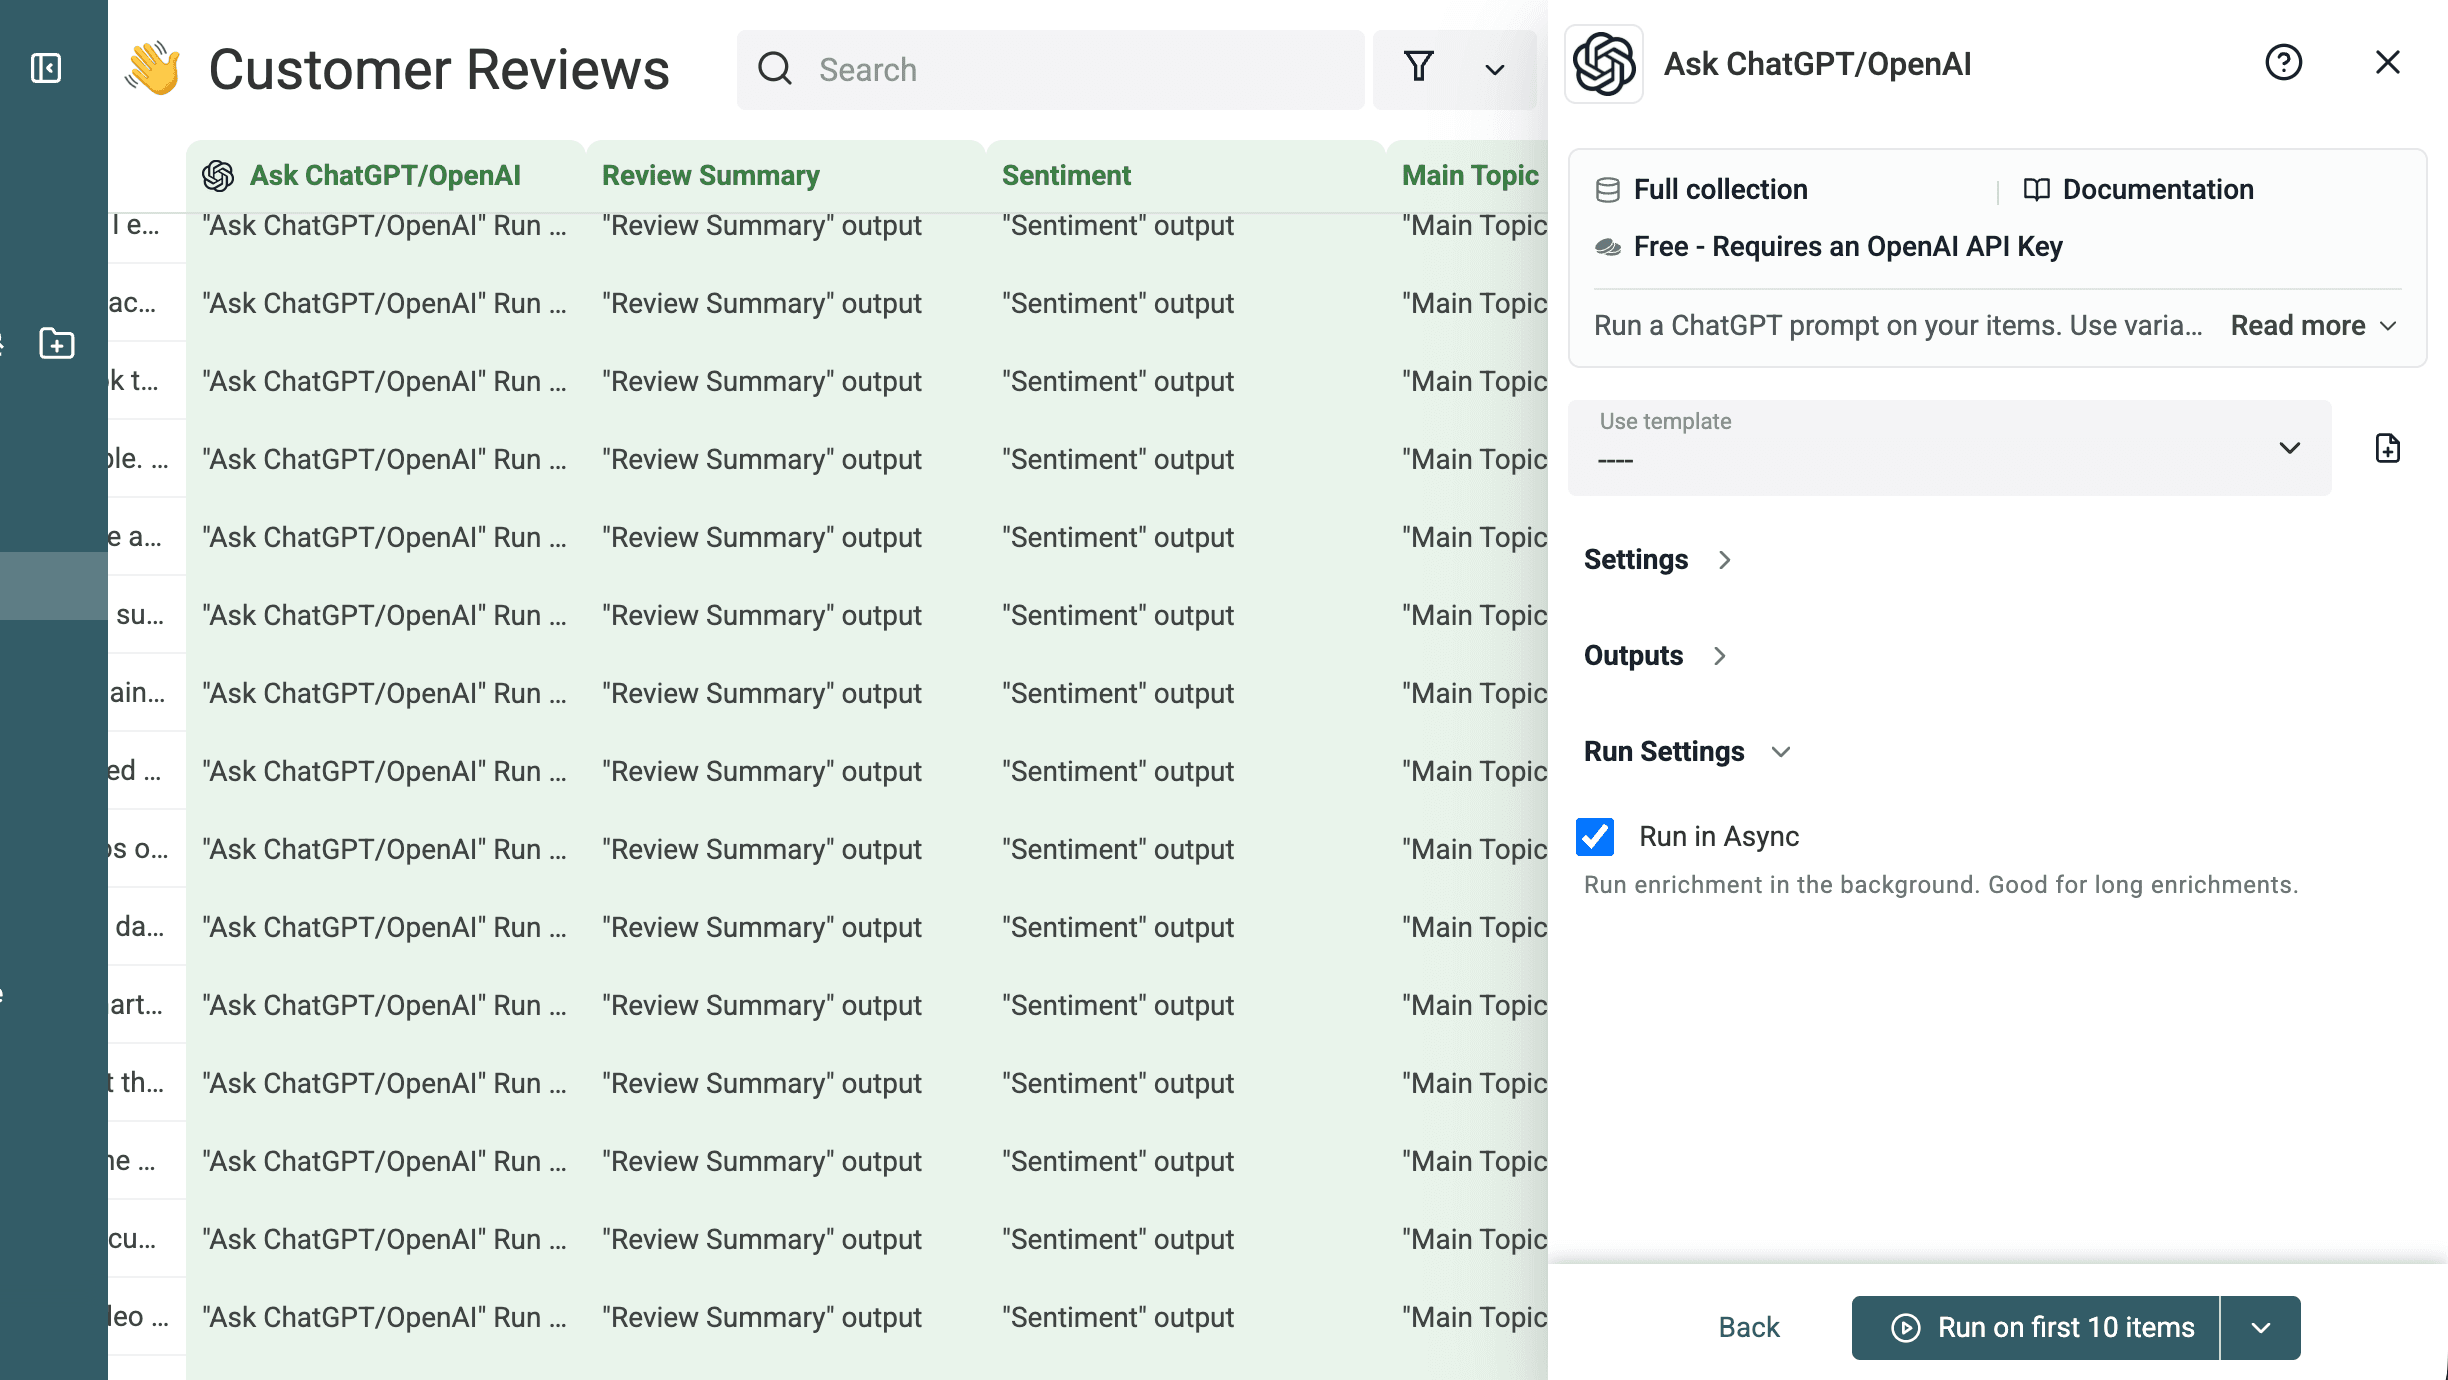
レビューの意図と投稿者の感情が保たれていれば、要約を合格としました。プレビューの品質に問題がなかったため、プロンプトと出力設定は変更していません。
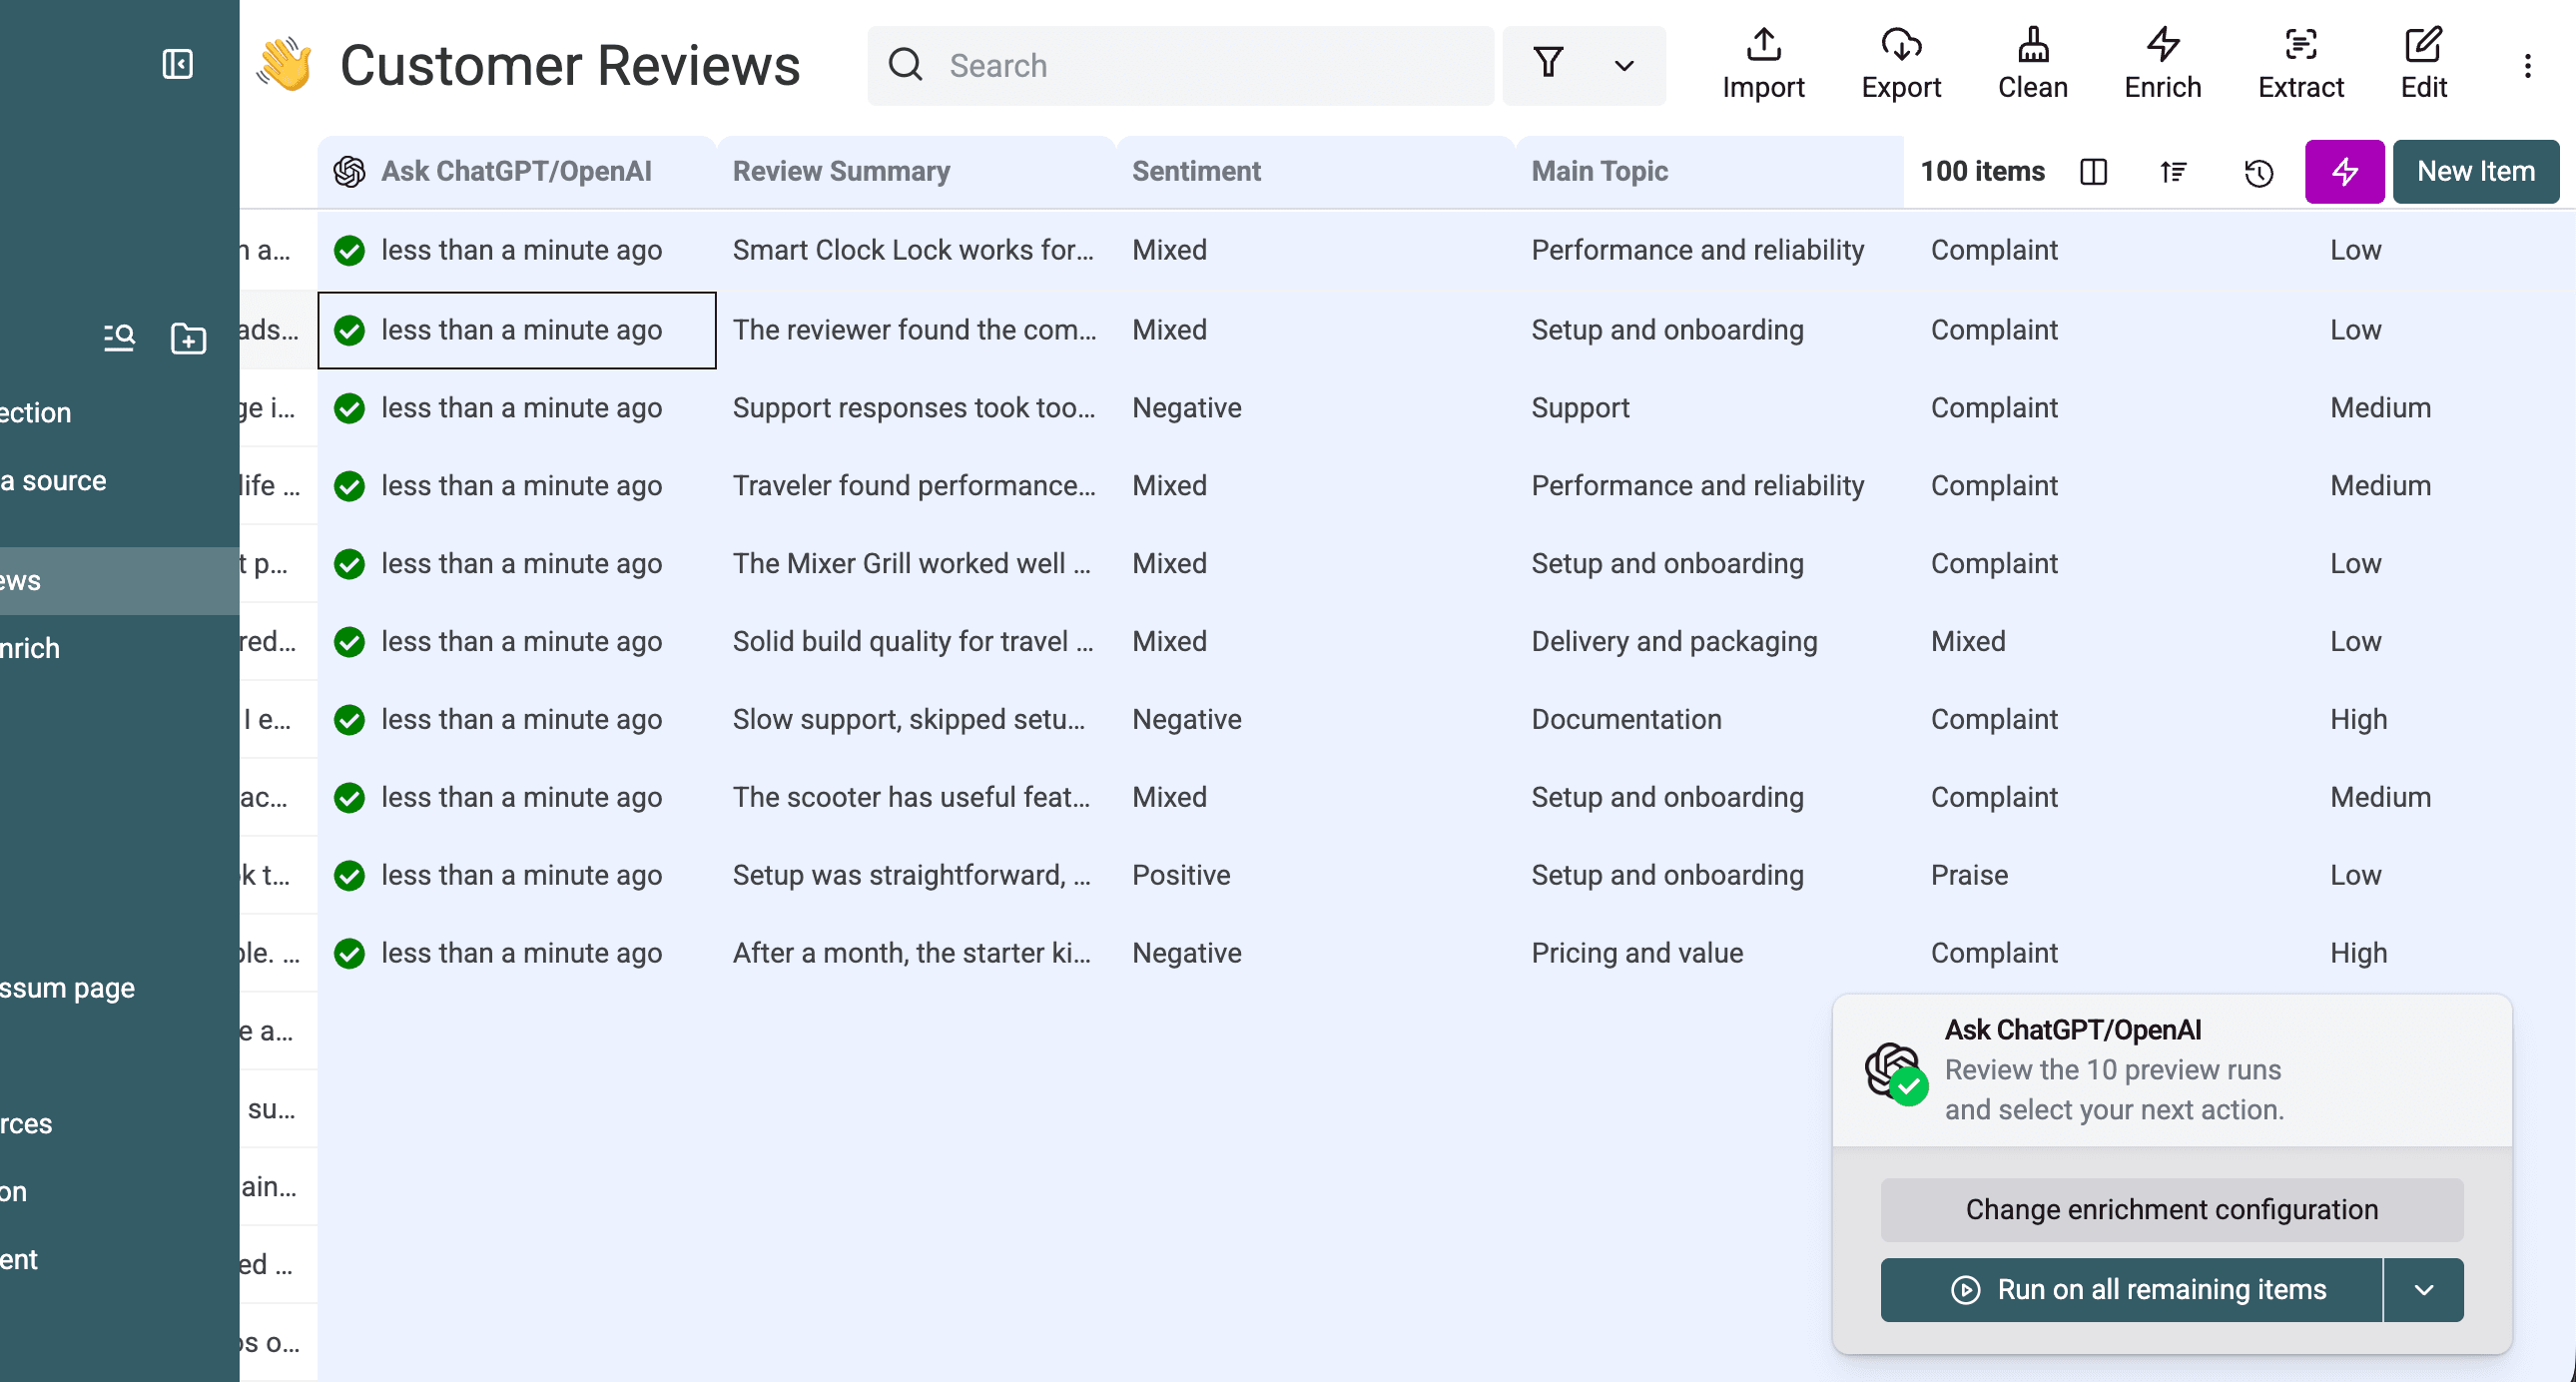
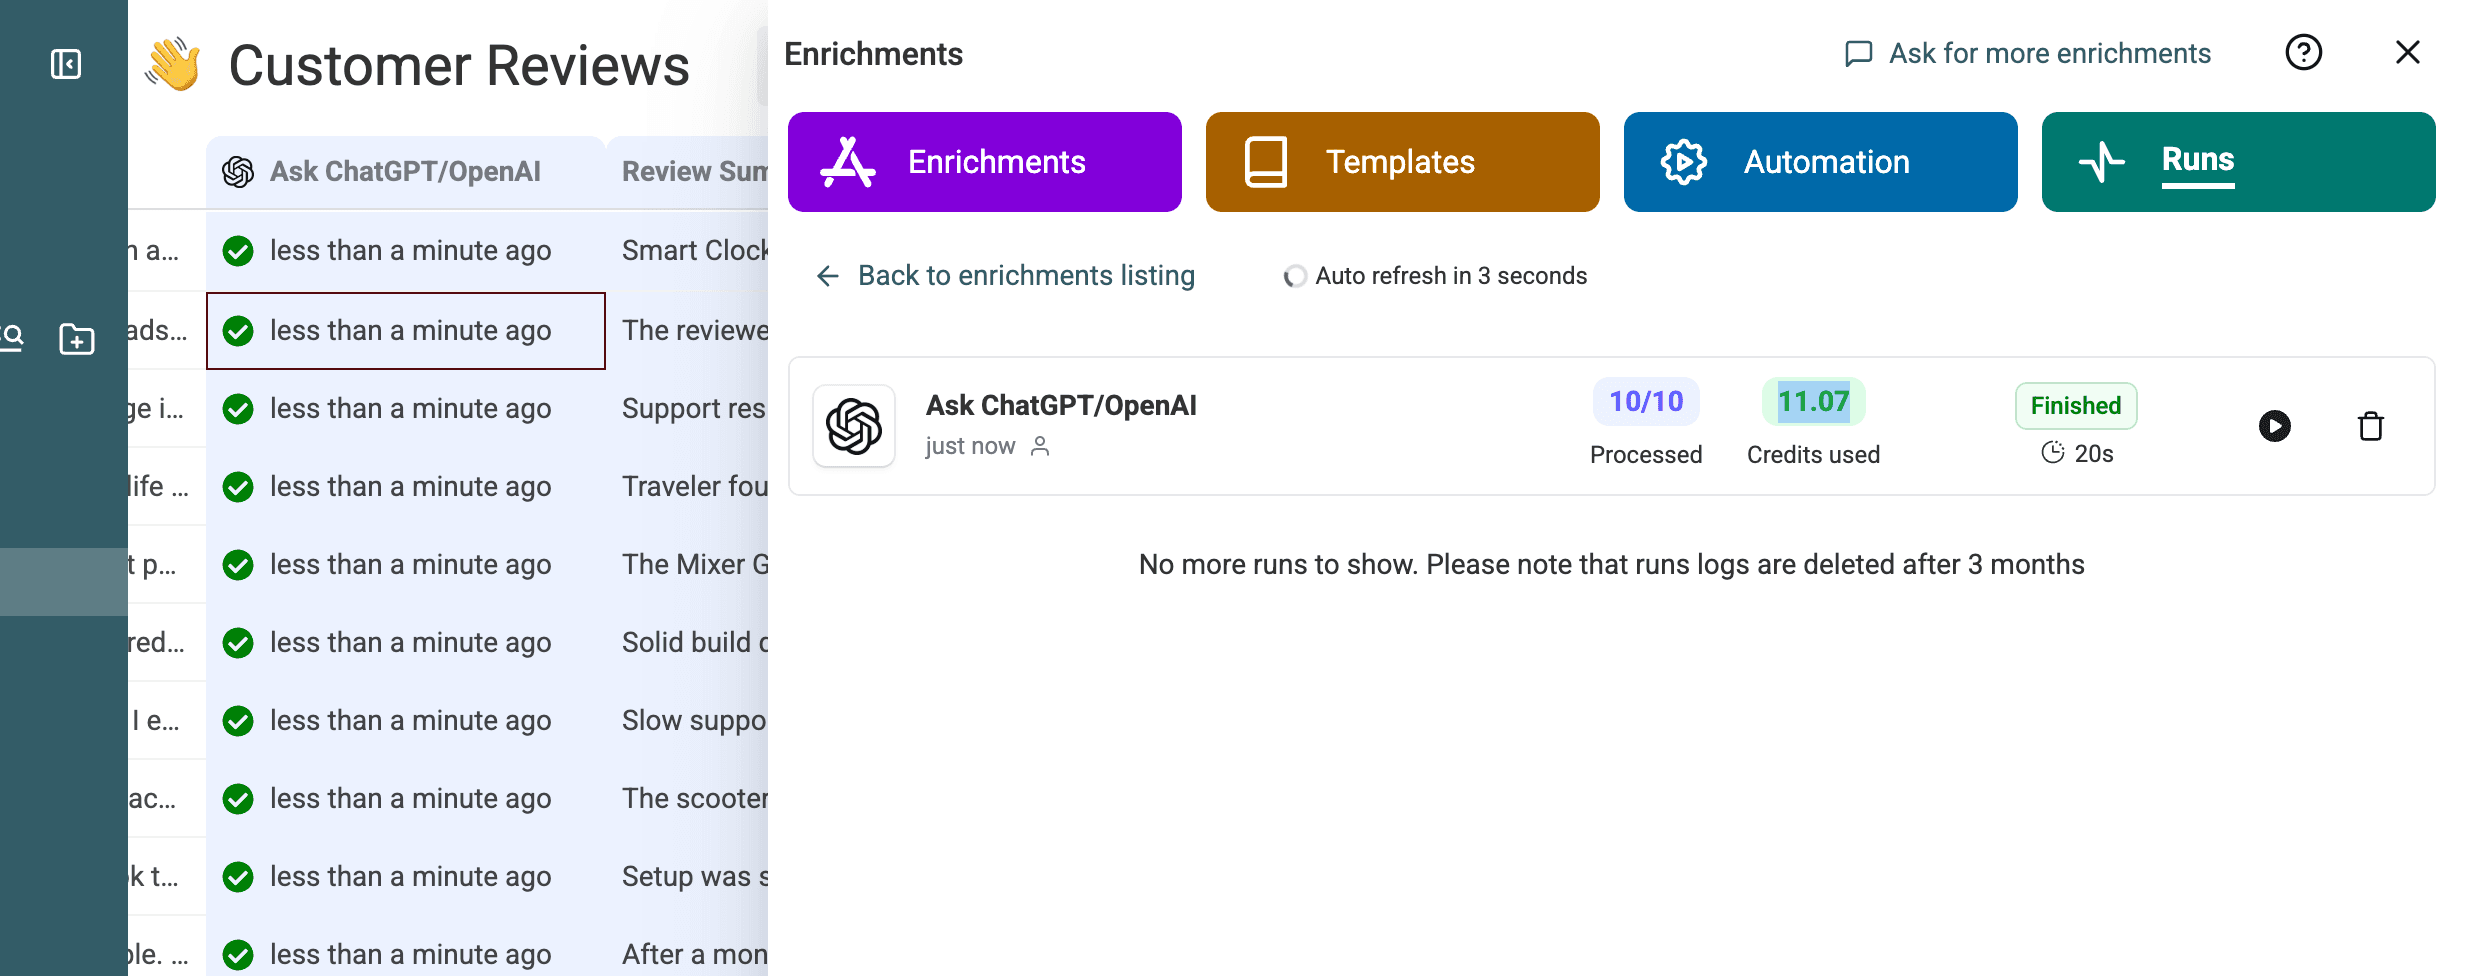
プレビューでは10行中10行を20秒で処理し、11.07 creditsを使用しました。
残りのレビューを処理する
プレビューに問題がなければ、残りの行を実行します。最初のバッチが再送信されないよう、処理済みフラグを残してください。リクエストが失敗した場合は、失敗ステータスだけを絞り込み、その行のみ再実行します。
📌 テスト済みの実行結果
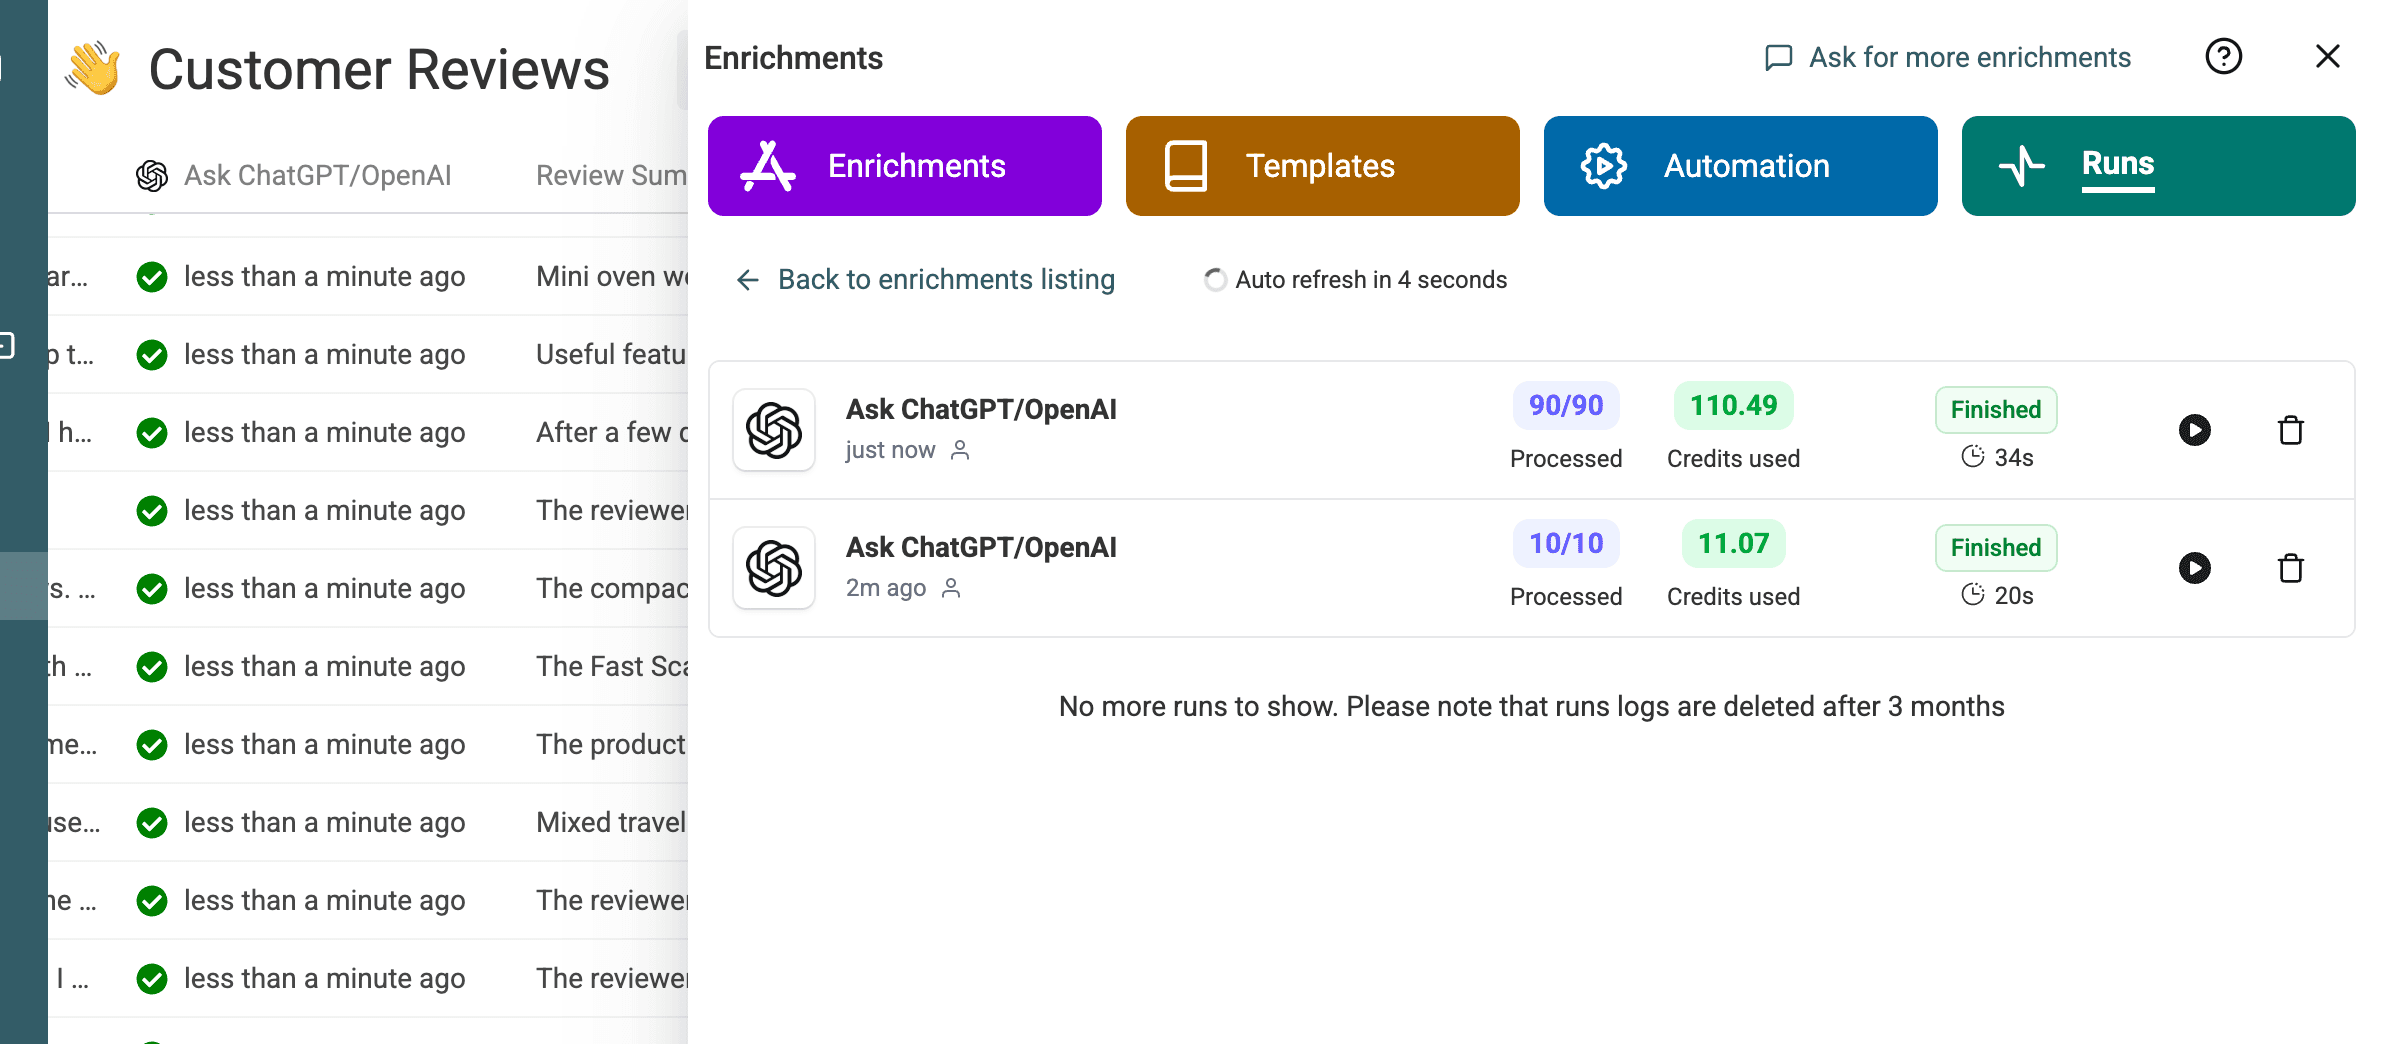
100行のサンプルは、10行のプレビューと、同じプロンプト・設定による残り90行の2バッチで処理しました。
2回目のバッチでは90行中90行を34秒で処理し、110.49 creditsを使用しました。
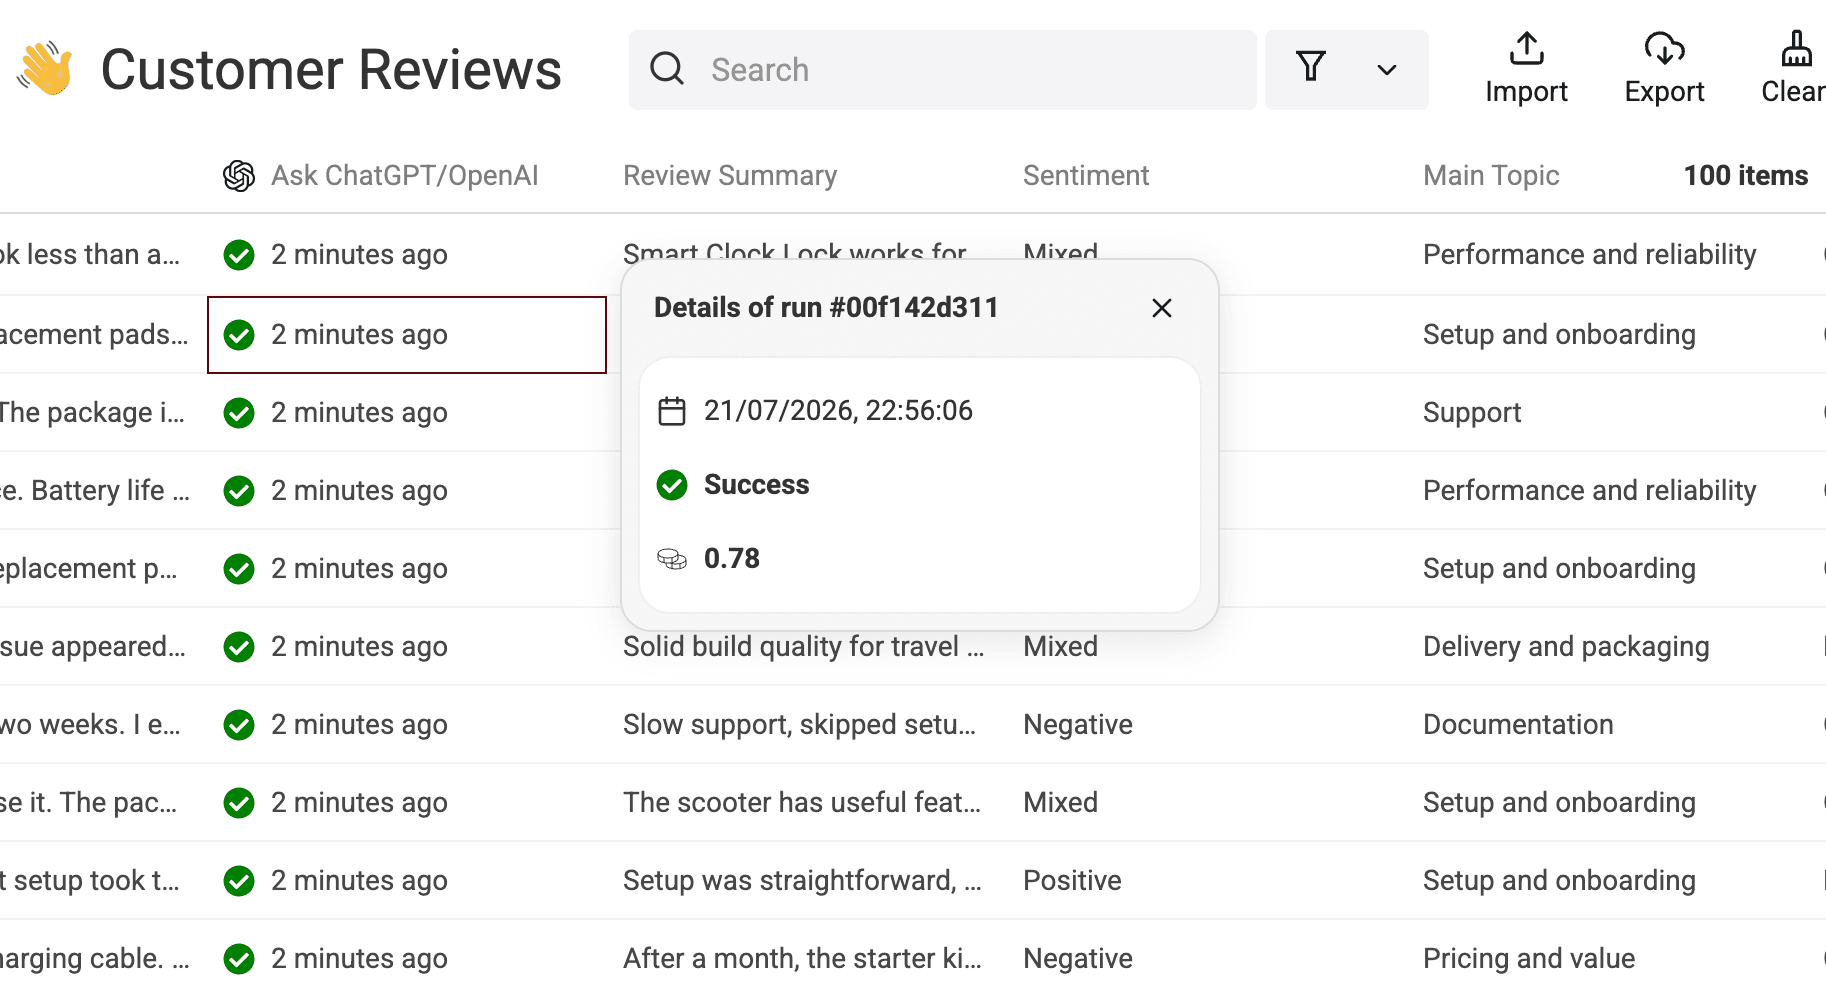
各行の実行詳細を開き、ステータスとcreditsの使用量を確認することもできます。
出力と実測結果を確認する
元データと生成フィールドを比較する
生成フィールドだけを切り離して確認しないでください。各判断を監査できるよう、元レビューの抜粋とReview IDも表示しておきます。
| Review ID | 元レビューの抜粋 | 要約 | Sentiment | Main Topic | Issue Type | Urgency | Recommended Action | Needs Review |
|---|---|---|---|---|---|---|---|---|
7wQDdSKxrw | リモートチームではスムーズに使えず、サポートへ2回問い合わせた。 | Smart Clock Lockは交換対応と初期設定では機能したが、リモートチームでの動作がスムーズではなく、2回のサポートが必要だった。 | Mixed | Performance and reliability | Complaint | Low | リモートチームでの利用上の問題を調査し、サポートへの依存を減らせるよう、より分かりやすいトラブルシューティング情報を公開する。 | No |
9xSyNNTkPZ | サポートの対応が遅く、必要な機能も安定して動作しなかった。 | メールでの案内と収納ポーチは分かりやすかったものの、サポートの返信が遅く、必要な機能も不安定だった。 | Negative | Support | Complaint | Medium | 投稿者へフォローアップしてサポートの遅延を解決し、必要な機能の信頼性向上について記録する。 | No |
ZjmazxYl87 | サポートが遅く、設定手順に抜けがあり、設定に2週間かかった。 | サポートの遅れ、設定手順の抜け、2週間に及ぶ初期設定により、交換部品のテスト後も品質への期待を下回った。 | Negative | Documentation | Complaint | High | 設定手順を最初から最後まで更新し、交換部品に関するサポートチケットへの対応を迅速化する。 | Yes |
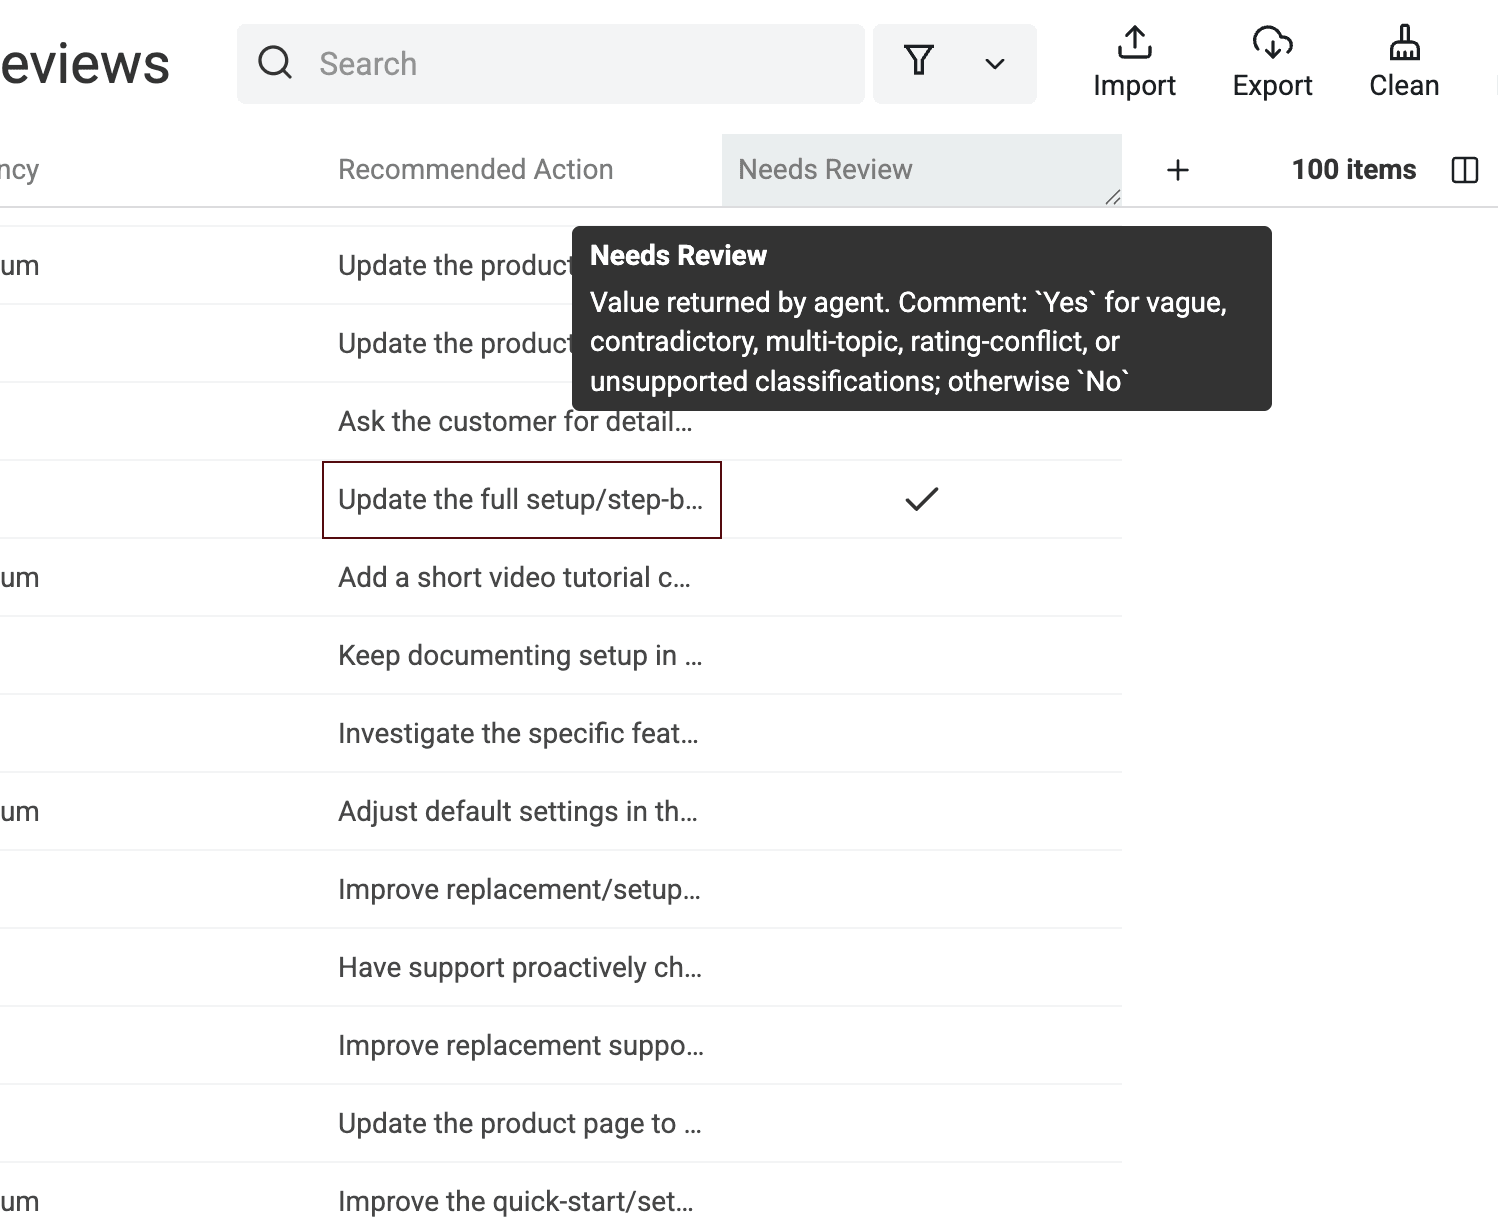
生成された結果列を並べることで、異なる判断をまとめて確認できます。ここで、元のテキストと整合しないラベルがないかをチェックします。
実測値を一般化せず報告する
測定対象は、100件のレビューを含む1つの合成CSVです。GPT 5.4 nano、Flex mode、Datablist Creditsを使用し、10行のプレビューに続いて90行のバッチを実行しました。
100行すべての実行ステータスが成功でした。2回の実行時間はそれぞれ20秒と34秒で、合計54秒です。creditsの使用量は11.07と110.49で、合計121.56 creditsでした。
今回のテストでは、2回の実行で100行中100行を54秒で処理し、121.56 Datablist Creditsを使用しました。 この数値は、今回のファイルと設定における実測値です。別のモデル、プロンプト、データセットでも同じ結果になるとは限りません。
人による確認が必要な行を絞り込む
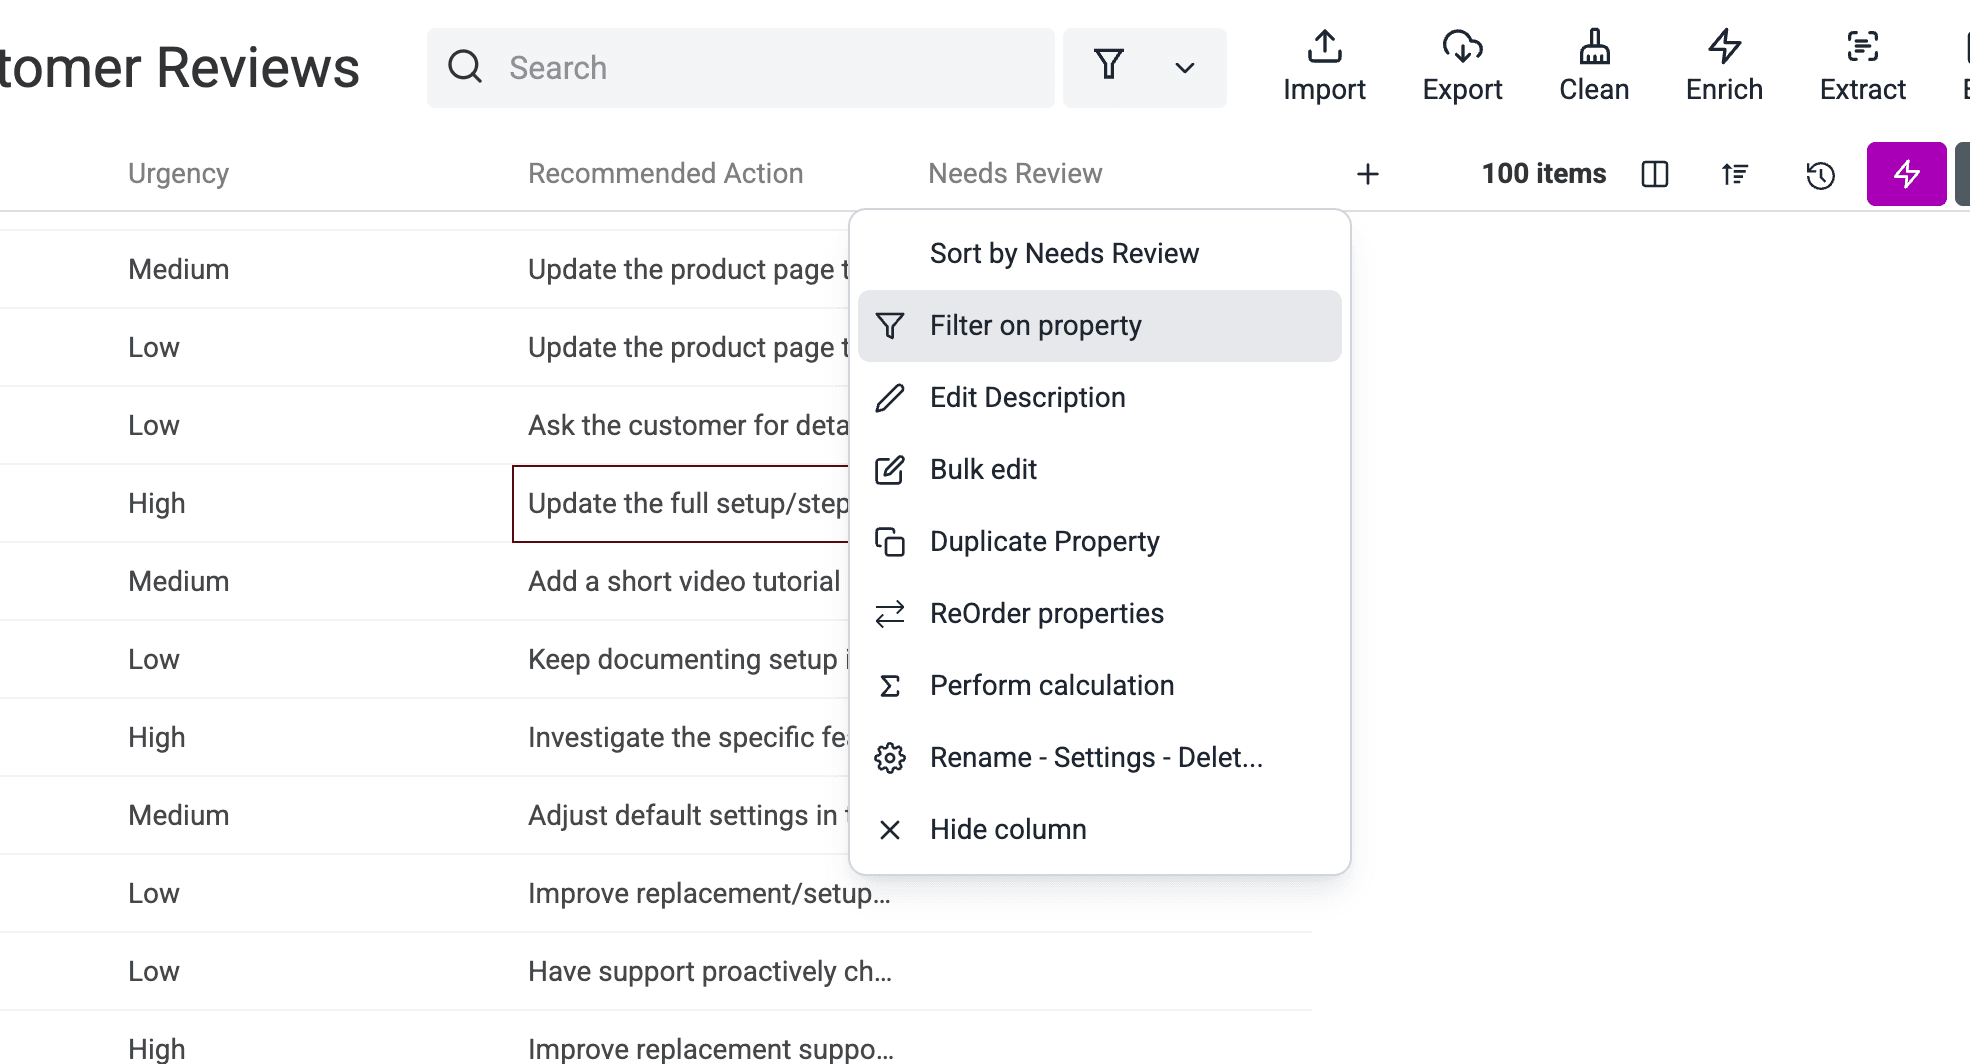
エクスポートには、Needs Review = Yesの行が5件含まれています。対象を抽出するには、Needs Reviewプロパティのメニューを開き、Filter on propertyを選択します。
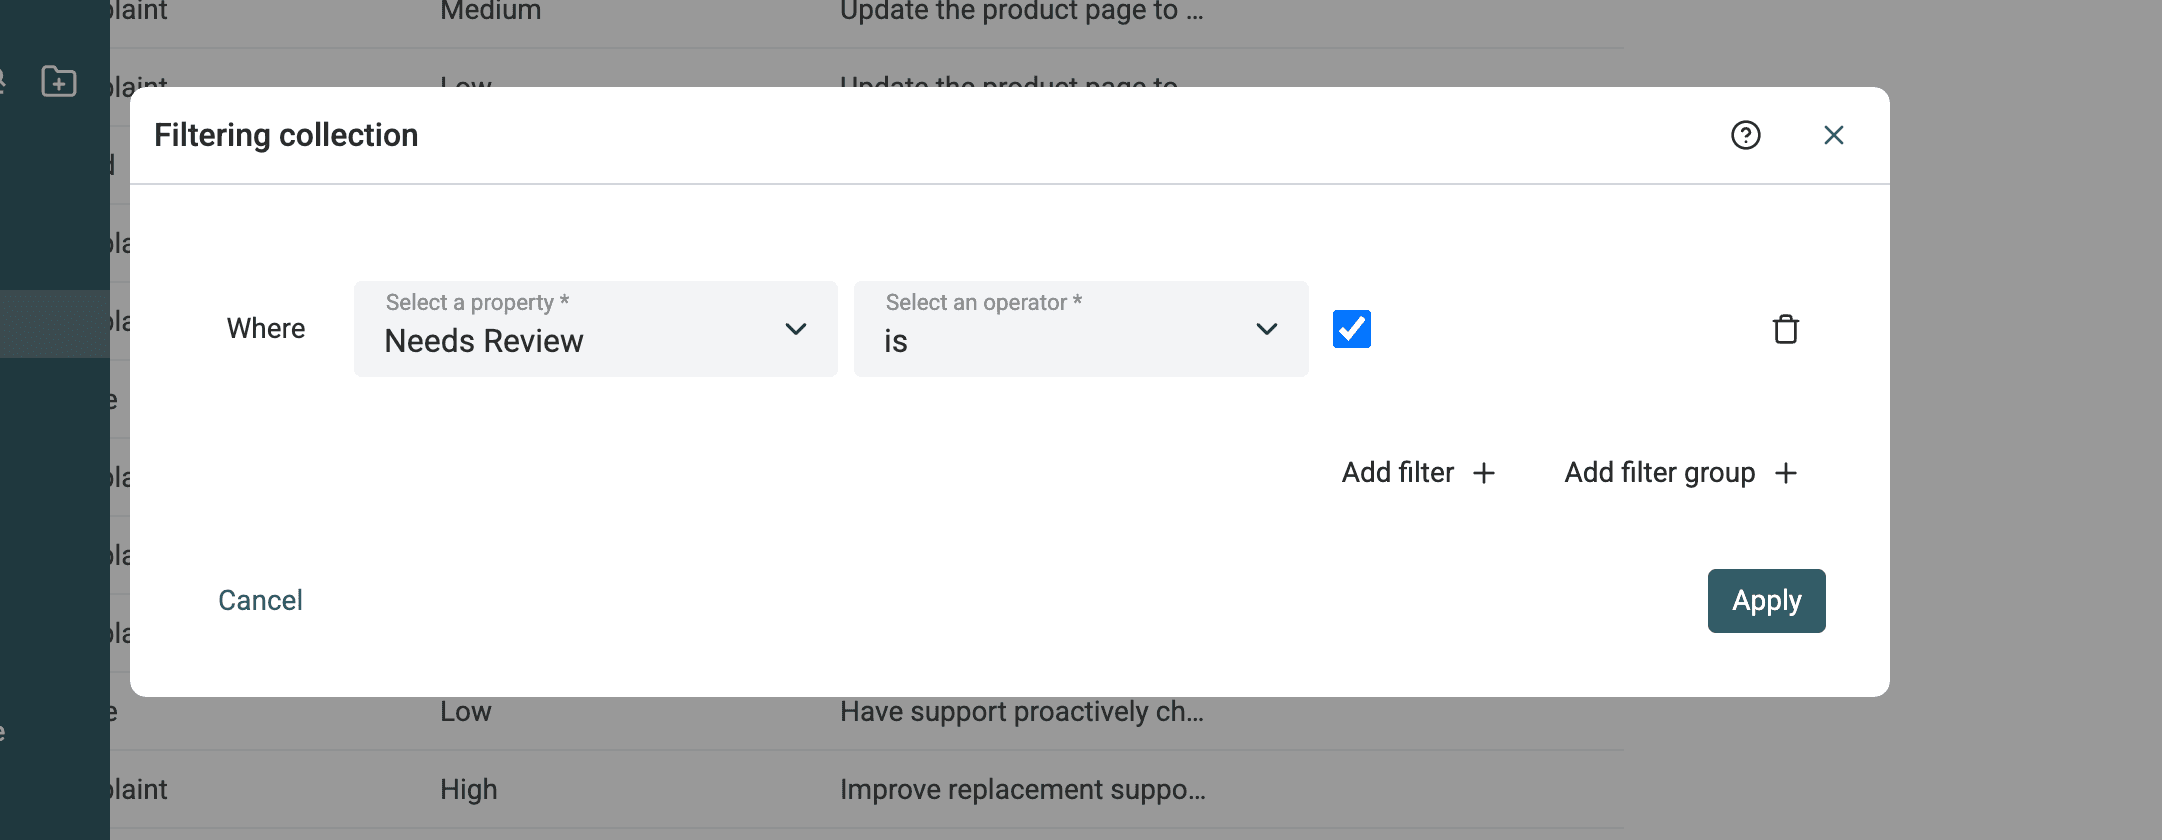
フィルターをNeeds Review is checkedに設定して適用します。
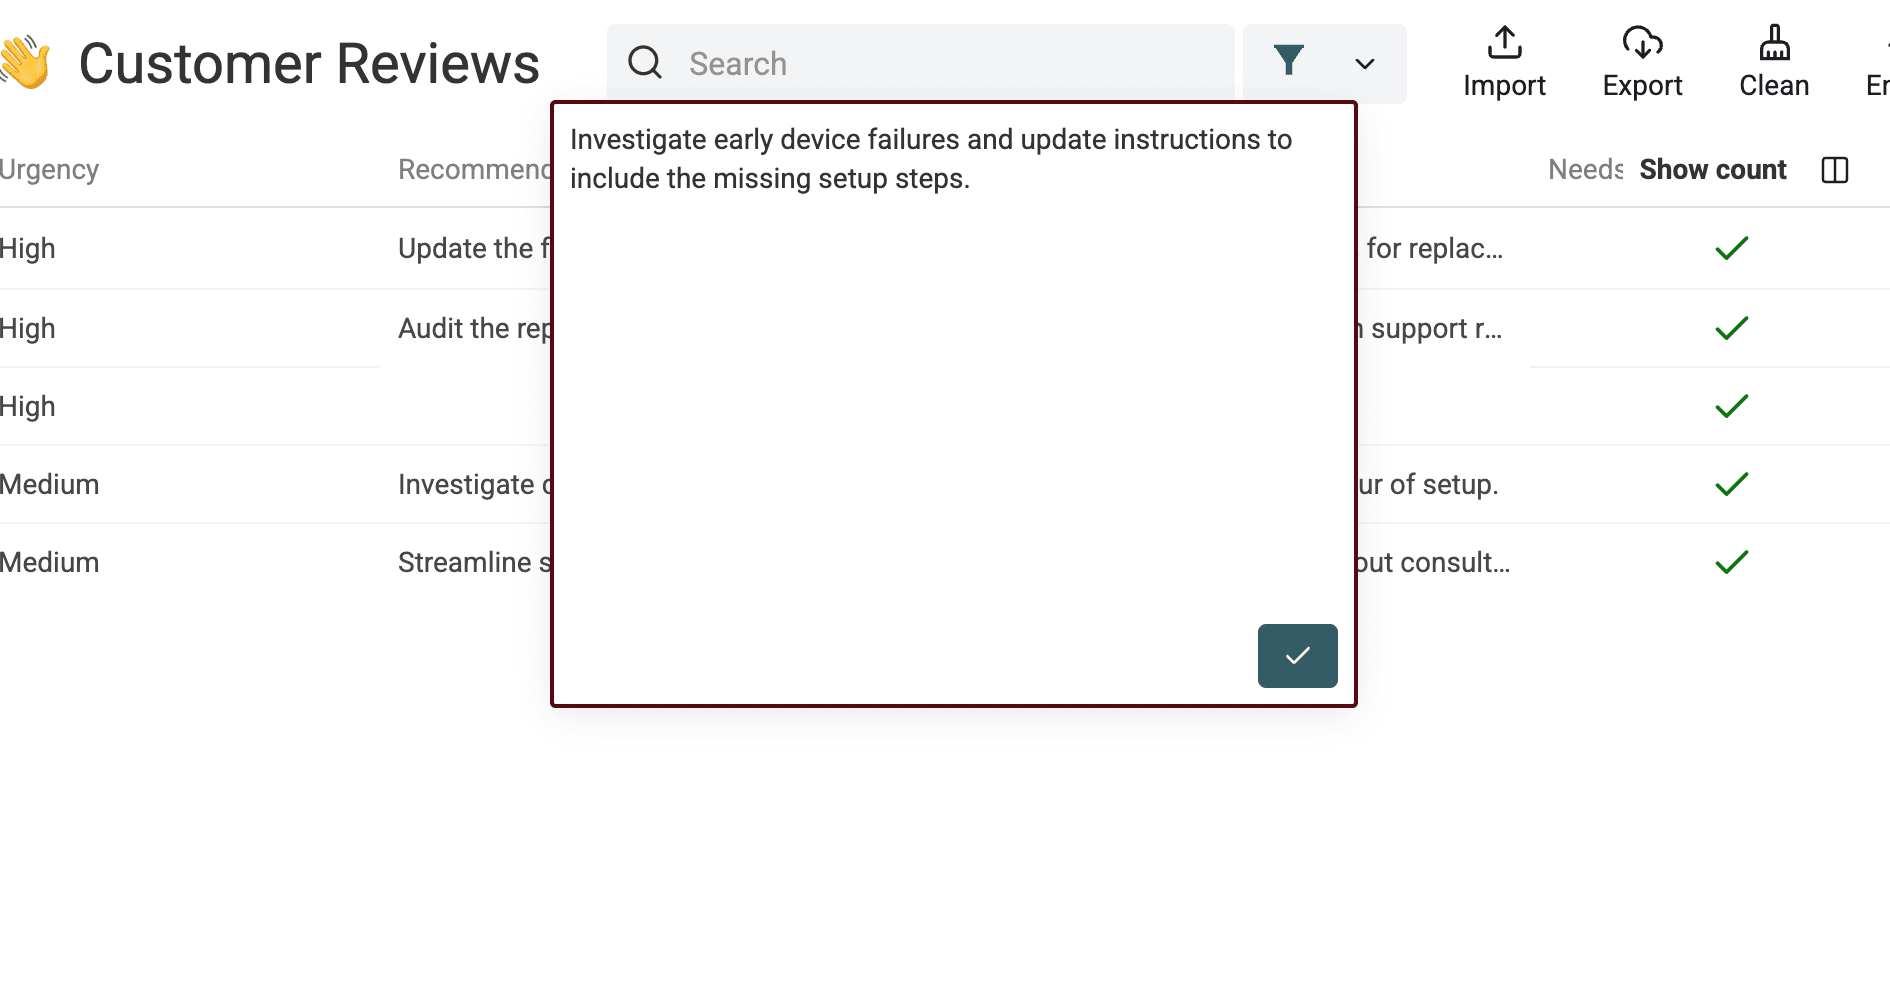
元のテキスト、分類、アクションをまとめて確認します。作成者は、フラグが付いたZjmazxYl87とnMtoYjtzgkの2行を目視確認し、どちらも修正せず承認しました。いずれも重要な問題を複数含んでいたため、レビューフラグを残す判断も妥当でした。
もう1つの診断方法として、SentimentとRatingを比較します。食い違いはニュアンスや曖昧さの発見に役立ちますが、それだけでSentimentが誤りだとは判断できません。
構造化レビューをチームのアクションに変える
ラベルの確認が完了したら、シートを上から順に読むのではなく、複数のフィルターを組み合わせます。多くのチームでは、次の3つのビューがあれば十分です。
- Product:Urgencyの高いComplaintを絞り込み、
Main Topic別にグループ化して優先順位を判断します。 - Support:Supportに関するComplaintを抽出し、元のレビューと提案されたフォローアップを並べて確認します。
- Marketingまたはecommerce:Praiseと、製品ページ、価格に対する価値、配送、梱包に関する問題を分けます。
トピックを集計する前に、ラベルの一貫性を確認してください。揺れのあるラベルを集計すると、見かけだけ精密な結果になります。すべてのアクションを根拠まで遡れるよう、エクスポートにはReview IDとReview Textを残します。
Datablistでは、これらの行を絞り込み、元フィールドと生成フィールドをCSVまたはExcelへエクスポートできます。経営層向けサマリーが必要な場合は、確認済みの行を先にグループ化または集計し、その集計結果を2回目の要約処理への入力として使用します。行単位の実行だけでは、全体をまとめた文章は自動生成されません。
失敗例・制約・検証方法
テスト結果から分かったこと
フラグが付いた2件のレビューには、重要な問題が複数含まれていました。どちらも処理自体は正常に完了し、目視確認後に分類も承認されました。フラグは、AIの出力を破棄することなく、主観的な判断を含む行を担当者へ振り分ける役割を果たしました。
一方、エクスポートからは、より明確なスキーマ上の問題も見つかりました。レビューpe2dhcKl7Jでは、許可されたIssue Typeラベルに含まれていないにもかかわらず、Issue Type = Mixedが返されました。実行ステータスは成功で、Needs Reviewもfalseでした。
⚠️ 成功は妥当性を意味しない
実行ステータスの成功が示すのは、処理が完了したことだけです。すべてのラベルが正しいとは限りません。トピックを集計したり、担当を割り当てたりする前に、分類体系と根拠を検証してください。
入力データに起因する制約もあります。空欄や曖昧なテキストでは、すべてのフィールドを判断できない場合があります。内容が矛盾していたり複数のトピックを含んでいたりすると、主要ラベルの選択は主観的になります。星評価とレビュー本文が食い違うこともあります。バッチの途中でプロンプトを編集すると、ラベルの一貫性が変わる可能性があります。複数言語を含むデータセットでは、出力言語を明示的に指定するか、言語別にテストする必要があります。
AIによる要約、トピック、Urgency、アクションはモデルの判断であり、絶対的に正しい業務上の事実ではありません。業務の整理と振り分けに活用しつつ、誤ったラベルが意思決定を左右し得る場面では、人による確認を残してください。
エクスポート前の検証チェックリスト
- レビューテキストがあるすべての行について、ステータスが成功しているか、再実行の結果が記録されていることを確認します。
- 要約が事実を追加せず、レビューの意図と感情を保っていることを確認します。
- Sentiment、トピック、Issue Type、Urgencyの全値が許可されたラベルに含まれていることを検証します。
- SentimentとRatingを比較して、確認すべき矛盾を見つけます。ただし、Ratingはあくまで診断材料として扱います。
- 各Recommended Actionが元のレビューに基づいていることを確認します。
Needs Reviewの全行を確認し、フラグのない成功行もサンプリングします。特に複数トピックを含むレビューを確認してください。Review ID、元テキスト、Rating、生成フィールド、処理済み状態、実行ステータスをエクスポートに残します。
Datablistでレビューファイルを分析する
顧客レビューのCSVまたはExcelファイルをDatablistへインポートし、Analyze customer reviewsを選択して、3つの入力項目をマッピングします。まず内容に幅を持たせた10〜20行をテストしてください。ラベルとレビューフラグが実用的であることを確認できたら、残りを処理し、検証済みの結果をエクスポートします。
FAQ
ChatGPTでCSVの顧客レビューを分析できますか?
はい。Datablistは各行の値を選択したモデルへ送信し、構造化されたレスポンスを新しいプロパティに書き込みます。ファイルを1つのチャットへアップロードする方法と異なり、行単位のワークフローでは、各要約、ラベル、アクション、ステータスが元のレビューに紐づいたまま保持されます。
数千件の顧客レビューを要約するには?
まず代表的なサンプルをプレビューし、ラベルとフラグを検証してから、残りの行をバッチで処理します。失敗した行を追跡可能な状態で再実行できるよう、元データのIDとステータスを残してください。実行時間とcreditsの使用量は、モデル、プロンプト、テキストの長さ、設定によって変わります。全件処理を見積もる前に、ご自身のサンプルでテストしてください。
多言語のレビューも分析できますか?
選択したモデルが対応する言語のテキストを処理できますが、複数言語が混在するファイルは事前のテストが必要です。すべての要約を1つの言語に統一したい場合は、出力言語を明示するルールを追加してください。一貫性が重要な場合は、言語ごとに別のバッチで処理します。
Sentimentは星評価と常に一致しますか?
いいえ。高評価でも深刻な不満が含まれることがあり、低評価でもサポートの良さや返品のしやすさに触れている場合があります。評価との食い違いを、読むべき行を見つける手掛かりとして使い、そのうえでレビュー本文に照らしてラベルを判断してください。
AIレビュー分析で目視確認は不要になりますか?
いいえ。AIは大量のレビューファイルを整理し、確認しやすくします。出力を製品、サポート、マーケティングの意思決定に使う前に、フラグが付いた行を確認し、定義済みラベルを検証し、成功した結果もサンプリングしてください。