
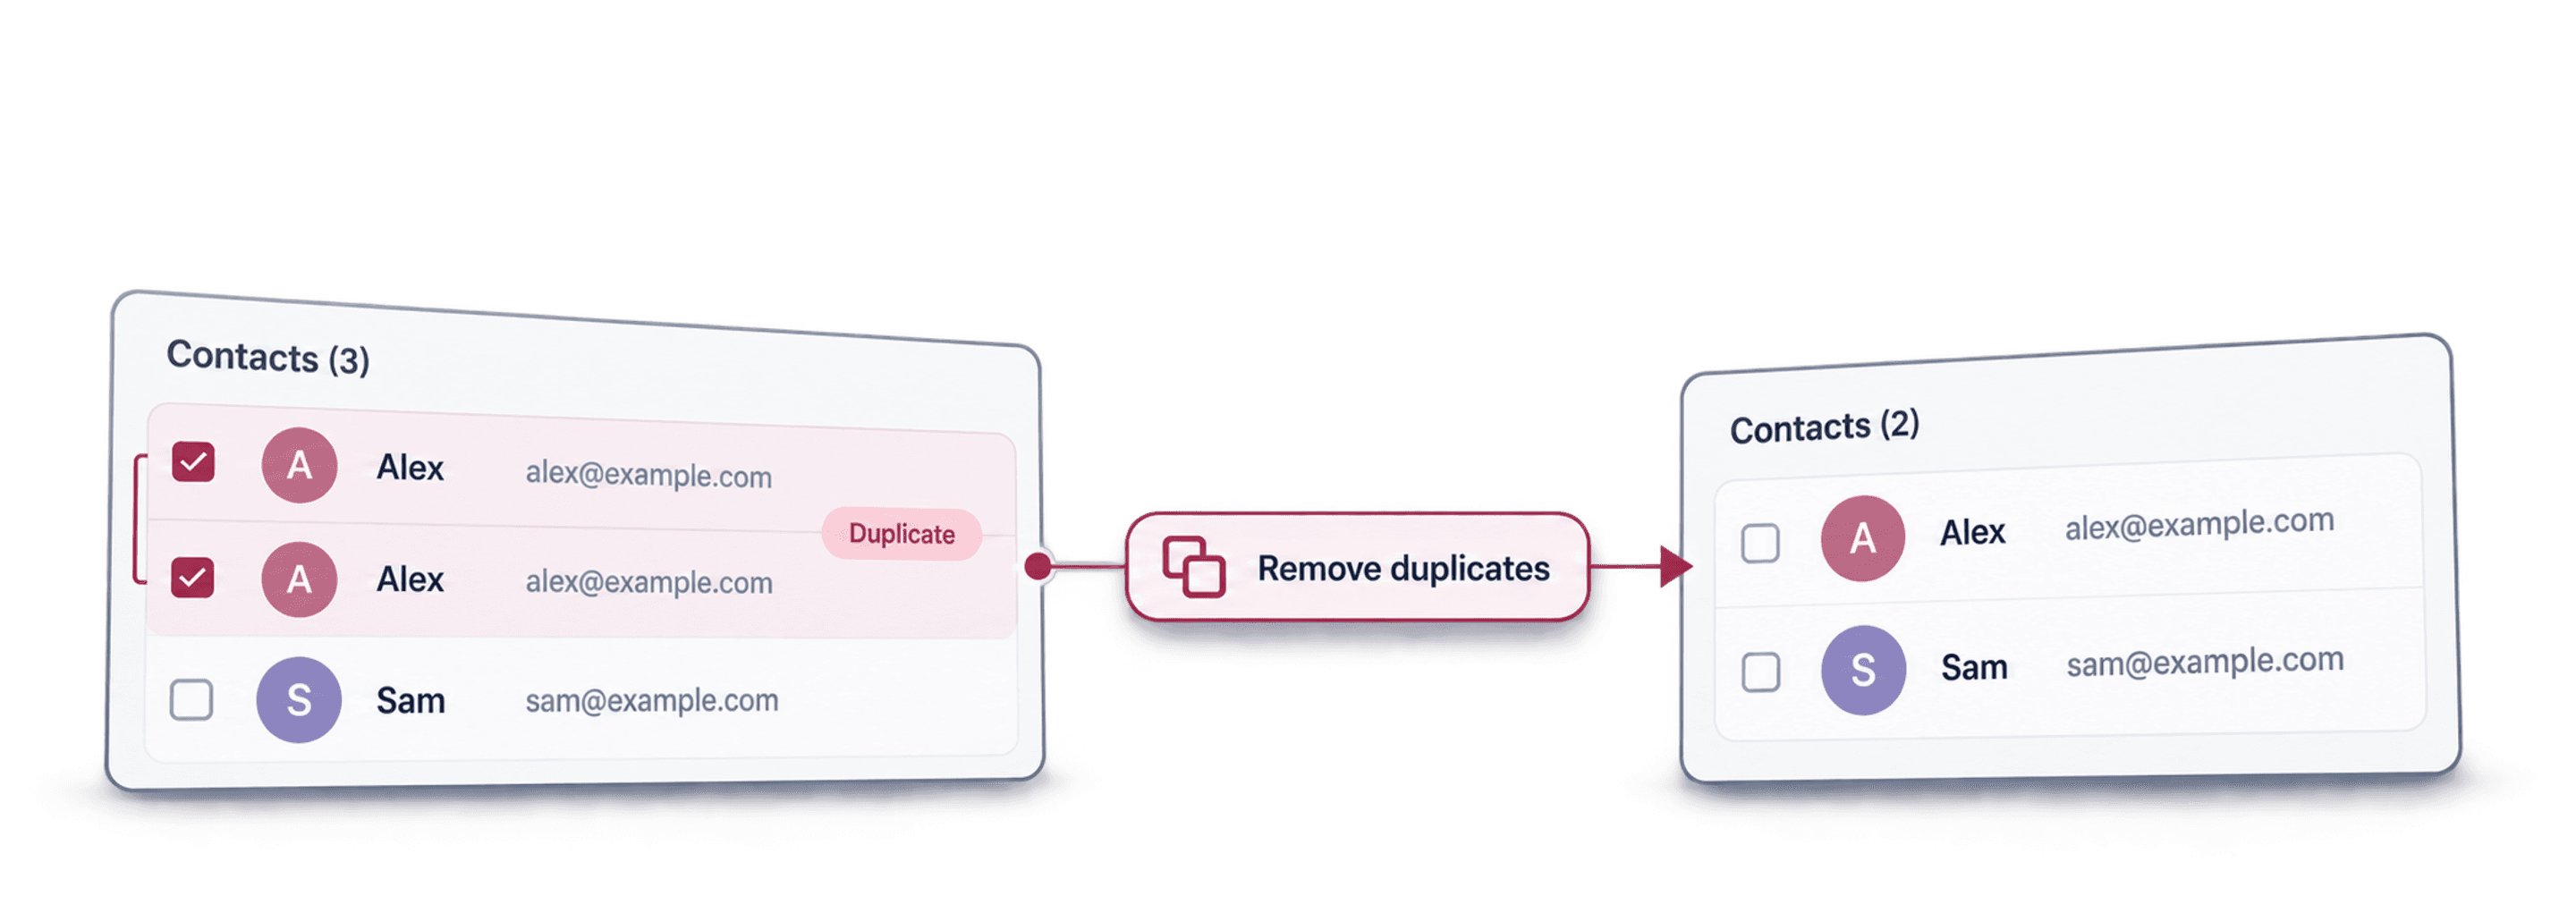
Om een lijst online te dedupliceren, bepaal je eerst welk veld een persoon, bedrijf of product uniek identificeert. Voer daarna een strikte matching uit, controleer de voorgestelde groepen met duplicaten en voeg nuttige waarden samen of verwijder rijen die niets toevoegen. Zo blijft het opschonen efficiënt, zonder elke vergelijkbare waarde automatisch als veilige match te behandelen.
Met Datablist doe je dit volledig in je browser. Importeer een CSV- of Excel-bestand, kies de eigenschappen voor de matching, vergelijk de rijen, controleer het resultaat en exporteer de opgeschoonde lijst. De controle op duplicaten is alleen-lezen totdat je een actie start met Remove, Merge of custom processing.
Deze handleiding gebruikt een downloadbaar voorbeeldbestand met 1.000 rijen. Het bevat exacte kopieën, e-mailaliassen, variaties in bedrijfsnamen en URL’s, eenvoudige verschillen in telefoonnotatie, spelfouten, conflicterende waarden en records met aanvullende gegevens.
🔑 De veilige regel voor deduplicatie
Match op de kleinste betrouwbare identifier, maar beoordeel aan de hand van de volledige rij welke gegevens je bewaart.
Een eenvoudige lijst met waarden dedupliceren
Bevat je lijst één waarde per regel? Sla deze dan op als CSV met één kolom en een kolomkop zoals Email, Domain of Value. Importeer het bestand in Datablist en voer voor die kolom Clean > Remove duplicates uit met Exact. Controleer de groepen, kies welk record je wilt bewaren, verwerk de dubbele rijen en exporteer daarna de resterende waarden.
Een voorbeeldlijst met alpha.example, beta.example en nogmaals alpha.example moet na het verwijderen van de herhaalde rij één alpha-waarde en één beta-waarde bevatten. Dit is uitsluitend een illustratie van de invoer en uitvoer, geen extra meting op basis van het downloadbare voorbeeldbestand.
Deze aanpak is geschikt voor een lijst met identifiers. Bevat je bestand meerdere kolommen, dan moet je dubbele records oplossen: als je een rij verwijdert, verdwijnen ook alle andere waarden uit die rij. Gebruik de merge-workflow hieronder wanneer een tweede rij met hetzelfde e-mailadres bijvoorbeeld een nuttig telefoonnummer of een belangrijke notitie bevat.
Behandel lege identifiers afzonderlijk. Bij de standaardvergelijking op geselecteerde eigenschappen vormt een ontbrekende tekstidentifier geen match. Wil je lege rijen verwijderen, voer die opschoning dan expliciet uit in plaats van deduplicatie te laten bepalen wat deze rijen voorstellen.
Bepaal wat een record uniek maakt
Begin niet bij het matching-algoritme, maar bepaal eerst om welk type entiteit het gaat.
Voor een contactpersoon, bedrijf, product en transactie heb je verschillende identifiers nodig:
| Lijst | Sterke identifiers om mee te beginnen | Nuttige tweede matching |
|---|---|---|
| Contactpersonen | E-mail, telefoonnummer, LinkedIn-URL | Volledige naam plus bedrijf |
| Bedrijven | Website-domein, bedrijfs-ID | Genormaliseerde bedrijfsnaam |
| Producten | SKU, EAN, GTIN, product-URL | Productnaam plus merk |
| CRM-leads | E-mail, telefoonnummer, CRM-ID | Naam plus bedrijfsdomein |
| Bestellingen | Bestellings-ID | Klant-ID plus besteldatum |
Met één matching vind je zelden elk duplicaat. Een contactpersoon kan in twee rijen hetzelfde e-mailadres hebben, terwijl iemand anders van e-mailadres is veranderd maar hetzelfde telefoonnummer gebruikt. Voer afzonderlijke matchings uit voor verschillende identifiers, in plaats van één regel met alle eigenschappen te maken.
Bijvoorbeeld:
- Match contactpersonen op e-mailadres.
- Verwerk de gecontroleerde groepen.
- Normaliseer telefoonnummers en voer daarna een Exact-controle uit op de opgeschoonde eigenschap.
- Voer voorzichtig fuzzy matching uit op de volledige naam plus het bedrijf.
Kies de regel voor lege waarden voordat je meerdere velden aan één controle toevoegt. Met Value required kan een ontbrekende identifier een relevante kandidaat uitsluiten.
Met Match on empty value krijgen eigenschappen die in beide records leeg zijn een score van 100%, waardoor de gemiddelde score kan stijgen: een matchend e-mailadres plus één ontbrekende achternaam scoort 87,5%; voeg je drie eigenschappen toe die in beide records leeg zijn, dan stijgt de score naar 95%. Bekijk het voorbeeld van scoring met lege waarden voordat je aanneemt dat meer kolommen altijd sterker bewijs opleveren.
Gebruik de specifieke handleidingen wanneer een identifier eerst moet worden genormaliseerd:
- E-mailadressen en aliassen dedupliceren
- Dubbele bedrijfsnamen matchen
- Een veld met meerdere waarden dedupliceren
- Lokale en internationale telefoonnummers normaliseren
Download de voorbeeldlijst met 1.000 rijen
Download de demo-CSV voor deduplicatie. Het bestand bevat 1.000 rijen die 800 vooraf samengestelde entiteiten voorstellen.
Het bestand combineert verschillende testcases:
| Samengestelde testcase | Groepen met duplicaten | Matching |
|---|---|---|
| Exacte kopieën van volledige rijen | 5 | All Properties met Exact |
| E-mailaliassen en wrappers | 100 | Email met Smart en de Email-processor |
| Variaties in bedrijfsnamen en URL’s | 50 | Company Name- of URL-processing |
| Eenvoudige verschillen in Amerikaanse telefoonnotatie | 25 | Phone met Smart, uitsluitend notatie |
| Gecontroleerde spelfouten in namen | 15 | Jaro-Winkler of Levenshtein |
| Fonetische variaties in voornamen | 5 | Metaphone |
| Records zonder samengesteld duplicaat | 600 | Moeten afzonderlijk blijven |
Dit zijn vooraf vastgestelde aantallen, geen garantie dat elke fuzzy drempelwaarde hetzelfde resultaat oplevert. Distance matching kan extra kandidaten meenemen wanneer de drempel laag staat. Controleer deze groepen voordat je ze verwerkt.
Dit zijn drie paren uit het bestand:
| Use case | Eerste opgeslagen waarde | Tweede opgeslagen waarde |
|---|---|---|
| E-mailalias | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| Bedrijf en URL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| Eenvoudige telefoonnotatie | +1 (202) 555-0768 | 1 202 555 0768 |
De rijen spreken elkaar ook tegen bij velden zoals functietitel, eigenaar, status, omzet, bron, tags en notities. Dankzij deze conflicten kun je met het bestand regels testen voor het masterrecord en het behoud van veldwaarden.
Importeer de lijst in Datablist
Open Datablist en importeer het CSV- of Excel-bestand in een collection. Een collection werkt als een gestructureerde spreadsheet: de rijen zijn items en de kolommen zijn properties.
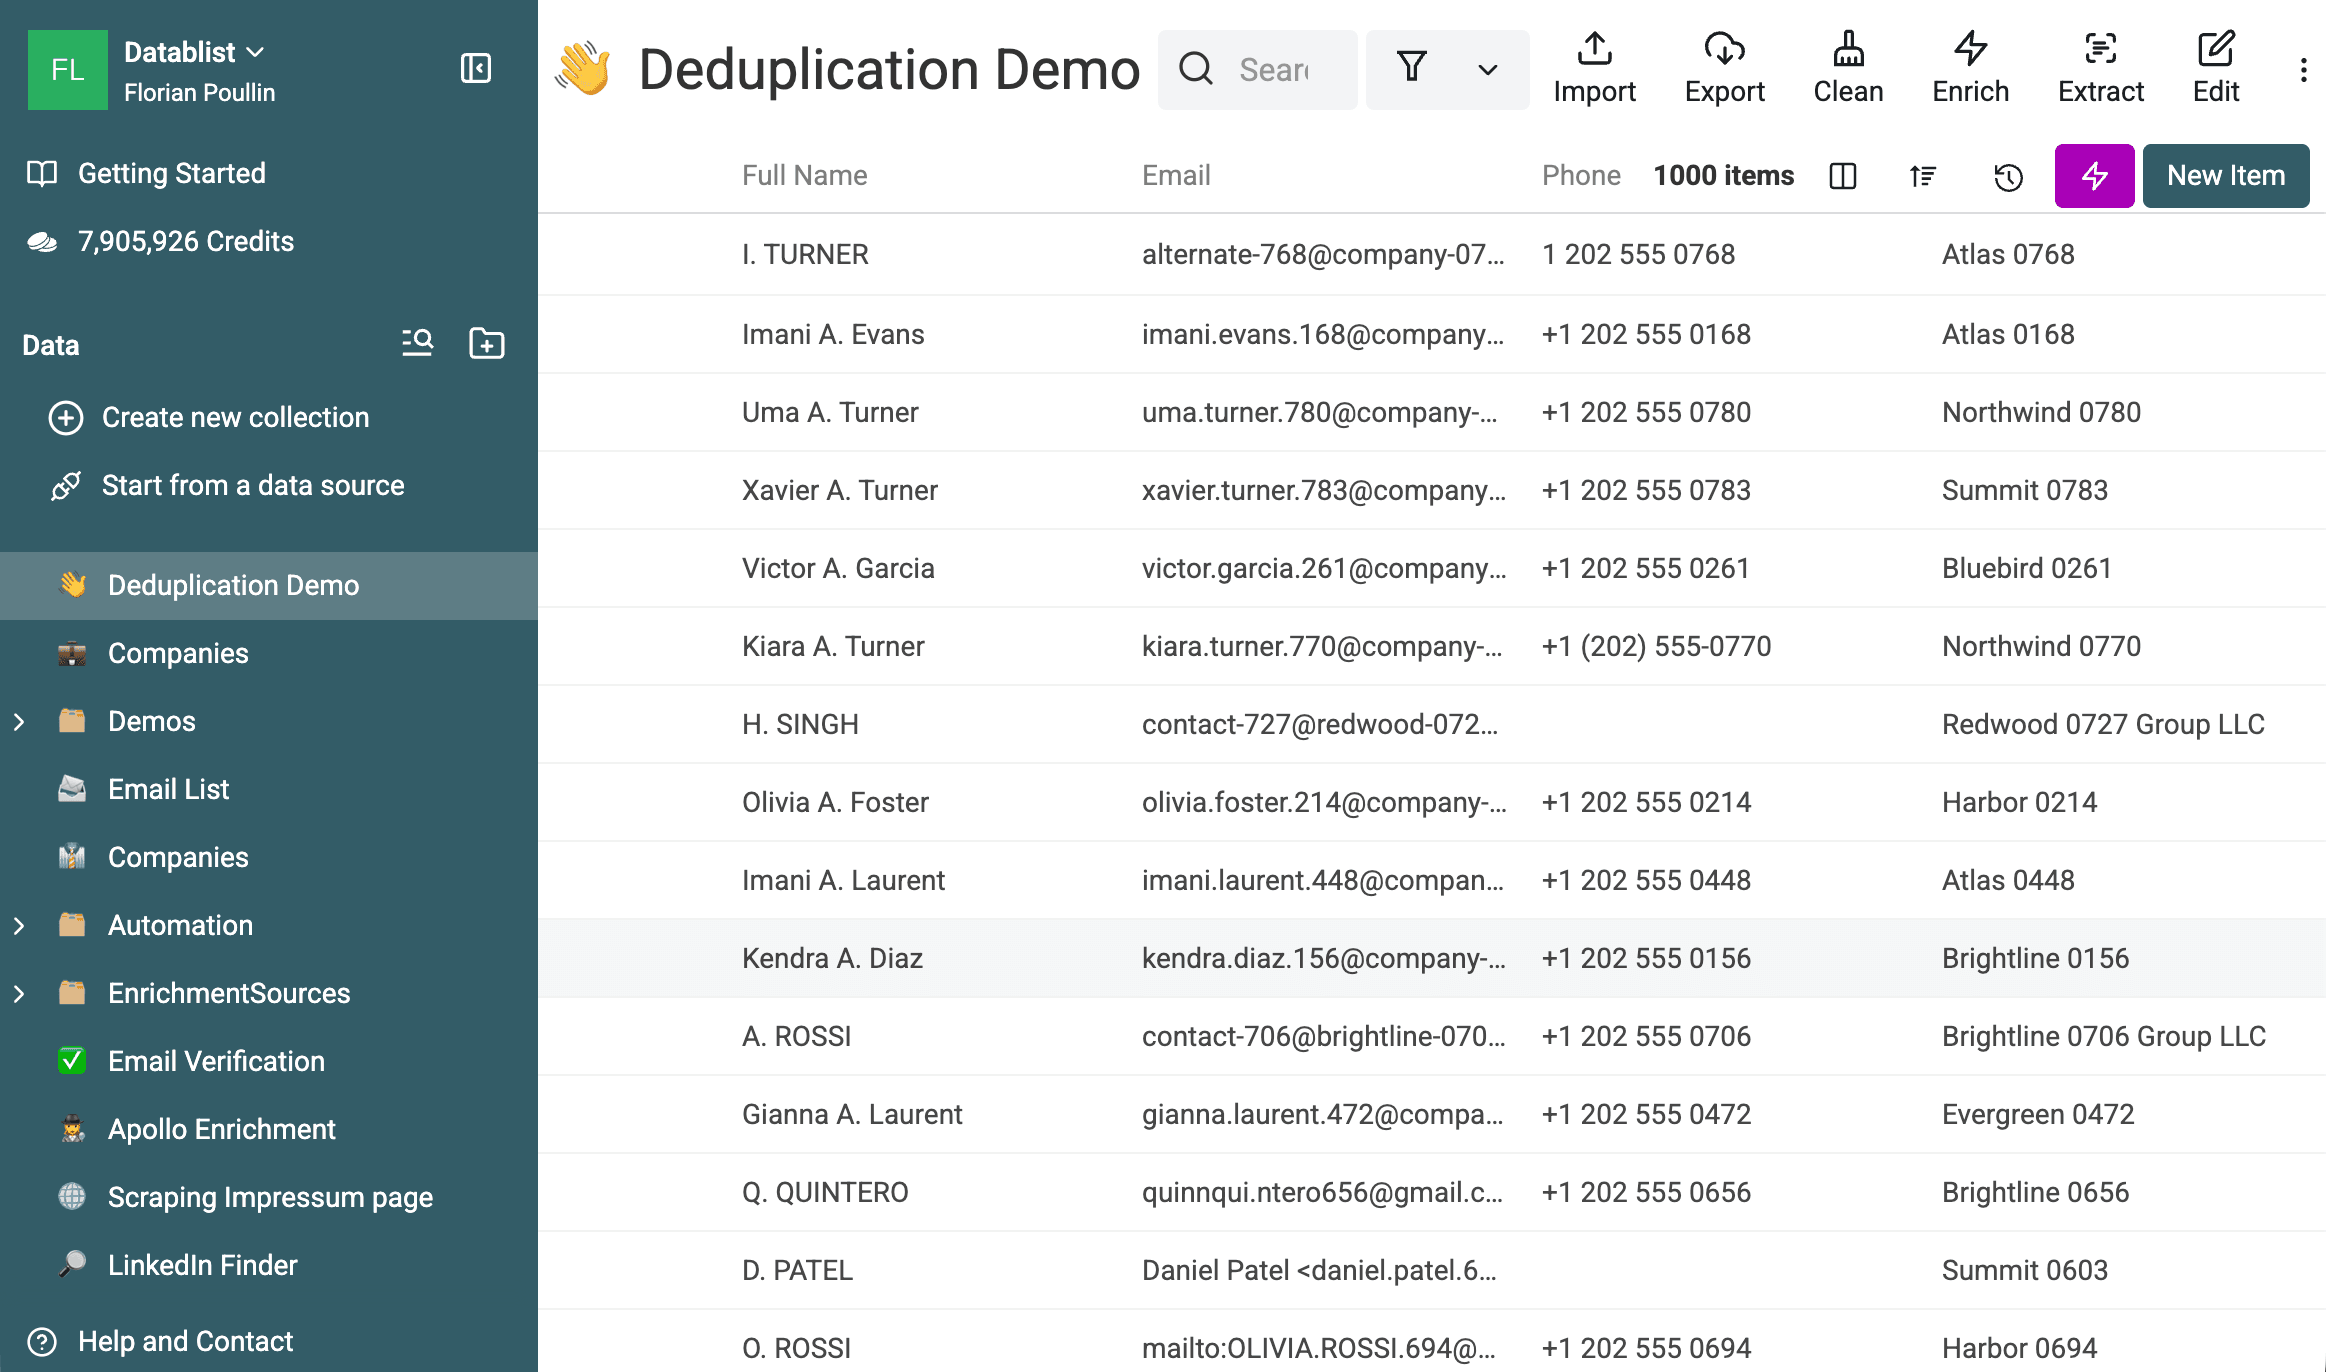
Controleer tijdens het importeren de gedetecteerde property types:
- Kolommen met e-mailadressen moeten het type Email gebruiken.
- Kolommen met websites moeten URL gebruiken.
- Kolommen met telefoonnummers moeten Phone gebruiken.
- Kolommen met omzet of aantallen moeten Number gebruiken.
- Datums van activiteiten en aanmaakdatums moeten DateTime gebruiken.
Bewaar kolommen met ID’s, bron, eigenaar, notities en status in de collection. Ze helpen je het juiste record te selecteren en te controleren welke gegevens bij de merge behouden blijven.
Voer Exact, Smart en fuzzy matching uit
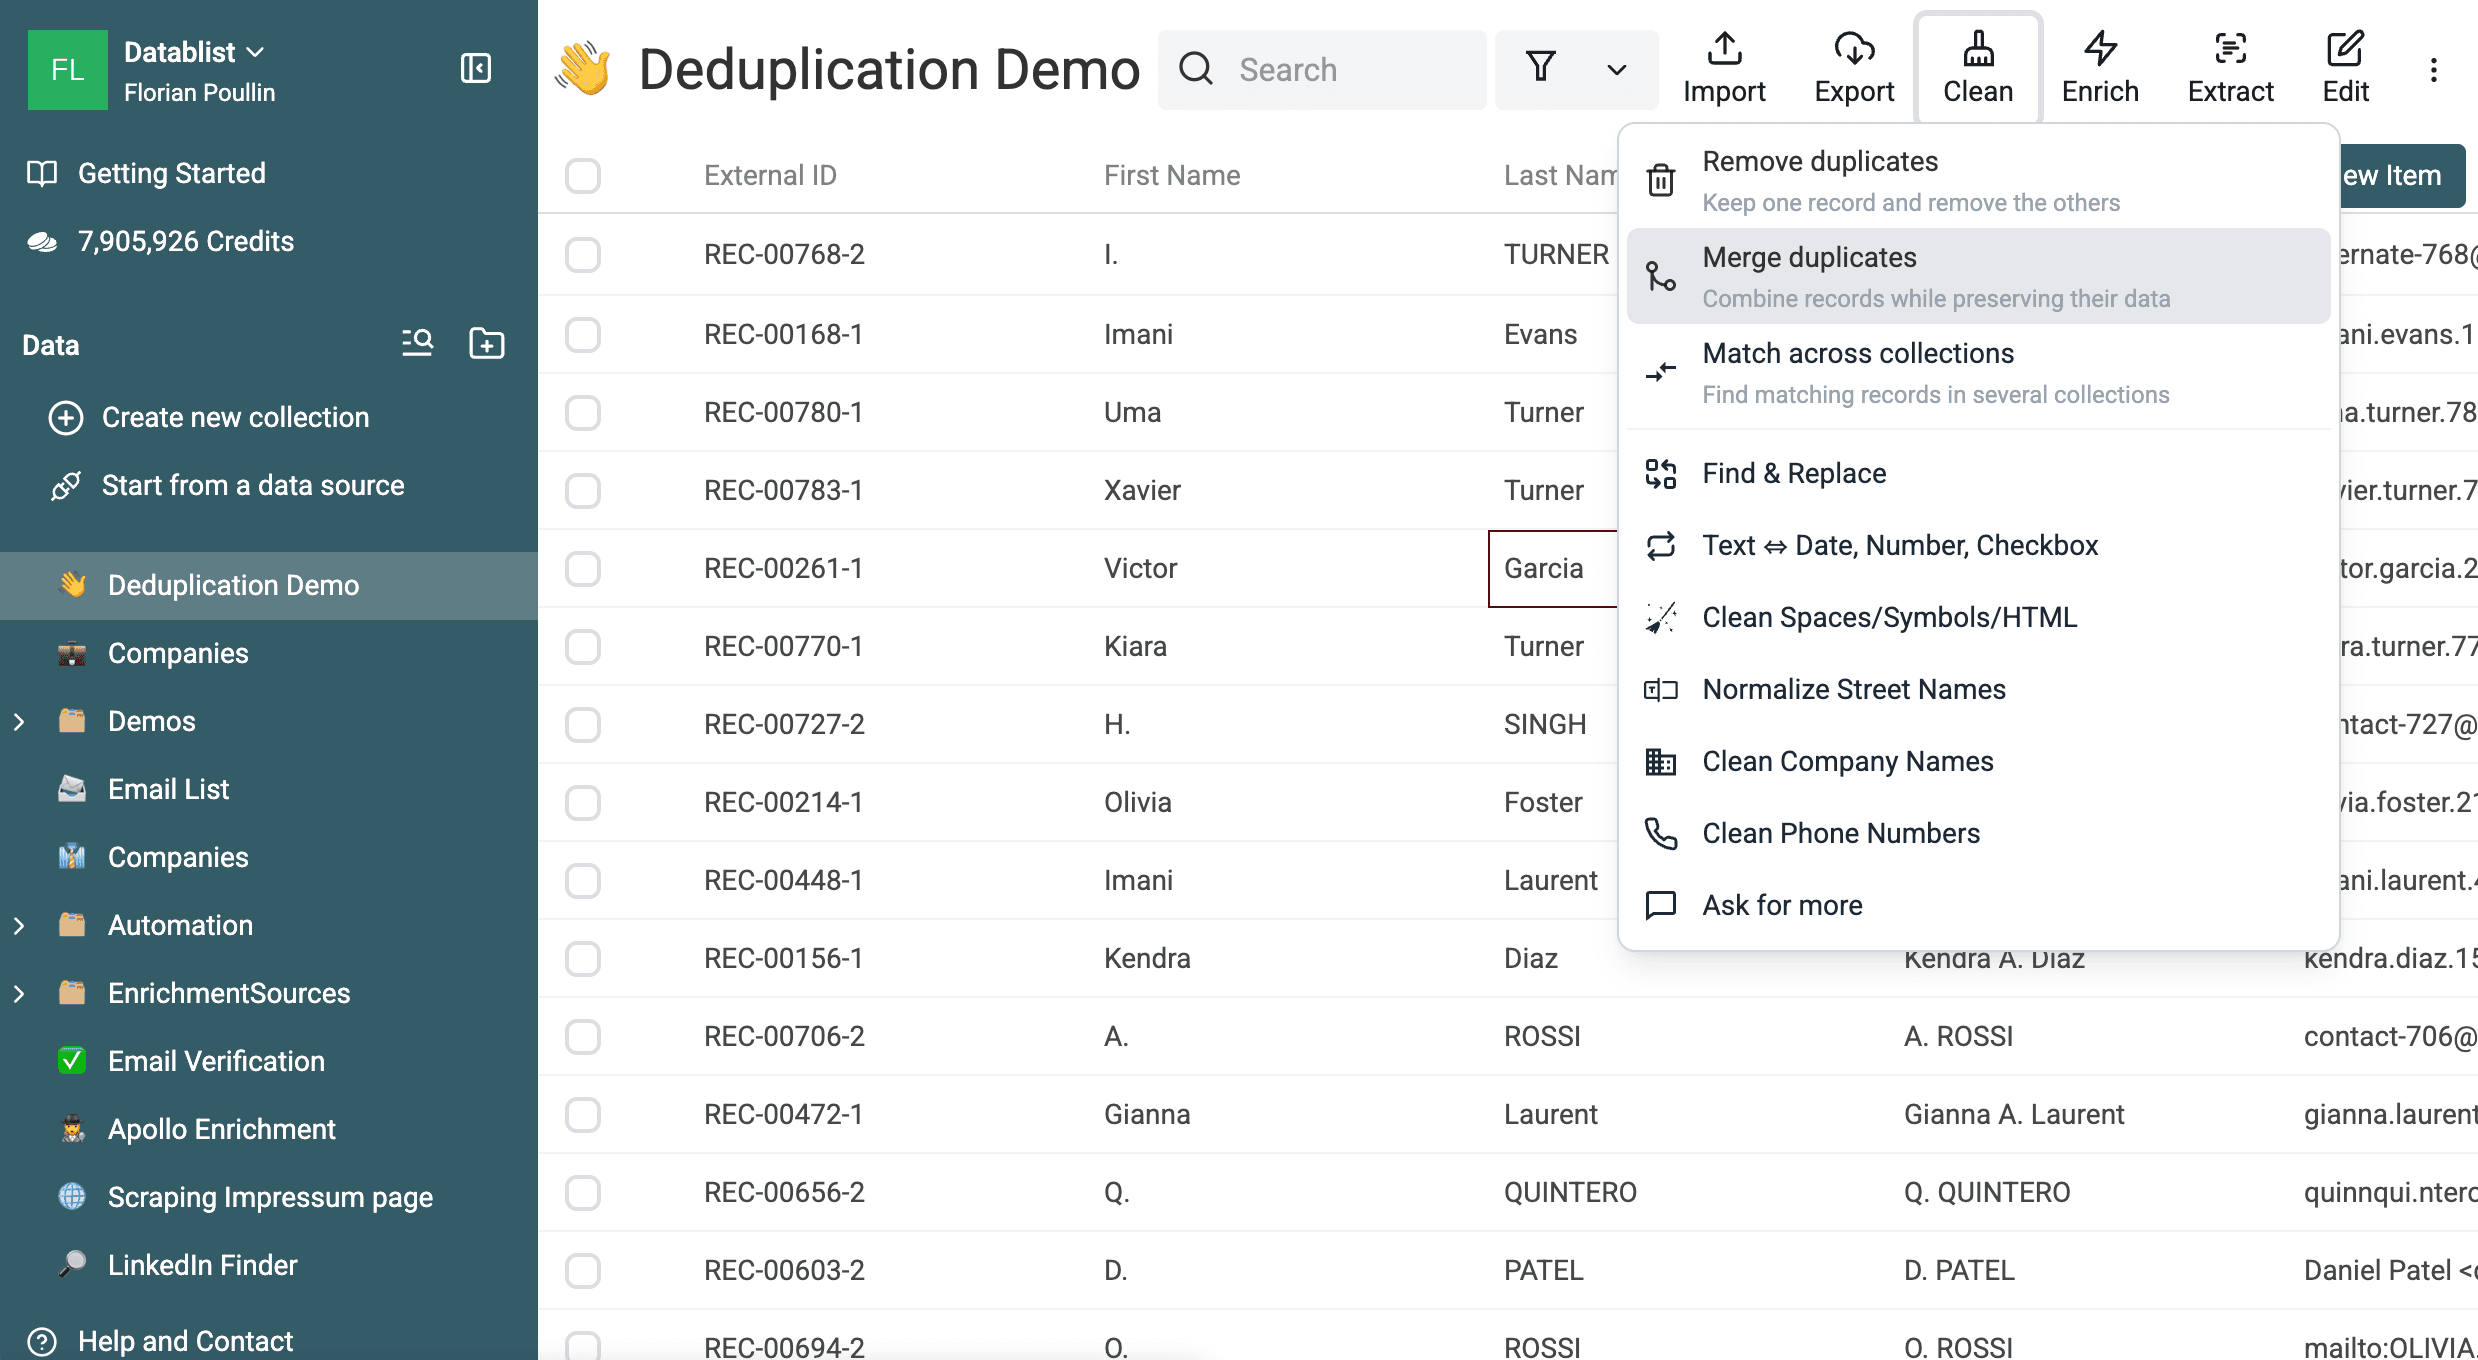
Open Clean en kies de actie die bij je doel past:
- Remove duplicates als je de secundaire rijen kunt verwijderen.
- Merge duplicates als de rijen informatie bevatten die je wilt bewaren.
- Match across collections als de records in verschillende collections staan.
De eerste twee acties gebruiken dezelfde detectie-engine. Ze openen de resultaatomgeving met een andere verwerkingsmodus geselecteerd.
Begin met Exact matching
Gebruik All Properties met Exact om rijen te vinden die zonder wijzigingen twee keer zijn gekopieerd. Gebruik Selected Properties wanneer één veld, zoals een externe ID, identiek moet zijn.
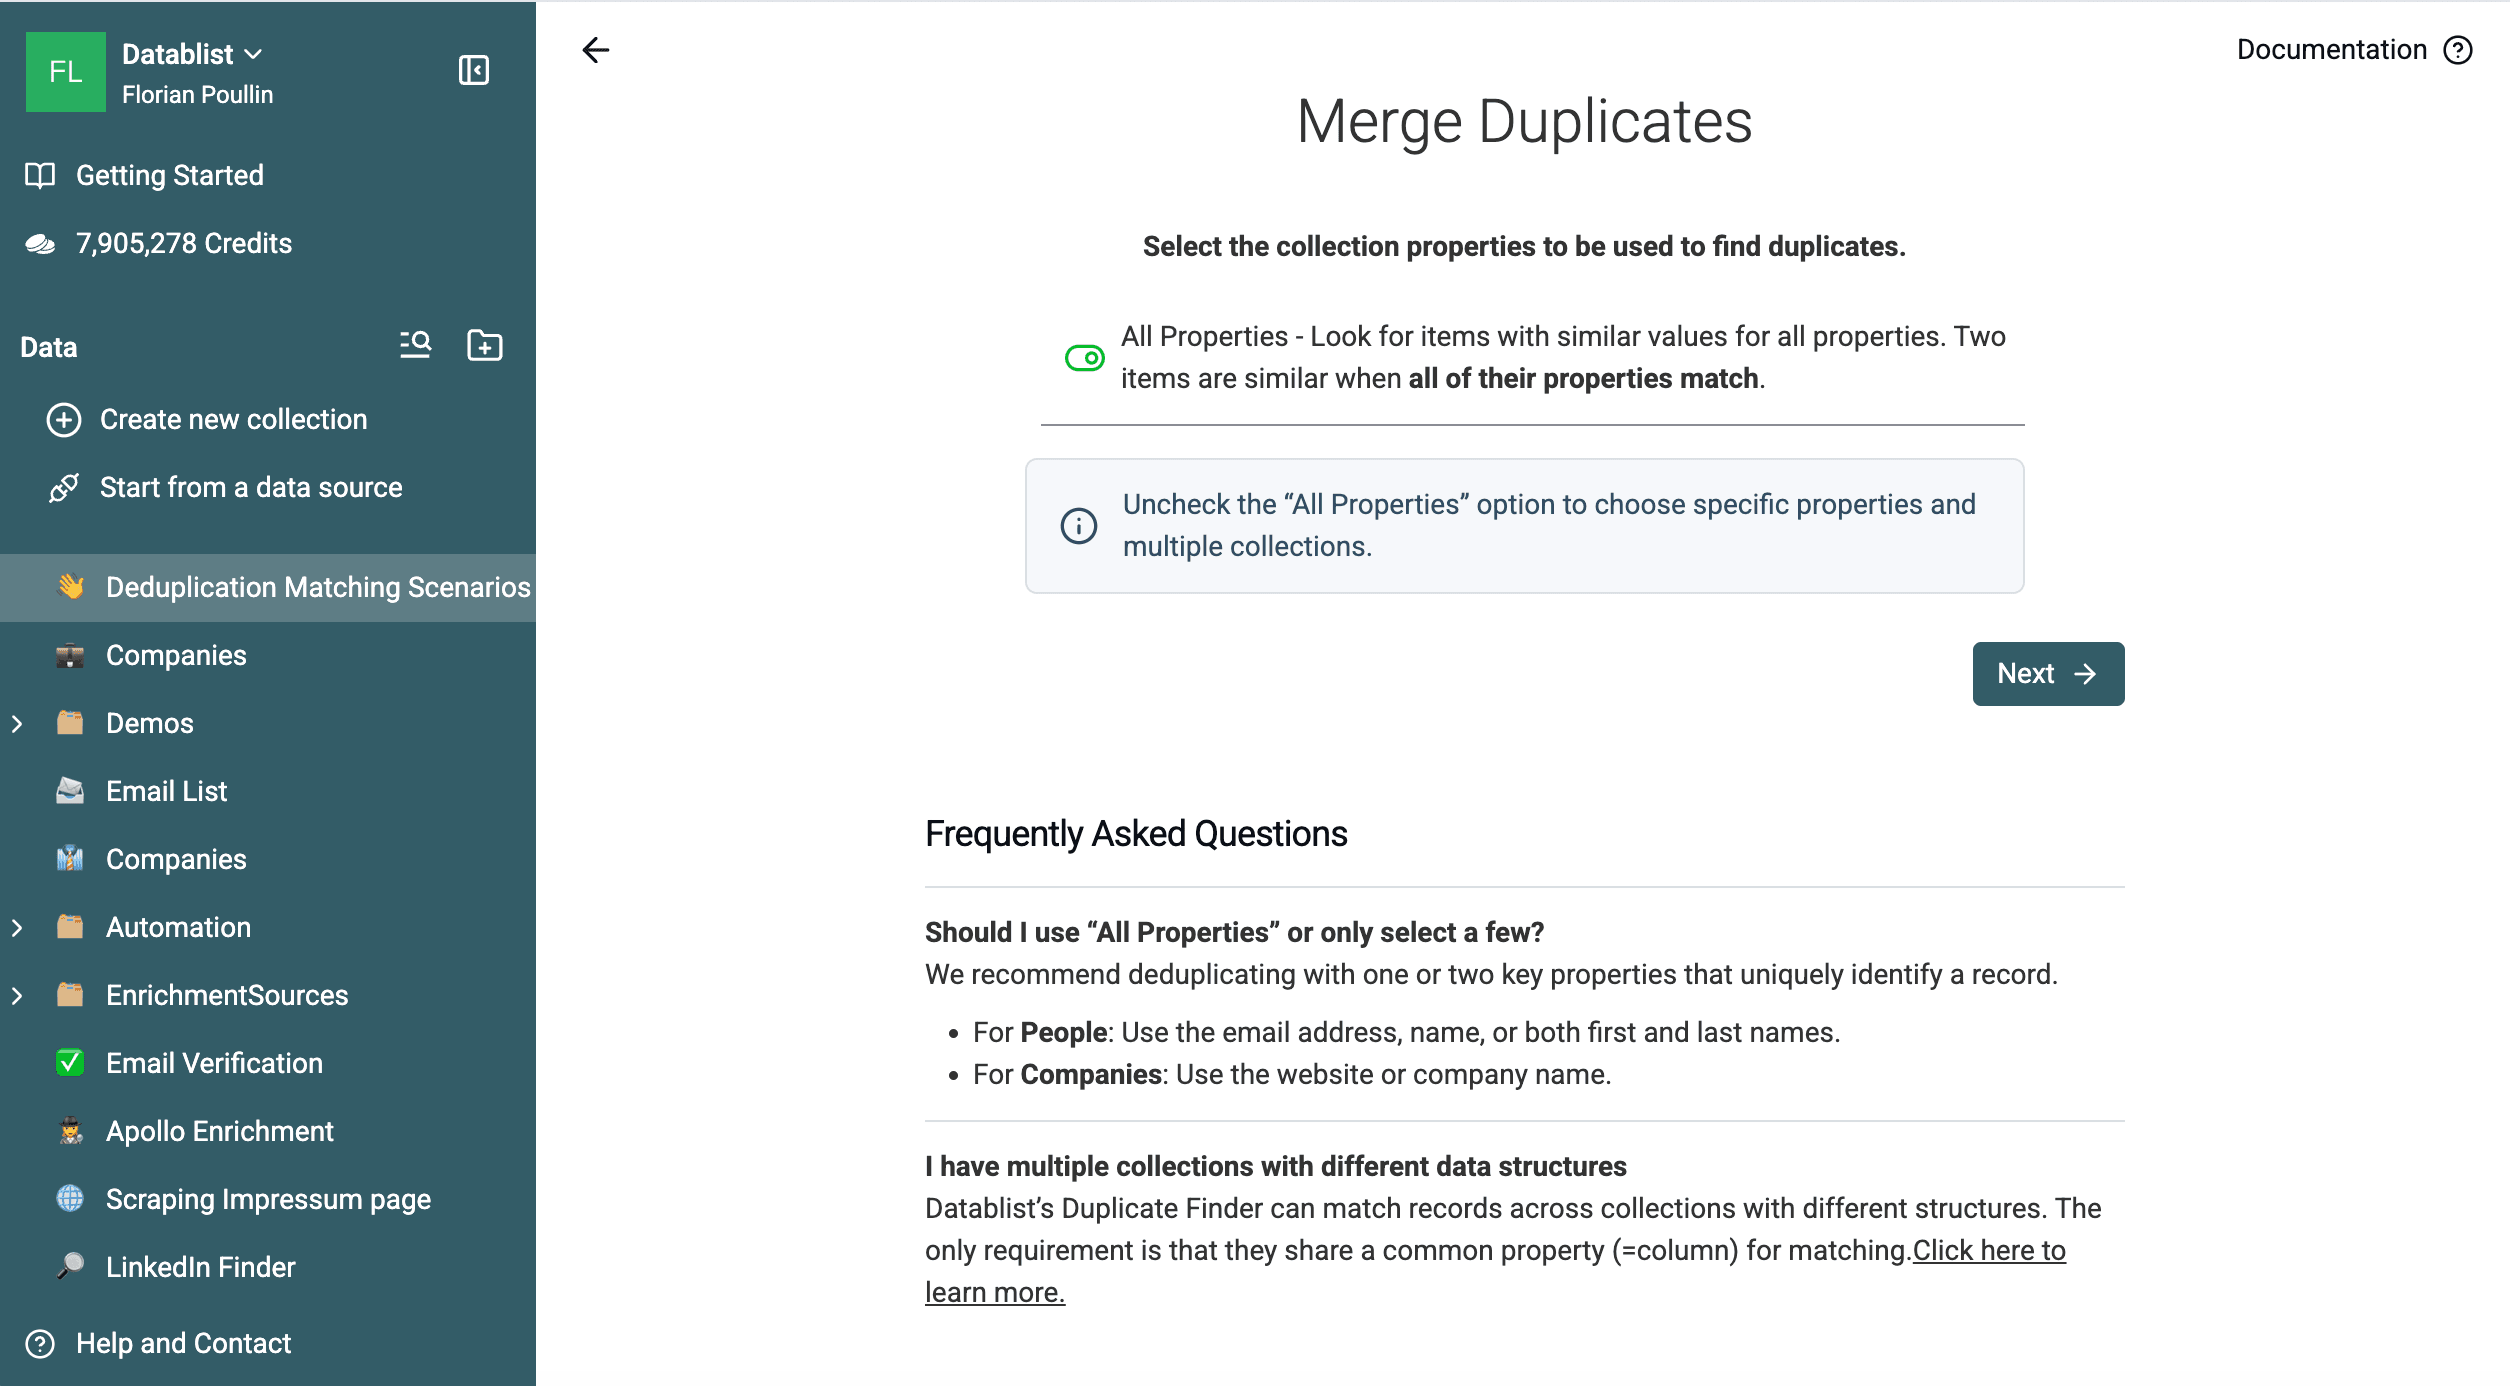
In het voorbeeldbestand met 1.000 rijen levert deze matching vijf groepen met duplicaten op. Elke groep bevat twee rijen met dezelfde waarden voor alle properties.
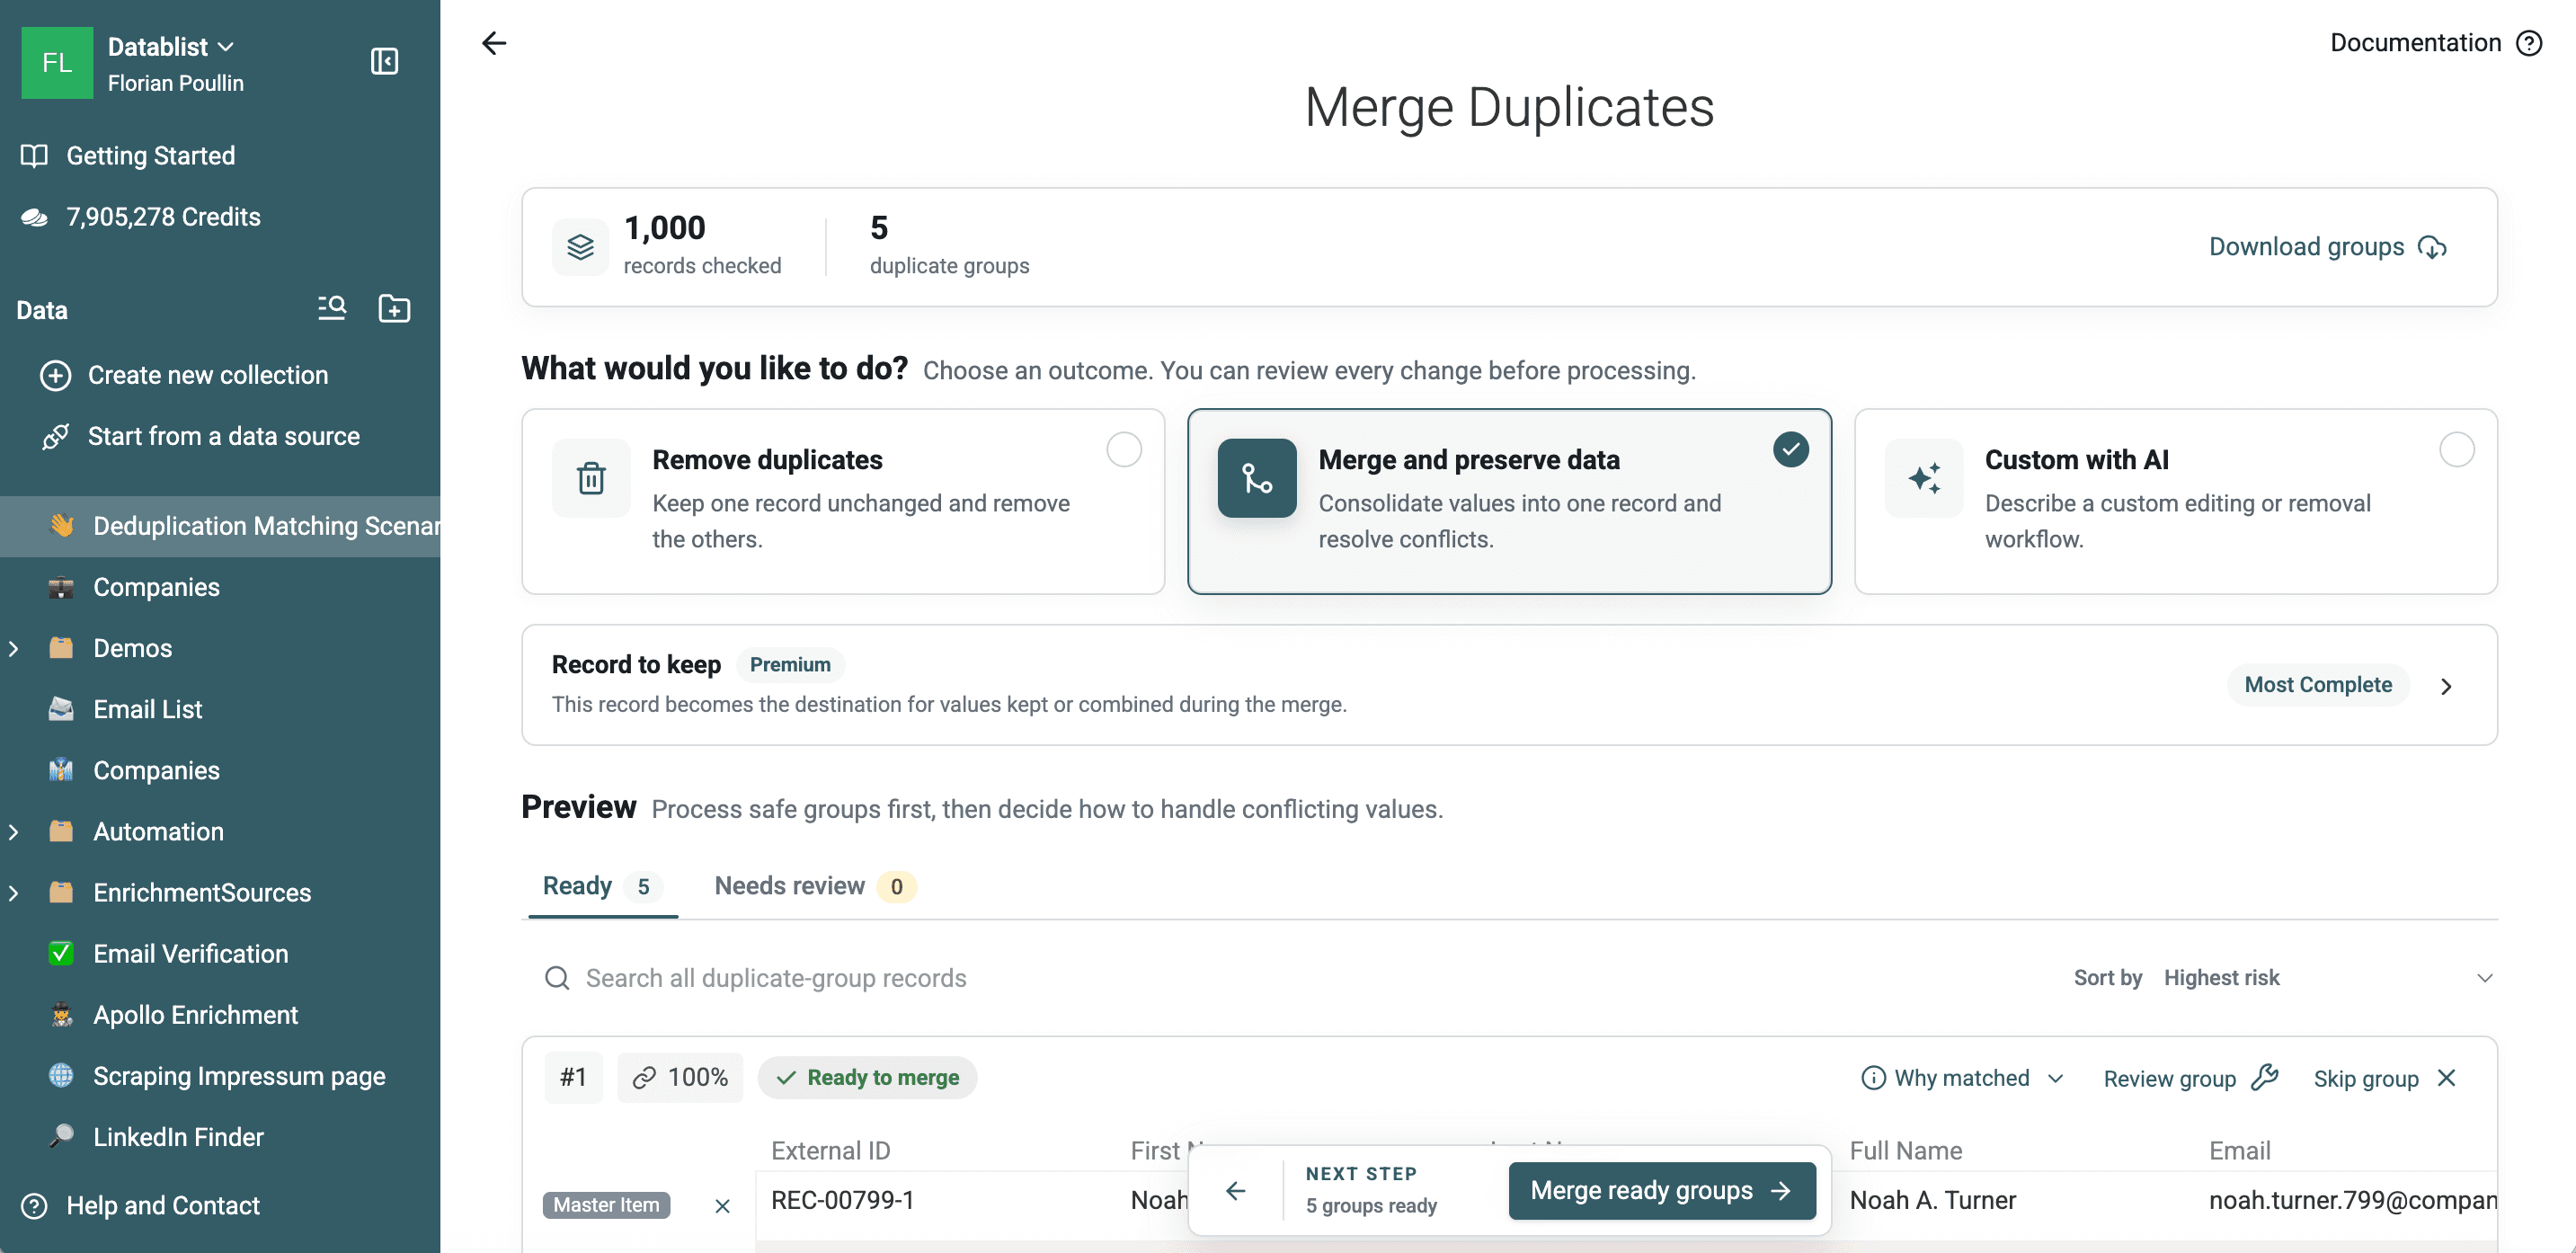
Exact is de veiligste eerste matching, omdat elke behouden match aan een strikte vergelijking voldoet. De methode vindt geen match tussen Acme Inc. en Acme, verschillende notaties van een telefoonnummer of een e-mailalias wanneer de opgeslagen waarden verschillen.
Bezoekers zonder account kunnen een Exact-controle op duplicaten uitvoeren. Met een gratis account krijg je toegang tot Smart comparison en de andere functies van het Free-plan.
Gebruik Smart matching voor bedrijfsdata
Smart matching standaardiseert waarden voor de vergelijking zonder de opgeslagen cellen te wijzigen. Selecteer een processor die bij de property past:
- Email verwerkt hoofdletters, omliggende spaties, plus-aliassen, punten in Gmail-adressen,
googlemail.com, display-name wrappers enmailto:-waarden. - URL kan protocollen en een afsluitende slash negeren, met optionele instellingen voor subdomeinen, paden en queryparameters.
- Phone negeert opmaaktekens. De processor valideert geen nummers, gebruikt geen Country-property en leidt geen ontbrekende landcode af.
- Company Name verwijdert veelvoorkomende juridische, zakelijke en geografische termen.
- Text negeert accenten, spaties, leestekens, symbolen, hoofdlettergebruik en woordvolgorde.
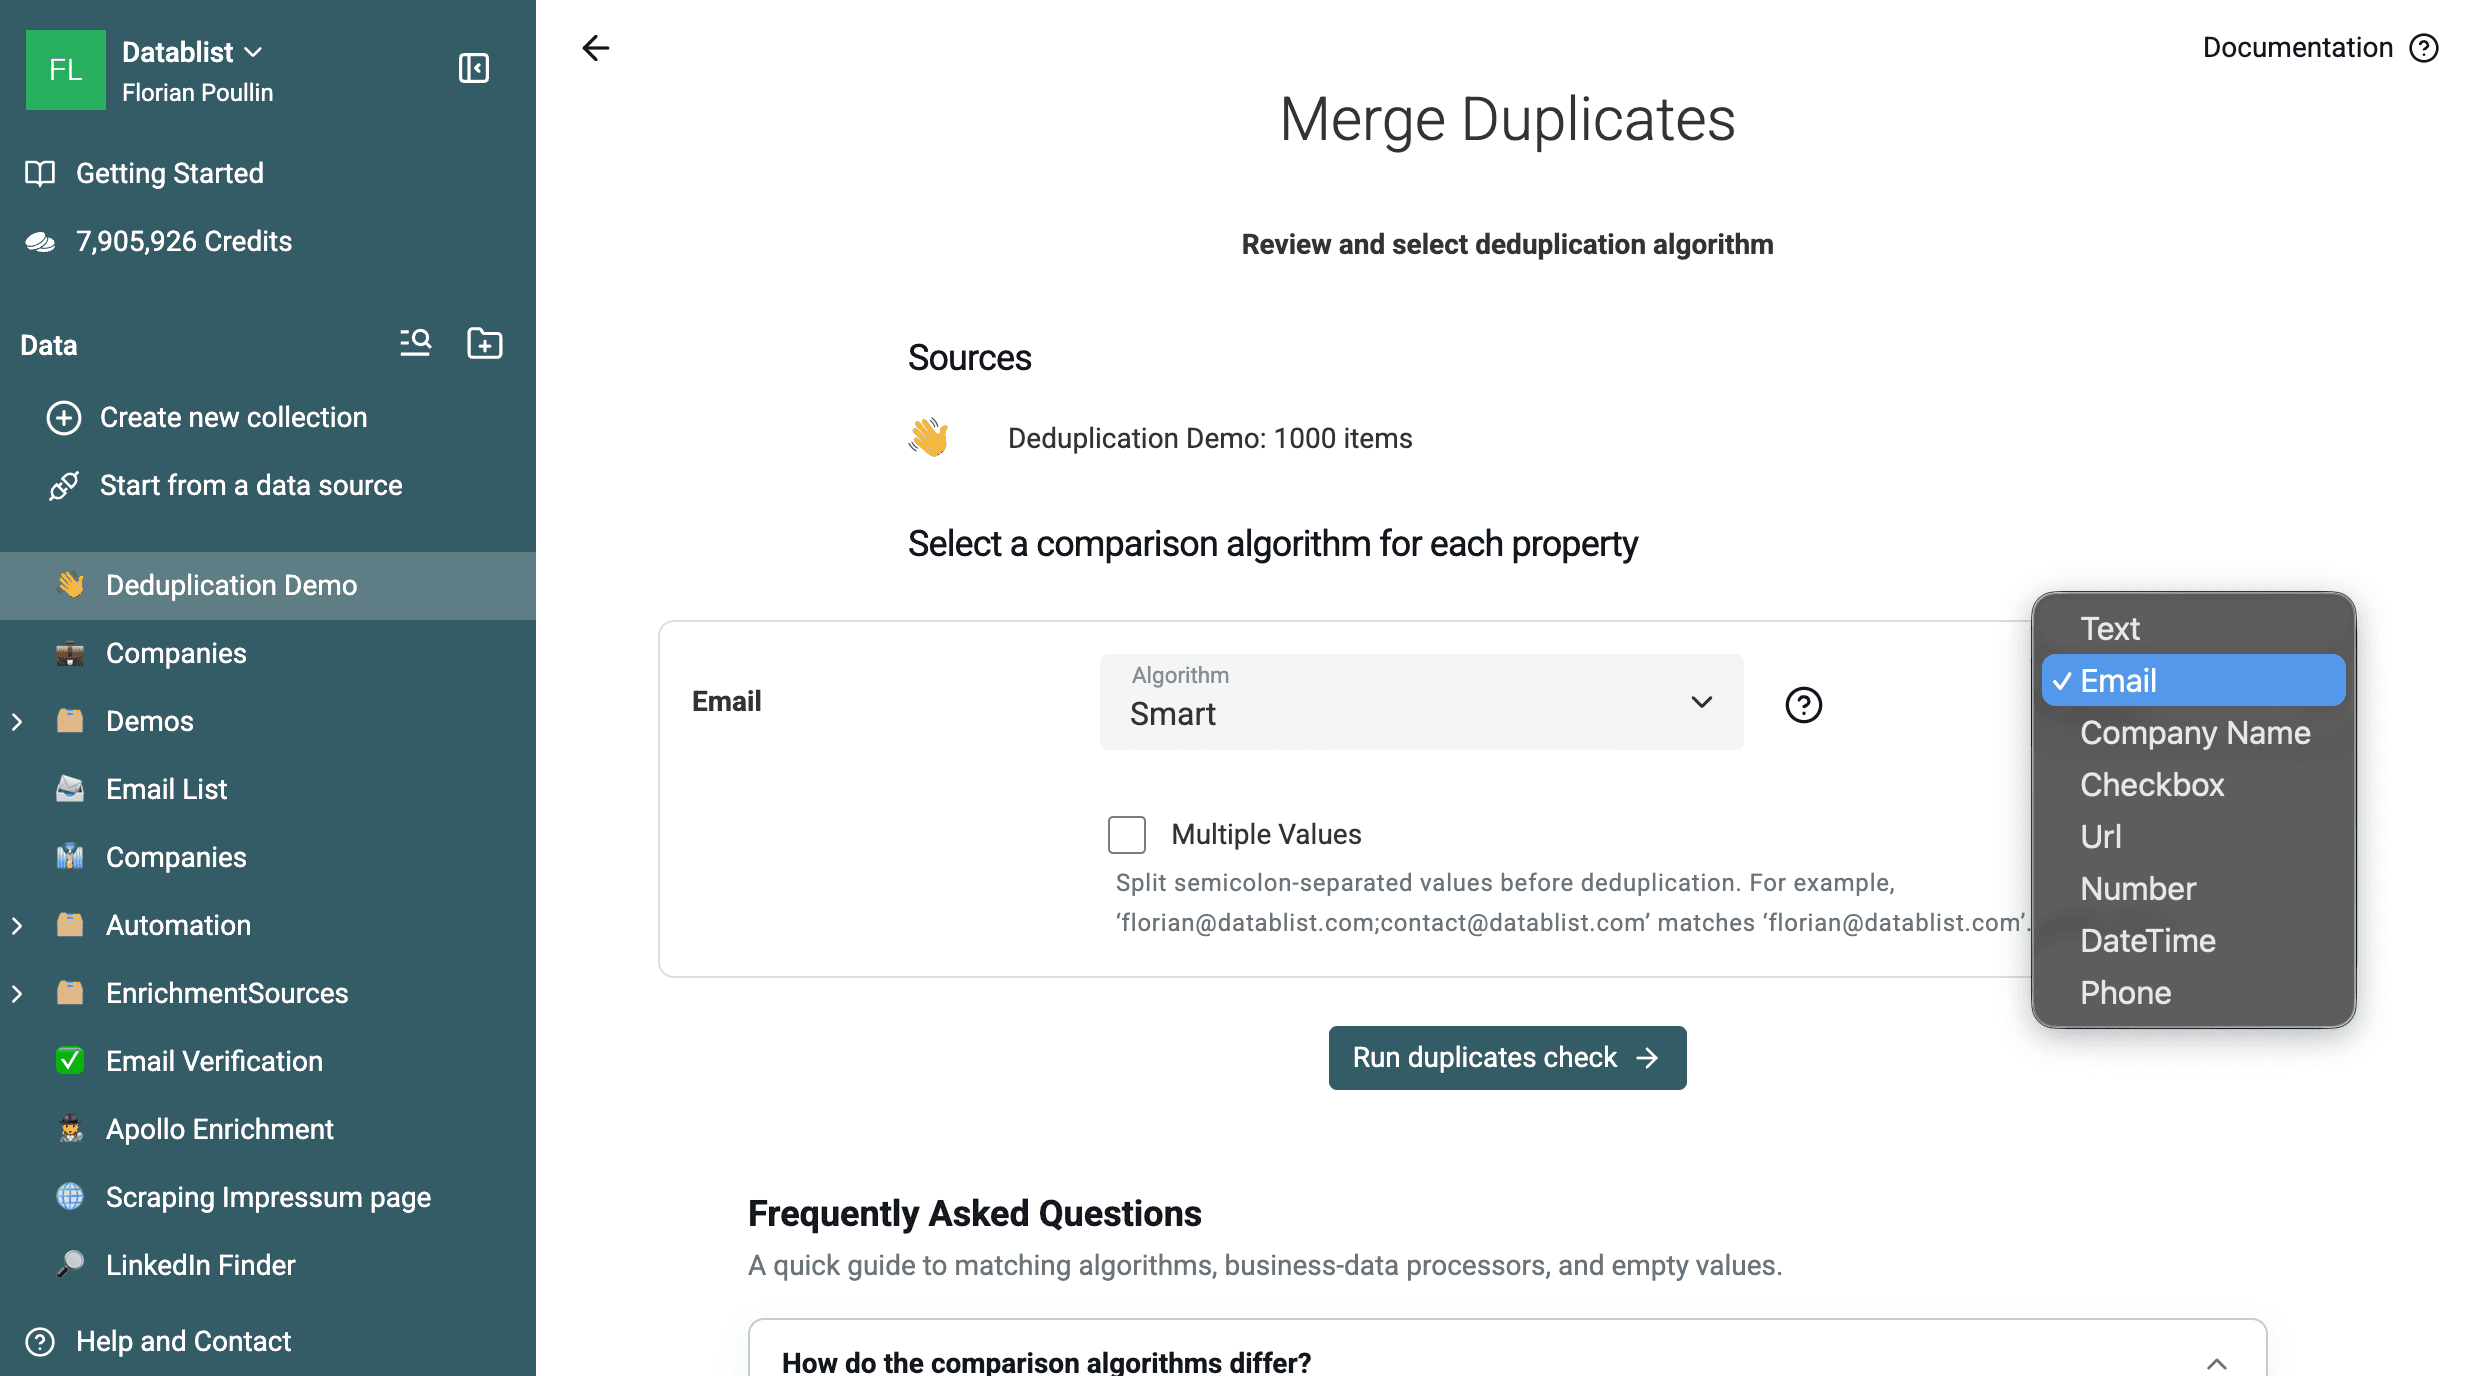
Voor de Company Name-processor, matching van meerdere waarden en geavanceerde algoritmen heb je een betaald plan nodig. Exact en Smart zijn in het Free-plan beschikbaar voor matching binnen één collection, al vereist Smart wel een gratis account.
Bevat één cel meerdere identifiers die met puntkomma’s zijn gescheiden? Schakel dan Multiple Values in. Datablist vergelijkt elk onderdeel en matcht de property zodra ten minste één paar overeenkomt. Een cel met primary@example.com;shared@example.com kan bijvoorbeeld matchen met een tweede cel die shared@example.com bevat.
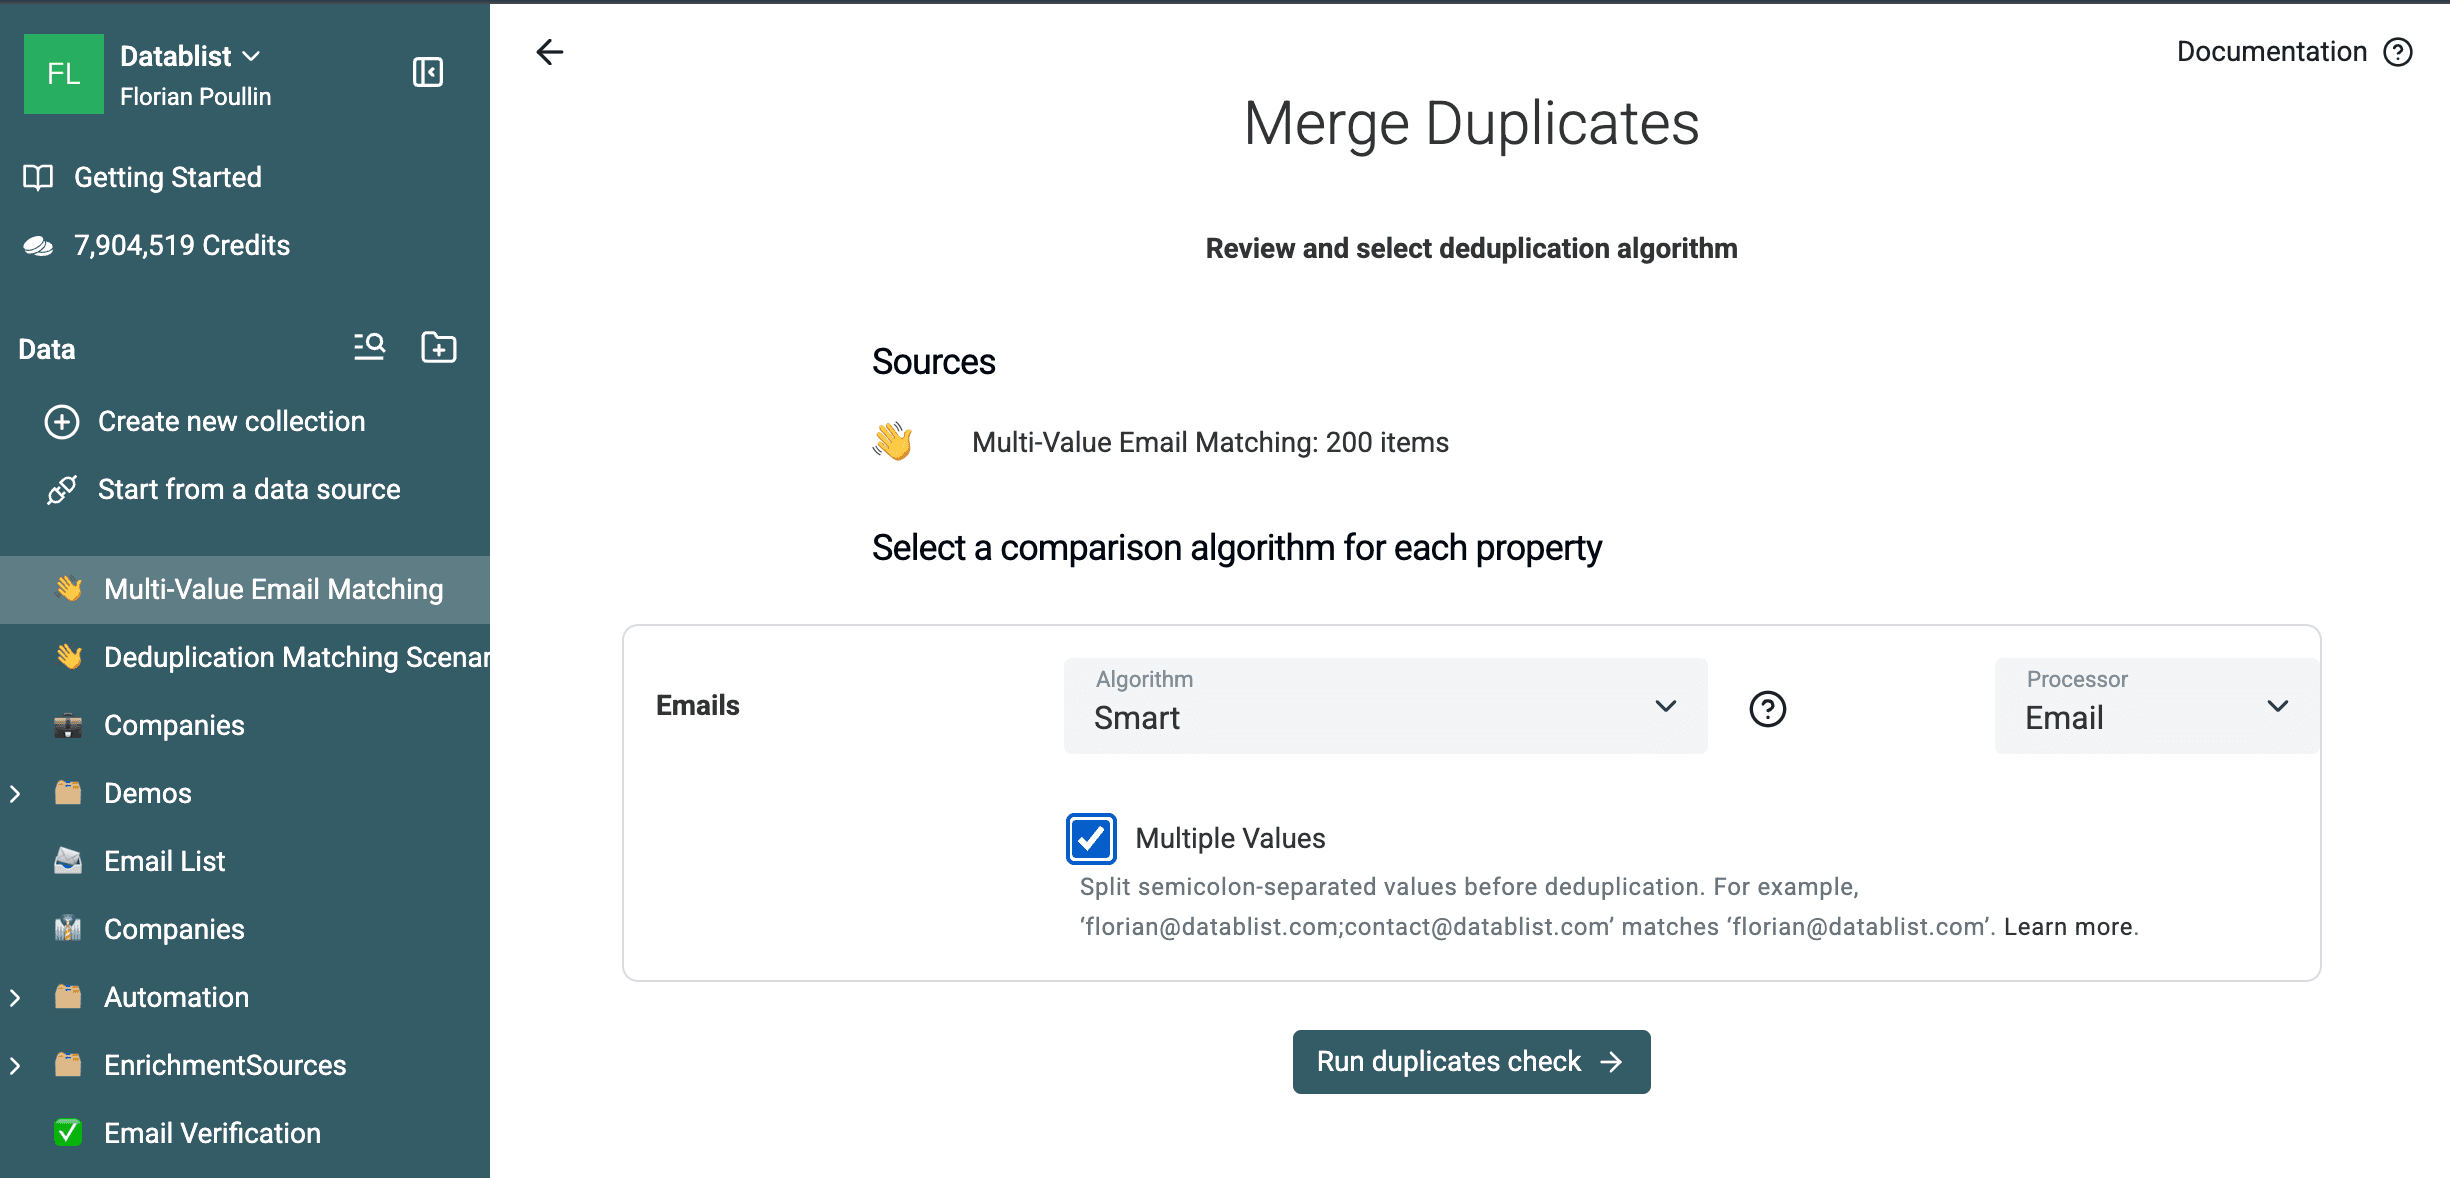
In het specifieke voorbeeldbestand met 200 rijen leverde deze configuratie 60 groepen van twee rijen op. De ground-truthvalidatie vond alle 60 vooraf samengestelde paren en sloot alle 80 controlerecords uit. Volg de workflow voor het dedupliceren van velden met meerdere waarden voor het voorbeeldbestand, de resultaat-CSV en de merge-beslissingen.
Deze matching op e-mail leverde 105 groepen van twee rijen op: 100 vooraf samengestelde paren die na e-mailnormalisatie overeenkomen en de vijf exacte kopieën, die ook hetzelfde e-mailadres hebben.
Normaliseer telefoonnummers vóór de matching
De Smart Phone-processor is geschikt voor één specifieke situatie: waarden met dezelfde cijfers, maar met verschillende spaties, haakjes, streepjes of symbolen. Zo kan (415) 555-0123 matchen met 4155550123.
De processor kan niet bepalen dat een lokaal en internationaal nummer hetzelfde zijn. Voor 06 12 34 50 08 en +33 6 12 34 50 08 is bijvoorbeeld landinformatie nodig voordat je ze kunt vergelijken.
Gebruik de Phone Number Cleaner vóór deduplicatie op basis van telefoonnummers:
- Koppel de onbewerkte property
Phone. - Selecteer voor een lijst uit één land het land onder Local Phone Countries. Schakel bij een gemengde lijst Define country per item in en koppel de property
Country. - Schrijf het enrichment-resultaat naar
Clean Phone Numberzonder de oorspronkelijke waarde te overschrijven. - Controleer mislukte of lege resultaten. Deze mogen niet meedoen aan matching op basis van telefoonnummers.
- Voer de Duplicates Finder uit op
Clean Phone Numbermet Exact.
Download het specifieke telefoonbestand met 200 rijen. Het bevat 50 paren met lokale en internationale nummers uit de Verenigde Staten, Frankrijk, het Verenigd Koninkrijk, Duitsland en Spanje, plus 100 niet-matchende controlerecords. Validatie met de productielogica van de cleaner leverde voor alle 200 rijen één genormaliseerd telefoonnummer op. De 50 vooraf samengestelde paren komen samen in 50 gedeelde internationale waarden; de controlerecords blijven uniek.
Deze voorbewerking valideert ook de telefoonnotatie. Bewaar de oorspronkelijke properties Phone en Country naast het opgeschoonde resultaat, zodat je elk record vóór de merge kunt controleren. Lees wat normalisatie van telefoonnummers inhoudt voor meer uitleg over landcodes en internationale waarden.
Voer voor bedrijfsrecords een afzonderlijke matching uit op Website. Kies Smart met de URL-processor. Schakel Ignore Subdomain, Ignore Path en Ignore Query Params alleen in wanneer die URL-onderdelen geen ander bedrijf of een andere locatie aanduiden.
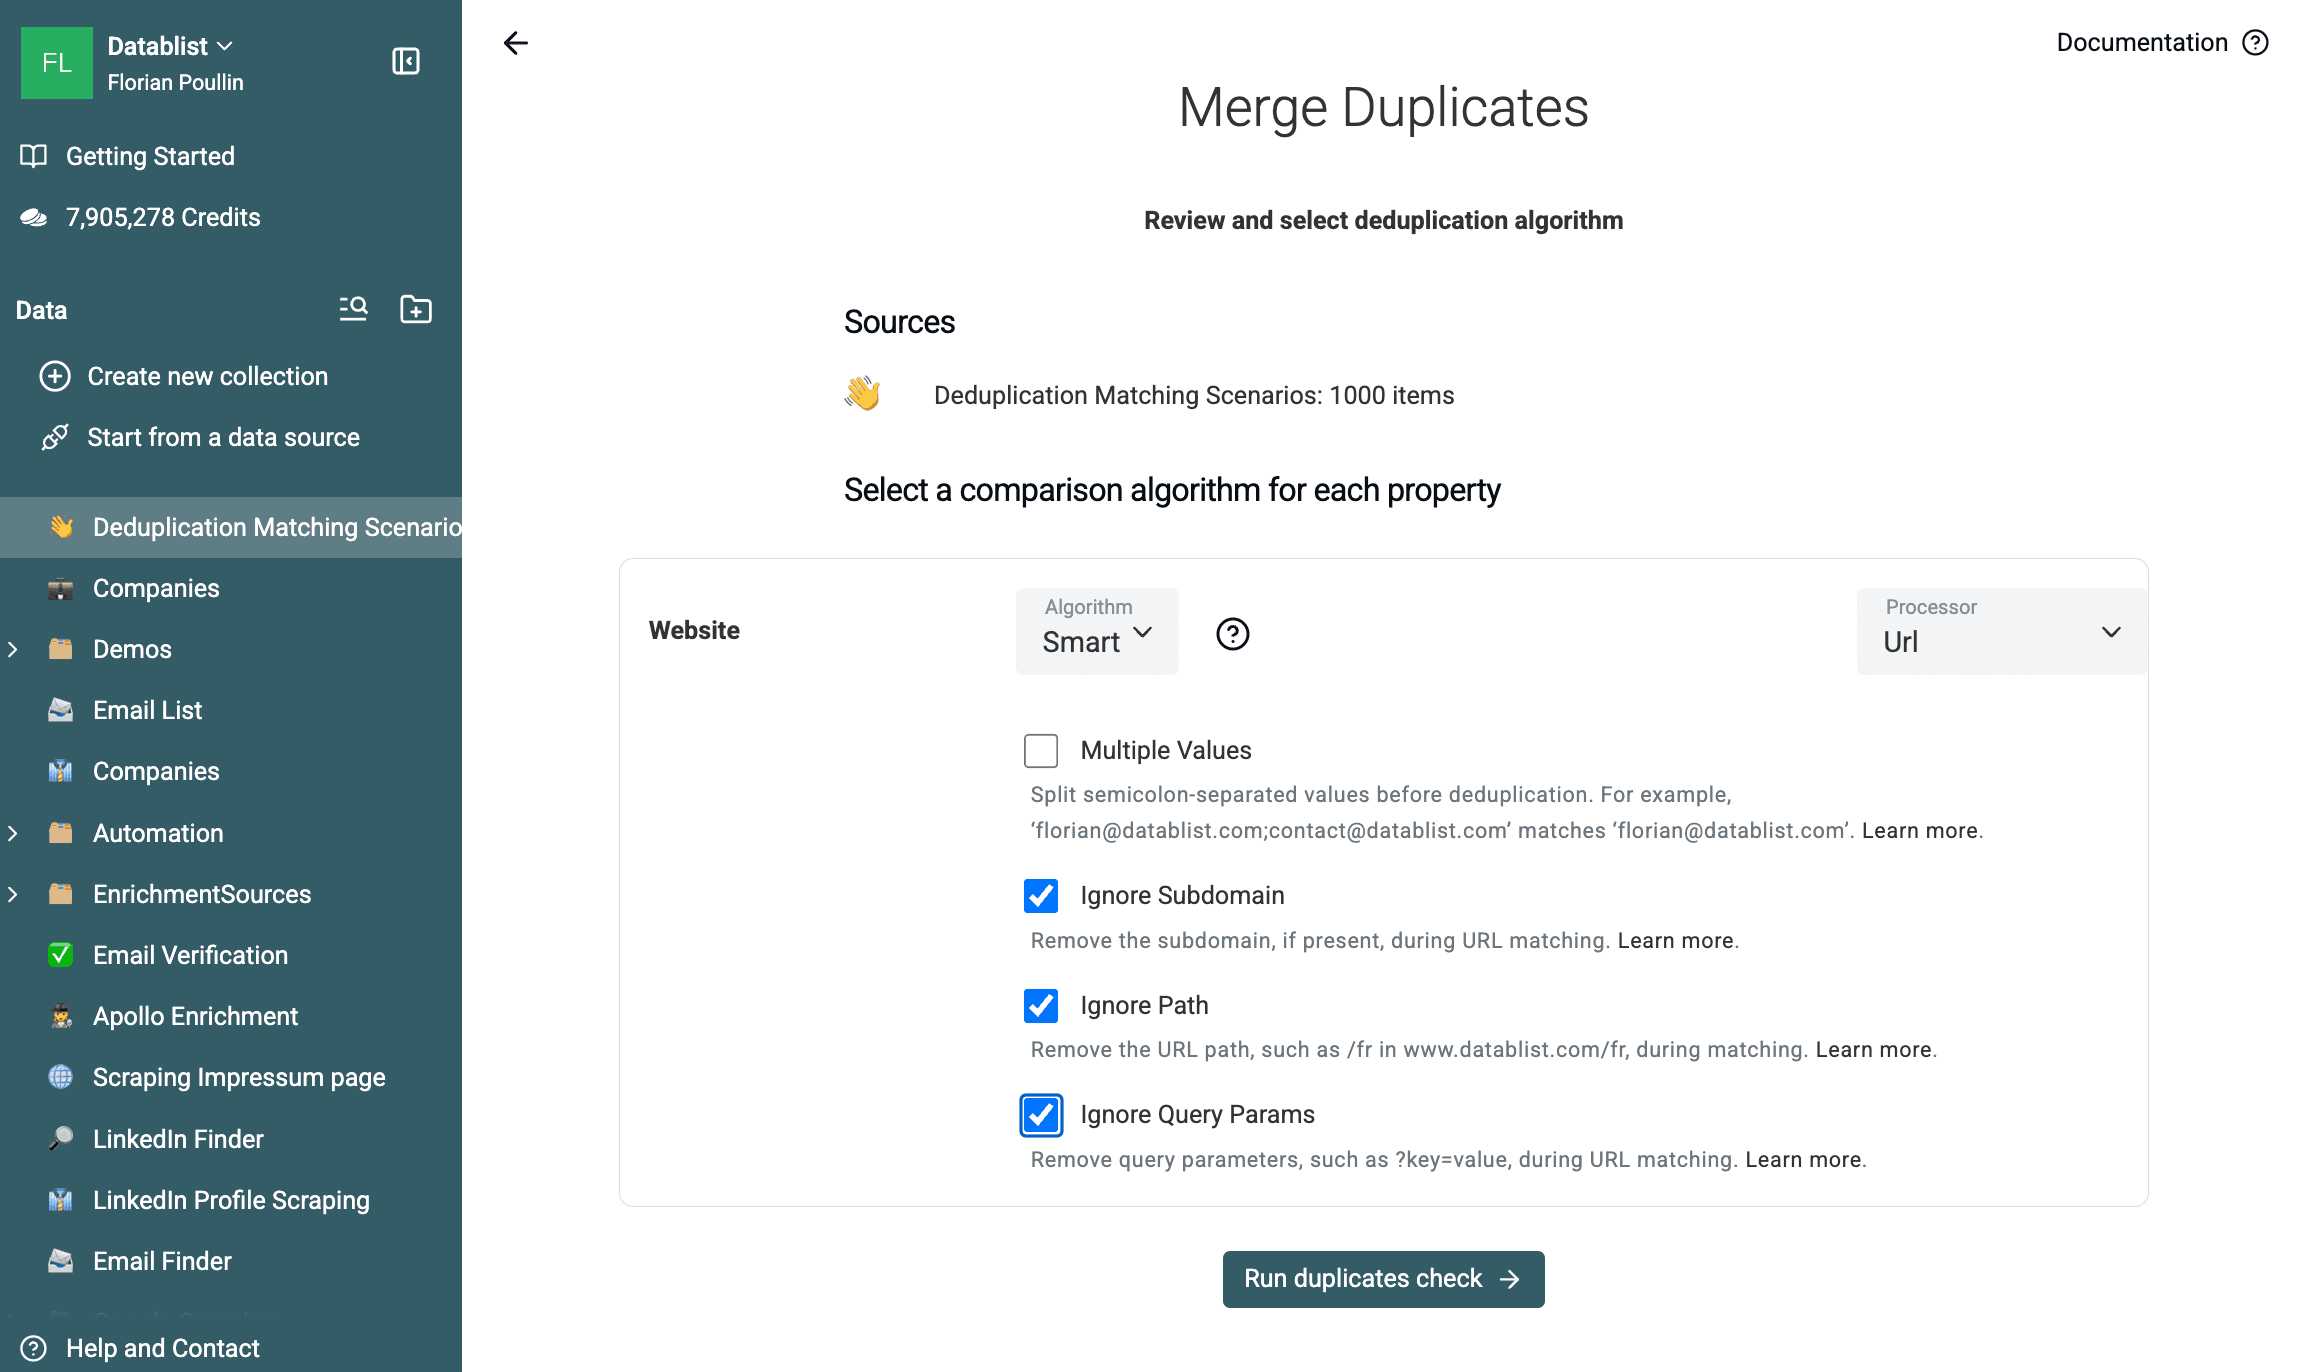
In hetzelfde voorbeeldbestand met 1.000 rijen leverde deze configuratie 200 groepen van twee rijen op. Vijftig paren bevatten vooraf samengestelde URL-variaties, terwijl 150 paren al exact dezelfde website hebben. In deze test verwees elk geëxporteerd paar na normalisatie naar dezelfde host.
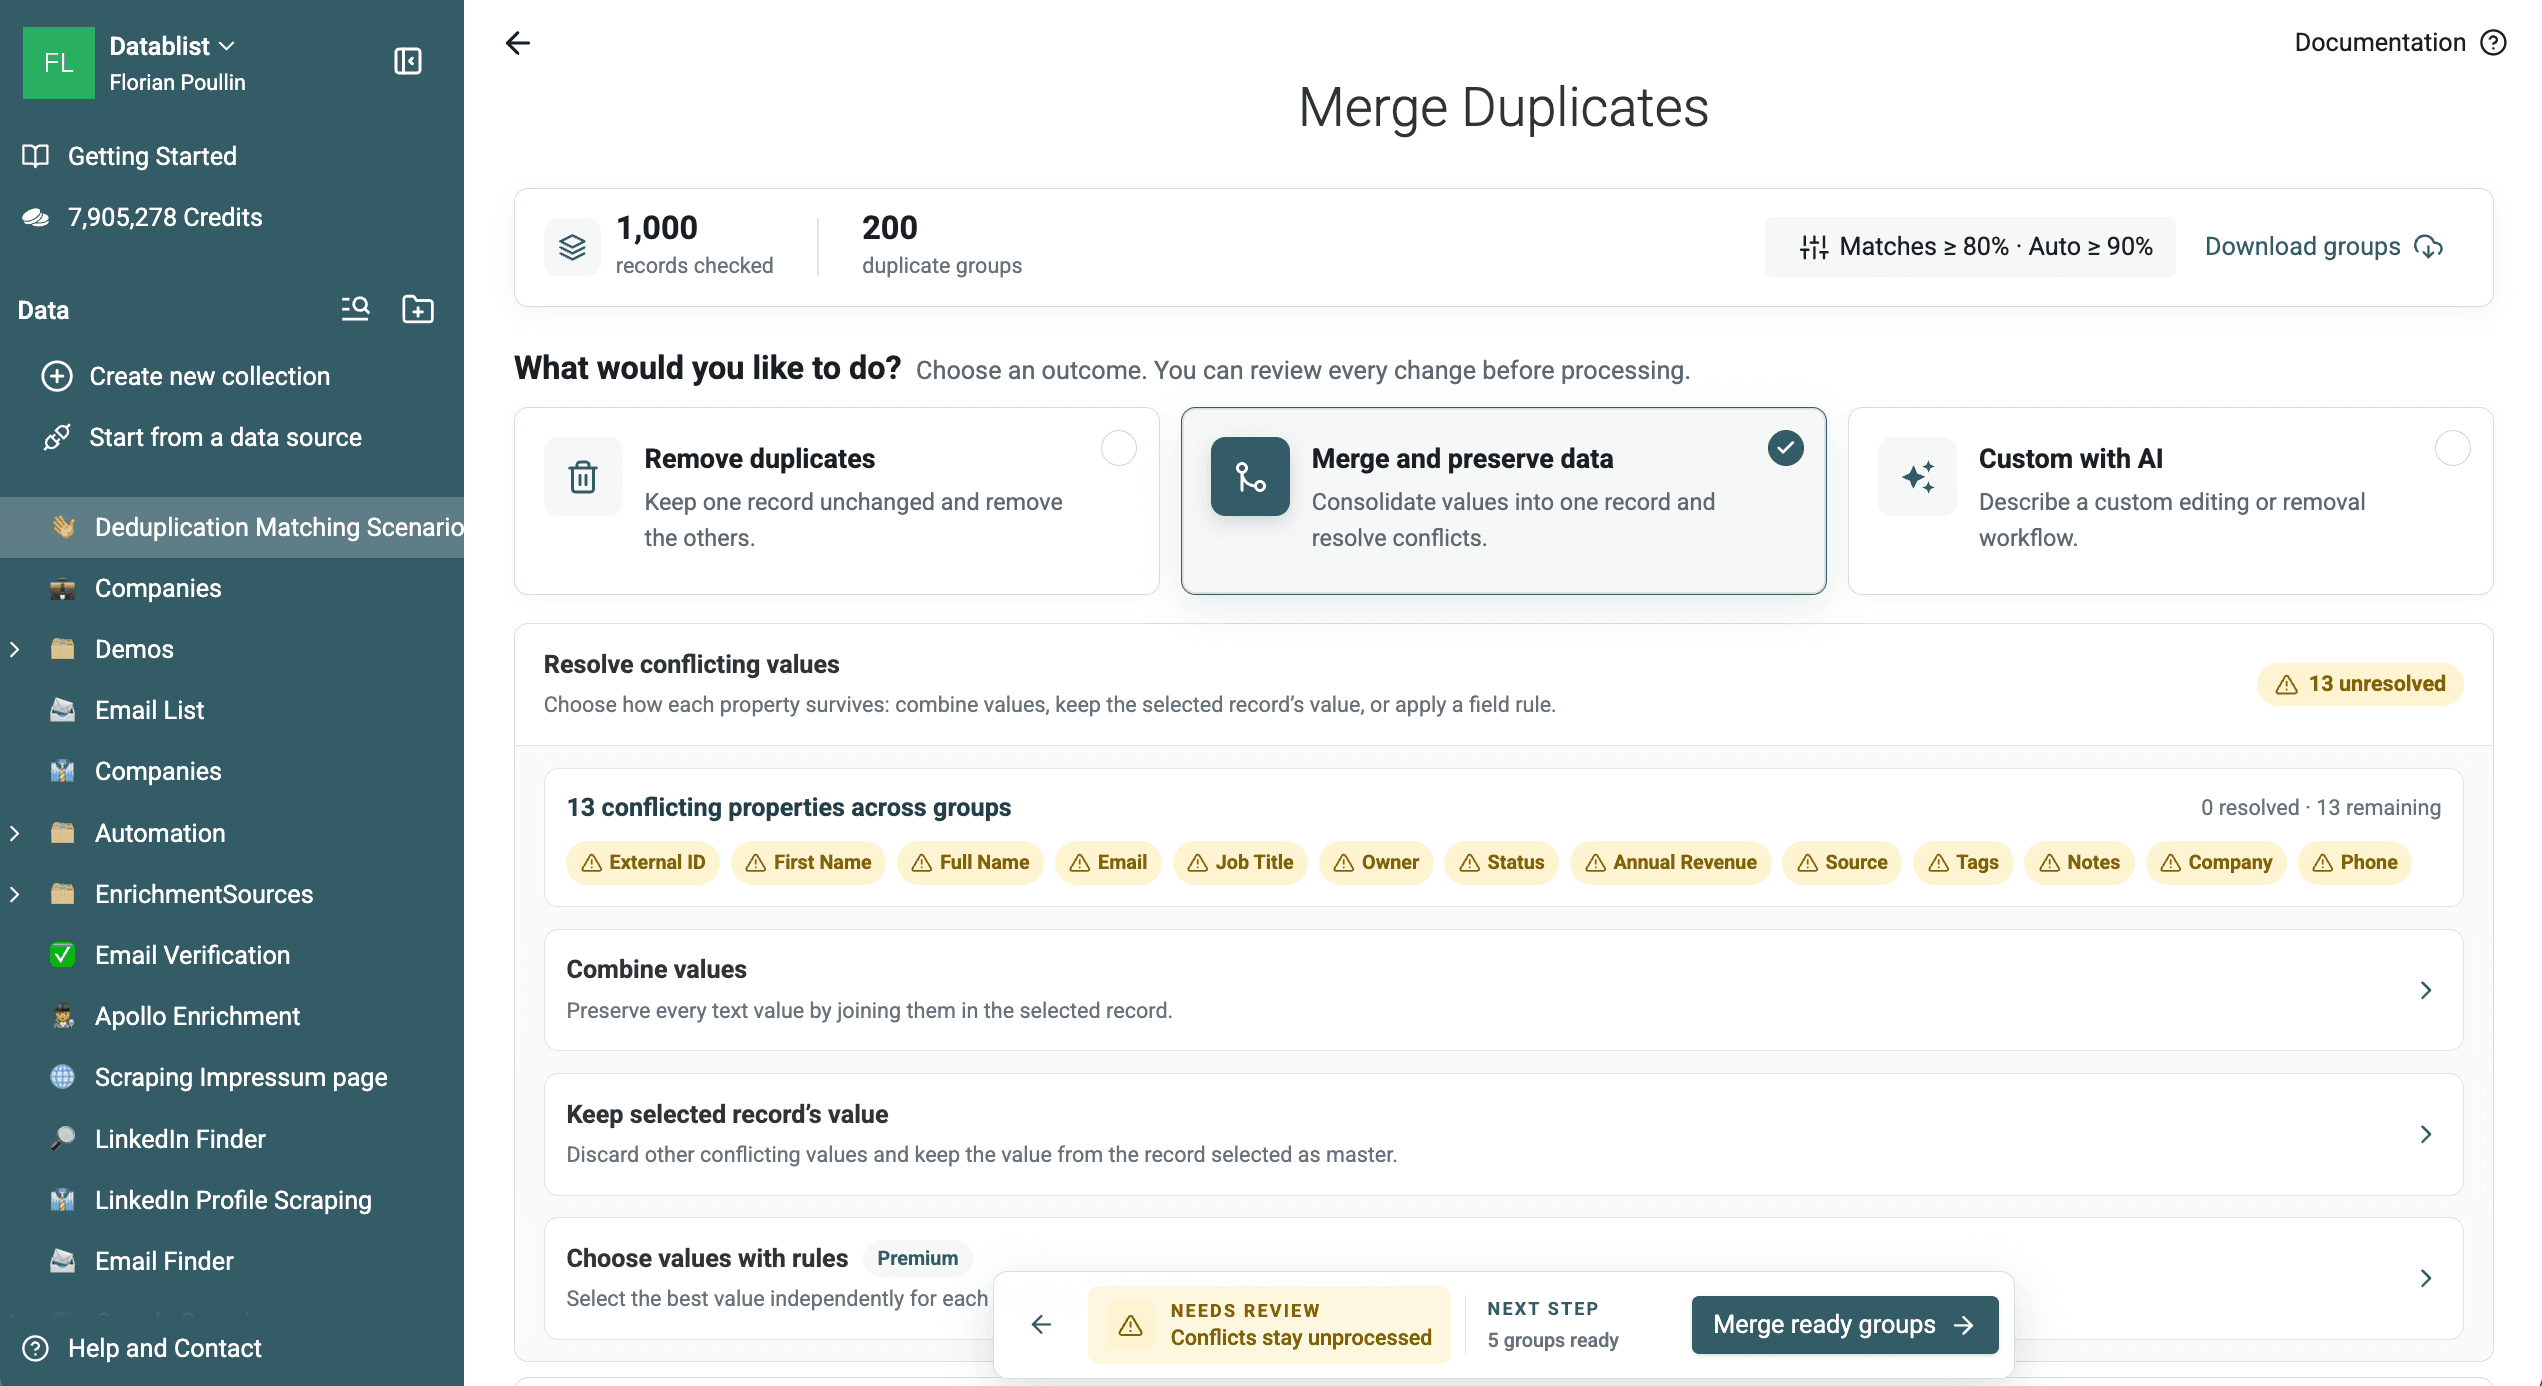
Download de 200 groepen met dubbele websites of bekijk de workflow voor het dedupliceren van bedrijven voor een matchingstrategie die begint bij het domein.
Gebruik fuzzy of fonetische matching als controle
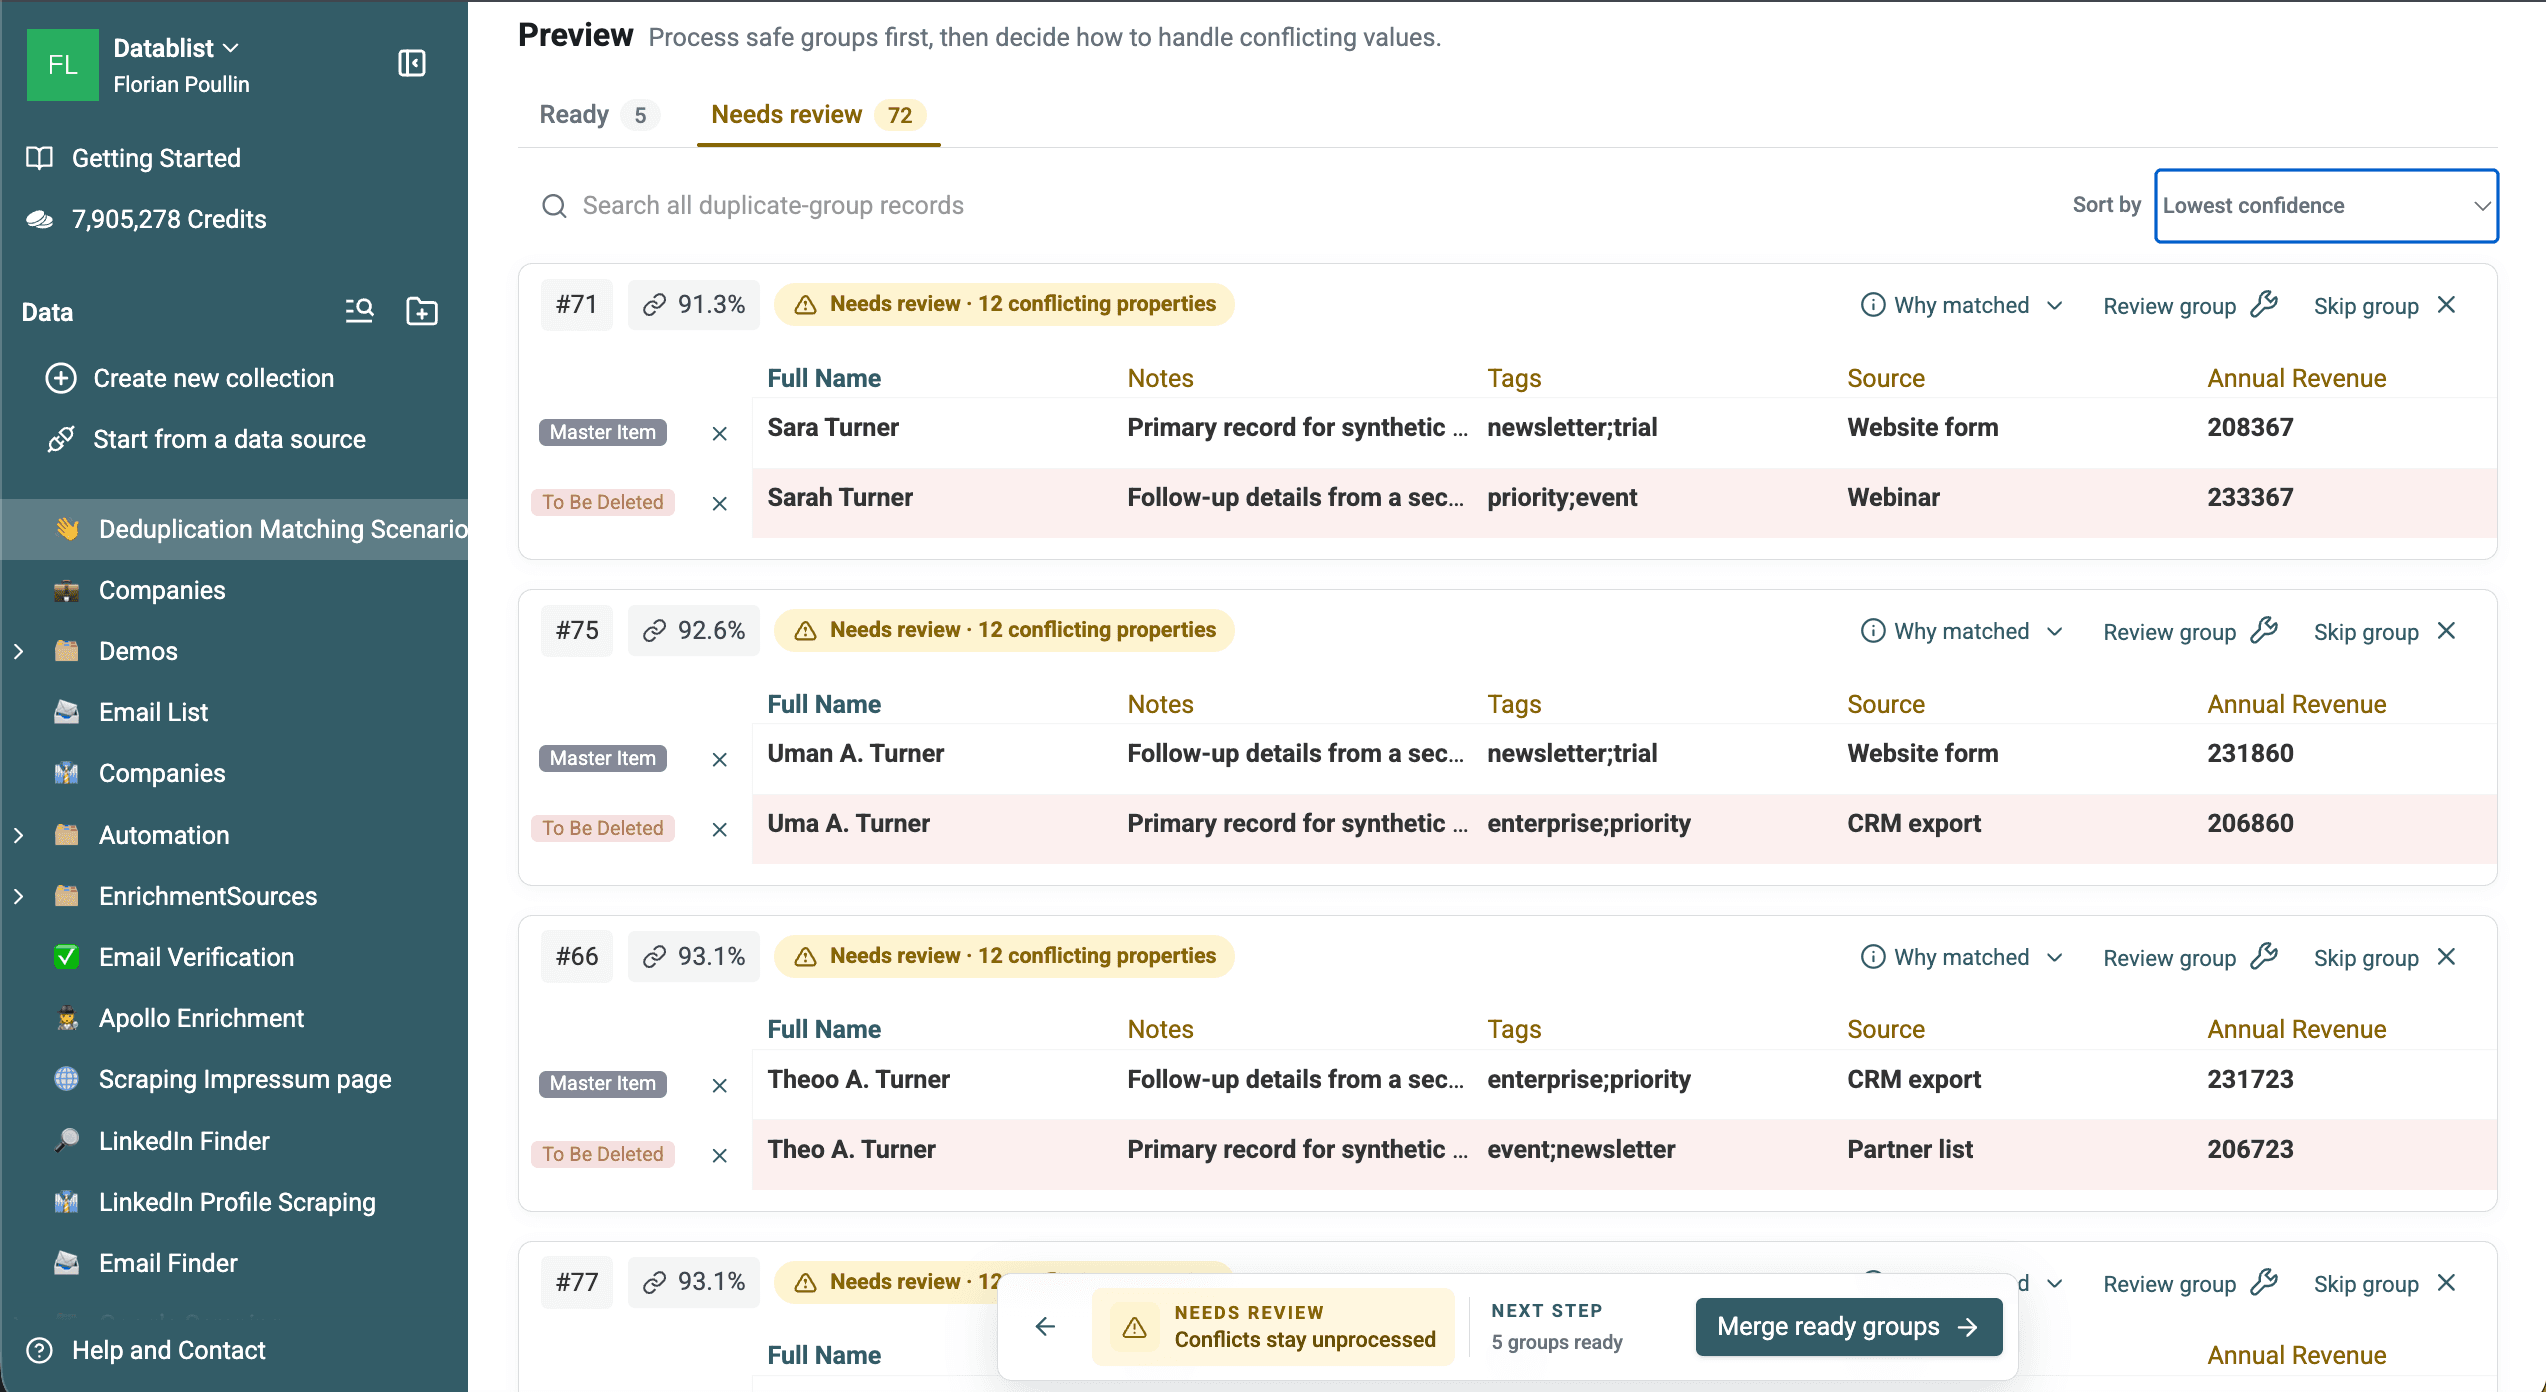
Metaphone vergelijkt hoe tekst klinkt. Jaro-Winkler en Levenshtein berekenen een overeenkomstscore, waarmee je spellingsverschillen zoals Uma Turner en Uman Turner kunt vinden.
Fuzzy matches zijn kandidaten, geen bevestigde duplicaten. Begin met een hoge drempelwaarde, controleer de zwakste groepen en verlaag de resultaatdrempel pas als de matches nauwkeurig blijven.
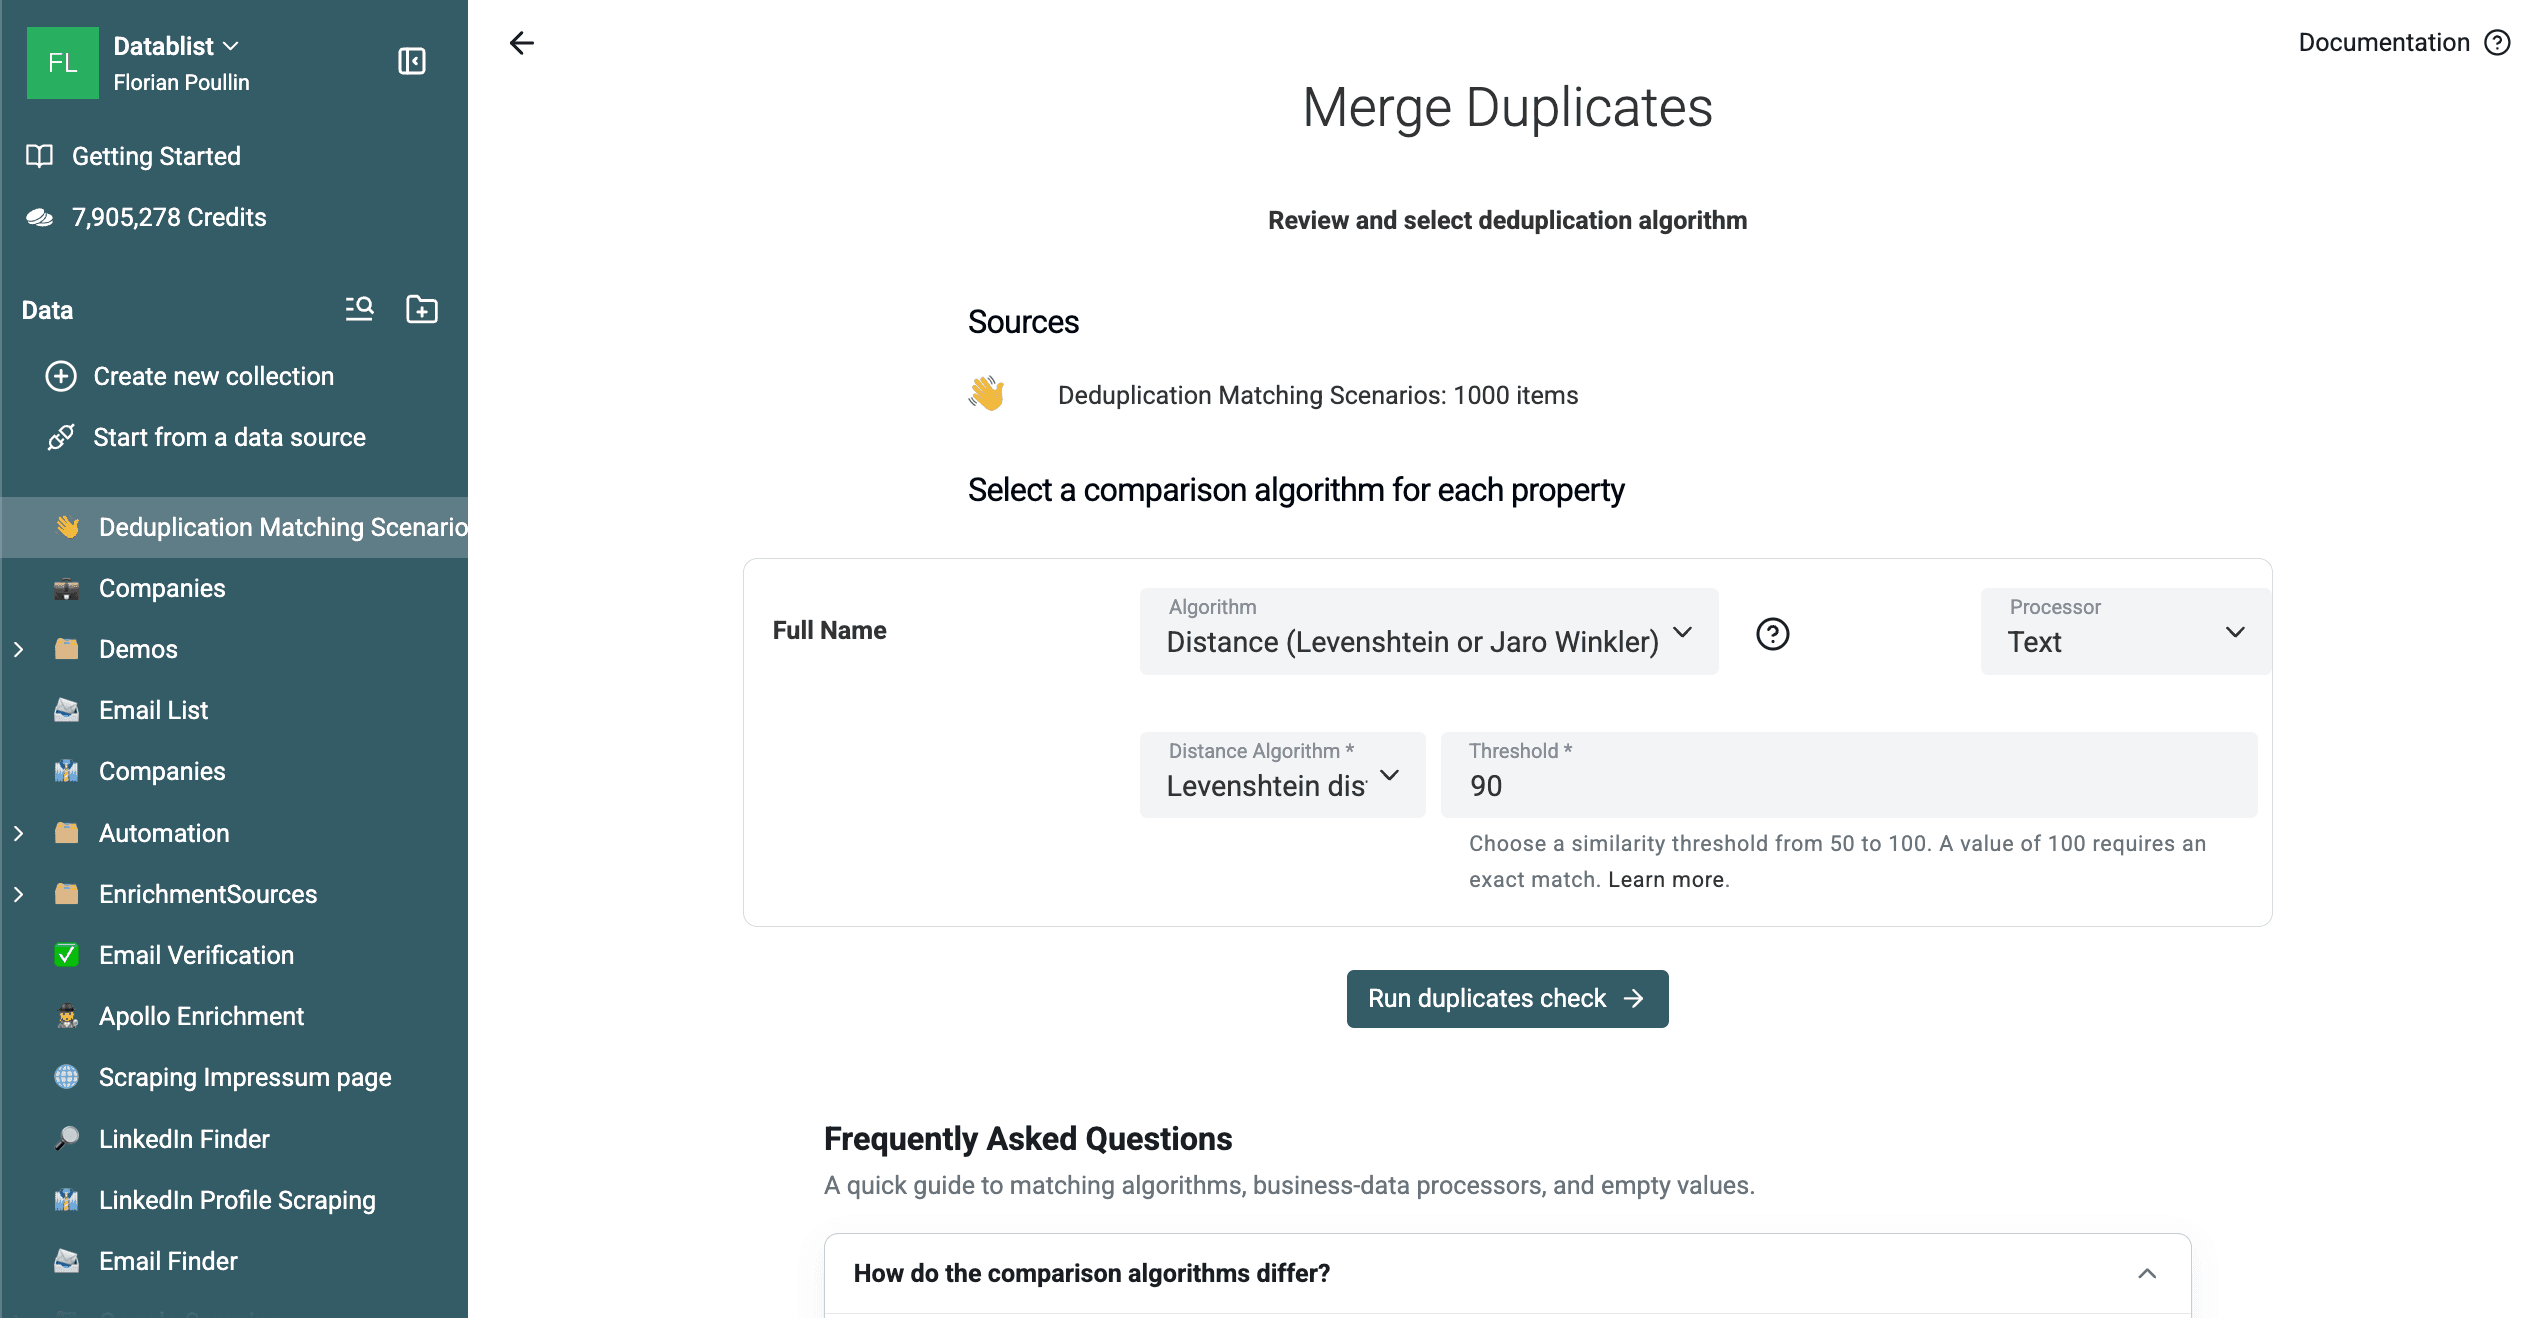
Selecteer voor een meetbare fuzzy matching Full Name, kies Distance met Levenshtein, behoud de Text-processor en stel de drempelwaarde in op 90%.
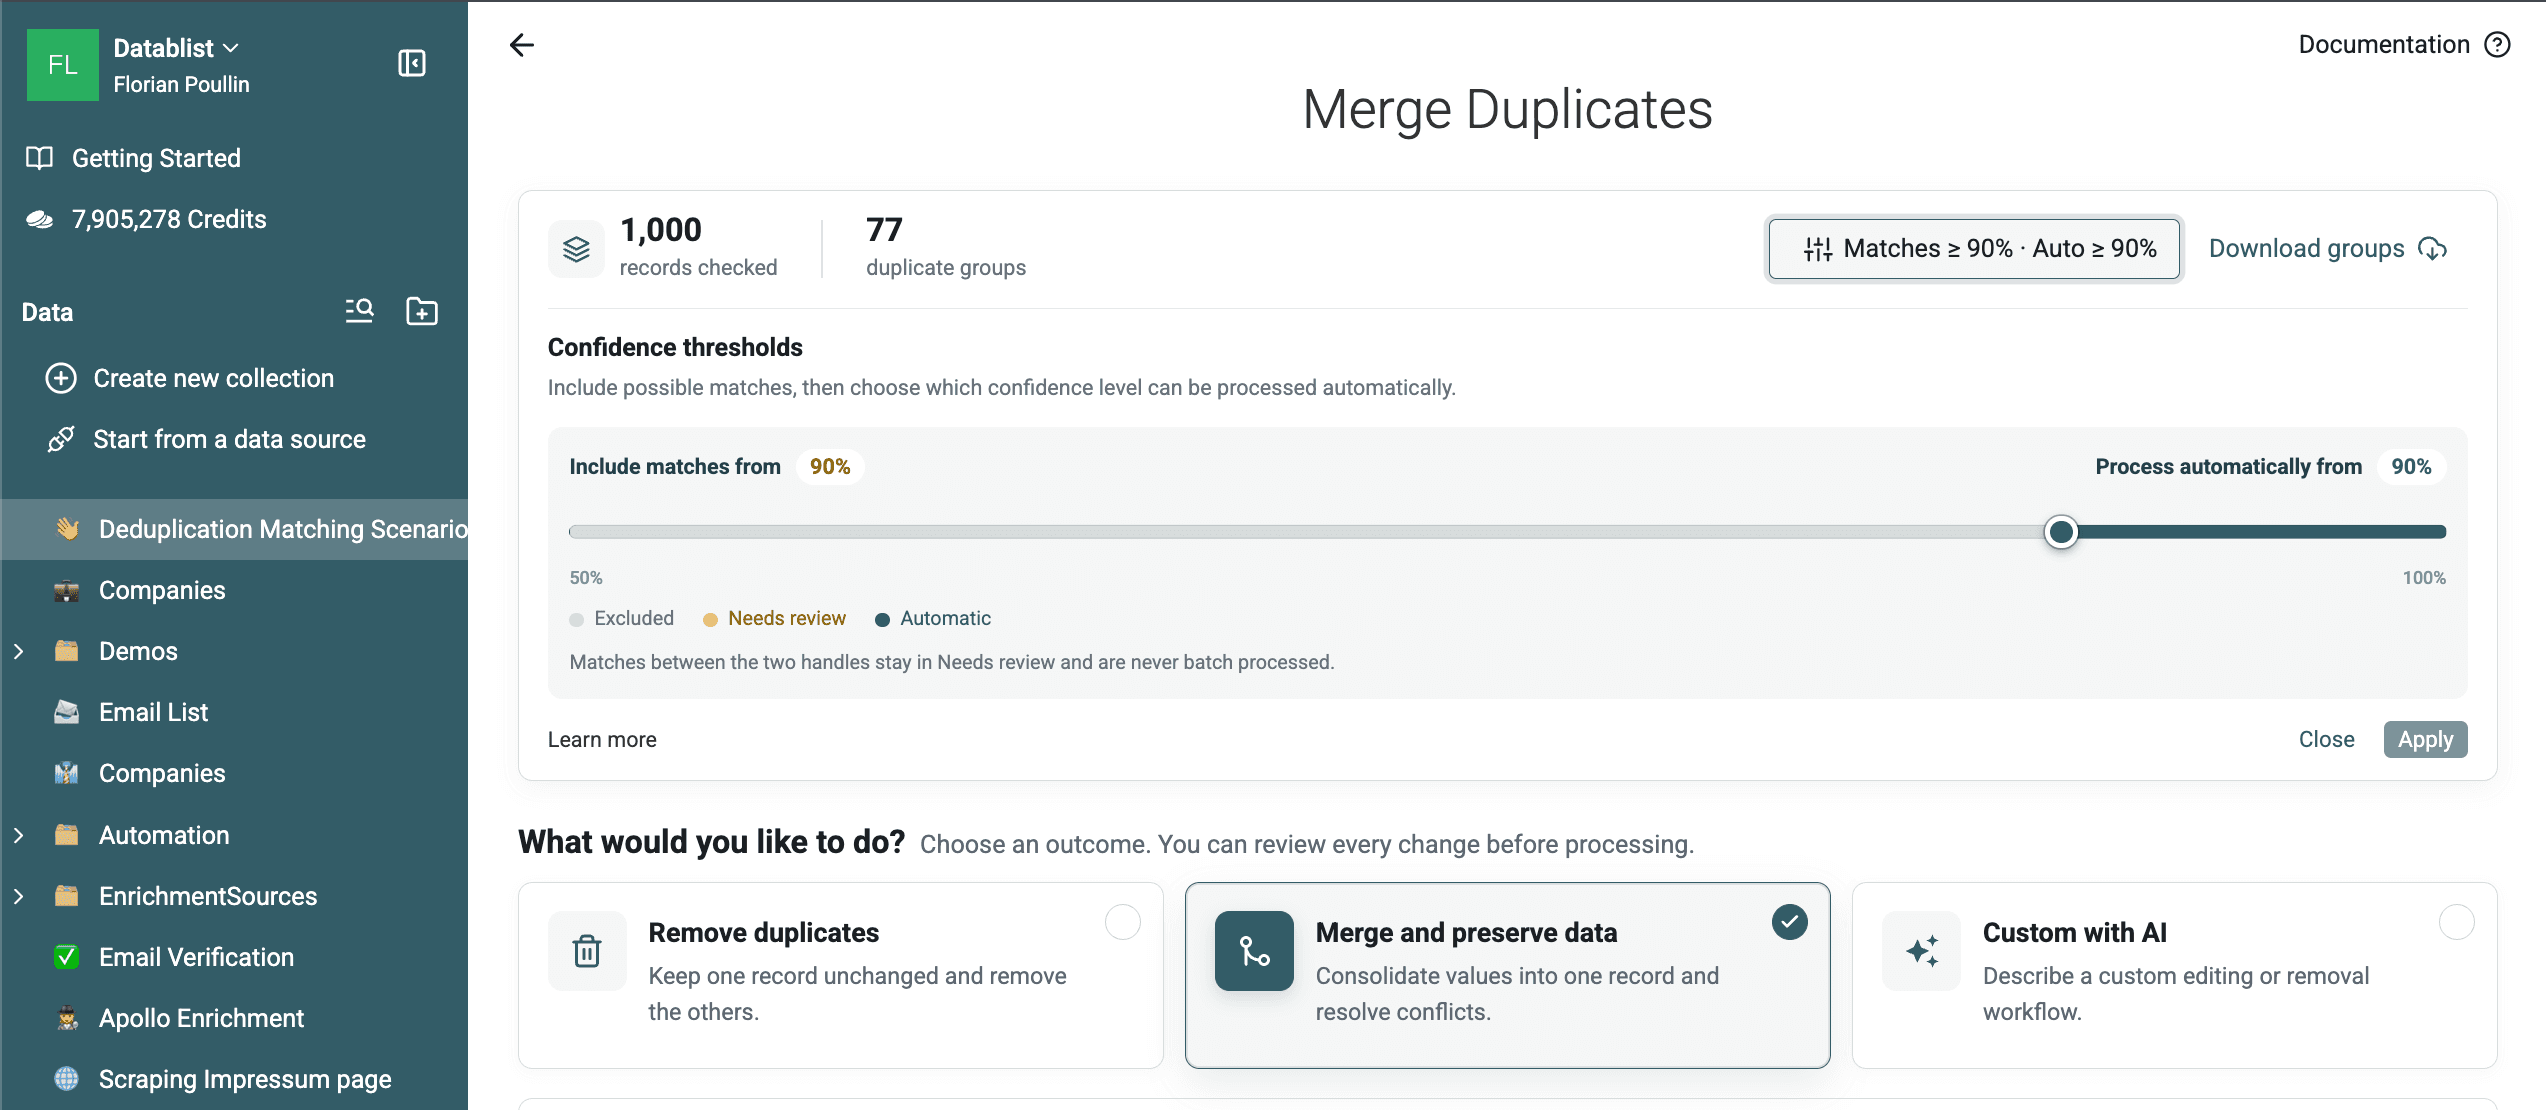
Deze controle leverde 77 groepen van twee rijen op uit het voorbeeldbestand met 1.000 rijen. De ground-truthvalidatie vond 21 groepen met dezelfde vooraf samengestelde entiteit en 56 groepen die verschillende entiteiten koppelden. De meeste false positives waren afgekorte namen zoals G. Rossi, waarbij Full Name alleen onvoldoende is om twee mensen van elkaar te onderscheiden.
De matching vindt bedoelde spellingsvariaties zoals Uma A. Turner en Uman A. Turner, maar laat ook zien waarom je fuzzy matches op alleen een naam moet controleren.
Download de 77 geëxporteerde Levenshtein-groepen om zowel de bruikbare matches als de false positives te bekijken.
Selecteer voor fonetische matching Full Name, kies Metaphone en behoud de Text-processor.
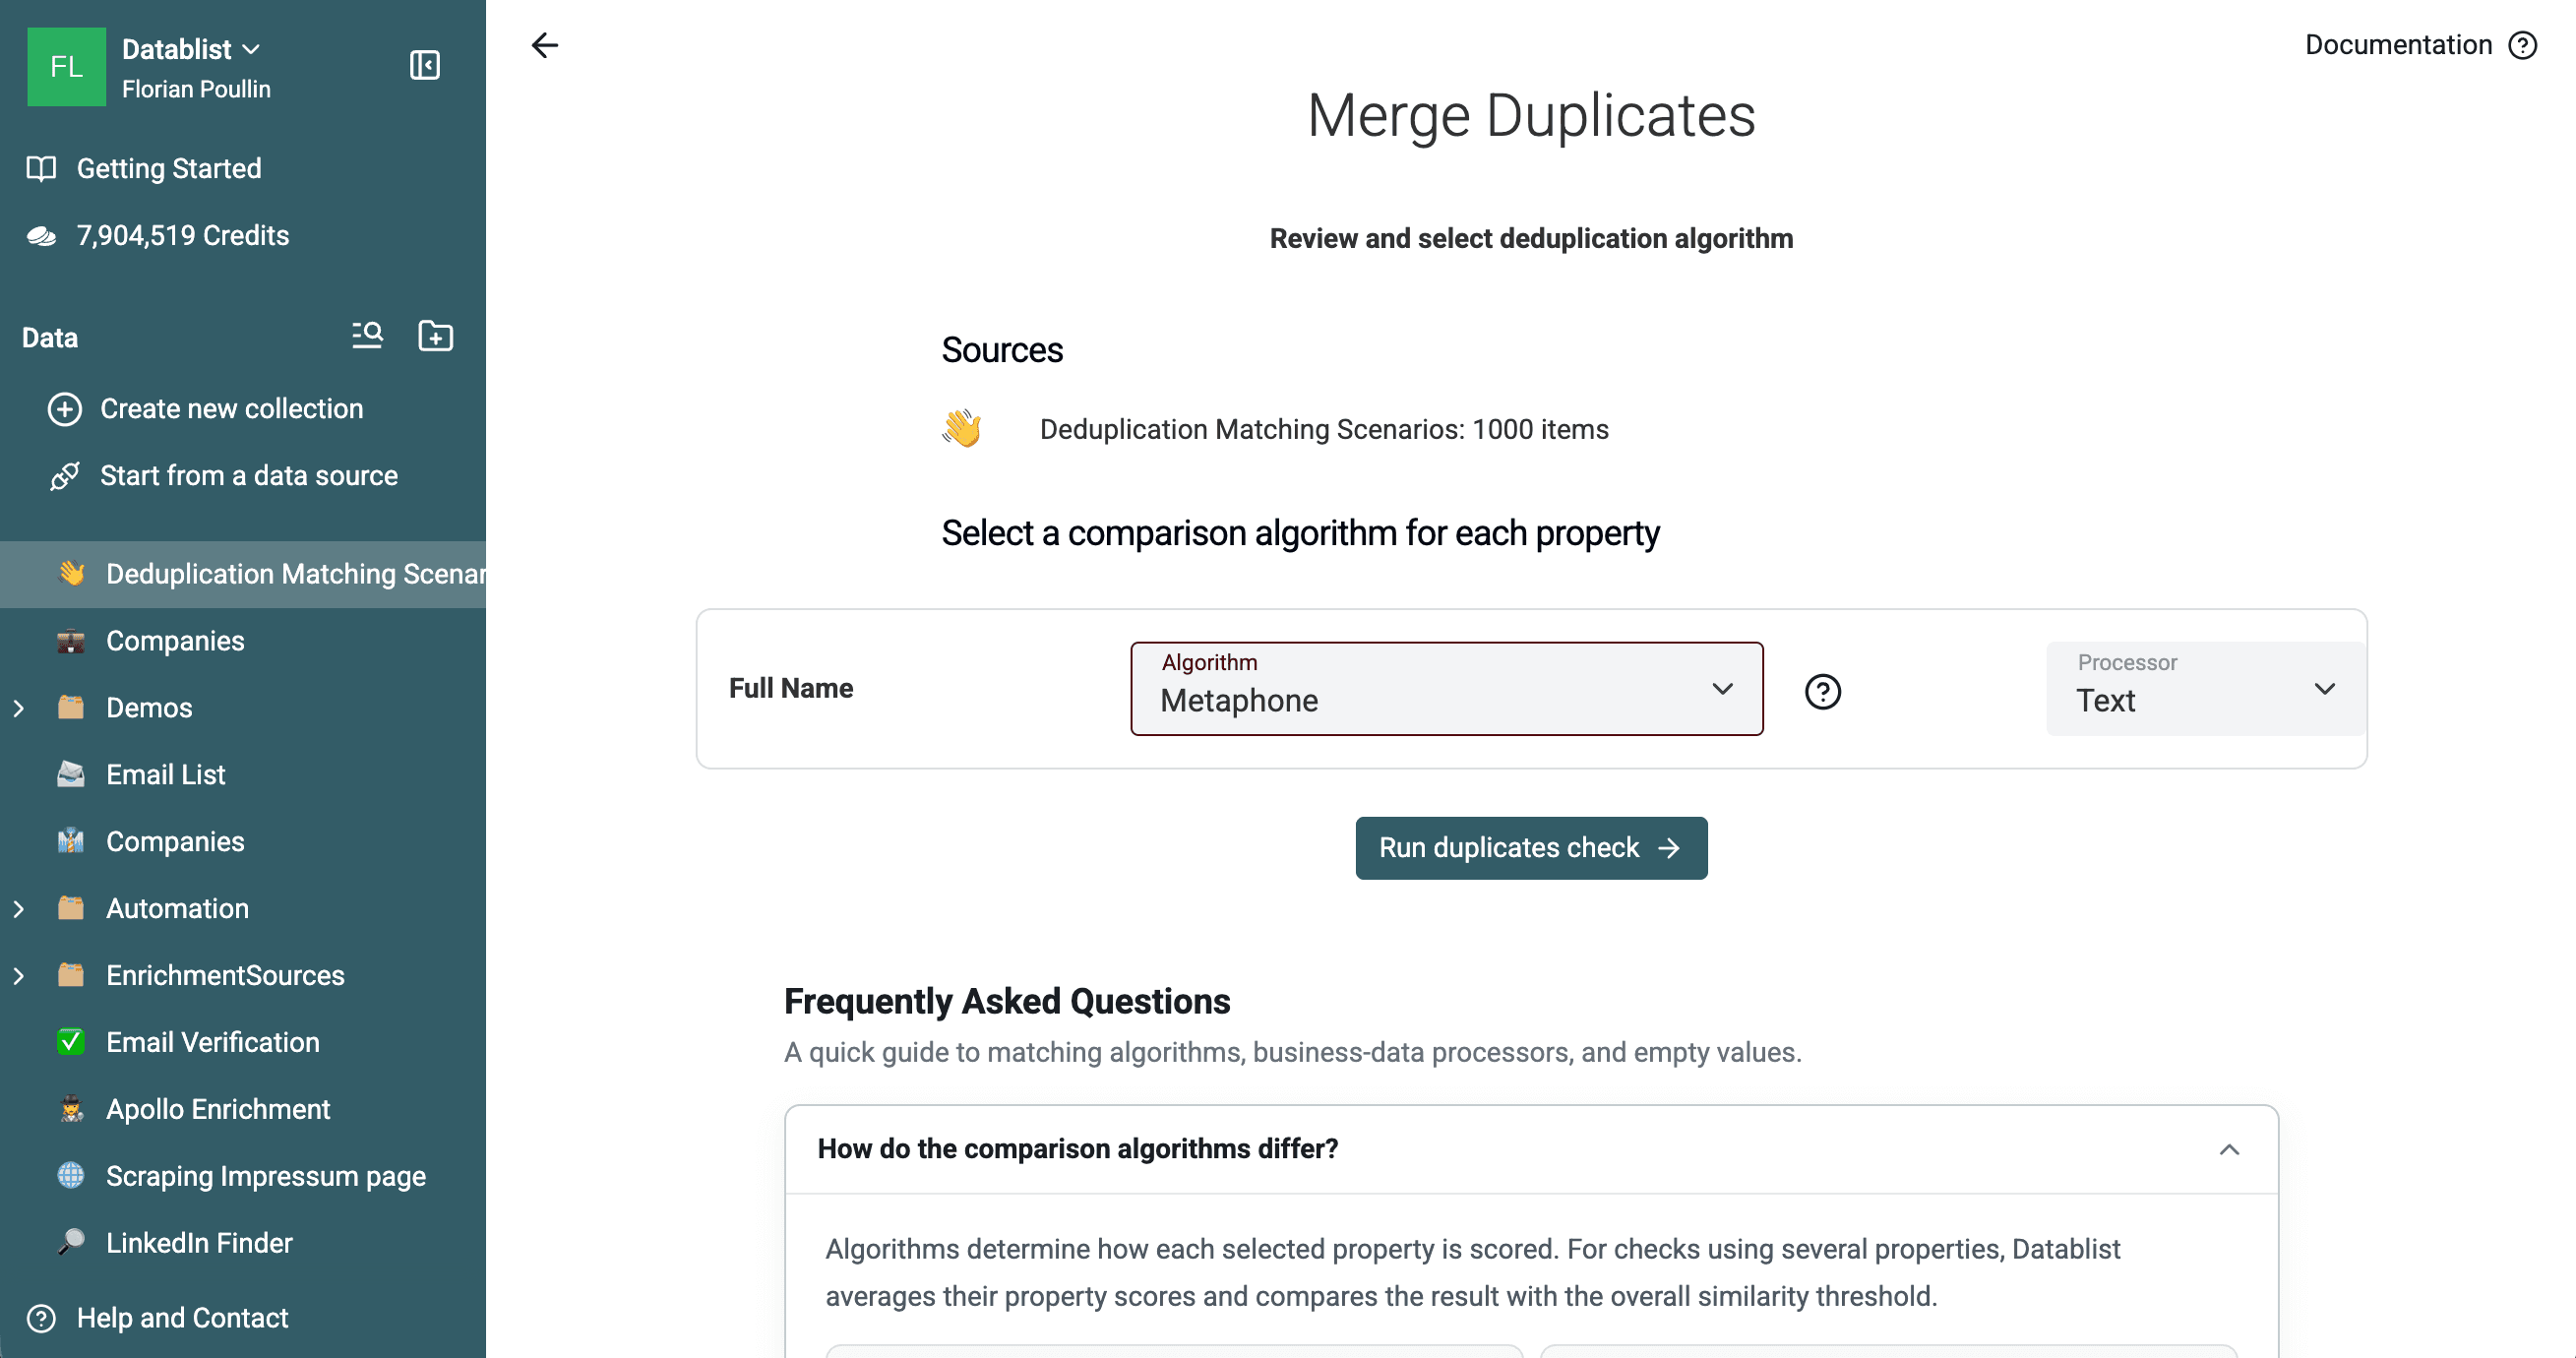
Deze matching toonde 69 groepen: 5 Ready en 64 Needs review. De geëxporteerde groepen bevatten 188 rijen. Uit validatie aan de hand van de bekende entiteiten in het voorbeeldbestand kwamen 19 zuivere groepen met dezelfde entiteit en 50 groepen met verschillende personen. De groepen bevatten twee tot zeven rijen.
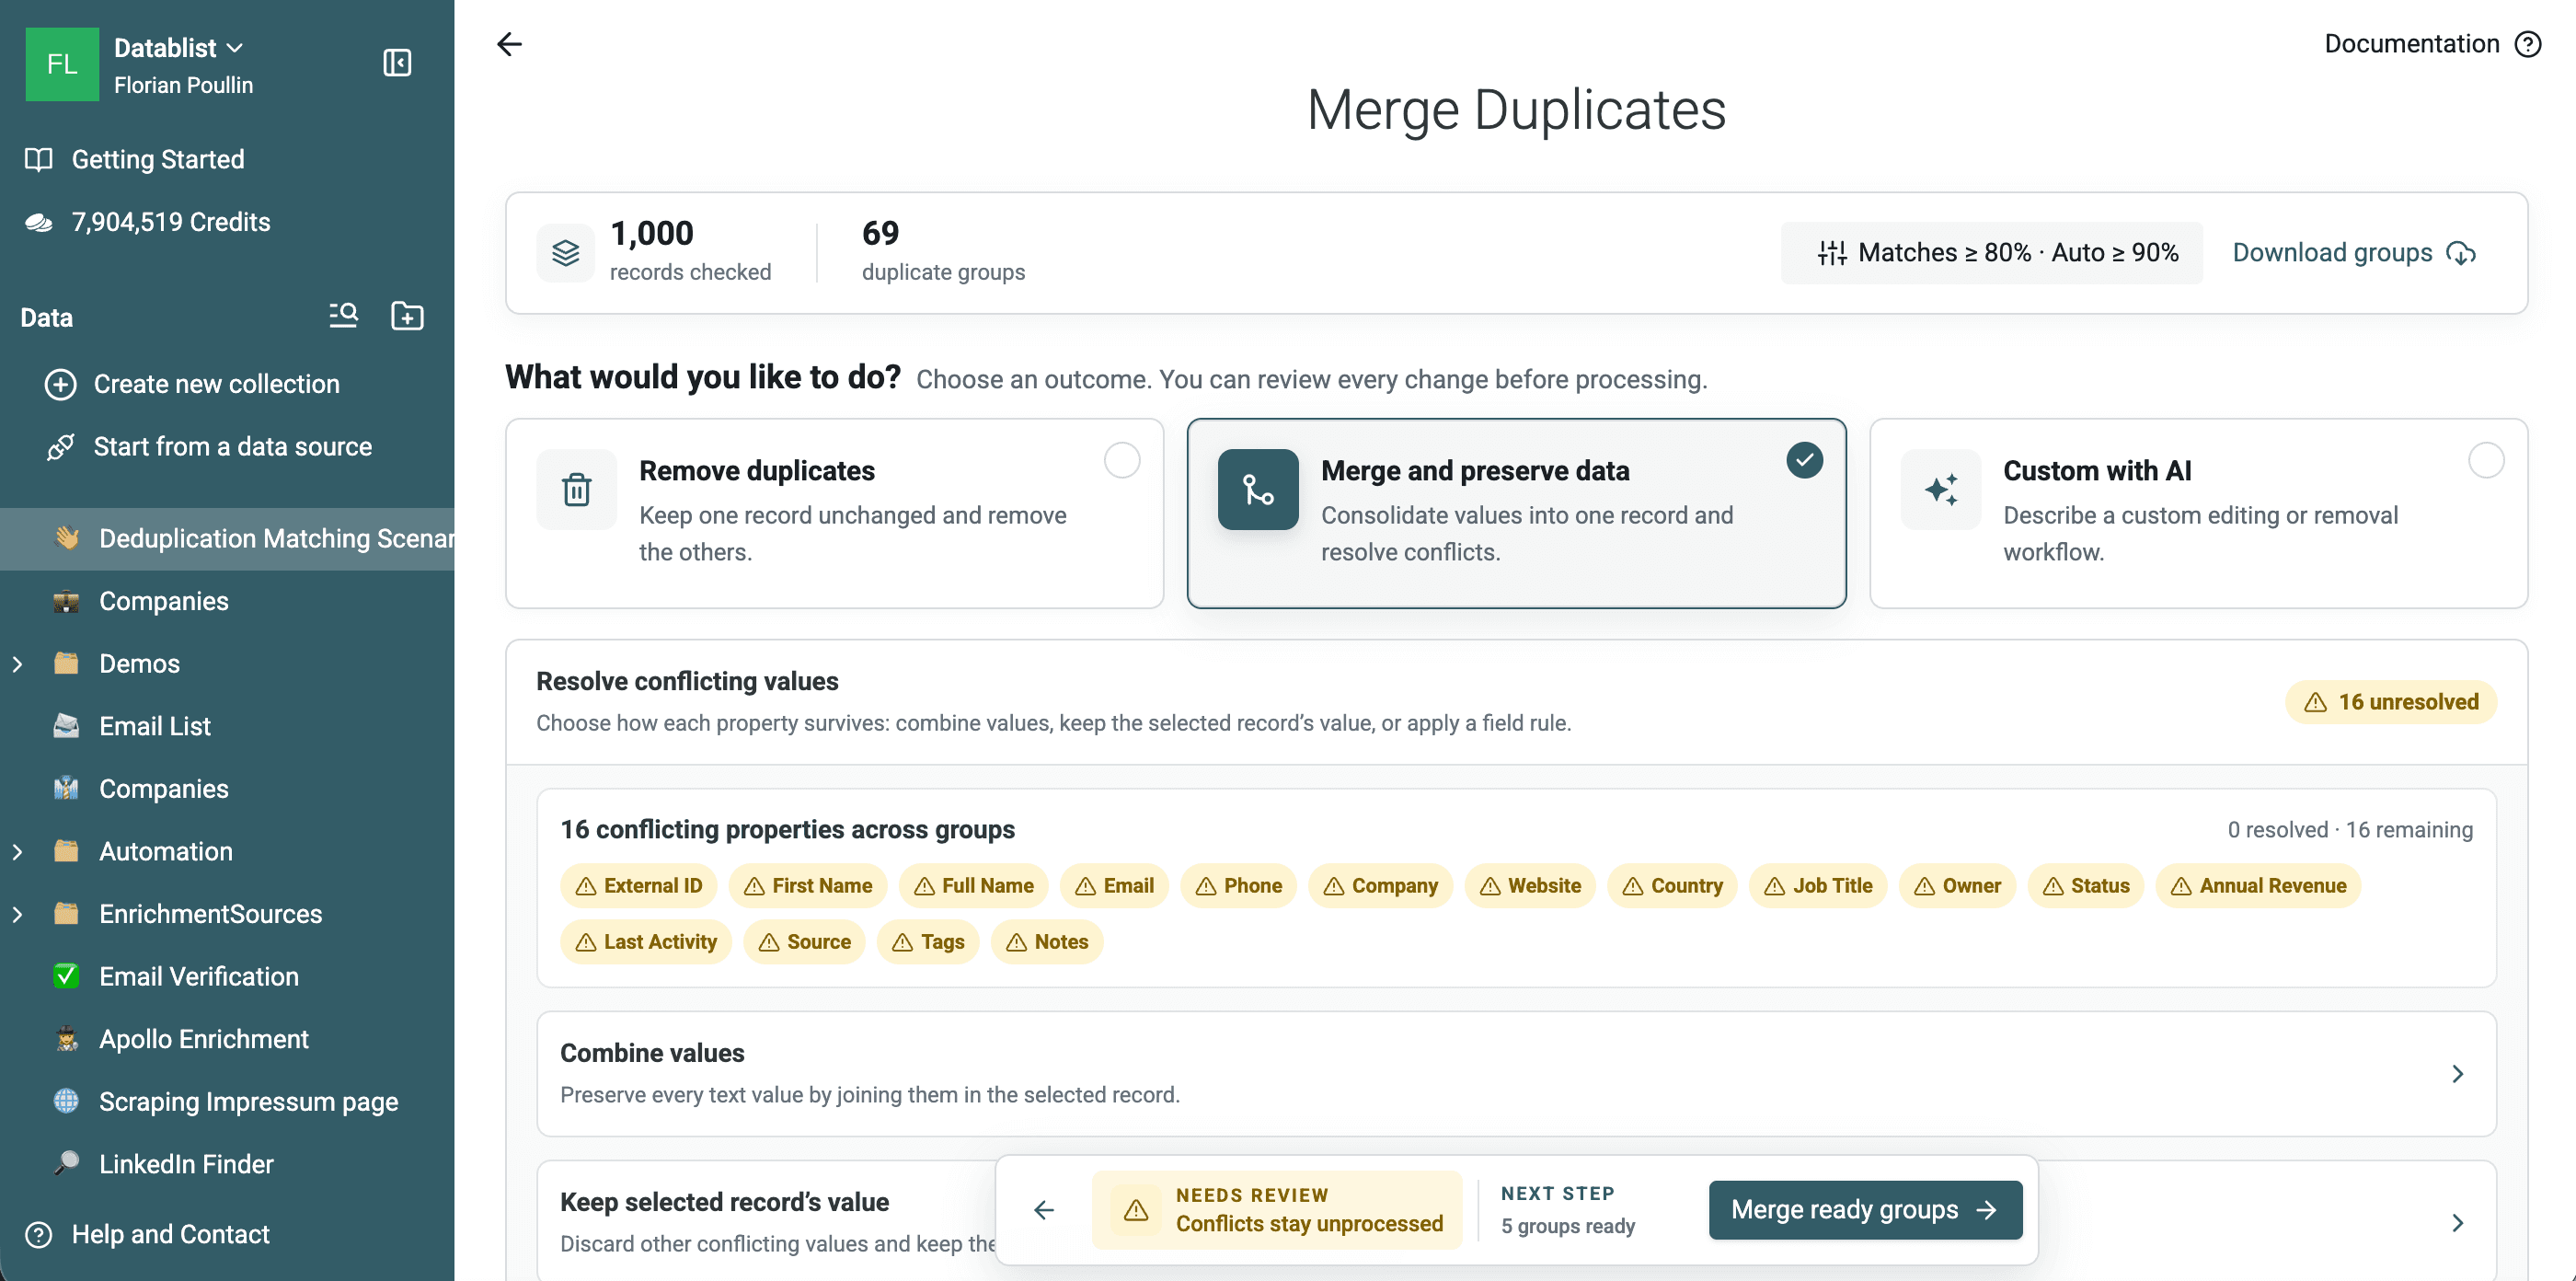
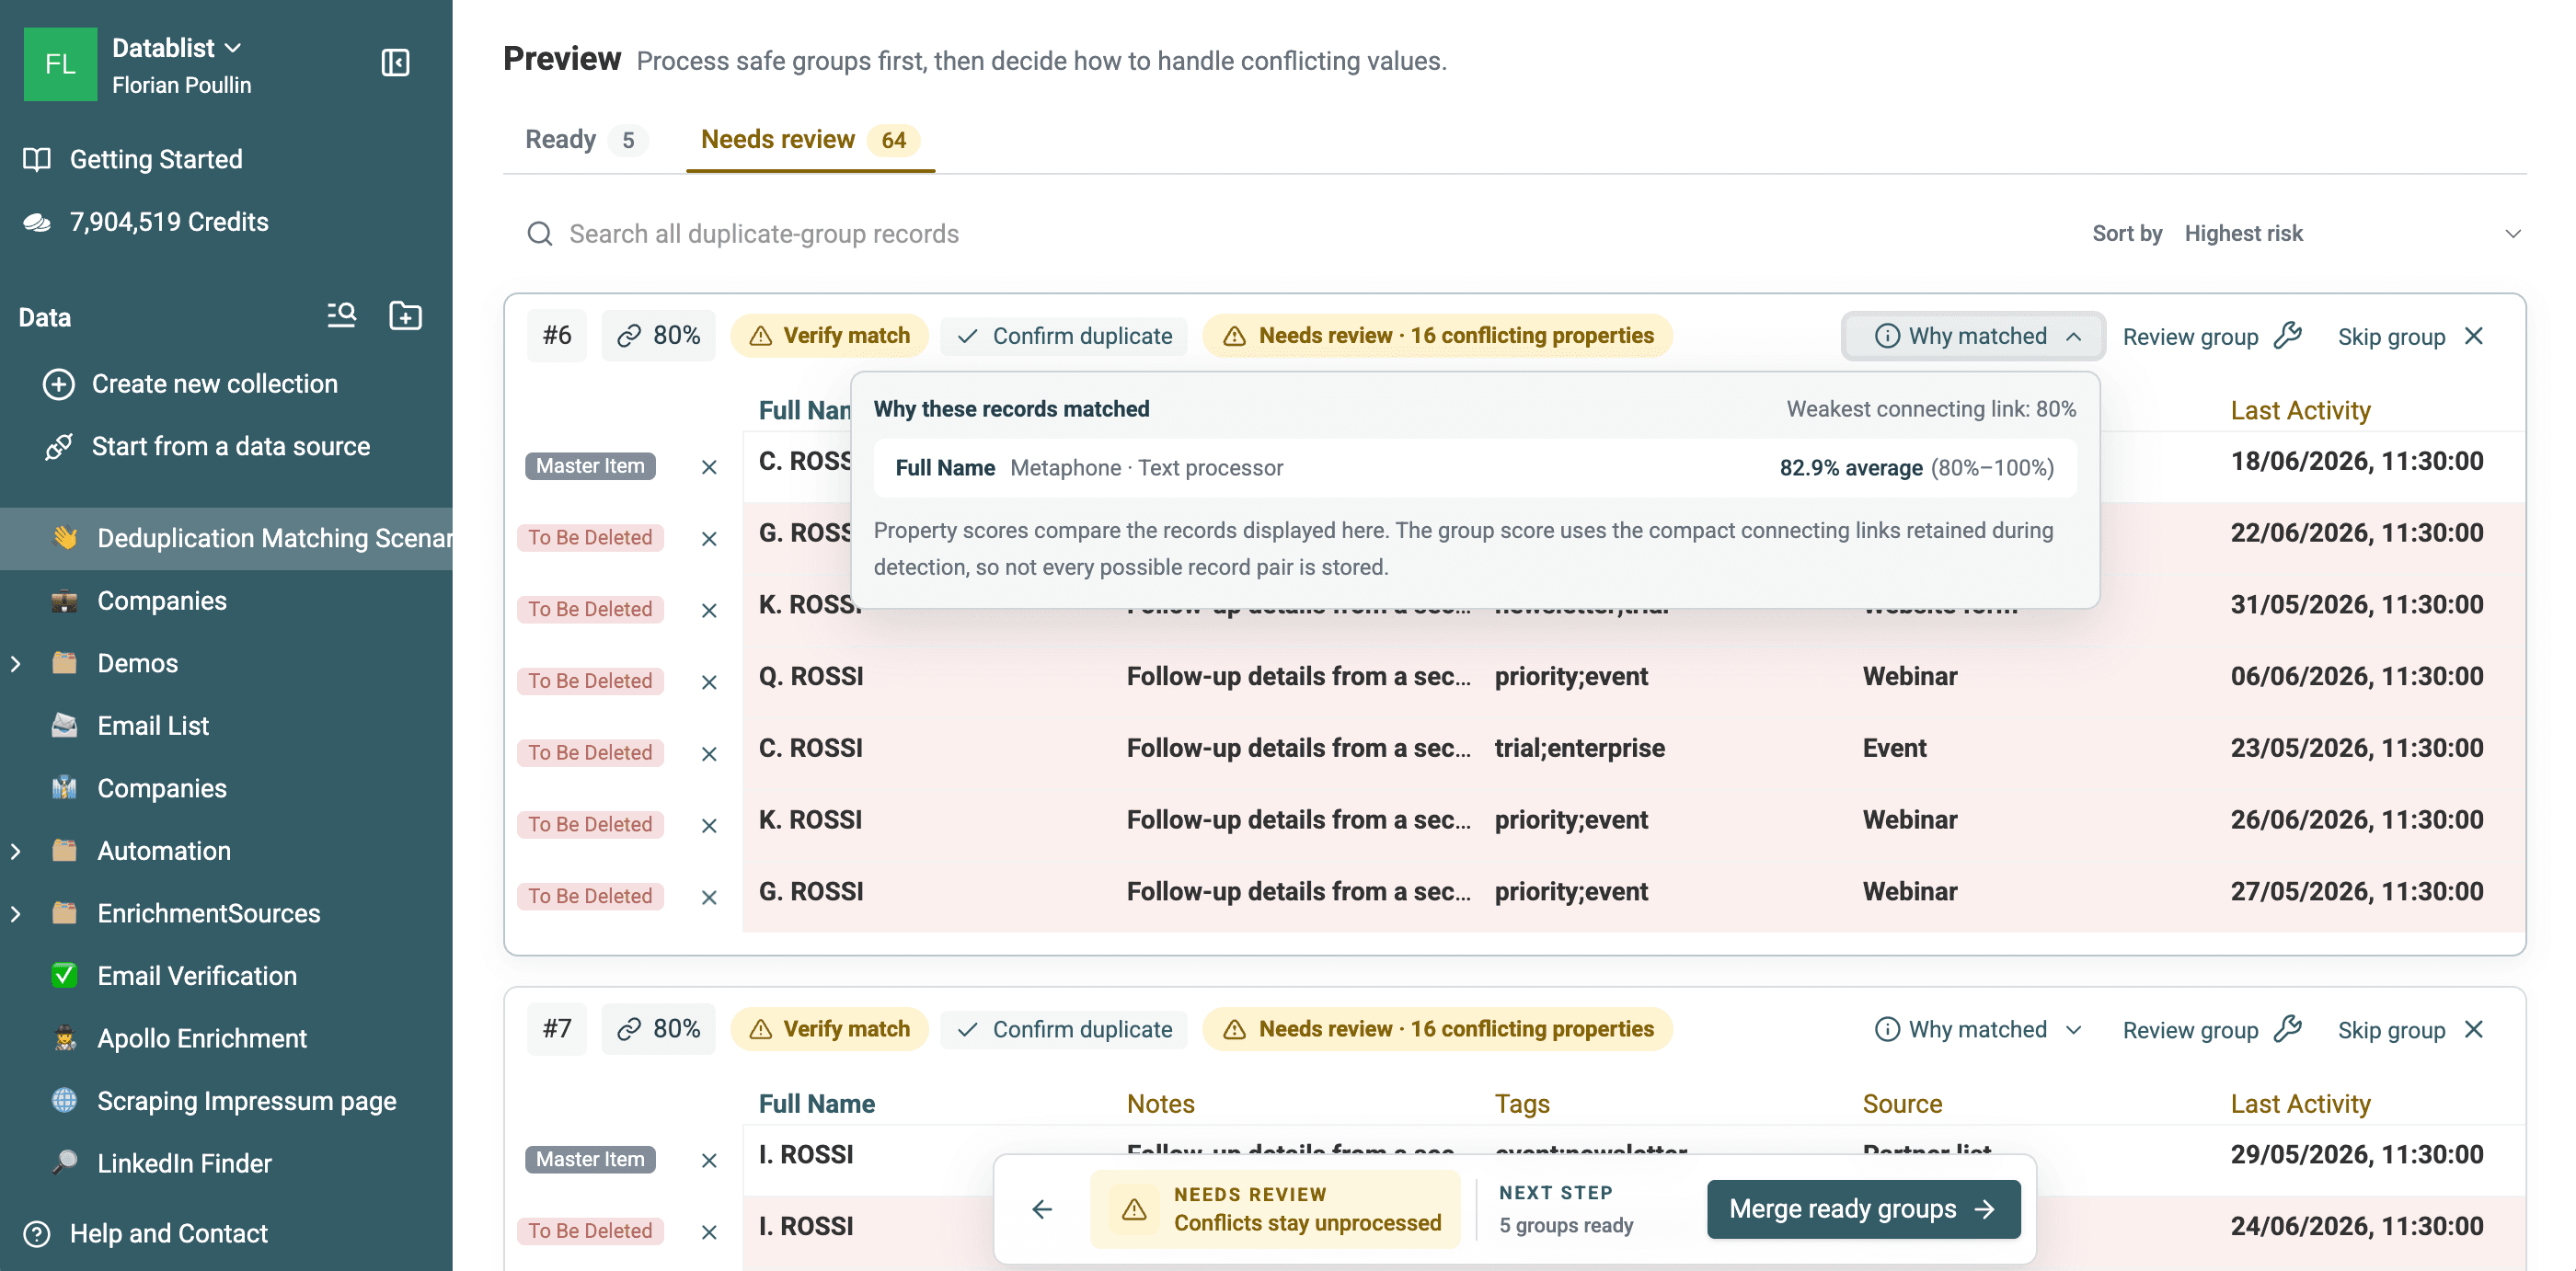
Why matched bevestigt de property Full Name, het Metaphone-algoritme, de Text-processor en de groepsscore. Gebruik deze details om de vergelijking te controleren, niet ter vervanging van een identiteitscontrole.
Download de 69 geëxporteerde Metaphone-groepen om de bruikbare fonetische matches en de false positives te bekijken. De grotere groepen met false positives combineren vaak initialen met een veelvoorkomende achternaam, zoals meerdere afgekorte Rossi-namen. Hun fonetische codes overlappen, maar de namen alleen bieden onvoldoende bewijs voor een automatische merge.
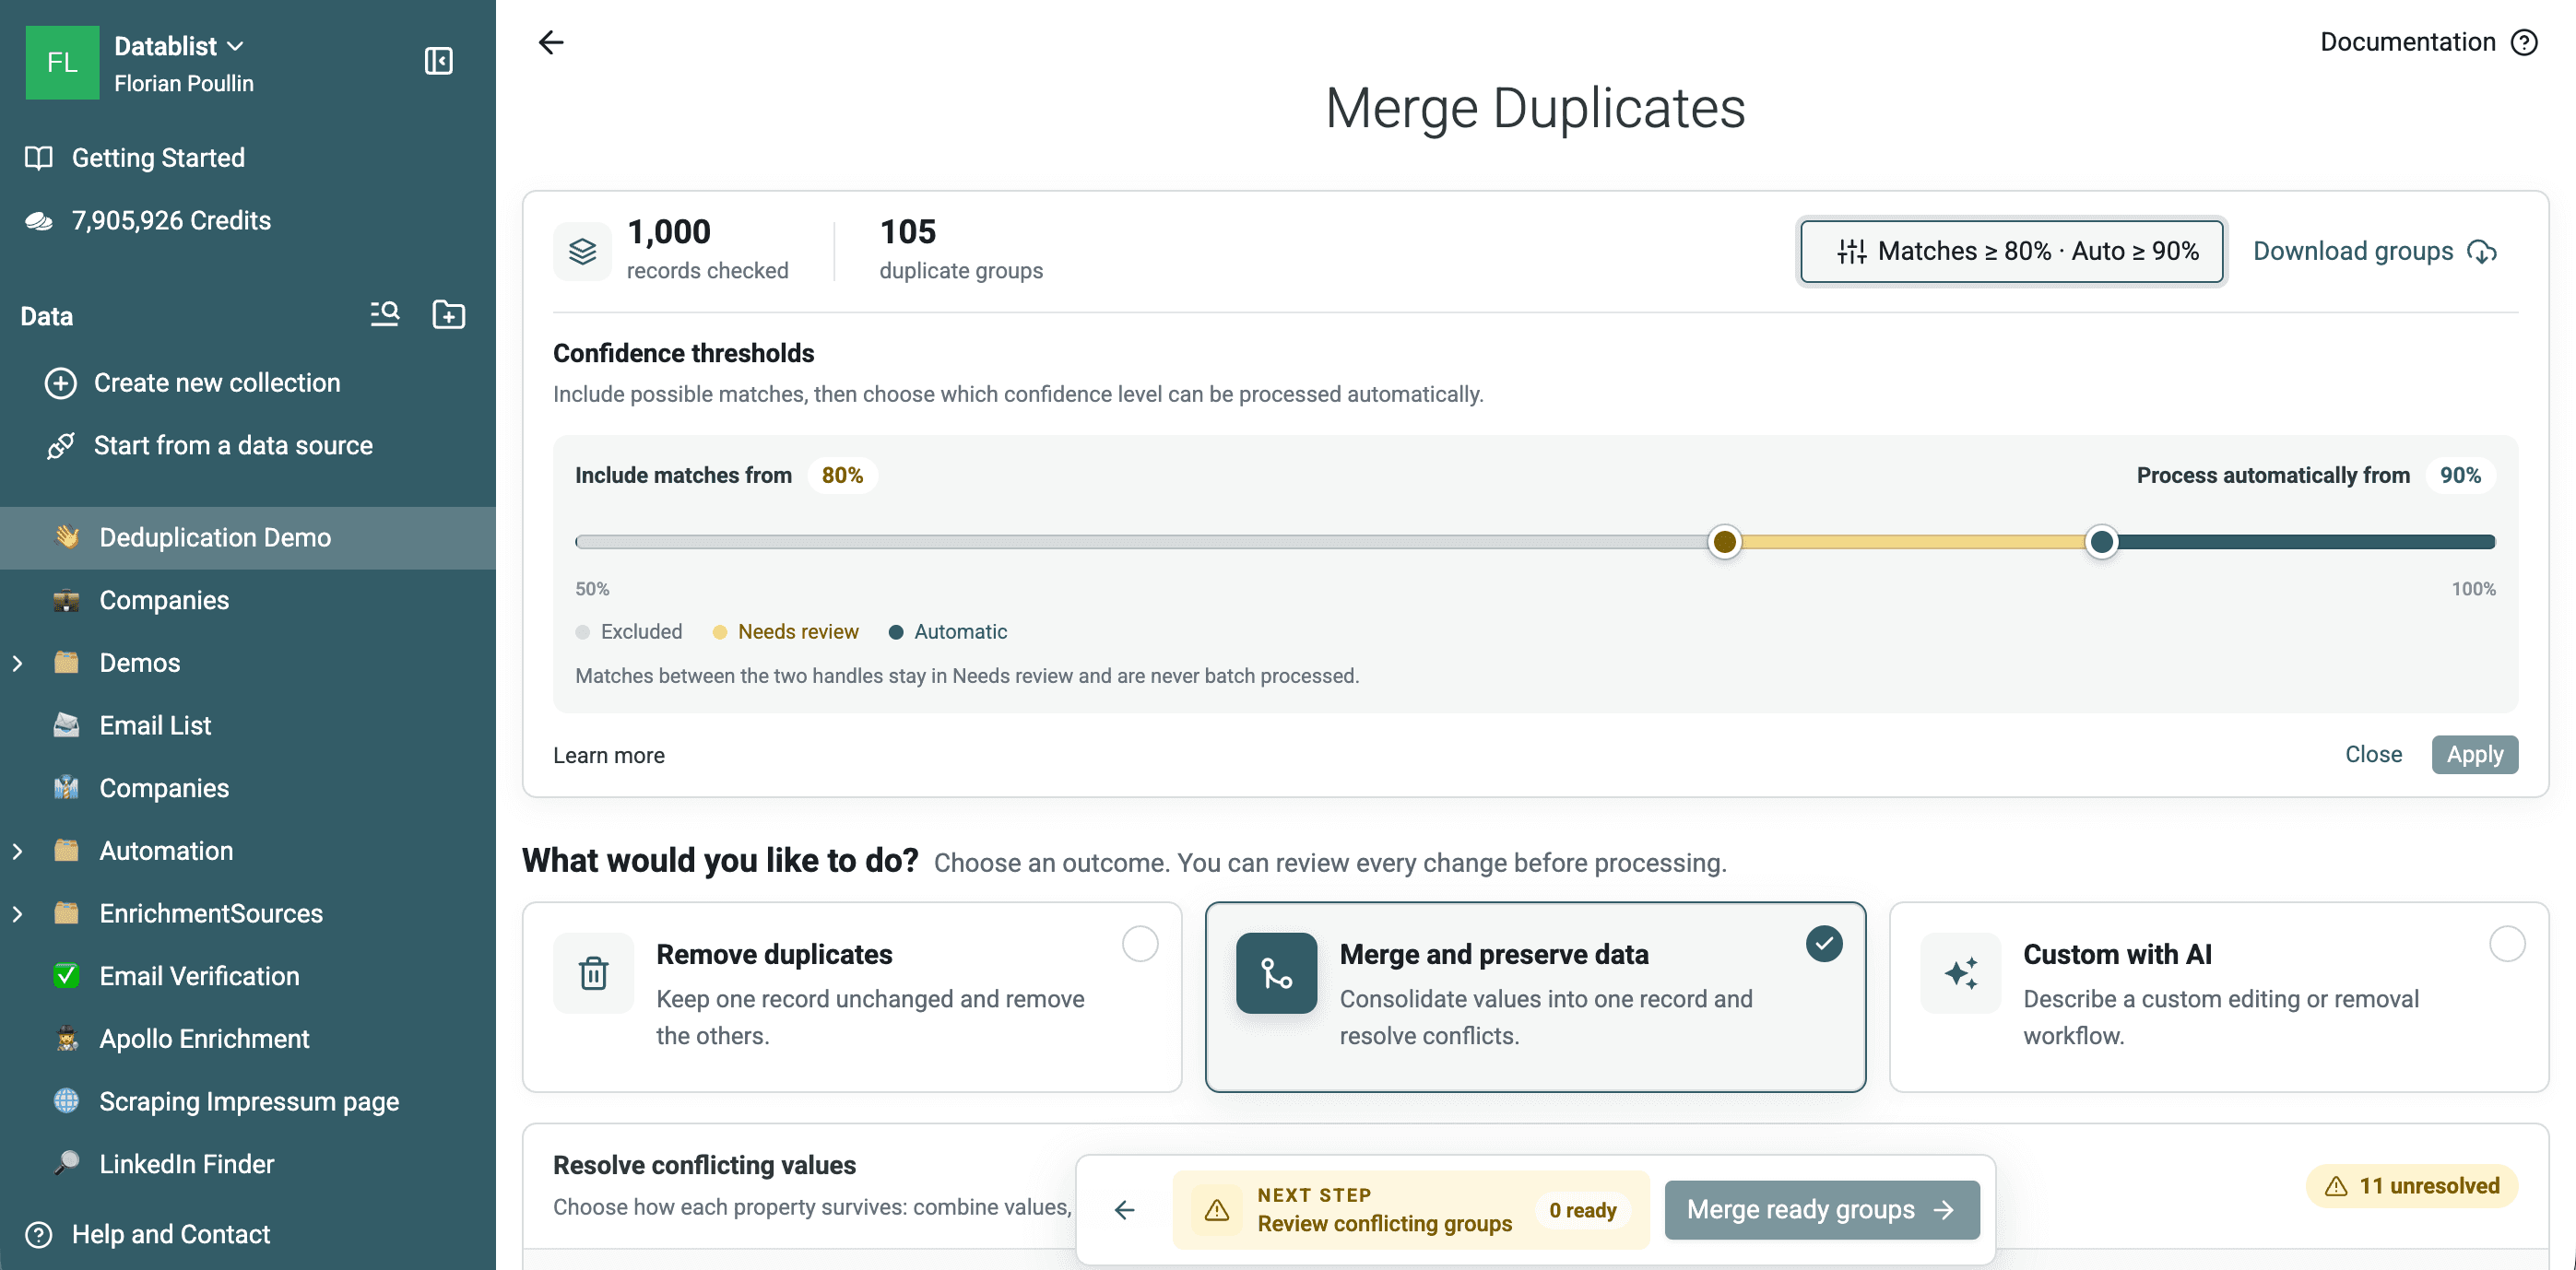
De resultaatpagina bevat twee instellingen:
- Include matches from bepaalt welke groepen worden weergegeven.
- Process automatically from houdt groepen met een lagere betrouwbaarheid in Needs review en sluit ze uit van batchverwerking.
Dankzij deze scheiding kun je een brede selectie kandidaten controleren zonder op alle groepen dezelfde automatiseringsregel toe te passen.
Controleer de groepen met duplicaten
De resultaatomgeving verdeelt groepen met duplicaten over Ready en Needs review.
- Ready-groepen hebben een concreet verwerkingsresultaat en voldoen aan de automatische betrouwbaarheidsdrempel.
- Needs review-groepen hebben een lagere betrouwbaarheid, onopgeloste merge-conflicten, een selectieregel die geen record vindt of een custom regel waardoor ze zijn overgeslagen.
Controleer voor elke onzekere groep:
- Vertegenwoordigt elke rij dezelfde persoon, hetzelfde bedrijf of hetzelfde product?
- Welke identifier veroorzaakte de match?
- Vullen bepaalde waarden elkaar aan?
- Welke bron is leidend?
- Zou je door een rij te verwijderen een telefoonnummer, ID, status, datum of notitie verliezen?
- Is de groep via een zwak derde record met elkaar verbonden?
Gebruik Why matched om de gebruikte properties, algoritmen, processors en scoreranges te bekijken. Bij fuzzy controles is de overeenkomstscore van de groep gebaseerd op de zwakste behouden verbinding die nodig is om de groep bij elkaar te houden.
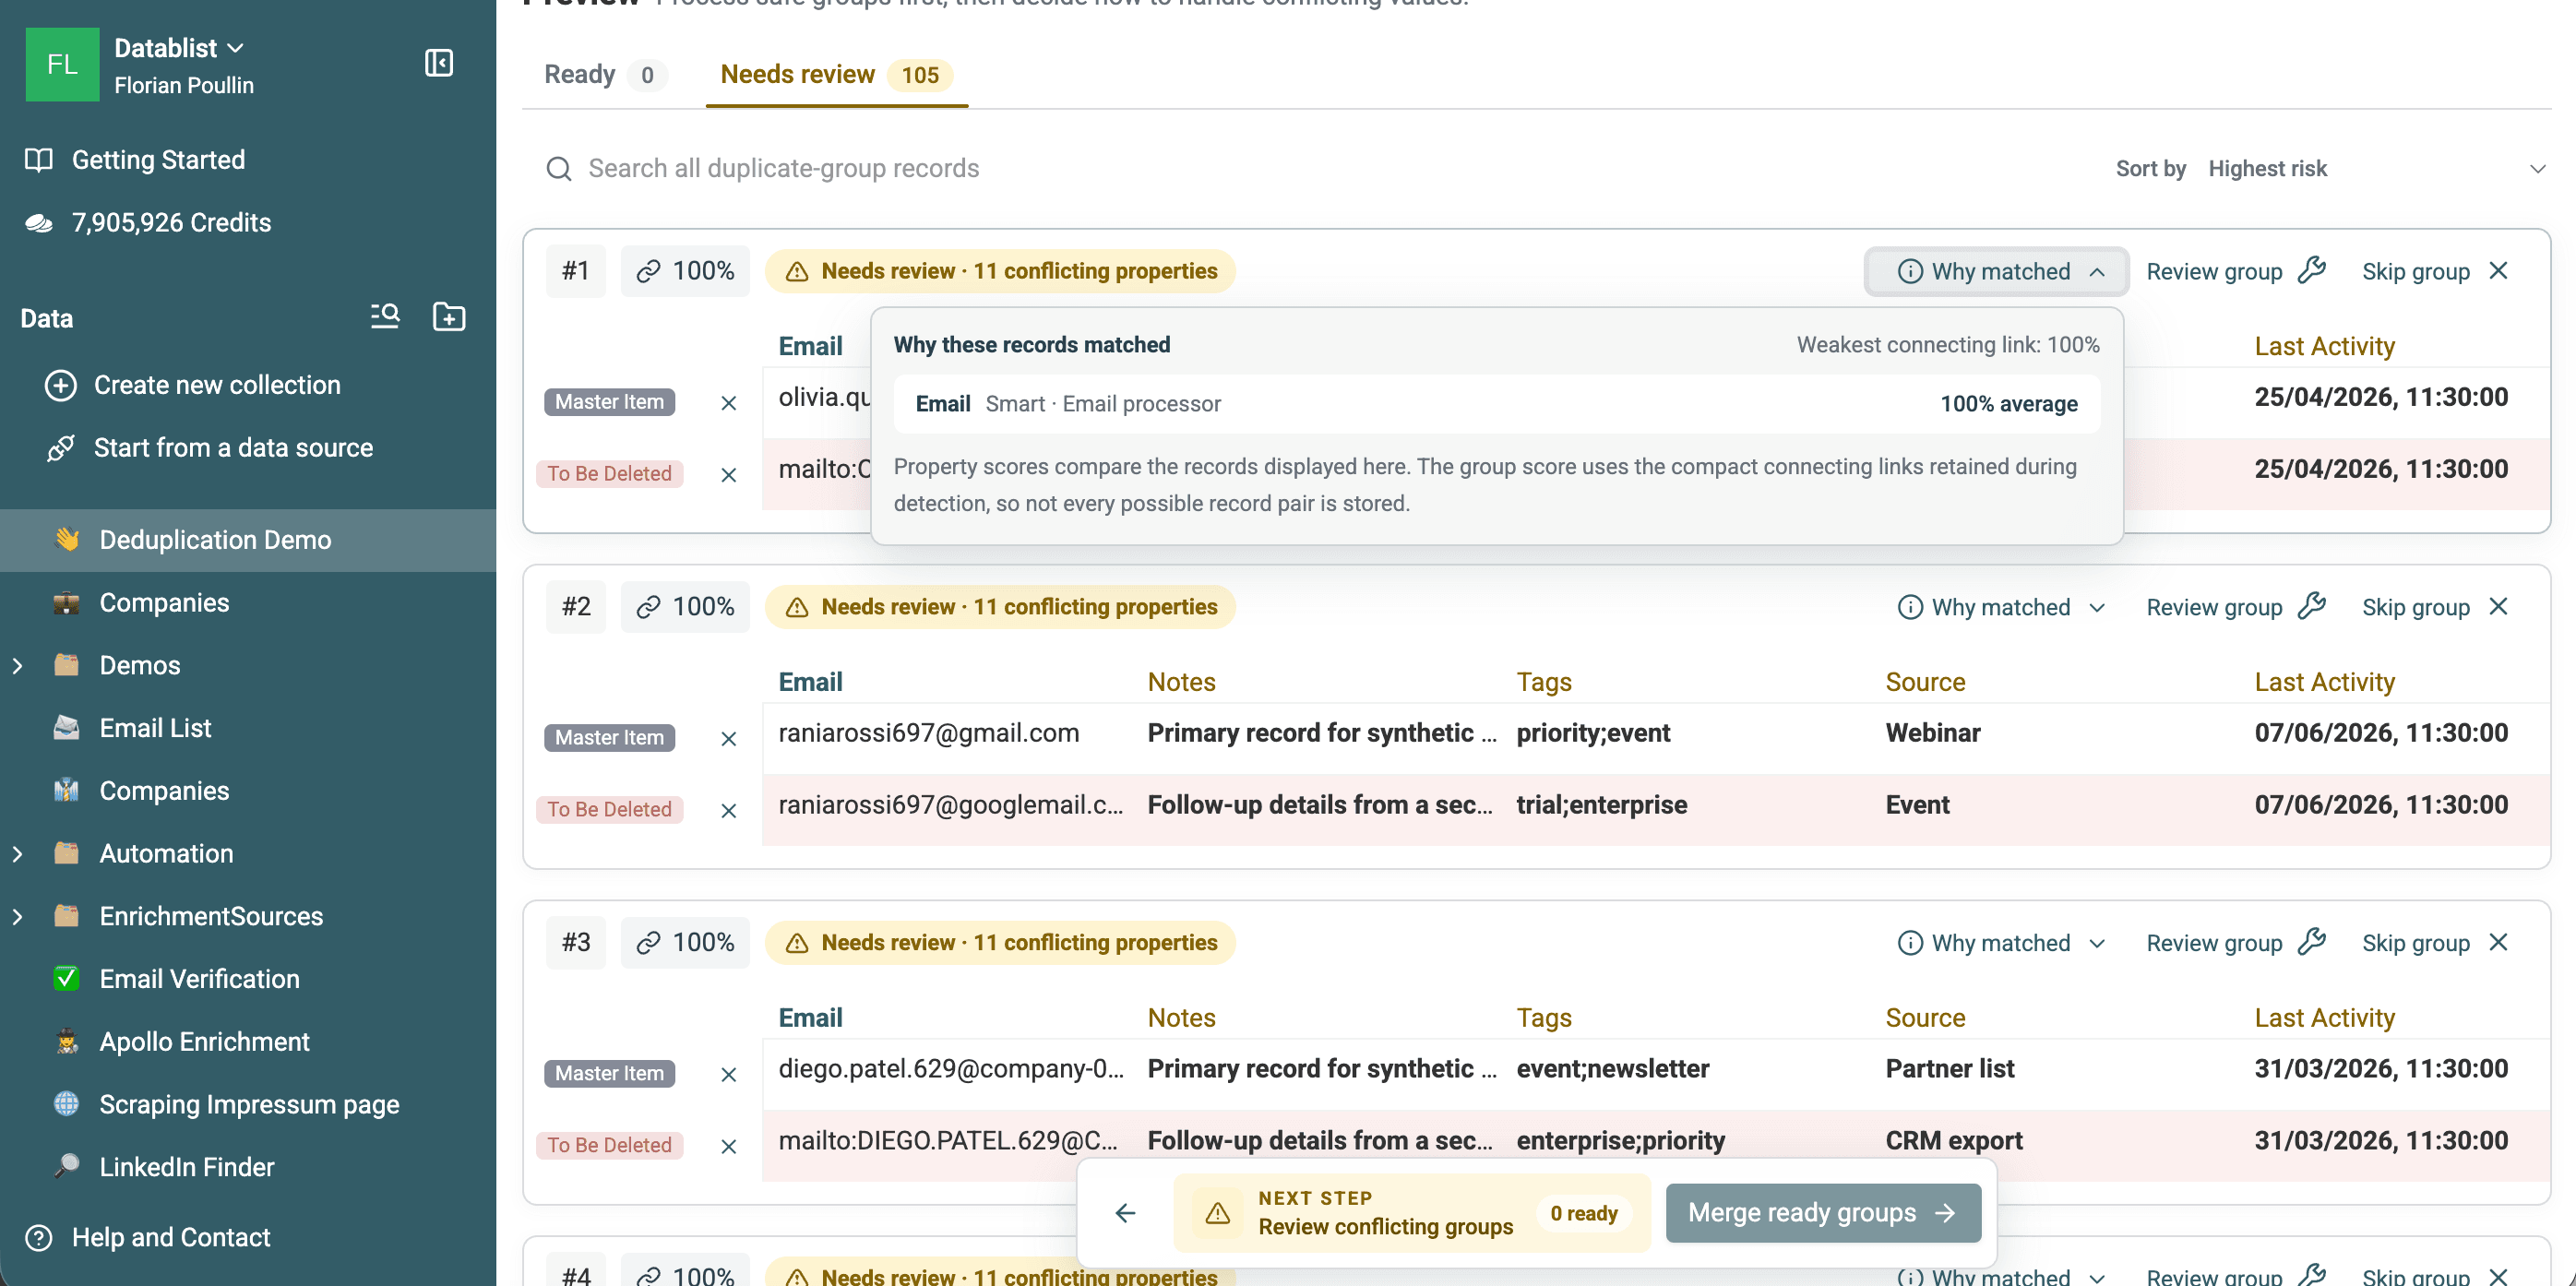
Je kunt ook:
- Een match met lage betrouwbaarheid bevestigen.
- Eén record uit een groep verwijderen zonder het record te wissen.
- De groep overslaan.
- Een record openen en bewerken.
- De groep controleren in de Merging Assistant.
- Alle resterende groepen doorzoeken en de riskantste kandidaten bovenaan zetten.
⚠️ Verwerk een fuzzy groep nooit alleen op basis van het percentage
Vergelijkbare namen kunnen bij verschillende mensen horen. Controleer de identifiers en omliggende velden voordat je de groep bevestigt.
Controleer gedeelde en ontbrekende identifiers
Een algemeen e-mailadres zoals info@company.example kan bij meerdere contactpersonen horen. Twee mensen met dat adres kunnen op Email matchen en toch verschillende personen zijn. Ook kan een bedrijfsdomein één bedrijf identificeren, terwijl het in de records van veel medewerkers voorkomt.
Ik zou zulke groepen niet automatisch op persoonsniveau samenvoegen totdat een andere identifier de match ondersteunt. Wil je juist één rij per bedrijf, dan kan het gedeelde domein wél de bedoelde groeperingssleutel zijn. Bepaal dus eerst de entiteit en interpreteer daarna het resultaat.
De regel voor lege waarden beïnvloedt ook een vergelijking op geselecteerde properties. Bij een controle van meerdere properties met een andere vergelijking dan Exact biedt de geavanceerde instelling Empty Value Rule de opties Value required (default) en Match on empty value. De standaardinstelling vereist dat de tekstidentifier aanwezig is; matches op lege waarden toestaan versoepelt die voorwaarde. Gebruik dit alleen wanneer de andere matchende velden voldoende bewijs voor dezelfde identiteit bieden. Twee ontbrekende e-mailadressen zijn geen bewijs dat twee mensen dezelfde persoon zijn.
Twee rijen met een leeg Email-veld en verschillende waarden voor Full Name mogen bijvoorbeeld niet worden samengevoegd alleen om het aantal rijen te verlagen. Een rij zonder e-mailadres kan nog steeds een contactpersoon bevatten die je wilt bewaren of later wilt verrijken.
Duplicaten verwijderen, mergen of custom verwerken
Duplicaten vinden en duplicaten oplossen zijn twee afzonderlijke beslissingen. Kies pas na controle van de secundaire rijen hoe je ze wilt verwerken.
Verwijder duplicaten bij één leidend record
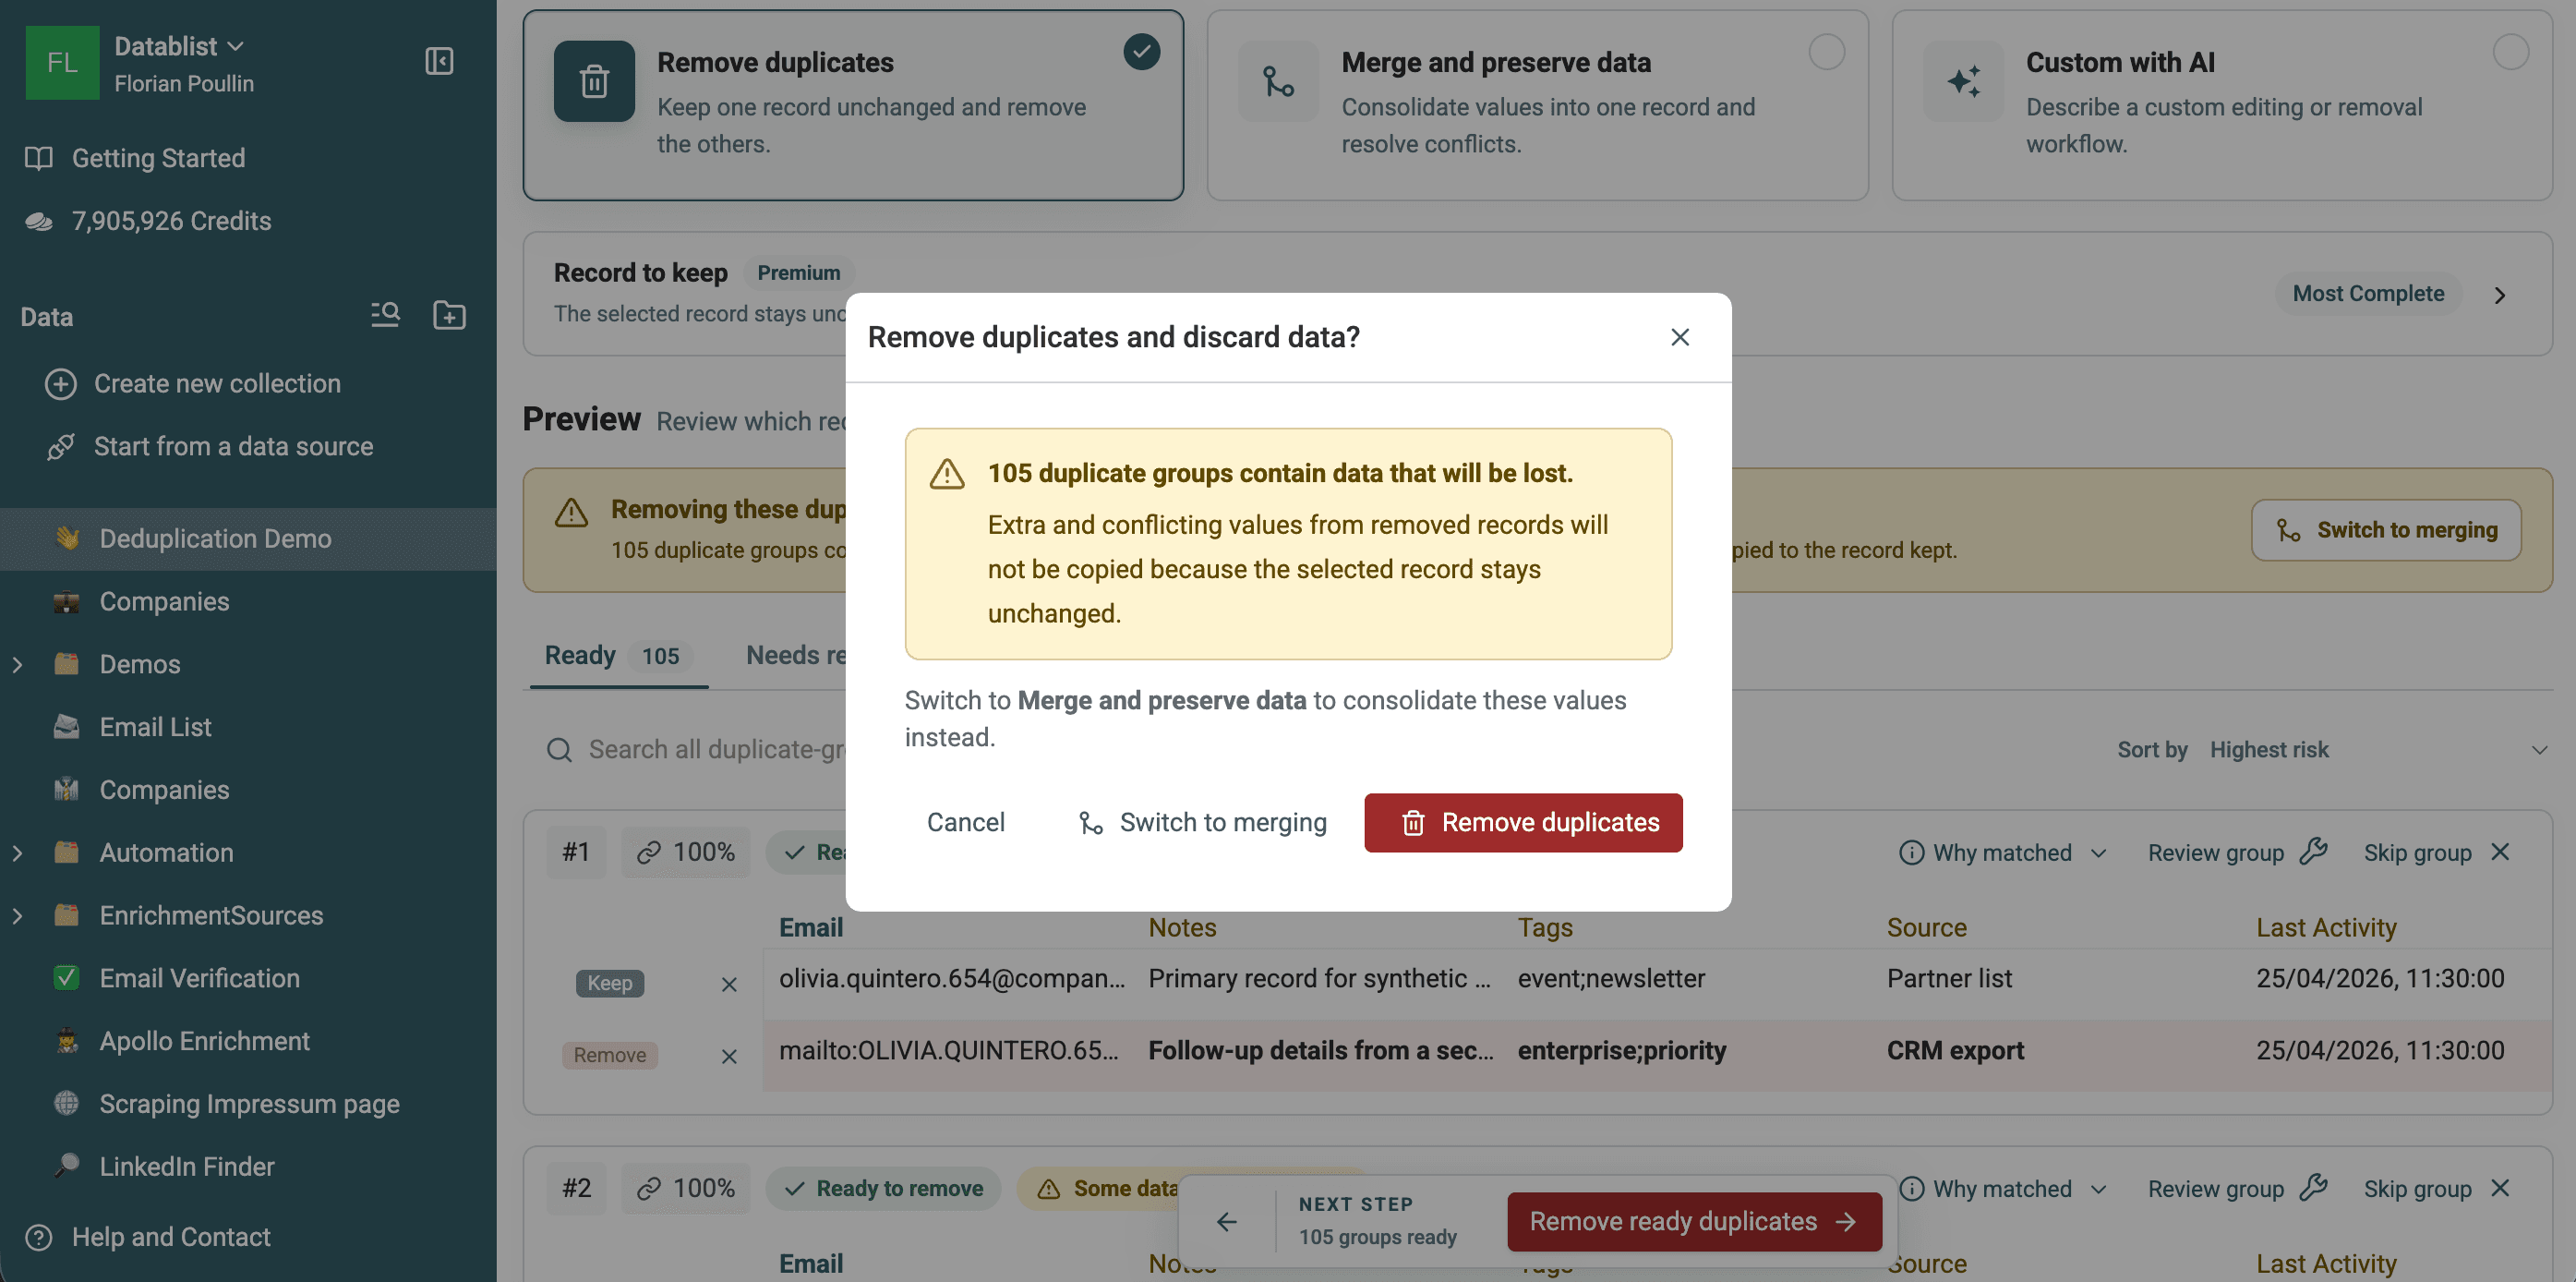
Remove duplicates bewaart één geselecteerd record zonder wijzigingen en verwijdert de andere rijen uit elke Ready-groep.
Gebruik dit voor gekopieerde rijen, tijdelijke imports of records waarvan je de secundaire waarden kunt missen. De preview waarschuwt als de te verwijderen records aanvullende of conflicterende informatie bevatten. Deze waarden worden niet naar de behouden rij gekopieerd.
Merge rijen met waardevolle gegevens
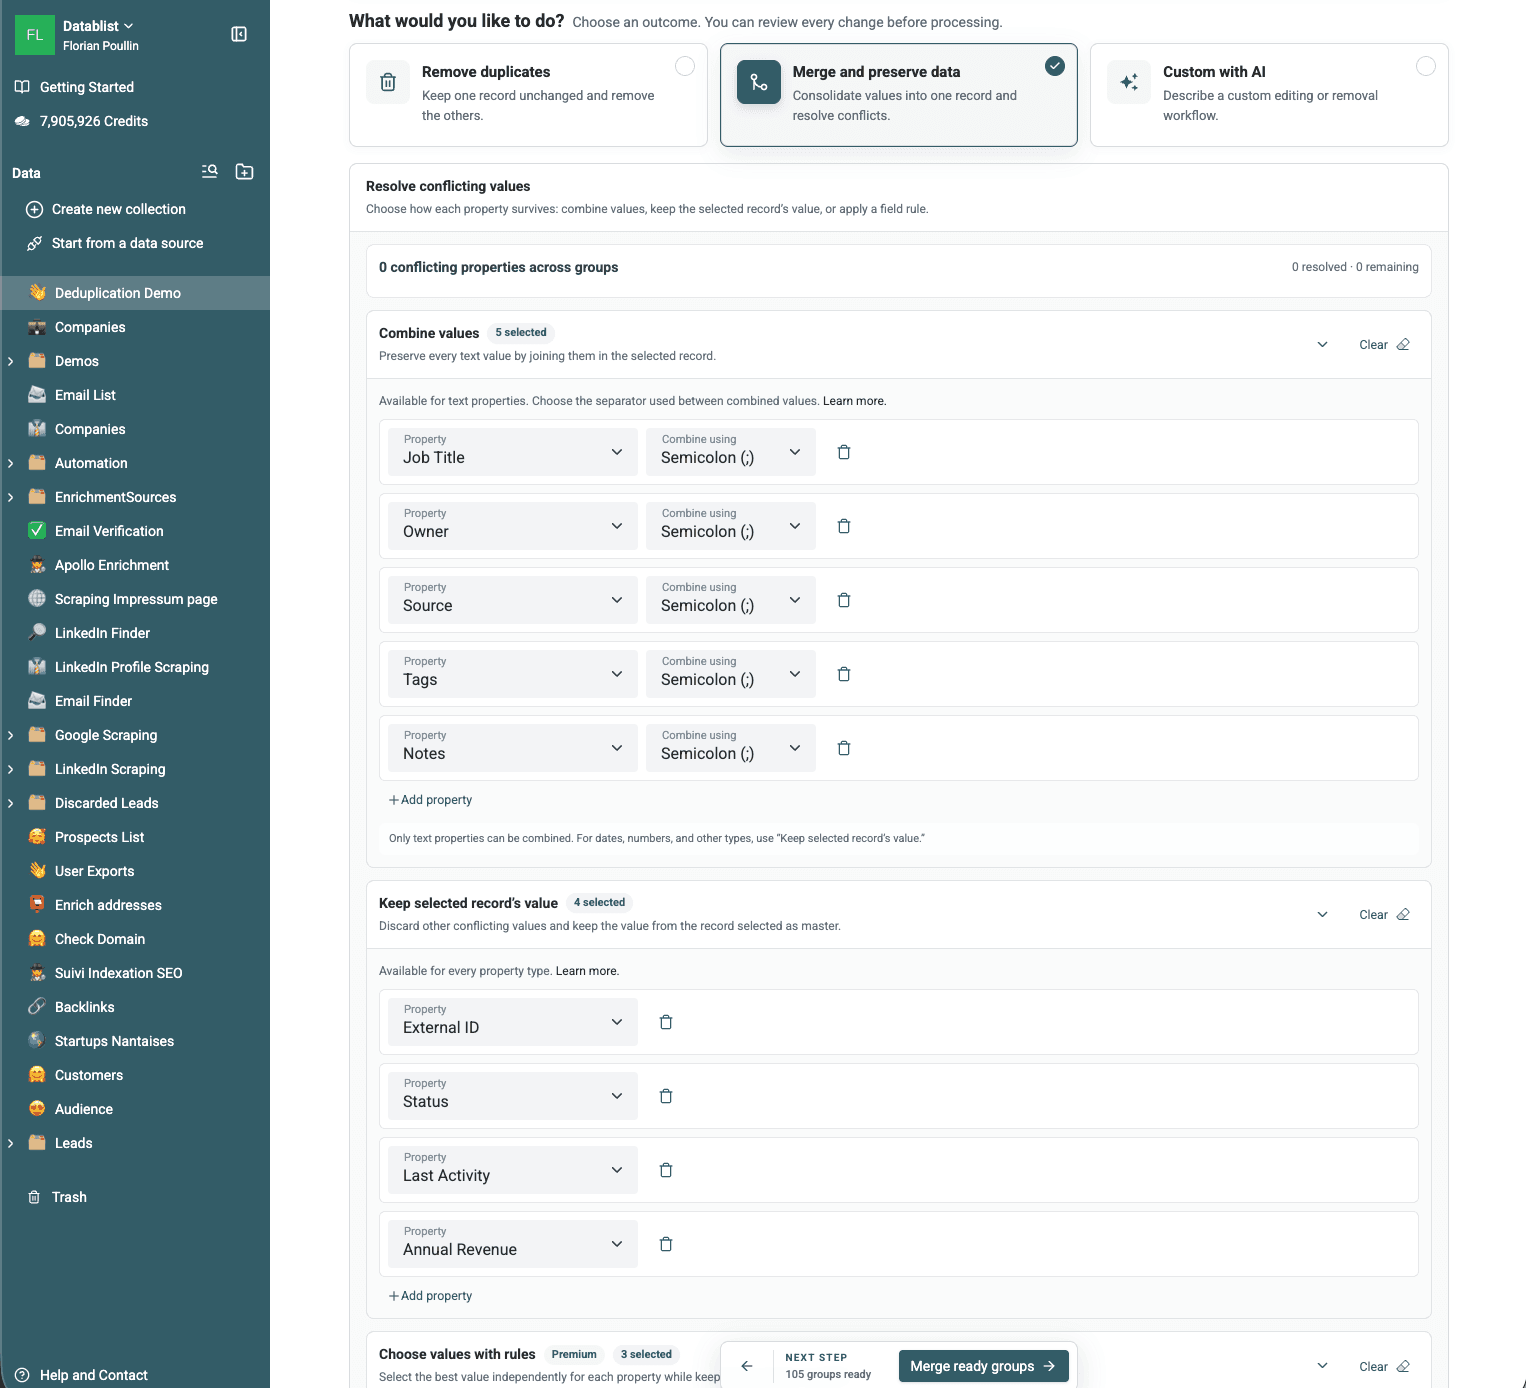
Merge and preserve data vult lege properties in het geselecteerde record, lost ingestelde conflicten op en verwijdert vervolgens de secundaire rijen.
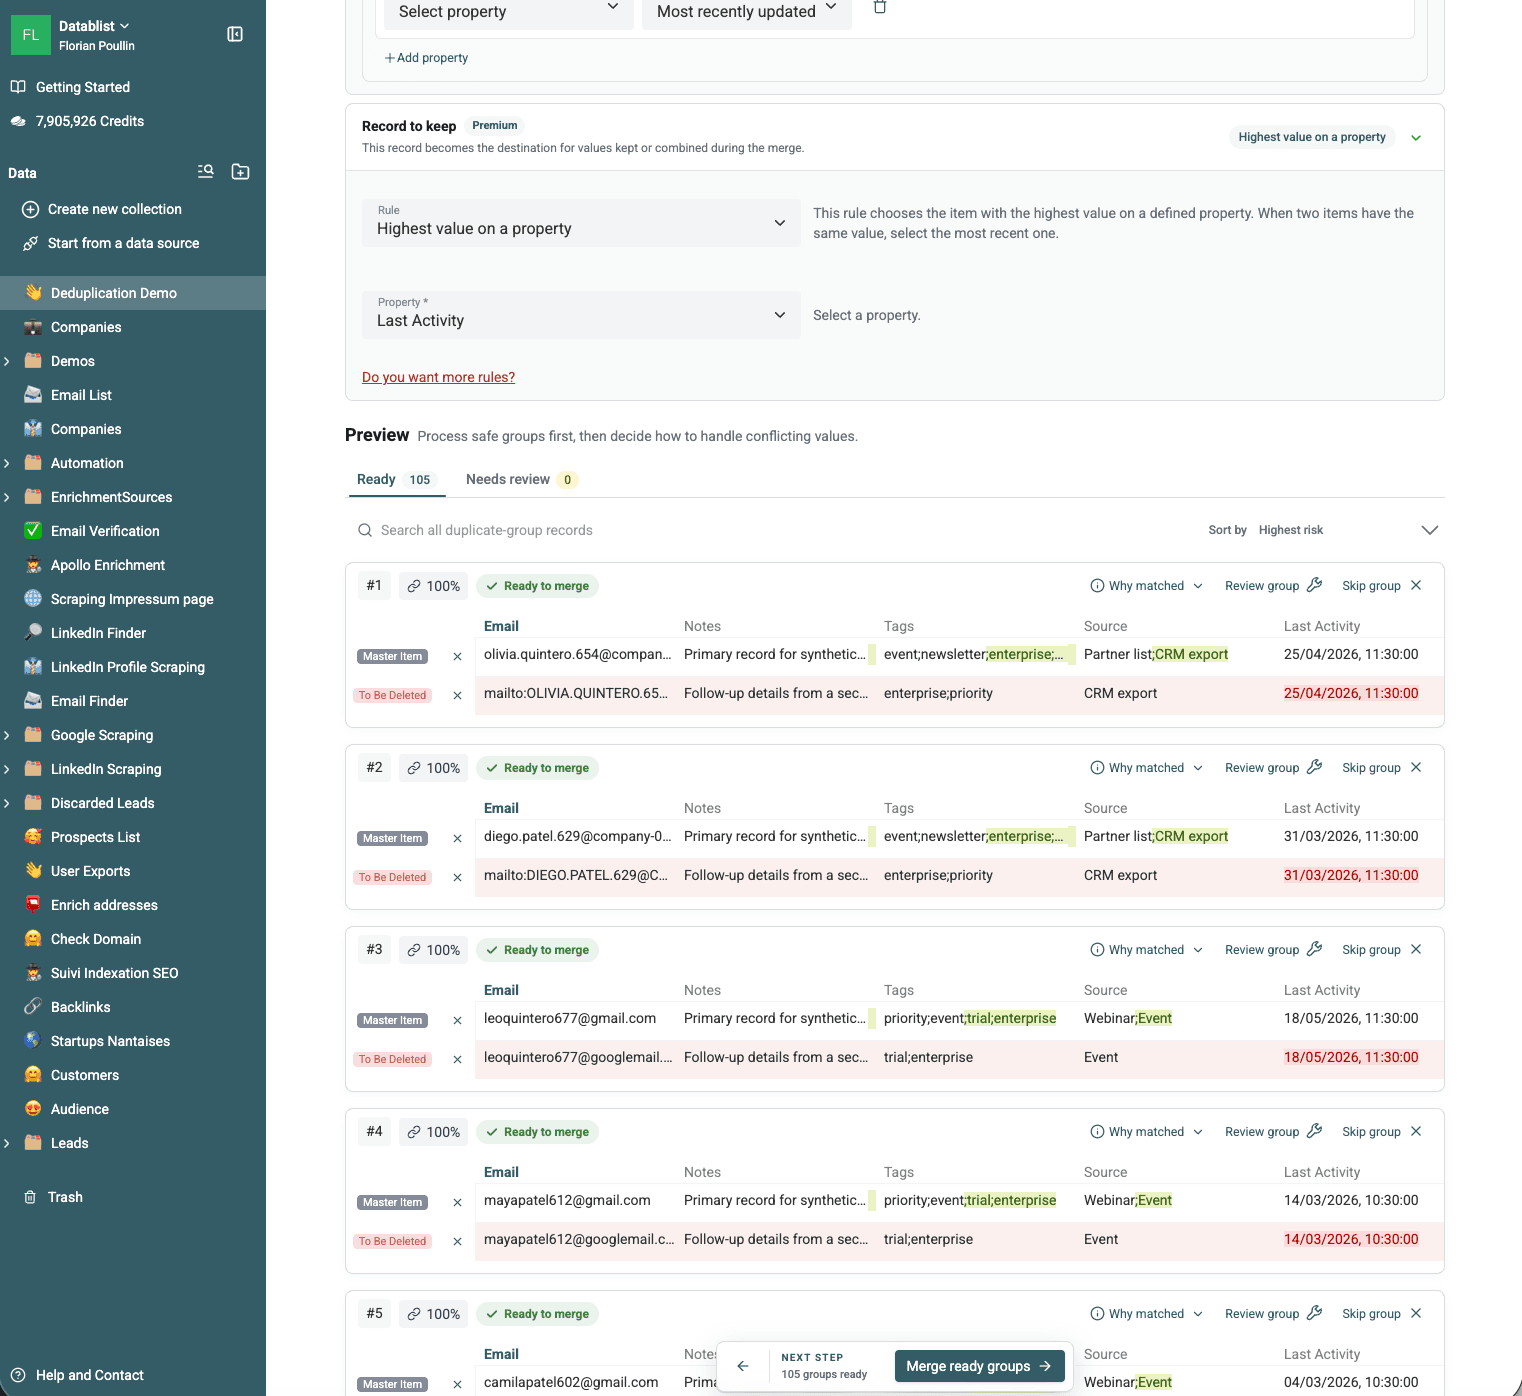
Begin met de regel Record to keep. Most Complete is de standaardinstelling. Met betaalde plannen kun je regels kiezen op basis van aanmaak- of wijzigingstijd, de hoogste of laagste property value of een verplichte property value.
Bepaal daarna per conflicterende property welke waarde behouden blijft:
- Combineer verschillende tekstwaarden met een scheidingsteken.
- Bewaar de waarde van het geselecteerde record.
- Met betaalde plannen kun je waarden afzonderlijk kiezen met regels zoals nieuwste, oudste, langste, kortste, hoogste, laagste of meest voorkomende.
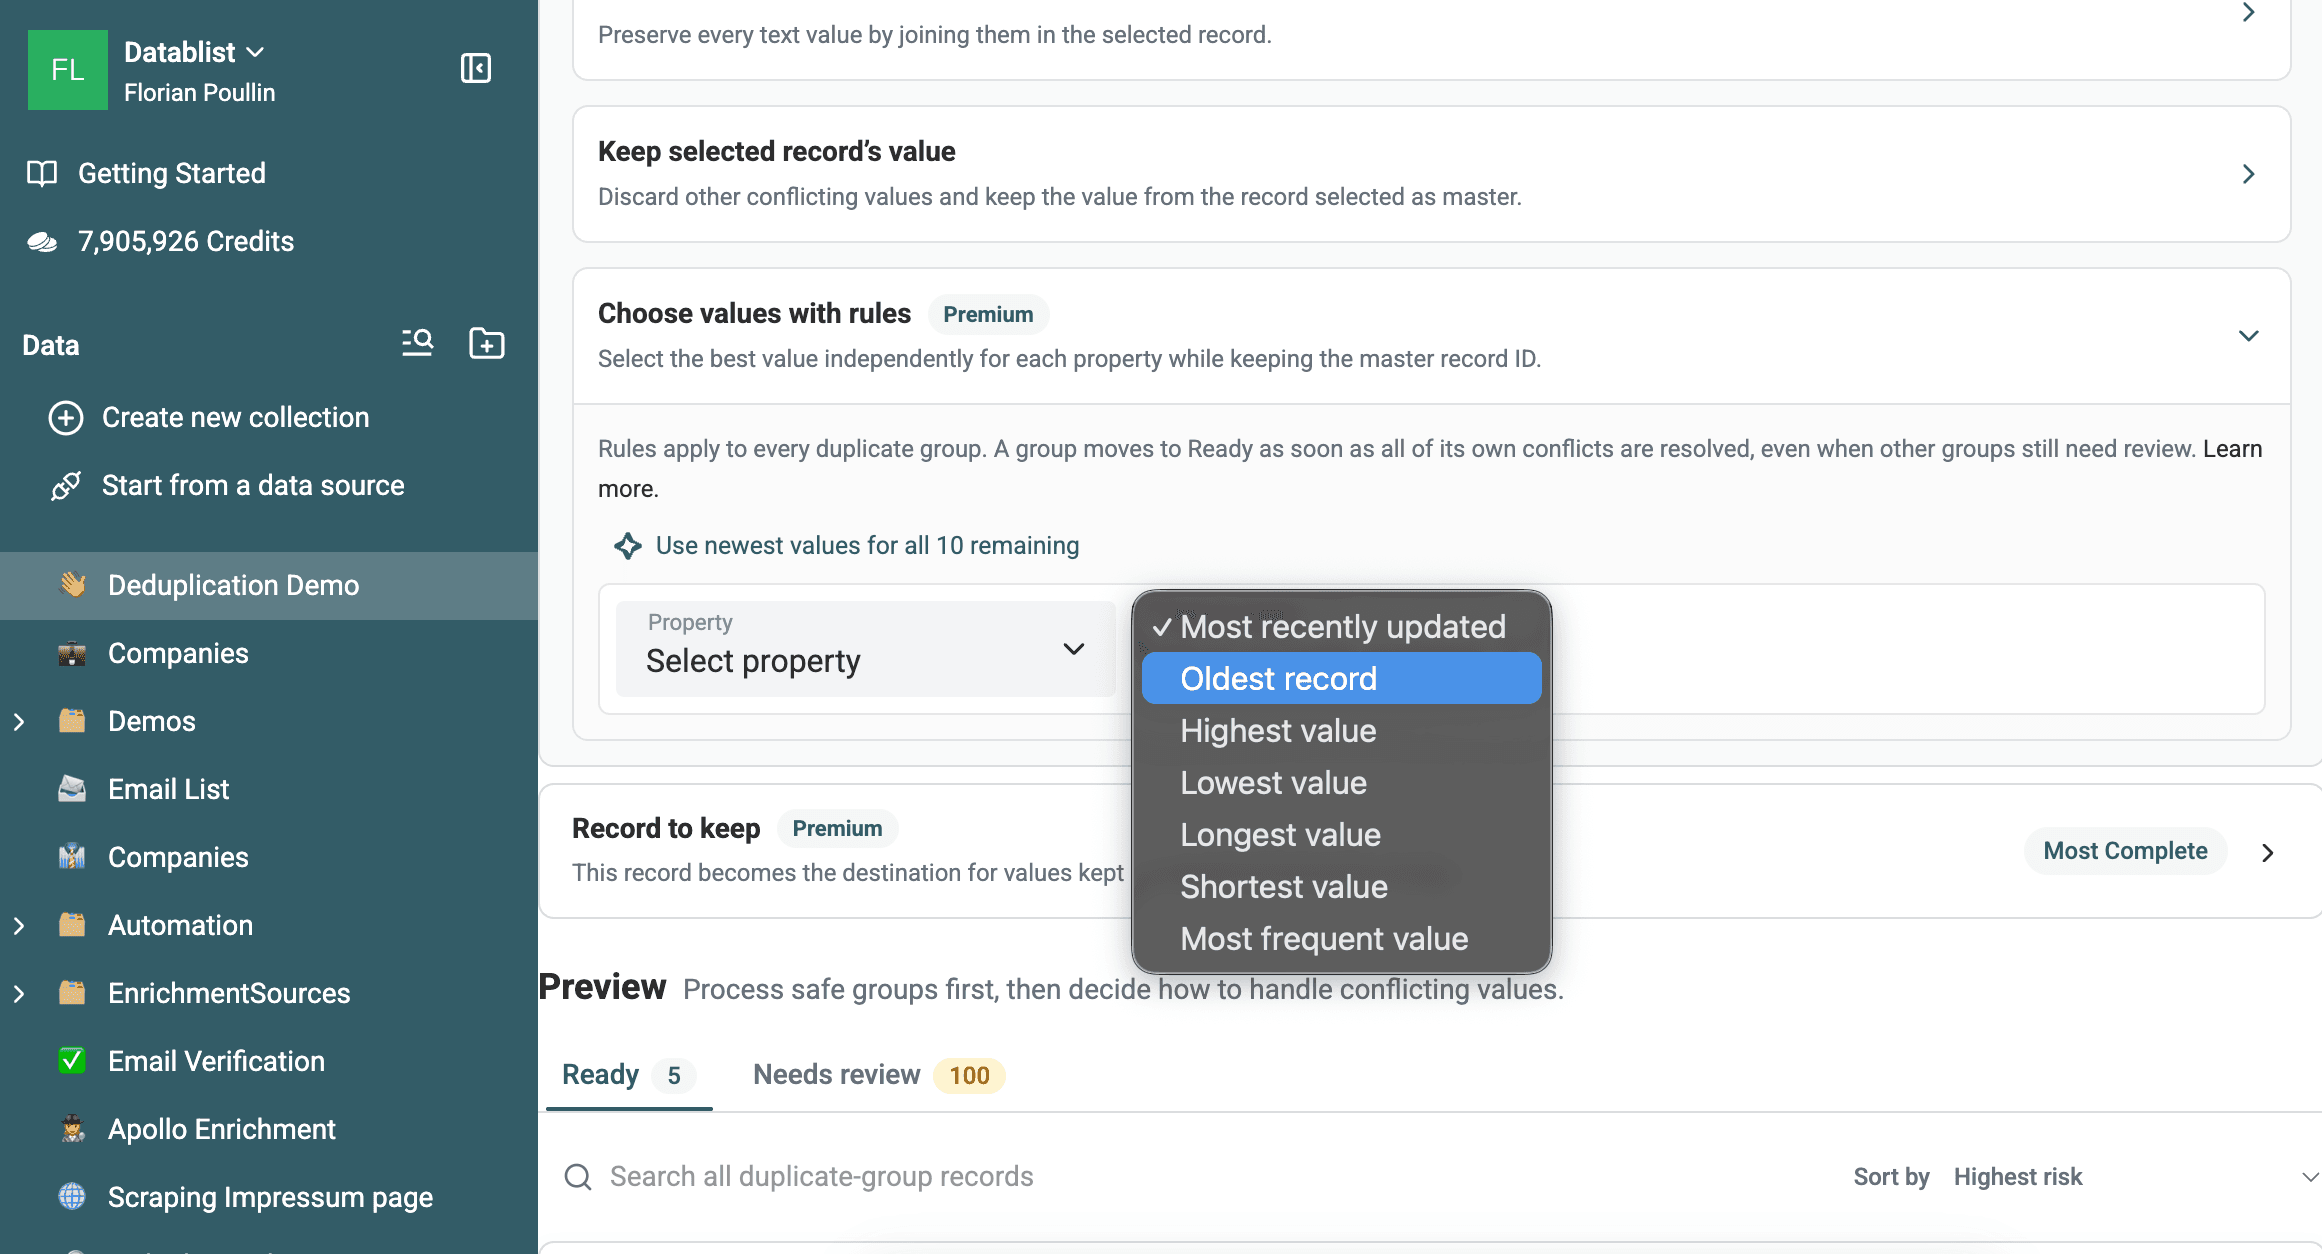
Gebruik regels op veldniveau wanneer geen enkele rij voor elke property de beste waarde bevat. Zo kun je de ID van het geselecteerde record bewaren en tegelijkertijd een nieuwere functietitel, een langere bedrijfsnaam en de meest voorkomende status uit andere rijen overnemen.
Vernieuw de preview nadat je de drempelwaarde, workflow, groepssamenstelling, conflictinstellingen of selectieregel voor records hebt gewijzigd.
Gebruik Custom with AI voor logica per groep
Custom with AI genereert op basis van een instructie in gewone taal een workflow voor de verwerking van groepen. De workflow kan een record selecteren, waarden kopiëren of normaliseren, een status-property toevoegen, een groepstotaal berekenen, secundaire rijen verwijderen of groepen overslaan die niet aan een voorwaarde voldoen.
Bijvoorbeeld:
Bewaar het record waarvan Source gelijk is aan CRM export. Kopieer de Job Title uit het meest recente record, combineer verschillende Notes met regeleinden, voeg een checkbox Duplicate Reviewed toe en verwijder daarna de secundaire records.
Verwijs naar properties uit de collection met /Property of {{Property}}. Genereer en controleer de workflow voordat je deze uitvoert. Custom with AI is beschikbaar voor ingelogde gebruikers met een betaald plan.
Open voor individuele uitzonderingen Review group en gebruik de Merging Assistant in plaats van de batchregel ingewikkelder te maken.
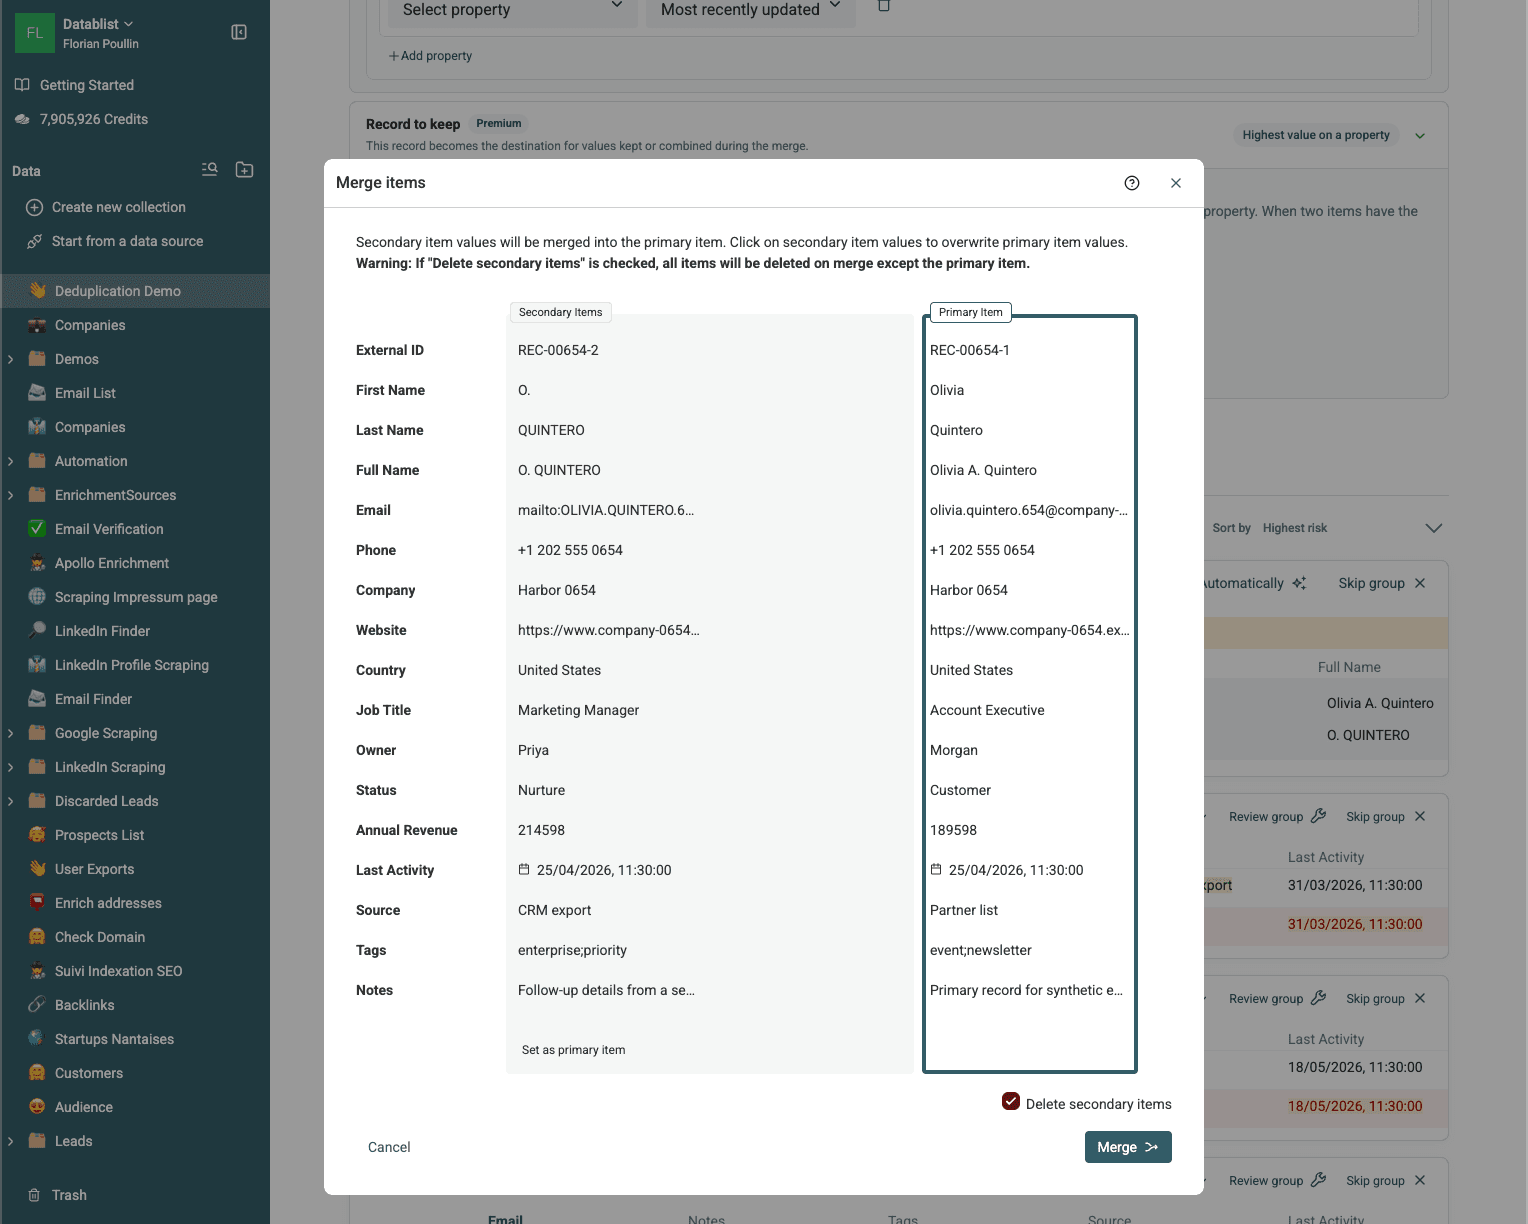
Controleer en exporteer de opgeschoonde lijst
Controleer voordat je Ready-groepen verwerkt:
- De preview komt overeen met de huidige instellingen.
- Groepen met een lage betrouwbaarheid of een gedeelde identifier zijn gecontroleerd.
- Het geselecteerde record bevat de ID die je wilt bewaren.
- Unieke waarden voor telefoonnummer, bron, notitie en status blijven behouden.
- Velden waarin maar één waarde is toegestaan, worden niet samengevoegd.
- Het weergegeven aantal Ready-groepen komt overeen met wat je wilt verwerken.
Controleer na de verwerking het aantal rijen:
Aantal beginrijen - verwijderde secundaire rijen = aantal eindrijen
Voor de Exact-matching in deze handleiding heeft Datablist vijf groepen van twee rijen samengevoegd. De collection ging daardoor van 1.000 naar 995 items.
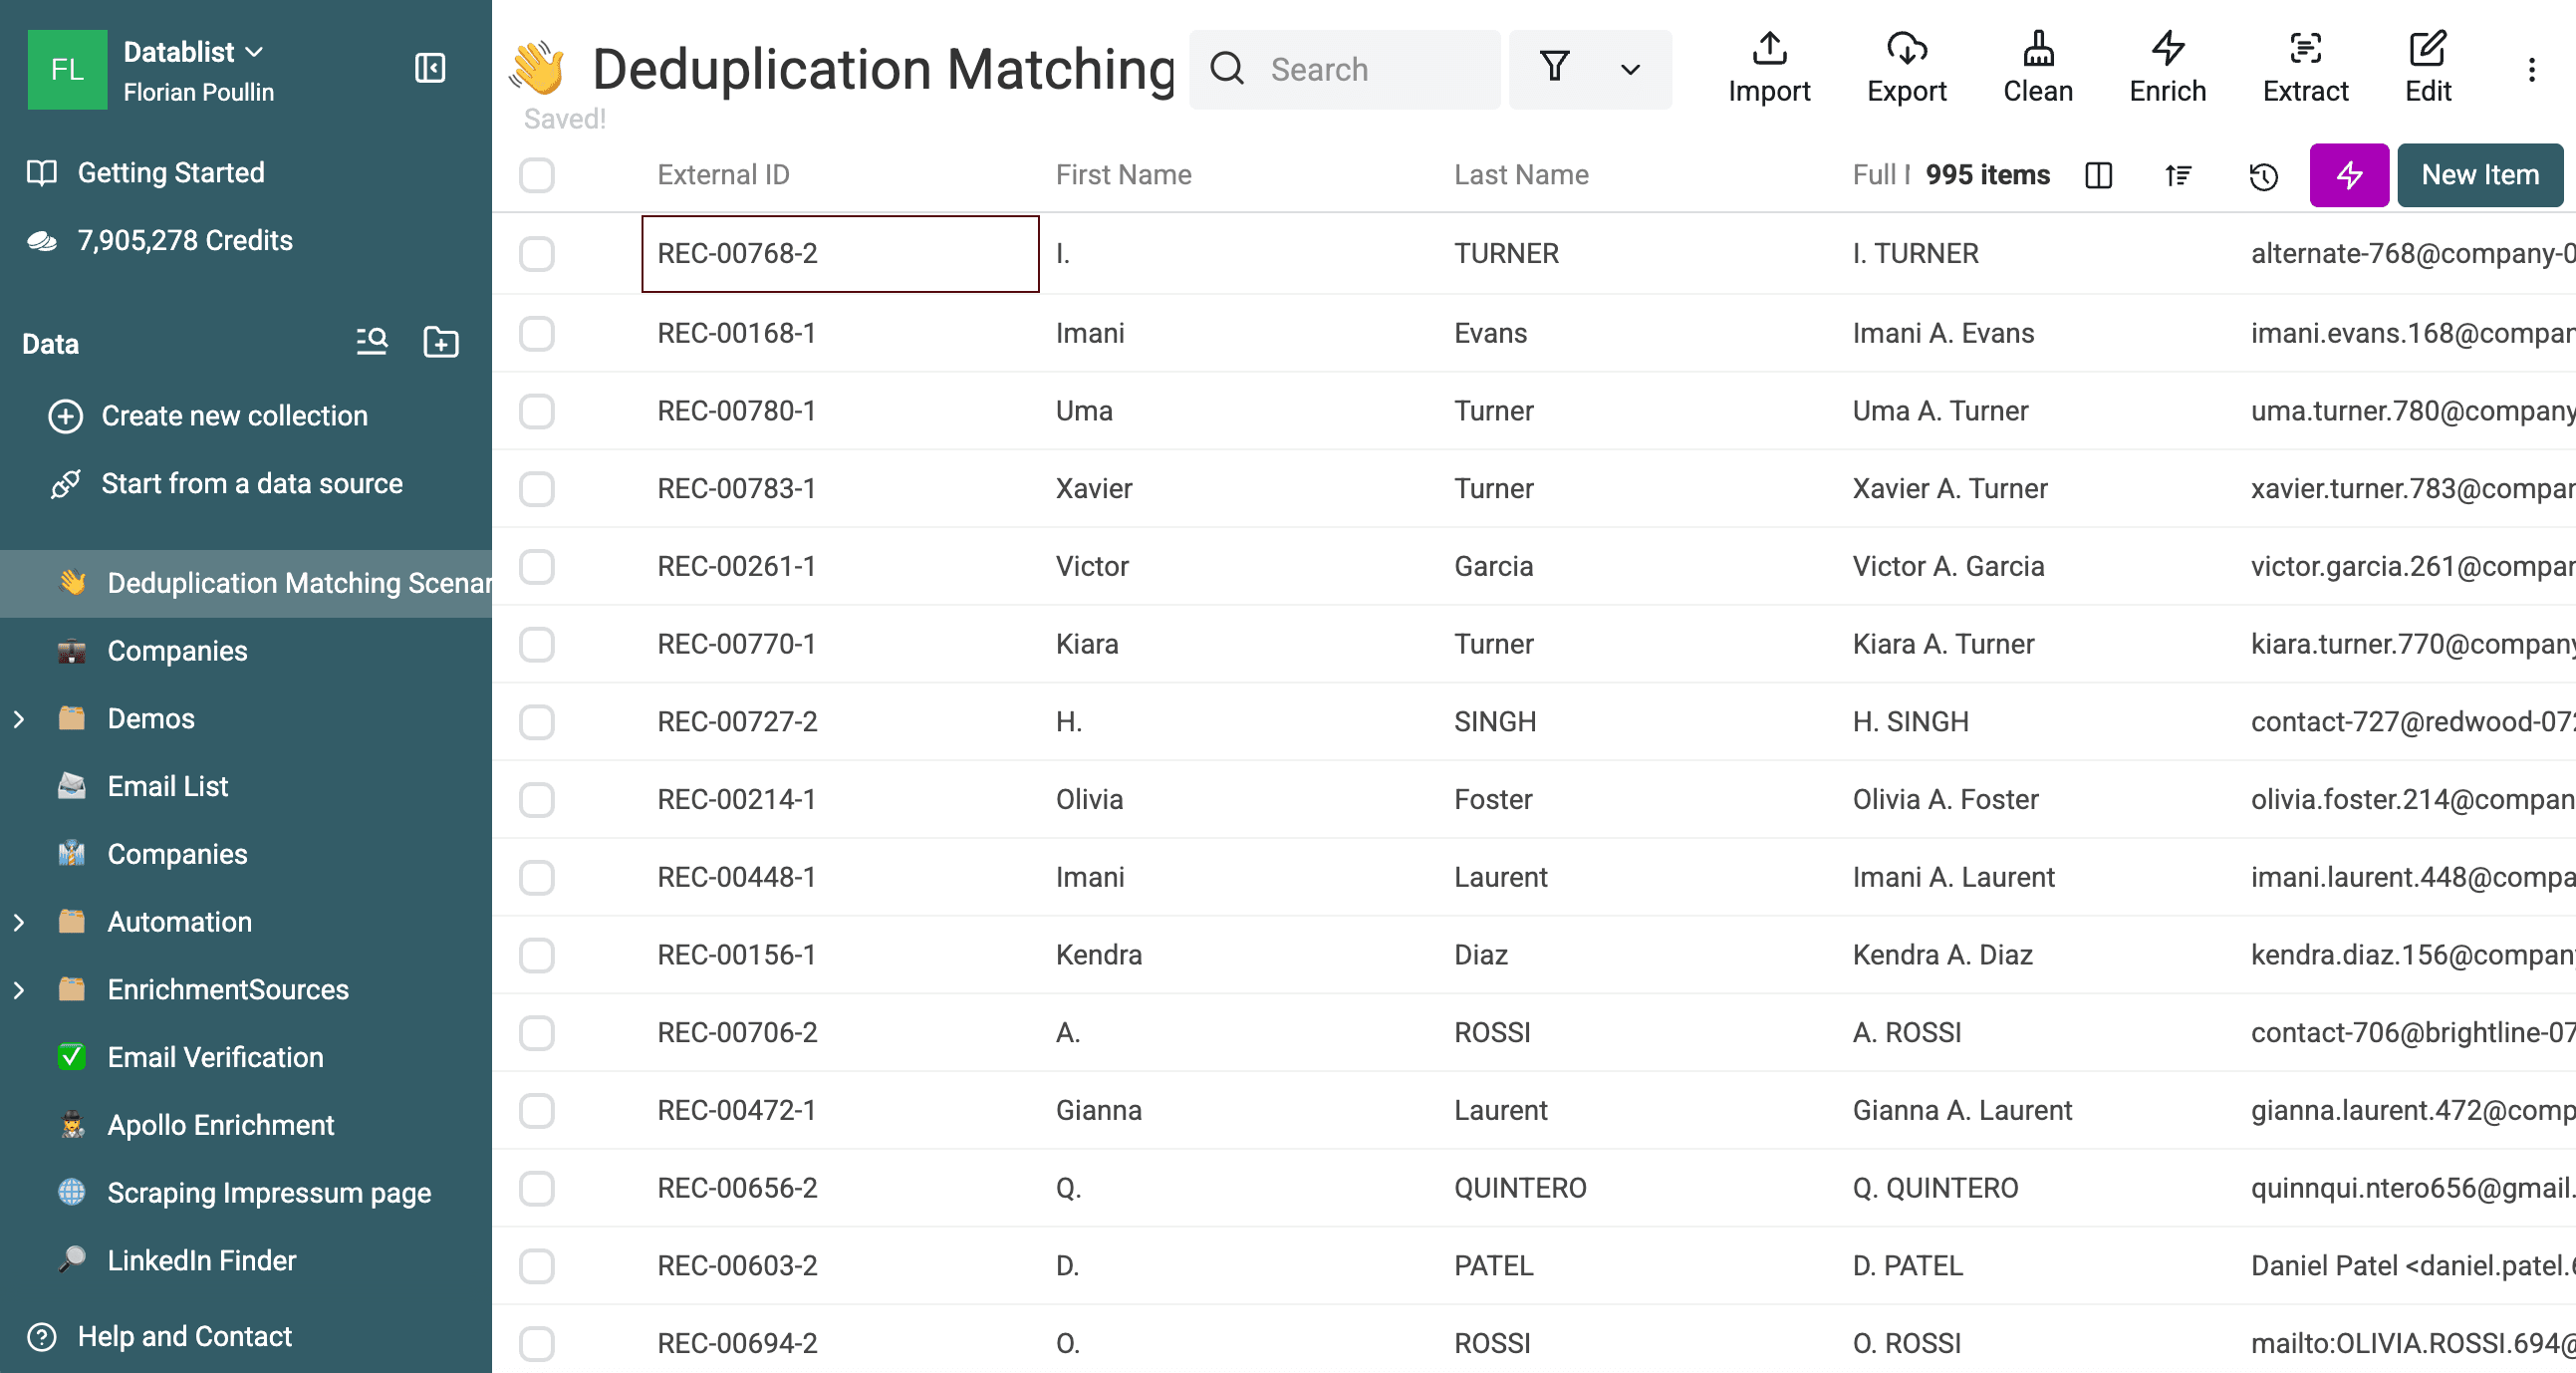
Download de groepen met duplicaten vóór de verwerking als je ze extern wilt laten controleren. Betaalde plannen bieden bruikbare ID’s voor groepen met duplicaten en een changelog na de verwerking. De changelog registreert verwijderde en bijgewerkte Datablist-ID’s, inclusief de vorige waarden en doelwaarden.
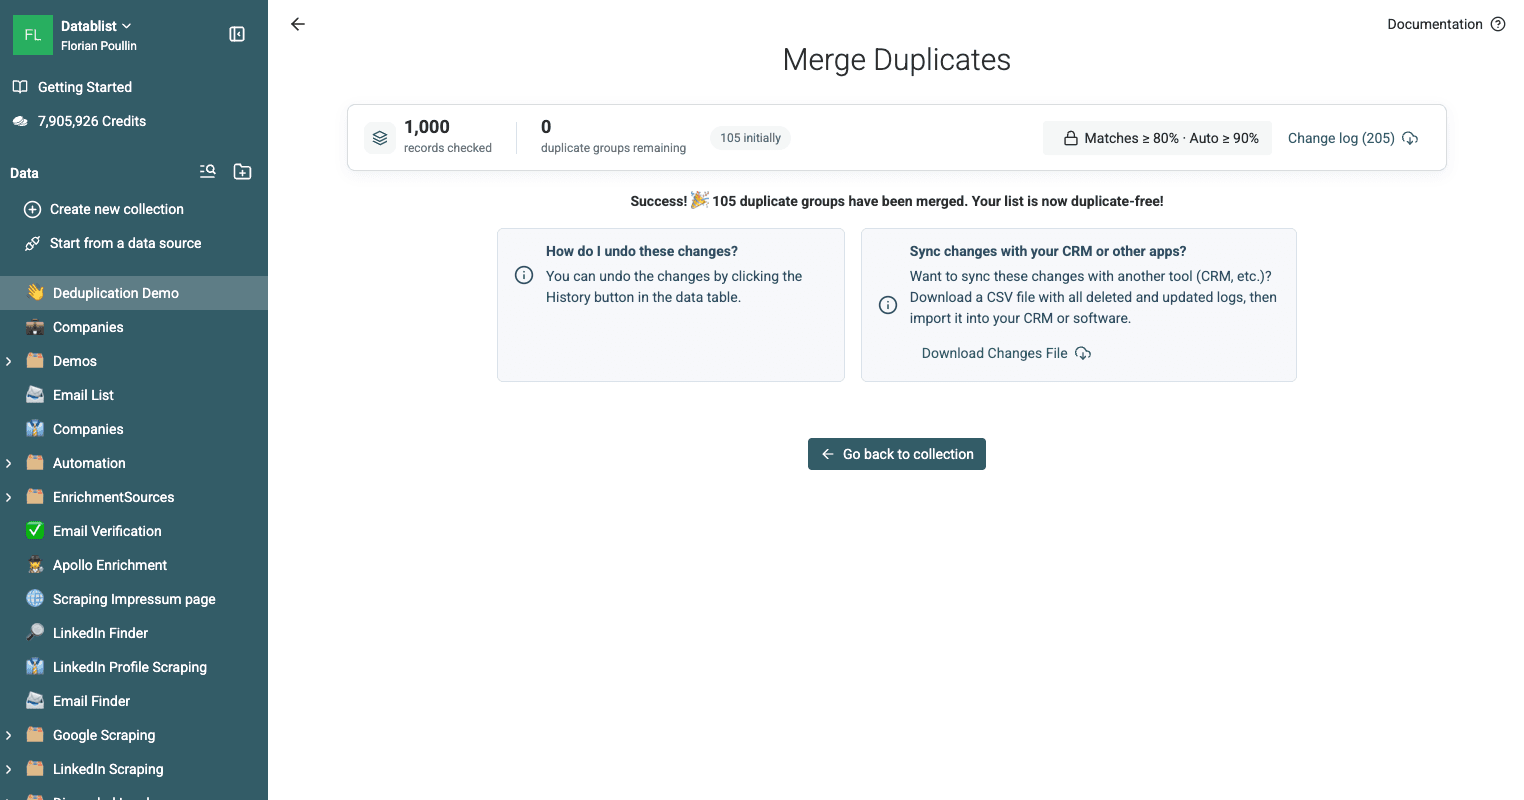
Automatische verwijderingen en merges verschijnen ook in de History van de collection, waar je ze ongedaan kunt maken.
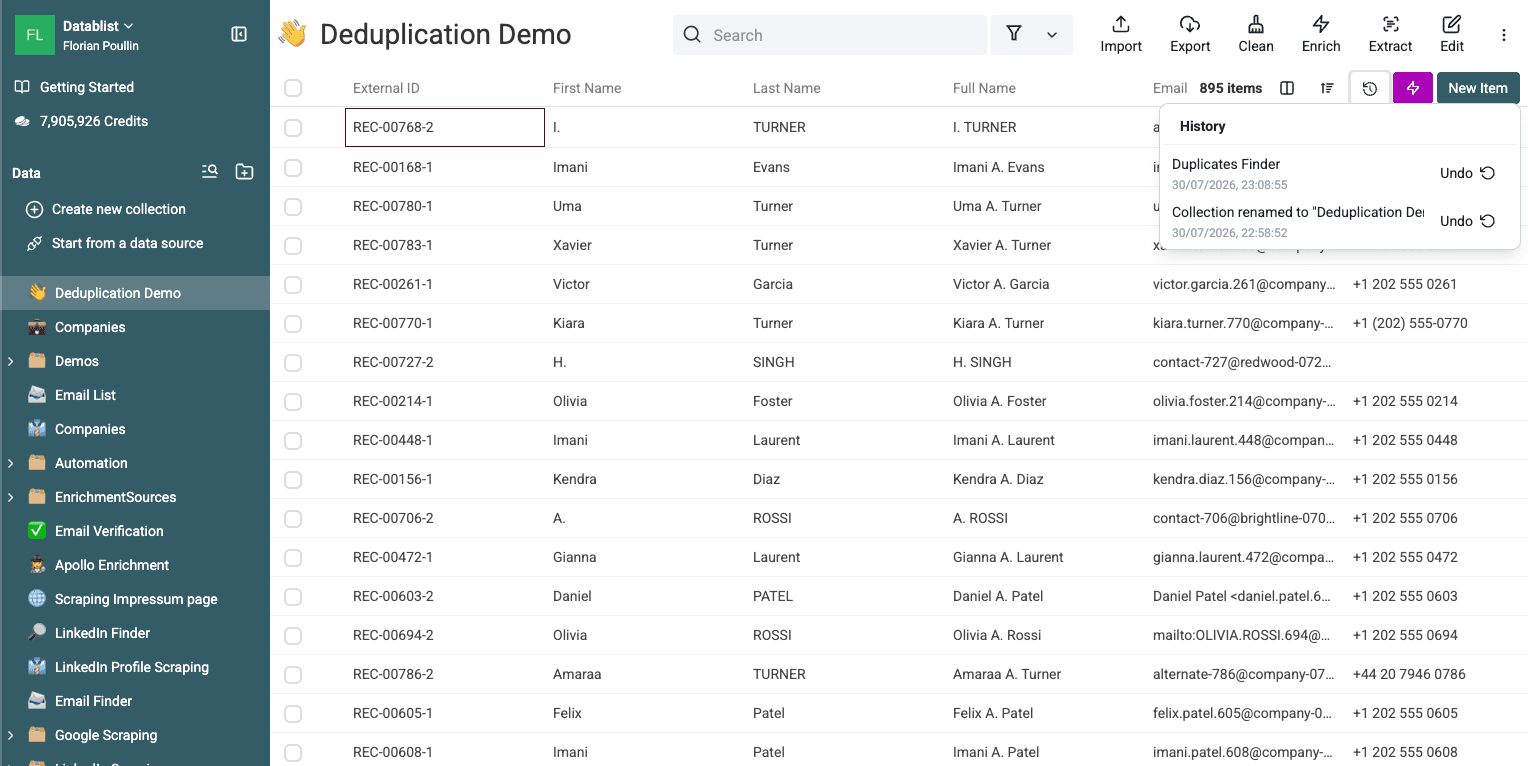
Ga terug naar de collection en open Export om het opgeschoonde CSV- of Excel-bestand te downloaden.
Meerdere lijsten dedupliceren
Gebruik matching tussen collections wanneer je een nieuw leadbestand met een CRM-export wilt vergelijken. Behandel het CRM als referentielijst en verwijder de matches uit de binnenkomende lijst voordat je deze importeert.
Download het CRM-demobestand en het demo-evenementbestand om deze workflow te testen. De twee bestanden gebruiken verschillende kolomkoppen en bevatten 100 vooraf samengestelde overlappingen op e-mailadres. Elk bestand begint met 250 rijen.
Importeer elk bestand in een eigen collection en open daarna Clean > Match across collections. Voeg beide collections toe en koppel overeenkomstige properties, zoals Email aan Attendee Email.
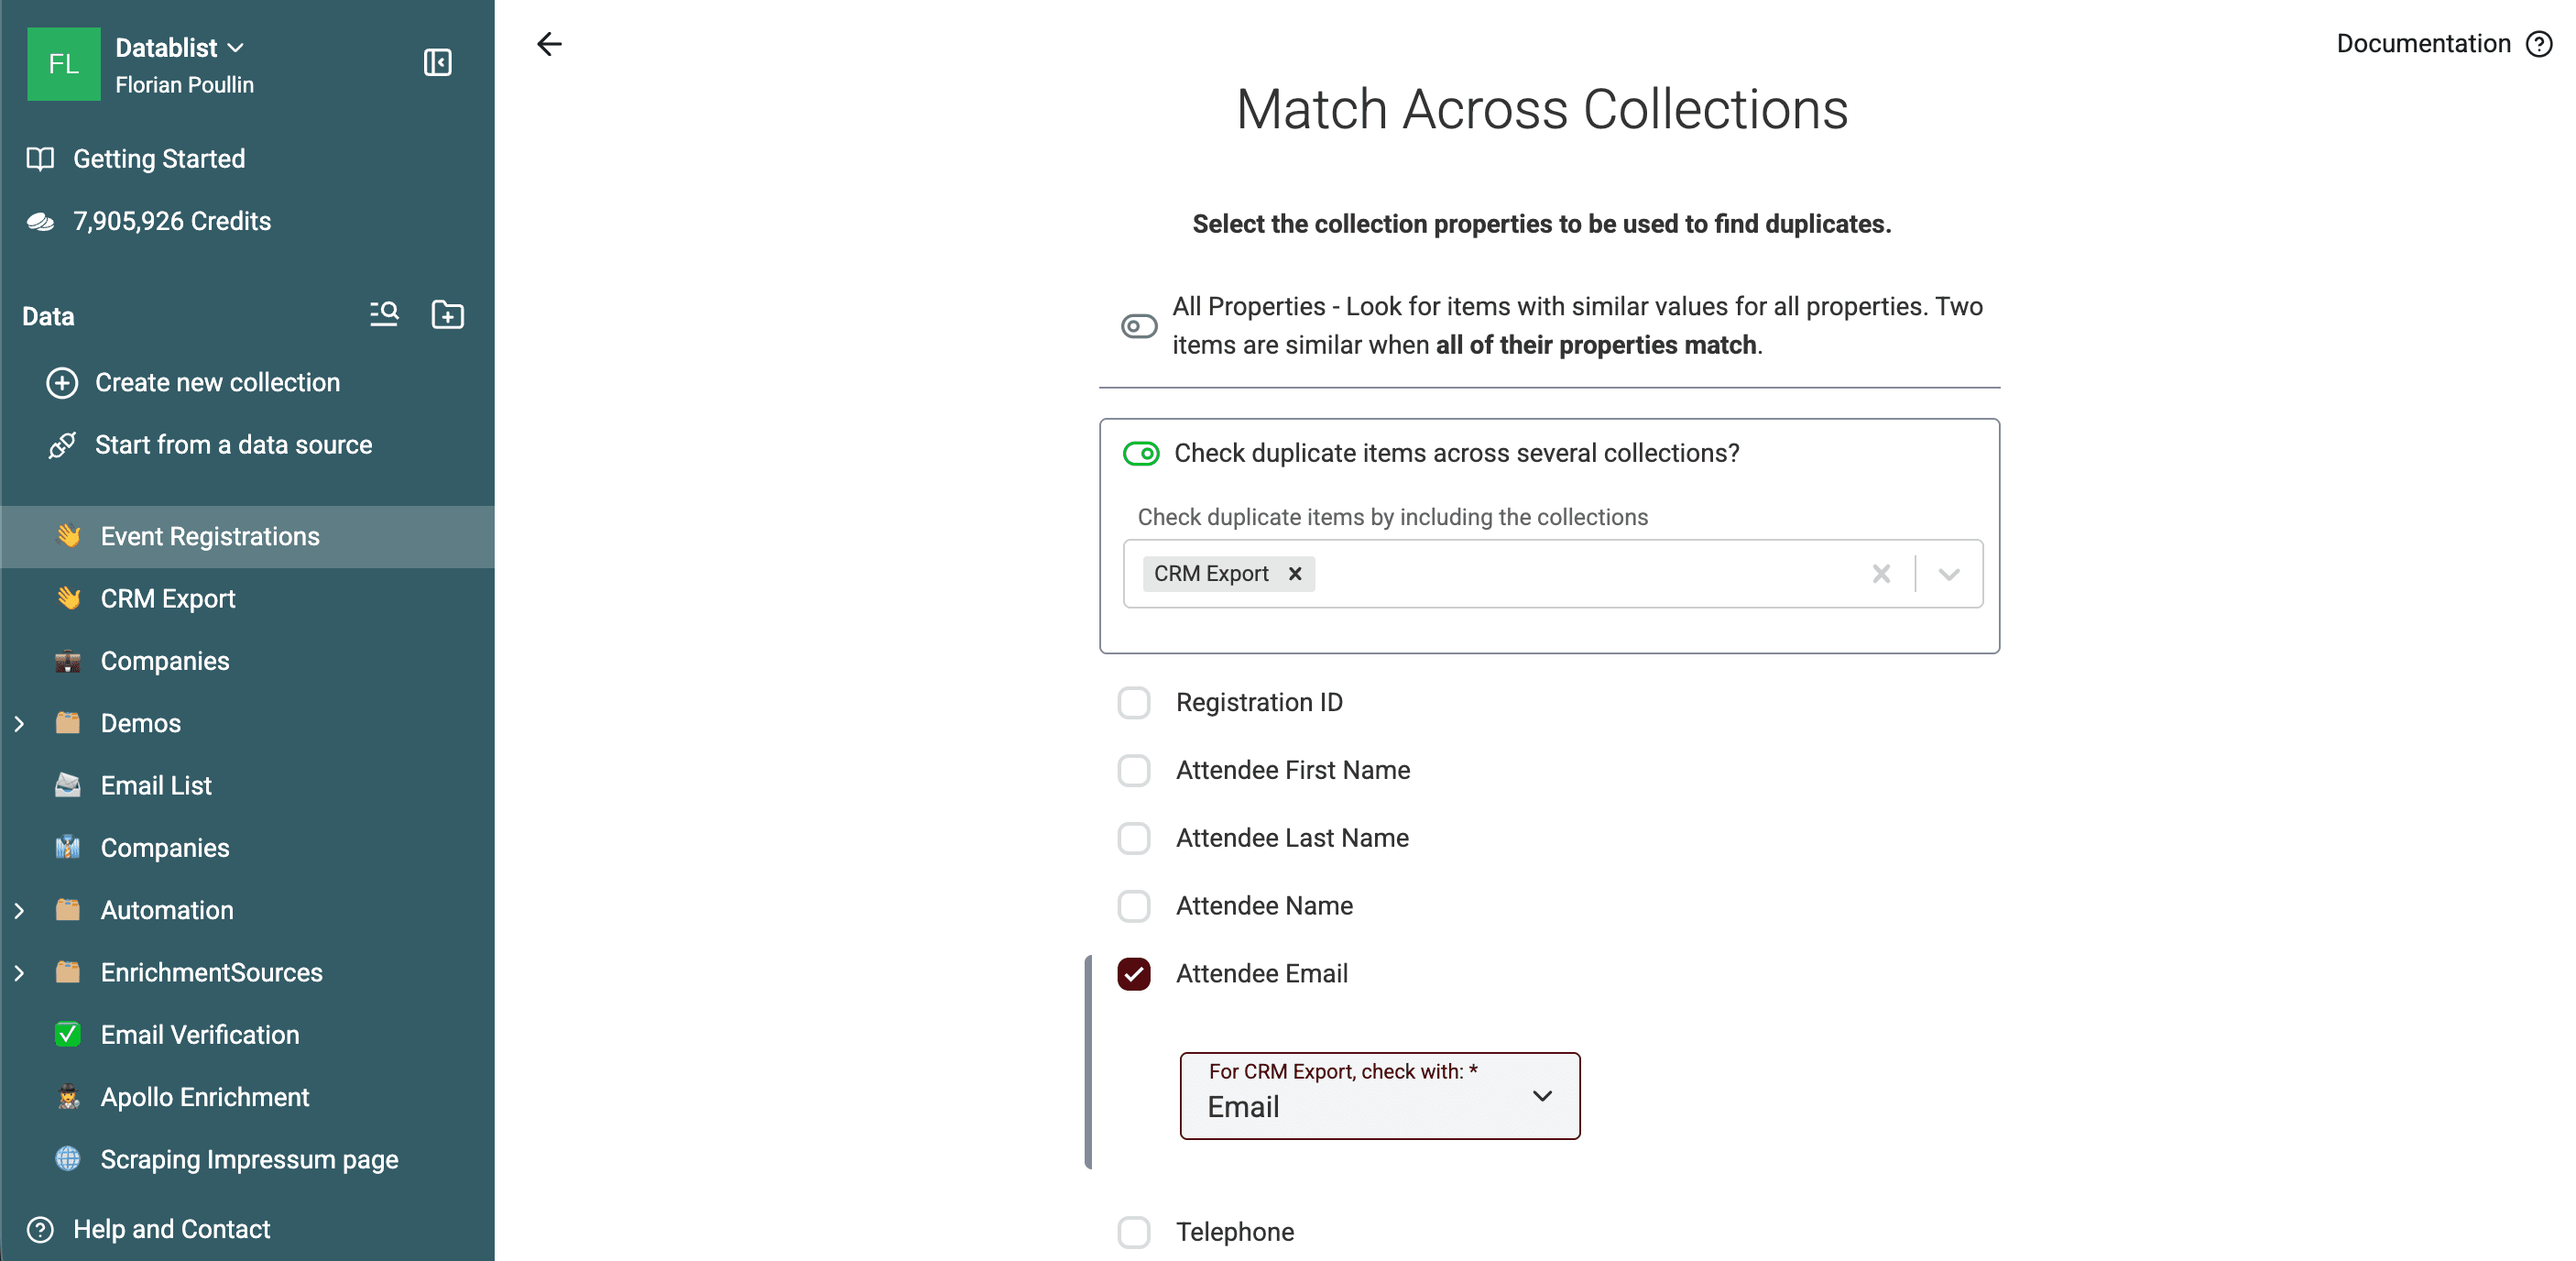
In deze test leverde Smart matching met de Email-processor 100 groepen tussen collections op uit 500 gecontroleerde records. Selecteer Event Registrations onder Remove duplicate items from collection {X} om het CRM ongewijzigd te laten en de matches uit de evenementenlijst te verwijderen.
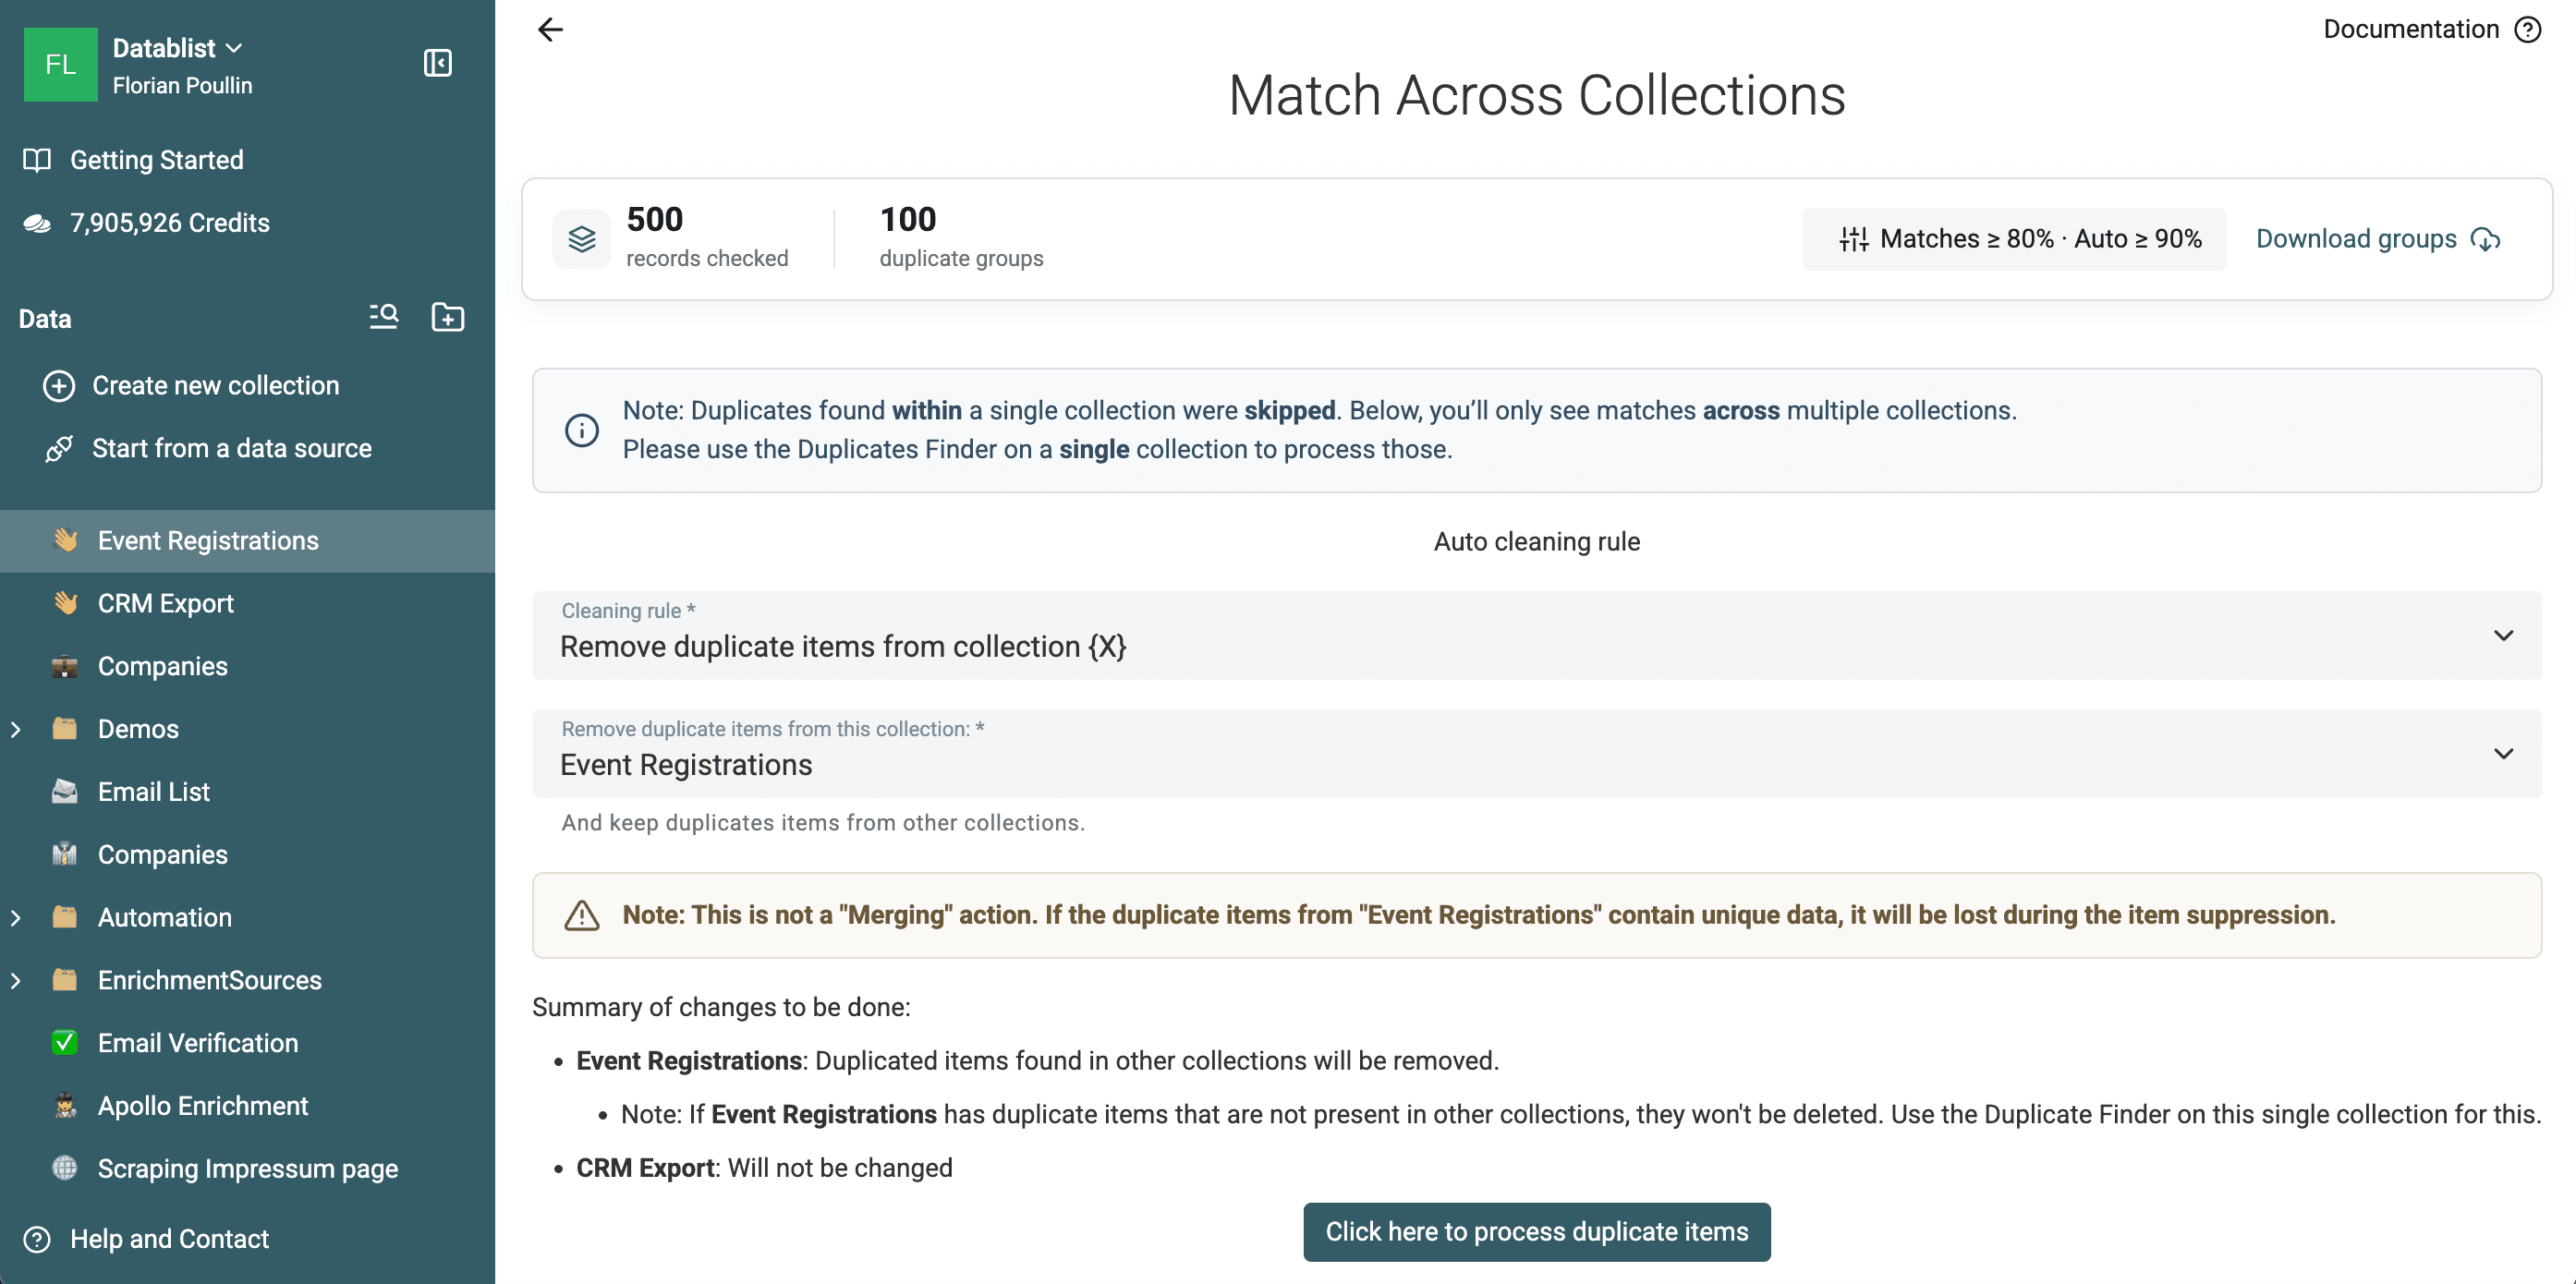
Automatische opschoning tussen collections verwijdert rijen. Unieke waarden uit het evenementbestand worden niet met het CRM samengevoegd. Exporteer of controleer daarom eerst de groepen als de binnenkomende records informatie bevatten die je wilt bewaren.
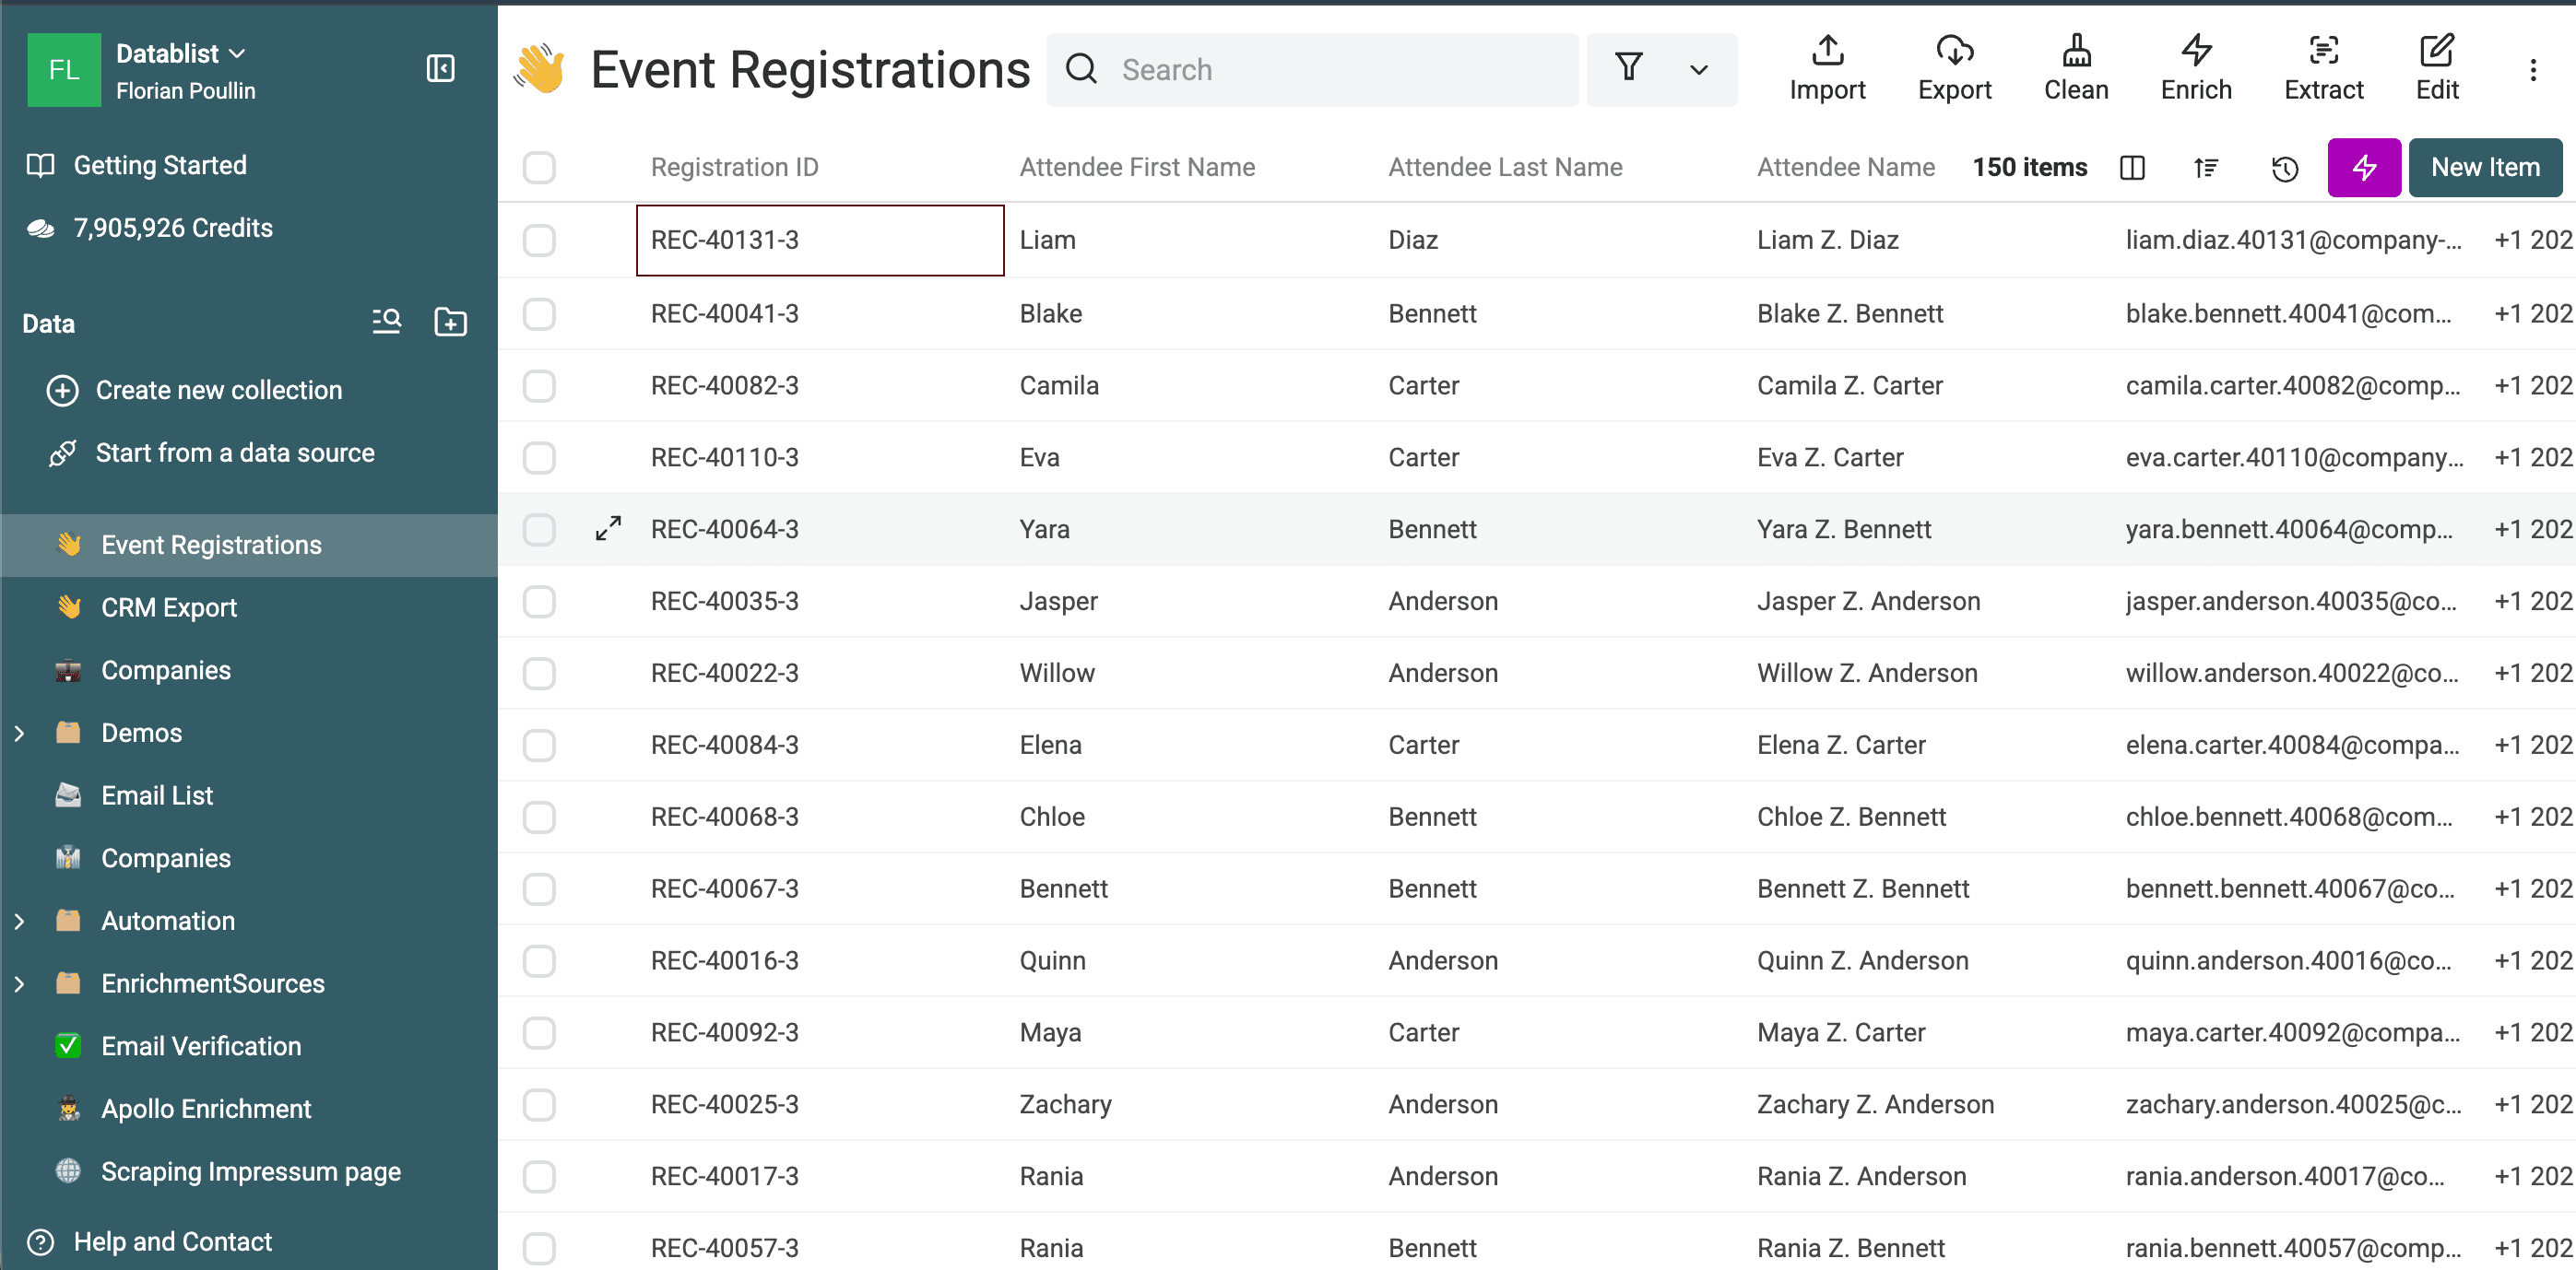
Na verwerking van de 100 overlappingen bevat Event Registrations 150 volledig nieuwe contactpersonen.
Matching tussen collections is een Premium-functie. Lees de uitgebreide handleiding om meerdere CSV- of Excel-bestanden te dedupliceren voor opties voor het koppelen en verwerken van collections.
FAQ
Kan ik een lijst gratis online dedupliceren?
Ja. Bezoekers zonder account kunnen een Exact-controle uitvoeren. Met een gratis account krijg je toegang tot Smart matching en de andere functies van het Free-plan voor één collection. Voor fuzzy en fonetische algoritmen, geavanceerde processors, matching tussen collections, instelbare regels voor gegevensbehoud en Custom with AI heb je een betaald plan nodig.
Moet ik dubbele rijen verwijderen of mergen?
Verwijder rijen wanneer één record leidend is en de overige records niets bevatten wat je nodig hebt. Kies voor een merge als secundaire rijen waardevolle gegevens bevatten. De Remove-preview waarschuwt wanneer er gegevens verloren zouden gaan.
Vindt Datablist duplicaten met spelfouten?
Ja. Jaro-Winkler en Levenshtein vergelijken de gelijkenis tussen teksten, terwijl Metaphone vergelijkt hoe tekst klinkt. Voor deze geavanceerde algoritmen heb je een betaald plan nodig en de gevonden matches moeten worden gecontroleerd.
Kan ik dubbele rijen mergen zonder dataverlies?
Datablist kan lege velden invullen, tekstwaarden combineren, de waarde van het geselecteerde record bewaren of regels voor gegevensbehoud op veldniveau toepassen. Controleer de preview, want waarden die je bewust verwijdert, komen niet terug in het samengevoegde record.
Hoe groot mag de lijst zijn?
Het Free-plan ondersteunt maximaal 1 miljoen items per collection in de browseropslag. Betaalde plannen ondersteunen imports tot 2 miljoen items per collection. Grote lokale bewerkingen blijven afhankelijk van de browser en het apparaat.
Kan ik duplicaten controleren zonder de lijst te wijzigen?
Ja. De detectie is alleen-lezen. Je kunt groepen bekijken, drempelwaarden aanpassen, Why matched gebruiken, resultaten doorzoeken en sorteren en dubbele rijen downloaden voordat je een verwerkingsactie start.
Lees voor alle instellingen en beperkingen de volledige documentatie van Duplicate Finder.