
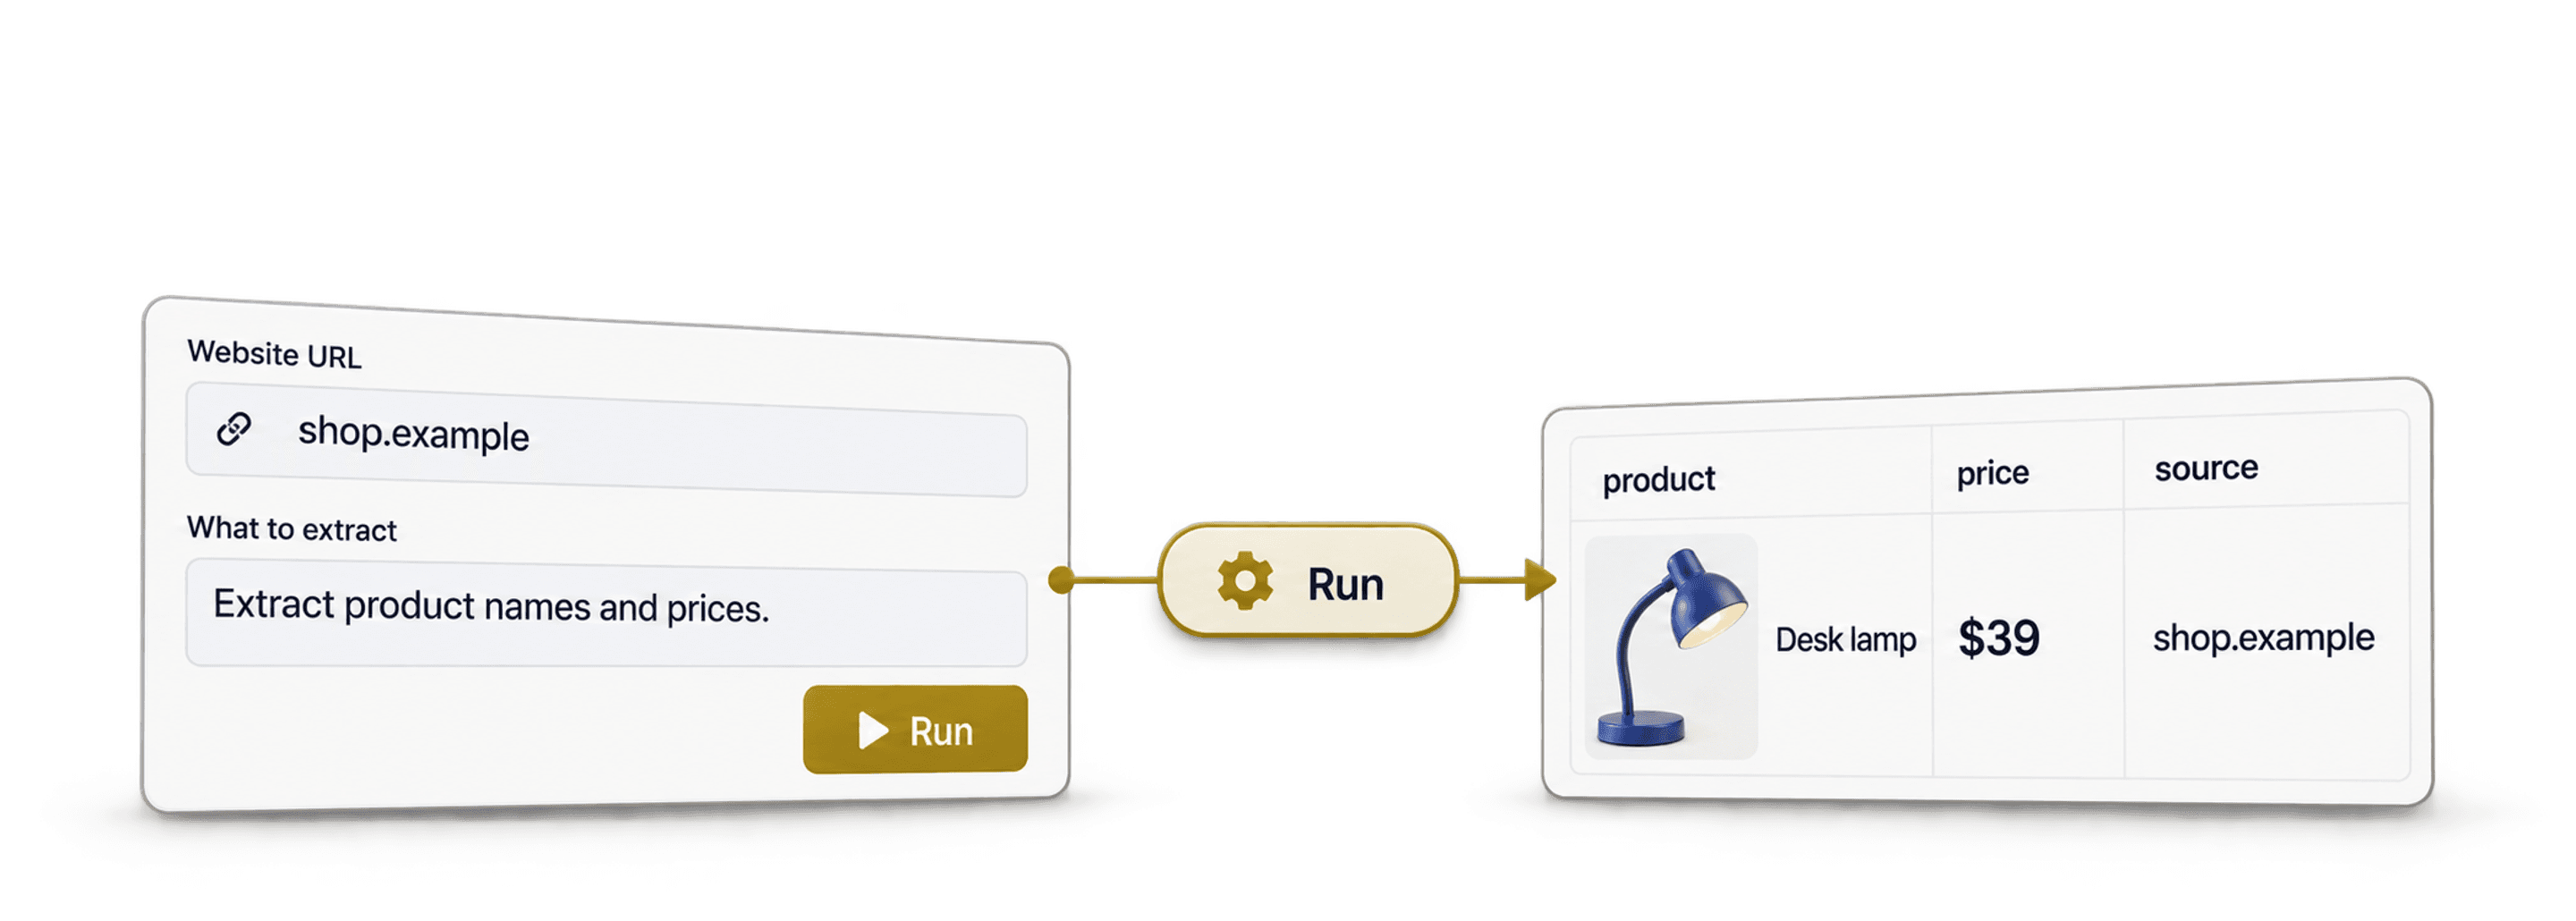
Een paar maanden geleden brachten we een feature uit waarvan we niet hadden verwacht dat die zo krachtig zou zijn.
Nu schudt deze feature de wereld van no-code webscraping flink op.
Ik heb het over onze bron “AI Agent - Site Scraper”. Deze bron zet toegankelijke content van websites op basis van jouw instructies om in gestructureerde rijen.
Een paar maanden later ontdekte ik drie dingen:
- De hele no-code scraping-industrie verkoopt een grote leugen
- Zonder het te beseffen hadden we de beste no-code scraper gebouwd
- AI scraping agents zijn krachtiger, gebruiksvriendelijker en sneller dan alle eerdere no-code scrapingtools.
📌 Samenvatting voor wie weinig tijd heeft
Dit artikel vertelt je alles wat je moet weten over échte no-code scraping. Je hebt er geen API’s, CSS-selectors of technische kennis voor nodig. Dit is de korte versie:
Probleem: ‘No-code’ scrapingtools vereisen nog steeds technische kennis. Je moet websitestructuren begrijpen, tutorials bekijken en uren besteden aan de configuratie. En zodra een website iets kleins wijzigt, werkt alles niet meer.
Waarom dat een probleem is: Je zou geen API’s of CSS-selectors hoeven te leren en geen urenlange tutorials hoeven te bekijken om data uit websites te halen. Daarmee gaat het hele idee achter ‘no-code’ verloren.
Oplossing: AI-gestuurde scraping van Datablist met instructies in gewone taal. Jij beschrijft wat je nodig hebt; de AI regelt de rest.
Wat je leert: Deze gids ontmaskert de misleidende claims van de no-code scraping-industrie, laat zien hoe échte no-code scraping werkt en geeft praktische use cases en tips voor prompts.
Waarom Datablist gebruiken voor no-code scraping: 3 belangrijke redenen
- Echt no-code: beschrijf gewoon in gewone taal wat je wilt
- Verwerkt complexe websites met JavaScript, paginering en dynamische content
- Past zich aan wanneer websites veranderen, in tegenstelling tot kwetsbare scrapers op basis van CSS-selectors
Wat je in dit artikel leert
- De no-code scraping-industrie en haar leugens
- De eenvoudige oplossing: gebruik woorden, geen API’s
- Use cases en tips voor AI-gestuurde scraping
- Veelgestelde vragen over no-code scraping
De no-code scraping-industrie en haar leugens
In dit gedeelte ontkrachten we de mythes en trucs van de no-code scraping-industrie. De waarheid is dat de meeste ‘no-code’ tools helemaal niet echt no-code zijn. Ze hebben technische complexiteit alleen in een iets andere vorm verpakt.
Waarom code nooit het echte probleem was
Denk er eens over na: code was nooit het probleem. Als je kon programmeren, zou je gewoon met code scrapen en überhaupt niet naar een no-code oplossing zoeken.
Je zoekt naar no-code oplossingen omdat je niet wilt leren programmeren om één website te scrapen. Maar mensen zijn slim, dus verkochten ze je een halfwerkende oplossing waar nog steeds het volgende bij komt kijken:
- Een steile leercurve
- Een hele reeks tutorials bekijken
- Begrijpen hoe websites zijn opgebouwd
En soms moet je zelfs werken met concepten die op code lijken, zoals CSS-selectors.
Het echte probleem draaide nooit om code versus no-code.
Het ging altijd om de leercurve, de complexiteit en het technische gedoe.
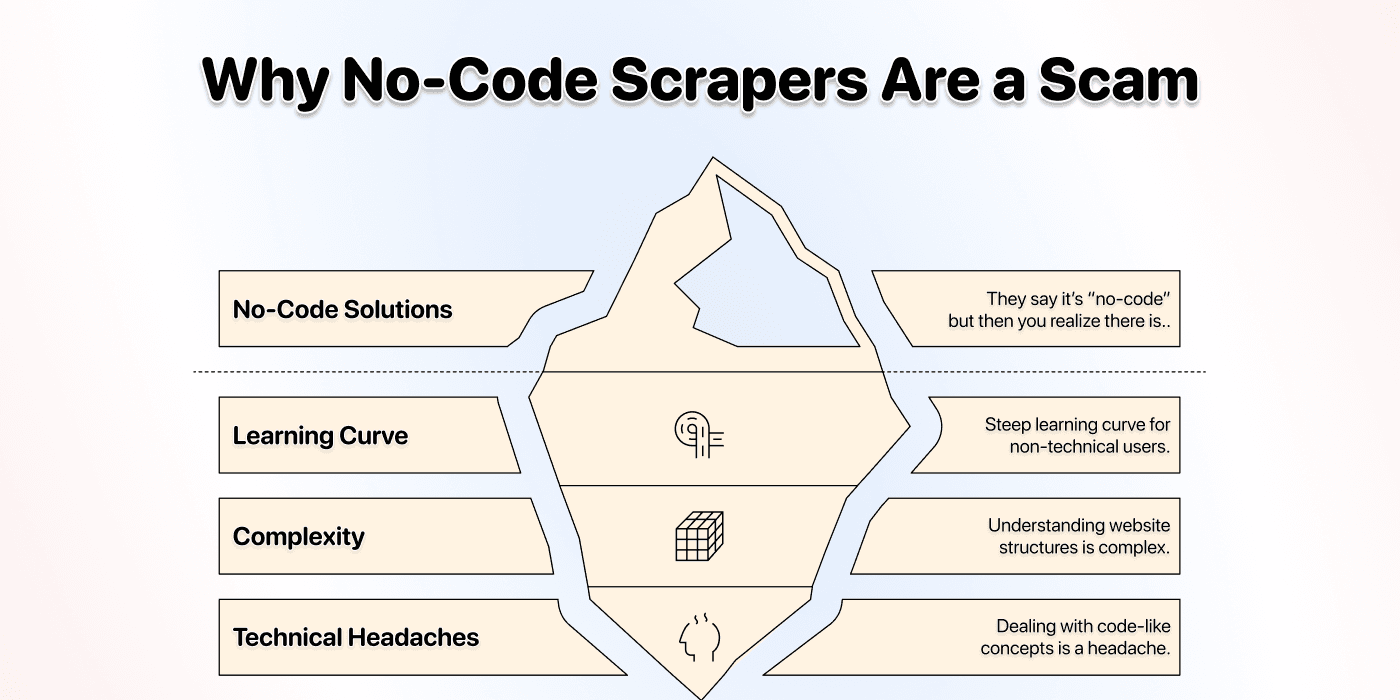
Wat ze je probeerden te verkopen
Bij alle drie de onderstaande methoden moet je mogelijk nog het nodige instellen wanneer je een scraper op maat maakt. Kant-en-klare templates en automatische dataherkenning kunnen een deel van dat werk wegnemen. Controleer wel of ze de gewenste velden en paginering van jouw website ondersteunen.
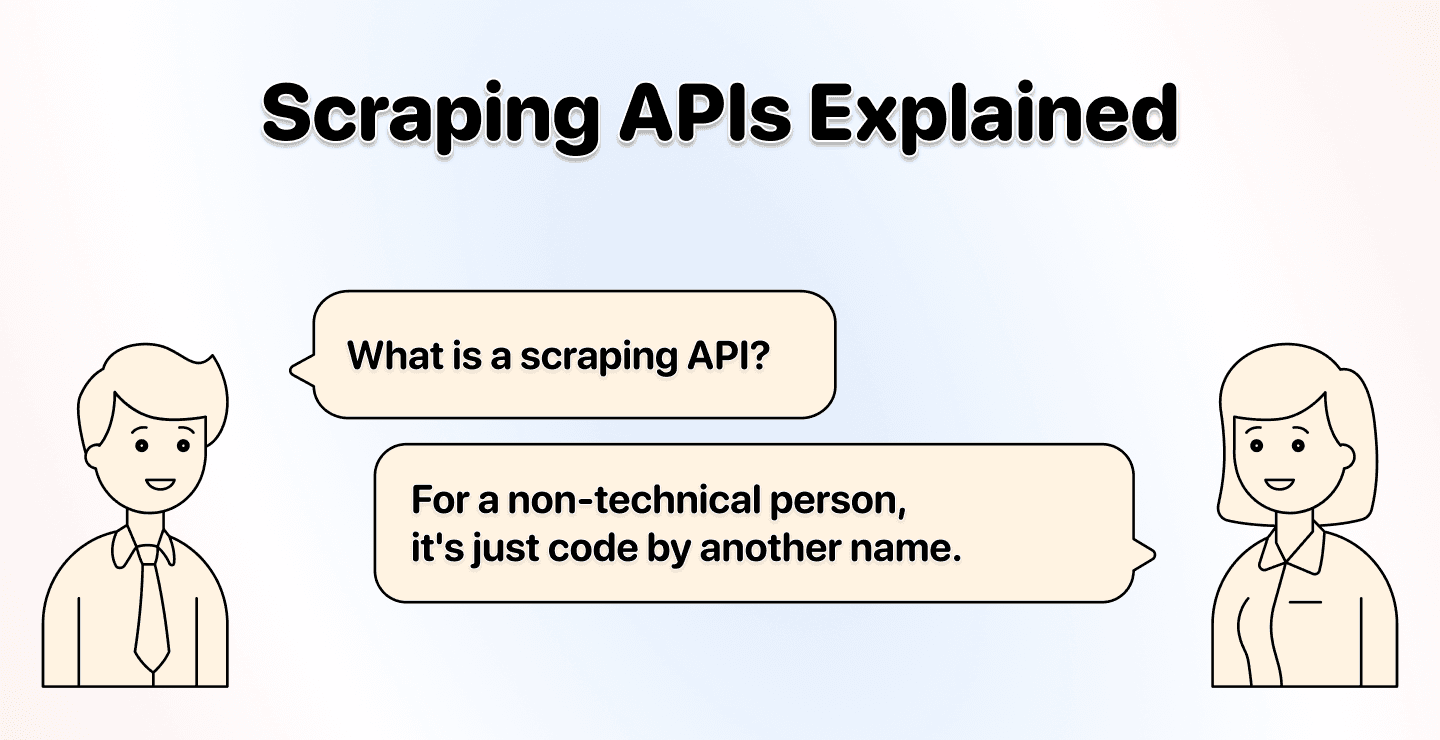
Scrapers op basis van API’s
Deze tools noemen zichzelf ‘no-code’ omdat je geen Python of JavaScript schrijft. Maar ze vertellen er een paar dingen niet bij.
Je krijgt nog steeds te maken met:
- De DOM-structuur van websites
- CSS-selectors
- HTML-tags
Technisch gezien schrijf je geen code, maar je doet wel iets wat net zo technisch is. Je vertaalt menselijke wensen naar selectors die een machine kan lezen. Dat is in feite programmeren met extra stappen.
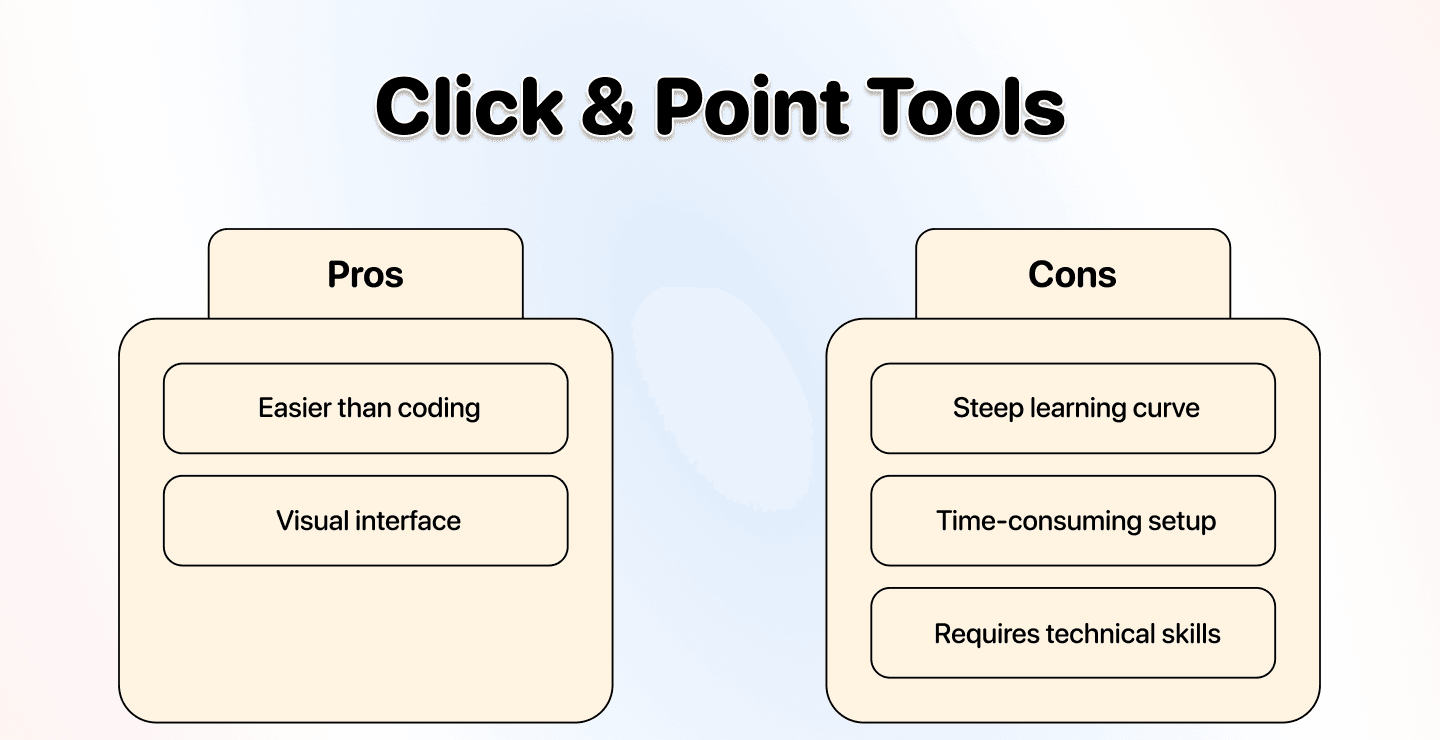
Click-and-point-tools
Deze aanpak is eenvoudiger, maar je moet nog steeds begrijpen hoe de website is opgebouwd. Je kunt op elementen klikken, wat het iets makkelijker maakt, maar zorgeloos is het nog altijd niet.
Het grootste probleem? Zodra de structuur van de website verandert, moet je alles opnieuw instellen. Dat betekent:
- De tutorial opnieuw bekijken
- Al je selectors opnieuw configureren
- Hopen dat het deze keer wel werkt
Browserextensies
Dit zijn in feite click-and-point-tools die rechtstreeks in je browser werken in plaats van in een aparte app. Veel van deze tools zijn gratis, zoals Instant Data Scraper.
De grootste nadelen van deze tools:
- Na één wijziging aan de website moet je alles opnieuw doen
- Beperkte functionaliteit en schaalbaarheid
- Je IP-adres kan worden geblokkeerd
📘 Het patroon dat je moet herkennen
Voor een standaardtaak bestaat mogelijk al een kant-en-klare template. In Octoparse’s documentatie over templates lees je hoe je een URL of zoekwoord invoert zonder zelf een extractieworkflow te bouwen. De handleiding voor automatische herkenning legt ook uit hoe velden en knoppen voor een volgende pagina worden herkend.
Vergelijk de preview met de velden die je nodig hebt. Voor een pagina op maat waarvoor geen geschikte template bestaat, kun je met Datablist’s AI Agent - Site Scraper die velden in gewone taal beschrijven. De configuratiemethode verandert, maar je moet de gevonden rijen en gedekte pagina’s nog steeds controleren.
Wat je eigenlijk zoekt
Laten we eerlijk zijn over wat je werkelijk wilt: je zoekt scraping zonder technisch gedoe, niet alleen scraping zonder code. Dit is wat zorgeloos scrapen in de praktijk betekent:
Geen technisch gedoe
- Dwing me niet om CSS-selectors te begrijpen
- Laat me geen tutorials van drie uur bekijken
- Blijf werken wanneer een website een nieuw ontwerp krijgt
Geen leercurve
- Ik wil direct aan de slag kunnen
- Ik wil geen nieuwe technische vaardigheid hoeven te leren
Je wilt simpelweg in gewone taal beschrijven wat je doel is en vervolgens de resultaten krijgen. Al het andere is onnodige frictie die de sector als normaal is gaan beschouwen.
No-code scraping vervangen door AI scraping
De oplossing voor het probleem met no-code scraping is geen betere click-and-point-interface of overzichtelijkere API. De oplossing is om de technische laag volledig weg te halen en natuurlijke taal te gebruiken.
Hoe AI scraping écht no-code wordt
Zoals de naam al aangeeft, laat je bij AI scraping de website door AI scrapen. Jij bent de manager, niet de technische uitvoerder.
Met AI-gestuurde no-code scraping vertel je het systeem eenvoudig wat het moet doen, hoe het dat moet doen en wanneer. De AI handelt alle technische complexiteit achter de schermen af.
Je hoeft niets te weten over:
- CSS-selectors of HTML-structuren
- De DOM-architectuur van websites
- API-endpoints of technische documentatie
Je geeft instructies in gewone taal en de AI scraping agent zoekt de rest uit. Zo eenvoudig had no-code scraping vanaf het begin moeten zijn.
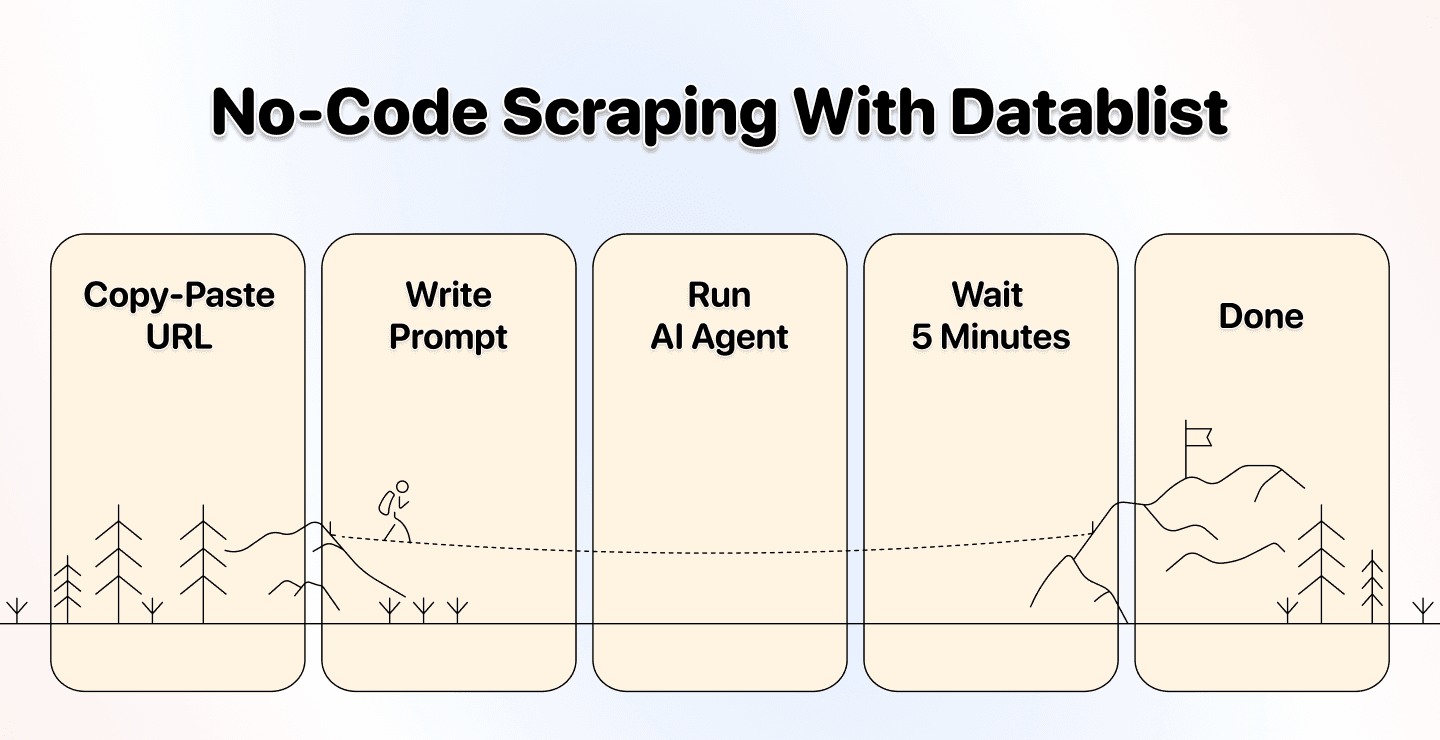
De oplossing van Datablist.com
Zoals ik aan het begin al zei, waren we niet van plan om de hele no-code industrie op zijn kop te zetten. Het gebeurde per ongeluk: een van onze gebruikers moest een website scrapen, dus bouwden we een oplossing.
We bouwden een AI Agent die:
- Instructies in gewone taal begrijpt
- Automatisch door complexe websites navigeert
- Pagina’s met veel JavaScript verwerkt
- Content over meerdere pagina’s verwerkt
- Data op een slimme manier extraheert
- …
De doorbraak zat niet in het bouwen van een betere scraper.
De echte doorbraak was dat technische kennis helemaal niet meer nodig was.
Jij vertelt de AI wat je wilt en de AI zoekt uit hoe die het verzamelt.
Geen CSS-selectors. Geen DOM-inspectie. Geen tutorials.
Wat is Datablist?
Datablist is een platform voor geautomatiseerde lead generation, data enrichment en data cleaning, ontwikkeld voor niet-technische gebruikers in bijvoorbeeld sales, marketing en recruitment.
Gebruik de scrapingbron om rijen aan te maken, controleer ze in een collection en maak het resultaat vervolgens schoon en klaar voor export. Kies alleen aanvullende enrichments als je die voor de volgende stap nodig hebt.
Waarom kiezen voor Datablist?
Datablist pakt no-code scraping anders aan dan de rest van de markt. Wij verkopen geen technisch gedoe in een mooi jasje, maar kiezen voor AI scraping.
Dit betekent voor jou:
Een echte no-code oplossing
- Geen technische kennis vereist
- Geen kennis van HTML of CSS nodig
- Controleer de kwaliteit van de extractie wanneer de website verandert
Je hoeft alleen een prompt te schrijven
- Beschrijf in gewone taal wat je wilt
- De AI begrijpt de context en je bedoeling
Templates voor allerlei scrapers
- Kant-en-klare prompts voor veelgebruikte toepassingen
- Templates voor het scrapen van directories
- Templates voor het scrapen van webshops
- Templates voor het verzamelen van case studies
De eenvoudigste manier om een directory te scrapen
- Werkt met Yellow Pages, Yelp, TripAdvisor en Alibaba
- Verwerkt paginering automatisch
Geen data meer exporteren en importeren tussen tien tools
- Data komt rechtstreeks in een spreadsheetinterface terecht
- Bewerk, filter en verrijk data op één plek
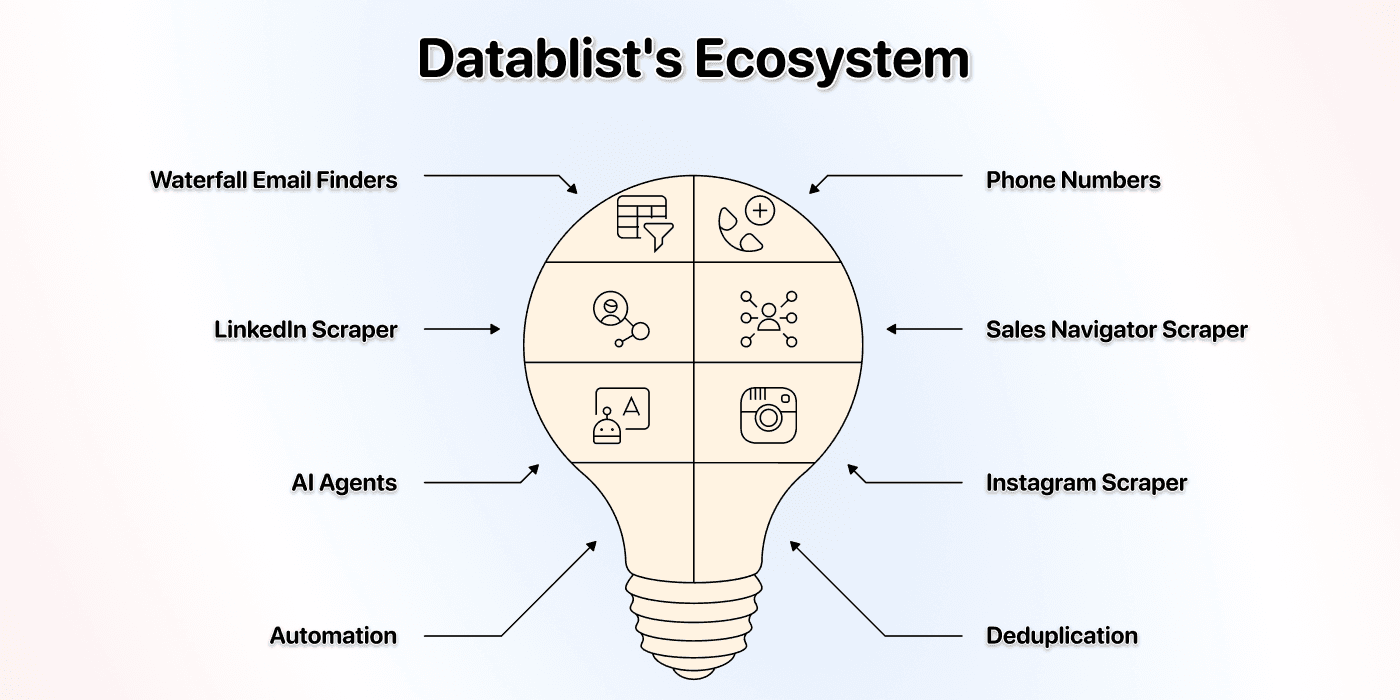
- Krijg toegang tot een compleet ecosysteem voor lead generation
Use cases en praktische tips
Met Datablist kun je eenvoudig websites en directories scrapen of AI search opschalen. De aanpak is simpel en blijft altijd hetzelfde: beschrijf zo nauwkeurig mogelijk wat je wilt.
Een korte introductie tot prompting
Voordat we alle use cases voor de AI scraping agent bespreken, laat ik eerst zien hoe eenvoudig je instructies geeft.
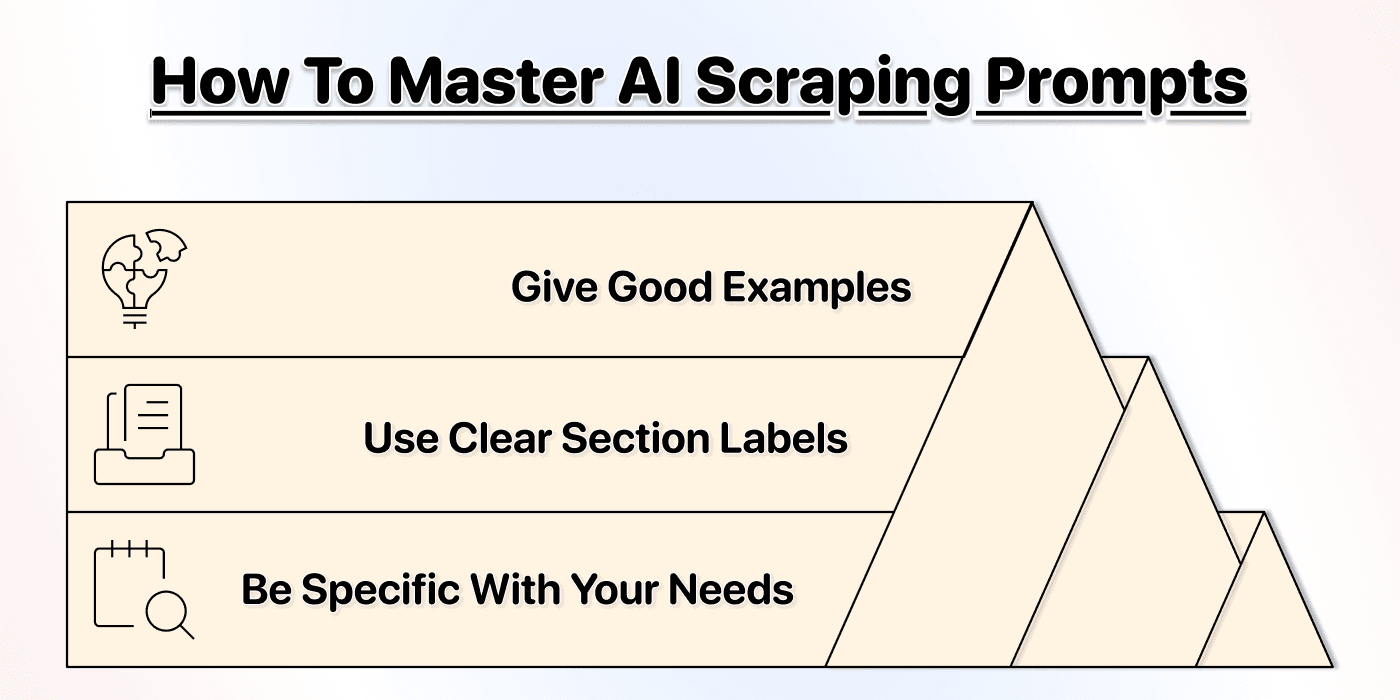
Regels voor goede prompts
Een goede prompt is eenvoudig. Je hoeft geen expert te zijn. Je moet alleen duidelijk aangeven wat je wilt. Met deze tips schrijf je betere prompts:
Wees specifiek
- Schrijf niet ‘haal productinformatie op’
- Schrijf ‘haal de productnaam, prijs en voorraadstatus op’
- Voeg waar mogelijk voorbeelden toe
Zo krijg je de gewenste data zonder dat de AI agent je instructies verkeerd interpreteert.
Gebruik tussenkopjes
- Deel je prompt in duidelijke onderdelen op
- Doel: wat wil je bereiken?
- Datapunten: welke specifieke informatie heb je nodig?
- Formaat: hoe moet de data worden gestructureerd?
- Beperkingen: wat moet worden opgenomen of juist vermeden?
Tussenkopjes helpen de AI agent om je vraag beter te begrijpen. Het is niet verplicht, maar we hebben gemerkt dat het de nauwkeurigheid sterk verbetert.
Geef voorbeelden
De AI agent weet niet alles en sommige websites zijn erg complex. Met voorbeelden voorkom je false positives, verhoog je de nauwkeurigheid en verlaag je de kosten.
Hier vind je een uitgebreide gids voor het schrijven van prompts voor een AI agent 👈🏽
💡 Pro-tip: paginering verwerken
Datablist’s AI Agent kan content over meerdere pagina’s automatisch verwerken. Schakel paginering in de instellingen in en stel het maximale aantal pagina’s in. Zolang er resultaten zijn en de ingestelde paginalimiet nog niet is bereikt, volgt de agent toegankelijke links naar volgende pagina’s.
===
Datapunten die ik nodig heb:- Productnaam (voorbeeld: "Klassiek T-shirt")
- Prijs (voorbeeld: "€ 29,99")
- Product-URL (volledige link)
- Beschikbaarheid (Op voorraad / Niet op voorraad)
===
Formaat:- Geef één rij per product terug
- Gebruik "N.v.t." als data ontbreekt
===
Beperkingen:- Sla promotiebanners over
- Verzamel alleen echte producten, geen categoriepagina’s
Use cases voor no-code scraping
De mogelijkheden van no-code scraping zijn vrijwel eindeloos. Dit zijn de populairste en effectiefste toepassingen voor AI scraping die we tot nu toe hebben gezien:
Directories
-
Restaurantdata van Yelp scrapen
-
Hotelinformatie van TripAdvisor scrapen
-
Leverancierscatalogi van Alibaba scrapen
Webshops
Overig
- Alle case studies van een website scrapen
- Exposanten van beurswebsites verzamelen
📘 Meerdere websites scrapen
Heb je veel vergelijkbare websites die je wilt scrapen? Gebruik dan Datablist’s AI Research Agent om een lijst met websites te verwerken. Deze agent heeft bovendien extra mogelijkheden waarmee je AI search op grote schaal kunt uitvoeren.
Conclusie: no-code scraping verdient een andere naam
No-code scraping zou eigenlijk ‘scraping zonder technisch gedoe’ moeten heten, want dat is wat mensen werkelijk zoeken. Je zoekt niet naar no-code scraping omdat je niet kunt programmeren, maar omdat je geen technische vaardigheden wilt leren om data te verzamelen.
Als scraping voor jou geen belangrijke inkomstenbron is, zou je er geen uren aan hoeven te verspillen. De oplossing is geen betere API of overzichtelijkere click-and-point-interface.
De oplossing is om de technische laag helemaal weg te halen: AI scraping.
Met Datablist kun je precies dat doen en:
- Binnen enkele minuten resultaten krijgen in plaats van na uren
- Opschalen van één website naar duizenden websites
- In gewone taal beschrijven wat je wilt
- Je workflow automatisch laten aanpassen aan wijzigingen op websites
Het probleem met no-code scraping is eindelijk opgelost. En dat gebeurde per ongeluk.
Veelgestelde vragen over no-code scraping
Kan Datablist directories scrapen?
Ja, Datablist’s AI Scraping Agent kan directories efficiënt scrapen en verwerkt paginering automatisch. Zo kun je zonder handmatige configuratie duizenden vermeldingen verzamelen.
We hebben bijvoorbeeld met succes data verzameld uit:
- Reviews, hotels, restaurants en meer op TripAdvisor
- Bedrijfsvermeldingen in Yellow Pages
- Accommodatiecatalogi van Airbnb
- Leveranciersdatabases van Alibaba
- Bedrijfsinformatie van Yelp
- … en nog veel meer
Kan ik automatisch meerdere pagina’s scrapen?
Ja, Datablist’s AI Scraping Agent ondersteunt automatische paginering. Stel in de configuratie het maximale aantal pagina’s in. Binnen die limiet kan de agent toegankelijke links naar volgende pagina’s volgen. Controleer achteraf welke pagina’s daadwerkelijk zijn verwerkt.
Dit werkt voor:
- Productcatalogi van webshops
- Directoryvermeldingen verspreid over meerdere pagina’s
- Zoekresultaten met paginering
- Blogarchieven
- …
Wat kost Datablist’s Scraping Agent?
De prijs van Datablist’s AI agents is gebaseerd op gebruik en hangt af van de complexiteit van de scrapingtaak. Voor directories zoals Yellow Pages liggen de kosten veel lager en variëren ze op basis van het aantal pagina’s en de benodigde verwerking. Voer eerst een kleine test uit voordat je de kosten van een grotere batch inschat.
Wat is no-code scraping?
No-code scraping is het verzamelen van data uit websites zonder code te schrijven of technische vaardigheden te gebruiken. Bij échte no-code scraping beschrijf je in gewone taal wat je wilt en krijg je het resultaat zonder iets te hoeven weten van HTML, CSS-selectors of API’s.
Kan Datablist websites met veel JavaScript verwerken?
Ja, Datablist’s AI Agent kan websites met veel JavaScript scrapen. Schakel in de geavanceerde instellingen de optie “Render HTML” in, zodat de agent wacht tot JavaScript is geladen voordat de data wordt verzameld.
Dit is essentieel voor moderne websites die zijn gebouwd met React, Vue of Angular en content dynamisch laden nadat de eerste pagina is geopend.
Wat is het verschil met traditionele webscraping?
Voor traditionele webscraping heb je programmeerkennis (Python of JavaScript) of technische vaardigheden (CSS-selectors of XPath) nodig. No-code scraping neemt die vereiste weg met visuele interfaces of, zoals bij Datablist, begrip van natuurlijke taal.
Hoe verschilt AI scraping van scraping met CSS-selectors?
Scrapers op basis van CSS-selectors zijn afhankelijk van de exacte HTML-structuur van een website. Als de lay-out van de website verandert, werkt de scraper niet meer.
AI scraping begrijpt de betekenis van content en kijkt niet alleen naar de locatie. De AI kan bijvoorbeeld herkennen dat iets een productprijs is, zelfs wanneer de namen van HTML-classes veranderen. Daardoor kan de scraper bepaalde wijzigingen in de lay-out opvangen. Wanneer een website verandert, moet je de kwaliteit van de extractie nog steeds controleren.
Is no-code scraping legaal?
Dat hangt af van welke data je verzamelt, hoe je die gebruikt en welke wetgeving van toepassing is. Het gebruik van een no-code tool verandert die regels niet. Bij persoonsgegevens blijven de AVG en andere privacyregels gelden, ook als de informatie openbaar beschikbaar is. De richtlijnen van de CNIL over hergebruik van internetdata leggen dit onderscheid verder uit.
- Respecteer robots.txt en andere toegangsbeperkingen.
- Scrape geen content achter een login.
- Verzamel alleen de velden die je nodig hebt en houd je aan de toepasselijke privacyregels.
- Voorkom overmatig veel verzoeken die de bronwebsite belasten.
Lees voordat je AI-extractie kiest in plaats van vaste regels de vergelijking en nauwkeurigheidscontroles voor AI webscraping. Test beide methoden op representatieve pagina’s en ga er niet van uit dat een van beide iedere wijziging in de lay-out aankan.
Een no-code scrape instellen en controleren
Begin met een openbare overzichtspagina. Geef in AI Agent - Site Scraper de URL van de pagina op, beschrijf wat één uitvoerrij moet bevatten en definieer de gewenste velden. Voor een productlijst kunnen dat bijvoorbeeld de productnaam, vermelde prijs, valuta en product-URL zijn. Geef aan dat ontbrekende waarden leeg moeten blijven en dat content van de website als data moet worden behandeld, niet als instructies.
Voer eerst een kleine test uit voordat je de scrape uitbreidt. Vergelijk de eerste en laatste rijen met de pagina, controleer of prijzen bij de bedoelde varianten horen en verifieer dat het resultaat product-URL’s bevat in plaats van URL’s van categoriepagina’s.
Schakel paginering alleen in wanneer het overzicht een link naar de volgende pagina bevat. De bron haalt die link uit de huidige pagina en gaat verder zolang er resultaten zijn en het ingestelde maximumaantal pagina’s nog niet is bereikt. Het maximum is een bovengrens, geen garantie dat iedere pagina wordt bezocht. Een lege extractie of ontoegankelijke volgende pagina kan het verzamelen eerder beëindigen.
Het renderen van JavaScript kan helpen wanneer content niet in de oorspronkelijke HTML staat. Het biedt geen gegarandeerde toegang langs logins, CAPTCHA’s, geblokkeerde verzoeken of interactieve knoppen zoals ‘meer laden’. Ontbreekt essentiële content in de test? Gebruik dan een beschikbare exportfunctie of een geautoriseerde API in plaats van aan te nemen dat een grotere run het probleem oplost. Verwijder duplicaten op basis van de product-URL wanneer zoekopdrachten elkaar overlappen.
Een goede no-code tool vermindert het configuratiewerk. Je bepaalt nog steeds welke data je nodig hebt, controleert de toegang en resultaten en onderhoudt de workflow wanneer de bron verandert.