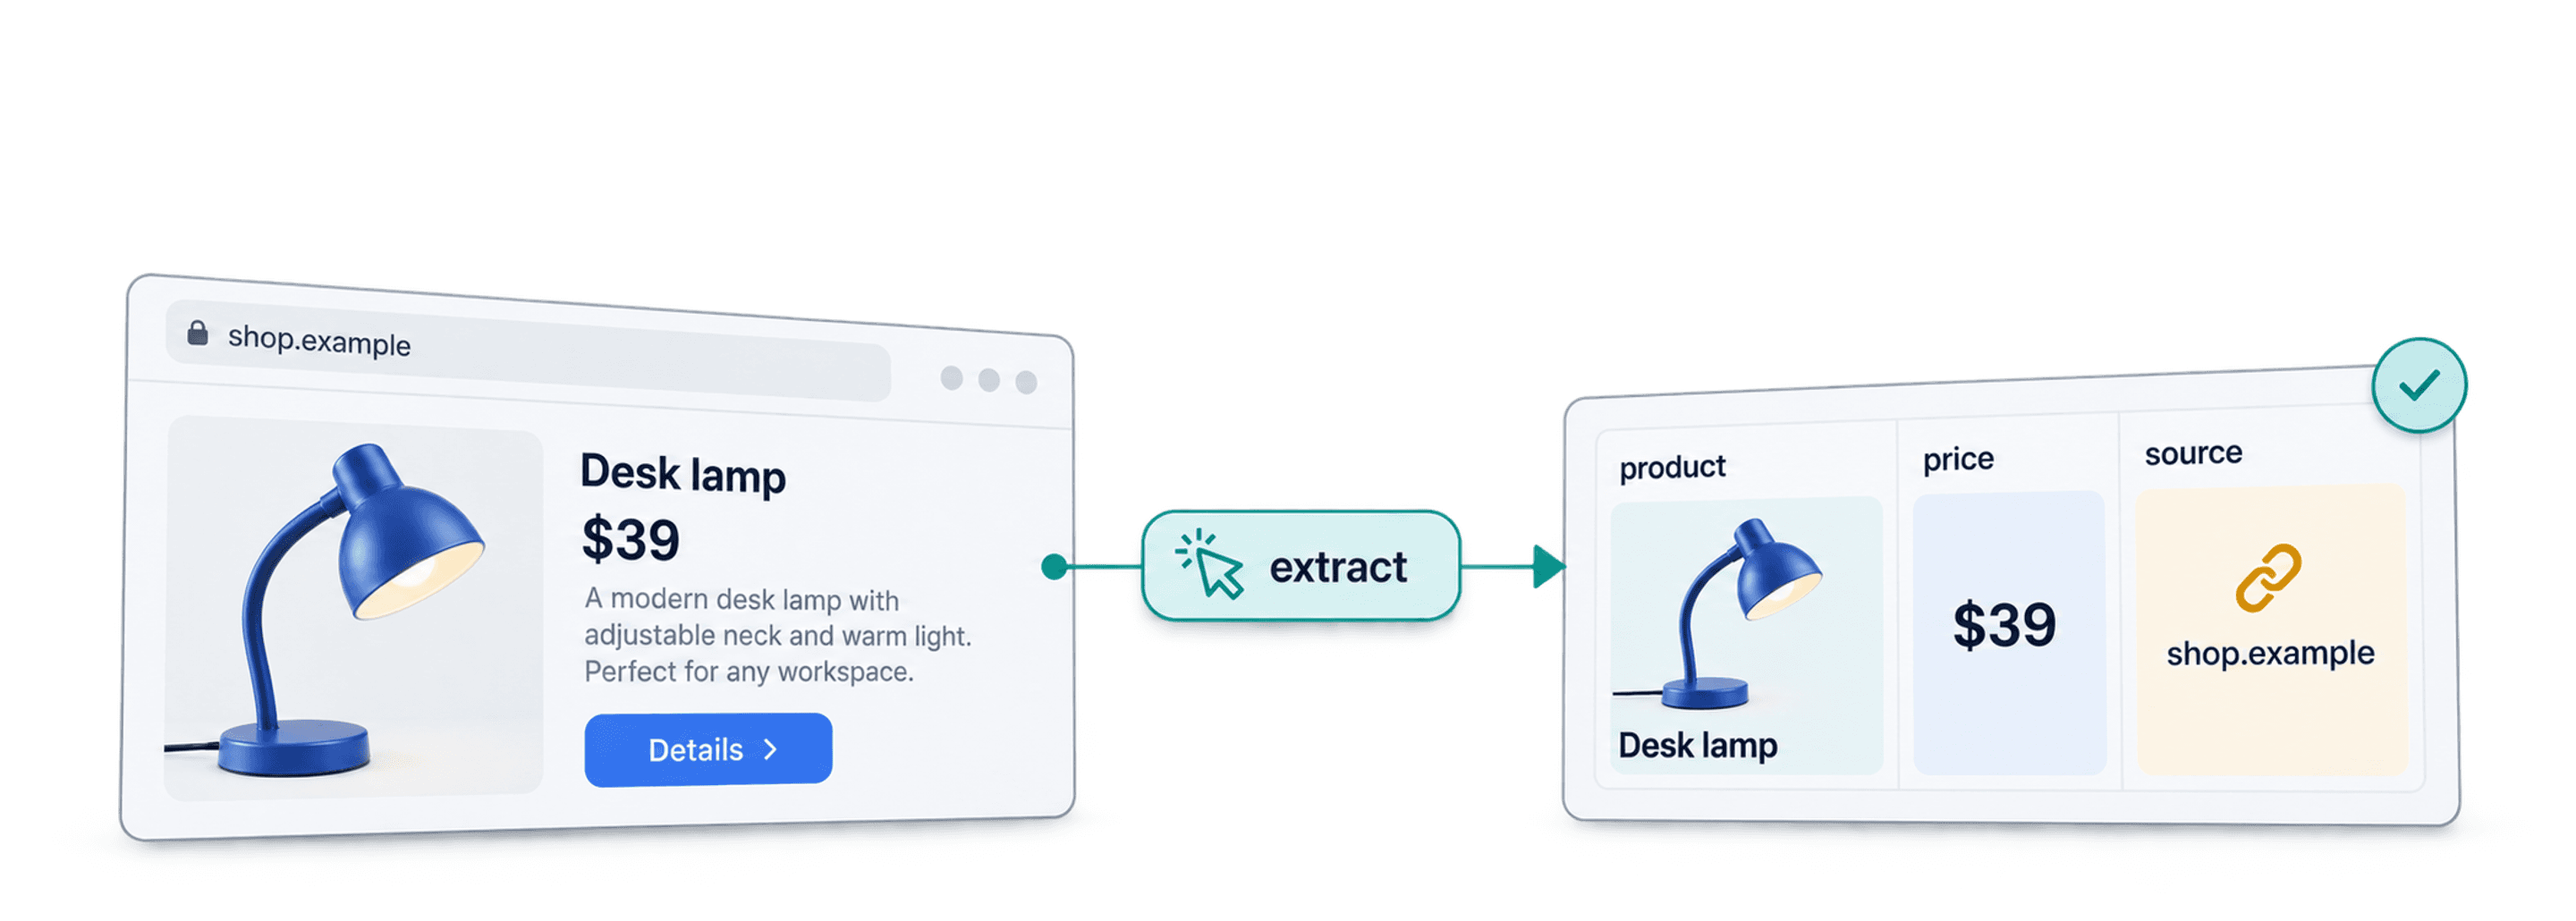
AI web scraping bruker en AI-modell til å lese innhold på nettsteder og returnere bestemte felt, for eksempel produktnavn, pris og kilde-URL. I stedet for å skrive en CSS-selektor for hvert felt beskriver du informasjonen du trenger, og kobler resultatet til kolonner. Du må likevel kontrollere resultatet: Modellen kan overse et felt, blande sammen to sider eller returnere en verdi uten støtte i kilden.
Du kan for eksempel gi en agent en produktside og be om Produktnavn, Gjeldende pris og Produkt-URL. Et nyttig resultat er én rad med disse tre feltene, der prisen er kontrollert mot kildesiden. Hvis siden ikke viser noen pris, bør feltet stå tomt i stedet for at modellen gjetter. Denne guiden forklarer forskjellen mellom AI-uttrekk og regelbasert scraping, hvilken arbeidsflyt du bør velge, og hva du må kontrollere før du bruker dataene.
Dette dekker guiden
- Hva er AI web scraping?
- De viktigste fordelene med AI scraping
- Praktiske bruksområder for AI scraping
- To metoder for AI-datainnhenting
- De beste verktøyene for AI scraping
Hva er AI web scraping?
Begrepene nedenfor beskriver den samme overordnede metoden. Verktøyet trenger fortsatt tilgjengelig kildeinnhold og tydelig definerte resultatfelt.
AI web scraping, AI scraping og AI data scraping
AI web scraping = AI scraping = AI data scraping
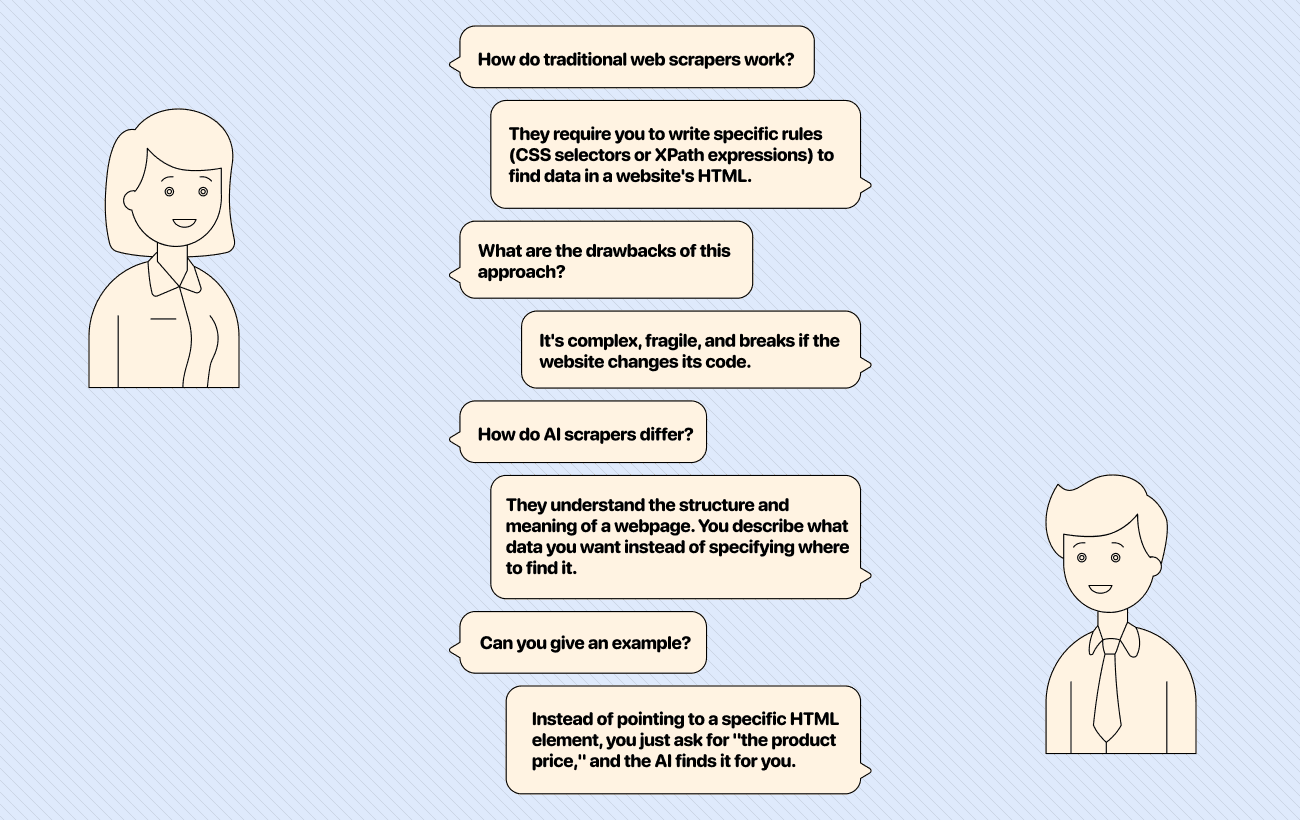
Alle disse begrepene viser til bruk av en AI-modell for å finne og strukturere informasjon fra nettinnhold. En tradisjonell scraper velger ofte elementer ved hjelp av en CSS-selektor eller XPath. I en arbeidsflyt for AI-uttrekk brukes i stedet en prompt eller et skjema for å identifisere felt etter betydning. Det kan være nyttig når sidene har ulik layout, men du må fortsatt håndtere utilgjengelige sider, endret innhold og feilaktige resultater.
Fordeler med AI scraping
AI-uttrekk er nyttig når den samme opplysningen finnes på forskjellige steder på ulike sider, eller når du vil gjøre ustrukturert tekst om til kolonner. Regelbasert scraping kan være enklere og rimeligere når sidene har en stabil og ensartet layout. Velg metode ut fra kilden og resultatet du trenger.
Ingen koding eller API-er
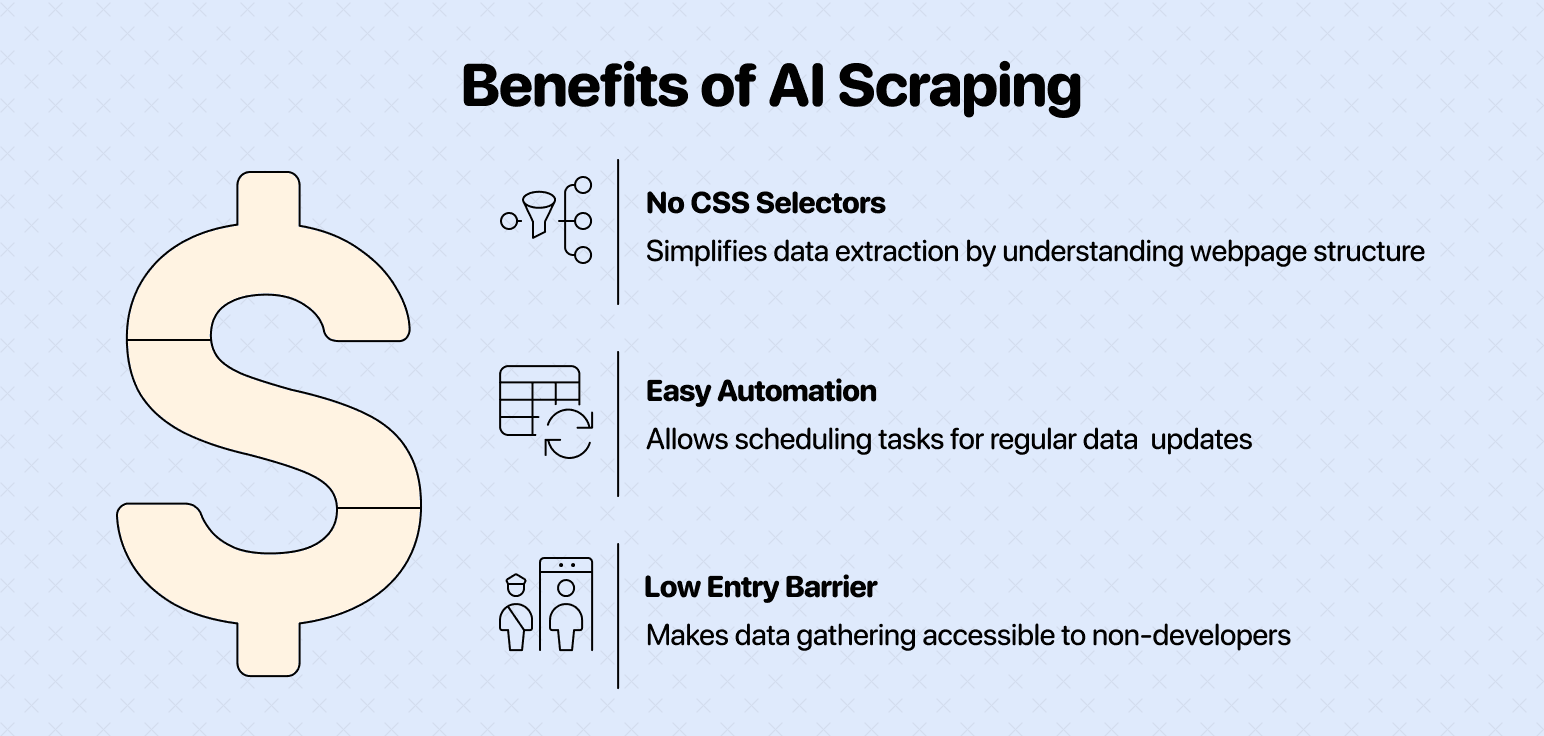
Enkelte AI scraping-verktøy lar deg skrive en prompt i naturlig språk direkte i brukergrensesnittet. Andre krever API eller kode. En tydelig forespørsel bør navngi hvert resultatfelt og forklare hva som skal skje når siden ikke inneholder en verdi.
Ingen CSS-selektorer, XPath-uttrykk eller kompleksitet
Med en selektorbasert scraper identifiserer du HTML-elementet som inneholder verdien. Med AI-uttrekk kan du be om et felt som «gjeldende produktpris» på tvers av sider med forskjellig layout. Test begge metodene på noen representative sider. Endret layout, blokkerte sider eller uklare priser kan fortsatt kreve en justert prompt eller manuell kontroll.
Enkel automatisering og lav terskel
Du kan kjøre en arbeidsflyt for AI-uttrekk på en liste med URL-er eller starte med URL-en til et nettsted. Før du gjentar en kjøring, bør du kontrollere et utvalg av resultatene for tomme felt, feil treff og endringer i kildenettstedets struktur. Automatisering må fortsatt overvåkes.
Bruksområder for AI scraping
AI scraping kan brukes på nesten ubegrenset mange områder i en virksomhet. Ved å automatisere innsamling av data fra nettet kan team hente ut viktig innsikt og jobbe mer effektivt.
Her er noen eksempler på hva du kan gjøre med AI Scraping:
- Scrape nettbutikker
- Team kan hente ut produktinformasjon som navn, priser, beskrivelser og bilder fra tusenvis av oppføringer.
- Dette er nyttig til konkurrentanalyse, prisovervåking og bygging av produktkataloger.
- Scrape anmeldelser
- Ved å samle kundeanmeldelser fra nettsteder som Trustpilot, G2 eller Amazon kan bedrifter forstå hvordan markedet oppfatter dem.
- AI kan analysere dataene for å finne gjennomgående temaer, produktsvakheter og hva som driver kundetilfredshet i en konkurrentanalyse.
- Overvåke prissider
- Salgs- og markedsteam kan automatisk følge konkurrentenes priser og kampanjer.
- Det støtter dynamiske prisstrategier og hjelper virksomheten med å holde seg konkurransedyktig.
- Scrape kundehistorier
- Markedsteam kan samle kundehistorier fra konkurrentenes nettsteder for å forstå posisjoneringen og suksesshistoriene deres.
- Informasjonen er verdifull når teamet skal forbedre egne markedsbudskap og salgspresentasjoner.
- Finne data som ikke finnes i databaser
- Enkelte opplysninger finnes rett og slett ikke i strukturerte databaser.
- AI-scrapere kan hente unike data fra forum, blogger eller nisjenettsteder til markedsundersøkelser, akademiske studier eller gravejournalistikk.
💡 Praktiske guider for å komme i gang med AI Scraping
Slik scraper du kundehistorier 👈🏼
Slik scraper du produkter fra nettbutikker 👈🏼
Slik scraper du brukeranmeldelser fra Trustpilot 👈🏼
Slik finner du kontoinformasjon som ikke finnes i databaser 👈🏼
To metoder for AI scraping
AI scraping-verktøy tilbyr ulike metoder avhengig av oppgaven. Selv om teknologien i bunn er den samme, avhenger valget av om du vil berike et eksisterende datasett eller utforske et nytt nettsted fra bunnen av.
La oss se på de to vanligste metodene:
Kjør en AI Scraping Agent på en liste
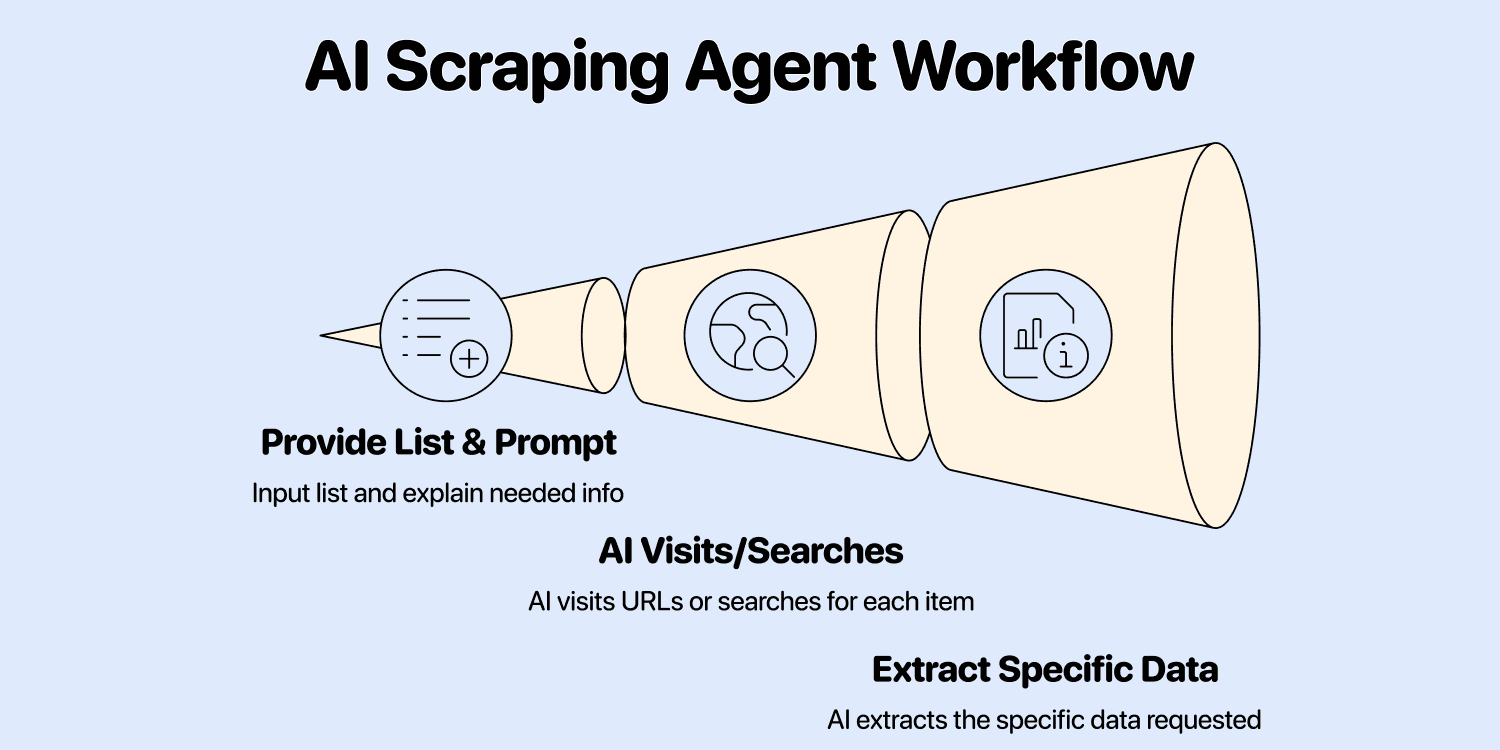
Denne metoden passer perfekt når du allerede har et utgangspunkt, for eksempel et regneark med bedriftsnavn eller produkt-URL-er. Du gir AI-agenten listen og en prompt som forklarer hvilken tilleggsinformasjon du trenger for hvert element.
AI-en besøker deretter hver URL eller søker etter hvert element og henter ut dataene du ba om.
- Best egnet til: Beriking av eksisterende datasett, for eksempel å finne bransjen til en liste med bedrifter eller navnet på CEO-en for en liste med kontoer.
- Kontroll: Test først et lite utvalg, og undersøk kildesidene for feltene som er viktige.
Bruk en AI Scraping Agent som nettstedsscraper
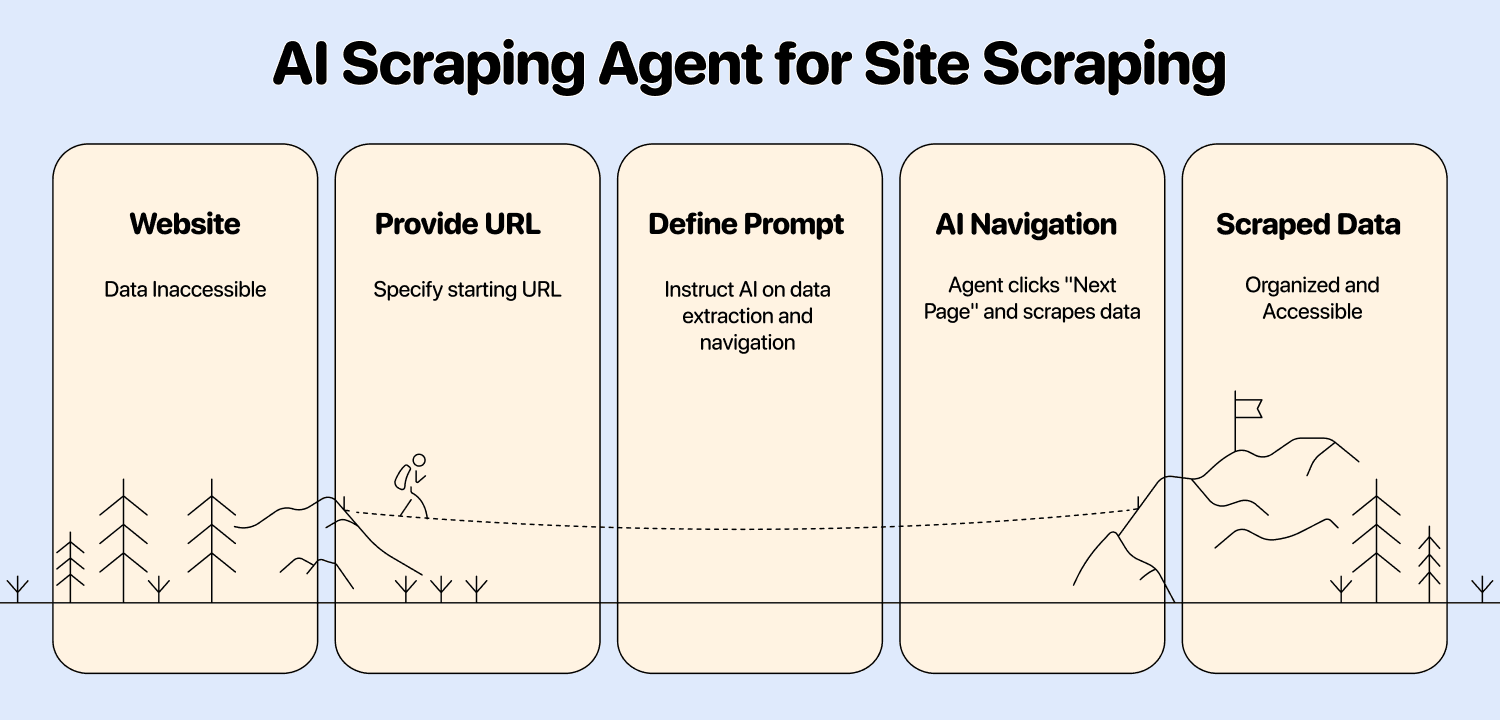
Denne metoden er utviklet for å utforske og hente data fra et helt nettsted eller deler av det. Du oppgir en start-URL, for eksempel en kategoriside i en nettbutikk, og en prompt som forteller AI-en hva den skal se etter og hvordan den skal navigere på nettstedet.
For Datablists website scraper oppgir du en start-URL og en prompt som beskriver elementene som skal hentes ut. Paginering er valgfritt. Konfigurer det når kilden har flere resultatsider.
Oppsettet for website scraping og kontroll av eksempelresultater viser hvordan du sammenligner resultatene med prompten, tester rendering og skiller mellom et manglende felt og en blokkert side.
- Best egnet til: Scraping av produktoppføringer fra nettsteder som Amazon eller eBay, innsamling av blogginnlegg eller uttrekk av oppføringer fra en hvilken som helst katalog.
- Kontroll: Start med et begrenset antall sider. Kontroller deretter at radene kommer fra de riktige sidene før du utvider kjøringen.
Verktøy for AI scraping
Markedet for AI scraping-verktøy vokser raskt. Riktig valg avhenger av teknisk kompetanse, budsjett og konkrete behov. Her er tre alternativer med startpris ved månedlig fakturering i USD.
| Verktøy | Viktigste bruksområde | Startpris | Inkludert bruk per måned |
|---|---|---|---|
| Datablist | No-code scraping og beriking av regneark | $25/måned | 5 000 credits |
| Firecrawl | Nettdata og strukturert uttrekk for apper | $19/måned | 5 000 credits |
| ScrapingBee | Scraping API med AI-uttrekk | $19/måned | 75 000 API credits |
Credits måler ulike ting. Datablist belaster for AI-modellen og verktøyene som brukes. Firecrawl belaster etter side og valgt format, mens ScrapingBee legger kostnaden for AI-uttrekk til grunnkostnaden for forespørselen. Eksemplene nedenfor viser hvorfor flest credits ikke automatisk betyr den rimeligste arbeidsflyten.
Datablist – laget for salg, markedsføring og drift
Datablist er en plattform for dataautomatisering som samler kraftige funksjoner for AI scraping i et brukervennlig regnearkgrensesnitt. Den er utviklet for salgs-, markeds- og driftsteam som må samle inn og berike data uten å skrive kode eller konfigurere API-er.
Viktige funksjoner:
- Prompter i naturlig språk: Beskriv behovet ditt på vanlig engelsk, så finner AI-agenten informasjonen for deg. Du trenger verken kode eller komplisert API-oppsett.
- To utgangspunkt: Kjør en AI Agent på eksisterende rader, eller start med URL-en til et nettsted, en prompt og valgfri paginering.
- Innstillinger for kjøringen: Website scraper har en sidegrense og en valgfri innstilling for HTML-rendering. Test en liten kjøring før du øker antallet sider.
- Strukturerte resultater: Koble de ønskede feltene til kolonner i samlingen, kontroller radene og kombiner dem med andre enrichments ved behov.
Pris:
- Starter: $25/måned med 5 000 credits. Growth koster $50/måned med 20 000 credits.
- Bruken av credits til AI scraping varierer med modell, verktøy og antall besøkte sider. HTML-rendering koster 2 ekstra credits per scrape når funksjonen er aktivert.
- For en jobb som bruker 25 000 credits, koster Starter pluss en påfylling på 20 000 credits $45 ($25 + $20). Dette er et eksempel på et credit-budsjett, ikke en fast pris for et bestemt antall sider. Påfylling krever et aktivt abonnement og utløper ikke.
💡 Datablists skjulte styrker
Fordelen med Datablists AI Scraper er at den egentlig er mye mer enn en AI Scraper. Det er en AI scraping agent som kan søke på Google, besøke Google News, kalle API-er, hente ut data, paginere nettsteder og mye mer.
Firecrawl – web data API for AI-apper
Firecrawl er et web data API med åpen kildekode, utviklet for utviklere. Det gjør nettsteder om til LLM-klare data som kan brukes i AI-applikasjoner.
Viktige funksjoner:
- Strukturert uttrekk: Oppgi en URL og et JSON-skjema eller en prompt som beskriver feltene du trenger. Kontroller de returnerte verdiene mot kildesiden.
- LLM-klare resultater: Få data i flere formater, blant annet JSON, Markdown og skjermbilder, klare til bruk i AI-behandling.
- Utviklerorientert løsning: Bygget med SDK-er for Python og Node.js, med omfattende dokumentasjon og eksempler.
Pris:
- Hobby: $19/måned med 5 000 credits. Standard koster $99/måned med 100 000 credits. Dette er månedsprisene, ikke de lavere prisene ved årlig fakturering.
- En grunnleggende scrape av én side koster 1 credit. Velger du JSON, kommer 4 i tillegg. Én side med JSON-uttrekk bruker derfor 5 credits. Andre modi kan endre forbruket.
ScrapingBee – AI Scraper for utviklere
ScrapingBee er et API-first scraping-verktøy som håndterer proxyer og nettlesere. Utviklere kan kalle det fra kode, mens integrasjoner som n8n og Make lar team koble det til andre arbeidsflyter. Du må fortsatt konfigurere forespørselen og koble de returnerte dataene til riktige felt.
Viktige funksjoner:
- AI-drevet web scraping: Bruker AI til å tolke og hente ut data, noe som gjør løsningen mer robust ved endringer på nettstedet.
- API-tilgang: Utviklet for at utviklere skal kunne integrere løsningen i egne applikasjoner og arbeidsflyter.
- JavaScript-rendering: Kan scrape moderne, dynamiske nettsteder som i stor grad er avhengige av JavaScript.
Pris:
- Hobby: $19/måned med 75 000 API credits. Freelance-abonnementet til $49/måned inkluderer 250 000.
- AI-uttrekk legger til 5 credits per forespørsel. En grunnleggende forespørsel bruker 1 credit, eller 5 med JavaScript-rendering, før kostnaden for AI-uttrekk legges til. Premium proxy-innstillinger kan øke grunnkostnaden ytterligere.
Hva koster en jobb med strukturert datauttrekk?
Eksemplene bruker én forespørsel per side med de oppgitte innstillingene. De priser API-bruk, ikke antallet korrekte dataposter som returneres.
| Verktøy og jobb | Nødvendige credits | Månedsabonnement og pris |
|---|---|---|
| Firecrawl: 1 000 sider med JSON-uttrekk | 5 000 | Hobby: $19 |
| Firecrawl: 10 000 sider med JSON-uttrekk | 50 000 | Standard: $99 |
| ScrapingBee: 10 000 forespørsler med AI-uttrekk, uten JavaScript-rendering | 60 000 | Hobby: $19 |
| ScrapingBee: 10 000 forespørsler med AI-uttrekk og JavaScript-rendering | 100 000 | Freelance: $49 |
For ScrapingBee tilsvarer de to siste radene 10 000 × (1 + 5) og 10 000 × (5 + 5). Rendering gjør at jobben overstiger kvoten i Hobby. Med Datablist bør du bruke en liten testkjøring for å fastslå forbruket til modellen, prompten og kildesidene. Deretter kan du beregne budsjettet ut fra de inkluderte creditene i Starter til $25 og prisene for påfylling ovenfor.
Slik kontrollerer du resultater fra AI scraping
Kontroller et utvalg av radene mot kildesidene før du bruker datasettet. Bekreft at hver verdi tilhører riktig element, at enheter og valutaer er bevart, og at manglende verdier står tomme. Hvis kildesiden er utilgjengelig eller resultatet er usikkert, bør du justere prompten eller kontrollere raden manuelt. Gjenta stikkprøven når kildenettstedet endres.
Ofte stilte spørsmål om AI scraping
Kan ChatGPT brukes til web scraping?
En AI-modell kan hente ut felt fra nettinnhold du gir den. For gjentakbare kjøringer på tvers av mange URL-er bør du bruke en arbeidsflyt som registrerer kilde-URL-er, kobler felt til kolonner og lar deg kontrollere mislykkede eller usikre rader.
Hva er AI scraping?
AI scraping bruker en modell til å identifisere etterspurte felt i innhold på nettsteder og returnere strukturerte resultater. Du kan beskrive feltene i en prompt i stedet for å angi CSS-selektorer, men viktige resultater bør kontrolleres mot kilden.
Er scraping lovlig?
Reglene avhenger av nettstedet, dataene og jurisdiksjonen. Kontroller nettstedets vilkår og relevante lovkrav før du samler inn eller bruker data, særlig personopplysninger.
Hva er data scraping?
Data scraping betyr å hente ut informasjon fra en kilde, for eksempel et nettsted eller dokument. AI scraping bruker en AI-modell til å identifisere eller strukturere den etterspurte informasjonen.
Hvordan skiller AI scraping seg fra tradisjonell web scraping?
Selektorbasert scraping retter seg mot bestemte elementer i HTML-koden på en side. AI-uttrekk bruker en prompt eller et skjema til å identifisere felt etter betydning. Begge metodene kan mislykkes når et nettsted endres eller en side ikke er tilgjengelig. Sammenlign derfor resultatene på representative sider.
Hvilke ferdigheter trenger jeg for å starte med AI scraping?
Med Datablist kan du oppgi en URL eller en liste med rader, beskrive de ønskede feltene og koble resultatene til kolonner uten å skrive kode. Du må likevel kontrollere et utvalg av resultatene.
Kan AI-scrapere håndtere nettsteder som endrer layout?
Noen ganger. En prompt kan fortsatt finne et felt etter en layoutendring, men blokkerte sider, manglende innhold og tvetydige etiketter kan likevel føre til feil. Kontroller et nytt utvalg når kildenettstedet endres.
Kilder
- [1] Datablist. Starter koster $25/måned med 5 000 credits, mens Growth koster $50 med 20 000. Aktive abonnenter kan kjøpe ekstra credits.
- [2] Firecrawl. Månedsprisene for Hobby og Standard er henholdsvis $19 og $99. Grunnleggende scraping koster 1 credit per side, og JSON legger til 4.
- [3] ScrapingBee. Hobby koster $19/måned for 75 000 credits, mens Freelance koster $49 for 250 000. AI-uttrekk legger 5 credits til grunnkostnaden per forespørsel.