

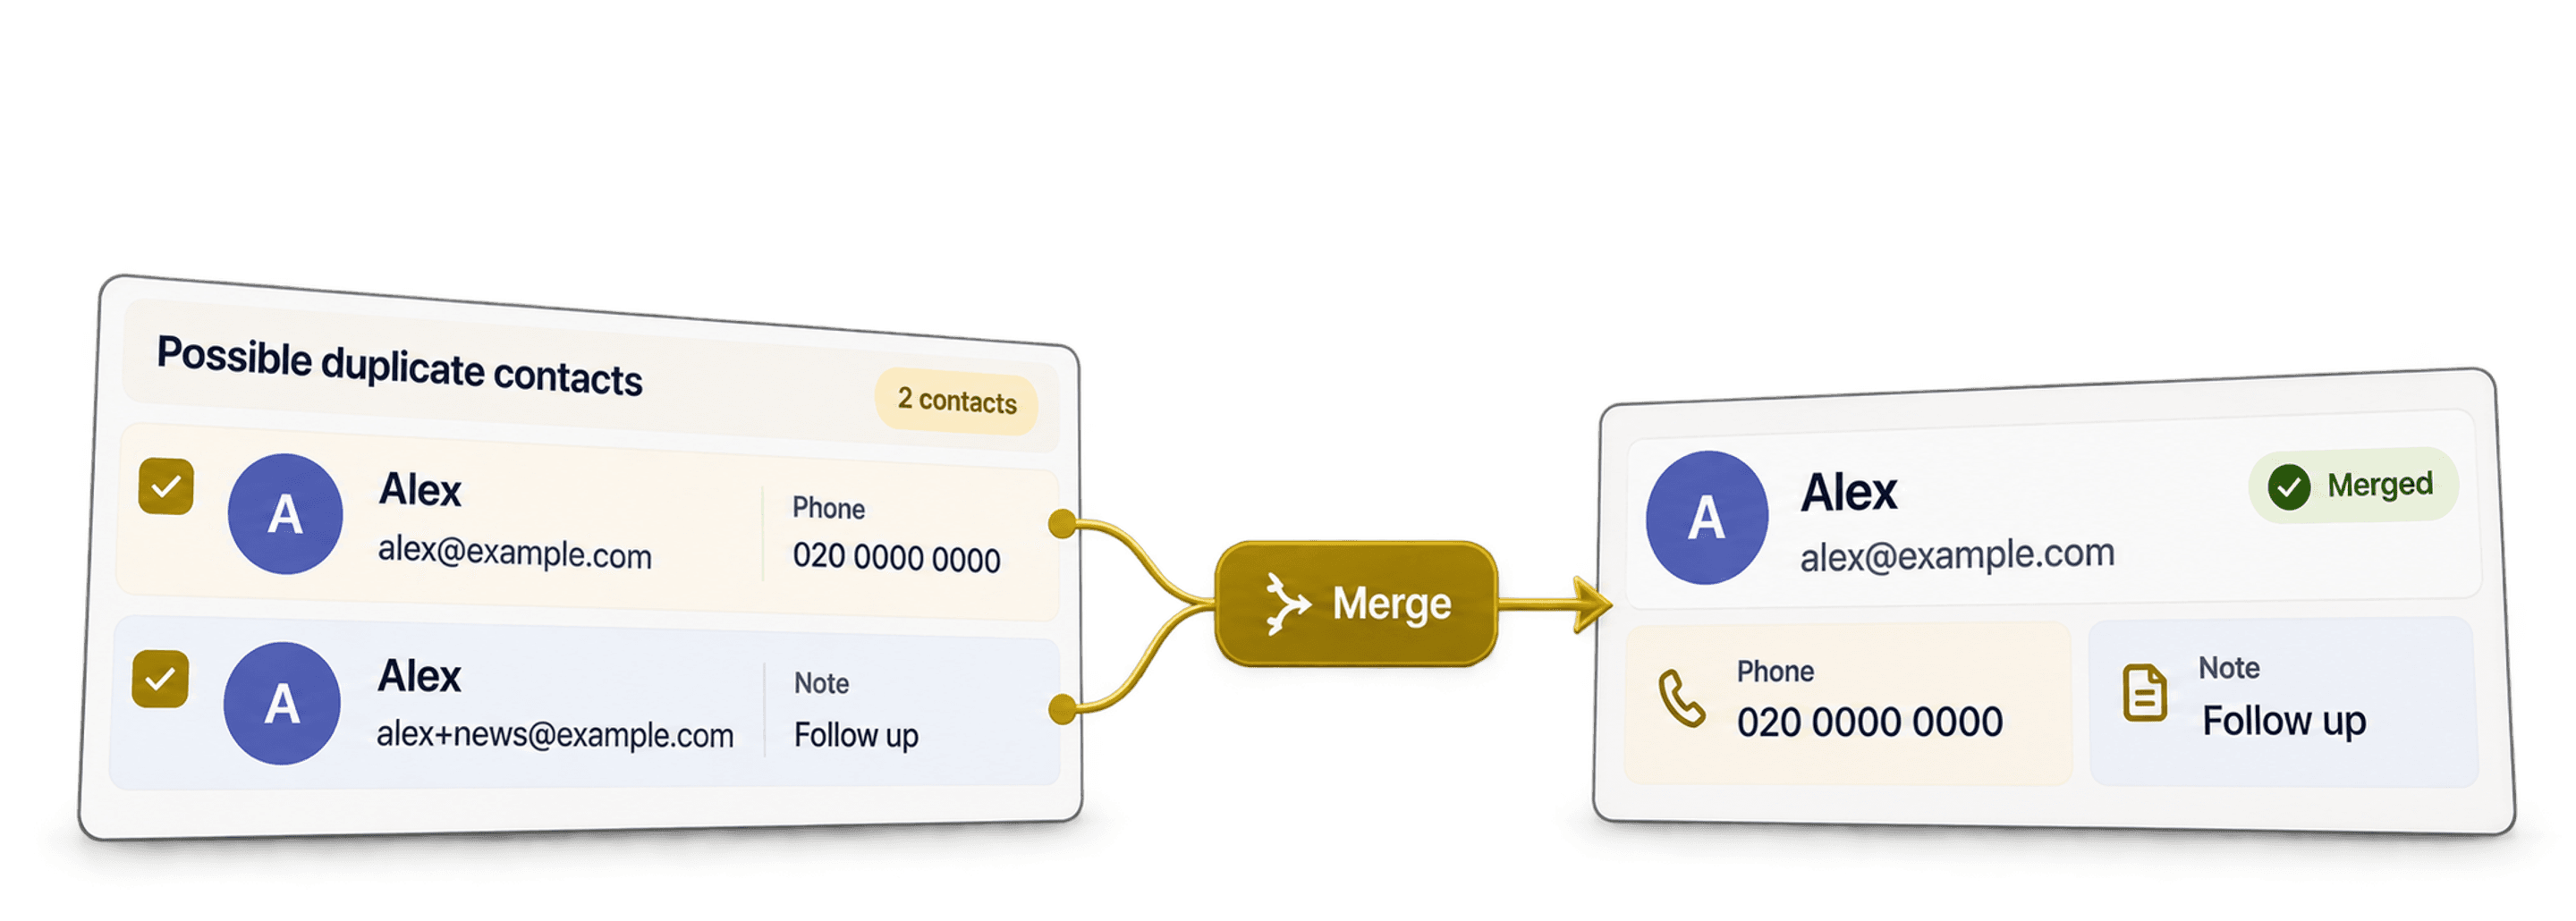
E-postduplikater har en tendens til å snike seg inn når du kombinerer en CRM-eksport med skjemainnsendinger eller en deltakerliste. Samme person dukker opp to ganger, men radene er sjelden identiske. Den ene kan inneholde telefonnummeret, mens den andre har kilden eller et nyttig notat.
Derfor begynner jeg ikke med å slette gjentatte e-postadresser. For å fjerne duplikate e-postadresser på en trygg måte bruker jeg Datablist Duplicates Finder med Smart matching og Email processor. Verktøyet grupperer varianter av samme e-postadresse, slik at jeg kan gå gjennom hele kontaktraden og slå sammen opplysningene jeg vil beholde.
Til denne gjennomgangen satte jeg sammen en testliste med 1 000 kontakter og typiske adressevarianter, fra plussaliaser og Gmail-varianter til adresser pakket inn i annen tekst. Datablist fant 200 duplikatpar, og den ryddede samlingen endte med 800 kontakter. Her viser jeg innstillingene jeg brukte, og hva jeg kontrollerte før jeg slo sammen noe.
Match først på e-post, men vurder hele kontaktraden når du bestemmer hva som skal beholdes. Hvis du i stedet må sammenligne navn, telefonnumre, firmadomener eller andre identifikatorer, kan du se hvordan du fjerner duplikater fra en liste på nett.
Hva Datablist regner som samme e-postadresse
Smart matching med Email processor sammenligner e-postidentiteter i stedet for den ubehandlede teksten i cellene. Den fjerner mellomrom rundt adressen, sammenligner verdier med små bokstaver og fjerner et +suffiks fra den lokale delen før matching.
Den bruker også Gmail-spesifikke regler. Punktum fjernes fra den lokale delen av Gmail-adresser, og googlemail.com tilordnes gmail.com. Datablist kan dessuten hente ut en gyldig adresse fra et visningsnavn eller en mailto:-verdi med en spørringsstreng.
Her er noen eksempler fra testdatasettet:
| Lagrede verdier | Resultat med Smart Email |
|---|---|
noraanderson40@demo.conoraanderson40+newsletter@demo.co | Samme identitet etter at plussuffikset er fjernet |
victorbennett62@gmail.comvictorb.ennett62@gmail.com | Samme Gmail-identitet etter at punktum er fjernet |
yasmincarter105@gmail.comyasmincarter105@googlemail.com | Samme Gmail-identitet etter normalisering av domenet |
camiladiaz123@testmail.netCamila Diaz <camiladiaz123@testmail.net> | Samme identitet etter at den innpakkede adressen er hentet ut |
marcusevans199@testmail.netmailto:MARCUSEVANS199@TESTMAIL.NET?subject=Hello | Samme identitet etter at innpakningen er fjernet og verdiene er sammenlignet med små bokstaver |
Håndtering av punktum gjelder bare Gmail. Datablist antar ikke at first.last@company.com og firstlast@company.com er samme adresse. På andre domener enn Gmail kan punktum ha betydning.
Smart Email er en sammenligningsregel, ikke en validator for e-postadresser. Den kontrollerer nok av strukturen til å normalisere en adresse, men validerer ikke domenet eller innboksen fullt ut. For eksempel blir person+tag@.example.com til person@.example.com ved matching, selv om domenet er ugyldig. Gå gjennom ugyldige verdier separat før du slår sammen rader.
Hvis plussaliaser, Gmail-punktum og innpakninger skal behandles som ulike adresser, velger du Exact. En eksakt tekstsammenligning fjerner fortsatt mellomrom rundt verdien og skiller som standard ikke mellom store og små bokstaver. Aktiver Case sensitive når store og små bokstaver må behandles forskjellig. Mellomrom rundt verdien fjernes fortsatt.
Kontroller adresser med plusstagger på firmadomener før du slår dem sammen. Smart Email grupperer sam+orders@example.com med sam@example.com under samme sammenligningsnøkkel. Exchange Online prøver først hele adressen og bruker basisadressen dersom den fullstendige adressen ikke kan løses. [1] Behold begge hvis adressene har forskjellige mottakeroppføringer eller rutingen er uklar. Kjør kontrollen med Exact på e-postkolonnen, og bekreft at de to radene forblir separate.
🔑 Normalisering foreslår en duplikatgruppe
Det beviser ikke at alle feltene tilhører samme person. Kontroller navn, selskaper og rollebaserte innbokser før du slår sammen.
For de fleste kontaktlister anbefaler jeg Smart matching med Email processor. Jeg bytter til Exact når aliaser må holdes atskilt, og kontrollerer deretter innstillingen for store og små bokstaver mot identifikatorene i filen.
Se referansen for Email processor for alle normaliseringsreglene og hvilke abonnementer funksjonen er tilgjengelig i.
Eksempellisten med e-postadresser
Testfilen inneholder 1 000 syntetiske kontaktrader som representerer 800 planlagte identiteter. Ingen av duplikatparene har nøyaktig samme ubehandlede e-posttekst. Det er viktig fordi en opprydding basert på eksakte verdier ikke ville demonstrert aliasbevisst matching.
Filen har åtte kolonner: record_id, first_name, last_name, email, company, phone, source og notes. Arbeidsflyten matcher på email, men de andre feltene forblir synlige, slik at jeg kan velge en hovedoppføring og bevare nyttige verdier.
Her er fire faktiske inndatarader fra to duplikatpar:
| record_id | first_name | last_name | phone | source | notes | |
|---|---|---|---|---|---|---|
CONTACT-0040-A | Nora | Anderson | noraanderson40@demo.co | CRM-eksport | Primær kontaktoppføring | |
CONTACT-0040-B | N. | A. | noraanderson40+newsletter@demo.co | +1-202-555-1039 | Nettskjema | Oppfølgingsinformasjon fra en annen kilde |
CONTACT-0062-A | Victor | Bennett | victorbennett62@gmail.com | +1-202-555-1061 | Nettskjema | Primær kontaktoppføring |
CONTACT-0062-B | victor | BENNETT | victorb.ennett62@gmail.com | Arrangement | Oppfølgingsinformasjon fra en annen kilde |
Nora-paret viser hvorfor jeg ikke sletter duplikater med én gang. Basisoppføringen har det foretrukne fulle navnet, mens raden med plussaliaset inneholder det eneste telefonnummeret og en annen anskaffelseskilde. Ved å slå sammen radene kan begge deler beholdes.
Datasettet inneholder 200 duplikatidentiteter med to rader hver, jevnt fordelt på fem variantgrupper: plussaliaser, Gmail-adresser med punktum, gmail.com kontra googlemail.com, visningsnavn rundt adressen og mailto:-verdier. De øvrige 600 identitetene forekommer én gang.
Du kan laste ned CSV-eksempelfilen med 1 000 rader for å gjenskape gjennomgangen. Hvis du bruker din egen fil, bør du ha én e-postadresse per rad og beholde tilknyttede felt som skal konsolideres.
Importer og klargjør e-postkolonnen
Importer CSV- eller Excel-filen til en ny samling i Datablist. Kontroller forhåndsvisningen av importen, og tilordne e-postkolonnen som en e-postegenskap.
Behold navn, selskap, telefon, kilde, notater og stabile ID-er som separate egenskaper. Disse kolonnene er ikke støy. De gir deg grunnlaget du trenger når to rader matcher på e-post, men inneholder ulike opplysninger ellers.
Jeg foretrekker også én adresse per celle i denne arbeidsflyten. Hvis en celle inneholder alice@example.com; bob@example.com, bør du først dele opp eller normalisere den. Veiledningen om å fjerne duplikater i et felt med flere e-postadresser dekker dette tilfellet.
For en celle med flere adresser sammenligner multi-value-deduplication de semikolonseparerte delene. Kontroller hvilken innboks som overlapper før du behandler to kontaktoppføringer som samme person.
💡 Behold grunnlaget for sammenslåingen
Ikke fjern kolonner for kilde, notater, telefonnummer eller stabil ID før dedupliseringen. De hjelper deg med å velge hovedraden og unngå å miste unike data.
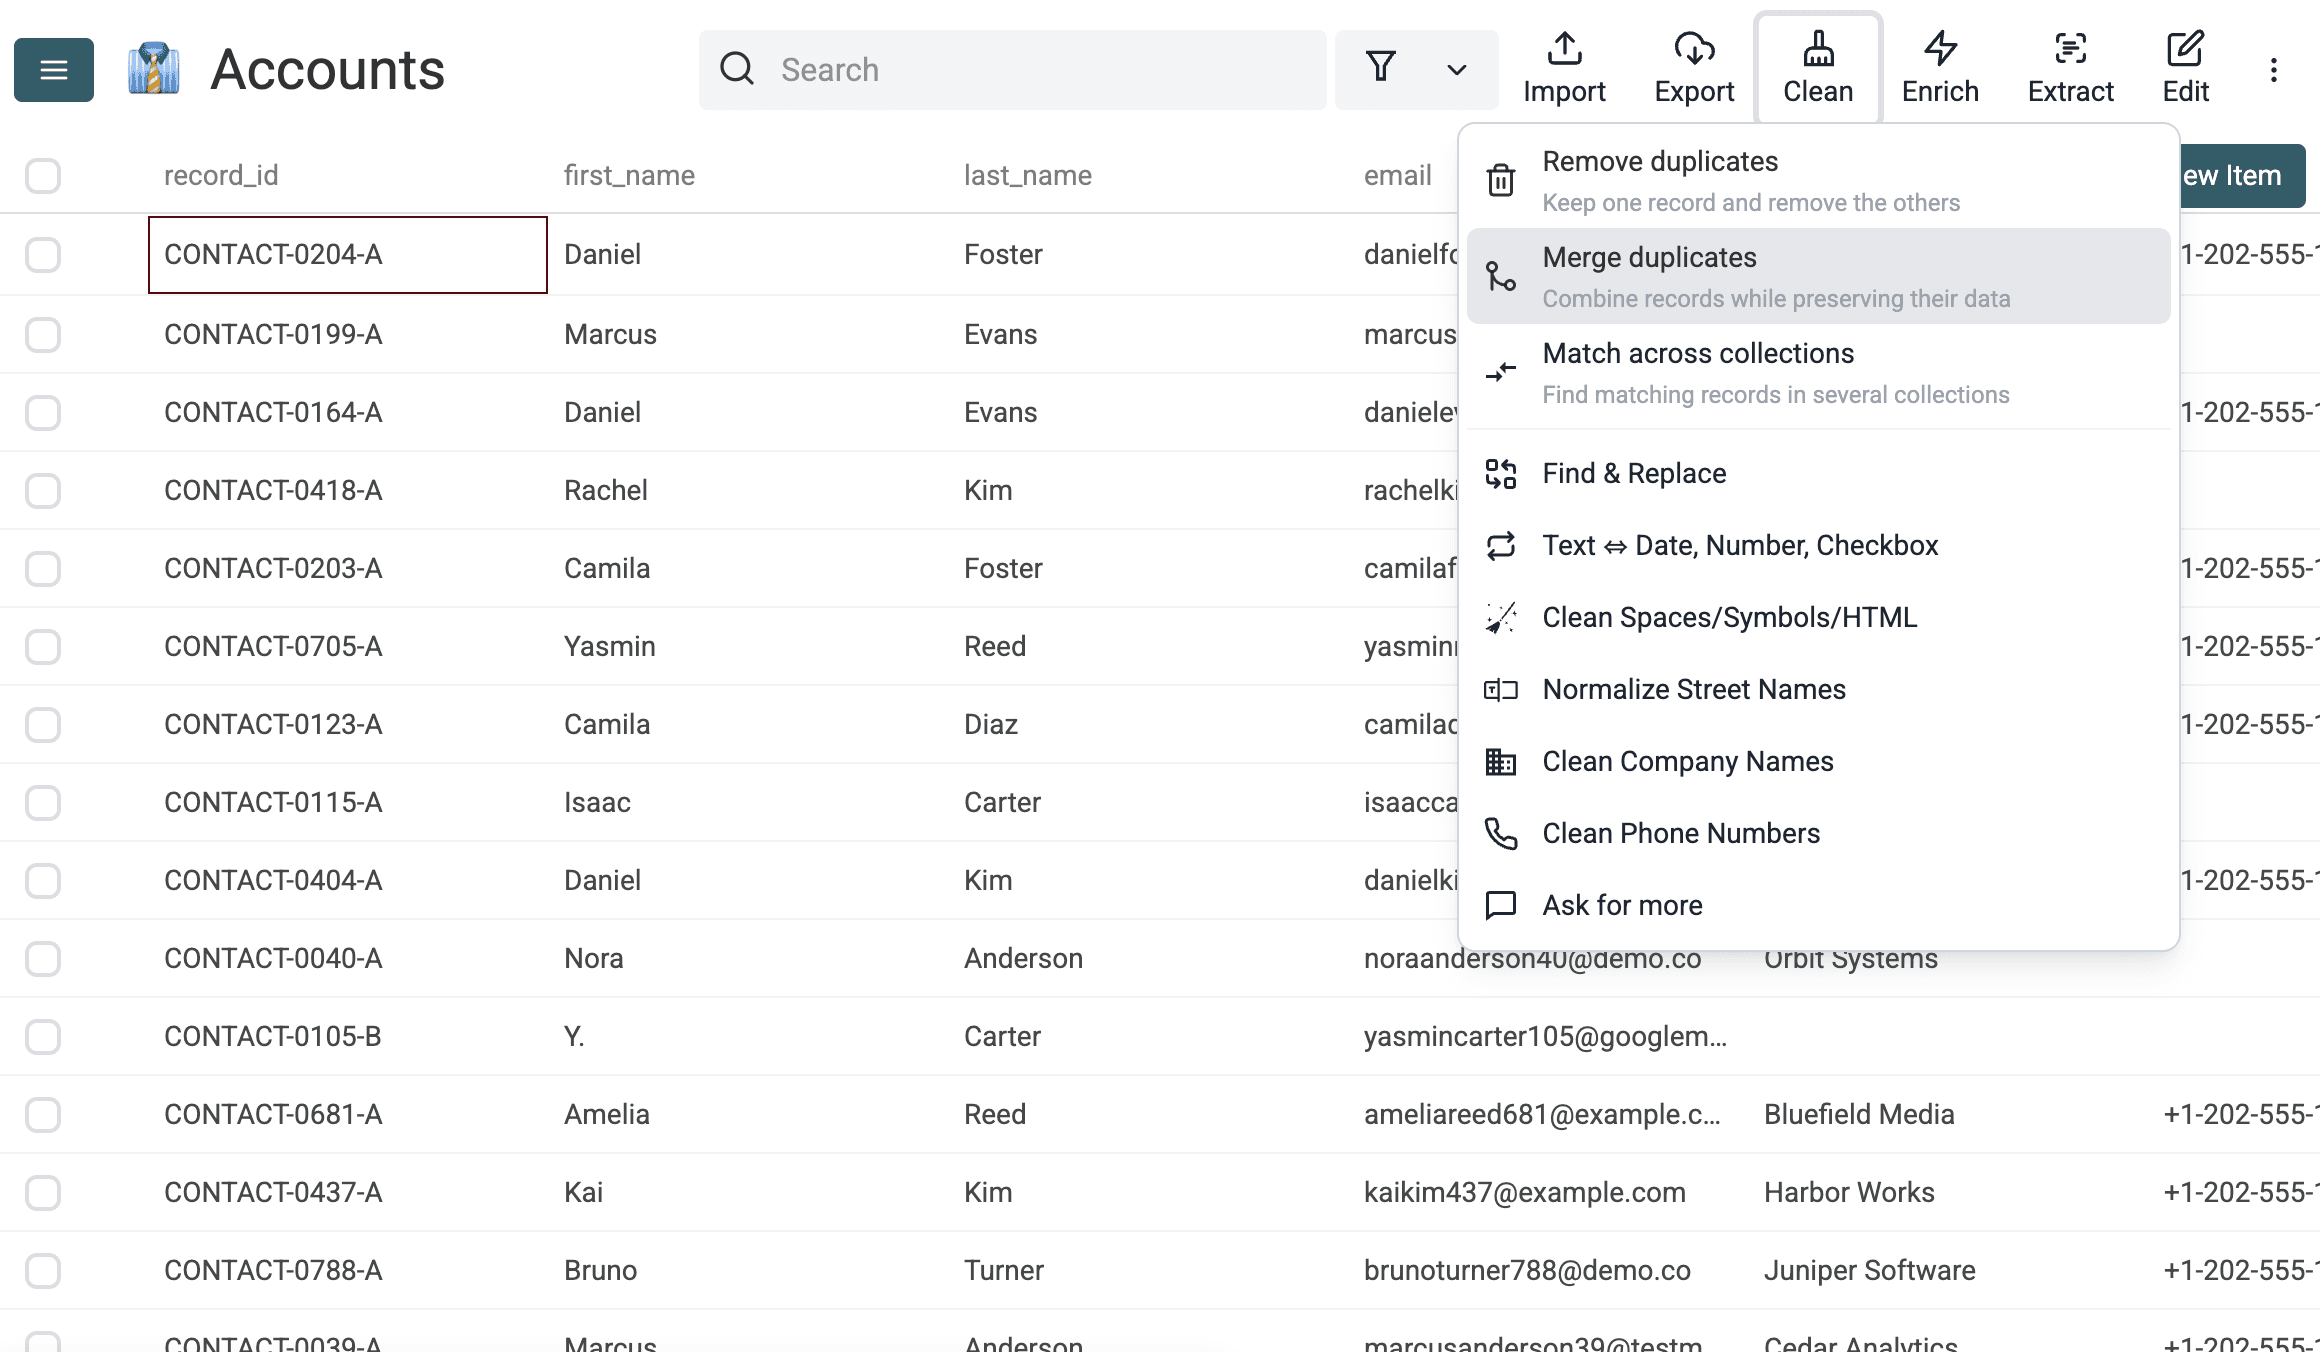
Åpne Clean > Merge duplicates. Velg Selected Properties, og velg deretter email for denne e-postbaserte gjennomgangen.
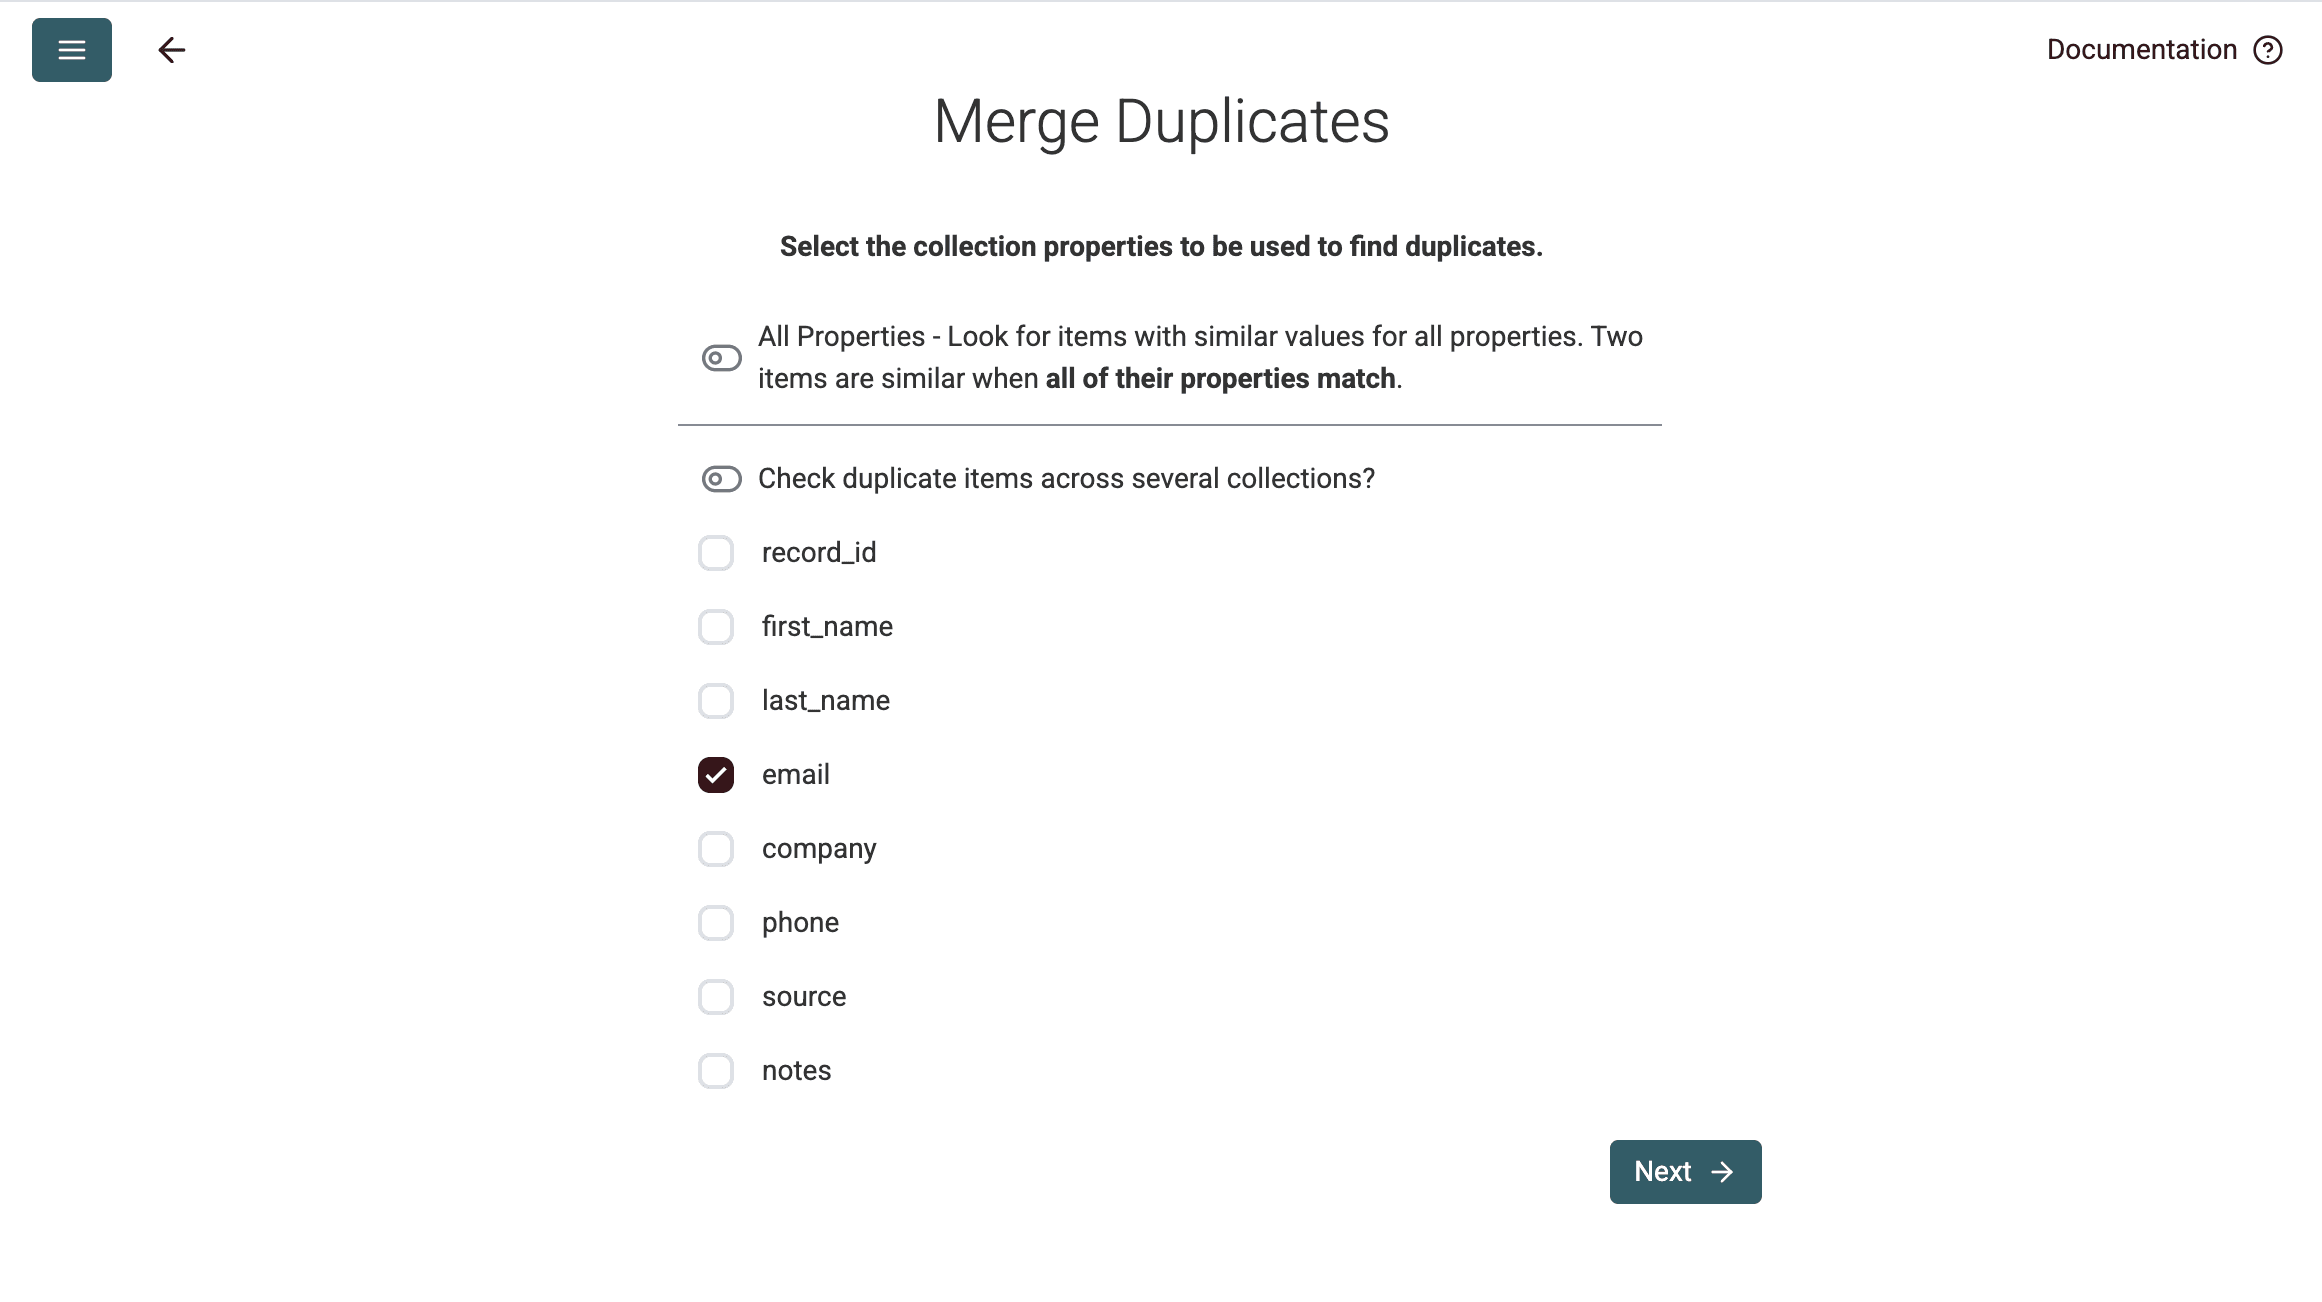
Når du velger én egenskap, er det enklere å forstå regelen. Hvis du legger til navn eller selskap nå, kan det hindre en gyldig e-postmatch når disse feltene mangler eller er formatert forskjellig.
Konfigurer Duplicates Finder
For egenskapen email velger du Smart som sammenligningsalgoritme og Email som processor.
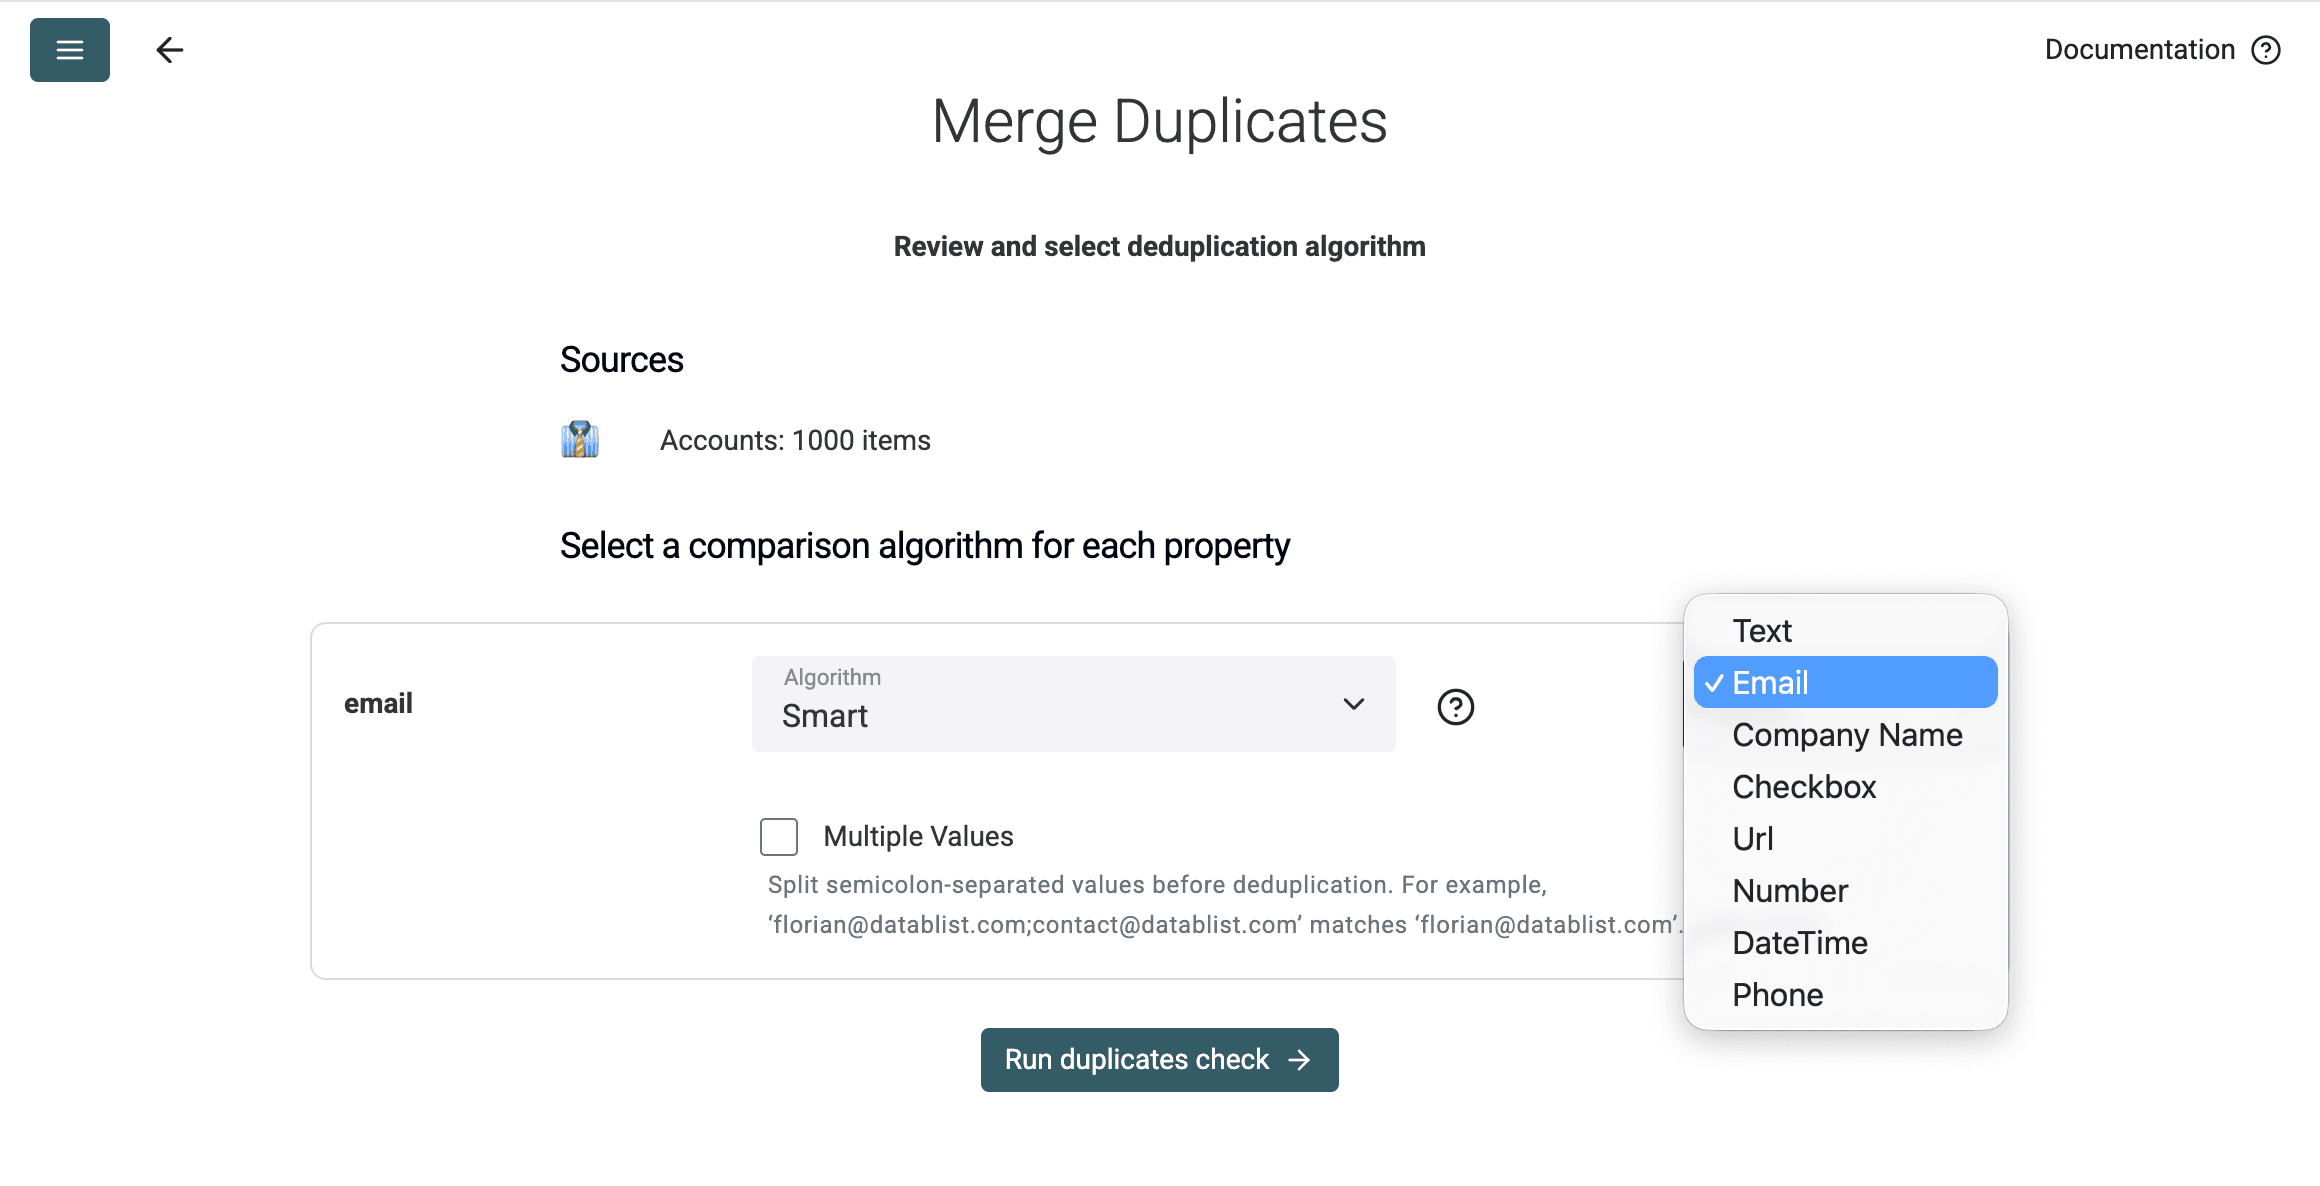
Hver innstilling har en bestemt funksjon:
- Selected Properties begrenser kontrollen til identifikatoren du vil sammenligne.
- Smart aktiverer processor-basert normalisering i stedet for en bokstavelig sammenligning av de lagrede tekststrengene.
- Email bruker de verifiserte reglene for aliaser, Gmail, visningsnavn og
mailto:som er beskrevet ovenfor.
Bruk Smart sammen med Email processor for identitetsvarianter. Exact hopper over e-postspesifikk normalisering, men fjerner fortsatt mellomrom og skiller som standard ikke mellom store og små bokstaver.
Selve duplikatkontrollen er skrivebeskyttet. Når du kjører den, opprettes kandidatgrupper som kan gjennomgås. Ingen rader i samlingen slettes eller slås sammen. Endringene skjer først når du velger og bruker en handling for sammenslåing eller sletting.
Dette skillet er nyttig. Jeg vil se hvilke verdier matchingregelen anser som like før jeg lar en massesammenslåing endre listen.
Kjør kontrollen og vurder duplikatgruppene
Klikk på Run duplicates check. I denne testen plasserte Datablist 400 av de 1 000 radene i 200 grupper med to rader hver.
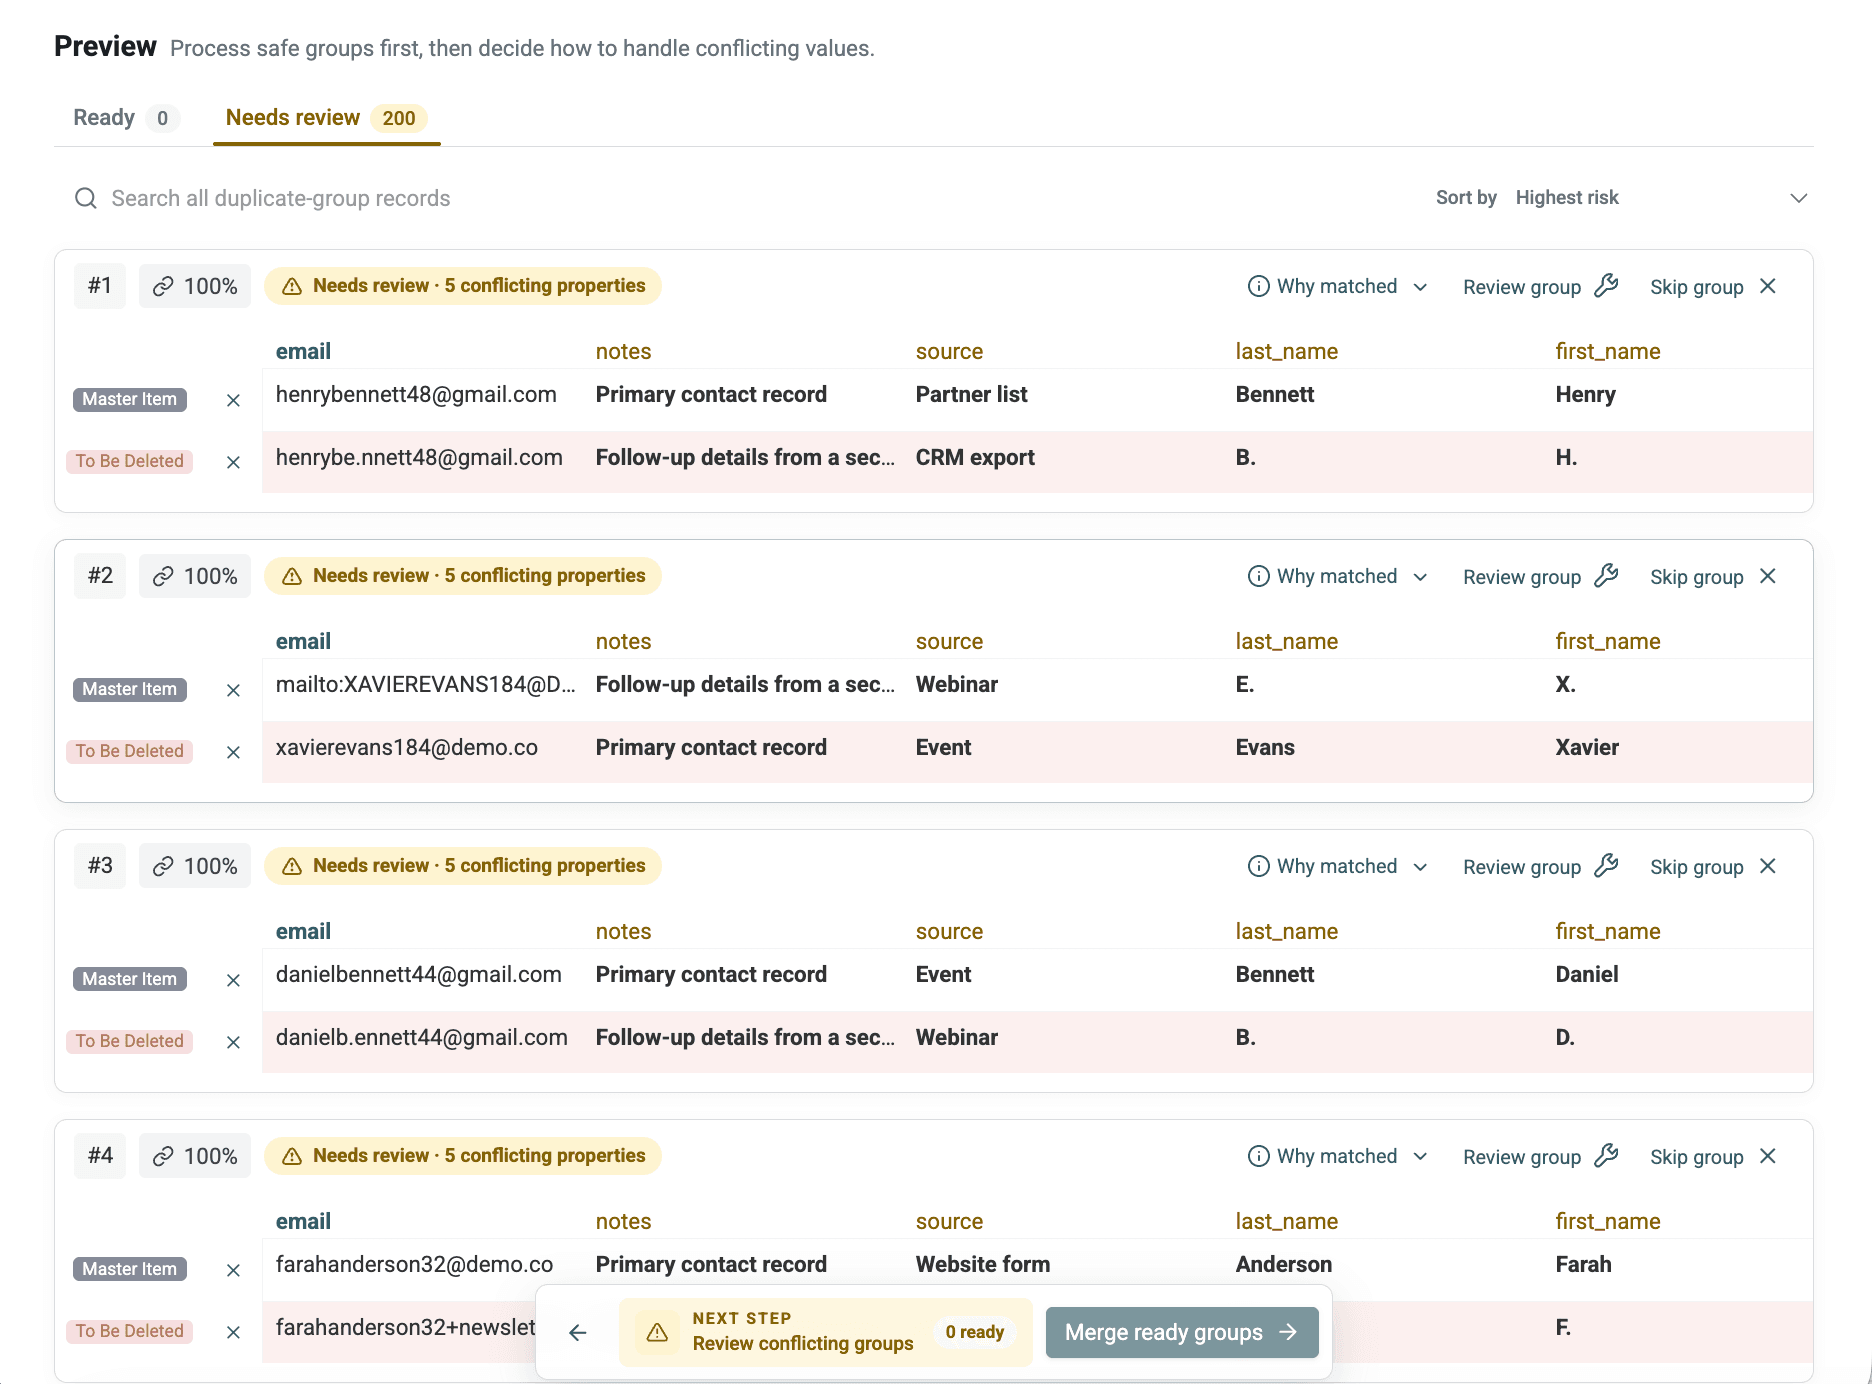
Ikke behandle antallet grupper som antallet rader som skal slettes ennå. En gruppe er en kandidat som må vurderes. Kontroller følgende for hver gruppe:
- om e-postvarianten er logisk;
- om for- og etternavn samsvarer eller har en forståelig variasjon;
- om selskaps- og telefonverdier er i konflikt;
- om kilde og notater tilfører utfyllende informasjon;
- om adressen er en delt innboks.
Jeg går vanligvis gjennom de første gruppene og alle overraskende matcher på tvers av selskaper før jeg bruker en regel på mange rader. Det går raskere enn å reparere en for aggressiv sammenslåing senere.
⚠️ En gjentatt adresse betyr ikke alltid samme person
En delt innboks som
sales@company.comkan være knyttet til flere reelle kontakter. Gå gjennom rollebaserte adresser manuelt i stedet for å anta at alle radene skal slås sammen.
Testfilen var utformet slik at hvert normaliserte par representerte én identitet. En ekte CRM-eksport vil være mer uryddig. Hvis navnene eller selskapene tyder på forskjellige personer, bør du hoppe over gruppen eller kontrollere den separat.
Velg mellom sammenslåing og sletting
Beslutningsregelen min er enkel:
- Slå sammen rader når de inneholder utfyllende data.
- Slett bare en ekstra rad når den ikke tilfører noen nyttig verdi.
- La tvetydige grupper stå til manuell gjennomgang.
I denne kjøringen valgte konfigurasjonen den mest komplette raden som hovedoppføring. Den beholdt hovedoppføringens record_id, brukte de lengste verdiene for for- og etternavn og kombinerte source og notes med semikolon.
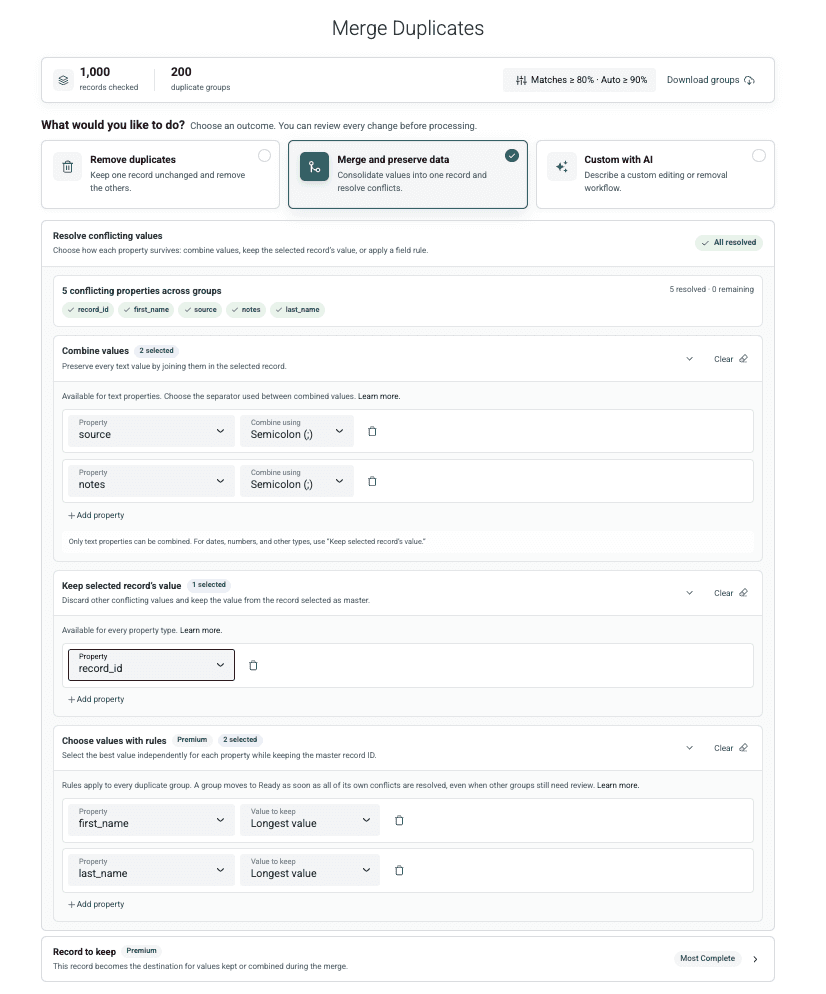
Disse innstillingene passer til eksemplet, men jeg ville ikke kombinert alle motstridende egenskaper som standard. En kildehistorikk kan fint bli Nettskjema;CRM-eksport. CRM-status, eier-ID eller primær e-post trenger vanligvis én autoritativ verdi.
I forhåndsvisningen kontrollerer du disse valgene. Etter at du har endret en regel, bør du inspisere målraden på nytt.
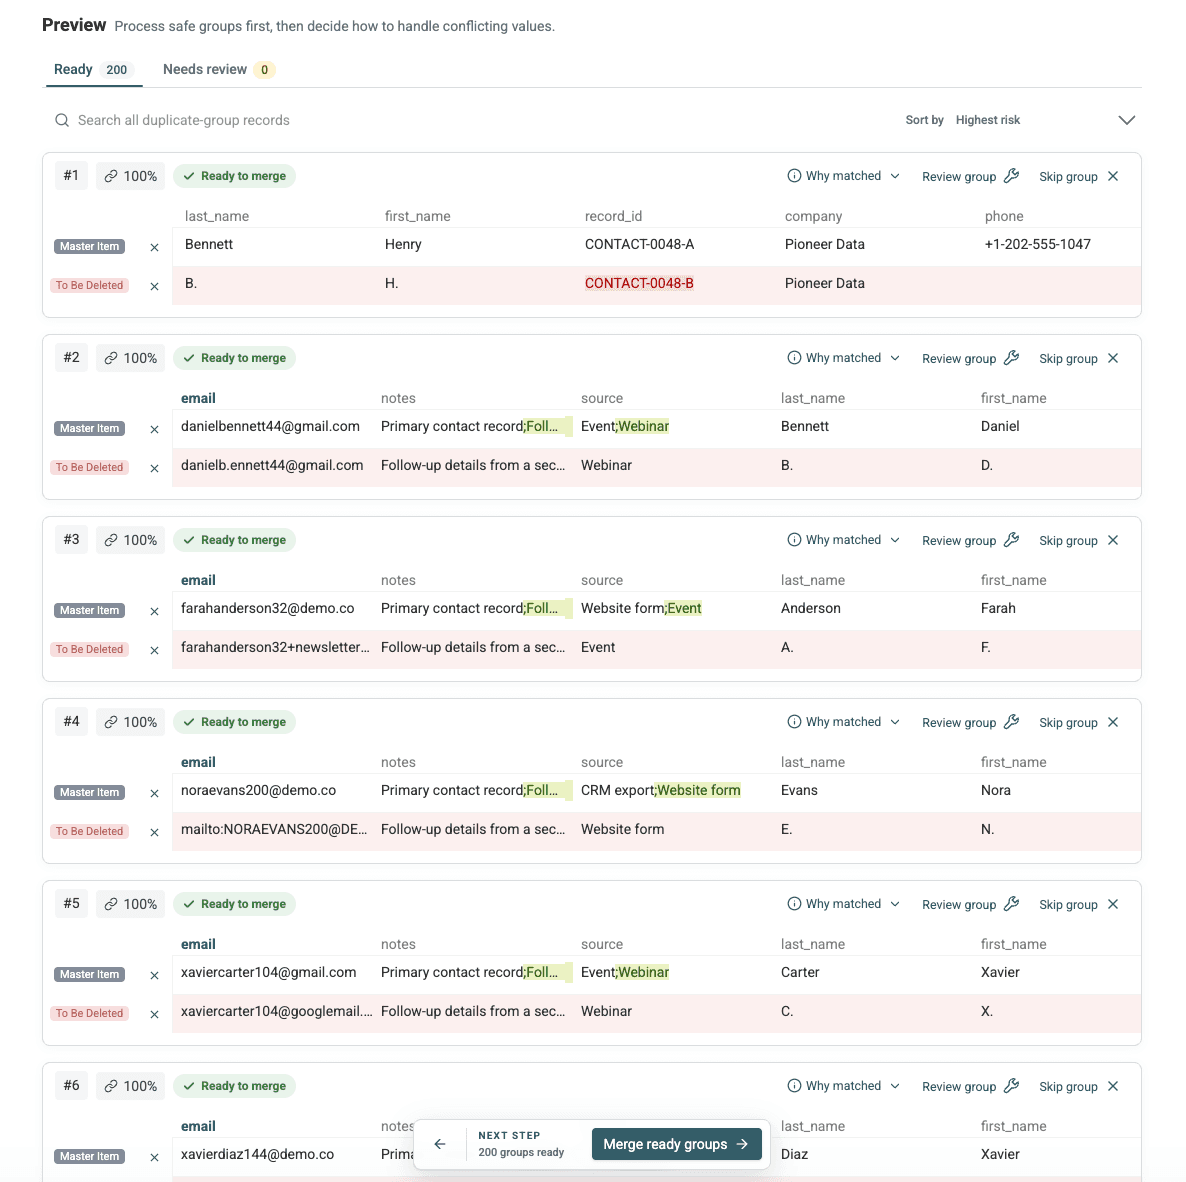
💡 Forhåndsvis etter hver regelendring
Kontroller hvilken rad som blir hovedoppføring, hvilke verdier som kombineres, og hvilke som forsvinner før du bruker regelen på alle godkjente grupper.
Hvis en duplikatrad inneholder et unikt telefonnummer, en kilde eller et notat, bør du slå den sammen i stedet for å slette den. I Nora-eksemplet beholdt sluttraden det fulle navnet fra én oppføring og telefonnummeret fra den andre.
De som håndterer mer komplekse konflikter i CRM-data, kan følge den grundigere arbeidsflyten for å slå sammen duplikate leads uten å miste data. I denne e-postbaserte gjennomgangen er målet å bevare nyttige tilknyttede felt uten å gjøre alle egenskaper om til tekststrenger med flere verdier.
Resultater fra testlisten med 1 000 rader
Sammenslåingen ga følgende målte resultater:
| Måling | Resultat |
|---|---|
| Antall rader ved start | 1 000 |
| Rader plassert i duplikatgrupper | 400 |
| Duplikatgrupper med to rader | 200 |
| Slettede duplikatrader | 200 |
| Oppdaterte hovedrader | 200 |
| Antall rader til slutt | 800 |
| Gjenværende duplikatgrupper | 0 |
Avstemmingen er enkel: 1 000 startrader - 200 slettede rader = 800 beholdte rader.
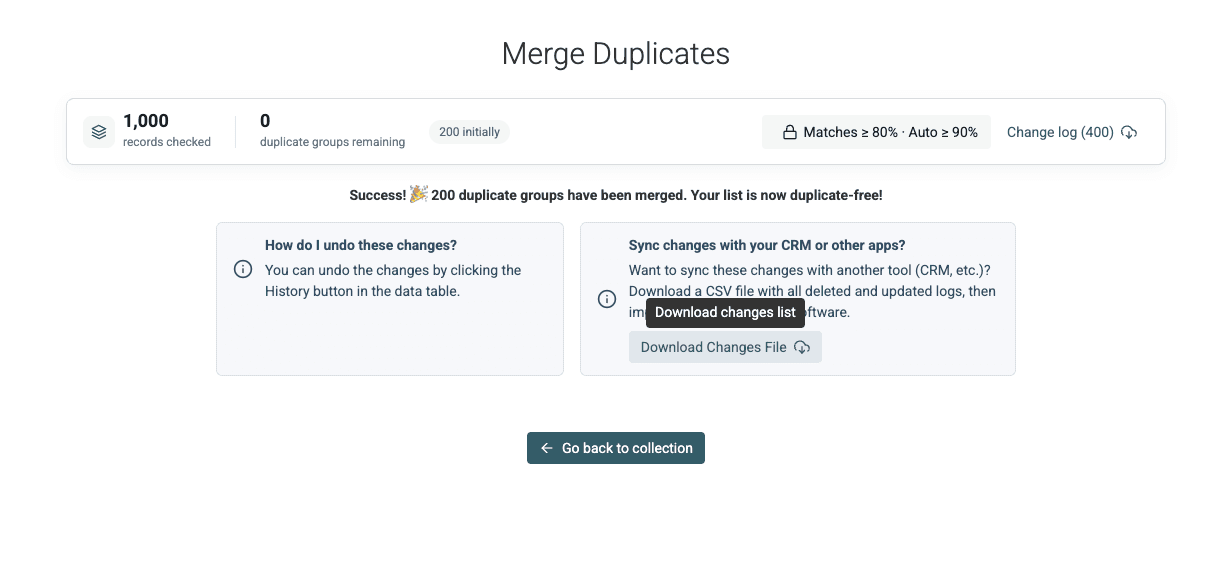
Sammenslåingen tok noen sekunder i den manuelle testen, men det ble ikke registrert noen nøyaktig tid. Se dette som en observasjon fra denne kjøringen, ikke som en ytelsesmåling.
Den nedlastede endringsloggen inneholder 400 oppføringer: 200 slettede rader og 200 oppdaterte hovedrader. For hver sammenslåtte gruppe viser den verdiene før sammenslåingen og verdiene som ble beholdt i målraden.
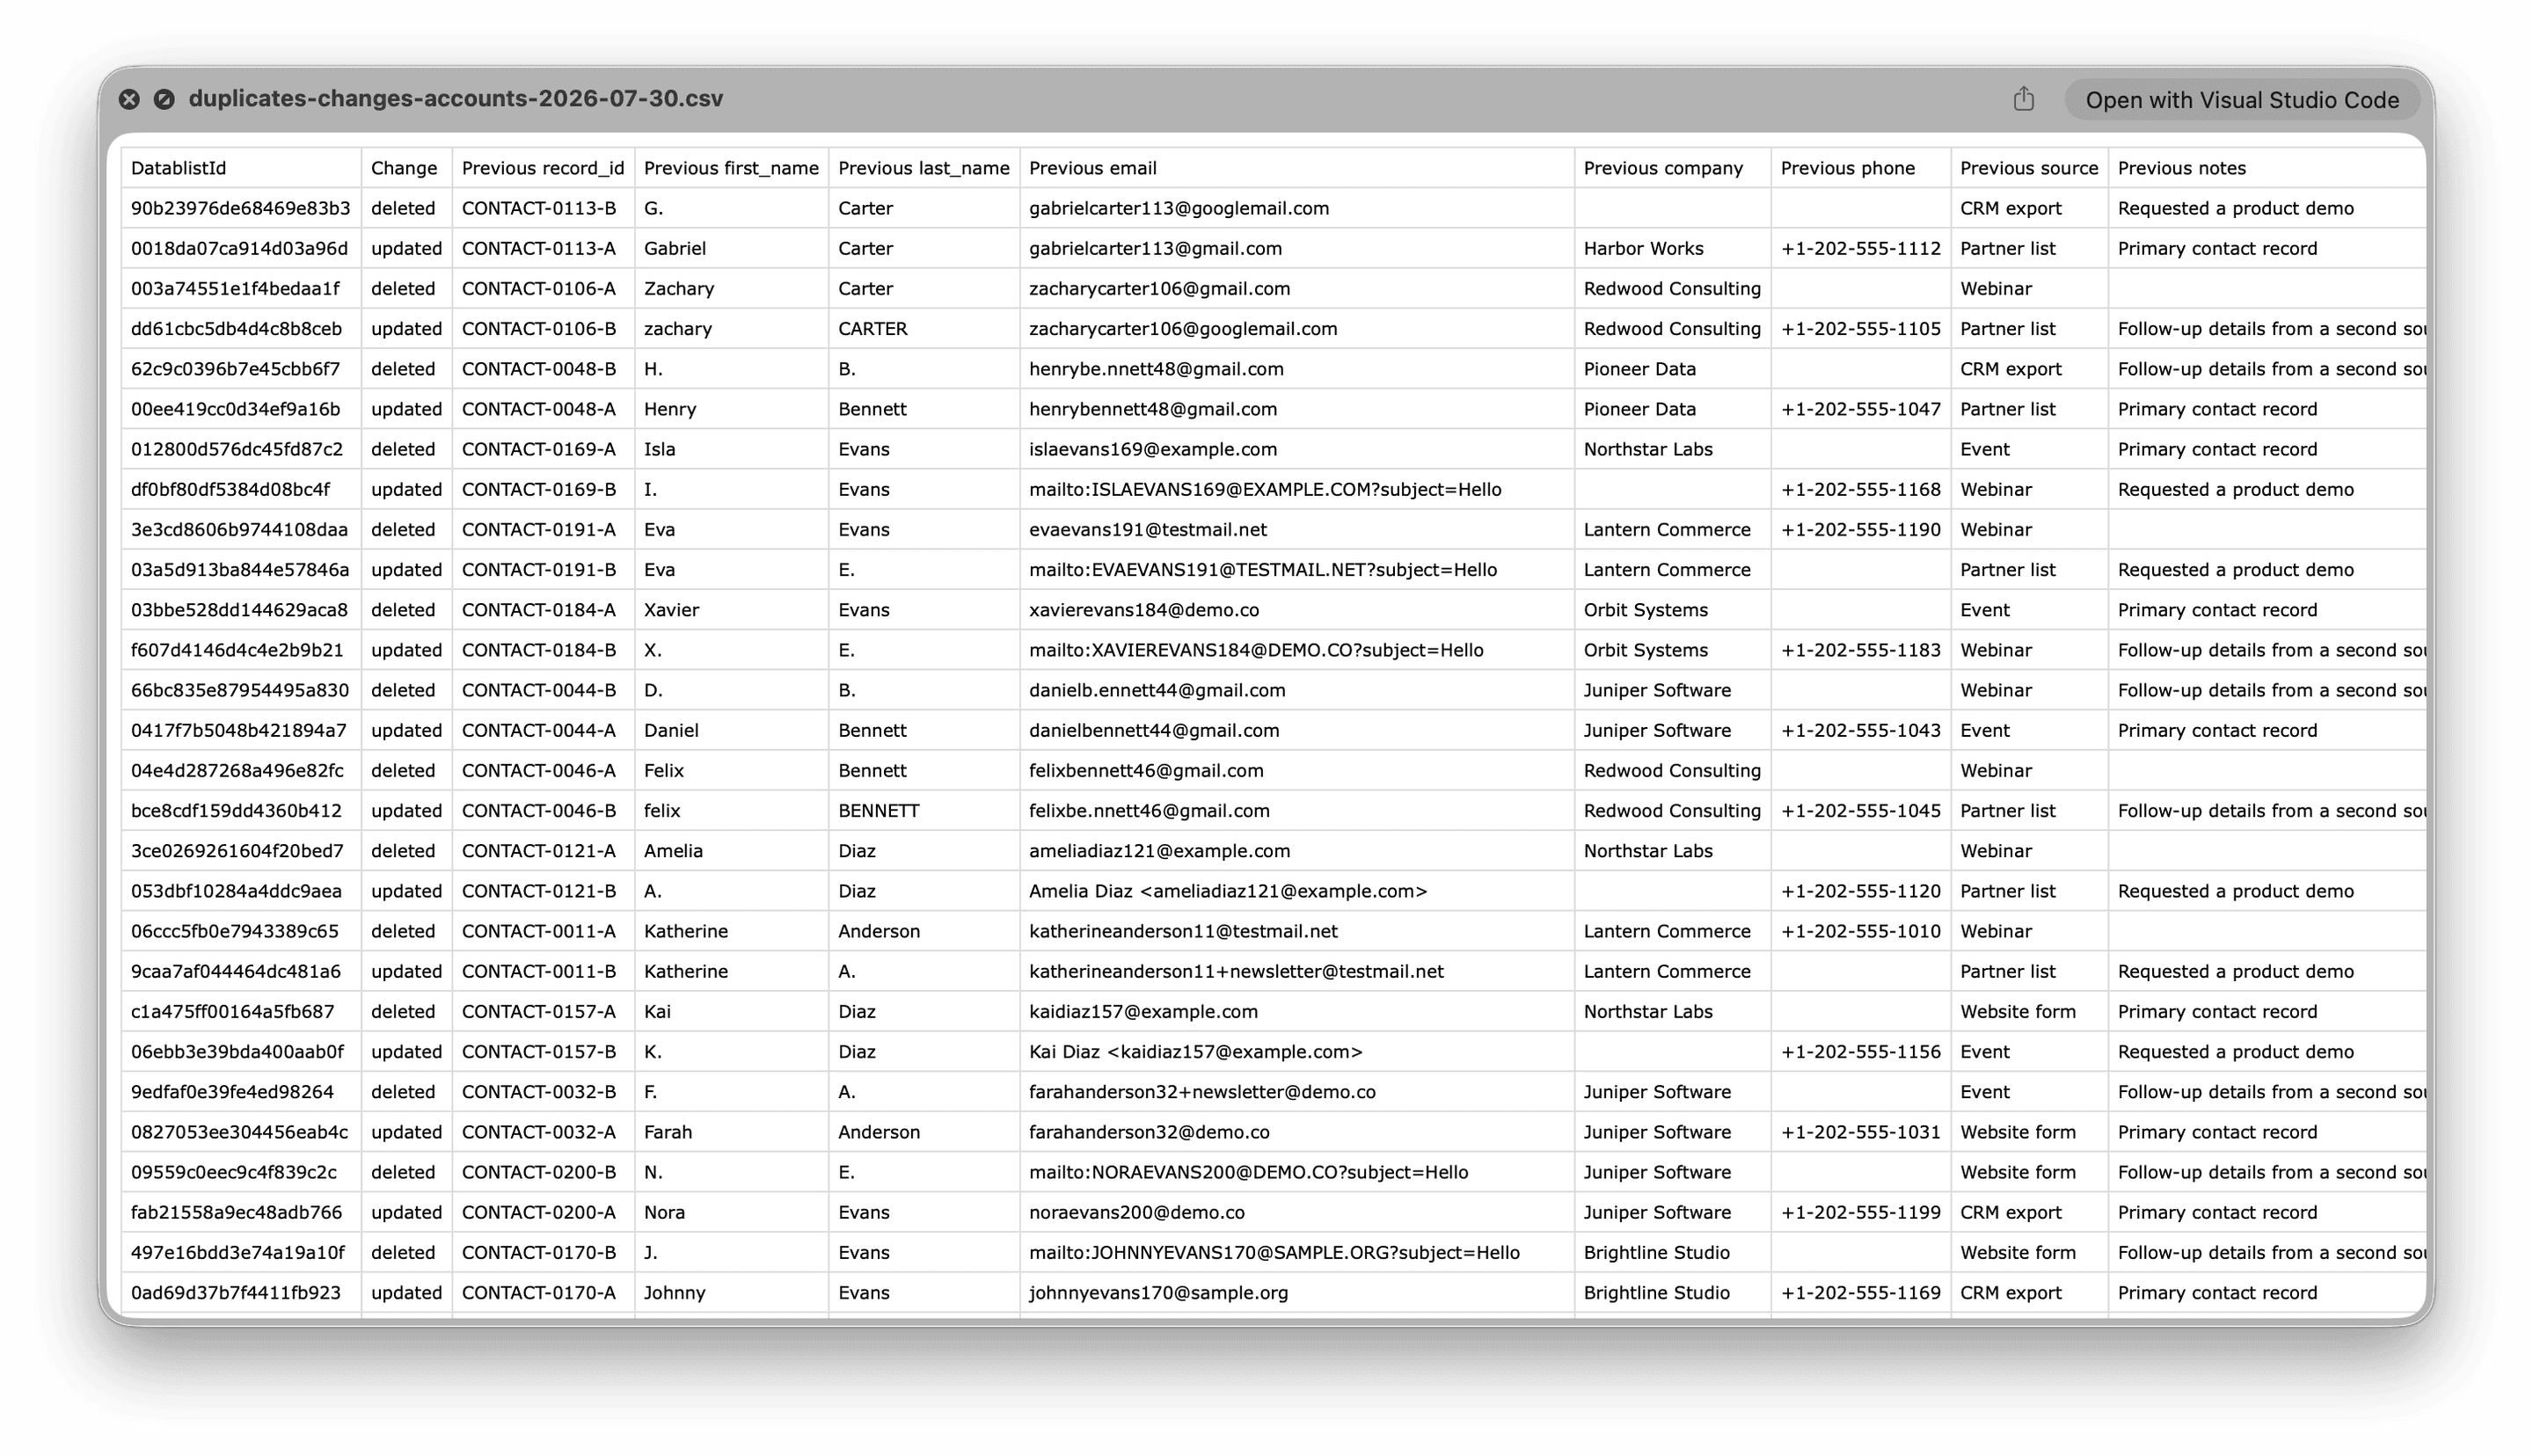
Tabellen nedenfor bruker de nøyaktige verdiene fra kjøringen:
| Opprinnelige varianter | Hvorfor de matchet | Beholdt e-postadresse | Handling | Beholdte felt |
|---|---|---|---|---|
noraanderson40@demo.conoraanderson40+newsletter@demo.co | Plussuffikset ble fjernet | noraanderson40+newsletter@demo.co | Slått sammen med CONTACT-0040-B | Fullt navn, telefonnummer, Nettskjema;CRM-eksport og begge notatene |
victorbennett62@gmail.comvictorb.ennett62@gmail.com | Punktum i Gmail-adressene ble normalisert | victorbennett62@gmail.com | Slått sammen med CONTACT-0062-A | Telefonnummer, Nettskjema;Arrangement og begge notatene |
gabrielcarter113@gmail.comgabrielcarter113@googlemail.com | Gmail-domenene ble normalisert | gabrielcarter113@gmail.com | Slått sammen med CONTACT-0113-A | Telefonnummer, Partnerliste;CRM-eksport og notatet om demoforespørselen |
camiladiaz123@testmail.netCamila Diaz <camiladiaz123@testmail.net> | Visningsnavnet rundt adressen ble fjernet | camiladiaz123@testmail.net | Slått sammen med CONTACT-0123-A | Fullt navn, telefonnummer, Partnerliste;CRM-eksport og begge notatene |
marcusevans199@testmail.netmailto:MARCUSEVANS199@TESTMAIL.NET?subject=Hello | mailto:-innpakningen ble fjernet og bokstavtypen normalisert | mailto:MARCUSEVANS199@TESTMAIL.NET?subject=Hello | Slått sammen med CONTACT-0199-B | Fullt navn, telefonnummer, Webinar;Arrangement og begge notatene |
Legg merke til at den beholdte verdien ikke alltid er den visuelt enkleste e-postadressen. Den valgte hovedoppføringen avgjør hvilken lagret e-postadresse som beholdes. Normaliseringen brukes til matching. Den skriver ikke automatisk om alle beholdte verdier til et standardformat.
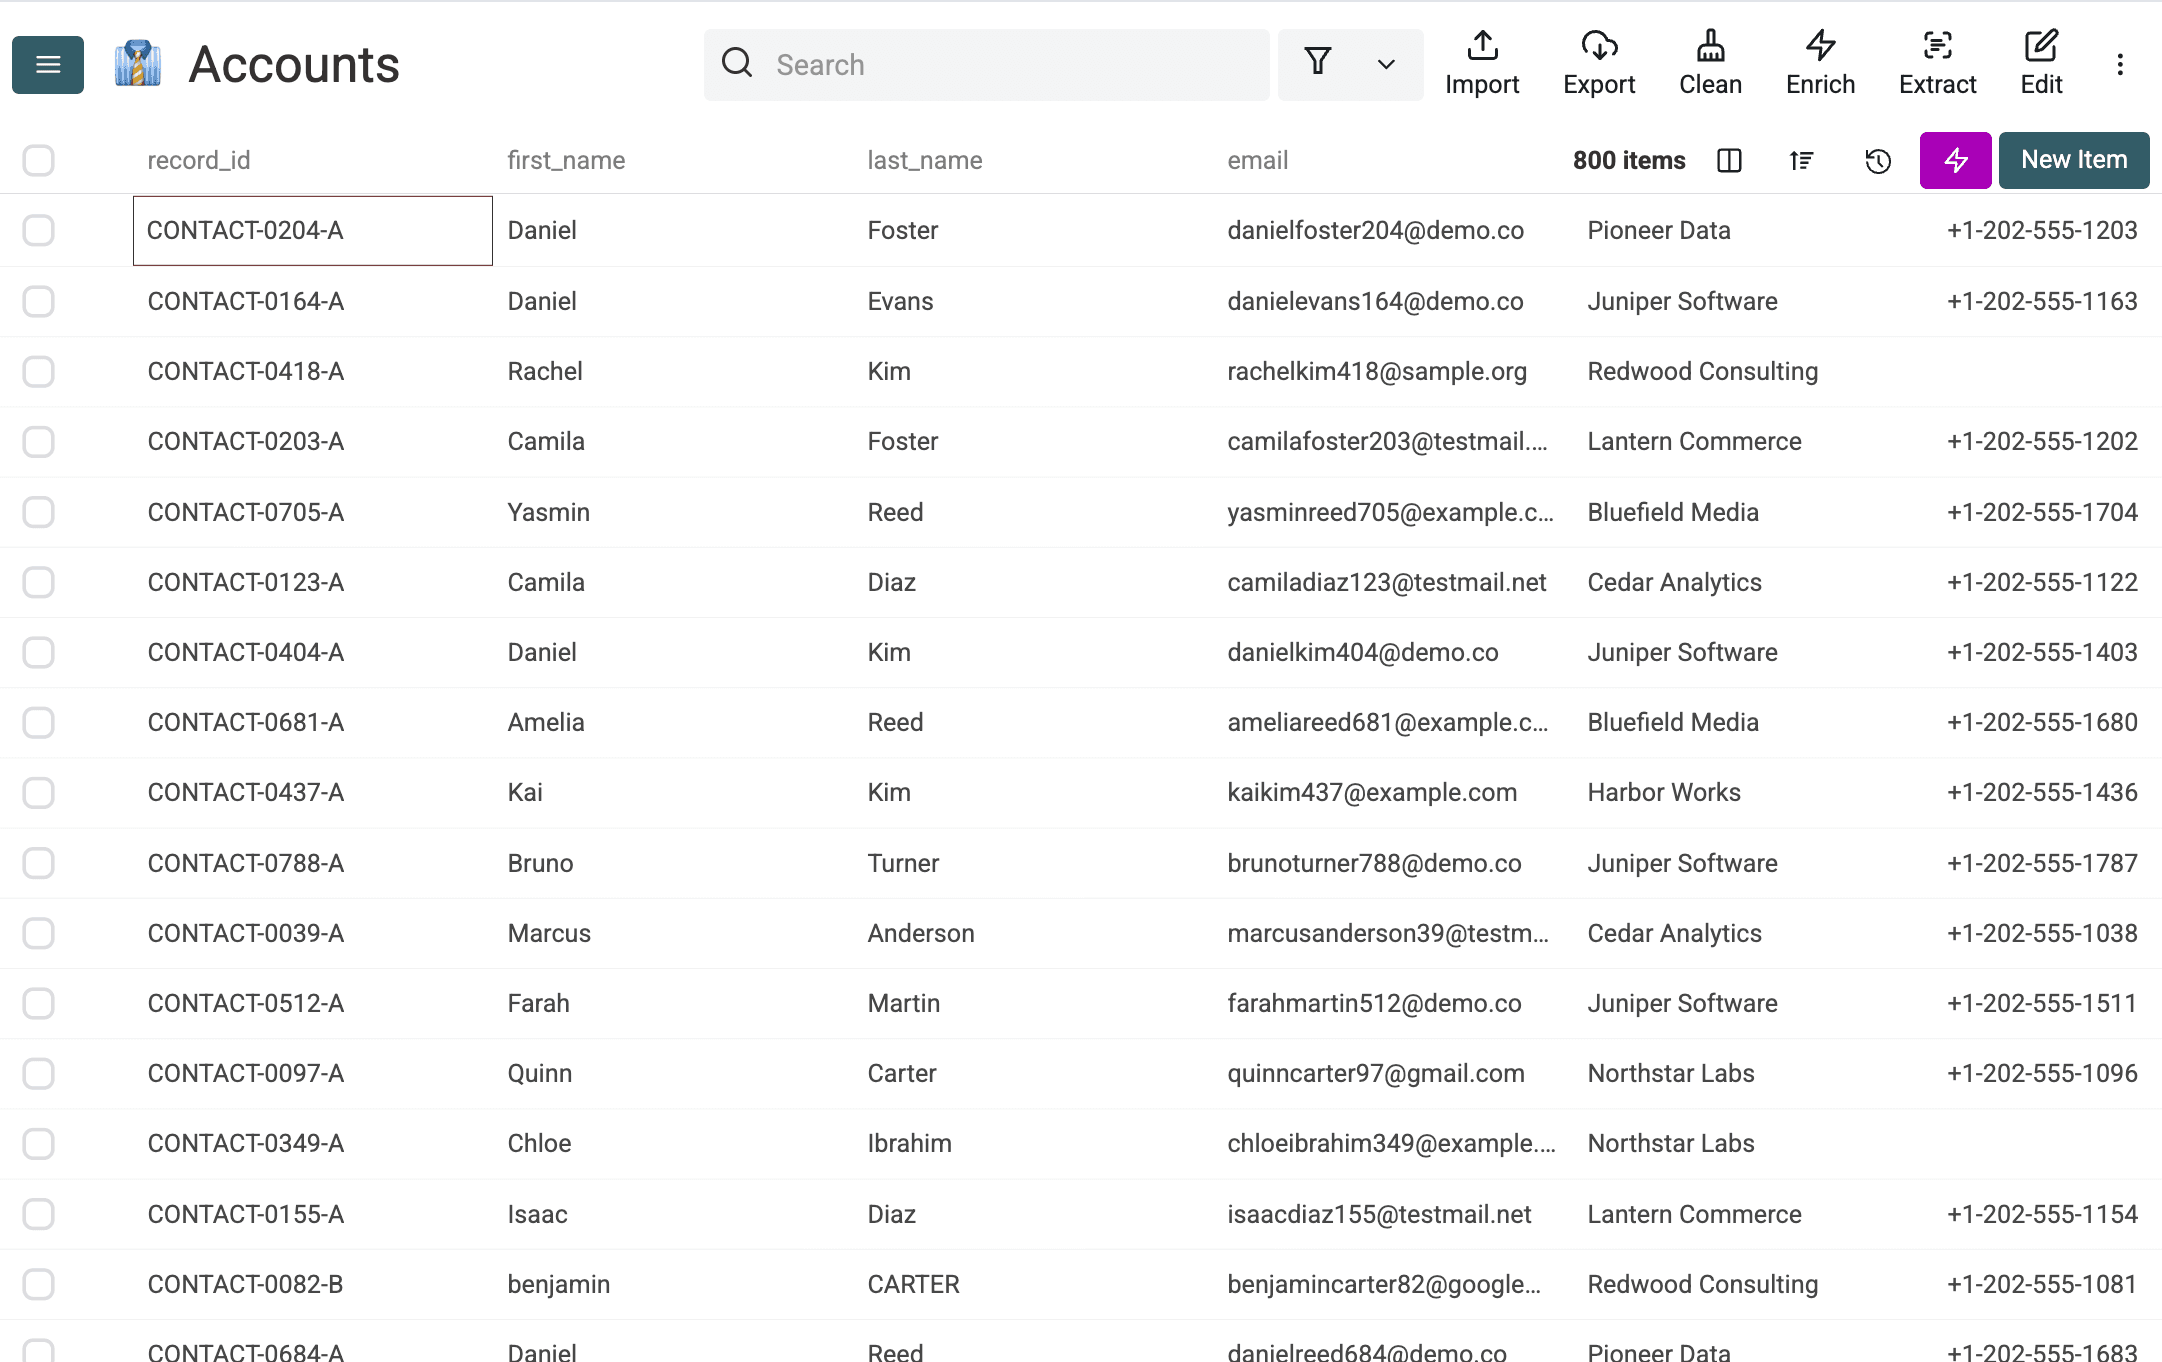
Testen reduserte listen fra 1 000 til 800 rader fordi 200 gjennomgåtte duplikatrader ble konsolidert med hovedoppføringene sine. Resultatet gjelder den konstruerte testlisten og er ikke en universell matchrate for alle e-postformater.
Feiltilfeller og sjekkliste for validering
Smart Email-matching håndterer de fem testede variantgruppene, men kan ikke erstatte en manuell vurdering.
Punktum utenfor Gmail
Punktum har fortsatt betydning på andre domener enn Gmail. Ikke anta at first.last@company.com og firstlast@company.com tilhører samme innboks. Hvis du har eksterne bevis på at de hører sammen, bør du håndtere paret manuelt.
Ugyldige verdier
Ikke bruk et matchresultat som en gyldighetskontroll. Inndata uten en brukbar @-struktur eller med mellomrom inne i adressen normaliseres ikke som vanlige adresser, men processoren avviser ikke alle ugyldige domeneformer. To ugyldige verdier kan fortsatt normaliseres til samme sammenligningsverdi. Kontroller adresseformatet og domenet separat, og hold tvilsomme rader utenfor automatiske sammenslåinger. Kontroll av innboks eller leveringsevne er et ytterligere trinn.
Eksakt matching
Exact fjerner ikke plussuffikser, Gmail-punktum, domenealiaser eller visningsnavn rundt adressen. Funksjonen fjerner mellomrom rundt verdien og sammenligner som standard tekst med små bokstaver. For eksempel matcher NAME@example.com og name@example.com med standardinnstillingene for Exact, mens name+tag@example.com og name@example.com forblir separate. Aktiver Case sensitive når bokstavtypen må bevares i sammenligningen. Exact er nyttig når aliasforskjeller er viktige, men er verken et valideringstrinn eller en byte-for-byte-sammenligning av originalcellen.
Flere adresser i én celle
Denne metoden forutsetter én adresse per celle. En celle med flere adresser atskilt med skilletegn må behandles med den separate arbeidsflyten for flere verdier før matching på radnivå.
Delte innbokser
To rader med sales@company.com kan beskrive forskjellige personer. Navn, stillingstitler, selskaper og notater bør styre vurderingen. Jeg ville ikke slått sammen rollebaserte innbokser i bulk uten å kontrollere dem.
Sletting av utfyllende felt
Hvis du sletter en ekstra rad, kan du miste det eneste telefonnummeret, anskaffelseskilden eller notatet. Bruk forhåndsvisningen til å kontrollere hva som blir beholdt.
Den konstruerte testen fant alle de 200 planlagte identitetene og ingen uventede grupper på tvers av identiteter. Den testet ikke alle reelle adresseformater, ugyldige verdier eller mønstre for delte innbokser.
Kontroller følgende før du eksporterer din egen liste:
- Hver godkjente gruppe representerer én identitet.
- Delte og rollebaserte innbokser er gjennomgått manuelt.
- Hovedraden inneholder foretrukket navn, ID og e-postverdi.
- Unike verdier for telefon, selskap, kilde og notater overlever sammenslåingen.
- Antall startrader minus slettede rader er lik det endelige radantallet.
- En stikkprøve dekker alle normaliseringsvariantene i listen.
- Antallet gjenværende duplikatgrupper samsvarer med forventningene dine.
📌 Avstem antallene
Startrader - slettede rader = sluttraderer den raskeste fullstendighetskontrollen etter en sammenslåing.
Fortsett oppryddingen av e-postlisten
Deduplisering løser gjentatte identiteter. Den kontrollerer ikke om innboksen finnes, om leverandøren tilbyr midlertidige adresser, om kontakten har meldt seg av, eller om e-posten kan leveres.
Jeg foretrekker å løse duplikate identiteter først. Senere kontroller kjøres da på kontaktene som er beholdt, i stedet for på flere varianter av samme person. Når sammenslåingen består sjekklisten, kan du rydde resten av e-postlisten, åpne Export og velge CSV eller Excel.
Fjern duplikater med Datablist
Importer kontaktfilen til Datablist, kjør den e-posttilpassede duplikatkontrollen, vurder de foreslåtte gruppene, slå sammen nyttige verdier og eksporter den ryddede listen.