
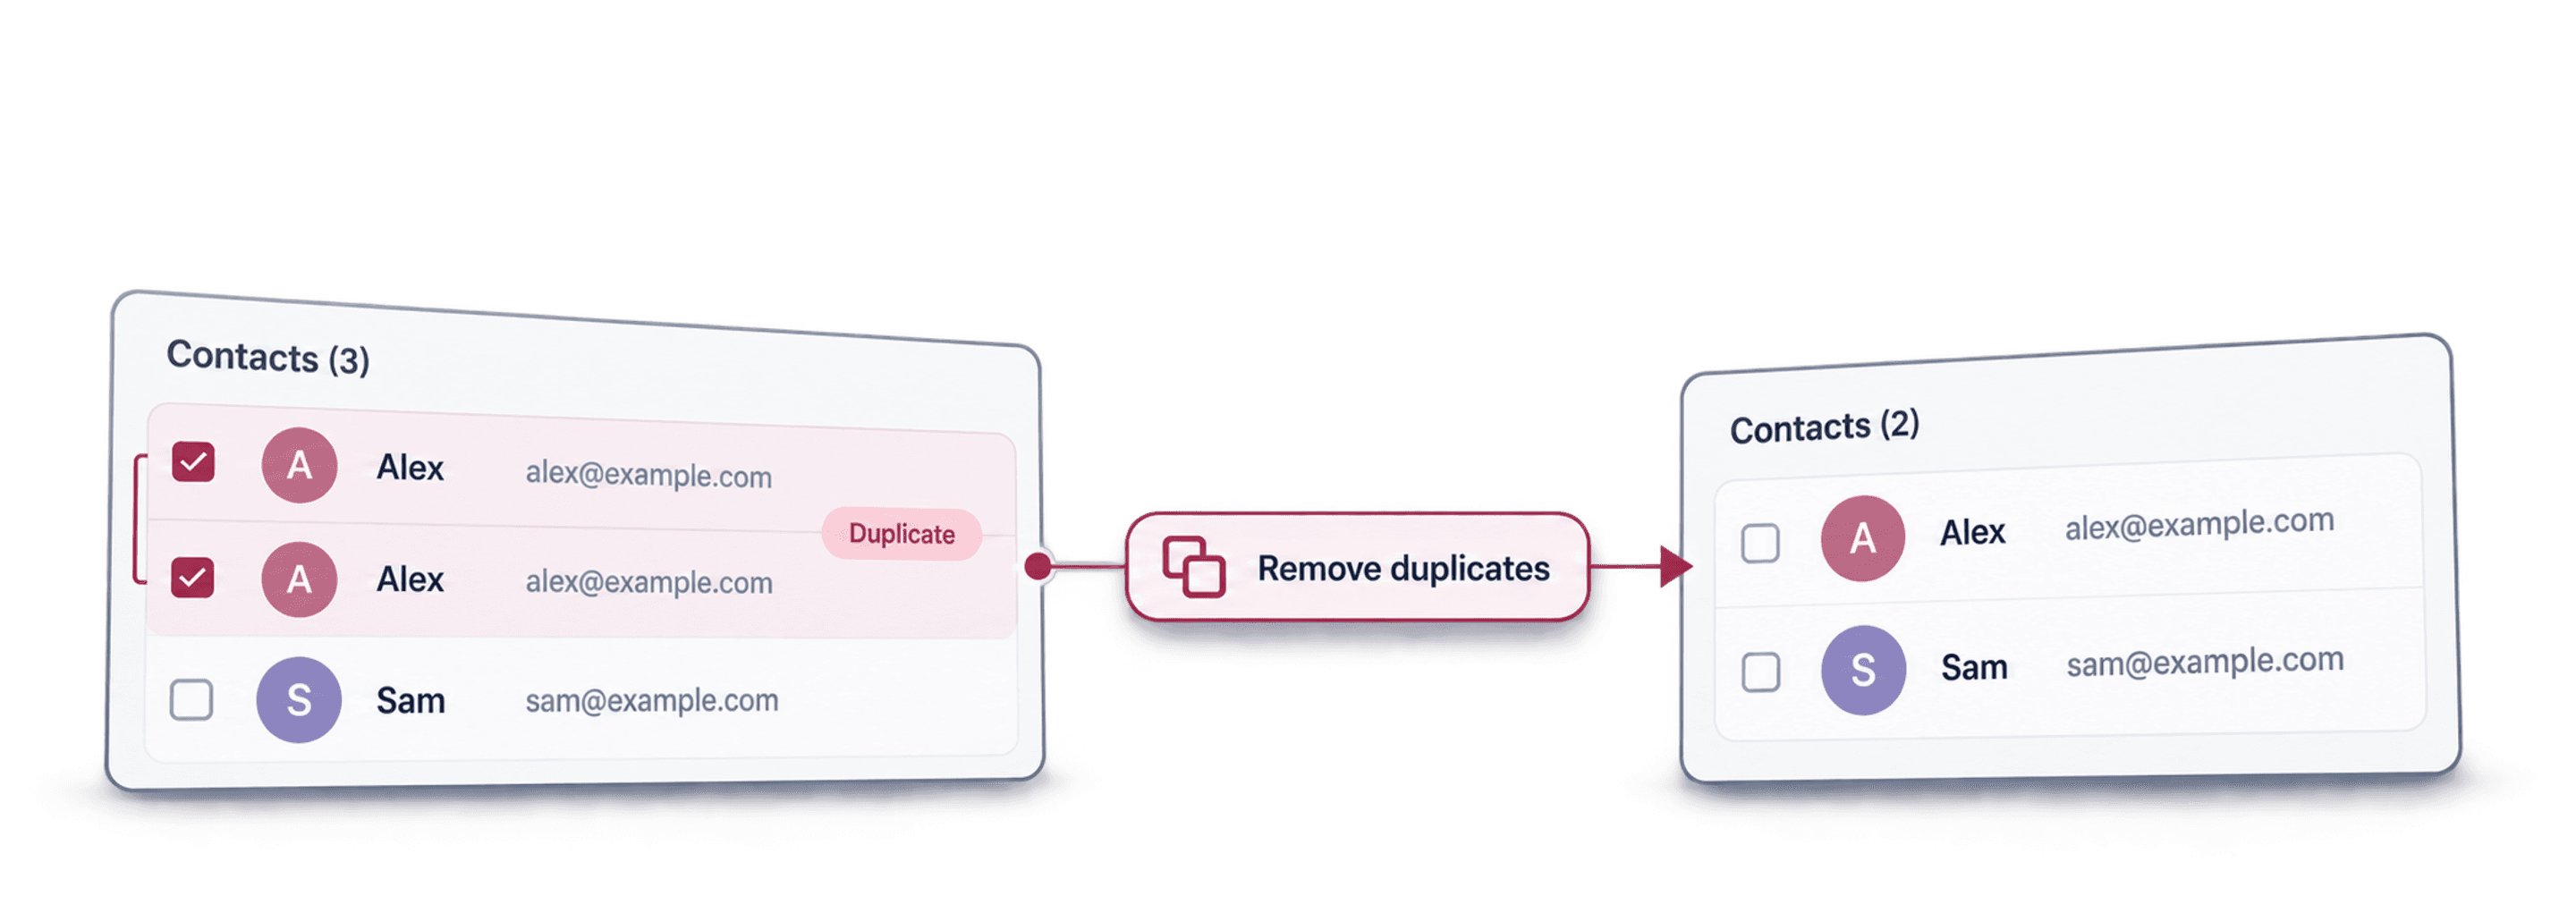
For å deduplisere en liste på nett må du først velge feltet som identifiserer én person, bedrift eller ett produkt. Kjør et strengt samsvarssøk, gå gjennom de foreslåtte duplikatgruppene, og slå deretter sammen nyttige verdier eller fjern rader som ikke tilfører noe. Da går oppryddingen raskt uten at alle lignende verdier behandles som sikre treff.
Med Datablist gjør du alt dette direkte i nettleseren. Importer en CSV- eller Excel-fil, velg egenskapene som skal sammenlignes, sammenlign radene, gå gjennom resultatet og eksporter den ryddede listen. Duplikatsøket er skrivebeskyttet frem til du starter en Remove-, Merge- eller egendefinert behandlingshandling.
Denne veiledningen bruker et nedlastbart eksempel med 1 000 rader. Det inneholder identiske kopier, e-postaliaser, varianter av bedriftsnavn, URL-forskjeller, enkle variasjoner i telefonnummerformatering, skrivefeil, motstridende verdier og poster som utfyller hverandre.
🔑 Regelen for trygg deduplisering
Finn treff med den minste pålitelige identifikatoren, men bruk hele raden til å avgjøre hva som skal beholdes.
Fjern duplikater fra en enkel verdiliste
Hvis listen har én verdi per linje, lagrer du den som en CSV-fil med én kolonne og en overskrift som Email, Domain eller Value. Importer den i Datablist, og kjør Clean > Remove duplicates på kolonnen med Exact. Gå gjennom gruppene, velg posten som skal beholdes, behandle duplikatradene og eksporter de gjenværende verdiene.
En tenkt liste med alpha.example, beta.example og alpha.example skal for eksempel sitte igjen med én alpha-verdi og én beta-verdi etter at den gjentatte raden er fjernet. Dette er kun et eksempel på input og output, ikke en ny måling fra det nedlastbare eksempelet.
Denne metoden passer best for en liste med identifikatorer. Hvis filen inneholder flere kolonner, må du håndtere duplikatposter: Når du fjerner en rad, forsvinner også de andre verdiene i raden. Bruk arbeidsflyten for sammenslåing nedenfor dersom en gjentatt e-postadresse har et nyttig telefonnummer eller notat i en annen rad.
Hold tomme identifikatorer adskilt. I standardsammenligningen av valgte egenskaper er ikke en manglende tekstidentifikator nok til å fastslå et treff. Hvis du vil slette tomme rader, må du rydde dem opp eksplisitt i stedet for å forvente at dedupliseringen avgjør hva de representerer.
Velg hva som gjør en post unik
Ikke start med matchingsalgoritmen. Begynn med å definere enheten.
Kontakter, bedrifter, produkter og transaksjoner trenger ulike identifikatorer:
| Liste | Gode identifikatorer å starte med | Nyttig andre søk |
|---|---|---|
| Kontakter | E-post, telefon, LinkedIn-URL | Fullt navn og bedrift |
| Bedrifter | Nettstedsdomene, bedrifts-ID | Normalisert bedriftsnavn |
| Produkter | SKU, EAN, GTIN, produkt-URL | Produktnavn og merkevare |
| CRM-leads | E-post, telefon, CRM-ID | Navn og bedriftens domene |
| Bestillinger | Ordre-ID | Kunde-ID og bestillingsdato |
Ett søk fanger sjelden opp alle duplikater. En kontakt kan ha samme e-postadresse i to rader, mens en annen kontakt har byttet e-postadresse, men beholdt samme telefonnummer. Kjør separate søk for ulike identifikatorer i stedet for å lage én regel med alle egenskapene.
For eksempel:
- Finn kontaktduplikater basert på e-post.
- Behandle gruppene du har kontrollert.
- Normaliser telefonnumrene, og kjør deretter en Exact-kontroll på den ryddede egenskapen.
- Kjør et forsiktig fuzzy-søk på fullt navn og bedrift.
Velg regelen for tomme verdier før du legger til flere felt i samme kontroll. Med Value required kan en manglende identifikator utelukke en relevant kandidat.
Med Match on empty value får egenskaper som er tomme i begge poster, en score på 100 % og kan øke gjennomsnittet: Et e-posttreff kombinert med ett manglende etternavn gir 87,5 %. Legger du til tre egenskaper som er tomme i begge postene, øker scoren til 95 %. Se eksempelet på poengberegning for tomme verdier før du antar at flere kolonner gir sterkere bevis.
Bruk de egne veiledningene når identifikatoren må normaliseres på en bestemt måte:
- Fjern duplikater blant e-postadresser og aliaser
- Finn duplikater blant bedriftsnavn
- Dedupliser et felt som inneholder flere verdier
- Normaliser lokale og internasjonale telefonnumre
Last ned eksempellisten med 1 000 rader
Last ned CSV-eksempelet for deduplisering. Det inneholder 1 000 rader som representerer 800 konstruerte enheter.
Filen kombinerer flere testscenarioer:
| Konstruert scenario | Duplikatgrupper | Matchingssøk |
|---|---|---|
| Identiske kopier av hele raden | 5 | All Properties med Exact |
| E-postaliaser og omsluttede adresser | 100 | Email med Smart og Email-prosessoren |
| Varianter av bedrift og URL | 50 | Behandling av Company Name eller URL |
| Enkle amerikanske telefonformater | 25 | Phone med Smart, kun formatering |
| Kontrollerte skrivefeil i navn | 15 | Jaro-Winkler eller Levenshtein |
| Fonetiske varianter av fornavn | 5 | Metaphone |
| Poster uten konstruerte duplikater | 600 | Skal forbli separate |
Dette er fasitverdier som er definert i datasettet, ikke en garanti for at alle fuzzy-terskler gir samme resultat. Avstandsmatching kan ta med ekstra kandidater når terskelen er lav. Gå gjennom gruppene før du behandler dem.
Her er tre par fra filen:
| Bruksområde | Første lagrede verdi | Andre lagrede verdi |
|---|---|---|
| E-postalias | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| Bedrift og URL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| Enkel telefonformatering | +1 (202) 555-0768 | 1 202 555 0768 |
Radene er også uenige om felt som stillingstittel, eier, status, omsetning, kilde, tags og notater. Disse konfliktene gjør filen nyttig når du skal teste regler for hovedpost og hvilke feltverdier som skal overleve sammenslåingen.
Importer listen i Datablist
Åpne Datablist, og importer CSV- eller Excel-filen i en collection. En collection fungerer som et strukturert regneark: Radene er items, og kolonnene er properties.
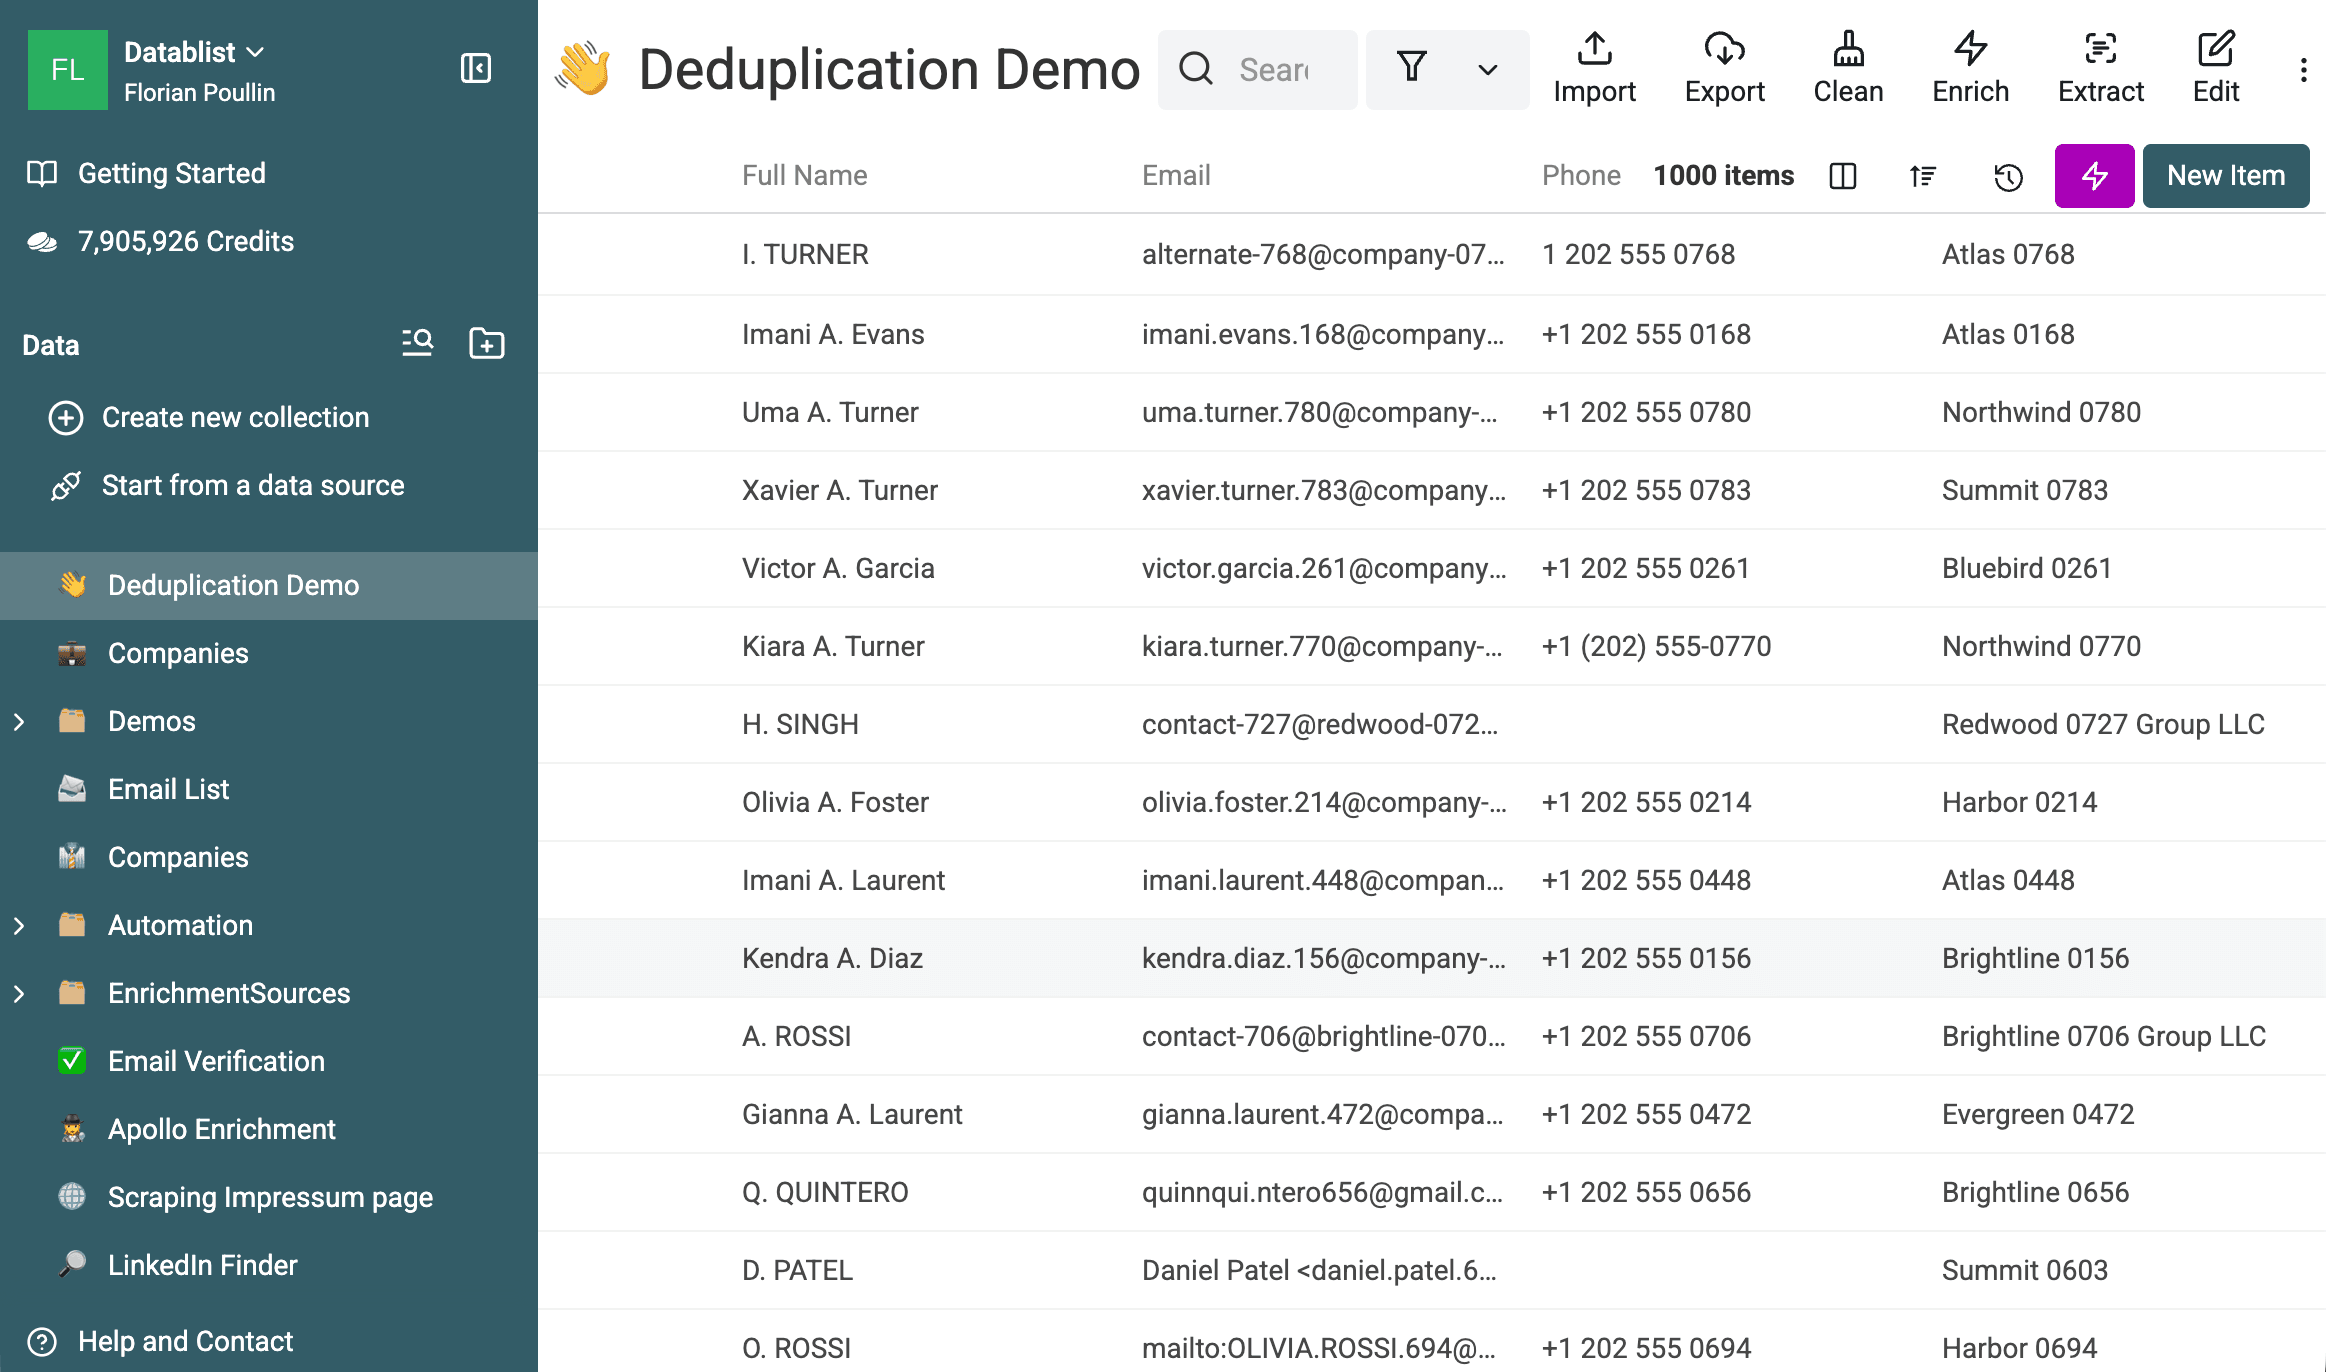
Kontroller de registrerte property-typene under importen:
- E-postkolonner skal bruke typen Email.
- Nettstedskolonner skal bruke URL.
- Telefonkolonner skal bruke Phone.
- Kolonner for omsetning eller antall skal bruke Number.
- Aktivitets- og opprettelsesdatoer skal bruke DateTime.
Behold kolonnene for ID, kilde, eier, notater og status i collectionen. De hjelper deg med å velge riktig post og kontrollere hva som bevares ved sammenslåingen.
Kjør Exact-, Smart- og fuzzy-matching
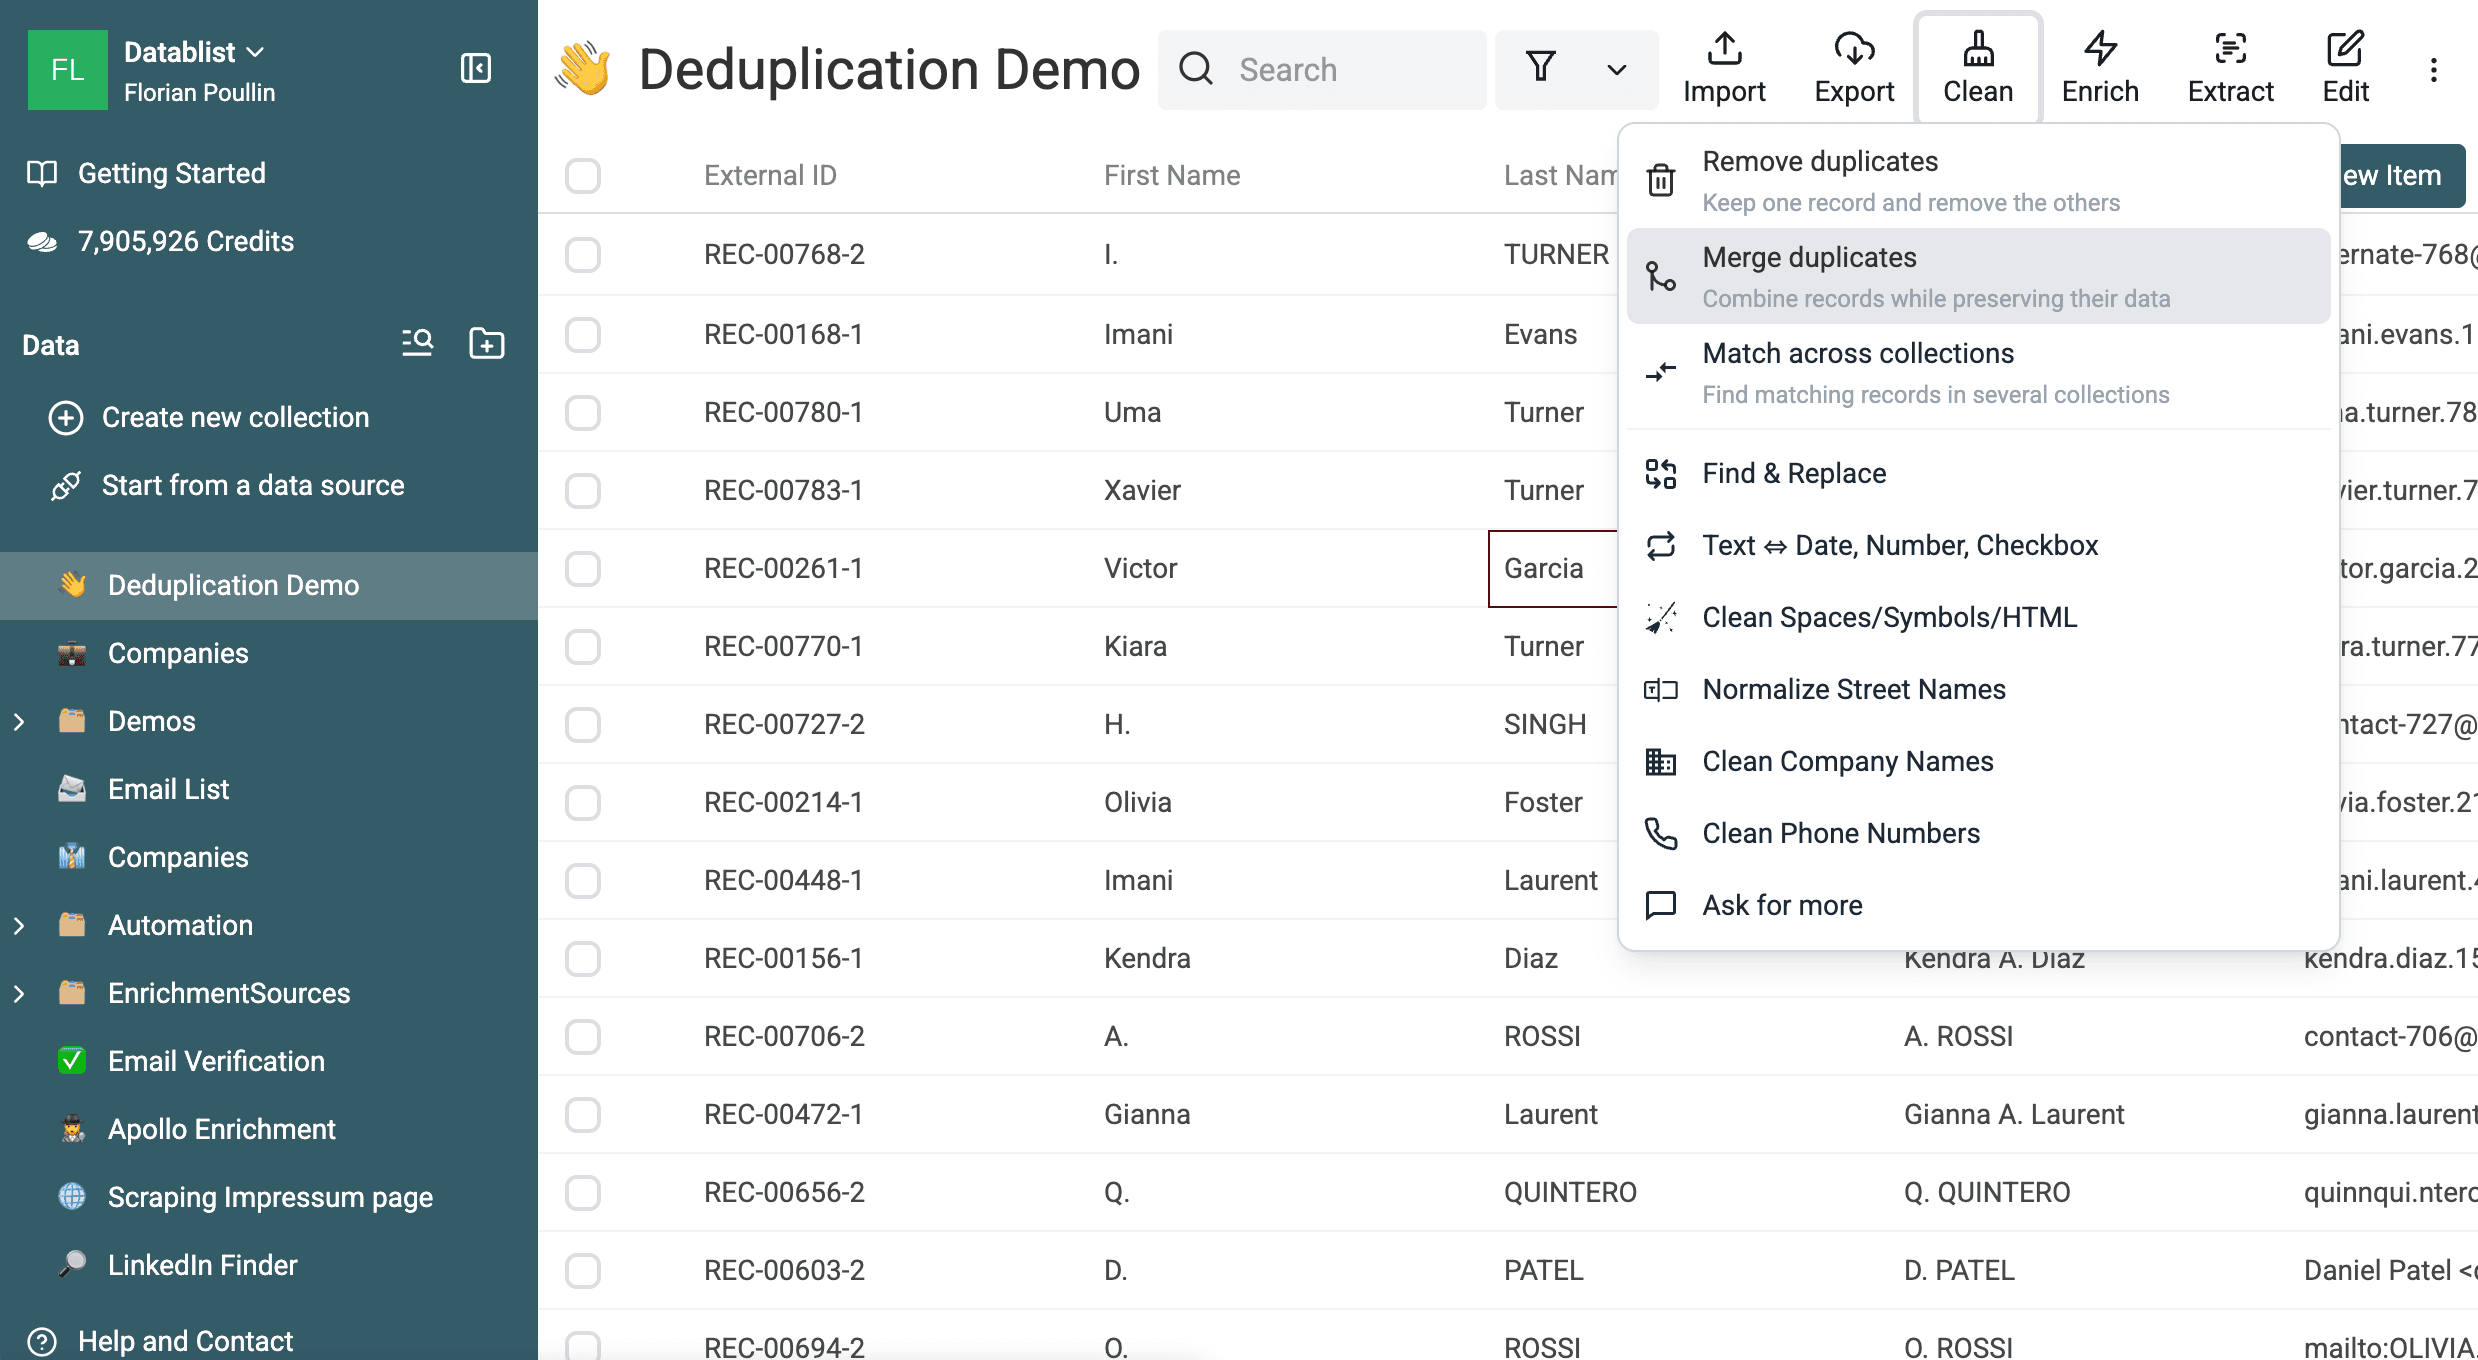
Åpne Clean, og velg handlingen som passer målet ditt:
- Remove duplicates når de øvrige radene kan forkastes.
- Merge duplicates når radene inneholder informasjon som bør bevares.
- Match across collections når postene ligger i ulike collections.
De to første handlingene bruker samme søkemotor. De åpner resultatområdet med ulike behandlingsmoduser valgt.
Start med Exact-matching
Bruk All Properties med Exact for å finne rader som er kopiert uten endringer. Bruk Selected Properties når ett felt, for eksempel en ekstern ID, må være identisk.
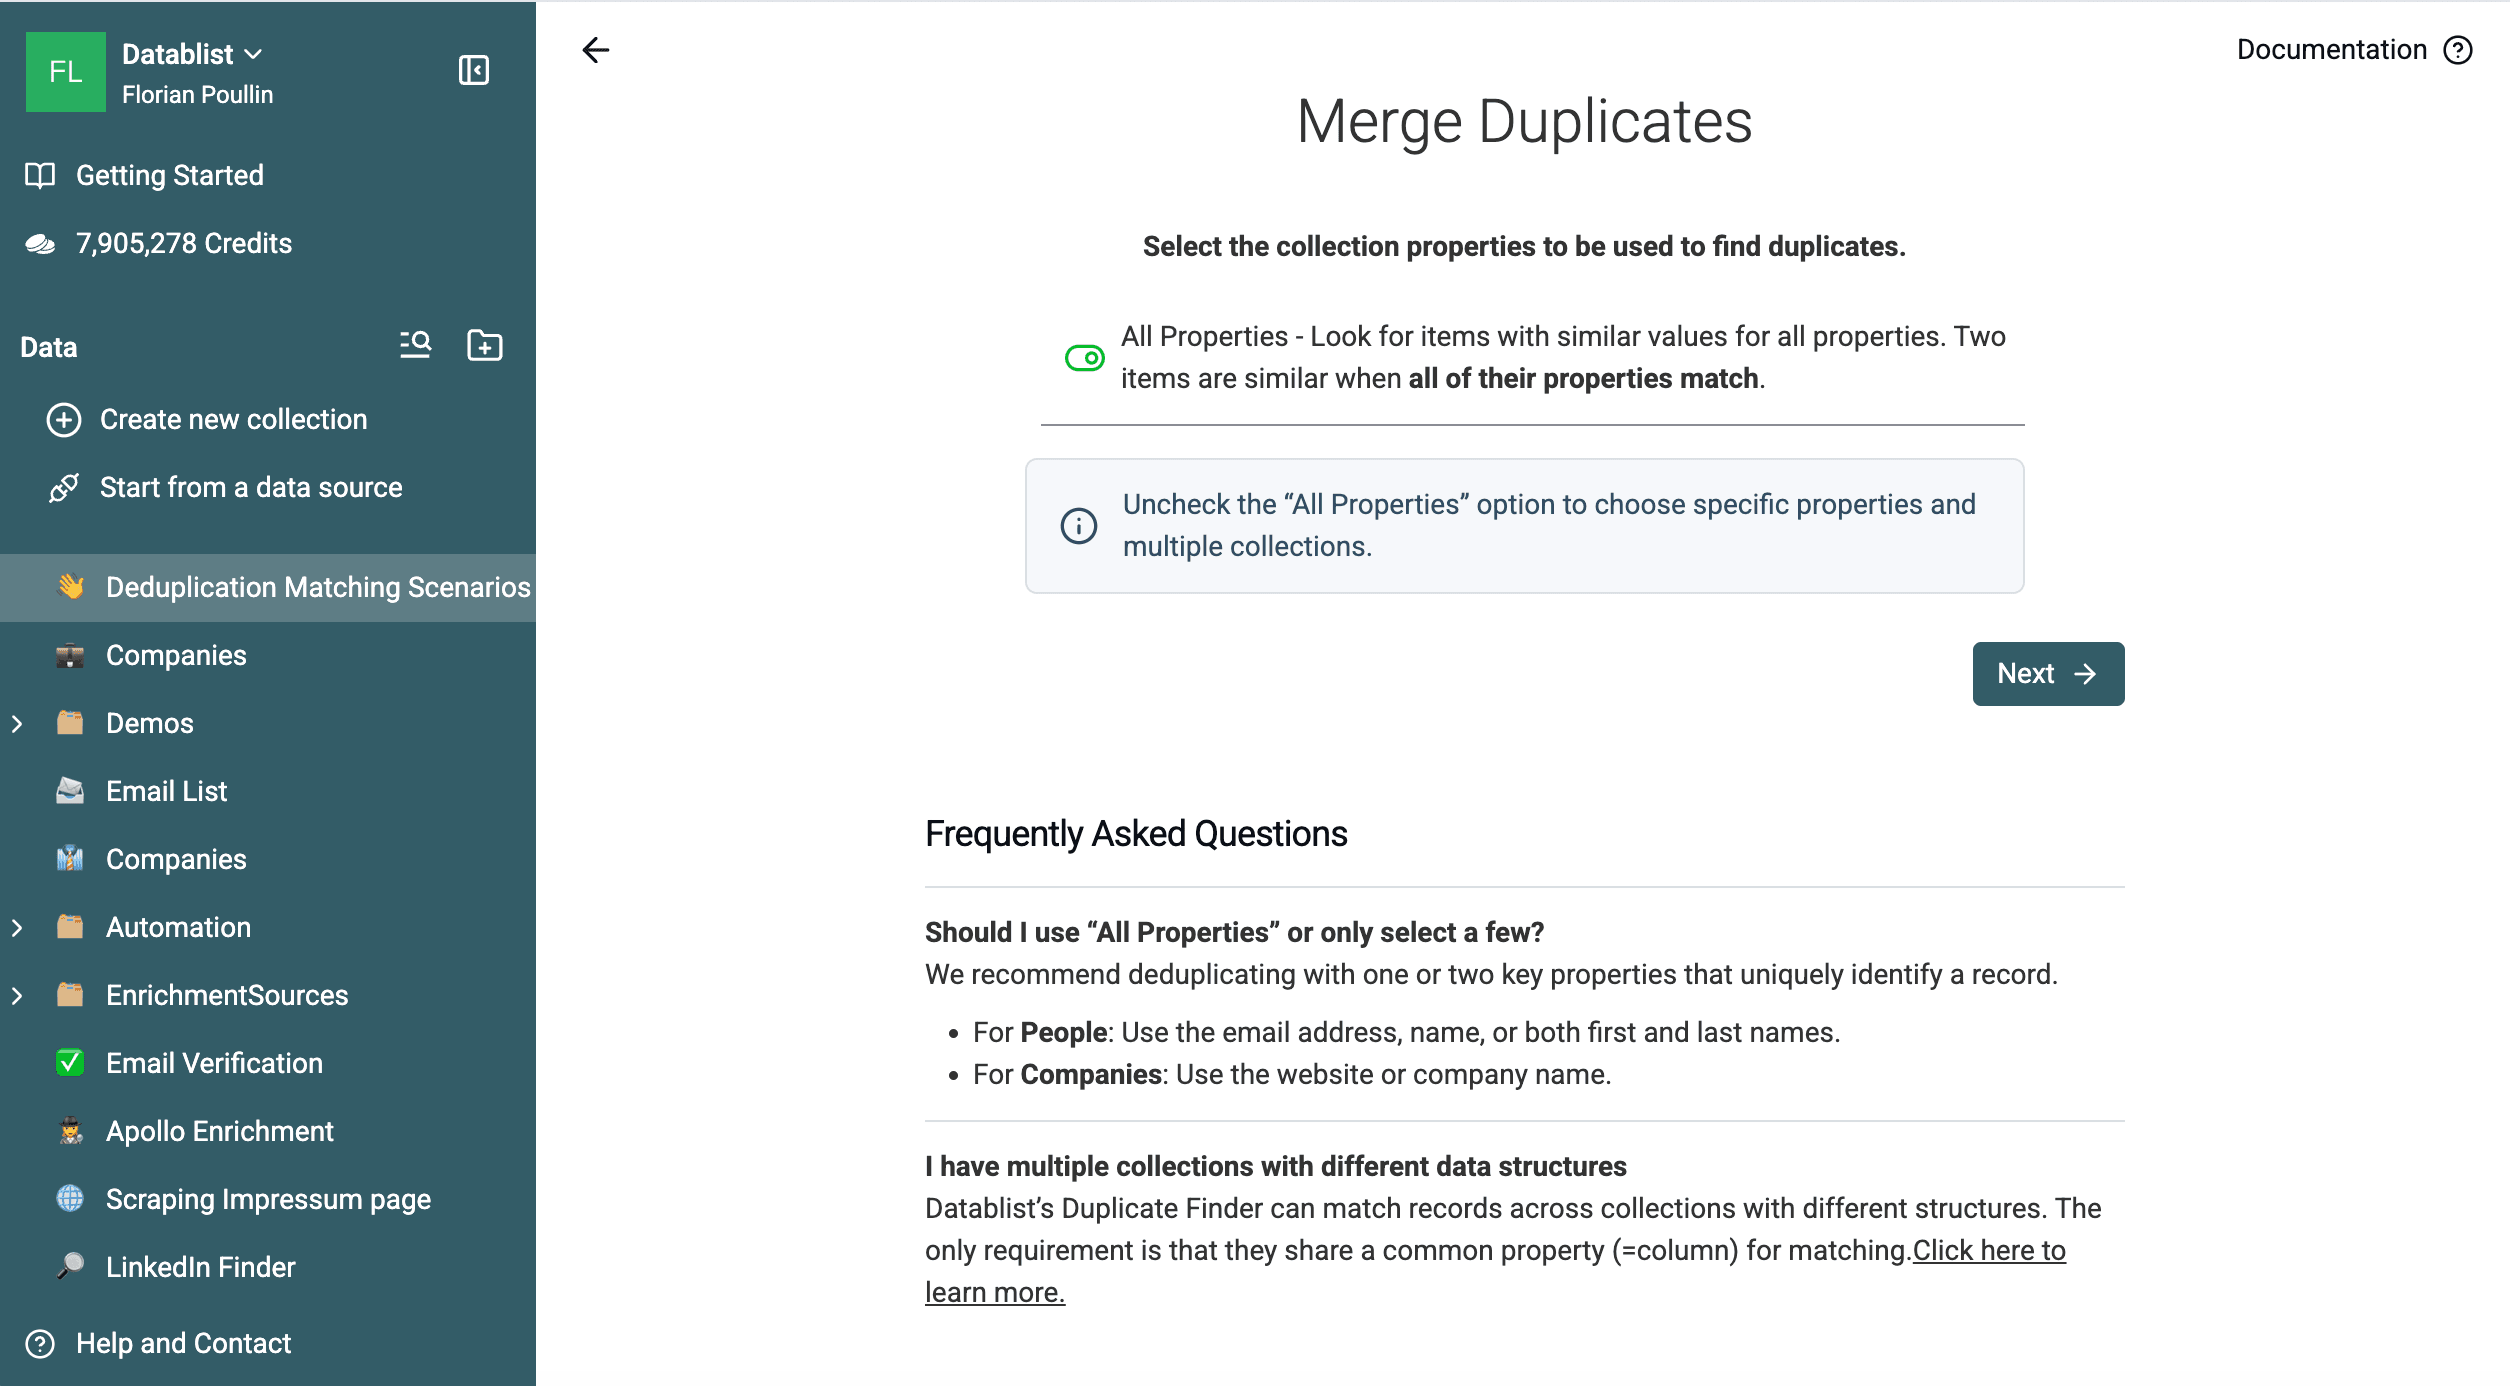
På eksempelet med 1 000 rader gir dette søket fem duplikatgrupper. Hver gruppe inneholder to rader med identiske verdier i alle properties.
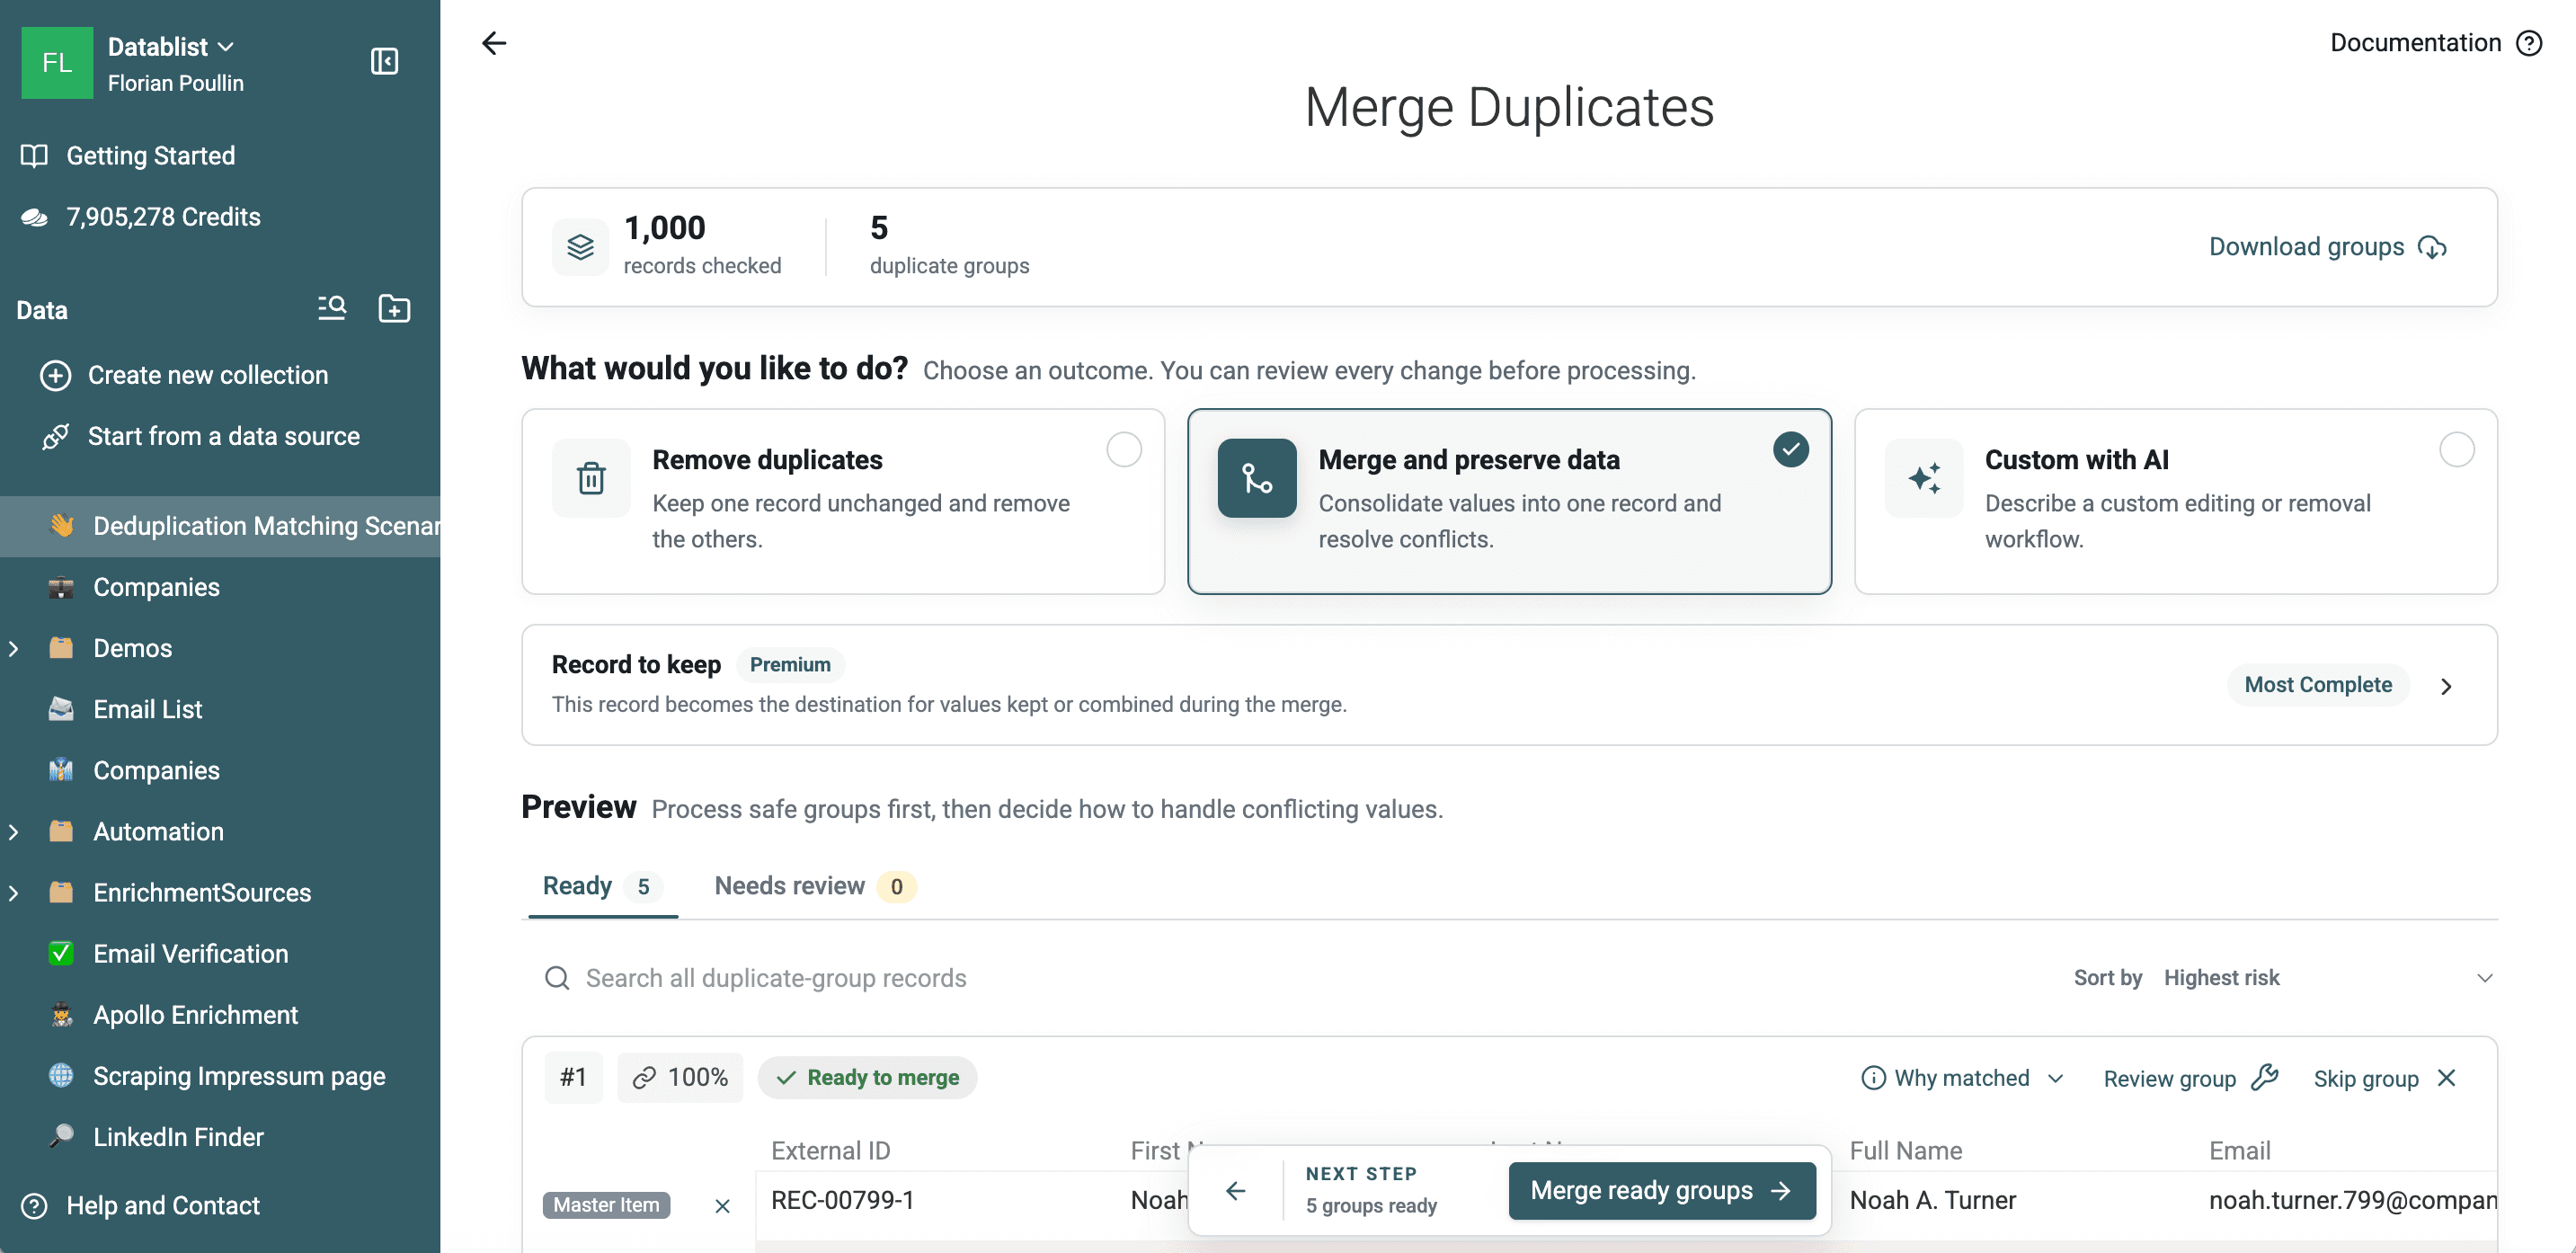
Exact er det tryggeste første søket fordi alle treff oppfyller en streng sammenligning. Det finner ikke Acme Inc. og Acme, et formatert telefonnummer eller et e-postalias når de lagrede verdiene er forskjellige.
Besøkende uten konto kan kjøre et Exact-duplikatsøk. En gratis konto gir tilgang til Smart-sammenligning og de andre funksjonene i Free-abonnementet.
Bruk Smart-matching på bedriftsdata
Smart-matching standardiserer verdier for sammenligning uten å endre de lagrede cellene. Velg prosessoren som passer egenskapen:
- Email håndterer store og små bokstaver, mellomrom rundt adressen, plussaliaser, Gmail-punktum,
googlemail.com, omsluttede visningsnavn ogmailto:-verdier. - URL kan ignorere protokoller og avsluttende skråstrek, med valgfrie innstillinger for subdomener, stier og spørringsparametere.
- Phone ignorerer formateringstegn. Den validerer ikke numre, bruker ingen Country-egenskap og utleder ikke en manglende landskode.
- Company Name fjerner vanlige juridiske, forretningsmessige og geografiske betegnelser.
- Text ignorerer aksenter, mellomrom, tegnsetting, symboler, store og små bokstaver samt ordrekkefølge.
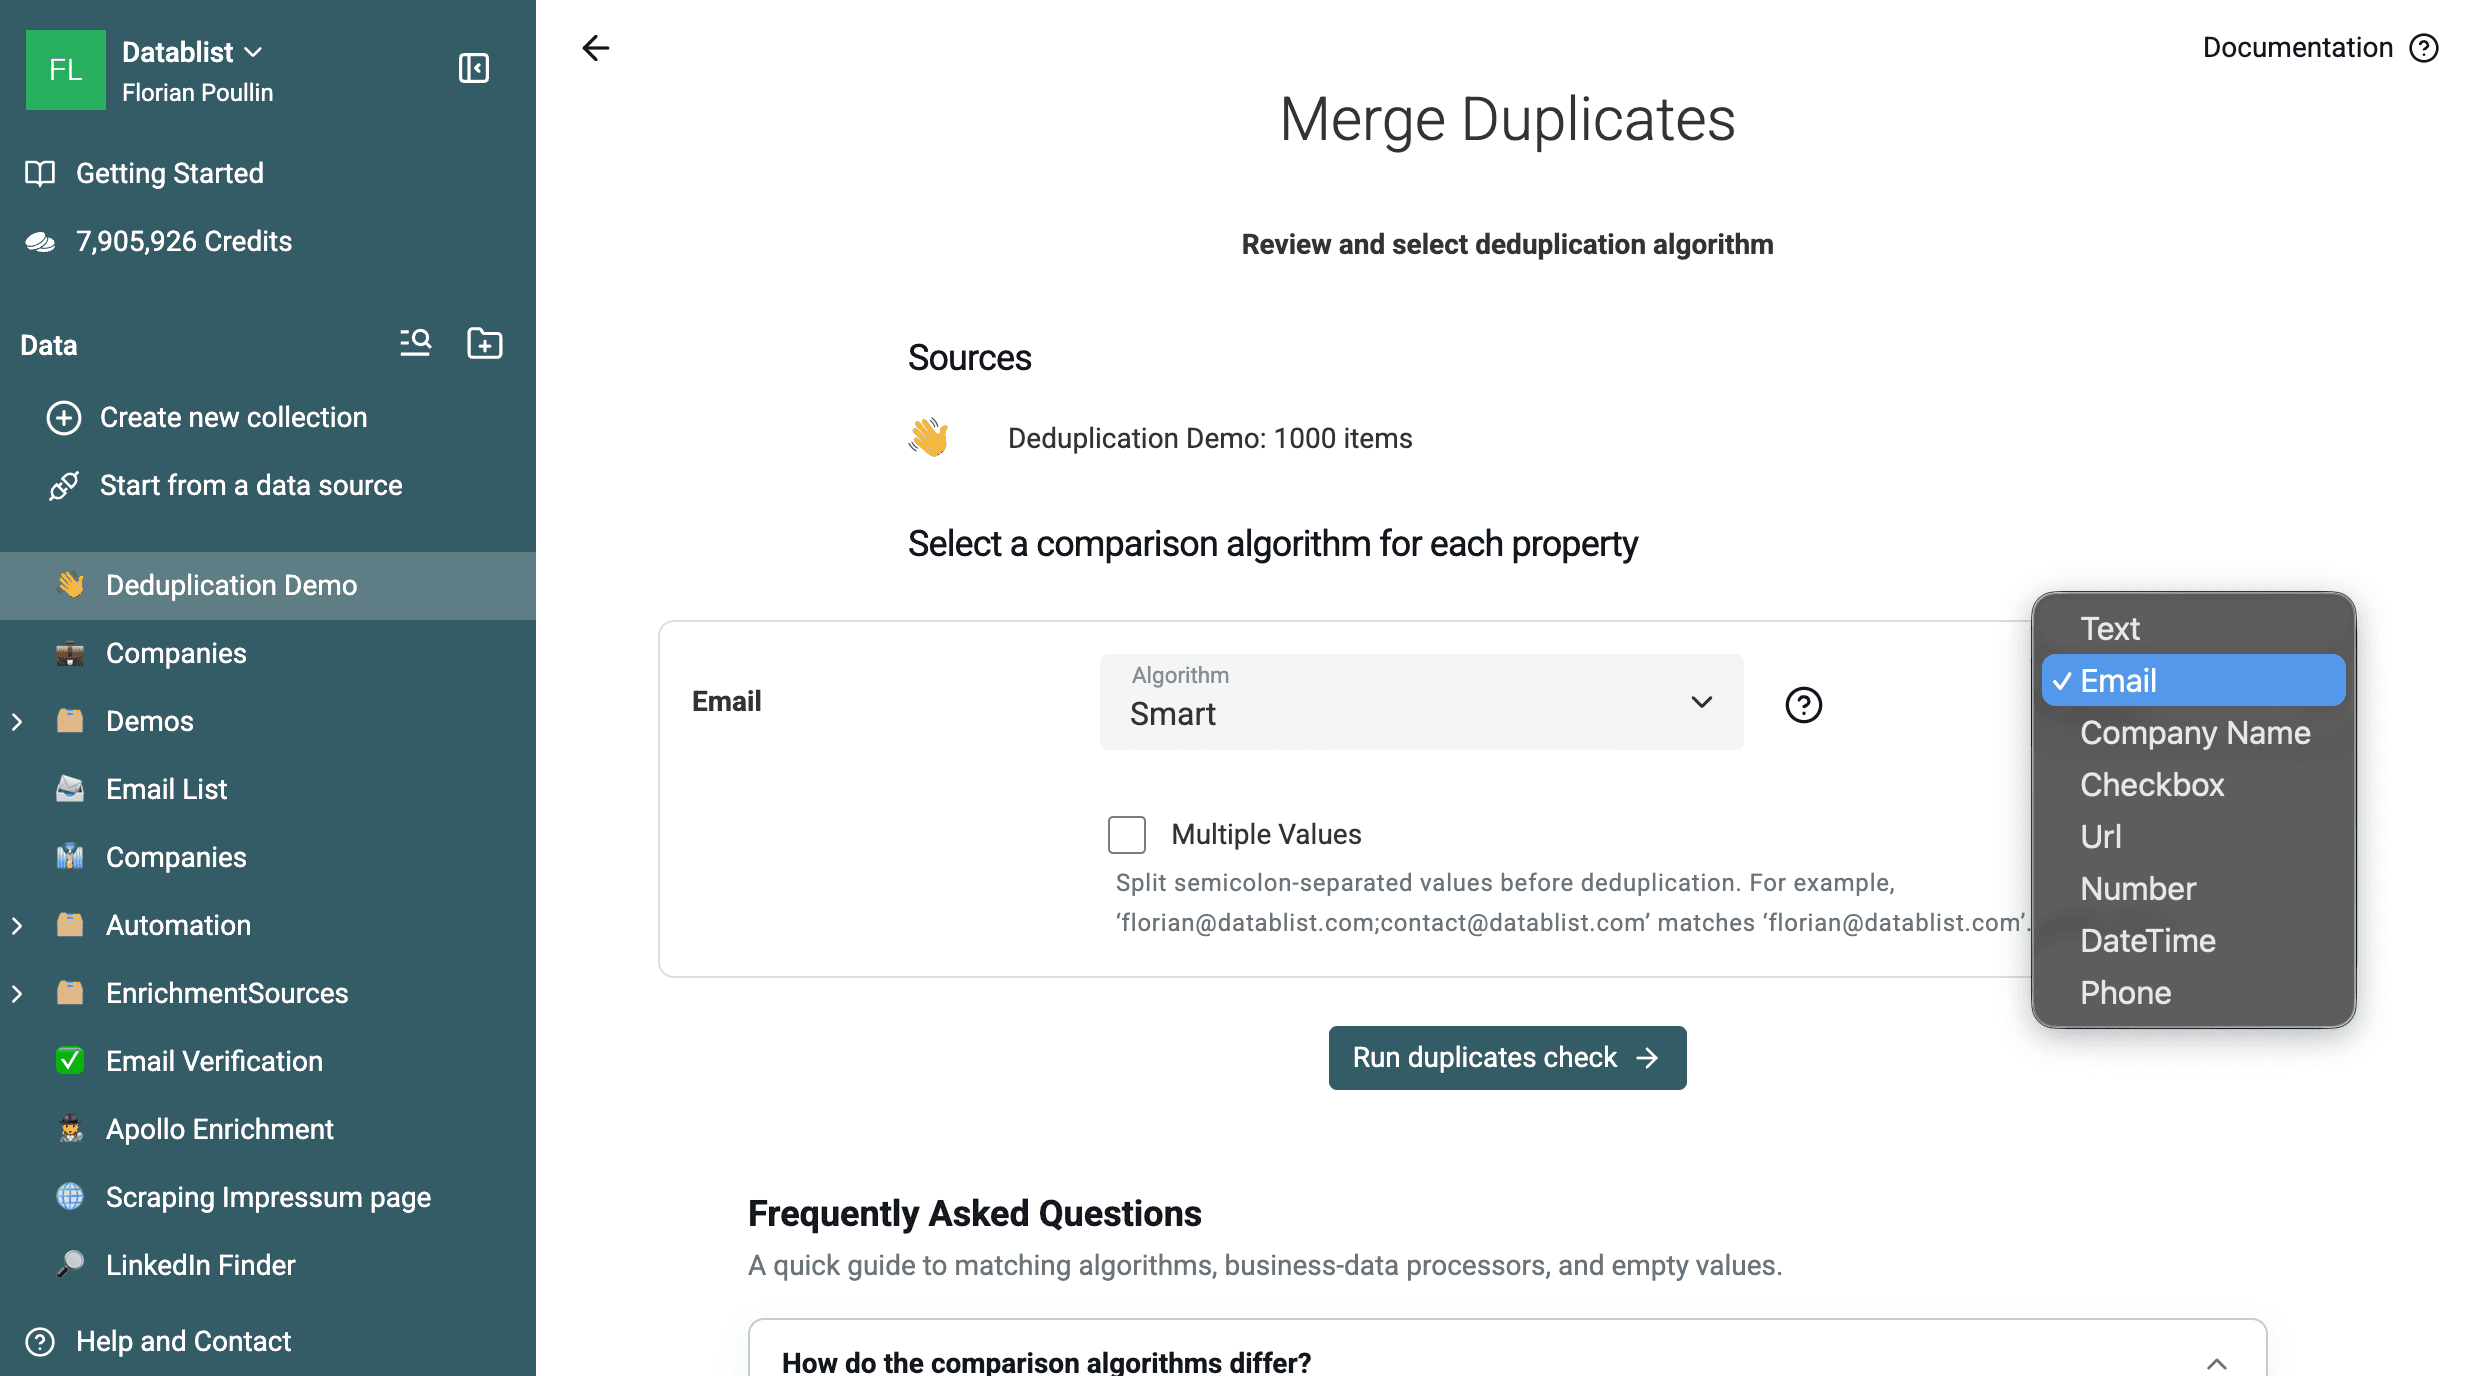
Company Name-prosessoren, matching av flere verdier og avanserte algoritmer krever et betalt abonnement. Exact og Smart er tilgjengelige for matching i én collection med Free-abonnementet, men Smart krever en gratis konto.
Hvis én celle inneholder flere semikolonseparerte identifikatorer, aktiverer du Multiple Values. Datablist sammenligner hver del og registrerer et treff for egenskapen når minst ett par samsvarer. En celle med primary@example.com;shared@example.com kan for eksempel matche en annen celle som inneholder shared@example.com.
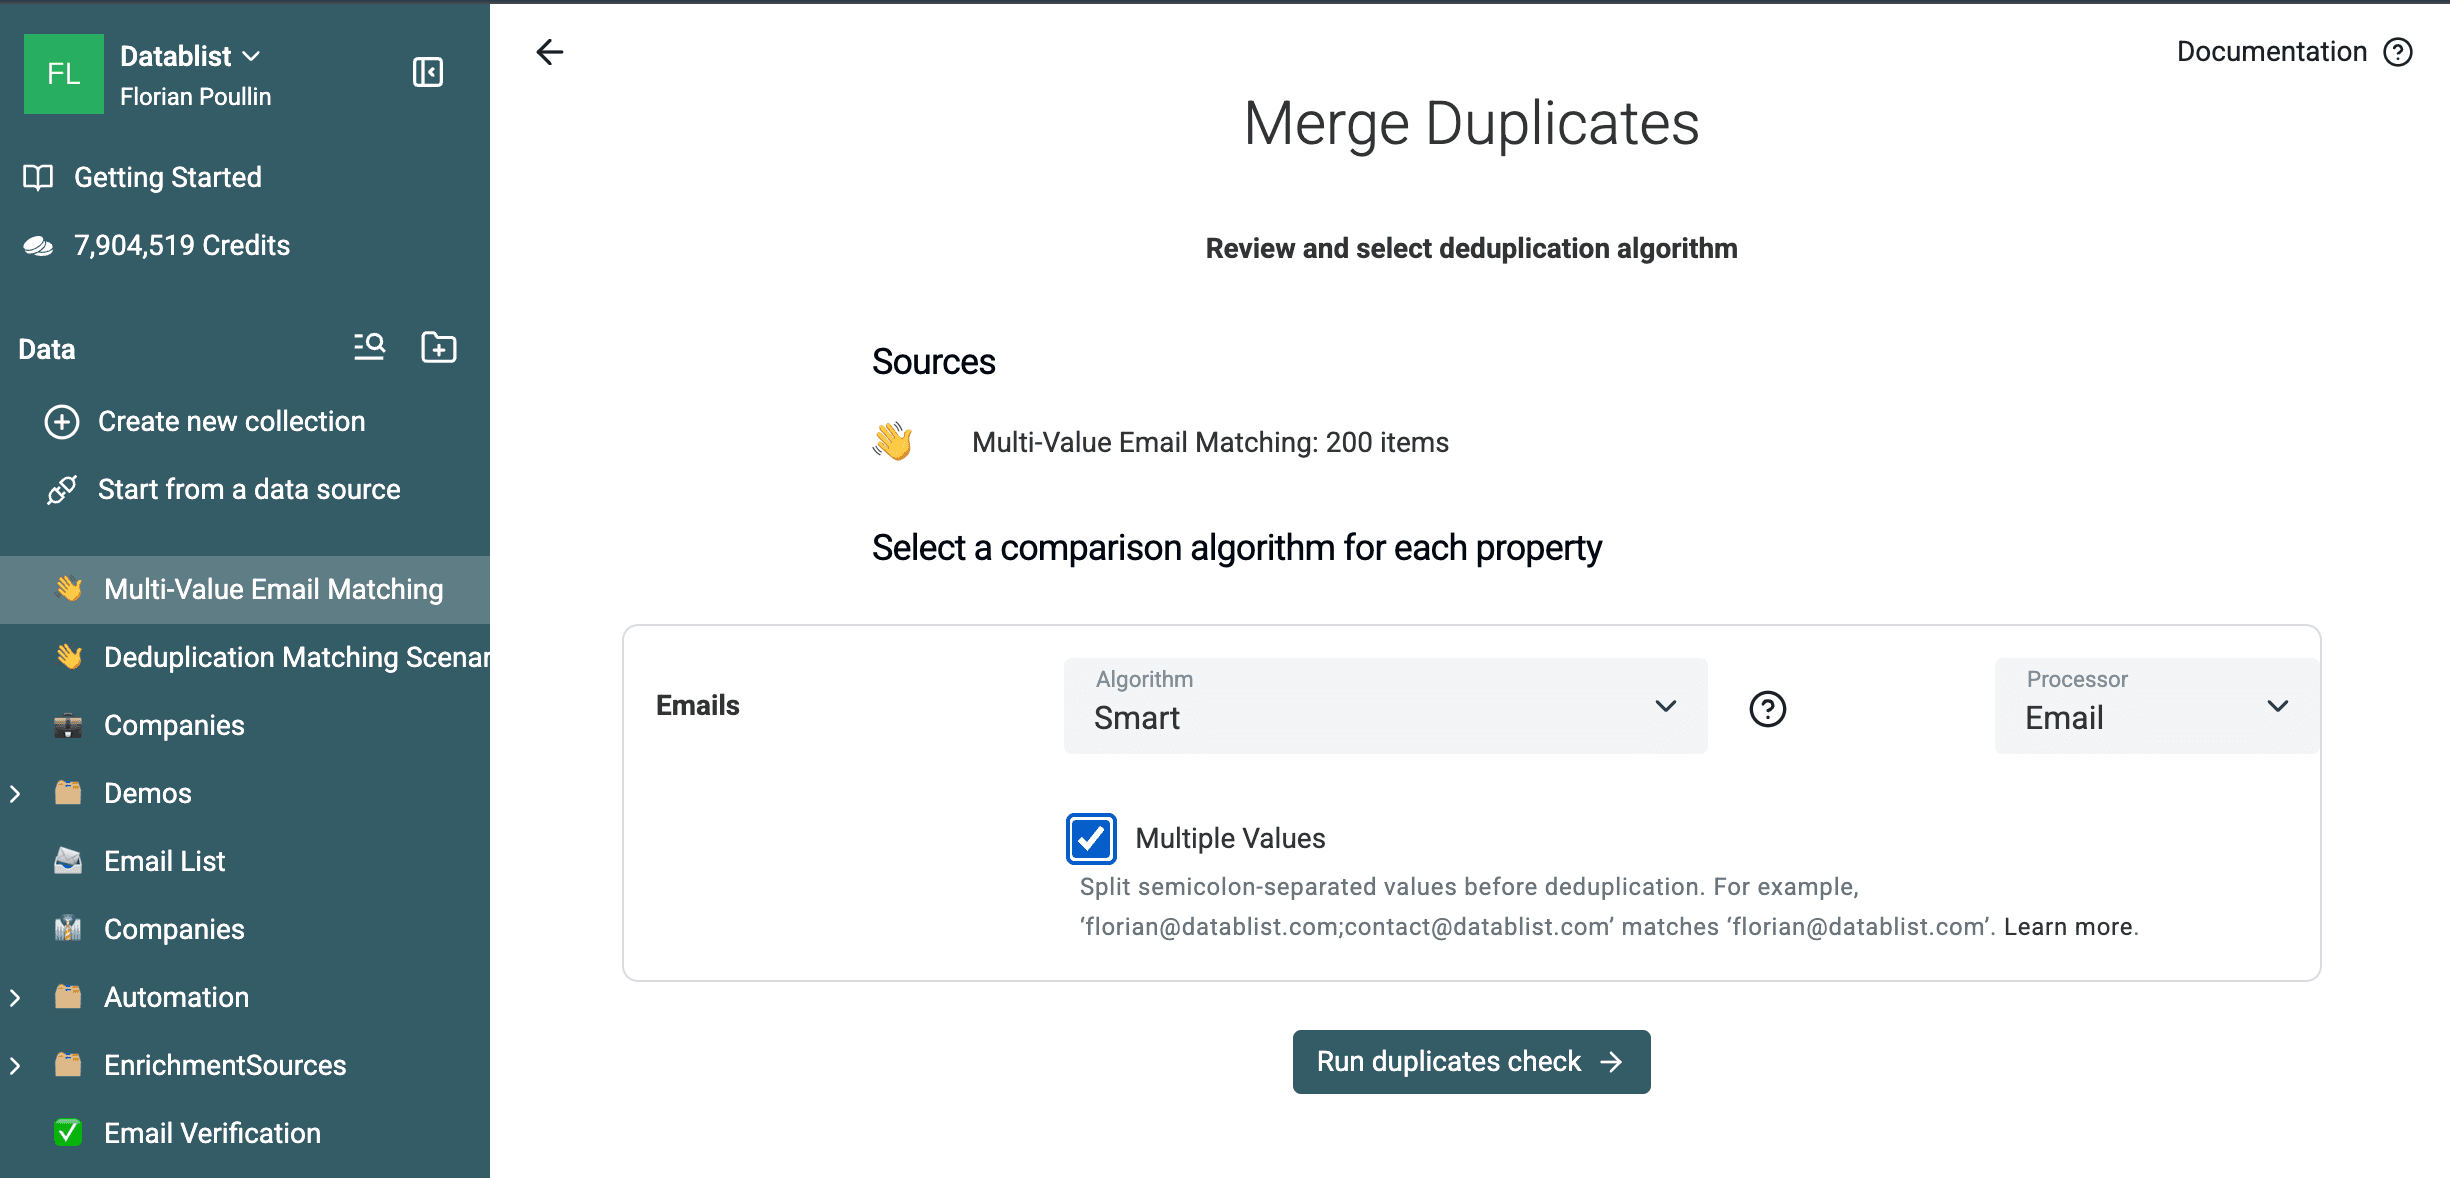
På det separate eksempelet med 200 rader ga denne konfigurasjonen 60 grupper med to rader. Kontrollen mot fasiten fant alle de 60 konstruerte parene og utelot alle de 80 kontrollpostene. Følg arbeidsflyten for deduplisering av felt med flere verdier for å få eksempelfilen, resultat-CSV-en og rådene om sammenslåing.
Dette e-postsøket ga 105 grupper med to rader: 100 konstruerte par for e-postnormalisering og de fem identiske kopiparene, som også har samme e-postadresse.
Normaliser telefonnumre før matching
Smart Phone-prosessoren er nyttig i ett avgrenset tilfelle: verdier med de samme sifrene, men ulike mellomrom, parenteser, bindestreker eller symboler. Den kan matche (415) 555-0123 med 4155550123.
Den kan ikke avgjøre at et lokalt og et internasjonalt nummer er det samme. 06 12 34 50 08 og +33 6 12 34 50 08 trenger for eksempel landkontekst før de kan sammenlignes.
Bruk Phone Number Cleaner før du dedupliserer etter telefonnummer:
- Koble til den ubehandlede
Phone-egenskapen. - For en liste fra ett land velger du landet under Local Phone Countries. For en liste med flere land aktiverer du Define country per item og kobler til
Country-egenskapen. - Skriv enrichment-resultatet til
Clean Phone Numberuten å overskrive den opprinnelige verdien. - Kontroller mislykkede eller tomme resultater. De skal ikke inngå i telefonmatchingen.
- Kjør Duplicates Finder på
Clean Phone Numbermed Exact.
Last ned det separate telefoneksempelet med 200 rader. Det inneholder 50 lokale/internasjonale par fra USA, Frankrike, Storbritannia, Tyskland og Spania, i tillegg til 100 kontrollposter som ikke skal matche. Validering med logikken fra produksjonsversjonen av renseverktøyet ga ett normalisert telefonnummer for alle de 200 radene. De 50 konstruerte parene samles til 50 felles internasjonale verdier, mens kontrollpostene forblir unike.
Denne forhåndsbehandlingen validerer også telefonformatet. Behold de opprinnelige Phone- og Country-egenskapene ved siden av det ryddede resultatet, slik at du kan kontrollere hver post før sammenslåing. Les hva normalisering av telefonnumre innebærer for å forstå betydningen av landskoder og internasjonale verdier.
For bedriftsposter kjører du et eget søk på Website. Velg Smart med URL-prosessoren. Aktiver Ignore Subdomain, Ignore Path og Ignore Query Params bare dersom disse URL-komponentene ikke skal identifisere en annen bedrift eller lokasjon.
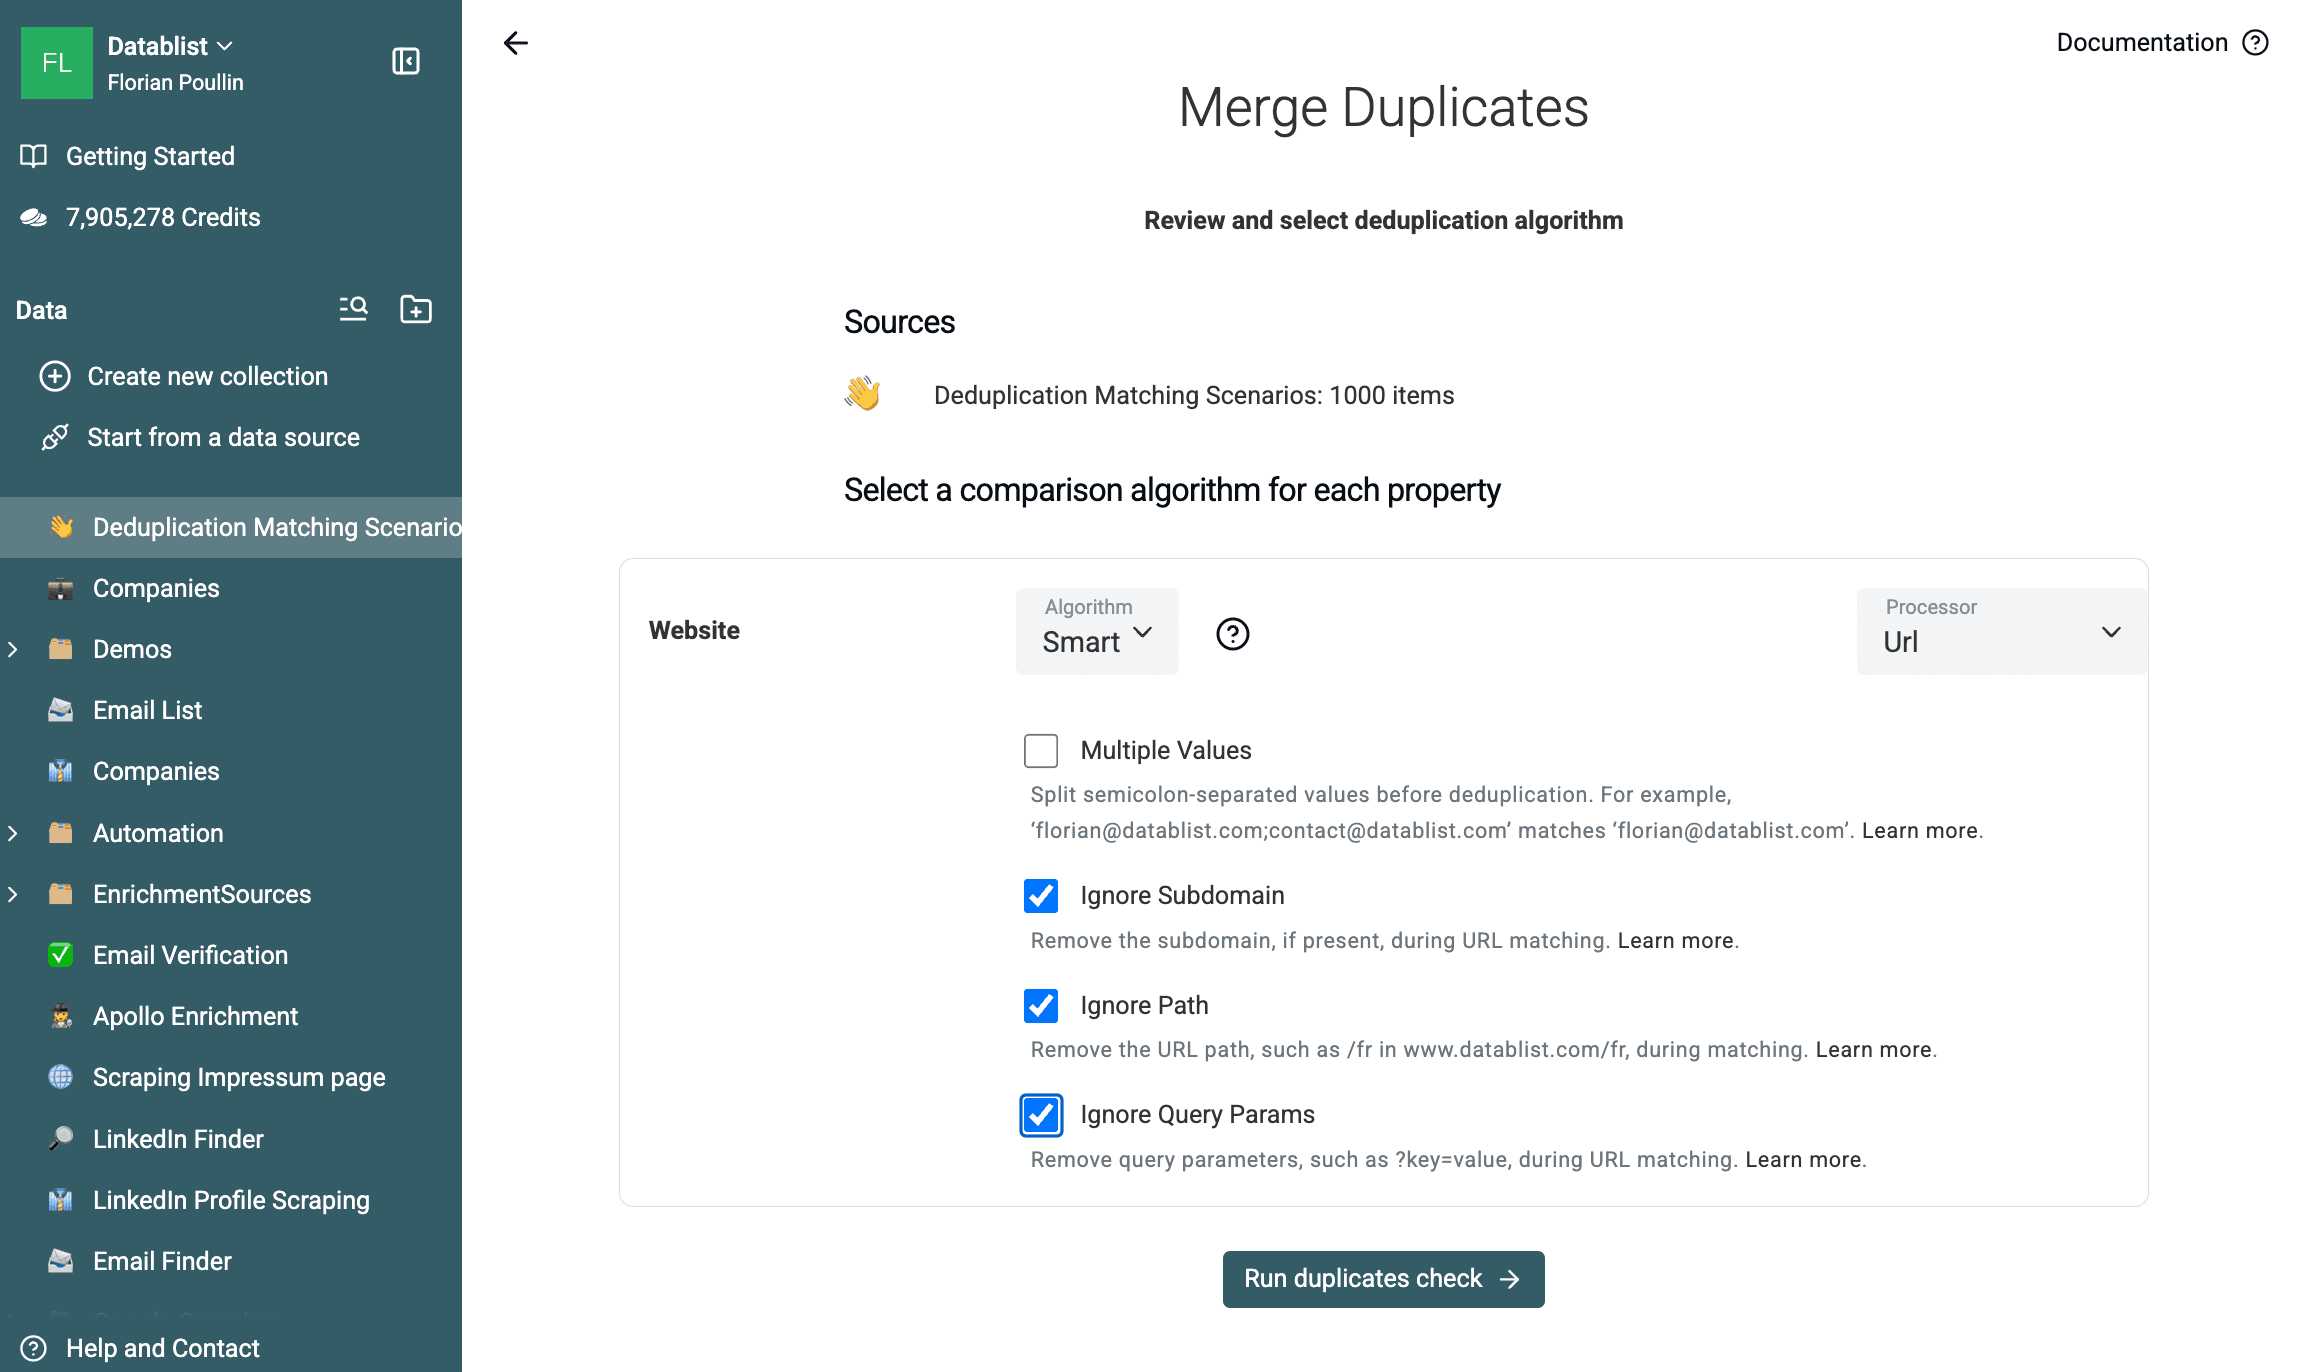
På det samme eksempelet med 1 000 rader ga denne konfigurasjonen 200 grupper med to rader. Femti par inneholder konstruerte URL-varianter, mens 150 par allerede har identisk nettsted. I denne testen ble alle eksporterte par normalisert til samme vert.
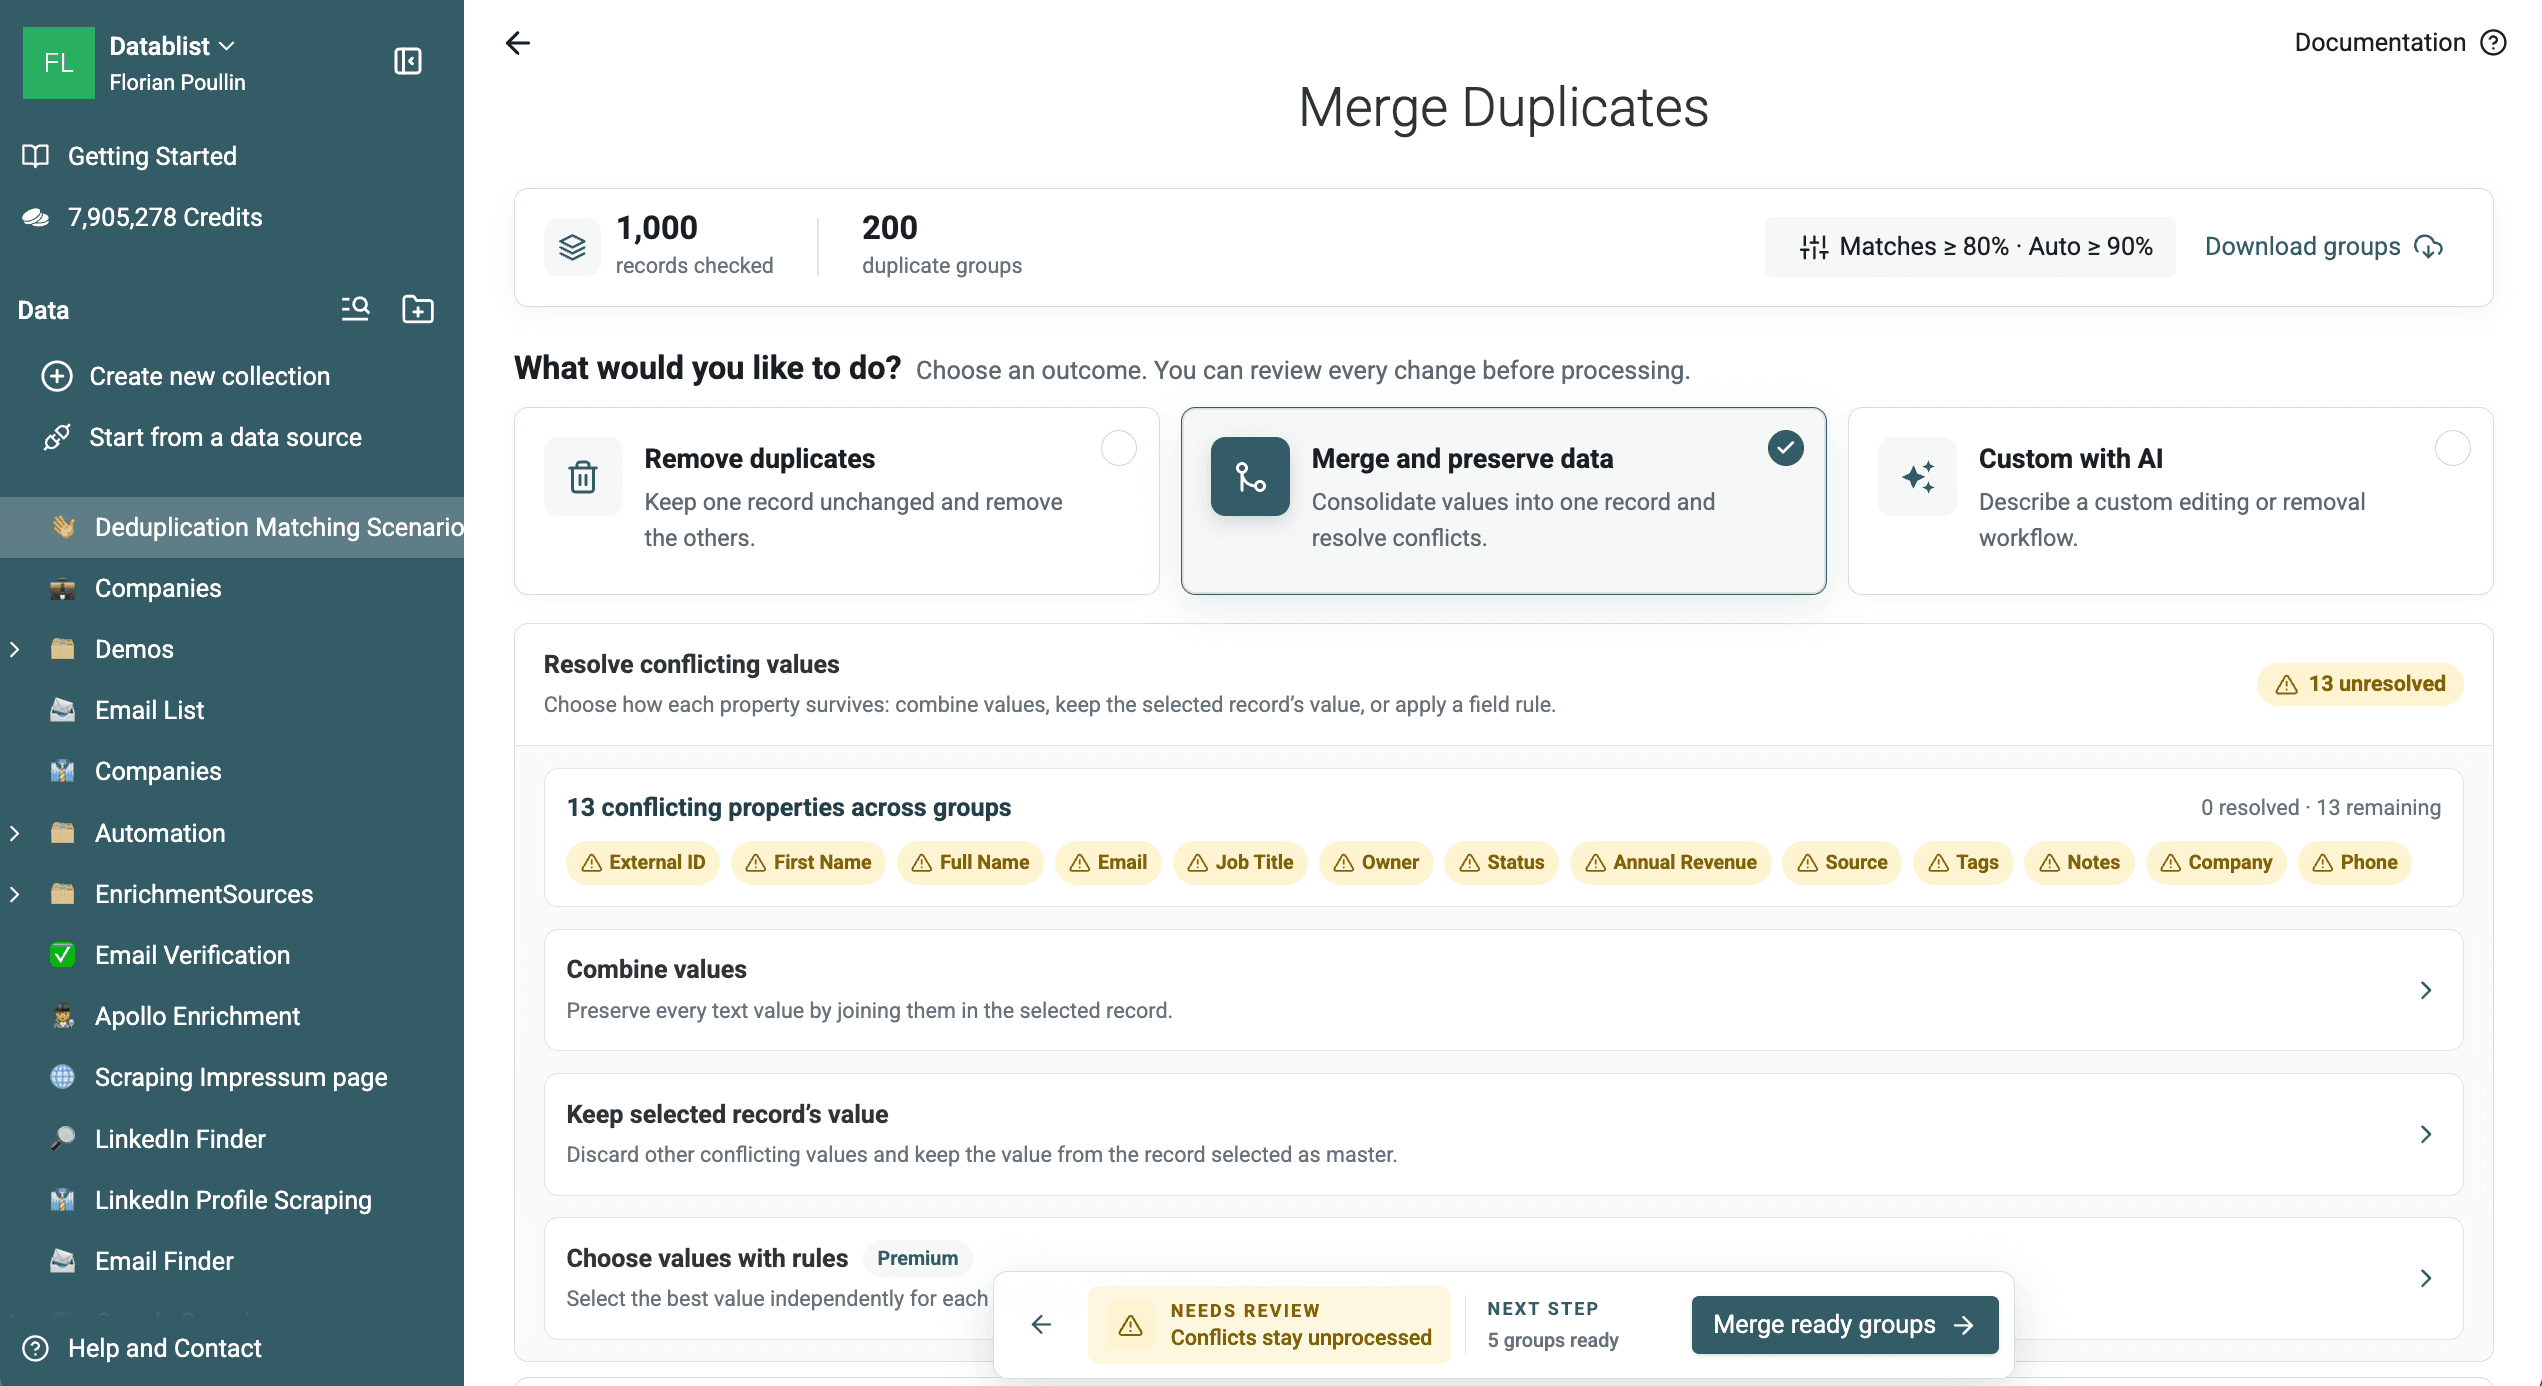
Last ned de 200 duplikatgruppene for Website, eller se arbeidsflyten for deduplisering av bedrifter for en strategi som matcher domener først.
Bruk fuzzy- eller fonetisk matching som kontroll
Metaphone sammenligner hvordan tekst høres ut. Jaro-Winkler og Levenshtein beregner en likhetsscore, noe som gjør det enklere å finne stavevarianter som Uma Turner og Uman Turner.
Fuzzy-treff er kandidater, ikke bekreftede duplikater. Start med en høy terskel, undersøk de svakeste gruppene, og senk resultatterskelen bare så lenge kontrollen fortsatt gir presise treff.
For et målbart fuzzy-søk velger du Full Name, deretter Distance med Levenshtein, beholder Text-prosessoren og setter terskelen til 90 %.
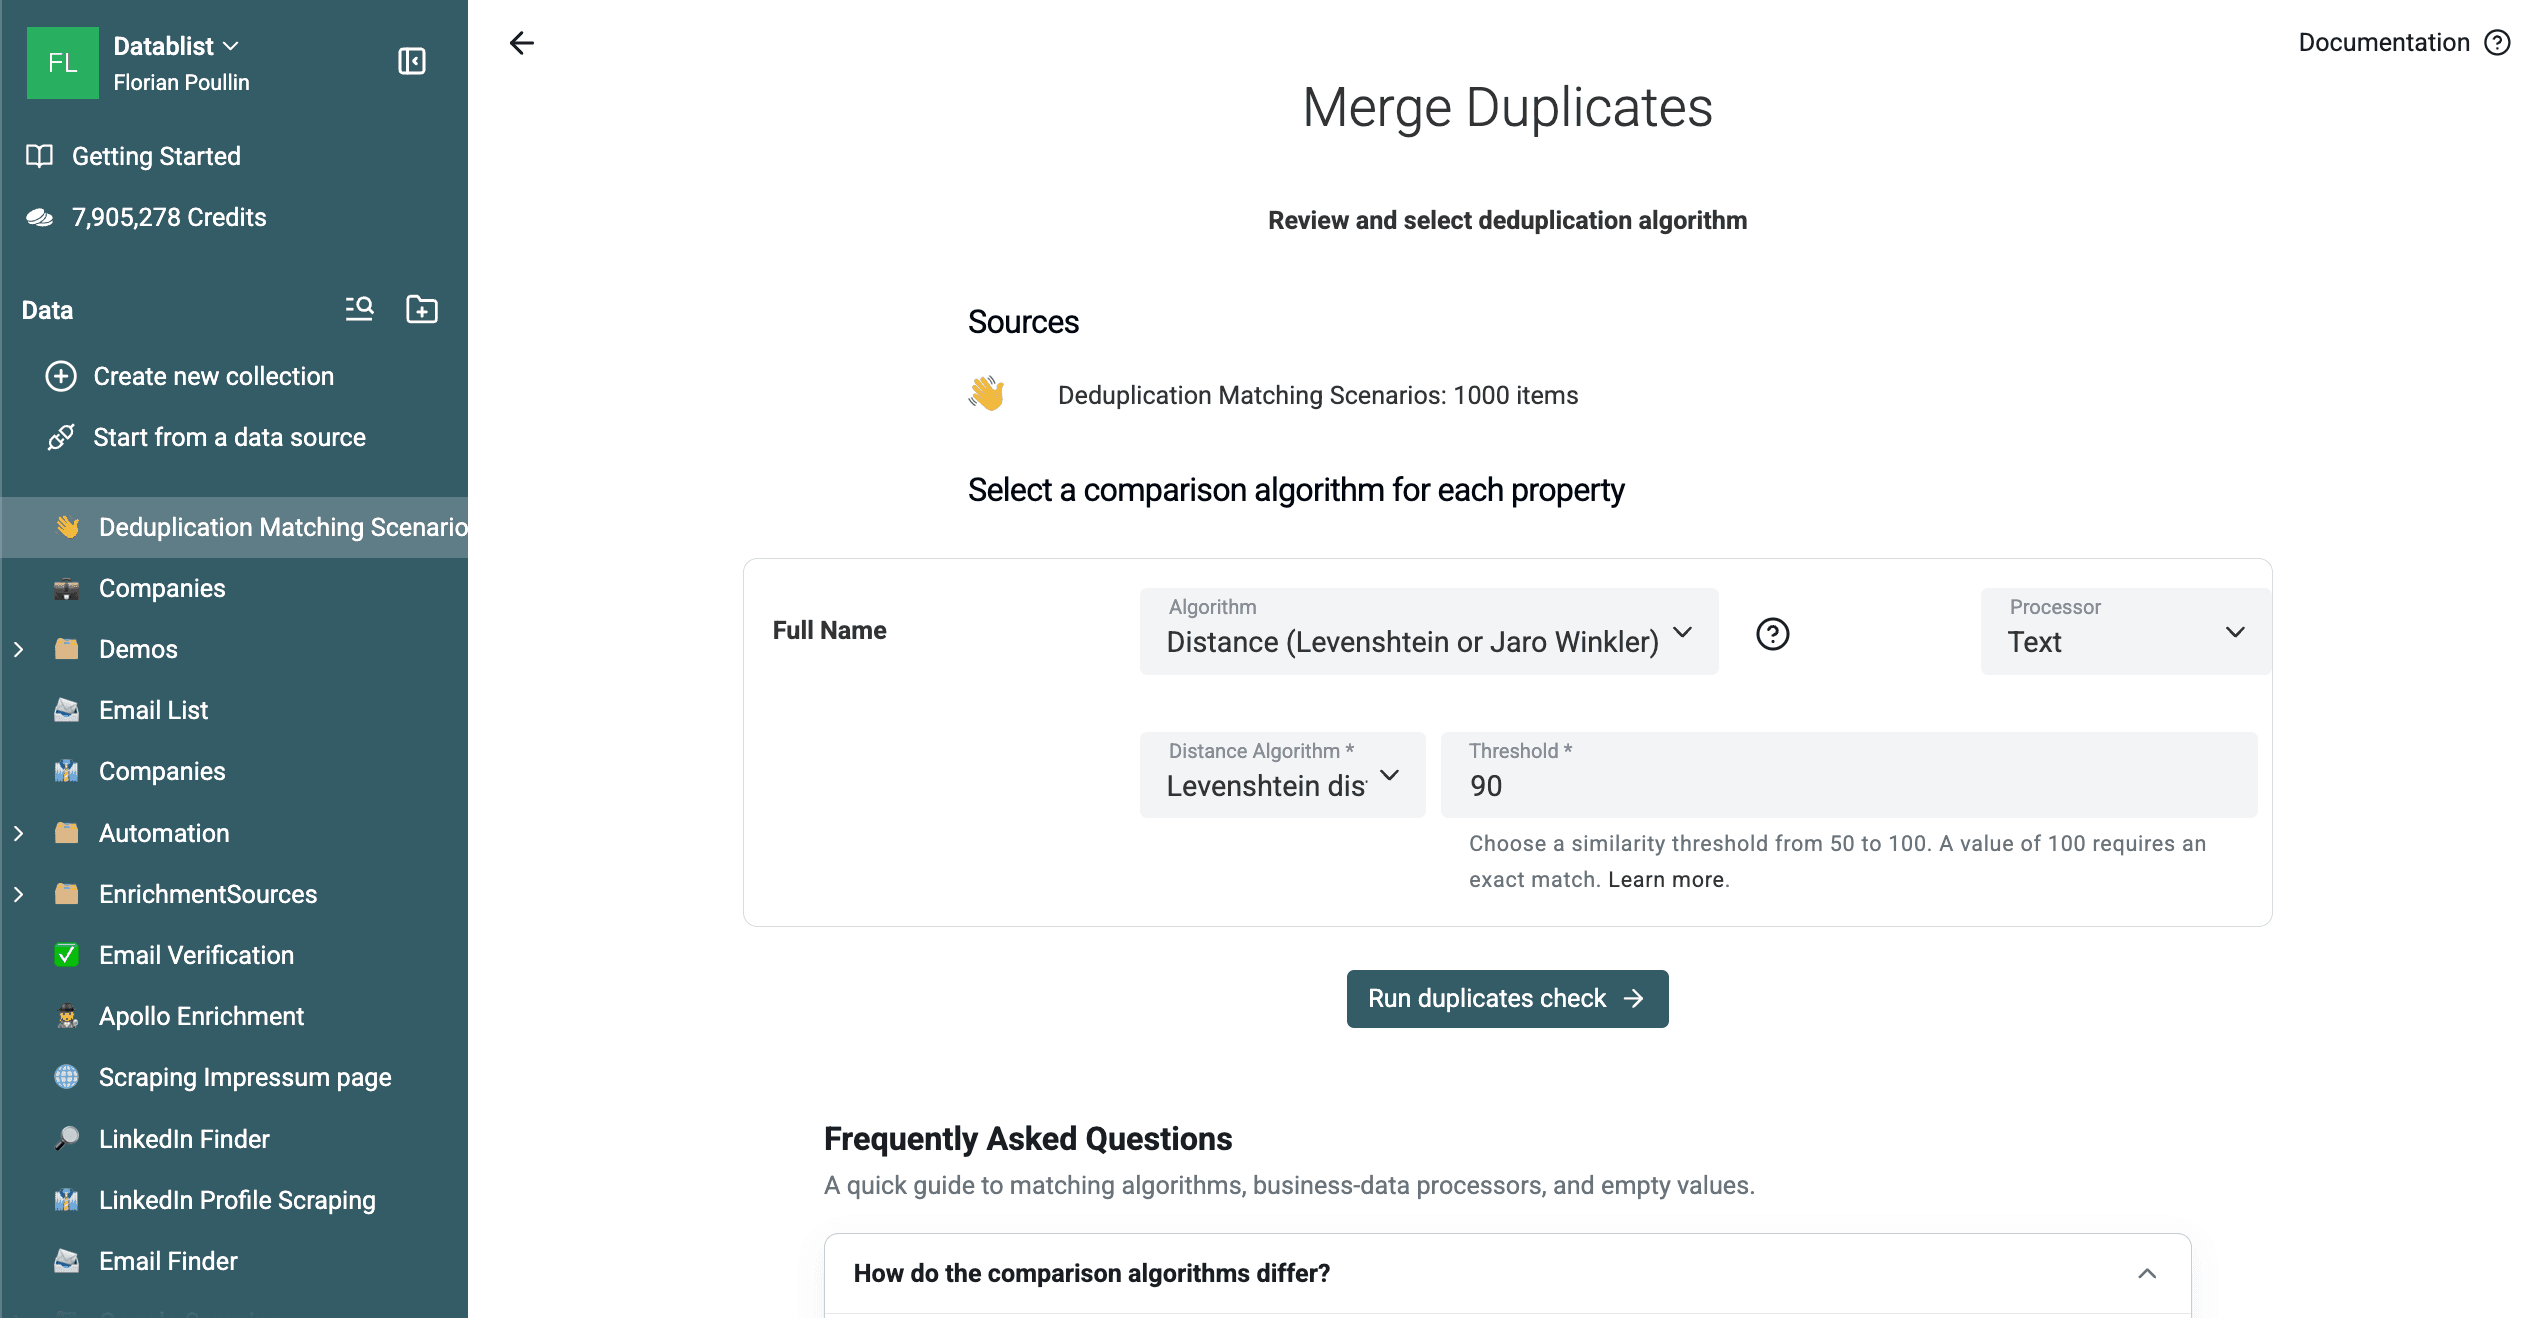
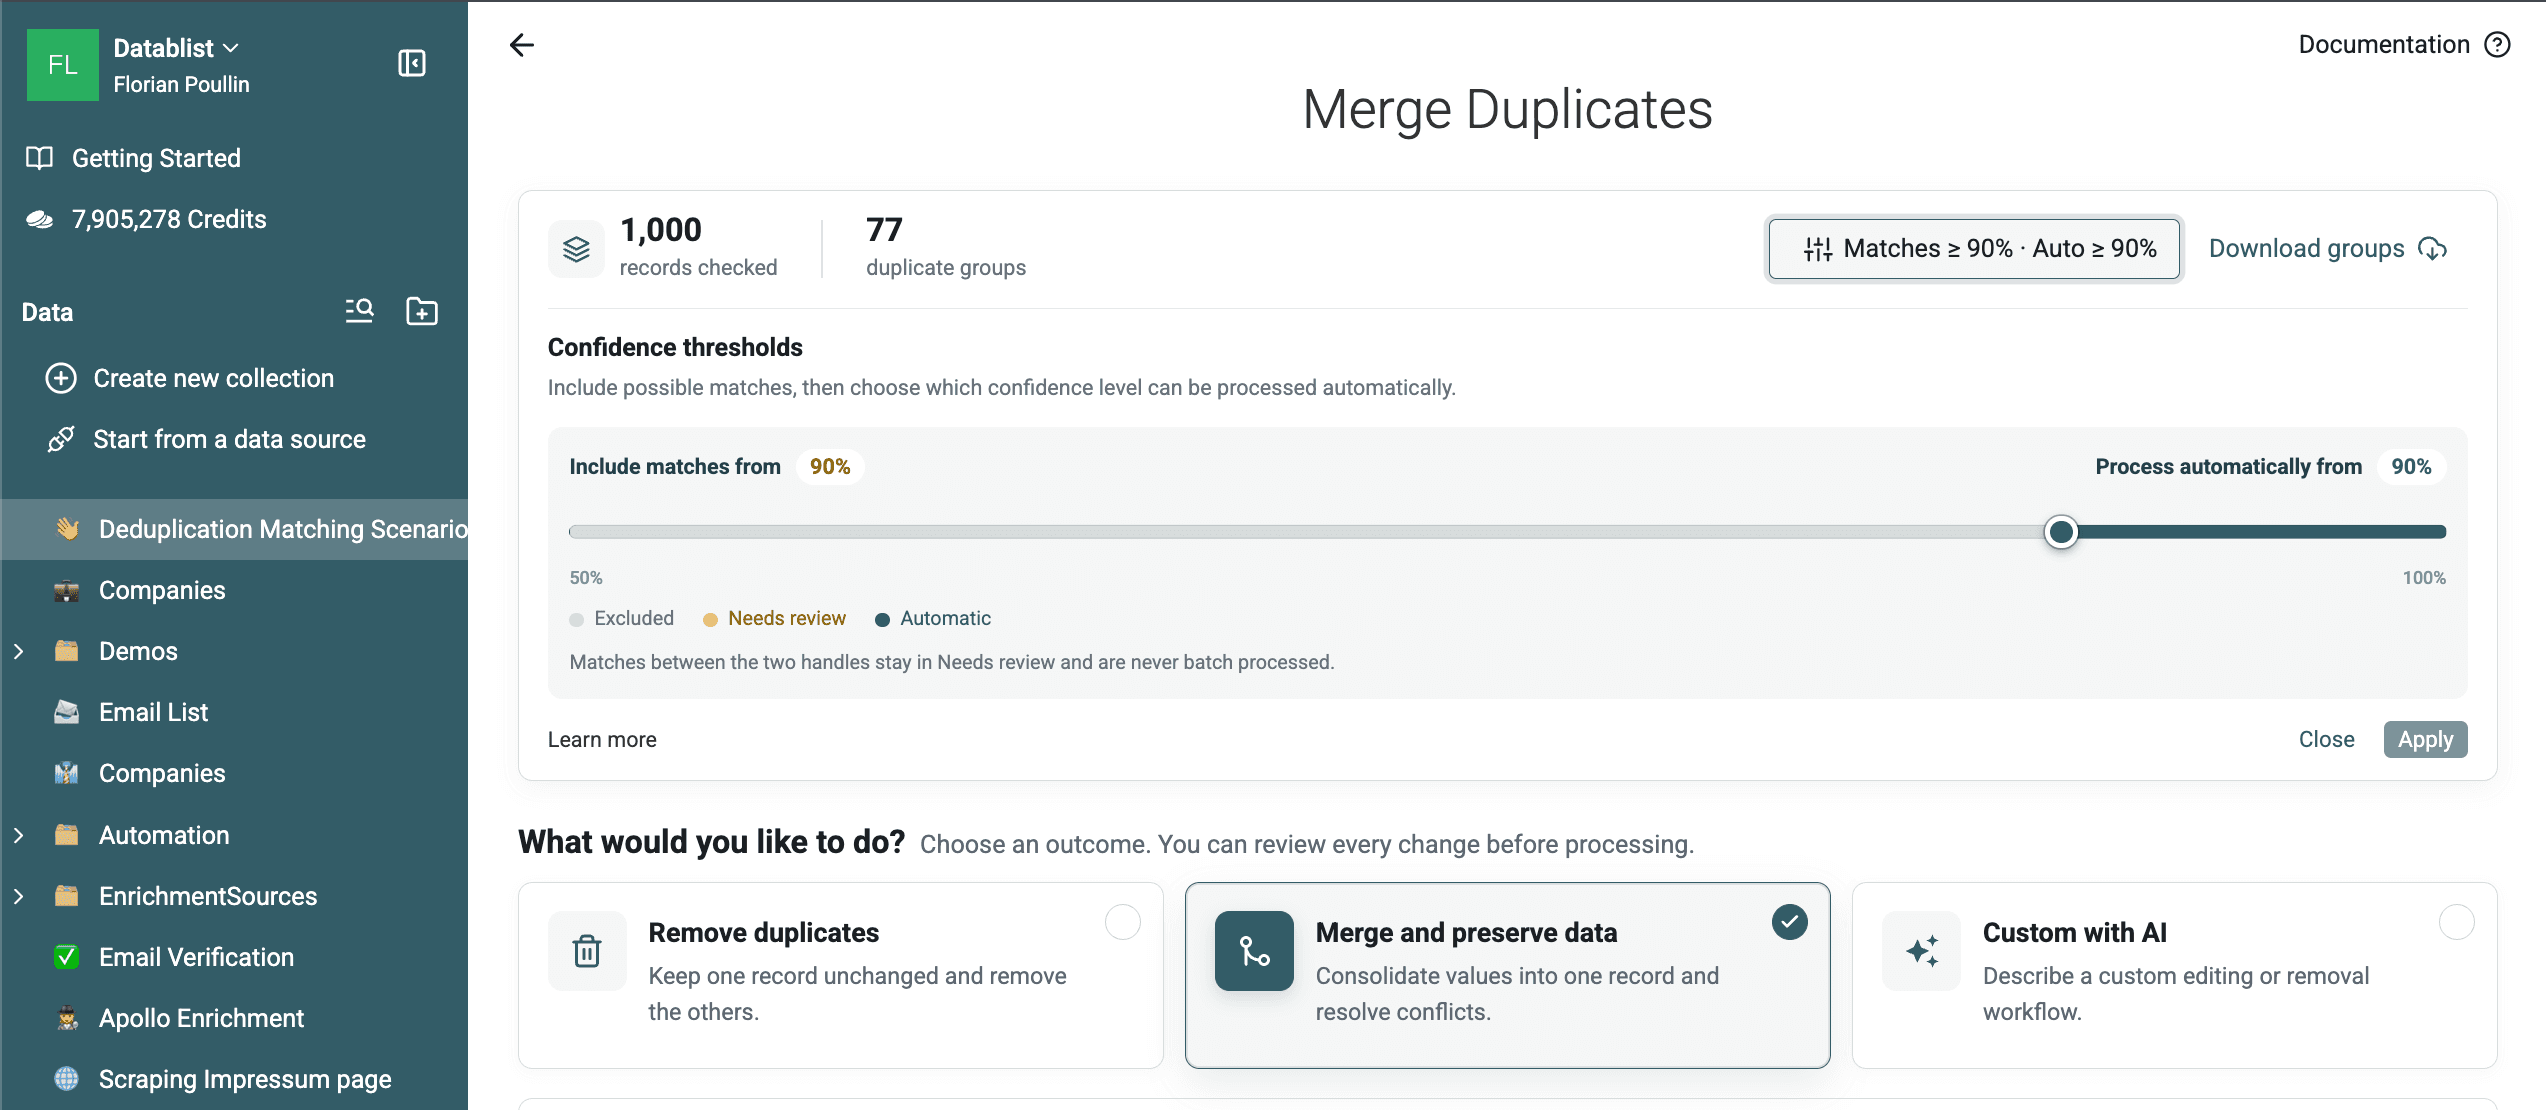
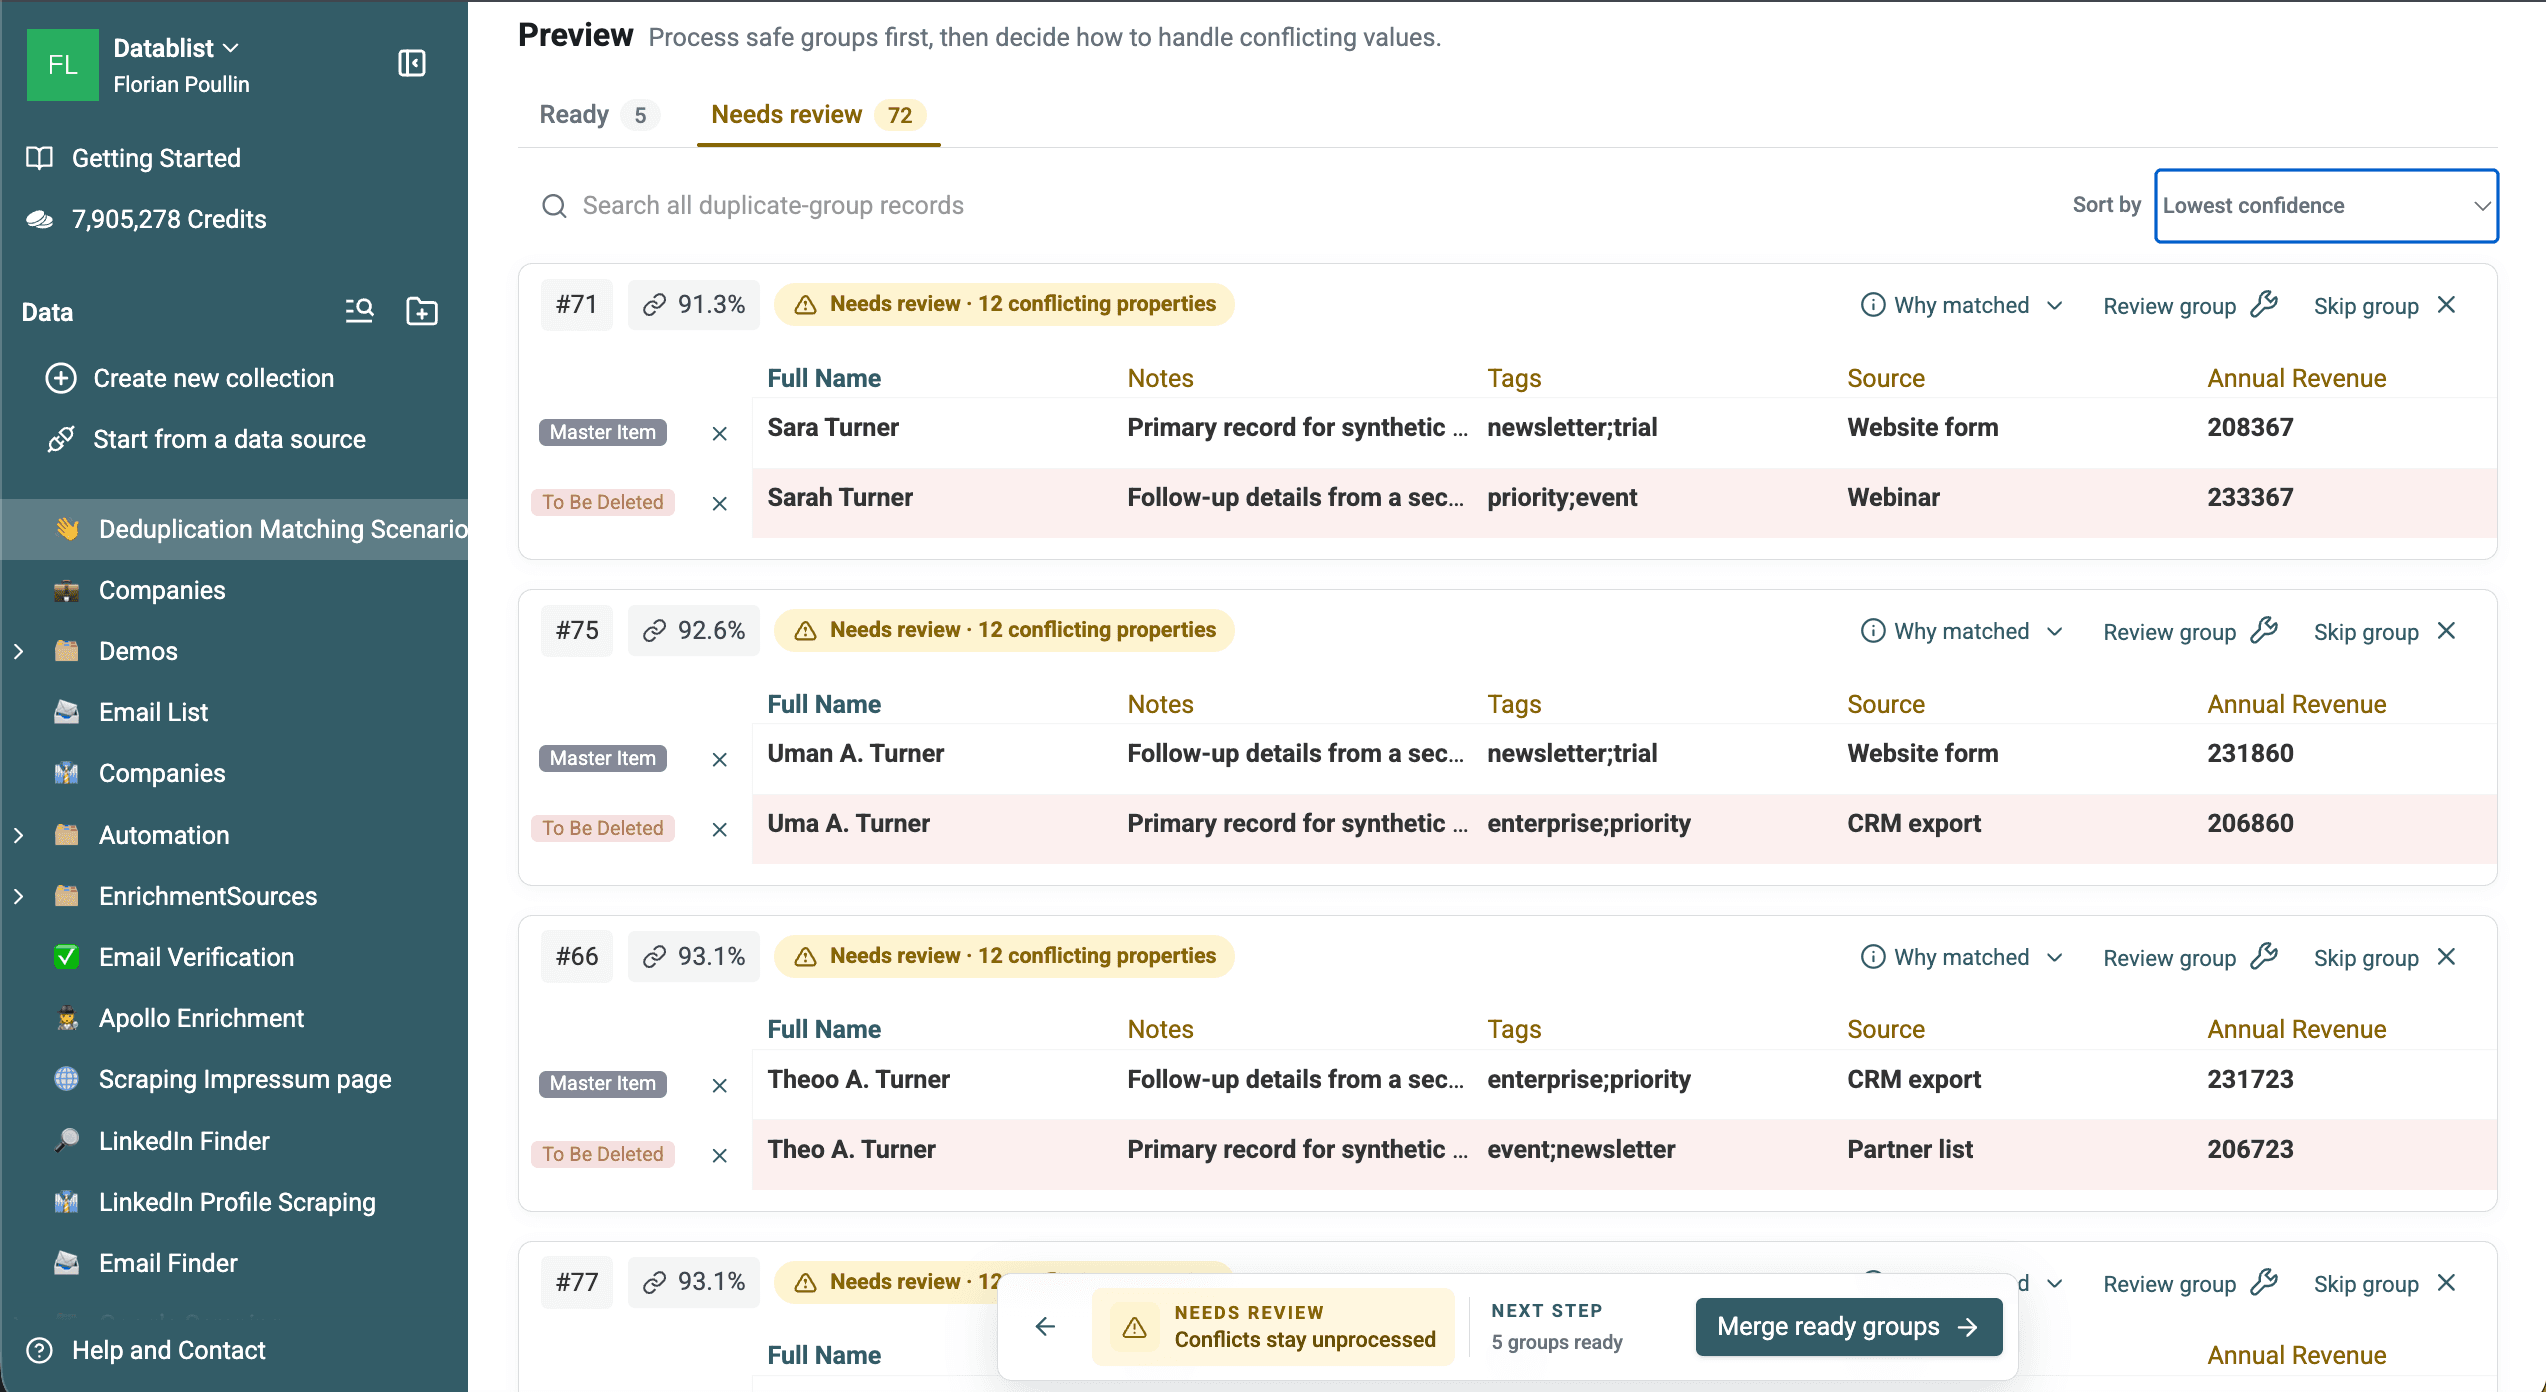
Denne kontrollen ga 77 grupper med to rader fra eksempelet med 1 000 rader. Valideringen mot fasiten fant 21 grupper som koblet sammen den samme konstruerte enheten, og 56 grupper som koblet sammen ulike enheter. De fleste falske positive var forkortede navn som G. Rossi, der Full Name alene ikke kan skille mellom to personer.
Søket finner tilsiktede stavevarianter som Uma A. Turner og Uman A. Turner, men viser også hvorfor fuzzy-treff basert kun på navn må kontrolleres.
Last ned de 77 eksporterte Levenshtein-gruppene for å undersøke både nyttige treff og falske positive.
For fonetisk matching velger du Full Name, deretter Metaphone, og beholder Text-prosessoren.
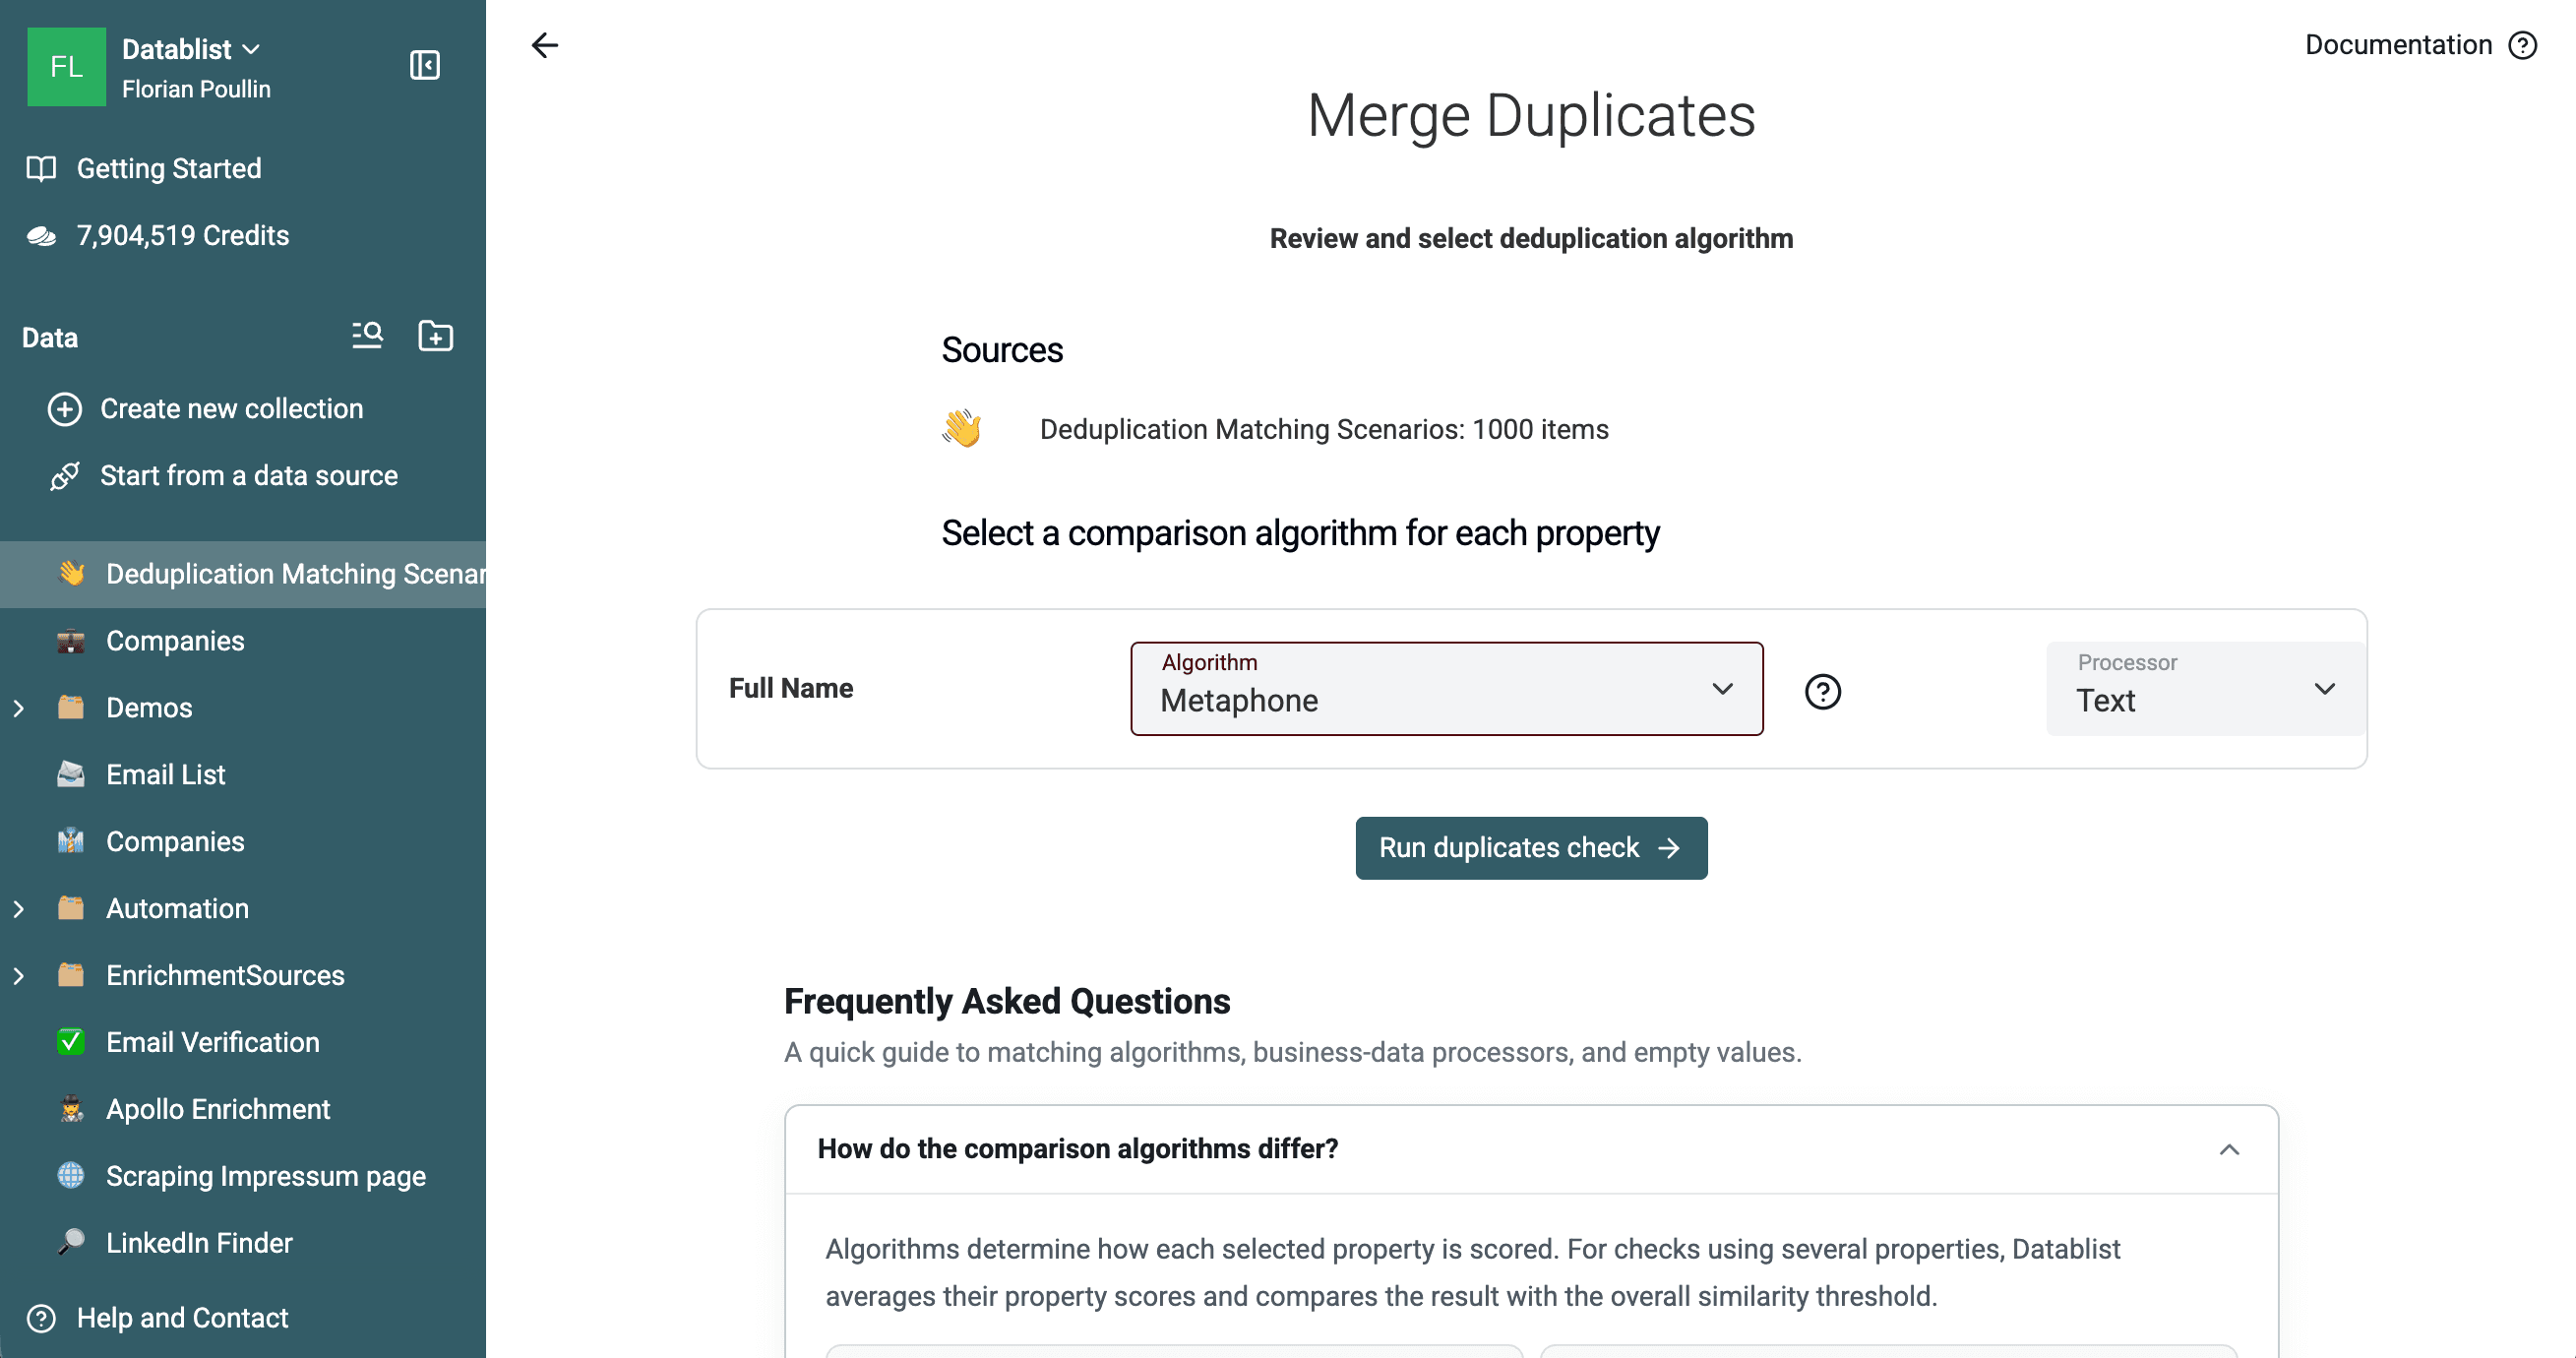
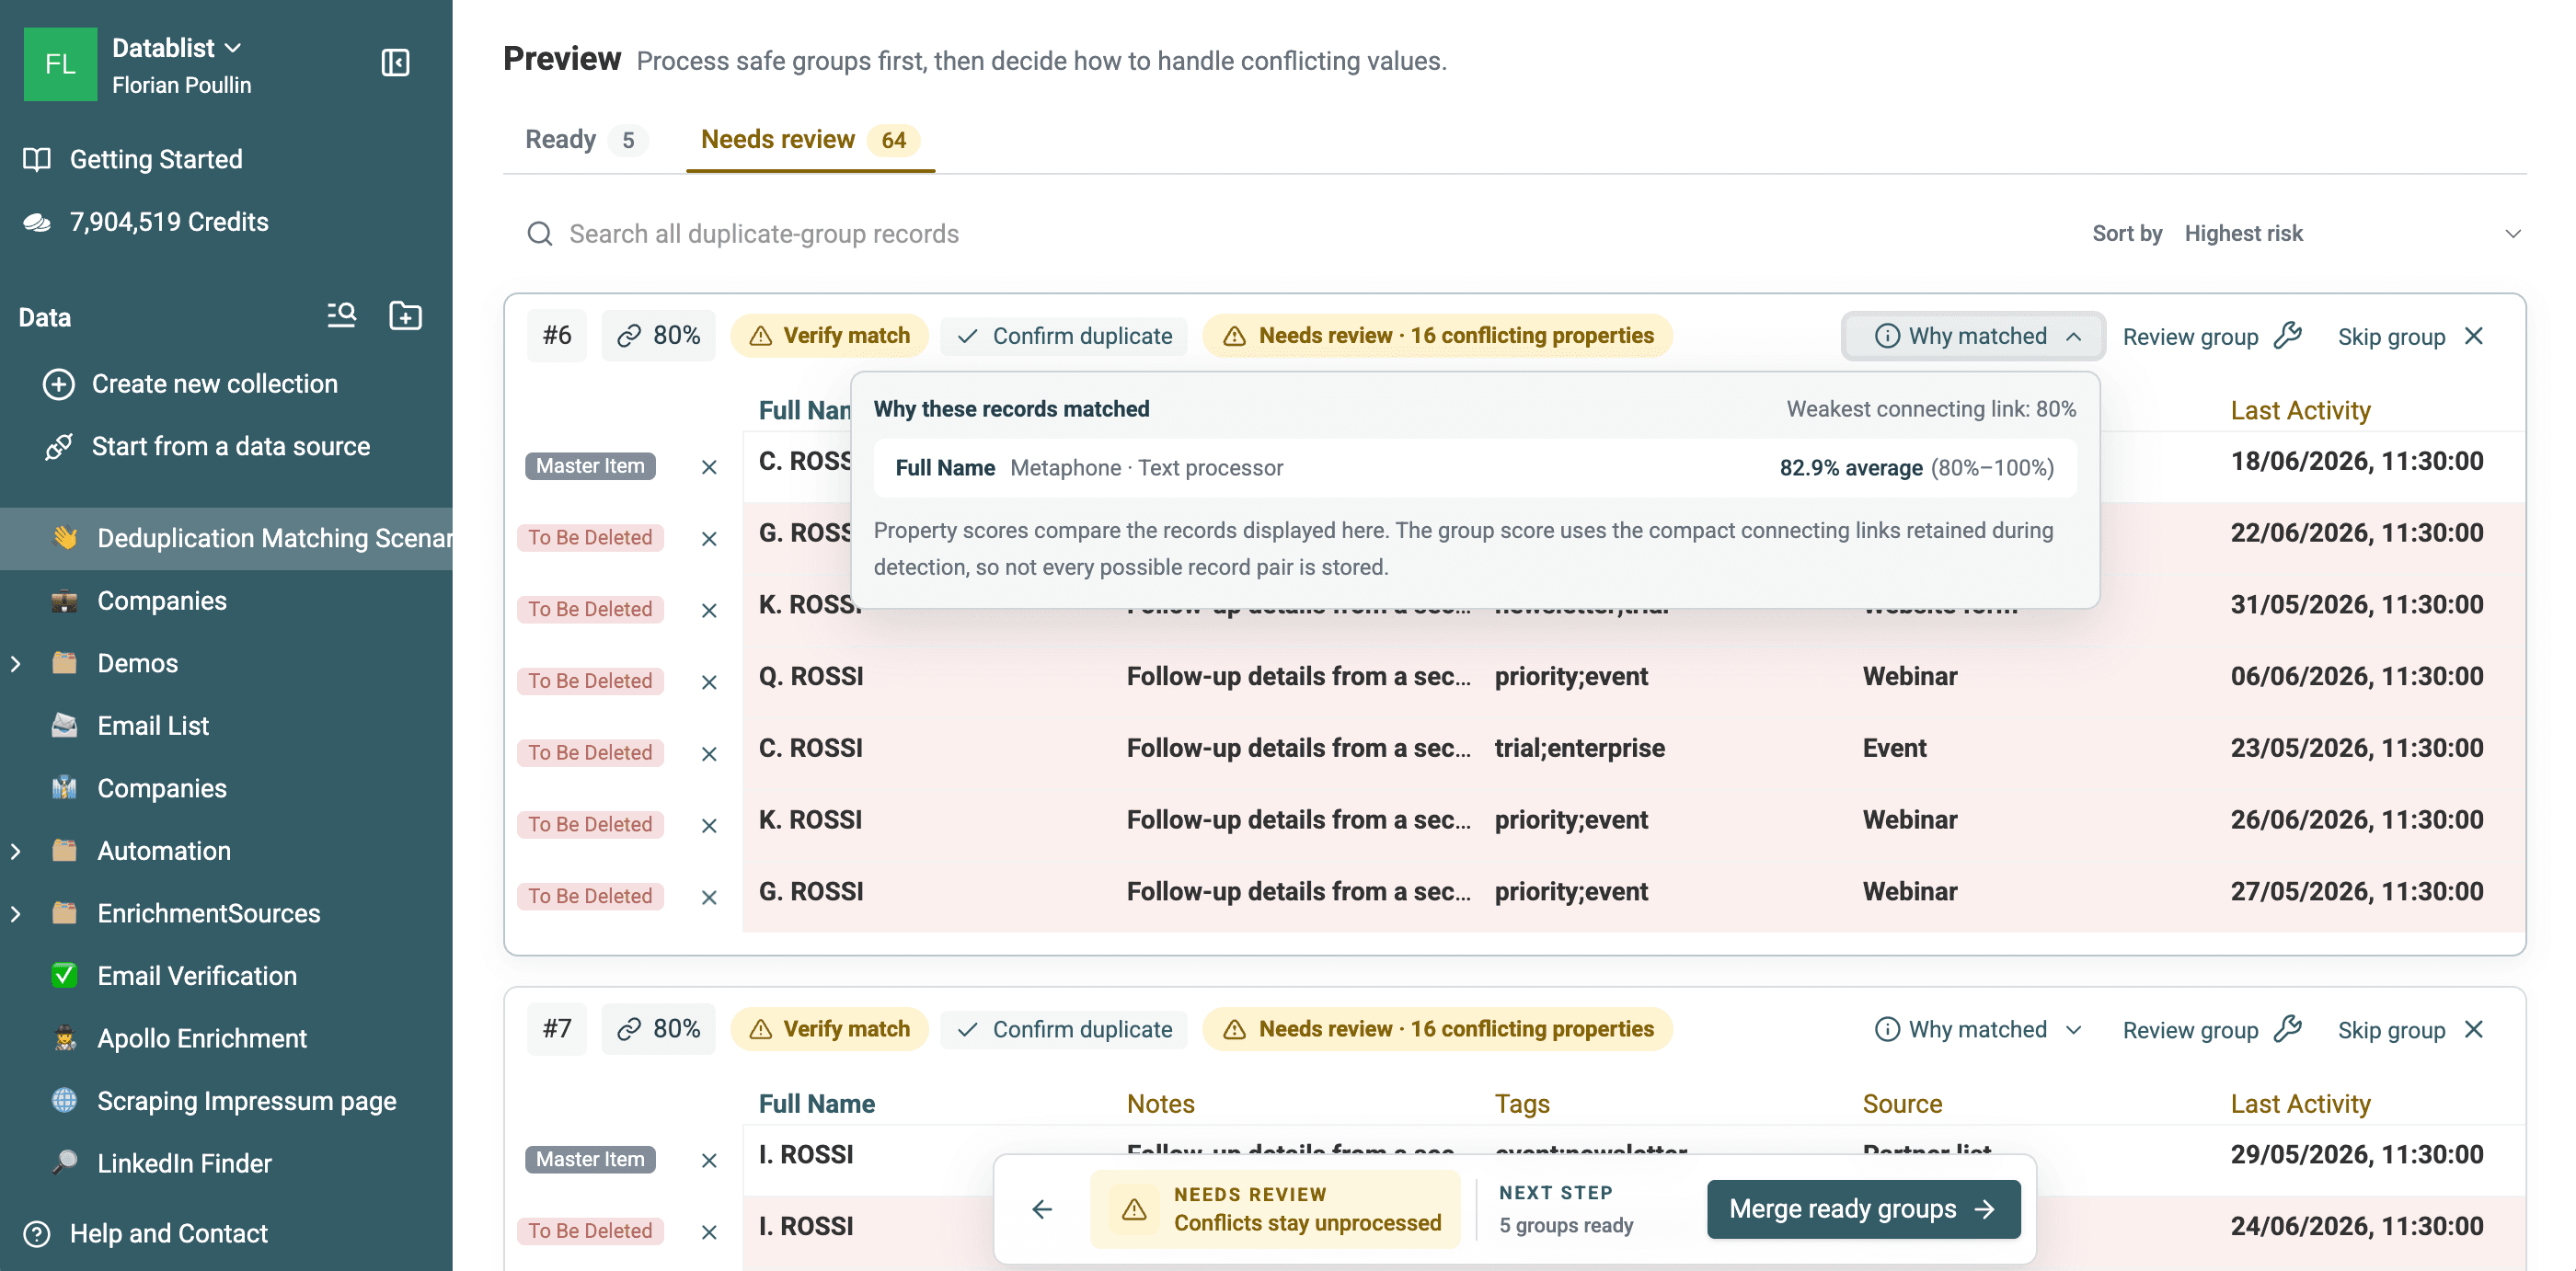
Dette søket viste 69 grupper: 5 Ready og 64 Needs review. De eksporterte gruppene inneholder 188 rader. Valideringen mot de kjente enhetene i eksempelet fant 19 rene grupper med samme enhet og 50 grupper som blander ulike personer. Gruppene inneholder fra to til sju rader.
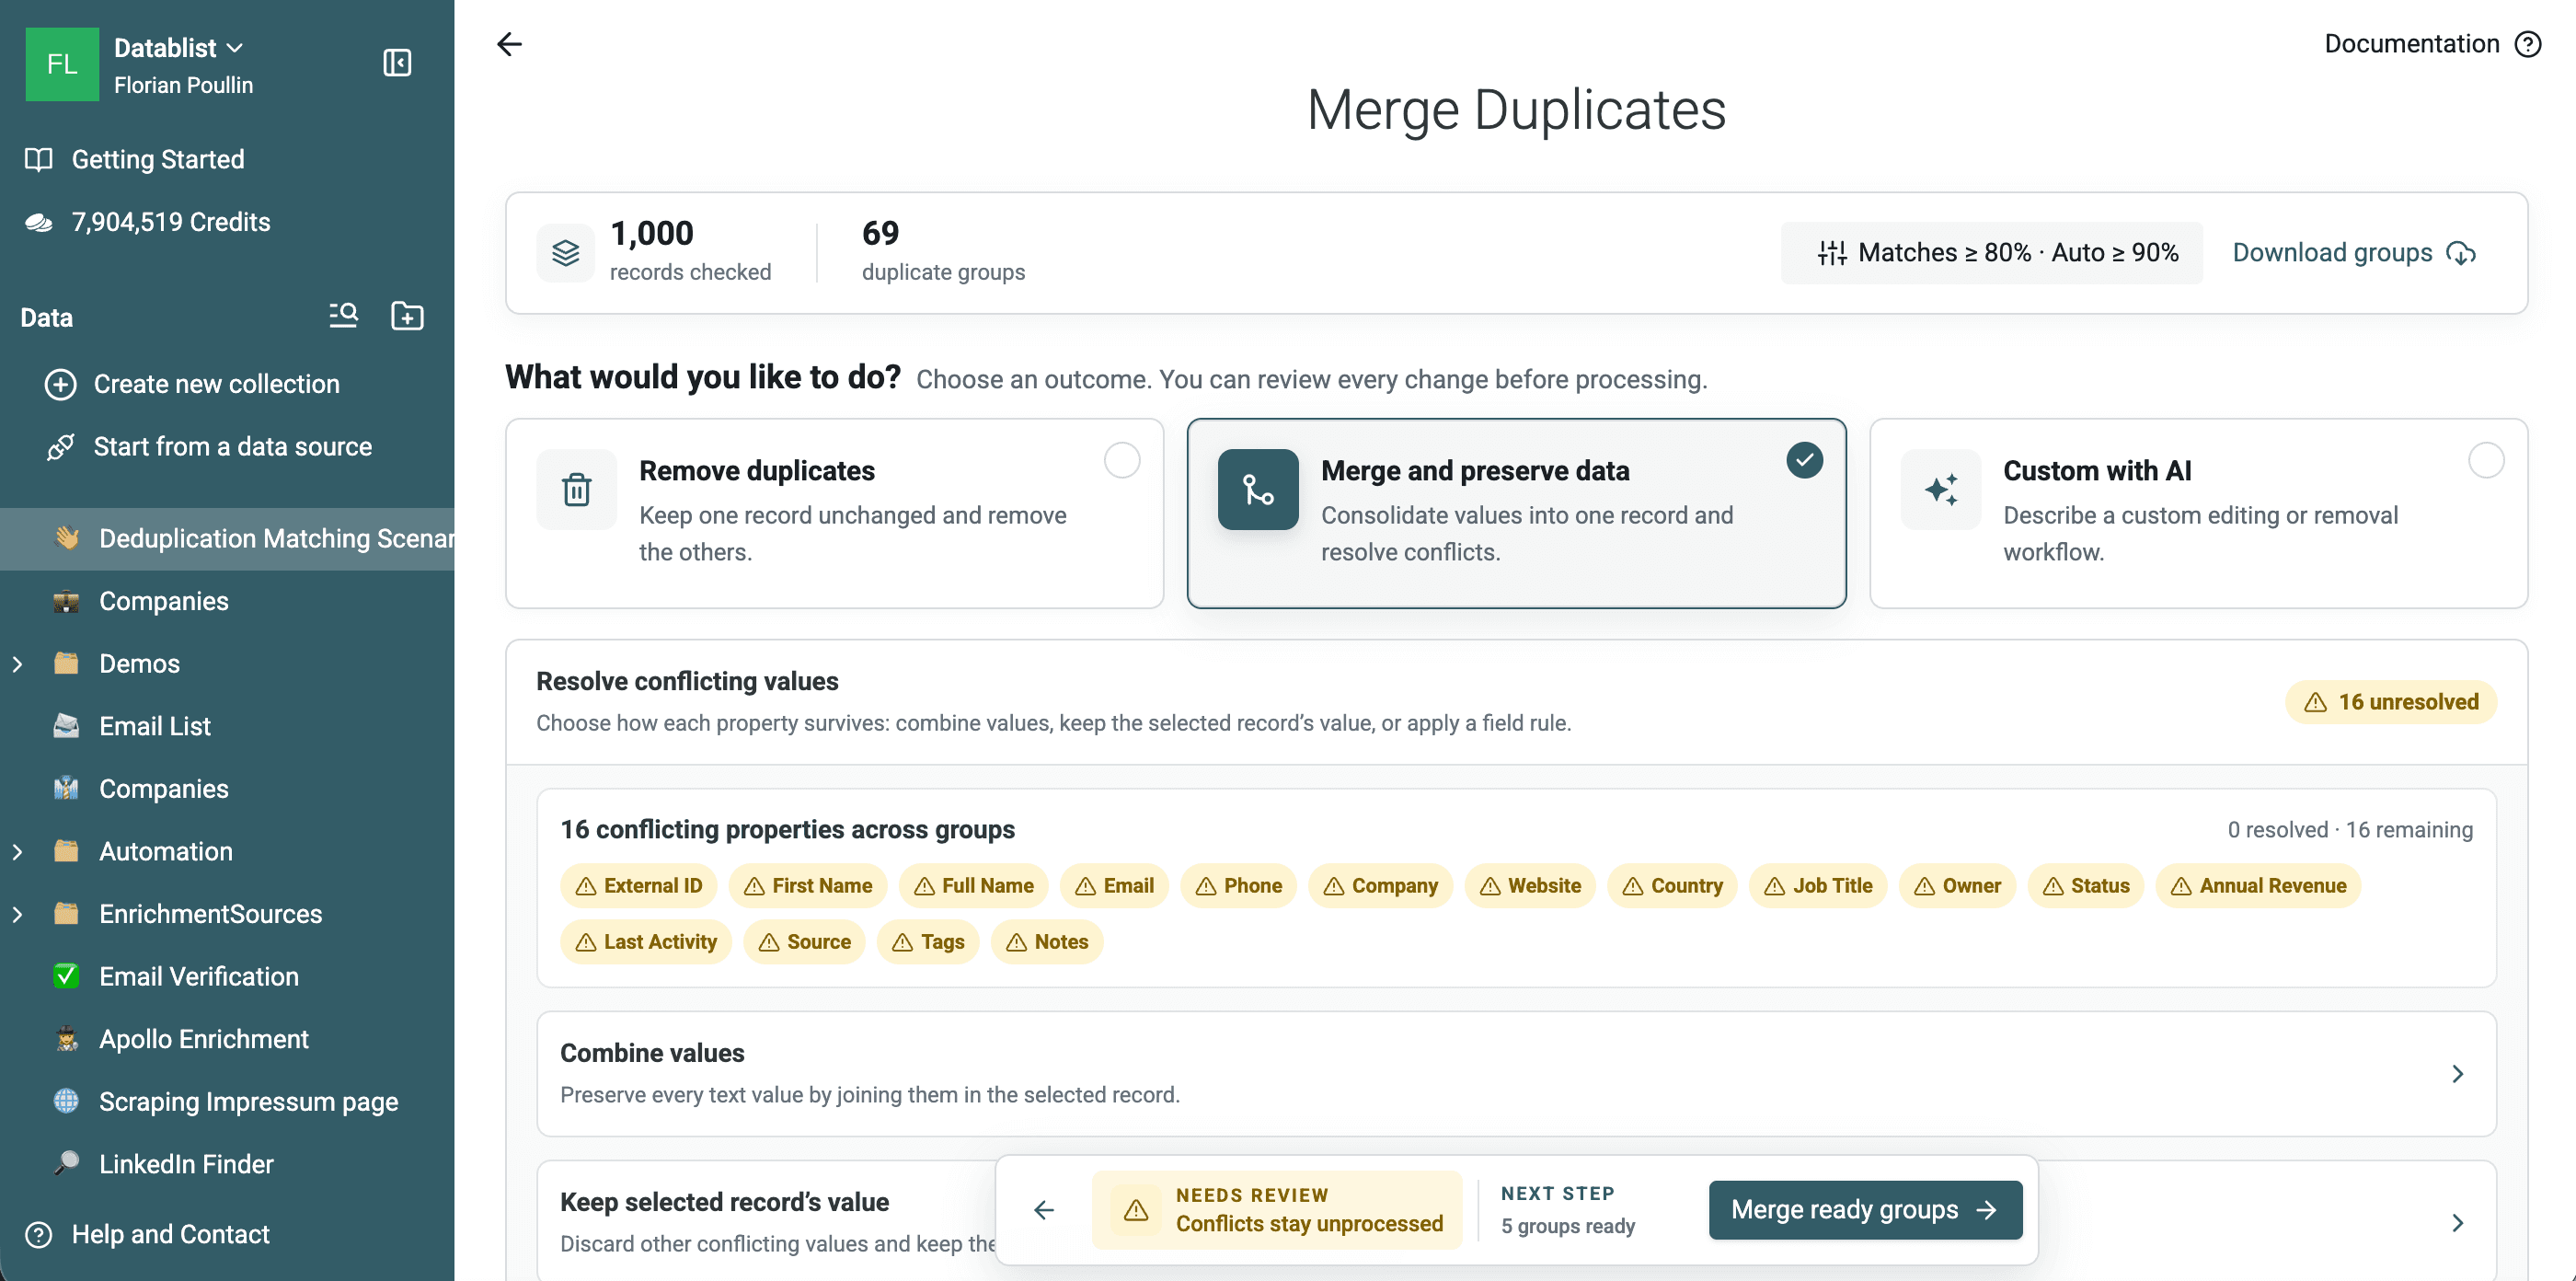
Why matched bekrefter Full Name-egenskapen, Metaphone-algoritmen, Text-prosessoren og gruppens score. Bruk detaljene til å kontrollere sammenligningen, ikke som en erstatning for identitetskontroll.
Last ned de 69 eksporterte Metaphone-gruppene for å undersøke nyttige fonetiske treff og falske positive. De større gruppene med falske positive kombinerer ofte initialer med et vanlig etternavn, for eksempel flere forkortede Rossi-navn. De fonetiske kodene overlapper, men navnene alene gir ikke tilstrekkelig identitetsbevis for automatisk sammenslåing.
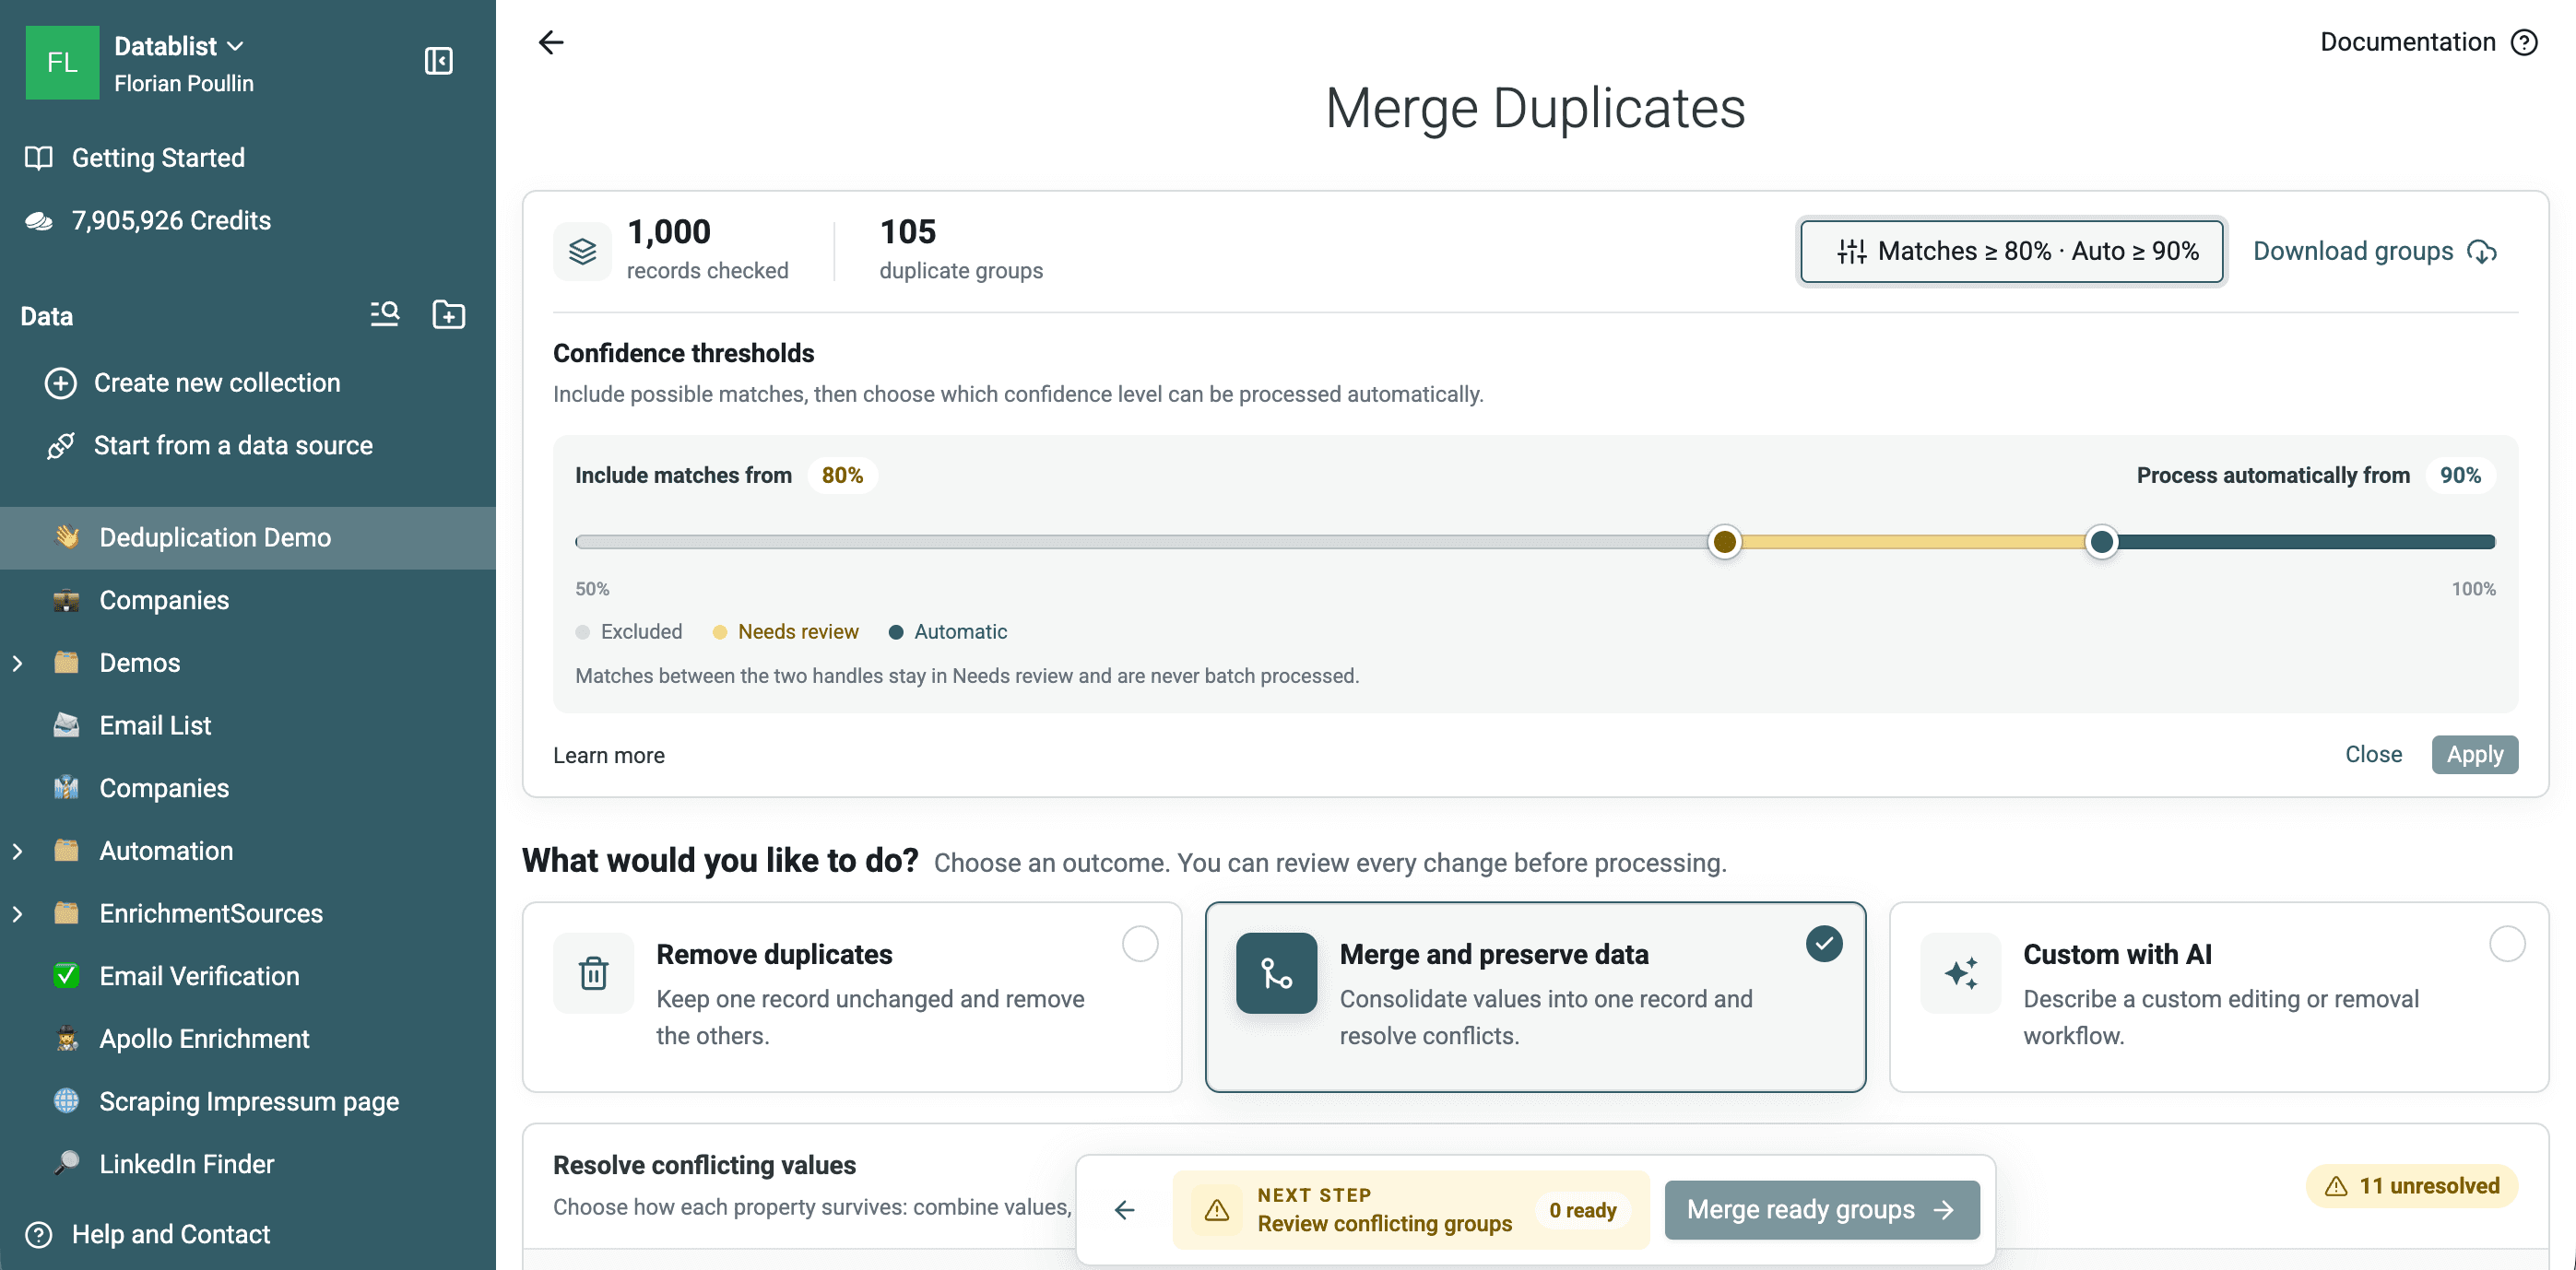
Resultatsiden har to kontroller:
- Include matches from bestemmer hvilke grupper som vises.
- Process automatically from lar grupper med lavere sikkerhet bli stående i Needs review og holder dem utenfor massebehandlingen.
Dette skillet lar deg kontrollere et bredt utvalg kandidater uten å bruke samme automatiseringsregel på alle.
Gå gjennom duplikatgruppene
Resultatområdet deler duplikatgruppene inn i Ready og Needs review.
- Ready-grupper har et konkret behandlingsresultat og oppfyller terskelen for automatisk behandling.
- Needs review-grupper har lavere sikkerhet, uløste sammenslåingskonflikter, en regel for valg av post som ikke ga treff, eller en egendefinert regel som hoppet over dem.
Kontroller følgende for hver usikre gruppe:
- Representerer alle radene samme person, bedrift eller produkt?
- Hvilken identifikator utløste treffet?
- Utfyller noen av verdiene hverandre?
- Hvilken kilde er autoritativ?
- Vil fjerning av en rad slette et telefonnummer, en ID, en status, en dato eller et notat?
- Er gruppen koblet sammen via en svak tredje post?
Bruk Why matched til å undersøke egenskapene, algoritmene, prosessorene og scoreintervallene som ga treff. Ved fuzzy-søk er gruppelikheten den svakeste bevarte forbindelsen som kreves for å holde gruppen samlet.
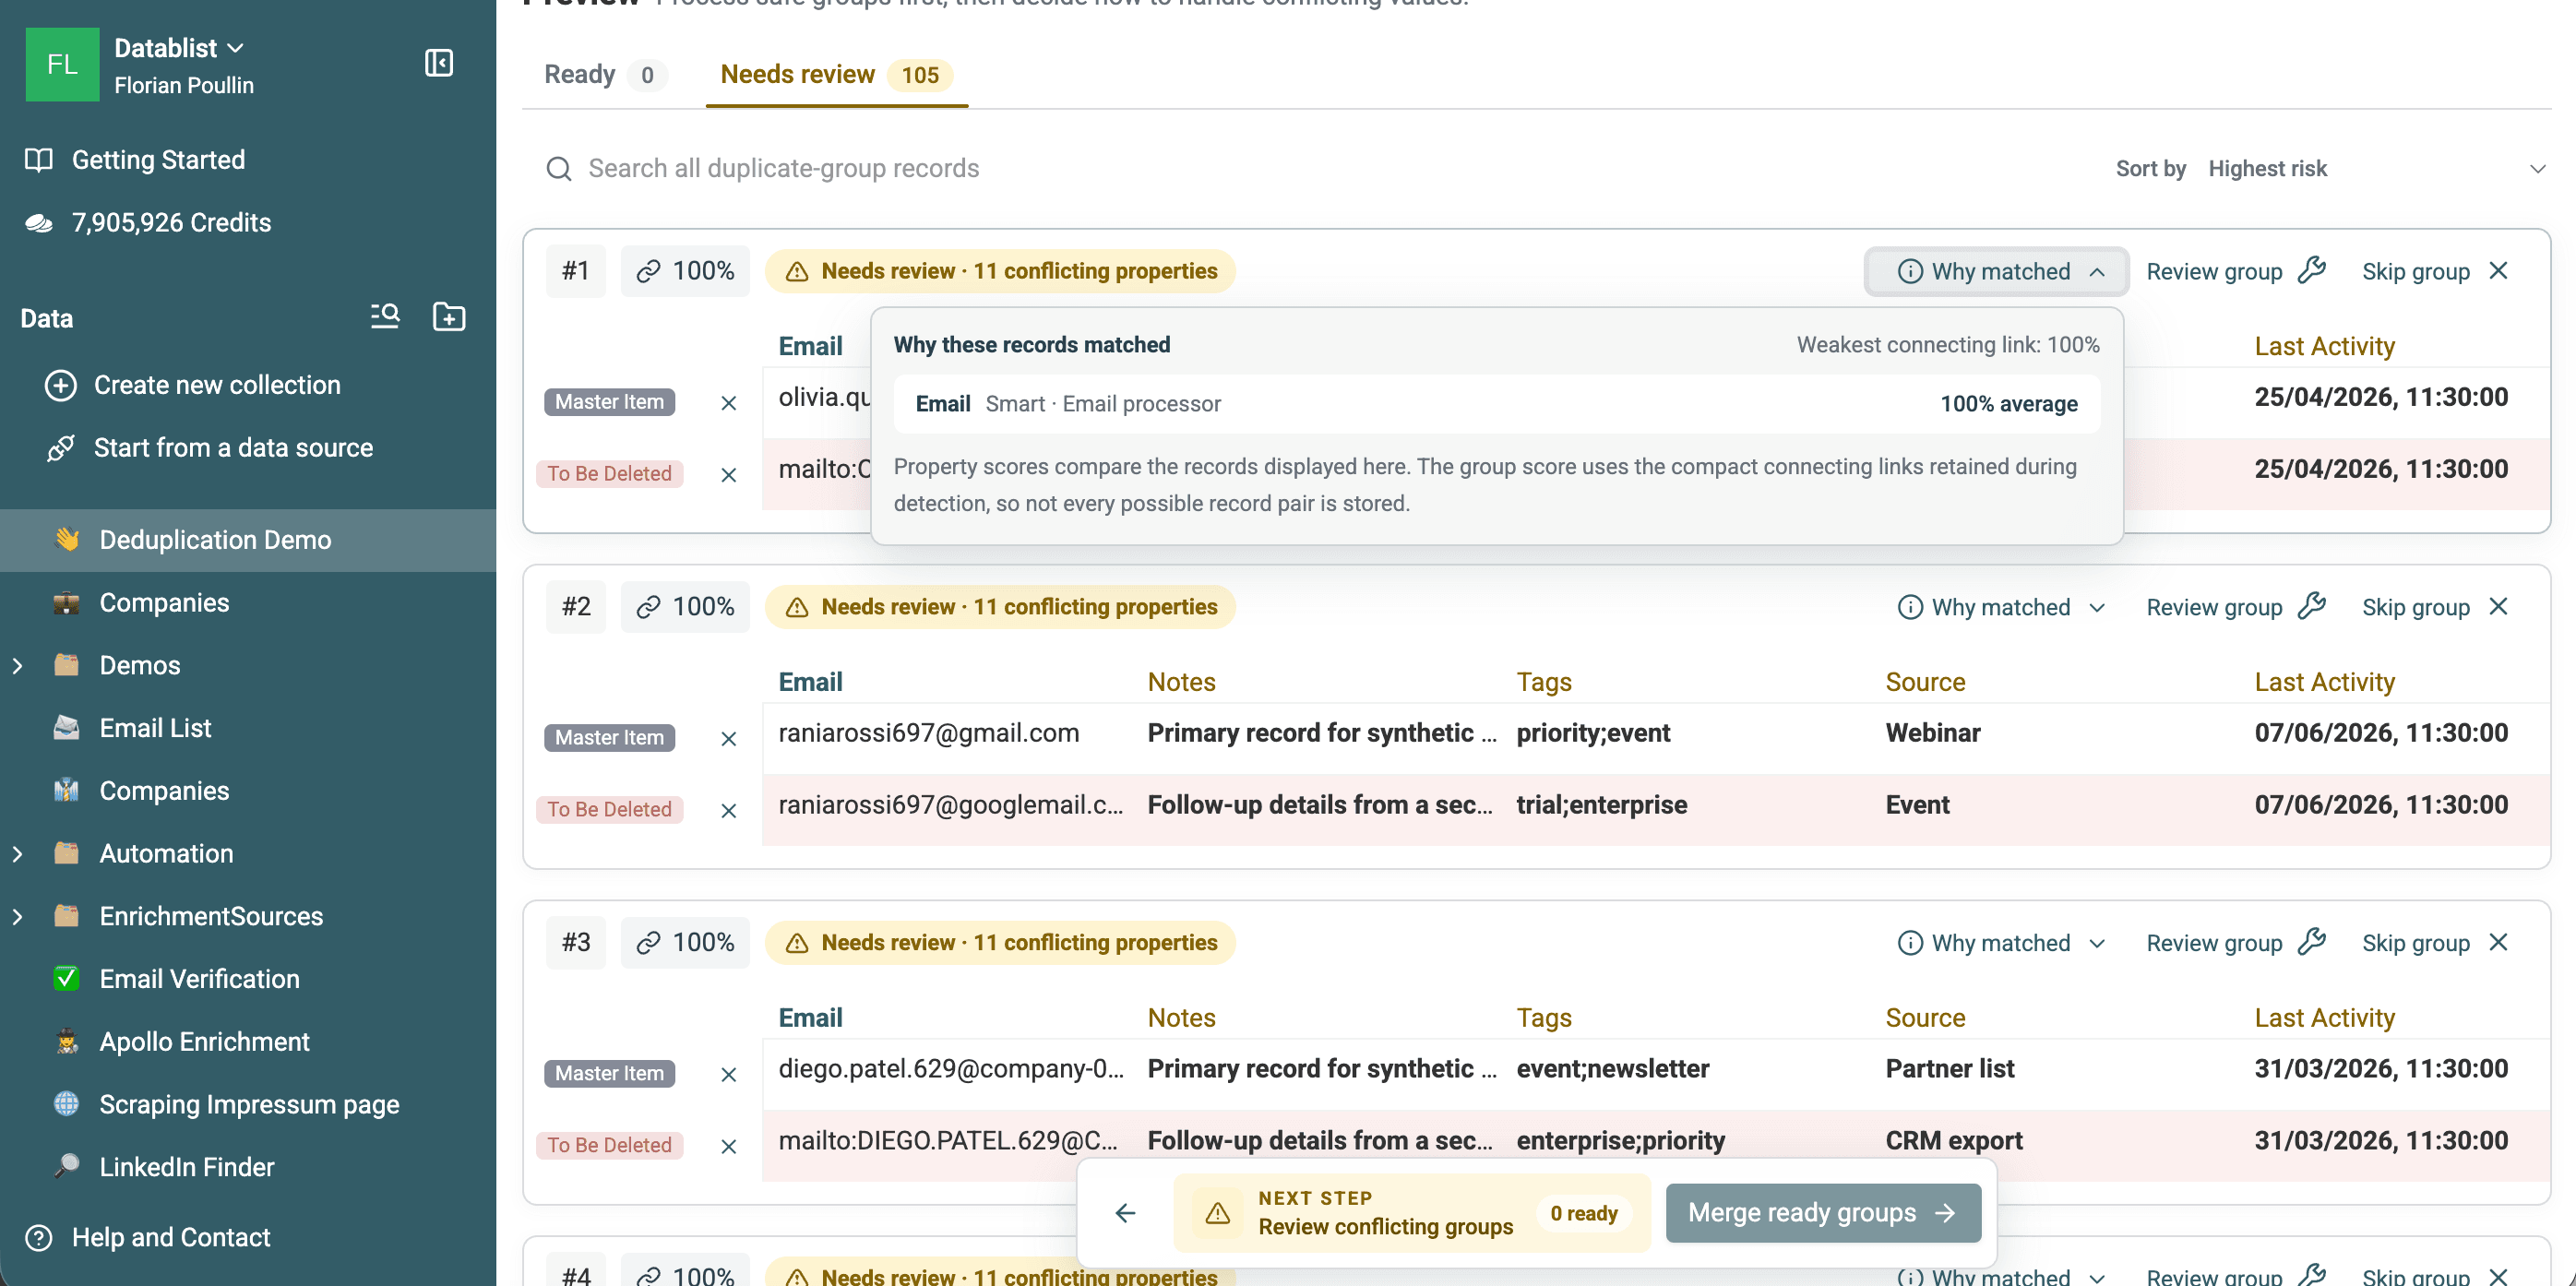
Du kan også:
- Bekrefte et treff med lav sikkerhet.
- Fjerne én post fra en gruppe uten å slette den.
- Hoppe over gruppen.
- Åpne og redigere en post.
- Kontrollere gruppen i Merging Assistant.
- Søke i alle gjenværende grupper og sortere de mest risikable kandidatene først.
⚠️ Ikke behandle en fuzzy-gruppe basert på prosenten alene
Lignende navn kan tilhøre forskjellige personer. Kontroller identifikatorene og feltene rundt før du bekrefter gruppen.
Kontroller delte og manglende identifikatorer før sammenslåing
En felles innboks som info@company.example kan tilhøre flere kontakter. To personer med denne adressen kan matche på Email, men likevel være forskjellige personer. På samme måte kan et bedriftsdomene identifisere én virksomhet, men forekomme i postene til mange ansatte.
Jeg ville holdt slike grupper utenfor automatisk sammenslåing på personnivå frem til en annen identifikator bekrefter treffet. Hvis målet i stedet er én rad per bedrift, kan det delte domenet være den ønskede grupperingsnøkkelen. Definer enheten før du tolker resultatet.
Regelen for tomme verdier påvirker også en sammenligning av valgte egenskaper. Ved en kontroll av flere egenskaper med en annen sammenligning enn Exact tilbyr den avanserte innstillingen Empty Value Rule valgene Value required (default) og Match on empty value. Standardvalget krever at tekstidentifikatoren finnes. Hvis du tillater treff på tomme verdier, lempes dette kravet. Bruk dette bare når de andre matchende feltene gir nok identitetsbevis. To manglende e-postadresser er ikke bevis på at to personer er den samme.
To rader med tom Email og forskjellige Full Name-verdier bør for eksempel ikke slås sammen bare for å redusere antall rader. En rad uten e-postadresse kan fortsatt inneholde en kontakt du må beholde eller enrich senere.
Fjern, slå sammen eller bruk egne regler
Å finne og håndtere duplikater er to forskjellige avgjørelser. Velg behandlingsmodus etter at du har kontrollert hva de øvrige radene inneholder.
Fjern duplikater når én rad er autoritativ
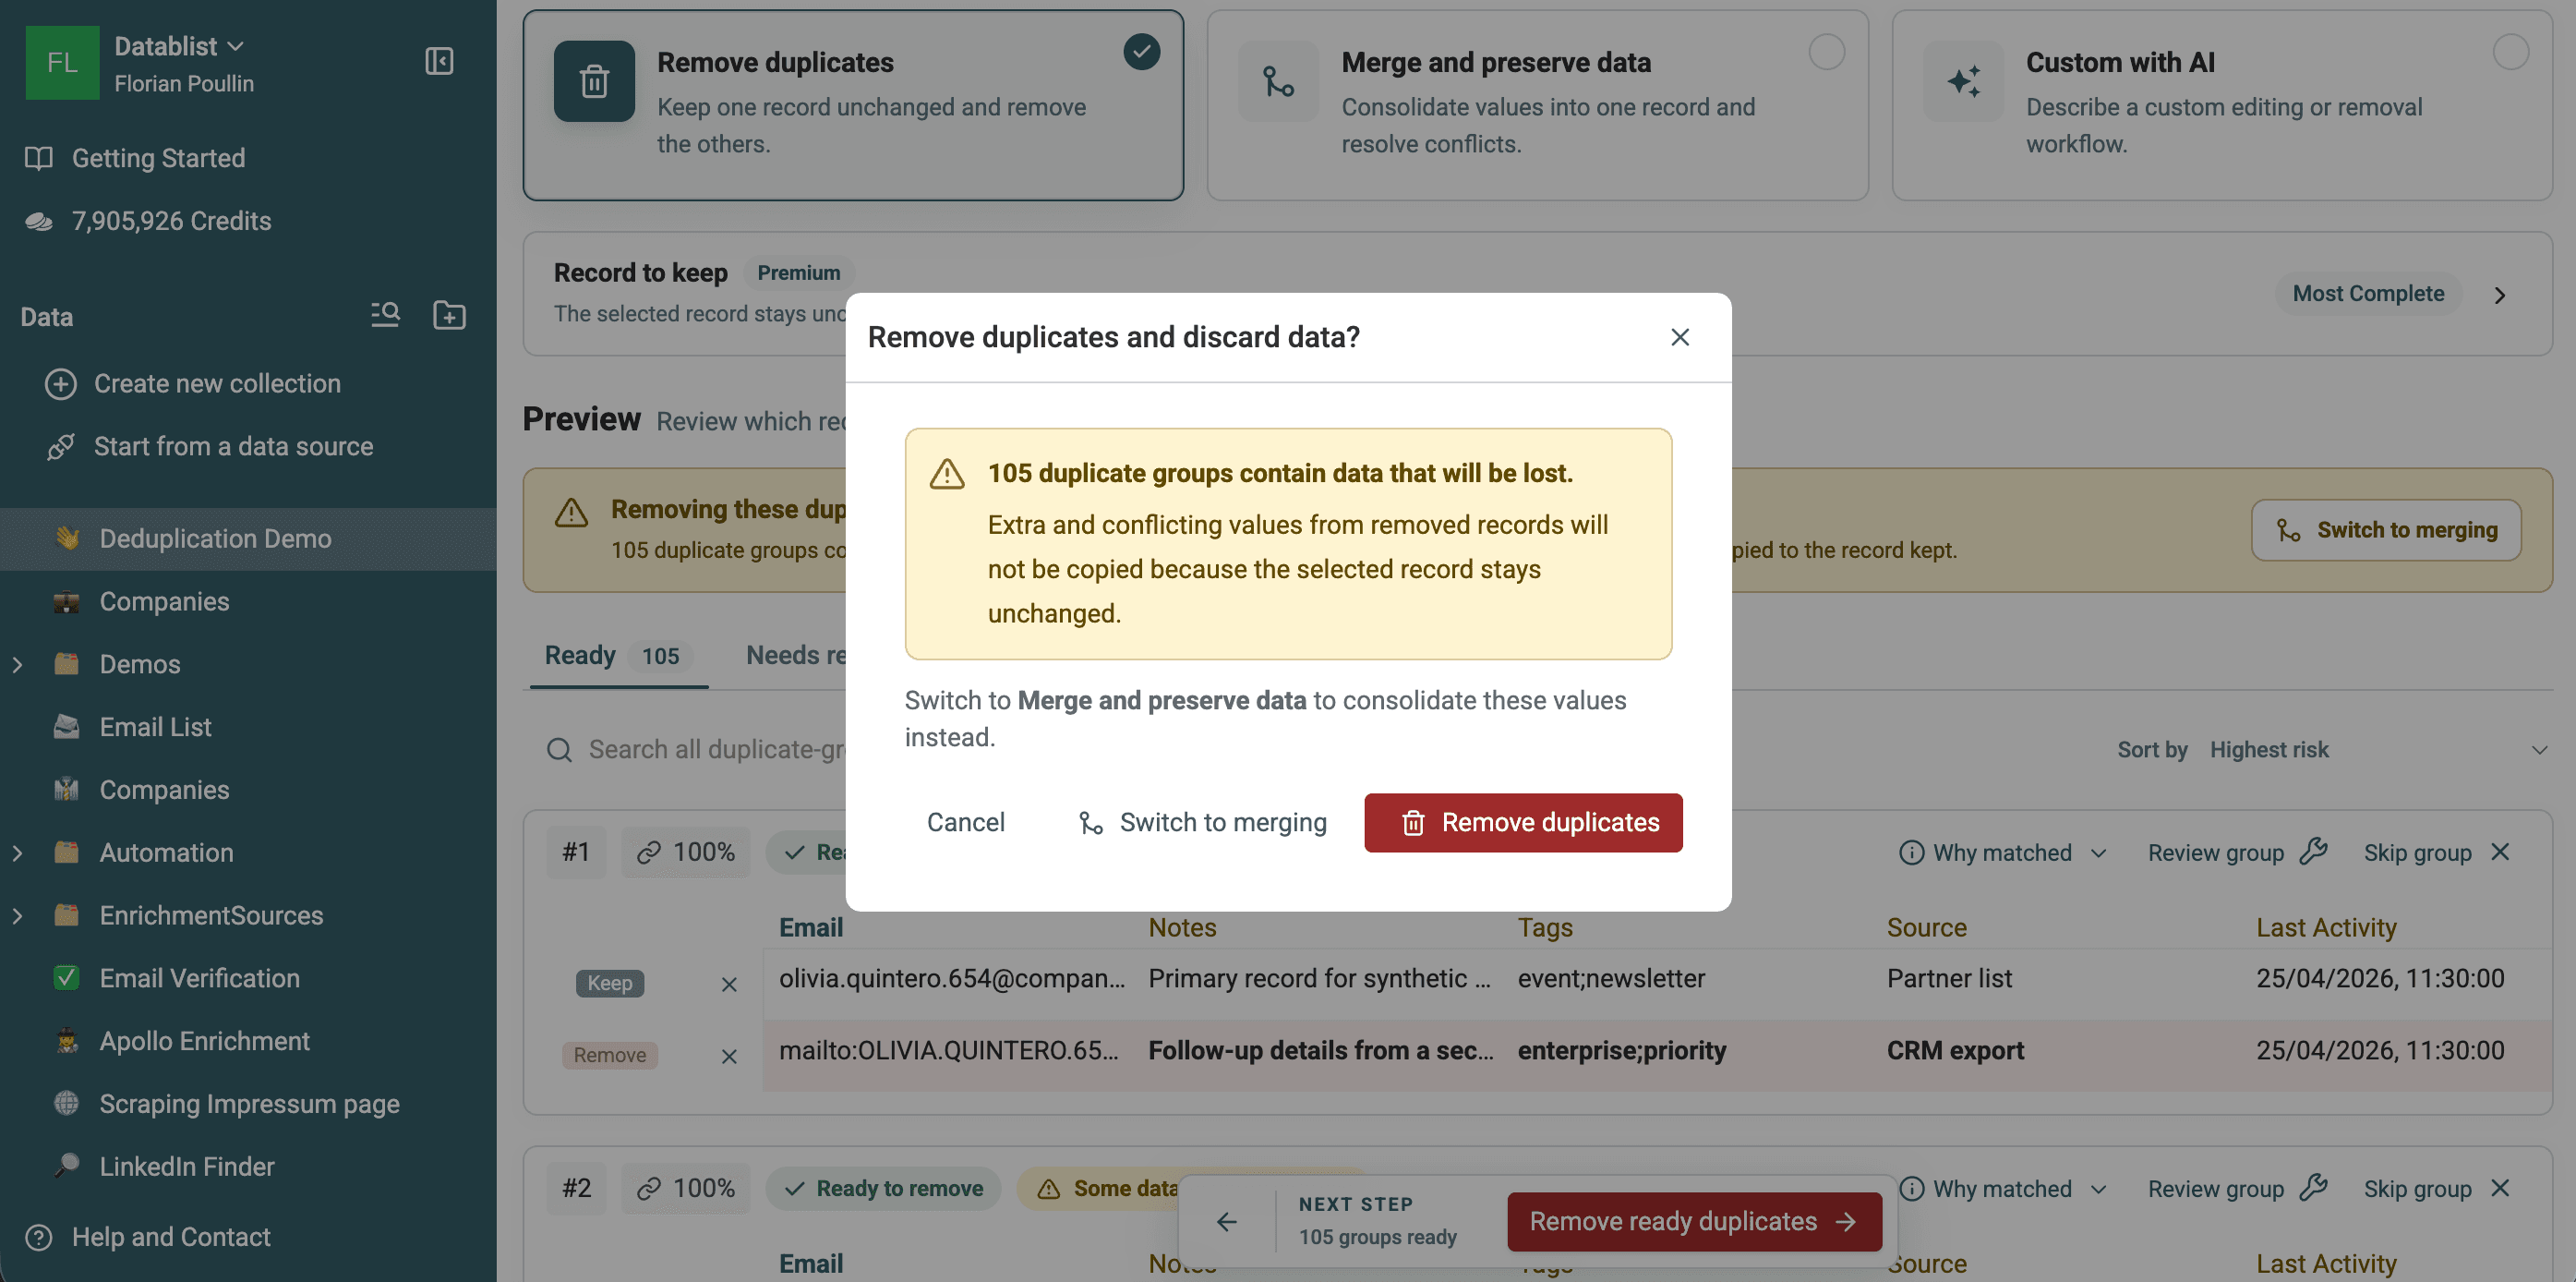
Remove duplicates beholder én valgt post uendret og sletter de øvrige radene i hver Ready-gruppe.
Bruk dette for kopierte rader, midlertidige importer eller poster der verdiene i de øvrige radene kan forkastes. Forhåndsvisningen varsler når postene som fjernes, inneholder ekstra eller motstridende informasjon. Disse verdiene kopieres ikke til raden som beholdes.
Slå sammen rader som inneholder nyttige data
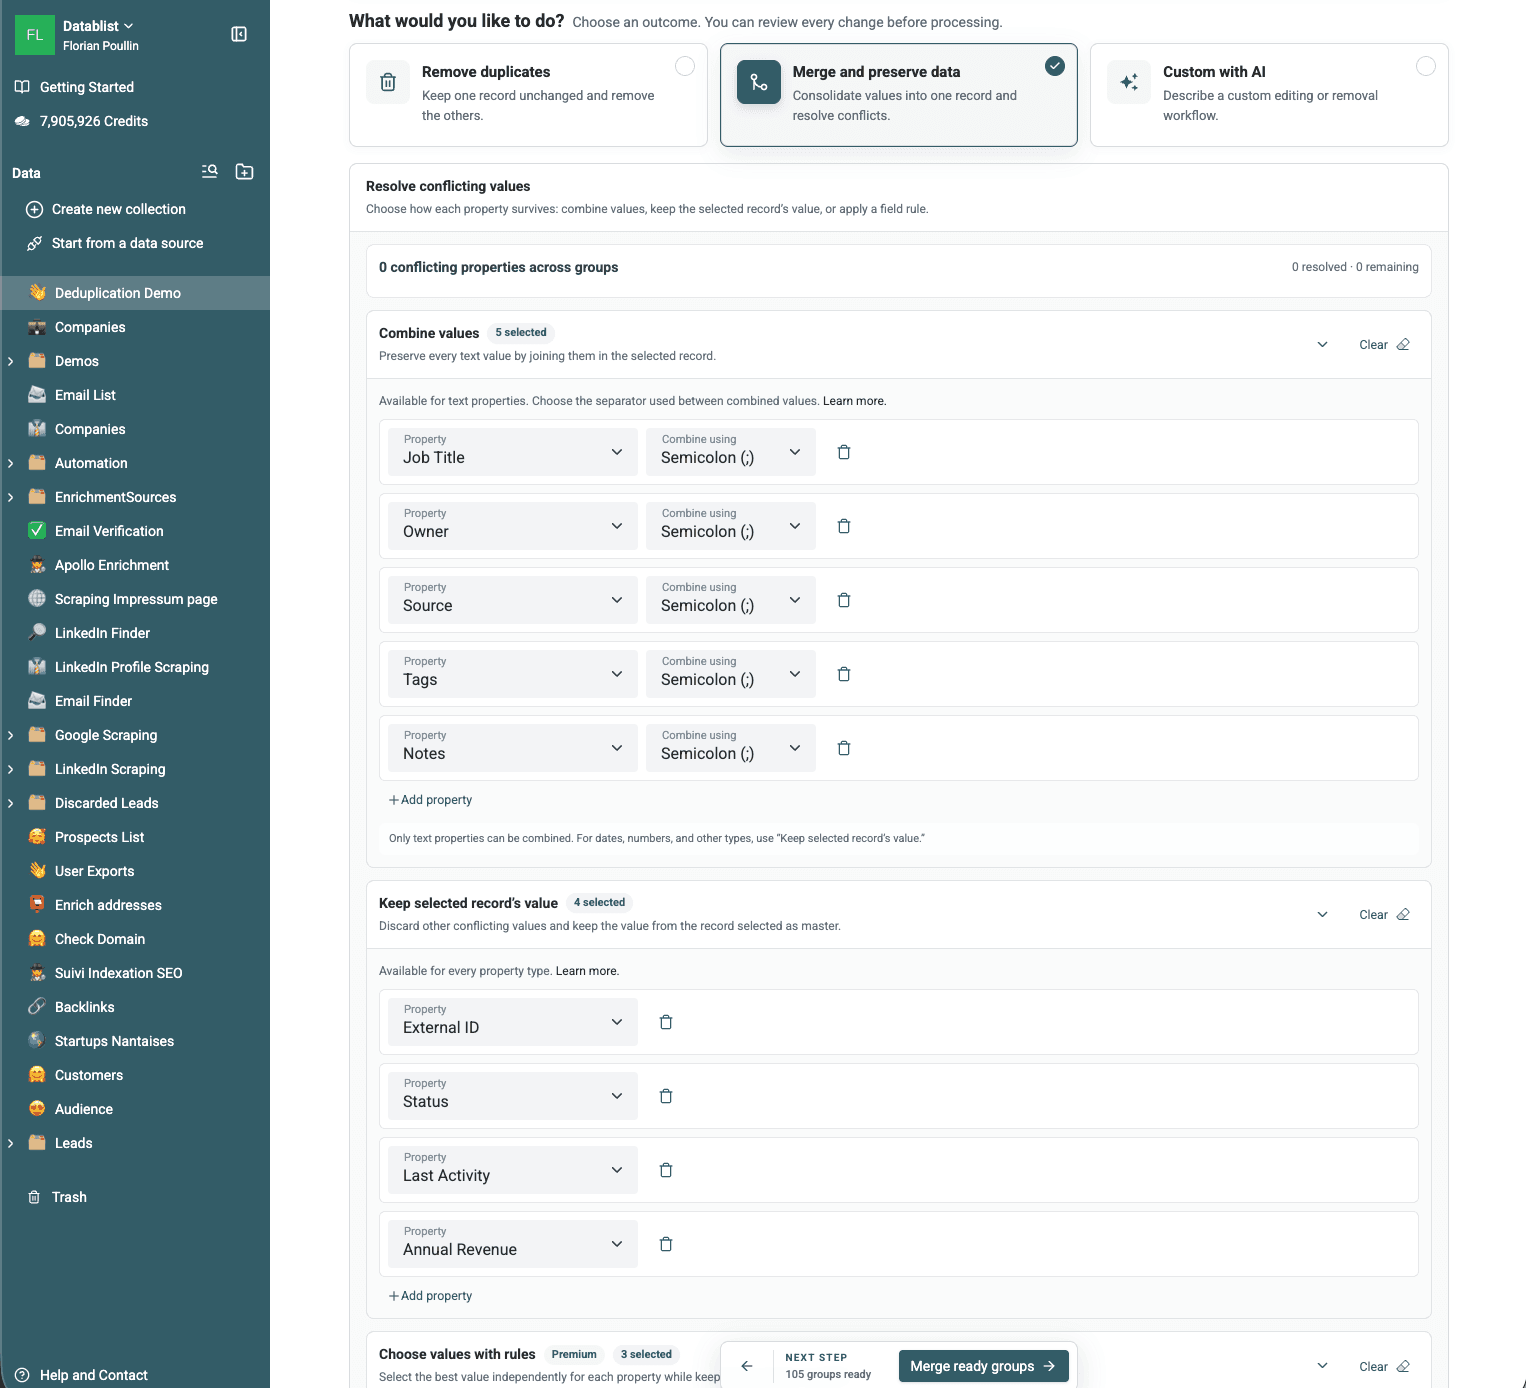
Merge and preserve data fyller ut tomme egenskaper i den valgte posten, løser konfigurerte konflikter og sletter deretter de øvrige radene.
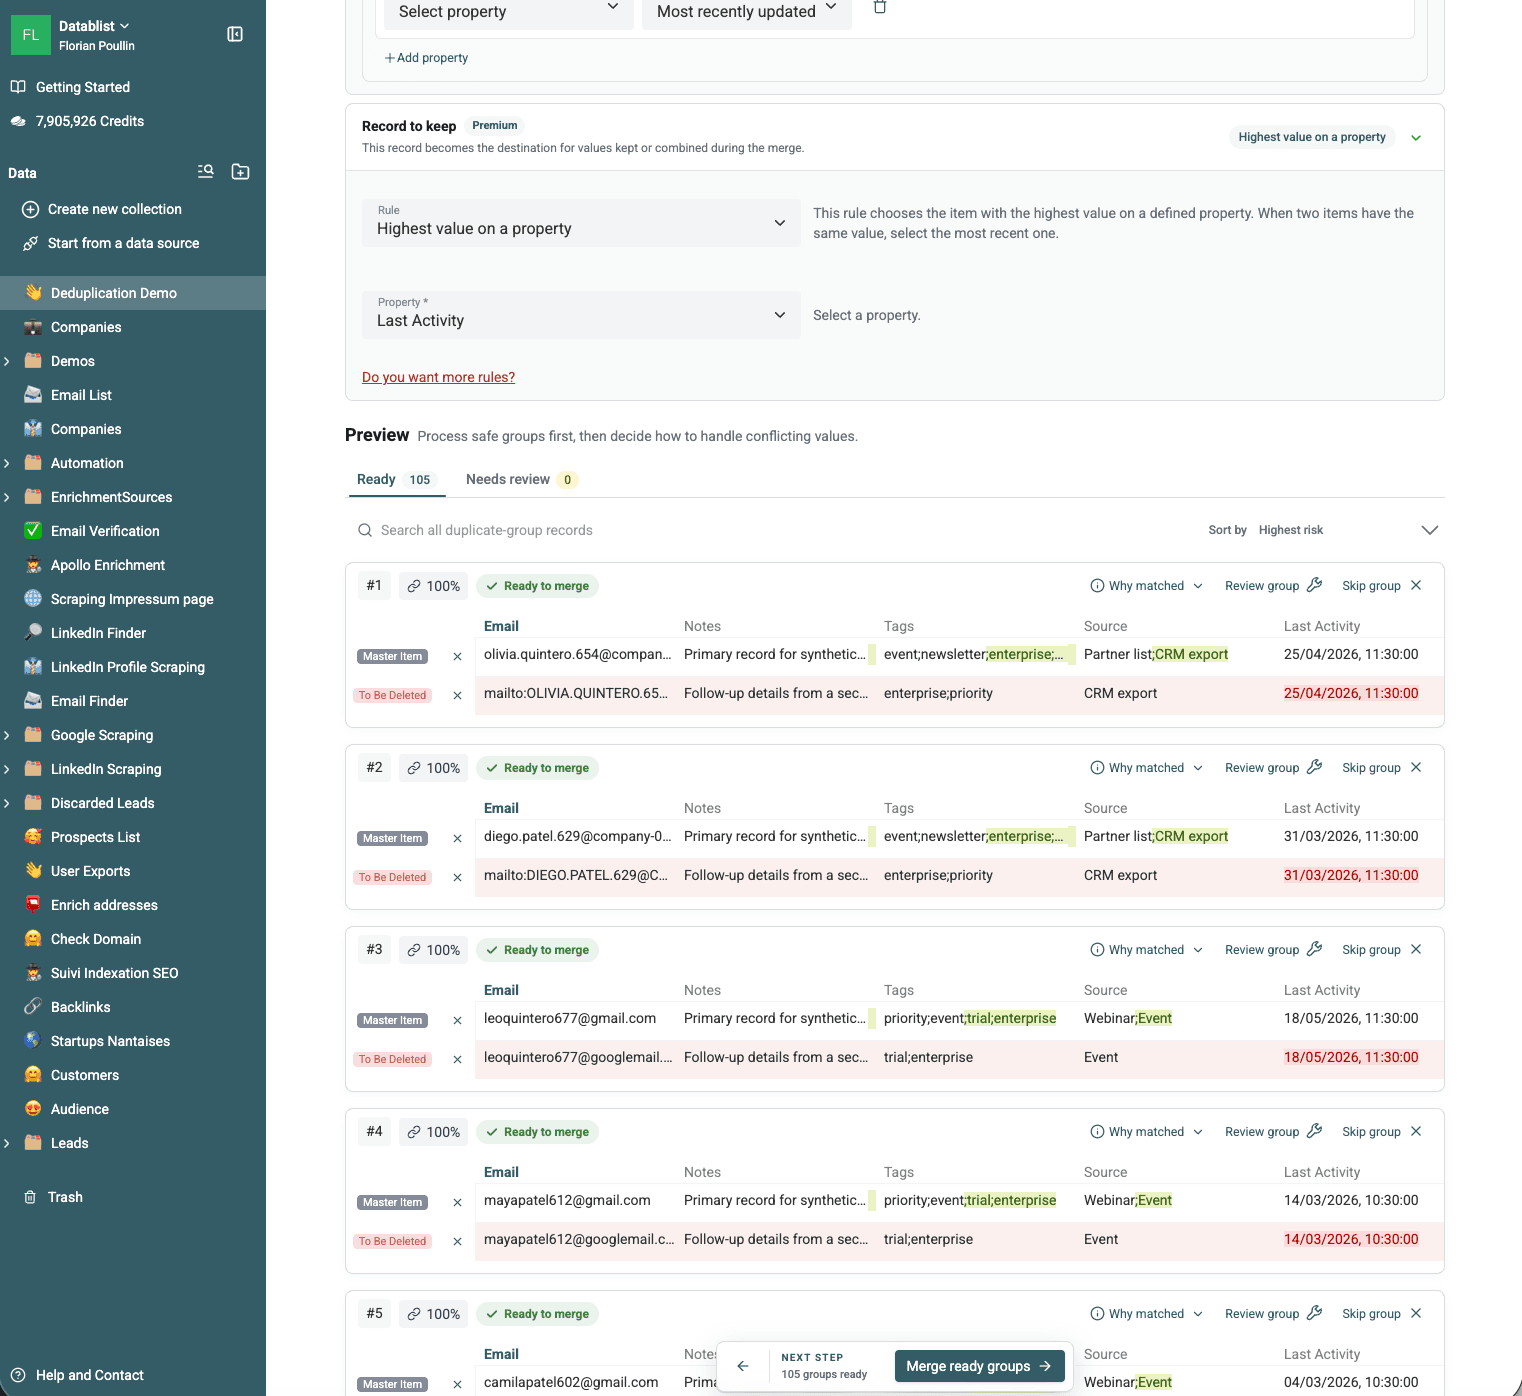
Start med regelen Record to keep. Most Complete er standardvalget. Med betalte abonnementer kan du velge regler basert på opprettelsestidspunkt, oppdateringstidspunkt, høyeste eller laveste egenskapsverdi eller en obligatorisk egenskapsverdi.
Bestem deretter hvordan hver motstridende egenskapsverdi skal bevares:
- Kombiner ulike tekstverdier med et skilletegn.
- Behold verdien fra den valgte posten.
- Med betalte abonnementer kan du velge verdier uavhengig med regler som nyeste, eldste, lengste, korteste, høyeste, laveste eller vanligste.
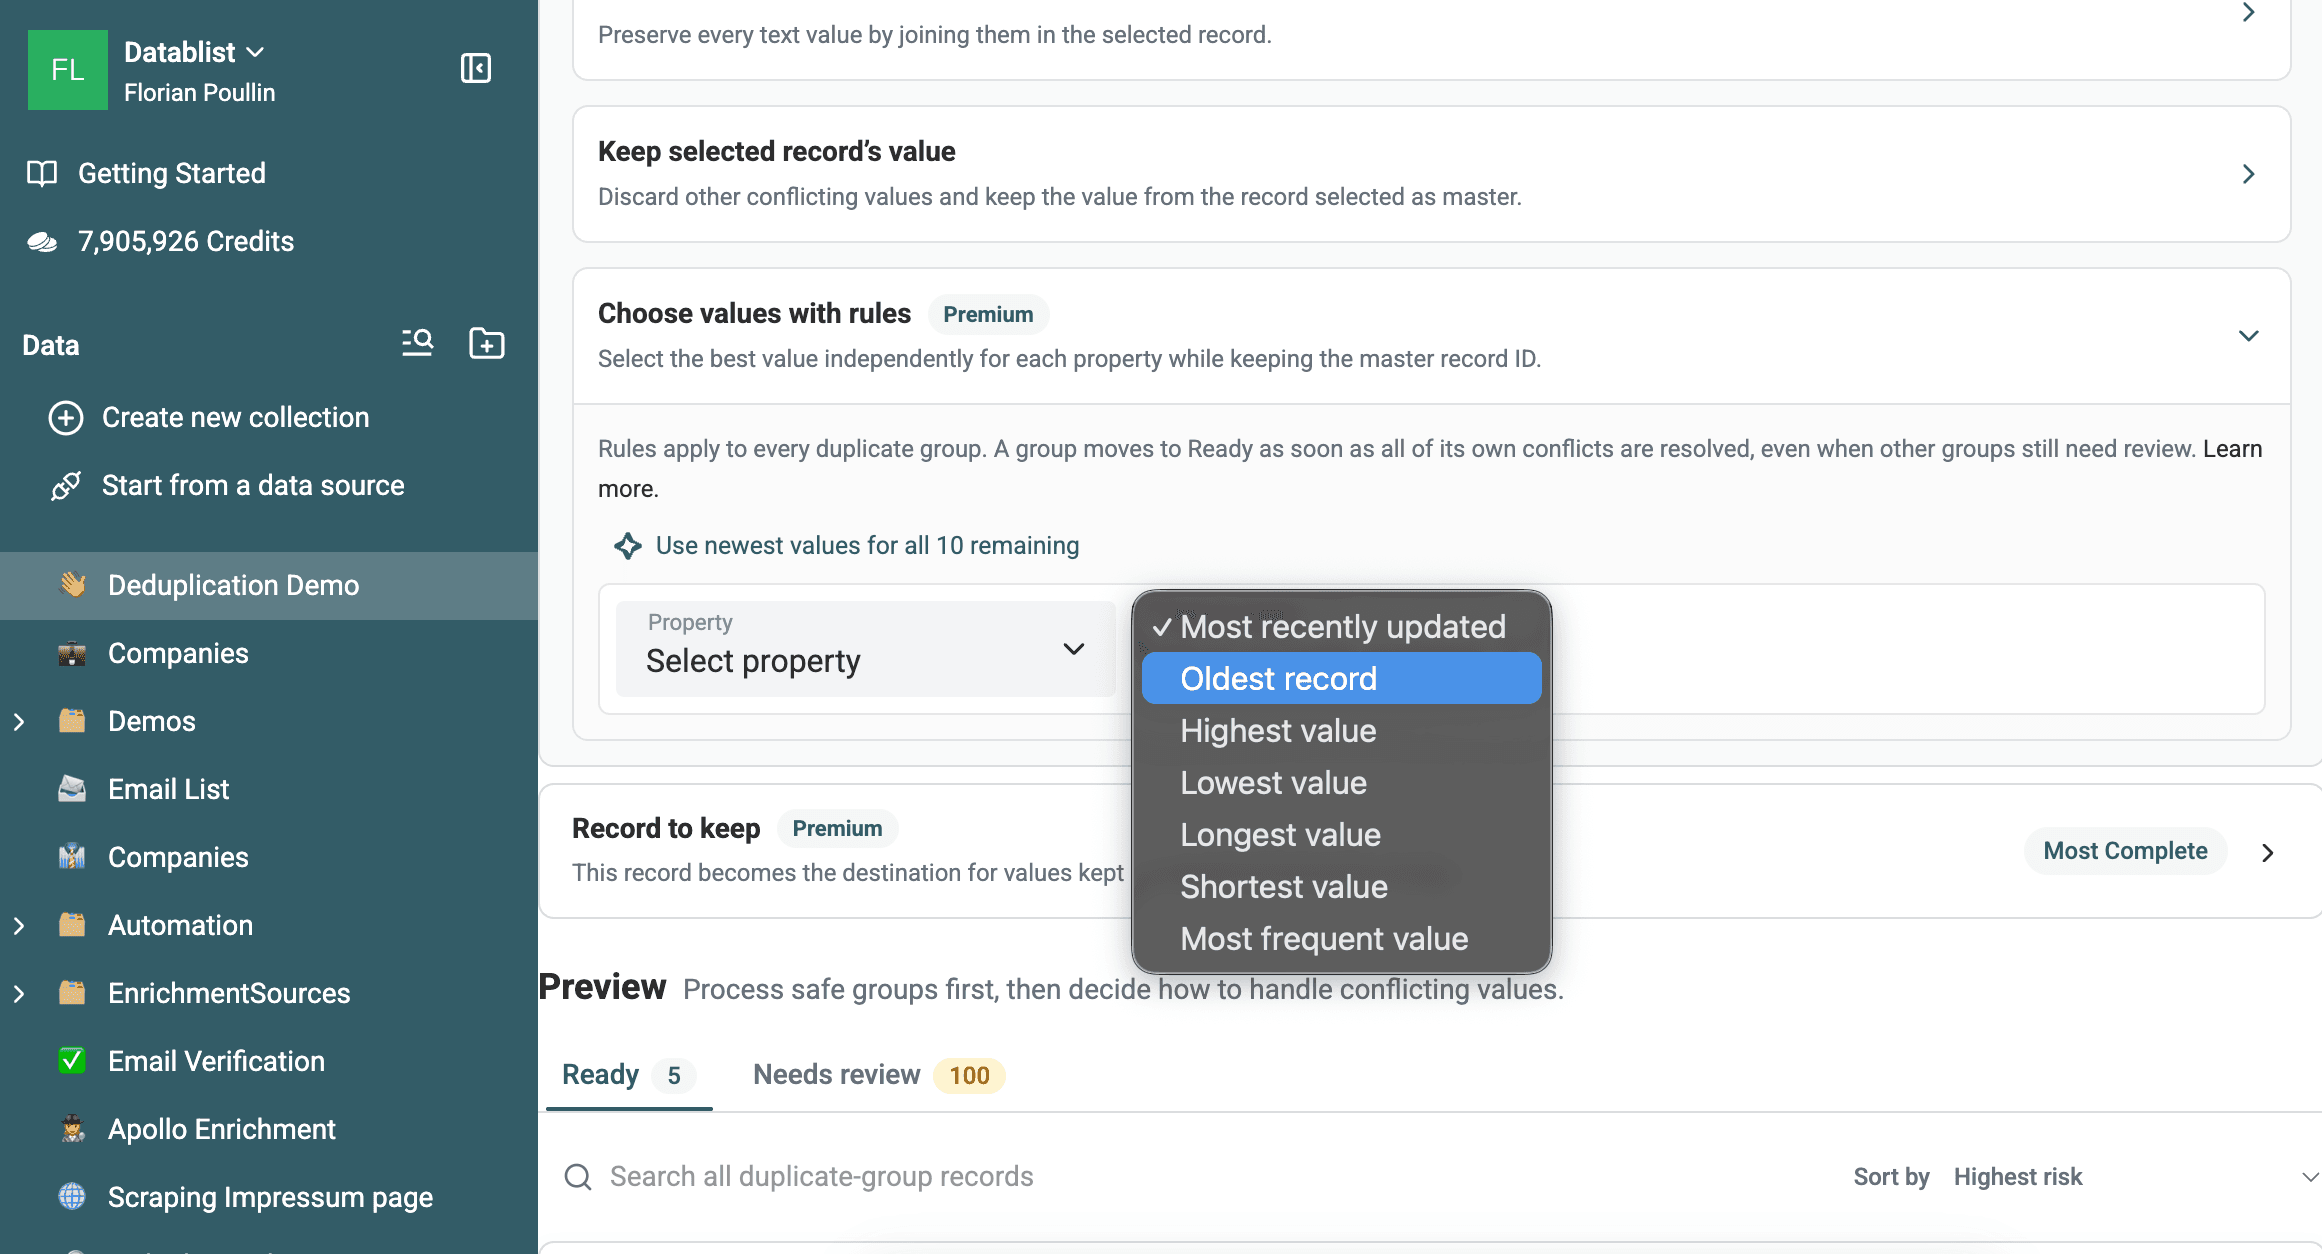
Bruk regler på feltnivå når ingen enkelt rad har den beste verdien for alle egenskapene. Du kan bevare ID-en fra den valgte posten, men hente en nyere stillingstittel, et lengre bedriftsnavn og den vanligste statusen fra andre rader.
Oppdater forhåndsvisningen etter at du har endret terskelen, arbeidsflyten, gruppemedlemskapet, konfliktinnstillingene eller regelen for valg av post.
Bruk Custom with AI for gruppespesifikk logikk
Custom with AI genererer en arbeidsflyt for behandling av grupper fra en instruksjon skrevet i vanlig språk. Den kan velge en post, kopiere eller normalisere verdier, legge til en statusegenskap, beregne en total for gruppen, slette de øvrige radene eller hoppe over grupper som ikke oppfyller en betingelse.
For eksempel:
Behold posten der Source er CRM export. Kopier Job Title fra den nyeste posten, kombiner unike Notes med linjeskift, legg til en Duplicate Reviewed-avmerkingsboks, og slett deretter de øvrige postene.
Referer til egenskaper i collectionen med /Property eller {{Property}}. Generer og forhåndsvis arbeidsflyten før du kjører den. Custom with AI er tilgjengelig for innloggede brukere med et betalt abonnement.
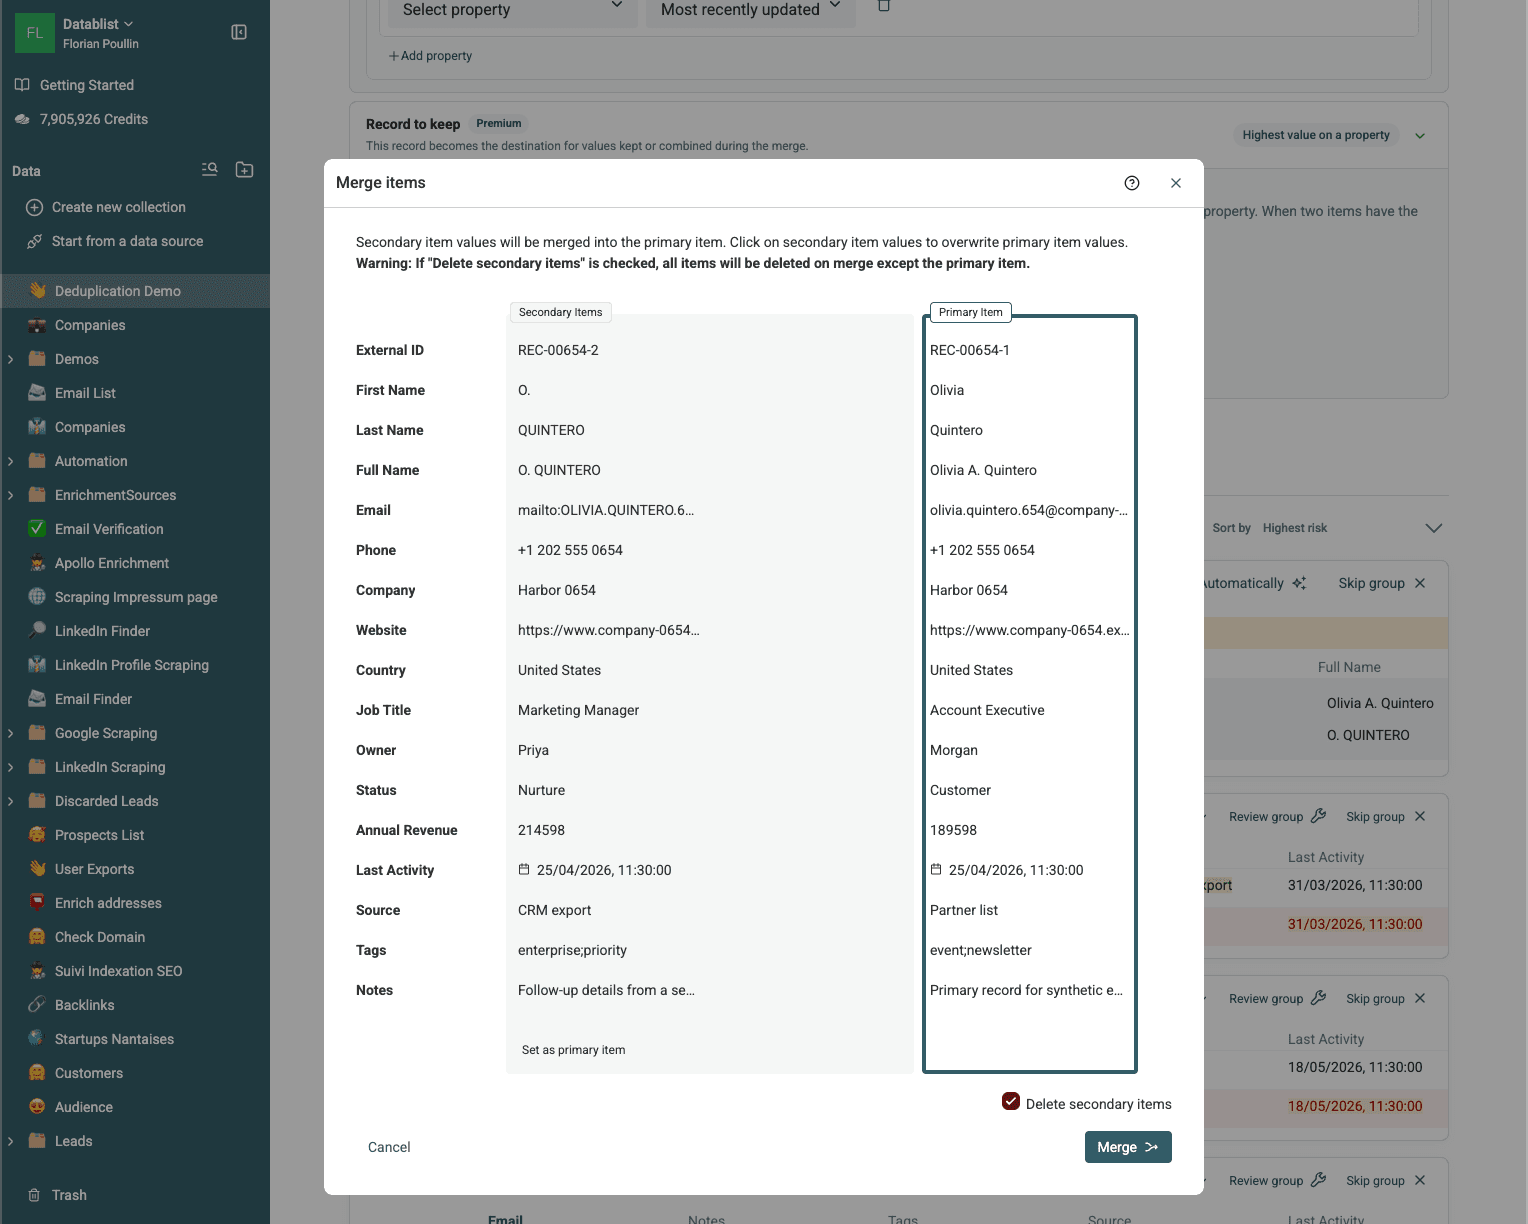
Ved enkeltstående unntak åpner du Review group og bruker Merging Assistant i stedet for å gjøre regelen for massebehandling mer komplisert.
Kontroller og eksporter den ryddede listen
Før du behandler Ready-grupper, bør du kontrollere at:
- Forhåndsvisningen gjenspeiler de gjeldende innstillingene.
- Grupper med lav sikkerhet og delte identifikatorer er kontrollert.
- Den valgte posten har ID-en du vil bevare.
- Unike verdier for telefon, kilde, notat og status blir bevart.
- Felt som bare skal ha én verdi, ikke blir slått sammen til en tekststreng.
- Antallet Ready-grupper som vises, samsvarer med omfanget du vil behandle.
Etter behandlingen kontrollerer du antall rader:
Antall rader ved start - slettede sekundærrader = antall rader til slutt
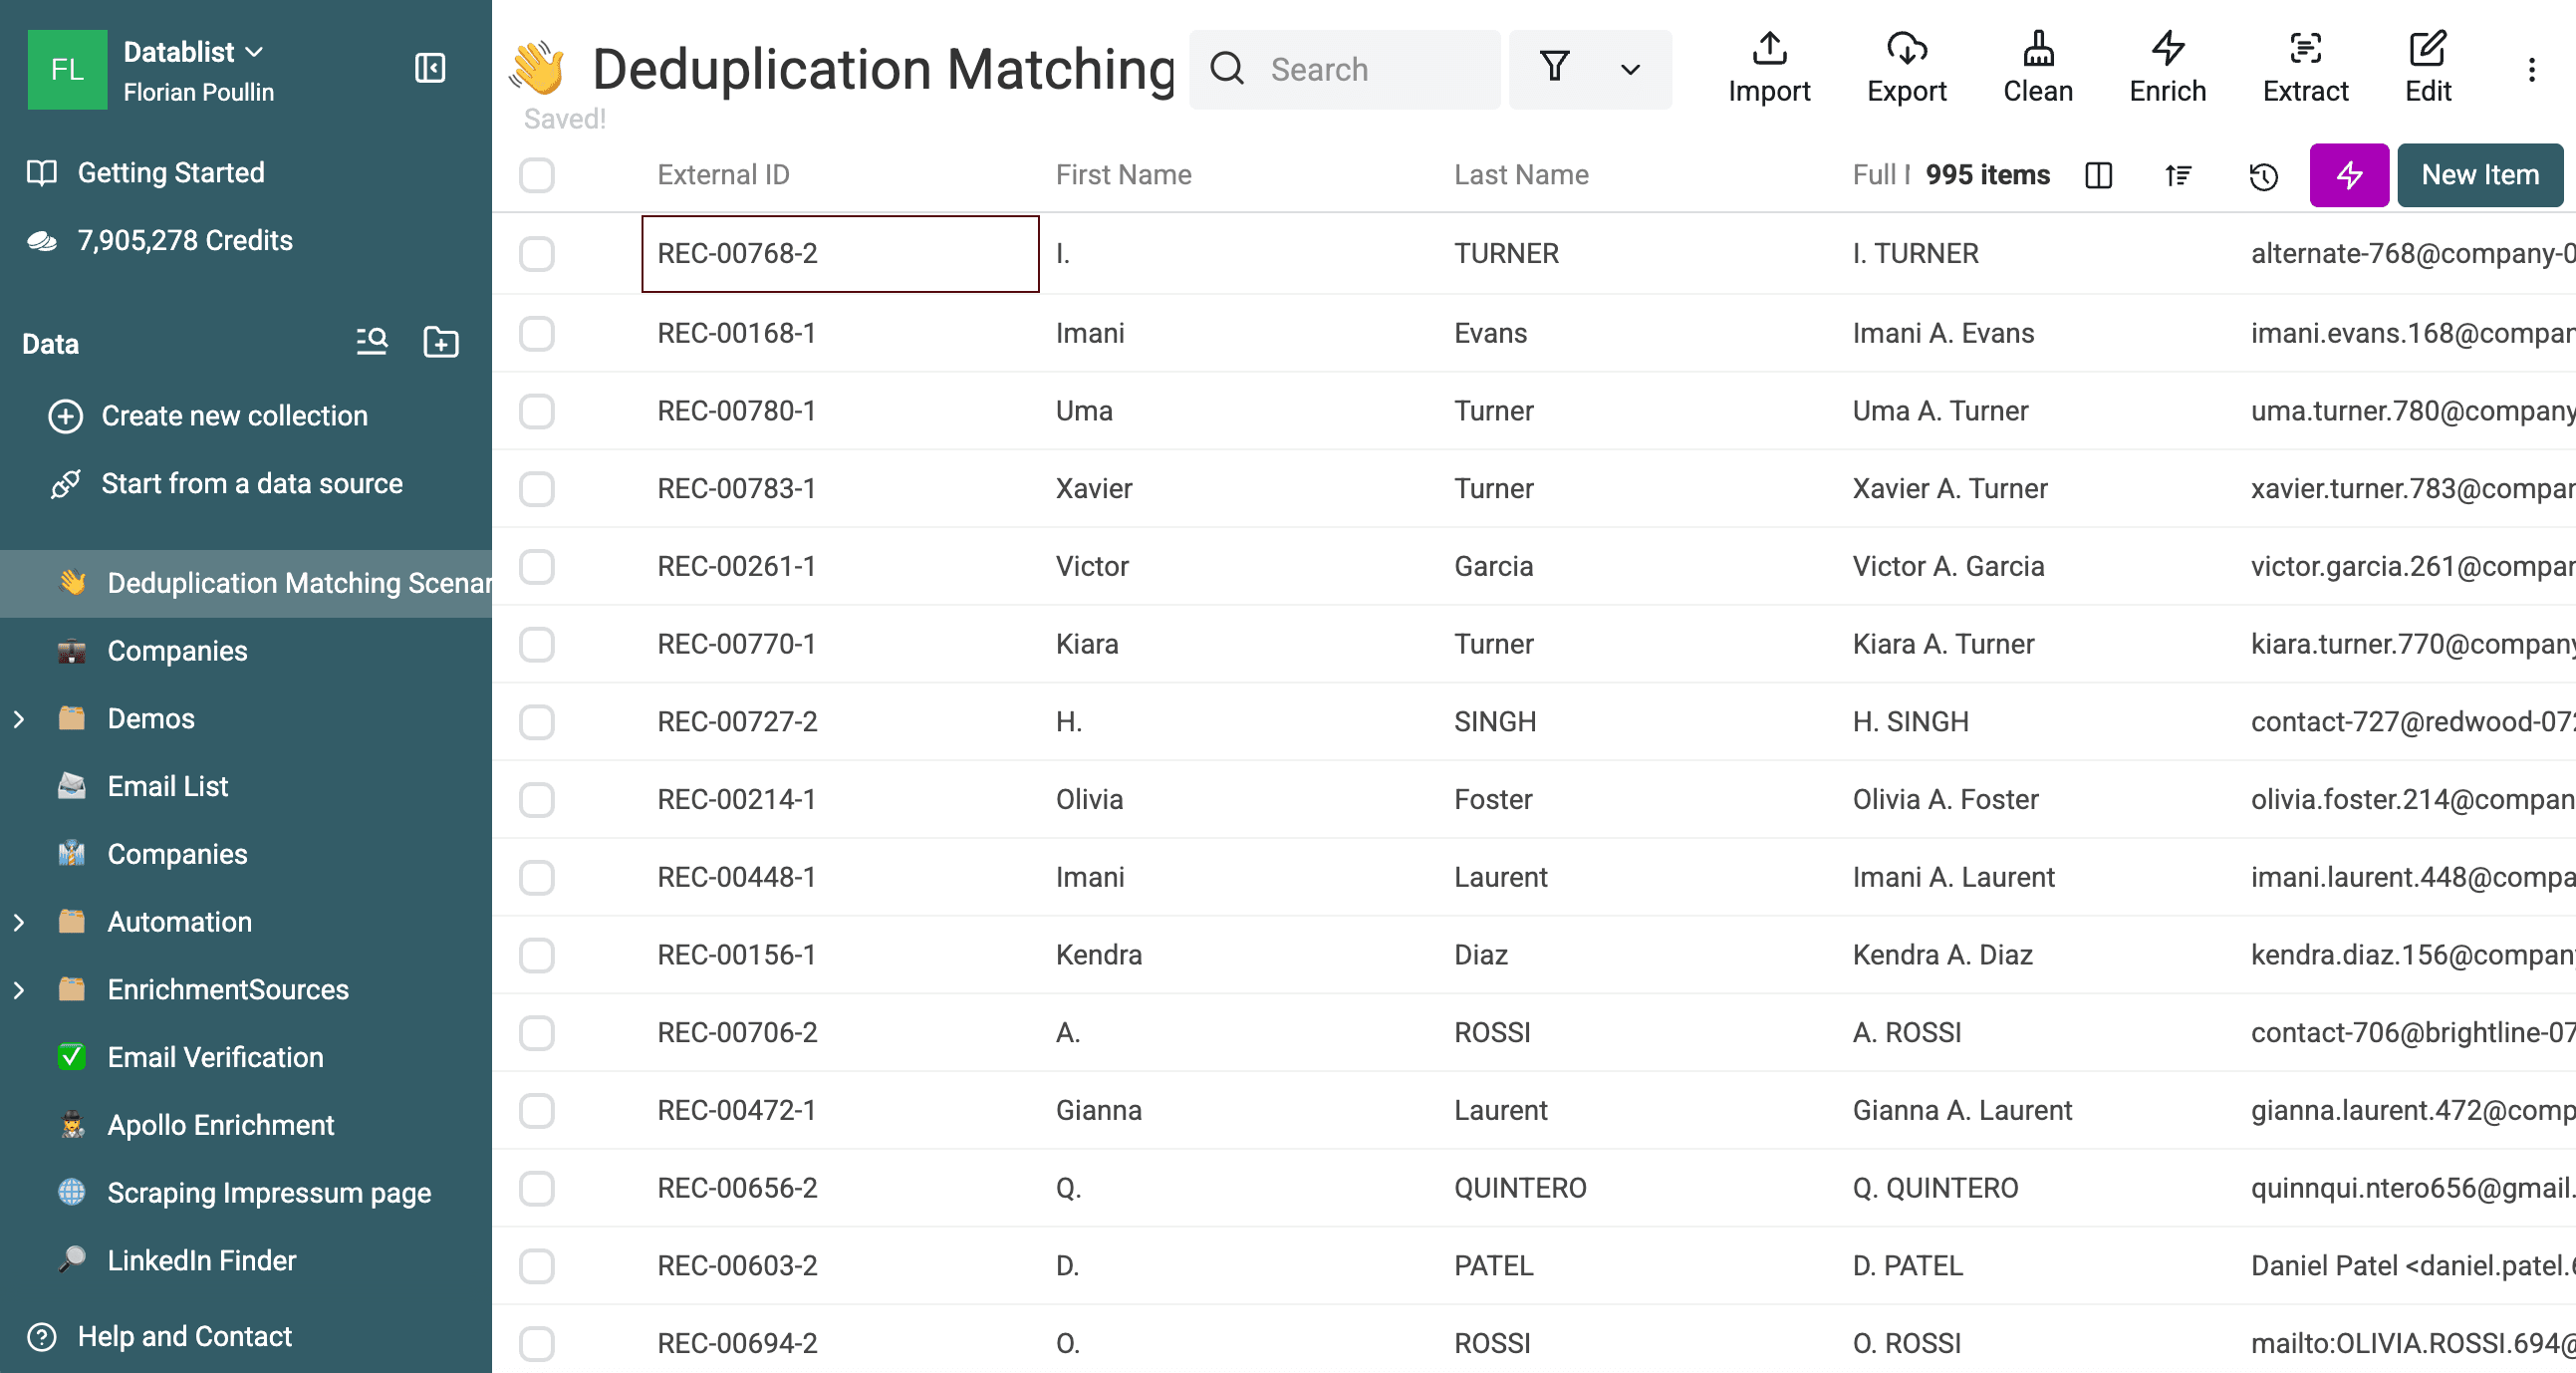
I Exact-søket i denne veiledningen slo Datablist sammen fem grupper med to rader. Collectionen gikk derfor fra 1 000 til 995 items.
Last ned duplikatgruppene før behandling dersom du trenger en ekstern kontrollfil. Betalte abonnementer inkluderer brukbare ID-er for duplikatgrupper og en endringslogg etter behandling. Endringsloggen registrerer slettede og oppdaterte Datablist-ID-er med tidligere verdier og målverdier.
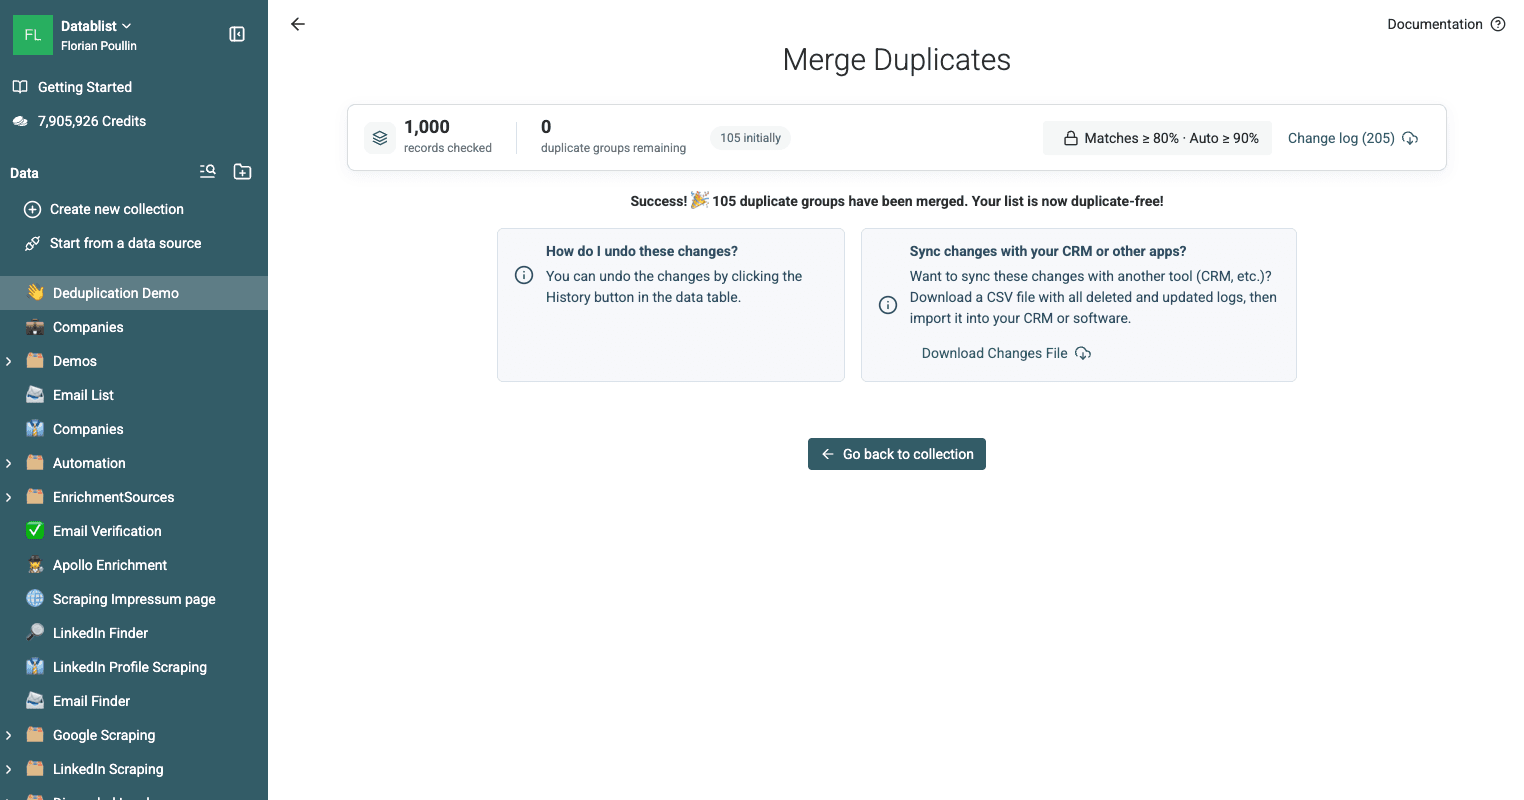
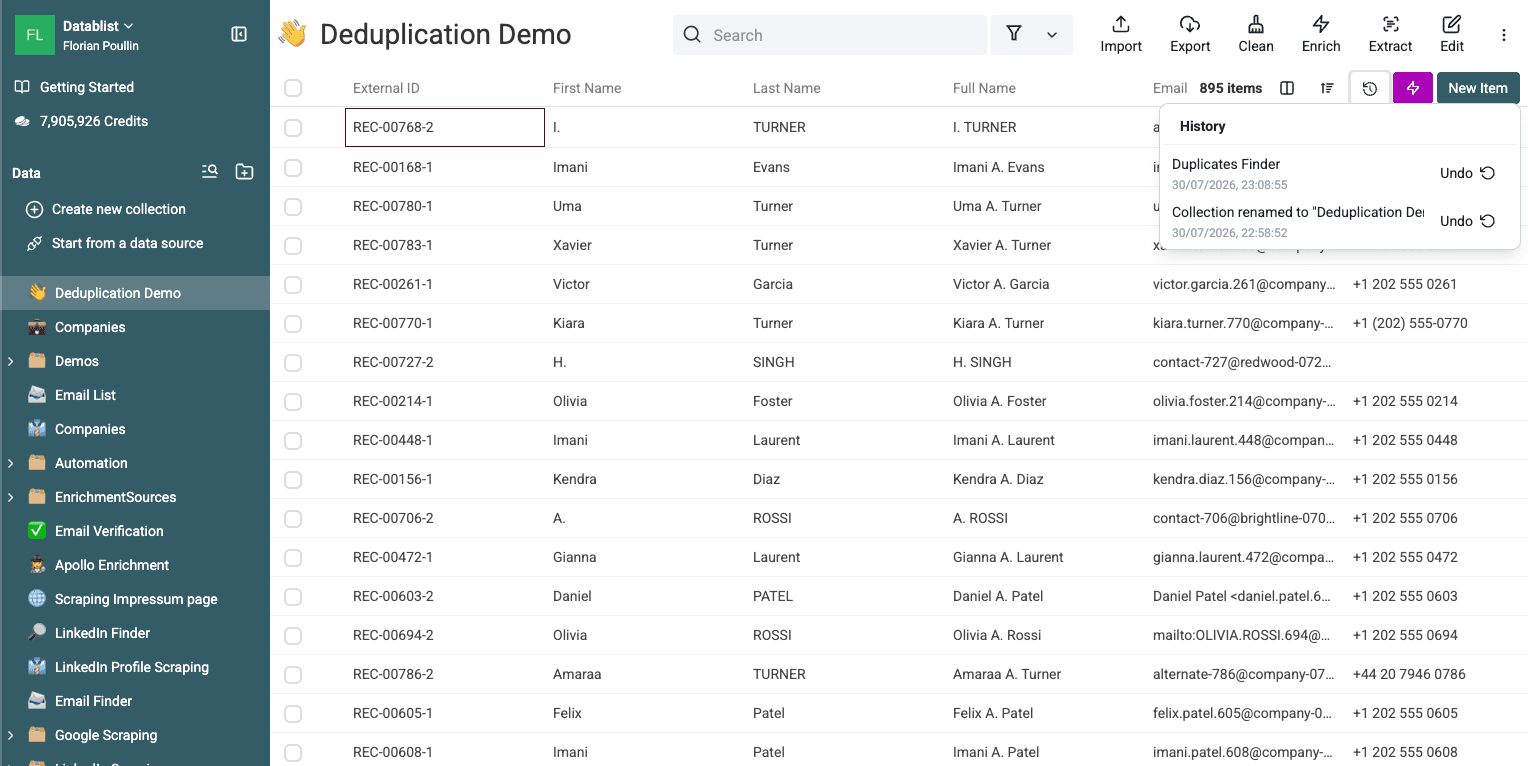
Automatiske handlinger for fjerning og sammenslåing vises også i collectionens History, der du kan angre dem.
Gå tilbake til collectionen, og åpne Export for å laste ned den ryddede CSV- eller Excel-filen.
Dedupliser flere lister
Bruk matching på tvers av collections når en ny lead-liste skal sammenlignes med en CRM-eksport. Behandle CRM-systemet som referanseliste, og fjern treffene fra den innkommende listen før import.
Last ned CRM-demofilen og demoens eventfil for å teste arbeidsflyten. Filene har forskjellige kolonneoverskrifter og inneholder 100 konstruerte e-postoverlapp. Begge filene starter med 250 rader.
Importer hver fil i sin egen collection, og åpne deretter Clean > Match across collections. Legg til begge collections, og koble sammen tilsvarende egenskaper, for eksempel Email og Attendee Email.
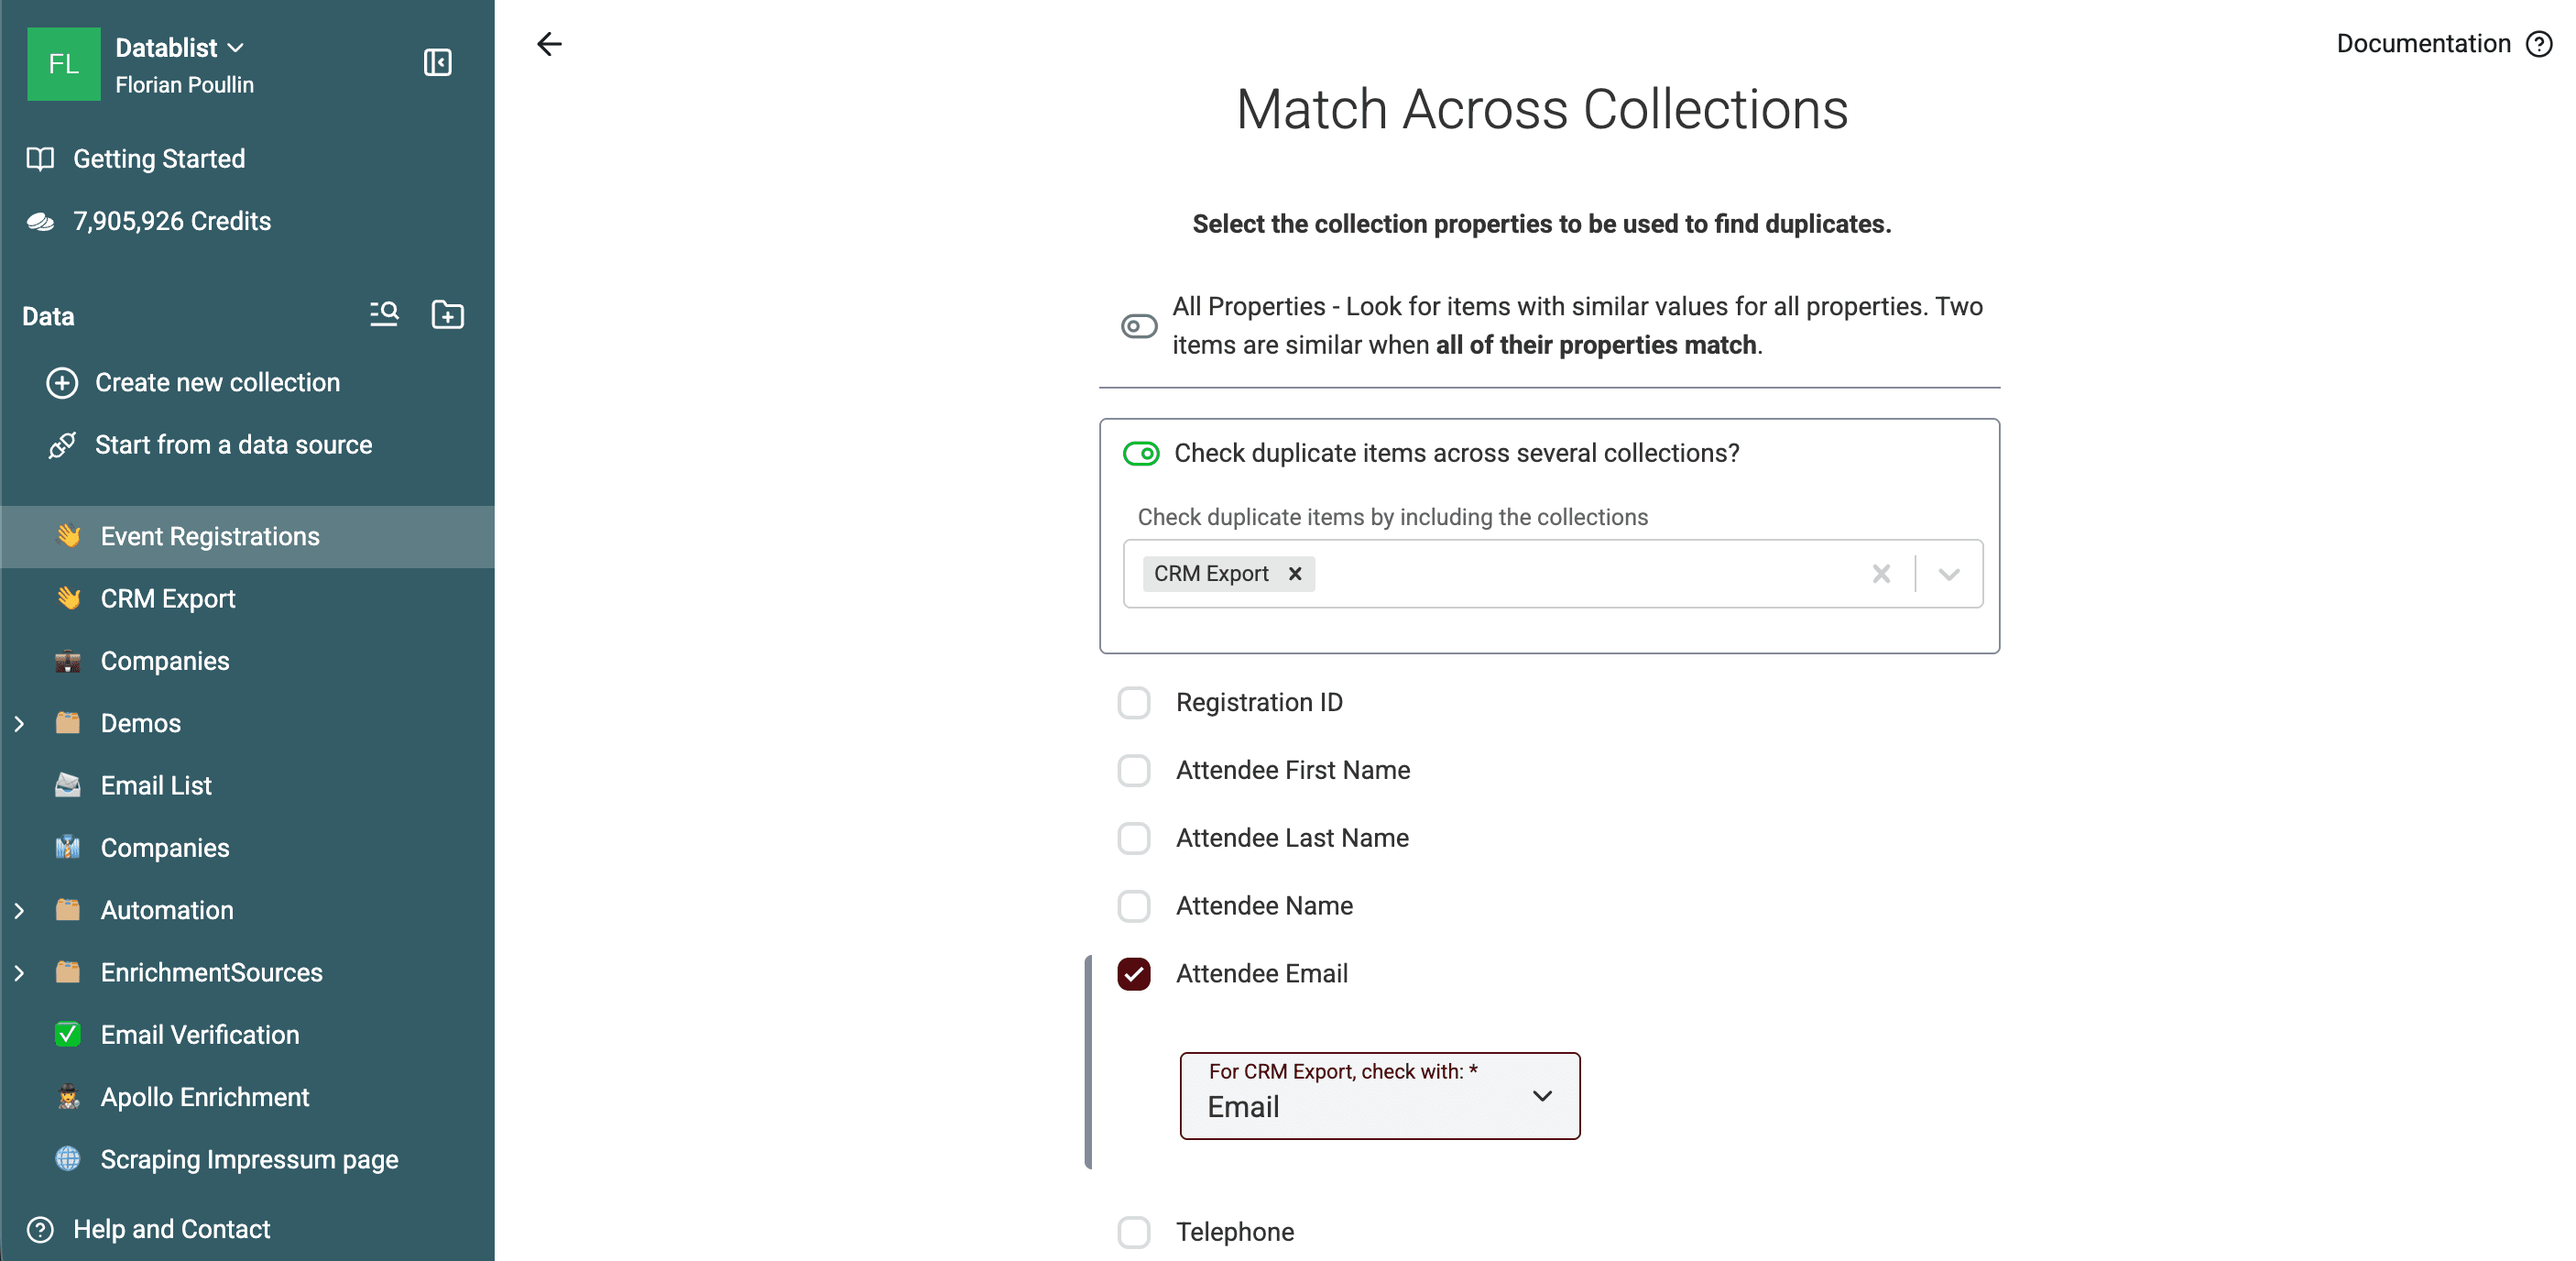
I denne testen ga Smart-matching med Email-prosessoren 100 grupper på tvers av collections blant 500 kontrollerte poster. Velg Event Registrations under Remove duplicate items from collection {X} for å la CRM-dataene stå uendret og fjerne treffene fra eventlisten.
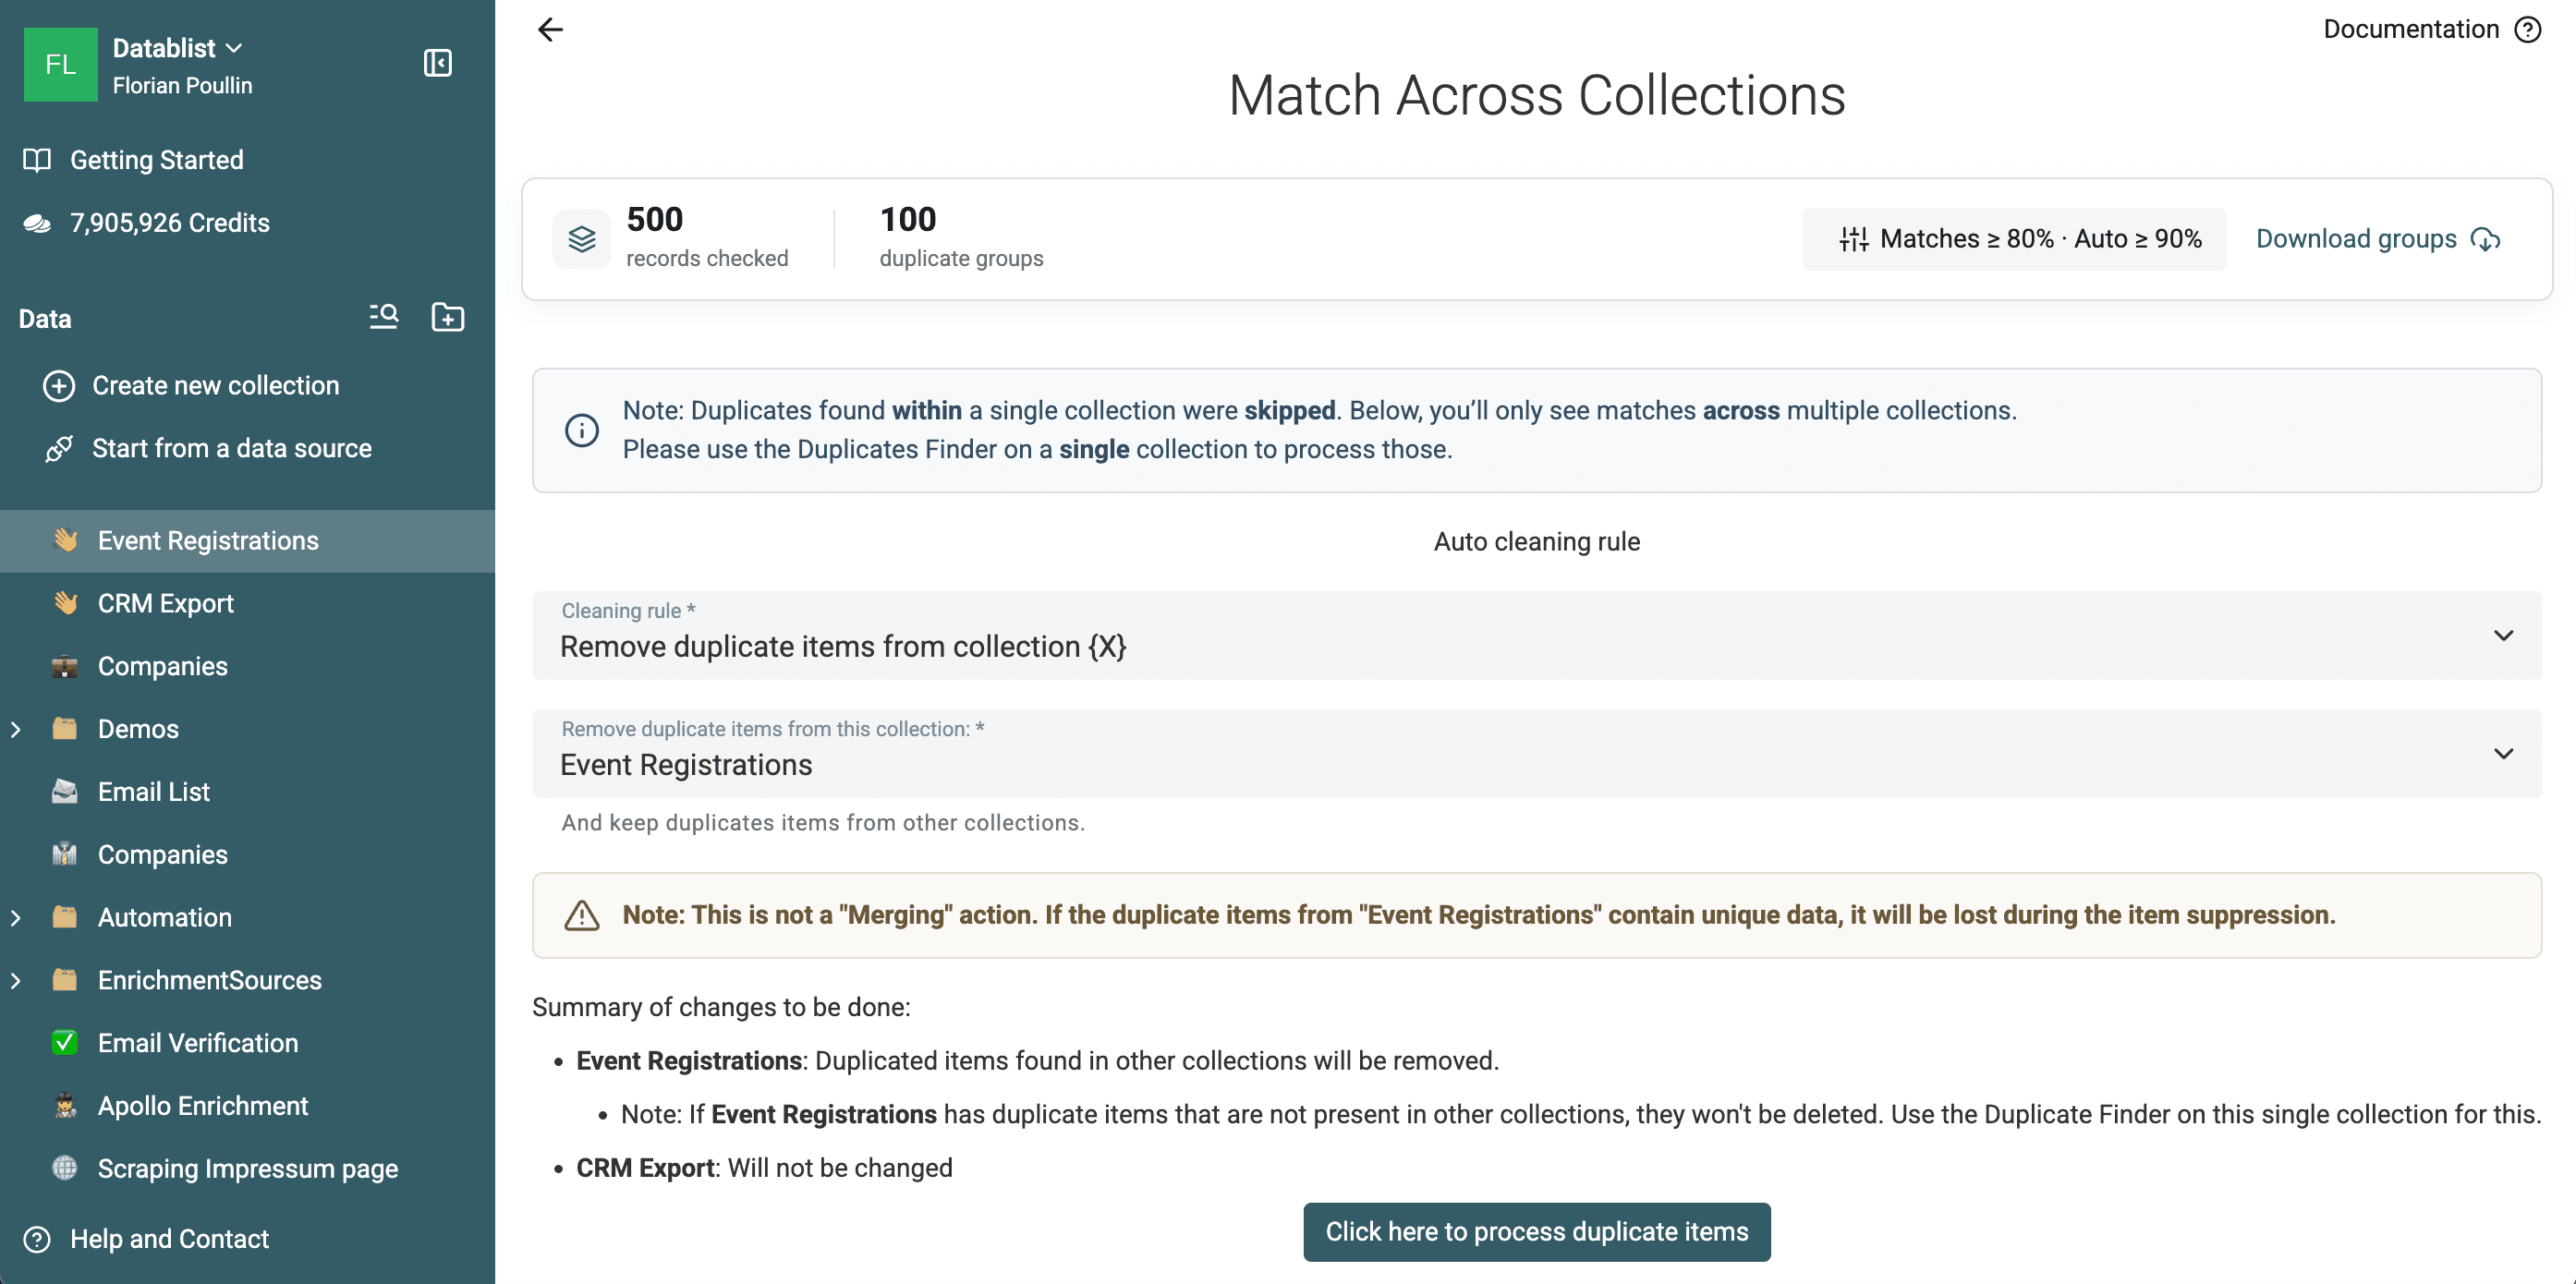
Automatisk rydding på tvers av collections fjerner rader. Den slår ikke sammen unike eventverdier med CRM-dataene. Eksporter eller kontroller gruppene først dersom de innkommende postene inneholder informasjon du vil bevare.
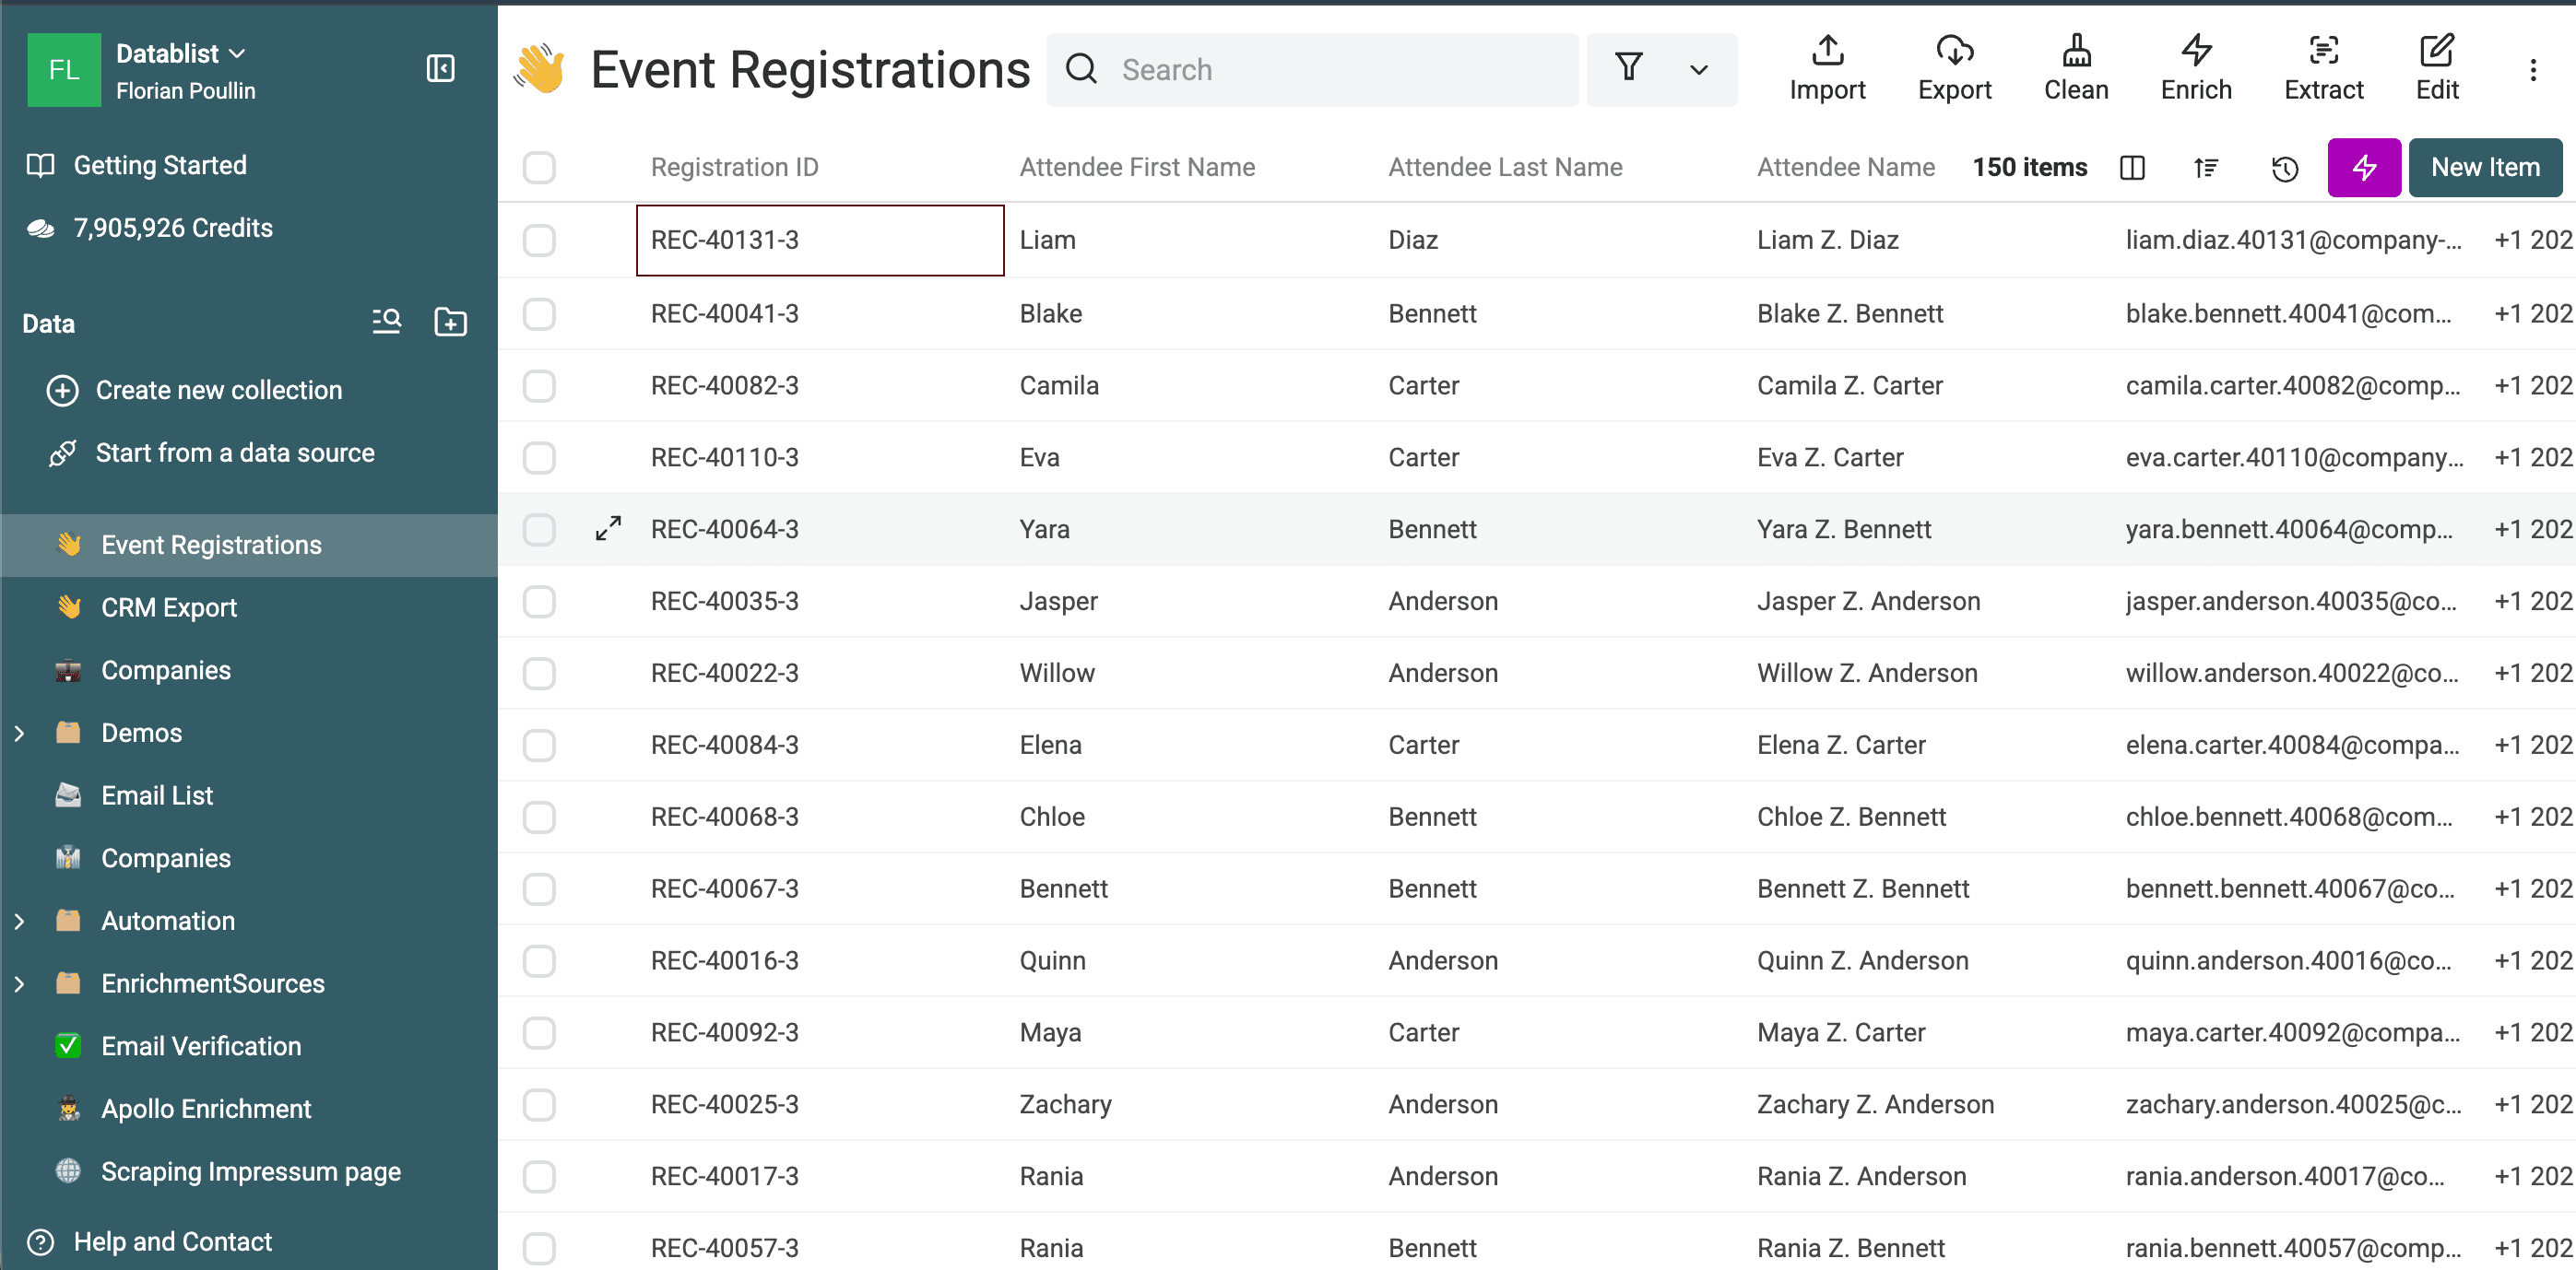
Etter behandling av de 100 overlappene inneholder Event Registrations 150 helt nye kontakter.
Matching på tvers av collections er en Premium-funksjon. Les den detaljerte veiledningen for å deduplisere flere CSV- eller Excel-filer og lære mer om kobling av collections og behandlingsalternativer.
FAQ
Kan jeg deduplisere en liste gratis på nett?
Ja. Besøkende uten konto kan kjøre en Exact-kontroll. En gratis konto gir tilgang til Smart-matching og de andre funksjonene for én collection i Free-abonnementet. Fuzzy- og fonetiske algoritmer, avanserte prosessorer, matching på tvers av collections, konfigurerbare regler for hvilke verdier som skal bevares, og Custom with AI krever et betalt abonnement.
Bør jeg fjerne eller slå sammen duplikatrader?
Fjern radene når én post er autoritativ og de andre ikke inneholder noe du trenger. Slå dem sammen når de øvrige radene har nyttige verdier. Forhåndsvisningen i Remove varsler når data vil bli forkastet.
Kan Datablist finne duplikater med skrivefeil?
Ja. Jaro-Winkler og Levenshtein sammenligner tekstlikhet, mens Metaphone sammenligner hvordan teksten høres ut. Disse avanserte algoritmene krever et betalt abonnement, og treffene bør kontrolleres.
Kan jeg slå sammen duplikatrader uten datatap?
Datablist kan fylle ut tomme felt, kombinere tekstverdier, beholde verdien fra den valgte posten eller bruke regler på feltnivå for å bestemme hvilke verdier som overlever. Kontroller forhåndsvisningen, for verdier du velger å forkaste, vil ikke vises i den sammenslåtte posten.
Hvor stor kan listen være?
Free-abonnementet støtter opptil 1 million items per collection i nettleserlagringen. Betalte abonnementer støtter import av opptil 2 millioner items per collection. Store lokale operasjoner avhenger fortsatt av nettleseren og enheten.
Kan jeg kontrollere duplikater uten å endre listen?
Ja. Duplikatsøket er skrivebeskyttet. Du kan undersøke grupper, justere terskler, bruke Why matched, søke og sortere resultater og laste ned duplikatrader før du starter en behandlingshandling.
Du finner alle innstillinger og begrensninger i den fullstendige Duplicate Finder-dokumentasjonen.