

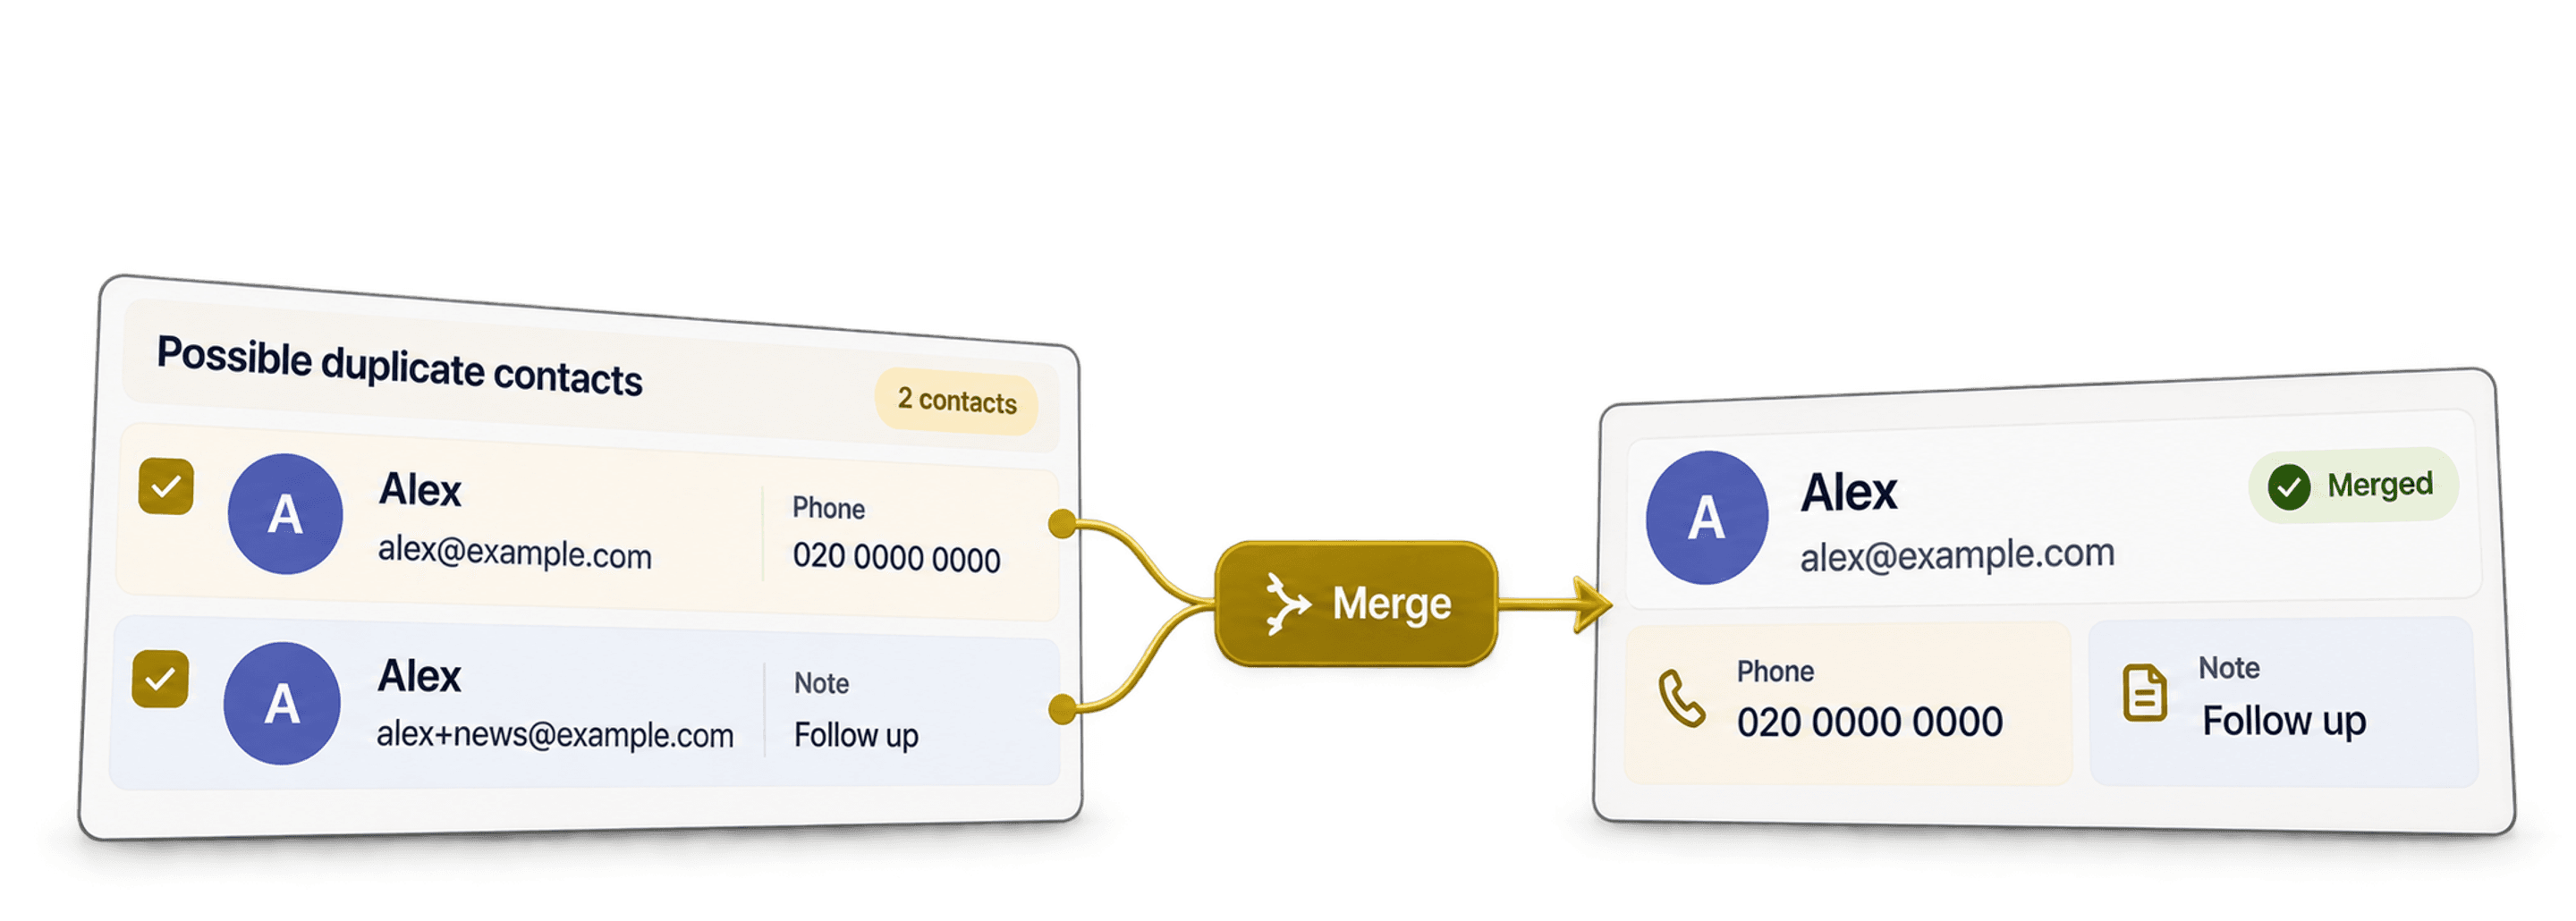
Duplikaty adresów e-mail często pojawiają się, gdy łączysz eksport z CRM z danymi z formularzy lub listą uczestników wydarzenia. Ta sama osoba występuje dwa razy, ale jej rekordy rzadko są identyczne. Jeden może zawierać numer telefonu, a drugi źródło pozyskania lub przydatną notatkę.
Dlatego nie zaczynam od usuwania powtarzających się adresów. Aby bezpiecznie deduplikować adresy e-mail, korzystam z narzędzia Datablist Duplicates Finder, trybu Smart matching i procesora Email. Narzędzie grupuje warianty tego samego adresu, a następnie pozwala przejrzeć pełne rekordy kontaktów i scalić dane, które warto zachować.
Na potrzeby tego poradnika przygotowałem testową listę 1000 kontaktów z typowymi wariantami adresów: od aliasów z plusem i różnic w adresach Gmail po adresy zapisane z nazwą wyświetlaną. Datablist znalazł 200 par duplikatów, a oczyszczona kolekcja zawierała 800 kontaktów. Pokażę Ci użyte ustawienia i elementy, które sprawdziłem przed scaleniem rekordów.
Najpierw dopasuj rekordy według adresu e-mail, ale o zachowaniu danych decyduj na podstawie całego rekordu kontaktu. Jeśli zamiast tego chcesz porównywać imiona i nazwiska, numery telefonów, domeny firmowe lub inne identyfikatory, sprawdź, jak deduplikować listę online.
Kiedy Datablist uznaje adresy e-mail za identyczne
Smart matching z procesorem Email porównuje tożsamości adresów e-mail, a nie nieprzetworzony tekst w komórkach. Usuwa spacje na początku i końcu, porównuje wartości zapisane małymi literami oraz usuwa +sufiks z części lokalnej adresu.
Stosuje również reguły właściwe dla Gmaila. Kropki są usuwane z części lokalnej adresów Gmail, a domena googlemail.com jest zamieniana na gmail.com. Datablist potrafi też wyodrębnić prawidłowy adres z zapisu zawierającego nazwę wyświetlaną albo z wartości mailto: z parametrami zapytania.
Oto przykłady z testowego zbioru danych:
| Zapisane wartości | Wynik Smart Email |
|---|---|
noraanderson40@demo.conoraanderson40+newsletter@demo.co | Ta sama tożsamość po usunięciu sufiksu z plusem |
victorbennett62@gmail.comvictorb.ennett62@gmail.com | Ta sama tożsamość Gmail po usunięciu kropek |
yasmincarter105@gmail.comyasmincarter105@googlemail.com | Ta sama tożsamość Gmail po normalizacji domeny |
camiladiaz123@testmail.netCamila Diaz <camiladiaz123@testmail.net> | Ta sama tożsamość po wyodrębnieniu adresu z pełnego zapisu |
marcusevans199@testmail.netmailto:MARCUSEVANS199@TESTMAIL.NET?subject=Hello | Ta sama tożsamość po usunięciu otoczki i porównaniu wartości zapisanych małymi literami |
Obsługa kropek dotyczy wyłącznie Gmaila. Datablist nie zakłada, że first.last@company.com i firstlast@company.com to ten sam adres. W domenach innych niż Gmail kropki mogą mieć znaczenie.
Smart Email jest regułą porównywania, a nie walidatorem adresów e-mail. Sprawdza strukturę w zakresie wystarczającym do normalizacji adresu, ale nie weryfikuje w pełni domeny ani skrzynki pocztowej. Przykładowo person+tag@.example.com zostanie na potrzeby dopasowania zmieniony na person@.example.com, mimo że domena jest nieprawidłowa. Przed scaleniem oddzielnie sprawdź błędne wartości.
Jeśli aliasy z plusem, kropki w Gmailu i pełne zapisy mają pozostać rozróżniane, wybierz Exact. Dokładne porównanie tekstu nadal usuwa skrajne spacje i domyślnie ignoruje wielkość liter. Włącz Case sensitive, jeśli wielkie i małe litery muszą być rozróżniane; spacje na początku i końcu nadal będą usuwane.
Przed scaleniem sprawdź adresy z tagiem po plusie w domenach firmowych. Smart Email grupuje sam+orders@example.com i sam@example.com pod tym samym kluczem porównania. Exchange Online najpierw próbuje dostarczyć wiadomość na pełny adres, a jeśli nie może go rozpoznać, korzysta z adresu bazowego. [1] Jeśli adresy mają odrębne rekordy odbiorców albo sposób routingu nie jest jasny, zachowaj oba. Uruchom kontrolę z ustawieniem Exact dla kolumny e-mail i upewnij się, że oba rekordy pozostają oddzielne.
🔑 Normalizacja wskazuje potencjalną grupę duplikatów
Nie dowodzi, że wszystkie pola dotyczą tej samej osoby. Przed scaleniem sprawdź imiona i nazwiska, firmy oraz skrzynki funkcyjne.
Przy większości operacji czyszczenia list kontaktów polecam Smart matching z procesorem Email. Przechodzę na Exact, gdy aliasy muszą pozostać oddzielne, a następnie dostosowuję ustawienie wielkości liter do identyfikatorów w pliku.
Pełne reguły normalizacji i informacje o dostępności w planach znajdziesz w dokumentacji procesora Email.
Przykładowa lista e-mail użyta w poradniku
Plik testowy zawiera 1000 syntetycznych rekordów kontaktów reprezentujących 800 zaplanowanych tożsamości. W żadnej parze duplikatów nie występuje identyczny, nieprzetworzony adres e-mail. To istotne, ponieważ czyszczenie oparte na dokładnych wartościach nie pokazałoby dopasowywania uwzględniającego aliasy.
Plik zawiera osiem kolumn: record_id, first_name, last_name, email, company, phone, source i notes. Workflow dopasowuje rekordy według pola email, ale pozostałe pola pozostają widoczne, dzięki czemu mogę wybrać rekord główny i zachować przydatne wartości.
Oto cztery dokładne rekordy wejściowe z dwóch par duplikatów:
| record_id | first_name | last_name | phone | source | notes | |
|---|---|---|---|---|---|---|
CONTACT-0040-A | Nora | Anderson | noraanderson40@demo.co | Eksport z CRM | Główny rekord kontaktu | |
CONTACT-0040-B | N. | A. | noraanderson40+newsletter@demo.co | +1-202-555-1039 | Formularz na stronie | Dane uzupełniające z drugiego źródła |
CONTACT-0062-A | Victor | Bennett | victorbennett62@gmail.com | +1-202-555-1061 | Formularz na stronie | Główny rekord kontaktu |
CONTACT-0062-B | victor | BENNETT | victorb.ennett62@gmail.com | Wydarzenie | Dane uzupełniające z drugiego źródła |
Para rekordów Nory pokazuje, dlaczego nie usuwam duplikatów od razu. Rekord bazowy zawiera preferowane pełne imię i nazwisko, natomiast rekord z aliasem ma jedyny numer telefonu i drugie źródło pozyskania. Scalenie pozwala zachować oba zestawy danych.
Zbiór zawiera 200 dwurekordowych, zduplikowanych tożsamości, podzielonych równo między pięć rodzajów wariantów: aliasy z plusem, adresy Gmail z kropkami, domeny gmail.com i googlemail.com, adresy z nazwą wyświetlaną oraz wartości mailto:. Pozostałe 600 tożsamości występuje tylko raz.
Możesz pobrać przykładowy plik CSV z 1000 rekordów, aby odtworzyć ten proces. Jeśli korzystasz z własnego pliku, umieść jeden adres e-mail w każdym rekordzie i zachowaj sąsiednie pola, które chcesz skonsolidować.
Import i przygotowanie kolumny e-mail
Zaimportuj plik CSV lub Excel do nowej kolekcji Datablist. Sprawdź podgląd importu i przypisz kolumnę e-mail jako właściwość typu e-mail.
Imiona i nazwiska, firmę, numer telefonu, źródło, notatki oraz trwałe identyfikatory przechowuj w oddzielnych właściwościach. Te kolumny nie są zbędne. To na ich podstawie ocenisz rekordy, które pasują do siebie według adresu e-mail, lecz różnią się w innych miejscach.
W tym workflow preferuję również jeden adres w każdej komórce. Jeśli komórka zawiera alice@example.com; bob@example.com, najpierw rozdziel lub znormalizuj jej zawartość. Osobny poradnik wyjaśnia, jak deduplikować pole zawierające wiele adresów e-mail.
W przypadku komórki z kilkoma adresami deduplikacja wartości wielokrotnych porównuje elementy rozdzielone średnikami. Zanim uznasz dwa rekordy kontaktów za tę samą osobę, sprawdź wspólną skrzynkę pocztową.
💡 Zachowaj dane potrzebne do podjęcia decyzji
Przed deduplikacją nie usuwaj kolumn ze źródłem, notatkami, numerem telefonu ani trwałym identyfikatorem. Pomogą Ci wybrać rekord główny i uniknąć utraty unikalnych danych.
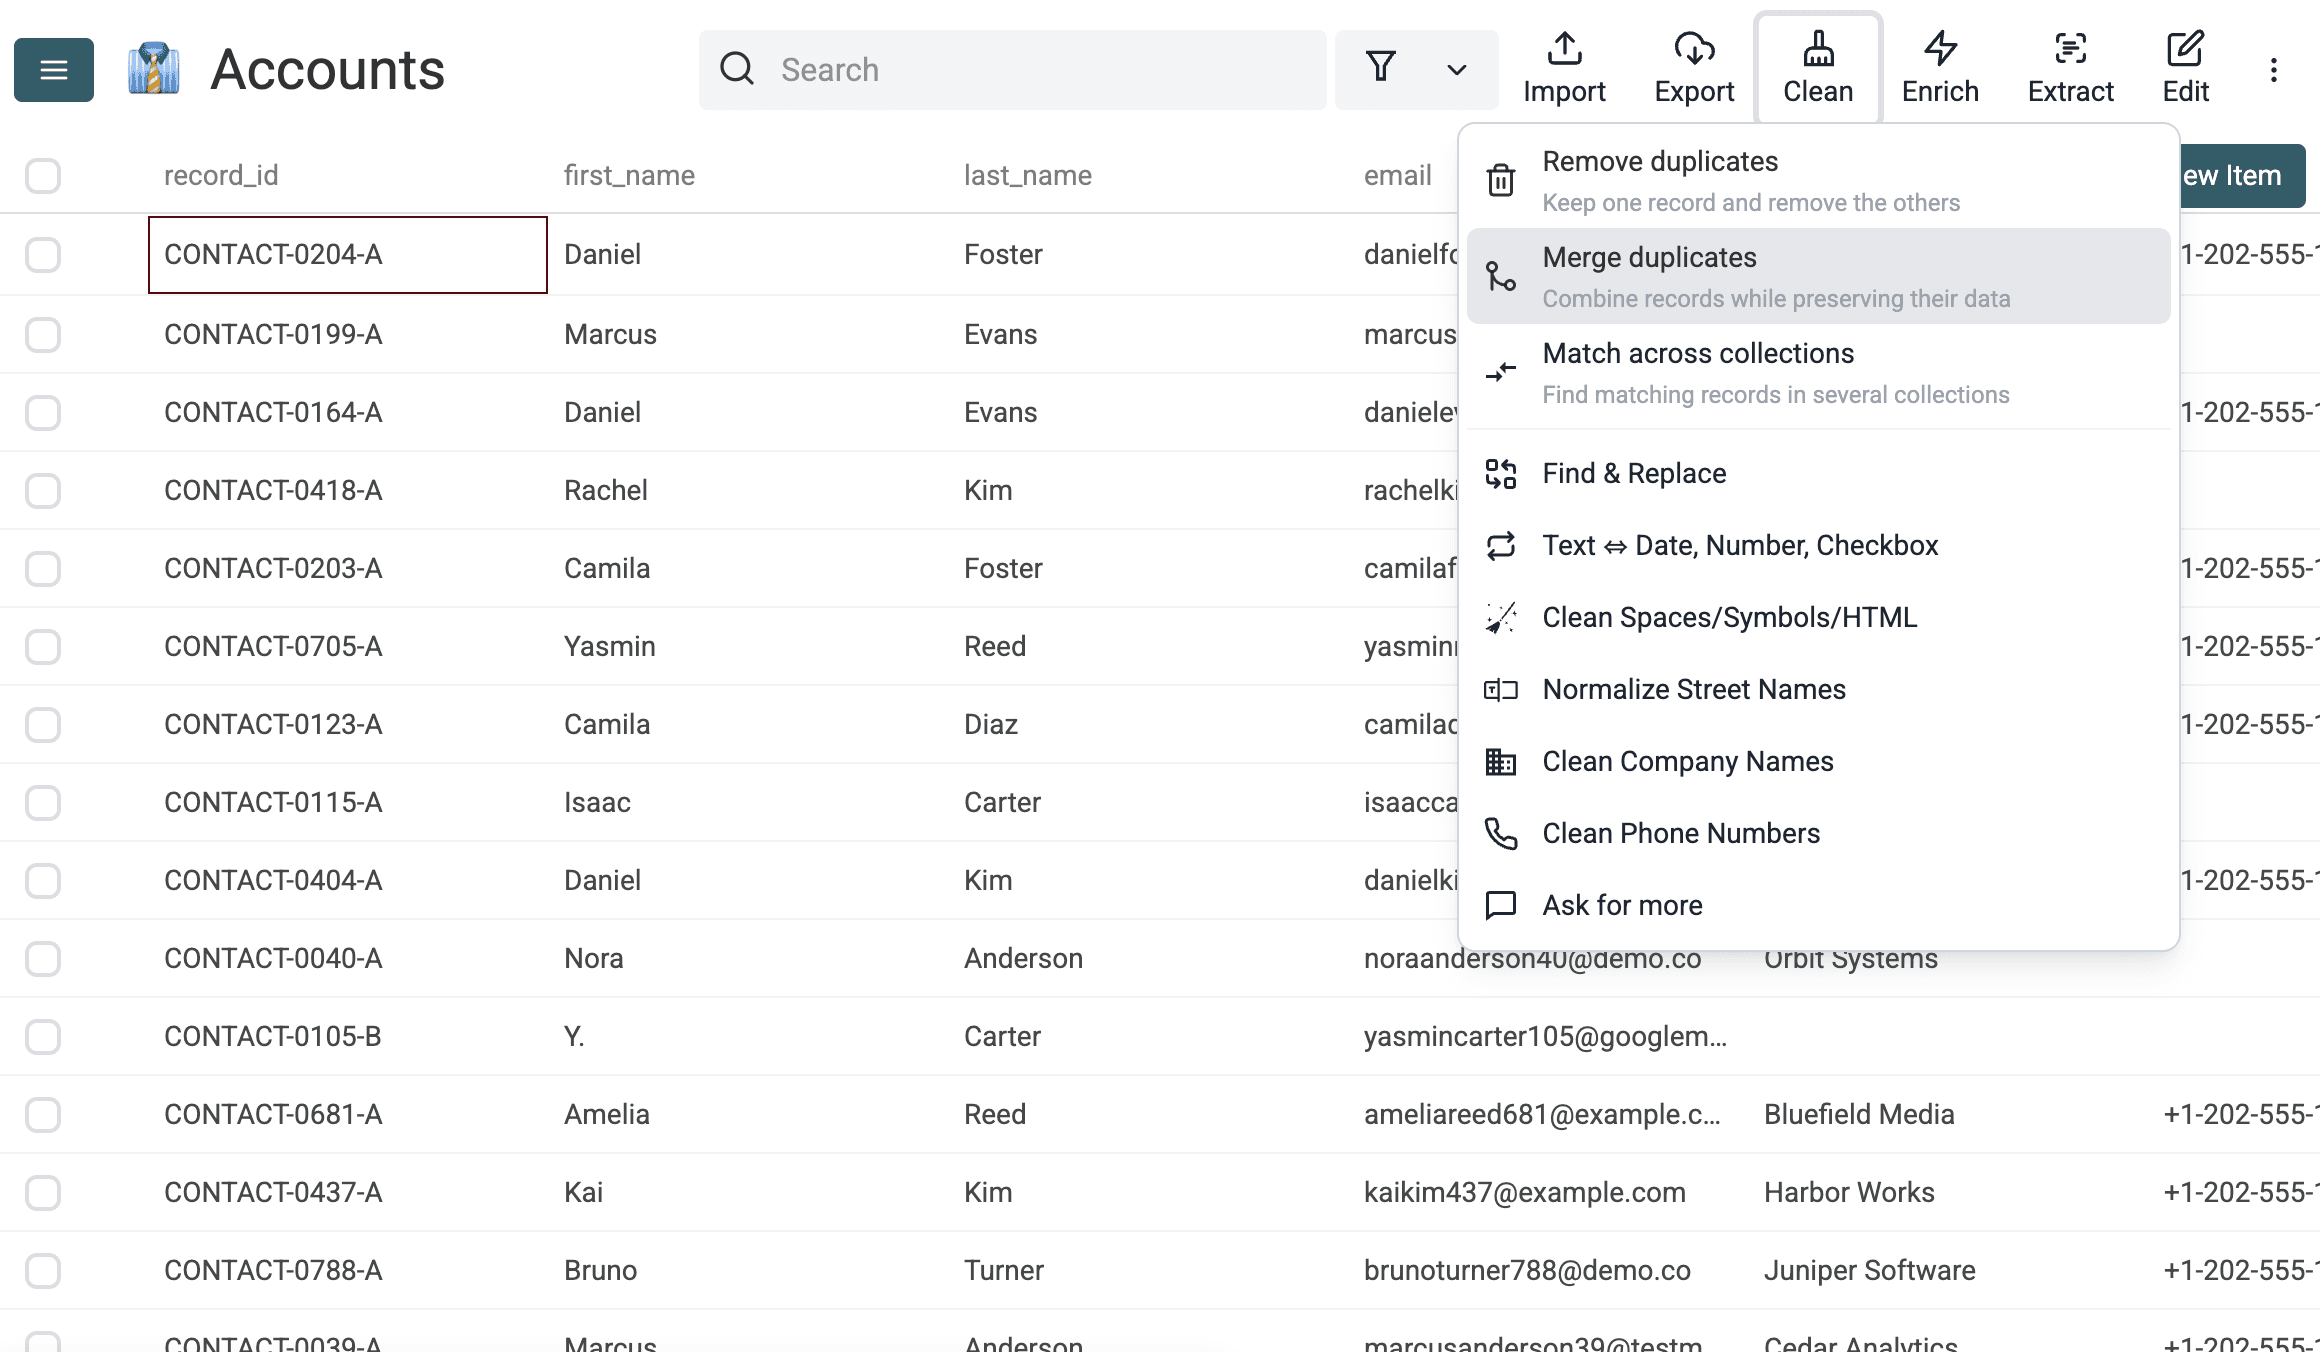
Otwórz Clean > Merge duplicates. Wybierz Selected Properties, a następnie zaznacz email na potrzeby tego przebiegu opartego na adresach e-mail.
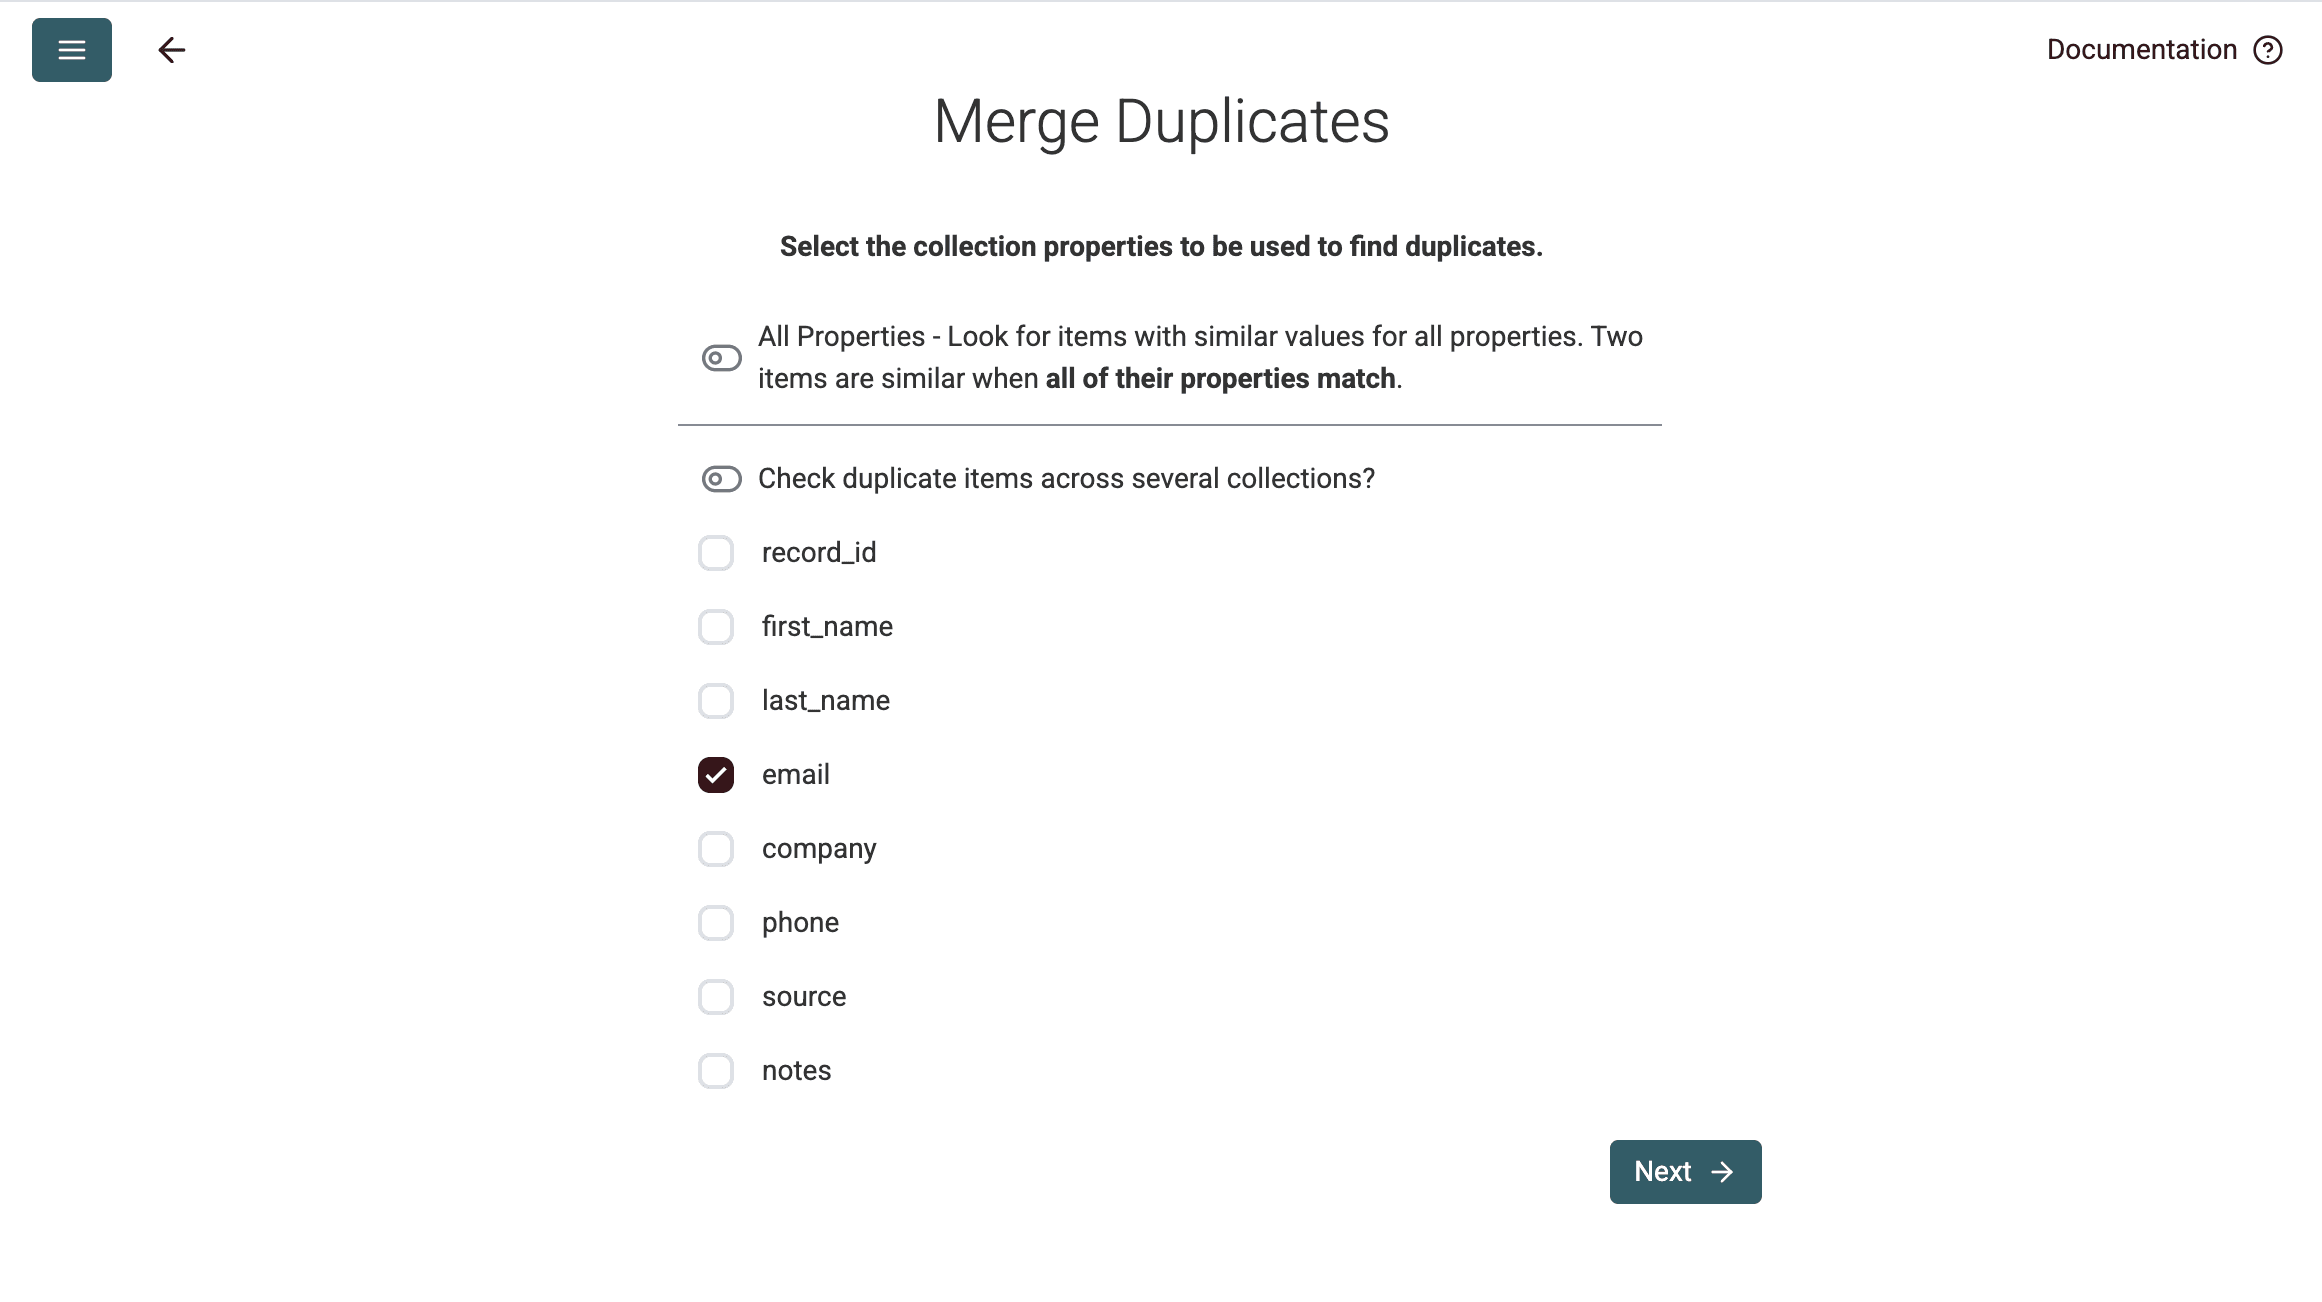
Wybranie jednej właściwości ułatwia zrozumienie działania reguły. Dodanie na tym etapie imienia, nazwiska lub firmy mogłoby uniemożliwić prawidłowe dopasowanie adresów, jeśli te pola są puste albo inaczej sformatowane.
Konfiguracja Duplicates Finder
Dla właściwości email wybierz algorytm porównywania Smart i procesor Email.
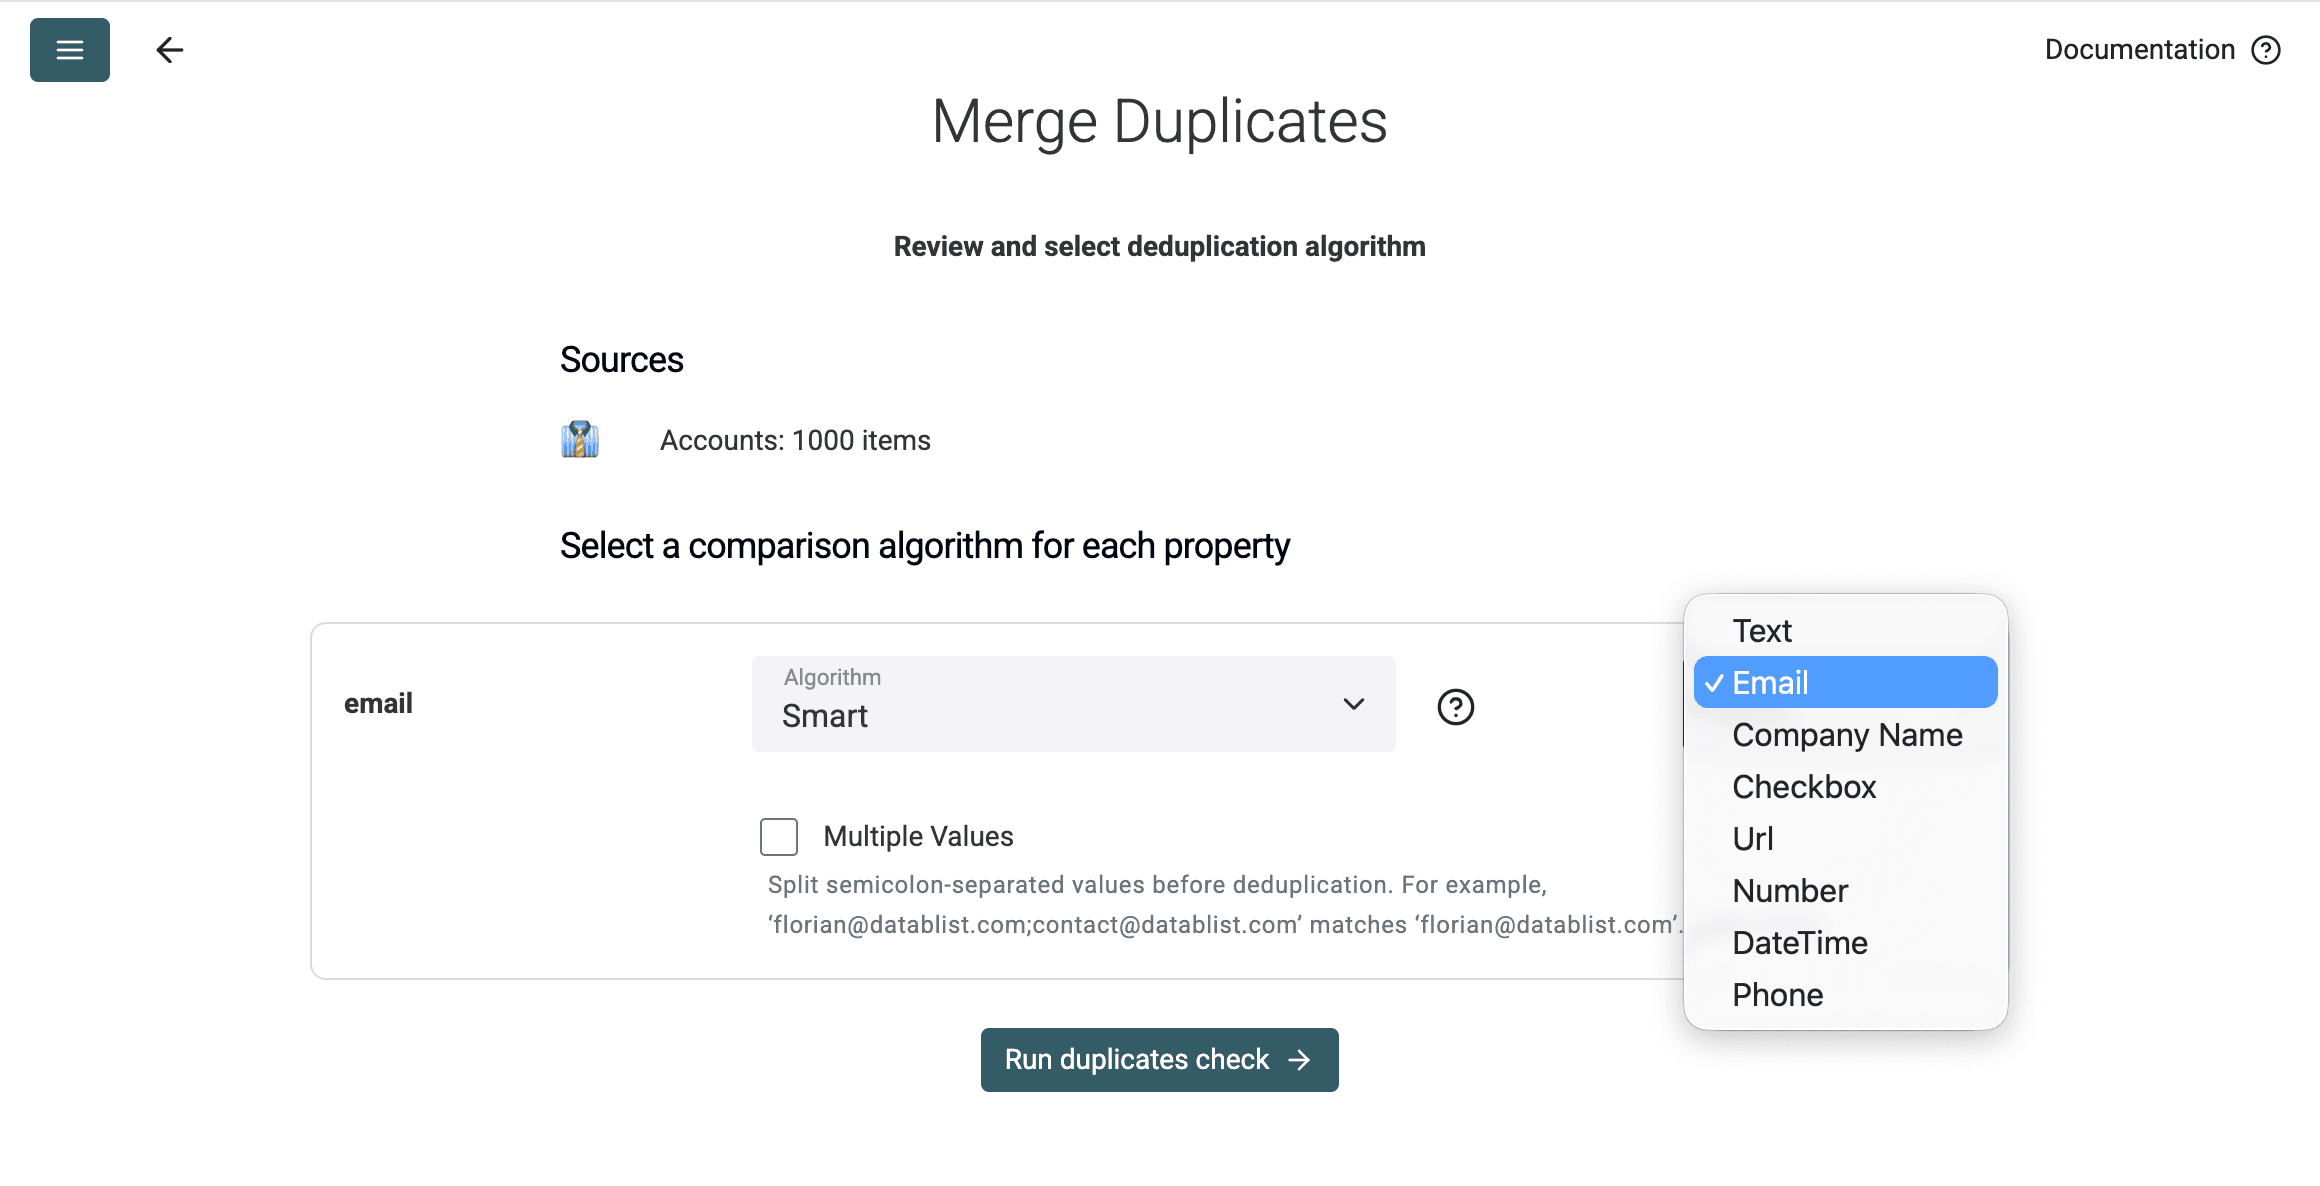
Każde ustawienie pełni określoną funkcję:
- Selected Properties ogranicza kontrolę do identyfikatora, który chcesz porównać.
- Smart włącza normalizację opartą na procesorze zamiast dosłownego porównywania zapisanych ciągów znaków.
- Email stosuje opisane wyżej reguły dotyczące aliasów, Gmaila, nazw wyświetlanych oraz
mailto:.
Użyj Smart z procesorem Email, aby wykrywać warianty tej samej tożsamości. Exact pomija normalizację właściwą dla adresów e-mail, ale nadal usuwa skrajne spacje i domyślnie ignoruje wielkość liter.
Samo sprawdzanie duplikatów nie modyfikuje danych. Uruchomienie procesu tworzy grupy potencjalnych duplikatów do weryfikacji. Nie usuwa ani nie scala rekordów kolekcji. Zmiany następują dopiero po wybraniu i zastosowaniu operacji scalania lub usuwania.
To rozdzielenie jest przydatne. Zanim zbiorcze scalanie zmieni listę, chcę zobaczyć, które wartości reguła dopasowania uznaje za równoważne.
Uruchomienie kontroli i weryfikacja duplikatów
Kliknij Run duplicates check. W tym teście Datablist przypisał 400 z 1000 rekordów do 200 dwurekordowych grup.
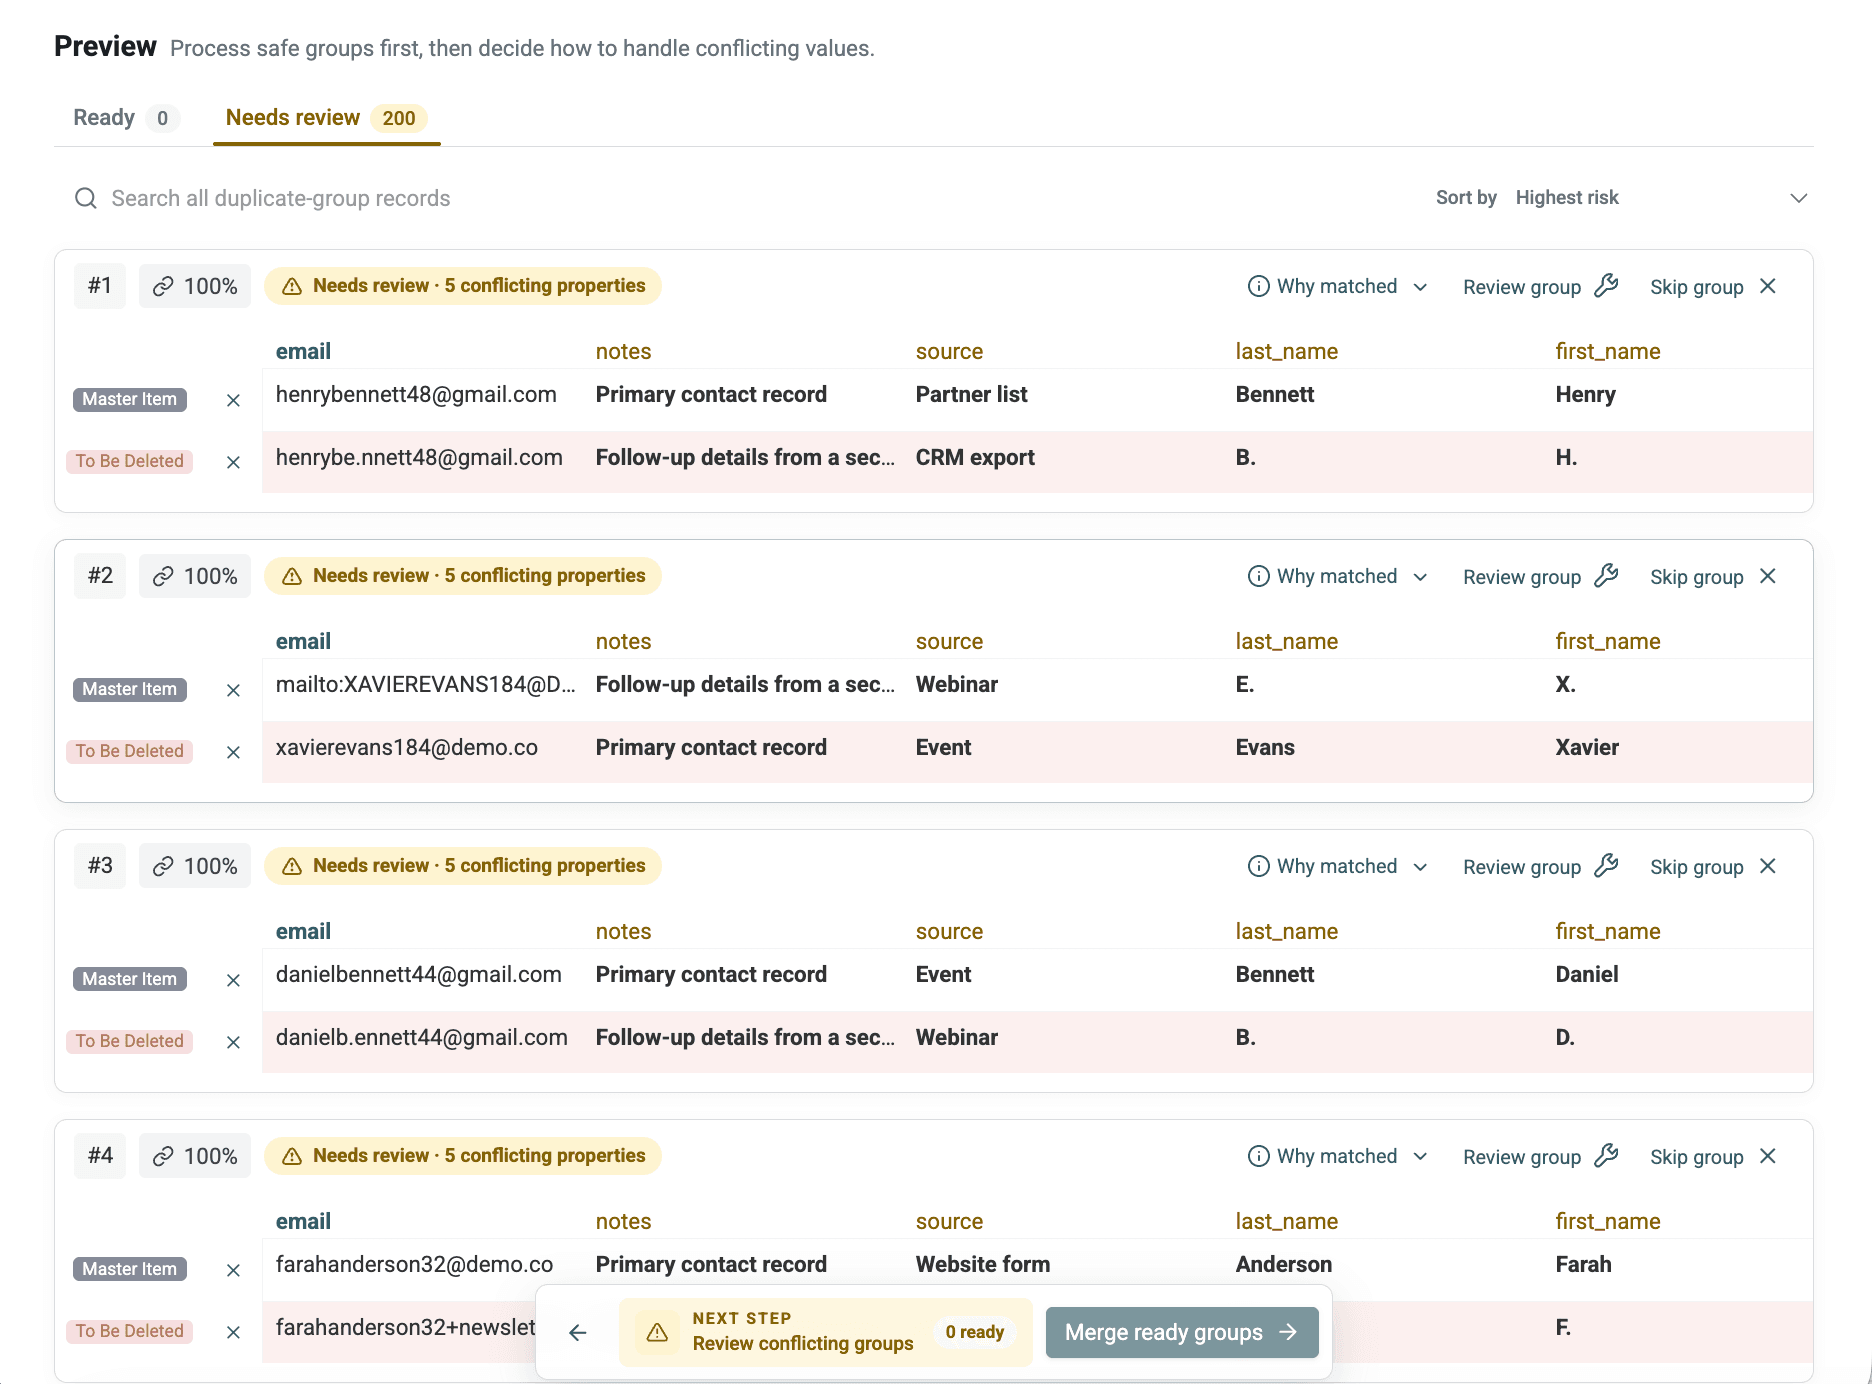
Nie traktuj jeszcze liczby grup jako liczby rekordów do usunięcia. Każda grupa jest kandydatem do weryfikacji. W przypadku każdej z nich sprawdź:
- czy wariant adresu e-mail ma sens;
- czy imiona i nazwiska są zgodne lub różnią się w możliwy do wyjaśnienia sposób;
- czy wartości firmy i numeru telefonu nie są sprzeczne;
- czy źródło i notatki zawierają uzupełniające się informacje;
- czy adres nie należy do współdzielonej skrzynki.
Zazwyczaj sprawdzam kilka pierwszych grup oraz każde zaskakujące dopasowanie między różnymi firmami, zanim zastosuję regułę zbiorczą. To szybsze niż późniejsze naprawianie zbyt agresywnego scalania.
⚠️ Powtarzający się adres nie zawsze oznacza tę samą osobę
Współdzielona skrzynka, taka jak
sales@company.com, może występować przy kilku prawidłowych kontaktach. Adresy funkcyjne weryfikuj ręcznie, zamiast zakładać, że wszystkie rekordy należy połączyć.
Plik testowy zaprojektowano tak, aby każda znormalizowana para reprezentowała jedną tożsamość. Prawdziwy eksport z CRM będzie mniej uporządkowany. Jeśli imiona, nazwiska lub firmy wskazują na różne osoby, pomiń daną grupę albo sprawdź ją oddzielnie.
Scalić czy usunąć duplikaty
Stosuję prostą regułę:
- Scalaj rekordy, gdy zawierają uzupełniające się dane.
- Usuwaj dodatkowy rekord tylko wtedy, gdy nie wnosi żadnej przydatnej wartości.
- Niejednoznaczne grupy pozostaw do ręcznej weryfikacji.
W tym przebiegu konfiguracja scalania wybierała najbardziej kompletny rekord jako główny. Zachowywała jego record_id, używała najdłuższych wartości imienia i nazwiska oraz łączyła pola source i notes średnikami.
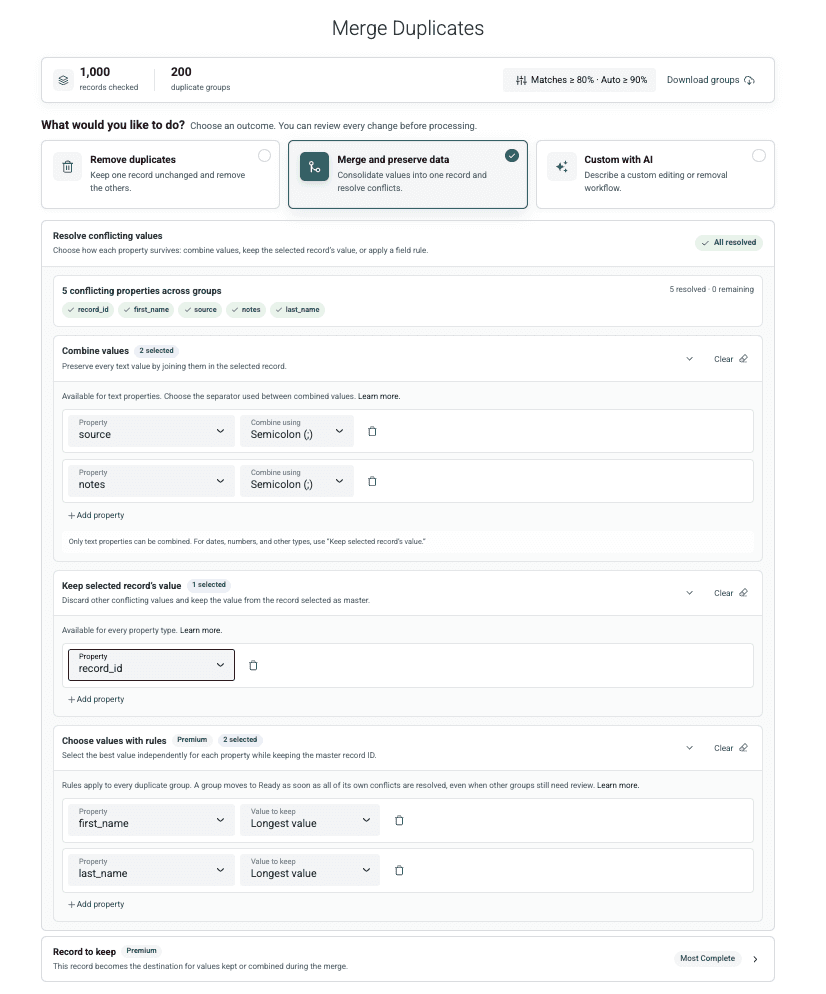
Te ustawienia pasują do przykładu, ale nie zalecam domyślnego łączenia każdej właściwości zawierającej sprzeczne wartości. Historia źródeł może z powodzeniem przyjąć postać Formularz na stronie;Eksport z CRM. Status w CRM, identyfikator właściciela czy główny adres e-mail zwykle wymagają jednej wiążącej wartości.
Podgląd służy do weryfikacji tych wyborów. Po każdej zmianie reguły ponownie sprawdź rekord docelowy.
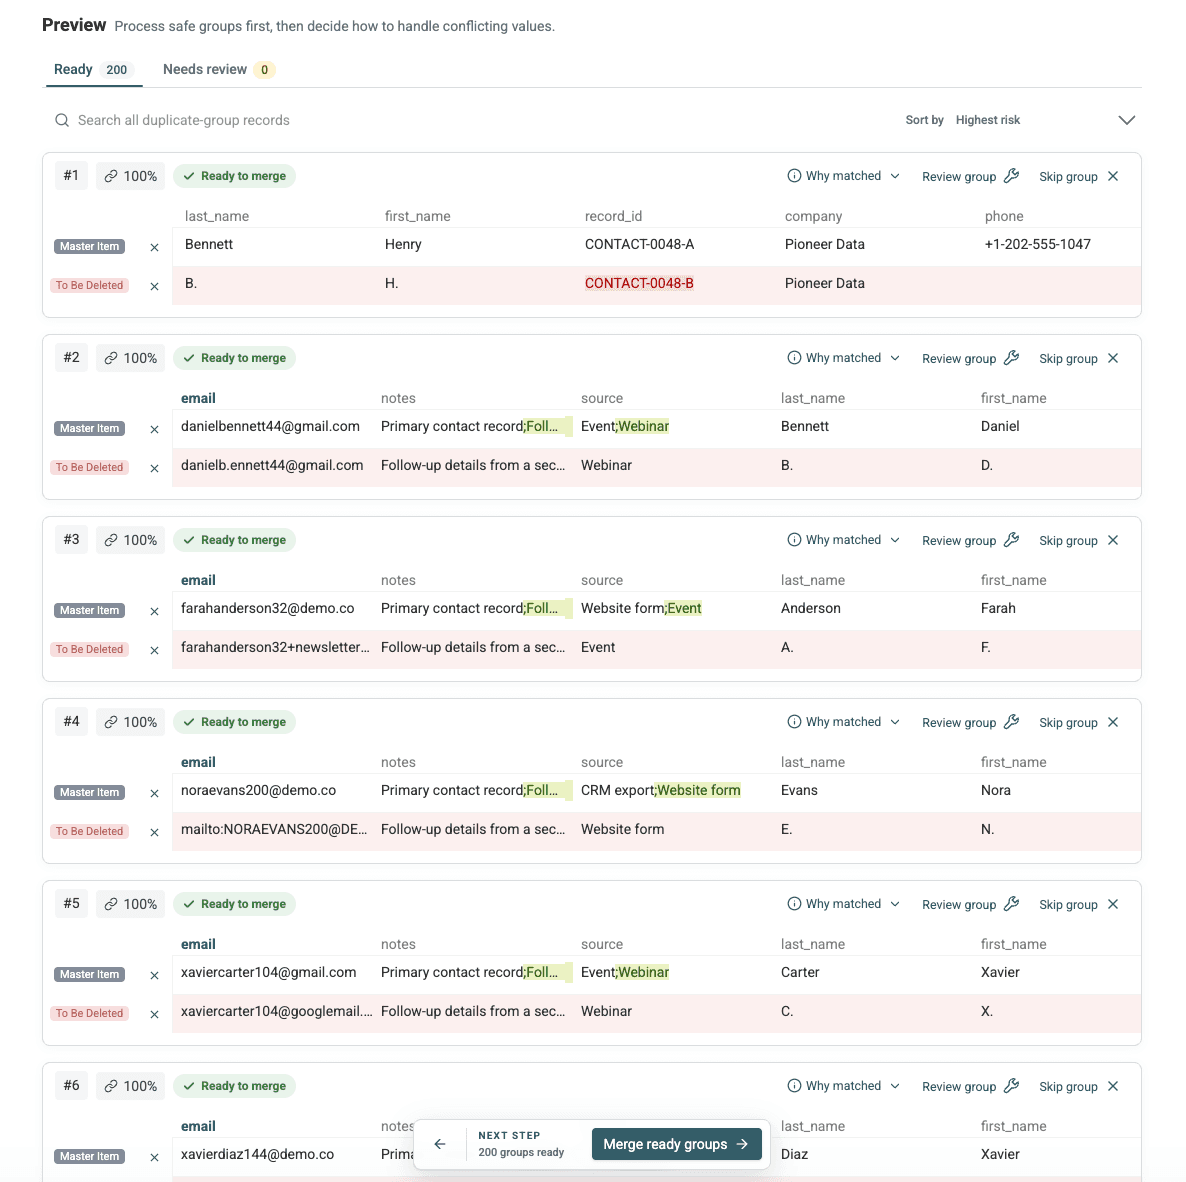
💡 Sprawdzaj podgląd po każdej zmianie reguły
Zanim zastosujesz regułę do wszystkich gotowych grup, sprawdź, który rekord zostanie głównym, jakie wartości zostaną połączone i które znikną.
Jeśli zduplikowany rekord zawiera unikalny numer telefonu, źródło lub notatkę, scal go, zamiast usuwać. W przykładzie Nory rekord wynikowy zachował pełne imię i nazwisko z jednego rekordu oraz numer telefonu z drugiego.
Przy bardziej złożonych konfliktach w CRM skorzystaj z rozszerzonego workflow pokazującego, jak scalać zduplikowane leady bez utraty danych. W tym przebiegu skoncentrowanym na adresach e-mail celem jest zachowanie przydatnych pól sąsiednich bez zamieniania każdej właściwości w ciąg wielu wartości.
Wyniki testu listy 1000 rekordów
Scalanie przyniosło następujące wyniki:
| Pomiar | Wynik |
|---|---|
| Liczba rekordów początkowych | 1000 |
| Rekordy przypisane do grup duplikatów | 400 |
| Dwurekordowe grupy duplikatów | 200 |
| Usunięte zduplikowane rekordy | 200 |
| Zaktualizowane rekordy główne | 200 |
| Liczba rekordów końcowych | 800 |
| Pozostałe grupy duplikatów | 0 |
Rachunek jest prosty: 1000 rekordów początkowych - 200 usuniętych rekordów = 800 zachowanych rekordów.
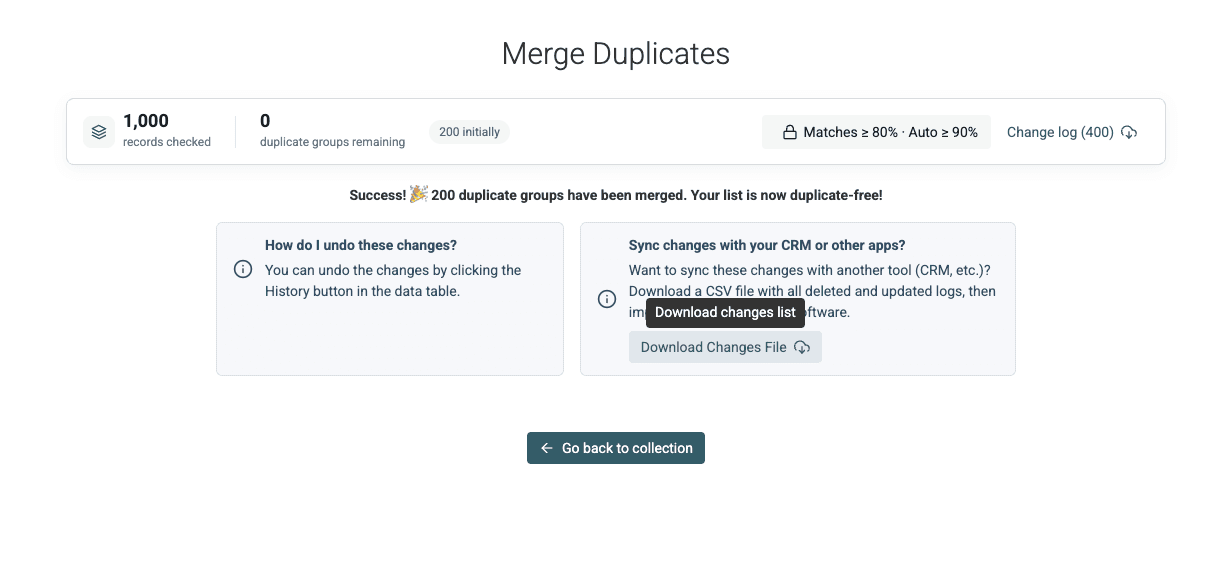
W ręcznie przeprowadzonym teście scalanie trwało kilka sekund, ale nie wykonano dokładnego pomiaru czasu. Traktuj to jako obserwację z tego przebiegu, a nie test wydajności.
Pobrany dziennik zmian zawiera 400 wpisów: 200 usuniętych rekordów i 200 zaktualizowanych rekordów głównych. Dla każdej scalonej grupy pokazuje wartości sprzed scalenia oraz te zachowane w rekordzie docelowym.
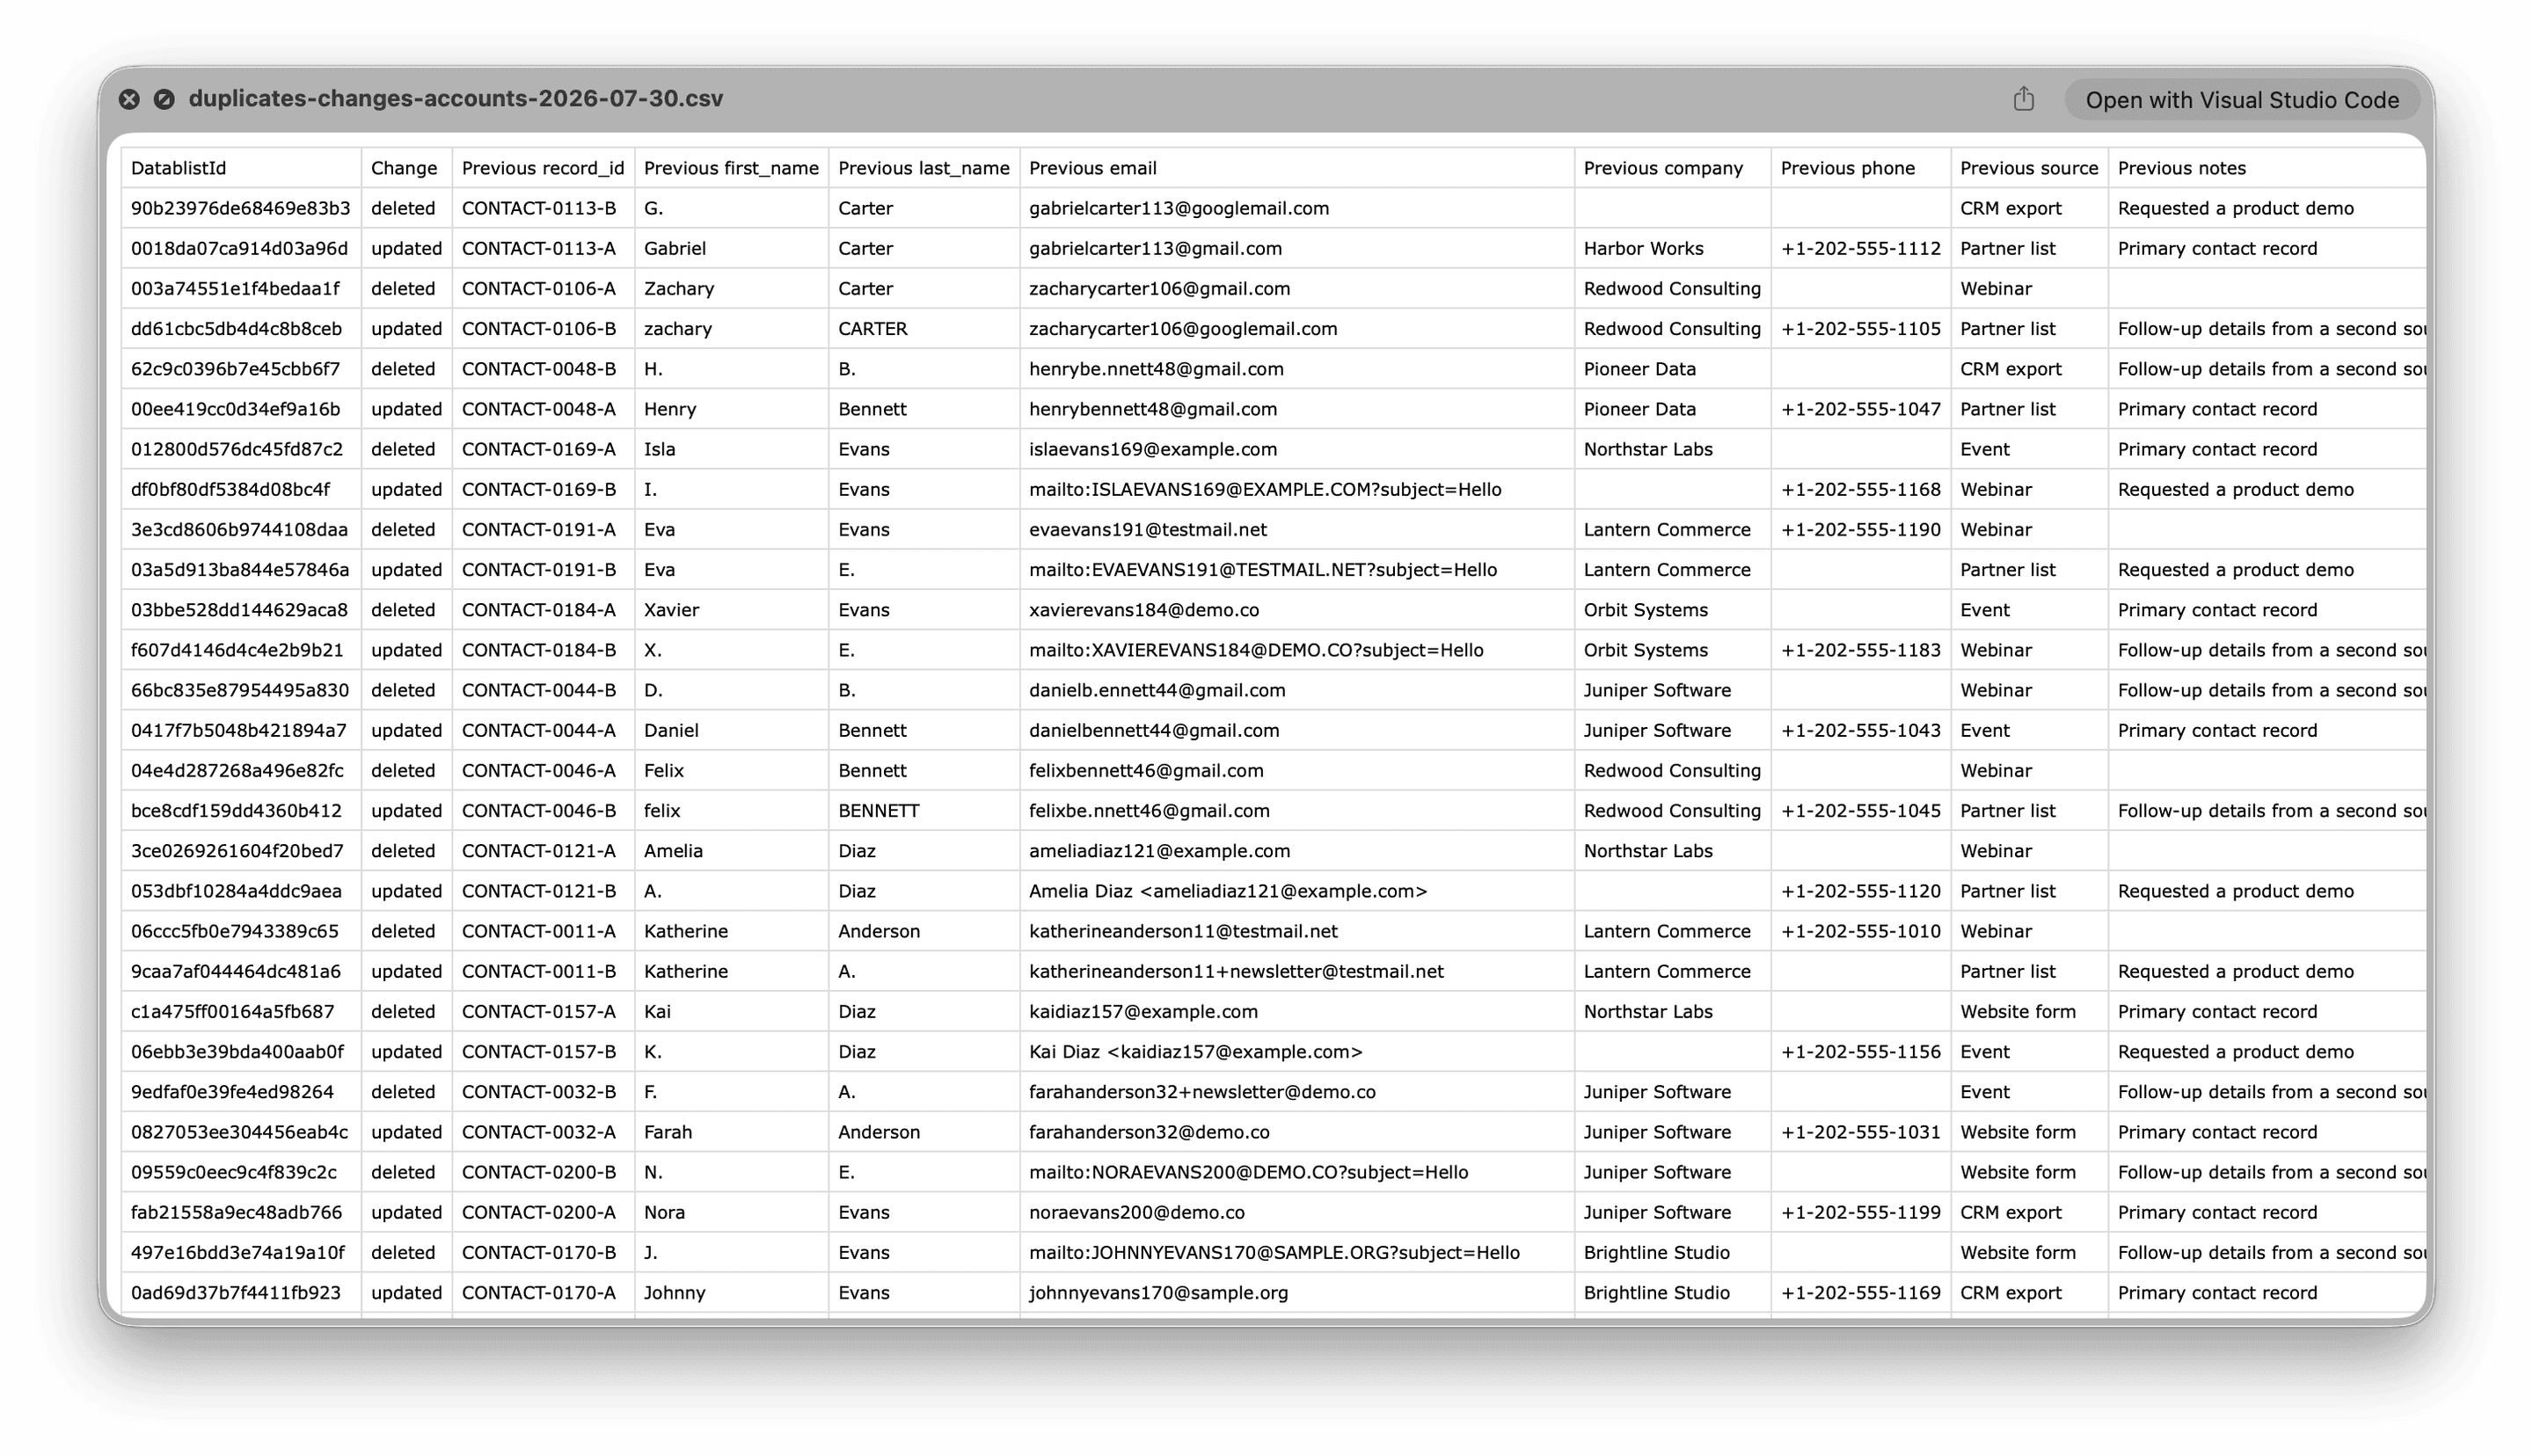
Poniższa tabela przedstawia dokładne wartości z testu:
| Pierwotne warianty | Przyczyna dopasowania | Zachowany adres e-mail | Operacja | Zachowane pola |
|---|---|---|---|---|
noraanderson40@demo.conoraanderson40+newsletter@demo.co | Usunięto sufiks z plusem | noraanderson40+newsletter@demo.co | Scalono z CONTACT-0040-B | Pełne imię i nazwisko, telefon, Formularz na stronie;Eksport z CRM i obie notatki |
victorbennett62@gmail.comvictorb.ennett62@gmail.com | Znormalizowano kropki w Gmailu | victorbennett62@gmail.com | Scalono z CONTACT-0062-A | Telefon, Formularz na stronie;Wydarzenie i obie notatki |
gabrielcarter113@gmail.comgabrielcarter113@googlemail.com | Znormalizowano domeny Gmail | gabrielcarter113@gmail.com | Scalono z CONTACT-0113-A | Telefon, Lista partnera;Eksport z CRM i notatka dotycząca prośby o demo |
camiladiaz123@testmail.netCamila Diaz <camiladiaz123@testmail.net> | Usunięto nazwę wyświetlaną | camiladiaz123@testmail.net | Scalono z CONTACT-0123-A | Pełne imię i nazwisko, telefon, Lista partnera;Eksport z CRM i obie notatki |
marcusevans199@testmail.netmailto:MARCUSEVANS199@TESTMAIL.NET?subject=Hello | Usunięto otoczkę mailto: i ujednolicono wielkość liter | mailto:MARCUSEVANS199@TESTMAIL.NET?subject=Hello | Scalono z CONTACT-0199-B | Pełne imię i nazwisko, telefon, Webinar;Wydarzenie i obie notatki |
Zwróć uwagę, że zachowana wartość nie zawsze jest wizualnie najprostszym adresem. To wybrany rekord główny decyduje, który zapisany adres pozostanie. Normalizacja służy do dopasowywania; nie przekształca automatycznie każdej zachowanej wartości do postaci kanonicznej.
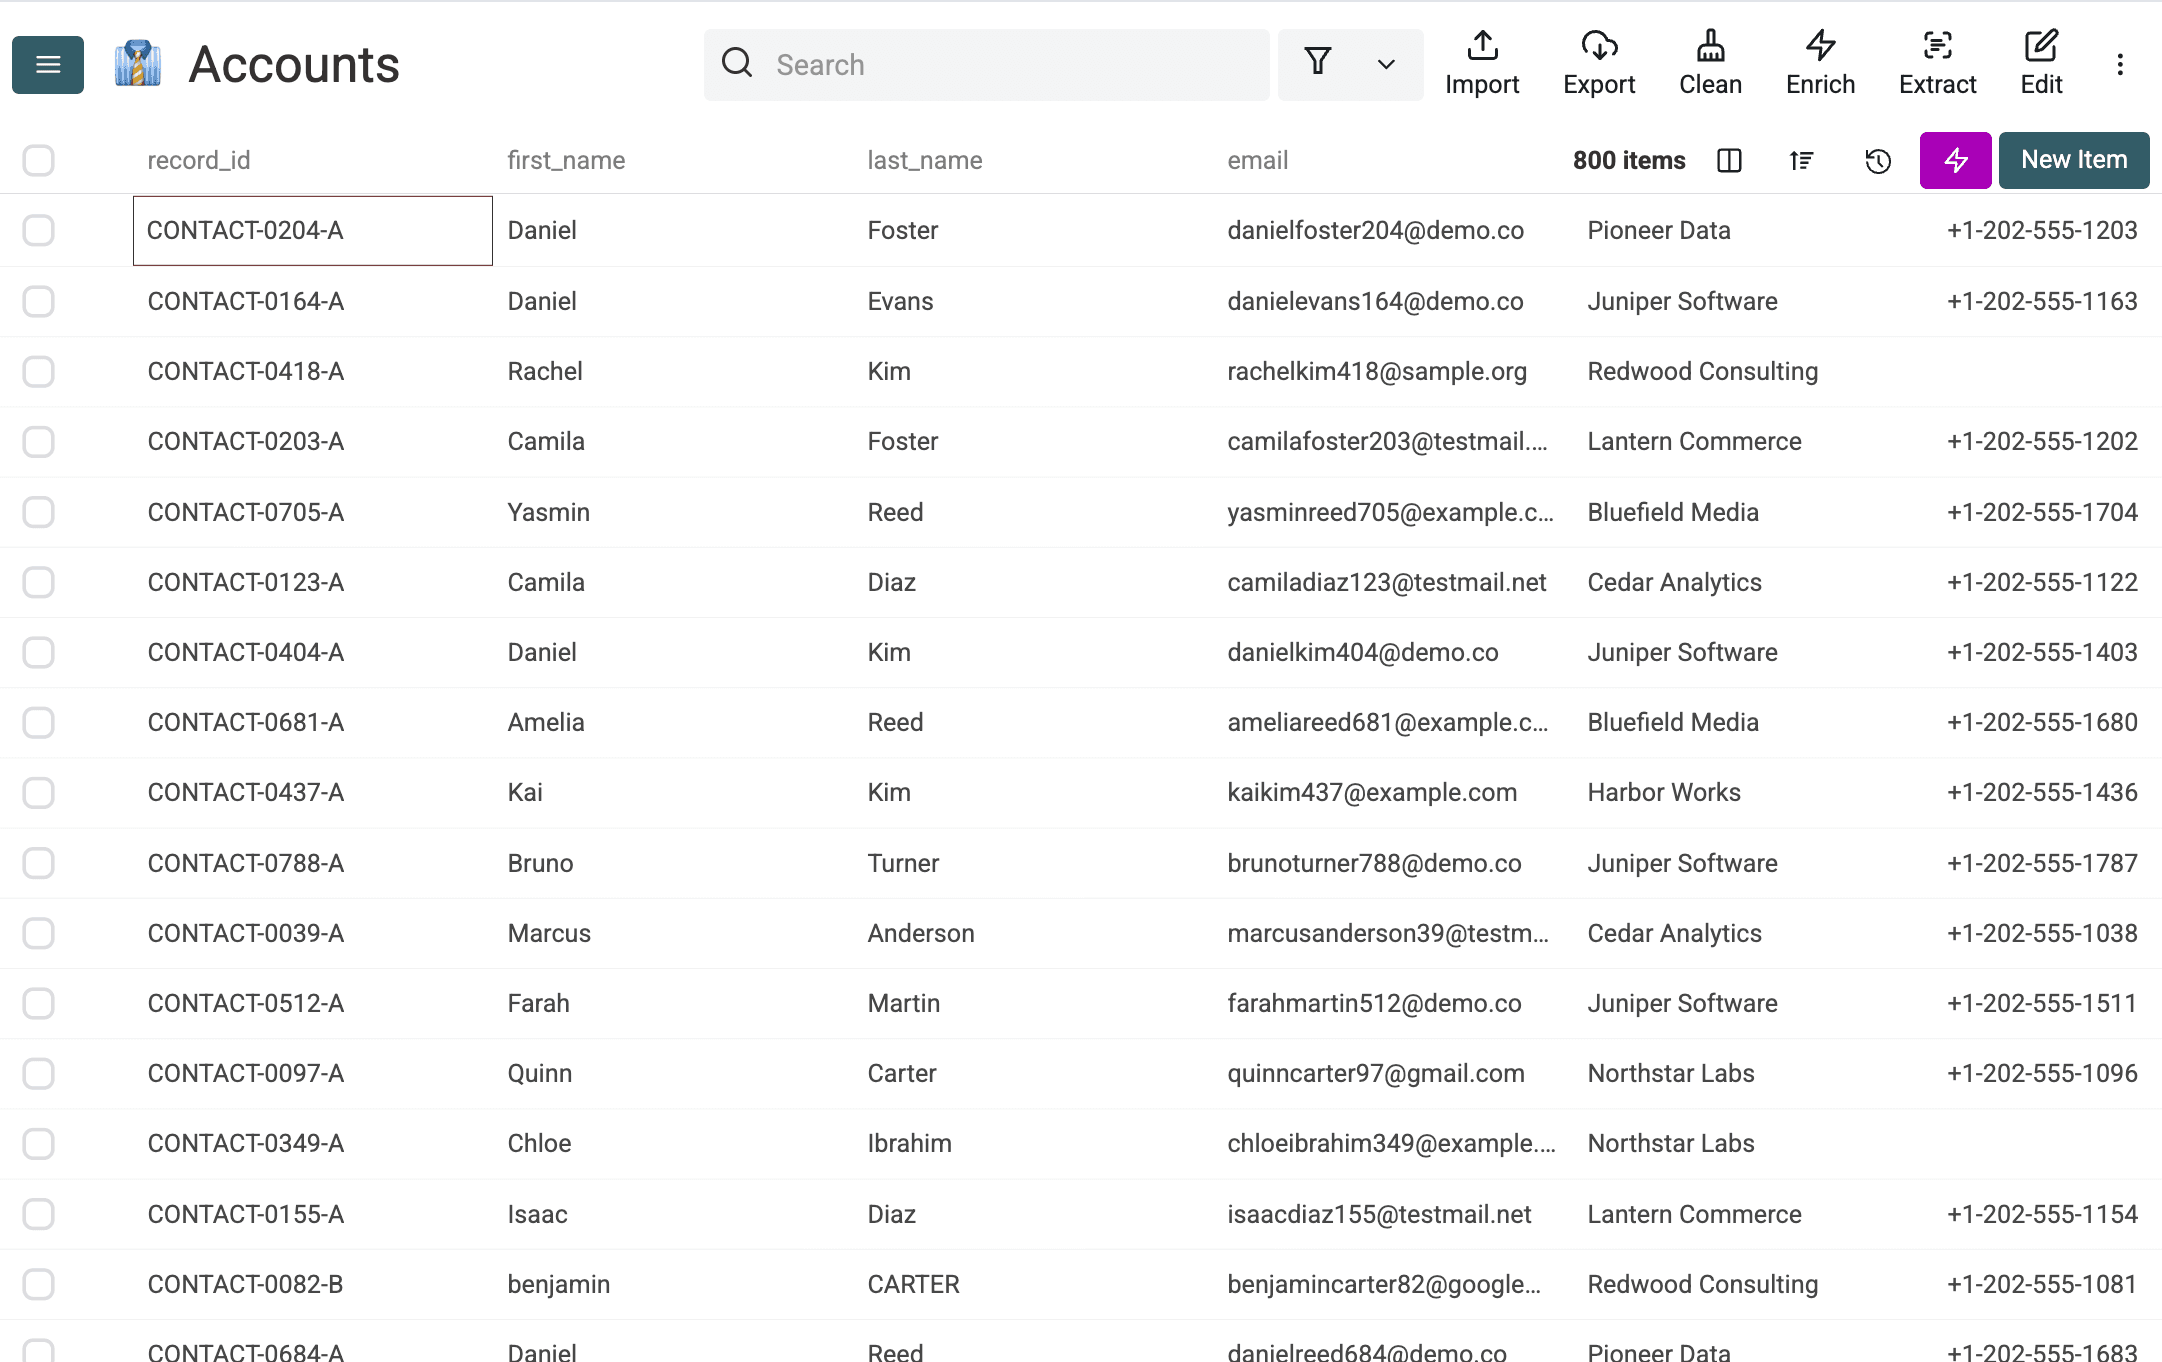
Testowe scalanie zmniejszyło liczbę rekordów z 1000 do 800, ponieważ 200 zweryfikowanych duplikatów skonsolidowano z ich rekordami głównymi. Wynik ten dotyczy zaprojektowanej listy testowej, a nie uniwersalnego współczynnika dopasowania dla wszystkich formatów e-mail.
Przypadki błędów i lista kontrolna
Smart Email obsługuje pięć testowanych rodzajów wariantów, ale nie powinien zastępować ręcznej weryfikacji.
Kropki poza Gmailem
W domenach innych niż Gmail kropki zachowują znaczenie. Nie zakładaj, że first.last@company.com i firstlast@company.com prowadzą do tej samej skrzynki. Jeśli masz zewnętrzne dowody potwierdzające ich powiązanie, obsłuż tę parę ręcznie.
Nieprawidłowe wartości
Nie traktuj wyniku dopasowania jako potwierdzenia poprawności adresu. Wartości bez użytecznej struktury z @ albo zawierające spacje wewnętrzne nie są normalizowane jak zwykłe adresy, ale procesor nie odrzuca każdego nieprawidłowego formatu domeny. Dwie błędne wartości nadal mogą zostać znormalizowane do tej samej wartości porównawczej. Oddzielnie sprawdź format adresu i domenę, a wątpliwe rekordy wyklucz z automatycznego scalania. Kolejnym krokiem może być weryfikacja skrzynki lub dostarczalności.
Dopasowanie Exact
Exact nie usuwa sufiksów z plusem, kropek w Gmailu, aliasów domen ani nazw wyświetlanych. Usuwa jednak skrajne spacje i domyślnie porównuje tekst zapisany małymi literami. Przykładowo NAME@example.com i name@example.com zostaną dopasowane przy domyślnych ustawieniach Exact, natomiast name+tag@example.com i name@example.com pozostaną oddzielne. Włącz Case sensitive, jeśli porównanie ma uwzględniać wielkość liter. Exact przydaje się, gdy różnice między aliasami mają znaczenie, ale nie służy do walidacji ani porównywania pierwotnej zawartości komórek bajt po bajcie.
Kilka adresów w jednej komórce
Ta metoda zakłada jeden adres w każdej komórce. Komórka zawierająca kilka adresów rozdzielonych separatorem wymaga najpierw zastosowania osobnego workflow dla wartości wielokrotnych.
Współdzielone skrzynki
Dwa rekordy z adresem sales@company.com mogą opisywać różne osoby. Decyzję należy podjąć na podstawie imion i nazwisk, stanowisk, firm oraz notatek. Nie scalałbym zbiorczo skrzynek funkcyjnych bez ich sprawdzenia.
Usuwanie uzupełniających się pól
Usunięcie dodatkowego rekordu może oznaczać utratę jedynego numeru telefonu, źródła pozyskania lub notatki. Skorzystaj z podglądu scalania, aby zobaczyć, które dane zostaną zachowane.
W zaprojektowanym teście wykryto wszystkie 200 zamierzonych tożsamości i żadnych nieoczekiwanych grup łączących różne osoby. Test nie obejmował jednak każdego rzeczywistego formatu adresu, błędnej wartości ani rodzaju współdzielonej skrzynki.
Przed wyeksportowaniem własnej listy sprawdź:
- Czy każda zatwierdzona grupa reprezentuje jedną tożsamość.
- Czy współdzielone i funkcyjne skrzynki zostały zweryfikowane ręcznie.
- Czy rekord główny zawiera preferowane imię i nazwisko, identyfikator oraz adres e-mail.
- Czy unikalne wartości telefonu, firmy, źródła i notatek przetrwały scalanie.
- Czy liczba rekordów początkowych pomniejszona o usunięte rekordy jest równa liczbie rekordów końcowych.
- Czy kontrola wyrywkowa obejmuje każdy rodzaj normalizacji występujący na liście.
- Czy liczba pozostałych grup duplikatów jest zgodna z oczekiwaniami.
📌 Sprawdź zgodność liczb
Rekordy początkowe - rekordy usunięte = rekordy końcoweto najszybszy sposób sprawdzenia kompletności po scaleniu.
Dalsze czyszczenie listy e-mail
Deduplikacja rozwiązuje problem powtarzających się tożsamości. Nie sprawdza jednak, czy skrzynka istnieje, czy dostawca oferuje adresy tymczasowe, czy odbiorca zrezygnował z subskrypcji ani czy wiadomość zostanie dostarczona.
Wolę najpierw rozwiązać problem zduplikowanych tożsamości. Późniejsze kontrole obejmują wtedy zachowane kontakty, zamiast przetwarzać kilka wersji tej samej osoby. Gdy wynik scalania przejdzie listę kontrolną, oczyść pozostałą część listy e-mail, a następnie otwórz Export i wybierz CSV lub Excel.
Deduplikuj listę w Datablist
Zaimportuj plik kontaktów do Datablist, uruchom wyszukiwanie duplikatów uwzględniające specyfikę adresów e-mail, sprawdź proponowane grupy, scal przydatne wartości i wyeksportuj oczyszczoną listę.