
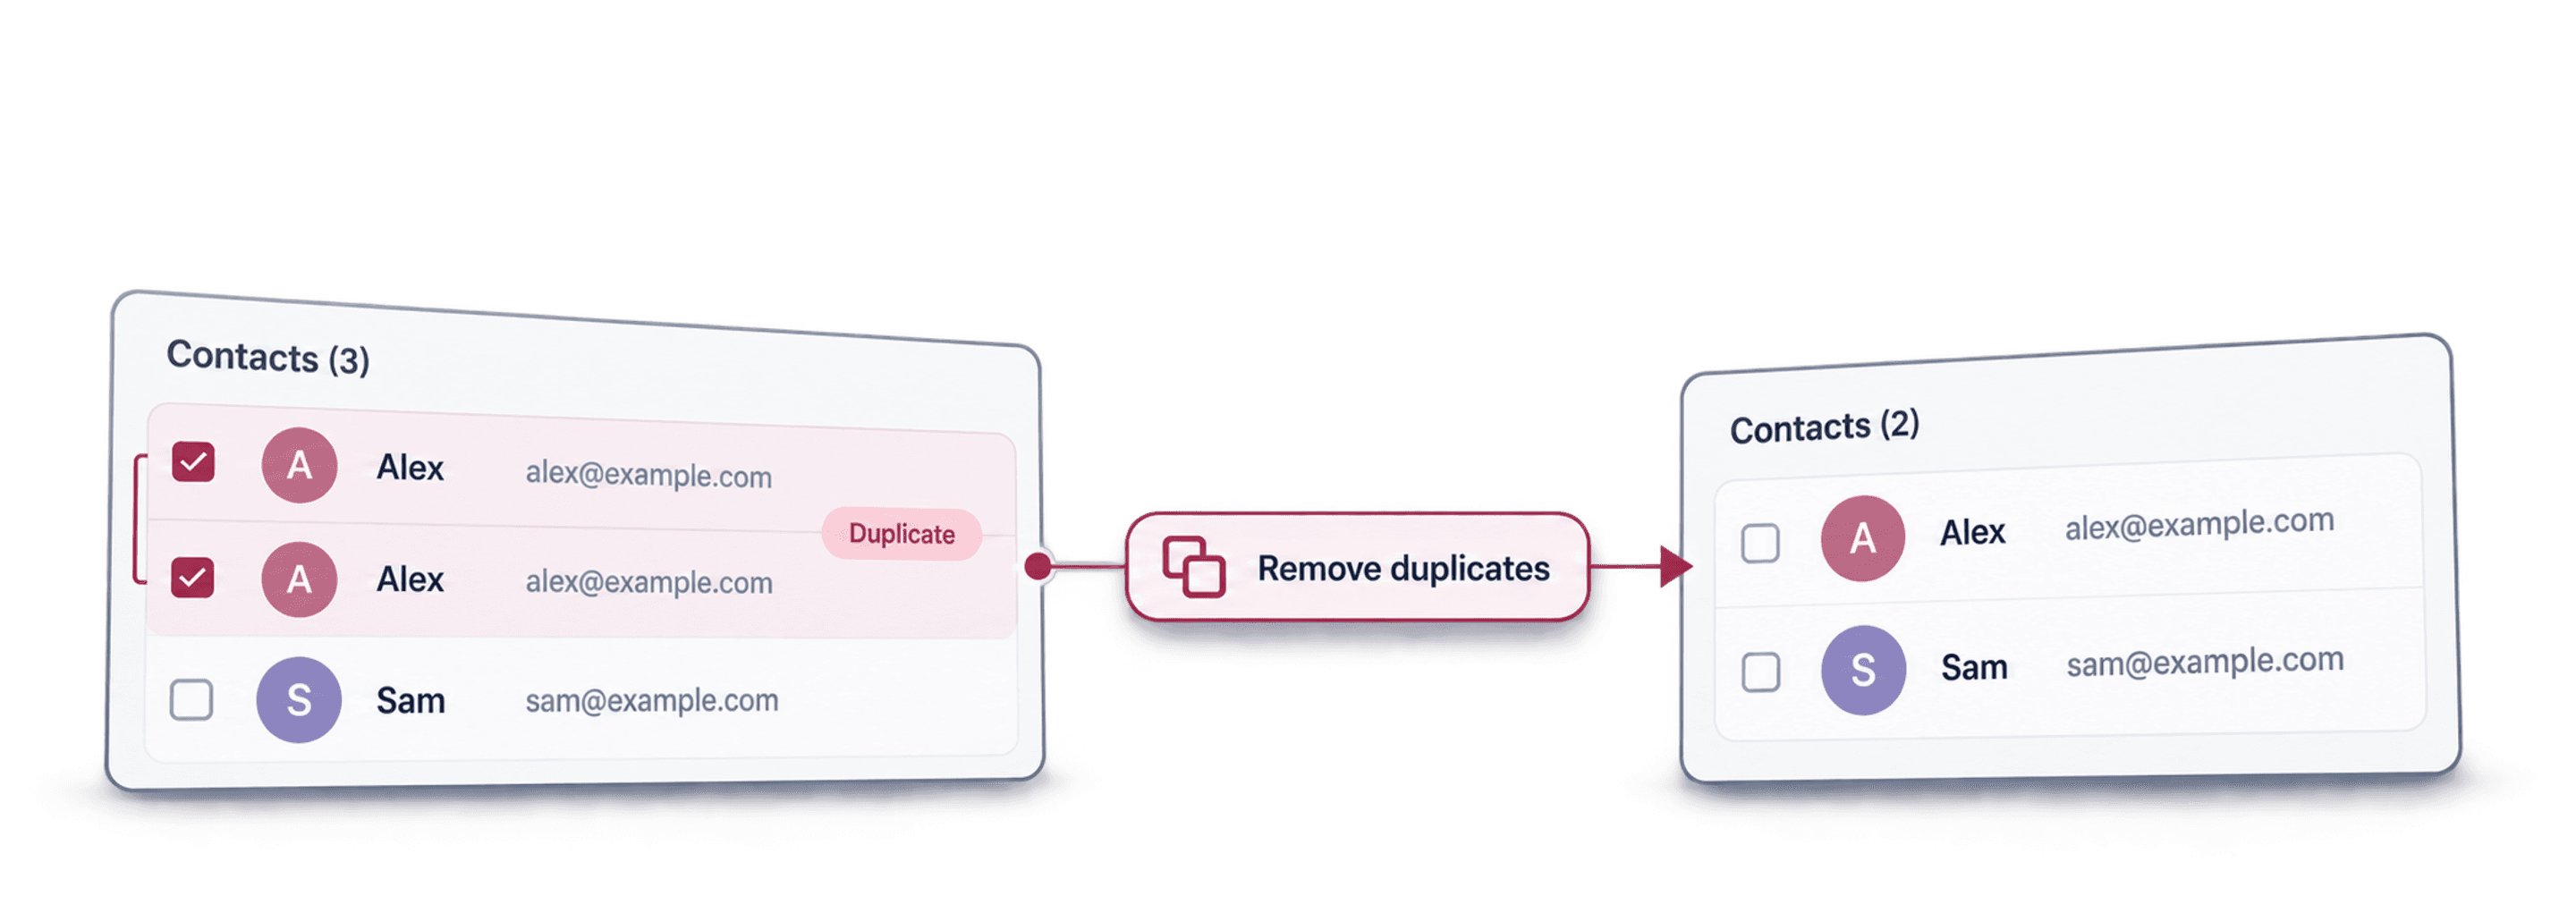
Aby usunąć duplikaty z listy online, najpierw wybierz pole, które jednoznacznie identyfikuje osobę, firmę lub produkt. Zacznij od ścisłego dopasowania, przejrzyj proponowane grupy duplikatów, a następnie scal przydatne wartości albo usuń wiersze, które nie wnoszą żadnych nowych informacji. Dzięki temu szybko uporządkujesz dane, nie uznając automatycznie każdej podobnej wartości za pewne dopasowanie.
Datablist pozwala przeprowadzić cały proces w przeglądarce. Zaimportuj plik CSV lub Excel, wybierz właściwości używane do dopasowania, porównaj wiersze, sprawdź wyniki i wyeksportuj oczyszczoną listę. Samo wykrywanie duplikatów działa w trybie tylko do odczytu, dopóki nie uruchomisz operacji Remove, Merge lub własnego procesu.
W tym poradniku wykorzystujemy przykładowy plik z 1000 wierszy. Zawiera on identyczne kopie, aliasy e-mail, warianty nazw firm i adresów URL, podstawowe różnice w zapisie numerów telefonu, literówki, sprzeczne wartości oraz rekordy z uzupełniającymi się danymi.
🔑 Zasada bezpiecznej deduplikacji
Dopasowuj rekordy na podstawie najmniejszego wiarygodnego identyfikatora, ale o tym, co zachować, decyduj na podstawie całego wiersza.
Usuwanie duplikatów z prostej listy wartości
Jeśli lista zawiera jedną wartość w każdym wierszu, zapisz ją jako jednokolumnowy plik CSV z nagłówkiem, na przykład Email, Domain lub Value. Zaimportuj plik do Datablist i dla tej kolumny uruchom Clean > Remove duplicates z ustawieniem Exact. Przejrzyj grupy, wybierz rekord, który ma pozostać, przetwórz zduplikowane wiersze, a następnie wyeksportuj pozostałe wartości.
Przykładowo lista zawierająca alpha.example, beta.example i alpha.example powinna po usunięciu powtórzonego wiersza zawierać jedną wartość alpha i jedną beta. To poglądowy przykład danych wejściowych i wyniku, a nie kolejny pomiar wykonany na udostępnionym pliku.
Tę metodę warto stosować do list identyfikatorów. Jeśli plik ma kilka kolumn, trzeba rozstrzygnąć, które całe rekordy są duplikatami: usunięcie wiersza usuwa również wszystkie pozostałe wartości z tego wiersza. Skorzystaj z opisanego niżej scalania, gdy powtórzony adres e-mail ma w drugim wierszu przydatny numer telefonu lub notatkę.
Puste identyfikatory traktuj osobno. Przy domyślnym porównaniu wybranych właściwości brak tekstowego identyfikatora nie stanowi podstawy do dopasowania. Jeśli chcesz usunąć puste wiersze, zrób to w osobnym etapie czyszczenia, zamiast oczekiwać, że deduplikacja samodzielnie określi ich znaczenie.
Wybierz, co jednoznacznie identyfikuje rekord
Nie zaczynaj od wyboru algorytmu. Najpierw określ, jaki typ obiektu reprezentuje rekord.
Kontakt, firma, produkt i transakcja wymagają innych identyfikatorów:
| Lista | Najlepsze identyfikatory na początek | Przydatny drugi etap |
|---|---|---|
| Kontakty | Email, telefon, URL profilu LinkedIn | Imię i nazwisko oraz firma |
| Firmy | Domena strony, ID firmy | Znormalizowana nazwa firmy |
| Produkty | SKU, EAN, GTIN, URL produktu | Nazwa produktu oraz marka |
| Leady w CRM | Email, telefon, ID w CRM | Imię i nazwisko oraz domena firmy |
| Zamówienia | ID zamówienia | ID klienta oraz data zamówienia |
Jeden etap rzadko wykrywa wszystkie duplikaty. Kontakt może mieć ten sam adres e-mail w dwóch wierszach, a inna osoba mogła zmienić adres e-mail, zachowując ten sam numer telefonu. Zamiast tworzyć jedną regułę obejmującą wszystkie właściwości, przeprowadź osobne dopasowania dla różnych identyfikatorów.
Na przykład:
- Dopasuj kontakty według adresu e-mail.
- Przetwórz sprawdzone grupy.
- Znormalizuj numery telefonów, a następnie uruchom kontrolę Exact na oczyszczonej właściwości.
- Ostrożnie przeprowadź dopasowanie fuzzy według imienia i nazwiska oraz firmy.
Przed dodaniem kilku pól do jednego sprawdzenia wybierz regułę obsługi pustych wartości. Przy ustawieniu Value required brak identyfikatora może wykluczyć wartościowego kandydata.
Przy ustawieniu Match on empty value właściwości puste w obu rekordach uzyskują wynik 100% i mogą zawyżyć średnią: zgodny adres e-mail oraz brak nazwiska dają 87,5%, ale dodanie trzech właściwości pustych w obu rekordach podnosi wynik do 95%. Zanim uznasz, że większa liczba kolumn dostarcza mocniejszych dowodów, sprawdź przykład punktacji pustych wartości.
Jeśli identyfikator wymaga normalizacji, skorzystaj z odpowiedniego poradnika:
- Usuwanie duplikatów adresów e-mail i aliasów
- Dopasowywanie zduplikowanych nazw firm
- Deduplikacja pola zawierającego wiele wartości
- Normalizacja lokalnych i międzynarodowych numerów telefonu
Pobierz przykładową listę z 1000 wierszy
Pobierz demonstracyjny plik CSV do deduplikacji. Zawiera 1000 wierszy reprezentujących 800 celowo przygotowanych obiektów.
W pliku połączono kilka przypadków testowych:
| Przygotowany przypadek | Grupy duplikatów | Etap dopasowania |
|---|---|---|
| Identyczne kopie całych wierszy | 5 | All Properties z Exact |
| Aliasy i opakowane adresy e-mail | 100 | Email z opcją Smart i procesorem Email |
| Warianty nazw firm i adresów URL | 50 | Przetwarzanie Company Name lub URL |
| Podstawowe różnice w formacie numerów z USA | 25 | Phone z opcją Smart, wyłącznie różnice formatowania |
| Kontrolowane literówki w nazwach | 15 | Jaro-Winkler lub Levenshtein |
| Fonetyczne warianty imion | 5 | Metaphone |
| Rekordy bez celowo utworzonego duplikatu | 600 | Powinny pozostać osobno |
To zaplanowane wartości referencyjne, a nie gwarancja, że każdy próg dopasowania fuzzy zwróci identyczny wynik. Przy niskim progu algorytmy odległości mogą uwzględnić dodatkowych kandydatów. Przejrzyj takie grupy przed ich przetworzeniem.
Oto trzy pary z pliku:
| Przypadek użycia | Pierwsza zapisana wartość | Druga zapisana wartość |
|---|---|---|
| Alias e-mail | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| Firma i URL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| Podstawowe formatowanie telefonu | +1 (202) 555-0768 | 1 202 555 0768 |
Wiersze różnią się również wartościami w polach takich jak stanowisko, opiekun, status, przychód, źródło, tagi i notatki. Dzięki tym konfliktom plik dobrze nadaje się do testowania reguł wyboru rekordu głównego i wartości zachowywanych w poszczególnych polach.
Zaimportuj listę do Datablist
Otwórz Datablist i zaimportuj plik CSV lub Excel do kolekcji. Kolekcja działa jak uporządkowany arkusz kalkulacyjny: wiersze są elementami, a kolumny właściwościami.
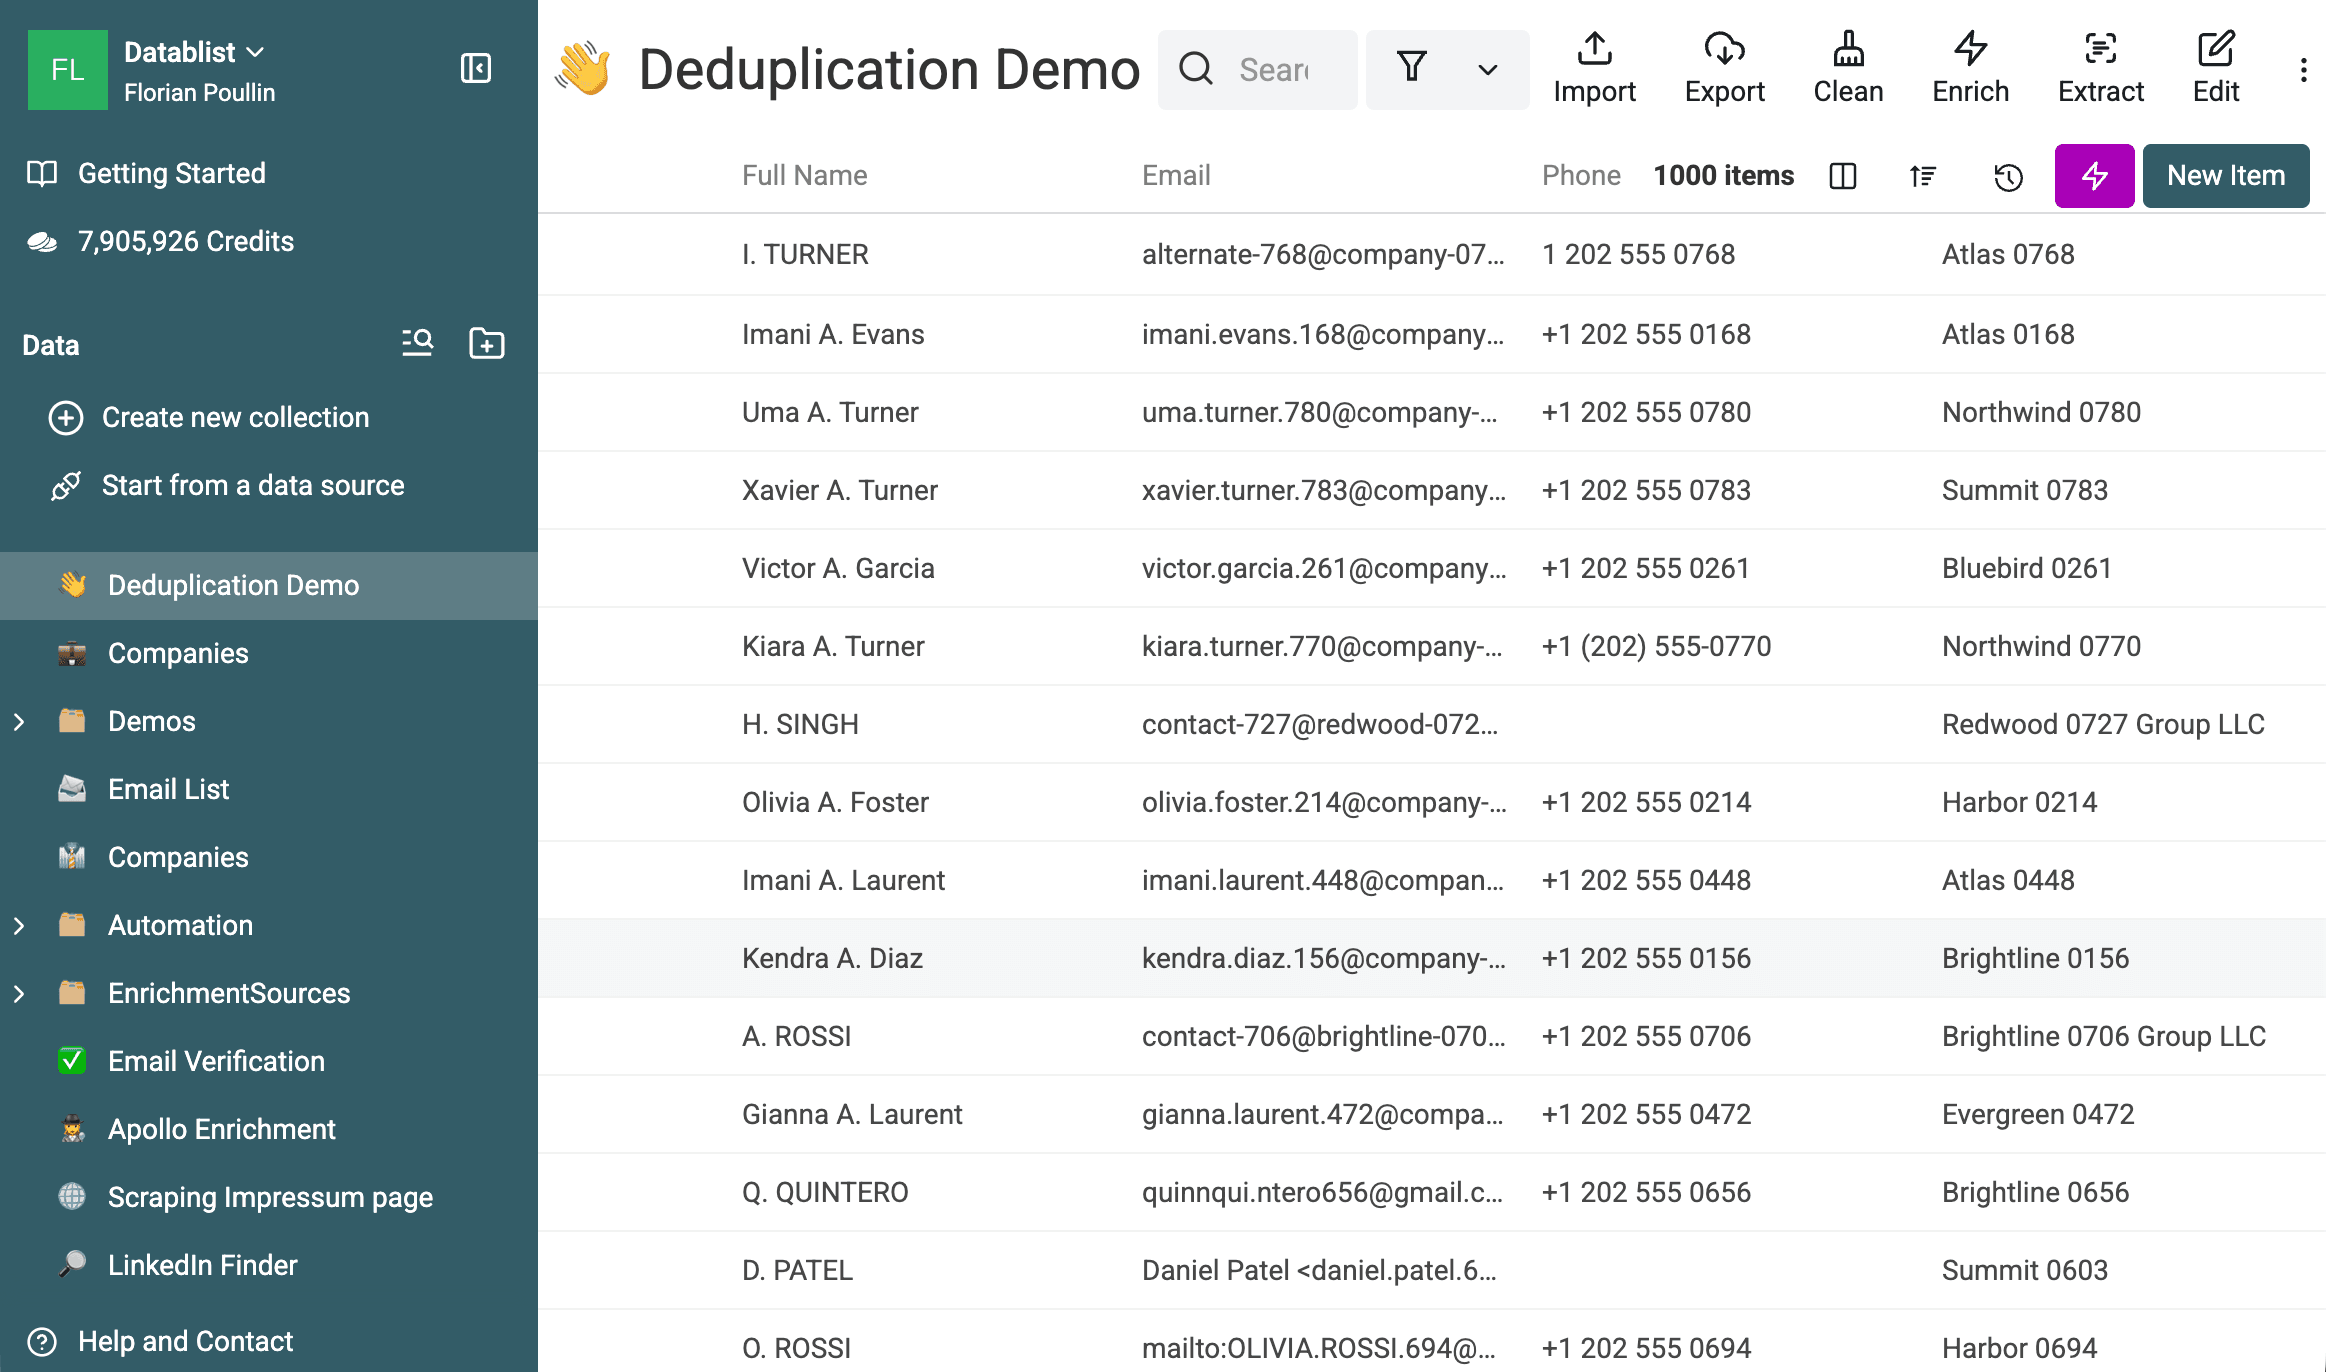
Podczas importu sprawdź wykryte typy właściwości:
- Kolumny z adresami e-mail powinny mieć typ Email.
- Kolumny ze stronami internetowymi powinny mieć typ URL.
- Kolumny z numerami telefonu powinny mieć typ Phone.
- Kolumny z przychodami lub ilościami powinny mieć typ Number.
- Daty aktywności i utworzenia powinny mieć typ DateTime.
Pozostaw w kolekcji kolumny z ID, źródłem, opiekunem, notatkami i statusem. Pomogą wybrać właściwy rekord oraz sprawdzić, jakie dane zostaną zachowane podczas scalania.
Uruchom dopasowanie Exact, Smart i fuzzy
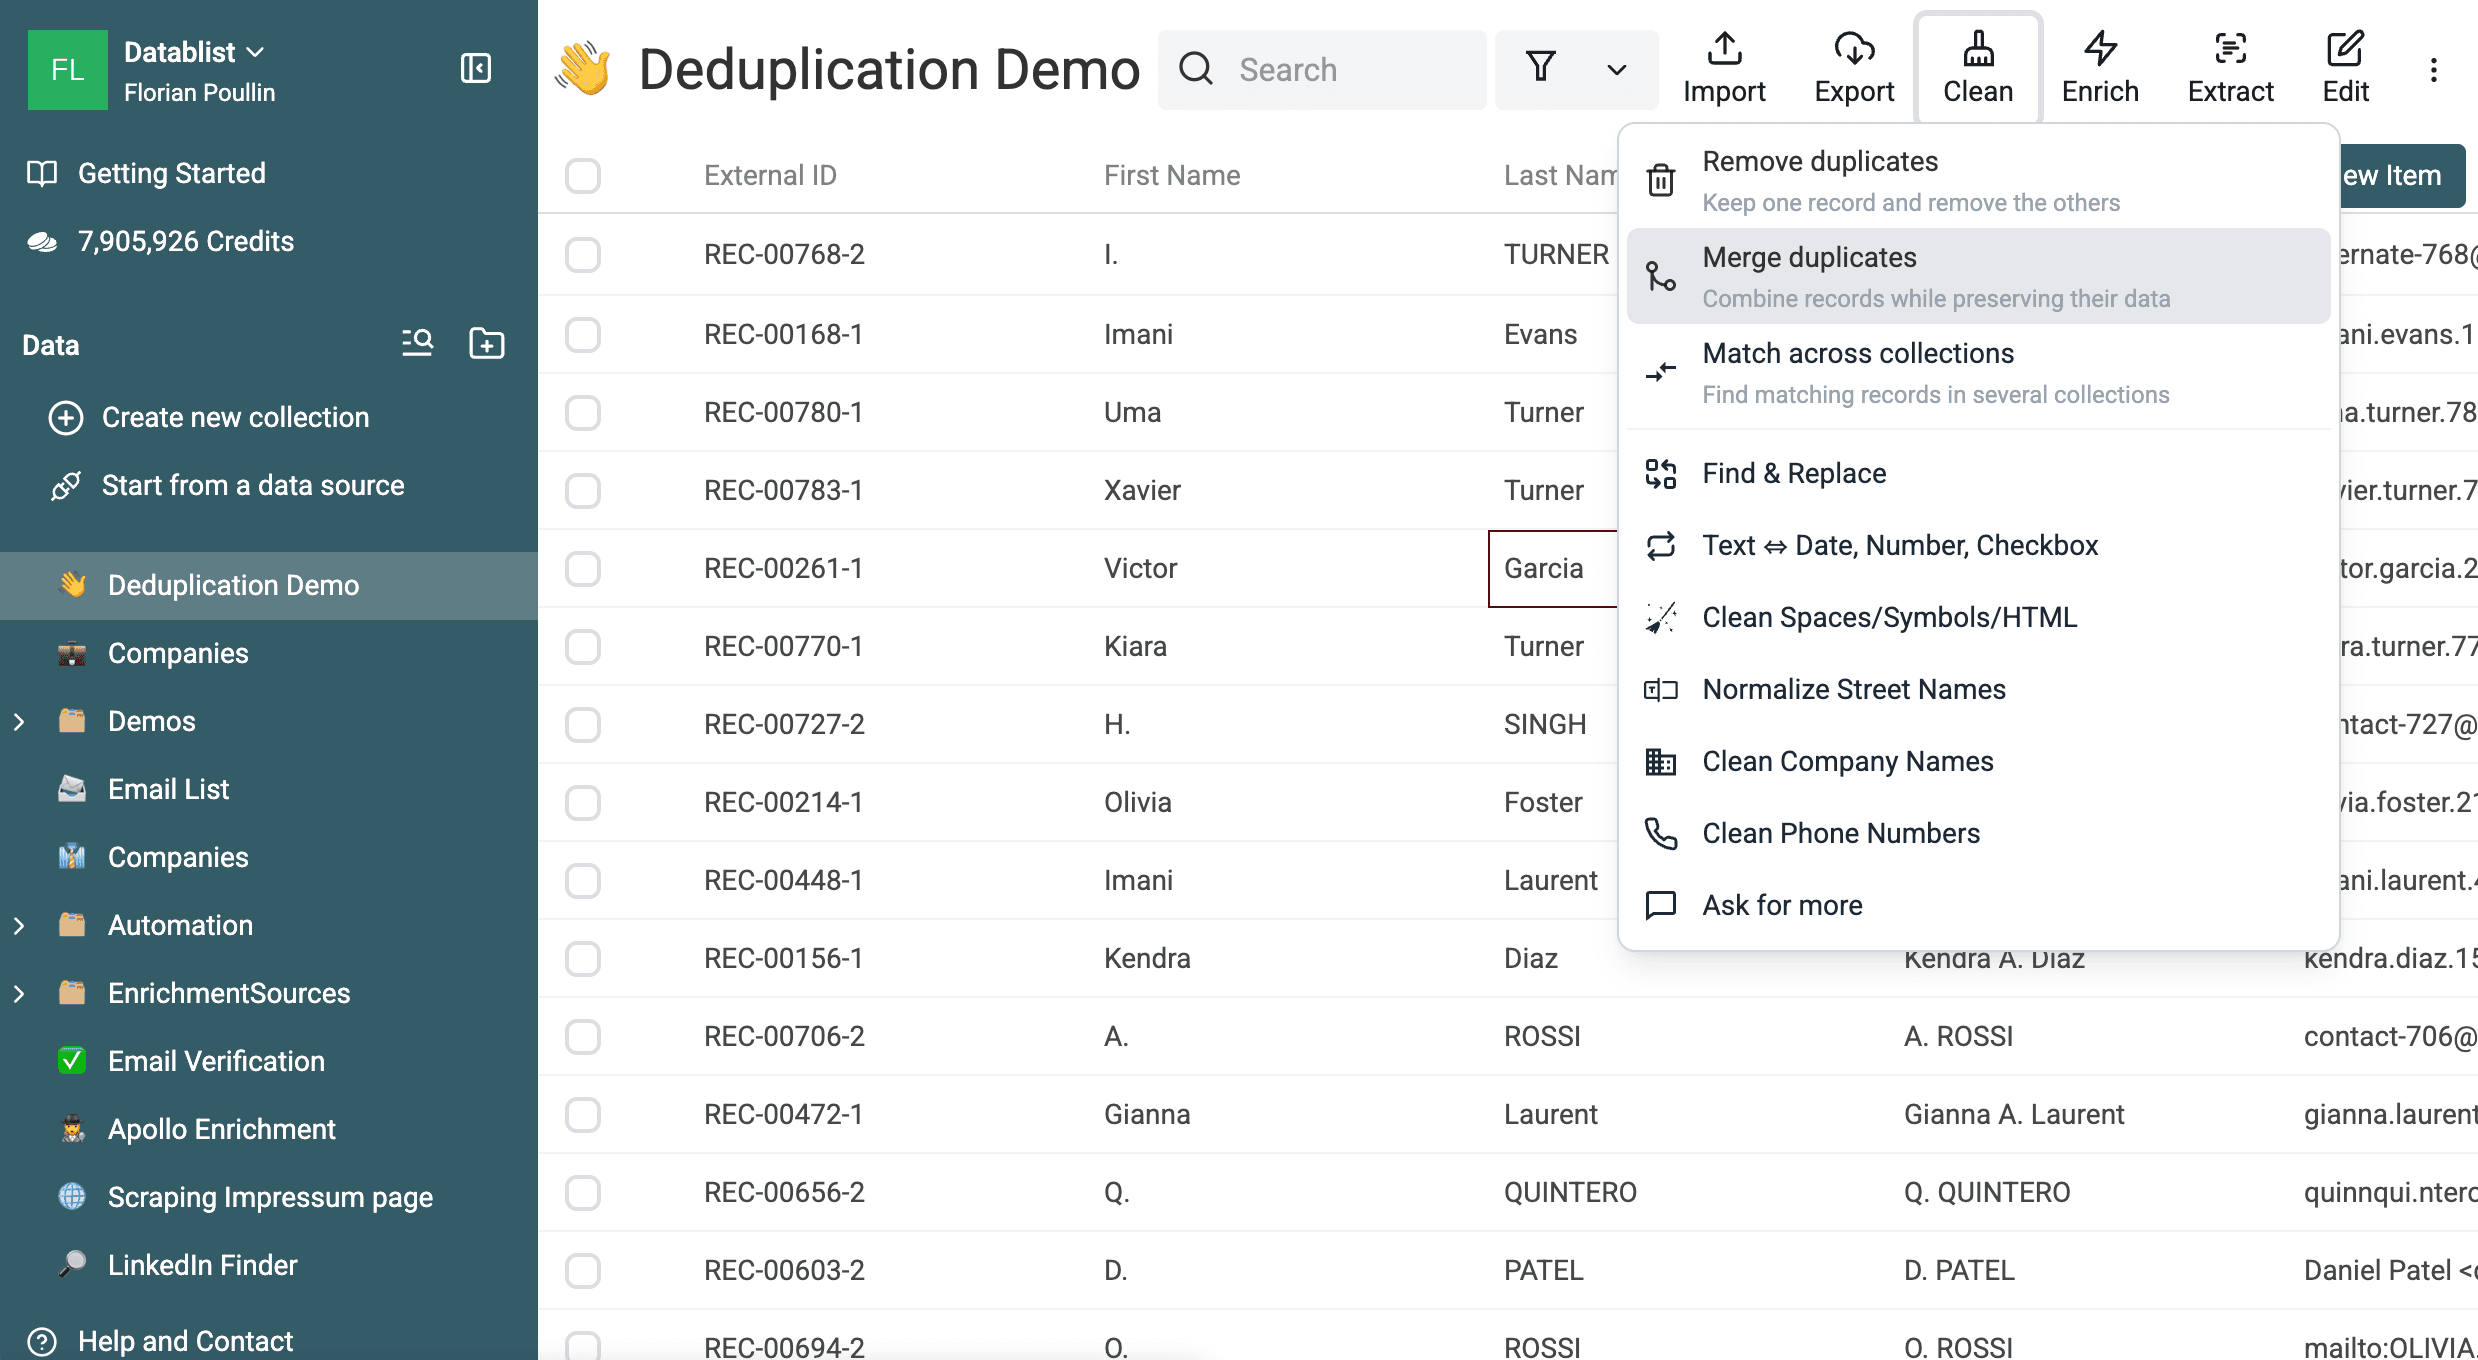
Otwórz Clean i wybierz operację odpowiadającą Twojemu celowi:
- Remove duplicates, gdy dodatkowe wiersze można usunąć.
- Merge duplicates, gdy wiersze zawierają informacje, które warto zachować.
- Match across collections, gdy rekordy znajdują się w osobnych kolekcjach.
Dwie pierwsze operacje korzystają z tego samego mechanizmu wykrywania. Otwierają obszar wyników z wybranym innym trybem przetwarzania.
Zacznij od dopasowania Exact
Użyj All Properties z opcją Exact, aby wykryć wiersze skopiowane bez żadnych zmian. Wybierz Selected Properties, jeśli jedna wartość, na przykład zewnętrzne ID, musi być identyczna.
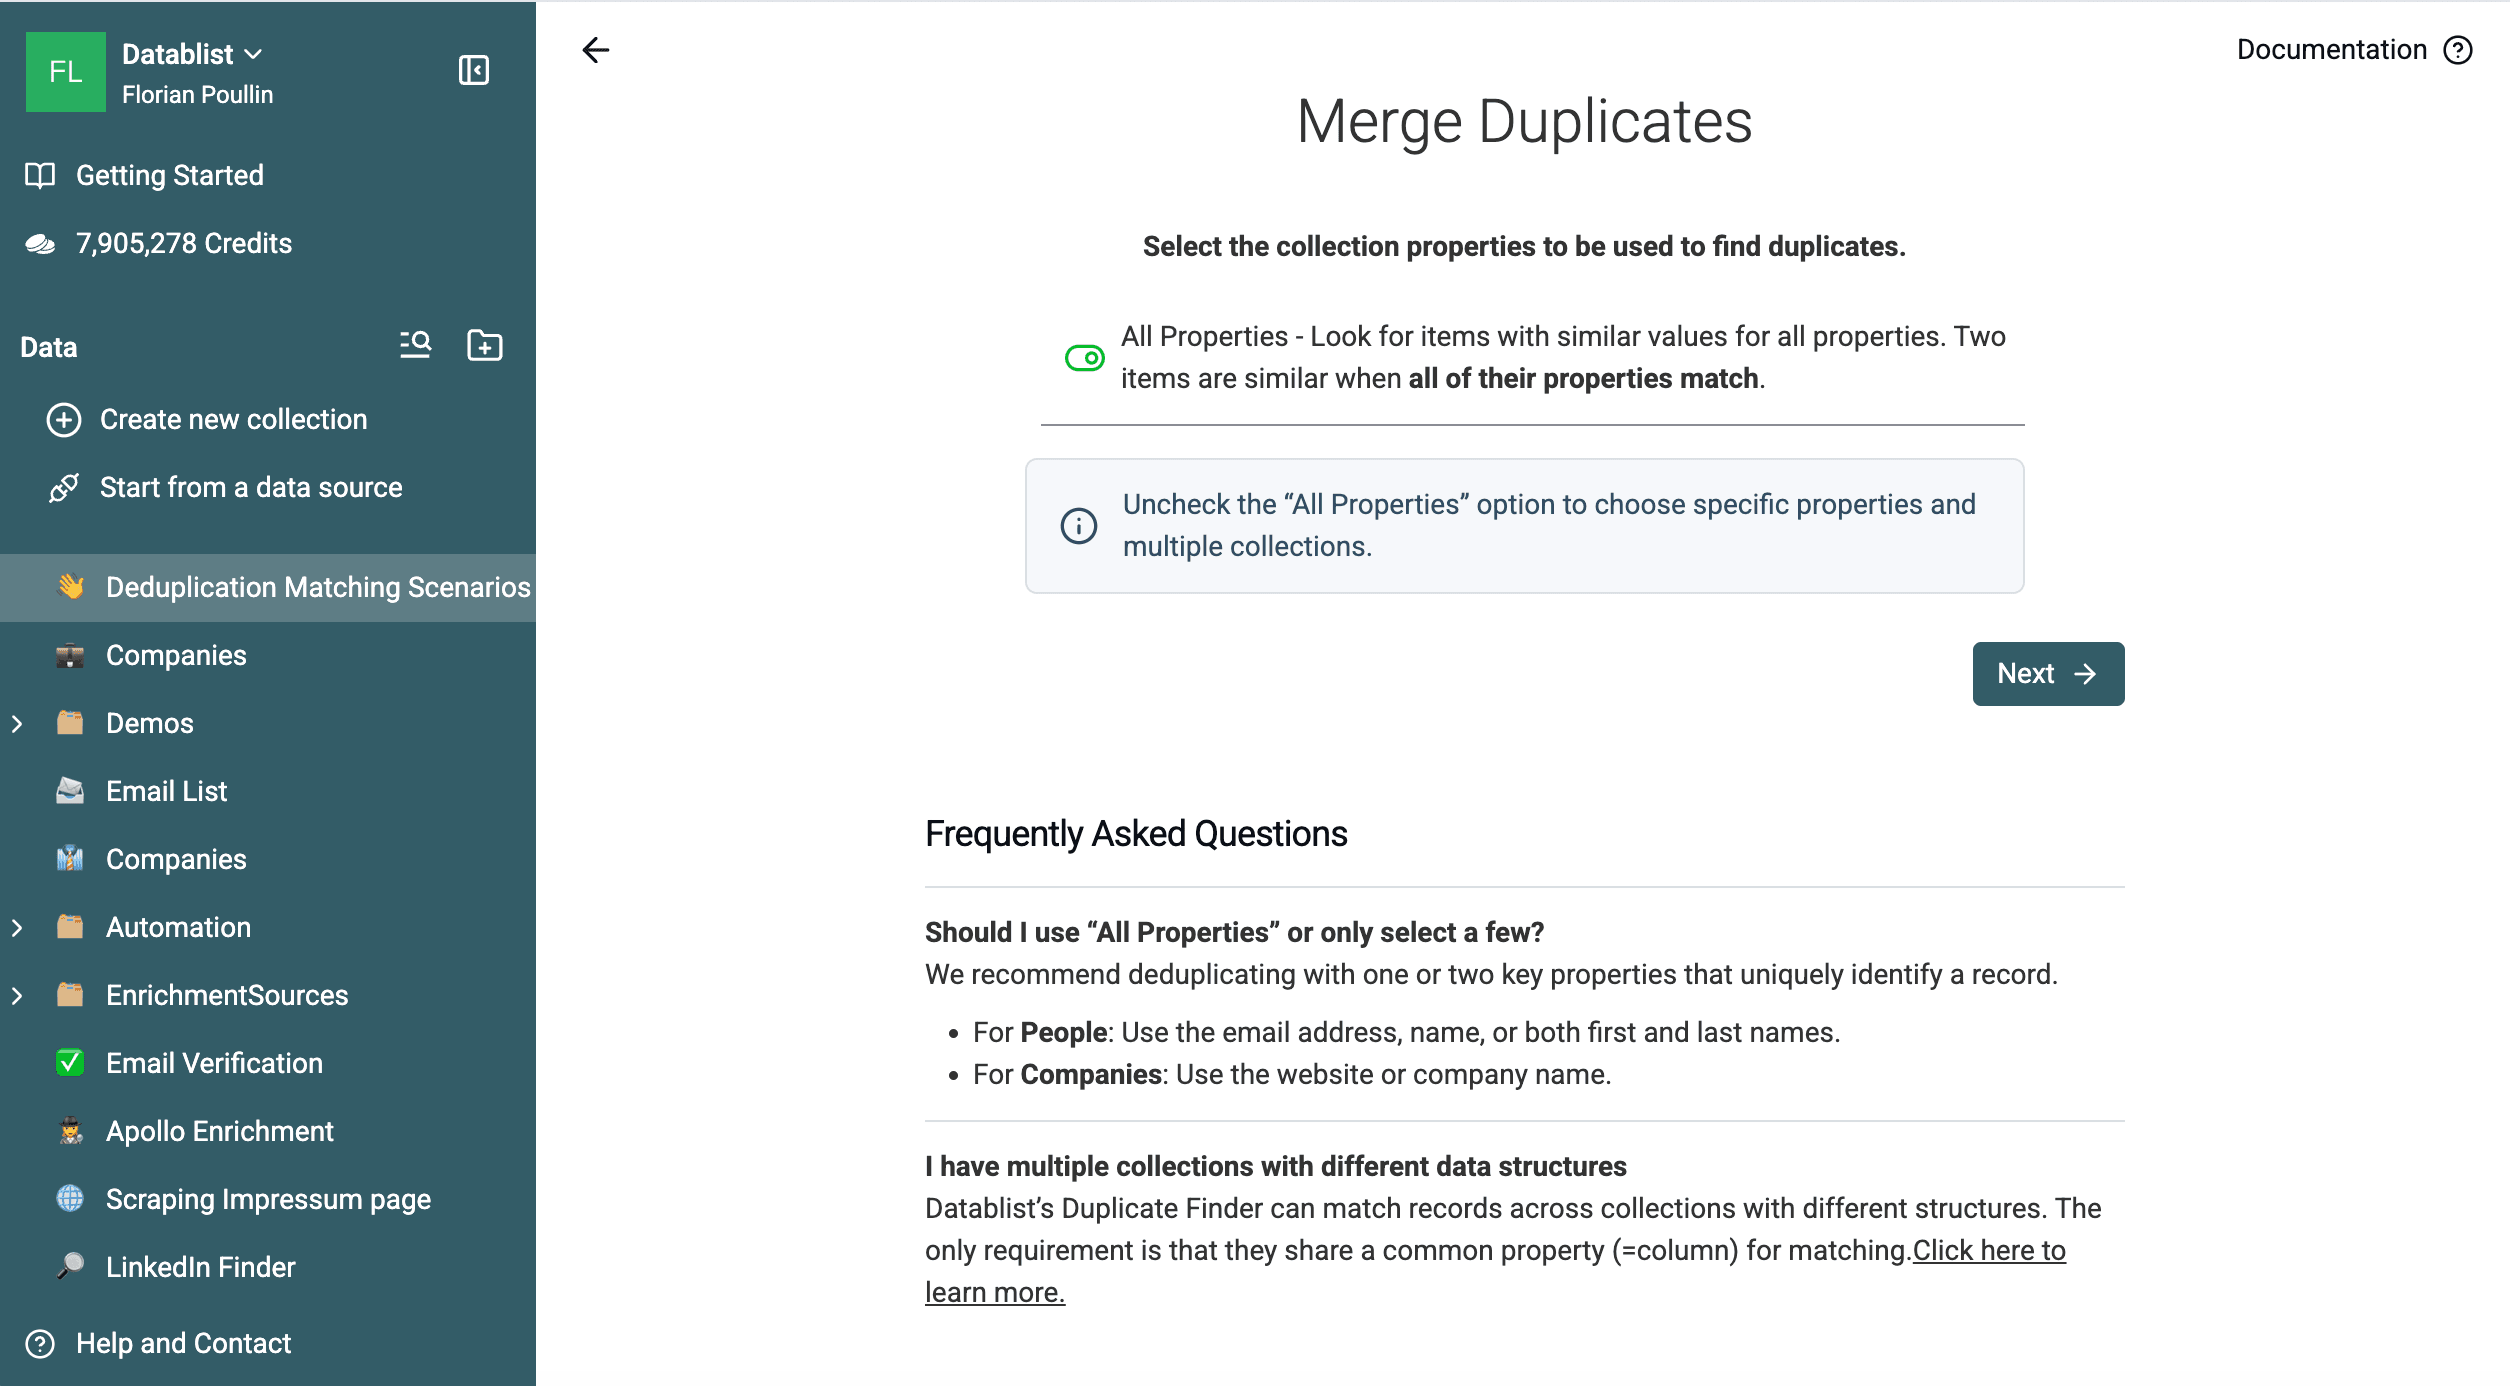
Dla próbki z 1000 wierszy ten etap zwraca pięć grup duplikatów. Każda grupa zawiera dwa wiersze o takich samych wartościach we wszystkich właściwościach.
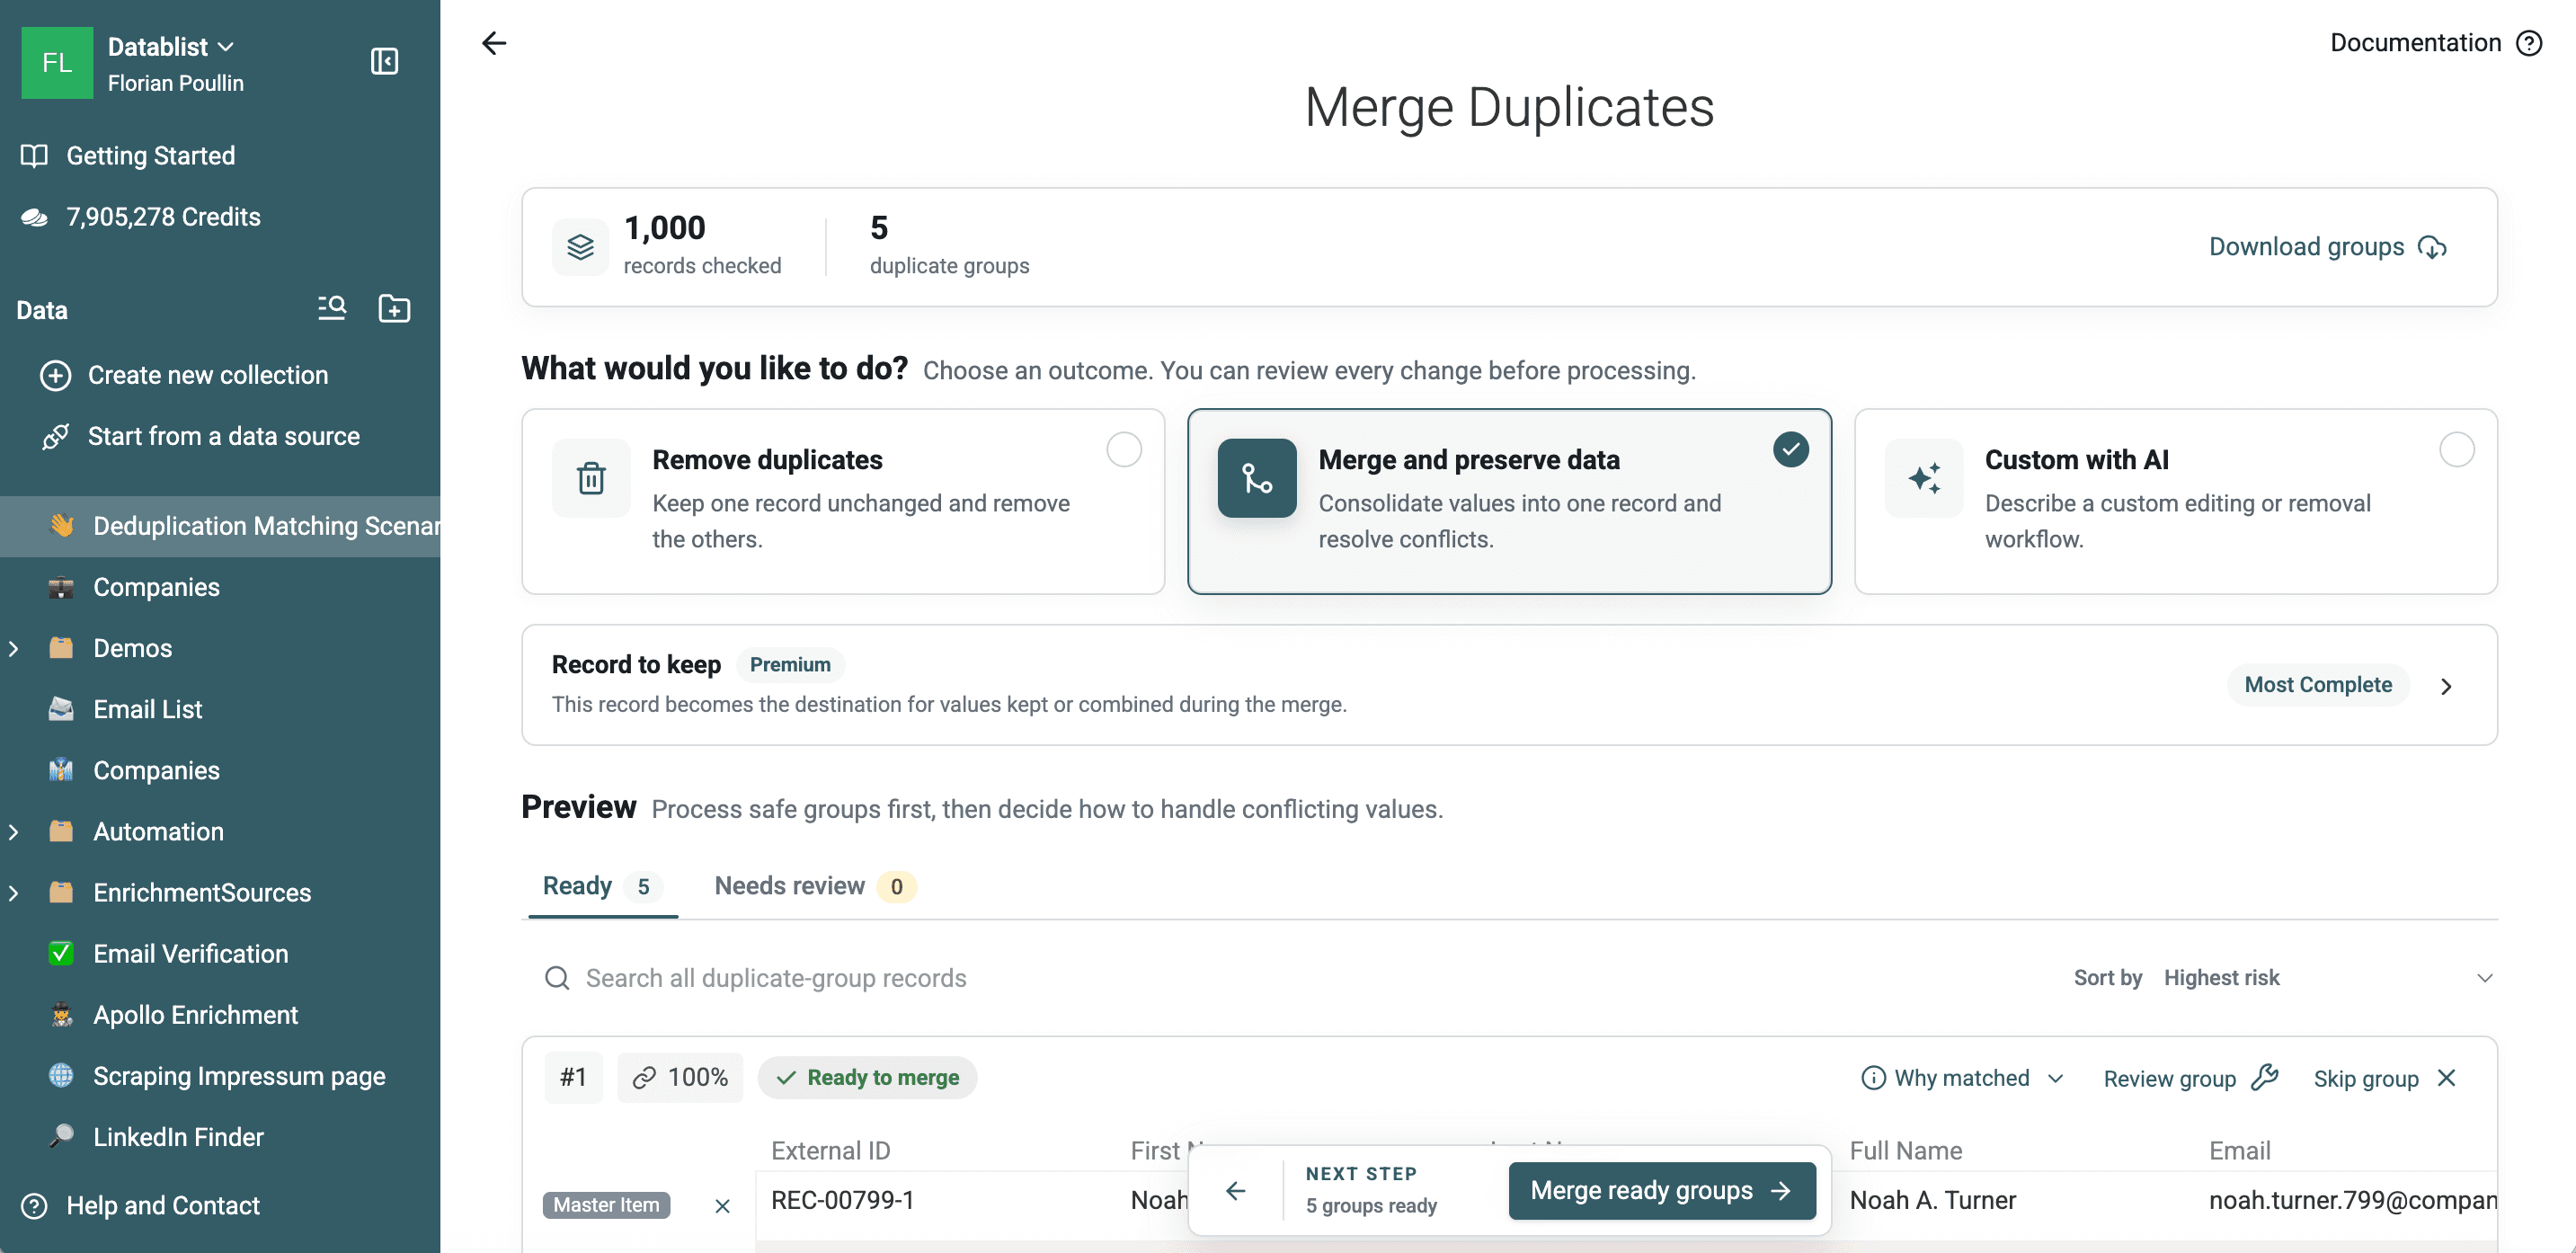
Exact to najbezpieczniejszy pierwszy etap, ponieważ każde zachowane dopasowanie spełnia ścisłe kryteria porównania. Nie znajdzie jednak par takich jak Acme Inc. i Acme, inaczej sformatowanych numerów telefonu ani aliasów e-mail, jeśli zapisane wartości się różnią.
Niezalogowani użytkownicy mogą uruchomić wykrywanie duplikatów Exact. Założenie bezpłatnego konta odblokowuje porównanie Smart i pozostałe funkcje planu Free.
Użyj Smart do dopasowywania danych biznesowych
Smart standaryzuje wartości na potrzeby porównania, nie zmieniając danych zapisanych w komórkach. Wybierz procesor odpowiedni dla danej właściwości:
- Email uwzględnia wielkość liter, otaczające spacje, aliasy z plusem, kropki w Gmailu, domenę
googlemail.com, adresy z nazwą wyświetlaną i wartościmailto:. - URL może ignorować protokół i końcowy ukośnik, a opcjonalnie także subdomeny, ścieżki i parametry zapytania.
- Phone ignoruje znaki formatujące. Nie sprawdza poprawności numerów, nie korzysta z właściwości Country ani nie rozpoznaje brakującego numeru kierunkowego kraju.
- Company Name usuwa popularne określenia prawne, biznesowe i geograficzne.
- Text ignoruje akcenty, spacje, interpunkcję, symbole, wielkość liter i kolejność słów.
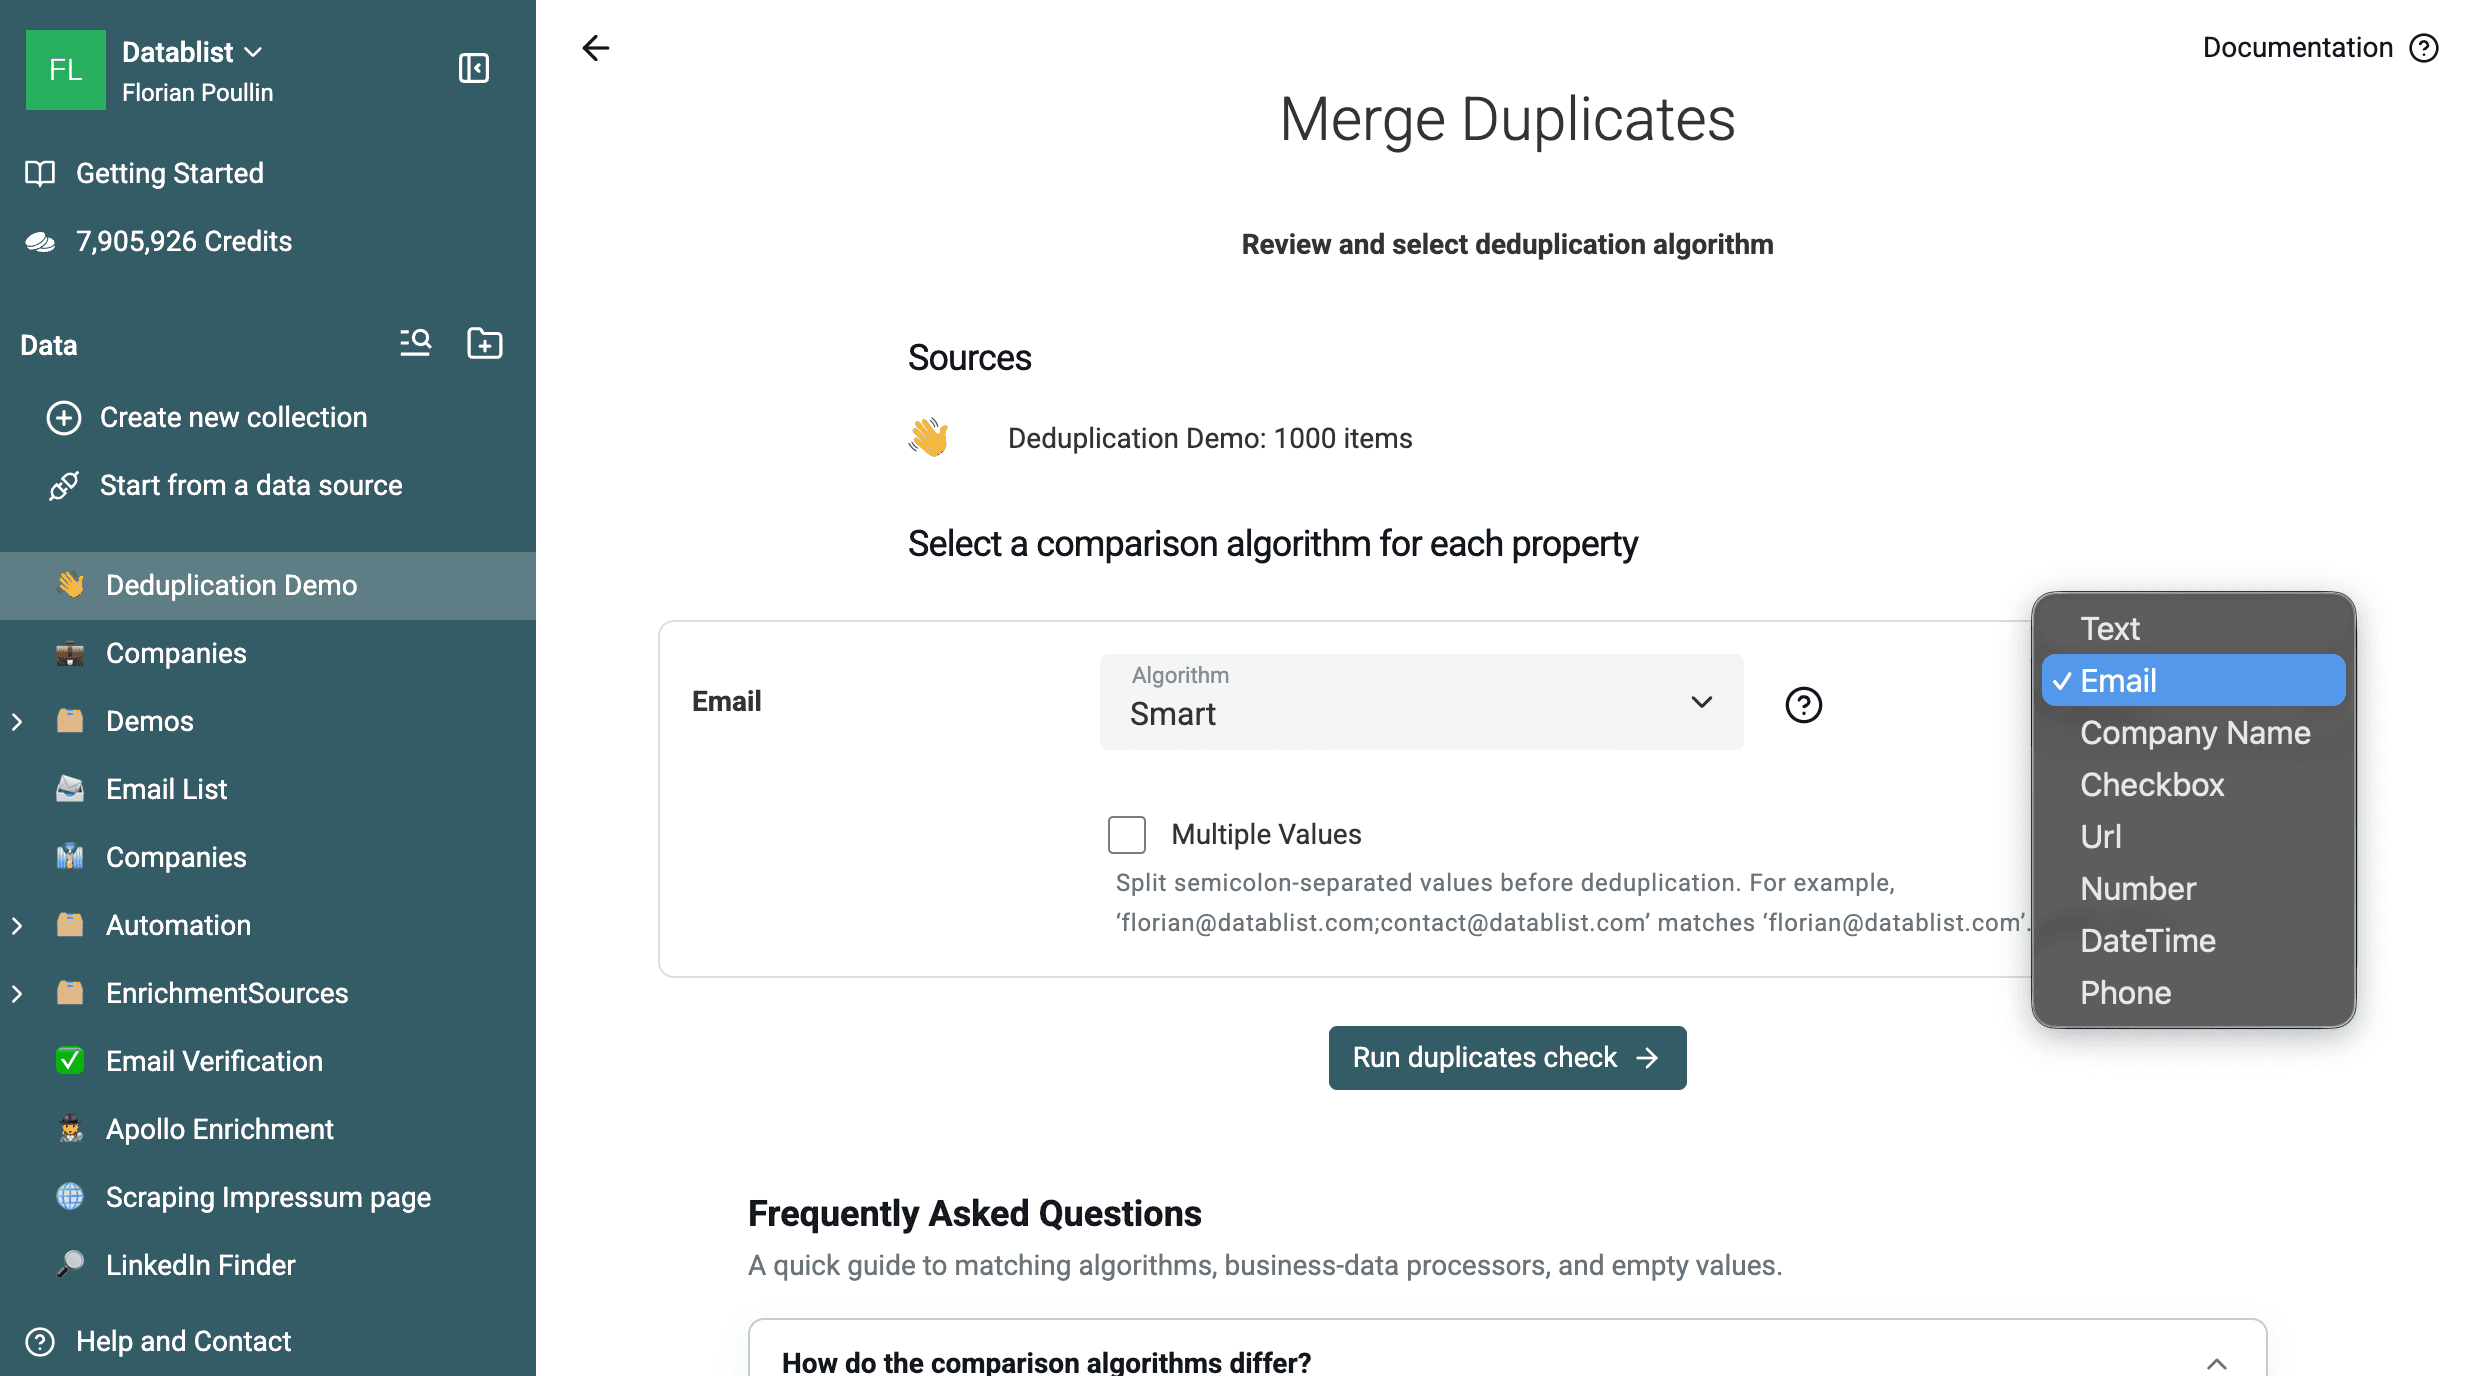
Procesor Company Name, dopasowywanie wielu wartości i zaawansowane algorytmy wymagają płatnego planu. Exact i Smart są dostępne w planie Free przy dopasowywaniu w obrębie jednej kolekcji, choć Smart wymaga bezpłatnego konta.
Jeśli jedna komórka zawiera kilka identyfikatorów rozdzielonych średnikami, włącz Multiple Values. Datablist porównuje każdą część i uznaje właściwość za zgodną, gdy znajdzie co najmniej jedną pasującą parę. Na przykład komórka z wartością primary@example.com;shared@example.com może zostać dopasowana do drugiej komórki zawierającej shared@example.com.
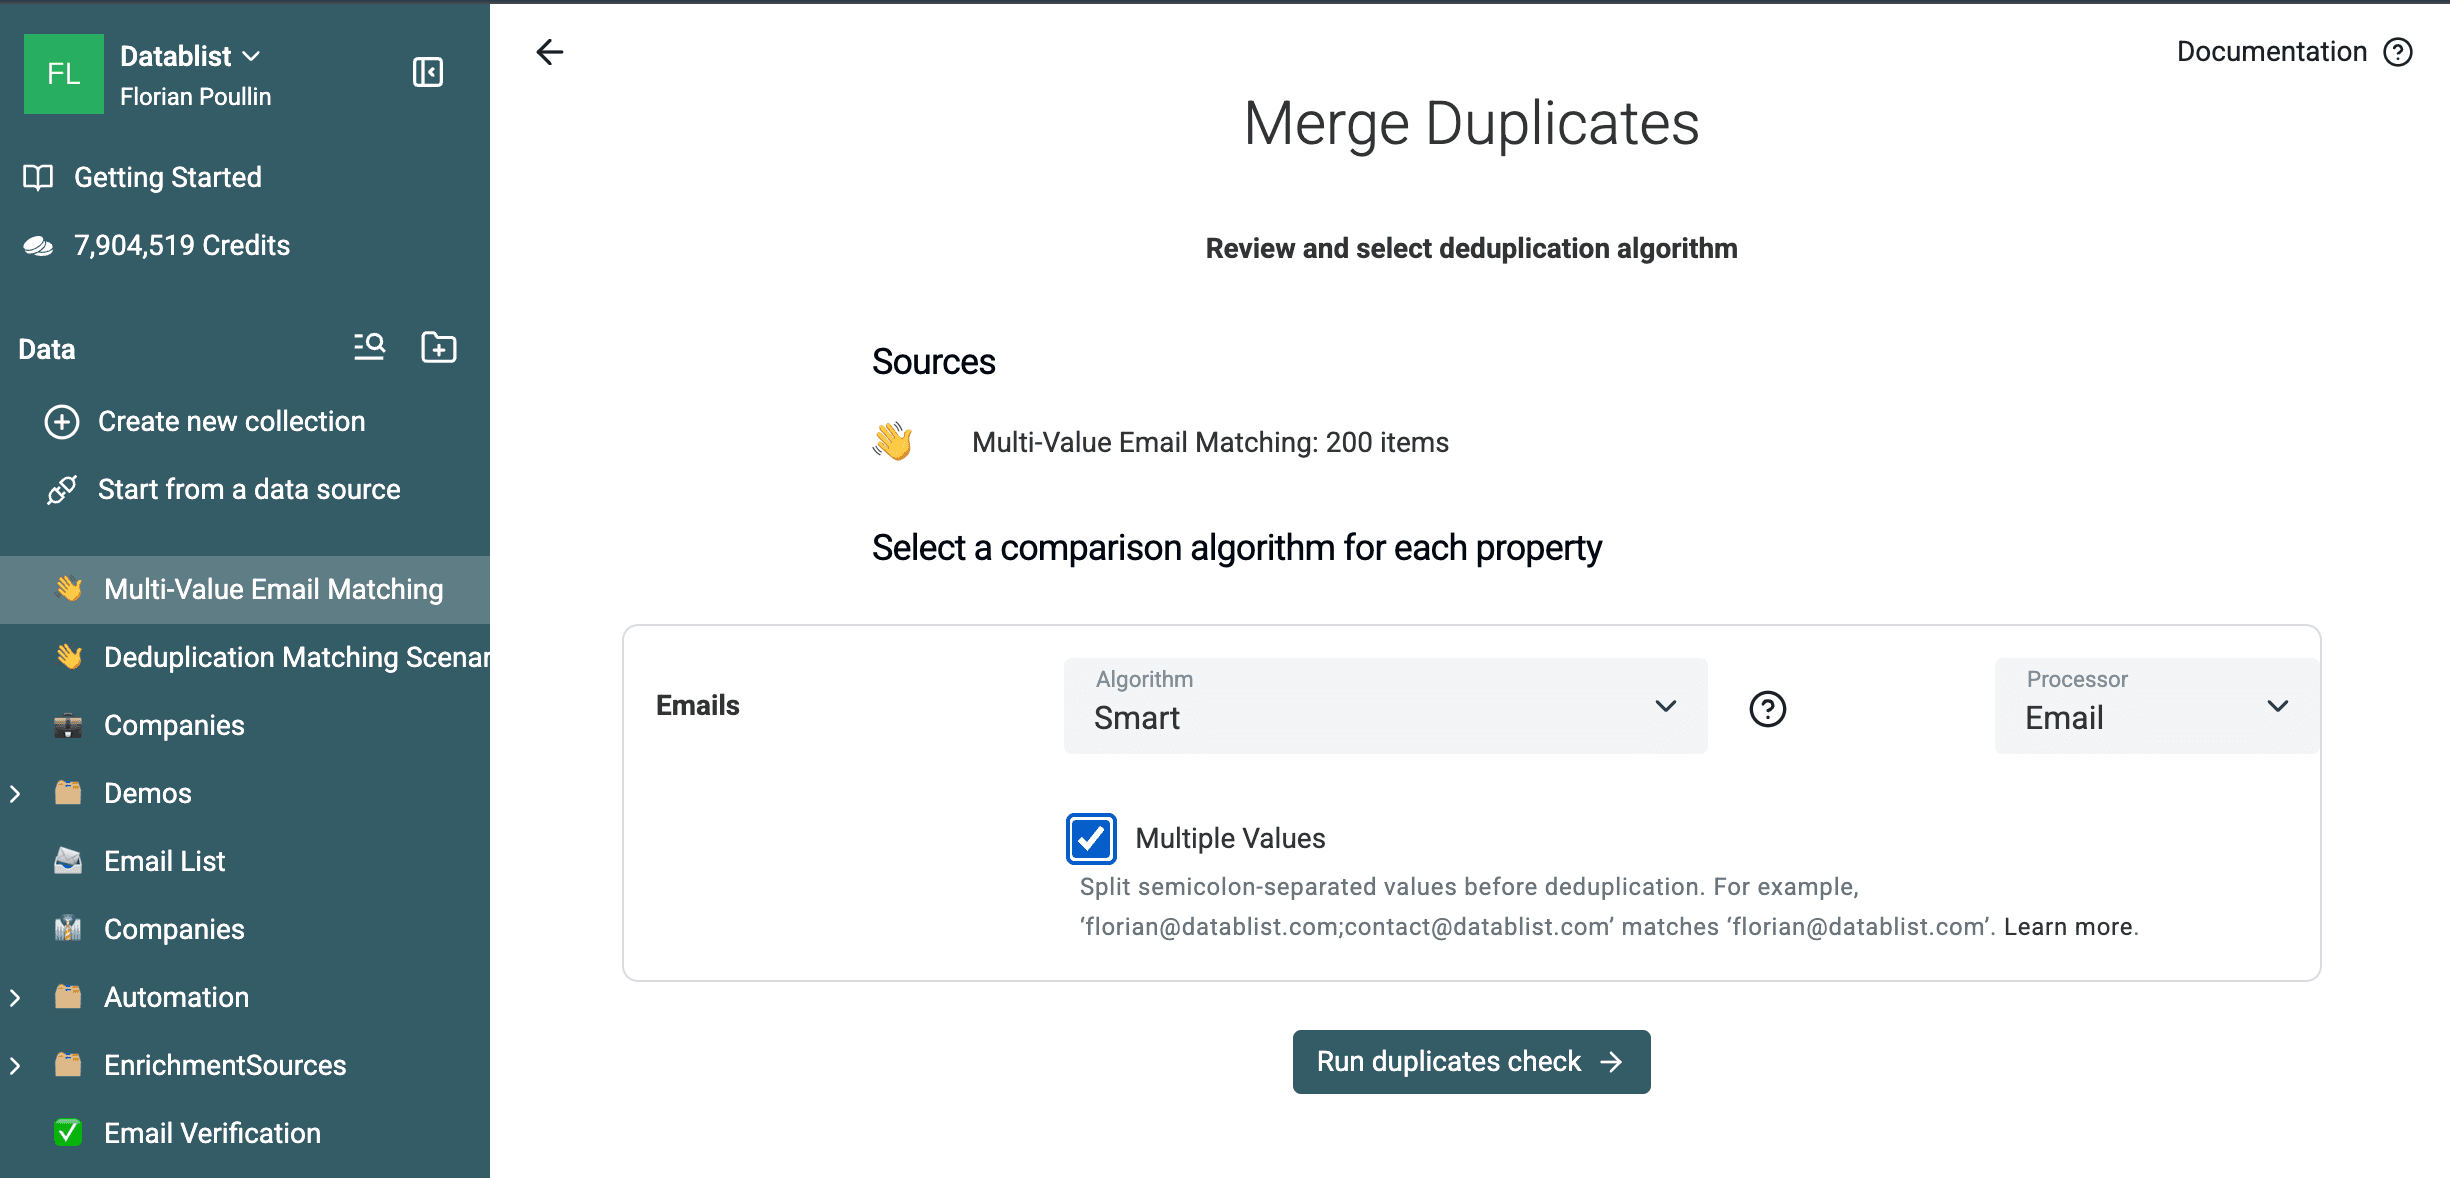
W osobnej próbce z 200 wierszami ta konfiguracja zwróciła 60 grup po dwa wiersze. Weryfikacja względem danych referencyjnych wykryła wszystkie 60 zaplanowanych par i wykluczyła wszystkie 80 rekordów kontrolnych. W procesie deduplikacji pól wielowartościowych znajdziesz plik przykładowy, wynikowy CSV i wskazówki dotyczące scalania.
Ten etap dopasowywania adresów e-mail zwrócił 105 grup po dwa wiersze: 100 zaplanowanych par wymagających normalizacji e-mail oraz pięć par identycznych kopii, które również mają ten sam adres.
Znormalizuj numery telefonu przed dopasowaniem
Procesor Smart Phone sprawdza się w jednym konkretnym przypadku: gdy wartości zawierają te same cyfry, ale różnią się spacjami, nawiasami, myślnikami lub symbolami. Może dopasować (415) 555-0123 do 4155550123.
Nie potrafi jednak rozpoznać, że numer lokalny i międzynarodowy są tym samym numerem. Na przykład 06 12 34 50 08 i +33 6 12 34 50 08 wymagają informacji o kraju.
Przed deduplikacją według telefonu użyj Phone Number Cleaner:
- Przypisz surową właściwość
Phone. - Dla listy z jednego kraju wybierz kraj w sekcji Local Phone Countries. Dla listy międzynarodowej włącz Define country per item i przypisz właściwość
Country. - Zapisz wynik enrichmentu we właściwości
Clean Phone Number, nie nadpisując surowej wartości. - Sprawdź błędne i puste wyniki. Nie powinny brać udziału w dopasowaniu według telefonu.
- Uruchom Duplicates Finder dla
Clean Phone Numberz opcją Exact.
Pobierz osobną próbkę 200 numerów telefonu. Zawiera 50 par lokalnych i międzynarodowych numerów ze Stanów Zjednoczonych, Francji, Wielkiej Brytanii, Niemiec i Hiszpanii oraz 100 niepasujących rekordów kontrolnych. Weryfikacja z użyciem produkcyjnej logiki czyszczenia zwróciła po jednym znormalizowanym numerze dla wszystkich 200 wierszy. Zaplanowane 50 par zostało sprowadzonych do 50 wspólnych wartości międzynarodowych, a rekordy kontrolne pozostały unikalne.
Ten etap wstępny sprawdza również poprawność formatu telefonu. Zachowaj oryginalne właściwości Phone i Country obok oczyszczonego wyniku, aby móc sprawdzić każdy rekord przed scaleniem. Przeczytaj, na czym polega normalizacja numerów telefonu, aby lepiej zrozumieć rolę numerów kierunkowych kraju i zapisu międzynarodowego.
Dla rekordów firm uruchom osobne dopasowanie właściwości Website. Wybierz Smart z procesorem URL. Włącz Ignore Subdomain, Ignore Path i Ignore Query Params tylko wtedy, gdy te elementy adresu URL nie powinny oznaczać innej firmy lub lokalizacji.
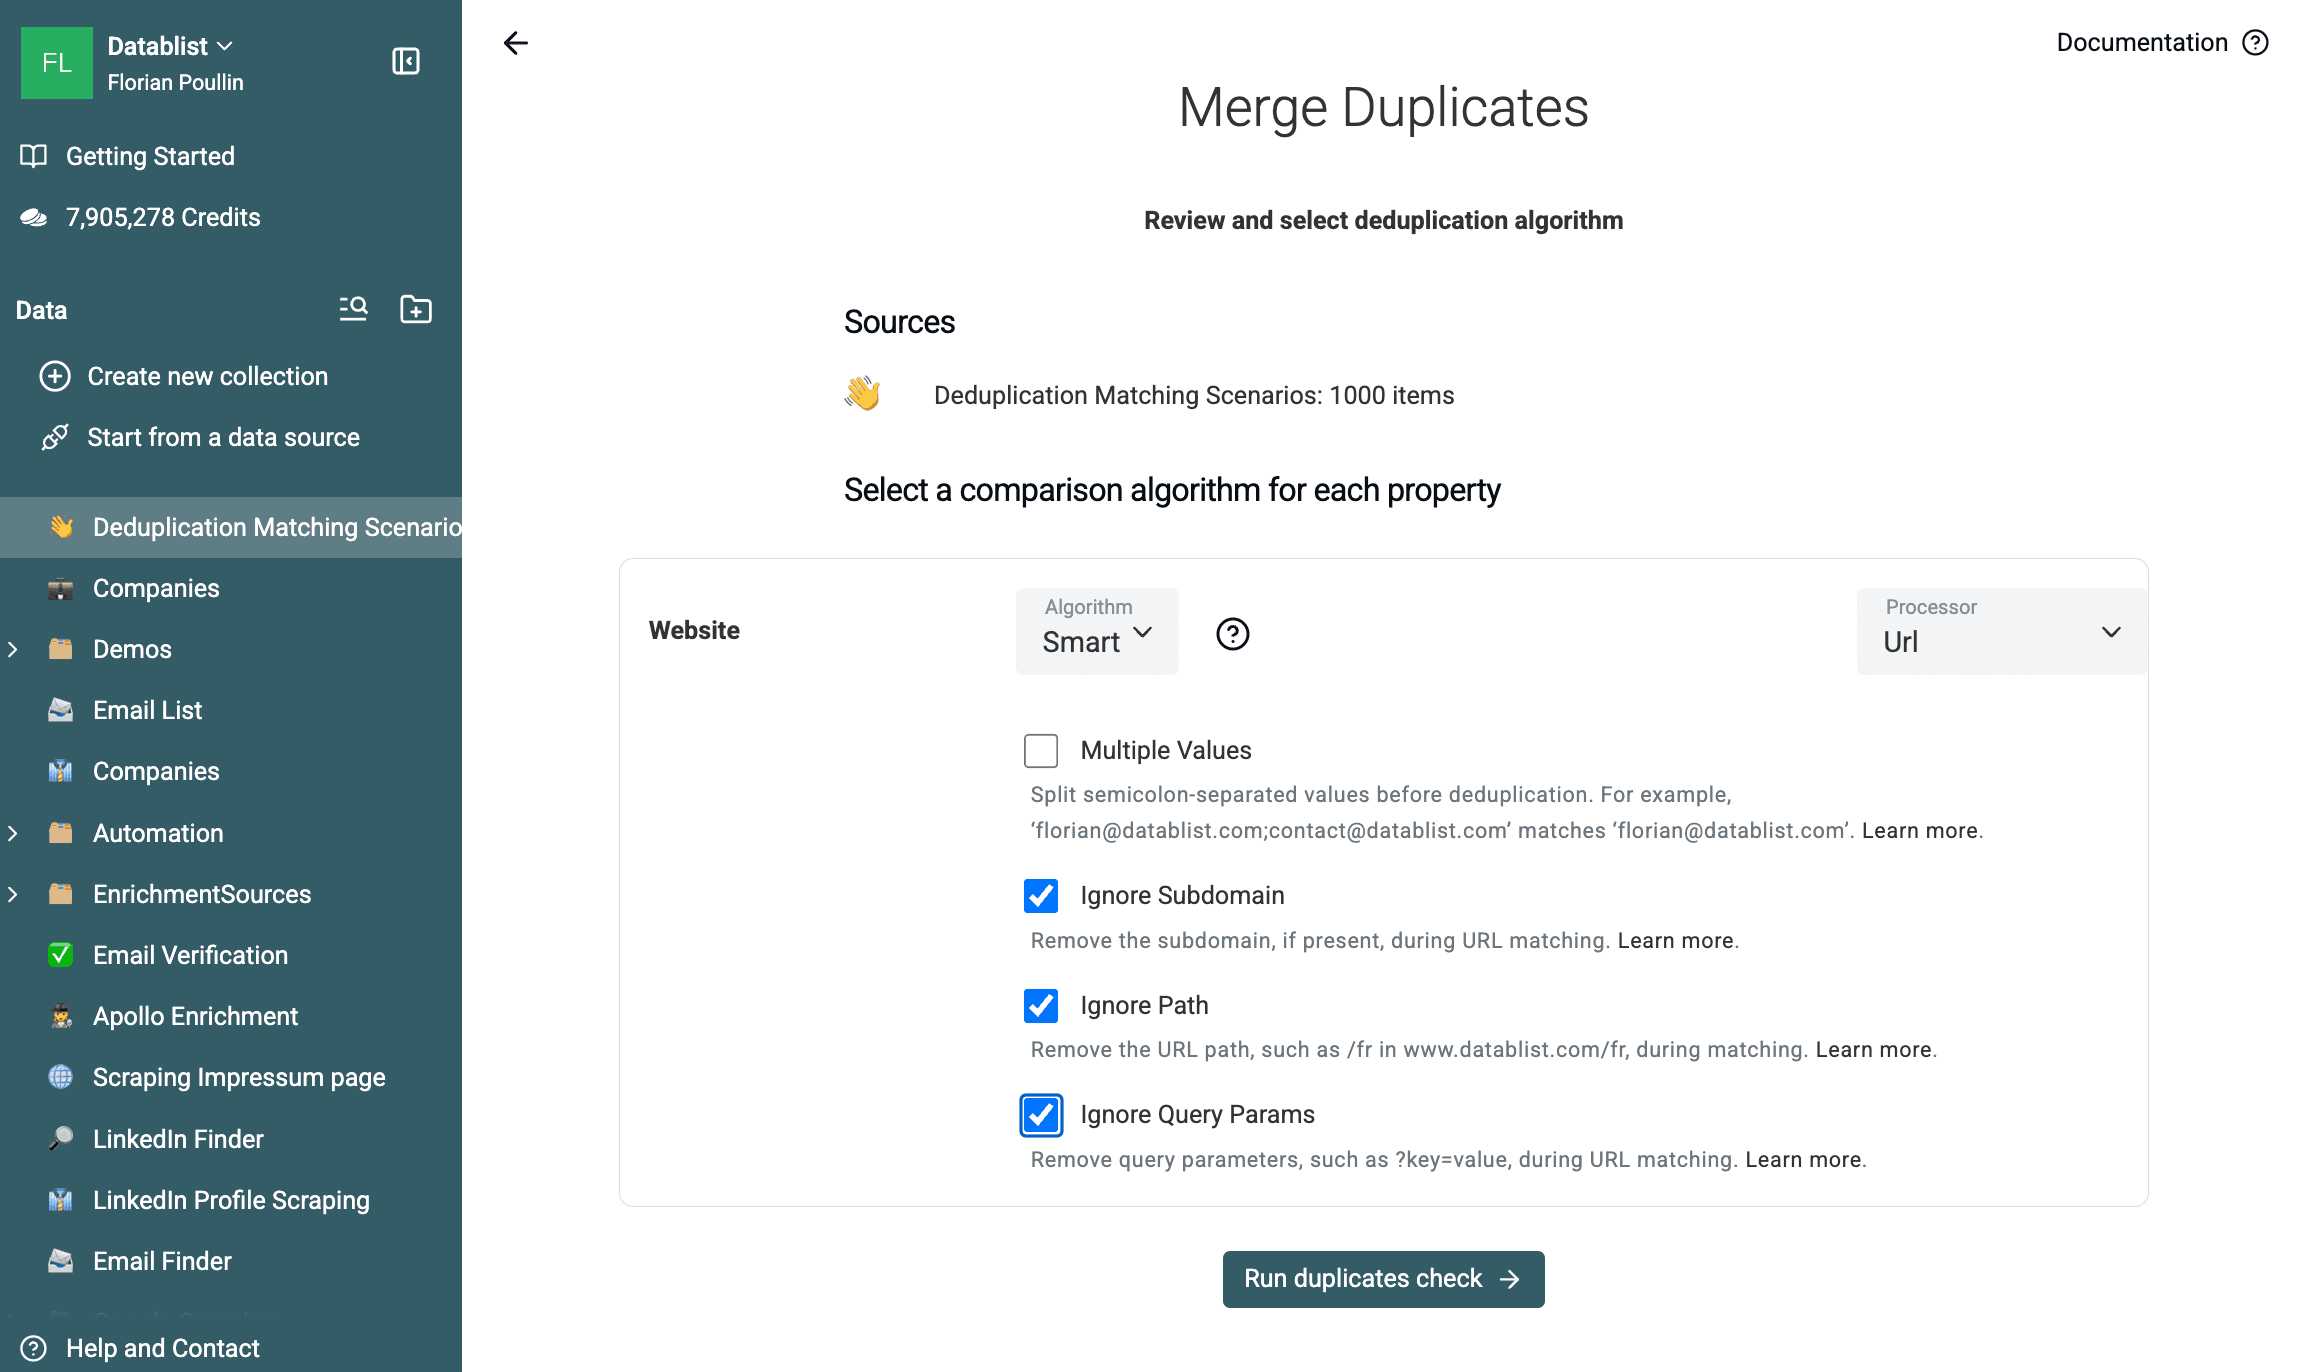
Dla tej samej próbki z 1000 wierszy konfiguracja zwróciła 200 grup po dwa rekordy. Pięćdziesiąt par zawierało zaplanowane warianty adresów URL, a 150 par miało już identyczną stronę internetową. W tym teście każda wyeksportowana para została sprowadzona do tego samego znormalizowanego hosta.
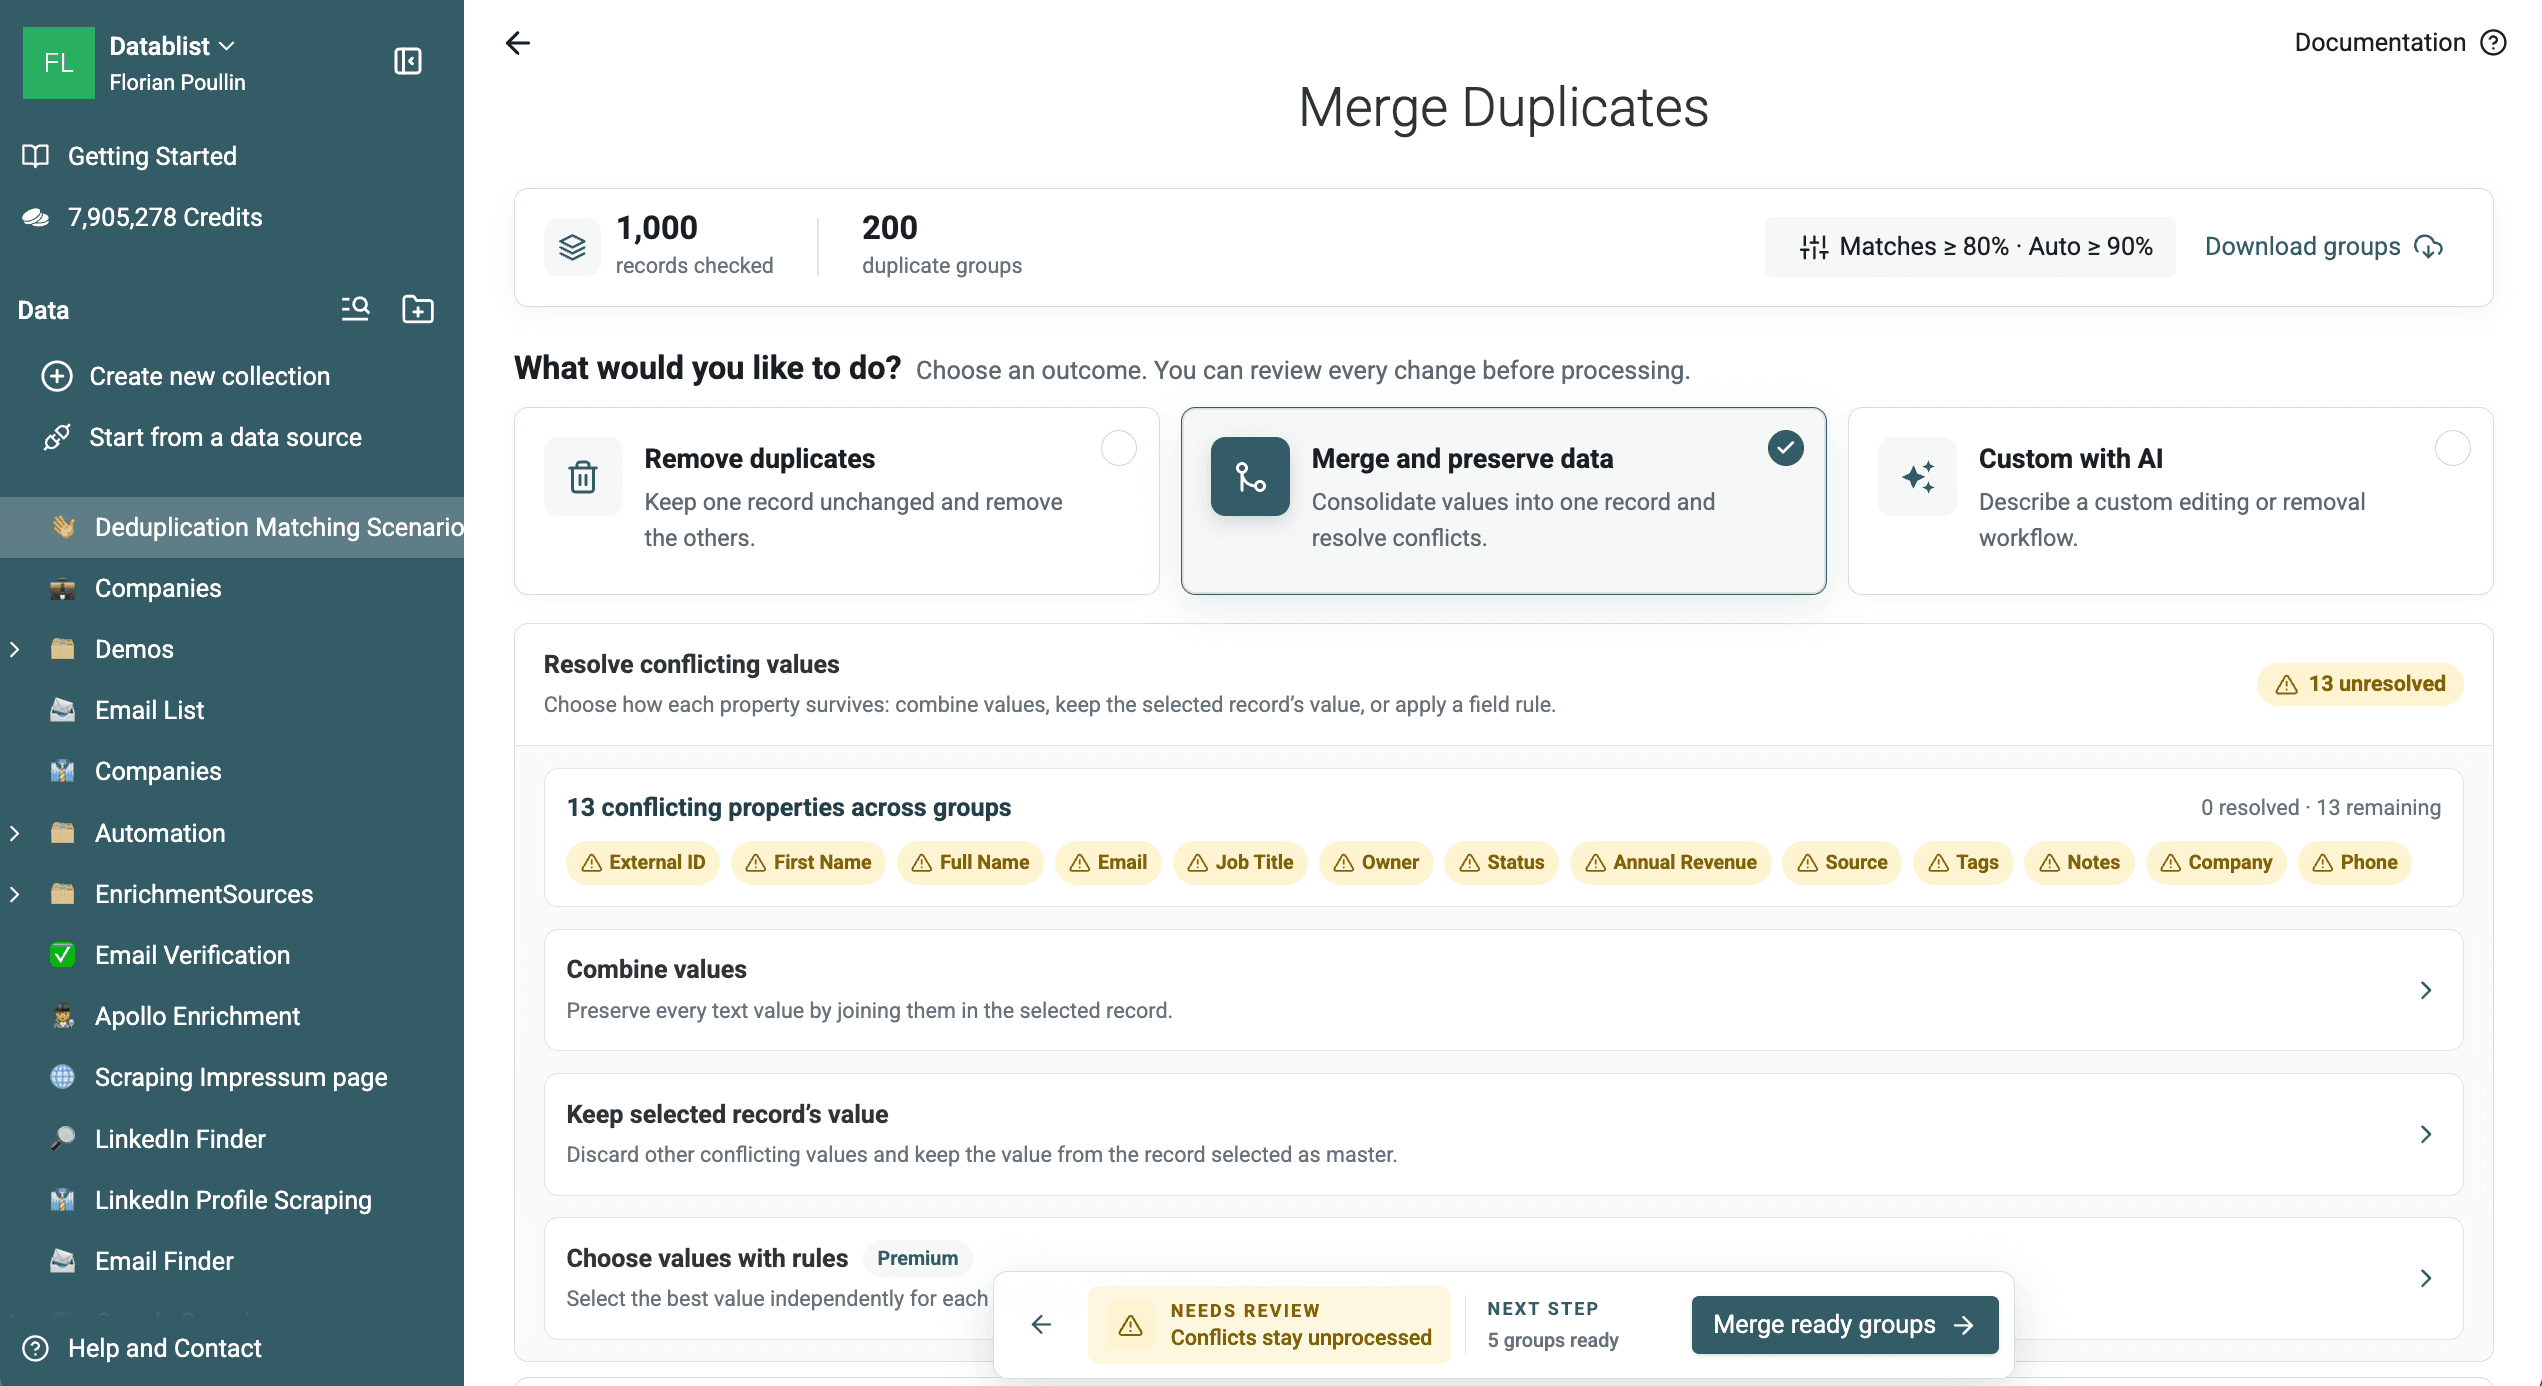
Pobierz 200 grup duplikatów Website lub zobacz proces deduplikacji firm, który w pierwszej kolejności wykorzystuje domenę.
Traktuj dopasowanie fuzzy i fonetyczne jako etap weryfikacji
Metaphone porównuje brzmienie tekstu. Jaro-Winkler i Levenshtein obliczają współczynnik podobieństwa, co pomaga wykrywać różnice w pisowni, takie jak Uma Turner i Uman Turner.
Dopasowania fuzzy są kandydatami, a nie potwierdzonymi duplikatami. Zacznij od wysokiego progu, sprawdź najsłabsze grupy i obniżaj próg wyników tylko wtedy, gdy dopasowania nadal są precyzyjne.
Aby przeprowadzić mierzalne dopasowanie fuzzy, wybierz Full Name, ustaw Distance z algorytmem Levenshtein, pozostaw procesor Text i ustaw próg na 90%.
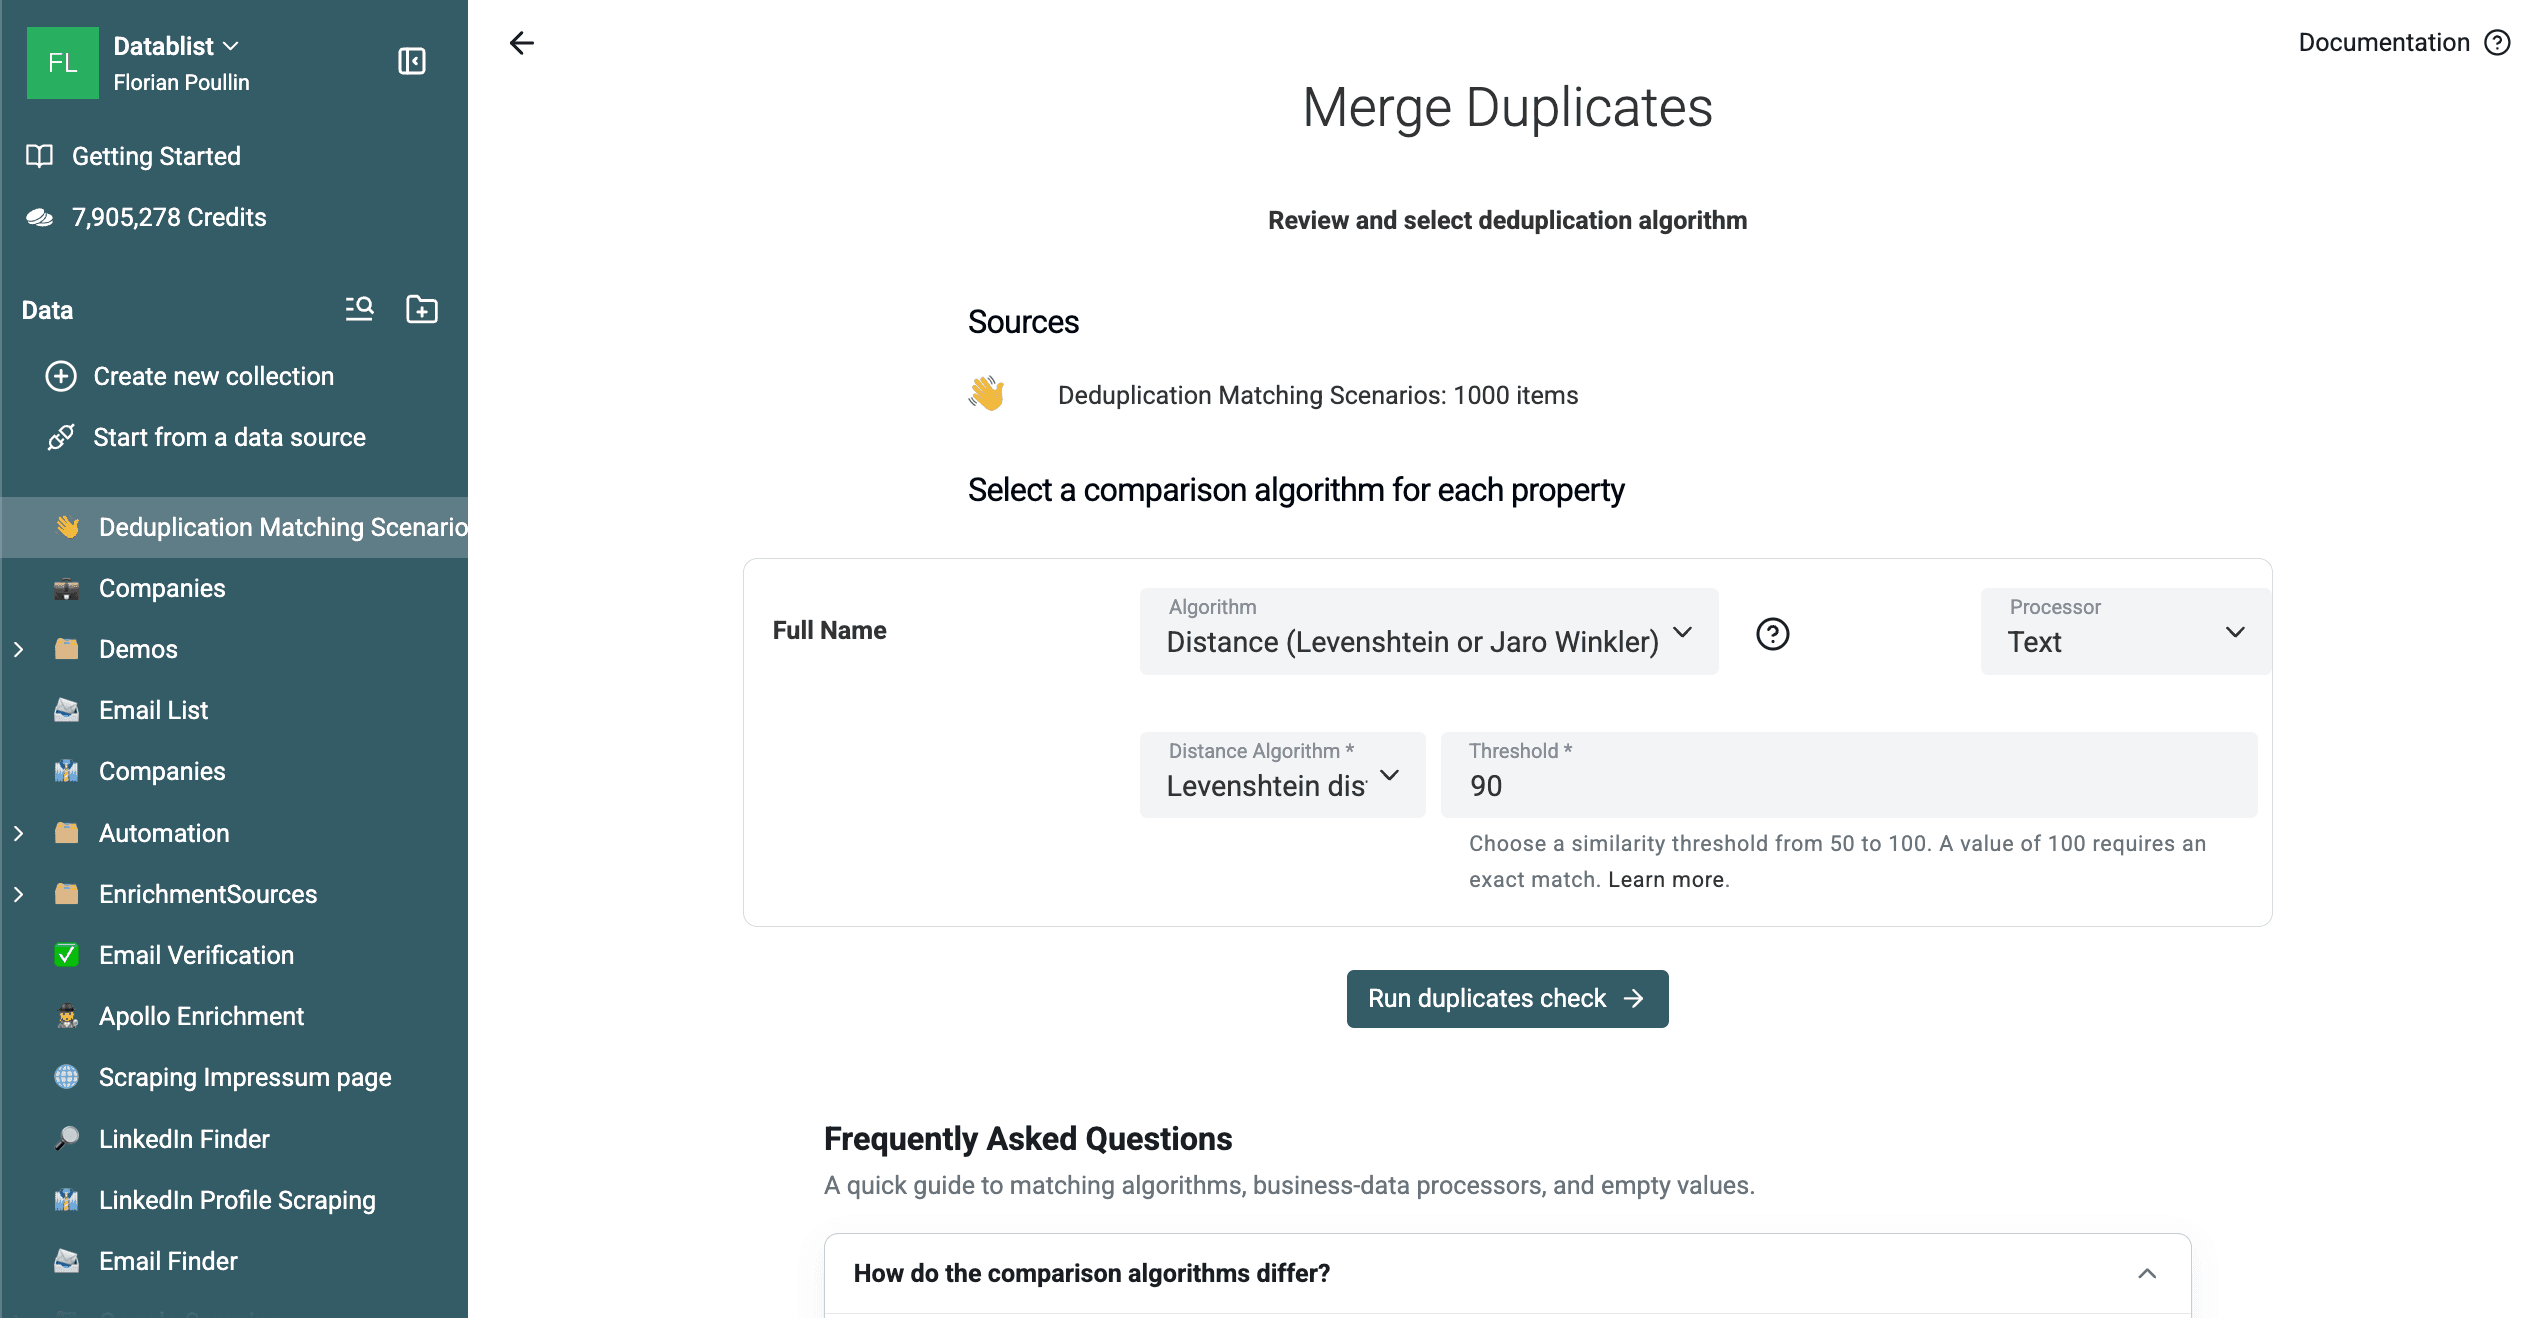
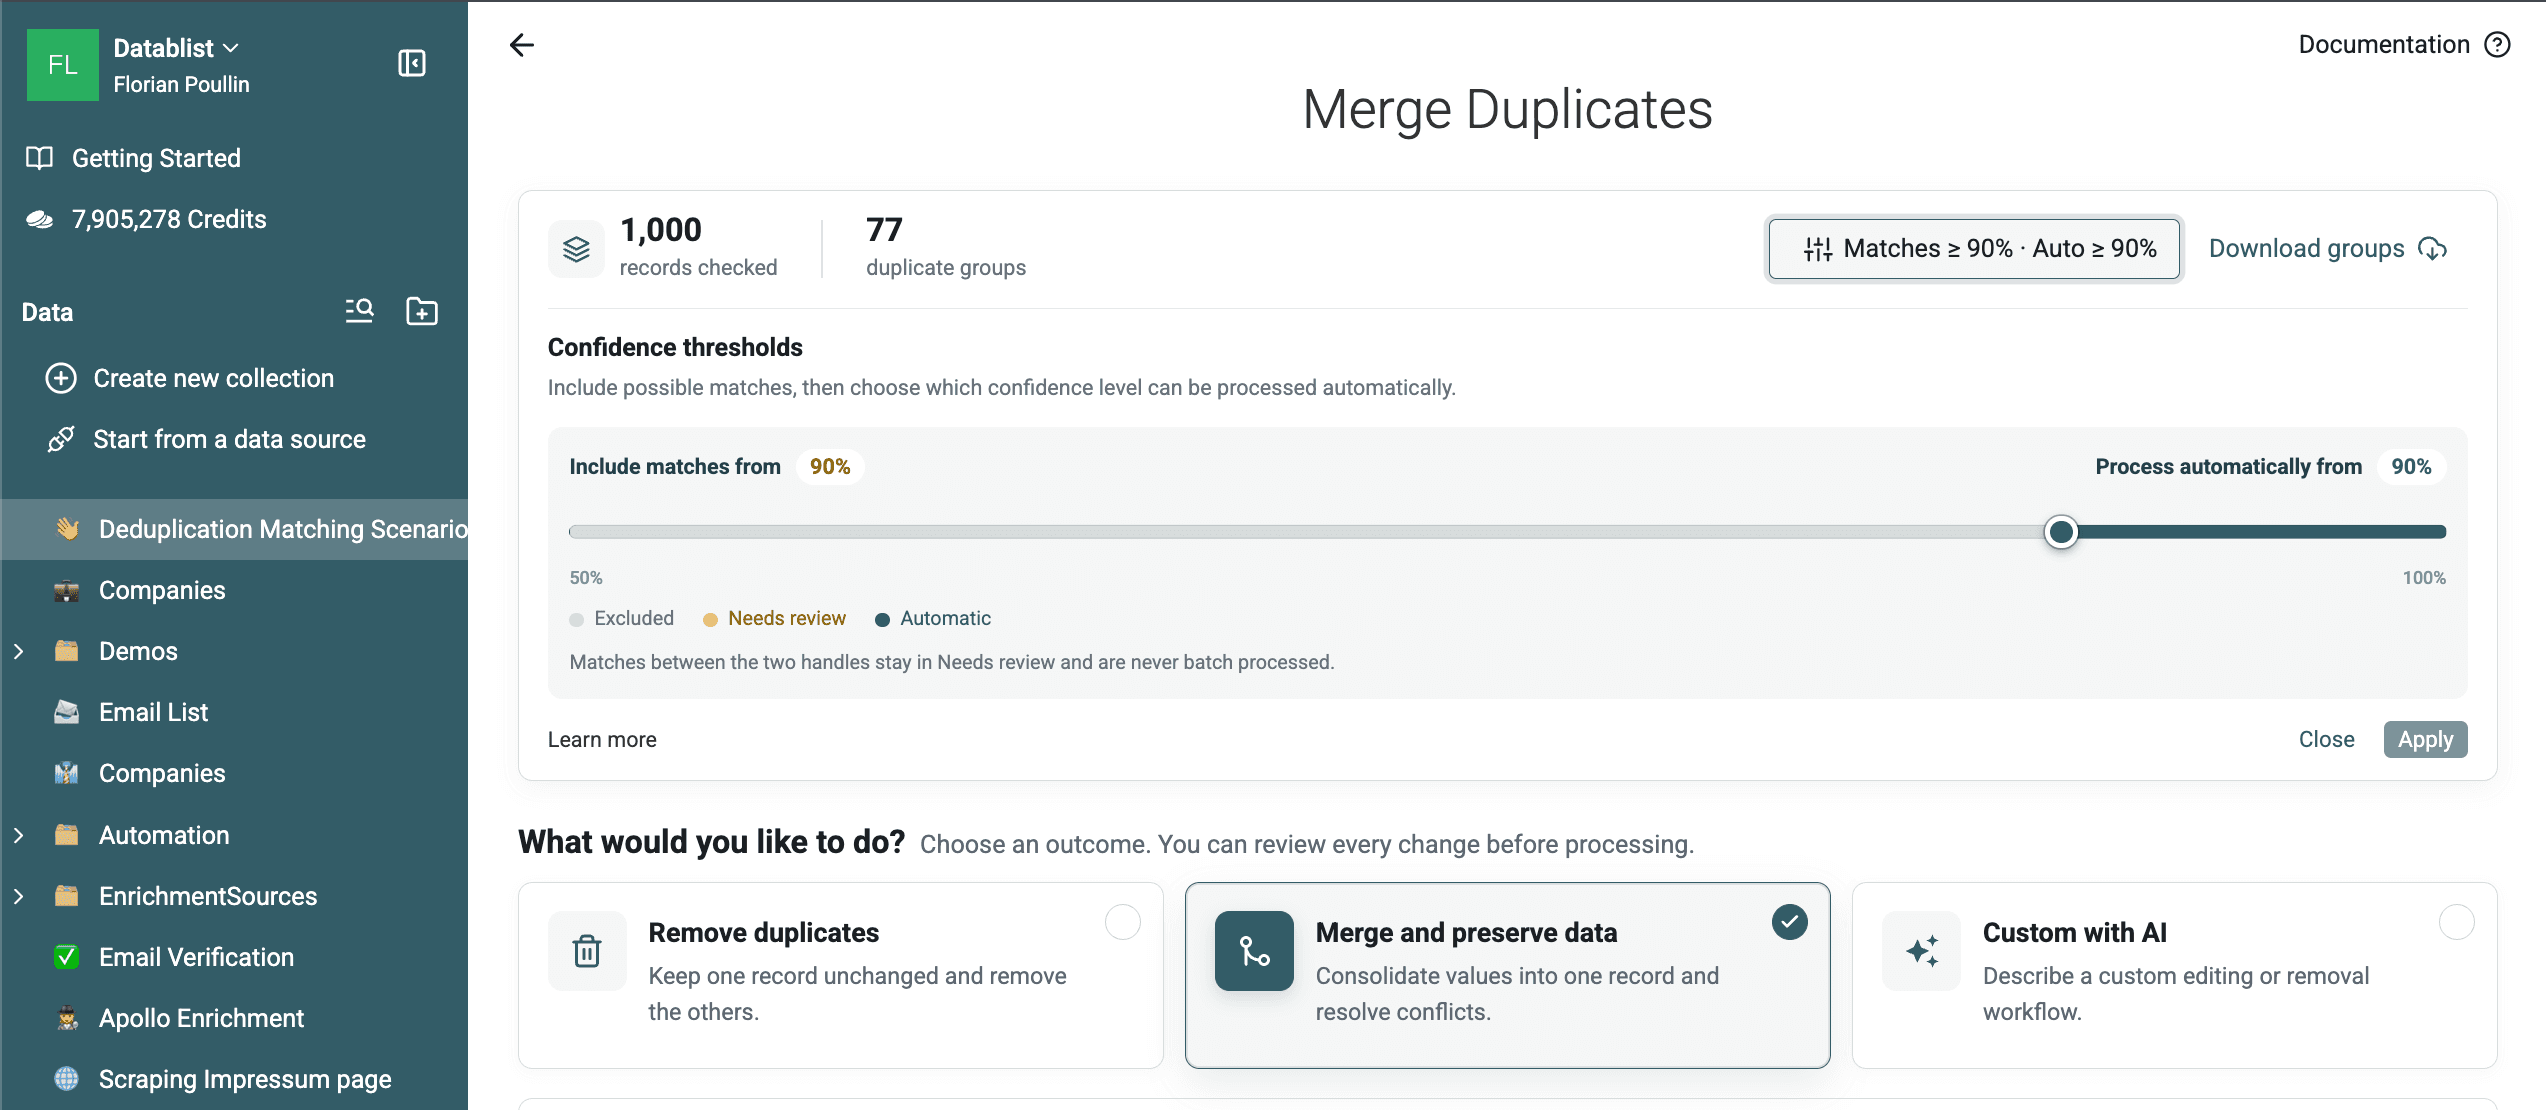
To sprawdzenie zwróciło 77 grup po dwa wiersze z próbki zawierającej 1000 rekordów. Weryfikacja względem danych referencyjnych wykazała, że 21 grup łączy ten sam zaplanowany obiekt, a 56 grup — różne obiekty. Większość fałszywie dodatnich wyników dotyczyła skróconych nazw, takich jak G. Rossi, gdzie samo pole Full Name nie pozwala odróżnić dwóch osób.
Ten etap wykrywa zamierzone warianty pisowni, takie jak Uma A. Turner i Uman A. Turner, ale pokazuje też, dlaczego dopasowania fuzzy oparte wyłącznie na imieniu i nazwisku wymagają kontroli.
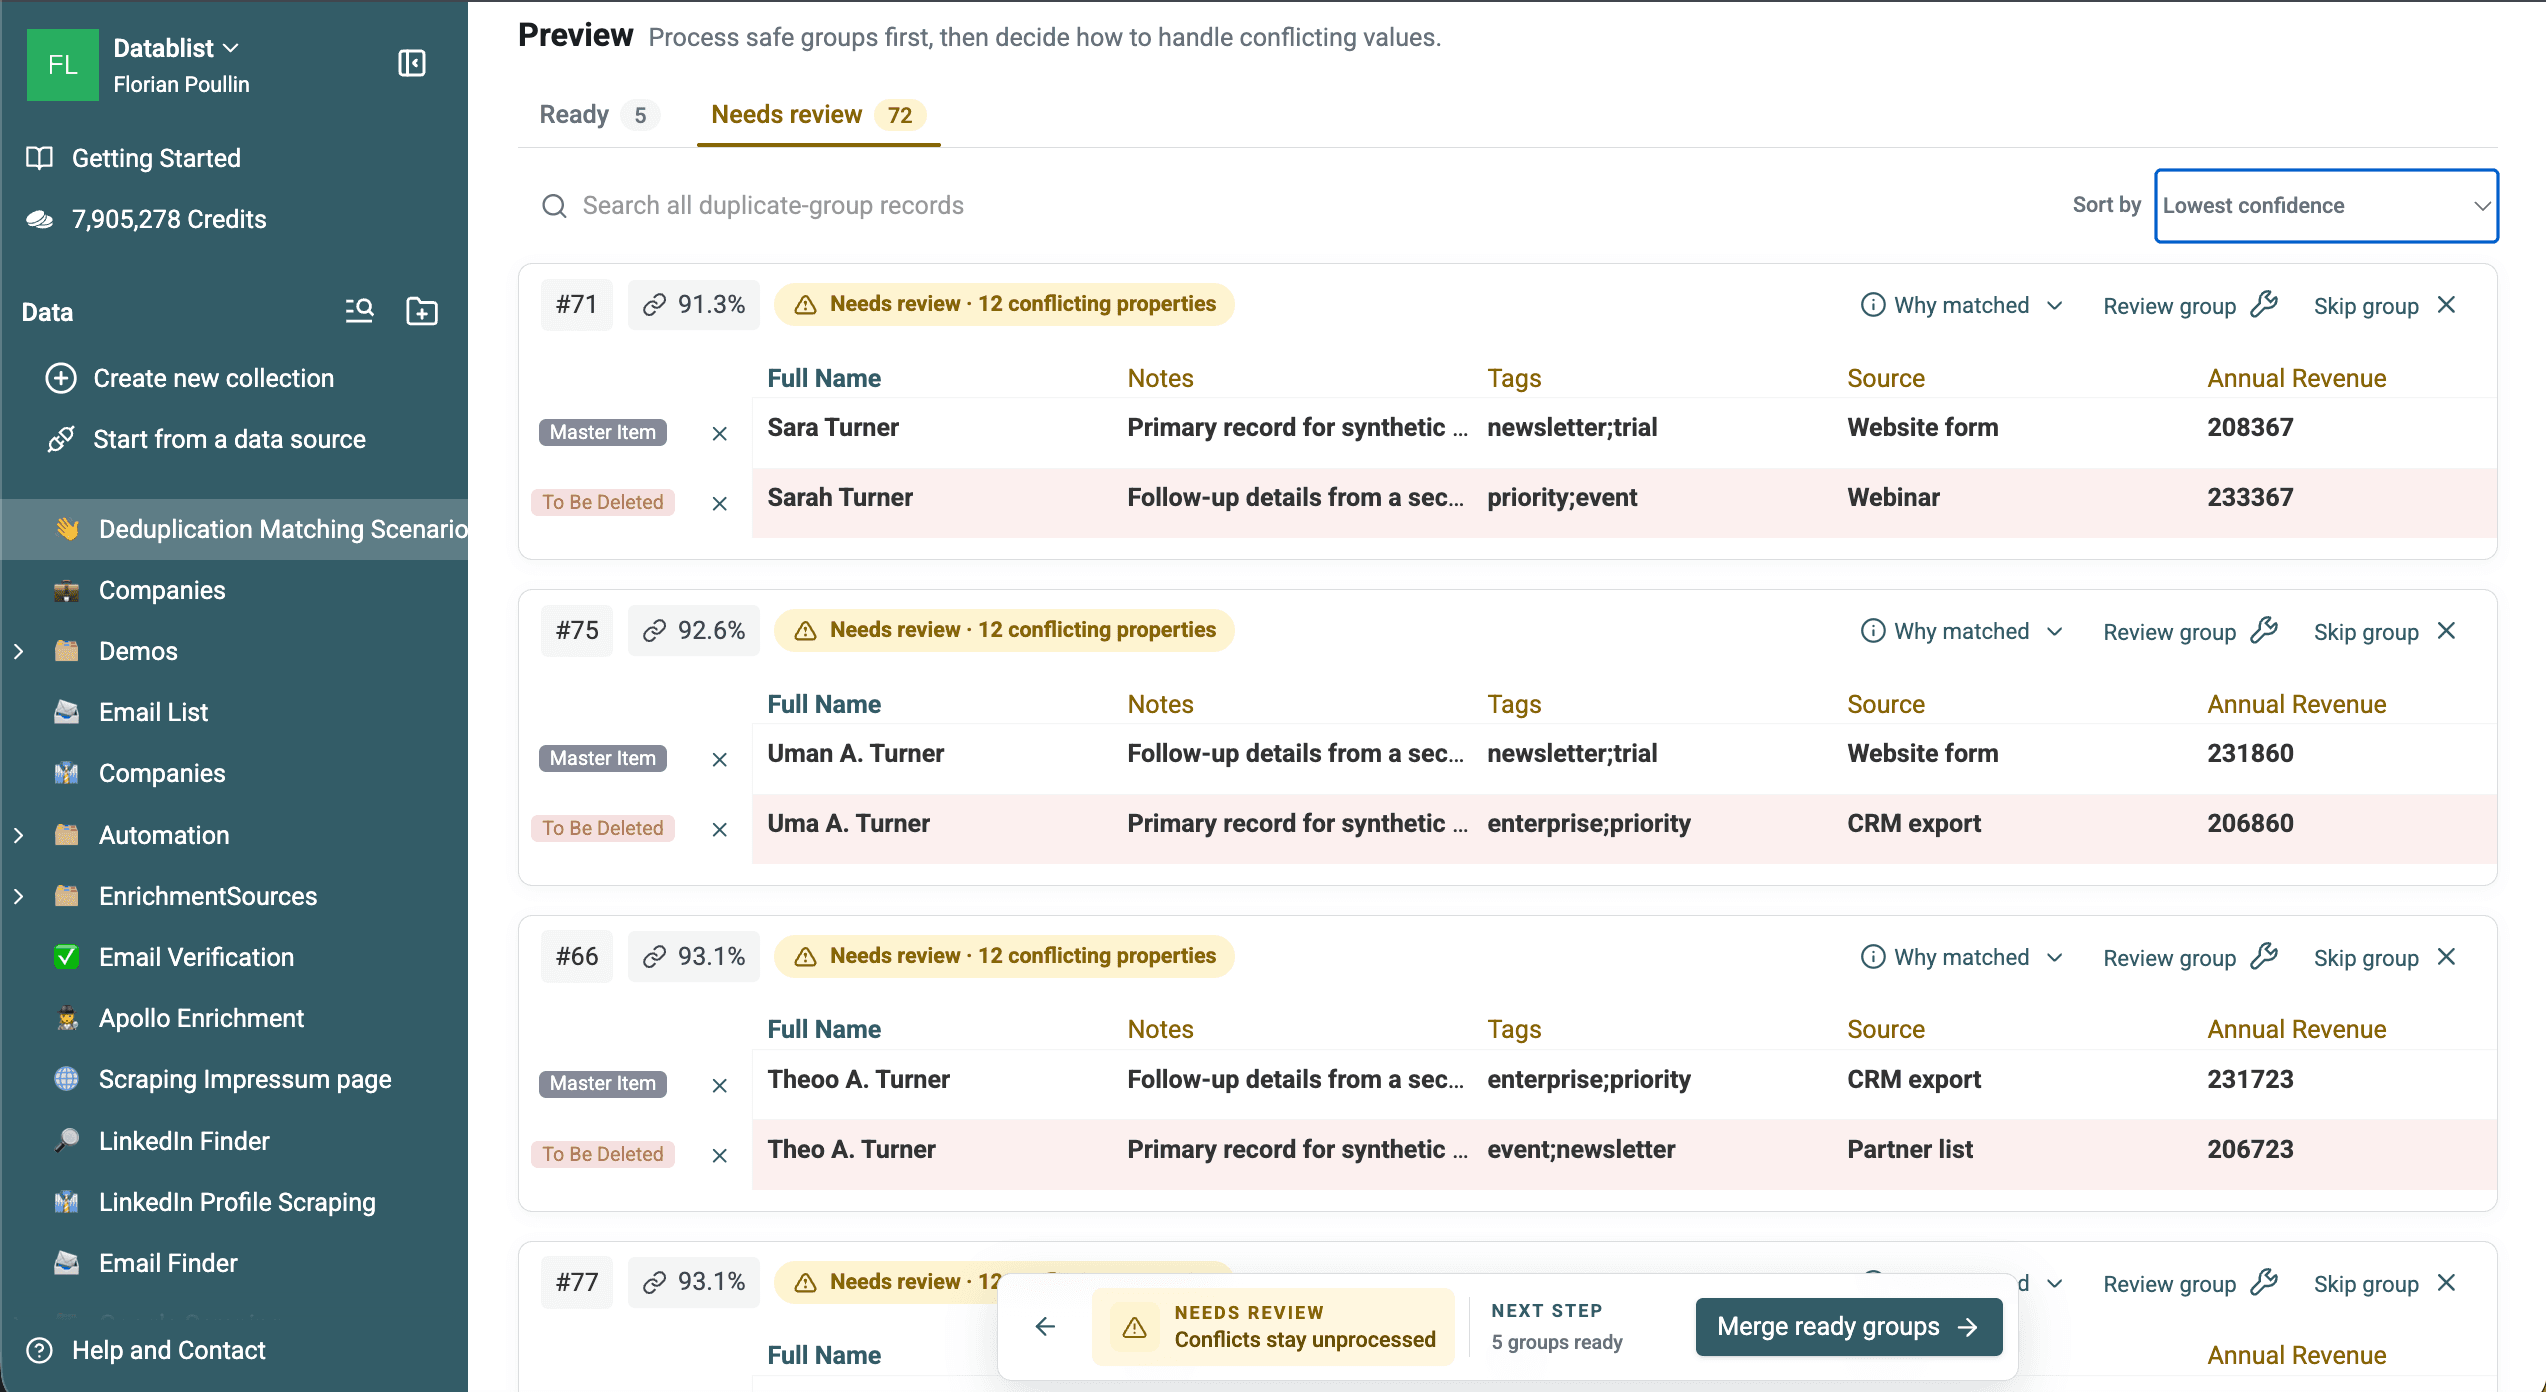
Pobierz 77 wyeksportowanych grup Levenshteina, aby przejrzeć zarówno trafne dopasowania, jak i wyniki fałszywie dodatnie.
W przypadku dopasowania fonetycznego wybierz Full Name, ustaw Metaphone i pozostaw procesor Text.
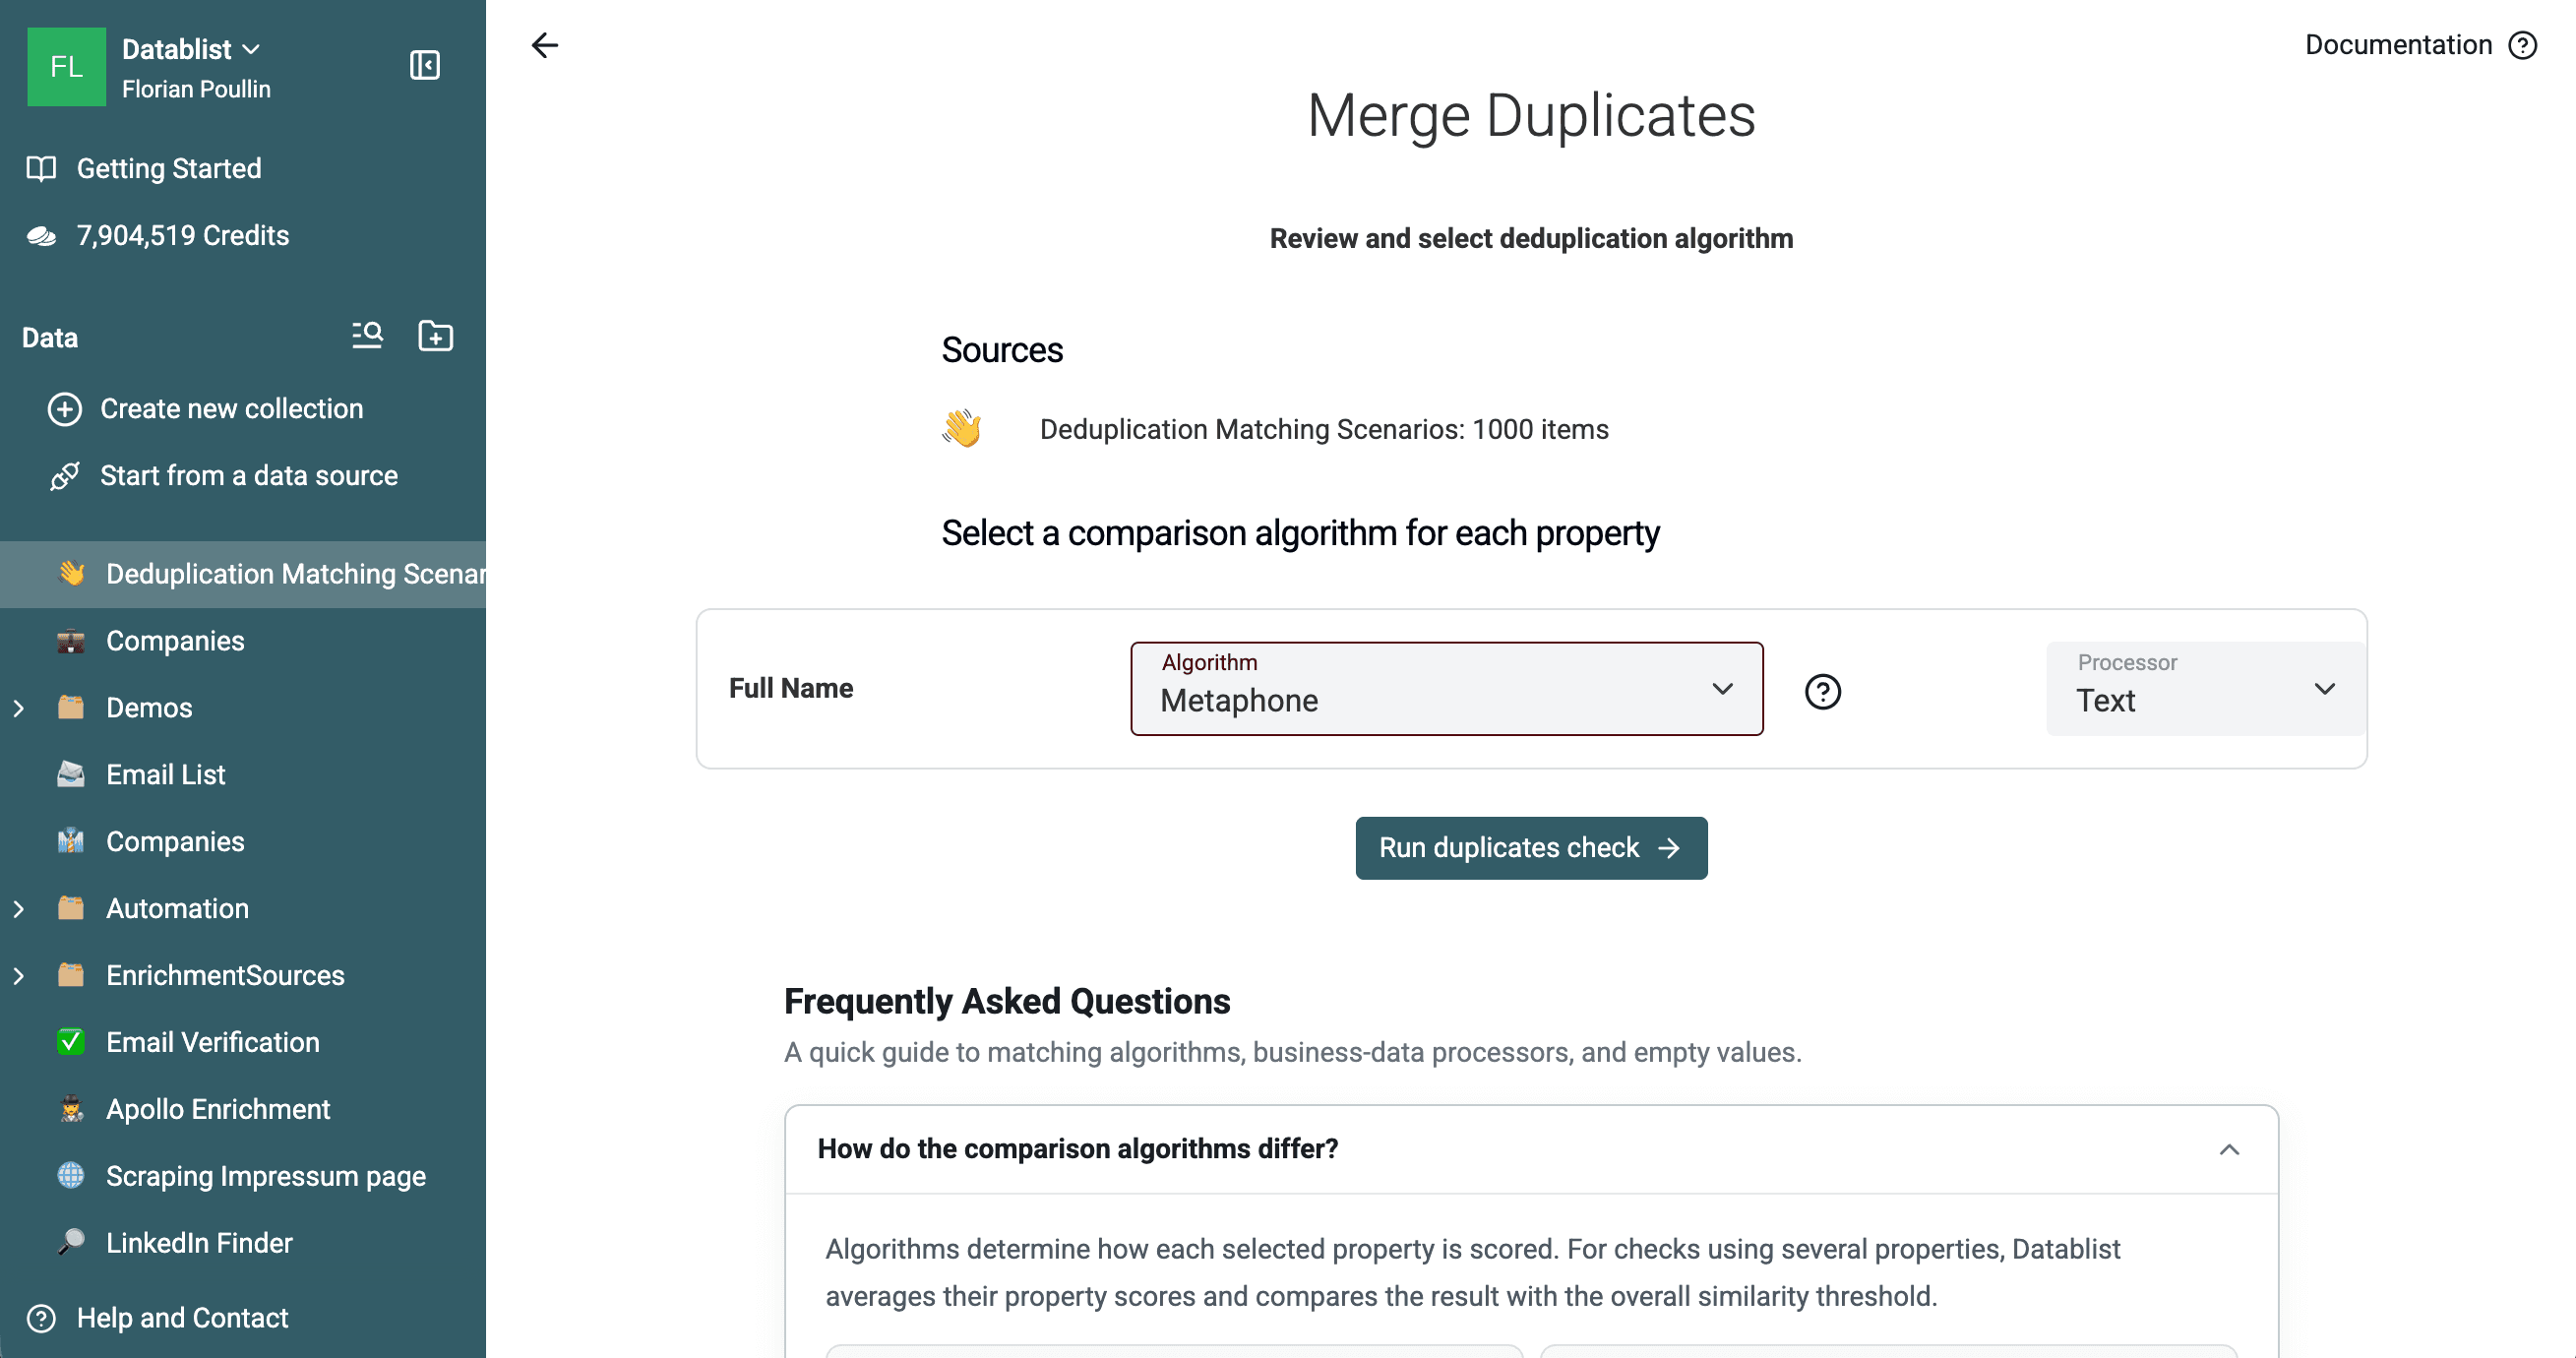
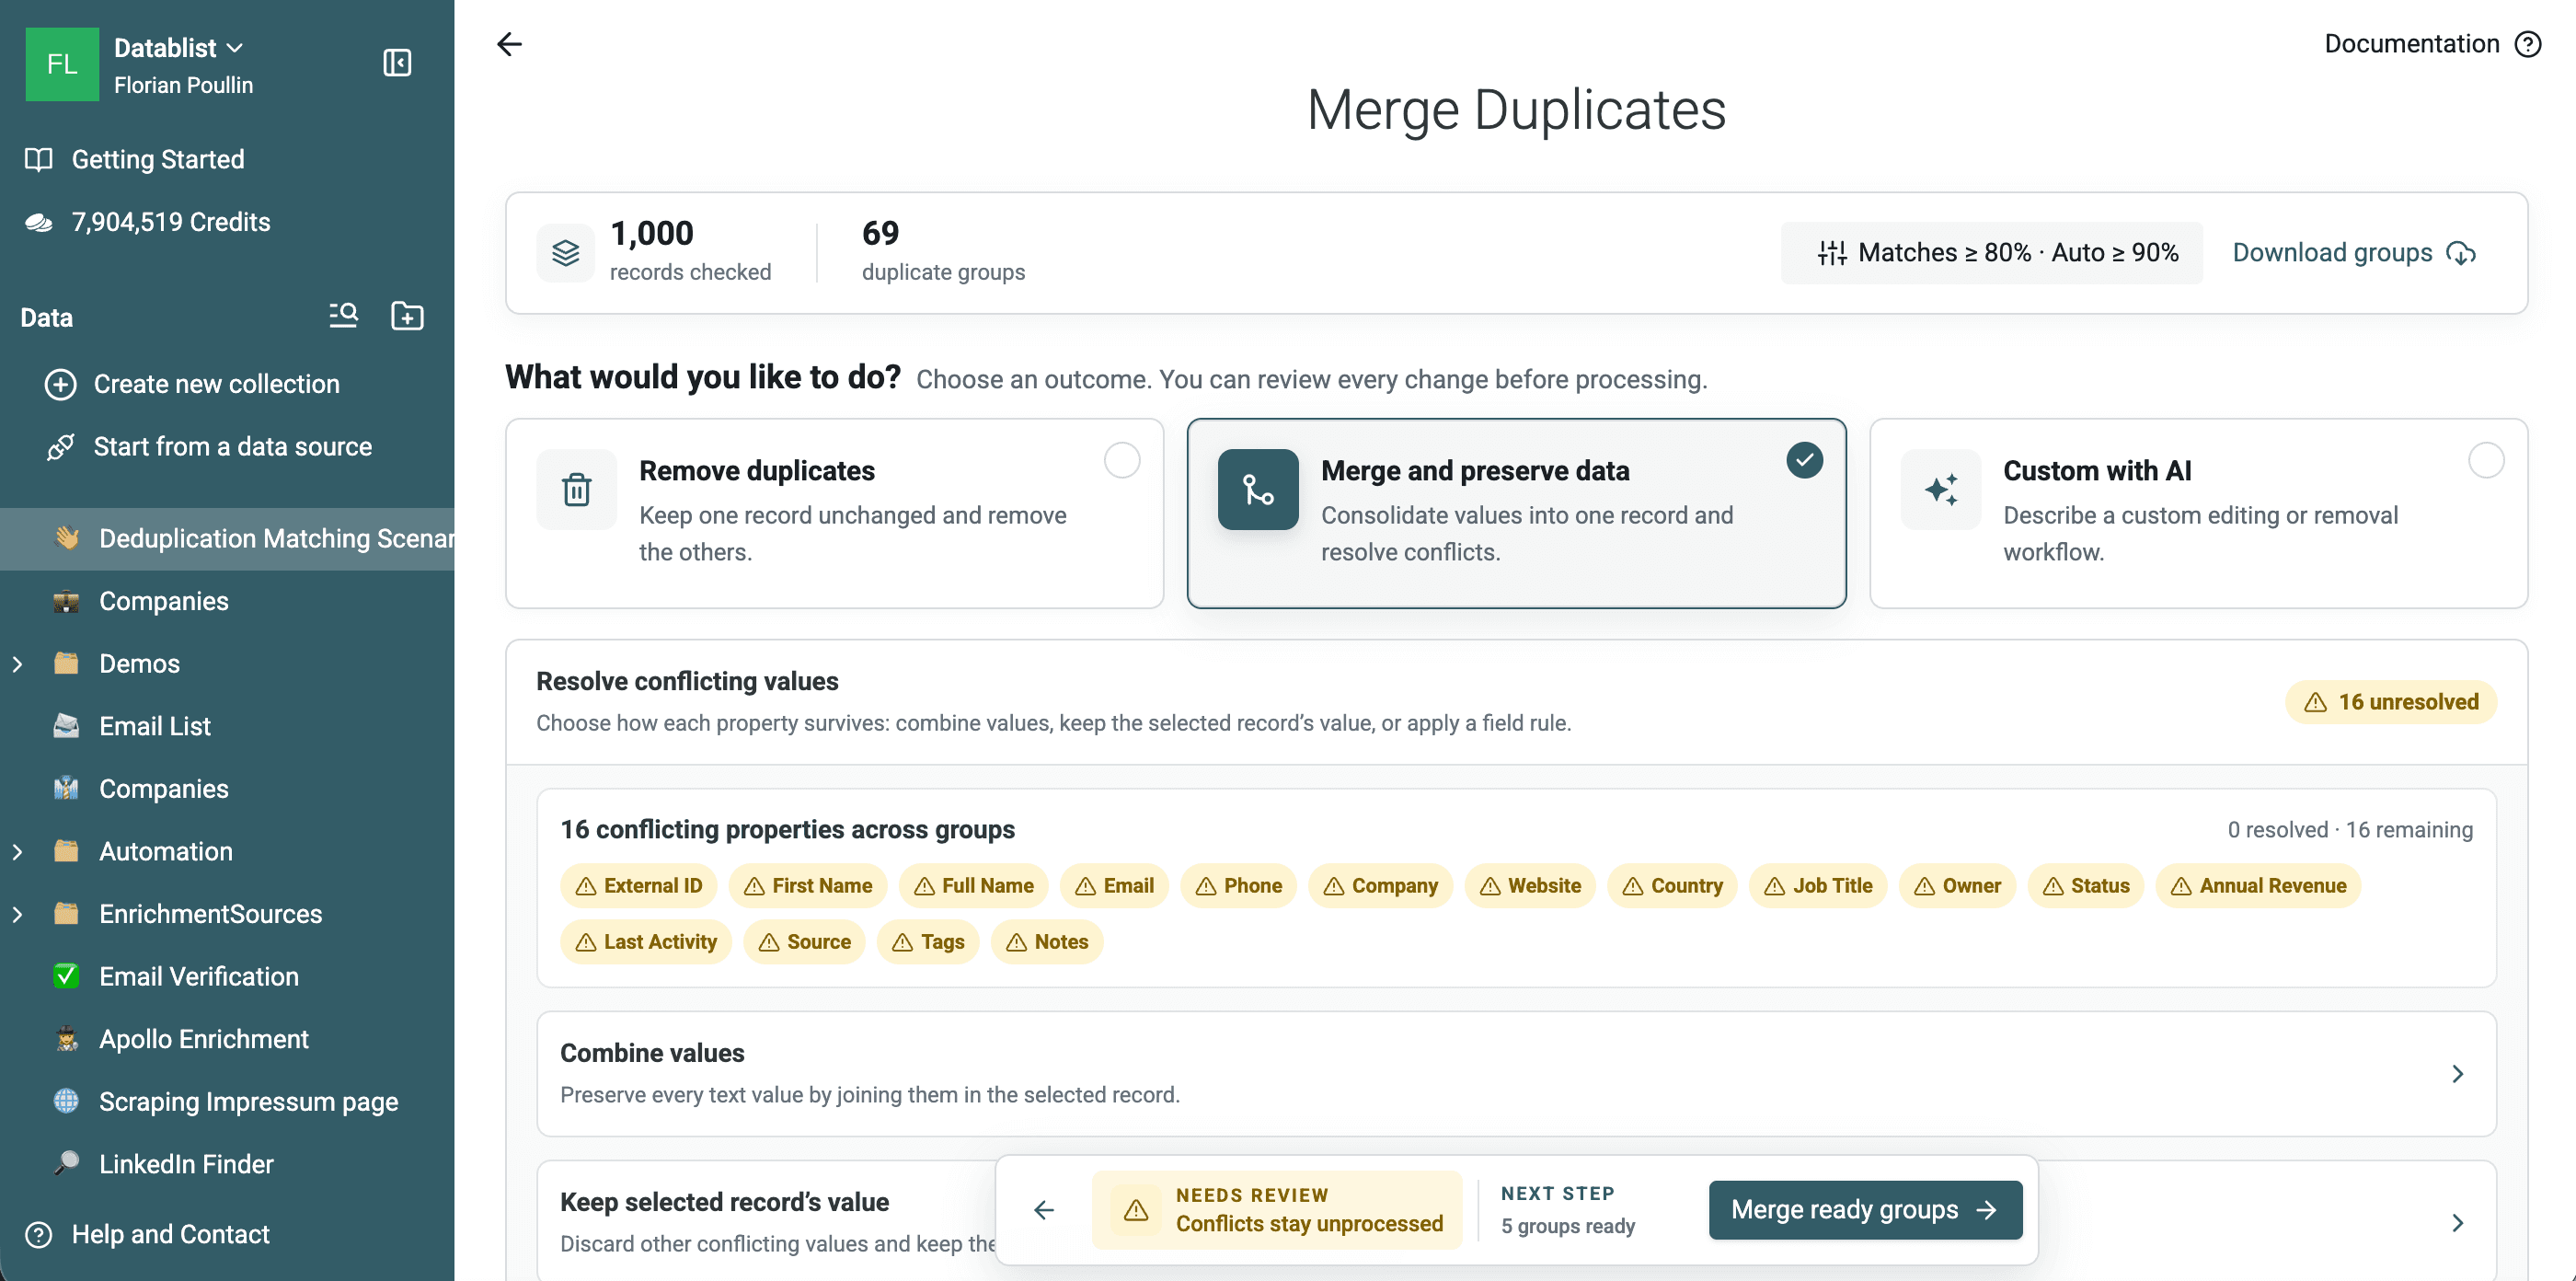
Ten etap wyświetlił 69 grup: 5 Ready i 64 Needs review. Wyeksportowane grupy zawierają 188 wierszy. Porównanie ze znanymi obiektami z próbki wykazało 19 jednorodnych grup obejmujących ten sam obiekt oraz 50 grup łączących różne osoby. Grupy mają od dwóch do siedmiu wierszy.
Why matched pokazuje właściwość Full Name, algorytm Metaphone, procesor Text oraz wynik grupy. Używaj tych informacji do audytu porównania, a nie jako zamiennika weryfikacji tożsamości.
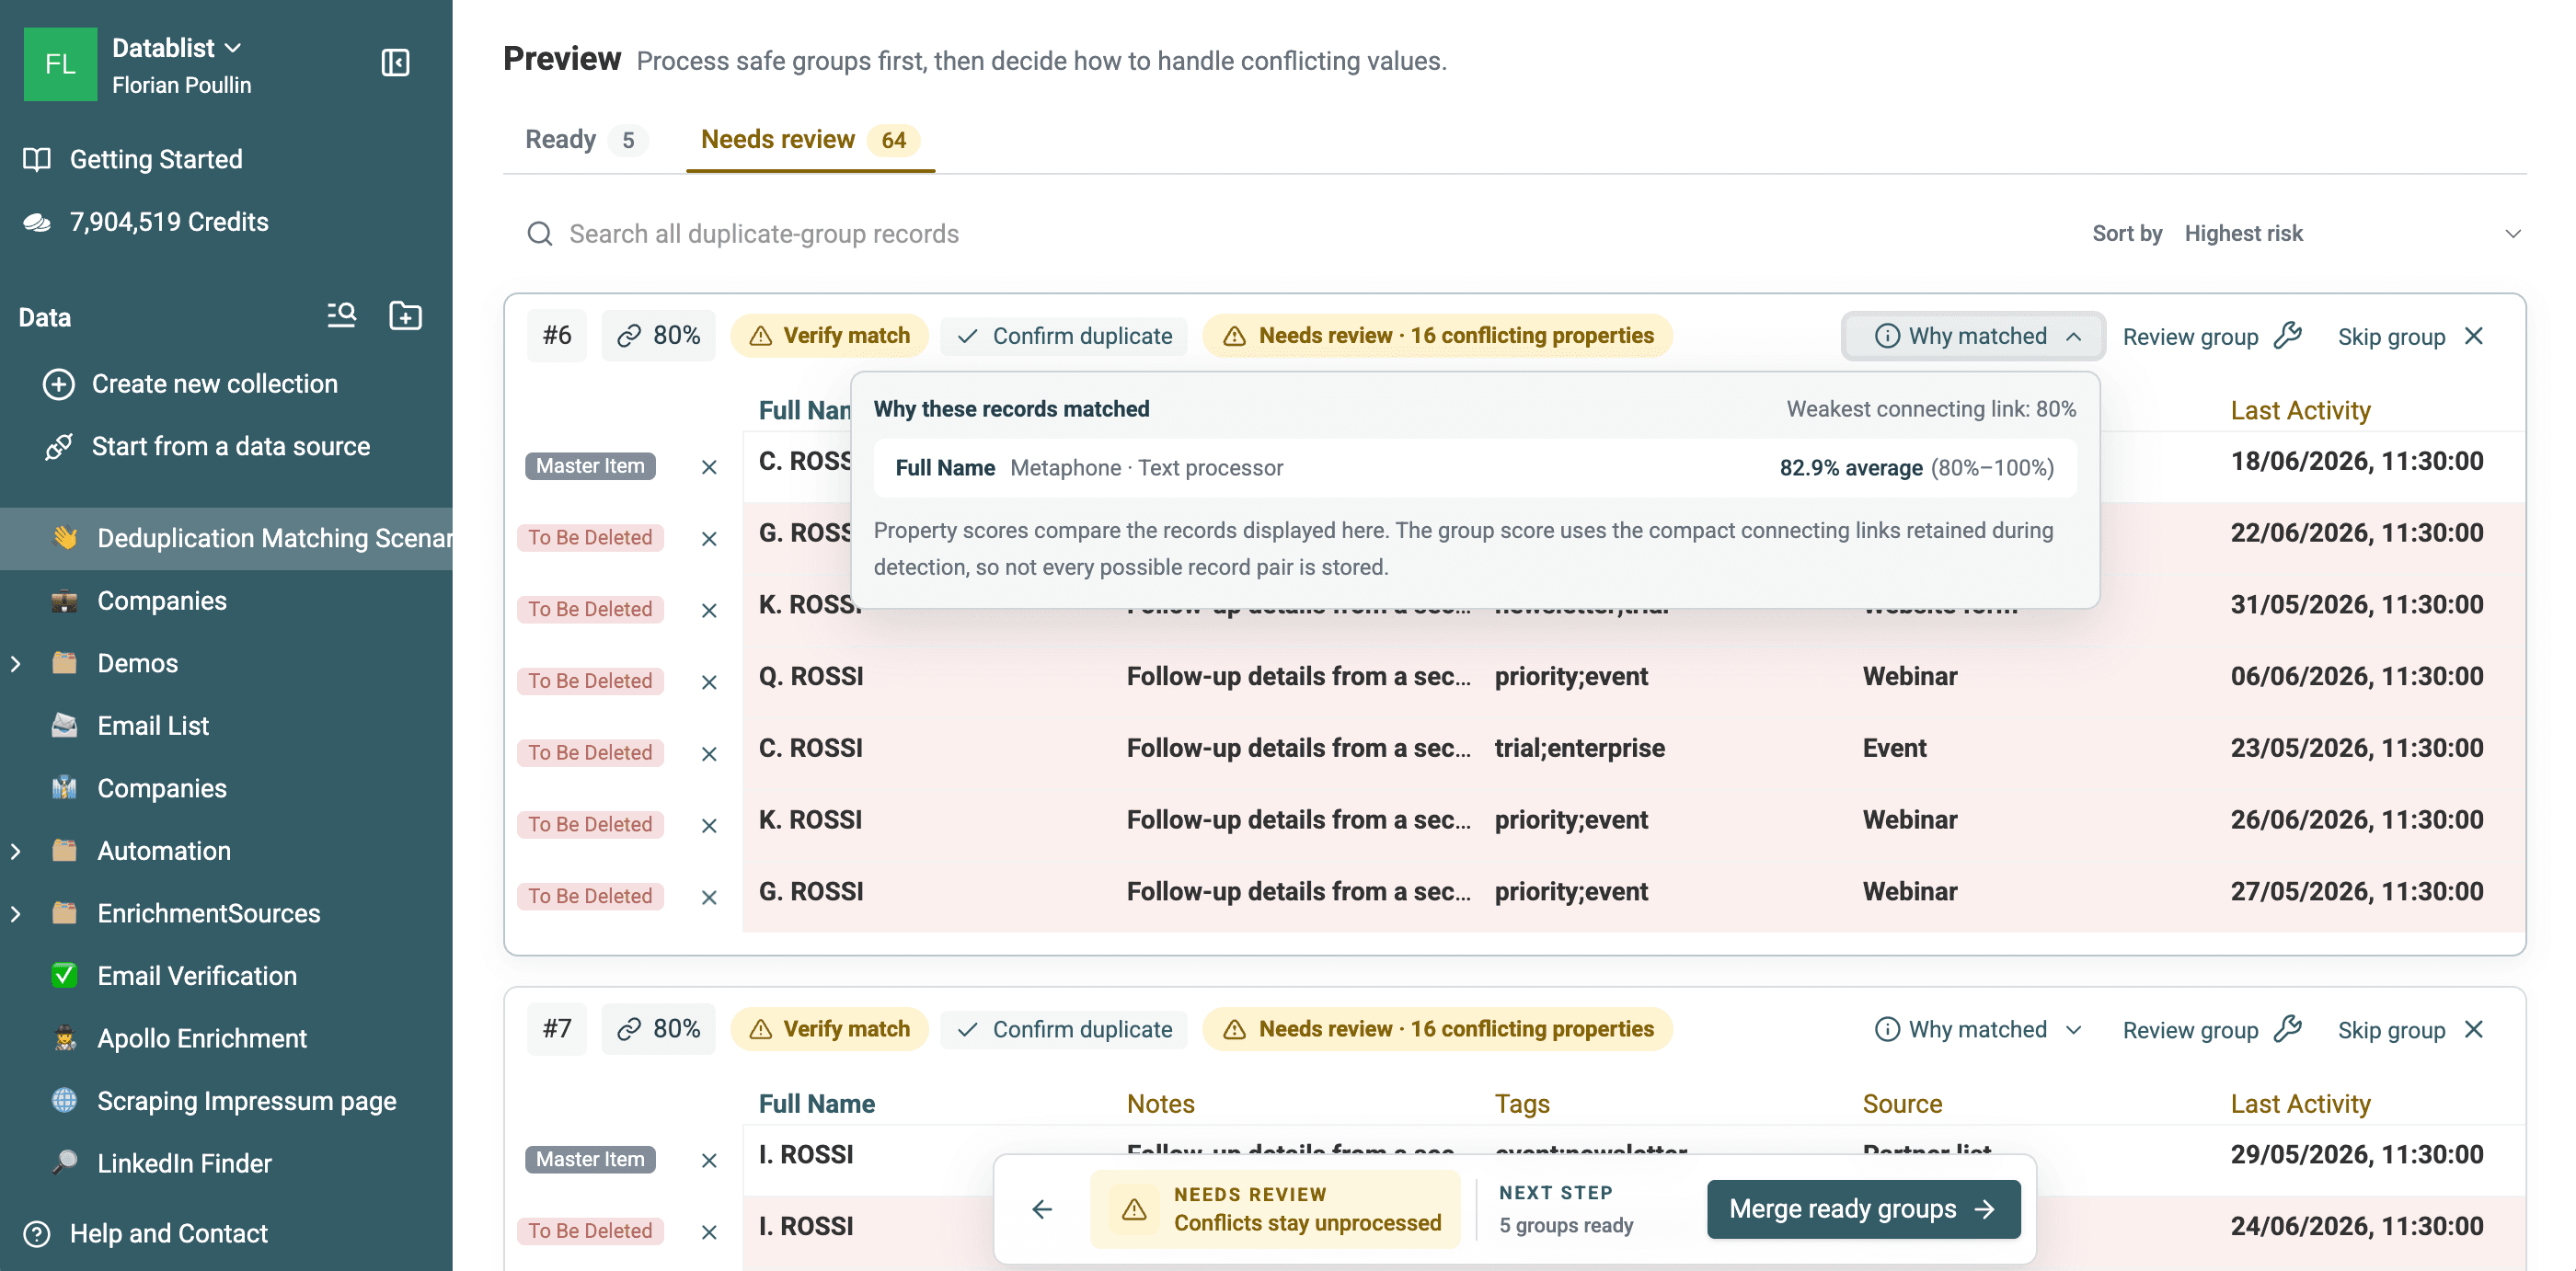
Pobierz 69 wyeksportowanych grup Metaphone, aby przejrzeć trafne dopasowania fonetyczne i wyniki fałszywie dodatnie. Większe błędne grupy często łączą inicjały z popularnym nazwiskiem, na przykład kilka skróconych nazw Rossi. Ich kody fonetyczne się pokrywają, ale same nazwy nie są wystarczającym dowodem tożsamości, by scalić rekordy automatycznie.
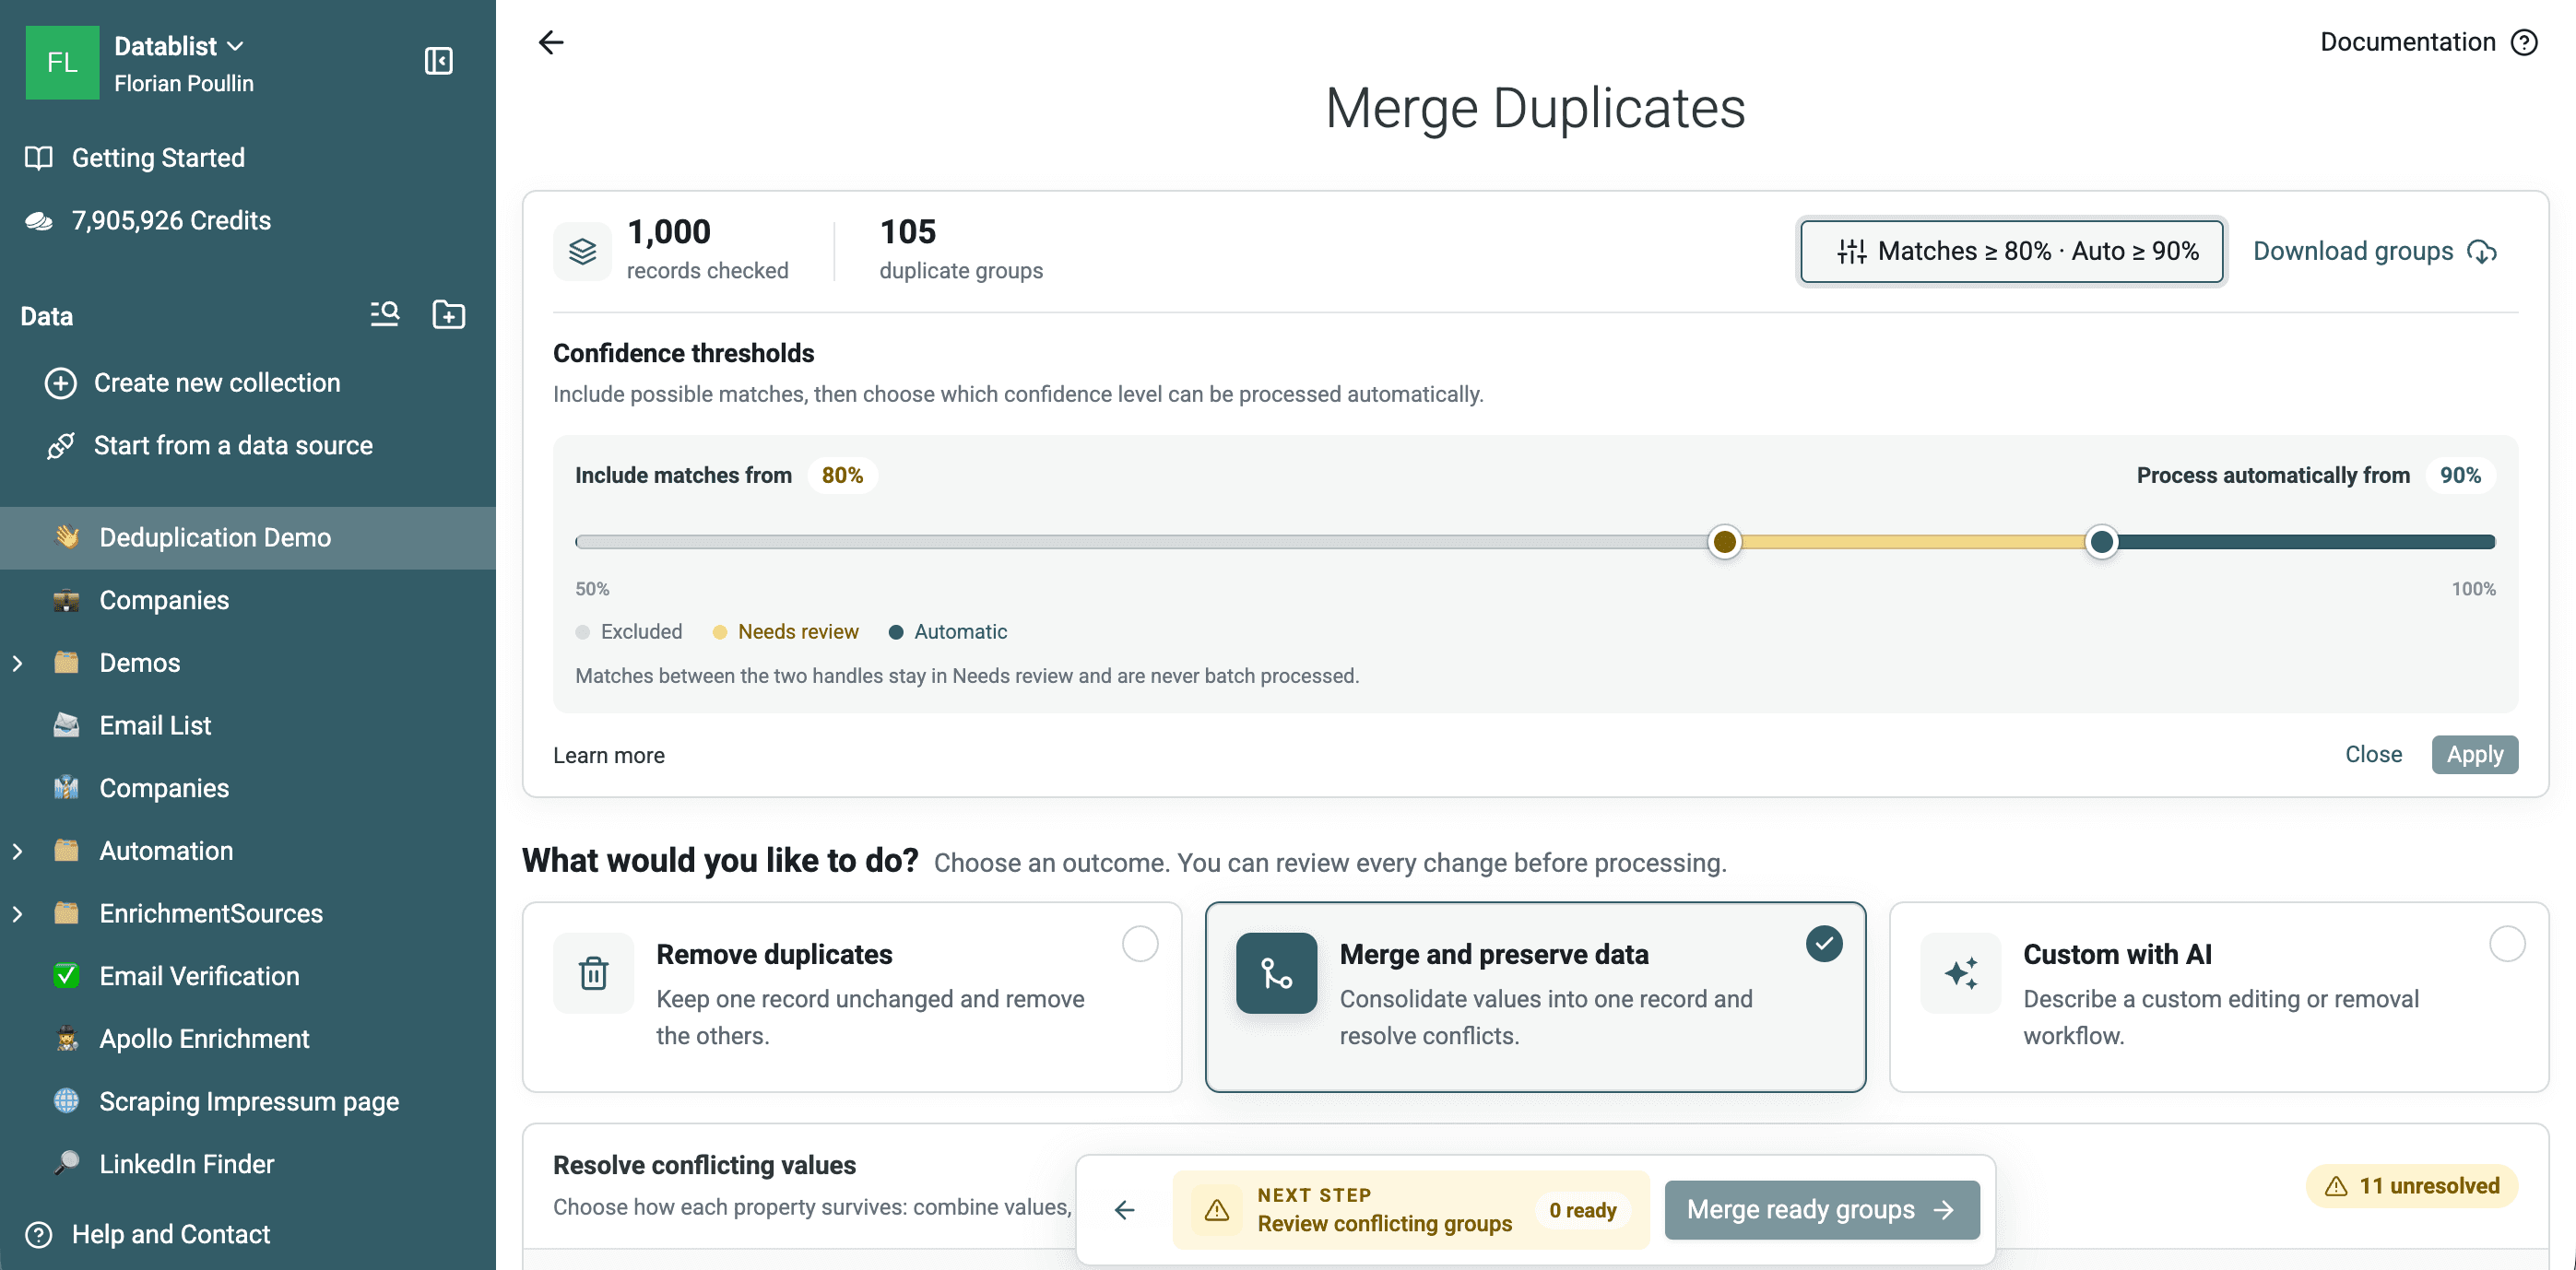
Na stronie wyników znajdują się dwa ustawienia:
- Include matches from określa, które grupy są wyświetlane.
- Process automatically from pozostawia grupy o niższej pewności w Needs review i wyklucza je z przetwarzania zbiorczego.
Takie rozdzielenie pozwala analizować szeroki zestaw kandydatów bez stosowania tej samej reguły automatyzacji do wszystkich grup.
Przejrzyj grupy duplikatów
Obszar wyników dzieli grupy duplikatów na Ready i Needs review.
- Grupy Ready mają określony wynik przetwarzania i spełniają próg pewności dla automatyzacji.
- Grupy Needs review mają niższą pewność, nierozwiązane konflikty scalania, niedopasowaną regułę wyboru rekordu albo własną regułę, która je pominęła.
W każdej niepewnej grupie sprawdź:
- Czy wszystkie wiersze reprezentują tę samą osobę, firmę lub produkt?
- Który identyfikator spowodował dopasowanie?
- Czy wartości wzajemnie się uzupełniają?
- Które źródło jest nadrzędne?
- Czy usunięcie wiersza spowoduje utratę telefonu, ID, statusu, daty lub notatki?
- Czy grupa została połączona przez słaby trzeci rekord?
Użyj Why matched, aby sprawdzić właściwości, algorytmy, procesory i zakresy wyników użyte do dopasowania. Przy dopasowaniu fuzzy podobieństwo grupy odpowiada najsłabszemu zachowanemu połączeniu niezbędnemu do utrzymania grupy w całości.
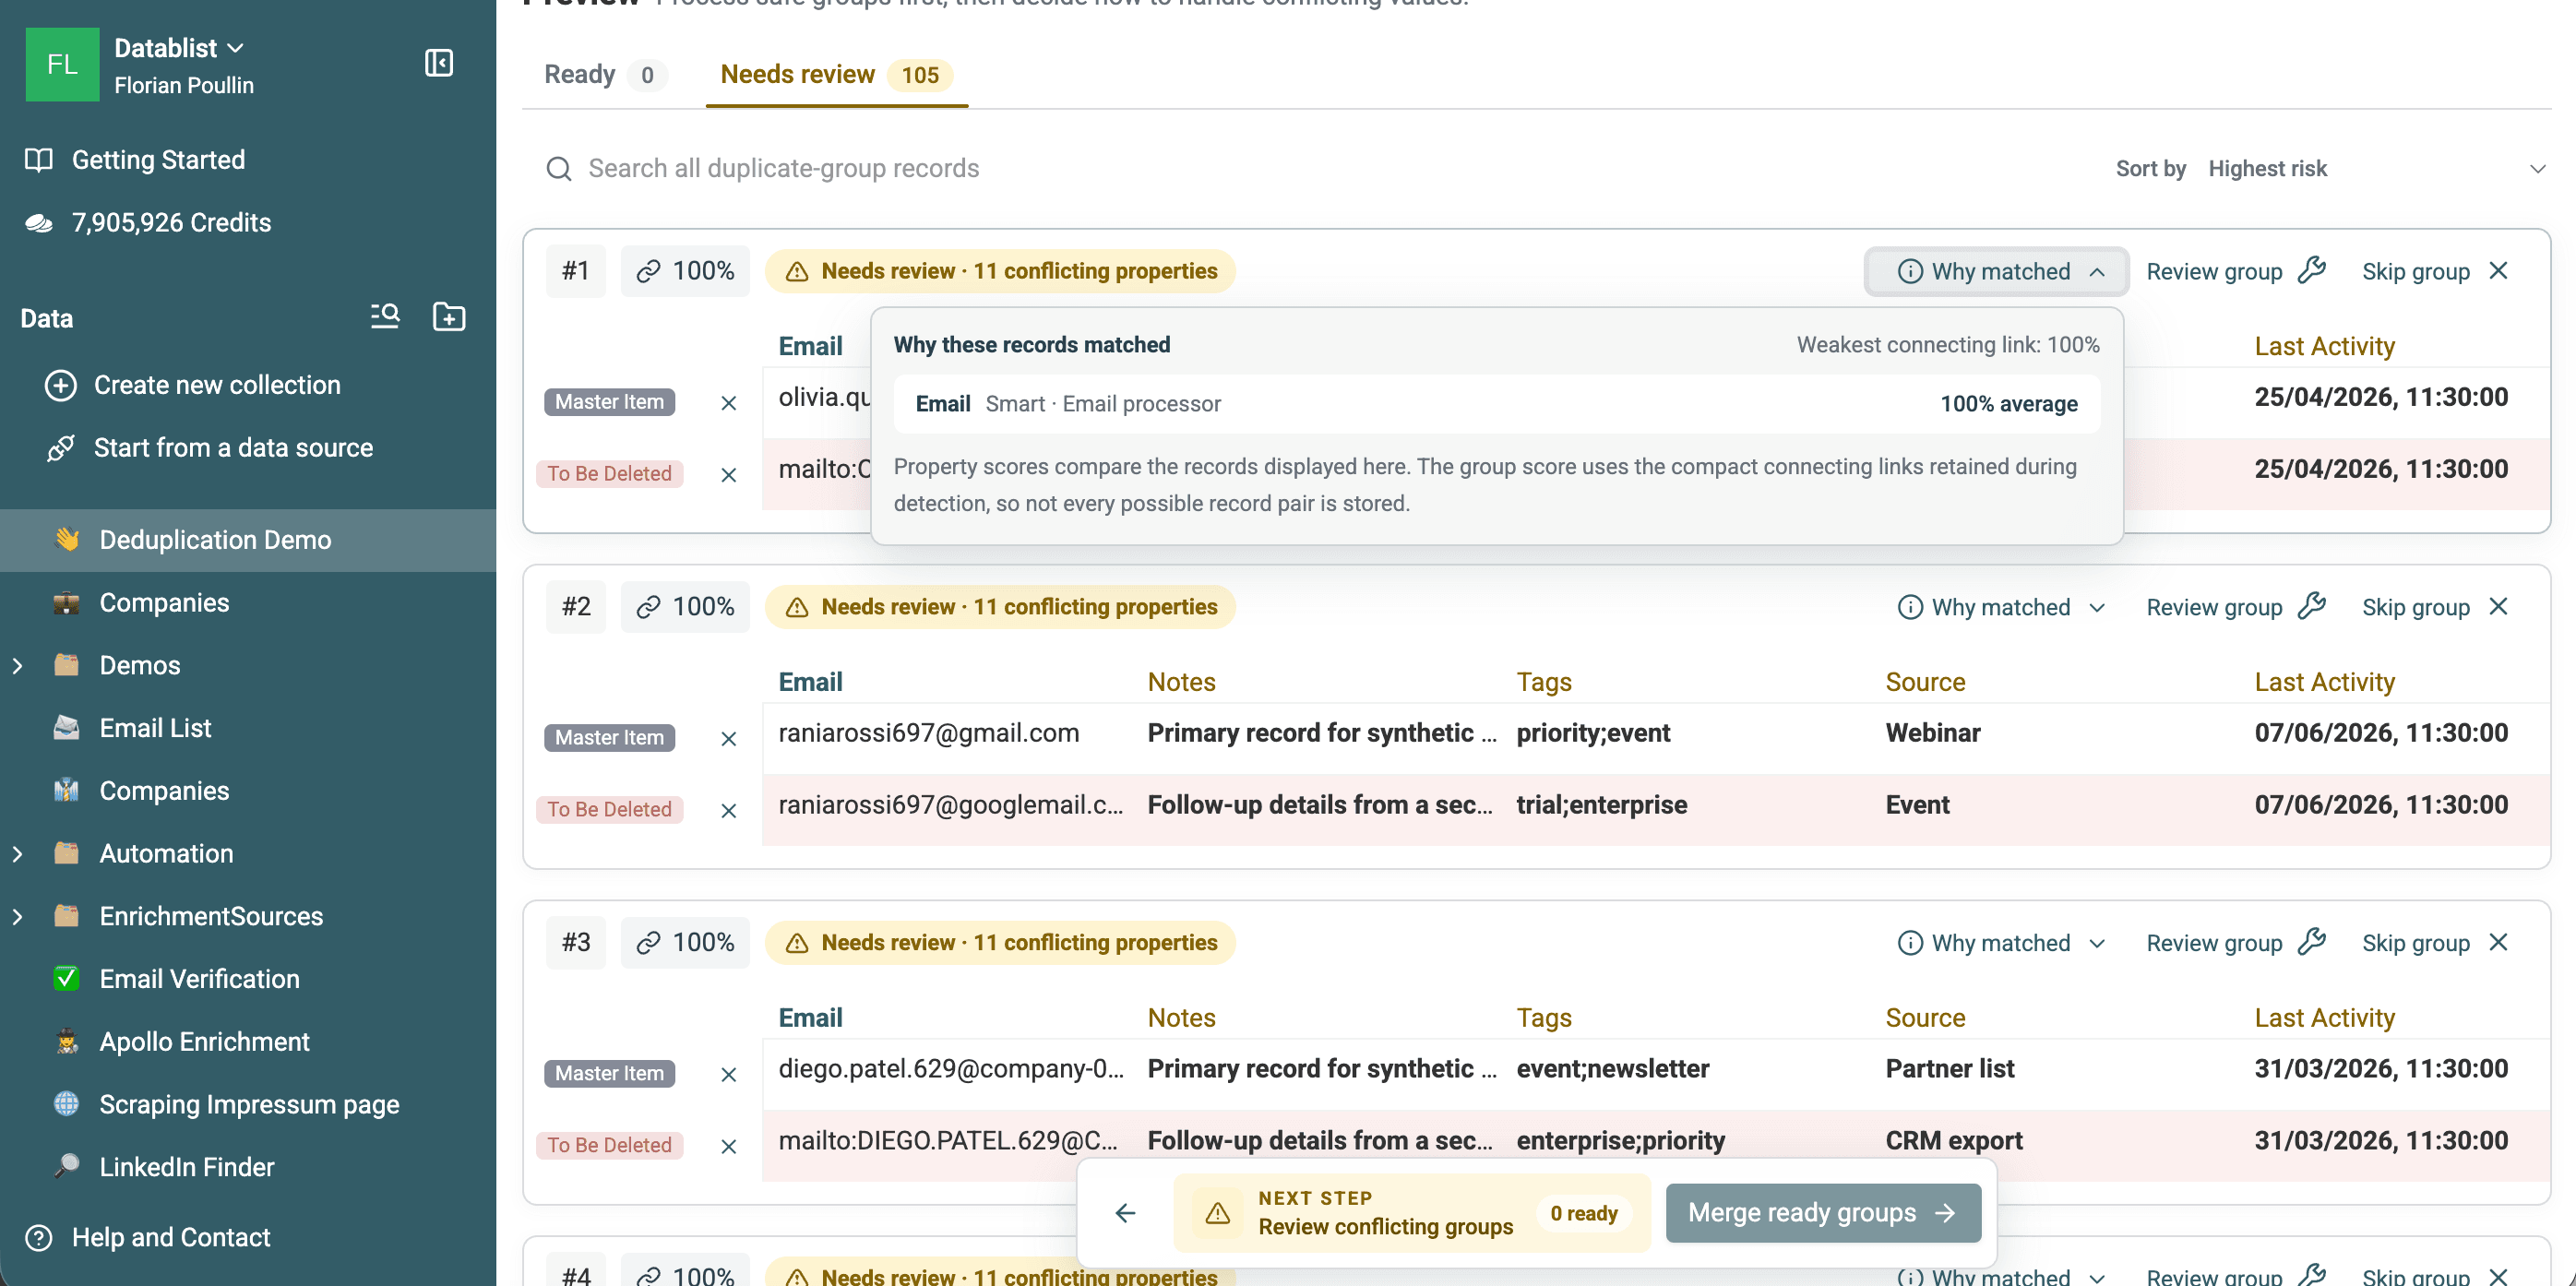
Możesz również:
- Potwierdzić dopasowanie o niskiej pewności.
- Usunąć rekord z grupy bez kasowania go z kolekcji.
- Pominąć grupę.
- Otworzyć rekord i go edytować.
- Sprawdzić grupę w Merging Assistant.
- Przeszukiwać pozostałe grupy i sortować kandydatów od najbardziej ryzykownych.
⚠️ Nie przetwarzaj grupy fuzzy wyłącznie na podstawie procentowego wyniku
Podobne imiona i nazwiska mogą należeć do różnych osób. Przed potwierdzeniem grupy sprawdź identyfikatory i pozostałe pola.
Sprawdź wspólne i brakujące identyfikatory przed scaleniem
Wspólna skrzynka, taka jak info@company.example, może należeć do kilku kontaktów. Dwie osoby korzystające z tego adresu mogą zostać dopasowane według Email, choć nadal są różnymi osobami. Podobnie domena firmy może wskazywać jedną organizację, ale występować w rekordach wielu pracowników.
Takich grup nie należy automatycznie scalać na poziomie osób, dopóki dopasowania nie potwierdzi inny identyfikator. Jeśli jednak celem jest jeden wiersz na firmę, wspólna domena może być właściwym kluczem grupowania. Zanim zinterpretujesz wynik, określ typ obiektu.
Reguła pustych wartości również zmienia sposób porównywania wybranych właściwości. Przy wielopolowym sprawdzeniu innym niż Exact zaawansowane ustawienie Empty Value Rule oferuje opcje Value required (default) oraz Match on empty value. Domyślna opcja wymaga obecności tekstowego identyfikatora, natomiast dopuszczenie zgodności pustych wartości łagodzi ten wymóg. Stosuj je tylko wtedy, gdy pozostałe pola dostarczają wystarczających dowodów tożsamości — dwa brakujące adresy e-mail nie świadczą o tym, że dwie osoby są tym samym kontaktem.
Przykładowo dwóch wierszy z pustym polem Email i różnymi wartościami Full Name nie należy scalać tylko po to, aby zmniejszyć liczbę rekordów. Wiersz bez adresu e-mail może nadal zawierać kontakt, który trzeba zachować lub później wzbogacić.
Usuń, scal lub przetwórz duplikaty własnymi regułami
Wykrywanie i rozwiązywanie duplikatów to dwie odrębne decyzje. Tryb przetwarzania wybierz dopiero po sprawdzeniu, co zawierają dodatkowe wiersze.
Usuń duplikaty, gdy jeden rekord jest nadrzędny
Remove duplicates pozostawia wybrany rekord bez zmian i usuwa pozostałe wiersze z każdej grupy Ready.
Użyj tej opcji dla skopiowanych wierszy, tymczasowych importów lub rekordów, których dodatkowe wartości można odrzucić. Podgląd ostrzega, gdy usuwane rekordy zawierają dodatkowe lub sprzeczne informacje. Wartości te nie zostaną skopiowane do zachowanego rekordu.
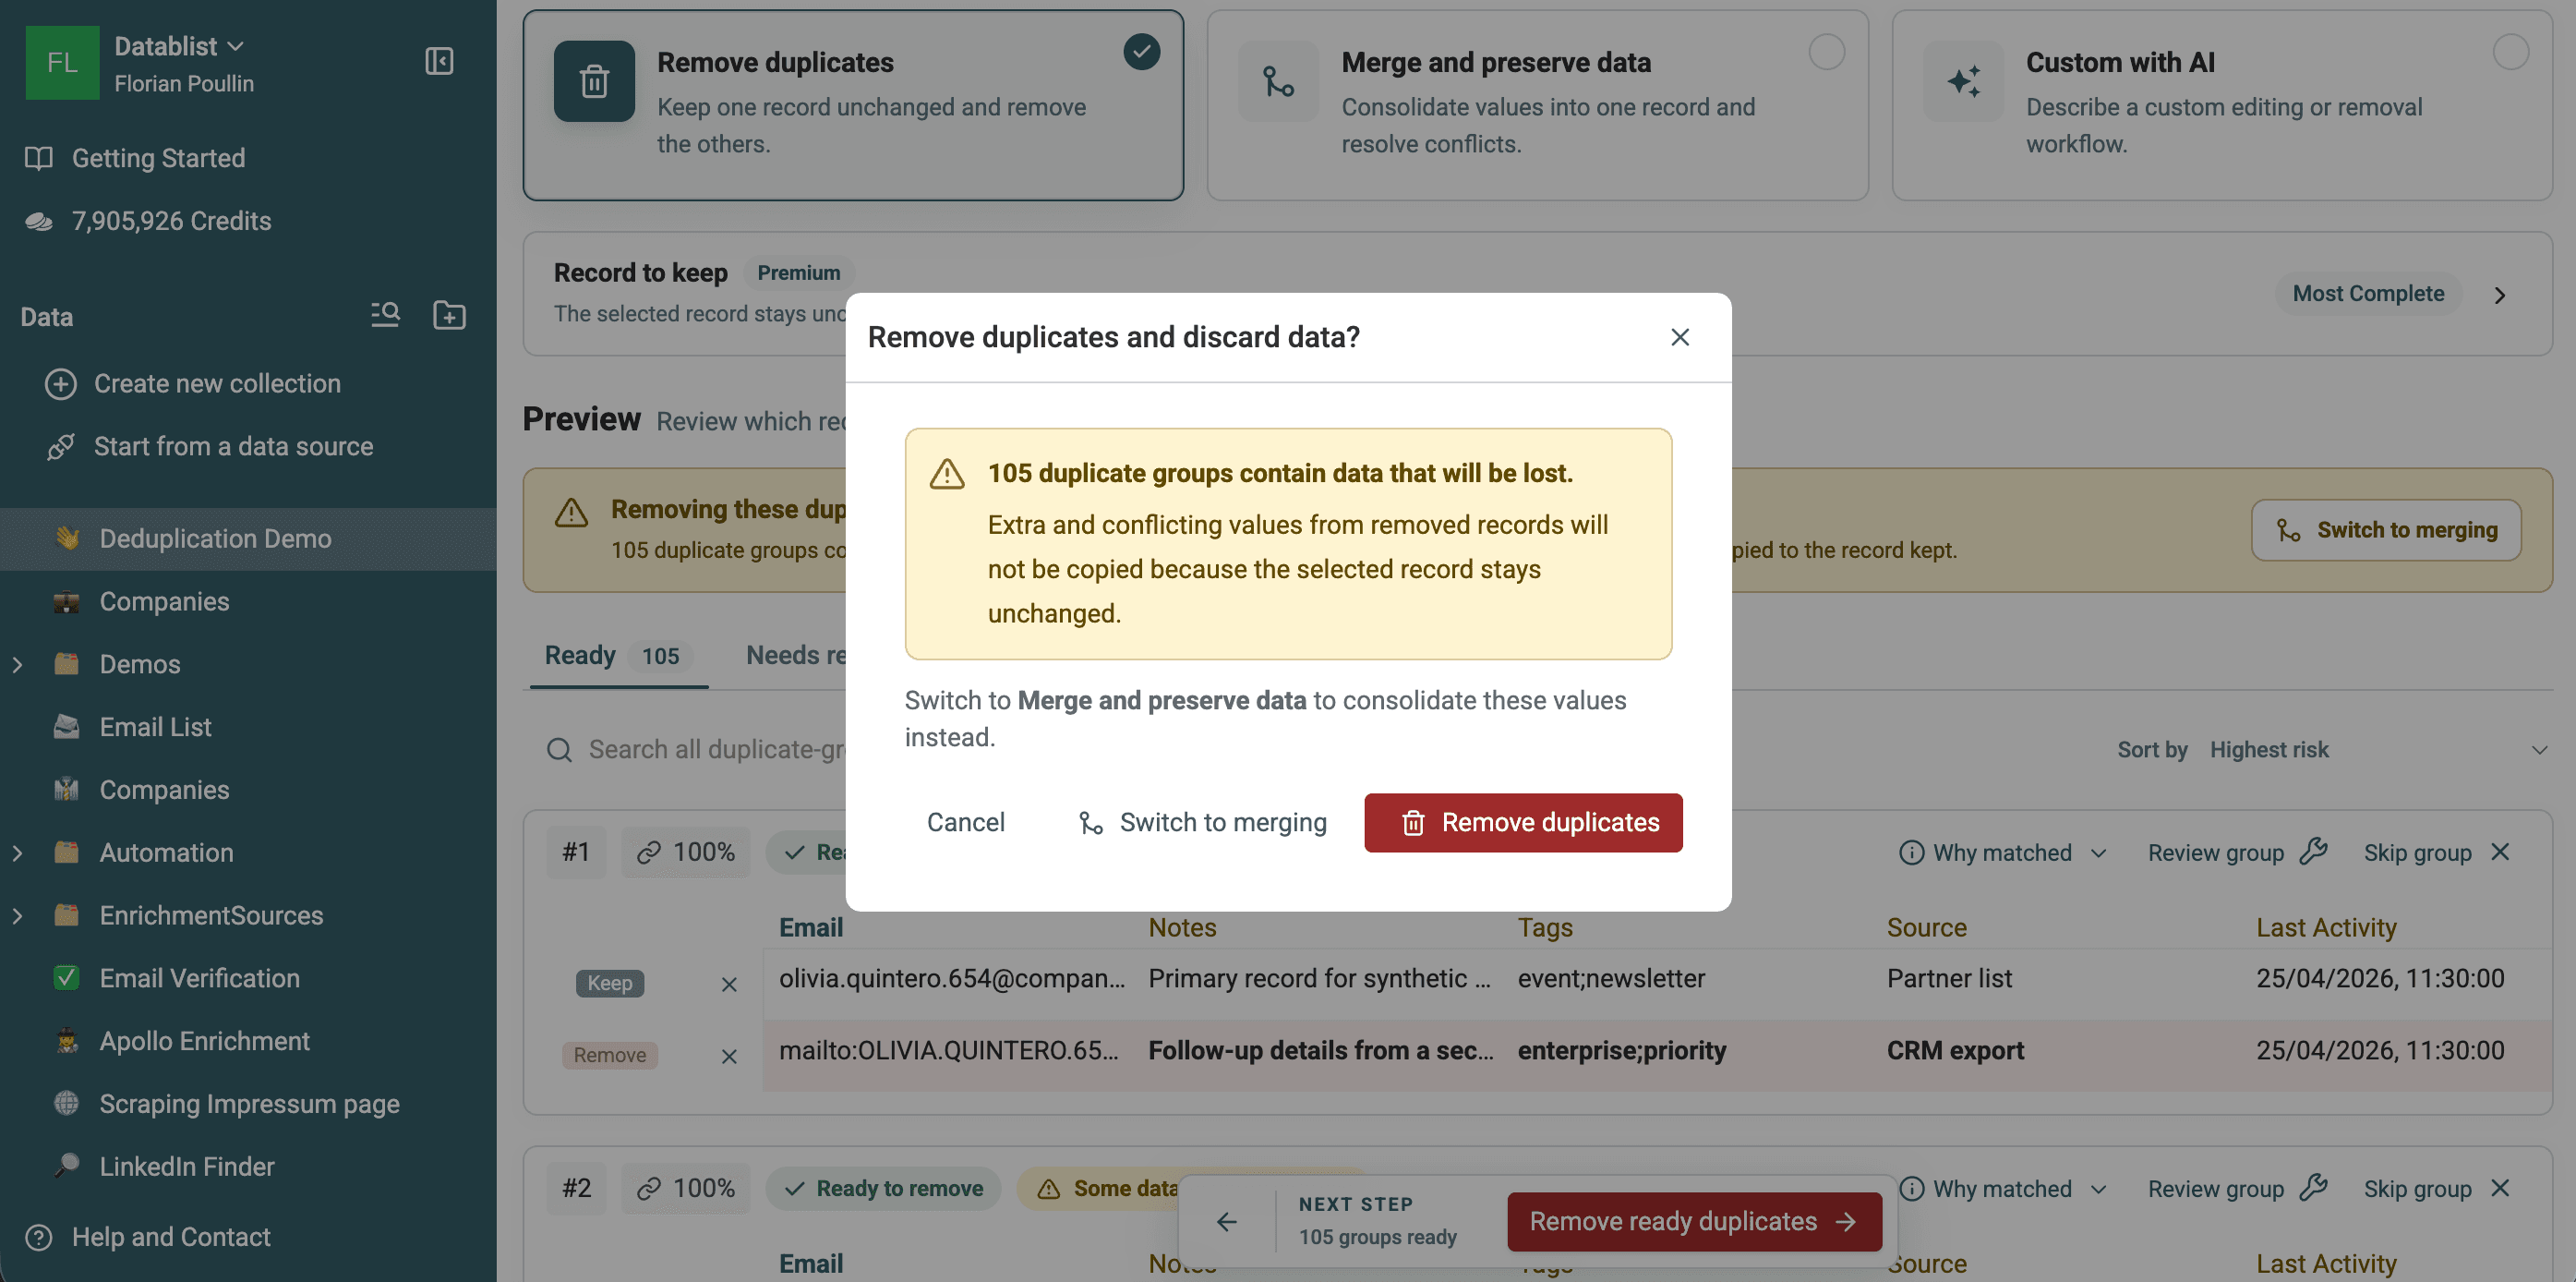
Scal rekordy, gdy zawierają przydatne dane
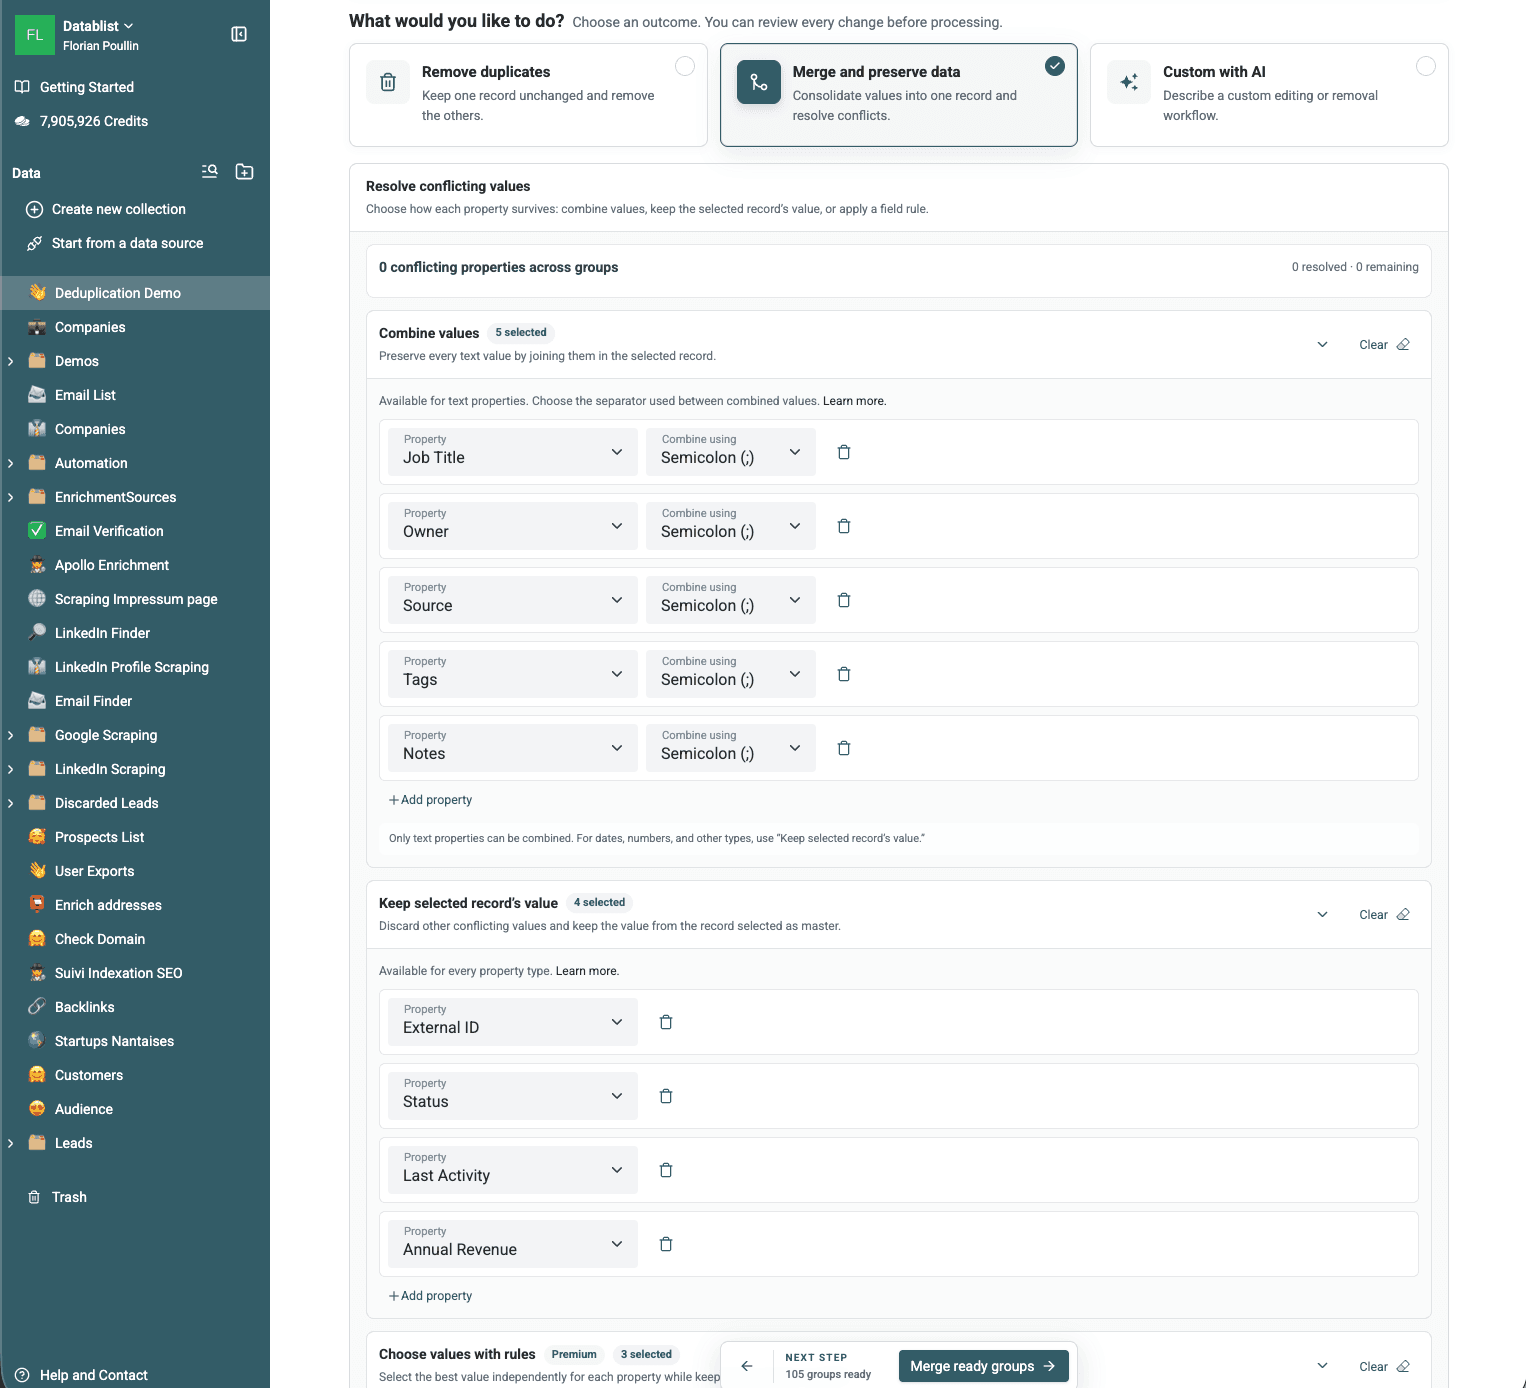
Merge and preserve data uzupełnia puste właściwości w wybranym rekordzie, rozwiązuje konflikty zgodnie z konfiguracją, a następnie usuwa dodatkowe wiersze.
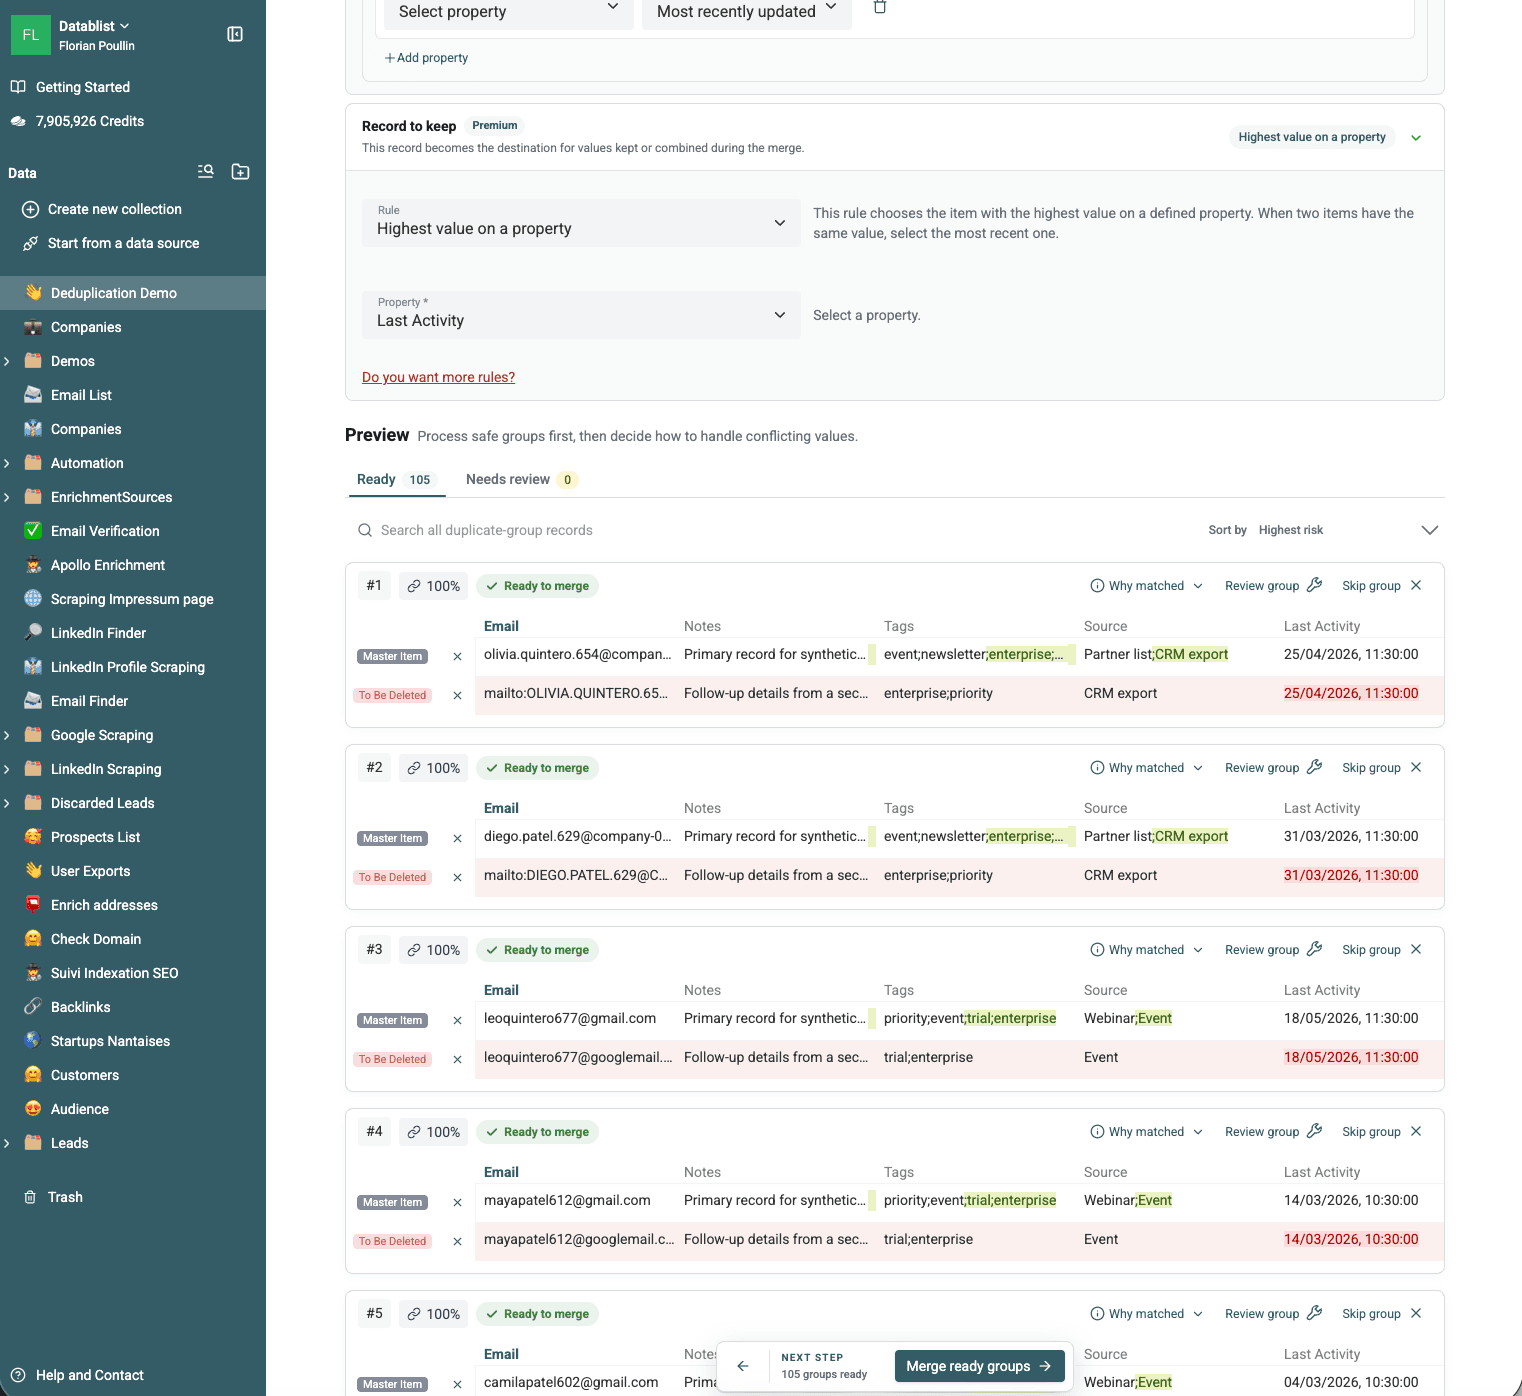
Zacznij od reguły Record to keep. Domyślnie wybrana jest opcja Most Complete. W płatnych planach można stosować reguły oparte na dacie utworzenia lub aktualizacji, najwyższej bądź najniższej wartości właściwości albo wymaganej wartości właściwości.
Następnie zdecyduj, która wartość ma pozostać w przypadku konfliktu:
- Połącz różne wartości tekstowe za pomocą separatora.
- Zachowaj wartość z wybranego rekordu.
- W płatnych planach wybieraj wartości niezależnie według reguł takich jak najnowsza, najstarsza, najdłuższa, najkrótsza, najwyższa, najniższa lub najczęstsza.
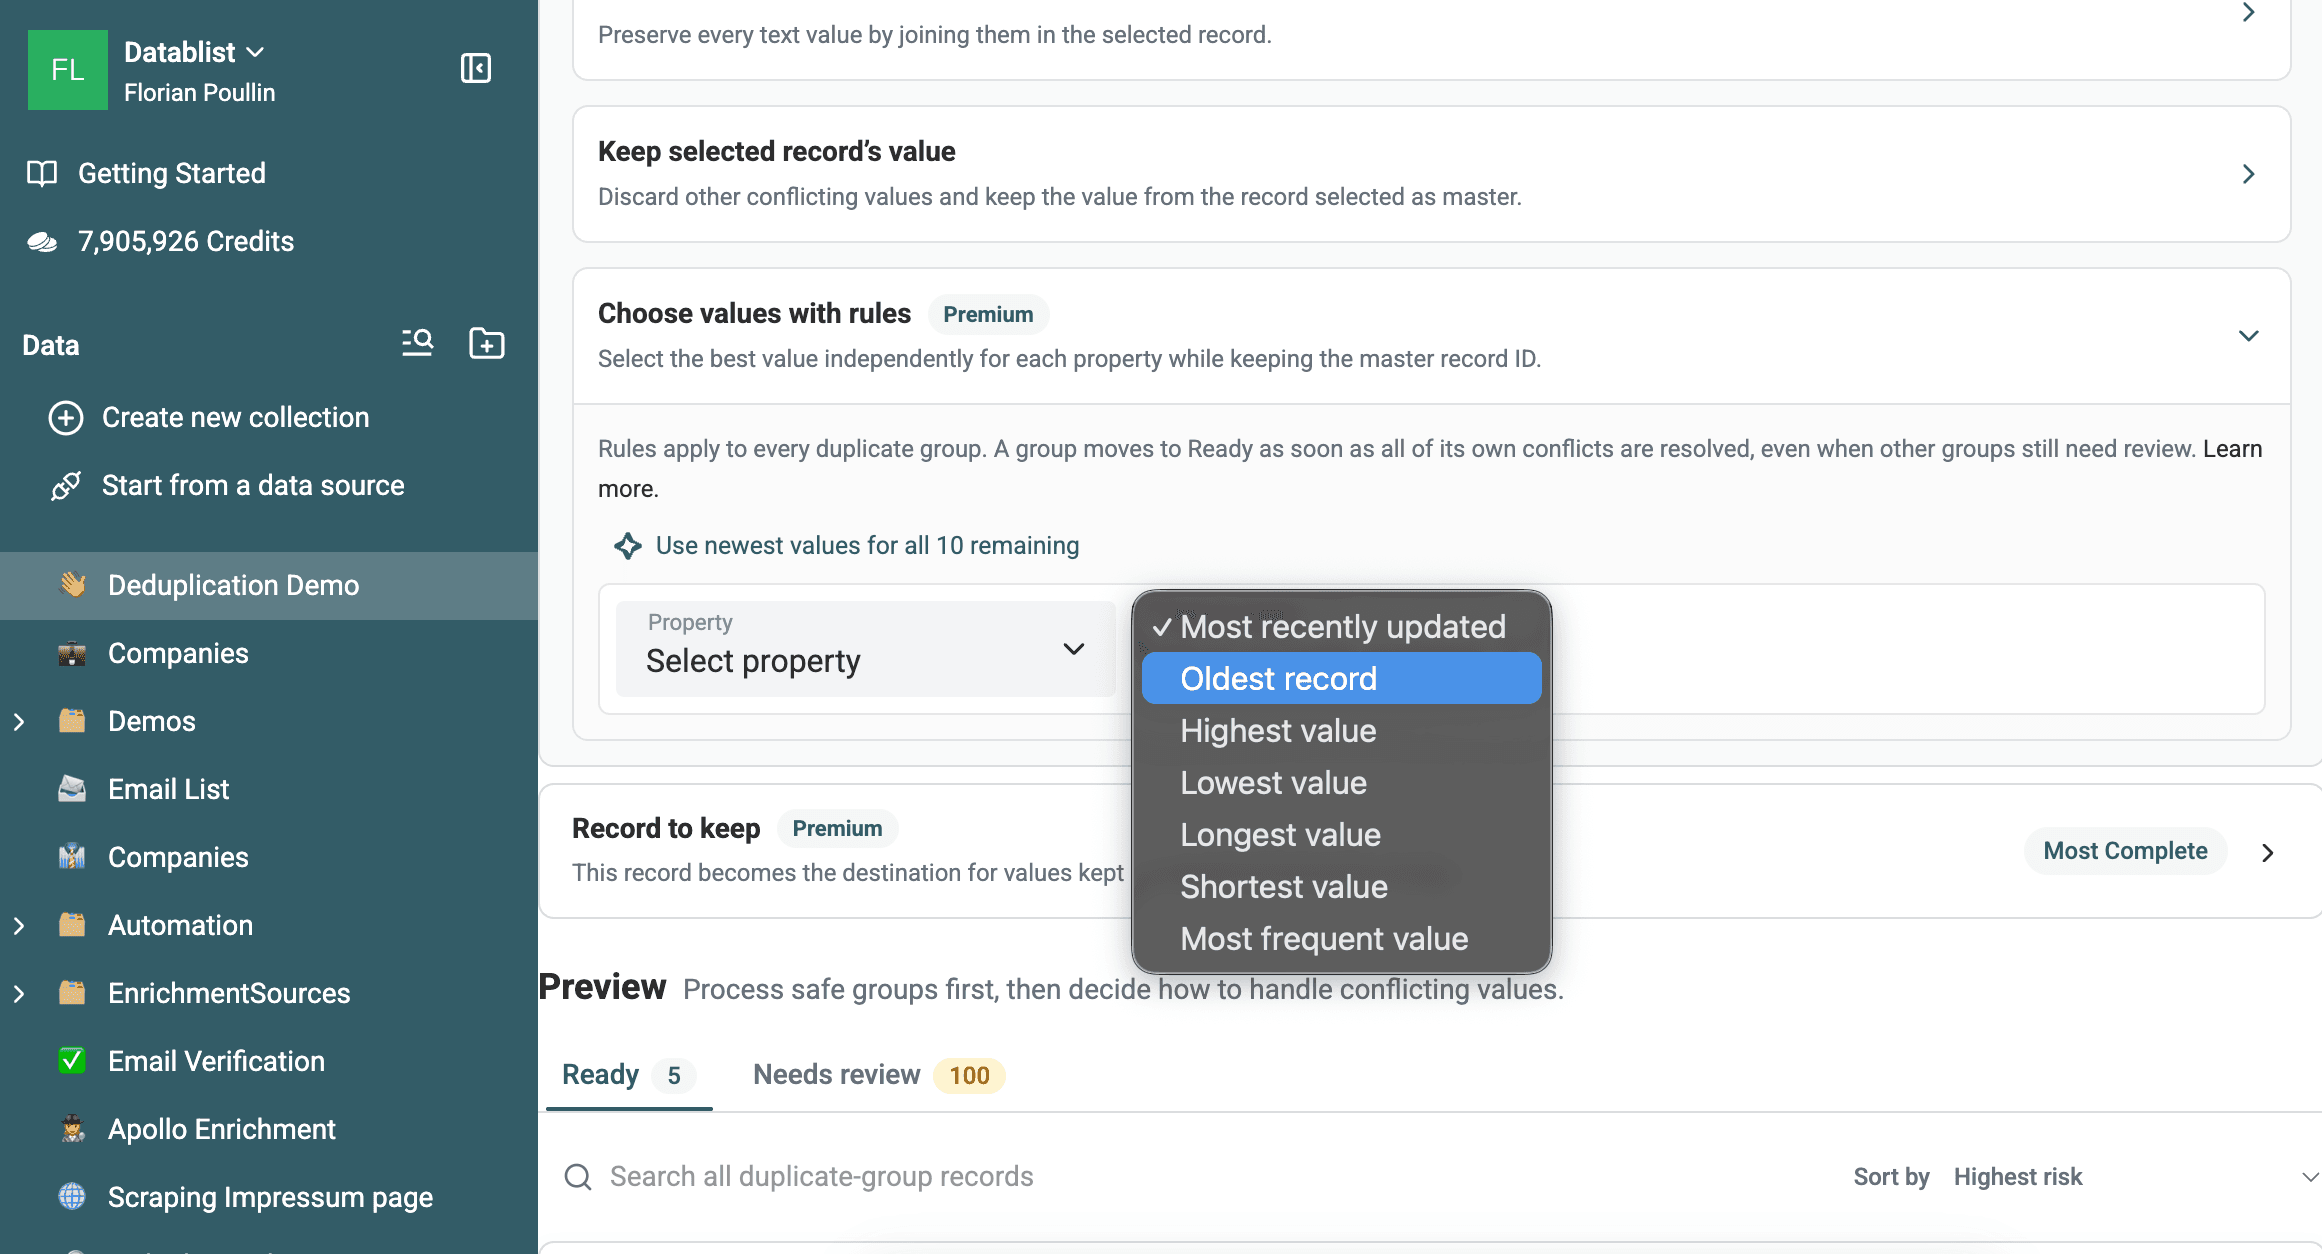
Reguły na poziomie pól przydają się, gdy żaden pojedynczy wiersz nie zawiera najlepszej wartości dla każdej właściwości. Możesz zachować ID wybranego rekordu, a jednocześnie pobrać nowsze stanowisko, dłuższą nazwę firmy i najczęściej występujący status z pozostałych wierszy.
Odśwież podgląd po zmianie progu, procesu, składu grup, ustawień konfliktów lub reguły wyboru rekordu.
Użyj Custom with AI do reguł zależnych od grupy
Custom with AI tworzy proces przetwarzania grup na podstawie instrukcji zapisanej naturalnym językiem. Może wybrać rekord, kopiować lub normalizować wartości, dodać właściwość statusu, obliczyć sumę dla grupy, usunąć dodatkowe wiersze albo pominąć grupy niespełniające warunku.
Na przykład:
Zachowaj rekord, którego Source to CRM export. Skopiuj Job Title z najnowszego rekordu, połącz różne wartości Notes, rozdzielając je podziałem wiersza, dodaj pole wyboru Duplicate Reviewed, a następnie usuń dodatkowe rekordy.
Odwołuj się do właściwości kolekcji za pomocą /Property lub {{Property}}. Przed uruchomieniem wygeneruj proces i sprawdź jego podgląd. Custom with AI jest dostępne dla zalogowanych użytkowników płatnych planów.
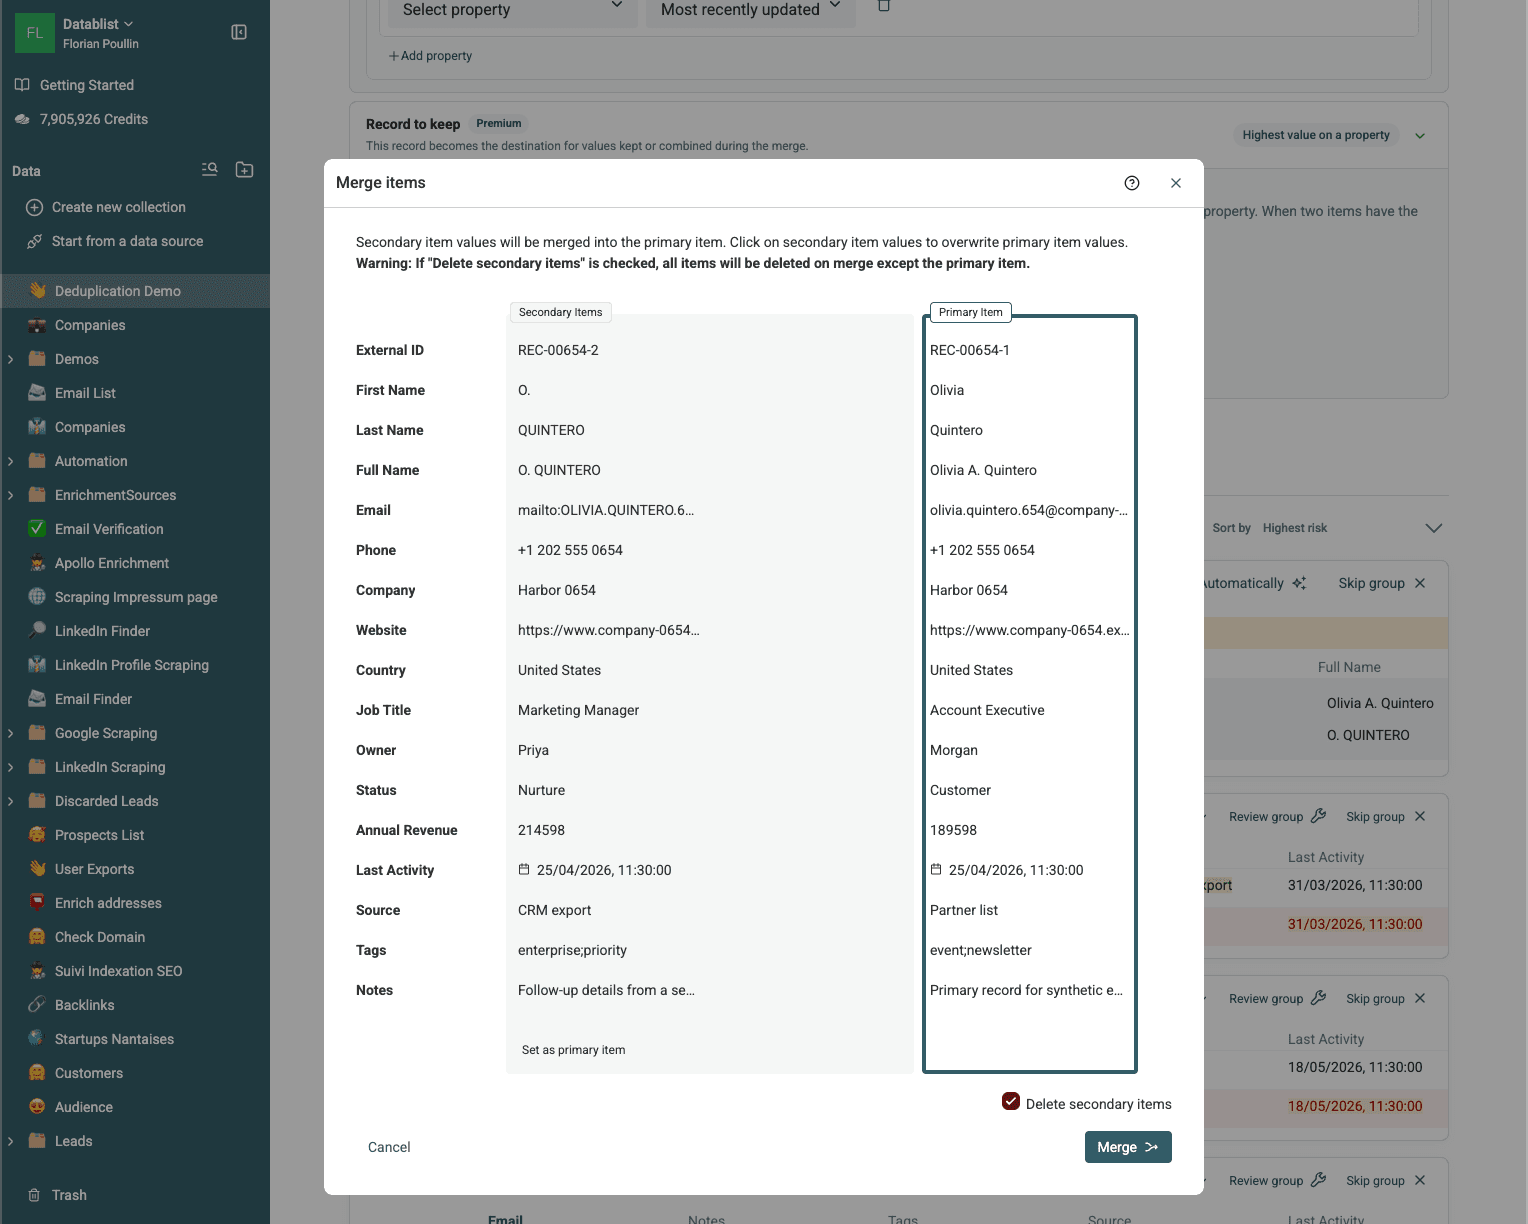
W przypadku pojedynczych wyjątków otwórz Review group i użyj Merging Assistant, zamiast nadmiernie komplikować regułę zbiorczą.
Sprawdź i wyeksportuj oczyszczoną listę
Przed przetworzeniem grup Ready sprawdź, czy:
- Podgląd odpowiada bieżącym ustawieniom.
- Grupy o niskiej pewności i ze wspólnymi identyfikatorami zostały sprawdzone.
- Wybrany rekord zawiera ID, które trzeba zachować.
- Unikalne wartości telefonu, źródła, notatki i statusu zostaną zachowane.
- Pola dopuszczające tylko jedną wartość nie zostaną połączone w ciąg.
- Wyświetlana liczba grup Ready odpowiada zakresowi, który chcesz przetworzyć.
Po zakończeniu sprawdź liczbę wierszy:
Liczba początkowa - usunięte dodatkowe wiersze = liczba końcowa
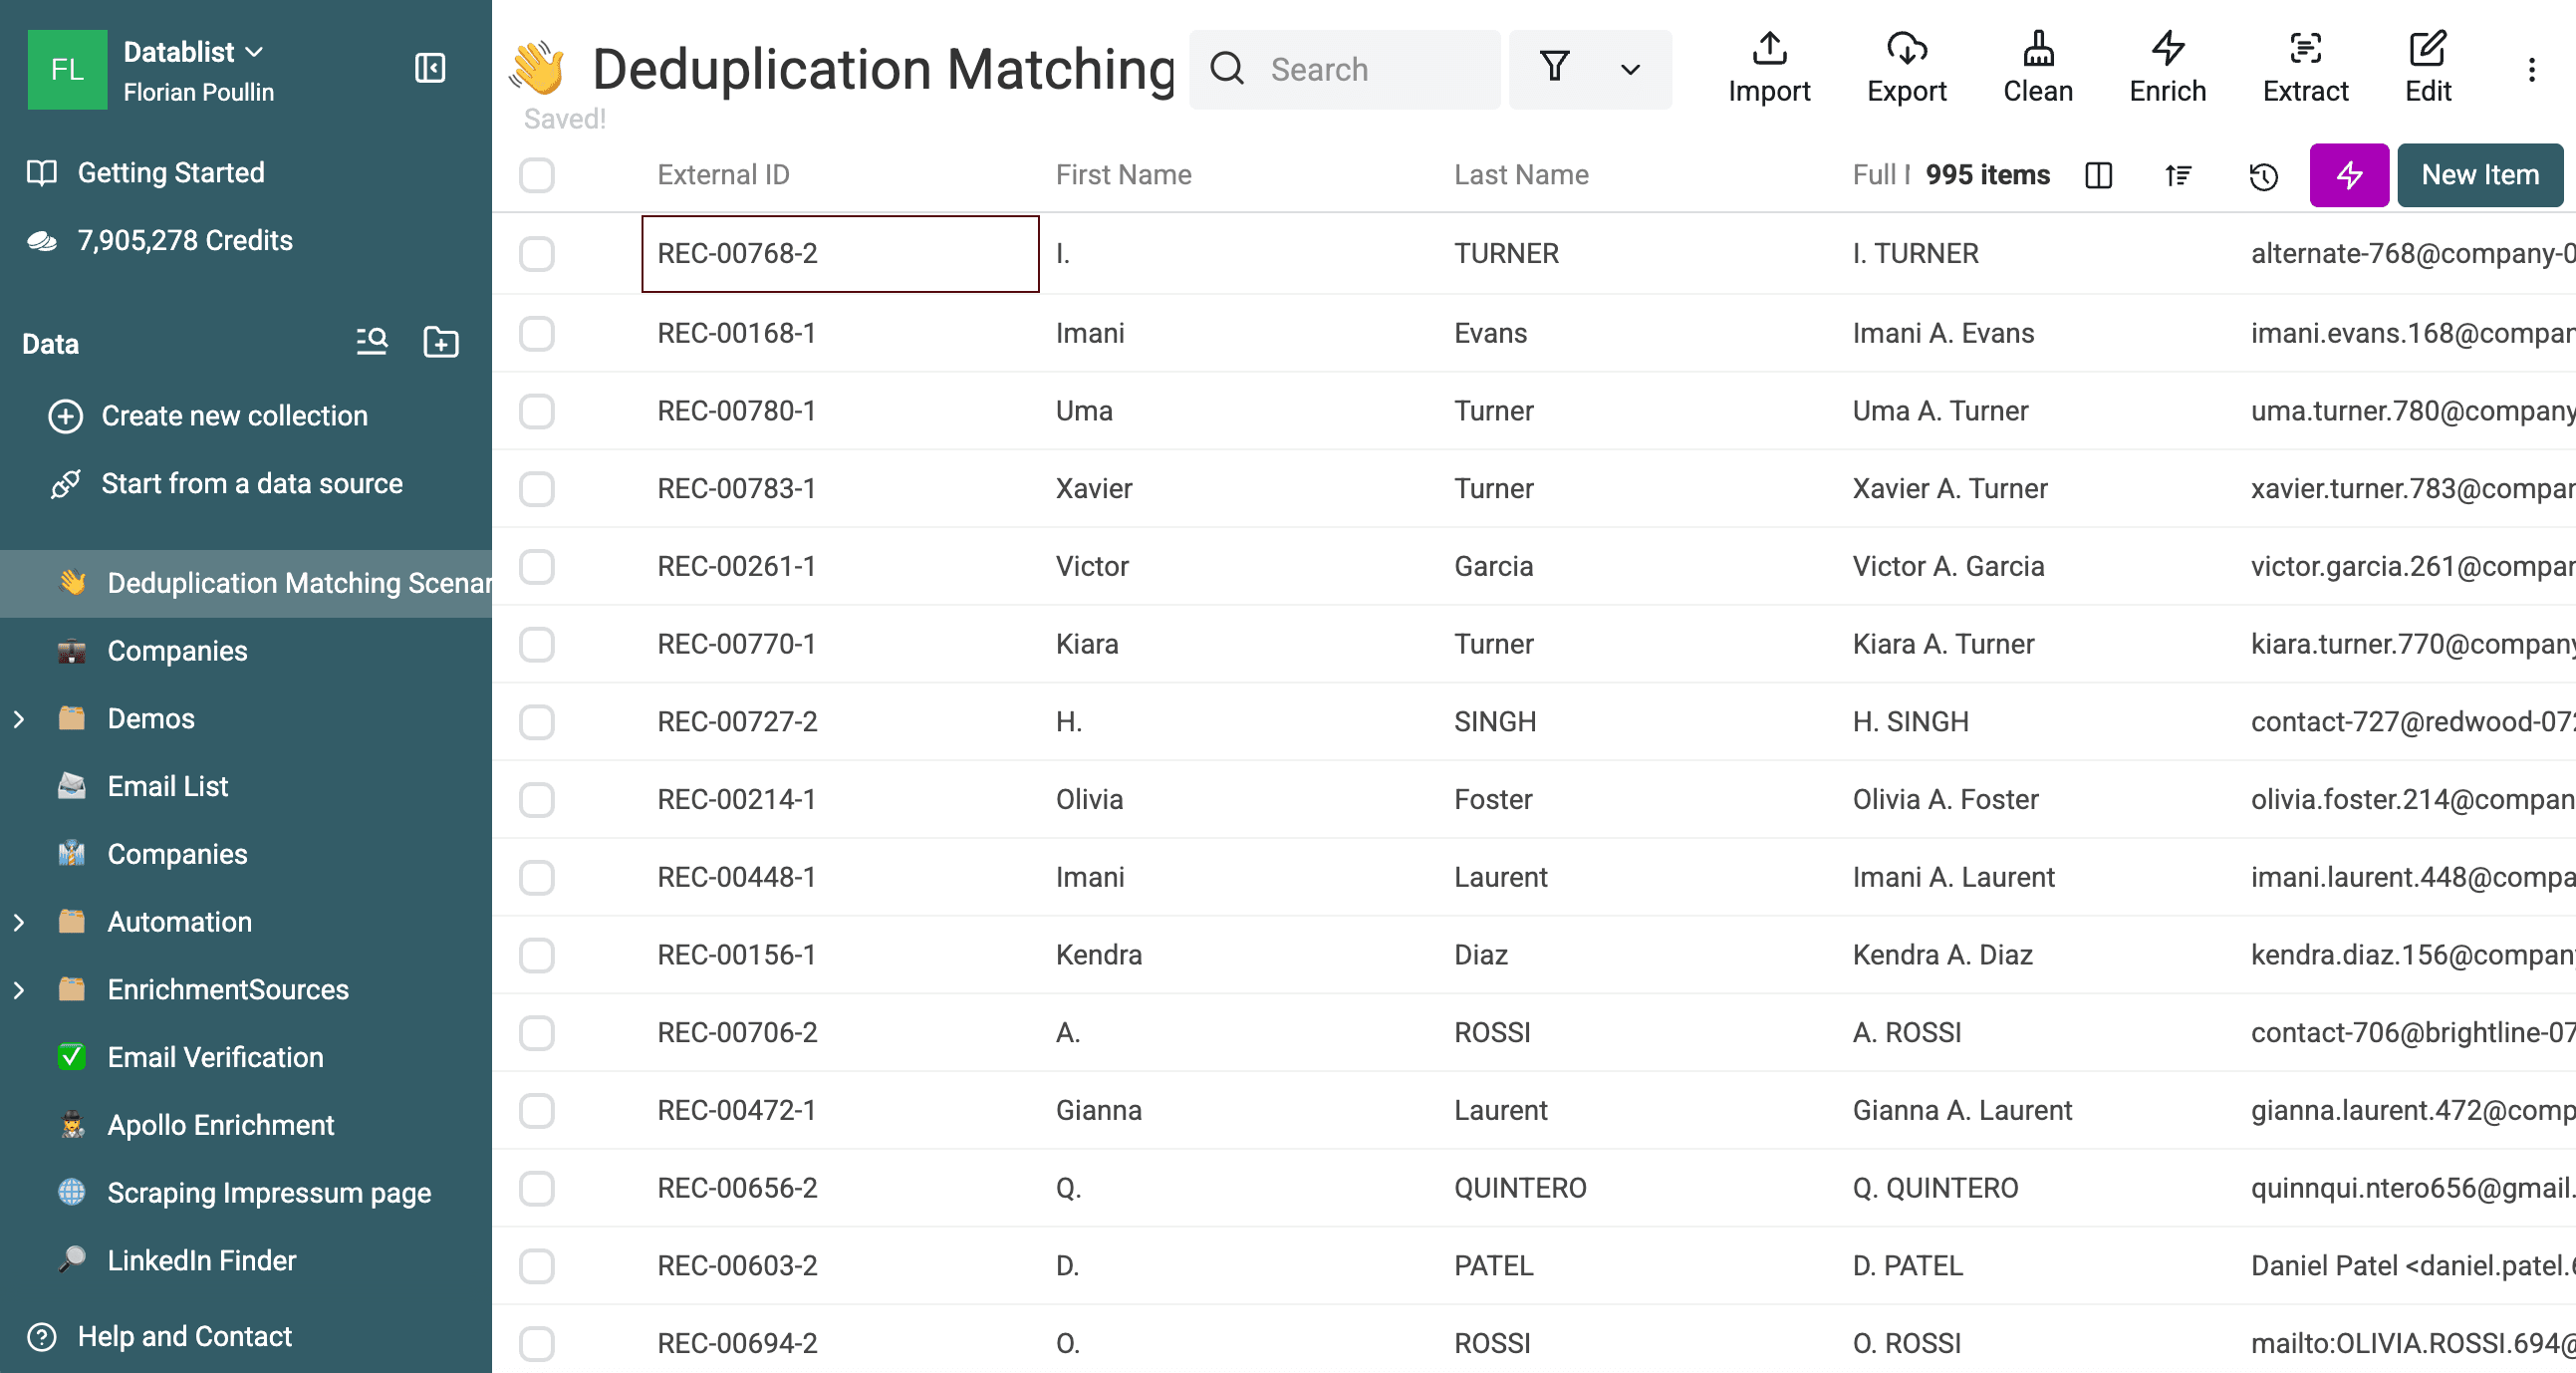
W etapie Exact opisanym w tym poradniku Datablist scalił pięć grup po dwa wiersze. Liczba elementów w kolekcji spadła więc z 1000 do 995.
Pobierz grupy duplikatów przed przetworzeniem, jeśli potrzebujesz zewnętrznego pliku do weryfikacji. Płatne plany udostępniają użyteczne ID grup duplikatów oraz dziennik zmian po przetworzeniu. Dziennik rejestruje usunięte i zaktualizowane ID Datablist wraz z poprzednimi oraz docelowymi wartościami.
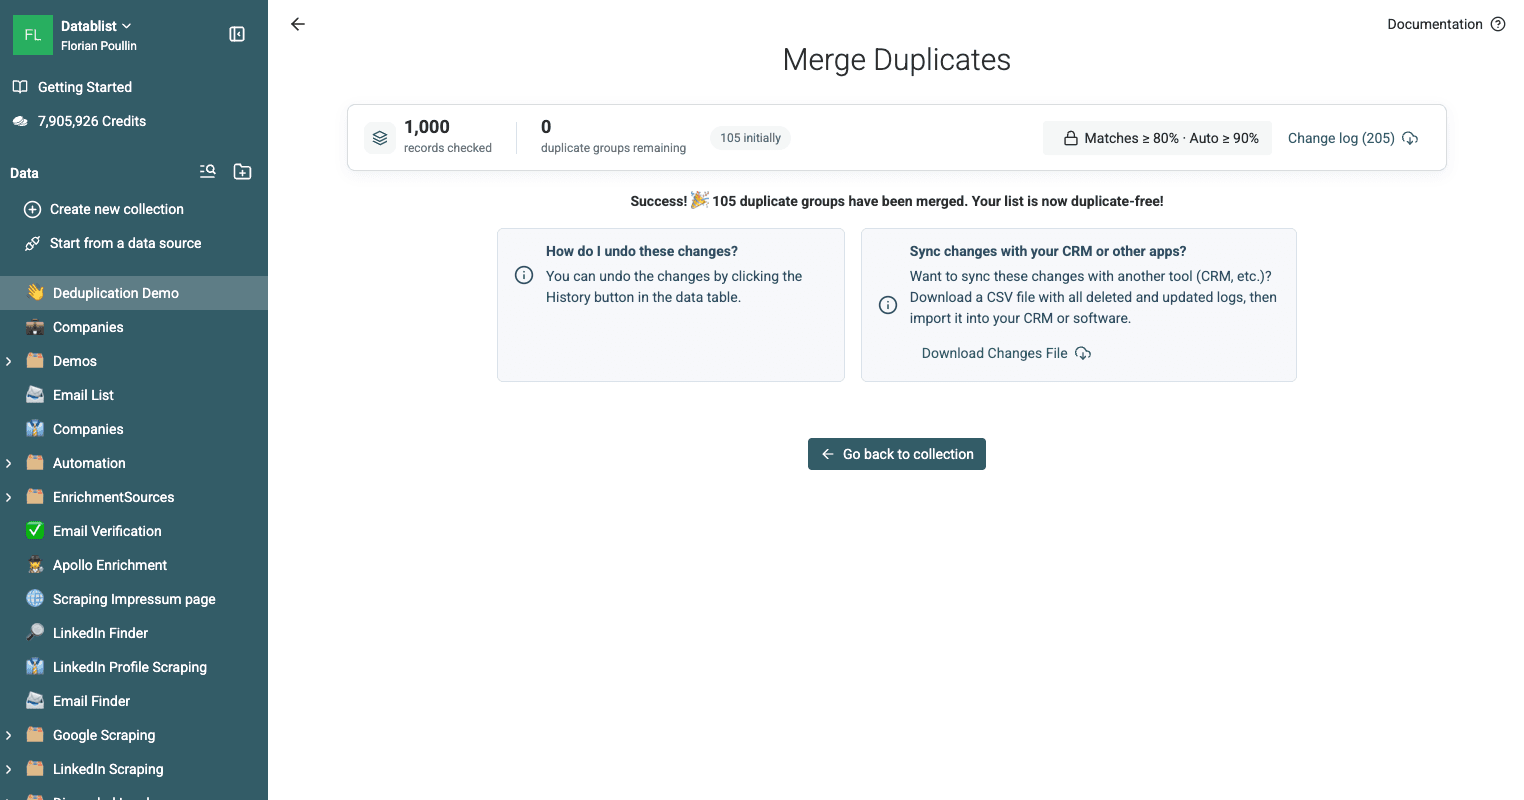
Automatyczne operacje usuwania i scalania pojawiają się również w historii kolekcji, gdzie można je cofnąć.
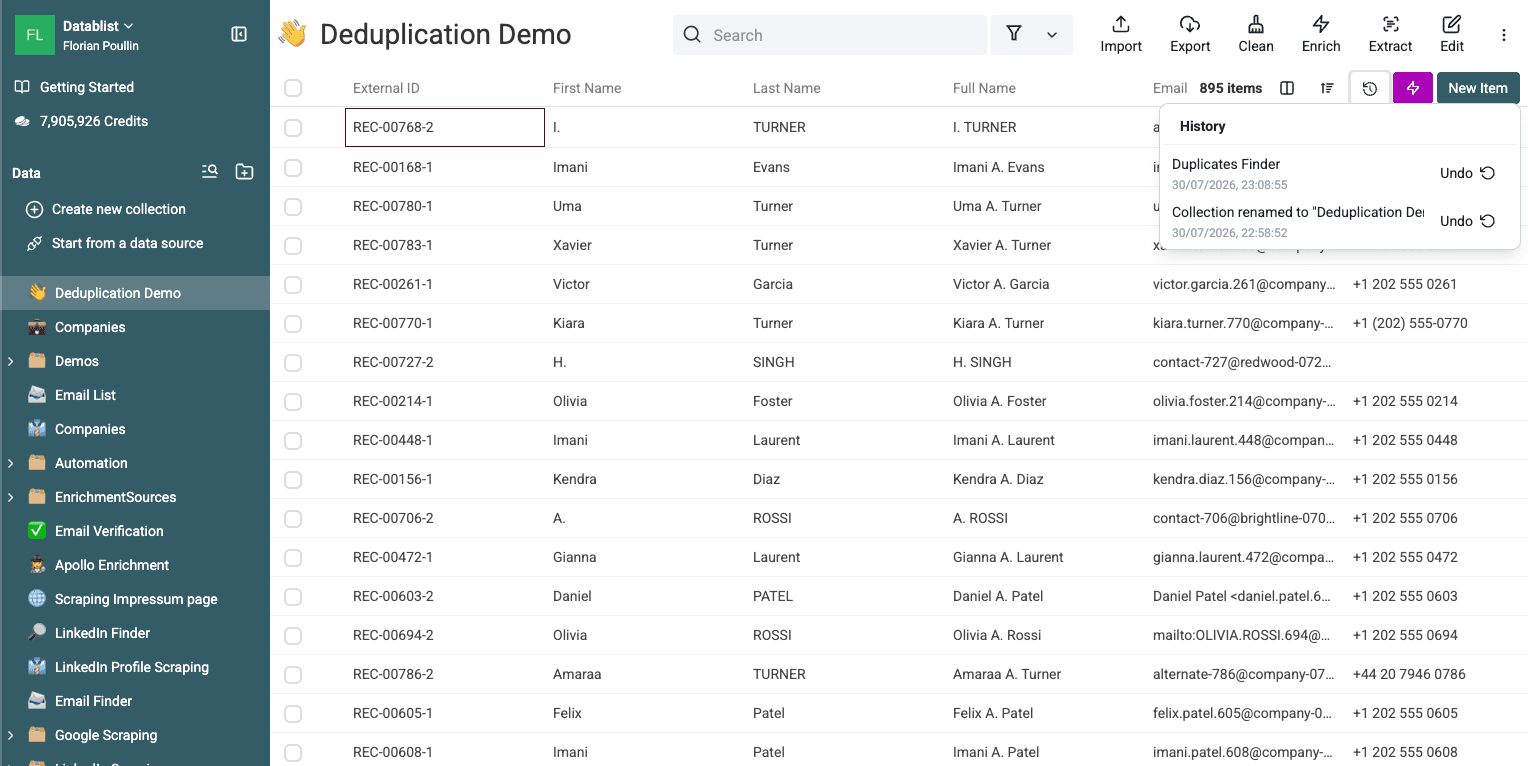
Wróć do kolekcji i otwórz Export, aby pobrać oczyszczony plik CSV lub Excel.
Usuń duplikaty z kilku list
Użyj dopasowania między kolekcjami, gdy nowy plik leadów trzeba porównać z eksportem z CRM. Potraktuj CRM jako listę referencyjną i przed importem usuń z nowej listy rekordy, które już się w nim znajdują.
Pobierz demonstracyjny plik CRM oraz demonstracyjny plik z wydarzenia, aby przetestować ten proces. Pliki mają różne nagłówki i zawierają 100 zaplanowanych powtórzeń adresów e-mail. Każdy plik początkowo ma 250 wierszy.
Zaimportuj każdy plik do osobnej kolekcji, a następnie otwórz Clean > Match across collections. Dodaj obie kolekcje i przypisz odpowiadające sobie właściwości, na przykład Email do Attendee Email.
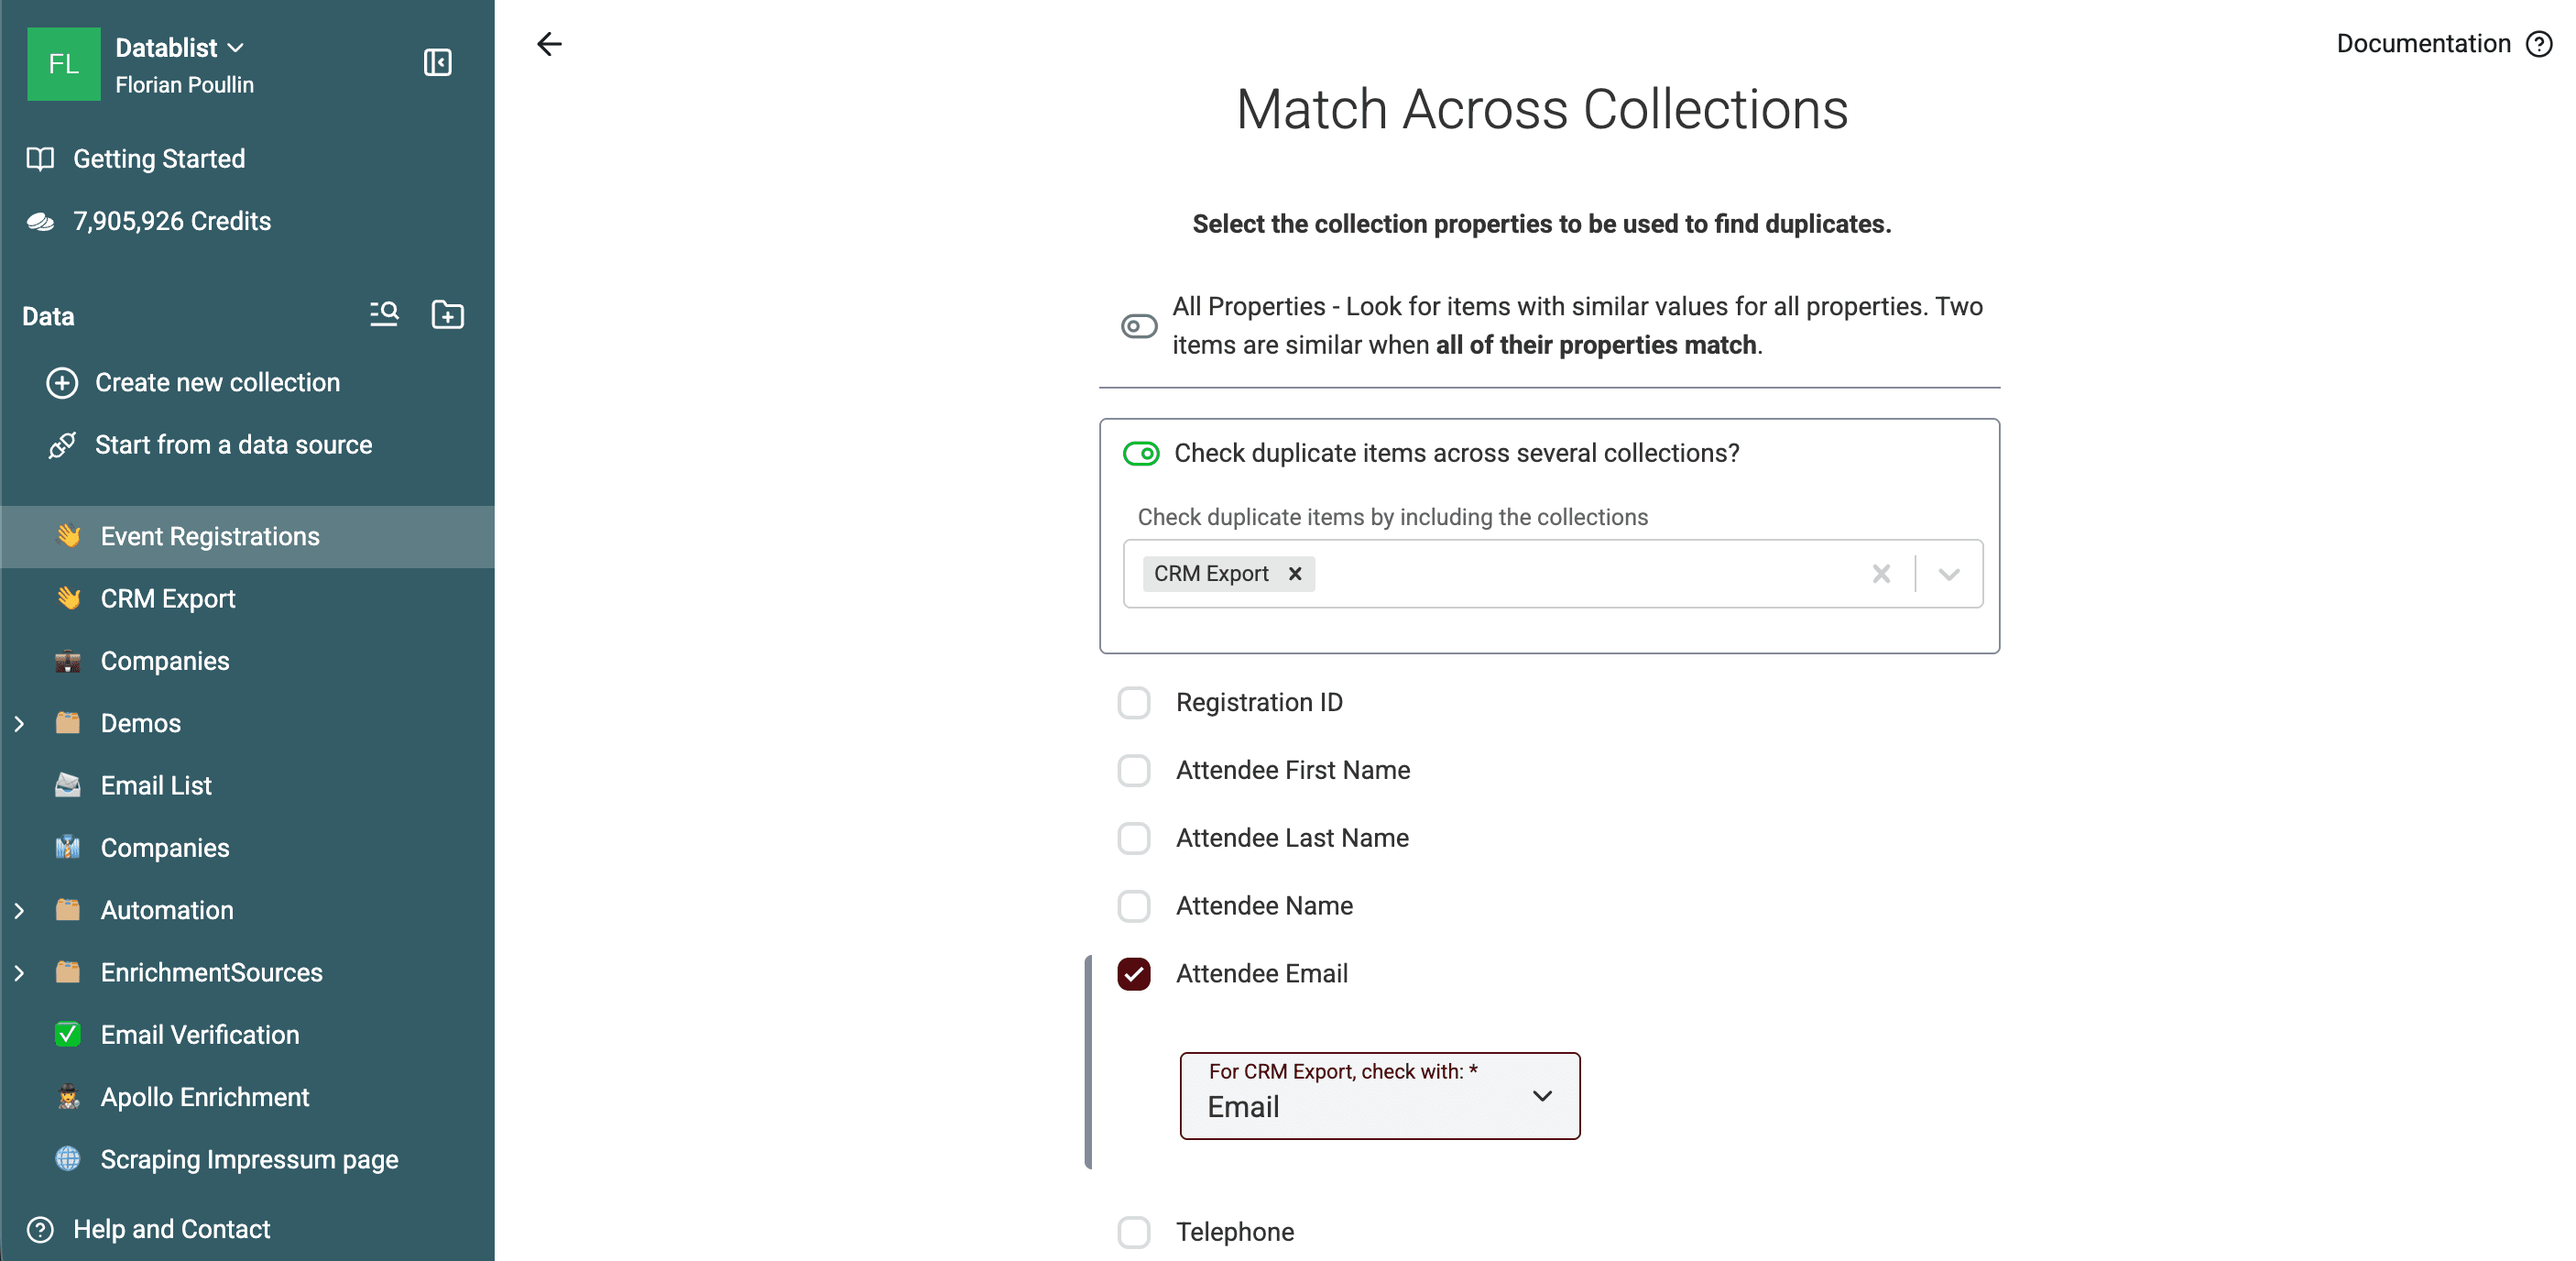
W tym teście dopasowanie Smart z procesorem Email zwróciło 100 grup między kolekcjami spośród 500 sprawdzonych rekordów. W sekcji Remove duplicate items from collection {X} wybierz Event Registrations, aby pozostawić CRM bez zmian i usunąć jego odpowiedniki z listy wydarzenia.
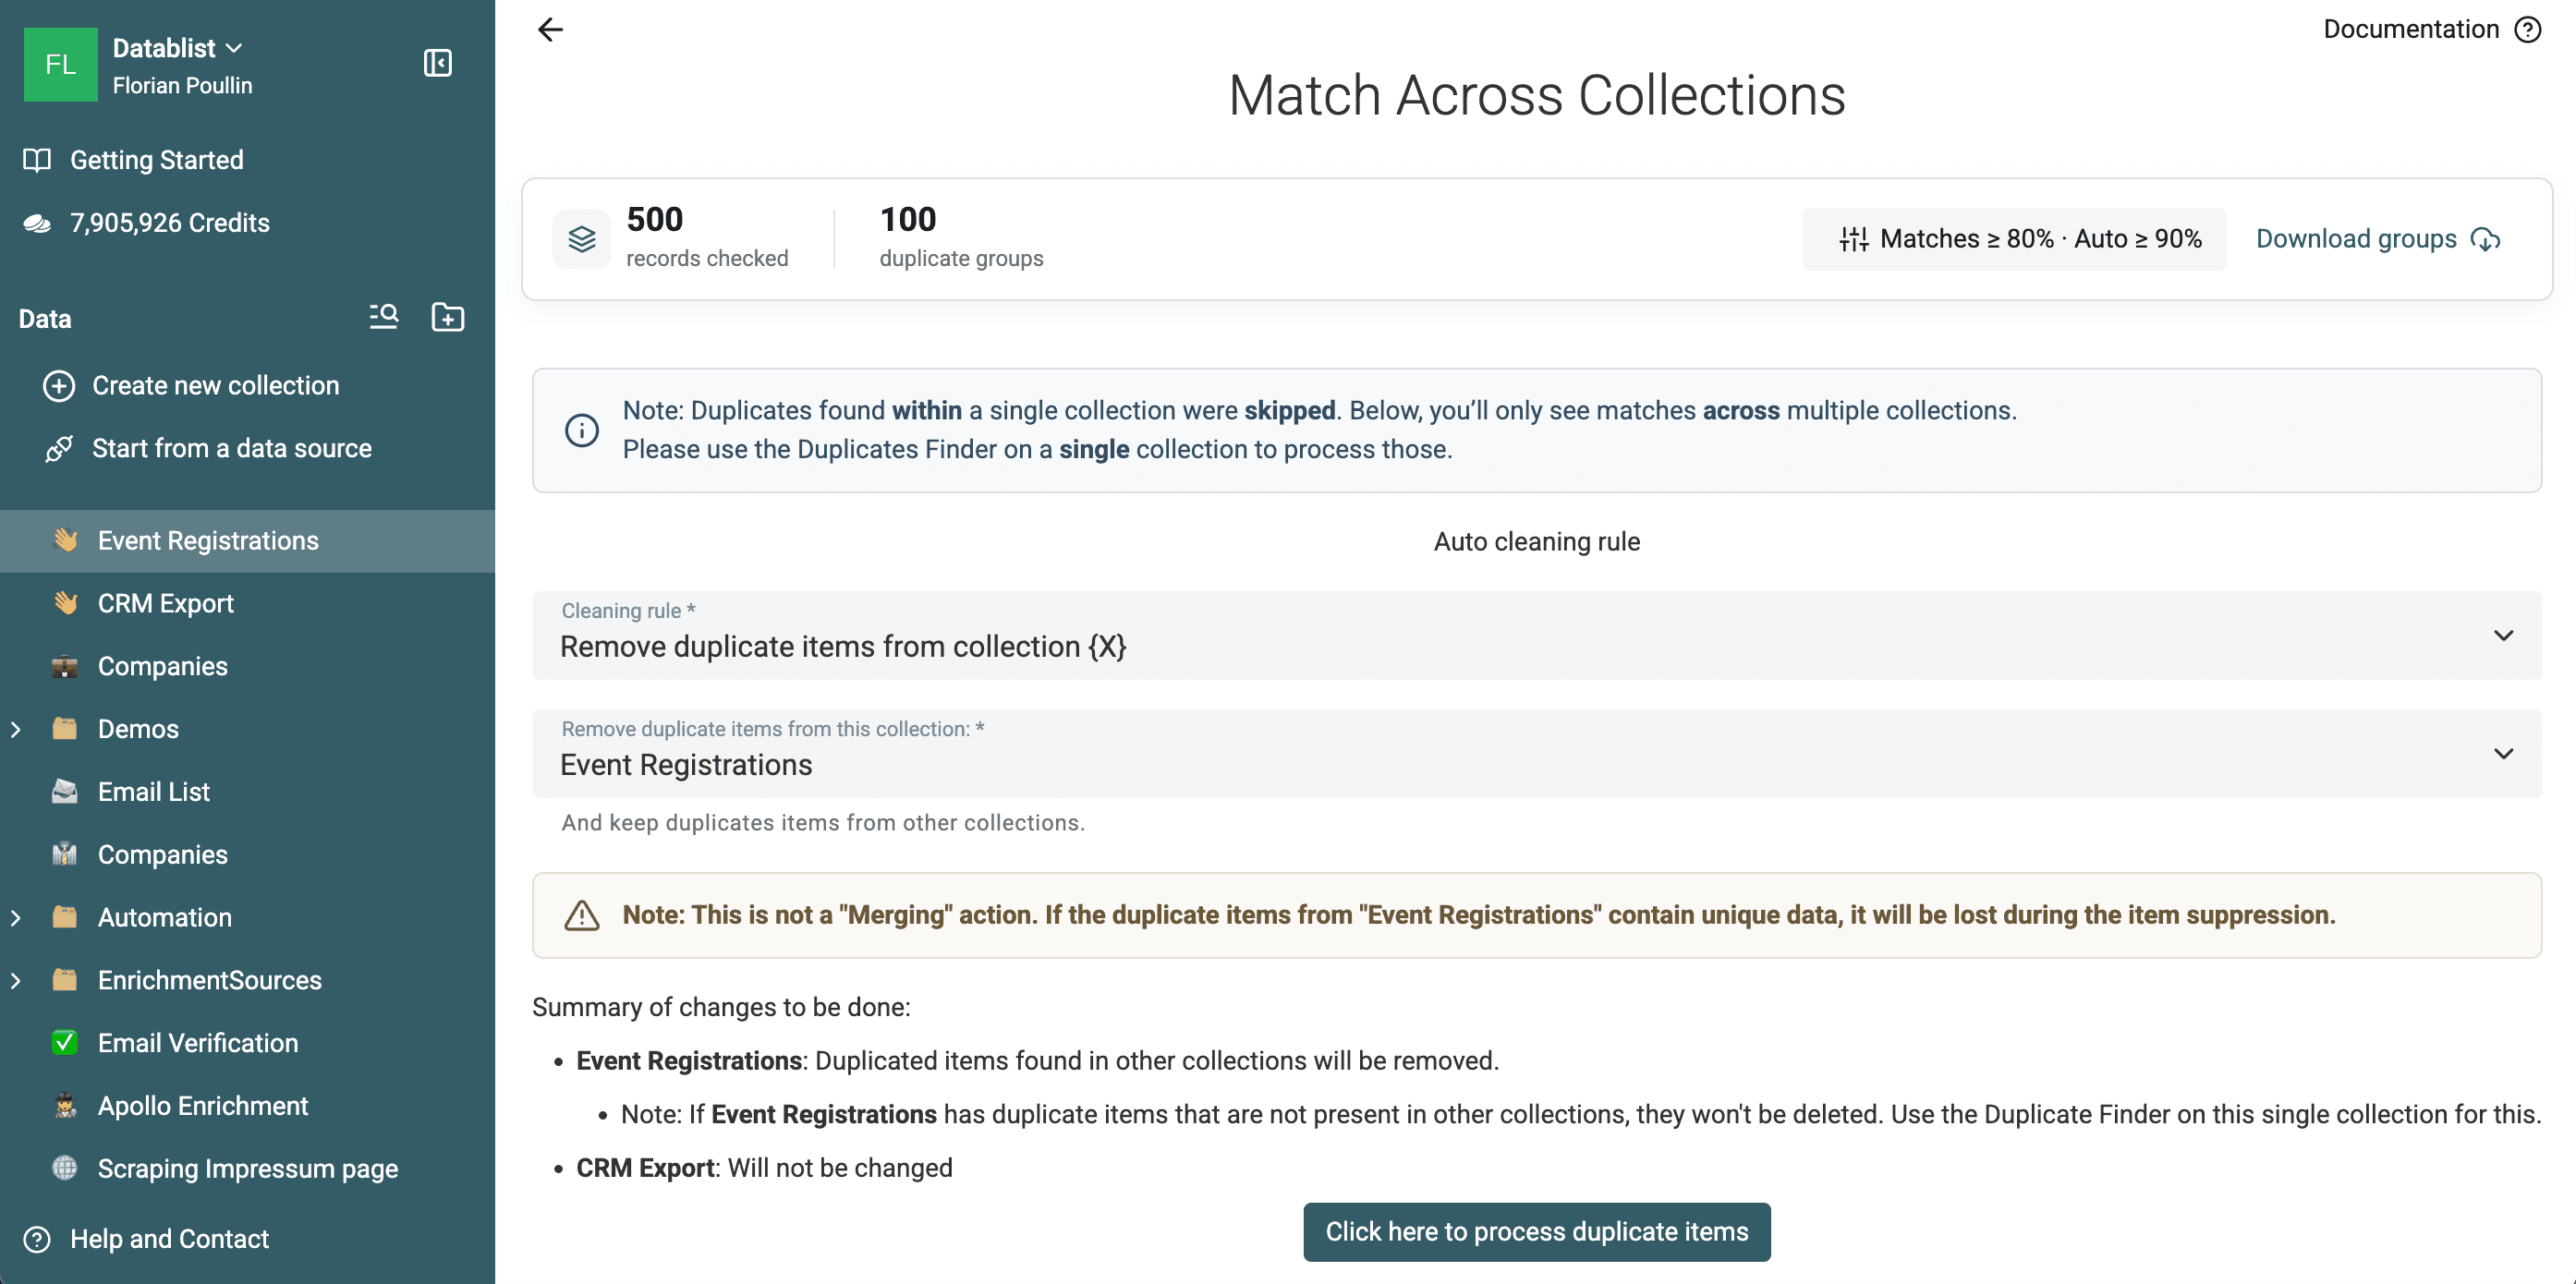
Automatyczne czyszczenie między kolekcjami usuwa wiersze. Nie scala unikalnych wartości z listy wydarzenia z rekordami CRM. Jeśli nowe rekordy zawierają informacje, które trzeba zachować, najpierw wyeksportuj lub sprawdź grupy.
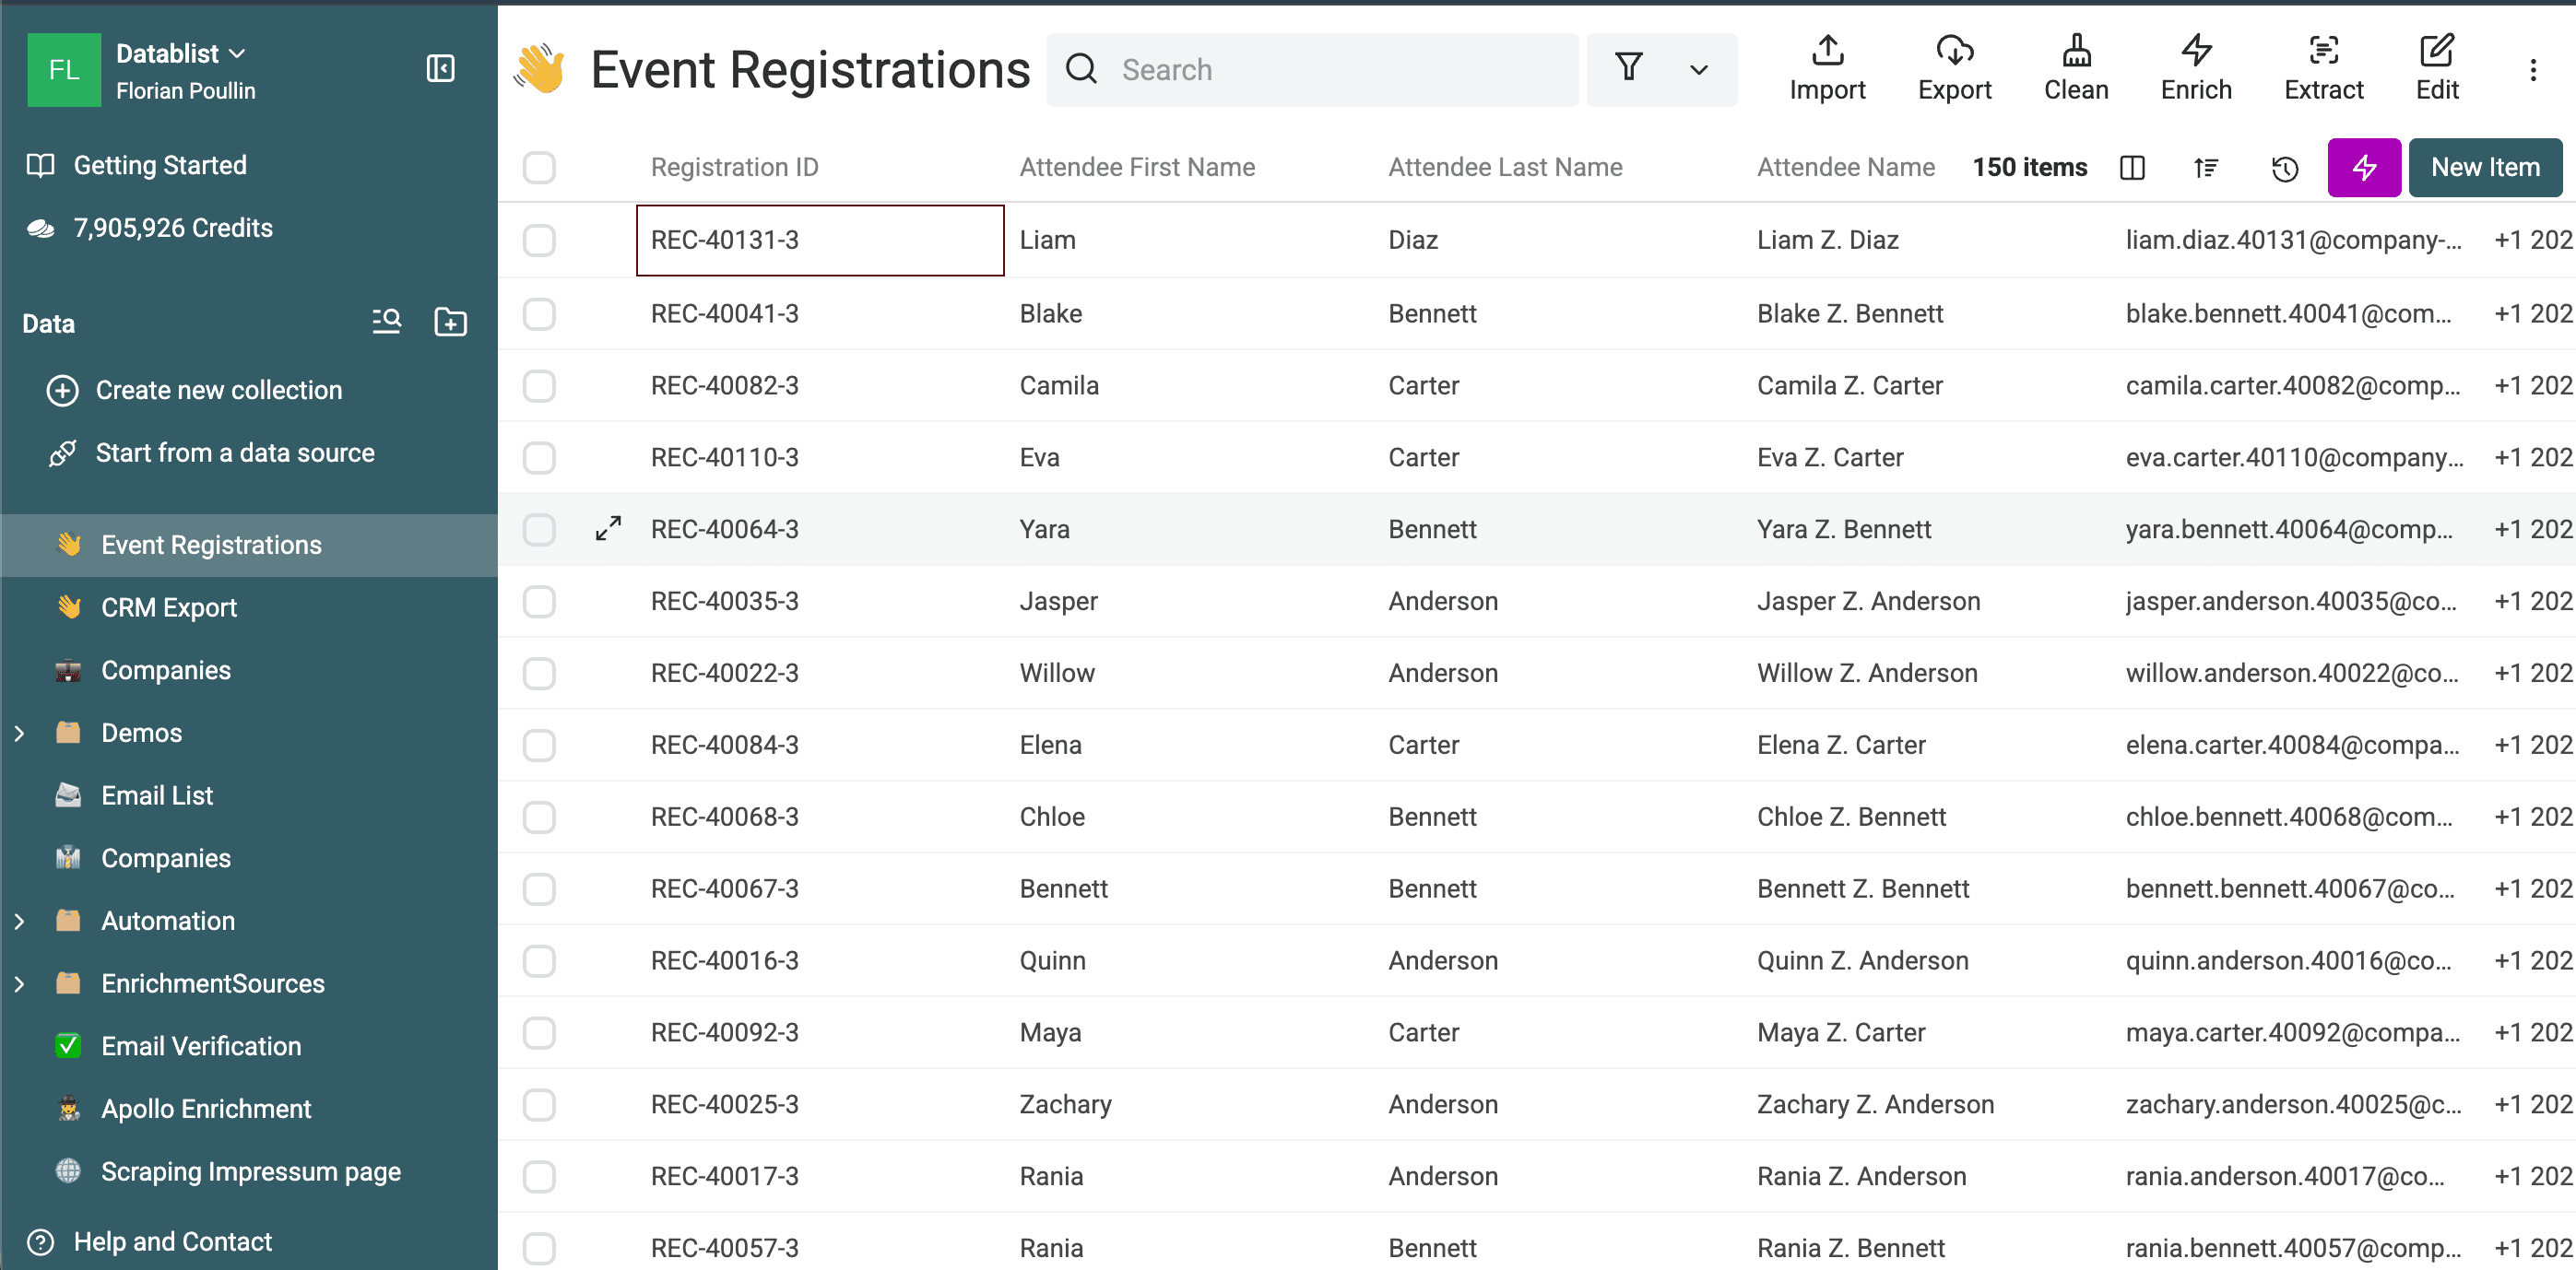
Po przetworzeniu 100 powtórzeń kolekcja Event Registrations zawiera 150 nowych kontaktów netto.
Dopasowanie między kolekcjami jest funkcją planu Premium. Szczegółowe opcje przypisywania kolekcji i przetwarzania opisano w poradniku dotyczącym usuwania duplikatów z kilku plików CSV lub Excel.
FAQ
Czy mogę bezpłatnie usunąć duplikaty z listy online?
Tak. Niezalogowani użytkownicy mogą uruchomić kontrolę Exact. Bezpłatne konto odblokowuje dopasowanie Smart i pozostałe funkcje planu Free dla pojedynczej kolekcji. Algorytmy fuzzy i fonetyczne, zaawansowane procesory, dopasowanie między kolekcjami, konfigurowalne reguły zachowywania wartości oraz Custom with AI wymagają płatnego planu.
Czy duplikaty lepiej usuwać, czy scalać?
Usuń wiersze, gdy jeden rekord jest nadrzędny, a pozostałe nie zawierają potrzebnych danych. Scal rekordy, jeśli dodatkowe wiersze mają przydatne wartości. Podgląd Remove ostrzega, gdy operacja spowodowałaby utratę danych.
Czy Datablist wykrywa duplikaty z literówkami?
Tak. Jaro-Winkler i Levenshtein porównują podobieństwo tekstu, a Metaphone — jego brzmienie. Te zaawansowane algorytmy wymagają płatnego planu, a ich wyniki należy sprawdzać.
Czy mogę scalać duplikaty bez utraty danych?
Datablist może uzupełniać puste pola, łączyć wartości tekstowe, zachowywać wartość z wybranego rekordu lub stosować reguły zachowywania danych na poziomie pól. Sprawdź podgląd, ponieważ każda odrzucona wartość nie pojawi się w scalonym rekordzie.
Jak duża może być lista?
Plan Free obsługuje do 1 miliona elementów w kolekcji przechowywanej w pamięci przeglądarki. W płatnych planach można importować do 2 milionów elementów na kolekcję. Wydajność dużych operacji lokalnych nadal zależy od przeglądarki i urządzenia.
Czy mogę przejrzeć duplikaty bez zmieniania listy?
Tak. Wykrywanie działa w trybie tylko do odczytu. Przed rozpoczęciem przetwarzania możesz analizować grupy, zmieniać progi, korzystać z Why matched, przeszukiwać i sortować wyniki oraz pobierać zduplikowane wiersze.
Wszystkie ustawienia i ograniczenia opisano w pełnej dokumentacji Duplicate Finder.