
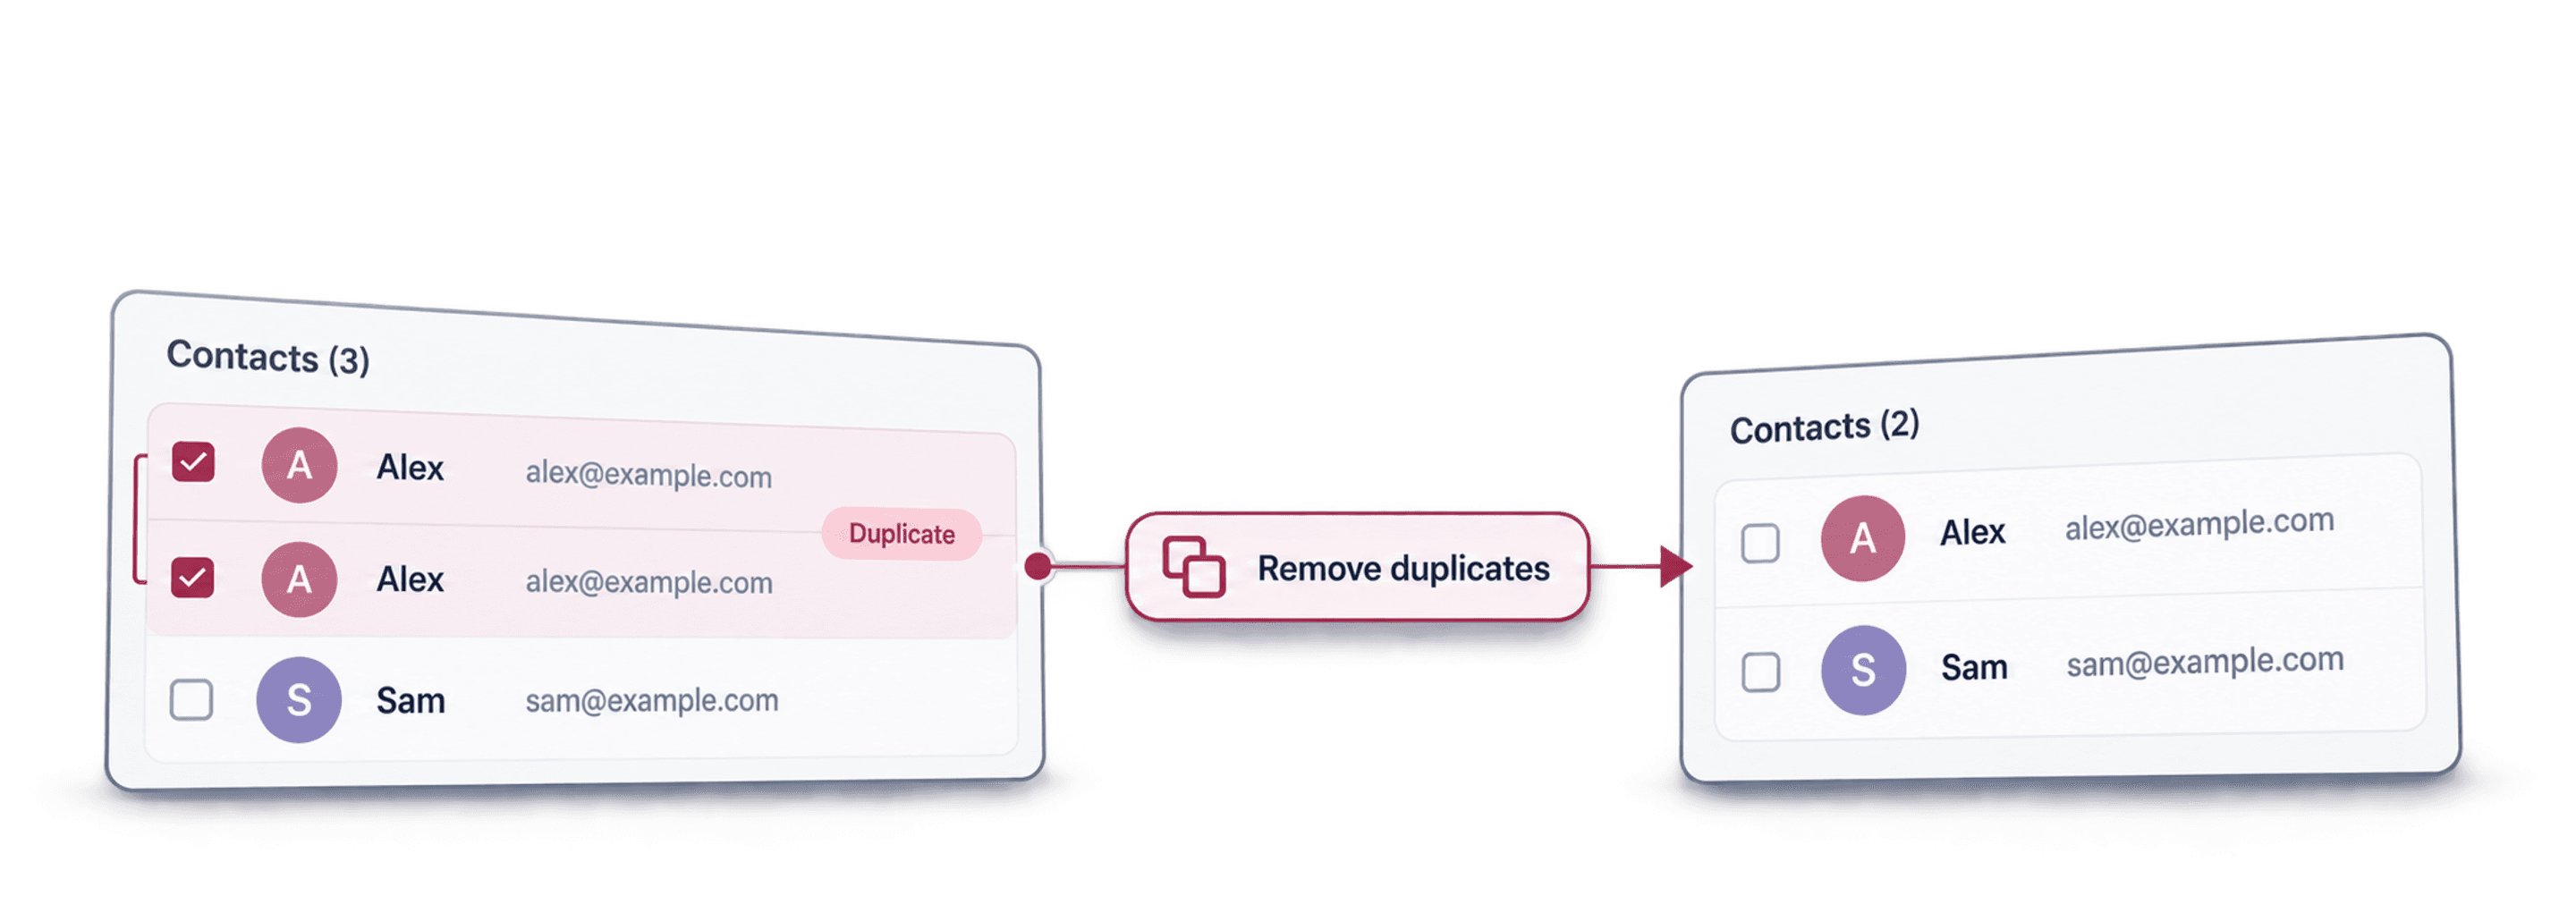
Чтобы удалить дубликаты из списка онлайн, сначала определите поле, которое однозначно идентифицирует человека, компанию или товар. Запустите строгий поиск совпадений, проверьте предложенные группы дублей, а затем объедините полезные значения или удалите строки, в которых нет ничего ценного. Так вы быстро очистите данные, не принимая каждое похожее значение за достоверное совпадение.
В Datablist весь процесс выполняется в браузере. Импортируйте файл CSV или Excel, выберите свойства для сопоставления, сравните строки, проверьте результат и экспортируйте очищенный список. Проверка на дубликаты работает в режиме только для чтения, пока вы не запустите действие Remove, Merge или пользовательскую обработку.
В этом руководстве используется доступный для скачивания пример на 1 000 строк. В нём есть точные копии, алиасы email, варианты названий компаний и URL, различия в форматировании телефонов, опечатки, конфликтующие значения и записи, дополняющие друг друга.
🔑 Правило безопасной дедупликации
Ищите совпадения по минимальному надёжному идентификатору, но при выборе сохраняемых данных учитывайте всю строку.
Как удалить дубликаты из простого списка значений
Если каждое значение в списке находится на отдельной строке, сохраните его как CSV с одним столбцом и заголовком, например Email, Domain или Value. Импортируйте файл в Datablist и запустите Clean > Remove duplicates для этого столбца, выбрав Exact. Проверьте группы, укажите сохраняемую запись, обработайте дублирующиеся строки и экспортируйте оставшиеся значения.
Например, в условном списке со значениями alpha.example, beta.example и alpha.example после удаления повторяющейся строки должны остаться по одному значению alpha и beta. Это лишь пример входных и выходных данных, а не дополнительный результат измерений по скачиваемому образцу.
Такой способ подходит для списка идентификаторов. Если в файле несколько столбцов, нужно устранять дубли записей: вместе со строкой удаляются и все остальные значения в ней. Используйте описанный ниже сценарий объединения, если во второй строке с тем же email есть полезный номер телефона или примечание.
Пустые идентификаторы обрабатывайте отдельно. При стандартном сравнении по выбранным свойствам отсутствующий текстовый идентификатор не считается совпадением. Если нужно удалить пустые строки, сделайте это явно, не полагаясь на дедупликацию при определении их смысла.
Определите, что делает запись уникальной
Начинайте не с алгоритма сопоставления, а с определения сущности.
Для контакта, компании, товара и транзакции нужны разные идентификаторы:
| Список | Надёжные исходные идентификаторы | Полезная вторая проверка |
|---|---|---|
| Контакты | Email, телефон, LinkedIn URL | Полное имя и компания |
| Компании | Домен сайта, ID компании | Нормализованное название компании |
| Товары | SKU, EAN, GTIN, URL товара | Название товара и бренд |
| Leads в CRM | Email, телефон, CRM ID | Имя и домен компании |
| Заказы | ID заказа | ID клиента и дата заказа |
Одна проверка редко выявляет все дубли. В двух строках контакта может быть одинаковый email, а у другого контакта email мог измениться при сохранении прежнего номера телефона. Выполняйте отдельные проверки для разных идентификаторов, а не создавайте одно правило сразу со всеми свойствами.
Например:
- Сопоставьте контакты по email.
- Обработайте проверенные группы.
- Нормализуйте номера телефонов, затем запустите проверку Exact по очищенному свойству.
- Осторожно выполните нечёткое сопоставление по полному имени и компании.
Прежде чем добавлять поля в одну проверку, выберите правило для пустых значений. При Value required отсутствующий идентификатор может исключить подходящую запись.
При Match on empty value свойства, пустые в обеих записях, получают 100% и могут повысить средний балл: совпадение по email и одна отсутствующая фамилия дают 87,5%; если добавить ещё три свойства, пустые в обеих записях, результат вырастет до 95%. Изучите пример расчёта для пустых значений, прежде чем считать, что большее число столбцов всегда усиливает доказательство совпадения.
Если идентификатор требует отдельной нормализации, воспользуйтесь профильными руководствами:
- Удаление дублей email и алиасов
- Поиск дубликатов названий компаний
- Дедупликация поля с несколькими значениями
- Нормализация местных и международных номеров телефонов
Скачайте пример списка на 1 000 строк
Скачать демонстрационный CSV для дедупликации. В нём 1 000 строк, представляющих 800 специально созданных сущностей.
В файле объединены разные тестовые сценарии:
| Тестовый сценарий | Группы дублей | Способ сопоставления |
|---|---|---|
| Полные точные копии строк | 5 | All Properties с Exact |
| Алиасы и обёртки email | 100 | Email со Smart и процессором Email |
| Варианты компаний и URL | 50 | Обработка Company Name или URL |
| Базовые различия в формате номеров США | 25 | Phone со Smart, только форматирование |
| Контролируемые опечатки в именах | 15 | Jaro-Winkler или Levenshtein |
| Фонетические варианты имён | 5 | Metaphone |
| Записи без специально созданного дубля | 600 | Должны остаться раздельными |
Это контрольные значения, заложенные в набор данных, а не обещание, что любой порог нечёткого сопоставления даст тот же результат. При низком пороге дистанционные алгоритмы могут добавить лишних кандидатов. Проверяйте такие группы перед обработкой.
Вот три пары из файла:
| Сценарий | Первое сохранённое значение | Второе сохранённое значение |
|---|---|---|
| Алиас email | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| Компания и URL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| Базовое форматирование телефона | +1 (202) 555-0768 | 1 202 555 0768 |
Строки также различаются по должности, владельцу, статусу, выручке, источнику, тегам и примечаниям. Благодаря этим конфликтам файл подходит для тестирования правил выбора основной записи и сохранения значений отдельных полей.
Импортируйте список в Datablist
Откройте Datablist и импортируйте файл CSV или Excel в коллекцию. Коллекция устроена как структурированная таблица: строки — это элементы, а столбцы — свойства.
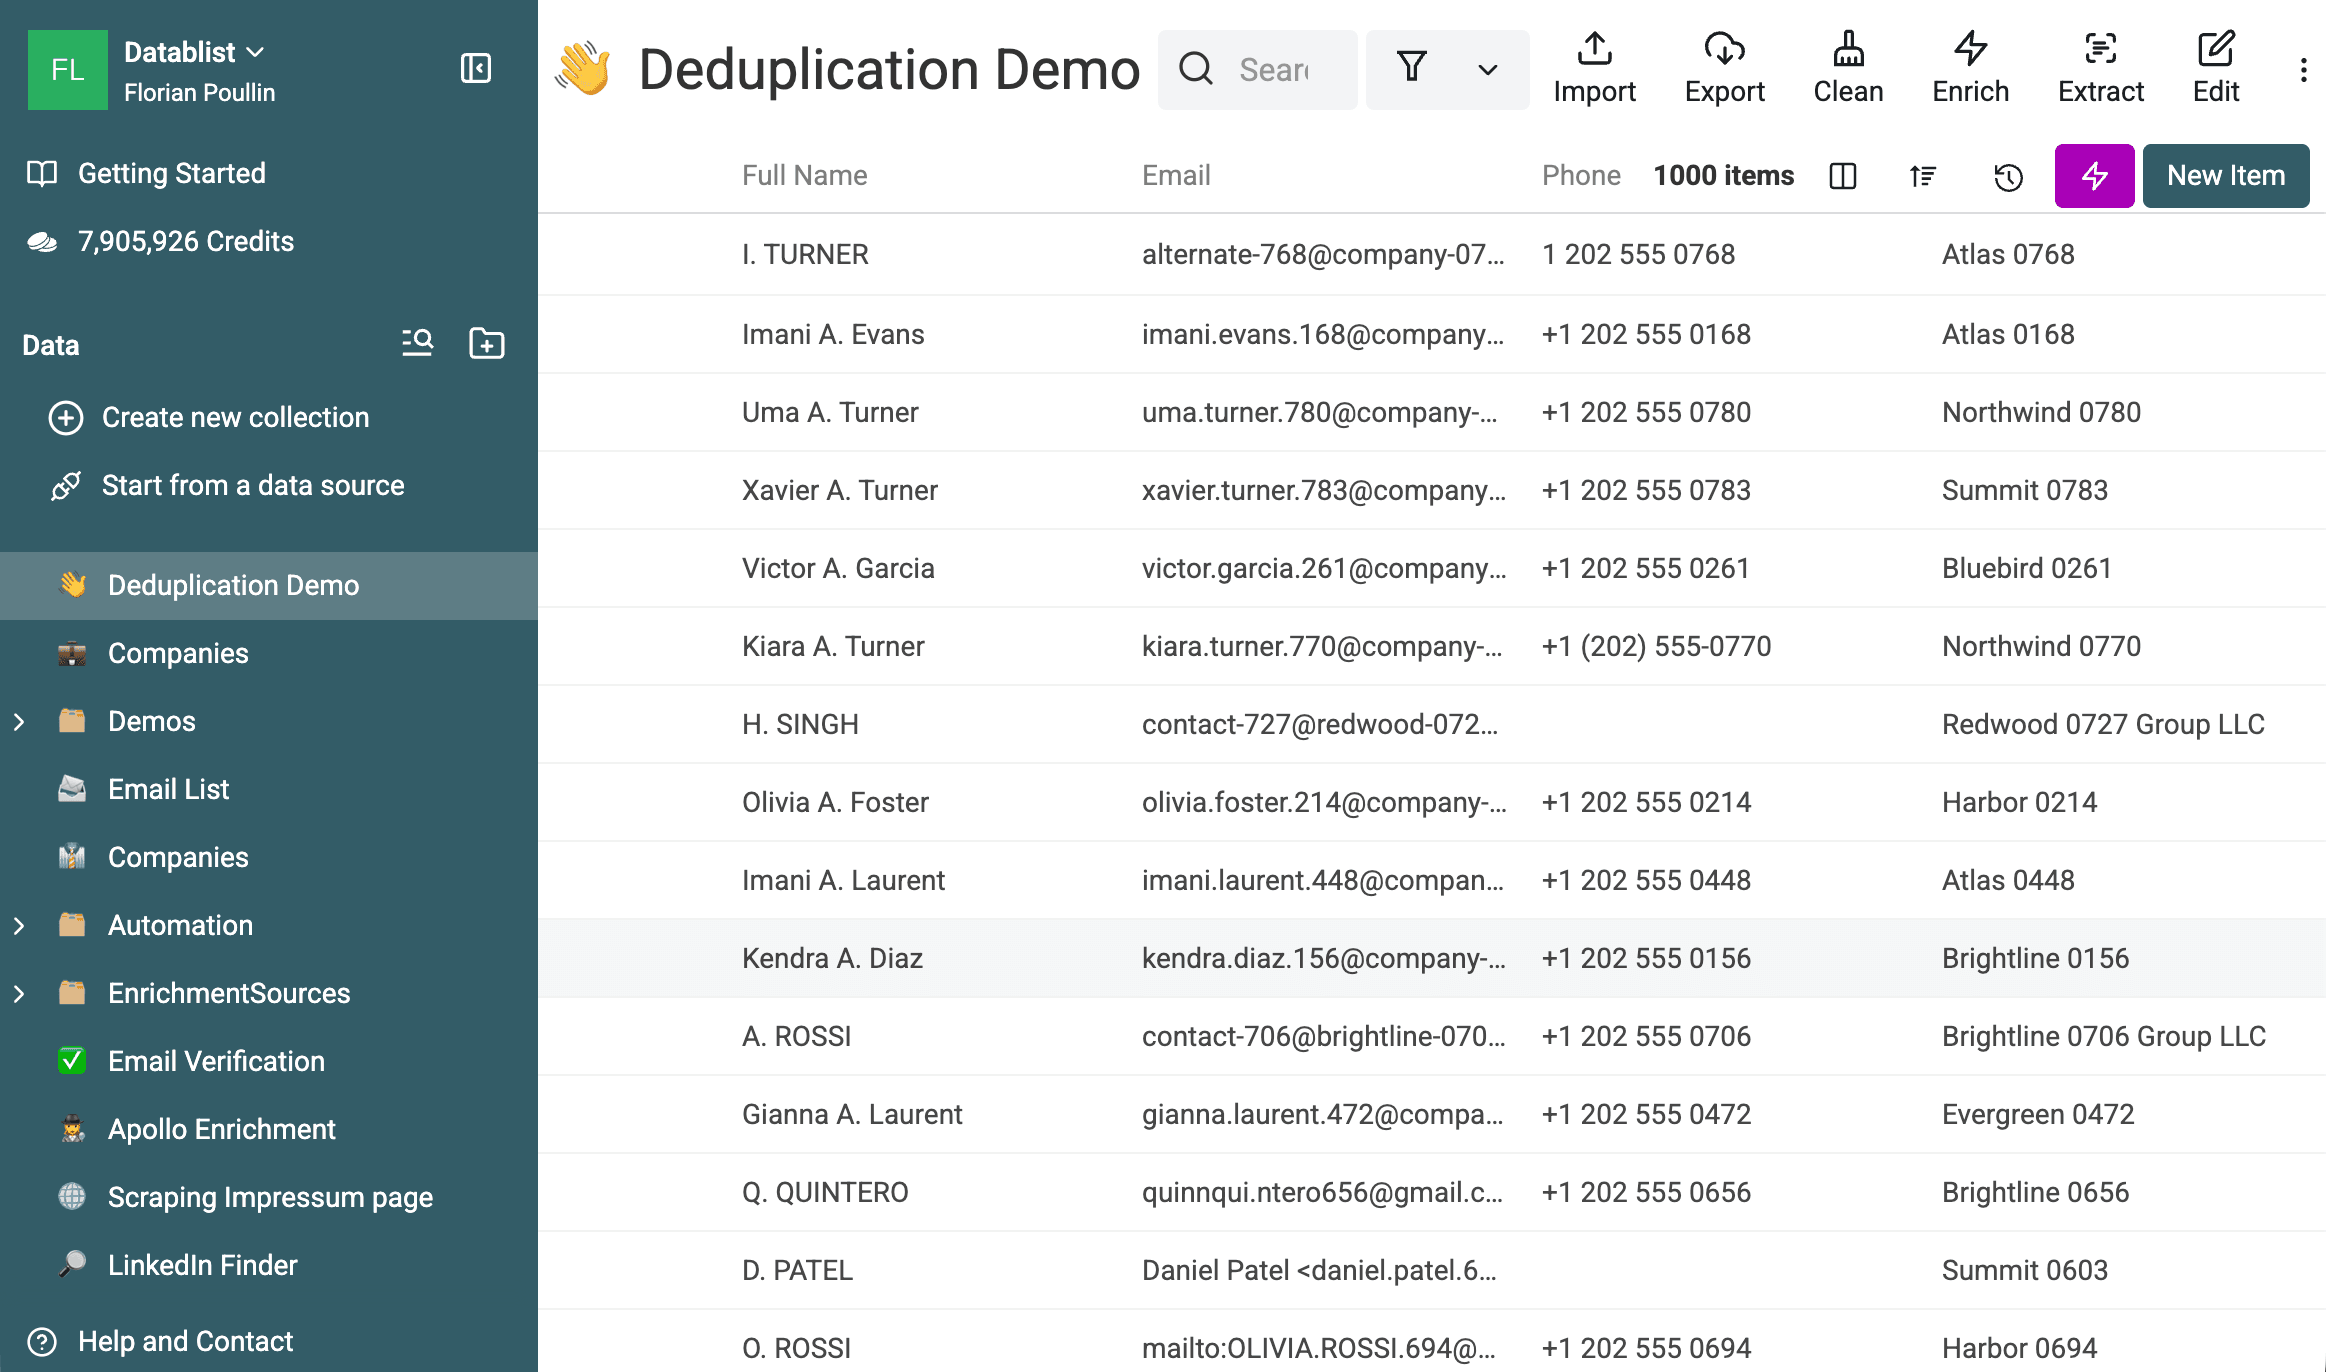
Во время импорта проверьте распознанные типы свойств:
- Для столбцов с email должен использоваться тип Email.
- Для столбцов с сайтами — URL.
- Для столбцов с телефонами — Phone.
- Для выручки или количества — Number.
- Для дат активности и создания — DateTime.
Оставьте в коллекции столбцы с ID, источником, владельцем, примечаниями и статусом. Они помогут выбрать правильную запись и проверить, какие данные сохранит объединение.
Запустите Exact, Smart и нечёткое сопоставление
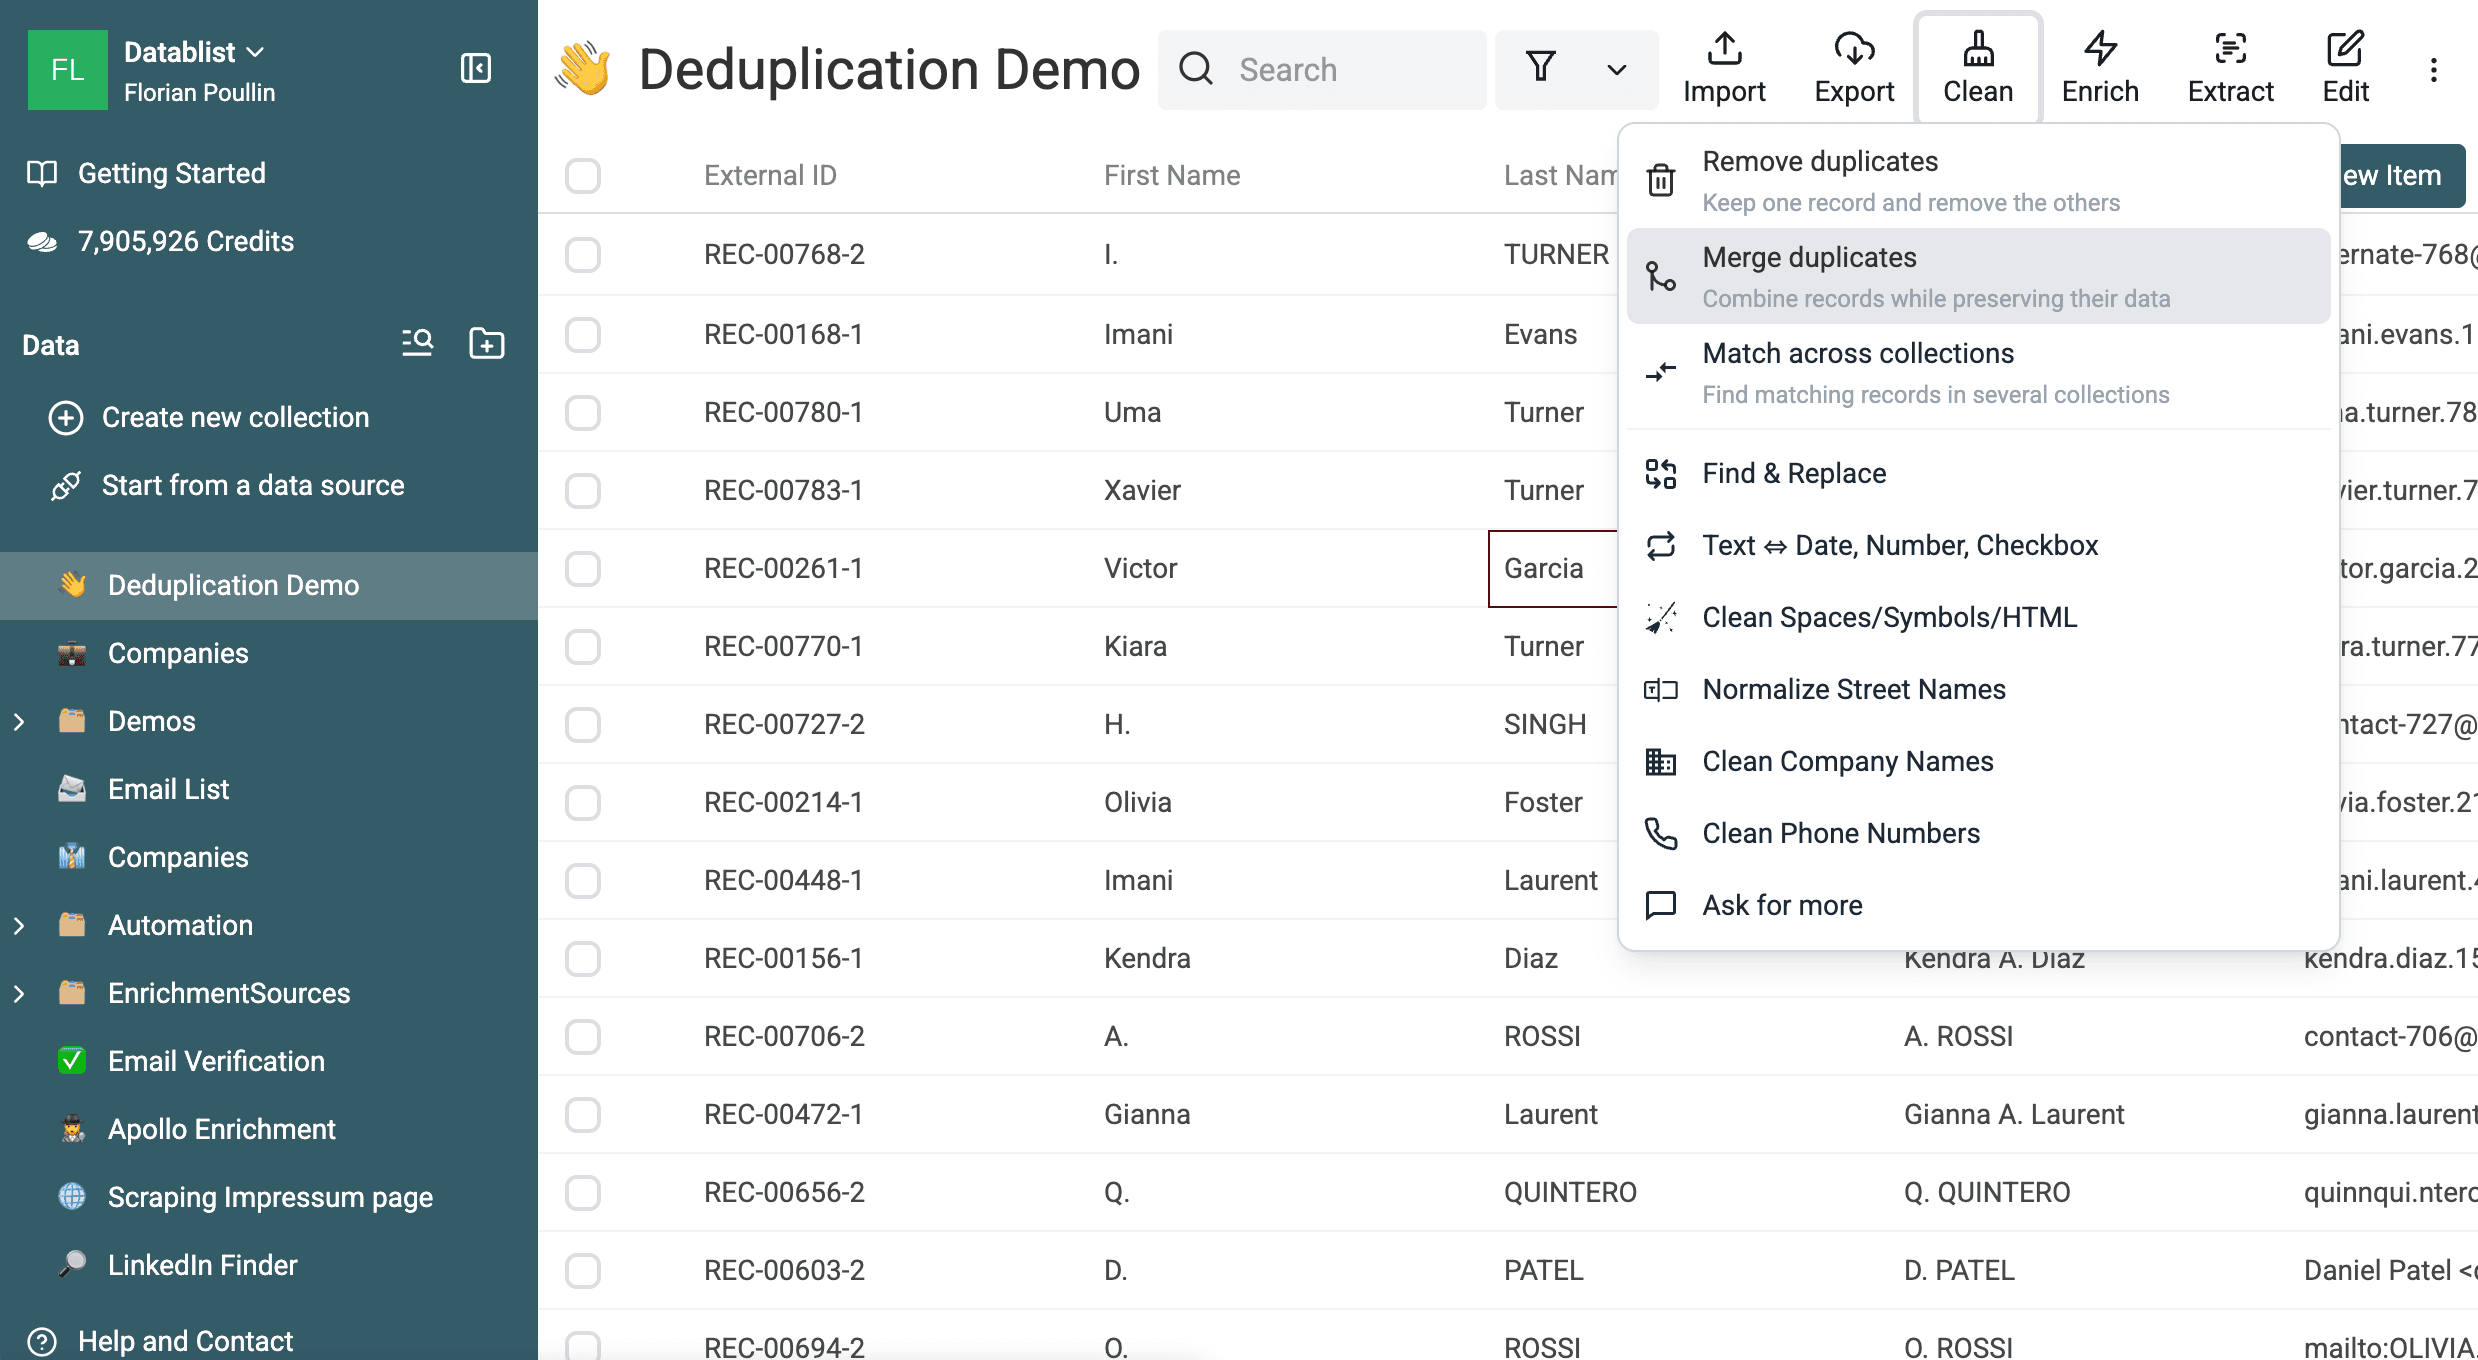
Откройте Clean и выберите действие в соответствии с задачей:
- Remove duplicates — если вторичные строки можно удалить.
- Merge duplicates — если в строках есть информация, которую нужно сохранить.
- Match across collections — если записи находятся в разных коллекциях.
Первые два действия используют один механизм поиска. Они открывают рабочую область результатов с разными заранее выбранными режимами обработки.
Начните с сопоставления Exact
Используйте All Properties с Exact, чтобы найти строки, скопированные без изменений. Выберите Selected Properties, если одно поле, например внешний ID, должно полностью совпадать.
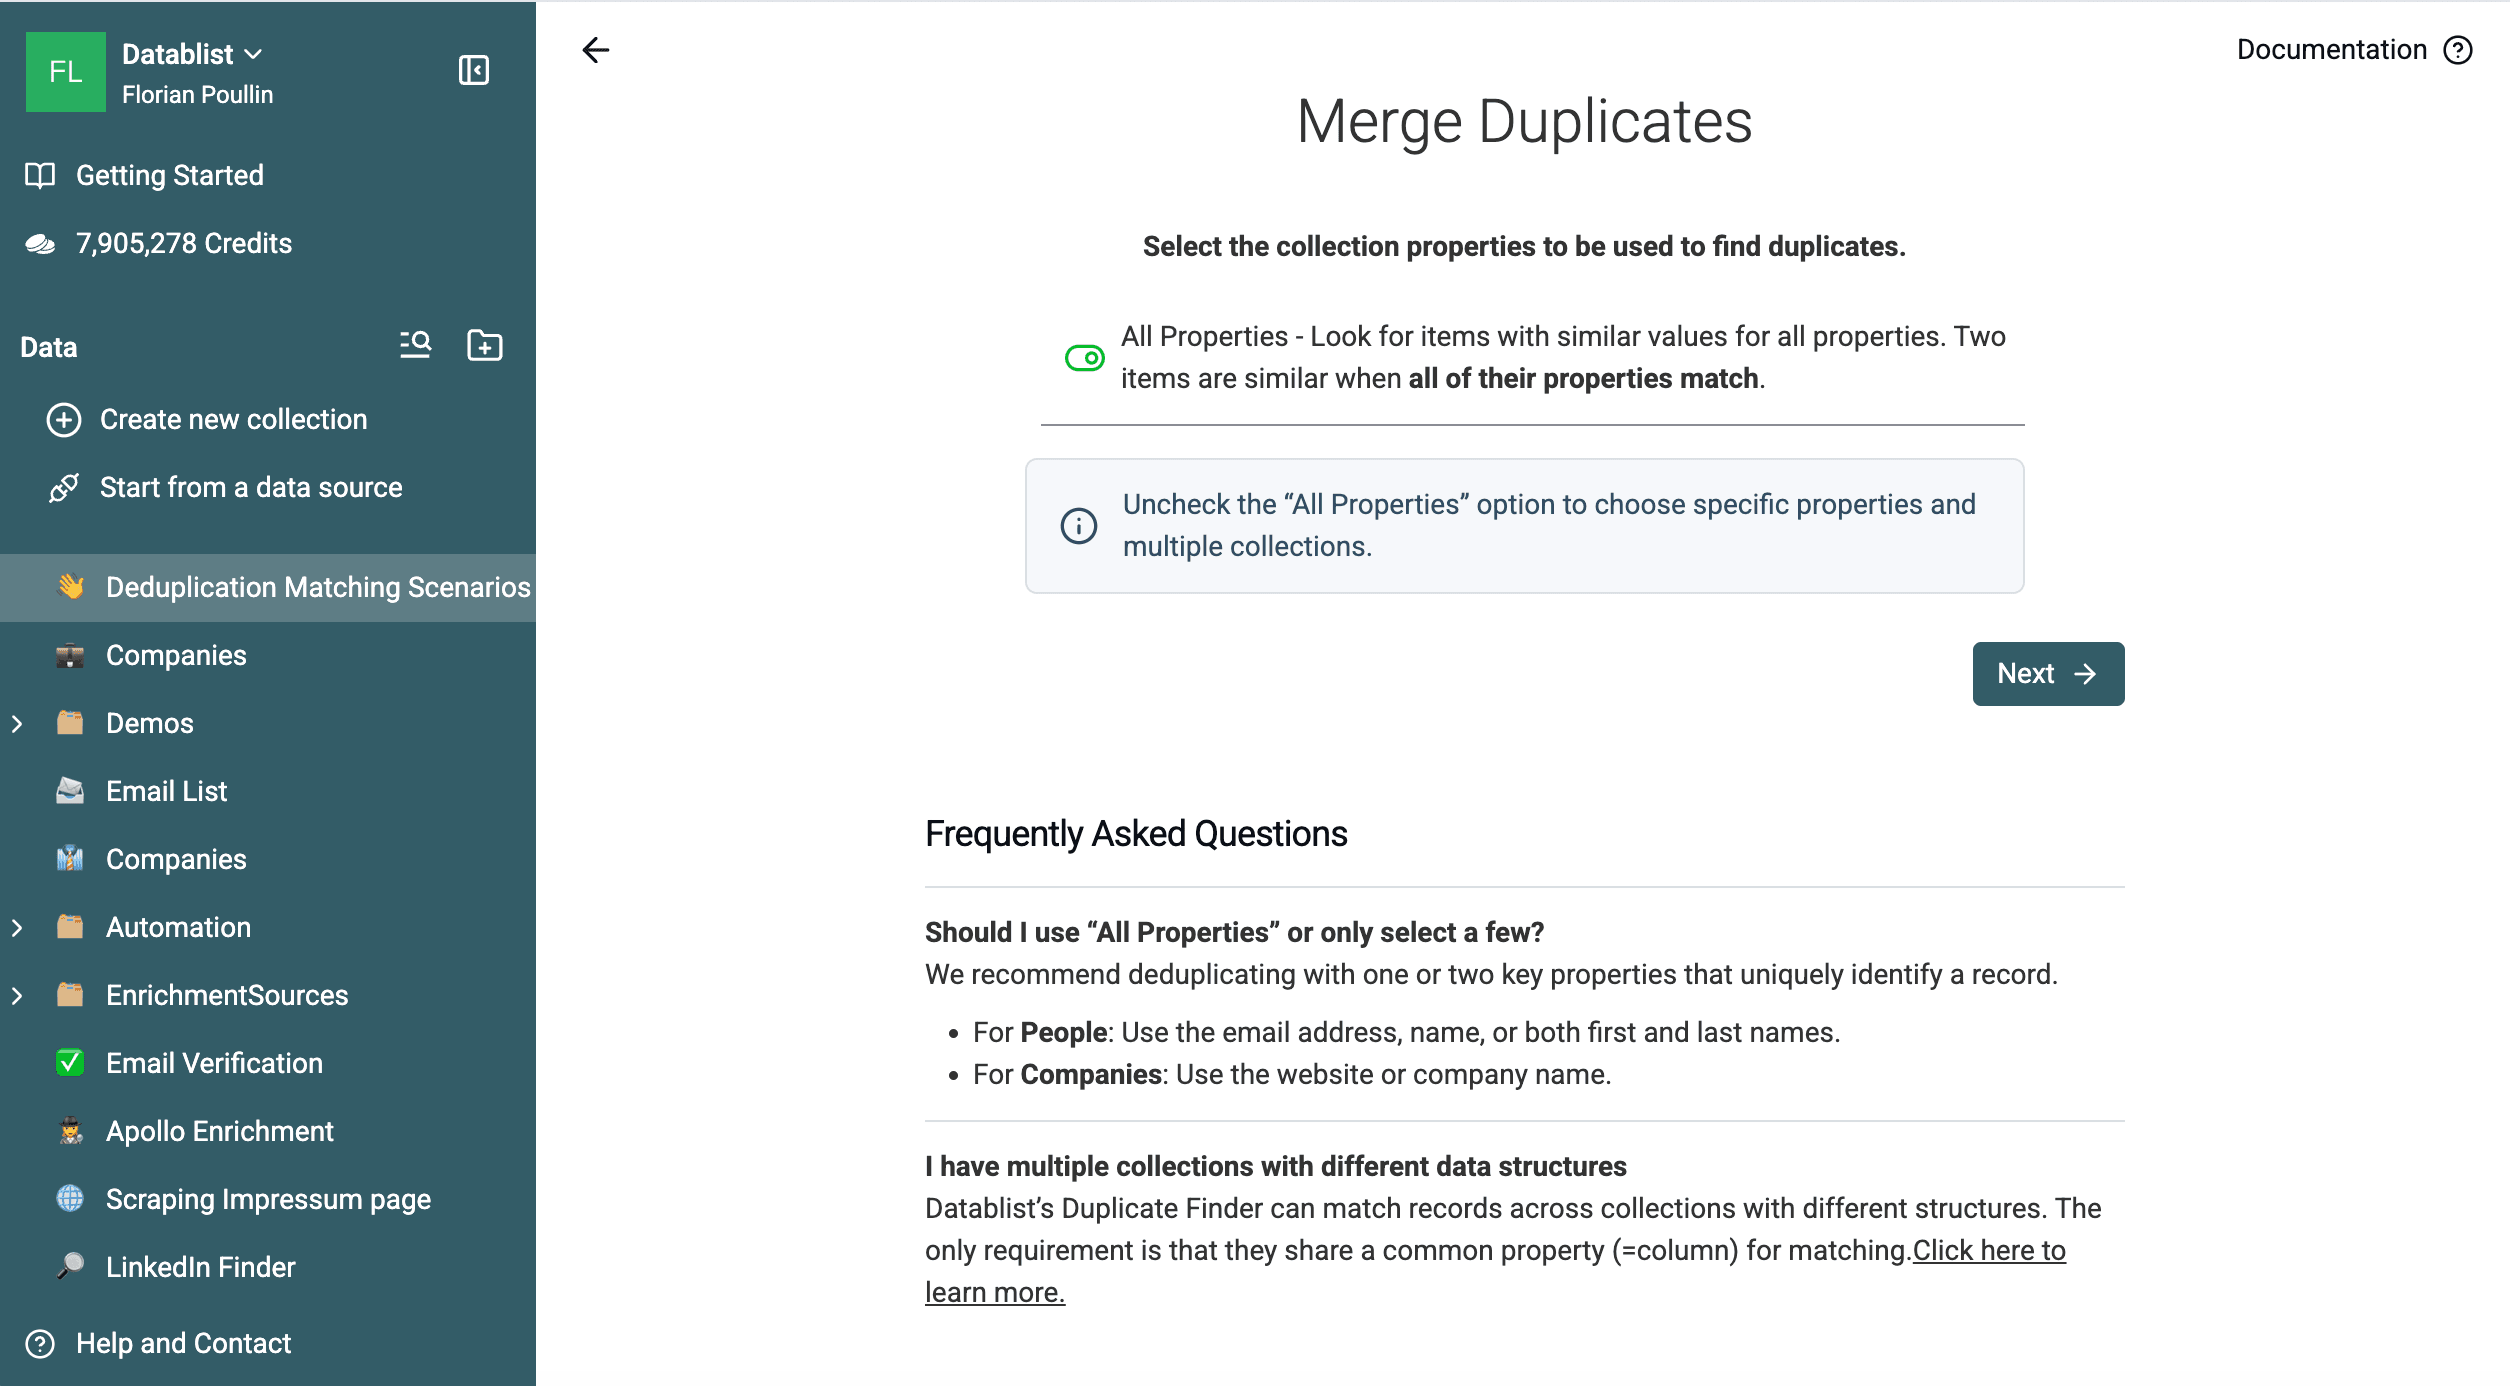
Для примера на 1 000 строк эта проверка возвращает пять групп дублей. В каждой группе находятся две строки с одинаковыми значениями всех свойств.
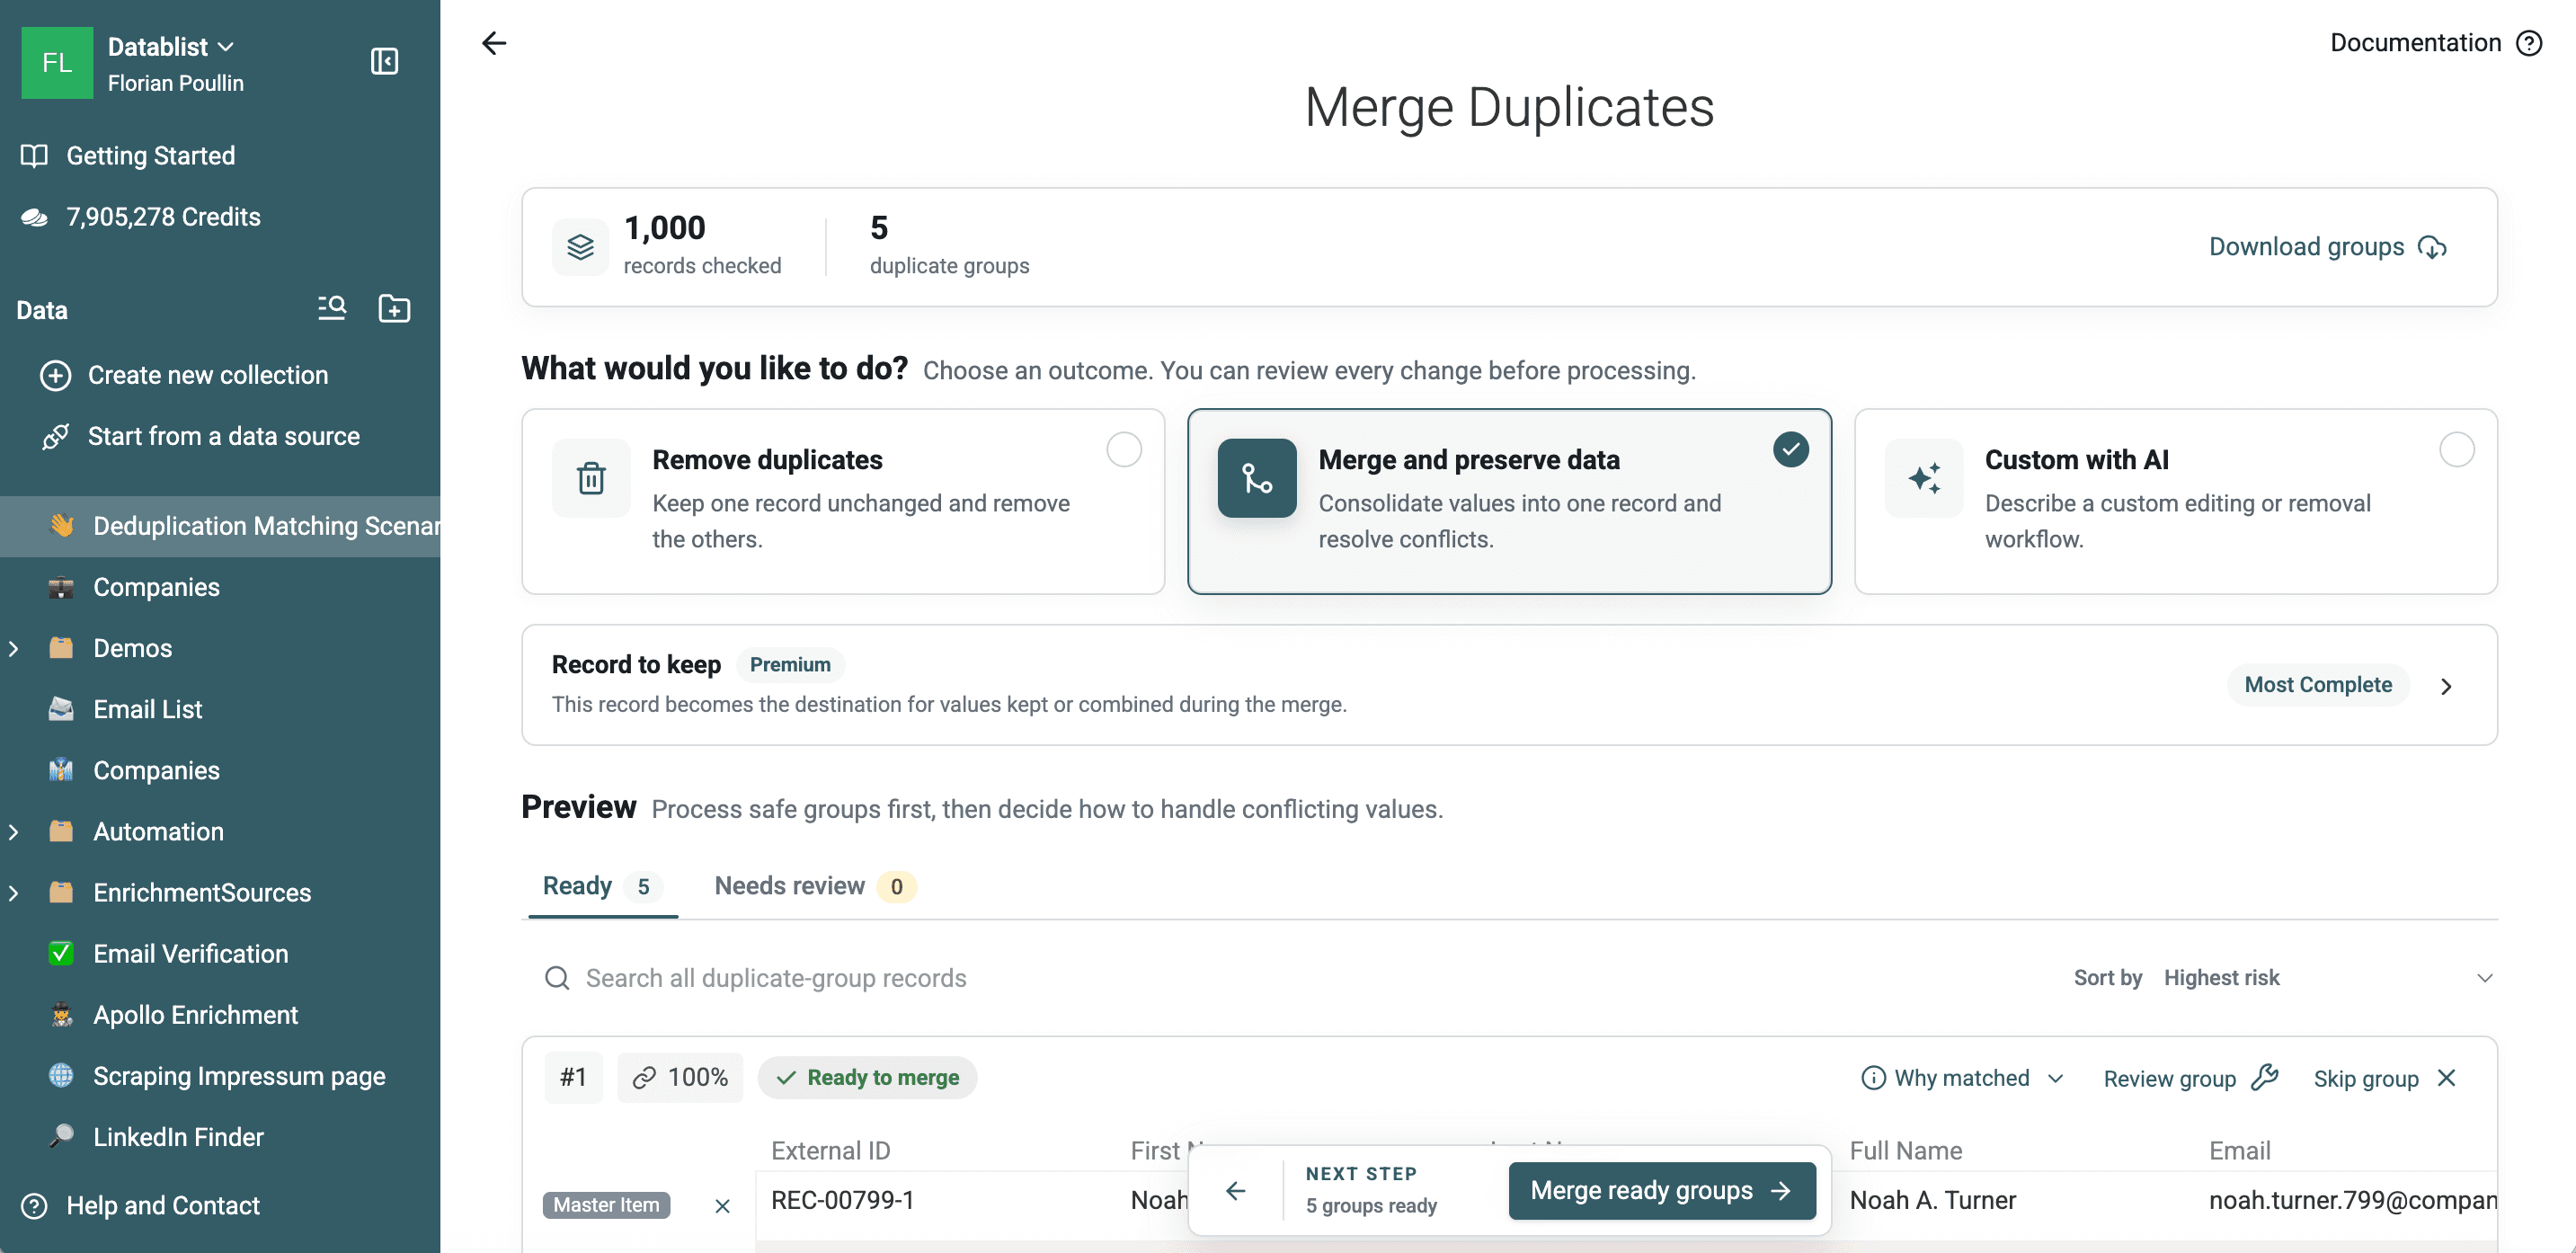
Exact — самый безопасный первый этап, поскольку каждое найденное совпадение проходит строгое сравнение. Но он не найдёт Acme Inc. и Acme, по-разному отформатированные номера телефонов или алиасы email, если сохранённые значения различаются.
Незарегистрированные пользователи могут запустить проверку Exact. Бесплатный аккаунт открывает сравнение Smart и другие функции тарифа Free.
Используйте Smart для бизнес-данных
Smart стандартизирует значения для сравнения, не изменяя сохранённые ячейки. Выберите процессор, соответствующий свойству:
- Email учитывает регистр, пробелы по краям, алиасы с плюсом, точки Gmail,
googlemail.com, обёртки с отображаемым именем и значенияmailto:. - URL может игнорировать протокол и завершающий слеш; отдельно настраивается учёт поддоменов, путей и параметров запроса.
- Phone игнорирует символы форматирования. Он не проверяет номера, не использует свойство Country и не восстанавливает отсутствующий код страны.
- Company Name удаляет распространённые юридические, деловые и географические обозначения.
- Text игнорирует диакритические знаки, пробелы, пунктуацию, символы, регистр и порядок слов.
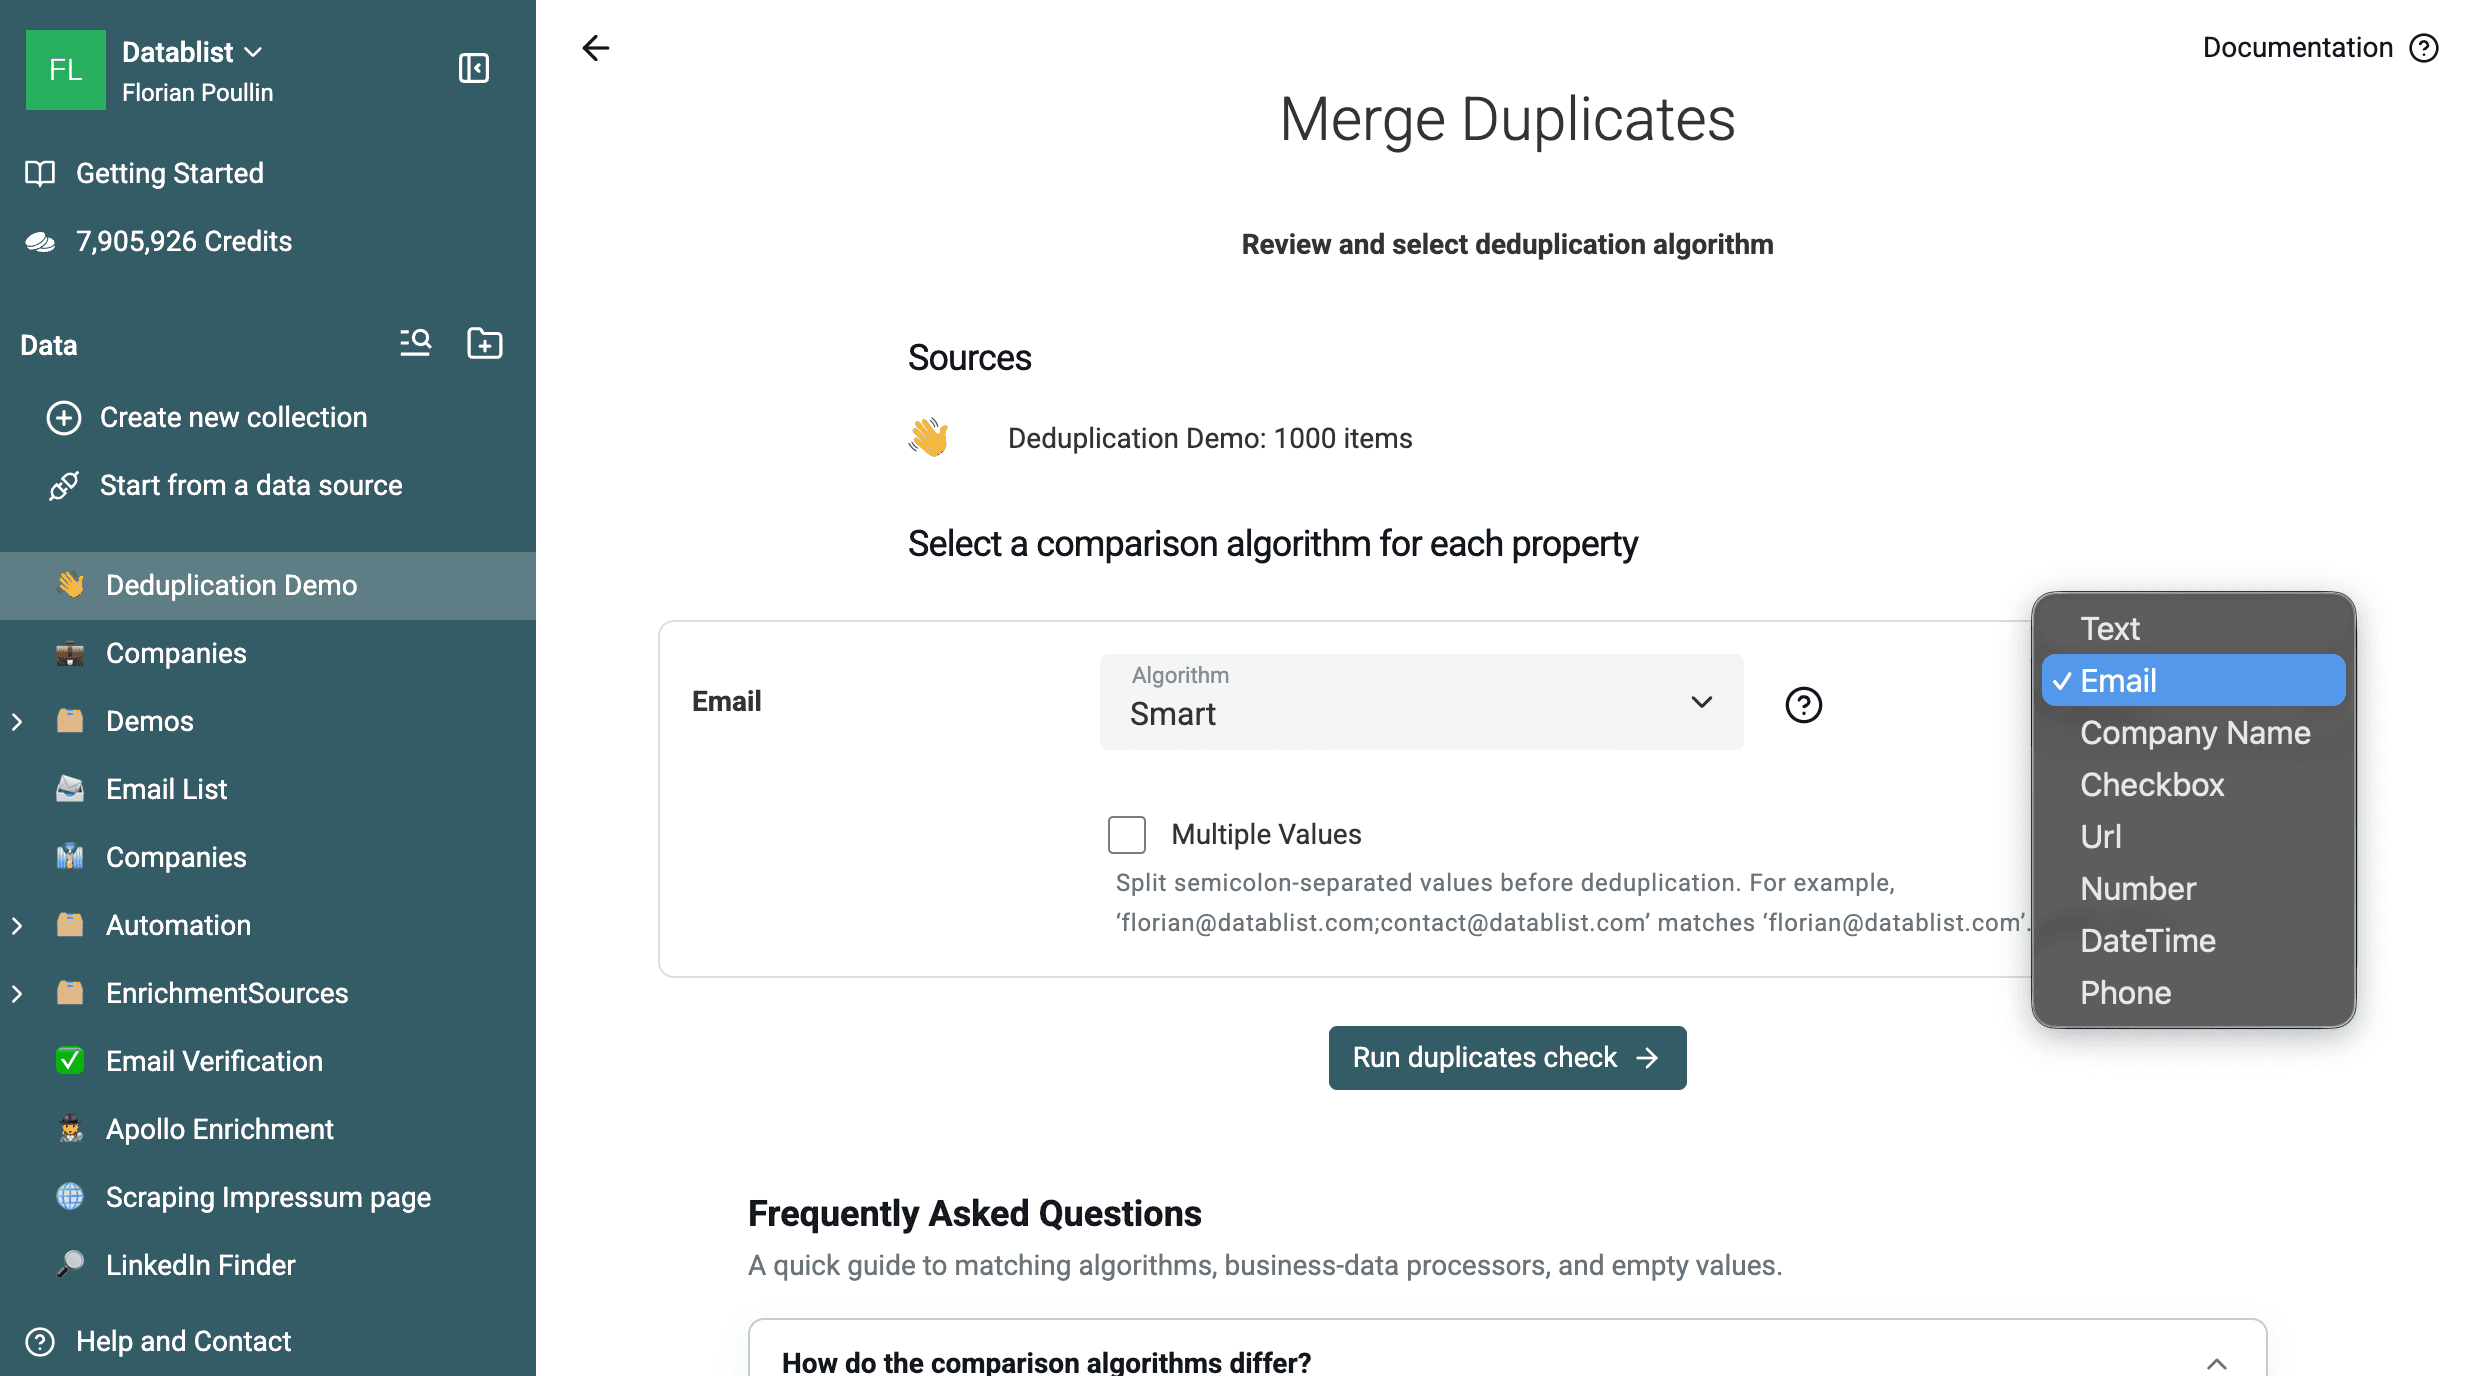
Процессор Company Name, сопоставление нескольких значений и продвинутые алгоритмы доступны на платном тарифе. Exact и Smart можно использовать для сопоставления внутри одной коллекции на тарифе Free, но для Smart нужен бесплатный аккаунт.
Если в одной ячейке содержится несколько идентификаторов, разделённых точкой с запятой, включите Multiple Values. Datablist сравнит каждую часть и признает свойство совпадающим, если совпадёт хотя бы одна пара. Например, ячейка primary@example.com;shared@example.com может совпасть с ячейкой shared@example.com.
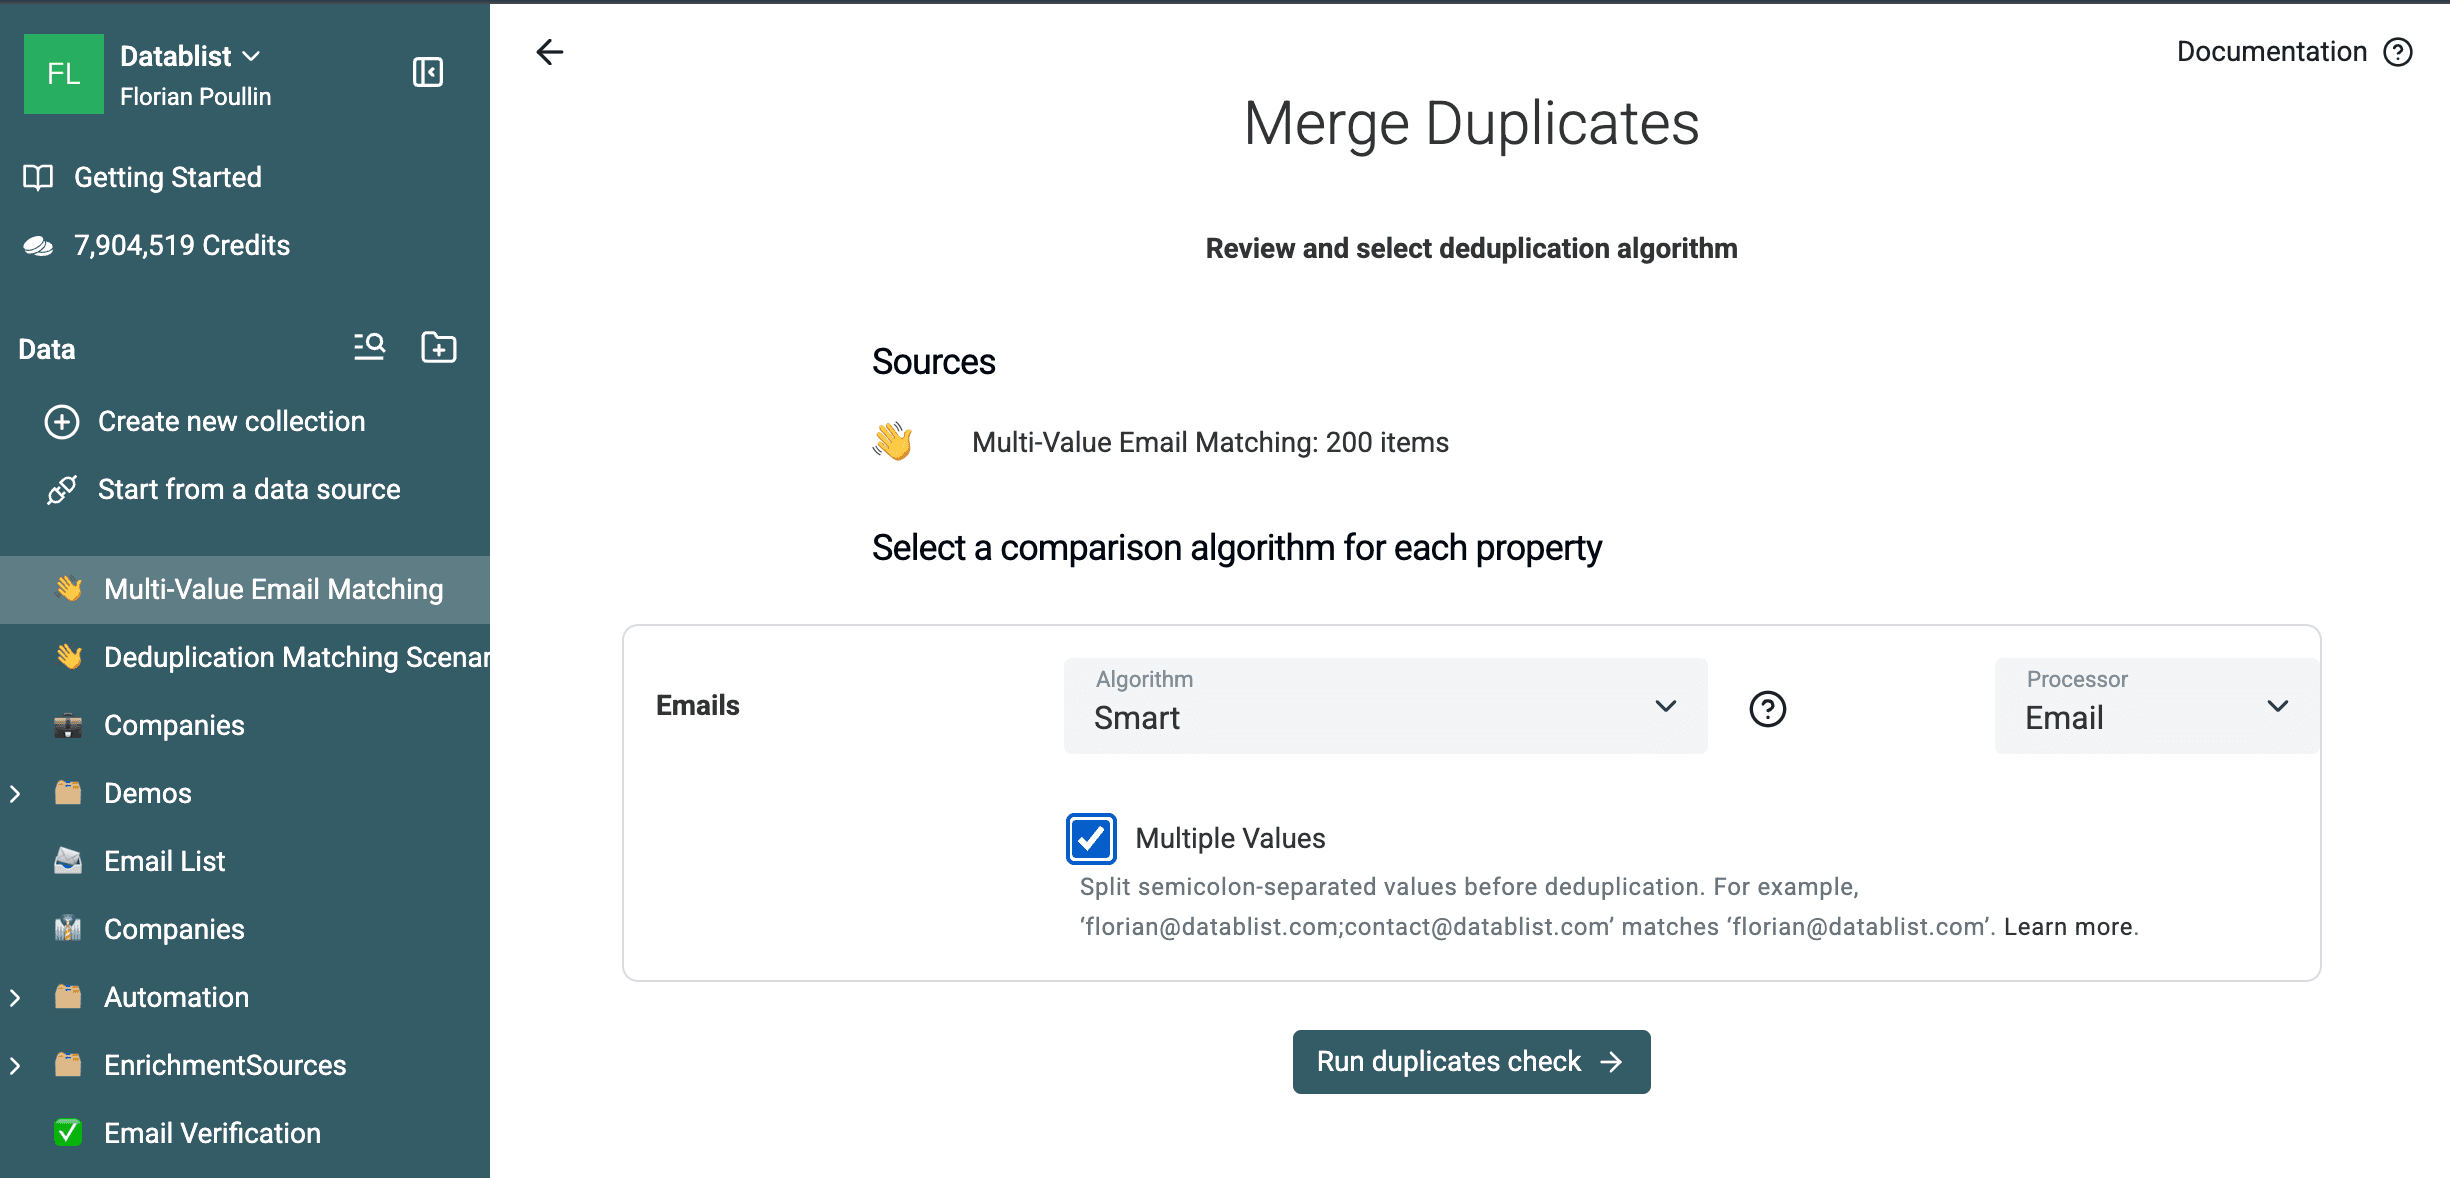
В специальном примере на 200 строк эта настройка вернула 60 групп по две строки. Проверка по контрольным данным выявила все 60 заложенных пар и исключила все 80 контрольных записей. В руководстве по дедупликации полей с несколькими значениями доступны файл примера, итоговый CSV и рекомендации по объединению.
Эта проверка по email вернула 105 групп по две строки: 100 заложенных пар, выявленных после нормализации email, и пять пар точных копий, у которых email также совпадает.
Нормализуйте телефоны перед сопоставлением
Процессор Smart Phone полезен в одном конкретном случае: когда значения содержат одинаковые цифры, но отличаются пробелами, скобками, дефисами или другими символами. Например, он сопоставит (415) 555-0123 и 4155550123.
Он не может определить, что местный и международный номера относятся к одному телефону. Например, для сравнения 06 12 34 50 08 и +33 6 12 34 50 08 нужен контекст страны.
Перед дедупликацией по телефону используйте Phone Number Cleaner:
- Сопоставьте исходное свойство
Phone. - Для списка из одной страны выберите страну в разделе Local Phone Countries. Для смешанного списка включите Define country per item и сопоставьте свойство
Country. - Запишите результат enrichment в
Clean Phone Number, не перезаписывая исходное значение. - Проверьте ошибки и пустые результаты. Они не должны участвовать в сопоставлении по телефону.
- Запустите Duplicates Finder для
Clean Phone Numberс Exact.
Скачать специальный пример с 200 телефонными номерами. Он содержит 50 пар с местными и международными форматами для США, Франции, Великобритании, Германии и Испании, а также 100 контрольных записей без совпадений. Проверка с помощью рабочей логики очистки сформировала по одному нормализованному номеру для всех 200 строк. Заложенные 50 пар преобразовались в 50 общих международных значений, а контрольные записи остались уникальными.
Такая предварительная обработка также проверяет формат телефона. Сохраните исходные свойства Phone и Country рядом с очищенным результатом, чтобы можно было проверить запись перед объединением. Подробнее о роли кодов стран и международных значений читайте в материале что такое нормализация телефонных номеров.
Для записей компаний запустите отдельную проверку по Website. Выберите Smart с процессором URL. Включайте Ignore Subdomain, Ignore Path и Ignore Query Params только в том случае, если соответствующие компоненты URL не должны обозначать другую компанию или филиал.
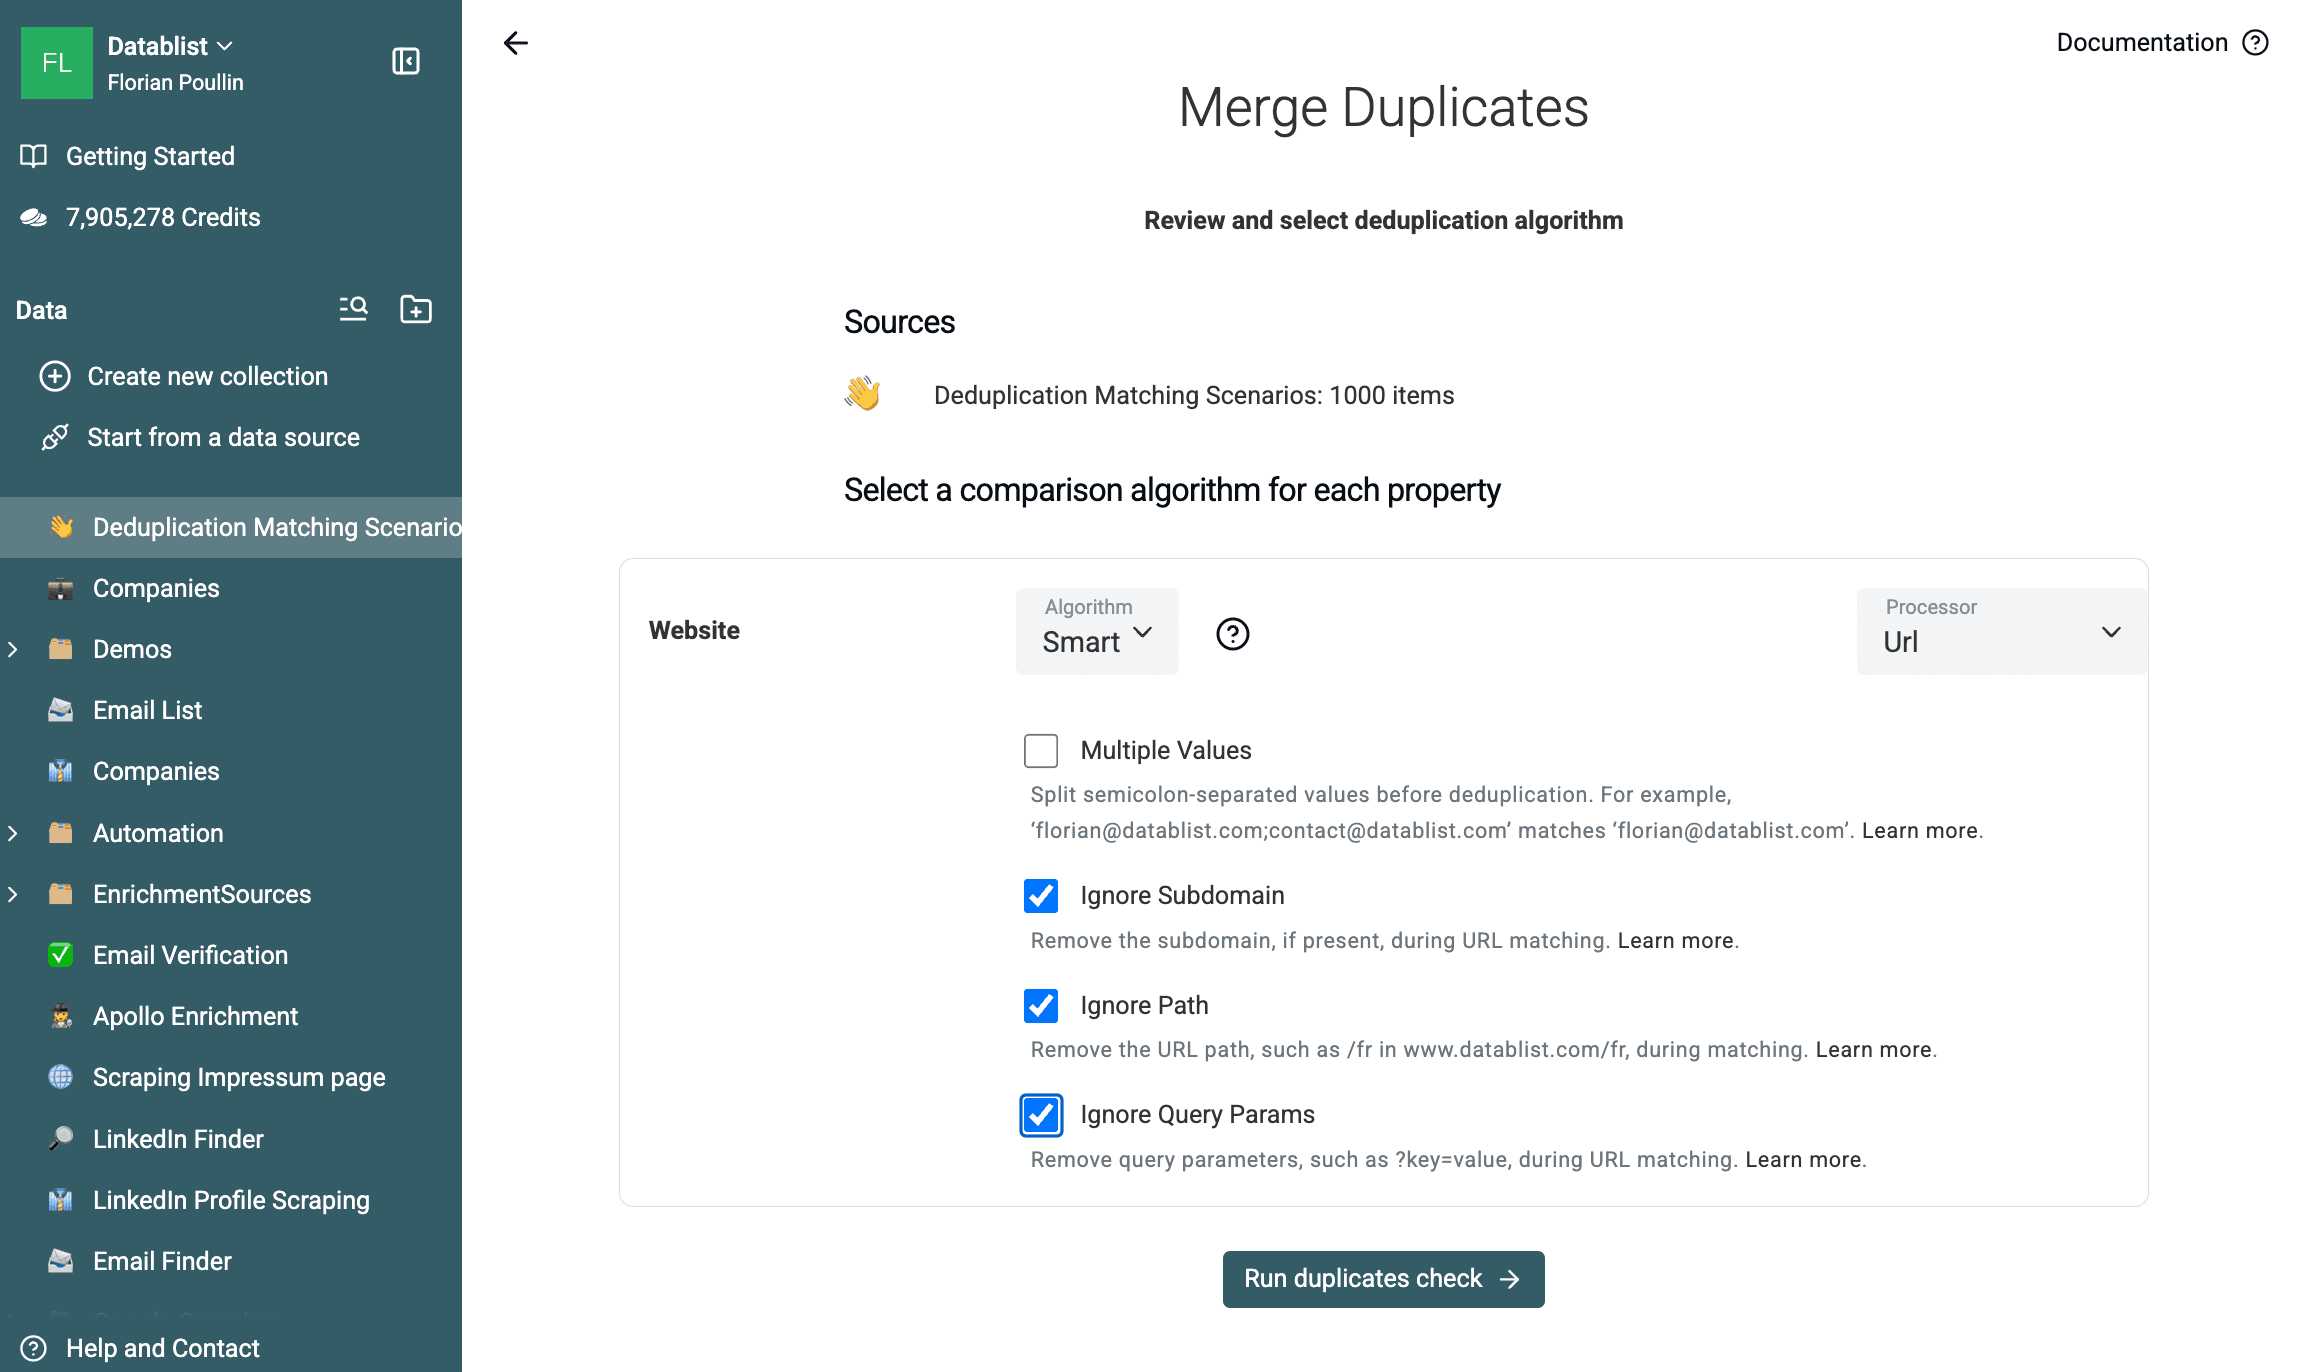
Для того же примера на 1 000 строк эта настройка вернула 200 групп по две строки. В 50 парах присутствуют специально созданные варианты URL, а ещё 150 пар уже имеют одинаковый сайт. В этом тесте каждая экспортированная пара свелась к одному нормализованному хосту.
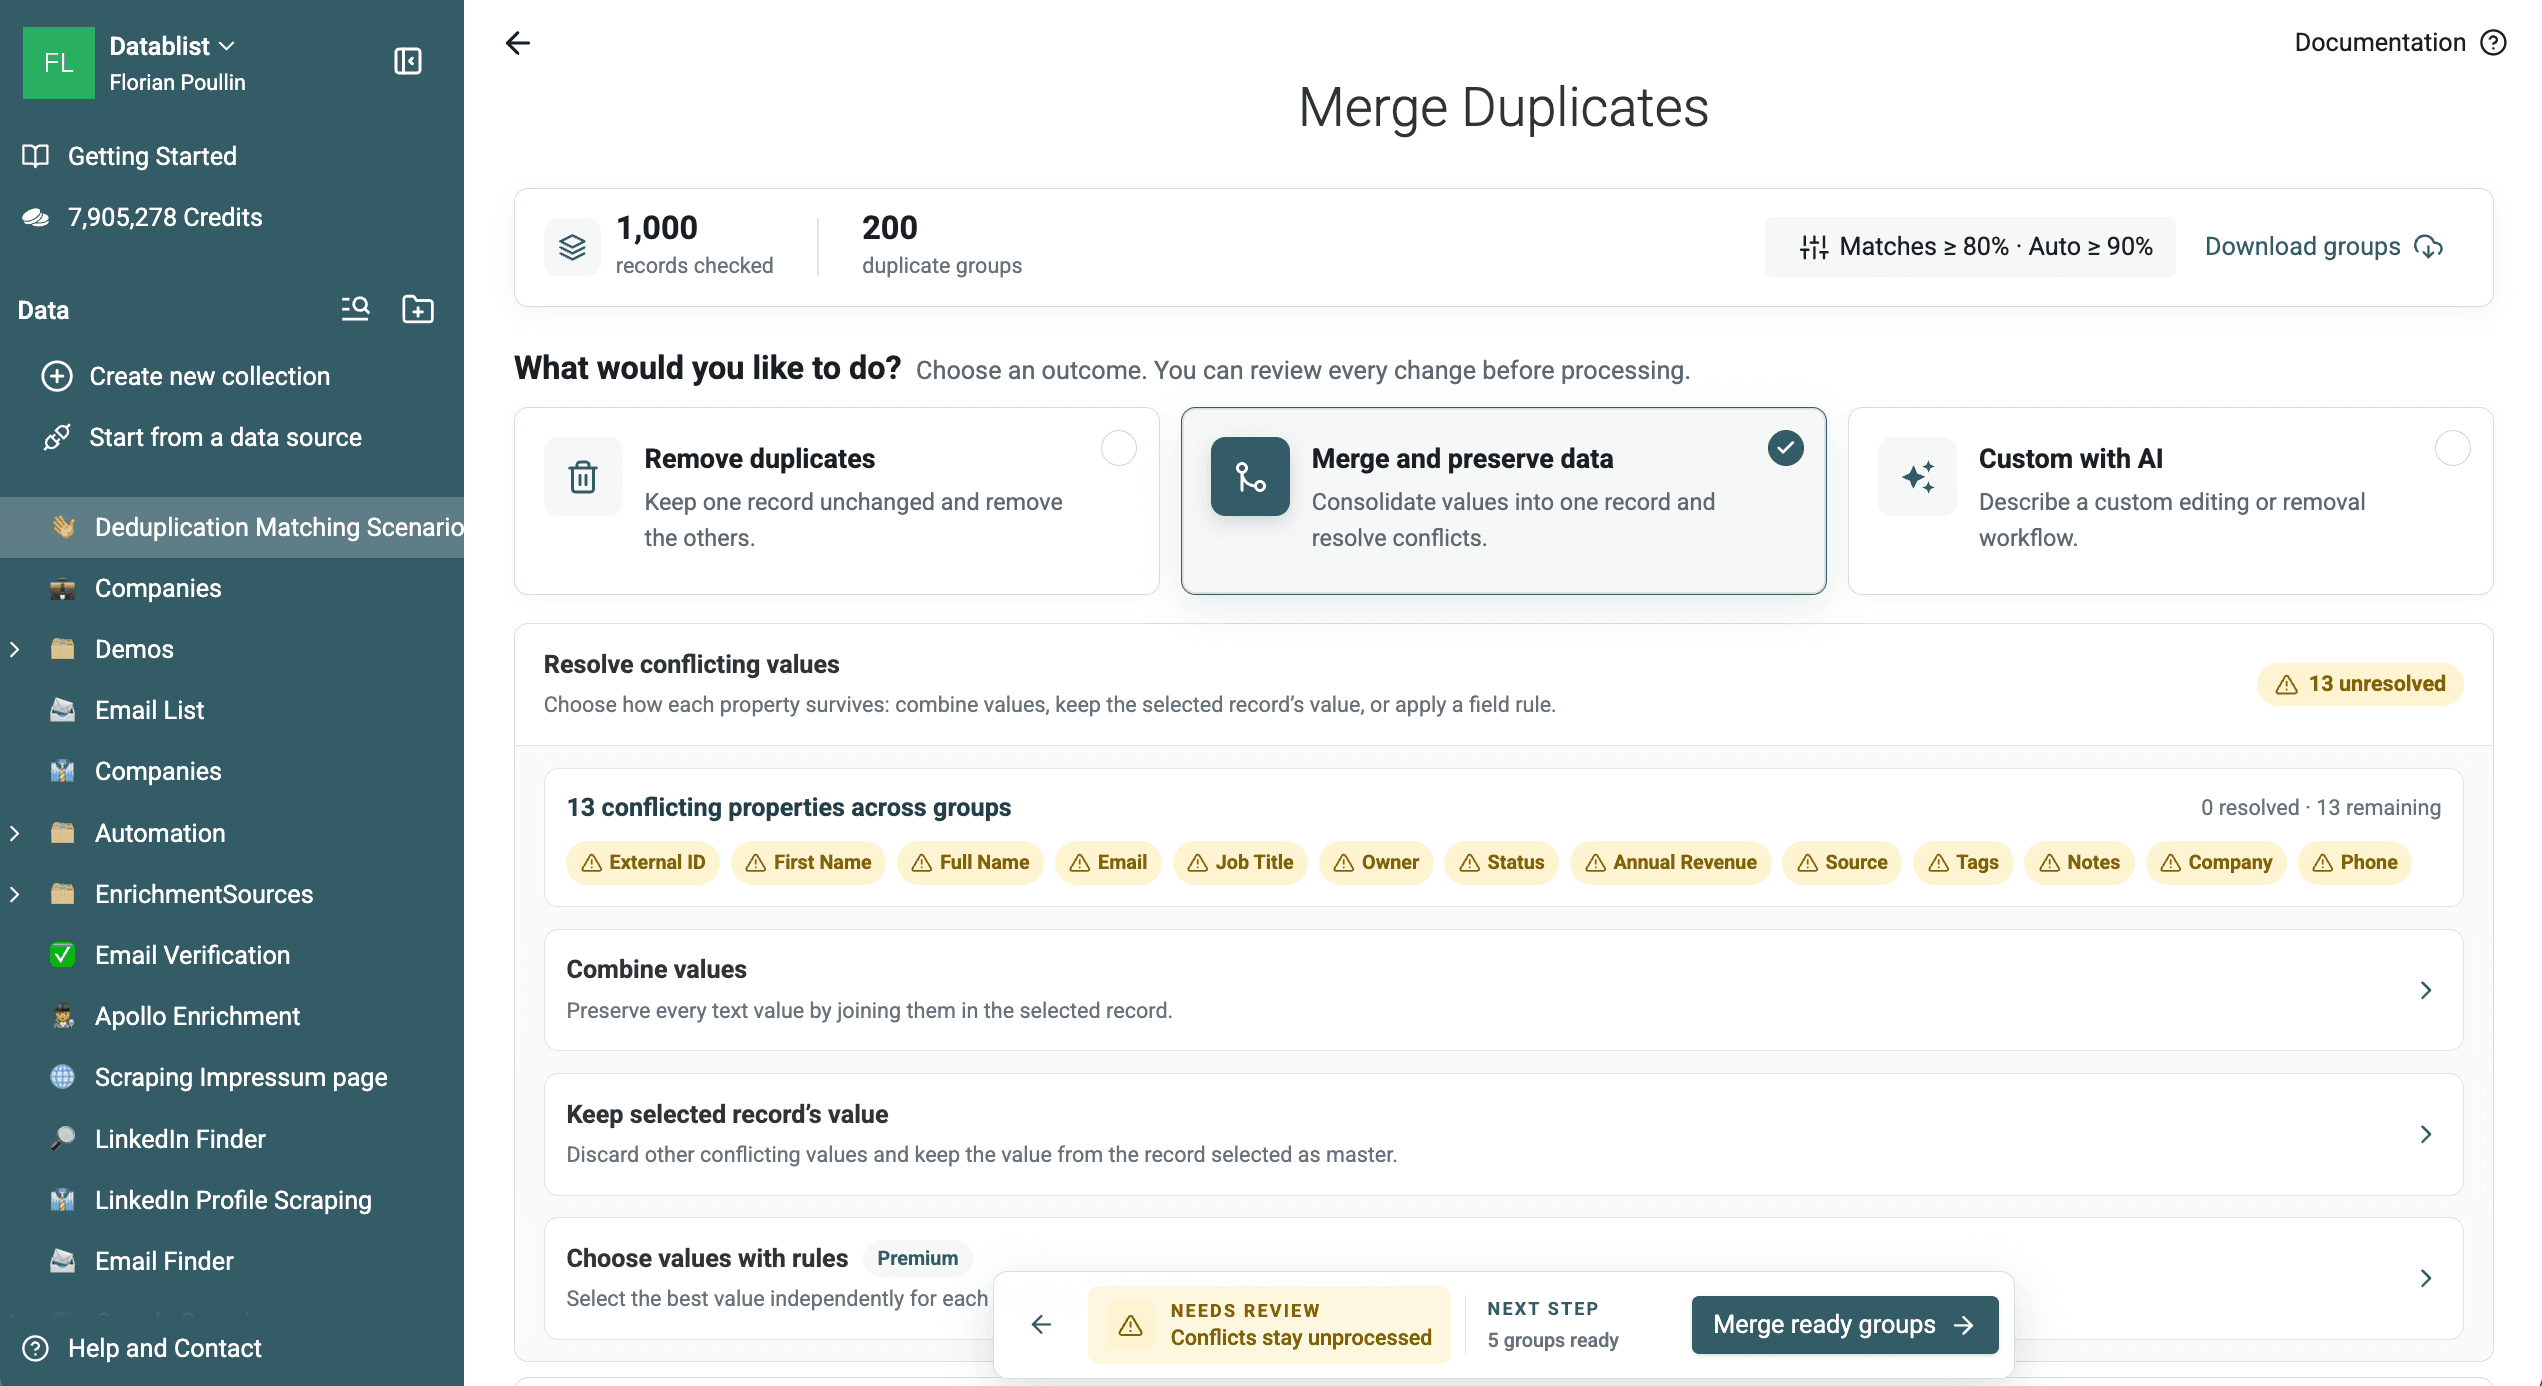
Скачать 200 групп дублей Website или изучить сценарий дедупликации компаний со стратегией сопоставления прежде всего по домену.
Используйте нечёткий и фонетический поиск для проверки
Metaphone сравнивает звучание текста. Jaro-Winkler и Levenshtein рассчитывают коэффициент сходства, что помогает находить различия в написании, например Uma Turner и Uman Turner.
Нечёткие совпадения — это кандидаты, а не подтверждённые дубли. Начните с высокого порога, проверьте самые слабые группы и снижайте порог результатов только при сохранении достаточной точности.
Для измеримой нечёткой проверки выберите Full Name, затем Distance с Levenshtein, оставьте процессор Text и задайте порог 90%.
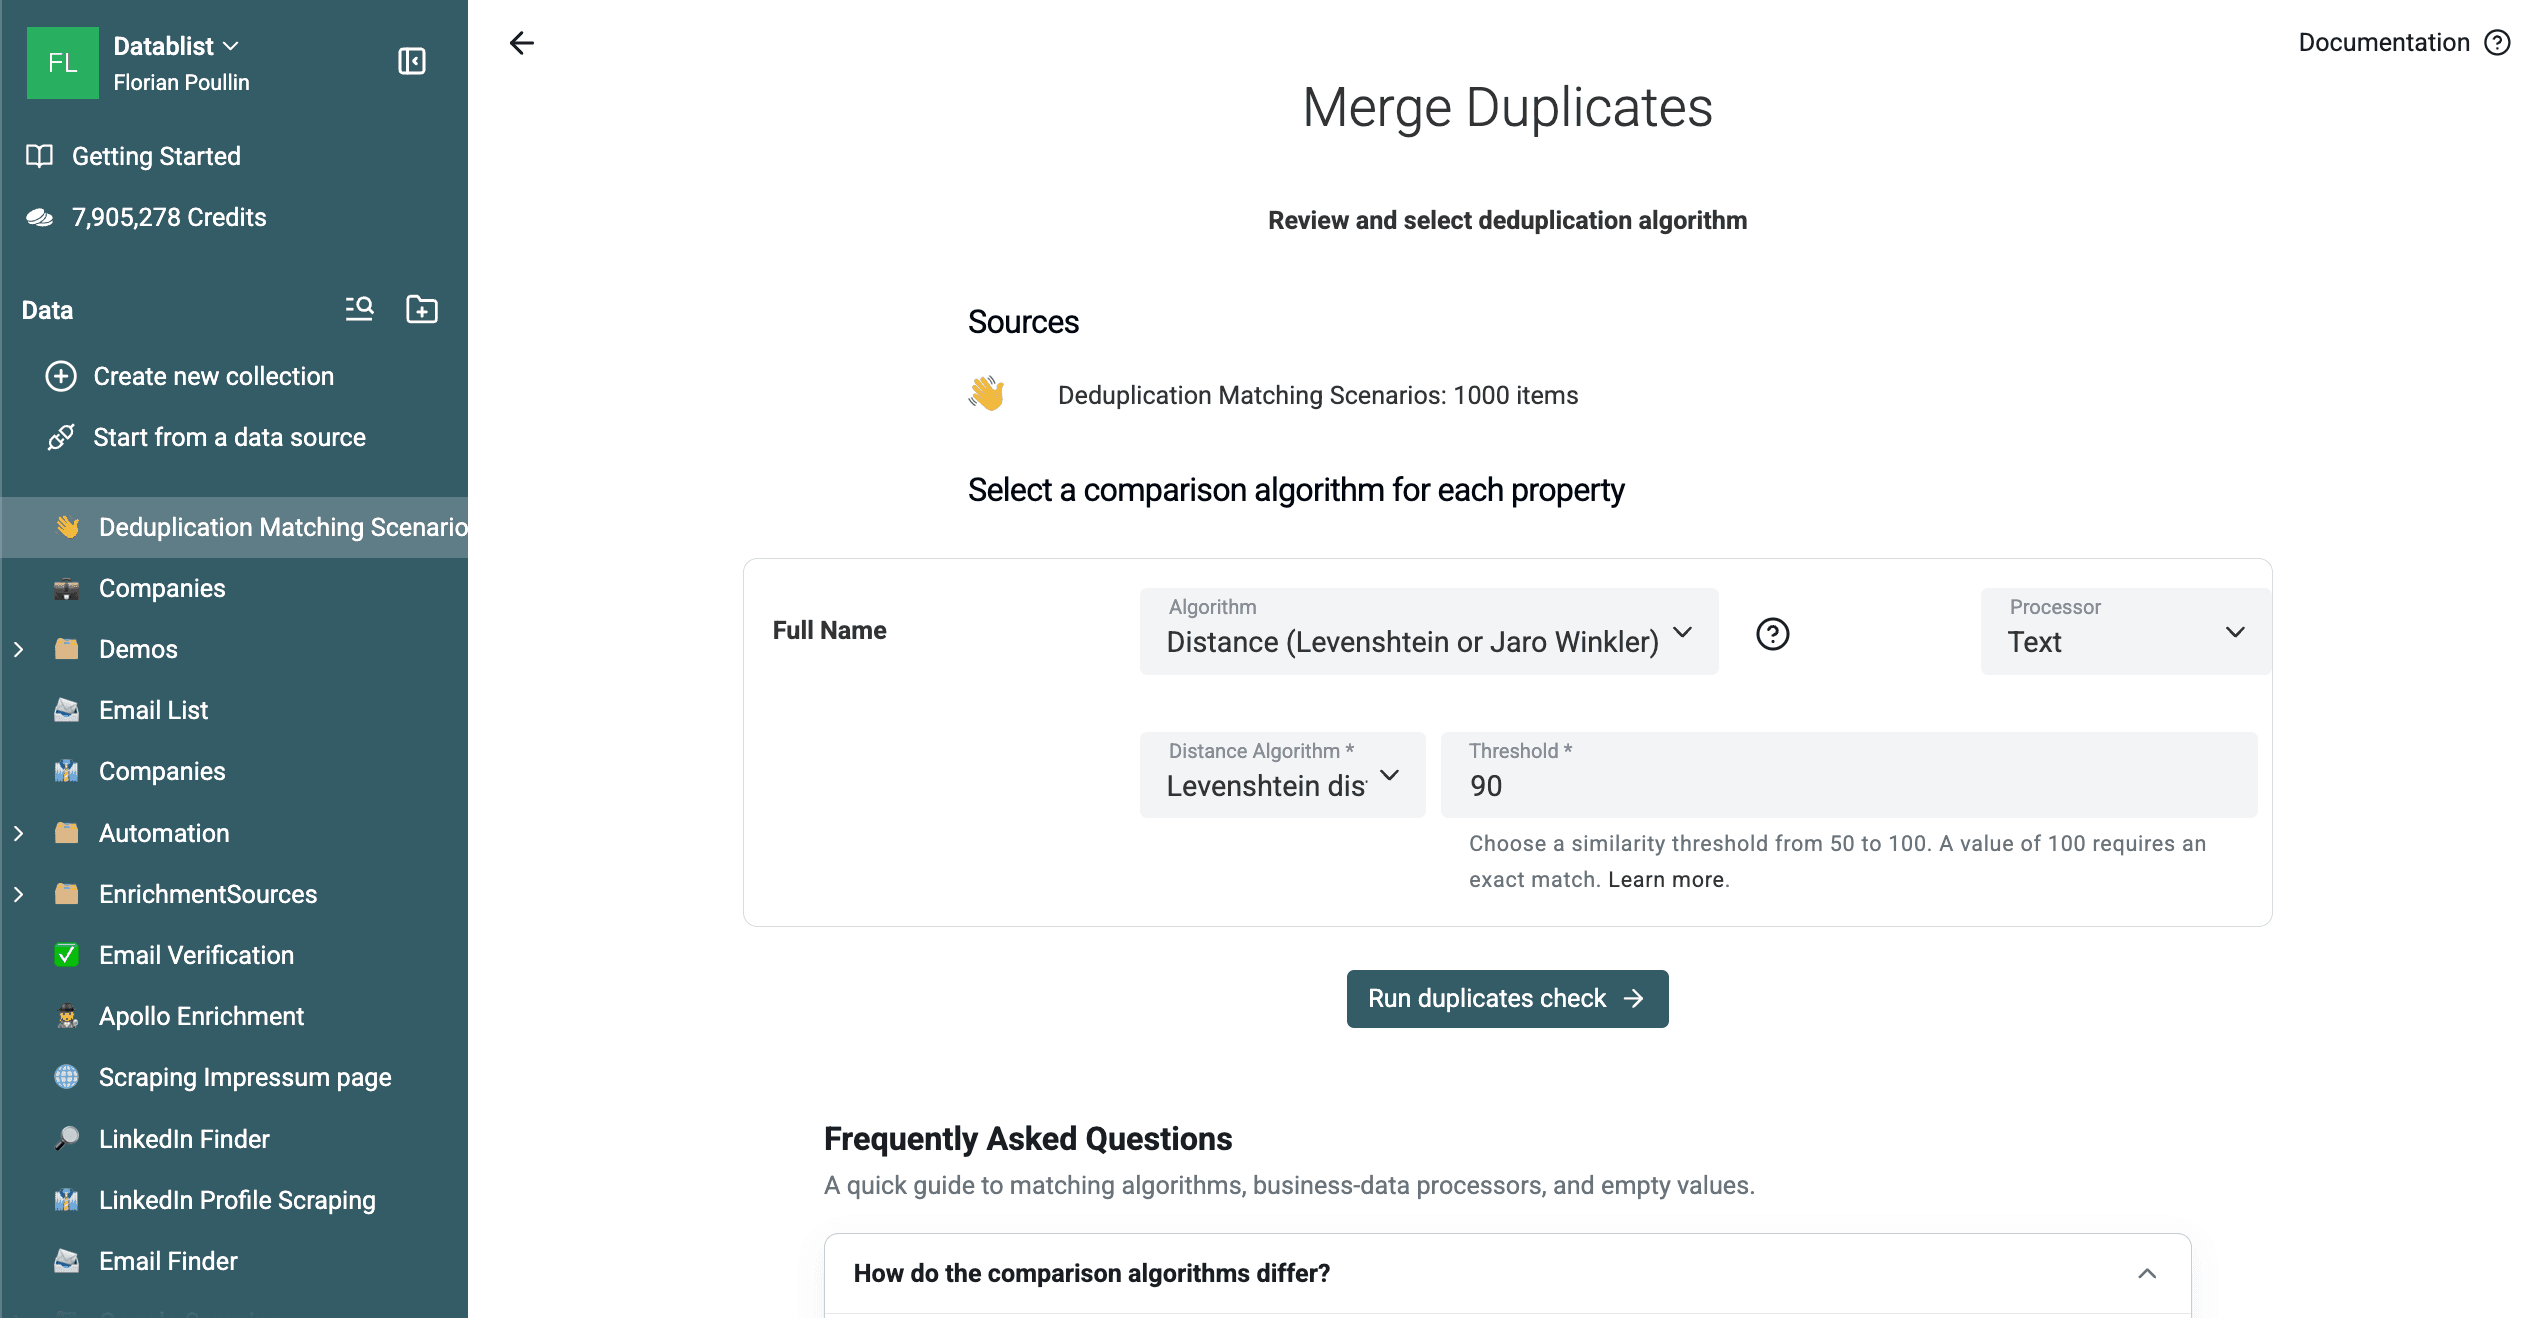
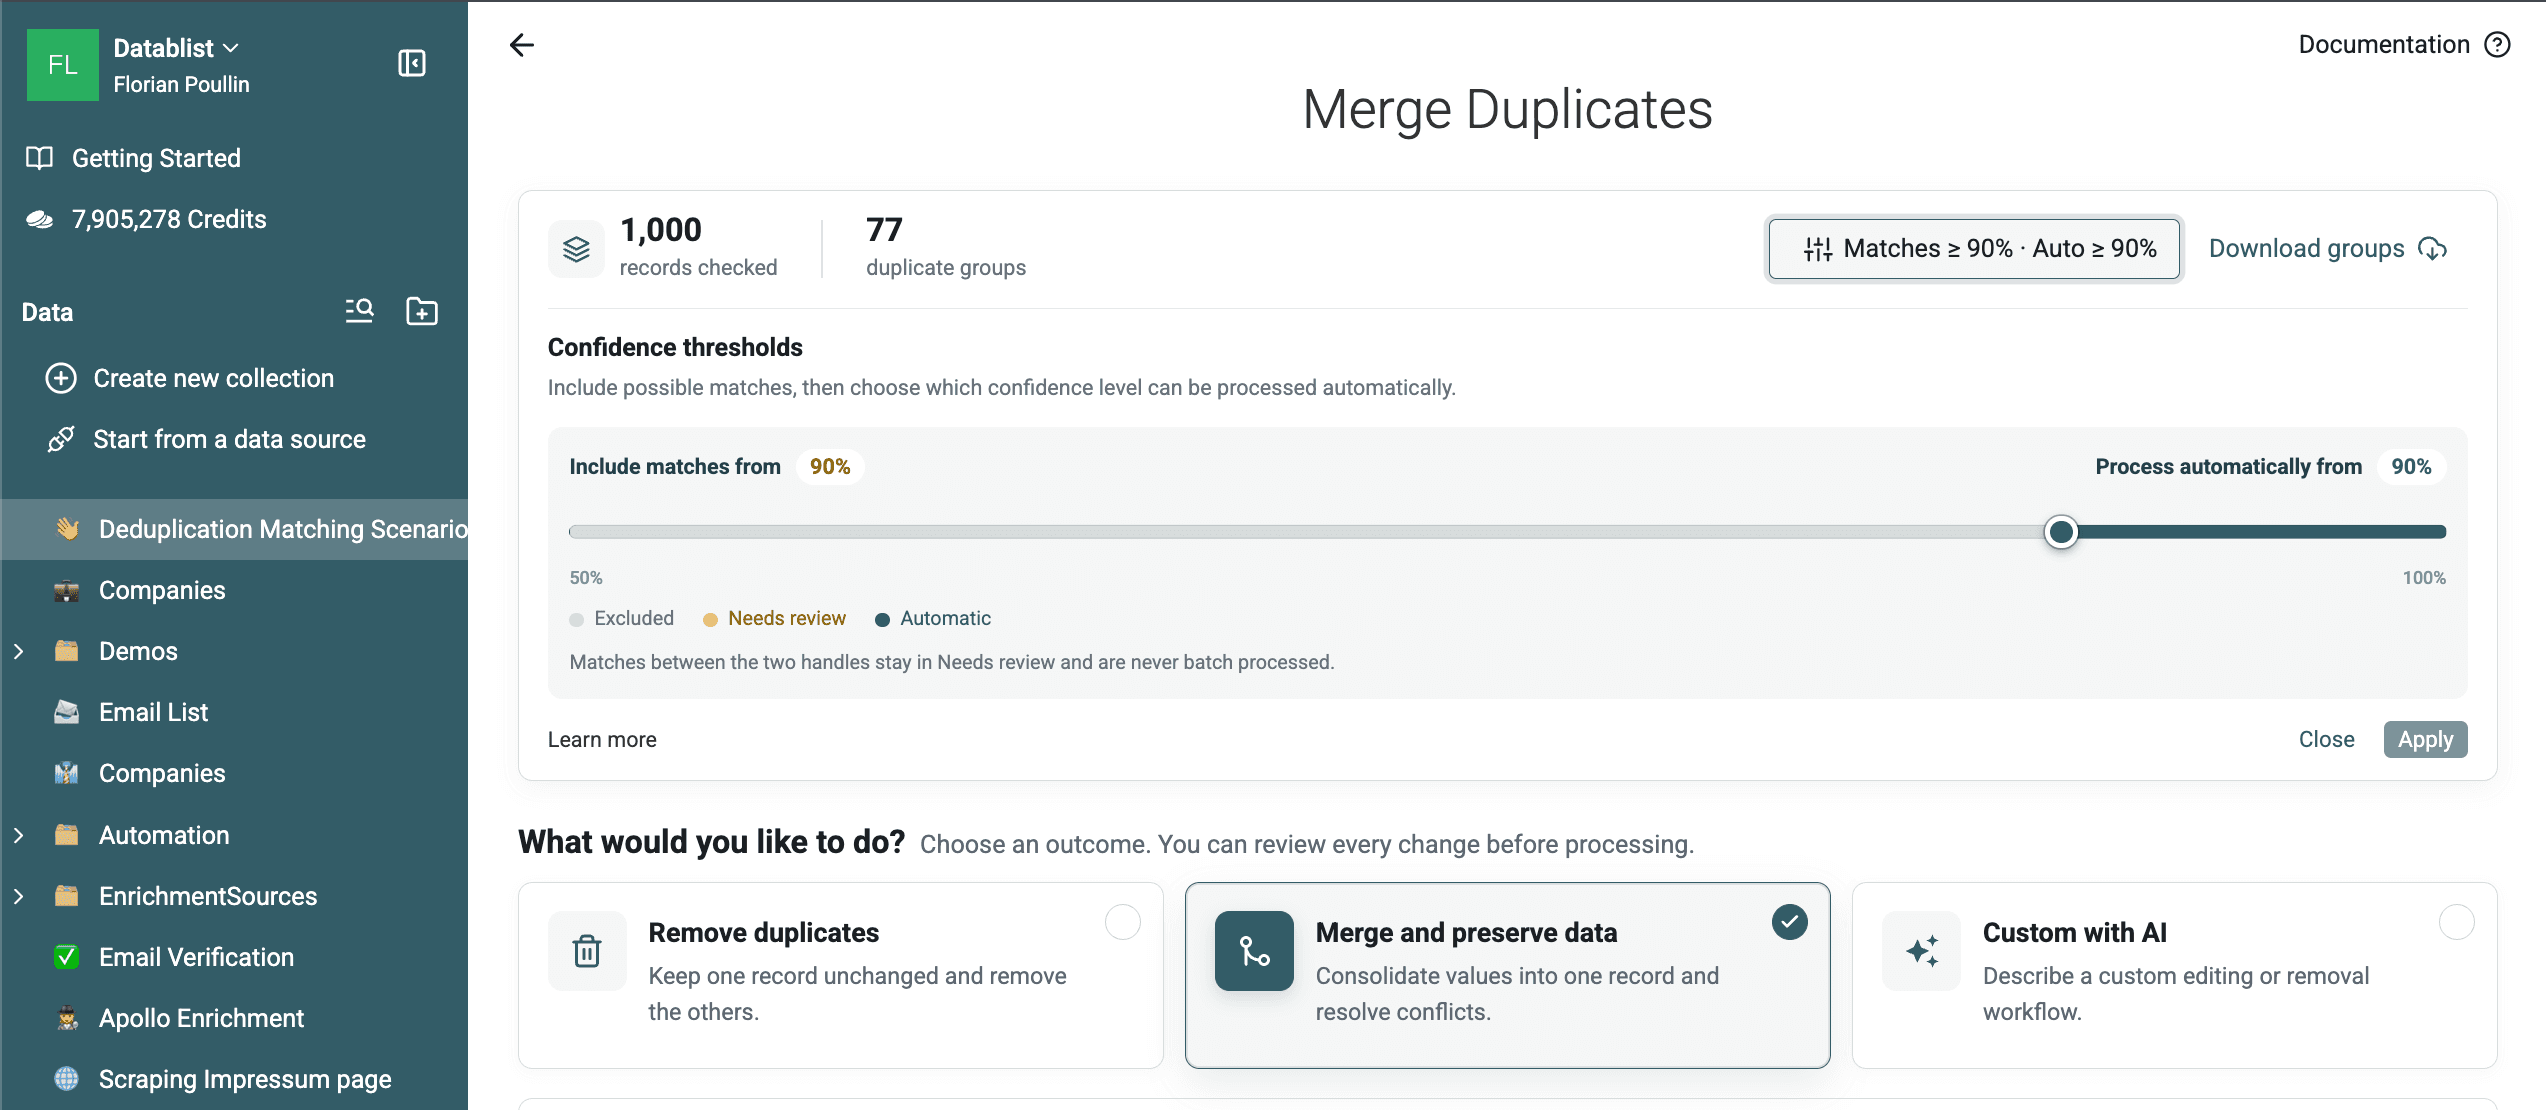
Эта проверка вернула 77 групп по две строки из примера на 1 000 строк. Сверка с контрольными данными выявила 21 группу, связывающую одну и ту же заложенную сущность, и 56 групп, объединяющих разные сущности. Большинство ложных совпадений пришлось на сокращённые имена вроде G. Rossi, где одного значения Full Name недостаточно, чтобы различить людей.
Проверка находит заданные варианты написания, такие как Uma A. Turner и Uman A. Turner, но одновременно показывает, почему нечёткие совпадения только по имени требуют ручной проверки.
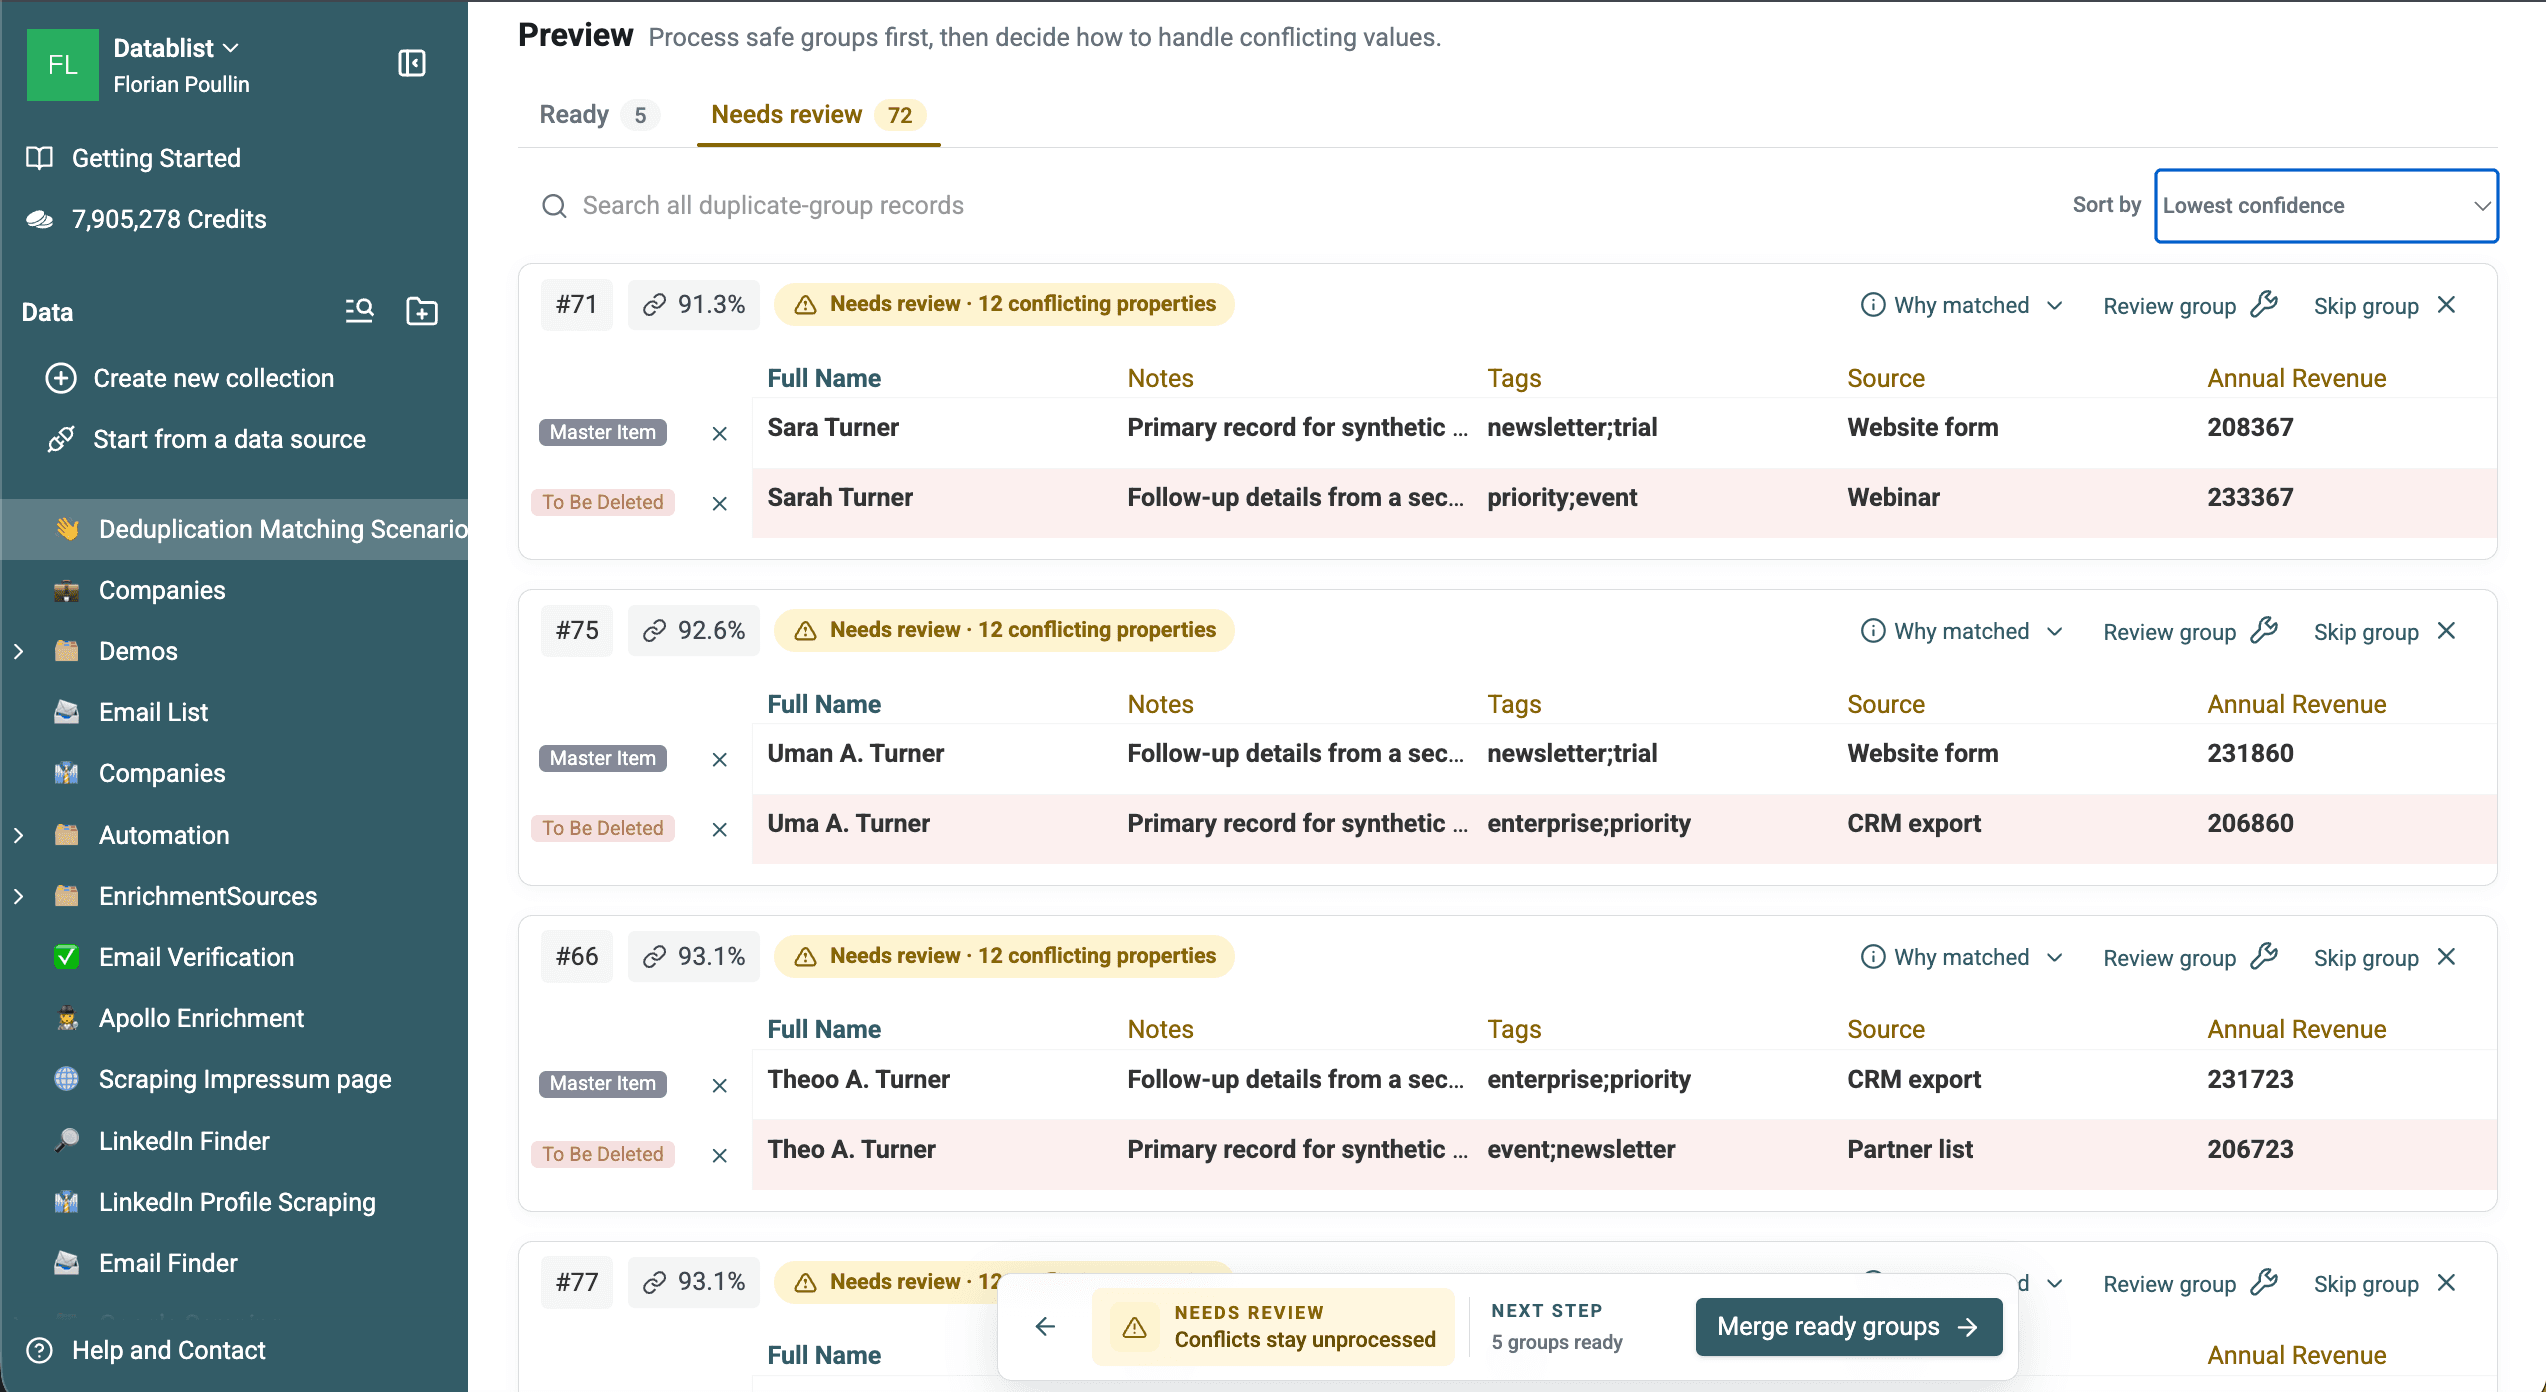
Скачать 77 экспортированных групп Levenshtein, чтобы изучить как полезные, так и ложные совпадения.
Для фонетического сопоставления выберите Full Name, затем Metaphone и оставьте процессор Text.
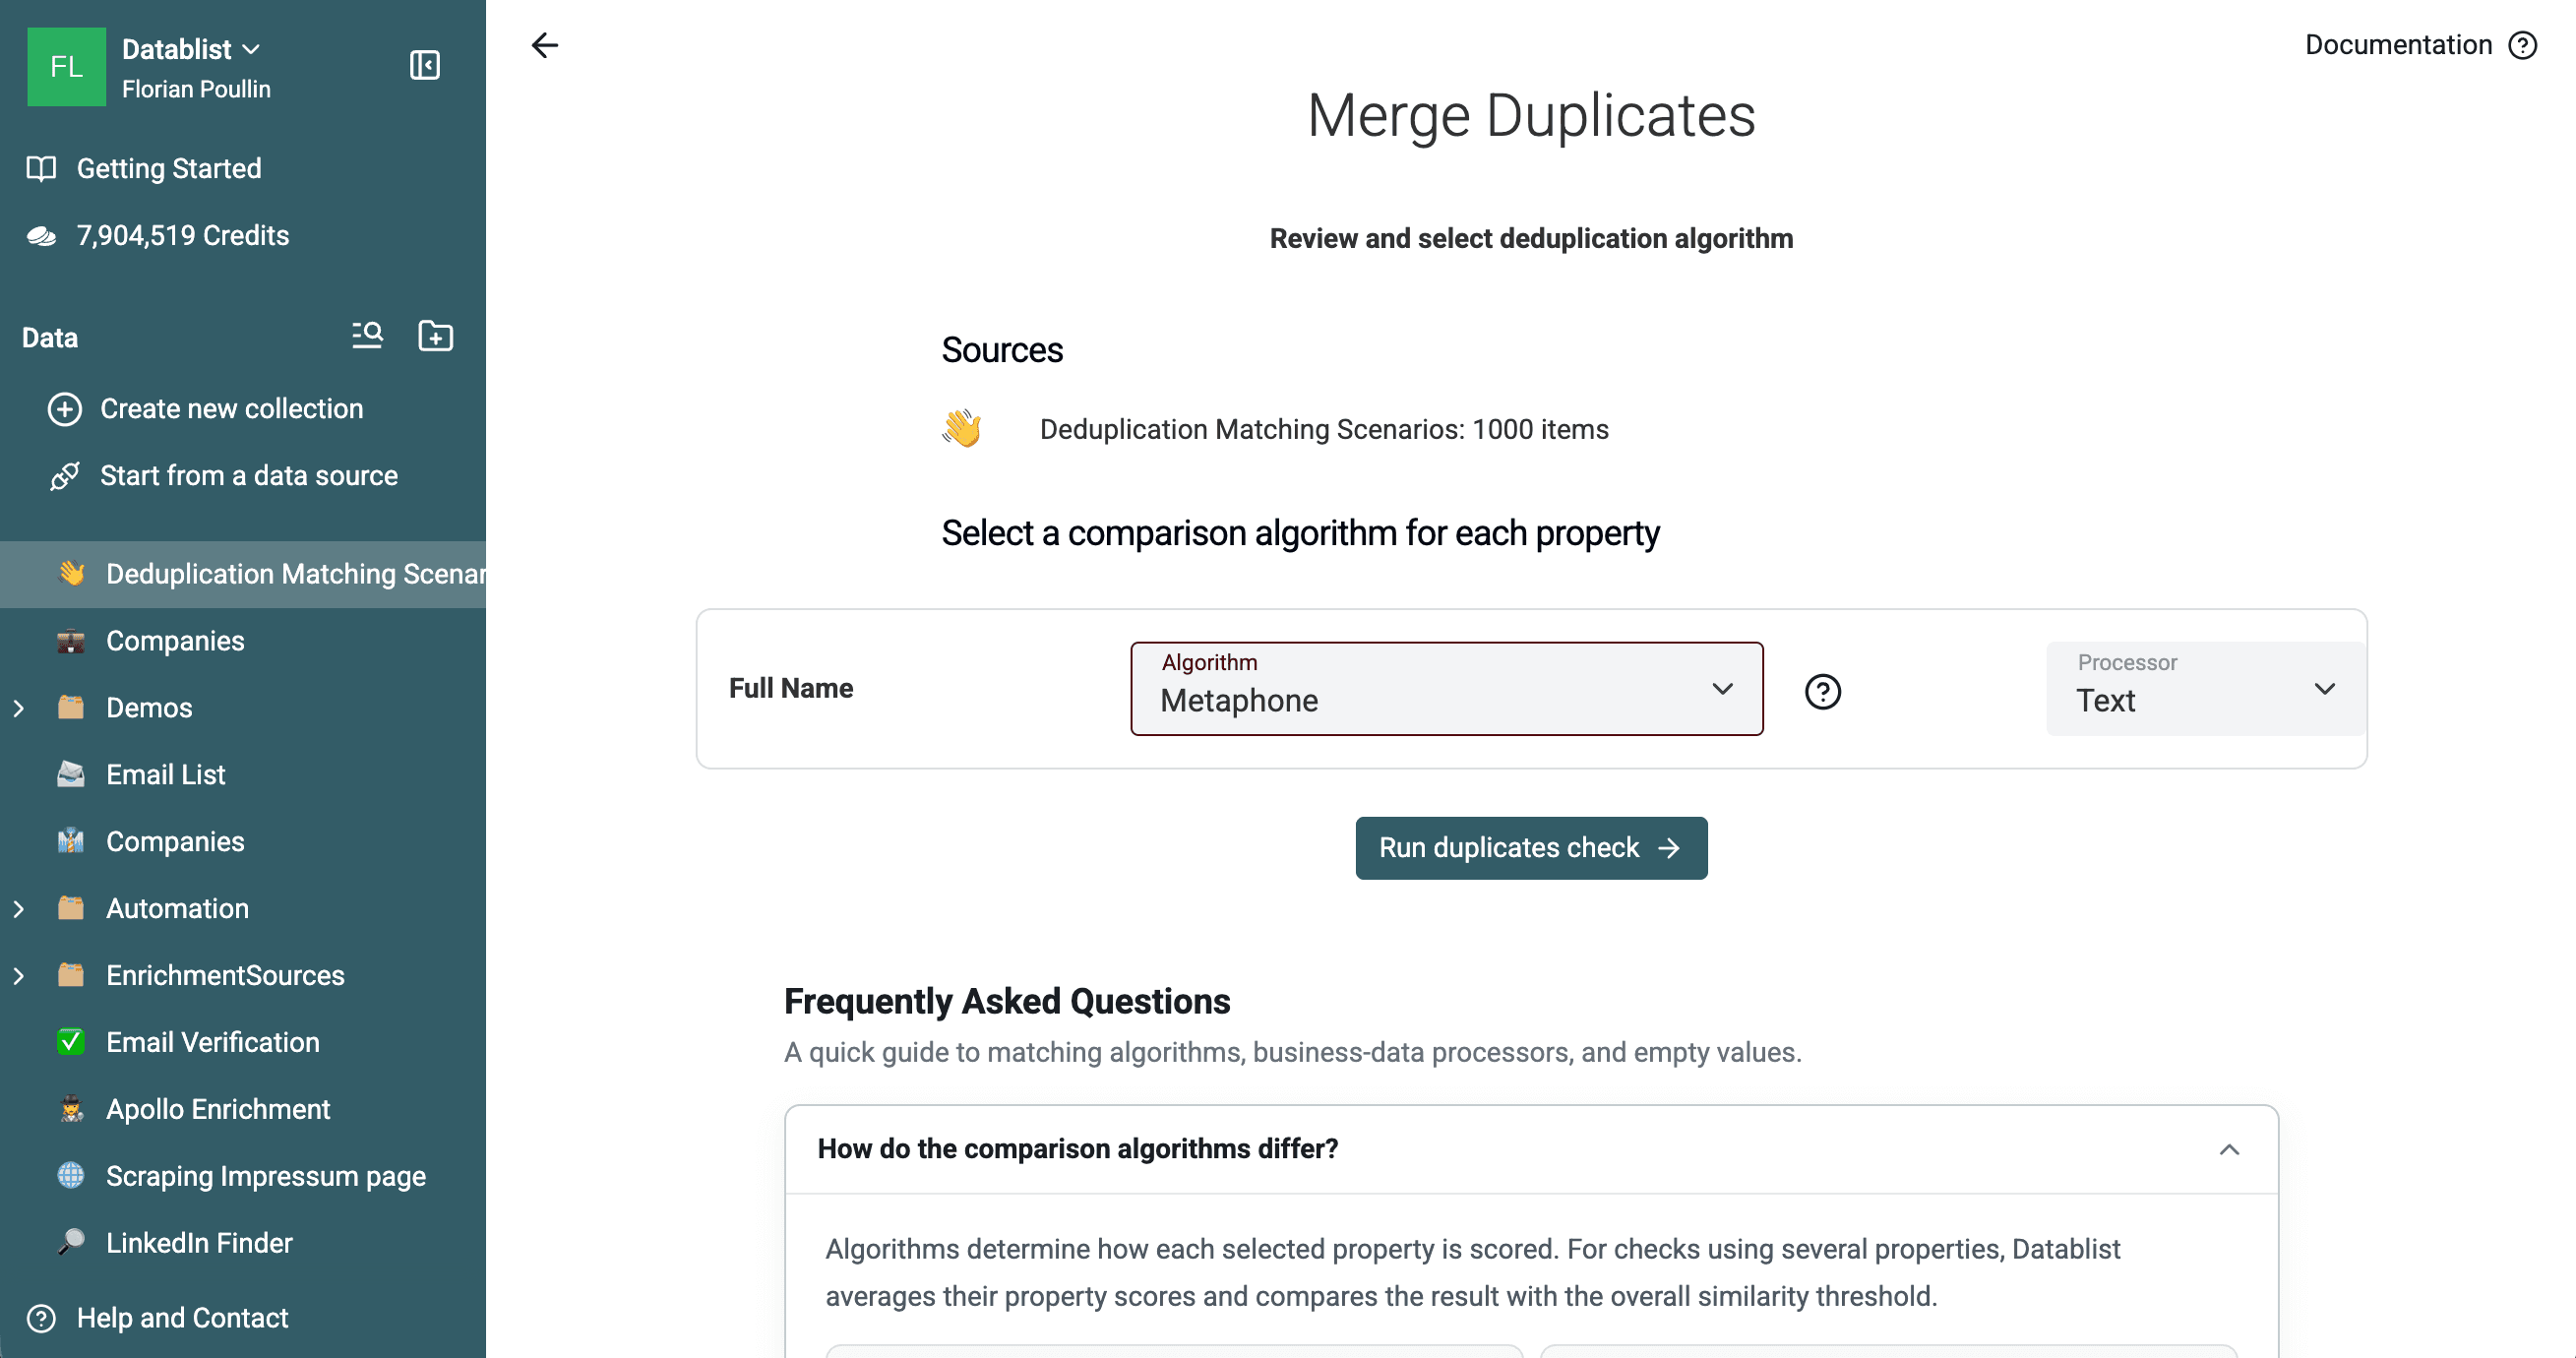
Эта проверка показала 69 групп: 5 в Ready и 64 в Needs review. Экспортированные группы содержат 188 строк. Сверка с известными сущностями примера выявила 19 однородных групп одной сущности и 50 групп, в которых смешаны разные люди. Размер групп составляет от двух до семи строк.
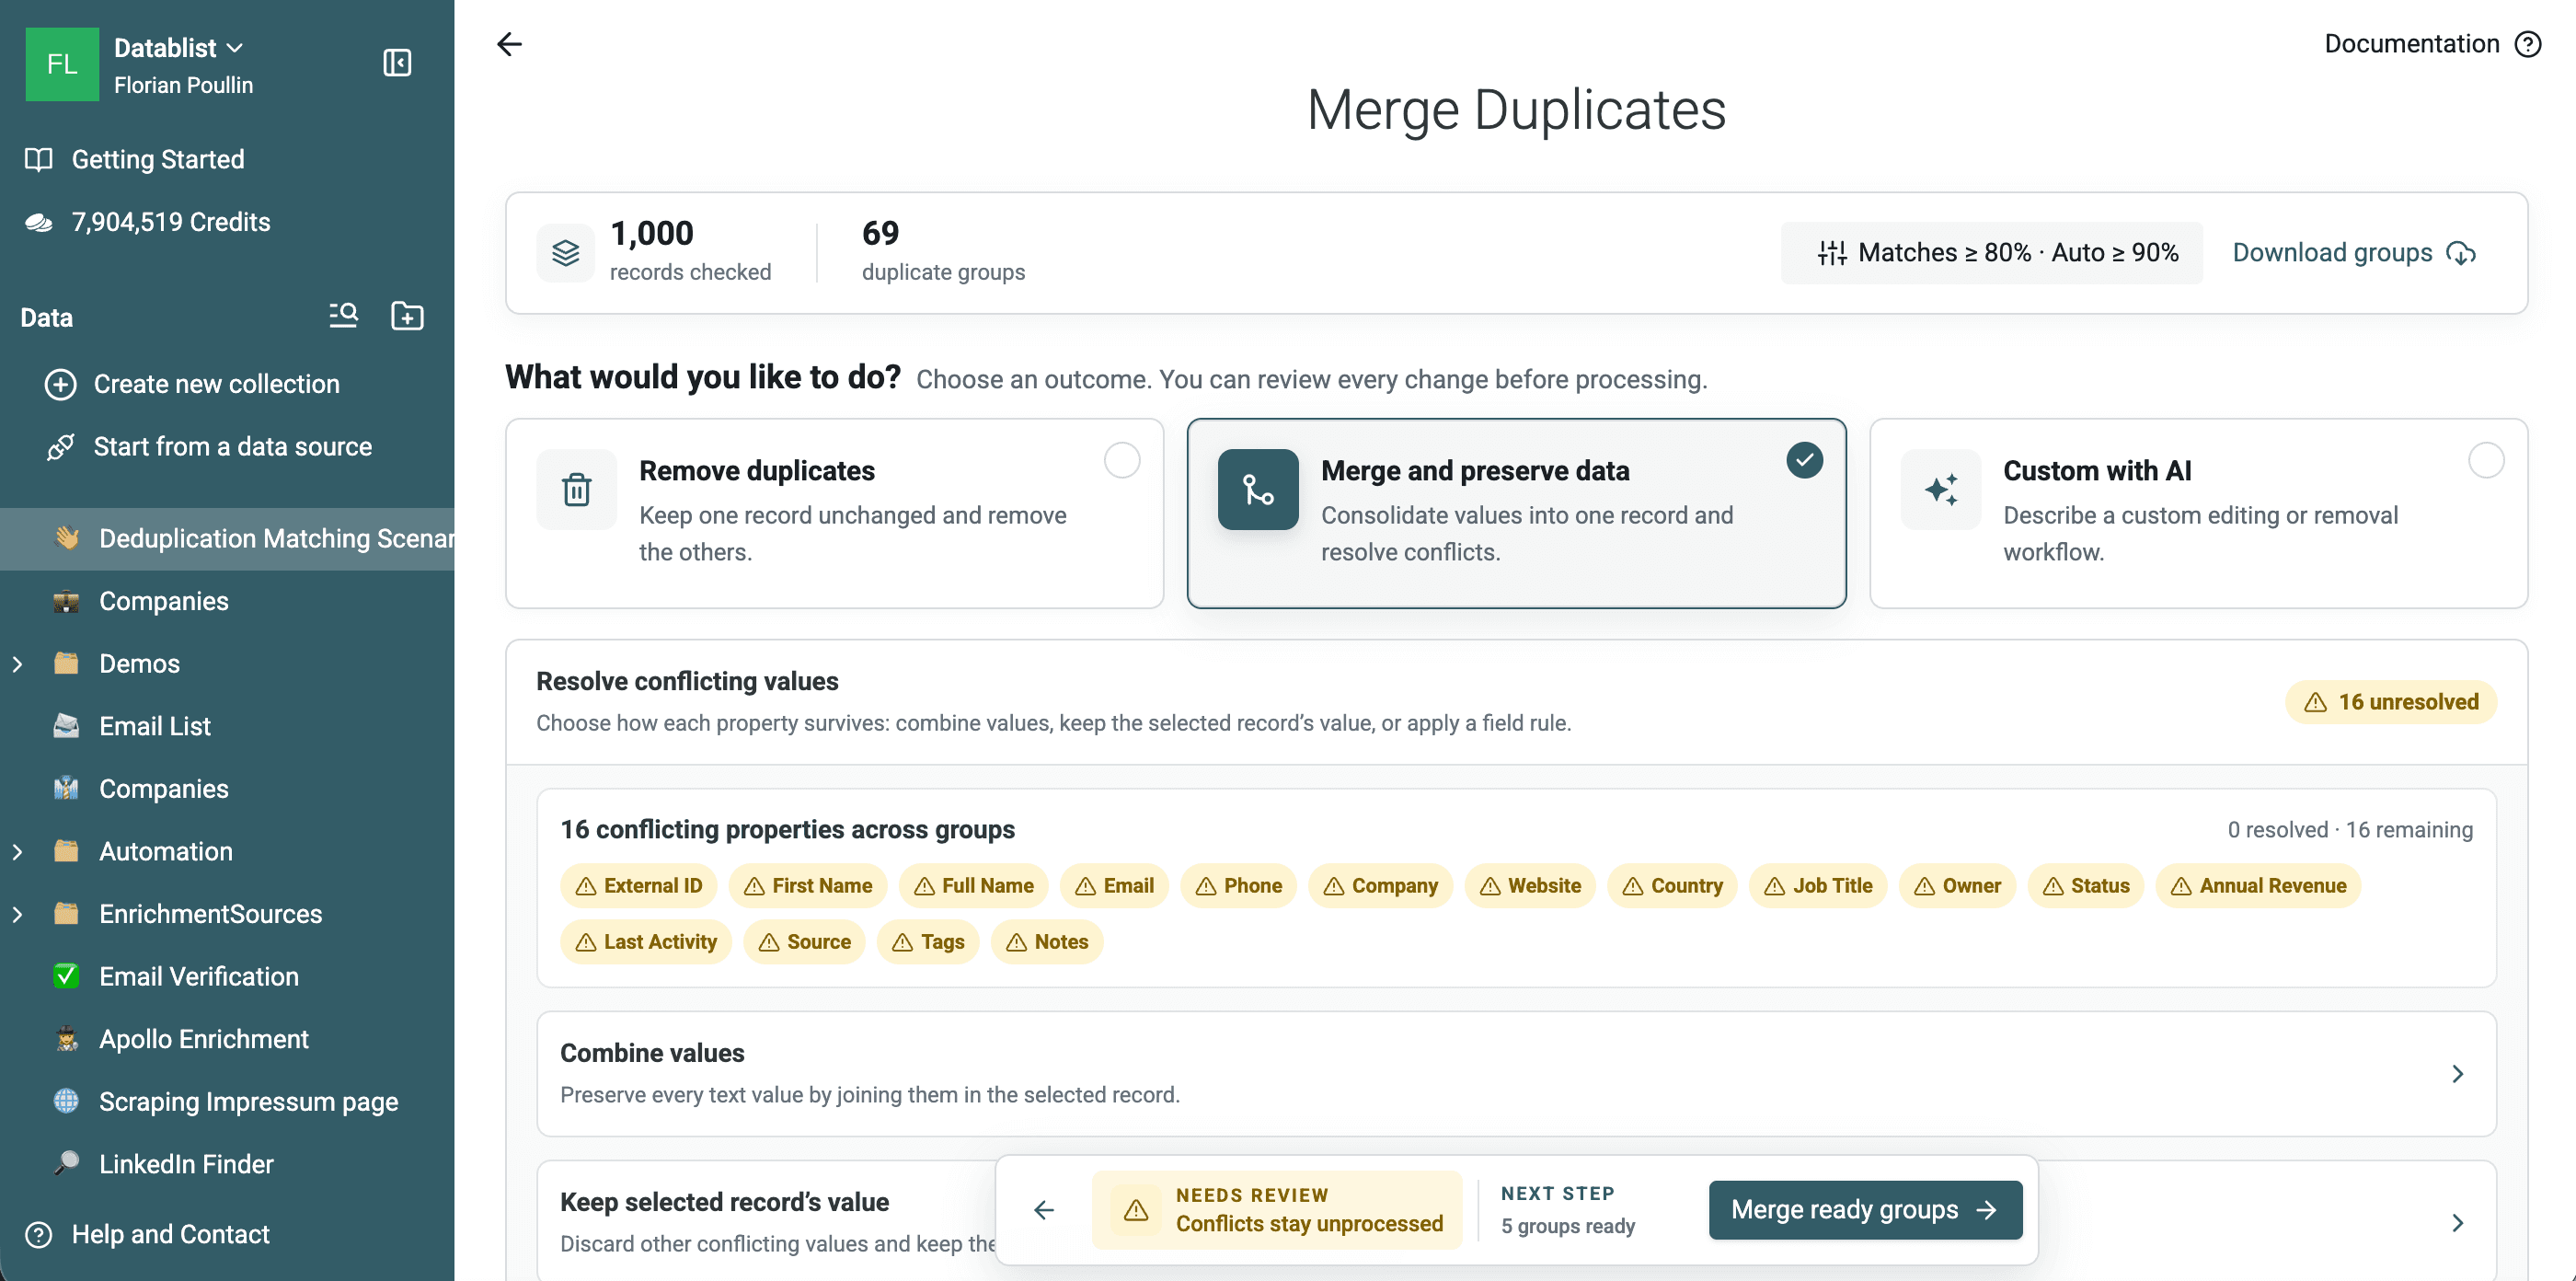
Why matched показывает свойство Full Name, алгоритм Metaphone, процессор Text и оценку группы. Используйте эти сведения для аудита сравнения, но не вместо проверки личности.
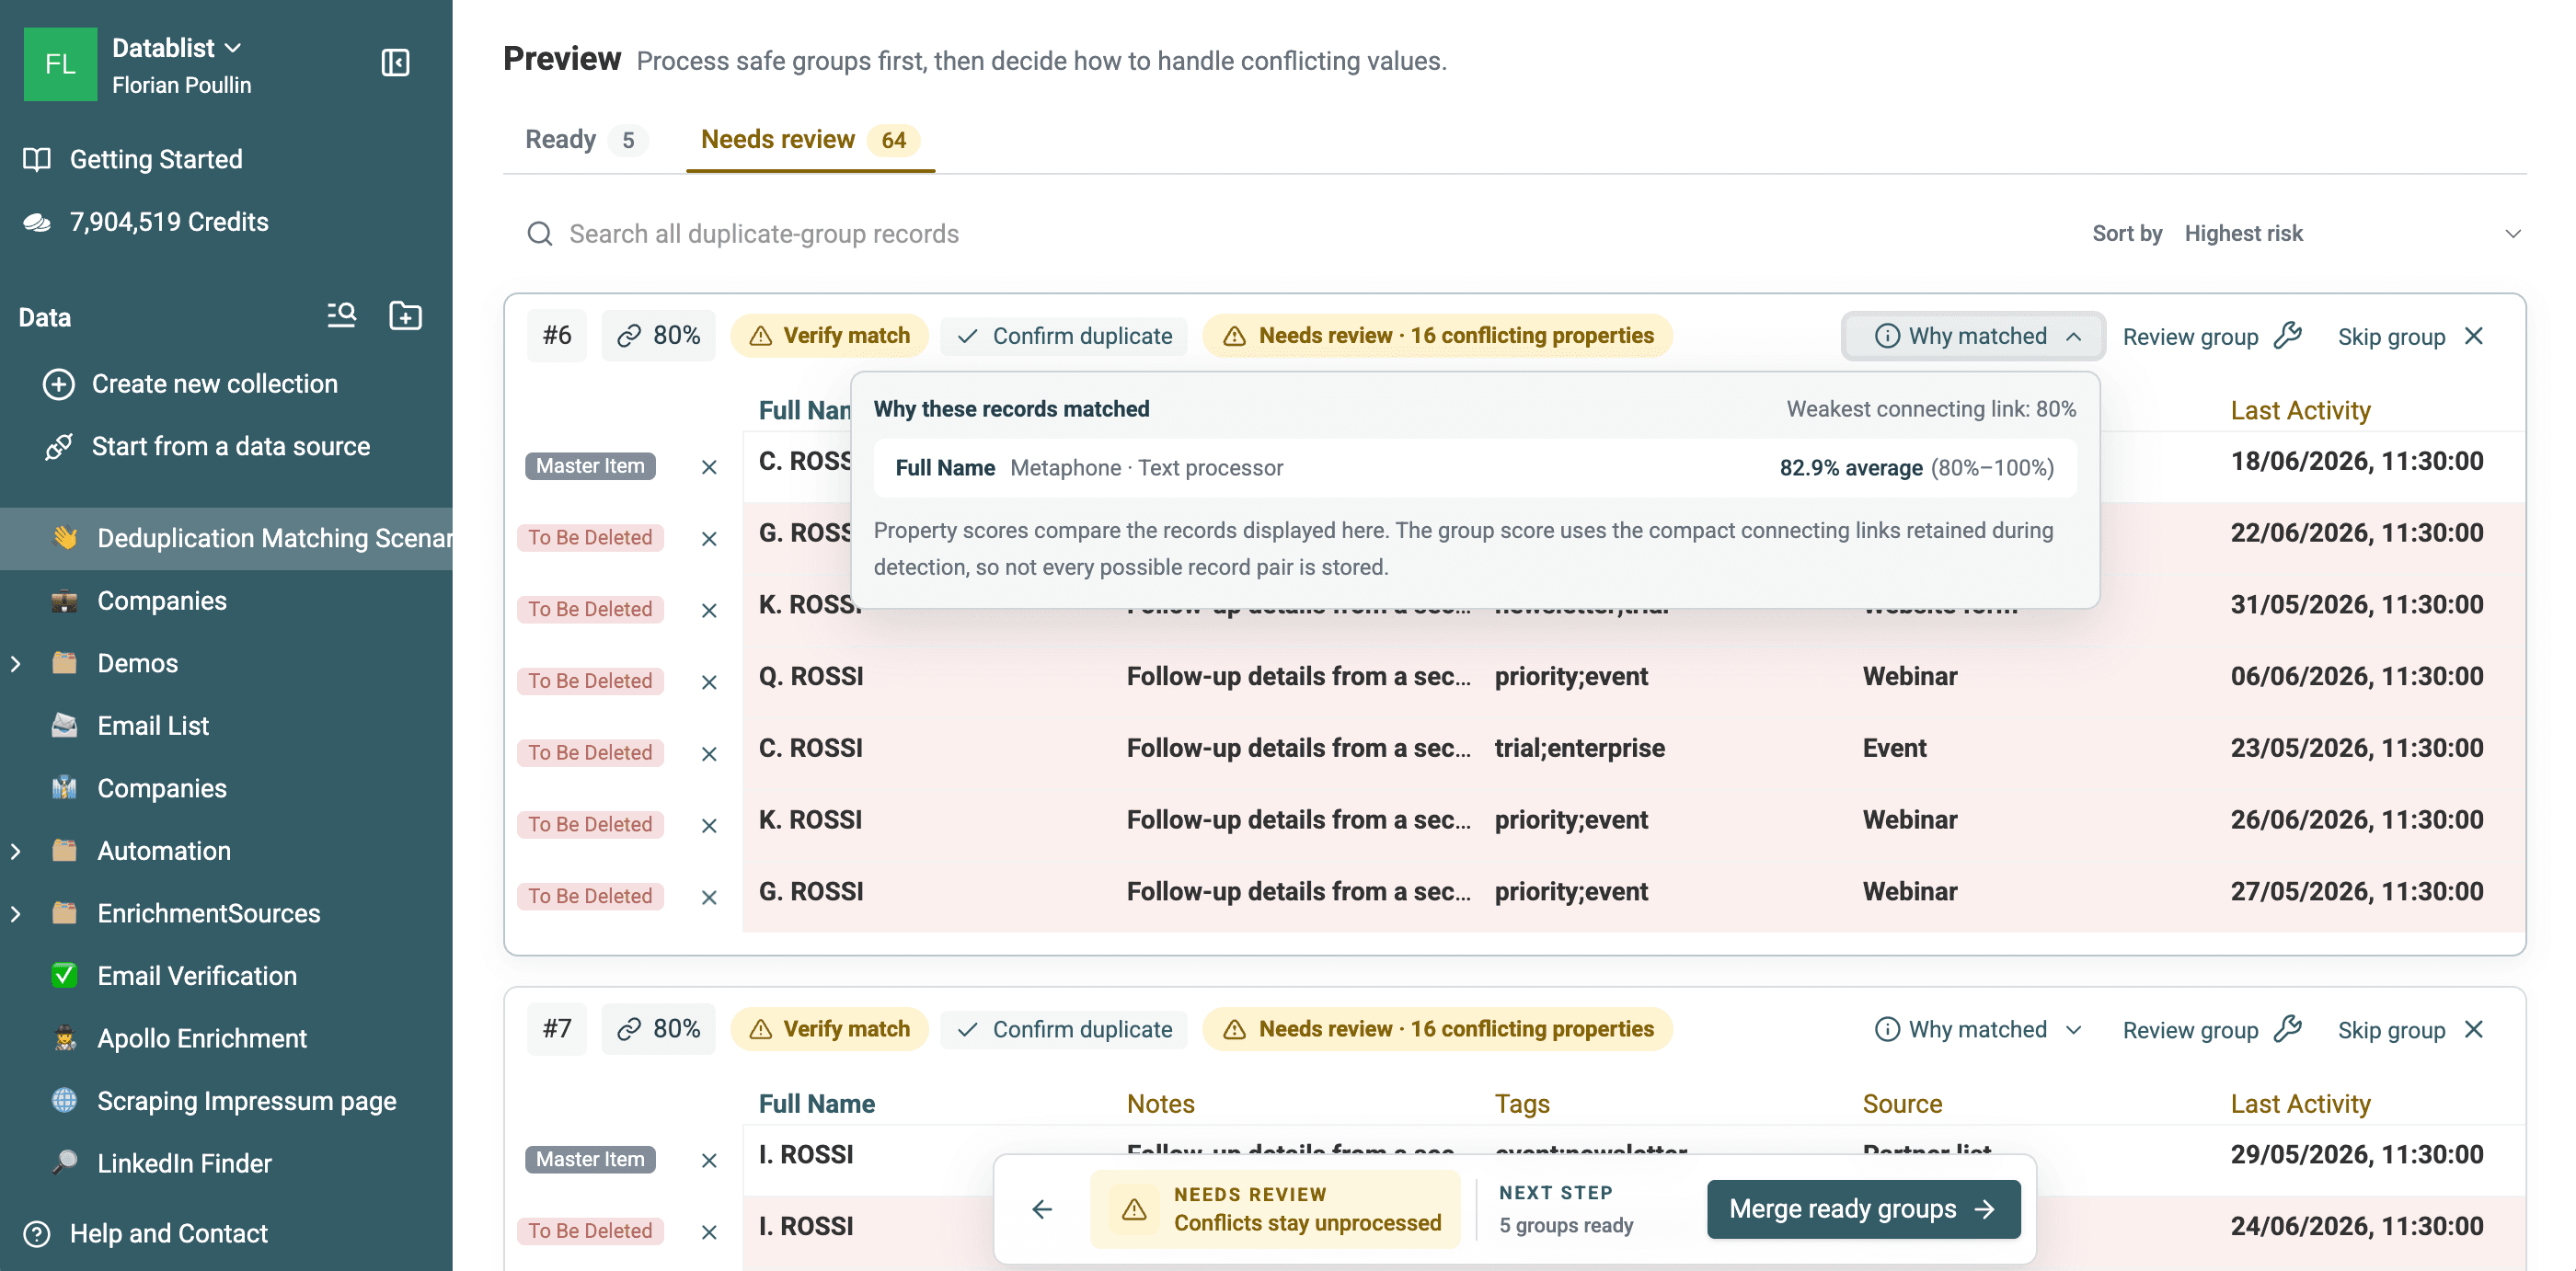
Скачать 69 экспортированных групп Metaphone, чтобы проверить полезные фонетические и ложные совпадения. В крупных группах с ложными совпадениями часто объединяются инициалы и распространённая фамилия — например, несколько сокращённых имён Rossi. Их фонетические коды пересекаются, но одних имён недостаточно для автоматического объединения.
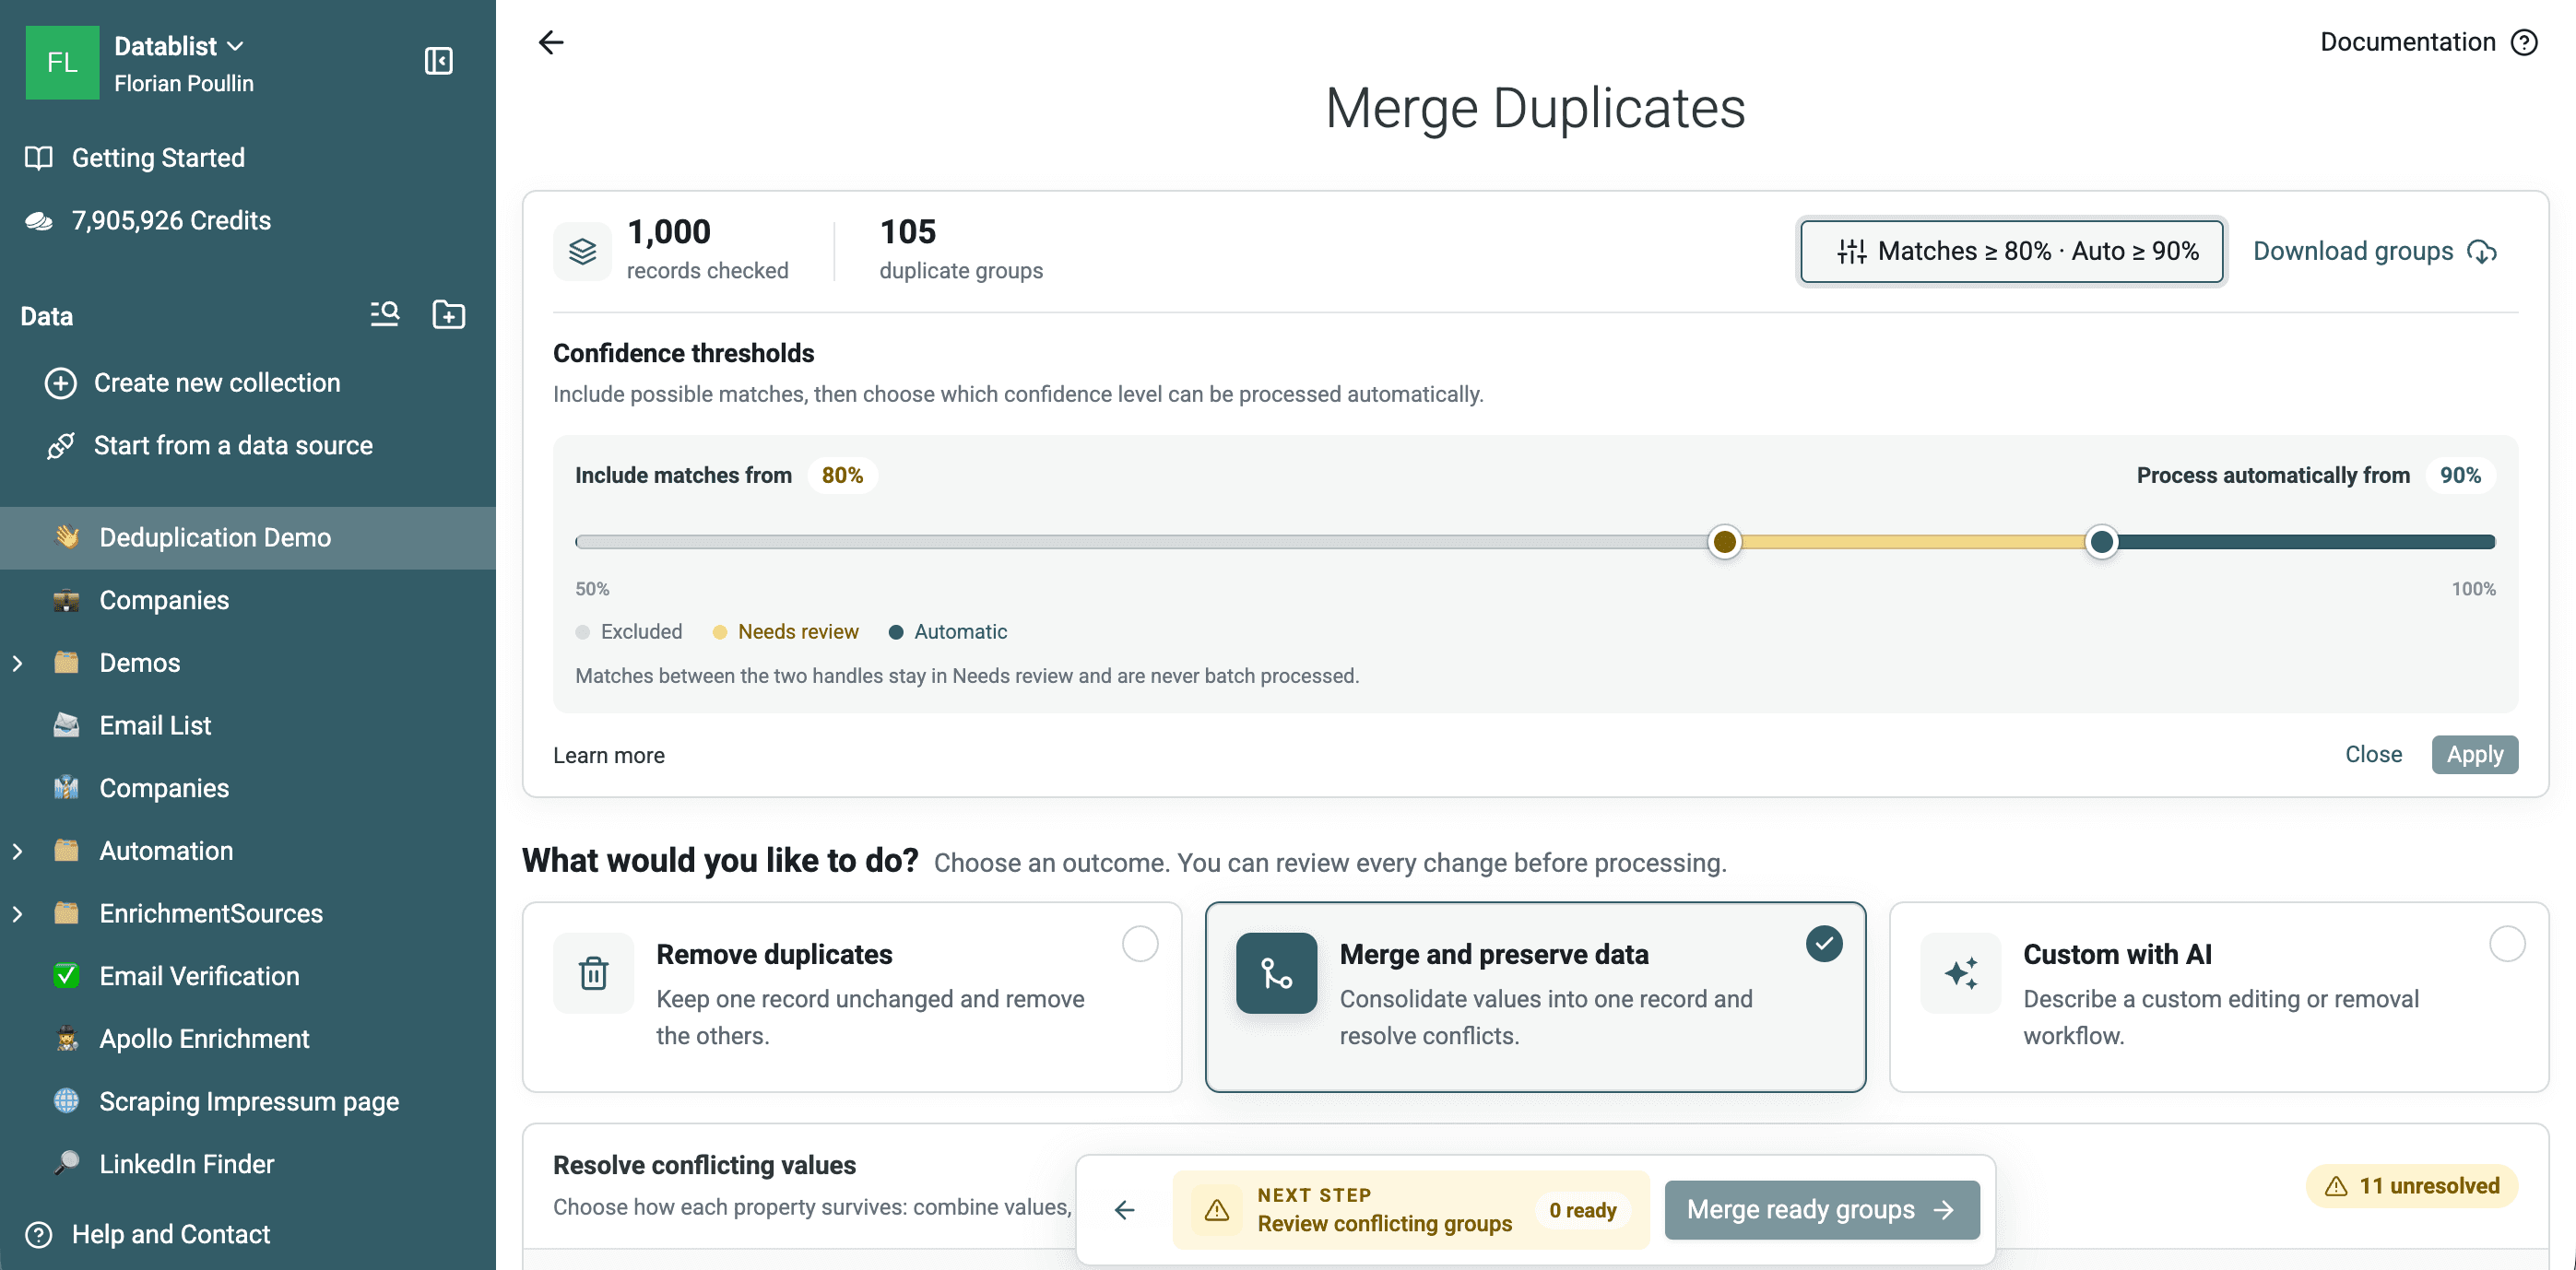
На странице результатов есть два параметра:
- Include matches from определяет, какие группы показывать.
- Process automatically from оставляет группы с меньшей уверенностью в Needs review и исключает их из пакетной обработки.
Так можно просматривать широкий набор кандидатов, не применяя ко всем одинаковое правило автоматизации.
Проверьте группы дубликатов
Рабочая область результатов разделяет группы дублей на Ready и Needs review.
- У групп Ready есть конкретный результат обработки, и они соответствуют порогу автоматической уверенности.
- В Needs review попадают группы с меньшей уверенностью, неразрешёнными конфликтами объединения, неподходящим правилом выбора записи или пользовательским правилом, которое их пропустило.
Для каждой сомнительной группы проверьте:
- Все ли строки относятся к одному человеку, компании или товару?
- Какой идентификатор привёл к совпадению?
- Дополняют ли значения друг друга?
- Какой источник является авторитетным?
- Не приведёт ли удаление строки к потере телефона, ID, статуса, даты или примечания?
- Не связана ли группа через третью запись со слабым совпадением?
Используйте Why matched, чтобы проверить свойства, алгоритмы, процессоры и диапазоны оценок сопоставления. При нечётком поиске сходство группы определяется самой слабой сохранённой связью, необходимой для объединения группы.
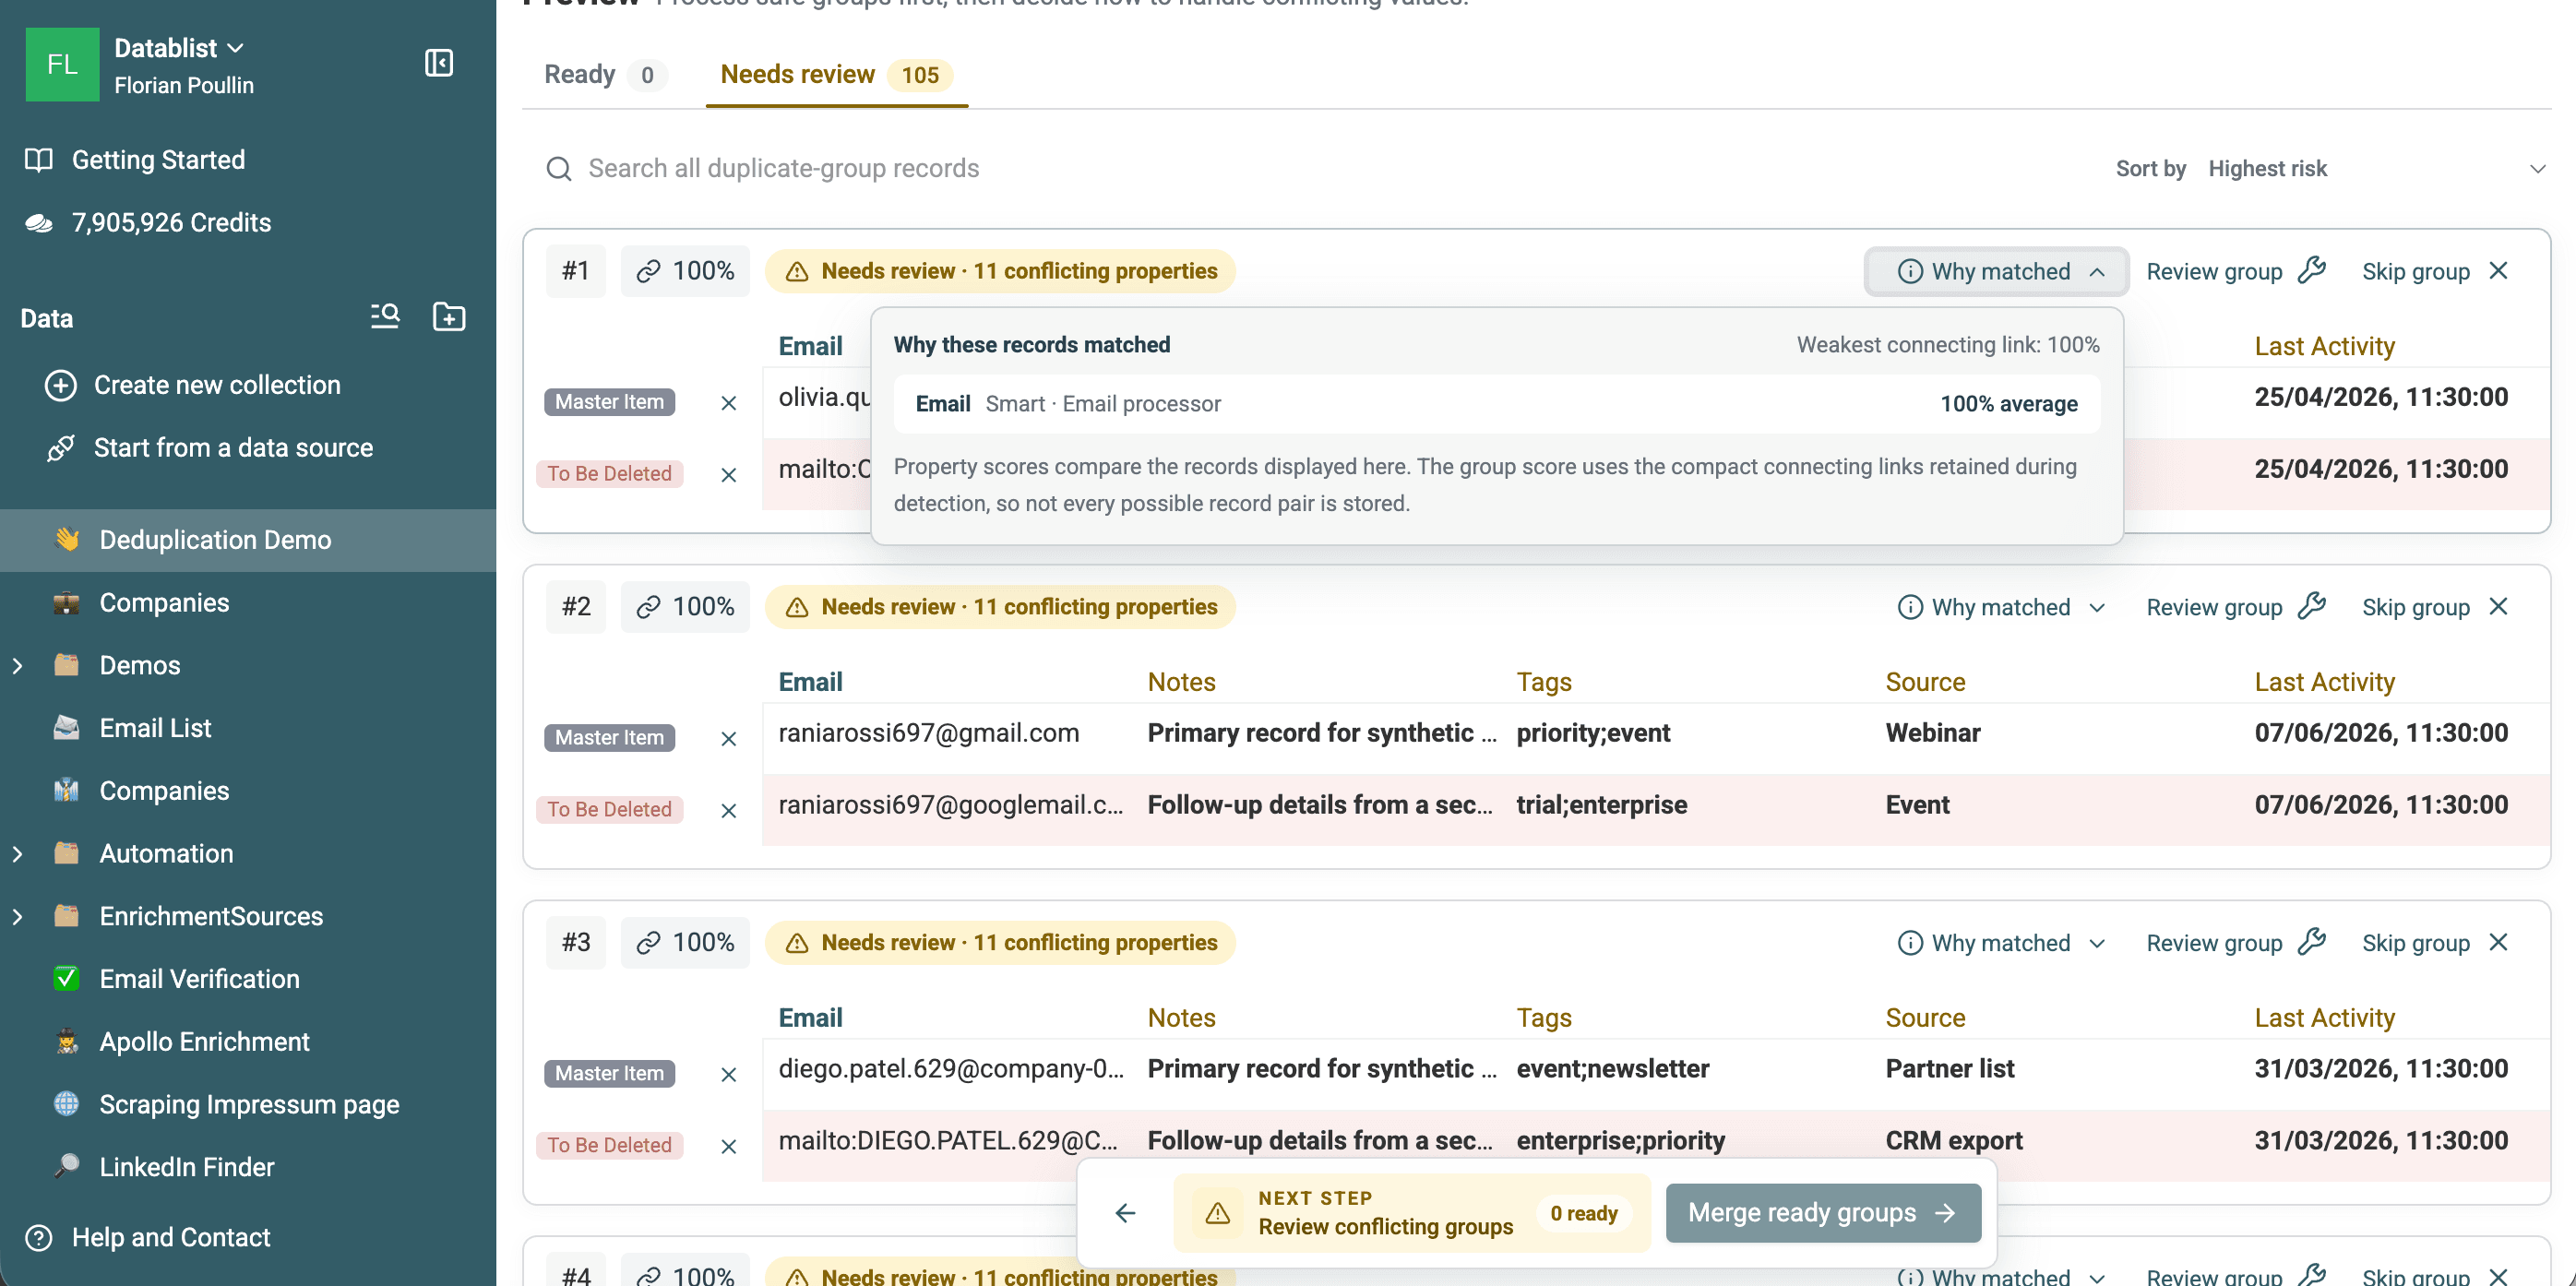
Также можно:
- Подтвердить совпадение с низкой уверенностью.
- Исключить одну запись из группы, не удаляя её.
- Пропустить группу.
- Открыть и отредактировать запись.
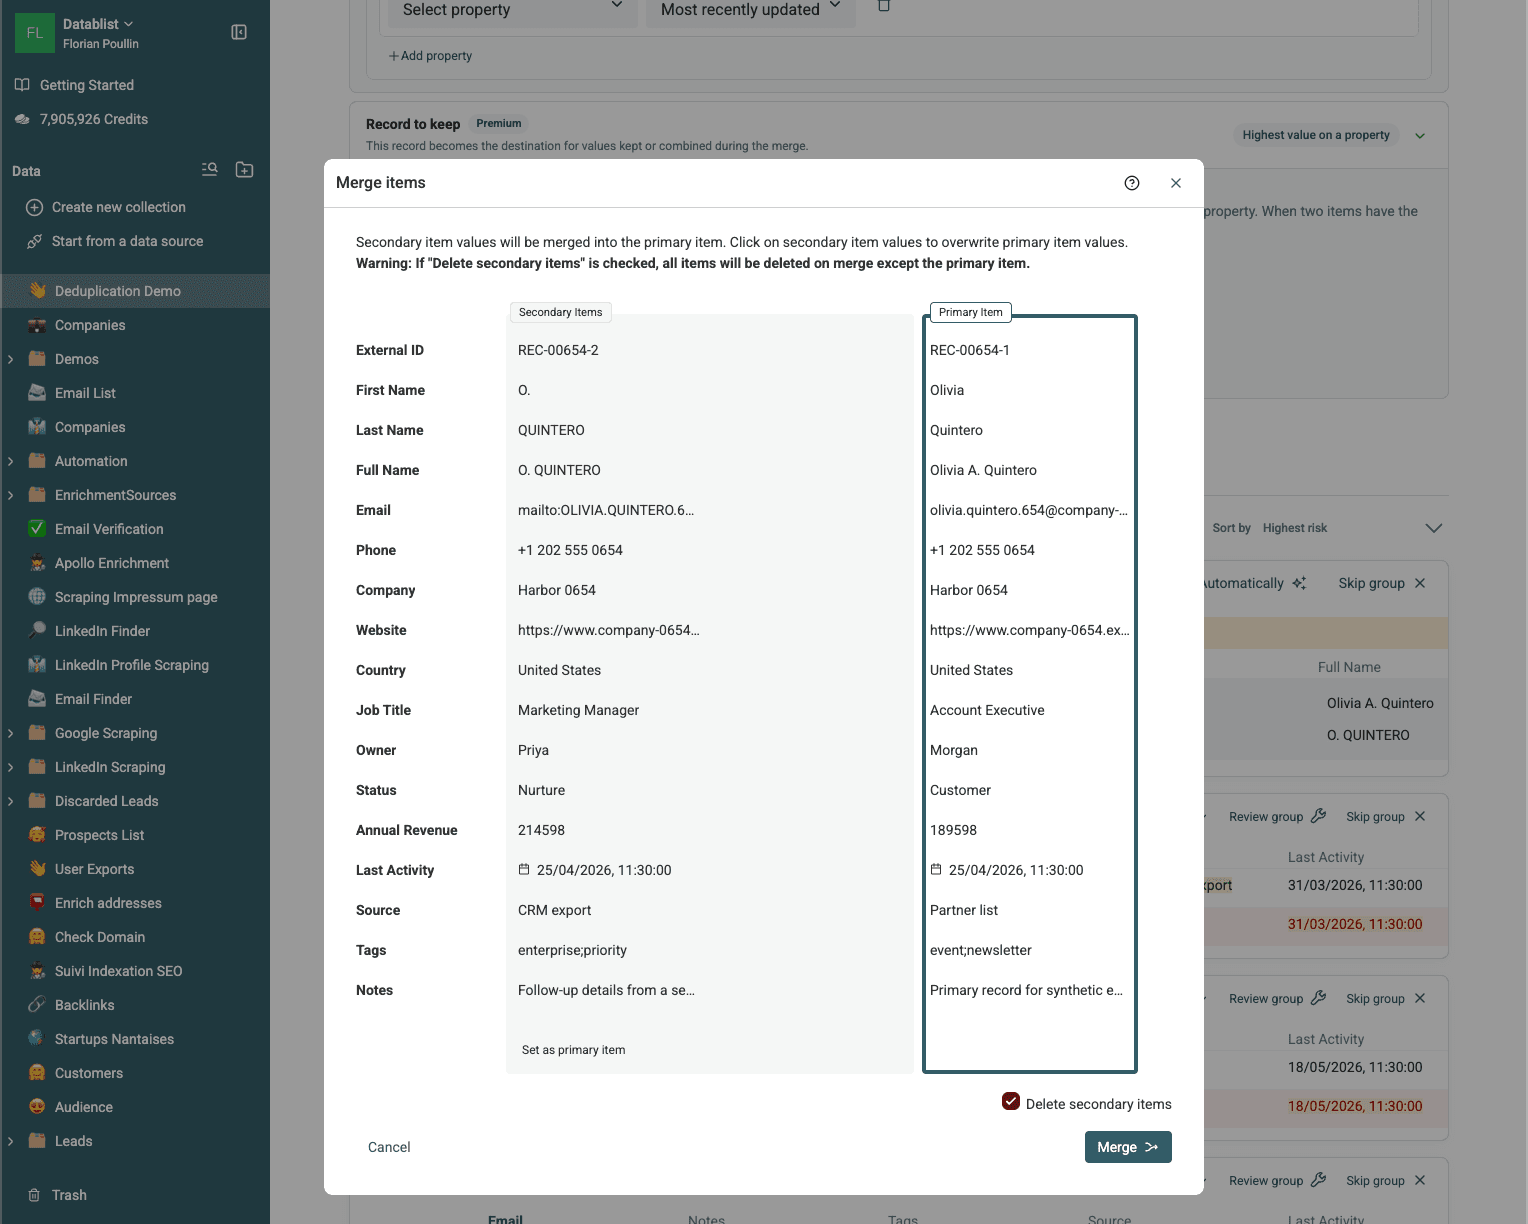
- Проверить группу в Merging Assistant.
- Выполнить поиск по оставшимся группам и сначала отсортировать самые рискованные варианты.
⚠️ Не обрабатывайте нечёткую группу только на основании процента
Похожие имена могут принадлежать разным людям. Перед подтверждением группы проверьте идентификаторы и соседние поля.
Проверьте общие и отсутствующие идентификаторы
Общий адрес вроде info@company.example может принадлежать нескольким контактам. Два человека с таким адресом совпадут по Email, хотя это разные люди. Аналогично домен может идентифицировать одну компанию, но встречаться в записях многих сотрудников.
Не включайте такие группы в автоматическое объединение людей, пока совпадение не подтверждено другим идентификатором. Если же вам нужна одна строка на компанию, общий домен может быть подходящим ключом группировки. Сначала определите сущность и лишь затем интерпретируйте результат.
Правило пустых значений тоже влияет на сравнение по выбранным свойствам. Для проверки нескольких свойств с режимом, отличным от Exact, расширенная настройка Empty Value Rule предлагает варианты Value required (default) и Match on empty value. По умолчанию текстовый идентификатор должен присутствовать; разрешение совпадений пустых значений ослабляет это требование. Используйте его только тогда, когда остальные поля дают достаточно оснований для идентификации: два отсутствующих email не доказывают, что речь идёт об одном человеке.
Например, две строки с пустым Email и разными значениями Full Name нельзя объединять лишь ради уменьшения числа строк. Запись без email всё ещё может содержать нужный контакт, который позднее можно сохранить или обогатить.
Удалите, объедините или обработайте дубли по правилам
Поиск и устранение дубликатов — разные задачи. Выбирайте режим обработки после проверки данных во вторичных строках.
Удаляйте дубли, если одна запись приоритетная
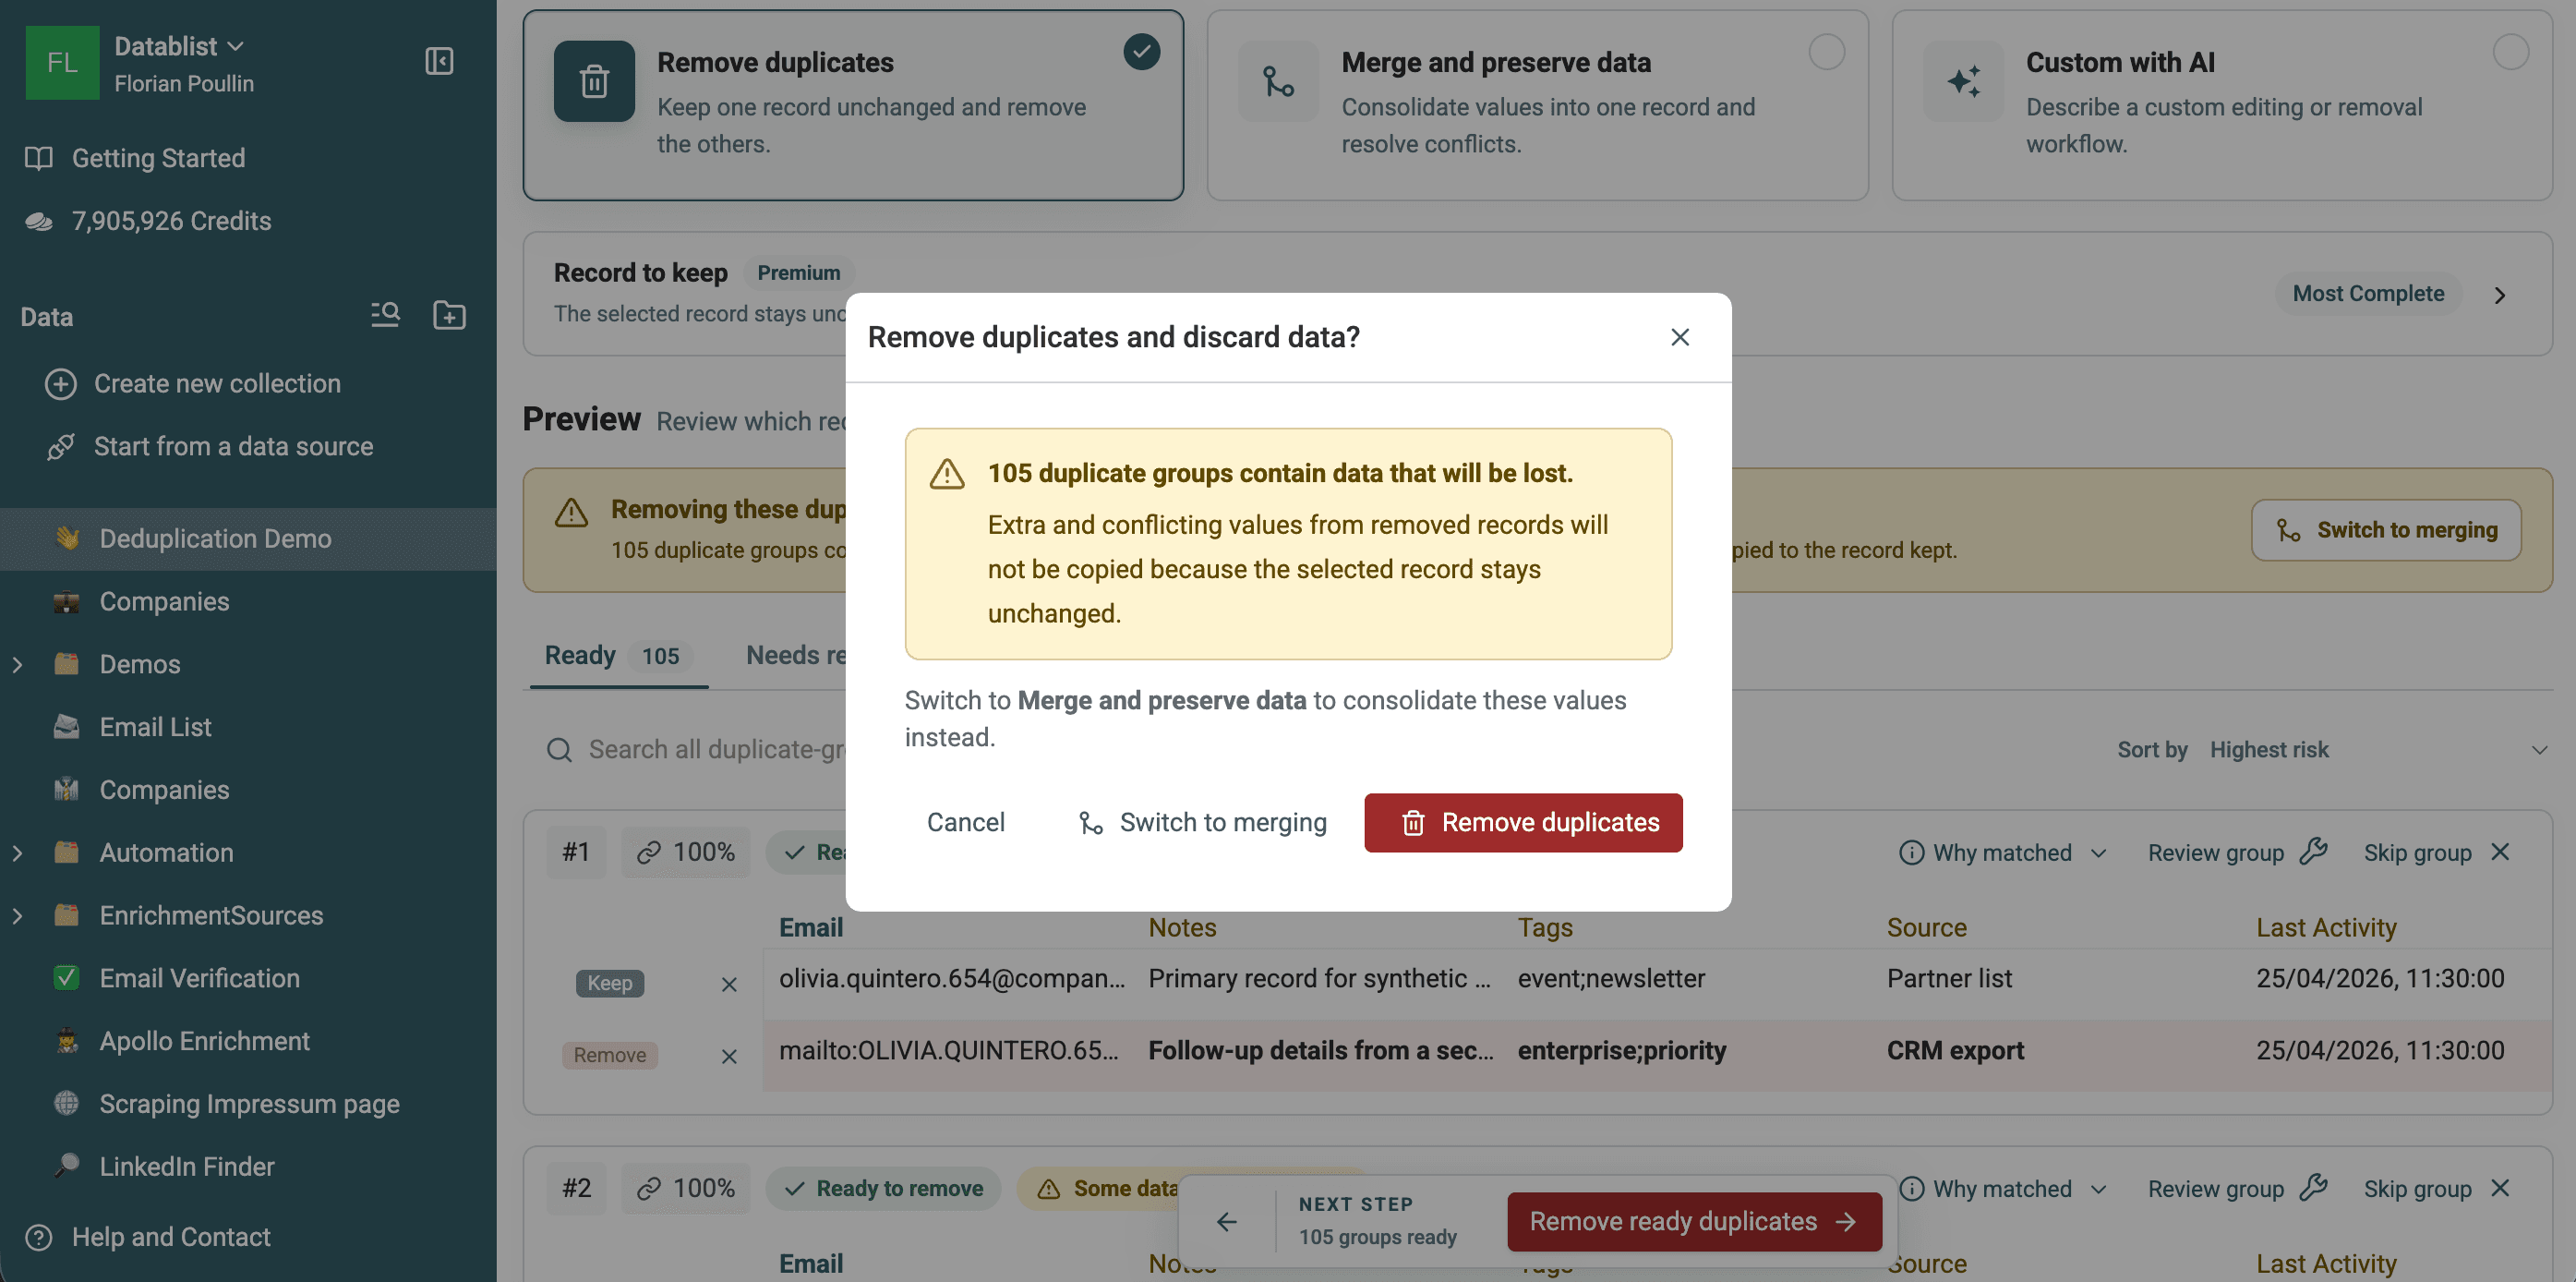
Remove duplicates оставляет одну выбранную запись без изменений и удаляет остальные строки в каждой группе Ready.
Используйте этот режим для скопированных строк, временных импортов или записей, вторичные значения которых можно удалить. В предварительном просмотре появится предупреждение, если удаляемые записи содержат дополнительные или конфликтующие данные. Эти значения не копируются в сохраняемую строку.
Объединяйте строки с полезными данными
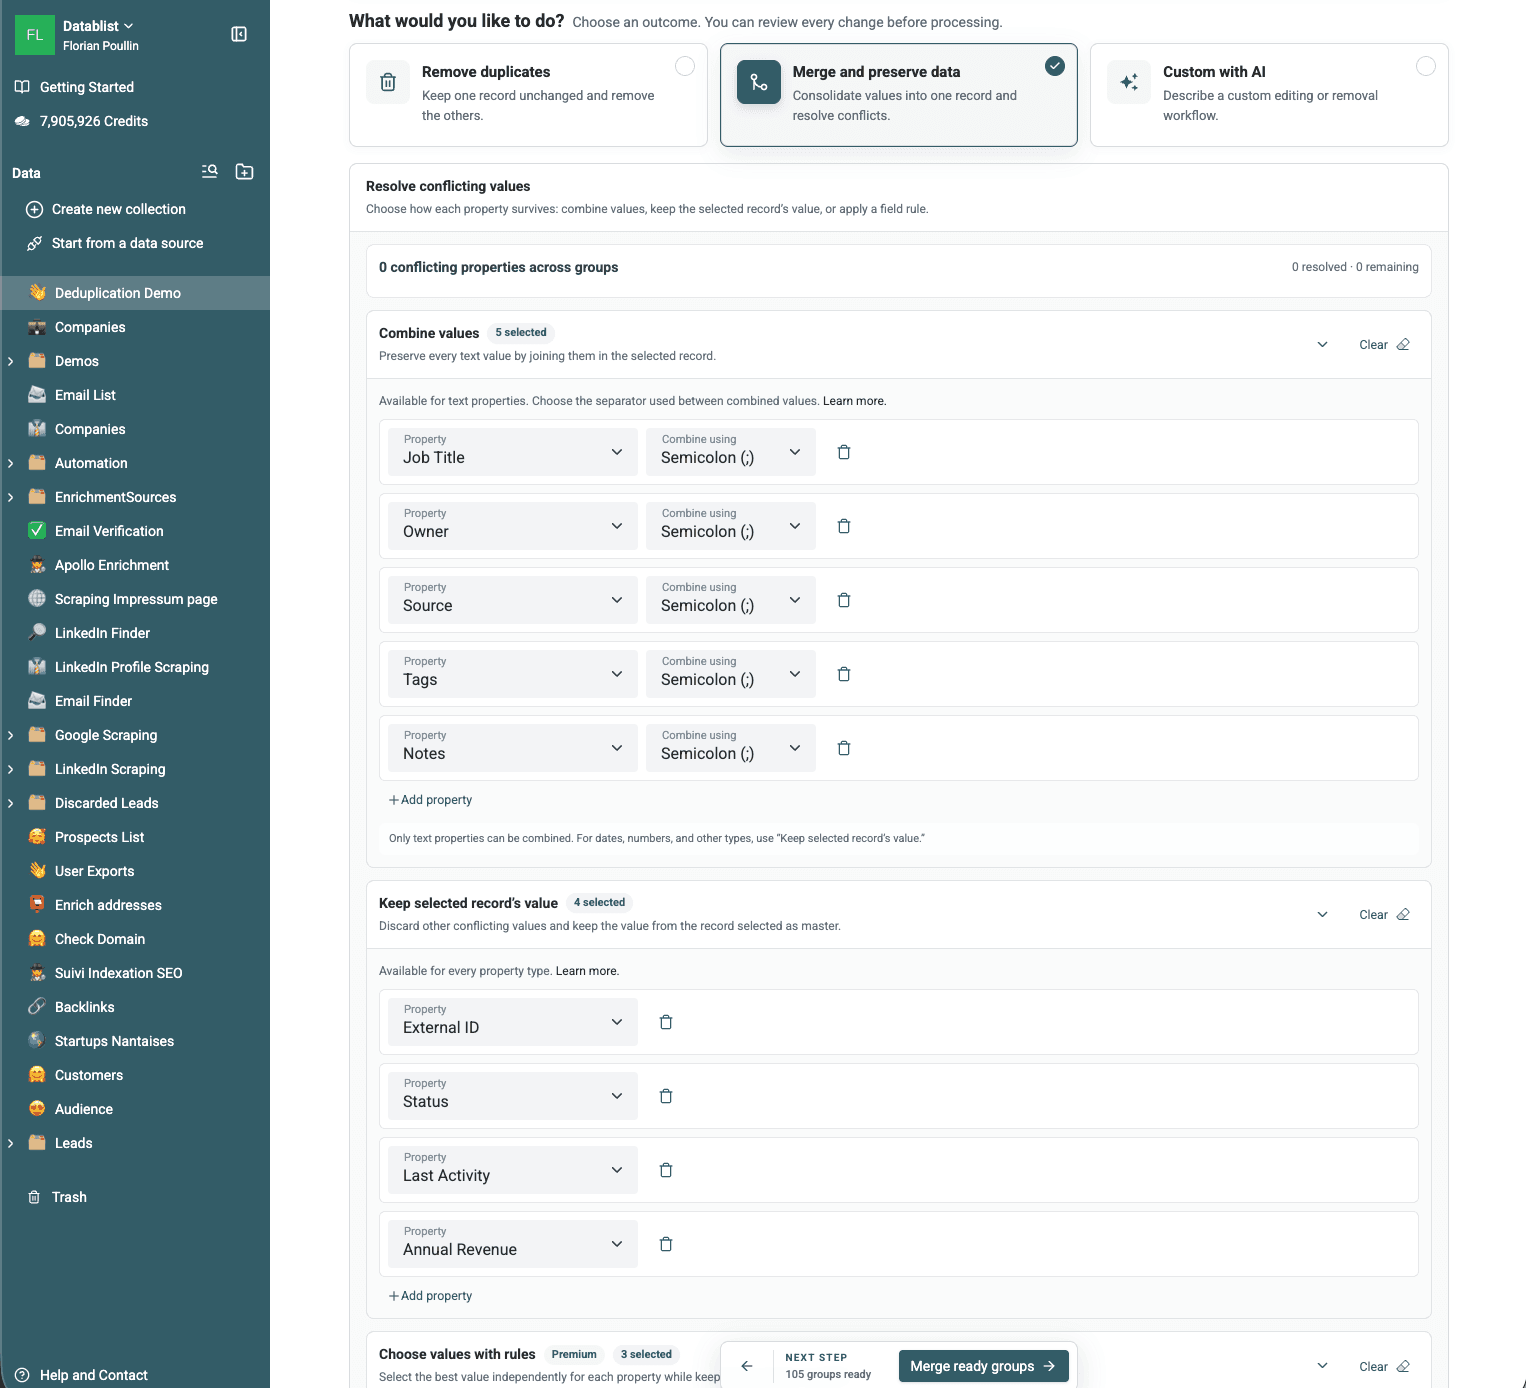
Merge and preserve data заполняет пустые свойства выбранной записи, разрешает настроенные конфликты, а затем удаляет вторичные строки.
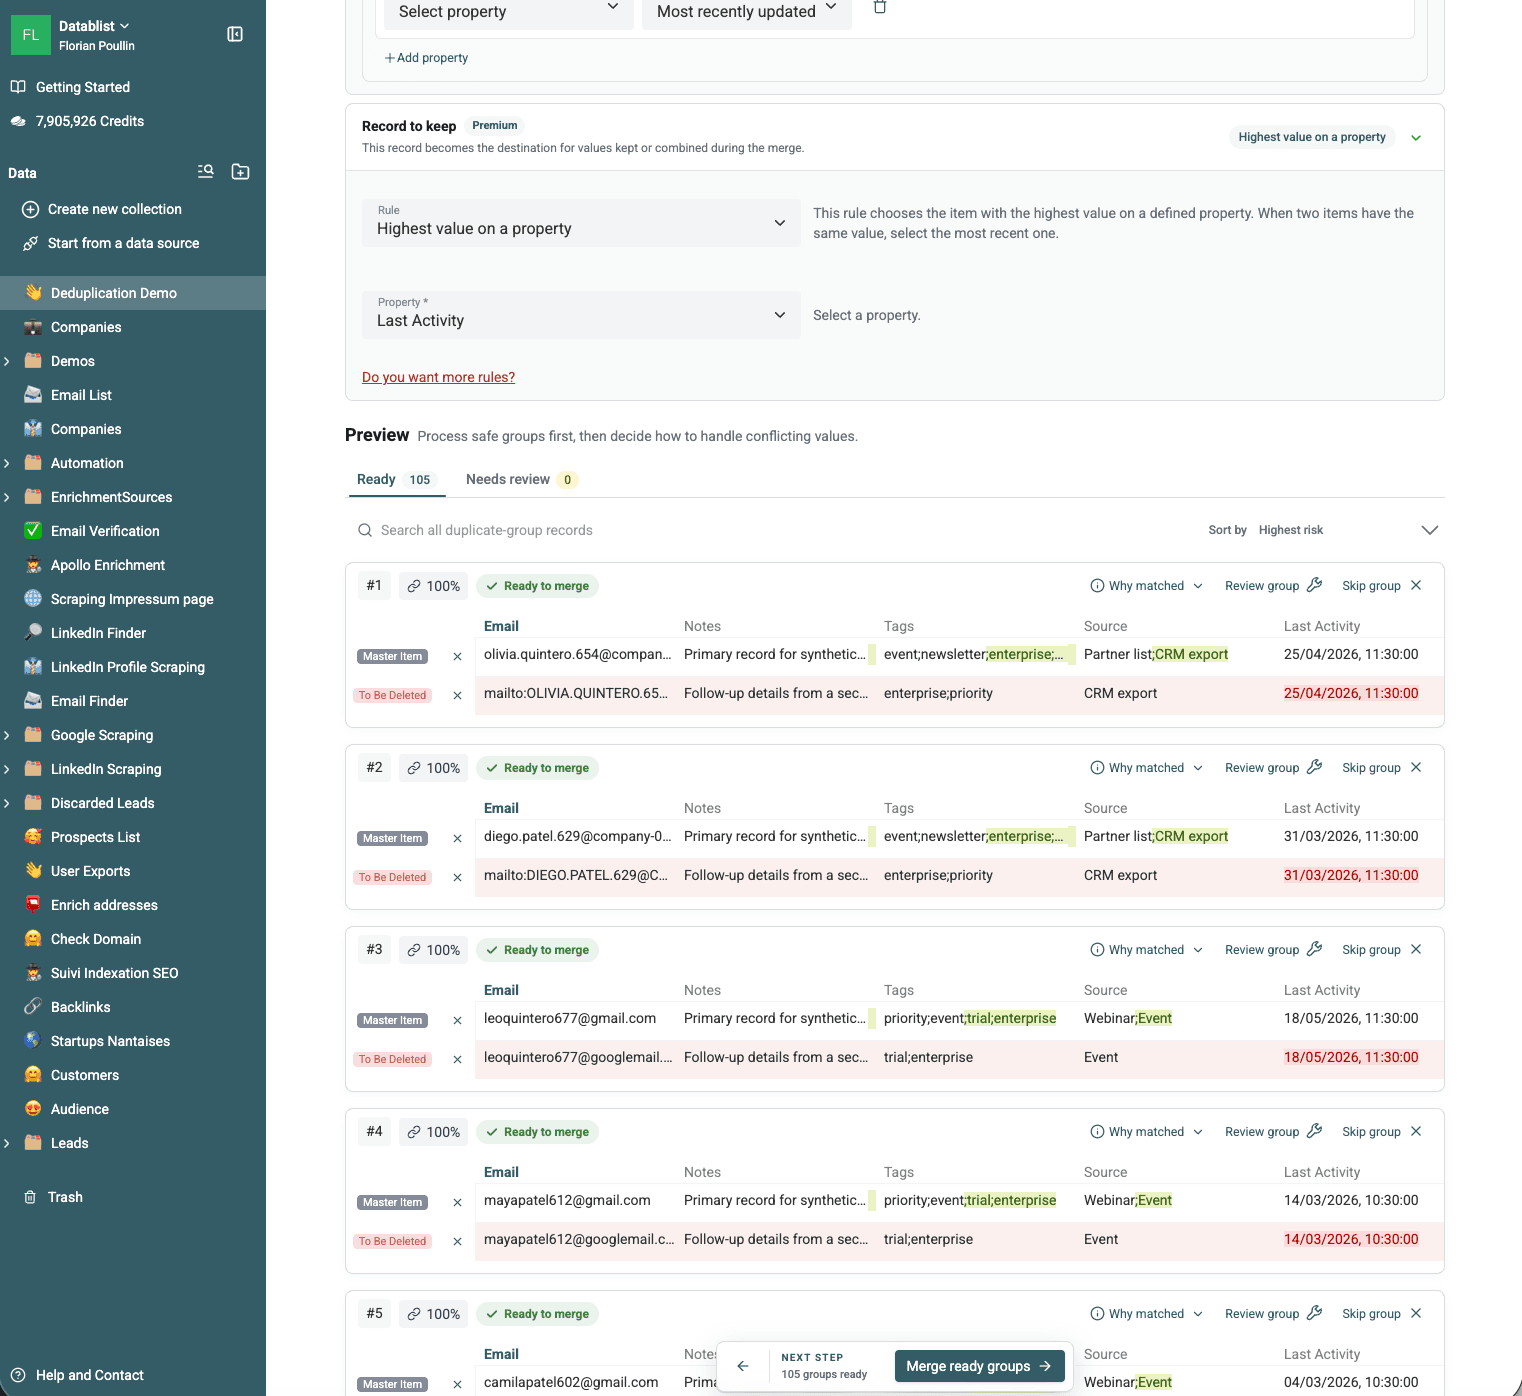
Начните с правила Record to keep. По умолчанию выбрано Most Complete. На платных тарифах доступны правила на основе времени создания или обновления, максимального или минимального значения свойства либо наличия обязательного значения.
Затем решите, как сохранять каждое конфликтующее свойство:
- Объединить уникальные текстовые значения с помощью разделителя.
- Оставить значение выбранной записи.
- На платных тарифах — независимо выбирать значения по таким правилам, как самое новое, старое, длинное, короткое, максимальное, минимальное или частое.
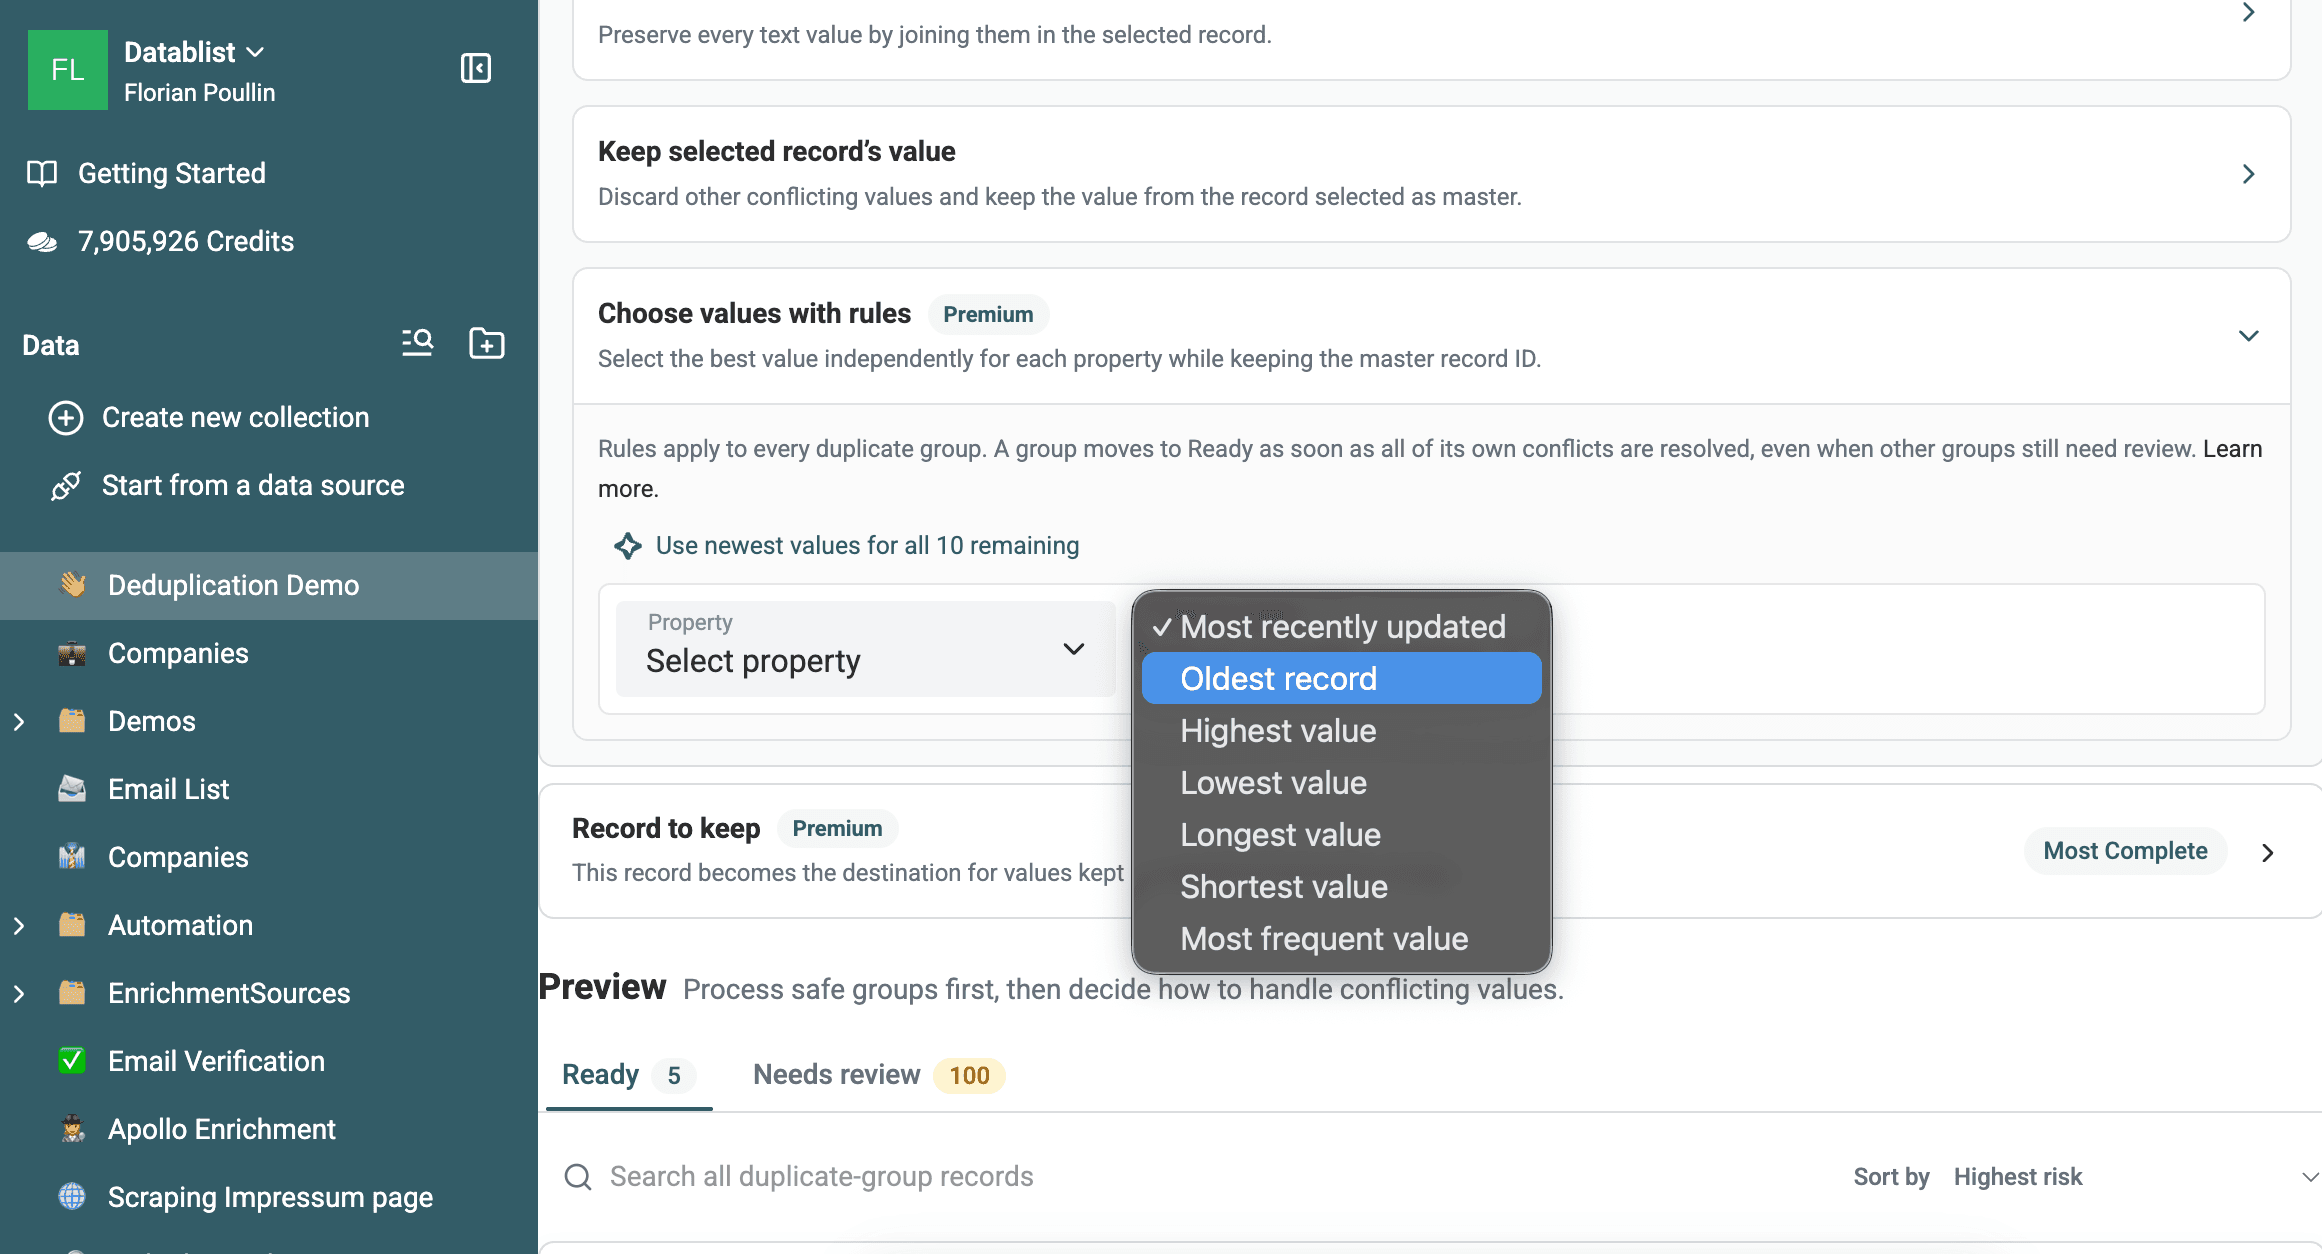
Используйте правила на уровне полей, если ни в одной строке нет лучших значений для всех свойств. Можно сохранить ID выбранной записи, взяв при этом более новую должность, более полное название компании и наиболее частый статус из других строк.
Обновляйте предварительный просмотр после изменения порога, сценария, состава группы, настроек конфликтов или правила выбора записи.
Применяйте Custom with AI для отдельных групп
Custom with AI создаёт сценарий обработки групп по инструкции на естественном языке. Он может выбрать запись, скопировать или нормализовать значения, добавить свойство статуса, рассчитать сумму по группе, удалить вторичные строки или пропустить группы, не отвечающие условию.
Например:
Сохранить запись, у которой Source равен CRM export. Скопировать Job Title из самой новой записи, объединить уникальные Notes с переносами строк, добавить чекбокс Duplicate Reviewed, затем удалить вторичные записи.
Обращайтесь к свойствам коллекции через /Property или {{Property}}. Сгенерируйте и проверьте сценарий перед запуском. Custom with AI доступен авторизованным пользователям на платных тарифах.
Для отдельных исключений откройте Review group и используйте Merging Assistant, не усложняя правило пакетной обработки.
Проверьте и экспортируйте очищенный список
Перед обработкой групп Ready убедитесь, что:
- Предварительный просмотр соответствует текущим настройкам.
- Группы с низкой уверенностью и общими идентификаторами проверены.
- У выбранной записи сохранится нужный ID.
- Уникальные значения телефона, источника, примечания и статуса не потеряются.
- Поля, допускающие только одно значение, не объединяются в строку.
- Показанное число Ready соответствует нужному объёму обработки.
После обработки сверьте число строк:
Исходное число строк - удалённые вторичные строки = итоговое число строк
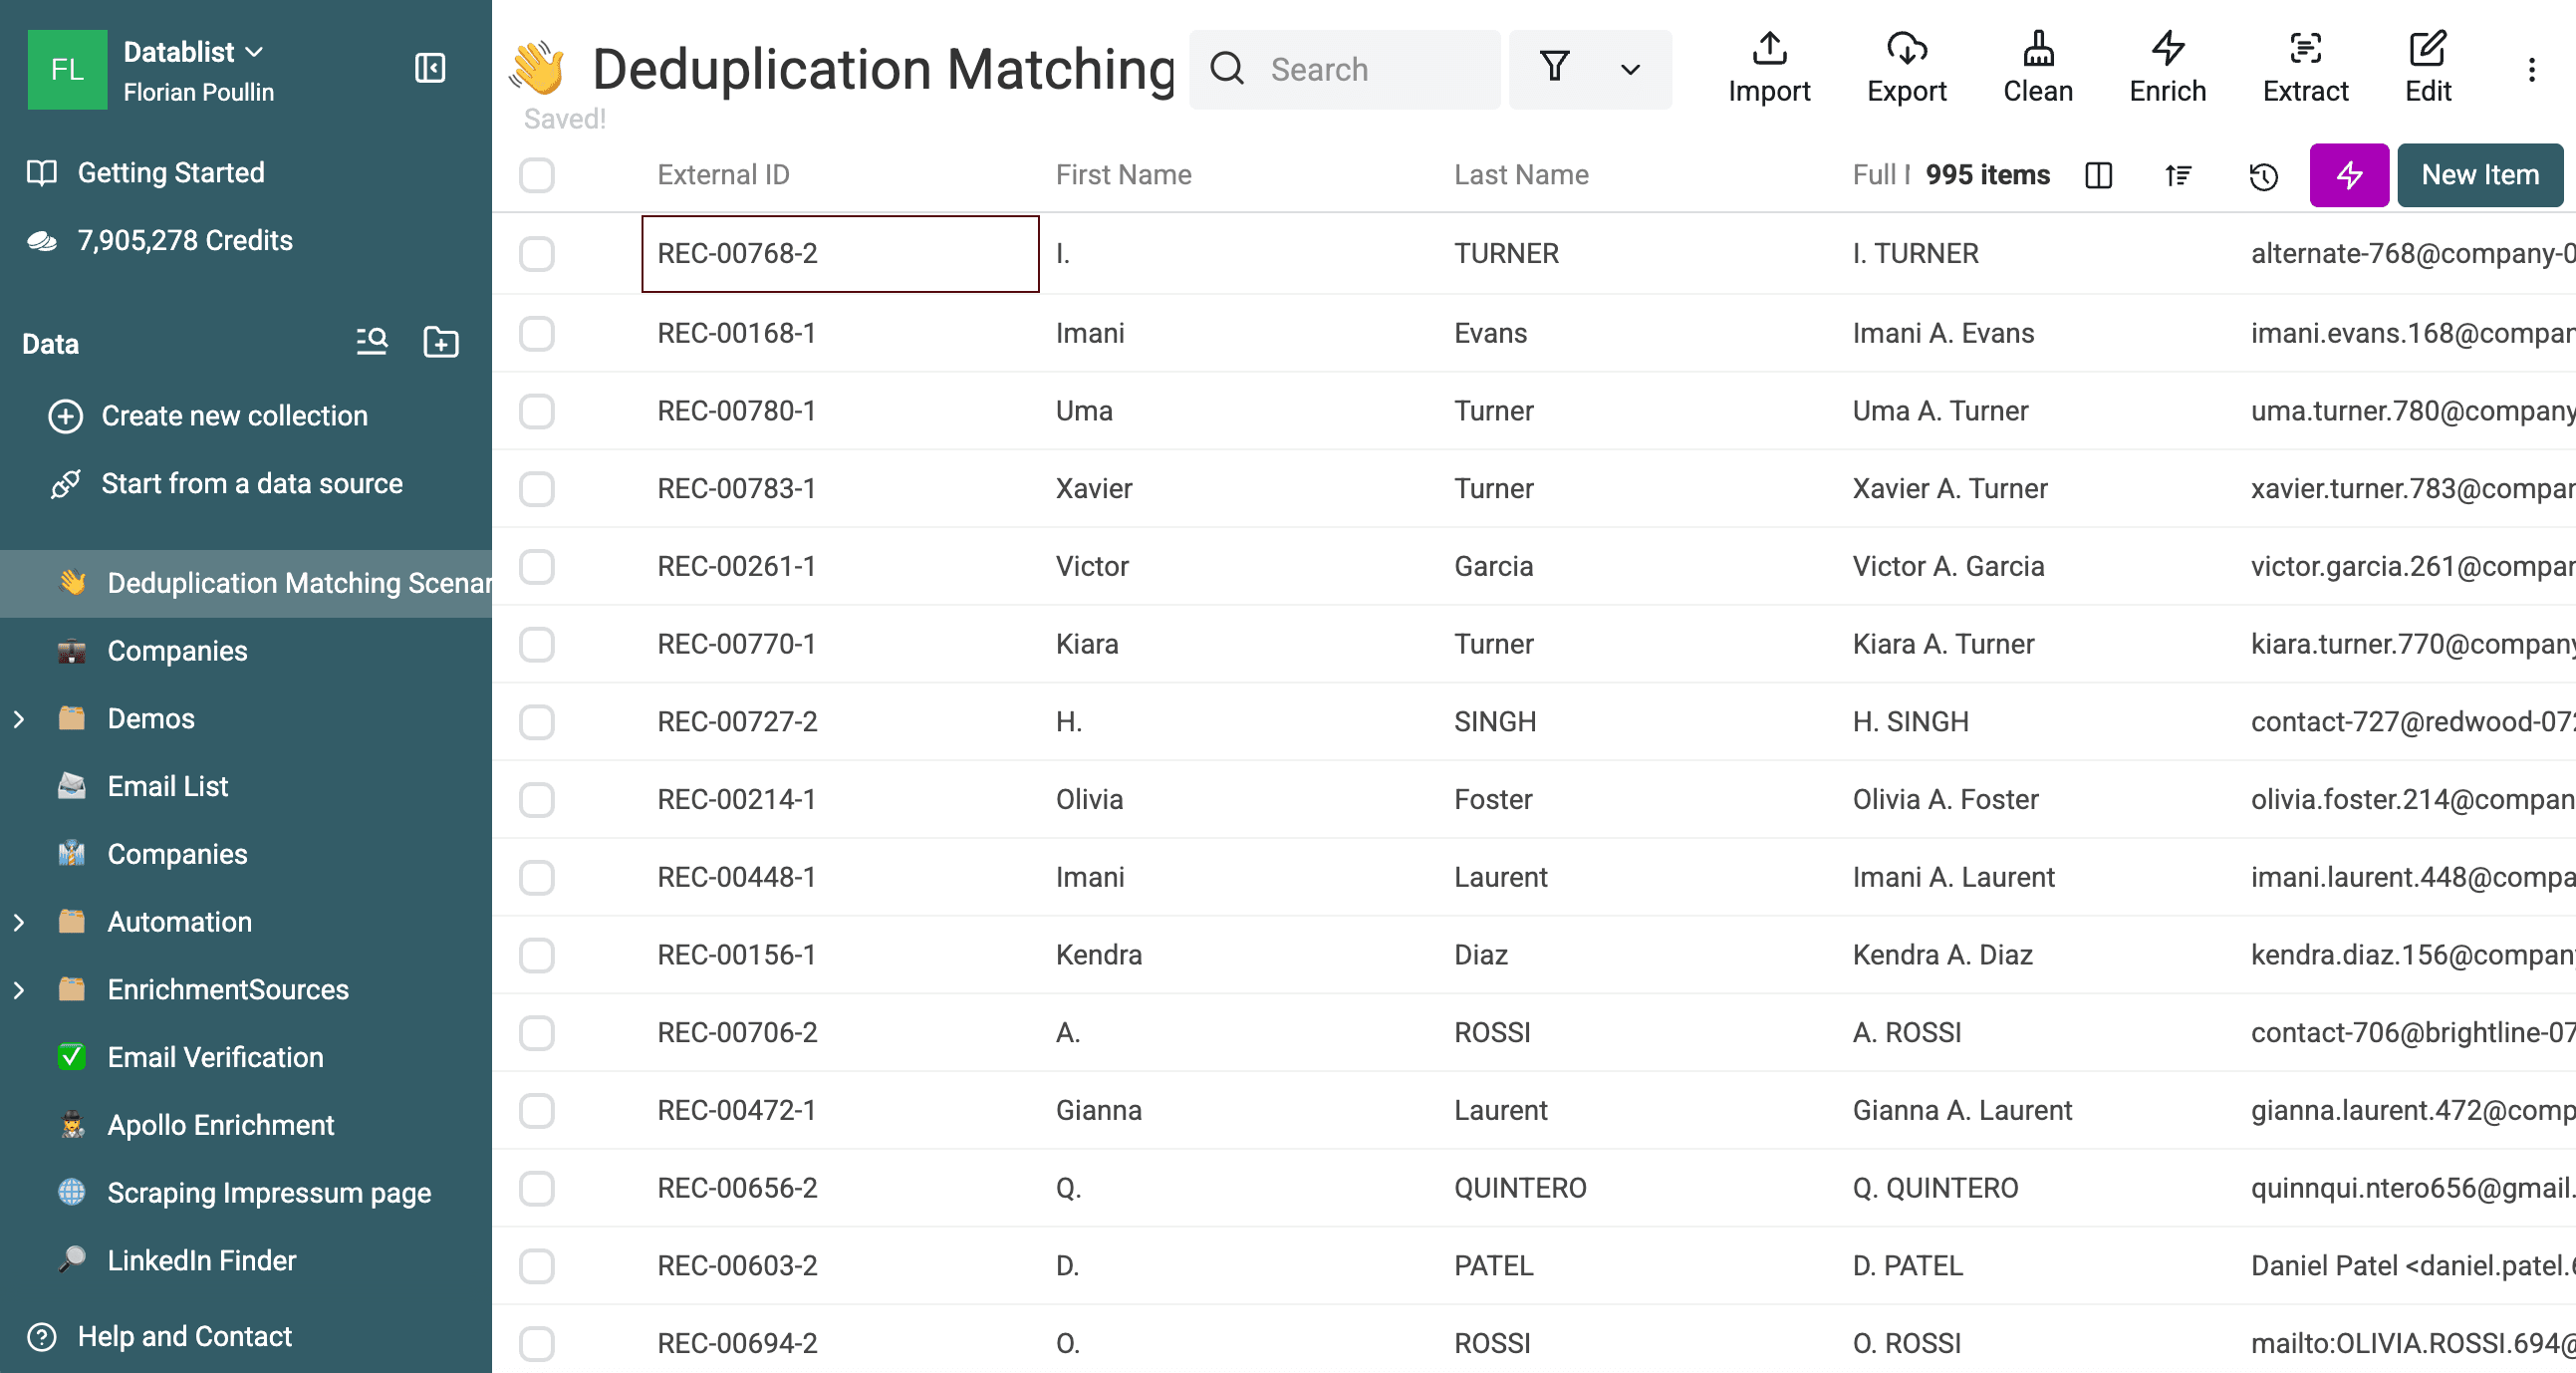
В описанной проверке Exact Datablist объединил пять групп по две строки. Поэтому в коллекции осталось 995 элементов вместо 1 000.
Скачайте группы дублей до обработки, если файл требуется для внешней проверки. Платные тарифы включают пригодные для работы ID групп дублей и журнал изменений после обработки. В журнале фиксируются ID удалённых и обновлённых записей Datablist, а также прежние и итоговые значения.
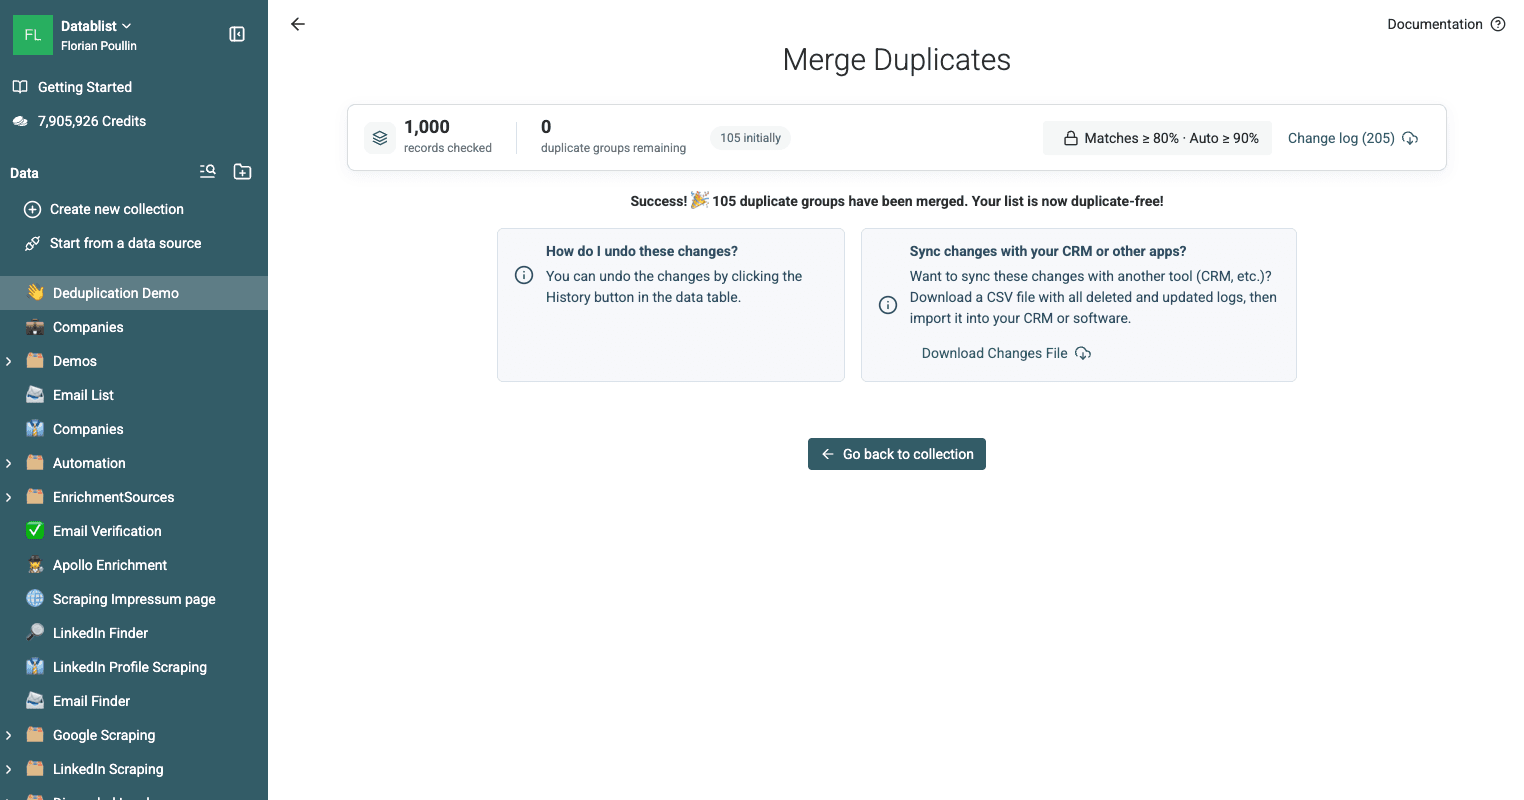
Автоматические операции удаления и объединения также отображаются в History коллекции, где их можно отменить.
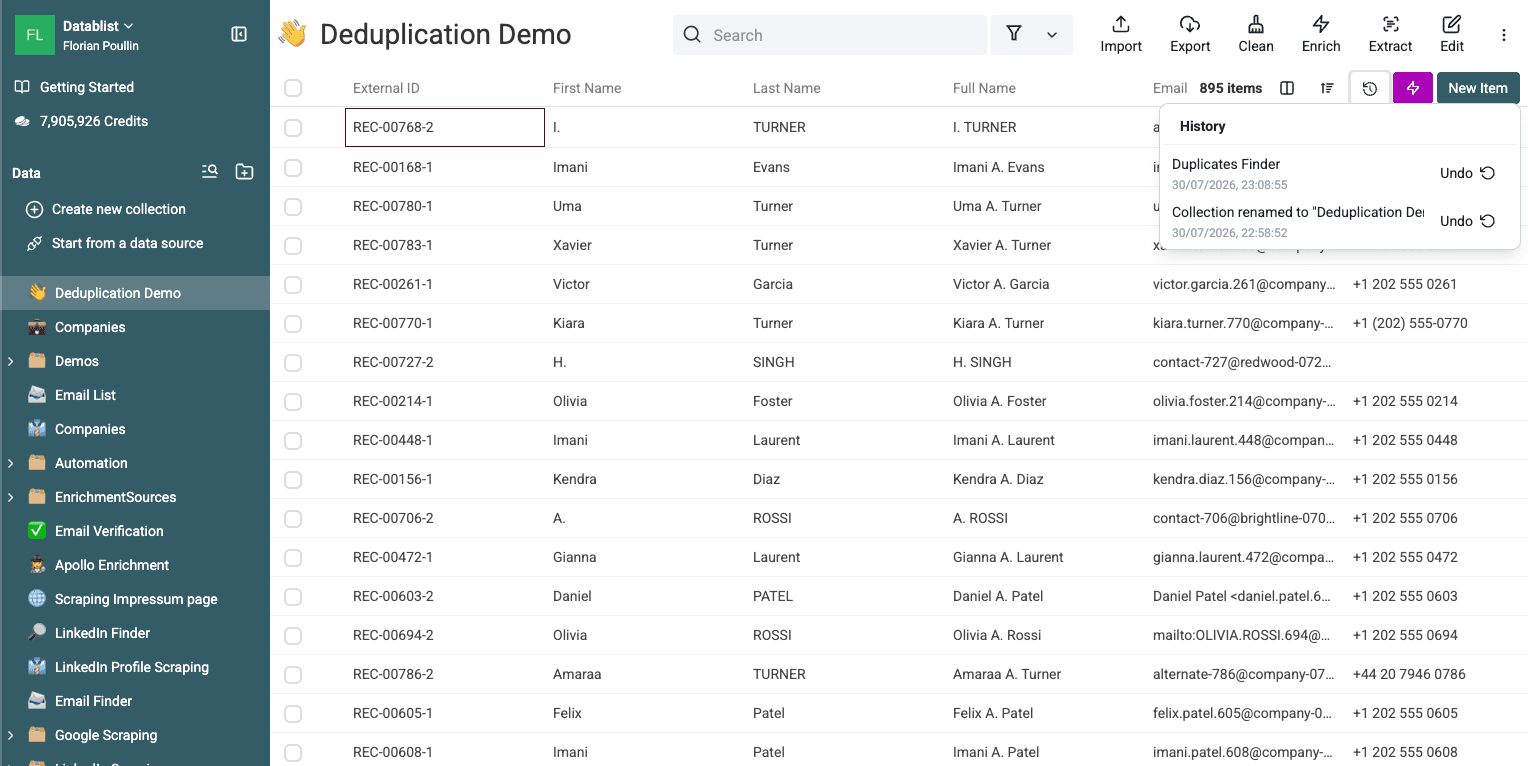
Вернитесь в коллекцию и откройте Export, чтобы скачать очищенный файл CSV или Excel.
Удалите дубли из нескольких списков
Используйте сопоставление коллекций, когда новый файл с leads нужно сравнить с экспортом из CRM. Считайте CRM эталонным списком и перед импортом удалите совпадения из входящего списка.
Скачать демонстрационный файл CRM и демонстрационный файл мероприятия, чтобы протестировать этот сценарий. У файлов разные заголовки, и в них заложено 100 пересечений по email. Изначально каждый файл содержит 250 строк.
Импортируйте каждый файл в отдельную коллекцию, затем откройте Clean > Match across collections. Добавьте обе коллекции и сопоставьте соответствующие свойства, например Email и Attendee Email.
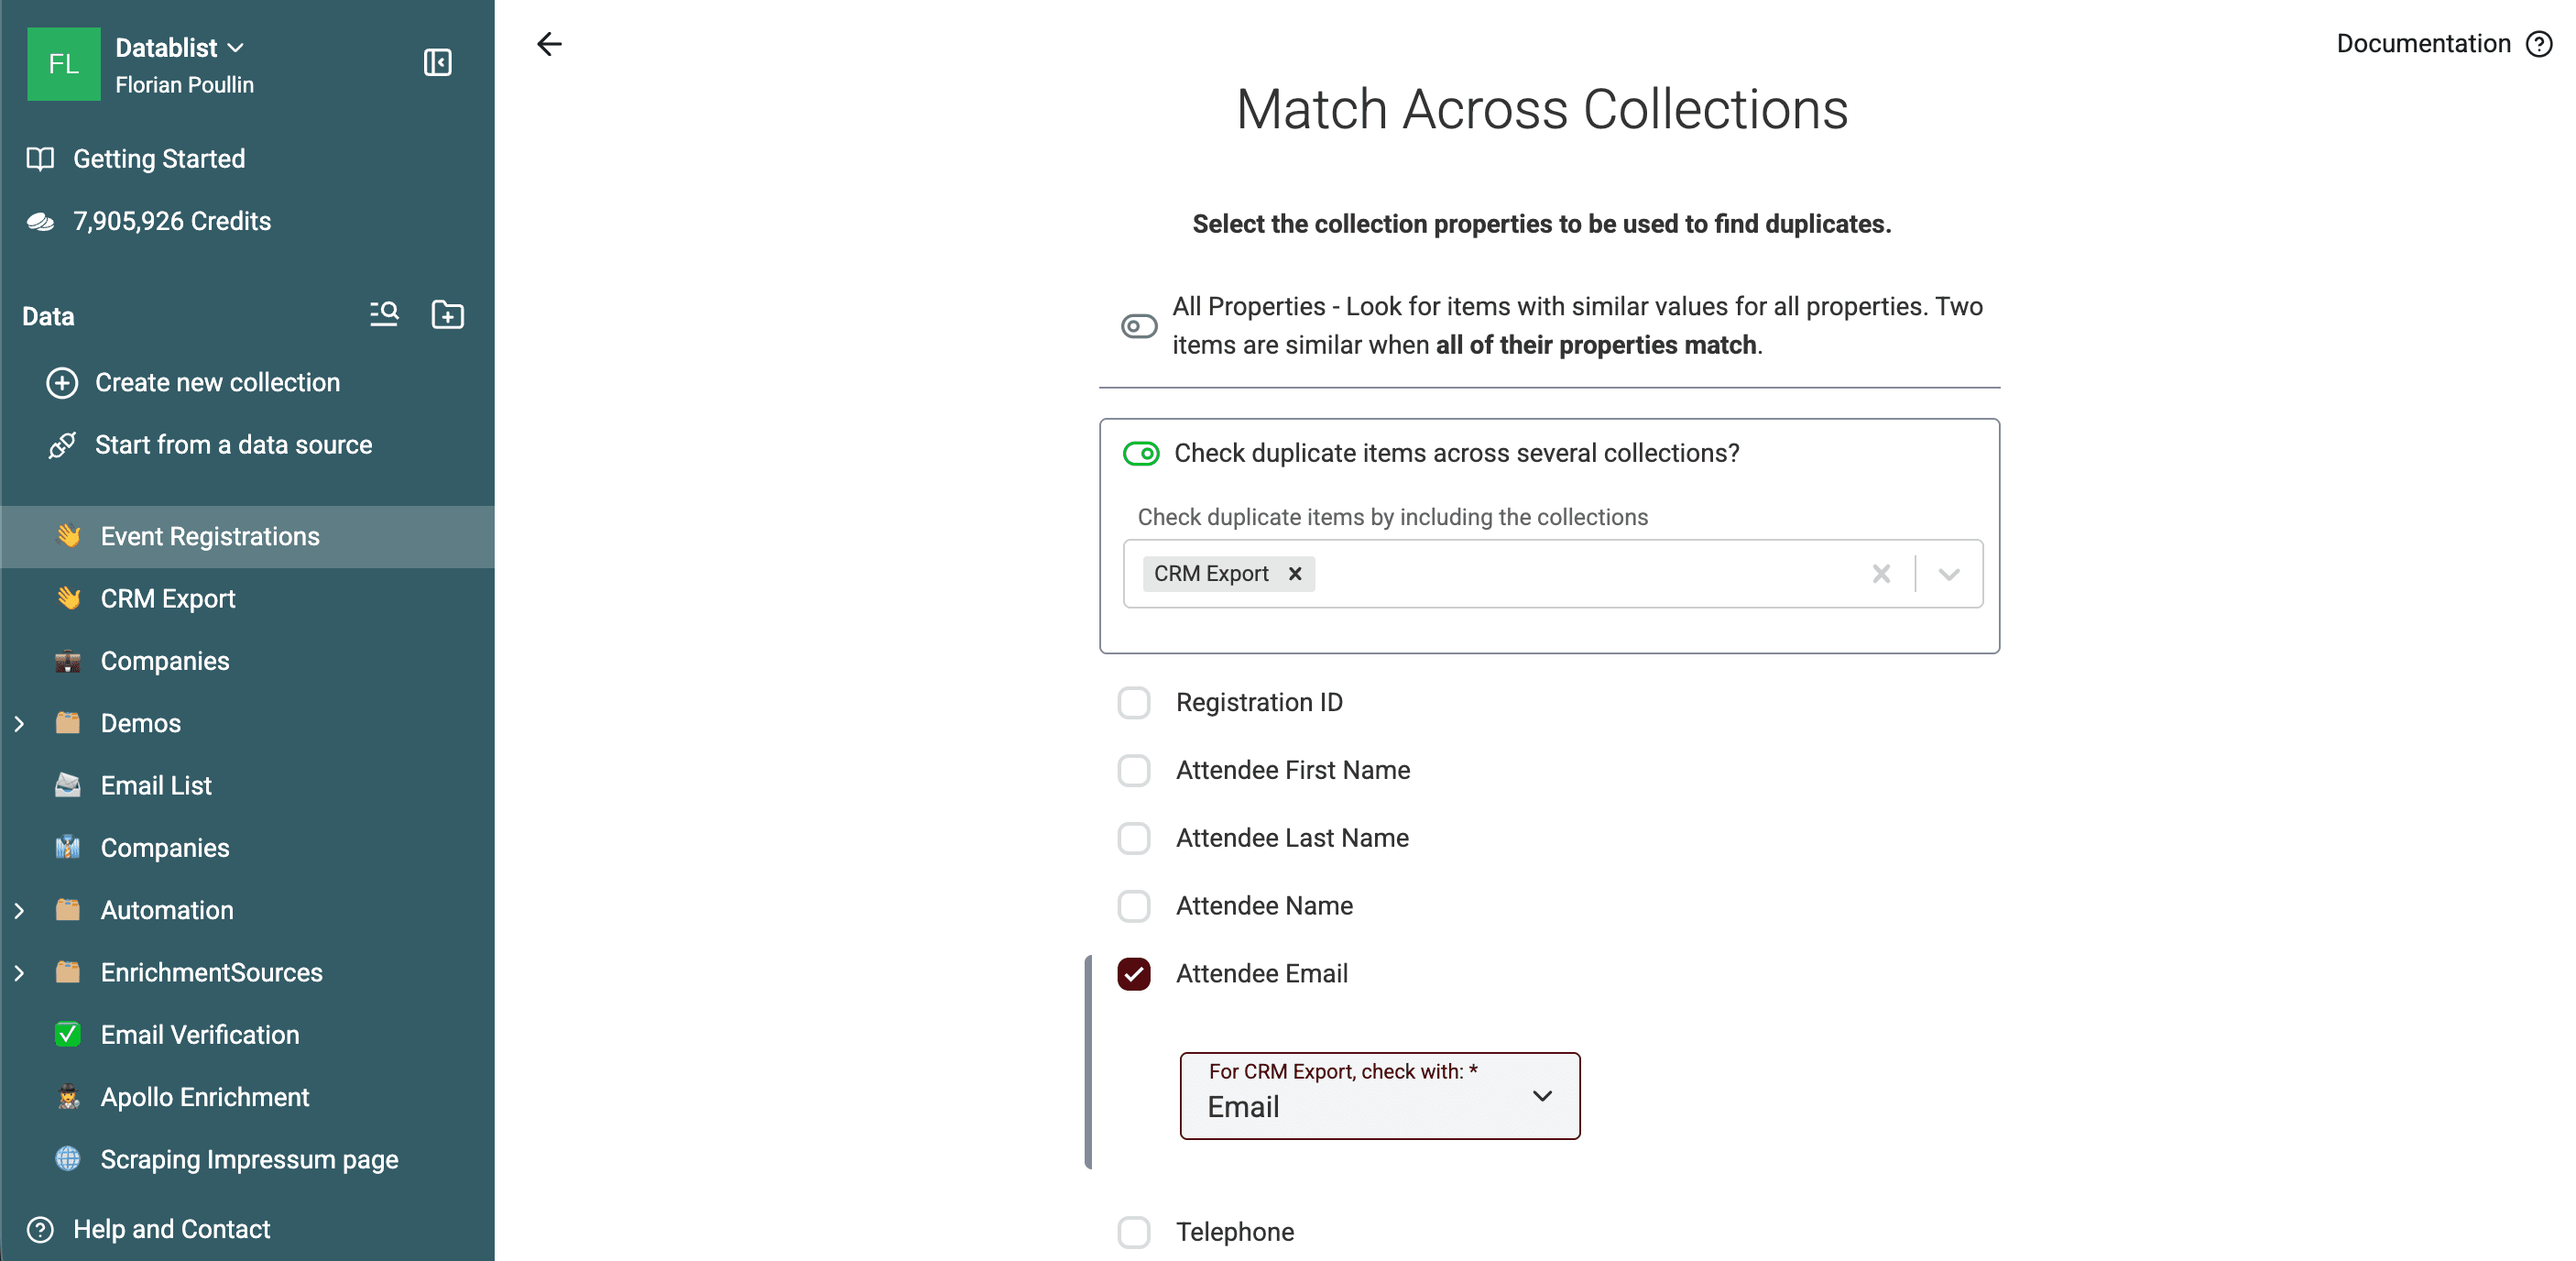
В этом тесте Smart с процессором Email вернул 100 межколлекционных групп среди 500 проверенных записей. Выберите Event Registrations в разделе Remove duplicate items from collection {X}, чтобы не менять CRM и удалить совпадения из списка мероприятия.
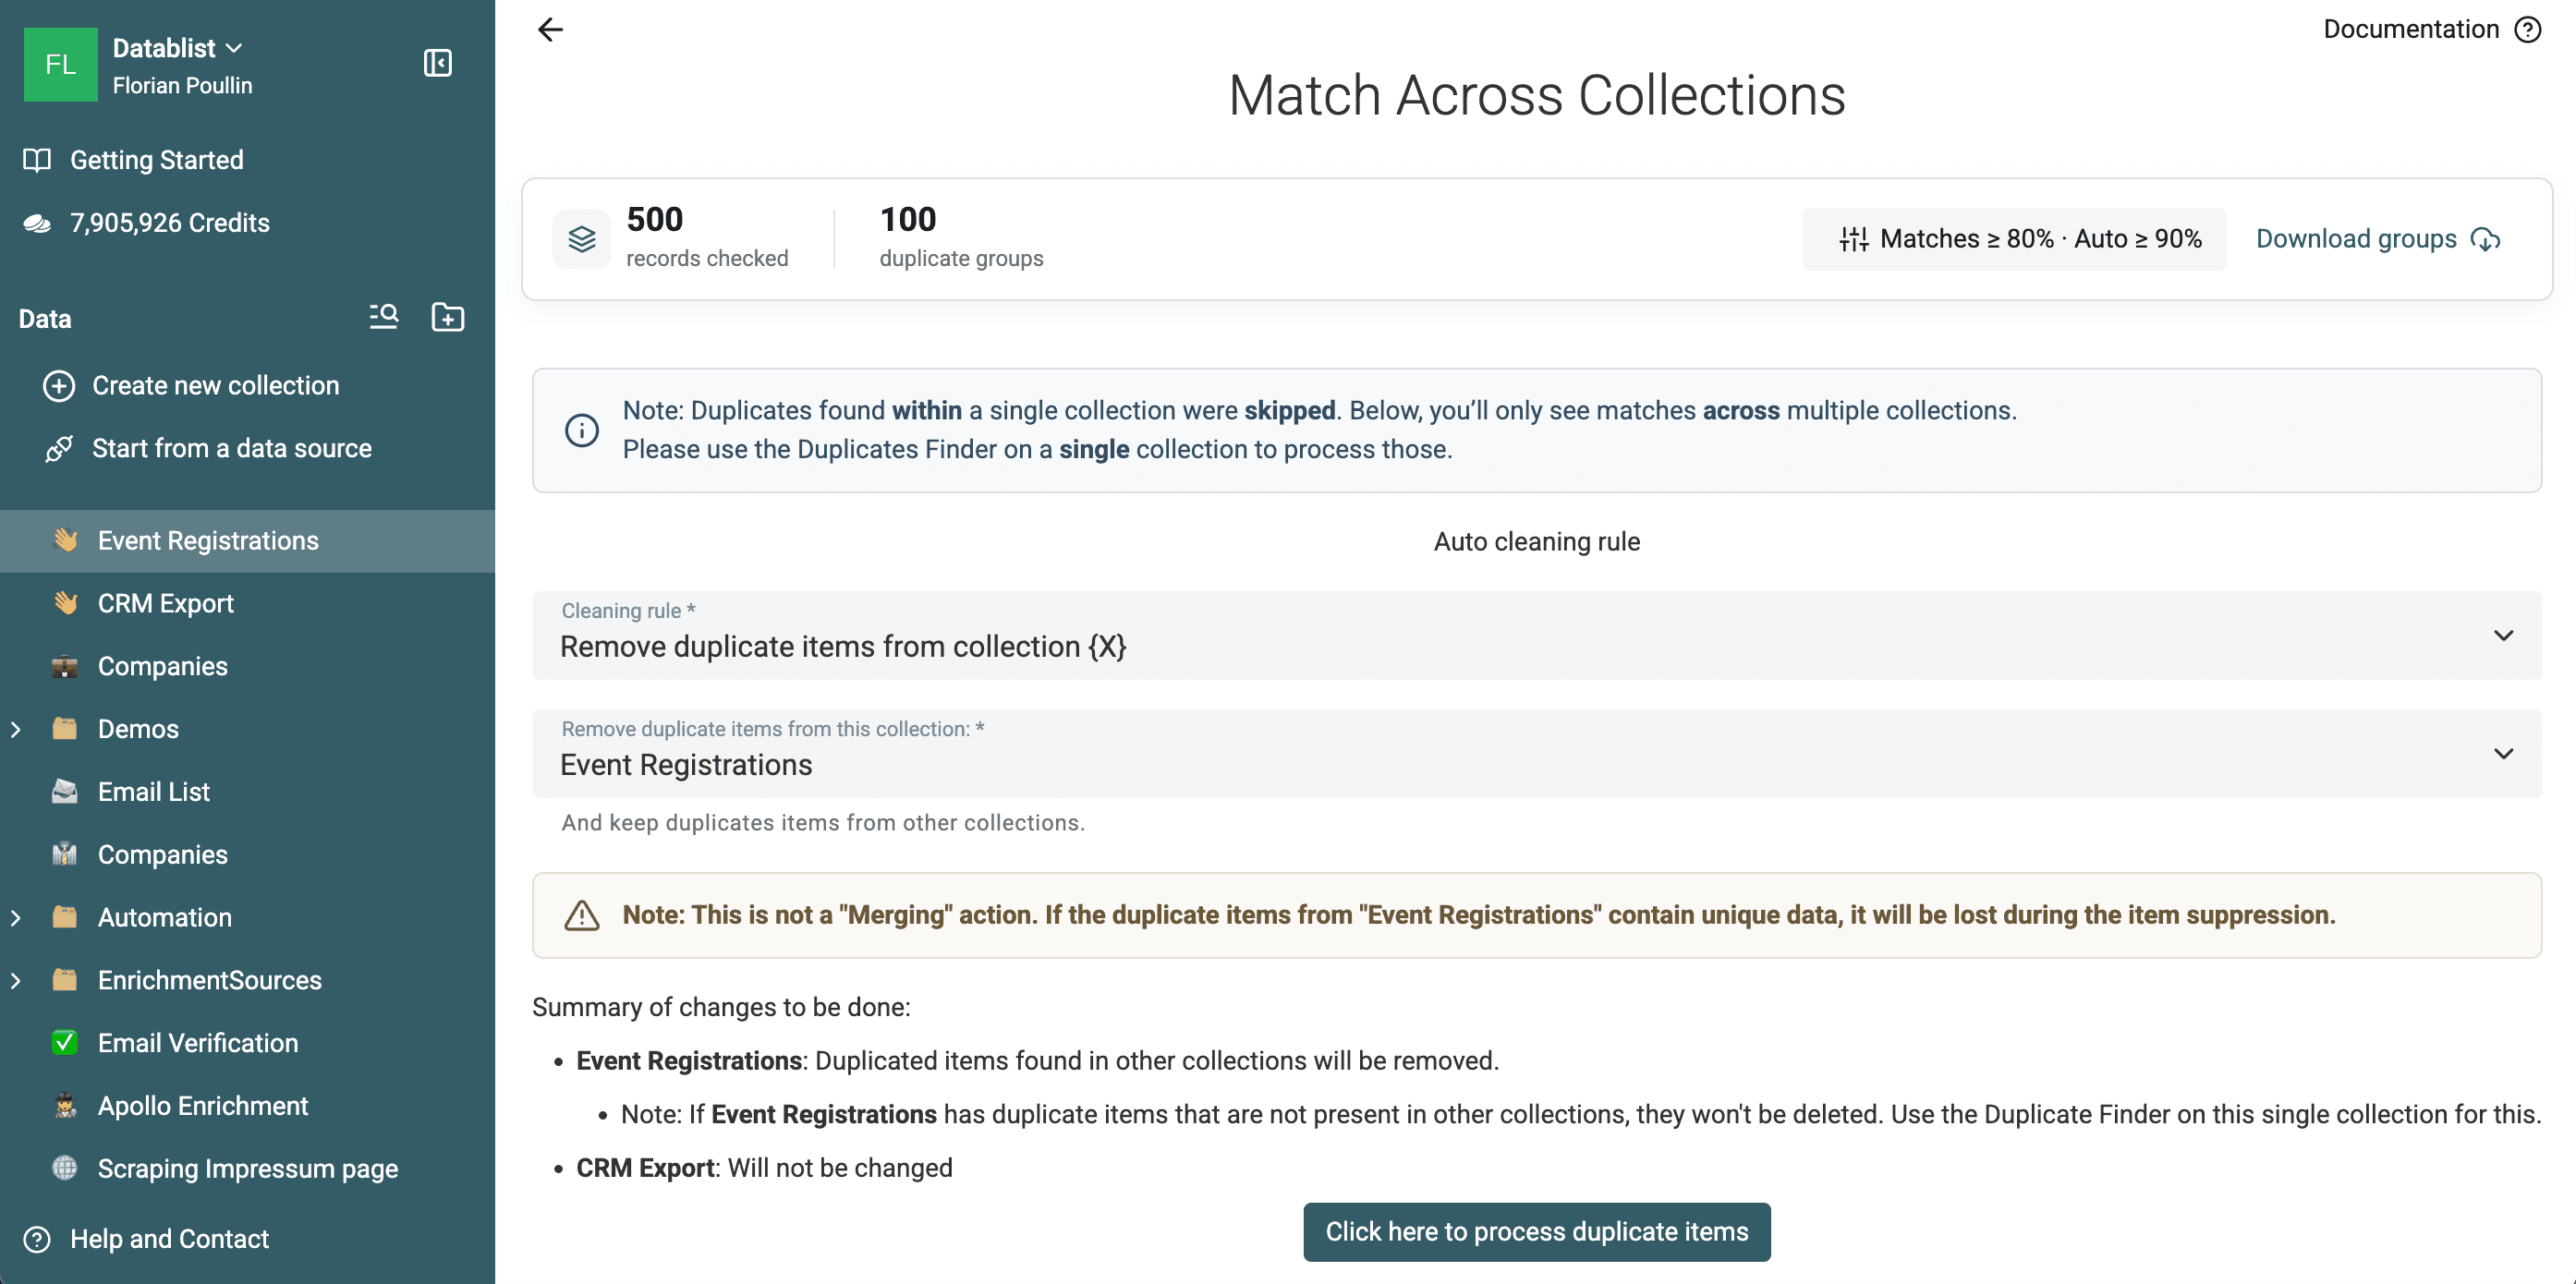
Автоматическая межколлекционная очистка удаляет строки. Она не переносит уникальные данные мероприятия в CRM. Если во входящих записях есть информация, которую нужно сохранить, сначала экспортируйте или проверьте группы.
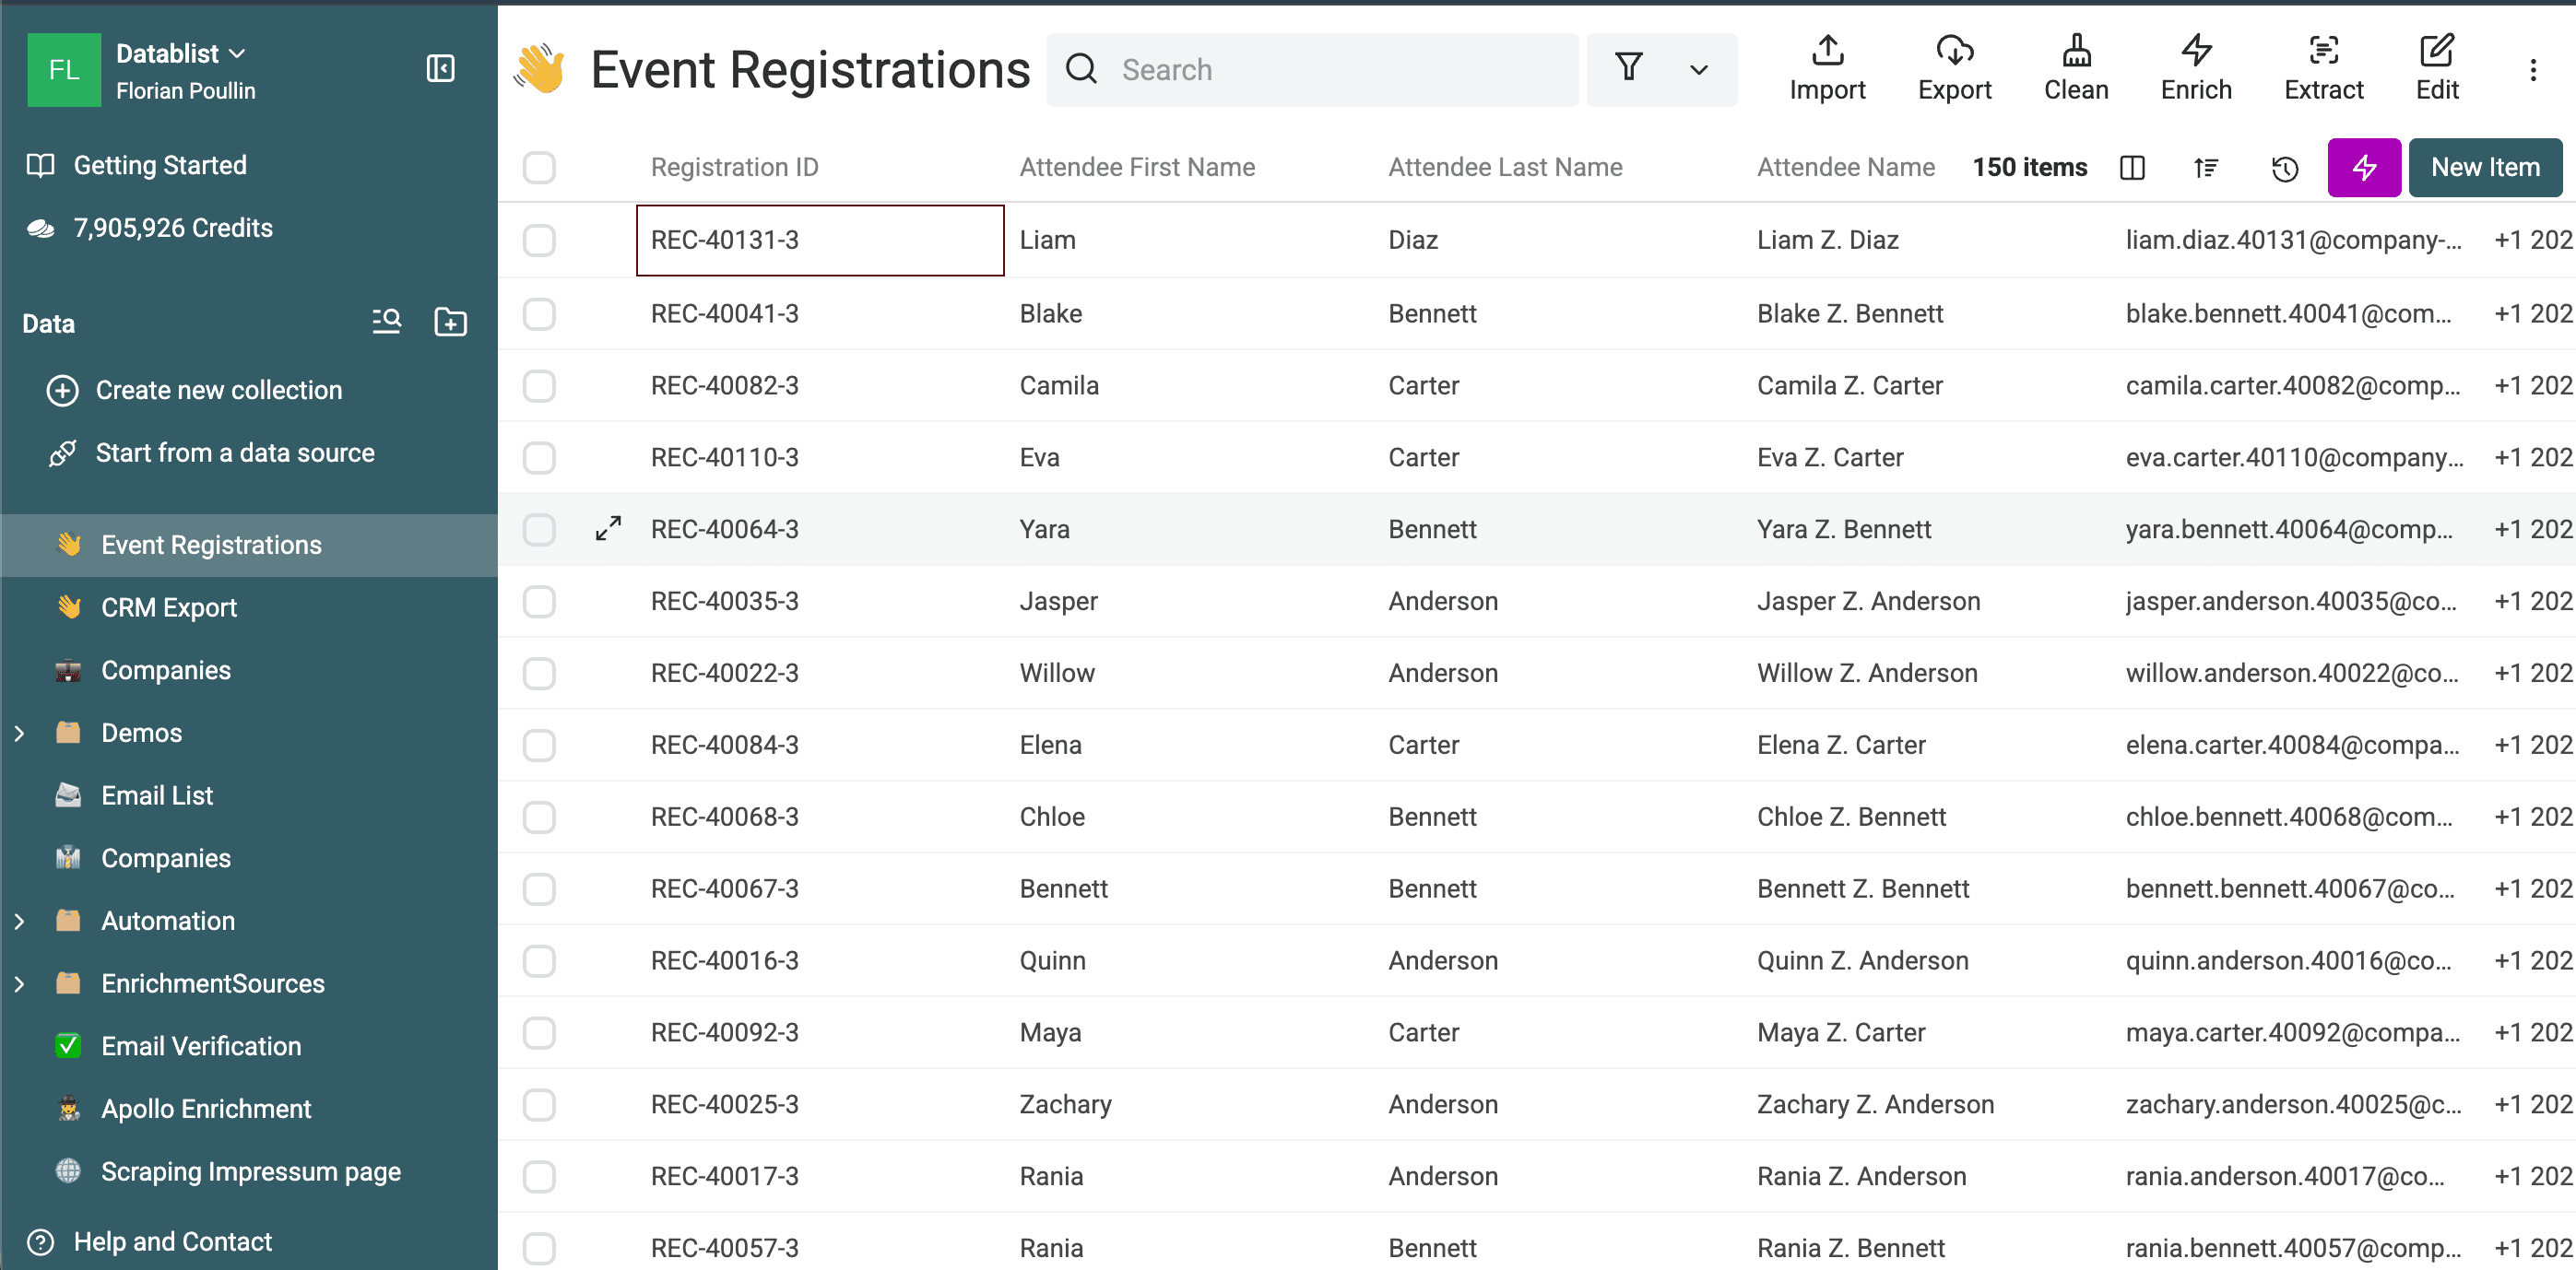
После обработки 100 пересечений в Event Registrations остаётся 150 новых контактов.
Сопоставление коллекций доступно на тарифе Premium. В подробном руководстве о том, как удалить дубли из нескольких файлов CSV или Excel, описаны сопоставление коллекций и варианты обработки.
FAQ
Можно ли бесплатно удалить дубли из списка онлайн?
Да. Незарегистрированные пользователи могут запустить проверку Exact. Бесплатный аккаунт открывает Smart и другие функции тарифа Free для одной коллекции. Нечёткие и фонетические алгоритмы, продвинутые процессоры, сопоставление коллекций, настраиваемые правила сохранения и Custom with AI требуют платного тарифа.
Что выбрать: удаление или объединение дублей?
Удаляйте строки, если одна запись является приоритетной, а в остальных нет нужных данных. Объединяйте их, если вторичные строки содержат полезные значения. Предварительный просмотр Remove предупредит о данных, которые будут потеряны.
Найдёт ли Datablist дубли с опечатками?
Да. Jaro-Winkler и Levenshtein сравнивают сходство текста, а Metaphone — его звучание. Эти продвинутые алгоритмы доступны на платном тарифе, а найденные ими совпадения следует проверять.
Можно ли объединить дубли без потери данных?
Datablist умеет заполнять пустые поля, объединять текстовые значения, сохранять значение выбранной записи и применять правила сохранения на уровне полей. Проверяйте предварительный просмотр: любое значение, которое вы решите отбросить, не попадёт в объединённую запись.
Какого размера может быть список?
Тариф Free поддерживает до 1 миллиона элементов в коллекции в хранилище браузера. На платных тарифах можно импортировать до 2 миллионов элементов в одну коллекцию. Производительность крупных локальных операций по-прежнему зависит от браузера и устройства.
Можно ли проверить дубли, не меняя список?
Да. Поиск выполняется в режиме только для чтения. До запуска обработки можно просматривать группы, менять пороги, использовать Why matched, искать и сортировать результаты, а также скачивать строки с дублями.
Все настройки и ограничения приведены в полной документации Duplicate Finder.