
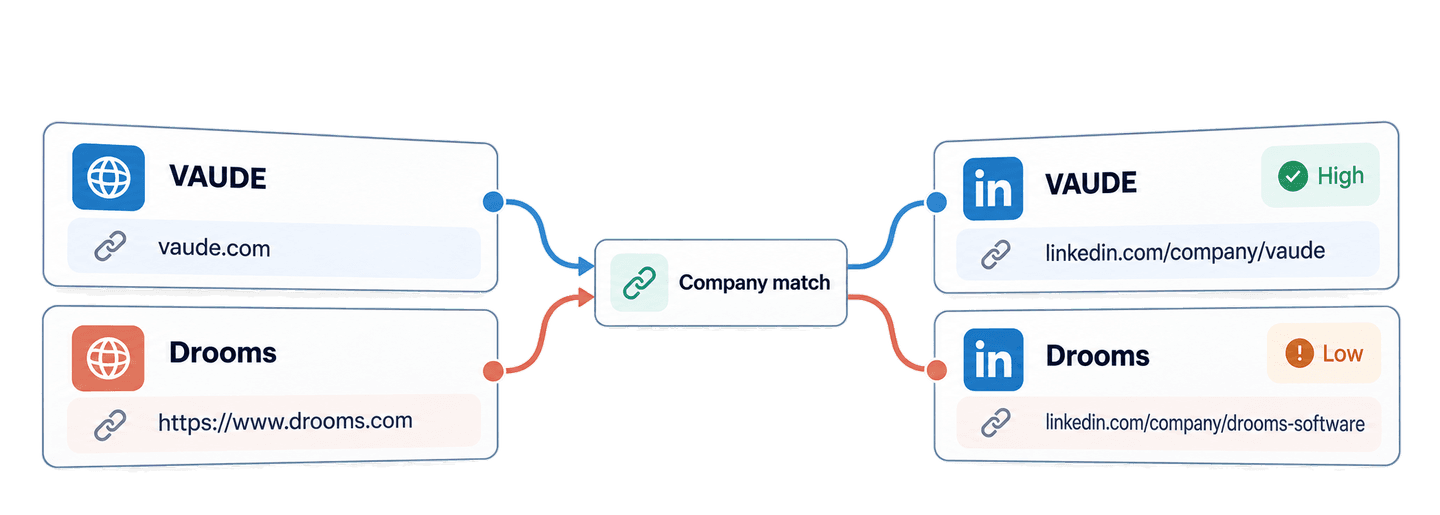
Använd Datablists Company to LinkedIn API för att hitta ett företags LinkedIn-sida utifrån dess webbplats med Python. Du kan skicka en ren domän eller en fullständig webbadress, vänta tills matchningen är klar och få tillbaka företagsnamn, webbplats, URL till LinkedIn-företagssidan och en konfidensnivå.
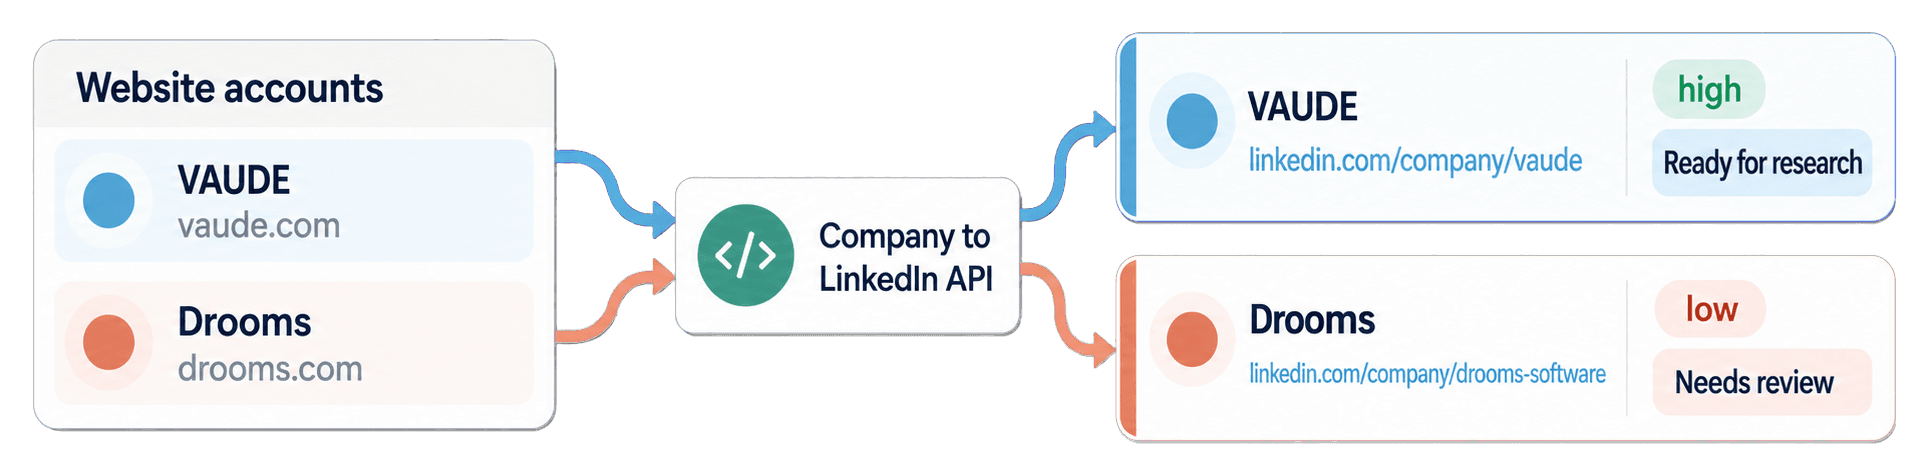
I den här guiden använder jag Python och Requests-biblioteket för att matcha fem företagswebbplatser. Listan innehåller välkända mjukvaruföretag samt VAUDE, som säljer friluftsutrustning, och Drooms, som erbjuder virtuella datarum. Därefter omvandlar jag resultaten till två lokala köer: matchningar som är klara för företagsresearch och matchningar som behöver granskas manuellt.
🔑 Snabb sammanfattning
Skicka webbplatserna från din account-lista till Datablists Company to LinkedIn API. API:et returnerar URL:er till företagens LinkedIn-sidor och konfidensnivåer som hjälper dig att avgöra vilka kopplingar du kan använda direkt och vilka som behöver granskas.
- Input: rena domäner och fullständiga URL:er till företagswebbplatser.
- Output: företagsnamn, matchade webbplatser, URL:er till LinkedIn-företagssidor samt
highellerlowconfidence, uppdelade i köernaReady for researchochNeeds review.
💡 Föredrar du en no-code-lösning? Använd Datablists LinkedIn Company Pages & Domain Lookup för att matcha företagswebbplatser och LinkedIn-sidor utan att skriva kod.
Konfigurera Python och din Datablist API-nyckel
I det här exemplet använder jag paketet requests. API:et fungerar via HTTP, så du kan senare anpassa samma sekvens av anrop till ett annat språk.
Du behöver ett Datablist-konto med åtkomst till REST API, vilket ingår i Growth-planen. Lyckade sökningar förbrukar också enrichment credits. Den exakta kreditberäkningen går jag igenom längre fram i guiden.
Skapa en arbetskatalog och en fil med namnet find_linkedin_company_pages.py. Skapa sedan en virtuell miljö och installera Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pySkapa en Personal API Key i ditt Datablist-konto och exportera den sedan som en miljövariabel:
export DATABLIST_API_KEY="your-api-key"Skriptet läser värdet och skickar det i headern X-API-Key.
Hitta LinkedIn-företagssidor med en Python-funktion
Exemplet använder följande fem source accounts:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
Varje account_id blir API-fältet inputId. Det är viktigt eftersom resultaten inte nödvändigtvis kommer tillbaka i samma ordning som input-posterna. Med ett stabilt ID kan du koppla varje resultat till rätt source account.
Klistra in följande fullständiga skript i find_linkedin_company_pages.py:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))Kör det med:
python find_linkedin_company_pages.pyFunktionen gör tre typer av anrop i tur och ordning.
Först skickar POST-anropet de fem webbplatserna med matchingDirection satt till domain_to_linkedin. API:et svarar med 202 Accepted och ett task-ID eftersom matchningen körs som en bakgrundsuppgift. Requests-skriptet upplevs ändå som sekventiellt eftersom det väntar innan det går vidare till nästa steg.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]Därefter kontrollerar statusanropet uppgiften tills den får statusen completed, failed eller stopped. Pausen på tre sekunder hindrar skriptet från att skicka statusanrop oavbrutet.
Till sist hämtar resultatanropet sidor med upp till 100 resultat. Om nextCursor innehåller ett värde skickar loopen det som cursor i nästa anrop. Den avslutas först när nextCursor är null.
Tolka matchningarna och välj vad som ska granskas
Här är hela resultatlistan för de fem input-posterna:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
Läs status och confidence separat. API:et returnerar ett resultatobjekt för varje input, även för poster som inte lyckas. Statusen success betyder att API:et har hittat en kandidat till företagssidan. Värdet i outputs.confidence visar om webbplatsmatchningen kunde valideras. inputId kopplar objektet till ditt source account, medan creditsUsed visar kostnaden för raden och error innehåller strukturerad felinformation när ett fel uppstår.
Behåll hela objektet outputs i applikationen, även om den första vyn bara behöver LinkedIn-URL:en och konfidensnivån. companyName och companyWebsite gör den manuella granskningen snabbare, särskilt när det returnerade företagsnamnet har en annan användning av stora och små bokstäver eller när input-värdet var en fullständig URL. Fälten ger också användbar kontext utan att du behöver göra ännu ett API-anrop.
Matchningsprocessen börjar med att normalisera den inskickade webbplatsen och söka efter en känd koppling mellan webbplatsen och LinkedIn i företagsdatakällor. Därefter jämförs input-domänen med webbplatsen som anges på den föreslagna LinkedIn-företagssidan. En matchning på registrerad domän ger high confidence.
Om datakällorna saknar en LinkedIn-URL kan sökningen göra en riktad Google-sökning efter möjliga företagssidor. En kandidat som inte kan valideras mot en publicerad webbplats kan returneras med low confidence. En känd avvikelse mellan webbplatser godkänns inte.
Se konfidensnivån som en granskningsinstruktion. VAUDE returnerade https://www.linkedin.com/company/vaude med high confidence och kan därför läggas i research-kön. Drooms returnerade https://www.linkedin.com/company/drooms-software med low confidence. Öppna Drooms webbplats och LinkedIn-sida innan du förlitar dig på kopplingen.
Datablist, PostHog och n8n gav också matchningar med hög konfidens. API:et hittar kopplingen mellan webbplatsen och företagssidan. Om du efter granskningen behöver företagsstorlek, bransch eller andra uppgifter från sidan kan du fortsätta med guiden för LinkedIn company scraper API.
Skapa en kö för account research från resultaten
Återanvänd nu match_results för att skapa en lokal kö för manuell företagsresearch. Det här kodblocket anropar inte API:et igen. Det indexerar resultaten efter inputId och går sedan igenom den ursprungliga account-listan, så att varje source account förblir synligt även om ett framtida resultat skulle saknas.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))Resultatordlistan gör kopplingen oberoende av svarsordningen. account-vaude kopplar den ursprungliga posten vaude.com till den identifierade VAUDE-sidan och hamnar i ready_for_research. account-drooms behåller hela sin input-URL och hela API-resultatet, men läggs i needs_review eftersom konfidensen är låg trots att resultatets status är success.
Samma logik behåller en saknad rad eller en rad med no_result eller error i granskningskön. De två utskrivna listorna ger teamet en tydlig utgångspunkt för manuell företagsresearch.
Du kan också ladda ned det underhållna synkrona Requests-exemplet. Repositoriet innehåller även ett asynkront HTTPX-exempel för applikationer som behöver icke-blockerande HTTP, men den blockerande versionen ovan är enklare att följa i en första integration.
Hitta en webbplats från en LinkedIn-företagssida
Samma funktion tar emot LinkedIn-företagssidor när du ändrar matchningsriktningen. Det är användbart när din källista innehåller URL:er till företagssidor och du behöver webbplatser före en kompatibel company- eller work email-enrichment.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)En vanlig sökning från en LinkedIn-företagssida använder den ordinarie matchningskostnaden. Numeriska företags-ID:n och företags-URL:er från Sales Navigator kan kosta 10 credits eftersom de använder en annan reverse lookup-process. En no-code-version för den här riktningen finns i guiden om hur du hittar webbadresser från LinkedIn-företagssidor.
Beräkna credits för webbplats-till-LinkedIn
En lyckad vanlig sökning från webbplats till LinkedIn förbrukar 1,5 credits. De fem matchningarna som visas använde därför 7,5 credits. Med samma kostnad förbrukar 1 000 lyckade matchningar 1 500 credits. Ogiltiga input-värden och rader utan resultat kan förbruka noll credits, så kontrollera värdet creditsUsed i varje resultat för att se den faktiska förbrukningen.
Åtkomst till REST API ingår i Growth-planen, och månadsabonnemanget är separat från top-up credits. En top-up på 20 USD ger 20 000 credits, vilket innebär att en credit kostar 0,001 USD. Med 1,5 credits per lyckad matchning förbrukar 1 000 matchningar 1 500 credits till ett värde av 1,50 USD. Se Datablists priser för aktuella planer och paket.
Lös vanliga problem med input, tasks och resultat
DATABLIST_API_KEYsaknas: skriptet stoppas innan något anrop skickas. Exportera miljövariabeln och kör kommandot igen.- API:et avvisar nyckeln: kontrollera att du har kopierat en Personal API Key och att anropet endast skickar den i
X-API-Key. - Input-formatet stöds inte: använd en företagswebbplats eller domän för
domain_to_linkedin. För den omvända riktningen ska du använda en kompatibel URL till en företagssida, inte en personlig profil eller ett tomt värde. - Du har för få credits: kontrollera saldot och använd sedan inkluderade credits eller gör en top-up innan du skapar en ny task.
- Tasken har status
failedellerstopped: kontrollera task-status, felmeddelande, befintliga resultat och kreditförbrukning innan du avgör om den ska skickas igen. - Ett resultat har låg confidence,
no_resulteller error: behåll källwebbplatsen och hela resultatet ineeds_review. Öppna kandidatsidan om det finns en sådan och gissa inte varför ett resultat saknas.
Om anslutningen bryts när tasken skapas använder du det uniqueId som skrevs ut före POST-anropet. Lista dina tasks och leta efter värdet innan du skapar en ny task:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"Task-listan kan inte filtreras efter uniqueId, så granska varje returnerad task och följ nextCursor vid behov. När du hittar rätt värde använder du dess @id med samma status- och resultat-URL:er som i skriptet.
En task kan innehålla upp till 10 000 input-poster. Fullständig information om gränser för anrop, lagring av tasks och paginering finns i dokumentationen för Company to LinkedIn API.
Nästa steg
Nu har du en återanvändbar Python Requests-funktion som omvandlar företagswebbplatser till kandidater för LinkedIn-företagssidor. Den lokala kön håller matchningar med hög konfidens redo för research och ser till att osäkra eller misslyckade poster förblir synliga för granskning.
Ersätt de fem exemplen med en mindre account-lista, granska alla kandidater med låg konfidens och använd sedan godkända URL:er för manuell företagsresearch eller som input till LinkedIn company scraper API. Om din källista innehåller företagsnamn i stället för webbplatser kan du börja med guiden för company website finder API.