
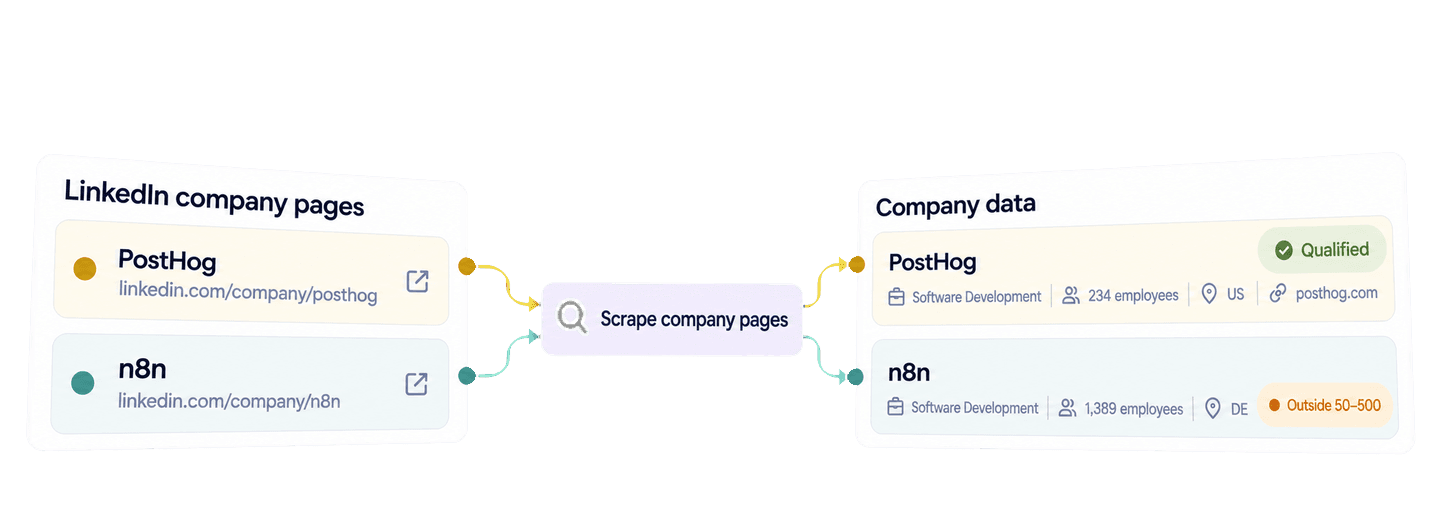
Du kan skrapa företagsdata från LinkedIn i Python genom att skicka en lista med URL:er till företagssidor till Datablists API med biblioteket Requests. API:et returnerar strukturerade företagsposter med uppgifter som bransch, antal anställda, huvudkontor, webbplats och beskrivning när informationen finns på den offentliga företagssidan.
I den här guiden använder jag en lättläst Python-funktion för att hämta poster för n8n, PostHog, Back Market och Datablist. Därefter återanvänder jag resultaten för att kvalificera mjukvaruföretag med 50–500 anställda och huvudkontor i USA eller Tyskland. Den kvalificerade posten behåller både webbplats och beskrivning för vidare sales research.
🔑 Snabb sammanfattning
Datablist omvandlar granskade URL:er till LinkedIn-företagssidor till strukturerade företagsposter som kan användas i ett arbetsflöde för sales research. Python-exemplet nedan hämtar samtliga resultatsidor och använder sedan ett lokalt filter för att kvalificera konton, utan ett andra API-anrop.
- Input: URL:er till LinkedIn-företagssidor.
- Output: Tillgängliga företagsuppgifter och ett lokalt kvalificeringsbeslut, där den ursprungliga URL:en sparas tillsammans med företagets fullständiga output.
💡 Föredrar du en no-code-lösning? Använd Datablists LinkedIn Company Page Scraper för att extrahera företagsuppgifter från kända LinkedIn-företagssidor utan att skriva kod.
Konfigurera Python och din API-nyckel för Datablist
I det här Python-exemplet använder jag paketet requests. Datablists REST API är tillgängligt med Growth-planen, och varje sökning på en företagssida förbrukar enrichment credits.
Skapa en Personal API Key på din API-kontosida i Datablist.
Skapa filen scrape_linkedin_companies.py. Konfigurera sedan en virtuell miljö och installera Requests:
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
export DATABLIST_API_KEY="your-api-key"Skriptet läser nyckeln från DATABLIST_API_KEY och skickar den i headern X-API-Key.
Skrapa LinkedIn-företag med en Python-funktion
Källistan nedan innehåller företag med olika branscher, storlekar och länder för huvudkontoret. Varje account_id blir API:ets inputId. Resultaten kopplas inte ihop utifrån deras position i svaret. Det stabila ID:t är därför det som länkar varje resultat till rätt käll-URL.
Klistra in hela skriptet i scrape_linkedin_companies.py:
import json
import os
import time
import uuid
import requests
accounts = [
{
"account_id": "account-n8n",
"linkedin_company_url": "https://www.linkedin.com/company/n8n/",
},
{
"account_id": "account-posthog",
"linkedin_company_url": "https://www.linkedin.com/company/posthog/",
},
{
"account_id": "account-back-market",
"linkedin_company_url": "https://www.linkedin.com/company/back-market/",
},
{
"account_id": "account-datablist",
"linkedin_company_url": "https://www.linkedin.com/company/datablist/",
},
]
def scrape_companies(accounts, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"companyLinkedInUrl": account["linkedin_company_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Request ID: {unique_id}")
payload = {
"enrichmentId": "linkedin-company-enrichment",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
company_results = scrape_companies(accounts, api_key)
print(json.dumps(company_results, indent=2, ensure_ascii=False))Kör skriptet med:
python scrape_linkedin_companies.pyDet viktigaste du behöver ändra är posterna i accounts. Se till att varje account_id är stabilt och unikt. Ersätt sedan linkedin_company_url med en granskad LinkedIn-företagssida. Funktionen omvandlar posterna till API:ets inputs-format och skickar företagets URL som companyLinkedInUrl. settings förblir tomt eftersom denna enrichment inte har några offentliga inställningar.
POST-anropet skapar en enrichment task som körs i bakgrunden. API:et svarar med 202 Accepted och ett task-ID, medan Requests-klienten väntar genom att regelbundet kontrollera status-URL:en. Den här blockerande Python-koden är praktisk för ett mindre skript, men själva tasken körs fortfarande asynkront hos Datablist.
Det första GET-anropet kontrollerar själva tasken. En task kan avslutas som completed, failed eller stopped. Skriptet fortsätter bara efter completed. Annars genereras ett fel som innehåller task-ID:t och API:ets felmeddelande. Spara detta ID under felsökningen, eftersom en misslyckad eller stoppad task fortfarande kan ha resultat och kreditförbrukning som behöver granskas.
När tasken är klar hämtar den sista loopen resultatsidor med en gräns på 100 poster. Den fortsätter hämta sidor tills nextCursor är null. Varje resultat behåller det inputId du angav. Därför kan den senare kvalificeringsloopen koppla resultaten rätt även om ordningen i svaret skiljer sig från ordningen i input.
Läs företagsresultatet och förstå hämtmetoden
LinkedIn-URL:en identifierar företaget direkt. Datablist normaliserar organisationens URL och hämtar tillgängliga offentliga uppgifter från företagssidan, i stället för att söka efter och poängsätta flera möjliga företag. För en angiven företags-URL utgår tjänsten från den offentliga sidan och kan komplettera olösta fält med hanterade fallback-källor, samtidigt som användbara värden som redan hittats behålls.
Den skillnaden är viktig när du läser resultatet. Valfria fält beror på vilken information som är offentligt tillgänglig. En null-adress för huvudkontoret eller en saknad specialisering betyder inte att hela företagssökningen misslyckades.
Här är den fullständiga resultatsidan som returnerades för de fyra URL:erna:
{
  "taskId": "69516a973dc34481920f41ade748e917",
  "results": [
    {
      "inputId": "account-n8n",
      "status": "success",
      "outputs": {
        "companyName": "n8n",
        "companyHQPostalCode": "10115",
        "companyDescription": "n8n is a workflow automation platform that uniquely combines AI capabilities with business process automation. The platform enables connection to any app or API while maintaining the flexibility of code with the speed of no-code.\n\nReleased under a fair-code license, n8n can be self-hosted and is supported by a vibrant community of developers and builders. Users can start simple and layer complexity as needed - utilizing the visual builder for quick wins, and adding custom Javascript or Python code where more control is required, enabling the connection of anything to everything.\n\nn8n is privately held, with funding from Sequoia, Felicis Ventures, Firstminute Capital, Harpoon Ventures, and others. Individual investors include Eventbrite's Kevin Hartz and Supercell's IIkka Paananen. n8n was founded in 2019 and is headquartered in Berlin.",
        "companyTagline": "Flexible AI workflow automation for technical teams.",
        "companyIndustry": "Software Development",
        "companySpecialities": "AI, SOAR, Workflow Automation, and AI agents",
        "companyWebsite": "https://n8n.io",
        "companyHQCity": "Berlin",
        "linkedInCompanyId": "28491094",
        "companyType": "Privately Held",
        "companyHQCountry": "DE",
        "companySize": 1389,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4D0BAQEgEphZqatXwA/company-logo_200_200/B4DaFY.Sa2JcAE-/0/1792494086070/n8n_logo?e=2147483647&v=beta&t=NTL4C6f5QAd_o9nXd15PO8pOMSSEoms_tJdDHEo6eLk",
        "companyHQAddress": "Novalisstraße 10",
        "companyFoundedYear": 2019,
        "companyFollowerCount": 442229
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-posthog",
      "status": "success",
      "outputs": {
        "companyName": "PostHog",
        "companyHQPostalCode": null,
        "companyDescription": "At PostHog, we're working to increase the number of successful products in the world.\n\nUntil now, tools for building products have been fragmented. Product analytics, heatmaps, session recording, web analytics, feature flags, and A/B testing are all helpful, but no one wants to buy, send data to, and integrate multiple products.\n\nPostHog offers these tools (and more) in an integrated, open source platform which can be hosted in either the US or EU. Both versions are SOC2 certified, GDPR-ready, and HIPAA compliant. \n\nWe started PostHog during Y Combinator's W20 cohort and had the most successful B2B software launch on Hacker News since 2012 - with a product that was just 4 weeks old.\n\nWith over 100,000 users, we're default alive, growing 97% through word of mouth, and we are in the top 0.01% most popular repos on GitHub.",
        "companyTagline": "Your product's context layer. Get started with npx @posthog/wizard",
        "companyIndustry": "Software Development",
        "companySpecialities": "analytics, open source, product analytics, product, data, engineering, self-driving product, session replay, context warehouse, AI, product context, and error tracking",
        "companyWebsite": "https://posthog.com/",
        "companyHQCity": "San Francisco",
        "linkedInCompanyId": "37415928",
        "companyType": "Privately Held",
        "companyHQCountry": "US",
        "companySize": 234,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D560BAQGQUyE_CXUxIw/company-logo_200_200/B56aCMWEgaJAAE-/0/1789060991251/posthog_logo?e=2147483647&v=beta&t=WfTGRSqp5UfYL33sBXx3tZ1zmFUECfUPf7JtEGPAvbA",
        "companyHQAddress": null,
        "companyFoundedYear": 2020,
        "companyFollowerCount": 59696
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-back-market",
      "status": "success",
      "outputs": {
        "companyName": "Back Market",
        "companyHQPostalCode": null,
        "companyDescription": "The world is waking up to what fast tech costs. Back Market is where the revolution shops. \nWe make refurbished tech the smart, confident choice by building trust in quality, repair and circularity. New is not always better. Smarter is.\n\nAs a certified B Corp, our mission is to create a world that does more with what we already have by prolonging the lifespan of electronic devices through circularity and repair. We have grown by double digits year over year and now serve 18 million customers across 17 markets, avoiding more than 2 million tons of CO2 emissions*\n*Back Market calculation based on ADEME 2022 methodology.\n\nFounded in Paris in 2014 by Thibaud Hug de Larauze, Quentin Le Brouster and Vianney Vaute, Back Market is a leading global marketplace where people can buy professionally refurbished technology or trade in their devices.\n\nAre you ready to join us?",
        "companyTagline": "Where the world shops refurbished tech.",
        "companyIndustry": "Internet Marketplace Platforms",
        "companySpecialities": "refurbished tech, marketplace, sustainability, circularity, Right to Repair, sustainable solutions, refurbished marketplace, circular economy, and sustainable alternatives",
        "companyWebsite": "http://www.backmarket.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "4793443",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 1054,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4E0BAQHRv6UClt5D2g/company-logo_200_200/B4EZnoUG3tKgAI-/0/1760539209613/back_market_logo?e=2147483647&v=beta&t=Pywpeu1Qs3h0Cl8kgvYurmBfXbImm5QIIc-aQog1MqM",
        "companyHQAddress": null,
        "companyFoundedYear": 2014,
        "companyFollowerCount": 101878
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-datablist",
      "status": "success",
      "outputs": {
        "companyName": "Datablist",
        "companyHQPostalCode": null,
        "companyDescription": "When people hear \"data,\" they think of something complicated. We will change this.\n\nDatablist is an AI-powered spreadsheet that helps you: get, manipulate, or clean data and create workflows that run automatically while you focus on what matters most.\n\nIf you want to separate Datablist.com into its main parts, you can say we have:\n\n- Deduplicating, grouping, and labeling data\n- Cleaning and editing data\n- Managing data and automated workflows\n- 50+ B2B data sources and scrapers\n- 3 AI agents:\n    - Editing assistant\n    - AI Research agent\n    - Deduplication assistant\n\nThe top 3 reasons why companies choose Datablist.com are:\n\n1. Simplicity: you don't need to have technical knowledge or experience with formulas to get everything out of it.\n2. Flexibility that allows you to do (almost) everything with your data and AI while keeping everything under your control.\n3. Scalability that no other solution can match. Up to 2 million rows—forget Excel.\n\nGo on try it for free!\n\nhttps://www.Datablist.com",
        "companyTagline": "Let your tasks become workflows: automated workflows.",
        "companyIndustry": "Information Technology & Services",
        "companyWebsite": "https://www.datablist.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "69842428",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 3,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/C4E0BAQFNFlMb8KEPRQ/company-logo_200_200/company-logo_200_200/0/1630622803412?e=2147483647&v=beta&t=UVkk7BOerChiWgS9Y06zOpT08SlK4kpAWGDYiVvUEVU",
        "companyFollowerCount": 134,
        "companyFoundedYear": 2020,
        "companyHQAddress": null
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
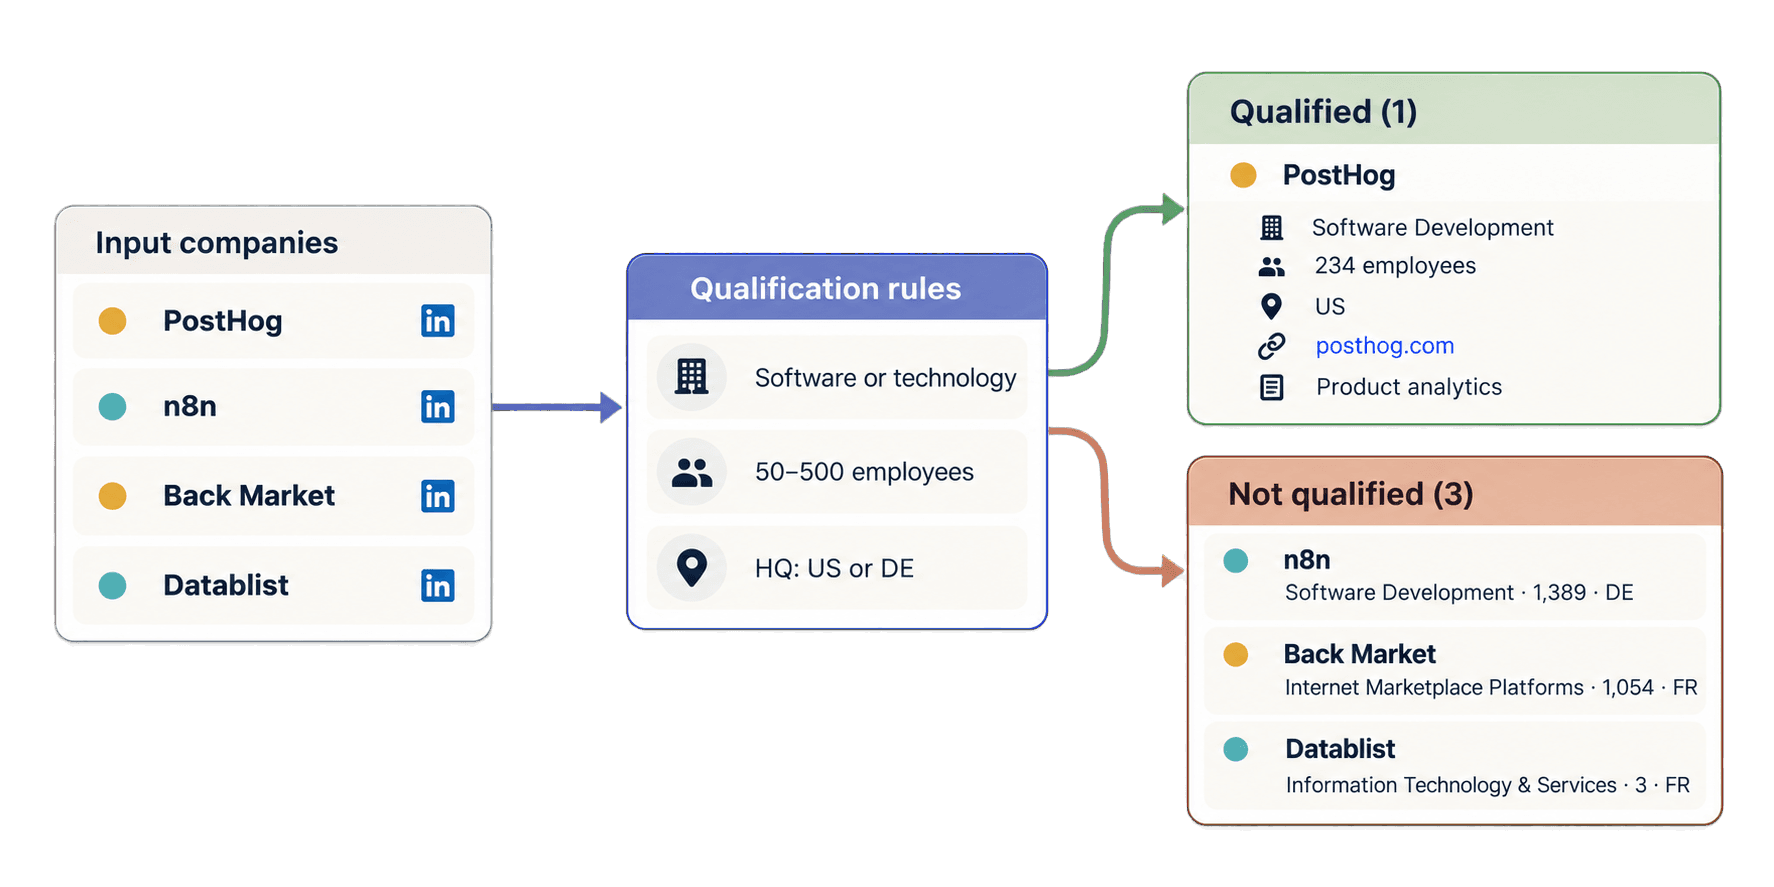
Alla fyra poster lyckades och använde 25 credits vardera. För PostHog returnerades Software Development, 234 anställda, huvudkontor i USA, webbplatsen och företagsbeskrivningen. n8n är också ett mjukvaruföretag i ett av de valda länderna, men det returnerade antalet anställda är 1 389. För Back Market returnerades Internet Marketplace Platforms, 1 054 anställda och huvudkontor i Frankrike. För Datablist returnerades Information Technology & Services, 3 anställda och huvudkontor i Frankrike.
Det fullständiga objektet är användbart eftersom account research sällan stannar vid ett enda fält. Du kan kvalificera utifrån bransch, antal anställda och land och samtidigt behålla den exakta webbplatsen och beskrivningen för nästa research-steg.
I det här svaret är companySize det returnerade antalet anställda, inte LinkedIns storleksintervall. companyHQCountry är landet där huvudkontoret ligger, inte alla länder där företaget är verksamt. Dessa skillnader är viktiga när du anpassar storleks- och landsfiltren efter din ideal customer profile.
Alla valfria fält behöver inte finnas för att ett företag ska kunna kvalificeras. En saknad adress eller specialisering kan lämnas tom om bransch, antal anställda och huvudkontorets land är tillgängliga. Behåll companyWebsite exakt som det returneras i stället för att anta att API:et omvandlar adressen till en ren domän. Beskrivningen kan hjälpa en säljare att förstå företagets produkt och förbereda kontospecifik research före outreach. Resultatets status, creditsUsed och error bör sparas tillsammans med företagsfälten när du granskar eller lagrar posten.
Kvalificera konton för sales research
Anta att din målgrupp är mjukvaru- eller teknikföretag med 50–500 anställda och huvudkontor i USA eller Tyskland. Lägg till loopen nedan efter det fullständiga skriptet. Den återanvänder company_results och skickar därför inte en ny task:
accounts_by_id = {account["account_id"]: account for account in accounts}
qualified_accounts = []
other_accounts = []
for result in company_results:
account = accounts_by_id.get(result["inputId"])
qualification = "needs_review"
if result["status"] == "success":
outputs = result["outputs"]
industry = outputs.get("companyIndustry")
company_size = outputs.get("companySize")
country = outputs.get("companyHQCountry")
if industry and isinstance(company_size, (int, float)) and country:
industry_matches = any(
keyword in industry.lower()
for keyword in ("software", "technology")
)
size_matches = 50 <= company_size <= 500
country_matches = country in {"US", "DE"}
if industry_matches and size_matches and country_matches:
qualification = "qualified"
else:
qualification = "not_qualified"
source_url = None
if account is not None:
source_url = account["linkedin_company_url"]
reviewed_account = dict(result)
reviewed_account["sourceLinkedInUrl"] = source_url
reviewed_account["qualification"] = qualification
if qualification == "qualified":
qualified_accounts.append(reviewed_account)
else:
other_accounts.append(reviewed_account)
print(json.dumps(qualified_accounts, indent=2, ensure_ascii=False))PostHog kopplas tillbaka till account-posthog även om API:et returnerar raderna i en annan ordning. Företaget kvalificeras eftersom Software Development, 234 anställda och US klarar alla tre kontrollerna. Loopen kopierar det ursprungliga resultatet med hela dess outputs, den returnerade webbplatsen https://posthog.com/, beskrivningen, creditsUsed och error. Den lägger endast till käll-URL:en och den lokala kvalificeringsetiketten.
n8n kopplas till account-n8n men kvalificeras inte eftersom 1 389 anställda överstiger den övre gränsen. Back Market uppfyller varken den valda branschen, storleken eller landet, medan Datablist ligger under storleksintervallet och utanför de valda länderna. Framtida poster som misslyckas eller är ofullständiga får needs_review i stället för att tas bort utan förklaring.
Du kan ladda ned det underhållna synkrona Requests-exemplet eller använda repositoryts asynkrona HTTPX-alternativ när du behöver icke-blockerande applikationskod.
Beräkna credits för LinkedIn-skrapning
En vanlig namngiven LinkedIn-företagssida använder 25 credits. En företags-URL med numeriskt ID kan använda 75 credits när den sista fallback-metoden behövs, men 75 credits är inte priset för varje numerisk URL. Misslyckade sökningar eller sökningar utan träff kan också förbruka credits. Använd därför taskens totalsumma och värdet creditsUsed för varje resultat som facit för den faktiska förbrukningen.
De fyra namngivna URL:erna i den här guiden använde sammanlagt 100 credits. Med standardpriset använder 1 000 företagssidor 25 000 credits. Om input till stor del består av numeriska ID:n behöver du större marginal för den möjliga vägen som kostar 75 credits.
Tillgång till REST API kräver Growth-planen. Månadsplanen inkluderar 20 000 credits, medan top-up credits köps separat. Med det aktuella grundpriset i USD på 20 dollar för 20 000 credits kostar en credit 0,001 dollar. Med den kostnaden motsvarar 25 000 credits 25 dollar. Se Datablists priser för aktuella planer och credit-paket.
Lös vanliga problem med input, tasks och resultat
DATABLIST_API_KEYsaknas: skriptet stoppas innan någon request skickas. Exportera variabeln och kör filen igen.- API:et avvisar nyckeln: kontrollera din Personal API Key och se till att den ligger i headern
X-API-Keysom i exemplet. - Käll-URL:en är ogiltig: ersätt en personlig profil, orelaterad webbplats, tomt värde eller felaktigt formaterad URL med en offentlig LinkedIn-URL som stöds för ett företag, en skola, en showcase-sida, ett numeriskt ID eller ett Sales Navigator-företag.
- Du har för få credits: kontrollera saldot och använd sedan inkluderade credits eller köp en top-up innan du skapar en ny task.
- Tasken är
failedellerstopped: granska felet, befintliga resultat och kreditförbrukningen innan du bestämmer om en ny betald task ska skickas. - Ett resultat är knapphändigt,
no_resultellererror: behåll käll-URL, status, credits och felmeddelande för granskning. Kontrollera att input är en offentlig företagssida innan du skickar den igen, utan att gissa varför uppgifterna saknades.
Om svaret från skapandet går förlorat använder du det request-ID som skriptet skrev ut före POST-anropet. Lista först alla tasks och matcha värdet i uniqueId:
curl "https://api.datablist.com/v1/enrichments/tasks?limit=100" \
-H "X-API-Key: $DATABLIST_API_KEY"Den matchande taskens @id är task-ID:t. Använd det för att fortsätta kontrollera /v1/enrichments/tasks/{taskId} eller hämta /v1/enrichments/tasks/{taskId}/results i stället för att automatiskt skapa en ny task. En enskild request kan innehålla upp till 10 000 inputs och 10 MiB. Läs dokumentationen för tasks för information om lagringstid och andra detaljer om livscykeln.
Nästa steg
Nu har du en återanvändbar Python-funktion med Requests som omvandlar en lista med URL:er till LinkedIn-företagssidor till strukturerade företagsposter. Du har också en lokal kvalificeringsloop som bevarar API:ets fullständiga output för sales research.
Ersätt de fyra exemplen med en mindre, granskad kontolista, behåll stabila ID:n och anpassa reglerna för bransch, antal anställda och land efter din ideal customer profile. Om du utgår från personer i stället för företag kan du använda API-guiden för att skrapa LinkedIn-profiler. Om du endast har företagsnamn börjar du med att hitta företagswebbplatser i Python.