
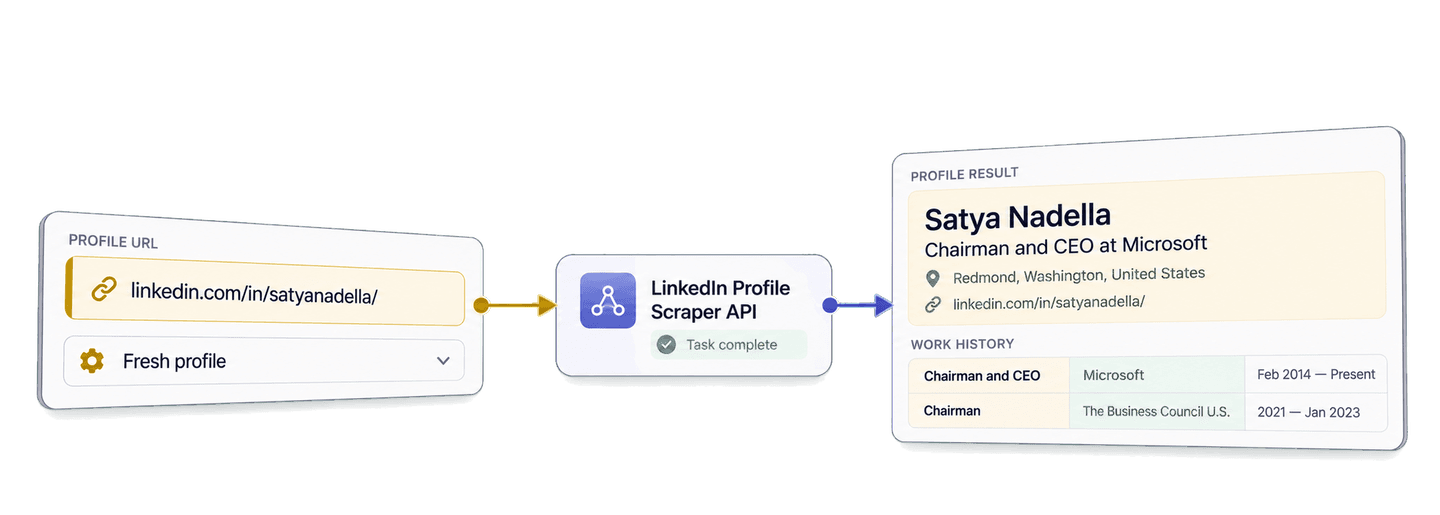
Du kan skrapa LinkedIn-profiler i Python genom att skicka kända offentliga profil-URL:er till Datablists LinkedIn Profile Scraper API med Requests-biblioteket. API:et returnerar strukturerade fält för identitet, plats, arbetshistorik, utbildning och företag. Informationen kan användas för att bygga leadlistor och anpassa outreach med relevant kontext om roller och företag.
I den här guiden använder vi URL:en till Satya Nadellas offentliga profil som ett kortfattat exempel. Du får köra en komplett uppgift för profilskrapning, tolka den returnerade Microsoft-rollen och de daterade posterna i arbetshistoriken och sedan spara resultatet tillsammans med ditt ursprungliga lead innan du förbereder din outreach.
🔑 Snabb sammanfattning: Skicka kända URL:er till personprofiler på LinkedIn till Datablist och hämta tillgängliga uppgifter om profil, plats, arbetshistorik, utbildning och företag som strukturerad JSON. Python-exemplet nedan sparar uppgifterna tillsammans med varje ursprungligt lead, så att du kan kvalificera listan och förbereda mer relevant outreach.
- Input: Kända URL:er till personprofiler på LinkedIn.
- Output: Strukturerade profiluppgifter som sparas med respektive ursprungskontakt.
💡 Föredrar du en no-code-lösning? Använd Datablists LinkedIn Profile Scraper för att hämta uppgifter från kända profil-URL:er utan att skriva kod.
Konfigurera Datablist API och Python-miljön
Åtkomst till Datablist REST API ingår i Growth-planen. Profilhämtningen förbrukar också enrichment credits, vilket jag går igenom i kostnadsavsnittet.
Skapa en Personal API Key på din kontosida för Datablist API. Det här exemplet visar formatet för en Personal API Key:
exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2🔑 Har du redan en API-nyckel? Äldre nycklar använder formatet
auth0|<userId>:<accountId>:<secret>:1. De stöds fortfarande. Fortsätt använda din befintliga nyckel exakt som den genererades. Du behöver inte ersätta eller formatera om den.
Skriptet läser din nyckel från miljövariabeln DATABLIST_API_KEY och skickar den i headern X-API-Key.
I det här Python-exemplet använder jag paketet requests. Följande installationskommandon är avsedda för ett macOS- eller Linux-skal. Skapa en projektmapp, öppna den i terminalen och kör:
python -m venv .venv
source .venv/bin/activate
python -m pip install requestsSkapa sedan filen scrape_linkedin_profiles.py och exportera din nyckel:
export DATABLIST_API_KEY="your-personal-api-key"Skrapa en komplett LinkedIn-profil med Python
Källposten i den här genomgången innehåller ett beständigt kontakt-ID och en känd profil-URL:
{
  "contact_id": "contact-satya-nadella",
  "profile_url": "https://www.linkedin.com/in/satyanadella/"
}
Skriptet skickar contact_id som API:ets inputId. Resultaten behöver inte komma i samma ordning som inputposterna, så detta ID ger dig ett tillförlitligt sätt att matcha varje resultat med rätt ursprungskontakt.
Klistra in följande kompletta skript i scrape_linkedin_profiles.py:
import json
import os
import time
import uuid
import requests
def scrape_profiles(source_contacts, api_key):
"""Submit one task, wait for completion, and return every result page."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": contact["contact_id"],
"data": {"profileUrl": contact["profile_url"]},
}
for contact in source_contacts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "linkedin-profile-scraper",
"uniqueId": unique_id,
"settings": {
"experiencesNb": "5",
"educationsNb": "3",
"acceptCachedProfiles": False,
"includeUrn": False,
"includePictures": False,
},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
source_contacts = [
{
"contact_id": "contact-satya-nadella",
"profile_url": "https://www.linkedin.com/in/satyanadella/",
}
]
profile_results = scrape_profiles(source_contacts, api_key)
print(json.dumps(profile_results, indent=2))Kör skriptet med:
python scrape_linkedin_profiles.pyInställningarna begär fem poster från arbetshistoriken och tre utbildningsposter. API:et förväntar sig att dessa antal anges som strängar. acceptCachedProfiles: false begär en ny hämtning, medan alternativen för bilder och interna ID:n är avstängda eftersom detta arbetsflöde använder beständiga text- och URL-fält.
Använd en vanlig offentlig /in/-profil-URL eller en Sales Navigator lead-URL för varje inputpost. En persons namn, en söksida på LinkedIn och en företagssida avser andra typer av uppgifter och är inte giltiga profilinput för denna scraper. Om din källa innehåller Sales Navigator-länkar kan den returnerade profileUrl vara den normaliserade offentliga profil-URL:en. För större listor bör varje inputId vara unikt och beständigt i stället för att baseras på radens position.
Antalet historikposter styr hur många platta, numrerade arbets- och utbildningsfält API:et kan returnera. Det påverkar inte antalet credits per profil. Begär tillräckligt mycket historik för ditt researchbeslut, men välj inte tio arbetsposter om du bara tänker granska de senaste rollerna.
Så fungerar de tre API-anropen
POST-anropet skickar de valda inställningarna och profilinputerna. Datablist tar emot arbetet som en bakgrundsuppgift och returnerar dess @id. Skriptet skriver ut både det genererade uniqueId och uppgiftens returnerade ID, så att du har de värden som krävs för att kontrollera uppgiften senare.
Det första GET-anropet kontrollerar uppgiftens status var tredje sekund. Python-klienten blockeras medan den väntar, men API-uppgiften fortsätter att köras i bakgrunden. Loopen avslutas vid completed, failed eller stopped.
Det andra GET-anropet hämtar resultat i sidor med upp till 100 poster. När nextCursor innehåller ett värde hämtar skriptet nästa sida. Det stannar när nextCursor är null.
Tolka profilresultatet och välj rätt inställningar
Den inskickade URL:en avgör vilken profil som hämtas. Datablist tar emot offentliga URL:er till personprofiler och Sales Navigator lead-URL:er, normaliserar profil-URL:en vid behov och mappar tillgängliga offentliga data till platta fält för profil, arbete, utbildning och företag.
Den nya hämtningen i den här guiden slutfördes utan fel och använde 25 credits. Här är det fullständiga resultatet:
{
  "inputId": "contact-satya-nadella",
  "status": "success",
  "outputs": {
    "profileUrl": "https://www.linkedin.com/in/satyanadella/",
    "fullName": "Satya Nadella",
    "firstName": "Satya",
    "lastName": "Nadella",
    "linkedInHeadline": "Chairman and CEO at Microsoft",
    "linkedInSummary": "As chairman and CEO of Microsoft, I define my mission and that of my company as empowering every person and every organization on the planet to achieve more.",
    "linkedInProfilePicture": "https://media.licdn.com/dms/image/v2/C5603AQHHUuOSlRVA1w/profile-displayphoto-shrink_800_800/profile-displayphoto-shrink_800_800/0/1579726625483?e=1794441600&v=beta&t=I1sL---bTuvjxqb1vdbNsNy-fAsLCpBj3-WtJjOGbOc",
    "linkedInInternalIdentifier": "ACoAAAEkwwAB9KEc2TrQgOLEQ-vzRyZeCDyc6DQ",
    "linkedInLocation": "Redmond, Washington, United States",
    "linkedInCity": "Redmond",
    "linkedInState": "Washington",
    "linkedInCountryName": "United States",
    "linkedInCountryCode": "US",
    "linkedInLanguages": "",
    "linkedInConnections": 832,
    "linkedInlastExpTitle": "Chairman and CEO",
    "linkedInlastExpCompany": "Microsoft",
    "linkedInlastExpEmploymentType": null,
    "linkedInlastExpLocation": "Greater Seattle Area",
    "linkedInlastExpStartsAt": "2014-02-01",
    "linkedInlastExpEndsAt": null,
    "linkedInlastExpDescription": null,
    "linkedInlastExpCompanyWebsite": "https://news.microsoft.com/",
    "linkedInlastExpCompanyPage": "https://www.linkedin.com/company/microsoft/",
    "linkedInlastExpCompanyIndustry": "Software Development",
    "linkedInlastExpCompanyRange": "10001+",
    "linkedInlastExpCompanyDescription": "Every company has a mission. What's ours? To empower every person and every organization to achieve more. We believe technology can and should be a force for good and that meaningful innovation contributes to a brighter world in the future and today. Our culture doesn’t just encourage curiosity; it embraces it. Each day we make progress together by showing up as our authentic selves. We show up with a learn-it-all mentality. We show up cheering on others, knowing their success doesn't diminish our own. We show up every day open to learning our own biases, changing our behavior, and inviting in differences. Because impact matters. \n\nMicrosoft operates in 190 countries and is made up of approximately 228,000 passionate employees worldwide.",
    "linkedInlastExpCompanyLogo": "https://media.licdn.com/dms/image/v2/D560BAQH32RJQCl3dDQ/company-logo_200_200/B56ZYQ0mrGGoAM-/0/1744038948046/microsoft_logo?e=1793836800&v=beta&t=4wXD40LQU4IfLY4DiEvT2bwvjUoPQPGgi5_T-vPsbQ8",
    "linkedIn2ExpTitle": "Chairman",
    "linkedIn2ExpCompanyName": "The Business Council U.S.",
    "linkedIn2ExpEmploymentType": null,
    "linkedIn2ExpStartsAt": "2021-01-01",
    "linkedIn2ExpEndsAt": "2023-01-01",
    "linkedIn2ExpDescription": null,
    "linkedIn2ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQGcnaZNpjMvrw/company-logo_200_200/company-logo_200_200/0/1630557702704/the_business_council_us_logo?e=1793836800&v=beta&t=Ejb0D8lV5sMTFwcz_-FKdfQvIvq-mKx_Nl8vRMib53k",
    "linkedIn3ExpTitle": "Member Board Of Trustees",
    "linkedIn3ExpCompanyName": "University of Chicago",
    "linkedIn3ExpEmploymentType": null,
    "linkedIn3ExpStartsAt": "2018-01-01",
    "linkedIn3ExpEndsAt": null,
    "linkedIn3ExpDescription": null,
    "linkedIn3ExpLogo": "https://media.licdn.com/dms/image/v2/D4E0BAQGDP-PXY3u8dw/company-logo_200_200/B4EaENqZTQGoAM-/0/1791230580227/uchicago_logo?e=1793836800&v=beta&t=NJGoETr0tY868Z2pvlyXeh939iXwW0WbSFwRctabEVU",
    "linkedIn4ExpTitle": "Board Member",
    "linkedIn4ExpCompanyName": "Starbucks",
    "linkedIn4ExpEmploymentType": null,
    "linkedIn4ExpStartsAt": "2017-01-01",
    "linkedIn4ExpEndsAt": "2024-01-01",
    "linkedIn4ExpDescription": null,
    "linkedIn4ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQEQxk9y2rk7Hw/company-logo_200_200/company-logo_200_200/0/1631316692275?e=1793836800&v=beta&t=NVjljhe0oI5KzvJHodAJjss5EdvxaOIzQQ2rAGyh_AQ",
    "linkedIn5ExpTitle": "Board Member",
    "linkedIn5ExpCompanyName": "Fred Hutch",
    "linkedIn5ExpEmploymentType": null,
    "linkedIn5ExpStartsAt": "2016-01-01",
    "linkedIn5ExpEndsAt": "2022-01-01",
    "linkedIn5ExpDescription": null,
    "linkedIn5ExpLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQGF4eOou62nvQ/company-logo_200_200/company-logo_200_200/0/1664795263764/fredhutch_logo?e=1793836800&v=beta&t=dJWSO-KkuBPd6I6aRYBoIcQVzcSEmGLwqYy-VMFXJQc",
    "linkedInlastEduSchool": "The University of Chicago Booth School of Business",
    "linkedInlastEduDegree": null,
    "linkedInlastEduField": null,
    "linkedInlastEduStartsAt": "1994-01-01",
    "linkedInlastEduEndsAt": "1996-01-01",
    "linkedInlastEduPage": "https://www.linkedin.com/school/universityofchicagoboothschoolofbusiness/",
    "linkedInlastEduLogo": "https://media.licdn.com/dms/image/v2/D560BAQFZO05jhYKSkw/company-logo_200_200/company-logo_200_200/0/1692627816910/universityofchicagoboothschoolofbusiness_logo?e=2147483647&v=beta&t=BTjFA4UVU5iKIIyicg8d44rhoiuMbetNDB97BmqpwhQ",
    "linkedIn2EduSchool": "Manipal Institute of Technology",
    "linkedIn2EduDegree": "Bachelor’s Degree",
    "linkedIn2EduField": "Electrical Engineering",
    "linkedIn2EduStartsAt": null,
    "linkedIn2EduEndsAt": null,
    "linkedIn2EduPage": "https://www.linkedin.com/school/manipal-institute-of-technology/",
    "linkedIn2EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQHodG_7cUqs6w/company-logo_200_200/B4DZ8hC8AUJQAE-/0/1782965846314/manipal_institute_of_technology_logo?e=2147483647&v=beta&t=jqJK15_r7lxUNgWdbbzdMq47aLa_PqnkDYxg4Jun4Zo",
    "linkedIn3EduSchool": "University of Wisconsin-Milwaukee",
    "linkedIn3EduDegree": "Master’s Degree",
    "linkedIn3EduField": "Computer Science",
    "linkedIn3EduStartsAt": null,
    "linkedIn3EduEndsAt": null,
    "linkedIn3EduPage": "https://www.linkedin.com/school/uwmilwaukee/",
    "linkedIn3EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQE47QlO_LG8SQ/company-logo_200_200/company-logo_200_200/0/1729615751602/uwmilwaukee_logo?e=2147483647&v=beta&t=l-w3ttd1mZRc-_j5aCPXEzNiYJzl1iJjMGw7q8B3eRI"
  },
  "creditsUsed": "25",
  "error": null
}
Läs jobbtitel, arbetsgivare, startdatum och slutdatum tillsammans. Microsoft-posten börjar i februari 2014 och saknar slutdatum. Posten för The Business Council U.S. sträcker sig från 2021 till januari 2023. Datumen skiljer en pågående post från en avslutad och visar även hur roller kan överlappa varandra.
linkedInlastExpTitle och linkedInlastExpCompany innehåller den nuvarande eller senast mappade erfarenheten. Den första mappade posten kan innehålla mer detaljerad företagsinformation, till exempel företagssida, webbplats, bransch, beskrivning och antal anställda. Numrerade poster lägger till tidigare titlar, arbetsgivare och datum. I det här svaret är den returnerade Microsoft-webbplatsen https://news.microsoft.com/. URL:en ger leadposten en användbar företagskälla vid sidan av personens rollhistorik.
Fälten linkedInlastEduSchool, linkedIn2EduSchool och linkedIn3EduSchool anger The University of Chicago Booth School of Business, Manipal Institute of Technology och University of Wisconsin-Milwaukee. Manipal-posten innehåller en Bachelor’s Degree i Electrical Engineering och Wisconsin-Milwaukee-posten en Master’s Degree i Computer Science. Värdena för examen och ämnesområde i Chicago-posten är tomma.
Använd värdena "3", "5" eller "10" för experiencesNb och "1", "3" eller "5" för educationsNb för att välja hur mycket historik du behöver. Läs fälten direkt från outputs när de är relevanta för din research. Ett tomt valfritt värde innebär inte att hela resultatet har misslyckats.
En ny hämtning passar när du förbereder leadlistor och vill ha en aktuell hämtning av tillgängliga offentliga profildata. Cacheläget kan returnera en tillgänglig lagrad profil till en lägre kostnad i credits och övergå till en ny hämtning om ingen cachad profil finns. Välj utifrån hur aktuell information du behöver och din budget för credits.
Förbered leadposter för outreach
När profile_results är tillgänglig kan du koppla varje svar till dess ursprungskontakt utan att skicka in en ny uppgift. Följande block återanvänder variablerna som skapades av det fullständiga skriptet:
results_by_input_id = {
result["inputId"]: result
for result in profile_results
}
contact_research = []
for contact in source_contacts:
result = results_by_input_id[contact["contact_id"]]
contact_research.append(
{
"contact_id": contact["contact_id"],
"source_profile_url": contact["profile_url"],
"result_status": result["status"],
"profile": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
research_record = contact_research[0]
profile = research_record["profile"]
print("Contact:", profile.get("fullName"))
print("Headline:", profile.get("linkedInHeadline"))
print("Location:", profile.get("linkedInLocation"))
print(
"First work entry:",
profile.get("linkedInlastExpTitle"),
"at",
profile.get("linkedInlastExpCompany"),
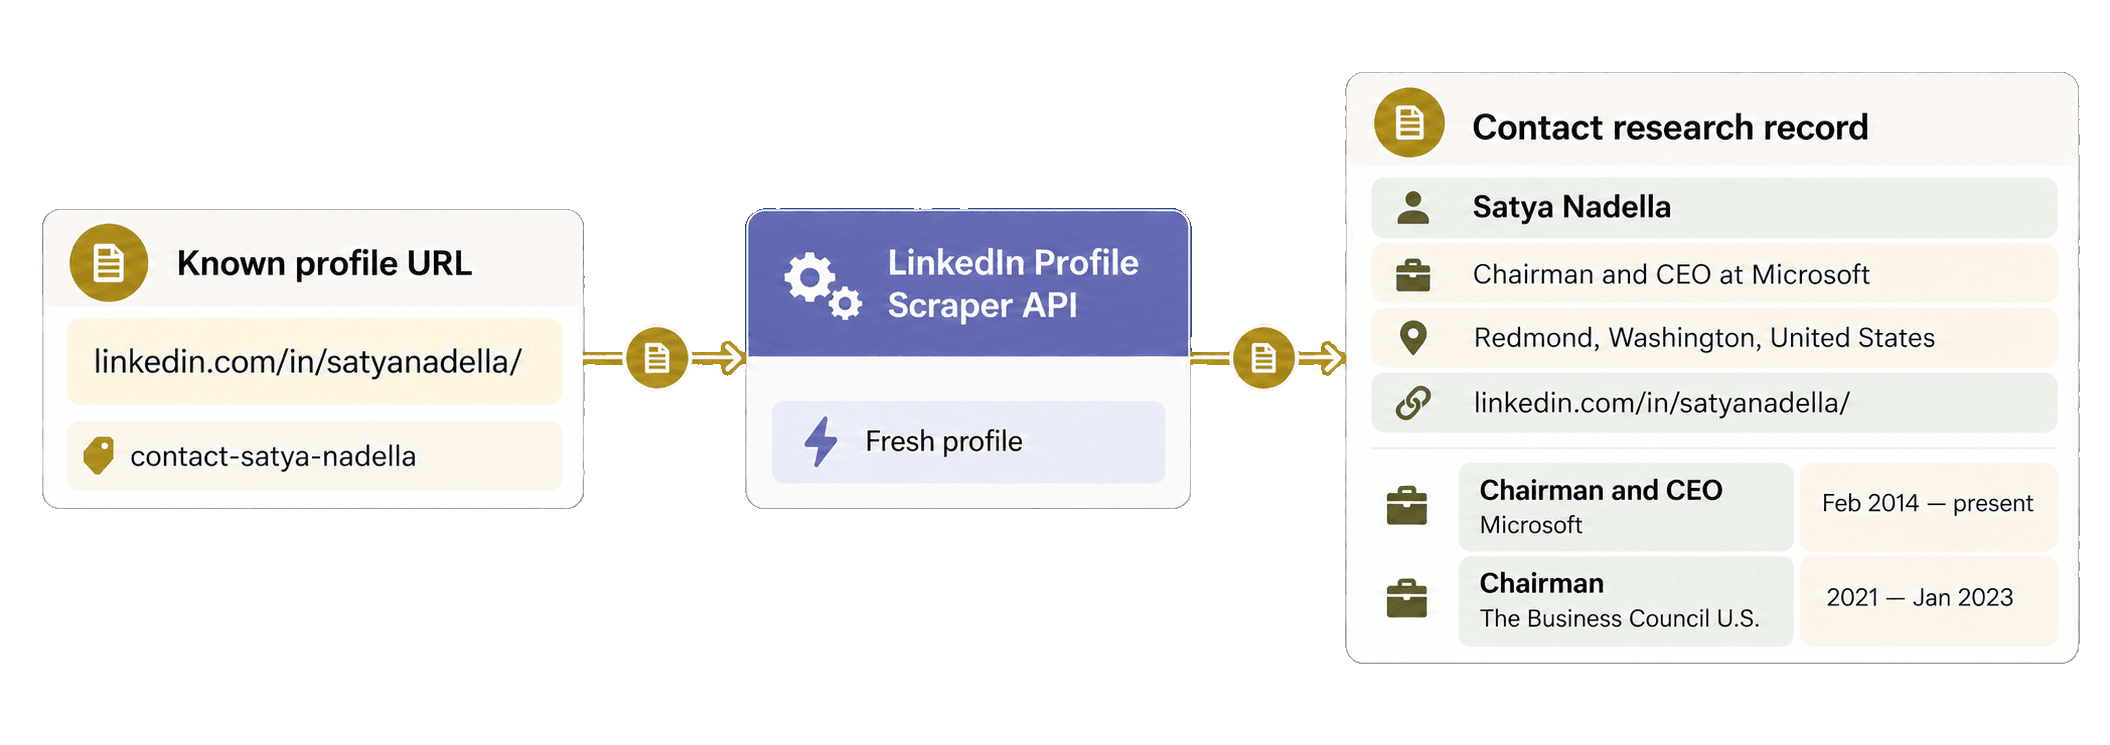
)Dictionary-objektet med inputId som nyckel hanterar svar som kommer i en annan ordning. contact-satya-nadella förblir både käll-ID och API-ID, den kända LinkedIn-URL:en ligger kvar som source_profile_url och profile behåller det ursprungliga outputs-objektet oförändrat.
Detta wrapper-objekt håller ihop hela den returnerade profilen med käll-URL, API-status och användningen av credits. Du kan använda utskriften av rubrik, plats och första arbetspost för att kvalificera leadet och lägga till relevant kontext om rollen eller företaget i din outreach. Misslyckade API-rader behåller sin returnerade status och sitt fel, så att de förblir synliga i leadlistan.
Du kan ladda ned det underhållna blockerande Requests-exemplet eller använda det asynkrona HTTPX-alternativet när du har fått grepp om det blockerande flödet.
Beräkna kostnaden för att skrapa LinkedIn-profiler
En ny hämtning använder 25 credits per profil. När cachade profiler är aktiverade kostar ett tillgängligt cachat resultat 20 credits, medan en cachemiss fortfarande kan leda till en ny hämtning för 25 credits. Det nya Satya Nadella-exemplet använde 25 credits.
För 1 000 profiler använder hämtningen därmed 20 000 credits om samtliga efterfrågade cachade profiler är tillgängliga, eller upp till 25 000 credits vid nya hämtningar. Åtkomst till Datablist REST API kräver Growth-planen. Abonnemanget, de credits som ingår och valfria påfyllningar utgör separata delar av kostnaden. Se prissidan för aktuellt utbud.
Med den nuvarande grundpåfyllningen på 20 USD för 20 000 credits som planeringsexempel motsvarar förbrukningen uppskattningsvis 20 USD för en körning med 1 000 helt cachade profiler eller 25 USD för en körning med nya hämtningar. Dessa uppskattningar gäller utöver kostnaden för Growth-abonnemanget.
Lös vanliga fel och återställ en uppgift
DATABLIST_API_KEYsaknas: skriptet stoppas innan något anrop görs. Exportera variabeln och kör sedan filen igen.- API:et avvisar nyckeln: kontrollera din Personal API Key och skicka endast autentiseringsuppgiften
X-API-Keysom används i exemplet. - Profil-URL:en saknas eller har fel format: använd en offentlig LinkedIn-URL till en person eller en Sales Navigator lead-URL som stöds. Ett personnamn, en söksida eller en företagssida är inte giltig profilinput.
- Du har för få credits: kontrollera saldot och använd sedan credits som ingår eller gör en påfyllning innan du skapar en ny uppgift.
- Uppgiften har status
failedellerstopped: granska felet, tillgängliga resultat och användningen av credits innan du avgör om en ny betald inskickning krävs. - Ett resultat är knapphändigt,
no_resultellererror: granska dess status och offentliga fel och kontrollera sedan URL:en och inställningarna. Vilka fält som är tillgängliga kan variera beroende på profilen, dess synlighet och hämtningen.
Om anslutningen bryts under POST-anropet använder du det uniqueId som skrevs ut före inskickningen. Lista de senaste scraper-uppgifterna och jämför deras värden innan du skapar en ny uppgift:
response = requests.get(
"https://api.datablist.com/v1/enrichments/tasks",
headers={"X-API-Key": api_key},
params={"enrichmentId": "linkedin-profile-scraper", "limit": 100},
)
response.raise_for_status()
printed_unique_id = "paste-the-printed-unique-id"
tasks = response.json()["tasks"]
matching_task = None
for task in tasks:
if task["uniqueId"] == printed_unique_id:
matching_task = task
break
if matching_task:
print("Task ID:", matching_task["@id"])Uppgiftslistan kan filtreras efter enrichmentId, men inte efter uniqueId. Följ dess nextCursor om uppgiften inte finns på den första sidan. När du har uppgiftens ID fortsätter du med samma URL:er för status och resultat som används av huvudfunktionen. Dokumentationen för task API beskriver livscykeln, pagineringen och beteendet vid avbrott mer ingående.
Nästa steg
Nu har du en återanvändbar Python Requests-funktion som omvandlar kända URL:er till LinkedIn-profiler till strukturerade resultat, plus leadposter som matchas med hjälp av beständiga ID:n. Byt ut exemplet mot en liten, granskad uppsättning URL:er, välj ny eller cachad hämtning utifrån hur aktuell information du behöver och din budget för credits och använd den returnerade kontexten om roller och företag för att kvalificera leads eller anpassa din outreach.
Om dina inputposter är URL:er till företagssidor ska du i stället följa Python-guiden för att skrapa företagsdata från LinkedIn.
Om du fortfarande behöver hitta profil-URL:er utifrån namn och ett sökord för företag eller skola följer du först den separata guiden om att hitta LinkedIn-profiler i Python med ett API innan du kör denna scraper.