
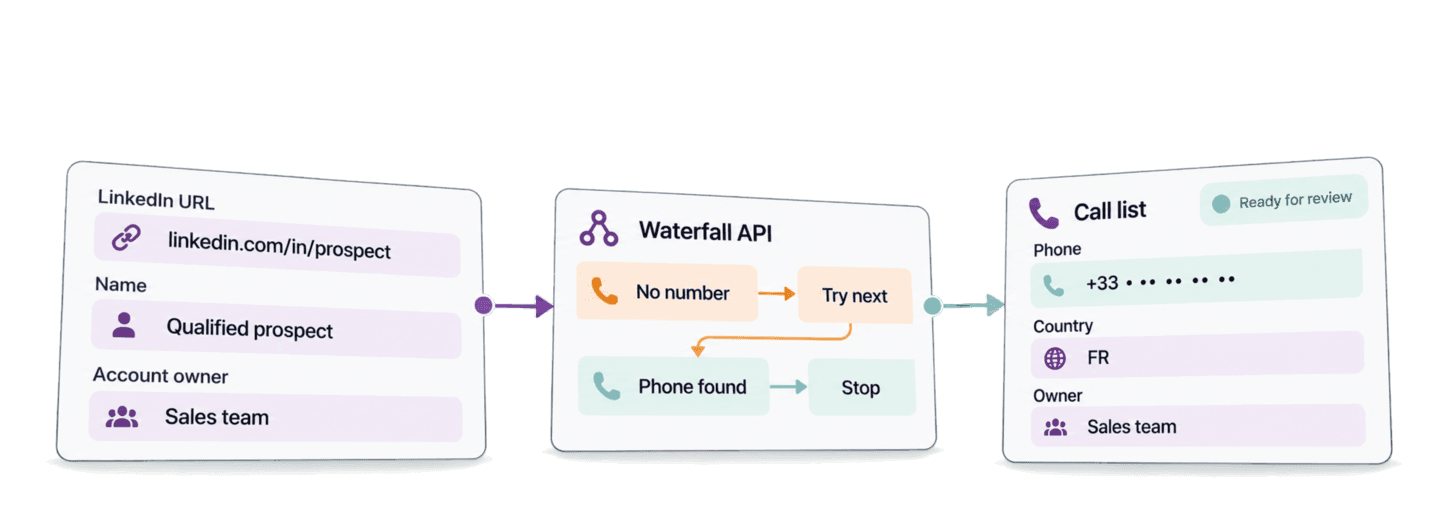
在 Python 中,只需将公开的 linkedin.com/in/... 个人主页 URL 发送到 Datablist 的 Waterfall Phone Finder API,即可查找 LinkedIn 联系人的电话号码。API 会依次查询符合条件的电话数据提供商,并以包含国家/地区代码的国际格式返回找到的号码。
本指南使用 Requests 库完成一次完整的 Python 集成。随后,我们会复用同一批结果,生成一份本地销售通话名单,同时保留每位潜在客户的姓名、LinkedIn URL 和 Account Owner。
📌 时间有限?先看摘要
使用一个 API,即可根据一组公开的 LinkedIn 个人主页 URL 查找电话号码,并生成包含潜在客户姓名和 Account Owner 的本地销售通话名单。Waterfall Phone Finder 会依次尝试符合条件的数据提供商,并整理找到的号码,供团队审核。
- 输入: 包含公开 LinkedIn 个人主页 URL 的潜在客户记录。
- 输出: 一份本地通话名单,包含找到的国际电话号码、号码所属国家/地区代码、姓名和 Account Owner。
💡 更倾向于 no-code 方案? 使用 Datablist 的 Waterfall Phone Finder,无需编写代码,即可根据 LinkedIn 个人主页 URL 查找电话号码。
如果你手中只有姓名而没有个人主页 URL,可以先按照从姓名查找电话号码的 no-code 流程操作,或者使用 Python 根据姓名查找 LinkedIn 个人主页。
配置 Python、Requests 和 Datablist API Key
本 Python 示例使用 requests package。请创建项目文件夹、激活虚拟环境、安装 Requests,并创建脚本文件:
mkdir waterfall-phone-lookup
cd waterfall-phone-lookup
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_phone_numbers.py
export DATABLIST_API_KEY="your-api-key"在 Datablist 账户中创建一个 Personal API Key,并将其设置为 DATABLIST_API_KEY。REST API 访问权限属于 Growth 套餐功能。本文稍后会介绍成功查询所消耗的 credits。
用一个完整的 Python 函数查找电话号码
示例中包含三条可编辑的潜在客户记录。每条记录都有一个稳定的 prospect_id、姓名、公开 LinkedIn URL,以及负责审核结果的 Account Owner:
- Florian Poullin:
https://www.linkedin.com/in/florianpoullin/ - Satya Nadella:
https://www.linkedin.com/in/satyanadella/ - Reid Hoffman:
https://www.linkedin.com/in/reidhoffman/
只需将稳定 ID 和 LinkedIn URL 发送给 API。姓名和 Account Owner 仍保留在本地源记录中。这样既能精简查询请求,又能保留团队在收到结果后所需的业务信息。
将以下完整脚本粘贴到 find_phone_numbers.py 中:
import json
import os
import time
import uuid
import requests
def find_phone_numbers(prospects, api_key, settings):
"""Submit one phone lookup task, wait, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": prospect["prospect_id"],
"data": {"profileUrl": prospect["linkedin_url"]},
}
for prospect in prospects
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-phone-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise SystemExit("Set DATABLIST_API_KEY before running this script.")
prospects = [
{
"prospect_id": "prospect-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"account_owner": "Habib",
},
{
"prospect_id": "prospect-satya-nadella",
"name": "Satya Nadella",
"linkedin_url": "https://www.linkedin.com/in/satyanadella/",
"account_owner": "Florian",
},
{
"prospect_id": "prospect-reid-hoffman",
"name": "Reid Hoffman",
"linkedin_url": "https://www.linkedin.com/in/reidhoffman/",
"account_owner": "Habib",
},
]
settings = {"cacheAge": "30"}
phone_results = find_phone_numbers(prospects, api_key, settings)
print(json.dumps(phone_results, indent=2, ensure_ascii=False))运行文件:
python find_phone_numbers.py你也可以下载 Datablist 持续维护的同步 Requests 示例。上面的脚本采用相同的简洁流程:提交一个任务、等待任务完成,然后获取所有结果分页。
提交电话号码查询
列表推导式会将每位源潜在客户转换为 API 所需的输入格式。你的 prospect_id 会成为 inputId,而 linkedin_url 会成为 data.profileUrl。请使用路径为 linkedin.com/in/... 的公开个人主页 URL。此 enrichment 不支持 Sales Navigator URL。
该函数会生成 uniqueId,并在发起 POST 请求前将其打印出来。请求会同时发送这个值、waterfall-phone-finder enrichment ID、缓存设置和输入数据。提交成功后,API 会返回 HTTP 202 Accepted 和任务 @id,任务则继续在后台处理。
Waterfall Phone Finder API 参考文档列出了当前可用的设置、输入字段、输出、credits 和限制。
查询一位潜在客户时,请求正文采用以下结构:
{
  "enrichmentId": "waterfall-phone-finder",
  "uniqueId": "generated-uuid",
  "settings": {
    "cacheAge": "30"
  },
  "inputs": [
    {
      "inputId": "prospect-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
公开个人主页 URL 是查询输入。inputId 是关联键,用于将结果与源记录中的姓名和 Account Owner 对应起来。请选择一个在你自己的系统中保持稳定、且在当前任务内唯一的 ID。
等待后台任务完成
Requests 客户端会在本地阻塞,并每三秒检查一次任务状态,但 Datablist 任务仍在后台运行。当状态变为 completed 时,函数开始获取结果。如果状态为 failed 或 stopped,脚本会抛出包含任务 ID 的错误,方便你进一步检查。
获取所有结果分页
结果请求每次最多获取 100 行,并持续请求后续分页,直到 nextCursor 为 null。每条结果都包含对应的源 inputId,因此无需依赖响应顺序,也能将结果映射回正确的潜在客户。
Managed Waterfall 如何查找电话号码
示例将 cacheAge 设置为 "30"。Datablist 会先检查是否存在不超过 30 天且符合条件的结果。如果存在,API 可以复用该结果。此设置允许命中缓存,但并不保证一定会命中。
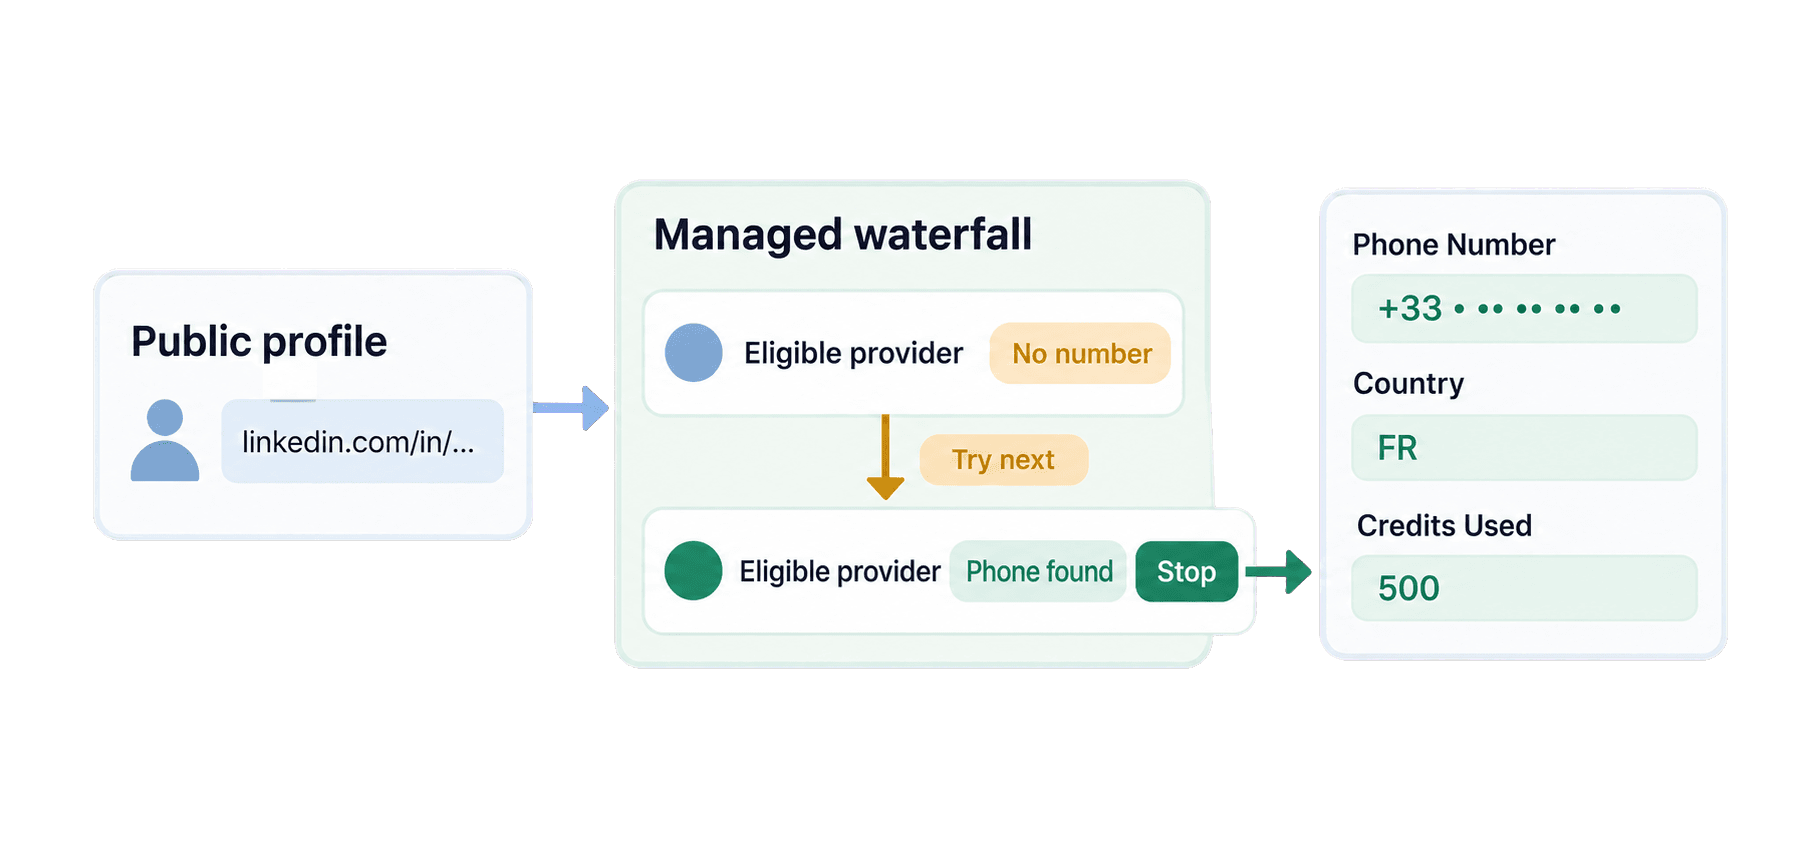
如果仍未找到该个人主页对应的号码,Managed Waterfall 会依次尝试符合条件的电话数据提供商。某个提供商没有返回可用号码时,该记录会继续交给下一个提供商处理;一旦找到可用号码,该记录的查询流程就会停止。
Waterfall 为何能覆盖更多国家和市场
Datablist 不依赖单一的电话数据提供商。不同提供商使用不同的数据集,在各个国家和市场的覆盖率也不一样。当一家提供商没有电话号码时,另一家可能可以找到。Datablist 通过同一个 API 集成来统一管理这些提供商。
对于需要跨多个市场创建通话名单的销售团队,这意味着即使一家提供商没有返回结果,也能减少被遗漏的潜在客户。你的 Python 代码只需提交一个任务并读取一种统一的结果格式,无需为每个提供商分别构建和维护集成。
如果你的工作流明确要求发起全新查询,请将 cacheAge 设置为 "0"。本示例保留 "30",以便复用符合条件的缓存结果。
读取完整查询结果
以下是 Florian Poullin 的一条查询结果。电话号码已做脱敏处理。
{
  "inputId": "prospect-florian-poullin",
  "status": "success",
  "outputs": {
    "finderProvider": "wizleads",
    "phoneNumber": "+33 • •• •• •• ••",
    "phoneNumberCountry": "FR"
  },
  "creditsUsed": "500",
  "error": null
}如果成功找到号码,phoneNumber 会包含国际格式的电话号码。+33 前缀和 phoneNumberCountry: "FR" 表明这是一个法国号码。
finderProvider 表示本次结果对应的查找服务商。该行消耗了 500 credits,而 error: null 表示 API 没有返回行级错误。
生成经过审核的销售通话名单
获得 phone_results 后,你可以生成一份本地名单,供销售团队审核。将以下代码块添加到同一文件中打印结果的代码之后。它会复用现有结果,不会再次调用 API:
results_by_id = {
result["inputId"]: result
for result in phone_results
}
call_list = []
for prospect in prospects:
result = results_by_id.get(prospect["prospect_id"])
if not result or result["status"] != "success":
continue
phone_number = result.get("outputs", {}).get("phoneNumber")
if not phone_number:
continue
call_list_record = prospect.copy()
call_list_record["result"] = result
call_list.append(call_list_record)
print(json.dumps(call_list, indent=2, ensure_ascii=False))结果索引使用 inputId 作为关联键,因此每条结果始终与对应的源记录绑定,不依赖列表位置。API payload 包含每位潜在客户的 ID 和个人主页 URL,而原始 prospects 列表则保留通话名单所需的姓名和 Account Owner。
对于 Florian 的记录,prospect-florian-poullin 会将返回结果与原始的 name、linkedin_url 和 account_owner 关联起来。团队可以从 result.outputs 中读取电话号码及其 FR 国家代码。包括状态、credits 和错误在内的完整 API 对象仍会保存在 result 下。
通话名单循环会按照 prospects 的顺序处理记录。每条纳入名单的潜在客户记录都会先被复制,再附加 result,因此原始源列表仍可用于修正数据或选择其他跟进渠道。
无结果、出现错误或电话号码为空的记录仍保留在未改动的 prospects 列表中,但不会进入 call_list。这样便可生成一份供审核的本地销售通话名单。
估算 Waterfall Phone Finder API 成本
默认 Managed Waterfall 每找到一个未缓存的新电话号码,会消耗 500 credits。命中并采用缓存结果消耗 0 credits,未找到结果的查询同样消耗 0 credits。请读取每条返回记录中的 creditsUsed 来确认实际消耗,不要简单地用提交的个人主页总数乘以 500。
规划预算时,可使用以下公式:
找到的未缓存新电话号码数量 × 500 credits
找到 40 个新号码会消耗 20,000 credits;找到 100 个新号码会消耗 50,000 credits。按照目前以美元计价的基础充值费率,20 美元可购买 20,000 credits,因此 500 credits 相当于 0.50 美元。提供 REST API 访问权限的 Growth 订阅费用需另行计算。当前套餐和 credits 包请参阅 Datablist 定价。
举例来说,假设查询 100 个个人主页后找到了 20 个新号码、5 个命中并采用缓存的号码,另外 75 个没有结果。计费数量仅为 20 个新号码,因此本次查询消耗 10,000 credits。通话名单则可以包含找到的全部 25 个号码。在计算器中应输入 20,而不是全部 100 条输入或找到的全部 25 个号码。此示例仅用于说明计费方式,并不代表预期成功率。
修复常见错误并恢复已有任务
- 缺少
DATABLIST_API_KEY: 脚本会在发起请求前停止。请导出该环境变量,然后重新运行文件。 - API 拒绝该 Key:
raise_for_status()会报告 HTTP 错误。请重新复制 Personal API Key,并确认请求通过X-API-Keyheader 发送该值。 - 不支持该个人主页 URL: 如果 URL 为空、格式错误、指向公司主页或来自 Sales Navigator,请将其替换为采用
linkedin.com/in/...路径的公开个人主页 URL。 - credits 不足: 提交更多任务前,请检查账户余额和可用 credits。
- 任务状态为
failed或stopped: 在决定哪些记录仍需重新运行前,请检查任务错误、已有结果和 credits 消耗情况。 - 某行没有结果或出现错误: 保留源潜在客户记录,以便修正数据或改用其他跟进渠道。仅凭该行无法判断结果是由具体提供商、地理覆盖还是资料可见性所导致。
如果 POST 响应丢失,可以使用提交前打印的 uniqueId。再次提交前,请先列出已有任务。 将以下请求中的 your-api-key 替换为你的 Key,然后查找 uniqueId 与打印值匹配的任务:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: your-api-key" \
--data-urlencode "enrichmentId=waterfall-phone-finder" \
--data-urlencode "limit=100"如果任务不在第一页,请根据任务列表响应中的 nextCursor 继续翻页。复制匹配任务的 @id,替换下方的 TASK_ID,然后检查任务状态或获取已有结果:
curl "https://api.datablist.com/v1/enrichments/tasks/TASK_ID" \
--header "X-API-Key: your-api-key"
curl --get "https://api.datablist.com/v1/enrichments/tasks/TASK_ID/results" \
--header "X-API-Key: your-api-key" \
--data-urlencode "limit=100"任务 API 文档介绍了任务状态、结果分页和中断行为。
后续步骤
现在,你已经拥有一个可复用的 Requests 函数,用于处理公开 LinkedIn 个人主页 URL;同时还有一套基于稳定 ID 的合并逻辑,可整理找到的电话号码,供销售团队审核。
请将示例数据替换为一小批经过筛选的潜在客户,同时保留其稳定 ID 和 Account Owner。将整理好的名单交给团队执行电话外呼前,请逐一审核找到的号码。建议先从小批量数据开始,以便检查 ID 映射和返回字段。如果需要非阻塞并发,可以使用持续维护的异步 HTTPX 示例。