
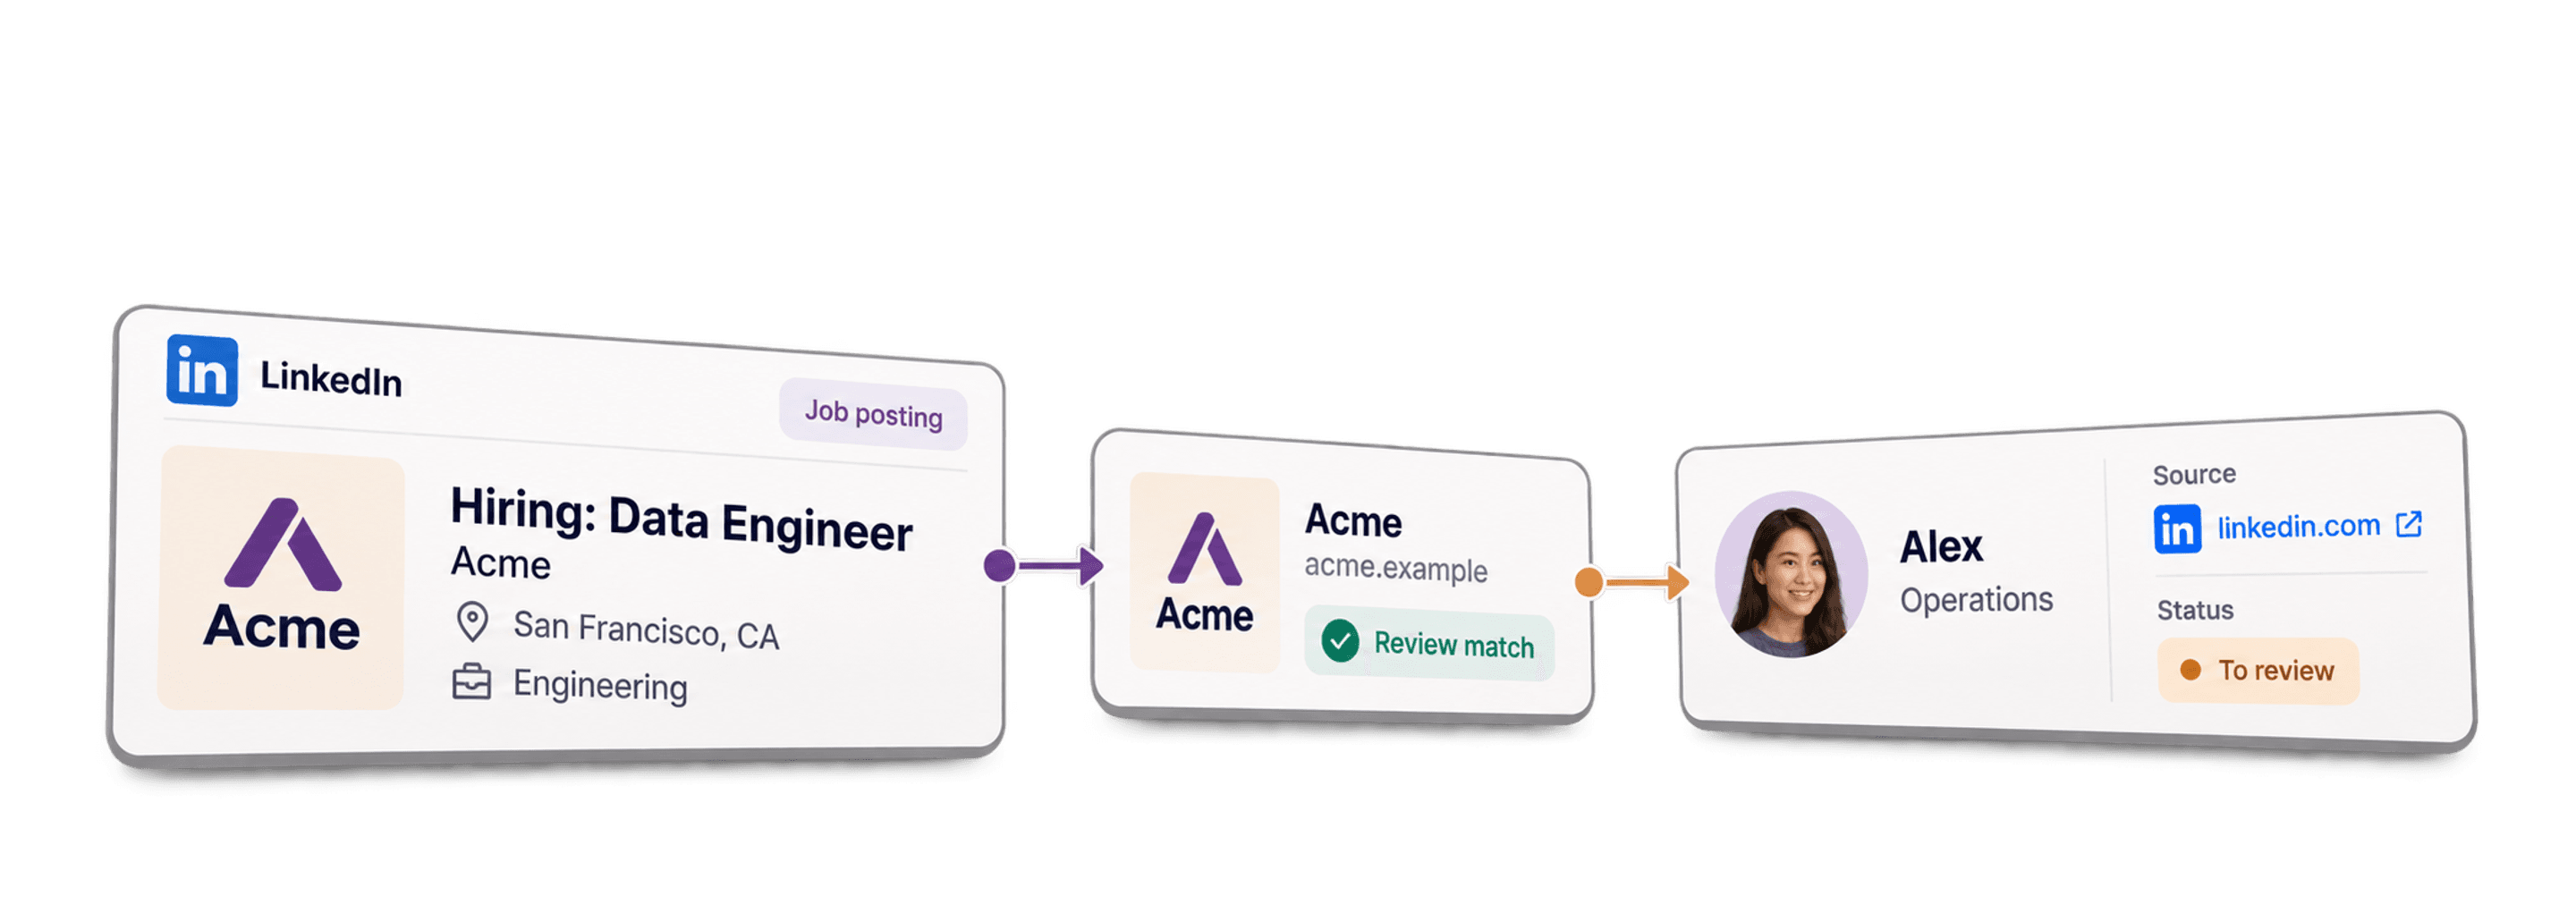
大多数关于抓取 LinkedIn 职位的教程,要么丢给你一段 Python 脚本,要么推荐有封号风险的浏览器扩展。即使这些方法能用,你最后得到的通常也只是一份职位 CSV,却不知道该联系谁。
职位发布只是线索的一半。它能告诉你某家公司正在招聘,这是非常明确的购买信号,但不会直接告诉你谁是真正的招聘决策人。
本指南将介绍一套无代码工作流:在不危及账号安全的情况下抓取 LinkedIn 职位,再将这些职位转化为公司域名和招聘负责人联系方式,而且所有步骤都能在同一个平台完成。
📌 赶时间?先看摘要
**核心思路:**抓取 LinkedIn 职位可以帮你发现哪些公司正在招聘,但职位发布本身并不是 Lead;真正有价值的是它背后的联系人。
本文会先解释为什么无代码、账号安全的抓取方式更可靠,再演示如何抓取 LinkedIn Jobs,并在同一个平台内将职位数据转化为公司域名和联系人。
读完后,你将掌握:
- 无需编程、不会危及账号安全的 LinkedIn 职位抓取方法
- 从职位发布到公司域名的完整工作流
- 招聘负责人和决策人 Leads;如能找到,还会包含邮箱
本指南将涵盖哪些内容
- 能否无代码抓取 LinkedIn 职位
- 如何抓取 LinkedIn 职位,同时避免账号风险
- Datablist 是什么,以及它如何将职位变成 Leads
- 如何使用 LinkedIn Jobs Scraper 抓取职位
- 如何将抓取的职位转化为公司域名
- 如何找到每条职位背后的招聘负责人
无代码抓取 LinkedIn 职位完全可行
在讨论工具之前,先回答一个最实际的问题:不懂技术的人,能否在不写任何代码的情况下抓取 LinkedIn 职位?简短答案是:可以。至于为什么过去一直让人觉得难以实现,下面会详细说明。
为什么 LinkedIn 不提供职位导出功能
LinkedIn 没有原生导出功能。你可以浏览一整天的职位,却找不到一个能将结果直接导入电子表格或 CSV 的按钮。
因此,大多数人只能尝试 Python 脚本、Apify actors,或者逐条复制粘贴。但这些方法处理十几行之后就会变得难以维护,最终得到的仍是一份扁平列表,既难筛选,也很难直接用于后续行动。
无代码 LinkedIn 职位抓取如何运作
无代码抓取完全绕过了脚本。你不需要自己运行代码访问 LinkedIn,只需让托管式 scraper 执行搜索,它就会将职位整理成结构化、可导出的数据行。
这意味着每条职位都会带有独立字段,例如职位名称、公司名称、行业、地点等。你得到的是一份可以排序、筛选和 Enrich 的干净列表,而不是一大段无法利用的文本。
这一点往往被偏重代码的教程忽略。想获得一份真正可用的 LinkedIn 职位列表,你不需要掌握技术,只需要让合适的工具替你完成数据提取。
如何安全抓取 LinkedIn 职位
账号安全正是许多免费抓取方式悄悄埋雷的地方。你选择的方法,会决定下周还能正常浏览 LinkedIn,还是只能面对被锁定的账号。
为什么抓取脚本和扩展容易导致账号被封
免费脚本和浏览器扩展会直接在你已登录的个人会话中抓取数据。它们会发出大量不像正常浏览行为的自动化请求,而这类模式恰恰最容易触发平台封锁。
此外,数据量也存在明确上限。**LinkedIn 单次搜索最多显示 1,000 条结果,**因此,试图用脚本暴力突破限制,只会让账号的异常行为更加显眼。
如果被封的是你日常寻找客户、与客户沟通的账号,那么为了一个免费下载工具承担这种风险,显然不划算。
📘 搜索上限一览
LinkedIn 单次搜索最多提供 1,000 条结果,而 scraper 每次搜索最多返回 500 条职位。若要覆盖整个市场,可按不同关键词和地点规划多组搜索。
无代码 LinkedIn Jobs Scraper 如何保护账号
托管式无代码 scraper 不会接触你的个人账号。数据提取运行在工具自己的基础设施上,因此发出大量请求的并不是你的 LinkedIn 登录会话。
这种隔离正是保护账号的关键。你的账号继续保持正常使用状态,繁重的数据抓取则交给专门为此设计的基础设施。不过,安全提取只是起点,并不是终点。更重要的问题是:哪个平台能把干净的抓取结果继续转化为可以直接联系的 Lead?
Datablist 如何将 LinkedIn 职位变成 Leads
如果你还不了解这套工作流所使用的工具,在进入实操环节前,我们先简单介绍一下。
Datablist:抓取职位并寻找 Leads 的无代码平台
Datablist.com 是一个无代码平台,拥有 60 多款工具和超过 30,000 名用户。无需编写任何代码,即可查找、Enrich 和清洗数据。
对于 LinkedIn 职位抓取而言,它的核心价值是让整套工作流都在一个地方完成。整个过程只有三个步骤:
- 使用 LinkedIn Jobs Scraper 抓取 LinkedIn 职位
- 将每个公司名称解析为经过验证的域名
- 查找每条职位背后的招聘负责人和决策人
所有步骤都在同一平台中运行,因此你不必为了继续处理数据,反复将 CSV 导出到其他工具。
为什么只抓取 LinkedIn 职位找不到客户
抓取到的职位能说明一家公司存在招聘需求,但不会告诉你谁有权批准招聘,也不会直接提供邮箱。多数抓取教程都会在这里停下。一份职位列表看起来像是有了进展,但你无法把销售方案发给一则招聘广告。
完成 scraper 操作后,接下来的两个实操环节会补上这个缺口:先找到公司域名,再找到背后的联系人。这正是一堆数据与真实商机之间的区别。
如何用 Datablist 抓取 LinkedIn 职位
下面进入实操。LinkedIn Jobs Scraper 位于 Sources 标签页,可以根据关键词和地点生成结构化职位列表。每导入一条职位需要 2 credits。
第 1 步:注册 Datablist.com
创建 Datablist 账号大约只需一分钟。免费试用会提供 500 credits,足够抓取 250 条职位。
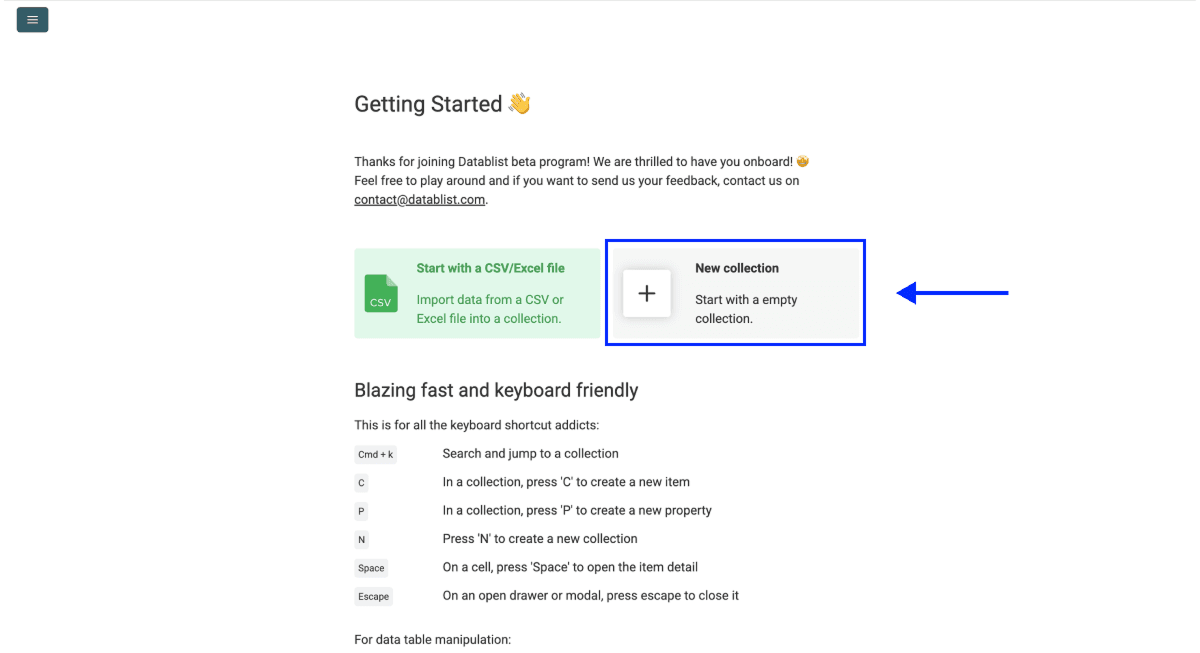
第 2 步:创建新的 Collection
进入平台后,点击 New Collection。抓取到的职位会进入这个工作区。
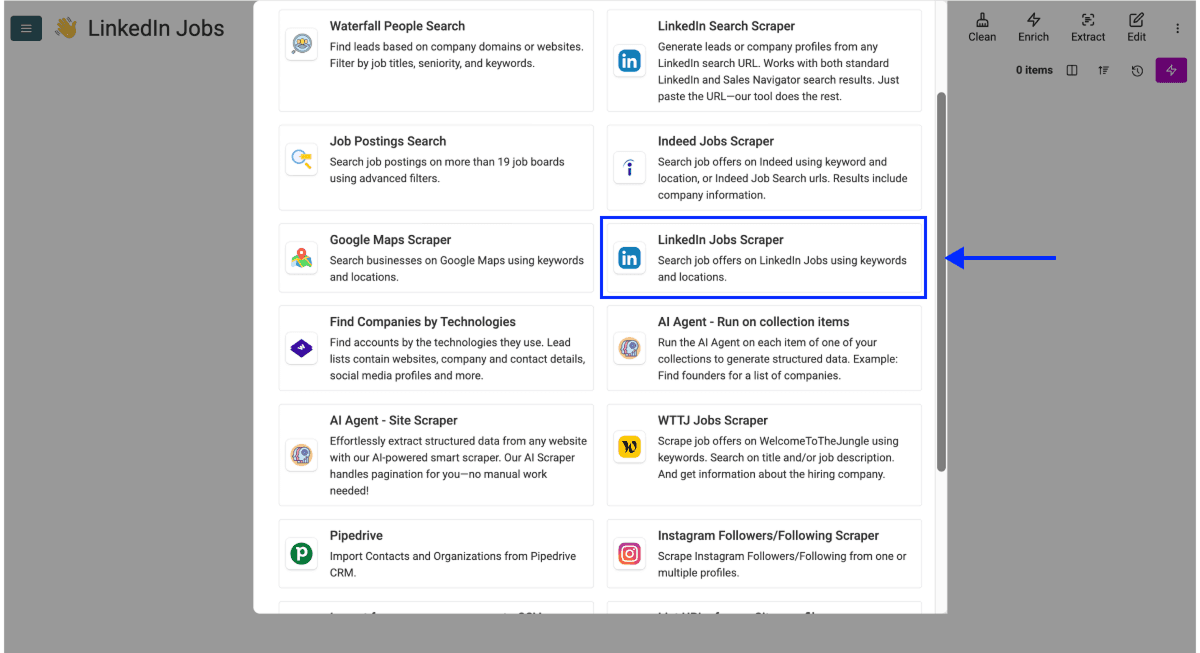
第 3 步:打开 LinkedIn Jobs Scraper
- 点击 See all Sources
- 选择 LinkedIn Jobs Scraper
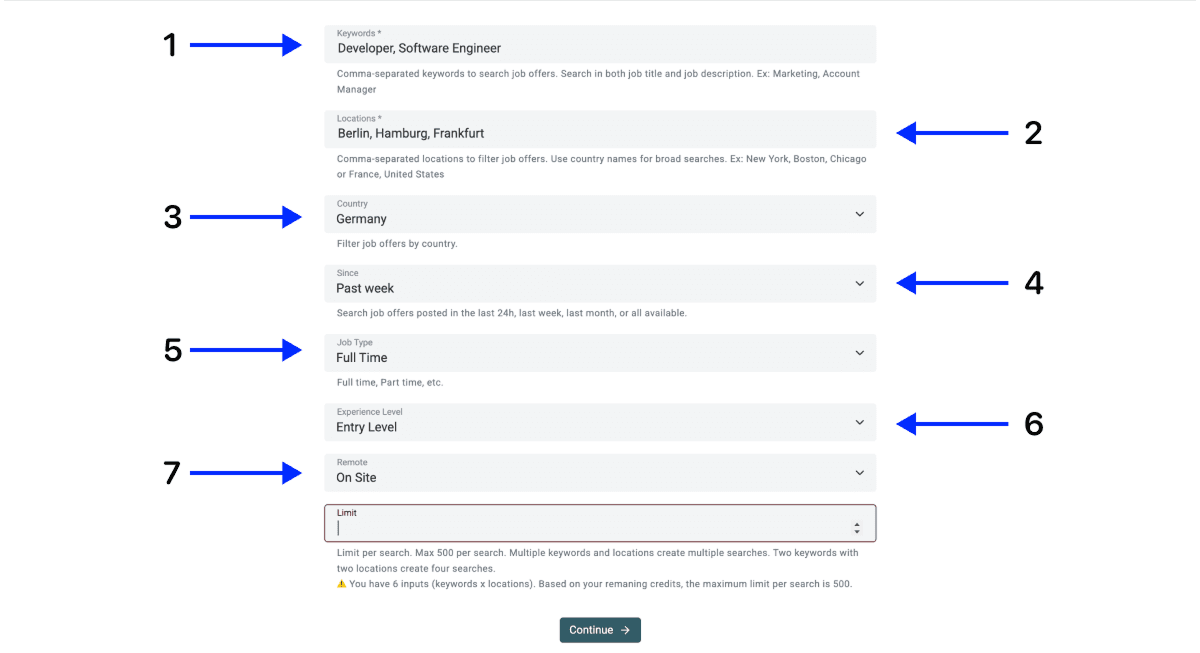
第 4 步:设置关键词和地点
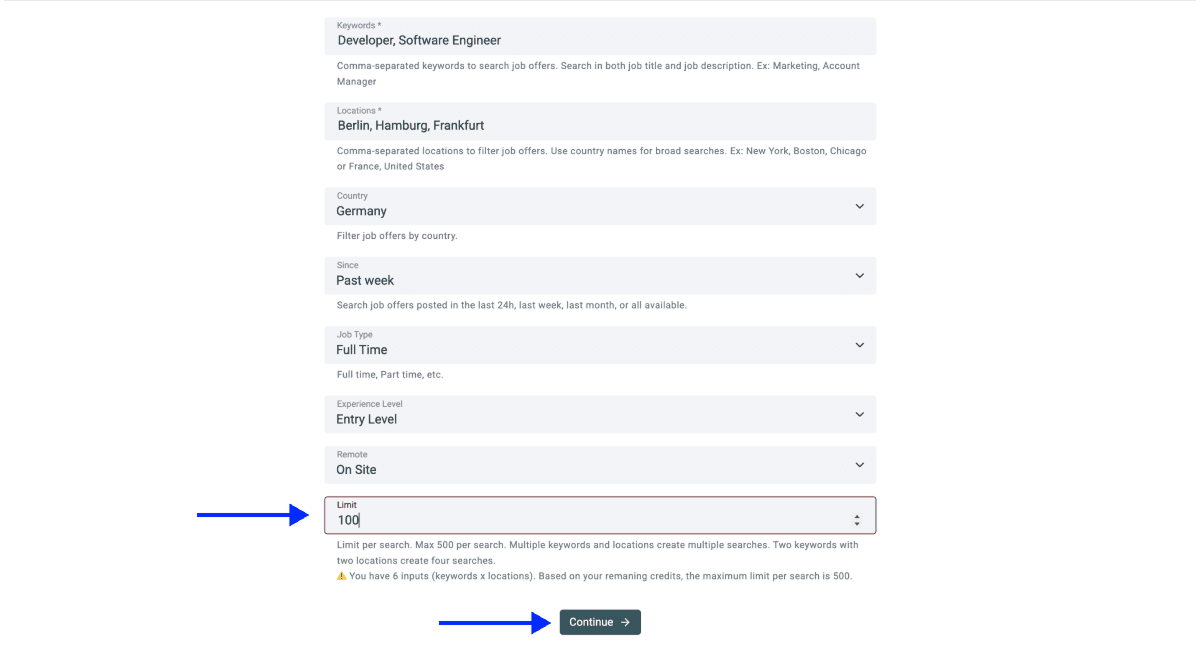
scraper 需要两个输入项:Keywords 和 Locations,此外还可以设置 Country、Job Type、Experience Level、Remote 和 Time Period 等筛选条件。本示例采用以下配置:
- **Keywords:**Developer、Software Engineer
- **Locations:**Berlin、Hamburg、Frankfurt
- **Country:**Germany
- **Time Period:**Past week
- **Job Type:**Full Time
- **Experience Level:**Entry Level
- **Remote:**On-Site
每一种关键词与地点的组合都会作为一次独立搜索运行。两个关键词搭配两个地点会生成四次搜索;上述配置是两个关键词搭配三个地点,因此总共会运行六次搜索。
**在一个任务中运行多组搜索,可以一次覆盖整个目标市场,**不用逐个城市抓取,再在之后手动拼接结果。
第 5 步:运行搜索
-
设置每次搜索的结果上限
-
点击 Continue
每次搜索最多返回 500 条职位。本例将每次搜索限制为 100 条,因此六次搜索总共会导入 600 条职位。
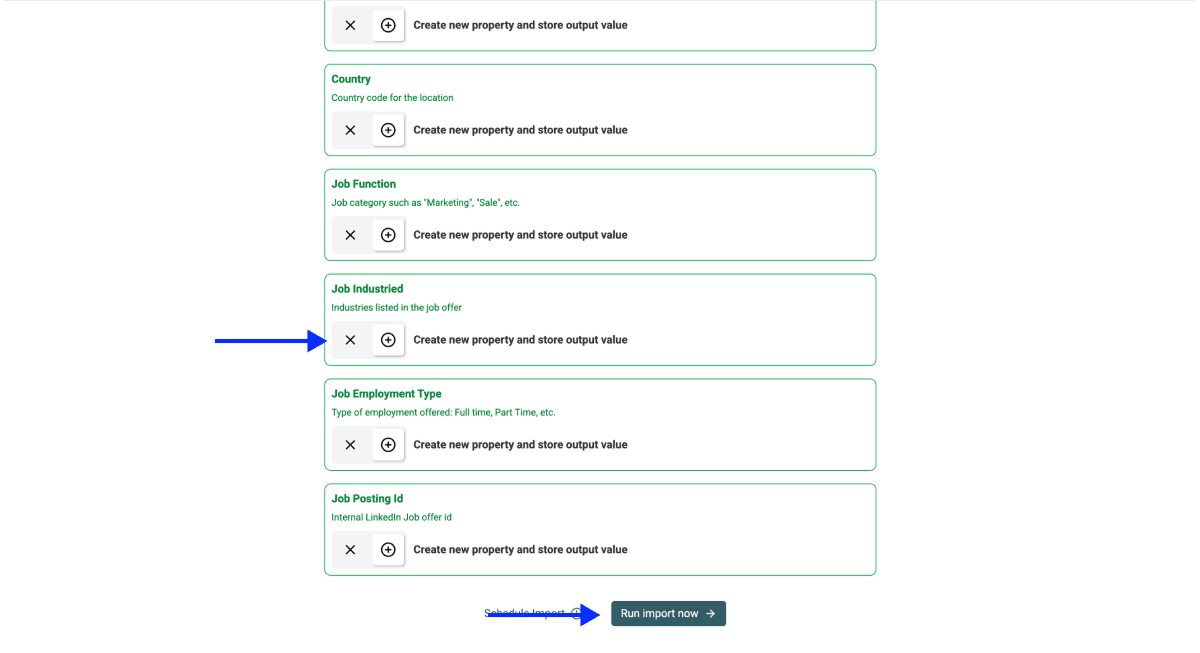
- 选择输出项。Datablist 会为每个可返回的数据点创建一个 property。使用 ✕ 图标删除不需要的项目
- 点击 Run Import Now
第 6 步:检查导入的职位
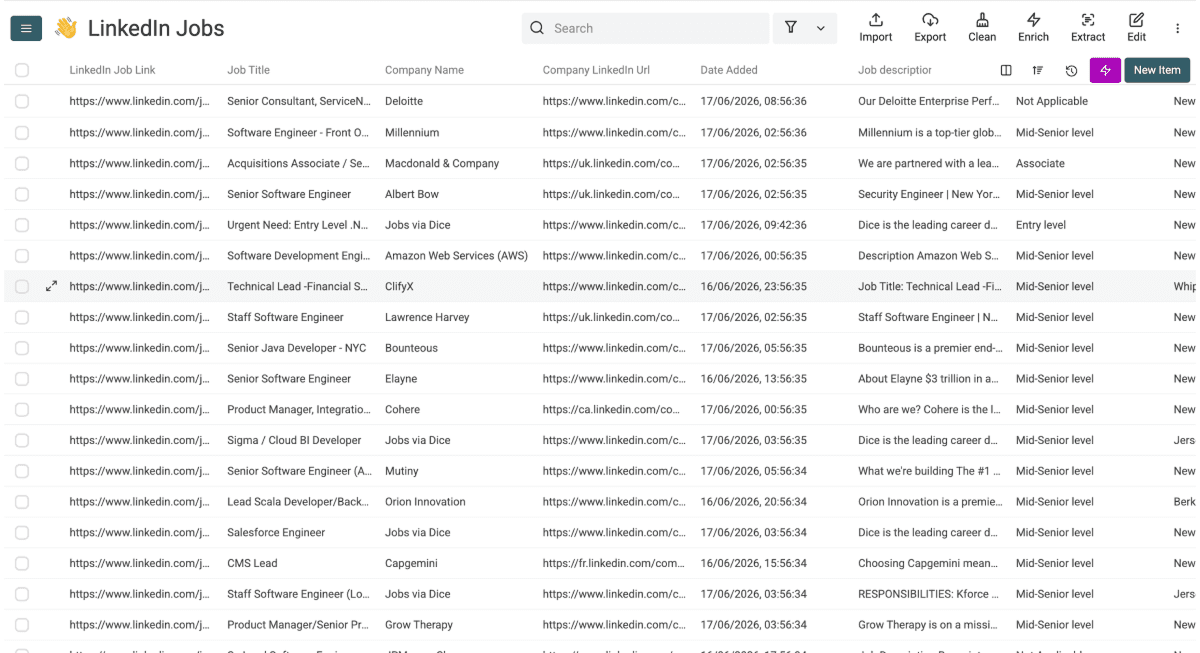
几分钟后,每条职位都会以结构化数据行的形式进入 Collection。scraper 会为每条职位返回 13 个字段,分为以下几组:
| 类别 | 数据点 |
|---|---|
| 职位详情 | Job Title、Job description、Seniority Level、Job Function、Job Industries、Job Employment Type |
| 公司详情 | Company Name、Company LinkedIn Url |
| 链接与 ID | LinkedIn Job Link、Job Posting Id |
| 地点与时间 | Location、Country、Date Added |
📘 每条职位的抓取成本
scraper 按每条导入职位收取 2 credits,而且只对实际导入的职位计费。导入 600 条职位需要 1,200 credits。
如何将 LinkedIn 职位转化为公司域名
职位发布只会提供公司名称和 LinkedIn URL,不会直接提供域名。但要寻找 Lead,首先需要获得公司域名,因此这一步将介绍如何根据公司名称查找域名。
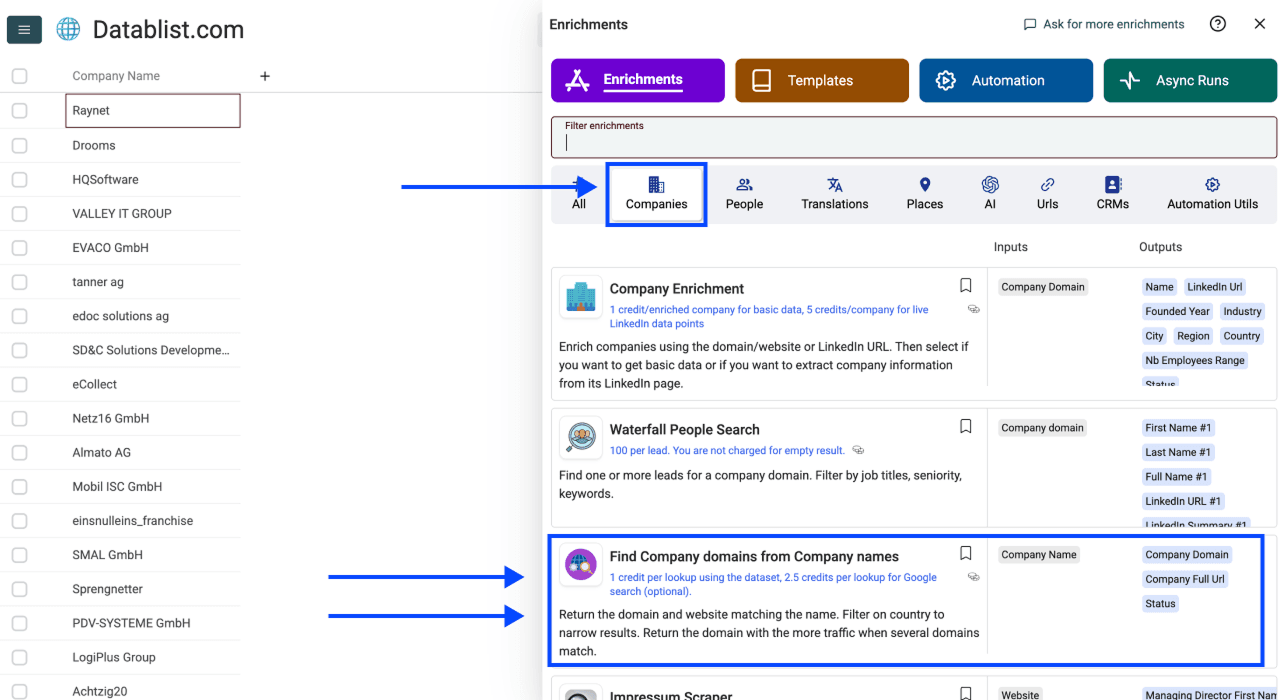
Datablist.com 通过 Companies 标签页中的 Domain Finder enrichment 完成这项工作。由于职位数据已经位于 Datablist 中,你可以直接运行,无需再导出和导入。
第 1 步:打开 Find Company Domain enrichment
- 点击顶部菜单中的 Enrich
- 切换到 Companies 标签页
- 选择 Find Company Domain from Company Name
第 2 步:选择数据库加 Google 兜底的 Workflow
在 Workflow 下,选择使用公司数据库并以 Google 作为 fallback 的选项。Datablist 会先查询已验证的数据库,只对无法匹配的公司名称使用 Google。
这样的顺序可以降低成本:通过数据库找到一个域名需要 1 credit,每次 Google fallback 查询则需要 2.5 credits。
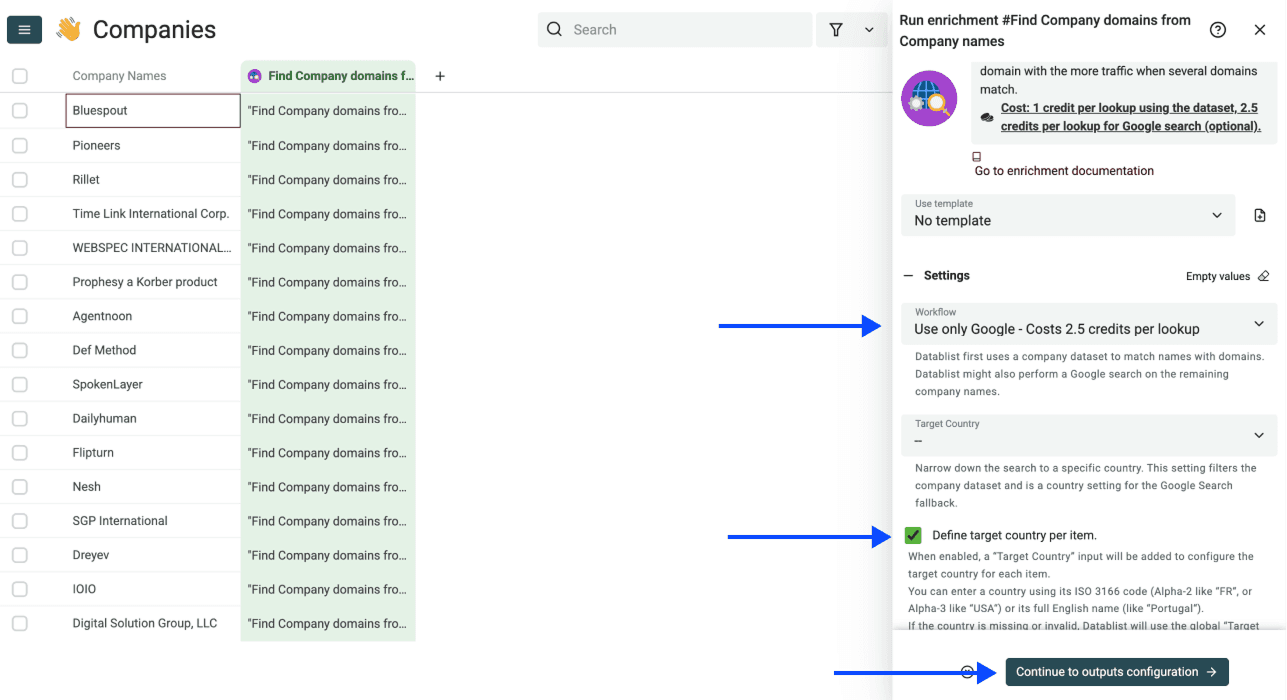
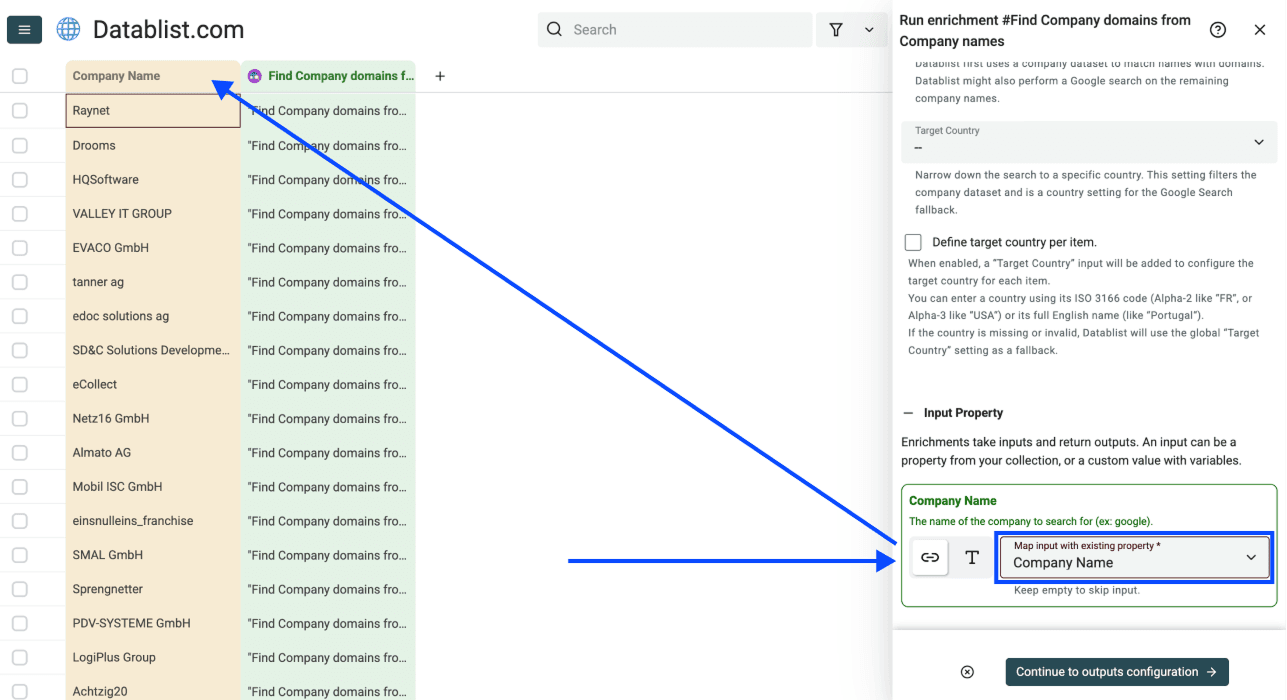
第 3 步:映射 Company Name 列
- 将 Company Name 列设置为 Input Property
- 点击 Continue to outputs configuration。
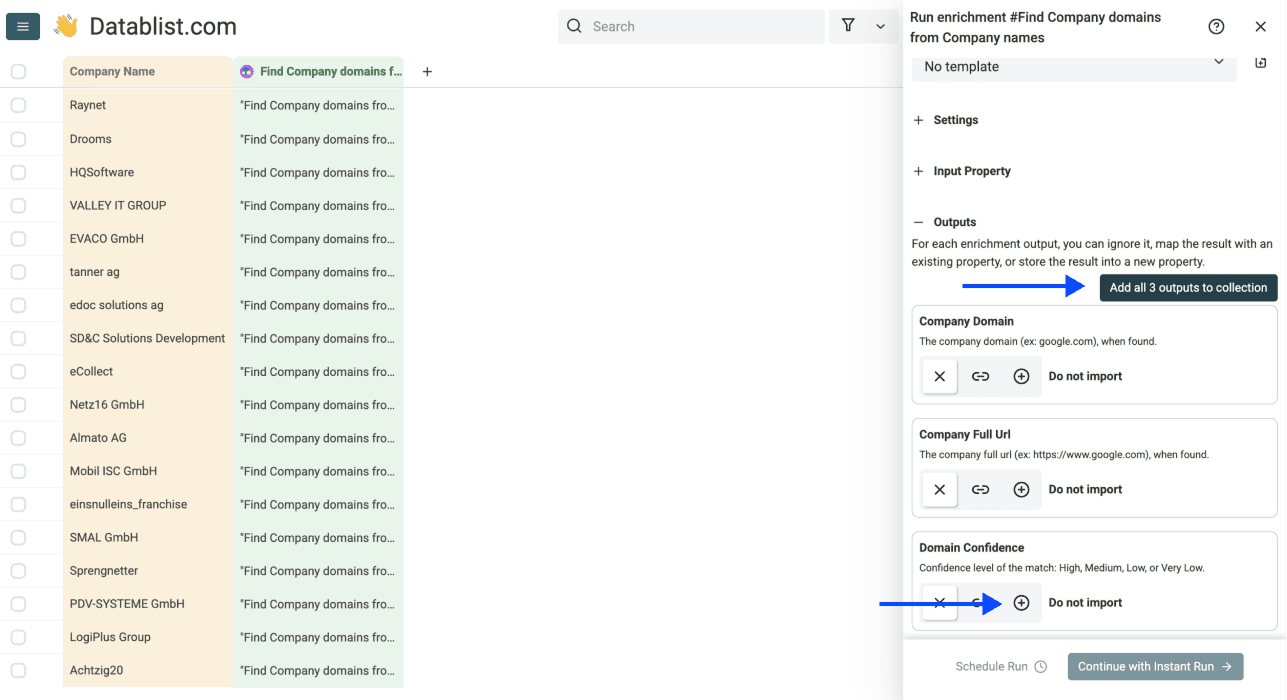
第 4 步:选择域名输出项
- 使用 ⊕ 图标或 Add all 3 outputs to collection,将域名、网站 URL 和置信度评分添加到 Collection
- 点击 Instant Run
第 5 步:批量运行 Enrichment
点击按钮右侧的箭头,配置运行设置。你可以选择:
- **Run on first 10 items:**适合在正式处理前快速检查结果
- **Run on first 100 items:**适合验证更大的样本
- **Run on first X items:**自行决定要处理多少行
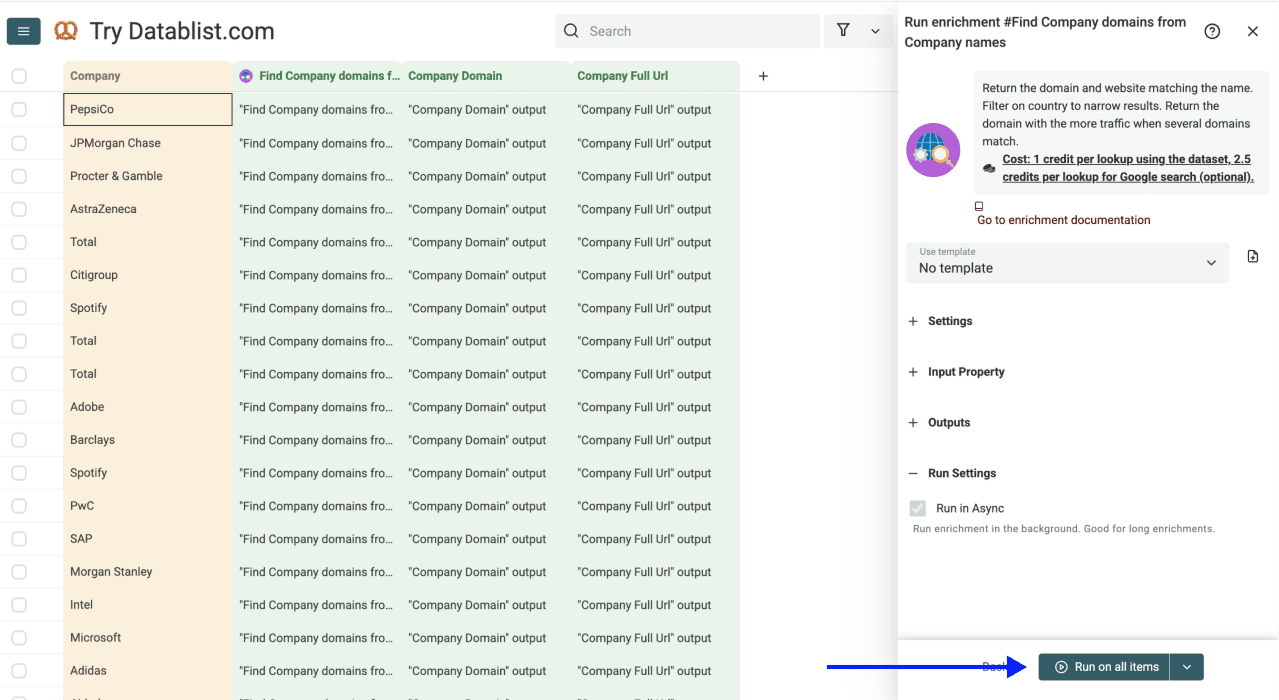
- **Run on all view items:**处理完整列表;如果启用了筛选条件,则只处理当前视图
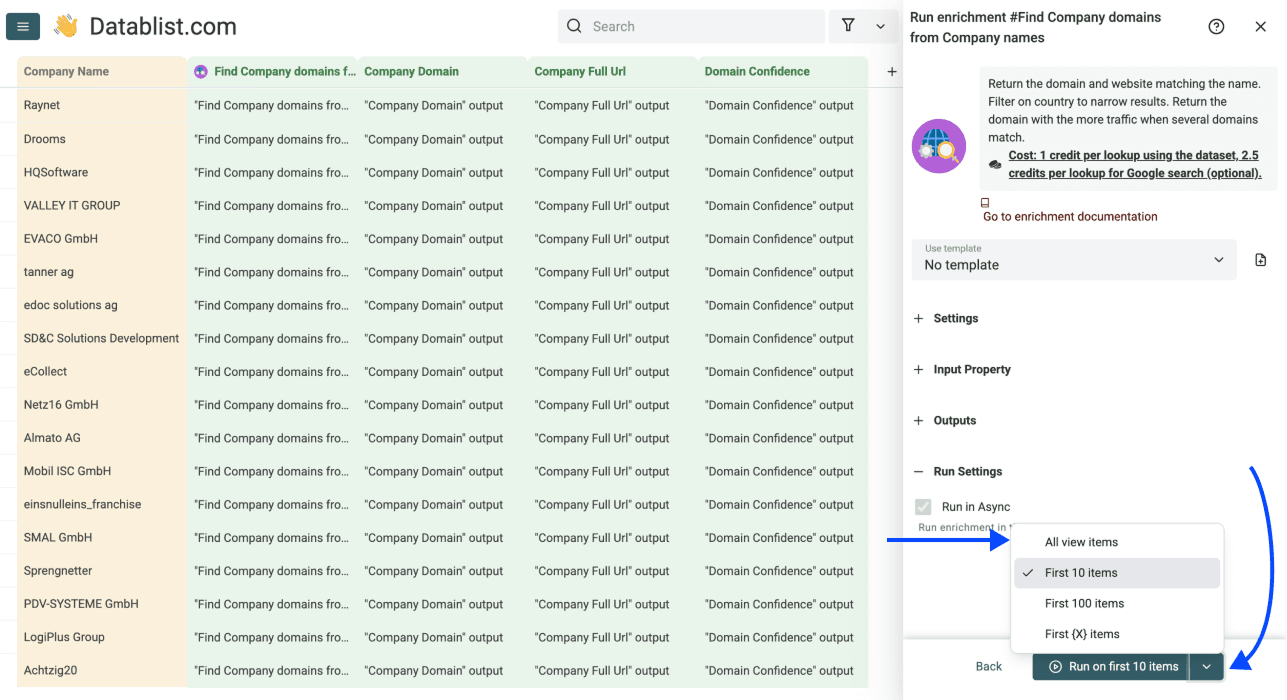
选好后,点击 Run on X items。
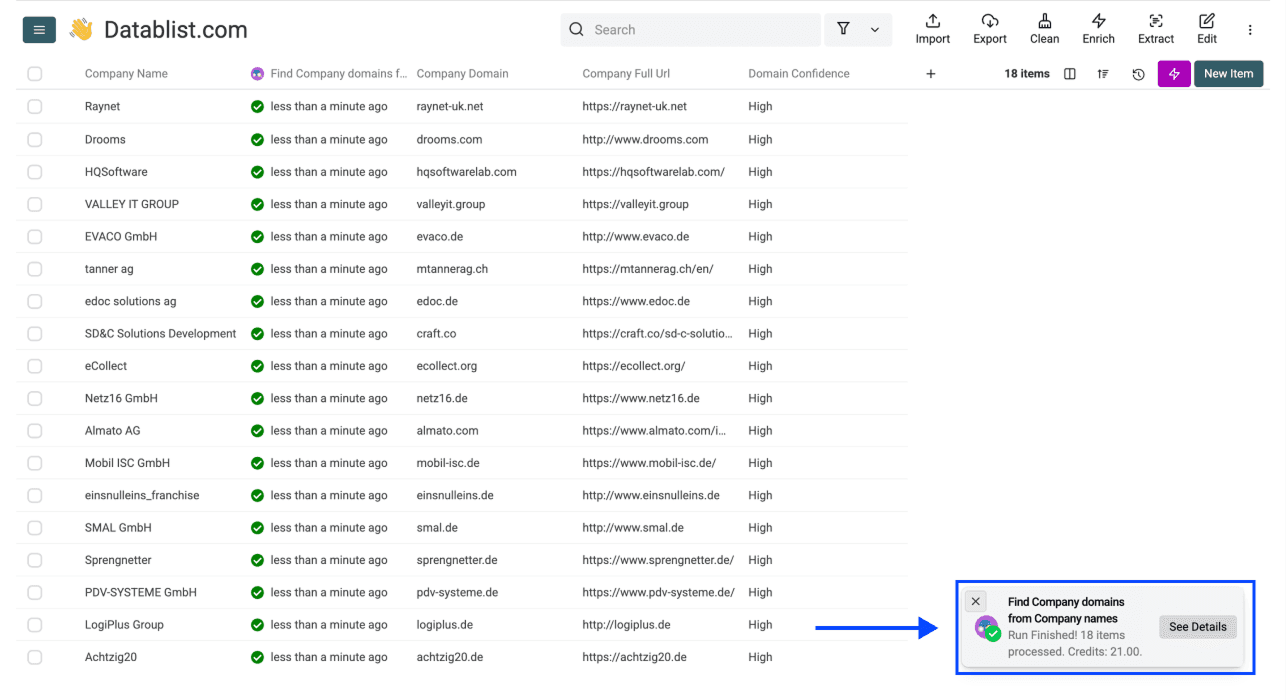
几分钟后,经过验证的域名就会出现在相应公司名称旁边,并附带置信度评分,方便你直接采用可靠匹配,同时复核不确定的结果。
📘 如果 Datablist 没有找到所有域名怎么办
有时,Datablist 无法在一次运行中找到所有公司的域名。这通常发生在公司名称含义模糊,或者公司规模太小、成立时间太短,尚未被任何数据库收录的情况下。
此时,你可以使用 Datablist 的 AI Agent 搜索缺失的域名。更多信息请参阅我们的公司名称转域名指南 👈🏽
如何找到招聘负责人和 CEO Leads
这一步会把抓取到的职位转化为可用于销售服务的 Lead List。Datablist 的 Waterfall People Search 会根据公司域名查找公司内部的相关人员,并在能够找到时返回邮箱。
想了解招聘信号之外的完整 Lead 构建流程?请参阅如何使用 Datablist 寻找 Leads 👈🏽
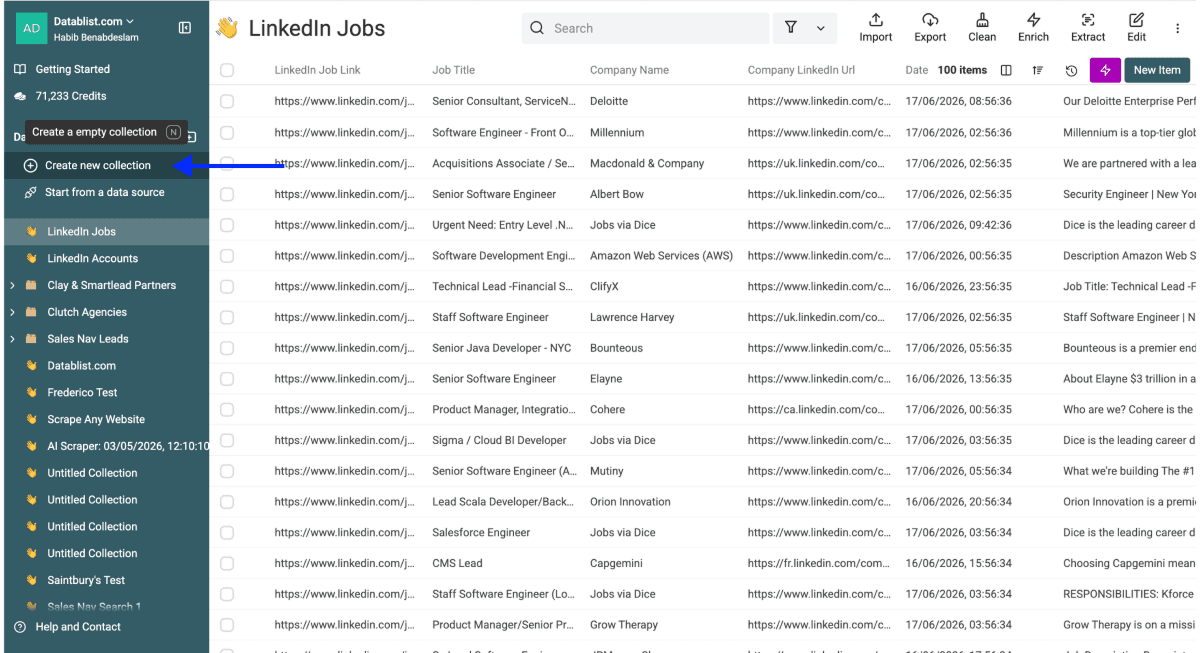
第 1 步:创建新的 Collection
运行 Lead 搜索之前,先创建一个单独的 Collection,用于存放找到的联系人。将 Leads 与职位和公司数据分开,可以避免搜索新增数据行时混淆两类数据集。
Datablist 支持将相关 Collection 放入同一个文件夹,因此你可以把公司和职位数据放在一个 Collection 中,把 Leads 放在另一个 Collection 中,并在同一位置并排管理。
第 2 步:打开 Waterfall People Search
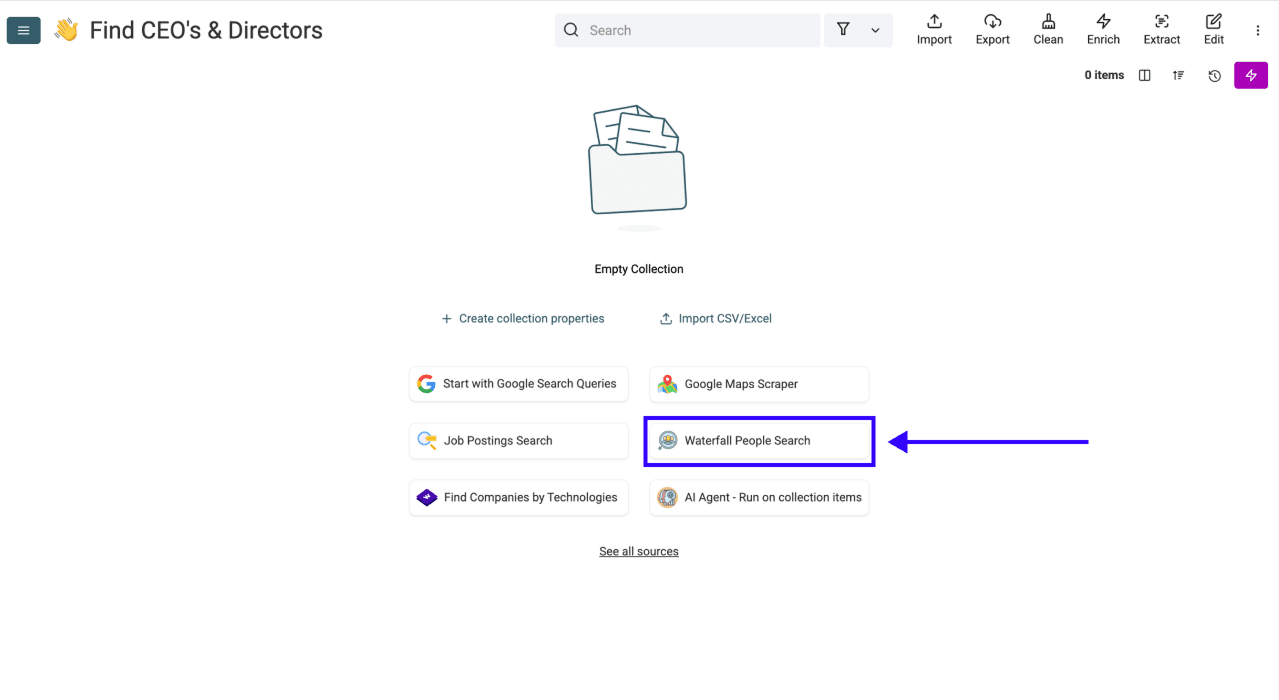
- 从 Source 列表中选择 Waterfall People Search
- 将你的 Collection 映射为 Input Collection
- 选择域名列作为 Input Property
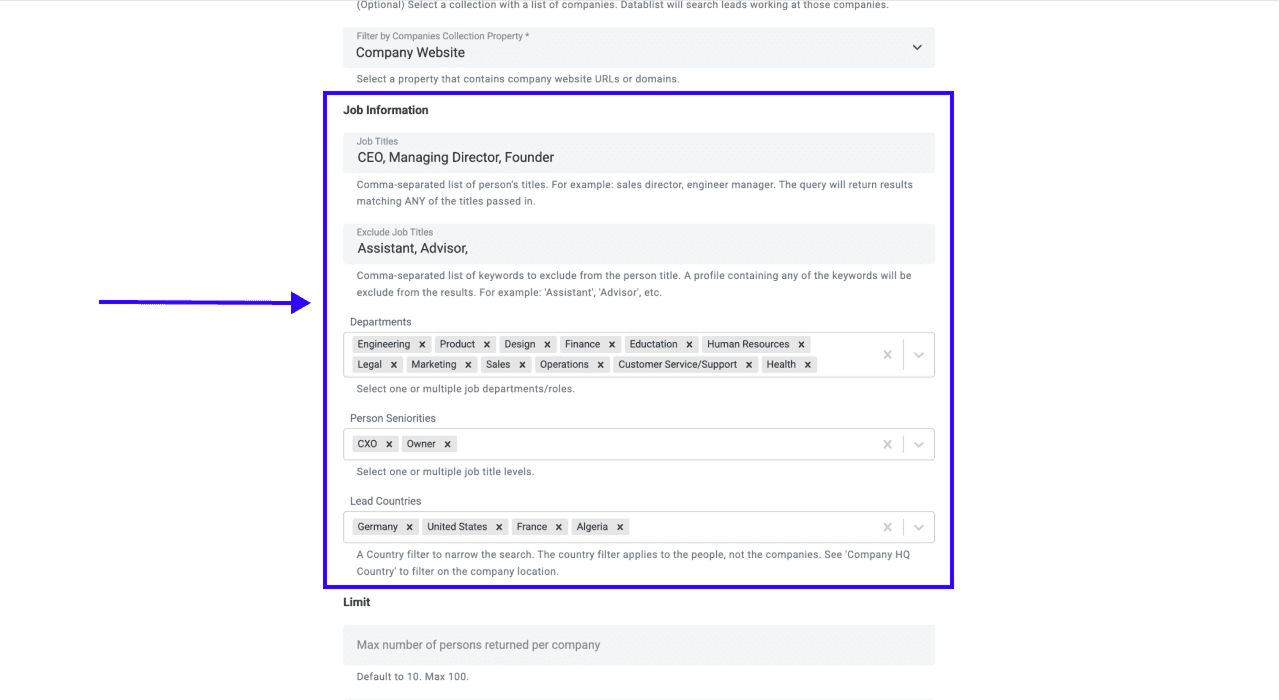
第 3 步:设置目标职位名称
Person's Titles 接受以逗号分隔的职位名称,并返回匹配其中任一职位的人。对于利用招聘信号获客的招聘顾问,可以采用这样的组合:Hiring Manager、CEO、Founder、VP of HR、Recruiting Manager、Owner。
如果只想寻找特定地区的决策人,还可以使用 Departments、Person Seniorities 和 Lead Countries 进一步缩小范围。
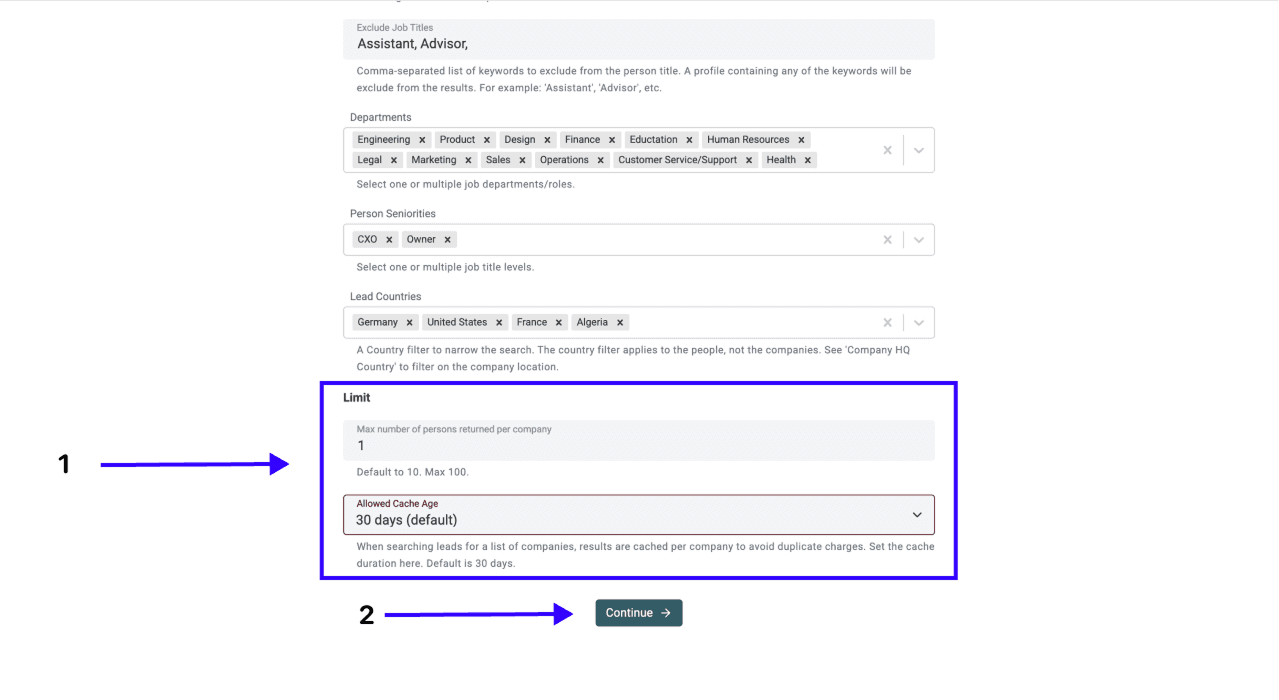
第 4 步:设置联系人上限和 Cache
- 设置 Contact Limit Returned Per Company
- 选择 Cache Settings
- 全部设置完成后,点击 Continue。
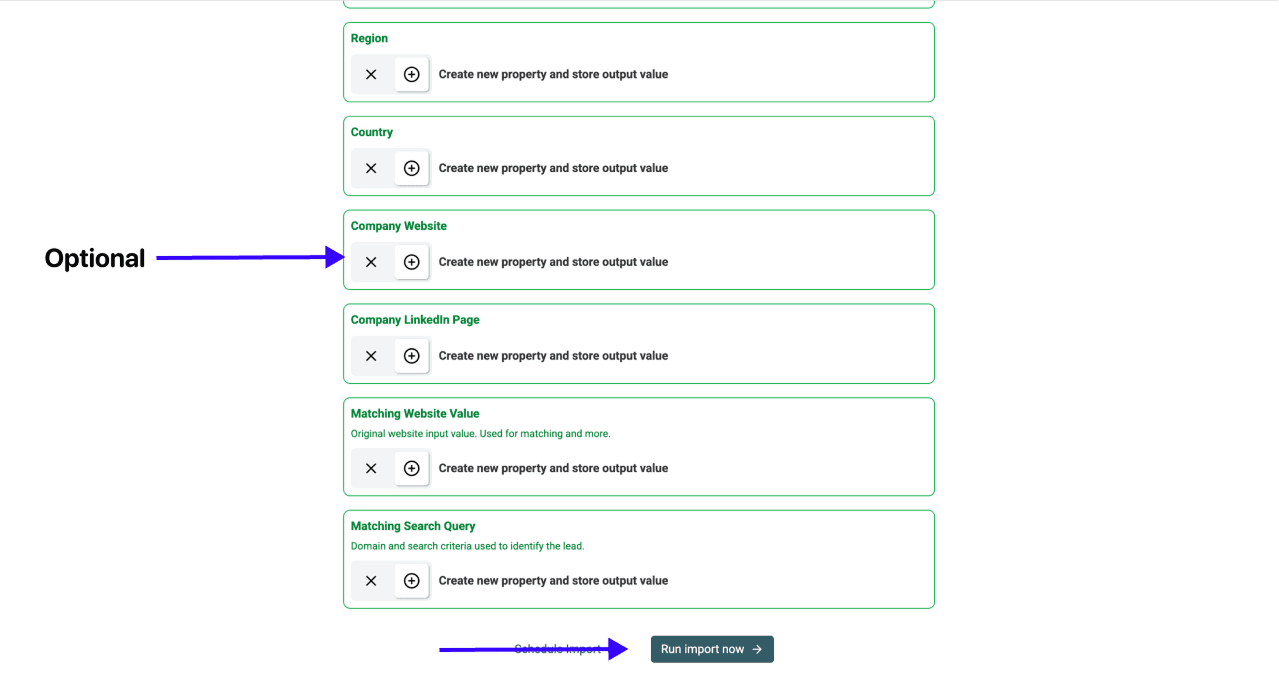
第 5 步:选择输出项并运行
Datablist 会为每个可返回的数据点创建一个 property。
- 使用 ✕ 图标删除不需要的项目
- 点击 Run import now
每条导入的 Lead 需要 100 credits;如果找到邮箱,费用中已包含该邮箱。
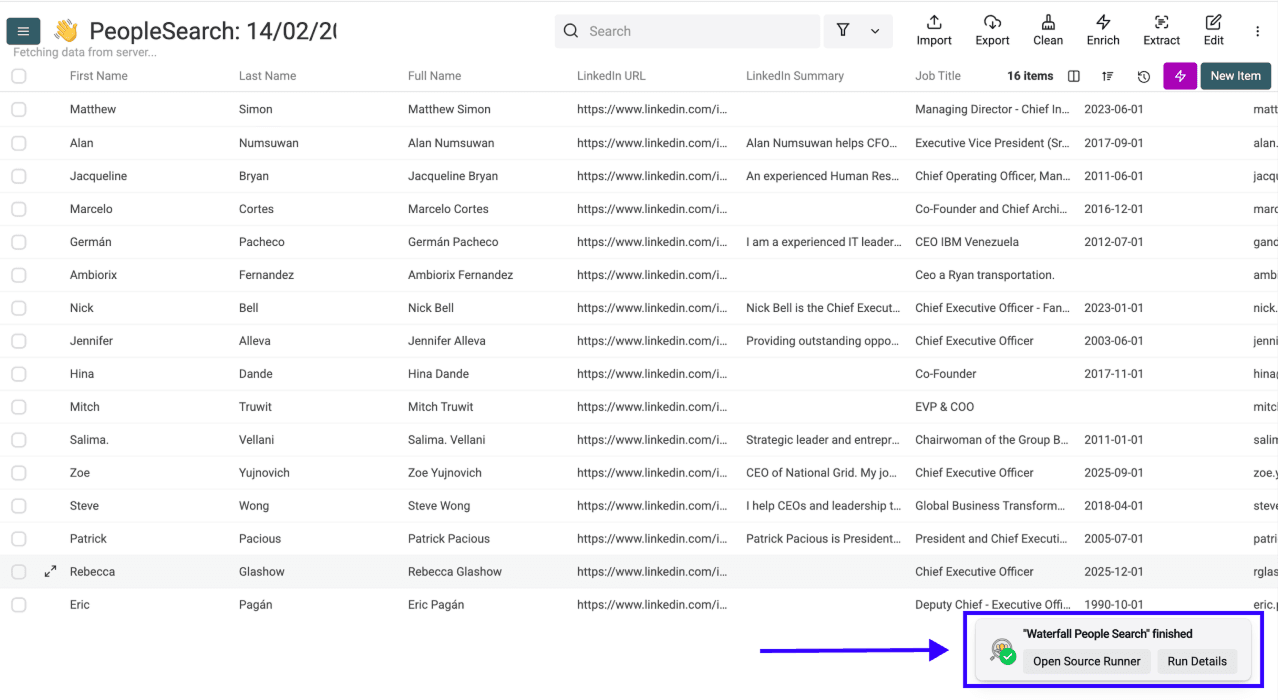
第 6 步:检查 Lead List
几分钟后,Collection 中就会出现姓名、职位和邮箱,并与发现这些联系人的职位数据对应。这是一条基于实时招聘信号、可以直接联系的 Lead,而不是静态的冷名单。
找到招聘负责人,职位数据才真正有价值
抓取 LinkedIn 职位很有用,但仅靠这些数据还无法真正获得 Leads。LinkedIn 职位说明一家公司当下确实存在需求,但最终推进合作的是负责招聘的人,而不是那则职位广告。
借助 Datablist,你可以在一个平台内完成整套无代码工作流:从职位到域名,再到联系人,将招聘信号转化为可直接开展 Outbound 的 Leads。
LinkedIn 职位抓取常见问题
用 Datablist 抓取 LinkedIn 职位需要多少钱?
每导入一条职位,scraper 收取 2 credits,约合 0.002 美元。Datablist 试用方案会赠送 500 credits,足够抓取 250 条 LinkedIn 职位。
批量抓取 LinkedIn 职位需要多久?
大多数任务几分钟内即可完成。设置关键词、地点和每次搜索的结果上限后启动任务,职位数据就会自动进入 Collection,你可以同时处理其他工作。
每次搜索能抓取多少条 LinkedIn 职位?
每次搜索最多返回 500 条职位,而 LinkedIn 单次搜索最多显示 1,000 条结果。如果需要覆盖更多数据,可以使用多组关键词和地点拆分任务,因为每一种组合都会作为独立搜索运行。
抓取 LinkedIn 职位能获得哪些数据?
每条职位会返回 13 个字段,包括职位名称、描述、职级、职能、行业和雇佣类型,以及公司名称、公司 LinkedIn URL、职位链接、职位 ID、地点、国家和添加日期。
抓取 LinkedIn 职位需要会编程吗?
不需要。使用 Datablist 时,整套工作流都是无代码的:选择 scraper,输入关键词和地点,然后运行即可。你不必维护脚本,也不用管理 API keys。
能从抓取的职位中找到招聘负责人邮箱吗?
可以。将公司名称转换为域名后,Waterfall People Search 可以根据职位名称查找相关人员,并在找到时返回邮箱。你可以定位招聘负责人、创始人、企业主或 HR 负责人。
可以无代码抓取 LinkedIn 职位吗?
可以。托管式无代码 scraper 会替你完成数据提取,并将职位作为结构化数据行返回,因此无需编写任何 Python,也不用安装浏览器扩展。
如何抓取 LinkedIn 职位而不被封号?
关键是让 scraper 在自己的基础设施上运行,而不是在你已登录的会话中抓取。免费脚本和扩展通常会直接通过个人账号获取数据,因此更容易触发封锁。Datablist 的 Sales Navigator Scraper 也采用同样的方式:不会给你的账号带来风险。
能把 LinkedIn 职位导出为 CSV 或电子表格吗?
LinkedIn 本身无法导出职位数据,这正是问题所在。Datablist 的 scraper 会将职位收集为结构化列表,方便你随时筛选、Enrich 和导出。
应该用 Python 脚本还是无代码工具抓取职位?
如果你是愿意长期维护脚本的开发者,Python 脚本也可以使用。但对于不懂技术的招聘人员,无代码职位抓取工具运行更快、账号风险更低,也不会因为页面布局每次变化就失效。
抓取 LinkedIn 职位还是购买现成 Lead List?
抓取职位可以获得来自真实招聘需求的最新信号,这是静态购买名单无法提供的。你还能自主控制目标条件,确保每条 Lead 都对应一个真实、当前有效的招聘职位。
招聘人员能如何利用抓取的职位数据?
职位发布能告诉你哪些公司当下正在招聘。将它 Enrich 为公司域名和决策人联系人后,你就有了自然且有针对性的沟通理由:你明确知道,对方存在你的服务能够解决的需求。