
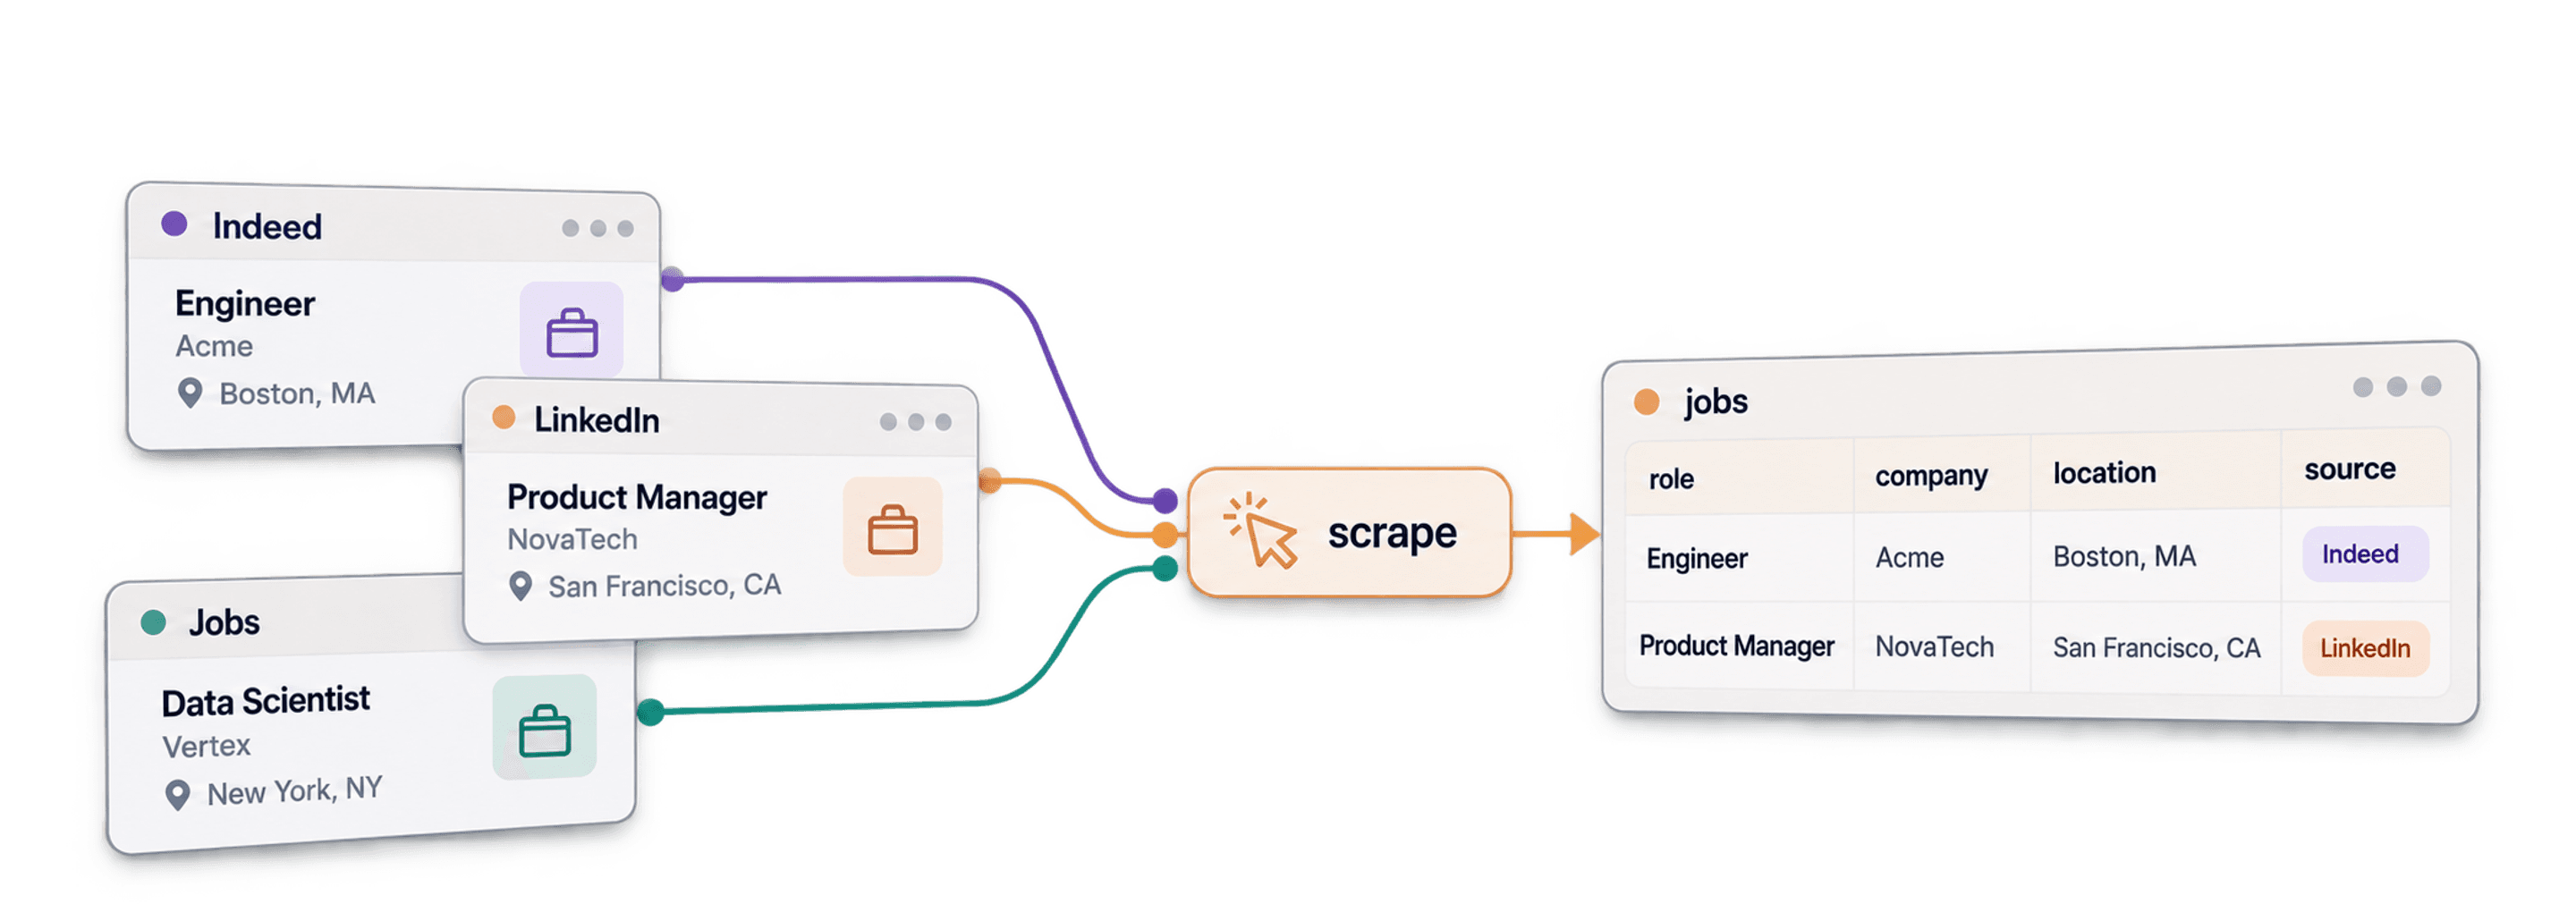
要使用 Datablist 抓取招聘网站,请打开 Job Postings Search,选择关键词和国家/地区,然后将匹配的职位导入 Collection。你也可以搜索 CRM 中现有公司的招聘职位。请保留职位 ID、公司网站和发布日期,以便再次搜索时对比结果。
建议将目标分成两类:发现正在招聘的新公司,以及监控已知公司的新职位。排除之前找到的公司有助于实现第一个目标,但对于第二个目标,这样做会漏掉这些公司后来发布的新职位。
本指南将介绍基于筛选条件和公司名单的两种搜索方式、可采集的字段,以及如何通过重复搜索跟踪新职位,同时避免重复计算同一职位。
📺 更喜欢看视频?
如果你和我一样更喜欢看视频而不是读文章,可以观看这段视频:如何同时抓取 19 个招聘网站的职位信息 👈🏽
本文内容概览
- 同时抓取 19 个招聘网站的方法
- Datablist 支持抓取的招聘网站
- 批量抓取多个招聘网站的详细教程
- 按 CRM 公司名单抓取招聘职位的教程
- 为什么要同时抓取 19 个招聘网站
- 如何将招聘数据用于销售和营销
同时抓取 19 个招聘网站的方法
如果想同时抓取 19 个招聘网站,你有两种选择:
- 自己为每个招聘网站开发 Scraper,并处理复杂的代码
- 使用 Datablist 的招聘网站 Scraper,聚合全球 19 个招聘平台的数据
Datablist 会通过数据供应商搜索聚合后的职位数据库。搜索会返回符合条件且已被收录的职位,而不是每次都从头爬取所有招聘网站。不同职位的数据覆盖范围和可用字段可能有所差异,因此在使用前,请检查职位对应的来源 URL。
💡 Datablist 是什么?
Datablist 是一个用于构建 Lead Generation 工作流的平台。借助超过 60 种工具,用户可以轻松查找、丰富和清洗数据,包括 AI Agents、Email Finders、AI processors 和 Technology enrichments 等。
此外,Datablist 还能创建按计划或按需运行的自动化工作流。以下是一些深受用户欢迎的实际应用场景:
- 构建 Lead 名单
- 利用 AI 个性化邮件
- 清洗 CRM 数据并删除重复项
- 一次抓取 19 个招聘网站的职位
- 在不影响账号安全的情况下抓取 LinkedIn Sales Navigator 搜索结果
相信你已经明白了:如果你需要获取或清洗数据,或者自动化涉及数据的工作流,同时又希望整个过程简单、快速、可靠,Datablist 会是一个合适的选择。
Datablist 支持抓取的招聘网站
与市面上的其他招聘数据 Scraper 相比,Datablist 有一些独特优势。它可以同时聚合 19 个招聘网站的数据,省去你分别创建和维护多个 Scraper 所需的大量时间。
以下是 Datablist 支持抓取的招聘网站:
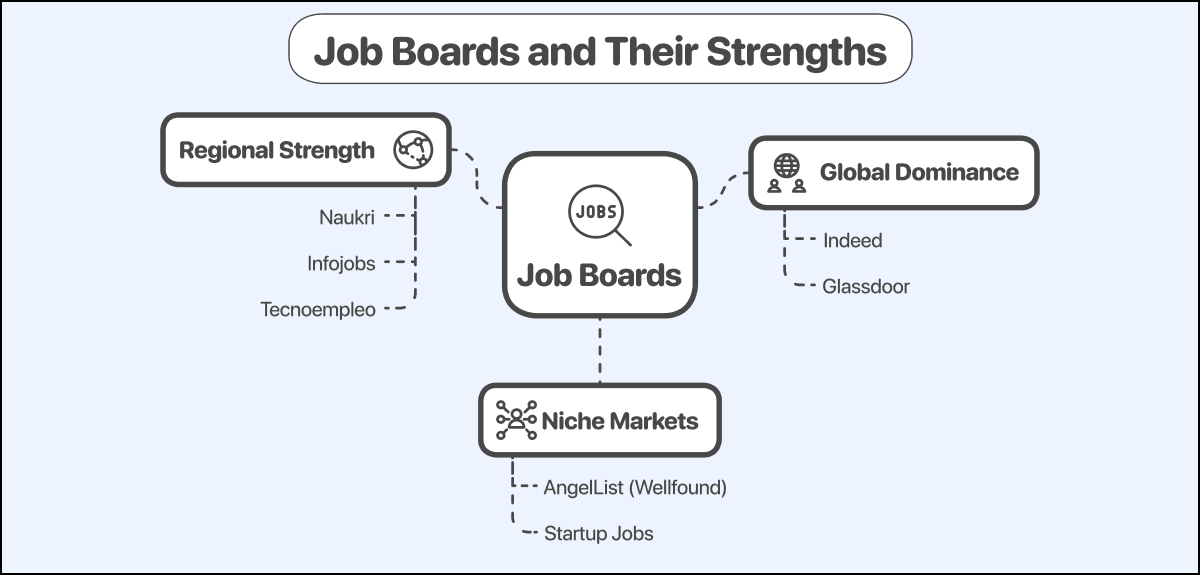
全球招聘网站:
- Indeed:覆盖全球大多数国家、地区和行业,是全球领先的招聘平台。
- Glassdoor:业务遍及全球,除职位信息外,也非常重视公司评价。
区域性招聘网站:
- 亚洲与大洋洲
- Seek:澳大利亚和新西兰的市场领导者
- Naukri:印度领先的招聘网站,拥有数百万条职位信息
- Naukri Gulf:专注于中东招聘市场
- JobsDB:在东南亚多个国家和地区拥有较强影响力
- Jobstreet:广泛应用于马来西亚、菲律宾、新加坡及其他亚洲市场
- 欧洲
- Infojobs:在西班牙及拉丁美洲部分地区占据领先地位
- Tecnoempleo:专注于西班牙市场,尤其擅长技术岗位招聘
- Welcome to The Jungle:法国大型招聘平台,并正向其他欧洲市场扩张
垂直招聘网站与 ATS 系统:
- Startup 生态
- AngelList(现为 Wellfound):主要面向美国科技行业的 Startup 职位
- Startup Jobs:专注于北美早期公司的招聘职位
- ATS 系统(Applicant Tracking Systems,招聘管理系统)
- Workable、Greenhouse、Lever、Ashby、Join、BambooHR、SimplyHired:Datablist 也会抓取这些系统中的职位,让你的招聘市场覆盖面更广
批量抓取多个招聘网站的详细教程
Datablist 希望用户能够充分掌控获取哪些数据,以及采用什么方式获取。
因此,我们提供两种抓取招聘职位的方式:
使用筛选条件抓取多个招聘网站
这一部分将介绍如何使用 Datablist 招聘信息聚合器的筛选条件,根据关键词、职级、地点等要求获取招聘职位。
开始吧!
首先,注册 Datablist。

创建一个 Collection。
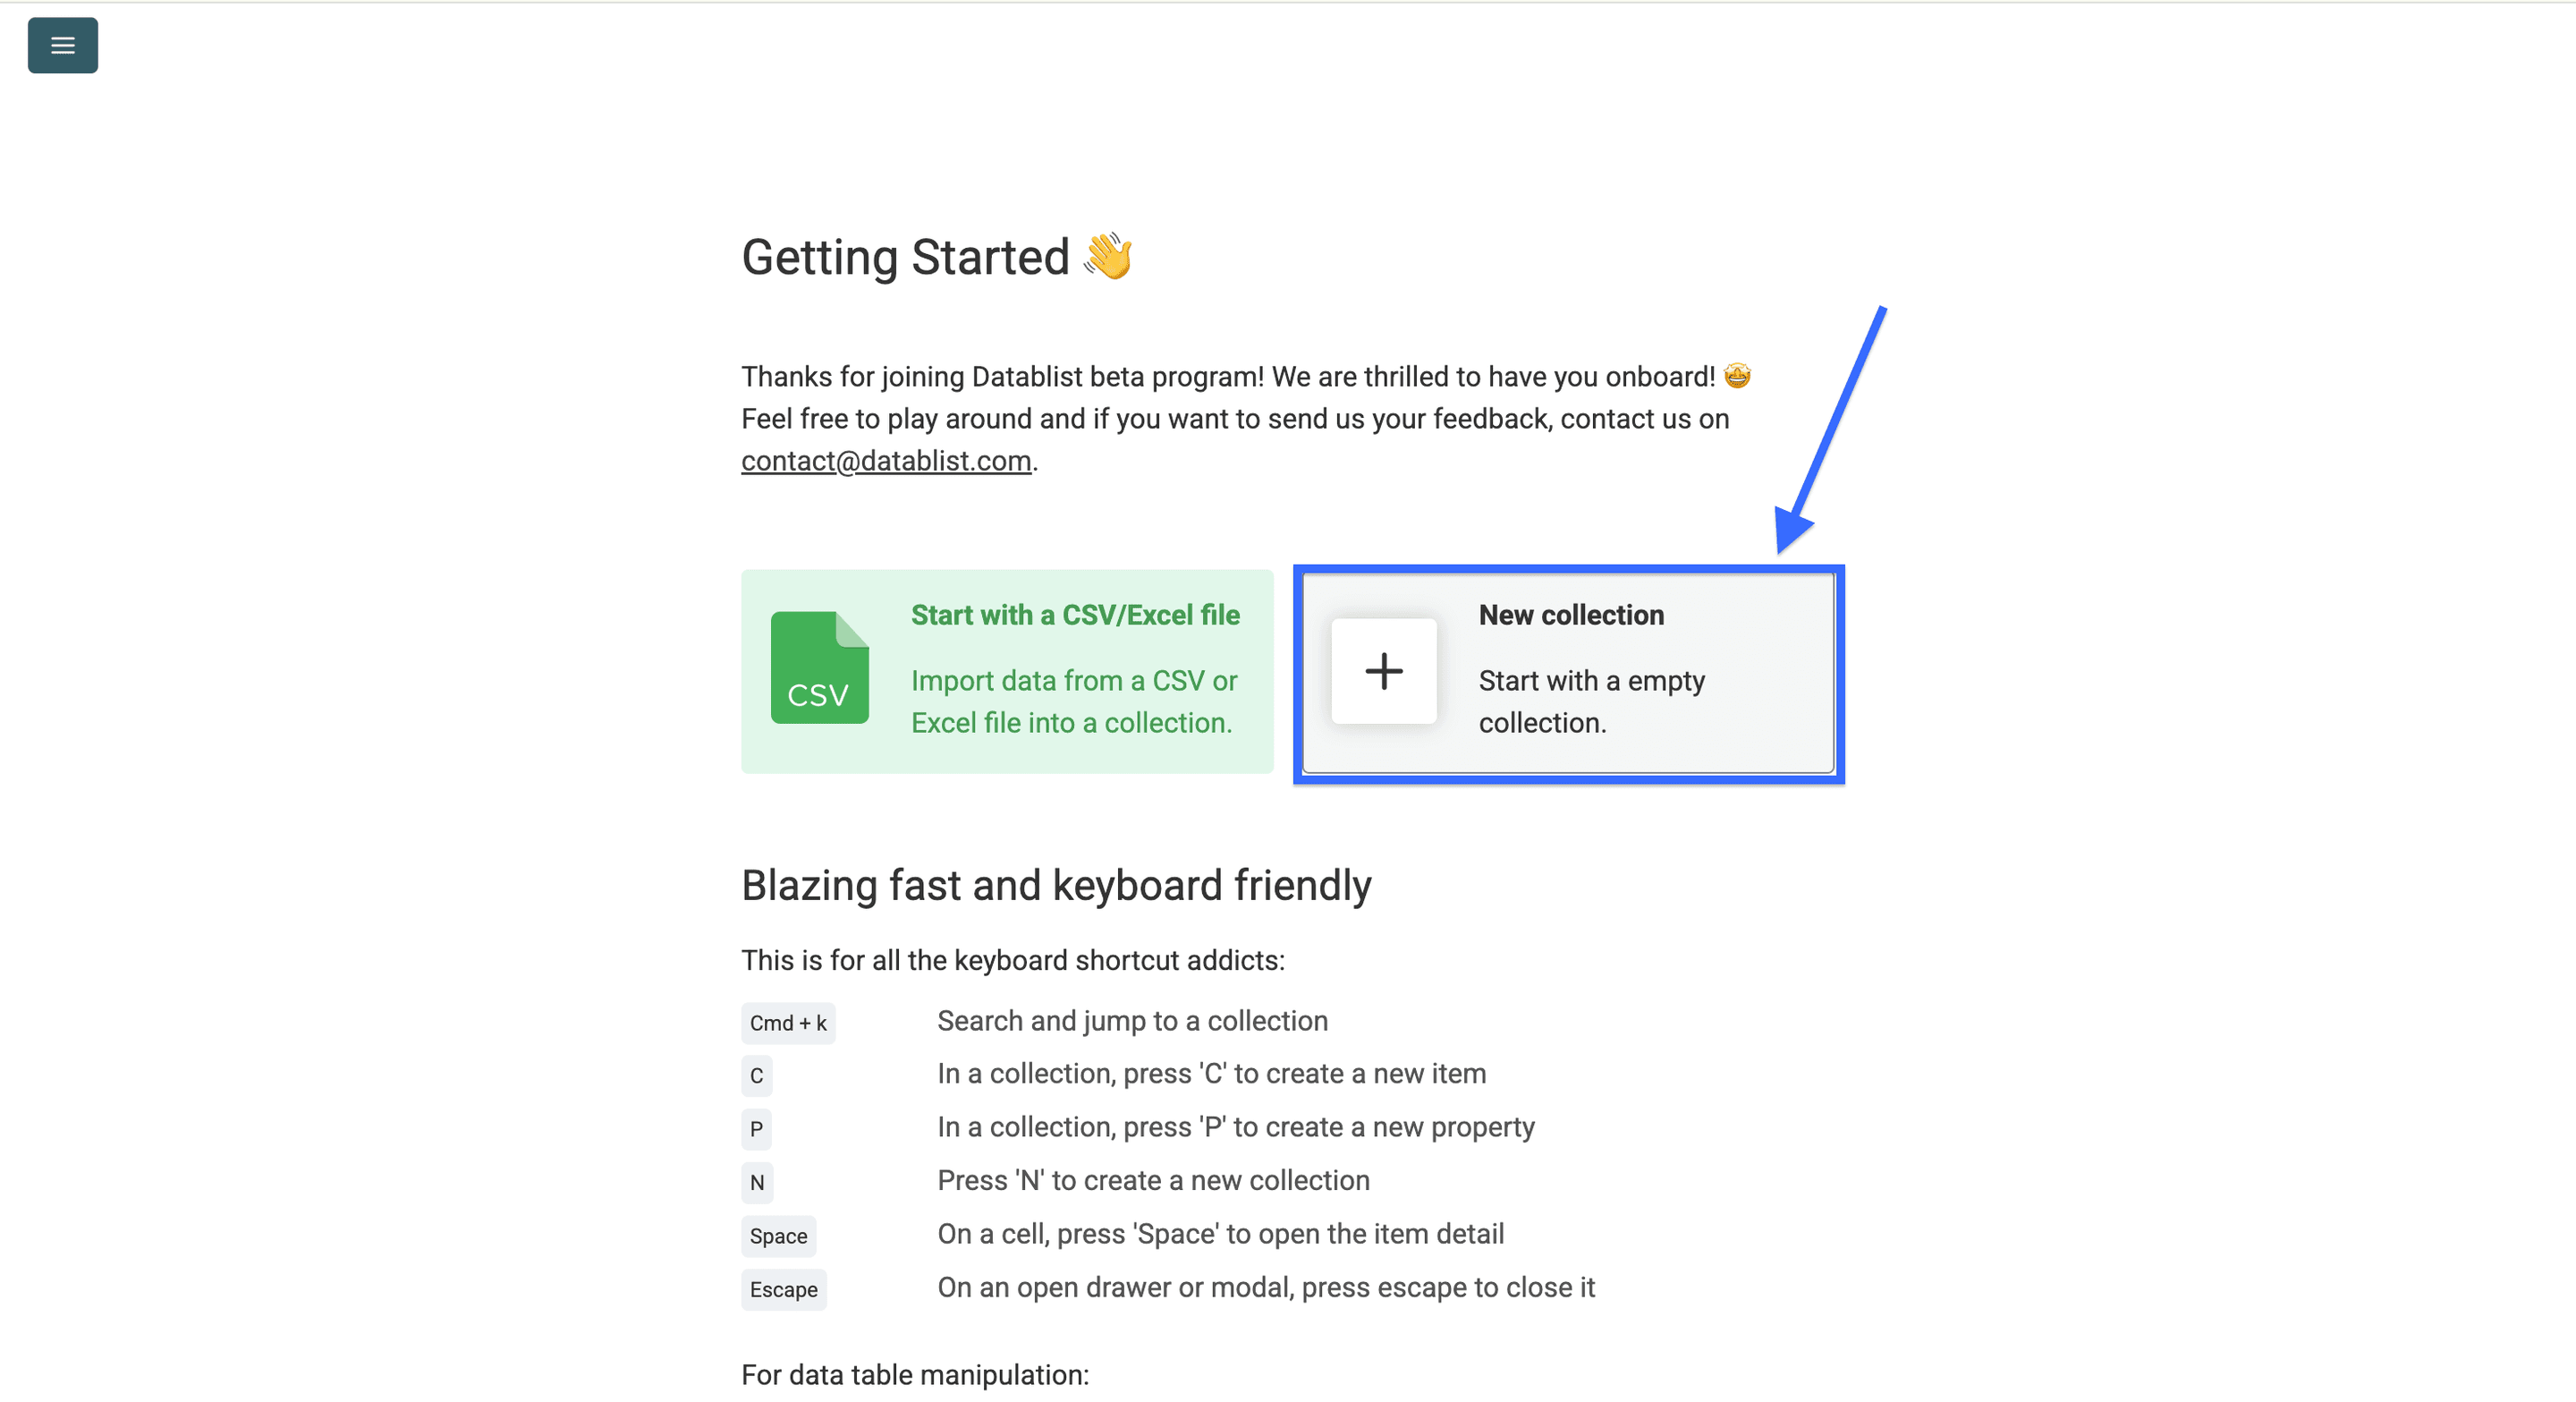
点击 Job Postings Search。
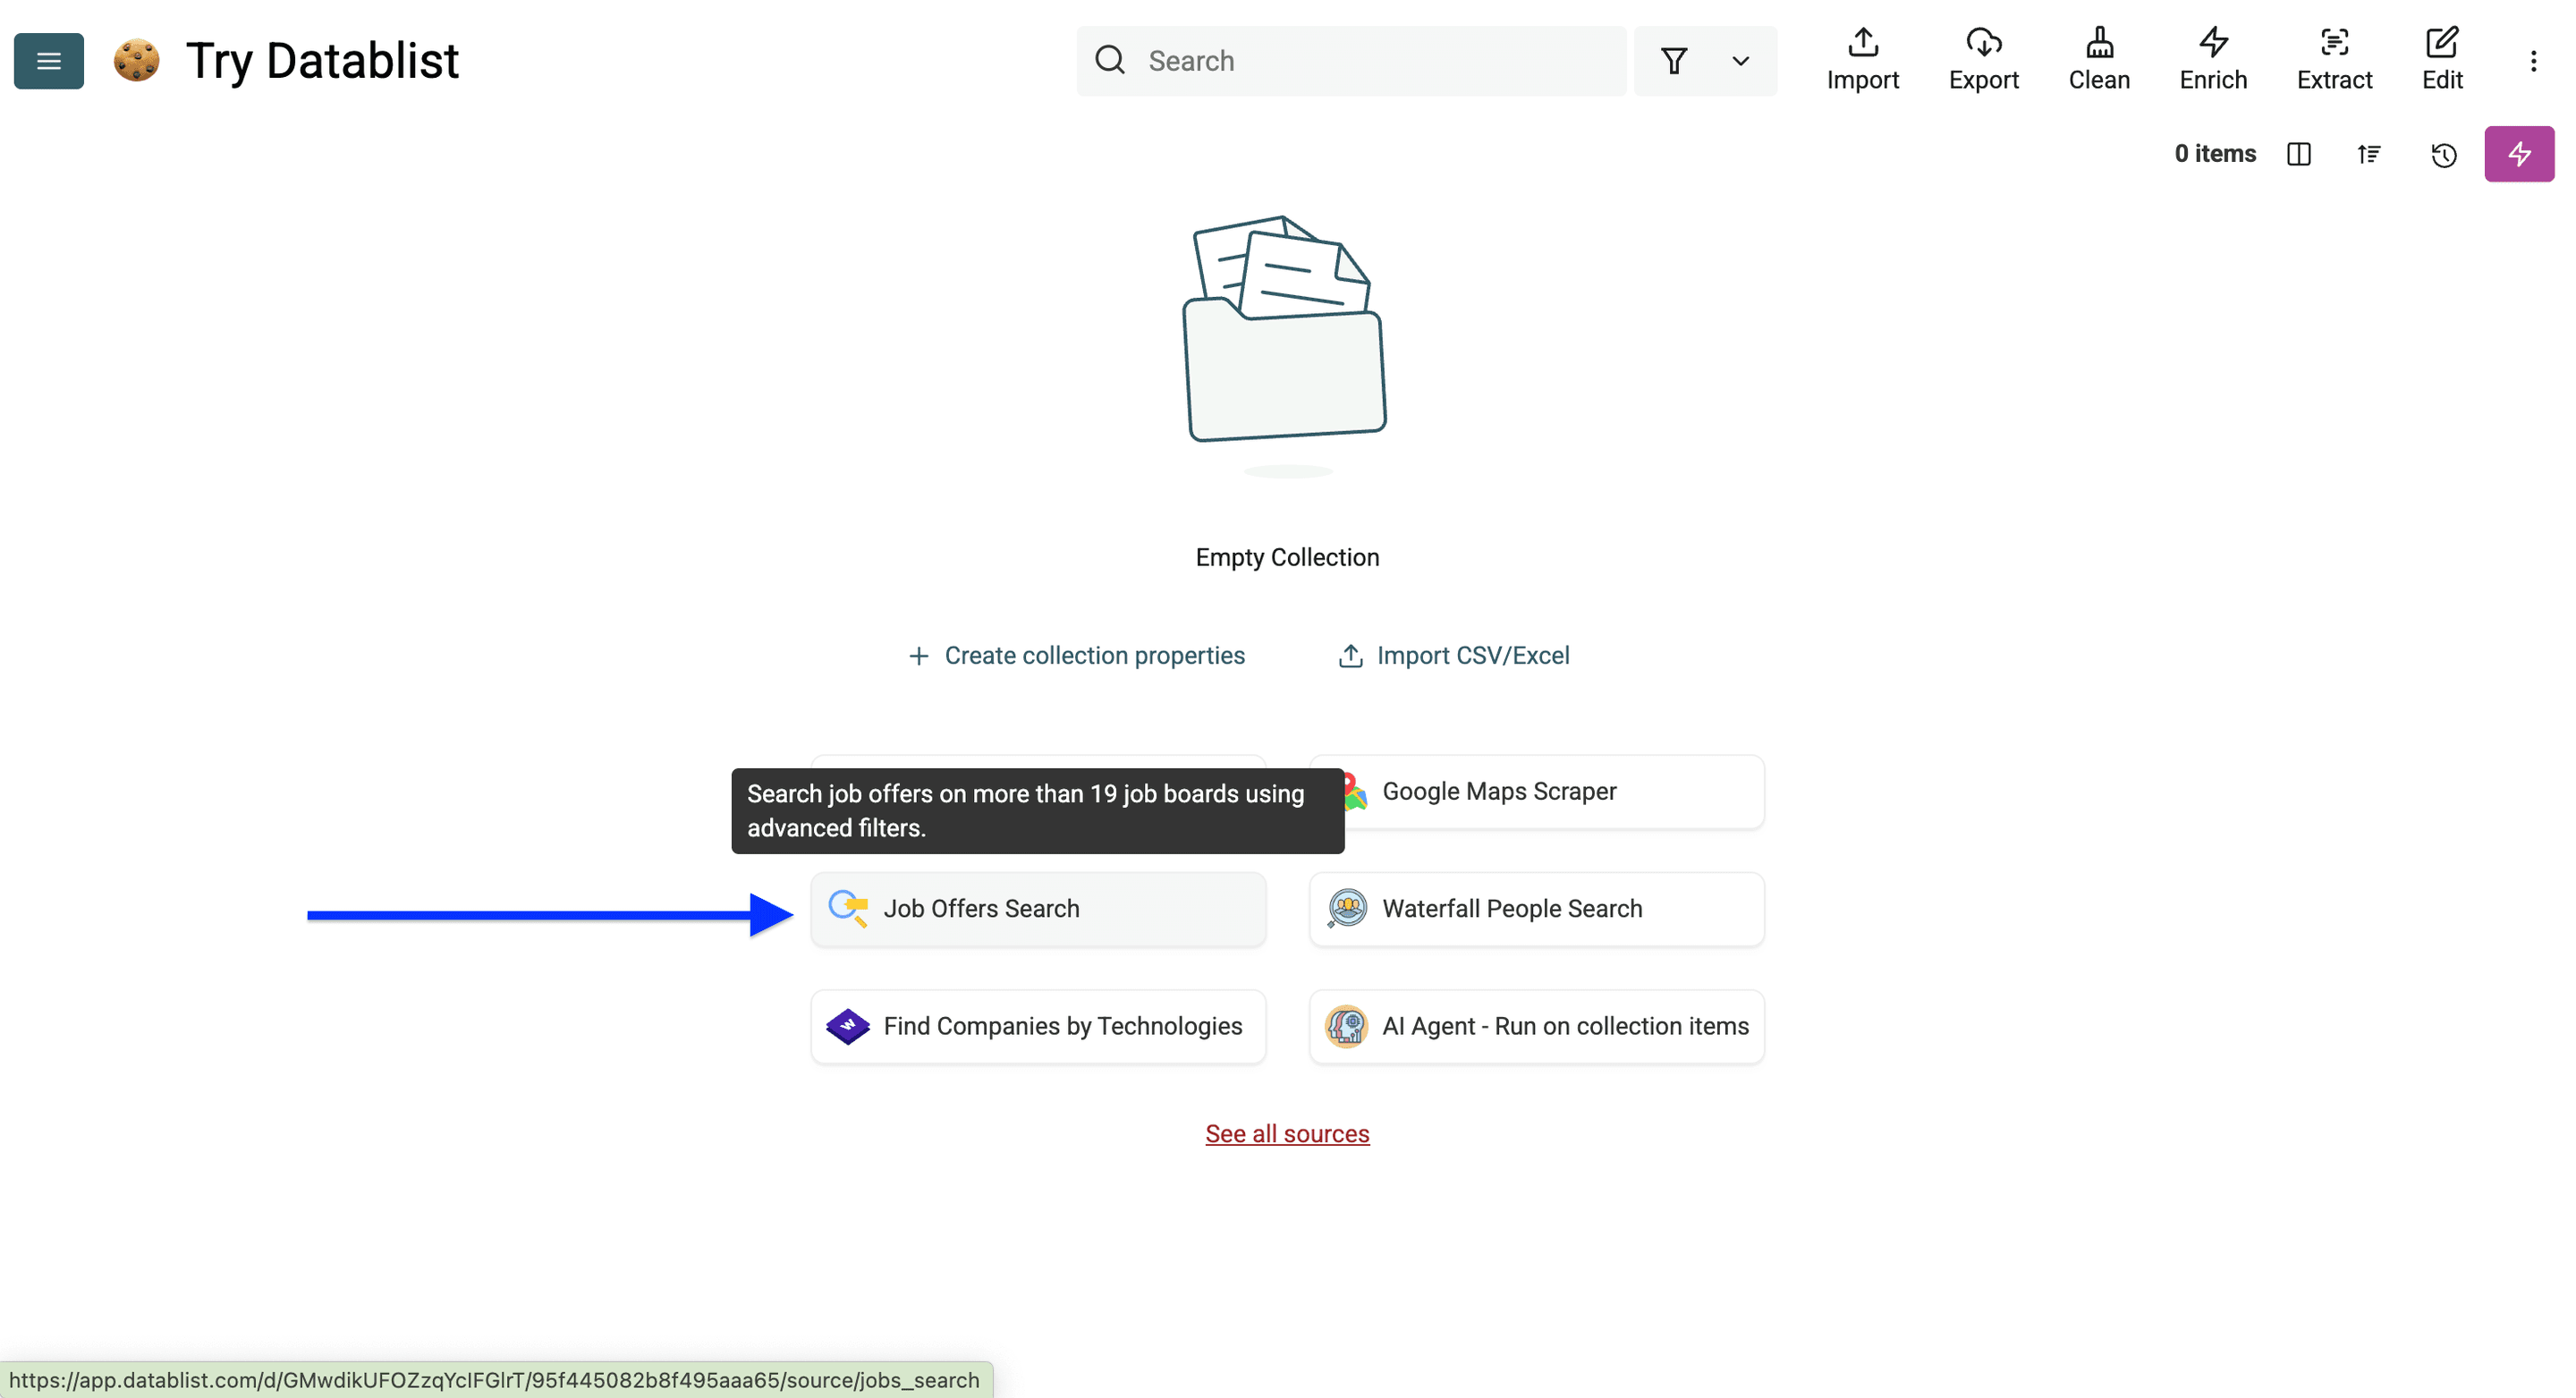
为目标职位配置筛选条件。当前显示的设置可能与旧版截图有所不同。
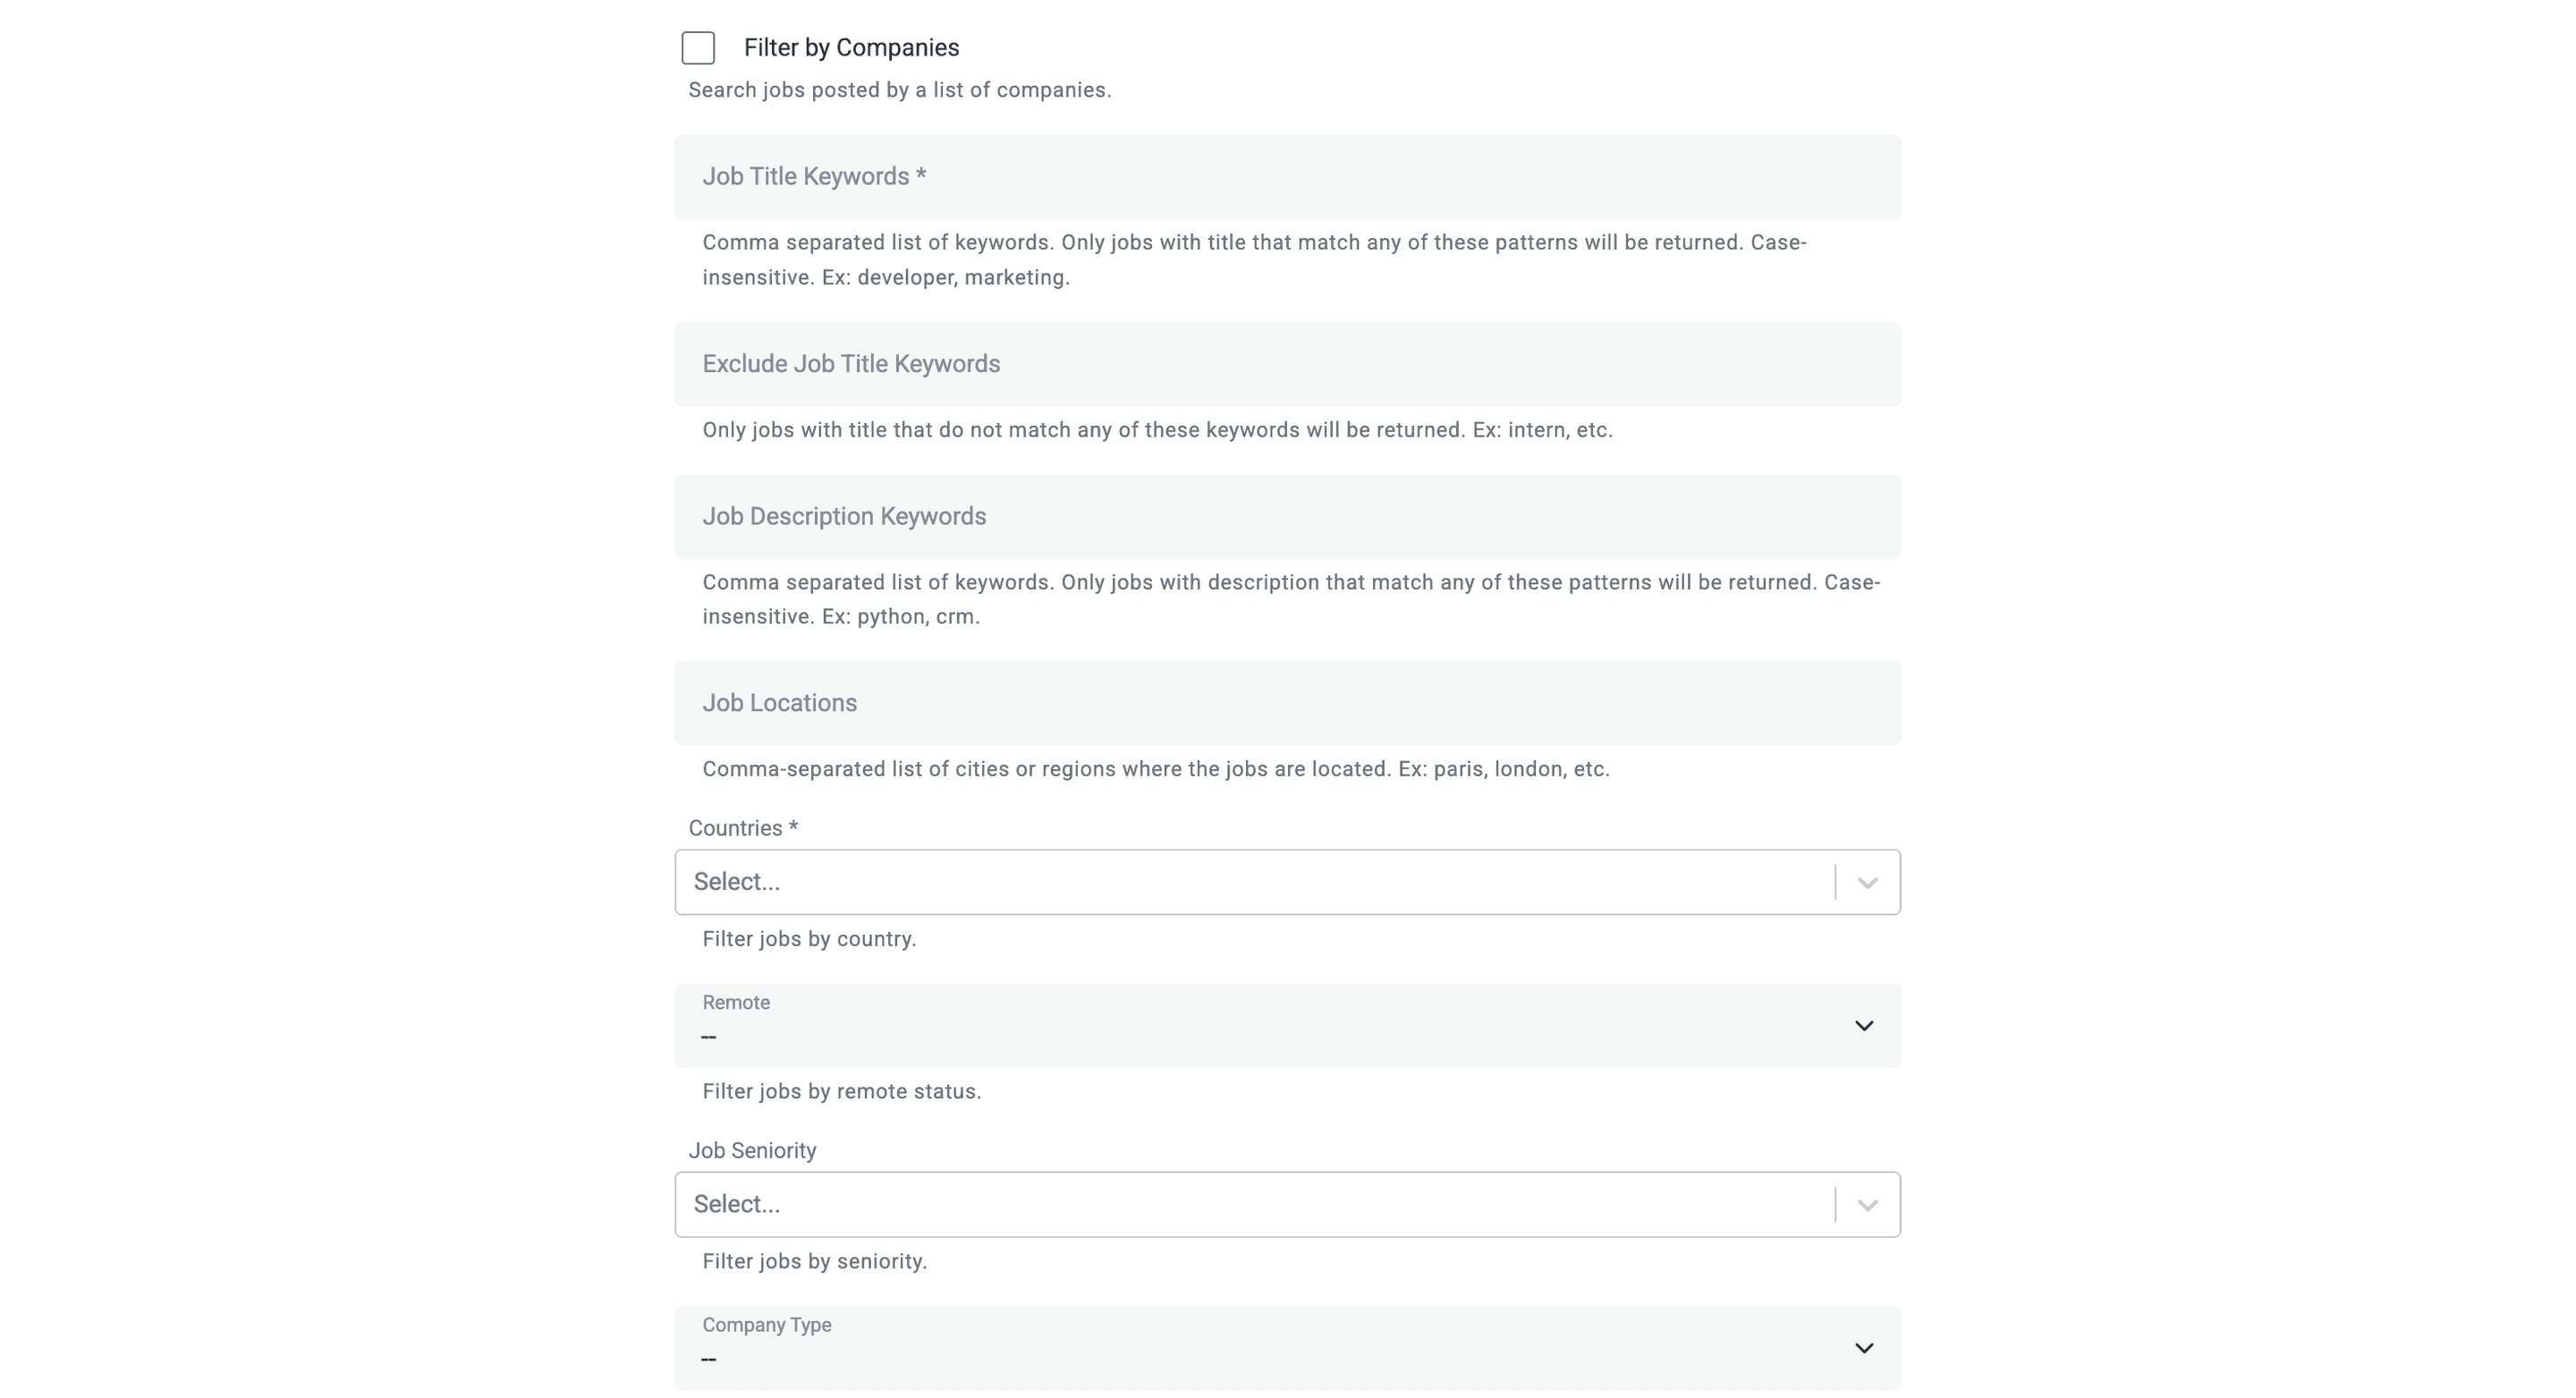
职位与公司筛选条件
建议先从范围较小的搜索开始。例如,要查找英国与 Python 相关的职位,可将 Job Description Keywords 设置为 python,在 Countries 中选择英国,将 Job Status 保持为 Only Open Jobs (default),在 Max Age 中选择 Last 7 days,并在首次运行时将 Limit 设为 100。
扩大搜索范围前,请先检查第一批结果。职位描述中提到 Python,并不一定意味着该岗位的主要工作是 Python 开发。
选择关键词的匹配方式:
- Job Title Keywords 接受以逗号分隔的词组。只要职位名称中包含某个词组的全部单词,即可匹配;匹配不区分大小写,也不限制单词顺序。例如,
data engineer可以匹配Senior Data Platform Engineer。 - Exclude Job Title Keywords 会排除标题中包含指定关键词的职位,例如包含
intern的岗位。 - Job Description Keywords 默认以纯文本方式匹配完整单词。
sales可以匹配sales manager,但不会匹配Salesforce。 - Use Regex for Description Matching 可启用正则表达式。在此模式下,Require All Description Patterns 可以要求职位描述匹配所有指定表达式,而不是任意一个。简单关键词搜索无需开启 Regex。
- Exclude Job Description Keywords 会沿用你选择的职位描述匹配模式。
选择职位地点和状态:
- Job Locations 用于筛选城市或地区;Countries 用于筛选职位所在国家。公司总部所在地需要使用单独的筛选条件。
- Workplace Types 提供 On-site、Hybrid 和 Remote;Employment Types 可筛选全职、兼职、合同工及其他用工类型。
- Job Seniority 用于筛选经验或职级。
- Job Status 可以返回开放、已关闭或全部职位。如需获取当前正在招聘的名单,请选择开放职位。
- Only with Recruiter Info 仅返回包含招聘人员信息的职位。部分职位可能只提供其中几个字段,因此请检查实际返回的数据。
选择公司和时间范围:
- Filter Job Postings for a specific list of Companies 会搜索 Collection 中指定公司的职位。具体操作请参阅公司名单工作流。
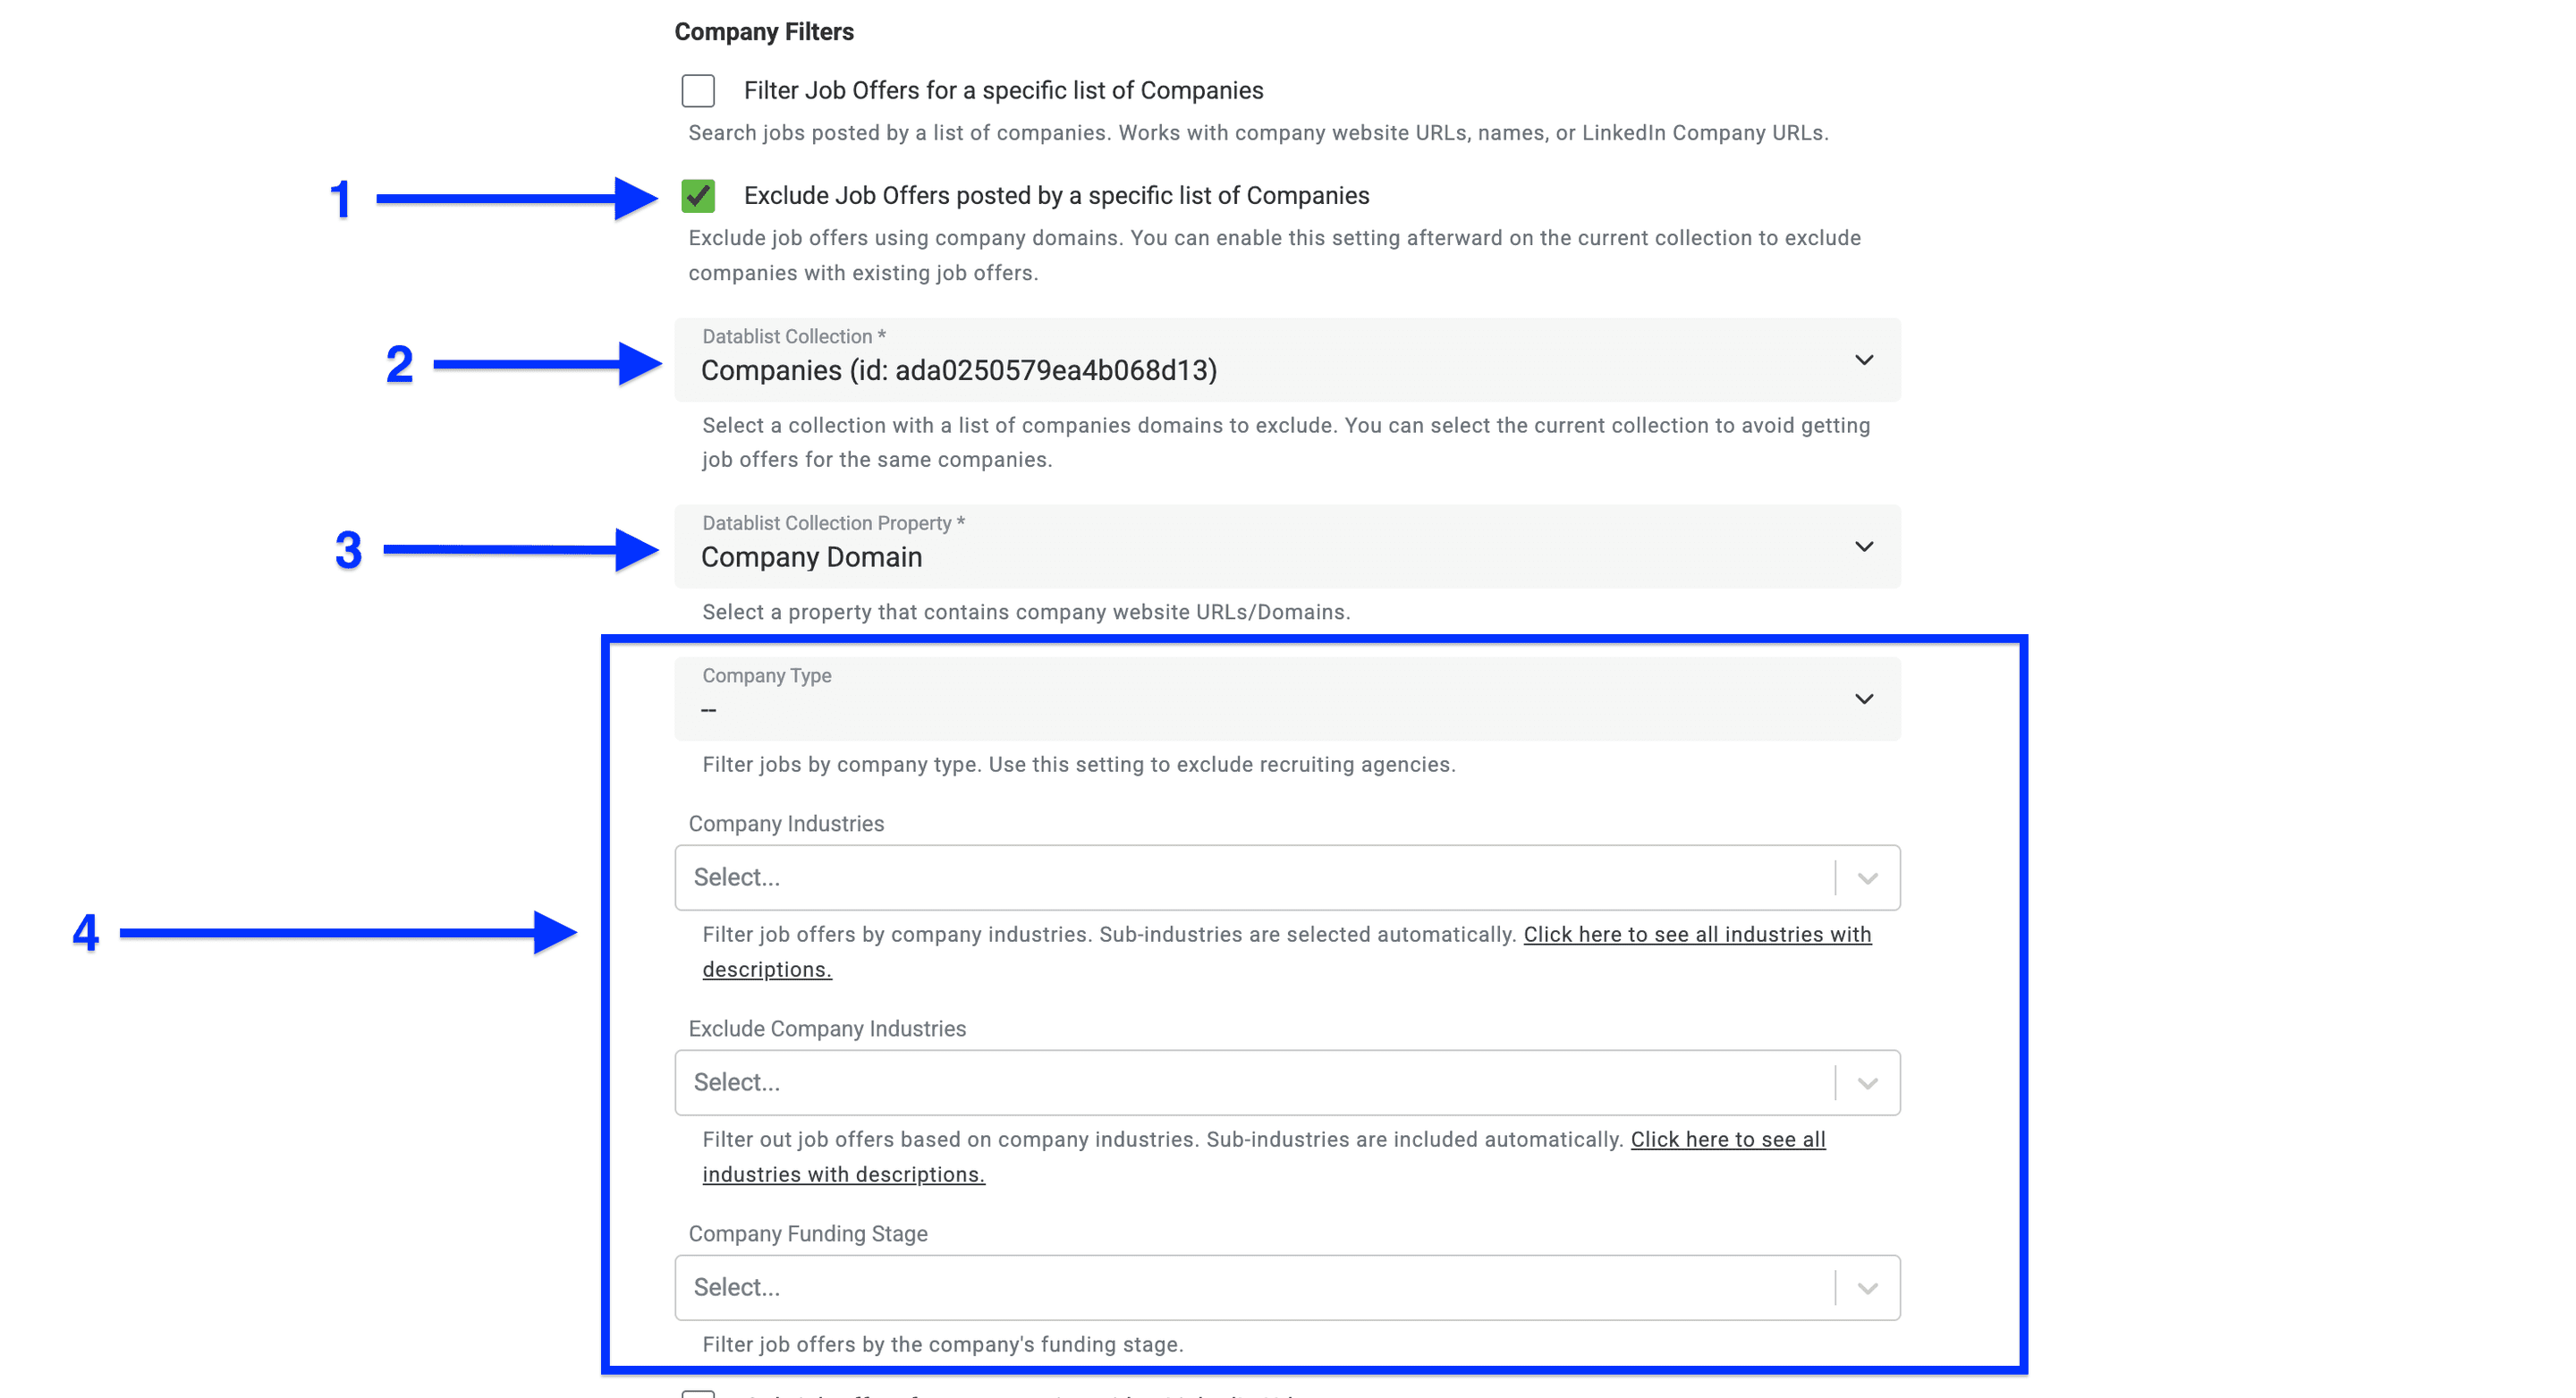
- Exclude Job Postings posted by a specific list of Companies 会排除所选公司域名发布的全部职位。它适合用于排除你明确不希望出现在结果中的公司。
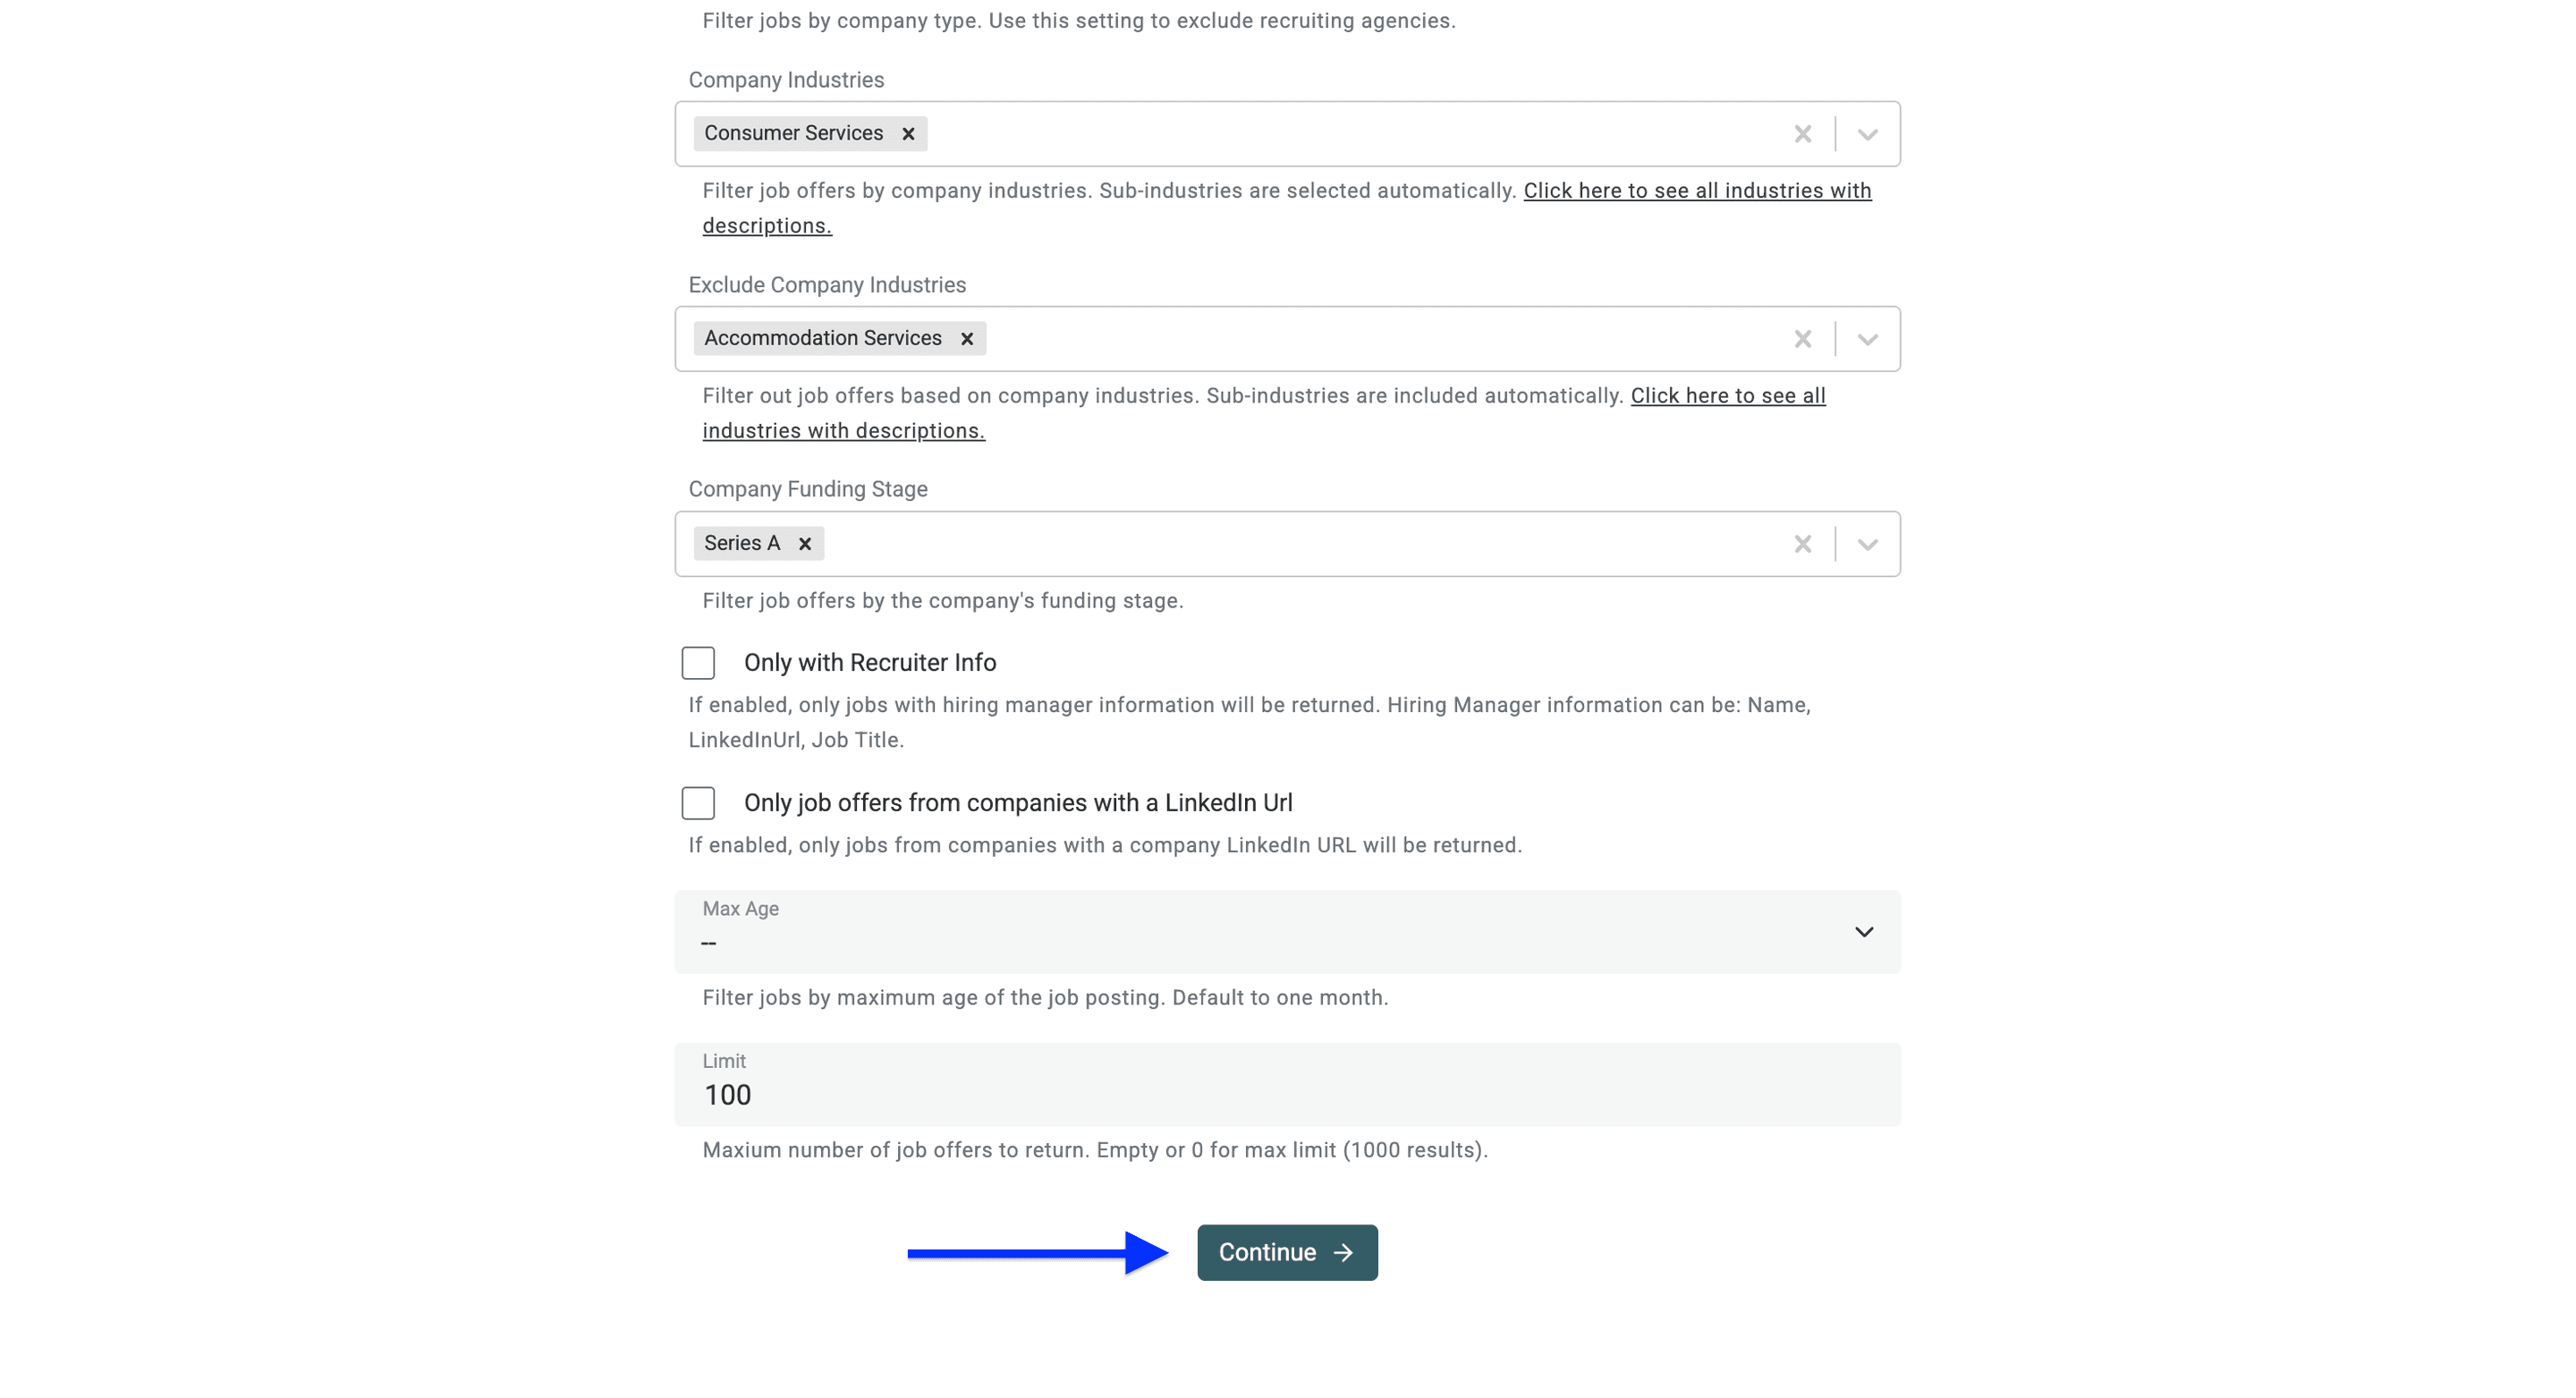
- 公司筛选条件包括 Company Type、Company Industries、Company Funding Stage,以及公司总部所在地或国家。
- Max Age 用于限制职位发布至今的最长时间。Posted On or After 和 Posted On or Before 可以定义精确日期范围;设置后会覆盖 Max Age。
- Limit 用于限制返回的职位数量。默认值为 1,000,每次搜索最多支持 2,000 条。如果结果达到上限,应进一步缩小搜索范围,而不能直接认为已经采集了所有匹配职位。
排除不需要监控的公司
排除公司适合用于过滤现有客户,或不属于目标范围的公司。**但这并不等同于职位级去重。**如果排除昨天找到的一家公司,那么该公司明天发布的另一个新职位也会被排除。
要设置公司排除名单:
- 启用 Exclude Job Postings posted by a specific list of Companies。
- 在 Datablist Collection 中选择排除名单。
- 将 Datablist Collection Property 映射到公司网站或域名所在的列。
开始搜索招聘职位
完成所有筛选条件设置后,点击 Continue。
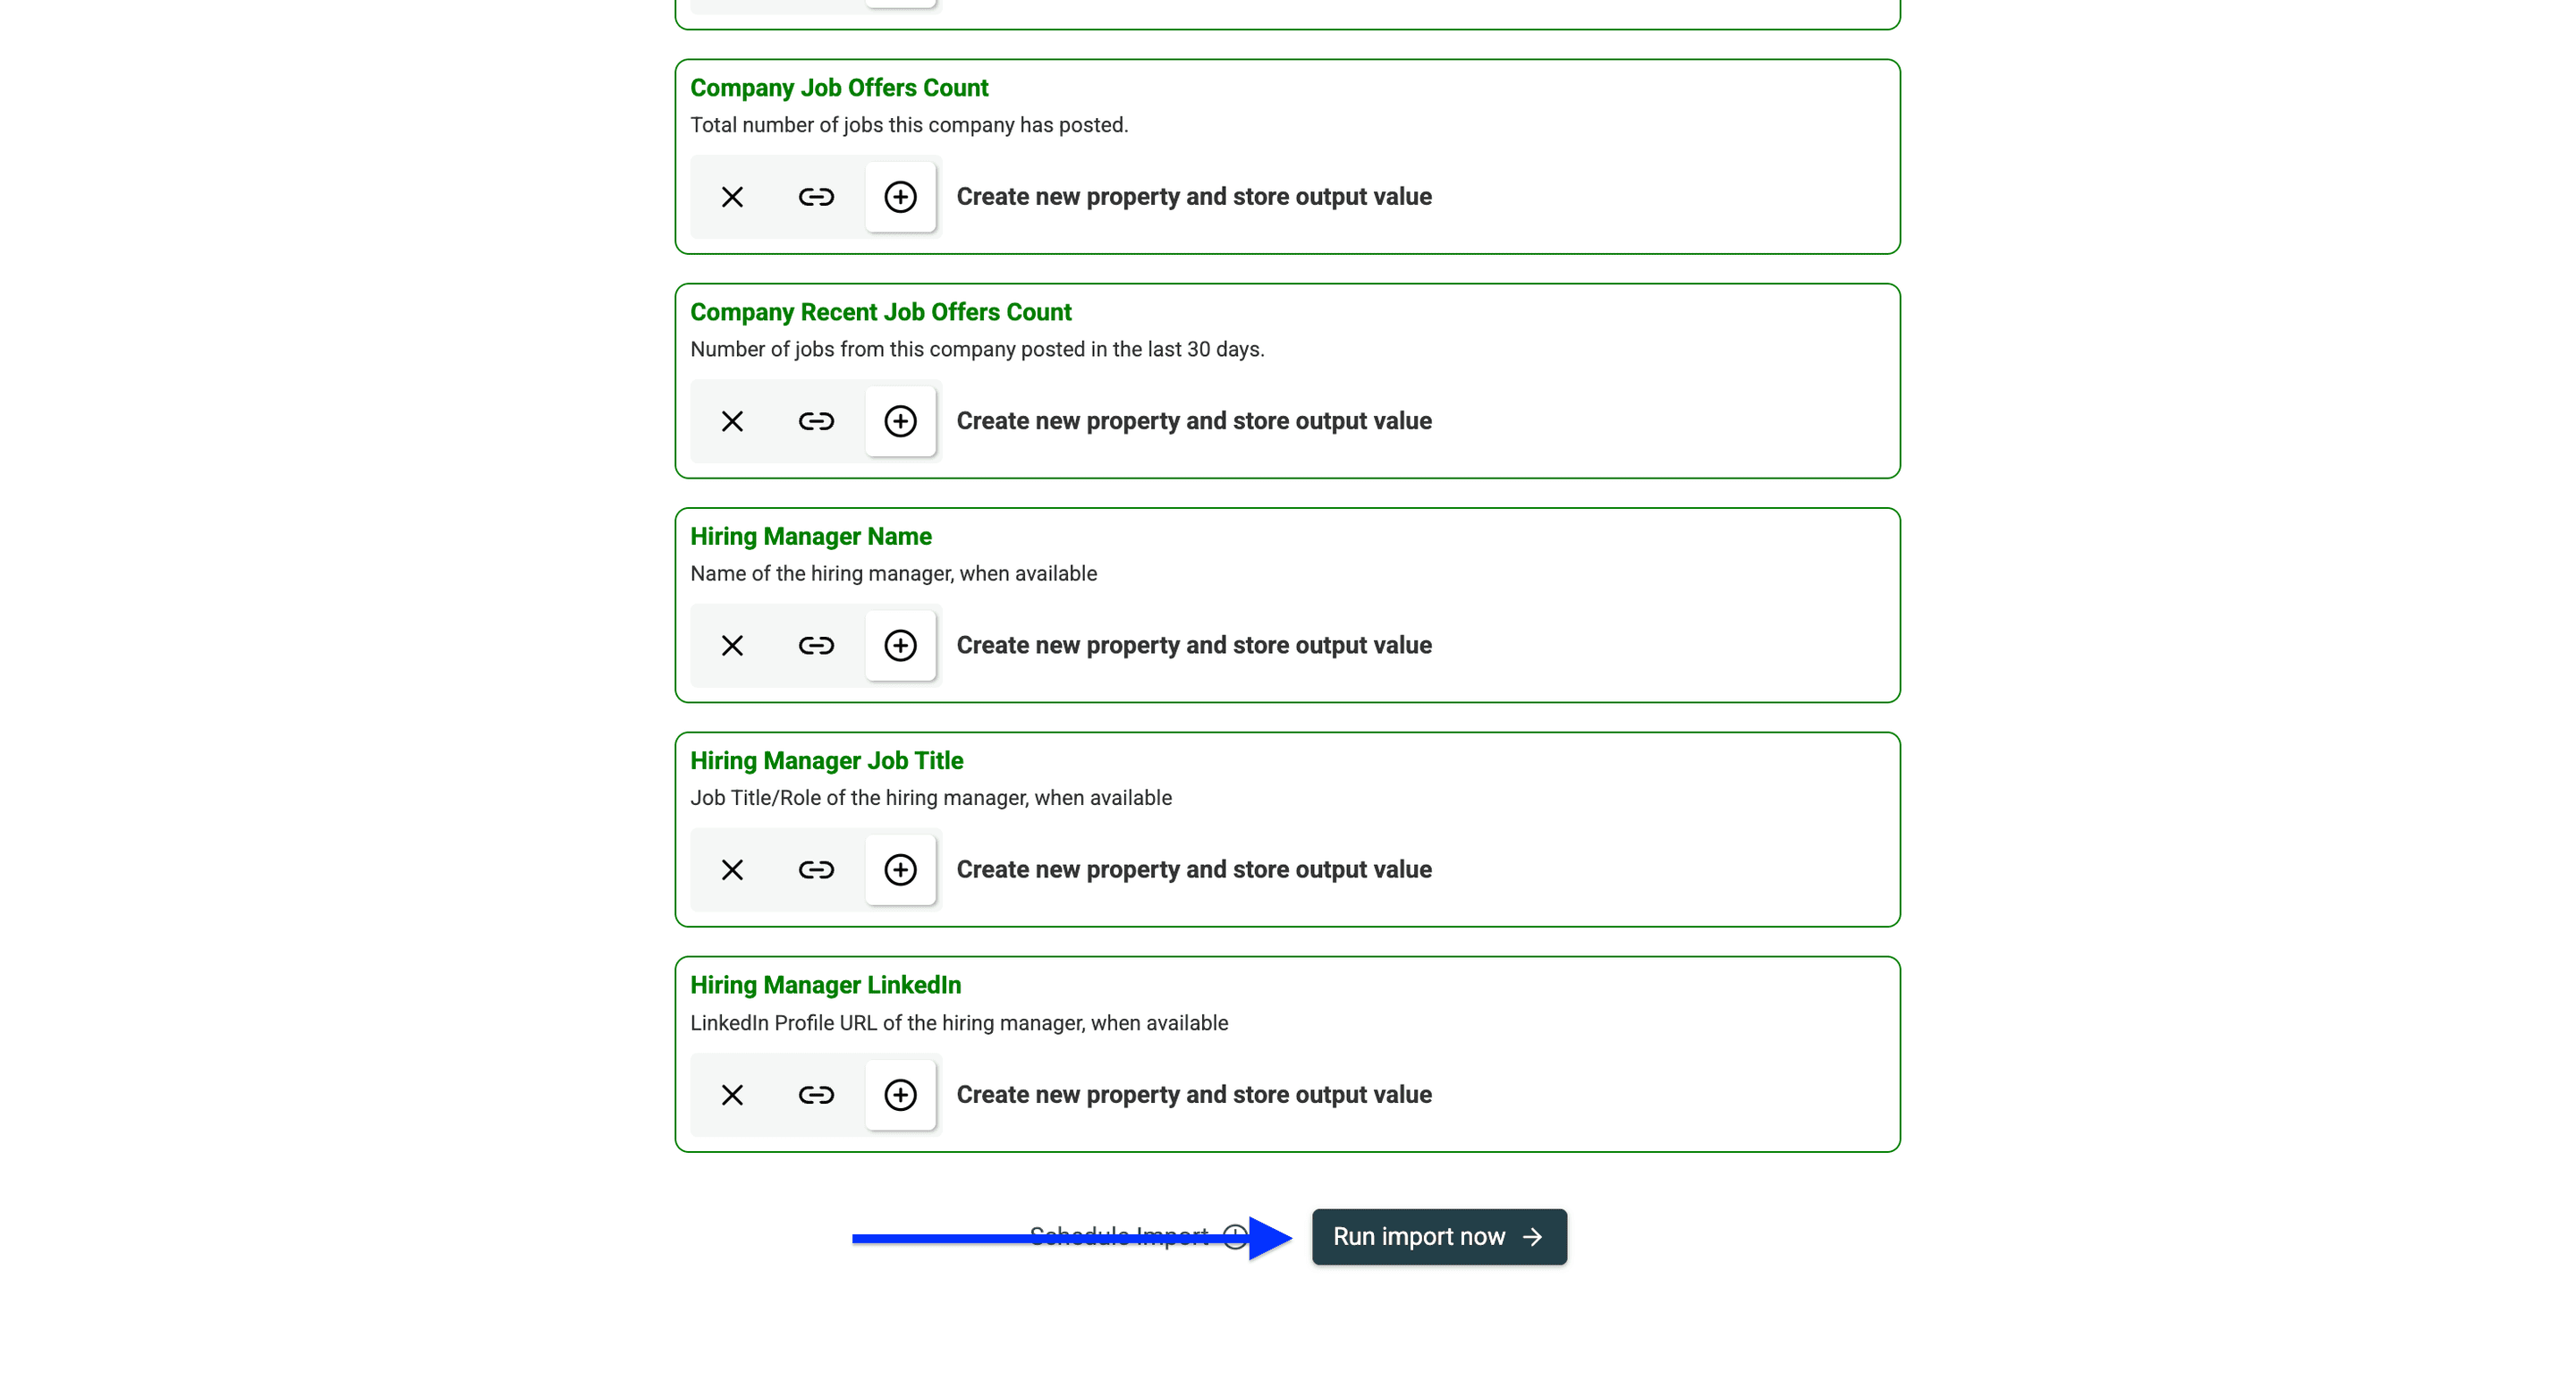
Datablist 将返回以下数据:
| 类别 | 字段 |
|---|---|
| 职位详情 | 职位名称、职位描述、职位类型、工作地点、所在国家、办公方式、职位级别、薪资范围 |
| 公司特征数据 | 公司名称、公司网站、LinkedIn URL、员工人数、员工规模区间、行业、成立年份、营收 |
| 其他信息 | 公司介绍、公司所在城市、公司所在国家、公司招聘职位总数、公司近期招聘职位数 |
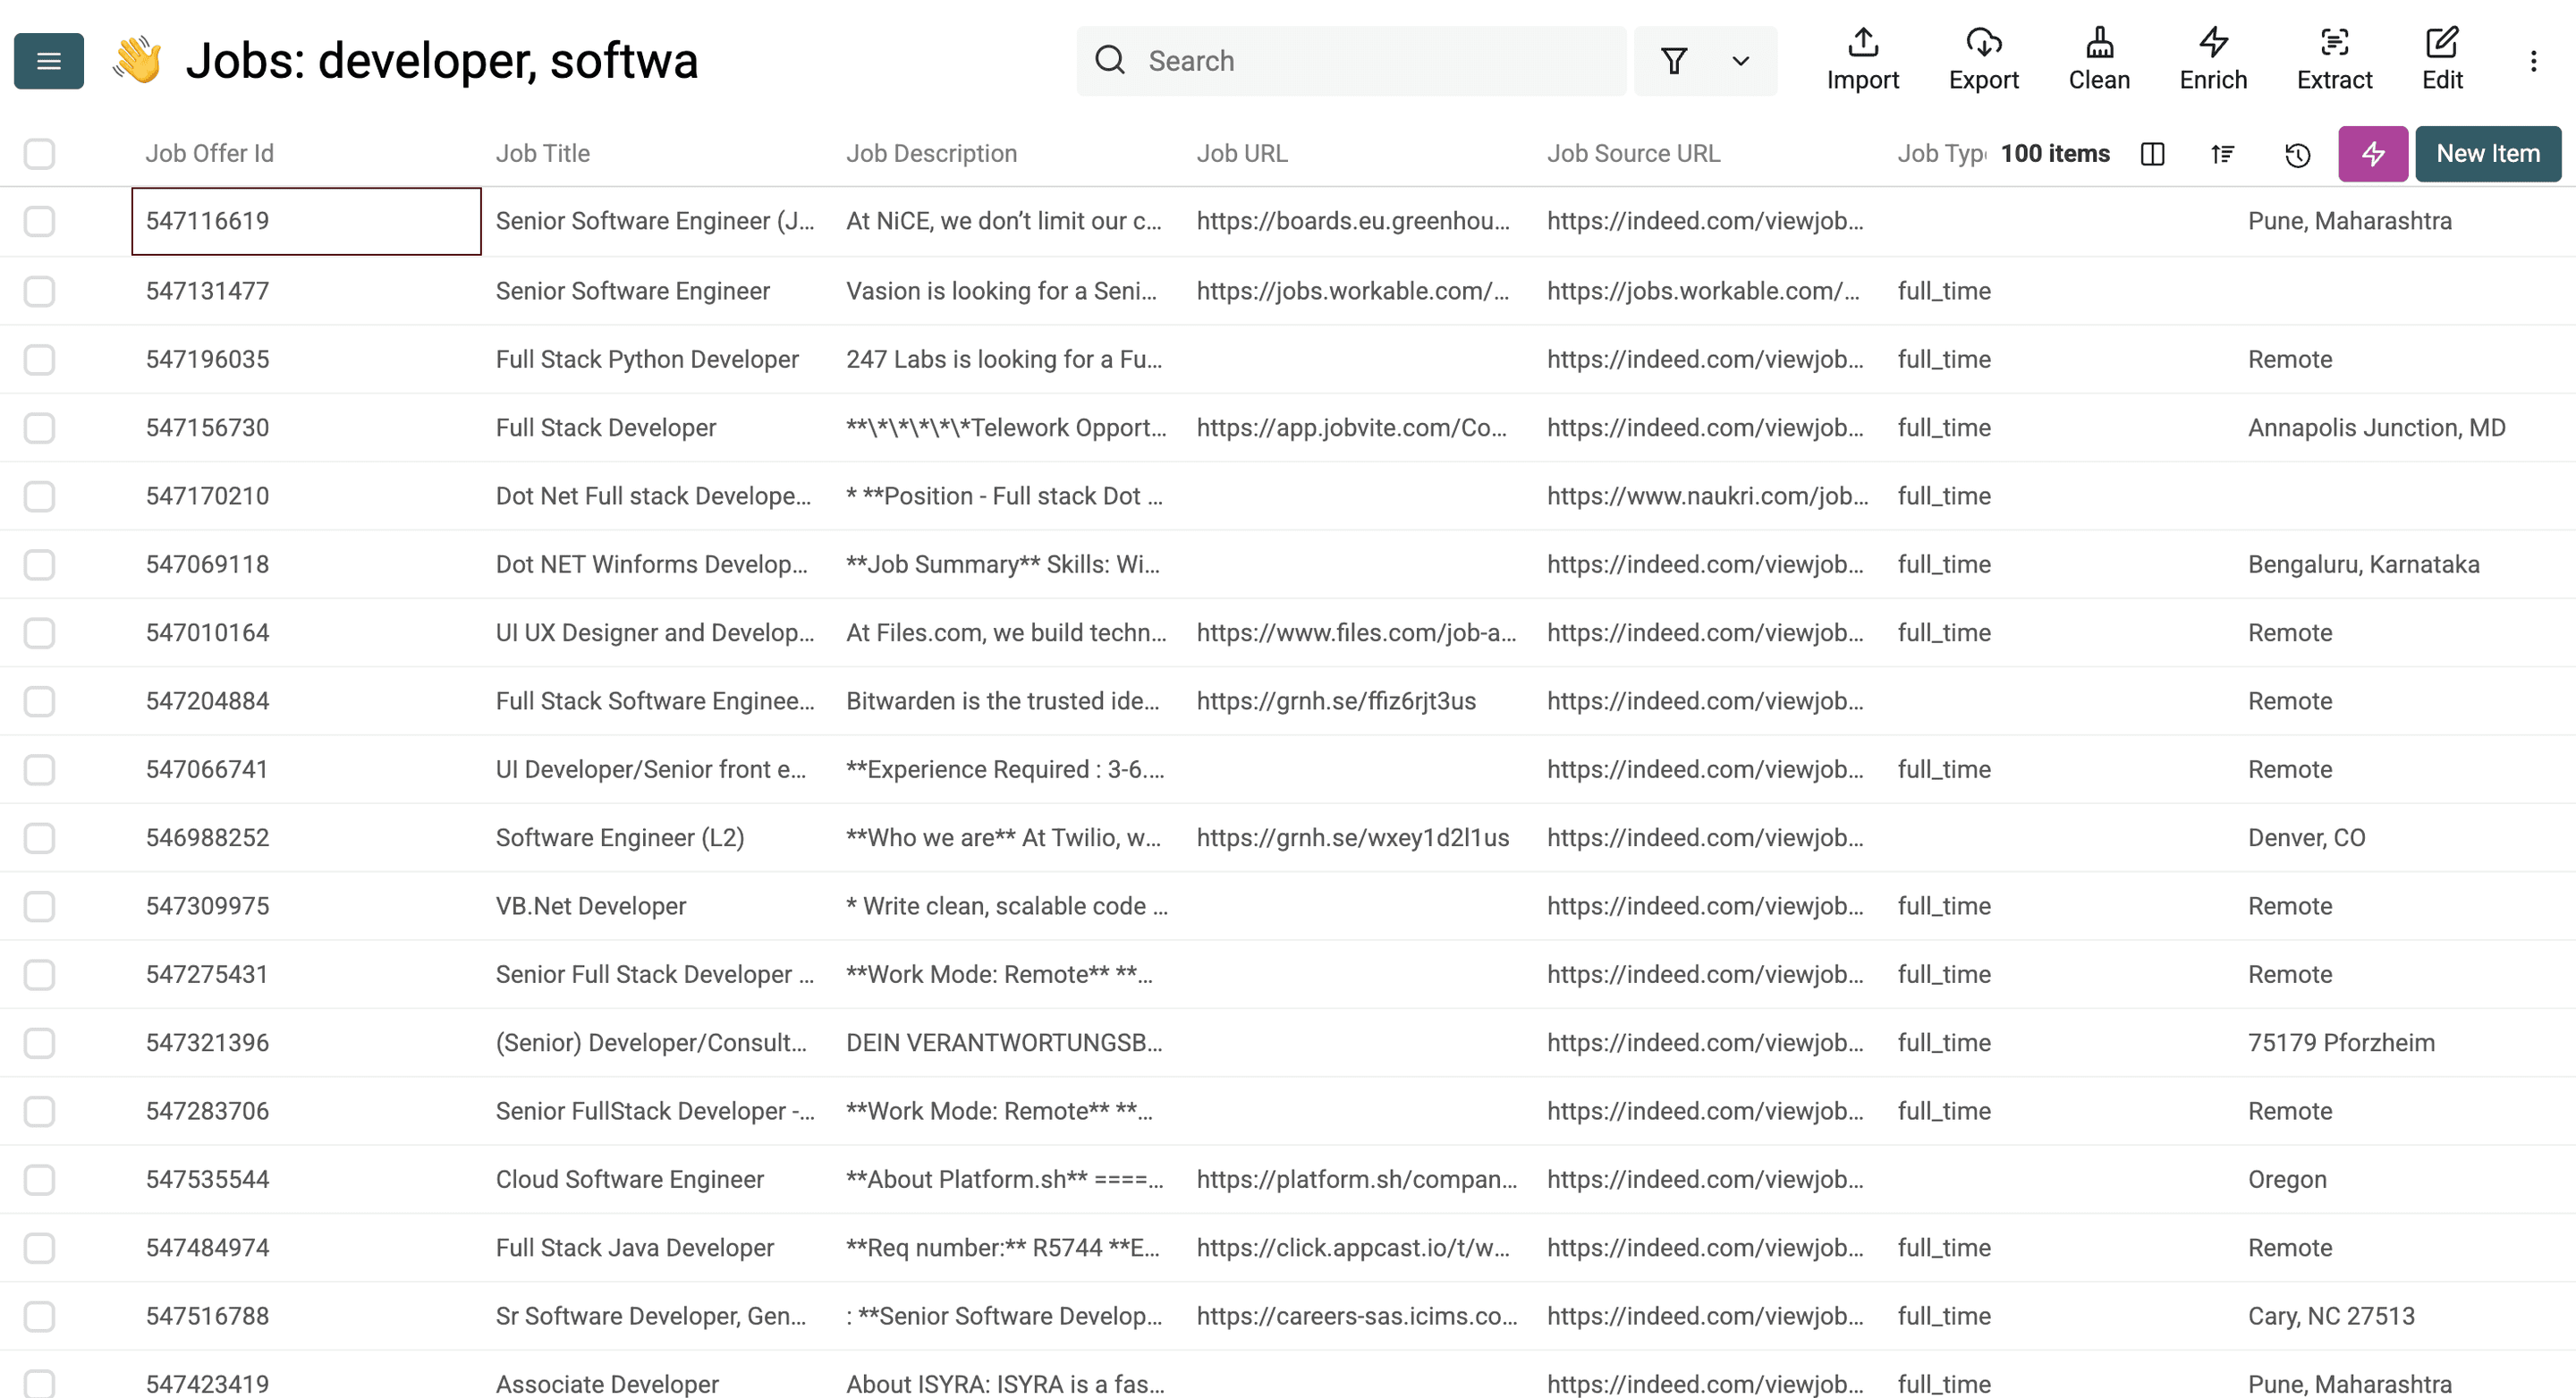
| 职位元数据 | 职位发布 ID、职位发布 URL、职位来源 URL、发布日期、关闭时间 |
| 招聘负责人信息 | 招聘负责人姓名、招聘负责人职位、招聘负责人 LinkedIn Profile |
滚动到页面底部,然后点击 Run import now。
Scraper 完成任务后,结果如下:
按 CRM 公司名单抓取招聘职位
如前所述,这个选项可以让你抓取 Datablist 工作区、CRM 或其他数据库中已有公司的招聘职位。
为此,你需要在 Datablist Collection 中准备好公司名称、公司 LinkedIn URL 或公司网站 URL。
首先,注册 Datablist。
Import 一份公司名单。
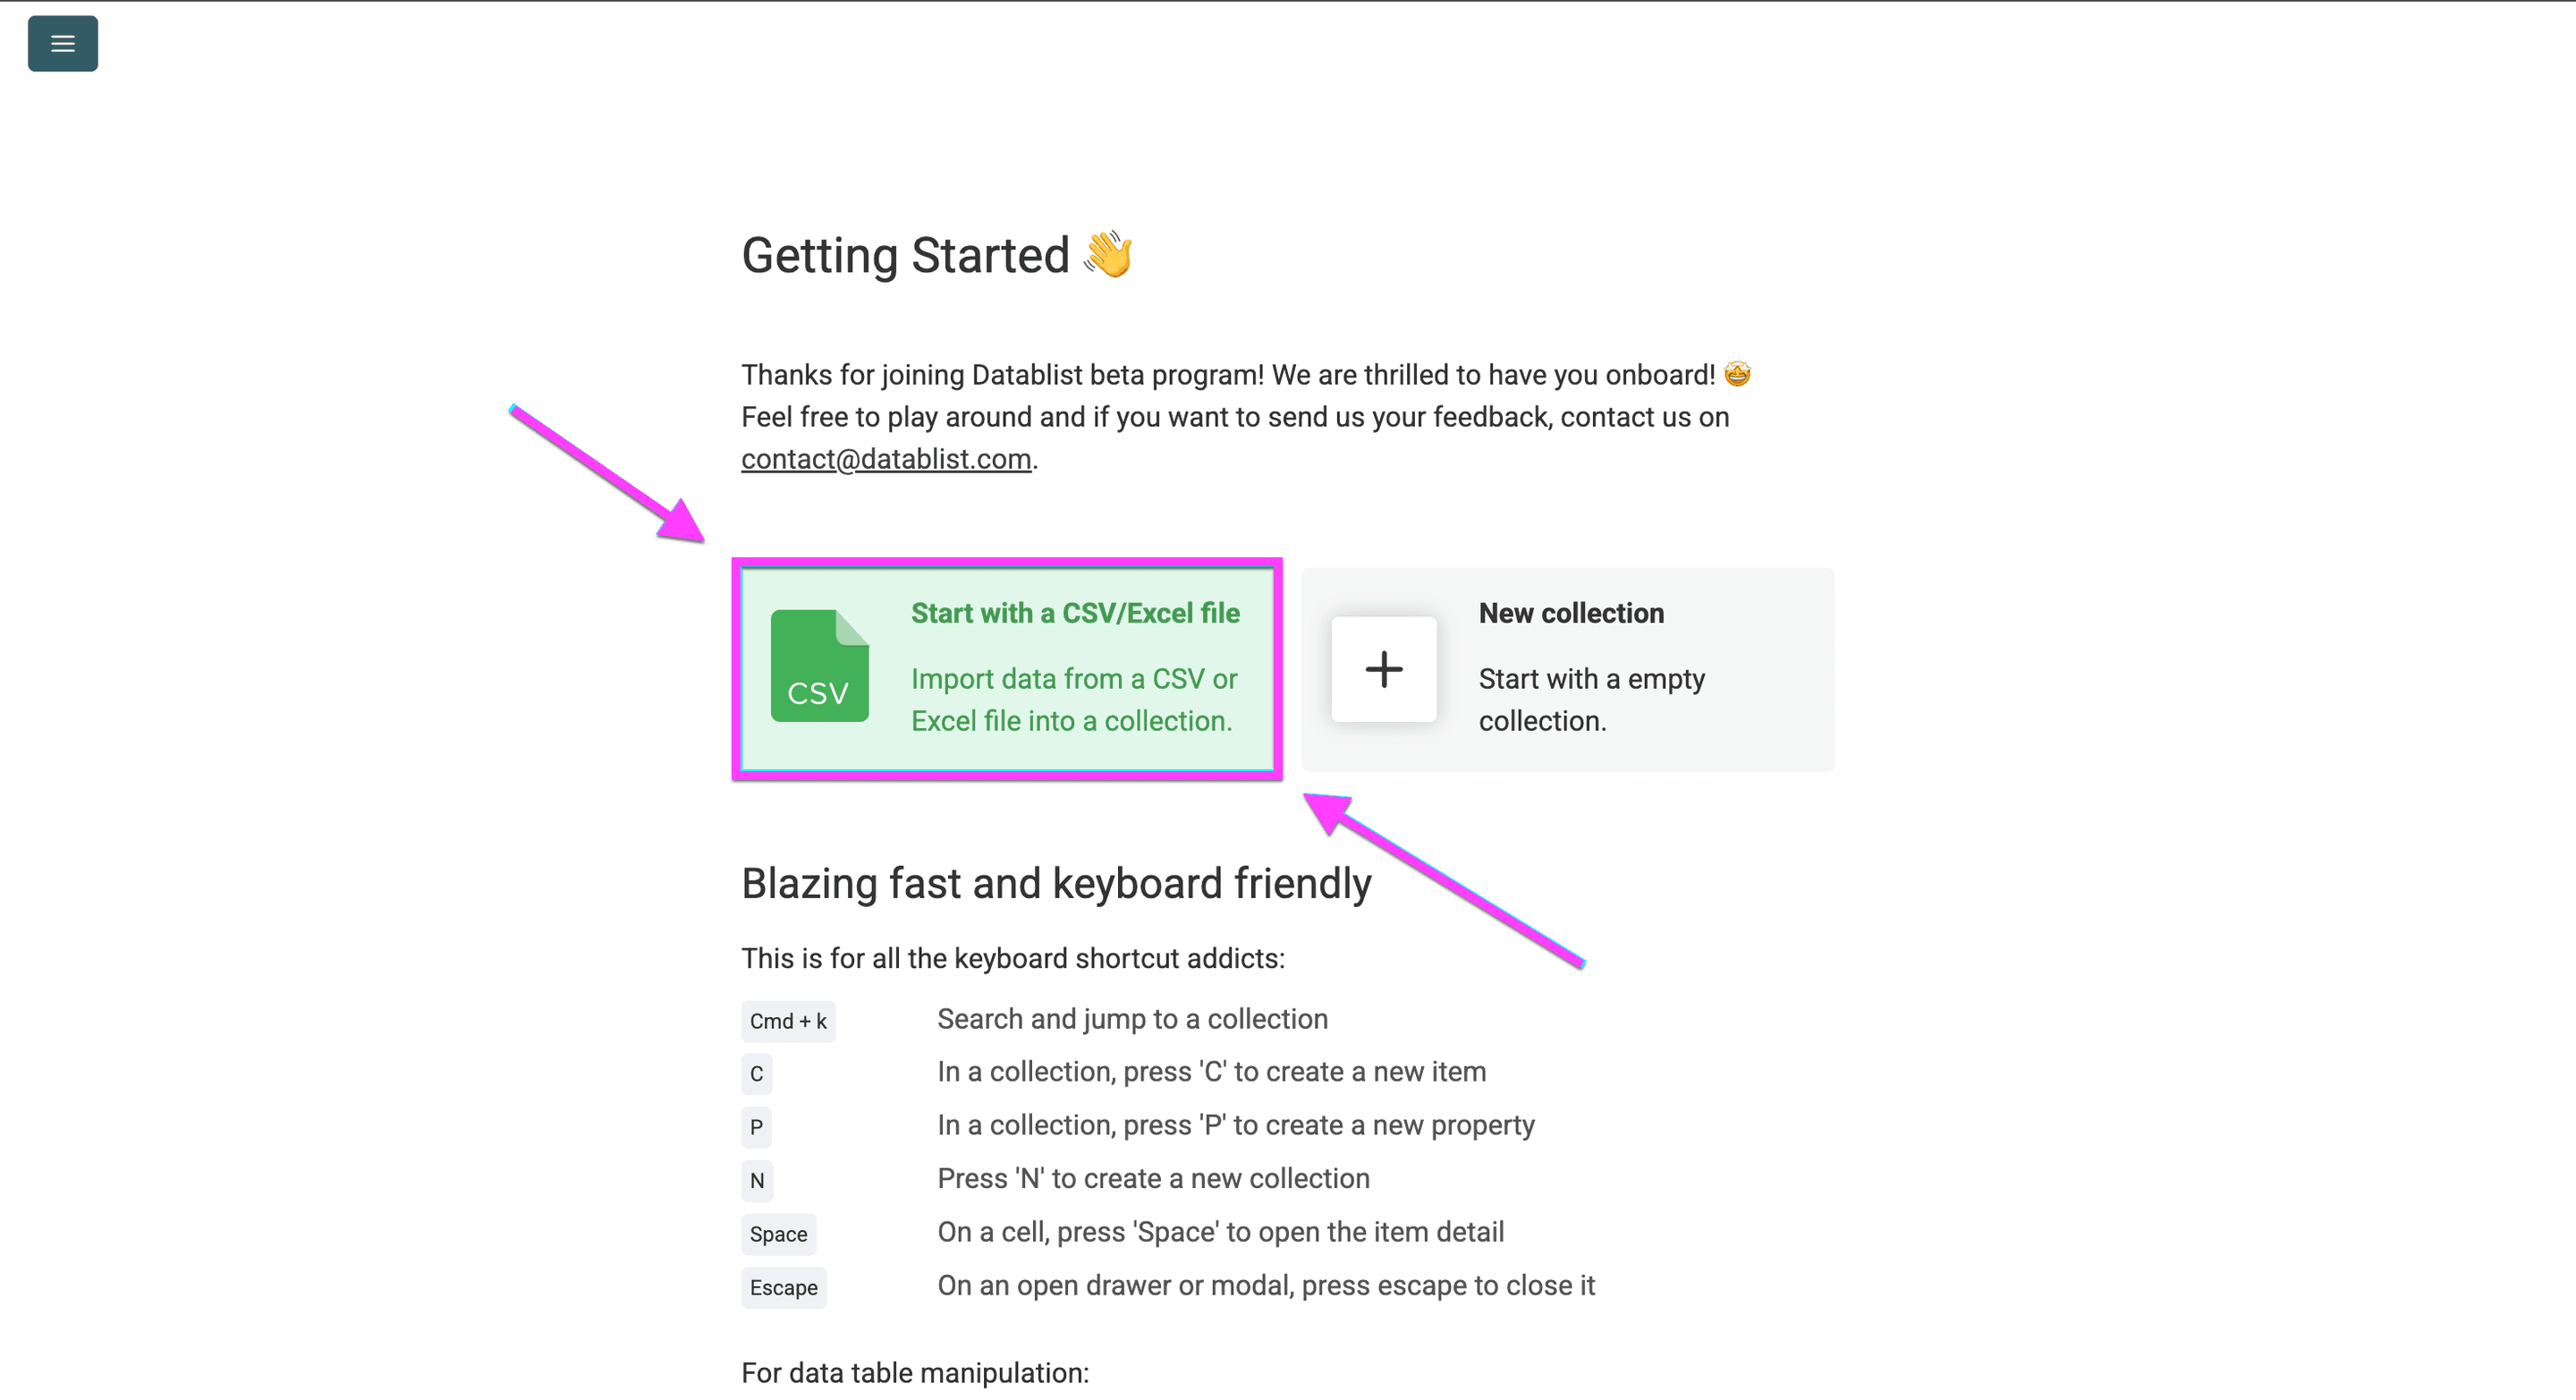
另外创建一个 Collection。
打开 Job Postings Search。
接下来执行以下操作:
- 启用 Filter Job Postings for a specific list of Companies。
- 在 Datablist Collection 中选择已上传的名单。
- 将 Datablist Collection Property 映射到公司网站、公司名称或公司 LinkedIn URL 所在的列。如果有公司网站,建议优先使用,以减少公司重名造成的误匹配。
- 使用筛选条件定义要抓取的招聘职位。点击此处查看全部筛选条件。
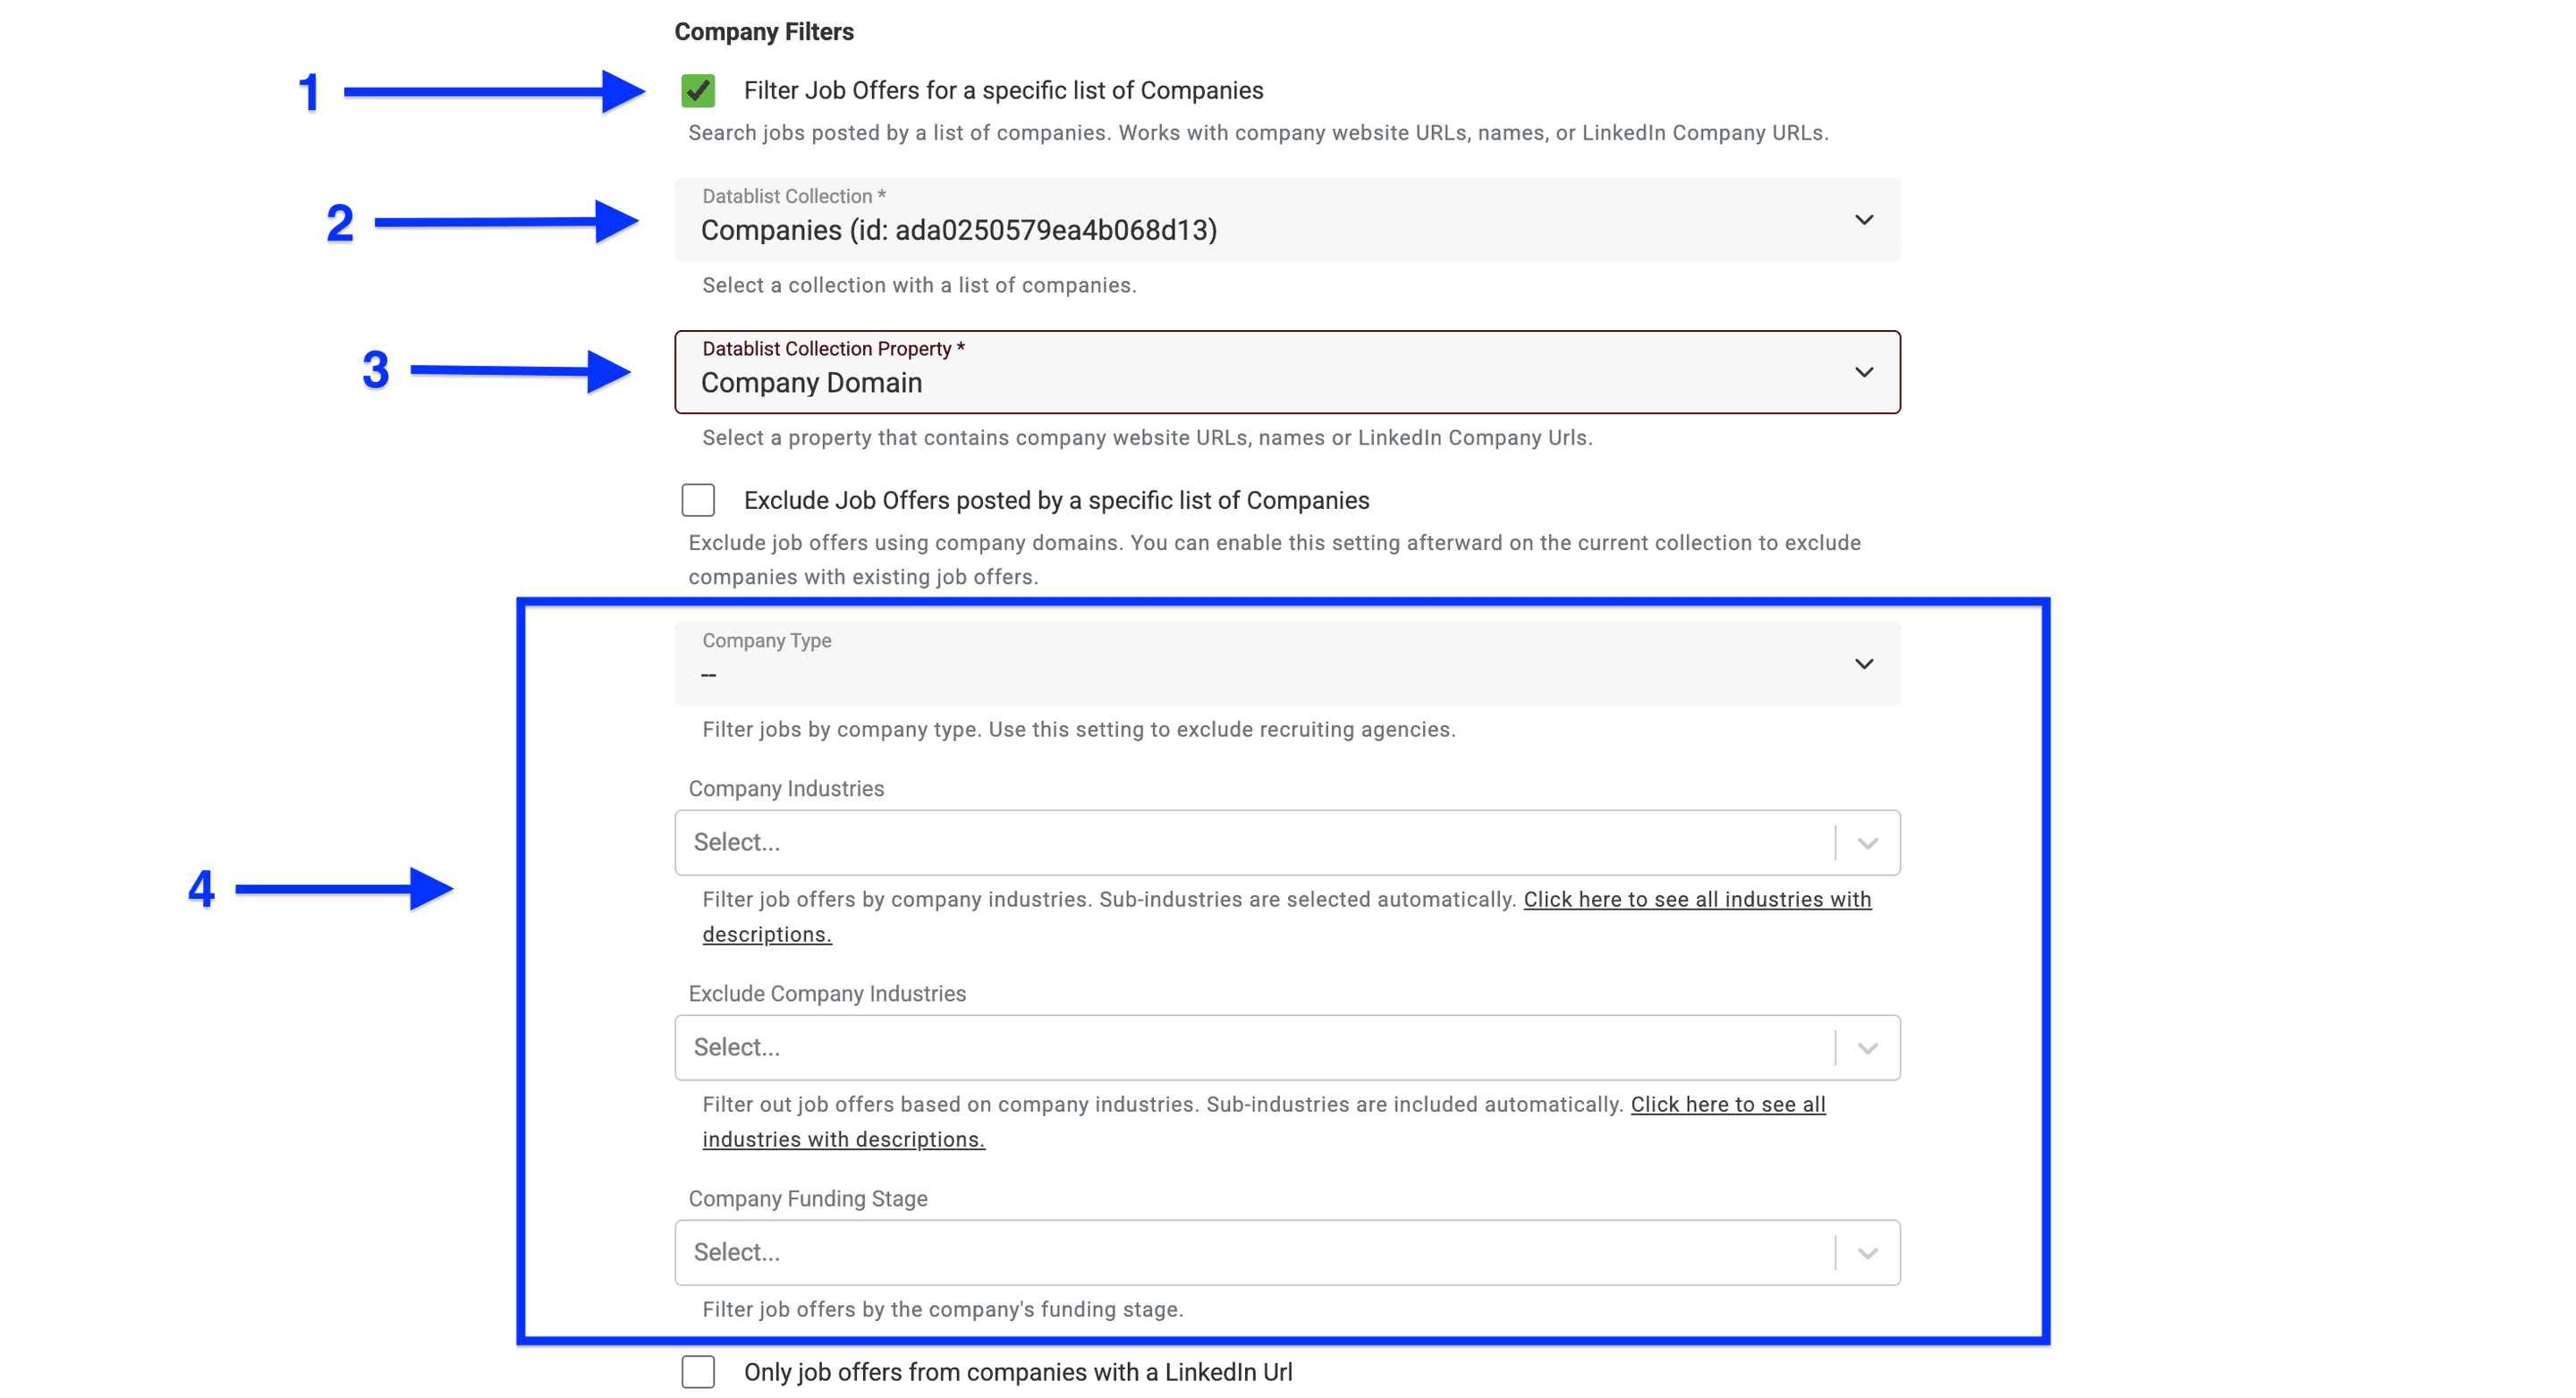
你也可以使用相同逻辑,创建一个包含公司网站或域名的 Collection,将这些公司从招聘职位结果中排除。
💡 抓取招聘网站的 3 个实用技巧
技巧 1: 从招聘职位搜索中排除现有客户,避免出现尴尬情况。
技巧 2: 将过去的客户纳入搜索,以便寻找重新激活合作关系的机会。
技巧 3: 除了域名,你还可以使用网站 URL 和公司名称来筛选或排除公司。
全部设置完成后,点击 Continue。
然后滚动到页面底部,点击 Run import now。
导入完成后,请检查匹配的职位及其来源 URL。最终收到哪些职位,取决于搜索筛选条件、结果数量上限和数据库的收录范围。
📘 职位搜索 Credits
每返回一条招聘职位需要消耗 10 Credits。例如,返回 100 条职位会消耗 1,000 Credits。在执行大规模或周期性搜索前,请检查 Credit 余额和当前的套餐选项。
如何通过重复搜索监控新职位
周期性职位搜索需要稳定的对比键和日期范围,而不只是每天运行一次。建议先每天搜索过去七天发布的职位,再根据你的市场情况调整重叠时间。保留重叠窗口可以让延迟收录的职位再次进入搜索范围,但也意味着同一职位可能被多次返回。
- 在结果中保留
Job Posting Id、Job Posting URL、Company Website和Date Posted。 - 使用
Job Posting Id将每批新结果与历史数据进行对比。你可以使用唯一属性设置阻止重复值,也可以在合并导出文件前检查重复项。 - 不要从监控名单中移除同一家公司。该公司出现不同的职位 ID,意味着它发布了值得检查的新职位,而不是应该删除的公司重复项。
- 如果需要记录首次发现职位的时间,请在自己的跟踪文件中单独保存。
Date Posted指职位发布日期,而不是工作流发现该职位的时间。 - 对于缺少 ID 或疑似重复发布的职位,请结合职位名称、公司、地点和 URL 进行检查。不同 ID 也可能描述相似岗位,因此不要仅因为职位名称相同就自动合并。
如果使用 Growth 套餐进行自动导入,请在数据源 Scheduler 中选择每天运行的频率、时间和时区,然后点击 Schedule Import。启用定时任务前,请先配置重复数据的处理方式。你也可以手动重复搜索。对已保存的数据行去重,并不会让数据供应商免费返回重复结果,因此规划 Credit 预算时应考虑重叠搜索带来的消耗。
例如,如果每天搜索一次、连续 30 天,每次返回 100 条职位,你需要为 3,000 条返回结果付费:30 × 100 × 10 = 30,000 Credits。即使去重后只剩 400 个不同的职位 ID,搜索成本仍然是 30,000 Credits。这些数字仅用于说明;规划下个月的预算时,请使用实际返回的职位总数。
不要因为某个职位在一次搜索中消失,就推断它已经关闭。它可能只是超出了日期范围、筛选条件或结果数量上限。检查已关闭职位时,请使用 Job Status 和返回结果中的 Closed At 字段,并前往来源页面核实重要职位。
为什么要同时抓取 19 个招聘网站
你听过有人说“我的数据太多了”吗?我也没有,因为**数据就是金矿。**不过,大家都认同一点:数据的价值并不相同,有些很有价值,有些则毫无关联。
为什么更多数据源很重要
抓取更多招聘网站可以获得更多职位信息,从而提高找到有价值数据的概率。更广泛的数据源覆盖还能确保你不会错过分散在不同平台上的宝贵机会。
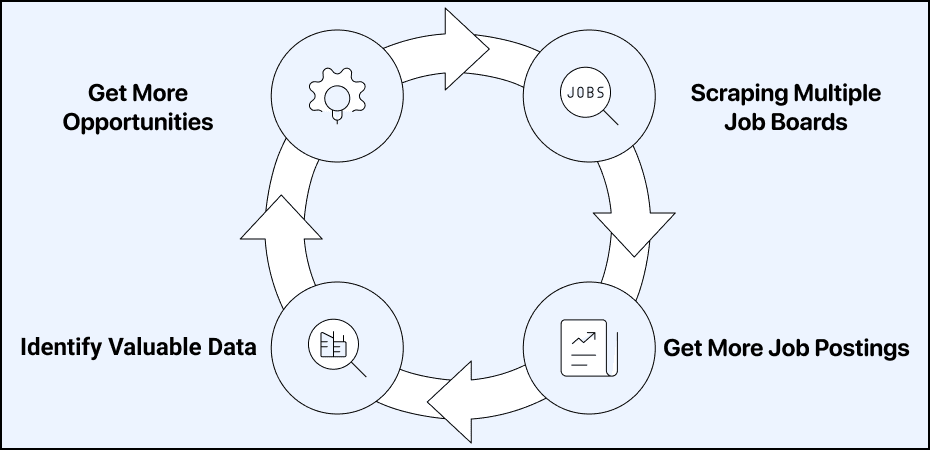
多平台招聘职位抓取的优势
- 扩大数据规模
- 对比多个来源的招聘职位
- 发现目标公司中的更多机会
- 战略性商业情报
- 识别有迫切需求的公司,招聘职位正是这种需求的信号
- 根据公司的当前优先事项锁定目标 Account
- 在 Cold Emailing Campaign 中将招聘数据用作 Lead Qualification 变量
- 竞争优势
- 帮助招聘顾问更高效地赢得订单
- 为求职者提供更全面的洞察
- 比竞争对手更早发现招聘趋势
- 获得优于单一招聘网站搜索的市场覆盖率
- 在潜在客户加大增长投入时及时建立联系
现在你已经了解这些数据为何如此有用,接下来看看可以如何利用它们。
如何利用招聘数据
**没错,Datablist 非常适合抓取招聘网站,**但这甚至不到它全部能力的 1%。获得招聘职位数据后,你还可以:
- 使用更多数据丰富公司信息
- 使用 AI Agent 搜索数据库中没有的信息
- 在目标 Account 中查找决策者
- 使用 Waterfall Enrichment 查找 Email 和电话号码
- 使用 AI 撰写个性化邮件
- 分析公司的 Tech Stack
这样的应用场景还有很多。重点在于:Datablist 不只是一款数据抓取工具。只需一个价格合理的订阅,你就能使用完整的 Lead Generation 生态系统。
总结
抓取多个招聘网站可以带来竞争优势,你应该尽可能利用它保持领先。Datablist 让获取招聘数据变得比使用其他工具更简单,还可以直接搜索 CRM 中现有公司的招聘职位。
FAQ
此工作流如何抓取招聘职位?
Datablist 会根据你的筛选条件查询数据供应商聚合的职位数据库,然后将匹配的职位逐行导入。它适合创建涵盖多个来源的结构化职位名单,但不能保证收录每个招聘网站的所有职位。因此,请保留来源 URL,并在采取行动前核实相关职位。
Scrape Job Postings 是什么意思?
Scrape Job Postings 是指使用自动化工具,从不同网站提取招聘职位信息。这个过程可以采集职位名称、职位描述、公司详情、地点和薪资范围等数据。
哪款招聘职位抓取工具最好?
Datablist 是一款功能强大的招聘职位抓取工具,可以同时聚合 19 个招聘网站的职位。它为职位详情、公司信息和招聘负责人数据提供了丰富的筛选条件。除数据抓取外,Datablist 还支持 Data Enrichment、AI 搜索和自动化工作流。
可以使用 AI 分析招聘职位吗?
可以。导入职位后,你可以使用 AI enrichment 对职位描述进行分类、识别相关要求,或生成简短的 Account Research 摘要。请将原始招聘信息和来源 URL 与 AI 结果保存在一起,以便核查模型使用的内容。有关标签和审核规则,请参阅 AI 分类指南。
如何将招聘数据用于 Outreach Campaign?
抓取的招聘数据可以为精准 Outreach Campaign 提供有价值的商业情报。你可以识别正在积极招聘、释放增长信号的公司,寻找决策者、丰富联系人信息,并使用 AI 根据对方的具体需求撰写个性化消息。在 Outreach 中使用招聘信号前,请先核实其真实性,并将其接入相关的 Lead 抓取工作流。
抓取招聘网站可以获得哪些数据?
Datablist 等招聘网站抓取工具可以提取全面的数据,包括职位详情(名称、描述、类型、地点和薪资)、公司信息(名称、网站、LinkedIn、规模和行业)、招聘负责人详情(姓名、职位和 LinkedIn),以及发布日期等元数据。这些丰富的数据能够提供有价值的商业情报。
应该抓取多少个招聘网站?
与依赖单一数据源相比,抓取多个招聘网站通常能获得更好的结果。Datablist 等工具可以同时抓取 19 个招聘网站,让你更全面地覆盖市场、发现更多潜在客户,并抢在竞争对手之前洞察招聘趋势。