
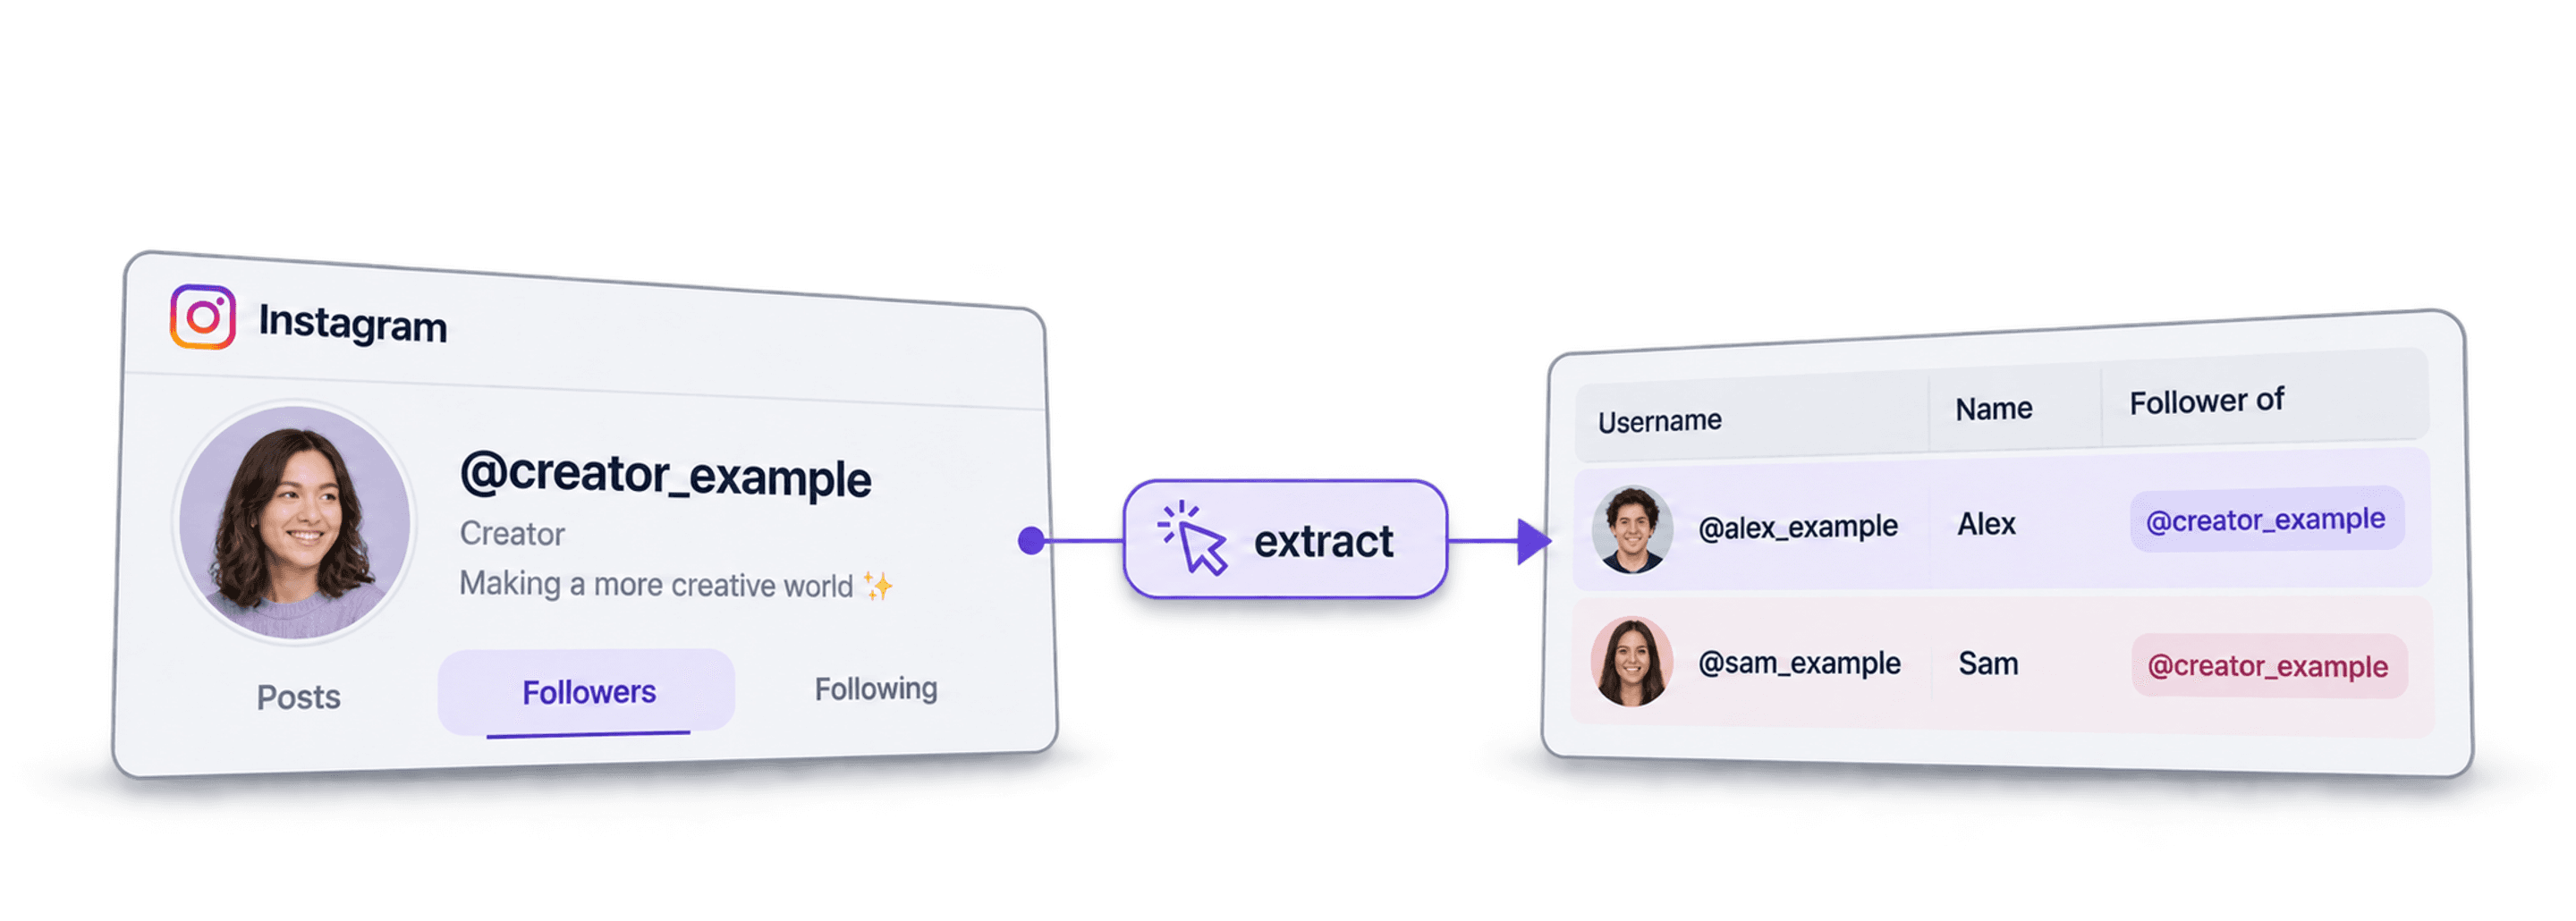
For at scrape Instagram-følgere i Datablist skal du åbne kilden Instagram Followers/Following Scraper, angive en offentlig profil-URL, et brugernavn eller et bruger-ID, vælge en grænse pr. profil og gennemgå de returnerede følger-rækker, før du eksporterer dem.
Jeg vil anbefale at starte med én profil og en lav grænse. Den returnerede liste er et øjebliksbillede af de konti, som udbyderen kunne hente – ikke en garanti for profilens komplette, aktuelle følgerliste. At en person følger en influencer inden for en bestemt niche, dokumenterer heller ikke personens job, placering eller købsinteresse.
Denne guide gennemgår kildeindstillinger, relationsfelter, kontrol og deduplikering, genoptagelse af større scrapes samt den separate enrichment af profildetaljer. Du behøver ikke angive dine loginoplysninger til Instagram.
📌 Hurtigt workflow
Opret en collection, åbn See all sources, og vælg Instagram Followers/Following Scraper. Indtast én profil pr. linje under Instagram Profiles, behold Followers (default) under Scrape followers or following, og angiv Scraping Limit Per Profile. Tilføj følger-id'er og felter for kildeprofilen, kør en test, og kontrollér og eksportér derefter resultatet.
Hvad koster det at scrape Instagram-følgere?
Udtræk af følgerlister koster 0,01 credits pr. returneret følger. Det kan koste yderligere 1 credit at identificere kildeprofilen, hvis dens id ikke ligger i cachen. Enrichment af profildetaljer afregnes separat.
Lad os tage et eksempel, hvor én kildeprofil returnerer præcis 1.000 følger-rækker:
- Følgerliste: 1.000 × 0,01 = 10 credits plus 1 for et kildeopslag, der ikke ligger i cachen: 11 credits.
- Detaljer for 100 udvalgte følgere: Med de returnerede User Id-værdier koster standardopslaget af profiler 2 credits pr. profil: 200 credits. Denne mulighed kan returnere offentlige felter med e-mail og telefonnummer, når de er tilgængelige, men ingen af delene er garanteret.
- I alt: 211 credits for listen og de 100 profilopslag. Prisen på enrichment ændres, hvis du tilføjer About-data eller vælger en anden scraping-type.
Ved månedlig fakturering i USD koster Starter $25 og inkluderer 5.000 credits. Hvis hele denne kvote er ubrugt ved start, kræver eksemplet ingen ekstra credits og efterlader 4.789 credits. Abonnementet på $25 er den faktiske betaling, mens 211 credits er workflowets forbrug. Credits har ikke én fast dollarværdi på tværs af abonnementer og pakker med ekstra credits.
Brug det returnerede User Id til dette eksempel med enrichment af profiler. Et brugernavn eller en URL kan kræve endnu et opslag for at finde id'et. Kontrollér det faktiske antal returnerede rækker og forbruget af credits efter testen. Udbyderens sider kan overskride en lav, angivet grænse, og et profilopslag kan bruge credits, selvom der ikke returneres følger-rækker. Den valgte grænse er derfor ikke et præcist udgiftsloft.
Hvad er Datablist? Et hurtigt overblik
Datablist er et regnearksbaseret workspace til workflows for leadgenerering. Du kan indsamle, gennemgå, enrich og eksportere rækker ved hjælp af enrichments – fra AI Agents og Email Finders til AI processors, Technology enrichments og meget mere.
Derudover giver Datablist dig mulighed for at konfigurere automatiserede workflows, der kører efter en tidsplan eller efter behov. Her er nogle praktiske use cases, som Datablist-brugere er særligt glade for:
- Opbygning af leadlister
- Personalisering af e-mails med AI
- Rensning og deduplikering af CRM-data
- Scraping af jobopslag
- Scraping af leads fra Sales Navigator
Sådan scraper du Instagram-følgere billigt – trin for trin
Lad os komme i gang. Først skal du åbne Datablist og konfigurere, hvad du vil scrape – dvs. indsætte profil-URL'er eller brugernavne for de influencere, hvis følgere du vil hente.
Start med en test, og udvid den først, når du har kontrolleret kildeprofilen og de returnerede felter. Du behøver hverken en browserudvidelse eller din egen API-nøgle til udbyderen for at bruge dette workflow.
📘 Vigtigt: Private profiler
Følgerlisten for en privat profil er ikke tilgængelig via dette workflow. En kørsel kan bruge credits på at identificere en profil, selvom den ikke returnerer nogen følger-rækker. Enrichment af profildetaljer er et separat opslag og giver ikke adgang til private opslag eller følgerlister.
Trin 1: Opret en konto på Datablist.com
Gå til Datablist.com, og opret en konto. Følg opsætningen for at åbne dit workspace.
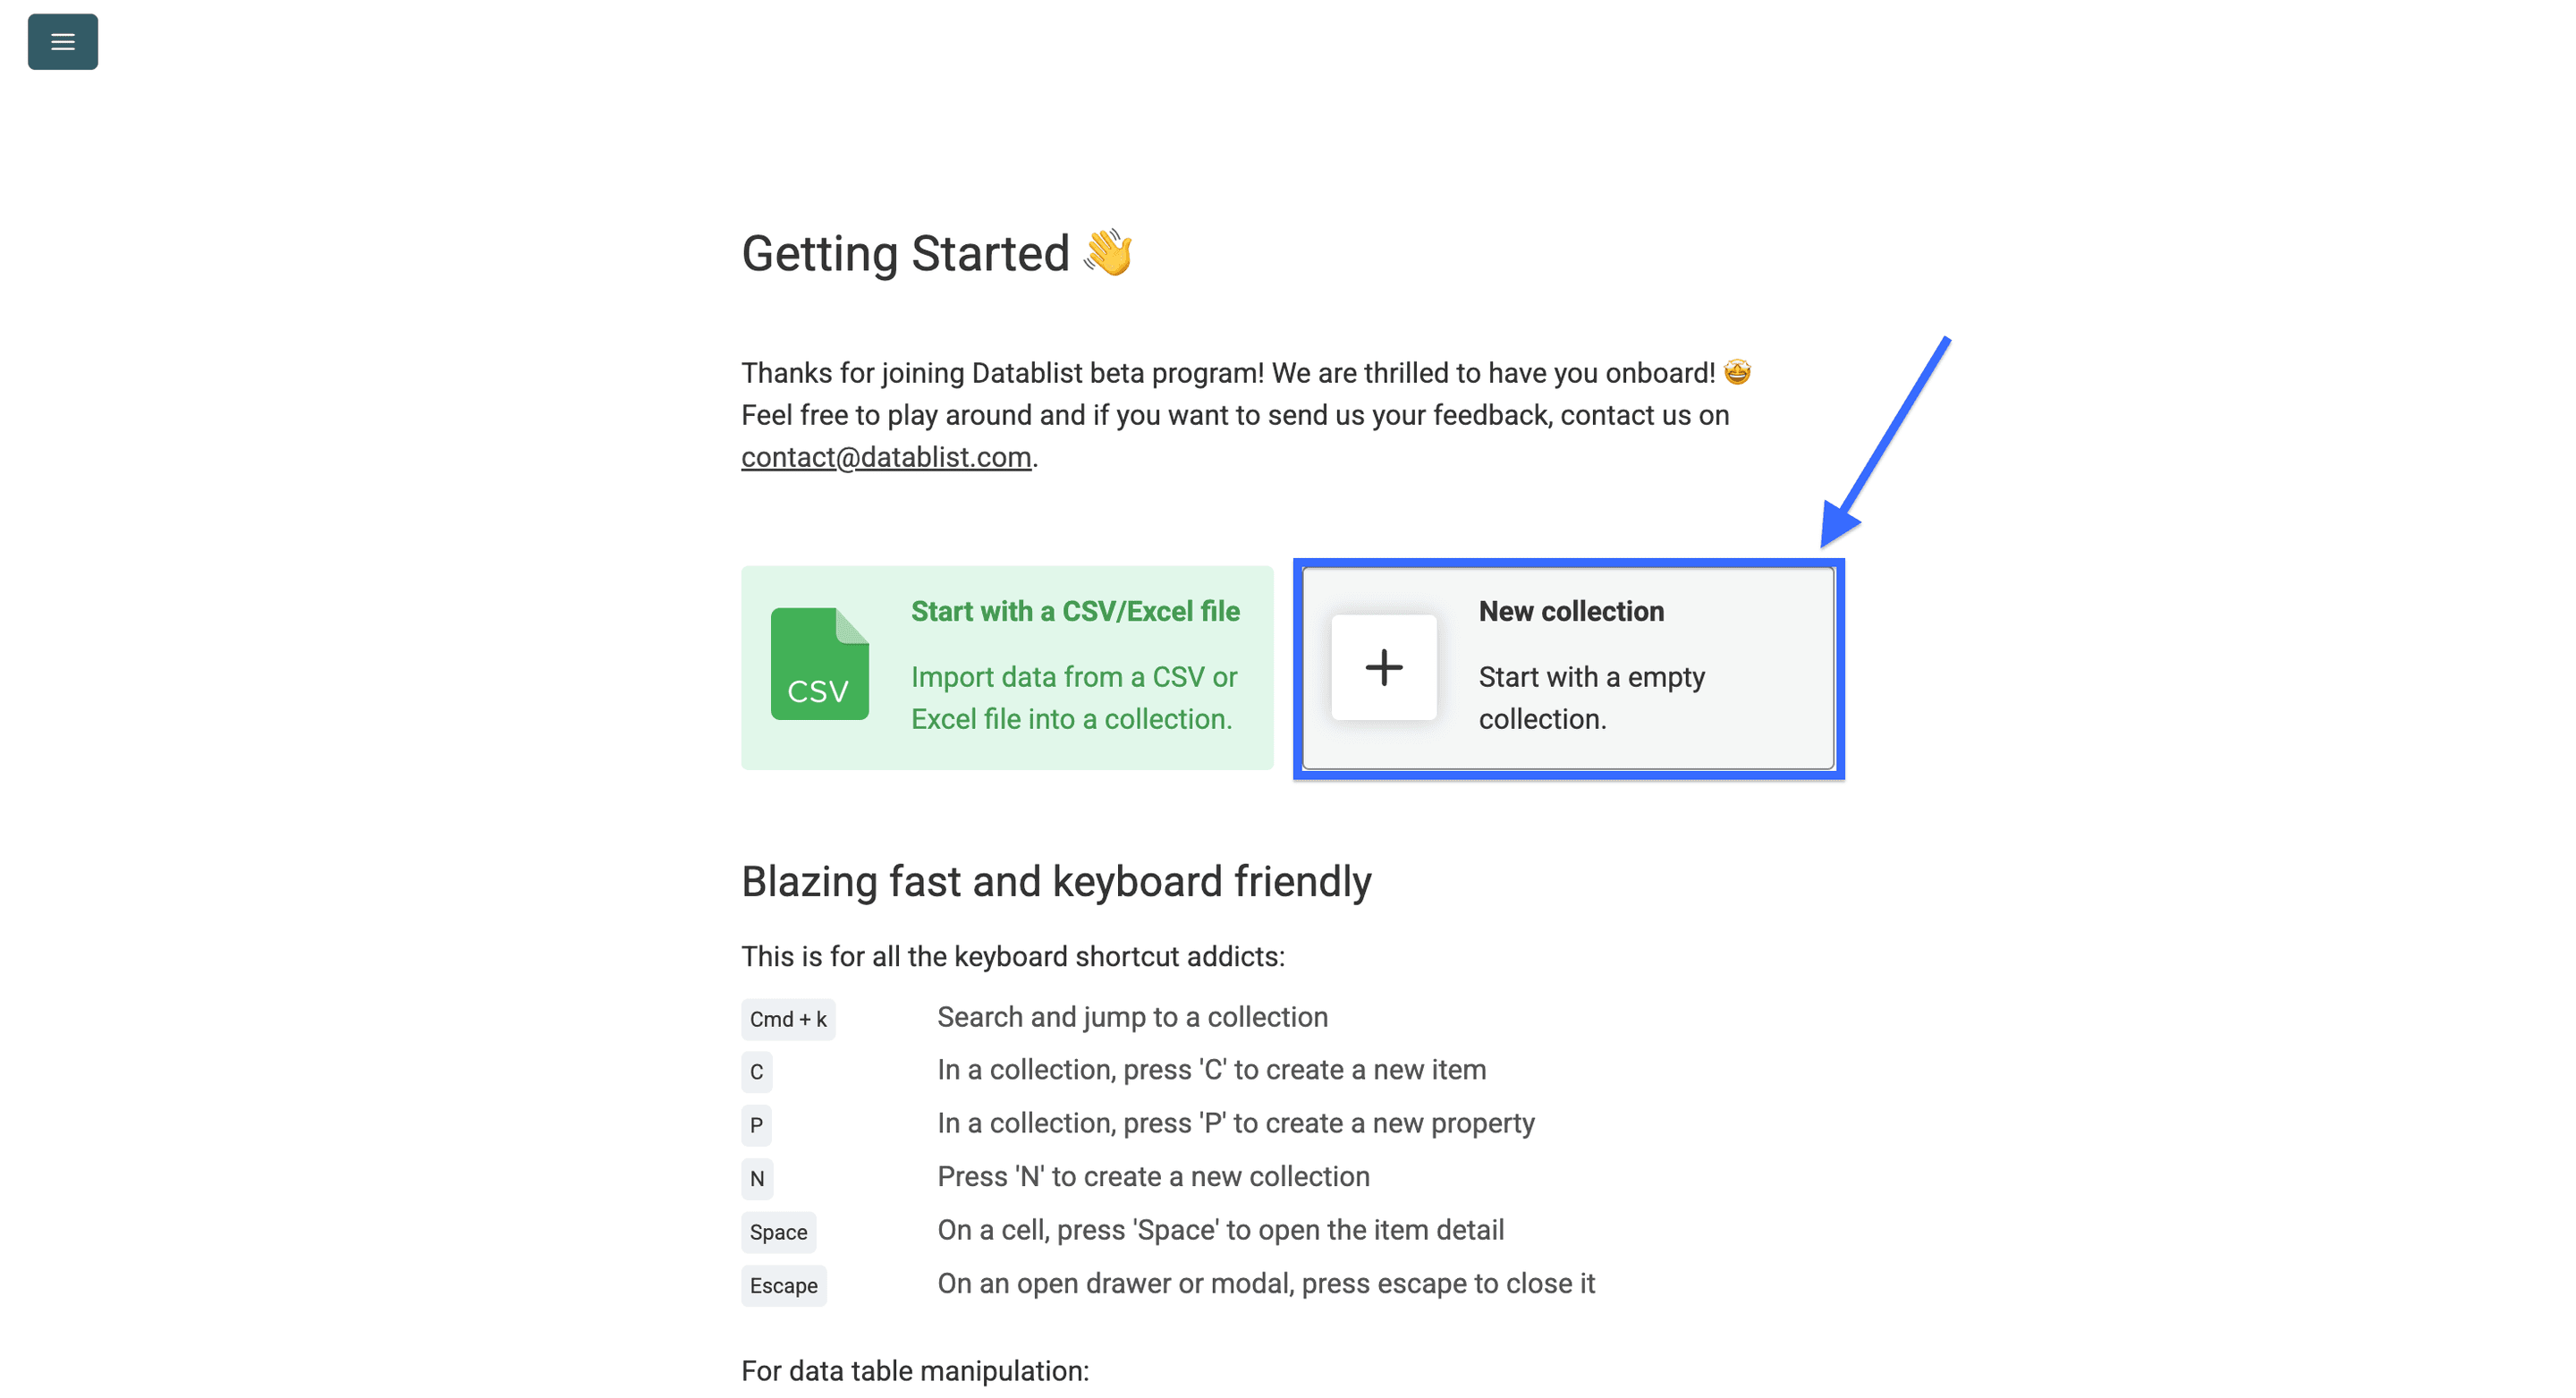
Trin 2: Opret en ny collection
Når du er logget ind, skal du klikke på New Collection.
Trin 3: Find Instagram Followers/Following Scraper
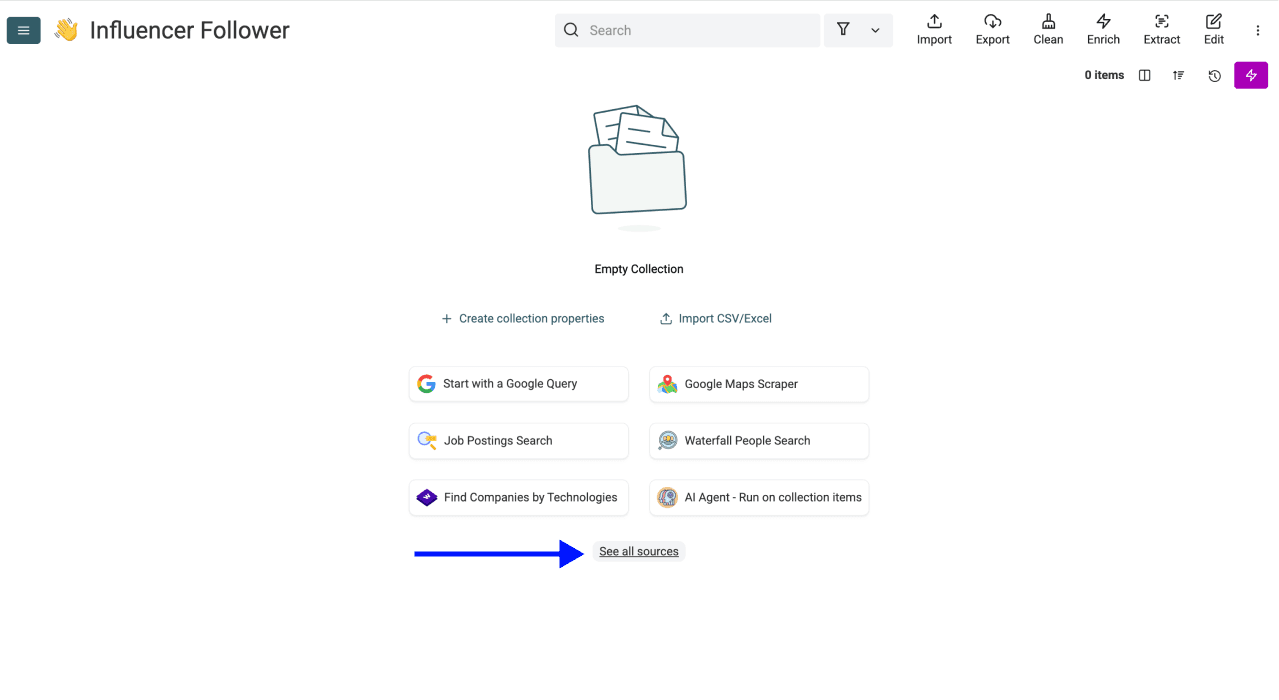
Klik på See all sources.
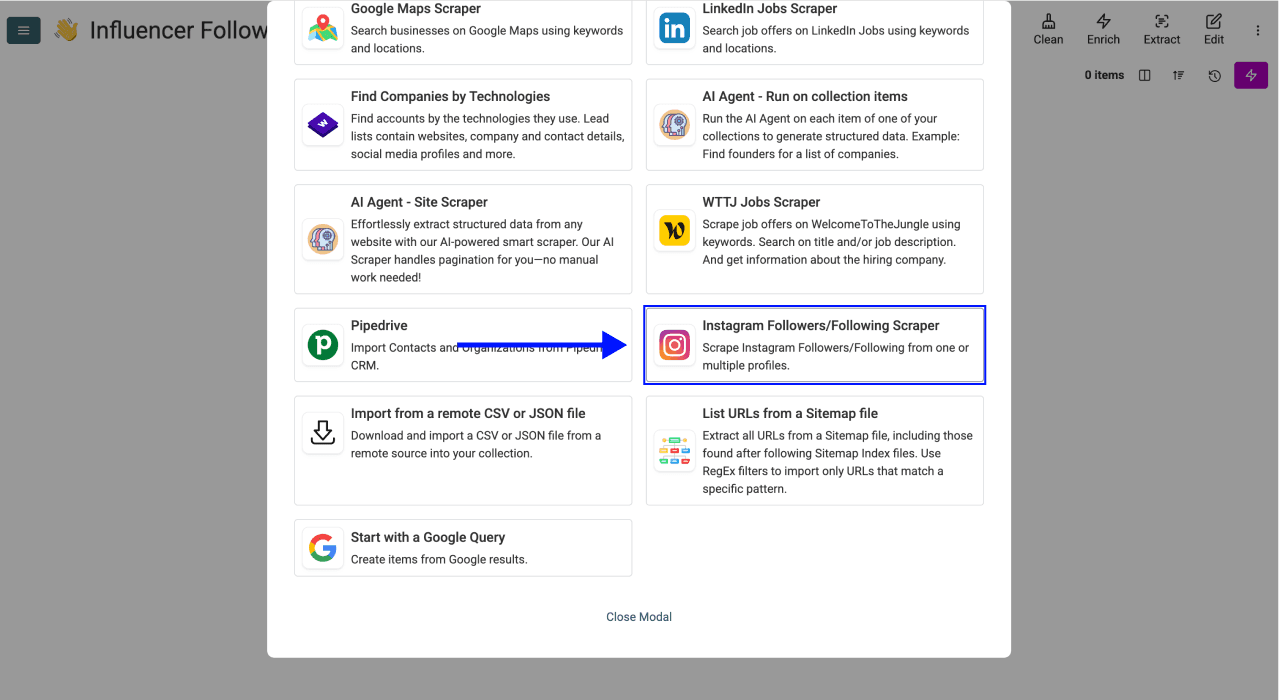
Rul ned, og vælg Instagram Followers/Following Scraper på listen.
Trin 4: Konfigurer dine indstillinger
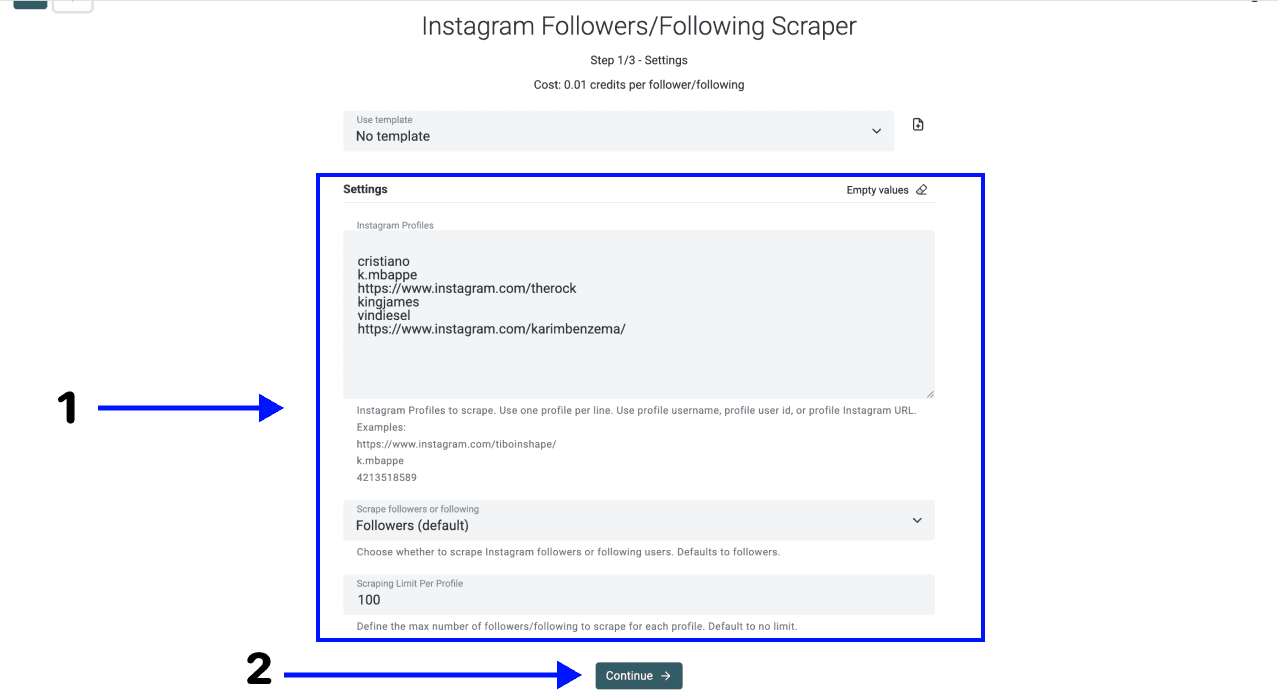
Du får vist en enkel konfigurationsside. Sådan får du de bedste resultater:
- Under Instagram Profiles indtaster du én offentlig profil-URL, ét brugernavn eller ét bruger-ID pr. linje. Kontrollér, at hvert id henviser til den rigtige konto.
- Under Scrape followers or following vælger du Followers (default). Vælg kun Following, hvis du vil hente de konti, som den angivne profil følger.
- Sæt Scraping Limit Per Profile til en lav testmængde, før du udvider kørslen. En grænse er ikke en garanti for, at listen er komplet.
- Klik på Continue, og konfigurer outputkolonnerne.
Trin 5: Vælg dine outputfelter
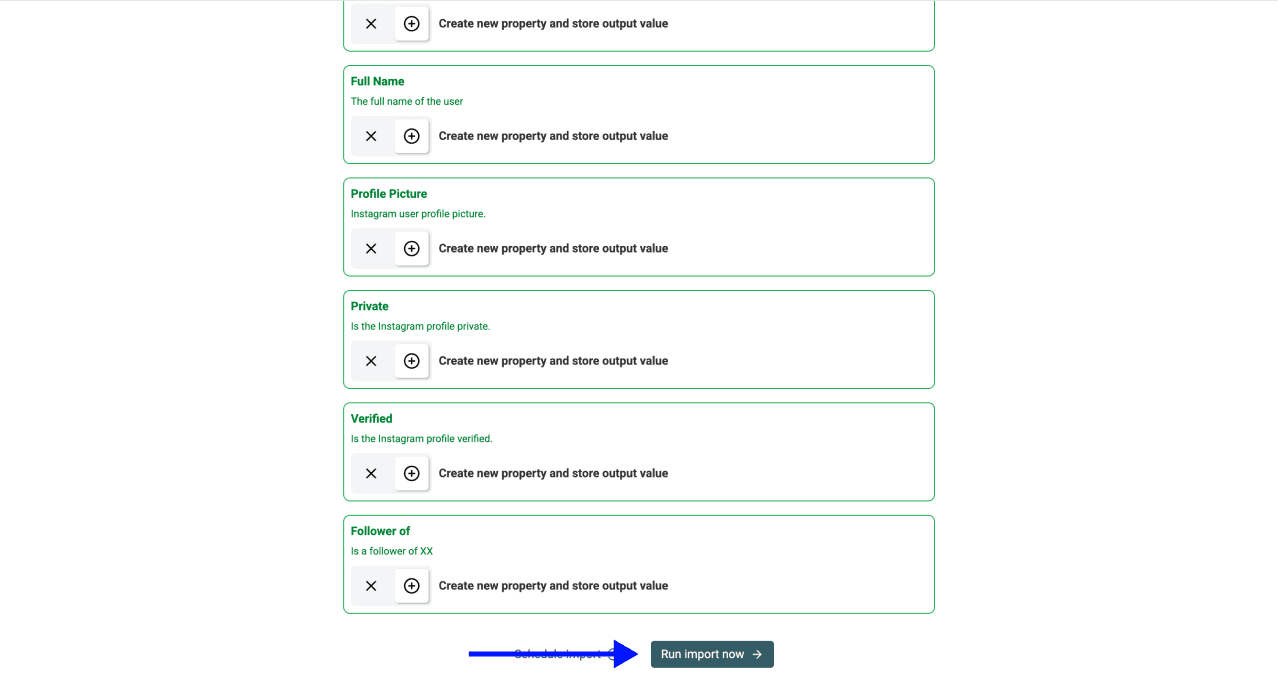
Datablist viser de tilgængelige outputfelter. Behold følgerens User Id, User Username og User Profile URL samt felterne for kildeprofilen. De gør det muligt at kontrollere, hvem hver række repræsenterer, og hvilken inputprofil den stammer fra.
Klik på ✕-ikonerne for at fjerne de felter, du ikke skal bruge, og klik derefter på Run import now.
Trin 6: Hent dine resultater
Når kildekørslen er færdig, skal du sammenligne de returnerede rækker med den valgte grænse og kontrollere kørselsstatussen. Varigheden afhænger af udbyderens svar, pagineringen, profilen og kørselsstørrelsen. Gå ikke ud fra, at et lavt antal rækker betyder, at profilen ikke har flere følgere.
Bemærk: Resultaterne indeholder også fulde navne. Vi har skjult dem på billedet nedenfor for at beskytte personernes privatliv.
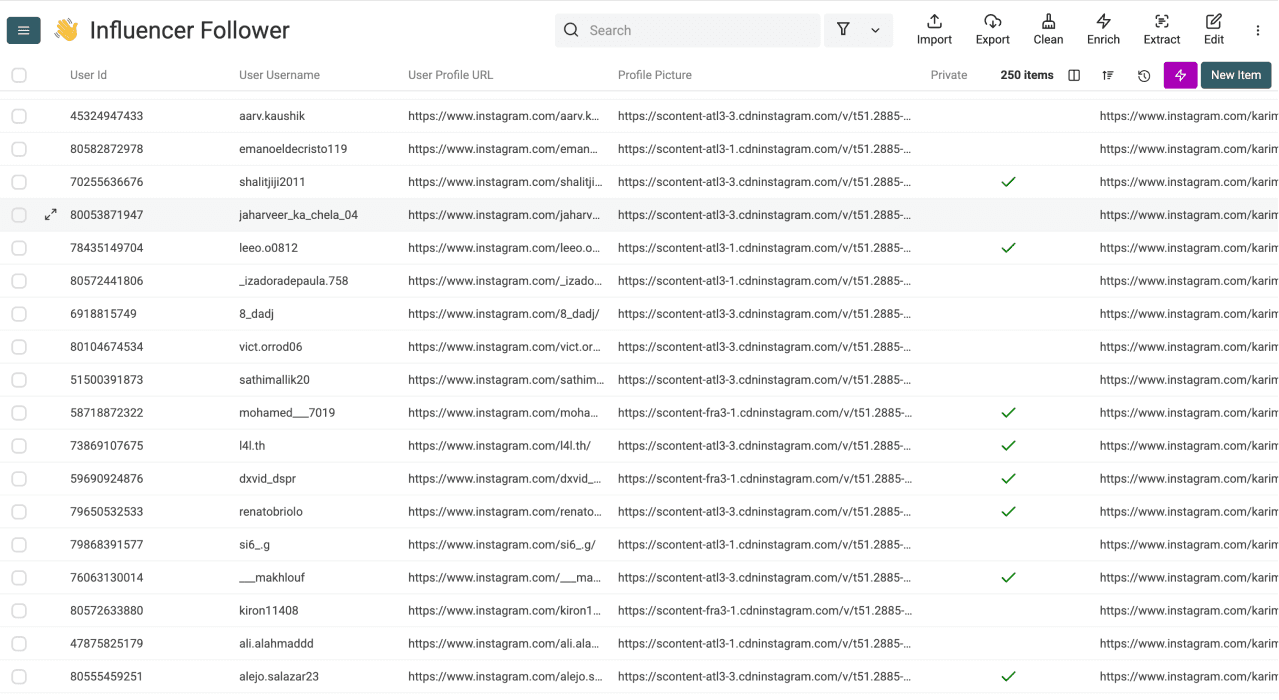
Hvis du bruger flere inputprofiler, skal du beholde Follower of (UserId), Follower of (Username) eller Follower of (ProfileUrl). Brug dem til at filtrere relationerne efter kildekonto i stedet for at stole på kolonnernes placering.
💡 Godt at vide: Store scrapes
Kildekørslen har sine egne grænser for paginering og antal rækker. De er uafhængige af collection-lageret og synkroniseringen i clouden. Hvis en kørsel stopper, selvom der er flere resultater, skal du bruge muligheden for at genoptage nedenfor i stedet for at antage, at de resterende følgere kan være med i samme kørsel.
Trin 7: Enrich følgerne med profildetaljer
En liste over følgere er kun begyndelsen. For at gøre brugernavnene til anvendelige leads skal du vide, hvem personerne er. Med Instagram Profile Scraper kan du enrich din liste med offentlige data som e-mailadresser, biografier og engagementstal.
Når du opbygger leadlister, bør du bruge profildetaljer som dokumentation for et segment. En følgerrelation er ikke i sig selv et pålideligt kriterium for leadkvalificering.
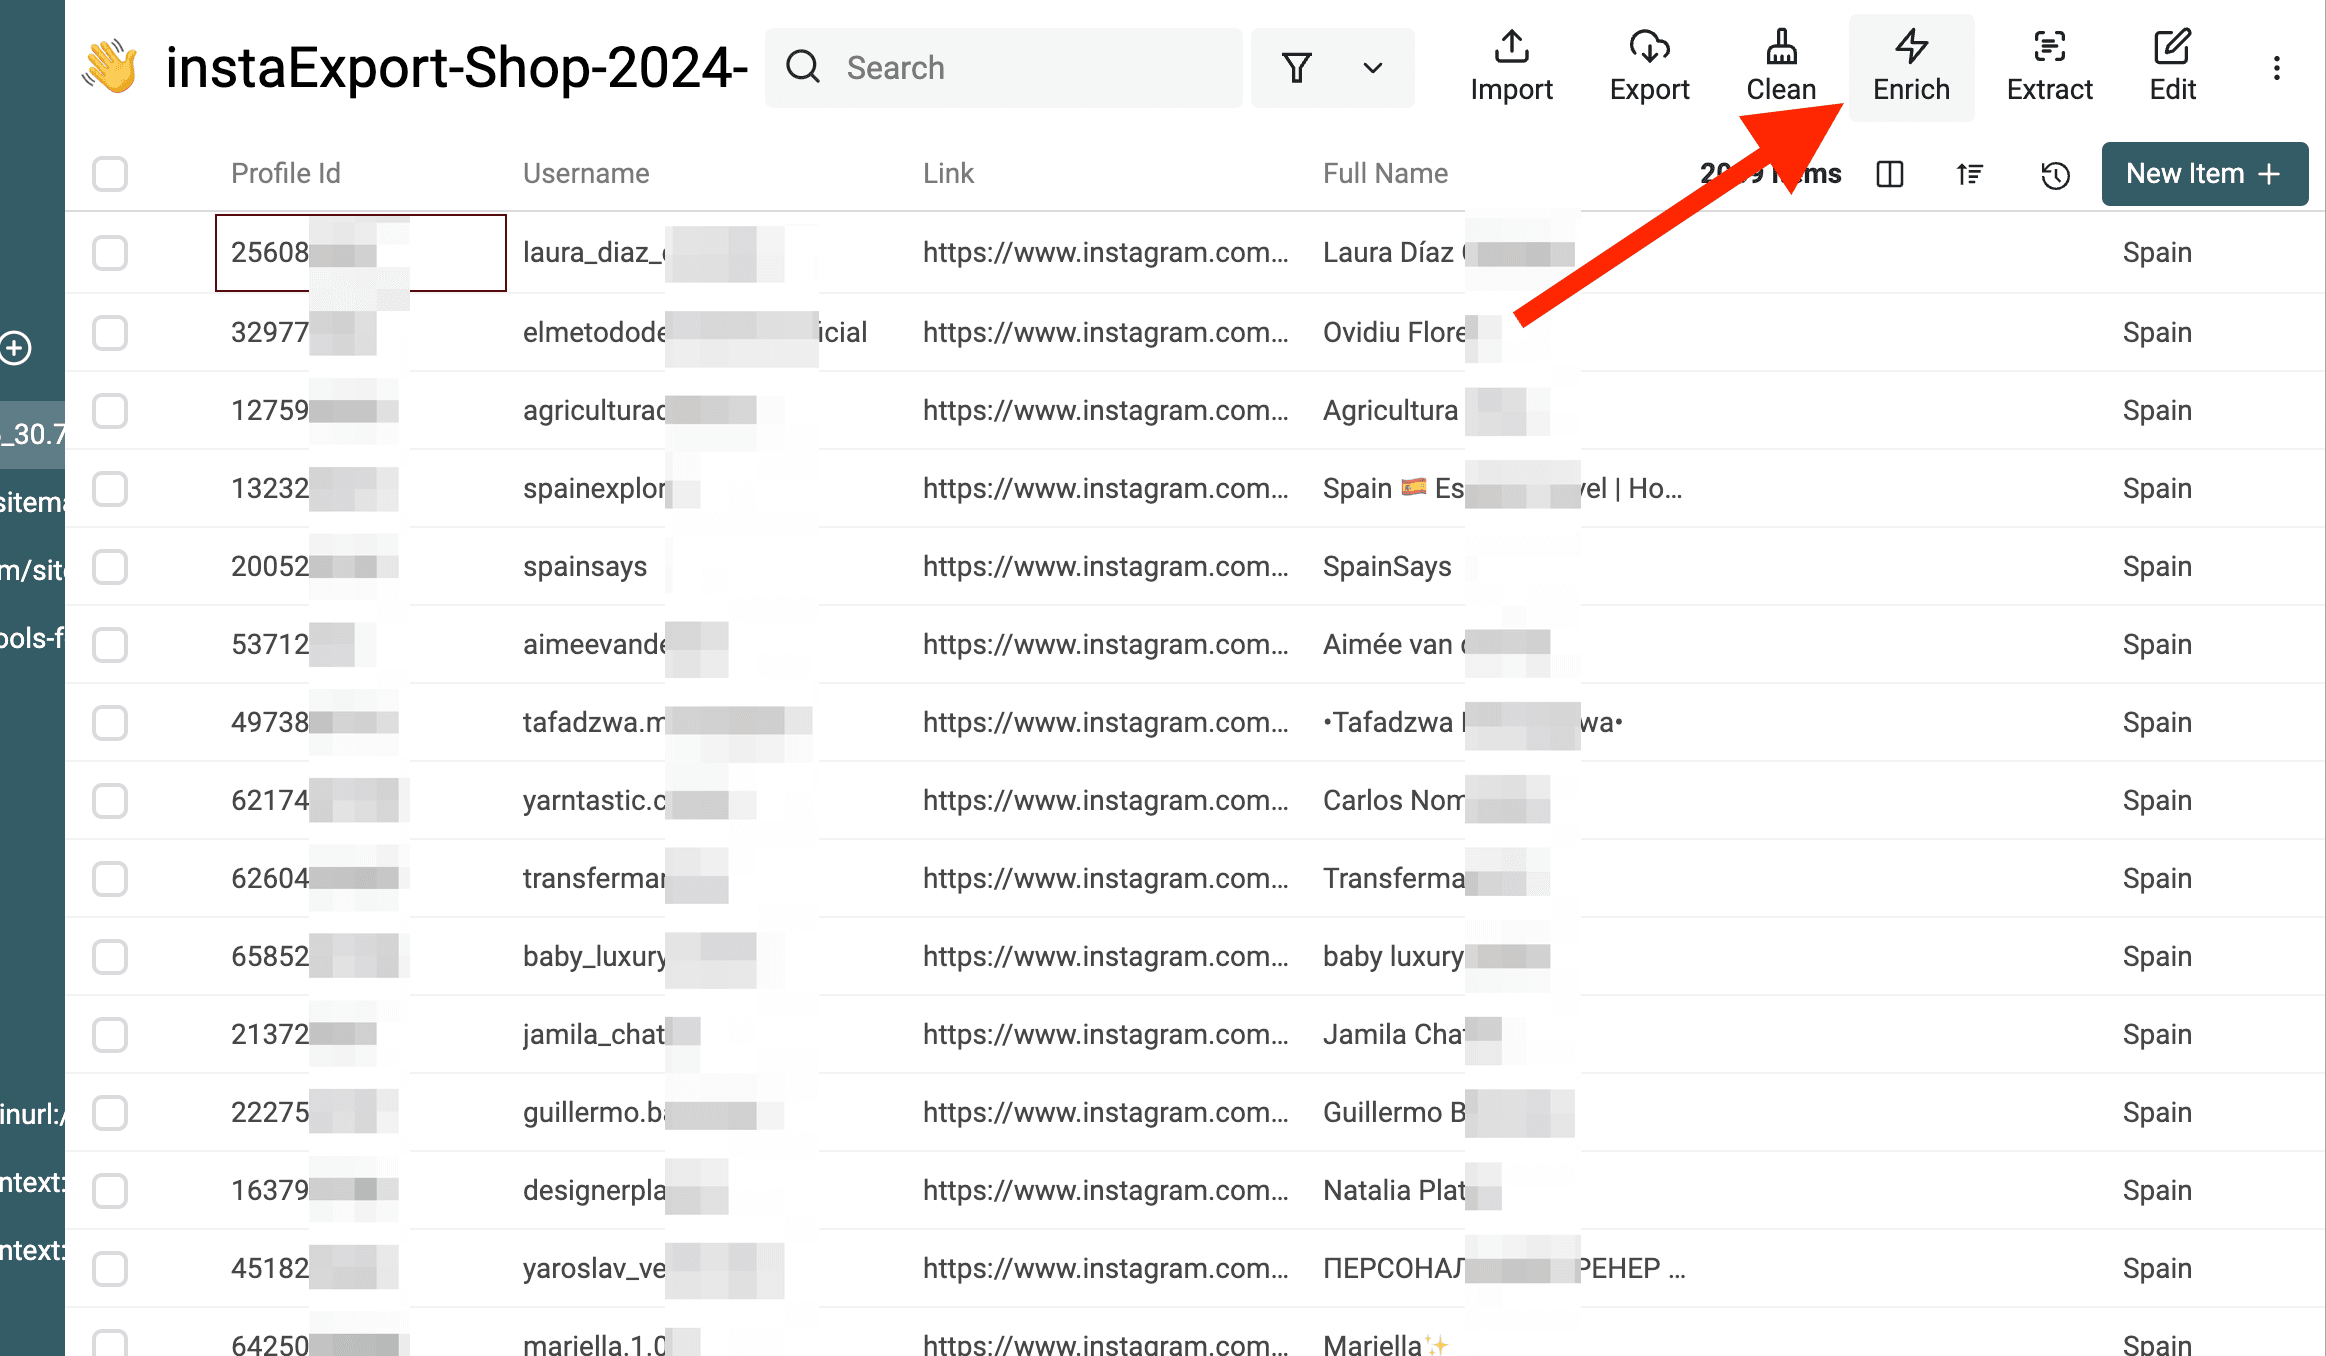
1. Åbn Enrichment-menuen Klik på Enrich øverst i dit dashboard, mens du står i din collection med de scrapede følgere.
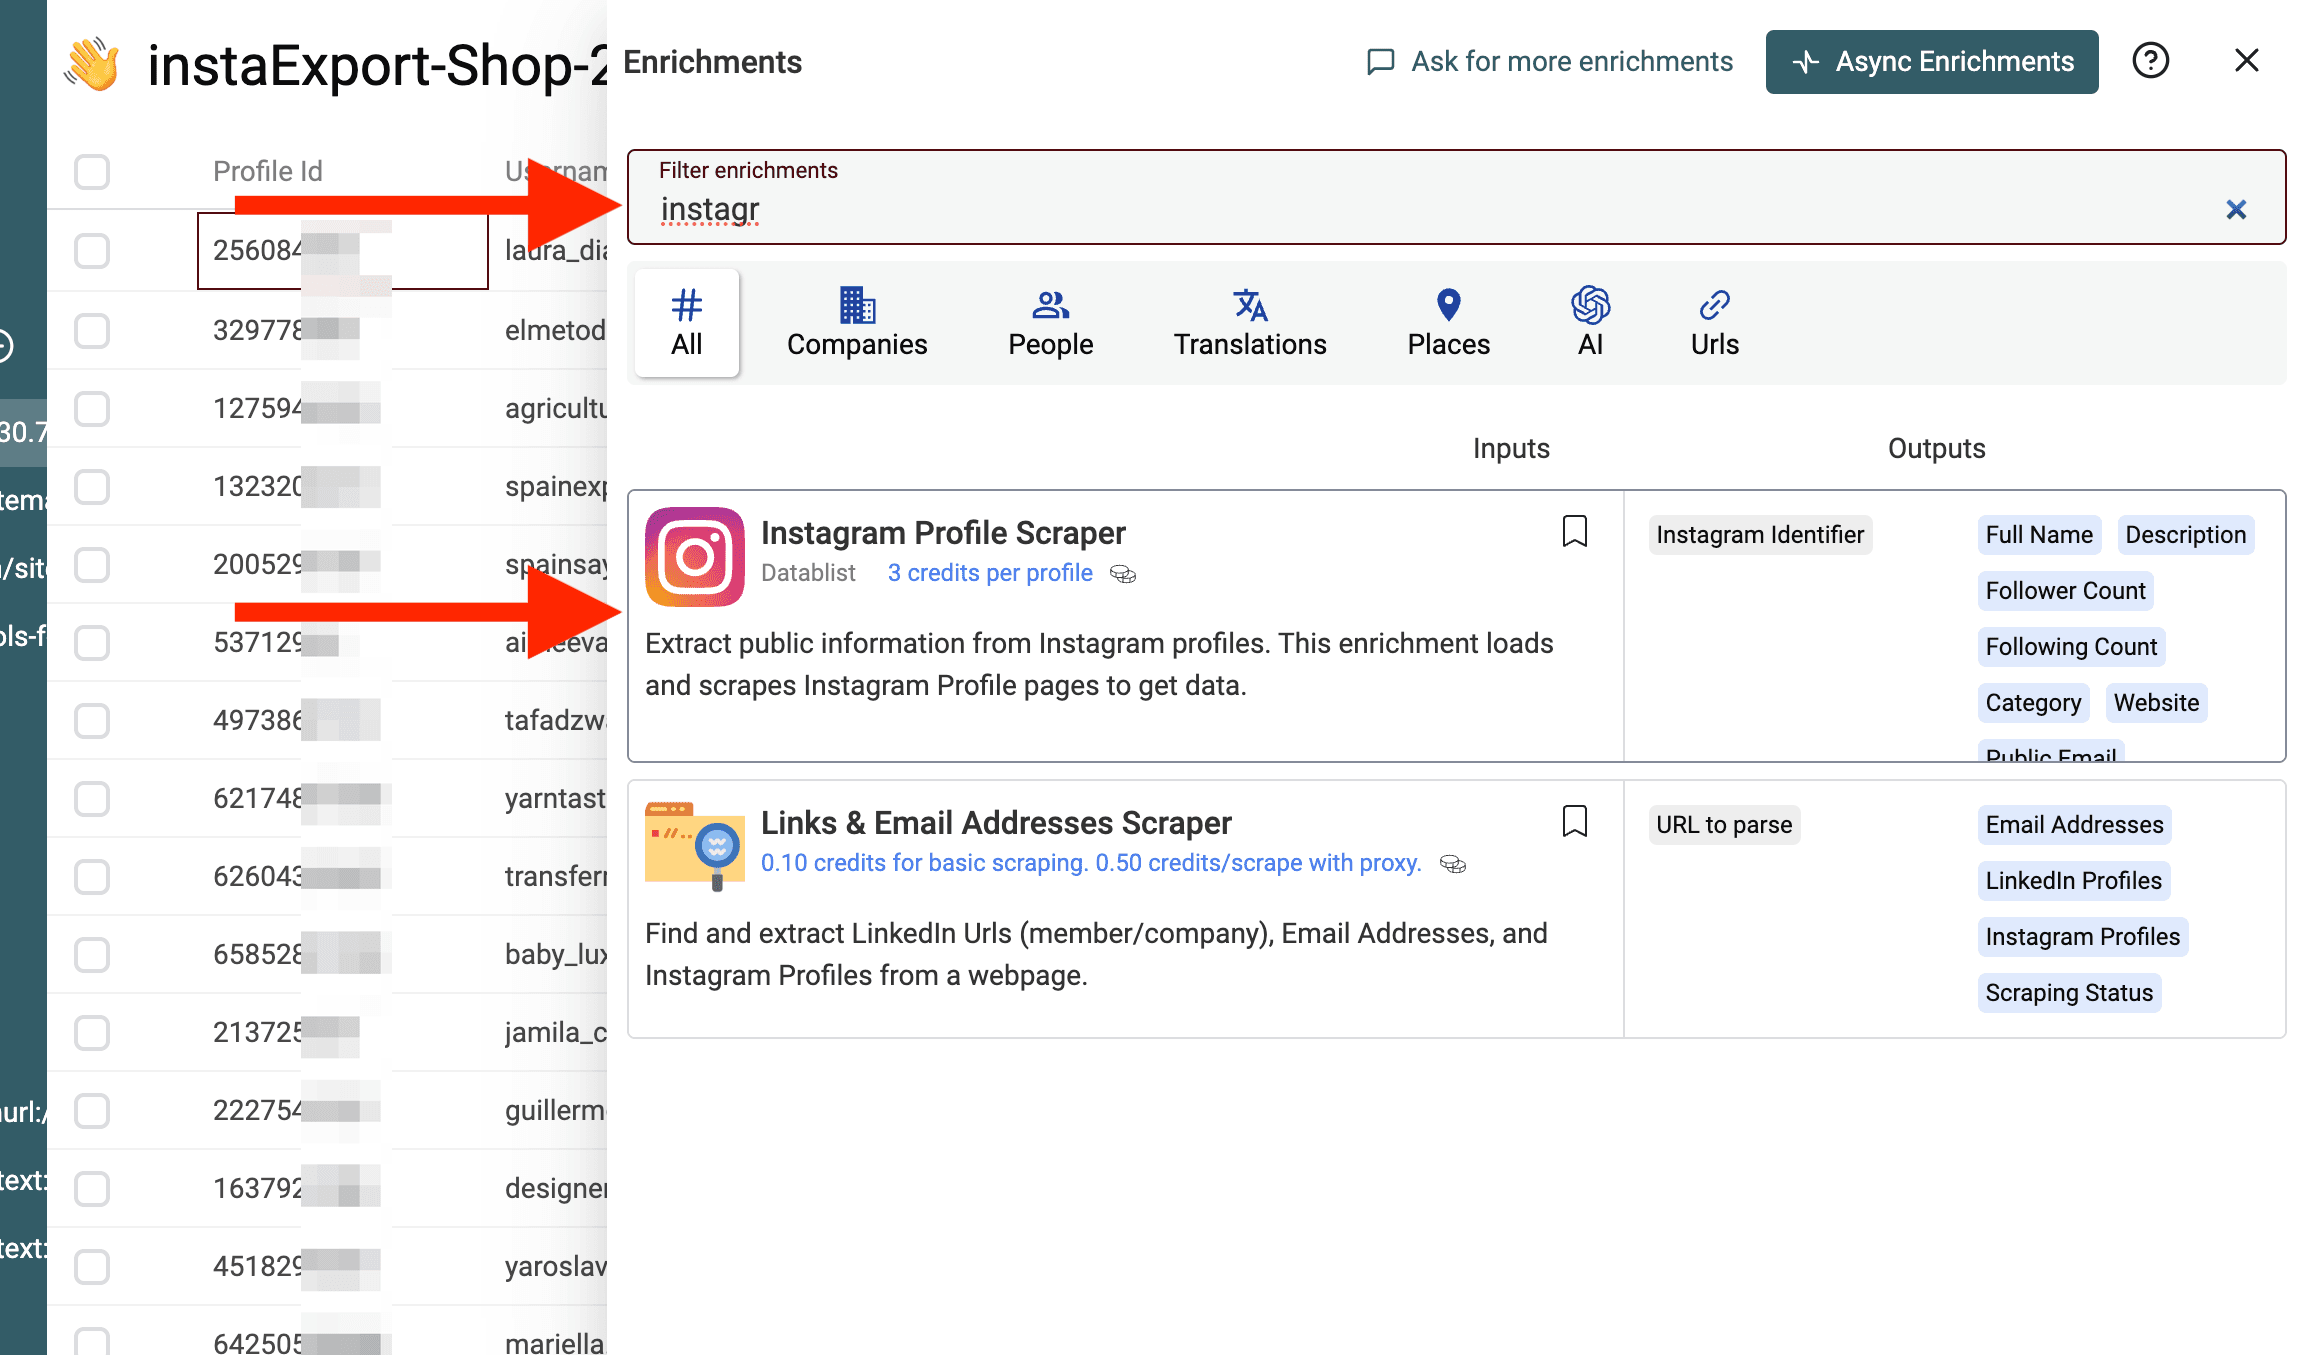
2. Vælg Instagram Profile Scraper Søg efter Instagram Profile Scraper, og vælg den. Denne enrichment bruger profil-id'erne fra kilderesultaterne til at hente yderligere profilfelter. Tilgængeligheden afhænger af den valgte scraping-type og de data, som udbyderen kan returnere.
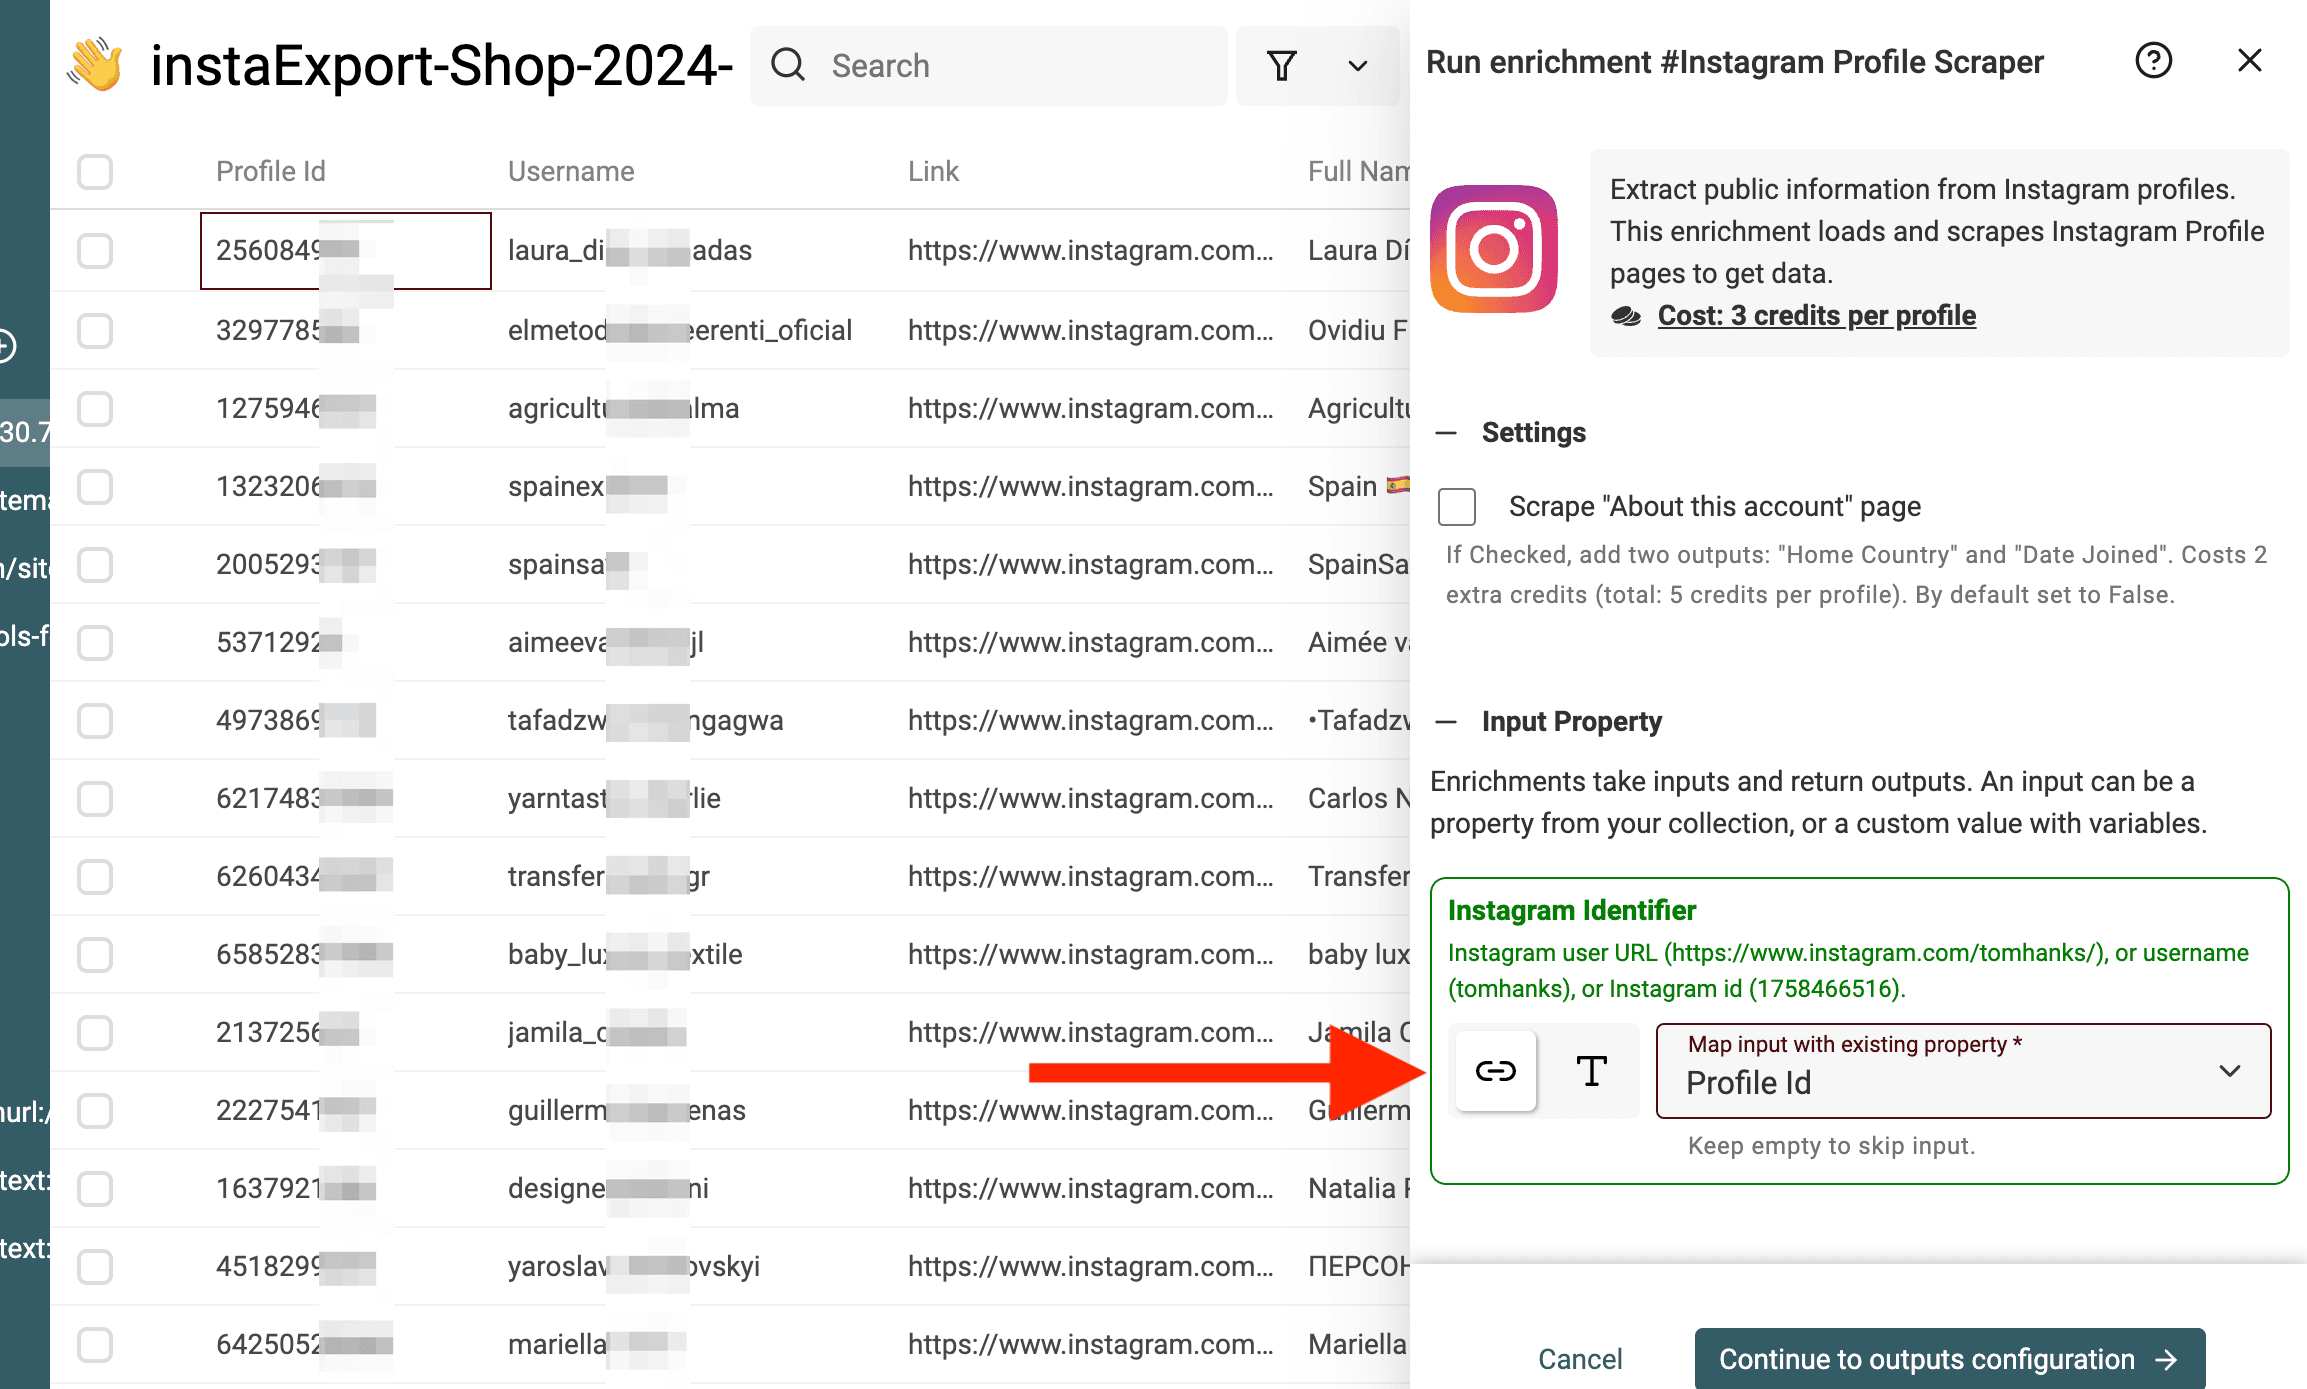
3. Map dine datakolonner Fortæl Datablist, hvilken kolonne der indeholder brugernavnene. Du skal mappe kolonnen Instagram Username eller Profile URL fra trin 6 til scraperens inputfelt.
4. Vælg dine outputfelter Vælg de konkrete datapunkter, du vil føje til din collection.
Map de ønskede outputfelter til nye kolonner, så de oprindelige følger-id'er bevares.
Du kan blandt andet få følgende output:
- Public Email: Hent e-mailadresser direkte fra virksomhedsprofiler.
- Description: Brug feltet til at filtrere dine data efter bestemte jobtitler eller interesser.
- Follower Count: Skeln mellem "micro-influencere" og almindelige brugere.
- Website: Hent linket i biografien til yderligere virksomhedsresearch.
5. Kør enrichment
Vælg den Scraping Type, der returnerer de felter, du skal bruge, og kør derefter en test. Muligheden med kun offentlige profiler inkluderer ikke outputfelter med e-mail eller telefonnummer. Profiltypen kan returnere en offentlig e-mailadresse eller et telefonnummer, hvis brugeren har oplyst det, men felterne kan stadig være tomme. Kontrollér de tilgængelige indstillinger og estimatet for credits, før du behandler resten.
Gennemgå Enrichment Status og eventuelle manglende felter, når enrichment er færdig. Et manglende offentligt e-mailfelt skal forblive tomt; det beviser ikke, at personen ikke har en e-mailadresse. Du kan derefter bruge Data Extractor, hvis en e-mailadresse er skjult i biografiteksten frem for angivet i det officielle e-mailfelt.
Kontrollér overlap, og genoptag en større scrape
Hold disse to forskellige datasæt adskilt:
- Følgerrelationer: Én række pr. kombination af følger og kildeprofil. En person, der følger to inputkonti, kan derfor helt legitimt optræde to gange.
- Unikke profiler: Én række pr. User Id, når hver person kun skal enriches én gang. Gem tilknytningen til kildeprofiler separat, før du fjerner dubletter.
I et illustrativt eksempel repræsenterer User Id 101, som følger både konto A og konto B, to relationer, men én profil. Hvis du kun deduplikerer efter User Id, mister du den ene kilderelation, medmindre du først samler denne kontekst.
Jeg vil anbefale at kontrollere manglende id'er, gentagne kombinationer af kilde og følger samt uventet små resultatsæt før enrichment. Vælg et repræsentativt udsnit af profiler, og gennemgå Description, Website og eventuelle returnerede e-mailfelter. Du bør ikke kategorisere alle følgere af en fitnesskonto som fitnessprofessionelle.
Hvis en tidligere kørsel har en gemt fortsættelse, skal du åbne kildeindstillingerne og vælge Continue a previous scrape. De tilgængelige poster er knyttet til det aktuelle workspace og gemmes i syv dage. Den valgte post genbruger kildeprofilen og scraping-typen, så du behøver ikke erstatte dem med et nyt profilinput.
Når kilden når grænsen for en collection, skal du følge indstillingen og genoptage i en anden collection i samme workspace. Hvis fortsættelsen ikke er tilgængelig, skal du kontrollere kildekørslen, før du starter forfra. En genstartet scrape kan overlappe med et tidligere øjebliksbillede, så sammenlign id'er, og bevar konteksten for både kilde og collection.
Gem en Checked At-dato sammen med hvert batch, og eksportér de kontrollerede resultater som CSV eller Excel. Et ændret antal følgere er ikke dokumentation for, at dit udtræk er komplet – følgere kan ændre sig mellem sider eller kørsler.
Konklusion
Start med en offentlig profil og en lav grænse, behold id'erne for både følger og kilde, og gennemgå de returnerede relationer, før du enricher eller eksporterer dem. Brug en gemt fortsættelse, når den er tilgængelig, hvis du skal køre en større scrape.
Åbn Datablist for at afprøve det samme workflow med en profil, der er relevant for dit projekt.
Ofte stillede spørgsmål om scraping af Instagram-følgere
Er det lovligt at scrape Instagram-følgere?
At data er offentligt synlige, er ikke i sig selv en tilladelse til automatisk indsamling eller genbrug. Gennemgå Instagrams aktuelle vilkår og kravene til dit konkrete formål, før du indsamler følgerdata.
Kan jeg scrape følgere fra flere influencere samtidig?
Ja. Indtast ét id pr. linje under Instagram Profiles. Kilden behandler de angivne konti og inkluderer relationsfelter for kildeprofilerne i de returnerede rækker. Kørslens varighed og resultat kan variere fra konto til konto.
Kan jeg scrape følgere fra private Instagram-profiler?
Nej. Dette workflow giver ikke adgang til en privat profils følgerliste. Et opslag af profildetaljer er en separat enrichment og kan ikke bruges til at låse op for begrænsede følgerdata.
Hvor hurtigt kan jeg scrape Instagram-følgere?
Der findes ikke én fast behandlingstid for alle profiler. Kør en lille test, og kontrollér den faktiske varighed, de returnerede rækker og forbruget af credits, før du udvider den.
Hvad sker der, hvis jeg scraper over 100.000 følgere?
Betragt grænsen for kildekørslen og lagerpladsen i din collection som to separate begrænsninger. En kilde kan stoppe, før hele profilens liste er hentet. Brug en tilgængelig fortsættelse i en anden collection, når indstillingen beder dig om det, og eksportér hvert færdigt batch. Gå ikke ud fra, at kapaciteten for import til en collection svarer til kildens kapacitet for dataudtræk.
Hvilke data får jeg, når jeg scraper Instagram-følgere?
Du kan vælge mellem en række profildatafelter for hver følger, herunder:
- User Id: Instagrams interne bruger-id
- User Username: Følgerens Instagram-brugernavn
- User Profile URL: Direkte link til personens Instagram-profil
- Full Name: Det viste navn på profilen
- Profile Picture: URL til profilbilledet
- Private: Om kontoen er privat eller offentlig
- Verified: Status for verificering med blåt flueben
- Follower of (UserId), Follower of (Username) og Follower of (ProfileUrl): Id'er for kildekontoen, som bruges til at kontrollere relationen
Hvor mange Instagram-følgere kan jeg scrape ad gangen?
Angiv Scraping Limit Per Profile for kildekørslen, og kontrollér dens status og indstillinger for fortsættelse. De faktiske resultater afhænger af de tilgængelige følgersider, udbyderens svar, kørselsgrænser og dine tilgængelige credits. Importkapaciteten er ikke en garanti for, at en følgerkilde kan returnere det samme antal i én kørsel.
Skal jeg bruge en browserudvidelse til at scrape Instagram-følgere?
Nej. Datablist kører udelukkende som en webapp. Du behøver hverken udvidelser, downloads eller installationer.
Hvad er den billigste måde at scrape Instagram-følgere på?
Vælg en lav grænse, kontrollér estimatet for credits, og gennemgå de returnerede rækker, før du kører enrichment af profildetaljer. Sammenlign prisen pr. brugbar, kontrolleret profil i stedet for at antage, at hver returneret følger er en kvalificeret kontakt.
Hvordan scraper jeg Instagram-følgere uden at blive blokeret?
Datablist beder ikke om dine loginoplysninger eller session-cookies til Instagram i dette workflow. Det betyder dog ikke, at scraping er risikofrit, eller at du automatisk har tilladelse til at indsamle data. Brug tilgængelige kildedata, gennemgå platformens krav, og stop, hvis den ønskede liste ikke er tilgængelig.
Hvad er forskellen på at scrape Followers og Following?
Followers er de personer, der følger en profil. Following er listen over konti, som profilen selv følger. Denne guide handler specifikt om scraping af følgere, men Datablist tilbyder begge muligheder.
Kan jeg scrape Instagram-følgere fra en virksomhedskonto?
Ja, så længe virksomhedskontoen er offentlig. Scraperen fungerer på samme måde for personlige konti, creator-konti og virksomhedskonti.
Hvordan downloader jeg en liste over Instagram-følgere?
Opret en konto hos Datablist og en ny collection, vælg Instagram Followers/Following Scraper, indsæt profilen, og start kørslen. Når den er færdig, kan du eksportere resultaterne som CSV eller Excel.
Hvilke værktøjer kan scrape Instagram-følgere?
Der findes flere muligheder, herunder browserudvidelser, Python-scripts og platforme som Datablist. Sammenlign kravene til kontoadgang, de returnerede felter, muligheden for at fortsætte en kørsel, testens varighed og prisen pr. brugbart resultat. Datablist kræver ikke dine Instagram-loginoplysninger til dette workflow.