
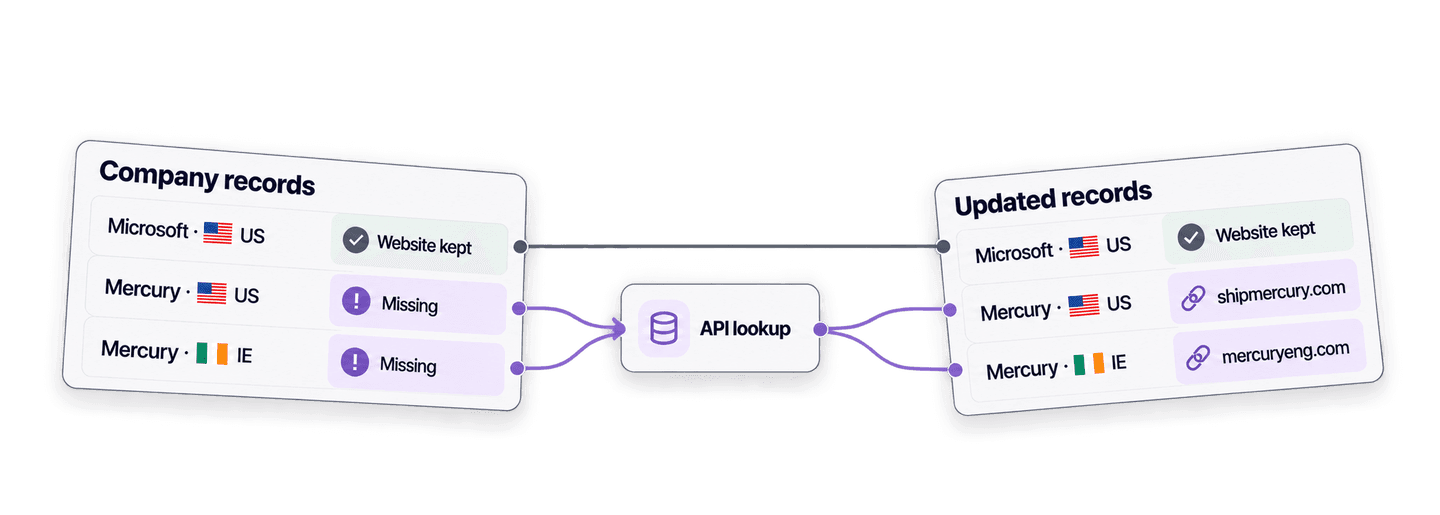
Para encontrar el sitio web de una empresa a partir de su nombre con Python, envíe el nombre y, si dispone de él, el país a la API Company Name to Domain de Datablist. La API procesa la búsqueda en segundo plano y devuelve el dominio y la URL completa del sitio web.
Primero le mostraré una solicitud sencilla a la API con Python. Después, reutilizaré la misma función para completar únicamente los sitios web que falten en una lista de empresas, sin modificar las URL existentes.
Si prefiere una interfaz similar a una hoja de cálculo, consulte la guía para buscar sitios web de empresas en bloque.
💡 Resumen para quienes tienen prisa
Cree una función de Python que encuentre sitios web a partir del nombre de la empresa y úsela para completar registros sin sitio web, sin sustituir las URL conocidas.
- Entrada: nombres de empresas y, opcionalmente, el país.
- Salida: dominio, URL completa, nivel de confianza, estado del resultado y créditos utilizados.
Configure Python y su clave API de Datablist
Para este ejemplo, utilizo el paquete Requests para realizar llamadas HTTP síncronas. Instálelo en un entorno virtual:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsTambién necesita un plan Growth de Datablist, ya que el acceso a la REST API es una función de Growth. Cree una Personal API Key desde la página de API de su cuenta de Datablist y guárdela en una variable de entorno:
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 ¿Ya tiene una clave API? Las claves antiguas utilizan
auth0|<userId>:<accountId>:<secret>:1y siguen siendo compatibles. Continúe usando su clave actual exactamente como se generó; no necesita sustituirla ni cambiar su formato.
Sustituya el valor de ejemplo por la clave generada en la página de su cuenta. Las búsquedas de sitios web consumen créditos. Antes de escalar el script, explicaré cuándo se cobra 1 crédito y cuándo 2,5 créditos. Puede consultar los valores actuales de los planes en la página de precios de Datablist.
Busque el sitio web de una empresa con Python
Cree un archivo llamado find_company_websites.py. El script envía los nombres, espera a que termine la tarea y obtiene los resultados mediante una sola función. Cada entrada utiliza el ID estable de su registro como inputId, de modo que pueda asociar cada resultado con el registro correcto aunque cambie el orden de la respuesta.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))Ejecútelo desde el terminal en el que exportó la clave:
python find_company_websites.pyEste es el resultado de Microsoft:
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
Utilice inputId para asociar el resultado con el registro original. status puede ser success, no_result, error o skipped. Un resultado correcto puede incluir companyDomain, la URL completa en companyUrl y domainConfidence. creditsUsed indica el coste de esa entrada, mientras que error explica cualquier fallo individual.
La función realiza tres tipos de llamadas a la API, en este orden.
Primero, envía la búsqueda. El payload contiene la configuración y los registros de las empresas. La solicitud POST devuelve 202 Accepted, y @id es el ID de tarea necesario para las siguientes llamadas:
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]Si DATABLIST_API_KEY no está definida, Python genera un KeyError al consultar el entorno, antes de realizar la solicitud HTTP. Exporte la variable y vuelva a ejecutar el script. Si contiene una clave no válida, la solicitud POST llegará a la API y devolverá un error HTTP 401. Copie una Personal API Key vigente desde la página de su cuenta y sustituya el valor incorrecto.
Segundo, consulta periódicamente la tarea. La solicitud POST inicia un proceso en segundo plano, por lo que el script consulta la tarea cada tres segundos hasta que alcanza el estado completed, failed o stopped:
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)Si la tarea falla por falta de créditos, el motivo del error será credits_error. Añada créditos o espere a que se renueven sus créditos mensuales, revise los resultados ya devueltos y envíe únicamente las entradas pendientes en una nueva tarea.
Tercero, recupera todas las páginas de resultados. Cada respuesta añade sus resultados a la lista y proporciona el cursor para la siguiente solicitud:
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakEl script continúa obteniendo páginas hasta que nextCursor es null.
Antes de la solicitud POST, el script muestra el uniqueId generado. Si la conexión se interrumpe antes de recibir la respuesta de creación, consulte primero la lista de tareas y compruebe su estado antes de crear otra:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"Busque la tarea cuyo uniqueId coincida con el valor generado por el script y copie su @id. El endpoint de listado permite filtrar por enrichmentId, pero no por uniqueId. Utilice el @id con las mismas URL de estado y resultados empleadas por el script. Si la tarea sigue activa, continúe consultándola. Si se ha detenido o ha fallado, revise si existen resultados parciales antes de volver a enviar las entradas.
Cómo funciona la búsqueda por país y dataset
El script utiliza dataset_google, la opción predeterminada recomendada. Datablist consulta primero sus datasets de empresas. Si no encuentra una coincidencia o detecta información contradictoria, puede recurrir a Google. Antes de devolver un nivel de confianza, comprueba las posibles coincidencias.
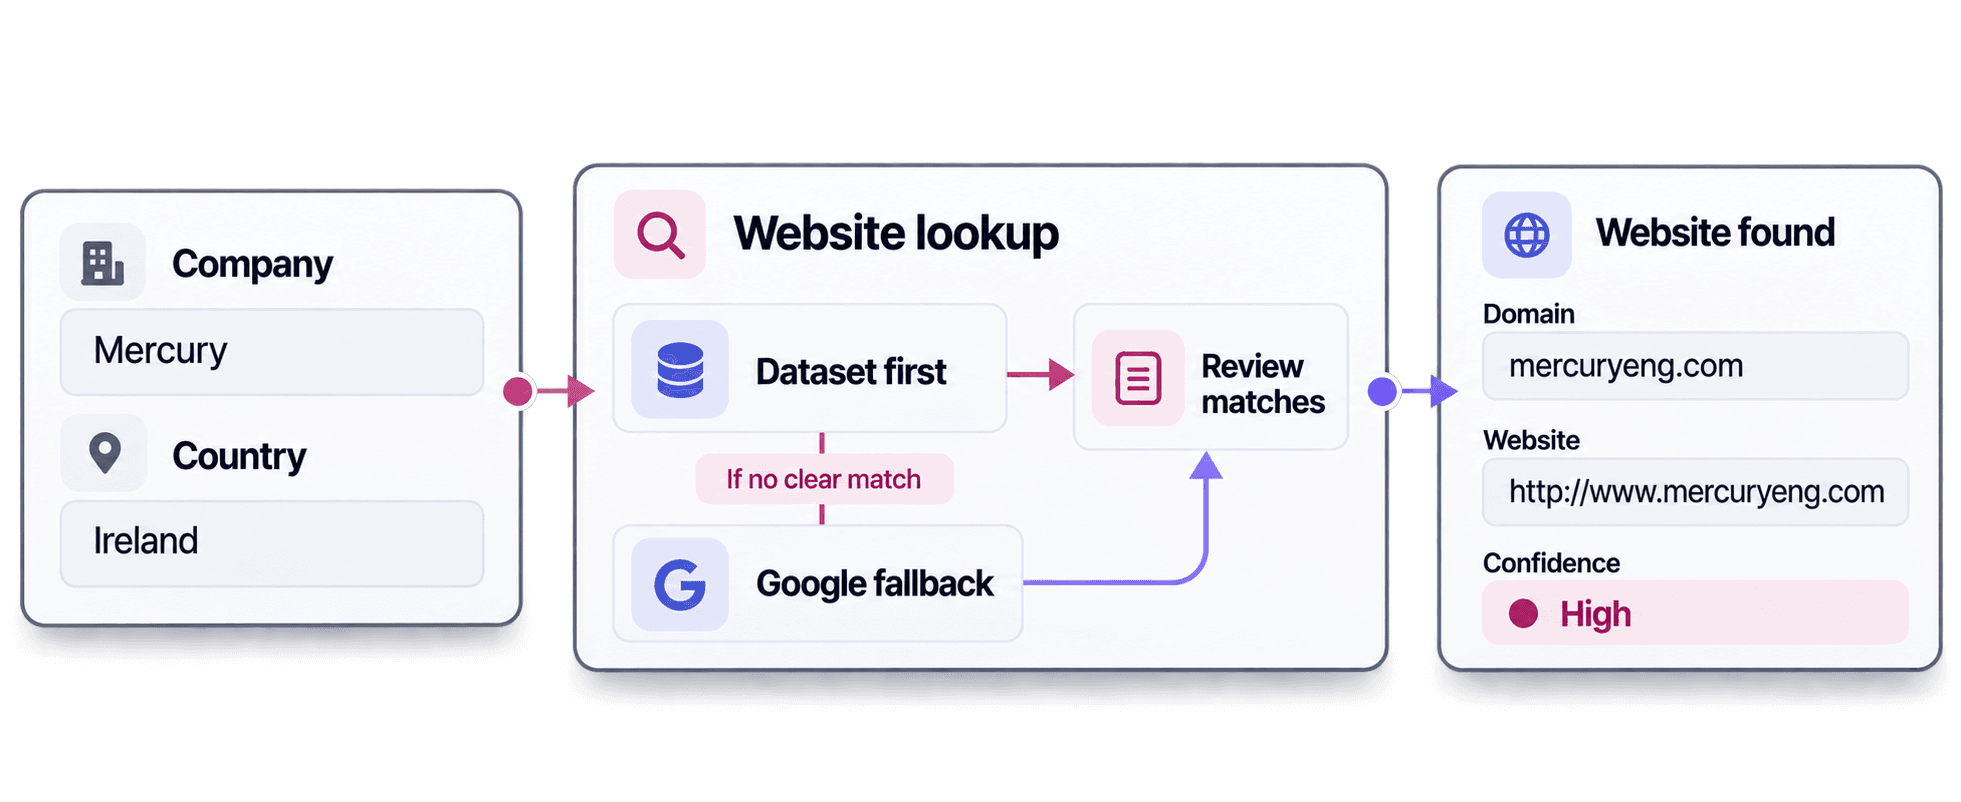
El país ayuda a resolver nombres ambiguos. En este ejemplo, el mismo nombre de empresa produjo resultados diferentes:
MercuryconUSdevolvióshipmercury.comyhttps://www.shipmercury.com/.MercuryconIEdevolviómercuryeng.comyhttp://www.mercuryeng.com.
Ambos obtuvieron un nivel de confianza High. El país permite elegir entre empresas con el mismo nombre, mientras que el nivel de confianza le ayuda a decidir qué resultados debe revisar.
Cuando la coincidencia también dependa del sector, el tamaño de la empresa u otros datos comerciales, utilice el workflow de investigación con AI Agent. Añada esos datos al prompt de AI Agent para que pueda investigar la empresa correcta con más contexto de negocio.
Complete solo los sitios web que faltan
Ahora que find_domains() puede encontrar un sitio web a partir del nombre de una empresa, reutilice la función para completar únicamente los sitios web que falten en sus registros. Los registros que ya tengan un sitio web no se envían a la API, por lo que sus valores permanecen intactos y no consumen créditos de búsqueda.
En find_company_websites.py, sustituya todo el contenido desde companies = [ hasta el bucle final de impresión por el siguiente bloque. Conserve la asignación de api_key que aparece antes. La comprobación de campos vacíos contempla None, una cadena vacía y espacios en blanco. Si todos los registros tienen sitio web, no se realiza ninguna llamada a la API.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))El código indexa los resultados por inputId y después recorre los registros originales en el mismo orden. El objeto website_lookup conserva el resultado y los datos necesarios para revisar cada registro procesado, incluidos los resultados fallidos o ausentes.
En crm-001, website_is_missing() devuelve False porque la URL de Microsoft ya está presente. El registro no se añade a records_to_lookup, por lo que la API nunca lo recibe. Al combinar los datos, se conserva el sitio web y se registra el estado not_requested.
En crm-002, el sitio web está vacío, por lo que la solicitud envía la panadería con inputId: crm-002. La API devuelve el mismo inputId. results_by_id lo utiliza para localizar el resultado correcto y la combinación guarda https://boulangerie-du-palais-lyon.eatbu.com en ese registro, sin depender del orden de los resultados.
| ID | Empresa | Sitio web tras combinar | Estado | Dominio | Confianza | Créditos |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
La panadería utiliza un subdominio propio del negocio: boulangerie-du-palais-lyon.eatbu.com. Conserve ese valor en lugar de reducirlo a eatbu.com y guarde la dirección exacta de companyUrl. La opción acceptNonRoot: true también admite una página alojada cuya dirección incluya una ruta después del hostname, por lo que la URL completa es importante en ambos casos.
Una tarea completada puede contener elementos con estado no_result, error o skipped. El ejemplo solo modifica website cuando el estado es success y existe companyUrl. Si el estado es no_result, el sitio web permanece vacío y el estado sigue visible en website_lookup. Compruebe primero el nombre y el país de la empresa. Si alguno es incorrecto, corríjalo y envíe ese registro en una nueva tarea. De lo contrario, mantenga el sitio web vacío para revisarlo manualmente.
Calcule los créditos antes de escalar el script
Las cinco búsquedas del ejemplo devolvieron success con un nivel de confianza High y consumieron 5 créditos en total.
Una búsqueda resuelta mediante el dataset cuesta 1 crédito. Una búsqueda procesada con Google cuesta 2,5 créditos. Se cobra la vía utilizada, no ambas. Para 1000 entradas, esto supone 1000 créditos si todas se resuelven mediante el dataset o 2500 créditos si todas utilizan Google. Son escenarios orientativos, no una garantía de que todas las búsquedas vayan a ofrecer resultados.
Mueva el control deslizante para comparar el consumo de créditos de su lista.
Con un precio de 20 $ por 20 000 créditos, esos escenarios cuestan 1 $ y 2,50 $. La suscripción Growth se cobra por separado y actualmente incluye 20 000 créditos mensuales, que se utilizan antes que las recargas. Consulte los precios actuales, ya que los planes y paquetes pueden cambiar.
Cada tarea admite hasta 10 000 entradas, con un límite de 16 KiB por entrada y 10 MiB por solicitud. Este ejemplo utiliza llamadas bloqueantes de Requests para enviar, consultar y recuperar los resultados de una pequeña tarea asíncrona de Datablist. El repositorio mantenido también incluye ejemplos de procesamiento de CSV por lotes y clientes no bloqueantes.
Próximos pasos
Cuando confirme que el sitio web devuelto pertenece a la empresa correcta, puede extraer su Impressum con Python para añadir al mismo registro del proveedor los datos legales de la empresa y la URL de la página legal utilizada como fuente. Mantenga la revisión de la coincidencia del sitio web separada de esta extracción posterior.
Sustituya los registros de ejemplo por una pequeña muestra de sus propios datos, ejecute el script y revise los registros combinados. Conserve IDs estables y el país, y amplíe el volumen solo después de comprobar que el script respeta los sitios web conocidos y completa los campos vacíos previstos. Si necesita descargar el script, procesar archivos CSV por lotes o utilizar una versión asíncrona, puede partir de los ejemplos mantenidos de la API Company Name to Domain en GitHub.