
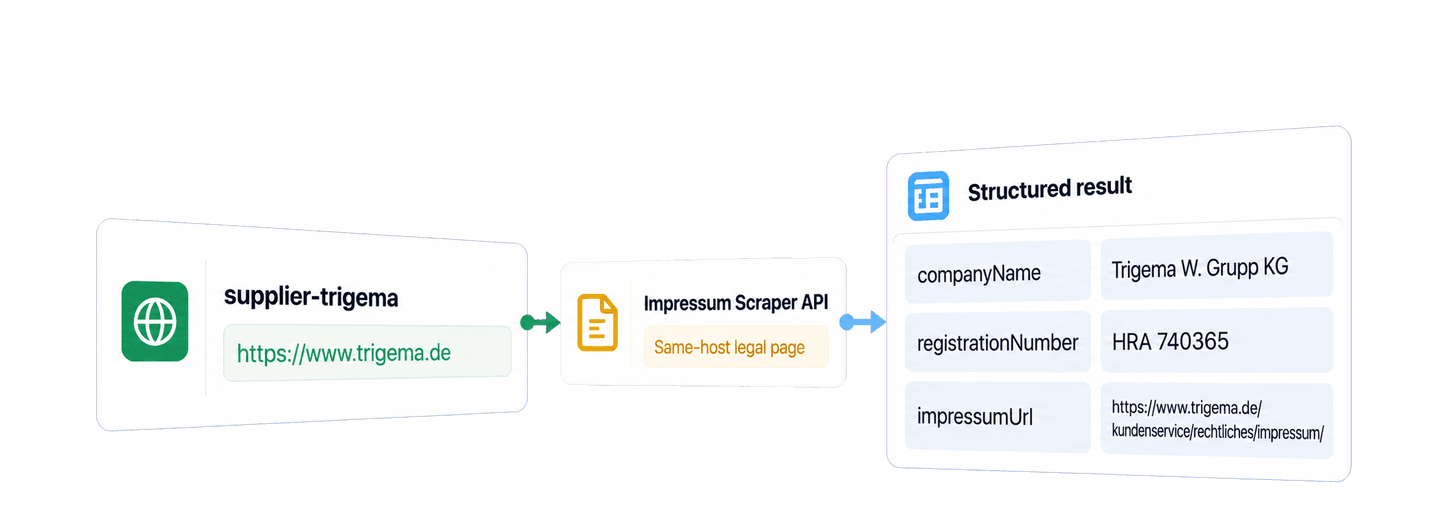
Para extraer datos de un Impressum con Python sin tener que crear un crawler propio, utilice la API Impressum Scraper de Datablist junto con la librería Requests. Usted proporciona las URLs de los sitios web de las empresas, la API localiza la página de Impressum de cada sitio y extrae de ella datos estructurados de la empresa y sus contactos.
En este ejemplo utilizo dos marcas alemanas consolidadas: el fabricante de ropa Trigema y la marca de productos para actividades al aire libre VAUDE. Un pequeño ejemplo ejecutable en Python realiza la consulta y conserva tanto los datos extraídos como la URL del Impressum de origen en cada registro de proveedor.
📌 Resumen para quienes tienen prisa
Utilice la API Impressum Scraper de Datablist para convertir sitios web de empresas alemanas en datos estructurados de empresa y contacto. El ejemplo en Python envía dos sitios web, espera a que termine la tarea en segundo plano, recupera todas las páginas de resultados y guarda en cada registro la URL de la página legal localizada.
- Entrada: URLs de sitios web de empresas alemanas.
- Salida: Datos de empresa y contacto, además del enlace al Impressum de origen.
💡 ¿Prefiere una solución no-code? Utilice Impressum Scraper de Datablist para extraer estos datos empresariales sin escribir código.
Configure su clave API y el entorno de Python
Cree una cuenta de Datablist y, después, una Personal API Key. El acceso a la REST API está disponible con el plan Growth. Este es un ejemplo del formato de la clave:
auth0|exampleuser:exampleaccount:EXAMPLE_TOKEN_NOT_VALID:1Exporte su propia clave como DATABLIST_API_KEY:
export DATABLIST_API_KEY="your-personal-api-key"Para este ejemplo en Python utilizo el paquete requests. Cree un archivo llamado
scrape_impressum.py e instale el paquete:
python -m pip install requestsCada sitio web enviado consume 10 créditos. El ejemplo siguiente, con dos sitios web, consume 20 créditos cuando se procesan ambas entradas.
Cree la función scrape_impressums()
Pegue este script completo en scrape_impressum.py:
import json
import os
import time
import uuid
import requests
def scrape_impressums(suppliers, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]
payload = {
"enrichmentId": "impressum-scraper",
"uniqueId": str(uuid.uuid4()),
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
suppliers = [
{
"id": "supplier-trigema",
"label": "Trigema",
"website_url": "https://www.trigema.de",
},
{
"id": "supplier-vaude",
"label": "VAUDE",
"website_url": "https://www.vaude.com",
},
]
impressum_results = scrape_impressums(suppliers, api_key)
for result in impressum_results:
print(json.dumps(result, ensure_ascii=False))Ejecute el script completo con:
python scrape_impressum.pyLa función sigue tres pasos para interactuar con la API: envía los sitios web de entrada, espera a que termine la tarea y recupera todas las páginas de resultados.
Envíe los sitios web de entrada
El script transforma cada proveedor en una entrada para la API como esta:
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]inputId es su propio identificador estable. data.websiteUrl es la página de inicio de la empresa que inspeccionará el scraper. Utilice el sitio web de la propia empresa, no un directorio ni un perfil en redes sociales. El payload selecciona el enrichment público impressum-scraper y utiliza un objeto settings vacío porque esta API no requiere ajustes públicos.
La solicitud POST crea una tarea en segundo plano. Datablist acepta la solicitud y devuelve un objeto de tarea cuyo @id identifica esa ejecución. La función utiliza ese ID para construir las URLs de estado y resultados.
Una respuesta de creación abreviada tiene este aspecto:
{
  "@id": "task-id",
  "enrichmentId": "impressum-scraper",
  "status": "queued",
  "links": {
    "self": "https://api.datablist.com/v1/enrichments/tasks/task-id",
    "results": "https://api.datablist.com/v1/enrichments/tasks/task-id/results"
  }
}
queued significa que la solicitud se ha aceptado, no que el resultado esté listo. El script lleva el @id devuelto a los dos pasos siguientes, por lo que no necesita copiar manualmente las URLs de la tarea. También llama a raise_for_status() antes de leer cada respuesta. De este modo, un error de autenticación o validación detiene el proceso en la solicitud HTTP que ha fallado, en vez de confundirse con una consulta completada.
Espere a que termine la tarea en segundo plano
Datablist procesa la tarea en segundo plano. El ejemplo comprueba su estado cada tres segundos hasta que llega a completed, failed o stopped. Requests es una librería bloqueante de Python, por lo que su script local espera durante estas llamadas, aunque la tarea de la API se ejecute en segundo plano.
Si la tarea termina con failed o stopped, la función genera un error que incluye el ID de la tarea y su estado final. Conserve ese ID cuando investigue la tarea existente, en lugar de volver a enviar inmediatamente el mismo trabajo de pago.
Recupere todas las páginas de resultados
Una vez completada la tarea, el script solicita hasta 100 resultados por página. La regla de paginación es sencilla: recupere la página siguiente hasta que nextCursor sea null. Cuando el cursor contiene un valor, el script lo envía con la siguiente solicitud.
No vincule los registros devueltos con su aplicación según la posición que ocupan en la lista. Los resultados pueden llegar en un orden distinto al de las entradas enviadas. Utilice inputId como clave de unión.
Cómo encuentra la API una página de Impressum
La página de inicio es el punto de partida, no la página de la que la API espera extraer los datos. Impressum Scraper utiliza AI para inspeccionar los enlaces internos del host proporcionado e identificar un Impressum o una página legal o de contacto equivalente. Esto es importante porque el enlace puede aparecer bajo nombres como Rechtliches, Kontakt o Legal, en vez de encontrarse en /impressum.
Si la AI no encuentra un enlace interno adecuado, el scraper prueba las rutas habituales /impressum y /imprint en el mismo host. Cuando llega a una página de origen, la AI extrae en un único resultado los campos de razón social, dirección, contacto, registro mercantil, IVA y fuente. No utiliza un motor de búsqueda ni accede a un directorio externo.
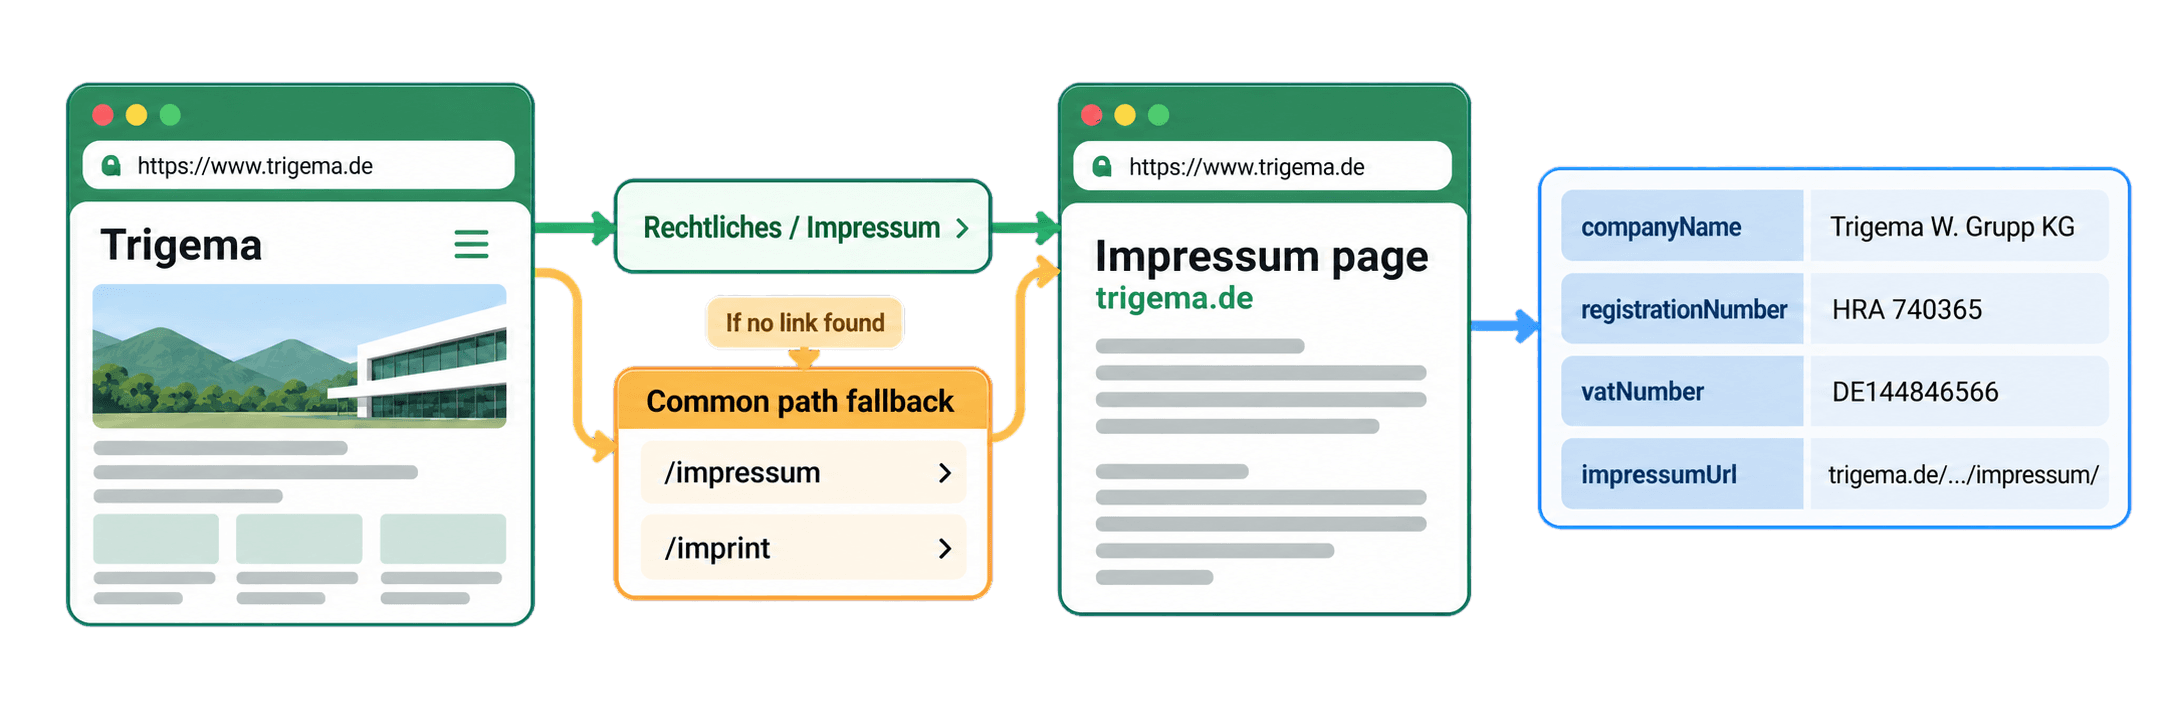
Los dos resultados muestran en la práctica que las rutas pueden variar. Trigema devolvió /kundenservice/rechtliches/impressum/, mientras que VAUDE devolvió /de/de/impressum.html. Conserve impressumUrl en cada resultado, ya que registra la página de origen exacta de los campos extraídos.
Analice los resultados de Trigema y VAUDE
Este es un extracto compacto de los resultados de ambos ejemplos.
📘 Direcciones de email de ejemplo: Los emails aparecen ocultos con
**a continuación. La API devuelve las direcciones completas.
[
  {
    "inputId": "supplier-trigema",
    "status": "success",
    "outputs": {
      "firstName": "Wolfgang",
      "lastName": "Grupp",
      "companyName": "Trigema W. Grupp KG",
      "postalAddress": "Josef-Mayer-Str. 31-35, D-72393 Burladingen",
      "emailAddress": "b**@trigema.de",
      "registrationNumber": "HRA 740365",
      "vatNumber": "DE144846566",
      "impressumUrl": "https://www.trigema.de/kundenservice/rechtliches/impressum/",
      "agentConfidenceScore": 90
    },
    "creditsUsed": "10",
    "error": null
  },
  {
    "inputId": "supplier-vaude",
    "status": "success",
    "outputs": {
      "firstName": "Antje",
      "lastName": "von Dewitz",
      "companyName": "VAUDE Sport GmbH & Co. KG",
      "postalAddress": "Vaude Straße 2, 88069 Tettnang",
      "emailAddress": "s**@service.vaude.com",
      "registrationNumber": "HRA 631071",
      "vatNumber": "DE203894755",
      "impressumUrl": "https://www.vaude.com/de/de/impressum.html",
      "agentConfidenceScore": 95
    },
    "creditsUsed": "10",
    "error": null
  }
]
Comience por los nombres. Trigema es la etiqueta del proveedor en la entrada de Python, mientras que Trigema W. Grupp KG es la razón social extraída del Impressum. La misma distinción aparece con VAUDE: la etiqueta de entrada es VAUDE y la empresa devuelta es VAUDE Sport GmbH & Co. KG. Conservar ambos valores le permite mantener el nombre reconocible que utiliza su equipo y, al mismo tiempo, añadir la entidad legal que figura en el sitio web de la empresa. Esto resulta especialmente útil al comparar el registro de un proveedor con una factura, un contrato u otro conjunto de datos empresariales que pueda utilizar la razón social completa.
Los campos devueltos responden a distintas necesidades de investigación:
firstNameylastNamecontienen el nombre del director gerente o fundador extraído de la página, cuando se encuentra. En este caso son Wolfgang Grupp y Antje von Dewitz.postalAddressproporciona la dirección comercial extraída de la página legal, mientras que los campos de email y teléfono incluyen los datos de contacto publicados allí.registrationNumberyvatNumberconservan los identificadores mostrados en la página. Para Trigema sonHRA 740365yDE144846566; para VAUDE,HRA 631071yDE203894755. Estos valores concretos pueden compararse con los identificadores que ya tenga guardados en sus datos de proveedores.impressumUrlidentifica la página utilizada para la extracción. Es distinta de la página de inicio enviada: una registra la empresa desde la que comenzó y la otra, la fuente de los datos legales de la compañía.
Ambos registros tienen status: success y consumieron 10 créditos. agentConfidenceScore es una señal de 0 a 100 que le ayuda a priorizar la revisión; no representa un porcentaje de precisión. Los campos de salida pueden quedar vacíos si un dato no aparece en la página o no se puede extraer. Por eso, conserve el estado del elemento y abra la URL del Impressum devuelta cuando un dato sea importante para el siguiente paso.
La salida documentada también puede incluir el género, el número de teléfono y otros datos de contacto. Consulte la documentación de la API Impressum Scraper para conocer el esquema actual.
Convierta la salida en registros de proveedores
La llamada directa a la API ya funciona. Ahora puede situarla en el contexto de una tarea de investigación de proveedores. El descubrimiento o onboarding de proveedores puede proporcionarle un ID estable, el nombre corto que utiliza su equipo y una página de inicio. El resultado del Impressum añade la entidad legal detrás de ese sitio web, sus identificadores y datos de contacto publicados, así como la página donde aparecieron esos valores.
El siguiente fragmento indexa los resultados por inputId y crea registros locales de investigación empresarial. Añádalo después de la llamada a scrape_impressums() en el script completo:
results_by_id = {
result["inputId"]: result for result in impressum_results
}
company_research = []
for supplier in suppliers:
result = results_by_id[supplier["id"]]
company_research.append(
{
"supplier_id": supplier["id"],
"supplier_label": supplier["label"],
"website_url": supplier["website_url"],
"status": result["status"],
"outputs": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
print(json.dumps(company_research, indent=2, ensure_ascii=False))En el caso de Trigema, el registro conserva supplier-trigema, la etiqueta visible Trigema y https://www.trigema.de. El objeto anidado outputs añade Trigema W. Grupp KG, su dirección e identificadores, el nombre devuelto de Wolfgang Grupp y la URL del Impressum de origen. El registro de VAUDE sigue la misma cadena: parte de la etiqueta VAUDE y su página de inicio para llegar a VAUDE Sport GmbH & Co. KG y su propia página de origen. Así puede comparar o agrupar registros por entidad legal sin perder la identidad original del proveedor que inició la investigación.
El registro mantiene unidos los datos devueltos, el estado correcto de la API, el consumo de 10 créditos y el valor público del error, junto con el ID, la etiqueta y el sitio web del proveedor.
La regla de combinación importante es la búsqueda en el diccionario mediante el ID del proveedor. Así se sigue vinculando el resultado correcto aunque la API devuelva VAUDE antes que Trigema. El fragmento también conserva en company_research los resultados de elementos que no se han procesado correctamente, ya que no filtra por estado. Un elemento con no_result o error permanece disponible con su ID y su error, en lugar de desaparecer de la cola de revisión.
Este código prepara registros de investigación locales. Puede serializar la lista o enviarla a su propio código downstream sin realizar otra llamada a la API.
Calcule el coste de la API
Impressum Scraper consume una cantidad fija de 10 créditos por cada sitio web enviado. Los dos sitios web del ejemplo consumieron 20 créditos en total. Con la misma tarifa, 1.000 sitios web consumen 10.000 créditos.
El plan Growth ofrece acceso a la REST API e incluye créditos en la suscripción. Las recargas opcionales permiten añadir más créditos cuando los necesite. El acceso al plan, los créditos incluidos y la compra de recargas son componentes distintos del coste, así que consulte los precios actuales de Datablist antes de planificar una ejecución de mayor tamaño.
Resuelva problemas sin repetir tareas de pago
El script se detiene antes de enviar una solicitud
Si falta DATABLIST_API_KEY, el script genera el error Set DATABLIST_API_KEY before running this script. Exporte la variable en el mismo terminal y vuelva a ejecutar el archivo:
export DATABLIST_API_KEY="your-personal-api-key"
python scrape_impressum.pyLa API rechaza la solicitud
response.raise_for_status() detiene la ejecución cuando se produce un error HTTP. Compruebe que ha proporcionado una Personal API Key válida y que su cuenta dispone de acceso a la REST API. Este caso es distinto al de una variable ausente: un valor no válido sí llega a la API y recibe una respuesta HTTP.
La tarea falla o se detiene
El error generado contiene el ID y el estado de la tarea. Inspeccione esa tarea existente, sus resultados y sus campos de créditos antes de crear otra. Una tarea con estado failed o stopped puede conservar resultados y consumo de créditos, por lo que repetirla inmediatamente podría duplicar un trabajo de pago.
Un resultado está incompleto
Una tarea completada puede contener elementos con no_result, error o campos de salida incompletos. Conserve el inputId, el status, el impressumUrl cuando esté disponible y el error público del registro. Compruebe que la entrada sea la página de inicio o el dominio raíz de la propia empresa y, después, inspeccione el sitio antes de decidir si merece la pena realizar otra consulta.
La documentación sobre tareas explica con más detalle los estados, la paginación de resultados, el historial de tareas, los límites y la retención.
Próximos pasos
Ahora dispone de una integración ejecutable con Python Requests que envía sitios web de empresas alemanas, espera a que termine la tarea de Impressum Scraper, recupera todas las páginas de resultados y conserva los datos empresariales estructurados junto con sus URLs de origen en registros locales de investigación de proveedores.
Sustituya los dos proveedores de ejemplo por sus propios IDs estables y URLs de sitios web. Después, revise cada impressumUrl devuelto antes de utilizar los campos extraídos en su proceso downstream. Puede descargar el
ejemplo síncrono con Requests
que se mantiene actualizado o pasar al
ejemplo asíncrono con HTTPX
del repositorio cuando necesite concurrencia no bloqueante.