
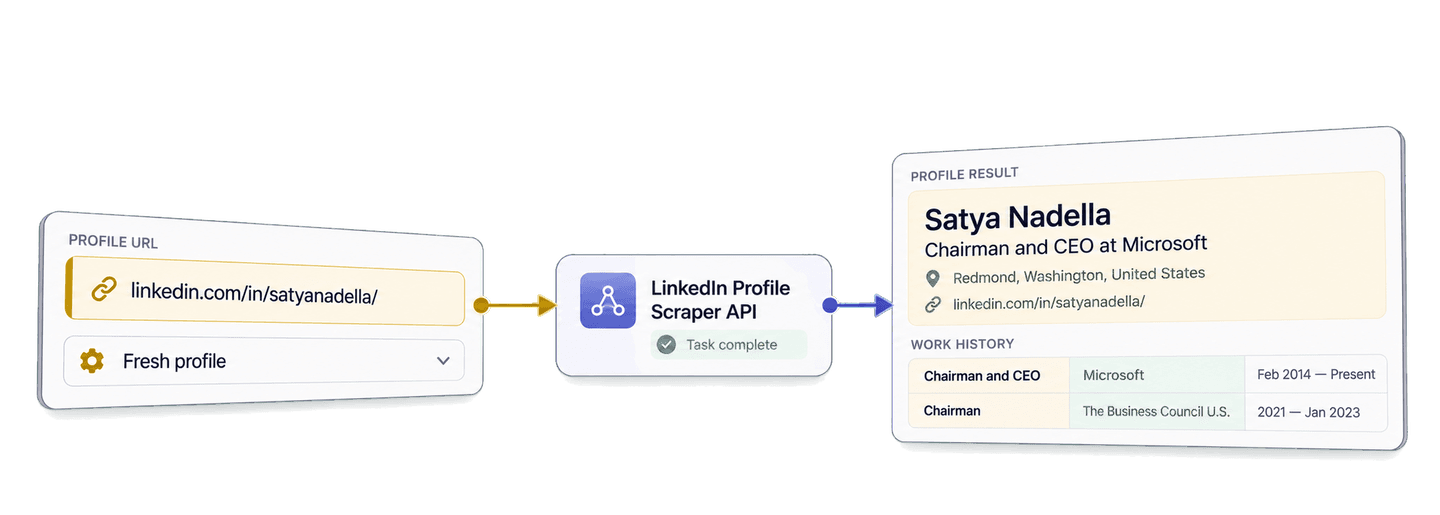
Puede extraer perfiles de LinkedIn con Python enviando URLs públicas conocidas a la LinkedIn Profile Scraper API de Datablist mediante la librería Requests. La API devuelve campos estructurados de identidad, ubicación, experiencia laboral, formación y empresa, que puede utilizar para crear listas de leads y personalizar su outreach con información relevante sobre cada cargo y empresa.
Esta guía utiliza la URL del perfil público de Satya Nadella como ejemplo práctico. Ejecutará una tarea completa de extracción de perfiles, interpretará el cargo en Microsoft y las experiencias laborales con fechas y, después, conservará el resultado junto al lead de origen antes de preparar su outreach.
🔑 Resumen para quienes tienen prisa: Envíe a Datablist URLs conocidas de perfiles personales de LinkedIn y obtenga los datos disponibles del perfil, la ubicación, la experiencia laboral, la formación y la empresa en formato JSON estructurado. El ejemplo de Python que aparece a continuación conserva estos datos junto a cada lead de origen para que pueda cualificar su lista y preparar un outreach más relevante.
- Input: URLs conocidas de perfiles personales de LinkedIn.
- Output: Datos estructurados del perfil almacenados con cada contacto de origen.
💡 ¿Prefiere una solución no-code? Utilice el LinkedIn Profile Scraper de Datablist para extraer datos de URLs de perfiles conocidas sin escribir código.
Configure la API de Datablist y el entorno de Python
El acceso a la API REST de Datablist está incluido en el plan Growth. La consulta de perfiles también consume créditos de enriquecimiento, cuyo cálculo se explica en la sección sobre costes.
Cree una Personal API Key desde la página de su cuenta de la API de Datablist. Este ejemplo muestra el formato de una Personal API Key:
exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2🔑 ¿Ya tiene una API key? Las claves antiguas utilizan
auth0|<userId>:<accountId>:<secret>:1y siguen siendo compatibles. Continúe usando su clave actual exactamente como se generó; no necesita sustituirla ni cambiar su formato.
El script lee la clave desde la variable de entorno DATABLIST_API_KEY y la envía en el header X-API-Key.
Para este ejemplo de Python se utiliza el paquete requests. Los siguientes comandos de configuración están pensados para una shell de macOS o Linux. Cree una carpeta para el proyecto, ábrala en su terminal y ejecute:
python -m venv .venv
source .venv/bin/activate
python -m pip install requestsA continuación, cree un archivo llamado scrape_linkedin_profiles.py y exporte su clave:
export DATABLIST_API_KEY="your-personal-api-key"Extraiga perfiles de LinkedIn con Python
El registro de origen de este ejemplo contiene un ID de contacto estable y una URL de perfil conocida:
{
  "contact_id": "contact-satya-nadella",
  "profile_url": "https://www.linkedin.com/in/satyanadella/"
}
El script envía contact_id como inputId de la API. Los resultados no tienen por qué llegar en el mismo orden que los inputs, por lo que este ID le permite asociar cada resultado de forma fiable con su contacto de origen.
Pegue el siguiente script completo en scrape_linkedin_profiles.py:
import json
import os
import time
import uuid
import requests
def scrape_profiles(source_contacts, api_key):
"""Submit one task, wait for completion, and return every result page."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": contact["contact_id"],
"data": {"profileUrl": contact["profile_url"]},
}
for contact in source_contacts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "linkedin-profile-scraper",
"uniqueId": unique_id,
"settings": {
"experiencesNb": "5",
"educationsNb": "3",
"acceptCachedProfiles": False,
"includeUrn": False,
"includePictures": False,
},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
source_contacts = [
{
"contact_id": "contact-satya-nadella",
"profile_url": "https://www.linkedin.com/in/satyanadella/",
}
]
profile_results = scrape_profiles(source_contacts, api_key)
print(json.dumps(profile_results, indent=2))Ejecútelo con:
python scrape_linkedin_profiles.pyLa configuración solicita cinco experiencias laborales y tres registros de formación. La API espera recibir esas cantidades como strings. acceptCachedProfiles: false solicita una consulta nueva, mientras que las opciones de imágenes e identificadores internos permanecen desactivadas porque este workflow utiliza campos de texto y URL duraderos.
Utilice para cada input una URL pública estándar de perfil /in/ o una URL de lead de Sales Navigator. El nombre de una persona, una página de búsqueda de LinkedIn y una página de empresa corresponden a tareas distintas y no son inputs de perfil válidos para este scraper. Si sus datos de origen contienen enlaces de Sales Navigator, el profileUrl devuelto puede ser la URL pública normalizada del perfil. Para listas más grandes, mantenga cada inputId único y estable en lugar de generarlo a partir de la posición de la fila.
Las cantidades del historial controlan cuántos campos planos y numerados de experiencia laboral y formación puede devolver la API. No modifican el coste en créditos por perfil. Solicite suficiente historial para tomar su decisión de research, pero evite seleccionar diez experiencias si solo va a analizar los últimos cargos.
Qué hacen las tres llamadas a la API
La petición POST envía la configuración seleccionada y los perfiles de entrada. Datablist acepta el trabajo como una tarea en segundo plano y devuelve su @id. El script imprime tanto el uniqueId generado como el ID de tarea devuelto, de modo que disponga de los valores necesarios para consultar la tarea más adelante.
La primera llamada GET comprueba el estado de la tarea cada tres segundos. El cliente de Python queda bloqueado mientras espera, pero la tarea de la API continúa ejecutándose en segundo plano. El bucle se detiene cuando alcanza completed, failed o stopped.
La segunda llamada GET recupera los resultados en páginas de hasta 100 registros. Cuando nextCursor contiene un valor, el script obtiene la página siguiente. El proceso termina cuando nextCursor es null.
Interprete el resultado y ajuste la consulta
La URL enviada determina qué perfil recupera el scraper. Datablist acepta URLs públicas de perfiles personales y URLs de leads de Sales Navigator, normaliza la URL del perfil cuando es necesario y asigna los datos públicos disponibles a campos planos de perfil, experiencia laboral, formación y empresa.
La consulta nueva utilizada en esta guía se completó correctamente y consumió 25 créditos. Este es el resultado completo:
{
  "inputId": "contact-satya-nadella",
  "status": "success",
  "outputs": {
    "profileUrl": "https://www.linkedin.com/in/satyanadella/",
    "fullName": "Satya Nadella",
    "firstName": "Satya",
    "lastName": "Nadella",
    "linkedInHeadline": "Chairman and CEO at Microsoft",
    "linkedInSummary": "As chairman and CEO of Microsoft, I define my mission and that of my company as empowering every person and every organization on the planet to achieve more.",
    "linkedInProfilePicture": "https://media.licdn.com/dms/image/v2/C5603AQHHUuOSlRVA1w/profile-displayphoto-shrink_800_800/profile-displayphoto-shrink_800_800/0/1579726625483?e=1794441600&v=beta&t=I1sL---bTuvjxqb1vdbNsNy-fAsLCpBj3-WtJjOGbOc",
    "linkedInInternalIdentifier": "ACoAAAEkwwAB9KEc2TrQgOLEQ-vzRyZeCDyc6DQ",
    "linkedInLocation": "Redmond, Washington, United States",
    "linkedInCity": "Redmond",
    "linkedInState": "Washington",
    "linkedInCountryName": "United States",
    "linkedInCountryCode": "US",
    "linkedInLanguages": "",
    "linkedInConnections": 832,
    "linkedInlastExpTitle": "Chairman and CEO",
    "linkedInlastExpCompany": "Microsoft",
    "linkedInlastExpEmploymentType": null,
    "linkedInlastExpLocation": "Greater Seattle Area",
    "linkedInlastExpStartsAt": "2014-02-01",
    "linkedInlastExpEndsAt": null,
    "linkedInlastExpDescription": null,
    "linkedInlastExpCompanyWebsite": "https://news.microsoft.com/",
    "linkedInlastExpCompanyPage": "https://www.linkedin.com/company/microsoft/",
    "linkedInlastExpCompanyIndustry": "Software Development",
    "linkedInlastExpCompanyRange": "10001+",
    "linkedInlastExpCompanyDescription": "Every company has a mission. What's ours? To empower every person and every organization to achieve more. We believe technology can and should be a force for good and that meaningful innovation contributes to a brighter world in the future and today. Our culture doesn’t just encourage curiosity; it embraces it. Each day we make progress together by showing up as our authentic selves. We show up with a learn-it-all mentality. We show up cheering on others, knowing their success doesn't diminish our own. We show up every day open to learning our own biases, changing our behavior, and inviting in differences. Because impact matters. \n\nMicrosoft operates in 190 countries and is made up of approximately 228,000 passionate employees worldwide.",
    "linkedInlastExpCompanyLogo": "https://media.licdn.com/dms/image/v2/D560BAQH32RJQCl3dDQ/company-logo_200_200/B56ZYQ0mrGGoAM-/0/1744038948046/microsoft_logo?e=1793836800&v=beta&t=4wXD40LQU4IfLY4DiEvT2bwvjUoPQPGgi5_T-vPsbQ8",
    "linkedIn2ExpTitle": "Chairman",
    "linkedIn2ExpCompanyName": "The Business Council U.S.",
    "linkedIn2ExpEmploymentType": null,
    "linkedIn2ExpStartsAt": "2021-01-01",
    "linkedIn2ExpEndsAt": "2023-01-01",
    "linkedIn2ExpDescription": null,
    "linkedIn2ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQGcnaZNpjMvrw/company-logo_200_200/company-logo_200_200/0/1630557702704/the_business_council_us_logo?e=1793836800&v=beta&t=Ejb0D8lV5sMTFwcz_-FKdfQvIvq-mKx_Nl8vRMib53k",
    "linkedIn3ExpTitle": "Member Board Of Trustees",
    "linkedIn3ExpCompanyName": "University of Chicago",
    "linkedIn3ExpEmploymentType": null,
    "linkedIn3ExpStartsAt": "2018-01-01",
    "linkedIn3ExpEndsAt": null,
    "linkedIn3ExpDescription": null,
    "linkedIn3ExpLogo": "https://media.licdn.com/dms/image/v2/D4E0BAQGDP-PXY3u8dw/company-logo_200_200/B4EaENqZTQGoAM-/0/1791230580227/uchicago_logo?e=1793836800&v=beta&t=NJGoETr0tY868Z2pvlyXeh939iXwW0WbSFwRctabEVU",
    "linkedIn4ExpTitle": "Board Member",
    "linkedIn4ExpCompanyName": "Starbucks",
    "linkedIn4ExpEmploymentType": null,
    "linkedIn4ExpStartsAt": "2017-01-01",
    "linkedIn4ExpEndsAt": "2024-01-01",
    "linkedIn4ExpDescription": null,
    "linkedIn4ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQEQxk9y2rk7Hw/company-logo_200_200/company-logo_200_200/0/1631316692275?e=1793836800&v=beta&t=NVjljhe0oI5KzvJHodAJjss5EdvxaOIzQQ2rAGyh_AQ",
    "linkedIn5ExpTitle": "Board Member",
    "linkedIn5ExpCompanyName": "Fred Hutch",
    "linkedIn5ExpEmploymentType": null,
    "linkedIn5ExpStartsAt": "2016-01-01",
    "linkedIn5ExpEndsAt": "2022-01-01",
    "linkedIn5ExpDescription": null,
    "linkedIn5ExpLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQGF4eOou62nvQ/company-logo_200_200/company-logo_200_200/0/1664795263764/fredhutch_logo?e=1793836800&v=beta&t=dJWSO-KkuBPd6I6aRYBoIcQVzcSEmGLwqYy-VMFXJQc",
    "linkedInlastEduSchool": "The University of Chicago Booth School of Business",
    "linkedInlastEduDegree": null,
    "linkedInlastEduField": null,
    "linkedInlastEduStartsAt": "1994-01-01",
    "linkedInlastEduEndsAt": "1996-01-01",
    "linkedInlastEduPage": "https://www.linkedin.com/school/universityofchicagoboothschoolofbusiness/",
    "linkedInlastEduLogo": "https://media.licdn.com/dms/image/v2/D560BAQFZO05jhYKSkw/company-logo_200_200/company-logo_200_200/0/1692627816910/universityofchicagoboothschoolofbusiness_logo?e=2147483647&v=beta&t=BTjFA4UVU5iKIIyicg8d44rhoiuMbetNDB97BmqpwhQ",
    "linkedIn2EduSchool": "Manipal Institute of Technology",
    "linkedIn2EduDegree": "Bachelor’s Degree",
    "linkedIn2EduField": "Electrical Engineering",
    "linkedIn2EduStartsAt": null,
    "linkedIn2EduEndsAt": null,
    "linkedIn2EduPage": "https://www.linkedin.com/school/manipal-institute-of-technology/",
    "linkedIn2EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQHodG_7cUqs6w/company-logo_200_200/B4DZ8hC8AUJQAE-/0/1782965846314/manipal_institute_of_technology_logo?e=2147483647&v=beta&t=jqJK15_r7lxUNgWdbbzdMq47aLa_PqnkDYxg4Jun4Zo",
    "linkedIn3EduSchool": "University of Wisconsin-Milwaukee",
    "linkedIn3EduDegree": "Master’s Degree",
    "linkedIn3EduField": "Computer Science",
    "linkedIn3EduStartsAt": null,
    "linkedIn3EduEndsAt": null,
    "linkedIn3EduPage": "https://www.linkedin.com/school/uwmilwaukee/",
    "linkedIn3EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQE47QlO_LG8SQ/company-logo_200_200/company-logo_200_200/0/1729615751602/uwmilwaukee_logo?e=2147483647&v=beta&t=l-w3ttd1mZRc-_j5aCPXEzNiYJzl1iJjMGw7q8B3eRI"
  },
  "creditsUsed": "25",
  "error": null
}
Interprete conjuntamente el cargo, la empresa, la fecha de inicio y la fecha de finalización. La experiencia en Microsoft comienza en febrero de 2014 y no tiene fecha de finalización. La experiencia en The Business Council U.S. abarca desde 2021 hasta enero de 2023. Estas fechas permiten distinguir una experiencia vigente de otra finalizada y muestran cómo pueden solaparse distintos cargos.
linkedInlastExpTitle y linkedInlastExpCompany contienen la experiencia actual o la última experiencia asignada. Este primer registro puede incluir datos más completos de la empresa, como su página, sitio web, sector, descripción y número de empleados. Los registros numerados añaden cargos, empresas y fechas anteriores. En esta respuesta, el sitio web de Microsoft devuelto es https://news.microsoft.com/. Esta URL aporta al registro del lead una fuente útil sobre la empresa, junto con el historial profesional de la persona.
Los campos linkedInlastEduSchool, linkedIn2EduSchool y linkedIn3EduSchool indican The University of Chicago Booth School of Business, Manipal Institute of Technology y University of Wisconsin-Milwaukee. El registro de Manipal incluye un grado en Ingeniería Eléctrica, mientras que el de Wisconsin-Milwaukee incluye un máster en Informática. Los valores de titulación y especialidad de Chicago están vacíos.
Utilice los valores "3", "5" o "10" en experiencesNb, y "1", "3" o "5" en educationsNb, para elegir cuánto historial necesita. Lea esos campos directamente desde outputs cuando sean útiles para su research. Que un valor opcional esté vacío no significa que todo el resultado haya fallado.
El modo fresh es adecuado para preparar listas de leads cuando desea obtener de nuevo los datos públicos disponibles del perfil. El modo cached puede devolver un perfil almacenado disponible por menos créditos y recurrir a una consulta nueva si no existe un perfil en caché. Elija según el nivel de actualización que necesite y su presupuesto de créditos.
Prepare registros de leads para su outreach
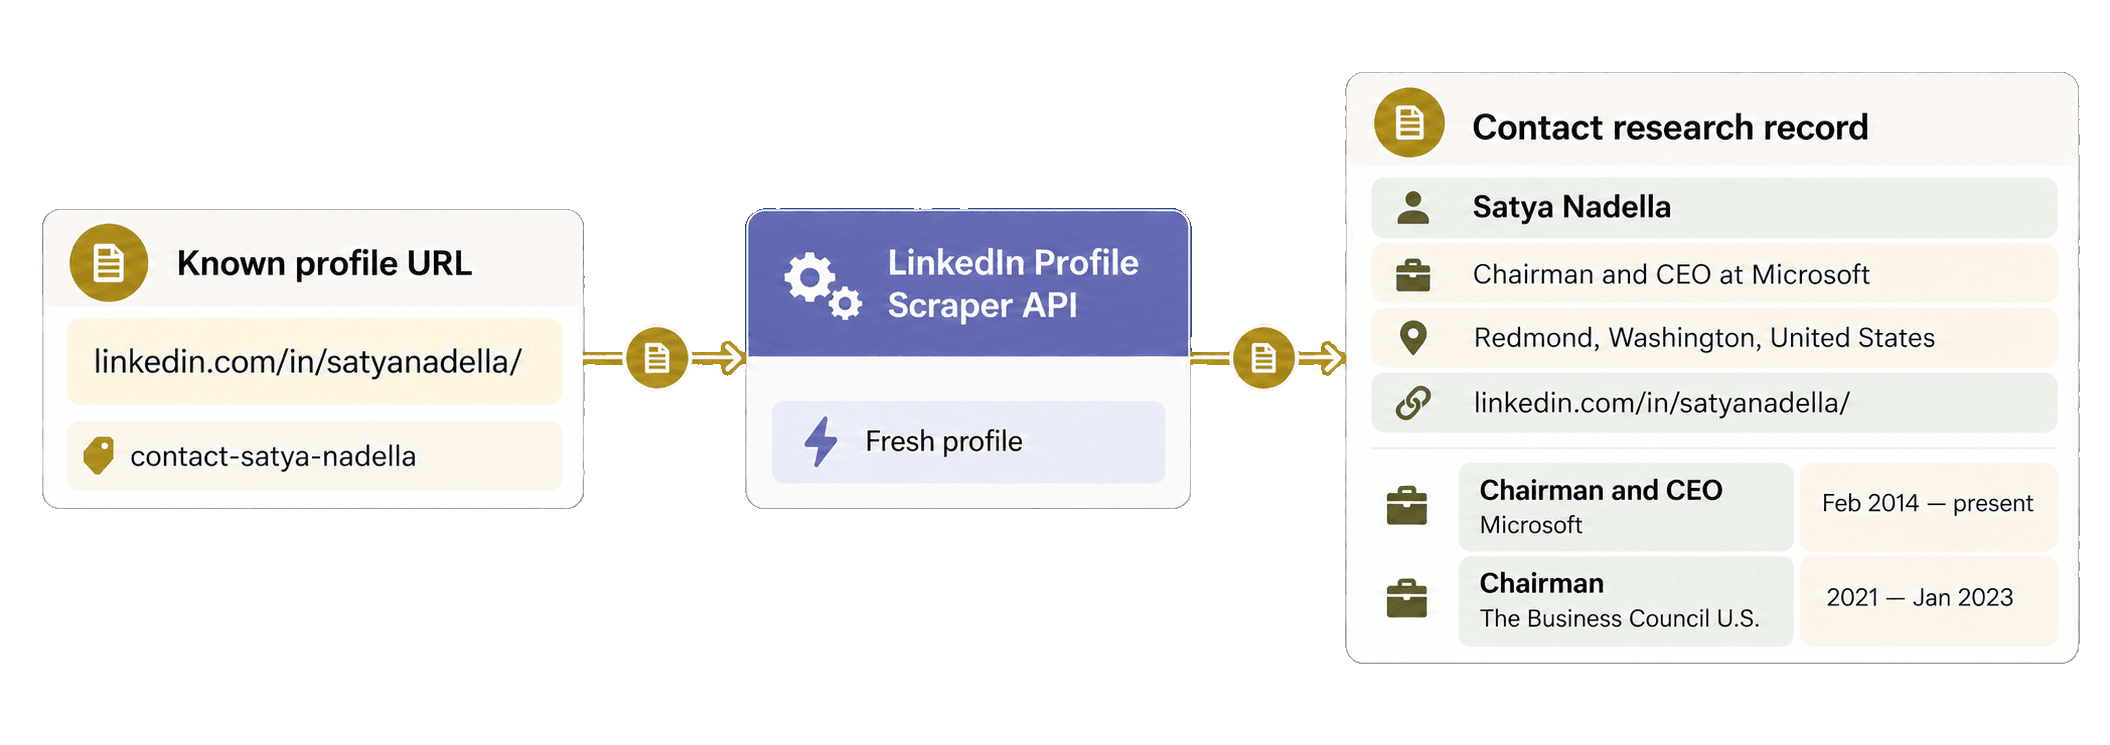
Una vez que profile_results esté disponible, puede asociar cada respuesta con su contacto de origen sin enviar otra tarea. El siguiente bloque reutiliza las variables creadas por el script completo:
results_by_input_id = {
result["inputId"]: result
for result in profile_results
}
contact_research = []
for contact in source_contacts:
result = results_by_input_id[contact["contact_id"]]
contact_research.append(
{
"contact_id": contact["contact_id"],
"source_profile_url": contact["profile_url"],
"result_status": result["status"],
"profile": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
research_record = contact_research[0]
profile = research_record["profile"]
print("Contact:", profile.get("fullName"))
print("Headline:", profile.get("linkedInHeadline"))
print("Location:", profile.get("linkedInLocation"))
print(
"First work entry:",
profile.get("linkedInlastExpTitle"),
"at",
profile.get("linkedInlastExpCompany"),
)El diccionario indexado por inputId gestiona las respuestas que llegan desordenadas. contact-satya-nadella sigue siendo tanto el ID de origen como el ID de la API, la URL conocida de LinkedIn permanece en source_profile_url y profile conserva sin cambios el objeto outputs original.
Esta estructura mantiene el perfil completo devuelto junto con la URL de origen, el estado de la API y el consumo de créditos. Puede utilizar el headline, la ubicación y la primera experiencia laboral que se imprimen para cualificar el lead y añadir a su outreach un contexto relevante sobre su cargo o empresa. Las filas de la API que no se procesen correctamente conservan el estado y el error devueltos, por lo que siguen siendo visibles en la lista de leads.
Puede descargar el ejemplo síncrono con Requests o utilizar la alternativa asíncrona con HTTPX cuando domine el flujo síncrono.
Calcule el coste de extraer perfiles de LinkedIn
Una consulta nueva consume 25 créditos por perfil. Cuando se habilitan los perfiles en caché, un resultado almacenado disponible consume 20 créditos, mientras que un fallo de caché puede recurrir a una consulta nueva de 25 créditos. El ejemplo fresh de Satya Nadella consumió 25 créditos.
Por tanto, consultar 1.000 perfiles consume 20.000 créditos si todos los perfiles solicitados están disponibles en caché, o hasta 25.000 créditos con consultas nuevas. Para acceder a la API REST de Datablist se requiere el plan Growth. La suscripción, los créditos incluidos y las recargas opcionales son componentes distintos del coste. Consulte la página de precios para ver el catálogo actualizado.
Tomando como referencia la recarga base actual de 20 USD por 20.000 créditos, los créditos consumidos equivaldrían a un coste estimado de 20 USD para procesar 1.000 perfiles disponibles en caché o de 25 USD para una ejecución fresh. Estas estimaciones no incluyen el coste de la suscripción Growth.
Solucione errores comunes y recupere una tarea
- Falta
DATABLIST_API_KEY: el script se detiene antes de realizar una petición. Exporte la variable y vuelva a ejecutar el archivo. - La API rechaza la clave: compruebe la Personal API Key y envíe únicamente la credencial
X-API-Keyutilizada en este ejemplo. - La URL del perfil falta o tiene un formato incorrecto: utilice una URL pública de un perfil personal de LinkedIn o una URL compatible de un lead de Sales Navigator. El nombre de una persona, una página de búsqueda o una página de empresa no son inputs de perfil.
- No hay créditos suficientes: compruebe su saldo y utilice los créditos incluidos o añada una recarga antes de crear otra tarea.
- La tarea aparece como
failedostopped: revise su error, los resultados disponibles y el consumo de créditos antes de decidir si necesita realizar otro envío de pago. - Un resultado contiene pocos datos,
no_resultoerror: revise su estado y el error público y, después, confirme la URL y la configuración. Los campos disponibles pueden variar según el perfil, su visibilidad y la consulta.
Si la conexión se interrumpe durante el POST, utilice el uniqueId impreso antes del envío. Consulte las tareas recientes del scraper y compare sus valores antes de crear otra tarea:
response = requests.get(
"https://api.datablist.com/v1/enrichments/tasks",
headers={"X-API-Key": api_key},
params={"enrichmentId": "linkedin-profile-scraper", "limit": 100},
)
response.raise_for_status()
printed_unique_id = "paste-the-printed-unique-id"
tasks = response.json()["tasks"]
matching_task = None
for task in tasks:
if task["uniqueId"] == printed_unique_id:
matching_task = task
break
if matching_task:
print("Task ID:", matching_task["@id"])La lista de tareas se puede filtrar por enrichmentId, pero no por uniqueId. Siga su nextCursor si la tarea no aparece en la primera página. Cuando tenga el ID de la tarea, continúe con las mismas URLs de estado y resultados que utiliza la función principal. La documentación de la API de tareas explica con más detalle el ciclo de vida, la paginación y el comportamiento ante interrupciones.
Próximos pasos
Ahora dispone de una función reutilizable de Python Requests que convierte URLs conocidas de perfiles de LinkedIn en resultados estructurados, además de registros de leads asociados mediante un ID estable. Sustituya el ejemplo por un pequeño conjunto de URLs revisadas, elija entre una consulta fresh o cached según la actualidad de los datos y el coste en créditos que necesite, y utilice el contexto devuelto sobre cargos y empresas para cualificar leads o personalizar su outreach.
Si sus inputs son URLs de páginas de empresa, siga en su lugar la guía de Python para extraer datos de empresas de LinkedIn.
Si todavía necesita descubrir URLs de perfiles a partir de nombres y una palabra clave de empresa o centro educativo, consulte primero la guía independiente para encontrar perfiles de LinkedIn con Python y una API antes de ejecutar este scraper.