
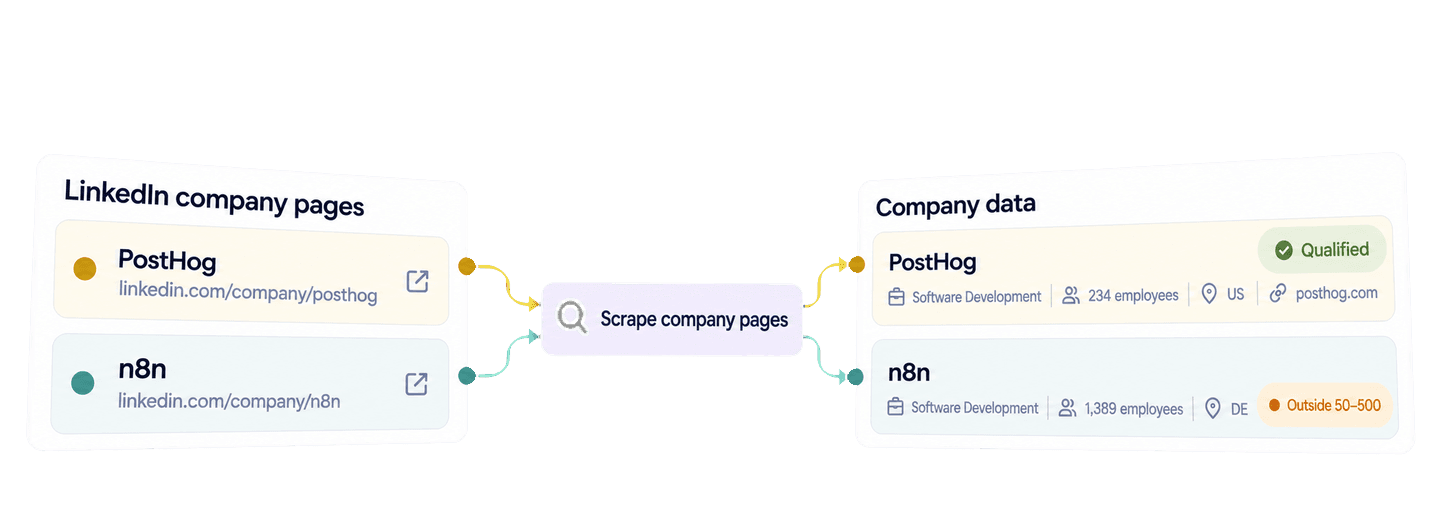
Puede extraer datos de empresas de LinkedIn con Python enviando una lista de URLs de páginas de empresa a la API de Datablist mediante la librería Requests. La API devuelve registros estructurados con campos como sector, número de empleados, sede, sitio web y descripción, siempre que estén disponibles en la página pública de la empresa.
En esta guía, utilizo una única función de Python fácil de entender para obtener los registros de n8n, PostHog, Back Market y Datablist. Después, reutilizo esos resultados para cualificar cuentas de software con entre 50 y 500 empleados y sede en Estados Unidos o Alemania. El registro cualificado conserva su sitio web y descripción para profundizar en la investigación comercial.
🔑 Resumen para quienes tienen prisa
Datablist convierte URLs revisadas de páginas de empresa de LinkedIn en registros estructurados que puede utilizar en un flujo de investigación comercial. El ejemplo de Python que aparece a continuación recupera todas las páginas de resultados y aplica después un filtro local de cualificación de cuentas sin realizar una segunda llamada a la API.
- Entrada: URLs de páginas de empresa de LinkedIn.
- Salida: datos disponibles de cada empresa y una decisión local de cualificación, manteniendo juntos la URL original y todos los datos obtenidos de la empresa.
💡 ¿Prefiere una solución no-code? Utilice LinkedIn Company Page Scraper de Datablist para extraer campos de empresas a partir de URLs conocidas de páginas de LinkedIn sin escribir código.
Configure Python y su clave API de Datablist
Para este ejemplo de Python, utilizo el paquete requests. La API REST de Datablist está disponible con el plan Growth, y cada consulta de una página de empresa consume créditos de enriquecimiento.
Cree una Personal API Key desde la página de API de su cuenta de Datablist.
Cree un archivo llamado scrape_linkedin_companies.py, prepare un entorno virtual e instale Requests:
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
export DATABLIST_API_KEY="your-api-key"El script lee la clave desde DATABLIST_API_KEY y la envía en el header X-API-Key.
Extraiga páginas de empresa de LinkedIn con una función de Python
La lista de origen que aparece a continuación contiene empresas de distintos sectores, tamaños y países de sede. Cada account_id se convierte en el inputId de la API. Los resultados no se vinculan según su posición en la respuesta, por lo que este ID estable es el que conecta cada resultado con la URL de origen correcta.
Pegue este script completo en scrape_linkedin_companies.py:
import json
import os
import time
import uuid
import requests
accounts = [
{
"account_id": "account-n8n",
"linkedin_company_url": "https://www.linkedin.com/company/n8n/",
},
{
"account_id": "account-posthog",
"linkedin_company_url": "https://www.linkedin.com/company/posthog/",
},
{
"account_id": "account-back-market",
"linkedin_company_url": "https://www.linkedin.com/company/back-market/",
},
{
"account_id": "account-datablist",
"linkedin_company_url": "https://www.linkedin.com/company/datablist/",
},
]
def scrape_companies(accounts, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"companyLinkedInUrl": account["linkedin_company_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Request ID: {unique_id}")
payload = {
"enrichmentId": "linkedin-company-enrichment",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
company_results = scrape_companies(accounts, api_key)
print(json.dumps(company_results, indent=2, ensure_ascii=False))Ejecútelo con:
python scrape_linkedin_companies.pyLos principales valores que debe cambiar son los registros de accounts. Mantenga cada account_id estable y único y sustituya linkedin_company_url por una página de empresa de LinkedIn que haya revisado. La función convierte esos registros al formato inputs de la API y envía la URL de la empresa como companyLinkedInUrl. settings permanece vacío porque este enriquecimiento no tiene ajustes públicos.
El POST crea una tarea de enriquecimiento en segundo plano. La API responde con 202 Accepted y un ID de tarea, mientras el cliente Requests espera consultando periódicamente la URL de estado. Este código bloqueante de Python resulta práctico para un script pequeño, aunque la tarea se sigue ejecutando de forma asíncrona en Datablist.
El primer GET consulta la propia tarea. Una tarea puede terminar con el estado completed, failed o stopped. El script solo continúa si el estado es completed; en caso contrario, genera un error que incluye el ID de la tarea y el error devuelto por la API. Conserve ese ID durante la investigación, porque una tarea fallida o detenida puede seguir teniendo resultados y consumo de créditos que conviene revisar.
Cuando finaliza la tarea, el último bucle obtiene las páginas de resultados con un límite de 100. Continúa recuperando páginas hasta que nextCursor es null. Cada resultado conserva el inputId proporcionado. Por eso, el posterior bucle de cualificación puede asociar correctamente los resultados aunque el orden de la respuesta sea distinto al de entrada.
Interprete el resultado y el método de obtención
La URL de LinkedIn identifica directamente a la empresa. Datablist normaliza la URL de la organización y recupera los datos públicos disponibles en su página, en lugar de buscar y puntuar varias empresas posibles. A partir de la URL de una empresa concreta, consulta la página pública y puede completar los campos que falten mediante fuentes alternativas gestionadas, sin sustituir los datos útiles que ya haya encontrado.
Esta diferencia es importante al interpretar el resultado. Los campos opcionales dependen de la información disponible públicamente. Una dirección de sede con valor null o la ausencia de una especialidad no significa que haya fallado toda la consulta de la empresa.
Esta es la página completa de resultados devuelta para las cuatro URLs:
{
  "taskId": "69516a973dc34481920f41ade748e917",
  "results": [
    {
      "inputId": "account-n8n",
      "status": "success",
      "outputs": {
        "companyName": "n8n",
        "companyHQPostalCode": "10115",
        "companyDescription": "n8n is a workflow automation platform that uniquely combines AI capabilities with business process automation. The platform enables connection to any app or API while maintaining the flexibility of code with the speed of no-code.\n\nReleased under a fair-code license, n8n can be self-hosted and is supported by a vibrant community of developers and builders. Users can start simple and layer complexity as needed - utilizing the visual builder for quick wins, and adding custom Javascript or Python code where more control is required, enabling the connection of anything to everything.\n\nn8n is privately held, with funding from Sequoia, Felicis Ventures, Firstminute Capital, Harpoon Ventures, and others. Individual investors include Eventbrite's Kevin Hartz and Supercell's IIkka Paananen. n8n was founded in 2019 and is headquartered in Berlin.",
        "companyTagline": "Flexible AI workflow automation for technical teams.",
        "companyIndustry": "Software Development",
        "companySpecialities": "AI, SOAR, Workflow Automation, and AI agents",
        "companyWebsite": "https://n8n.io",
        "companyHQCity": "Berlin",
        "linkedInCompanyId": "28491094",
        "companyType": "Privately Held",
        "companyHQCountry": "DE",
        "companySize": 1389,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4D0BAQEgEphZqatXwA/company-logo_200_200/B4DaFY.Sa2JcAE-/0/1792494086070/n8n_logo?e=2147483647&v=beta&t=NTL4C6f5QAd_o9nXd15PO8pOMSSEoms_tJdDHEo6eLk",
        "companyHQAddress": "Novalisstraße 10",
        "companyFoundedYear": 2019,
        "companyFollowerCount": 442229
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-posthog",
      "status": "success",
      "outputs": {
        "companyName": "PostHog",
        "companyHQPostalCode": null,
        "companyDescription": "At PostHog, we're working to increase the number of successful products in the world.\n\nUntil now, tools for building products have been fragmented. Product analytics, heatmaps, session recording, web analytics, feature flags, and A/B testing are all helpful, but no one wants to buy, send data to, and integrate multiple products.\n\nPostHog offers these tools (and more) in an integrated, open source platform which can be hosted in either the US or EU. Both versions are SOC2 certified, GDPR-ready, and HIPAA compliant. \n\nWe started PostHog during Y Combinator's W20 cohort and had the most successful B2B software launch on Hacker News since 2012 - with a product that was just 4 weeks old.\n\nWith over 100,000 users, we're default alive, growing 97% through word of mouth, and we are in the top 0.01% most popular repos on GitHub.",
        "companyTagline": "Your product's context layer. Get started with npx @posthog/wizard",
        "companyIndustry": "Software Development",
        "companySpecialities": "analytics, open source, product analytics, product, data, engineering, self-driving product, session replay, context warehouse, AI, product context, and error tracking",
        "companyWebsite": "https://posthog.com/",
        "companyHQCity": "San Francisco",
        "linkedInCompanyId": "37415928",
        "companyType": "Privately Held",
        "companyHQCountry": "US",
        "companySize": 234,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D560BAQGQUyE_CXUxIw/company-logo_200_200/B56aCMWEgaJAAE-/0/1789060991251/posthog_logo?e=2147483647&v=beta&t=WfTGRSqp5UfYL33sBXx3tZ1zmFUECfUPf7JtEGPAvbA",
        "companyHQAddress": null,
        "companyFoundedYear": 2020,
        "companyFollowerCount": 59696
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-back-market",
      "status": "success",
      "outputs": {
        "companyName": "Back Market",
        "companyHQPostalCode": null,
        "companyDescription": "The world is waking up to what fast tech costs. Back Market is where the revolution shops. \nWe make refurbished tech the smart, confident choice by building trust in quality, repair and circularity. New is not always better. Smarter is.\n\nAs a certified B Corp, our mission is to create a world that does more with what we already have by prolonging the lifespan of electronic devices through circularity and repair. We have grown by double digits year over year and now serve 18 million customers across 17 markets, avoiding more than 2 million tons of CO2 emissions*\n*Back Market calculation based on ADEME 2022 methodology.\n\nFounded in Paris in 2014 by Thibaud Hug de Larauze, Quentin Le Brouster and Vianney Vaute, Back Market is a leading global marketplace where people can buy professionally refurbished technology or trade in their devices.\n\nAre you ready to join us?",
        "companyTagline": "Where the world shops refurbished tech.",
        "companyIndustry": "Internet Marketplace Platforms",
        "companySpecialities": "refurbished tech, marketplace, sustainability, circularity, Right to Repair, sustainable solutions, refurbished marketplace, circular economy, and sustainable alternatives",
        "companyWebsite": "http://www.backmarket.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "4793443",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 1054,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4E0BAQHRv6UClt5D2g/company-logo_200_200/B4EZnoUG3tKgAI-/0/1760539209613/back_market_logo?e=2147483647&v=beta&t=Pywpeu1Qs3h0Cl8kgvYurmBfXbImm5QIIc-aQog1MqM",
        "companyHQAddress": null,
        "companyFoundedYear": 2014,
        "companyFollowerCount": 101878
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-datablist",
      "status": "success",
      "outputs": {
        "companyName": "Datablist",
        "companyHQPostalCode": null,
        "companyDescription": "When people hear \"data,\" they think of something complicated. We will change this.\n\nDatablist is an AI-powered spreadsheet that helps you: get, manipulate, or clean data and create workflows that run automatically while you focus on what matters most.\n\nIf you want to separate Datablist.com into its main parts, you can say we have:\n\n- Deduplicating, grouping, and labeling data\n- Cleaning and editing data\n- Managing data and automated workflows\n- 50+ B2B data sources and scrapers\n- 3 AI agents:\n    - Editing assistant\n    - AI Research agent\n    - Deduplication assistant\n\nThe top 3 reasons why companies choose Datablist.com are:\n\n1. Simplicity: you don't need to have technical knowledge or experience with formulas to get everything out of it.\n2. Flexibility that allows you to do (almost) everything with your data and AI while keeping everything under your control.\n3. Scalability that no other solution can match. Up to 2 million rows—forget Excel.\n\nGo on try it for free!\n\nhttps://www.Datablist.com",
        "companyTagline": "Let your tasks become workflows: automated workflows.",
        "companyIndustry": "Information Technology & Services",
        "companyWebsite": "https://www.datablist.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "69842428",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 3,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/C4E0BAQFNFlMb8KEPRQ/company-logo_200_200/company-logo_200_200/0/1630622803412?e=2147483647&v=beta&t=UVkk7BOerChiWgS9Y06zOpT08SlK4kpAWGDYiVvUEVU",
        "companyFollowerCount": 134,
        "companyFoundedYear": 2020,
        "companyHQAddress": null
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
Los cuatro registros se procesaron correctamente y consumieron 25 créditos cada uno. PostHog devolvió Software Development, 234 empleados, sede en Estados Unidos, su sitio web y su descripción. n8n también es una empresa de software situada en uno de los países seleccionados, pero el número de empleados devuelto es 1.389. Back Market devolvió Internet Marketplace Platforms, 1.054 empleados y sede en Francia. Datablist devolvió Information Technology & Services, 3 empleados y sede en Francia.
El objeto completo resulta útil porque una investigación de cuentas rara vez se limita a un solo campo. Puede cualificar por sector, número de empleados y país, a la vez que conserva el sitio web y la descripción exactos devueltos para la siguiente fase de investigación.
En esta respuesta, companySize es el número de empleados devuelto, no una etiqueta de rango de tamaño de LinkedIn. companyHQCountry indica la ubicación de la sede, no todos los países en los que opera la empresa. Estas diferencias son importantes al adaptar los filtros de tamaño y país a su perfil de cliente ideal.
No es necesario que estén presentes todos los campos opcionales para cualificar una cuenta. Una dirección o especialidad ausente puede quedar vacía si se dispone del sector, el número de empleados y el país de la sede. Conserve companyWebsite tal como se devuelve, en lugar de asumir que la API lo convierte en un dominio sin protocolo. La descripción puede ayudar a un investigador comercial a entender el producto de la empresa y preparar una investigación específica de la cuenta antes del outreach. Al revisar o almacenar el registro, mantenga status, creditsUsed y error junto a los campos de la empresa.
Cualifique cuentas para la investigación comercial
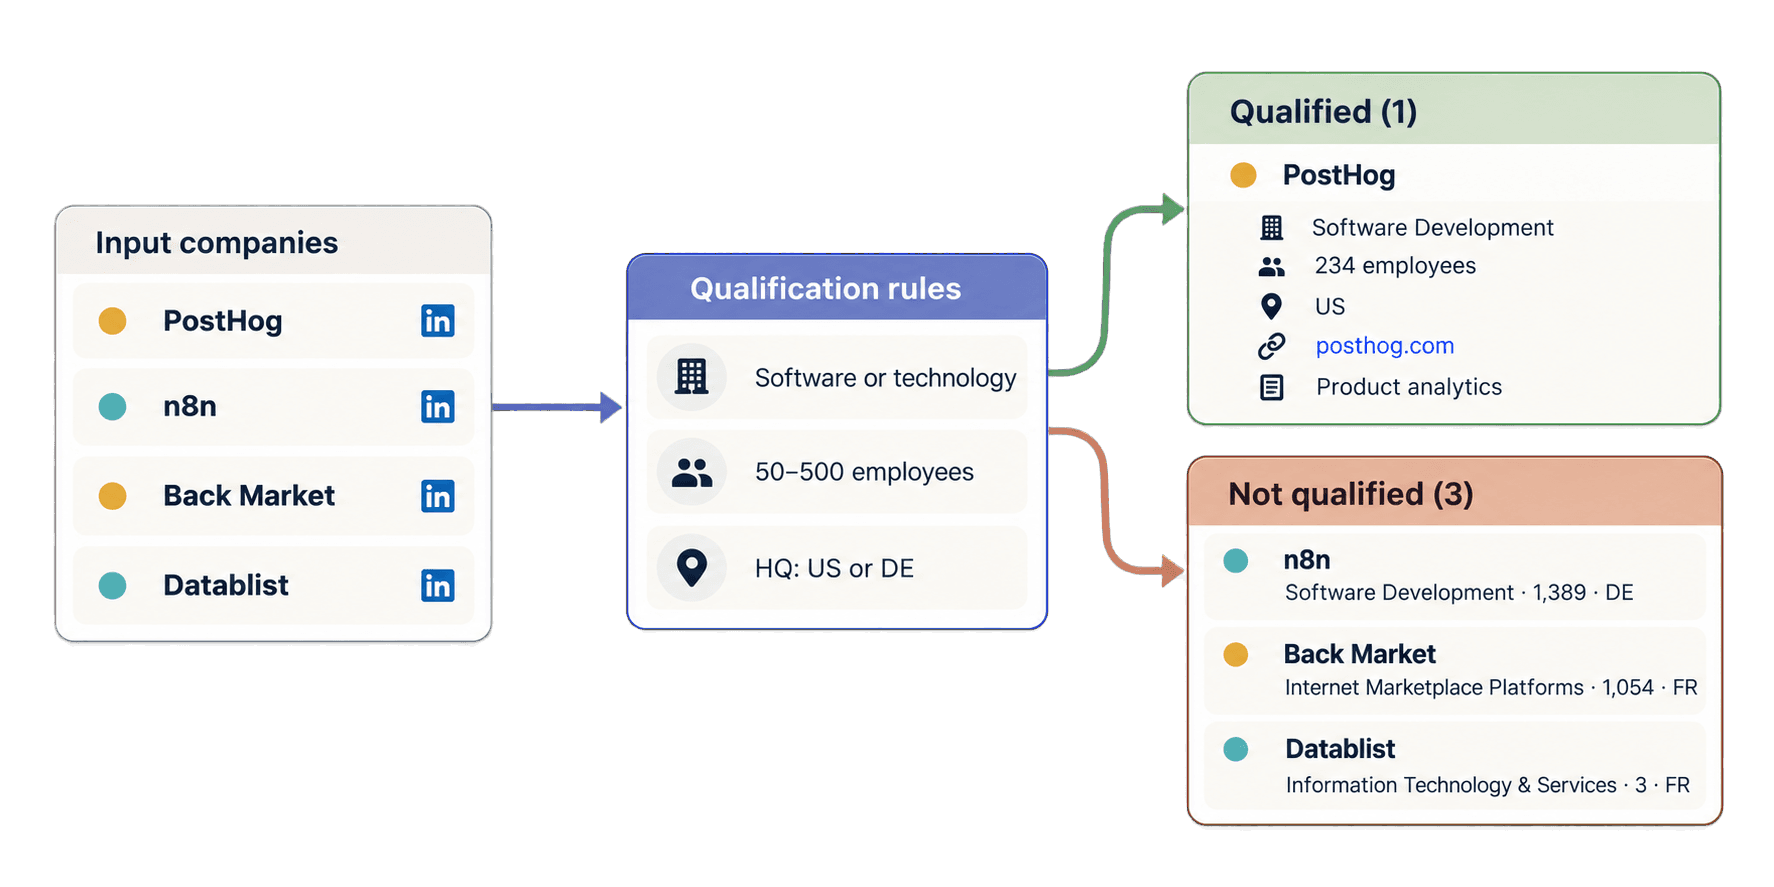
Supongamos que su objetivo es una empresa de software o tecnología con entre 50 y 500 empleados y sede en Estados Unidos o Alemania. Añada este bucle debajo del script completo. Reutiliza company_results, por lo que no envía otra tarea:
accounts_by_id = {account["account_id"]: account for account in accounts}
qualified_accounts = []
other_accounts = []
for result in company_results:
account = accounts_by_id.get(result["inputId"])
qualification = "needs_review"
if result["status"] == "success":
outputs = result["outputs"]
industry = outputs.get("companyIndustry")
company_size = outputs.get("companySize")
country = outputs.get("companyHQCountry")
if industry and isinstance(company_size, (int, float)) and country:
industry_matches = any(
keyword in industry.lower()
for keyword in ("software", "technology")
)
size_matches = 50 <= company_size <= 500
country_matches = country in {"US", "DE"}
if industry_matches and size_matches and country_matches:
qualification = "qualified"
else:
qualification = "not_qualified"
source_url = None
if account is not None:
source_url = account["linkedin_company_url"]
reviewed_account = dict(result)
reviewed_account["sourceLinkedInUrl"] = source_url
reviewed_account["qualification"] = qualification
if qualification == "qualified":
qualified_accounts.append(reviewed_account)
else:
other_accounts.append(reviewed_account)
print(json.dumps(qualified_accounts, indent=2, ensure_ascii=False))PostHog vuelve a asociarse con account-posthog aunque la API devuelva los registros en otro orden. Cumple los criterios porque Software Development, 234 empleados y US superan las tres comprobaciones. El bucle copia el resultado original con todos sus outputs, el sitio web devuelto (https://posthog.com/), la descripción, creditsUsed y error. Solo añade la URL de origen y la etiqueta local de cualificación.
n8n se asocia con account-n8n y no cumple los criterios porque sus 1.389 empleados superan el límite máximo. Back Market no coincide con el sector, el tamaño ni el país seleccionados, mientras que Datablist queda por debajo del intervalo de tamaño y fuera de los países elegidos. Los futuros registros fallidos o incompletos reciben needs_review en lugar de descartarse silenciosamente.
Puede descargar el ejemplo síncrono con Requests mantenido por Datablist o utilizar la alternativa asíncrona con HTTPX del repositorio cuando necesite código de aplicación no bloqueante.
Calcule los créditos para extraer empresas de LinkedIn
Una página estándar de empresa de LinkedIn con nombre utiliza 25 créditos. Una URL con un ID numérico de empresa puede consumir 75 créditos cuando se necesita la última fuente alternativa, pero 75 créditos no es el coste de todas las URLs numéricas. Las consultas fallidas o sin coincidencias también pueden consumir créditos. Por eso, utilice el total de la tarea y el valor creditsUsed de cada resultado como registro del consumo real.
Las cuatro URLs con nombre de esta guía consumieron 100 créditos en total. Con la tarifa estándar, 1.000 páginas de empresa utilizan 25.000 créditos. Si la entrada contiene muchos IDs numéricos, necesitará más margen para la posible ruta de 75 créditos.
El acceso a la API REST requiere el plan Growth. El plan mensual incluye 20.000 créditos y los créditos adicionales se compran por separado. Con el precio base actual de 20 USD por 20.000 créditos adicionales, cada crédito cuesta 0,001 USD. A esa tarifa, 25.000 créditos equivalen a 25 USD. Consulte los precios de Datablist para conocer el plan y el catálogo de créditos vigentes.
Solucione problemas de entrada, tareas y resultados
- Falta
DATABLIST_API_KEY: el script se detiene antes de enviar una solicitud. Exporte la variable y vuelva a ejecutar el archivo. - La API rechaza la clave: compruebe su Personal API Key y manténgala en el header
X-API-Keyutilizado en el ejemplo. - La URL de origen no es válida: sustituya cualquier perfil personal, sitio no relacionado, valor vacío o URL mal formada por una URL pública compatible de una empresa, centro educativo, showcase, ID numérico o empresa de Sales Navigator en LinkedIn.
- No hay suficientes créditos: compruebe su saldo y utilice los créditos incluidos o compre créditos adicionales antes de crear otra tarea.
- La tarea tiene el estado
failedostopped: revise el error, los resultados existentes y el consumo de créditos antes de decidir si envía otra tarea de pago. - Un resultado contiene pocos datos o tiene el estado
no_resultoerror: conserve su URL de origen, estado, créditos y error para revisarlos. Antes de volver a enviarlo, confirme que la entrada corresponde a una página pública de empresa, sin hacer suposiciones sobre el motivo por el que los datos no estaban disponibles.
Si pierde la respuesta de creación, utilice el ID de solicitud que el script imprimió antes del POST. Primero enumere las tareas y busque ese valor en uniqueId:
curl "https://api.datablist.com/v1/enrichments/tasks?limit=100" \
-H "X-API-Key: $DATABLIST_API_KEY"El @id de la tarea coincidente es el ID de la tarea. Utilícelo para seguir consultando /v1/enrichments/tasks/{taskId} o recuperar /v1/enrichments/tasks/{taskId}/results, en lugar de crear automáticamente otra tarea. Una sola solicitud puede contener hasta 10.000 entradas y 10 MiB. Consulte la documentación de tareas para obtener información sobre la retención y otros detalles del ciclo de vida.
Próximos pasos
Ahora dispone de una función reutilizable de Python con Requests que convierte una lista de URLs de páginas de empresa de LinkedIn en registros estructurados, además de un bucle local de cualificación que conserva toda la respuesta de la API para la investigación comercial.
Sustituya los cuatro ejemplos por una pequeña lista revisada de cuentas, mantenga IDs estables y adapte las reglas de sector, número de empleados y país a su perfil de cliente ideal. Si sus puntos de partida son personas en lugar de empresas, consulte la guía de la API para extraer perfiles de LinkedIn. Si solo dispone de nombres de empresas, empiece por encontrar sus sitios web con Python.