

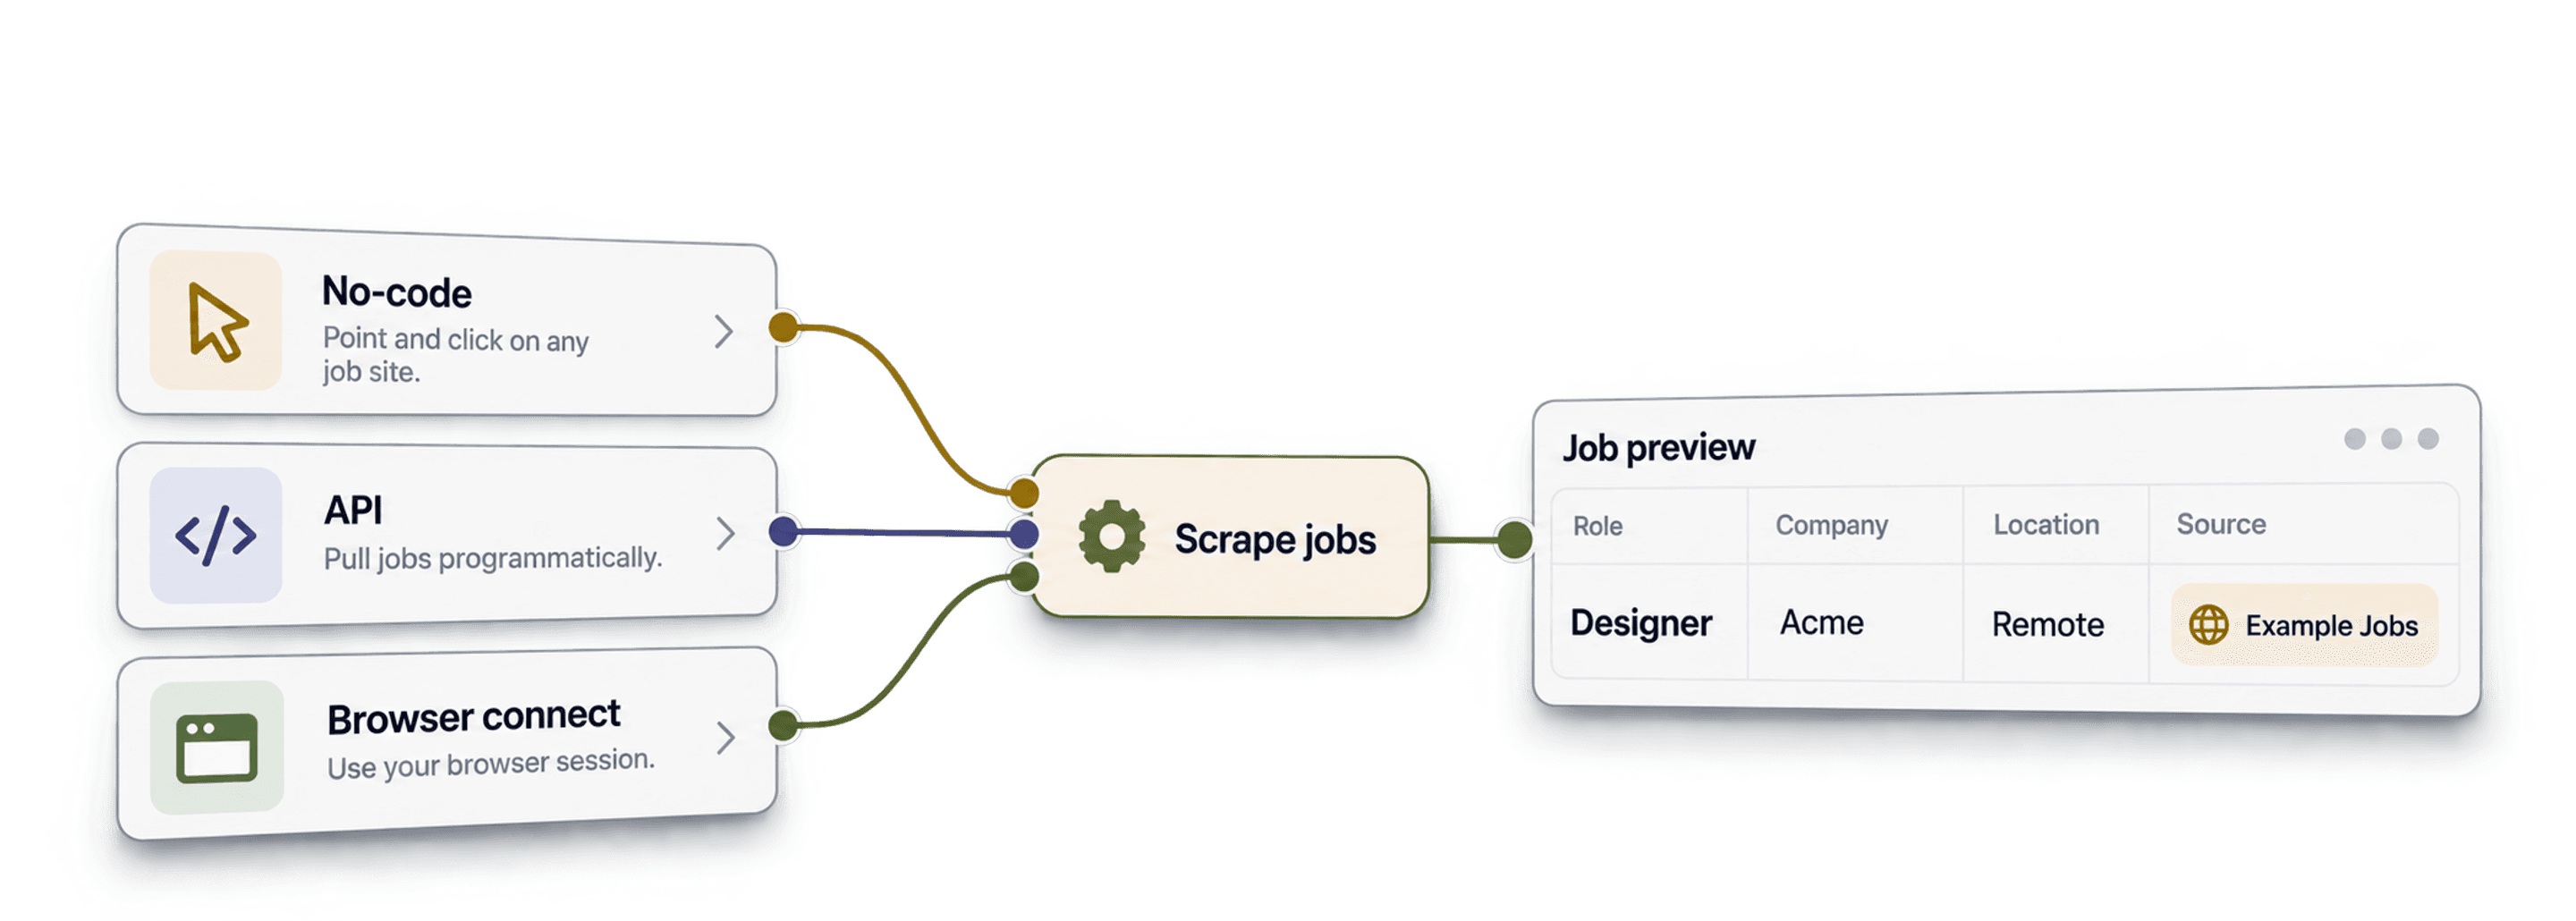
Les outils de scraping d’offres d’emploi transforment les annonces en lignes que vous pouvez filtrer, comparer et exporter. Choisissez une source de données emploi prête à l’emploi pour lancer des recherches récurrentes sur plusieurs job boards, un scraper visuel pour extraire les champs propres à un site, ou une API pour construire un pipeline de données.
Pour la génération de leads, le résultat utile est un signal de recrutement pertinent associé à la bonne entreprise. Une offre d’emploi n’est ni un profil de candidat ni une fiche de contact vérifiée. Ce guide compare sept outils selon leur workflow et vous indique les critères à vérifier avant de faire votre choix.
Les premiers forfaits payants vont de 19 $ pour l’API de ScrapingBee à 189 $ pour le forfait de scraping visuel de ParseHub. Datablist démarre à 25 $/mois, ce qui permet d’importer 500 résultats avec Job Postings Search au tarif actuel de dix crédits par annonce. Le tableau ci-dessous distingue les quotas d’annonces, de pages et de requêtes, avec des exemples de budget pour les listes plus volumineuses.
Au programme de ce guide
- Les critères pour choisir un outil de scraping d’offres d’emploi
- Les meilleurs scrapers d’emploi no-code
- Les meilleurs outils pour les profils semi-techniques
- Les solutions de scraping pour les profils techniques
Choisir un scraper d’emploi selon le résultat attendu
| Outil | Usage principal | Premier tarif payant | Quota inclus / unité de facturation |
|---|---|---|---|
| Datablist | Rechercher des annonces et les examiner dans un tableur | 25 $/mois | 5 000 crédits ; 10 par annonce importée |
| PhantomBuster | Extraire les URL d’offres LinkedIn | 69 $/mois | 20 heures d’exécution |
| Octoparse | Créer des tâches visuelles et utiliser des templates de job boards | 83 à 119 $/mois* | Forfait Standard ; options supplémentaires |
| ParseHub | Créer des projets d’extraction visuelle | 189 $/mois | 10 000 pages par exécution ; 20 projets |
| ScrapingBee | Intégrer une API de scraping | 19 $/mois | 75 000 crédits API |
| Bright Data | Utiliser des API de scraping managées | 1,50 $/1 000 enregistrements livrés | Paiement à l’usage ; sans engagement mensuel |
| Oxylabs | Construire un pipeline avec une API web | 30 $/mois | Forfait unifié ; tarif par résultat selon la cible |
Prix en dollars américains vérifiés le 28 octobre 2026. Les abonnements sont indiqués avec une facturation mensuelle ; la ligne de Bright Data correspond à un tarif à l’usage. *Le guide officiel d’Octoparse indique des options mensuelles Standard à 83 $ et 119 $ ; vérifiez la configuration choisie. Les pages, crédits API et annonces importées sont des unités différentes : ces quotas ne correspondent donc pas au même nombre d’offres exploitables.
Critères pour choisir un outil de scraping d’offres d’emploi
Commencez par une petite requête et examinez les lignes obtenues. Un outil peut renvoyer des offres valides qui ne correspondent pas aux entreprises que vous ciblez.
1. Couverture des sources et fraîcheur des données
Une recherche dans des données emploi indexées et le scraping en direct d’une page Carrières ne répondent pas à la même question. Vérifiez quels job boards ou sites sont couverts, à quelle date l’annonce a été collectée et si le poste est toujours ouvert. Le nombre de résultats d’un outil ne prouve jamais qu’il a trouvé toutes les offres disponibles.
2. Filtres sur les offres ou sur les entreprises
La localisation du poste indique où se trouve l’emploi ; le siège social indique où se trouve l’employeur. Gardez ces filtres séparés. Déterminez si vous recherchez des employeurs directs, des agences de recrutement ou les deux, puis examinez les fiches dont les informations sur l’entreprise sont incomplètes.
Pour un exemple détaillé propre à LinkedIn, consultez comment scraper les offres LinkedIn, notamment la différence entre la limite d’une recherche et le nombre d’offres distinctes renvoyées.
Le tutoriel sur les emplois tech à Boston applique ces contrôles aux postes en présentiel local et en remote, tout en conservant les identifiants et les URL sources pour vérification.
3. Identifiants des annonces et URL sources
Conservez l’identifiant de l’annonce et son URL source. Un même employeur peut publier plusieurs postes, et une même offre peut apparaître sur plusieurs job boards. Une déduplication fondée uniquement sur Company Name risque de supprimer des annonces utiles.
4. Exclusion des comptes existants
Dans une démarche de prospection commerciale, vérifiez si vous pouvez exclure vos clients à partir du domaine de leur entreprise. Une comparaison fondée uniquement sur le nom peut confondre des sociétés aux appellations proches. Avec un scraper générique, vous devrez parfois effectuer ce filtrage après l’export plutôt que dans la recherche.
5. Exécutions répétées et unité de facturation
Comparez le coût d’un même résultat : requêtes, pages, lignes d’offres importées ou temps d’exécution. Évaluez la planification séparément d’un scraping ponctuel. Un workflow récurrent doit également définir une règle pour conserver, actualiser ou regrouper les annonces collectées plusieurs fois.
Scrapers d’emploi no-code
Ces solutions permettent de configurer le workflow sans développer de scraper. Leur fonctionnement diffère : une source prête à l’emploi accepte des filtres, tandis qu’une tâche visuelle vous demande de sélectionner les champs et le mode de navigation entre les pages.
1. Datablist
Datablist en bref
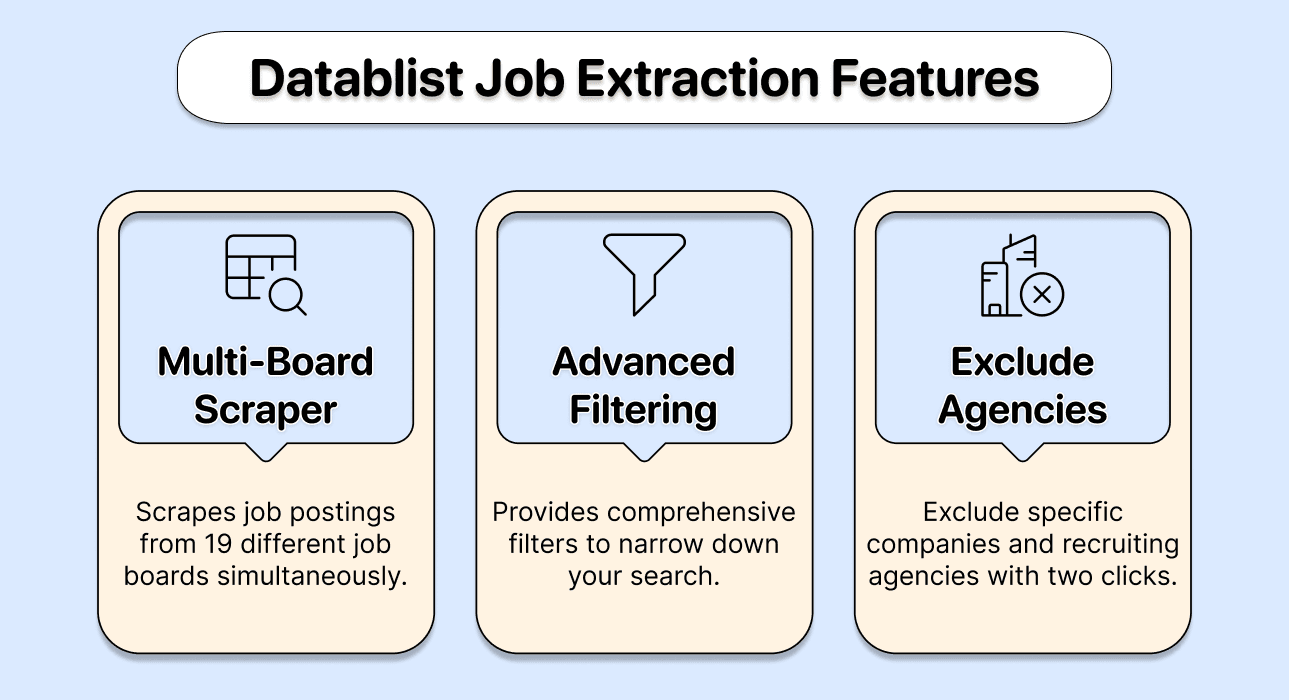
Le Job Postings Search de Datablist recherche des offres sur plusieurs job boards et crée des lignes dans une collection. Utilisez-le pour analyser les signaux de recrutement, filtrer les employeurs et poursuivre le nettoyage ou l’enrichissement de votre liste dans un même tableur.
Une petite recherche d’offres facile à vérifier
Pour effectuer, à titre d’exemple, une recherche de postes en data engineering :
- Sélectionnez Job Postings Search dans Import From Data Sources. Saisissez
data engineerdans Job Title Keywords. Les expressions de titre correspondent à leurs mots, quel que soit leur ordre : examinez donc les résultats au lieu d’attendre une égalité exacte avec l’intitulé. - Définissez Countries pour la localisation du poste. Si vous ciblez des employeurs dont le siège se trouve dans ce pays, configurez séparément Company HQ Countries.
- Sélectionnez Direct Employer sous Company Type si les annonces d’agences ne font pas partie de votre cible. Choisissez une durée courte et adaptée à votre recherche dans Max Age.
- Associez Job Posting Id, Job Title, Job Posting URL, Job Posting Source URL, Company Name, Company Website et Date Posted aux colonnes de sortie.
- Ouvrez plusieurs URL sources. Vérifiez l’employeur, le poste, la localisation et si l’offre est toujours active. Laissez les valeurs manquantes visibles au lieu de les remplacer par des suppositions.
Si vous utilisez des mots-clés dans la description, la configuration par défaut recherche des mots entiers. sales ne correspond donc pas à Salesforce ; le mode regex est un réglage distinct. Pour suivre toutes les étapes, consultez le guide expliquant comment rechercher sur plusieurs job boards.
Pour constituer une liste locale de postes techniques, le workflow consacré aux emplois tech à San Francisco distingue les offres situées dans la ville, celles des villes voisines et les postes accessibles en remote.
Données à conserver dans votre dataset
Si une entreprise recrute deux data engineers, conservez deux lignes dès lors qu’il s’agit de deux annonces différentes. Gardez Job Posting Id pour examiner les occurrences répétées issues du même workflow, et utilisez les URL sources ainsi que les informations sur le poste pour comparer les annonces entre plusieurs fournisseurs. Créez une liste d’entreprises séparée si l’étape suivante nécessite un seul compte par employeur.
Les lignes obtenues décrivent des postes et des employeurs. Trouver un recruteur ou un autre contact constitue une étape d’enrichissement distincte ; une description de poste ne fournit pas une base complète de candidats.
Tarifs et limites du workflow
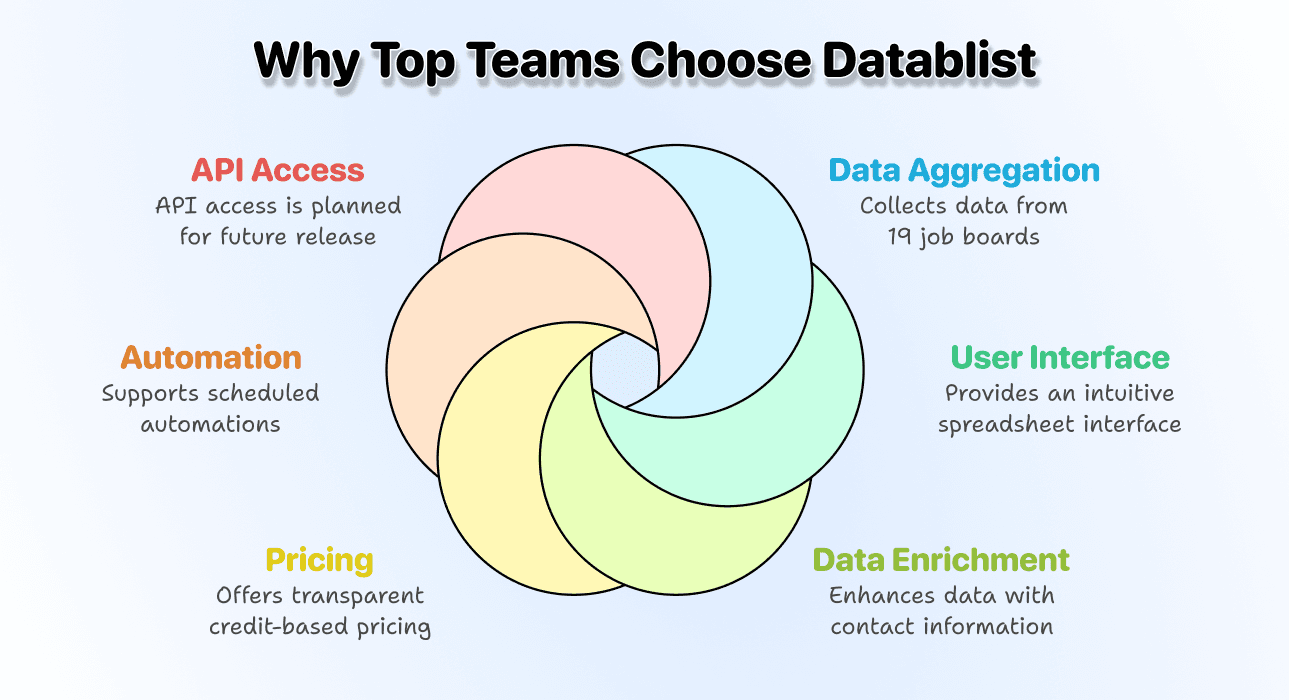
Le coût actuel de Job Postings Search est de 10 crédits par offre importée. Un solde de 5 000 crédits permet d’importer 500 annonces si vous le consacrez entièrement à cette source. L’AI scraping, l’enrichissement de contacts et les autres sources suivent leurs propres tarifs.
Le forfait Starter de Datablist démarre à 25 $ ou 25 € par mois et inclut 5 000 crédits. Growth comprend davantage de crédits ainsi que des fonctionnalités d’API et d’automatisation pour les workflows compatibles. Job Postings Search ne figure toutefois pas actuellement dans le catalogue public des sources accessibles par API. Utilisez cette source dans l’application et ne partez pas du principe qu’un forfait API donne accès à toutes les sources. Ses filtres et la couverture de ses fournisseurs ne garantissent pas de trouver chaque offre publiée sur chaque job board.
Pour Job Postings Search, voici le budget réel, abonnement et recharge compris :
| Annonces importées | Crédits nécessaires | Formule à acheter | Montant payé |
|---|---|---|---|
| 500 | 5 000 | Starter | 25 $ |
| 2 500 | 25 000 | Starter + recharge de 20 000 crédits | 45 $ |
| 10 000, traitement manuel | 100 000 | Starter + recharge de 100 000 crédits | 113 $ |
| 10 000, forfait Growth | 100 000 | Growth + recharge de 80 000 crédits | 121 $ |
Pour 2 500 annonces, le calcul est de 25 $ + 20 $ = 45 $, soit exactement 25 000 crédits. Pour 10 000 annonces, les 5 000 crédits de Starter auxquels s’ajoute un pack de 100 000 crédits à 88 $ fournissent 105 000 crédits pour un total de 113 $, avec 5 000 crédits restants. Growth coûte 50 $/mois et inclut 20 000 crédits ; une recharge de 80 000 crédits à 71 $ apporte la capacité restante, soit 121 $ au total. Ces calculs supposent que la source importe le nombre indiqué d’annonces et excluent tout enrichissement supplémentaire par AI ou de contacts. Une annonce en double issue d’une autre exécution doit toujours être vérifiée avant de compter les postes ou les entreprises qui recrutent.
2. PhantomBuster
Le LinkedIn Job Scraper de PhantomBuster extrait les informations d’URL précises d’offres LinkedIn. Son workflow documenté nécessite une session LinkedIn connectée et ces URL en entrée. Pour collecter les URL à partir d’une recherche, son tutoriel décrit une étape distincte d’export des résultats.
Choisissez-le pour un workflow centré sur LinkedIn. Vérifiez les limites de lancement et les formats d’export autorisés par votre forfait avant de lui transmettre une liste volumineuse. La session connectée est une dépendance du workflow ; cet outil n’effectue pas de recherche générale sur l’ensemble des job boards. Si votre workflow nécessite aussi des données d’entreprise ou de contact, comparez les alternatives à PhantomBuster selon leurs sources, leurs résultats et leurs fonctions d’enrichissement avant de choisir une autre solution.
Tarifs : le forfait mensuel Start coûte 69 $ et comprend 20 heures d’exécution ainsi que cinq slots d’automatisation. Grow coûte 159 $ avec 80 heures, et Scale 439 $ avec 300 heures. L’export d’une recherche suivi de l’extraction détaillée des offres partage les ressources du forfait. Ne considérez pas le quota d’exécution comme un prix fixe par offre extraite.
3. Octoparse
Octoparse propose des templates prêts à l’emploi, un éditeur visuel desktop et des exécutions managées dans le cloud. Il est utile lorsque vous souhaitez sélectionner des champs précis dans les annonces ou parcourir les pages d’un site sans écrire de code.
Vérifiez si un template existant couvre le job board et les champs de sortie ciblés. Lorsque vous créez une tâche personnalisée, testez séparément les pages de résultats, les pages détaillées et la pagination. L’exécution dans le cloud et l’interface visuelle ne dispensent pas de contrôler les lignes extraites lorsque le site évolue.
Tarifs : le guide officiel de mise à niveau indique le forfait Standard à 83 $ ou 119 $ par mois et Professional à 299 $ par mois. Un forfait local gratuit permet d’évaluer l’outil. Ajoutez le coût des templates premium, des proxys et des CAPTCHA lorsqu’ils sont nécessaires à la tâche choisie ; le tarif annuel d’appel à 69 $ ne correspond pas au prix mensuel utilisé ici.
4. ParseHub
ParseHub permet de créer un projet d’extraction visuelle. Il convient aux workflows dans lesquels vous définissez les éléments à extraire et la manière de parcourir le site cible.
Sa documentation sur les forfaits précise que le scroll ou les clics nécessaires pour charger davantage de contenu peuvent être comptabilisés dans le nombre de pages par exécution. Comparez ces limites avec la navigation réelle du site au lieu de supposer qu’une URL de recherche équivaut à une seule page facturée. Testez le projet sur plusieurs annonces avant de planifier des collectes récurrentes.
Tarifs : Standard coûte 189 $/mois et comprend 10 000 pages par exécution ainsi que 20 projets privés. Professional coûte 599 $/mois, avec 120 projets privés et un nombre illimité de pages par exécution. Le forfait gratuit autorise 200 pages par exécution et cinq projets publics. Il s’agit de limites de pages et de projets, et non de la garantie d’obtenir 10 000 fiches d’emploi complètes à partir d’une recherche.
Scrapers d’emploi pour les profils semi-techniques
Une API de scraping peut récupérer des pages ou renvoyer des champs structurés, mais vous devez toujours connecter les requêtes, stocker les résultats et définir ce qui constitue une fiche complète.
5. ScrapingBee
ScrapingBee fournit une API de scraping avec rendu navigateur et options d’extraction. La solution convient si vous souhaitez déléguer l’accès aux pages tout en conservant votre propre workflow applicatif.
Vérifiez si l’endpoint choisi renvoie du HTML ou les champs structurés dont vous avez besoin. Une réponse de page réussie ne correspond pas nécessairement à une ligne d’offre déjà parsée. Testez les intitulés de poste, les champs employeur, les URL sources et la pagination, puis comparez le nombre de crédits consommés par ces requêtes.
Tarifs : Hobby coûte 19 $/mois pour 75 000 crédits API, Freelance 49 $ pour 250 000 crédits et Startup 99 $ pour 1 000 000. Les requêtes standard démarrent à un crédit, celles avec rendu JavaScript en utilisent cinq, et celles qui passent par des proxys premium en consomment 10 ou 25 selon le rendu. Ainsi, 10 000 requêtes réussies avec rendu à cinq crédits consomment 50 000 crédits, ce qui reste dans le quota de Hobby. Il faut néanmoins encore parser les résultats, et chaque requête ne correspond pas forcément à une offre. À 25 crédits par requête, ce même volume nécessite 250 000 crédits et le forfait à 49 $.
6. Bright Data
Bright Data propose des API de scraping managées et des datasets. Commencez par sélectionner la source pertinente et contrôler son schéma de sortie plutôt que de comparer le nombre total de scrapers disponibles sur la plateforme.
La solution s’adresse aux équipes qui intègrent les données collectées dans un autre système. Vérifiez le mode de livraison des résultats, les champs disponibles et le délai de collecte. Les snapshots de datasets et la collecte à la demande peuvent répondre à des exigences de fraîcheur différentes.
Tarifs : l’API Web Scraper affiche un tarif à l’usage de 1,50 $ pour 1 000 enregistrements livrés, ainsi qu’un quota gratuit de 5 000 enregistrements par mois. Scale coûte 499 $/mois pour 384 000 enregistrements, puis 1,30 $ par tranche de 1 000 enregistrements supplémentaires. Les proxys, le contournement des blocages et le parsing sont inclus dans le prix annoncé pour ce produit. L’achat d’un dataset précollecté constitue une offre distincte ; vérifiez la source des offres et le schéma avant d’appliquer l’un ou l’autre tarif à votre projet.
Scrapers d’emploi pour les profils techniques
Les équipes techniques peuvent intégrer une API web managée à leur propre pipeline. Elles restent responsables des identifiants, du stockage, des jointures et de l’interprétation des résultats manquants.
7. Oxylabs
L’API web d’Oxylabs fournit des fonctions de web scraping managées pour les workflows applicatifs. Vérifiez la prise en charge des cibles et les options de parsing pour les sites d’emploi qui vous intéressent.
Elle convient aux équipes qui veulent maîtriser l’intégration des requêtes et des résultats dans leur pipeline de données. Établissez votre budget en fonction de la cible et de la configuration réelles des requêtes. Ne comparez pas les forfaits de proxys aux tarifs de données emploi parsées comme s’il s’agissait du même produit.
Tarifs : la page tarifaire actuelle de Web API /scrape affiche un abonnement unifié Starter à 30 $/mois, Basic à 100 $ et Flexible à 500 $. Le prix par résultat dépend de la cible et du rendu : le minimum annoncé commence à 0,50 $ pour 1 000 résultats, tandis que les scrapers LLM sont facturés 1,50 $ pour 1 000 avec Starter. N’appliquez pas le tarif le moins cher à tous les job boards.
L’ancien prix de 49 $ pour Micro Web Scraper API correspond à une offre précédente. Pour tout nouvel achat, consultez l’offre /scrape actuelle. La bande passante des proxys constitue également une unité de facturation différente des résultats renvoyés par l’API et doit être chiffrée séparément si votre implémentation l’utilise.
Conclusion
Choisissez la méthode qui renvoie des champs réellement exploitables : une source de recherche pour suivre régulièrement les signaux de recrutement, une tâche visuelle adaptée à la structure d’un site ou une API pour alimenter votre propre pipeline. Vérifiez la pertinence des données et leurs sources avant de passer à l’échelle.
Pour une prospection de comptes plus large, comparez les outils de scraping de leads. Gardez les lignes d’offres séparées des fiches d’entreprises et de contacts afin de ne pas perdre des postes distincts lors de la création de votre liste d’outreach. Notre guide du lead scraping explique comment choisir des fiches d’entreprises ou de personnes pour l’étape de sourcing suivante.