

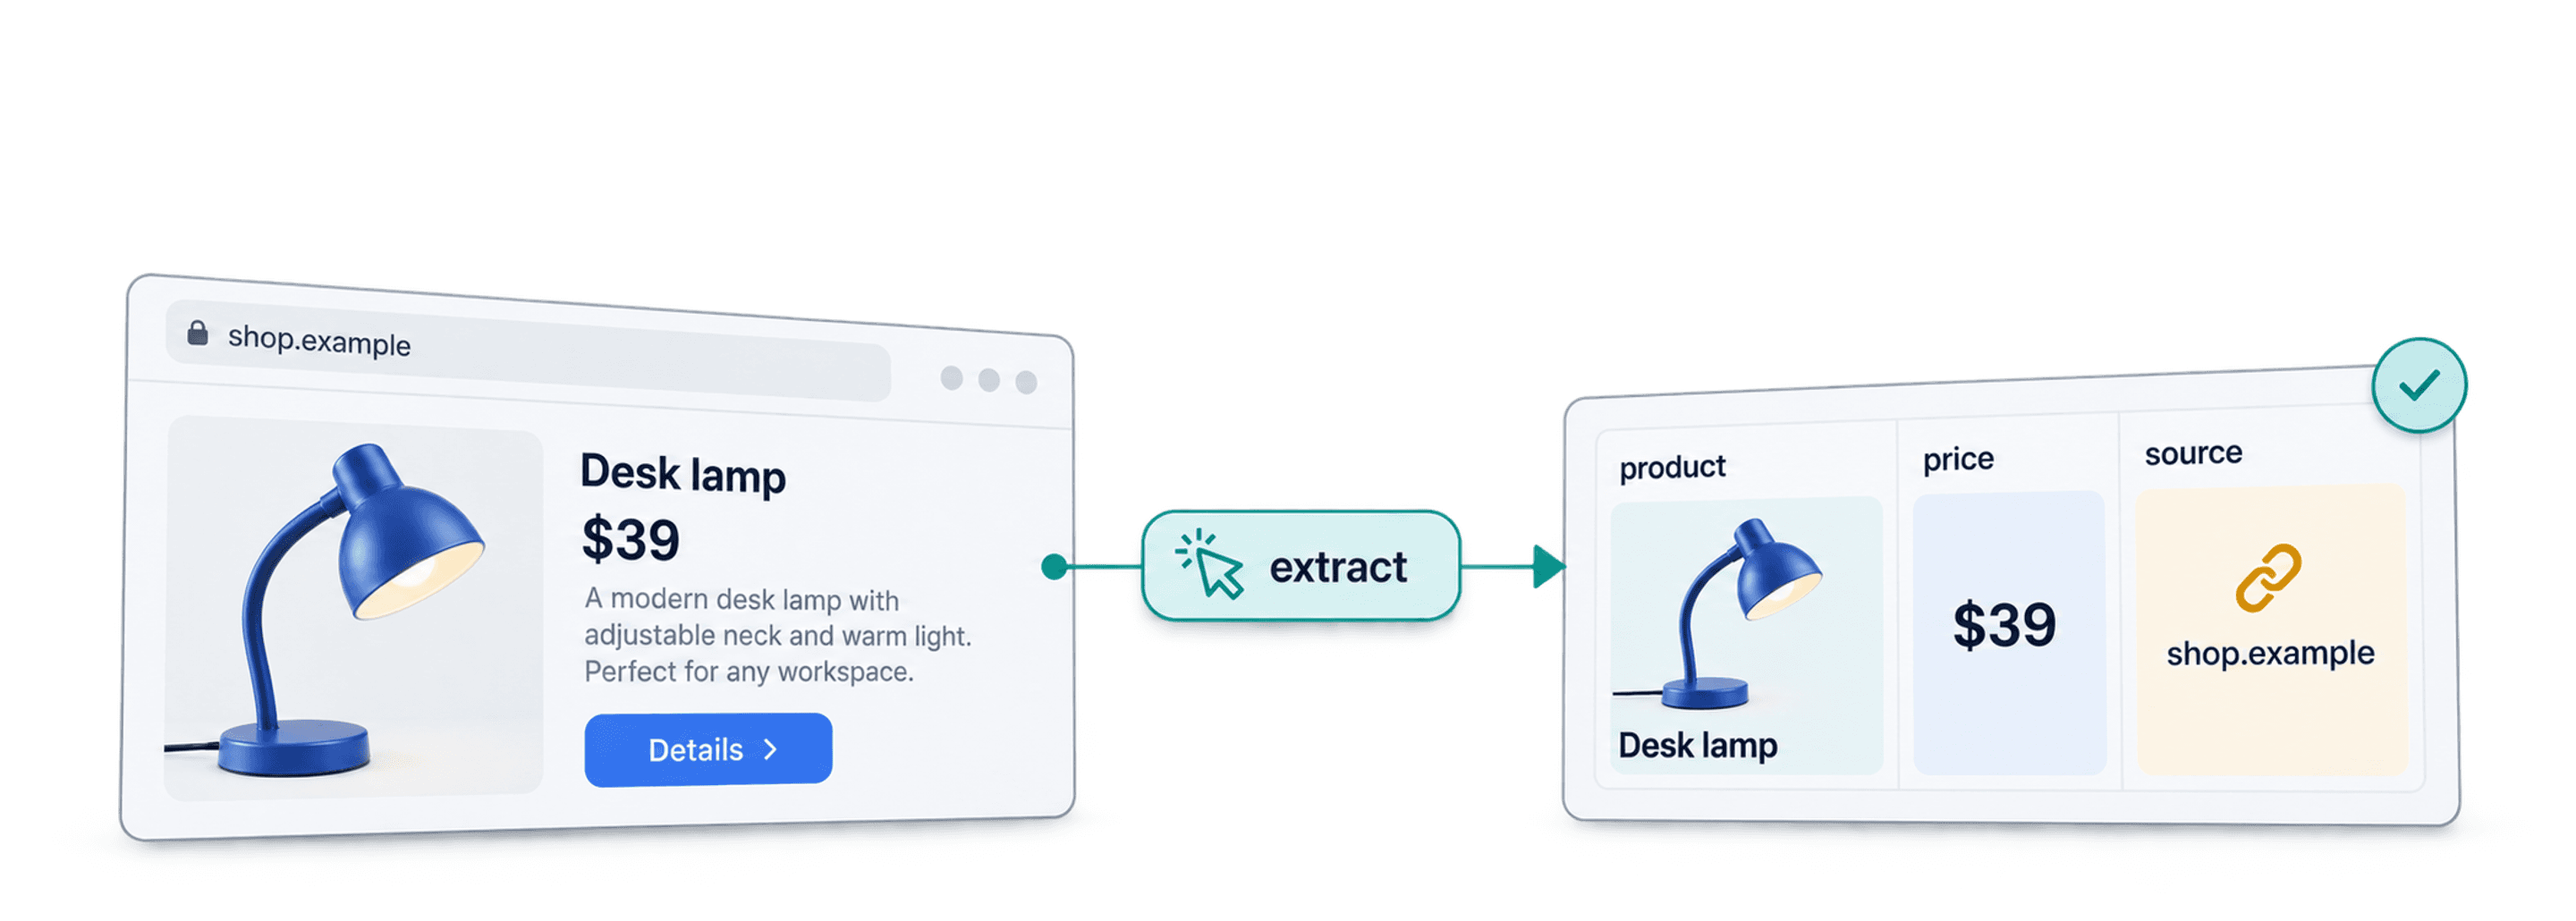
Le web scraping par IA utilise un modèle d’IA pour lire le contenu d’un site et renvoyer des champs précis, comme le nom d’un produit, son prix et l’URL source. Au lieu d’écrire un sélecteur CSS pour chaque champ, vous décrivez les informations recherchées et associez les résultats à des colonnes. Une vérification reste indispensable : le modèle peut omettre un champ, confondre deux pages ou renvoyer une valeur qui n’est pas étayée par la source.
Par exemple, fournissez une page produit à un agent et demandez-lui Nom du produit, Prix actuel et URL du produit. Le résultat attendu est une ligne contenant ces trois champs, avec un prix vérifié sur la page source. Si aucun prix n’est visible, laissez le champ vide plutôt que de l’inventer. Ce guide explique les différences entre l’extraction par IA et le scraping fondé sur des règles, comment choisir le bon workflow et quels éléments vérifier avant d’utiliser les données.
Ce que vous trouverez dans ce guide
- Comprendre le web scraping par IA
- Les principaux avantages du scraping par IA
- Cas d’usage concrets du scraping par IA
- Deux méthodes de scraping par IA
- Les meilleurs outils de scraping par IA
Qu’est-ce que le web scraping par IA ?
Les expressions ci-dessous désignent la même approche générale. L’outil a toujours besoin d’un contenu source accessible et de champs de sortie clairement définis.
Web scraping par IA, AI scraping et AI data scraping
AI web scraping = AI scraping = AI data scraping
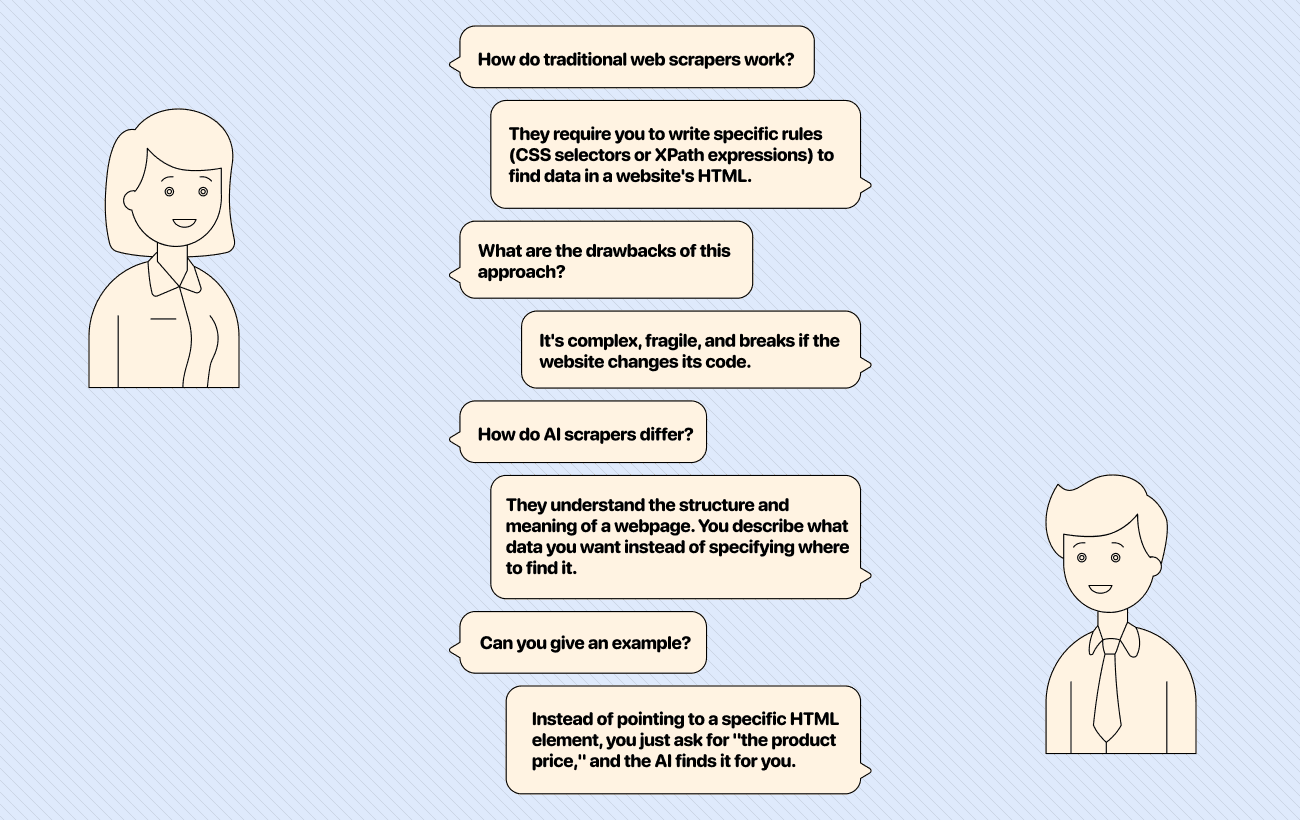
Toutes ces expressions désignent l’utilisation d’un modèle d’IA pour identifier et structurer des informations issues du web. Un scraper classique sélectionne généralement des éléments à l’aide de sélecteurs CSS ou d’expressions XPath. Dans un workflow d’extraction par IA, un prompt ou un schéma permet plutôt d’identifier les champs selon leur signification. Cette méthode est utile lorsque la mise en page varie, mais elle ne dispense pas de gérer les pages inaccessibles, les changements de contenu ou les résultats erronés.
Pourquoi utiliser l’IA pour le scraping ?
L’extraction par IA est particulièrement utile lorsqu’une même information apparaît à différents endroits selon les pages, ou lorsque vous devez transformer du texte non structuré en colonnes. Pour une mise en page stable et uniforme, le scraping fondé sur des règles peut être plus simple et moins coûteux. Choisissez votre méthode en fonction de la source et du résultat attendu.
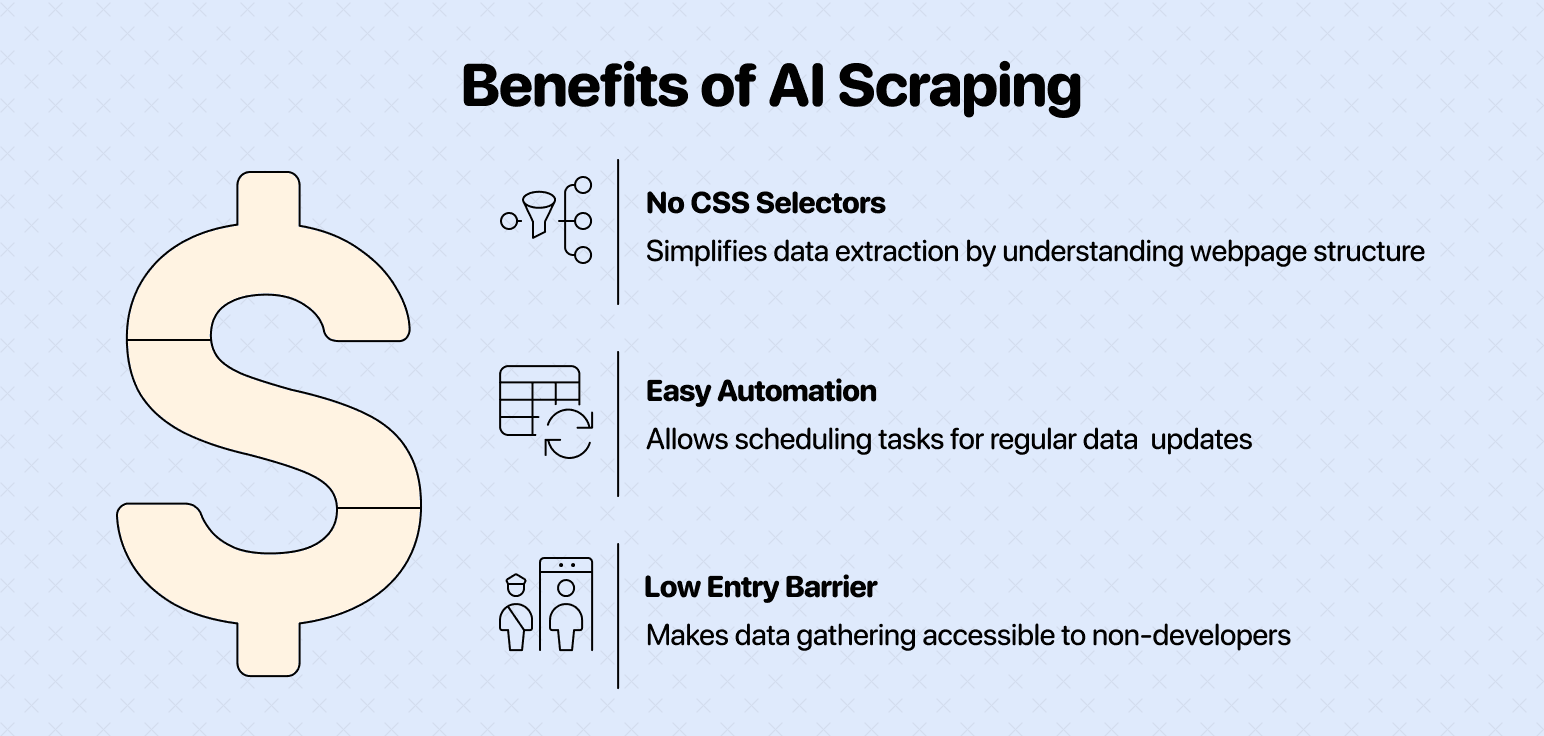
Sans code ni API
Certains outils de scraping par IA acceptent un prompt en langage naturel directement dans leur interface. D’autres nécessitent une API ou du code. Une demande claire doit nommer chaque champ attendu et préciser la marche à suivre lorsqu’une valeur n’est pas disponible sur la page.
Sans sélecteurs CSS, XPath ni complexité
Avec un scraper fondé sur des sélecteurs, vous devez identifier l’élément HTML qui contient la valeur. Avec l’extraction par IA, vous pouvez demander un champ comme « prix actuel du produit » sur des pages dont la mise en page diffère. Testez les deux approches sur quelques pages représentatives. Un changement de structure, une page bloquée ou un prix ambigu peuvent toujours nécessiter une modification du prompt ou une vérification manuelle.
Automatisation simple et accessible
Vous pouvez lancer un workflow d’extraction par IA sur une liste d’URL ou partir de l’URL d’un site. Avant de répéter une opération, contrôlez un échantillon des résultats afin de repérer les champs vides, les mauvaises correspondances et les changements de structure du site source. Même automatisé, le processus doit être surveillé.
Cas d’usage du scraping par IA
Les applications du scraping par IA sont presque illimitées et concernent la plupart des fonctions d’une entreprise. En automatisant la collecte de données sur le web, les équipes accèdent à des informations stratégiques et gagnent en efficacité.
Voici quelques exemples d’utilisation du scraping par IA :
- Scraper des boutiques e-commerce
- Les équipes peuvent extraire les noms, prix, descriptions et images de milliers de fiches produit.
- Ces données servent à l’analyse concurrentielle, au suivi des prix et à la création de catalogues produits.
- Scraper des avis clients
- La collecte d’avis sur des plateformes comme Trustpilot, G2 ou Amazon aide les entreprises à comprendre l’opinion du public.
- L’IA peut analyser ces données afin d’identifier les thèmes récurrents, les défauts des produits ou les facteurs de satisfaction client dans le cadre d’une analyse concurrentielle.
- Surveiller les pages tarifaires
- Les équipes commerciales et marketing peuvent suivre automatiquement les tarifs et les promotions de leurs concurrents.
- Elles peuvent ainsi ajuster leur stratégie tarifaire et préserver leur compétitivité.
- Scraper des études de cas
- Les équipes marketing peuvent collecter les études de cas publiées par leurs concurrents pour mieux comprendre leur positionnement et leurs réussites.
- Ces informations permettent d’affiner leurs propres messages marketing et argumentaires commerciaux.
- Rechercher des données absentes des bases de données
- Certaines informations n’existent tout simplement dans aucune base de données structurée.
- Les scrapers par IA peuvent extraire des données uniques depuis des forums, des blogs ou des sites de niche pour alimenter des études de marché, des travaux universitaires ou des enquêtes journalistiques.
💡 Guides pratiques pour débuter avec le scraping par IA
Comment scraper des études de cas 👈🏼
Comment scraper les produits de sites e-commerce 👈🏼
Comment scraper les avis clients sur Trustpilot 👈🏼
Comment trouver des informations sur vos comptes absentes des bases de données 👈🏼
2 méthodes de scraping par IA
Les outils de scraping par IA proposent différentes approches selon la tâche à accomplir. La technologie sous-jacente reste similaire, mais la méthode dépend de votre objectif : enrichir un dataset existant ou explorer un nouveau site à partir de zéro.
Examinons les deux principales méthodes :
- [Lancer un agent de scraping par IA sur une liste](#agent-scraping-ia-sur-liste)
- Utiliser un agent de scraping par IA avec une URL et un prompt
Lancer un agent de scraping par IA sur une liste
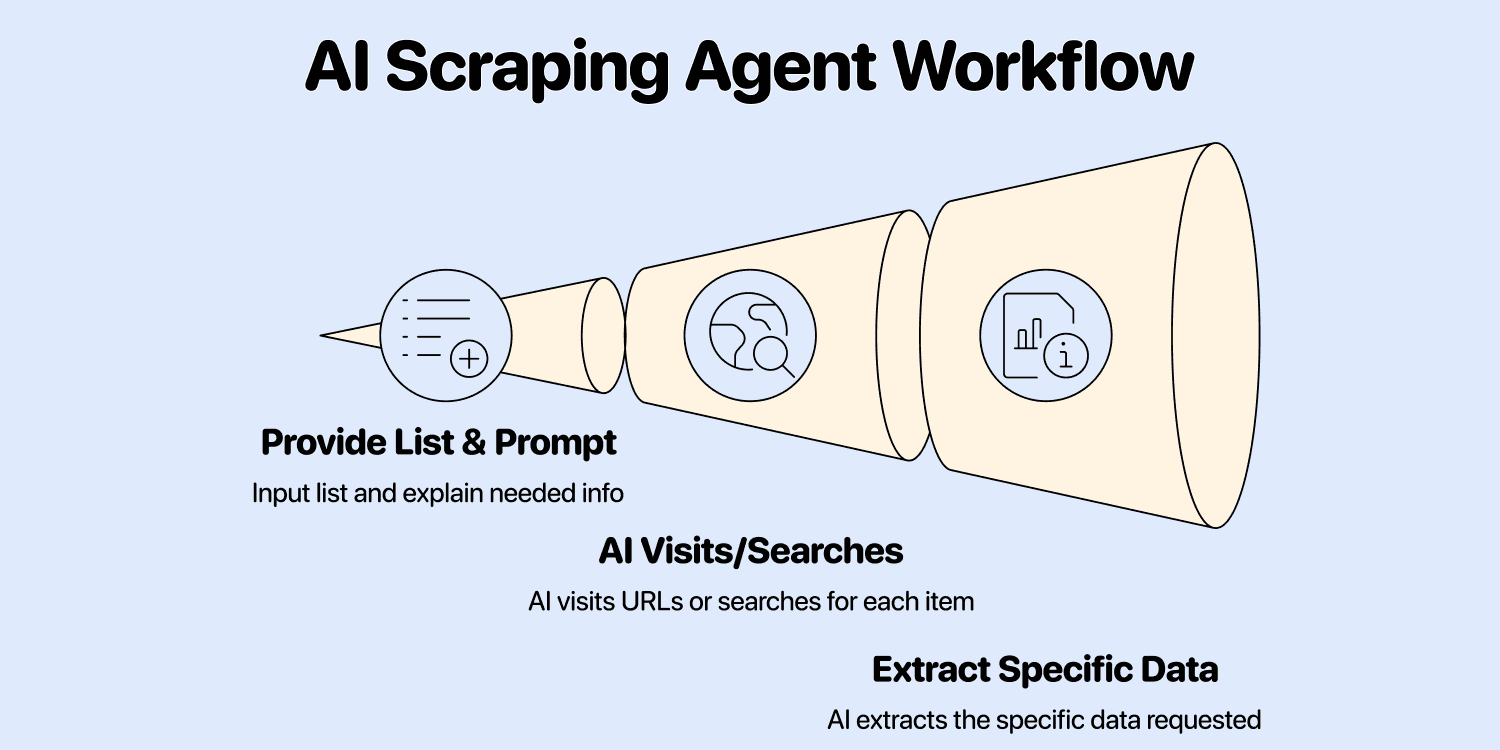
Cette méthode convient parfaitement si vous disposez déjà d’un point de départ, comme une feuille de calcul contenant des noms d’entreprises ou des URL de produits. Vous transmettez votre liste à l’agent IA, accompagnée d’un prompt qui décrit les informations supplémentaires à rechercher pour chaque élément.
L’IA consulte ensuite chaque URL ou effectue une recherche pour chaque élément, puis extrait précisément les données demandées.
- Idéal pour : enrichir des datasets existants, par exemple trouver le secteur d’activité d’une liste d’entreprises ou le nom du CEO pour une liste de comptes.
- Vérification : commencez par tester un petit échantillon et consultez les pages sources pour les champs importants.
Utiliser un agent de scraping par IA avec une URL et un prompt
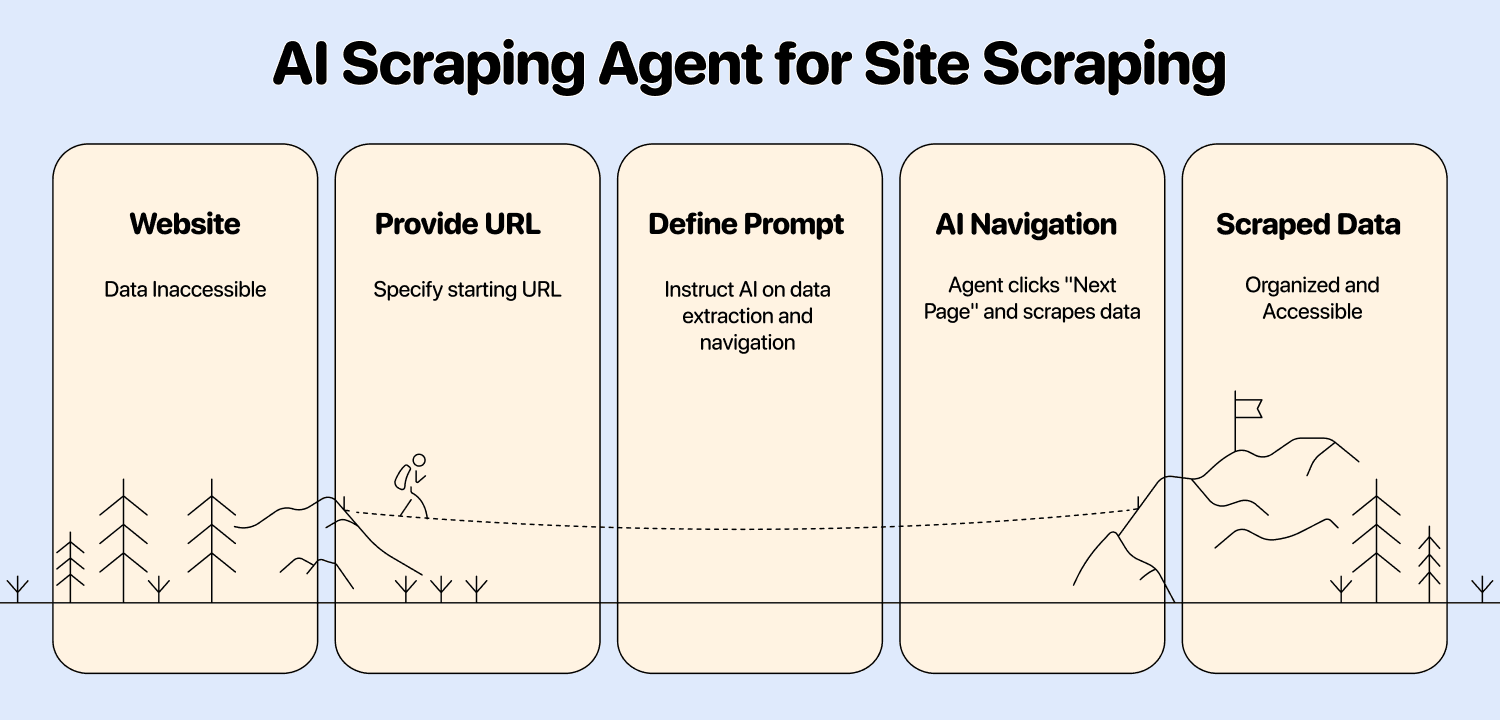
Cette méthode sert à explorer et à extraire les données d’un site entier ou de l’une de ses sections. Vous fournissez une URL de départ, comme une page de catégorie sur un site e-commerce, ainsi qu’un prompt indiquant à l’IA les éléments à rechercher et la manière de parcourir le site.
Pour le website scraper de Datablist, indiquez une URL de départ et un prompt décrivant les éléments à extraire. La pagination est facultative : configurez-la lorsque la source comporte plusieurs pages de résultats.
Le guide sur la configuration du website scraping et la vérification d’échantillons explique comment comparer les résultats au prompt, tester le rendu et distinguer un champ manquant d’une page bloquée.
- Idéal pour : scraper des listes de produits sur des sites comme Amazon ou eBay, collecter les articles d’un blog ou extraire les entrées de n’importe quel annuaire. Le guide Amazon explique quand collecter d’abord les listes et quand ouvrir chaque fiche produit.
- Vérification : commencez avec un nombre de pages limité, puis assurez-vous que les lignes renvoyées proviennent bien des pages ciblées avant d’étendre l’opération.
Les meilleurs outils de scraping par IA
Le marché des outils de scraping par IA se développe rapidement. Le bon choix dépend de vos compétences techniques, de votre budget et de vos besoins. Voici trois solutions et leur tarif d’entrée en facturation mensuelle, exprimé en dollars américains.
| Outil | Usage principal | Tarif de départ | Utilisation mensuelle incluse |
|---|---|---|---|
| Datablist | Scraping no-code et enrichissement de feuilles de calcul | 25 $/mois | 5 000 crédits |
| Firecrawl | Données web et extraction structurée pour les applications | 19 $/mois | 5 000 crédits |
| ScrapingBee | API de scraping avec extraction par IA | 19 $/mois | 75 000 crédits API |
Les crédits ne correspondent pas aux mêmes usages. Datablist facture le modèle d’IA et les outils utilisés ; Firecrawl facture selon le nombre de pages et le format sélectionné ; ScrapingBee ajoute le coût de l’extraction par IA au coût de base de la requête. Les exemples ci-dessous montrent pourquoi le nombre de crédits le plus élevé ne correspond pas nécessairement au workflow le moins cher. Si vous hésitez entre une feuille de calcul et une API, consultez notre comparatif des outils de scraping par IA pour évaluer les compromis liés à la configuration et à la maintenance.
Datablist : conçu pour les équipes Sales, Marketing et Ops
Datablist est une plateforme d’automatisation des données qui intègre de puissantes fonctionnalités de scraping par IA dans une interface de feuille de calcul intuitive. Elle s’adresse aux équipes Sales, Marketing et Ops qui souhaitent collecter et enrichir des données sans écrire de code ni configurer d’API.
Fonctionnalités principales :
- Prompts en langage naturel : décrivez simplement ce dont vous avez besoin, et l’agent IA s’en charge. Aucun code ni configuration complexe d’API n’est nécessaire.
- Deux points de départ : lancez un AI Agent sur des lignes existantes, ou partez de l’URL d’un site avec un prompt et une pagination facultative.
- Paramètres d’exécution : le website scraper permet de définir une limite de pages et d’activer, si nécessaire, le rendu HTML. Effectuez un petit test avant d’augmenter le nombre de pages.
- Résultats structurés : associez les champs demandés aux colonnes de votre collection, vérifiez les lignes et combinez-les au besoin avec d’autres enrichissements.
Tarifs :
- Starter : 25 $/mois avec 5 000 crédits. L’offre Growth coûte 50 $/mois et comprend 20 000 crédits.
- La consommation du scraping par IA varie selon le modèle, les outils et les pages consultées. Lorsqu’il est activé, le rendu HTML ajoute 2 crédits par scraping.
- Pour une opération qui consomme 25 000 crédits, l’offre Starter complétée par une recharge de 20 000 crédits coûte 45 $ (25 $ + 20 $). Il s’agit d’un exemple de budget en crédits, et non d’un prix fixe pour un nombre donné de pages. Les recharges nécessitent un abonnement actif et n’expirent pas.
💡 Les atouts méconnus de Datablist
Le principal avantage de l’AI Scraper de Datablist est qu’il va bien au-delà du simple scraping par IA. Cet AI scraping agent peut lancer des recherches sur Google, consulter Google Actualités, appeler des API, extraire des données, parcourir des pages grâce à la pagination, et bien plus encore.
Firecrawl : une Web Data API pour les applications IA
Firecrawl est une Web Data API open source destinée aux développeurs. Elle transforme les sites web en données prêtes à être exploitées par des LLM pour alimenter des applications IA.
Fonctionnalités principales :
- Extraction structurée : fournissez une URL ainsi qu’un schéma JSON ou un prompt décrivant les champs recherchés. Comparez les valeurs renvoyées avec la page source.
- Résultats prêts pour les LLM : obtenez des données dans différents formats, comme JSON, Markdown ou des captures d’écran, immédiatement exploitables par une IA.
- Approche Developer-First : la plateforme propose des SDK pour Python et Node.js, avec une documentation et des exemples complets.
Tarifs :
- Hobby : 19 $/mois avec 5 000 crédits. L’offre Standard coûte 99 $/mois et comprend 100 000 crédits. Il s’agit des tarifs mensuels, et non des prix réduits avec facturation annuelle.
- Le scraping simple d’une page coûte 1 crédit. Le format JSON en ajoute 4 : une page avec extraction JSON consomme donc 5 crédits. Les autres modes peuvent modifier cette consommation.
ScrapingBee : un scraper par IA pour les développeurs
ScrapingBee est un outil de scraping API-first qui gère les proxys et les navigateurs. Les développeurs peuvent l’appeler depuis leur code, tandis que des intégrations comme n8n et Make permettent aux équipes de le connecter à d’autres workflows. Vous devez néanmoins configurer la requête et associer les données renvoyées aux champs appropriés.
Fonctionnalités principales :
- Web scraping assisté par IA : l’IA facilite l’analyse et l’extraction des données, ce qui améliore la résistance aux changements des sites.
- Accès API : l’outil est conçu pour être intégré par les développeurs à leurs applications et workflows.
- Rendu JavaScript : il peut scraper les sites modernes et dynamiques qui reposent fortement sur JavaScript.
Tarifs :
- Hobby : 19 $/mois avec 75 000 crédits API. L’offre Freelance à 49 $/mois en comprend 250 000.
- L’extraction par IA ajoute 5 crédits par requête. Avant cet ajout, une requête simple consomme 1 crédit, ou 5 avec le rendu JavaScript. Les options de proxy premium peuvent encore augmenter le coût de base.
Combien coûte une extraction de données structurées ?
Ces exemples reposent sur une requête par page et sur les paramètres indiqués. Ils évaluent le coût d’utilisation de l’API, et non le nombre d’enregistrements corrects obtenus.
| Outil et opération | Crédits nécessaires | Offre mensuelle et prix |
|---|---|---|
| Firecrawl : 1 000 pages avec extraction JSON | 5 000 | Hobby : 19 $ |
| Firecrawl : 10 000 pages avec extraction JSON | 50 000 | Standard : 99 $ |
| ScrapingBee : 10 000 requêtes d’extraction par IA, sans rendu JavaScript | 60 000 | Hobby : 19 $ |
| ScrapingBee : 10 000 requêtes d’extraction par IA, avec rendu JavaScript | 100 000 | Freelance : 49 $ |
Pour ScrapingBee, les deux dernières lignes correspondent respectivement à 10 000 × (1 + 5) et 10 000 × (5 + 5). L’activation du rendu fait dépasser le quota de l’offre Hobby. Pour Datablist, effectuez d’abord un petit test afin de mesurer la consommation en crédits de votre modèle, de votre prompt et des pages sources. Établissez ensuite votre budget en fonction des crédits inclus dans l’offre Starter à 25 $ et des tarifs de recharge indiqués ci-dessus.
Comment vérifier les résultats du scraping par IA
Avant d’utiliser le dataset, comparez un échantillon de lignes avec les pages sources. Vérifiez que chaque valeur correspond au bon élément, que les unités et les devises sont conservées et que les valeurs absentes restent vides. Si la page source est inaccessible ou si le résultat est incertain, modifiez le prompt ou contrôlez manuellement la ligne concernée. Répétez cette vérification lorsque le site source évolue.