
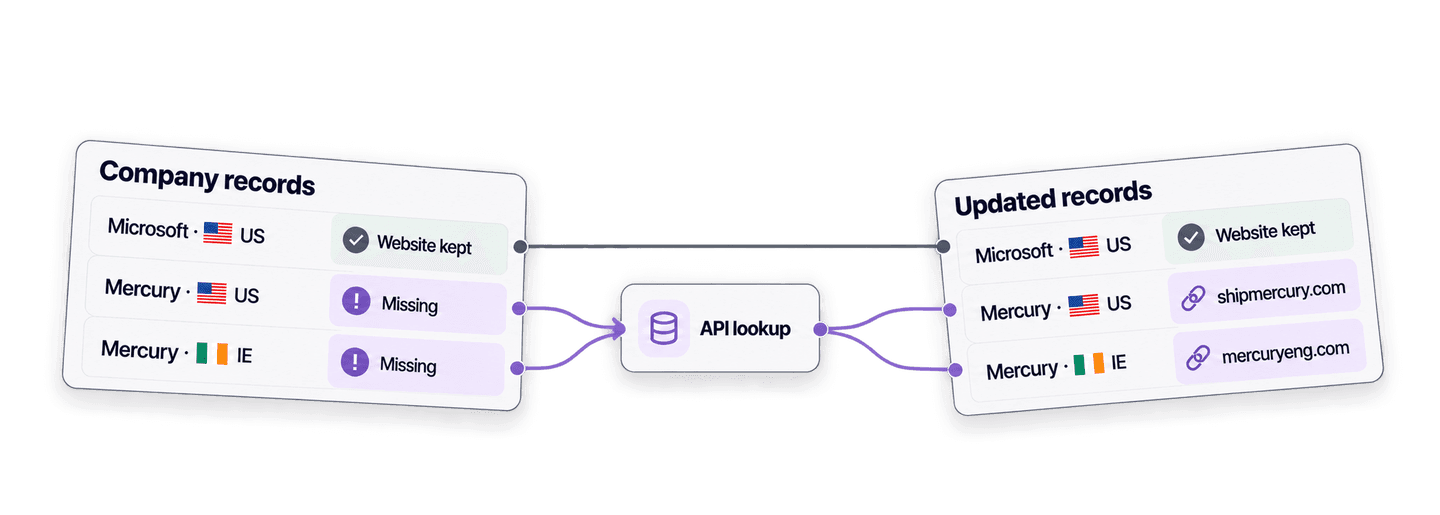
Per trovare il sito web di un’azienda partendo dal suo nome in Python, invia il nome e, se disponibile, il Paese di riferimento alla Company Name to Domain API di Datablist. L’API elabora la ricerca in background, quindi restituisce il dominio e l’URL completo del sito.
Per prima cosa ti mostrerò una semplice richiesta API in Python. Poi riutilizzerò la stessa funzione per compilare solo i siti web mancanti in un elenco di aziende, senza sovrascrivere gli URL già presenti.
Se preferisci un’interfaccia simile a un foglio di calcolo, consulta la guida per trovare in blocco i siti web dai nomi delle aziende.
💡 Riepilogo per chi va di fretta
Crea una funzione Python che trovi i siti web dai nomi delle aziende, quindi usala per completare i record con il sito vuoto senza sostituire gli URL già noti.
- Input: nomi delle aziende con Paese facoltativo.
- Output: dominio, URL completo del sito, livello di confidenza, stato del risultato e crediti utilizzati.
Configurare Python e la chiave API Datablist
Per questo esempio uso il package Requests per effettuare chiamate HTTP sincrone. Installalo in un ambiente virtuale:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsTi serve anche un piano Datablist Growth, perché l’accesso alla REST API è una funzionalità Growth. Crea una Personal API Key dalla pagina API del tuo account Datablist, quindi salvala in una variabile d’ambiente:
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 Hai già una chiave API? Le chiavi meno recenti usano il formato
auth0|<userId>:<accountId>:<secret>:1e sono ancora supportate. Continua a usare la chiave esistente esattamente come è stata generata: non devi sostituirla né modificarne il formato.
Sostituisci il valore di esempio con la chiave generata nella pagina del tuo account. Le ricerche dei siti aziendali consumano crediti. Prima di estendere lo script spiegherò i percorsi da 1 e 2,5 crediti; i valori aggiornati dei piani sono disponibili nella pagina dei prezzi di Datablist.
Trovare il sito di un’azienda con Python
Crea un file chiamato find_company_websites.py. Lo script invia i nomi, attende il completamento del task e recupera i risultati tramite un’unica funzione. Ogni input usa l’ID stabile del tuo record come inputId, così puoi associare ogni risultato al record corretto anche se l’ordine della risposta cambia.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))Eseguilo dal terminale in cui hai esportato la chiave:
python find_company_websites.pyEcco il risultato per Microsoft:
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
Usa inputId per associare il risultato al record originale. status può essere success, no_result, error o skipped. Un risultato positivo può includere companyDomain, l’URL completo companyUrl e domainConfidence. creditsUsed indica il costo di questo input, mentre error descrive un errore relativo al singolo elemento.
La funzione effettua tre tipi di chiamate API, in quest’ordine.
Per prima cosa invia la ricerca. Il payload contiene le impostazioni e i record aziendali. La richiesta POST restituisce 202 Accepted, mentre @id è l’ID del task necessario per le chiamate successive:
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]Se DATABLIST_API_KEY non è impostata, Python genera un KeyError durante la lettura della variabile d’ambiente, prima ancora di effettuare una richiesta HTTP. Esporta la variabile e avvia nuovamente lo script. Se la variabile contiene una chiave non valida, la richiesta POST raggiunge l’API e restituisce l’errore HTTP 401. Copia una Personal API Key valida dalla pagina del tuo account e sostituisci il valore errato.
Poi verifica periodicamente il task. La richiesta POST avvia l’elaborazione in background, quindi lo script legge lo stato del task ogni tre secondi finché non diventa completed, failed o stopped:
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)Se il task non riesce per mancanza di crediti, l’errore riporta il motivo credits_error. Aggiungi crediti oppure attendi il rinnovo di quelli mensili, controlla gli eventuali risultati già restituiti e invia in un nuovo task solo gli input non completati.
Infine recupera tutte le pagine dei risultati. Ogni risposta aggiunge i risultati all’elenco e fornisce il cursore per la richiesta successiva:
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakLo script recupera la pagina successiva finché nextCursor non è null.
Prima della richiesta POST, lo script stampa il valore uniqueId generato. Se la connessione si interrompe prima che tu riceva la risposta di creazione, controlla innanzitutto l’elenco dei task e il loro stato, evitando di crearne subito un altro:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"Trova il task il cui uniqueId corrisponde al valore generato dallo script, quindi copia il relativo @id. L’endpoint dell’elenco consente di filtrare per enrichmentId, ma non per uniqueId. Usa l’@id con gli stessi URL di stato e risultati utilizzati dallo script. Se il task è ancora attivo, continua a verificarne lo stato. Se si è interrotto o non è riuscito, controlla i risultati parziali prima di inviare nuovamente gli input.
Matching dei dati e fallback basato sul Paese
Lo script usa dataset_google, l’opzione predefinita consigliata. Datablist controlla innanzitutto i propri dataset aziendali. Se il match non è disponibile o presenta incongruenze, può usare Google come fallback. Prima di restituire un livello di confidenza, verifica i possibili risultati.
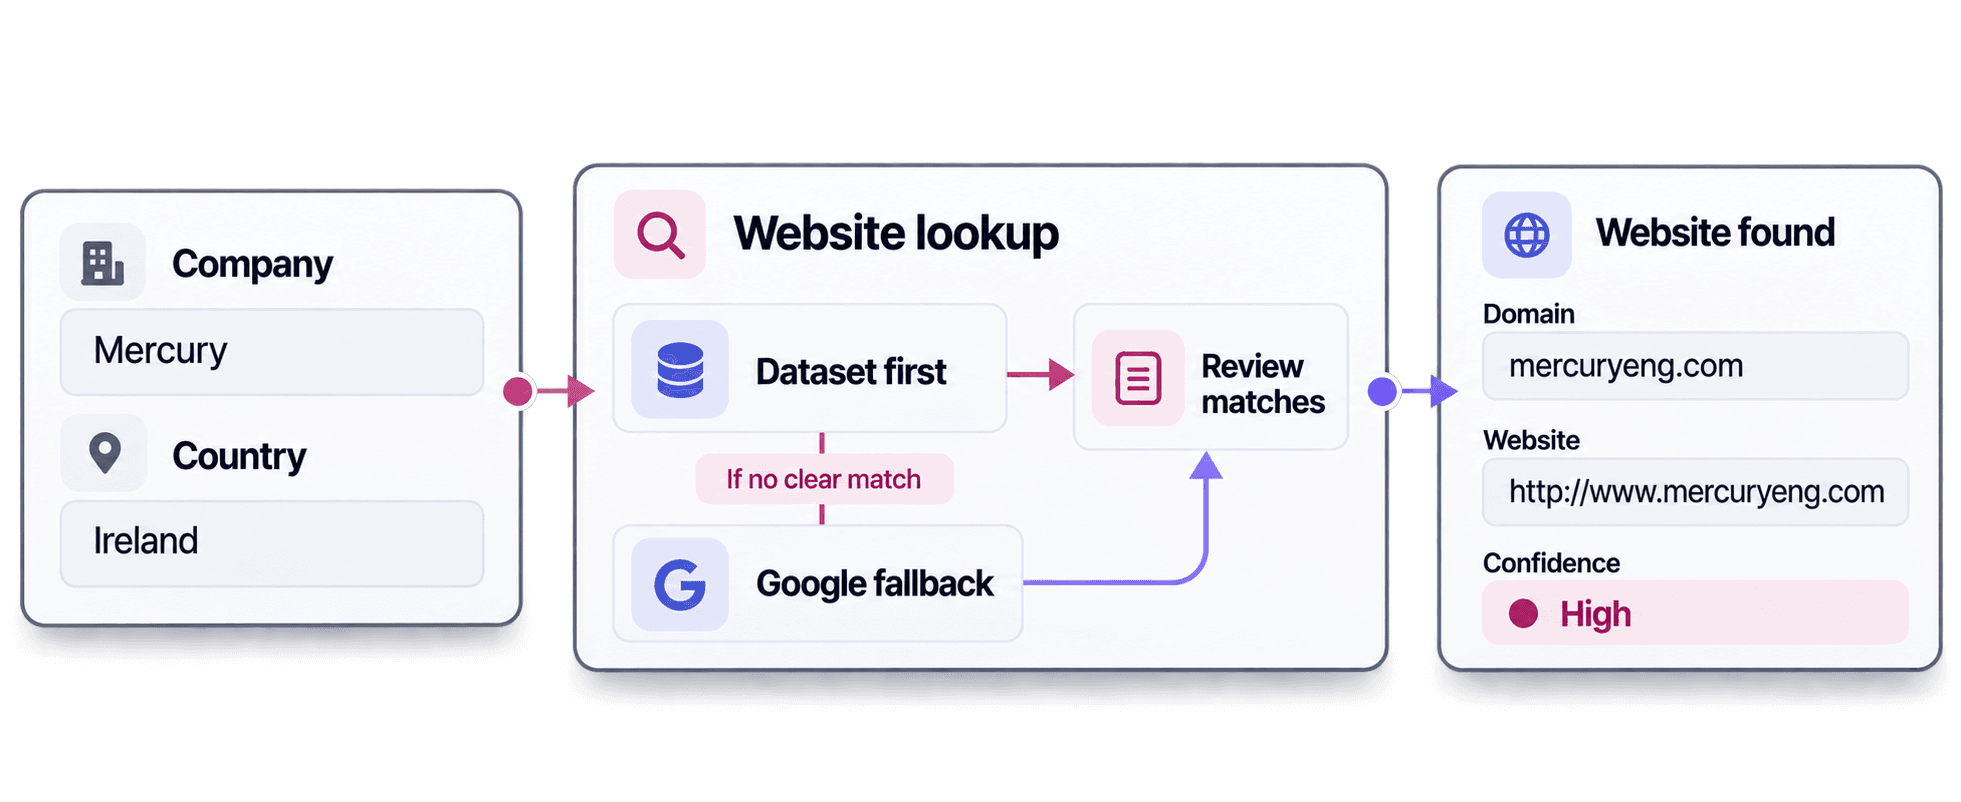
Il Paese aiuta a distinguere i nomi ambigui. In questo esempio, lo stesso nome aziendale ha prodotto risultati diversi:
MercuryconUSha restituitoshipmercury.comehttps://www.shipmercury.com/.MercuryconIEha restituitomercuryeng.comehttp://www.mercuryeng.com.
Entrambi avevano un livello di confidenza High. Il Paese aiuta la ricerca a scegliere tra aziende con lo stesso nome, mentre il livello di confidenza ti permette di stabilire quali risultati richiedono una verifica.
Quando il match dipende anche dal settore, dalle dimensioni dell’azienda o da altri dati di business, usa il workflow di ricerca AI Agent. Inserisci queste informazioni nel prompt di AI Agent, così potrà individuare l’azienda corretta usando un contesto di business più completo.
Compilare solo i siti web mancanti nei record
Ora che find_domains() può trovare un sito web dal nome dell’azienda, riutilizzala per compilare solo i siti mancanti nei tuoi record aziendali. I record che contengono già un sito web non vengono inviati all’API: i valori restano invariati e non consumano crediti.
Nel file find_company_websites.py, sostituisci tutto il codice da companies = [ fino al ciclo di stampa finale con il blocco seguente. Mantieni l’assegnazione di api_key che si trova più in alto. Il controllo dei campi vuoti gestisce None, una stringa vuota e una stringa composta da soli spazi. Se tutti i siti sono già presenti, non viene effettuata alcuna chiamata API.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))Il codice indicizza i risultati per inputId, quindi scorre i record originali nello stesso ordine. L’oggetto website_lookup conserva l’esito e i dati necessari alla verifica accanto a ogni record elaborato, inclusi i risultati mancanti o non riusciti.
Per crm-001, website_is_missing() restituisce False perché l’URL di Microsoft è già presente. Il record non viene aggiunto a records_to_lookup, quindi l’API non lo riceve. Il merge mantiene il sito web esistente e registra lo stato not_requested.
Per crm-002, il sito web è vuoto, quindi la richiesta invia la panetteria con inputId: crm-002. L’API restituisce lo stesso inputId. results_by_id lo usa per individuare il risultato corretto e il merge scrive https://boulangerie-du-palais-lyon.eatbu.com nel record, senza dipendere dall’ordine dei risultati.
| ID | Azienda | Sito web dopo il merge | Stato | Dominio | Confidenza | Crediti |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
La panetteria usa un sottodominio specifico per l’attività, boulangerie-du-palais-lyon.eatbu.com. Conserva questo valore senza ridurlo a eatbu.com e salva l’indirizzo esatto restituito in companyUrl. L’impostazione acceptNonRoot: true consente anche di accettare una pagina aziendale ospitata il cui indirizzo contiene un percorso dopo l’hostname: in entrambi i casi, quindi, è importante conservare l’URL completo.
Un task completato può comunque contenere elementi no_result, error o skipped. L’esempio modifica website solo quando lo stato è success e companyUrl è presente. In caso di no_result, il sito rimane vuoto e lo stato resta visibile in website_lookup. Controlla innanzitutto il nome dell’azienda e il Paese. Se uno dei due input è errato, correggilo e invia nuovamente quel record in un altro task. In caso contrario, lascia visibile il sito vuoto per una verifica manuale.
Stimare i crediti prima di estendere lo script
Le cinque ricerche dell’esempio hanno restituito success con confidenza High e utilizzato in totale 5 crediti.
Una ricerca risolta tramite il dataset costa 1 credito. Una ricerca elaborata con Google costa 2,5 crediti. Paghi solo il percorso utilizzato, non entrambi. Per 1.000 input, il costo è quindi di 1.000 crediti se tutti vengono risolti tramite il dataset oppure di 2.500 crediti se tutti usano Google. Si tratta di scenari utili alla pianificazione, non della garanzia che ogni ricerca produca un risultato.
Sposta il cursore per confrontare il consumo di crediti del tuo elenco.
Con un prezzo di 20 $ per 20.000 crediti, questi scenari costano rispettivamente 1 $ e 2,50 $. L’abbonamento Growth è separato e attualmente include 20.000 crediti mensili, che vengono utilizzati prima dei crediti aggiuntivi. Consulta i prezzi aggiornati, perché i valori dei piani e dei pacchetti possono cambiare.
Un task accetta fino a 10.000 input, con un limite di 16 KiB per input e di 10 MiB per richiesta. Questo esempio usa chiamate Requests bloccanti per inviare, monitorare e recuperare i risultati di un piccolo task asincrono di Datablist. Il repository ufficiale include anche esempi di elaborazione in batch dei file CSV e client non bloccanti.
Prossimi passaggi
Dopo aver verificato che il sito restituito appartenga all’azienda corretta, puoi estrarre l’Impressum con Python per aggiungere allo stesso record del fornitore i dati legali dell’azienda e l’URL della pagina legale di origine. Mantieni separata la verifica del match del sito dalla successiva estrazione dei dati.
Sostituisci i record di esempio con un piccolo campione dei tuoi dati, quindi esegui lo script e controlla i record ottenuti dopo il merge. Mantieni ID stabili e il Paese di riferimento; aumenta i volumi solo dopo aver verificato che lo script conservi i siti già noti e compili correttamente quelli mancanti. Se vuoi scaricare lo script oppure usare l’elaborazione in batch dei CSV o una versione asincrona, puoi partire dagli esempi ufficiali della Company Name to Domain API su GitHub.