
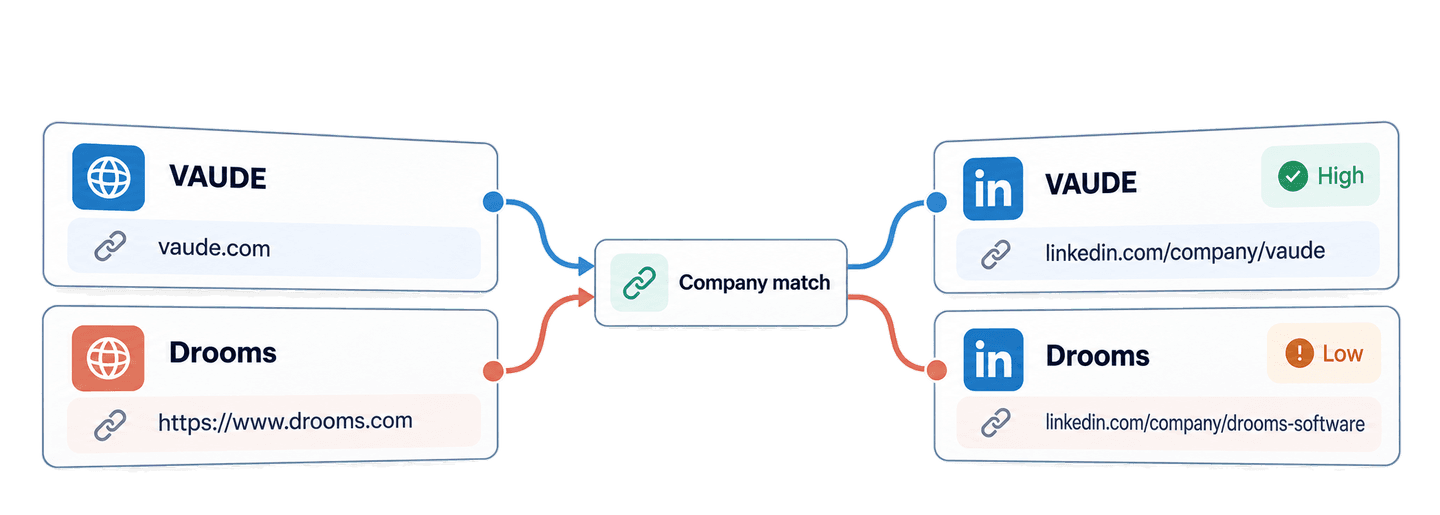
DatablistのCompany to LinkedIn APIを使用すると、PythonでWebサイトからLinkedIn企業ページを検索できます。ドメインのみ、またはWebサイトの完全なURLを送信し、マッチングタスクの完了を待つと、企業名、Webサイト、LinkedIn企業URL、信頼度が返されます。
このガイドでは、PythonとRequestsライブラリを使い、5社のWebサイトを照合します。よく知られたソフトウェア企業に加え、アウトドア用品メーカーのVAUDEと、バーチャルデータルームを提供するDroomsを対象にします。その後、結果を「企業調査に進めるマッチ」と「手動確認が必要なマッチ」という2つのローカルキューに振り分けます。
🔑 お急ぎの方向けのまとめ
アカウントリスト内のWebサイトをDatablistのCompany to LinkedIn APIへ送信します。APIから返されるLinkedIn企業ページURLと信頼度を基に、そのまま利用できるマッチと確認が必要なマッチを判断できます。
- Input: ドメインのみ、または企業Webサイトの完全なURL。
- Output: 企業名、マッチしたWebサイト、LinkedIn企業ページURL、
highまたはlowの信頼度。「Ready for research」と「Needs review」のキューに分類します。
💡 ノーコードで進めたい場合
コードを書かずに企業WebサイトとLinkedInページを照合するには、DatablistのLinkedIn Company Pages & Domain Lookupをご利用ください。
PythonとDatablist APIキーを設定する
この例ではrequestsパッケージを使用します。API自体はHTTPで動作するため、同じリクエスト手順を後から別の言語にも応用できます。
REST APIを利用できるDatablistアカウントが必要です。この機能はGrowthプランで提供されています。また、検索に成功するとenrichment creditsが消費されます。正確なクレジット計算については、このガイドの後半で説明します。
作業用ディレクトリとfind_linkedin_company_pages.pyファイルを作成し、仮想環境を用意してRequestsをインストールします。
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyDatablistアカウントでPersonal API Keyを作成し、環境変数として設定します。
export DATABLIST_API_KEY="your-api-key"スクリプトはこの値を読み取り、X-API-Keyヘッダーで送信します。
1つのPython関数でLinkedIn企業ページを検索する
この例では、次の5つのアカウントを入力データとして使用します。
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
各account_idがAPIのinputIdになります。結果は入力と同じ順序で返されるとは限らないため、この設定が重要です。固定IDがあれば、それぞれの結果を正しい入力アカウントに紐付けられます。
以下の完全なスクリプトをfind_linkedin_company_pages.pyへ貼り付けます。
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))次のコマンドで実行します。
python find_linkedin_company_pages.pyこの関数は、3種類のAPIコールを順番に実行します。
最初に、POSTで5つのWebサイトを送信します。このとき、matchingDirectionにはdomain_to_linkedinを指定します。マッチングはバックグラウンドタスクとして実行されるため、APIはタスクIDとともに202 Acceptedを返します。Requestsスクリプトは次の処理へ進む前に完了を待つため、処理の流れ自体は逐次的です。
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]次に、ステータスリクエストでタスクがcompleted、failed、またはstoppedになるまで確認します。3秒間の待機を入れることで、ステータスリクエストが連続送信されるのを防ぎます。
最後に、結果リクエストで1ページあたり最大100件を取得します。nextCursorに値が入っている場合、ループは次のリクエストでその値をcursorとして送信します。nextCursorがnullになった時点で終了します。
マッチ結果を読み取り、要確認データを判断する
5件の入力に対する全結果は次のとおりです。
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]statusとconfidenceは分けて確認してください。APIは、検索に成功しなかった入力も含め、すべての入力に対して結果オブジェクトを返します。successステータスは、企業ページの候補が見つかったことを示します。outputs.confidenceの値は、Webサイトとのマッチが検証済みかどうかを示します。inputIdはオブジェクトと入力アカウントを結び付け、creditsUsedにはその行で消費されたクレジット、errorにはエラー発生時の構造化された情報が格納されます。
最初の画面でLinkedIn URLと信頼度しか使用しない場合でも、アプリケーションにはoutputsオブジェクト全体を保持しておくことをおすすめします。返された企業名の大文字・小文字表記が異なる場合や、完全なURLを入力した場合は、companyNameとcompanyWebsiteが手動確認に役立ちます。追加のAPIコールを行わずに有用なコンテキストも得られます。
マッチング処理では、まず送信されたWebサイトを正規化し、企業データセット内に既知の「WebサイトとLinkedIn」の関連付けがあるか確認します。その後、入力ドメインとLinkedIn企業ページに掲載されているWebサイトを比較します。登録ドメインが一致すると、信頼度はhighになります。
データセット内にLinkedIn URLがない場合は、企業ページ候補を探すために対象を絞ったGoogle検索が実行されることがあります。掲載Webサイトとの照合ができない候補は、信頼度lowで返される場合があります。Webサイトの不一致が確認された候補は採用されません。
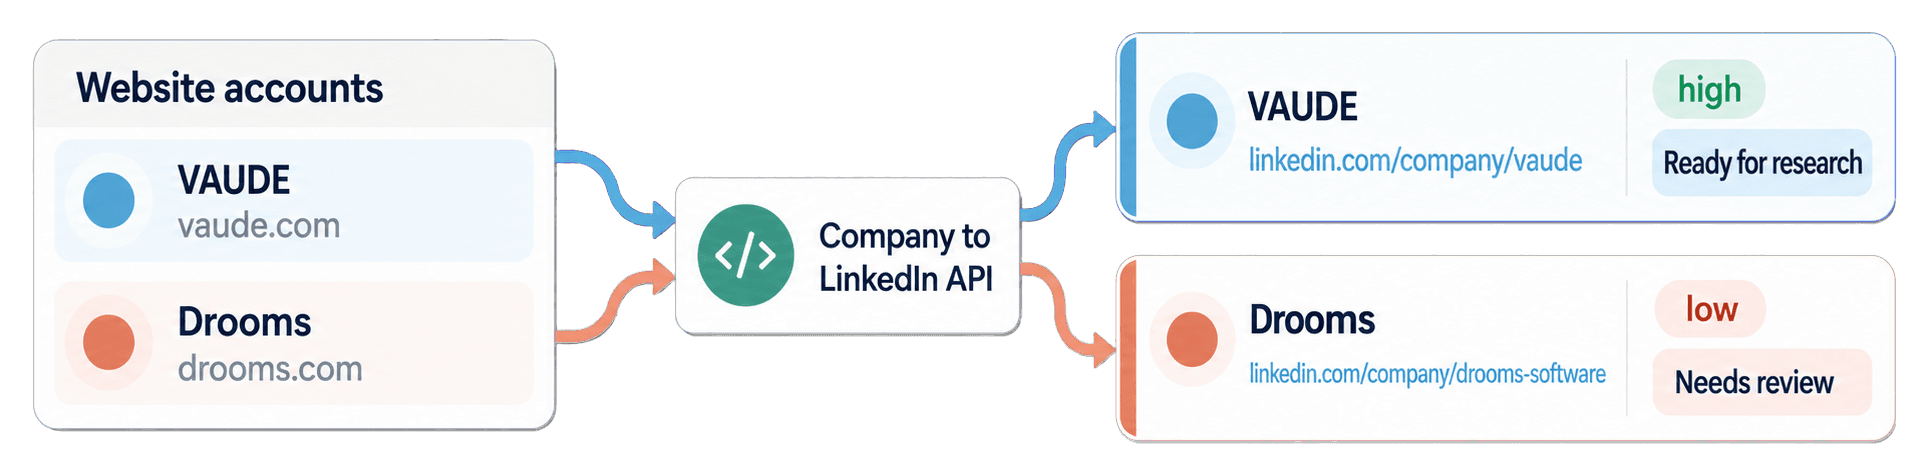
信頼度は、レビュー方法を決める指標としてお使いください。VAUDEはhttps://www.linkedin.com/company/vaudeがhighで返されたため、調査キューに追加できます。Droomsはhttps://www.linkedin.com/company/drooms-softwareがlowで返されました。この関連付けを利用する前に、DroomsのWebサイトとLinkedInページを開いて確認してください。
Datablist、PostHog、n8nも信頼度の高いマッチとして返されました。このAPIが特定するのは、Webサイトと企業ページの関連性です。URLの確認後に企業規模、業種、その他のページ情報が必要な場合は、次のステップとしてLinkedIn企業スクレイピングAPIガイドをご覧ください。
結果から企業調査キューを作成する
次に、match_resultsを再利用し、手動で企業調査を行うためのローカルキューを作成します。このコードブロックではAPIを再度呼び出しません。結果をinputIdでインデックス化し、元のアカウントリストを順番に処理します。これにより、今後結果が欠落するケースでも、すべての入力アカウントを表示したままにできます。
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))結果の辞書を作成することで、レスポンスの順序に依存せずデータを結合できます。account-vaudeは元のvaude.comレコードと取得されたVAUDEページを紐付け、ready_for_researchに追加されます。account-droomsは完全な入力URLとAPI結果全体を保持しますが、結果ステータスがsuccessでも信頼度が低いため、needs_reviewに追加されます。
同じロジックにより、結果が欠落している行、no_resultの行、エラー行も確認キューに残ります。出力される2つのリストが、チームによる手動の企業調査を始める明確な起点になります。
メンテナンスされている同期版Requestsサンプルもダウンロードできます。リポジトリには、ノンブロッキングHTTPが必要なアプリケーション向けの非同期HTTPXサンプルも含まれています。ただし、初めて実装する場合は、上記のブロッキング版のほうが処理を理解しやすいでしょう。
LinkedIn企業ページからWebサイトを逆引きする
マッチング方向を変更すると、同じ関数でLinkedIn企業ページを入力として使用できます。入力リストに企業ページURLしかなく、企業情報や勤務先メールアドレスに対応したenrichmentを実行する前にWebサイトが必要な場合に便利です。
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)通常のLinkedIn企業ページ検索には、標準のマッチング料金が適用されます。数字のみの企業IDとSales Navigatorの企業URLでは、別の逆引きルートを使用するため、10クレジットを消費する場合があります。この方向の検索をノーコードで行う方法は、LinkedIn企業ページからWebサイトURLを取得する方法をご覧ください。
WebサイトからLinkedInを検索するクレジットを試算する
通常のWebサイトからLinkedInへの検索に成功すると、1.5クレジットを消費します。したがって、表示した5件のマッチでは合計7.5クレジットが使用されています。同じレートなら、1,000件の検索成功で1,500クレジットを消費します。無効な入力や結果が見つからなかった行では、消費クレジットがゼロになる場合があります。実際の使用量は、各結果のcreditsUsedをご確認ください。
REST APIへのアクセスはGrowthプランに含まれ、月額サブスクリプションと追加クレジットは別料金です。20ドルのtop-upで20,000クレジットを追加できるため、1クレジットあたりの料金は0.001ドルです。検索成功1件につき1.5クレジットの場合、1,000件では1,500クレジット、金額にして1.50ドルとなります。最新のプランとパッケージはDatablistの料金ページをご確認ください。
入力・タスク・結果のよくある問題を解決する
DATABLIST_API_KEYが設定されていない: スクリプトはリクエストを送信する前に停止します。環境変数を設定してから、コマンドを再実行してください。- APIがキーを拒否する: Personal API Keyをコピーしたことと、リクエストでは
X-API-Keyのみにキーを設定していることをご確認ください。 - 入力がサポートされていない:
domain_to_linkedinでは企業のWebサイトまたはドメインを使用してください。逆方向では、個人プロフィールや空の値ではなく、サポートされている企業ページURLを使用します。 - クレジットが不足している: 残高を確認し、プランに含まれるクレジットを利用するか、top-upを追加してから新しいタスクを作成してください。
- タスクが
failedまたはstoppedになっている: 再送信を判断する前に、タスクステータス、エラー、既存の結果、クレジット使用量をご確認ください。 - 結果が低信頼度、
no_result、またはエラーになっている: 入力元のWebサイトと完全な結果をneeds_reviewに残してください。候補ページがある場合は実際に開き、結果が見つからなかった理由を推測で決めつけないようにしてください。
タスク作成中に接続が切れた場合は、POSTの前に出力されたuniqueIdを使用します。別のタスクを作成する前にタスク一覧を取得し、その値を探してください。
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"タスク一覧はuniqueIdで絞り込めないため、返された各タスクを確認し、必要に応じてnextCursorをたどります。一致する値が見つかったら、その@idをスクリプトと同じステータスURLおよび結果URLで使用してください。
1つのタスクには最大10,000件のinputを含められます。リクエスト、タスク保持期間、ページネーションに関する制限の詳細は、Company to LinkedIn APIドキュメントをご覧ください。
次のステップ
これで、企業WebサイトをLinkedIn企業ページの候補に変換できる、再利用可能なPython Requests関数が完成しました。ローカルキューでは、信頼度の高いマッチを調査対象として準備し、不確実なレコードや検索に成功しなかったレコードも確認用として残せます。
5件のサンプルを少量のアカウントリストに置き換え、信頼度の低い候補をすべて確認してください。承認したURLは、手動の企業調査やLinkedIn company scraper APIのinputとして利用できます。入力リストにWebサイトではなく企業名が含まれている場合は、企業Webサイト検索APIガイドから始めてください。