
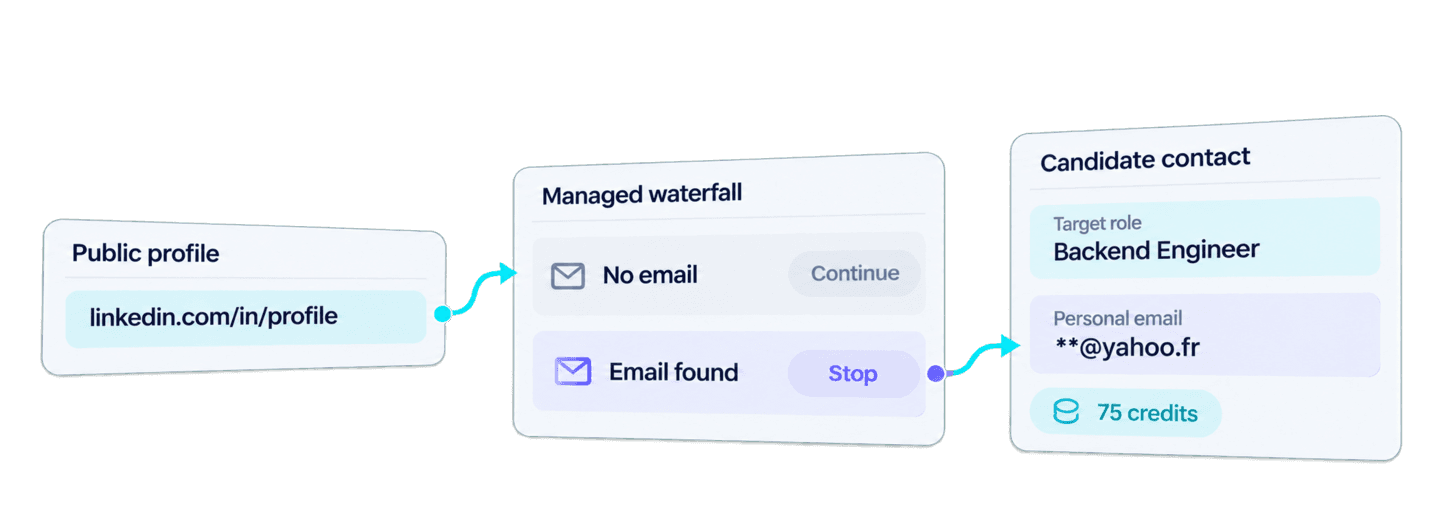
PythonからLinkedInの個人メールアドレスを検索するには、公開されている linkedin.com/in/... 形式のプロフィールURLをDatablistのWaterfall Personal Email Finder APIへ送信します。このAPIは、利用可能なメールプロバイダーを順番に呼び出し、いずれかで見つかった個人メールアドレスを返します。
以下のRequestsを使った完全なサンプルでは、バックグラウンドタスクを1件送信し、完了を待ってから、すべての結果ページを取得します。検索が正常に動作したら、返されたオブジェクトを再利用し、候補者の氏名、LinkedIn URL、募集ポジション、見つかったメールアドレスを紐づけた採用担当者向けの連絡先レコードを作成します。
このワークフローで検索するのは、候補者の現在の勤務先に依存しない個人メールアドレスです。勤務先に紐づくアドレスが必要な場合は、別ガイドのLinkedInプロフィールから仕事用メールアドレスを検索する方法をご覧ください。
🔑 お急ぎの方向けの要点
候補者の氏名、公開LinkedInプロフィールURL、募集ポジションを用意します。このPythonワークフローは、取得可能な個人メールアドレスを検索し、元の採用情報と紐づけた状態で保持します。
- 入力: 候補者の氏名、公開
linkedin.com/in/...プロフィールURL、募集ポジション。- 出力: 対応する候補者情報と紐づけられた個人メールアドレス。
💡 ノーコードで進めたい場合 DatablistのWaterfall Personal Email Finderを使えば、コードを書かずに個人メールアドレスを検索できます。
元データに氏名だけがあり、プロフィールURLがない場合は、まずPythonで公開LinkedInプロフィールを検索し、取得したURLをこのAPIへ渡してください。
Python、Requests、Datablist APIキーの準備
この例では、Pythonと requests パッケージを使用します。find_personal_emails.py というファイルを作成し、Requestsをインストールしてください。
python -m pip install requestsDatablistアカウントでPersonal API Keyを作成し、環境変数として設定します。
export DATABLIST_API_KEY='your-api-key'REST APIはGrowthプランで利用できます。また、個人メールアドレスの検索に成功するとcreditsが消費されます。料金については、後述のコストセクションで計算します。
1つのPython関数で個人メールを検索
このスクリプト内の編集可能な candidates リストには、採用候補者のレコードが1件入っています。target_role は採用ワークフロー内にのみ保持される入力値の例です。APIのpayloadに含まれるのは、candidate_id と linkedin_url だけです。
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))同じターミナルからファイルを実行します。
python find_personal_emails.pyメンテナンスされている同期版Requestsサンプルもダウンロードできます。上記のスクリプトは、元レコードの候補者IDを使用しながら、タスクの送信、ポーリング、ページネーションという同じ処理順序を維持しています。
検索タスクを送信する
この関数は、各候補者をAPIのinputへ変換します。inputId には変更されない候補者IDを、data.profileUrl には公開LinkedIn個人プロフィールURLを指定します。標準的な linkedin.com/in/... 形式のURLが必要です。Sales NavigatorのURL、企業ページ、空の値、プロフィールURLを伴わない氏名は、このenrichmentの有効な入力ではありません。
リクエストでは、Waterfall Personal Email Finder APIドキュメントに記載されているとおり、enrichmentId に waterfall-personal-email-finder、settings に空のオブジェクトを使用します。スクリプトは、生成した uniqueId を送信前に表示します。APIがリクエストを受理した後に接続が切れても既存タスクを特定できるため、この値を保存しておいてください。
1件のプロフィールを検索する場合の完全なリクエストbodyは次のとおりです。
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
送信に成功するとHTTP 202 Accepted が返り、@id にタスクIDが入ります。レスポンスが返った後も、Datablistのサーバー上で処理が続行されます。
バックグラウンドタスクの完了を待つ
Requestsスクリプトは、サーバーがバックグラウンドタスクを実行している間、ローカルで待機します。3秒ごとにタスクを確認し、statusがqueuedまたはrunningの間はポーリングを続けます。タスクが completed になると結果の取得へ進みます。failed または stopped の場合は、タスクIDと取得可能なエラーメッセージを含むエラーが発生します。
すべての結果ページを取得する
結果endpointは、各行の元ID、status、outputs、credits、errorを返します。最初のリクエストでは最大100件の結果を取得します。nextCursor が null になるまで次のページを取得します。
タスク結果では入力順が維持されます。結果が複数ページに分かれていても、inputId によって各結果と候補者レコードを明確に紐づけられます。
より多くのレコードにこのサンプルを適用する場合も、元システムの各 candidate_id を変更せずに使用してください。この値があれば、タスク結果が複数ページに分かれても確実に結合できます。
個人メールWaterfallの検索ロジック
Datablistは、送信された公開LinkedInプロフィールURLをcleaningし、まだ結果が得られていないプロフィールを、現在利用可能な個人メールプロバイダーへ順番に渡します。あるプロバイダーから利用可能なアドレスが返されなければ、次の対象プロバイダーへ進みます。利用可能なメールアドレスが見つかると、そのプロフィールに対する検索を停止し、outputs.emailFound として返します。
利用可能なプロバイダーはDatablistが管理するため、連携側でプロバイダー別のリクエストやfallbackコードを実装する必要はありません。公開される結果にはメールアドレスの検索結果が含まれますが、固定されたプロバイダー順や試行履歴は含まれません。
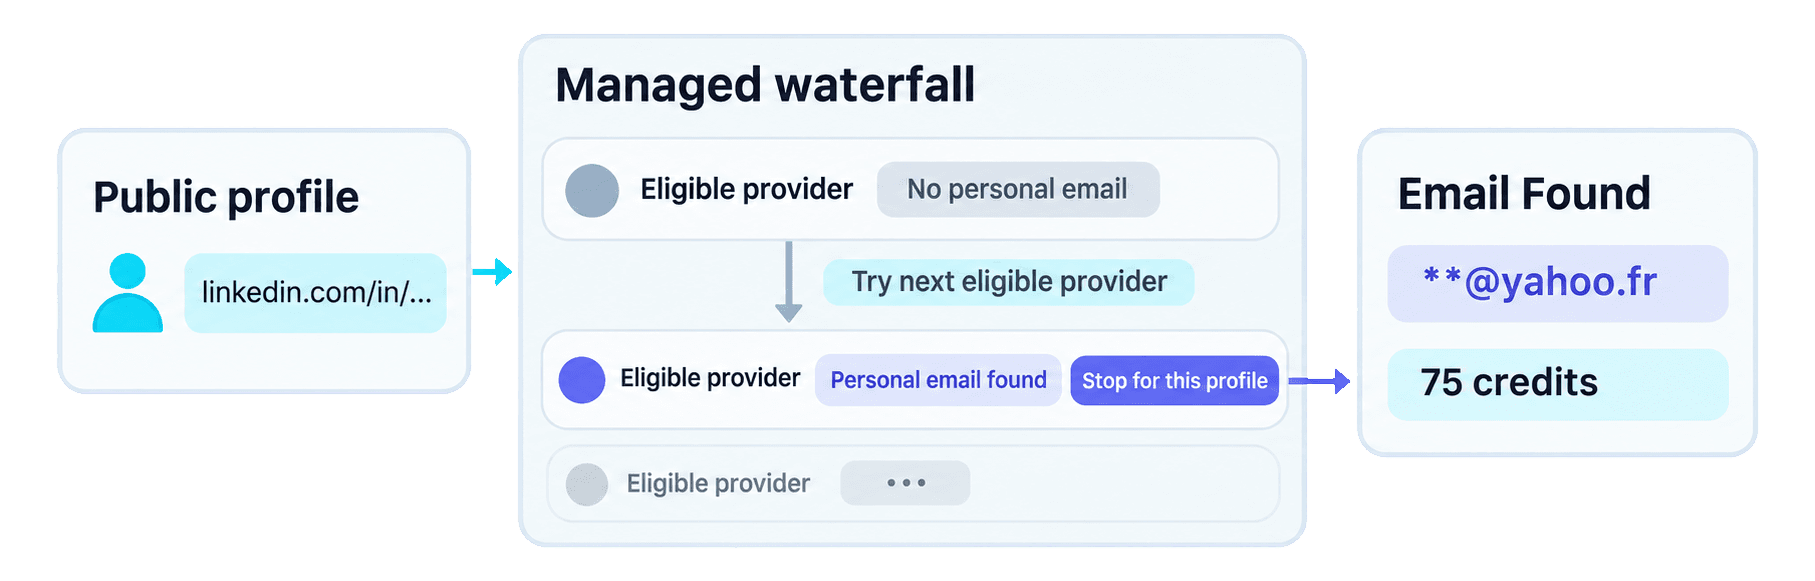
Waterfallは検索方式です。一方、ポーリングには別の役割があり、Pythonクライアントがバックグラウンド処理の完了を待つために使用します。
Waterfallが海外採用チームに適している理由
個人メールプロバイダーが使用するデータセットはそれぞれ異なるため、得意とする国や市場も異なります。最初のプロバイダーが候補者のメールアドレスを保有していなくても、Waterfall内の別のプロバイダーで見つかる可能性があります。
複数の国で活動する採用チームは、1つのAPI連携だけで、より幅広いプロバイダーを利用できます。Datablistが検索順序を管理するため、複数のプロバイダーAPIを個別に連携・保守することなく、単一プロバイダーでは見つからない連絡先を取得できます。
APIの完全な結果を確認する
📘 マスク済みメールアドレス: 以下では、アドレスのlocal-partを
**に置き換えています。実際のAPI結果には完全な値が含まれます。
候補者を入力した際に返される完全な結果ページは次のとおりです。
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
inputId は、元の候補者レコードと結合するためのkeyです。outputs.emailFound には個人メールアドレスが入ります。creditsUsed はこの行に対する正式な課金credits数です。error: null は、APIから行単位のエラーが返されなかったことを示します。cursorがnullであるため、このレスポンスに次の結果ページはありません。
このアドレスは、送信したプロフィールに関連する連絡手段の1つとして扱い、採用活動で使用する前に確認してください。
採用担当者向けの候補者連絡先を作成
検索結果が返されたら、APIへ追加のリクエストを送らずに、採用担当者が確認するためのローカルリストを作成できます。次のコードでは、既存の candidates 変数と personal_email_results 変数を再利用します。
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))candidate-florian-poullin の場合、辞書検索によって同じ inputId を持つ結果が見つかります。コピーされたレコードには、Florian Poullinの氏名、LinkedIn URL、サンプルの募集ポジション Backend Engineer が保持されます。その後、完全なAPIオブジェクトが result の下に追加され、採用担当者は result.outputs.emailFound からメールアドレスを確認できます。
このloopは、元の候補者リストを起点に処理します。今後、結果なし、行単位のエラー、結果の欠落、空の emailFound が発生しても、元のリストは変更されず、その候補者が prepared_contacts に追加されることもありません。
より幅広い確認プロセスやほかの連絡チャネルについては、採用担当者が候補者のメールアドレスを検索する方法をご覧ください。
Waterfall Personal Email Finder APIの料金計算
個人メールアドレスが1件見つかるごとに75 creditsを使用します。結果が得られなかった検索では、creditsを消費しません。実際の利用額を確認する際は、送信したプロフィール総数にcredits数を掛けるのではなく、各結果の creditsUsed を参照してください。
予算計画の計算式は次のとおりです。
見つかった個人メール数 × 75 credits
たとえば、100件のプロフィールを送信し、そのうち20件で個人メールアドレスが見つかった場合、タスクは 20 × 75 = 1,500 credits を使用します。これは予算計画用の計算であり、想定される検索成功率ではありません。件数が多い場合、100件の検索成功で7,500 credits、1,000件で75,000 creditsを使用します。
現在のUSD建て基本top-upレートでは、$20 ÷ 20,000 credits = 1 creditあたり$0.001 です。そのため、見つかったメールアドレス1件につき $0.075 相当、100件なら $7.50 相当のcreditsを消費します。この見積もりは、使用するcreditsの価値を示したものです。REST APIの利用に必要なGrowthサブスクリプションは別料金です。最新のプランとcredit packageは、Datablistの料金ページでご確認ください。
よくあるエラーの解決と既存タスクの復旧
多くの問題は、送信前、HTTPリクエスト時、または個別の結果で発生します。エラーの発生箇所に応じて、次の対応を選んでください。
DATABLIST_API_KEYがない: リクエストを送る前に、スクリプトがローカルで停止します。環境変数を設定してから、ファイルを再度実行してください。- HTTP認証エラー:
DATABLIST_API_KEYに設定したPersonal API Keyを確認してください。この関数は、X-API-Keyheaderでkeyを送信します。認証情報を修正してから再送信してください。 - 未対応のプロフィールURL: Sales Navigator URL、企業ページ、空の値、不正なURLを、
linkedin.com/in/...形式の公開個人プロフィールに置き換えてください。 - credits不足: 追加タスクを送信する前に、アカウント残高と利用可能なcreditsを確認してください。
- タスクが
failedまたはstopped: 再実行が必要な処理を判断する前に、タスクのerror、取得可能なresults、credits使用量を確認してください。 - 行に結果がない、またはエラーがある: 元の候補者を確認用、または別の連絡チャネル用に保持してください。検索が成功しなかった理由は、結果だけでは判断できません。
POSTレスポンスを受信できなかった場合は、新しいタスクを作成する前にタスク一覧を取得します。レスポンスからスクリプトが出力した uniqueId を検索し、一致するタスクの @id をコピーしてください。
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"最初のタスク履歴レスポンスに該当するタスクがなければ、返されたpagination cursorを使って次のページを確認してください。新しい有料タスクを自動的に作成するのではなく、復旧したタスクの確認を続けるか、取得可能な結果を取得します。タスクのドキュメントでは、lifecycle、pagination、結果の保持期間について確認できます。
次のステップ
これで、公開LinkedInプロフィールURLに使える再利用可能なPython Requests関数と、各候補者の元情報に個人メール検索結果を紐づける、変更されないIDを使ったmerge処理が用意できました。
サンプルの候補者リストを少数の実データに置き換え、各候補者のIDと募集ポジションを変更せずに保持してください。そのうえで、作成されたすべての連絡先を採用プロセスで使用する前に確認します。アプリケーションでnon-blockingな並行処理が必要になったら、次の実装ステップとして、メンテナンスされているasync HTTPXサンプルをご利用ください。