
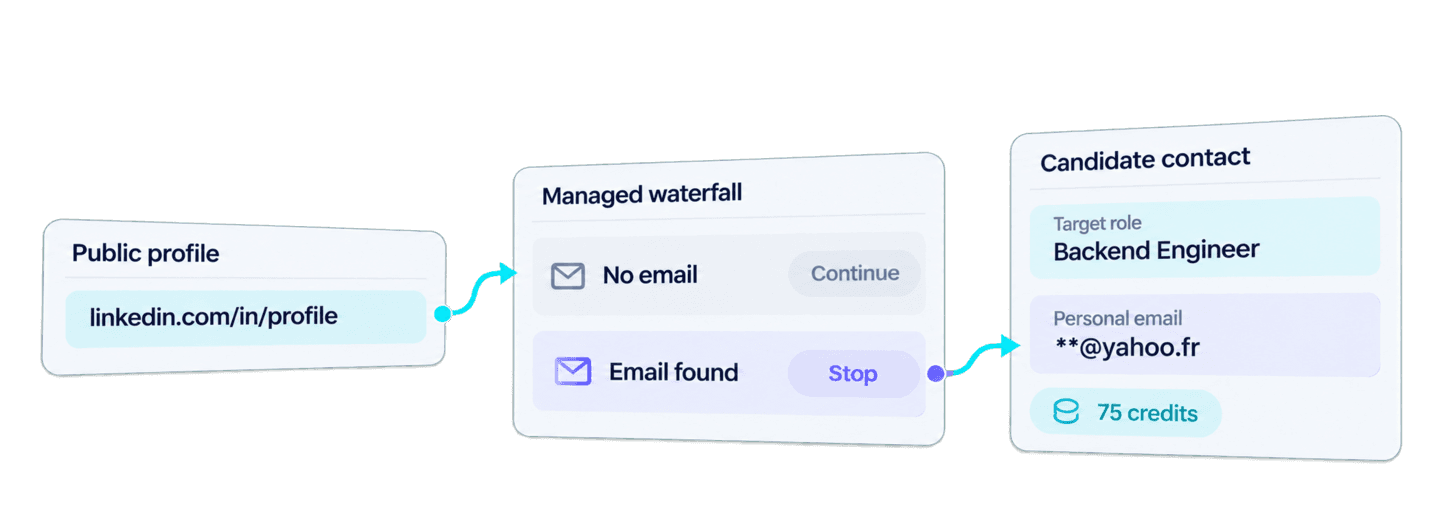
Python에서 공개 linkedin.com/in/... 프로필 URL을 Datablist의 Waterfall Personal Email Finder API로 전송하면 LinkedIn에서 개인 이메일을 찾을 수 있습니다. 이 API는 사용 가능한 이메일 제공업체를 관리형 순서로 조회하고, 그중 한 곳에서 결과를 찾으면 개인 이메일 주소를 반환합니다.
아래의 전체 Requests 예제는 백그라운드 작업 하나를 제출하고 완료될 때까지 기다린 다음, 모든 결과 페이지를 가져옵니다. 조회가 정상적으로 끝나면 반환된 객체를 재사용해 후보자의 이름, LinkedIn URL, 채용 대상 직무와 찾은 이메일을 함께 보관하는 채용 연락처 레코드를 만들 수 있습니다.
이 워크플로는 후보자의 현재 직장과 무관한 개인 이메일 주소를 찾습니다. 회사에 연결된 업무용 주소가 필요하다면 별도 가이드인 LinkedIn 프로필에서 업무용 이메일 찾기를 참고하세요.
🔑 바쁜 분을 위한 요약
후보자 이름, 공개 LinkedIn 프로필 URL, 채용 대상 직무를 입력하세요. Python 워크플로가 사용 가능한 개인 이메일을 찾고, 처음 입력한 채용 정보와 각 이메일 주소를 함께 보관합니다.
- 입력: 후보자 이름, 공개
linkedin.com/in/...프로필 URL, 채용 대상 직무- 출력: 해당 후보자 정보와 함께 저장된 개인 이메일
💡 노코드 솔루션을 선호하시나요? 코드를 작성하지 않고 개인 이메일을 찾으려면 Datablist의 Waterfall Personal Email Finder를 사용하세요.
소스 데이터에 이름만 있고 프로필 URL이 없다면 먼저 Python에서 공개 LinkedIn 프로필을 찾은 후, 해당 URL을 이 API로 전달하세요.
Python, Requests, Datablist API 키 설정
이 예제에서는 requests 패키지와 Python을 사용합니다. find_personal_emails.py 파일을 만든 다음 Requests를 설치하세요.
python -m pip install requestsDatablist 계정에서 Personal API Key를 생성하고 환경 변수로 등록합니다.
export DATABLIST_API_KEY='your-api-key'REST API는 Growth 플랜에서 사용할 수 있습니다. 개인 이메일을 성공적으로 찾은 경우에도 크레딧이 사용되며, 비용은 아래 비용 섹션에서 계산합니다.
하나의 Python 함수로 개인 이메일 찾기
이 스크립트에서 수정할 수 있는 candidates 목록에는 채용 레코드 하나가 들어 있습니다. target_role은 채용 워크플로 내부에만 유지되는 소스 값의 예시입니다. API payload에는 candidate_id와 linkedin_url만 포함됩니다.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))같은 터미널에서 파일을 실행하세요.
python find_personal_emails.py관리 중인 동기식 Requests 예제를 다운로드할 수도 있습니다. 위 스크립트는 소스 레코드의 후보자 ID를 사용하면서 제출, polling, pagination 순서를 동일하게 유지합니다.
조회 요청 제출
함수는 각 후보자를 API input으로 변환합니다. inputId에는 변경되지 않는 후보자 ID가, data.profileUrl에는 공개 LinkedIn 개인 프로필 URL이 들어갑니다. 표준 linkedin.com/in/... URL이 필요합니다. Sales Navigator URL, 회사 페이지, 빈 값, 프로필 URL이 없는 이름은 이 enrichment의 유효한 입력이 아닙니다.
요청에서는 Waterfall Personal Email Finder API 문서에 나온 것처럼 waterfall-personal-email-finder를 enrichmentId로 사용하고 빈 settings 객체를 전달합니다. 스크립트는 제출 전에 생성한 uniqueId를 출력합니다. API가 요청을 수락한 뒤 연결이 끊기더라도 기존 작업을 식별할 수 있으므로 이 값을 보관하세요.
프로필 하나를 조회하는 예제의 전체 request body는 다음과 같습니다.
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
제출에 성공하면 @id에 작업 ID가 담긴 HTTP 202 Accepted 응답이 반환됩니다. 이후 처리는 Datablist 서버에서 계속 진행됩니다.
백그라운드 작업 완료 대기
Requests 스크립트는 서버에서 백그라운드 작업이 실행되는 동안 로컬에서 대기합니다. 3초마다 작업을 확인하며 상태가 queued 또는 running인 동안 polling을 계속합니다. 작업이 completed 상태가 되면 결과를 가져옵니다. failed 또는 stopped 상태가 되면 작업 ID와 확인 가능한 오류 메시지를 포함한 오류가 발생합니다.
모든 결과 페이지 가져오기
결과 endpoint는 각 행의 소스 ID, 상태, output, 크레딧, 오류를 반환합니다. 첫 번째 요청에서는 최대 100개의 결과를 가져옵니다. nextCursor가 null이 될 때까지 다음 페이지를 계속 가져옵니다.
작업 결과에는 입력 순서가 유지됩니다. 여러 결과 페이지에 걸쳐 있더라도 inputId를 통해 각 결과를 해당 후보자 레코드와 명확하게 연결할 수 있습니다.
더 많은 레코드에 맞게 예제를 수정할 때는 소스 시스템의 각 candidate_id가 변경되지 않도록 유지하세요. 작업 결과가 여러 페이지로 나뉘어도 이 값을 사용하면 예측 가능한 방식으로 join할 수 있습니다.
개인 이메일 Waterfall의 검색 원리
Datablist는 제출된 공개 LinkedIn 프로필 URL을 정리한 뒤, 아직 결과를 찾지 못한 프로필을 현재 사용 가능한 개인 이메일 제공업체에 순서대로 전달합니다. 한 제공업체가 유효한 주소를 반환하지 못하면 다음 제공업체로 넘어갑니다. 유효한 이메일을 찾으면 해당 프로필의 조회가 중단되고 주소가 outputs.emailFound로 반환됩니다.
사용 가능한 제공업체는 Datablist가 관리하므로 integration에 제공업체별 요청이나 fallback 코드를 구현할 필요가 없습니다. 공개 결과에는 고정된 제공업체 순서나 시도 이력이 아니라 이메일 검색 결과가 표시됩니다.
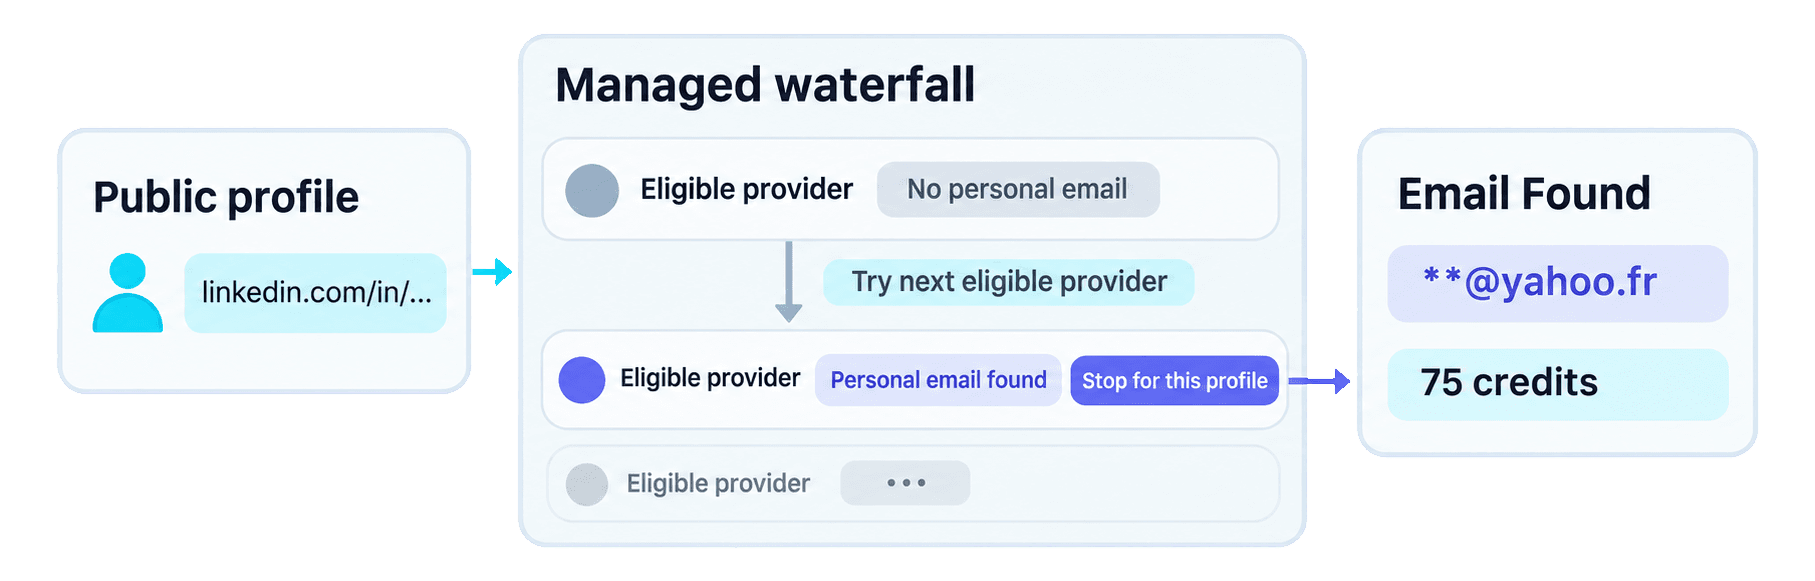
Waterfall은 이메일을 조회하는 방식입니다. Polling의 역할은 다릅니다. Python client가 백그라운드 작업이 끝날 때까지 기다릴 수 있게 해줍니다.
글로벌 채용팀에 Waterfall이 유용한 이유
개인 이메일 제공업체마다 사용하는 dataset이 달라 국가와 시장에 따라 강점도 다릅니다. 첫 번째 제공업체에서 후보자의 이메일을 찾지 못해도 Waterfall의 다른 제공업체가 찾아낼 수 있습니다.
여러 국가에서 활동하는 채용팀은 하나의 API integration으로 더 폭넓은 제공업체 커버리지를 확보할 수 있습니다. Datablist가 조회 순서를 관리하므로 여러 제공업체 API를 직접 연결하고 유지하지 않아도, 단일 제공업체 조회에서 놓칠 수 있는 연락처를 찾을 수 있습니다.
전체 결과 확인하기
📘 마스킹된 이메일: 아래에서는 이메일 주소의 local part를
**로 대체했습니다. 실제 API 결과에는 전체 값이 포함됩니다.
후보자 input에 대한 전체 결과 페이지는 다음과 같습니다.
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}inputId는 소스 후보자와 연결하는 join key입니다. outputs.emailFound에는 개인 이메일 주소가 들어 있습니다. creditsUsed는 이 행에 실제로 청구된 크레딧이며, error: null은 API가 행 단위 오류를 반환하지 않았다는 뜻입니다. cursor가 null이므로 이 응답에는 다음 결과 페이지가 없습니다.
이 주소는 제출한 프로필과 연결된 연락 수단으로 취급하고, 채용에 사용하기 전에 검토하세요.
채용 담당자 검토용 후보자 연락처 만들기
조회가 완료되면 API를 다시 요청하지 않고도 채용 담당자가 검토할 로컬 목록을 만들 수 있습니다. 다음 코드는 기존 candidates와 personal_email_results 변수를 재사용합니다.
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))candidate-florian-poullin의 경우 dictionary lookup으로 동일한 inputId를 가진 결과를 찾습니다. 복사된 레코드에는 Florian Poullin의 이름과 LinkedIn URL, 예시 채용 대상 직무인 Backend Engineer가 그대로 유지됩니다. 그런 다음 전체 API 객체를 result 아래에 추가하며, 채용 담당자는 result.outputs.emailFound에서 이메일을 확인할 수 있습니다.
loop는 소스 후보자 목록에서 시작합니다. 향후 결과가 없거나 행 오류가 발생하거나 결과 자체 또는 emailFound가 비어 있더라도 소스 목록은 그대로 유지되며, 해당 후보자는 prepared_contacts에 추가되지 않습니다.
더 폭넓은 검토 프로세스와 다른 연락 채널이 필요하다면 채용 담당자가 후보자의 이메일 주소를 찾는 방법 가이드를 참고하세요.
Waterfall Personal Email Finder API 비용 계산
개인 이메일 하나를 찾을 때마다 75크레딧이 사용됩니다. 결과가 없는 조회에는 크레딧이 사용되지 않습니다. 실제 비용을 확인할 때는 제출한 전체 프로필 수에 단가를 곱하지 말고 각 결과의 creditsUsed를 확인하세요.
예상 비용 계산식은 다음과 같습니다.
찾은 개인 이메일 수 × 75크레딧
예를 들어 프로필 100개를 제출해 개인 이메일 20개를 찾았다면 작업에 20 × 75 = 1,500크레딧이 사용됩니다. 이는 비용 계획을 위한 계산일 뿐 예상 검색 성공률은 아닙니다. 더 큰 예산을 계산하면 이메일 100개를 찾을 때 7,500크레딧, 1,000개를 찾을 때 75,000크레딧이 사용됩니다.
현재 기본 USD 충전 요율은 $20 / 20,000크레딧 = 크레딧당 $0.001입니다. 따라서 이메일 하나를 찾을 때 $0.075, 100개를 찾을 때 $7.50 상당의 크레딧이 사용됩니다. 이 추정치는 사용된 크레딧의 가치만 계산한 것입니다. REST API 사용에 필요한 Growth 구독료는 별도입니다. 최신 플랜과 크레딧 패키지는 Datablist 요금제에서 확인하세요.
자주 발생하는 오류 해결 및 기존 작업 복구
대부분의 문제는 제출 전, HTTP 요청 단계 또는 개별 결과에서 발생합니다. 오류가 발생한 위치에 따라 다음 조치를 선택하세요.
DATABLIST_API_KEY누락: 요청을 보내기 전에 로컬에서 스크립트가 중단됩니다. 환경 변수를 등록한 다음 파일을 다시 실행하세요.- HTTP 인증 실패:
DATABLIST_API_KEY의 Personal API Key를 확인하세요. 함수는 이 값을X-API-Keyheader로 전송합니다. 다시 제출하기 전에 credential을 수정하세요. - 지원되지 않는 프로필 URL: Sales Navigator URL, 회사 페이지, 빈 값 또는 잘못된 URL을 공개 개인 프로필의
linkedin.com/in/...형식으로 교체하세요. - 크레딧 부족: 추가 작업을 제출하기 전에 계정 잔액과 사용 가능한 크레딧을 확인하세요.
- 작업 상태가
failed또는stopped: 무엇을 다시 실행해야 하는지 결정하기 전에 작업 오류, 확인 가능한 결과, 크레딧 사용량을 살펴보세요. - 행에 결과가 없거나 오류가 있음: 검토하거나 다른 연락 채널에서 활용할 수 있도록 소스 후보자를 유지하세요. 조회 실패만으로는 주소를 찾지 못한 이유를 알 수 없습니다.
POST 응답을 받지 못했다면 새 작업을 만들기 전에 작업 목록을 조회하세요. 응답에서 스크립트가 출력한 uniqueId를 검색한 다음, 일치하는 작업의 @id를 복사합니다.
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"일치하는 작업이 첫 번째 작업 이력 응답에 없다면 반환된 pagination cursor를 따라 다음 페이지를 확인하세요. 유료 작업을 자동으로 새로 만들지 말고 복구한 작업을 계속 확인하거나, 이미 생성된 결과를 가져오세요. 작업 lifecycle, pagination, 결과 보관에 관한 자세한 내용은 작업 문서를 참고하세요.
다음 단계
이제 공개 LinkedIn 프로필 URL에 재사용할 수 있는 Python Requests 함수 하나와, 찾은 개인 이메일 결과를 각 후보자의 소스 정보와 결합하는 stable ID 기반 merge 로직을 갖추었습니다.
예시 후보자 목록을 실제 후보자 레코드의 소규모 목록으로 바꾸고, 각 레코드의 stable ID와 채용 대상 직무를 유지하세요. 그런 다음 채용 프로세스에 사용하기 전에 준비된 모든 연락처를 검토합니다. 애플리케이션에 non-blocking concurrency가 필요하다면 관리 중인 async HTTPX 예제를 다음 구현 단계로 활용하세요.