
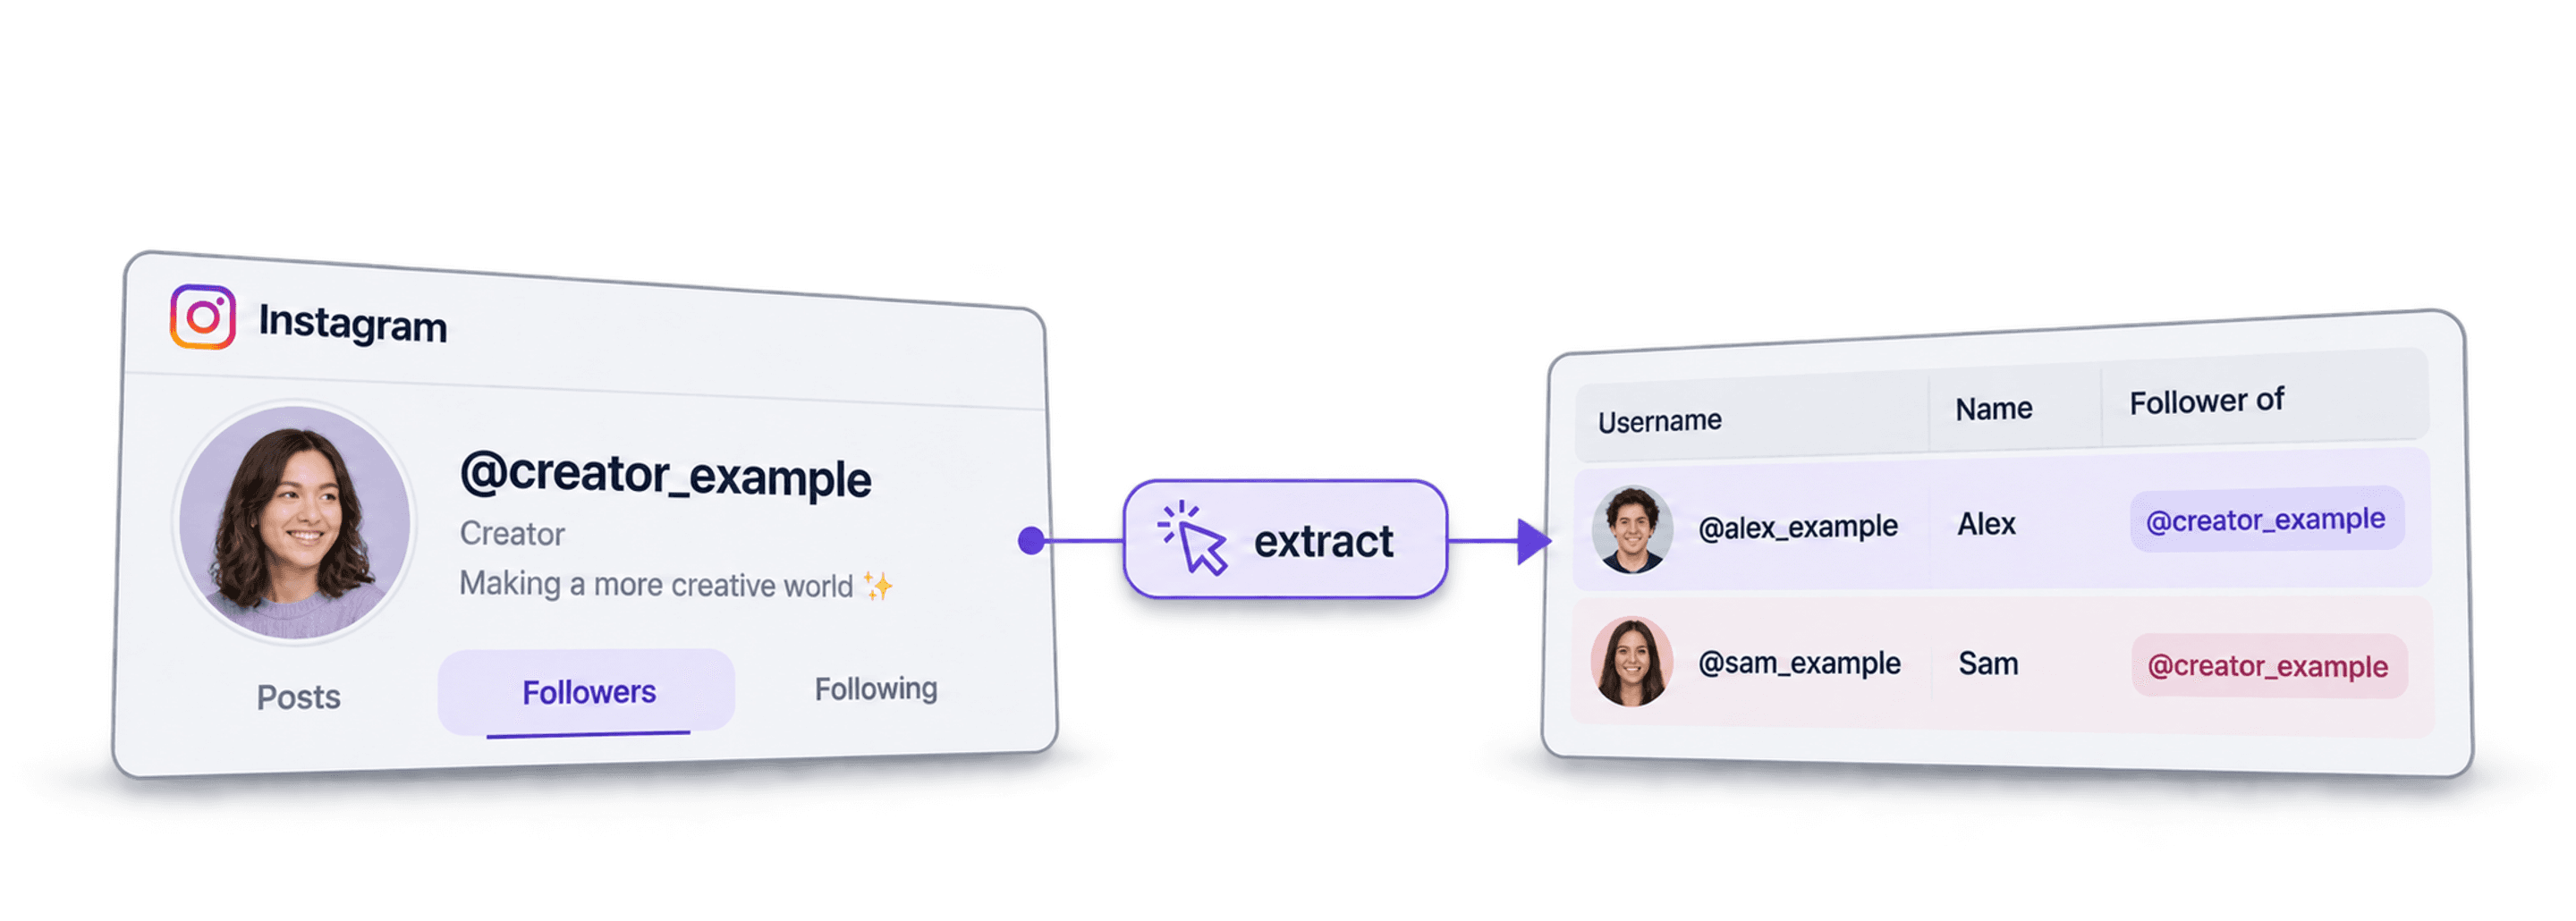
Om Instagram-volgers te scrapen in Datablist open je de source Instagram Followers/Following Scraper. Voer een openbare profiel-URL, gebruikersnaam of User ID in, kies een limiet per profiel en controleer de gevonden volgers voordat je ze exporteert.
Ik zou beginnen met één profiel en een lage limiet. De gevonden lijst is een momentopname van de accounts die de provider kon ophalen, geen garantie dat je de volledige, actuele volgerslijst van het profiel krijgt. Dat iemand een niche-influencer volgt, zegt bovendien niets met zekerheid over diens beroep, locatie of koopbereidheid.
In deze gids behandelen we de source-instellingen, relatievelden, controle en deduplicatie, het hervatten van een grotere scrape en de afzonderlijke enrichment voor profielgegevens. Je hebt hiervoor geen inloggegevens van Instagram nodig.
📌 Snelle workflow
Maak een collection, open See all sources en kies Instagram Followers/Following Scraper. Voer onder Instagram Profiles één profiel per regel in, laat Followers (default) geselecteerd bij Scrape followers or following en stel Scraping Limit Per Profile in. Voeg identifiers van volgers en outputvelden van het bronprofiel toe, voer een test uit en controleer en exporteer daarna het resultaat.
Wat kost het scrapen van Instagram-volgers?
Het ophalen van een volgerslijst kost 0,01 credit per gevonden volger. Het identificeren van het bronprofiel kan 1 extra credit kosten als de identifier nog niet in de cache staat. Enrichment met profielgegevens wordt apart berekend.
Stel bijvoorbeeld dat één bronprofiel precies 1.000 volgers oplevert:
- Volgerslijst: 1.000 × 0,01 = 10 credits, plus 1 voor het opzoeken van een bronprofiel dat nog niet in de cache staat: 11 credits.
- Gegevens van 100 geselecteerde volgers: met de gevonden User Id-waarden kost de standaard profile lookup 2 credits per profiel: 200 credits. Deze optie kan openbare e-mailadressen en telefoonnummers opleveren wanneer die beschikbaar zijn, maar geeft daarop geen garantie.
- Totaal: 211 credits voor de lijst en deze 100 profile lookups. Het toevoegen van About-data of kiezen van een ander scraping type verandert de kosten van de enrichment.
Bij maandelijkse facturering in Amerikaanse dollars kost Starter $25 en krijg je 5.000 credits. Als je met dit ongebruikte tegoed begint, hoef je voor dit voorbeeld geen credits bij te kopen en houd je 4.789 credits over. Het abonnement van $25 is het bedrag dat je betaalt; 211 credits is het verbruik van de workflow. Credits hebben niet bij elk abonnement en top-uppakket dezelfde vaste dollarwaarde.
Gebruik voor deze profile enrichment de gevonden User Id. Bij een gebruikersnaam of URL kan een extra identifier lookup nodig zijn. Controleer na de test hoeveel rijen er daadwerkelijk zijn gevonden en hoeveel credits er zijn verbruikt. Providerpagina’s kunnen een lage ingestelde limiet overschrijden en een profile lookup kan credits kosten, ook als er geen volgers worden gevonden. De ingestelde limiet is dus geen exacte bestedingsgrens.
Wat is Datablist? Een kort overzicht
Datablist is een spreadsheetachtige workspace voor lead generation-workflows. Je kunt rijen verzamelen, controleren, verrijken en exporteren met enrichments, van AI Agents en Email Finders tot AI processors, Technology enrichments en meer.
Daarnaast kun je in Datablist geautomatiseerde workflows instellen die volgens een planning of op aanvraag draaien. Dit zijn enkele praktische toepassingen die populair zijn onder Datablist-gebruikers:
- Leadlijsten samenstellen
- E-mails personaliseren met AI
- CRM’s opschonen en dedupliceren
- Vacatures scrapen
- Leads scrapen uit Sales Navigator
Goedkoop Instagram-volgers scrapen: stappenplan
Laten we beginnen. Open eerst Datablist en stel in wat je wilt scrapen. Plak hiervoor de profiel-URL’s of gebruikersnamen van de influencers van wie je de volgers wilt ophalen.
Begin met een test en schaal daarna op zodra je het bronprofiel en de gevonden velden hebt gecontroleerd. Voor deze workflow heb je geen browserextensie of eigen API key van een provider nodig.
📘 Belangrijk: privéprofielen
De volgerslijst van een privéprofiel is niet beschikbaar via deze workflow. Een run kan credits verbruiken om een profiel te identificeren, zelfs wanneer er geen volgers worden gevonden. Enrichment met profielgegevens is een afzonderlijke lookup en geeft geen toegang tot privéberichten of afgeschermde volgerslijsten.
Stap 1: registreer je bij Datablist.com
Ga naar Datablist.com en maak een account aan. Volg de configuratiestappen om je workspace te openen.
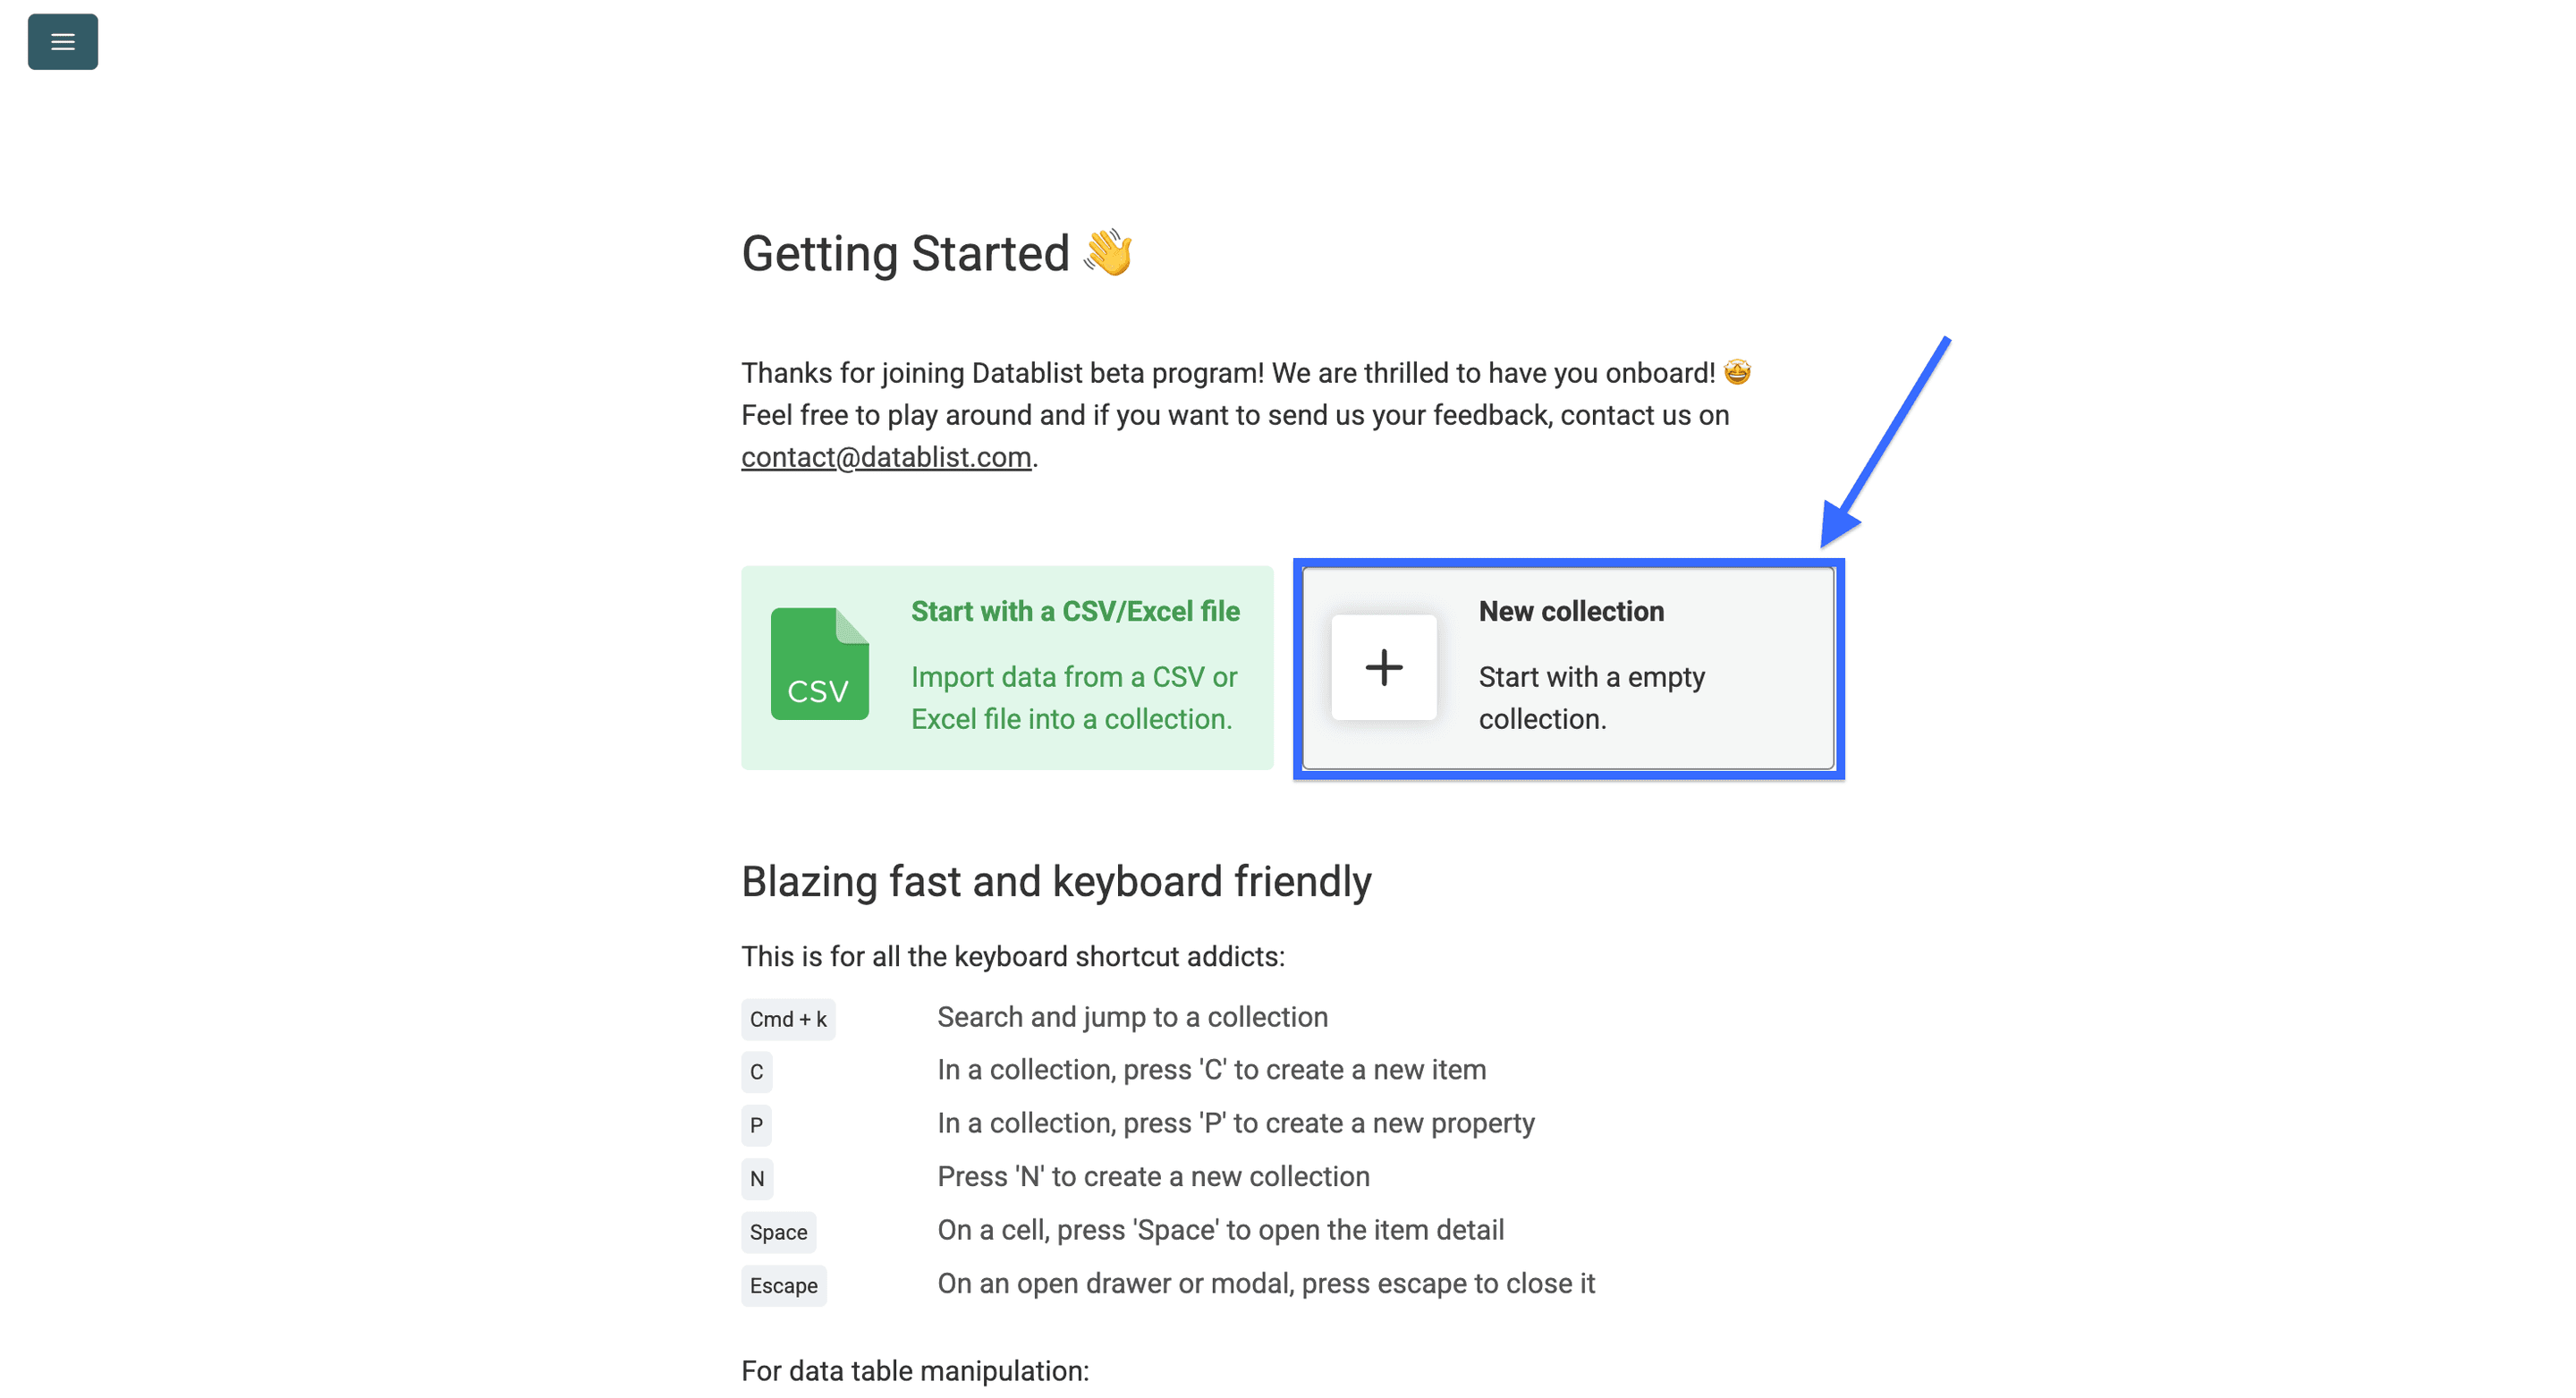
Stap 2: maak een nieuwe collection
Klik na het inloggen op New Collection.
Stap 3: open Instagram Followers/Following Scraper
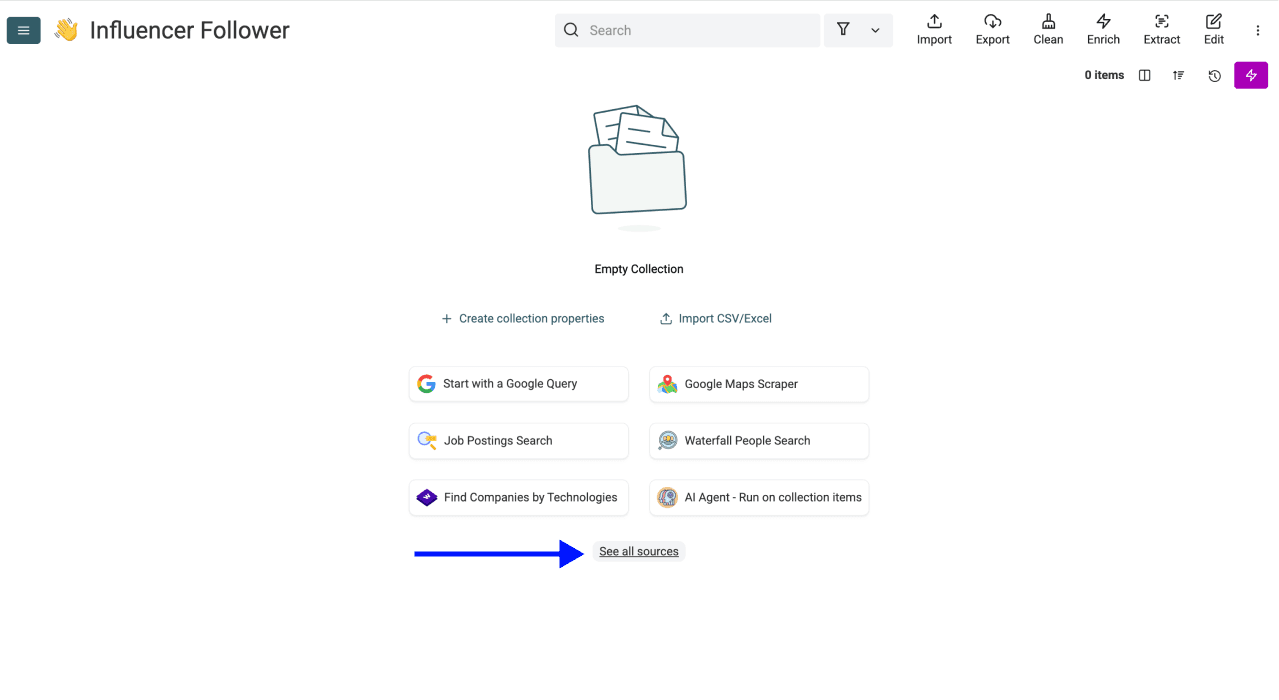
Klik op See all sources.
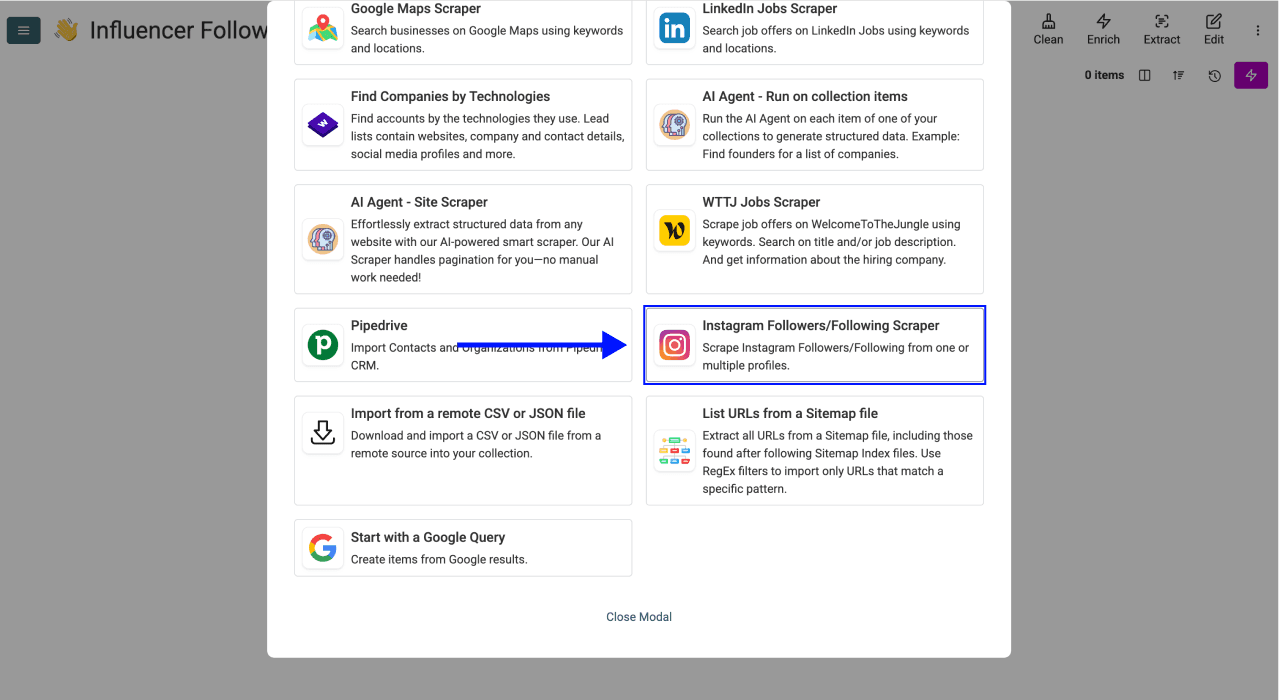
Scrol naar beneden en kies Instagram Followers/Following Scraper uit de lijst.
Stap 4: configureer je instellingen
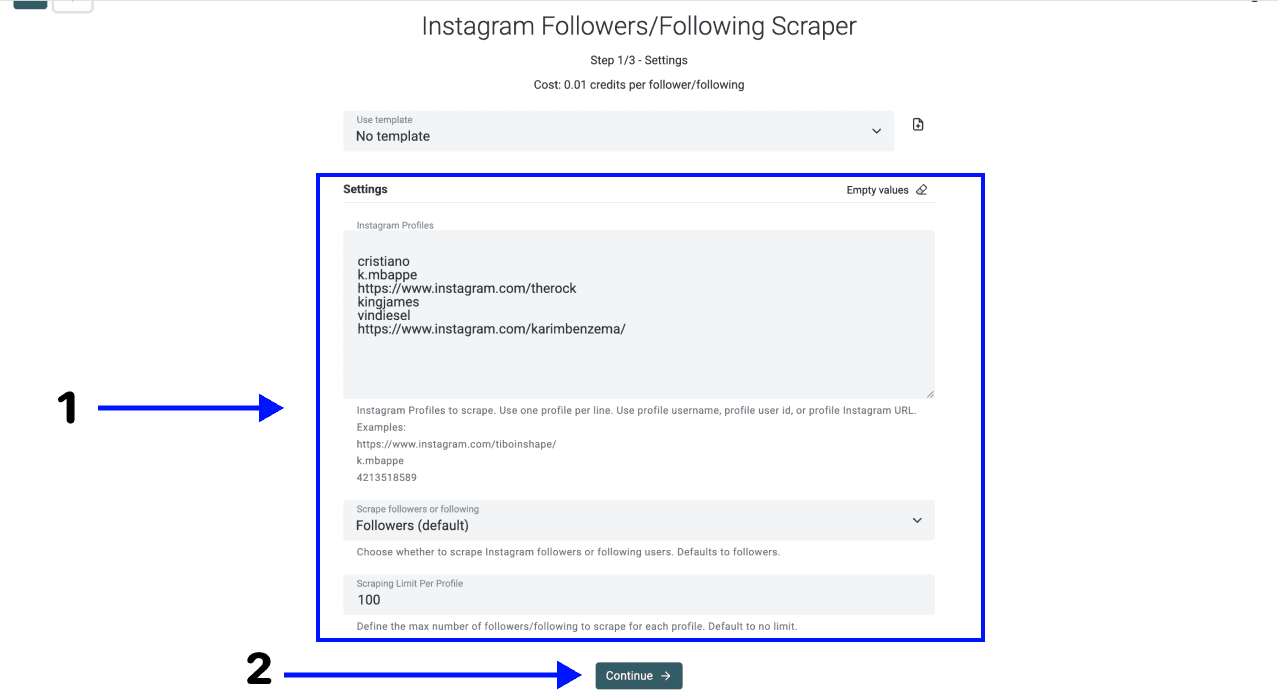
Je ziet nu een eenvoudig configuratiescherm. Volg deze stappen voor het beste resultaat:
- Voer onder Instagram Profiles per regel één openbare profiel-URL, gebruikersnaam of User ID in. Controleer of iedere identifier naar het juiste account verwijst.
- Kies onder Scrape followers or following voor Followers (default). Selecteer Following alleen als je de accounts wilt ophalen die door het ingevoerde profiel worden gevolgd.
- Stel Scraping Limit Per Profile eerst in op een klein aantal voor je test. Een limiet garandeert niet dat de lijst volledig is.
- Klik op Continue en configureer de outputkolommen.
Stap 5: selecteer je outputvelden
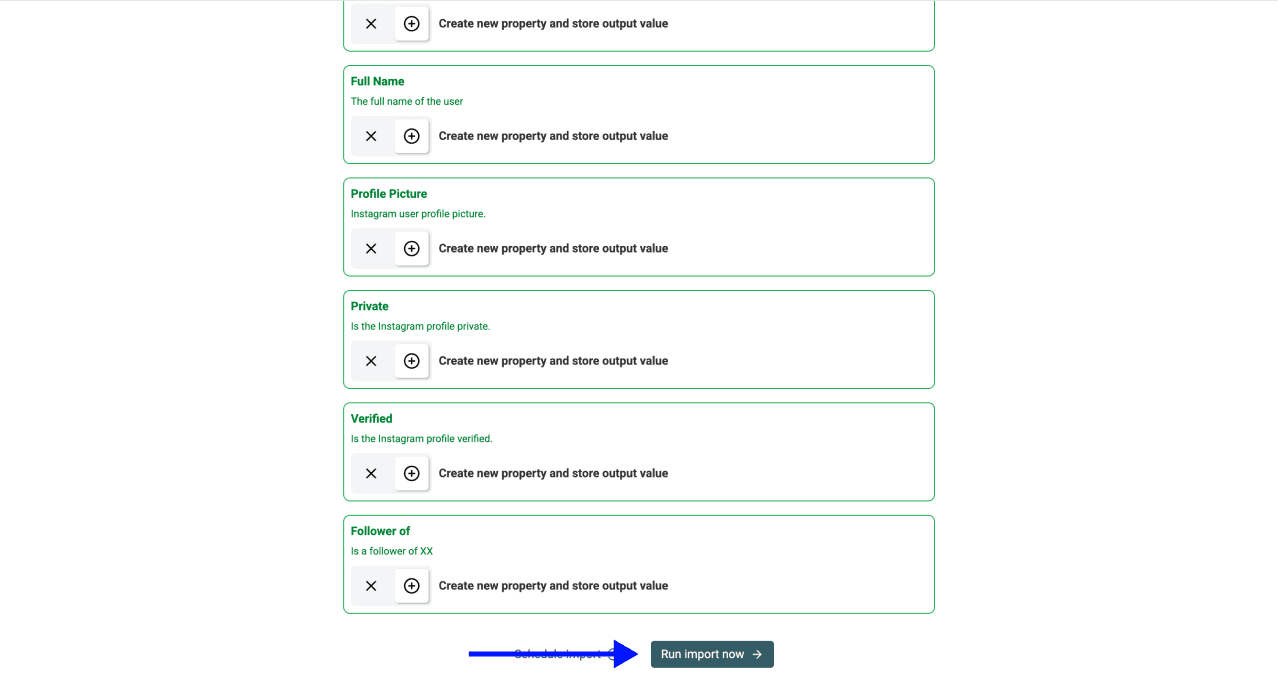
Datablist toont de beschikbare outputvelden. Bewaar User Id, User Username en User Profile URL van de volger, samen met de velden van het bronprofiel. Zo kun je controleren bij wie iedere rij hoort en welk ingevoerd profiel de rij heeft opgeleverd.
Klik op de ✕-iconen om ongewenste velden te verwijderen en klik daarna op Run import now.
Stap 6: bekijk je resultaten
Vergelijk na afloop van de source run het aantal gevonden rijen met de ingestelde limiet en controleer de status. De duur hangt af van de responses van de provider, paginering, het profiel en de omvang van de run. Ga er niet van uit dat een laag aantal rijen betekent dat het profiel geen andere volgers heeft.
Opmerking: de resultaten bevatten ook de volledige namen. In de onderstaande afbeelding hebben we die verborgen om de privacy van mensen te beschermen.
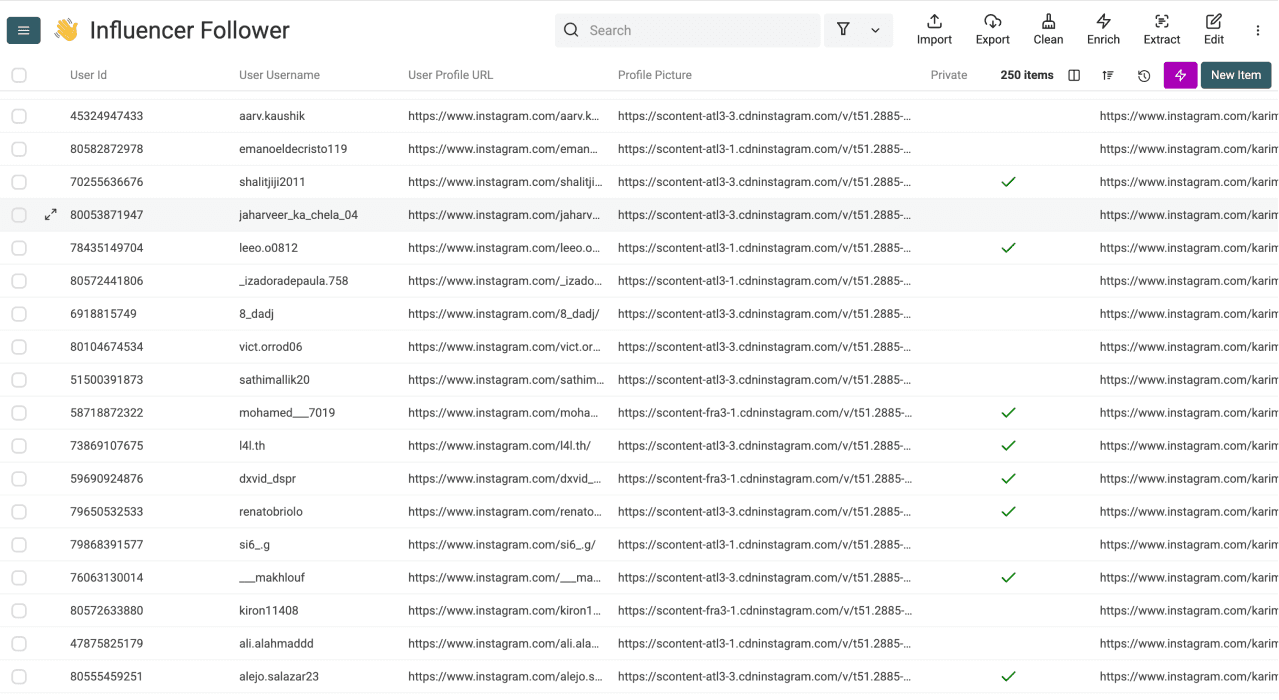
Behoud bij meerdere ingevoerde profielen Follower of (UserId), Follower of (Username) of Follower of (ProfileUrl). Gebruik deze velden om relaties op bronaccount te filteren, in plaats van te vertrouwen op de positie van kolommen.
💡 Goed om te weten: grote scrapes
De source run heeft eigen paginering en rijlimieten. Deze staan los van de opslagcapaciteit van een collection en cloudsynchronisatie. Als een run stopt terwijl er nog resultaten beschikbaar zijn, gebruik dan de onderstaande hervatoptie. Ga er niet van uit dat alle resterende volgers in dezelfde run passen.
Stap 7: verrijk volgers met profielgegevens
Een volgerslijst is pas het begin. Om van deze gebruikersnamen bruikbare leads te maken, moet je weten wie erachter zit. Met Instagram Profile Scraper kun je de lijst verrijken met openbare data, zoals e-mailadressen, bio’s en engagementstatistieken.
Gebruik profielgegevens bij het samenstellen van leadlijsten als onderbouwing voor een segment. Alleen het feit dat iemand een profiel volgt, is geen betrouwbare kwalificatieregel.
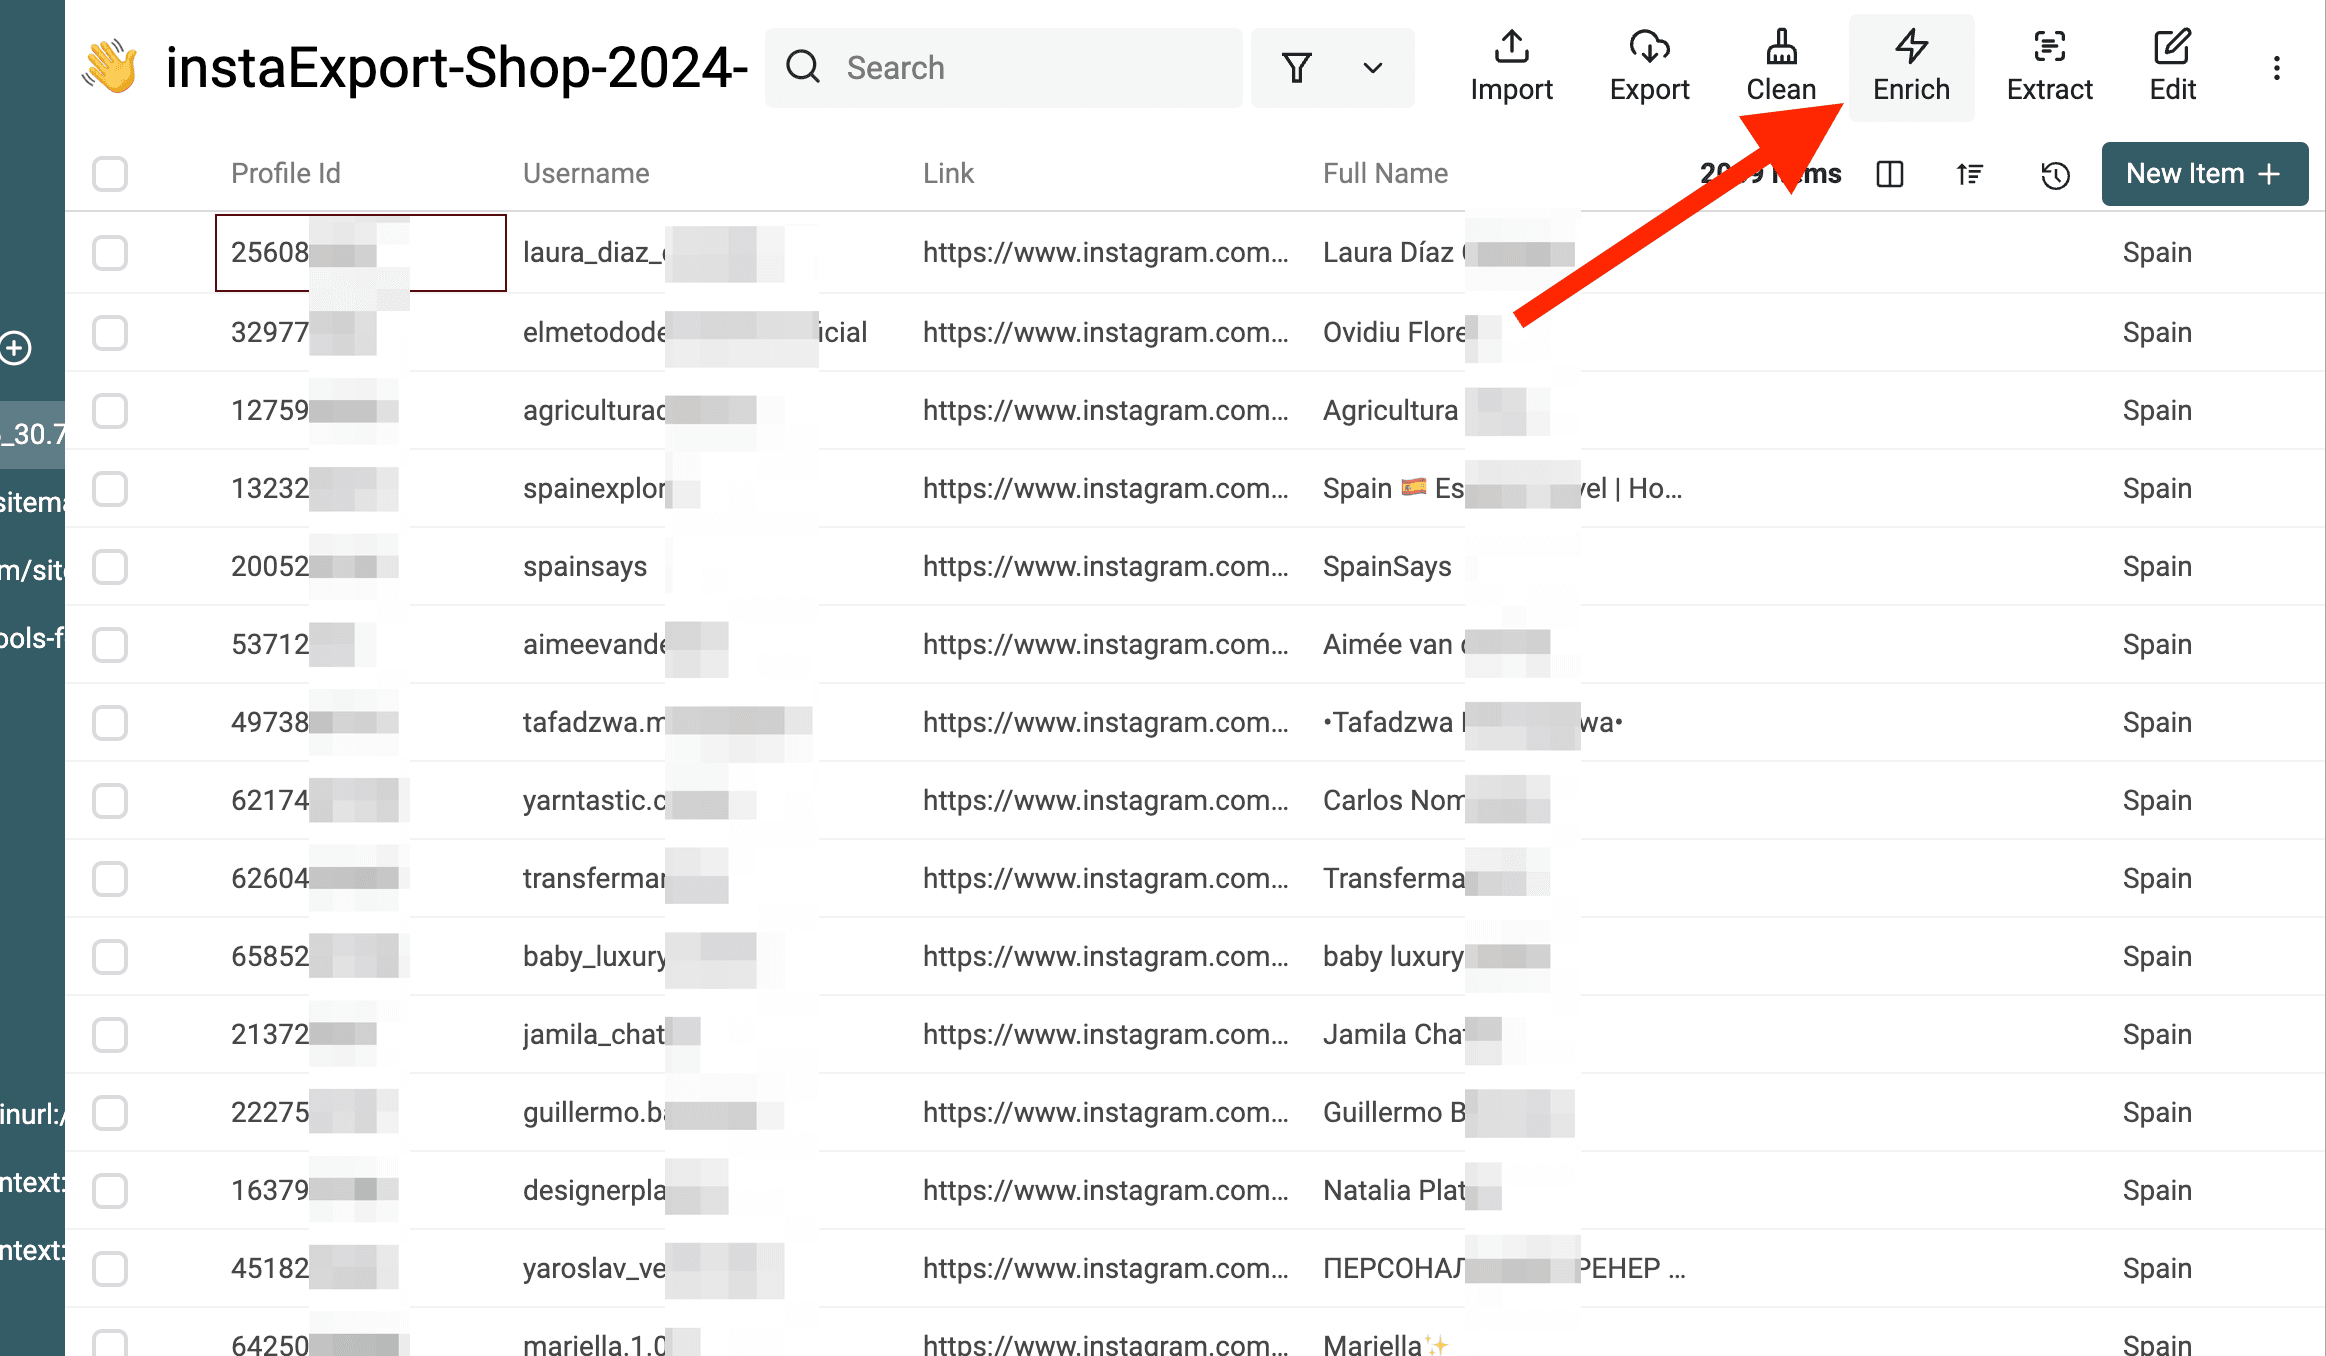
1. Open het enrichment-menu Klik bovenaan het dashboard van de collection met de gescrapete volgers op Enrich.
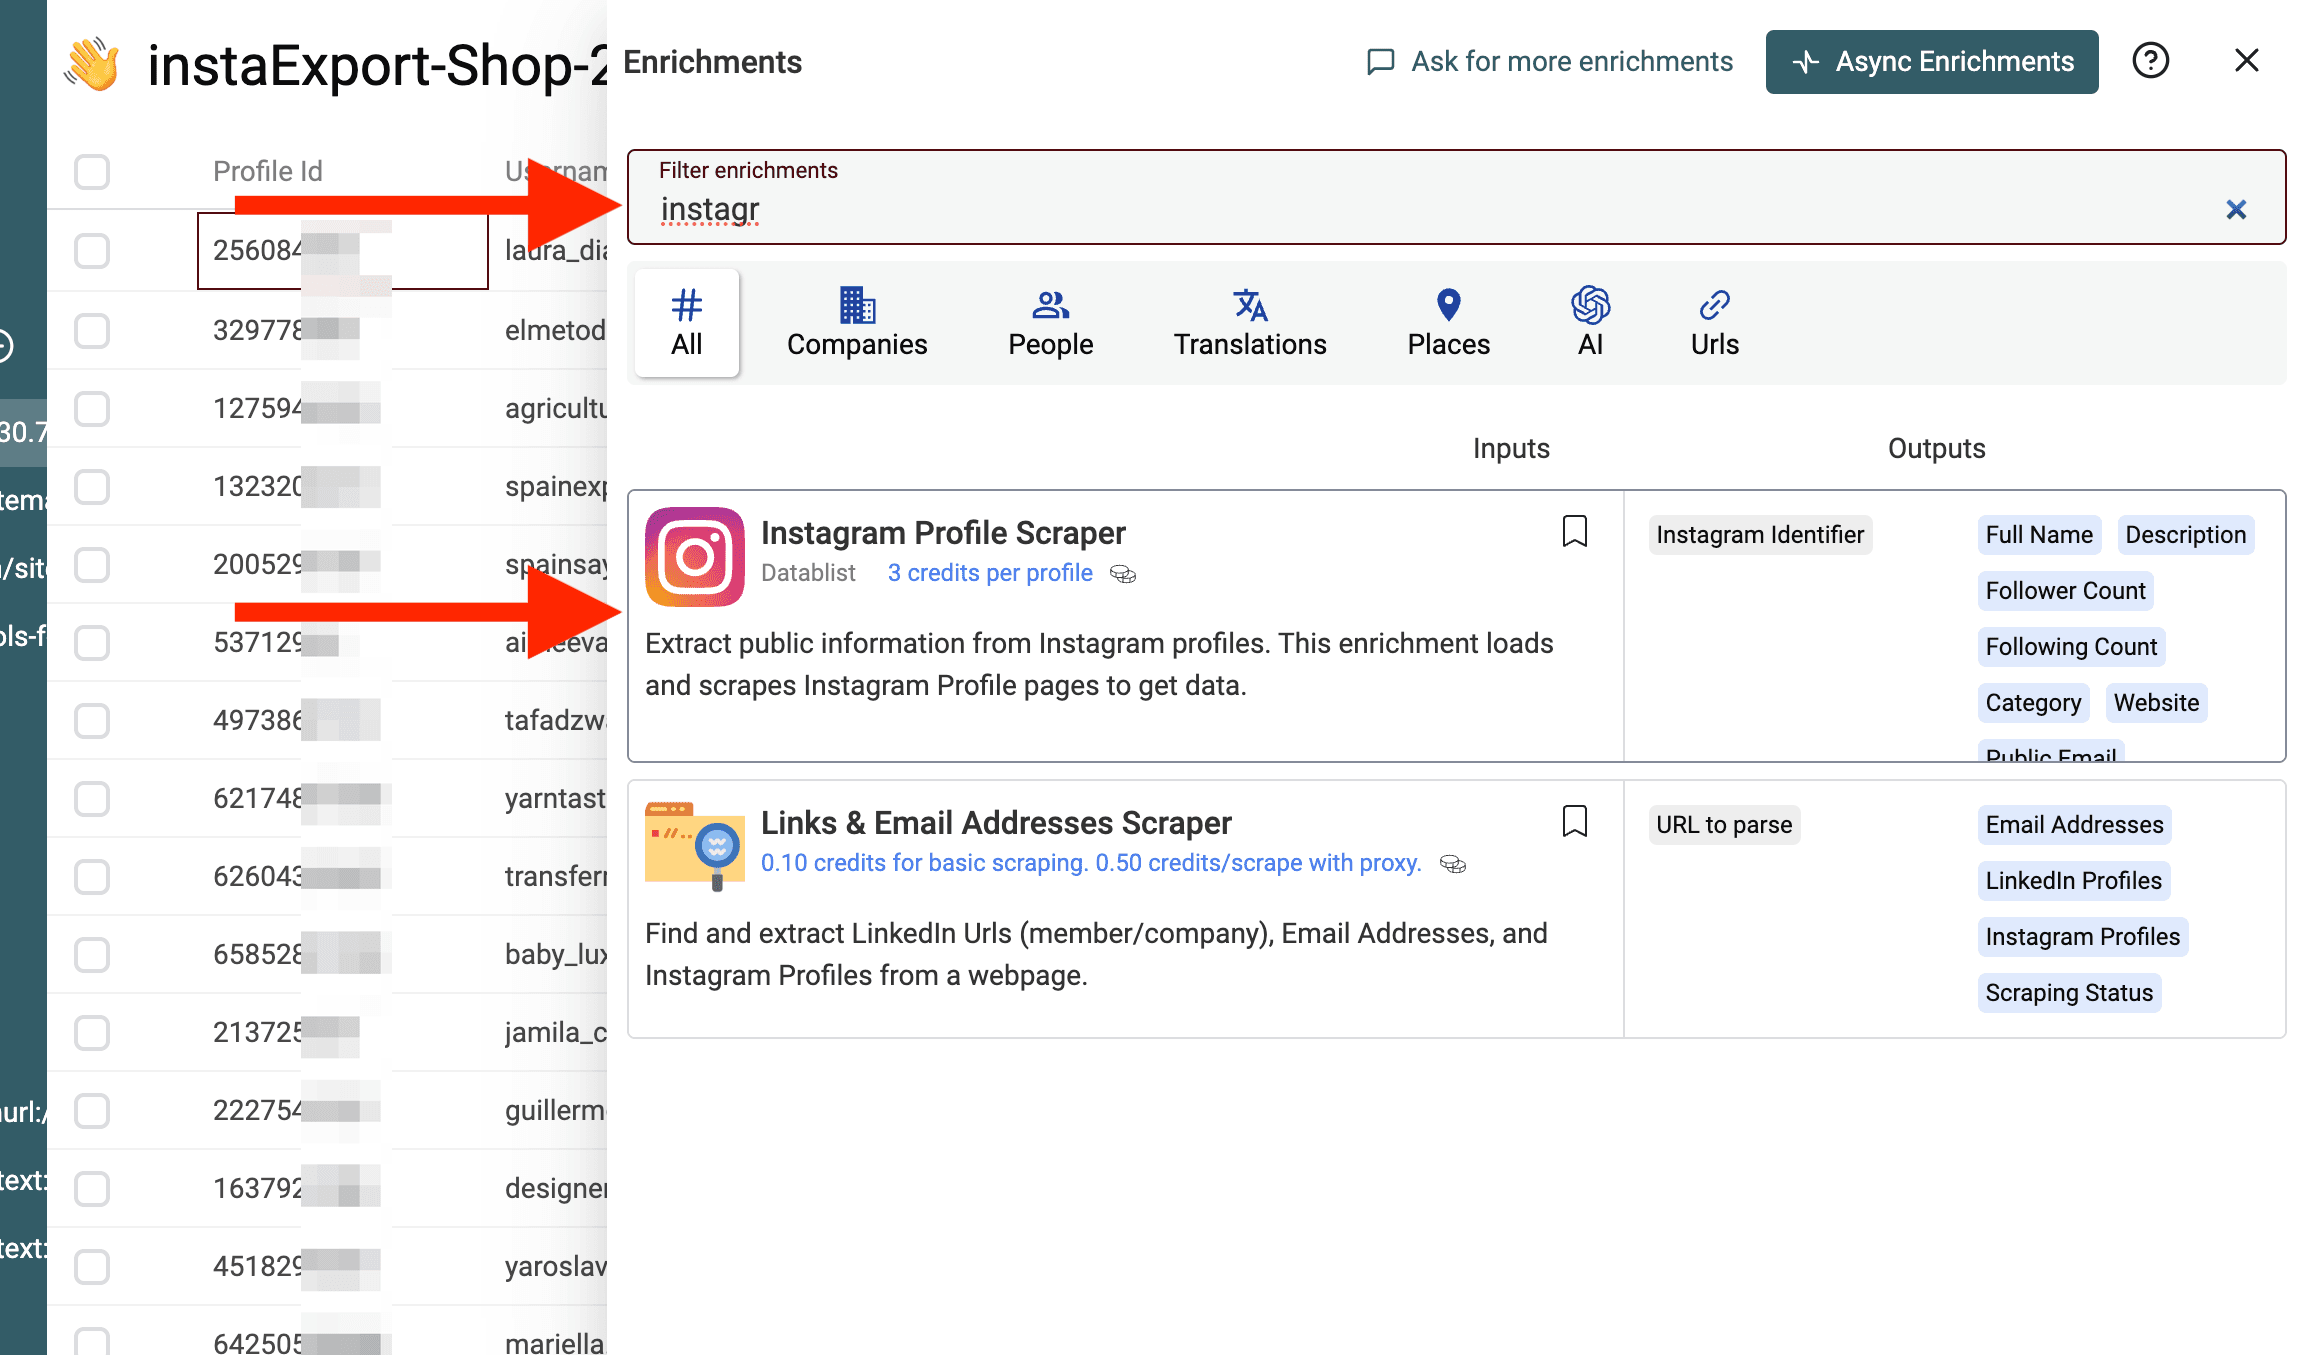
2. Selecteer Instagram Profile Scraper Zoek naar Instagram Profile Scraper en selecteer deze enrichment. De enrichment gebruikt de profielidentifiers uit je source-resultaten om aanvullende profielvelden op te vragen. De beschikbaarheid hangt af van het gekozen scraping type en de gegevens die de provider kan leveren.
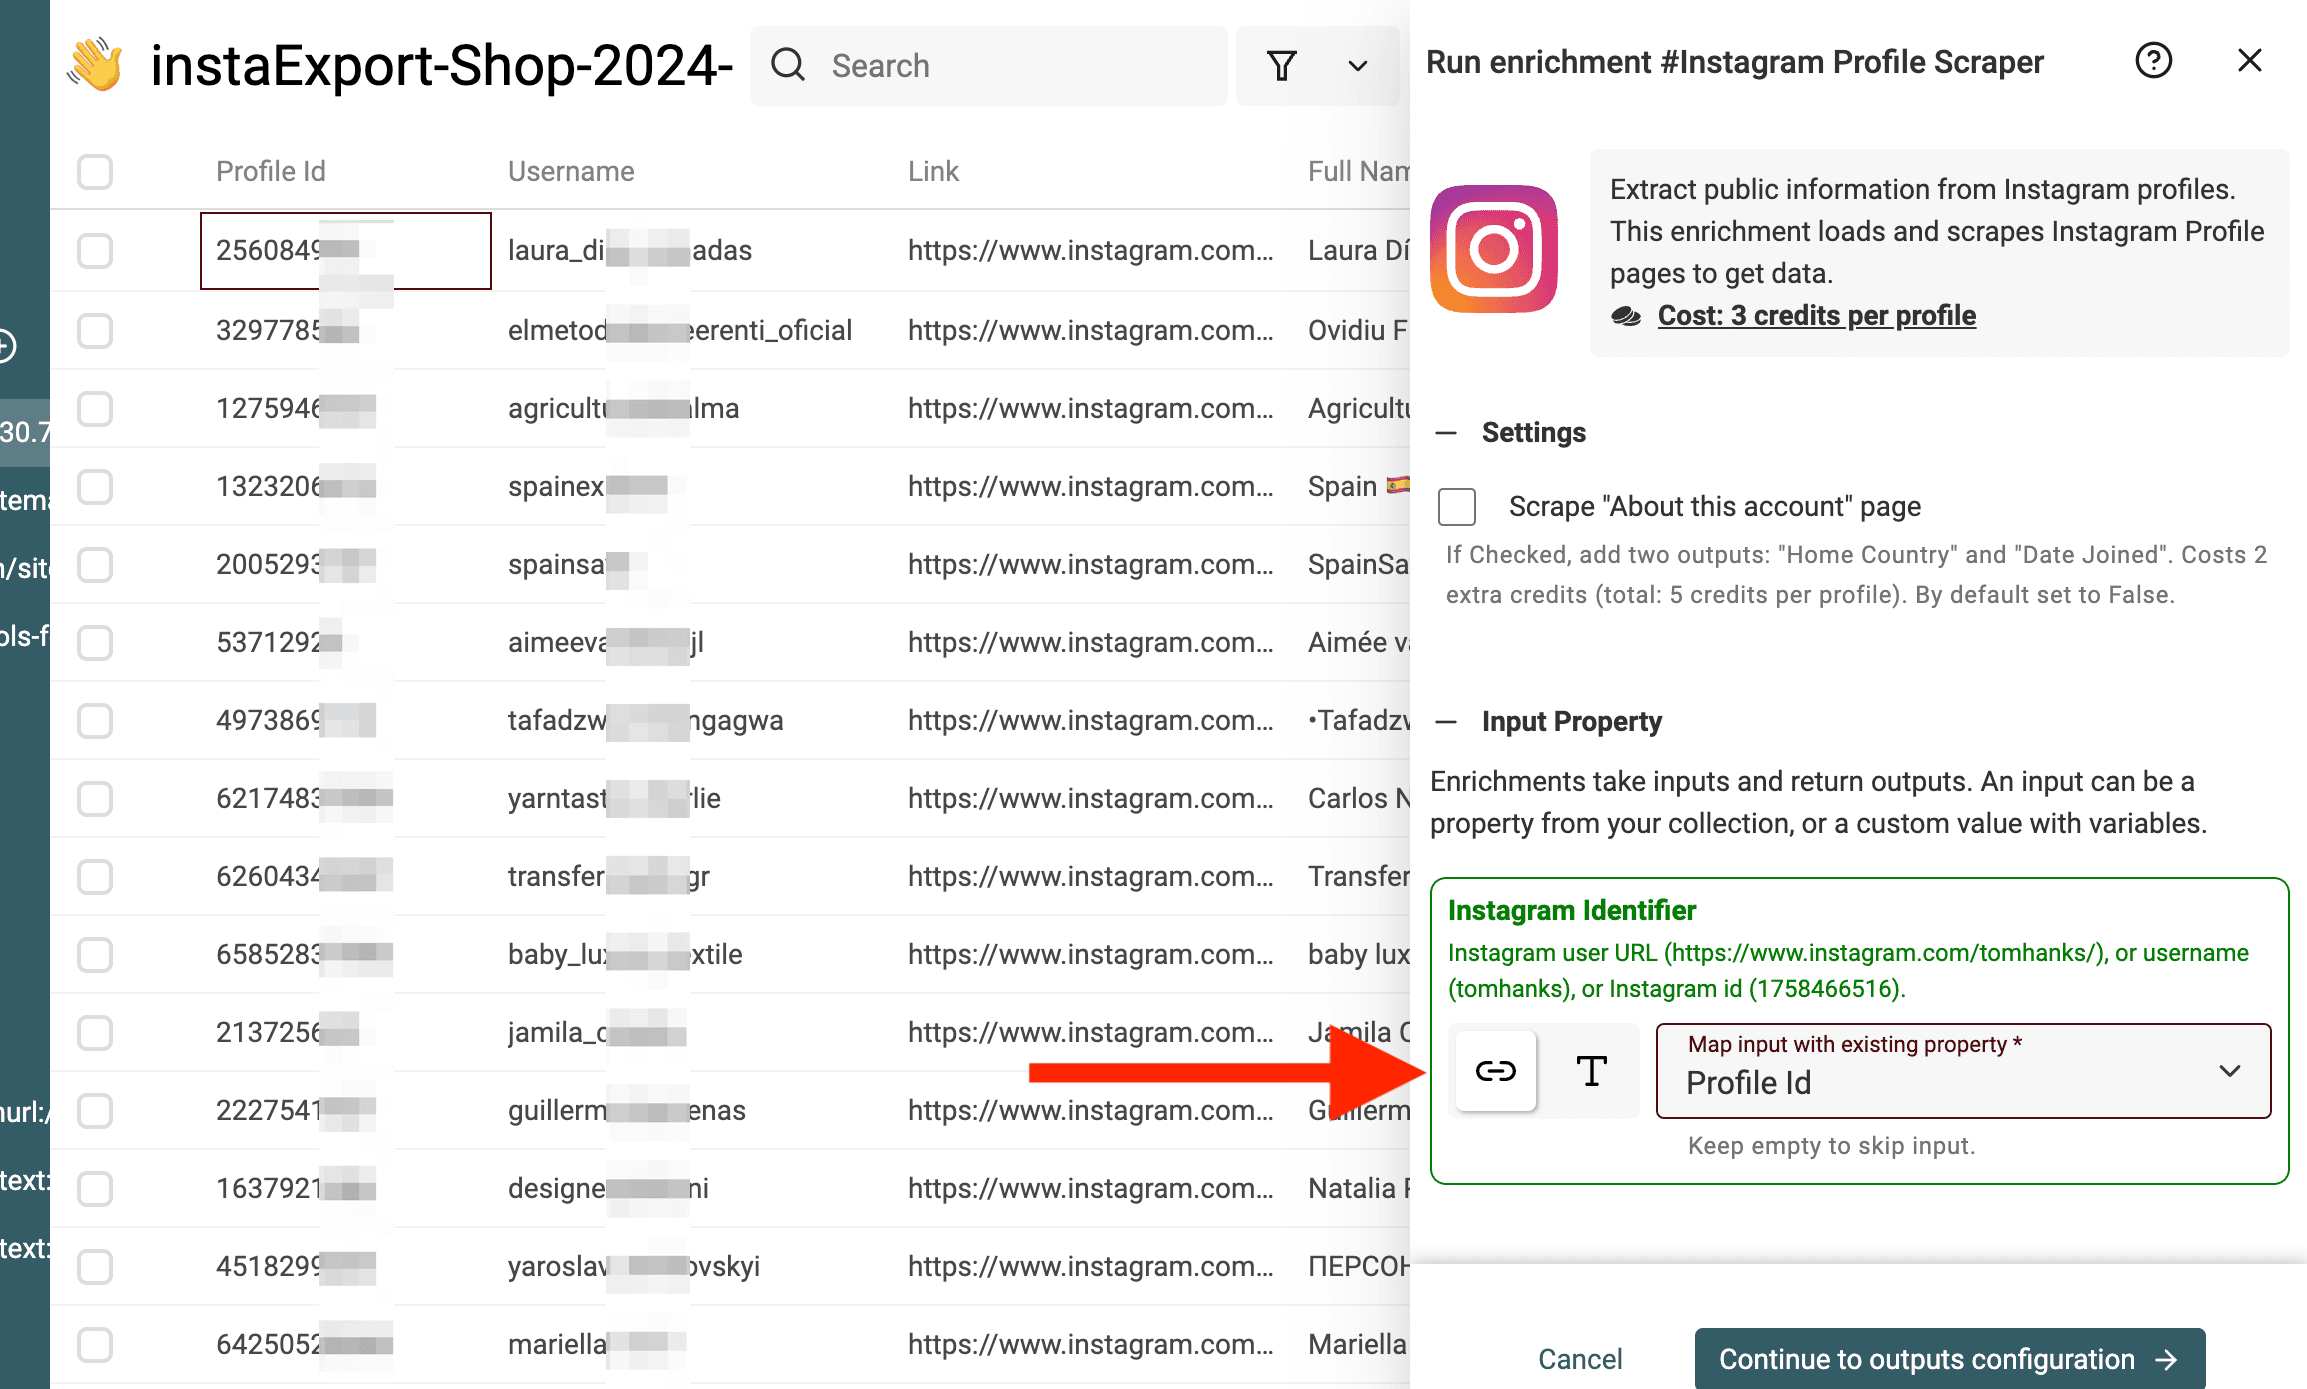
3. Koppel je datakolommen Geef aan in welke kolom de handles staan. Koppel de kolom Instagram Username of Profile URL uit stap 6 aan het invoerveld van de scraper.
4. Kies je outputvelden Selecteer de gegevens die je aan de collection wilt toevoegen.
Koppel de gewenste outputvelden aan nieuwe kolommen, zodat de oorspronkelijke identifiers van de volgers behouden blijven.
Je kunt onder meer deze output krijgen:
- Public Email: haal e-mailadressen rechtstreeks uit zakelijke profielen.
- Description: gebruik dit veld om je data te filteren op specifieke functietitels of interesses.
- Follower Count: maak onderscheid tussen ‘micro-influencers’ en reguliere gebruikers.
- Website: haal de link uit de bio op voor verder bedrijfsonderzoek.
5. Voer de enrichment uit
Kies het Scraping Type dat de gewenste velden oplevert en voer eerst een test uit. De optie die uitsluitend openbare profielgegevens ophaalt, bevat geen output voor e-mailadressen of telefoonnummers. De profieloptie kan een openbaar e-mailadres of telefoonnummer vinden als de gebruiker dit heeft opgegeven, maar deze velden kunnen ook leeg blijven. Controleer de beschikbare instellingen en de kostenraming in credits voordat je de rest verwerkt.
Controleer na afloop Enrichment Status en eventuele ontbrekende velden. Een ontbrekend openbaar e-mailadres moet leeg blijven; het bewijst niet dat de persoon geen e-mailadres heeft. Vervolgens kun je Data Extractor gebruiken als er e-mailadressen in de biotekst staan in plaats van in het officiële e-mailveld.
Controleer overlap en hervat een grote scrape
Houd rekening met twee verschillende datasets:
- Volgerrelaties: één rij per combinatie van volger en bronprofiel. Iemand die twee ingevoerde accounts volgt, kan terecht twee keer voorkomen.
- Unieke profielen: één rij per User Id als je iedere persoon maar één keer wilt verrijken. Bewaar eerst afzonderlijk bij welke bronnen iemand hoort voordat je dubbele profielen verwijdert.
In een voorbeeldbatch vertegenwoordigt User Id 101, die zowel Account A als Account B volgt, twee relaties en één profiel. Als je uitsluitend op User Id dedupliceert, verlies je één bronrelatie, tenzij je die context eerst samenvoegt.
Controleer vóór de enrichment ontbrekende ID’s, herhaalde combinaties van bron en volger en onverwacht kleine resultaten. Selecteer een representatieve steekproef van profielen en bekijk Description, Website en eventueel gevonden e-mailvelden. Bestempel niet iedere volger van een fitnessaccount als fitnessprofessional.
Als een eerdere run een opgeslagen vervolg heeft, open je de source-instellingen en gebruik je Continue a previous scrape. Beschikbare items zijn gekoppeld aan de huidige workspace en worden zeven dagen bewaard. Het geselecteerde item gebruikt opnieuw het bronprofiel en scraping type; je hoeft deze niet te vervangen door nieuwe profielinput.
Als de source de grens van een collection bereikt, hervat je de scrape volgens de instructies van de instelling in een andere collection binnen dezelfde workspace. Controleer eerst de source run als het vervolg niet beschikbaar is, voordat je opnieuw begint. Een opnieuw gestarte scrape kan overlappen met een eerdere momentopname. Vergelijk daarom de identifiers en bewaar de context van de source en collection.
Sla bij iedere batch een datum op in een veld Checked At en exporteer de gecontroleerde resultaten als CSV of Excel. Een veranderend aantal volgers is geen bewijs dat je extract volledig is; volgers kunnen tussen pagina’s of runs veranderen.
Conclusie
Begin met een openbaar profiel en een lage limiet, bewaar de identifiers van zowel de volger als de source en controleer de gevonden relaties voordat je ze verrijkt of exporteert. Gebruik voor een grotere source run een opgeslagen vervolg wanneer dat beschikbaar is.
Open Datablist en probeer dezelfde workflow met een profiel dat relevant is voor jouw project.
Veelgestelde vragen over Instagram-volgers scrapen
Is het legaal om Instagram-volgers te scrapen?
Dat gegevens openbaar zichtbaar zijn, betekent niet automatisch dat je toestemming hebt om ze geautomatiseerd te verzamelen of opnieuw te gebruiken. Controleer vóór het verzamelen van volgersdata de actuele voorwaarden van Instagram en de regels die gelden voor je beoogde toepassing.
Kan ik tegelijk volgers van meerdere influencers scrapen?
Ja. Voer onder Instagram Profiles één identifier per regel in. De source verwerkt de ingevoerde accounts en voegt aan de gevonden rijen relatievelden van de bronprofielen toe. De looptijd en voltooiing kunnen per account verschillen.
Kan ik volgers van privéprofielen op Instagram scrapen?
Nee. Deze workflow geeft geen toegang tot de volgerslijst van een privéprofiel. Een lookup van profielgegevens is een afzonderlijke enrichment en kan afgeschermde volgersdata niet ontsluiten.
Hoe snel kan ik Instagram-volgers scrapen?
Er is geen vaste verwerkingstijd die voor elk profiel geldt. Voer een kleine test uit en controleer de werkelijke duur, het aantal gevonden rijen en het creditverbruik voordat je opschaalt.
Wat gebeurt er als ik meer dan 100.000 volgers scrape?
Beschouw de limiet van de source run en de opslagcapaciteit van de collection als afzonderlijke beperkingen. Een source kan stoppen voordat de volledige lijst van een profiel is opgehaald. Gebruik, wanneer dat wordt aangegeven, een beschikbaar vervolg in een andere collection en exporteer iedere voltooide batch. Ga er niet van uit dat de importcapaciteit van een collection gelijk is aan de extractiecapaciteit van de source.
Welke data krijg ik bij het scrapen van Instagram-volgers?
Je kunt voor iedere volger uit verschillende profielvelden kiezen, waaronder:
- User Id: de interne gebruikersidentifier van Instagram
- User Username: de Instagram-handle van de volger
- User Profile URL: directe link naar het Instagram-profiel
- Full Name: de weergegeven naam op het profiel
- Profile Picture: URL van de profielafbeelding
- Private: of het account privé of openbaar is
- Verified: verificatiestatus met het blauwe vinkje
- Follower of (UserId), Follower of (Username) en Follower of (ProfileUrl): identifiers van het bronaccount om de relatie te controleren
Hoeveel Instagram-volgers kan ik tegelijk scrapen?
Stel Scraping Limit Per Profile in voor de source run en controleer de voortgang en instellingen voor het hervatten. De werkelijke resultaten hangen af van toegankelijke volgerspagina’s, responses van de provider, runlimieten en beschikbare credits. De importcapaciteit is geen garantie dat een source hetzelfde aantal volgers in één run kan opleveren.
Heb ik een browserextensie nodig om Instagram-volgers te scrapen?
Nee. Datablist werkt volledig als webapp. Je hebt geen extensies, downloads of installaties nodig.
Wat is de goedkoopste manier om Instagram-volgers te scrapen?
Stel een lage limiet in, bekijk de kostenraming in credits en controleer de gevonden rijen voordat je enrichment met profielgegevens uitvoert. Vergelijk de kosten per bruikbaar, gecontroleerd profiel en ga er niet van uit dat iedere gevonden volger een gekwalificeerd contact is.
Hoe scrape ik Instagram-volgers zonder geblokkeerd te worden?
Datablist vraagt in deze workflow niet om je Instagram-inloggegevens of sessiecookies. Dat betekent niet dat de scraping zonder risico is of dat je toestemming hebt om data te verzamelen. Gebruik toegankelijke sourcedata, controleer de voorwaarden van de site en stop wanneer de gevraagde lijst niet beschikbaar is.
Wat is het verschil tussen Followers en Following scrapen?
Followers zijn de mensen die een profiel volgen. Following is de lijst met accounts die het profiel zelf volgt. Deze gids gaat specifiek over het scrapen van volgers, maar Datablist biedt beide opties.
Kan ik volgers van een zakelijk Instagram-account scrapen?
Ja, zolang het zakelijke account openbaar is. De scraper werkt op dezelfde manier voor persoonlijke accounts, creator-accounts en zakelijke accounts.
Hoe download ik een lijst met Instagram-volgers?
Registreer je bij Datablist, maak een collection, selecteer Instagram Followers/Following Scraper, plak het profiel en start de run. Na afloop exporteer je de resultaten als CSV of Excel.
Welke tools kunnen Instagram-volgers scrapen?
Er zijn verschillende opties, waaronder browserextensies, Python-scripts en platforms zoals Datablist. Vergelijk de benodigde accounttoegang, gevonden velden, ondersteuning voor hervatten, duur van een test en kosten per bruikbaar resultaat. Voor deze workflow heeft Datablist je Instagram-inloggegevens niet nodig.