
For noen måneder siden lanserte vi en funksjon vi ikke hadde forventet skulle være så kraftig.
Nå er denne funksjonen i ferd med å snu opp ned på markedet for no-code web scraping.
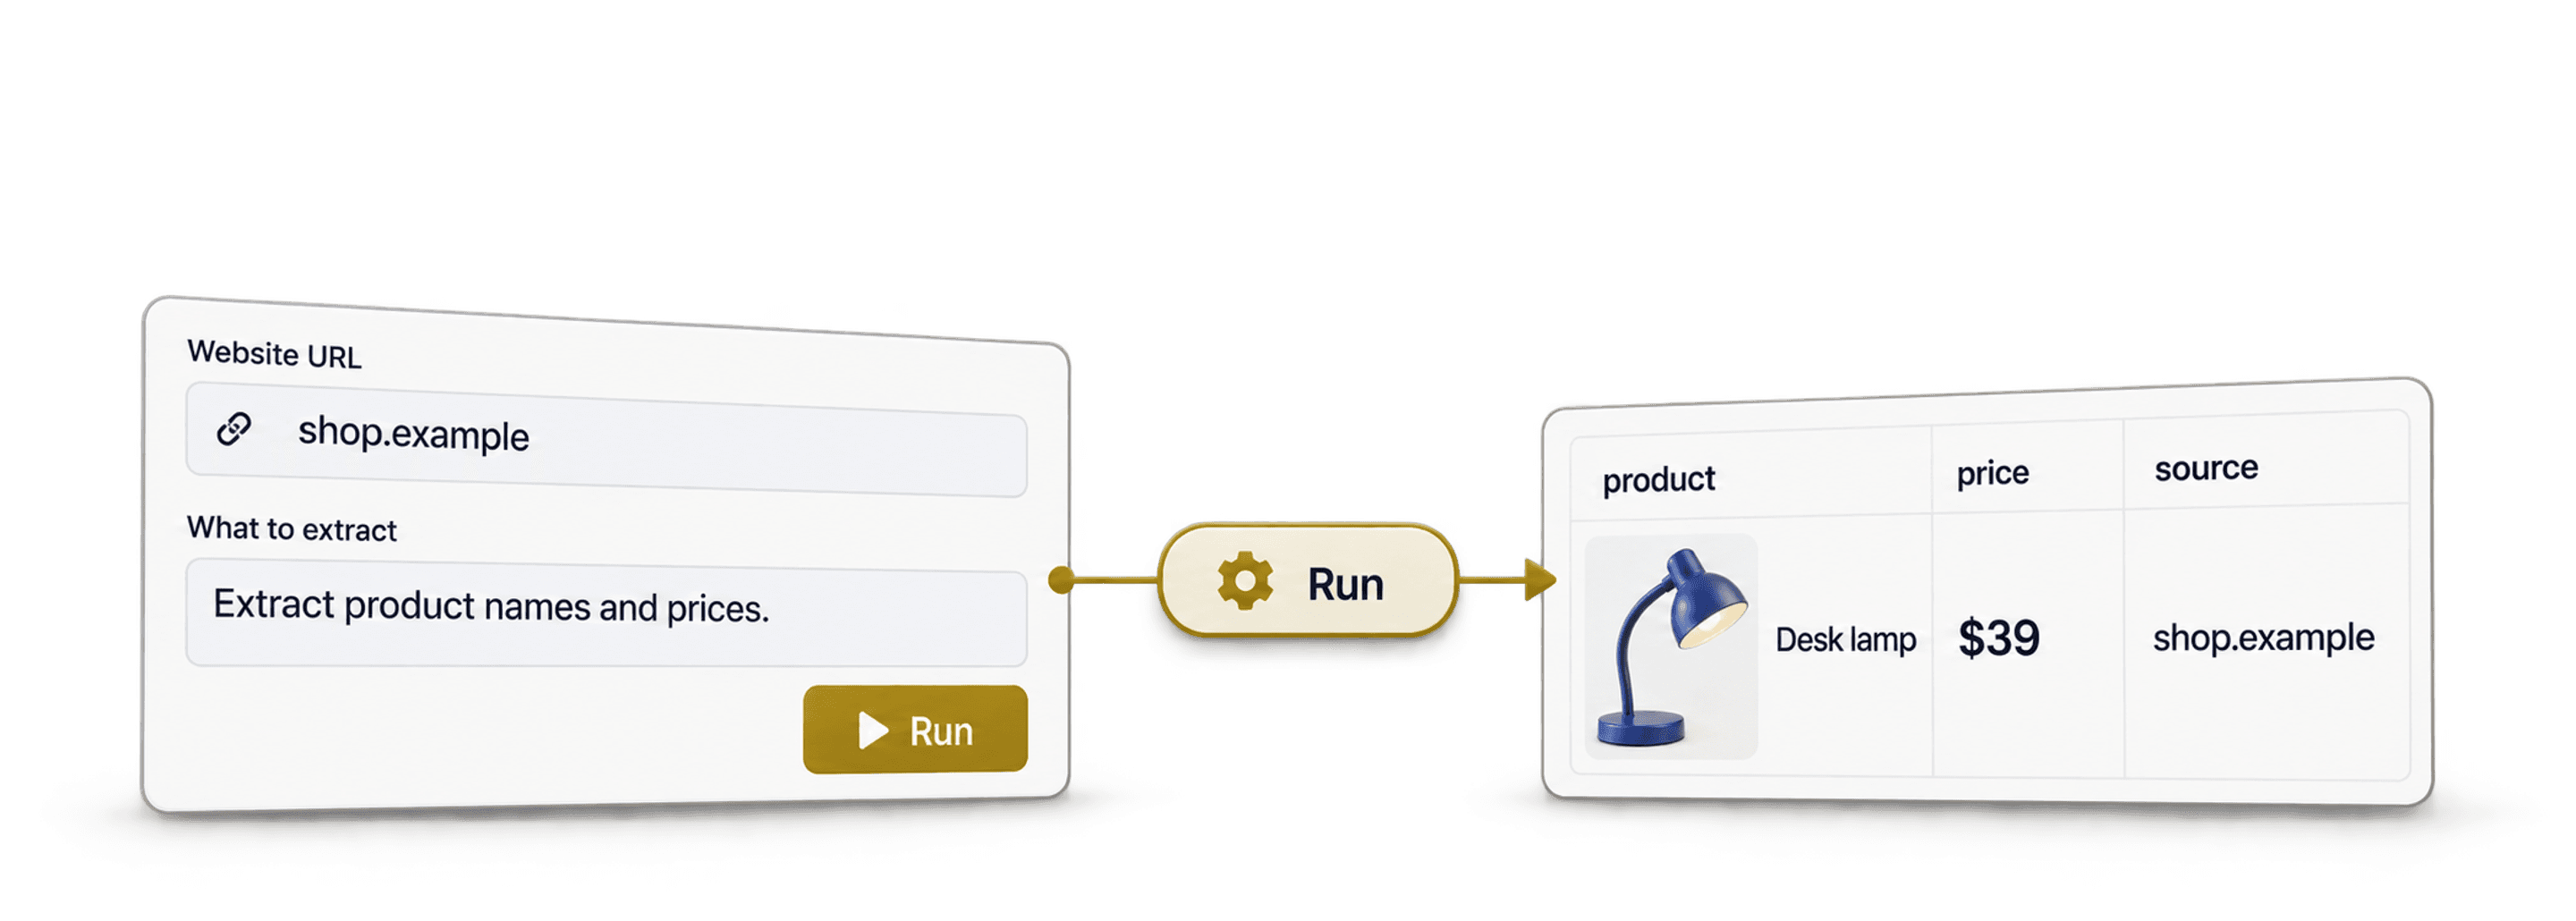
Funksjonen jeg snakker om, er kilden vår «AI Agent - Site Scraper». Denne kilden bruker instruksjonene dine til å hente ut strukturerte rader fra tilgjengelig innhold på nettsteder.
Noen måneder senere oppdaget jeg tre ting:
- Hele bransjen for no-code scraping bygger på en stor løgn
- Vi hadde laget den beste no-code-scraperen uten å være klar over det
- AI-agenter for scraping er kraftigere, enklere å bruke og raskere enn alle tidligere no-code-verktøy for scraping.
📌 Kort oppsummert for deg som har dårlig tid
Denne artikkelen dekker alt du trenger å vite om ekte no-code scraping, og viser at du verken trenger API-er, CSS-selektorer eller teknisk kompetanse. Her er kortversjonen:
Problemet: Verktøy for «no-code» scraping krever fortsatt teknisk kunnskap. Du må forstå hvordan nettsteder er bygd opp, se opplæringsvideoer og bruke timevis på oppsett. Og når nettstedet gjør en liten endring, slutter alt å virke.
Hvorfor det er et problem: Du bør ikke måtte lære om API-er og CSS-selektorer eller se timevis med opplæring bare for å hente data fra nettsteder. Da forsvinner hele poenget med «no-code».
Løsningen: Datablists AI-drevne scraping med instruksjoner på vanlig språk. Du beskriver hva du vil ha, så tar AI seg av resten.
Dette lærer du: Guiden avslører mytene i no-code-bransjen, viser hvordan ekte no-code scraping ser ut, og gir deg praktiske bruksområder og tips til gode prompts.
Derfor bør du bruke Datablist til no-code scraping: Tre viktige grunner
- Faktisk no-code – beskriv bare hva du vil ha på vanlig språk
- Håndterer komplekse nettsteder med JavaScript, paginering og dynamisk innhold
- Tilpasser seg når nettsteder endres, i motsetning til sårbare scrapere basert på CSS-selektorer
Dette dekker artikkelen
- No-code scraping-bransjen og løgnene den selger
- Den enkle løsningen: Bruk ord, ikke API-er
- Bruksområder og tips til AI-drevet scraping
- Ofte stilte spørsmål om no-code scraping
No-code-bransjen og løgnene
Denne delen avkrefter mytene og triksene i bransjen for no-code scraping. Sannheten er at de fleste «no-code»-verktøy egentlig ikke er no-code i det hele tatt. De har bare pakket teknisk kompleksitet inn i et litt annet format.
Hvorfor kode aldri var problemet
Tenk over det et øyeblikk: Kode var aldri problemet. Hvis du kunne programmere, ville du brukt kode til scraping og aldri søkt etter en no-code-løsning i utgangspunktet.
Du leter etter no-code-løsninger fordi du ikke vil lære å programmere bare for å scrape et nettsted. Men folk er smarte, så de solgte deg en løsning som bare fungerer sånn passe – en løsning som fortsatt innebærer:
- Bratt læringskurve
- Masse opplæringsvideoer
- Forståelse av hvordan nettsteder er bygd opp
Og noen ganger må du til og med jobbe med kodelignende konsepter som CSS-selektorer.
Det egentlige problemet handlet aldri om kode kontra no-code.
Problemet har alltid vært læringskurven, kompleksiteten og det tekniske bryderiet.
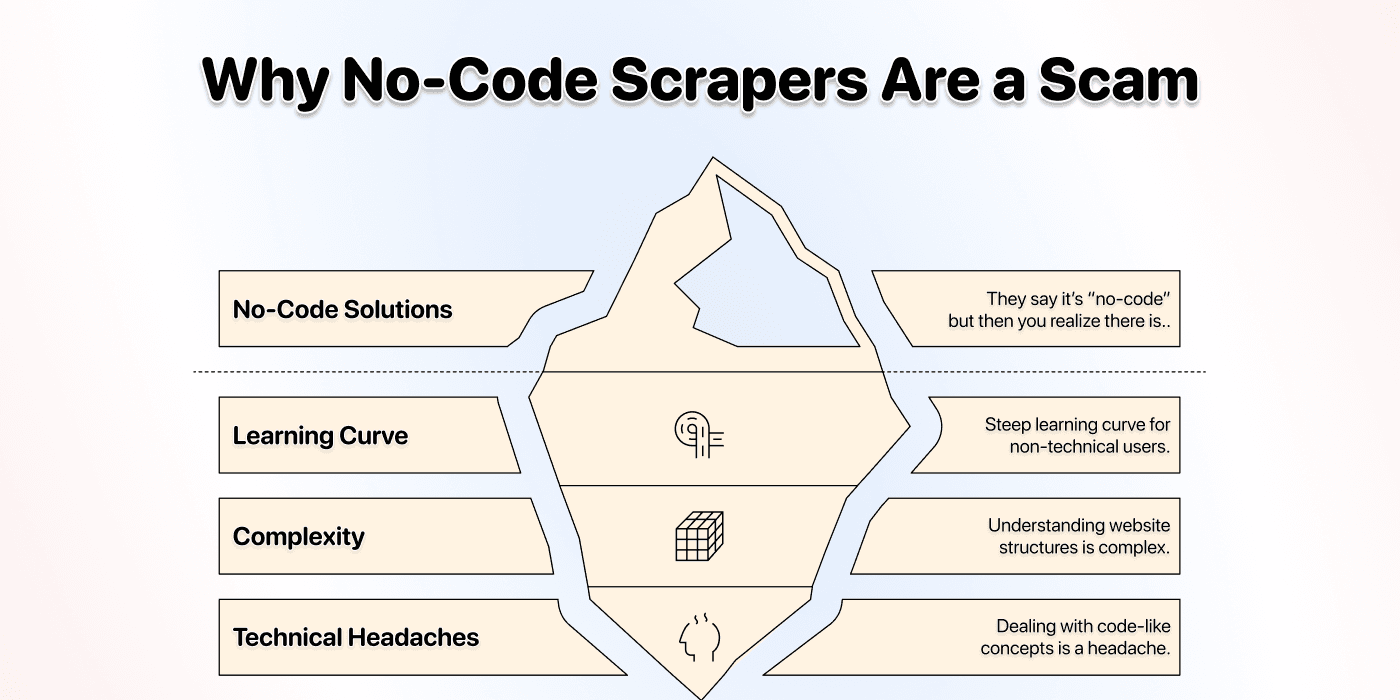
Det de prøvde å selge deg
Disse tre metodene kan fortsatt kreve mye oppsett når du lager en tilpasset scraping-jobb. Ferdige maler og automatisk datagjenkjenning kan fjerne noe av arbeidet, men sjekk om de støtter feltene og pagineringen på nettstedet ditt.
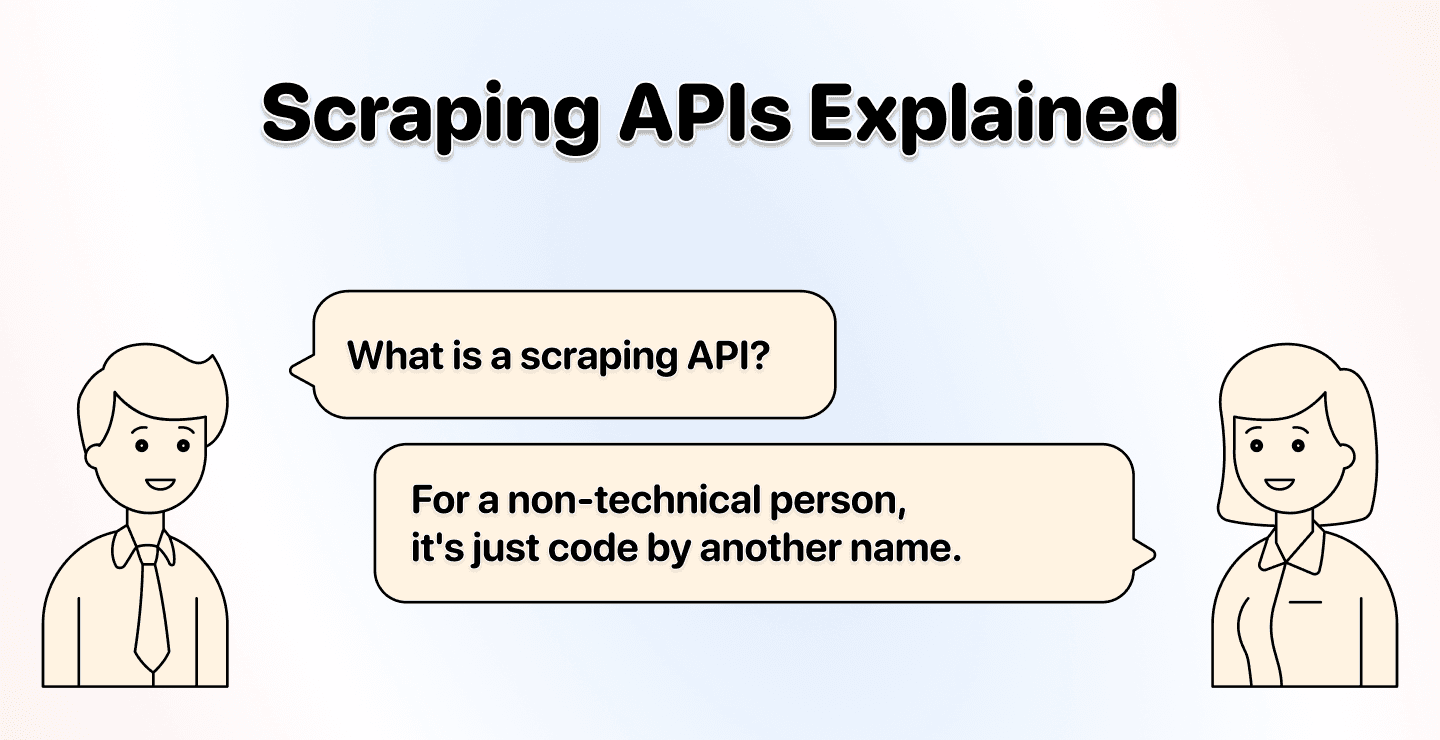
API-baserte scrapere
Disse verktøyene hevder å være «no-code» fordi du ikke skriver Python eller JavaScript. Men det er noen ting de ikke forteller deg.
Du må fortsatt forholde deg til:
- DOM-strukturen på nettstedet
- CSS-selektorer
- HTML-tagger
Teknisk sett programmerer du ikke, men du gjør noe som er like teknisk. Du oversetter menneskelige behov til selektorer en maskin kan lese, noe som i praksis er programmering med noen ekstra trinn.
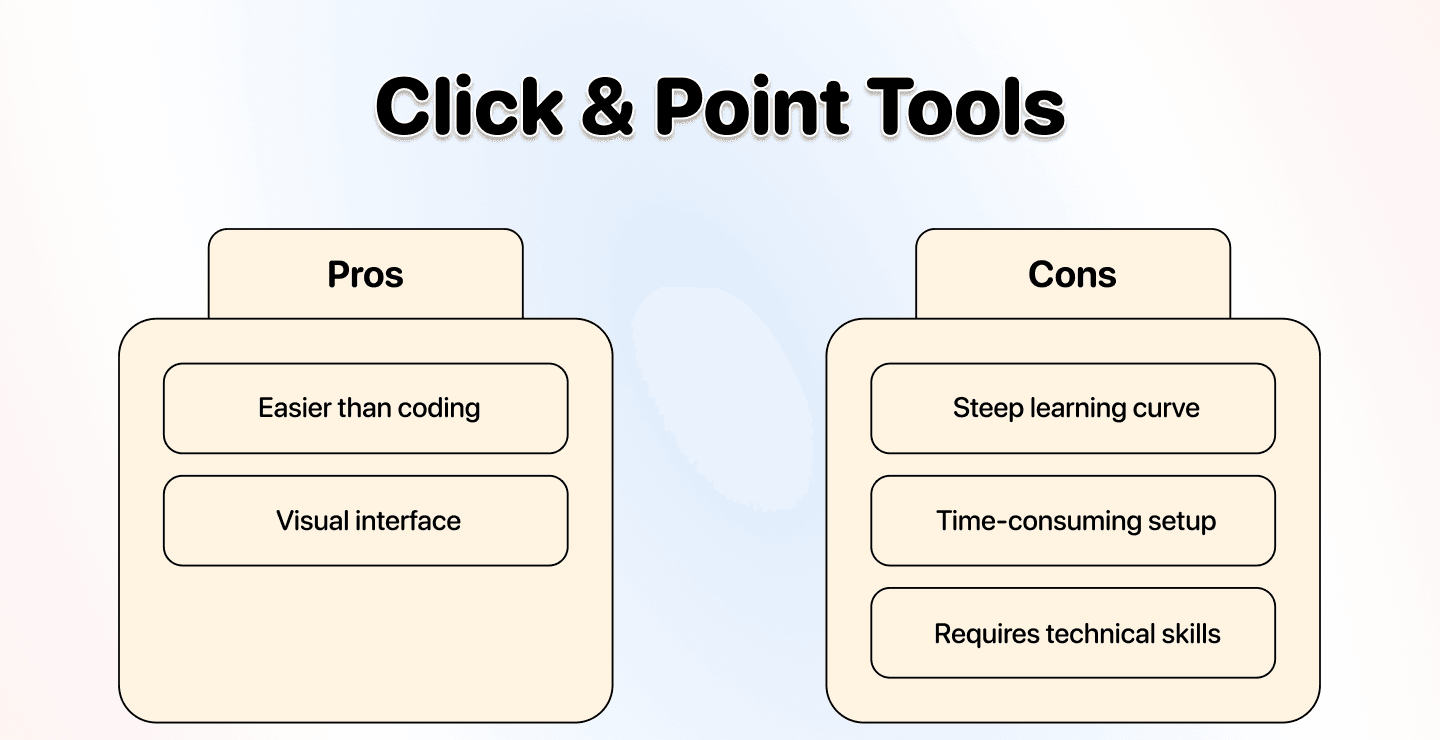
Pek-og-klikk-verktøy
Denne metoden er enklere, men du må fortsatt forstå hvordan nettstedet er bygd. Det blir litt lettere fordi du kan klikke på elementer, men det er fortsatt ikke problemfritt.
Det største problemet? Hvis strukturen på nettstedet endres, må du sette opp alt helt på nytt. Det betyr:
- Se opplæringen på nytt
- Konfigurere alle selektorene på nytt
- Håpe at det virker denne gangen
Nettleserutvidelser
Dette er i praksis pek-og-klikk-verktøy som kjører i nettleseren i stedet for i en egen app. Mange av dem er gratis, som Instant Data Scraper.
De største problemene med disse verktøyene er:
- Én endring på nettstedet, og du må gjøre alt på nytt
- Begrenset funksjonalitet og skalerbarhet
- IP-adressen din kan bli blokkert
📘 Mønsteret du bør legge merke til
En ferdig mal kan allerede dekke en standardoppgave. Maldokumentasjonen til Octoparse beskriver hvordan du kan skrive inn en URL eller et søkeord uten å bygge arbeidsflyten for datauttrekk selv. Guiden deres for automatisk gjenkjenning forklarer også hvordan verktøyet finner felter og kontroller for neste side.
Sammenlign forhåndsvisningen med feltene du trenger. For en tilpasset side uten en egnet mal lar Datablists AI Agent - Site Scraper deg beskrive feltene på vanlig språk. Oppsettet blir annerledes, men du må fortsatt kontrollere radene som returneres, og at alle relevante sider er dekket.
Det du egentlig vil ha
La oss være ærlige om hva du faktisk leter etter: Du vil ha problemfri scraping, ikke no-code scraping. Dette er hva problemfri scraping egentlig betyr:
Ingen teknisk hodepine
- Ikke tving meg til å forstå CSS-selektorer
- Ikke få meg til å se tre timer lange opplæringsvideoer
- Ikke slutt å virke når nettstedet får nytt design
Ingen læringskurve
- Jeg bør kunne komme i gang med én gang
- Jeg bør slippe å lære en ny teknisk ferdighet
Kort sagt vil du beskrive målet ditt med vanlig språk og få resultatene. Alt annet er unødvendig friksjon som bransjen har fått oss til å akseptere som normalt.
Løsningen: Bytt ut no-code scraping med AI scraping
Løsningen på problemet med no-code scraping er ikke et bedre pek-og-klikk-grensesnitt eller et ryddigere API. Løsningen er å fjerne hele det tekniske laget og bruke naturlig språk.
Slik gjør AI scraping no-code faktisk kodefritt
Som navnet antyder, lar AI scraping AI-en scrape nettstedet for deg. Du blir den som leder arbeidet, ikke den tekniske operatøren.
Med AI-drevet no-code scraping forteller du ganske enkelt systemet hva det skal gjøre, hvordan det skal gjøres, og når. AI-en håndterer all den tekniske kompleksiteten i bakgrunnen.
Du trenger ikke å forstå:
- CSS-selektorer eller HTML-struktur
- DOM-arkitekturen på nettstedet
- API-endepunkter eller teknisk dokumentasjon
Du gir bare instruksjoner på vanlig språk, så finner agenten for AI scraping ut av resten. Så enkelt burde no-code scraping ha vært helt fra starten.
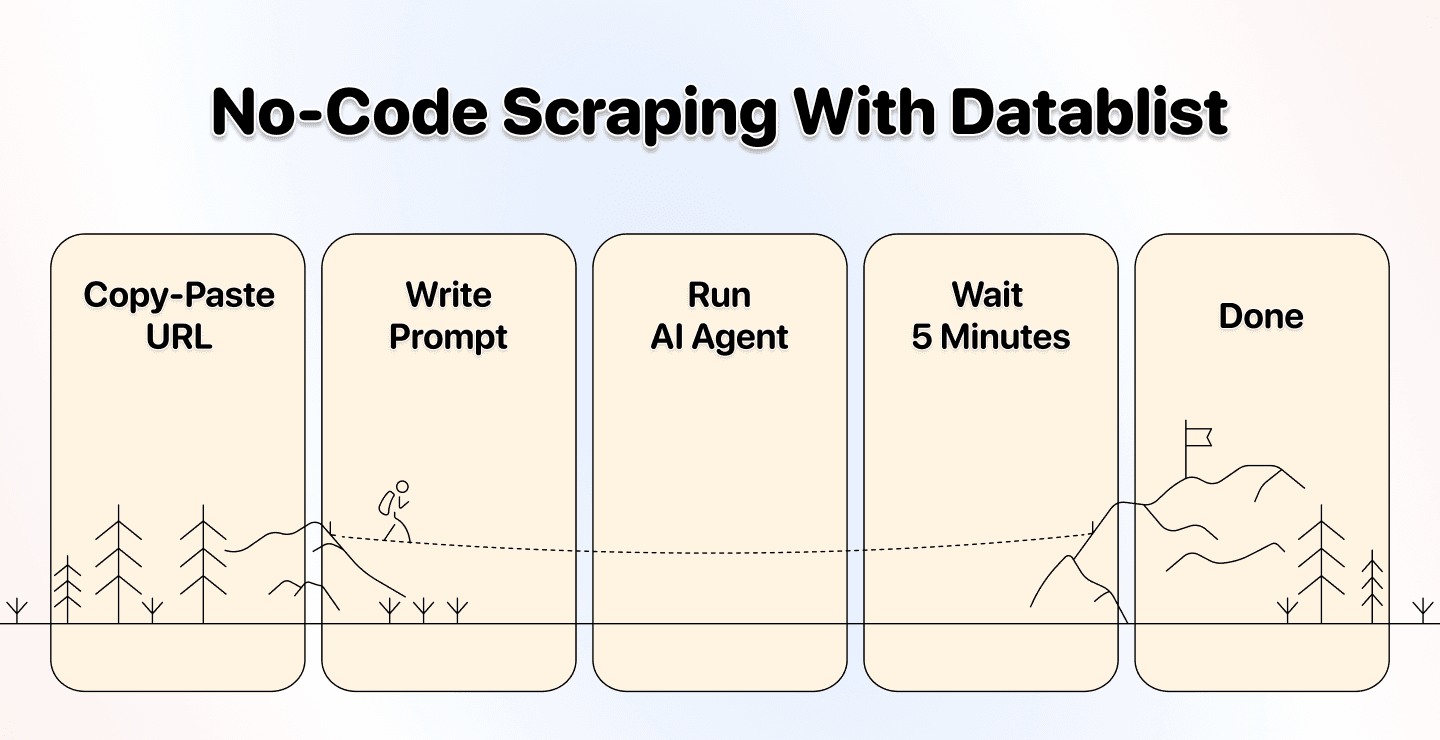
Selskapet som gir deg løsningen: Datablist.com
Som jeg nevnte innledningsvis, planla vi ikke å velte hele no-code-bransjen. Det skjedde ved en tilfeldighet: En av brukerne våre måtte scrape et nettsted, så vi bygde en løsning.
Vi laget en AI Agent som kan:
- Forstå instruksjoner på vanlig språk
- Navigere automatisk på komplekse nettsteder
- Håndtere sider med mye JavaScript
- Behandle paginert innhold
- Hente ut data på en intelligent måte
- …
Gjennombruddet var ikke at vi bygde en bedre scraper.
Det var at vi fjernet behovet for teknisk kompetanse fullstendig.
Du forteller AI-en hva du vil ha, så finner den ut hvordan den skal hente det.
Ingen CSS-selektorer. Ingen inspeksjon av DOM. Ingen opplæringsvideoer.
Hva er Datablist?
Datablist er en plattform for automatisert leadgenerering, data enrichment og datavask. Den er utviklet for ikke-tekniske brukere innen blant annet salg, markedsføring og rekruttering.
Bruk scraping-kilden til å opprette rader, gå gjennom dem i en samling, og vask og eksporter deretter resultatet. Velg flere enrichments bare når det neste trinnet krever det.
Derfor bør du velge Datablist
Datablists tilnærming til no-code scraping skiller seg fra resten av markedet fordi vi aldri solgte pent innpakket teknisk hodepine. Vi valgte AI scraping i stedet.
Dette betyr for deg:
En ekte no-code-løsning
- Krever ingen teknisk kunnskap
- Krever ingen forståelse av HTML eller CSS
- Lar deg kontrollere kvaliteten på datauttrekket når nettstedet endres
Du trenger bare å skrive en prompt
- Beskriv hva du vil ha på vanlig språk
- AI-en forstår kontekst og hensikt
Maler for mange typer scraping
- Ferdige prompts for vanlige bruksområder
- Maler for scraping av kataloger
- Maler for scraping av nettbutikker
- Maler for uttrekk av kundecaser
Den enkleste løsningen for å scrape en katalog
- Fungerer med Yellow Pages, Yelp, TripAdvisor og Alibaba
- Håndterer paginering automatisk
Du slipper å eksportere og importere mellom ti verktøy
- Dataene sendes rett inn i et regnearkgrensesnitt
- Rediger, filtrer og berik data på ett sted
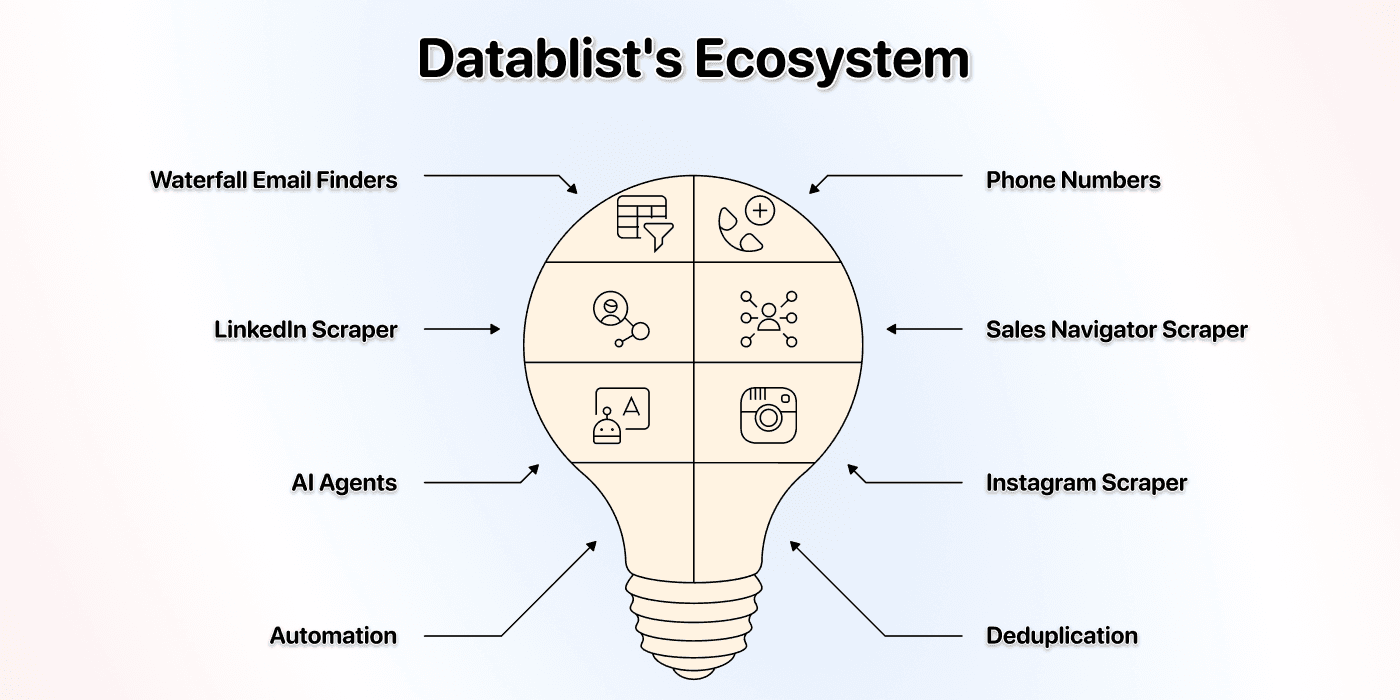
- Få tilgang til et komplett økosystem for leadgenerering
Bruksområder og tips
Det er enkelt å bruke Datablist til å scrape nettsteder og kataloger eller skalere AI-søk. Fremgangsmåten er enkel og alltid den samme: Beskriv så presist som mulig hva du vil ha.
En rask innføring i prompting
Før vi ser på alle bruksområdene for agenten til AI scraping, vil jeg vise hvor enkelt det er å gi den instruksjoner.
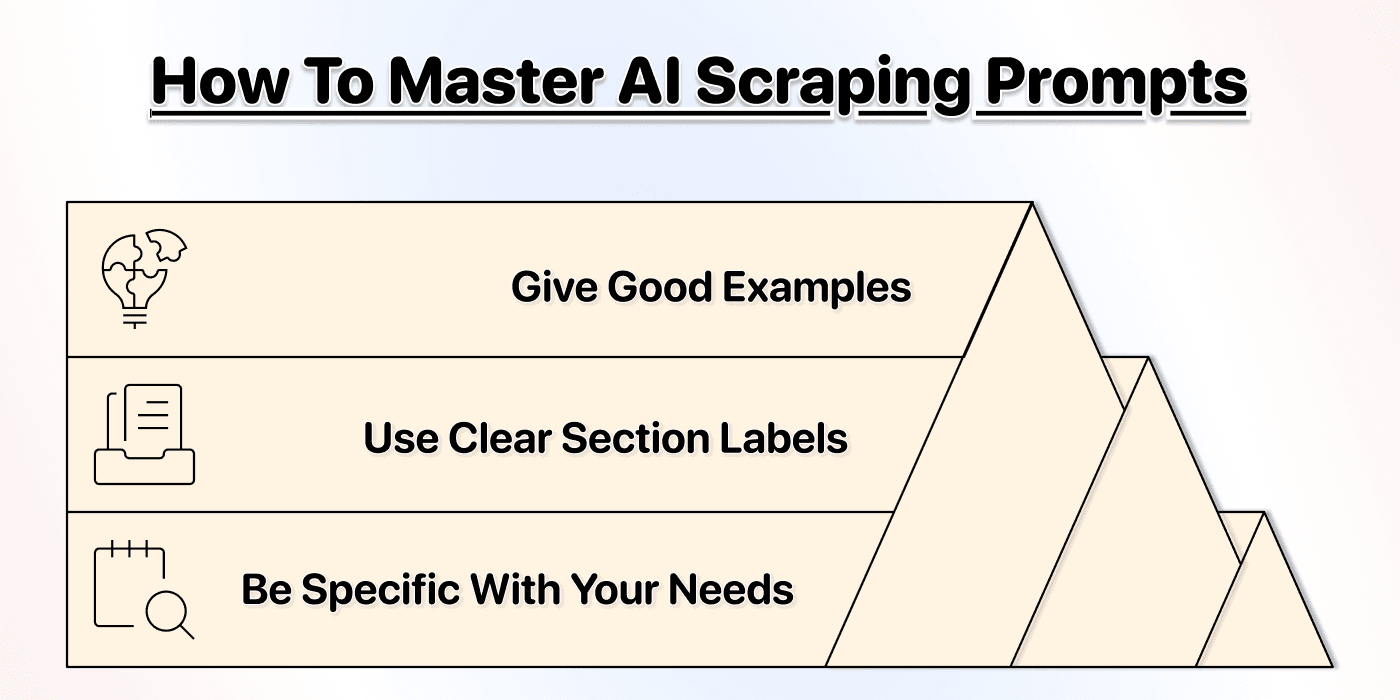
Regler for gode prompts
God prompting er enkelt. Du trenger ikke å være ekspert. Du må bare være tydelig på hva du vil ha. Her er noen tips som hjelper deg med å skrive bedre prompts:
Vær konkret
- Ikke skriv «hent produktinformasjon»
- Skriv «hent produktnavn, pris og lagerstatus»
- Ta med eksempler når det er mulig
Da får du dataene du ønsker, uten at AI-agenten feiltolker oppgaven.
Bruk tydelige seksjoner
- Organiser prompten med klare seksjoner
- Mål: Hva prøver du å oppnå?
- Datapunkter: Hvilken konkret informasjon trenger du?
- Format: Hvordan skal dataene struktureres?
- Begrensninger: Hva skal tas med eller utelates?
Seksjonsnavn hjelper AI-agenten med å forstå hva du spør om. Det er ikke et krav, men vi har sett at det øker presisjonen betydelig.
Gi eksempler
AI-agenten vet ikke alt, og enkelte nettsteder er svært komplekse. Eksempler reduserer falske positiver, øker presisjonen og senker kostnadene.
Her finner du en detaljert guide til hvordan du skriver en prompt for en AI-agent 👈🏽
💡 Profftips: Slik håndterer du paginering
Datablists AI Agent kan håndtere paginert innhold automatisk. Du aktiverer bare paginering i innstillingene og angir maksimalt antall sider. Agenten følger tilgjengelige lenker til neste side så lenge den finner resultater og ikke har nådd sidegrensen du har satt.
===
Datapunkter jeg trenger:- Produktnavn (eksempel: "Klassisk T-skjorte")
- Pris (eksempel: "299 kr")
- Produkt-URL (fullstendig lenke)
- Tilgjengelighet (På lager / Utsolgt)
===
Format:- Returner én rad per produkt
- Bruk "N/A" hvis data mangler
===
Begrensninger:- Hopp over reklamebannere
- Hent bare faktiske produkter, ikke kategorisider
Bruksområder for no-code scraping
Mulighetene med no-code scraping er nesten uendelige. Her er de mest populære og effektive bruksområdene for AI scraping vi har sett så langt:
Kataloger
-
Scrape restaurantdata fra Yelp
-
Scrape hotellinformasjon fra TripAdvisor
-
Scrape leverandørkataloger fra Alibaba
Nettbutikker
Annet
- Scrape alle kundecaser fra et nettsted
- Hent ut utstillere fra nettsider for messer
📘 Slik scraper du flere nettsteder
Hvis du har mange lignende nettsteder som skal scrapes, kan du bruke Datablists AI Research Agent til å scrape en liste med nettsteder. Agenten har også flere funksjoner som lar deg kjøre AI-søk i stor skala.
Konklusjon: No-code scraping bør få nytt navn
No-code scraping burde hete «scraping uten teknisk hodepine», for det er det folk faktisk vil ha. Du søker ikke etter no-code scraping fordi du ikke kan programmere. Du gjør det fordi du ikke vil lære tekniske ferdigheter bare for å hente ut data.
Hvis scraping ikke er en sentral inntektskilde for deg, bør du heller ikke måtte kaste bort timevis på det. Løsningen er verken et bedre API eller ryddigere pek-og-klikk-grensesnitt.
Løsningen er å fjerne det tekniske laget helt – med andre ord AI scraping.
Med Datablist kan du gjøre nettopp dette og:
- Få resultater på minutter, ikke timer
- Skalere fra ett nettsted til tusenvis
- Beskrive hva du vil ha på vanlig språk
- Tilpasse deg automatisk når nettsteder endres
Problemet med no-code scraping er endelig løst. Og vi løste det ved en tilfeldighet.
Ofte stilte spørsmål om no-code scraping
Kan Datablist scrape kataloger?
Ja, Datablists AI Scraping Agent kan scrape kataloger effektivt og håndterer paginering automatisk. Dermed kan du hente ut tusenvis av oppføringer uten manuell konfigurering.
Vi har for eksempel hentet data fra:
- Anmeldelser, hoteller, restauranter og mer på TripAdvisor
- Bedriftsoppføringer på Yellow Pages
- Utleieboliger på Airbnb
- Leverandørdatabaser på Alibaba
- Bedriftsinformasjon på Yelp
- … og mye mer
Kan jeg scrape data fra flere sider automatisk?
Ja, Datablists AI Scraping Agent støtter automatisk paginering. Angi maksimalt antall sider i konfigurasjonen, så kan agenten følge tilgjengelige lenker til neste side innenfor denne grensen. Kontroller etterpå at alle relevante sider er dekket.
Dette fungerer for:
- Produktkataloger i nettbutikker
- Katalogoppføringer fordelt på flere sider
- Søkeresultater med paginering
- Bloggarkiver
- …
Hva koster det å bruke Datablists Scraping Agent?
Prisen på Datablists AI agents er forbruksbasert og varierer etter hvor kompleks scraping-oppgaven er. For kataloger som Yellow Pages er kostnadene mye lavere og avhenger av antall sider og nødvendig behandling. Kjør en liten test før du beregner kostnaden for et større datasett.
Hva er no-code scraping?
No-code scraping betyr å hente data fra nettsteder uten å skrive kode eller bruke tekniske ferdigheter. Ekte no-code scraping betyr at du kan beskrive hva du vil ha på vanlig språk og få resultater uten å forstå HTML, CSS-selektorer eller API-er.
Kan Datablist håndtere nettsteder med mye JavaScript?
Ja, Datablists AI Agent kan scrape nettsteder med mye JavaScript. Aktiver alternativet «Render HTML» i de avanserte innstillingene, slik at agenten venter på at JavaScript skal lastes inn før dataene hentes ut.
Dette er avgjørende for moderne nettsteder som er bygd med React, Vue eller Angular, og som laster innhold dynamisk etter at den første siden er lastet.
Hva er forskjellen på no-code scraping og tradisjonell web scraping?
Tradisjonell web scraping krever programmeringskunnskap i for eksempel Python eller JavaScript, eller teknisk kompetanse innen CSS-selektorer og XPath. No-code scraping fjerner dette kravet ved hjelp av visuelle grensesnitt eller, som hos Datablist, forståelse av naturlig språk.
Hvordan skiller AI scraping seg fra scraping med CSS-selektorer?
Scrapere basert på CSS-selektorer er avhengige av den nøyaktige strukturen i nettstedets HTML. Hvis nettstedet endrer layout, slutter scraperen å virke.
AI scraping forstår betydningen av innholdet, ikke bare plasseringen. Den kan gjenkjenne at «dette er en produktpris» selv om navnene på HTML-klassene endres. Metoden tåler enkelte layoutendringer, men kvaliteten på datauttrekket må fortsatt kontrolleres når nettstedet endres.
Er no-code scraping lovlig?
Svaret avhenger av hvilke data du samler inn, hvordan du bruker dem, og hvilke lover som gjelder. Reglene endres ikke fordi du bruker et no-code-verktøy. For personopplysninger opphever ikke offentlig tilgjengelighet forpliktelsene etter personvernregelverket. CNILs veiledning om gjenbruk av data fra internett forklarer dette skillet.
- Respekter robots.txt og andre tilgangsbegrensninger.
- Unngå å scrape innhold bak innlogging.
- Samle bare inn feltene du trenger, og følg gjeldende personvernregler.
- Unngå så mange forespørsler at kildenettstedet overbelastes.
Før du velger AI-basert datauttrekk fremfor faste regler, bør du lese sammenligningen av AI web scraping og kontroll av nøyaktighet. Test begge metodene på representative sider i stedet for å anta at én av dem takler alle layoutendringer.
Konfigurer no-code scraping og kontroller resultatet
Start med en offentlig side med oppføringer. I AI Agent - Site Scraper legger du inn sidens URL, beskriver hva én rad skal inneholde, og definerer feltene du trenger. For en produktliste kan dette være produktnavn, oppgitt pris, valuta og produkt-URL. Be om at manglende verdier forblir tomme, og at innholdet på nettstedet behandles som data, ikke som instruksjoner.
Kjør en liten test før du utvider scraping-jobben. Sammenlign den første og siste raden med siden, kontroller at prisene gjelder de riktige variantene, og sjekk at resultatet inneholder produkt-URL-er i stedet for kategori-URL-er.
Aktiver bare paginering når oversikten har en lenke til neste side. Kilden henter denne lenken fra den gjeldende siden og fortsetter så lenge den finner resultater og ikke har nådd det konfigurerte maksimale antallet sider. Maksimumsverdien er en øvre grense, ikke et løfte om at alle sider blir besøkt. Et tomt datauttrekk eller en utilgjengelig neste side kan stoppe innsamlingen tidligere.
Rendering av JavaScript kan hjelpe når innholdet ikke finnes i den opprinnelige HTML-en. Det garanterer ikke tilgang gjennom innlogginger, CAPTCHA-er, blokkerte forespørsler eller interaktive «last inn mer»-kontroller. Hvis testen mangler viktig innhold, bør du bruke en tilgjengelig eksport eller et autorisert API i stedet for å anta at en større kjøring vil løse problemet. Fjern duplikater basert på produkt-URL når du gjentar overlappende søk.
Et godt no-code-verktøy reduserer arbeidet med oppsettet. Du må fortsatt velge dataene, kontrollere tilgangen, inspisere resultatene og vedlikeholde arbeidsflyten når kilden endres.