
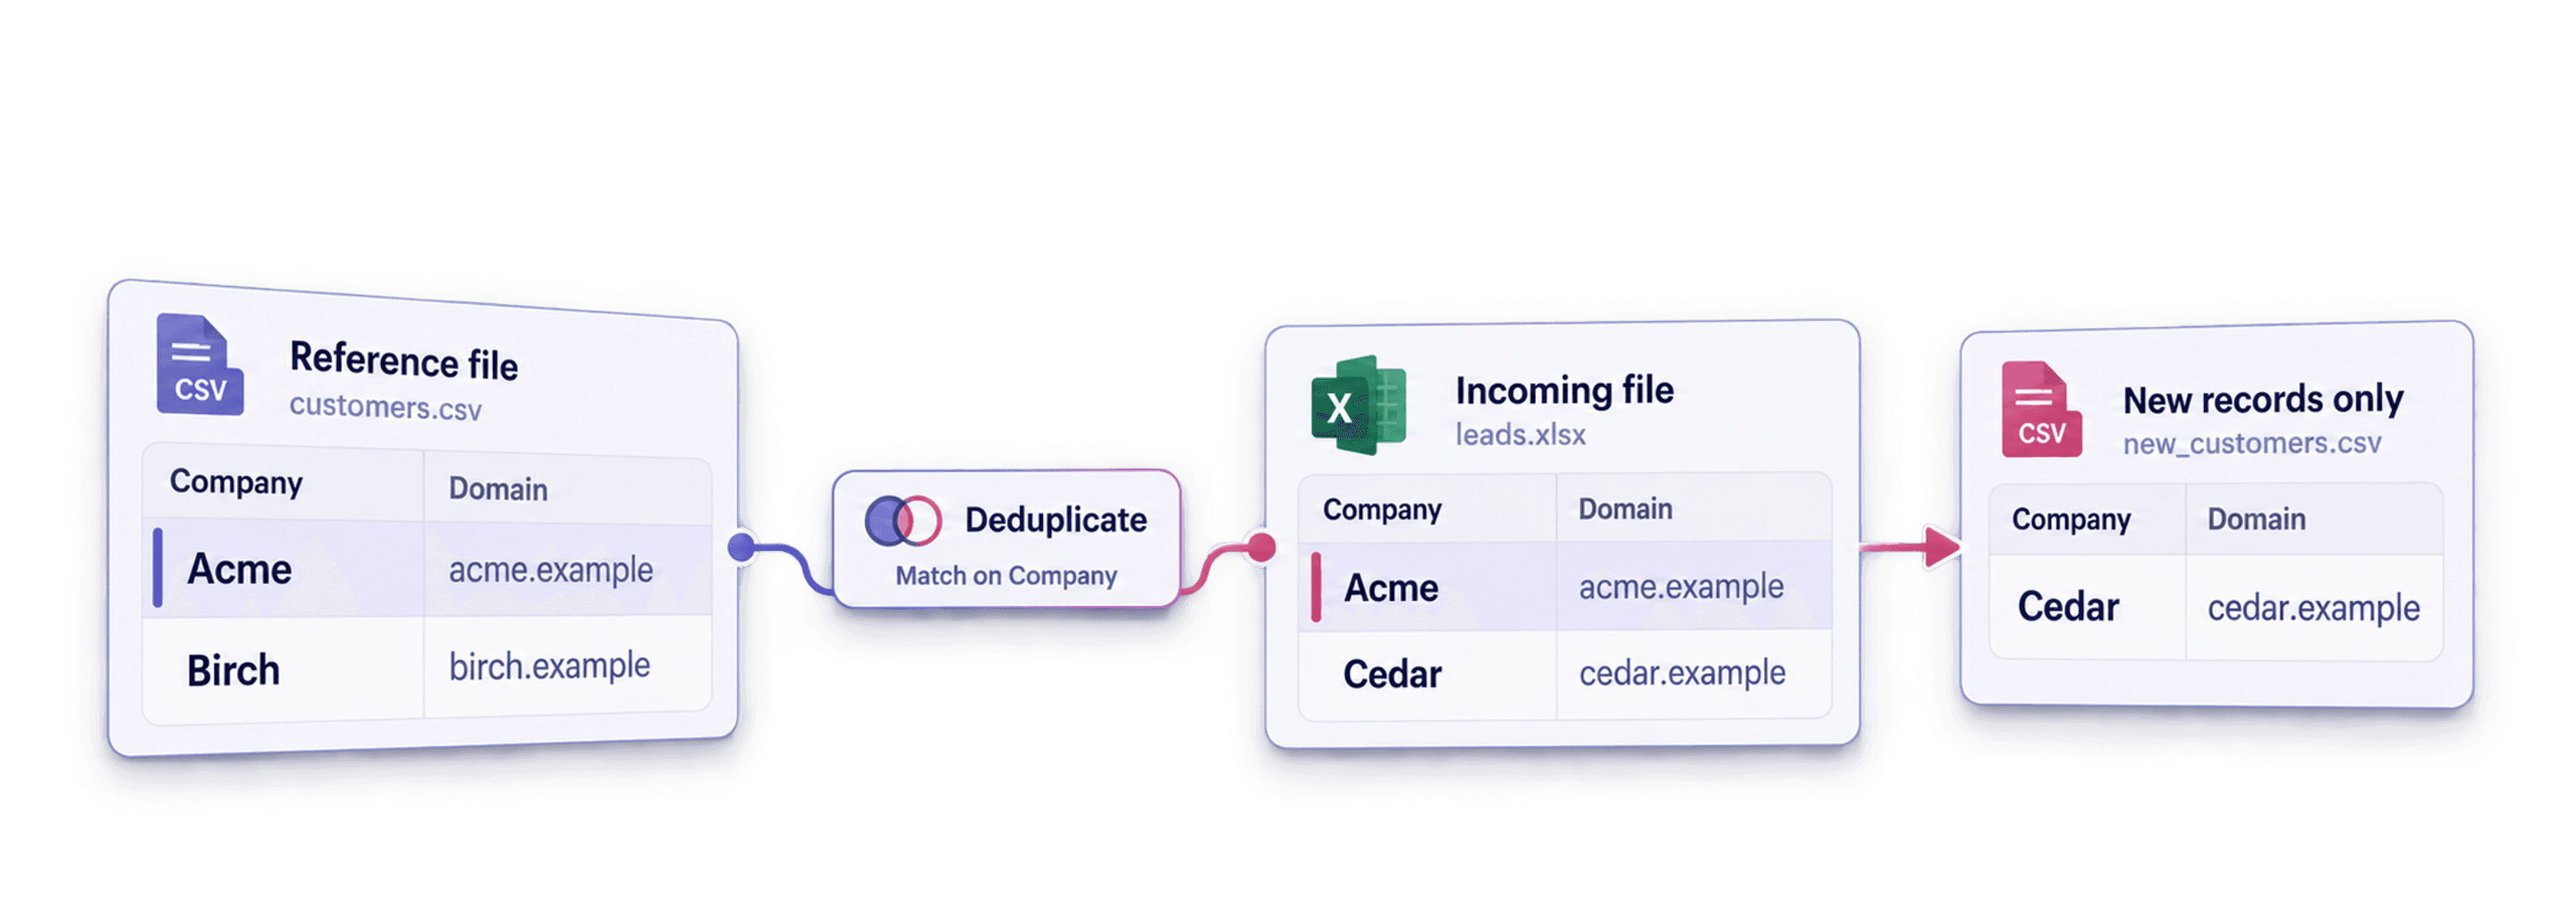
Aby usunąć duplikaty z kilku plików Excel lub CSV, umieść każdy plik w osobnej kolekcji Datablist, zmapuj właściwości identyfikujące te same rekordy i porównaj kolekcje. Następnie możesz usunąć pasujące wiersze z nowej listy, pozostawiając listę referencyjną bez zmian.
Ten workflow sprawdza się, gdy masz eksport z CRM i nowy plik z prospectami. Pozwala odpowiedzieć na konkretne pytanie: którzy prospekci znajdują się już w CRM?
Automatyczna operacja służy do wykluczania rekordów, a nie do ich scalania. Usuwa dopasowane rekordy z wybranej kolekcji. Nie kopiuje ich unikalnych wartości do innej kolekcji.
W tym poradniku przedstawiamy rzeczywisty test z użyciem dwóch plików CSV, z których każdy zawiera 250 wierszy:
| Kolekcja | Rola | Liczba wierszy przed operacją | Właściwość dopasowania |
|---|---|---|---|
CRM Export | Lista referencyjna, którą należy zachować | 250 | Email |
Event Registrations | Nowa lista do oczyszczenia | 250 | Attendee Email |
Pliki zawierają 100 celowo utworzonych duplikatów występujących na obu listach. Po usunięciu tych dopasowań z Event Registrations pozostaje 150 nowych kontaktów z wydarzenia.
W tym przykładzie dopasowujemy rekordy według adresu e-mail. Jeśli na listach brakuje adresów e-mail lub kontakty mają kilka identyfikatorów, przed podjęciem decyzji o bezpiecznym usunięciu dopasowań przeczytaj poradnik o deduplikacji leadów.
Pobierz dwa pliki przykładowe
Aby odtworzyć test, pobierz poniższe pliki:
Nagłówki celowo się różnią. W pliku z CRM użyto kolumn Email, First Name i Last Name. Plik wydarzenia zawiera kolumny Attendee Email, Attendee First Name i Attendee Last Name. Mapowanie właściwości między kolekcjami pozwala zachować oryginalną strukturę obu plików.
Dane testowe obejmują różne sposoby formatowania adresów e-mail oraz aliasy. Dlatego dopasowanie Smart z procesorem Email jest w tym przypadku bardziej przydatne niż zwykłe porównanie Exact.
Zaimportuj oba pliki
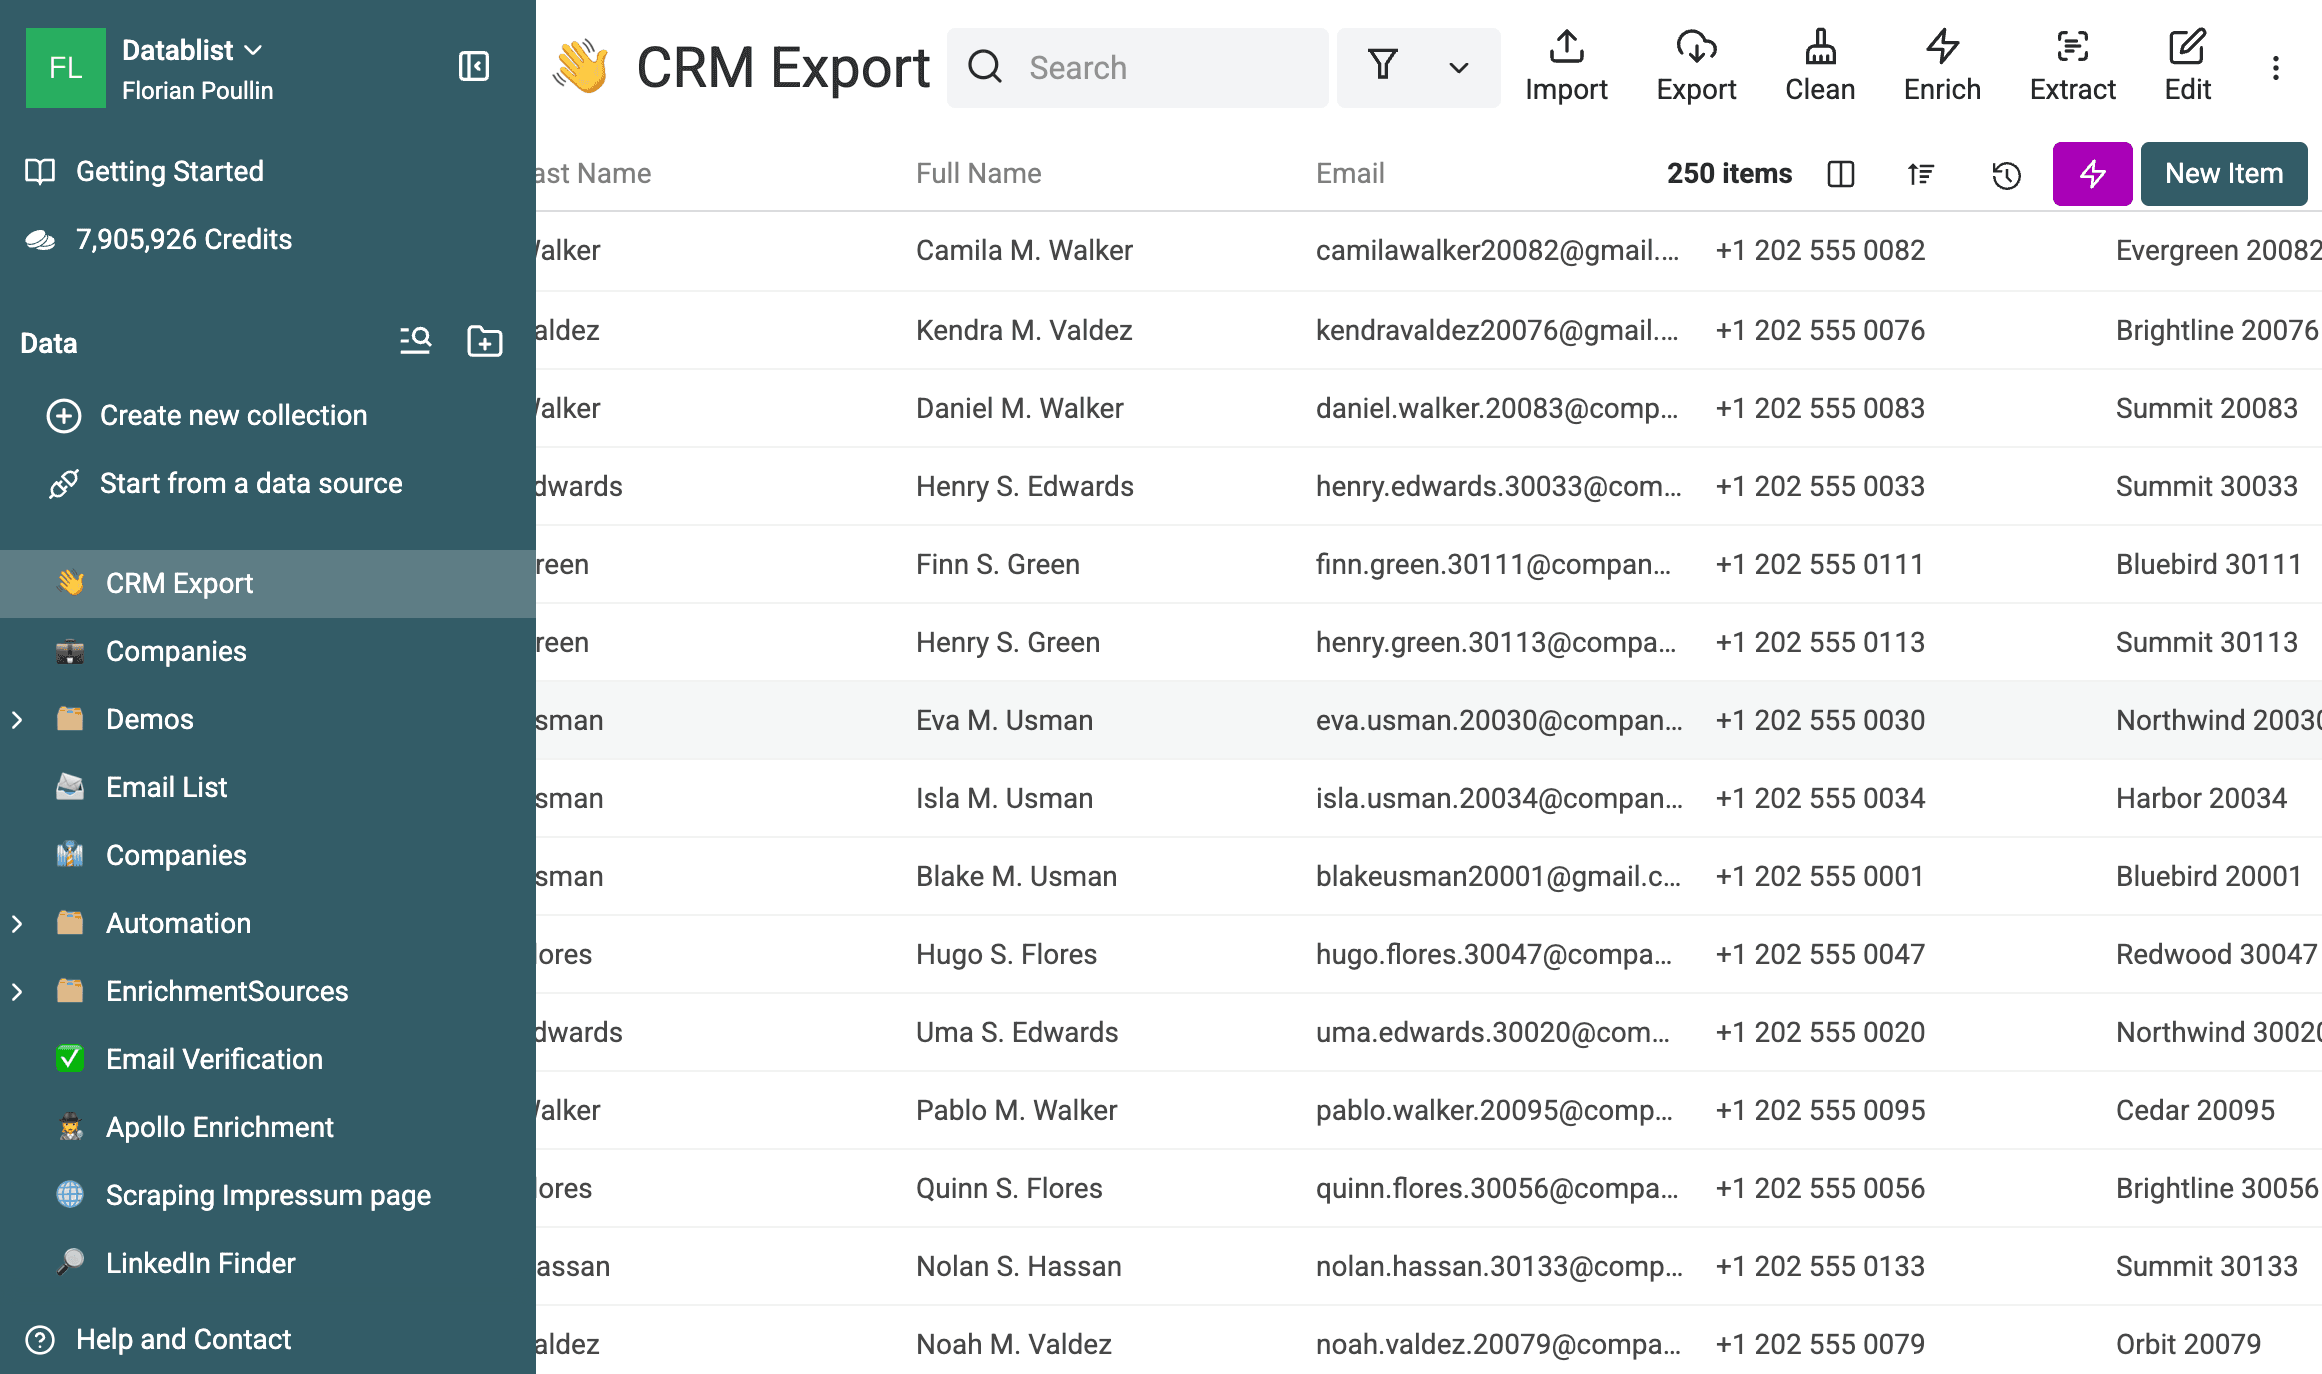
Otwórz Datablist i zaimportuj każdy plik CSV lub Excel do osobnej kolekcji. Nazwij kolekcje zgodnie z ich rolą, aby łatwo zweryfikować regułę czyszczenia.
Pierwsza kolekcja w tym teście to lista referencyjna z CRM. Zawiera 250 rekordów i musi pozostać bez zmian.
Druga kolekcja to nowa lista uczestników wydarzenia. Początkowo również zawiera 250 rekordów.
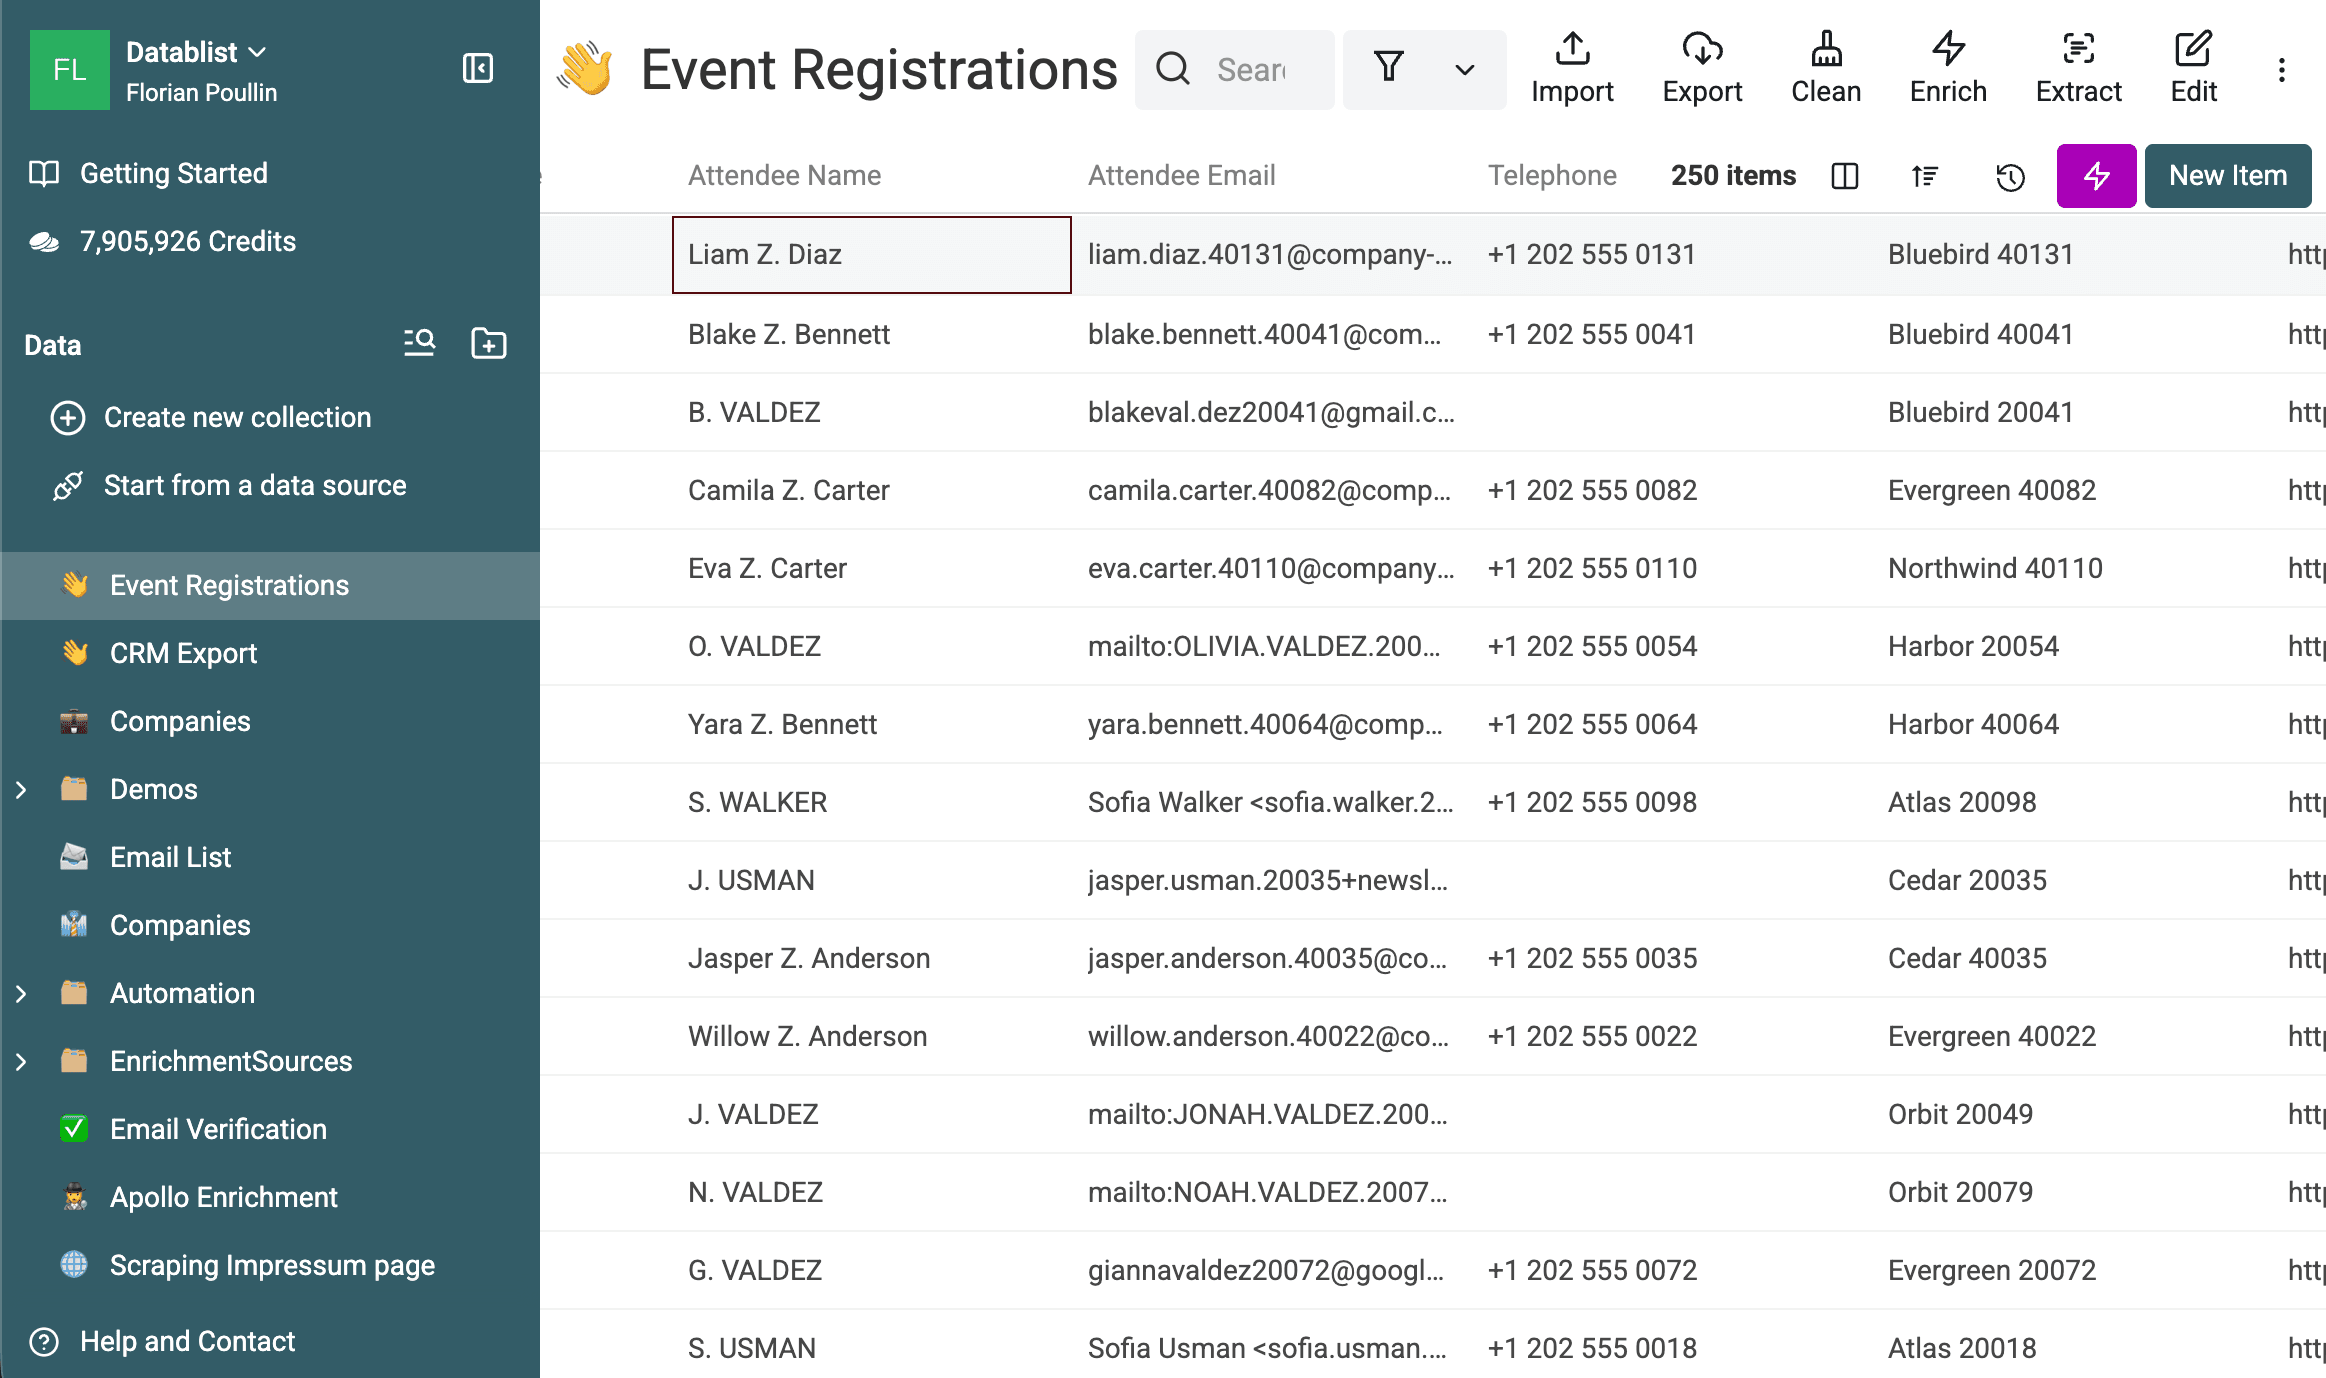
Podczas importowania sprawdź typy właściwości. Obie kolumny z adresami e-mail ustaw jako typ Email. Zachowaj zewnętrzne identyfikatory, imiona i nazwiska, numery telefonów oraz pozostałe pola — pomogą Ci ocenić niejednoznaczne dopasowania.
Zmapuj właściwości identyfikujące rekordy
Otwórz nową kolekcję Event Registrations. Wybierz Clean > Match across collections.
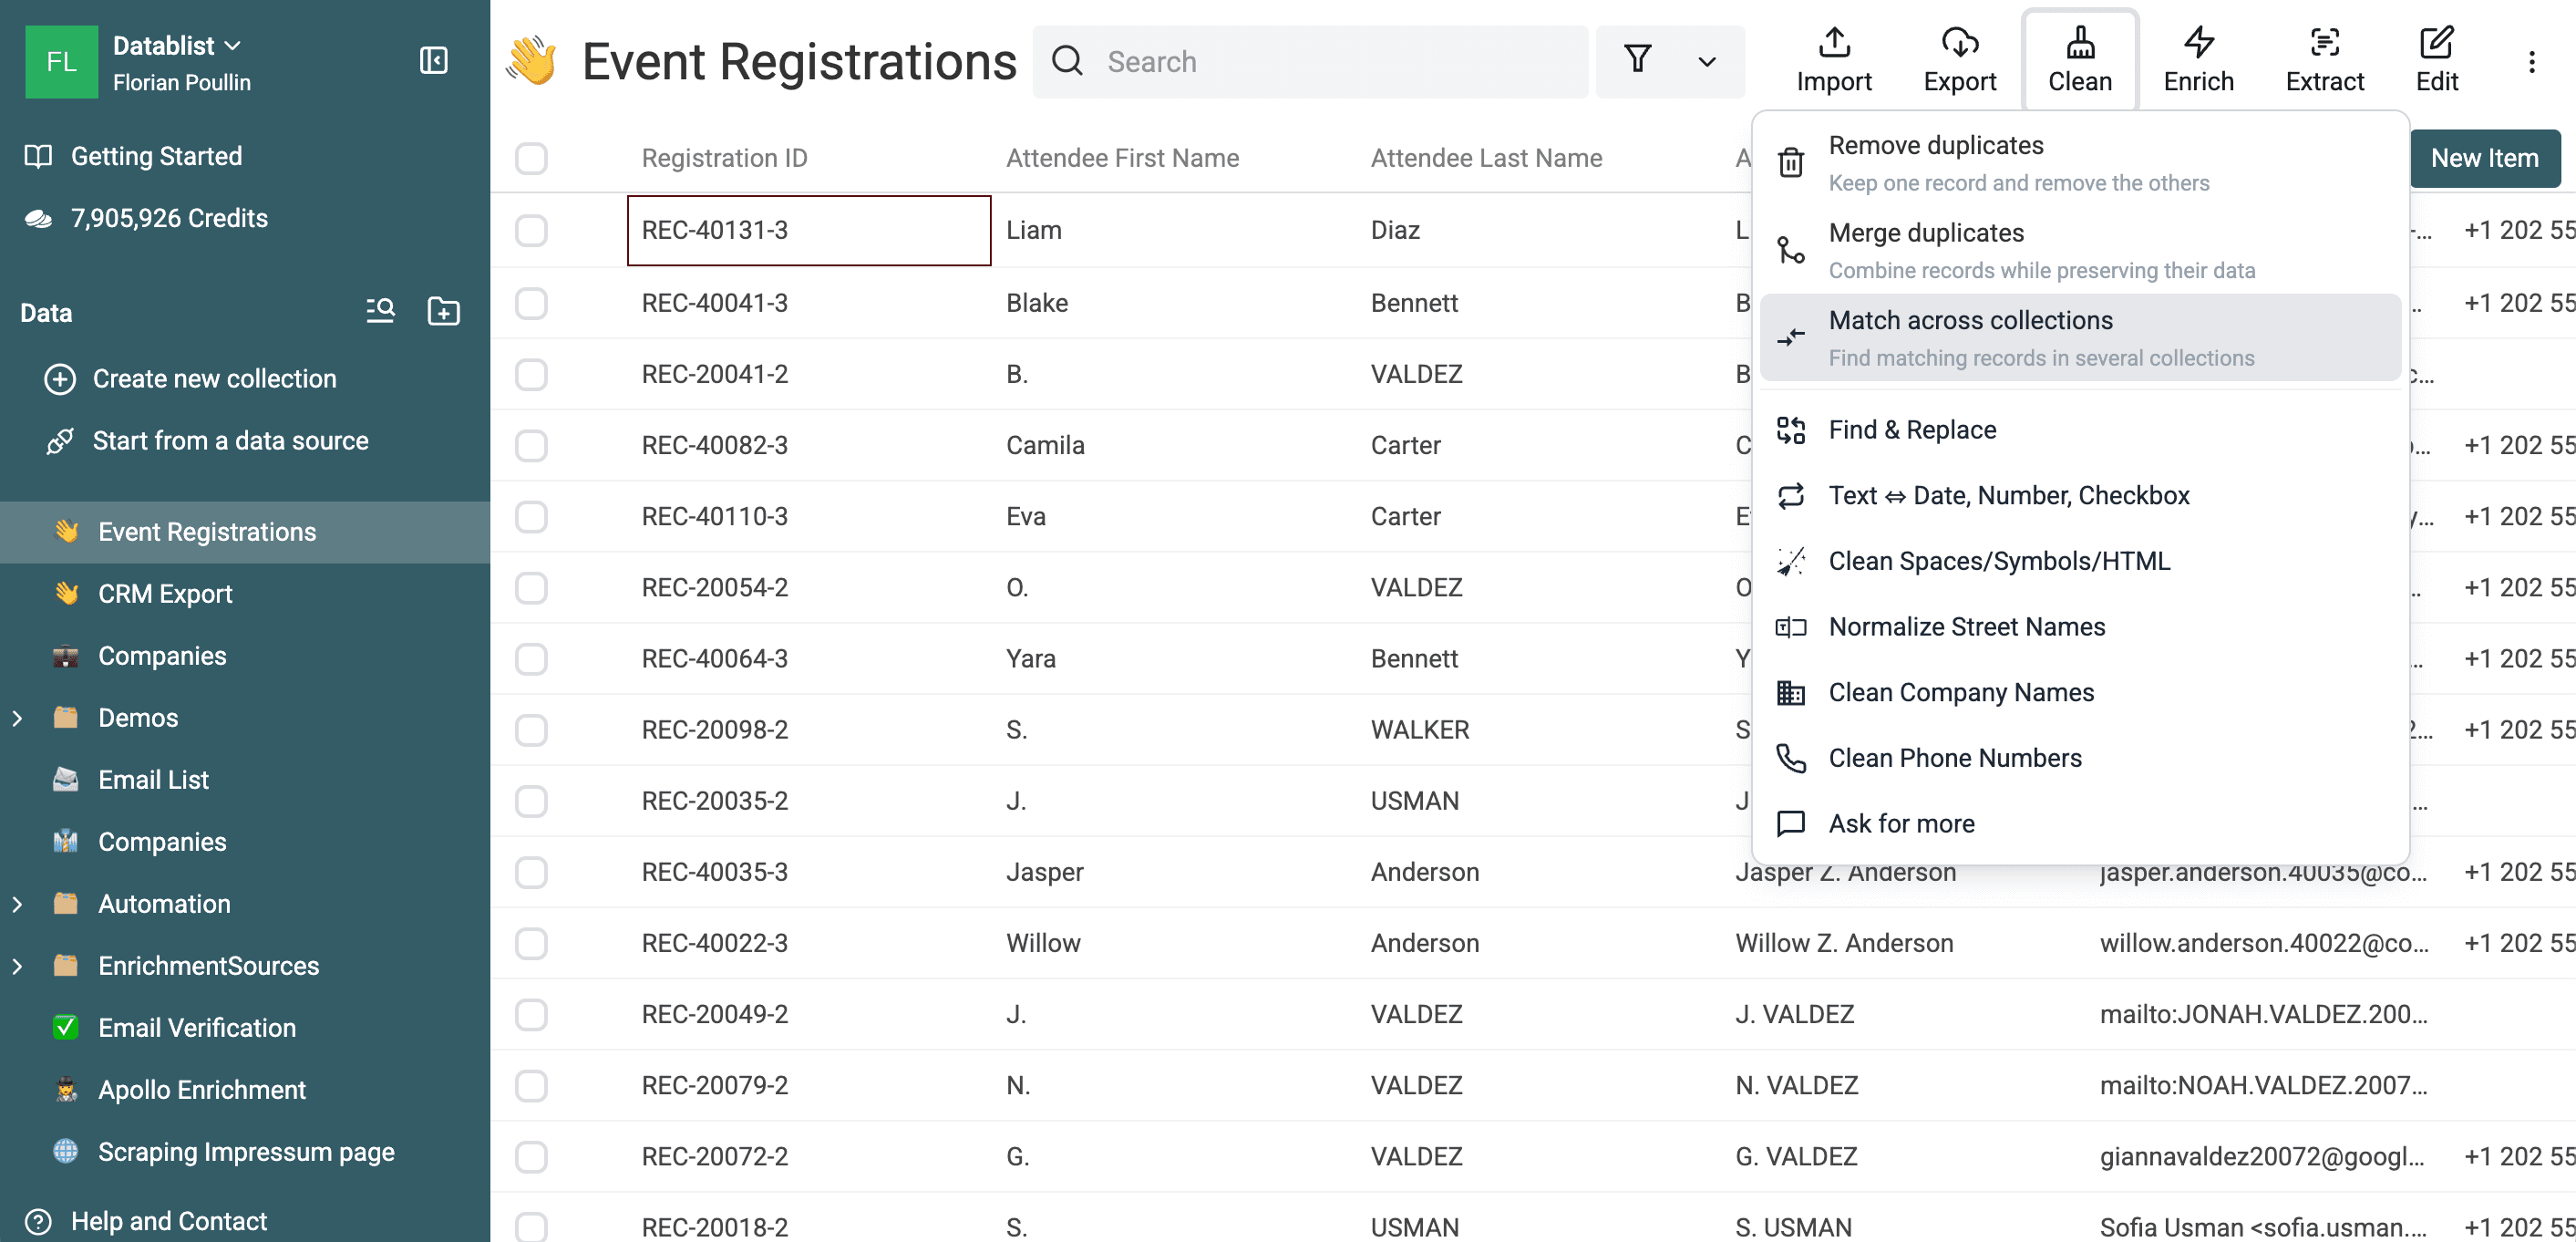
Włącz opcję Check duplicate items across several collections? i dodaj kolekcję CRM Export.
W kolekcji wydarzenia wybierz Attendee Email, a następnie zmapuj tę właściwość na Email w kolekcji CRM.
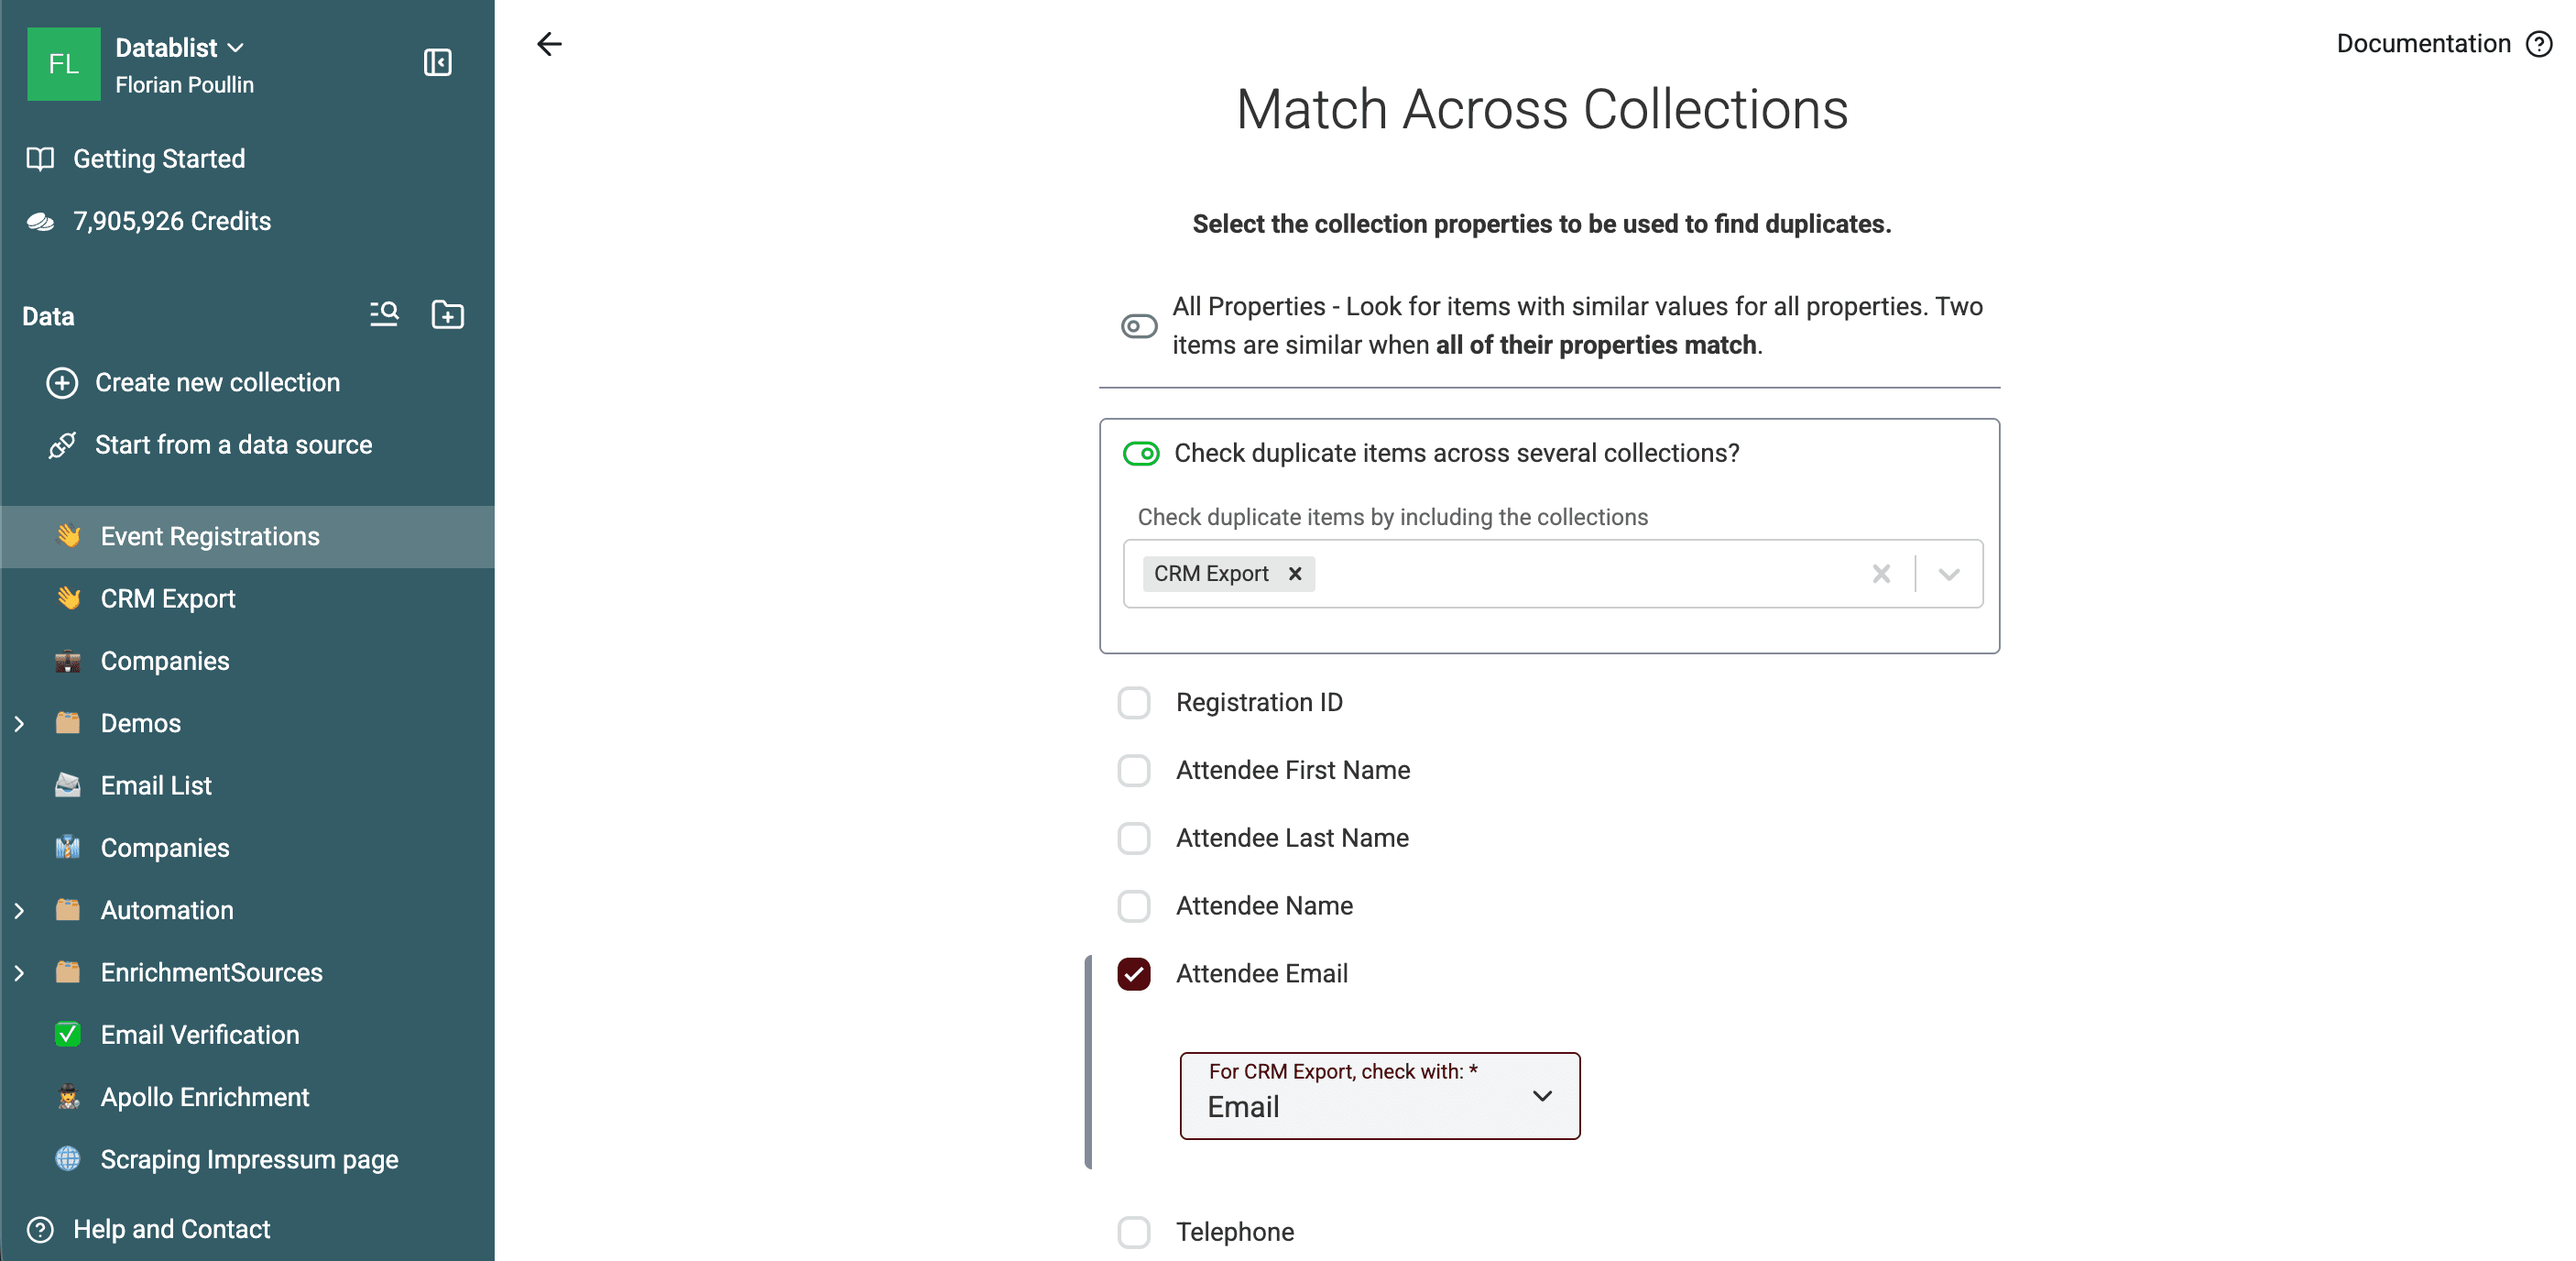
Dobry identyfikator jest ważniejszy niż nazwa kolumny. Odpowiednie identyfikatory to między innymi:
- Adres e-mail w przypadku kontaktów.
- Numer telefonu, jeśli oba pliki korzystają ze zgodnych kodów krajów.
- URL profilu LinkedIn na listach prospectów.
- Domena strony internetowej w przypadku firm.
- SKU lub inny stały identyfikator produktów.
Nie dopasowuj rekordów wyłącznie na podstawie imienia. Wiele różnych osób może mieć takie samo imię.
Jeśli wybierzesz kilka właściwości, Datablist oceni ich łączny wynik. Gdy chcesz niezależnie sprawdzić adresy e-mail i numery telefonów, uruchom osobne porównania. Po włączeniu opcji Match on empty value właściwości, które są puste w obu rekordach, otrzymują wynik 100% i mogą zawyżyć średnią. Przed usunięciem grupy sprawdź uzupełnione identyfikatory i zapoznaj się z przykładem punktacji pustych wartości.
Skonfiguruj porównanie
Trybu Exact używaj w przypadku stałych identyfikatorów, które muszą być identyczne. Dla adresów e-mail wybierz tryb Smart z procesorem Email.
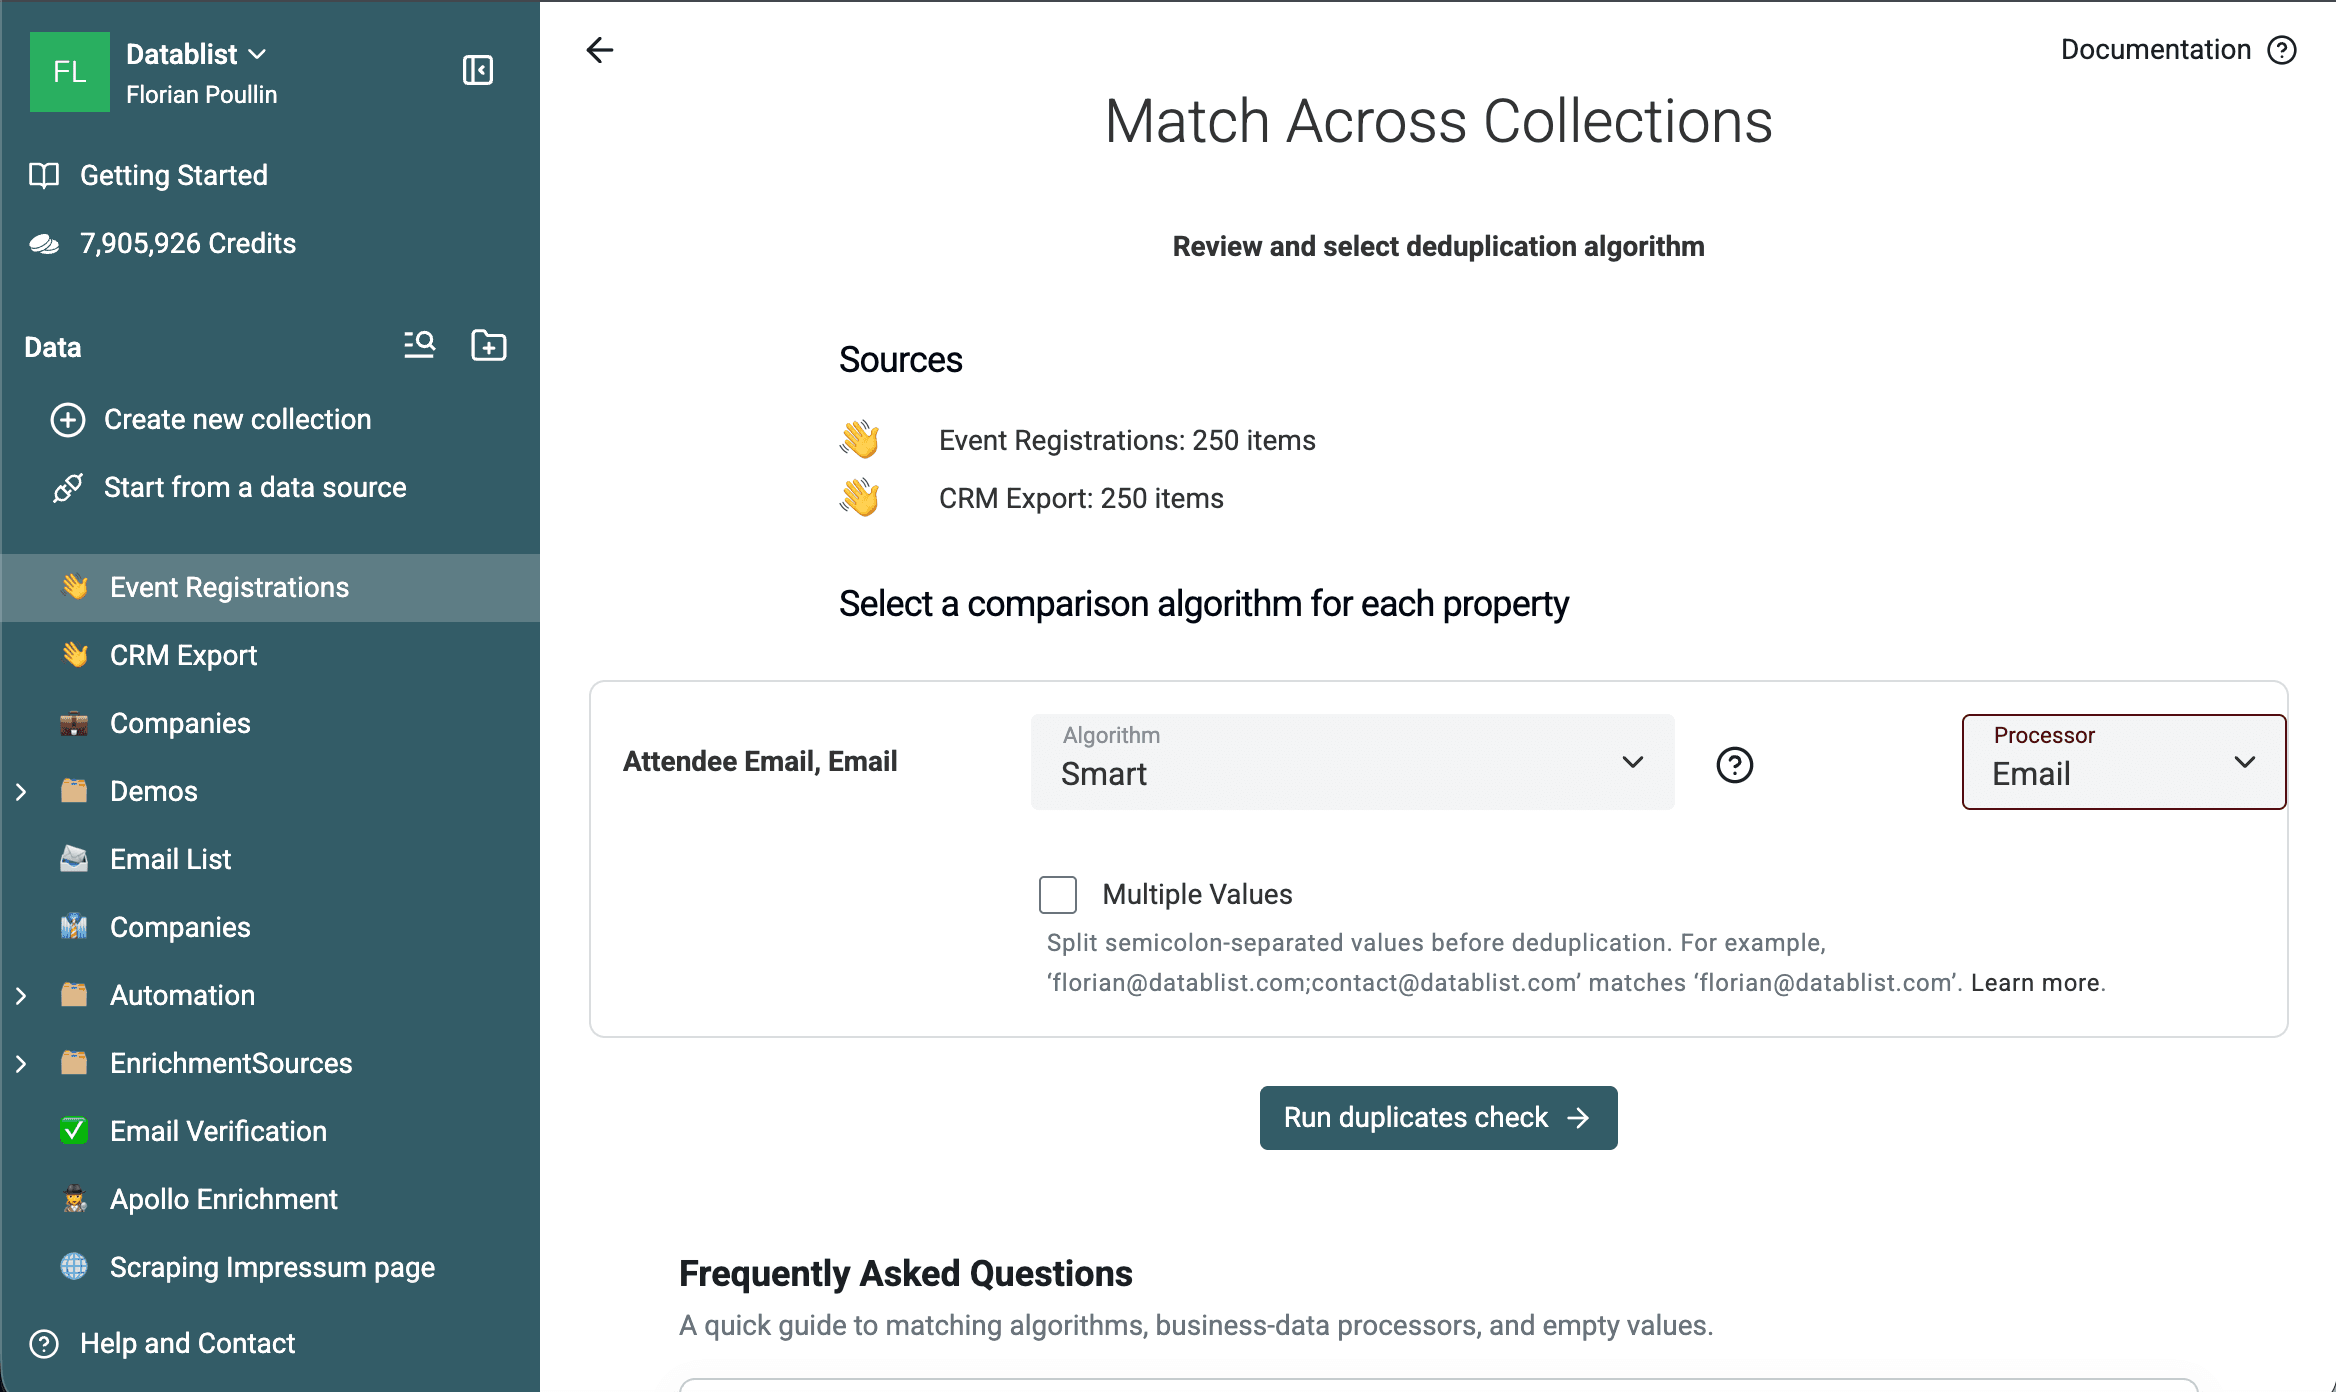
Procesor Email standaryzuje obsługiwane warianty adresów na potrzeby porównania, nie zmieniając zawartości komórek źródłowych. Szczegółowe informacje o działaniu tej funkcji i jej ograniczeniach znajdziesz w poradniku dotyczącym usuwania duplikatów adresów e-mail i aliasów.
Po sprawdzeniu obu źródeł, liczby elementów, zmapowanych właściwości i ustawień porównania kliknij Run duplicates check.
Sprawdź dopasowania między listami
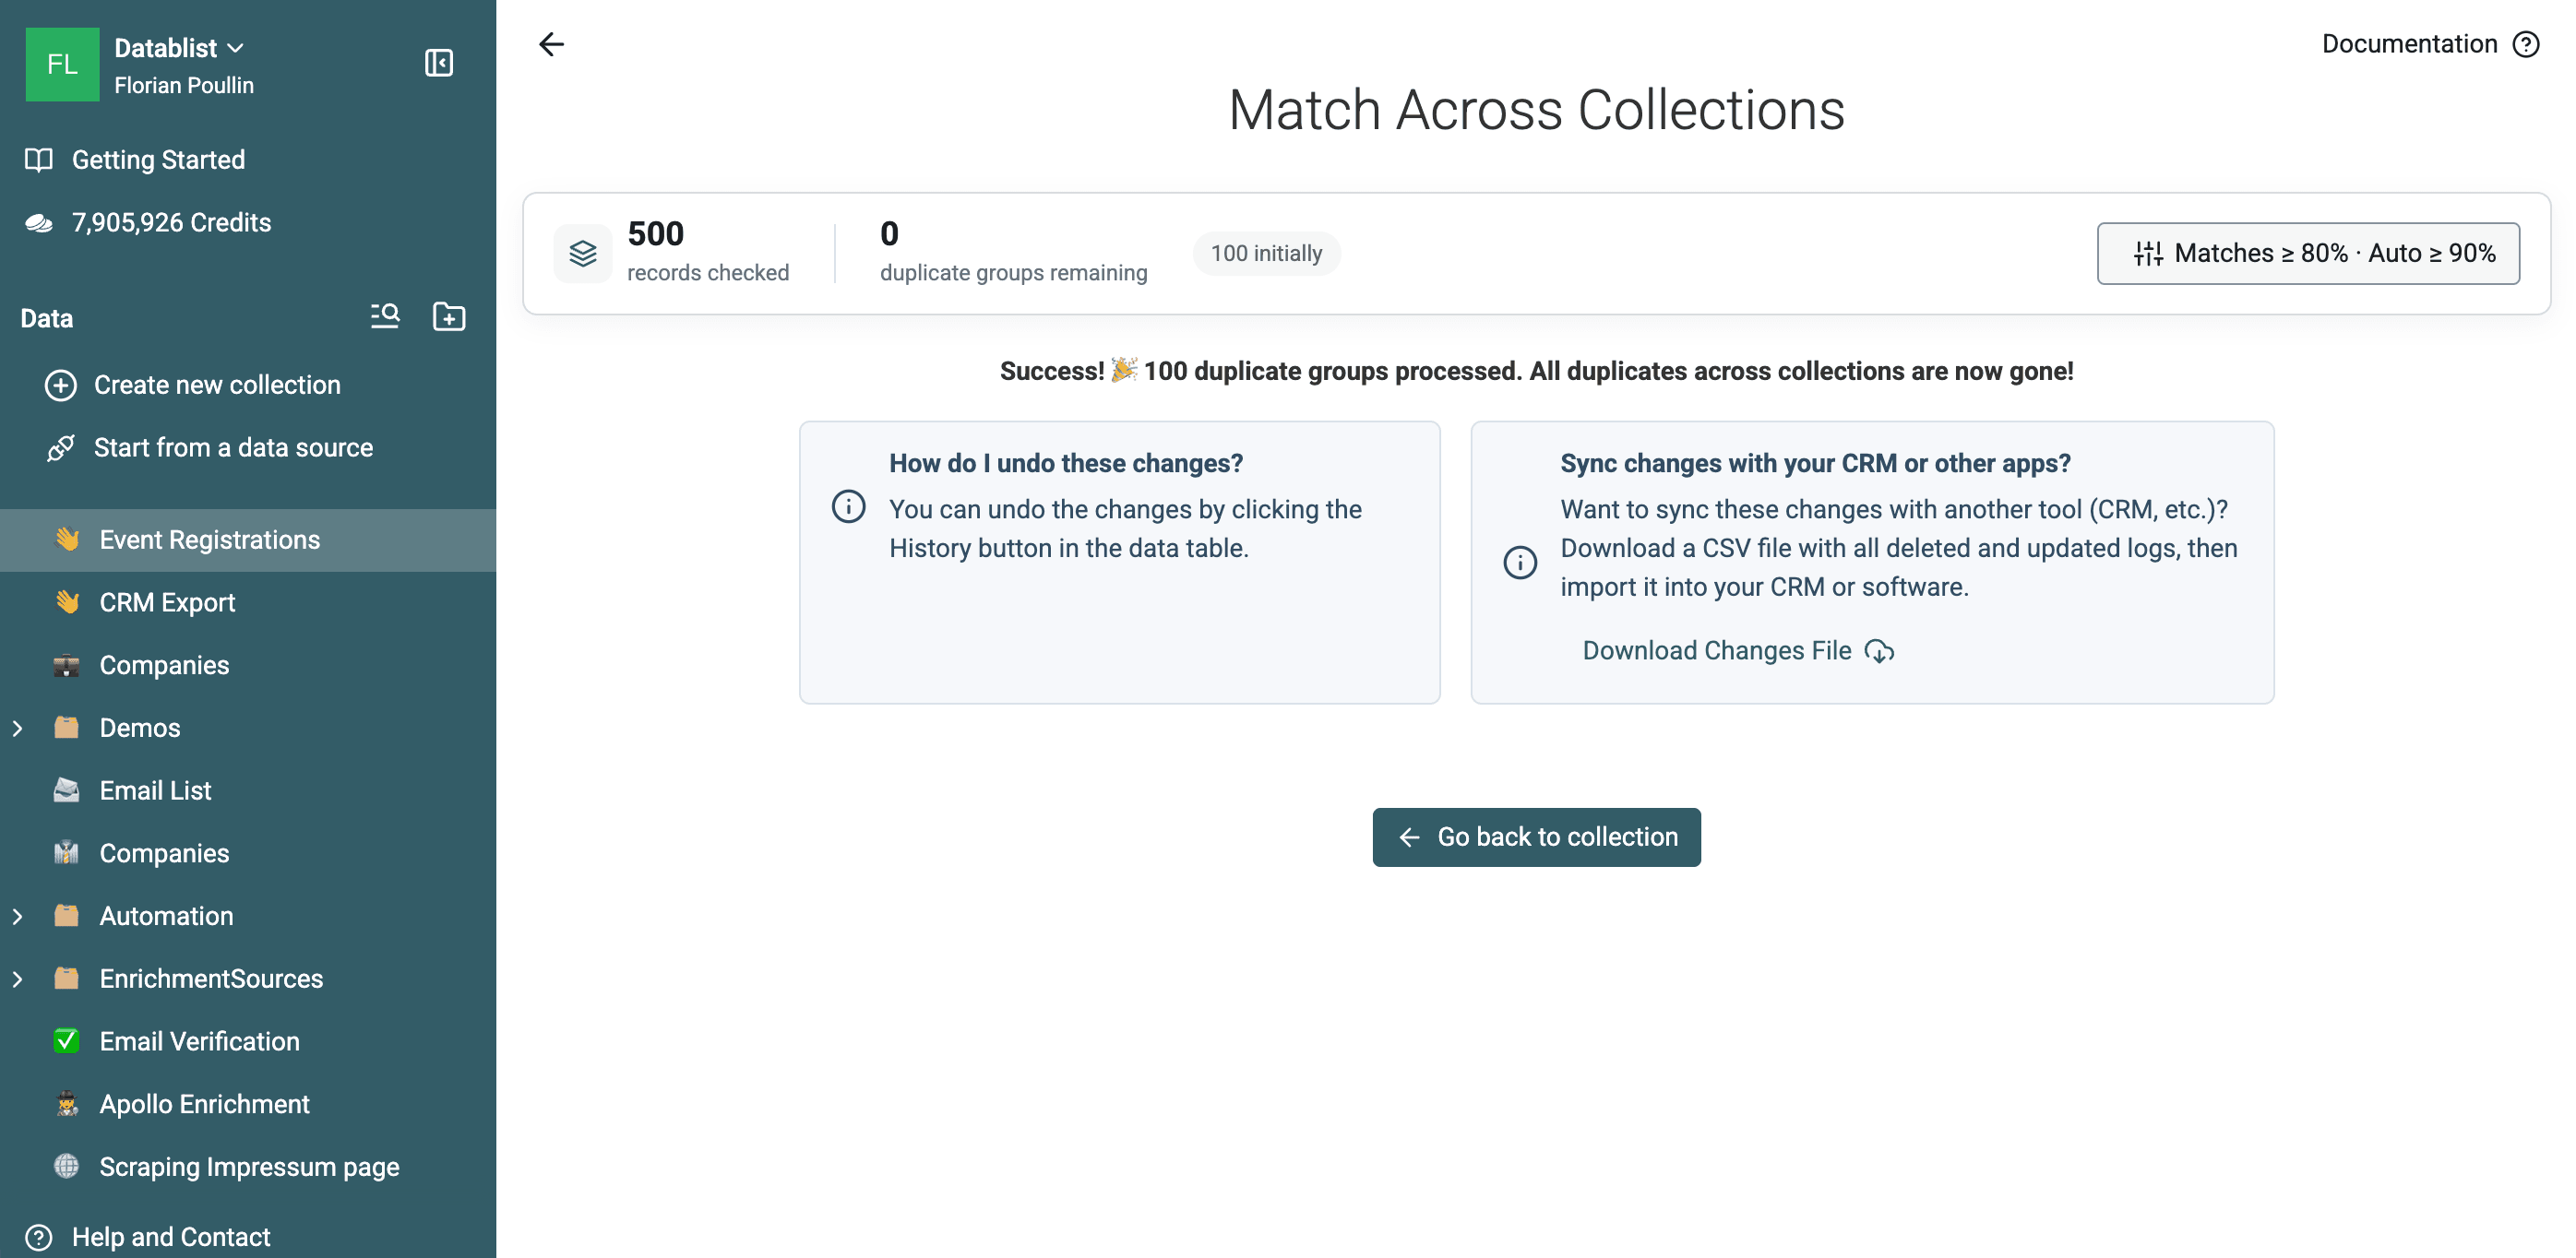
W tym teście sprawdzono 500 rekordów i wykryto 100 grup duplikatów występujących w różnych kolekcjach.
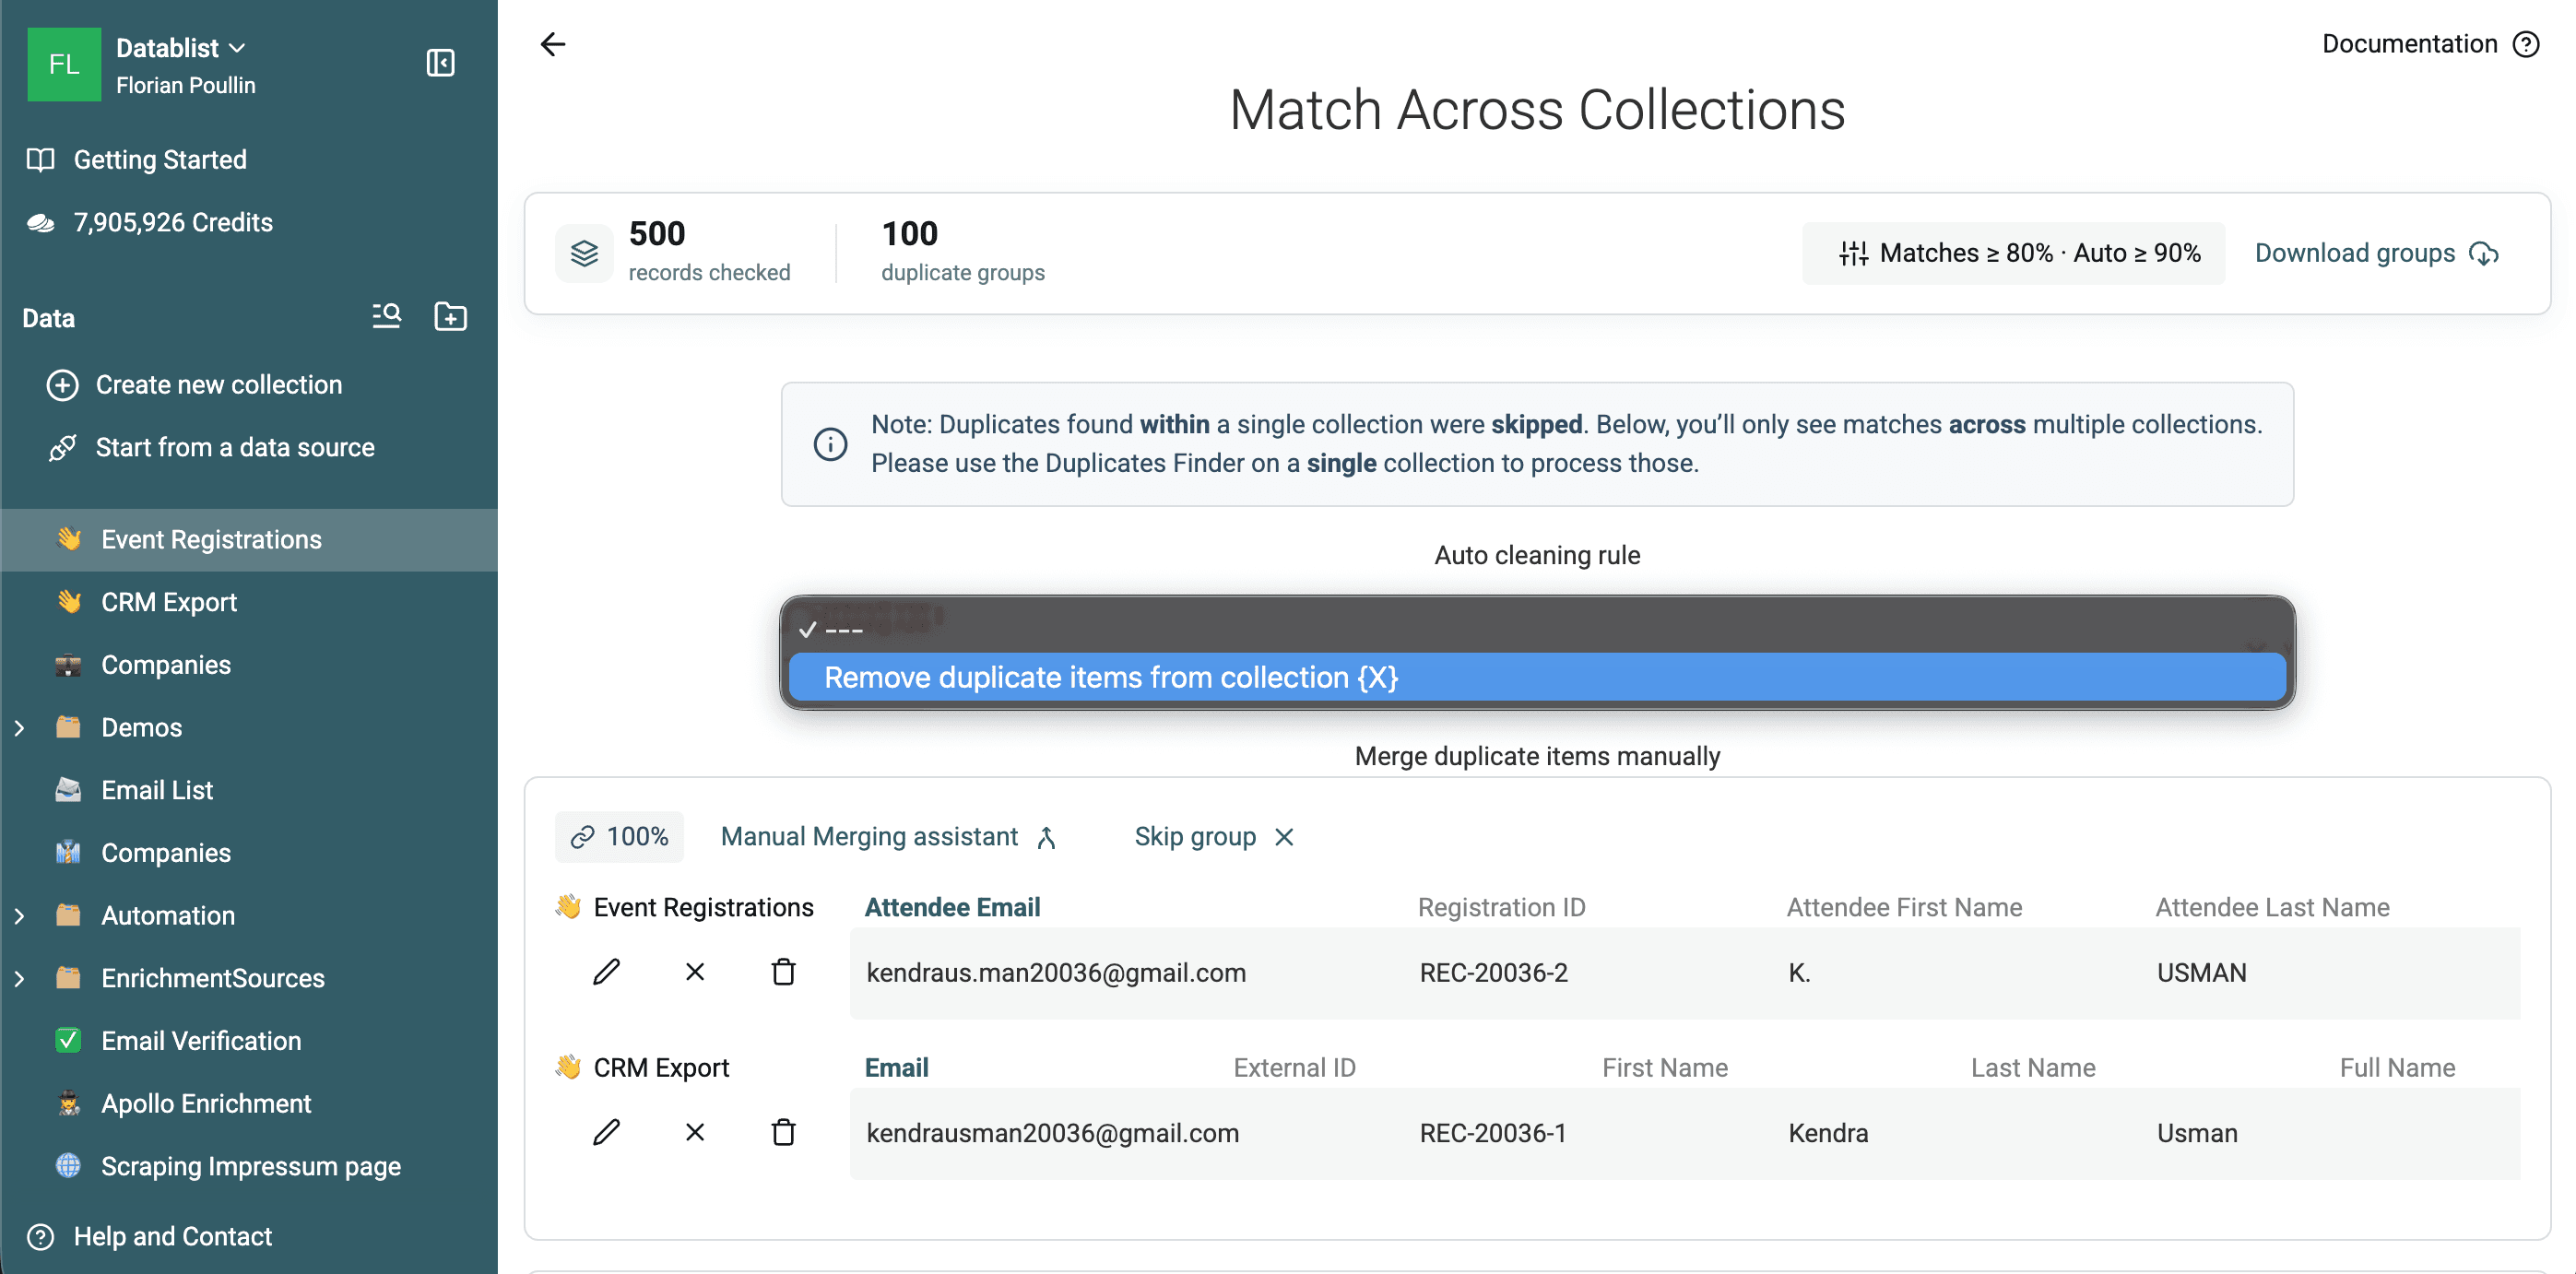
Tryb porównywania między kolekcjami zwraca wyłącznie grupy zawierające rekordy z więcej niż jednej kolekcji. Pomija duplikaty występujące tylko w CRM Export lub tylko w Event Registrations.
Przed usunięciem danych sprawdź wykryte grupy:
- Upewnij się, że zmapowany identyfikator wskazuje tę samą osobę lub firmę.
- Sprawdź, czy nowy wiersz zawiera unikalne dane.
- Zweryfikuj, która kolekcja jest listą referencyjną.
- Pobierz grupy, jeśli usunięcie dopasowań wymaga zatwierdzenia przez inną osobę.
- Jeśli pojedyncza grupa wymaga scalenia zamiast usunięcia, użyj Manual Merging Assistant.
Jeśli chcesz również usunąć duplikaty wewnątrz któregoś pliku, uruchom osobno workflow Duplicates Finder dla danej kolekcji.
Usuń duplikaty z nowej listy
Wybierz Remove duplicate items from collection {X}, a następnie wskaż Event Registrations jako kolekcję do oczyszczenia.
Przed rozpoczęciem operacji Datablist wyświetli jej skutki:
- Dopasowane rekordy zostaną usunięte z
Event Registrations. - Kolekcja
CRM Exportpozostanie bez zmian. - Rekordy wydarzenia, które nie mają odpowiednika w CRM, zostaną zachowane.
- Unikalne wartości znajdujące się wyłącznie w usuwanych rekordach wydarzenia zostaną utracone.
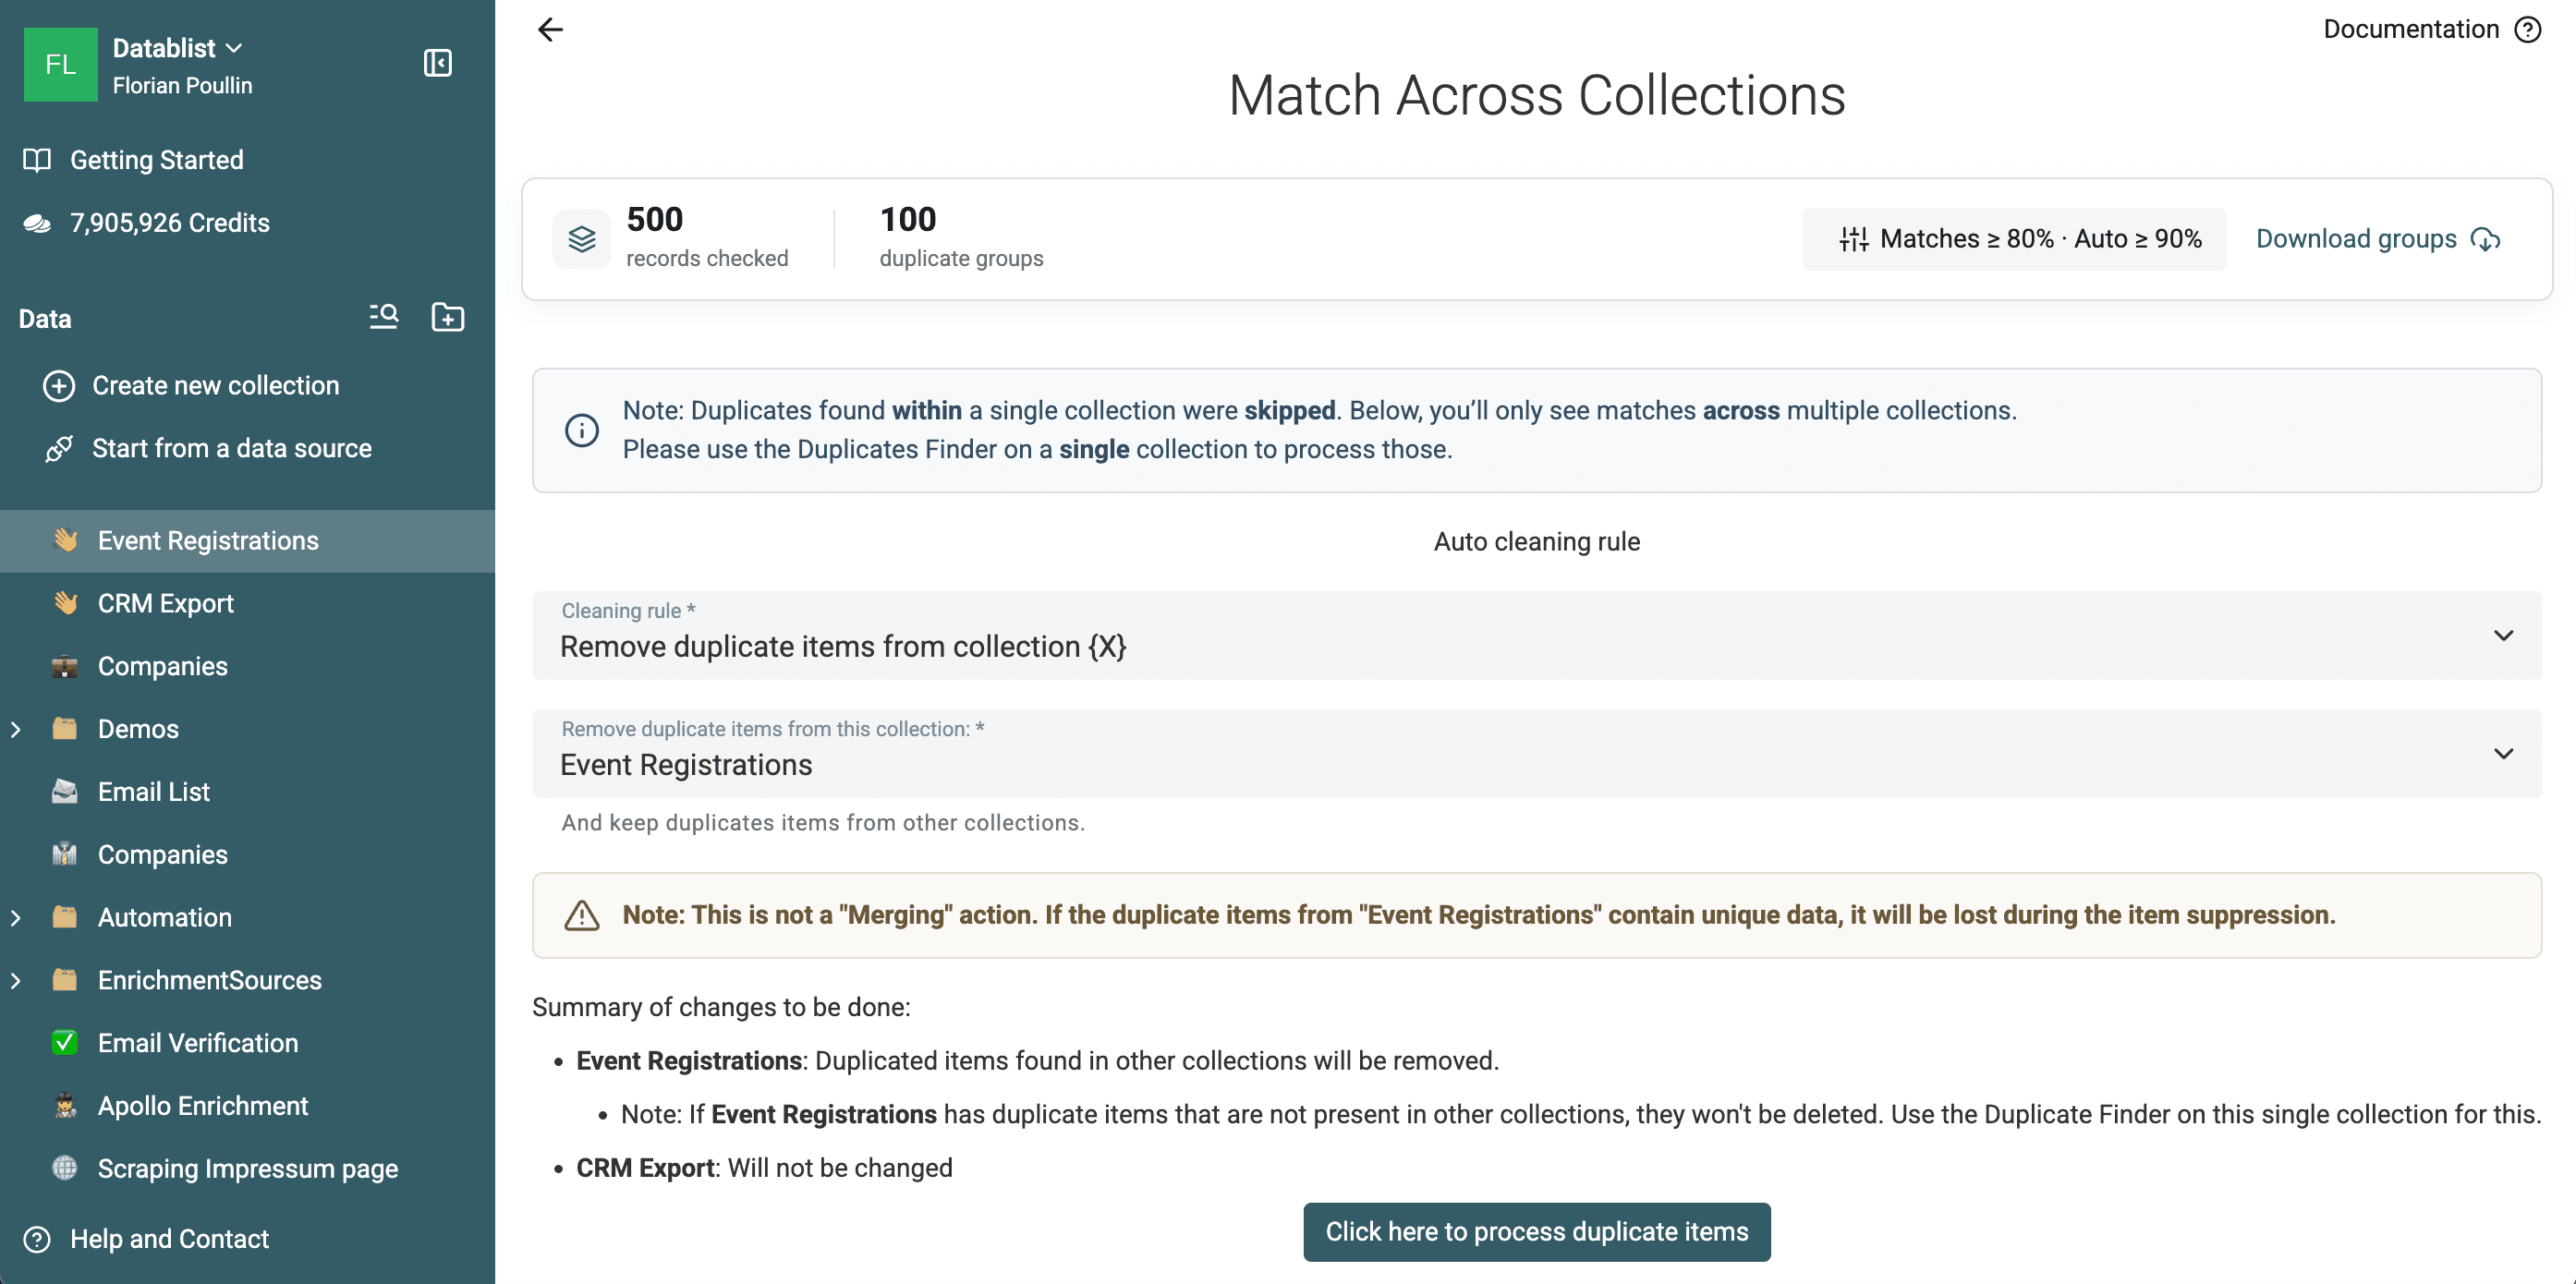
⚠️ Ta operacja nie scala danych z CRM
Jeśli rekord wydarzenia zawiera przydatny numer telefonu, źródło, pole zgody lub notatkę, których brakuje w CRM, automatyczne usunięcie nie skopiuje tych danych. Najpierw sprawdź lub wyeksportuj grupy albo użyj Manual Merging Assistant dla odpowiednich grup.
W przypadku co najmniej trzech kolekcji Datablist oferuje również regułę, która zachowuje duplikaty tylko w jednej wybranej kolekcji. Przed rozpoczęciem operacji dokładnie sprawdź podsumowanie, ponieważ rekordy mogą zostać usunięte z kilku źródeł.
Gdy wybrana kolekcja i podsumowanie odpowiadają planowanej operacji, kliknij Process duplicate items.
W tym teście Datablist przetworzył wszystkie 100 grup duplikatów między kolekcjami. Na ekranie wyników liczba pozostałych grup wyniosła zero.
Zweryfikuj oczyszczoną listę
Wróć do kolekcji Event Registrations. Zawiera teraz 150 elementów.
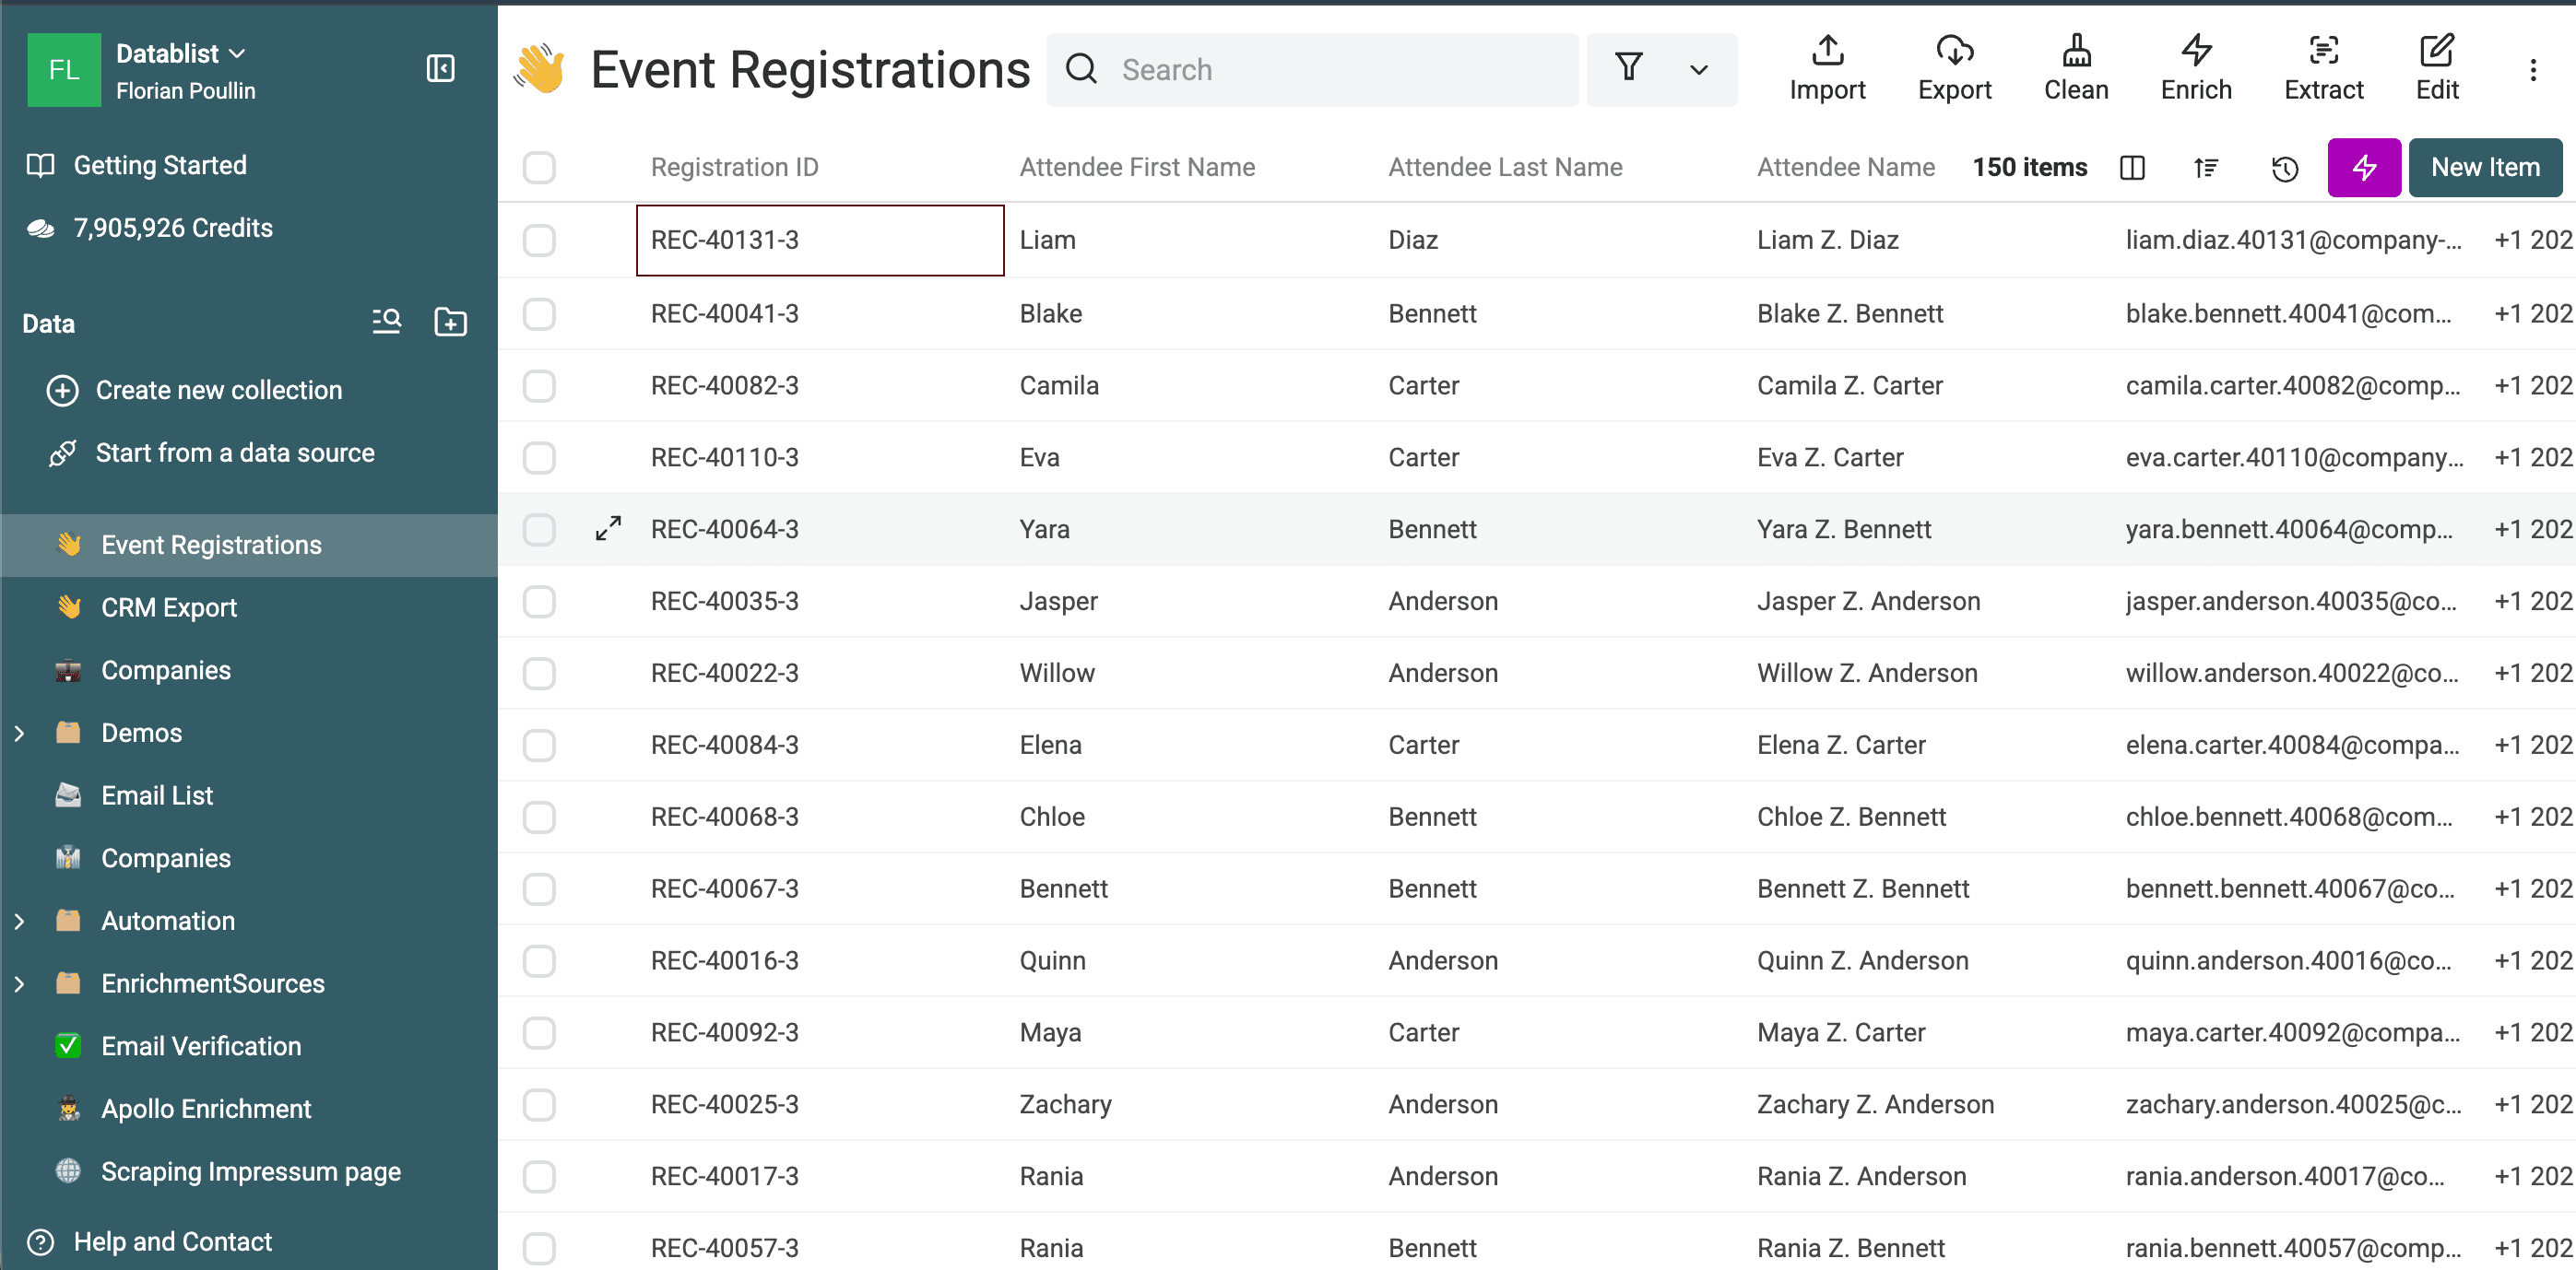
Liczbę wierszy można uzgodnić następująco:
250 nowych wierszy - 100 kontaktów dopasowanych do CRM = 150 nowych wierszy
Przed eksportem upewnij się, że:
CRM Exportnadal zawiera 250 elementów.Event Registrationszawiera 150 elementów.- Kilka znanych adresów e-mail z CRM nie występuje już na liście wydarzenia.
- Niedopasowane kontakty z wydarzenia pozostały na liście.
- Wykonana operacja jest widoczna w History, aby w razie potrzeby można było ją cofnąć.
Wyeksportuj oczyszczoną kolekcję wydarzenia do pliku CSV lub Excel. Lista jest teraz gotowa do workflow dla nowych leadów bez ponownego importowania kontaktów, które znajdują się już w CRM.
Ograniczenia deduplikacji między kolekcjami
Dopasowywanie rekordów między kolekcjami ma węższe zastosowanie niż scalanie plików:
- Automatyczne przetwarzanie usuwa rekordy. Nie łączy pól pochodzących z różnych kolekcji.
- Duplikaty wewnątrz jednej kolekcji są pomijane.
- Każda właściwość używana do porównania musi zostać zmapowana we wszystkich wybranych kolekcjach.
- Dopasowania według wybranych właściwości zależą od łącznych wyników i ustawień pustych wartości.
- Dopasowania Smart, fuzzy i phonetic mogą zwracać kandydatów wymagających ręcznej weryfikacji.
- Dopasowywanie między kolekcjami wymaga płatnego planu.
Ten workflow sprawdzi się w przypadku list wykluczeń, kontroli importu do CRM, czyszczenia leadów z wydarzeń, wykluczania odbiorców kampanii oraz każdego procesu, w którym jedna lista musi pozostać źródłem prawdy.
Jeśli przed deduplikacją chcesz połączyć pliki w jedną tabelę, skorzystaj z poradnika dotyczącego scalania arkuszy kalkulacyjnych. Jeśli chcesz zachować uzupełniające się wartości w obrębie jednej kolekcji, użyj workflow dla pojedynczej listy, aby scalić zduplikowane leady bez utraty danych.