
Kilka miesięcy temu udostępniliśmy funkcję, po której nie spodziewaliśmy się aż takich możliwości.
Dziś ta funkcja zmienia rynek web scrapingu no-code.
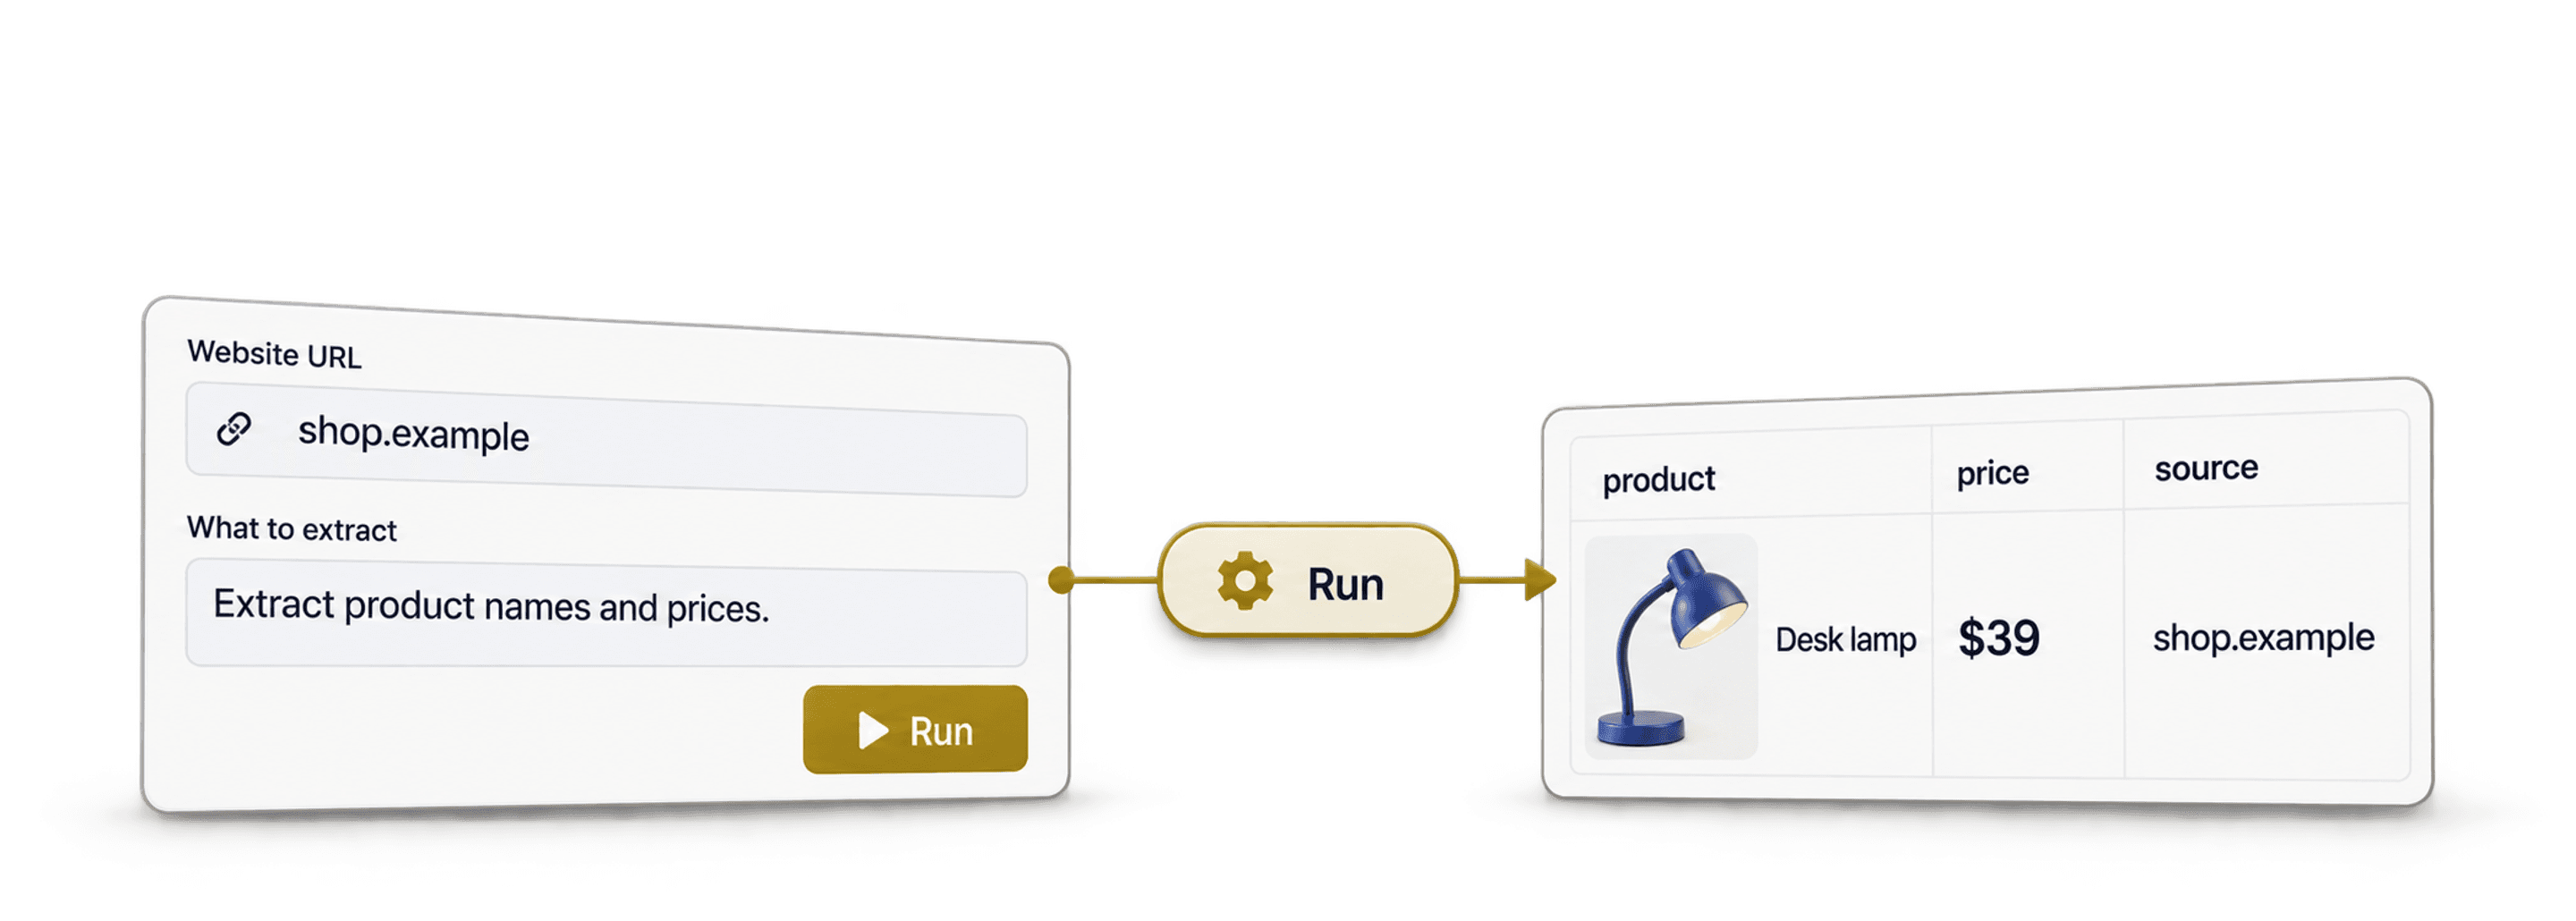
Mowa o naszym źródle „AI Agent - Site Scraper”. Pozwala ono wyodrębniać uporządkowane wiersze z dostępnej treści stron internetowych na podstawie Twoich instrukcji.
Kilka miesięcy później doszedłem do trzech wniosków:
- Cała branża scrapingu no-code opiera się na wielkim kłamstwie
- Nieświadomie stworzyliśmy najlepszy scraper no-code
- Agenci AI do scrapingu są skuteczniejsi, łatwiejsi w obsłudze i szybsi niż wszystkie wcześniejsze narzędzia no-code do scrapingu.
📌 Podsumowanie dla zabieganych
Ten artykuł wyjaśnia wszystko, co musisz wiedzieć o prawdziwym scrapingu no-code, i pokazuje, że nie wymaga on API, selektorów CSS ani wiedzy technicznej. Jeśli nie masz czasu, oto najważniejsze informacje:
Problem: Narzędzia do scrapingu reklamowane jako „no-code” nadal wymagają wiedzy technicznej, zrozumienia struktury stron, oglądania tutoriali i wielogodzinnej konfiguracji. Wystarczy też drobna zmiana na stronie, aby wszystko przestało działać.
Dlaczego to problem: Samo pozyskanie danych ze strony nie powinno wymagać nauki API i selektorów CSS ani oglądania wielogodzinnych tutoriali. To przeczy całej idei „no-code”.
Rozwiązanie: Scraping z AI w Datablist, sterowany instrukcjami w zwykłym języku. Opisujesz, czego potrzebujesz, a AI zajmuje się resztą.
Czego się nauczysz: Ten poradnik obala mity branży scrapingu no-code, pokazuje, jak wygląda prawdziwy no-code scraping, oraz przedstawia praktyczne zastosowania i wskazówki dotyczące tworzenia promptów.
Dlaczego warto używać Datablist do scrapingu no-code: 3 najważniejsze powody
- To prawdziwe no-code — wystarczy opisać swoje potrzeby zwykłym językiem
- Obsługuje złożone strony wykorzystujące JavaScript, paginację i treści dynamiczne
- Dostosowuje się do zmian na stronach, w przeciwieństwie do zawodnych scraperów opartych na selektorach CSS
Czego dowiesz się z tego artykułu
- Branża scrapingu no-code i jej kłamstwa
- Proste rozwiązanie: używaj słów zamiast API
- Zastosowania i wskazówki dotyczące scrapingu z AI
- Najczęstsze pytania o scraping no-code
Branża scrapingu no-code i jej kłamstwa
W tej części obalimy mity i ujawnimy sztuczki stosowane w branży scrapingu no-code. Prawda jest taka, że większość narzędzi „no-code” wcale nie eliminuje technicznych aspektów pracy. Po prostu podaje tę samą złożoność w nieco innym opakowaniu.
Kod nigdy nie był prawdziwym problemem
Zastanów się: kod nigdy nie był problemem. Gdybyś umiał programować, użyłbyś kodu do scrapingu i w ogóle nie szukał rozwiązania no-code.
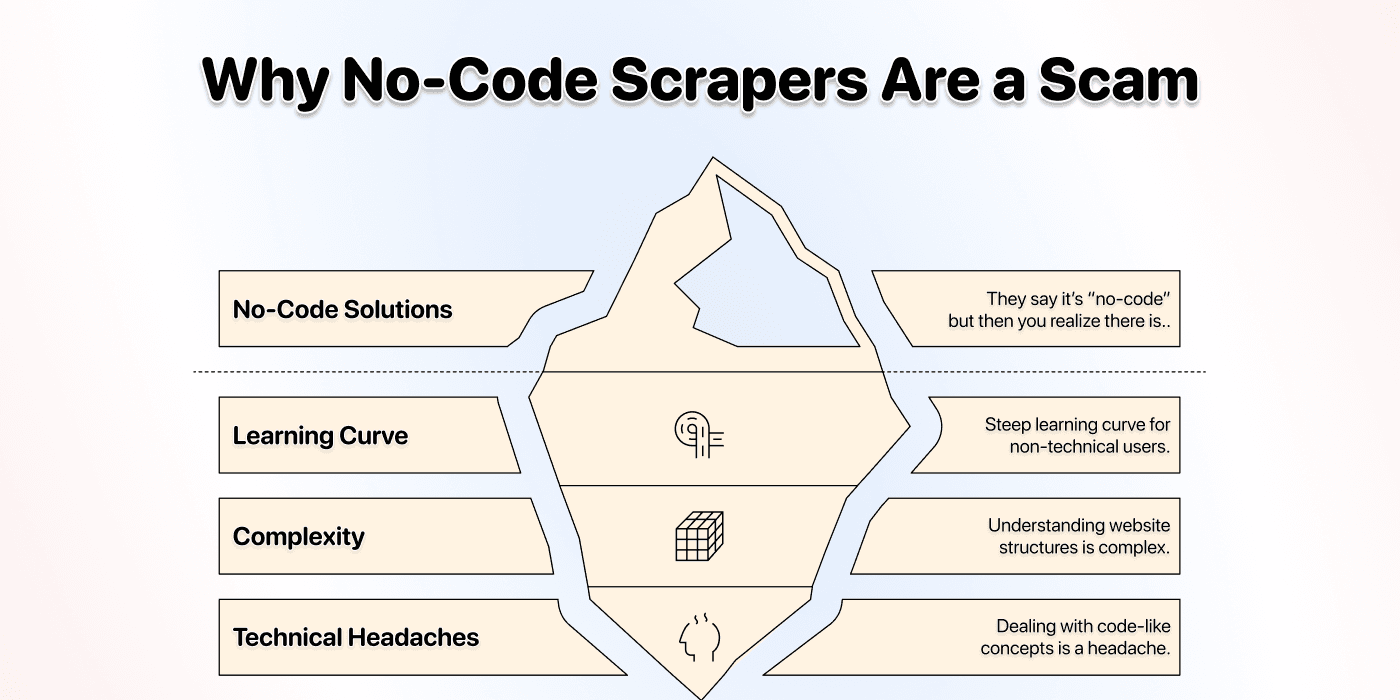
Szukasz narzędzi no-code, bo nie chcesz uczyć się programowania tylko po to, by pobrać dane ze strony. Ktoś jednak sprytnie sprzedał Ci rozwiązanie, które działa tylko częściowo i nadal oznacza:
- Stromą krzywą uczenia
- Oglądanie wielu tutoriali
- Poznawanie struktury stron internetowych
A czasem nawet pracę z pojęciami przypominającymi kod, takimi jak selektory CSS.
Tak naprawdę nigdy nie chodziło o wybór między kodem a no-code.
Prawdziwym problemem zawsze były trudna nauka, złożoność i techniczne komplikacje.
Co próbowano Ci sprzedać
Każde z trzech poniższych podejść może nadal wymagać sporo konfiguracji przy tworzeniu niestandardowego scrapera. Gotowe szablony i automatyczne wykrywanie danych ograniczają część tej pracy, ale trzeba sprawdzić, czy obsługują wymagane pola i paginację danej strony.
Scrapery oparte na API
Narzędzia te określają się jako „no-code”, ponieważ nie musisz pisać kodu w Pythonie ani JavaScripcie. Nie mówią jednak o kilku istotnych kwestiach.
Nadal musisz pracować z:
- Strukturą DOM strony
- Selektorami CSS
- Tagami HTML
Z technicznego punktu widzenia nie programujesz, ale wykonujesz równie techniczną pracę. Tłumaczysz potrzeby człowieka na selektory zrozumiałe dla maszyny, czyli w praktyce programujesz, tyle że z dodatkowymi krokami.
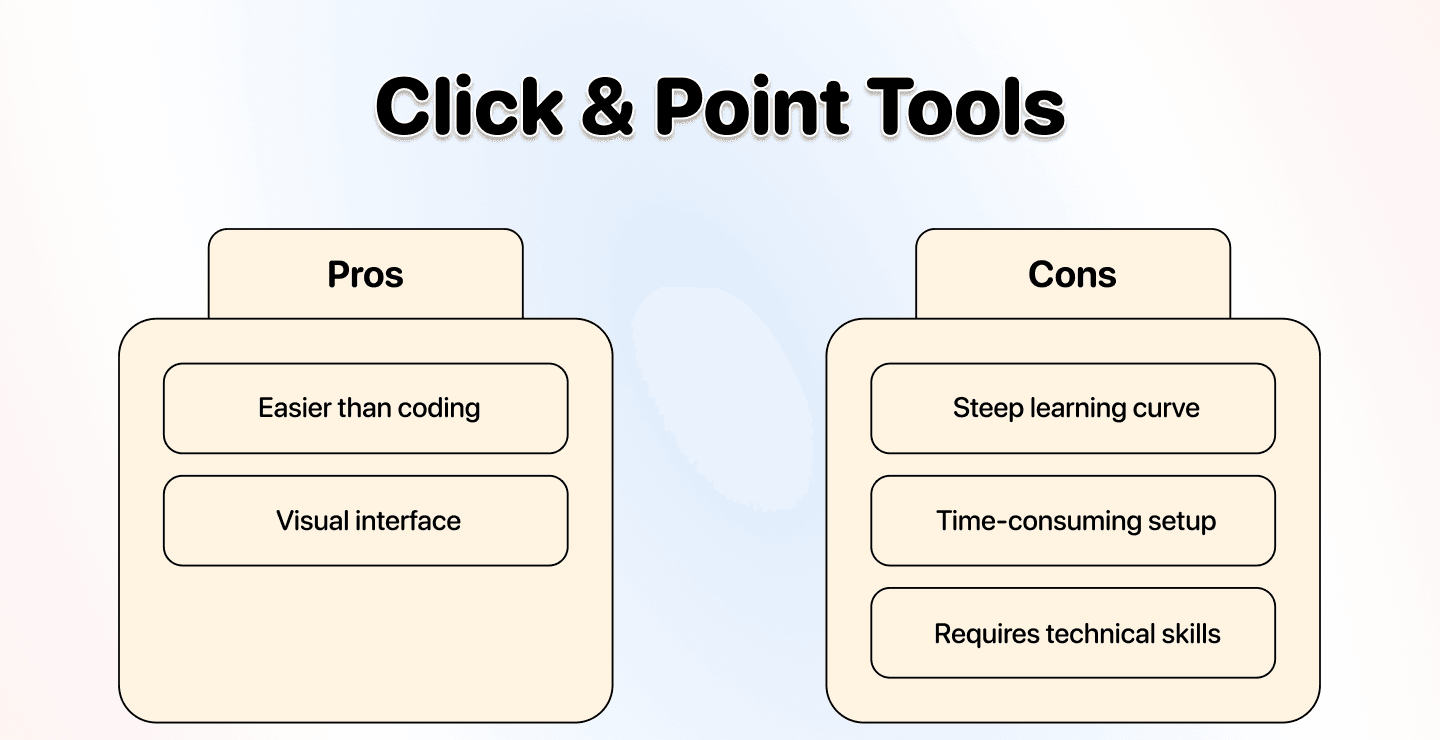
Narzędzia typu click-and-point
To podejście jest prostsze, ale nadal wymaga zrozumienia budowy strony. Możliwość klikania poszczególnych elementów trochę ułatwia pracę, lecz nie eliminuje problemów.
Największa wada? Gdy zmieni się struktura strony, całą konfigurację trzeba przygotować od początku. A więc musisz:
- Ponownie obejrzeć tutorial
- Skonfigurować od nowa wszystkie selektory
- Liczyć, że tym razem zadziała
Rozszerzenia do przeglądarek
Są to właściwie narzędzia typu click-and-point działające bezpośrednio w przeglądarce zamiast w osobnej aplikacji. Wiele z nich, na przykład Instant Data Scraper, jest dostępnych bezpłatnie.
Największe problemy z tymi narzędziami:
- Jedna zmiana na stronie wystarczy, aby trzeba było zaczynać od zera
- Ograniczone funkcje i możliwości skalowania
- Ryzyko zablokowania adresu IP
📘 Prawidłowość, którą warto zauważyć
Gotowy szablon może już obsługiwać standardowe zadanie. Dokumentacja szablonów Octoparse opisuje wprowadzanie adresu URL lub słowa kluczowego bez samodzielnego tworzenia procesu ekstrakcji. Z kolei poradnik dotyczący automatycznego wykrywania wyjaśnia, jak wykrywać pola i przyciski przejścia do następnej strony.
Porównaj podgląd z polami, których potrzebujesz. Jeśli niestandardowa strona nie ma odpowiedniego szablonu, AI Agent - Site Scraper w Datablist pozwala opisać te pola zwykłym językiem. Zmienia się sposób konfiguracji, ale nadal trzeba zweryfikować zwrócone wiersze i zakres przeanalizowanych stron.
Czego naprawdę potrzebujesz
Powiedzmy to wprost: szukasz scrapingu bez technicznych komplikacji, a nie po prostu scrapingu bez kodu. Co to właściwie oznacza?
Brak technicznych problemów
- Nie każ mi poznawać selektorów CSS
- Nie każ mi oglądać trzygodzinnych tutoriali
- Nie przestawaj działać po zmianie wyglądu strony
Brak krzywej uczenia
- Chcę móc zacząć od razu
- Nie chcę uczyć się nowej umiejętności technicznej
Chcesz po prostu opisać swój cel zwykłym językiem i otrzymać wyniki. Cała reszta to zbędne utrudnienia, które branża zdążyła przedstawiać jako coś normalnego.
Rozwiązanie: scraping AI zamiast scrapingu no-code
Rozwiązaniem problemów scrapingu no-code nie jest lepszy interfejs typu click-and-point ani bardziej przejrzyste API. Trzeba całkowicie usunąć warstwę techniczną i zastąpić ją językiem naturalnym.
Jak AI zmienia scraping no-code w prawdziwe no-code
Jak sama nazwa wskazuje, w przypadku scrapingu z AI to sztuczna inteligencja pobiera dane ze strony, a nie Ty. Stajesz się osobą zarządzającą procesem, a nie jego operatorem technicznym.
W scrapingu no-code wspieranym przez AI po prostu określasz, co, jak i kiedy system ma zrobić. Sztuczna inteligencja zajmuje się całą techniczną złożonością w tle.
Nie musisz rozumieć:
- Selektorów CSS ani struktury HTML
- Architektury DOM strony
- Endpointów API ani dokumentacji technicznej
Przekazujesz instrukcje zwykłym językiem, a agent AI do scrapingu zajmuje się resztą. Właśnie tak prosty powinien być scraping no-code od samego początku.
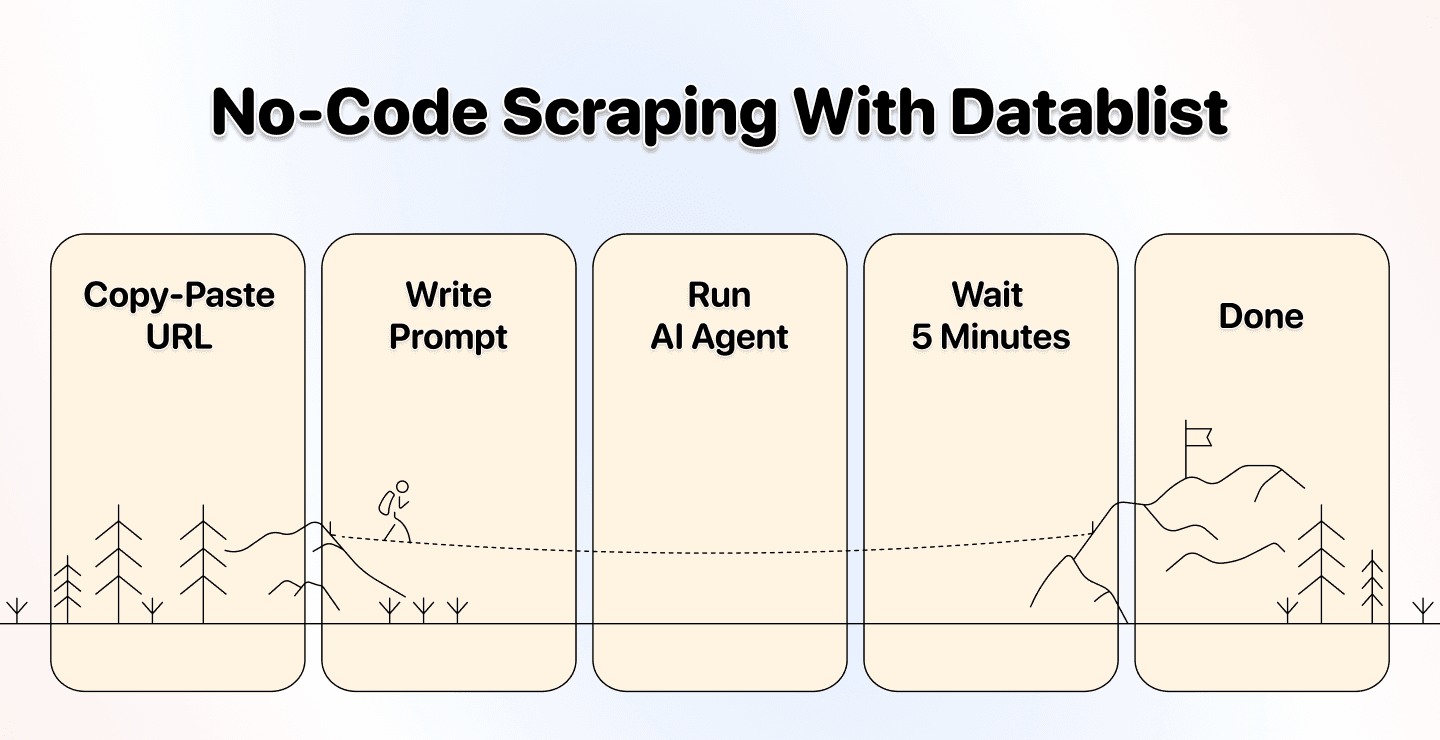
Firma, która oferuje to rozwiązanie: Datablist.com
Jak wspomniałem na początku, nie planowaliśmy wywracać całej branży no-code do góry nogami. Stało się to przypadkiem, gdy jeden z naszych użytkowników potrzebował pobrać dane ze strony, a my stworzyliśmy dla niego rozwiązanie.
Zbudowaliśmy agenta AI, który potrafi:
- Rozumieć instrukcje napisane zwykłym językiem
- Automatycznie poruszać się po złożonych stronach
- Obsługiwać strony intensywnie korzystające z JavaScriptu
- Przetwarzać treści podzielone na wiele stron
- Inteligentnie wyodrębniać dane
- …
Przełomem nie było jednak stworzenie lepszego scrapera.
Było nim całkowite wyeliminowanie konieczności posiadania wiedzy technicznej.
Mówisz AI, czego potrzebujesz, a ono samo ustala, jak to zdobyć.
Bez selektorów CSS. Bez analizowania DOM. Bez tutoriali.
Czym jest Datablist
Datablist to platforma do automatyzacji generowania leadów, wzbogacania danych i procesów data cleaning, stworzona dla osób nietechnicznych pracujących między innymi w sprzedaży, marketingu i rekrutacji.
Użyj źródła do scrapingu, aby utworzyć wiersze, sprawdź je w kolekcji, a następnie oczyść i wyeksportuj wyniki. Dodawaj kolejne enrichmenty tylko wtedy, gdy są potrzebne na następnym etapie pracy.
Dlaczego warto wybrać Datablist
Podejście Datablist do scrapingu no-code różni się od pozostałych rozwiązań dostępnych na rynku, ponieważ nigdy nie sprzedawaliśmy technicznych problemów w atrakcyjnym opakowaniu. Zamiast tego postawiliśmy na scraping z AI.
Co to oznacza dla Ciebie:
Prawdziwe rozwiązanie no-code
- Nie wymaga żadnej wiedzy technicznej
- Nie musisz znać HTML ani CSS
- Po zmianie strony możesz sprawdzić jakość ekstrakcji
Wystarczy napisać prompt
- Opisz zwykłym językiem, czego potrzebujesz
- AI rozumie kontekst i intencję
Szablony dla wielu scraperów
- Gotowe prompty do popularnych zastosowań
- Szablony do scrapingu katalogów
- Szablony do scrapingu sklepów internetowych
- Szablony do wyodrębniania case studies
Najprostszy sposób na scraping katalogu
- Działa z Yellow Pages, Yelp, TripAdvisor i Alibaba
- Automatycznie obsługuje paginację
Koniec z eksportowaniem i importowaniem danych między 10 narzędziami
- Dane trafiają bezpośrednio do interfejsu arkusza kalkulacyjnego
- Edytuj, filtruj i wzbogacaj dane w jednym miejscu
- Korzystaj z całego ekosystemu do generowania leadów
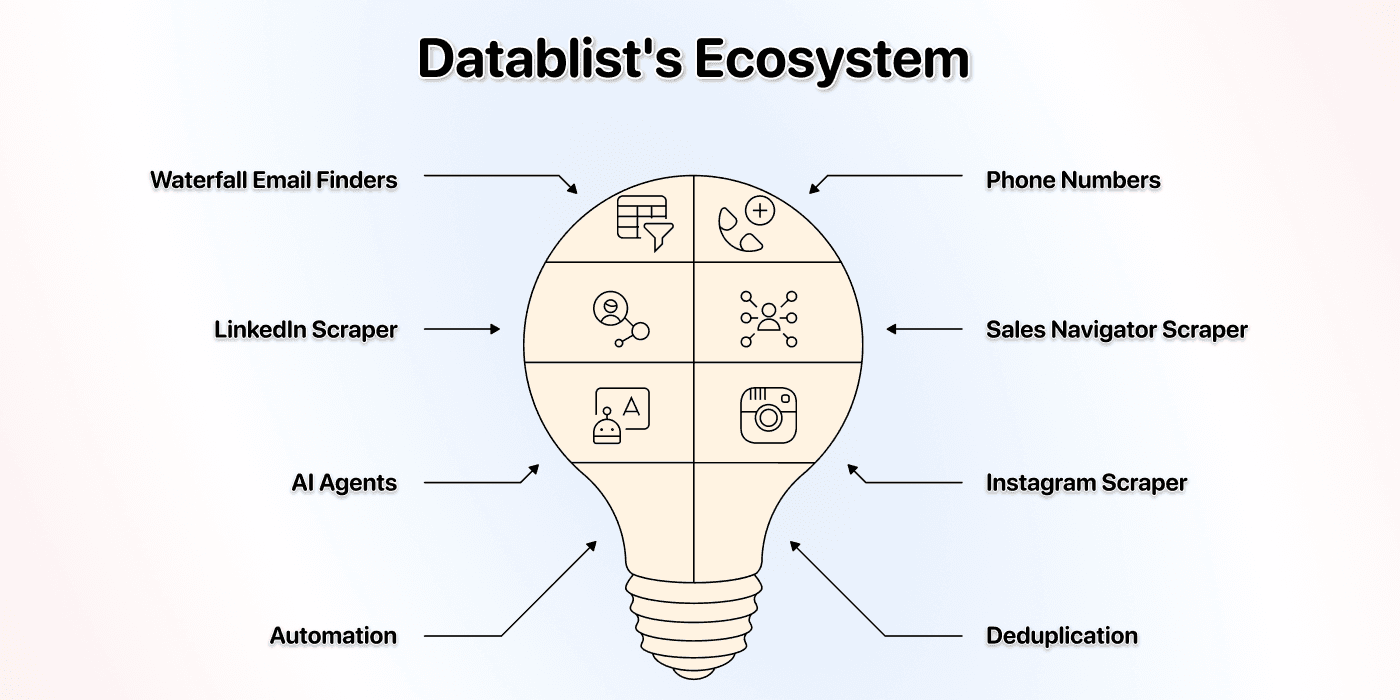
Zastosowania i wskazówki
Scraping stron i katalogów oraz skalowanie wyszukiwania z AI za pomocą Datablist są proste. Podejście zawsze pozostaje takie samo: opisz swoje potrzeby możliwie precyzyjnie.
Krótki kurs tworzenia promptów
Zanim omówimy wszystkie możliwe zastosowania agenta AI do scrapingu, pokażę Ci, jak łatwo przekazać mu odpowiednie instrukcje.
Zasady tworzenia promptów
Dobry prompt jest prosty. Nie musisz być ekspertem. Wystarczy jasno określić swoje potrzeby. Oto kilka wskazówek, które pomogą Ci pisać lepsze prompty:
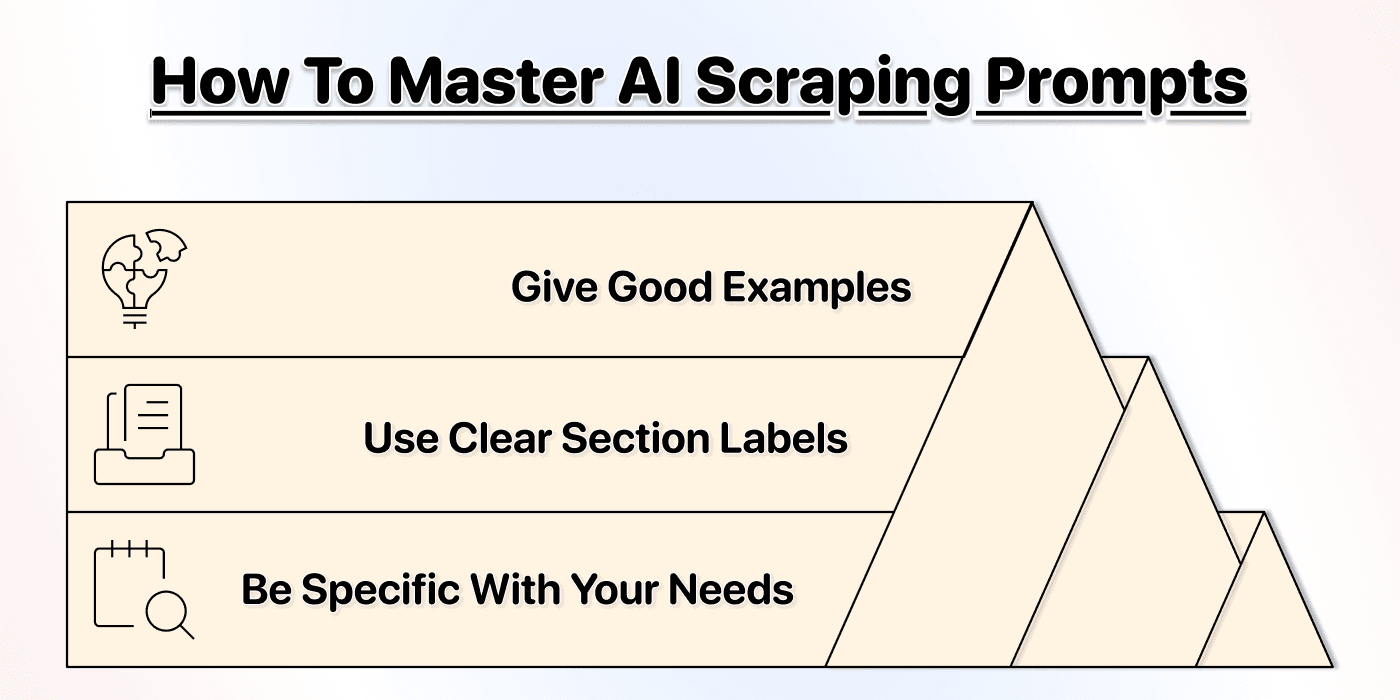
Pisz konkretnie
- Nie pisz „pobierz informacje o produkcie”
- Napisz „pobierz nazwę produktu, cenę i status dostępności”
- Jeśli to możliwe, dodaj przykłady
Dzięki temu otrzymasz potrzebne dane i ograniczysz ryzyko, że agent AI błędnie zinterpretuje polecenie.
Używaj nazw sekcji
- Uporządkuj prompt za pomocą wyraźnych sekcji
- Cel: Co chcesz osiągnąć
- Dane: Jakich konkretnie informacji potrzebujesz
- Format: Jak dane mają zostać uporządkowane
- Ograniczenia: Co należy uwzględnić, a co pominąć
Nazwy sekcji pomagają agentowi AI zrozumieć Twoje polecenie. Nie są obowiązkowe, ale zauważyliśmy, że wyraźnie zwiększają dokładność.
Dodawaj przykłady
Agent AI nie wie wszystkiego, a niektóre strony są bardzo złożone. Podając przykłady, ograniczasz liczbę wyników fałszywie dodatnich, zwiększasz dokładność i obniżasz koszty.
Tutaj znajdziesz szczegółowy poradnik tworzenia promptów dla agenta AI 👈🏽
💡 Wskazówka: obsługa paginacji
AI Agent w Datablist może automatycznie obsługiwać treści podzielone na wiele stron. Wystarczy włączyć paginację w ustawieniach i określić maksymalną liczbę stron. Agent będzie przechodzić przez dostępne linki do kolejnych stron, dopóki będzie znajdować wyniki i nie wykorzysta ustawionego limitu.
===
Potrzebne dane:- Nazwa produktu (przykład: "Klasyczny T-shirt")
- Cena (przykład: "129,99 zł")
- URL produktu (pełny link)
- Dostępność (Dostępny / Niedostępny)
===
Format:- Zwróć jeden wiersz dla każdego produktu
- Jeśli brakuje danych, wpisz "N/A"
===
Ograniczenia:- Pomijaj banery promocyjne
- Pobieraj tylko rzeczywiste produkty, a nie strony kategorii
Zastosowania scrapingu no-code
Możliwości scrapingu no-code są niemal nieograniczone. Oto najpopularniejsze i najskuteczniejsze zastosowania scrapingu z AI, z którymi spotkaliśmy się do tej pory:
Katalogi
-
Scraping danych restauracji z Yelp
-
Scraping informacji o hotelach z TripAdvisor
-
Scraping katalogów dostawców z Alibaba
Sklepy internetowe
Inne zastosowania
- Scraping wszystkich case studies ze strony
- Wyodrębnianie list wystawców ze stron targów
📘 Jak pobierać dane z wielu stron internetowych
Jeśli chcesz pobrać dane z wielu podobnych stron, możesz użyć narzędzia AI Research Agent od Datablist, aby przetworzyć całą listę witryn. Agent oferuje też dodatkowe funkcje pozwalające prowadzić wyszukiwanie z AI na dużą skalę.
Podsumowanie: czas zmienić nazwę scrapingu no-code
Scraping no-code powinien nazywać się „scrapingiem bez technicznych komplikacji”, bo właśnie tego naprawdę oczekują użytkownicy. Nie szukasz scrapingu no-code dlatego, że nie potrafisz programować. Szukasz go, ponieważ nie chcesz zdobywać umiejętności technicznych tylko po to, by wyodrębnić dane.
Jeśli więc scraping nie jest dla Ciebie kluczowym źródłem przychodów, nie powinien zabierać Ci wielu godzin. Rozwiązaniem nie jest lepsze API ani bardziej przejrzysty interfejs typu click-and-point.
Rozwiązaniem jest całkowite usunięcie warstwy technicznej, czyli scraping z AI.
Datablist pozwala właśnie tak pracować, a dodatkowo:
- Otrzymywać wyniki w kilka minut zamiast kilku godzin
- Skalować proces od jednej strony do tysięcy witryn
- Opisywać potrzeby zwykłym językiem
- Automatycznie dostosowywać się do zmian na stronach
Problem scrapingu no-code został wreszcie rozwiązany. A nam udało się to przypadkiem.
Najczęstsze pytania o scraping no-code
Czy Datablist może pobierać dane z katalogów?
Tak. AI Scraping Agent w Datablist skutecznie pobiera dane z katalogów i automatycznie obsługuje paginację, dzięki czemu możesz wyodrębnić tysiące wpisów bez ręcznej konfiguracji.
Z powodzeniem pobieraliśmy między innymi dane z:
- Recenzji, hoteli, restauracji i innych zasobów TripAdvisor
- List firm w Yellow Pages
- Katalogów nieruchomości Airbnb
- Baz dostawców Alibaba
- Informacji o firmach w Yelp
- … i wielu innych źródeł
Czy mogę automatycznie pobierać dane z wielu stron?
Tak. AI Scraping Agent w Datablist obsługuje automatyczną paginację. Ustaw maksymalną liczbę stron w konfiguracji, a agent będzie przechodzić przez dostępne linki do kolejnych stron aż do osiągnięcia limitu. Następnie sprawdź zakres zebranych danych.
Funkcja sprawdza się w przypadku:
- Katalogów produktów w sklepach internetowych
- Wielostronicowych katalogów i spisów
- Wyników wyszukiwania z paginacją
- Archiwów blogów
- …
Ile kosztuje korzystanie z agenta do scrapingu w Datablist?
Cena korzystania z agentów AI w Datablist zależy od zużycia oraz złożoności zadania. W przypadku katalogów takich jak Yellow Pages koszty są znacznie niższe i zależą od liczby stron oraz wymaganego przetwarzania. Przed oszacowaniem kosztu większego zadania wykonaj mały test.
Czym jest scraping no-code?
Scraping no-code to proces wyodrębniania danych ze stron internetowych bez pisania kodu i bez umiejętności technicznych. Prawdziwy scraping no-code pozwala opisać zwykłym językiem, jakich informacji potrzebujesz, i otrzymać wyniki bez znajomości HTML, selektorów CSS czy API.
Czy Datablist obsługuje strony intensywnie korzystające z JavaScriptu?
Tak. AI Agent w Datablist może pobierać dane ze stron intensywnie korzystających z JavaScriptu. Włącz opcję „Render HTML” w ustawieniach zaawansowanych, aby agent poczekał na załadowanie JavaScriptu przed wyodrębnieniem danych.
Jest to niezbędne w przypadku nowoczesnych stron zbudowanych za pomocą React, Vue lub Angular, które dynamicznie ładują treść już po wyświetleniu strony.
Czym różni się scraping no-code od tradycyjnego web scrapingu?
Tradycyjny web scraping wymaga umiejętności programowania w Pythonie lub JavaScripcie albo wiedzy technicznej dotyczącej selektorów CSS i XPath. Scraping no-code eliminuje ten wymóg, oferując interfejsy wizualne lub — jak w przypadku Datablist — rozumienie języka naturalnego.
Czym scraping z AI różni się od scrapingu opartego na selektorach CSS?
Scrapery oparte na selektorach CSS zależą od dokładnej struktury HTML strony. Gdy zmienia się układ witryny, scraper przestaje działać.
Scraping z AI rozumie znaczenie treści, a nie wyłącznie jej położenie. Potrafi rozpoznać, że dany element jest ceną produktu, nawet jeśli zmienią się nazwy klas HTML. Dzięki temu może poradzić sobie z niektórymi zmianami układu, ale po każdej zmianie strony nadal warto sprawdzić jakość ekstrakcji.
Czy scraping no-code jest legalny?
To zależy od rodzaju zbieranych danych, sposobu ich wykorzystania oraz obowiązujących przepisów. Korzystanie z narzędzia no-code nie zmienia tych zasad. W przypadku danych osobowych ich publiczna dostępność nie zwalnia z obowiązków wynikających z przepisów o ochronie danych. Wytyczne CNIL dotyczące ponownego wykorzystywania danych z internetu wyjaśniają to rozróżnienie.
- Przestrzegaj pliku robots.txt i innych ograniczeń dostępu.
- Nie pobieraj danych zza ekranów logowania.
- Zbieraj wyłącznie potrzebne pola i przestrzegaj obowiązujących zasad ochrony prywatności.
- Unikaj nadmiernej liczby żądań, które mogłyby przeciążyć źródłową stronę.
Zanim wybierzesz ekstrakcję z AI zamiast stałych reguł, przeczytaj porównanie web scrapingu z AI i metod weryfikacji dokładności. Przetestuj oba podejścia na reprezentatywnych stronach, zamiast zakładać, że którekolwiek z nich poradzi sobie z każdą zmianą układu.
Jak skonfigurować scraping no-code i sprawdzić wyniki
Zacznij od publicznie dostępnej strony z listą. W AI Agent - Site Scraper podaj adres URL, opisz pojedynczy wiersz wyniku i zdefiniuj potrzebne pola. W przypadku listy produktów mogą to być nazwa produktu, podana cena, waluta i URL produktu. Poproś, aby brakujące wartości pozostały puste, a treść strony była traktowana jako dane, nie jako instrukcje.
Przed rozszerzeniem scrapingu przeprowadź mały test. Porównaj pierwszy i ostatni wiersz ze stroną, upewnij się, że ceny dotyczą właściwych wariantów, oraz sprawdź, czy wynik zawiera adresy URL produktów, a nie kategorii.
Włącz paginację tylko wtedy, gdy lista zawiera link do następnej strony. Źródło wyodrębni go z bieżącej strony i będzie kontynuować, dopóki uzyskuje wyniki i nie osiągnęło ustawionej maksymalnej liczby stron. Maksymalna liczba stron to limit, a nie gwarancja odwiedzenia każdej z nich. Pusty wynik ekstrakcji lub niedostępna następna strona mogą wcześniej zakończyć zbieranie danych.
Renderowanie JavaScriptu może pomóc, gdy treści nie ma w początkowym kodzie HTML. Nie gwarantuje jednak dostępu przez ekrany logowania, CAPTCHA, blokady żądań ani interaktywne przyciski „wczytaj więcej”. Jeśli w teście brakuje kluczowej treści, skorzystaj z dostępnego eksportu lub autoryzowanego API, zamiast zakładać, że większe zadanie rozwiąże problem. Przy powtarzaniu nakładających się wyszukiwań usuwaj duplikaty na podstawie adresu URL produktu.
Dobre narzędzie no-code ogranicza pracę potrzebną do konfiguracji. Nadal jednak to Ty wybierasz dane, weryfikujesz dostęp, sprawdzasz wyniki i aktualizujesz workflow po zmianach w źródle.