
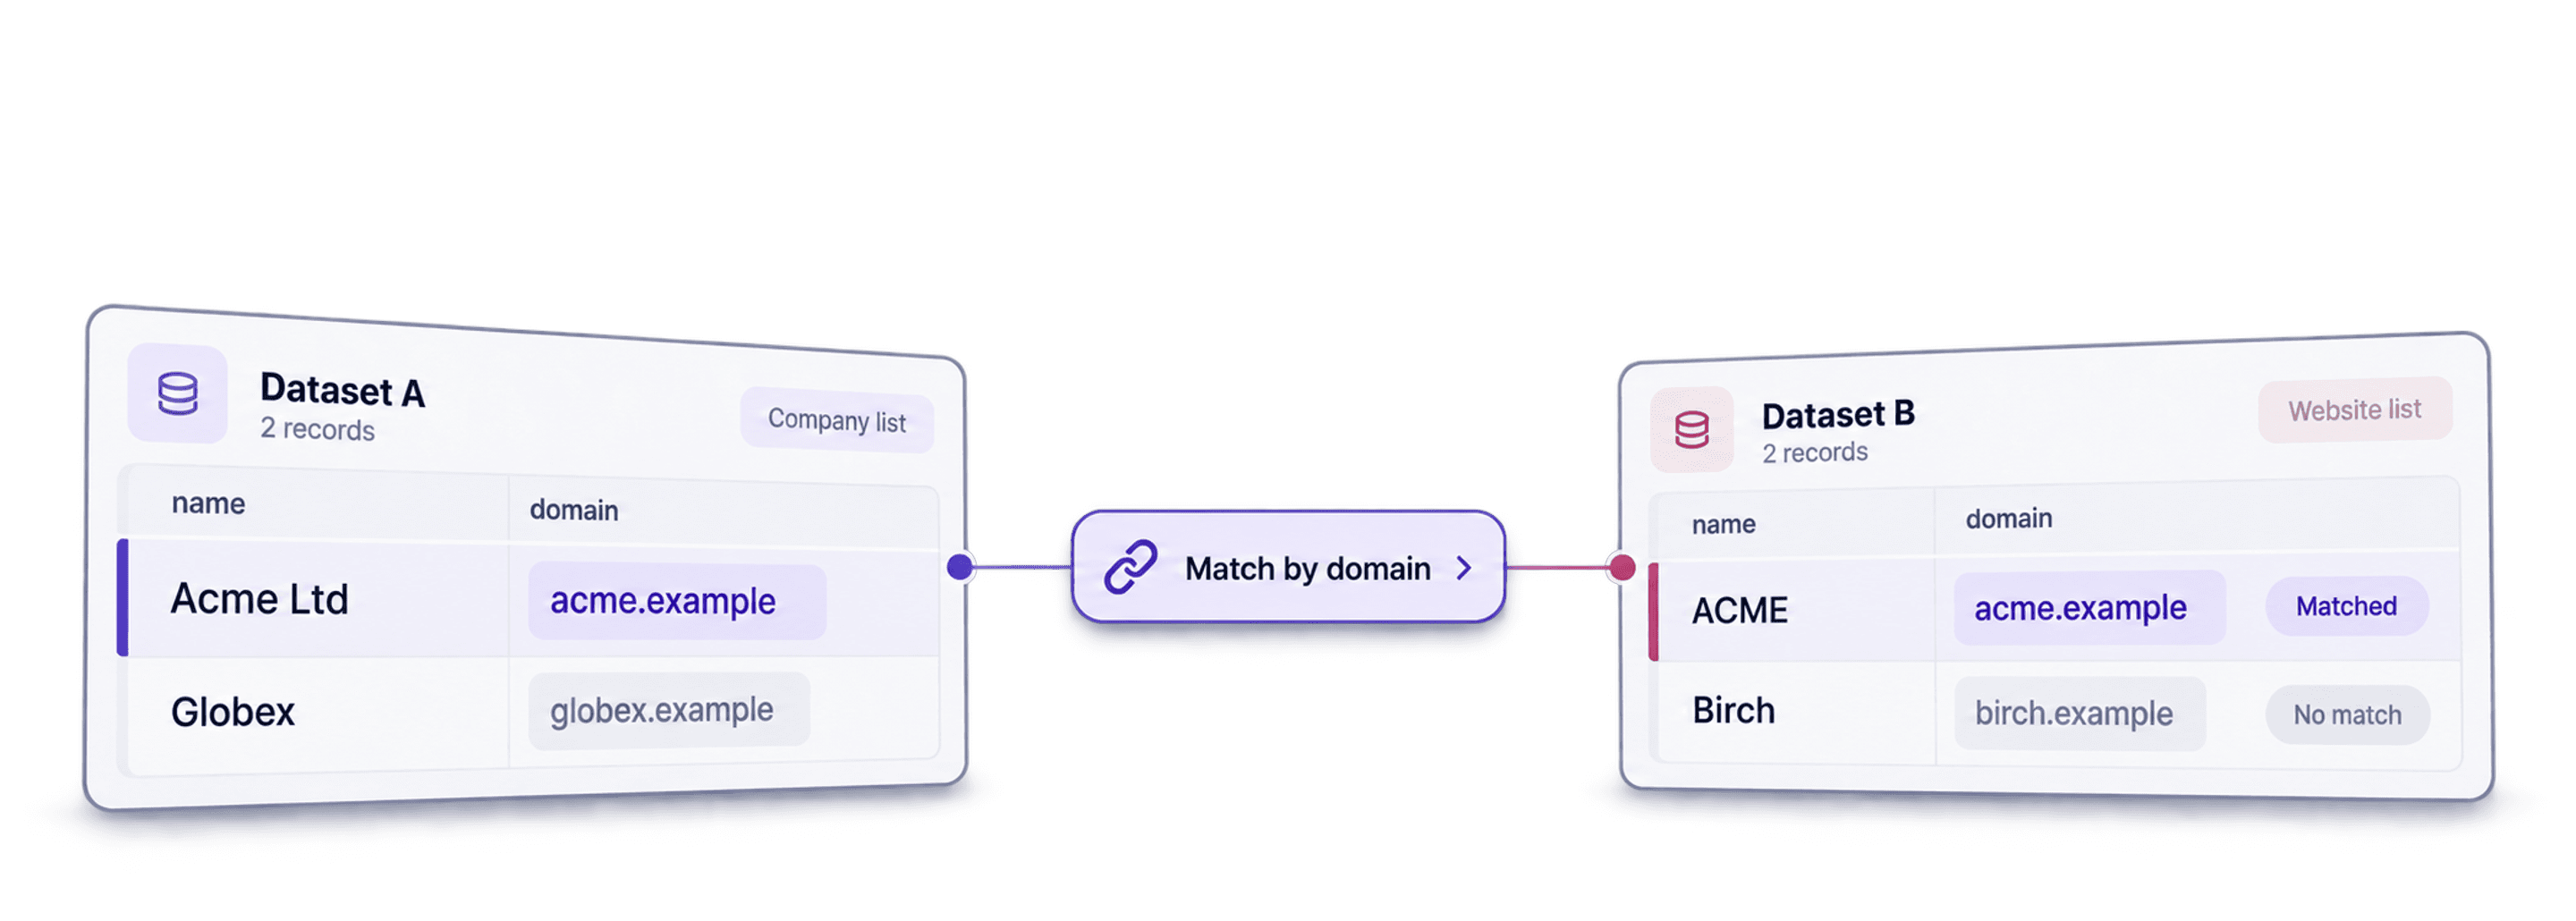
Use uma ferramenta de data matching quando duas listas puderem conter as mesmas pessoas ou empresas com nomes ligeiramente diferentes. No Datablist, importe as listas para collections, mapeie as colunas que deseja comparar, escolha um algoritmo de matching e revise os grupos candidatos antes de mesclá-los ou exportá-los. Comece com um identificador exato, como um endereço de e-mail ou domínio da empresa. Use fuzzy matching de nomes apenas quando não houver um identificador estável e confira os resultados com um segundo campo.
Por exemplo, uma lista de leads pode conter Acme Ltd em acme.com, enquanto outra traz ACME no mesmo domínio. O domínio é um indício mais forte para associar essas linhas do que apenas a semelhança entre os nomes. O Duplicates Finder do Datablist compara registros dentro de uma collection ou entre várias collections e exibe os grupos para revisão. Algoritmos avançados de matching fonético e fuzzy matching estão disponíveis nos planos pagos.
Veja um resumo dos principais tópicos de Data Matching abordados neste artigo:
- Carregue seus conjuntos de dados
- Prepare, limpe e normalize os dados
- Compare registros em uma ou várias collections
- Remova ou mescle grupos correspondentes
Revise as correspondências antes de mesclar. Nomes semelhantes podem identificar pessoas ou empresas diferentes, principalmente quando são curtos ou abreviados.
Etapa 1: carregue seus conjuntos de dados
O primeiro passo é carregar seus conjuntos de dados no Datablist. O Datablist é uma ferramenta online para gerenciar listas. Com ele, você pode visualizar e editar arquivos CSV e Excel. É a ferramenta ideal para gerenciar sua lista de leads, limpar dados de clientes ou limpar dados extraídos da web.
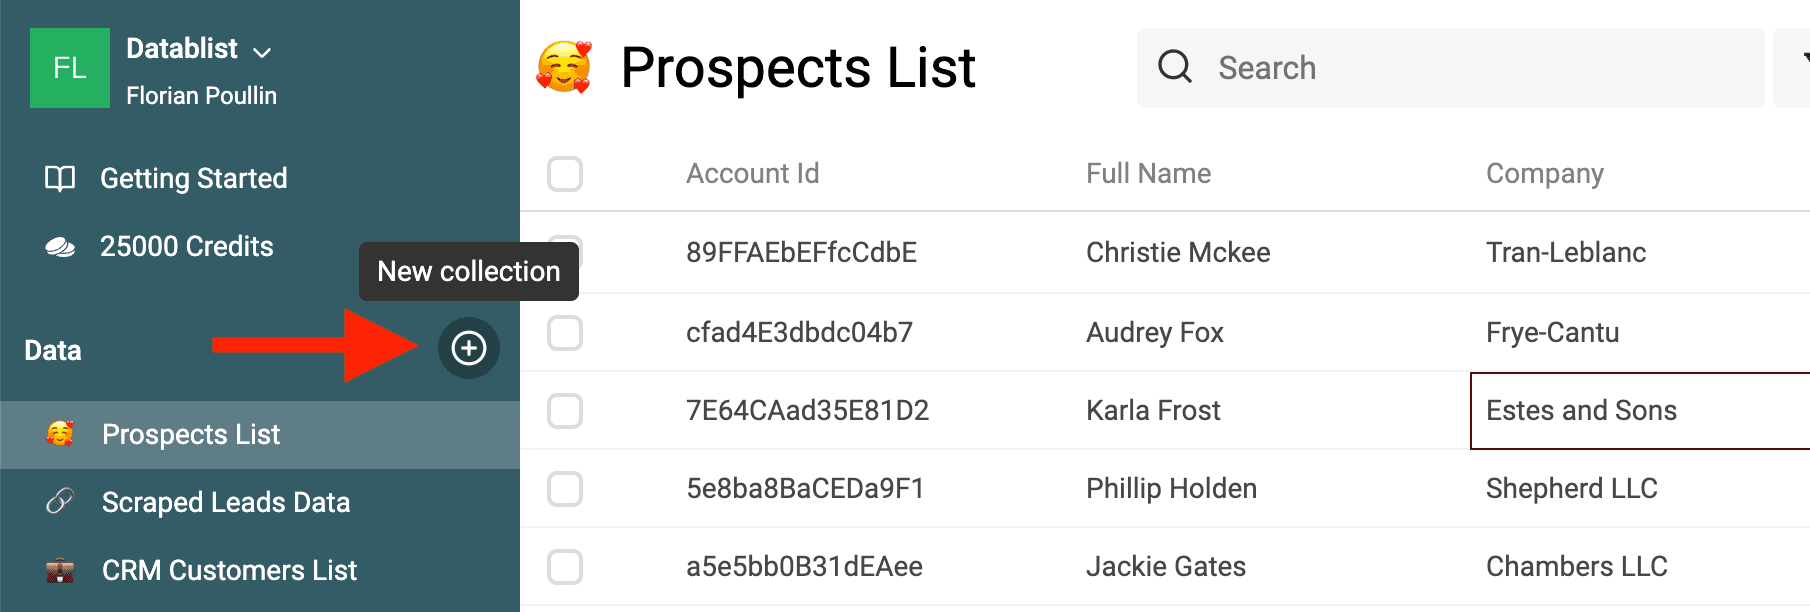
Para começar, crie uma collection e carregue seu primeiro conjunto de dados.
Em seguida, clique no botão Import.
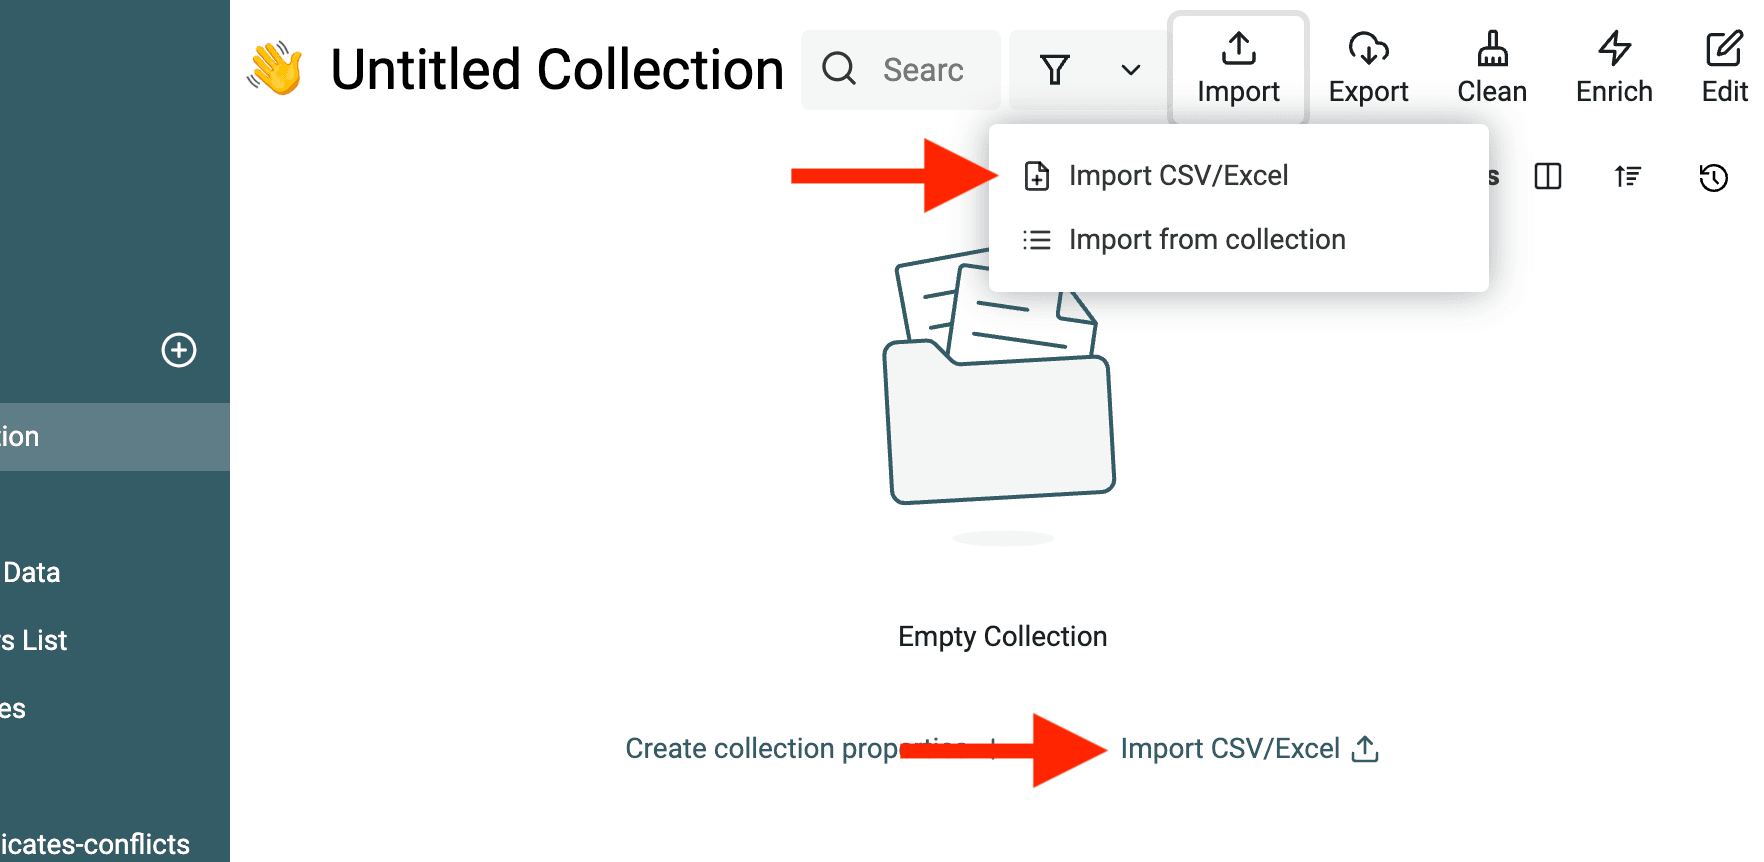
Depois de importar o primeiro conjunto de dados, você pode:
- Importar outros conjuntos com estruturas de dados semelhantes para a mesma collection.
- Importar conjuntos com estruturas diferentes para novas collections.
O Duplicates Finder do Datablist encontra registros correspondentes em uma única collection ou entre collections com estruturas de dados diferentes.
Etapa 2: limpe seus dados, se necessário
O segundo passo é a limpeza de dados. Ela é um pré-requisito essencial para o data matching, pois garante a precisão e a confiabilidade do processo. Dados sujos ou inconsistentes podem gerar correspondências incorretas e resultados pouco confiáveis. Em resumo, a limpeza de dados prepara o caminho para um data matching bem-sucedido.
Quando aparecem em nomes de pessoas ou empresas, certos elementos não acrescentam informação e ainda podem impedir que o algoritmo de deduplicação detecte registros duplicados.
O Datablist inclui várias ferramentas de limpeza de dados:
- Remover símbolos e pontuação - Textos extraídos da web podem conter emojis, símbolos ASCII ou nomes com pontuação. O algoritmo de matching do Datablist ignora esses elementos ao comparar os dados, mas eles podem impedir a mesclagem automática durante o processo de deduplicação.
- Remover espaços extras - Um único espaço a mais entre palavras já torna duas strings diferentes. Os algoritmos de matching do Datablist pré-processam os textos para remover espaços extras, mas esses espaços também podem impedir a mesclagem automática durante o processo de deduplicação.
- Extrair endereços de e-mail, URLs e outros dados de textos - Se seus dados incluem texto não estruturado com endereços de e-mail, URLs, menções, tags e outros elementos, use o Data Extractor para extrair essas entidades e estruturar os dados. O Data Matching fica muito mais simples quando há entidades estruturadas para comparar.
- Remover tags HTML - Outro recurso de limpeza permite transformar strings com tags HTML em texto simples. Assim, você pode comparar listas extraídas da web que contenham HTML com seus outros conjuntos de dados.
- Converter texto em DateTime, Number, Boolean etc. - O Datablist oferece estruturas de dados reais com formatos nativos como DateTime, Number e Boolean. Uma etapa importante da limpeza é converter texto bruto para o formato nativo correto. Datas, números e outros formatos nativos são fundamentais para regras avançadas de mesclagem, especialmente quando é preciso escolher um registro principal pela comparação de valores, como a data mais recente.
- Alterar maiúsculas e minúsculas para padronizar o texto - Padronizar o uso de maiúsculas e minúsculas é uma etapa simples, mas necessária. O Datablist oferece vários algoritmos nativos para essa transformação).
- Dividir ou mesclar propriedades - Esse recurso é ideal para dados com vários valores. Se uma propriedade contiver diversos endereços de e-mail separados por vírgulas, ponto e vírgula ou espaços, a ferramenta Split Property do Datablist criará várias propriedades, cada uma com um único endereço.
- Remover ou substituir valores vazios - Use os recursos de filtragem do Datablist para filtrar valores ou linhas vazias.
Consulte nosso guia de limpeza de dados para ver mais exemplos e instruções.
Normalize nomes de pessoas
Trabalhar com conjuntos de dados de pessoas é comum na deduplicação de dados. Listas de clientes, Leads e prospects são bons exemplos. No melhor cenário, o data matching nesses conjuntos utiliza identificadores únicos, como endereços de e-mail ou números de identificação. Sem esses identificadores — ou para comparar pessoas entre diferentes conjuntos — será necessário usar os nomes no processo.
O pré-processamento dos nomes garante um formato uniforme e reduz erros durante a deduplicação.
Remova ruídos dos nomes
Nomes de pessoas podem variar bastante. Apelidos, abreviações, grafias alternativas e caracteres especiais são diferenças comuns.
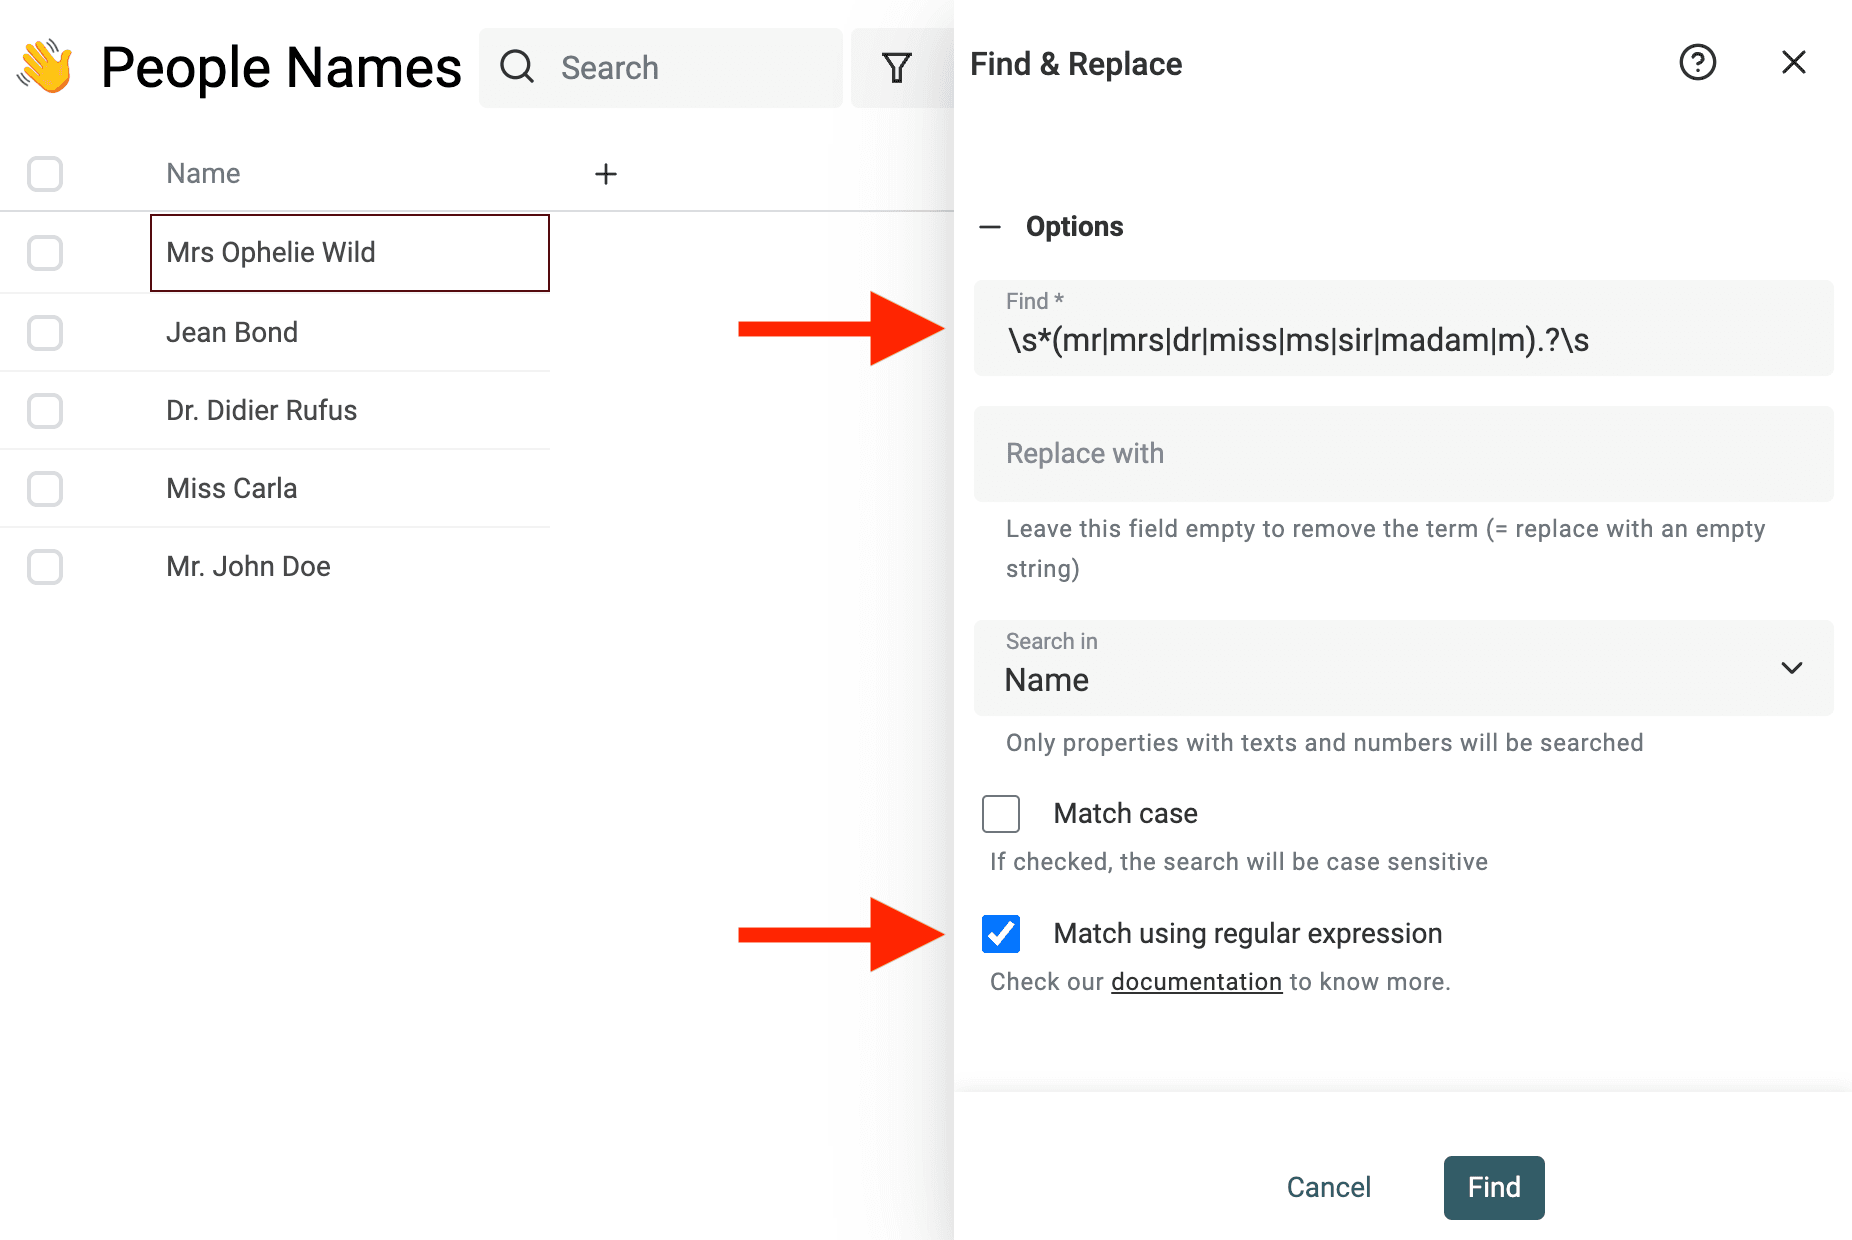
Use a poderosa ferramenta Find & Replace para remover prefixos, sufixos, stop words, complementos regionais e outros termos desnecessários.
Por exemplo, para remover títulos de tratamento, você pode usar esta expressão regular:
^\s*(mr|mrs|dr|miss|ms|sir|madam|m).?\s
E substituí-los por uma string vazia.
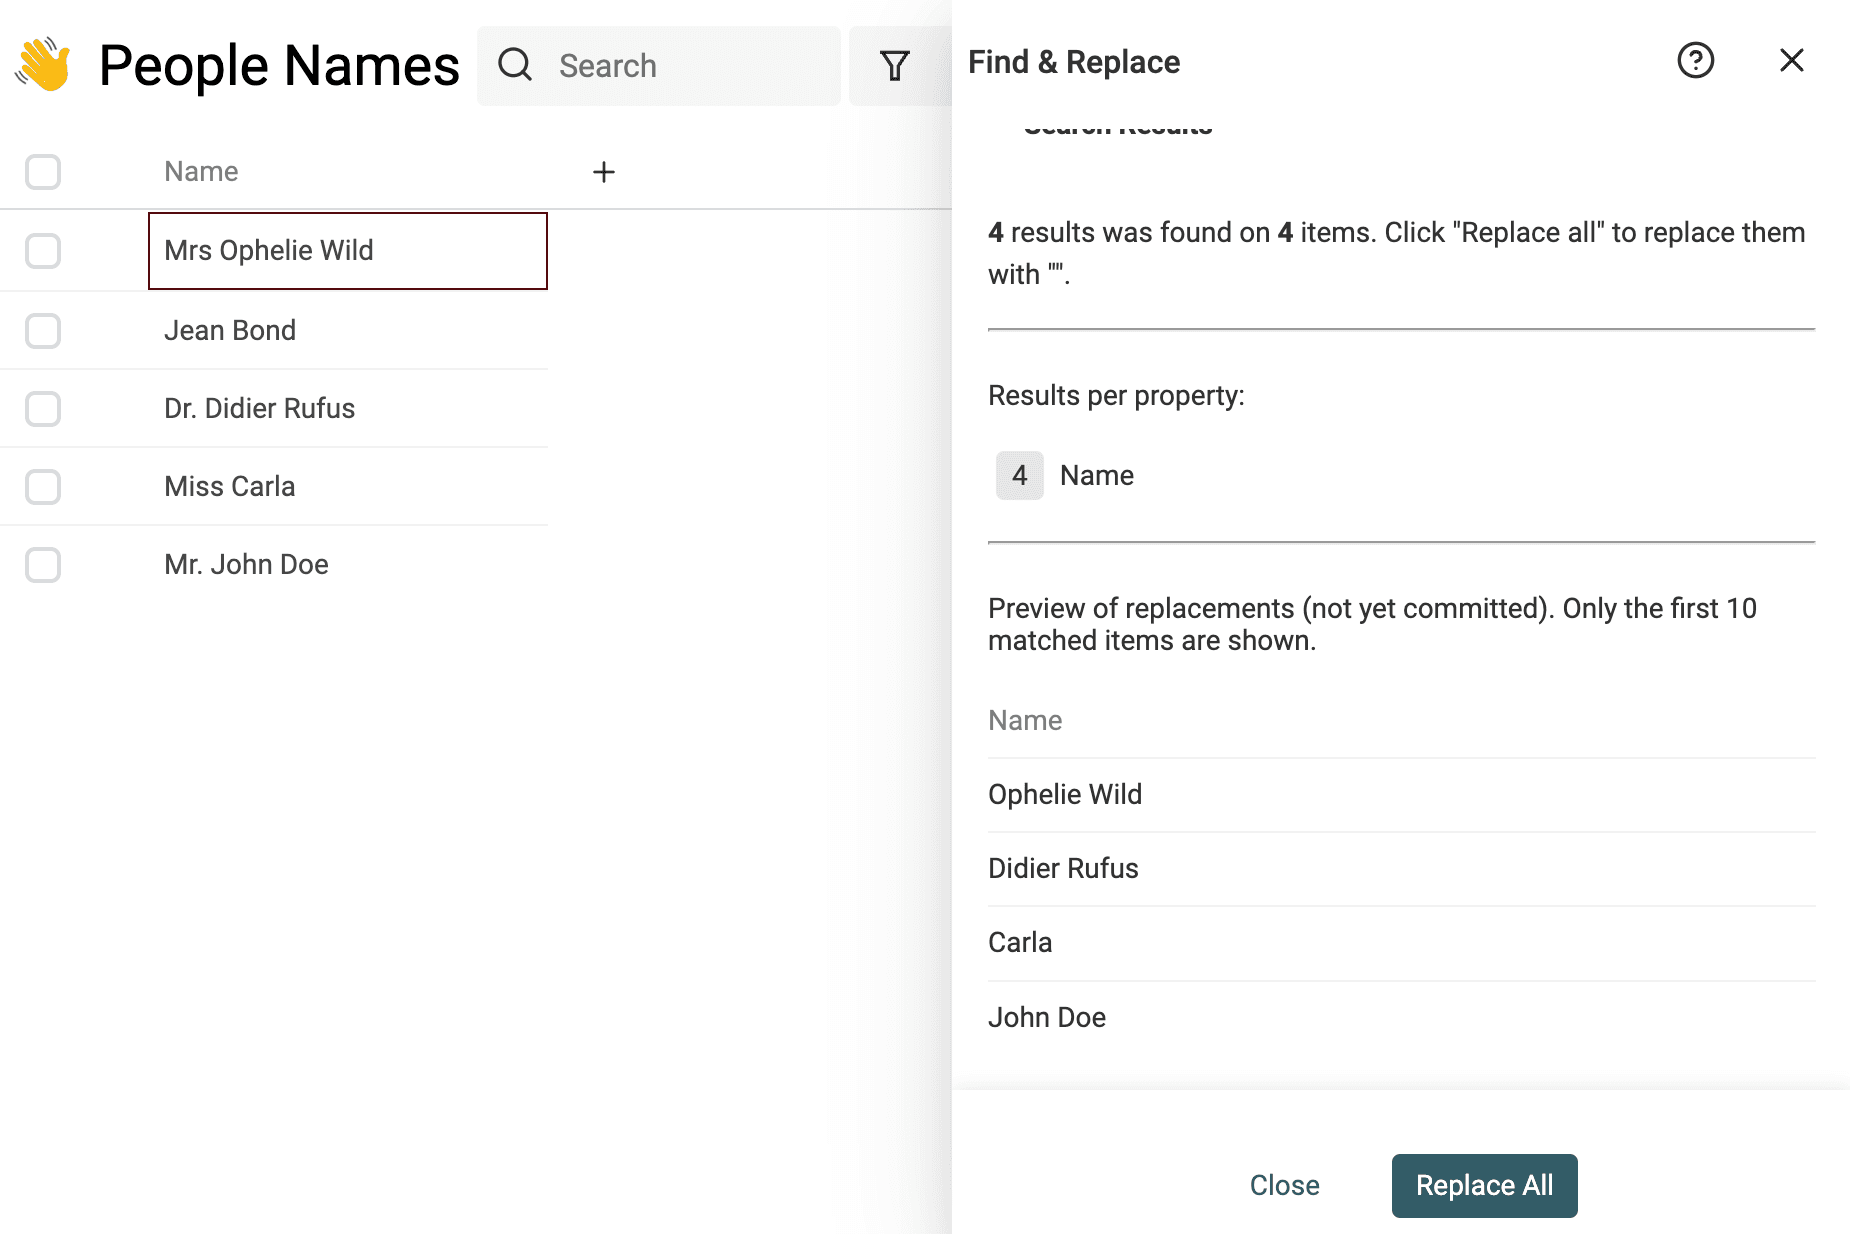
Observação: se você não conhece expressões regulares, basta entrar em contato conosco. Ajudaremos você a limpar seus dados.
Separe o nome completo em partes
O Datablist vai além da limpeza e também oferece enriquecimento de dados. Alguns exemplos são o enriquecimento de leads e a tradução de arquivos CSV com o DeepL.
O Name Parser é um enrichment ideal para limpar nomes de pessoas. Ele recebe um nome completo e retorna suas partes: nome, nome do meio e sobrenome. Também informa o gênero e o país mais associados ao nome.
Para separar os nomes completos, ele utiliza dados estatísticos.
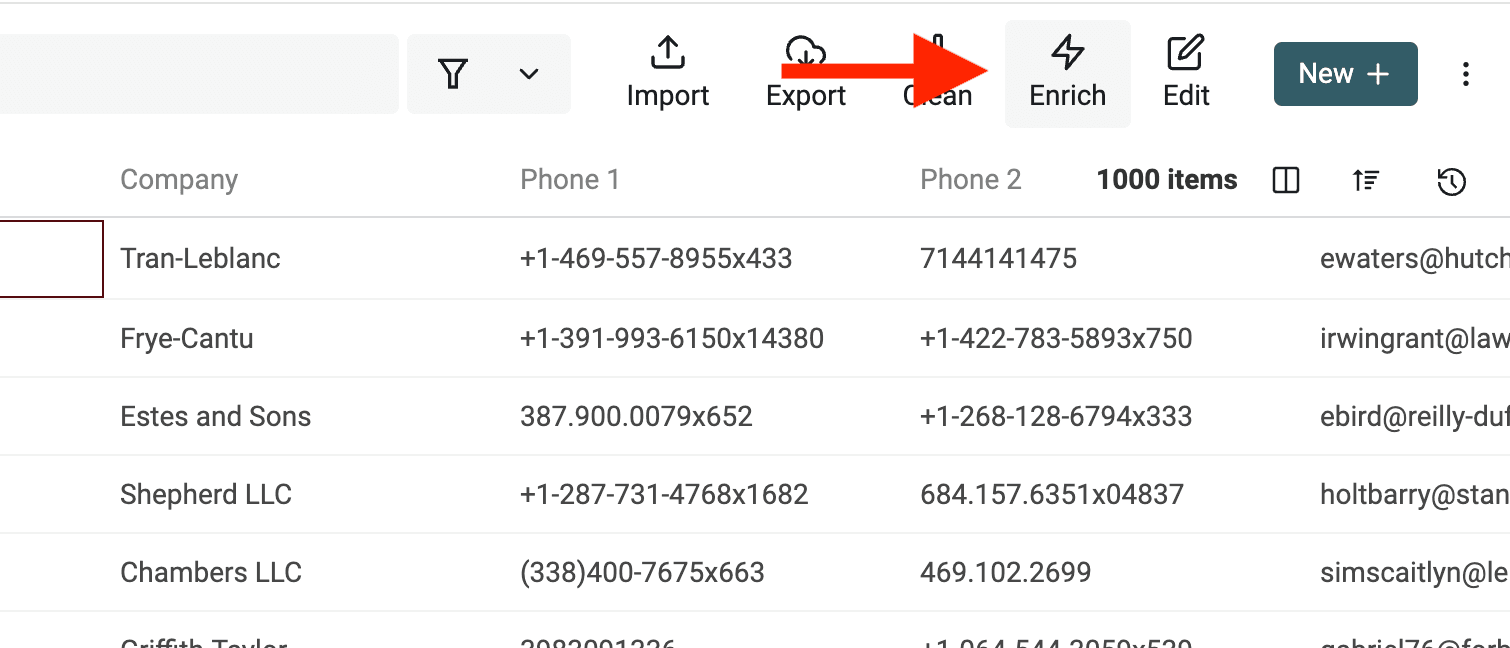
Para usá-lo, abra o "Enrich Menu" nos botões superiores.
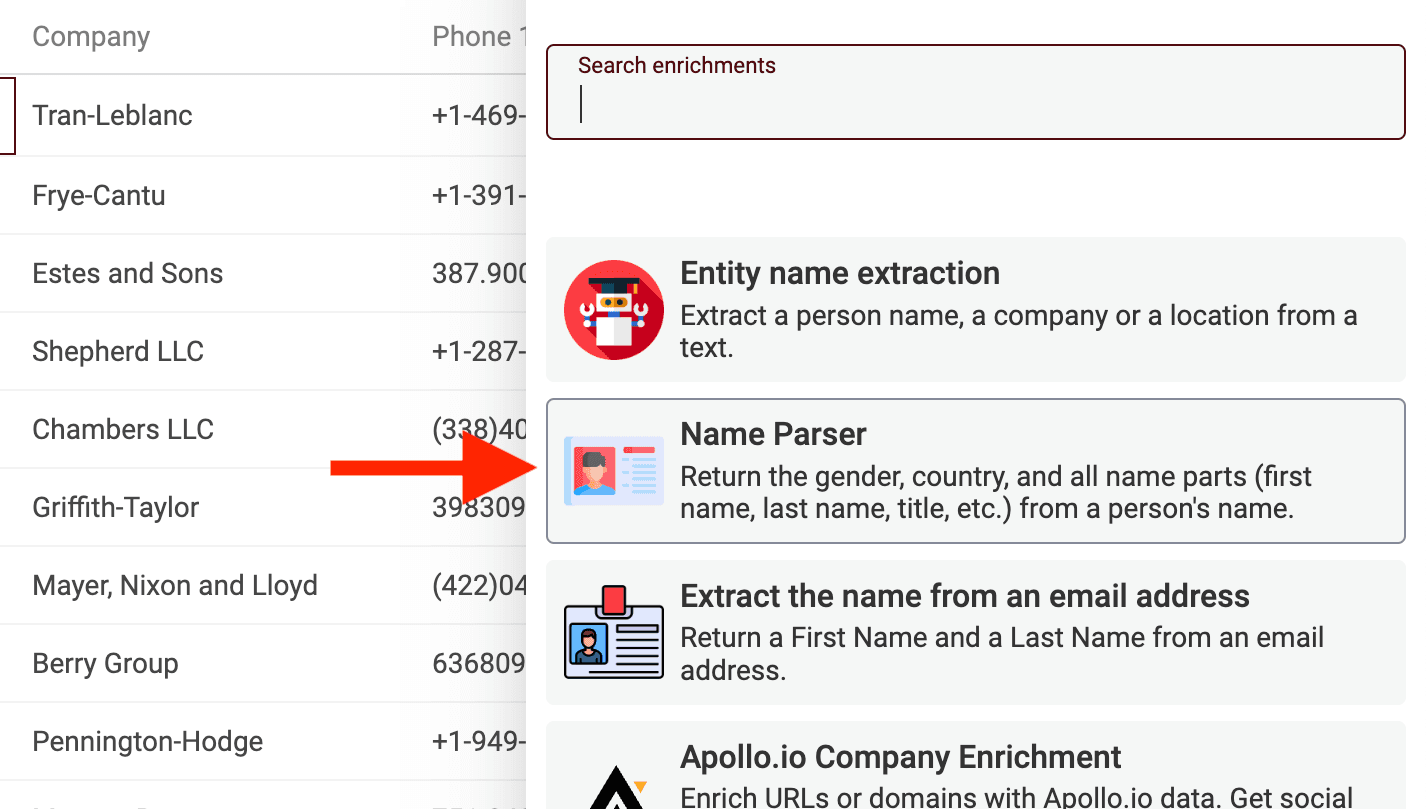
Em seguida, selecione "Name Parser".
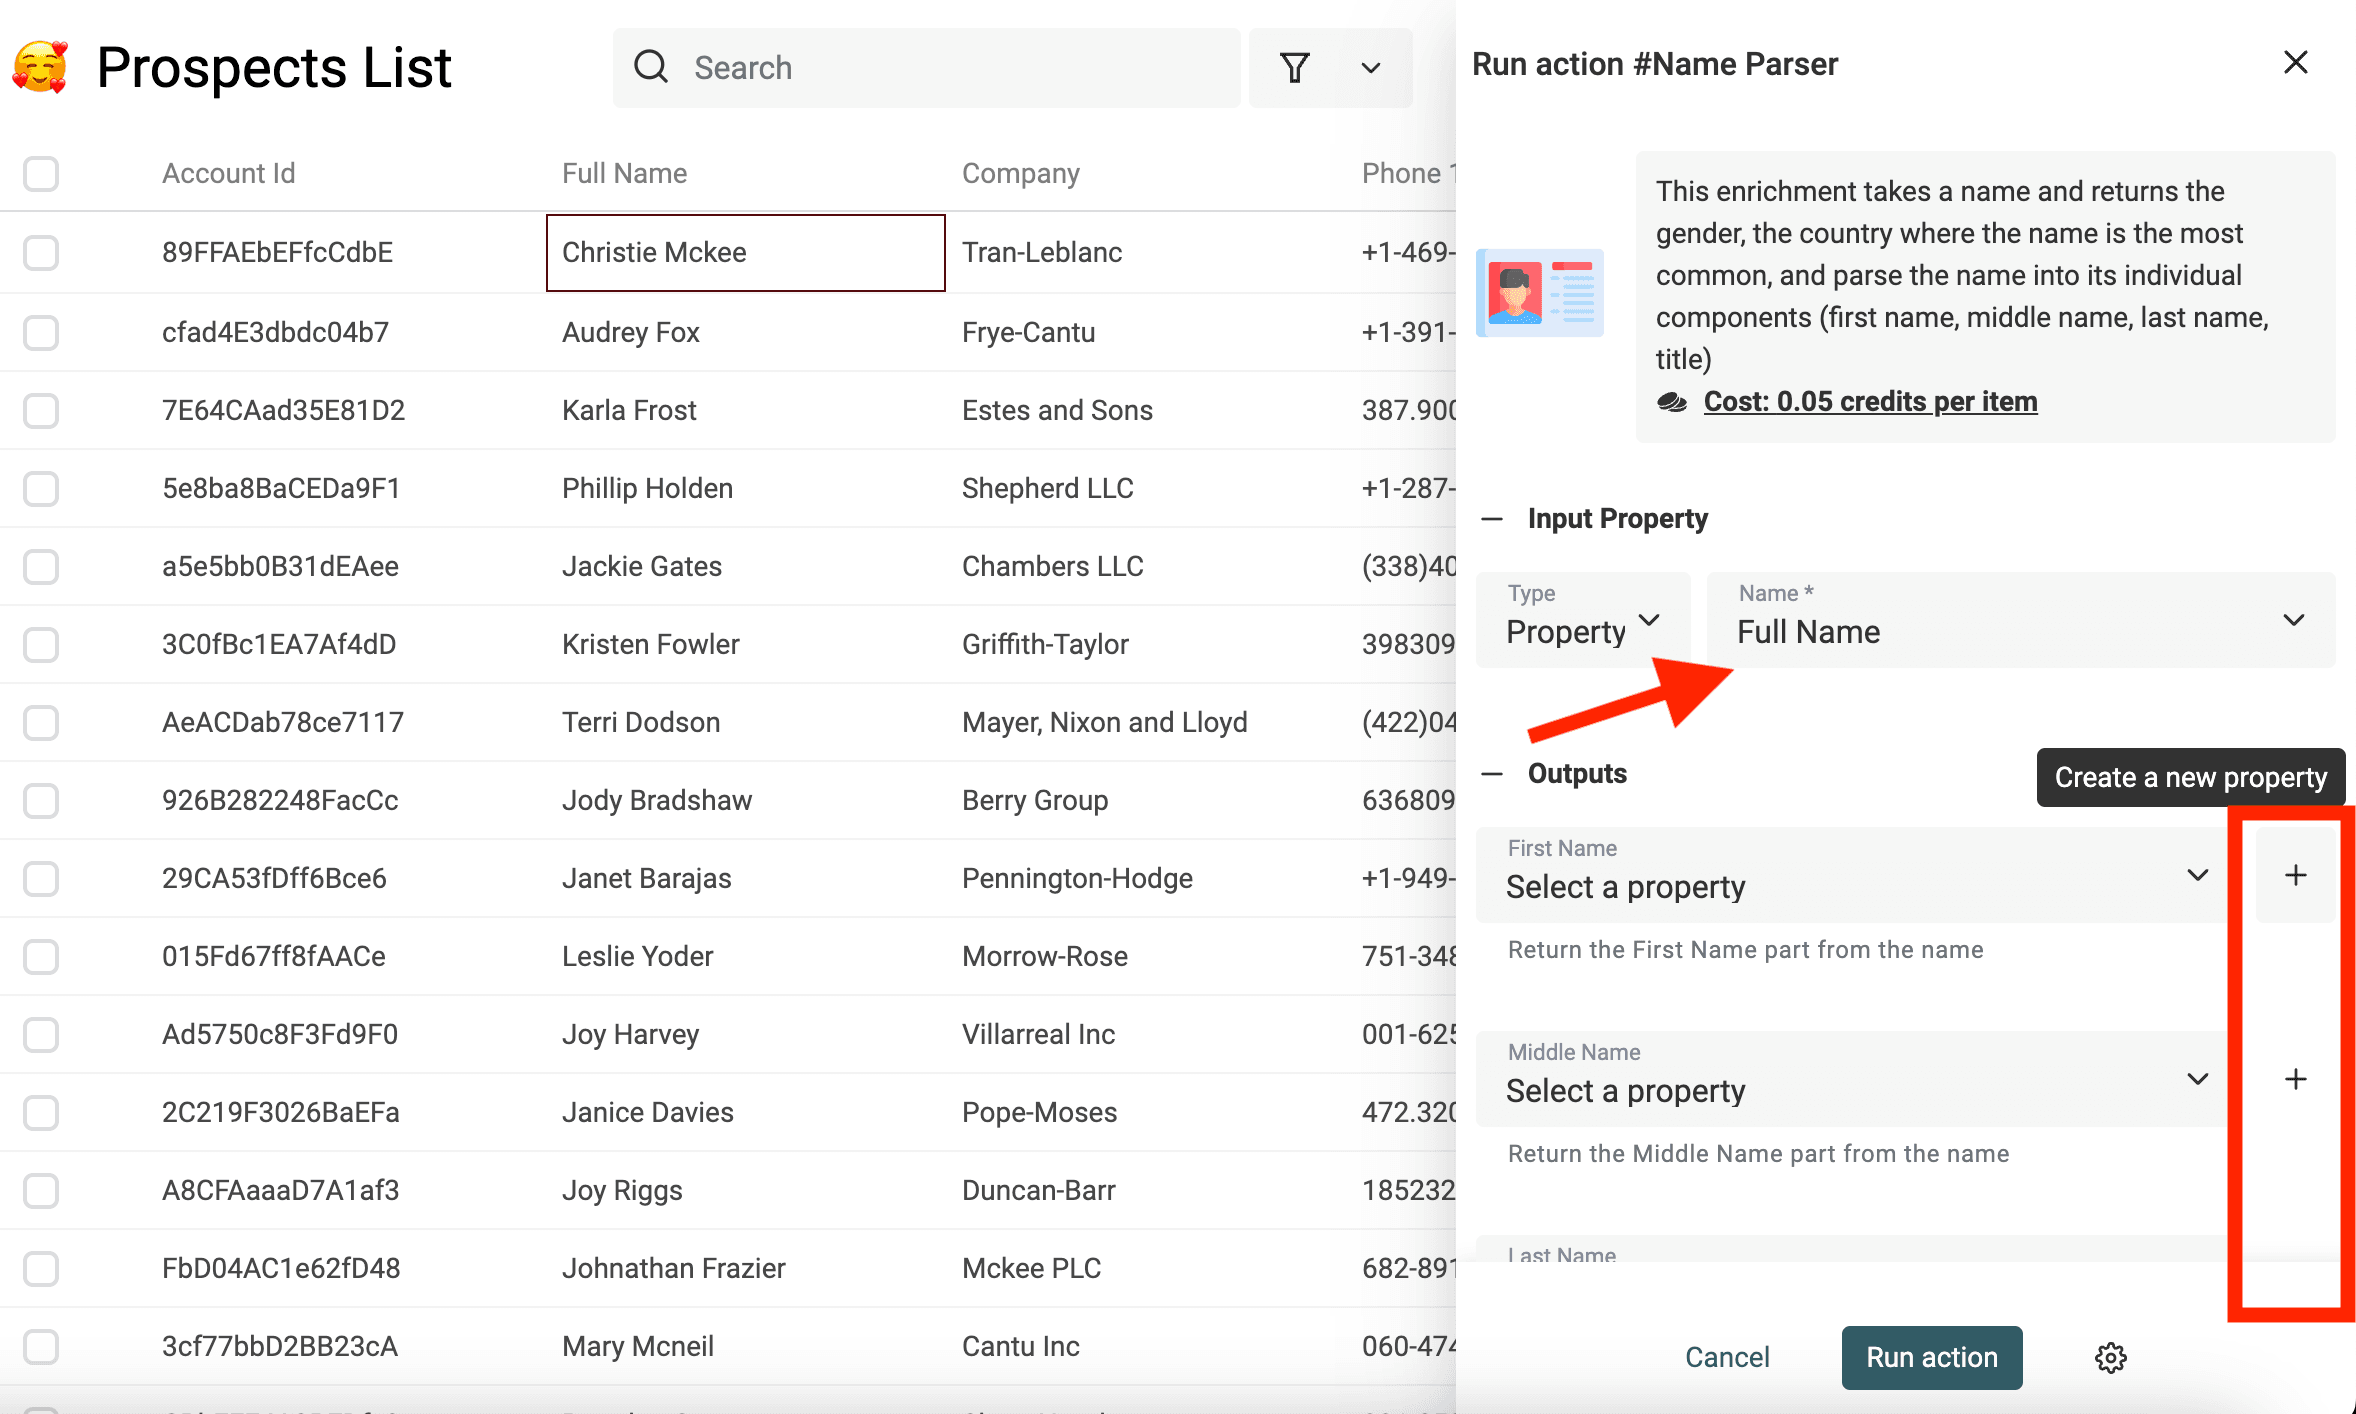
Depois, selecione a propriedade que contém os nomes. Mapeie ou crie novas propriedades para armazenar os resultados da análise. A propriedade com o nome completo não será alterada; apenas as propriedades de saída receberão os resultados.
Normalize nomes de empresas
Também é possível remover ruídos dos nomes de empresas, como prefixos, sufixos, stop words, complementos regionais ou outros elementos que prejudiquem o matching.
Um exemplo de limpeza é remover sufixos empresariais como "Inc." ou "GmbH".
Use esta expressão regular na ferramenta Find & Replace:
,?\s(llc|inc|incorporated|corporation|corp|co|gmbh|ltd).?$
E substitua o resultado por uma string vazia.
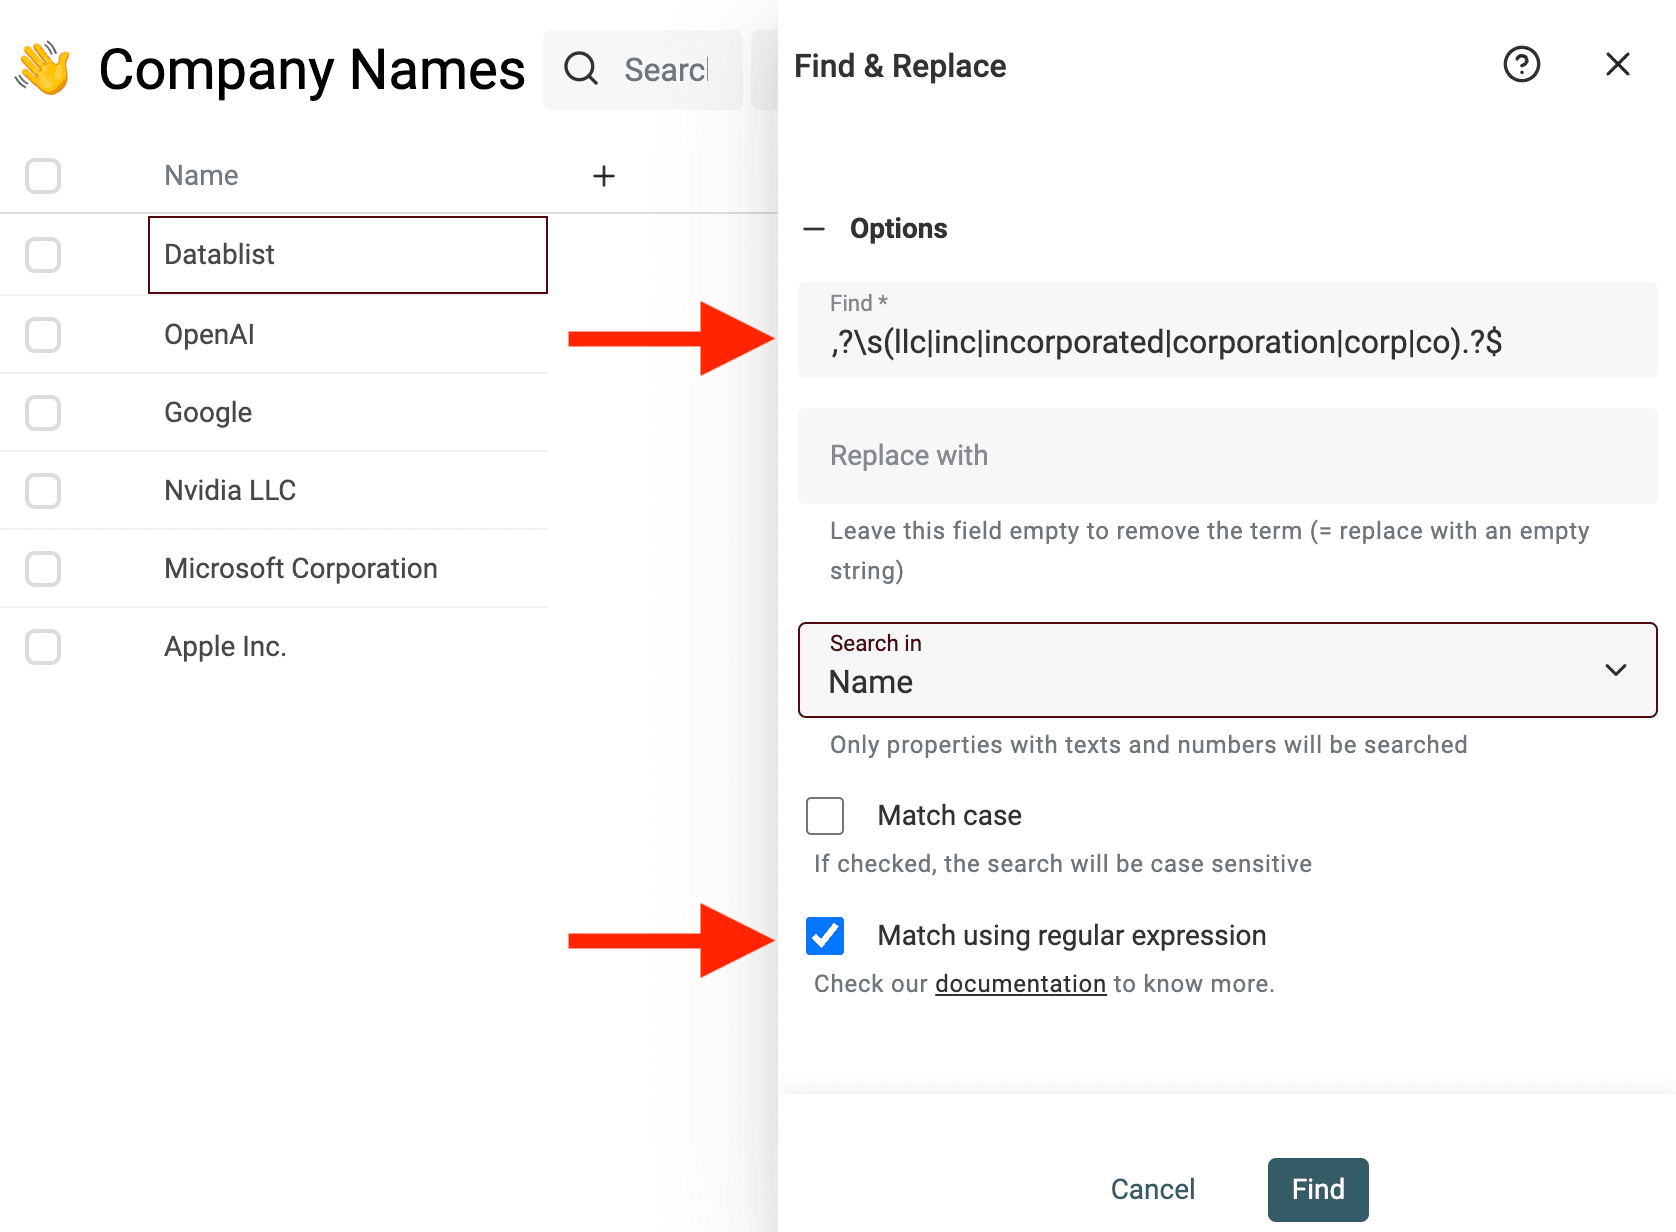
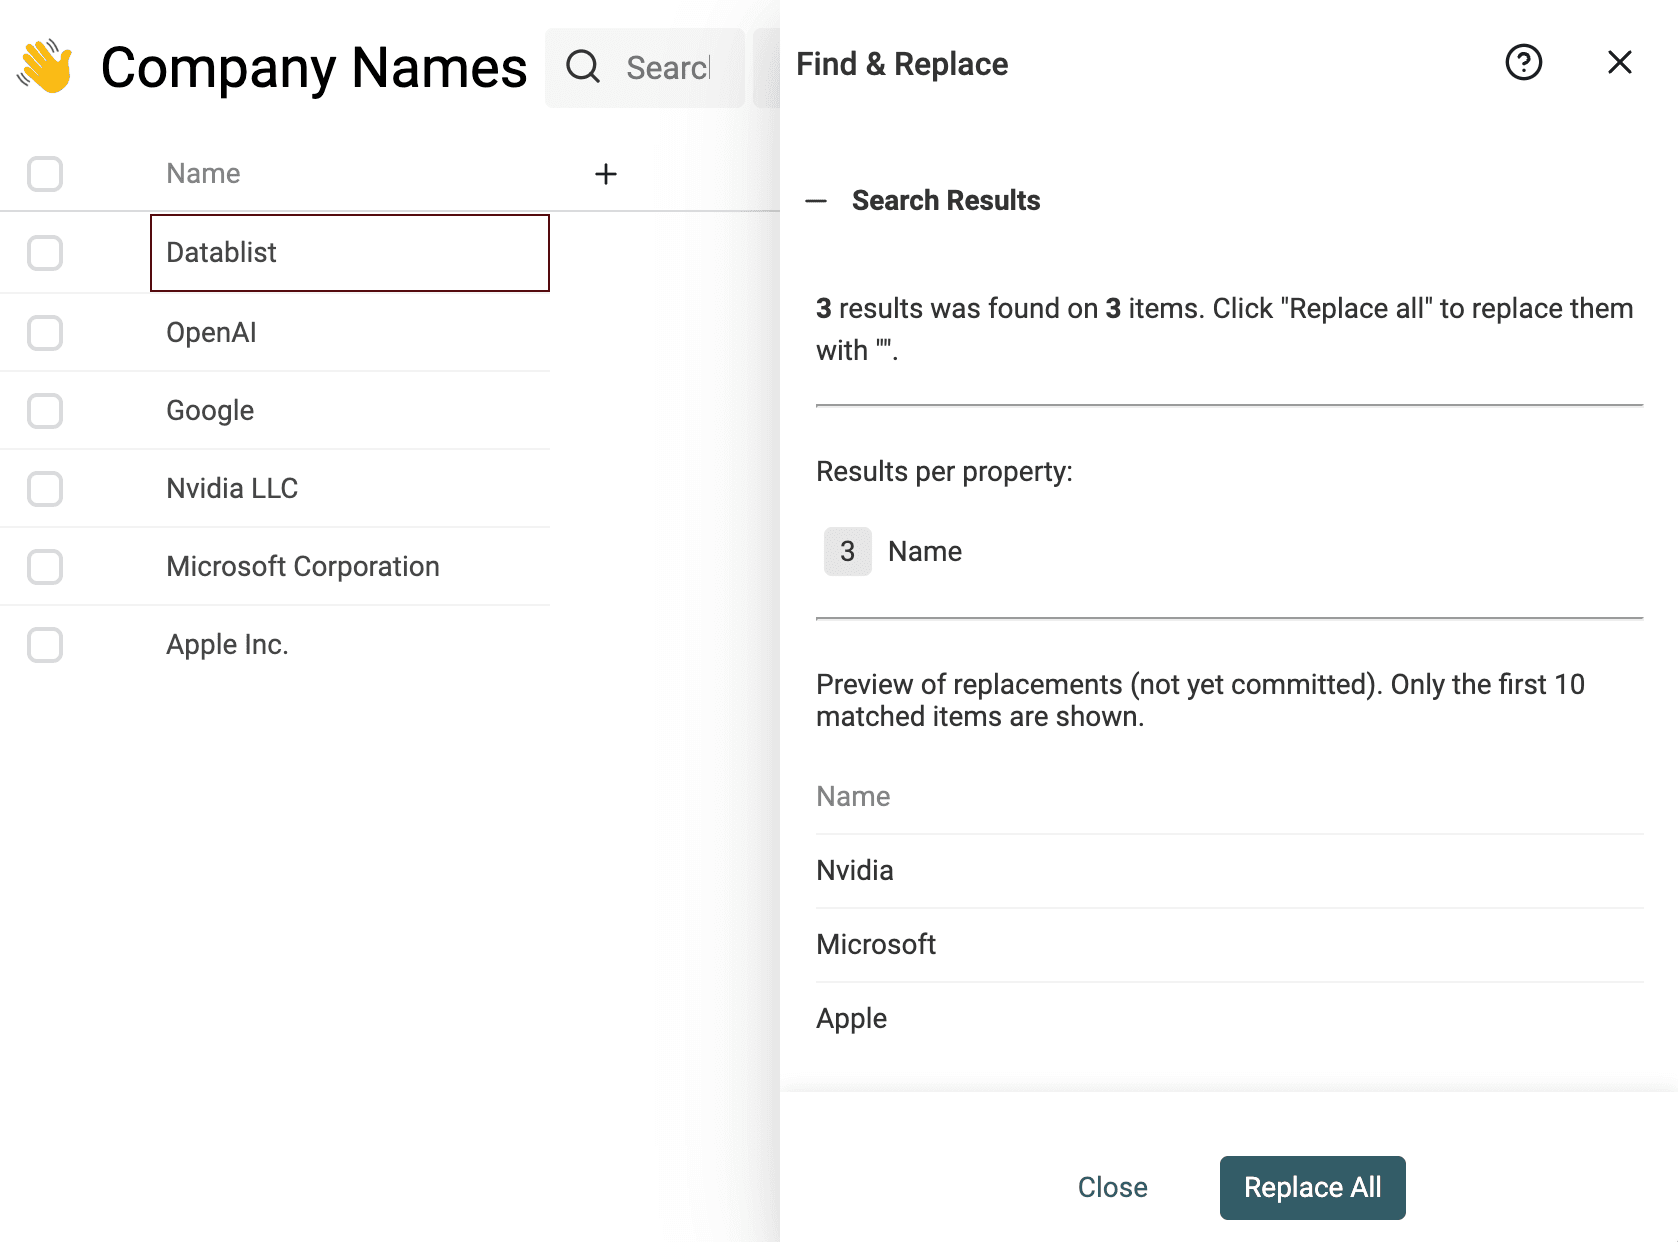
Normalizar nomes e endereços de empresas em todos os conjuntos de dados é importante para manter um formato padronizado.
Normalize nomes de ruas
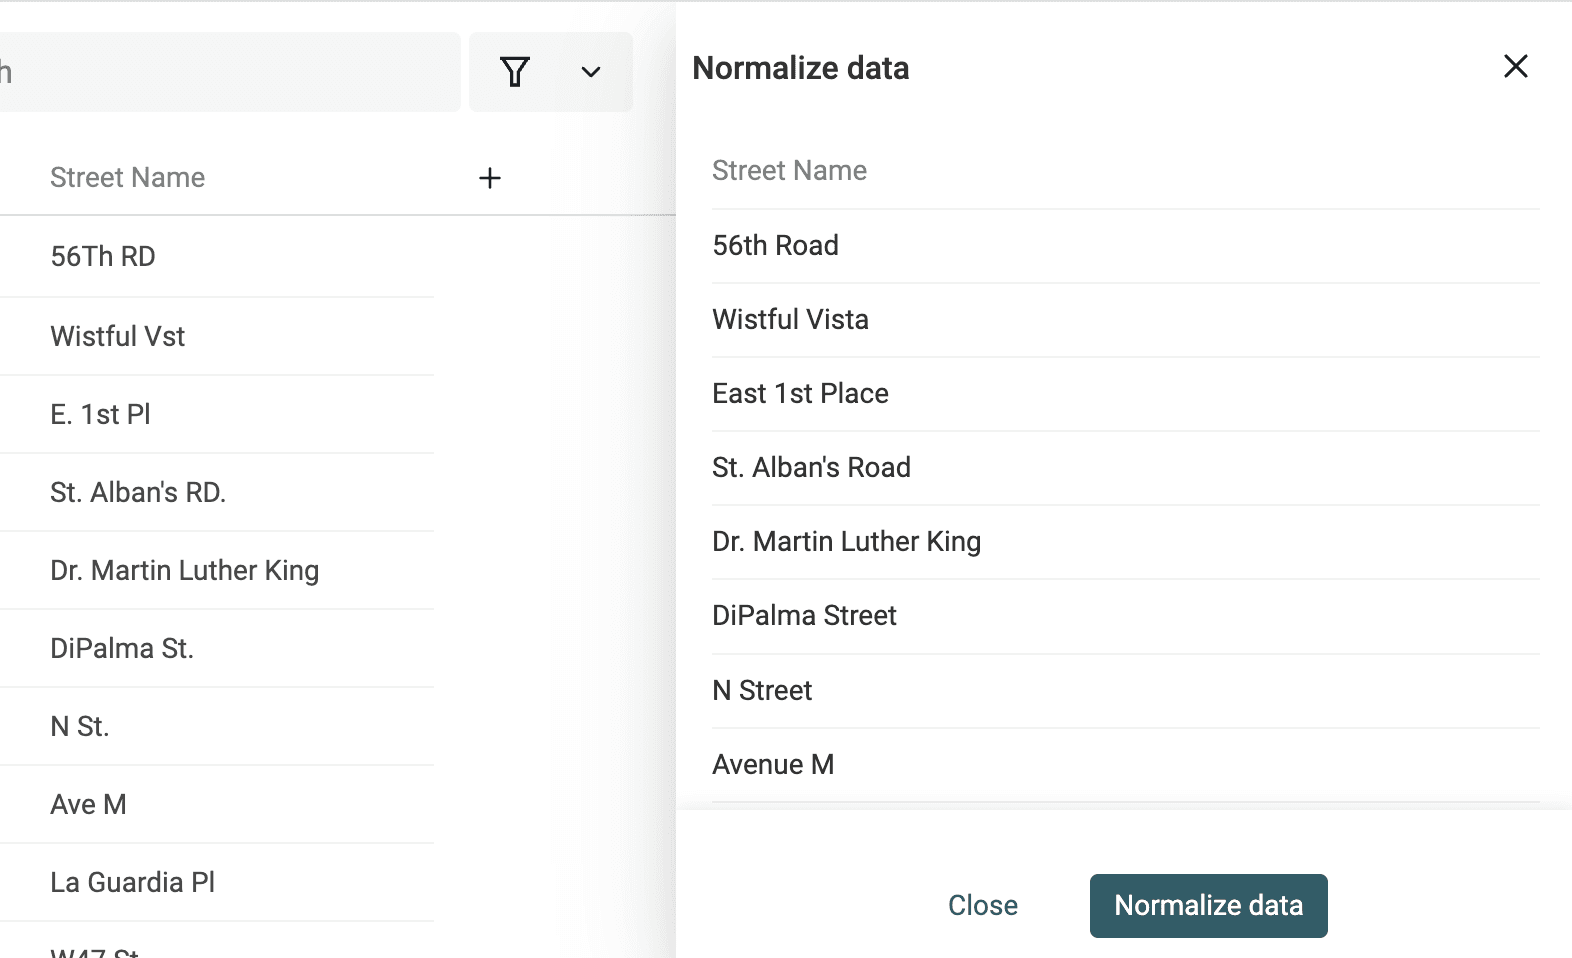
Se você estiver fazendo Data Matching com endereços postais, normalizar os nomes das ruas é fundamental. Endereços podem usar abreviações, prefixos de direção ou sufixos numéricos. Sem normalização, a mesma rua pode aparecer várias vezes em formatos diferentes, tornando o data matching muito mais difícil.
Por exemplo, Main 9 St, Main 9TH St. e Main 9th Street se referem à mesma rua. O mesmo vale para Washington Blvd e Washington Boulevard.
Usar algoritmos fuzzy para tratar essas diferenças é ineficiente. Seriam necessárias várias alterações de letras entre Washington Blvd e Washington Boulevard, e a distância de similaridade calculada pelos algoritmos de fuzzy matching seria alta.
Uma abordagem melhor é normalizar os nomes das ruas. Adotar um formato único garante consistência.
O Datablist oferece normalização para formatos de nomes de ruas em inglês, incluindo abreviações, números e outros elementos.
Observação
A normalização de nomes de ruas funciona com endereços separados em partes. O nome da rua precisa estar em uma propriedade específica. O recurso não funciona com o endereço completo em um único campo.
Clique em "Normalize Street Names" no menu "Clean".
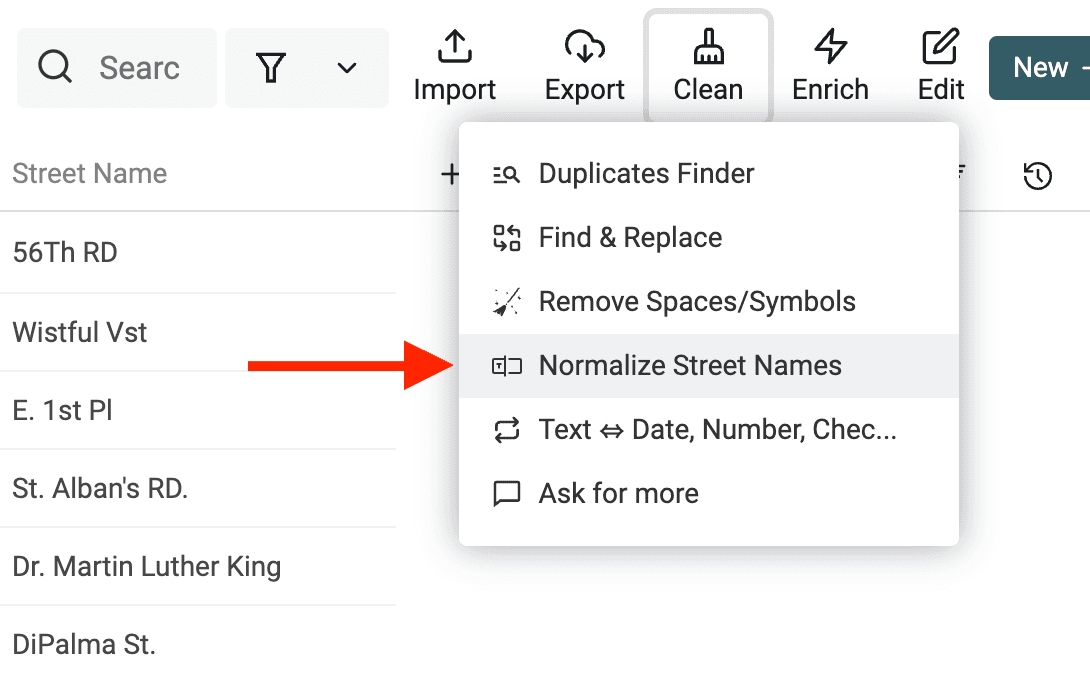
Depois, selecione a propriedade com os nomes das ruas e escolha "Normalize english street names".
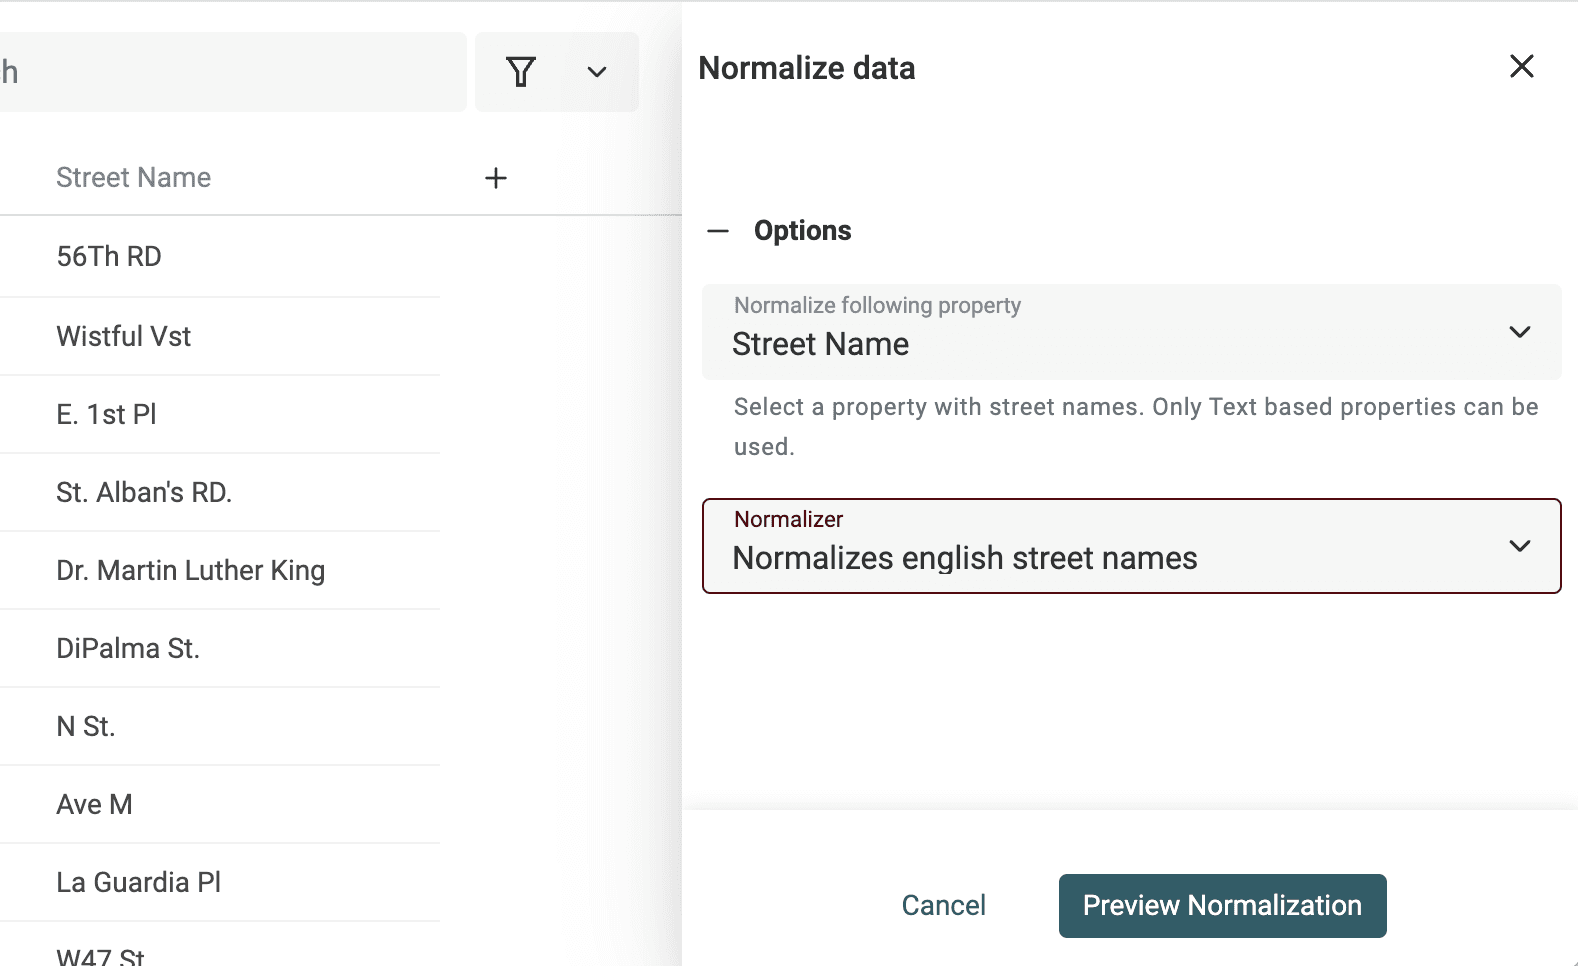
Confira as alterações na prévia e clique em "Run".
Etapa 3: compare registros em uma ou várias collections
Agora que seus dados estão limpos e normalizados, chegou a hora do data matching. Nesta etapa, queremos agrupar registros semelhantes.
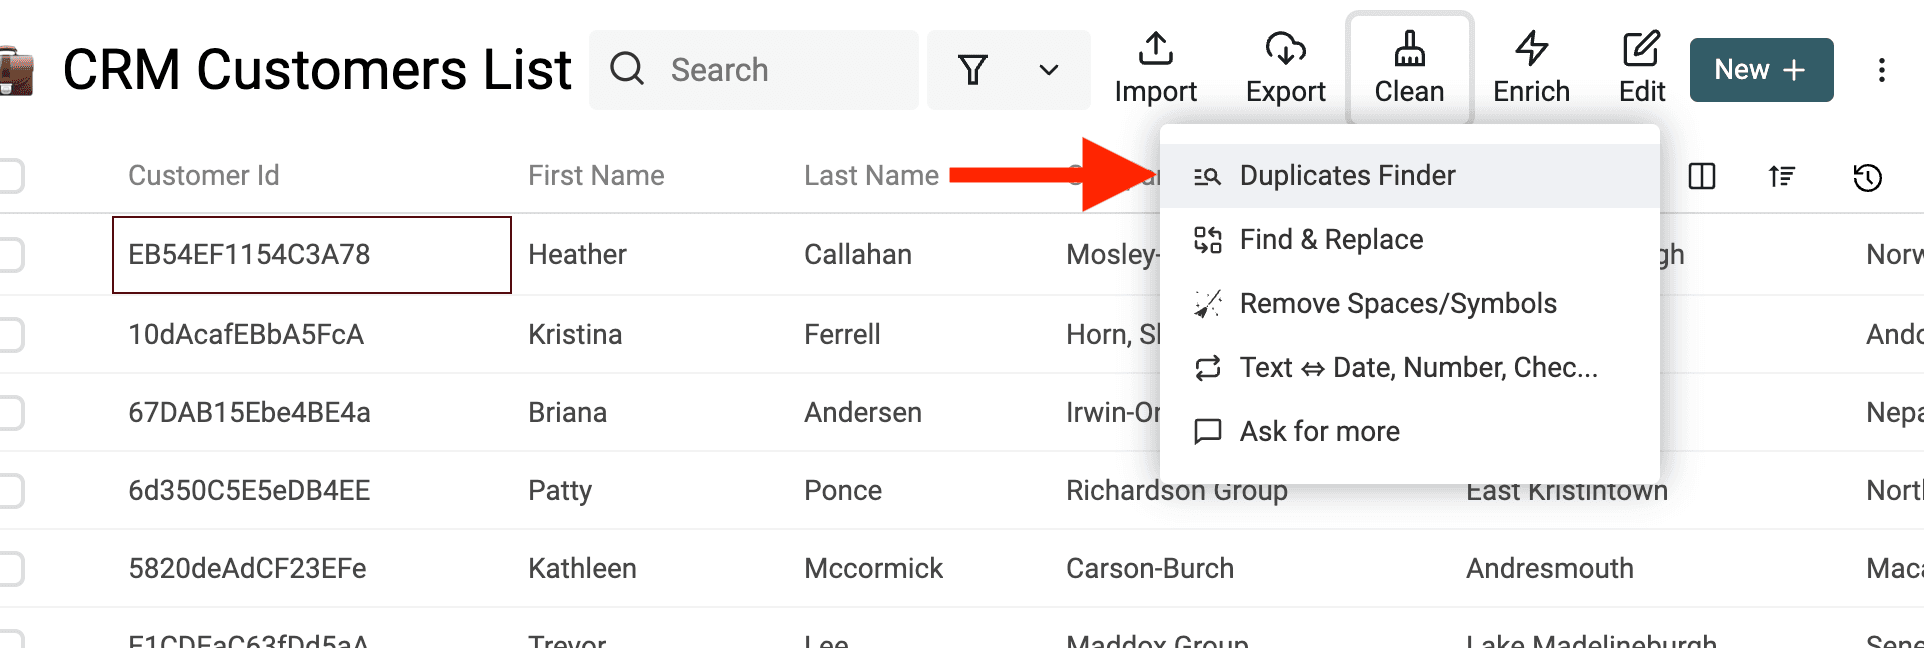
O Datablist oferece três modos iniciais:
- Selected Properties compara os campos escolhidos em uma collection.
- All Properties compara registros completos em uma collection.
- Match across collections mapeia e compara propriedades de várias collections.
Para dois arquivos de leads com Email e Company, mapeie primeiro as propriedades de e-mail. Se não houver e-mails, compare os nomes das empresas e, quando possível, acrescente um campo de site ou localização. O resultado será um conjunto de grupos candidatos, e não uma lista limpa garantida. Abra alguns grupos e confira os valores de origem antes de mesclar os registros.
Selecione as propriedades para comparação
No restante deste guia, use Match across collections.
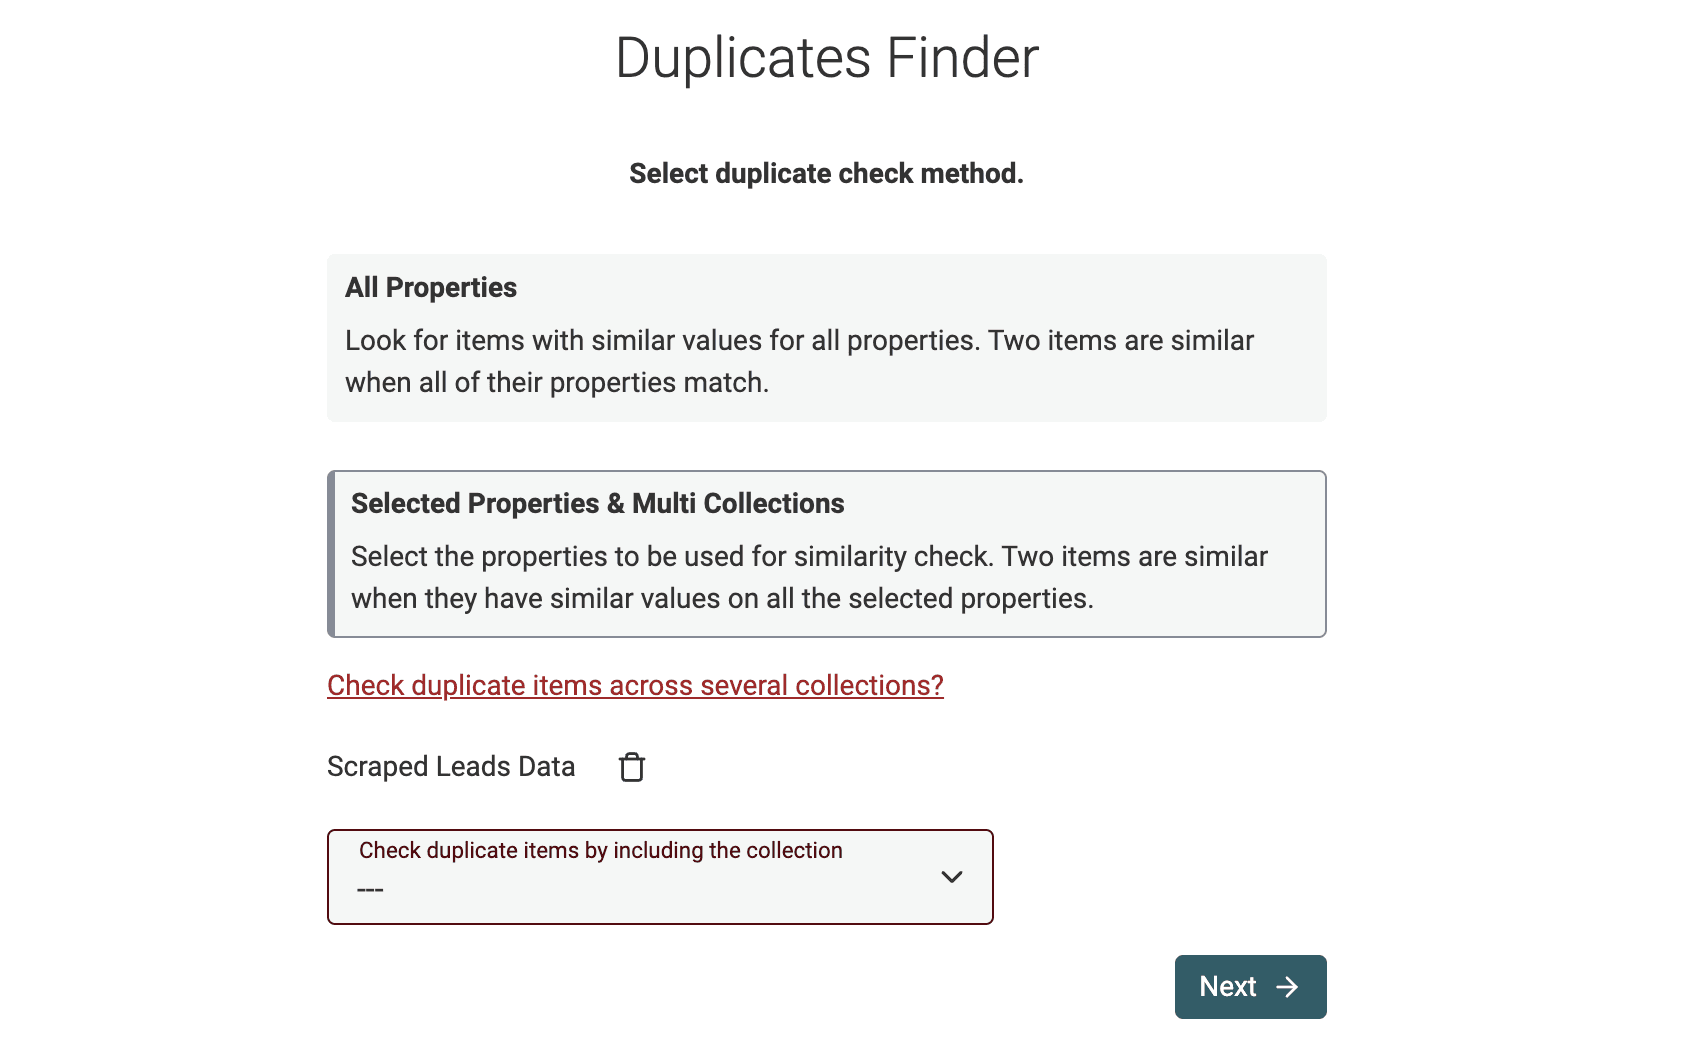
A próxima etapa é selecionar as propriedades usadas no data matching. Se você escolheu várias collections na etapa anterior, será necessário selecionar uma propriedade de mapeamento para cada uma delas.
Observação
O Datablist tentará mapear automaticamente as propriedades entre as collections com base no nome delas.
Selecione o algoritmo de matching
Na etapa seguinte, as propriedades selecionadas são listadas para que você configure os algoritmos de comparação.
O Datablist oferece os seguintes algoritmos de matching:
-
Exact - O algoritmo Exact é recomendado para propriedades que não sejam texto, como DateTime, Number e Boolean. Ao usá-lo em propriedades de texto, uma opção permite definir se a comparação deve diferenciar maiúsculas e minúsculas. O algoritmo também remove espaços no início e no fim dos textos.
-
Smart - O algoritmo Smart pré-processa os itens para encontrar pequenas variações nos dados. Ele reconhece URLs com protocolos diferentes e também considera a ordem das palavras e a pontuação. Assim, "John-Doe" e "Doe John" serão associados.
-
Phonetic com o algoritmo Double Metaphone - O Datablist utiliza o algoritmo Double Metaphone no matching fonético. Ele converte palavras em códigos que representam sua pronúncia. Duas palavras com sons semelhantes recebem o mesmo código Double Metaphone.
-
Fuzzy matching com algoritmos de distância - O Datablist também oferece fuzzy matching com as distâncias Jaro-Winkler e Levenshtein. Ao selecionar uma delas, você precisa definir um limite de similaridade. Quanto maior o limite, menor será a variação aceita.
Consulte nossa documentação para saber mais sobre os algoritmos de matching.
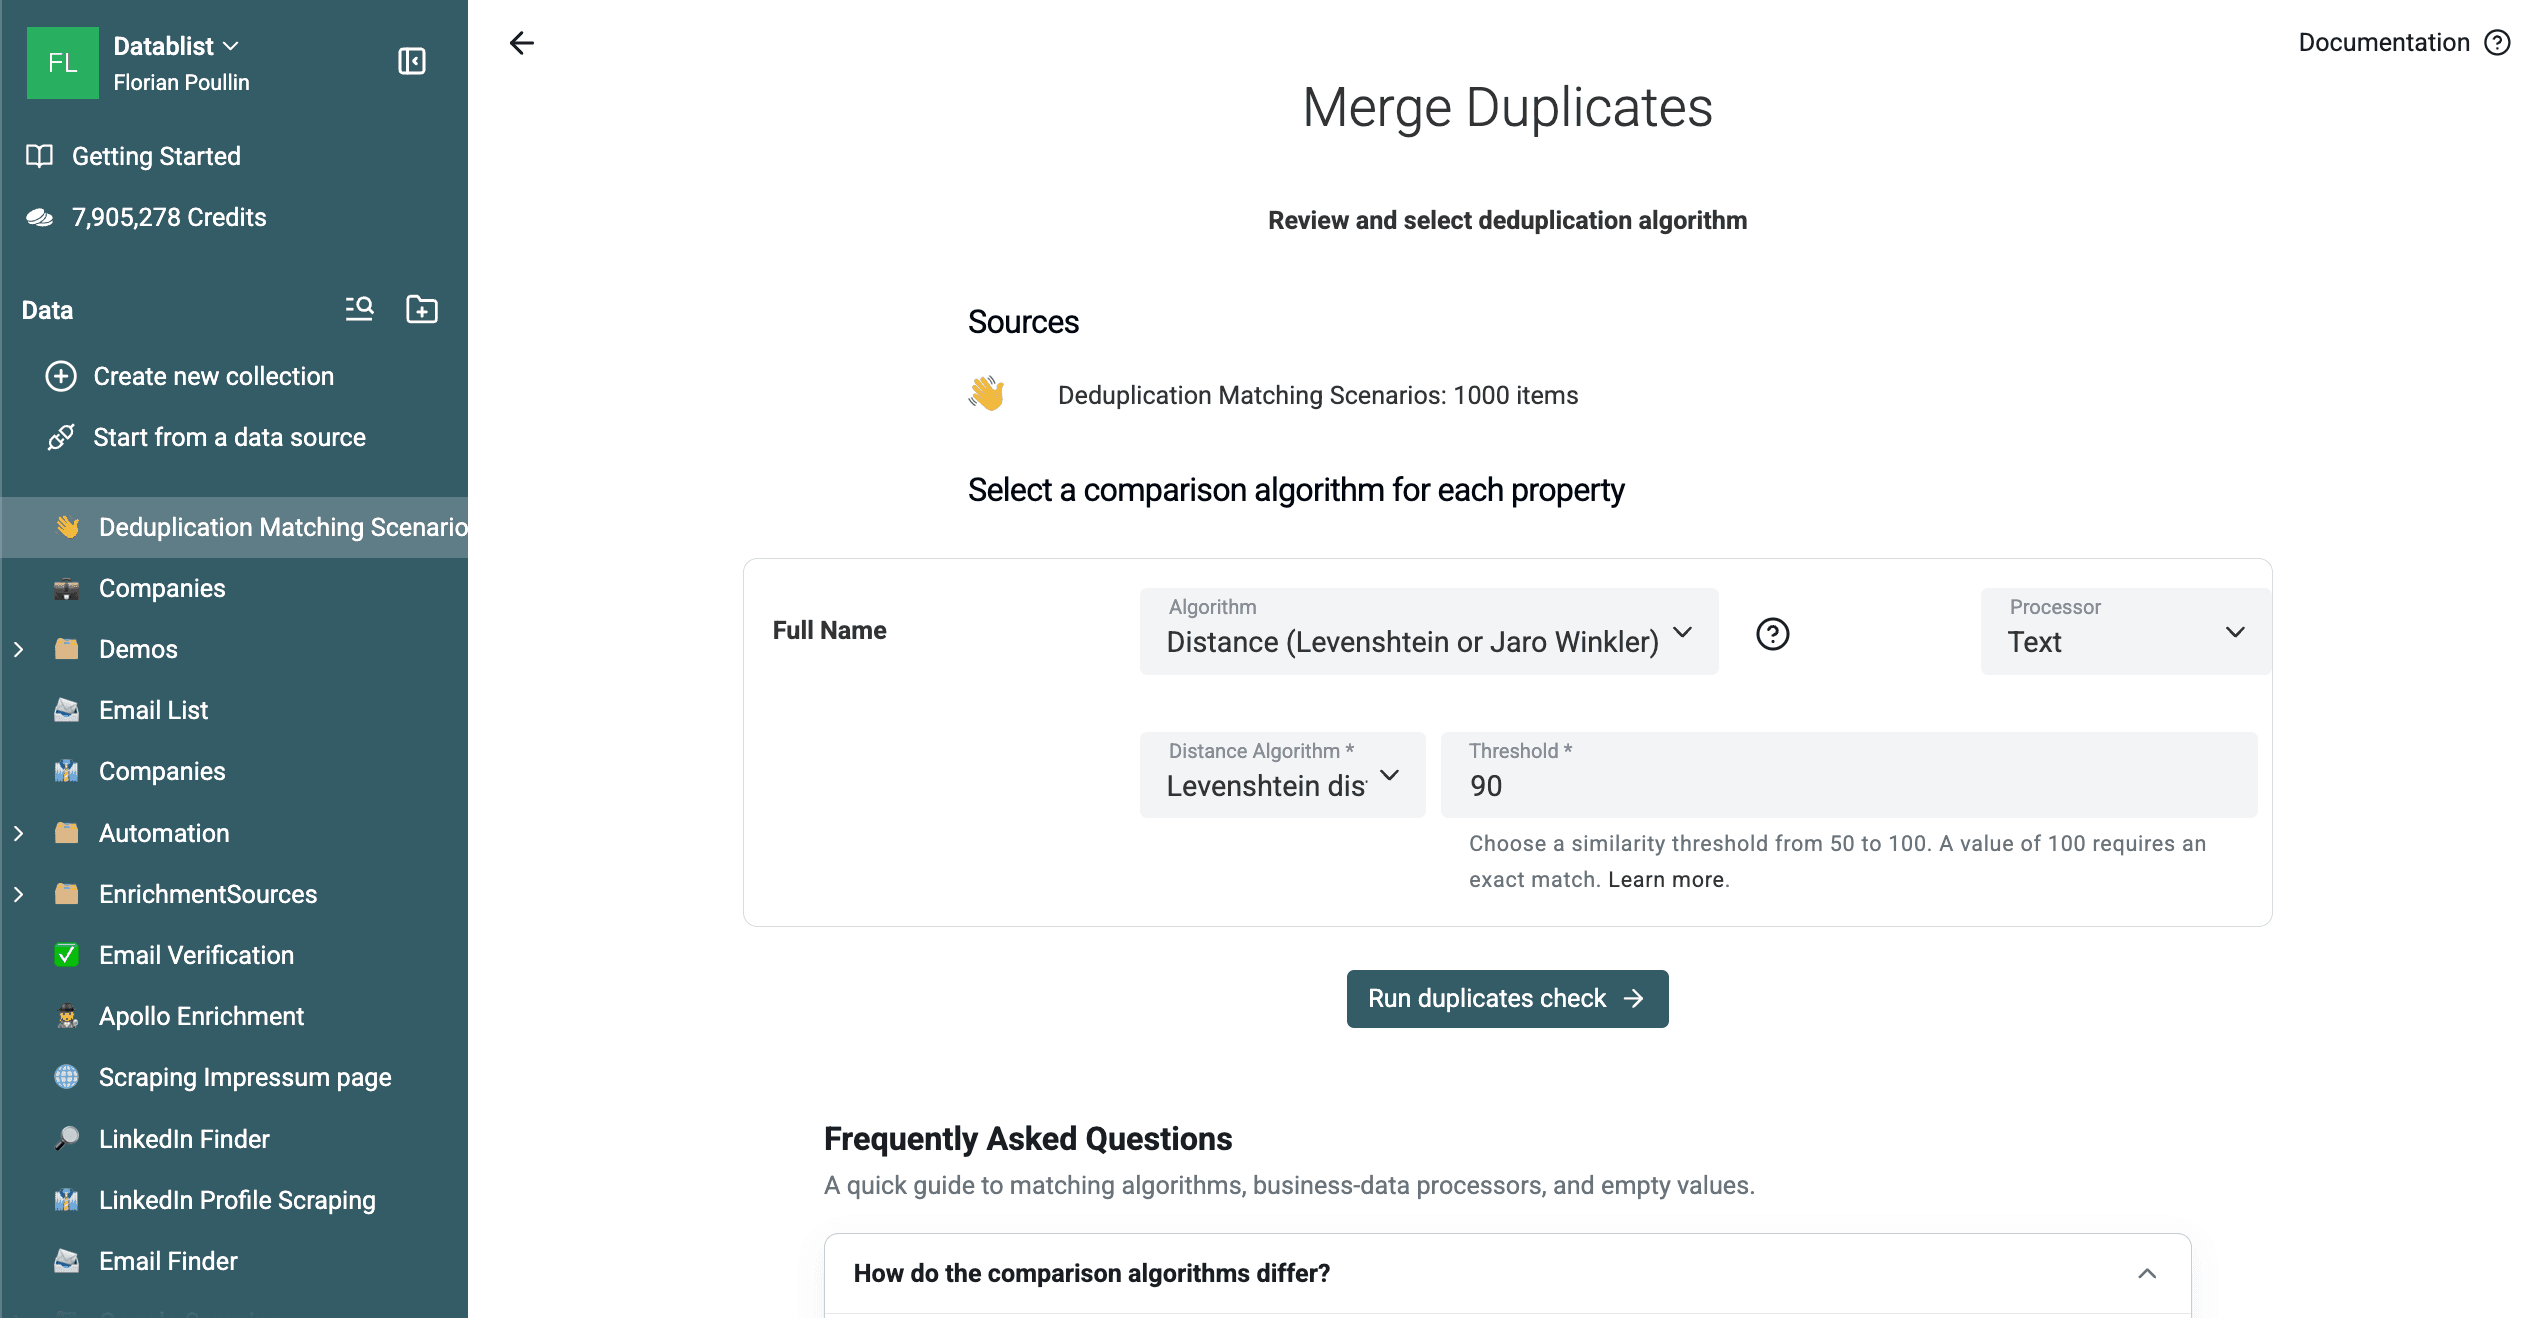
Na amostra de deduplicação com 1.000 linhas, essa configuração de Full Name retornou
77 grupos com duas linhas. A validação com dados de referência identificou 21 grupos da mesma
entidade e 56 grupos que uniam entidades diferentes. A maioria dos falsos positivos
era formada por abreviações curtas e idênticas, como G. Rossi.
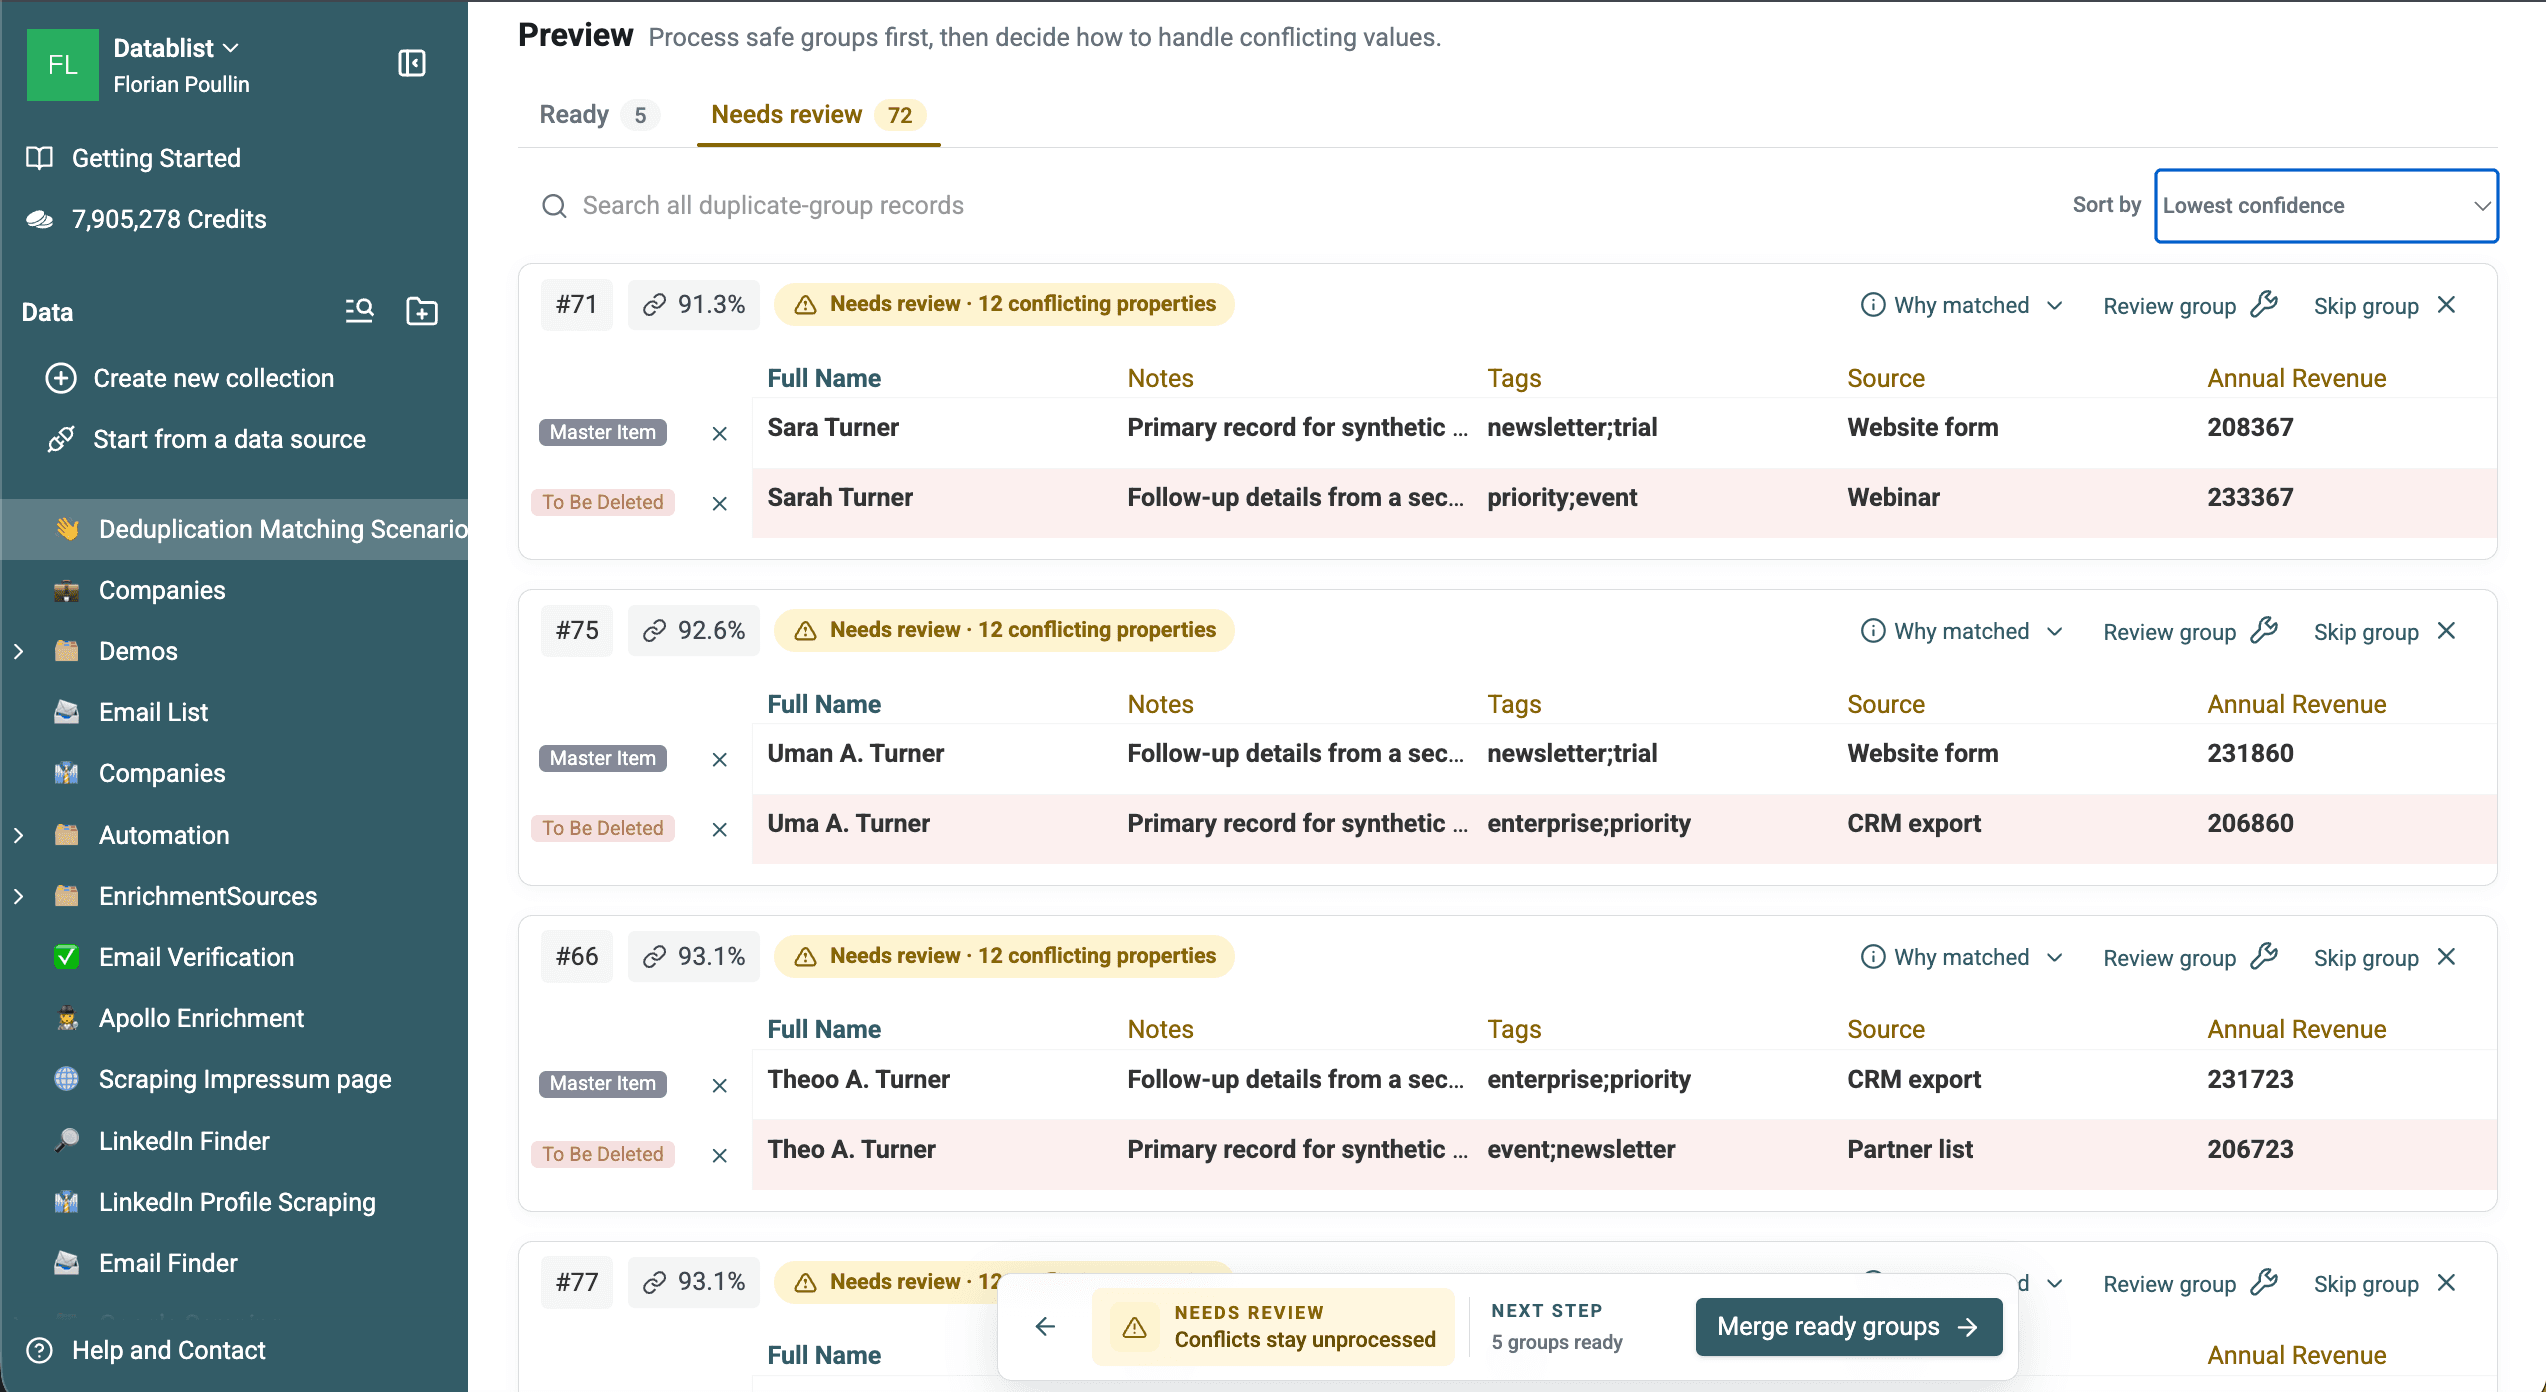
Use um segundo identificador, como e-mail, telefone, empresa ou site, antes de processar correspondências de nomes ambíguas. Baixe os 77 grupos exportados para analisar o resultado.
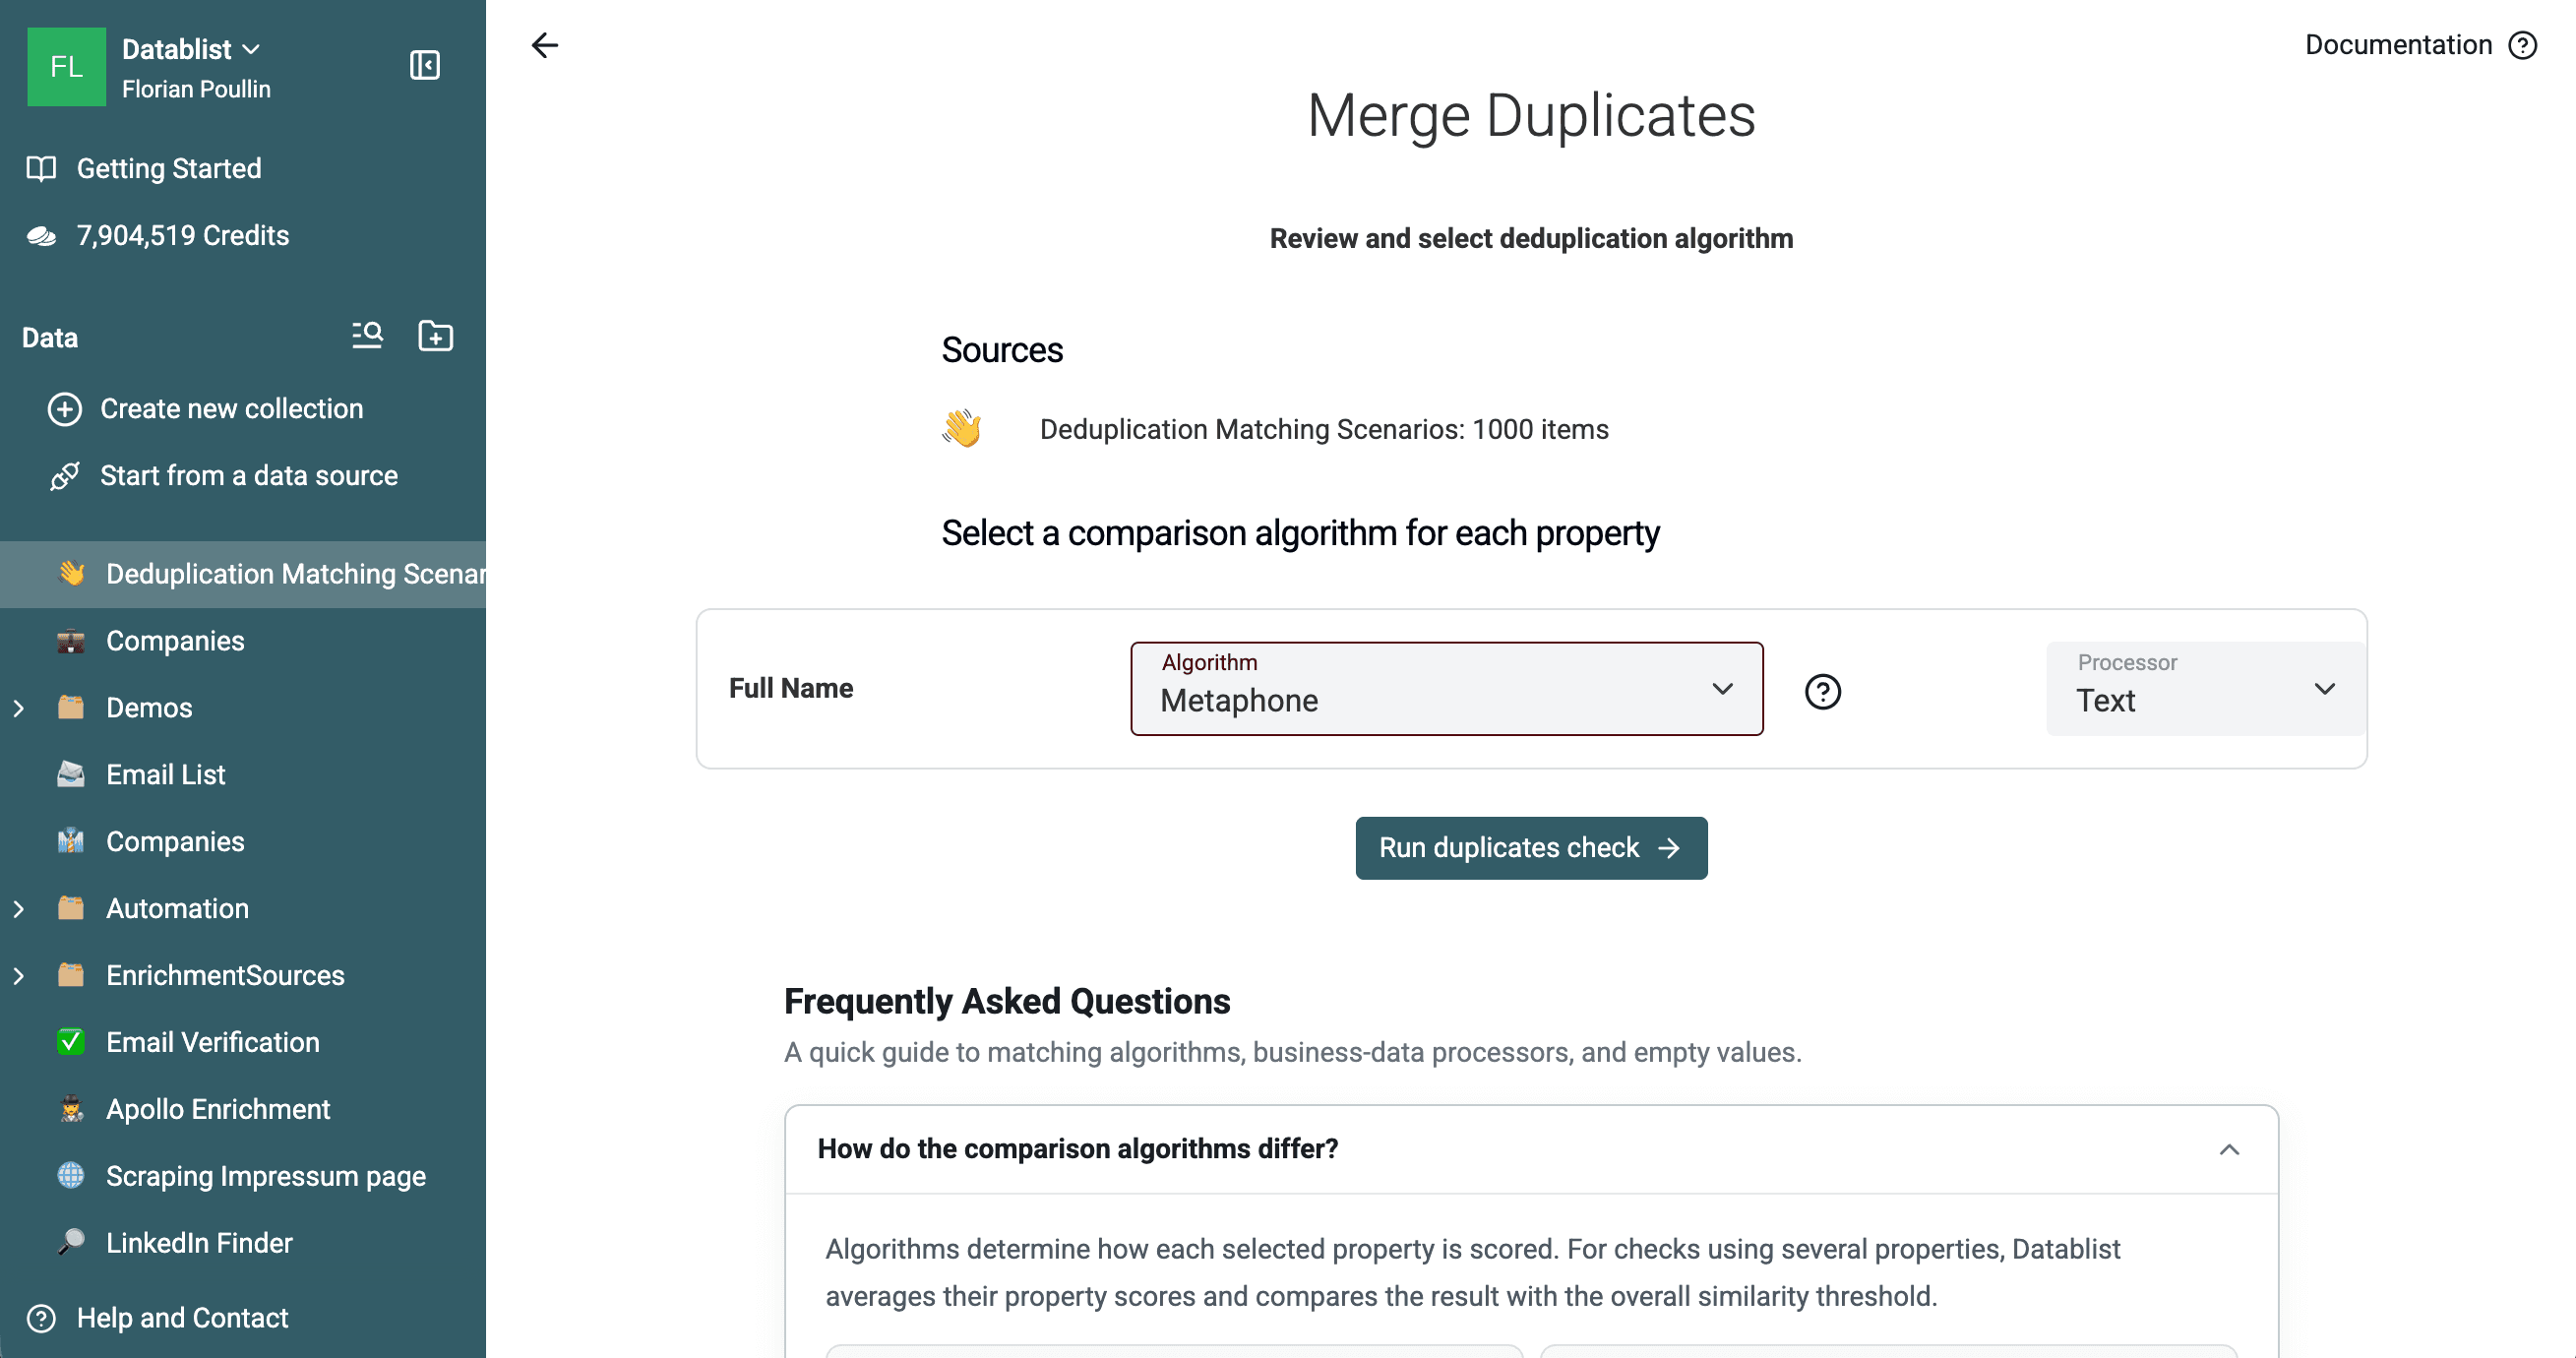
A mesma amostra retornou 69 grupos e 188 linhas agrupadas quando Full Name usou
Metaphone com o processador Text. A validação com dados de referência encontrou 19
grupos formados apenas pela mesma entidade e 50 grupos que misturavam pessoas diferentes.
O resultado incluiu grupos grandes de nomes abreviados com o mesmo sobrenome. A similaridade fonética é útil para encontrar candidatos, mas não comprova que duas linhas pertençam à mesma pessoa.
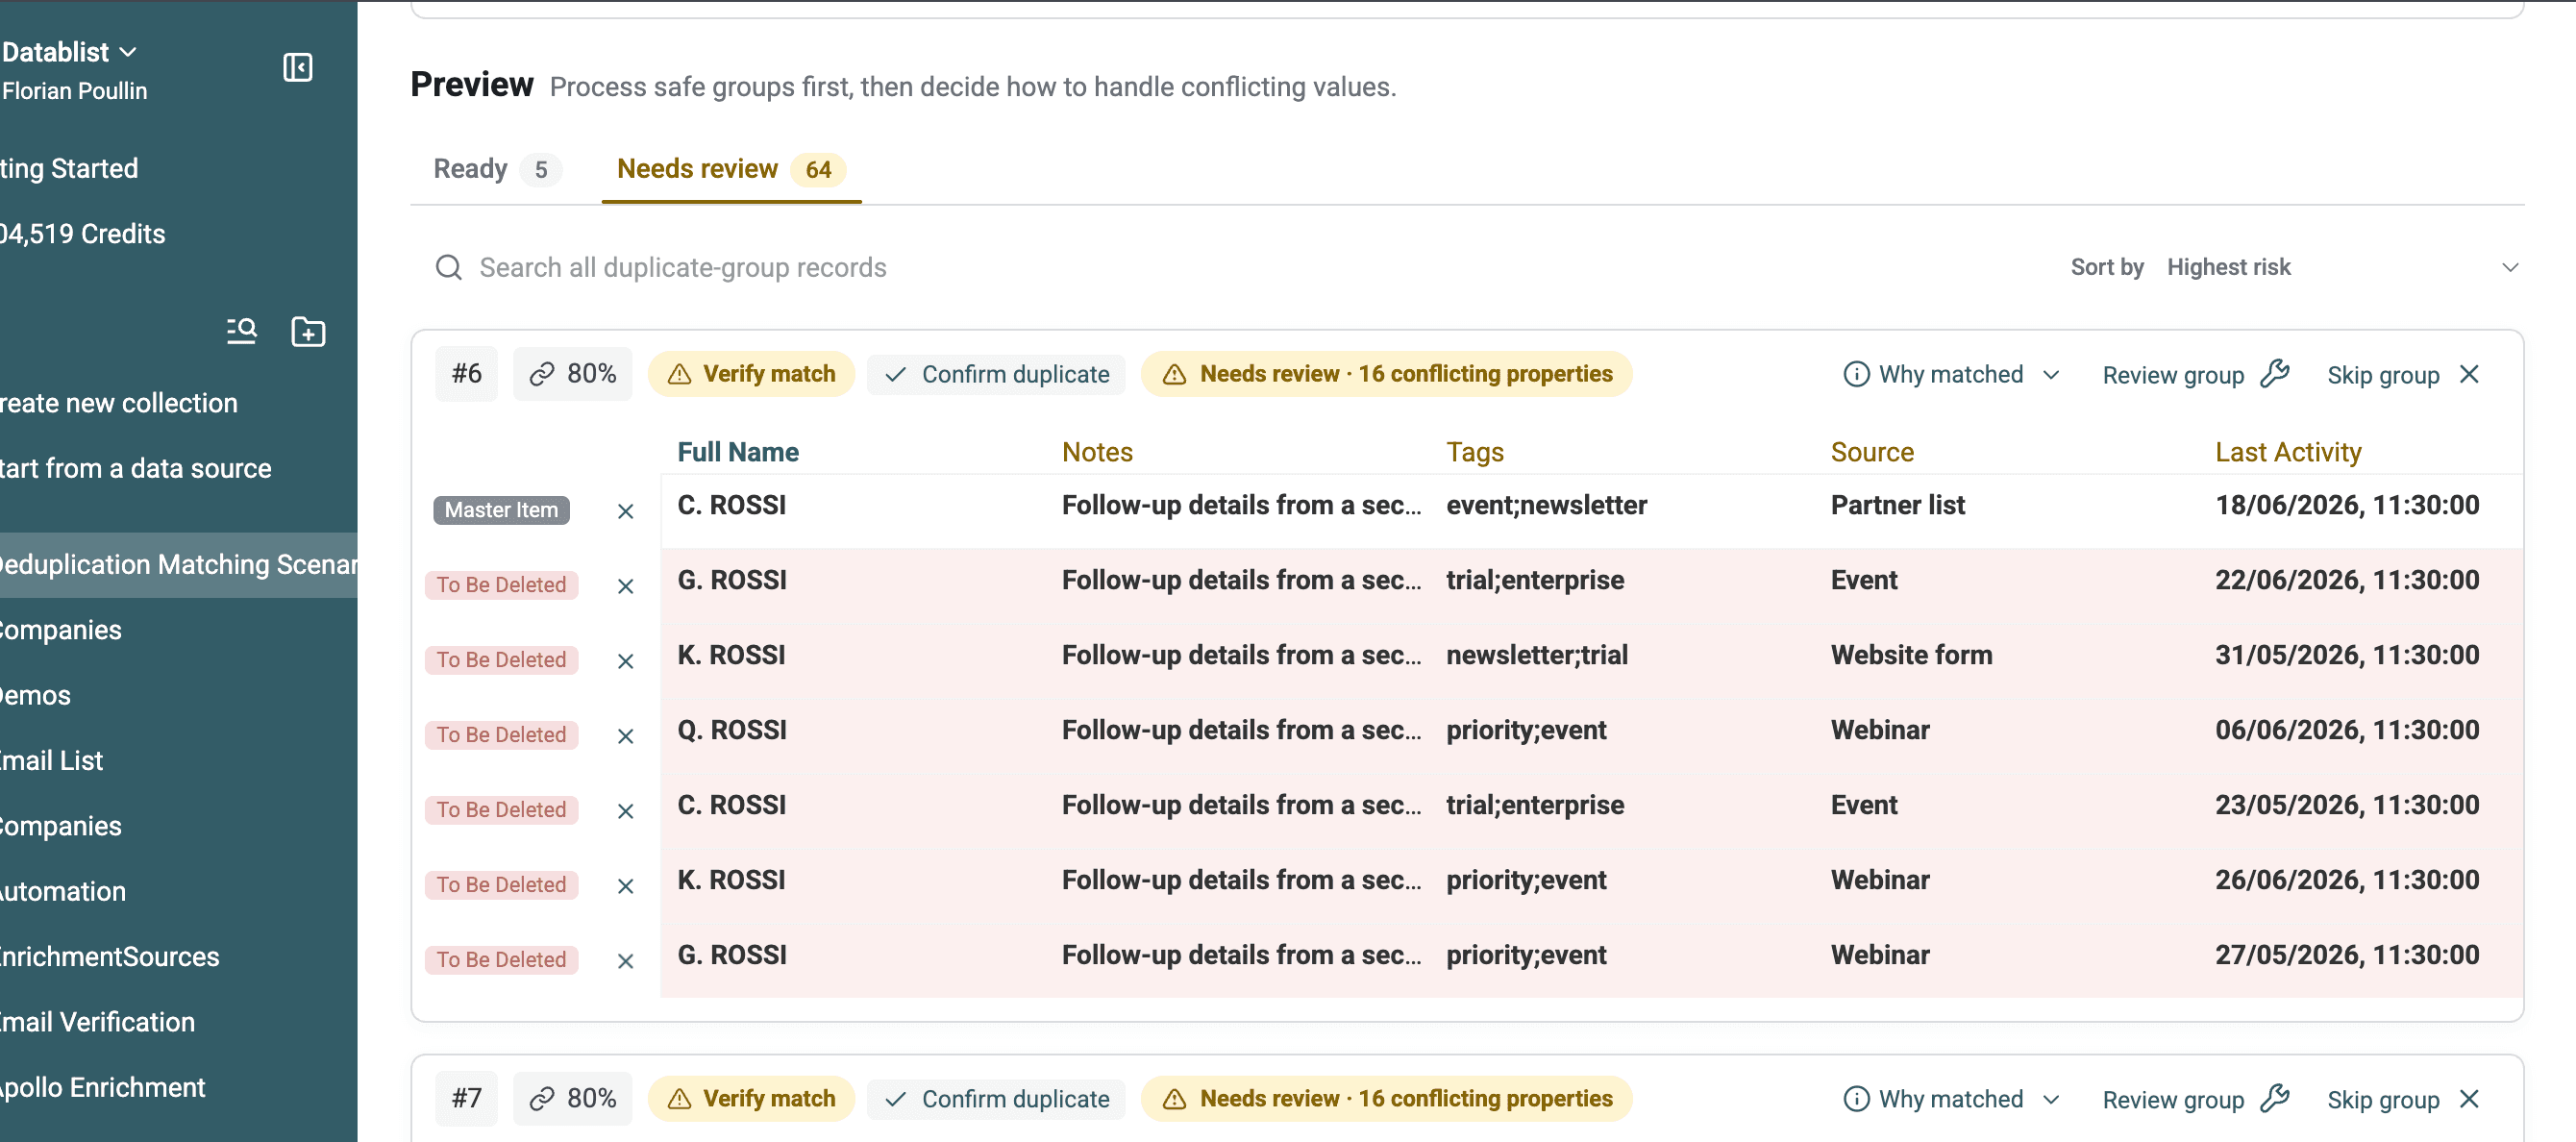
Baixe os 69 grupos exportados pelo Metaphone para revisar os grupos de duas a sete linhas e comparar as correspondências úteis com os falsos positivos.
Observação
- Os algoritmos Smart, Phonetic e fuzzy só se aplicam a propriedades de texto, incluindo Email, Text e LongText.
- Propriedades de URL são compatíveis apenas com os algoritmos Exact e Smart.
Etapa 4: remova ou mescle grupos correspondentes
O Duplicates Finder do Datablist retorna grupos correspondentes para revisão. A página de resultados explica por que as linhas foram associadas e separa os grupos Ready dos candidatos que precisam ser revisados.
Mesclagem automática na deduplicação de uma collection
Para uma única collection, selecione Merge and preserve data. O Datablist preenche propriedades vazias e aplica suas regras de conflito e Record to keep.
Observação:
Esse recurso está disponível apenas para a deduplicação de uma única collection. Na deduplicação de várias collections, a estrutura dos dados pode ser diferente entre elas.
Mesclagem automática sem conflitos de dados
O Datablist marca um grupo como Ready quando a mesclagem tem um resultado concreto e não há nenhum requisito pendente.
O processo funciona assim:
- Se todos os itens duplicados tiverem os mesmos valores nas propriedades, apenas um será mantido e os demais serão excluídos.
- Se os itens duplicados forem complementares, o item com mais informações será escolhido como principal, e suas propriedades serão preenchidas com os valores dos outros itens. Depois, todos os itens, exceto o principal, serão excluídos.
- Se houver valores conflitantes, configure uma regra ou deixe o grupo em Needs review.
Mesclagem automática com resolução de conflitos
Ao executar o algoritmo de Auto-Merging, o Duplicates Finder do Datablist detecta automaticamente as propriedades conflitantes. Um conflito ocorre quando dois itens têm valores diferentes na mesma propriedade. Para mesclá-los, você precisa escolher uma das opções:
- Combine concatena valores de texto distintos usando o separador selecionado.
- Keep the selected record's value descarta os outros valores.
- As regras pagas de sobrevivência de campos podem selecionar, em cada propriedade, o valor mais recente, mais antigo, mais longo, mais curto, mais alto, mais baixo ou mais frequente.
Regras de limpeza no matching entre várias collections
Ao executar a ferramenta de Data Matching do Datablist em vários conjuntos de dados, a mesclagem automática não fica disponível. Suas collections podem ter estruturas diferentes, com propriedades distintas.
Como alternativa, o Datablist oferece um recurso de limpeza que remove os itens duplicados de todas as collections, exceto uma. Use essa ferramenta para garantir a unicidade dos itens em seus conjuntos de dados.
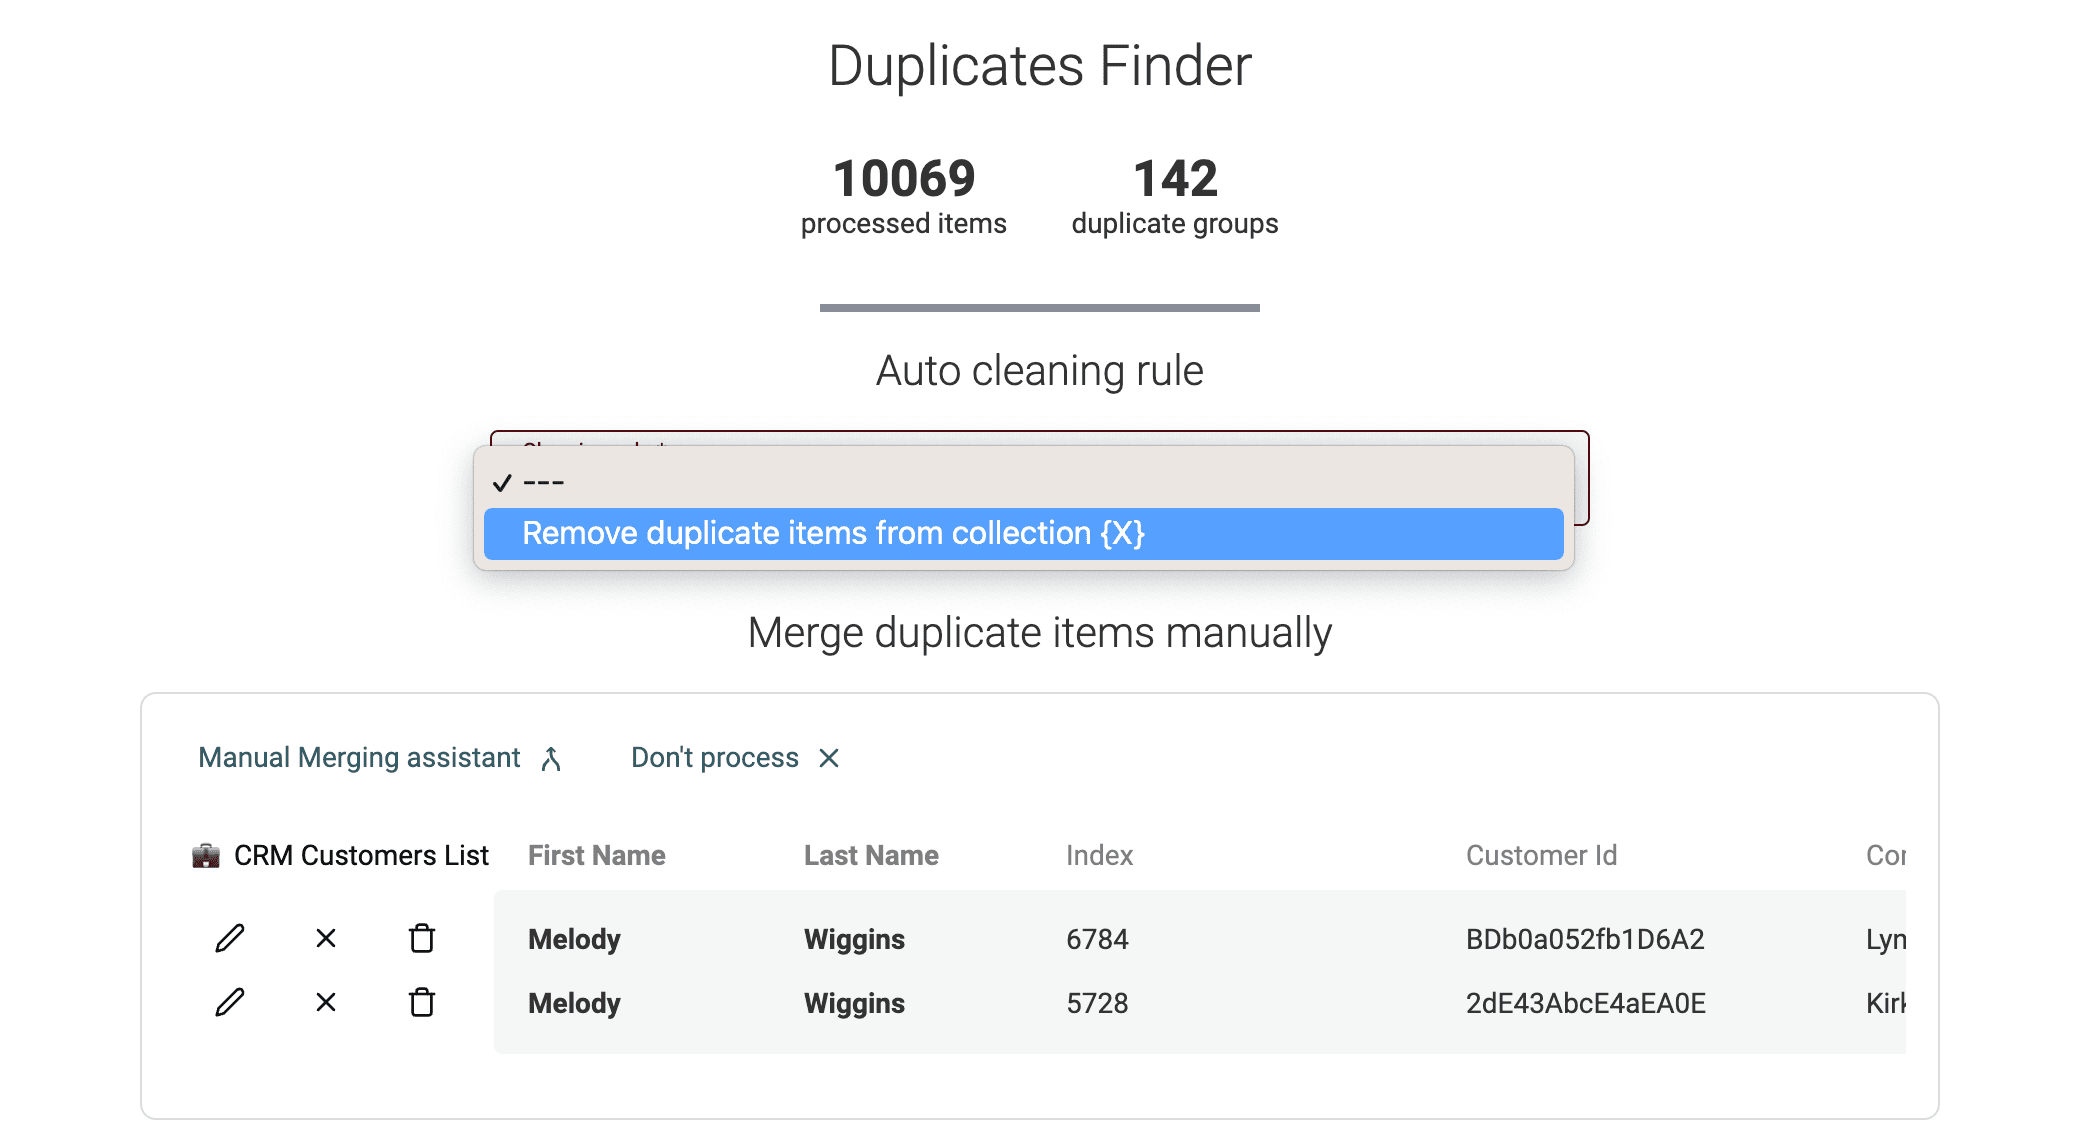
Antes da execução do algoritmo de limpeza, uma prévia das alterações é exibida.
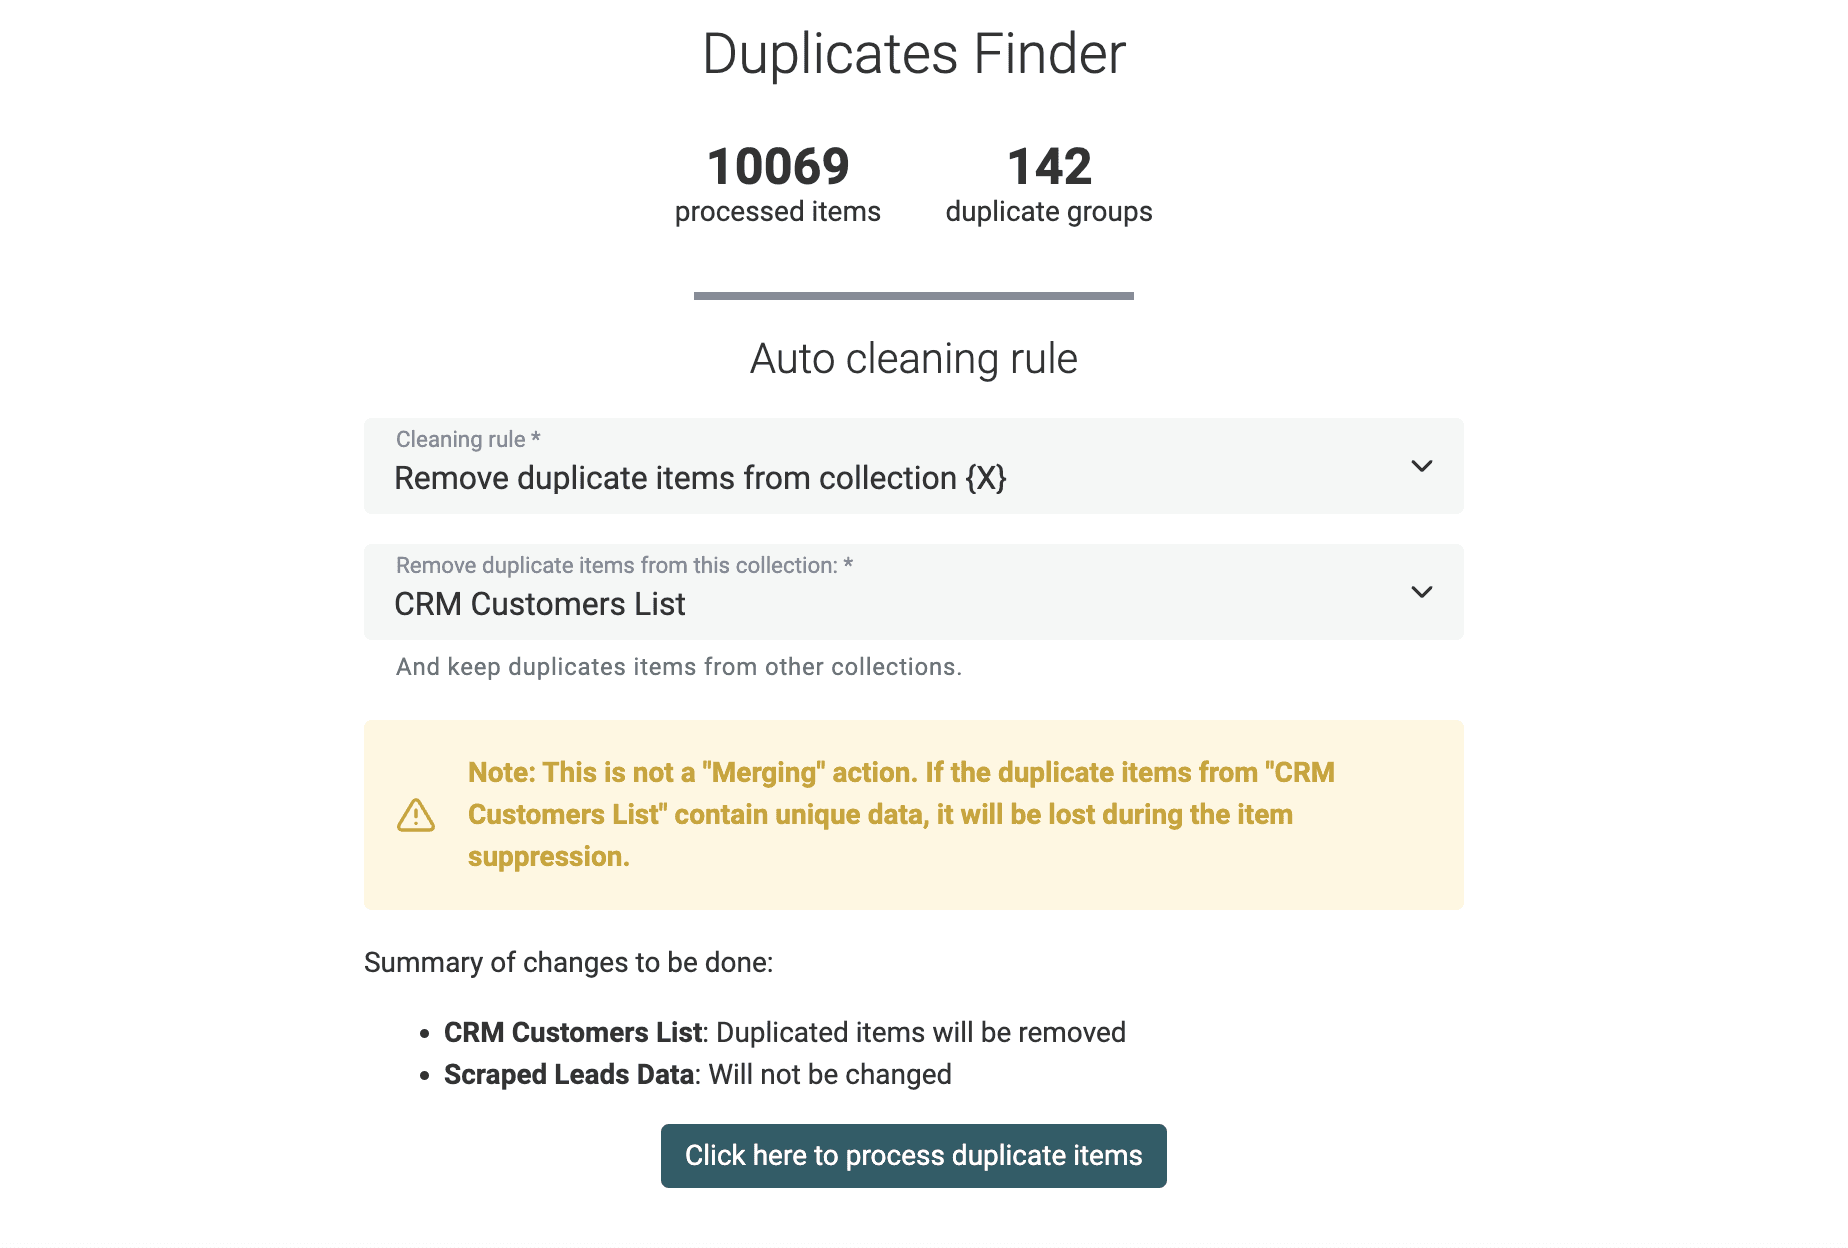
Mesclagem manual com o Merging Assistant
Para os registros duplicados restantes, você pode usar um assistente de mesclagem manual.
Clique em Review group e abra o Manual Merging Assistant.
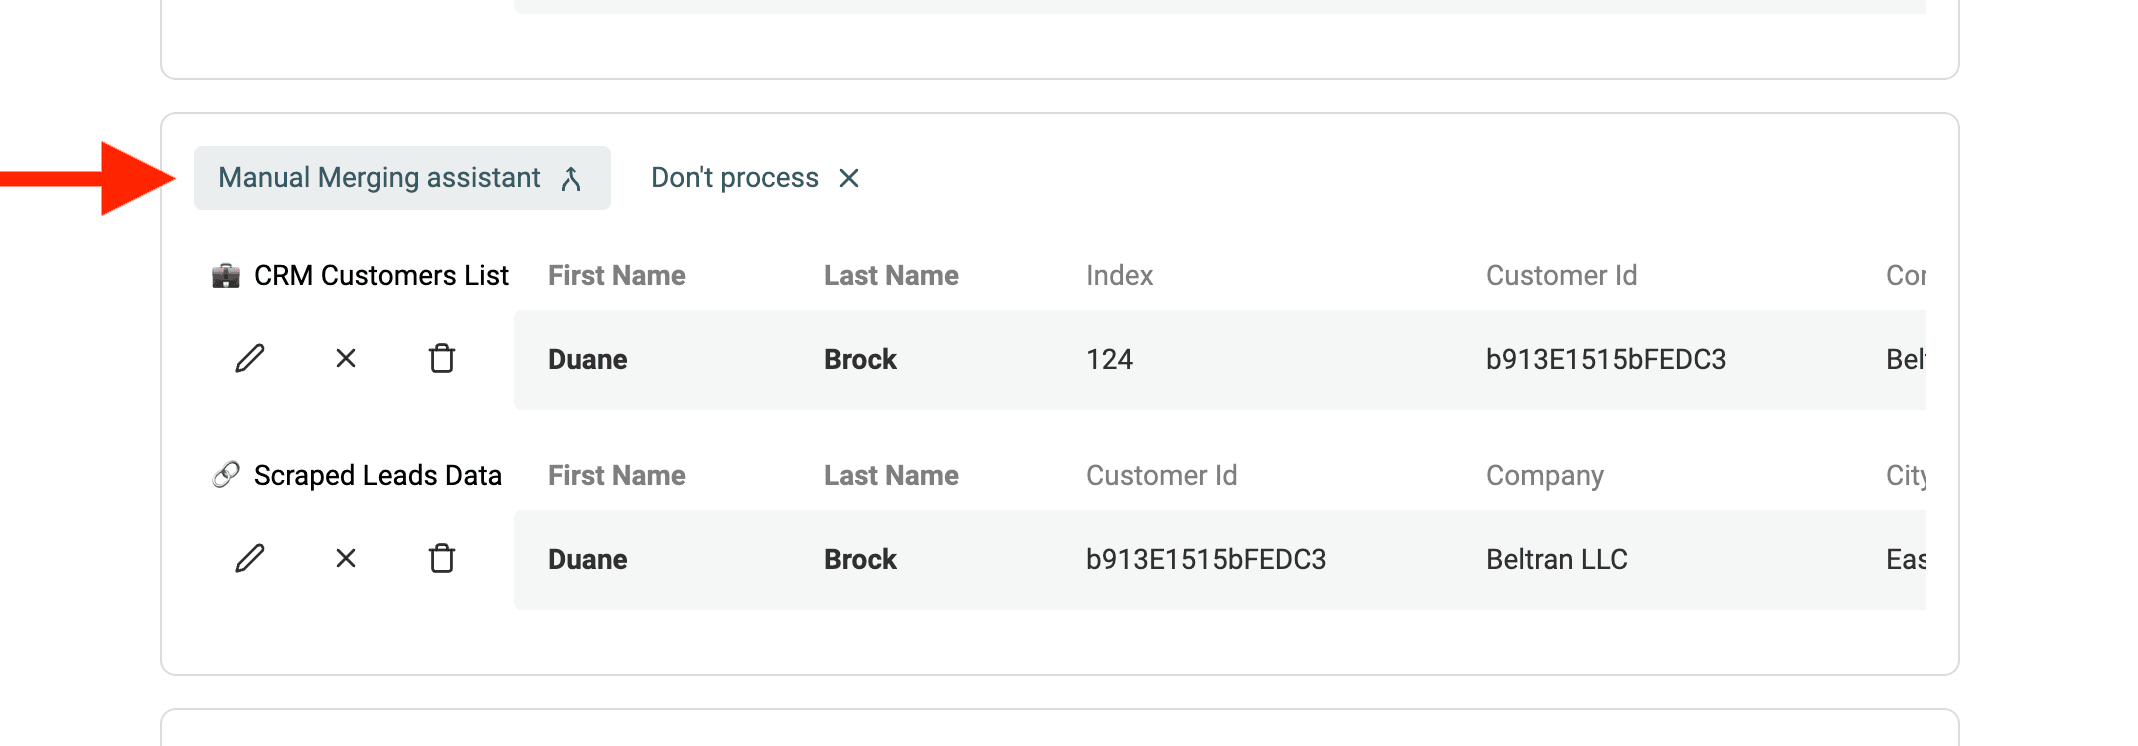
A ferramenta de mesclagem será aberta. À direita aparece o "Primary Item" e, à esquerda, os demais itens duplicados, chamados de "Secondary Items". O Datablist escolhe como "Primary Item" aquele que contém mais dados.
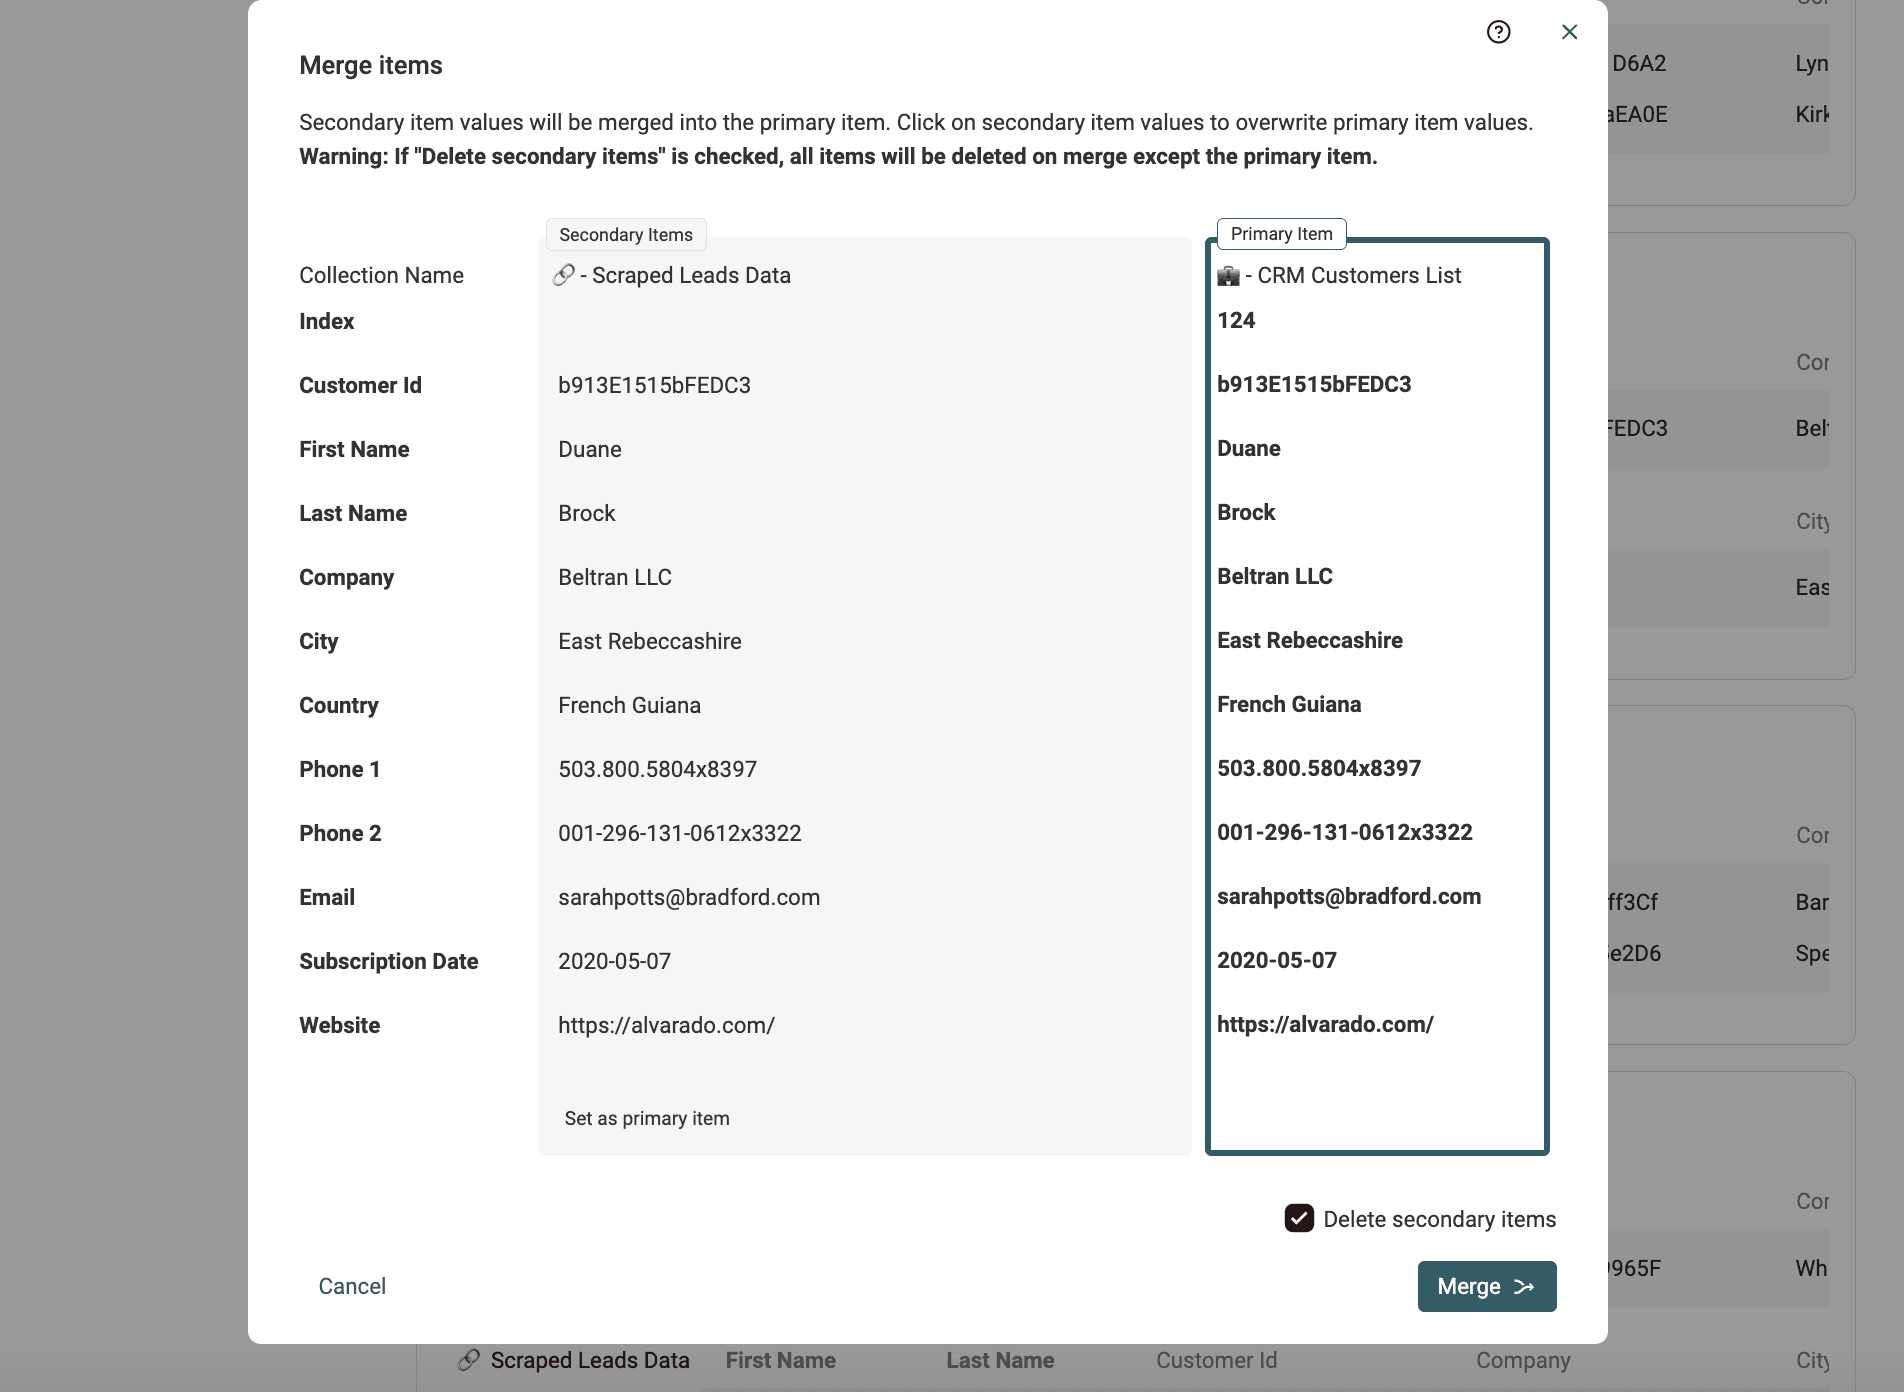
Sempre que possível, os valores das propriedades dos itens secundários são selecionados automaticamente para serem incorporados ao item principal. Se vários valores entrarem em conflito, você precisará decidir qual deles manter.
Se o "Primary Item" resultante estiver correto, clique no botão Merge para confirmar a mesclagem. Todos os itens secundários serão excluídos, mantendo apenas um item consolidado.
Observação O Manual Merging Assistant fica disponível na deduplicação de várias collections quando elas têm estruturas de dados semelhantes, com as mesmas propriedades.
Baixe os grupos duplicados para mesclar em outra ferramenta
Por fim, a ferramenta de Data Matching do Datablist permite exportar os grupos duplicados detectados. Você pode gerar um arquivo CSV ou Excel com todos os itens duplicados listados em sequência.
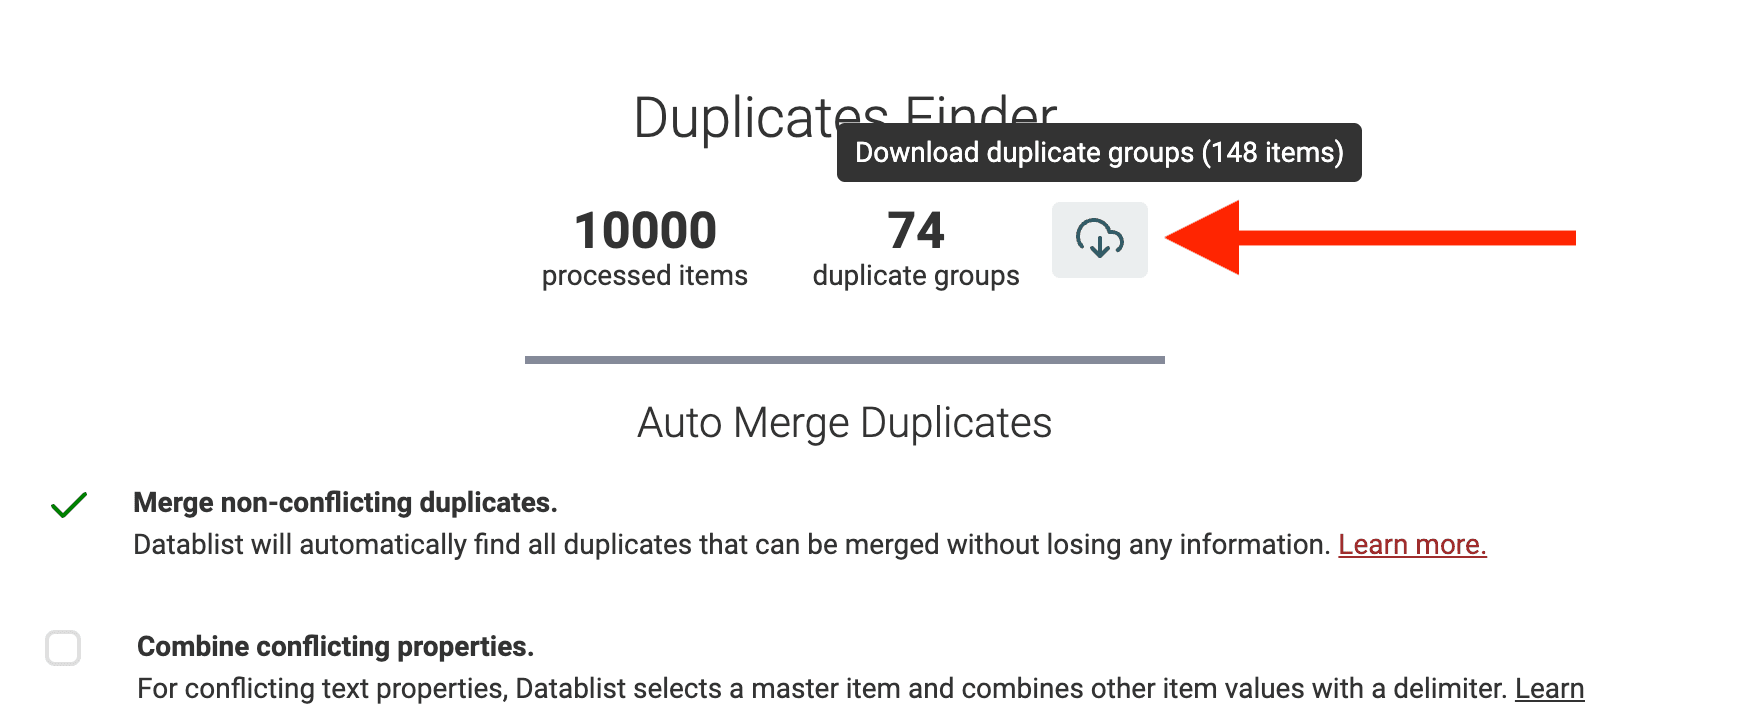
Use o arquivo exportado para limpar seus registros em outra ferramenta, como uma planilha, ou para realizar análises mais complexas.
FAQ
O que é data matching?
Data matching, também conhecido como record linkage ou deduplicação, é o processo de identificar e associar registros relacionados dentro de um conjunto de dados ou entre vários deles. Seu principal objetivo é melhorar a qualidade, a precisão e a consistência dos dados ao reconhecer e consolidar registros duplicados ou semelhantes que representam as mesmas entidades, pessoas ou objetos.
Esse processo ajuda a limpar conjuntos de dados que acumulam registros duplicados ao longo do tempo e também a combinar vários conjuntos com campos semelhantes ou sobrepostos.
O data matching pode usar campos discriminatórios, como endereço de e-mail, URL de um site ou strings e números de identificação. Também pode combinar atributos não exclusivos — como nome, data de nascimento, empresa ou localização — para gerar uma pontuação de similaridade entre registros.
Qual é a velocidade do data matching do Datablist?
A ferramenta de Data Matching do Datablist carrega seus conjuntos de dados na memória para executar a análise. Ela é indicada para conjuntos com menos de 1 milhão de registros e conclui a maioria das análises de data matching em poucos minutos.
Preciso de conhecimentos técnicos para fazer Data Matching?
Não. O Datablist é uma solução no-code feita para todos, de analistas de dados a profissionais de marketing e vendas.
Quando usar data matching?
O data matching é amplamente utilizado em áreas como finanças, saúde, marketing e gestão de clientes, nas quais dados confiáveis são essenciais para tomar decisões bem fundamentadas ou integrar informações a outras ferramentas.
Esse processo facilita tarefas como detecção de fraudes, consolidação de perfis de usuários e enriquecimento de dados provenientes de várias fontes.
Próximos passos
Se você tem interesse em limpeza de dados, confira também estes guias: