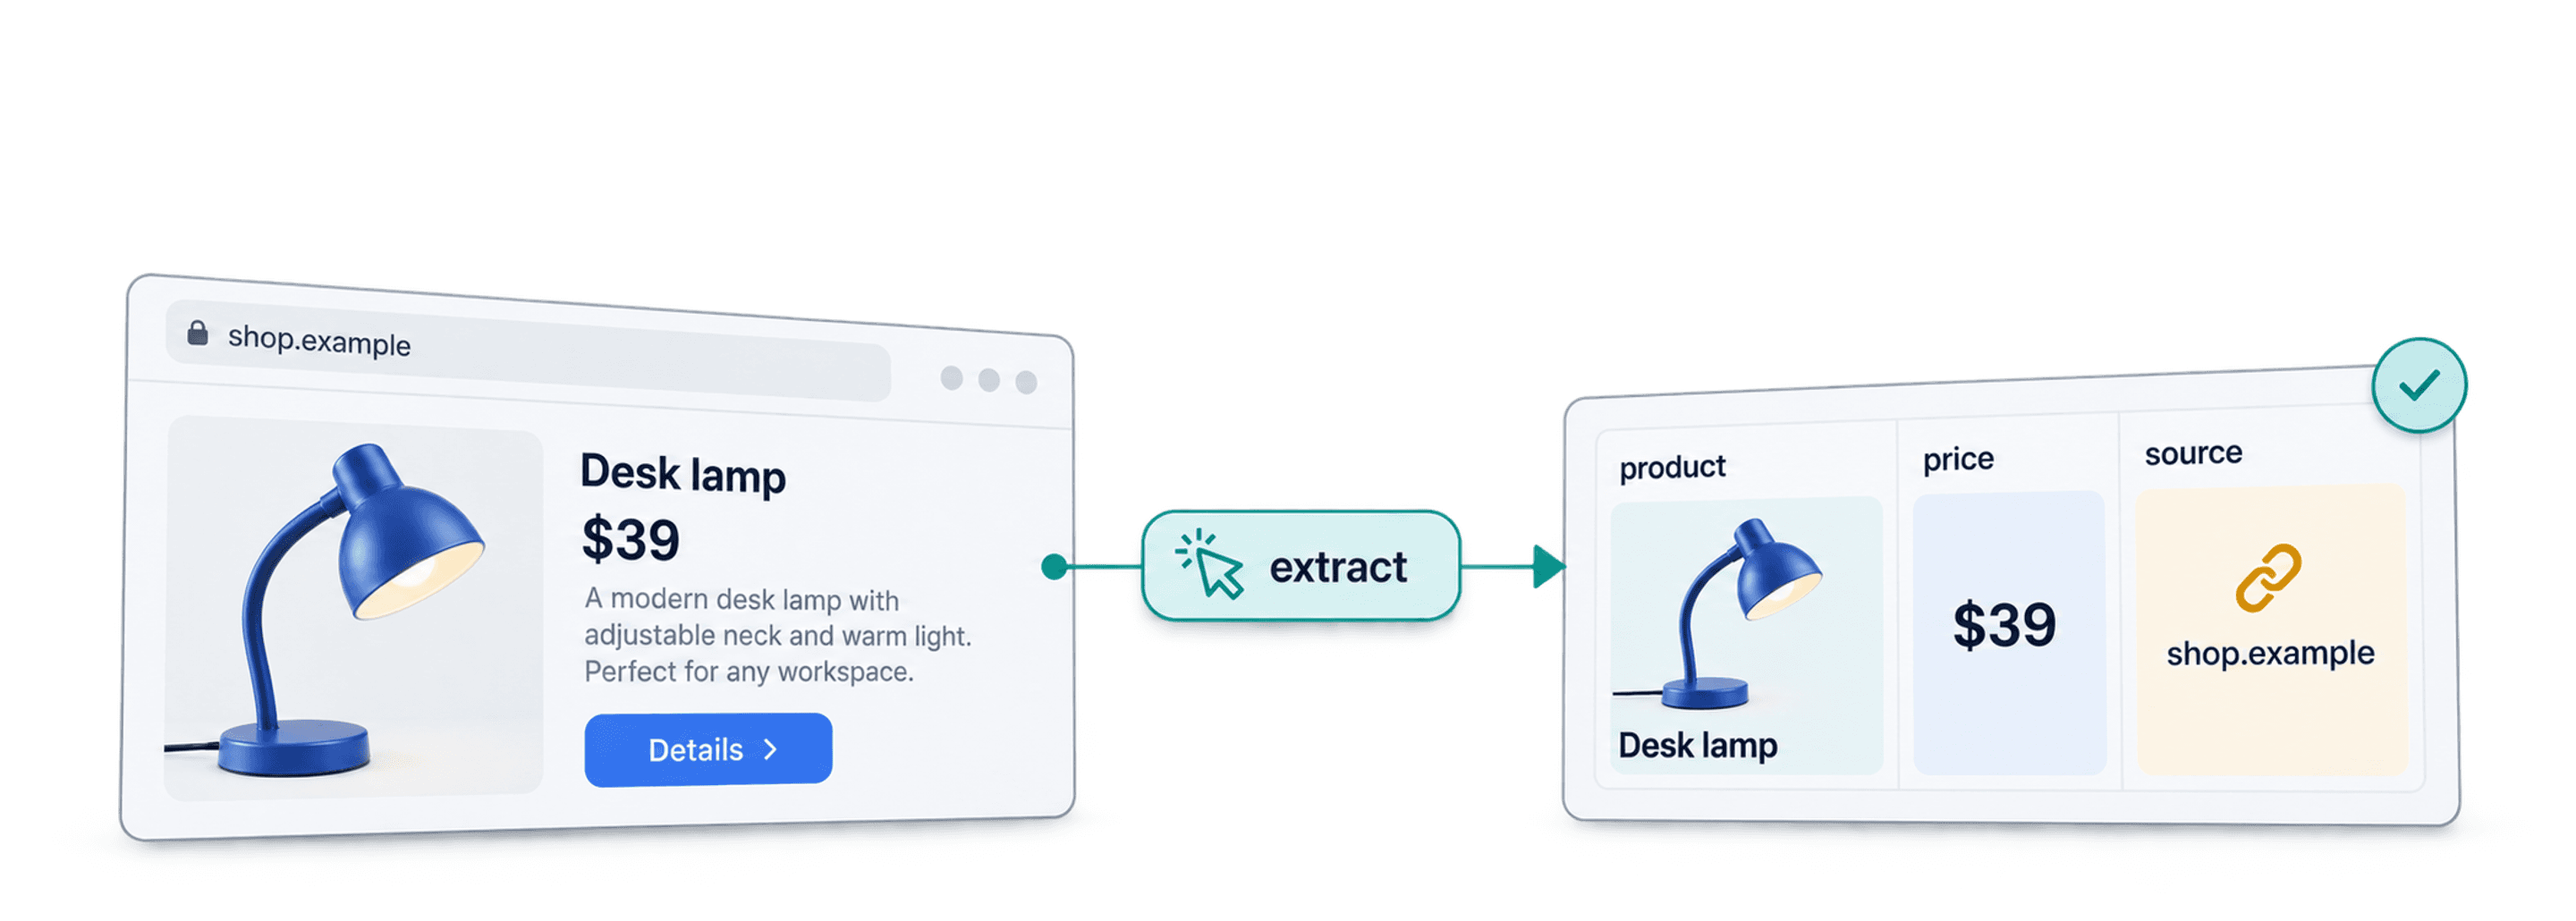
AI-web scraping använder en AI-modell för att läsa innehåll på webbplatser och returnera angivna fält, till exempel produktnamn, pris och käll-URL. I stället för att skriva en CSS-selektor för varje fält beskriver du vilken information du behöver och mappar resultatet till kolumner. Du behöver fortfarande kontrollera resultatet: modellen kan missa ett fält, blanda ihop två sidor eller returnera ett värde som saknar stöd i källan.
Du kan till exempel ge en agent en produktsida och be om Produktnamn, Aktuellt pris och Produkt-URL. Ett användbart resultat är en rad med dessa tre fält, där priset har kontrollerats mot källsidan. Om sidan inte visar något pris ska fältet lämnas tomt i stället för att fyllas med en gissning. I den här guiden går vi igenom hur AI-extrahering skiljer sig från regelbaserad scraping, vilket arbetsflöde du bör välja och vad du behöver verifiera innan du använder datan.
Det här innehåller guiden
- Vad AI-web scraping är
- De främsta fördelarna med AI-scraping
- Praktiska användningsområden för AI-scraping
- Två metoder för AI-scraping
- De bästa verktygen för AI-scraping
Vad är AI-web scraping?
Begreppen nedan beskriver samma övergripande metod. Verktyget behöver fortfarande åtkomst till källinnehållet och tydligt definierade utdatafält.
AI-web scraping, AI-scraping och AI data scraping
AI-web scraping = AI-scraping = AI data scraping
Alla dessa begrepp syftar på att använda en AI-modell för att identifiera och strukturera information från webbinnehåll. En traditionell scraper väljer ofta element med en CSS-selektor eller XPath. Ett arbetsflöde för AI-extrahering använder i stället en prompt eller ett schema för att identifiera fält utifrån deras betydelse. Det kan vara en fördel när sidornas layout varierar, men du behöver fortfarande hantera otillgängliga sidor, ändrat innehåll och felaktiga resultat.
Fördelar med AI-scraping
AI-extrahering är användbart när samma uppgift finns på olika ställen på olika sidor eller när du behöver omvandla ostrukturerad text till kolumner. Regelbaserad scraping kan vara enklare och billigare när sidlayouten är stabil och enhetlig. Välj metod utifrån källan och det resultat du behöver.
Ingen kod och inga API:er
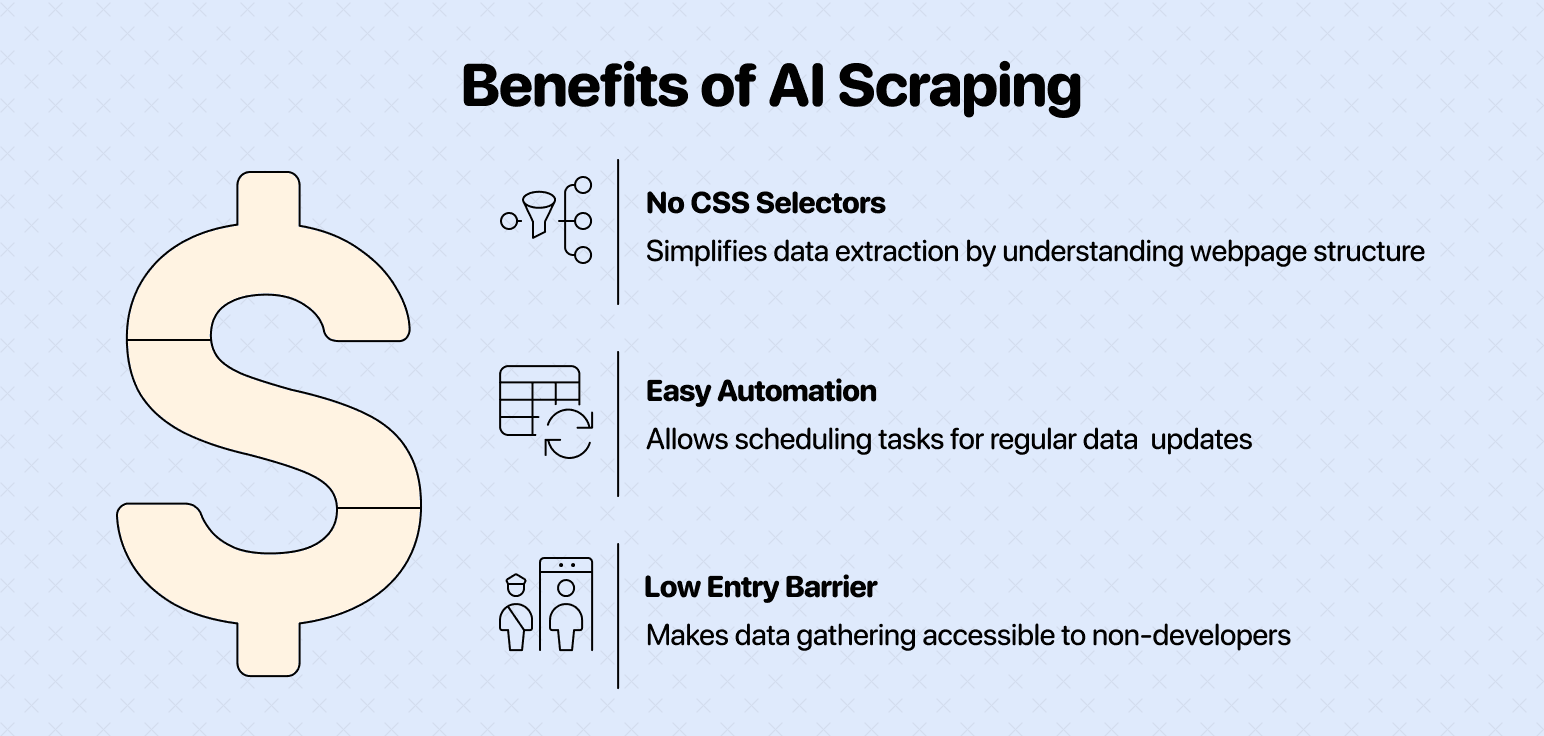
Vissa verktyg för AI-scraping tar emot en prompt på naturligt språk direkt i ett användargränssnitt. Andra kräver ett API eller kod. En tydlig instruktion bör namnge varje utdatafält och ange vad som ska hända om sidan saknar ett värde.
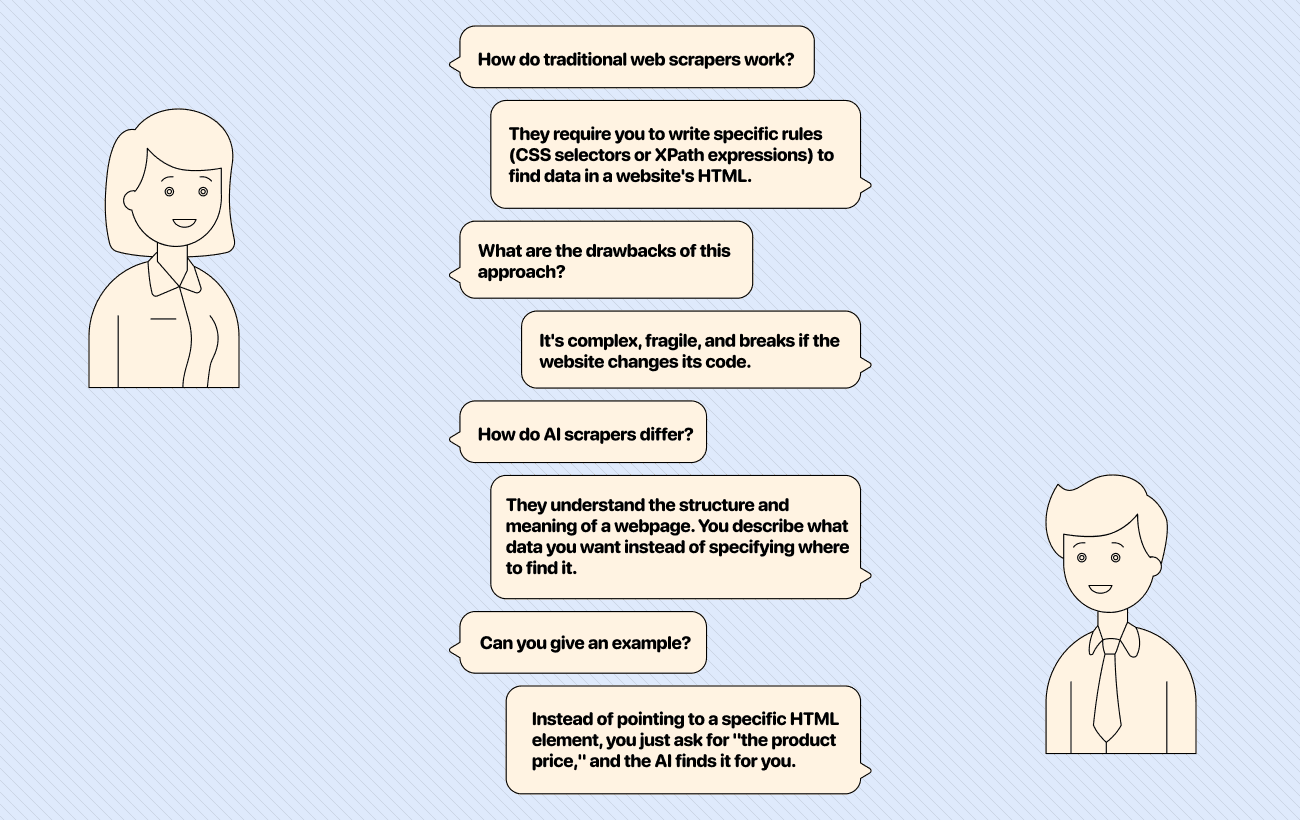
Inga CSS-selektorer, XPath-uttryck eller krångel
Med en selektorbaserad scraper identifierar du HTML-elementet som innehåller ett värde. Med AI-extrahering kan du i stället efterfråga ett fält som ”aktuellt produktpris” på sidor med olika layout. Testa båda metoderna på några representativa sidor. En layoutändring, blockerad sida eller ett tvetydigt pris kan fortfarande kräva att du ändrar prompten eller granskar resultatet manuellt.
Enkelt att automatisera och lätt att komma igång
Du kan köra ett arbetsflöde för AI-extrahering på en lista med URL:er eller utgå från en webbplatsadress. Innan du upprepar en körning bör du granska ett urval av resultaten och leta efter tomma fält, felaktiga matchningar och förändringar i källwebbplatsens struktur. Även automatiserade flöden behöver övervakas.
Användningsområden för AI-scraping
AI-scraping kan användas inom nästan alla delar av ett företag. Genom att automatisera datainsamling från webben kan team få fram viktiga insikter och arbeta mer effektivt.
Här är några exempel på vad du kan göra med AI-scraping:
- Scrapa e-handelsbutiker
- Team kan extrahera produktuppgifter som namn, priser, beskrivningar och bilder från tusentals annonser.
- Det är användbart för konkurrensanalys, prisbevakning och uppbyggnad av produktkataloger.
- Scrapa recensioner
- Genom att samla in kundrecensioner från sajter som Yelp, G2 eller Amazon kan företag förstå hur marknaden ser på dem.
- AI kan analysera datan för att hitta återkommande teman, produktbrister och faktorer som driver kundnöjdhet i en konkurrensanalys.
- Bevaka prissidor
- Sälj- och marknadsteam kan automatiskt följa konkurrenternas priser och kampanjer.
- Det ger stöd för dynamiska prisstrategier och hjälper företag att behålla sin konkurrenskraft.
- Scrapa kundcase
- Marknadsteam kan samla in kundcase från konkurrenternas webbplatser för att förstå deras positionering och framgångshistorier.
- Informationen är värdefull när de egna marknadsbudskapen och säljpitcharna ska vässas.
- Hitta data som saknas i databaser
- Viss information finns helt enkelt inte i strukturerade databaser.
- AI-scrapers kan hämta unik data från forum, bloggar och nischade webbplatser som underlag för marknadsundersökningar, akademiska studier eller granskande journalistik.
💡 Praktiska guider för att komma igång med AI-scraping
Så scrapar du kundcase 👈🏼
Så scrapar du produkter från e-handelssajter 👈🏼
Två metoder för AI-scraping
Verktyg för AI-scraping erbjuder olika metoder beroende på uppgiften. Den underliggande tekniken är likartad, men valet av metod beror på om du vill berika ett befintligt dataset eller utforska en ny webbplats från grunden.
Här är de två vanligaste metoderna:
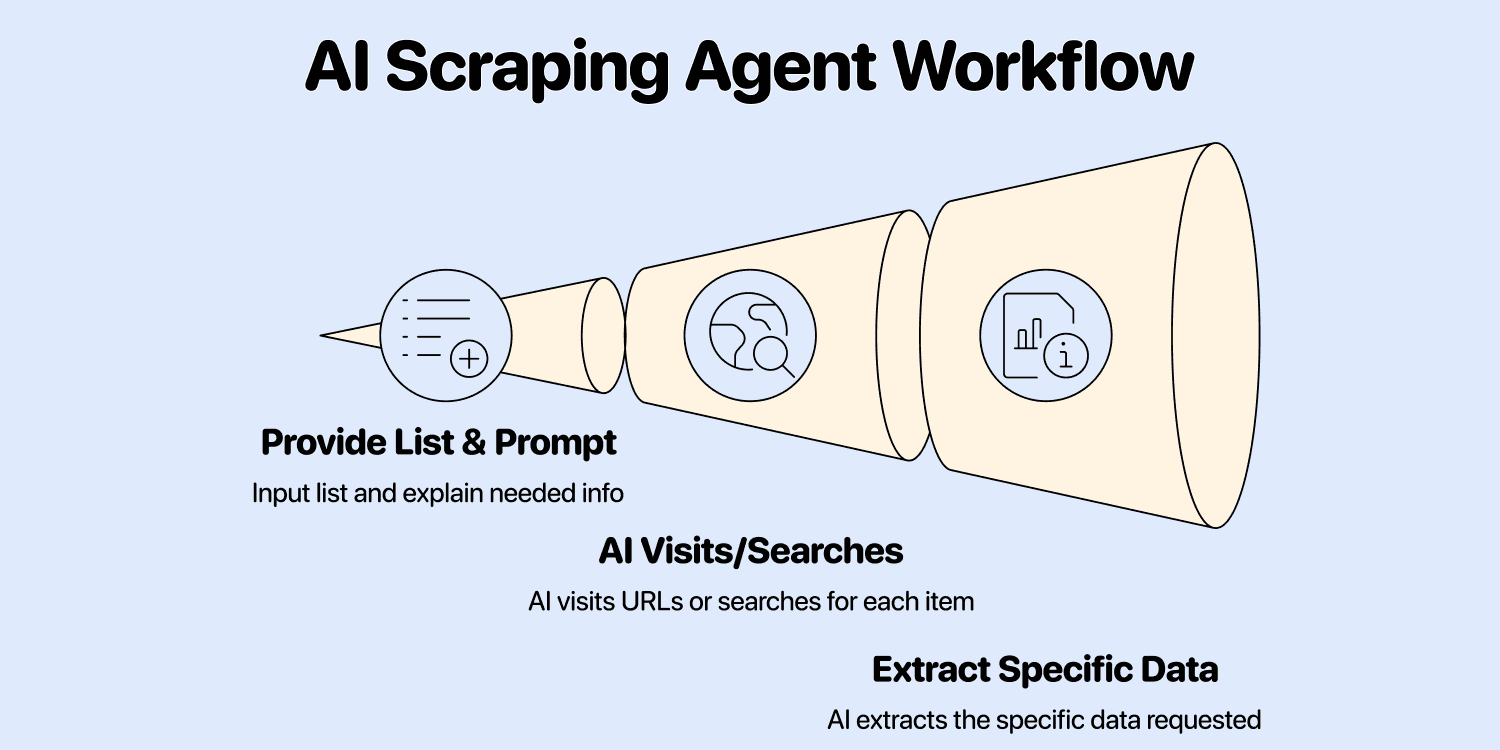
Kör en AI Scraping Agent på en lista
Den här metoden passar perfekt när du redan har en utgångspunkt, till exempel ett kalkylblad med företagsnamn eller produkt-URL:er. Du ger AI-agenten din lista och en prompt som förklarar vilken ytterligare information du behöver för varje post.
AI:n besöker sedan varje URL eller gör en sökning för varje post och extraherar den data du har efterfrågat.
- Passar bäst för: Berikning av befintliga dataset, till exempel för att hitta bransch för en lista med företag eller vd-namn för en lista med accounts.
- Granskning: Börja med ett litet urval och kontrollera källsidorna för de viktigaste fälten.
Använd en AI Scraping Agent som webbplatsscraper
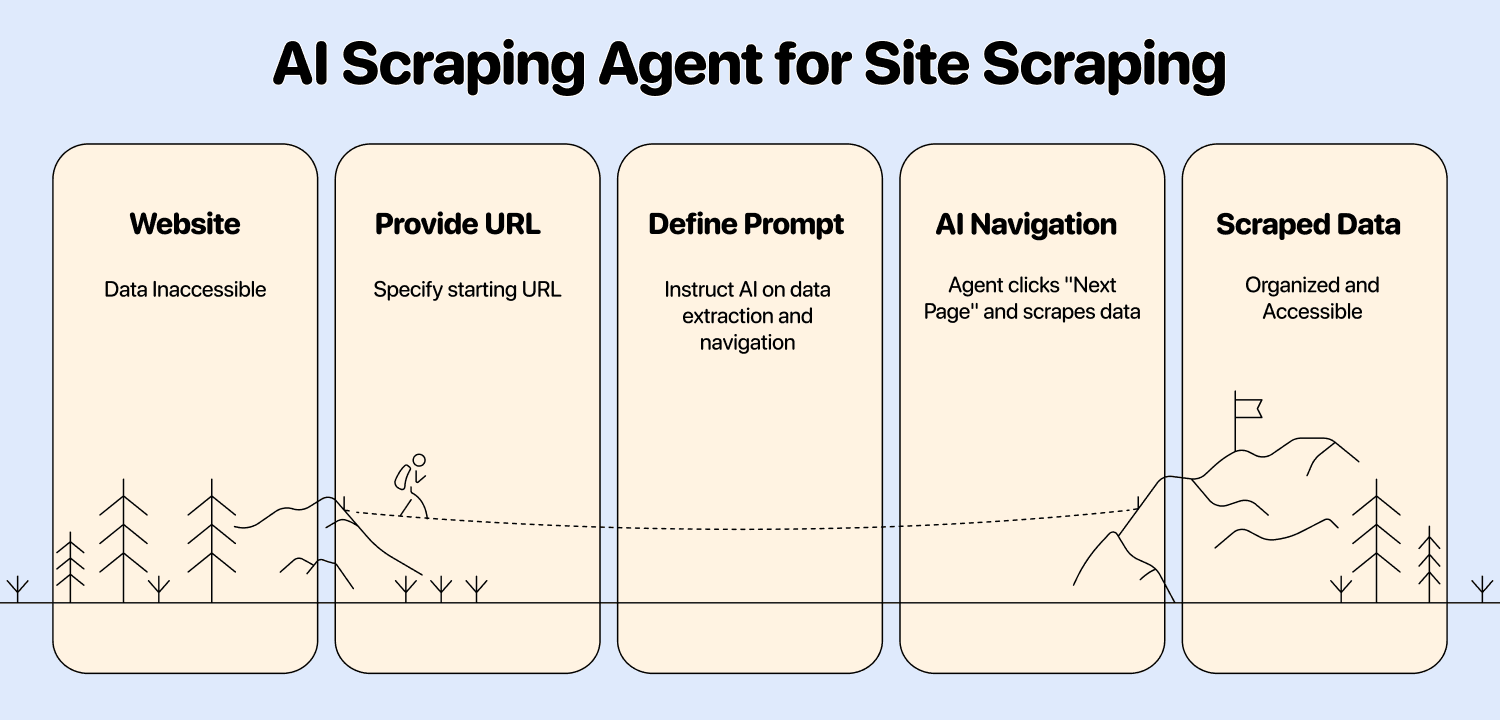
Den här metoden är utformad för att utforska och extrahera data från en hel webbplats eller en del av den. Du anger en start-URL, till exempel en kategorisida på en e-handelssajt, och en prompt som talar om för AI:n vad den ska leta efter och hur den ska navigera på webbplatsen.
I Datablists website scraper anger du en start-URL och en prompt som beskriver vilka poster som ska extraheras. Paginering är valfritt och konfigureras när källan har flera resultatsidor.
I guiden om konfiguration och stickprov för website scraping ser du hur du matchar resultat mot prompten, testar rendering och skiljer ett saknat fält från en blockerad sida.
- Passar bäst för: Att scrapa produktlistor från sajter som Amazon eller eBay, samla in bloggartiklar eller extrahera poster från olika kataloger.
- Granskning: Börja med ett begränsat antal sidor och kontrollera att de returnerade raderna kommer från rätt sidor innan du utökar körningen.
Verktyg för AI-scraping
Marknaden för verktyg inom AI-scraping växer snabbt. Vilket verktyg som passar bäst beror på din tekniska kompetens, budget och dina specifika behov. Här är tre alternativ och deras startpriser vid månadsbetalning i USD.
| Verktyg | Primärt användningsområde | Startpris | Inkluderad användning per månad |
|---|---|---|---|
| Datablist | No-code scraping och berikning i kalkylblad | 25 USD/månad | 5 000 credits |
| Firecrawl | Webbdata och strukturerad extrahering för appar | 19 USD/månad | 5 000 credits |
| ScrapingBee | Scraping API med AI-extrahering | 19 USD/månad | 75 000 API-credits |
Antalet credits mäter olika saker. Datablist debiterar utifrån AI-modellen och de verktyg som används, Firecrawl utifrån antal sidor och valt format, medan ScrapingBee lägger kostnaden för AI-extrahering ovanpå förfrågans grundkostnad. Exemplen nedan visar varför flest credits inte automatiskt innebär det billigaste arbetsflödet.
Datablist – för sälj, marknad och operations
Datablist är en plattform för data automation som samlar kraftfulla funktioner för AI-scraping i ett användarvänligt kalkylbladsgränssnitt. Den är utvecklad för team inom sälj, marknad och operations som behöver samla in och berika data utan att skriva kod eller konfigurera API:er.
Viktiga funktioner:
- Prompter på naturligt språk: Beskriv vad du behöver på vanlig engelska, så hämtar AI-agenten det åt dig. Ingen kod eller komplicerad API-konfiguration krävs.
- Två startpunkter: Kör en AI Agent på befintliga rader eller utgå från en webbplats-URL med en prompt och valfri paginering.
- Inställningar för körningen: Website scraper har en sidgräns och en valfri inställning för HTML-rendering. Testa en liten körning innan du ökar antalet sidor.
- Strukturerat resultat: Mappa de efterfrågade fälten till kolumner i din collection, granska raderna och kombinera dem med andra enrichments vid behov.
Priser:
- Starter: 25 USD/månad med 5 000 credits. Growth kostar 50 USD/månad och inkluderar 20 000 credits.
- Förbrukningen vid AI-scraping varierar beroende på modell, verktyg och besökta sidor. HTML-rendering kostar ytterligare 2 credits per scraping när funktionen är aktiverad.
- För ett jobb som använder 25 000 credits kostar Starter tillsammans med en top-up på 20 000 credits 45 USD (25 + 20 USD). Det är ett exempel på en credit-budget, inte ett fast pris för ett visst antal sidor. Top-ups kräver en aktiv plan och upphör inte att gälla.
💡 Datablists dolda styrkor
Fördelen med Datablists AI Scraper är att den faktiskt är mycket mer än en AI Scraper. Det är en AI scraping agent som kan söka på Google, besöka Google News, anropa API:er, extrahera data, paginera webbplatser och mycket mer.
Firecrawl – Web Data API för AI-appar
Firecrawl är ett open source Web Data API för utvecklare som omvandlar webbplatser till LLM-färdig data för AI-applikationer.
Viktiga funktioner:
- Strukturerad extrahering: Ange en URL och ett JSON-schema eller en prompt som beskriver de fält du behöver. Kontrollera de returnerade värdena mot källsidan.
- LLM-färdigt resultat: Få data i flera format, bland annat JSON, Markdown och skärmbilder, redo att användas direkt i AI-bearbetning.
- Utvecklarfokus: Byggt med SDK:er för Python och Node.js samt omfattande dokumentation och exempel.
Priser:
- Hobby: 19 USD/månad med 5 000 credits. Standard kostar 99 USD/månad och inkluderar 100 000 credits. Det här är månadspriser, inte de lägre priserna för årsbetalning.
- En enkel scraping av en sida kostar 1 credit. Om du väljer JSON tillkommer 4, vilket innebär att en sida med JSON-extrahering använder 5 credits. Andra lägen kan påverka förbrukningen.
ScrapingBee – AI Scraper för utvecklare
ScrapingBee är ett API-first scrapingverktyg som hanterar proxyservrar och webbläsare. Utvecklare kan anropa det från kod, och integrationer som n8n och Make gör det möjligt att koppla verktyget till andra arbetsflöden. Du behöver fortfarande konfigurera förfrågan och mappa den returnerade datan.
Viktiga funktioner:
- AI-driven web scraping: Använder AI för att tolka och extrahera data, vilket gör lösningen mer tålig mot förändringar på webbplatsen.
- API-åtkomst: Utformat för utvecklare som vill integrera tjänsten i sina egna applikationer och arbetsflöden.
- JavaScript-rendering: Kan scrapa moderna, dynamiska webbplatser som är starkt beroende av JavaScript.
Priser:
- Hobby: 19 USD/månad med 75 000 API-credits. Freelance för 49 USD/månad inkluderar 250 000.
- AI-extrahering kostar ytterligare 5 credits per förfrågan. Innan AI-extraheringen läggs till använder en enkel förfrågan 1 credit, eller 5 med JavaScript-rendering. Premiuminställningar för proxy kan höja grundkostnaden ytterligare.
Vad kostar ett jobb med strukturerad extrahering?
Exemplen utgår från en förfrågan per sida och de angivna inställningarna. De visar priset för API-användning, inte antalet korrekta poster som returneras.
| Verktyg och jobb | Credits som krävs | Månadsplan och kostnad |
|---|---|---|
| Firecrawl: 1 000 sidor med JSON-extrahering | 5 000 | Hobby: 19 USD |
| Firecrawl: 10 000 sidor med JSON-extrahering | 50 000 | Standard: 99 USD |
| ScrapingBee: 10 000 förfrågningar med AI-extrahering, utan JavaScript-rendering | 60 000 | Hobby: 19 USD |
| ScrapingBee: 10 000 förfrågningar med AI-extrahering och JavaScript-rendering | 100 000 | Freelance: 49 USD |
För ScrapingBee beräknas de två sista raderna som 10 000 × (1 + 5) respektive 10 000 × (5 + 5). Inställningen för rendering gör att jobbet överskrider vad Hobby-planen inkluderar. För Datablist bör du först göra en liten körning för att fastställa förbrukningen för din modell, prompt och dina källsidor. Därefter kan du planera budgeten utifrån de credits som ingår i Starter för 25 USD och priserna för top-ups ovan.
Så kontrollerar du resultat från AI-scraping
Kontrollera ett urval av rader mot källsidorna innan du använder datasetet. Bekräfta att varje värde hör till rätt post, att enheter och valutor har bevarats och att värden som saknas fortfarande är tomma. Om källsidan inte går att nå eller resultatet är osäkert bör du ändra prompten eller granska raden manuellt. Kontrollera urvalet igen när källwebbplatsen förändras.
Vanliga frågor om AI-scraping
Kan ChatGPT användas för web scraping?
En AI-modell kan extrahera fält från webbinnehåll som du tillhandahåller. För återkommande körningar över många URL:er bör du använda ett arbetsflöde som sparar käll-URL:er, mappar fält till kolumner och låter dig granska misslyckade eller osäkra rader.
Vad är AI-scraping?
AI-scraping använder en modell för att identifiera efterfrågade fält i innehåll på webbplatser och returnera strukturerade resultat. Du kan beskriva fälten i en prompt i stället för att ange CSS-selektorer, men viktiga resultat bör alltid verifieras mot källan.
Är web scraping lagligt?
Reglerna beror på webbplatsen, vilken data det gäller och tillämplig lagstiftning. Kontrollera webbplatsens användarvillkor och relevanta krav innan du samlar in eller använder data, särskilt personuppgifter.
Vad är data scraping?
Data scraping innebär att information extraheras från en källa, till exempel en webbplats eller ett dokument. AI-scraping använder en AI-modell för att identifiera eller strukturera den efterfrågade informationen.
Hur skiljer sig AI-scraping från traditionell web scraping?
Selektorbaserad scraping riktar in sig på specifika element i en sidas HTML. AI-extrahering använder en prompt eller ett schema för att identifiera fält utifrån deras betydelse. Båda metoderna kan misslyckas när en webbplats förändras eller en sida inte är tillgänglig. Jämför därför resultaten på representativa sidor.
Vilka kunskaper krävs för att börja med AI-scraping?
Med Datablist kan du ange en URL eller en lista med rader, beskriva de önskade fälten och mappa resultatet utan att skriva kod. Du behöver fortfarande kontrollera ett urval av resultaten.
Klarar AI-scrapers webbplatser som ändrar layout?
Ibland. En prompt kan fortsätta hitta ett fält efter en layoutändring, men blockerade sidor, saknat innehåll och tvetydiga etiketter kan fortfarande orsaka fel. Kontrollera ett urval igen när källwebbplatsen förändras.
Källor
- [1] Datablist. Starter kostar 25 USD/månad med 5 000 credits, Growth kostar 50 USD med 20 000 och aktiva prenumeranter kan köpa top-ups med ytterligare credits.
- [2] Firecrawl. Månadspriserna för Hobby och Standard är 19 respektive 99 USD. Enkel scraping kostar 1 credit per sida och JSON kostar ytterligare 4.
- [3] ScrapingBee. Hobby kostar 19 USD/månad för 75 000 credits och Freelance 49 USD för 250 000. AI-extrahering lägger till 5 credits till förfrågans grundkostnad.