
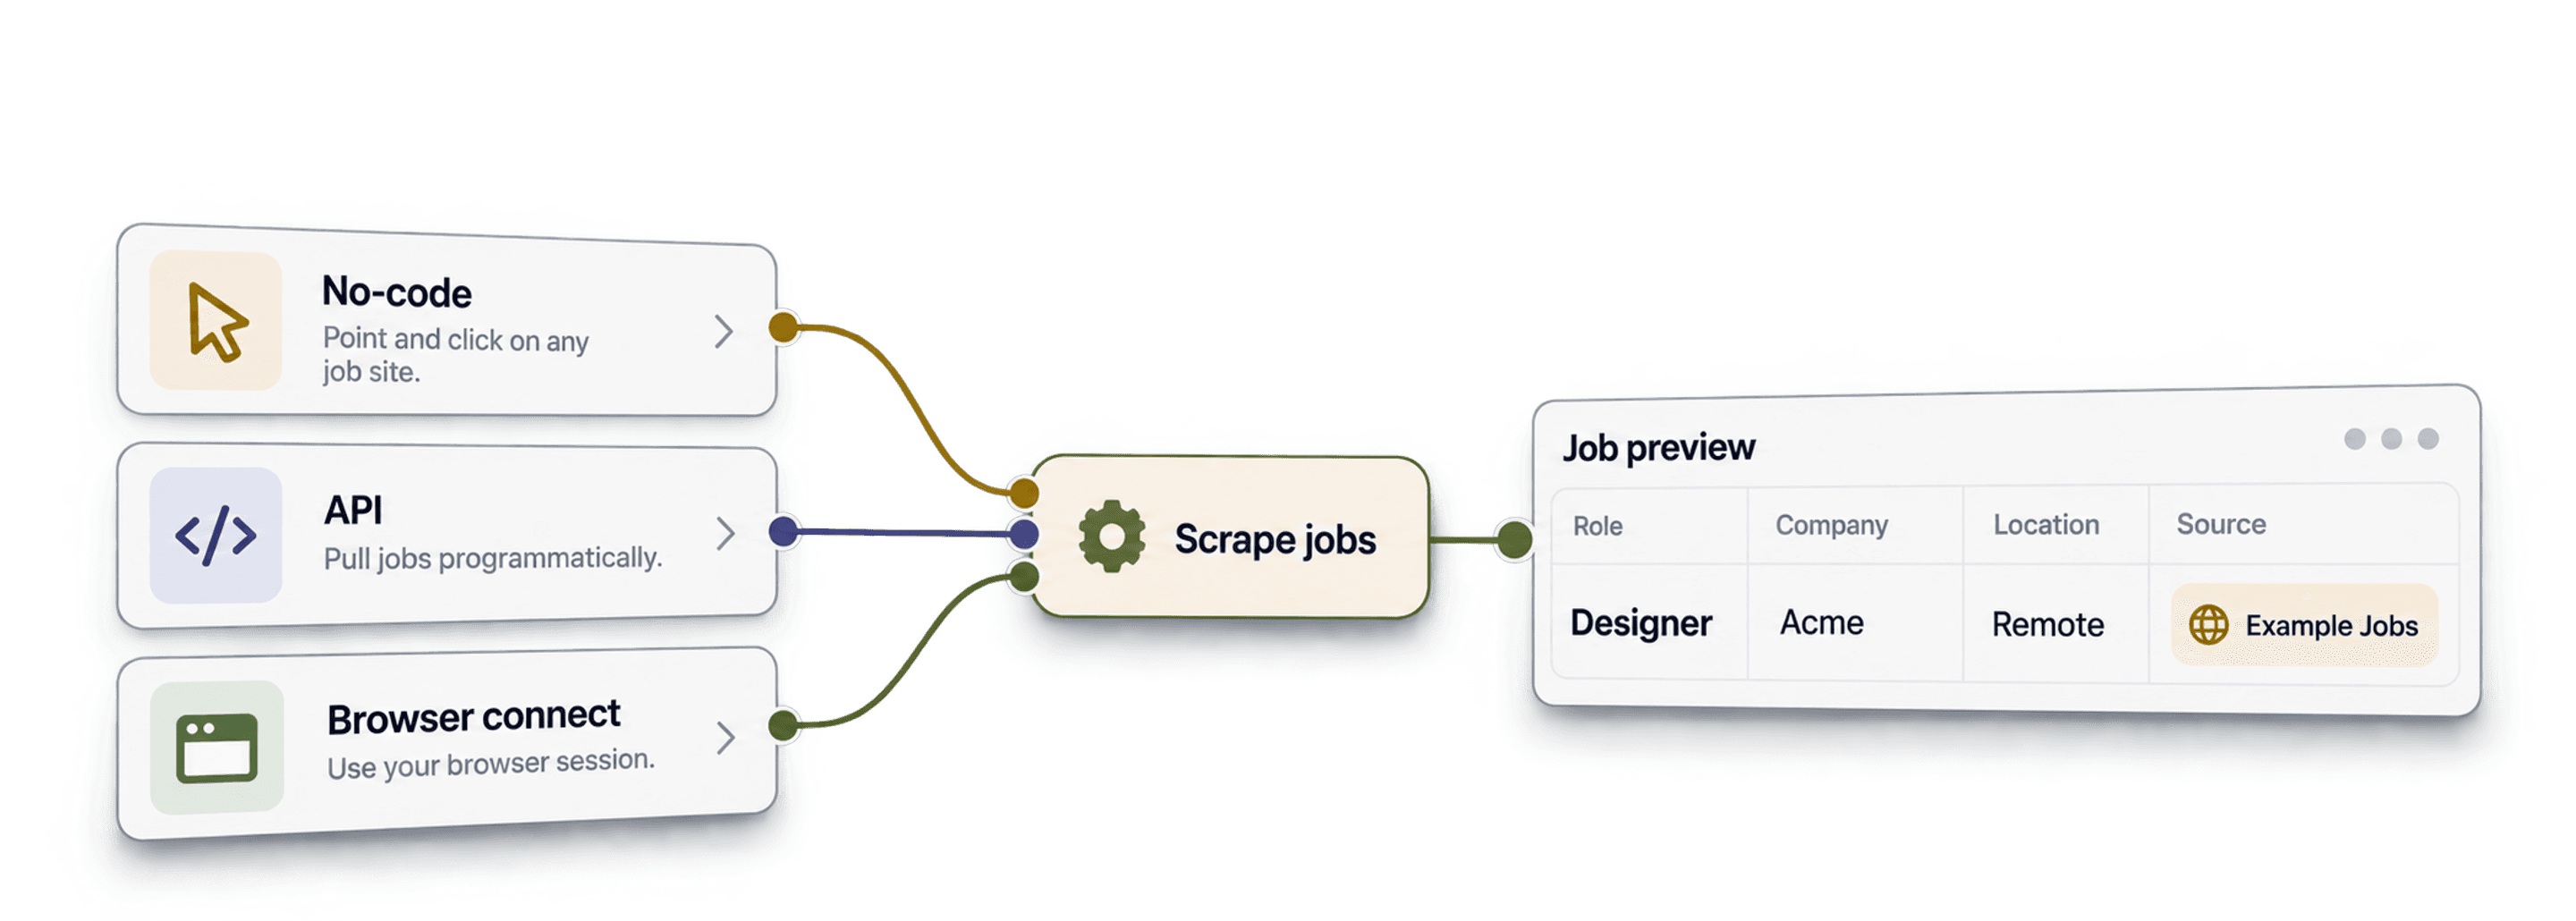
Job scraping-verktyg omvandlar jobbannonser till rader som du kan filtrera, jämföra och exportera. Välj en färdig datakälla för jobb när du behöver återkommande sökningar på flera jobbsajter, en visuell scraper när du behöver specifika fält från en viss webbplats eller ett API när du bygger en datapipeline.
För lead generation är det användbara resultatet en relevant rekryteringssignal kopplad till rätt företag. En jobbannons är inte en kandidatprofil eller en verifierad kontaktpost. I den här guiden jämför vi sju verktyg utifrån arbetsflöde och visar vad du bör kontrollera innan du väljer.
De billigaste betalplanerna per månad sträcker sig från 19 USD för ScrapingBees API till 189 USD för ParseHubs visuella scraping-plan. Datablist kostar från 25 USD/månad, vilket räcker till 500 importerade resultat från Job Postings Search med det nuvarande priset på tio credits. Tabellen nedan skiljer mellan inkluderade jobbannonser, sidor och requests, med kostnadsexempel för större listor.
Det här går vi igenom
- Viktiga faktorer när du väljer Job scraping-verktyg
- De bästa no-code-verktygen för Job scraping
- Bästa Job scraping-verktygen för semi-tekniska användare
- Kraftfull Job scraping för tekniska experter
Välj Job scraper efter vilket resultat du behöver
| Verktyg | Primärt användningsområde | Lägsta pris för betalplan | Inkluderad volym/prisenhet |
|---|---|---|---|
| Datablist | Söka jobbannonser och granska rader i ett kalkylblad | 25 USD/månad | 5 000 credits; 10 per importerad jobbannons |
| PhantomBuster | Hämta URL:er till LinkedIn-jobb | 69 USD/månad | 20 exekveringstimmar |
| Octoparse | Visuella uppgifter och mallar för jobbsajter | 83–119 USD/månad* | Standard-plan; valfria tillägg |
| ParseHub | Bygga visuella extraktionsprojekt | 189 USD/månad | 10 000 sidor per körning; 20 projekt |
| ScrapingBee | Integrera ett scraping-API | 19 USD/månad | 75 000 API-credits |
| Bright Data | Hanterade scraper-API:er | 1,50 USD/1 000 levererade poster | Betala efter användning; ingen månadsbindning |
| Oxylabs | Bygga en pipeline med webb-API | 30 USD/månad | Enhetlig plan; resultatpriser beroende på målwebbplats |
Priserna i USD kontrollerades den 28 oktober 2026. Prenumerationspriserna avser månadsbetalning; raden för Bright Data visar ett användningsbaserat pris. *Octoparses officiella guide anger Standard-alternativ på 83/119 USD per månad; kontrollera den valda konfigurationen. Sidor, API-credits och importerade jobbannonser är olika enheter, så de inkluderade volymerna motsvarar inte samma antal användbara jobb.
Viktiga faktorer när du väljer Job scraping-verktyg
Börja med en liten sökning och granska de returnerade raderna. Ett verktyg kan returnera giltiga jobbposter som ändå är irrelevanta för dina målföretag.
1. Täckning och aktualitet
En sökning i indexerad jobbdata och scraping av en aktuell karriärsida besvarar olika frågor. Kontrollera vilka jobbsajter eller webbplatser som ingår, när annonsen samlades in och om tjänsten fortfarande är öppen. Antalet resultat från ett verktyg bevisar inte att alla lediga tjänster har hittats.
2. Jobbfilter kontra företagsfilter
Jobbplatsen visar var tjänsten är placerad, medan företagets huvudkontor visar var arbetsgivaren är baserad. Håll isär dessa filter. Bestäm om du vill hitta direktanställande företag, rekryteringsbyråer eller båda, och granska poster där företagsinformation saknas.
Ett konkret LinkedIn-exempel finns i guiden om hur du scrapar jobb från LinkedIn, inklusive skillnaden mellan taket per sökning och antalet unika lediga tjänster som returneras.
Genomgången av techjobb i Boston tillämpar kontrollerna på lokala tjänster och distansjobb, samtidigt som annons-ID:n och käll-URL:er sparas för granskning.
3. Annons-ID:n och käll-URL:er
Spara annonsens ID och käll-URL. Samma arbetsgivare kan annonsera flera tjänster, och samma tjänst kan visas på flera jobbsajter. Om du deduplicerar enbart efter Company Name kan värdefulla annonser tas bort.
4. Exkludera befintliga kunder
Vid sales prospecting bör du kontrollera om kunder kan exkluderas med hjälp av företagsdomänen. En jämförelse som bara bygger på namn kan blanda ihop företag med liknande namn. Med en generell scraper kan du behöva göra filtreringen efter export i stället för direkt i sökningen.
5. Återkommande körningar och prisenhet
Jämför kostnaden för samma typ av resultat: requests, sidor, importerade jobbrader eller exekveringstid. Kontrollera schemaläggning separat från en engångskörning. Ett återkommande arbetsflöde behöver också regler för hur upprepade annonser ska sparas, uppdateras eller slås ihop.
Job scrapers för icke-tekniska användare
Med de här alternativen kan du konfigurera arbetsflödet utan att skriva en scraper. Upplägget skiljer sig åt: en färdig sökkälla använder filter, medan en visuell uppgift kräver att du väljer fält och sidnavigering.
1. Datablist
Datablist i korthet
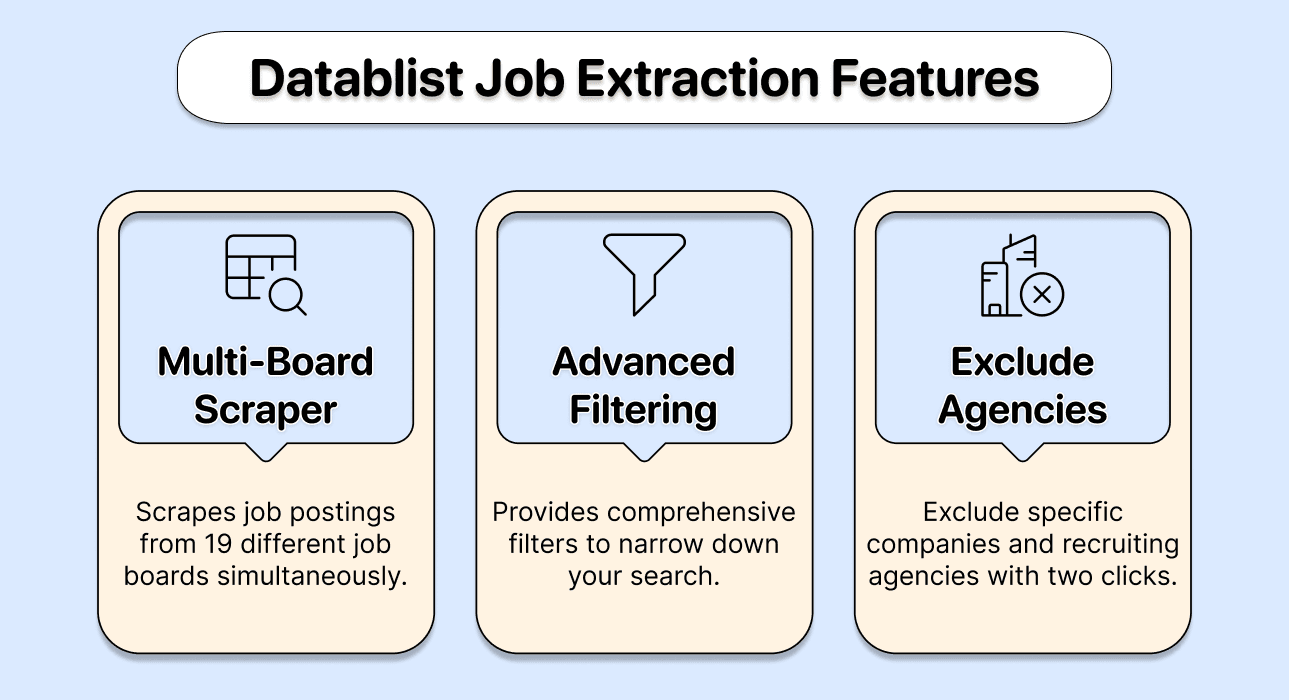
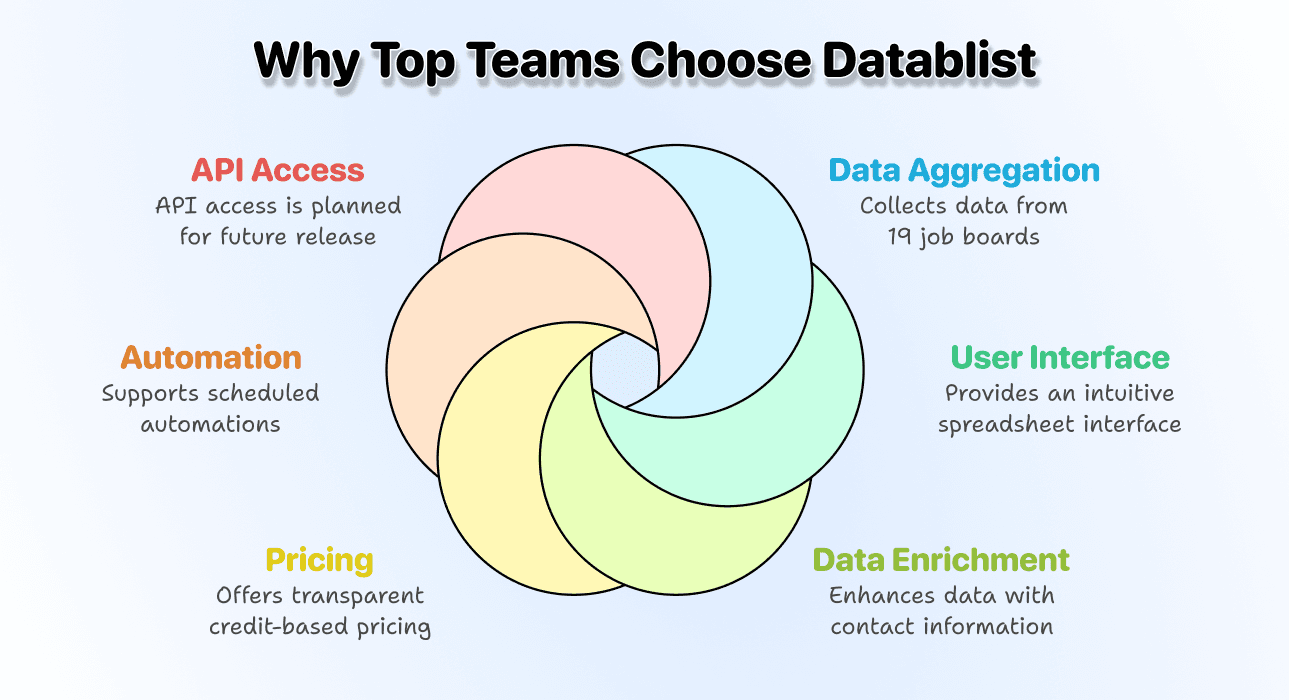
Datablists Job Postings Search söker i jobbdata från flera jobbsajter och skapar rader i en collection. Använd den när du vill granska rekryteringssignaler, filtrera arbetsgivare och fortsätta med datarensning eller enrichment i samma kalkylblad.
En liten jobbsökning som du kan granska
Så här kan en enkel sökning efter roller inom data engineering se ut:
- Välj Job Postings Search under Import From Data Sources. Ange
data engineeri Job Title Keywords. Ord i titelfraser matchas oavsett ordning, så granska resultaten i stället för att förvänta dig en exakt titelmatchning. - Ange jobbets land under Countries. Om du behöver arbetsgivare med huvudkontor i landet konfigurerar du Company HQ Countries separat.
- Välj Direct Employer under Company Type om annonser från rekryteringsbyråer inte ingår i målgruppen. Välj en kort och relevant period under Max Age.
- Koppla Job Posting Id, Job Title, Job Posting URL, Job Posting Source URL, Company Name, Company Website och Date Posted till kolumner i resultatet.
- Öppna flera käll-URL:er. Kontrollera arbetsgivare, roll, plats och om tjänsten fortfarande är öppen. Låt saknade värden vara synliga i stället för att fylla i dem med antaganden.
Om du använder nyckelord för beskrivningen matchar standardinställningen hela ord. sales skiljer sig därför från Salesforce; regex-läget är en separat inställning. En fullständig genomgång finns i guiden om hur du söker på flera jobbsajter.
För en stadsspecifik lista med tekniska roller visar arbetsflödet för techjobb i San Francisco hur du skiljer mellan jobb i staden, närliggande städer och möjligheten till distansarbete.
Det här bör finnas kvar i datasetet
Ett företag som söker två data engineers ska fortfarande ha två jobbrader om annonserna är olika. Spara Job Posting Id för att granska återkommande poster från samma källflöde och använd käll-URL:er samt rolldetaljer när du jämför annonser mellan leverantörer. Skapa en separat företagslista om nästa steg kräver ett account per arbetsgivare.
De returnerade raderna beskriver jobb och arbetsgivare. Att hitta en rekryterare eller annan kontakt är ett separat enrichment-steg; en arbetsbeskrivning ger inte tillgång till en komplett kandidatdatabas.
Priser och begränsningar i arbetsflödet
Det aktuella priset för Job Postings Search är 10 credits per importerad jobbannons. Ett saldo på 5 000 credits räcker till 500 importerade annonser om allt används för den källan. AI scraping, contact enrichment och andra källor har egna priser.
Datablists Starter-plan kostar från 25 USD eller 25 EUR per månad och innehåller 5 000 credits. Growth har fler credits samt API- och automationsfunktioner för arbetsflöden som stöds, men Job Postings Search ingår för närvarande inte i den publika katalogen över source-API:er. Kör källan i appen och utgå inte från att en API-plan ger åtkomst till alla källor. Filtren och leverantörens täckning garanterar inte heller att alla jobb på samtliga jobbsajter hittas.
För Job Postings Search blir den faktiska kostnaden för prenumeration och top-up:
| Importerade jobbannonser | Credits som krävs | Det här behöver du köpa | Betalning |
|---|---|---|---|
| 500 | 5 000 | Starter | 25 USD |
| 2 500 | 25 000 | Starter + top-up med 20 000 credits | 45 USD |
| 10 000, manuell bearbetning | 100 000 | Starter + top-up med 100 000 credits | 113 USD |
| 10 000, Growth-plan | 100 000 | Growth + top-up med 80 000 credits | 121 USD |
Exemplet med 2 500 annonser kostar 25 + 20 = 45 USD och ger exakt 25 000 credits. För 10 000 annonser ger Starters 5 000 credits tillsammans med ett paket med 100 000 credits för 88 USD totalt 105 000 credits för 113 USD, vilket lämnar 5 000 credits. Growth kostar 50 USD/månad och innehåller 20 000 credits; en top-up med 80 000 credits för 71 USD ger den återstående kapaciteten, totalt 121 USD. Beräkningarna förutsätter att källan importerar det angivna antalet annonser och inkluderar inte ytterligare AI- eller contact enrichment. En dubblett från en annan körning måste fortfarande granskas innan du räknar unika jobb eller rekryterande företag.
2. PhantomBuster
PhantomBusters LinkedIn Job Scraper hämtar information från specifika URL:er till LinkedIn-jobb. Det dokumenterade arbetsflödet kräver en ansluten LinkedIn-session och URL:erna som input. För att samla in jobb-URL:er från en sökning beskriver guiden ett separat exportsteg.
Välj det för ett LinkedIn-fokuserat arbetsflöde. Kontrollera begränsningarna per körning och vilka exportformat planen tillåter innan du matar in en stor lista. En ansluten session är ett krav för arbetsflödet; verktyget gör inte generella sökningar på alla jobbsajter. Om arbetsflödet även behöver företags- eller kontaktdata kan du jämföra alternativ till PhantomBuster utifrån källa, resultat och enrichment-behov innan du väljer en ersättare.
Pris: Start-planen kostar 69 USD per månad och innehåller 20 exekveringstimmar samt fem automationsplatser. Grow kostar 159 USD med 80 timmar och Scale 439 USD med 300 timmar. Ett sökexportsteg följt av hämtning av jobbdetaljer delar på planens resurser. Se därför inte exekveringstiden som ett fast pris per extraherat jobb.
3. Octoparse
Octoparse erbjuder färdiga mallar, en visuell task builder för desktop och hanterade molnkörningar. Verktyget passar när du vill välja specifika annonsfält eller navigera mellan sidor på en webbplats utan att skriva kod.
Kontrollera om det finns en mall för den aktuella jobbsajten och de fält du behöver. När du bygger en egen uppgift bör du testa listsidor, detaljsidor och paginering separat. Molnkörning och ett visuellt gränssnitt ersätter inte behovet av att granska extraherade rader när webbplatsen förändras.
Pris: Den officiella uppgraderingsguiden anger 83/119 USD per månad för Standard och 299 USD per månad för Professional. Det finns en kostnadsfri lokal plan för utvärdering. Räkna även med kostnader för premiummallar, proxy och CAPTCHA om den valda uppgiften använder dem; ett marknadsfört årspris på 69 USD är inte det månadspris som används här.
4. ParseHub
Med ParseHub kan du bygga ett visuellt extraktionsprojekt. Det passar arbetsflöden där du själv definierar vilka element som ska hämtas och hur verktyget ska navigera på målwebbplatsen.
I plandokumentationen förklaras att scrollning eller klick för att läsa in mer innehåll kan räknas in i antalet sidor per körning. Jämför dessa gränser med webbplatsens navigering i stället för att anta att en sök-URL motsvarar en debiterad sida. Granska projektet på flera annonser innan du schemalägger återkommande insamling.
Pris: Standard kostar 189 USD/månad och omfattar 10 000 sidor per körning samt 20 privata projekt. Professional kostar 599 USD/månad med 120 privata projekt och obegränsat antal sidor per körning. Free tillåter 200 sidor per körning och fem offentliga projekt. Det här är gränser för sidor och projekt, inte en garanti för 10 000 kompletta jobbposter från en sökning.
Job scrapers för semi-tekniska användare
Ett scraping-API kan hämta sidor eller returnera parsade fält, men du behöver fortfarande koppla ihop requests, lagra resultat och avgöra vad som räknas som en komplett post.
5. ScrapingBee
ScrapingBee erbjuder ett scraping-API med browser rendering och extraktionsalternativ. Det passar när du vill ha hanterad åtkomst till webbsidor men behålla kontrollen över ditt eget applikationsflöde.
Kontrollera om den valda endpointen returnerar HTML eller de strukturerade fält du behöver. Ett lyckat svarsanrop är inte samma sak som en parsad jobbrad. Testa jobbtitlar, arbetsgivarfält, käll-URL:er och paginering och jämför sedan hur många credits dessa requests använder.
Pris: Hobby kostar 19 USD/månad för 75 000 API-credits, Freelance 49 USD för 250 000 och Startup 99 USD för 1 000 000. Standard-requests kostar från en credit, requests med JavaScript rendering kostar fem och premium proxy-requests kostar 10 eller 25 beroende på rendering. Därmed förbrukar 10 000 lyckade renderade requests à fem credits 50 000 credits, vilket ryms i Hobby-planen. Resultaten behöver fortfarande parsas, och en request motsvarar inte nödvändigtvis en jobbannons. Vid 25 credits per request kräver samma antal requests 250 000 credits och planen för 49 USD.
6. Bright Data
Bright Data erbjuder hanterade scraper-API:er och dataset. Börja med att välja relevant källa och kontrollera dess output schema i stället för att jämföra plattformens totala antal scrapers.
Det passar team som integrerar insamlad data i ett annat system. Bekräfta hur resultaten levereras, vilka fält som finns och när insamlingen sker. Ögonblicksbilder av dataset och insamling on demand kan tillgodose olika krav på aktualitet.
Pris: Web Scraper API har ett pay-as-you-go-pris på 1,50 USD per 1 000 levererade poster, plus en kostnadsfri månadsnivå med 5 000 poster. Scale kostar 499 USD/månad och omfattar 384 000 poster, därefter 1,30 USD per 1 000 extra poster. Proxy, unblocking och parsing ingår i produktens angivna pris. Att köpa ett färdiginsamlat dataset är en separat produkt; kontrollera jobbkällan och schemat innan du använder något av priserna i din kalkyl.
Job scrapers för tekniska experter
Tekniska team kan använda ett hanterat webb-API som en del av sin egen pipeline. De ansvarar fortfarande för identifierare, lagring, joins och tolkningen av saknade resultat.
7. Oxylabs
Oxylabs web API erbjuder hanterad web scraping för applikationsflöden. Kontrollera stöd för målwebbplatser och parsing-alternativ för de jobbsajter du behöver.
Det passar team som vill styra hur requests och resultat integreras i resten av datapipelinen. Beräkna kostnaden utifrån den faktiska målwebbplatsen och request-konfigurationen. Jämför inte proxy-planer med priser för parsad jobbdata som om de vore samma produkt.
Pris: Den aktuella prissidan för Web API /scrape anger en enhetlig Starter-prenumeration för 30 USD/månad, Basic för 100 USD och Flexible för 500 USD. Resultatpriset beror på målwebbplats och rendering: det marknadsförda minimipriset börjar på 0,50 USD/1 000, medan LLM scrapers kostar 1,50 USD/1 000 med Starter. Använd inte det lägsta priset för alla jobbsajter.
Det tidigare priset på 49 USD för Micro Web Scraper API tillhör den äldre produktplanen. Kontrollera det aktuella /scrape-erbjudandet inför ett nytt köp. Proxy-bandbredd är också en annan prisenhet än returnerade API-resultat och bör prissättas separat om implementationen använder den.
Slutsats
Välj den metod som ger dig fält du faktiskt kan använda: en sökkälla för återkommande rekryteringssignaler, en visuell uppgift för en specifik webbplatslayout eller ett API för din egen pipeline. Granska relevans och källunderlag innan du skalar upp.
För bredare account prospecting kan du jämföra verktyg för lead scraping. Håll jobbrader åtskilda från företags- och kontaktposter så att du inte förlorar enskilda roller när du bygger en outreach-lista. Översikten om lead scraping förklarar hur du väljer företags- eller personposter inför nästa sourcing-steg.
Vanliga frågor om Job scraping-verktyg
Hur scrapar jag flera jobbsajter samtidigt?
Använd en källa som söker i jobbdata från flera sajter, exempelvis Datablists Job Postings Search. Granska käll-URL:er och täckning; en aggregerad sökning är inte en fullständig kartläggning av alla aktuella jobbannonser.
Är AI scraping olagligt?
Användning av AI avgör inte om insamling eller återanvändning är laglig. Det beror på åtkomsten, datan, webbplatsens villkor och tillämplig lag. För personuppgifter som omfattas av GDPR förklarar CNIL:s vägledning om återanvändning varför det inte räcker att uppgifterna är offentligt tillgängliga.
Vilken Job scraper är enklast att använda?
En färdig datakälla är en bra utgångspunkt när dess filter och fält passar dina behov. En visuell uppgift ger större kontroll över en enskild webbplats, medan ett API passar en befintlig applikation. Testa först med ett litet antal resultat.
Kan ChatGPT scrapa jobbannonser?
För att skapa ett repeterbart jobbdataset behöver du kontrollera hur källor hittas, hur paginering hanteras, vilka fält som krävs samt hur data exporteras eller lagras. Ett svar i en chatt om lediga jobb bör inte ses som bevis på en komplett lista över jobbannonser. Använd ett särskilt källflöde när du behöver rader som går att granska och köra på nytt.
Vad är en Job scraper?
En Job scraper hämtar information från jobbannonser, exempelvis titel, arbetsgivare, plats och käll-URL, och omvandlar den till strukturerad data. Den kan hämta aktuella webbsidor eller erbjuda sökning i tidigare insamlad jobbdata; kontrollera vilken modell verktyget använder.
Vilka risker finns med Job scraping-verktyg?
Saknade fält, dubbletter, inaktuella annonser och åtkomstfel kan förvränga ett dataset. Spara käll-URL:er och granska stickprov så att du kan skilja ett genuint tomt resultat från en misslyckad insamling.
Vad kostar Job scraping-verktyg vanligtvis?
De publicerade månadspriserna börjar på 25 USD för Datablist, 69 USD för PhantomBuster, 83/119 USD för Octoparse Standard, 189 USD för ParseHub, 19 USD för ScrapingBee och 30 USD för Oxylabs Web API. Bright Data erbjuder även pay-as-you-go för 1,50 USD per 1 000 levererade poster. Jämför samma resultat: 2 500 importerade annonser i Datablist kräver Starter plus top-up för totalt 45 USD, medan ett API:s request-volym fortfarande kräver extraktion och validering av jobbfälten.
Kan jag använda Job scraping-verktyg för rekrytering?
Ja, jobbdata kan hjälpa dig att undersöka arbetsgivares rekryteringsaktivitet och krav för olika roller. En jobbpost beskriver en tjänst; den identifierar inte kandidater och garanterar inte kontaktuppgifter till en rekryterare.
Källor
Priserna kontrollerades den 28 oktober 2026. Antalen annonser och requests i exemplen är antagna debiteringsvolymer, inte uppmätt täckning.
- [1] Datablist. Starter/Growth-planer och inkluderade credits.
- [2] Datablist. Användning av credits och top-up-paket.
- [3] PhantomBuster. Månadspriser och exekveringsresurser.
- [4] Octoparse. Standard/Professional och månatliga prenumerationsalternativ.
- [5] ParseHub. Priser för Standard/Professional samt projekt- och sidgränser.
- [6] ParseHub. Sidräkning, projekthastighet och betalplanernas omfattning.
- [7] ScrapingBee. Månadsplaner, API-credits och multiplikatorer för rendering/proxy.
- [8] Bright Data. Pay-as-you-go- och Scale-priser för Web Scraper API.
- [9] Oxylabs. Aktuella Web API /scrape-prenumerationer och målberoende resultatpriser.