

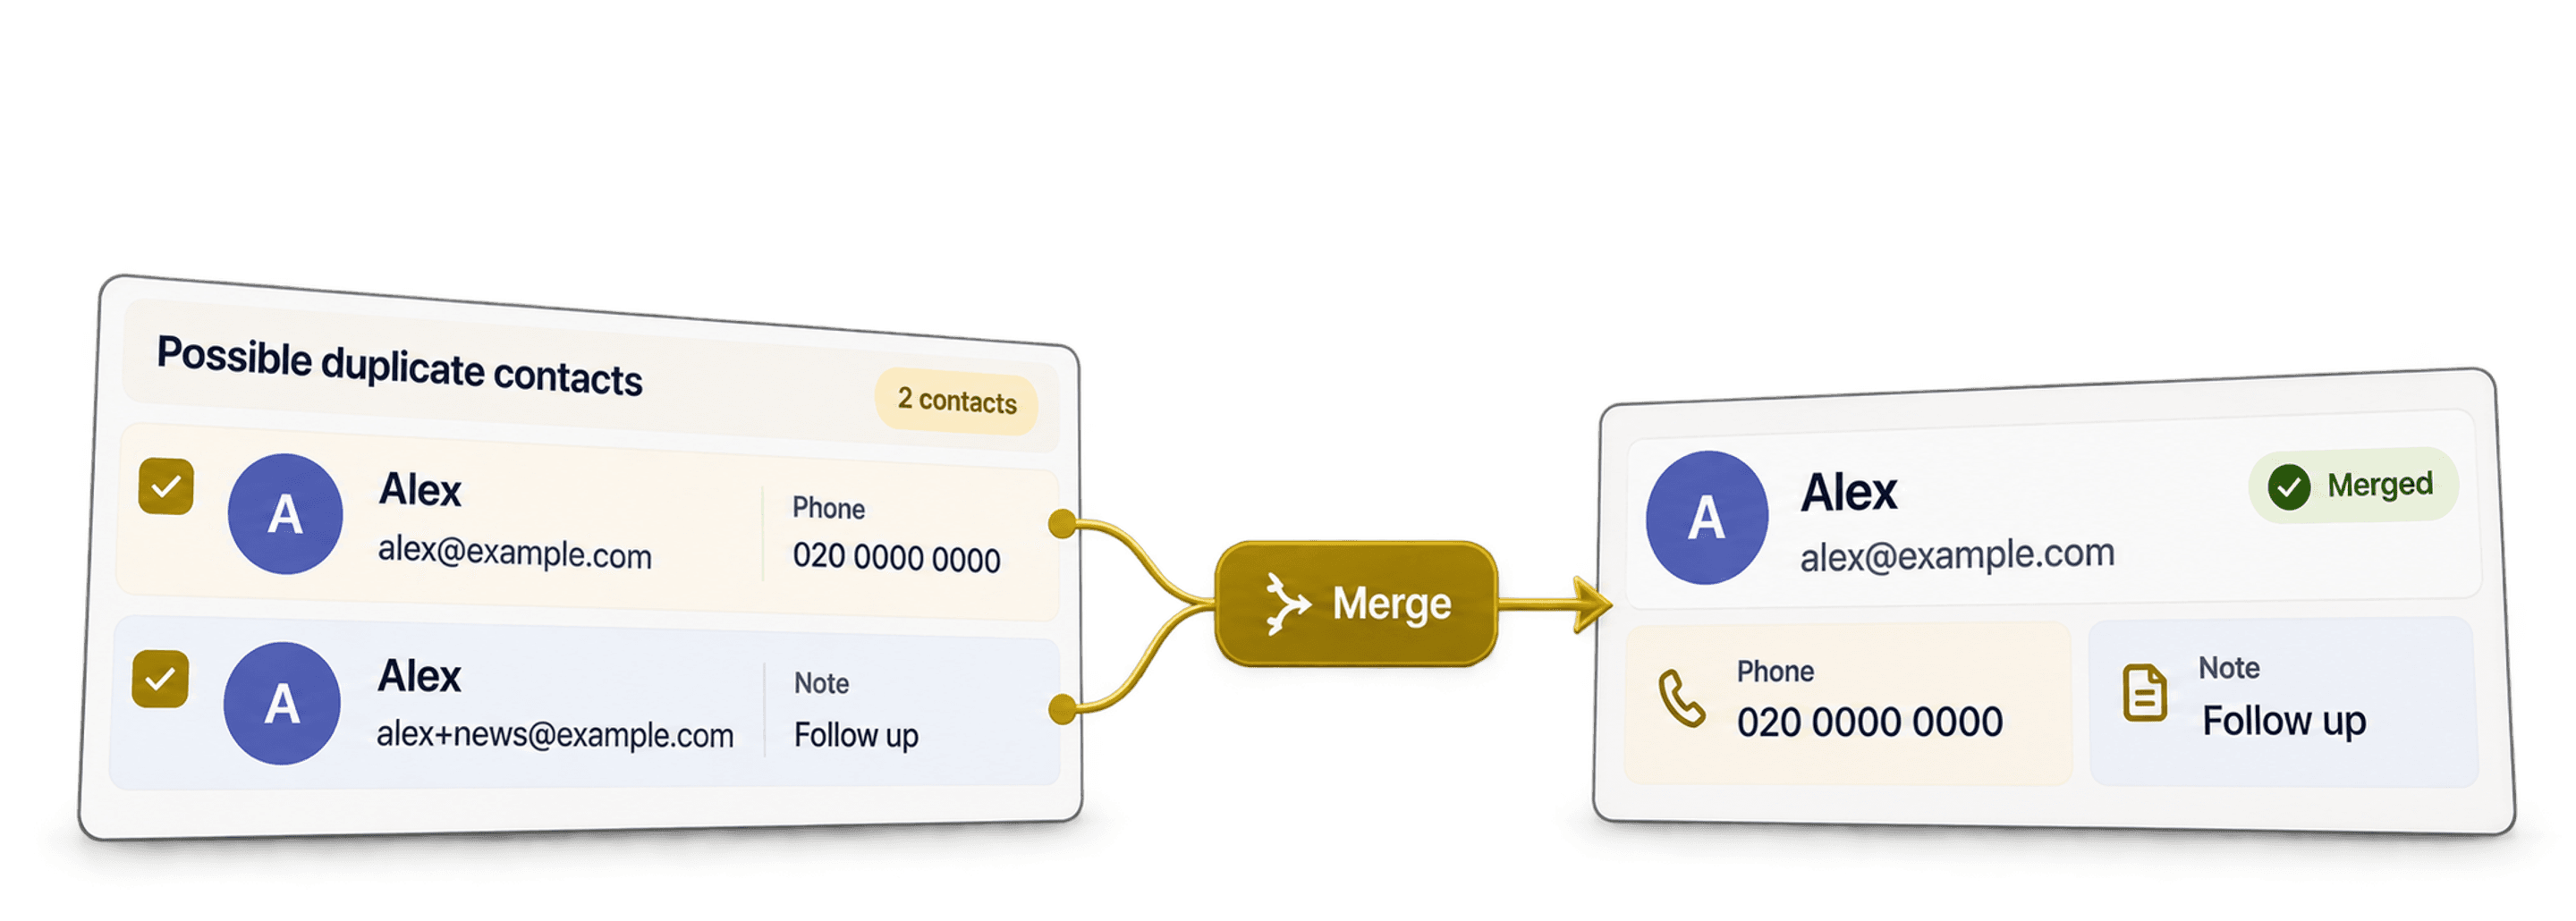
当你把 CRM 导出数据、表单提交记录或活动名单合并到一起时,重复 Email 往往会悄悄混进来。同一个人可能出现两次,但两行数据通常并不完全相同:一行有电话号码,另一行则保留了来源或有用的备注。
因此,我不会一上来就删除重复 Email。为了安全地进行 Email 地址去重,我会使用带 Smart matching 和 Email processor 的 Datablist Duplicates Finder。它会将不同形式的 Email 归为一组,让我查看完整的联系人行,再合并需要保留的信息。
在本教程中,我准备了一份包含 1,000 位联系人的测试名单,涵盖我经常遇到的 Email 变体,包括加号别名、Gmail 地址差异以及带包装格式的地址。Datablist 找到了 200 对重复记录,清理后的 collection 最终保留了 800 位联系人。下面我会展示所用设置,以及合并前检查了哪些内容。
先按 Email 匹配,再根据整行联系人数据决定保留什么。 如果你需要比较姓名、电话号码、公司域名或其他标识符,请参阅如何在线对名单去重。
Datablist 如何判断两个 Email 地址相同
使用 Email processor 的 Smart matching 比较的是 Email 身份,而不是单元格中的原始文本。它会去除地址前后的空格、按小写值进行比较,并在匹配前删除本地部分中的 +suffix。
它还会应用 Gmail 专属规则:删除 Gmail 地址本地部分中的点,并将 googlemail.com 映射为 gmail.com。Datablist 还可以从显示名称包装格式,或带查询字符串的 mailto: 值中提取有效地址。
以下是测试数据集中的一些示例:
| 存储的值 | Smart Email 结果 |
|---|---|
noraanderson40@demo.conoraanderson40+newsletter@demo.co | 删除加号后缀后,属于同一身份 |
victorbennett62@gmail.comvictorb.ennett62@gmail.com | 删除点后,属于同一 Gmail 身份 |
yasmincarter105@gmail.comyasmincarter105@googlemail.com | 统一域名后,属于同一 Gmail 身份 |
camiladiaz123@testmail.netCamila Diaz <camiladiaz123@testmail.net> | 提取包装格式中的地址后,属于同一身份 |
marcusevans199@testmail.netmailto:MARCUSEVANS199@TESTMAIL.NET?subject=Hello | 移除包装格式并按小写值比较后,属于同一身份 |
忽略点的规则仅适用于 Gmail。 Datablist 不会默认认为 first.last@company.com 和 firstlast@company.com 是同一地址。在非 Gmail 域名中,点可能具有实际意义。
Smart Email 是一种比较规则,并非 Email 验证工具。它会检查足够的结构来标准化地址,但不会完整验证域名或邮箱。例如,person+tag@.example.com 会被转换为 person@.example.com 用于匹配,即使该域名格式有误。请在合并前单独检查无效值。
如果需要把加号别名、Gmail 中的点以及包装格式视为不同地址,请选择 Exact。精确文本比较仍会去除前后空格,并默认忽略大小写。如果必须区分大小写,请启用 Case sensitive;前后空格仍会被去除。
合并前,请检查公司域名中带加号标签的地址。Smart Email 会使用相同的比较键,将 sam+orders@example.com 和 sam@example.com 归为一组。Exchange Online 会先尝试解析完整地址;如果无法解析,再回退到基础地址。[1] 如果两个地址对应不同的收件人记录,或邮件路由关系不明确,请同时保留。对 Email 列使用 Exact 运行检查,并确认两行记录保持分开。
🔑 标准化只是在提出一个疑似重复组
它无法证明每个字段都属于同一个人。合并前,请检查姓名、公司以及角色型公共邮箱。
对于大多数联系人名单清理任务,我建议使用 Smart matching 和 Email processor。如果必须保留不同别名,我会切换到 Exact,再根据文件中的标识符检查大小写设置。
完整的标准化规则和套餐可用性,请参阅 Email processor 参考文档。
本教程使用的 Email 名单示例
测试文件包含 1,000 行合成联系人数据,对应预先设计的 800 个身份。所有重复记录对的原始 Email 字符串都不完全相同。这一点很重要,因为只按精确值清理,无法体现识别别名的匹配效果。
文件包含八列:record_id、first_name、last_name、email、company、phone、source 和 notes。工作流按 email 匹配,但其他字段会继续显示,以便我选择主记录并保留有用的值。
以下是两组重复记录中的四行原始输入数据:
| record_id | first_name | last_name | phone | source | notes | |
|---|---|---|---|---|---|---|
CONTACT-0040-A | Nora | Anderson | noraanderson40@demo.co | CRM 导出 | 主要联系人记录 | |
CONTACT-0040-B | N. | A. | noraanderson40+newsletter@demo.co | +1-202-555-1039 | 网站表单 | 来自第二个来源的跟进信息 |
CONTACT-0062-A | Victor | Bennett | victorbennett62@gmail.com | +1-202-555-1061 | 网站表单 | 主要联系人记录 |
CONTACT-0062-B | victor | BENNETT | victorb.ennett62@gmail.com | 活动 | 来自第二个来源的跟进信息 |
Nora 这组记录说明了为什么我不会看到重复项就直接删除。基础记录中有更合适的完整姓名,而加号别名所在行则包含唯一的电话号码和另一个获客来源。通过合并,两者都能保留。
该数据集包含 200 个由两行组成的重复身份,平均分为五类变体:加号别名、带点的 Gmail 地址、gmail.com 与 googlemail.com、显示名称包装格式,以及 mailto: 值。其余 600 个身份仅出现一次。
你可以下载包含 1,000 行数据的示例 CSV 来复现本教程。如果使用自己的文件,请确保每行只有一个 Email,并保留需要整合的相邻字段。
导入并准备 Email 列
将 CSV 或 Excel 文件导入新的 Datablist collection。检查导入预览,并将 Email 列映射为 Email property。
将姓名、公司、电话、来源、备注和稳定 ID 分别放在独立的 property 中。这些列不是无用数据,而是在两行 Email 匹配、其他内容却不一致时,帮助你做出判断的依据。
在这个工作流中,我也倾向于每个单元格只放一个地址。如果单元格包含 alice@example.com; bob@example.com,请先拆分或标准化。关于这种情况,请参阅包含多个 Email 地址的字段如何去重。
对于包含多个地址的单元格,多值去重会比较以分号分隔的各个部分。在把两条联系人记录视为同一个人之前,请先检查重叠的邮箱。
💡 保留用于判断合并的数据
去重前不要删除来源、备注、电话或稳定 ID 列。它们可以帮助你选择主记录,避免丢失独有数据。
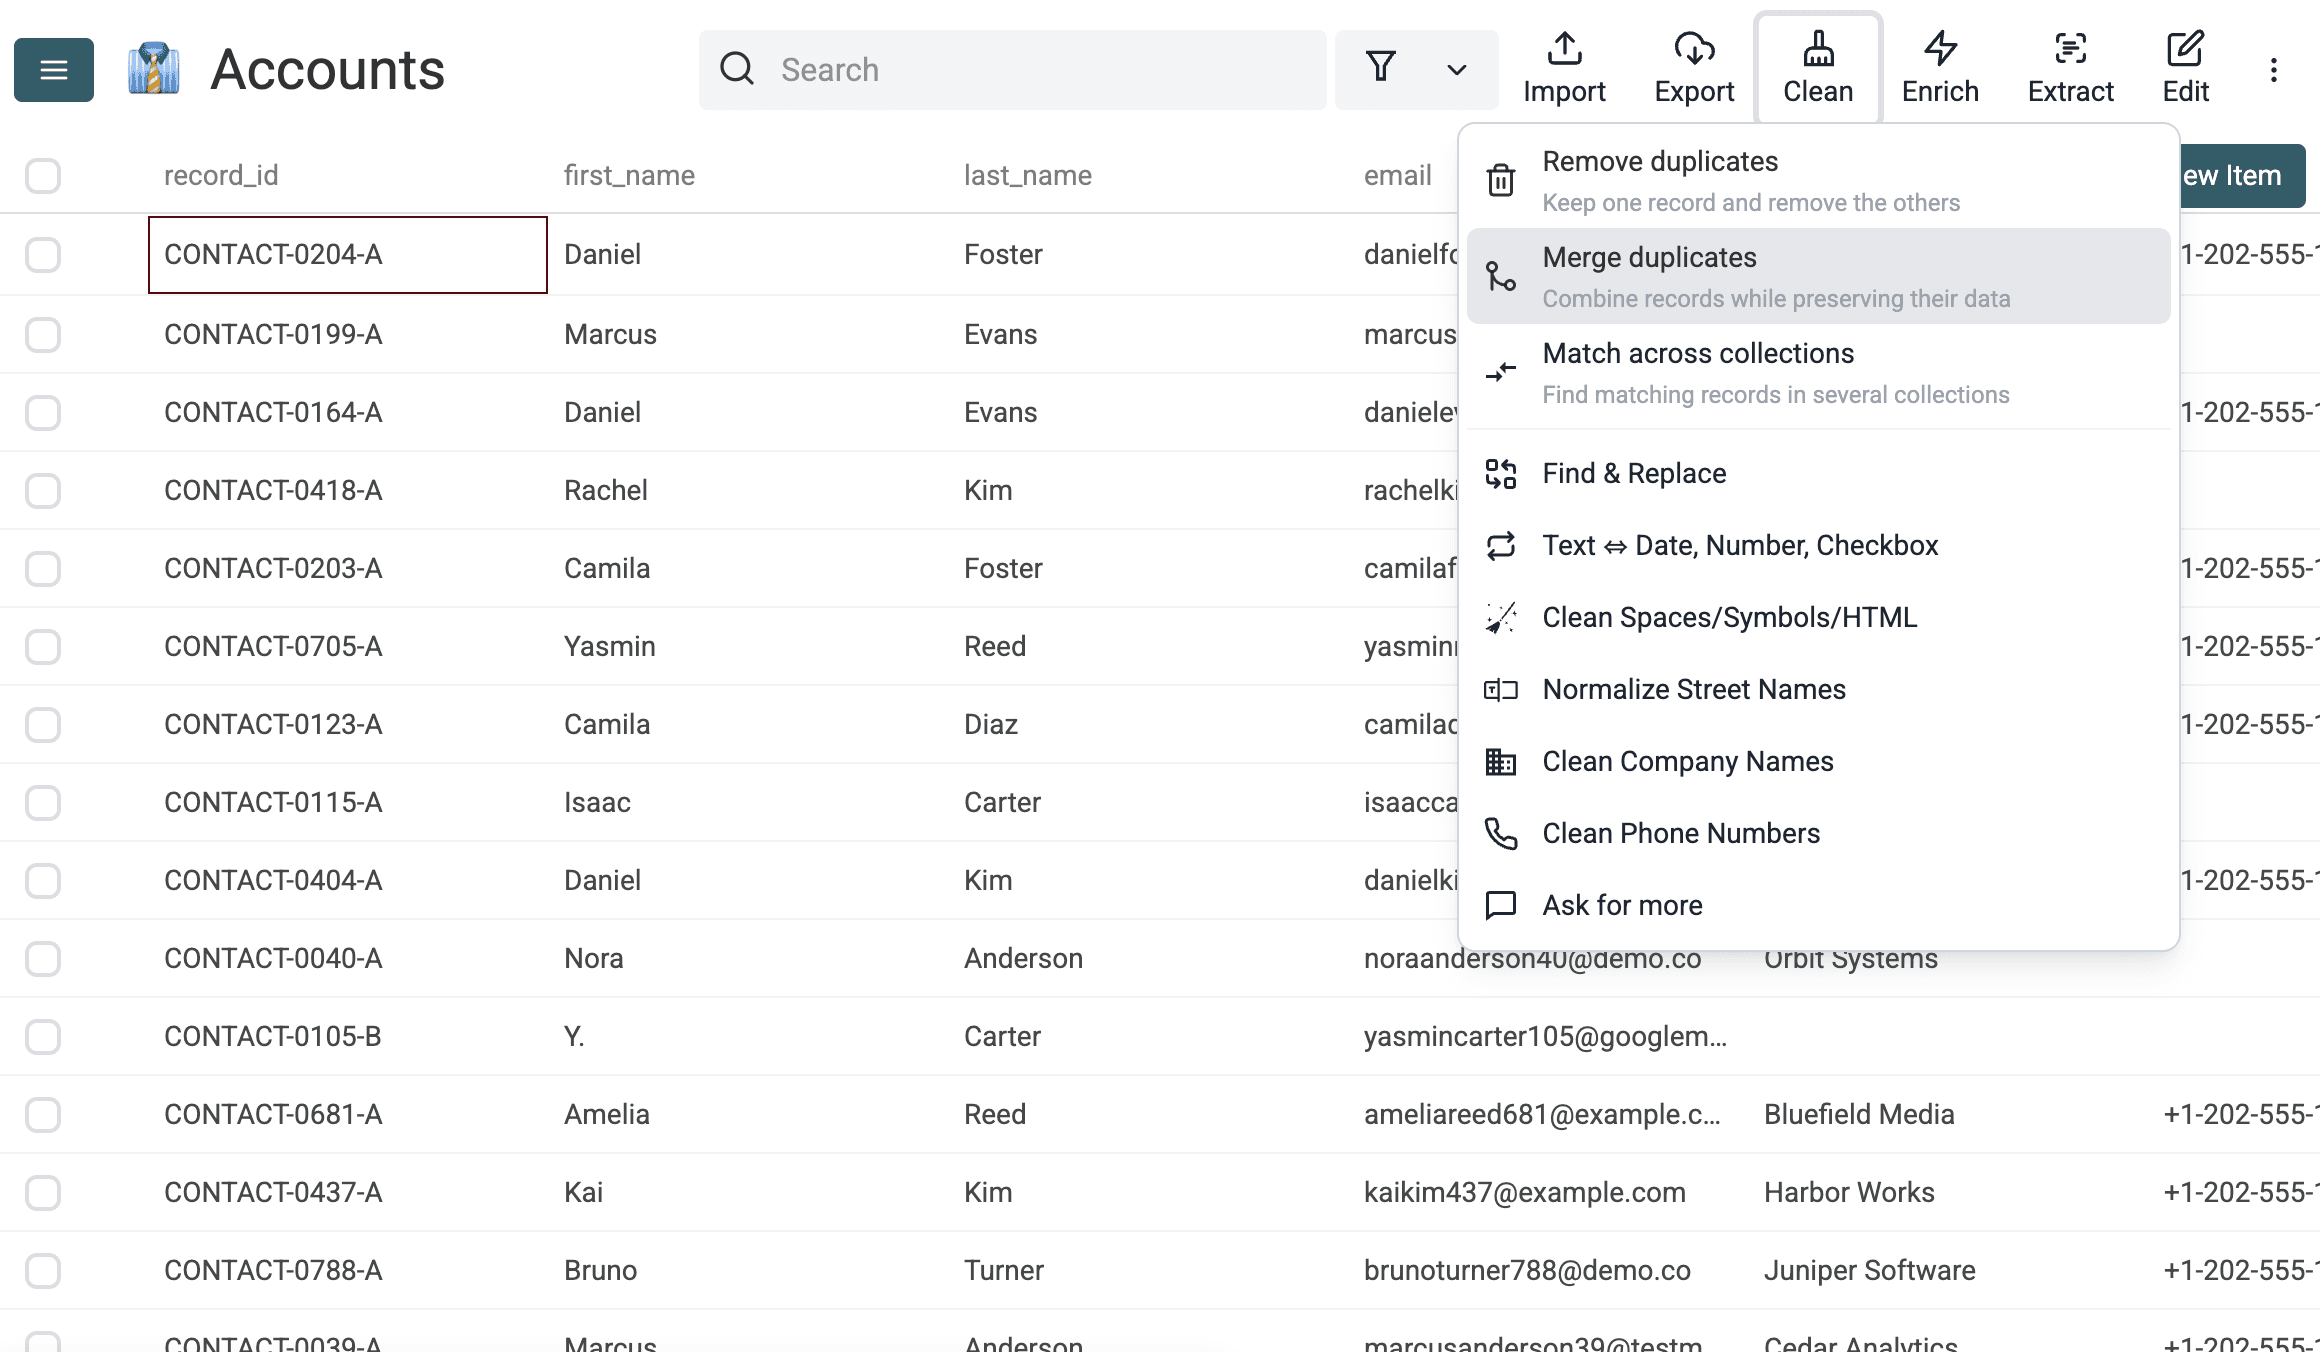
打开 Clean > Merge duplicates。选择 Selected Properties,然后在这次以 Email 为主的检查中选择 email。
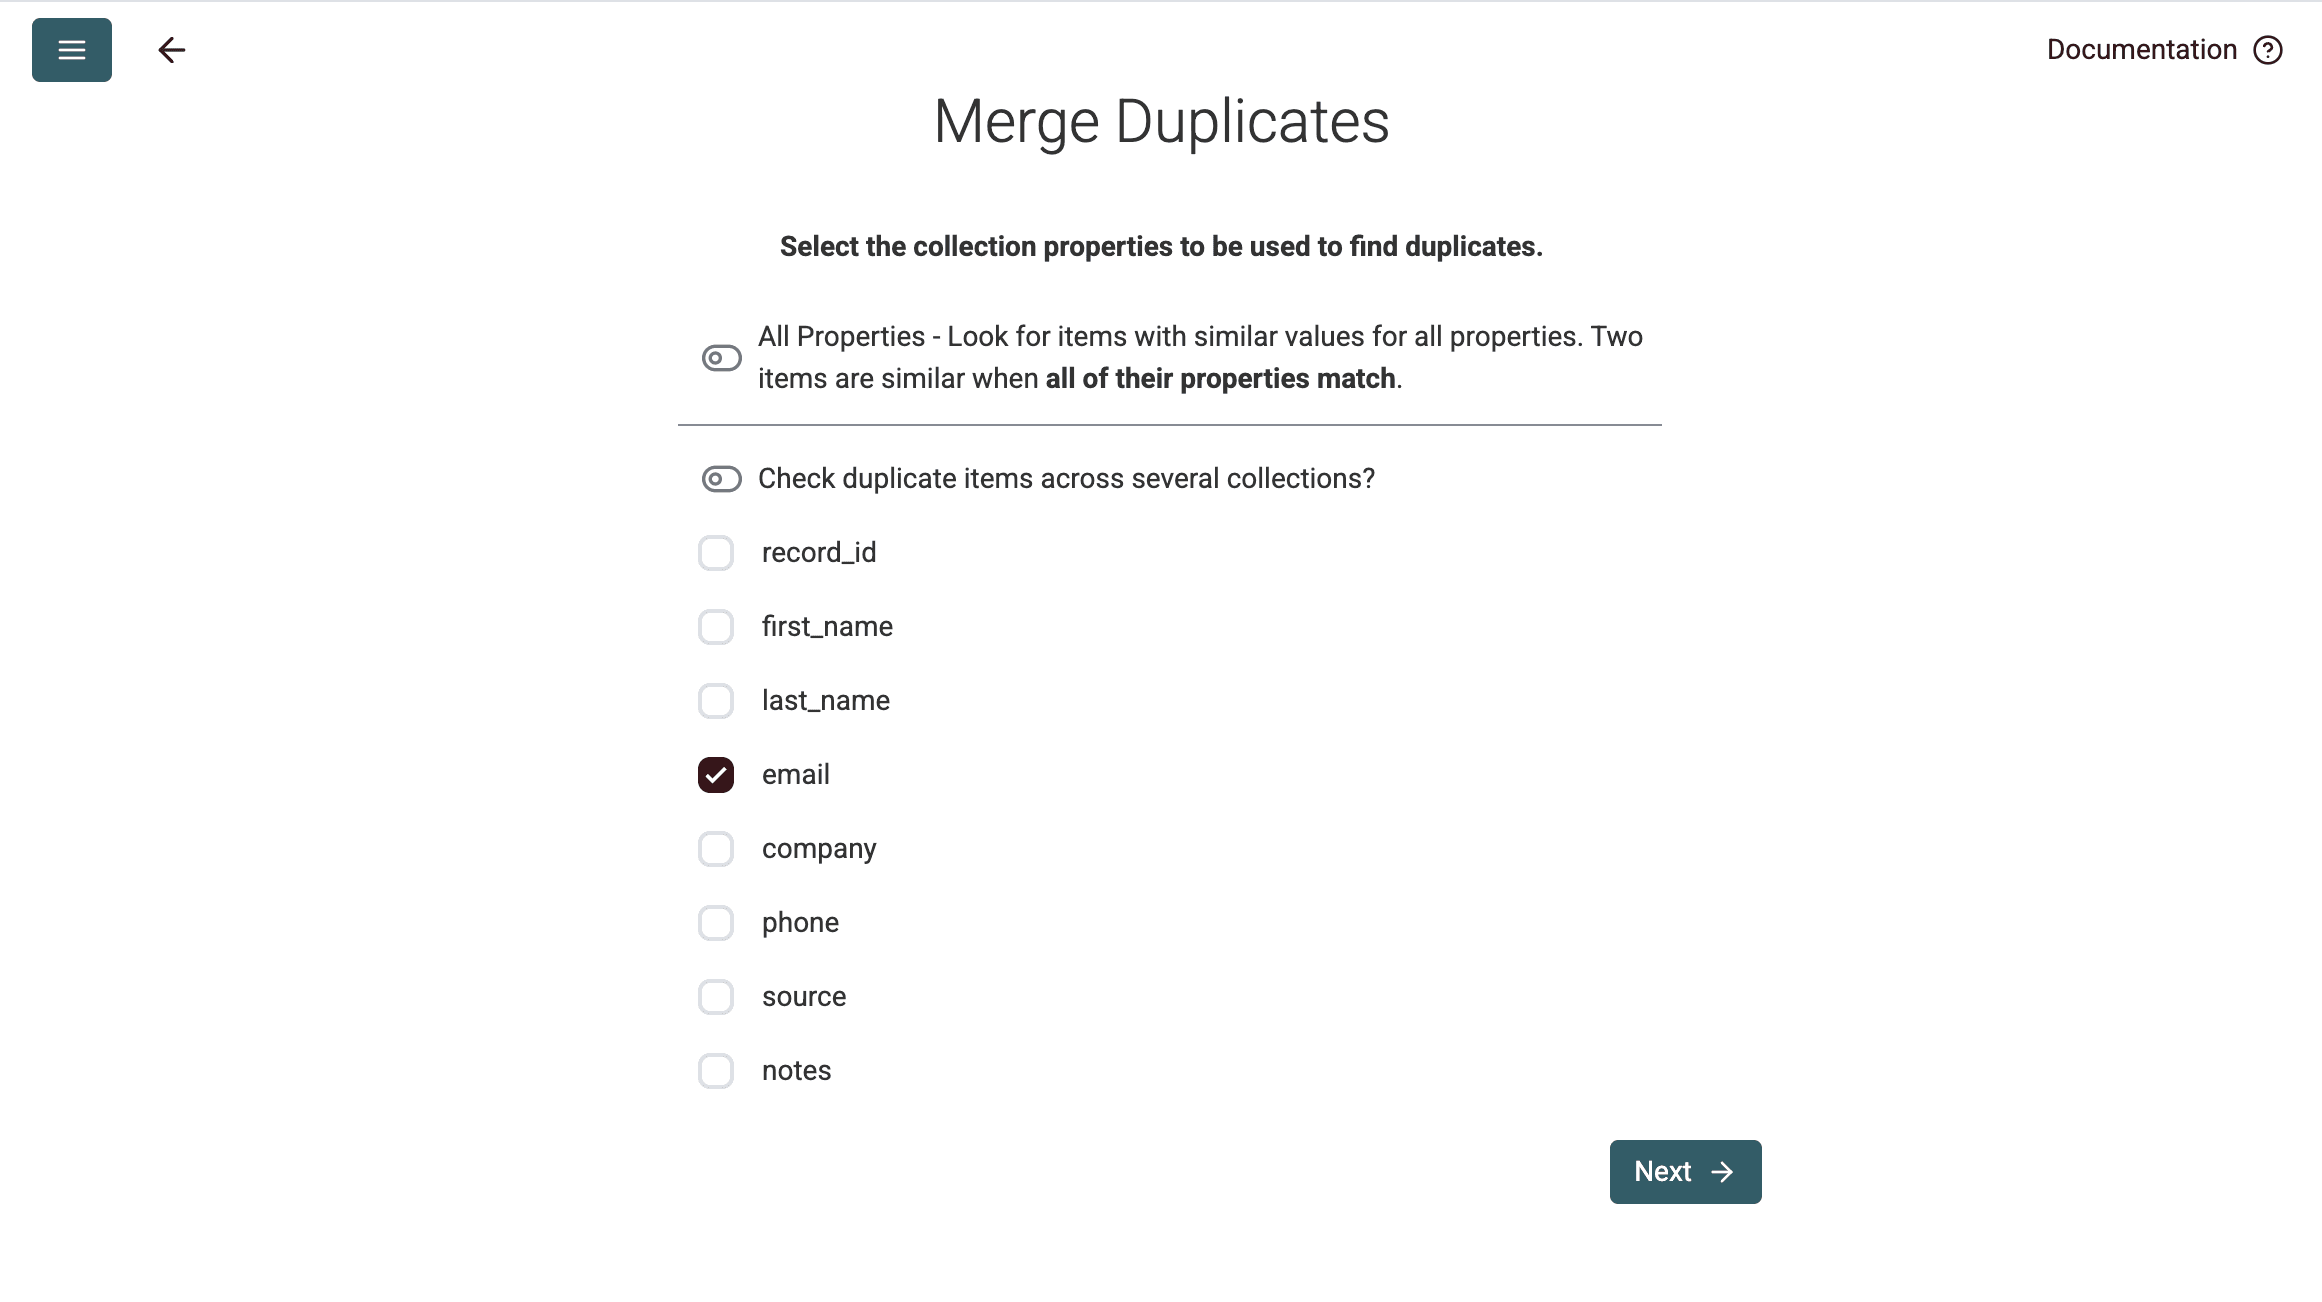
只选择一个 property,更容易理解匹配规则。如果此时加入姓名或公司 property,当这些字段缺失或格式不同时,反而可能阻止有效的 Email 匹配。
配置 Duplicates Finder
对于 email property,选择 Smart 作为比较算法,并选择 Email processor。
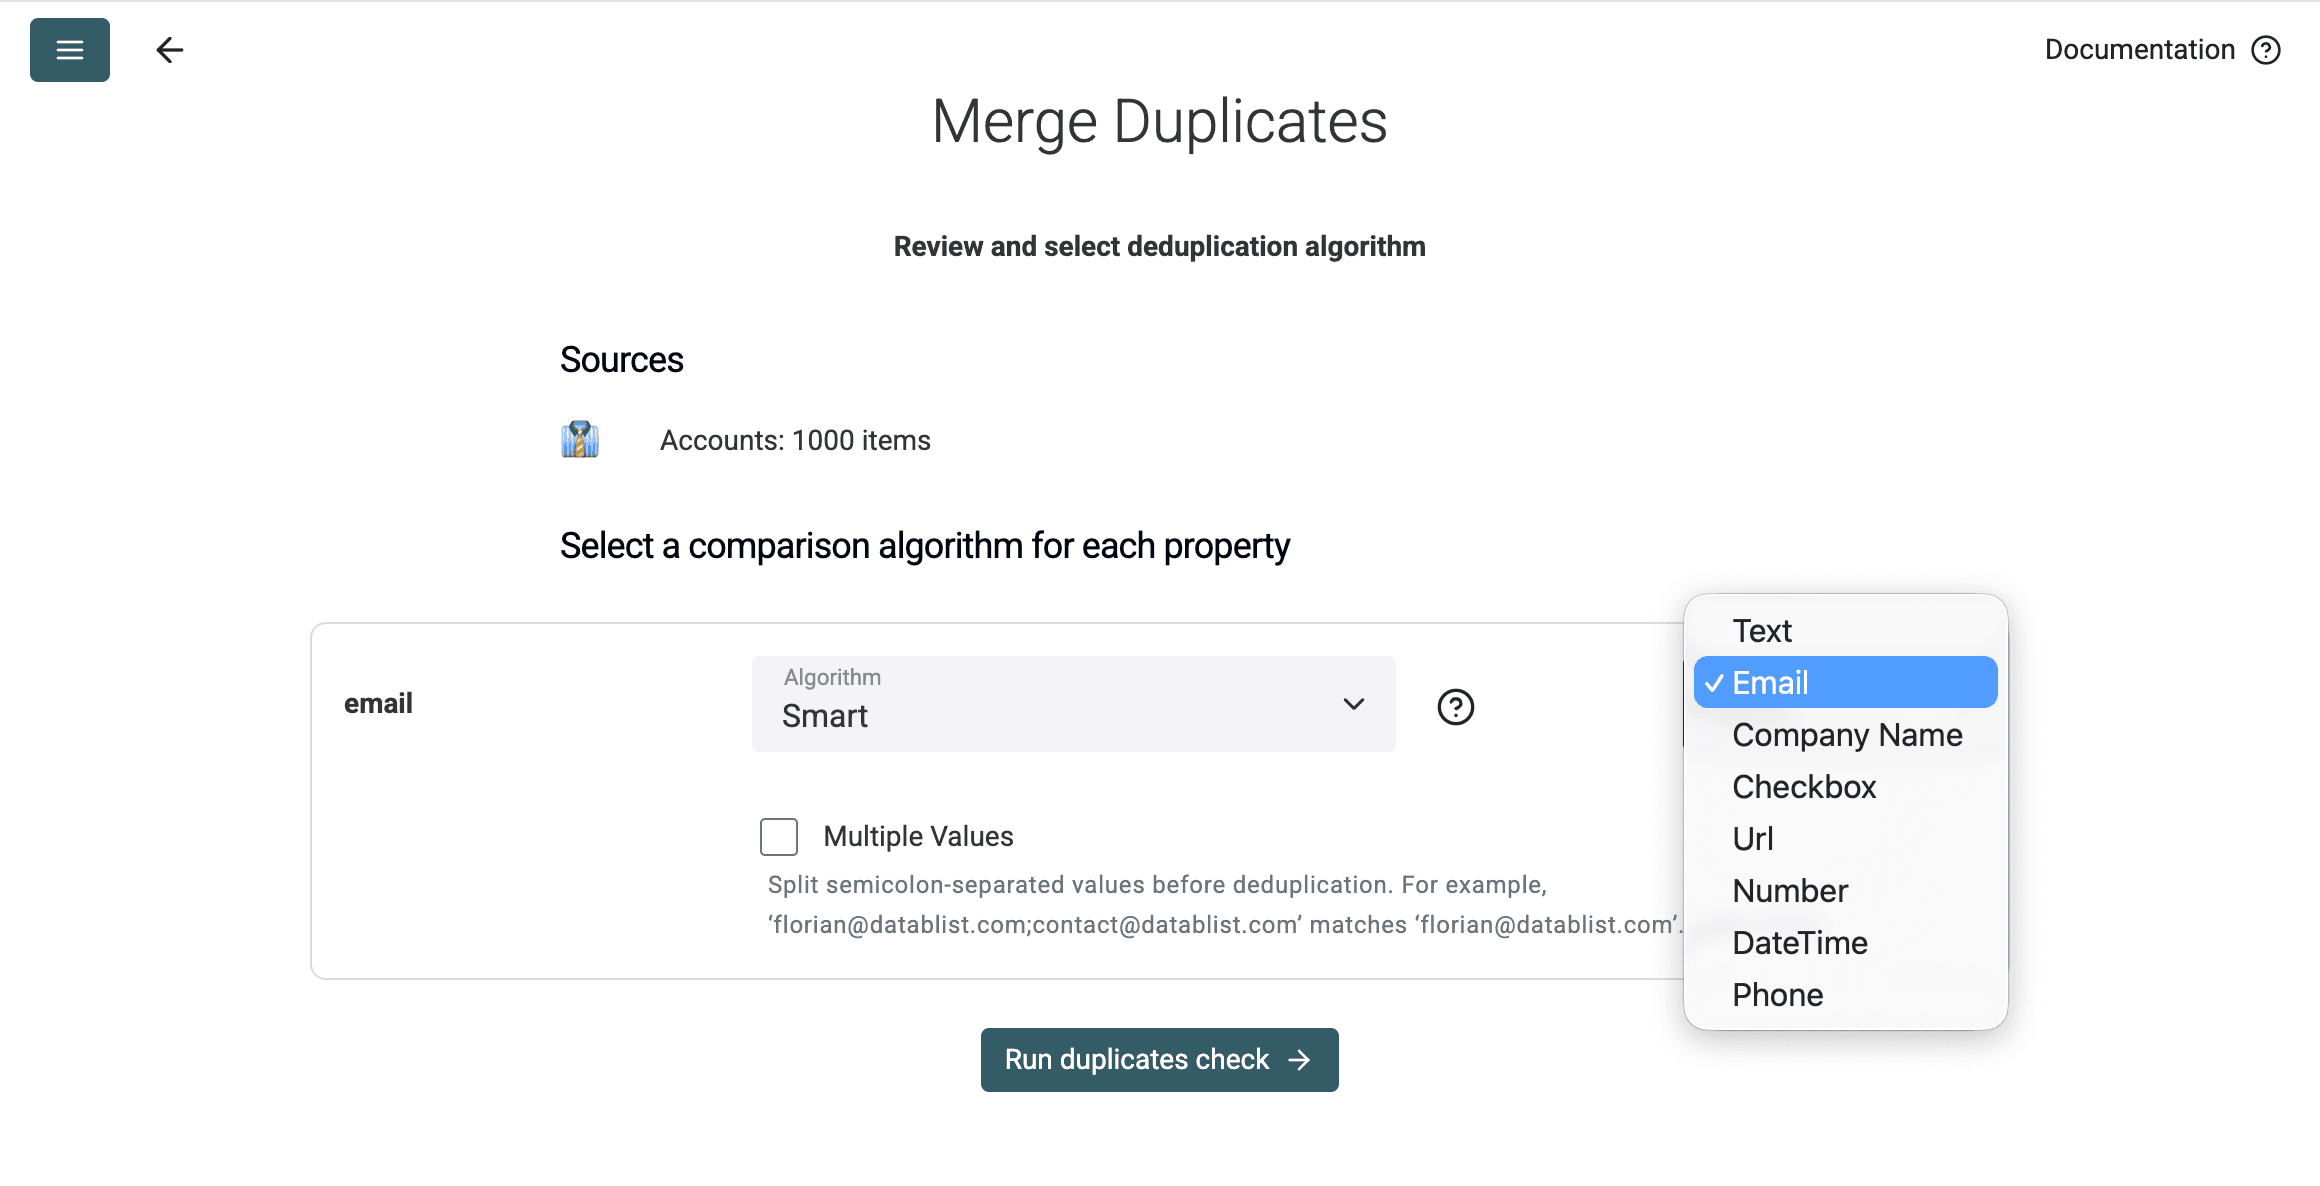
每项设置都有明确作用:
- Selected Properties 将检查范围限定在你要比较的标识符上。
- Smart 启用基于 processor 的标准化,而不是逐字比较存储的字符串。
- Email 应用前文介绍并经过验证的别名、Gmail、显示名称和
mailto:规则。
如需识别同一身份的不同 Email 形式,请使用 Smart 和 Email processor。Exact 会跳过 Email 专属标准化,但仍会去除空格,并默认忽略大小写。
重复项检查本身是只读操作。运行后只会生成待审核的候选组,不会删除或合并 collection 中的行。只有在你选择并执行合并或删除操作后,数据才会发生变化。
这种分离方式很实用。我希望先看清匹配规则认定了哪些等效记录,再允许批量合并修改名单。
运行检查并审核重复组
点击 Run duplicates check。在本次测试中,Datablist 将 1,000 行中的 400 行归入了 200 个双行重复组。
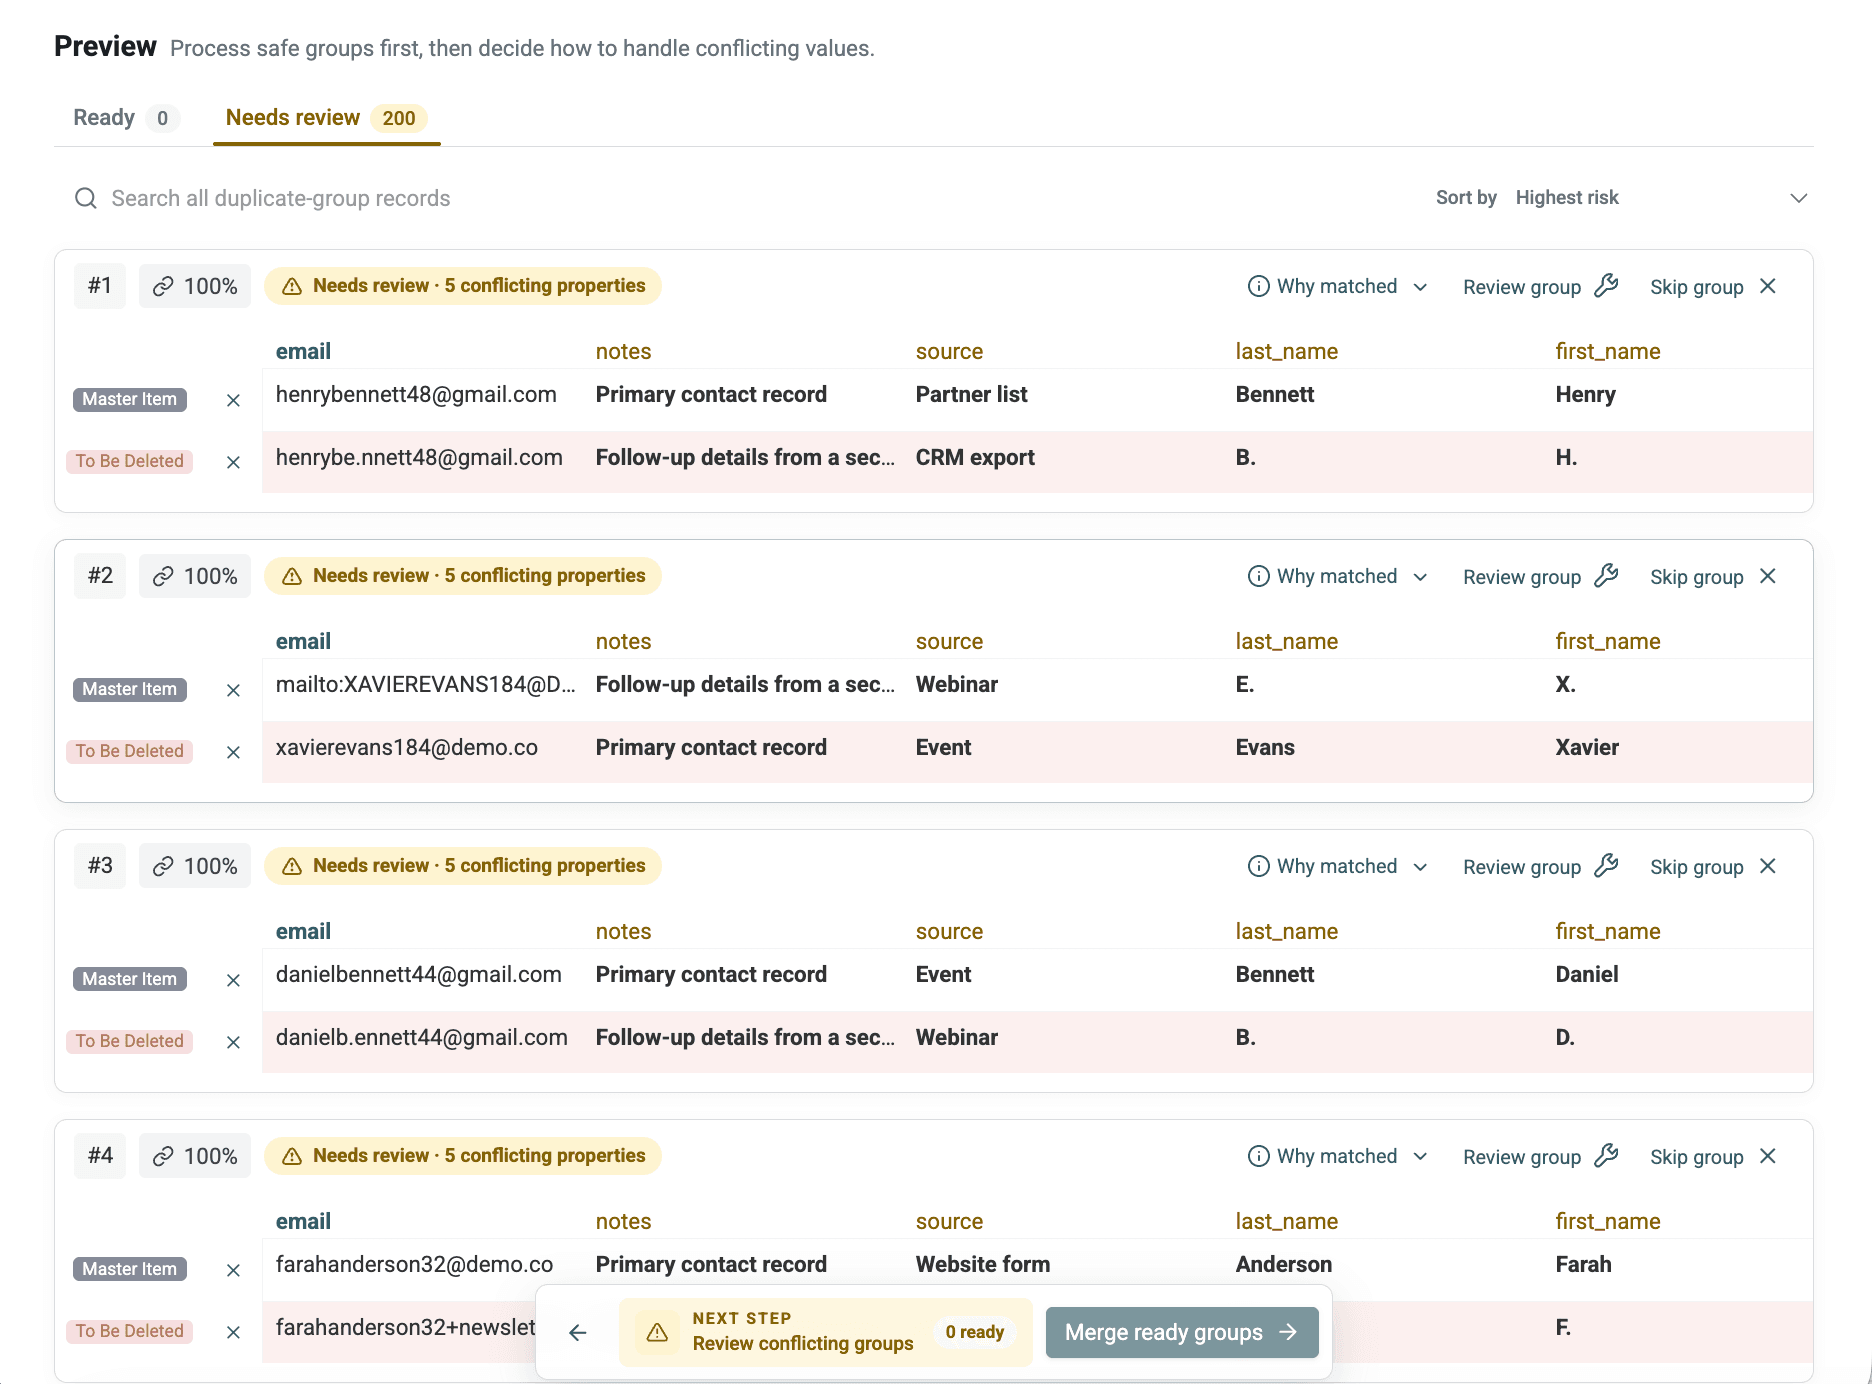
此时不要把组数直接当作需要删除的记录数。每个组都只是待审核的候选项。请逐组检查:
- Email 变体是否合理;
- 姓名是否一致,或差异是否可以解释;
- 公司和电话号码是否冲突;
- 来源和备注是否包含互补信息;
- 该地址是否为共享邮箱。
在应用批量规则前,我通常会检查前几组,以及所有出人意料的跨公司匹配。这比之后修复过度合并要省时得多。
⚠️ 重复地址不一定代表同一个人
sales@company.com之类的共享邮箱可能对应多位真实联系人。请手动审核角色型邮箱,不要默认把所有记录合并为一行。
测试文件经过专门设计,每一对标准化后的记录都代表同一个身份。真实的 CRM 导出数据会更加混乱。如果姓名或公司信息表明记录属于不同的人,请跳过该组或单独审核。
选择合并还是删除
我的判断规则很简单:
- 当多行记录包含互补数据时,选择合并。
- 只有当额外记录不包含任何有用信息时,才将其删除。
- 有歧义的组留待人工审核。
本次操作的合并配置会选择信息最完整的一行作为主记录。它保留主记录的 record_id,采用最长的姓名值,并用分号合并 source 和 notes。
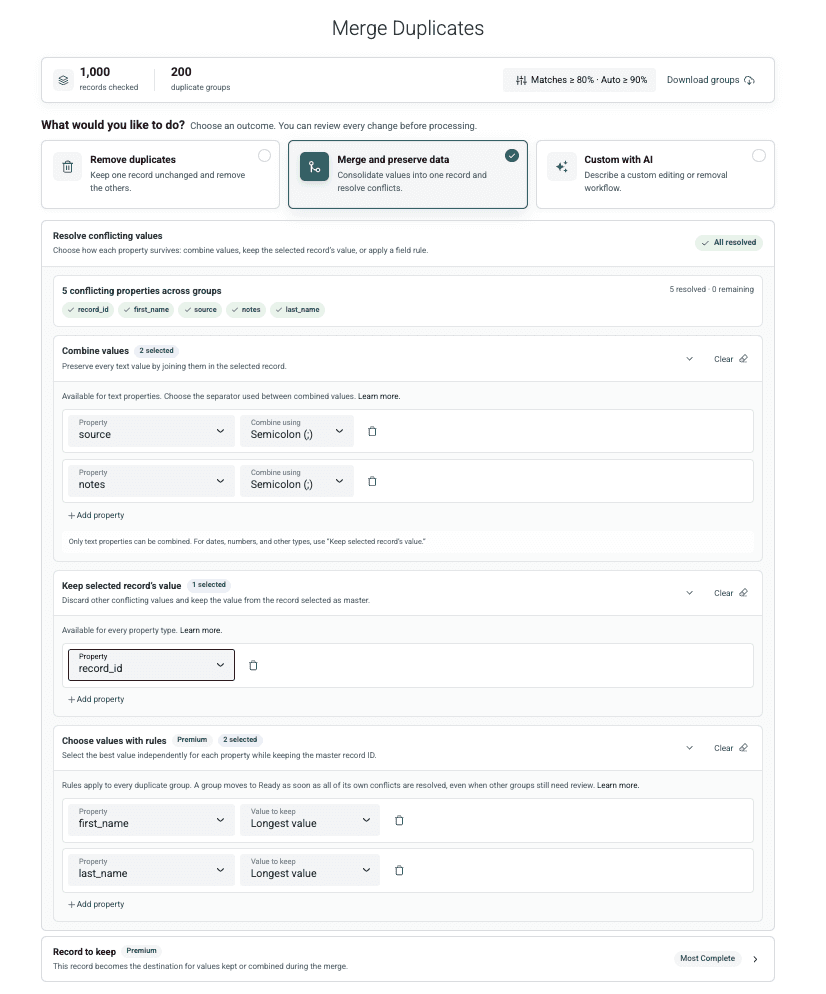
这些设置适合本示例,但我不会默认合并每个存在冲突的 property。来源历史可以合理地变成 网站表单;CRM 导出,但 CRM 状态、负责人 ID 或主 Email 通常需要保留一个权威值。
你需要在预览中验证这些选择。每次更改规则后,都应重新检查目标行。
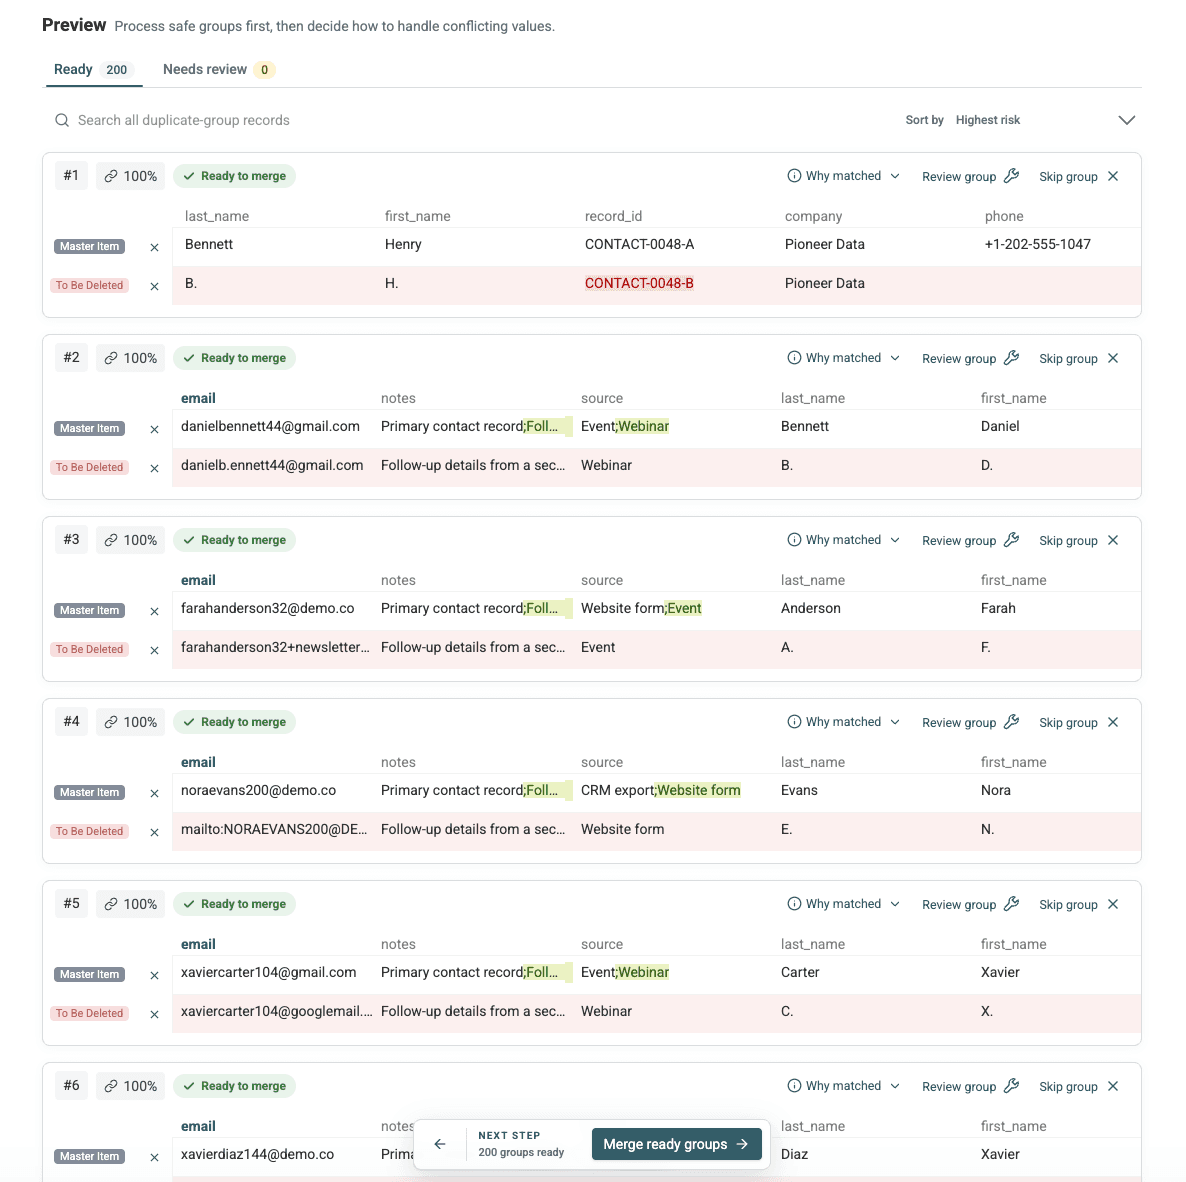
💡 每次修改规则后都要预览
在将规则应用到所有准备就绪的组之前,检查哪一行会成为主记录、哪些值会被合并,以及哪些值会消失。
如果重复行包含独有的电话号码、来源或备注,请合并,而不是删除。 在 Nora 的示例中,最终记录保留了一条记录中的完整姓名,以及另一条记录中的电话号码。
如果需要处理更复杂的 CRM 冲突,可以参考更深入的工作流,了解如何合并重复 Leads 且不丢失数据。在这次以 Email 为核心的处理中,目标是保留有用的相邻字段,而不是把每个 property 都变成多值字符串。
1,000 行测试名单的去重结果
本次合并得到的实测数据如下:
| 指标 | 结果 |
|---|---|
| 初始行数 | 1,000 |
| 被归入重复组的行数 | 400 |
| 双行重复组 | 200 |
| 删除的重复行 | 200 |
| 更新的主记录行 | 200 |
| 最终行数 | 800 |
| 剩余重复组 | 0 |
数据核对非常直接:1,000 个初始行 - 200 个删除行 = 800 个保留行。
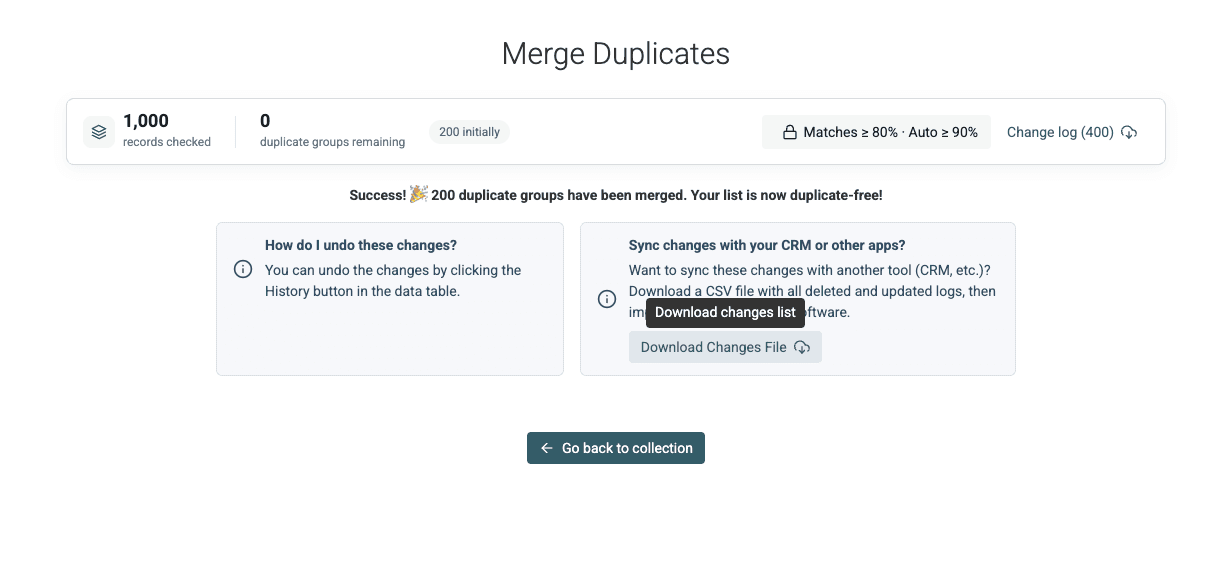
在人工测试中,合并只用了几秒,但没有记录精确计时。请将其视为本次操作中的观察结果,而不是性能基准。
下载的变更日志包含 400 条记录:200 条已删除行和 200 条已更新的主记录行。对于每个合并组,日志都会显示合并前的值,以及目标行中最终保留的值。
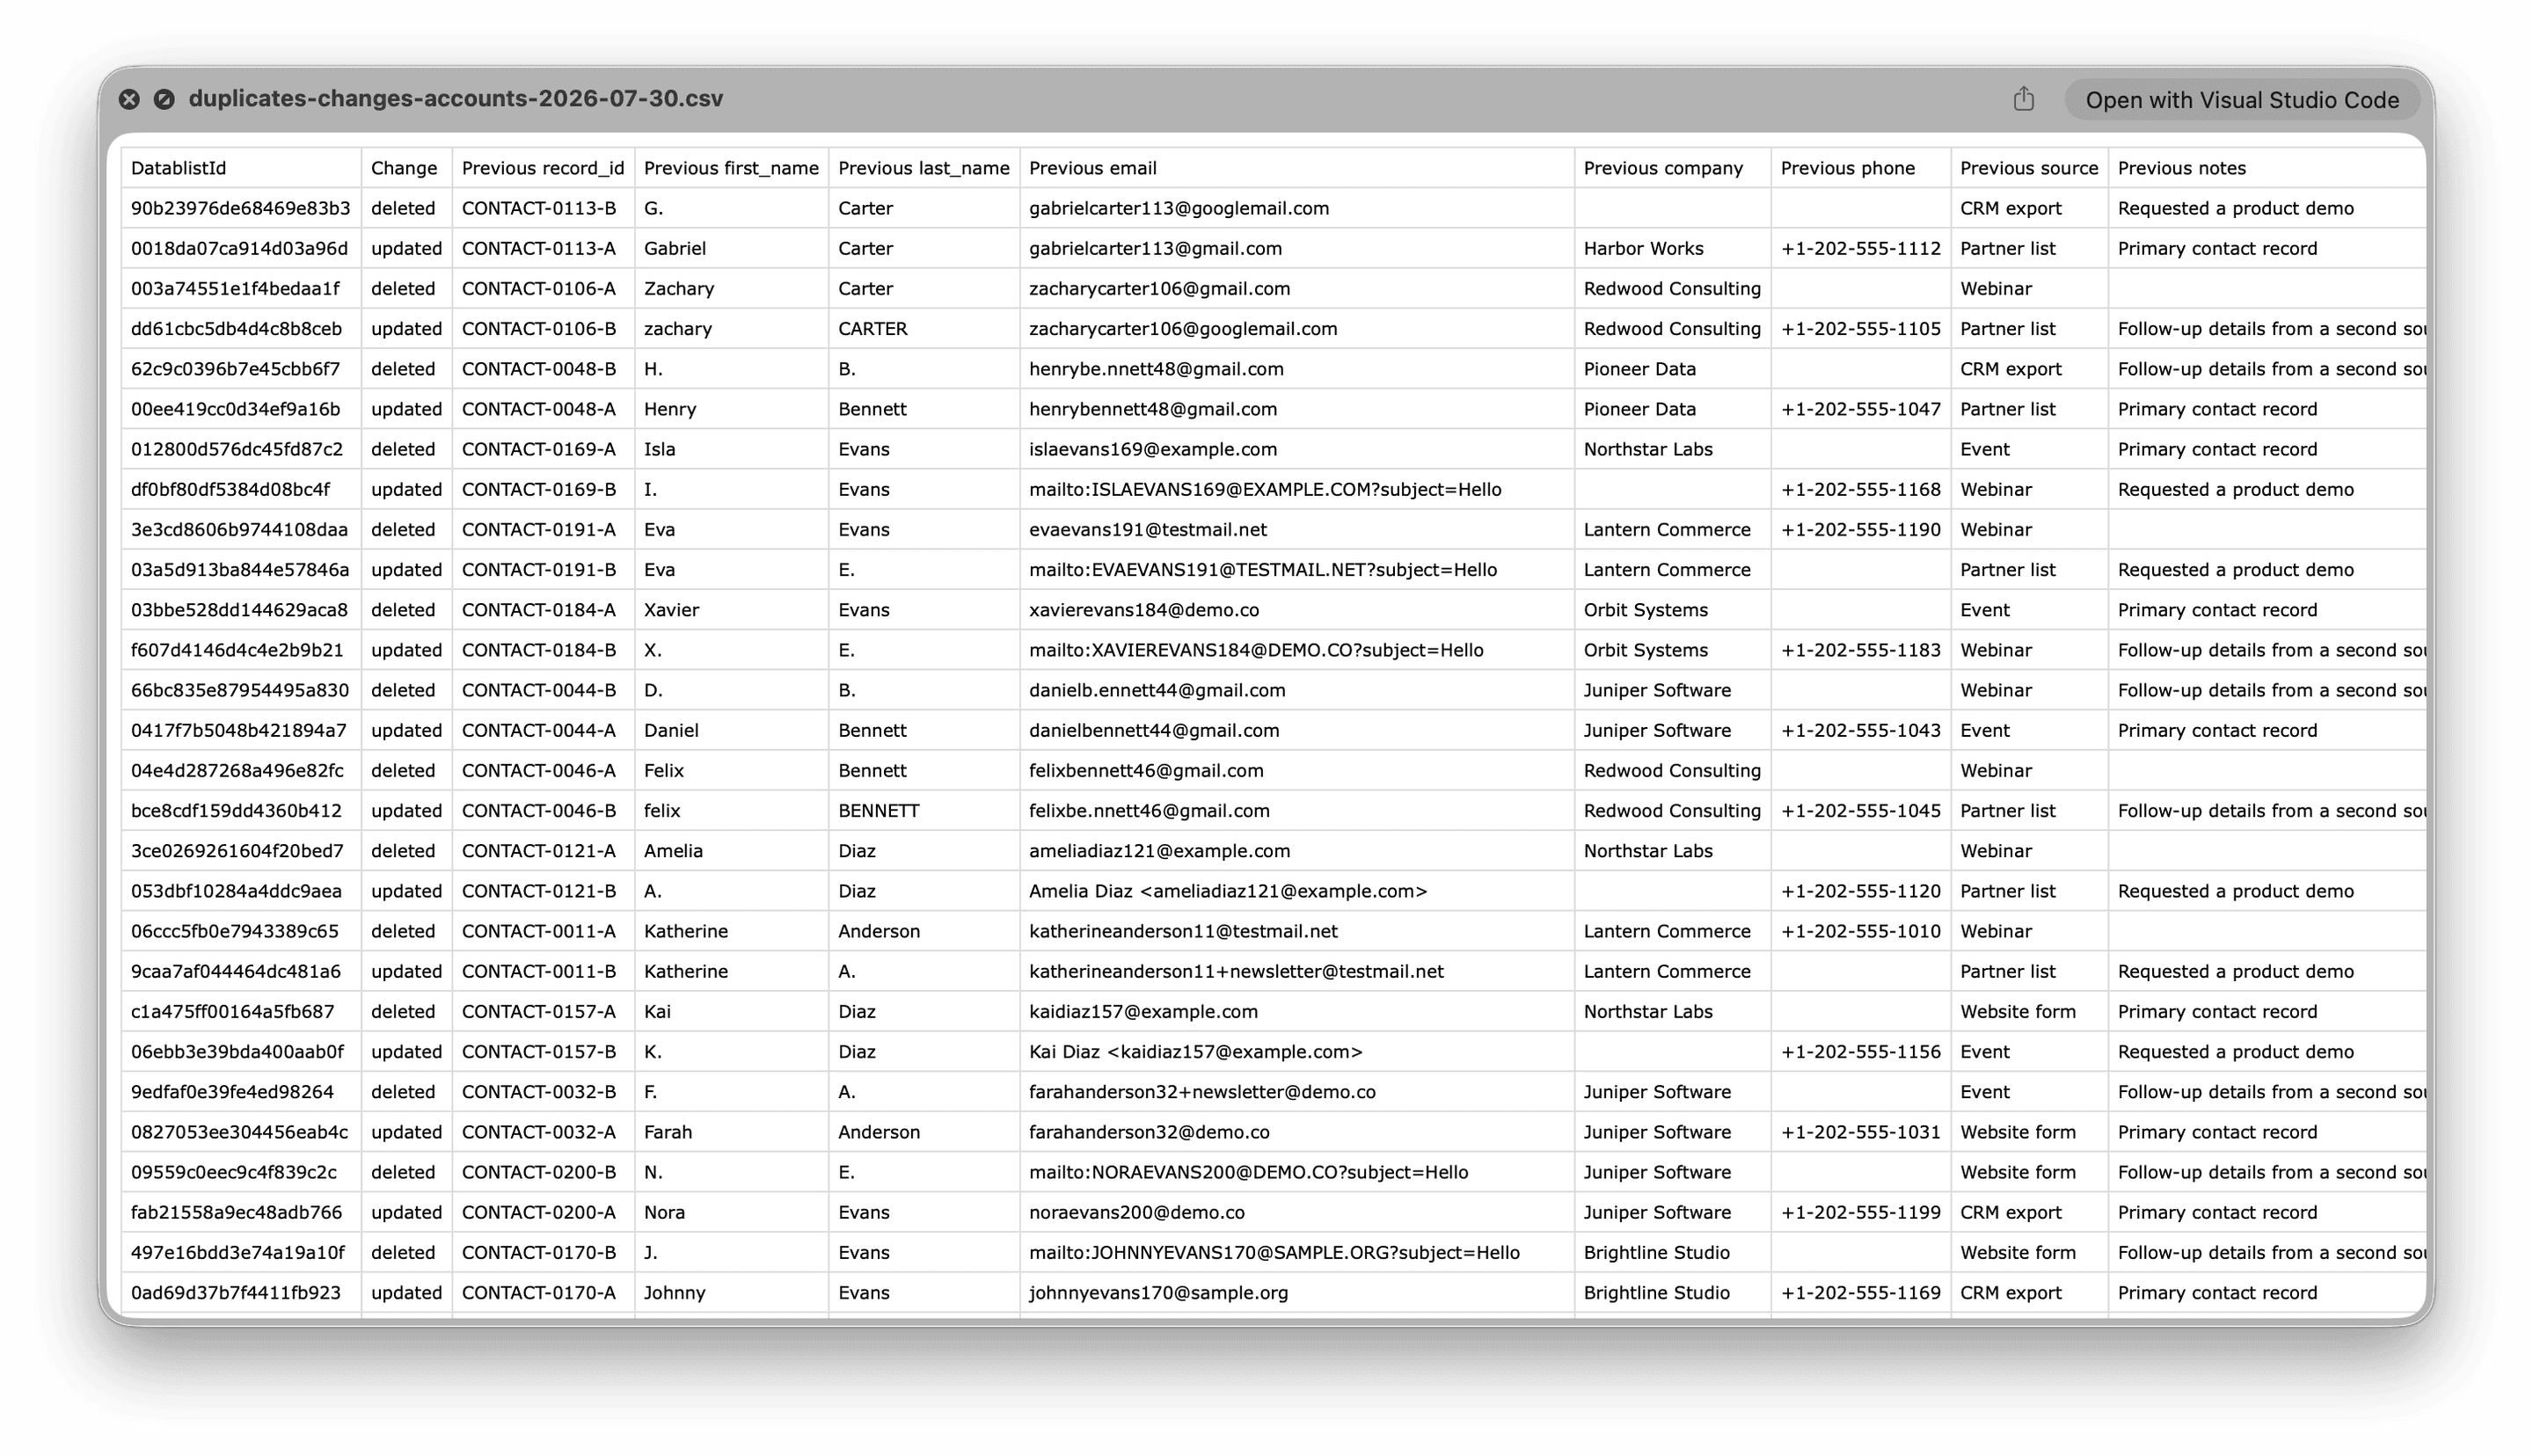
下表采用本次操作中的准确数据:
| 原始变体 | 匹配原因 | 保留的 Email | 操作 | 保留的字段 |
|---|---|---|---|---|
noraanderson40@demo.conoraanderson40+newsletter@demo.co | 删除了加号后缀 | noraanderson40+newsletter@demo.co | 合并至 CONTACT-0040-B | 完整姓名、电话、网站表单;CRM 导出及两条备注 |
victorbennett62@gmail.comvictorb.ennett62@gmail.com | 标准化了 Gmail 中的点 | victorbennett62@gmail.com | 合并至 CONTACT-0062-A | 电话、网站表单;活动及两条备注 |
gabrielcarter113@gmail.comgabrielcarter113@googlemail.com | 标准化了 Gmail 域名 | gabrielcarter113@gmail.com | 合并至 CONTACT-0113-A | 电话、合作伙伴名单;CRM 导出及 Demo 申请备注 |
camiladiaz123@testmail.netCamila Diaz <camiladiaz123@testmail.net> | 移除了显示名称包装格式 | camiladiaz123@testmail.net | 合并至 CONTACT-0123-A | 完整姓名、电话、合作伙伴名单;CRM 导出及两条备注 |
marcusevans199@testmail.netmailto:MARCUSEVANS199@TESTMAIL.NET?subject=Hello | 移除了 mailto: 包装格式并统一了大小写 | mailto:MARCUSEVANS199@TESTMAIL.NET?subject=Hello | 合并至 CONTACT-0199-B | 完整姓名、电话、Webinar;活动及两条备注 |
请注意,最终保留的值并不总是视觉上最简洁的 Email。所选主记录决定保留哪个存储值。标准化只用于匹配,不会在后台自动把所有保留值改写为统一格式。
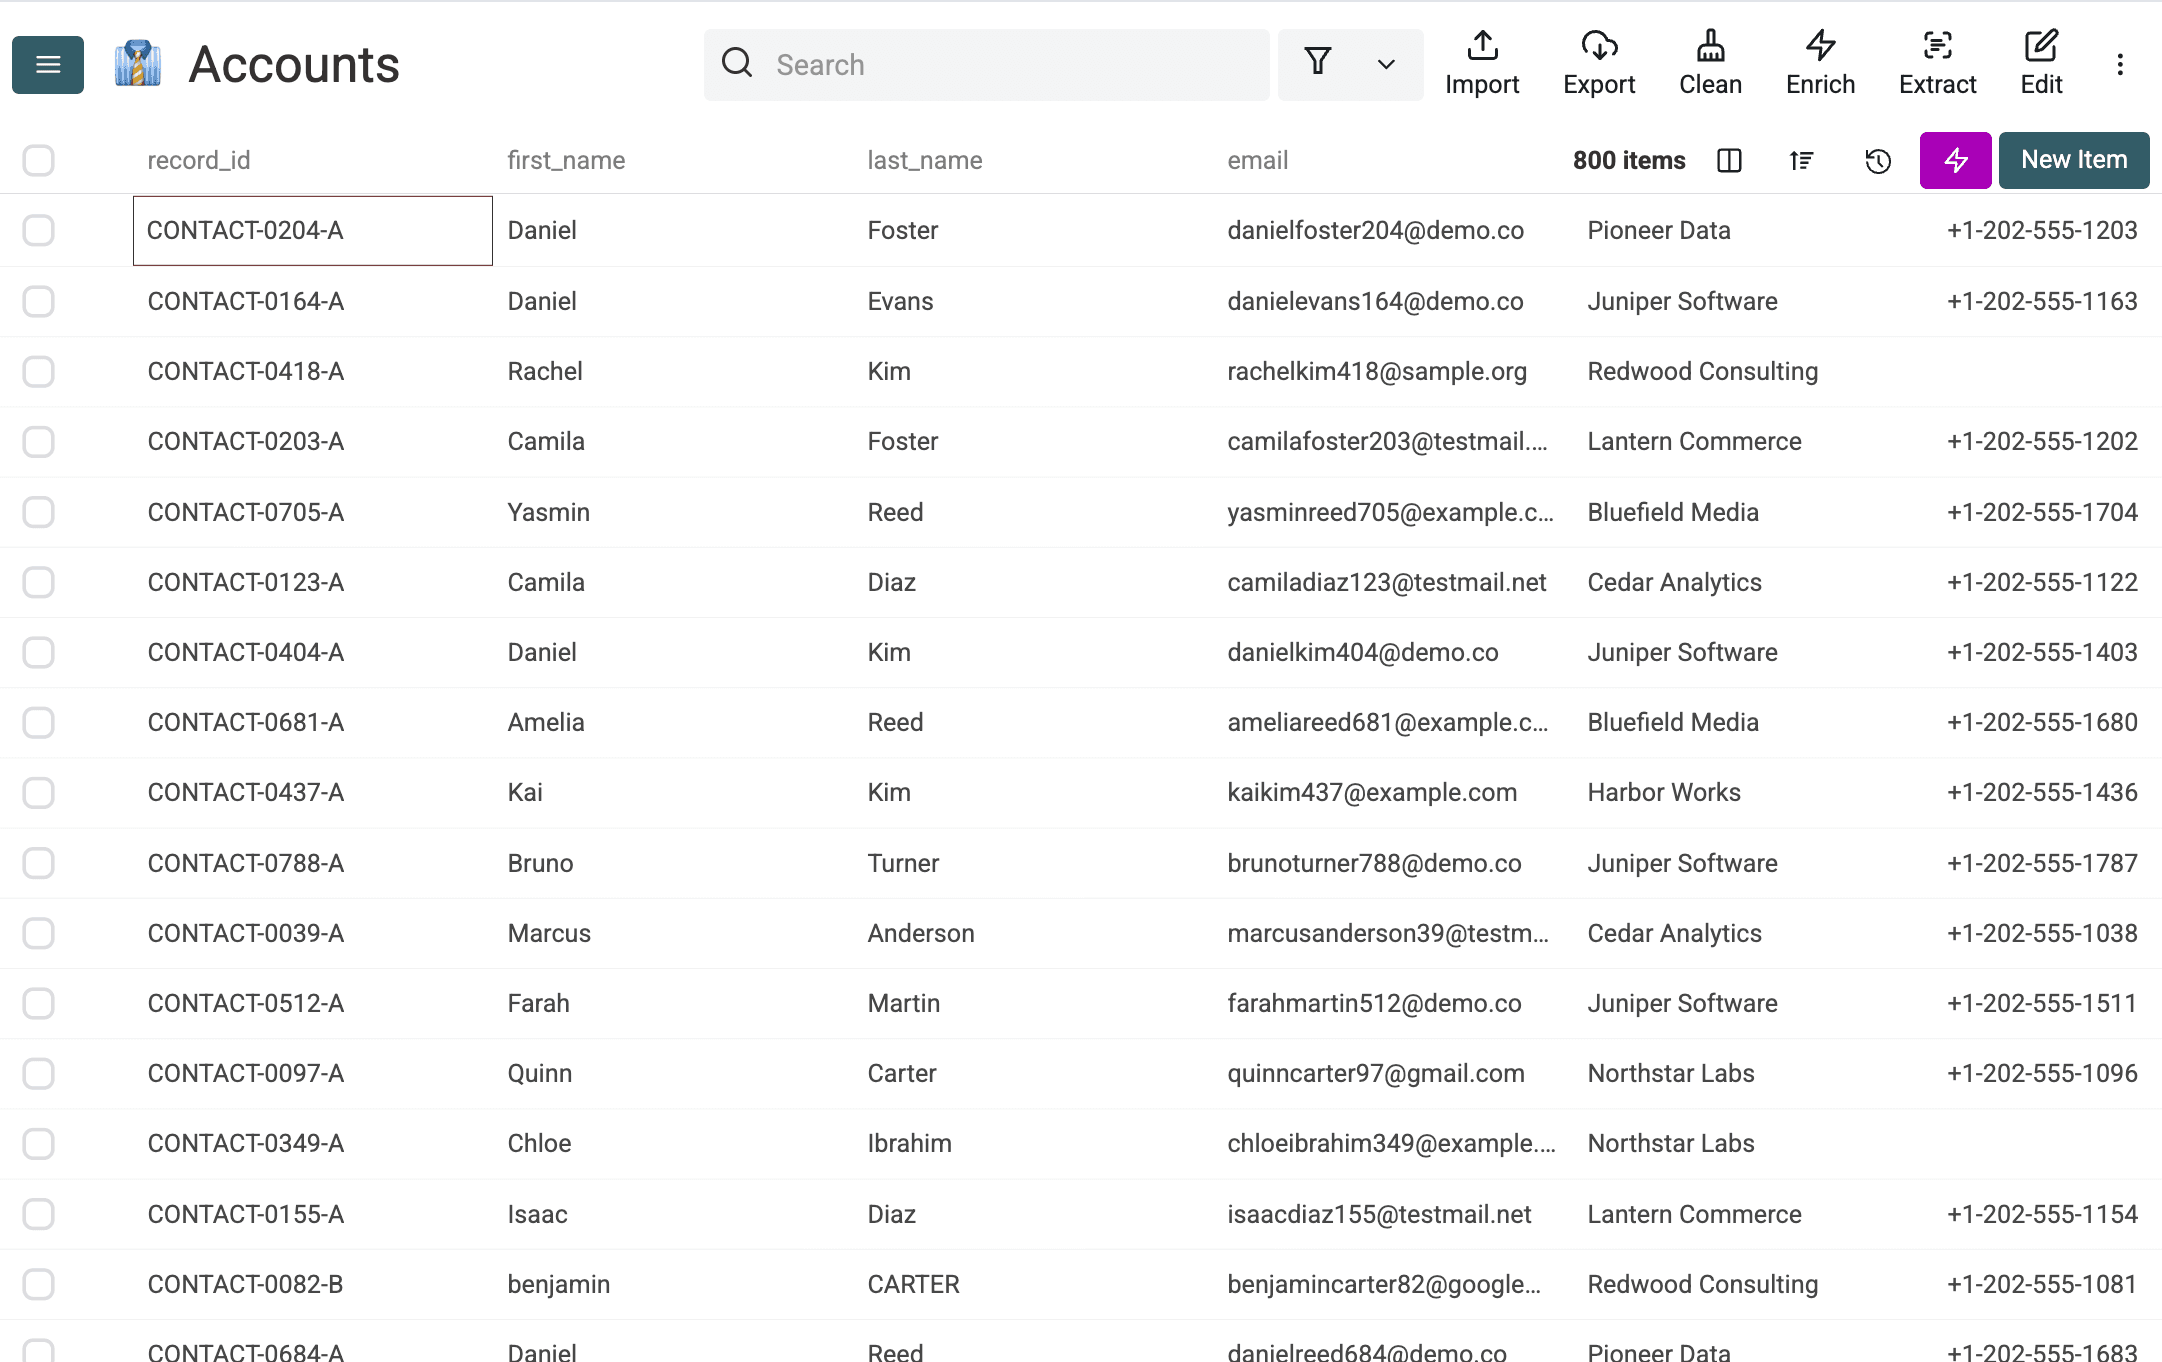
测试合并将 1,000 行减少到 800 行,因为 200 行经审核的重复记录被整合到了各自主记录中。 这一结果仅适用于专门设计的测试名单,并不代表所有 Email 格式都能达到相同的匹配率。
常见失败情况与验证清单
Smart Email matching 可以处理本次测试中的五类变体,但它不能替代人工审核。
非 Gmail 地址中的点
在非 Gmail 域名中,点仍然具有实际意义。不要默认认为 first.last@company.com 和 firstlast@company.com 属于同一个邮箱。如果有外部证据证明二者相关,请手动处理这组记录。
格式错误的值
不要把匹配结果当作有效性检查。缺少可用 @ 结构或包含内部空格的输入,不会像普通地址一样被标准化,但 processor 并不会拒绝所有格式错误的域名。两个格式错误的值仍可能被标准化为相同的比较值。请单独检查地址格式和域名,并将可疑记录排除在自动合并之外。你还可以进一步执行邮箱存在性或送达率检查。
Exact 匹配
Exact 不会移除加号后缀、Gmail 中的点、域名别名或显示名称包装格式。它会去除前后空格,并默认按小写文本进行比较。例如,在默认 Exact 设置下,NAME@example.com 和 name@example.com 会匹配;name+tag@example.com 和 name@example.com 则仍被视为不同地址。如果比较时必须保留大小写差异,请启用 Case sensitive。当别名差异很重要时,Exact 很有用,但它既不是验证步骤,也不是对原始单元格进行逐字节比较。
一个单元格中包含多个地址
本方法假设每个单元格只有一个地址。如果单元格包含多个以分隔符隔开的地址,需要先使用单独的多值工作流,再进行行级匹配。
共享邮箱
两行包含 sales@company.com 的记录可能描述不同的人。审核时应参考姓名、职位、公司和备注。我不会在未经检查的情况下批量合并角色型邮箱。
删除包含互补字段的记录
删除额外记录可能会丢失唯一的电话号码、获客来源或备注。请通过合并预览确认哪些数据会被保留。
在这个专门设计的测试中,系统找到了全部 200 个预期身份,没有出现意外的跨身份分组。不过,它并未覆盖现实中的所有地址格式、错误值或共享邮箱模式。
导出自己的名单前,请检查:
- 每个已批准的组都代表同一个身份。
- 共享邮箱和角色型邮箱均已人工审核。
- 主记录包含首选的姓名、ID 和 Email 值。
- 独有的电话、公司、来源和备注值在合并后仍然保留。
- 初始行数减去删除行数等于最终行数。
- 抽样检查覆盖名单中出现的每一种标准化类型。
- 剩余重复组数量符合预期。
📌 核对行数
合并后,
初始行数 - 删除行数 = 最终行数是最快的完整性检查方式。
继续清理 Email 名单
去重可以解决身份重复问题,但不会检查邮箱是否真实存在、是否来自一次性邮箱服务商、是否已退订或能否正常送达。
我更倾向于先解决重复身份问题。这样,后续检查只需处理保留下来的联系人,不必重复处理同一个人的多个版本。合并通过验证清单后,请继续清理 Email 名单,然后打开 Export,选择 CSV 或 Excel。
在 Datablist 中为名单去重
将联系人文件导入 Datablist,运行能够识别 Email 变体的重复项检查,审核建议分组,合并有用的数据,然后导出清理后的名单。