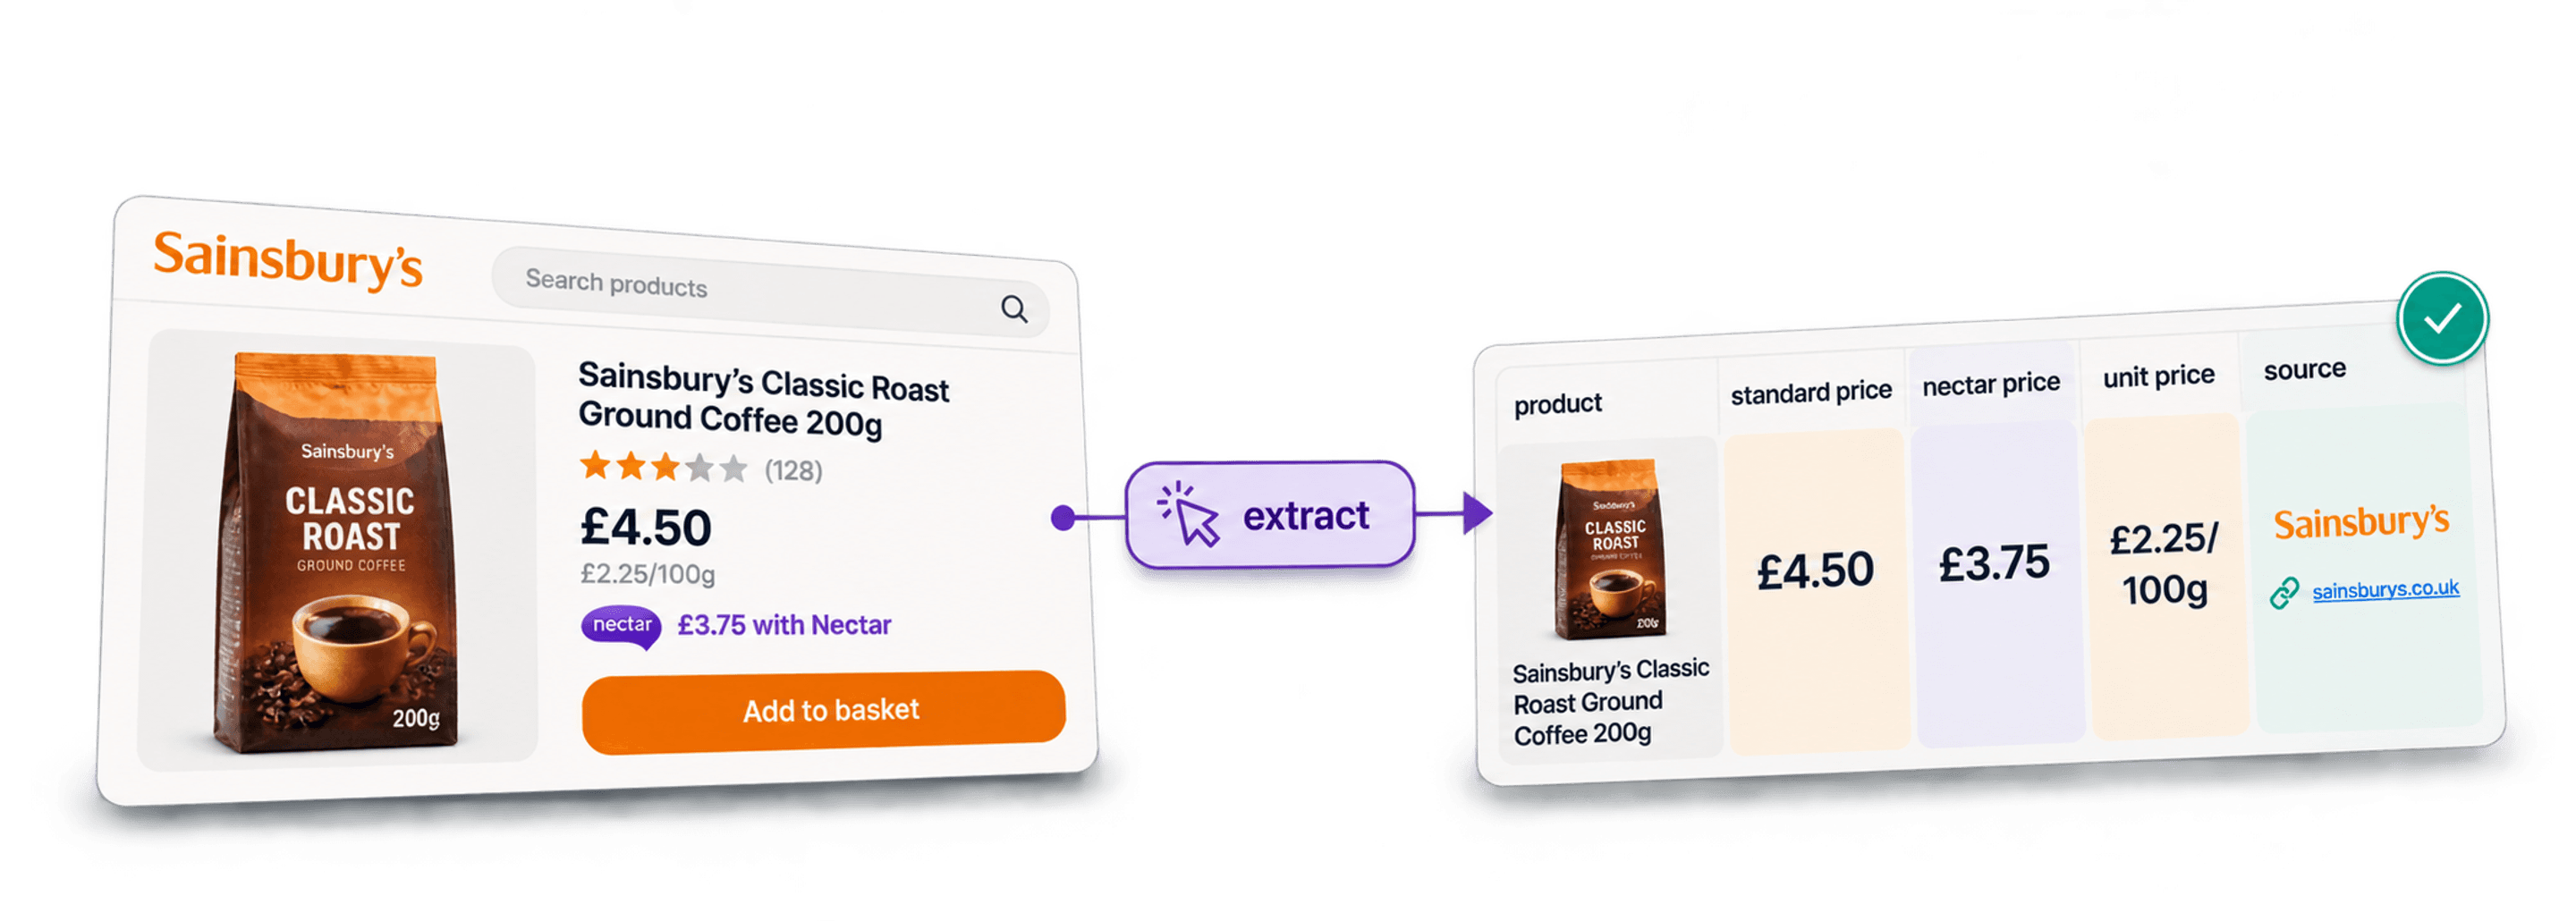
无需编写代码,只需向 Datablist 的 AI Scraping Agent 提供一个品类 URL,说明需要提取的字段,并先用单页进行测试,再扩大抓取范围。最终应得到一张包含商品 URL 和清晰价格标签的表格,方便导出数据,或与之后保存的快照进行对比。
我建议将标准价格、Nectar 会员价和单位价格分别放在不同列中。如果把所有看似优惠的数值都当作促销价,比较结果就会失真:会员优惠与每公斤价格所反映的信息完全不同。
📌 工作流程概览
**输入:**一个品类 URL 和一段商品提取 prompt。
**输出:**商品名称、URL、标准价格、Nectar 会员价、单位价格、促销说明和来源列表页 URL。
**扩大抓取前:**将第一页结果与网站内容进行核对,检查分页,并记录消耗的 credits。
**用于监控时:**每次运行都保留带日期的快照,让重复出现的商品能够保留历史价格。
本指南涵盖的内容
选择规模可控的商品快照
先选择一个便于人工检查的品类,例如 Sainsbury's 鱼类和海鲜列表页。商品卡片可能同时显示标准价格、Nectar 优惠、单位价格和优惠条件,因此提取指令必须明确区分这些字段。
为测试运行预留 credits
AI scraping 会消耗 credits,用于模型处理和网页浏览。先进行一次小规模抓取,就能在覆盖多个品类前检查输出和成本。不要根据其他零售商的案例,直接假设每件商品的成本是固定的。
扩大抓取前先定义输出
Retail Product Scraper 模板提供了初始 prompt 和输出字段。请根据 Sainsbury's 的价格结构调整这些字段,然后检查单页样本。所需时间取决于页面内容和 Agent 的研究工作量;设置页数上限并不代表数据一定完整。
页面变化后重新检查结果
AI scraping 无需为每个字段设置固定的 CSS selector,也能理解页面内容。不过,它仍可能漏掉某件商品、混淆价格标签,或遇到访问限制。当页面布局或促销格式发生变化时,请重新检查样本结果。
使用 Datablist AI Agent 抓取 Sainsbury's 商品
AI Scraping Agent 会接收 URL 和指令,再按照你配置的输出字段返回结构化记录。
什么是 Datablist AI Scraping Agent?
可以使用 Retail Product Scraper 模板作为起点。目前,该模板已配置 HTML rendering 和 pagination,并使用 GPT-5 mini。模板可能随时调整,因此请检查实际加载的设置。无论选择哪个模型,都不能省略输出验证。
从品类页或品牌页开始
建议先选择范围较小的品类,而不是首页或宽泛的搜索结果页。这样,你可以获得一个边界明确的商品集合,并将其与返回的数据行逐一比较。大型页面可能被截断,也可能难以人工检查;必要时,应将宽泛品类拆分为多个较小品类。
请在快照中保留列表页 URL,以及页面上可见的地区或配送信息。结果只能反映 Agent 在该次浏览会话中能够读取的内容,并不能证明完整覆盖了全部商品,也不能代表每个地址下的库存情况。
可以从 Sainsbury's 提取哪些数据?
若要建立价格快照,请配置以下输出:
- Product Name 和 **Product URL:**用于识别列表中的商品及其包装规格。
- **Standard Price:**页面显示的 GBP 商品价格,不包含单独标注的会员优惠价。
- **Nectar Price:**页面单独标注的 Nectar 会员价;如果没有显示,则留空。
- **Unit Price:**包含计量单位的对比价格,例如 £/kg。
- **Promotion Text:**商品旁显示的优惠条件或活动日期。
- **Availability:**仅提取明确显示的库存或可购状态标签;不要根据商品卡片是否存在来推断库存。
- **Listing URL:**读取该条记录时所在的品类页或列表页。
两个商品价格字段使用 Number 输出,Unit Price 和 Promotion Text 使用 Text 输出。缺失的数字价格应保持为空。通用模板中的 Sale Price 字段不足以描述所有优惠类型;请针对本 prompt 重命名该字段并更新说明。
逐步抓取 Sainsbury's 商品
准备一个品类 URL,并确定需要的字段。首次运行只抓取一页,以便轻松核对结果。
第 1 步:注册并创建 Collection
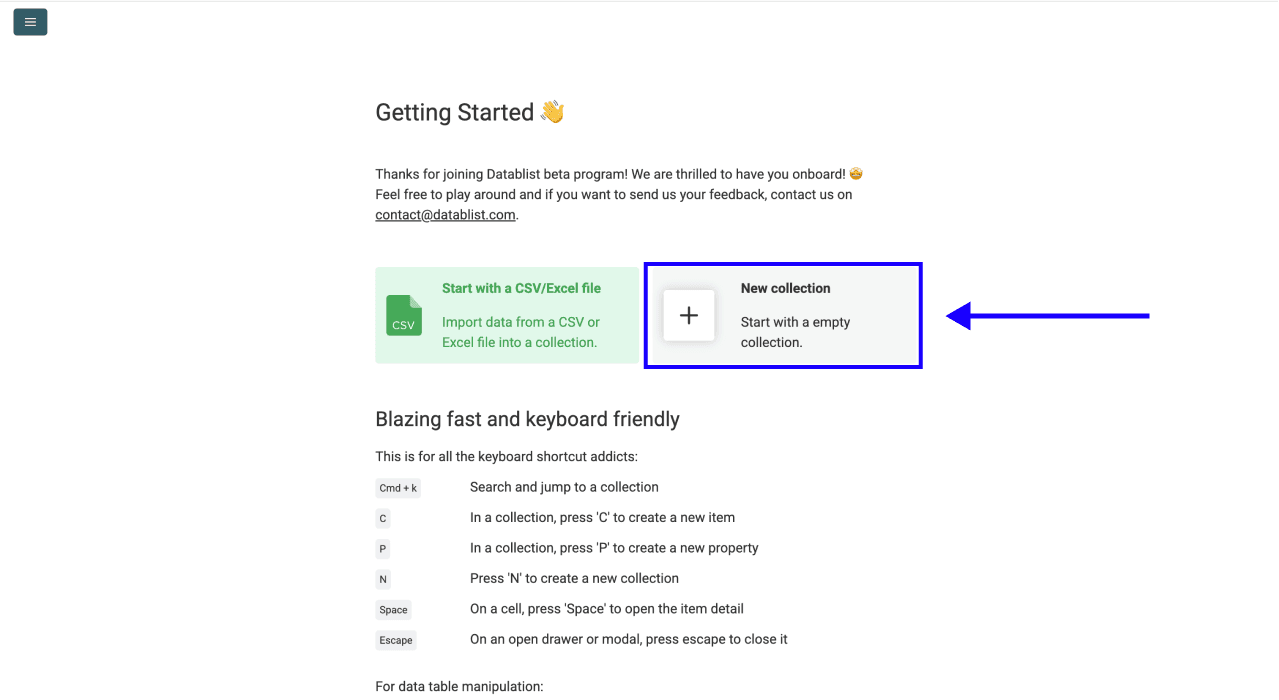
注册 Datablist.com,然后创建一个 New Collection。
第 2 步:进入 AI Scraping Agent
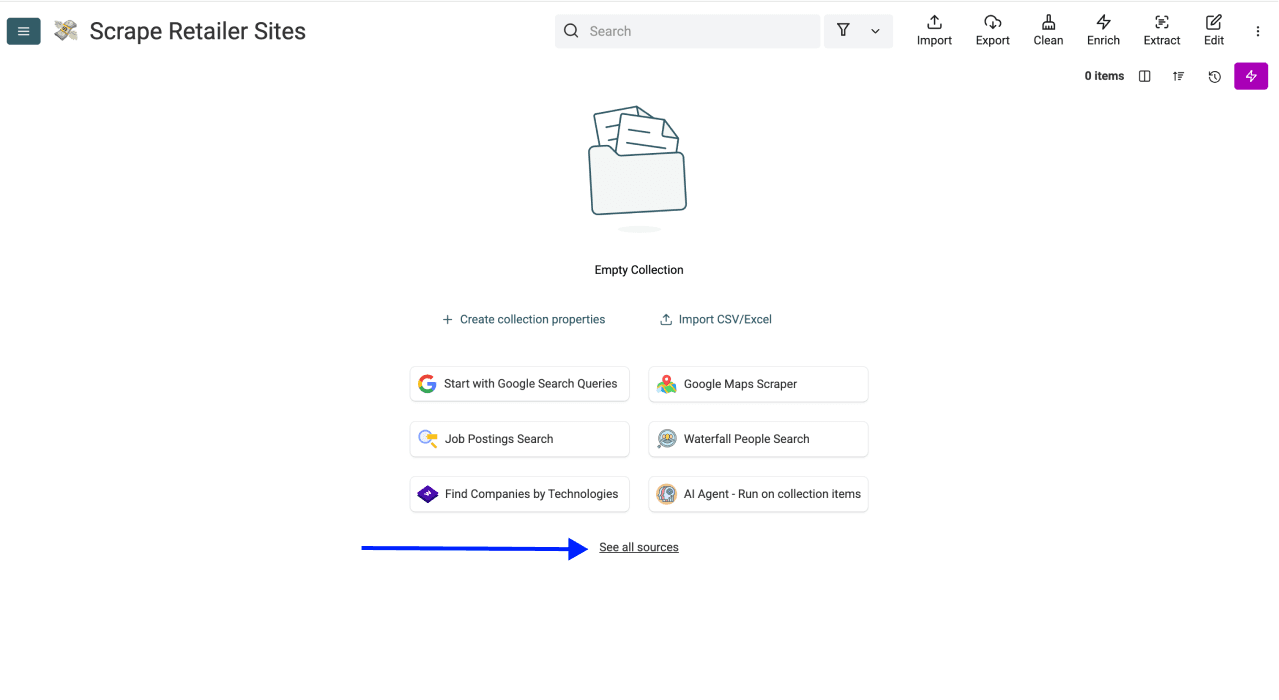
点击 See all sources,然后选择 AI Scraping Agent (Site Scraper)。
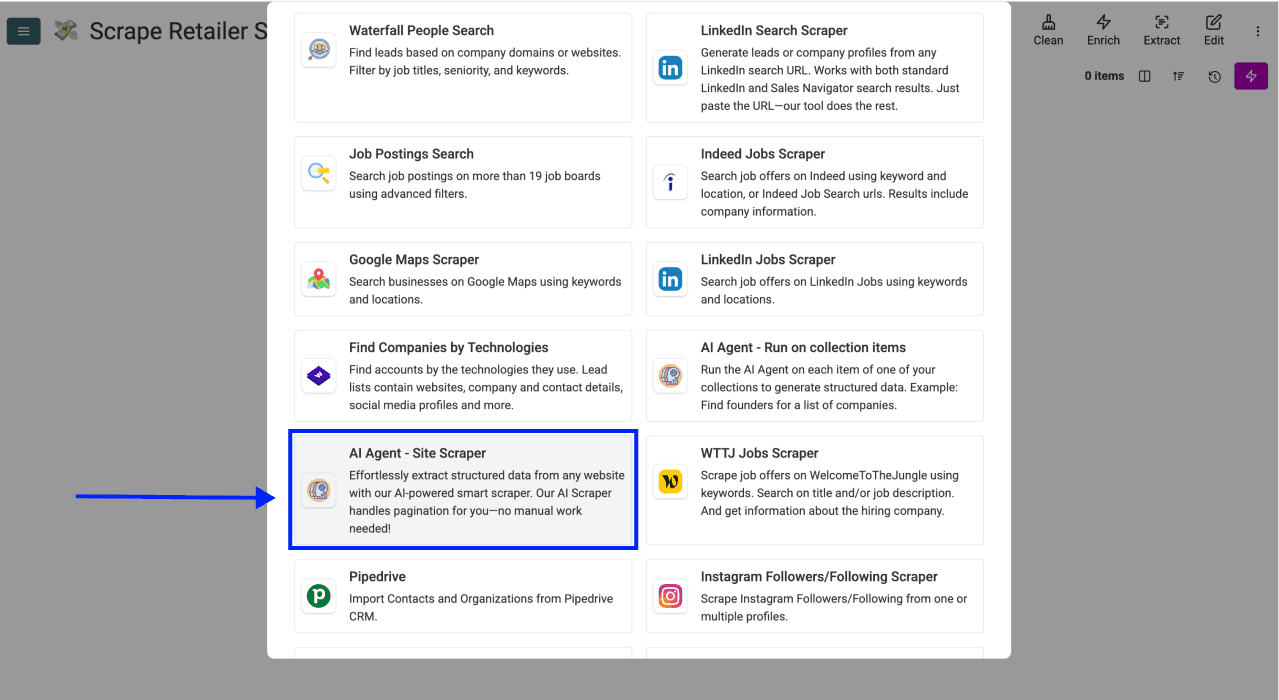
配置界面包含 URL、prompt、pagination 和高级设置。
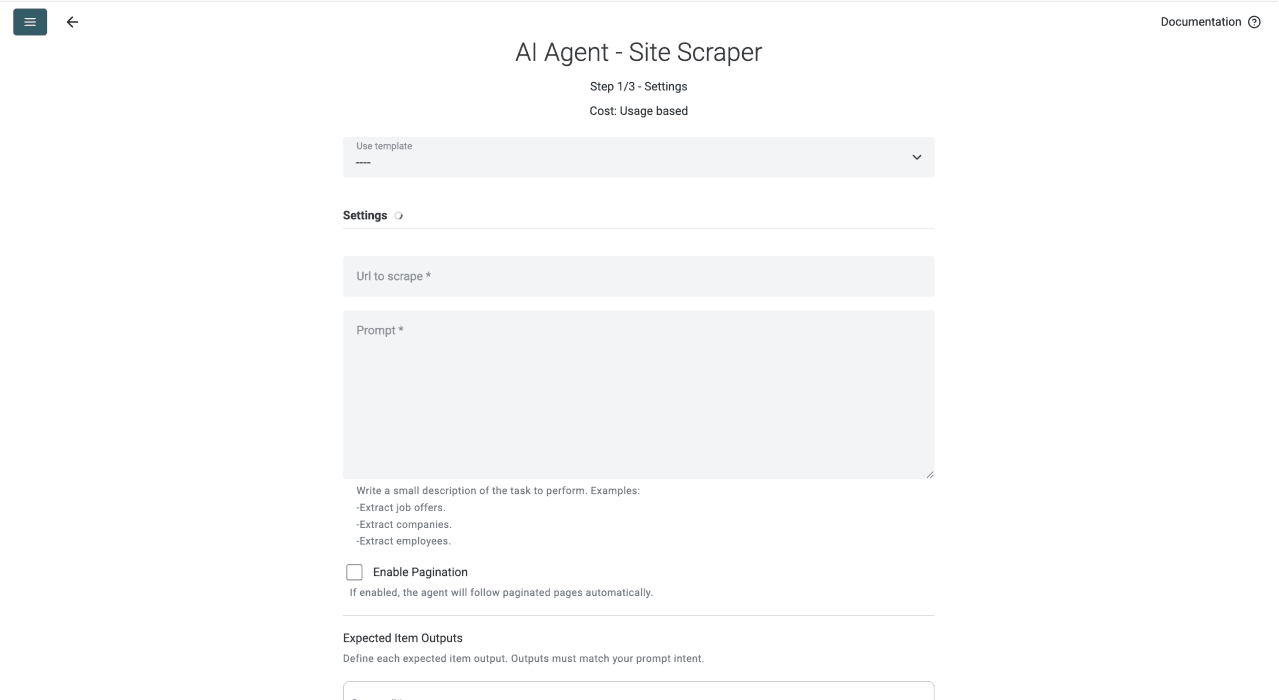
第 3 步:选择 Retail Product Scraper 模板并粘贴 Sainsbury's URL
- 加载 Retail Product Scraper 模板。
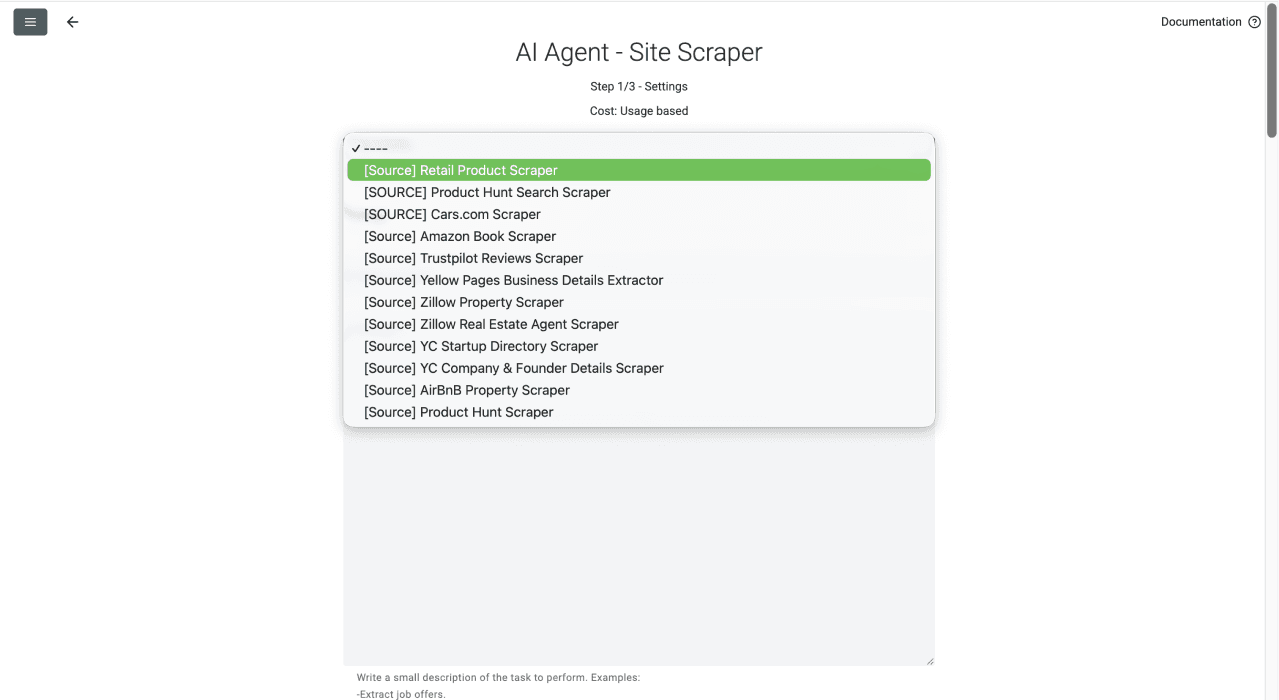
- 粘贴当前有效的品类 URL,例如
https://www.sainsburys.co.uk/groceries/browse/frozen/fish-and-seafood/c:1019924。请从第一页开始,不要使用之前保存的第二页链接。
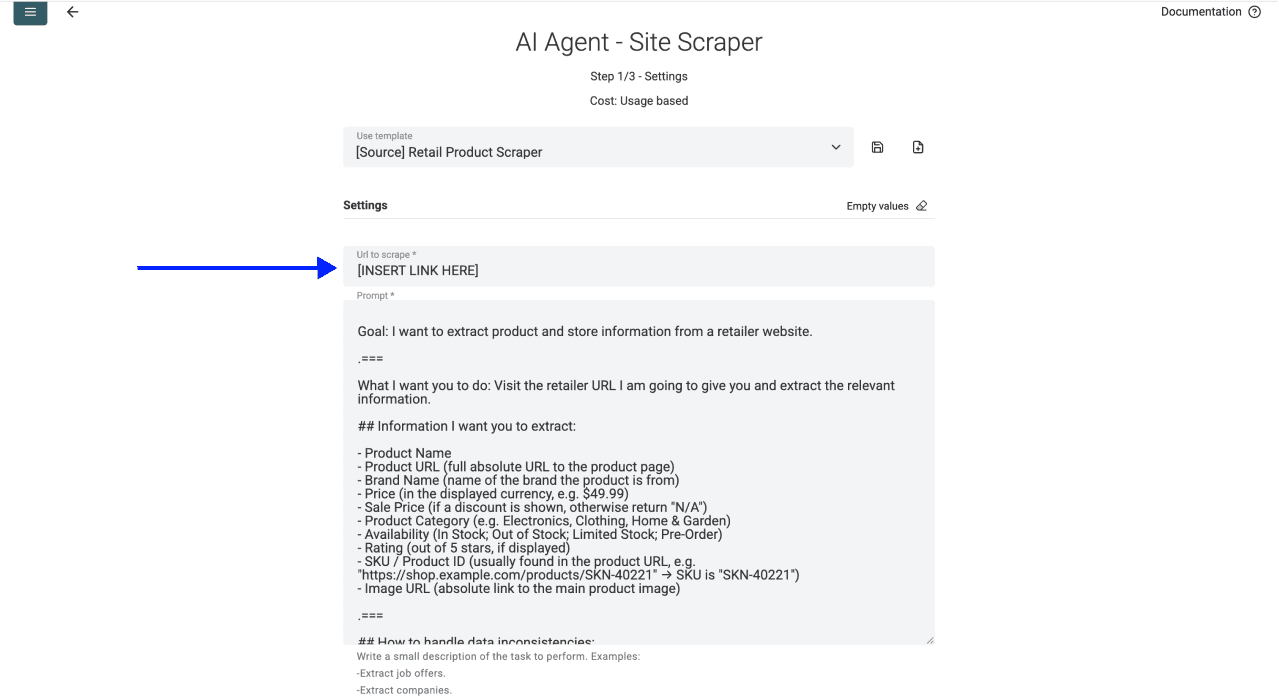
- 用下面的 prompt 替换通用指令。URL 应填入 source 的 URL 字段,而 prompt 用于定义提取规则。
从提供的 Sainsbury's 商品列表页中,为每张商品卡片提取一条记录。请同时读取商品标签和价格,确保每个数值都归属于正确的商品。
返回 Product Name、Product URL、Standard Price、Nectar Price、Unit Price、Promotion Text、Availability 和 Listing URL。URL 必须是完整的绝对地址。Standard Price 和 Nectar Price 必须是纯数字 GBP 金额,不包含货币符号。Unit Price 应按页面显示的原文保留,并包含计量单位。
单独标注的 Nectar 价格必须写入 Nectar Price。不得用每公斤、每升或每件的对比价格替代商品价格。将优惠条件复制到 Promotion Text;如果多件优惠含义不明确,不要自行计算单件价格。缺失值保持为空。不得推断库存或虚构价格。
排除横幅、推荐内容和非商品内容。只有在启用 pagination 时才跟随下一页链接。不要把拒绝访问、登录或验证页面报告为空商品品类。为每条记录保留实际使用的准确 Listing URL。
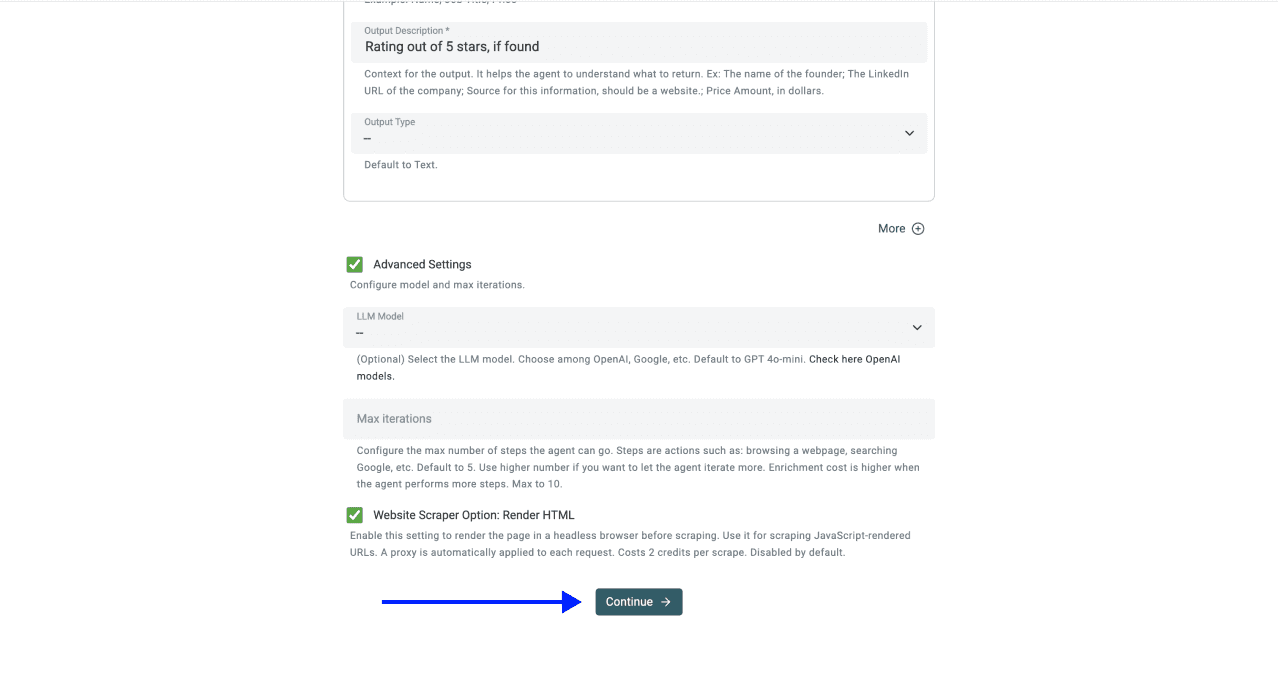
- 开启 Enable Pagination,并将测试的页数上限设为
1。检查样本后,只有在确认可以读取下一页品类数据时,才提高 Max Pages。
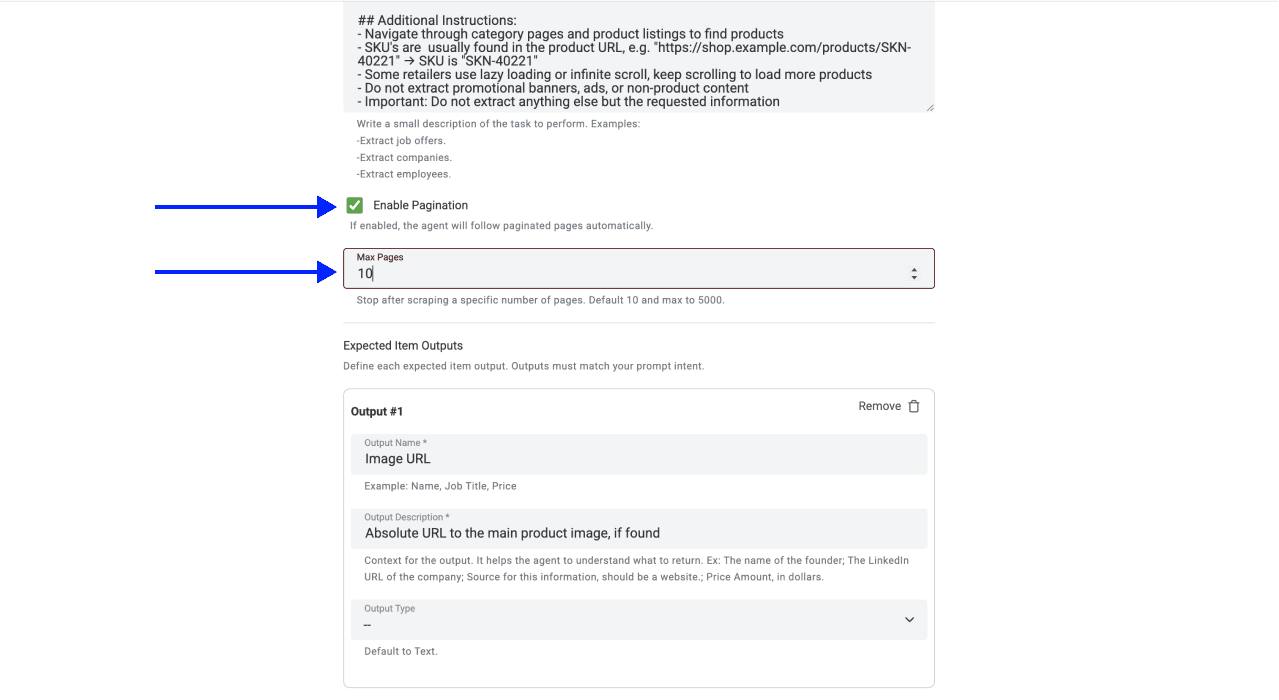
如果列表页需要 JavaScript 渲染,请保持启用 Website Scraper Option: Render HTML。在高级设置中检查模型和 Max iterations,然后点击 Continue。提高迭代次数上限可以让 Agent 进行更多研究,也可能增加成本,但并不保证能抓取更多商品。
第 4 步:配置输出字段
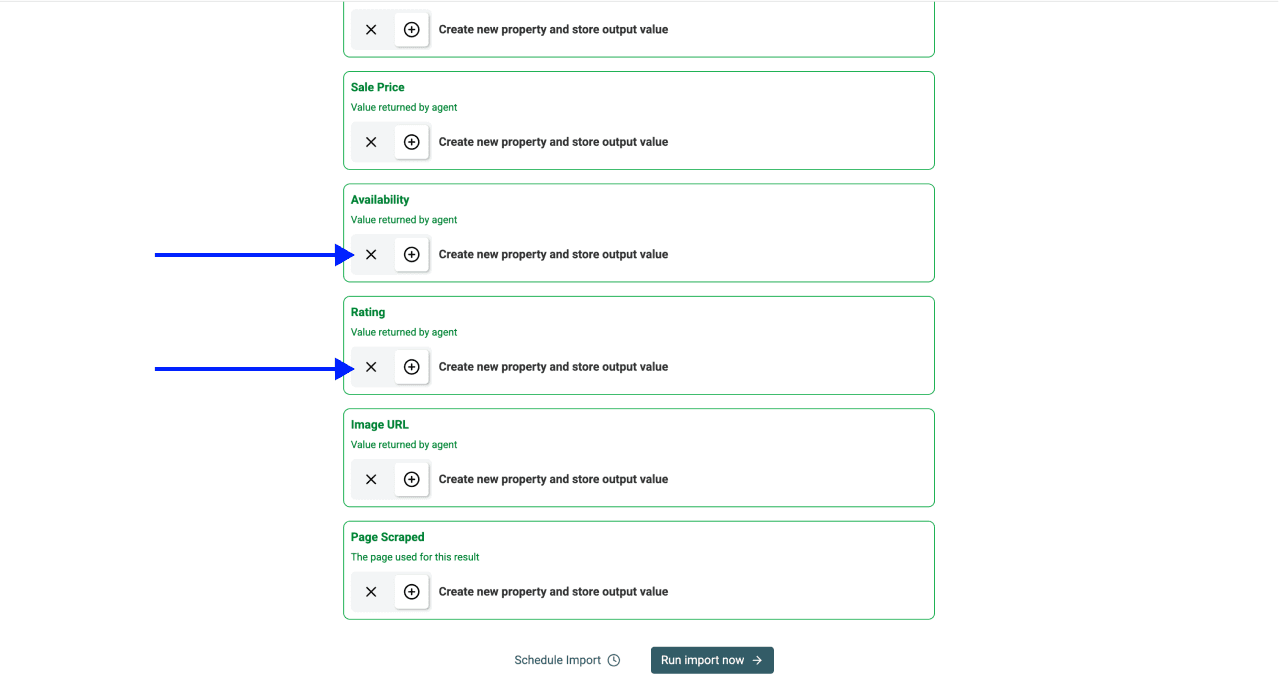
确保输出名称和说明与 prompt 一致。如果缺少 Nectar Price、Unit Price、Promotion Text 和 Listing URL,请将其添加。应将 Sale Price 重命名为 Nectar Price,不要保留相互冲突的字段说明;两个商品价格都应使用 Number 输出。
使用 X Icons 删除不需要的输出。表格中每个需要的字段都必须对应一个 output property。
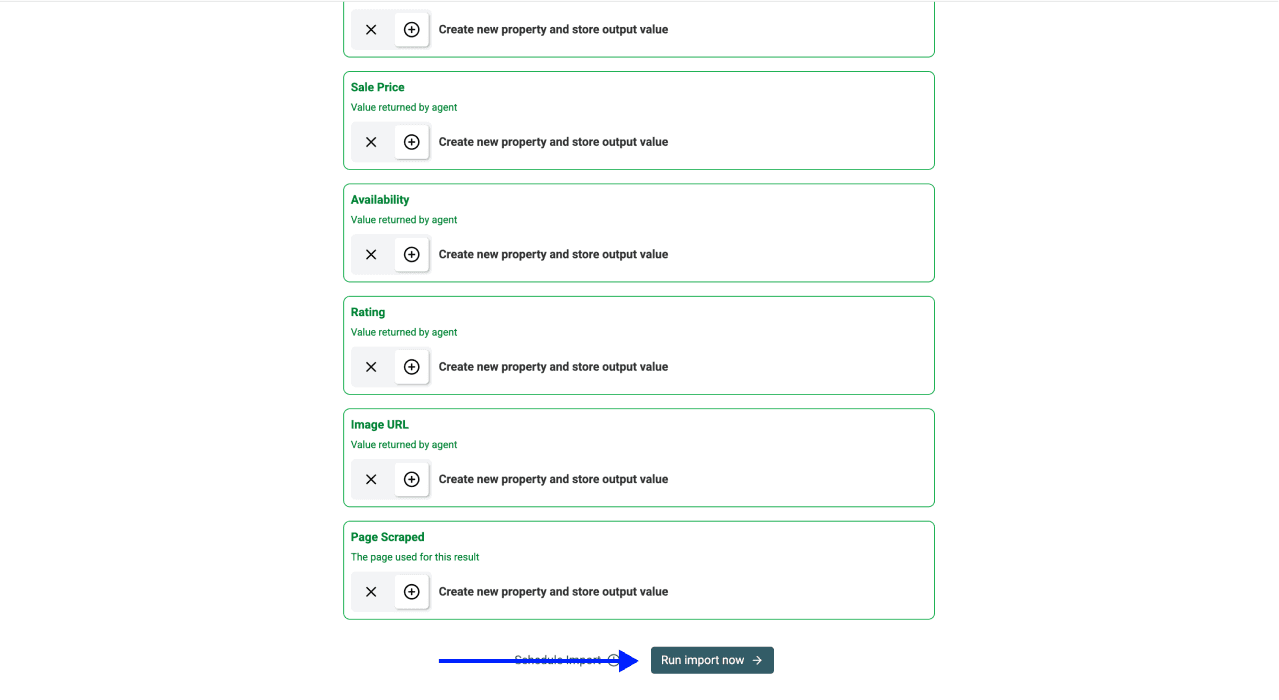
第 5 步:运行抓取
点击 Run Import Now 开始测试。
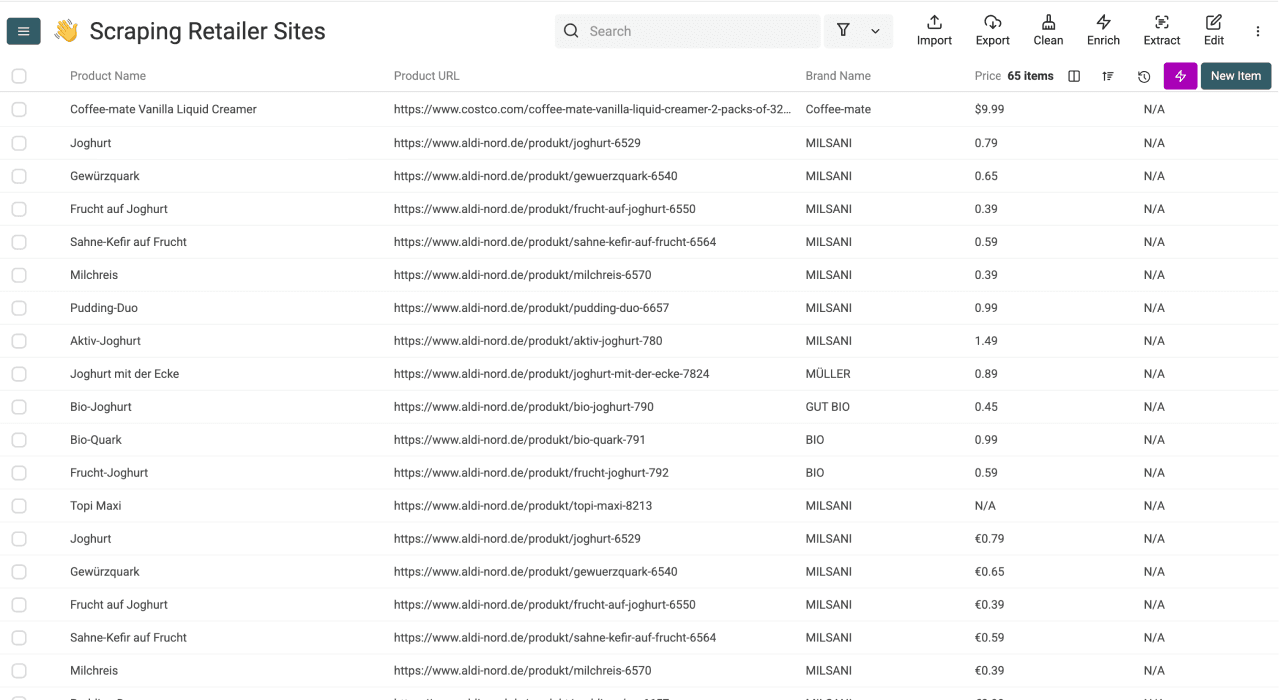
下方截图仅用于展示输出表格的布局,并不能证明这是一次经过实测的 Sainsbury's 抓取结果。
扩大运行范围前:
- 将多行数据与对应商品卡片进行比较,其中至少包括一件有 Nectar 优惠的商品和一件没有优惠的商品。
- 检查标准价格和单位价格是否被调换,并确认缺少 Nectar 价格时字段保持为空。
- 核对包装规格和 URL,再检查本次运行中是否存在重复的 Product URL。
- 将返回的数据行与页面可见列表进行比较;提高 pagination 上限后,还应检查后续页面。
- 记录 credits 消耗,以及被阻止或未完整抓取的页面。不要把部分结果当成完整品类数据。
使用 Datablist 的导出选项保存 CSV 快照。价格字段应始终与来源 URL 一起保留。
重复运行时保留价格历史
唯一的 Product URL 可以识别重复商品,但如果在同一个长期使用的 Collection 中阻止 URL 重复,之后的价格观察记录可能会被丢弃。这种做法无法生成价格历史。
建议将每次运行保存为单独的带日期 Collection 或导出文件。在与其他快照比较前,应添加实际的抓取时间戳。通过 Product URL 匹配记录,并比较同类字段:标准价格与标准价格对比,Nectar 价格与 Nectar 价格对比。同时保留包装规格和单位价格,以发现商品规格变化。
如果需要合并多个快照,请同时保留 Product URL 和抓取时间戳。只删除同一个快照内的重复商品;不同日期中同一商品的数据行必须保留。
Datablist AI Agent 也能抓取其他零售网站
你可以调整模板来抓取其他零售商,但需要分别检查各网站的标签和 pagination。以下指南提供了可供参考的工作流程:
核心要点
- 从一个品类和一页样本开始。
- 在 prompt 和输出字段中分别设置标准价格、Nectar 价格和单位价格。
- 提高 pagination 上限前,先检查数据完整性和成本。
- 比较不同时期的价格时,保留带日期的快照。
Sainsbury's 商品抓取常见问题
抓取 Sainsbury's 商品需要多少费用?
成本取决于模型用量和网页浏览工作,包括页面渲染以及处理的页数。先检查单页测试消耗的 credits,再估算较大规模运行的费用。详情请参阅 Datablist credits 的工作方式。
抓取完整的 Sainsbury's 商品目录需要多久?
仅凭一次品类测试,无法确定完整商品目录的运行时间或覆盖率。先明确需要哪些品类,逐一检查 pagination,并记录已完成和未完成的页面。不同品类可能包含同一商品,因此在统计覆盖率前,应在每个带日期的快照内进行去重。
为什么应抓取 Sainsbury's 品类页而不是全部商品?
范围较小的品类能够提供一组便于人工检查的商品。大型列表可能超出 Agent 单次可读取的范围。请将其拆分为更小的品类并检查输出,不要默认所有商品都已被抓取。
可以抓取 Sainsbury's 促销价和优惠信息吗?
可以。在标准价格之外,单独提取明确标注的 Nectar 价格和 Promotion Text。比较价格前,请先检查适用条件。单位价格是一种对比指标;附带条件的会员优惠或多件优惠不应在没有说明的情况下取代商品标准价格。
在英国抓取 Sainsbury's 数据合法吗?
本工作流程并不能证明你有权收集或重复使用这些数据。运行前,请阅读 Sainsbury's 最新条款,并确认数据的预期用途。页面公开可见或成功提取数据,本身并不能回答是否合法的问题。
Sainsbury's 会屏蔽 Scraper 吗?
运行过程中可能遇到访问限制,或页面没有可读取的商品内容。重试前应先检查失败原因。HTML rendering 有助于处理 JavaScript 内容,但不能保证能够访问页面。不要把被屏蔽的页面统计为商品数量为零的品类。
可以定期抓取数据来监控 Sainsbury's 价格吗?
在自动执行重复抓取前,先验证一个快照,并确定如何保存每次运行及其抓取时间戳。请参阅上文的价格历史方法。如果只根据 Product URL 防止重复,则无法保留不同运行之间不断变化的价格。
不会编程也能抓取 Sainsbury's 商品吗?
可以。加载模板,输入 URL,调整 prompt 和输出字段,然后运行一个小规模样本即可。整个配置过程无需编写代码,但仍需人工检查结果。
哪些 Sainsbury's 品类最适合抓取?
从一个方便人工检查的具体食品杂货品类开始。请使用网站当前提供的 URL,不要使用旧的分页链接。将相同设置用于其他品类前,应先检查页面上的可见字段和访问条件。
AI Agent 能自动处理 Sainsbury's 分页吗?
开启 Enable Pagination 后,source 可以跟随找到的下一页链接,直至达到 Max Pages。目前默认值为 10,最大可设置为 5,000。这些只是配置上限,并不保证每一页都能访问,也不保证返回所有商品。
什么是 AI scraping?
AI scraping使用语言模型,将网页内容转换为 prompt 中指定的字段。在这个工作流程中,价格标签和商品身份识别规则与 URL 同样重要。
AI scraping 与传统网页抓取有什么区别?
传统数据提取通常使用固定 selector。AI 数据提取则根据指令理解页面内容,因此更容易调整需要采集的字段。两种方法都需要能够访问页面,也都需要检查缺失值或被错误理解的数据。