
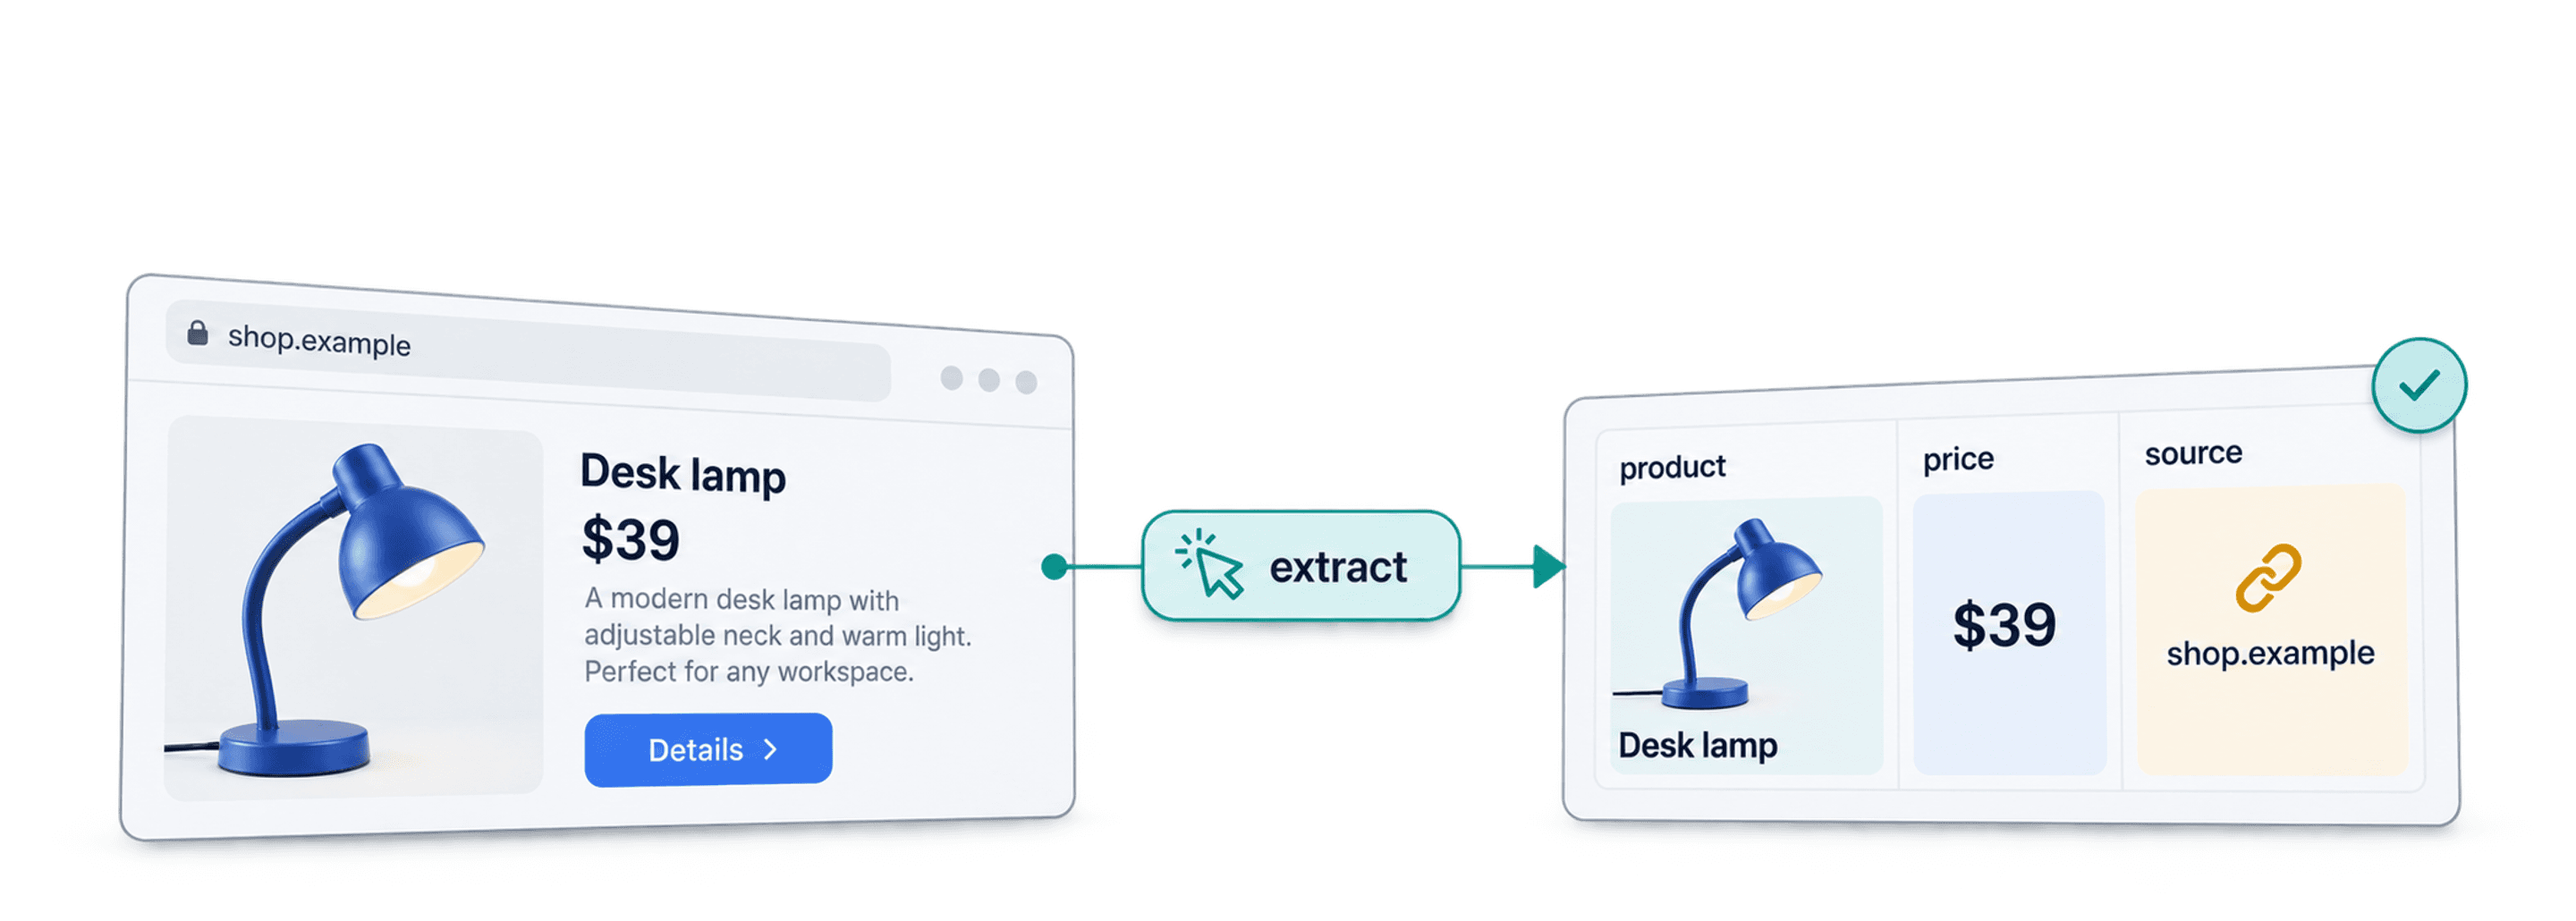
AI 网页抓取使用 AI 模型读取网站内容,并返回指定字段,例如产品名称、价格和来源 URL。你无需为每个字段编写 CSS selector,只需描述所需信息,再将输出映射到不同列。但结果仍需检查:模型可能漏掉字段、混淆两个页面,或返回缺乏来源依据的值。
例如,向 Agent 提供一个产品页面,并要求返回 产品名称、当前价格 和 产品 URL。理想的输出是包含这三个字段的一行数据,而且价格已与来源页面核对。如果页面上没有可见价格,该字段应留空,而不是让模型猜测。本指南将说明 AI 数据提取与基于规则的抓取有何不同、该选择哪种工作流,以及使用数据前需要核查什么。
本指南涵盖的内容
什么是 AI 网页抓取?
下面这些术语描述的是同一种广义方法。无论使用哪种叫法,工具都需要能够访问来源内容,并获得清晰的输出字段要求。
AI Web Scraping、AI Scraping 与 AI Data Scraping
AI web scraping = AI scraping = AI data scraping
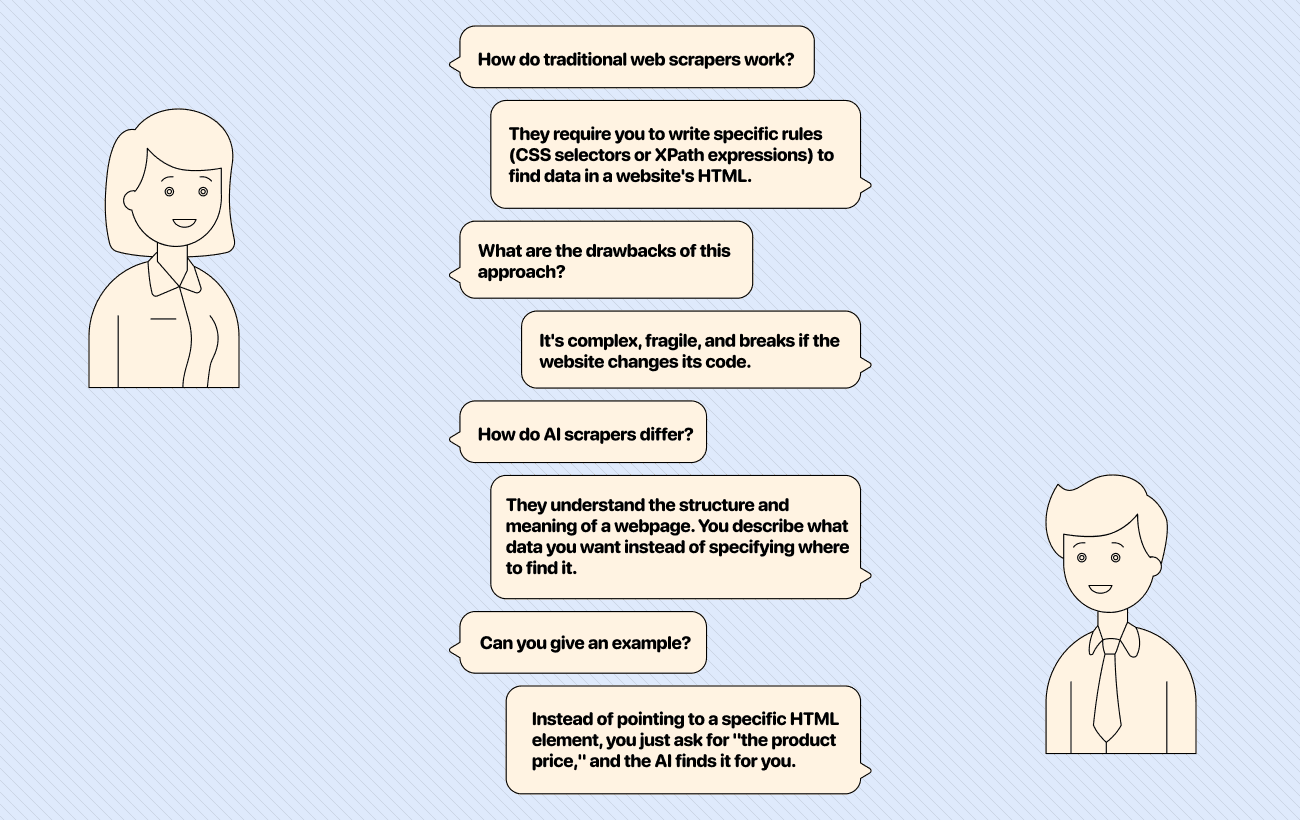
这些术语都指使用 AI 模型从网页内容中识别信息,并将其整理成结构化数据。传统 scraper 通常通过 CSS selector 或 XPath 选择元素;AI 数据提取工作流则使用 prompt 或 schema,按照字段的语义识别信息。当不同页面的布局不一致时,这种方式很有帮助,但它并不能解决页面无法访问、内容发生变化或输出错误等问题。
为什么要使用 AI 抓取
当同一信息出现在不同页面的不同位置,或者需要把非结构化文本转成数据列时,AI 数据提取尤其有用。如果页面布局稳定且统一,基于规则的抓取可能更简单、成本也更低。具体选择应取决于数据来源和所需输出。
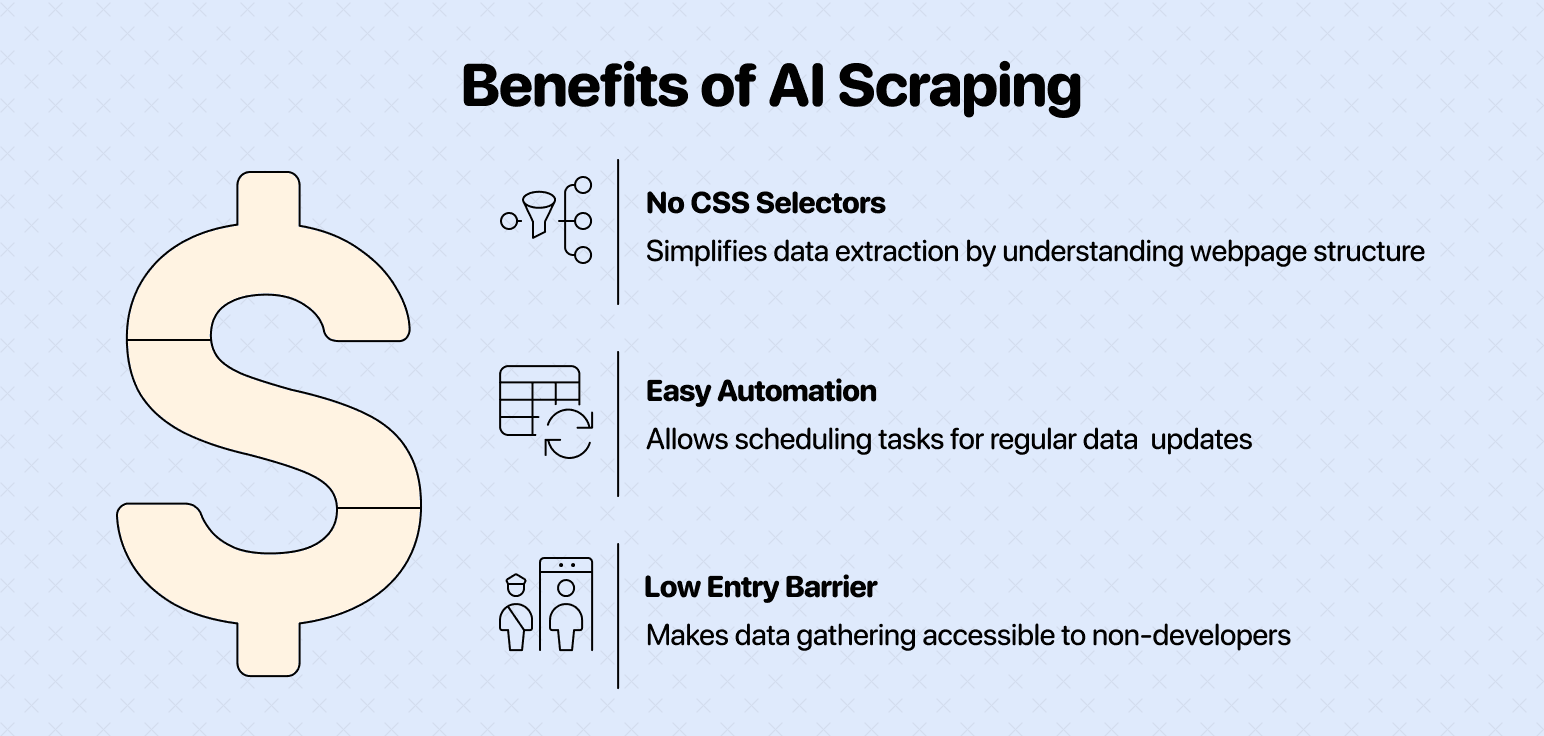
无需编程,也不一定需要 API
部分 AI 抓取工具允许用户直接在界面中输入自然语言 prompt,另一些则需要 API 或代码。清晰的请求应列出每个输出字段,并说明页面没有相应值时应如何处理。
无需 CSS Selector 和 XPath,降低复杂度
使用基于 selector 的 scraper 时,你需要找出 HTML 中包含目标值的元素。使用 AI 数据提取时,即使页面布局不同,也可以直接请求“当前产品价格”等字段。建议选取几个有代表性的页面测试两种方法。布局变化、页面被拦截或价格含义不明确时,仍可能需要调整 prompt 或人工复核。
易于自动化,上手门槛低
你可以针对一批 URL 运行 AI 数据提取工作流,也可以从一个网站 URL 开始抓取。批量执行前,应抽查输出,确认是否存在字段为空、匹配错误或来源网站结构变化等情况。自动化并不等于无需监控。
AI 抓取的应用场景
AI 抓取的应用几乎没有边界,能够覆盖企业运营的各个环节。通过自动采集网络数据,团队可以获得关键洞察,并提高工作效率。
以下是一些 AI Scraping 的常见用途:
- 抓取电商网站
- 团队可以从成千上万条商品信息中提取名称、价格、描述和图片等数据。
- 这些数据适用于竞品分析、价格监控和产品目录搭建。
- 抓取用户评价
- 收集 Yelp、G2 或 Amazon 等平台上的用户评价,有助于企业了解市场口碑。
- AI 可以分析这些数据,识别常见话题、产品缺陷或影响客户满意度的因素,为竞品分析提供支持。
- 监控价格页面
- 销售和市场团队可以自动追踪竞争对手的价格与促销活动。
- 这有助于制定动态定价策略,让企业保持市场竞争力。
- 抓取客户案例
- 市场团队可以收集竞争对手网站上的客户案例,了解其市场定位和成功故事。
- 这些信息可用于优化自身的营销信息和销售话术。
- 研究数据库中没有的数据
- 有些信息并不存在于结构化数据库中。
- AI scraper 可以从论坛、博客或垂直网站提取独有数据,为市场调研、学术研究或调查报道提供支持。
💡 AI 抓取实操入门指南
如何抓取客户案例 👈🏼
如何抓取电商网站的产品数据 👈🏼
如何抓取 Trustpilot 用户评价 👈🏼
如何查找数据库中没有的 Account 信息 👈🏼
AI 抓取的两种方法
AI 抓取工具会根据任务提供不同的方法。虽然底层技术相近,但具体选择取决于你是要丰富现有数据集,还是从零开始探索一个新网站。
下面来看两种主要方法:
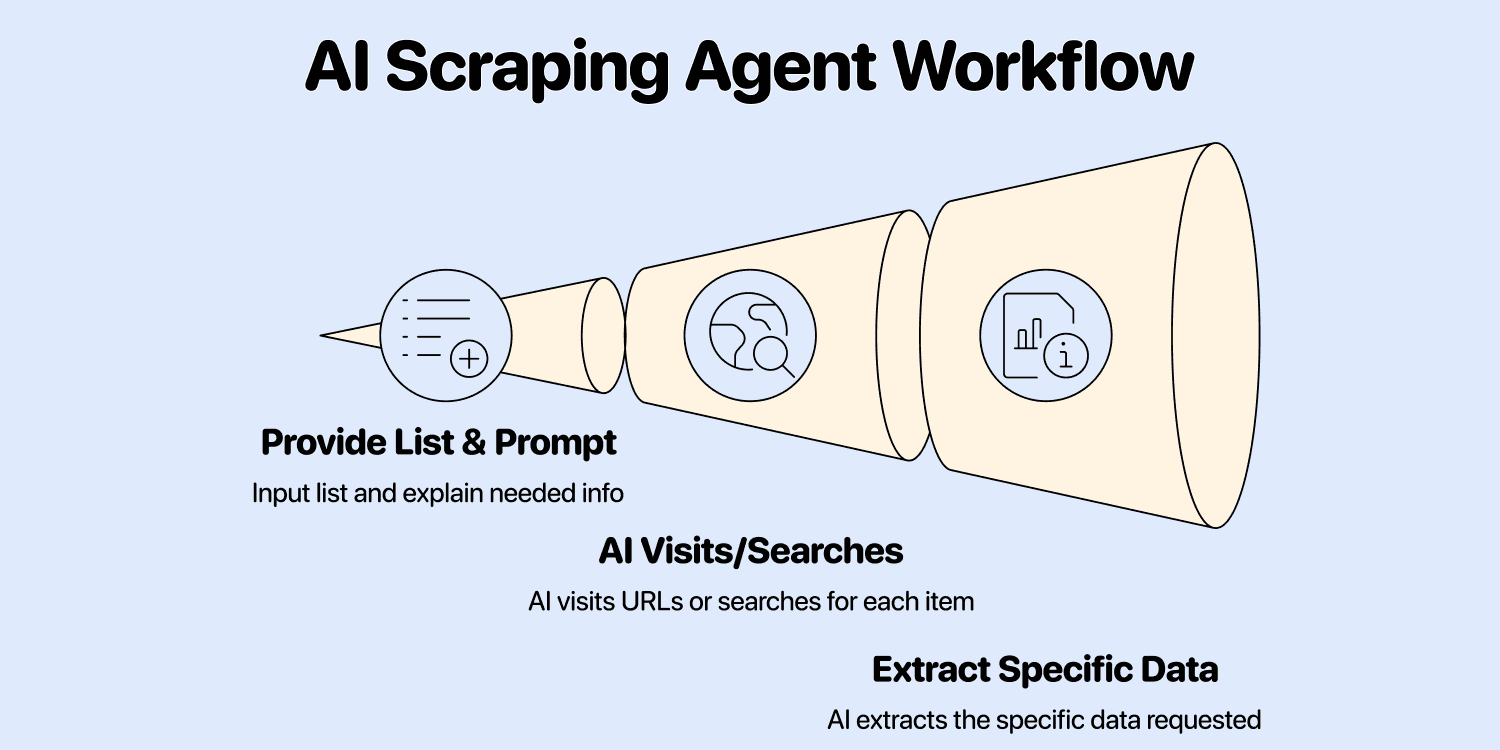
对一批数据运行 AI Scraping Agent
如果你已有起始数据,例如一份包含公司名称或产品 URL 的表格,这种方法非常合适。你只需向 AI Agent 提供数据列表,并通过 prompt 说明希望为每一项补充哪些信息。
随后,AI 会访问每个 URL,或逐项执行搜索,再提取你指定的数据。
- 最适合: Enrich 现有数据集,例如查找一批公司的所属行业,或一批 Account 对应的 CEO 姓名。
- 检查建议: 先测试少量样本,并针对重要字段核对来源页面。
通过 URL 和 Prompt 将 AI Scraping Agent 用作网站抓取工具
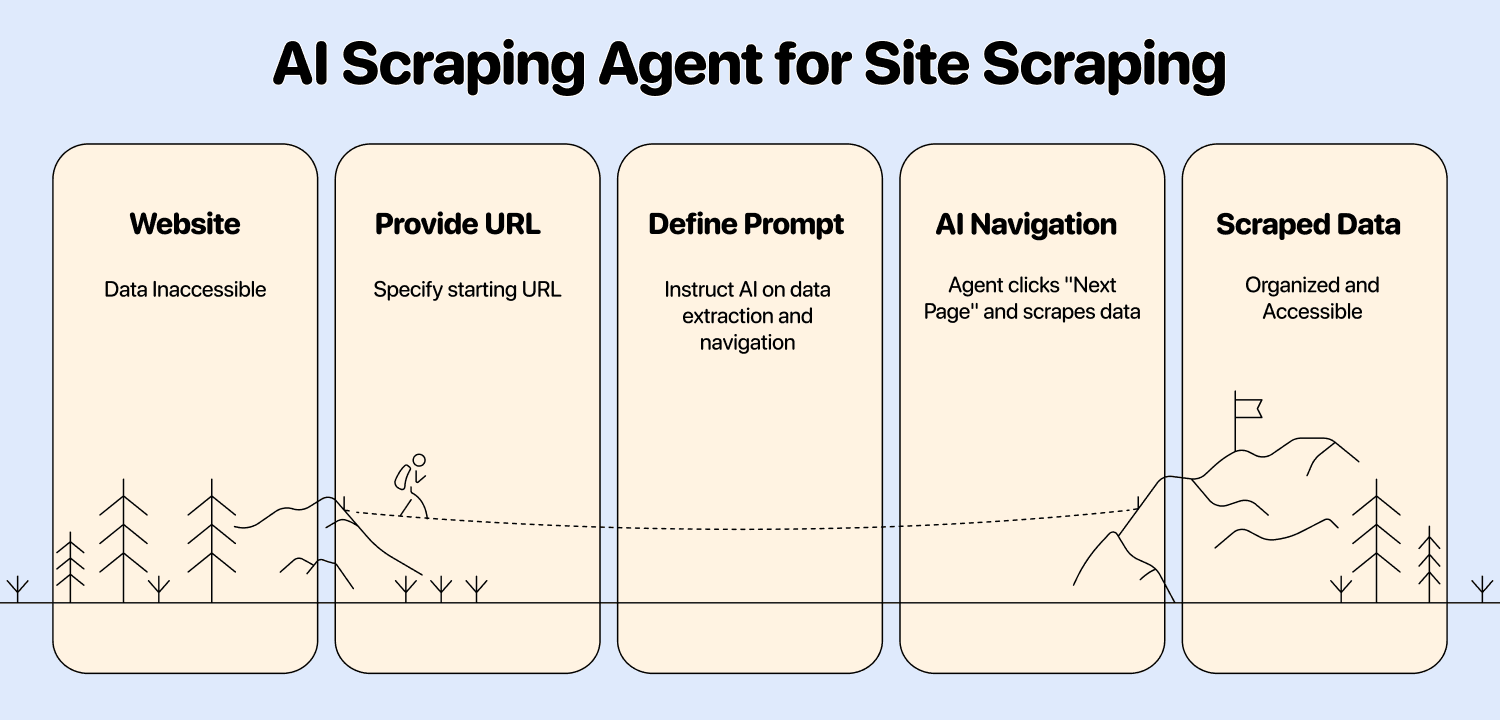
这种方法适合探索整个网站或其中某个板块并提取数据。你需要提供一个起始 URL,例如电商网站的分类页面,再用 prompt 告诉 AI 要寻找什么,以及如何浏览网站。
使用 Datablist 的 website scraper 时,只需提供起始 URL,并通过 prompt 描述要提取的项目。分页功能为可选项;如果来源网站包含多个结果页面,再进行配置即可。
网站抓取配置与样本检查指南介绍了如何核对输出是否符合 prompt、测试页面渲染,以及区分字段缺失与页面被拦截。
- 最适合: 抓取 Amazon、eBay 等网站的商品列表,收集博客文章,或从各类目录网站中提取条目。
- 检查建议: 先限制抓取页数,确认返回的数据行来自目标页面后,再扩大运行规模。
AI 抓取工具
AI 抓取工具市场正在快速发展。合适的选择取决于你的技术能力、预算和具体需求。以下是三种工具及其按月付费的美元起步价。
| 工具 | 主要用途 | 起步价 | 每月包含的用量 |
|---|---|---|---|
| Datablist | No-code 抓取与表格数据 Enrichment | 25 美元/月 | 5,000 credits |
| Firecrawl | 为应用提供网页数据与结构化提取 | 19 美元/月 | 5,000 credits |
| ScrapingBee | 支持 AI 数据提取的 Scraping API | 19 美元/月 | 75,000 API credits |
不同工具的 credits 衡量方式并不相同。Datablist 根据使用的 AI 模型和工具计费;Firecrawl 按页面和所选格式计费;ScrapingBee 则在请求的基础费用上叠加 AI 数据提取费用。下面的例子可以说明,credits 数量最多并不一定意味着工作流成本最低。
Datablist:专为销售、市场和运营团队打造
Datablist 是一个数据自动化平台,在易用的电子表格界面中集成了强大的 AI 抓取能力。它专为需要收集和 Enrich 数据的销售、市场和运营团队而设计,无需编写代码或配置 API。
主要功能:
- 自然语言 Prompt: 用自然语言描述需求,AI Agent 就会为你获取数据,无需编程或复杂的 API 配置。
- 两种起点: 可以针对现有数据行运行 AI Agent,也可以从网站 URL 开始,输入 prompt 并按需设置分页。
- 运行设置: website scraper 支持设置页面上限,并可选择是否启用 HTML rendering。增加页面数量前,先进行小规模测试。
- 结构化输出: 将所需字段映射到 collection 中的列,检查数据行,再按需与其他 Enrichment 结果结合。
价格:
- Starter:每月 25 美元,包含 5,000 credits。 Growth 每月 50 美元,包含 20,000 credits。
- AI 抓取的用量会随模型、工具和访问页数而变化。启用 HTML rendering 后,每次抓取额外消耗 2 credits。
- 对于消耗 25,000 credits 的任务,Starter 加购 20,000 credits 的总成本为 45 美元(25 + 20 美元)。这只是 credit 预算示例,并非特定页面数量的固定价格。只有有效套餐用户才能加购,且加购的 credits 永不过期。
💡 Datablist 不为人知的优势
Datablist AI Scraper 的优势在于,它并不只是一个 AI Scraper。它还是一个 AI scraping agent,可以搜索 Google、访问 Google News、调用 API、提取数据、对网站进行分页浏览,以及完成更多任务。
Firecrawl:面向 AI 应用的 Web Data API
Firecrawl 是一个面向开发者的开源 Web Data API,可以将网站转换为适合 LLM 使用的数据,为 AI 应用提供支持。
主要功能:
- 结构化提取: 提供 URL 和 JSON schema 或 prompt,描述所需字段,并将返回值与来源页面进行核对。
- 适用于 LLM 的输出: 支持 JSON、Markdown 和截图等多种格式,输出结果可直接用于 AI 处理。
- 开发者优先: 提供 Python 和 Node.js SDK,以及完整的文档与示例。
价格:
- Hobby:每月 19 美元,包含 5,000 credits。 Standard 每月 99 美元,包含 100,000 credits。这里采用月付价格,而非价格更低的年付方案。
- 基础页面抓取消耗 1 credit,选择 JSON 额外消耗 4 credits,因此使用 JSON 提取一个页面共需 5 credits。其他模式可能产生不同用量。
ScrapingBee:面向开发者的 AI Scraper
ScrapingBee 是一款 API-first 抓取工具,负责处理代理和浏览器。开发者可以在代码中调用它;通过 n8n、Make 等集成,团队也能将其接入其他工作流。你仍需配置请求,并映射返回的数据。
主要功能:
- AI 驱动的网页抓取: 使用 AI 辅助解析和提取数据,对网站变化有更强的适应能力。
- API Access: 专为开发者设计,可集成到自己的应用和工作流中。
- JavaScript Rendering: 能够抓取大量依赖 JavaScript 的现代动态网站。
价格:
- Hobby:每月 19 美元,包含 75,000 API credits。 每月 49 美元的 Freelance 套餐包含 250,000 credits。
- 每次请求使用 AI 数据提取会额外消耗 5 credits。在叠加 AI 提取费用前,基础请求消耗 1 credit,启用 JavaScript rendering 则消耗 5 credits。Premium proxy 设置可能进一步提高基础成本。
一项结构化数据提取任务需要多少钱?
以下示例假设每个页面发送一次请求,并采用表中所列设置。这里计算的是 API 使用成本,而非正确返回的数据记录数量。
| 工具与任务 | 所需 credits | 月付套餐与成本 |
|---|---|---|
| Firecrawl:使用 JSON 提取 1,000 个页面 | 5,000 | Hobby:19 美元 |
| Firecrawl:使用 JSON 提取 10,000 个页面 | 50,000 | Standard:99 美元 |
| ScrapingBee:执行 10,000 次 AI 提取请求,不启用 JavaScript rendering | 60,000 | Hobby:19 美元 |
| ScrapingBee:执行 10,000 次 AI 提取请求,启用 JavaScript rendering | 100,000 | Freelance:49 美元 |
对于 ScrapingBee,最后两行的计算方式分别为 10,000 ×(1 + 5)和 10,000 ×(5 + 5)。启用 rendering 后,任务用量会超过 Hobby 套餐的额度。使用 Datablist 时,建议先进行小规模测试,确定所选模型、prompt 和来源页面的 credits 用量,再根据上述 25 美元 Starter 套餐额度和加购价格制定预算。
如何检查 AI 抓取结果
使用数据集前,应抽取部分数据行与来源页面进行核对。确认每个值都属于正确的对象、单位和币种得到保留,并确保缺失值仍为空。如果来源页面无法访问或结果存在不确定性,应修改 prompt 或人工检查该行。当来源网站发生变化时,需要重新抽样核查。
AI 抓取常见问题
ChatGPT 能进行网页抓取吗?
AI 模型可以从你提供的网页内容中提取字段。如果需要对大量 URL 重复执行任务,应使用能够记录来源 URL、将字段映射到数据列,并支持检查失败或不确定数据行的工作流。
什么是 AI Scraping?
AI scraping 使用模型从网站内容中识别指定字段,并返回结构化结果。你可以在 prompt 中描述字段,而无需指定 CSS selector,但重要结果仍应与来源页面进行核对。
网页抓取合法吗?
相关规则取决于网站、数据类型和司法管辖区。采集或使用数据前,应查看网站条款和适用法规;涉及个人信息时尤其需要谨慎。
什么是 Data Scraping?
Data scraping 是指从网站、文档等来源中提取信息。AI scraping 则使用 AI 模型识别指定信息,或将其整理为结构化数据。
AI 抓取与传统网页抓取有何不同?
基于 selector 的抓取会定位页面 HTML 中的特定元素;AI 数据提取则使用 prompt 或 schema,按照语义识别字段。当网站发生变化或页面无法访问时,两种方法都可能失败,因此应在有代表性的页面上比较结果。
开始使用 AI 抓取需要哪些技能?
使用 Datablist 时,你可以提供一个 URL 或多行数据,描述所需字段并映射输出,全程无需编写代码。不过,你仍需抽样检查结果。
AI Scraper 能应对网站布局变化吗?
有时可以。布局变化后,prompt 可能仍能找到目标字段,但页面被拦截、内容缺失或标签含义模糊仍会导致错误。来源网站发生变化后,应重新抽样检查。
参考资料
- [1] Datablist。Starter 每月 25 美元,包含 5,000 credits;Growth 每月 50 美元,包含 20,000 credits;有效订阅用户还可加购 credits。
- [2] Firecrawl。Hobby 和 Standard 的月付价格分别为 19 美元和 99 美元;基础抓取每页消耗 1 credit,JSON 额外消耗 4 credits。
- [3] ScrapingBee。Hobby 每月 19 美元,包含 75,000 credits;Freelance 每月 49 美元,包含 250,000 credits;AI 数据提取会在基础请求成本上额外消耗 5 credits。