
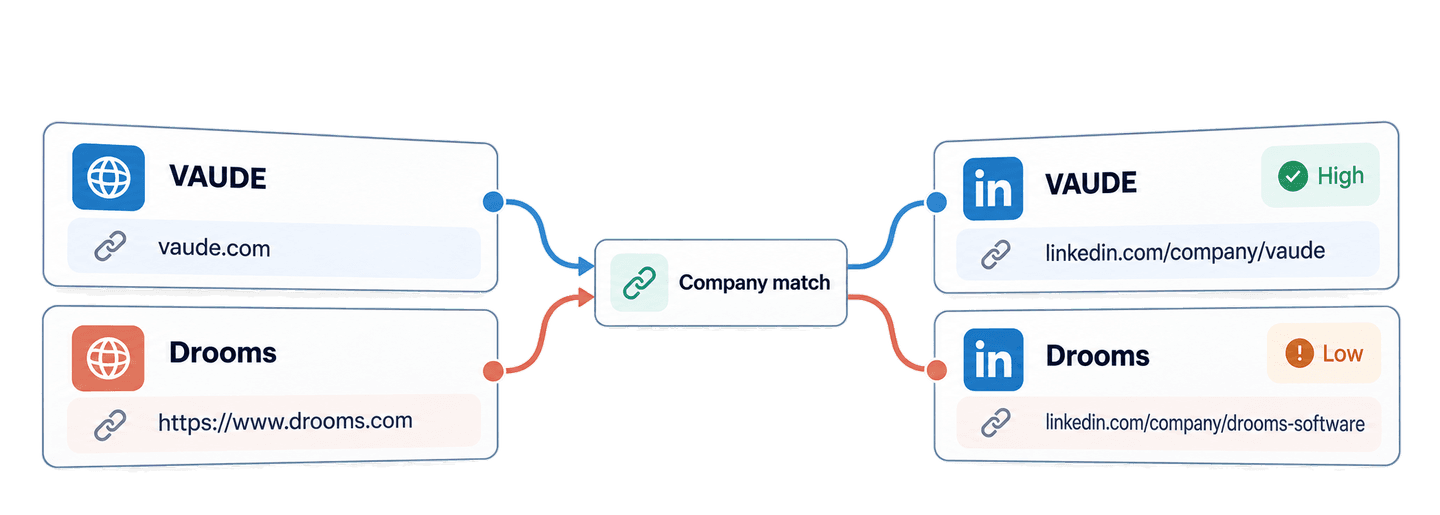
使用 Datablist 的 Company to LinkedIn API,即可在 Python 中根据企业网站查找对应的 LinkedIn 公司主页。你可以提交纯域名或完整的网站 URL,等待匹配任务完成,然后获得公司名称、网站、LinkedIn 公司主页 URL 和置信度信号。
本指南将使用 Python 和 Requests 库匹配 5 家公司的网站。名单中既有大家熟悉的软件公司,也包括户外装备公司 VAUDE 和虚拟数据室服务商 Drooms。随后,我们会把结果整理成两个本地队列:可直接用于企业调研的匹配项,以及需要人工核验的匹配项。
🔑 赶时间?先看摘要
将 Account 列表中的网站发送至 Datablist Company to LinkedIn API。API 会返回 LinkedIn 公司主页 URL 和置信度信号,帮助你判断哪些匹配关系可以直接使用,哪些需要进一步核验。
- **输入:**纯域名和完整的企业网站 URL。
- **输出:**公司名称、匹配的网站、LinkedIn 公司主页 URL,以及
high或low置信度,并分别归入Ready for research和Needs review队列。
💡 更想使用 no-code 方案? 使用 Datablist 的 LinkedIn Company Pages & Domain Lookup,无需编写代码即可匹配企业网站和 LinkedIn 公司主页。
配置 Python 和 Datablist API Key
本示例使用 requests 包。API 本身通过 HTTP 工作,因此之后也可以将同一套请求流程改写成其他编程语言。
你需要一个具备 REST API 访问权限的 Datablist 账户,该权限包含在 Growth 套餐中。成功的查询还会消耗 enrichment credits。本文稍后会详细说明具体的 credits 计算方式。
创建工作目录和名为 find_linkedin_company_pages.py 的文件,然后创建虚拟环境并安装 Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.py在你的 Datablist 账户中创建 Personal API Key,然后将其导出为环境变量:
export DATABLIST_API_KEY="your-api-key"脚本会读取该值,并通过 X-API-Key header 发送。
用一个 Python 函数查找 LinkedIn 公司主页
示例使用以下 5 个源 Account:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
每个 account_id 都会成为 API 的 inputId。这一点很重要,因为结果的返回顺序不一定与输入顺序相同。稳定的 ID 可以确保每条结果都能关联到正确的源 Account。
将下面的完整脚本粘贴到 find_linkedin_company_pages.py:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))运行脚本:
python find_linkedin_company_pages.py该函数会依次发起三类调用。
首先,POST 会发送 5 个网站,并将 matchingDirection 设置为 domain_to_linkedin。由于匹配以后台任务方式运行,API 会返回 202 Accepted 和一个任务 ID。Requests 脚本会等待任务完成后再进入下一步,因此执行流程看起来仍然是顺序的。
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]其次,状态请求会持续检查任务,直到状态变为 completed、failed 或 stopped。每次检查之间暂停 3 秒,避免脚本连续不断地发送状态请求。
最后,结果请求每页最多读取 100 条记录。如果 nextCursor 中包含值,循环会在下一次请求中将其作为 cursor 发送;只有当 nextCursor 为 null 时才会停止。
解读匹配结果并判断哪些需要核验
以下是 5 条输入对应的完整结果列表:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
需要分别解读 status 和 confidence。API 会为每条输入返回一个结果对象,包括未成功匹配的输入。success 状态表示 API 找到了一个公司主页候选项,而 outputs.confidence 则表明网站匹配是否经过验证。inputId 用于将对象关联到源 Account,creditsUsed 记录该行产生的费用,error 则会在失败时包含结构化错误信息。
即使首个界面只需要显示 LinkedIn URL 和置信度,也建议在应用中保留完整的 outputs 对象。companyName 和 companyWebsite 可以加快人工核验,尤其是在返回的公司名称大小写与输入不同,或输入内容是完整 URL 时。这样也能直接获得实用的上下文,无需再次调用 API。
匹配流程首先会将提交的网站标准化,并在公司数据集中查找已知的网站与 LinkedIn 关联关系。随后,它会把输入域名与候选 LinkedIn 公司主页上公布的网站进行比较。注册域名一致时,结果的置信度为 high。
如果数据集中没有 LinkedIn URL,查询流程可能会通过有针对性的 Google 搜索查找公司主页候选项。若候选项无法根据其公布的网站完成验证,返回结果的置信度可能为 low。已确认网站不一致的候选项不会被接受。
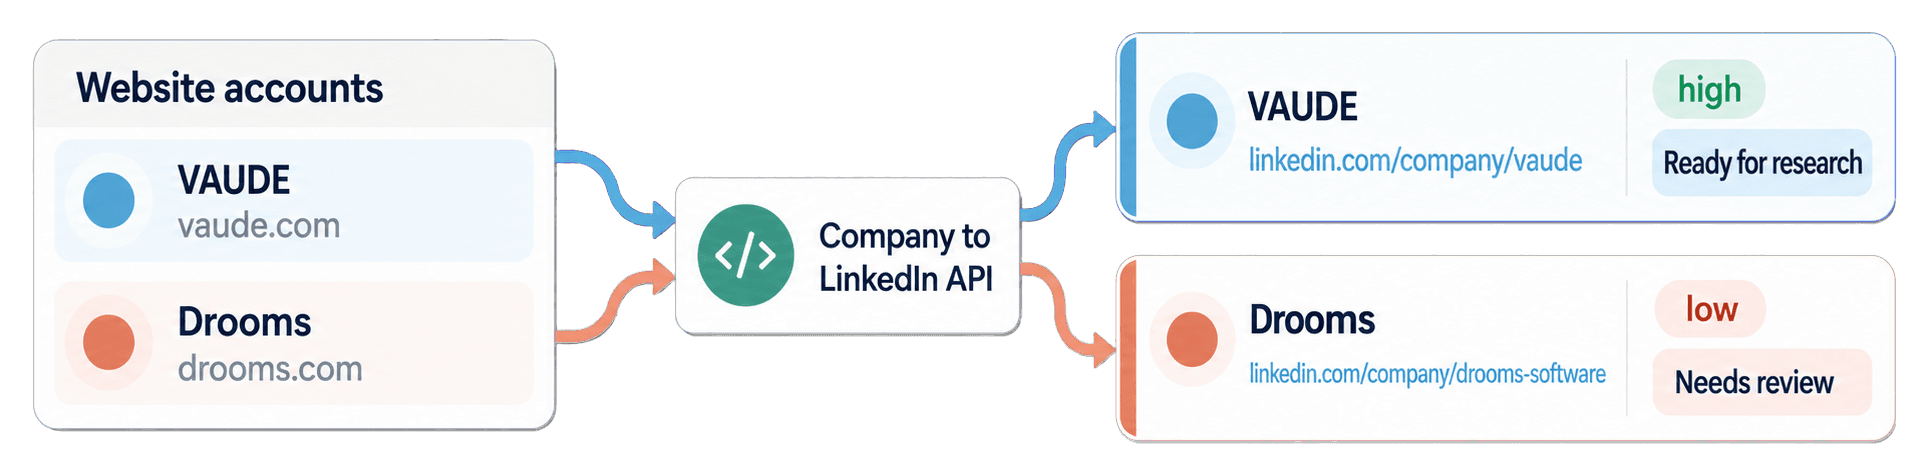
可以把置信度视为一条核验指令。VAUDE 返回了 https://www.linkedin.com/company/vaude,置信度为 high,因此可以进入调研队列。Drooms 返回了 https://www.linkedin.com/company/drooms-software,但置信度为 low。在依赖这条关联关系之前,应先打开 Drooms 网站和 LinkedIn 主页进行核验。
Datablist、PostHog 和 n8n 也都获得了高置信度匹配。该 API 的用途是找出网站与公司主页之间的关联关系。如果你在核验 URL 后还需要公司规模、行业或其他主页数据,可以继续阅读 LinkedIn 公司数据抓取 API 指南。
根据结果创建 Account 调研队列
现在复用 match_results,为人工企业调研创建本地队列。以下代码块不会再次调用 API。它先根据 inputId 为结果建立索引,再遍历原始 Account 列表。这样,即使未来缺少某条结果,每个源 Account 仍然清晰可见。
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))结果字典让数据关联不再依赖响应顺序。account-vaude 会把原始的 vaude.com 记录与找到的 VAUDE 主页关联起来,并进入 ready_for_research。account-drooms 会保留完整的输入 URL 和完整 API 结果,但由于置信度较低,即使结果状态是 success,它仍会进入 needs_review。
同样的逻辑还会把缺失结果、no_result 或错误记录保留在核验队列中。打印出的两个列表为团队开展人工企业调研提供了清晰的起点。
你也可以下载持续维护的同步 Requests 示例。对于需要非阻塞 HTTP 的应用,该代码库还提供了异步 HTTPX 示例。不过对于首次集成,上面的阻塞版本更容易理解。
从 LinkedIn 公司主页反向查找网站
更改匹配方向后,同一个函数也可以接收 LinkedIn 公司主页。当你的源列表中只有公司主页 URL,而你需要先找到网站,再进行兼容的公司数据 enrichment 或工作邮箱 enrichment 时,这种方式很有帮助。
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)标准 LinkedIn 公司主页查询采用常规匹配费率。数字形式的公司 ID 和 Sales Navigator 公司 URL 可能会消耗 10 credits,因为它们使用另一种反向查询路径。如果希望使用该方向的 no-code 版本,请参阅如何根据 LinkedIn 公司主页获取网站 URL。
估算网站到 LinkedIn 查询所需的 credits
每次成功的常规网站到 LinkedIn 查询会消耗 1.5 credits。因此,示例中的 5 次匹配共消耗 7.5 credits。按相同费率计算,成功匹配 1,000 次需要 1,500 credits。无效输入和没有结果的记录可能消耗 0 credits,因此请查看每条结果中的 creditsUsed,以确认实际用量。
REST API 访问权限包含在 Growth 套餐中,月度订阅费用与额外购买的 credits 分开计算。20 美元的 top-up 可获得 20,000 credits,因此每个 credit 的价格为 0.001 美元。按每次成功匹配消耗 1.5 credits 计算,1,000 次匹配会使用价值 1.50 美元的 1,500 credits。当前套餐和 credits 包请参阅 Datablist 定价。
解决常见的输入、任务与结果问题
- **缺少
DATABLIST_API_KEY:**脚本会在发送请求前停止。请导出环境变量,然后重新运行命令。 - **API 拒绝 Key:**确认复制的是 Personal API Key,并确保请求仅通过
X-API-Key发送该 Key。 - **输入不受支持:**使用
domain_to_linkedin时,请输入企业网站或域名。反向查询时,请使用受支持的公司主页 URL,不要提交个人 Profile 或空值。 - **credits 不足:**检查余额,然后使用套餐内包含的 credits,或在创建新任务前购买 top-up。
- **任务状态为
failed或stopped:**在决定是否重新提交前,请检查任务状态、错误信息、已有结果和 credits 用量。 - **结果置信度较低、为
no_result或出现错误:**将源网站和完整结果保留在needs_review中。如果存在候选主页,请打开核验;对于结果缺失的原因,不要主观猜测。
如果在创建任务时连接中断,请使用 POST 前打印的 uniqueId。先列出任务并查找该值,再决定是否创建新任务:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"任务列表无法按 uniqueId 筛选,因此需要检查返回的每项任务,并在必要时继续跟进 nextCursor。找到匹配值后,使用其 @id,并通过脚本中的同一组状态和结果 URL 继续操作。
单个任务最多可包含 10,000 条输入。有关完整请求规则、任务保留时间和分页限制,请查看 Company to LinkedIn API 文档。
后续步骤
现在,你已经有了一个可复用的 Python Requests 函数,能够将企业网站转换为 LinkedIn 公司主页候选项。本地队列会把高置信度匹配保留为可直接调研的记录,同时让不确定或未成功的记录继续显示,以便人工核验。
用一份小型 Account 列表替换这 5 个示例,逐一核验所有低置信度候选项,然后将确认后的 URL 用于人工企业调研,或作为 LinkedIn 公司数据抓取 API的输入。如果你的源列表只有公司名称而没有网站,可以先阅读企业网站查找 API 指南。