
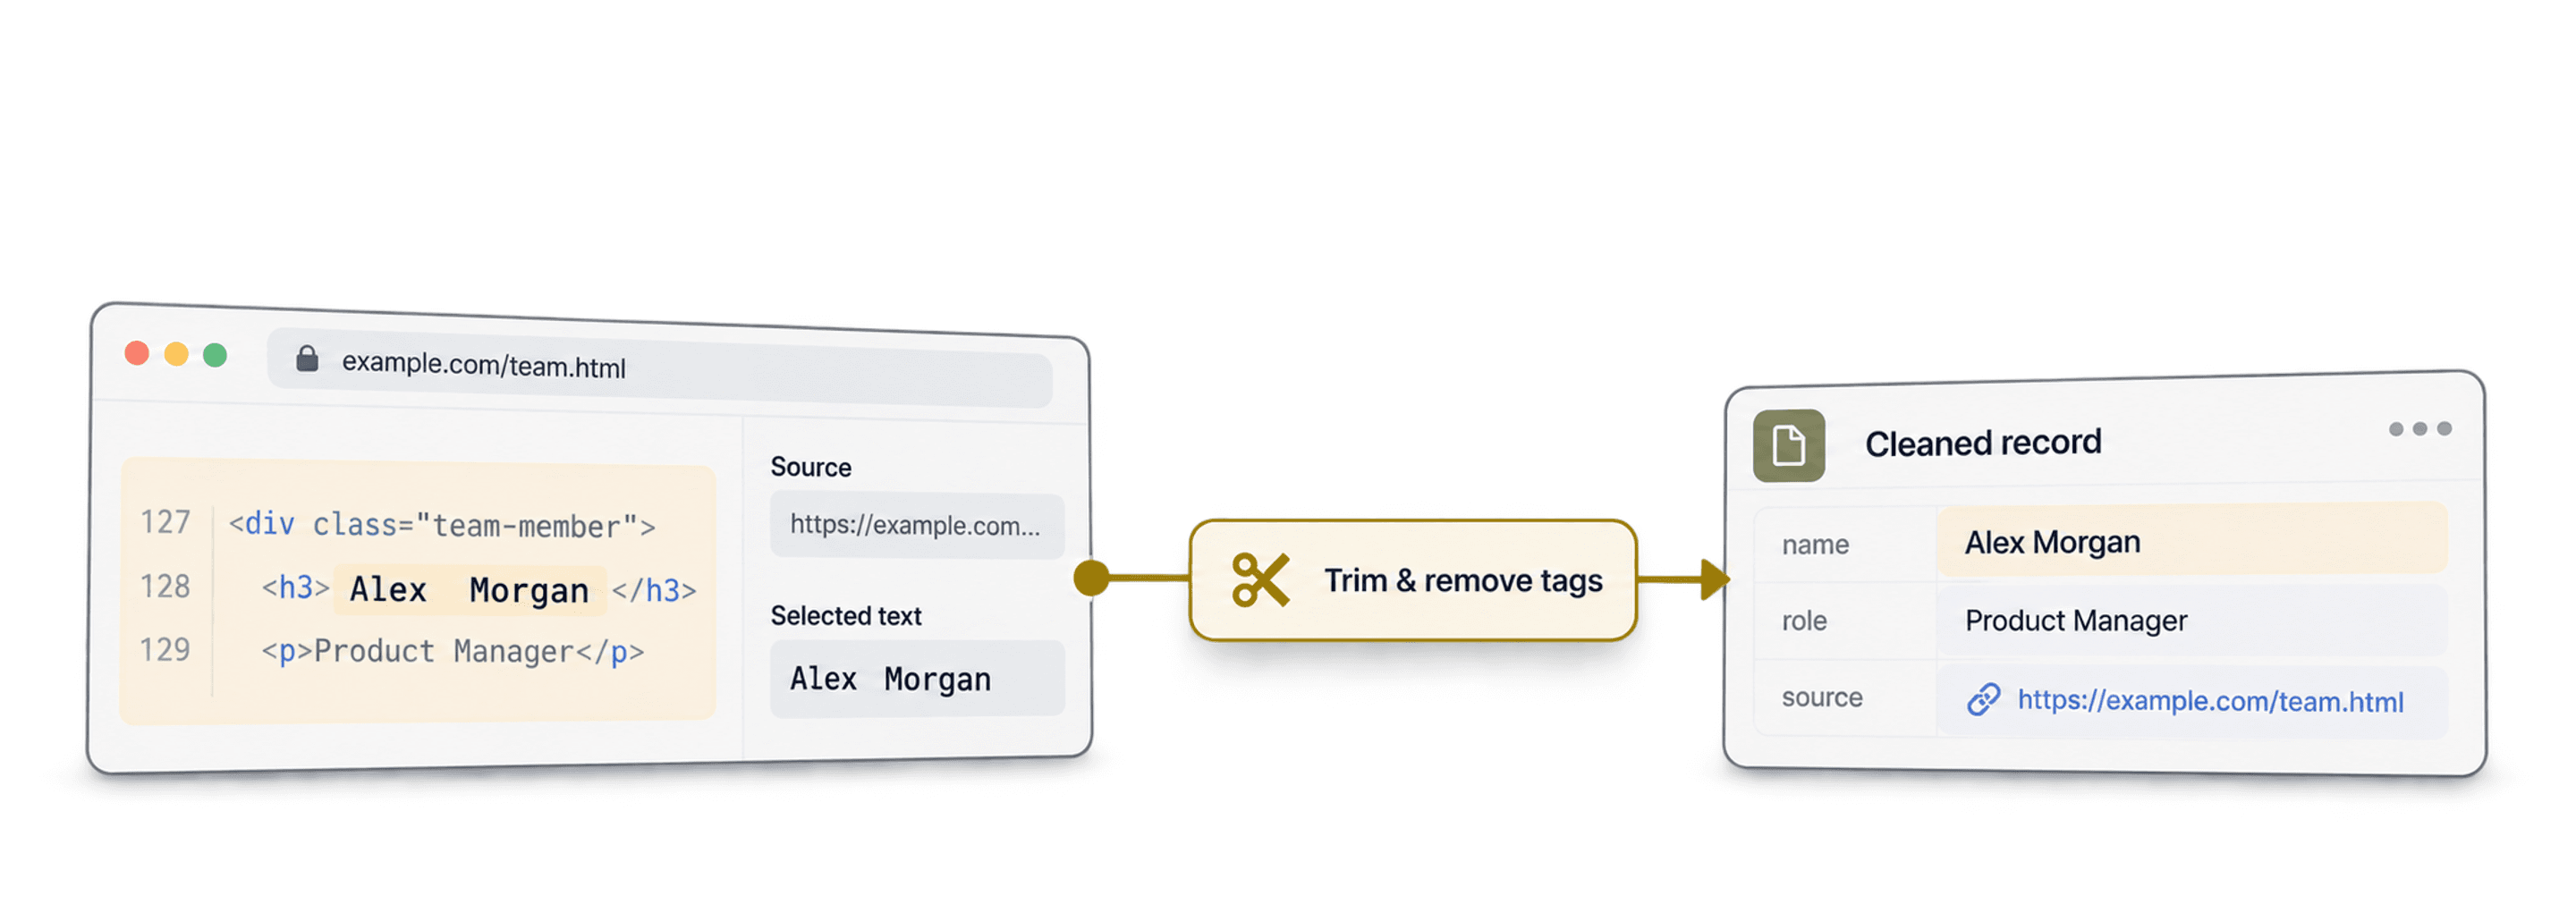
Um Web-Scraping-Daten zu bereinigen, solltest Du zuerst die Rohdaten sichern, anschließend die benötigten Felder vereinheitlichen, doppelte Datensätze prüfen und vor dem Export die Kontaktdaten validieren.
Ich arbeite immer mit einer separaten Kopie der Quelldatei, denn ein sauberer aussehender Wert kann wichtige Informationen verlieren. So kann ein URL-Parameter eine Produktvariante kennzeichnen und eine führende Null Teil einer Account-ID sein. Bewahre deshalb die Quell-URL und den Originaltext zusammen mit den bereinigten Feldern auf.
Für eine gescrapte Kontaktliste empfiehlt sich diese Reihenfolge:
- Importiere die Daten und prüfe die vorgeschlagenen Spaltentypen. Identifikatoren solltest Du als Text speichern.
- Entferne HTML und überflüssige Leerzeichen aus beschreibenden Texten. Vereinheitliche anschließend nur die Felder, die Du zum Filtern oder Abgleichen brauchst.
- Konvertiere Datumsangaben und Mengen, nachdem Du ihre Formate geprüft hast.
- Gleiche Duplikate anhand eines zuverlässigen Identifikators wie der E-Mail-Adresse ab und entscheide dann, welche Werte erhalten bleiben sollen.
- Prüfe E-Mail-Syntax und Domain-Informationen, kontrolliere Ausnahmen und exportiere die bereinigte Liste.
Mit den folgenden Tools kannst Du jeden Schritt in Datablist ohne Formeln erledigen. Die Beispiele zeigen Dir, welche Werte Du kontrollieren solltest, bevor Du eine Transformation auf die gesamte Collection anwendest.
Hier findest Du eine kurze Übersicht über die Bereinigungsschritte in diesem Artikel:
- Text in Datetime, Number oder Boolean konvertieren
- HTML in Text umwandeln und HTML-Tags entfernen
- Überflüssige Leerzeichen aus Texten entfernen
- Daten normalisieren
- Symbole aus Texten entfernen
- Vollständigen Namen in Vor- und Nachnamen aufteilen
- Doppelte Einträge bereinigen
- E-Mail-Adressen validieren
- Personen- oder Firmennamen aus gescrapten Texten extrahieren
Daten aus CSV importieren oder einfügen
Datablist eignet sich ideal zur Datenbereinigung. Der Online-CSV-Editor bietet Funktionen zum Bereinigen, zur Massenbearbeitung und zur Datenanreicherung. Und er skaliert auf mehrere Millionen Einträge pro Collection.
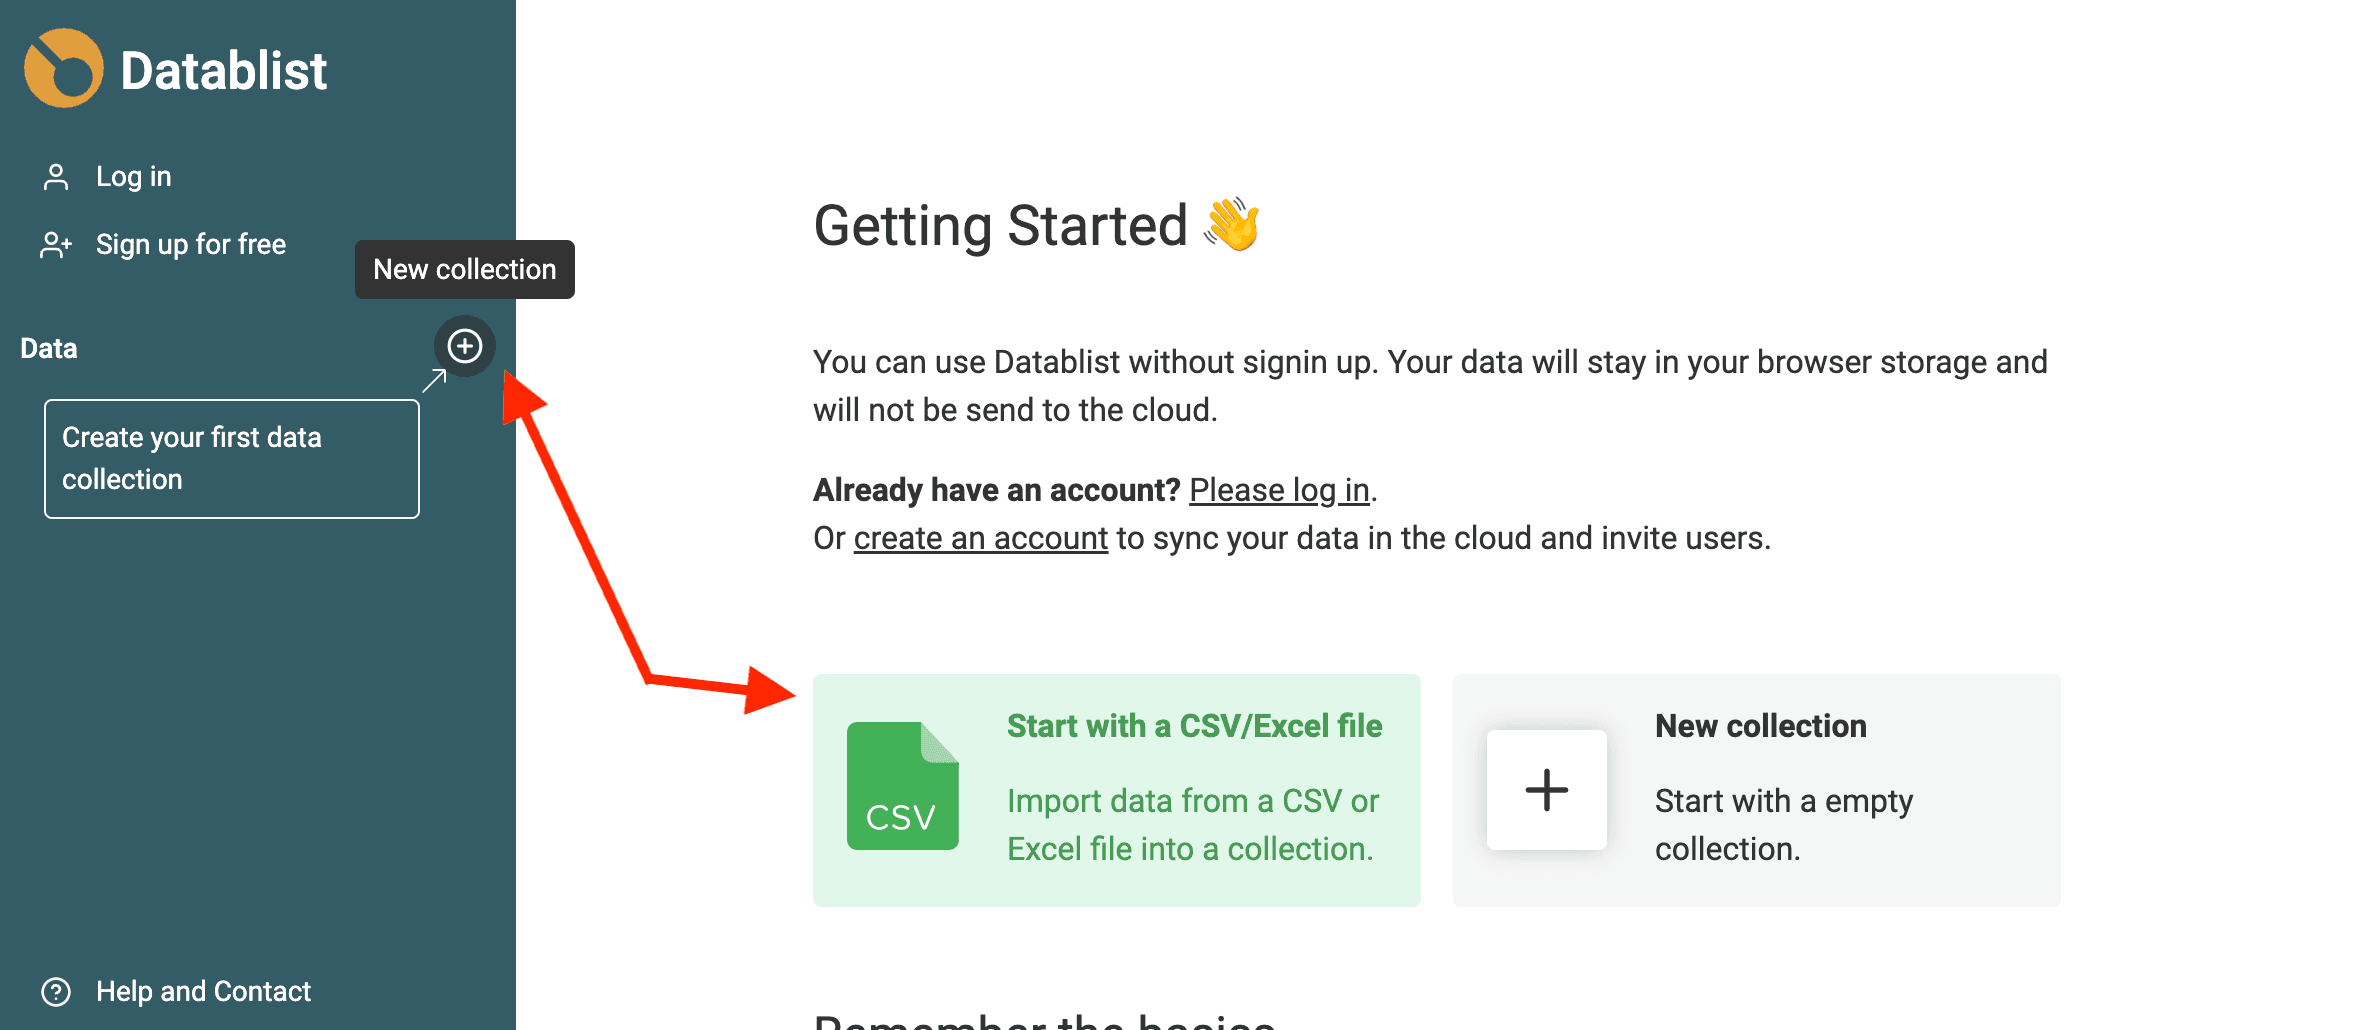
Öffne Datablist, erstelle eine Collection und lade die CSV-Datei mit Deinen gescrapten Daten hoch.
Um eine neue Collection zu erstellen, klickst Du in der Seitenleiste auf den Button +. Klicke danach auf "Import CSV/Excel", um Deine Datei zu laden. Alternativ kannst Du auf der Einstiegsseite die Verknüpfung nutzen, die Dich direkt zum Dateiimport führt.
Format automatisch erkennen
Der Import-Assistent von Datablist erkennt E-Mail-Adressen, Datetime-Werte im Format ISO 8601, Booleans, Numbers, URLs und weitere Datentypen automatisch – sofern sie korrekt formatiert sind.
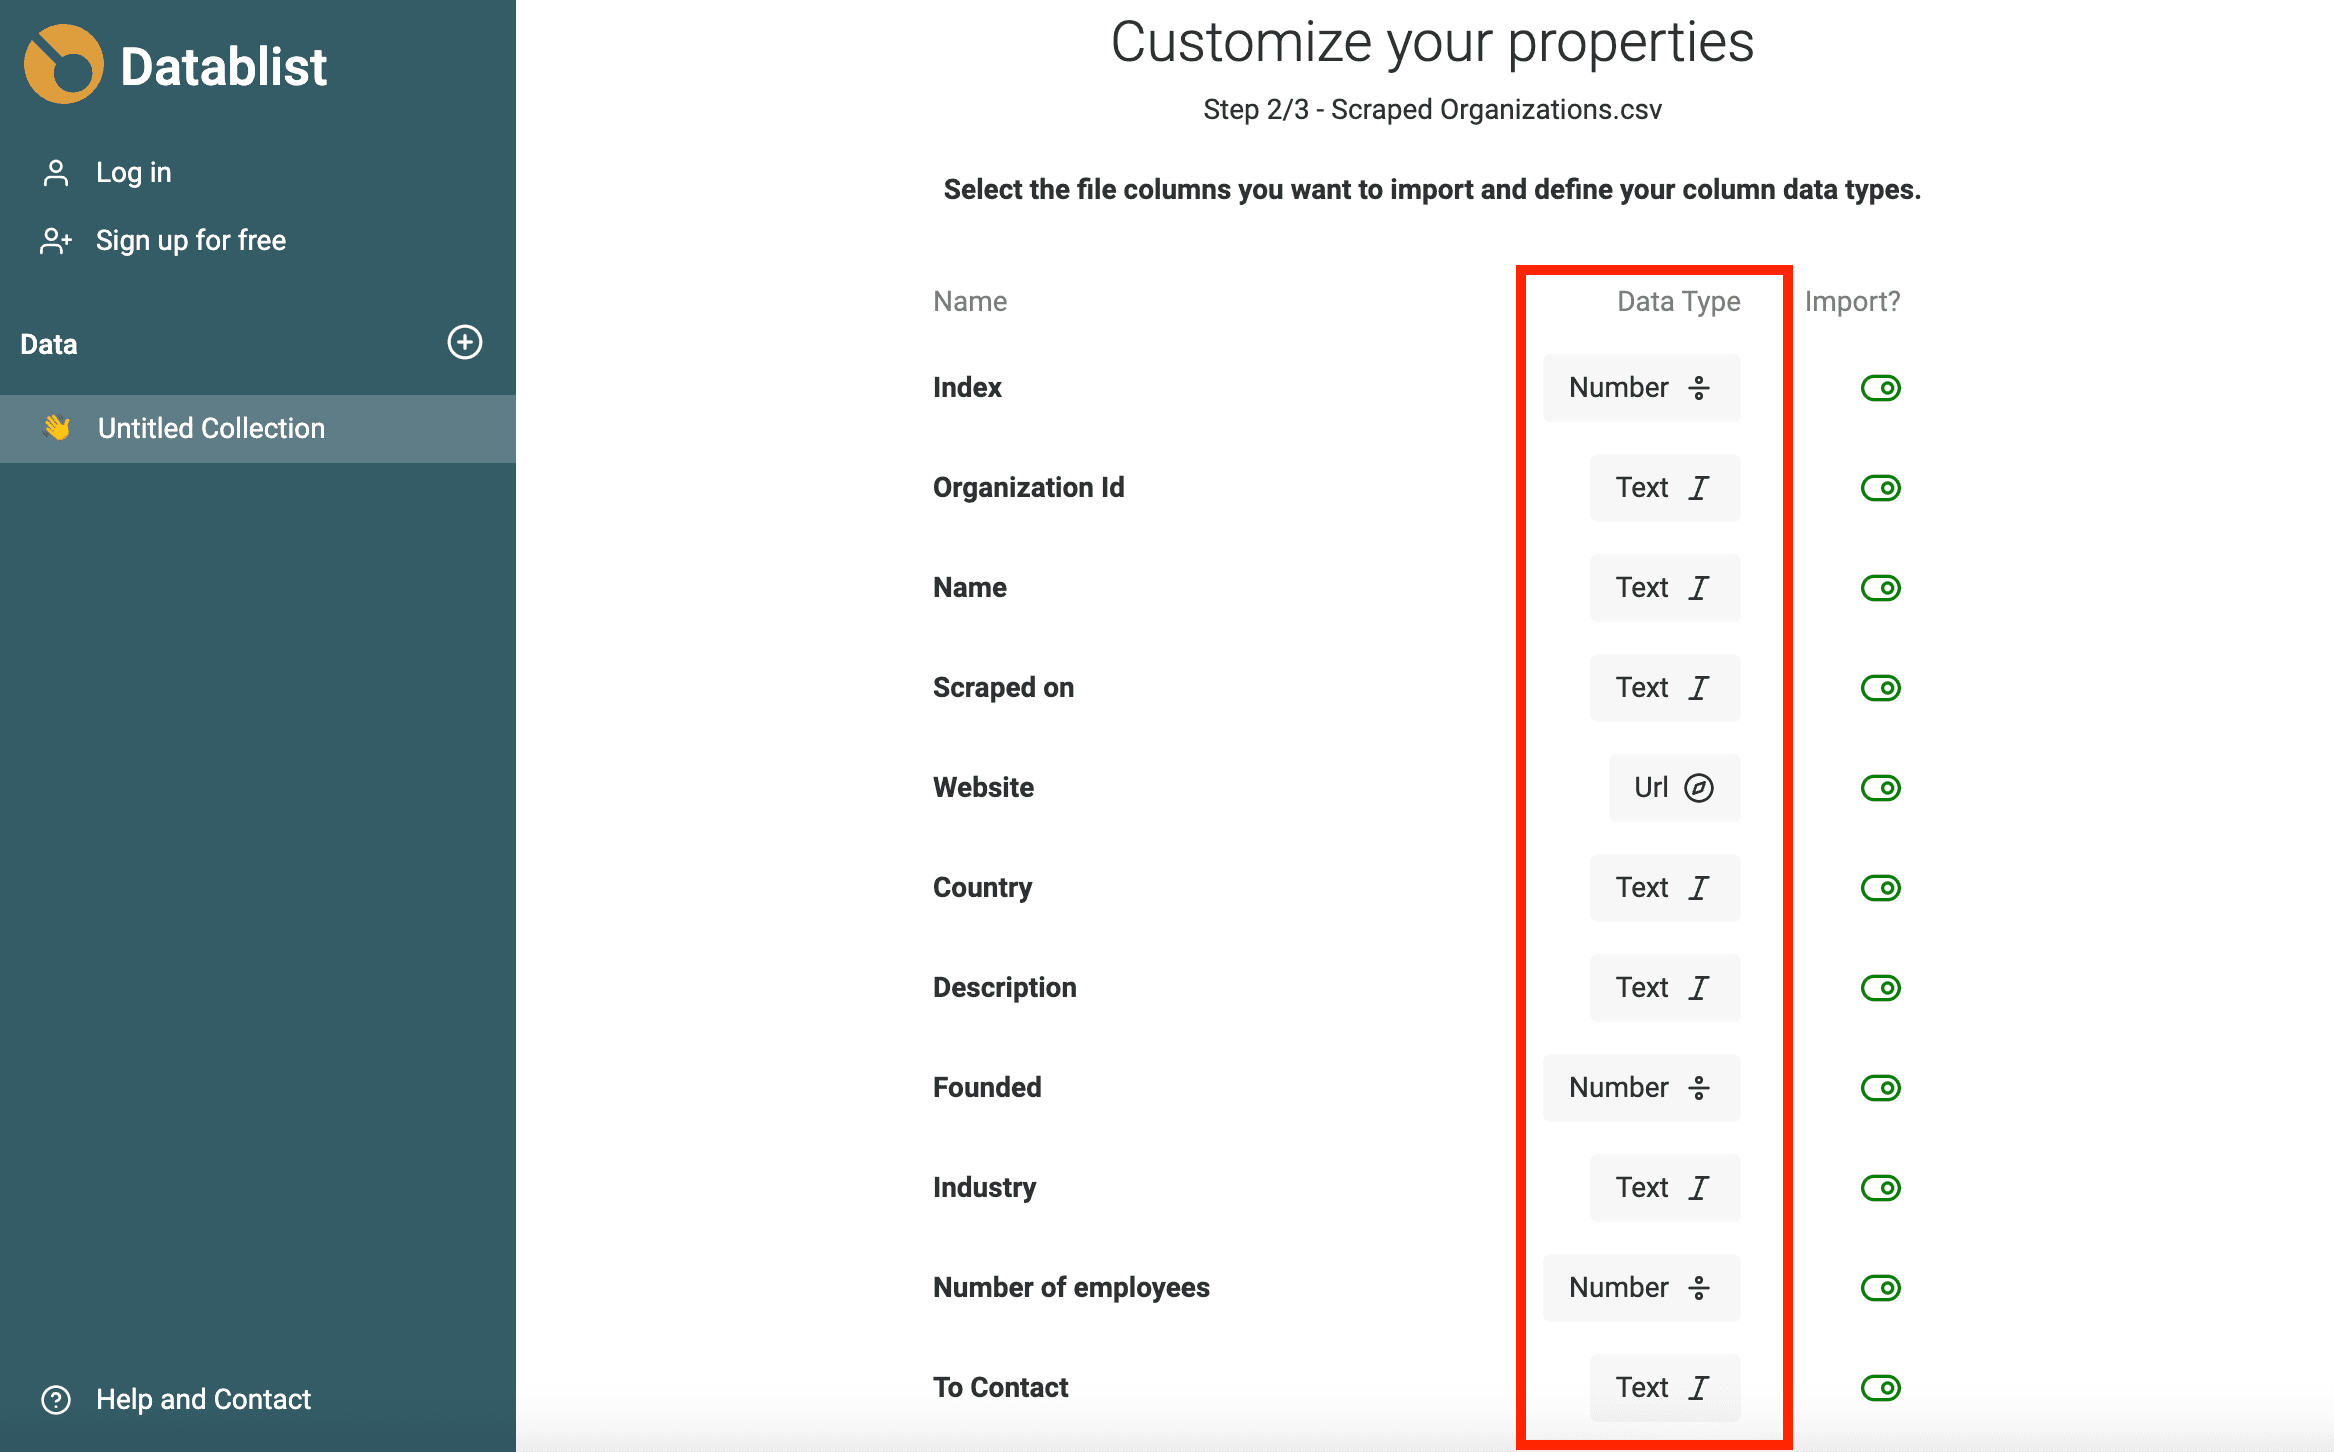
Wenn Deine Daten eine komplexere Analyse erfordern, etwa wegen abweichender Datumsformate oder Tippfehlern in URLs oder E-Mail-Adressen, importierst Du sie als Text Property. Im nächsten Abschnitt zeige ich Dir, wie Du Text Properties in Datetime, Boolean oder Number konvertierst.
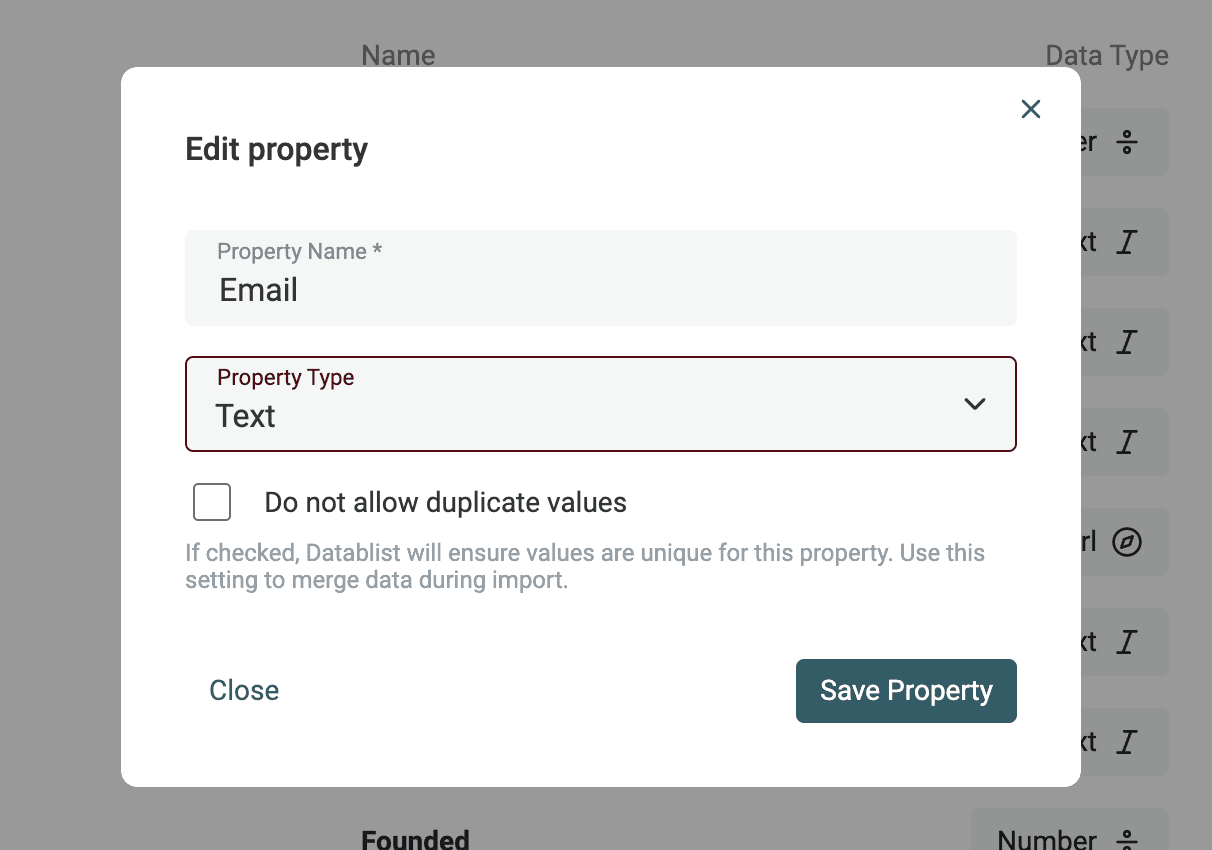
Text in Datetime, Boolean und Number konvertieren
Marie Kondo sagt: "Das Leben beginnt erst, wenn Du Dein Zuhause aufgeräumt hast." Bei gescrapten Daten ist es genauso: "Der Vertrieb beginnt erst, wenn Du Deine Daten aufgeräumt hast!" 😅
Das Filtern nach einem Datum (Erstellungsdatum, Finanzierungsdatum usw.), einer Zahl (Preis, Mitarbeiterzahl) oder einem Boolean ist viel einfacher, wenn die Werte als native Objekte und nicht nur als Text vorliegen.
Öffne im Menü "Clean" das Tool "Text to Datetime, Number, Checkbox".
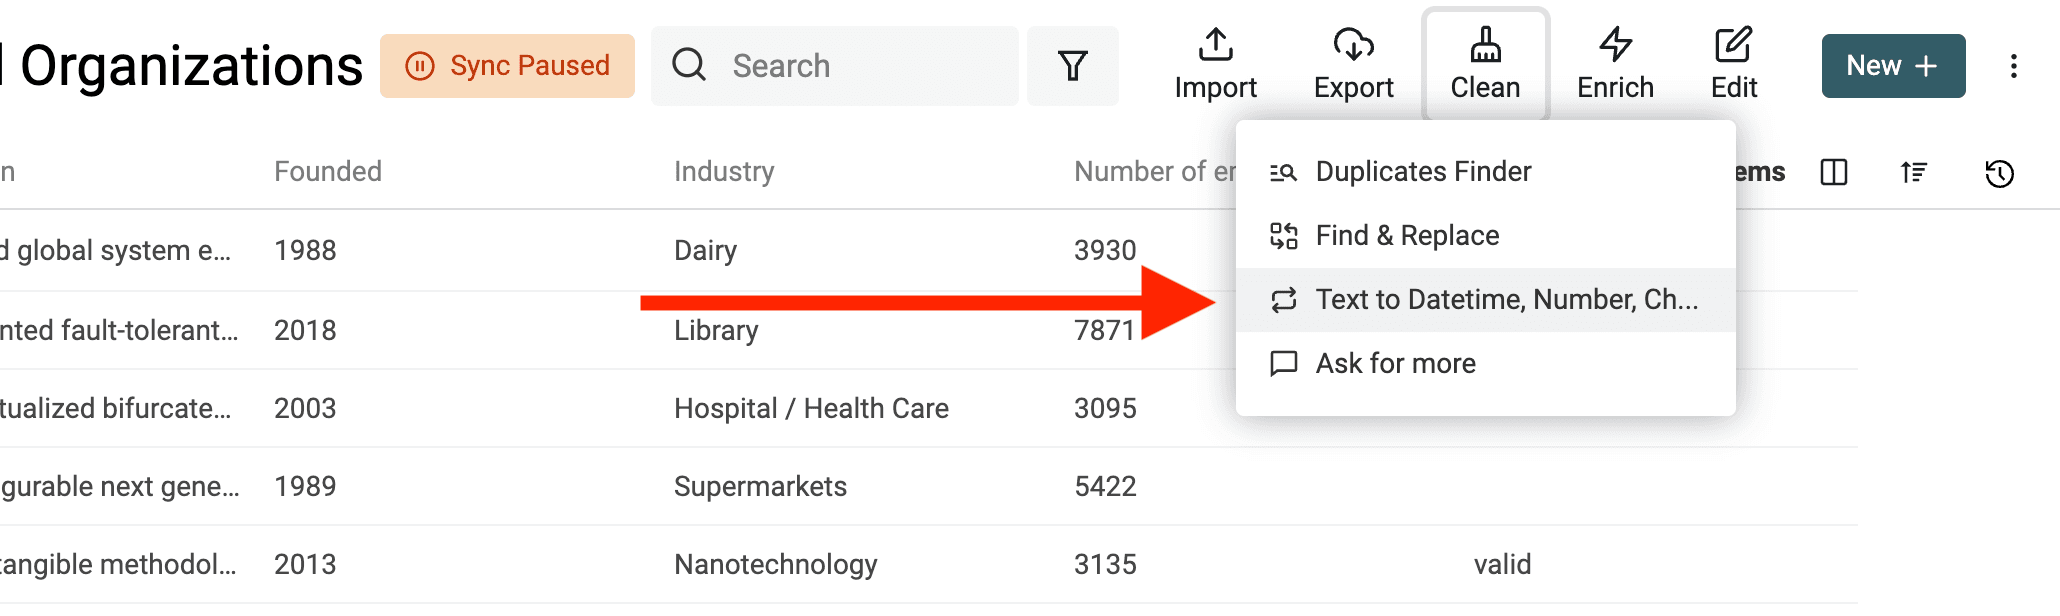
Beliebige Texte ins Datetime-Format konvertieren
Für Datetime gibt es mit ISO 8601 ein internationales Format mit klar definierter Struktur. Verwendet Deine Datei dieses Format, wird beim Import automatisch eine Datetime Property zum Speichern der Werte erstellt.
Bei Date- und Datetime-Werten in anderen Formaten musst Du das verwendete Format angeben, damit Datablist sie in strukturierte Datetime-Werte konvertieren kann.
Wähle die zu konvertierende Property und anschließend "Convert to Datetime" aus.
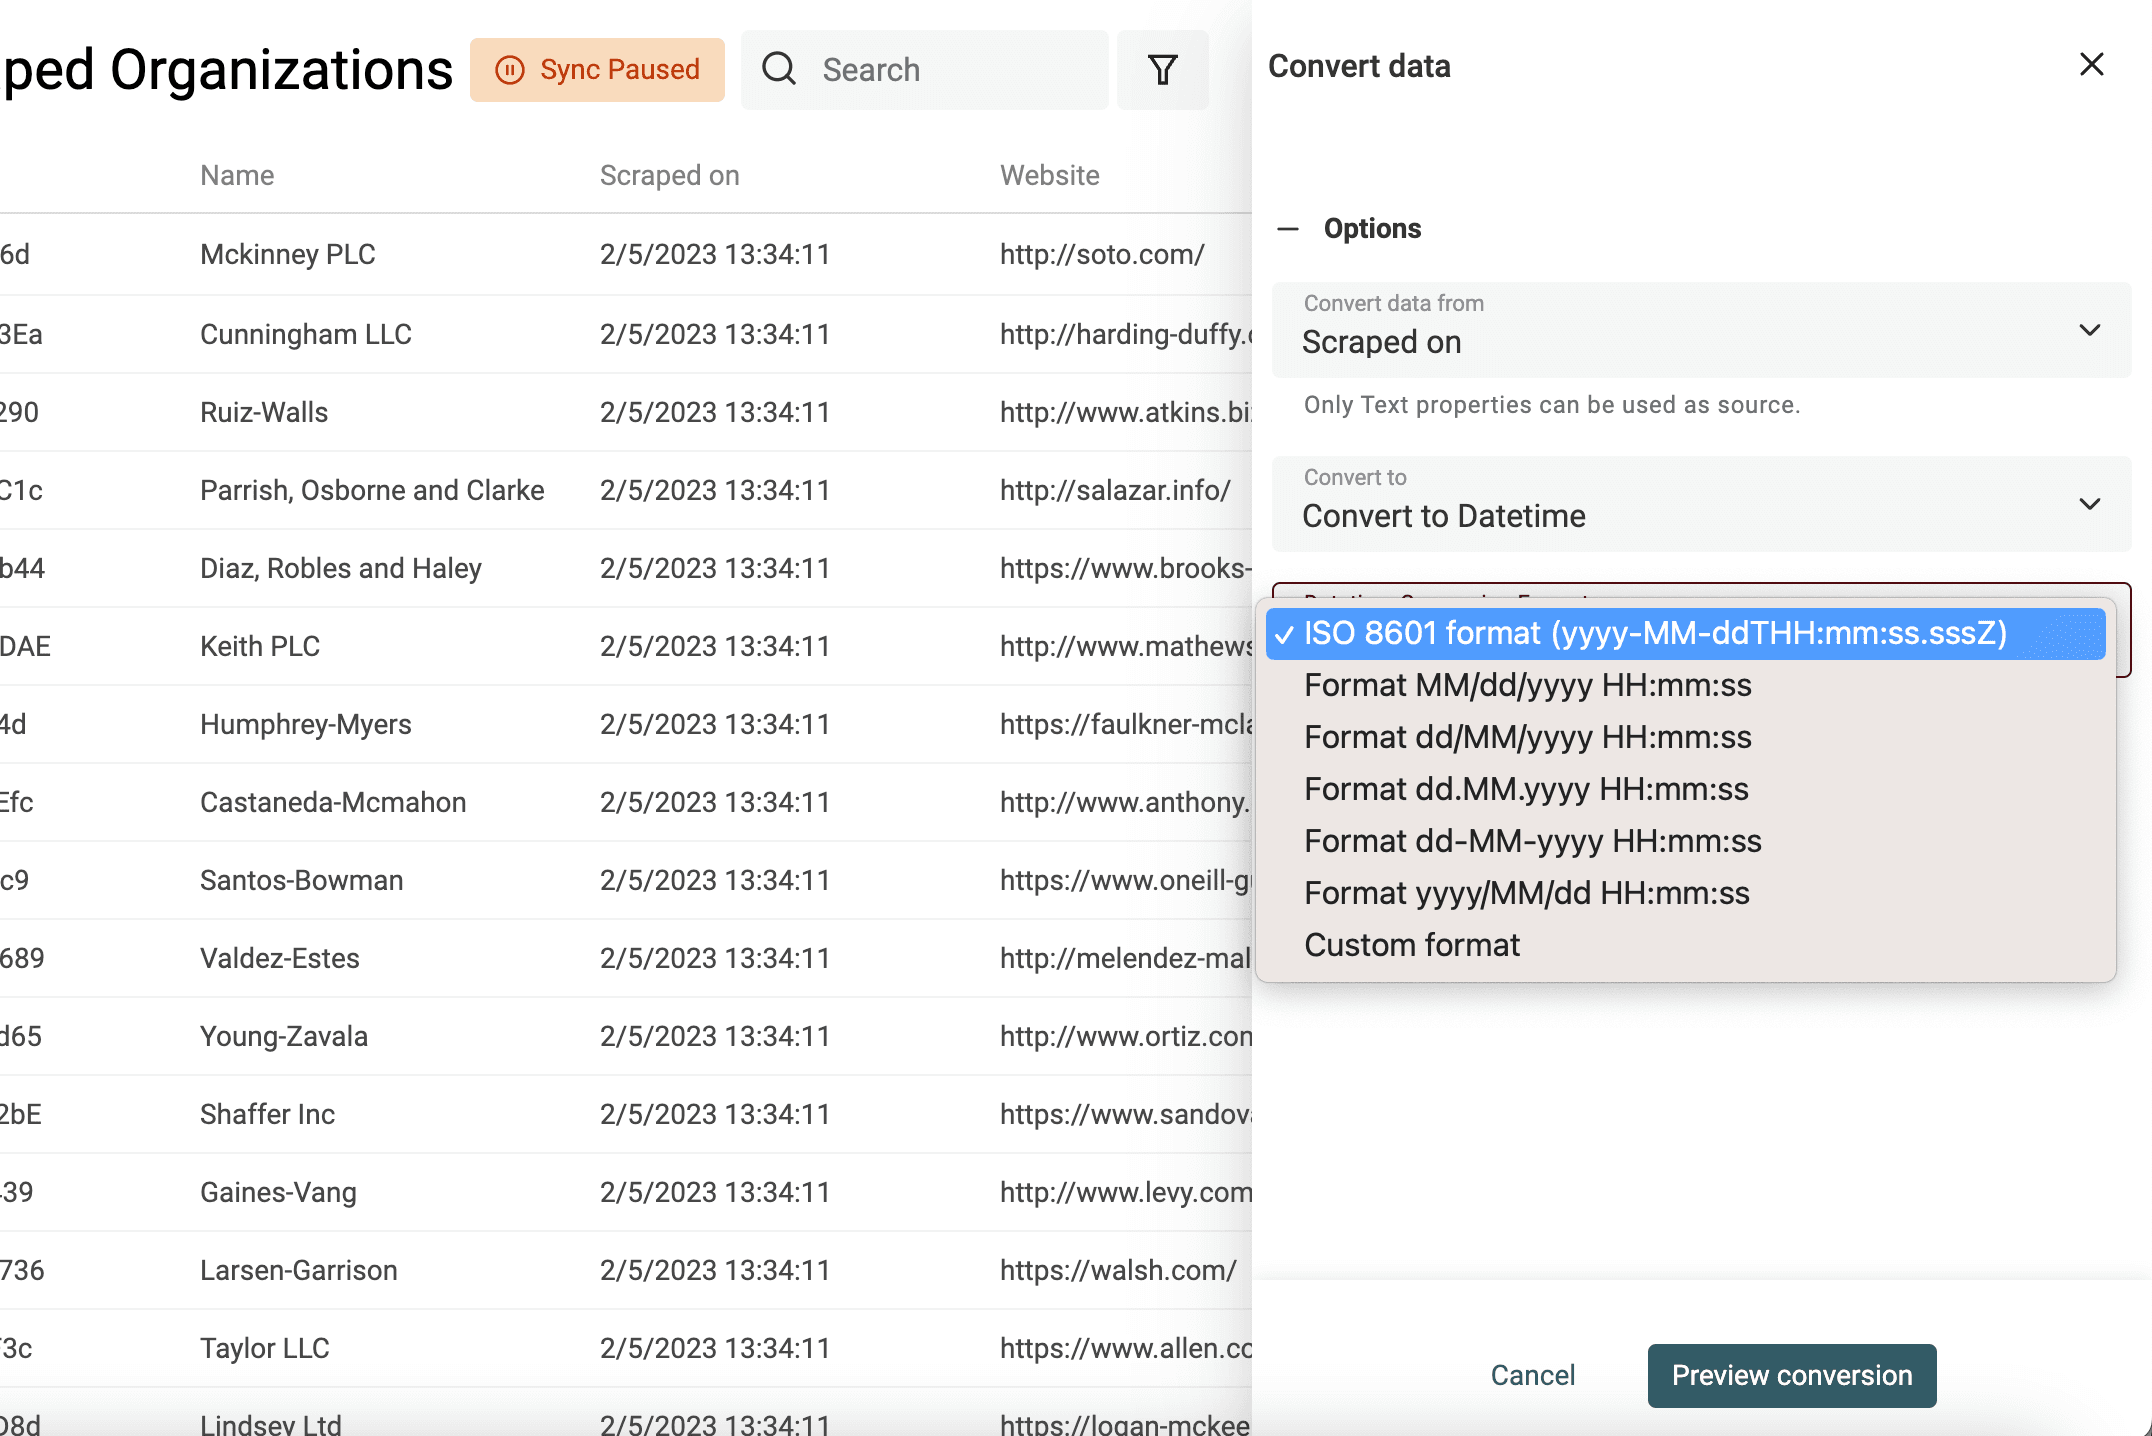
Gängige Formate sind bereits aufgeführt, darunter die von Google Sheets und Excel verwendeten Datetime-Formate. Mit "Custom format" kannst Du alternativ ein eigenes Datetime-Format definieren.
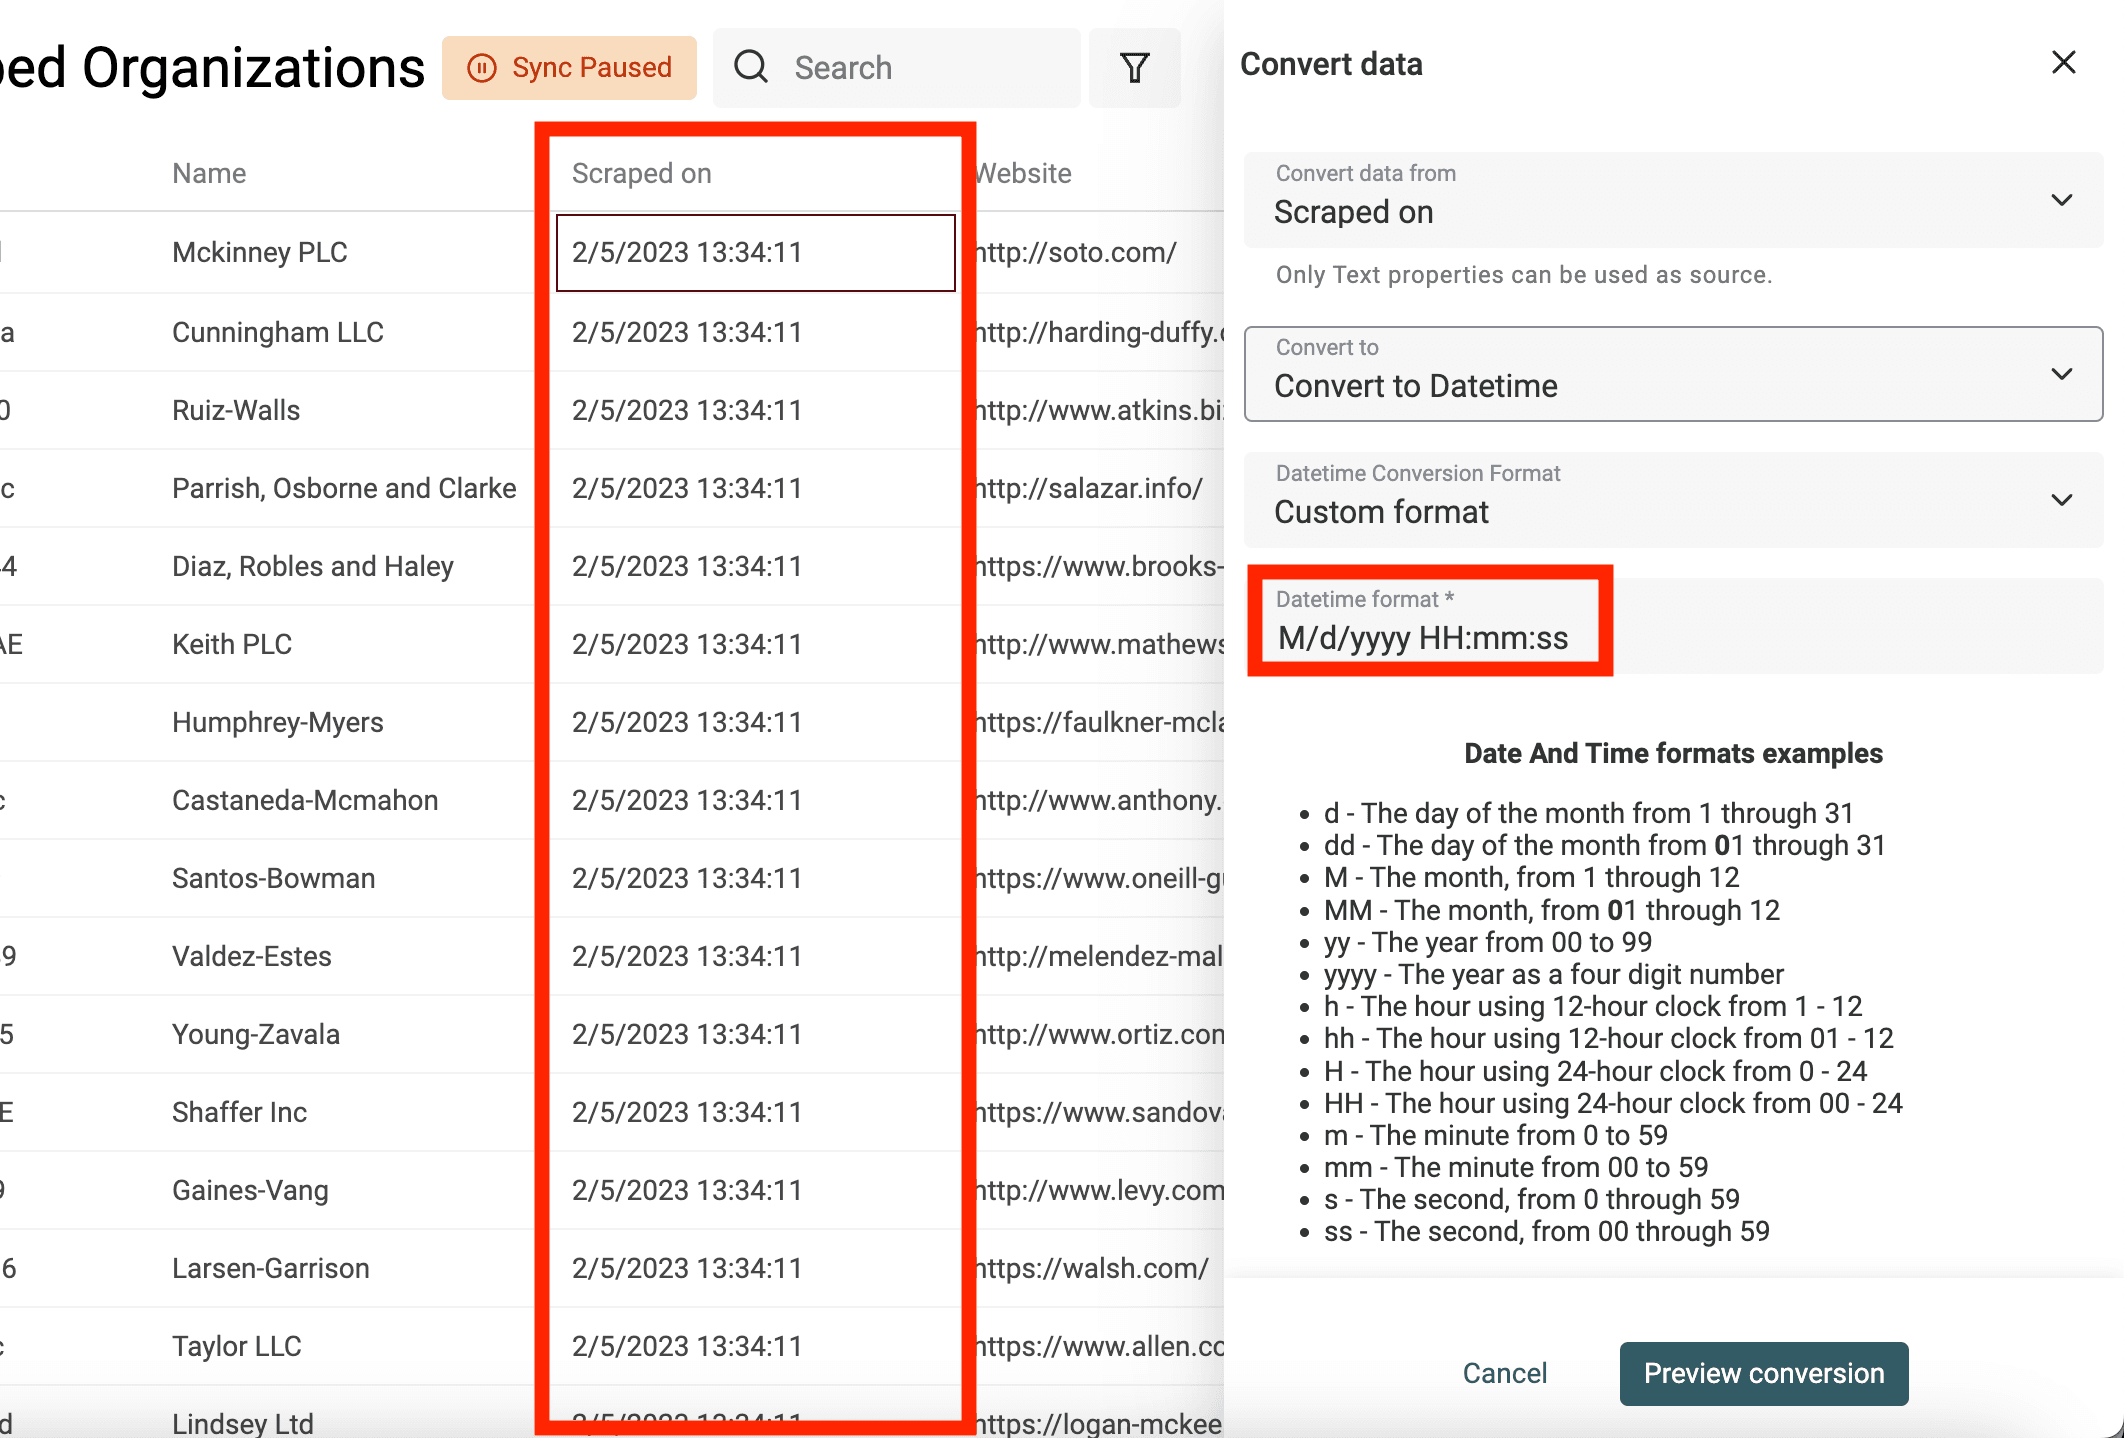
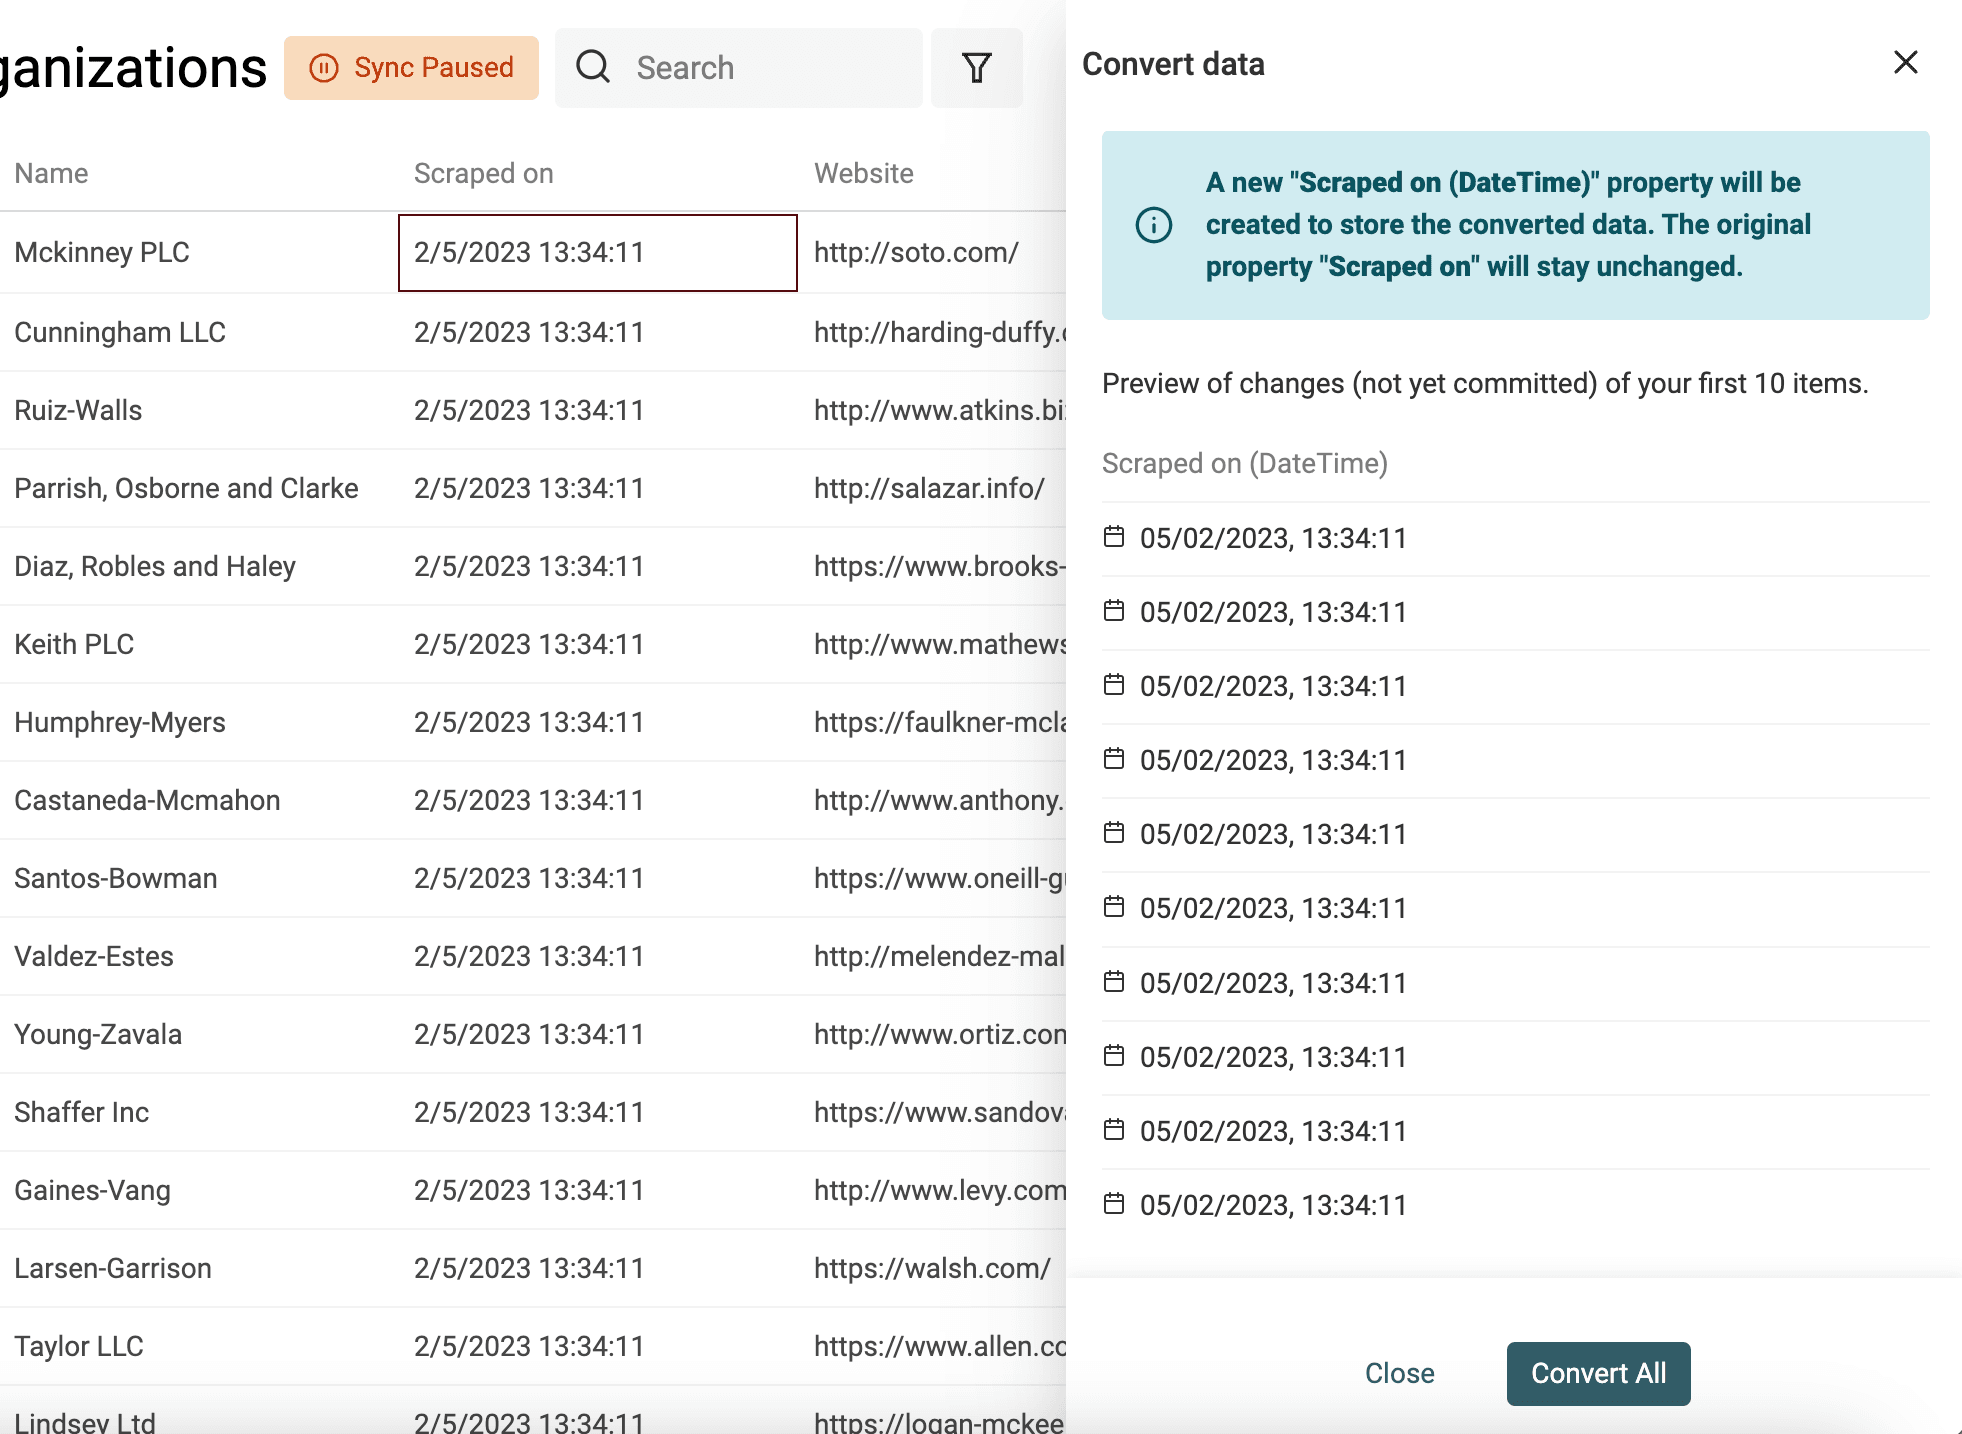
👉 In unserer Dokumentation erfährst Du mehr über benutzerdefinierte Datetime-Formate.
Checkboxen (Boolean) aus Textwerten erstellen
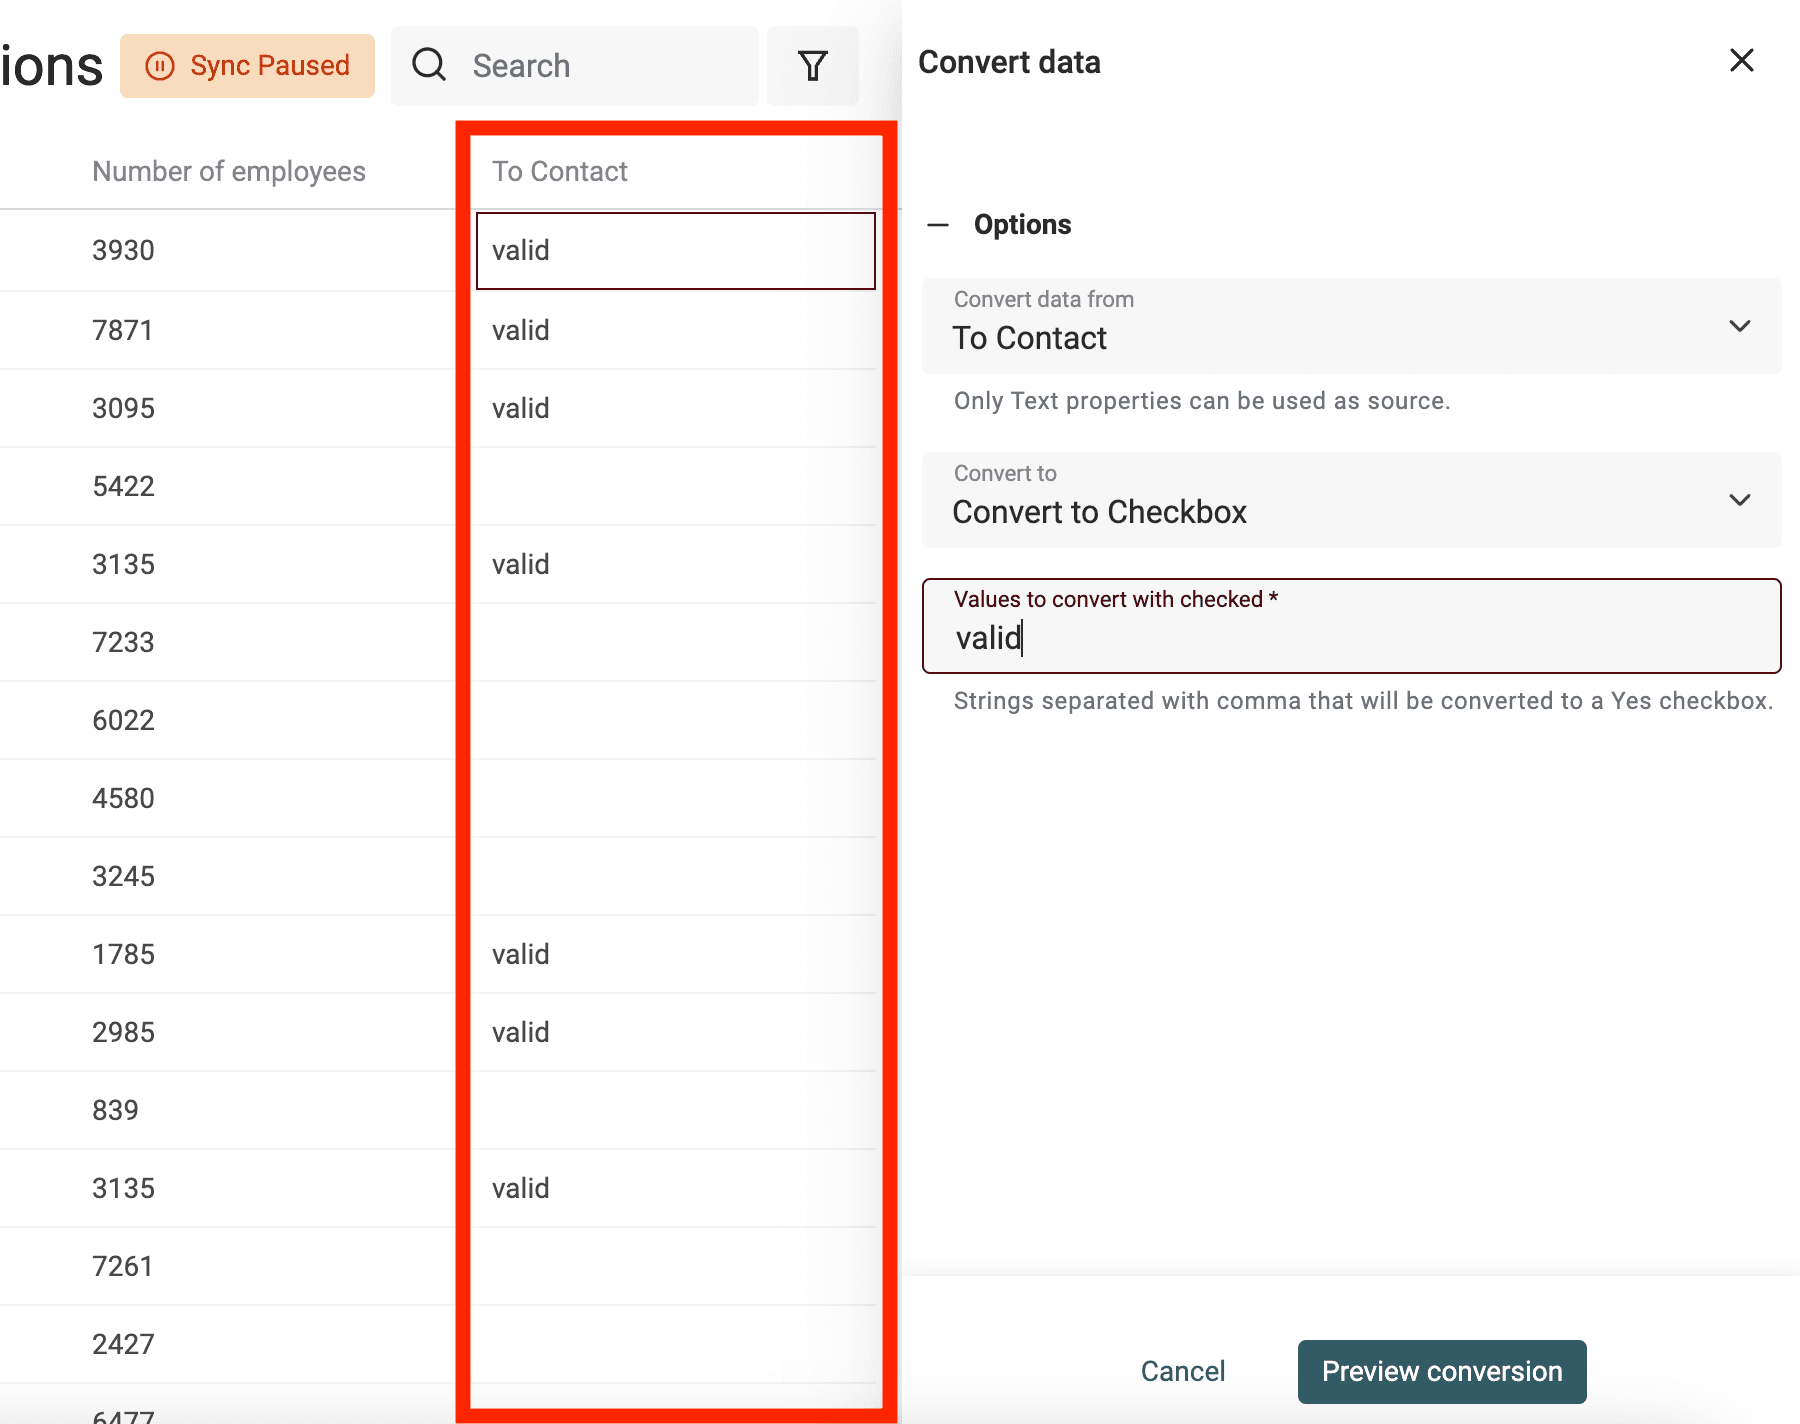
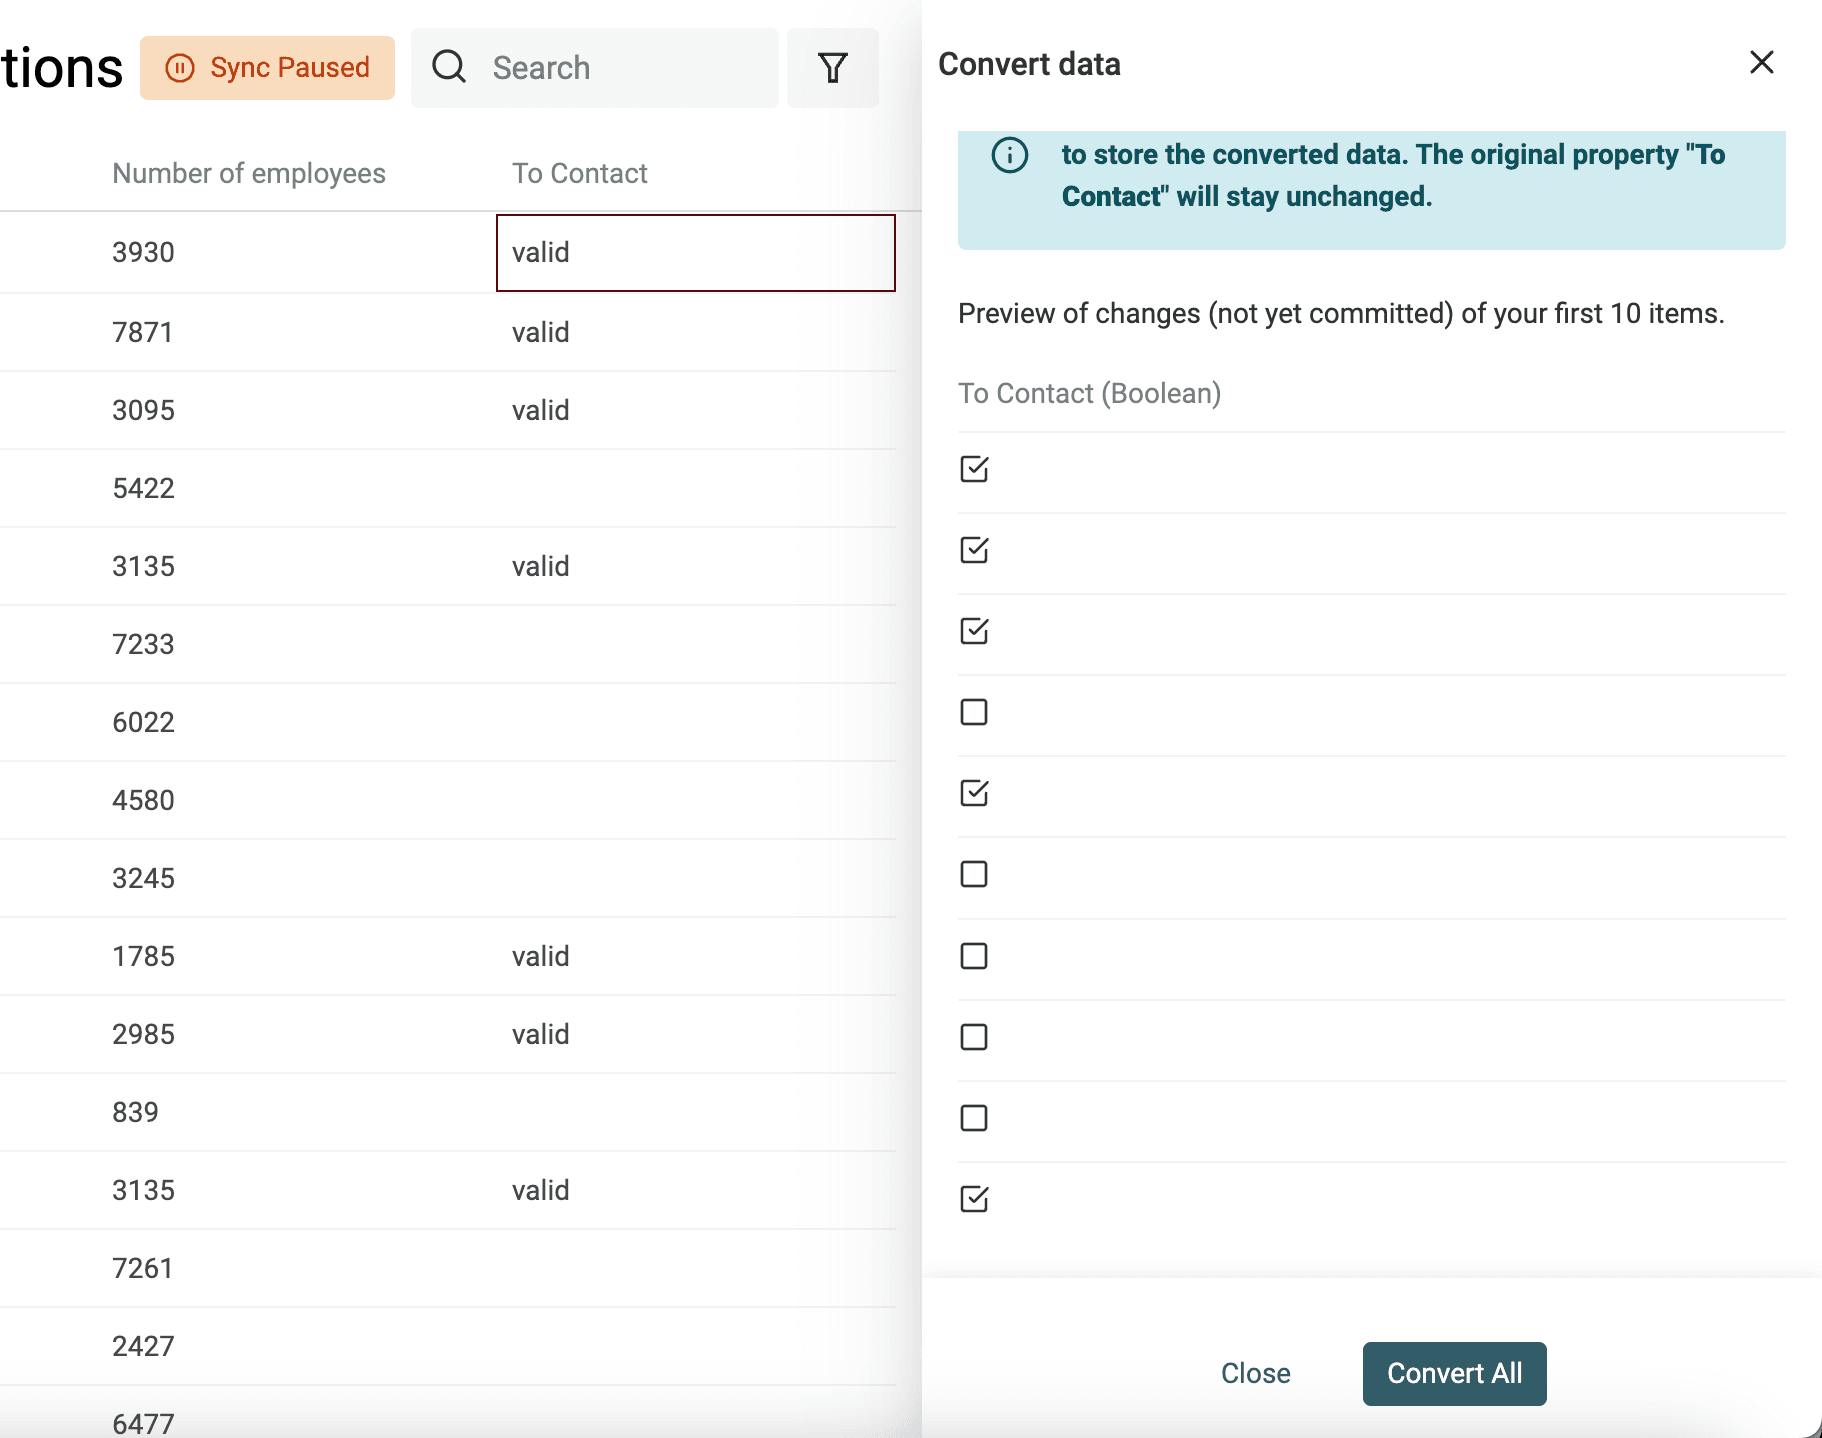
Datablist konvertiert Spalten mit Werten wie "Yes, No" oder "TRUE, FALSE" beim Import automatisch in Checkbox Properties. Für komplexere Konvertierungen kannst Du den Converter verwenden.
Lege die durch Kommas getrennten Werte fest, die in eine aktivierte Checkbox konvertiert werden sollen. Alle anderen Werte bleiben deaktiviert.
Zahlenwerte aus Texten extrahieren
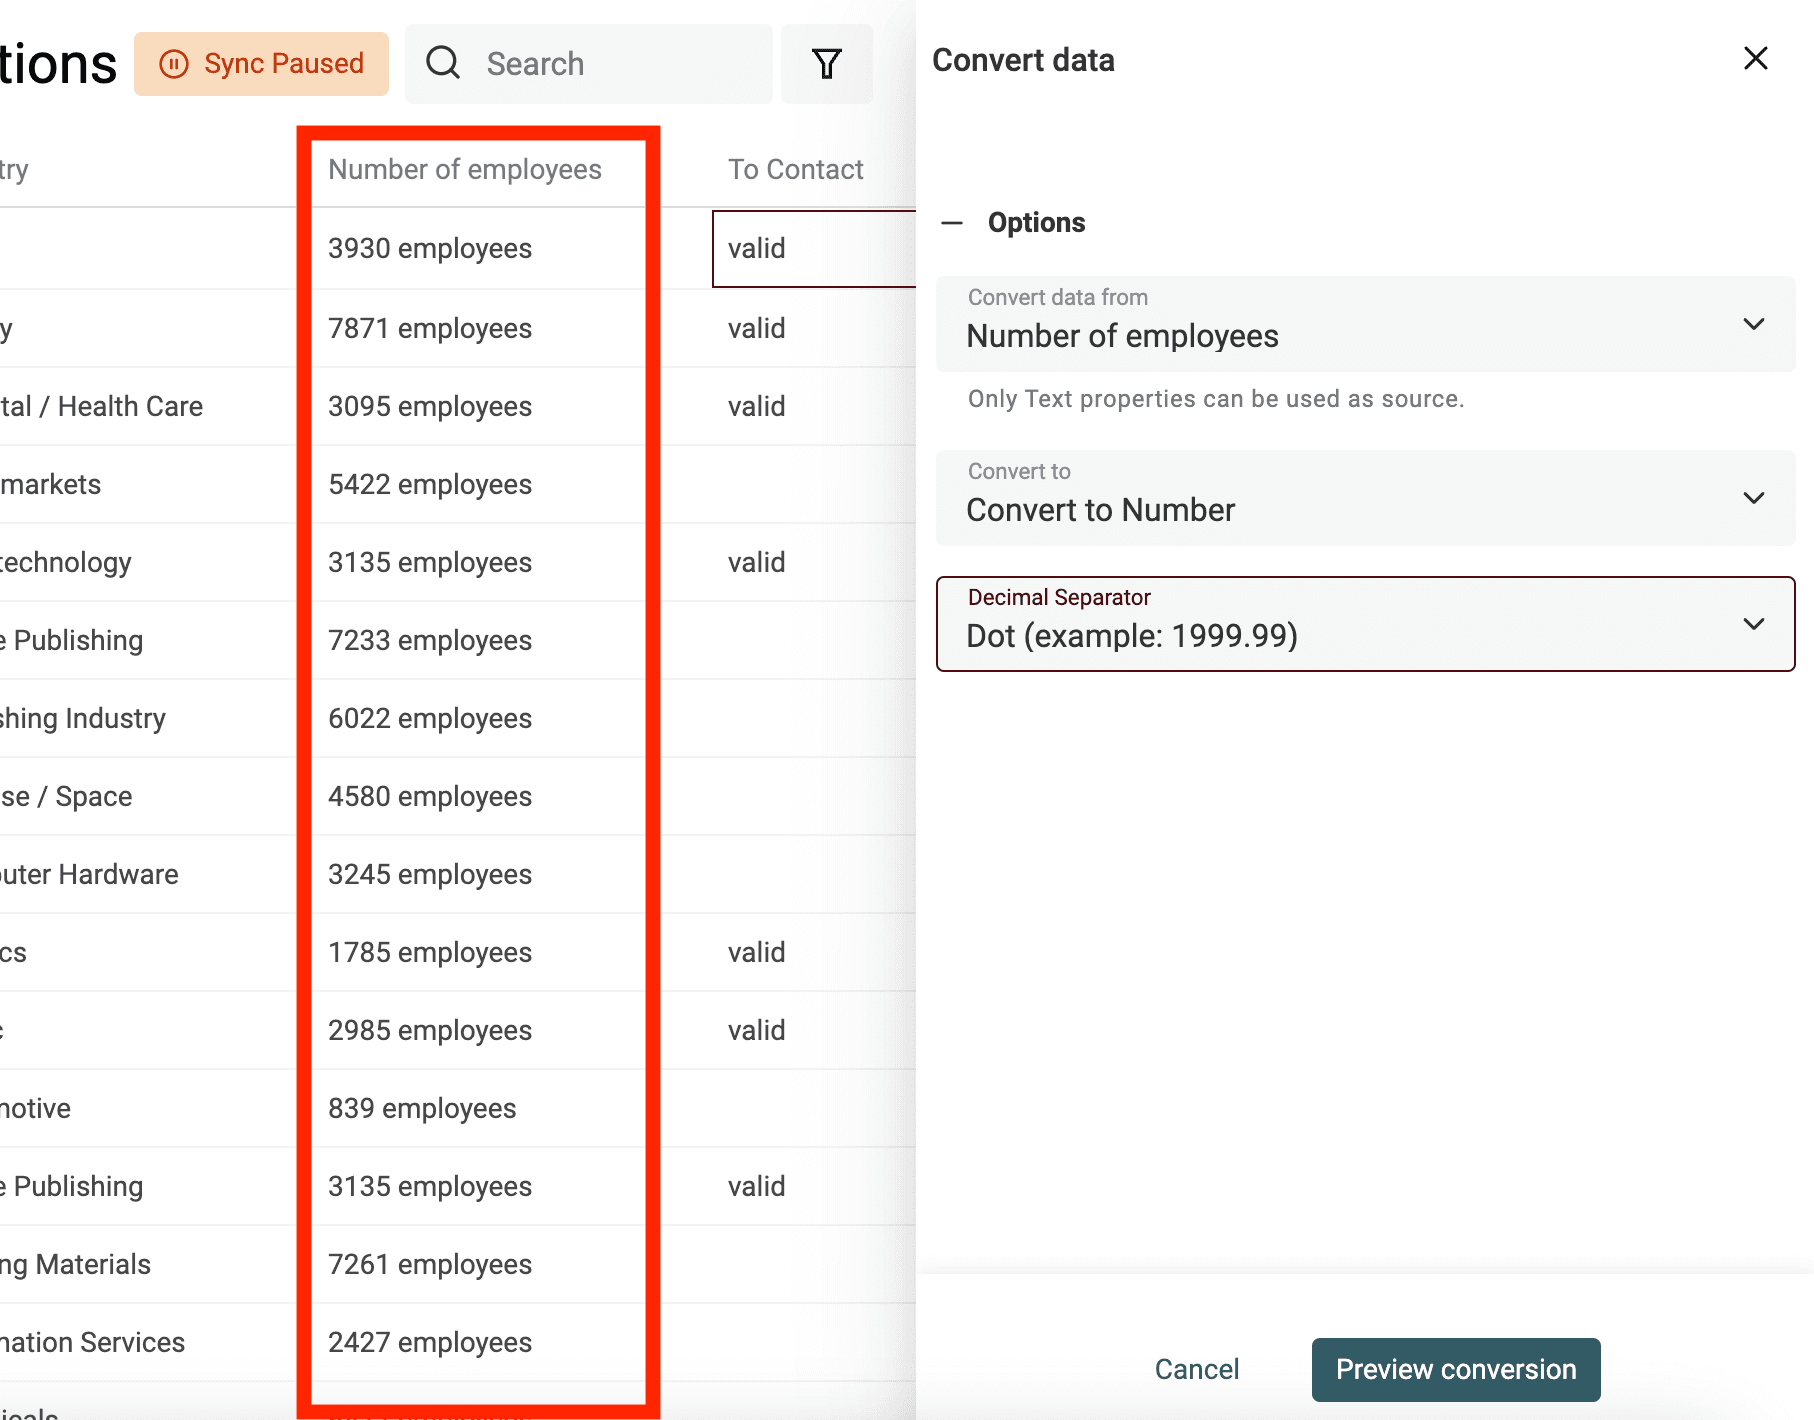
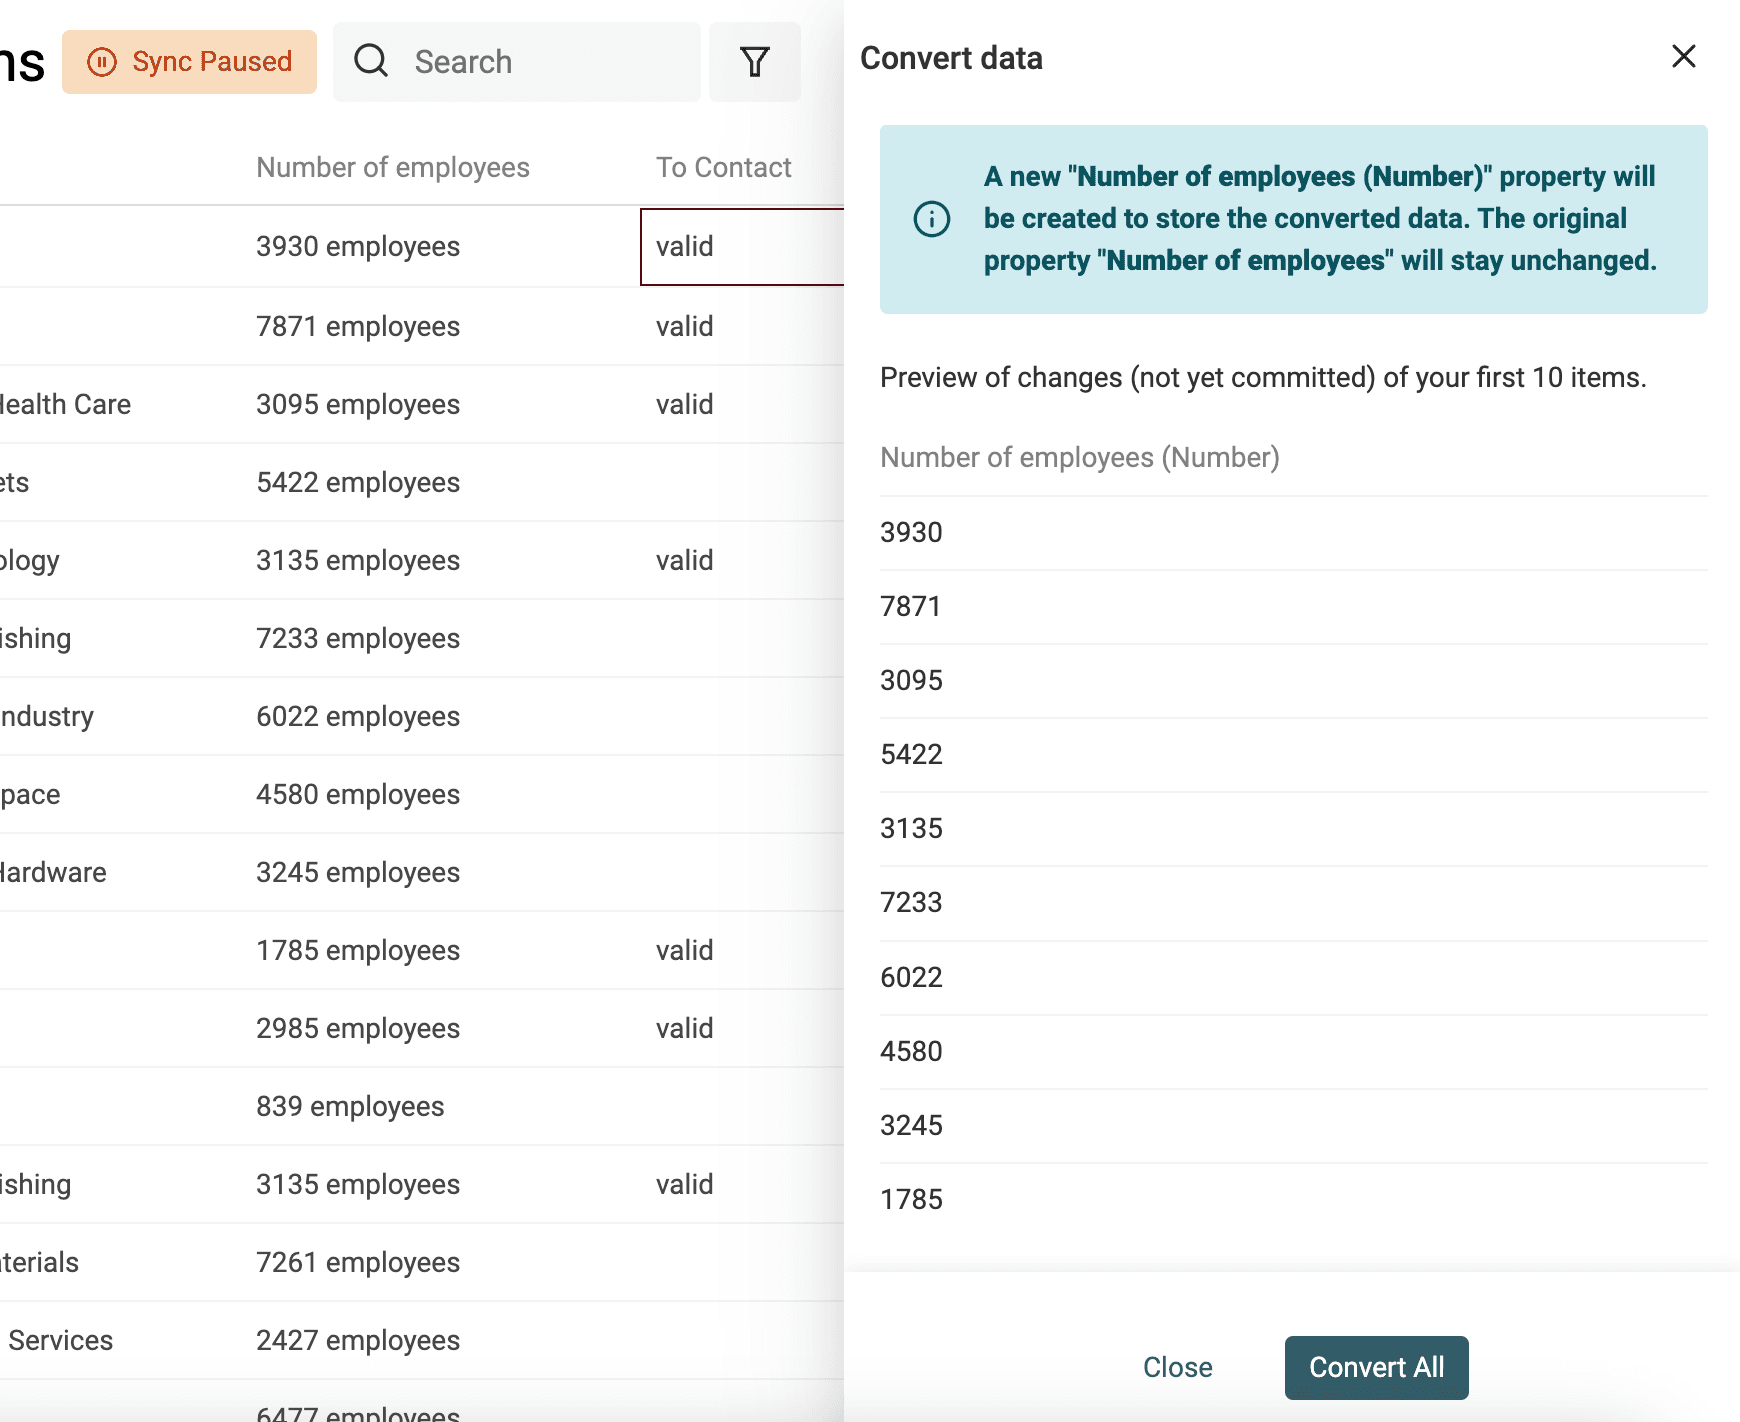
Mit dem Converter "Text to number" kannst Du:
- Zahlen mit individuellen Dezimal- und Tausendertrennzeichen vereinheitlichen
- Zahlen aus Texten extrahieren, die Buchstaben enthalten
👉 In unserer Dokumentation erfährst Du mehr über die Konvertierung von Zahlen.
Web-Scraping-Daten bereinigen
HTML in Text umwandeln
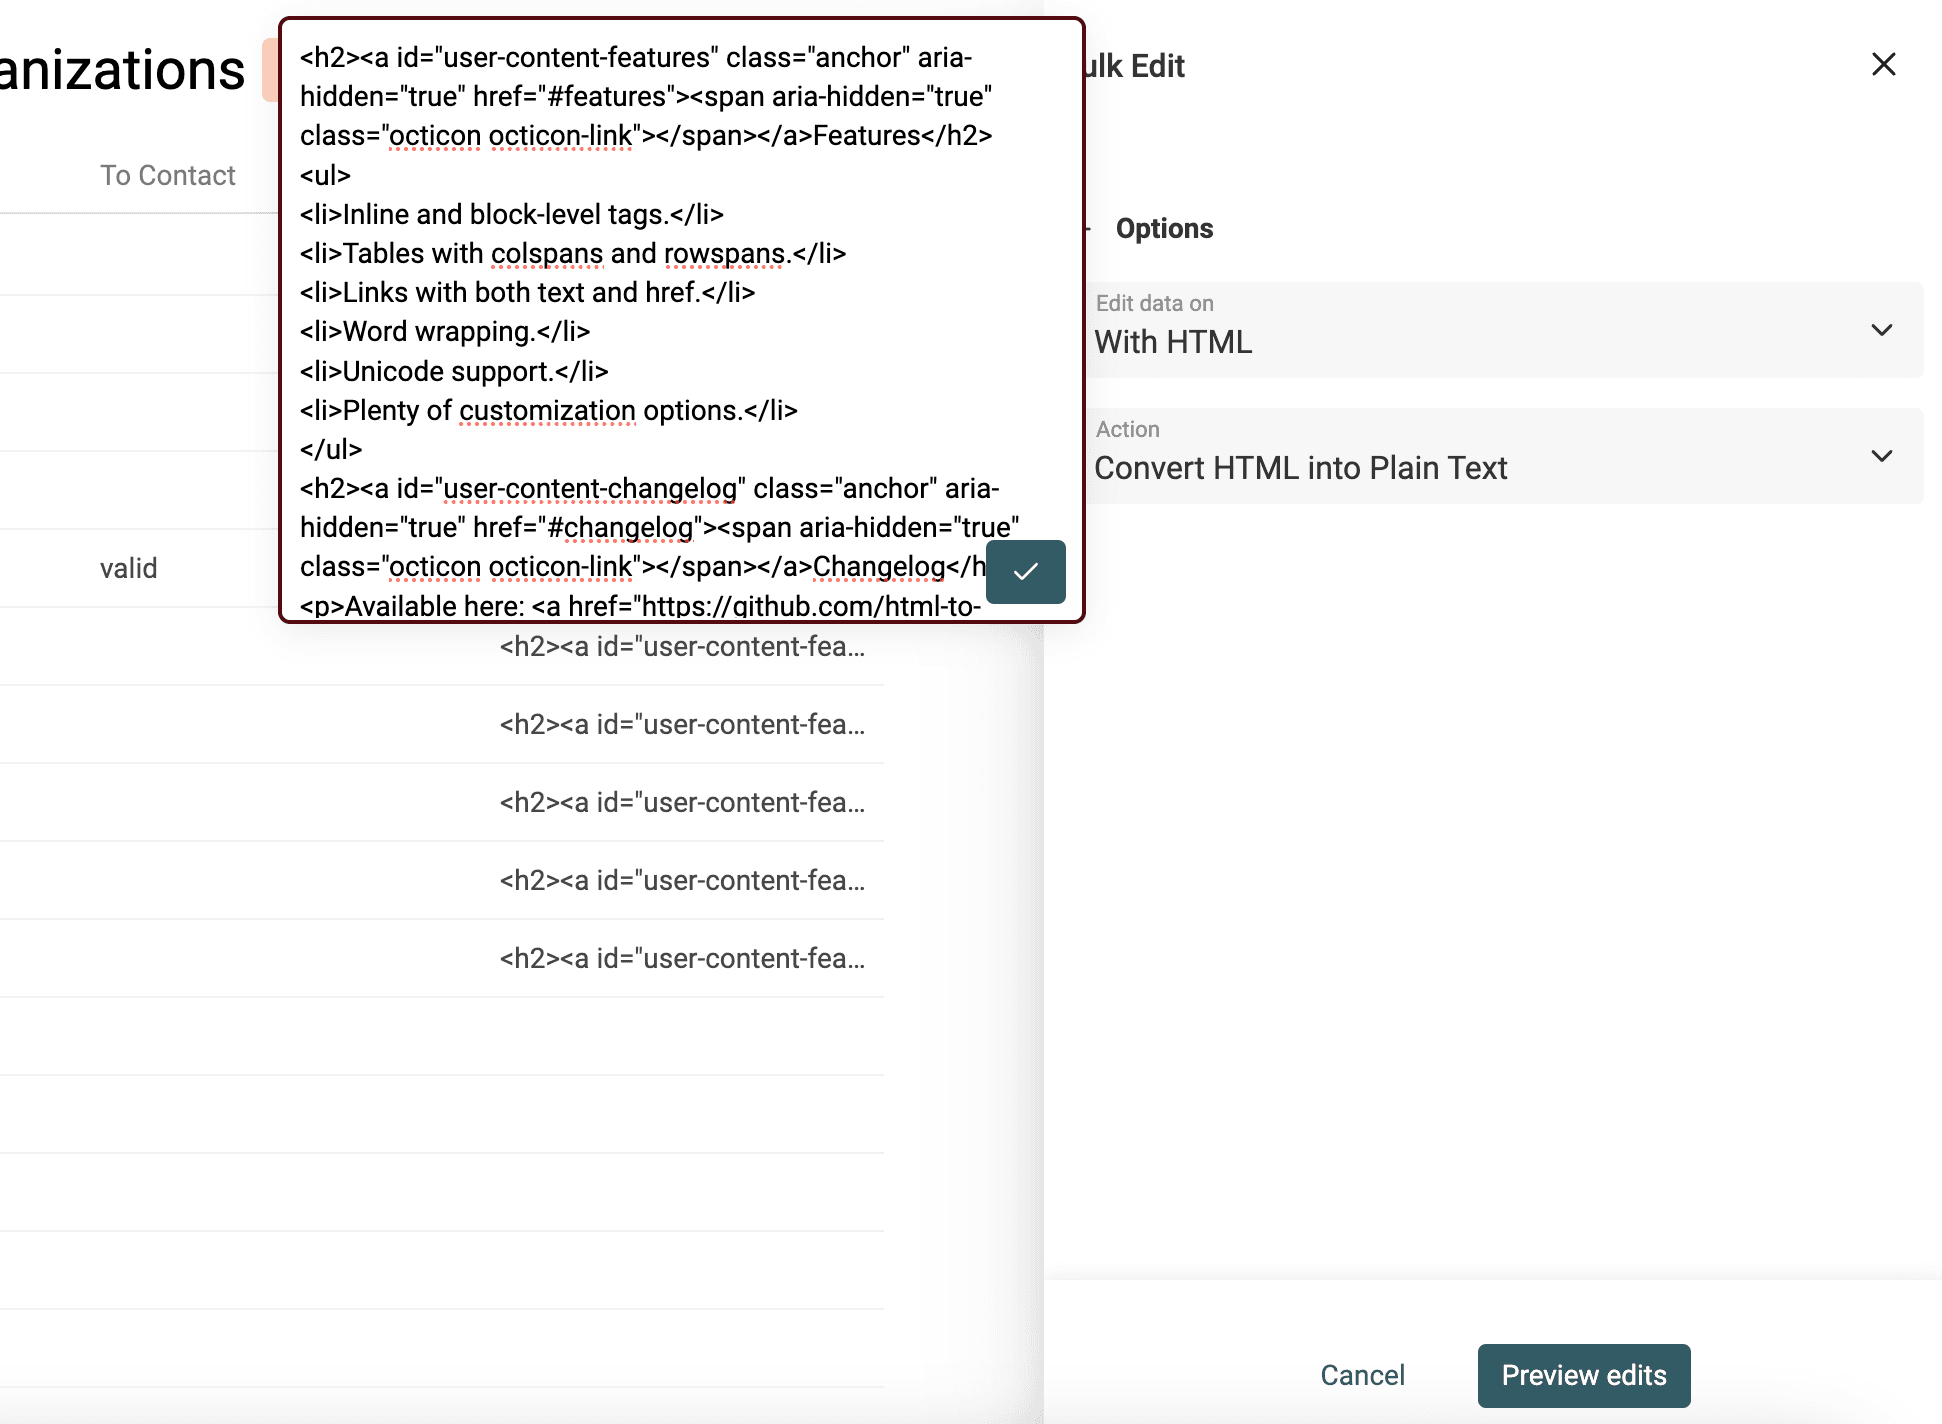
Scraping-Tools verarbeiten HTML-Code. Deshalb können Deine Texte noch HTML-Tags enthalten.
HTML-Code umfasst Links, Bilder und Aufzählungen. Außerdem nutzt er Absätze und Zeilenumbrüche.
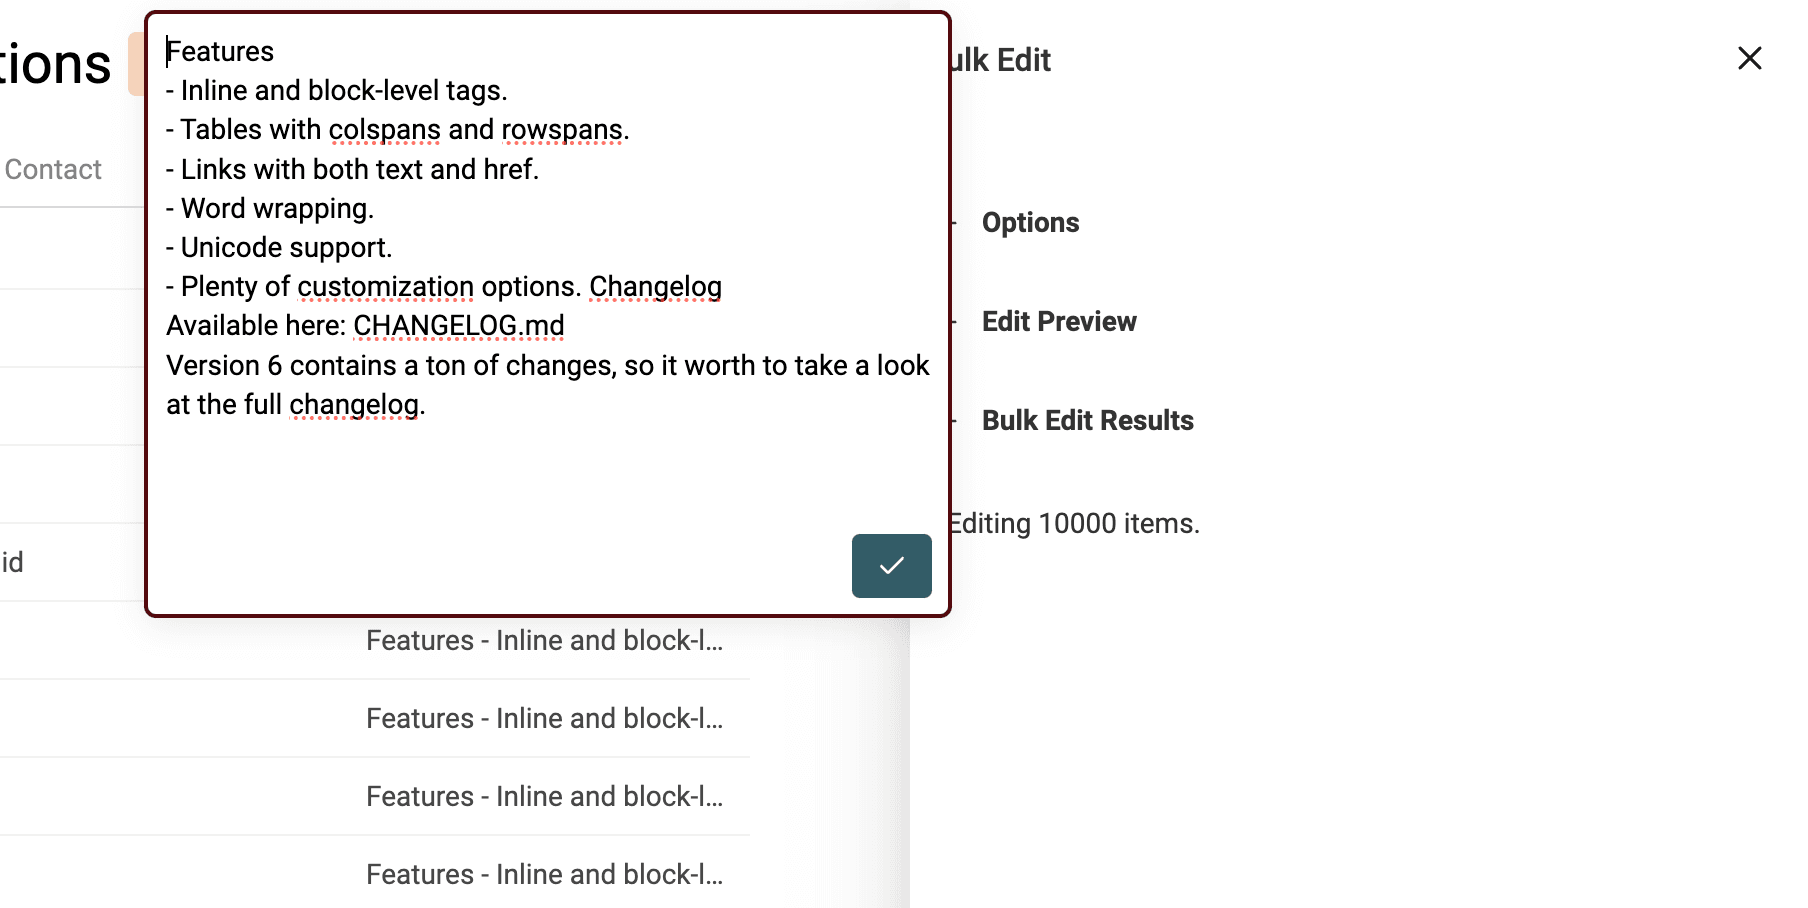
Ziel ist es, einen Teil der durch HTML vorgegebenen Struktur beizubehalten und gleichzeitig den schwer lesbaren Code in Klartext umzuwandeln.
Der HTML-to-Text-Converter von Datablist behält Zeilenumbrüche bei und wandelt Aufzählungspunkte in Listen mit dem Präfix - um.
Um Text mit HTML-Tags in Klartext umzuwandeln, öffnest Du im Menü Edit das Tool Bulk Edit.
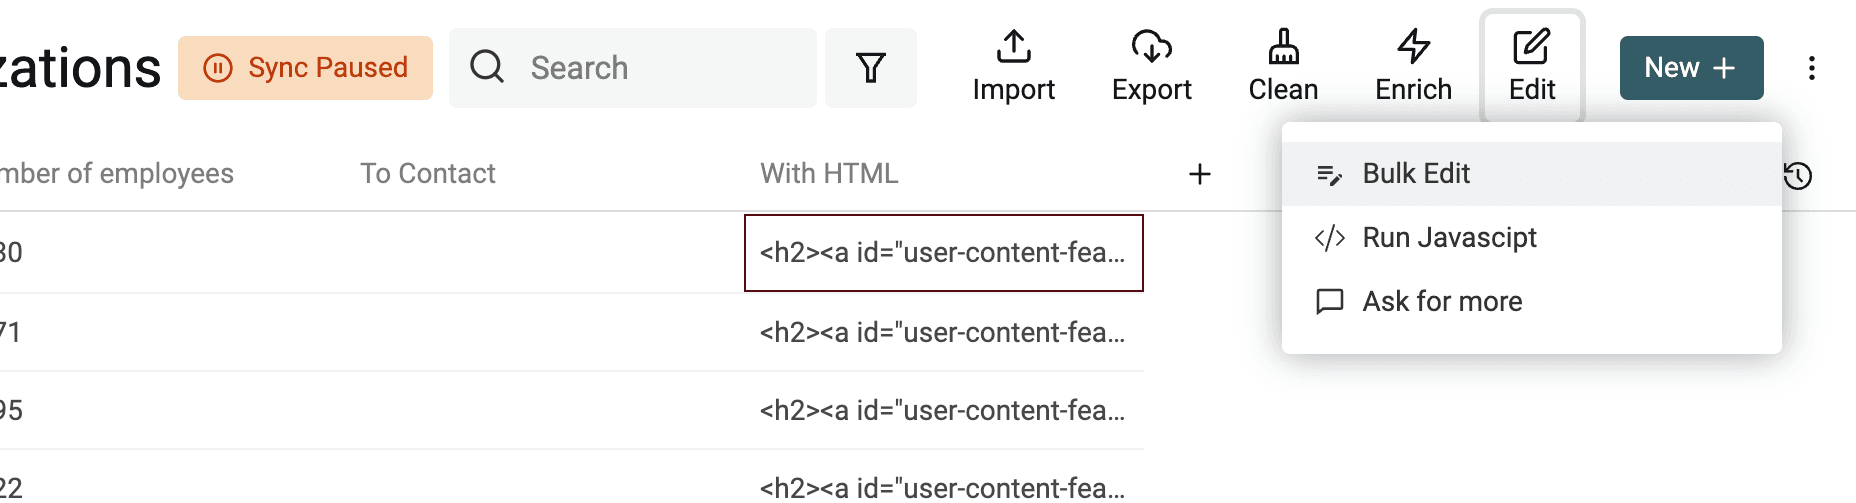
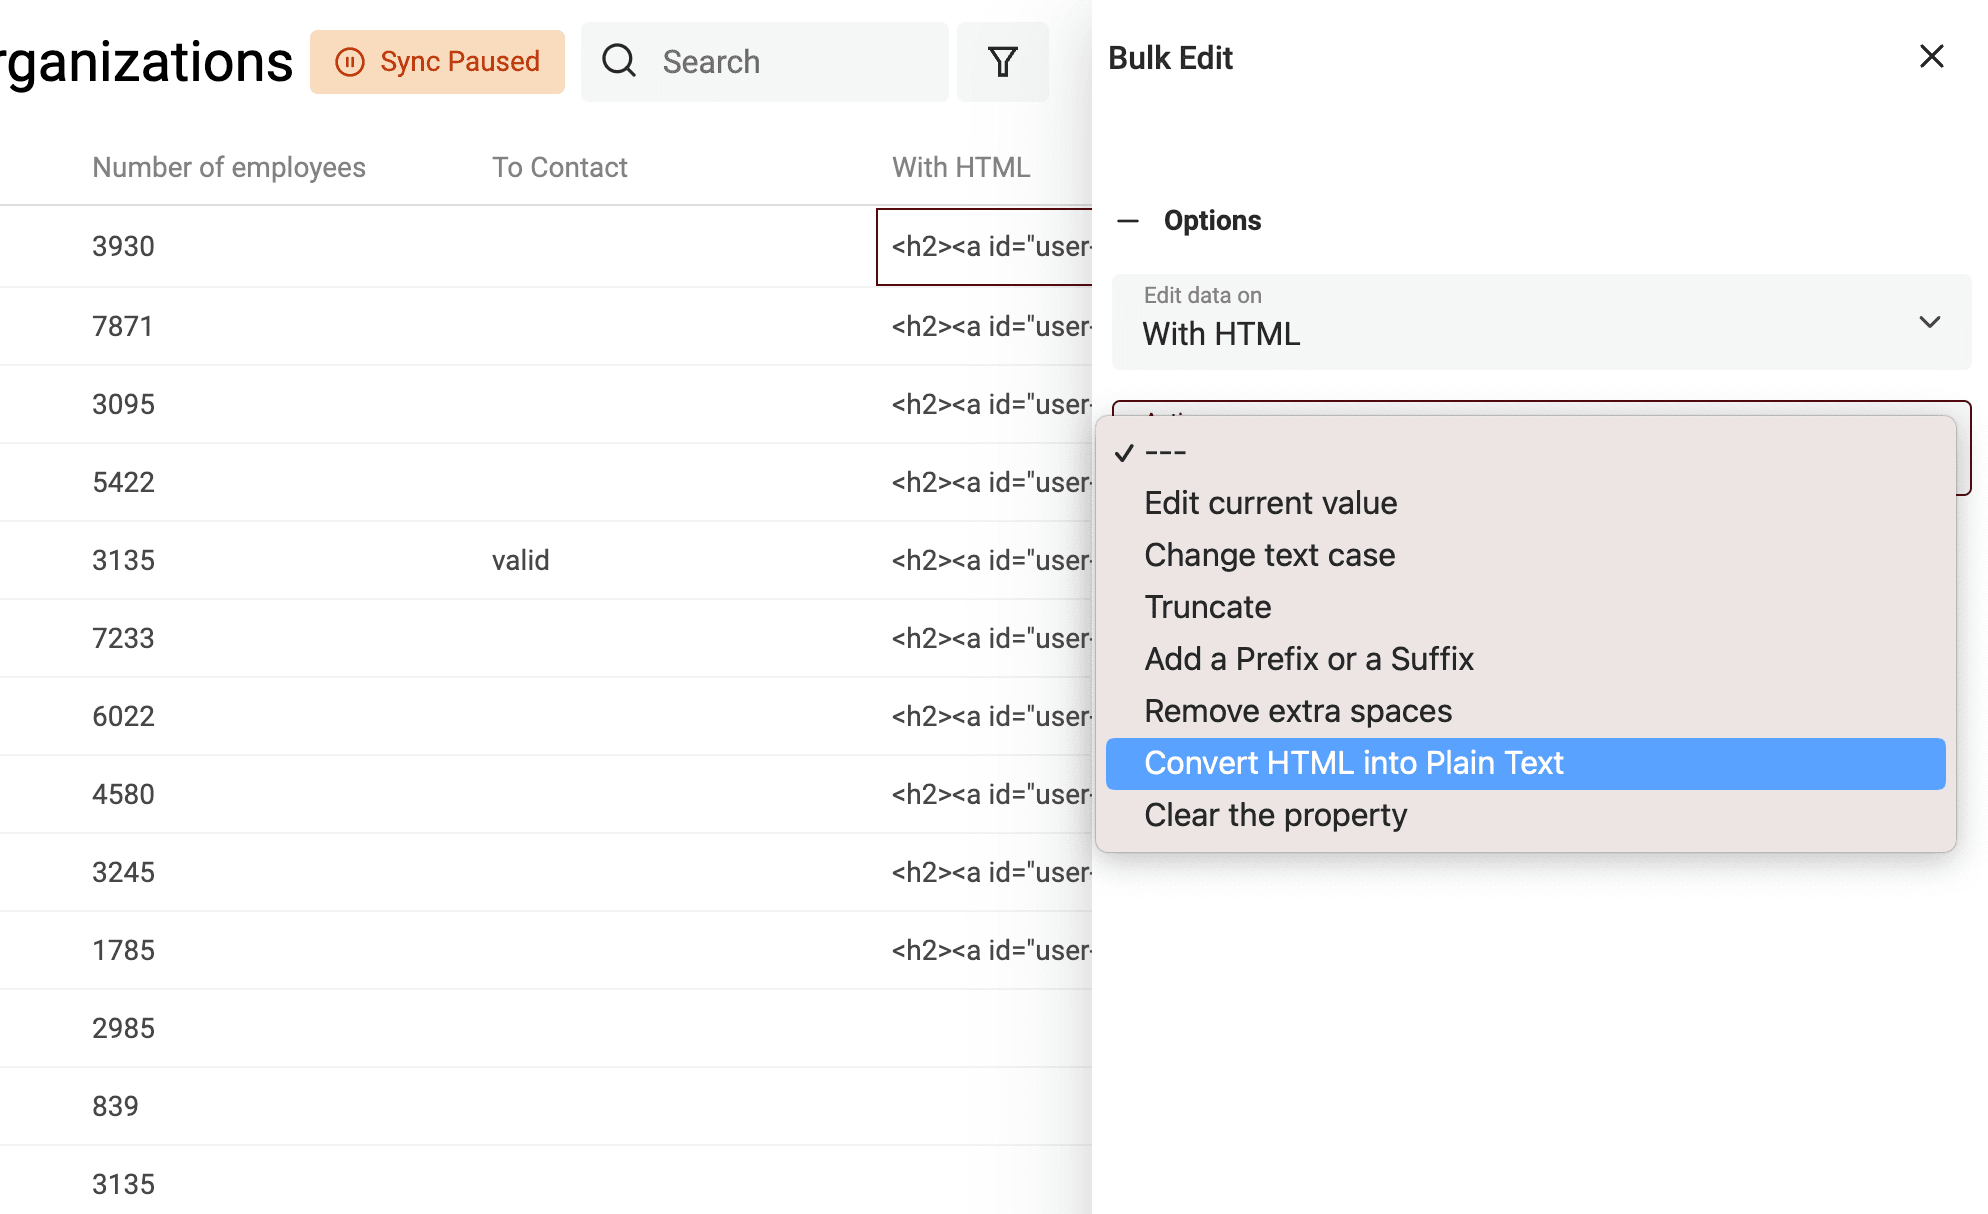
Wähle die Property mit den HTML-Tags und anschließend "Convert HTML into plain text" aus.
Überflüssige Leerzeichen entfernen
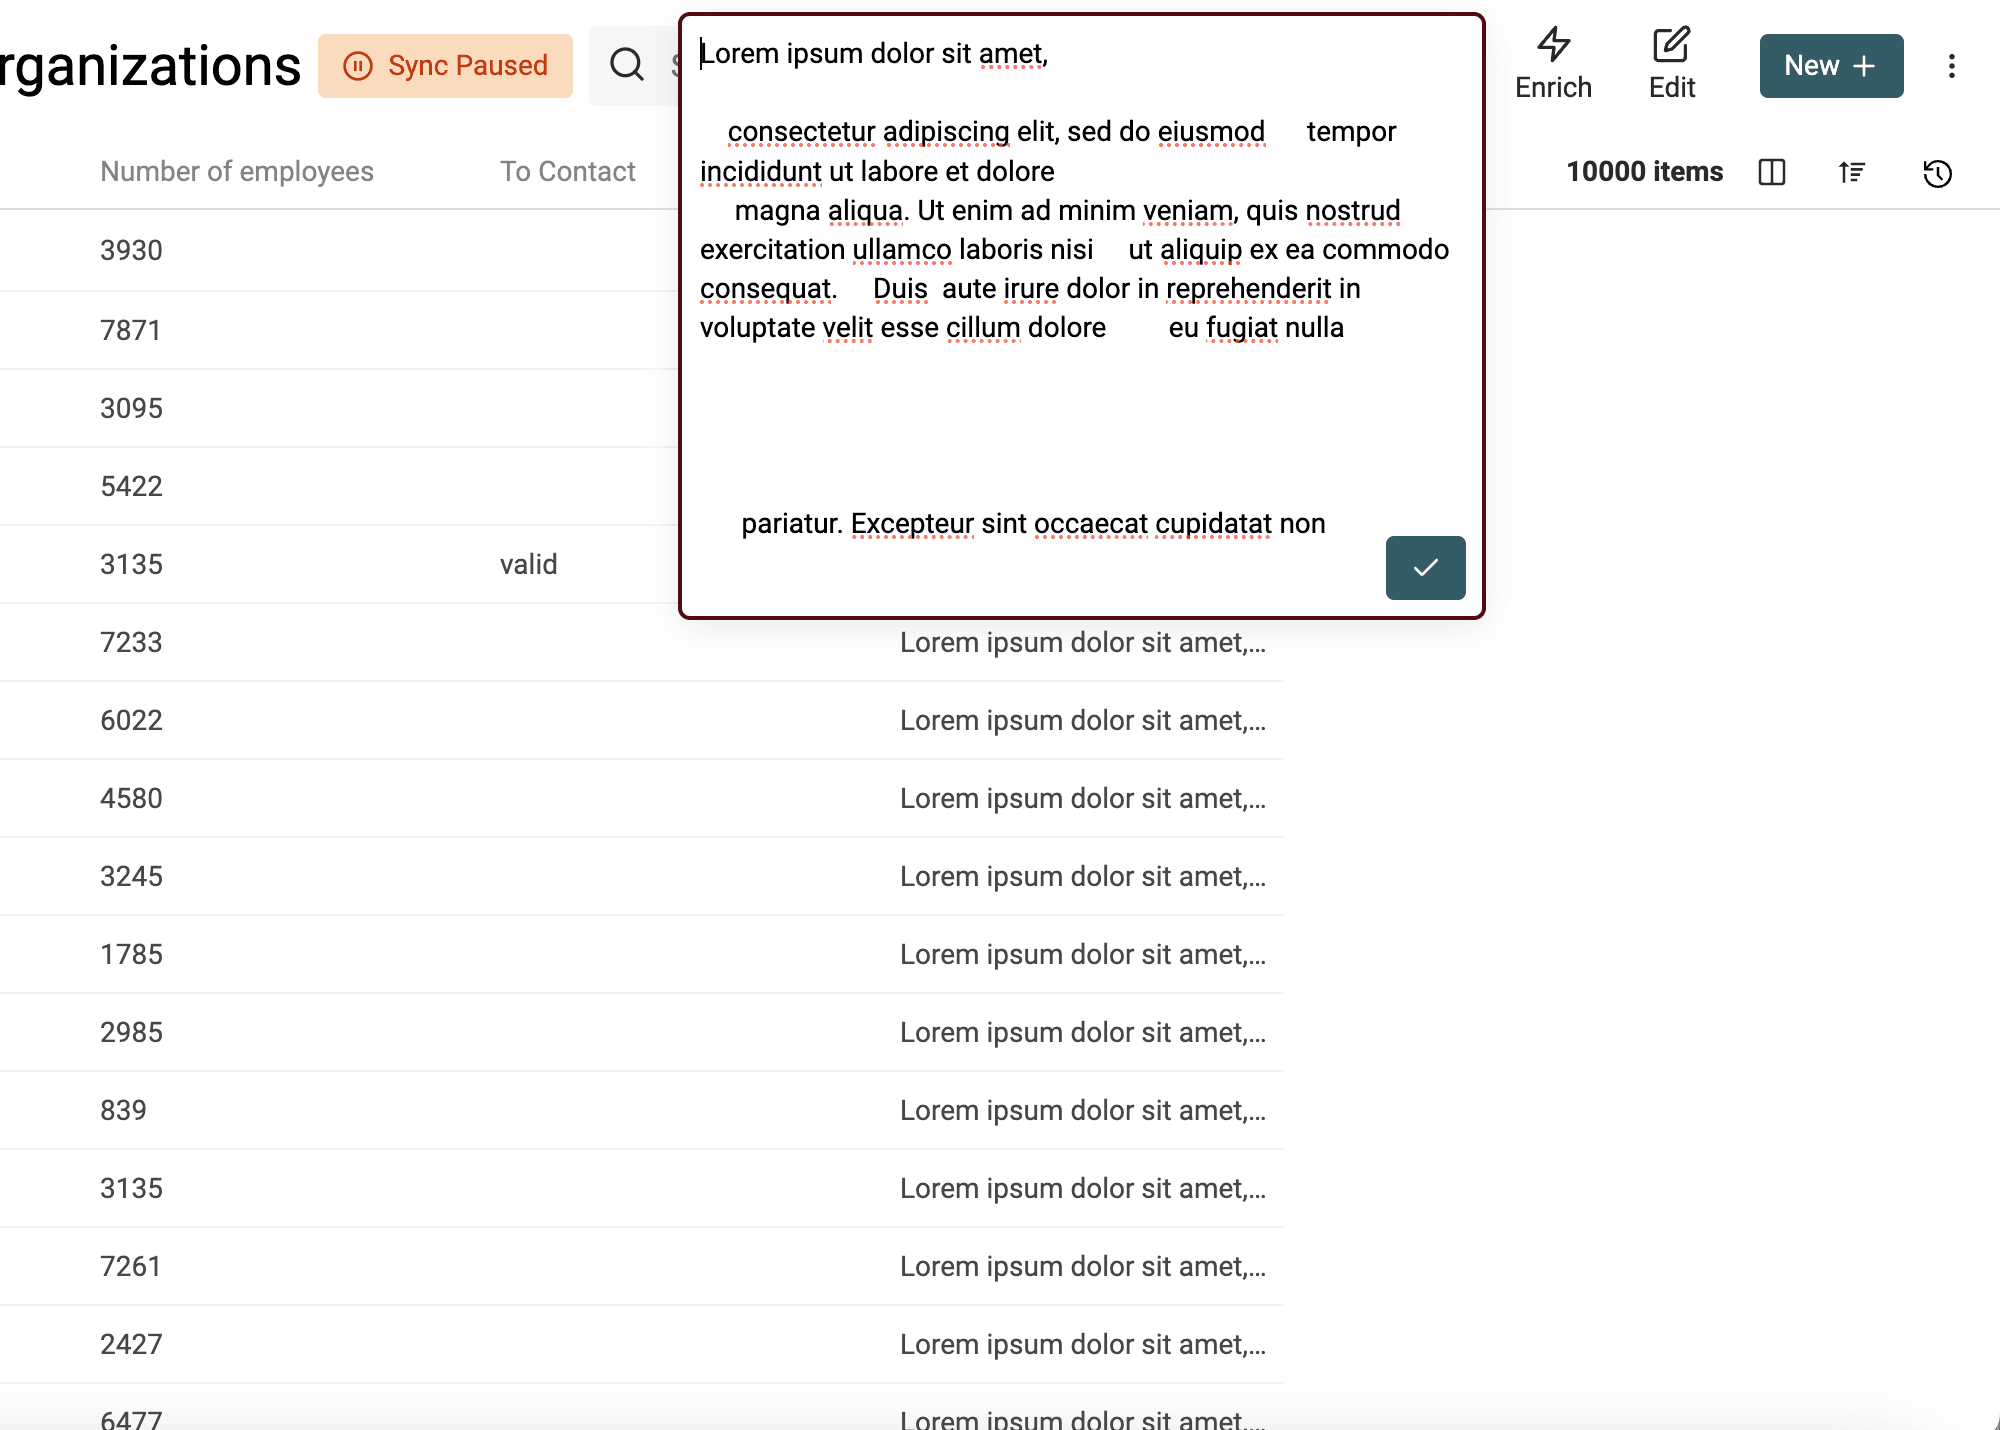
Überflüssige Leerzeichen sind ein weiteres häufiges Problem bei gescrapten Daten. Sie entstehen durch neue Zeilen, Tab und andere Zeichen, die in HTML einen Leerraum darstellen.
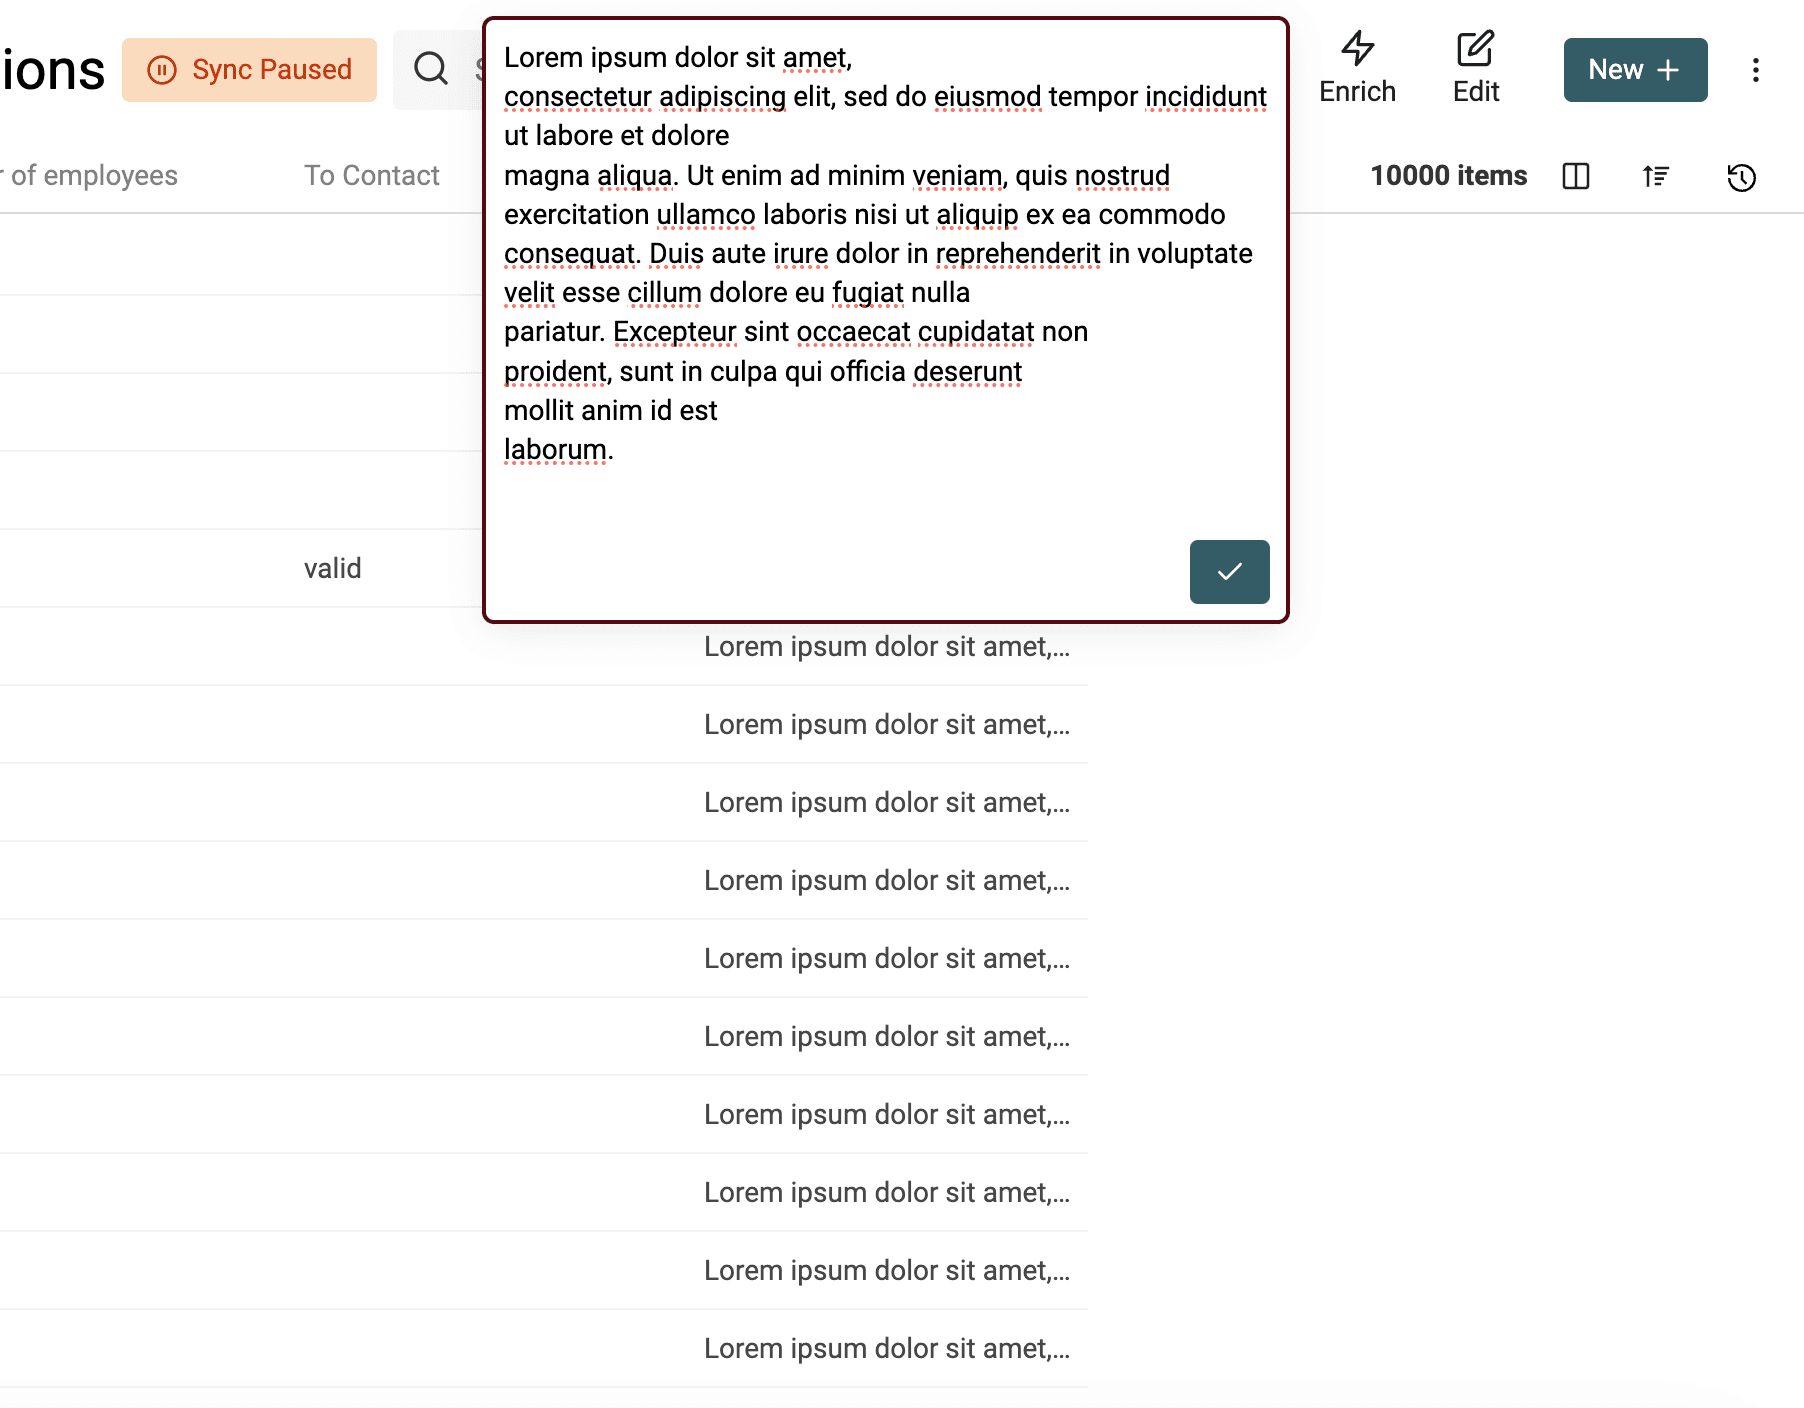
Datablist bietet ein Bereinigungstool, mit dem Du diese überflüssigen Leerzeichen entfernst.
- Es entfernt mehrfache Leerzeichen zwischen Wörtern
- Es entfernt leere Zeilen
- Es entfernt Leerzeichen am Anfang und Ende jeder Zeile
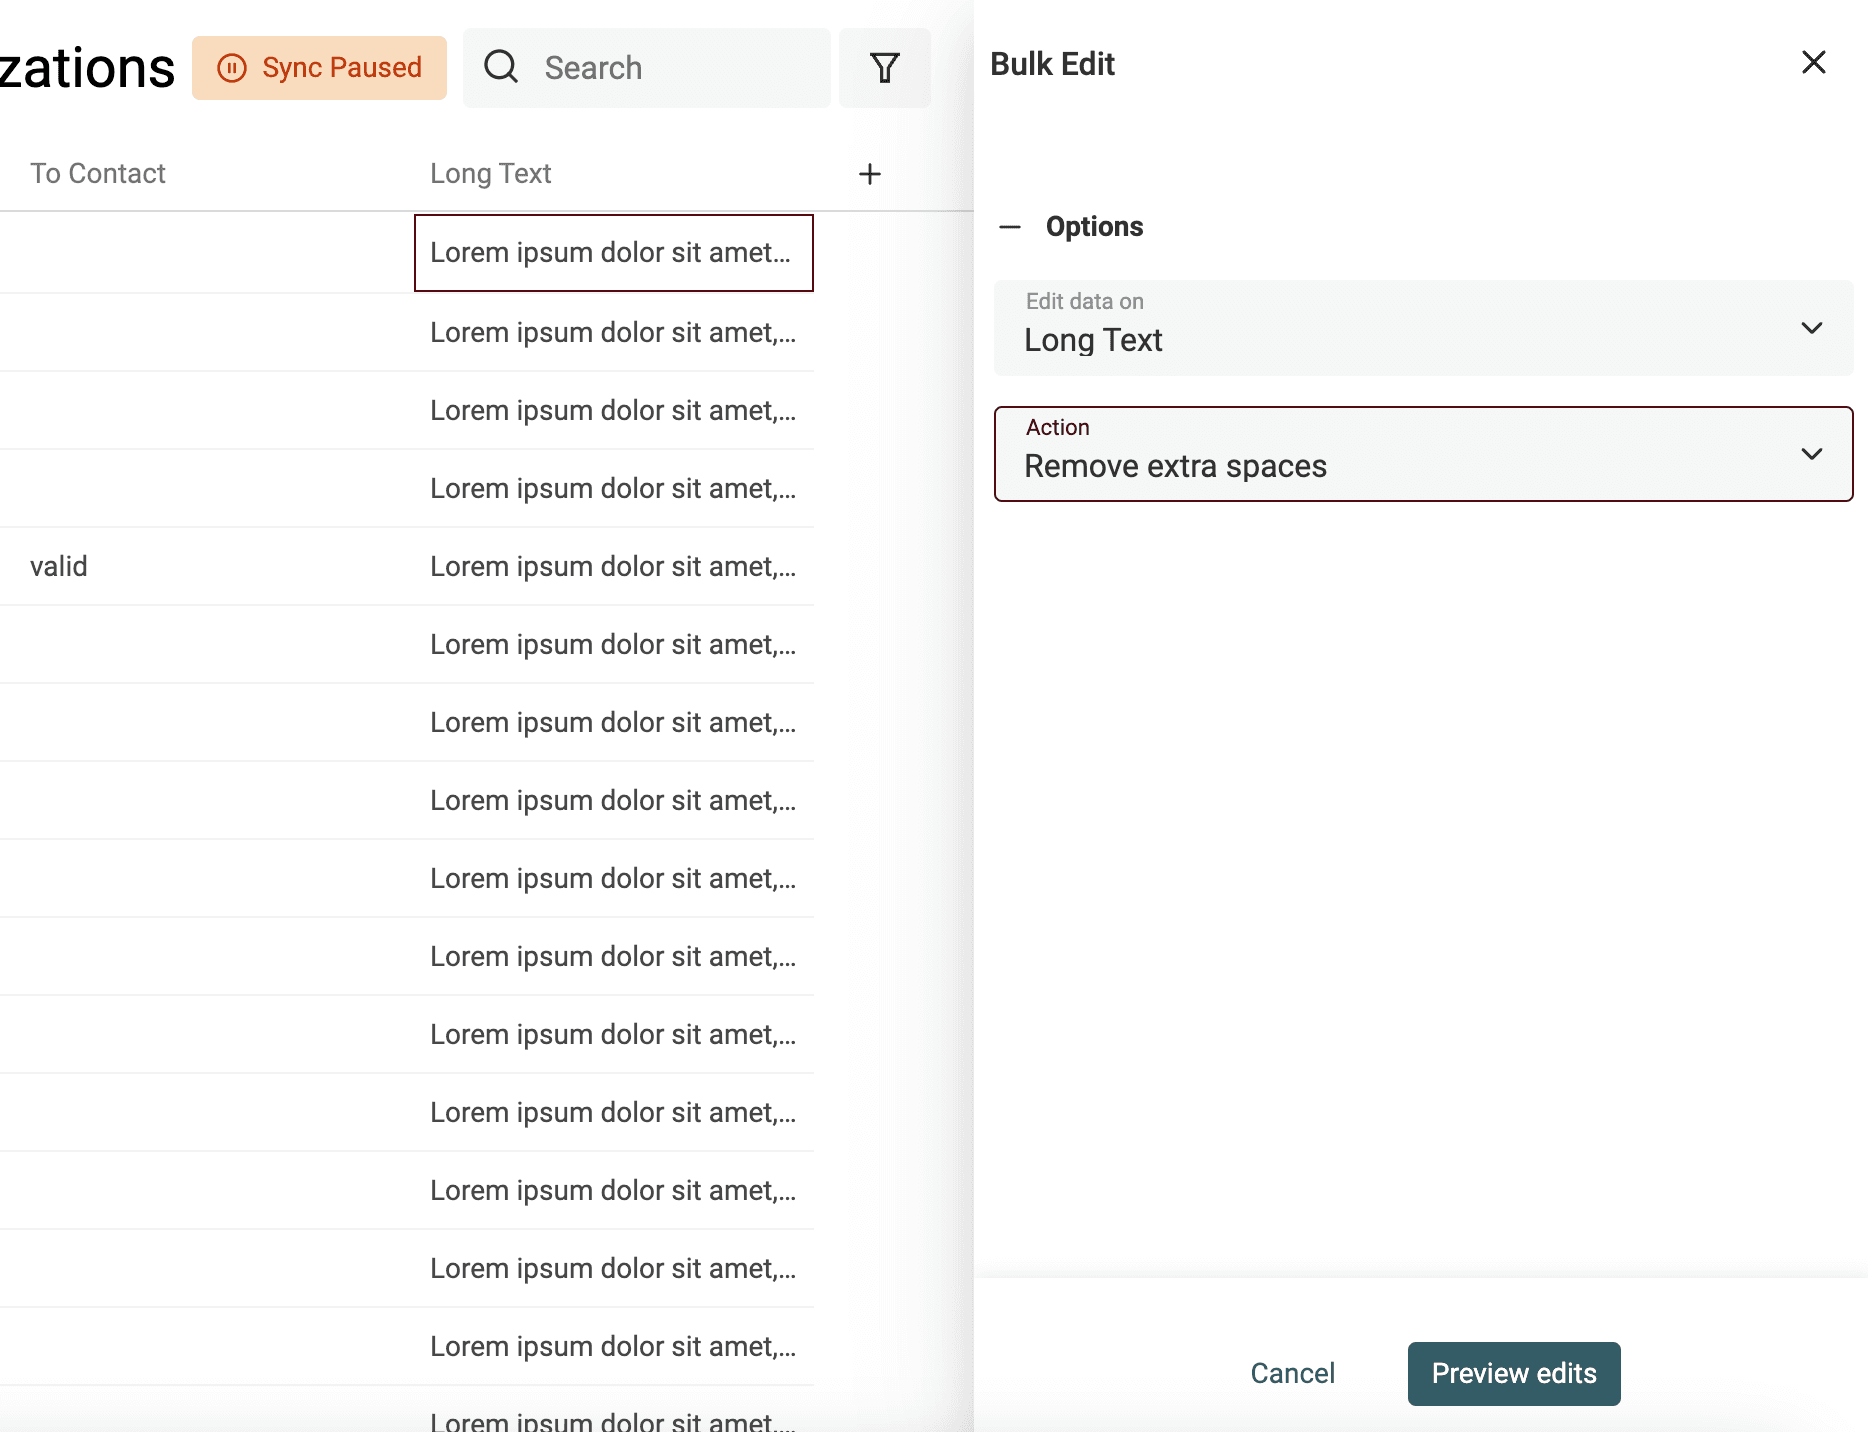
Um überflüssige Leerzeichen zu entfernen, öffnest Du im Menü "Edit" das Tool "Bulk Edit". Wähle Deine Property und danach die Aktion "Remove extra spaces" aus.
Groß- und Kleinschreibung vereinheitlichen
Die Groß- und Kleinschreibung Deiner Texte lässt sich ganz einfach ändern. Öffne dazu im Menü "Edit" das Tool "Bulk Edit".
Wähle die zu bearbeitende Property und nutze die Aktion "Change text case".
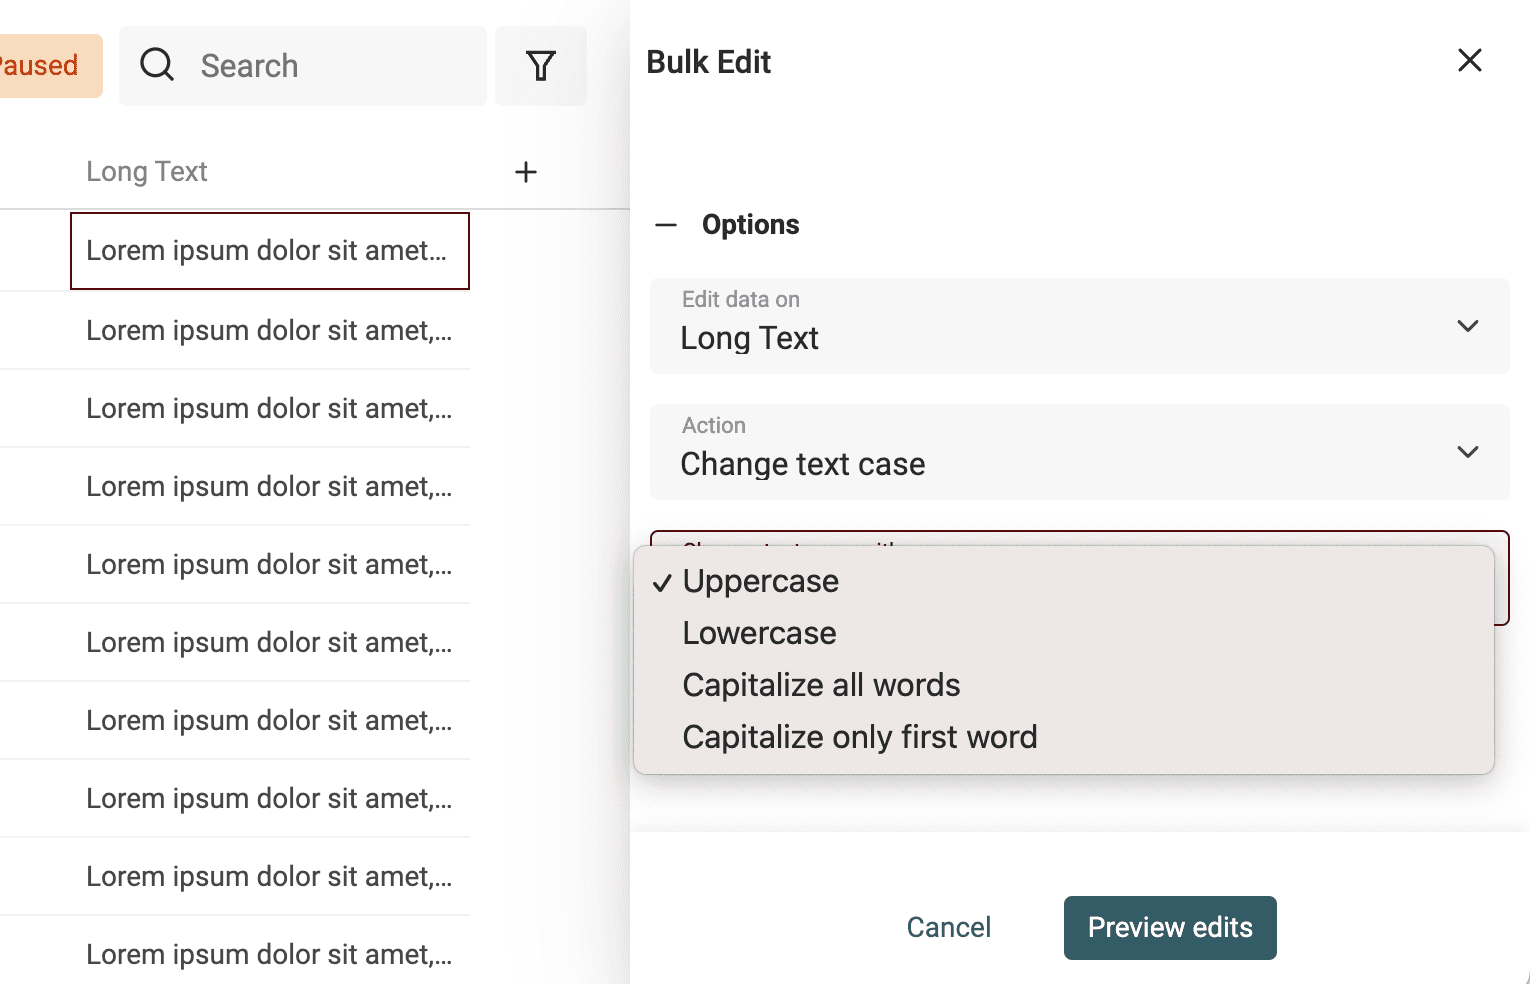
Vier Modi stehen zur Verfügung:
- Uppercase – Alle Buchstaben werden in Großbuchstaben umgewandelt. Beispiel:
john=>JOHN - Lowercase – Alle Buchstaben werden in Kleinbuchstaben umgewandelt. Beispiel:
API=>api - Capitalize – Der erste Buchstabe jedes Wortes wird großgeschrieben. Beispiel:
john is a good man=>John Is A Good Man - Capitalize only the first word – Nur der erste Buchstabe des ersten Wortes wird großgeschrieben. Beispiel:
john is a good man=>John is a good man
Symbole aus Texten entfernen
Aus HTML-Seiten gescrapte Texte oder Nutzereingaben wie LinkedIn-Profiltitel können Symbole enthalten, etwa Smileys und andere Zeichen, die die Verarbeitung Deiner Daten beeinträchtigen. Schon ein Smiley am Ende eines Namens kann verhindern, dass ein Deduplizierungsalgorithmus den Eintrag erkennt.
Datablist verfügt über einen integrierten Processor, der alle Symbole aus Deinen Textdaten entfernt.
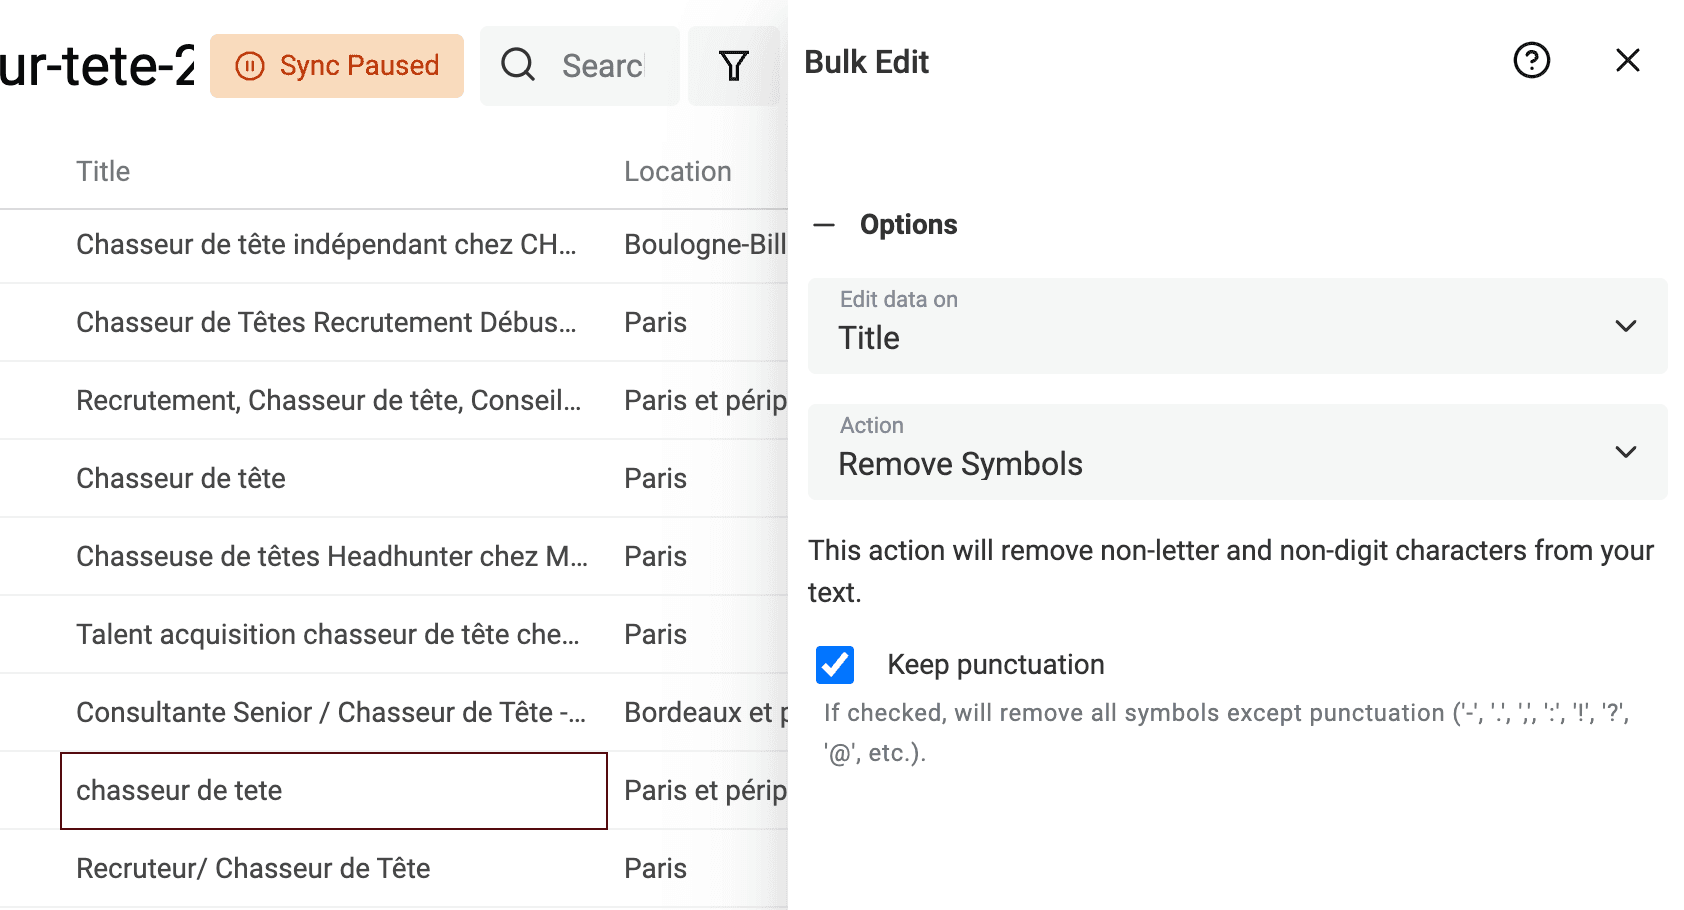
Klicke im Menü "Edit" auf "Bulk Edit", wähle eine Text Property und anschließend die Transformation "Remove symbols" aus.
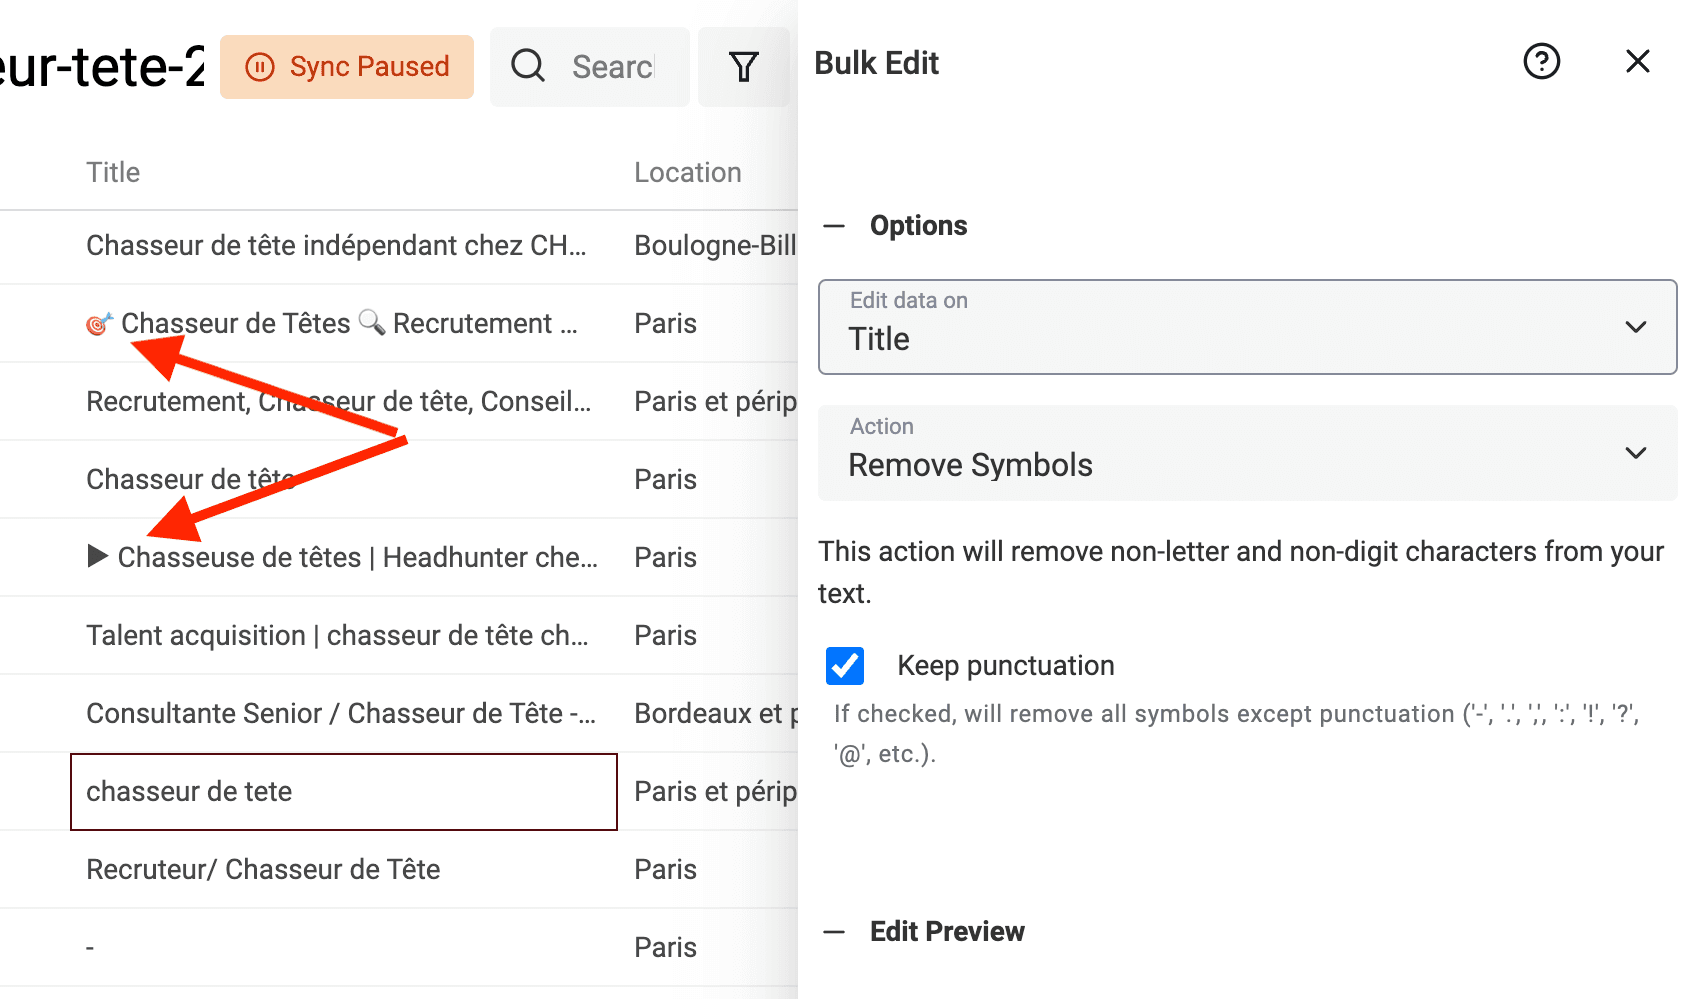
Wenn die Vorschau stimmt, startest Du die Transformation, um Deine Einträge zu bearbeiten.
Daten mit Find and Replace normalisieren
Um Segmente in Deinen Prospect-Listen zu erstellen, musst Du Deine Daten normalisieren.
- Jobtitel vereinheitlichen
- Länder und Städte vereinheitlichen
- URLs vereinheitlichen
- Und mehr
Dein Ziel besteht darin, eine Property mit Freitext auf eine begrenzte Anzahl von Auswahlmöglichkeiten zu reduzieren. Alternativ kannst Du Texte auf eine einfachere Form bringen, etwa eine URL mit Pfad auf ihre reine Domain reduzieren.
Datablist bietet dafür ein leistungsstarkes Find-and-Replace-Tool. Es funktioniert sowohl mit einfachem Text als auch mit regulären Ausdrücken.
Reguläre Ausdrücke sind komplex, aber ausgesprochen leistungsfähig.
Hier sind einige Beispiele dafür, wie Du RegEx zur Datenbereinigung einsetzen kannst.
Query-Parameter aus einer URL entfernen
Manche URL-Parameter dienen dem Kampagnen-Tracking, andere wählen ein Produkt, eine Variante, ein Suchergebnis oder eine Seitennummer aus. Wenn Du sie alle entfernst, können unterschiedliche Datensätze fälschlicherweise zu einer einzigen URL zusammengeführt werden.
Dupliziere deshalb zuerst die Property mit der Quell-URL. Verwende den folgenden Ausdruck nur, wenn Du geprüft hast, dass wirklich jeder Query-Parameter in dieser Spalte entfernt werden kann. Er entfernt zum Beispiel ?utm_source=newsletter aus einer Seiten-URL, würde aber auch ?variant=blue aus einer Produkt-URL löschen. Wenn Du die Variante benötigst, solltest Du den Query-String behalten oder in einer separaten Transformation nur bestimmte Tracking-Parameter entfernen.
Um den gesamten Query-String zu löschen, aktivierst Du Match using regular expression und verwendest diesen Ausdruck mit einem leeren Ersetzungswert:
\?.*$
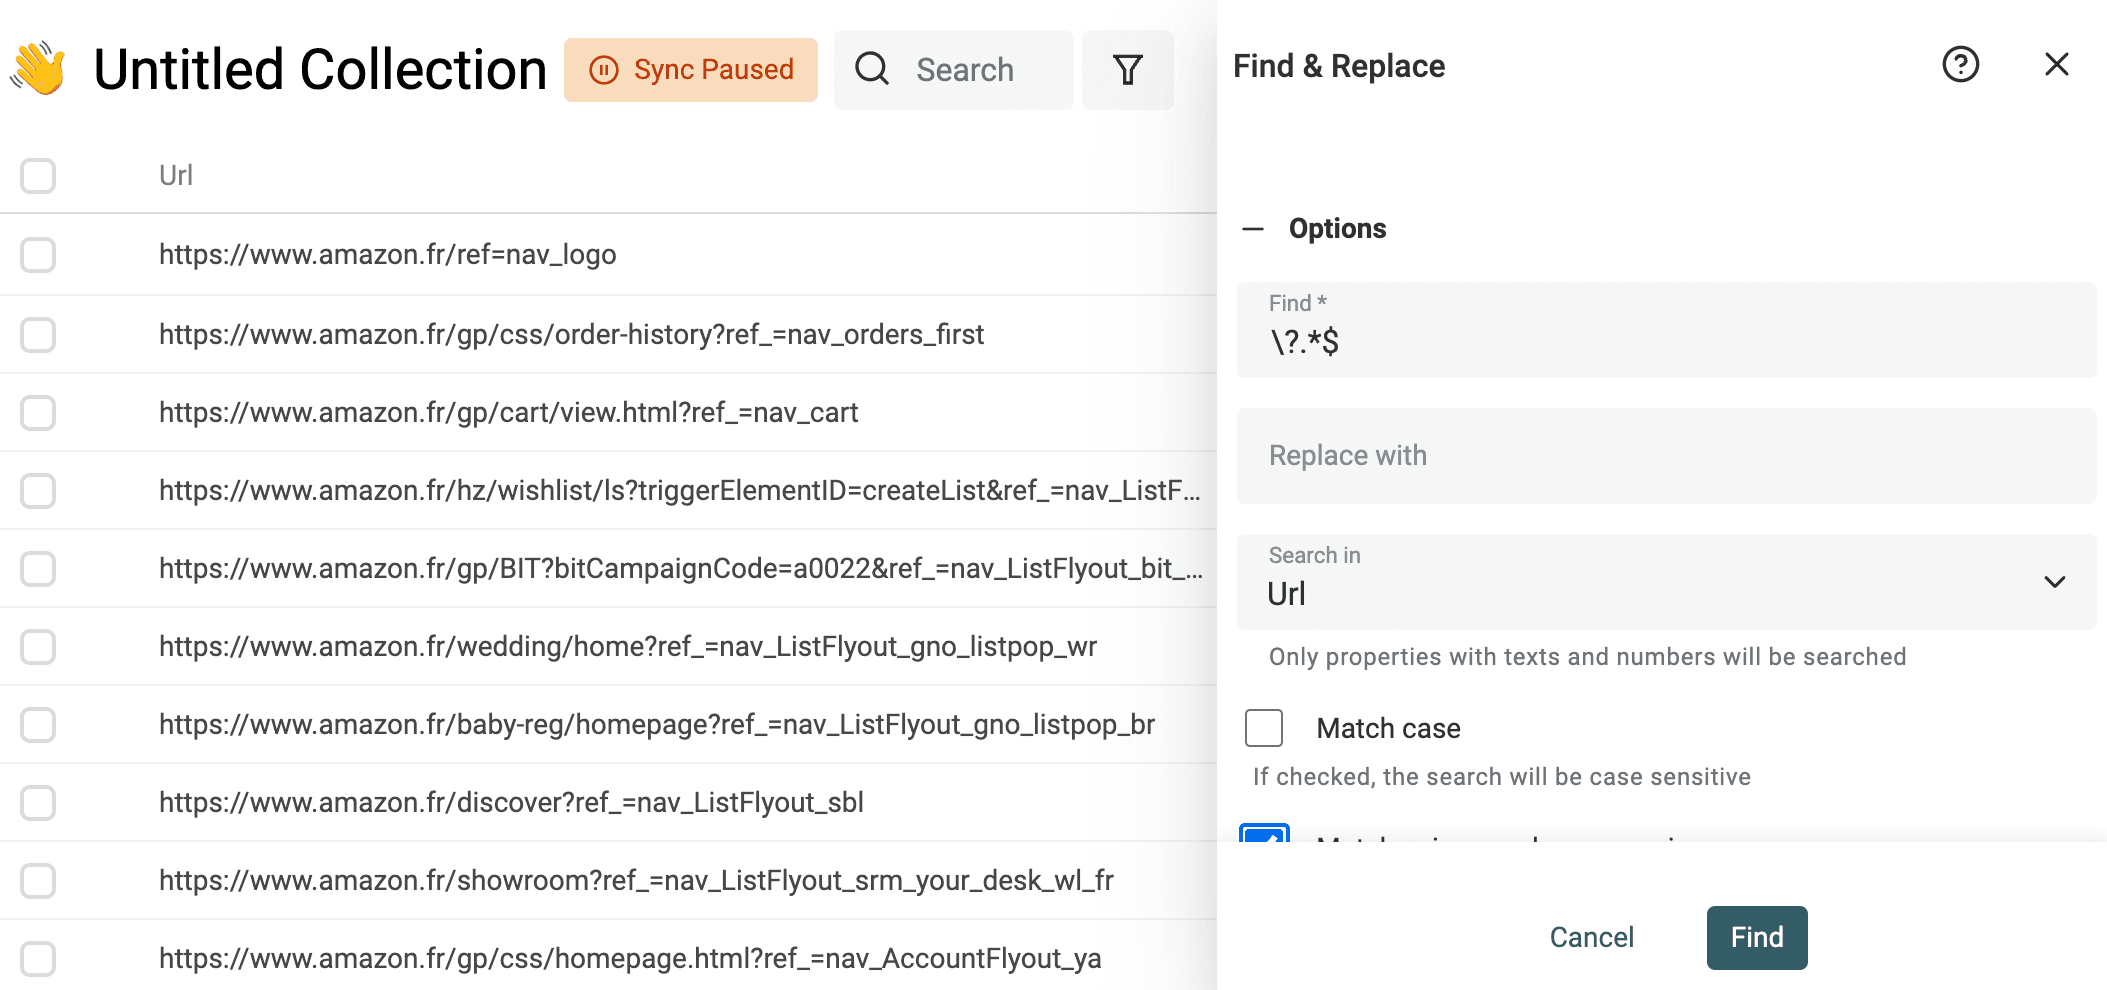
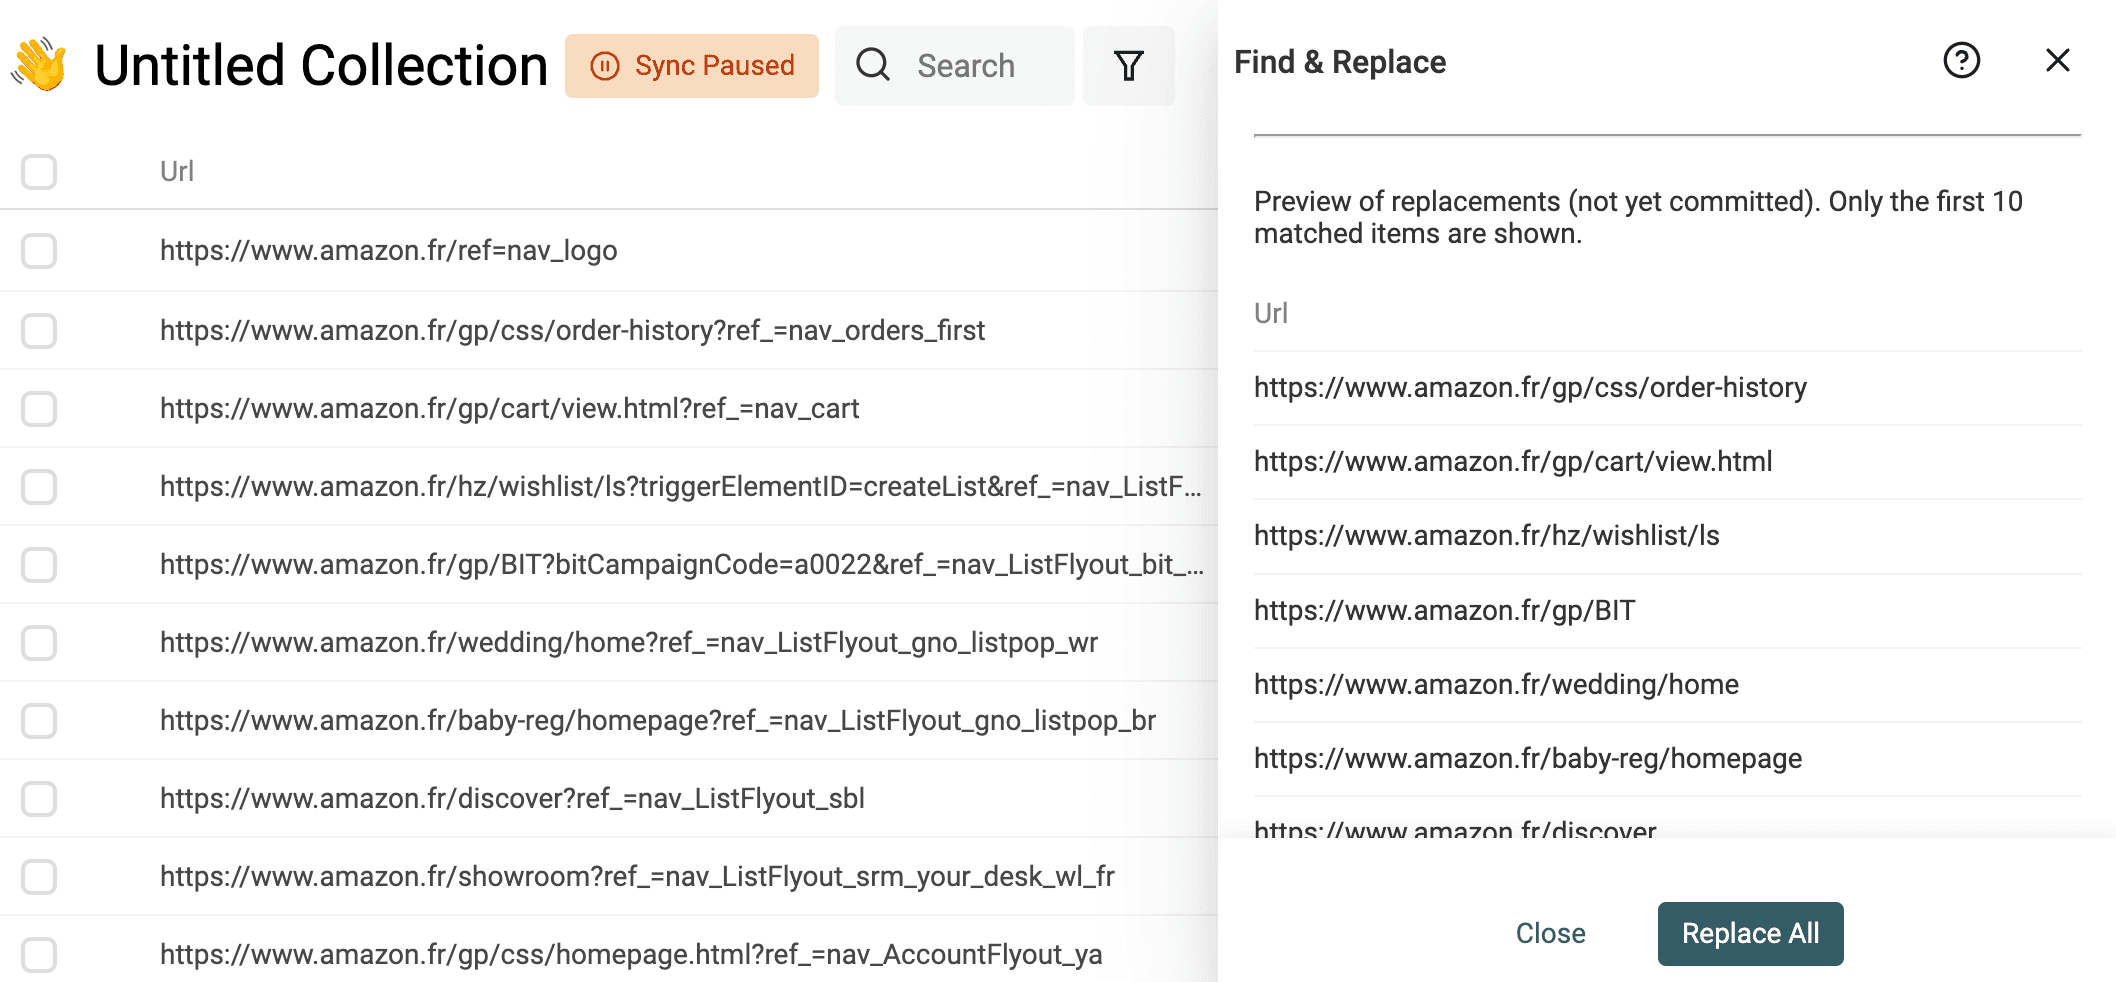
Prüfe in der Vorschau URLs mit und ohne Query-String. Wende die Transformation erst danach auf die kopierte URL Property an – und nur, wenn die URLs weiterhin die gewünschten Seiten eindeutig identifizieren.
Domain aus E-Mail-Adressen extrahieren
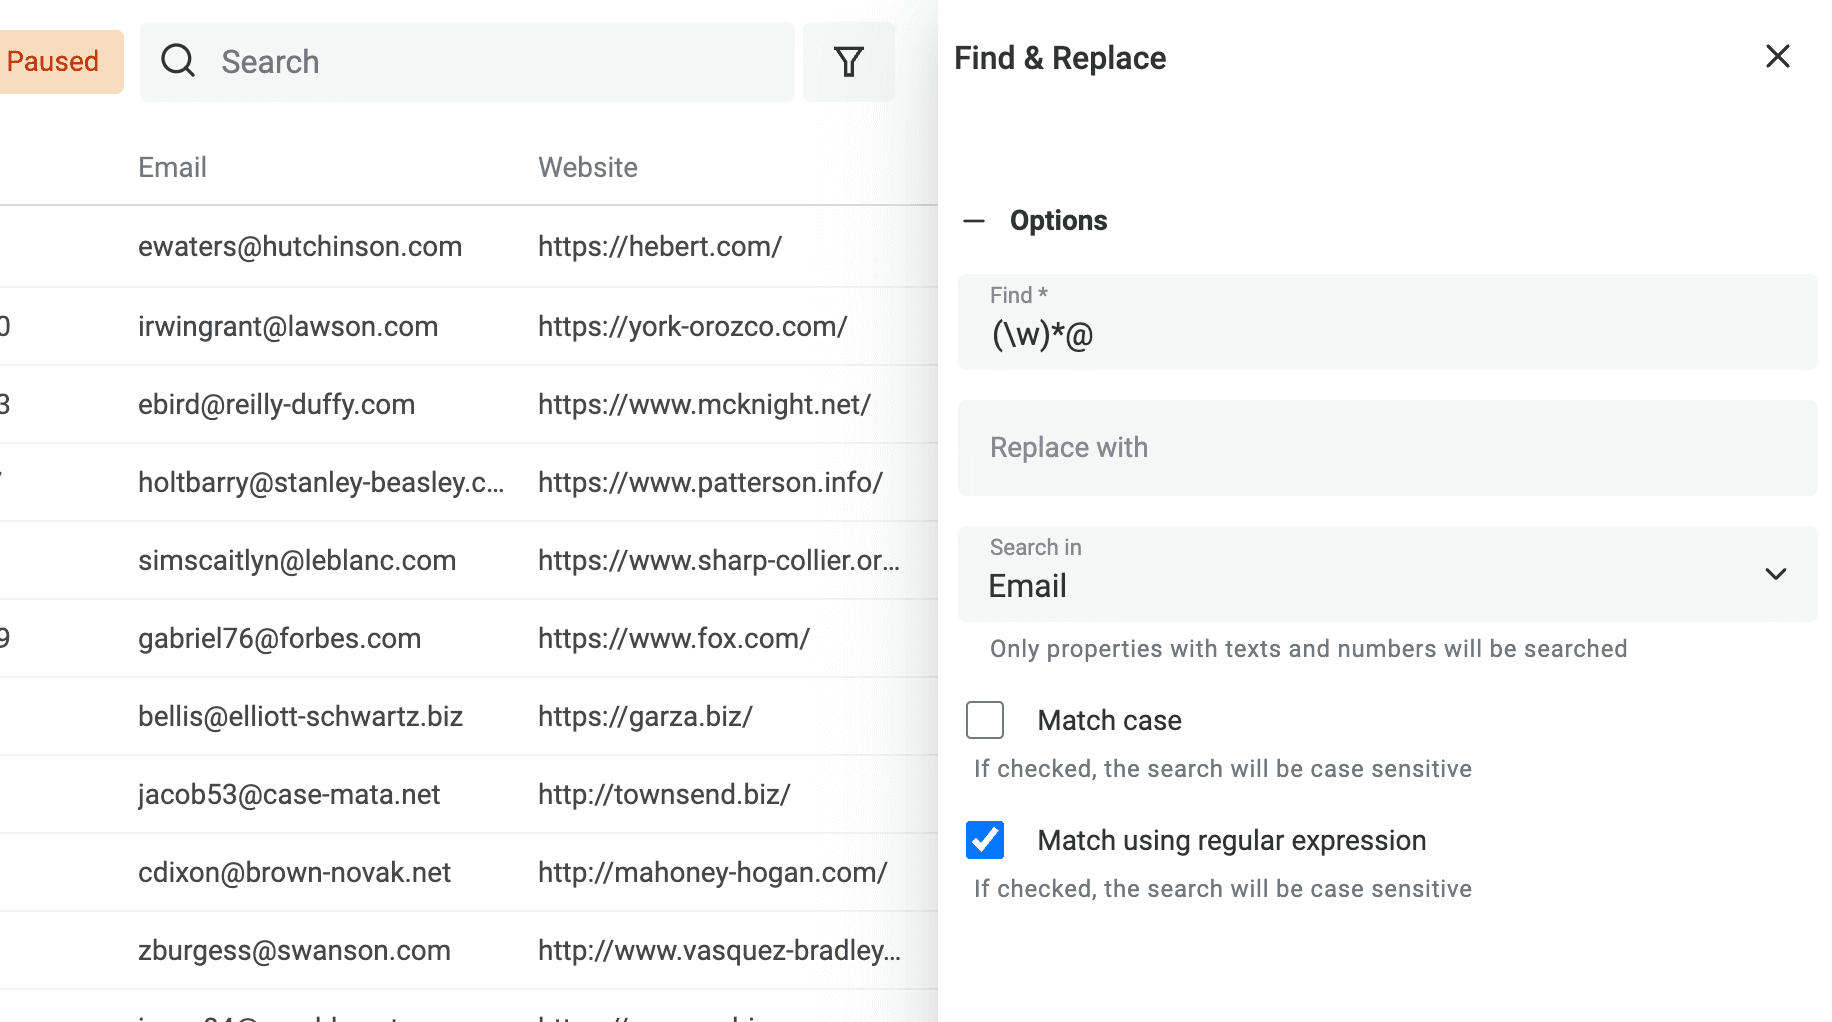
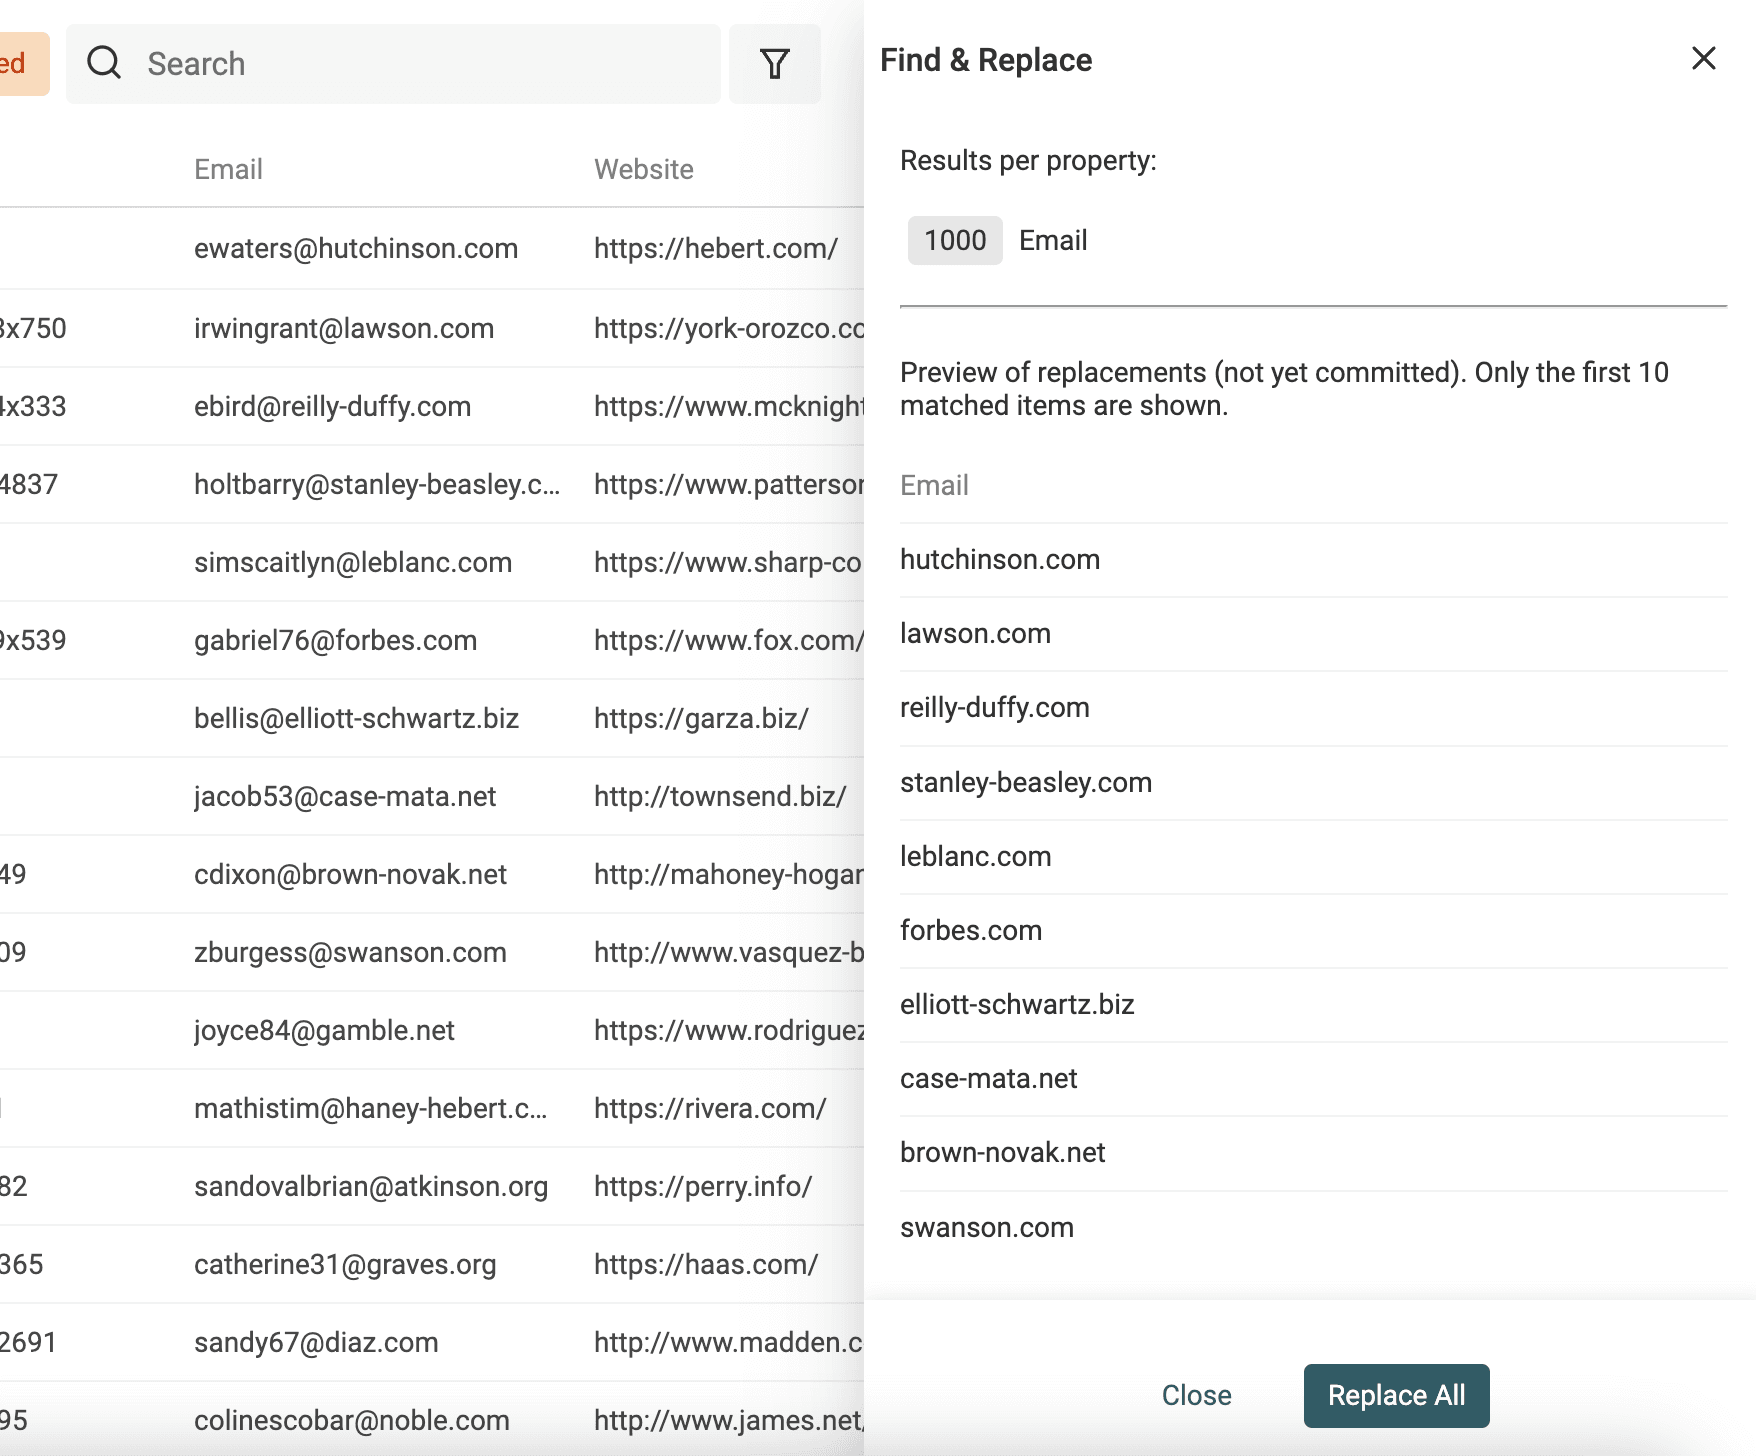
Find and Replace eignet sich auch dazu, die Domain einer E-Mail-Adresse zu extrahieren. Du erhältst dabei den Teil nach @. Dieser entspricht allerdings nicht immer der Unternehmenswebsite, denn ein Kontakt kann einen privaten E-Mail-Anbieter nutzen.
Dupliziere zuerst Deine E-Mail Property, damit die Quelldaten erhalten bleiben. Für Zellen mit genau einer reinen E-Mail-Adresse verwendest Du den folgenden regulären Ausdruck mit einem leeren Ersetzungswert:
^[^@\s]+@(?=[^@\s]+$)
Der Ausdruck unterstützt lokale Teile mit Punkten, Pluszeichen und Bindestrichen. Aus jane.smith+sales@example.com wird beispielsweise example.com. Der ältere Screenshot unten verwendet ein restriktiveres Muster; nutze stattdessen den oben angegebenen Ausdruck.
Entferne zuerst Leerzeichen am Anfang und Ende. Zellen mit einem Anzeigenamen, mehreren Adressen oder fehlerhaftem E-Mail-Text müssen separat bereinigt werden. Diese Transformation extrahiert lediglich eine Domain; sie validiert nicht das Postfach.
👉 Mehr dazu erfährst Du in unserer Dokumentation zu Find and Replace.
Vollständigen Namen in Vor- und Nachnamen aufteilen
Beim Scrapen von Lead-Listen erhältst Du Kontakte häufig mit einem "Full Name", den Du in "First Name" und "Last Name" aufteilen musst. Einen Personennamen zuverlässig in seine Bestandteile zu zerlegen, ist dabei ein wichtiger Schritt.
Separate Namensfelder helfen Dir bei der persönlichen Ansprache und beim Zuordnen von Daten zu einem CRM. Behalte den vollständigen Namen, damit Du fehlerhafte Aufteilungen später kontrollieren kannst. Aus einem Namen allein lassen sich weder Geschlecht noch Anrede einer Person zuverlässig ableiten.
Das Aufteilen von Namen kann kompliziert sein. Datablist bietet dafür zum Glück ein einfach zu bedienendes Tool, das "Name" anhand eines Leerzeichens in zwei Werte trennt.
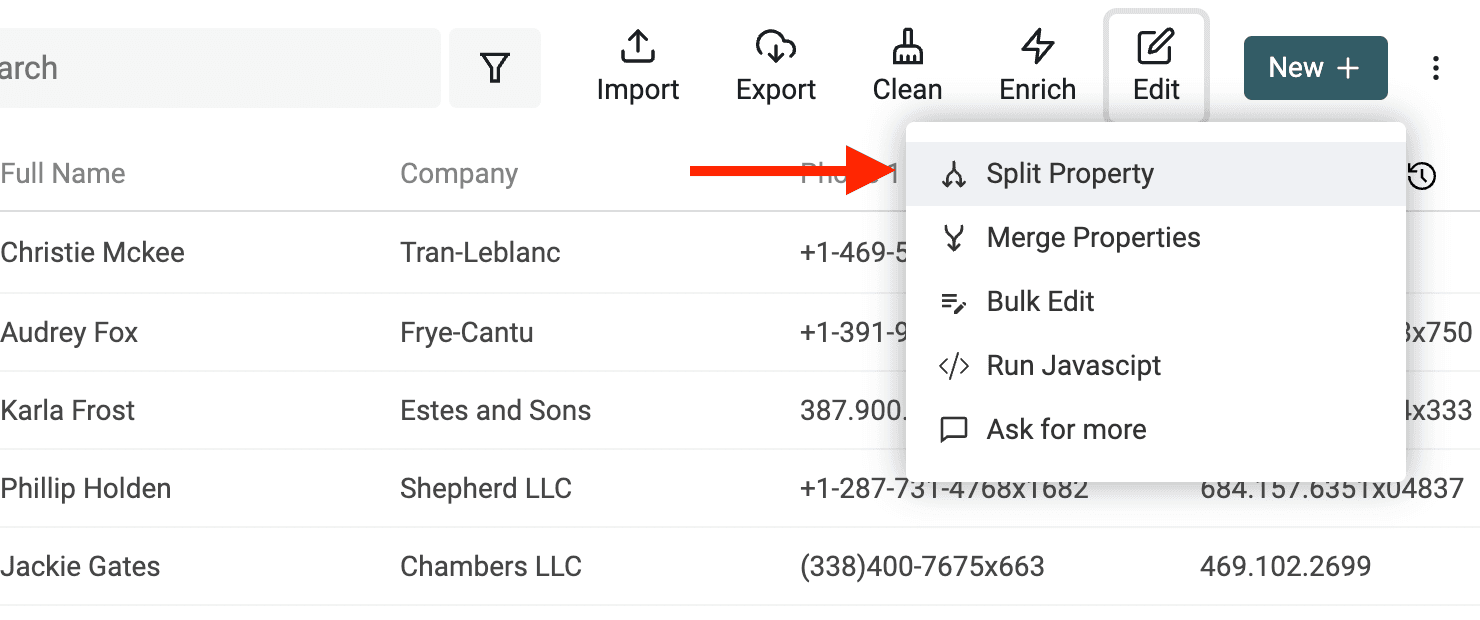
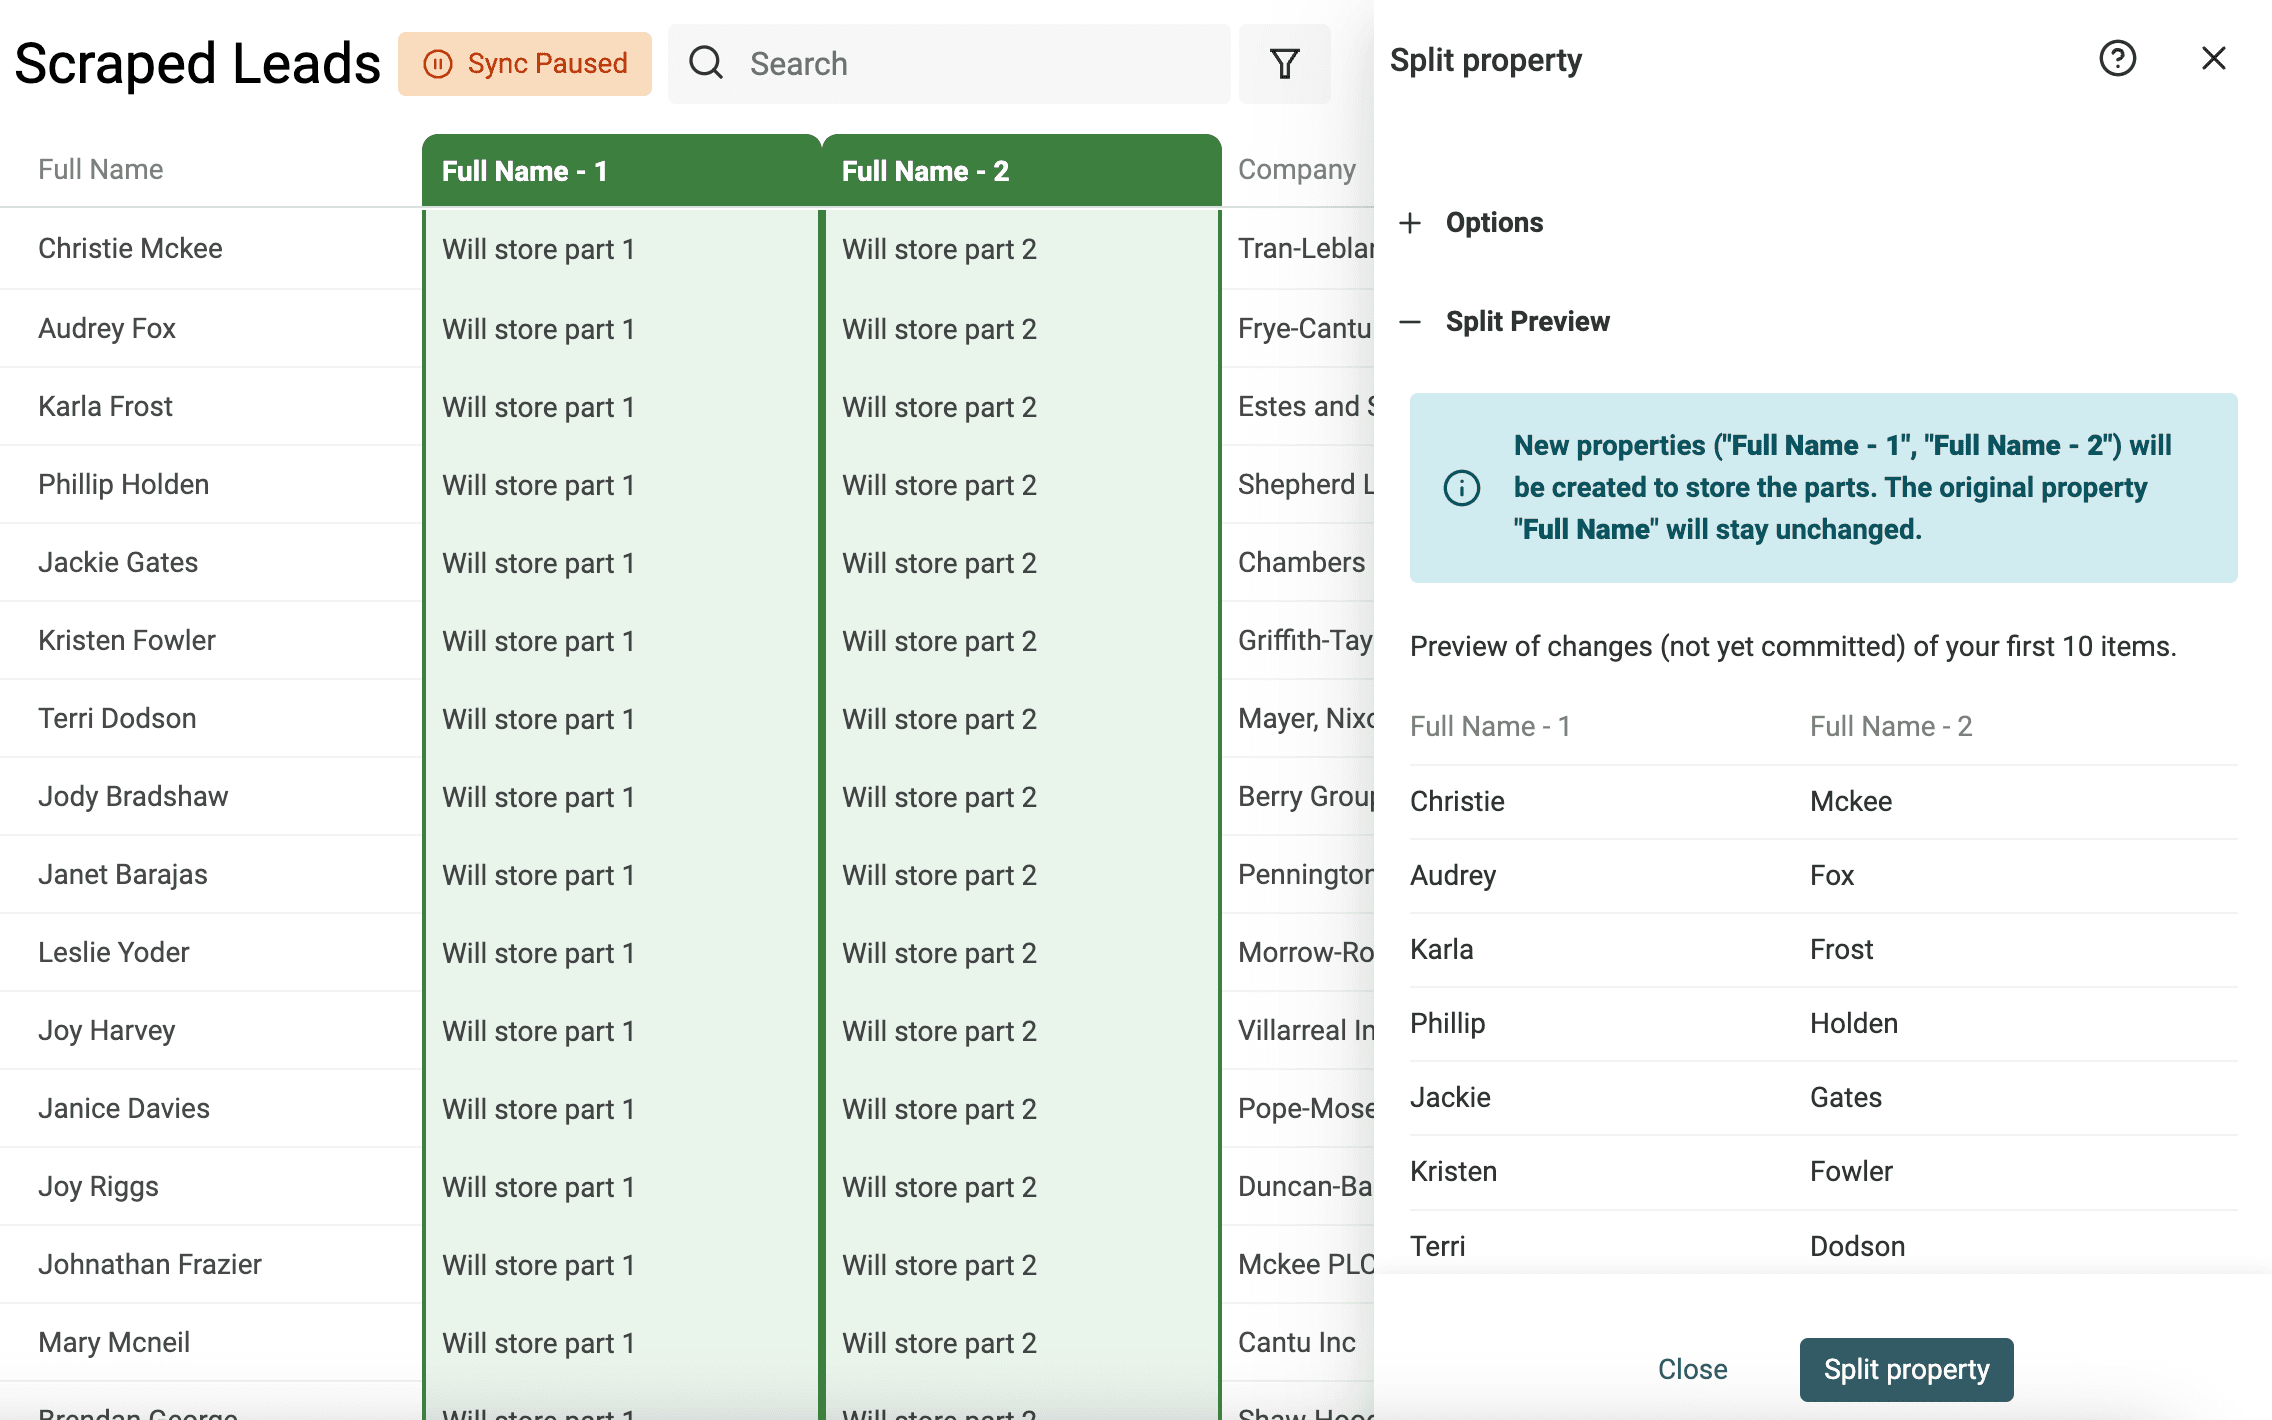
Öffne zunächst im Menü "Edit" das Tool "Split Property".
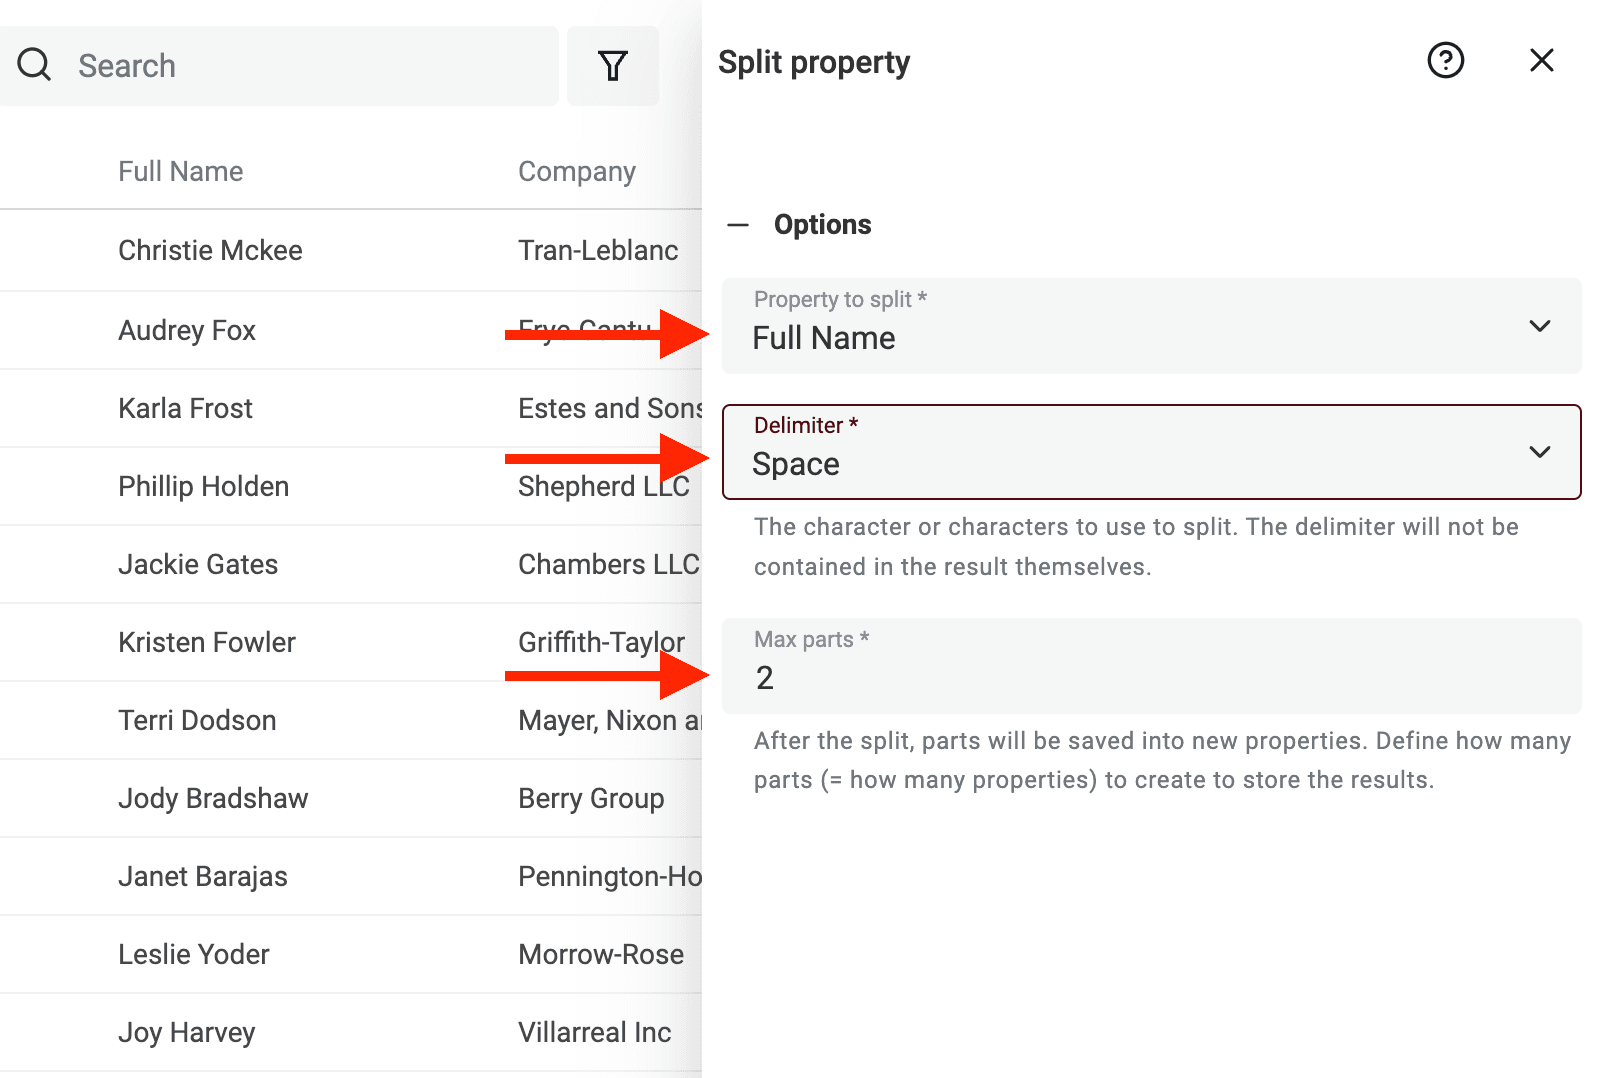
Wähle anschließend die Property mit den aufzuteilenden Namen. Nutze Space als Trennzeichen und setze die maximale Anzahl der Teile auf 2.
Starte die Vorschau. Datablist verarbeitet die ersten zehn Einträge und erstellt daraus eine Vorschau. Wenn das Ergebnis passt, klickst Du auf "Split Property", um den Algorithmus auf alle aktuellen Einträge anzuwenden.
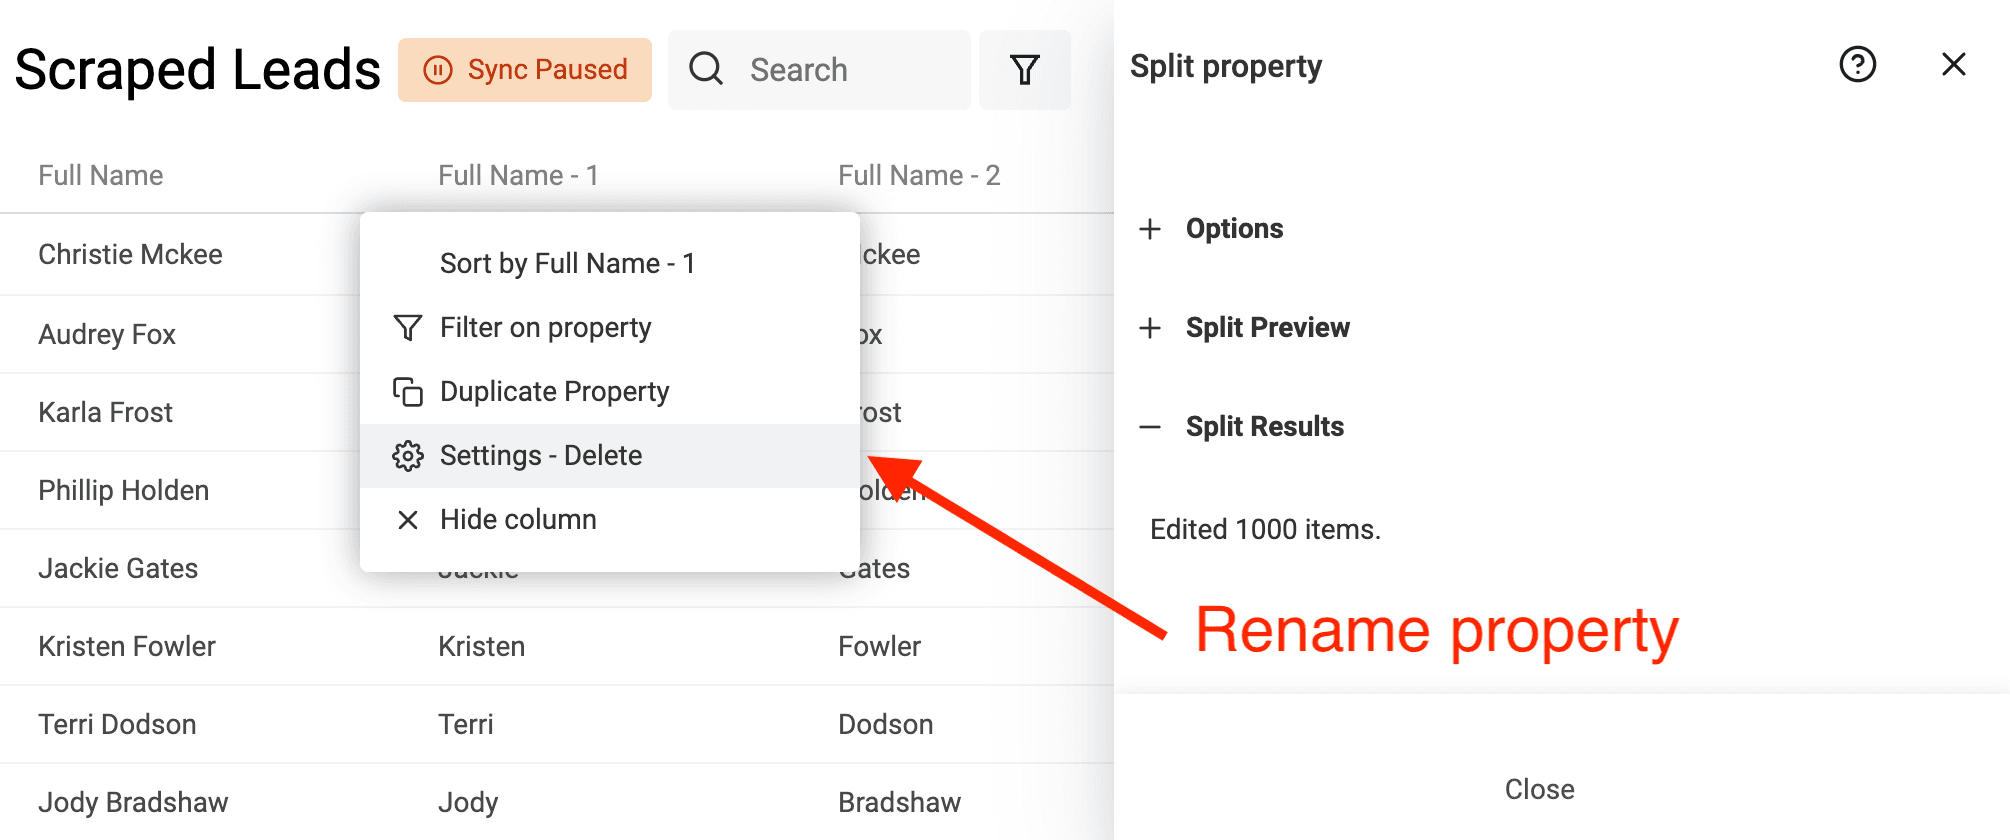
Benenne die beiden neu erstellten Properties nach der Aufteilung in "First Name" und "Last Name" um.
Dieses Beispiel konzentriert sich auf Namen nach westlicher Konvention, die üblicherweise aus einem Vor- und einem Nachnamen bestehen. Bei nicht westlichen Namen kann die Aufteilung komplexer sein, etwa wenn Personen mehrere Vor- oder Nachnamen haben. Das gilt auch für Namen mit Titeln oder Namenszusätzen.
Doppelte Datensätze bereinigen
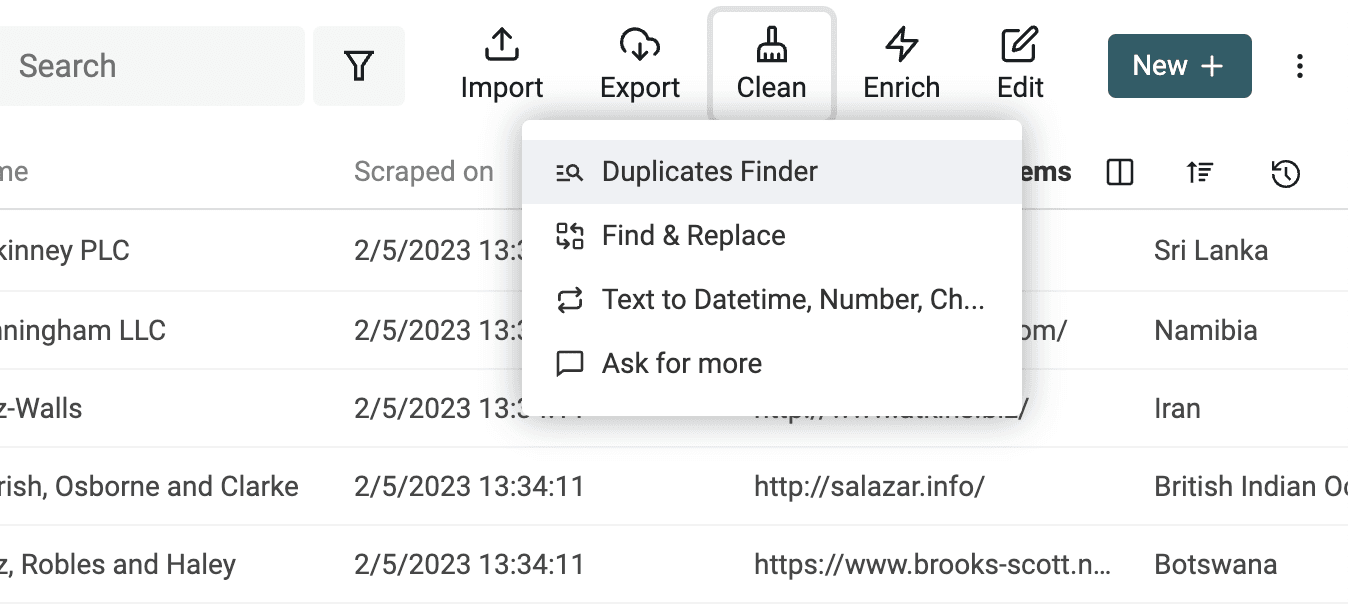
Öffne Clean > Merge duplicates, wenn mehrere Zeilen Informationen enthalten, die Du behalten möchtest. Nutze Remove duplicates, wenn eine Zeile unverändert bleiben und die übrigen gelöscht werden sollen. Der folgende Screenshot zeigt ein älteres Menü-Layout.
Wähle die Properties aus, die einen Datensatz eindeutig identifizieren. Ich beginne meist mit der E-Mail-Adresse eines Kontakts oder einer Produkt-URL statt nur mit dem Firmennamen. Du musst nicht jedes Feld normalisieren, wenn bereits ein zuverlässiger Match Key vorhanden ist.
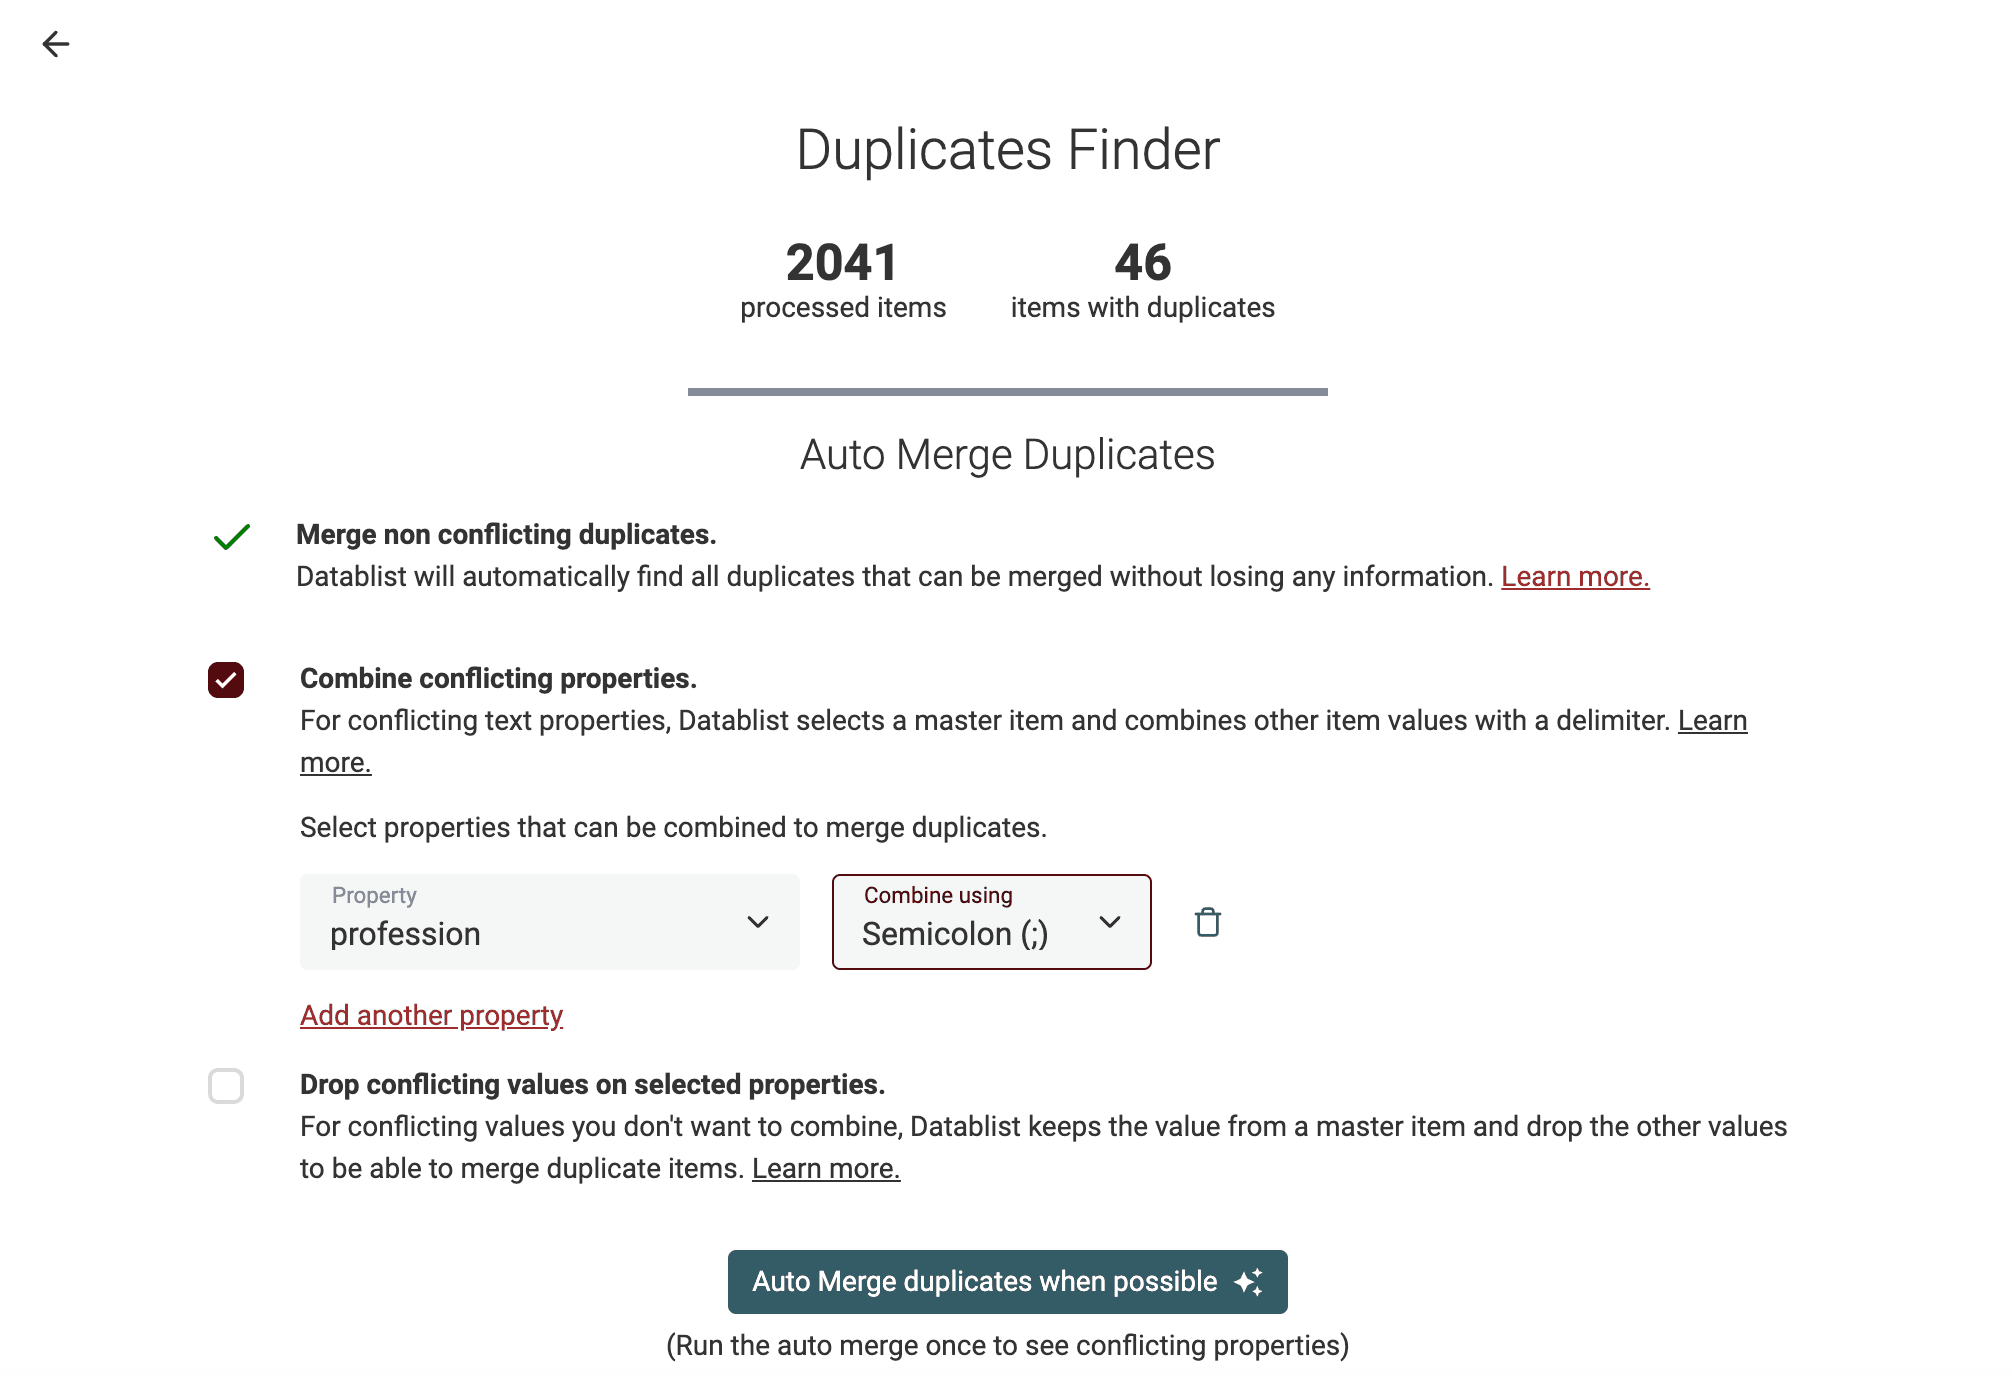
Die Prüfung erstellt Gruppen, die Du kontrollieren kannst, ohne Deine Daten zu verändern. Wähle im Ergebnisbereich Merge and preserve data, prüfe Record to keep und konfiguriere unter Resolve conflicting values die gewünschten Regeln. Führe Textwerte zusammen, wenn Du beide benötigst. Behalte nur einen einzelnen Wert, wenn Du die anderen bewusst verwerfen möchtest.
Prüfe die fertigen Gruppen, bevor Du auf Merge ready groups klickst. Wenn Du Dich stattdessen für das Entfernen entscheidest, kontrolliere die gelöschten Zeilen auf zusätzliche Daten. In diesem Modus bleibt die beibehaltene Zeile nämlich unverändert.
👉 Lies unseren Guide zum Zusammenführen von Duplikaten in CSV-Dateien.
E-Mail-Adressen validieren
Gescrapte Daten können veraltet sein, Tippfehler enthalten oder ungültig sein. Das gilt besonders für E-Mail-Adressen, die Du durch Scraping erhältst.
Bei nutzergenerierten Daten landen häufig erfundene E-Mail-Adressen oder Adressen von Wegwerf-Anbietern in Deiner Datenbank.
Datablist verfügt über ein integriertes Tool zur E-Mail-Validierung, mit dem Du Tausende E-Mail-Adressen prüfen kannst.
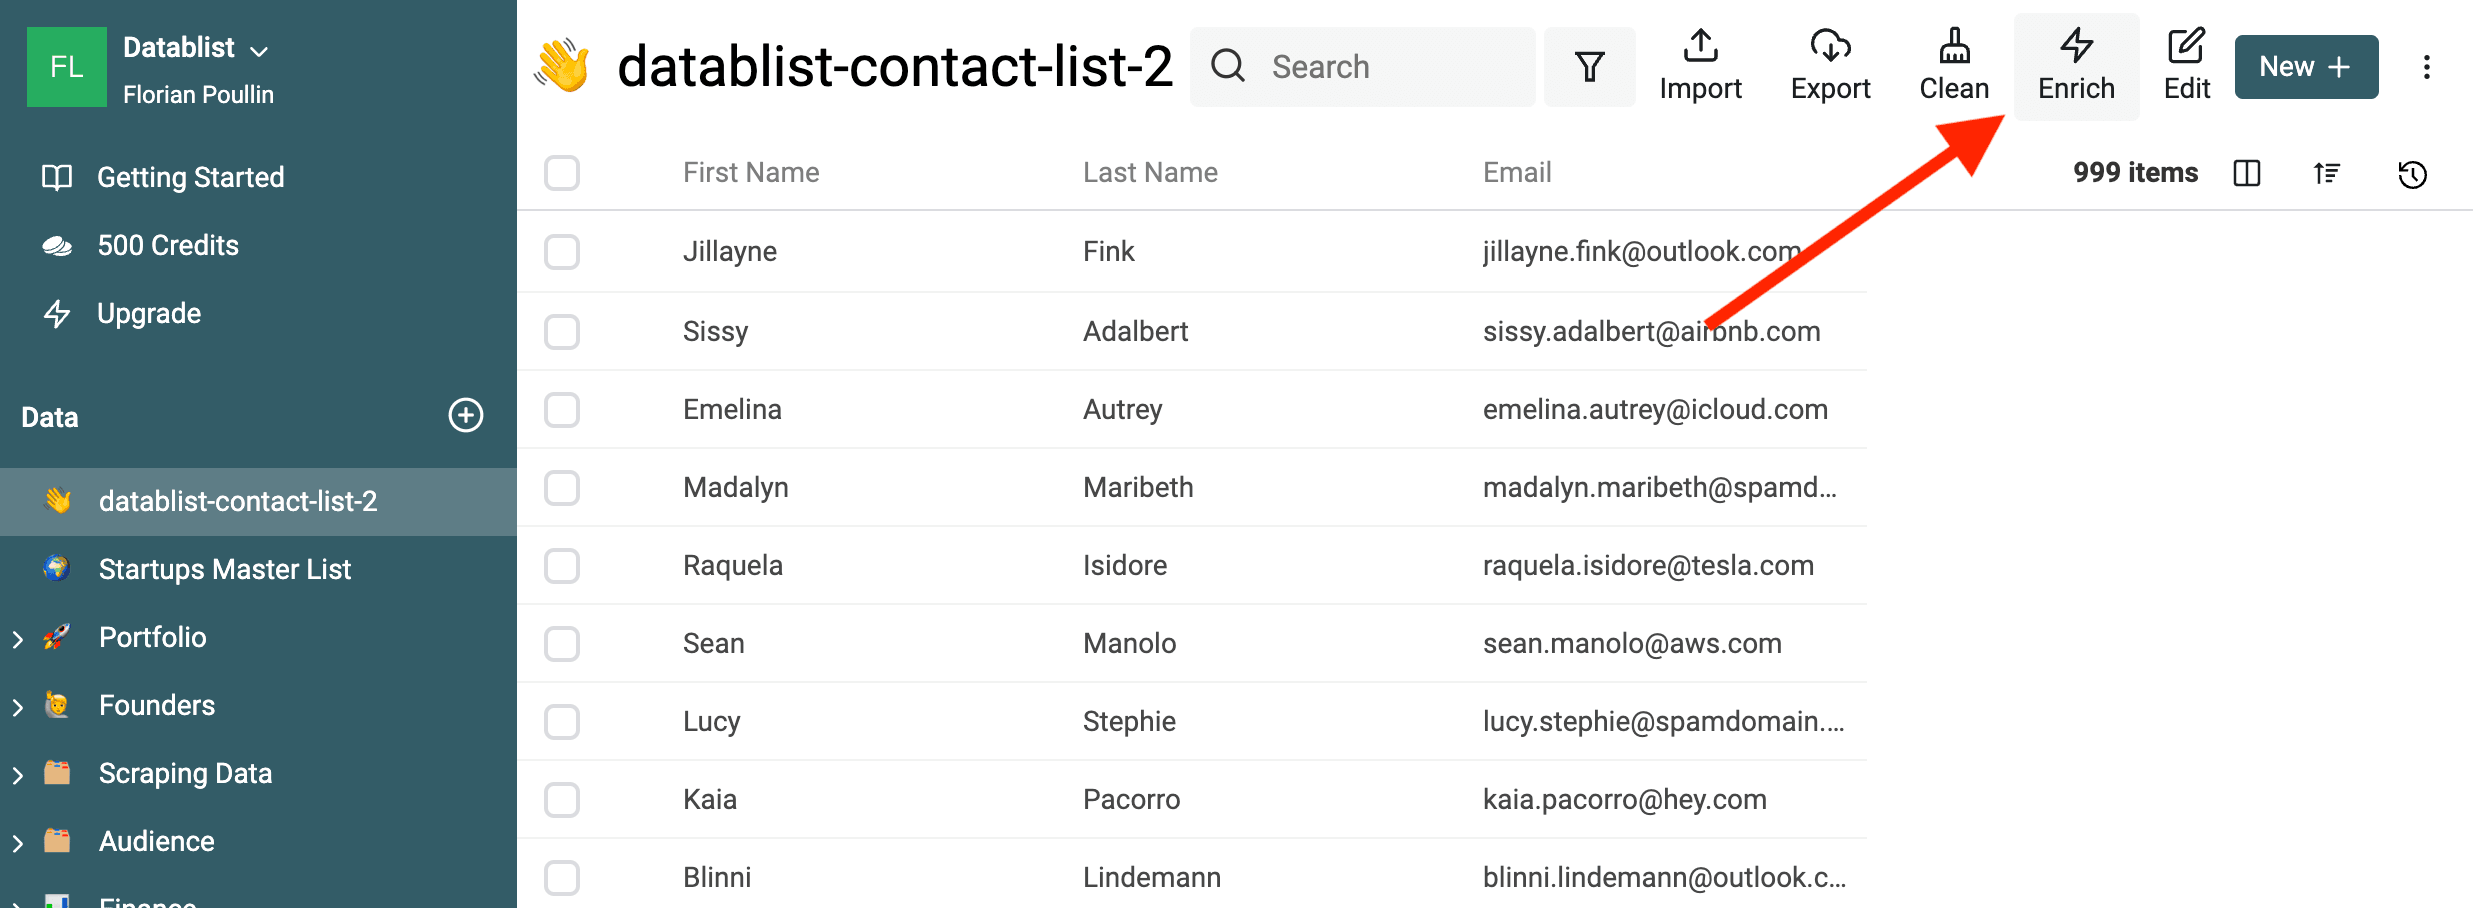
Der kostenlose Service zur E-Mail-Bereinigung prüft die Syntax, Wegwerf-Domains und – sofern aktiviert – die MX Records der Domain. Diese Prüfungen beweisen weder, dass ein bestimmtes Postfach existiert, noch dass eine Nachricht zugestellt wird. Bewahre den zurückgegebenen Status oder Grund auf, damit Du Ausnahmen später prüfen kannst.
Der Service bietet folgende Funktionen:
- Analyse der E-Mail-Syntax – Kennzeichnet fehlerhafte Adressen, etwa Text ohne
@-Zeichen oder mit einem ungültigen Domain-Format. - Prüfung auf Wegwerf-Anbieter – Die zweite Prüfung erkennt temporäre E-Mail-Adressen. Der Service sucht nach Domains von Disposable Email Address (DEA) Providern wie Mailinator, Temp-Mail oder YopMail.
- Prüfung der Domain-MX-Records – Fragt die Mailserver-Einträge der Domain ab, sofern Du nicht Disable MX-records analysis aktivierst. Fehlgeschlagene oder fehlende DNS-Ergebnisse solltest Du getrennt von Syntaxfehlern prüfen. Diese Prüfung betrifft die Domain, nicht das einzelne Postfach.
- Segmentierung geschäftlicher und privater E-Mail-Adressen – Bei Prospects aus Lead Magnets oder zur Segmentierung Deiner User Base kann es sinnvoll sein, Kontakte nach geschäftlichen und privaten E-Mail-Adressen zu unterscheiden. Der Service zur E-Mail-Validierung liefert Dir diese Information zur Anreicherung Deiner Kontaktdaten.
Personen- oder Firmennamen aus gescrapten Texten extrahieren
Wenn Du Texte von Websites oder aus anderen Quellen scrapest, ist es oft hilfreich, die Namen von Personen oder Unternehmen daraus zu extrahieren. Diese Informationen lassen sich für viele Zwecke nutzen, etwa zur Lead-Generierung oder Wettbewerbsanalyse. Namen aus unstrukturierten Texten zu extrahieren, kann allerdings schwierig sein: Sie treten in vielen unterschiedlichen Formen auf und sind oft in längere Textblöcke eingebettet.
Eine der größten Herausforderungen bei der Namensextraktion sind die vielen Namenskonventionen und Formate in unterschiedlichen Kulturen und Sprachen. In manchen Kulturen steht der Familienname beispielsweise vor dem Vornamen, in anderen ist es umgekehrt. Einige Menschen haben mehrere Vornamen, andere keinen. Außerdem können Namen falsch geschrieben, abgekürzt oder in nicht standardisierten Formaten angegeben sein. Einfache Verfahren zum Musterabgleich stoßen dabei schnell an ihre Grenzen.
Ein gängiger Ansatz ist Named Entity Recognition (NER), eine Technik aus der natürlichen Sprachverarbeitung, die benannte Entitäten in Texten erkennt und klassifiziert. NER-Modelle lassen sich darauf trainieren, unterschiedliche Arten benannter Entitäten wie Personen, Organisationen und Orte zu erkennen. Außerdem können sie an verschiedene Namenskonventionen und Varianten angepasst werden.
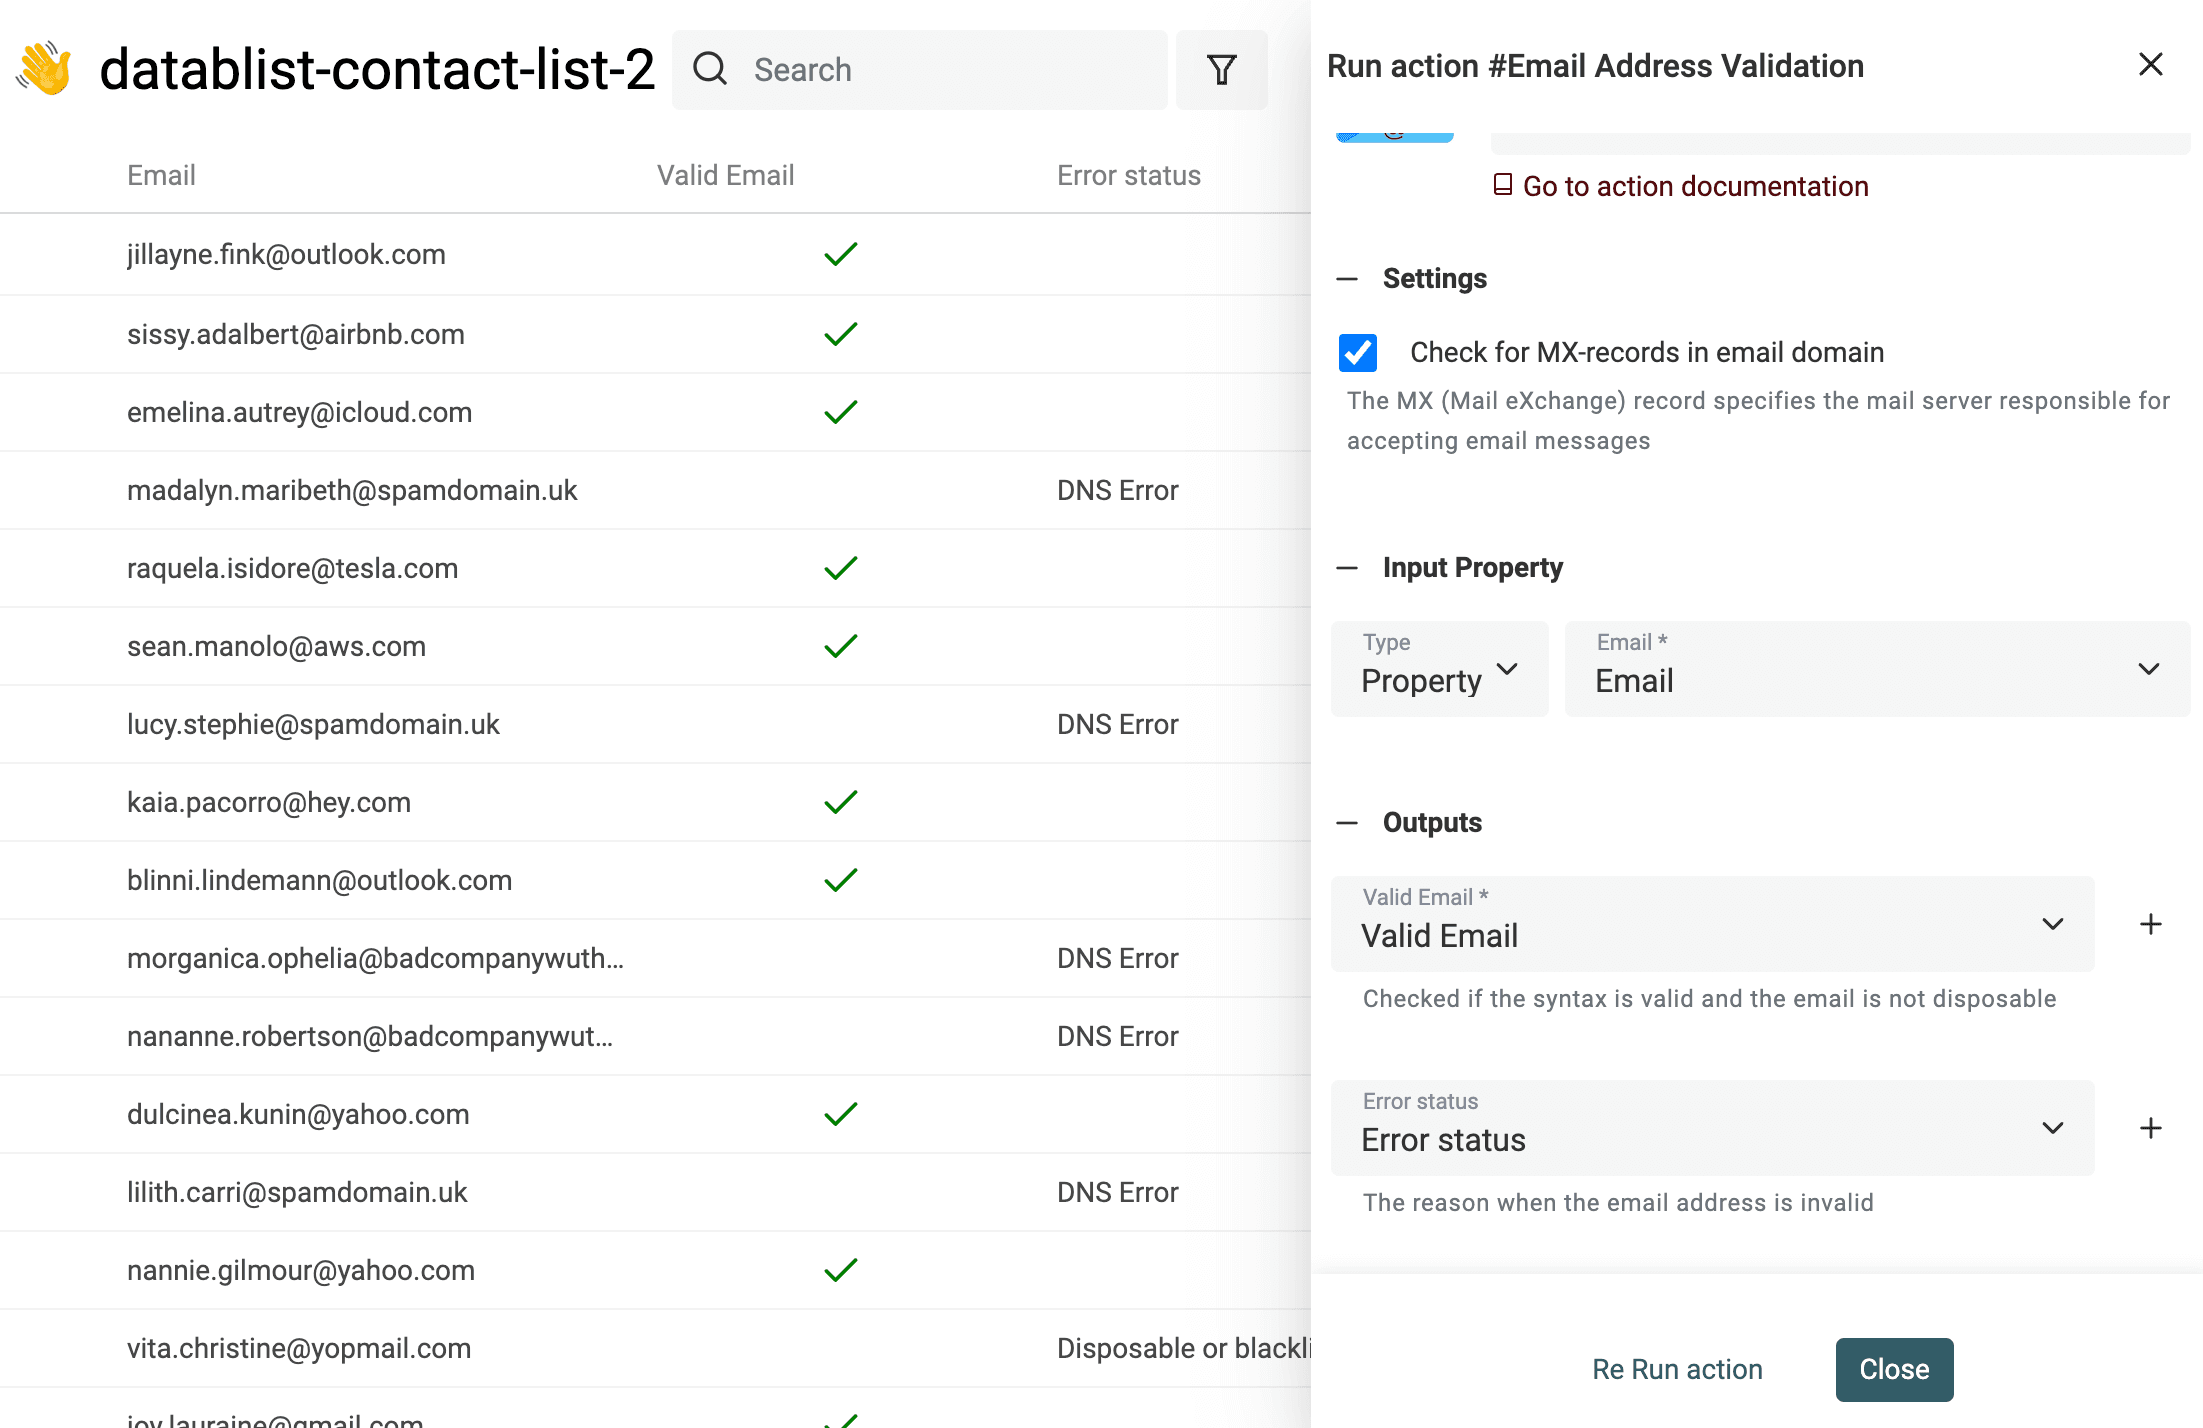
Datablist enthält ein leistungsstarkes "Named Entity Recognition" (NER) Modell, das Du direkt auf Deine Texte anwenden kannst. Es wurde für Arabisch, Deutsch, Englisch, Spanisch, Französisch, Italienisch, Lettisch, Niederländisch, Portugiesisch und Chinesisch trainiert.
Wähle im Menü "Enrichments" die Option "Entity name extraction" aus.
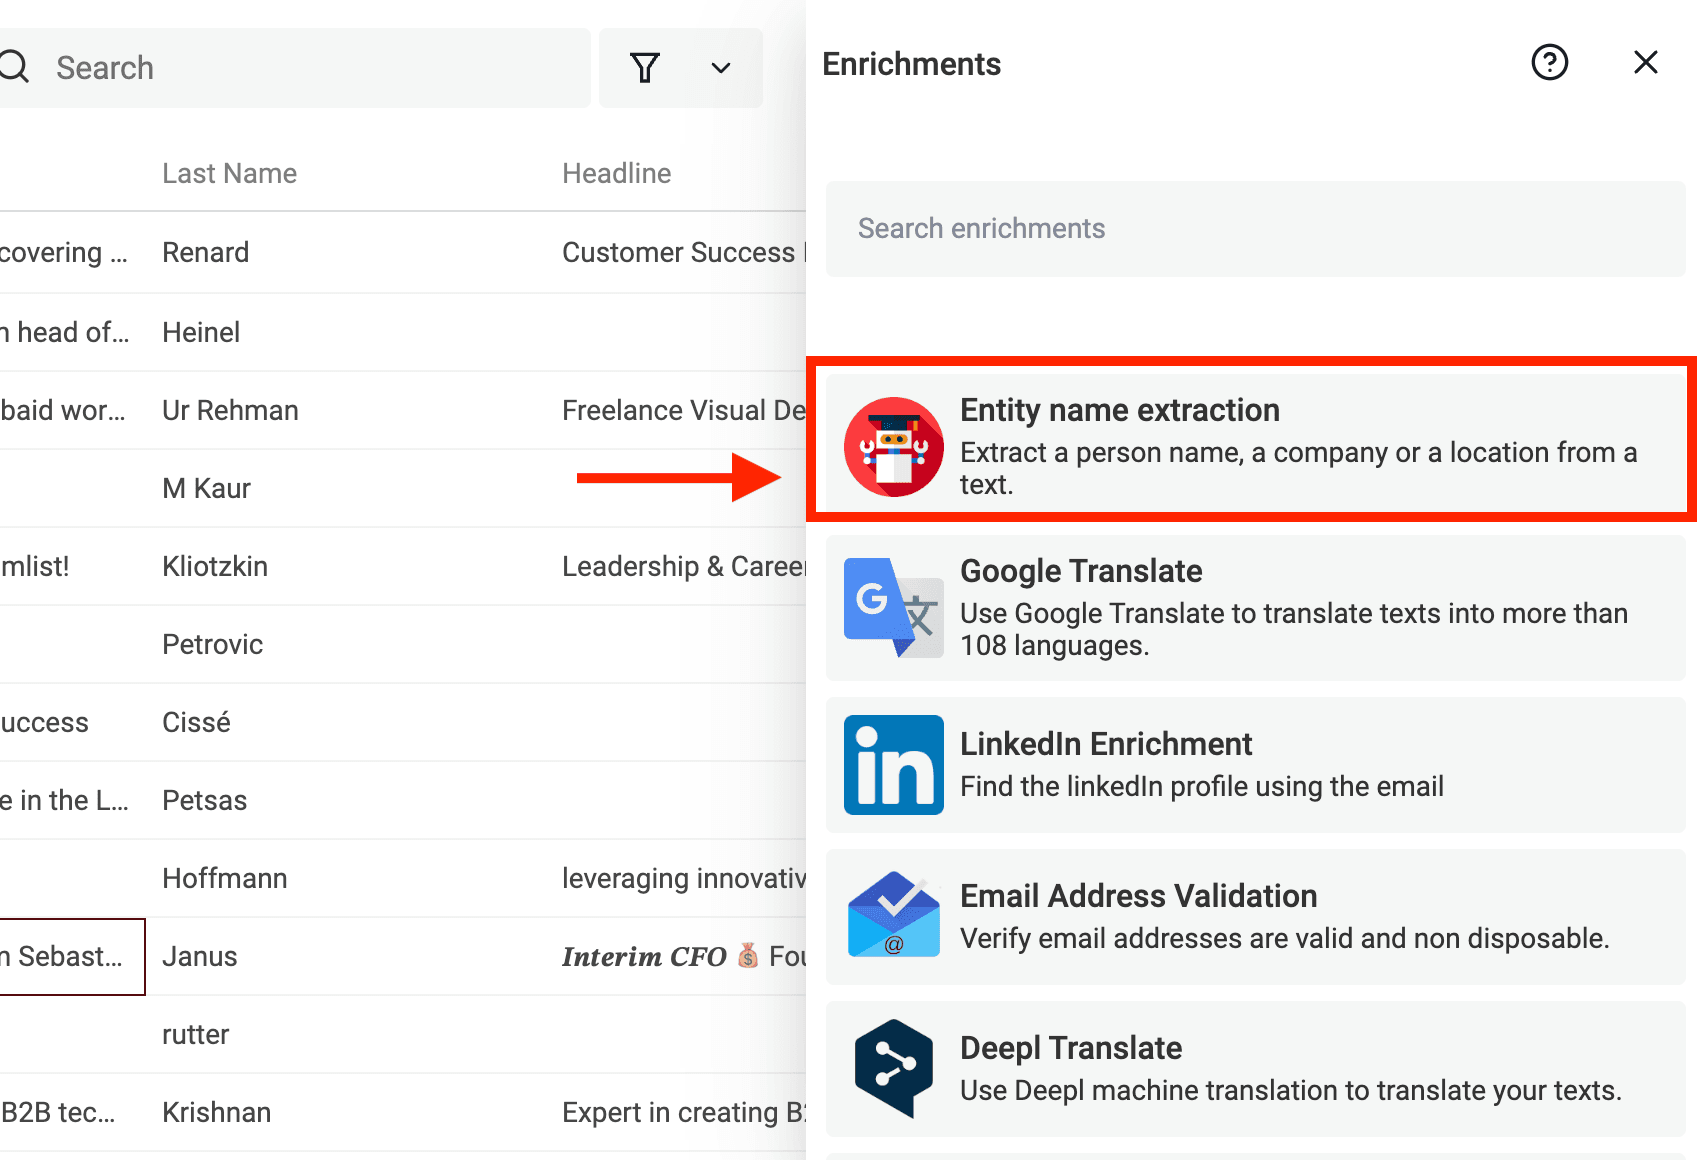
Wähle anschließend in den Input-Optionen die Text Property aus, aus der Du Namen extrahieren möchtest.
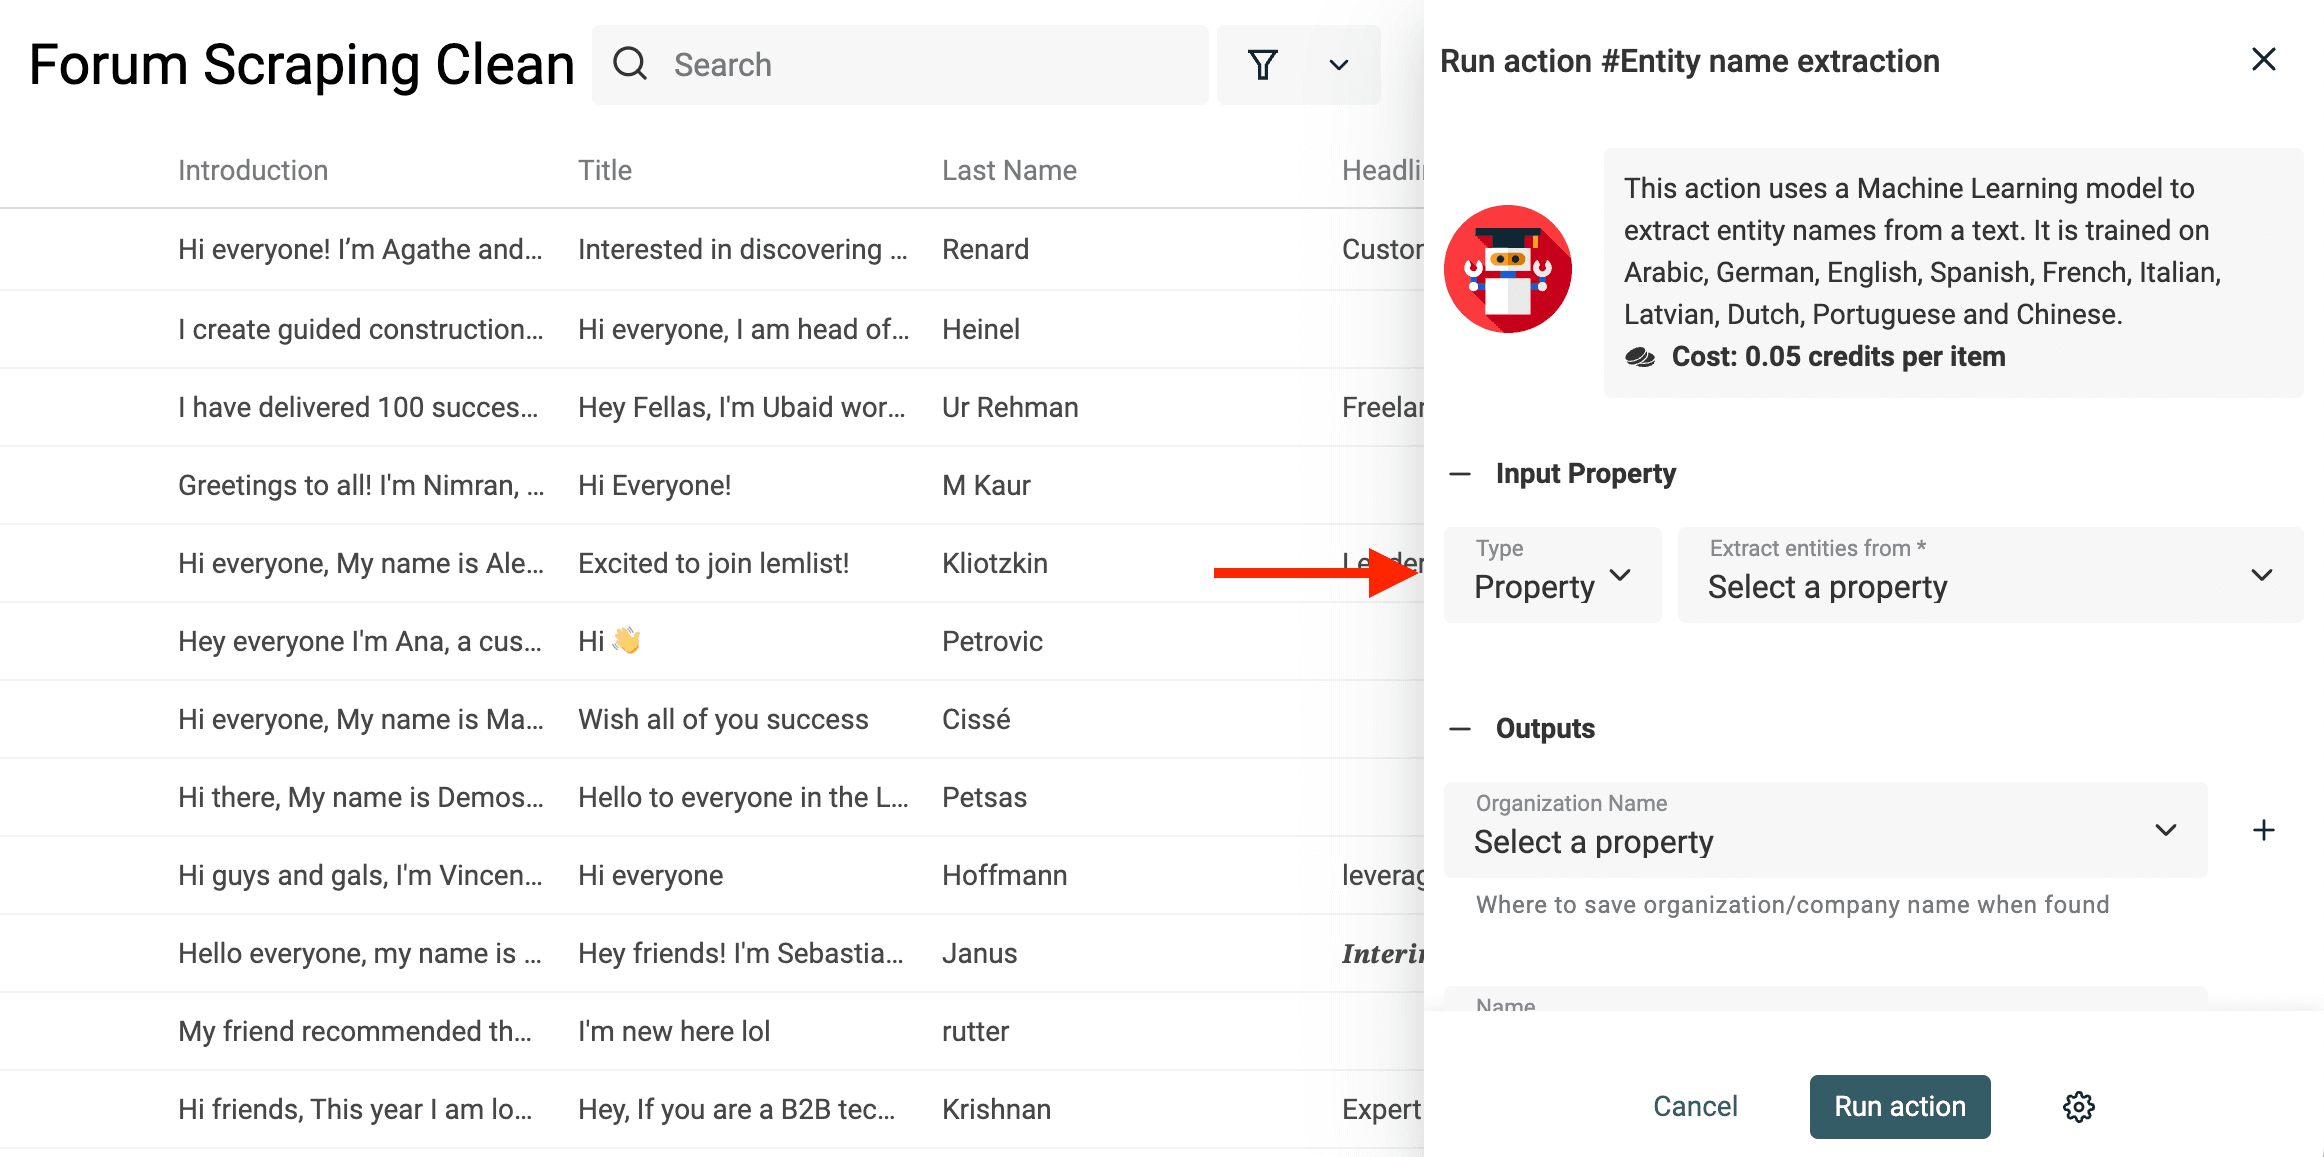
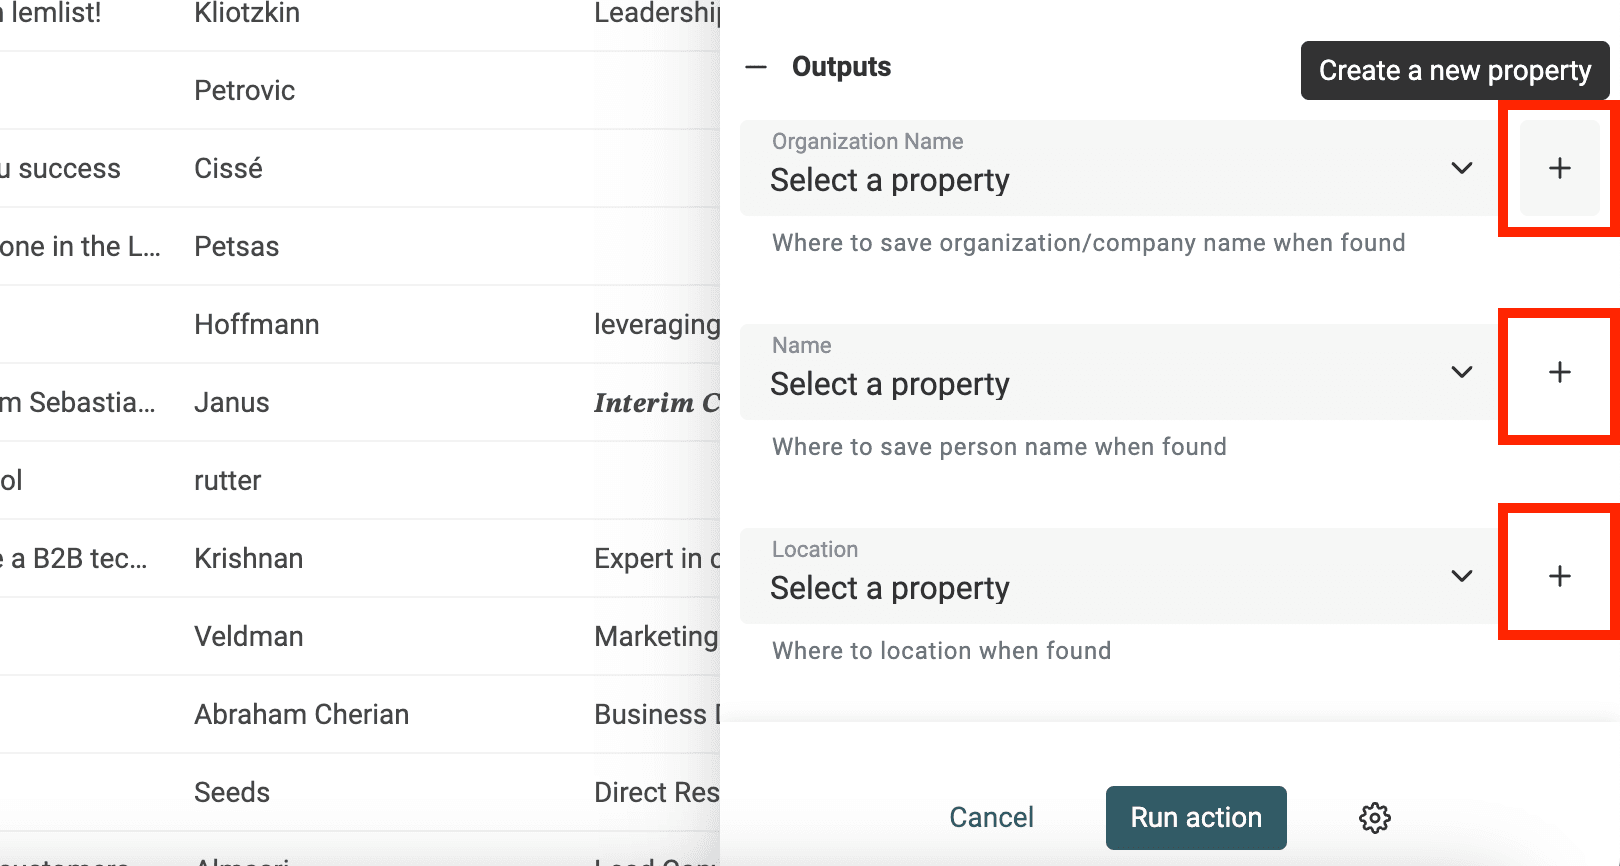
Klicke unter Outputs für jede Art von Namen, die Du extrahieren möchtest, auf den Button "Create a new property".
Der Entity Name Extractor von Datablist sucht nach:
- Organization Name: zum Beispiel Unternehmen
- Person Name: vollständiger Name oder First Name/Last Name
- Location: extrahiert Städte, Länder und Orte
Starte anschließend das Enrichment.
Hilfe bei der Datenbereinigung gesucht?
Ich freue mich immer über Feedback und neue Herausforderungen rund um die Datenbereinigung. Kontaktiere mich, um Deinen Use Case mit mir zu teilen.