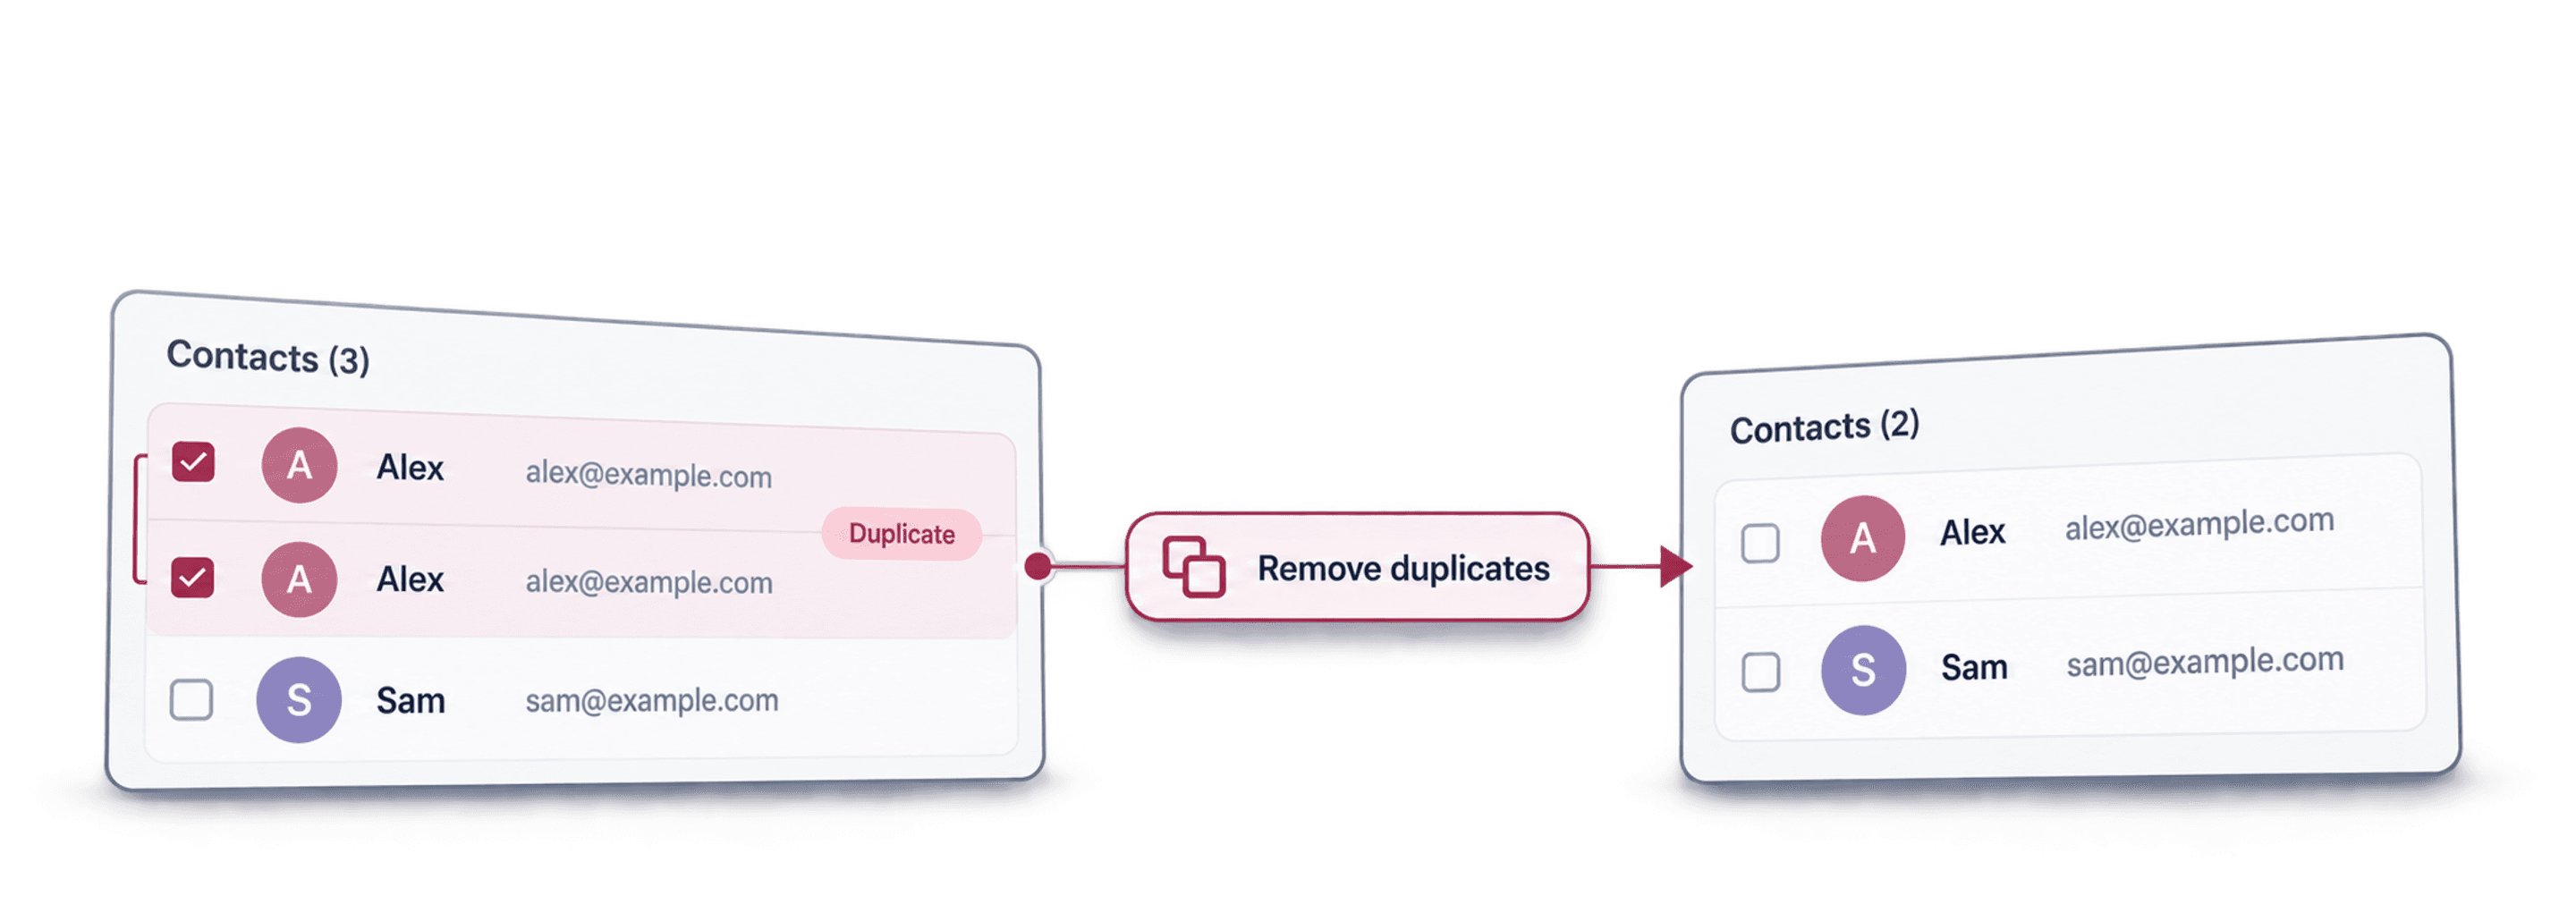
Para deduplicar una lista online, primero defina qué campo identifica a una persona, empresa o producto. Ejecute una comparación estricta, revise los grupos de duplicados propuestos y, después, combine los valores útiles o elimine las filas que no aportan nada. Así agilizará la limpieza sin asumir que todos los valores similares corresponden al mismo registro.
Datablist permite completar todo el proceso desde el navegador. Importe un archivo CSV o Excel, elija las propiedades que desea comparar, revise las filas y los resultados, y exporte la lista limpia. La detección de duplicados es de solo lectura hasta que inicia una acción Remove, Merge o un procesamiento personalizado.
Esta guía utiliza un archivo de muestra descargable con 1000 filas que incluye copias exactas, alias de email, variaciones de nombres de empresa, diferencias en las URL, formatos de teléfono distintos, errores ortográficos, valores contradictorios y registros complementarios.
🔑 La regla para deduplicar sin riesgos
Compare usando el identificador fiable más sencillo, pero revise la fila completa para decidir qué conservar.
Cómo deduplicar una lista sencilla de valores
Si su lista contiene un valor por línea, guárdela como un CSV de una sola columna con un encabezado como Email, Dominio o Valor. Impórtela en Datablist y ejecute Clean > Remove duplicates en esa columna con Exact. Revise los grupos, elija el registro que desea conservar, procese las filas duplicadas y exporte los valores restantes.
Por ejemplo, en una lista ilustrativa que contenga alpha.example, beta.example y alpha.example, debería quedar un valor alpha y otro beta tras eliminar la fila repetida. Se trata de un ejemplo de entrada y salida, no de otra medición realizada con el archivo de muestra descargable.
Recomiendo este método para una lista de identificadores. Si el archivo contiene varias columnas, deberá resolver registros duplicados: al eliminar una fila, también se borran sus demás valores. Utilice el flujo de Merge que se explica más adelante cuando un email repetido tenga un número de teléfono o una nota útil en una segunda fila.
Mantenga separados los identificadores vacíos. Con la comparación predeterminada de propiedades seleccionadas, la ausencia de un identificador de texto no basta para establecer una coincidencia. Si necesita eliminar filas vacías, realice esa limpieza expresamente en lugar de esperar que la deduplicación determine qué representan.
Elija qué hace único a cada registro
No empiece por el algoritmo de comparación. Primero defina la entidad.
Un contacto, una empresa, un producto y una transacción requieren identificadores diferentes:
| Lista | Identificadores iniciales sólidos | Segunda pasada útil |
|---|---|---|
| Contactos | Email, teléfono, URL de LinkedIn | Nombre completo más empresa |
| Empresas | Dominio web, ID de empresa | Nombre de empresa normalizado |
| Productos | SKU, EAN, GTIN, URL del producto | Nombre del producto más marca |
| Leads del CRM | Email, teléfono, ID del CRM | Nombre más dominio de la empresa |
| Pedidos | ID del pedido | ID del cliente más fecha del pedido |
Una sola pasada rara vez detecta todos los duplicados. Un contacto puede tener el mismo email en dos filas, mientras que otro puede haber cambiado de dirección de email pero conservar el mismo teléfono. Ejecute pasadas independientes para cada identificador en lugar de crear una única regla con todas las propiedades.
Por ejemplo:
- Compare los contactos por email.
- Procese los grupos revisados.
- Normalice los números de teléfono y ejecute una comprobación Exact sobre la propiedad limpia.
- Ejecute con cautela una comparación fuzzy del nombre completo más la empresa.
Añadir el email, el teléfono, el nombre y la empresa a una única comprobación hace que la comparación sea más estricta. Una fila debe cumplir toda la configuración, por lo que un solo valor ausente puede ocultar un duplicado real.
Consulte las guías específicas cuando el identificador necesite su propia normalización:
- Deduplicar direcciones de email y alias
- Detectar nombres de empresa duplicados
- Deduplicar un campo que contiene varios valores
- Normalizar números de teléfono nacionales e internacionales
Descargue la lista de ejemplo con 1000 filas
Descargue el CSV de demostración para deduplicar. Contiene 1000 filas que representan 800 entidades creadas para la prueba.
El archivo combina varios casos de prueba:
| Caso diseñado | Grupos de duplicados | Pasada de comparación |
|---|---|---|
| Copias exactas de filas completas | 5 | All Properties con Exact |
| Alias y formatos especiales de email | 100 | Email con Smart y el procesador Email |
| Variaciones de empresa y URL | 50 | Procesamiento de Company Name o URL |
| Diferencias básicas en el formato de teléfonos de EE. UU. | 25 | Phone con Smart, solo formato |
| Errores controlados en nombres | 15 | Jaro-Winkler o Levenshtein |
| Variaciones fonéticas de nombres | 5 | Metaphone |
| Registros sin duplicado diseñado | 600 | Deben permanecer separados |
Estas cifras corresponden a los resultados de referencia definidos para la prueba; no garantizan que todos los umbrales fuzzy produzcan el mismo resultado. Una comparación por distancia puede incluir candidatos adicionales cuando el umbral es bajo. Revise esos grupos antes de procesarlos.
Estos son tres pares del archivo:
| Caso de uso | Primer valor almacenado | Segundo valor almacenado |
|---|---|---|
| Alias de email | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| Empresa y URL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| Formato básico del teléfono | +1 (202) 555-0768 | 1 202 555 0768 |
Las filas también presentan discrepancias en campos como el cargo, el responsable, el estado, los ingresos, la fuente, las etiquetas y las notas. Estos conflictos hacen que el archivo resulte útil para probar las reglas de selección del registro maestro y de supervivencia de campos.
Importe la lista en Datablist
Abra Datablist e importe el archivo CSV o Excel en una colección. Una colección funciona como una hoja de cálculo estructurada: las filas son elementos y las columnas, propiedades.
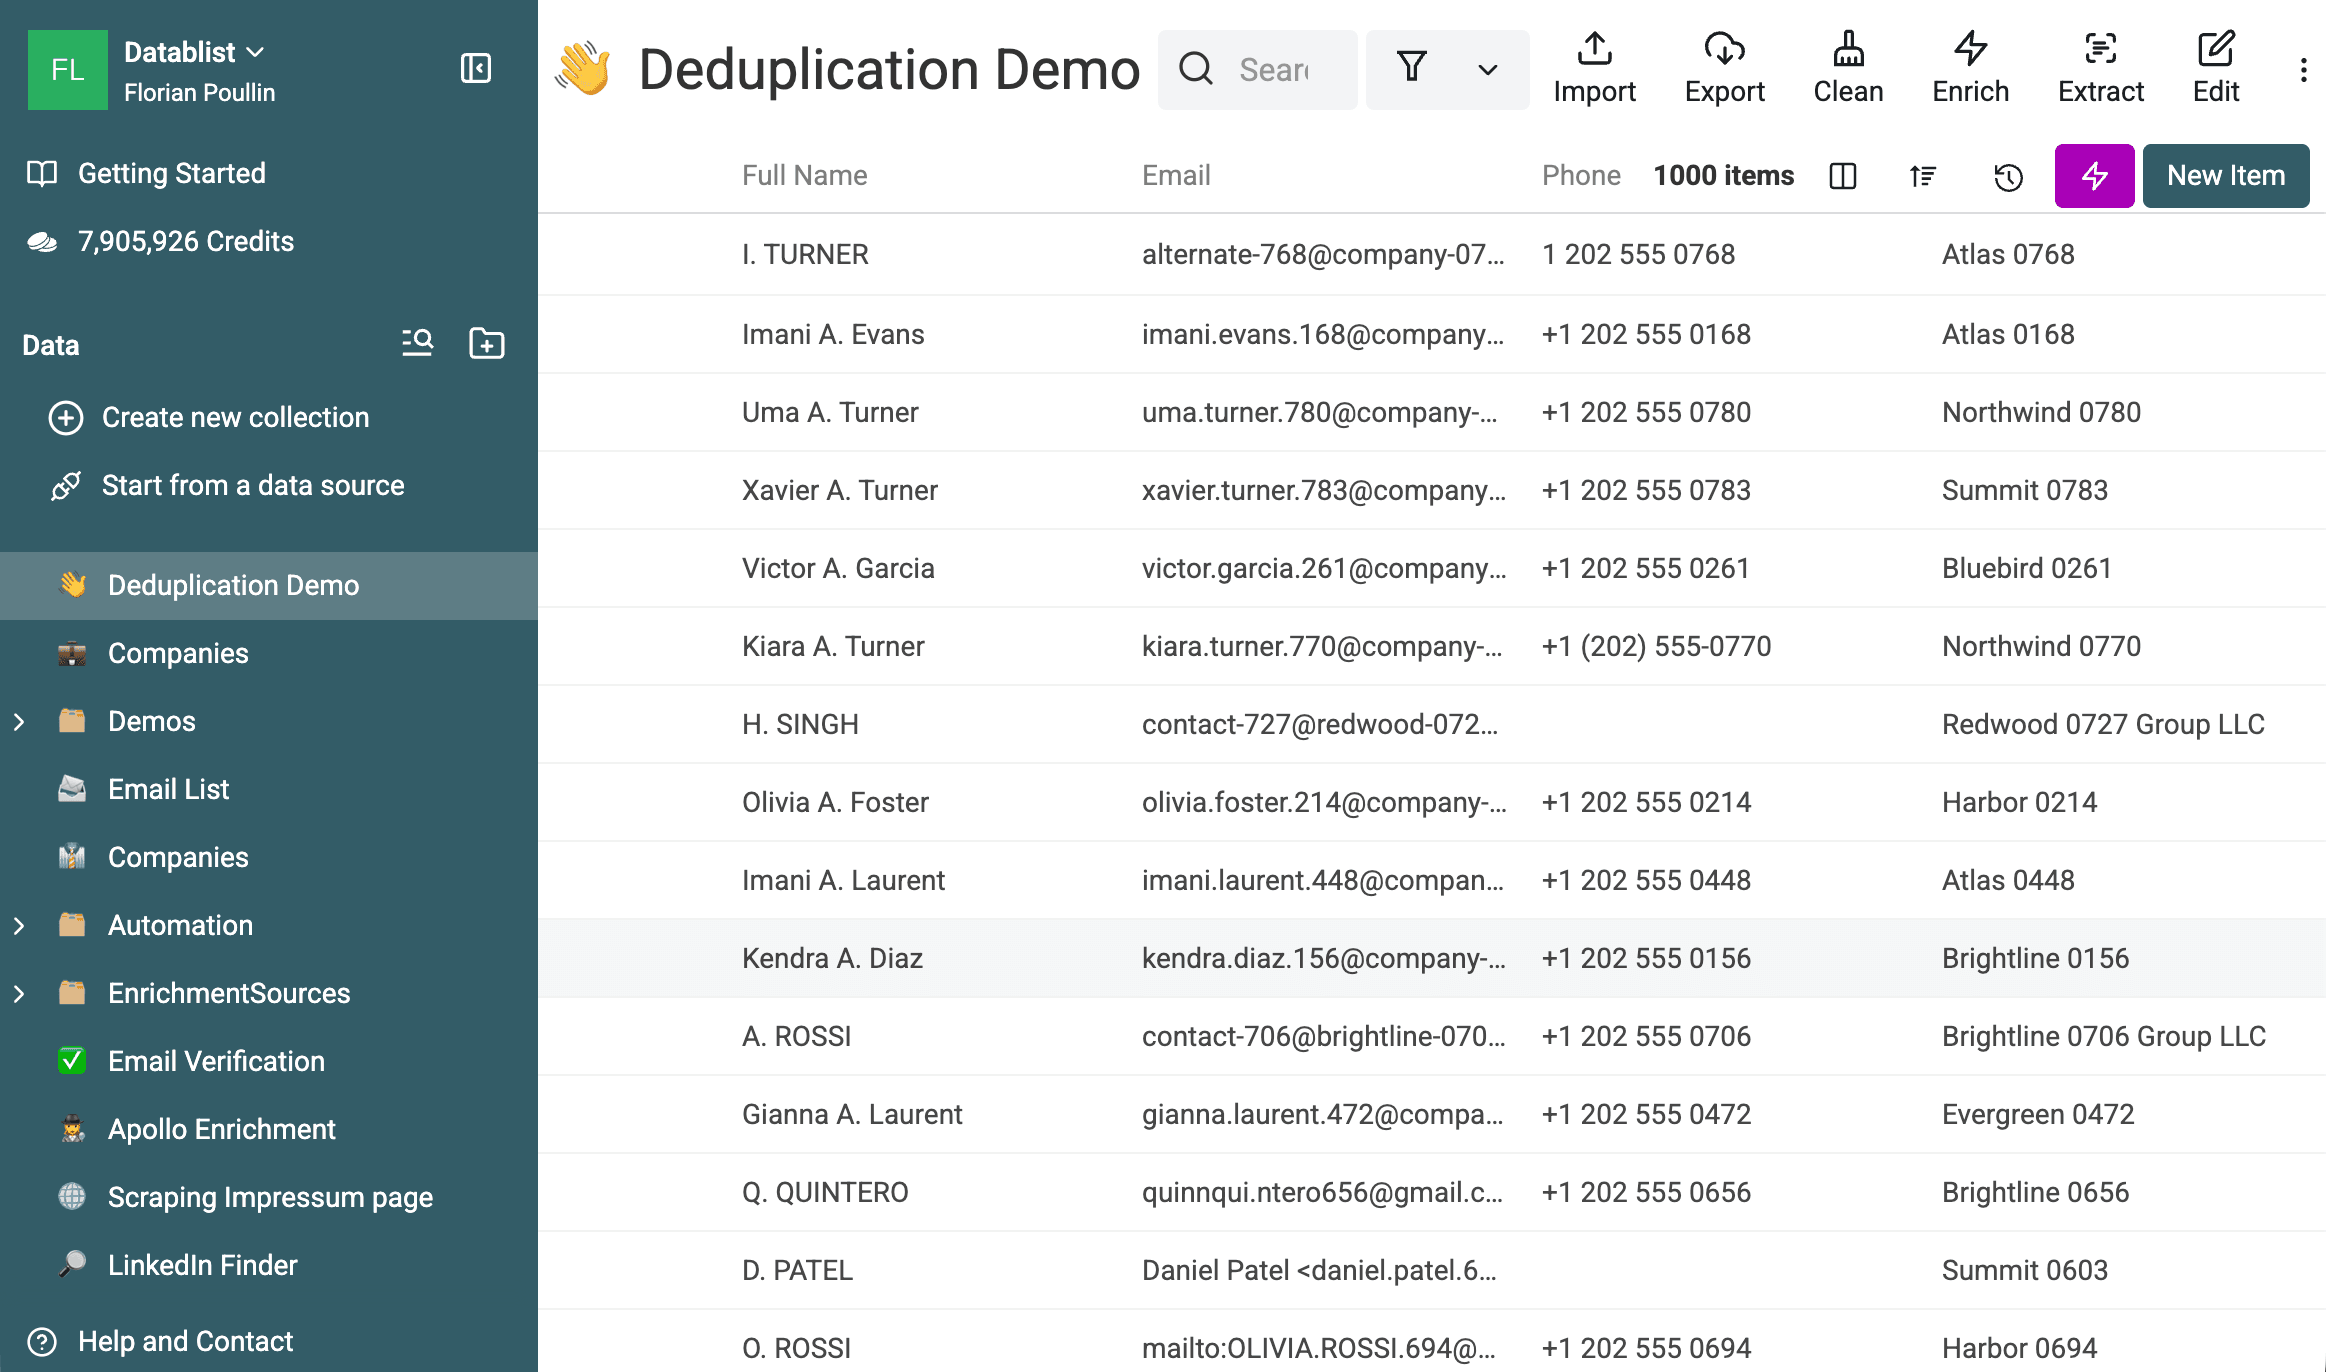
Compruebe los tipos de propiedad detectados durante la importación:
- Las columnas de email deben usar el tipo Email.
- Las columnas de sitios web deben usar URL.
- Las columnas de teléfono deben usar Phone.
- Las columnas de ingresos o cantidades deben usar Number.
- Las fechas de actividad y creación deben usar DateTime.
Conserve en la colección las columnas de ID, fuente, responsable, notas y estado. Le ayudarán a seleccionar el registro correcto y a comprobar qué conservará el Merge.
Ejecute comparaciones Exact, Smart y fuzzy
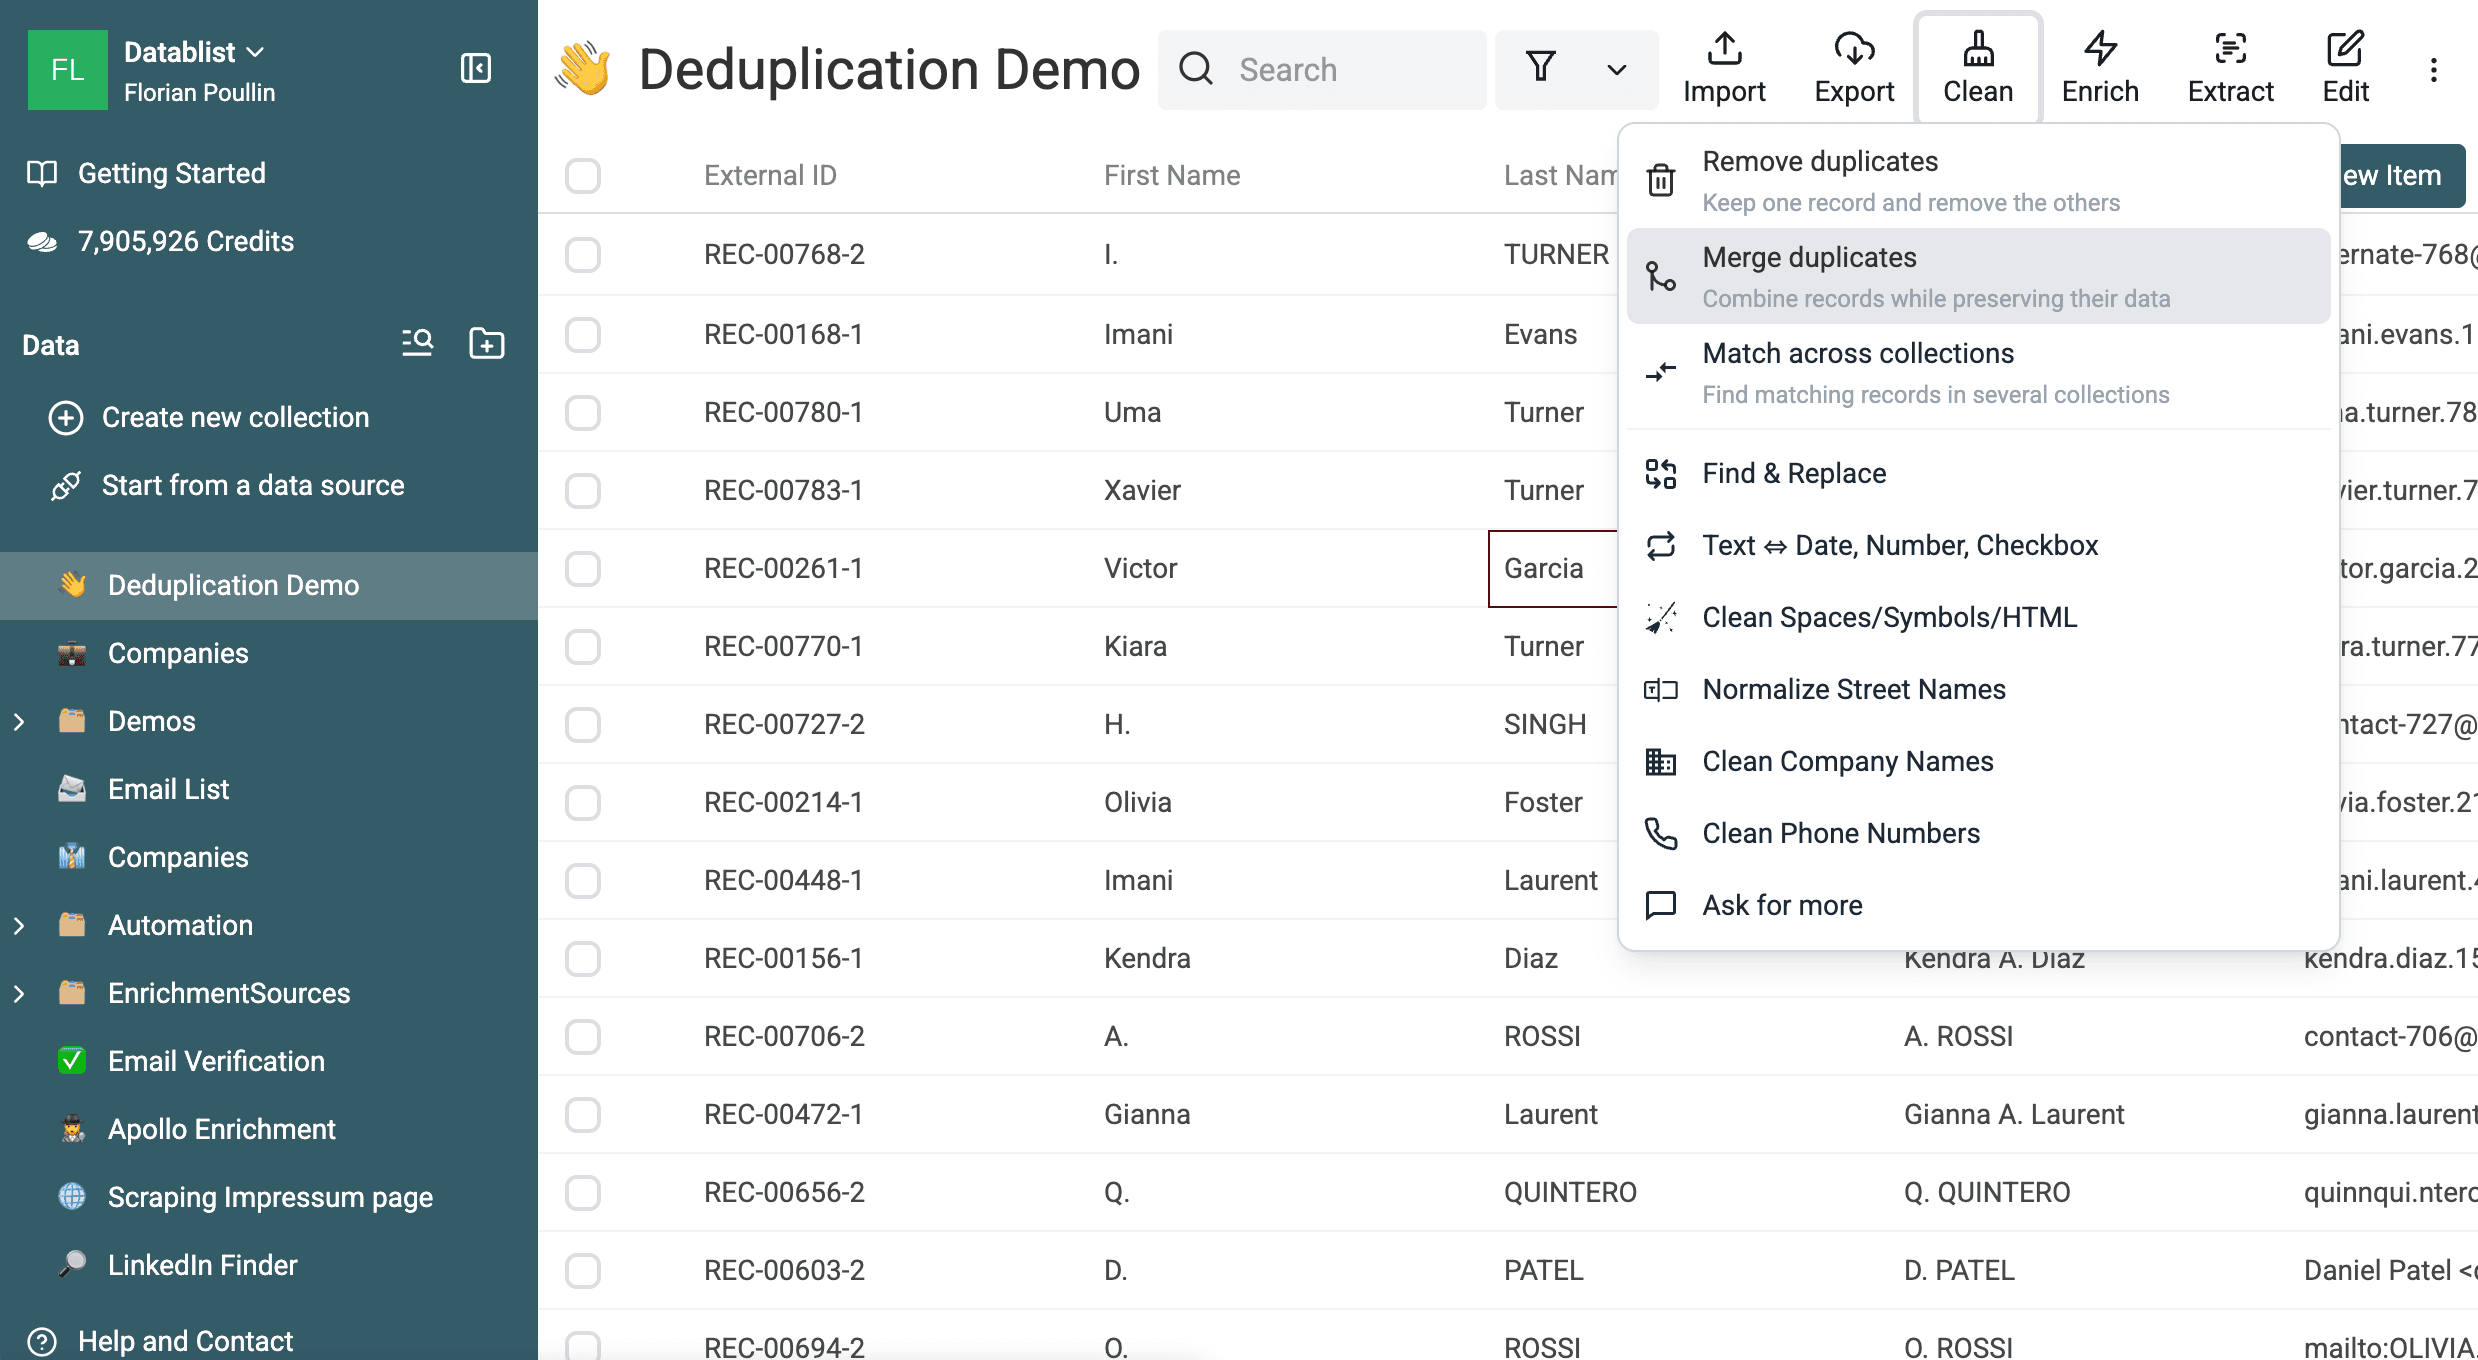
Abra Clean y elija la acción que corresponda a su objetivo:
- Remove duplicates cuando pueda descartar las filas secundarias.
- Merge duplicates cuando las filas contengan información que merezca la pena conservar.
- Match across collections cuando los registros estén en colecciones distintas.
Las dos primeras acciones utilizan el mismo motor de detección. Ambas abren el espacio de resultados, pero con un modo de procesamiento distinto seleccionado.
Empiece con una comparación Exact
Utilice All Properties con Exact para detectar filas que se hayan copiado dos veces sin ningún cambio. Utilice Selected Properties cuando un campo concreto, como un ID externo, deba ser idéntico.
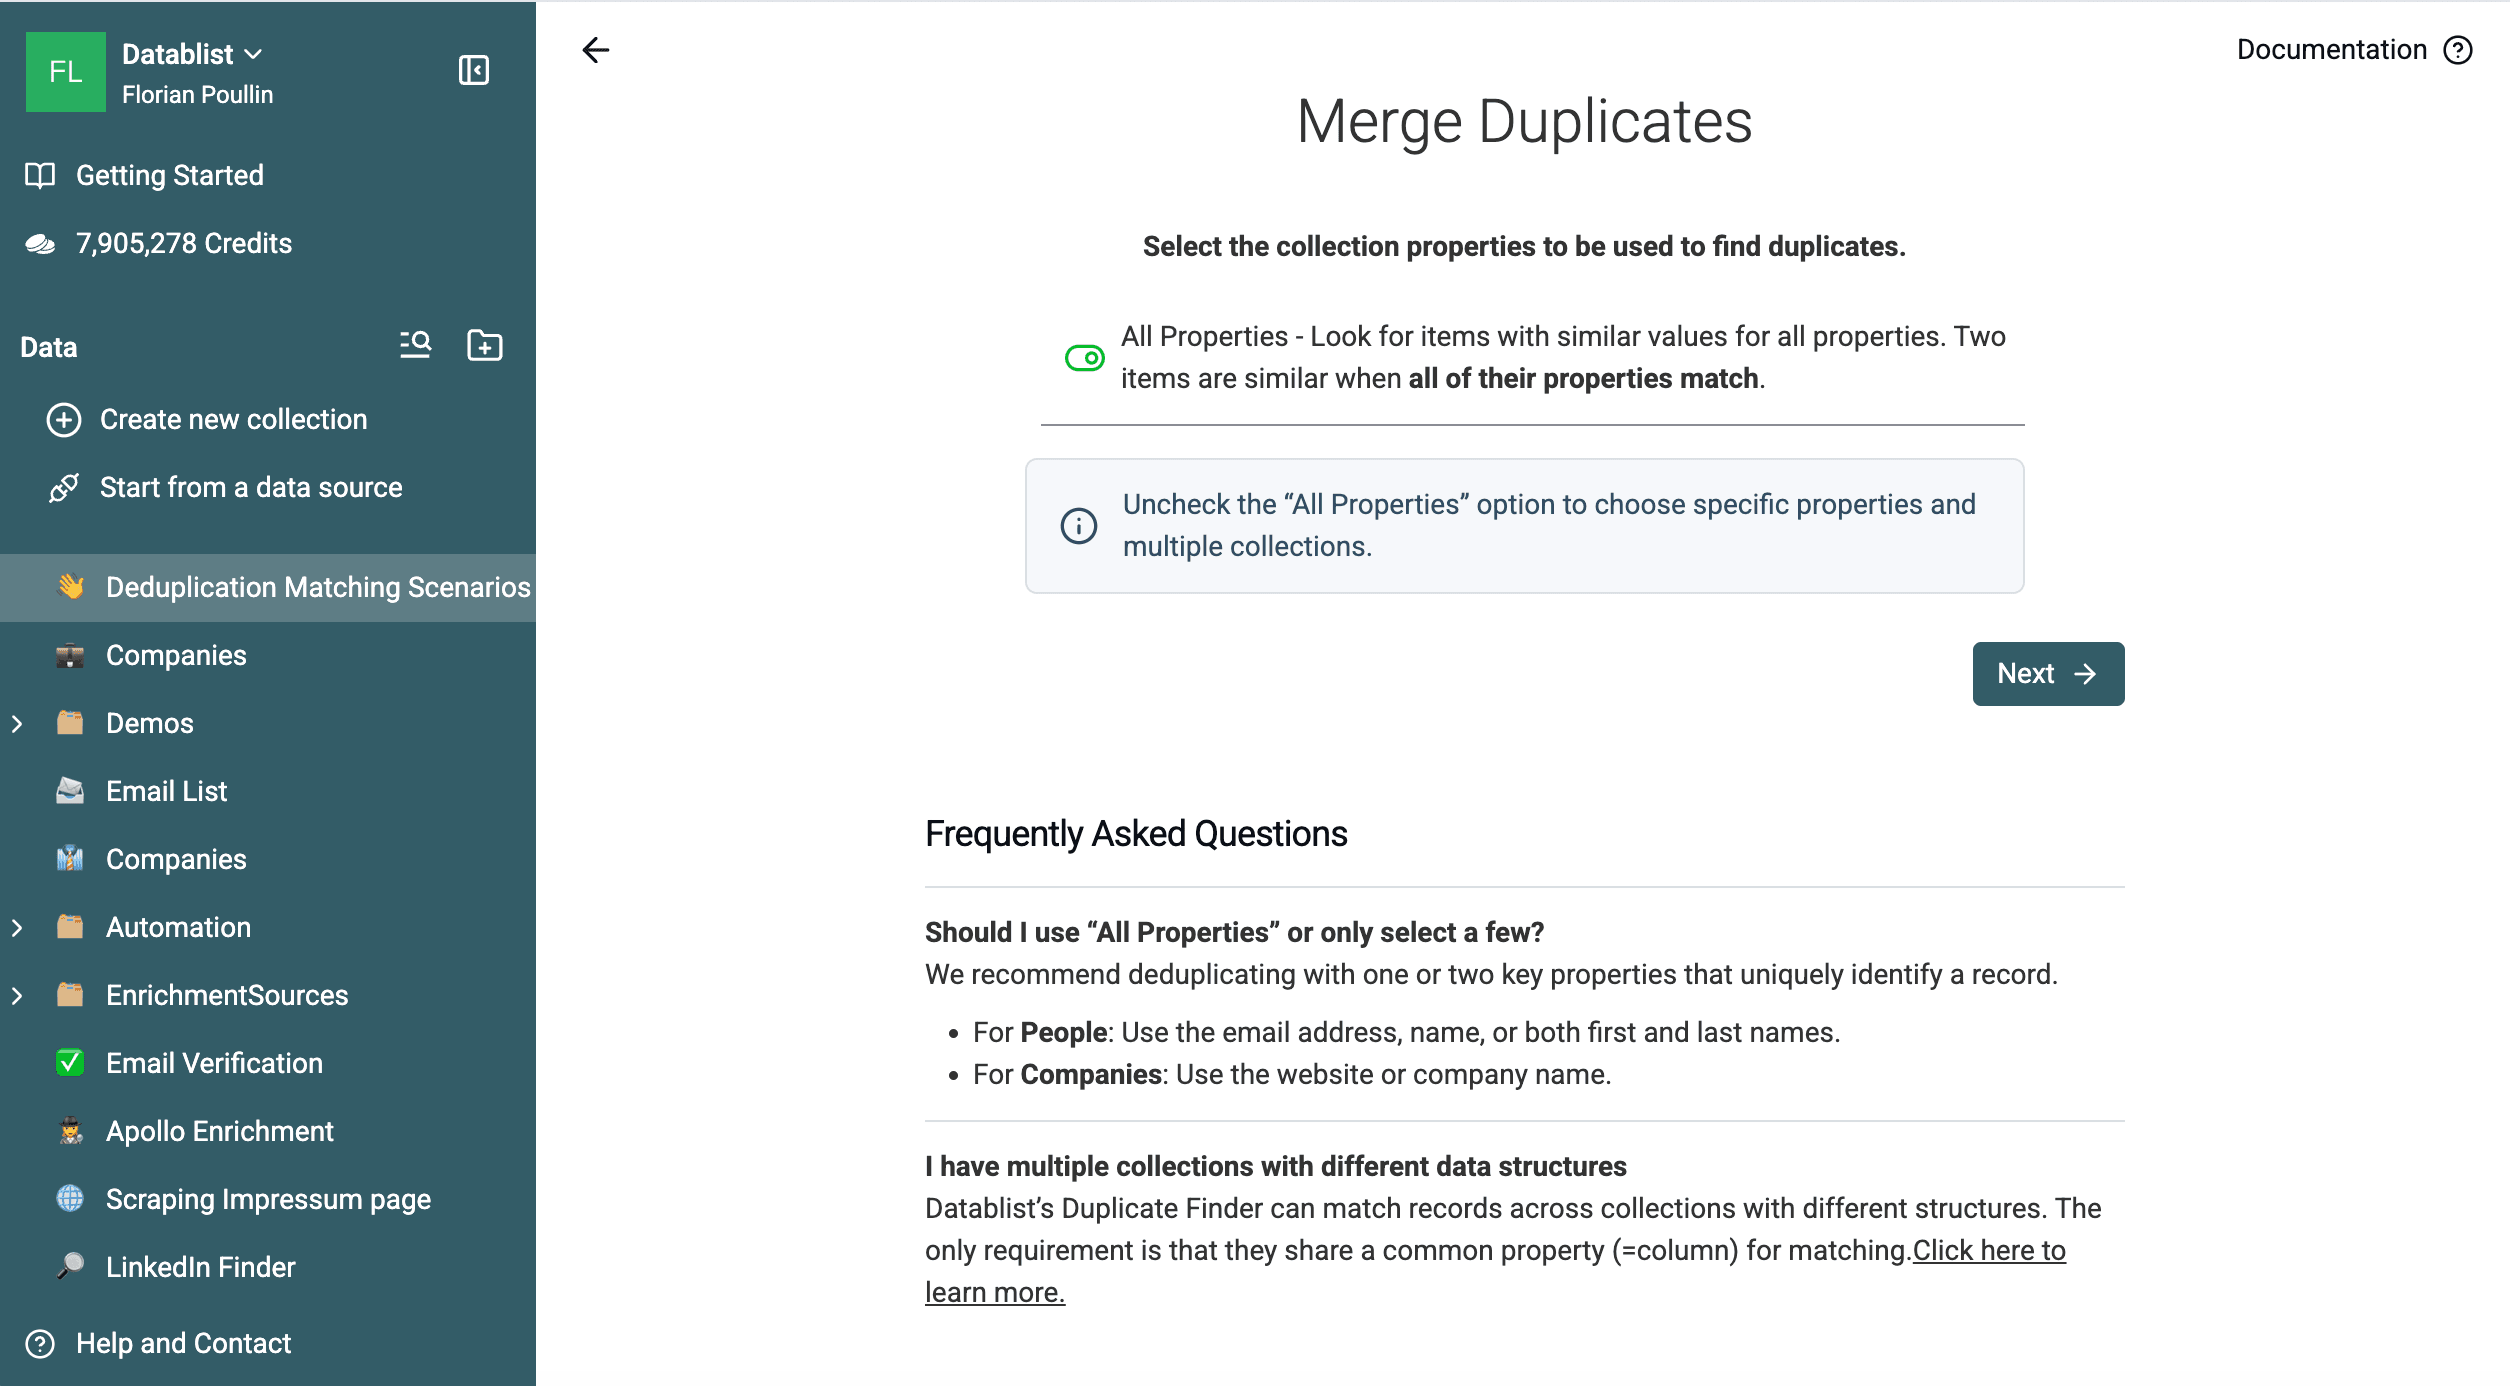
En la muestra de 1000 filas, esta pasada devuelve cinco grupos de duplicados. Cada grupo contiene dos filas con los mismos valores en todas las propiedades.
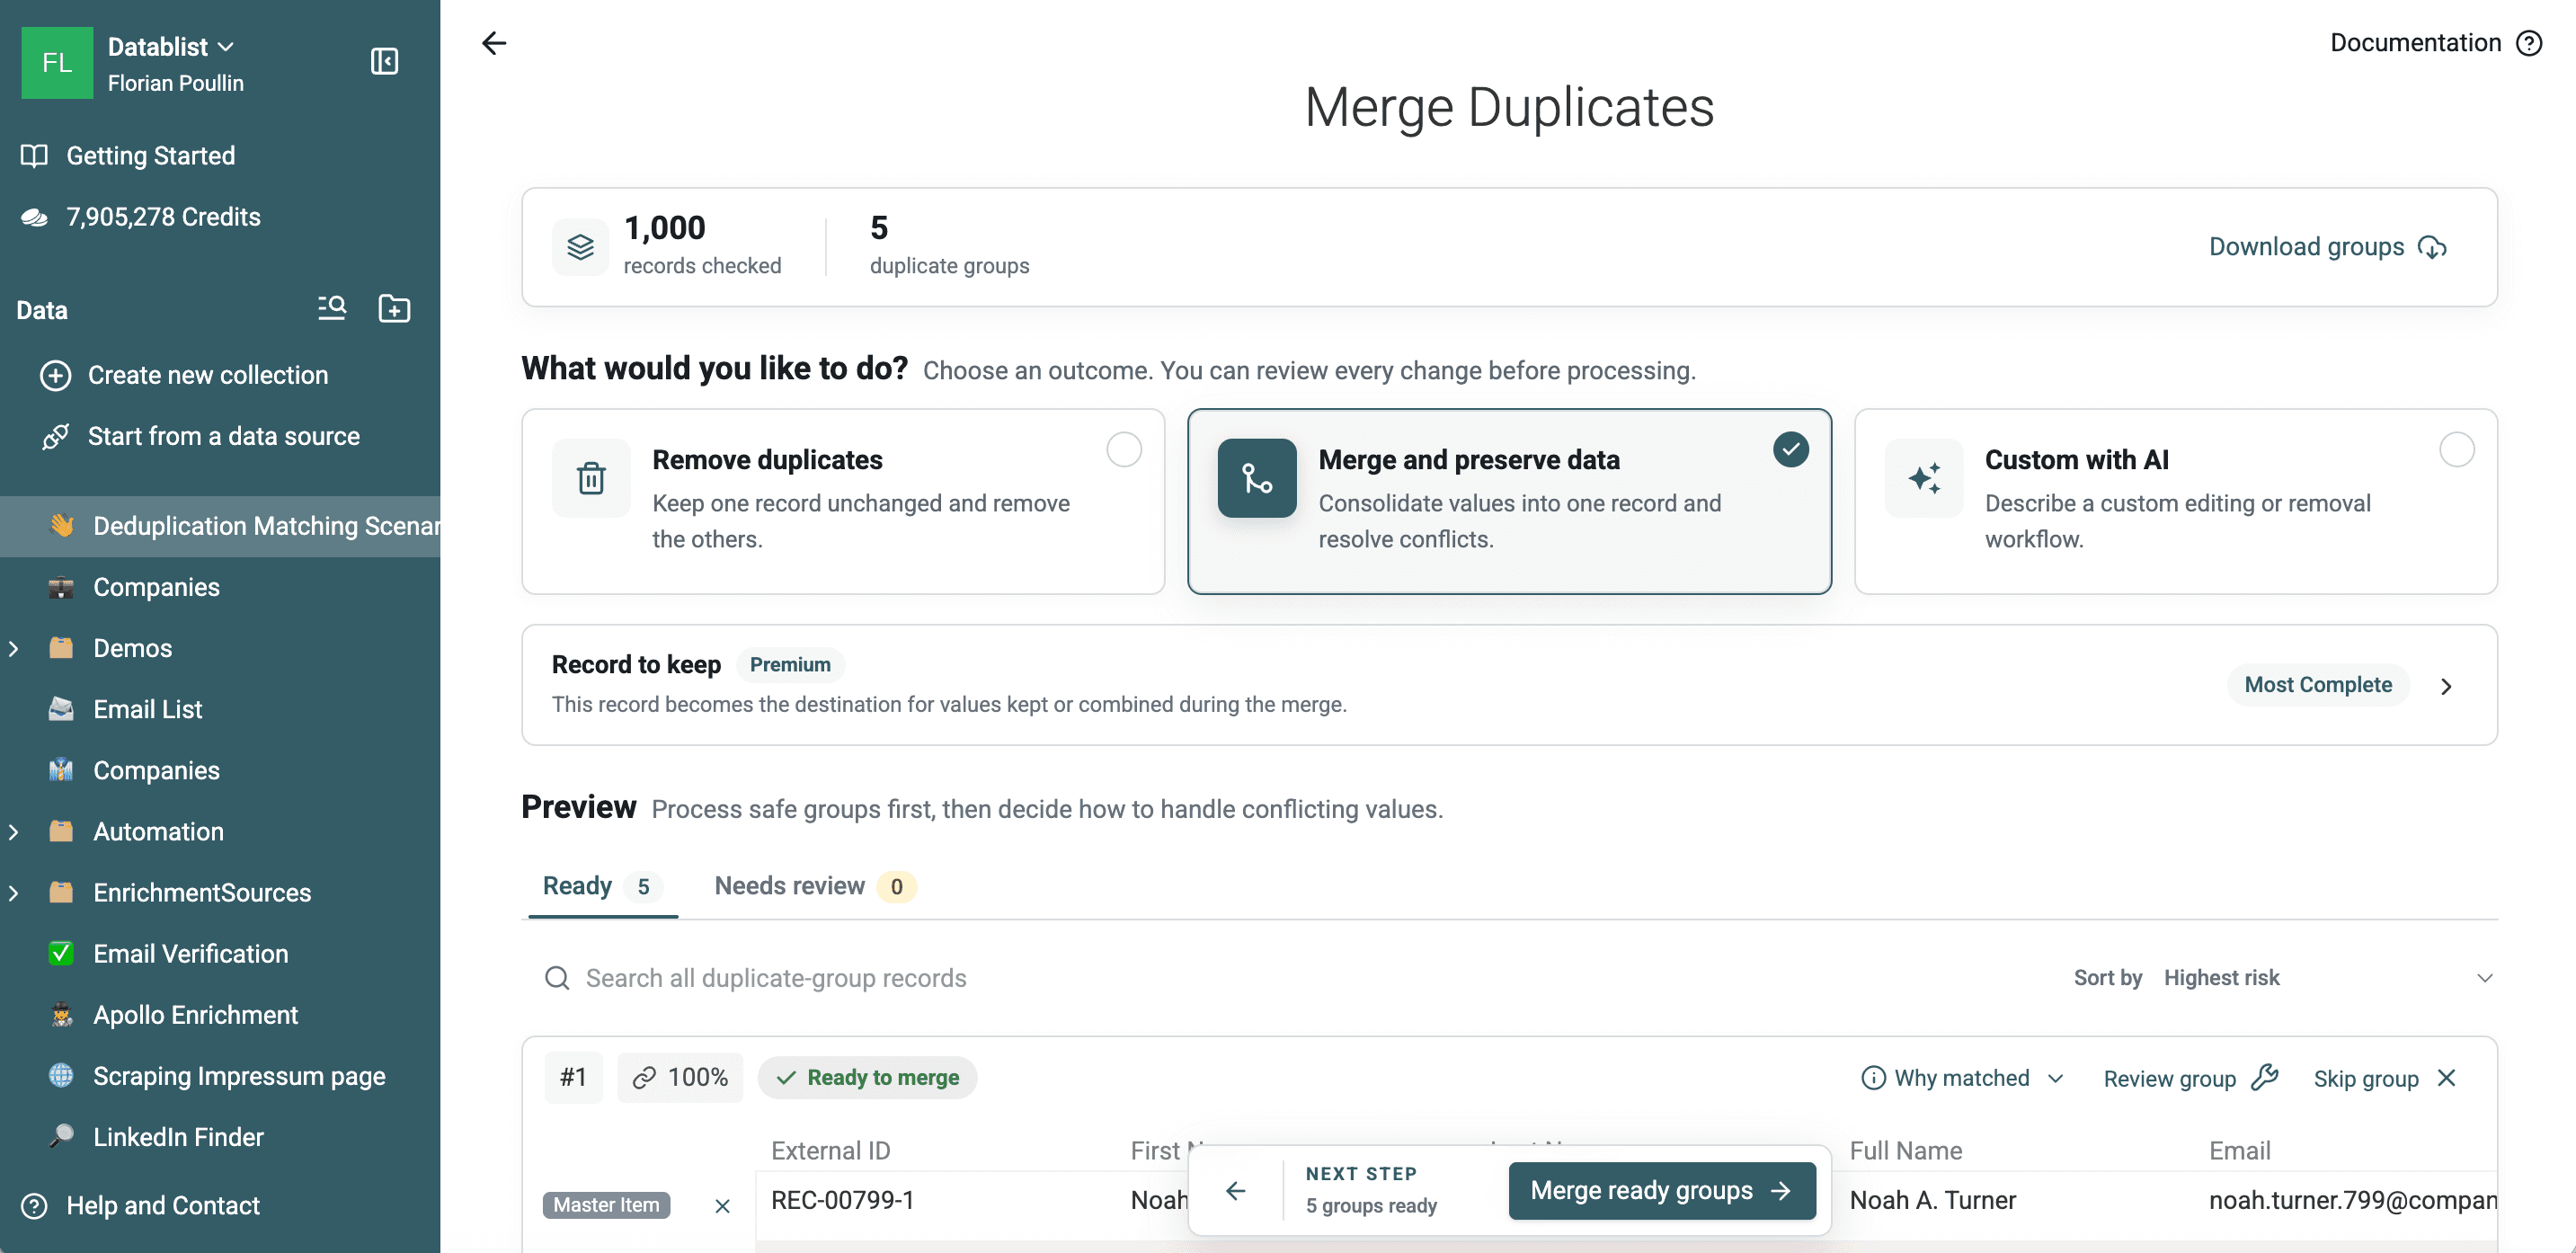
Exact es la opción más segura para la primera pasada porque todas las coincidencias conservadas cumplen una comparación estricta. No encontrará coincidencias entre Acme Inc. y Acme, entre dos formatos de un teléfono ni entre un email y su alias si los valores almacenados son diferentes.
Los visitantes sin cuenta pueden ejecutar una comprobación Exact de duplicados. Al crear una cuenta gratuita, se desbloquean la comparación Smart y las demás funciones del plan Free.
Use Smart para comparar datos empresariales
Smart estandariza los valores para compararlos sin modificar las celdas almacenadas. Seleccione el procesador adecuado para la propiedad:
- Email gestiona mayúsculas y minúsculas, espacios alrededor del valor, alias con el signo más, puntos de Gmail,
googlemail.com, formatos con nombre visible y valoresmailto:. - URL puede ignorar los protocolos y la barra final, con opciones para controlar los subdominios, las rutas y los parámetros de consulta.
- Phone ignora los caracteres de formato. No valida los números, no utiliza una propiedad Country ni deduce códigos de país ausentes.
- Company Name elimina términos jurídicos, empresariales y geográficos habituales.
- Text ignora acentos, espacios, puntuación, símbolos, mayúsculas y minúsculas, y el orden de las palabras.
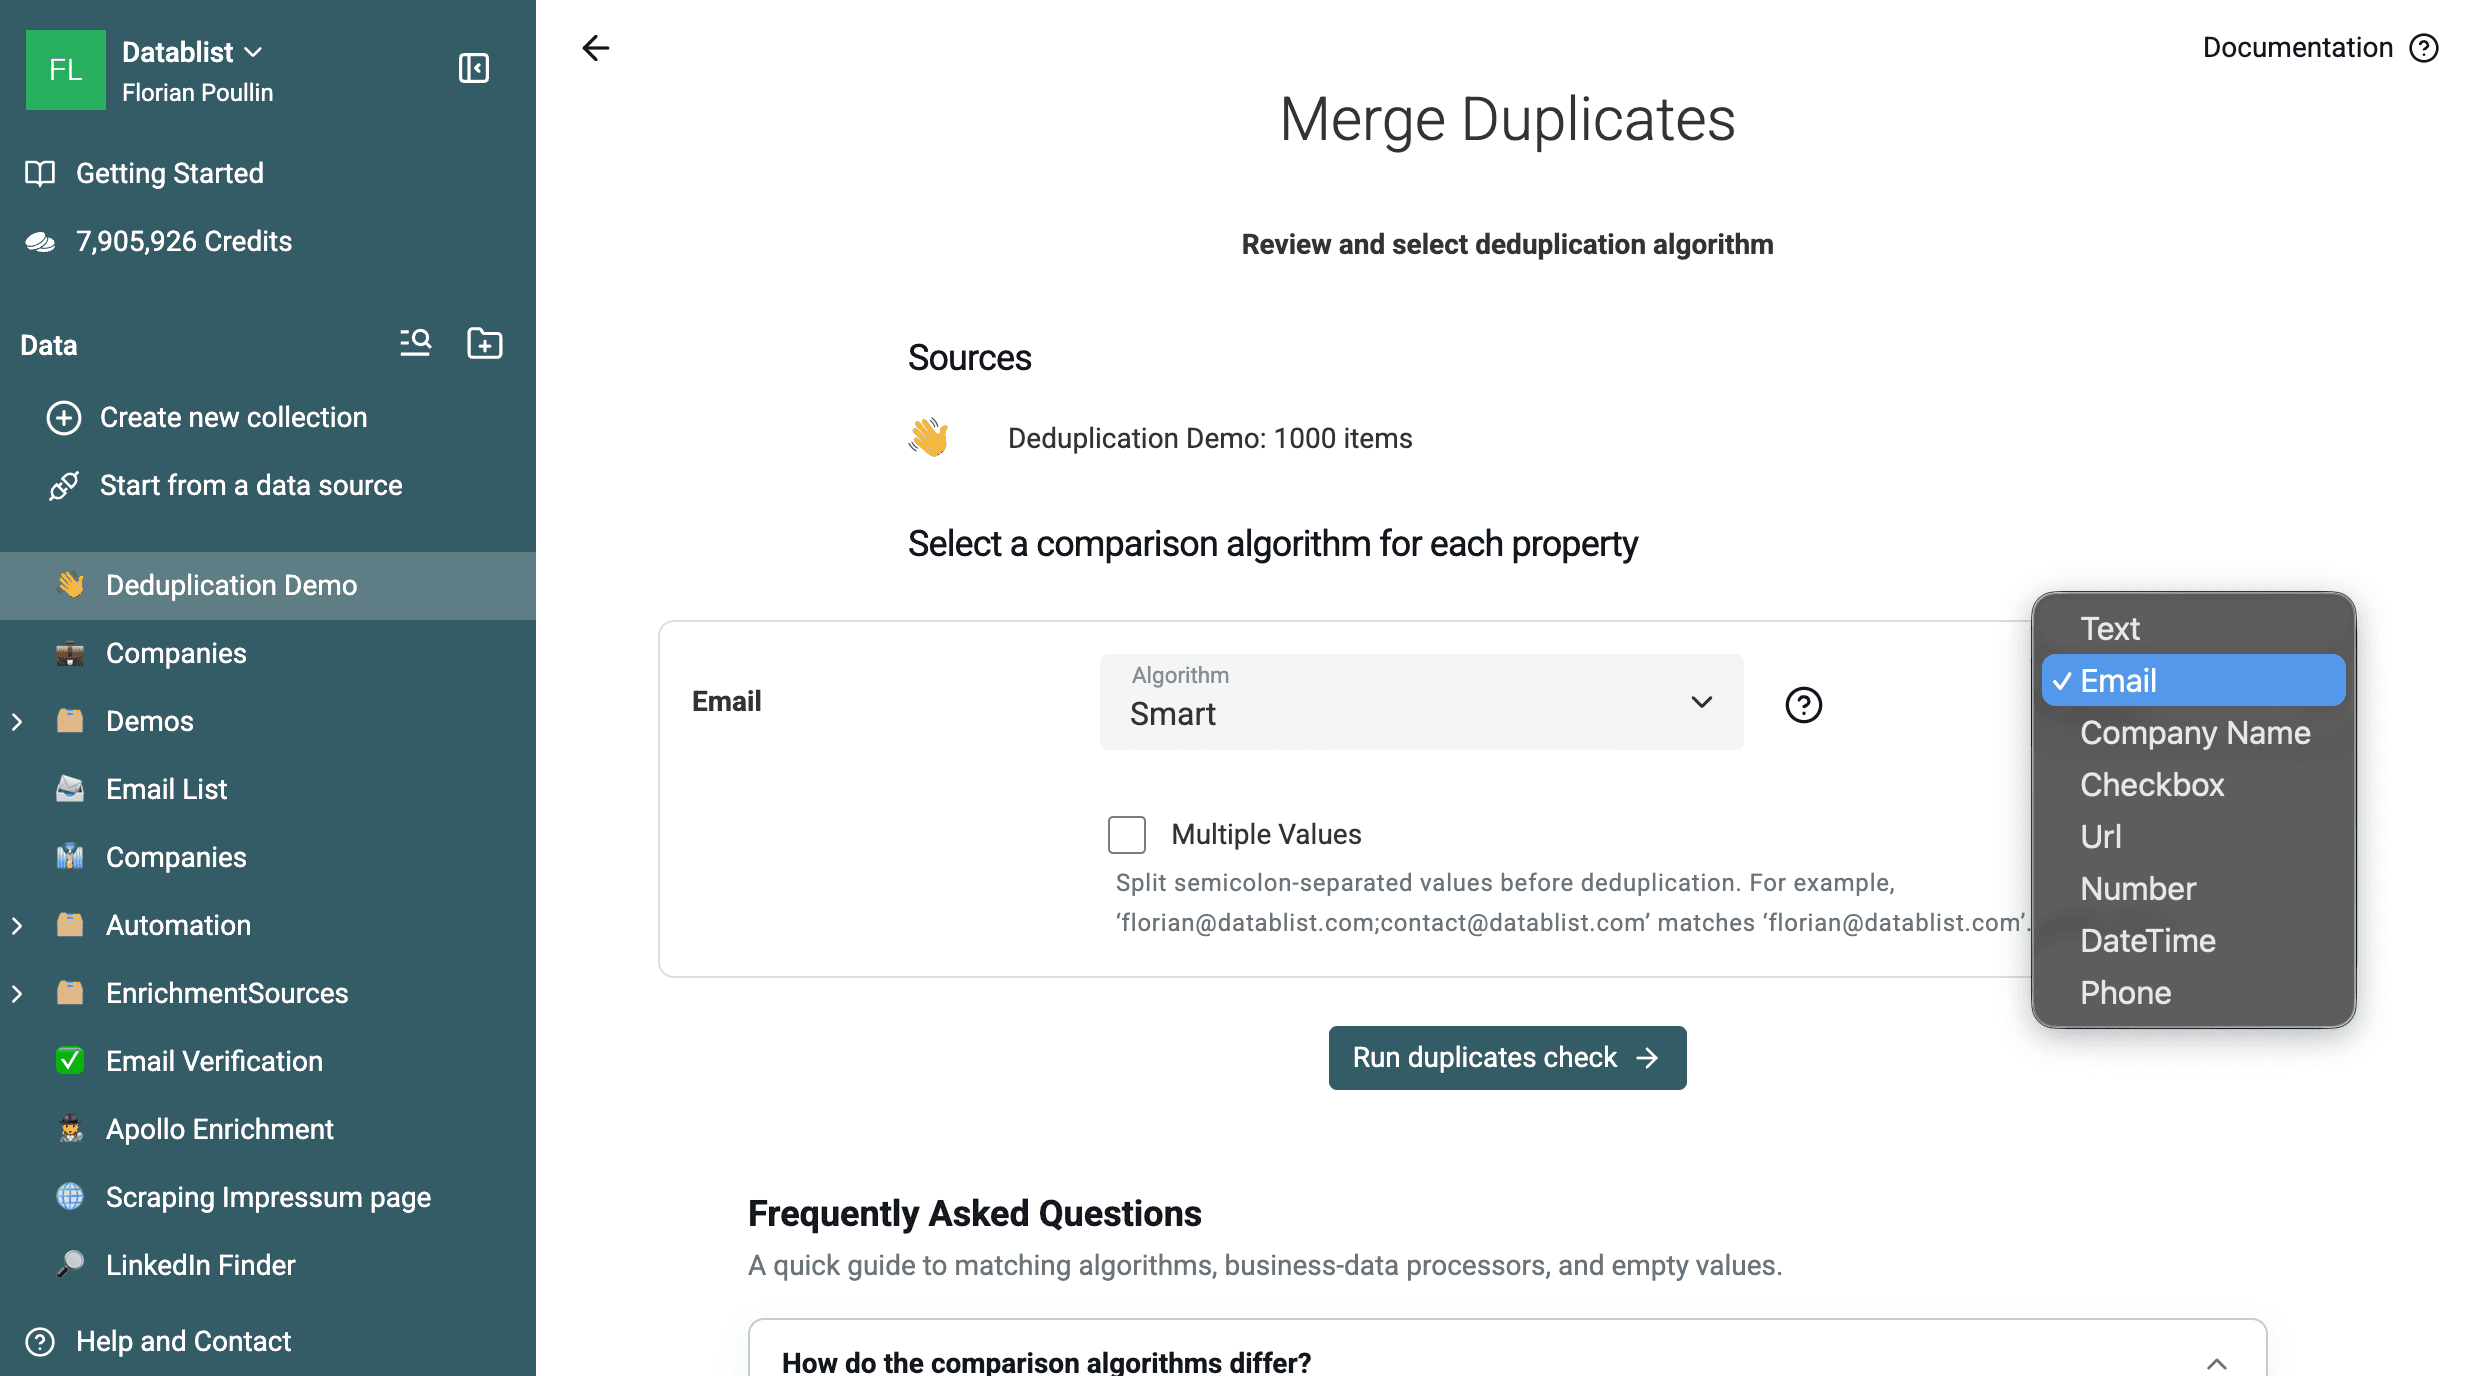
El procesador Company Name, la comparación de varios valores y los algoritmos avanzados requieren un plan de pago. Exact y Smart están disponibles para comparar una sola colección con el plan Free, aunque Smart exige una cuenta gratuita.
Cuando una celda contenga varios identificadores separados por punto y coma, active Multiple Values. Datablist compara cada parte y considera que la propiedad coincide cuando encuentra al menos un par coincidente. Por ejemplo, una celda que contenga primary@example.com;shared@example.com puede coincidir con otra que contenga shared@example.com.
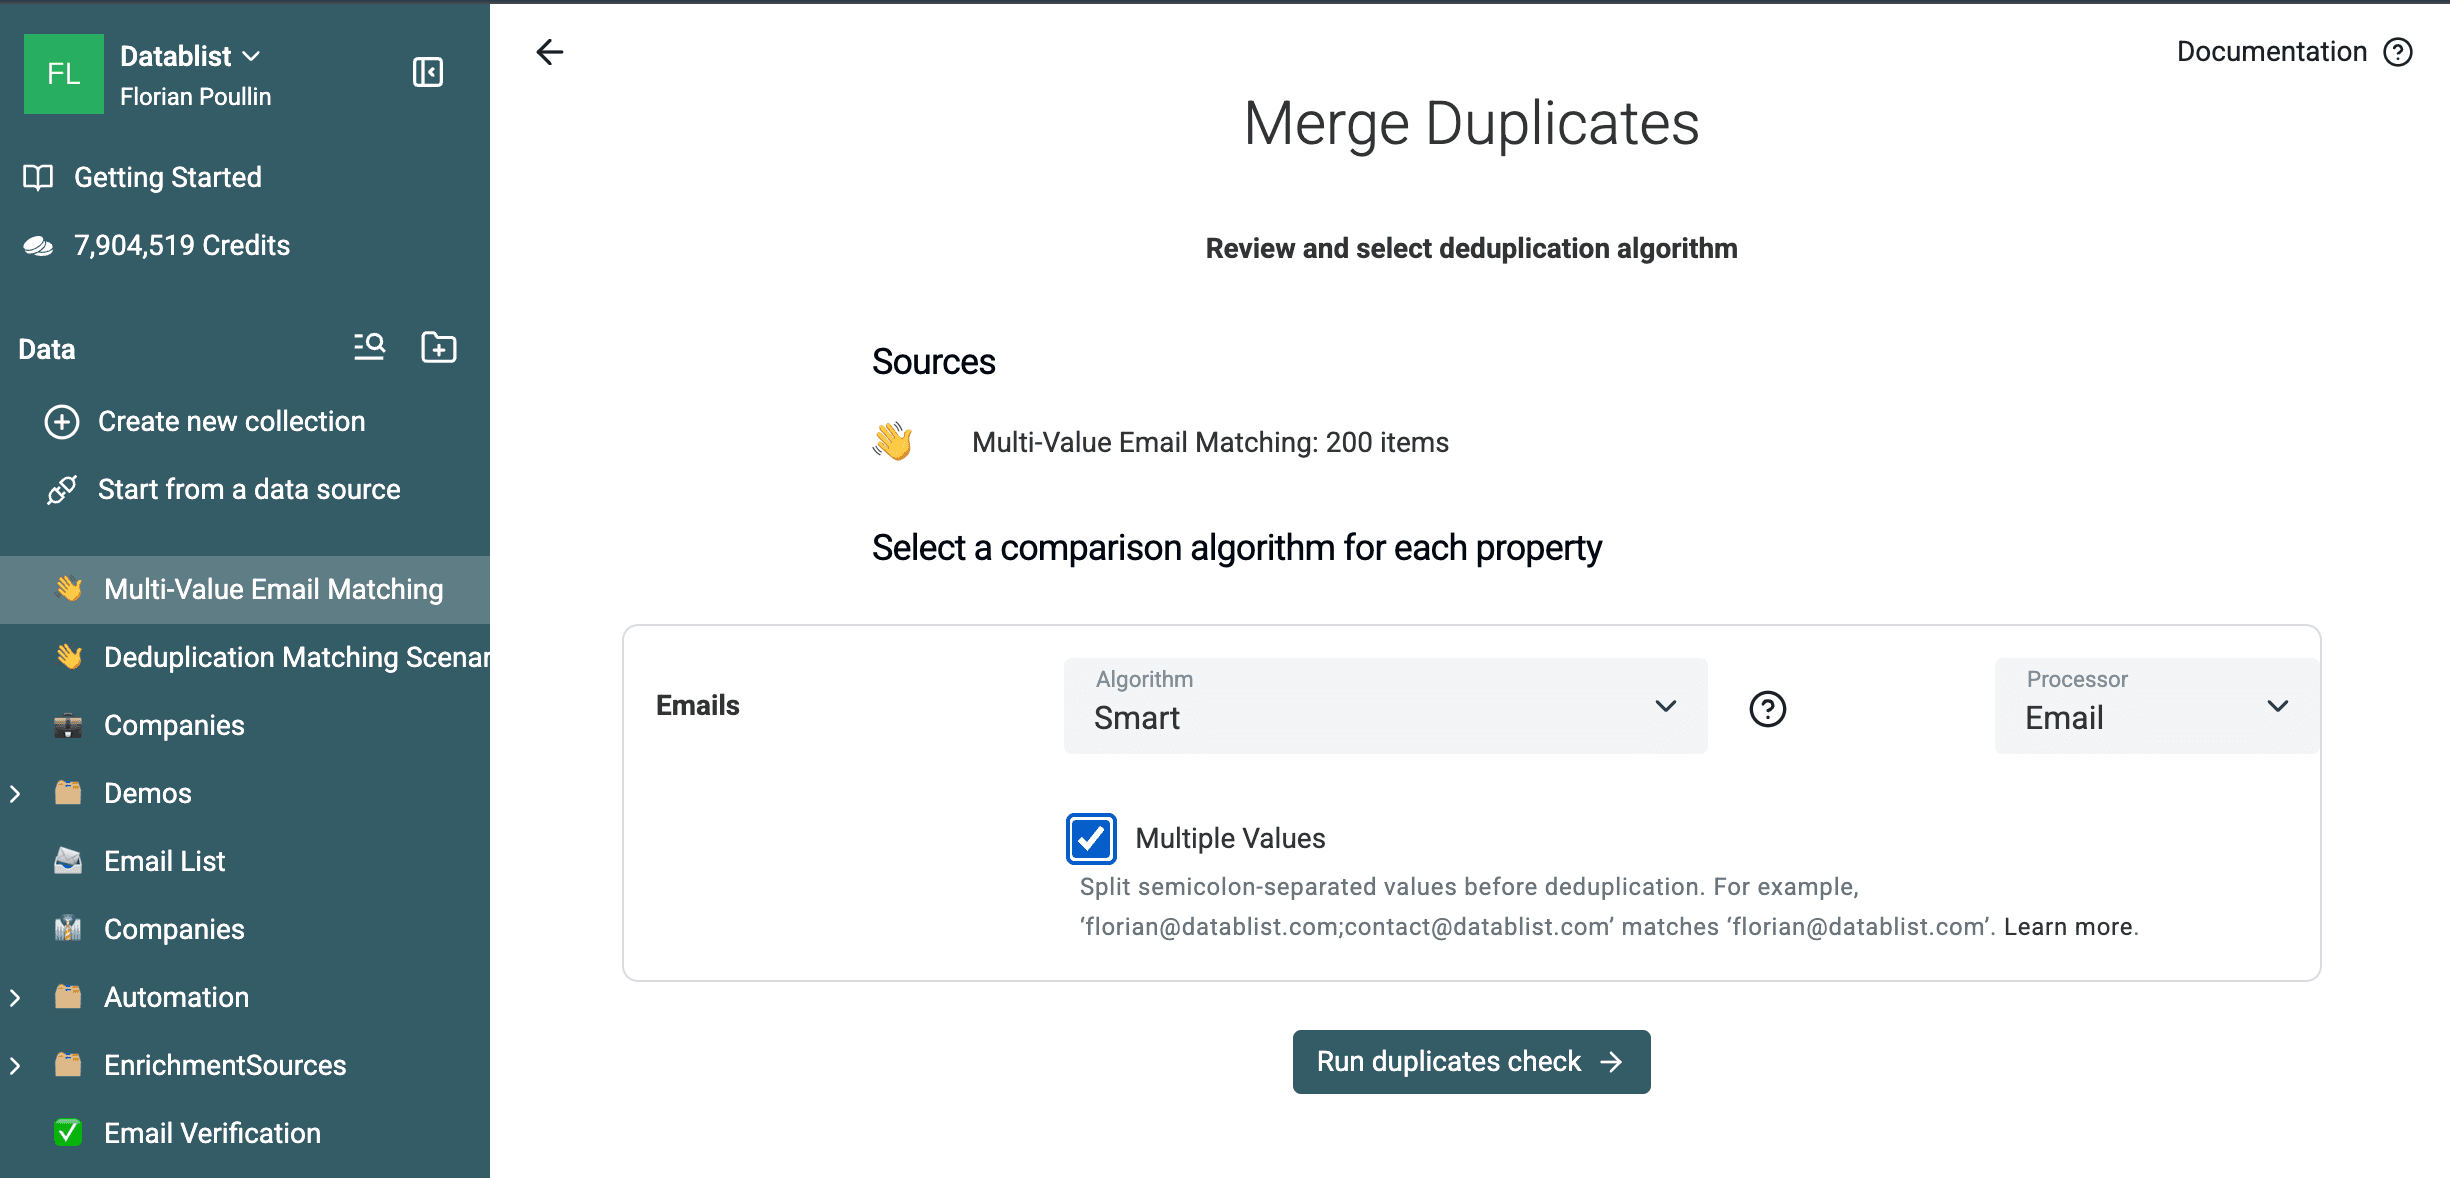
En la muestra específica de 200 filas, esta configuración devolvió 60 grupos de dos filas. La validación de referencia detectó los 60 pares diseñados y excluyó los 80 controles. Siga el flujo para deduplicar campos con varios valores para acceder al archivo de muestra, al CSV de resultados y a las decisiones de Merge.
Esta pasada por email devolvió 105 grupos de dos filas: 100 pares de normalización de emails y los cinco pares de copias exactas, que también comparten el mismo email.
Normalice los teléfonos antes de compararlos
El procesador Smart Phone resulta útil en un caso concreto: valores con los mismos dígitos pero con espacios, paréntesis, guiones o símbolos diferentes. Puede detectar la coincidencia entre (415) 555-0123 y 4155550123.
No puede determinar que un número nacional y otro internacional son el mismo. Por ejemplo, 06 12 34 50 08 y +33 6 12 34 50 08 necesitan el contexto del país antes de poder compararse.
Utilice Phone Number Cleaner antes de deduplicar por teléfono:
- Asigne la propiedad
Phoneoriginal. - Para una lista de un solo país, seleccione el país en Local Phone Countries. Si la lista contiene varios países, active Define country per item y asigne la propiedad
Country. - Escriba el resultado del enrichment en
Clean Phone Numbersin sobrescribir el valor original. - Revise los resultados fallidos o vacíos. No deben participar en la comparación por teléfono.
- Ejecute Duplicates Finder sobre
Clean Phone Numbercon Exact.
Descargue la muestra específica de 200 teléfonos. Contiene 50 pares de números nacionales e internacionales de Estados Unidos, Francia, Reino Unido, Alemania y España, además de 100 controles sin coincidencia. La validación con la lógica del limpiador en producción devolvió un teléfono normalizado para cada una de las 200 filas. Los 50 pares diseñados convergen en 50 valores internacionales compartidos, mientras que los controles siguen siendo únicos.
Este preprocesamiento también valida el formato del teléfono. Conserve las propiedades Phone y Country originales junto al resultado limpio para poder inspeccionar cualquier registro antes de combinarlo. Lea qué significa normalizar números de teléfono para entender la función de los códigos de país y los valores internacionales.
Para los registros de empresas, ejecute otra pasada sobre Website. Elija Smart con el procesador URL. Active Ignore Subdomain, Ignore Path e Ignore Query Params únicamente cuando esos componentes de la URL no deban identificar una empresa o ubicación diferente.
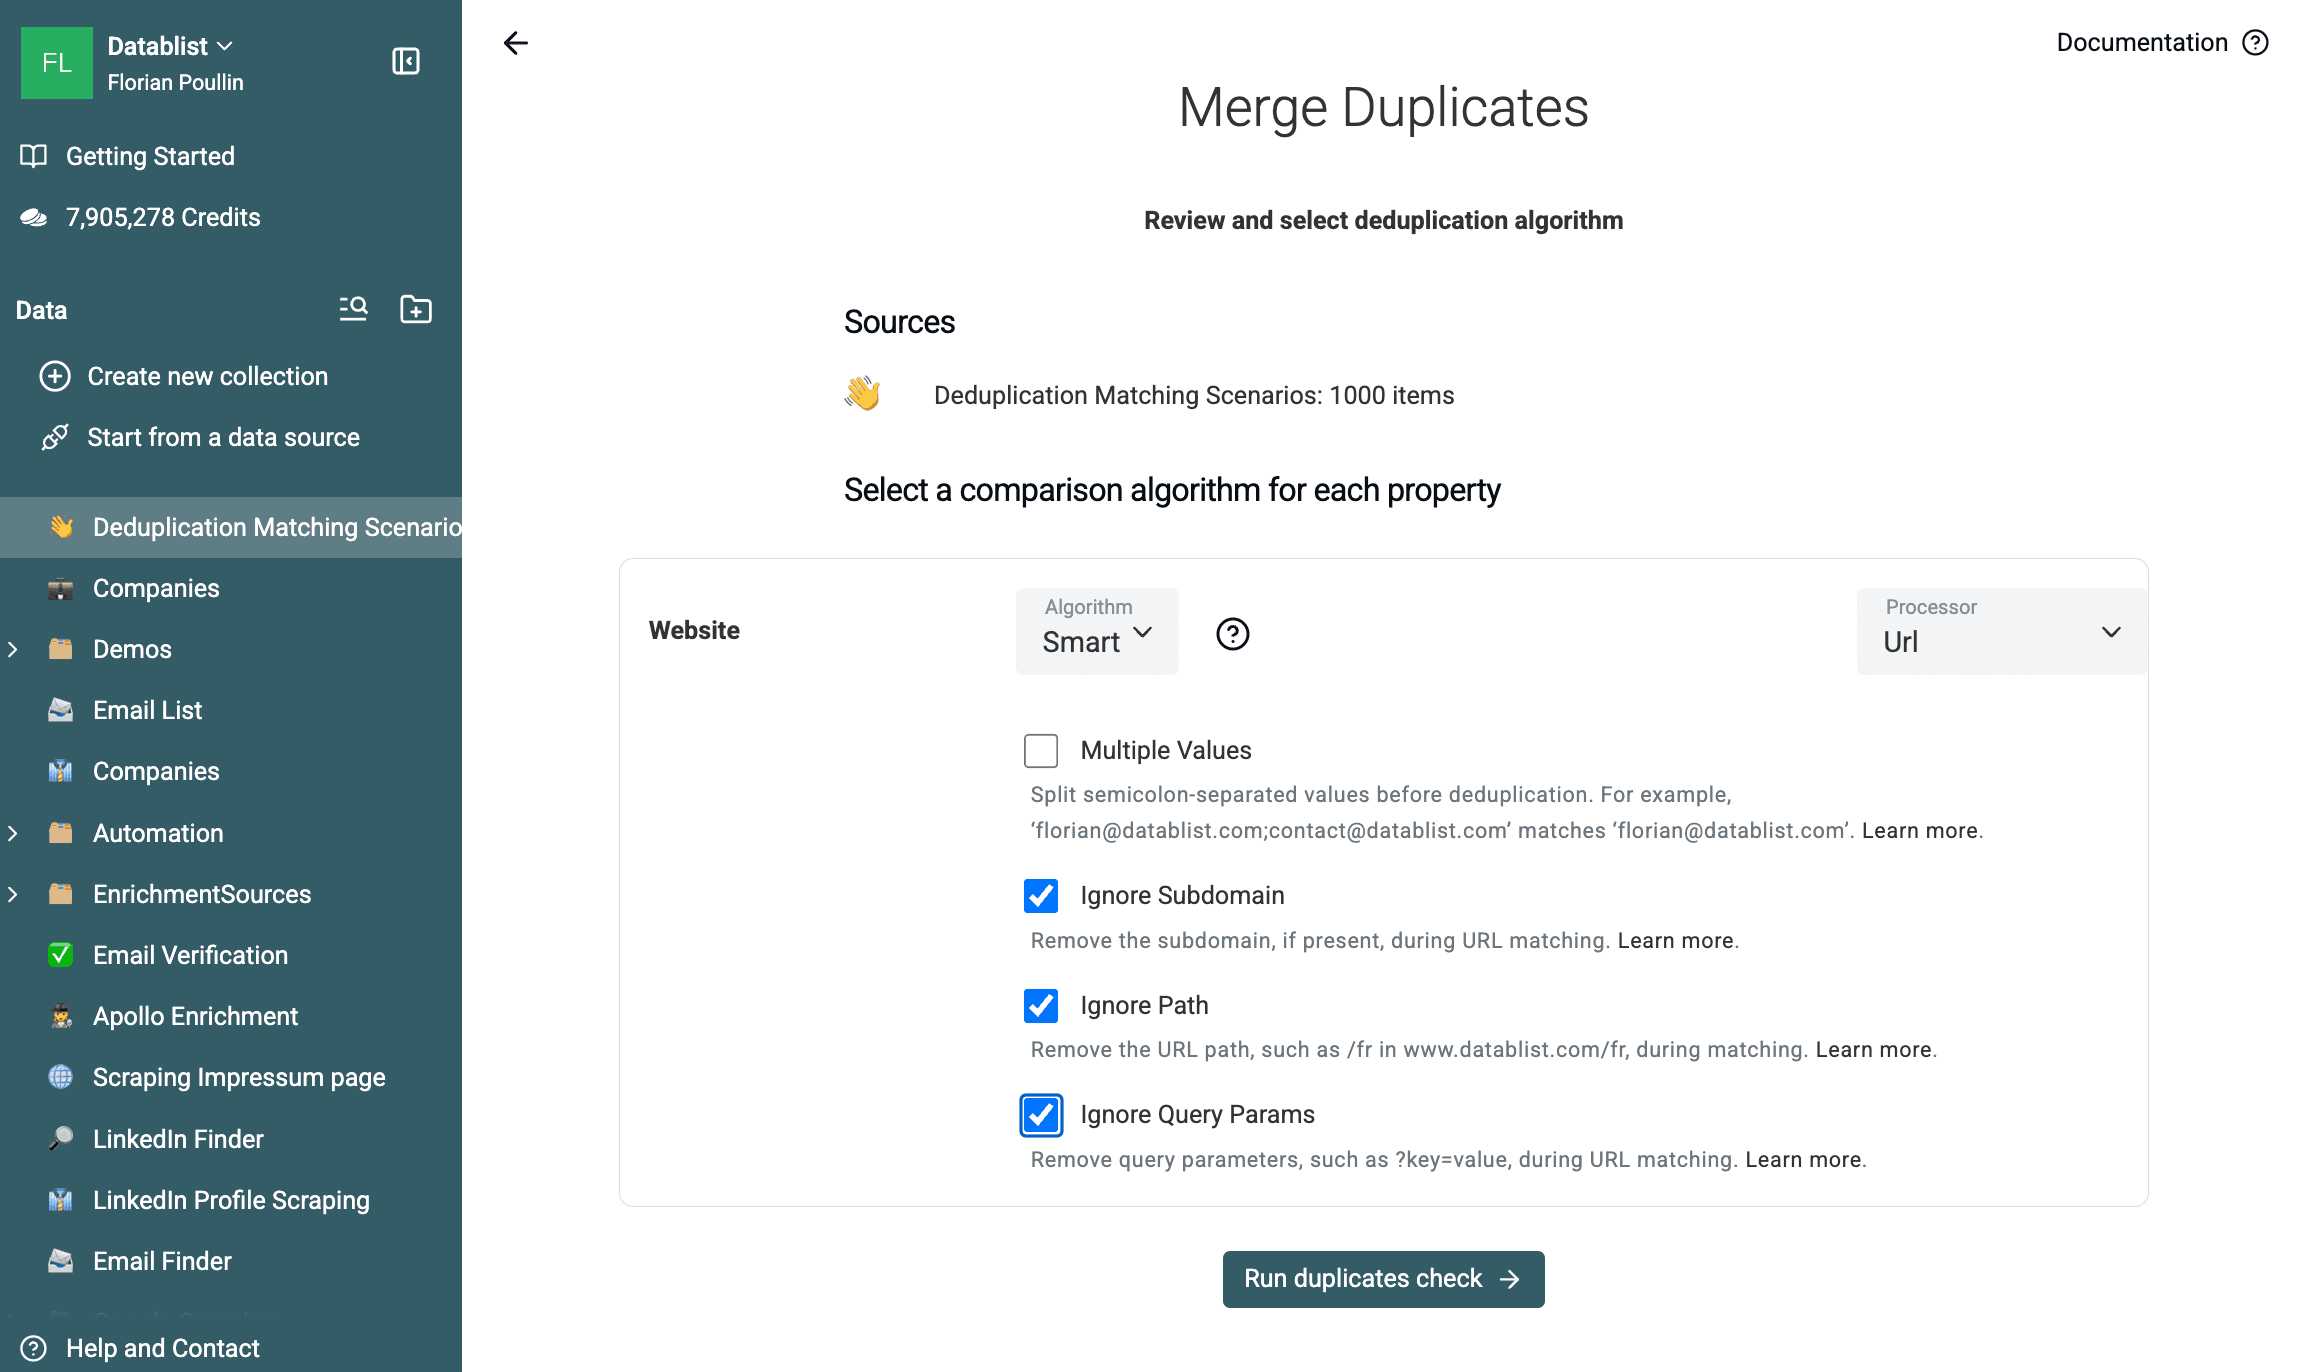
En la misma muestra de 1000 filas, esta configuración devolvió 200 grupos de dos filas. Cincuenta pares contienen las variaciones de URL diseñadas, mientras que otros 150 ya comparten un sitio web idéntico. En esta prueba, todos los pares exportados se resolvieron como el mismo host normalizado.
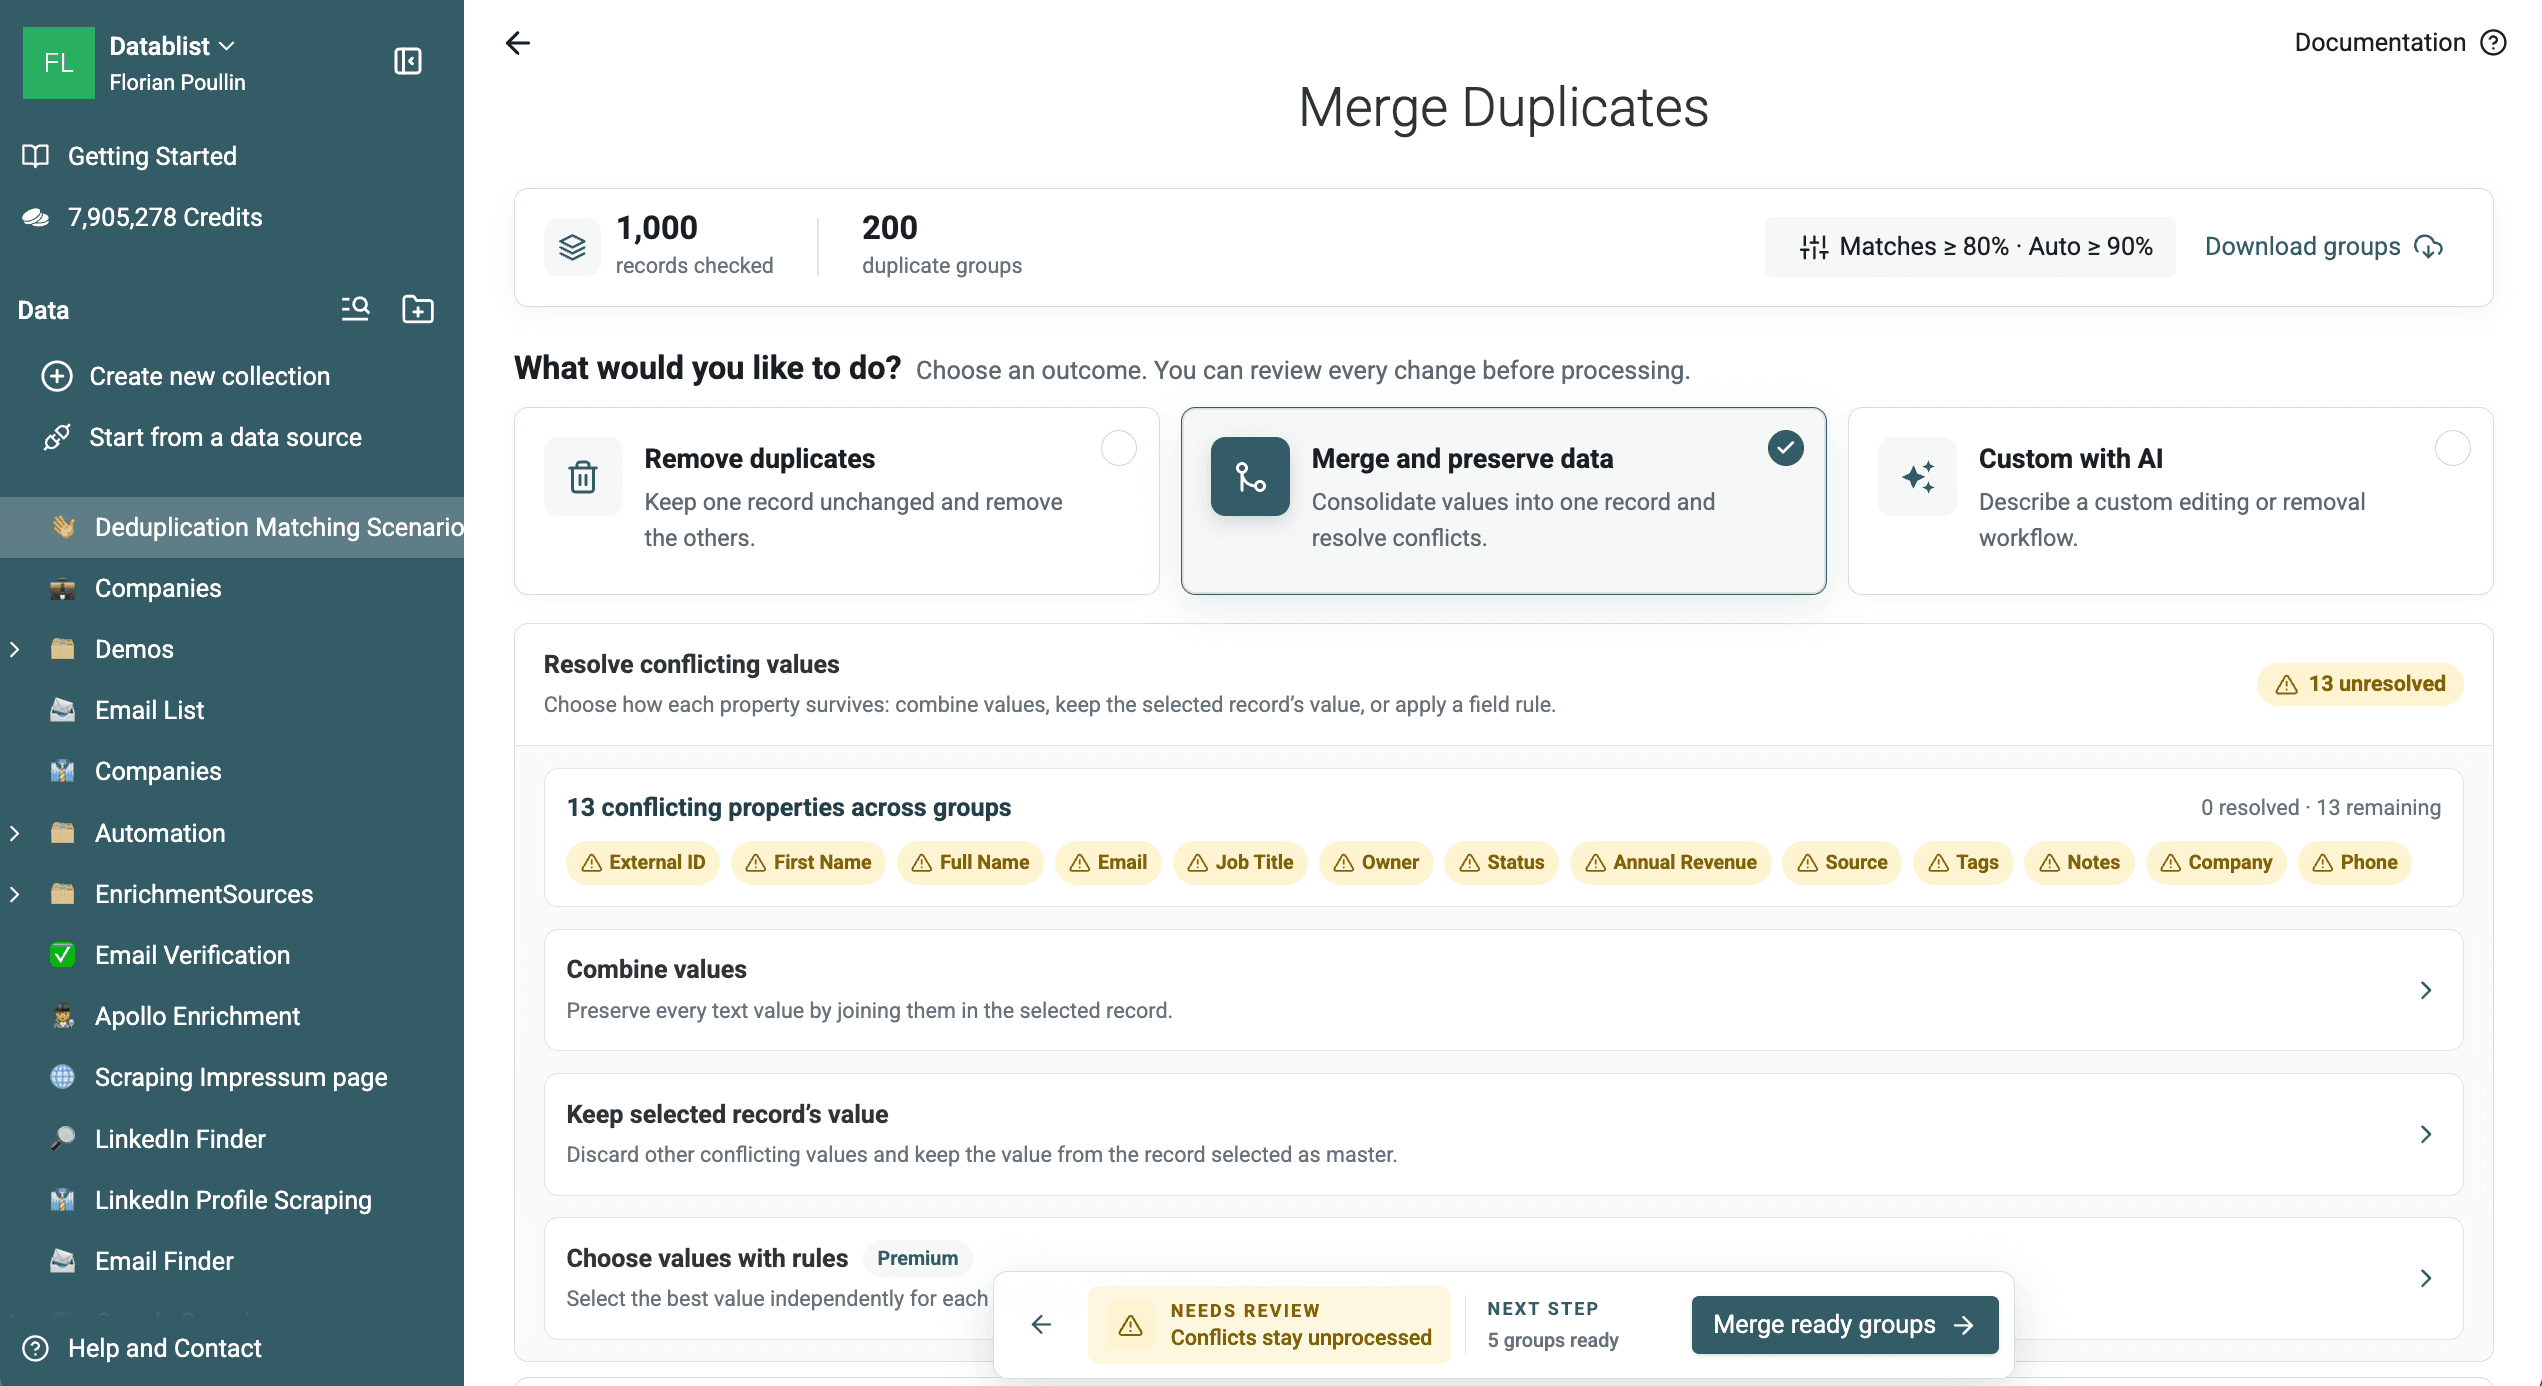
Descargue los 200 grupos de sitios web duplicados o consulte el flujo para deduplicar empresas si desea aplicar una estrategia de comparación que priorice el dominio.
Use comparaciones fuzzy o fonéticas para revisar
Metaphone compara cómo suena el texto. Jaro-Winkler y Levenshtein calculan una puntuación de similitud, lo que ayuda a detectar diferencias ortográficas como Uma Turner y Uman Turner.
Las coincidencias fuzzy son candidatas, no duplicados confirmados. Empiece con un umbral alto, inspeccione los grupos más débiles y reduzca el umbral de resultados solo si la revisión continúa siendo precisa.
Para realizar una pasada fuzzy medible, seleccione Full Name, elija Distance con Levenshtein, mantenga el procesador Text y establezca el umbral en el 90 %.
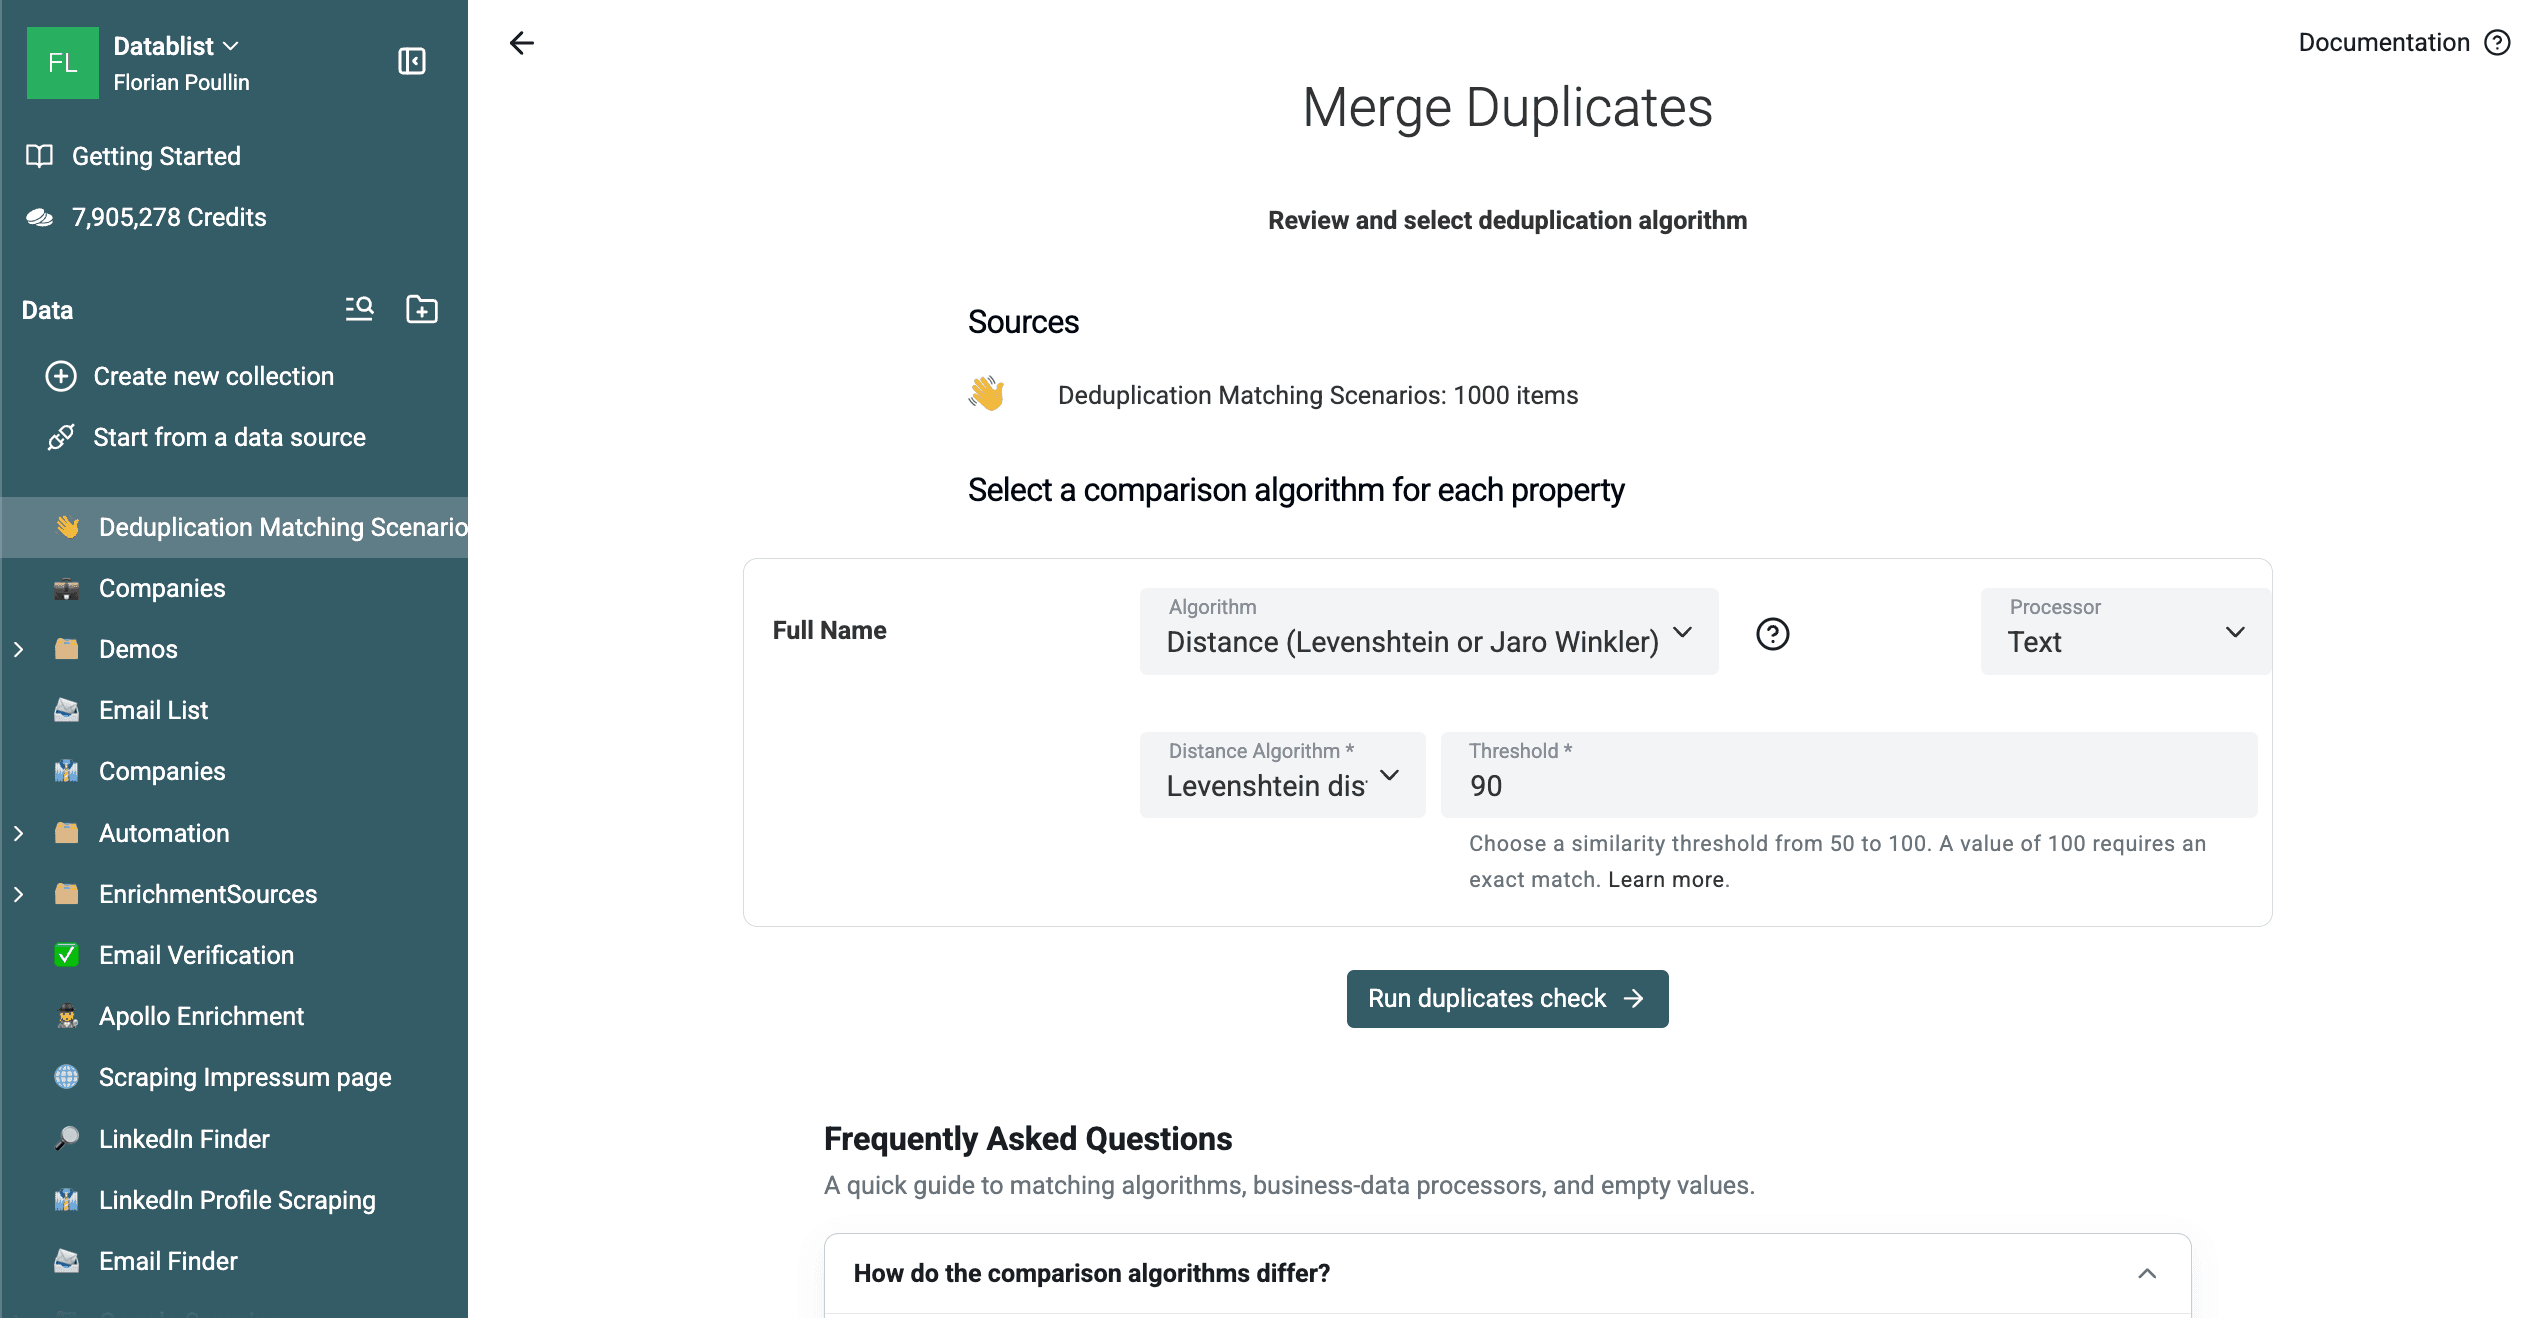
Esta comprobación devolvió 77 grupos de dos filas en la muestra de 1000 filas. La validación de referencia encontró 21 grupos que relacionan la misma entidad diseñada y 56 que relacionan entidades distintas. La mayoría de los falsos positivos eran nombres abreviados como G. Rossi, donde el valor Full Name por sí solo no permite distinguir entre dos personas.
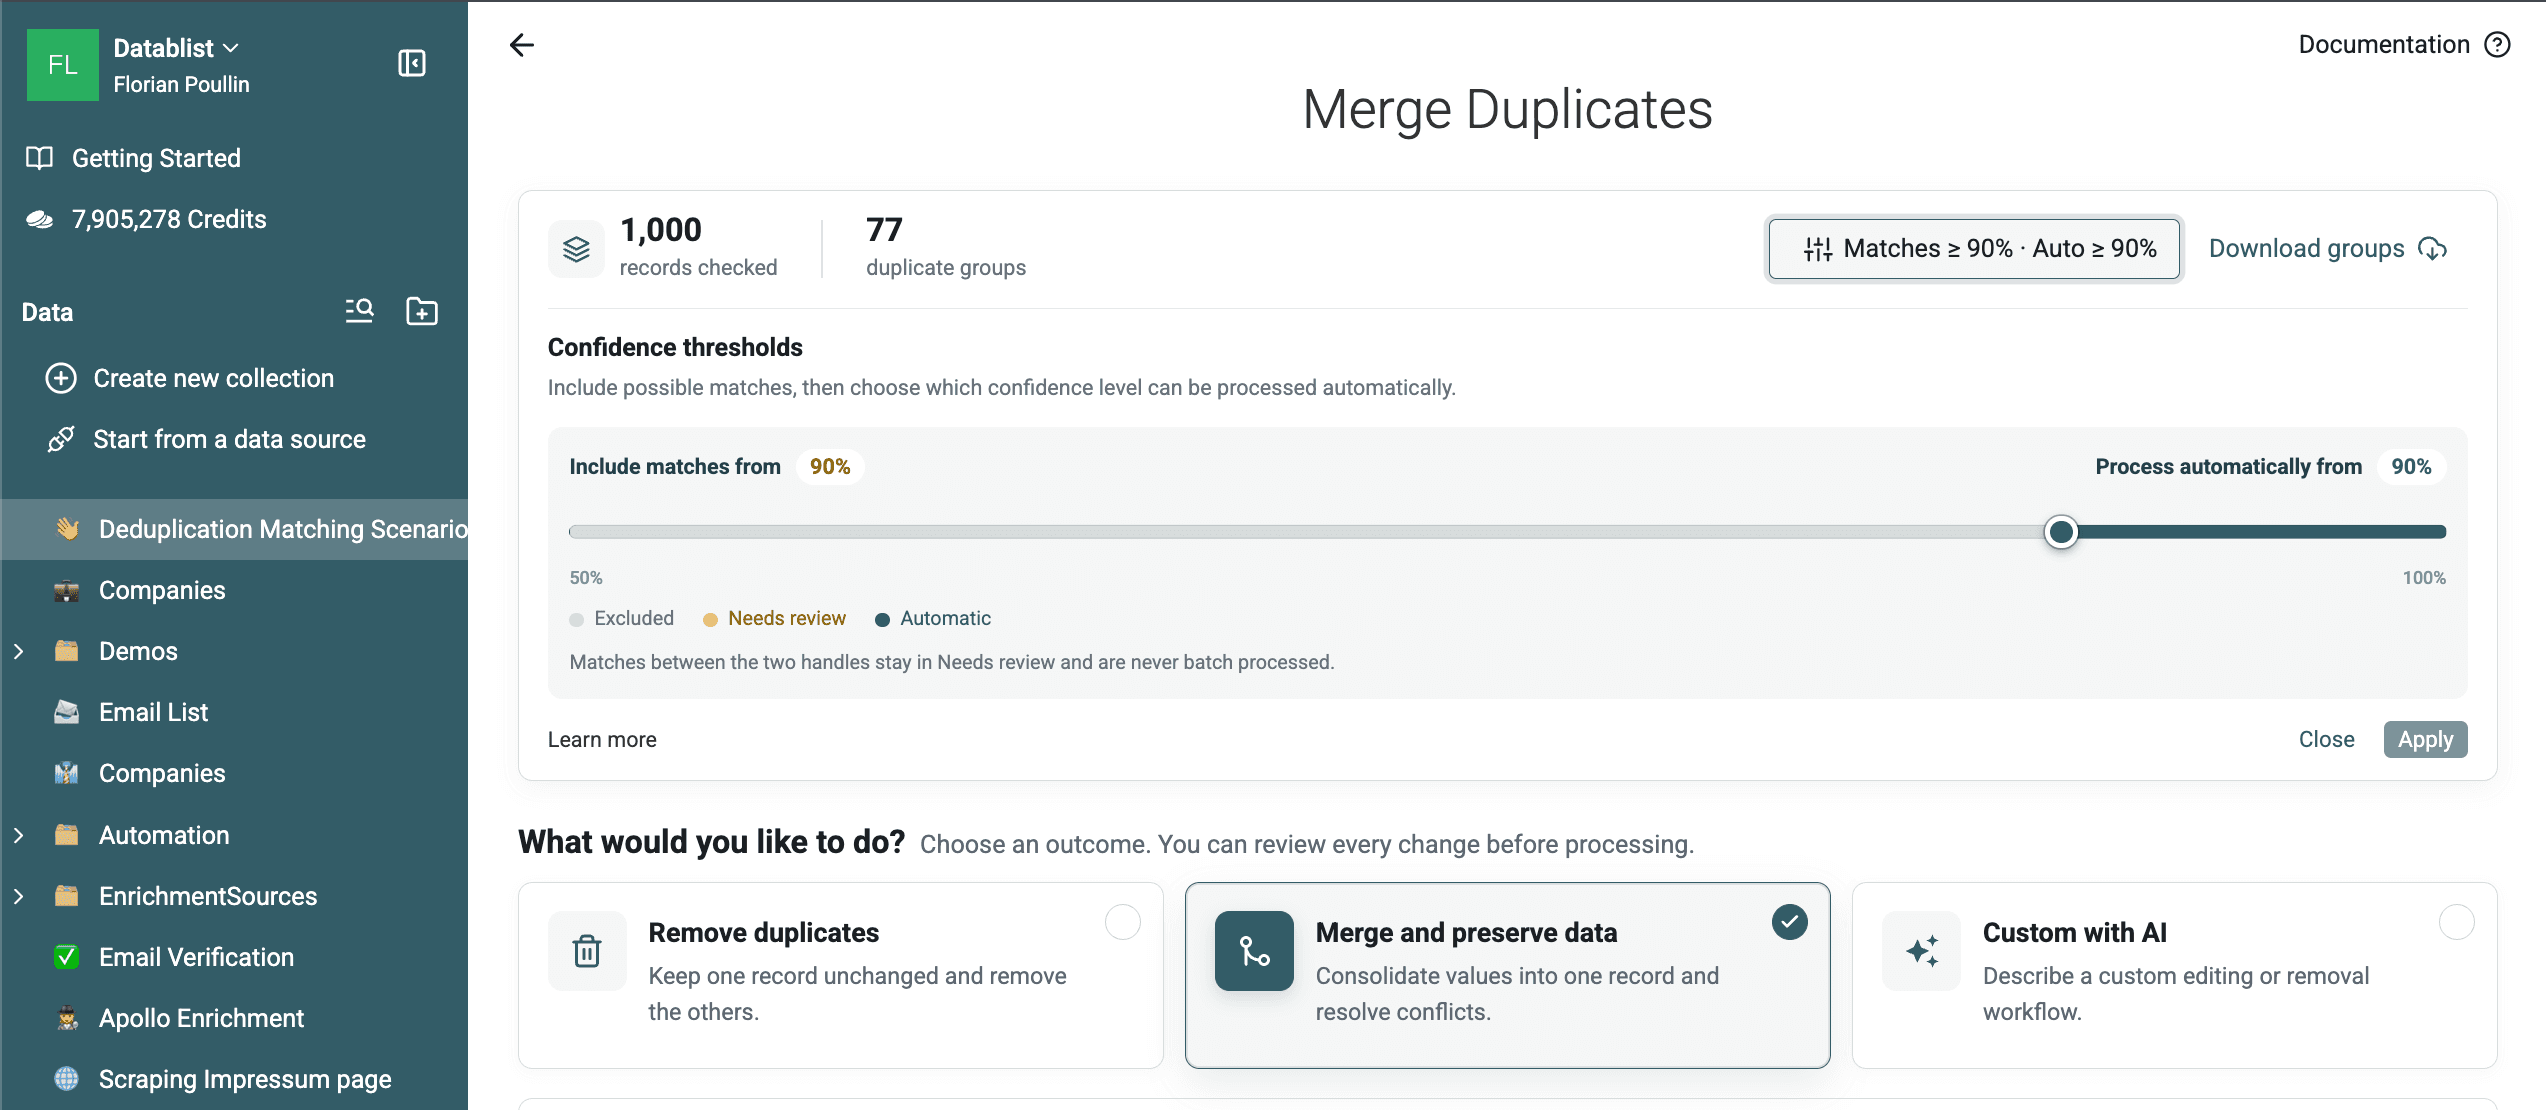
La pasada detecta las variaciones ortográficas previstas, como Uma A. Turner y Uman A. Turner, pero también demuestra por qué las coincidencias fuzzy basadas únicamente en el nombre requieren revisión.
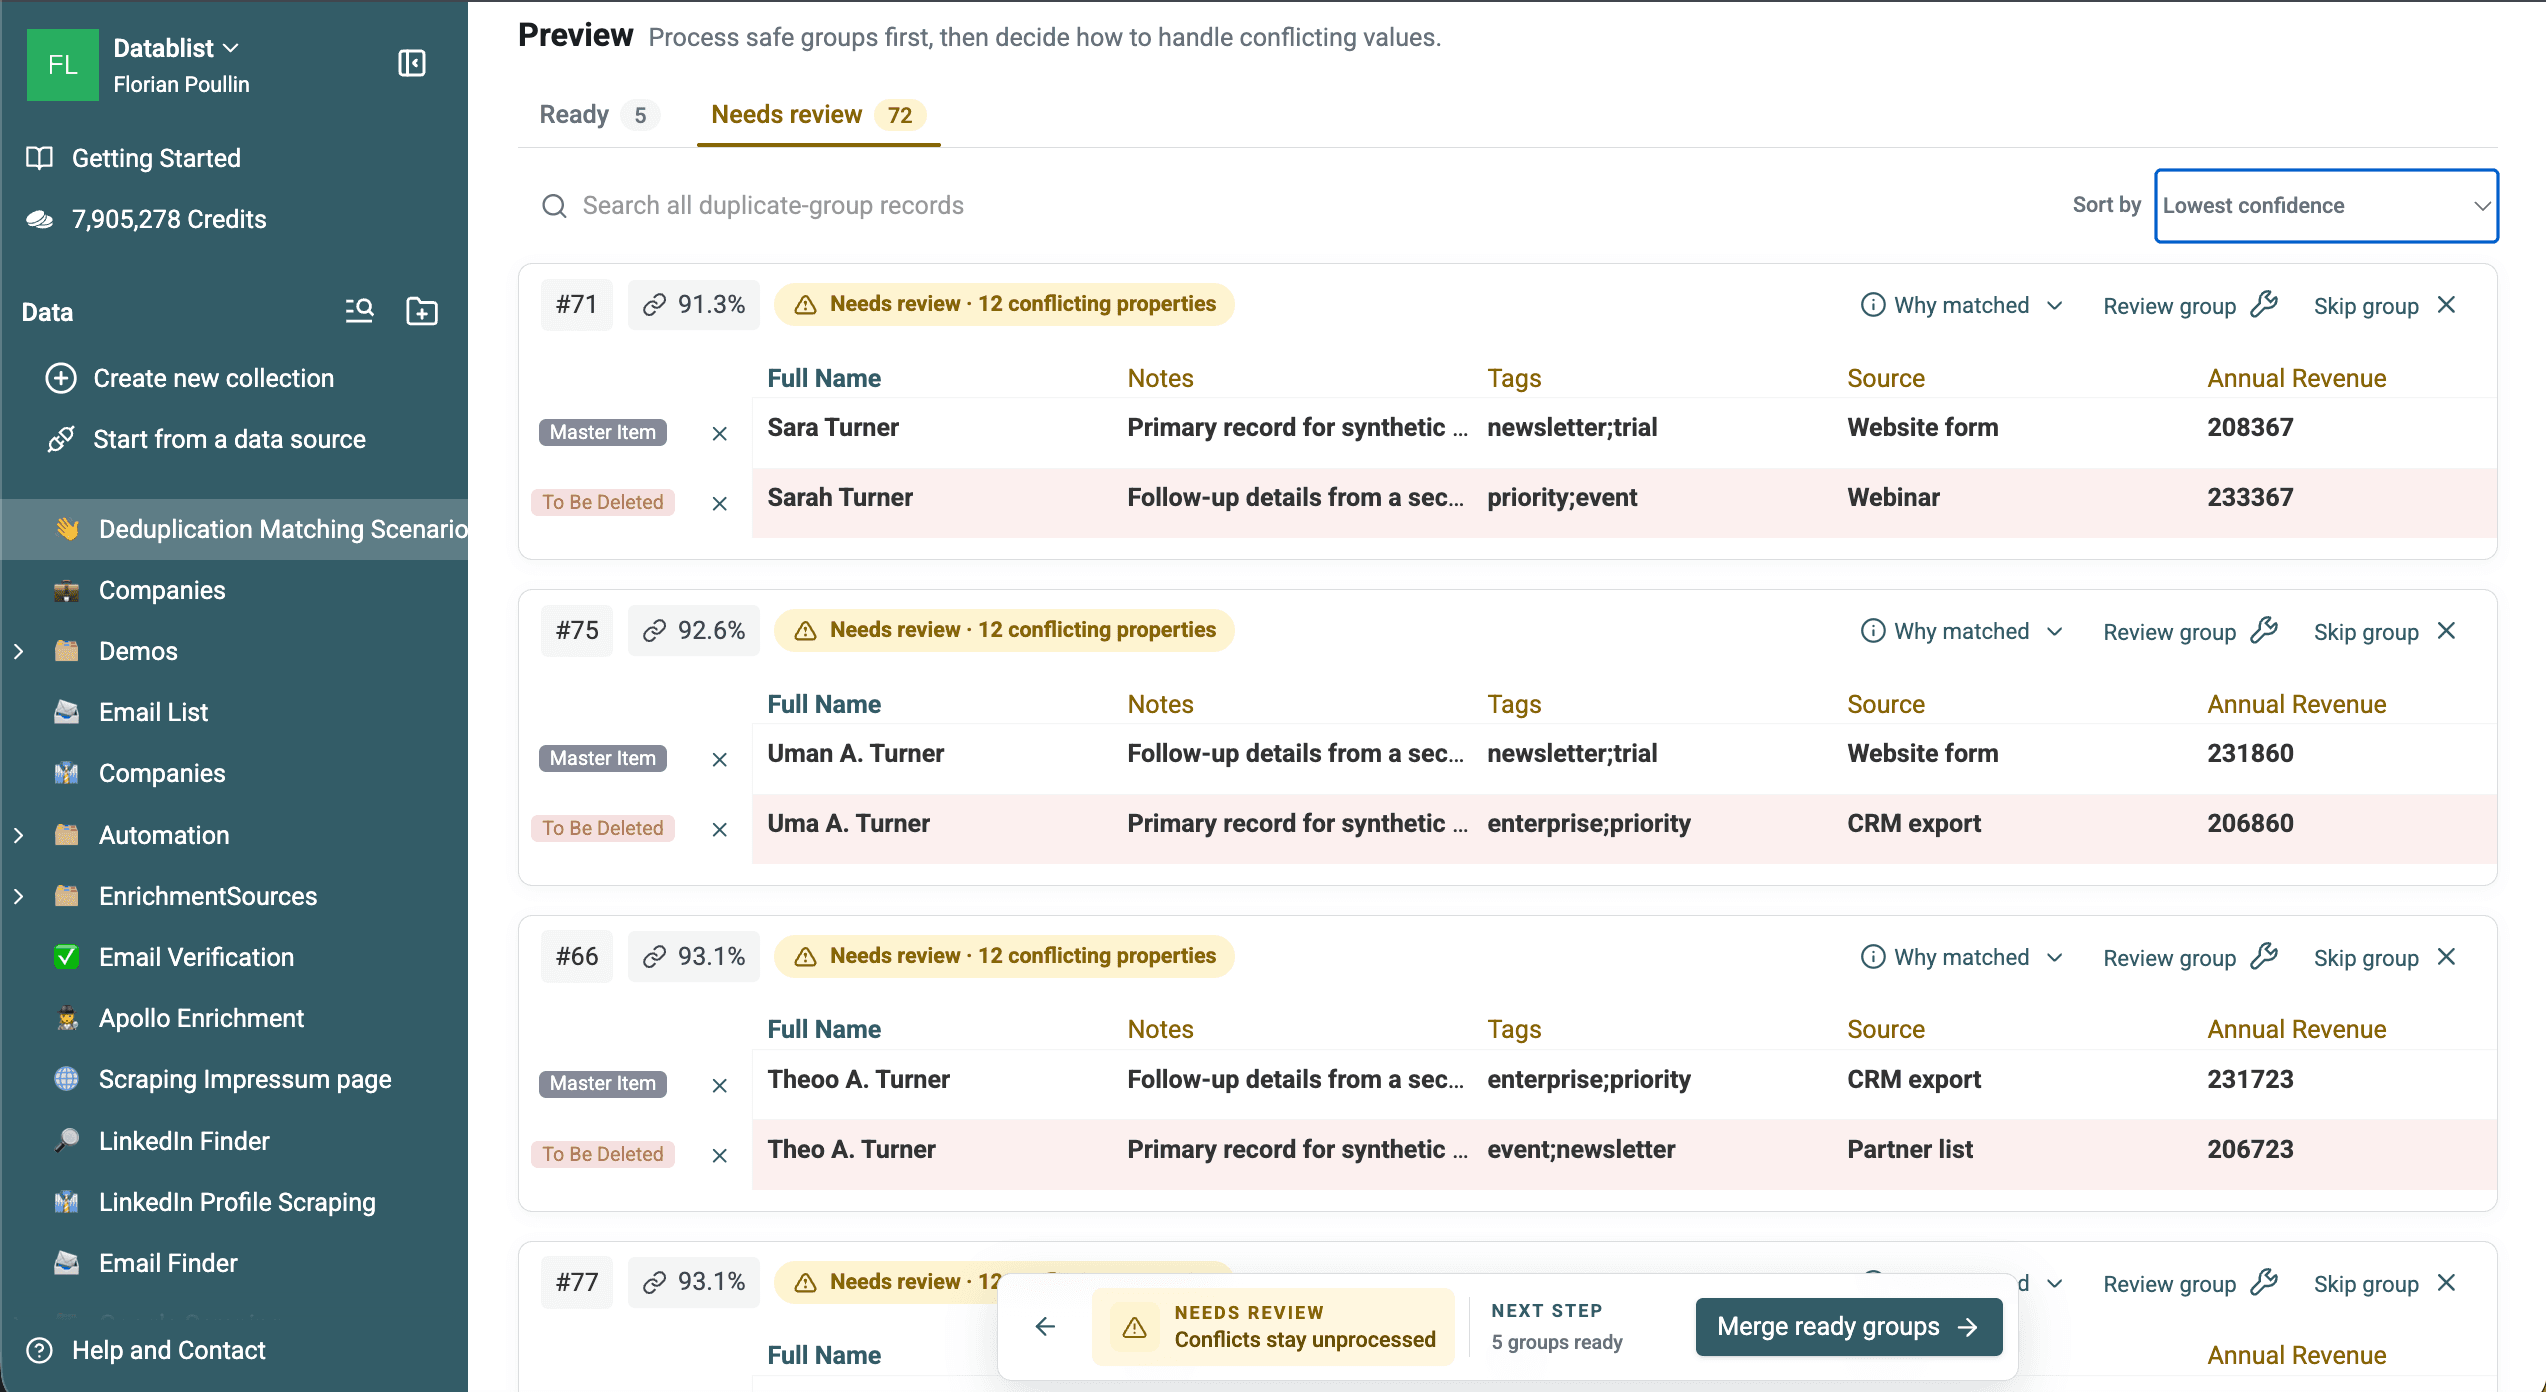
Descargue los 77 grupos exportados de Levenshtein para examinar tanto las coincidencias útiles como los falsos positivos.
Para la comparación fonética, seleccione Full Name, elija Metaphone y mantenga el procesador Text.
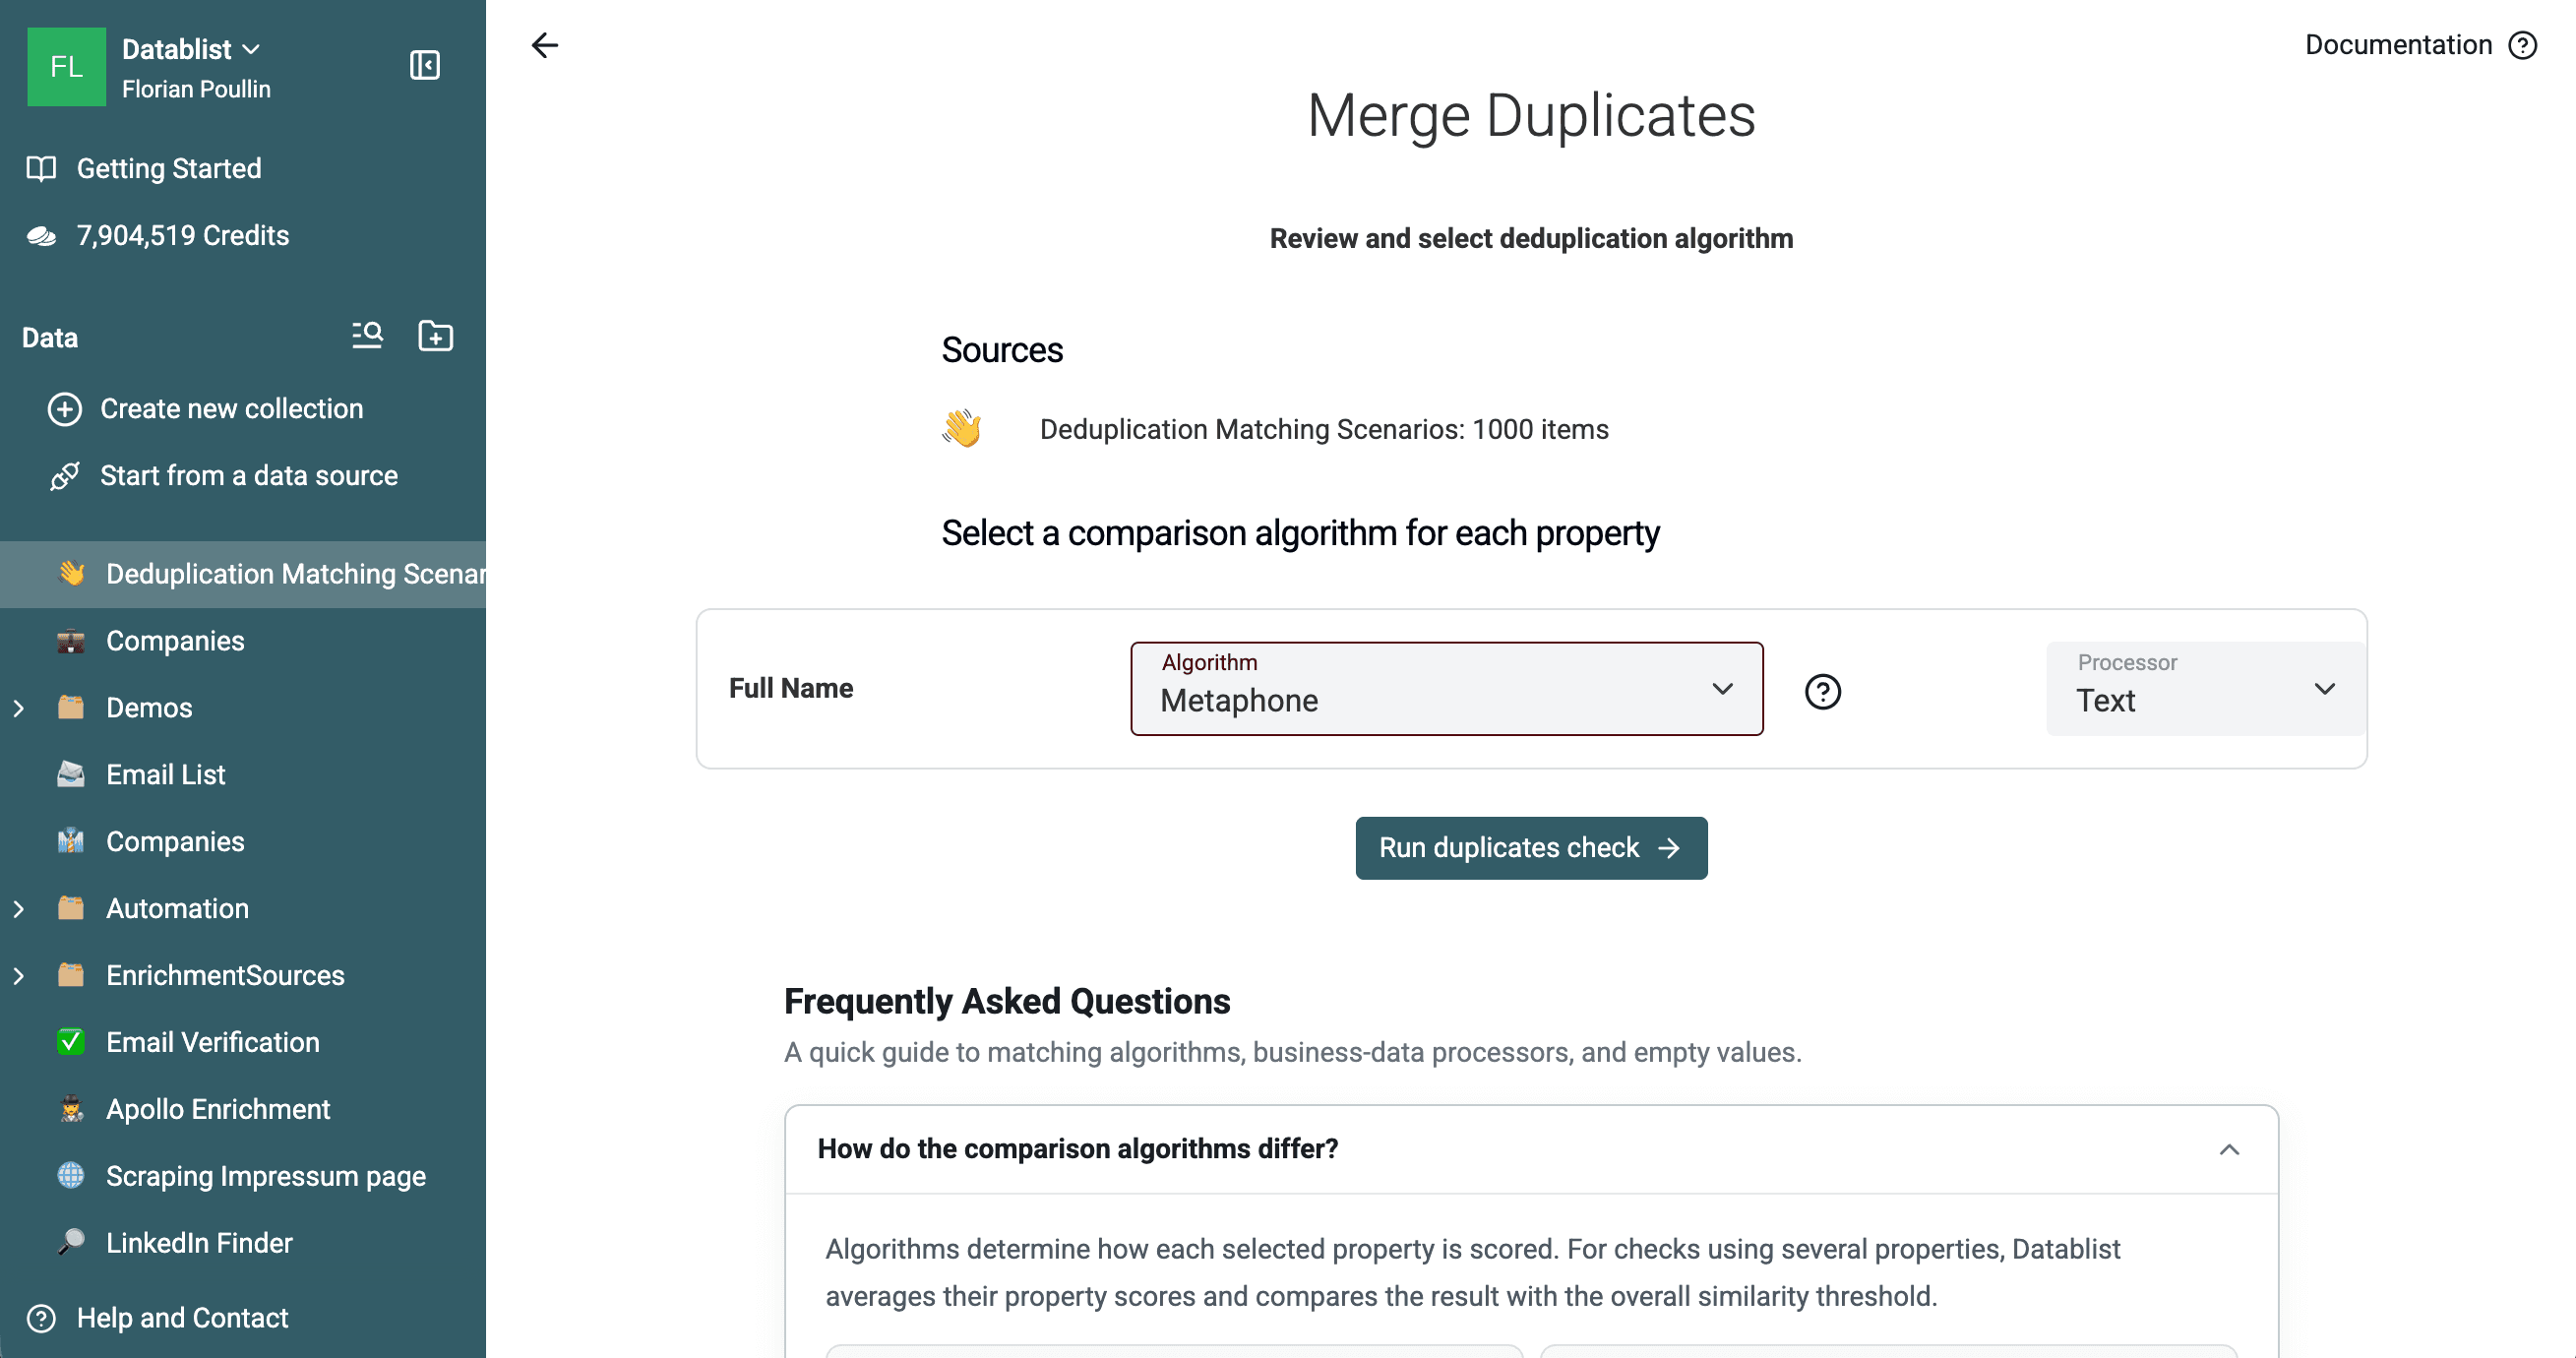
Esta pasada mostró 69 grupos: 5 en Ready y 64 en Needs review. Los grupos exportados contienen 188 filas. La validación frente a las entidades conocidas de la muestra encontró 19 grupos puros de una misma entidad y 50 grupos que mezclan personas diferentes. El tamaño de los grupos oscila entre dos y siete filas.
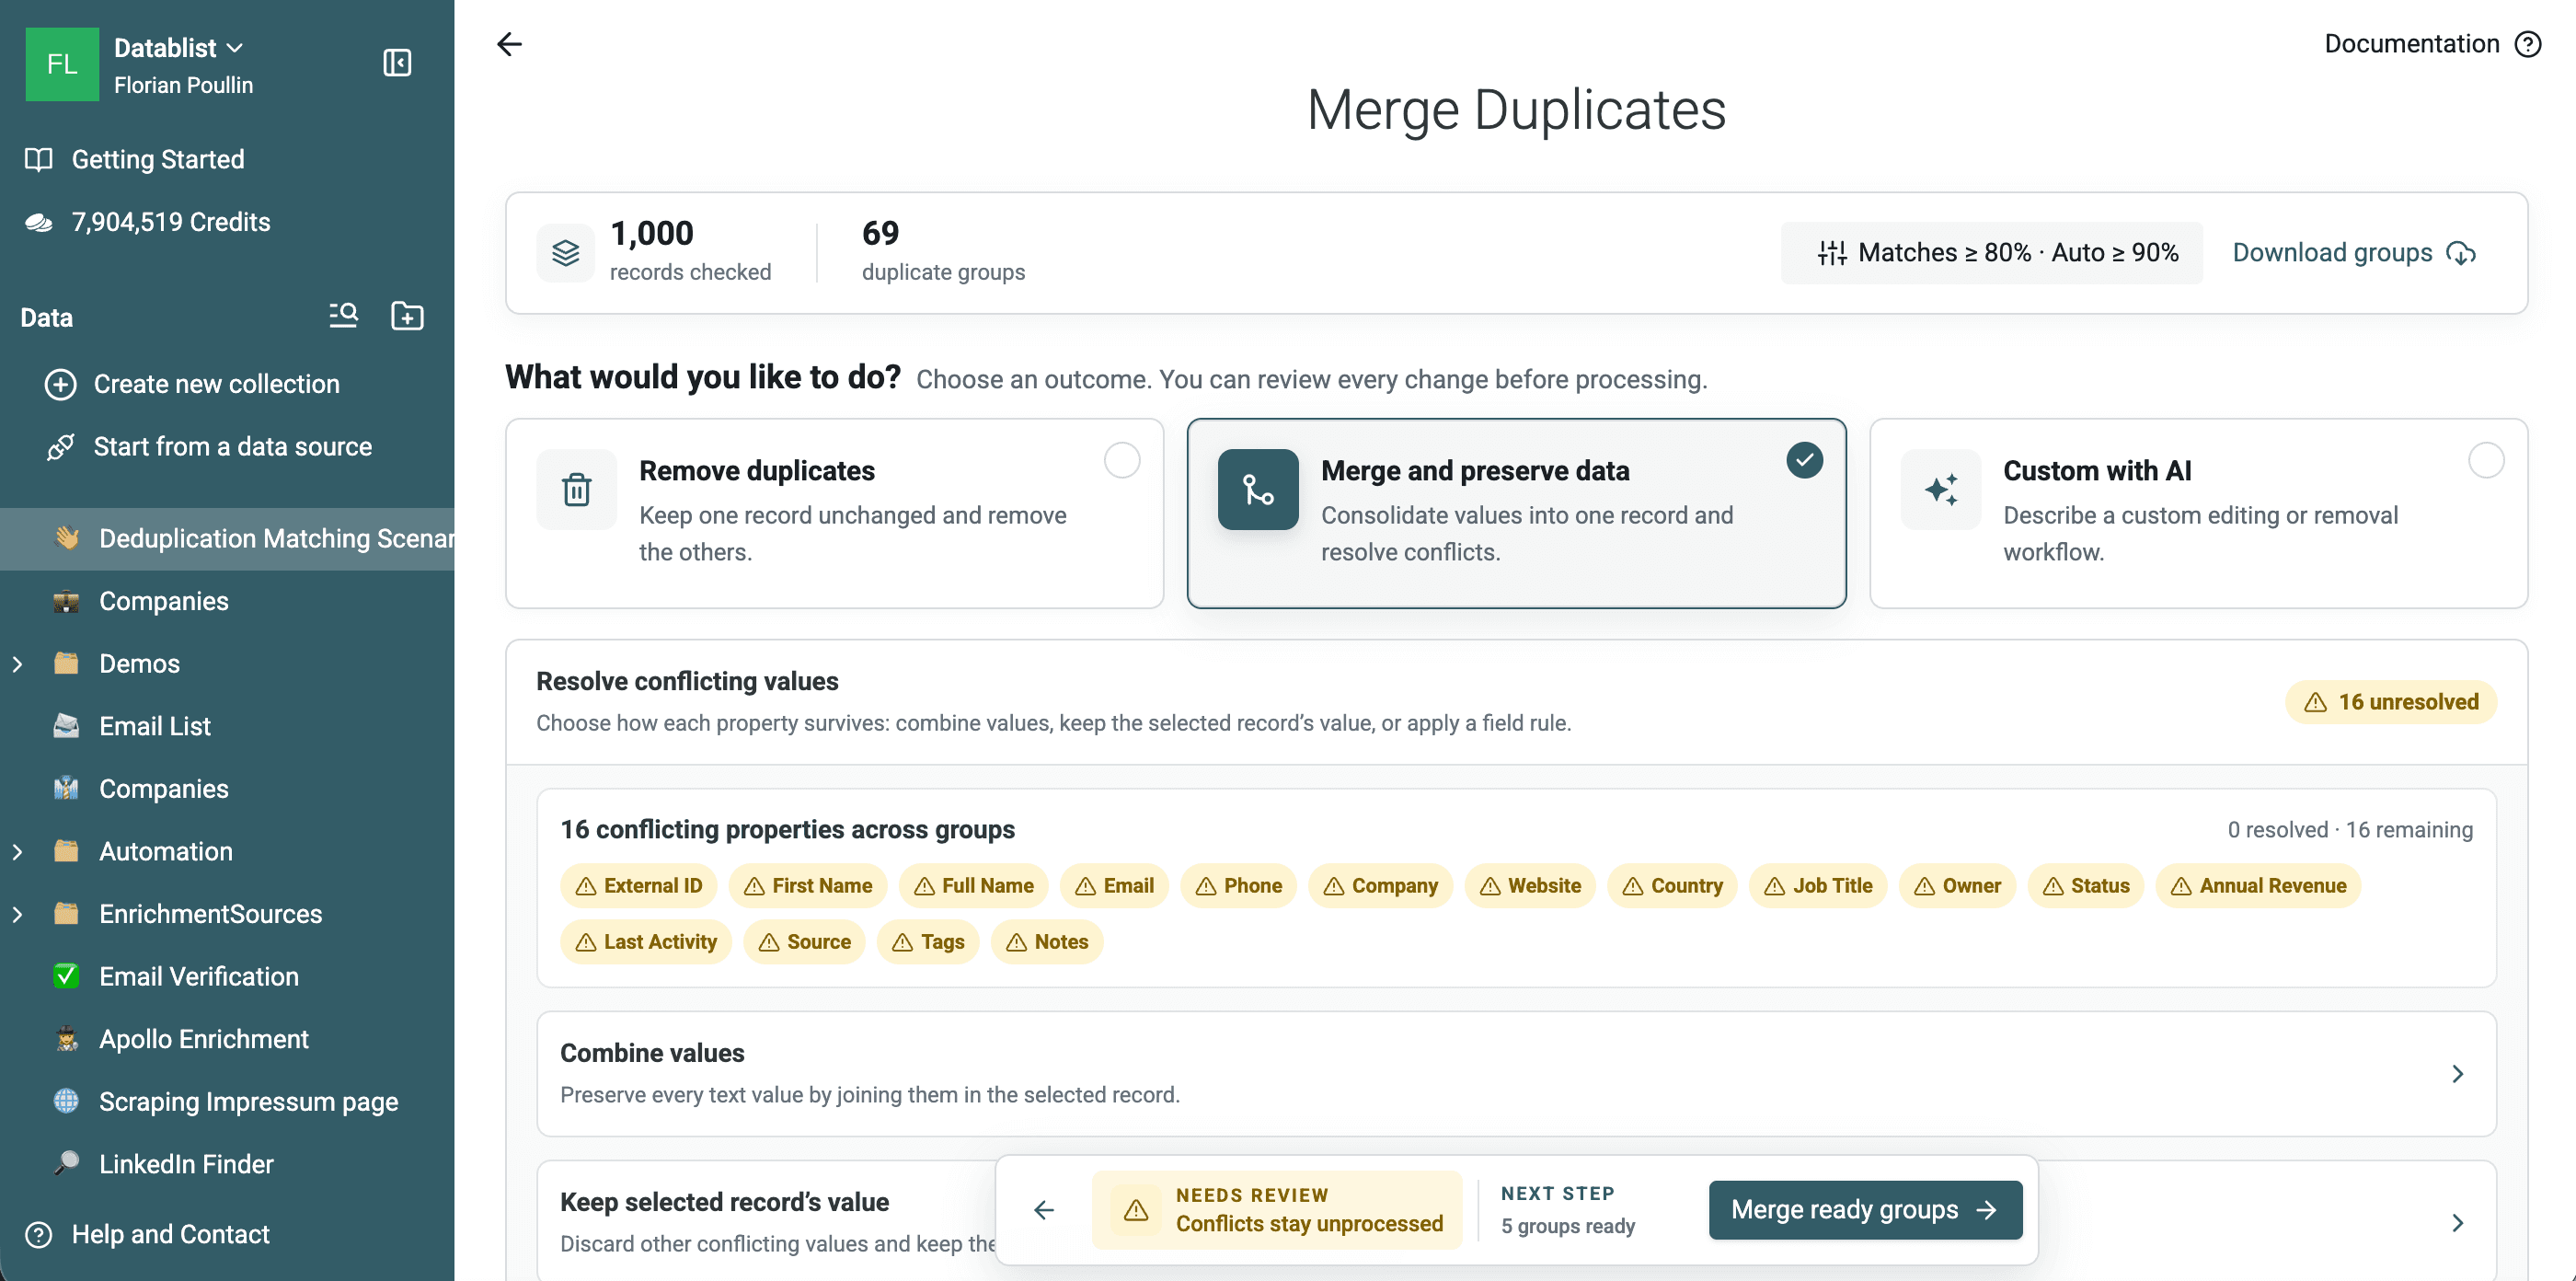
Why matched confirma la propiedad Full Name, el algoritmo Metaphone, el procesador Text y la puntuación del grupo. Utilice esta información para auditar la comparación, no para sustituir una comprobación de identidad.
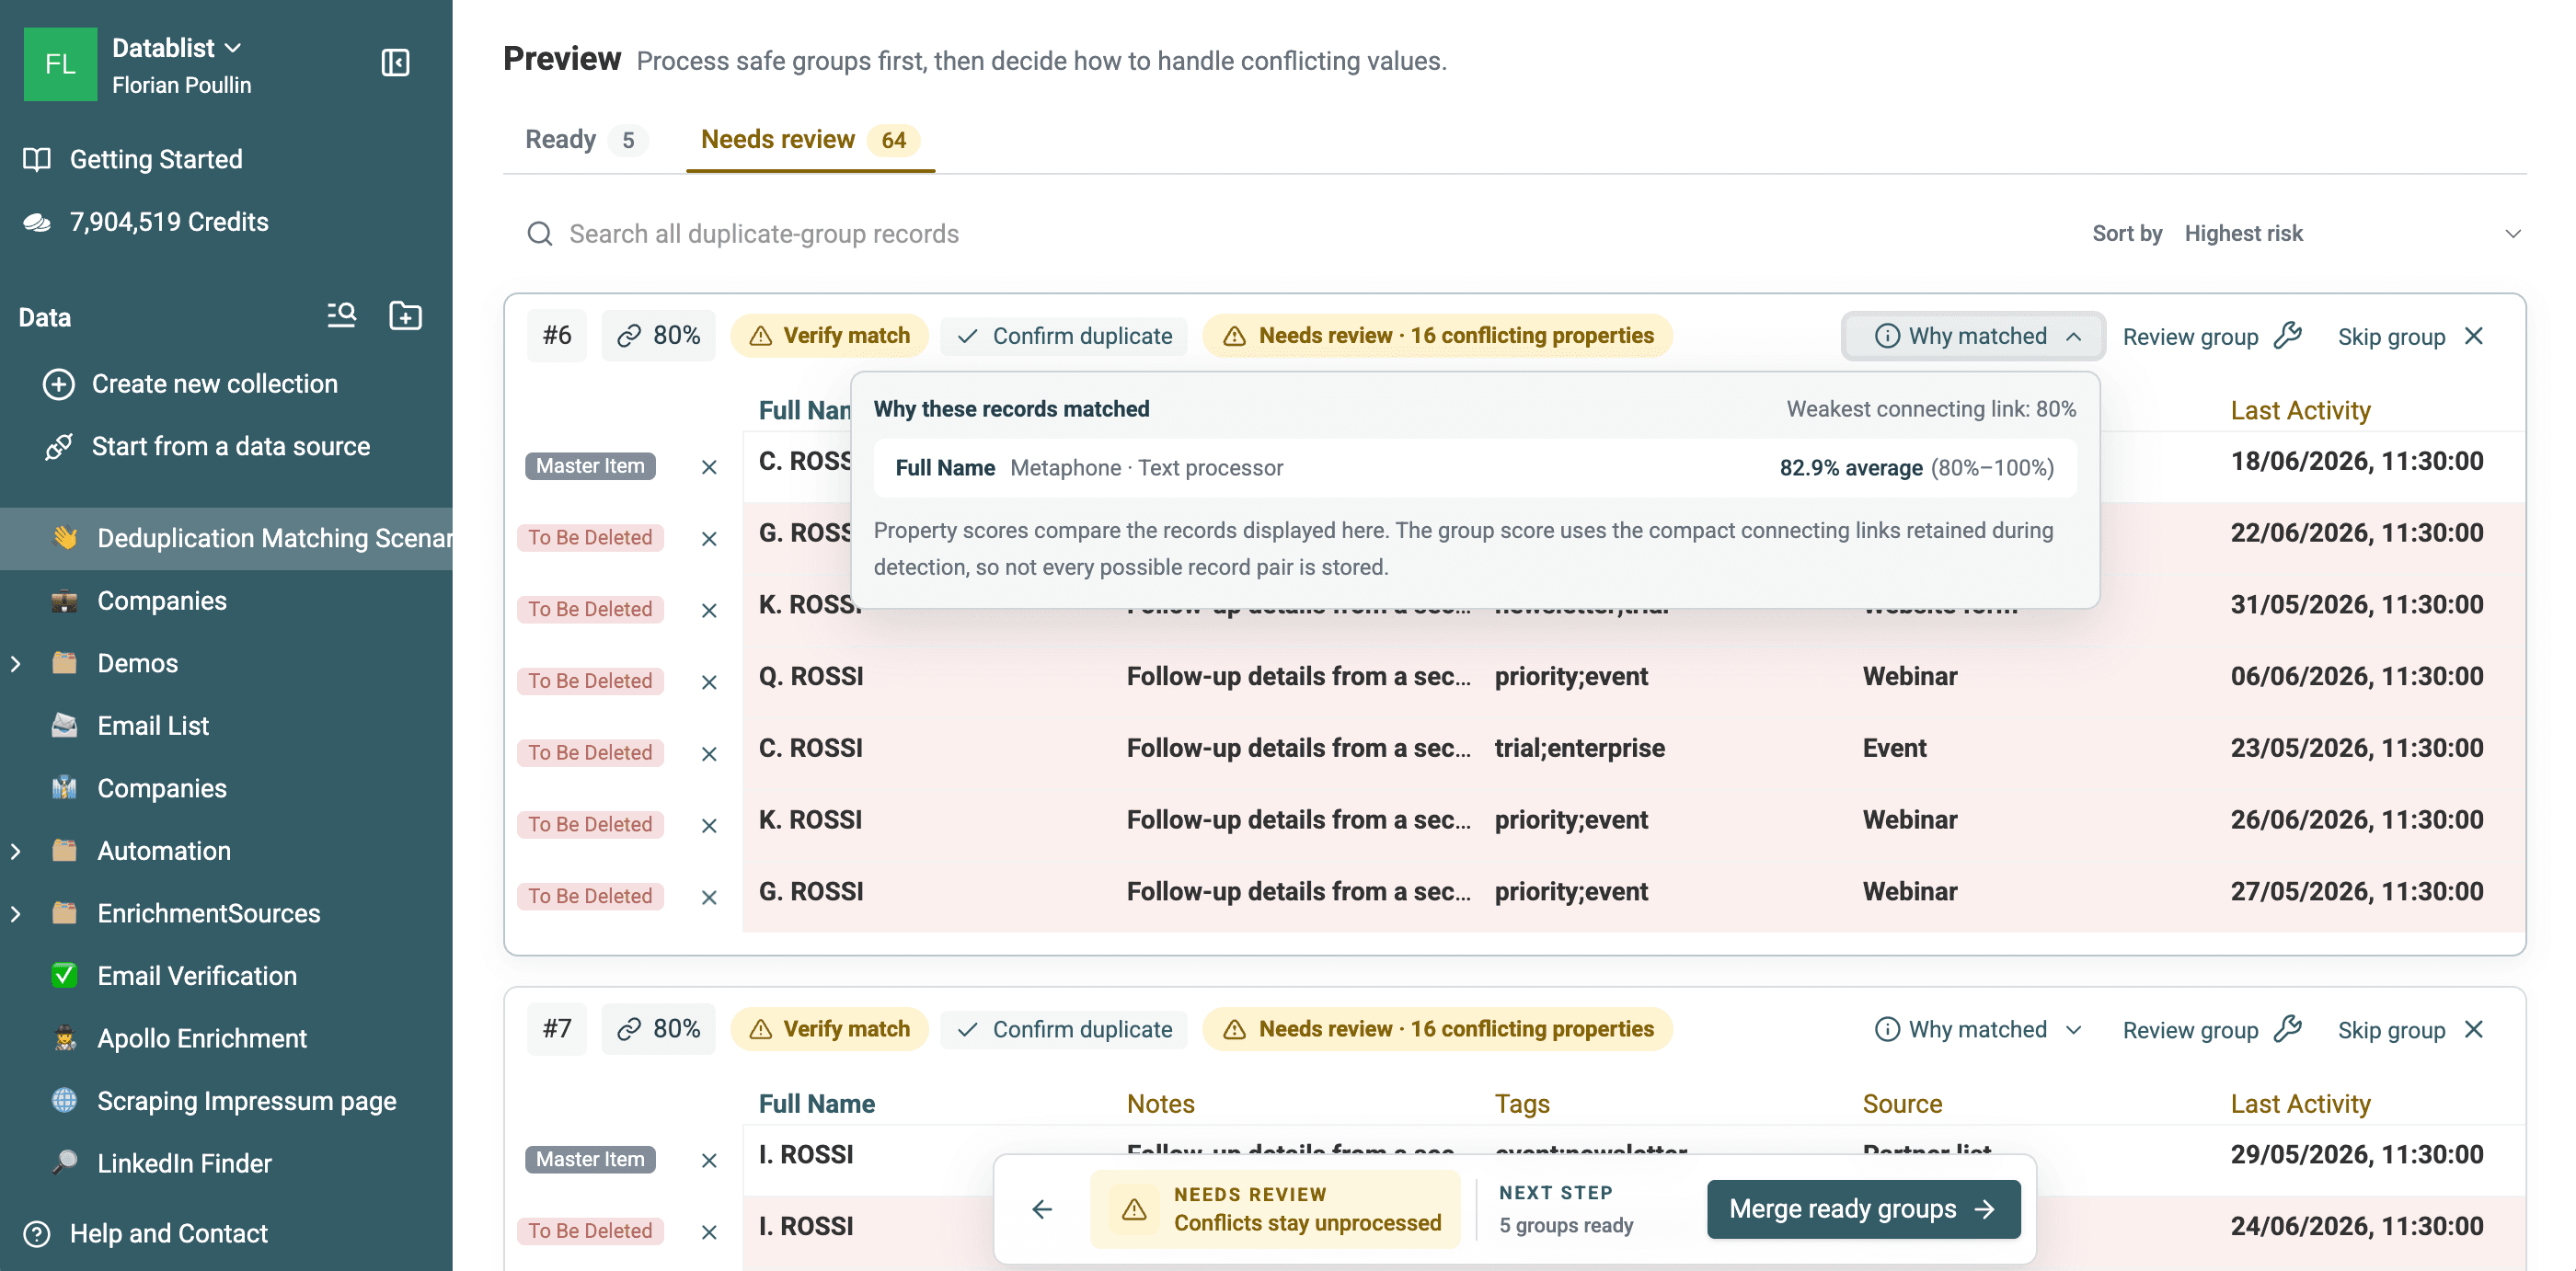
Descargue los 69 grupos exportados de Metaphone para examinar las coincidencias fonéticas útiles y los falsos positivos. Los grupos grandes de falsos positivos suelen combinar iniciales con un apellido común, como varios nombres Rossi abreviados. Sus códigos fonéticos coinciden, pero los nombres no aportan por sí solos pruebas de identidad suficientes para realizar un Merge automático.
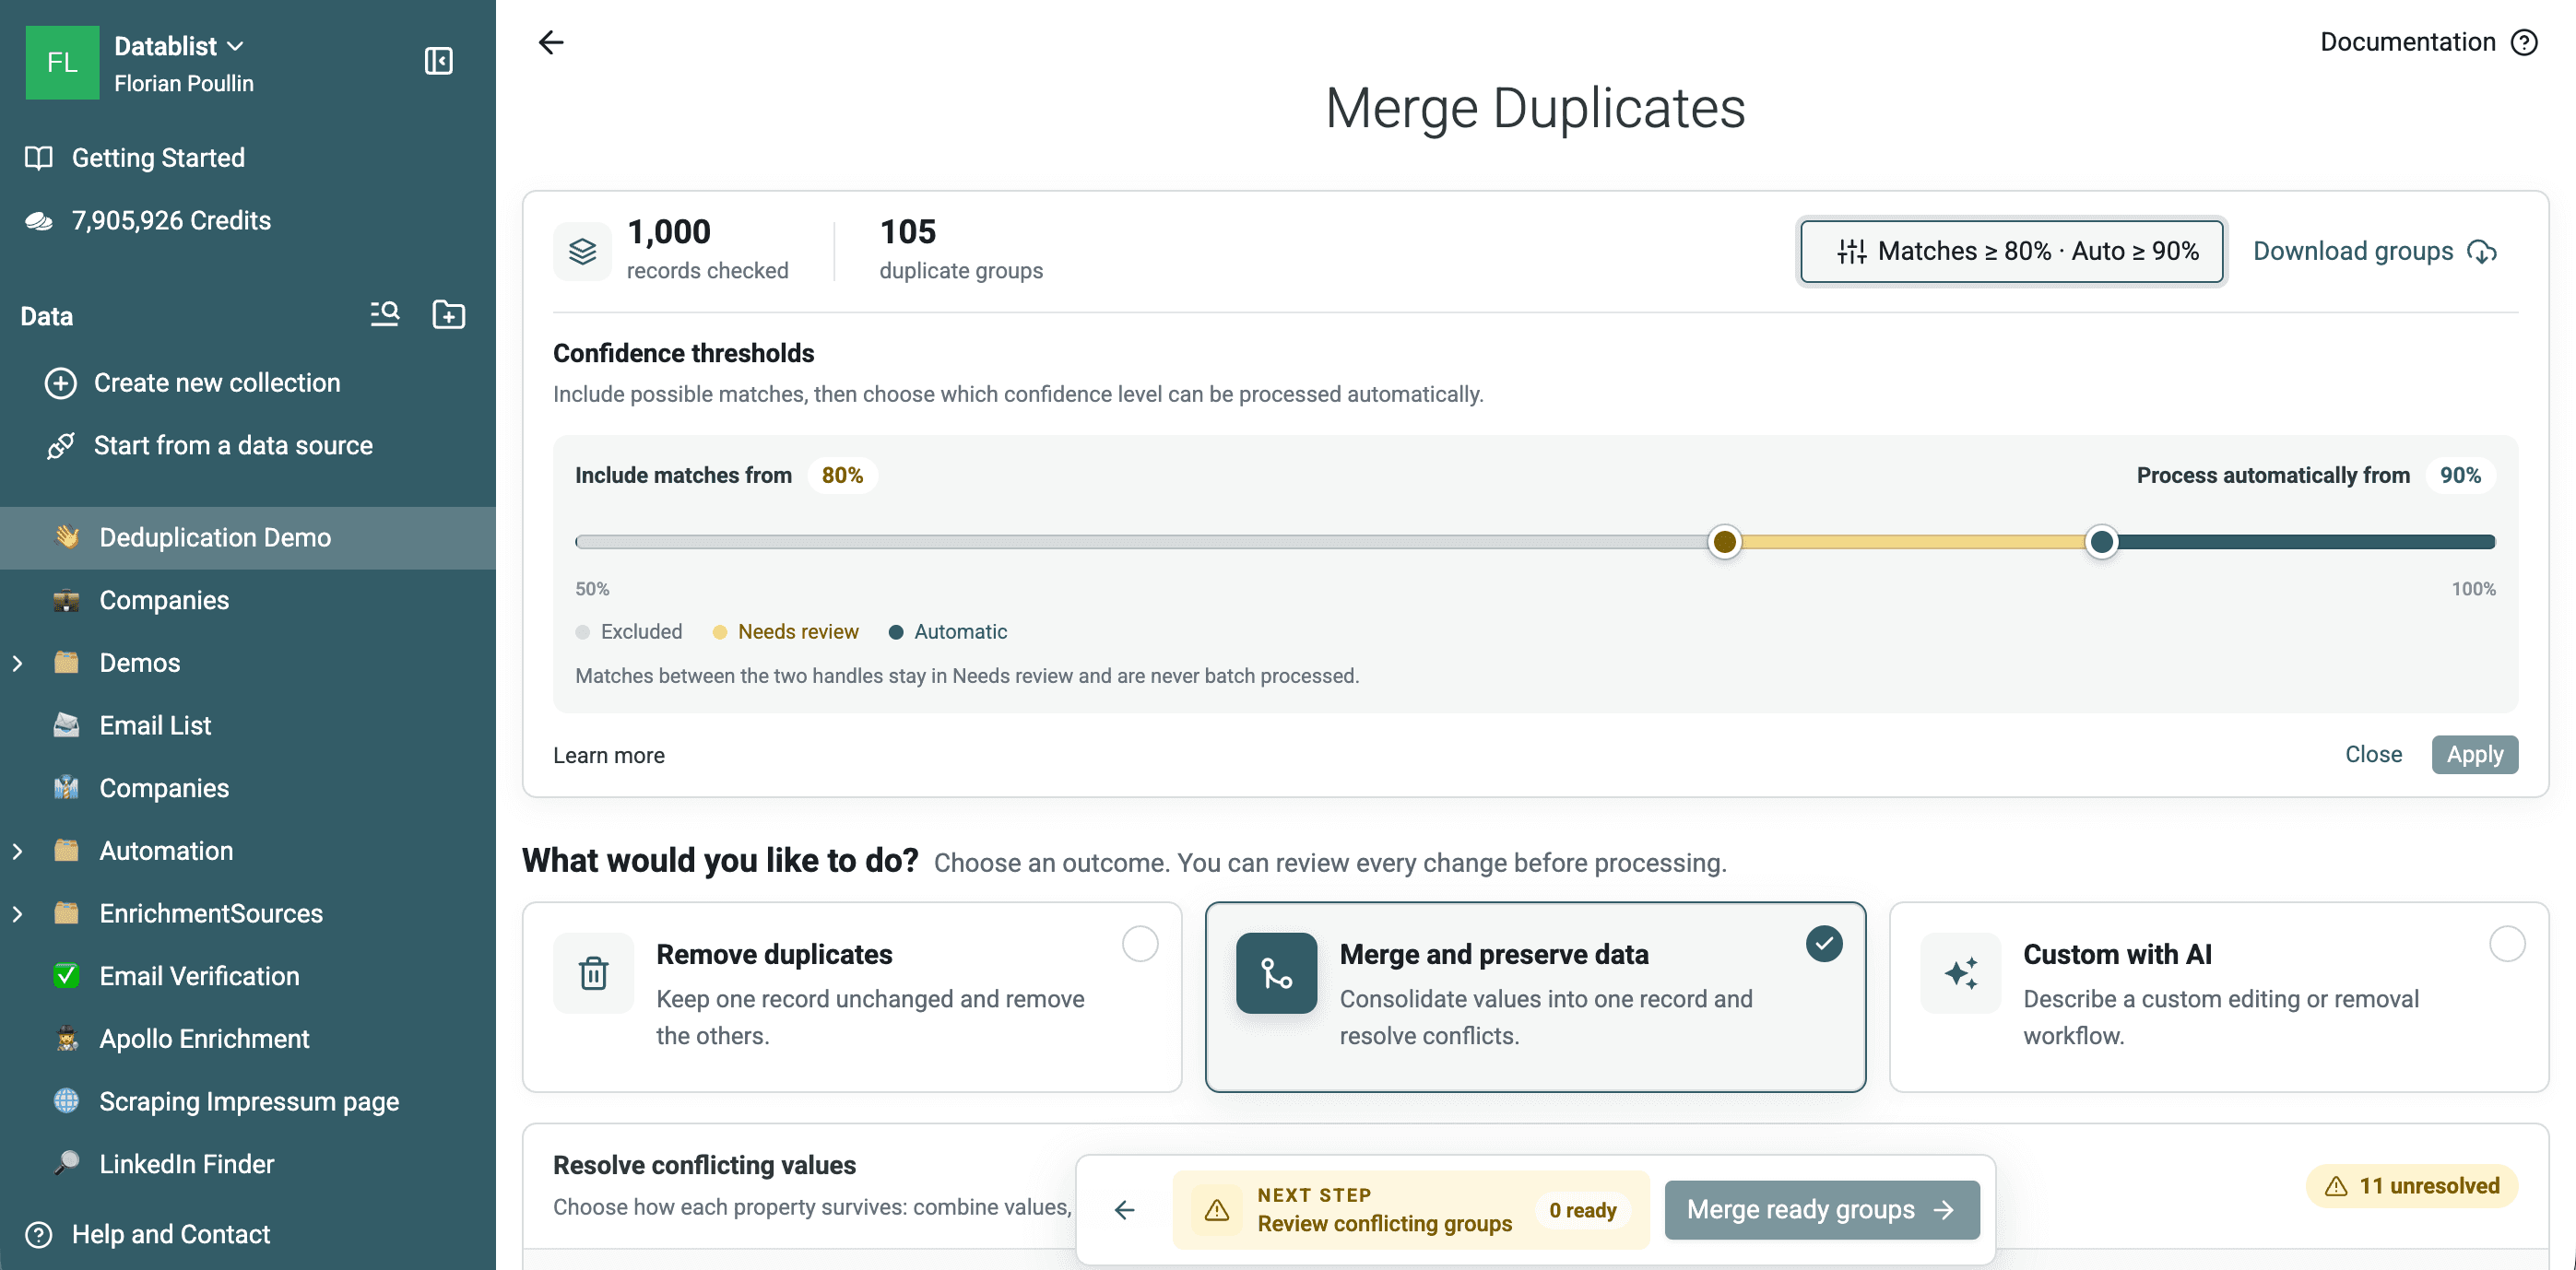
La página de resultados cuenta con dos controles:
- Include matches from determina qué grupos se muestran.
- Process automatically from mantiene los grupos de menor confianza en Needs review y fuera del procesamiento por lotes.
Esta separación permite revisar un conjunto amplio de candidatos sin aplicar la misma regla de automatización a todos.
Revise los grupos de duplicados
El espacio de resultados divide los grupos de duplicados entre Ready y Needs review.
- Los grupos Ready tienen un resultado de procesamiento concreto y cumplen el umbral de confianza automática.
- Los grupos Needs review presentan menor confianza, conflictos de Merge sin resolver, una regla de selección de registros sin coincidencias o una regla personalizada que los ha omitido.
Para cada grupo dudoso, compruebe lo siguiente:
- ¿Todas las filas representan a la misma persona, empresa o producto?
- ¿Qué identificador ha provocado la coincidencia?
- ¿Hay valores complementarios?
- ¿Qué fuente es la autoritativa?
- ¿Al eliminar una fila se perdería algún teléfono, ID, estado, fecha o nota?
- ¿Está conectado el grupo mediante un tercer registro poco fiable?
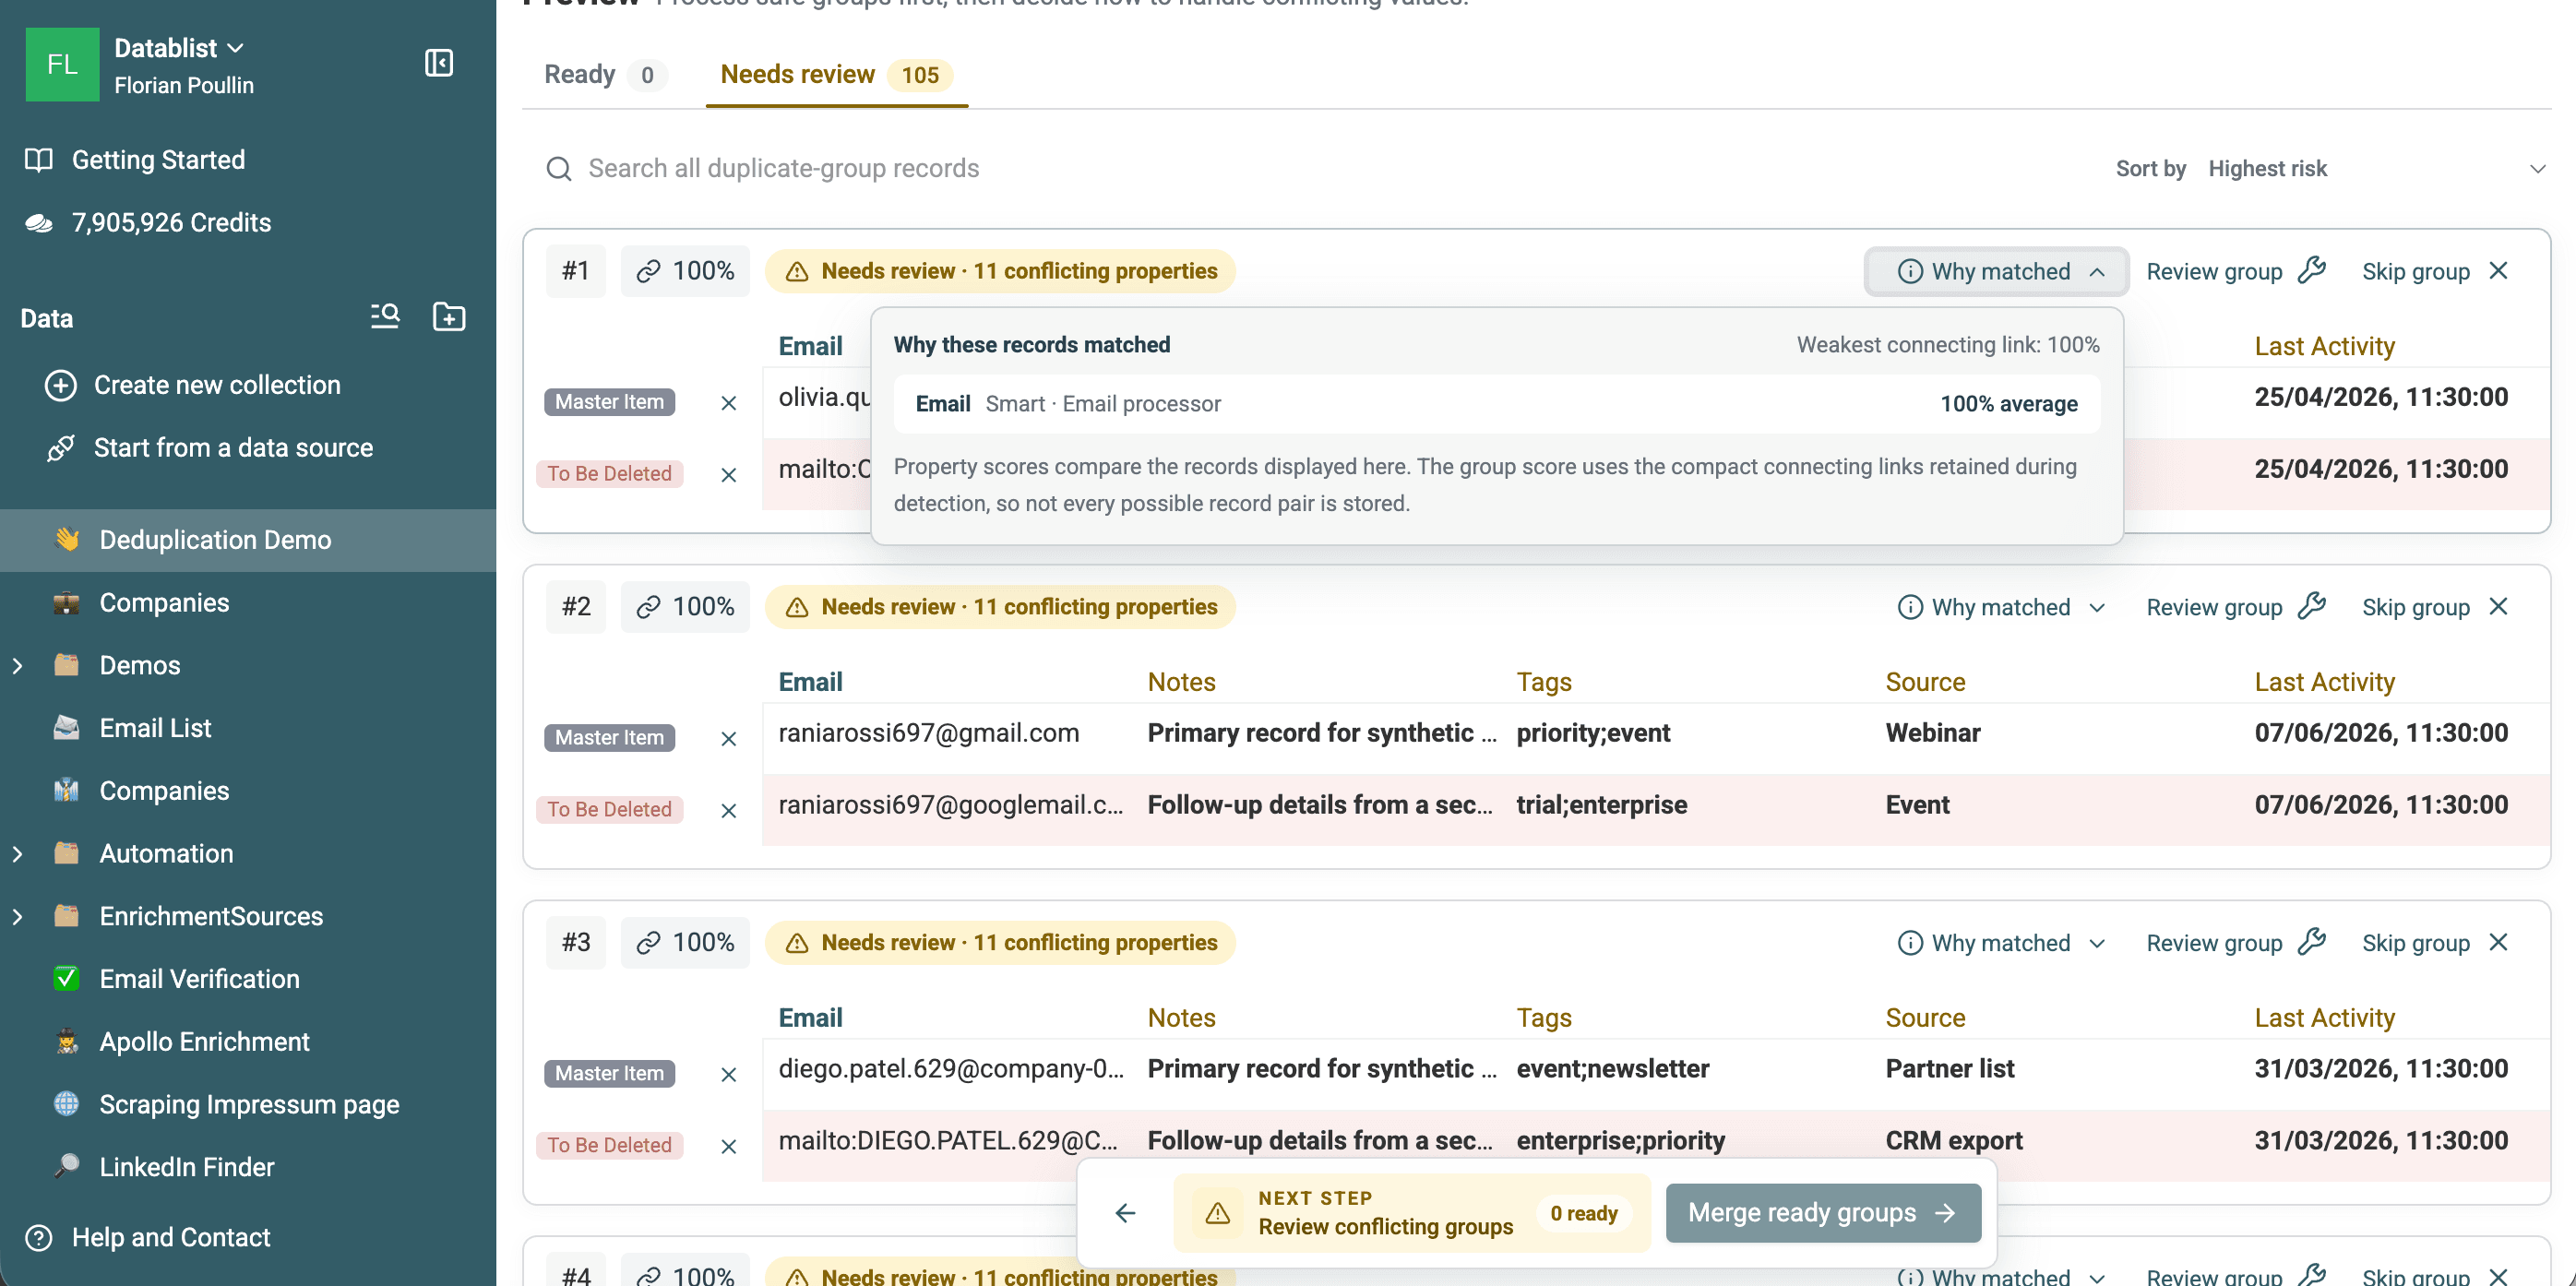
Utilice Why matched para examinar las propiedades, los algoritmos y los procesadores de comparación, así como los intervalos de puntuación. En las comprobaciones fuzzy, la similitud del grupo corresponde a la conexión conservada más débil necesaria para mantener el grupo unido.
También puede:
- Confirmar una coincidencia de baja confianza.
- Retirar un registro de un grupo sin eliminarlo.
- Omitir el grupo.
- Abrir y editar un registro.
- Revisar el grupo en Merging Assistant.
- Buscar entre los grupos restantes y ordenar primero los candidatos de mayor riesgo.
⚠️ No procese un grupo fuzzy basándose solo en el porcentaje
Dos personas distintas pueden tener nombres similares. Revise los identificadores y los campos relacionados antes de confirmar el grupo.
Compruebe los identificadores compartidos y ausentes
Un buzón compartido como info@company.example puede pertenecer a varios contactos. Dos personas con esa dirección pueden coincidir por Email y seguir siendo personas diferentes. Del mismo modo, el dominio de una empresa puede identificar a un negocio, pero aparecer en los registros de muchos empleados.
Recomiendo excluir esos grupos del Merge automático de personas hasta que otro identificador respalde la coincidencia. Si su objetivo es obtener una fila por empresa, el dominio compartido puede ser precisamente la clave de agrupación deseada. Defina la entidad antes de interpretar el resultado.
La regla de valores vacíos también modifica las comparaciones basadas en propiedades seleccionadas. En una comprobación de varias propiedades con una comparación distinta de Exact, el ajuste avanzado Empty Value Rule ofrece Value required (default) o Match on empty value. La opción predeterminada exige que exista el identificador de texto; permitir coincidencias entre valores vacíos relaja ese requisito. Utilícela únicamente cuando los demás campos comparados aporten pruebas de identidad suficientes: dos emails ausentes no demuestran que dos personas sean la misma.
Por ejemplo, dos filas con el campo Email vacío y valores Full Name diferentes no deberían combinarse solo para reducir el número de filas. Un registro sin email puede contener un contacto que necesite conservar o enriquecer más adelante.
Elimine, combine o procese duplicados con reglas
Encontrar duplicados y resolverlos son decisiones distintas. Elija el modo de procesamiento después de revisar qué contienen las filas secundarias.
Elimine duplicados si una fila es la referencia
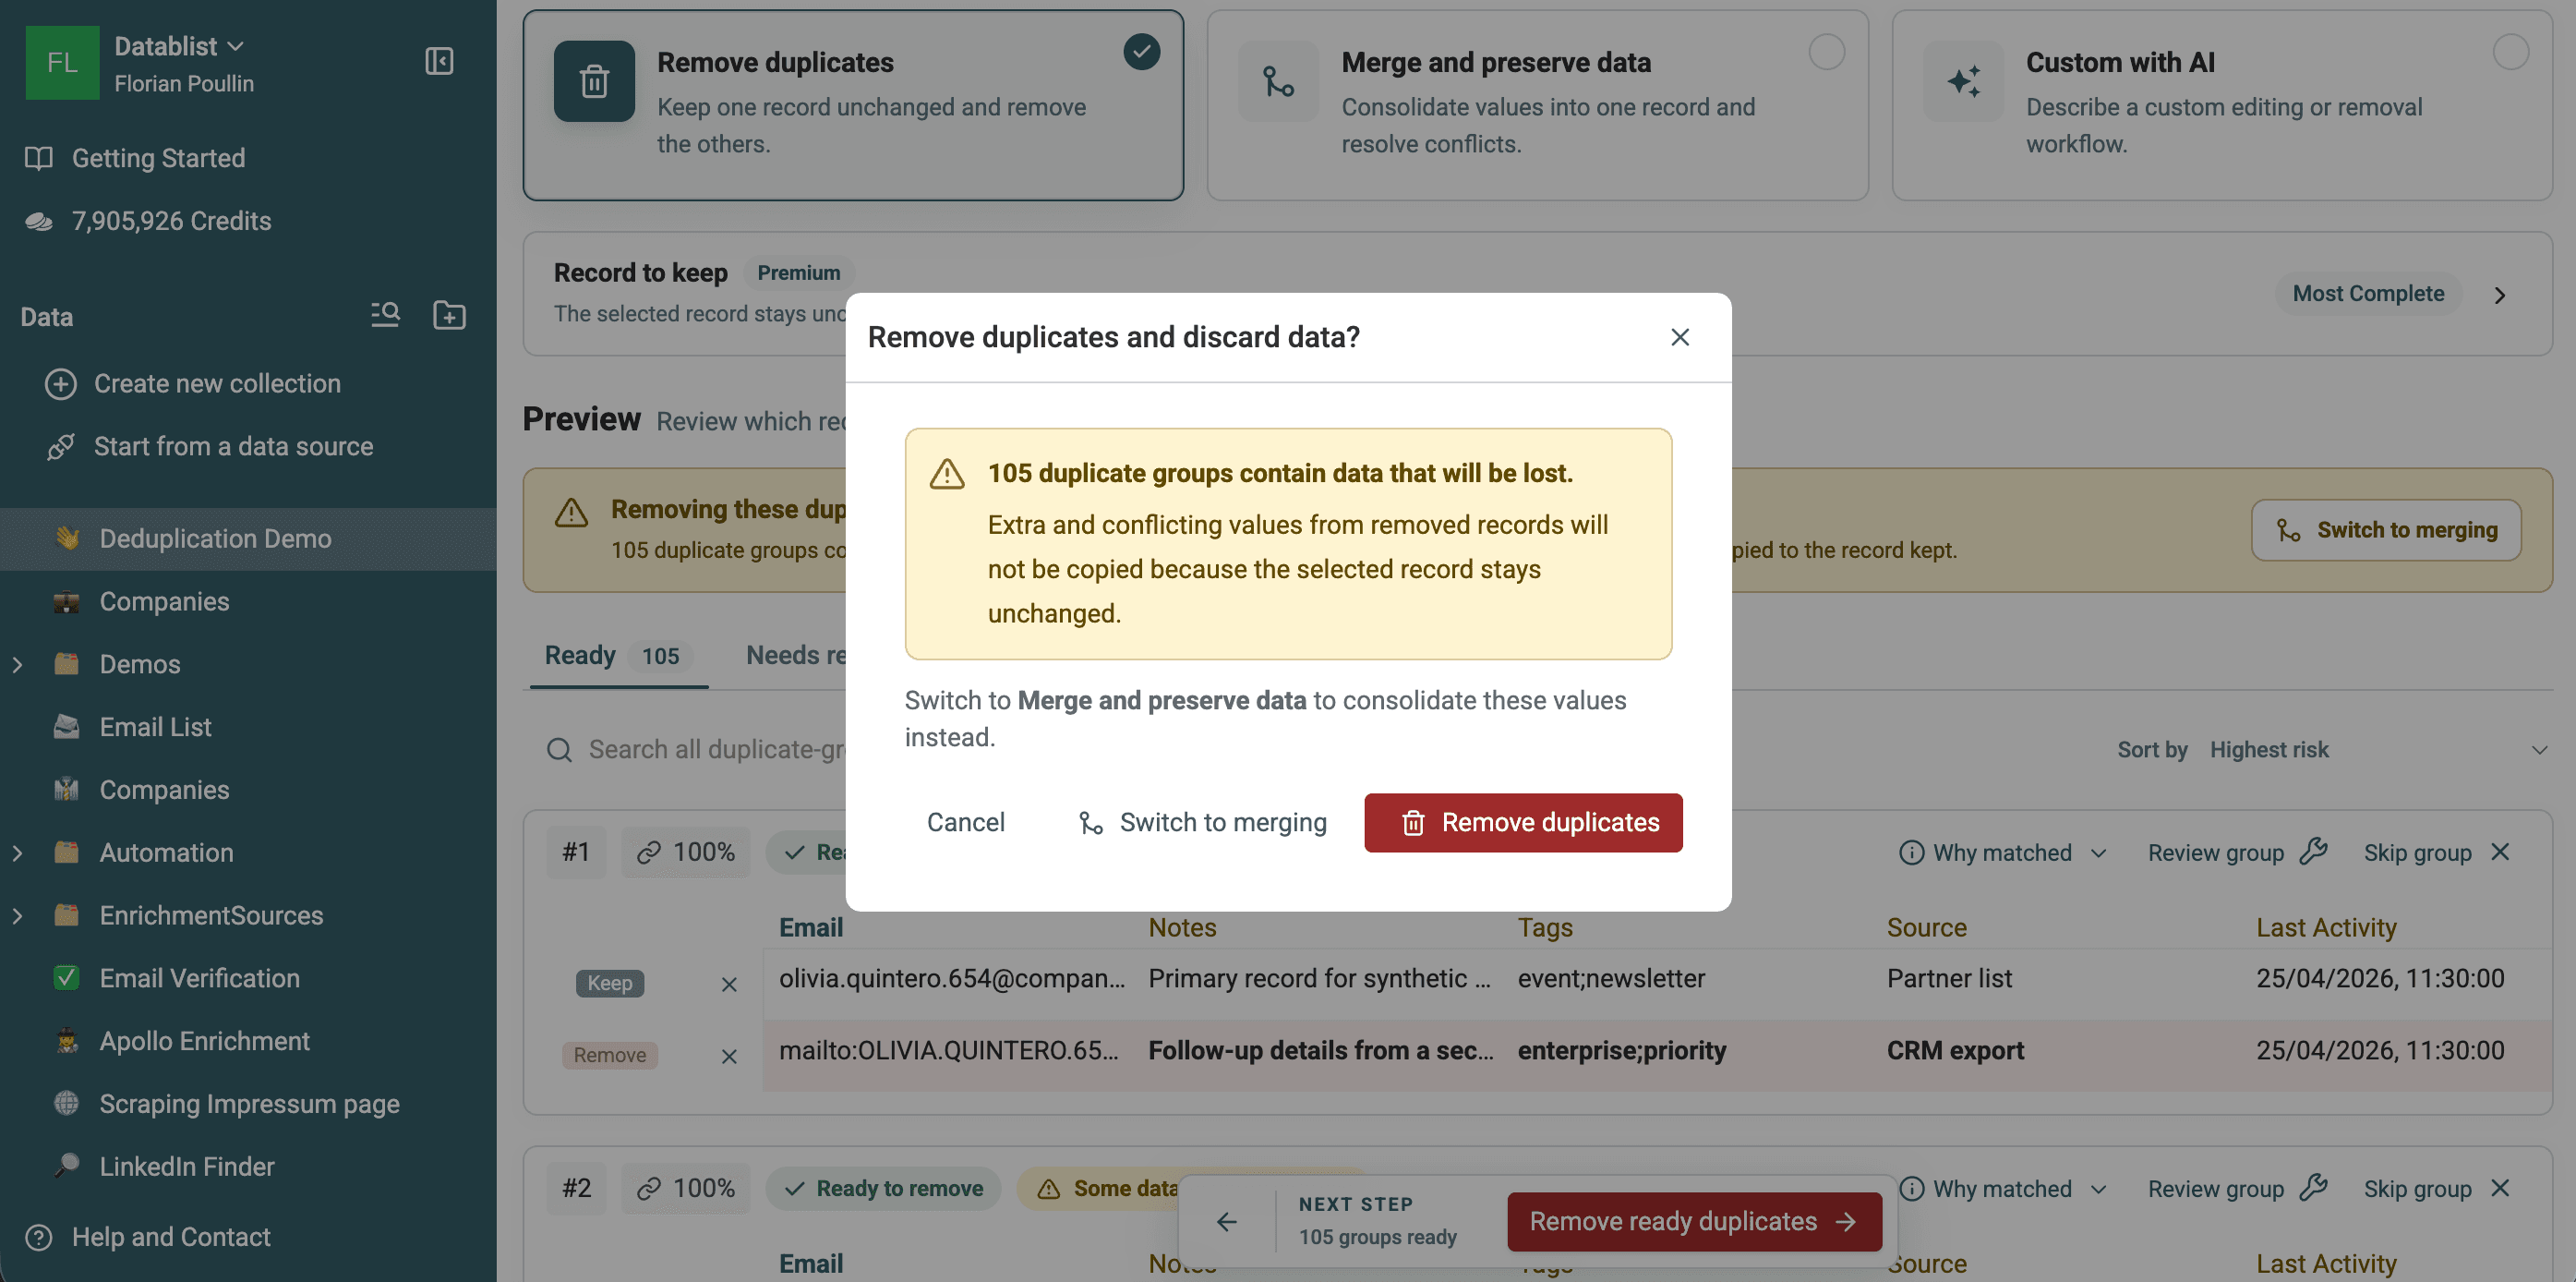
Remove duplicates conserva sin cambios un registro seleccionado y elimina las demás filas de cada grupo Ready.
Utilícelo para filas copiadas, importaciones temporales o registros cuyos valores secundarios puedan descartarse. La vista previa le avisa cuando los registros que se eliminarán contienen información adicional o contradictoria. Esos valores no se copian en la fila conservada.
Combine las filas que contienen datos útiles
Merge and preserve data completa las propiedades vacías del registro seleccionado, resuelve los conflictos configurados y elimina después las filas secundarias.
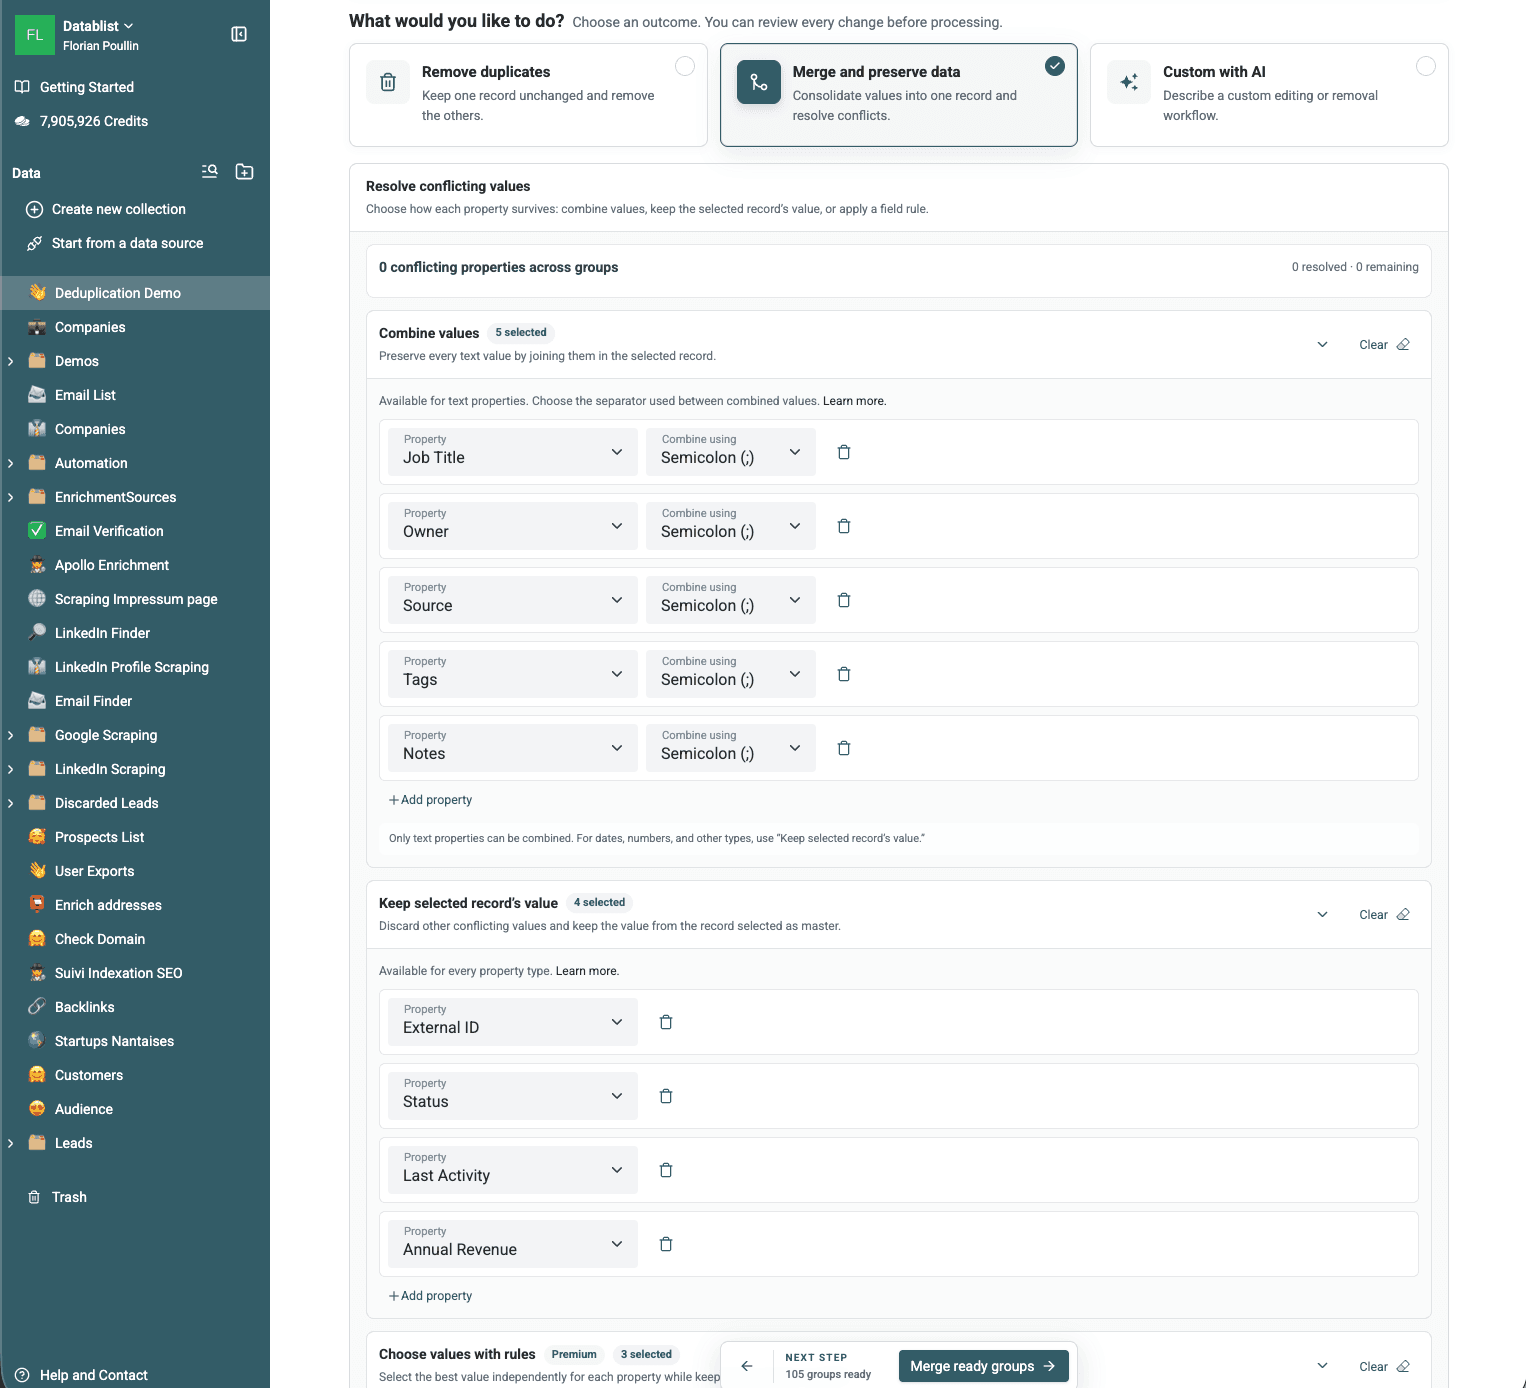
Empiece por la regla Record to keep. La opción predeterminada es Most Complete. Los planes de pago permiten seleccionar reglas basadas en la fecha de creación o actualización, el valor más alto o más bajo de una propiedad, o la presencia de un valor obligatorio.
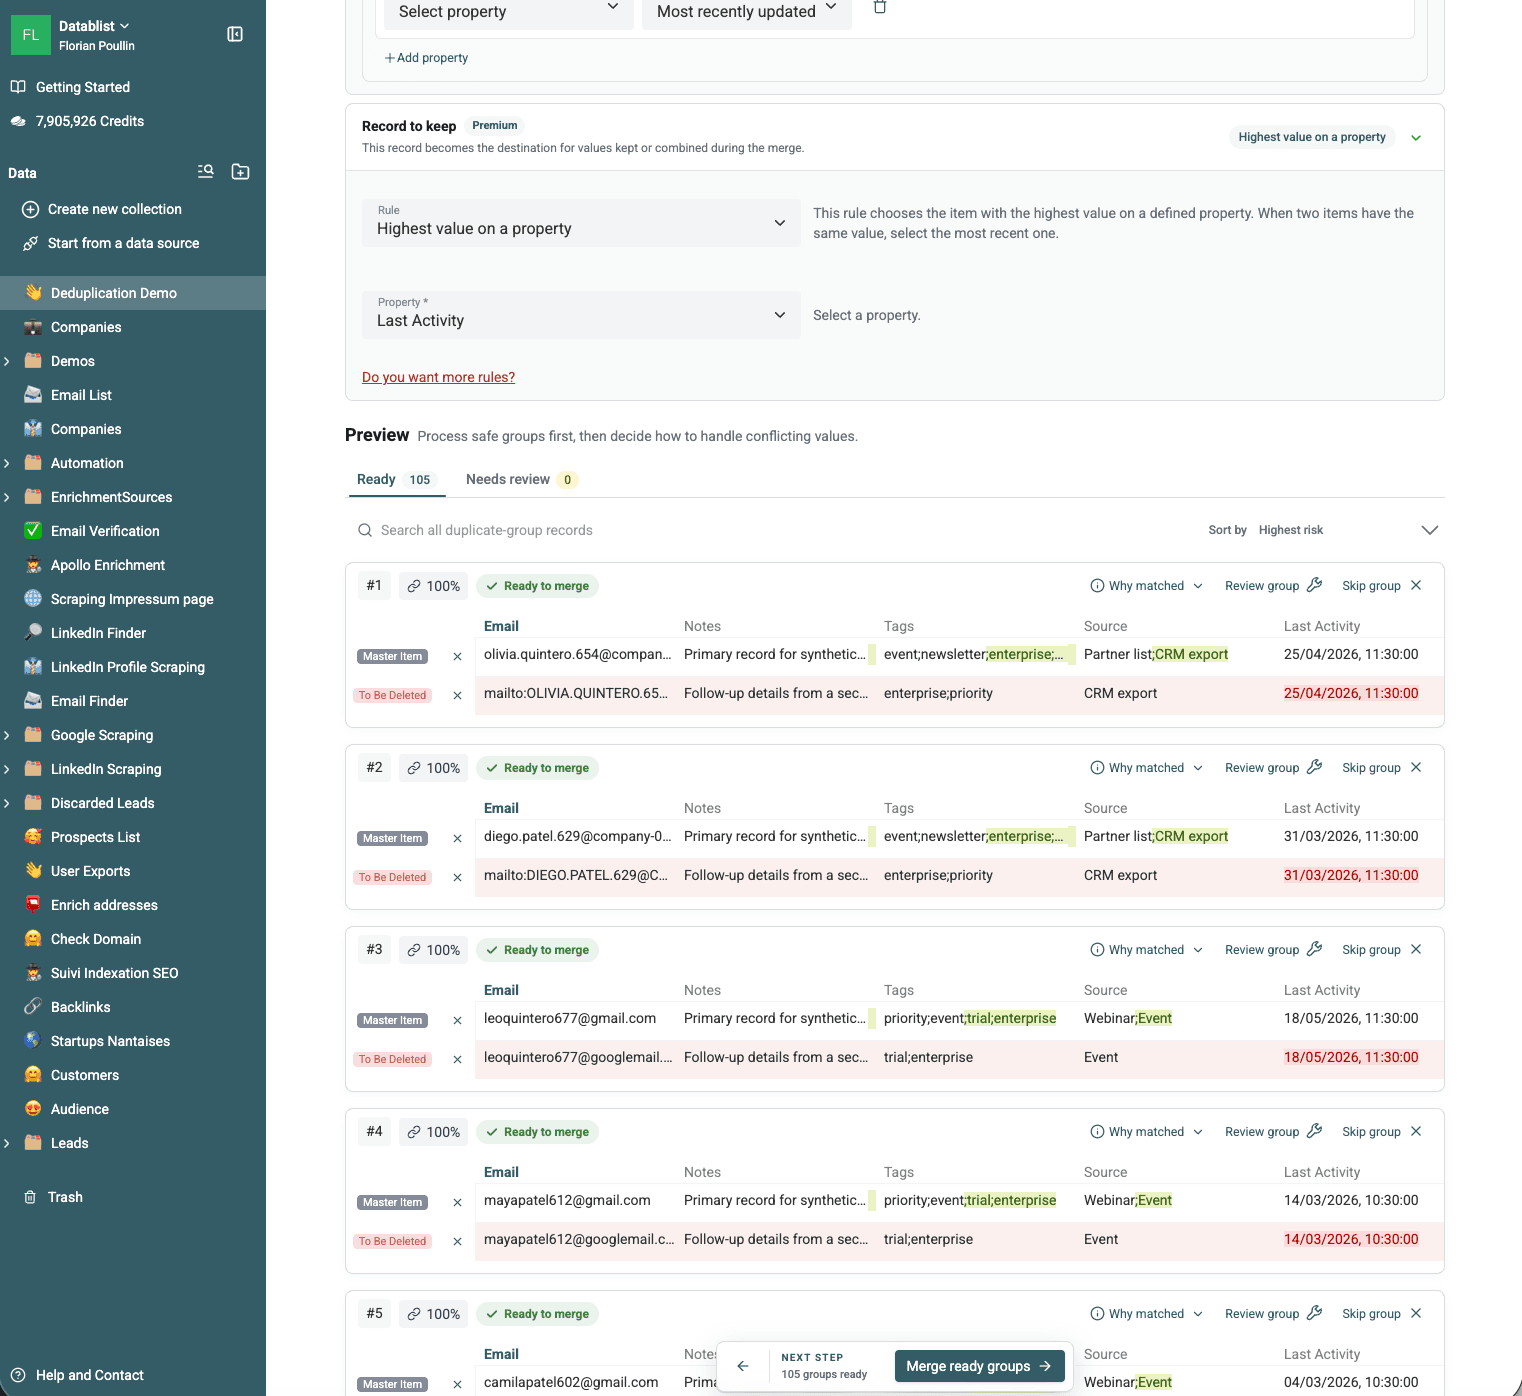
A continuación, decida qué valor debe sobrevivir en cada propiedad con conflictos:
- Combine valores de texto distintos mediante un delimitador.
- Conserve el valor del registro seleccionado.
- En los planes de pago, elija los valores de forma independiente mediante reglas como el más reciente, el más antiguo, el más largo, el más corto, el más alto, el más bajo o el más frecuente.
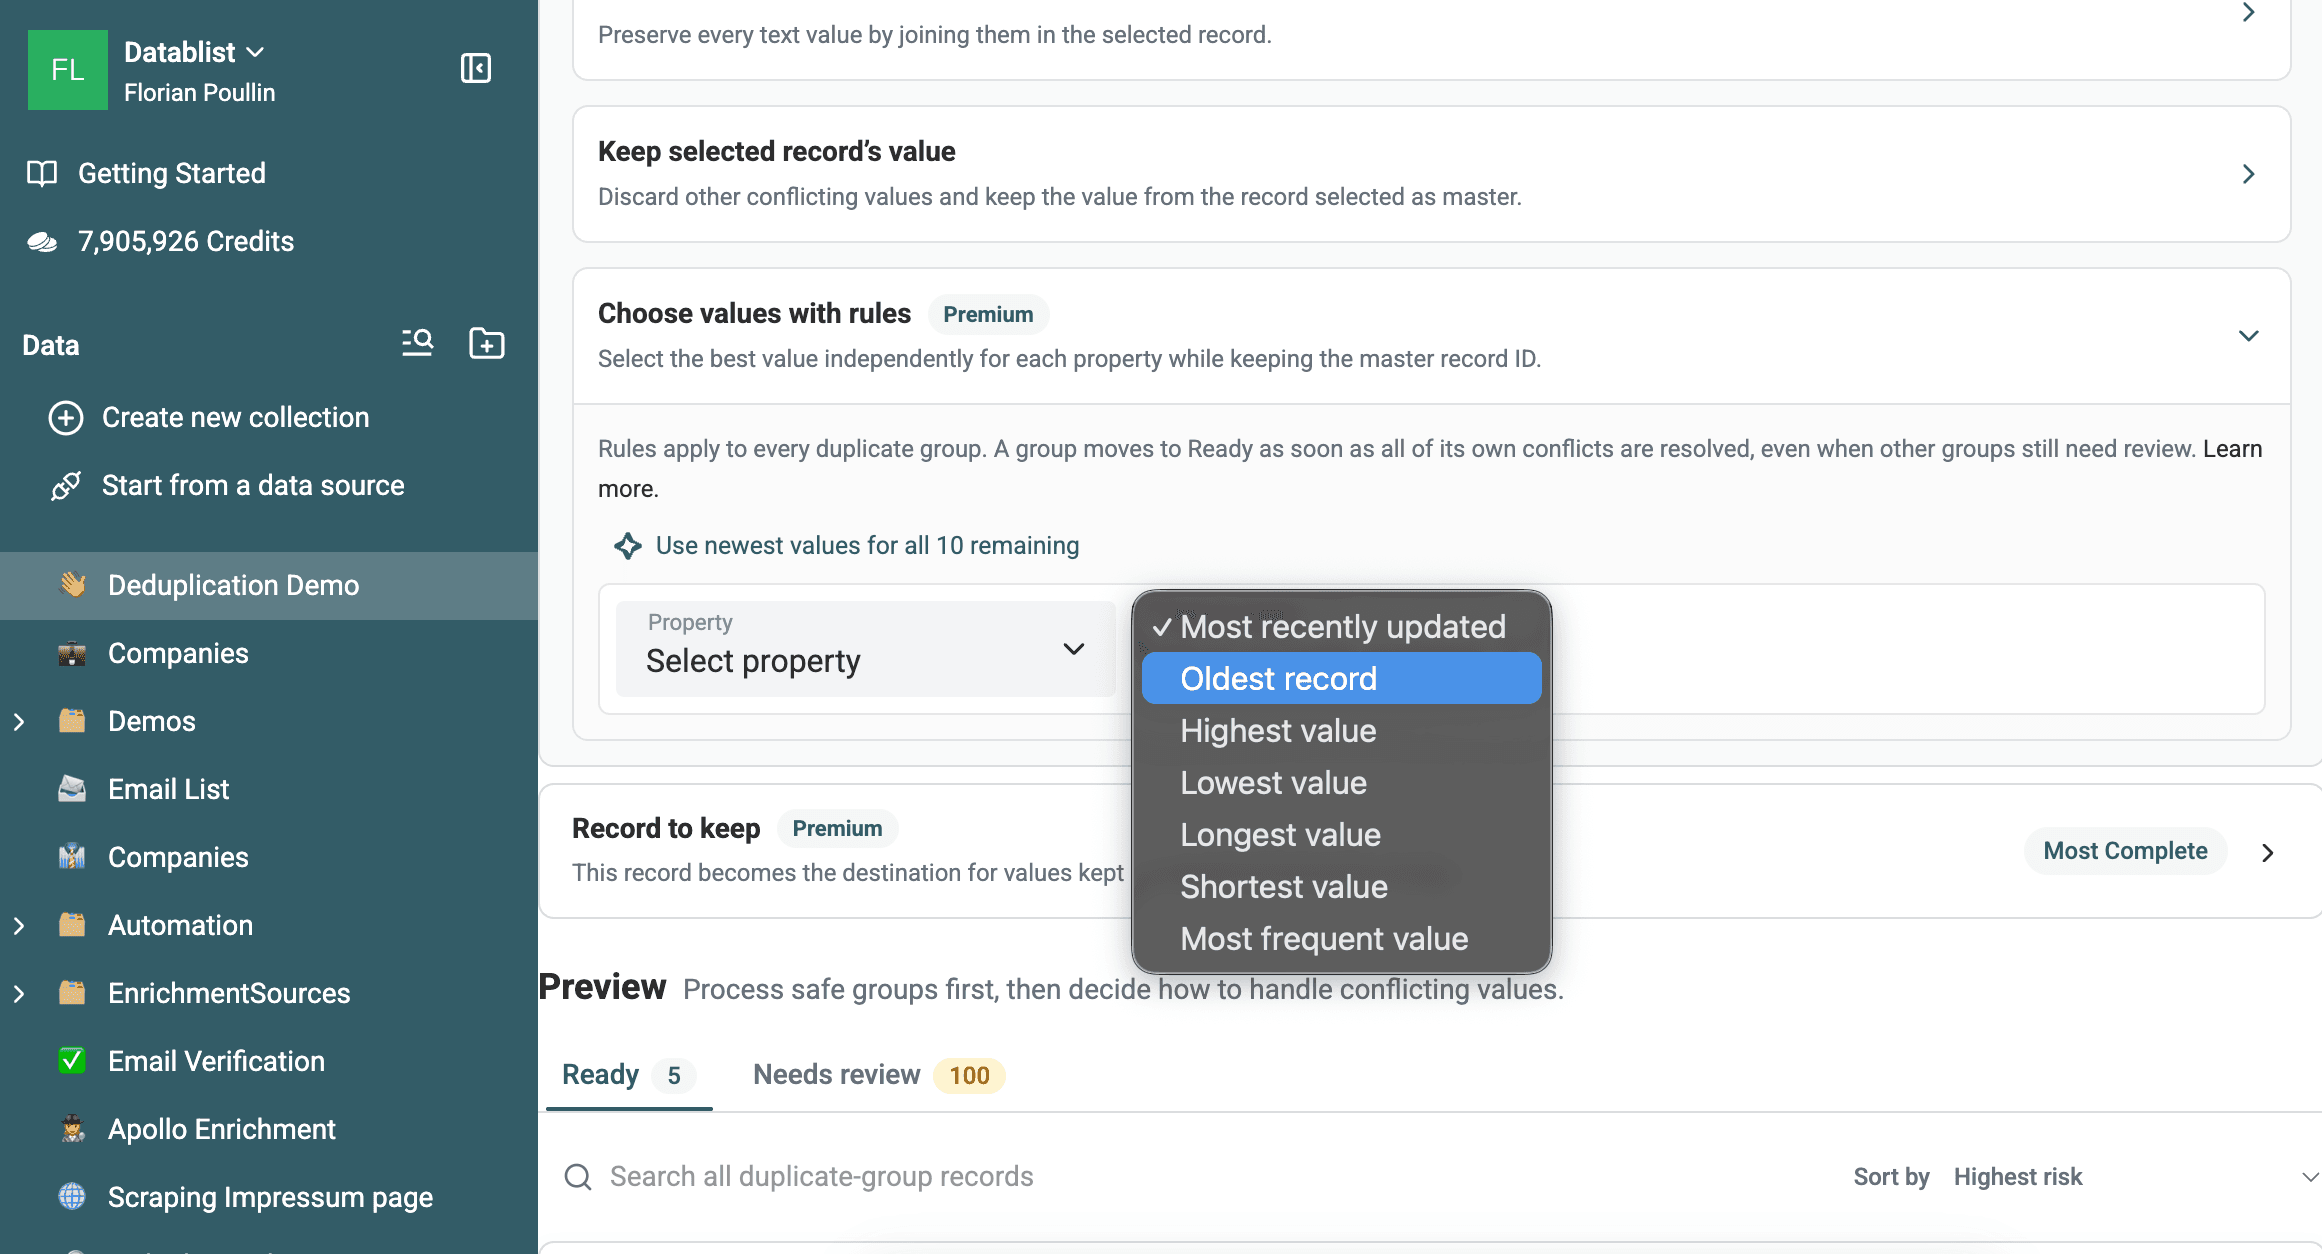
Utilice reglas por campo cuando ninguna fila contenga el mejor valor para todas las propiedades. Puede conservar el ID del registro seleccionado y, al mismo tiempo, tomar de otras filas un cargo más reciente, un nombre de empresa más largo y el estado más frecuente.
Actualice la vista previa después de cambiar el umbral, el flujo de trabajo, la composición de los grupos, los ajustes de conflictos o la regla de selección del registro.
Use Custom with AI para reglas específicas
Custom with AI genera un flujo de procesamiento de grupos a partir de una instrucción escrita en lenguaje natural. Puede seleccionar un registro, copiar o normalizar valores, añadir una propiedad de estado, calcular un total para el grupo, eliminar filas secundarias u omitir los grupos que no cumplan una condición.
Por ejemplo:
Conserve el registro cuyo campo Source sea CRM export. Copie el Job Title del registro más reciente, combine las distintas Notes con saltos de línea, añada una casilla Duplicate Reviewed y elimine después los registros secundarios.
Haga referencia a las propiedades de la colección con /Property o {{Property}}. Genere el flujo de trabajo y revise la vista previa antes de ejecutarlo. Custom with AI está disponible para usuarios autenticados con un plan de pago.
Para gestionar excepciones individuales, abra Review group y utilice Merging Assistant en lugar de complicar la regla por lotes.
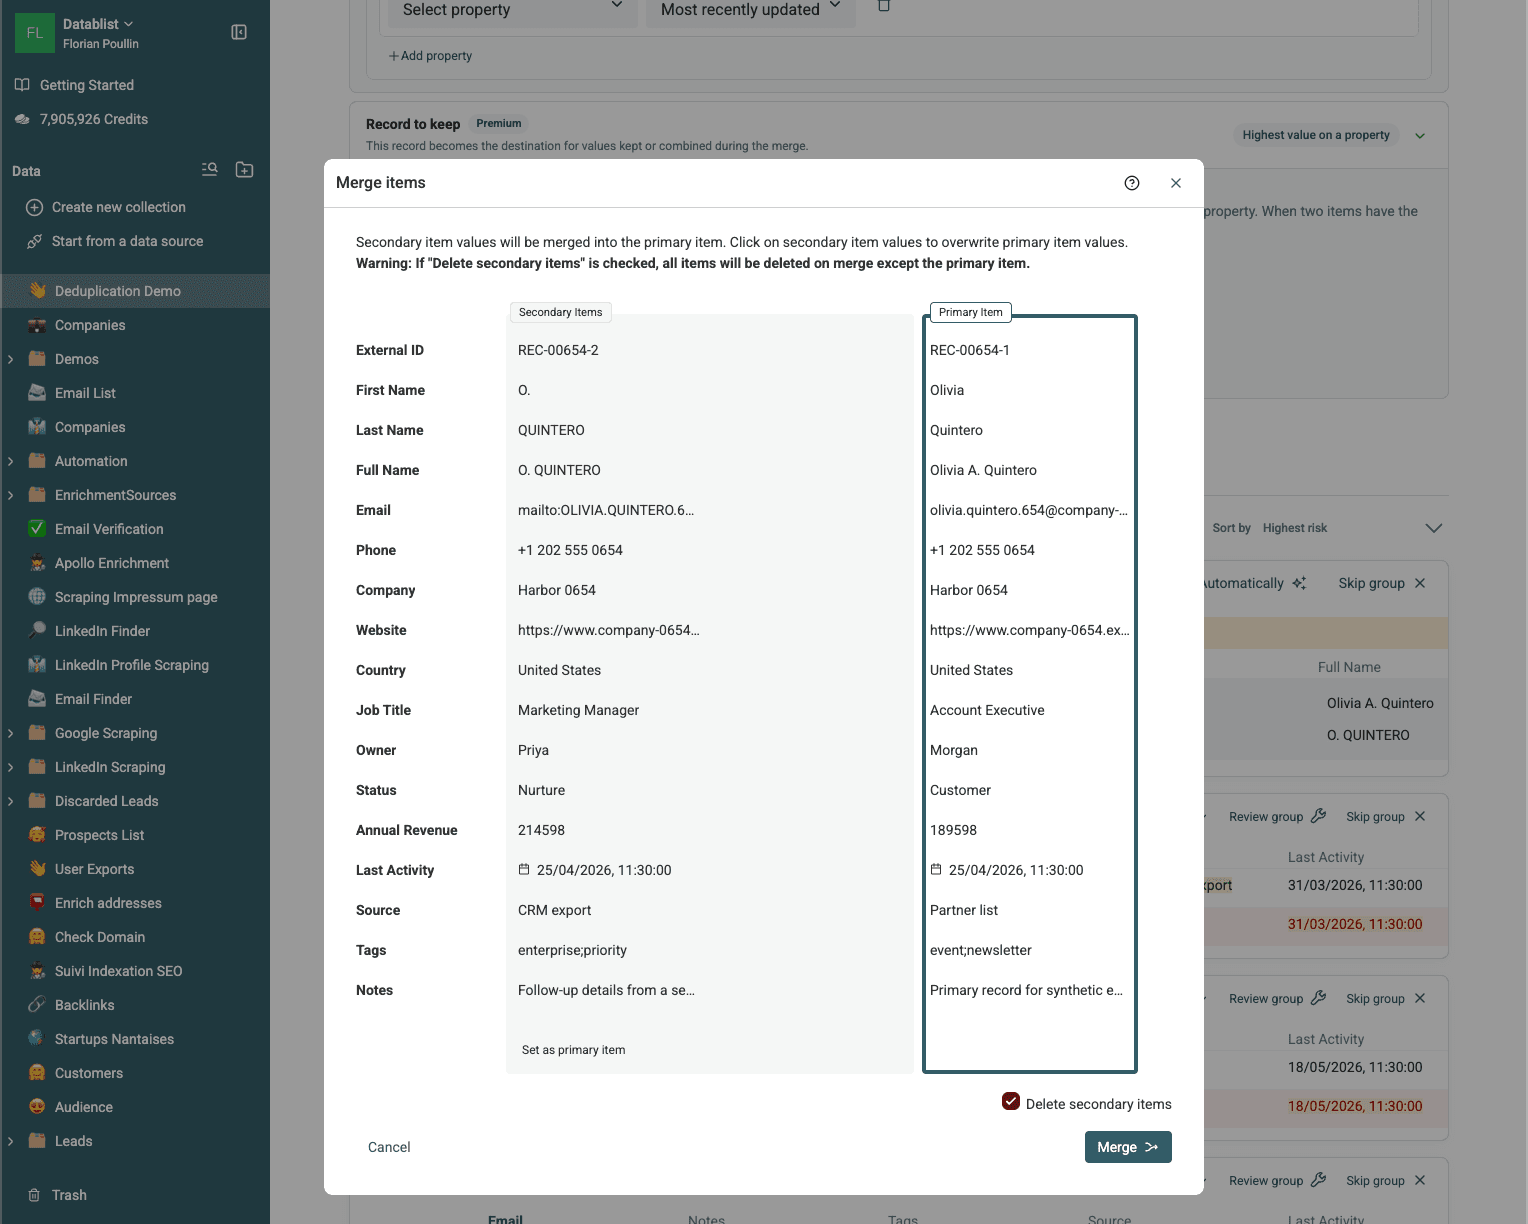
Valide y exporte la lista limpia
Antes de procesar los grupos Ready, compruebe lo siguiente:
- La vista previa refleja los ajustes actuales.
- Se han revisado los grupos de baja confianza y aquellos con identificadores compartidos.
- El registro seleccionado contiene el ID que necesita conservar.
- Se mantienen los valores únicos de teléfono, fuente, notas y estado.
- Los campos que solo admiten un valor no se concatenan.
- El número de grupos Ready mostrado coincide con el alcance que desea procesar.
Después del procesamiento, concilie el número de filas:
Filas iniciales - filas secundarias eliminadas = filas finales
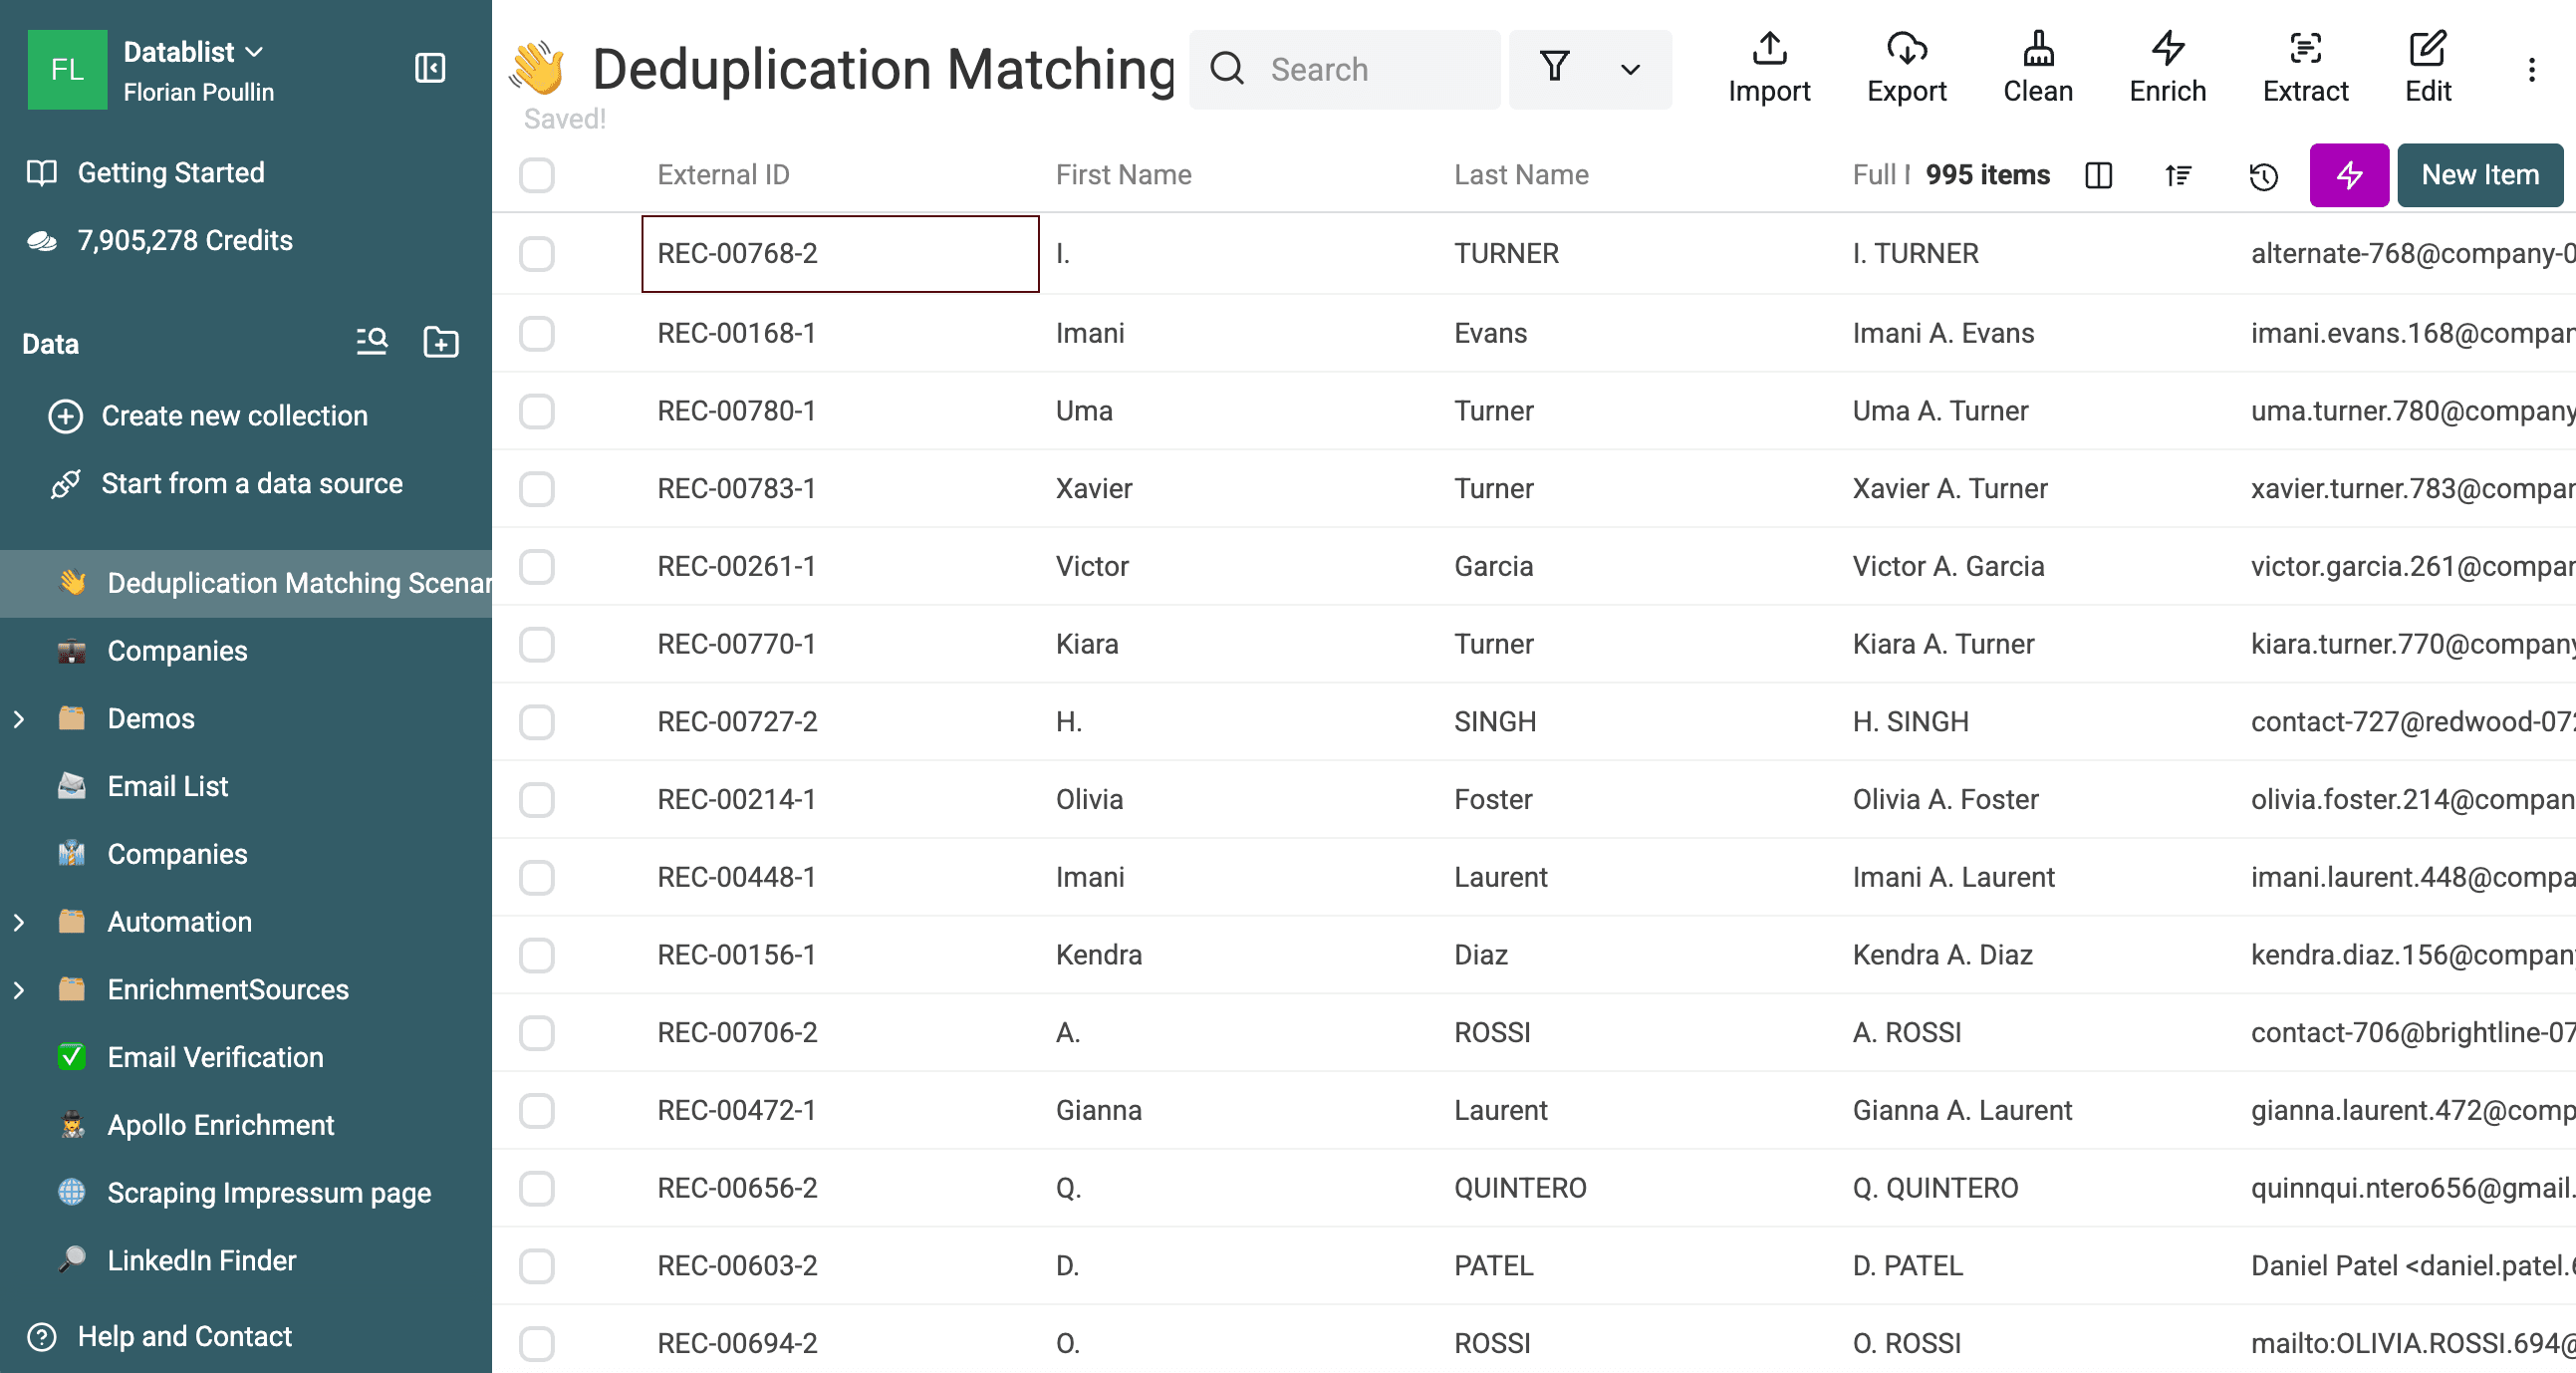
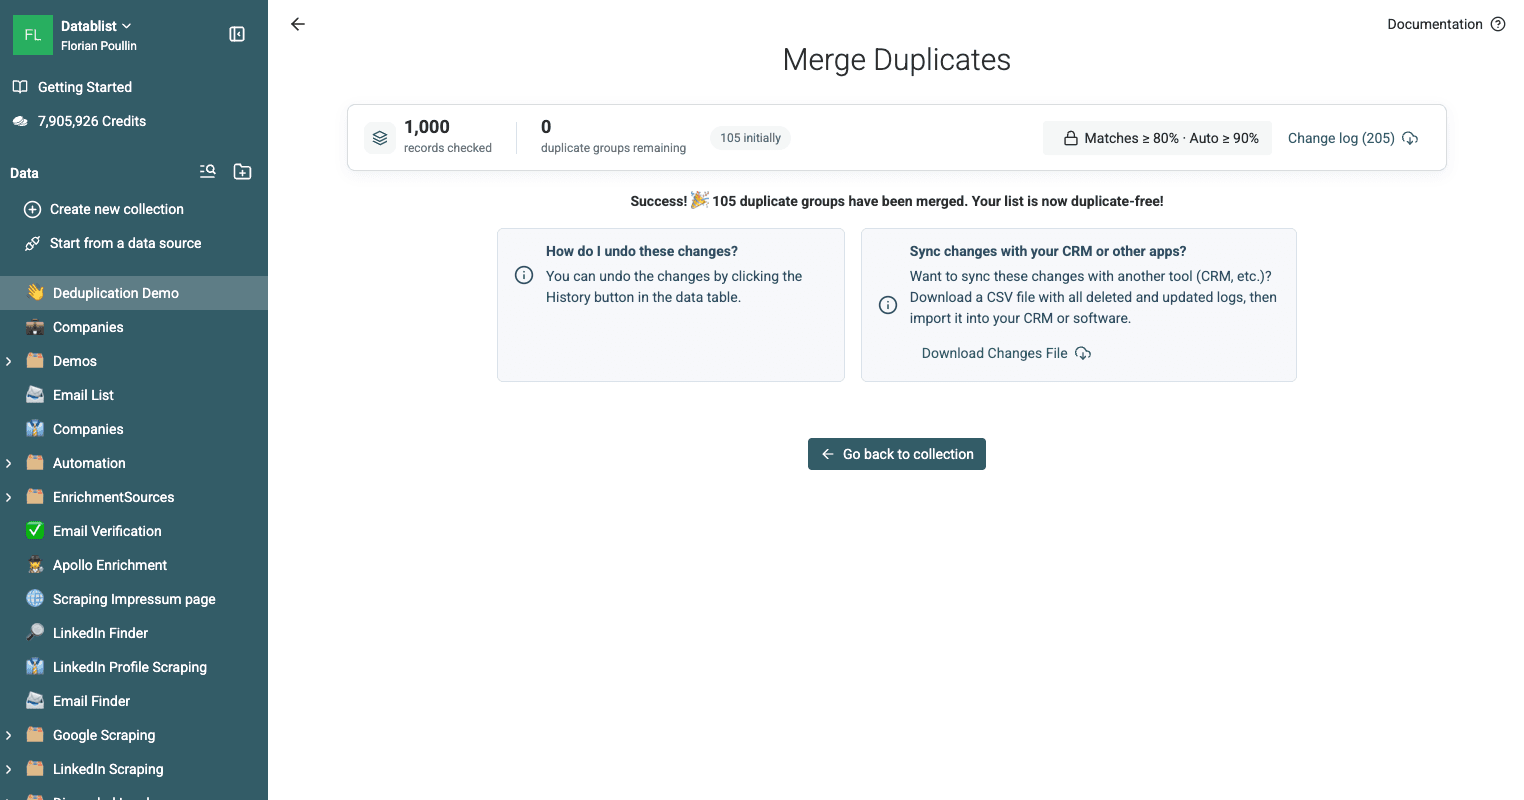
En la pasada Exact de esta guía, Datablist combinó cinco grupos de dos filas. Por tanto, la colección pasó de 1000 a 995 elementos.
Descargue los grupos de duplicados antes de procesarlos si necesita un archivo para revisarlos fuera de Datablist. Los planes de pago incluyen ID de grupos de duplicados utilizables y un registro de cambios posterior al procesamiento. Este registro recoge los ID de Datablist eliminados y actualizados, junto con los valores anteriores y de destino.
Las operaciones automáticas de eliminación y Merge también aparecen en el History de la colección, desde donde puede deshacerlas.
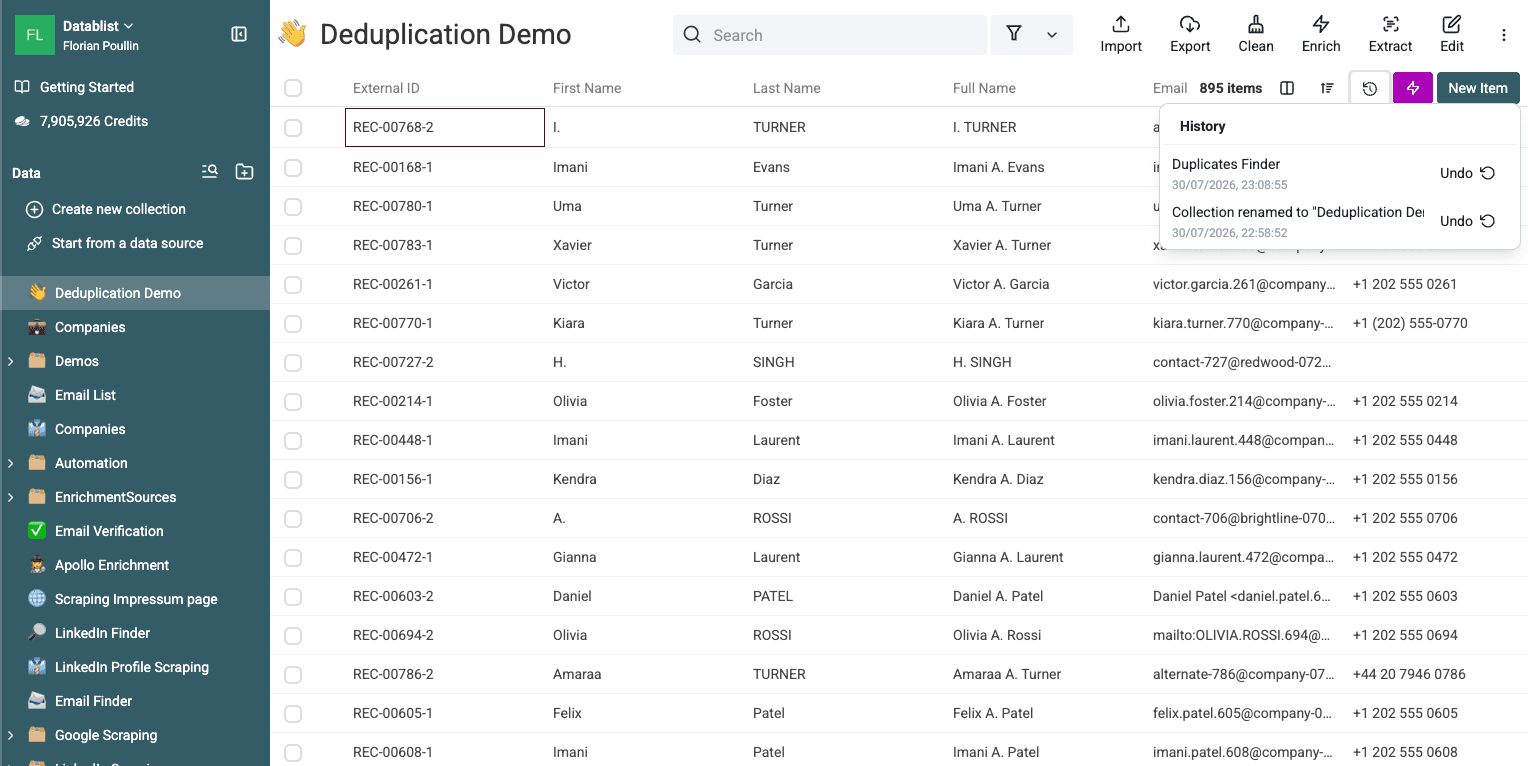
Vuelva a la colección y abra Export para descargar el archivo CSV o Excel limpio.
Deduplicar varias listas
Utilice la comparación entre colecciones cuando necesite cotejar un nuevo archivo de leads con una exportación del CRM. Trate el CRM como lista de referencia y elimine sus coincidencias de la lista entrante antes de importarla.
Descargue el archivo CRM de demostración y el archivo de eventos de demostración para probar este flujo de trabajo. Los dos archivos usan encabezados distintos y contienen 100 coincidencias de email diseñadas. Cada archivo comienza con 250 filas.
Importe cada archivo en su propia colección y abra después Clean > Match across collections. Añada ambas colecciones y asigne las propiedades correspondientes, como Email y Attendee Email.
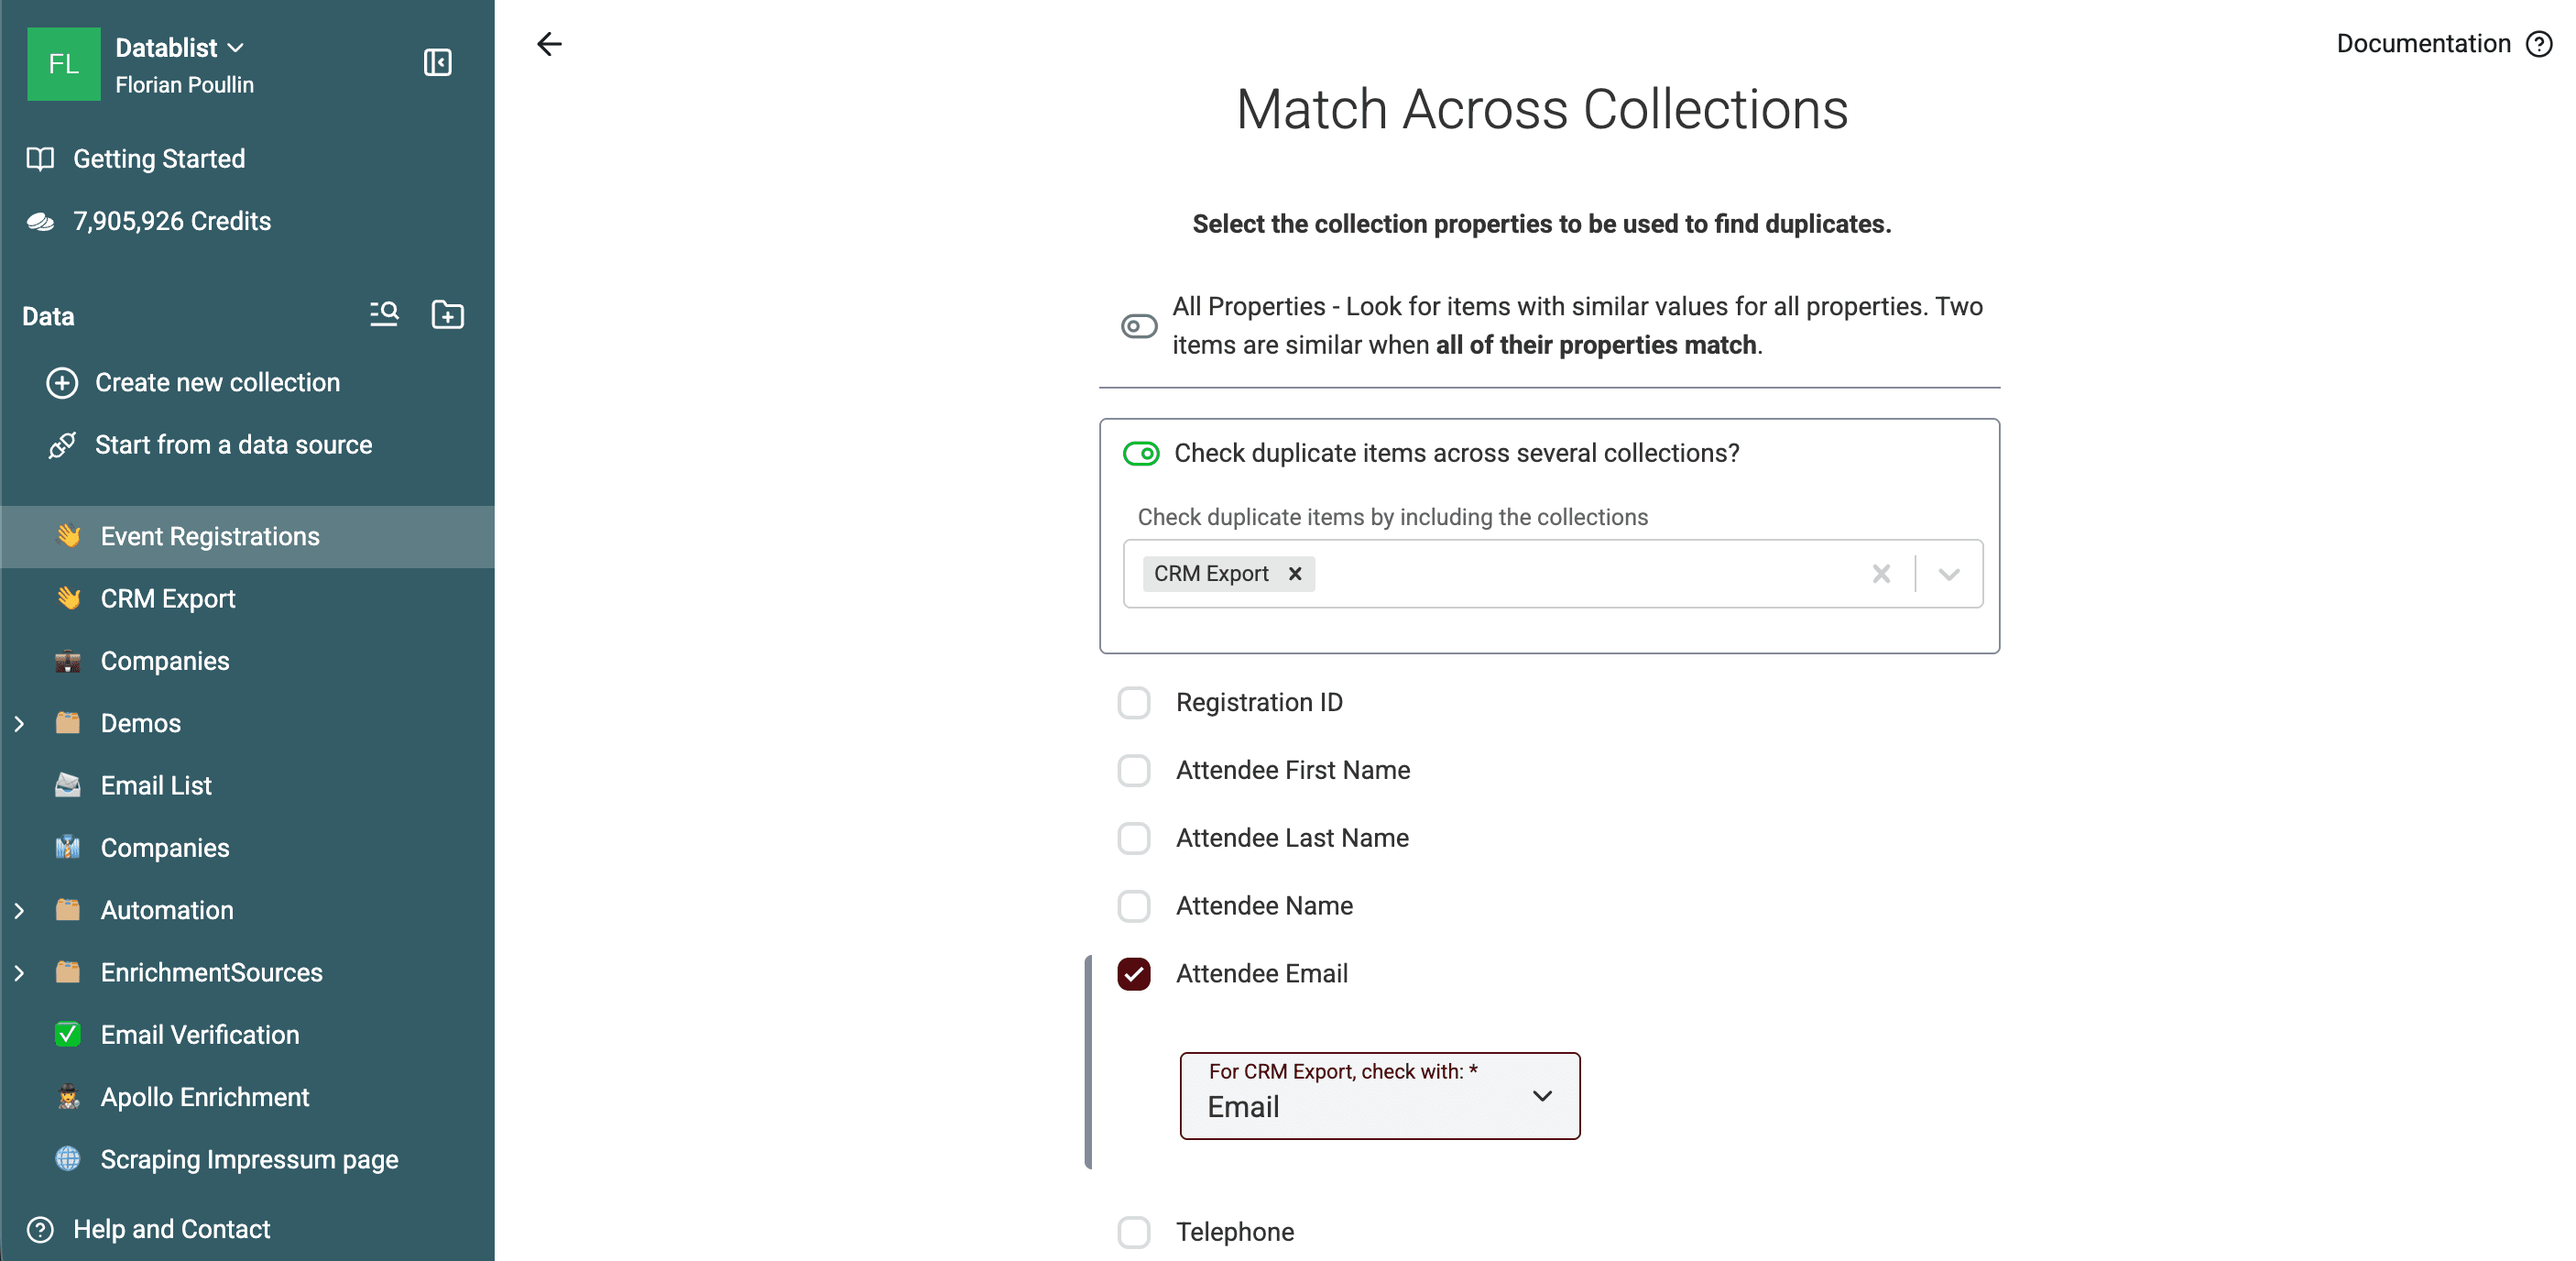
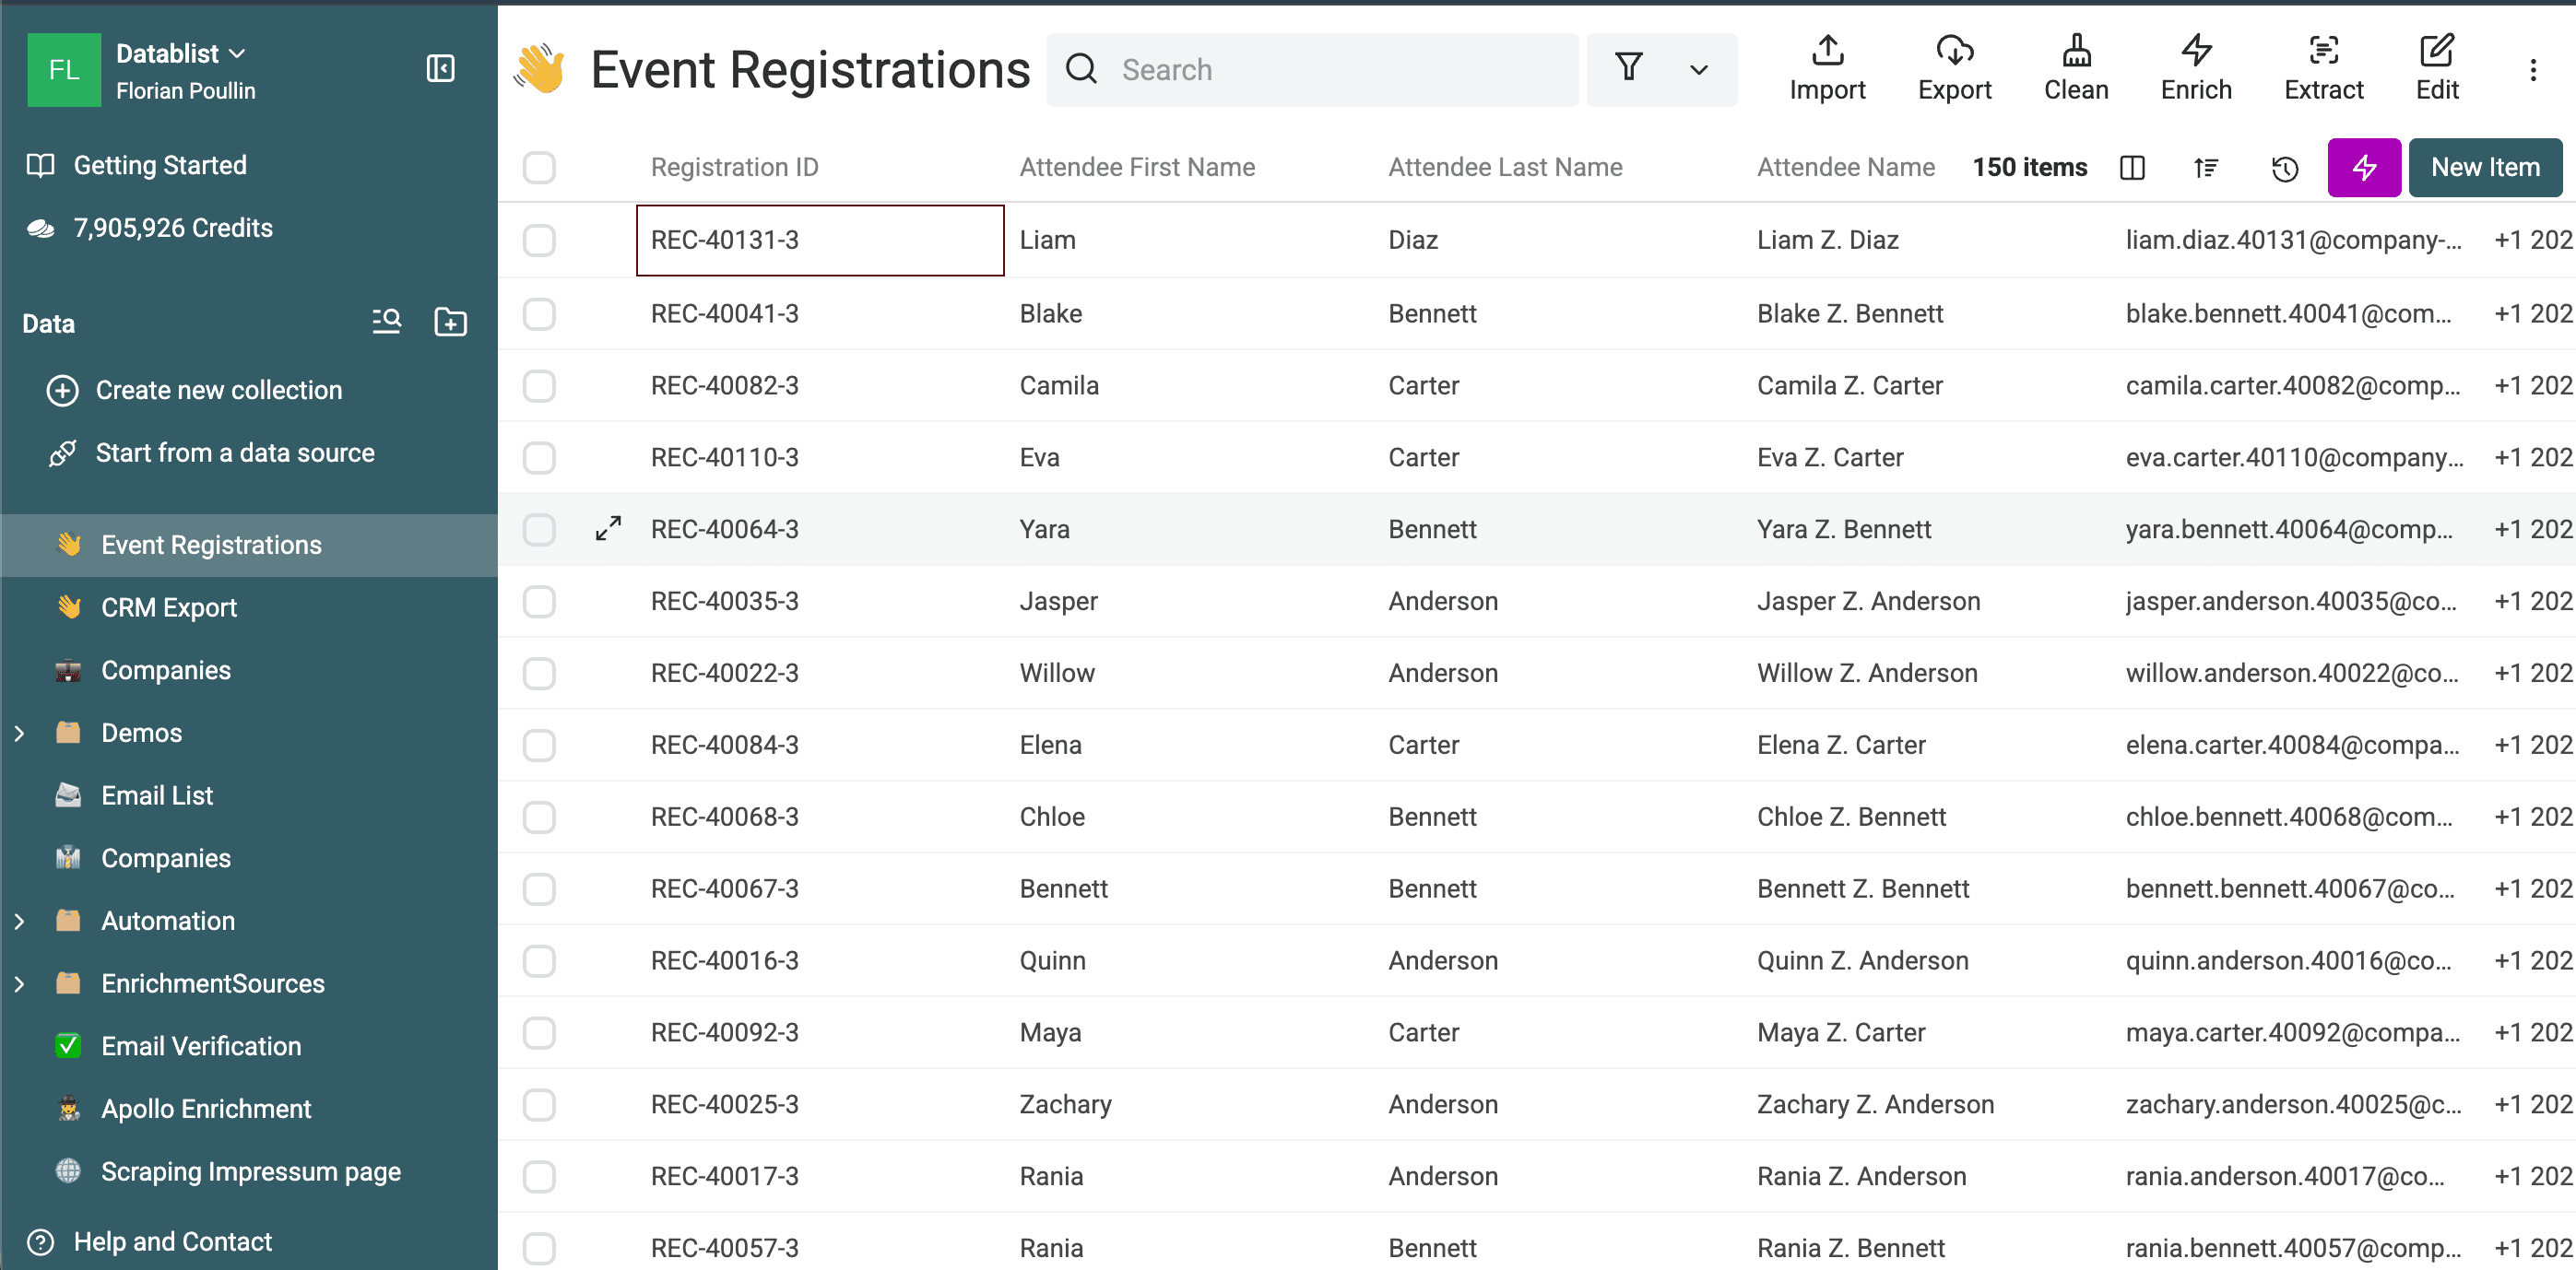
En esta prueba, la comparación Smart con el procesador Email devolvió 100 grupos entre colecciones a partir de 500 registros comprobados. Seleccione Event Registrations en Remove duplicate items from collection {X} para mantener el CRM sin cambios y excluir sus coincidencias de la lista del evento.
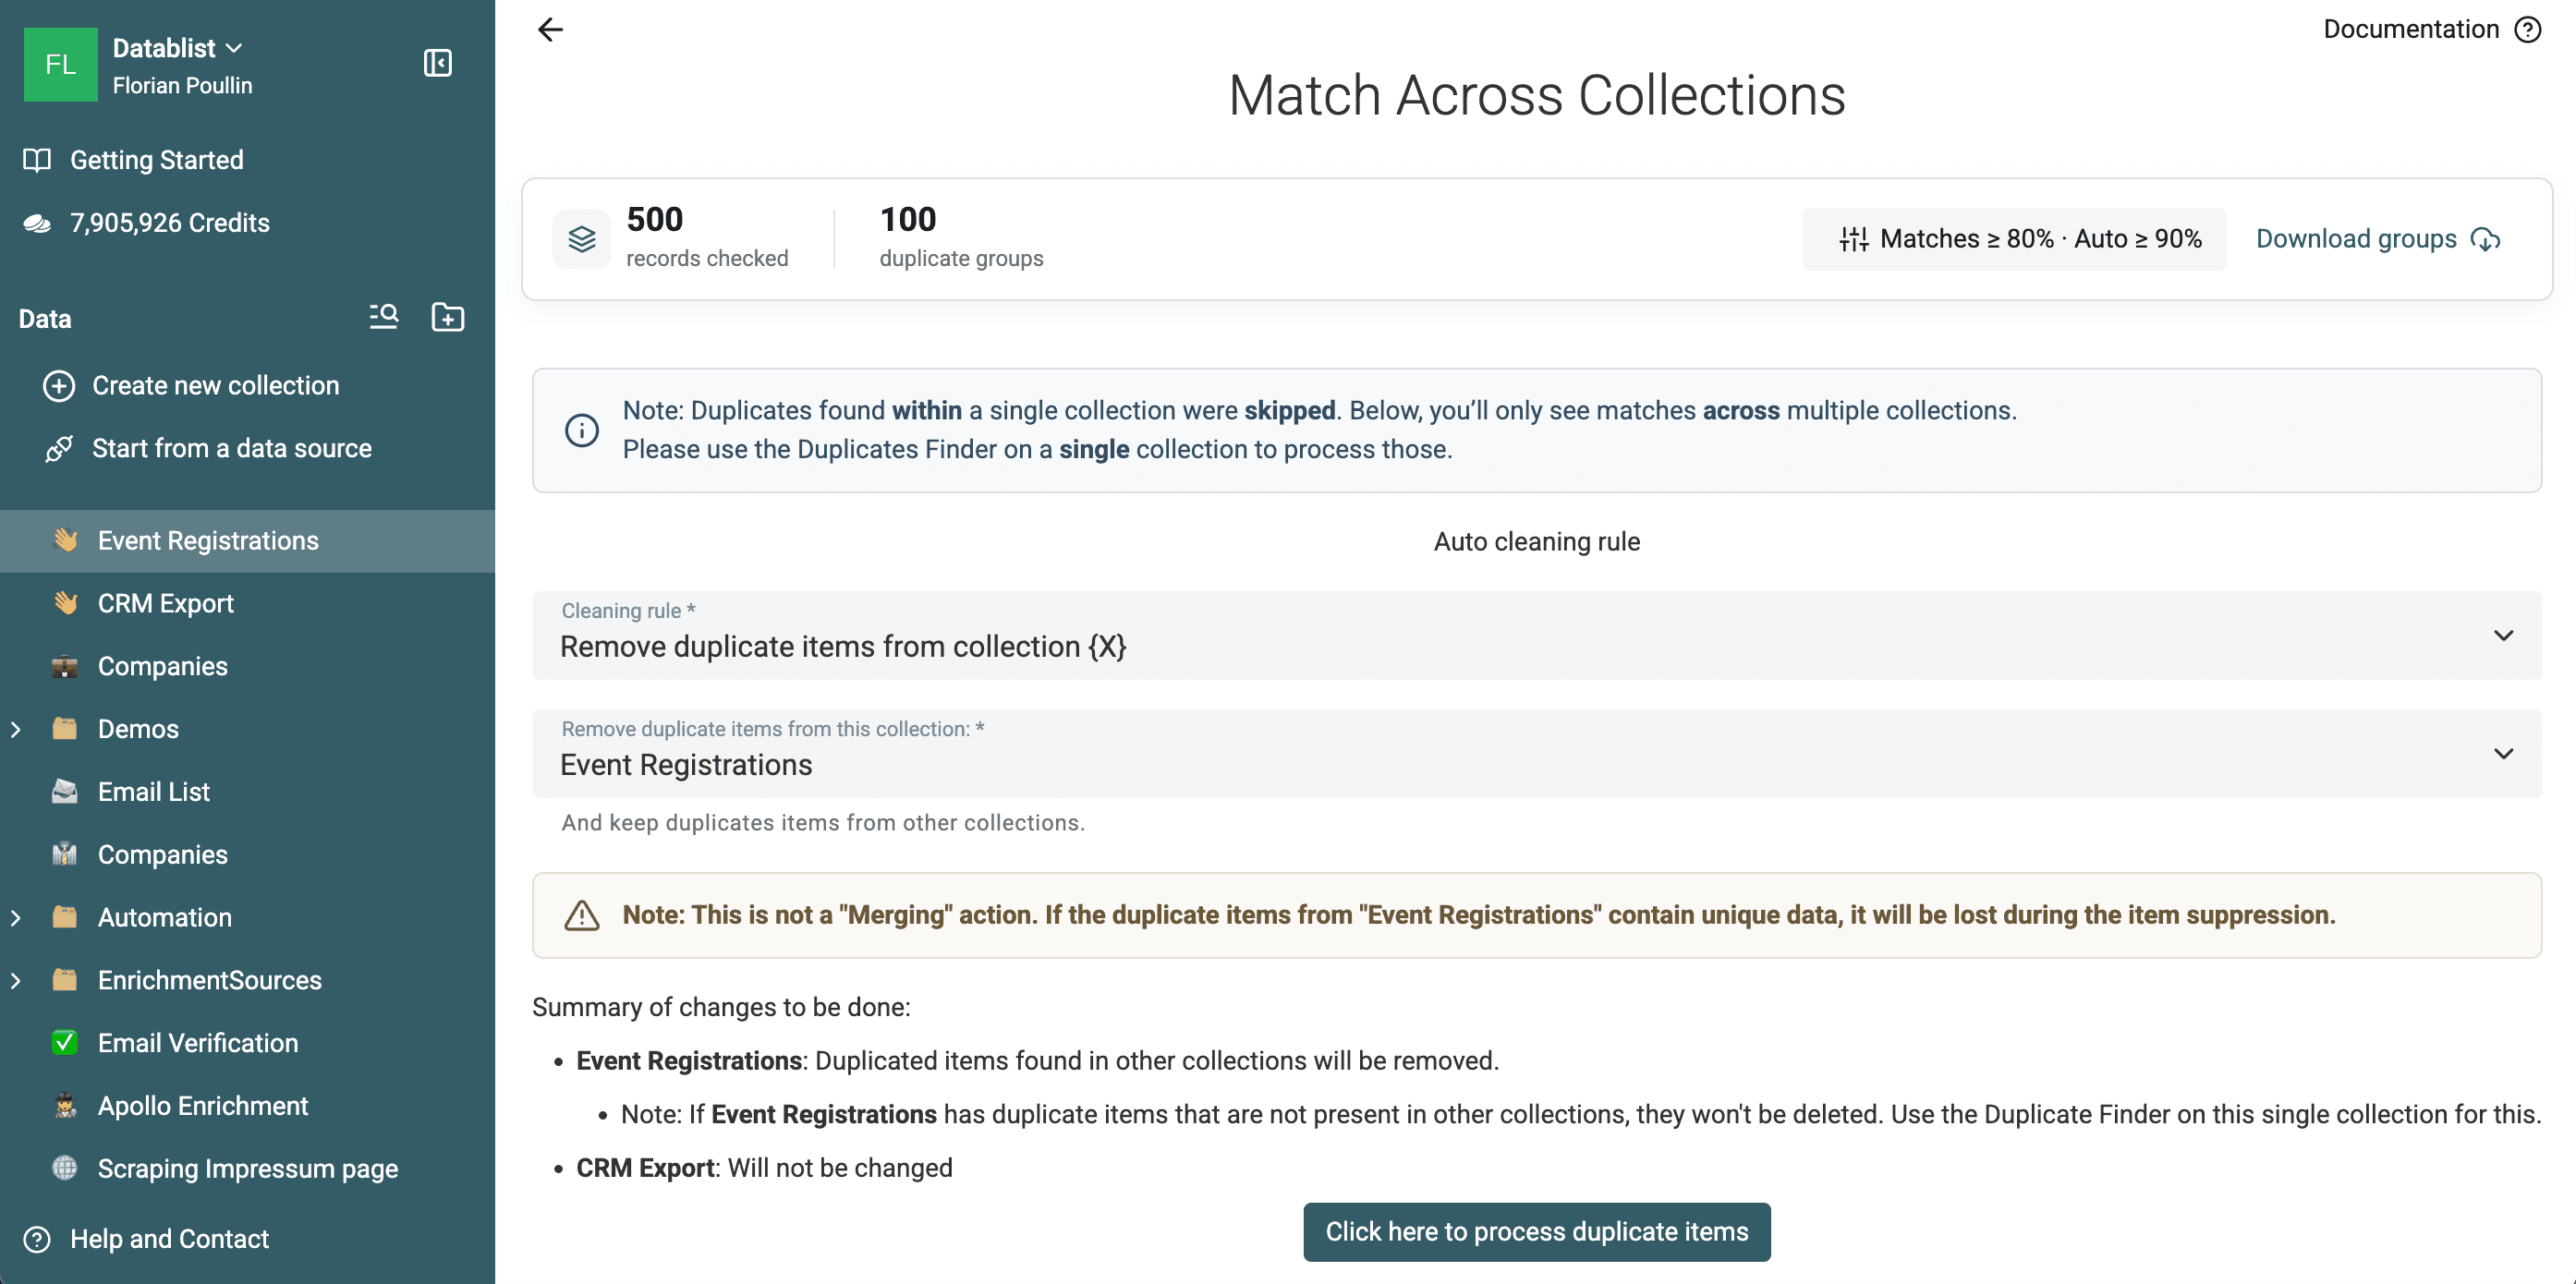
La limpieza automática entre colecciones elimina filas. No combina en el CRM los valores únicos de los registros del evento. Exporte o revise primero los grupos cuando los registros entrantes contengan información que necesite conservar.
Después de procesar las 100 coincidencias, Event Registrations contiene 150 contactos netos nuevos.
La comparación entre colecciones es una función Premium. Consulte la guía detallada para deduplicar varios archivos CSV o Excel, donde se explican la asignación de colecciones y las opciones de procesamiento.
FAQ
¿Puedo deduplicar una lista online gratis?
Sí. Los visitantes sin cuenta pueden ejecutar una comprobación Exact. Una cuenta gratuita desbloquea la comparación Smart y las demás funciones del plan Free para una sola colección. Los algoritmos fuzzy y fonéticos, los procesadores avanzados, la comparación entre colecciones, las reglas de supervivencia configurables y Custom with AI requieren un plan de pago.
¿Debo eliminar o combinar las filas duplicadas?
Elimine las filas cuando un registro sea la referencia y los demás no contengan nada que necesite. Utilice Merge cuando las filas secundarias contengan valores útiles. La vista previa de Remove le avisa si se van a descartar datos.
¿Detecta Datablist duplicados con errores ortográficos?
Sí. Jaro-Winkler y Levenshtein comparan la similitud de los textos, mientras que Metaphone compara cómo suenan. Estos algoritmos avanzados requieren un plan de pago y sus coincidencias deben revisarse.
¿Puedo combinar filas duplicadas sin perder datos?
Datablist puede completar campos vacíos, combinar valores de texto, conservar el valor del registro seleccionado o aplicar reglas de supervivencia por campo. Revise la vista previa, ya que cualquier valor que decida descartar no aparecerá en el registro combinado.
¿Qué tamaño puede tener la lista?
El plan Free admite hasta un millón de elementos por colección en el almacenamiento del navegador. Los planes de pago permiten importar hasta dos millones de elementos por colección. Las operaciones locales de gran tamaño siguen dependiendo del navegador y del dispositivo.
¿Puedo revisar duplicados sin modificar la lista?
Sí. La detección es de solo lectura. Puede inspeccionar los grupos, ajustar los umbrales, utilizar Why matched, buscar y ordenar los resultados, y descargar las filas duplicadas antes de iniciar una acción de procesamiento.
Para consultar todos los ajustes y limitaciones, lea la documentación completa de Duplicate Finder.