
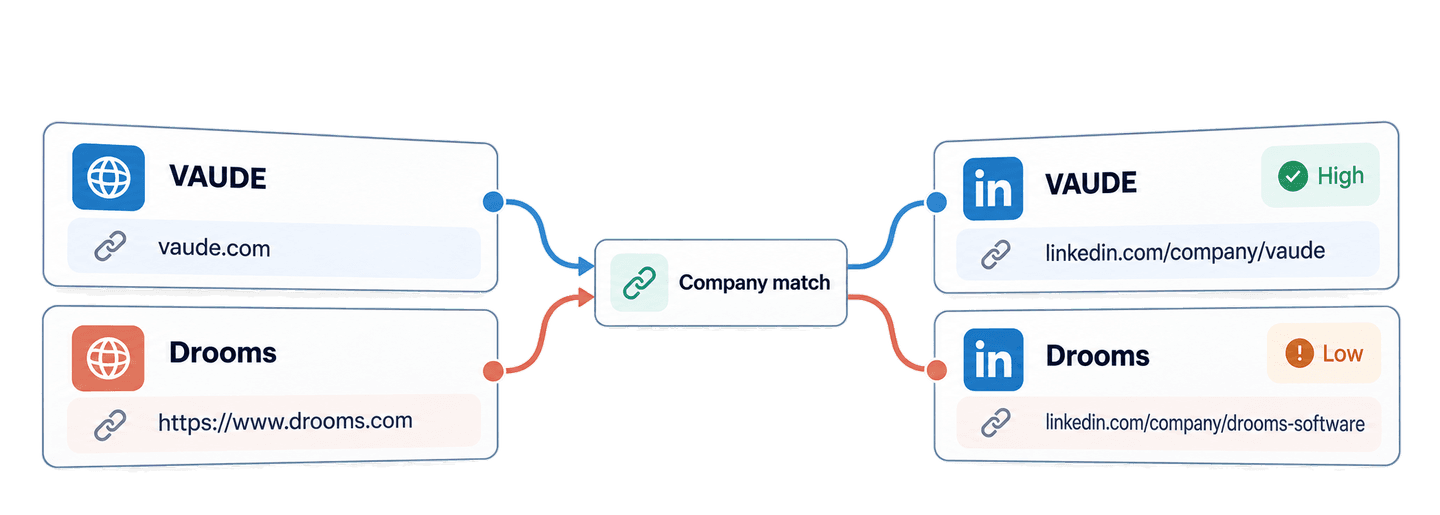
Use la Company to LinkedIn API de Datablist para encontrar en Python la página de empresa de LinkedIn asociada a un sitio web. Puede enviar un dominio sin protocolo o una URL completa, esperar a que termine la tarea de búsqueda y recibir el nombre de la empresa, su sitio web, la URL de LinkedIn y un indicador de confianza.
En esta guía, uso Python y la librería Requests para buscar coincidencias de cinco sitios web de empresas. La lista incluye compañías de software conocidas, además de VAUDE, una empresa de equipamiento para actividades al aire libre, y Drooms, especializada en salas de datos virtuales. Después, organizo los resultados en dos listas locales: coincidencias listas para investigar y coincidencias que requieren una revisión manual.
🔑 Resumen para quienes tienen prisa
Envíe los sitios web de su lista de cuentas a la Company to LinkedIn API de Datablist. La API devuelve las URLs de las páginas de empresa en LinkedIn y señales de confianza para ayudarle a decidir qué relaciones puede utilizar y cuáles debe revisar.
- Entrada: dominios sin protocolo y URLs completas de sitios web corporativos.
- Salida: nombres de empresas, sitios web asociados, URLs de páginas de empresa en LinkedIn y confianza
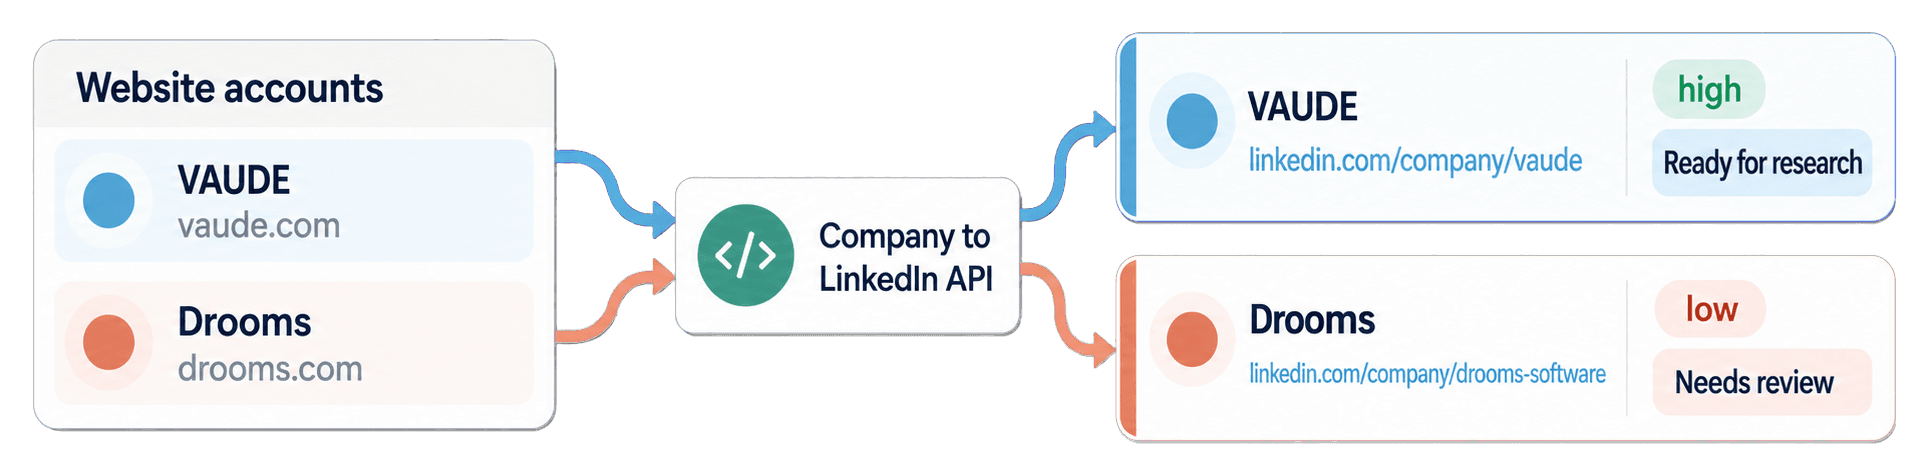
higholow, agrupados en las listasReady for researchyNeeds review.
💡 ¿Prefiere una solución no-code? Use LinkedIn Company Pages & Domain Lookup de Datablist para asociar sitios web con páginas de LinkedIn sin escribir código.
Configure Python y su clave API de Datablist
Para este ejemplo, uso el paquete requests. La API funciona mediante HTTP, por lo que más adelante podrá adaptar la misma secuencia de solicitudes a otro lenguaje.
Necesita una cuenta de Datablist con acceso a la REST API, disponible en el plan Growth. Las búsquedas que devuelven resultados también consumen créditos de enriquecimiento. Más adelante explico el cálculo exacto de créditos.
Cree un directorio de trabajo y un archivo llamado find_linkedin_company_pages.py. Después, cree un entorno virtual e instale Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyCree una Personal API Key desde su cuenta de Datablist y expórtela como variable de entorno:
export DATABLIST_API_KEY="your-api-key"El script lee este valor y lo envía en el encabezado X-API-Key.
Encuentre páginas de LinkedIn con una función de Python
El ejemplo utiliza estas cinco cuentas de origen:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
Cada account_id se convierte en el inputId de la API. Esto es importante porque los resultados no tienen por qué llegar en el mismo orden que las entradas. Un ID estable permite asociar cada resultado con la cuenta de origen correcta.
Pegue el siguiente script completo en find_linkedin_company_pages.py:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))Ejecútelo con:
python find_linkedin_company_pages.pyLa función realiza tres tipos de llamadas, en este orden.
Primero, la solicitud POST envía los cinco sitios web con matchingDirection establecido en domain_to_linkedin. La API responde con 202 Accepted y un ID de tarea porque la búsqueda se ejecuta en segundo plano. Aun así, el script con Requests se comporta de forma secuencial porque espera antes de pasar al siguiente paso.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]Después, la solicitud de estado consulta la tarea hasta que pasa a completed, failed o stopped. La pausa de tres segundos evita que el script envíe solicitudes de estado de forma continua.
Por último, la solicitud de resultados lee páginas de hasta 100 registros. Si nextCursor contiene un valor, el bucle lo envía como cursor en la siguiente solicitud. Solo se detiene cuando nextCursor es null.
Interprete las coincidencias y decida cuáles revisar
Esta es la lista completa de resultados para las cinco entradas:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
Interprete status y confidence por separado. La API devuelve un objeto de resultado para cada entrada, incluso si la búsqueda no tiene éxito. Un estado success significa que se ha encontrado una página de empresa candidata. El valor outputs.confidence indica si se ha validado la coincidencia con el sitio web. inputId vincula el objeto con su cuenta de origen, mientras que creditsUsed registra el coste de esa fila y error contiene un error estructurado cuando se produce alguno.
Conserve el objeto outputs completo en su aplicación, aunque la primera pantalla solo necesite la URL de LinkedIn y el nivel de confianza. companyName y companyWebsite agilizan la revisión manual, sobre todo cuando el nombre devuelto utiliza mayúsculas distintas o la entrada era una URL completa. También aportan contexto útil sin necesidad de realizar otra llamada a la API.
El proceso comienza normalizando el sitio web enviado y consultando datasets de empresas para encontrar una relación conocida entre el sitio web y LinkedIn. Después, compara el dominio de entrada con el sitio web publicado en la página de empresa candidata de LinkedIn. Si el dominio registrado coincide, devuelve una confianza high.
Cuando los datasets no proporcionan una URL de LinkedIn, la búsqueda puede realizar una consulta específica en Google para localizar páginas de empresa candidatas. Si una candidata no puede validarse con un sitio web publicado, puede devolverse con confianza low. Una discrepancia conocida entre sitios web no se acepta.
Utilice la confianza como una instrucción de revisión. VAUDE devolvió https://www.linkedin.com/company/vaude con confianza high, por lo que puede pasar a la lista de investigación. Drooms devolvió https://www.linkedin.com/company/drooms-software con confianza low. Abra el sitio web de Drooms y su página de LinkedIn antes de confiar en esa relación.
Datablist, PostHog y n8n también devolvieron coincidencias con confianza alta. Esta API identifica la relación entre el sitio web y la página de empresa. Si, después de revisar la URL, necesita el tamaño de la empresa, el sector u otros datos de la página, consulte como siguiente paso la guía de la API para extraer datos de empresas de LinkedIn.
Prepare una lista de cuentas para investigar
Ahora reutilice match_results para preparar una lista local destinada a la investigación manual de empresas. Este bloque no vuelve a llamar a la API. Indexa los resultados por inputId y, a continuación, recorre la lista original de cuentas para que todas sigan visibles, incluso si en el futuro falta algún resultado.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))El diccionario de resultados permite realizar la asociación sin depender del orden de respuesta. account-vaude vincula el registro original de vaude.com con la página de VAUDE encontrada y lo añade a ready_for_research. account-drooms conserva tanto su URL de entrada completa como el resultado íntegro de la API, pero pasa a needs_review porque la confianza es baja, aunque el estado del resultado sea success.
La misma lógica mantiene en la lista de revisión cualquier fila ausente, con no_result o con un error. Las dos listas impresas ofrecen al equipo un punto de partida claro para investigar las empresas manualmente.
También puede descargar el ejemplo síncrono mantenido con Requests. El repositorio incluye un ejemplo asíncrono con HTTPX para aplicaciones que necesitan HTTP no bloqueante, aunque la versión bloqueante anterior resulta más fácil de seguir en una primera integración.
Busque el sitio web desde una página de LinkedIn
La misma función admite páginas de empresa de LinkedIn cuando se cambia la dirección de búsqueda. Esto puede resultar útil si su lista de origen contiene URLs de páginas de empresa y necesita los sitios web antes de aplicar un enriquecimiento compatible de empresas o emails profesionales.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)Una búsqueda estándar desde una página de empresa de LinkedIn utiliza la tarifa de búsqueda habitual. Los ID numéricos de empresas y las URLs de empresa de Sales Navigator pueden consumir 10 créditos porque siguen una ruta de búsqueda inversa distinta. Si prefiere hacerlo sin código, consulte cómo obtener URLs de sitios web desde páginas de empresa de LinkedIn.
Calcule los créditos para búsquedas web-LinkedIn
Cada búsqueda estándar y correcta de un sitio web en LinkedIn consume 1,5 créditos. Por tanto, las cinco coincidencias mostradas utilizaron 7,5 créditos. Con la misma tarifa, 1.000 coincidencias correctas consumen 1.500 créditos. Las entradas no válidas y las filas sin resultados pueden consumir cero créditos, así que consulte el valor creditsUsed de cada resultado para conocer el consumo real.
El acceso a la REST API forma parte del plan Growth, y la suscripción mensual se factura por separado de los créditos adicionales. Una recarga de 20 $ proporciona 20.000 créditos, por lo que cada crédito cuesta 0,001 $. A razón de 1,5 créditos por coincidencia correcta, 1.000 coincidencias consumen 1.500 créditos, equivalentes a 1,50 $. Consulte los precios de Datablist para conocer los planes y paquetes actuales.
Solucione errores de entrada, tareas y resultados
- Falta
DATABLIST_API_KEY: el script se detiene antes de enviar una solicitud. Exporte la variable de entorno y vuelva a ejecutar el comando. - La API rechaza la clave: compruebe que ha copiado una Personal API Key y que la solicitud solo la envía en
X-API-Key. - La entrada no es compatible: utilice el sitio web o el dominio de una empresa para
domain_to_linkedin. En la dirección inversa, use una URL compatible de una página de empresa, no un perfil personal ni un valor vacío. - No hay suficientes créditos: compruebe su saldo y, antes de crear otra tarea, utilice los créditos incluidos o añada una recarga.
- La tarea aparece como
failedostopped: revise el estado de la tarea, el error, los resultados existentes y el consumo de créditos antes de decidir si debe volver a enviarla. - Un resultado tiene confianza baja,
no_resulto un error: conserve el sitio web de origen y el resultado completo enneeds_review. Abra la página candidata cuando exista y no haga suposiciones sobre la causa de un resultado ausente.
Si se pierde la conexión durante la creación de la tarea, utilice el uniqueId mostrado antes del POST. Consulte sus tareas y busque ese valor antes de crear otra:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"La lista de tareas no se puede filtrar por uniqueId, así que revise cada tarea devuelta y siga nextCursor si es necesario. Cuando encuentre el valor correspondiente, use su @id con las mismas URLs de estado y resultados que emplea el script.
Una tarea puede contener hasta 10.000 entradas. Para consultar todos los límites de solicitudes, conservación de tareas y paginación, revise la documentación de Company to LinkedIn API.
Próximos pasos
Ahora dispone de una función reutilizable de Python con Requests que convierte sitios web de empresas en páginas de LinkedIn candidatas. La lista local deja las coincidencias de alta confianza listas para investigar y mantiene visibles los registros dudosos o sin éxito para su revisión.
Sustituya los cinco ejemplos por una pequeña lista de cuentas, revise todas las candidatas con confianza baja y use las URLs aceptadas para investigar empresas manualmente o como entradas de la LinkedIn company scraper API. Si su lista de origen contiene nombres de empresas en lugar de sitios web, comience con la guía de la API para encontrar sitios web de empresas.