
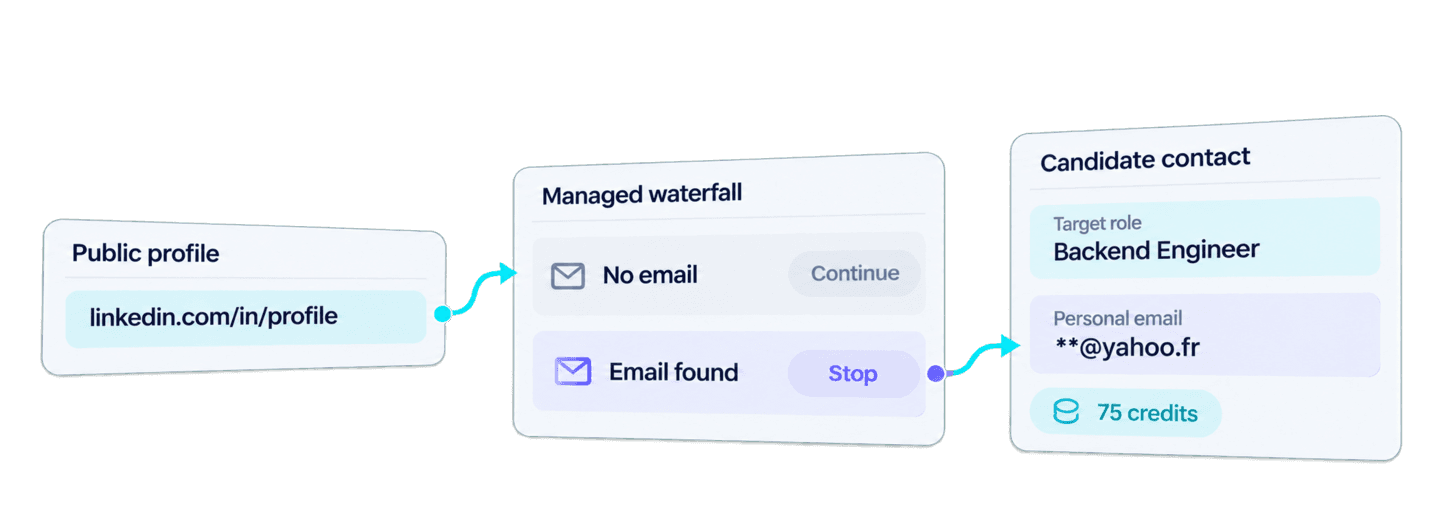
Puede encontrar emails personales a partir de LinkedIn con Python enviando URLs públicas de perfiles linkedin.com/in/... a la API Waterfall Personal Email Finder de Datablist. La API ejecuta una secuencia gestionada de proveedores de email compatibles y devuelve una dirección personal cuando alguno encuentra un resultado.
El ejemplo completo con Requests que verá a continuación envía una tarea en segundo plano, espera a que termine y recupera todas las páginas de resultados. Una vez realizada la búsqueda, reutilizará los objetos devueltos para preparar fichas de contacto de candidatos que conserven el nombre, la URL de LinkedIn y el puesto objetivo junto al email encontrado.
Este flujo busca una dirección de email personal independiente de la empresa en la que trabaja actualmente el candidato. Si necesita una dirección vinculada a su empresa, consulte la guía específica para encontrar un email profesional desde un perfil de LinkedIn.
🔑 Resumen para quienes tienen prisa
Proporcione los nombres de los candidatos, las URLs públicas de sus perfiles de LinkedIn y los puestos objetivo. El flujo de Python encuentra los emails personales disponibles y conserva cada dirección junto con los datos de selección de los que partió.
- Entrada: nombres de candidatos, URLs públicas
linkedin.com/in/...y puestos objetivo.- Salida: emails personales encontrados junto con los datos del candidato correspondiente.
💡 ¿Prefiere una solución no-code? Utilice Waterfall Personal Email Finder de Datablist para encontrar emails personales sin escribir código.
Si sus datos contienen nombres, pero no URLs de perfiles, primero debe encontrar perfiles públicos de LinkedIn con Python y después enviar esas URLs a esta API.
Configure Python, Requests y su clave API de Datablist
Para este ejemplo, utilizo Python con el paquete requests. Cree un archivo llamado find_personal_emails.py e instale Requests:
python -m pip install requestsCree una Personal API Key en su cuenta de Datablist y expórtela como variable de entorno:
export DATABLIST_API_KEY='your-api-key'El acceso a la REST API está disponible en el plan Growth. Cada resultado satisfactorio de búsqueda de un email personal también consume créditos, cuyo cálculo encontrará más adelante en la sección de costes.
Encuentre un email personal con una función de Python
La lista editable candidates de este script contiene una ficha de selección. target_role es un valor de origen de ejemplo que permanece en el flujo de selección local. Solo candidate_id y linkedin_url se incluyen en el payload de la API.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Envía una tarea, espera a que termine y devuelve todos los resultados."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))Ejecute el archivo desde el mismo terminal:
python find_personal_emails.pyTambién puede descargar el ejemplo síncrono con Requests, que se mantiene actualizado. El script anterior conserva la misma secuencia de envío, consulta y paginación, pero utiliza los IDs de candidato de los registros de origen.
Envíe la búsqueda
La función convierte cada candidato en un input de la API. inputId recibe el ID estable del candidato, mientras que data.profileUrl recibe la URL pública de su perfil personal de LinkedIn. Es necesario usar una URL estándar linkedin.com/in/.... Las URLs de Sales Navigator, las páginas de empresa, los valores vacíos y los nombres sin URL de perfil no son inputs válidos para este enrichment.
La solicitud utiliza waterfall-personal-email-finder como enrichmentId y un objeto settings vacío, tal como se muestra en la documentación de la API Waterfall Personal Email Finder. El script muestra el uniqueId generado antes de enviar la solicitud. Guarde este valor, ya que le permitirá identificar una tarea existente si se pierde la conexión después de que la API acepte la solicitud.
Este es el cuerpo completo de la solicitud para el ejemplo con un perfil:
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
Un envío correcto devuelve HTTP 202 Accepted con el ID de la tarea en @id. Tras esa respuesta, el procesamiento continúa en los servidores de Datablist.
Espere a que termine la tarea en segundo plano
El script de Requests bloquea la ejecución local mientras el servidor procesa la tarea en segundo plano. Comprueba su estado cada tres segundos y continúa mientras figure como queued o running. Cuando la tarea está completed, pasa a recuperar los resultados. Si está failed o stopped, genera un error con el ID de la tarea y el mensaje de error disponible.
Recupere todas las páginas de resultados
El endpoint de resultados devuelve el ID de origen, el estado, los outputs, los créditos y el error de cada fila. La primera solicitud pide hasta 100 resultados. Después recupera las páginas siguientes hasta que nextCursor sea null.
Los resultados de la tarea mantienen el orden de los inputs. inputId sigue ofreciendo una relación explícita entre cada resultado y su ficha de candidato, incluso cuando hay varias páginas de resultados.
Cuando adapte el ejemplo para procesar más registros, mantenga estable el candidate_id de cada uno en el sistema de origen. Este valor permite realizar una unión predecible cuando la tarea genera varias páginas de resultados.
Cómo encuentra resultados el waterfall de emails personales
Datablist limpia la URL pública del perfil de LinkedIn y envía el perfil aún no resuelto, de forma secuencial, a los proveedores de email personal compatibles en ese momento. Si un proveedor no devuelve una dirección válida, el perfil puede pasar al siguiente. Cuando uno encuentra un email válido, la secuencia se detiene para ese perfil y lo devuelve como outputs.emailFound.
Datablist gestiona los proveedores compatibles, por lo que su integración no necesita solicitudes específicas para cada uno ni código de fallback. El resultado público indica el email obtenido, pero no un orden fijo de proveedores ni el historial de intentos.
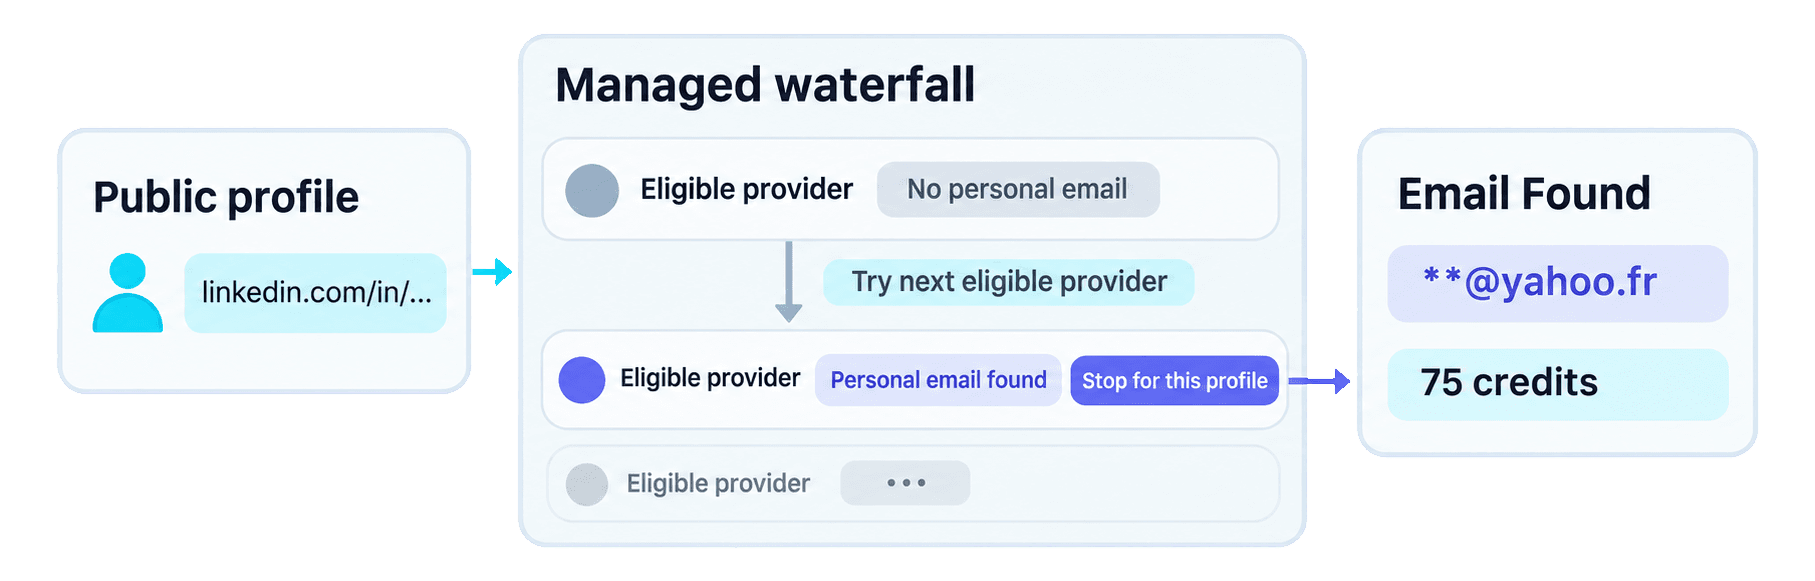
El waterfall es el método de búsqueda. El polling cumple otra función: permite que el cliente de Python espere a que termine el trabajo en segundo plano.
Ventajas del waterfall para equipos de selección internacionales
Los proveedores de emails personales utilizan conjuntos de datos diferentes, por lo que su eficacia varía según el país y el mercado. Si el primer proveedor no encuentra el email de un candidato, otro del waterfall podría localizarlo.
Los equipos de selección que trabajan en varios países obtienen una cobertura más amplia de proveedores mediante una única integración API. Datablist gestiona la secuencia para que el equipo pueda recuperar contactos que una búsqueda con un solo proveedor podría pasar por alto, sin tener que conectar y mantener varias APIs.
Consulte el resultado completo
📘 Email oculto: En el ejemplo siguiente, la parte local de la dirección se sustituye por
**. El resultado de su API contendrá el valor completo.
Esta es la página de resultados completa para el candidato introducido:
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
inputId es la clave de unión con el candidato de origen. outputs.emailFound contiene la dirección personal. creditsUsed indica el cargo oficial de esta fila y error: null significa que la API no ha devuelto ningún error en ella. El cursor nulo confirma que esta respuesta no tiene otra página de resultados.
Considere la dirección como una opción de contacto asociada al perfil enviado y revísela antes de utilizarla en un proceso de selección.
Prepare contactos de candidatos para su revisión
Una vez obtenidos los resultados, puede preparar una lista local para que el recruiter la revise sin realizar otra solicitud a la API. El siguiente bloque reutiliza las variables candidates y personal_email_results existentes:
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))Para candidate-florian-poullin, la consulta del diccionario encuentra el resultado con el mismo inputId. El registro copiado conserva el nombre de Florian Poullin, su URL de LinkedIn y el puesto objetivo de ejemplo Backend Engineer. Después adjunta el objeto completo de la API en result, donde el recruiter puede consultar result.outputs.emailFound.
El bucle parte de la lista de candidatos de origen. Si en el futuro no hay resultado, se produce un error en una fila, falta un resultado o emailFound está vacío, la lista de origen no se modifica y el registro no se añade a prepared_contacts.
Si necesita un proceso de revisión más amplio y otros canales de contacto, consulte la guía para encontrar el email personal de un candidato como recruiter.
Calcule el coste de la API Waterfall Personal Email Finder
Cada email personal encontrado consume 75 créditos. Una búsqueda sin resultados consume 0 créditos. Para conocer el gasto real, consulte creditsUsed en cada resultado en lugar de multiplicar el número total de perfiles enviados.
La fórmula para planificar el consumo es:
emails personales encontrados × 75 créditos
Por ejemplo, si envía 100 perfiles y 20 generan un email personal, la tarea consume 20 × 75 = 1.500 créditos. Este cálculo sirve para planificar y no representa una tasa de resultados esperada. Para presupuestos mayores, 100 emails encontrados consumen 7.500 créditos y 1.000 emails encontrados, 75.000 créditos.
Con la tarifa base actual de recarga en USD, $20 / 20,000 credits = $0.001 per credit. Por tanto, cada email encontrado consume créditos por valor de $0.075, y 100 emails encontrados, por valor de $7.50. Esta estimación representa el valor de los créditos consumidos. La suscripción Growth necesaria para acceder a la REST API se paga por separado. Consulte los precios de Datablist para conocer los planes y paquetes de créditos actuales.
Solucione errores y recupere una tarea existente
La mayoría de los problemas se producen antes del envío, en la solicitud HTTP o en un resultado individual. Utilice la ubicación del error para elegir el siguiente paso:
- Falta
DATABLIST_API_KEY: el script se detiene localmente antes de realizar una solicitud. Exporte la variable de entorno y vuelva a ejecutar el archivo. - Error de autenticación HTTP: compruebe la Personal API Key guardada en
DATABLIST_API_KEY. La función la envía en el headerX-API-Key. Corrija la credencial antes de volver a enviar la solicitud. - URL de perfil no compatible: sustituya cualquier URL de Sales Navigator, página de empresa, valor vacío o URL con formato incorrecto por un perfil personal público con el formato
linkedin.com/in/.... - Créditos insuficientes: compruebe el saldo de la cuenta y los créditos disponibles antes de enviar más tareas.
- La tarea está
failedostopped: revise el error de la tarea, los resultados disponibles y el consumo de créditos antes de decidir qué debe volver a ejecutar. - Una fila no tiene resultado o presenta un error: conserve el candidato de origen para revisarlo o utilizar otro canal de contacto. Una búsqueda sin éxito no explica por qué la dirección no estaba disponible.
Si se pierde la respuesta del POST, consulte sus tareas antes de crear otra. Busque en la respuesta el uniqueId mostrado por el script y copie el @id de la tarea correspondiente:
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"Si la tarea correspondiente no aparece en la primera respuesta del historial, siga el cursor de paginación devuelto y consulte la página siguiente. Continúe comprobando la tarea recuperada o recupere los resultados disponibles en lugar de crear automáticamente otra tarea de pago. La documentación sobre tareas explica el ciclo de vida, la paginación y la conservación de los resultados.
Próximos pasos
Ahora dispone de una función reutilizable de Python Requests para URLs públicas de perfiles de LinkedIn y de una unión mediante IDs estables que combina los emails personales encontrados con el contexto de origen de cada candidato.
Sustituya la lista de ejemplo por un pequeño conjunto de sus candidatos, mantenga un ID estable y un puesto objetivo para cada uno y revise todos los contactos preparados antes de utilizarlos en su proceso de selección. Cuando su aplicación necesite concurrencia no bloqueante, utilice el ejemplo asíncrono con HTTPX, que se mantiene actualizado, como siguiente paso de la implementación.