
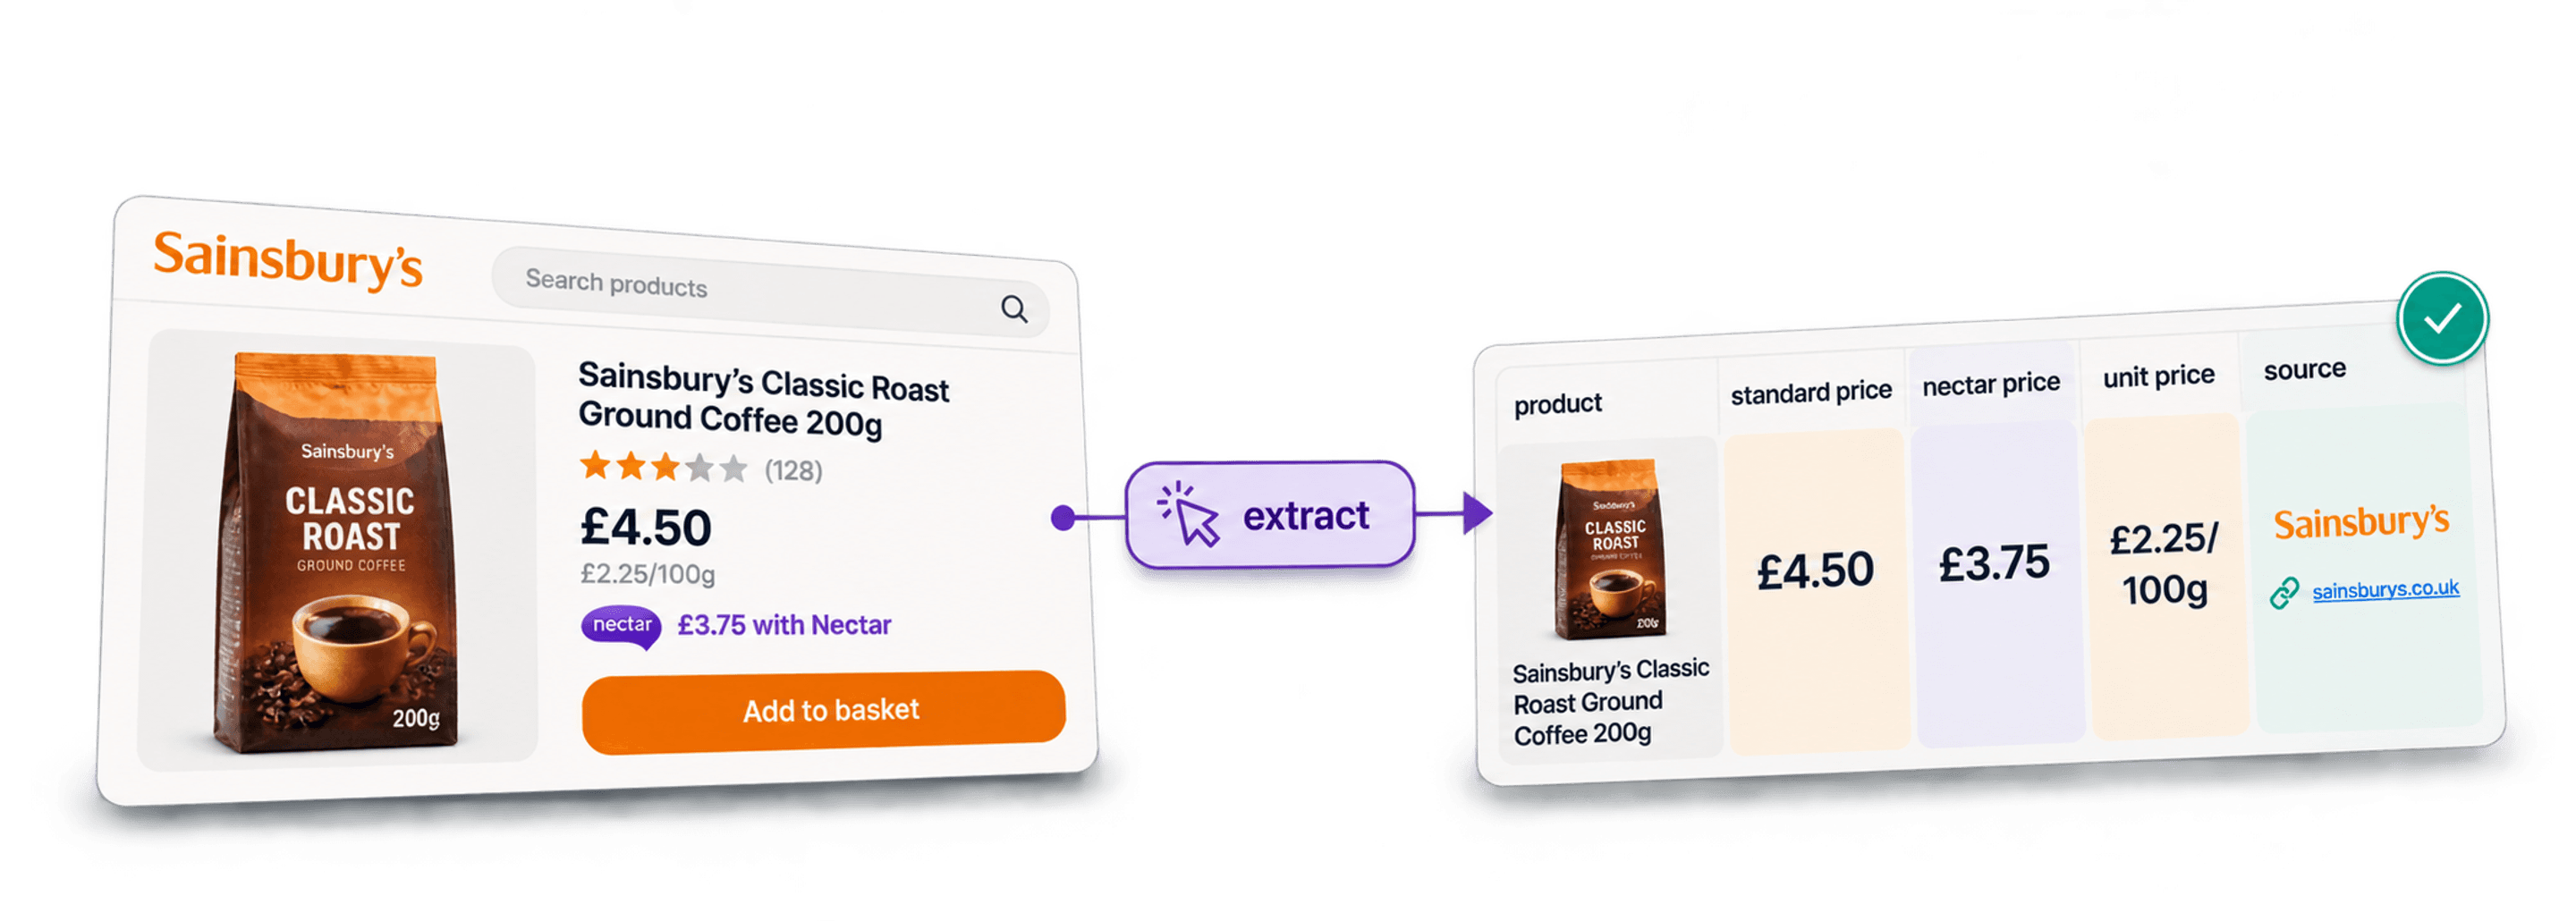
Pour scraper les données produit de Sainsbury's sans coder, transmettez une URL de catégorie à l’AI Scraping Agent de Datablist, décrivez les champs à extraire et testez une page avant d’étendre l’exécution. Vous obtiendrez un tableau contenant les URL des produits et des prix clairement identifiés, que vous pourrez exporter ou comparer à un relevé ultérieur.
Je vous recommande de conserver le prix standard, le prix Nectar et le prix unitaire dans des colonnes distinctes. Considérer chaque montant qui ressemble à une remise comme un prix promotionnel fausse les comparaisons : une offre de fidélité et un prix au kilogramme ne répondent pas au même besoin.
📌 Résumé du workflow
Entrée : une URL de catégorie et un prompt d’extraction des produits.
Sortie : nom du produit, URL, prix standard, prix Nectar, prix unitaire, texte de la promotion et URL de la page source.
Avant de passer à l’échelle : comparez la première page avec le site, vérifiez la pagination et notez les crédits consommés.
Pour le suivi : conservez un relevé daté à chaque exécution afin de préserver l’historique des prix des produits récurrents.
Ce que couvre ce guide
- Choisir un relevé de produits facile à contrôler
- Définir les champs et les différents prix
- Configurer l’agent étape par étape
- Vérifier les limites et répéter les extractions
Choisir un relevé de produits facile à contrôler
Commencez par une catégorie que vous pouvez vérifier manuellement, comme la liste des poissons et fruits de mer de Sainsbury's. Les fiches produit peuvent afficher un prix standard, une offre Nectar, un prix unitaire et les conditions d’une promotion. Vos instructions d’extraction doivent clairement distinguer ces différents champs.
Prévoir le budget d’un test
Le scraping par IA consomme des crédits pour le modèle et la navigation. Une exécution limitée vous permet de contrôler les résultats et le coût avant de traiter plusieurs catégories. Ne déduisez pas un coût fixe par produit à partir de l’exemple d’une autre enseigne.
Définir les données avant d’étendre l’extraction
Le template Retail Product Scraper fournit un prompt et des champs de sortie de départ. Adaptez-les à la structure tarifaire de Sainsbury's, puis examinez un échantillon d’une page. Le temps nécessaire dépend du contenu et du travail de recherche effectué ; une limite de pages ne garantit pas une extraction exhaustive.
Revérifier les résultats après chaque changement
Le scraping par IA peut interpréter le contenu sans sélecteur CSS fixe pour chaque champ. Il peut néanmoins manquer un produit, confondre deux libellés de prix ou rencontrer une restriction d’accès. Refaites le contrôle sur un échantillon dès que la mise en page ou le format des promotions change.
Scraper les produits Sainsbury's avec AI Scraping Agent
L’AI Scraping Agent reçoit une URL et des instructions, puis renvoie des enregistrements selon les champs de sortie configurés.
Qu’est-ce que l’AI Scraping Agent de Datablist ?
Utilisez le template Retail Product Scraper comme point de départ. Dans sa version actuelle, il configure le rendu HTML et la pagination, et utilise GPT-5 mini. Les templates peuvent évoluer : vérifiez donc les paramètres chargés. Le choix du modèle ne dispense pas de valider les résultats.
Commencer par une catégorie ou une marque
Je vous conseille de commencer par une catégorie précise plutôt que par la page d’accueil ou une recherche très large. Vous disposerez ainsi d’un ensemble de produits bien défini à comparer aux lignes obtenues. Une page volumineuse peut être tronquée ou difficile à contrôler ; divisez donc les catégories trop larges si nécessaire.
Conservez l’URL de la liste ainsi que toute information visible concernant la localisation ou la livraison avec votre relevé. Les résultats reflètent uniquement ce que l’agent a pu lire pendant cette session de navigation ; ils ne prouvent ni que l’ensemble du catalogue a été couvert ni que les produits sont disponibles à toutes les adresses.
Quelles données extraire de Sainsbury's ?
Configurez les sorties suivantes pour votre relevé de prix :
- Product Name et Product URL : identifient l’article listé et son format.
- Standard Price : prix du produit affiché en GBP, hors offre de fidélité indiquée séparément.
- Nectar Price : prix Nectar identifié comme tel, s’il est affiché.
- Unit Price : prix comparatif avec son unité, par exemple £/kg.
- Promotion Text : conditions ou dates de l’offre affichées avec le produit.
- Availability : uniquement une mention explicite de stock ou de disponibilité ; ne déduisez pas la disponibilité de la simple présence d’une fiche.
- Listing URL : page de catégorie ou de résultats sur laquelle l’enregistrement a été lu.
Utilisez des sorties Number pour les deux prix du produit, et Text pour Unit Price et Promotion Text. Laissez les prix numériques absents vides. Le champ Sale Price du template générique ne suffit pas à décrire toutes les offres : renommez-le et adaptez sa description à ce prompt.
Scraper Sainsbury's étape par étape
Préparez l’URL d’une catégorie et choisissez les champs dont vous avez besoin. Limitez la première exécution à une seule page afin de pouvoir facilement contrôler les résultats.
Étape 1 : créer un compte et une collection
Inscrivez-vous sur Datablist.com, puis créez une New Collection.
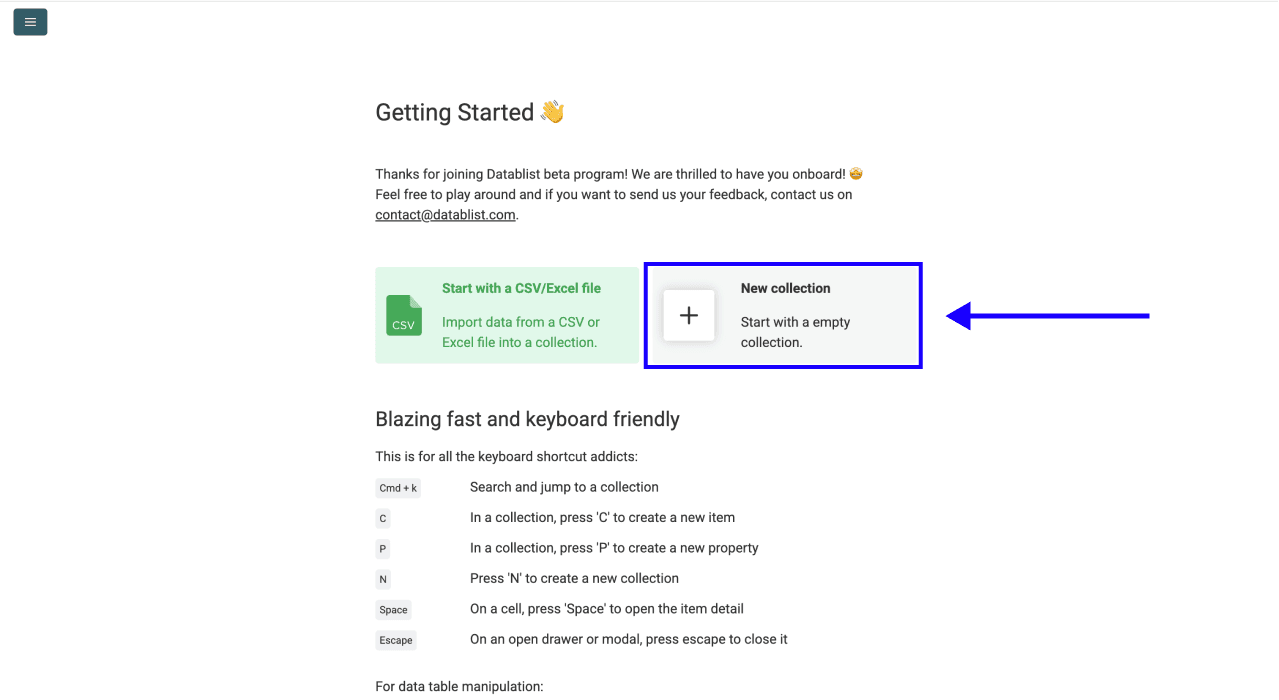
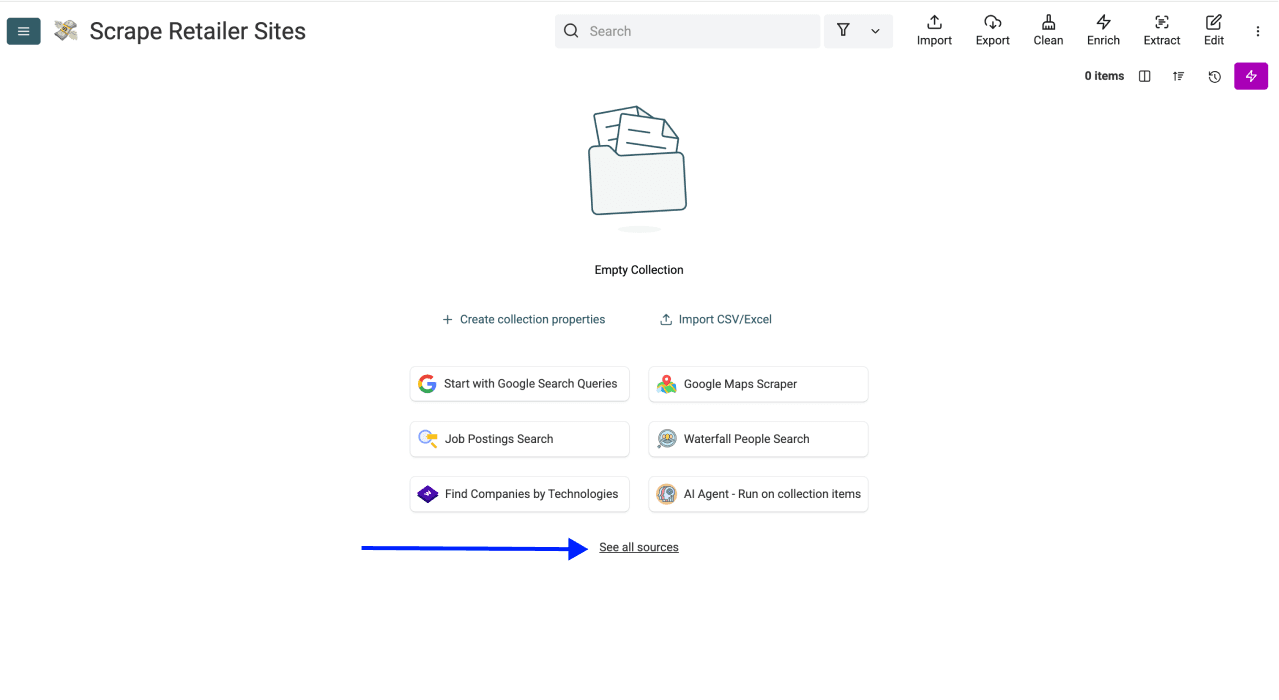
Étape 2 : accéder à AI Scraping Agent
Cliquez sur See all sources, puis sélectionnez AI Scraping Agent (Site Scraper).
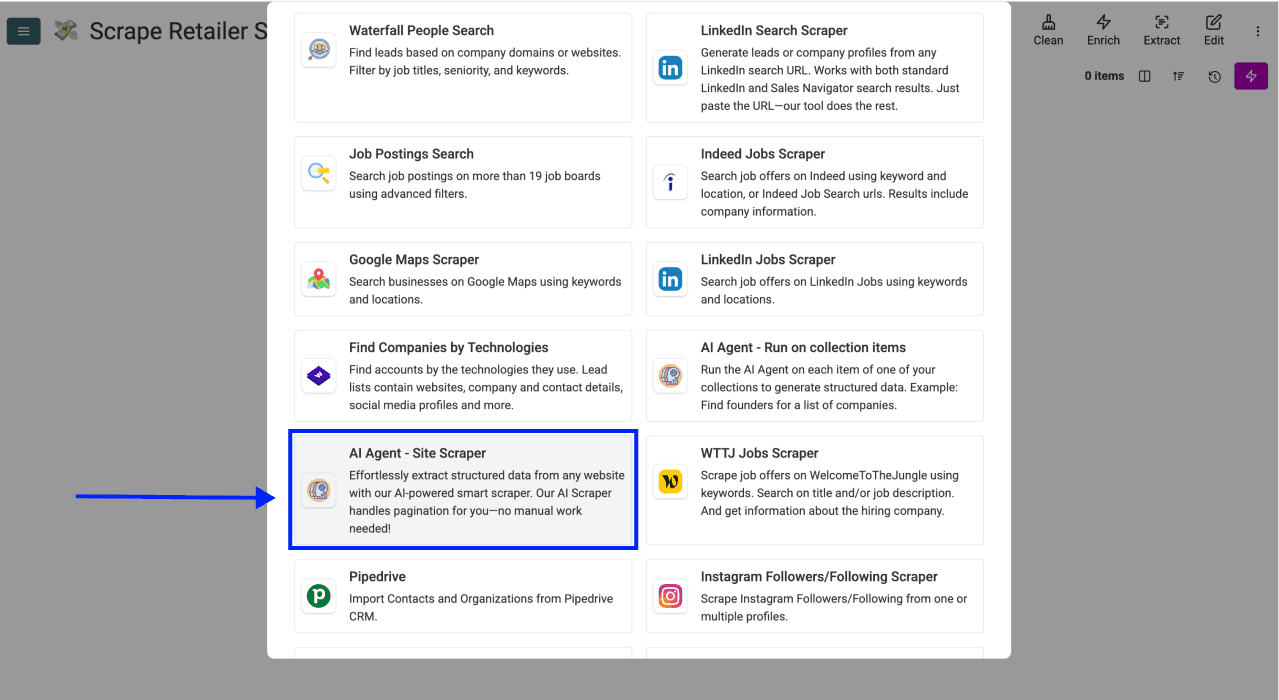
La configuration comprend l’URL, le prompt, la pagination et les paramètres avancés.
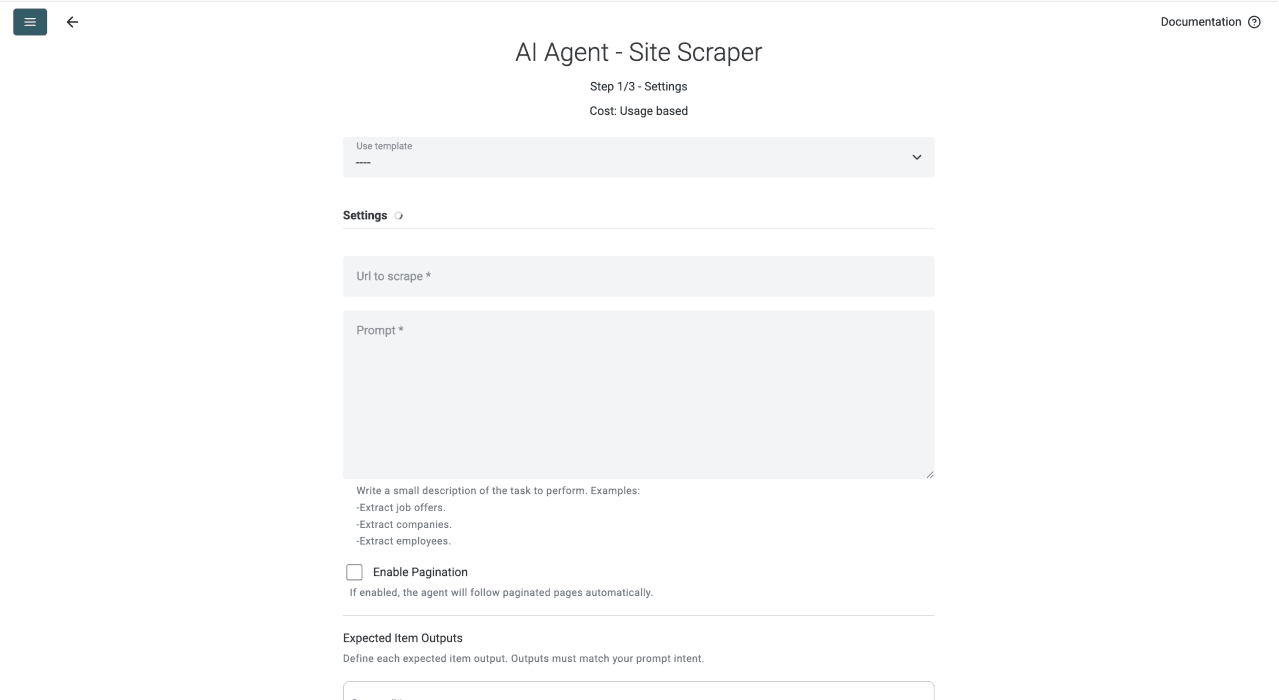
Étape 3 : choisir Retail Product Scraper et coller l’URL
- Chargez le template Retail Product Scraper.
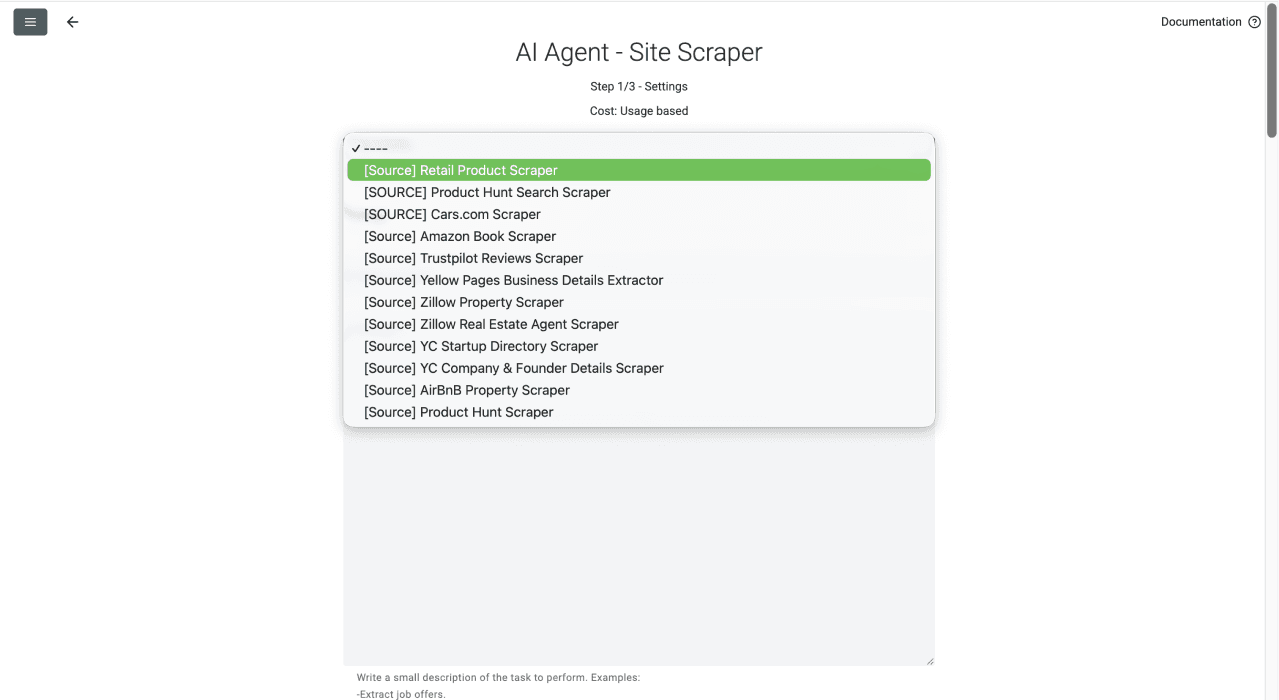
- Collez l’URL actuelle d’une catégorie, par exemple
https://www.sainsburys.co.uk/groceries/browse/frozen/fish-and-seafood/c:1019924. Partez de la première page plutôt que d’utiliser un ancien lien enregistré vers la deuxième page.
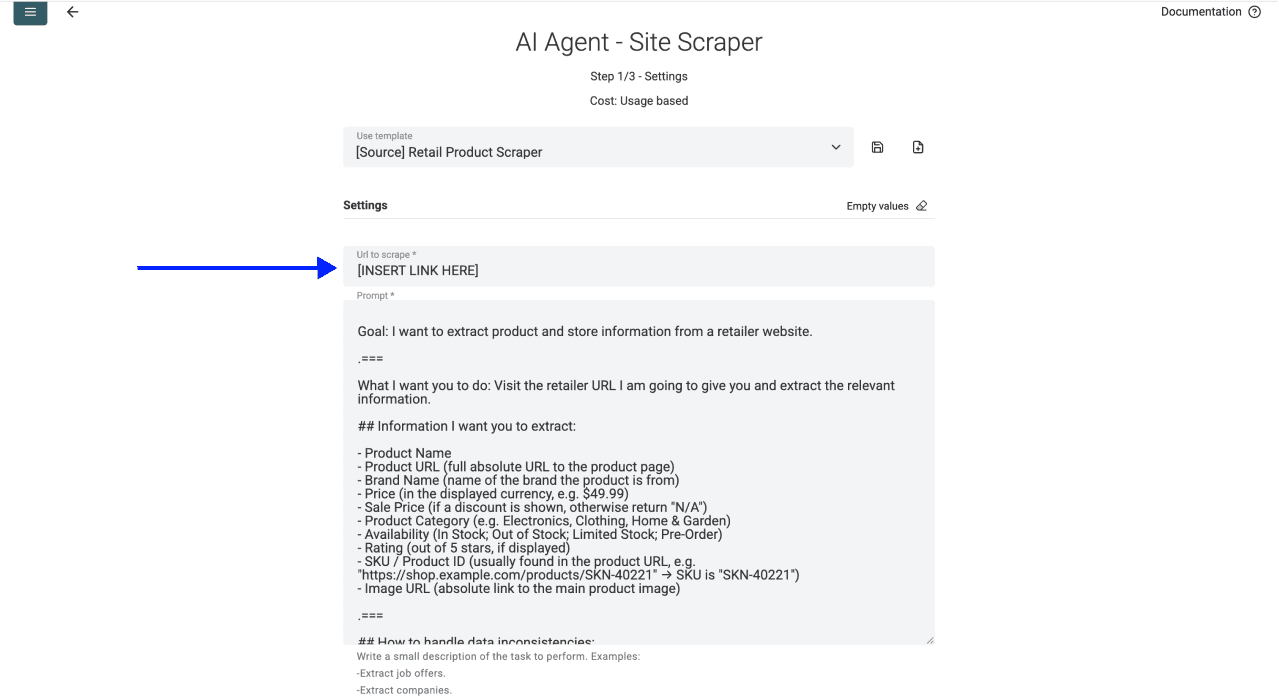
- Remplacez les instructions génériques par le prompt ci-dessous. L’URL doit être saisie dans le champ URL de la source ; le prompt définit les règles d’extraction.
Extrayez un enregistrement par fiche produit depuis la liste Sainsbury's fournie. Lisez ensemble les libellés et les prix afin que chaque valeur reste associée au bon produit.
Renvoyez Product Name, Product URL, Standard Price, Nectar Price, Unit Price, Promotion Text, Availability et Listing URL. Utilisez des URL absolues complètes. Standard Price et Nectar Price doivent être des montants numériques en GBP, sans symbole monétaire. Conservez Unit Price sous la forme affichée, avec son unité.
Placez tout prix explicitement identifié comme prix Nectar dans Nectar Price. Ne remplacez jamais le prix d’un produit par un prix comparatif au kilogramme, au litre ou à l’unité. Copiez les conditions de l’offre dans Promotion Text ; ne calculez pas le prix d’un article à partir d’une offre multiachat ambiguë. Laissez les valeurs absentes vides. Ne déduisez pas la disponibilité et n’inventez aucun prix.
Excluez les bannières, les recommandations et tout contenu qui ne correspond pas à un produit. Ne suivez un lien vers la page suivante que si la pagination est activée. Ne présentez pas une page de refus d’accès, de connexion ou de vérification comme une catégorie sans produit. Conservez pour chaque enregistrement l’URL exacte de la liste utilisée.
- Activez Enable Pagination et fixez la limite à
1page pour le test. Après avoir contrôlé l’échantillon, augmentez Max Pages uniquement si la page suivante de la catégorie est lisible.
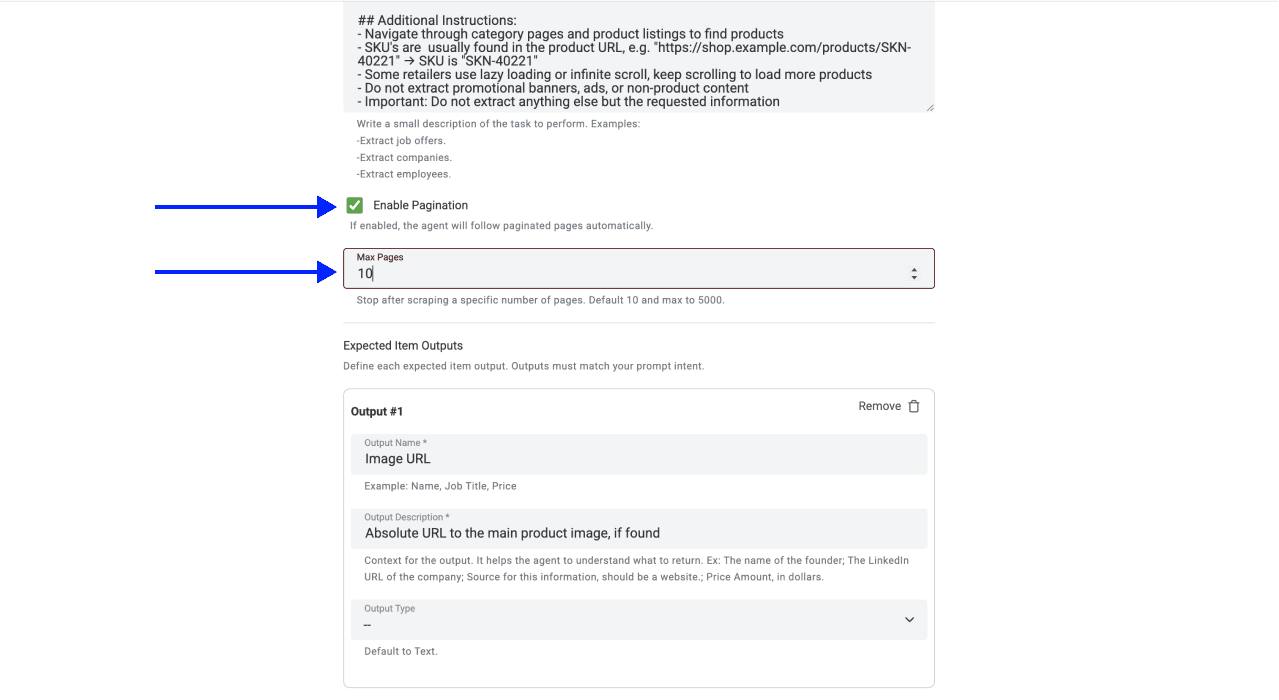
Laissez Website Scraper Option: Render HTML activé si la liste nécessite un rendu JavaScript. Vérifiez le modèle et Max iterations dans les paramètres avancés, puis cliquez sur Continue. Augmenter le nombre maximal d’itérations permet d’effectuer davantage de recherches et peut accroître le coût, sans garantir l’extraction d’un plus grand nombre de produits.
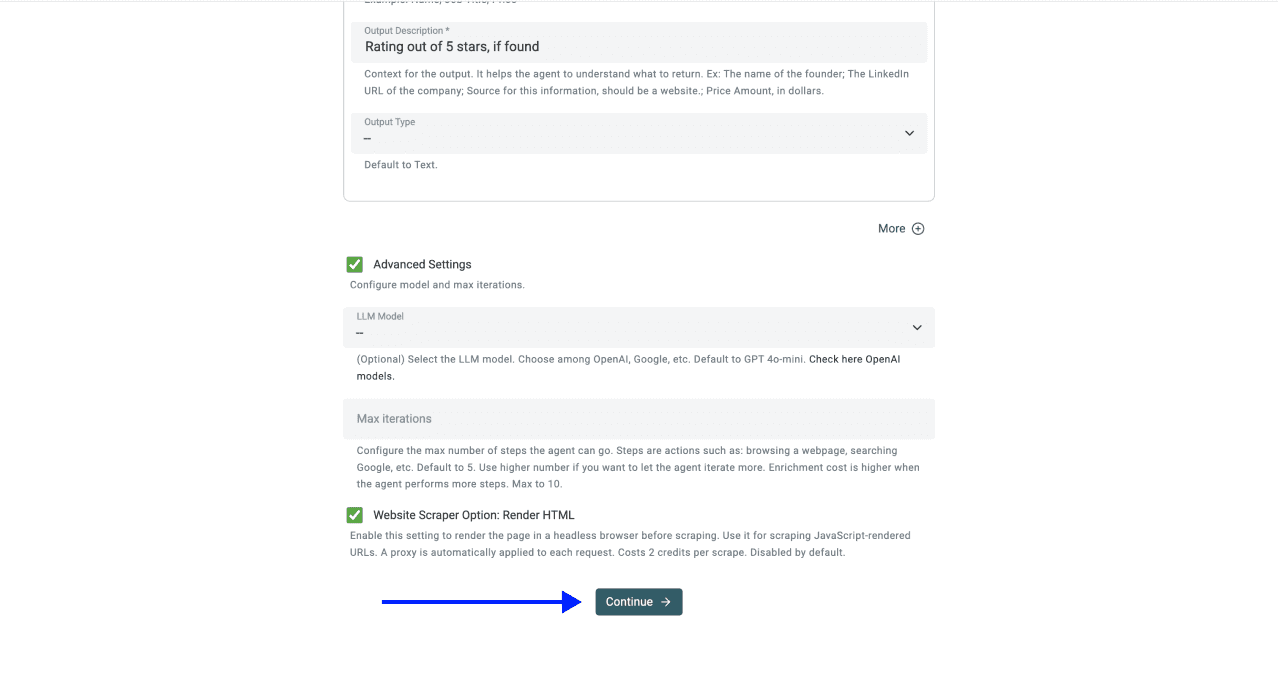
Étape 4 : configurer les sorties
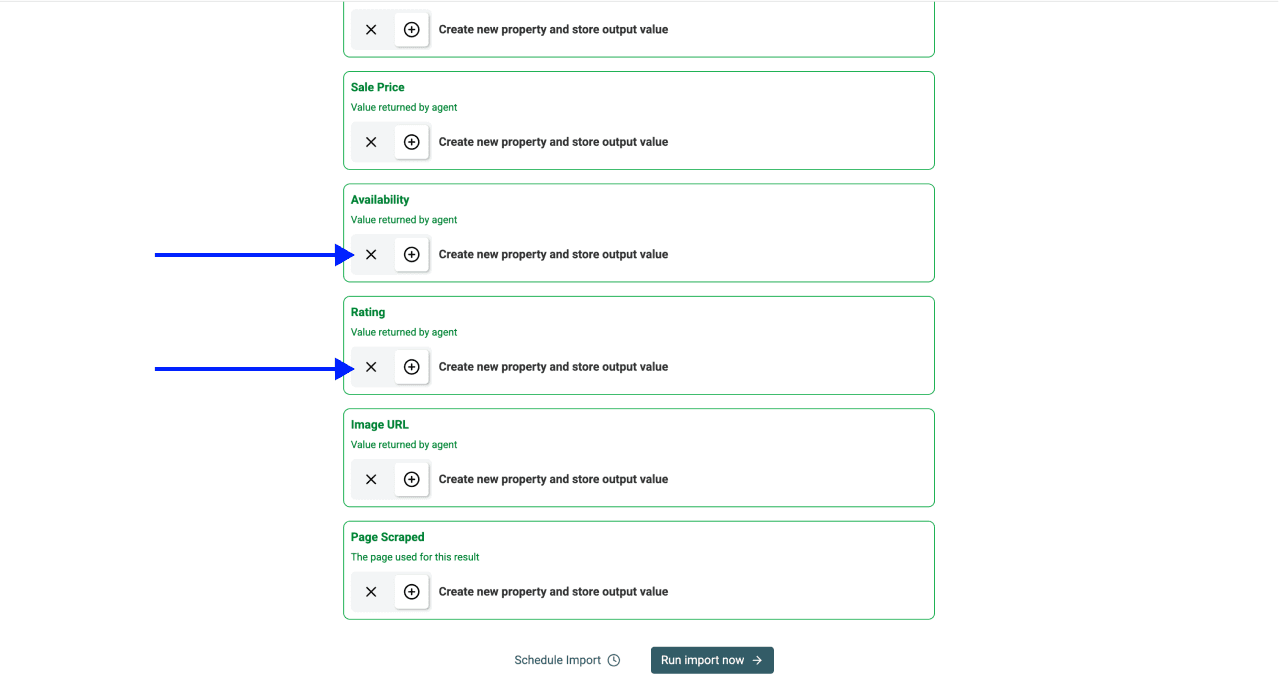
Faites correspondre les noms et les descriptions des sorties au prompt. Ajoutez Nectar Price, Unit Price, Promotion Text et Listing URL s’ils sont absents. Renommez Sale Price en Nectar Price au lieu de conserver des descriptions contradictoires, et choisissez le type Number pour les deux prix du produit.
Supprimez les sorties inutiles à l’aide des X Icons. Chaque champ que vous souhaitez retrouver dans le tableau doit avoir une propriété de sortie correspondante.
Étape 5 : lancer l’extraction
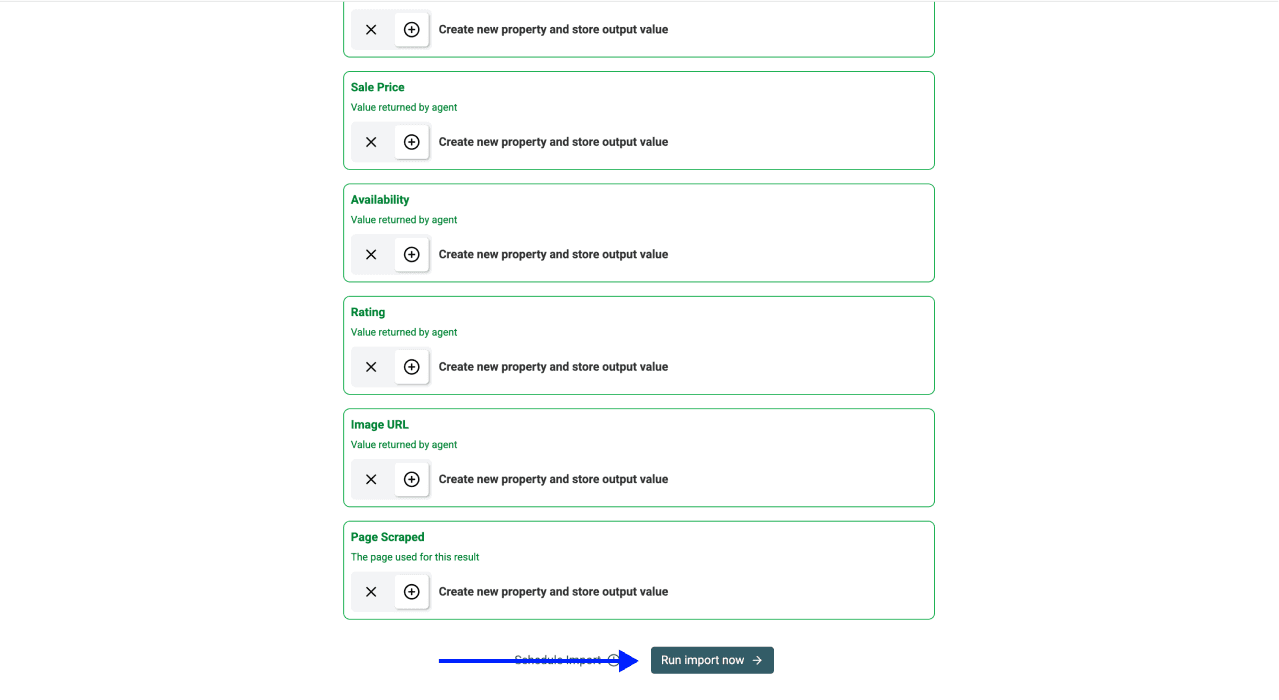
Cliquez sur Run Import Now pour lancer le test.
La capture ci-dessous illustre la présentation du tableau de résultats ; elle ne constitue pas la preuve d’un résultat mesuré lors d’une extraction sur Sainsbury's.
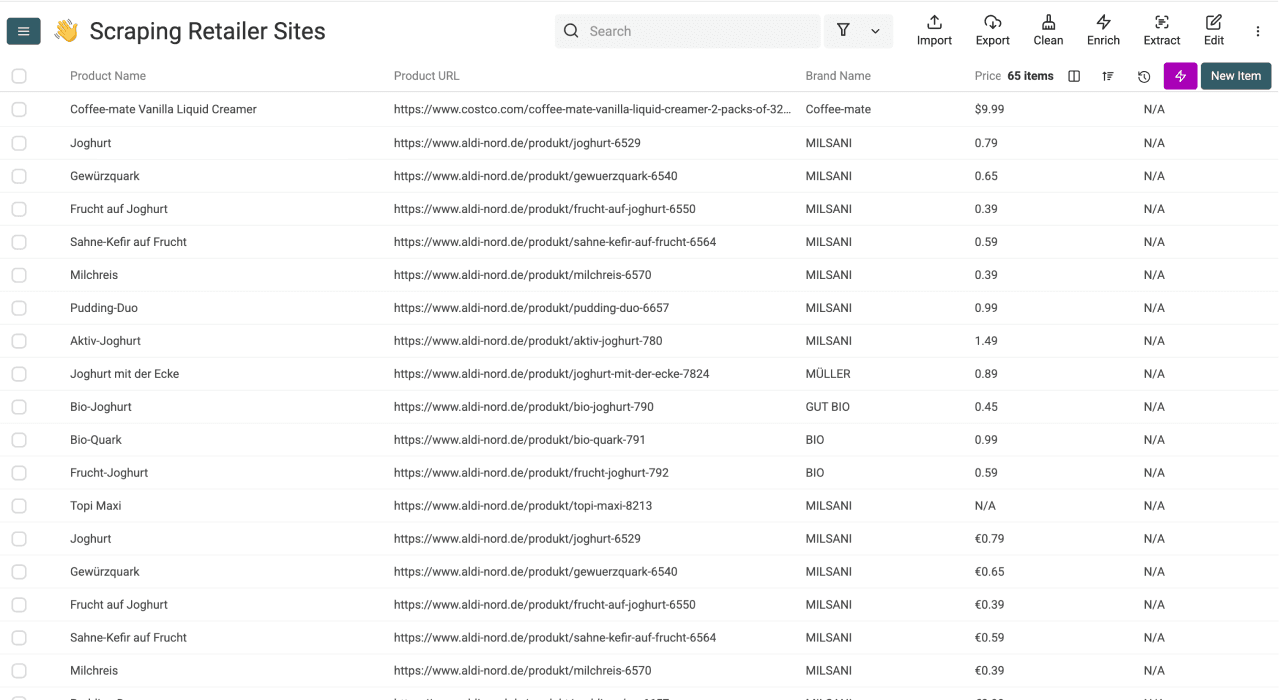
Avant d’étendre l’exécution :
- Comparez plusieurs lignes avec leurs fiches, dont une avec une offre Nectar et une sans.
- Vérifiez que le prix standard et le prix unitaire n’ont pas été intervertis, et que les prix Nectar absents sont restés vides.
- Confirmez les formats et les URL, puis recherchez d’éventuels doublons parmi les Product URL de l’exécution.
- Comparez les lignes renvoyées à la liste visible, puis examinez une page ultérieure après avoir augmenté la pagination.
- Notez les crédits consommés ainsi que les pages bloquées ou incomplètes. Ne considérez pas un résultat partiel comme une catégorie complète.
Utilisez les options d’export de Datablist pour créer un relevé CSV. Conservez ensemble les champs de prix et les URL sources.
Conserver l’historique des prix entre les extractions
Une Product URL unique permet d’identifier les produits récurrents, mais empêcher les URL en double dans une collection utilisée sur le long terme peut supprimer les observations ultérieures. Cela ne crée pas d’historique des prix.
Je vous recommande d’enregistrer chaque exécution dans une collection distincte et datée, ou dans un export daté. Ajoutez l’horodatage réel de la collecte avant toute comparaison avec un autre relevé. Associez les enregistrements à l’aide de Product URL et comparez des champs équivalents : prix standard avec prix standard, prix Nectar avec prix Nectar. Conservez également le format et le prix unitaire pour détecter les changements de quantité.
Si vous regroupez plusieurs relevés, conservez Product URL et l’horodatage de la collecte. Supprimez les produits en double uniquement au sein d’un même relevé ; gardez les lignes d’un même produit lorsqu’elles proviennent de dates différentes.
Scraper les sites d’autres enseignes avec l’agent IA
Vous pouvez adapter le template à une autre enseigne, mais contrôlez séparément ses libellés et sa pagination. Ces guides proposent des workflows de départ :
Les points clés à retenir
- Commencez par une catégorie et un échantillon d’une page.
- Séparez le prix standard, le prix Nectar et le prix unitaire dans le prompt et les sorties.
- Contrôlez l’exhaustivité et le coût avant d’augmenter la pagination.
- Conservez des relevés datés pour comparer l’évolution des prix.
FAQ sur le scraping de Sainsbury's
Combien coûte le scraping des produits Sainsbury's ?
Le coût dépend de l’utilisation du modèle et du travail de navigation, notamment du rendu et du nombre de pages traitées. Vérifiez les crédits consommés par un test d’une page avant d’estimer une exécution plus importante. Découvrez le fonctionnement des crédits Datablist.
Combien de temps faut-il pour scraper tout le catalogue ?
Le test d’une catégorie ne permet pas d’estimer le temps nécessaire ni la couverture de l’ensemble du catalogue. Définissez les catégories dont vous avez besoin, vérifiez leur pagination et notez les pages terminées ou incomplètes. Un même produit peut figurer dans plusieurs catégories : dédupliquez donc chaque relevé daté avant de mesurer la couverture.
Pourquoi scraper une catégorie plutôt que tous les produits ?
Une catégorie précise vous donne un ensemble de produits que vous pouvez contrôler. Les listes volumineuses peuvent dépasser la quantité de contenu lisible en une seule fois par l’agent. Divisez-les en catégories plus petites et vérifiez les résultats au lieu de supposer que chaque article a été extrait.
Peut-on scraper les promotions et prix Sainsbury's ?
Demandez le prix Nectar clairement identifié et le texte de la promotion en plus du prix standard. Vérifiez les conditions avant de comparer les valeurs. Un prix unitaire est un indicateur de comparaison ; une offre de fidélité conditionnelle ou multiachat ne doit pas remplacer discrètement le prix standard du produit.
Le scraping de Sainsbury's est-il légal au Royaume-Uni ?
Ce workflow ne vaut pas autorisation de collecter ou de réutiliser ces données. Consultez les conditions actuelles de Sainsbury's et vérifiez qu’elles permettent l’usage envisagé avant de lancer l’extraction. Le fait qu’une page soit publique ou qu’une extraction réussisse ne suffit pas à répondre à cette question.
Sainsbury's bloque-t-il les scrapers ?
Une exécution peut rencontrer des restrictions d’accès ou une page dont le contenu produit est illisible. Analysez l’échec avant de réessayer. Le rendu HTML facilite la lecture du contenu JavaScript, mais ne garantit pas l’accès. Ne comptabilisez pas une page bloquée comme une catégorie contenant zéro produit.
Peut-on planifier le suivi des prix Sainsbury's ?
Avant d’automatiser les extractions récurrentes, validez un premier relevé et déterminez comment stocker chaque exécution avec son horodatage de collecte. Consultez l’approche de suivi des prix décrite plus haut. Une règle de prévention des doublons fondée uniquement sur Product URL ne permet pas de conserver l’évolution des prix entre les exécutions.
Peut-on scraper Sainsbury's sans savoir coder ?
Oui. Chargez le template, saisissez l’URL, adaptez le prompt et les sorties, puis lancez un petit échantillon. La configuration est no-code, mais les résultats doivent tout de même être contrôlés.
Quelles catégories Sainsbury's scraper en priorité ?
Commencez par une catégorie de produits alimentaires précise que vous pouvez examiner. Utilisez l’URL actuelle du site plutôt qu’un ancien lien de pagination. Contrôlez les champs visibles et les conditions d’accès avant de réutiliser les paramètres sur une autre catégorie.
L’agent IA gère-t-il automatiquement la pagination ?
Lorsque Enable Pagination est activé, la source peut suivre les pages suivantes détectées jusqu’à la limite Max Pages. La valeur par défaut actuelle est de 10 et le maximum configurable est de 5 000. Il s’agit de limites de configuration, et non d’une garantie que chaque page sera accessible ou que tous les produits seront renvoyés.
Qu’est-ce que le scraping par IA ?
Le scraping par IA utilise un modèle de langage pour transformer le contenu d’une page en champs définis dans votre prompt. Pour ce workflow, les règles relatives aux libellés de prix et à l’identification des produits sont aussi importantes que l’URL.
Quelle différence entre scraping IA et scraping classique ?
L’extraction classique repose souvent sur des sélecteurs fixes. L’extraction par IA interprète le contenu à partir d’instructions, ce qui facilite l’adaptation des champs collectés. Les deux méthodes nécessitent un accès aux pages et des contrôles pour repérer les valeurs absentes ou mal interprétées.