
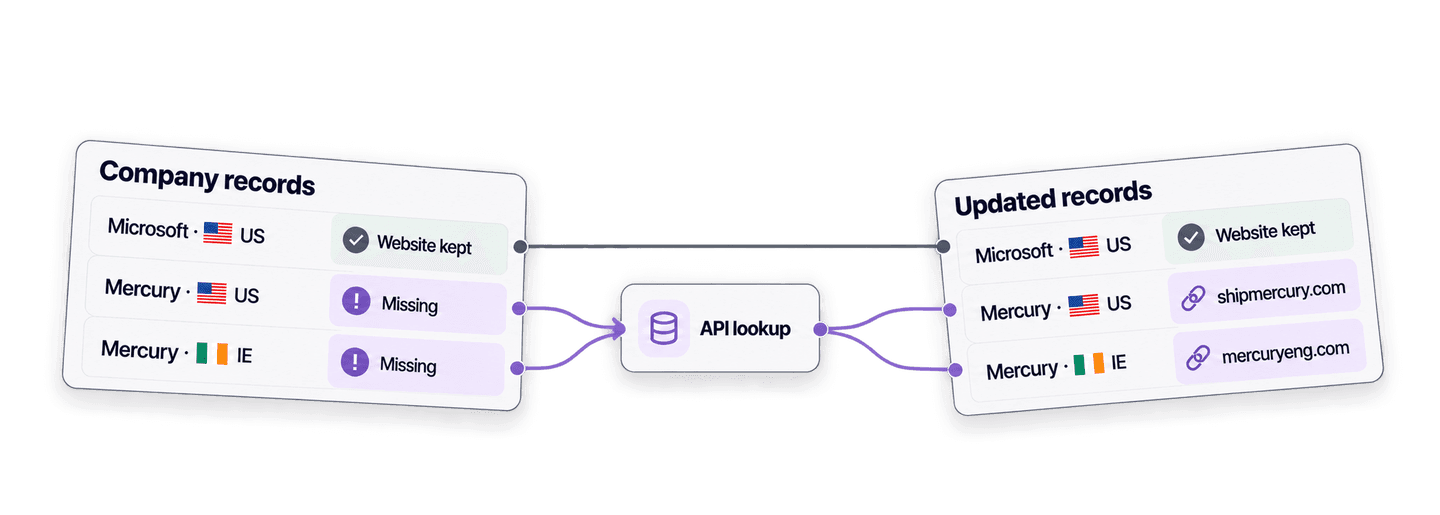
Pour trouver le site web d’une entreprise à partir de son nom en Python, envoyez son nom et, si vous le connaissez, son pays à l’API Company Name to Domain de Datablist. L’API traite la recherche en arrière-plan, puis renvoie le domaine et l’URL complète du site.
Je vais d’abord vous montrer une requête API Python simple. Nous réutiliserons ensuite la même fonction pour compléter uniquement les sites manquants dans une liste d’entreprises, sans modifier les URL déjà renseignées.
Si vous préférez une interface proche d’un tableur, consultez le guide pour trouver en masse le site d’une entreprise à partir de son nom.
💡 Résumé pour les plus pressés
Créez une fonction Python qui trouve un site à partir du nom d’une entreprise, puis utilisez-la pour compléter les fiches dont le champ site web est vide, sans remplacer les URL connues.
- Entrée : noms d’entreprises, avec le pays si disponible.
- Sortie : domaine, URL complète du site, niveau de confiance, statut du résultat et crédits consommés.
Configurer Python et votre clé API Datablist
Pour cet exemple, j’utilise le package Requests afin d’effectuer des appels HTTP synchrones. Installez-le dans un environnement virtuel :
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsVous devez également disposer d’un abonnement Datablist Growth, car l’accès à la REST API fait partie de cette offre. Créez une Personal API Key depuis la page API de votre compte Datablist, puis enregistrez-la dans une variable d’environnement :
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 Vous avez déjà une clé API ? Les anciennes clés utilisent le format
auth0|<userId>:<accountId>:<secret>:1. Elles restent compatibles. Continuez à utiliser votre clé existante exactement telle qu’elle a été générée : vous n’avez pas besoin de la remplacer ni d’en modifier le format.
Remplacez la valeur d’exemple ci-dessus par la clé générée sur la page de votre compte. Les recherches de sites d’entreprises consomment des crédits. Avant de passer à l’échelle, je vous explique les deux scénarios, à 1 crédit et à 2,5 crédits. Les tarifs à jour sont disponibles sur la page des tarifs Datablist.
Trouver le site d’une entreprise avec Python
Créez un fichier nommé find_company_websites.py. Le script envoie les noms, attend la fin de la tâche et récupère les résultats dans une seule fonction. Pour chaque entrée, il utilise l’identifiant stable de votre fiche comme inputId. Vous pouvez ainsi rattacher chaque résultat à la bonne entreprise, même si l’ordre de la réponse change.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))Exécutez-le depuis le terminal dans lequel vous avez exporté la clé :
python find_company_websites.pyVoici le résultat obtenu pour Microsoft :
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
Utilisez inputId pour rattacher ce résultat à la fiche d’origine. status peut prendre les valeurs success, no_result, error ou skipped. Un résultat positif peut contenir companyDomain, l’URL complète companyUrl et domainConfidence. creditsUsed indique le coût de cette entrée, tandis que error décrit une erreur propre à l’élément.
La fonction effectue successivement trois types d’appels API.
Elle envoie d’abord la recherche. Le payload contient les paramètres et les fiches d’entreprises. La requête POST renvoie 202 Accepted, et @id correspond à l’identifiant de tâche requis pour les appels suivants :
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]Si DATABLIST_API_KEY n’est pas définie, Python lève une exception KeyError lors de la lecture de l’environnement, avant même d’envoyer une requête HTTP. Exportez la variable, puis relancez le script. Si elle contient une clé invalide, la requête POST atteint l’API et renvoie une erreur HTTP 401. Copiez une Personal API Key valide depuis la page de votre compte et remplacez la valeur incorrecte.
Elle vérifie ensuite l’état de la tâche. La requête POST lance un traitement en arrière-plan. Le script consulte donc la tâche toutes les trois secondes jusqu’à ce qu’elle passe au statut completed, failed ou stopped :
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)Si la tâche échoue faute de crédits, son erreur contient le motif credits_error. Ajoutez des crédits ou attendez le renouvellement de votre quota mensuel, examinez les éventuels résultats déjà renvoyés, puis soumettez uniquement les entrées non traitées dans une nouvelle tâche.
Enfin, elle récupère toutes les pages de résultats. Chaque réponse ajoute des résultats à la liste et fournit le curseur nécessaire à la requête suivante :
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakLe script récupère les pages suivantes jusqu’à ce que nextCursor soit égal à null.
Avant la requête POST, le script affiche le uniqueId généré. Si la connexion est interrompue avant la réception de la réponse de création, commencez par lister vos tâches et vérifier leur statut avant d’en créer une autre :
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"Repérez la tâche dont le uniqueId correspond à la valeur générée par le script, puis copiez son @id. L’endpoint de liste permet de filtrer par enrichmentId, mais pas par uniqueId. Utilisez cet @id avec les mêmes URL de statut et de résultats que le script. Si la tâche est toujours active, continuez à vérifier son état. Si elle est arrêtée ou a échoué, recherchez d’éventuels résultats partiels avant de renvoyer les entrées.
Comprendre le matching et le fallback par pays
Le script utilise dataset_google, le réglage recommandé par défaut. Datablist vérifie d’abord ses datasets d’entreprises. Si aucun match n’est trouvé ou si les données se contredisent, Google peut servir de fallback. Les correspondances possibles sont contrôlées avant l’attribution d’un niveau de confiance.
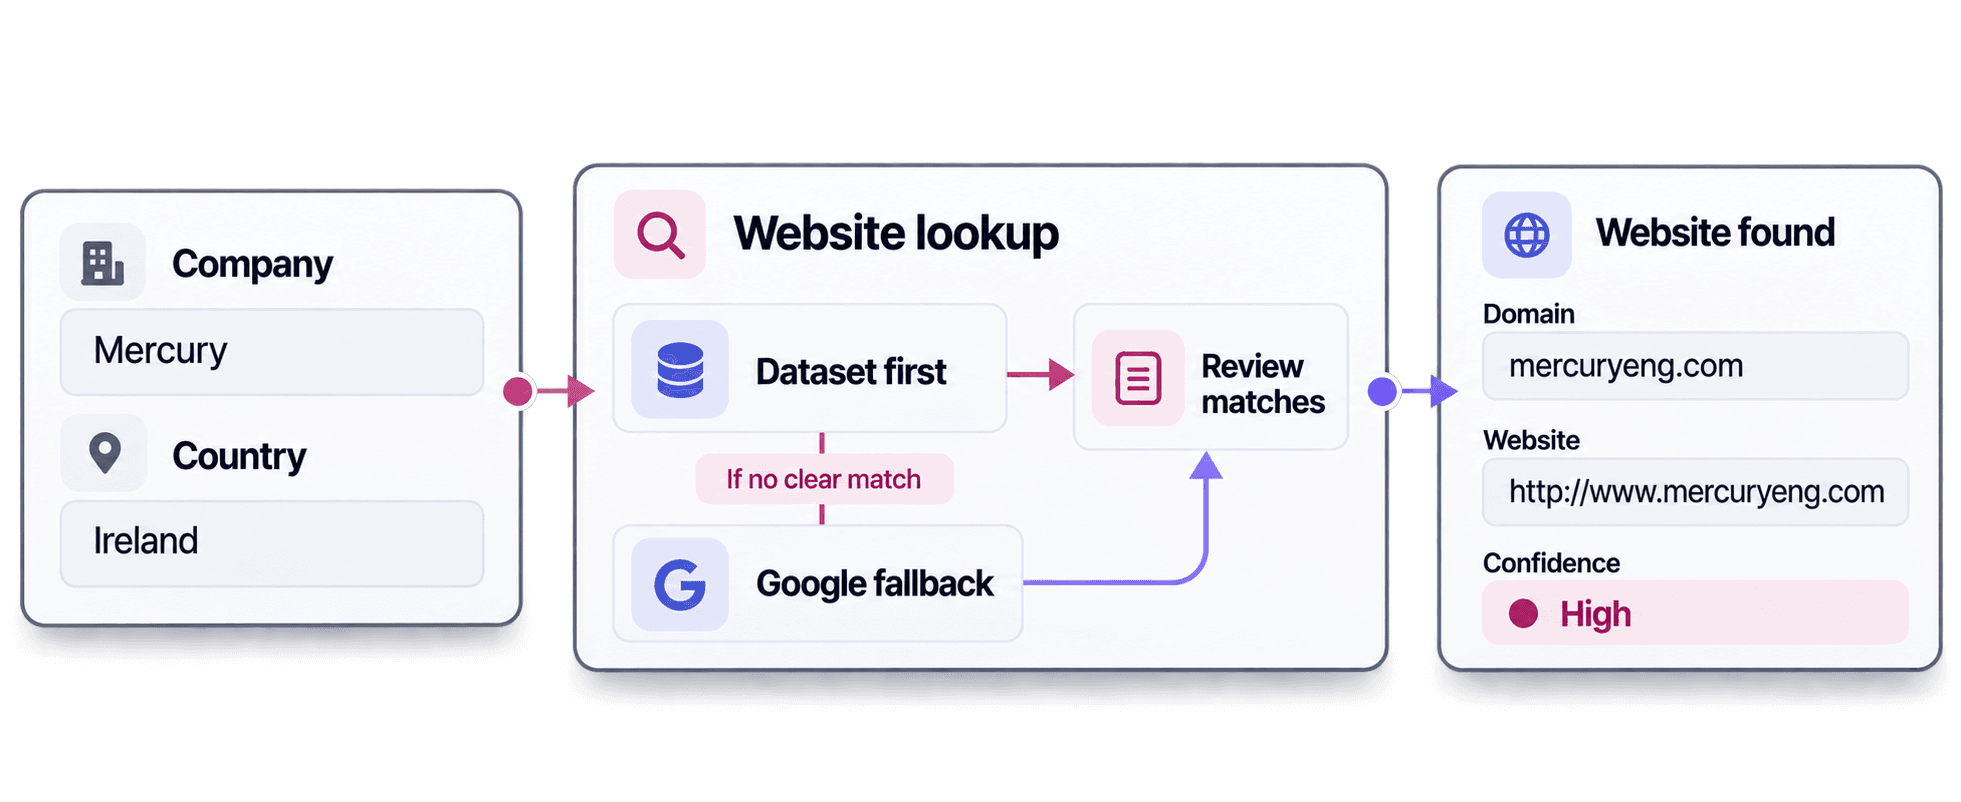
Le pays aide à départager les noms ambigus. Dans cet exemple, le même nom d’entreprise a produit deux résultats différents :
MercuryavecUSa renvoyéshipmercury.comethttps://www.shipmercury.com/.MercuryavecIEa renvoyémercuryeng.comethttp://www.mercuryeng.com.
Les deux résultats avaient un niveau de confiance High. Le pays permet à la recherche de distinguer plusieurs entreprises portant le même nom, tandis que le niveau de confiance vous aide à identifier les résultats qui nécessitent une vérification.
Lorsque le matching dépend également du secteur, de la taille de l’entreprise ou d’autres informations métier, utilisez le workflow de recherche AI Agent. Ajoutez ces précisions au prompt de l’AI Agent afin qu’il puisse rechercher l’entreprise visée avec davantage de contexte.
Compléter uniquement les sites web manquants
Maintenant que find_domains() sait trouver un site à partir du nom d’une entreprise, réutilisez cette fonction pour compléter uniquement les sites absents de vos fiches. Les fiches qui possèdent déjà un site ne sont pas envoyées à l’API : leur valeur reste donc inchangée et elles ne consomment aucun crédit de recherche.
Dans find_company_websites.py, remplacez tout le contenu compris entre companies = [ et la dernière boucle d’affichage par le bloc ci-dessous. Conservez l’affectation api_key qui le précède. La vérification des champs vides couvre None, les chaînes vides et les espaces. Aucun appel API n’est effectué si tous les sites sont renseignés.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))Le code indexe les résultats par inputId, puis parcourt les fiches d’origine dans leur ordre initial. L’objet website_lookup conserve le résultat et les informations nécessaires à sa vérification à côté de chaque fiche traitée, y compris en cas d’échec ou de résultat manquant.
Pour crm-001, website_is_missing() renvoie False, car l’URL de Microsoft est déjà présente. La fiche n’est pas ajoutée à records_to_lookup et n’est donc jamais envoyée à l’API. La fusion conserve son site et enregistre le statut not_requested.
Pour crm-002, le champ site web est vide. La requête envoie donc la boulangerie avec inputId: crm-002. L’API renvoie le même inputId, que results_by_id utilise pour retrouver le bon résultat. La fusion ajoute alors https://boulangerie-du-palais-lyon.eatbu.com à cette fiche sans dépendre de l’ordre des résultats.
| ID | Entreprise | Site après fusion | Statut | Domaine | Confiance | Crédits |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
La boulangerie utilise un sous-domaine propre à son activité : boulangerie-du-palais-lyon.eatbu.com. Conservez cette valeur au lieu de la réduire à eatbu.com, et enregistrez l’adresse exacte fournie par companyUrl. Le paramètre acceptNonRoot: true autorise également les pages professionnelles hébergées dont l’adresse contient un chemin après le nom d’hôte. Dans les deux cas, l’URL complète est donc importante.
Une tâche terminée peut tout de même contenir des éléments no_result, error ou skipped. L’exemple ne modifie website que si le statut est success et que companyUrl est présent. En cas de no_result, le site reste vide et le statut demeure visible dans website_lookup. Commencez par vérifier le nom et le pays de l’entreprise. Si l’une de ces données est erronée, corrigez-la et renvoyez cette fiche dans une nouvelle tâche. Sinon, laissez le champ site web vide pour signaler qu’une vérification manuelle est nécessaire.
Estimer les crédits avant de passer à l’échelle
Les cinq recherches de l’exemple ont toutes renvoyé success avec un niveau de confiance High, pour un total de 5 crédits.
Une recherche résolue à partir du dataset coûte 1 crédit. Une recherche traitée avec Google coûte 2,5 crédits. Vous payez uniquement le parcours utilisé, pas les deux. Pour 1 000 entrées, comptez donc 1 000 crédits si elles sont toutes résolues par le dataset, ou 2 500 crédits si elles passent toutes par Google. Il s’agit d’estimations budgétaires, et non d’une garantie que chaque recherche aboutira.
Déplacez le curseur pour comparer la consommation de crédits correspondant à votre liste.
À 20 $ pour 20 000 crédits, ces scénarios coûtent respectivement 1 $ et 2,50 $. L’abonnement Growth est facturé séparément et comprend actuellement 20 000 crédits mensuels, consommés avant les recharges. Consultez les tarifs actuels, car les offres et les volumes de crédits peuvent évoluer.
Une tâche accepte jusqu’à 10 000 entrées, avec une limite de 16 Kio par entrée et de 10 Mio par requête. Cet exemple utilise des appels Requests bloquants pour envoyer une petite tâche Datablist asynchrone, vérifier son état et récupérer ses résultats. Le repository maintenu comprend également des exemples de traitement CSV par lots et de clients non bloquants.
Prochaines étapes
Une fois que vous avez confirmé que le site renvoyé appartient bien à l’entreprise recherchée, vous pouvez scraper ses mentions légales avec Python afin d’ajouter à la même fiche fournisseur les informations légales de l’entreprise et l’URL de la page source. Vérifiez d’abord la correspondance du site, indépendamment de l’extraction qui suivra.
Remplacez les fiches d’exemple par un petit échantillon de vos propres données, puis exécutez le script et examinez les fiches fusionnées. Conservez des identifiants stables et le pays, puis augmentez le volume uniquement après avoir vérifié que le script préserve les sites connus et complète bien les champs attendus. Vous pouvez partir des exemples maintenus de la Company Name to Domain API sur GitHub si vous souhaitez télécharger le script, traiter des CSV par lots ou utiliser une version asynchrone.