
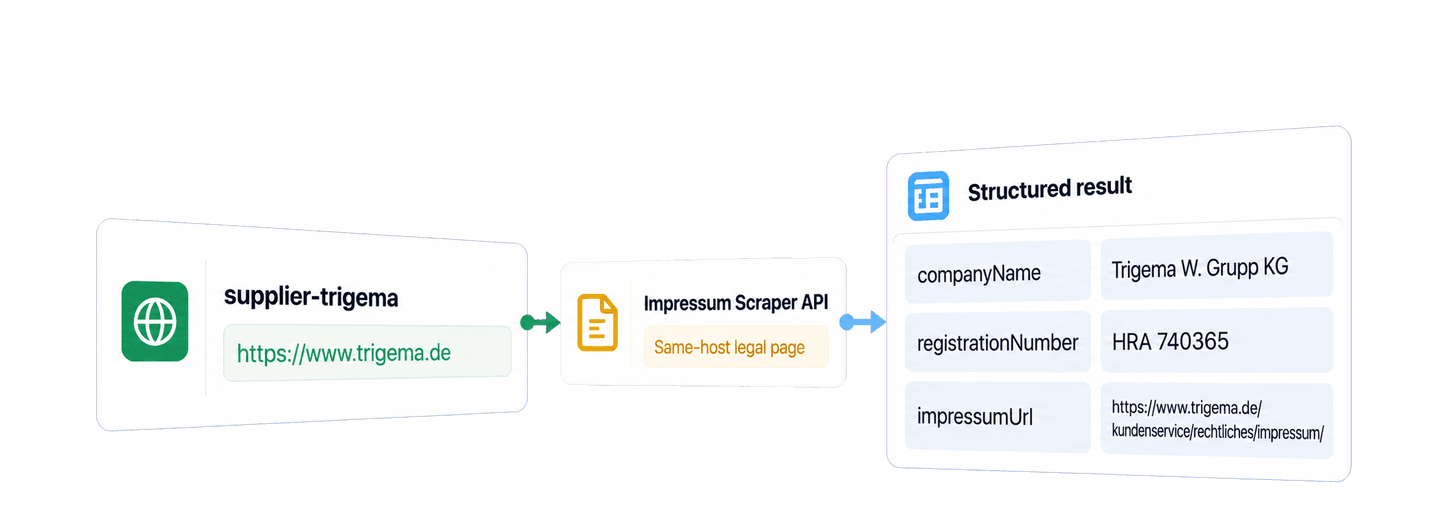
Pour scraper les données Impressum en Python sans développer de crawler sur mesure, utilisez l’API Impressum Scraper de Datablist avec la bibliothèque Requests. Vous fournissez les URL des sites d’entreprise, l’API repère la page Impressum de chaque site, puis en extrait des informations structurées sur l’entreprise et ses contacts.
Pour cet exemple, j’utilise deux marques allemandes bien établies : le fabricant de vêtements Trigema et la marque d’outdoor VAUDE. Un petit script Python prêt à l’emploi effectue la recherche, puis associe à chaque fournisseur les informations extraites et l’URL de la page Impressum source.
📌 L’essentiel en quelques secondes
Utilisez l’API Impressum Scraper de Datablist pour transformer des sites d’entreprises allemandes en données structurées sur les sociétés et leurs contacts. L’exemple Python envoie deux sites, attend la fin de la tâche en arrière-plan, récupère toutes les pages de résultats et conserve l’URL de la page légale trouvée avec chaque fiche.
- Entrée : URL de sites d’entreprises allemandes.
- Sortie : informations sur l’entreprise et ses contacts, avec le lien vers la page Impressum source.
💡 Vous préférez une solution no-code ? Utilisez l’outil Impressum Scraper de Datablist pour extraire ces informations d’entreprise sans écrire de code.
Configurez votre clé API et Python
Créez un compte Datablist, puis une Personal API Key. L’accès à la REST API est disponible avec le plan Growth. Voici un exemple de format de clé :
auth0|exampleuser:exampleaccount:EXAMPLE_TOKEN_NOT_VALID:1Exportez votre propre clé dans la variable DATABLIST_API_KEY :
export DATABLIST_API_KEY="your-personal-api-key"Pour cet exemple Python, j’utilise le package requests. Créez un fichier nommé
scrape_impressum.py, puis installez le package :
python -m pip install requestsChaque site envoyé consomme 10 crédits. L’exemple ci-dessous en utilise donc 20 lorsque les deux entrées sont traitées.
Créez la fonction scrape_impressums()
Collez ce script complet dans scrape_impressum.py :
import json
import os
import time
import uuid
import requests
def scrape_impressums(suppliers, api_key):
"""Envoie une tâche, attend sa fin et renvoie tous les résultats."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]
payload = {
"enrichmentId": "impressum-scraper",
"uniqueId": str(uuid.uuid4()),
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Tâche {task_id} {task['status']} : {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Définissez DATABLIST_API_KEY avant d’exécuter ce script.")
suppliers = [
{
"id": "supplier-trigema",
"label": "Trigema",
"website_url": "https://www.trigema.de",
},
{
"id": "supplier-vaude",
"label": "VAUDE",
"website_url": "https://www.vaude.com",
},
]
impressum_results = scrape_impressums(suppliers, api_key)
for result in impressum_results:
print(json.dumps(result, ensure_ascii=False))Exécutez le script complet avec :
python scrape_impressum.pyLa fonction utilise l’API en trois étapes. Elle envoie les sites en entrée, attend la fin de la tâche, puis récupère toutes les pages de résultats.
Envoyez les sites en entrée
Le script transforme chaque fournisseur en entrée API de cette manière :
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]inputId est votre propre identifiant stable. data.websiteUrl correspond à la page d’accueil de l’entreprise que le scraper va analyser. Utilisez le site officiel de l’entreprise, pas un annuaire ni un profil social. Le payload sélectionne l’enrichment public impressum-scraper et utilise un objet settings vide, car cette API ne requiert aucun paramètre public.
La requête POST crée une tâche en arrière-plan. Datablist accepte la requête et renvoie un objet de tâche dont le champ @id identifie cette exécution. La fonction se sert de cet ID pour construire les URL de statut et de résultats.
Voici une version abrégée de la réponse de création :
{
  "@id": "task-id",
  "enrichmentId": "impressum-scraper",
  "status": "queued",
  "links": {
    "self": "https://api.datablist.com/v1/enrichments/tasks/task-id",
    "results": "https://api.datablist.com/v1/enrichments/tasks/task-id/results"
  }
}
queued signifie que la requête a été acceptée, pas que le résultat est disponible. Le script réutilise le champ @id renvoyé lors des deux étapes suivantes : vous n’avez donc pas à copier manuellement les URL de la tâche. Il appelle aussi raise_for_status() avant de lire chaque réponse. Une erreur d’authentification ou de validation interrompt ainsi le script au niveau de la requête HTTP concernée, au lieu d’être prise pour une recherche terminée.
Attendez la fin de la tâche
Datablist traite la tâche en arrière-plan. L’exemple vérifie son statut toutes les trois secondes jusqu’à ce qu’il passe à completed, failed ou stopped. Requests étant une bibliothèque Python bloquante, votre script local reste en attente pendant ces appels, même si la tâche API s’exécute elle-même en arrière-plan.
Si la tâche se termine avec le statut failed ou stopped, la fonction lève une erreur contenant son ID et son statut final. Conservez cet ID pour examiner la tâche existante au lieu de renvoyer immédiatement le même traitement payant.
Récupérez toutes les pages de résultats
Une fois la tâche terminée, le script demande jusqu’à 100 résultats à la fois. La règle de pagination est simple : récupérez la page suivante jusqu’à ce que nextCursor soit égal à null. Lorsque le curseur contient une valeur, le script la transmet avec la requête suivante.
N’associez pas les fiches renvoyées à votre application selon leur position dans la liste. Les résultats peuvent arriver dans un ordre différent de celui des entrées. Utilisez inputId comme clé de jointure.
Comment l’API trouve une page Impressum
La page d’accueil constitue le point de départ, pas la page que l’API doit extraire. Impressum Scraper utilise l’AI pour analyser les liens internes du domaine fourni et identifier une page Impressum, ou une page légale ou de contact équivalente. C’est important, car le lien peut porter un libellé comme Rechtliches, Kontakt ou Legal, au lieu de se trouver directement à l’adresse /impressum.
Si l’AI ne trouve aucun lien interne adapté, le scraper essaie les chemins courants /impressum et /imprint sur le même domaine. Une fois la page source atteinte, l’AI rassemble dans un même résultat la raison sociale, l’adresse, les contacts, l’immatriculation, le numéro de TVA et les informations sur la source. Elle n’utilise pas de moteur de recherche et ne consulte aucun annuaire externe.
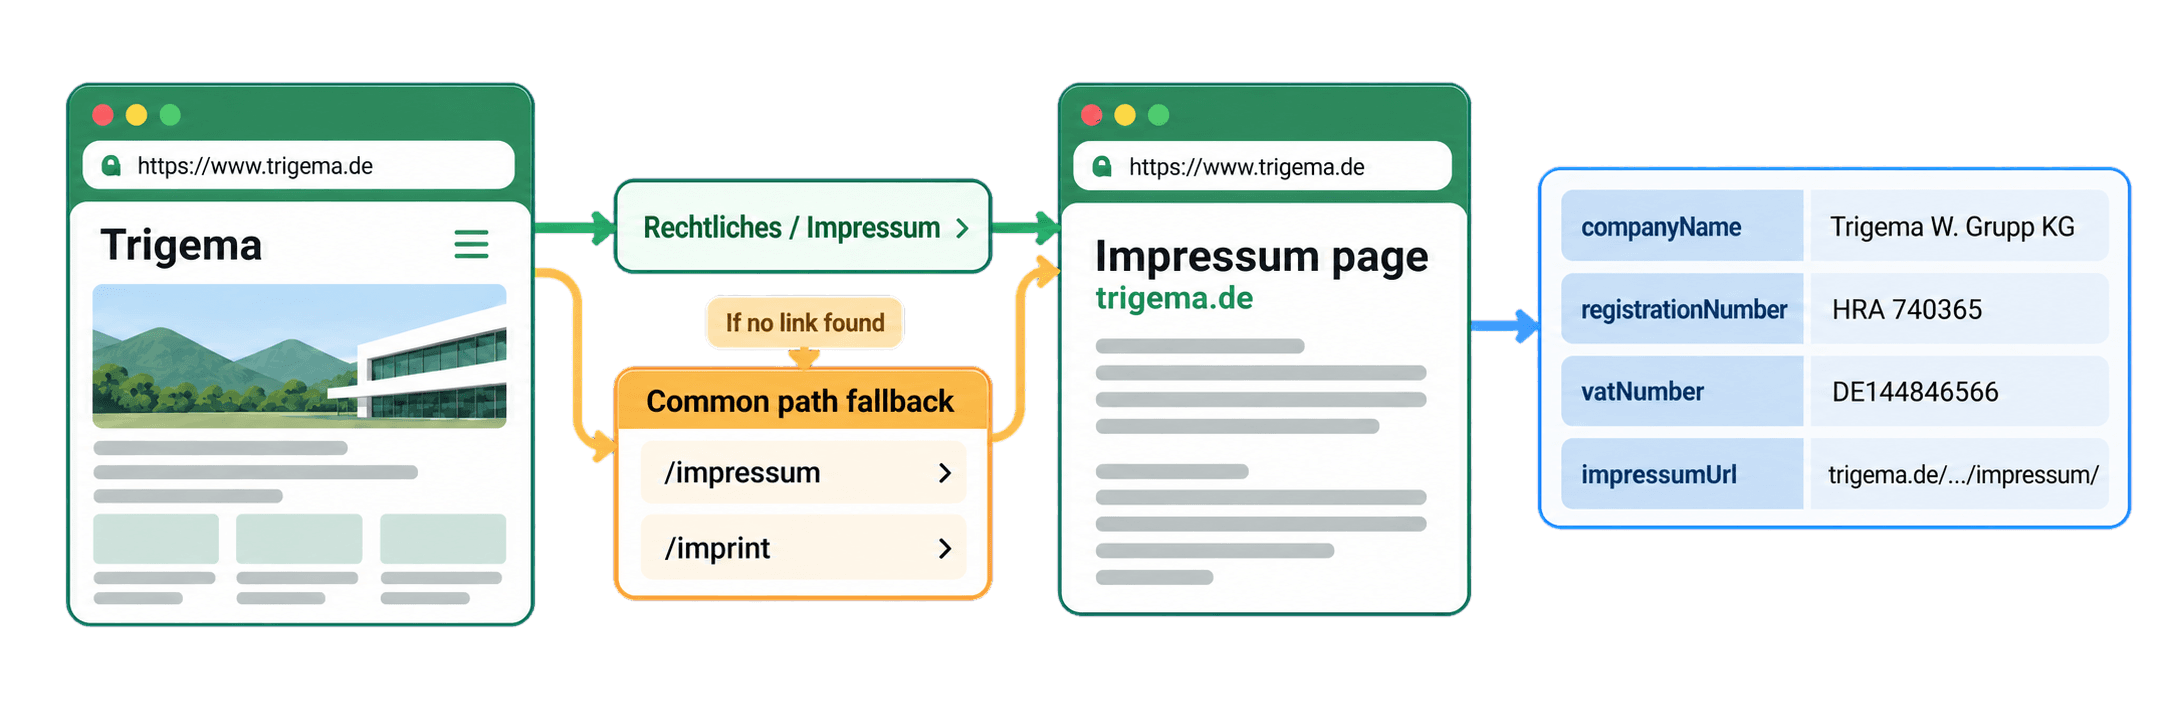
Les deux résultats illustrent concrètement ces variations de chemin. Pour Trigema, l’API a renvoyé /kundenservice/rechtliches/impressum/, contre /de/de/impressum.html pour VAUDE. Conservez impressumUrl avec chaque résultat : ce champ indique précisément la page source dont proviennent les données extraites.
Analysez les résultats de Trigema et VAUDE
Voici un extrait synthétique des deux résultats de l’exemple.
📘 Adresses e-mail d’exemple : Les e-mails sont masqués ci-dessous avec
**. L’API renvoie les adresses complètes.
[
  {
    "inputId": "supplier-trigema",
    "status": "success",
    "outputs": {
      "firstName": "Wolfgang",
      "lastName": "Grupp",
      "companyName": "Trigema W. Grupp KG",
      "postalAddress": "Josef-Mayer-Str. 31-35, D-72393 Burladingen",
      "emailAddress": "b**@trigema.de",
      "registrationNumber": "HRA 740365",
      "vatNumber": "DE144846566",
      "impressumUrl": "https://www.trigema.de/kundenservice/rechtliches/impressum/",
      "agentConfidenceScore": 90
    },
    "creditsUsed": "10",
    "error": null
  },
  {
    "inputId": "supplier-vaude",
    "status": "success",
    "outputs": {
      "firstName": "Antje",
      "lastName": "von Dewitz",
      "companyName": "VAUDE Sport GmbH & Co. KG",
      "postalAddress": "Vaude Straße 2, 88069 Tettnang",
      "emailAddress": "s**@service.vaude.com",
      "registrationNumber": "HRA 631071",
      "vatNumber": "DE203894755",
      "impressumUrl": "https://www.vaude.com/de/de/impressum.html",
      "agentConfidenceScore": 95
    },
    "creditsUsed": "10",
    "error": null
  }
]
Commençons par les noms. Trigema est le libellé du fournisseur dans l’entrée Python, tandis que Trigema W. Grupp KG est la raison sociale extraite de la page Impressum. La même distinction s’applique à VAUDE : le libellé d’entrée est VAUDE, alors que l’entreprise renvoyée est VAUDE Sport GmbH & Co. KG. En conservant les deux valeurs, vous gardez le nom usuel employé par votre équipe tout en ajoutant l’entité juridique indiquée sur le site officiel. C’est particulièrement utile pour comparer une fiche fournisseur à une facture, un contrat ou une autre base d’entreprises susceptible d’utiliser la raison sociale complète.
Les champs renvoyés répondent à différents besoins de recherche :
firstNameetlastNamecontiennent, lorsqu’il est trouvé, le nom du dirigeant ou du fondateur extrait de la page. Ici, il s’agit de Wolfgang Grupp et d’Antje von Dewitz.postalAddressfournit l’adresse de l’entreprise extraite de la page légale, tandis que les champs d’e-mail et de téléphone reprennent les coordonnées qui y sont publiées.registrationNumberetvatNumberconservent les identifiants affichés sur la page. Pour Trigema, leurs valeurs sontHRA 740365etDE144846566; pour VAUDE,HRA 631071etDE203894755. Vous disposez ainsi de données concrètes à comparer aux identifiants déjà enregistrés dans vos fiches fournisseurs.impressumUrlidentifie la page utilisée pour l’extraction. Ce champ est distinct de la page d’accueil envoyée : l’une indique l’entreprise de départ, l’autre la source des informations juridiques.
Les deux fiches ont le statut status: success et ont consommé 10 crédits. agentConfidenceScore est un indicateur compris entre 0 et 100 qui vous aide à prioriser les vérifications. Il ne s’agit pas d’un pourcentage de précision. Certains champs de sortie peuvent rester vides lorsqu’une valeur n’apparaît pas sur la page ou ne peut pas être extraite. Conservez donc le statut de l’élément et ouvrez l’URL Impressum renvoyée lorsqu’une information est déterminante pour la suite.
Le schéma documenté peut également inclure le genre, le numéro de téléphone et d’autres coordonnées. Consultez la documentation de l’API Impressum Scraper pour connaître le schéma actuel.
Transformez les résultats en fiches fournisseurs
L’appel direct à l’API fonctionne déjà. Plaçons-le maintenant dans le contexte d’une recherche sur des fournisseurs. La prospection ou l’onboarding d’un fournisseur peut vous fournir un ID stable, le nom court employé par votre équipe et une page d’accueil. Le résultat Impressum ajoute l’entité juridique derrière ce site, ses identifiants et coordonnées publiés, ainsi que la page sur laquelle ces informations apparaissent.
Le snippet suivant indexe les résultats par inputId et crée des fiches locales de recherche sur les entreprises. Ajoutez-le après l’appel à scrape_impressums() dans le script complet :
results_by_id = {
result["inputId"]: result for result in impressum_results
}
company_research = []
for supplier in suppliers:
result = results_by_id[supplier["id"]]
company_research.append(
{
"supplier_id": supplier["id"],
"supplier_label": supplier["label"],
"website_url": supplier["website_url"],
"status": result["status"],
"outputs": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
print(json.dumps(company_research, indent=2, ensure_ascii=False))Pour Trigema, la fiche conserve supplier-trigema, le libellé d’affichage Trigema et https://www.trigema.de. L’objet outputs imbriqué ajoute Trigema W. Grupp KG, son adresse et ses identifiants, le nom de Wolfgang Grupp renvoyé par l’API, ainsi que l’URL de la page Impressum source. La fiche VAUDE suit la même logique : elle relie le libellé VAUDE et sa page d’accueil à VAUDE Sport GmbH & Co. KG et à sa propre page source. Vous pouvez désormais comparer ou regrouper les fiches par entité juridique sans perdre l’identité initiale du fournisseur à l’origine de la recherche.
La fiche rassemble les informations renvoyées, le statut de réussite de l’API, les 10 crédits consommés et l’éventuelle erreur publique avec l’ID, le libellé et le site du fournisseur.
La règle de fusion essentielle repose sur la recherche dans le dictionnaire à partir de l’ID fournisseur. Elle associe toujours le bon résultat, même si l’API renvoie VAUDE avant Trigema. Le snippet conserve également les résultats qui ont échoué dans company_research, puisqu’il ne les filtre pas par statut. Un élément no_result ou error reste ainsi disponible avec son ID et son erreur, au lieu de disparaître de votre file de vérification.
Ce code prépare des fiches de recherche locales. Vous pouvez sérialiser la liste ou la transmettre à votre propre code downstream sans effectuer d’appel API supplémentaire.
Estimez le coût de l’API
Impressum Scraper consomme un forfait fixe de 10 crédits par site envoyé. Les deux sites de l’exemple ont donc utilisé 20 crédits au total. Au même tarif, 1 000 sites consomment 10 000 crédits.
Le plan Growth donne accès à la REST API et comprend des crédits dans l’abonnement. Des recharges facultatives permettent d’en ajouter si nécessaire. L’accès au plan, les crédits inclus et les recharges constituent des composantes distinctes du coût : consultez les tarifs Datablist actuels avant de planifier un traitement plus important.
Résolvez les problèmes sans repayer un traitement
Le script s’arrête avant toute requête
Si DATABLIST_API_KEY est absente, le script affiche l’erreur Définissez DATABLIST_API_KEY avant d’exécuter ce script. Exportez la variable dans le même terminal, puis relancez le fichier :
export DATABLIST_API_KEY="your-personal-api-key"
python scrape_impressum.pyL’API rejette la requête
response.raise_for_status() interrompt le script en cas d’erreur HTTP. Vérifiez que vous avez fourni une Personal API Key valide et que votre compte dispose d’un accès à la REST API. Ce cas diffère de celui d’une variable manquante : une valeur invalide est bien envoyée à l’API, qui renvoie alors une réponse HTTP.
La tâche échoue ou s’arrête
L’erreur levée contient l’ID et le statut de la tâche. Examinez cette tâche existante, ses résultats et ses champs de crédits avant d’en créer une nouvelle. Une tâche ayant échoué ou été interrompue peut conserver des résultats et une consommation de crédits ; la répéter immédiatement risque donc de dupliquer un traitement payant.
Un résultat est incomplet
Une tâche terminée peut contenir des éléments avec le statut no_result ou error, ou des données de sortie incomplètes. Conservez les champs inputId, status, impressumUrl lorsqu’il est disponible, ainsi que l’erreur publique de la fiche. Vérifiez que l’entrée correspond bien à la page d’accueil ou au domaine racine officiel de l’entreprise, puis examinez le site avant de décider si une nouvelle recherche est pertinente.
La documentation sur les tâches présente plus en détail les statuts, la pagination des résultats, l’historique des tâches, les limites et la durée de conservation.
Prochaines étapes
Vous disposez maintenant d’une intégration Python Requests prête à l’emploi : elle envoie des sites d’entreprises allemandes, attend la fin de la tâche Impressum Scraper, récupère toutes les pages de résultats et conserve les informations structurées sur chaque société avec leurs URL sources dans des fiches locales de recherche fournisseur.
Remplacez les deux fournisseurs d’exemple par vos propres ID stables et URL de sites. Vérifiez ensuite chaque impressumUrl renvoyée avant d’utiliser les champs extraits dans votre processus downstream. Vous pouvez télécharger
l’exemple synchrone avec Requests,
qui est maintenu à jour, ou adopter
l’exemple asynchrone avec HTTPX
du dépôt lorsque vous avez besoin d’une exécution concurrente non bloquante.