
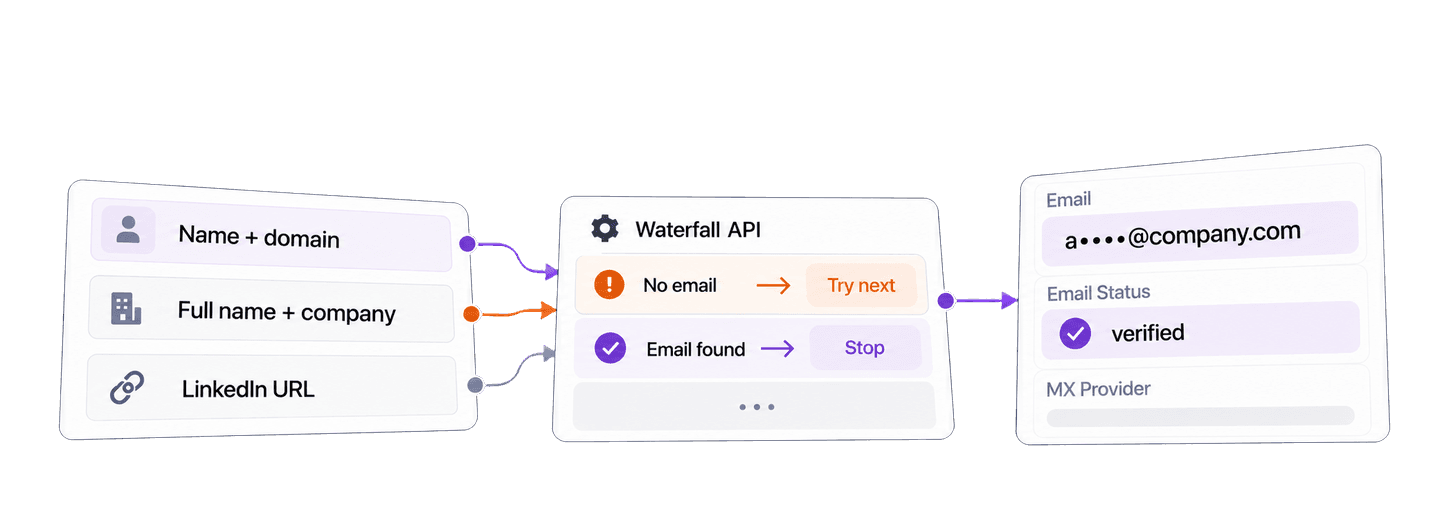
Pour trouver des emails professionnels en Python, envoyez le nom d’une personne et les informations de son entreprise, ou l’URL publique de son profil LinkedIn, à l’API Waterfall Email Finder de Datablist avec la bibliothèque Requests. L’API renvoie l’email professionnel trouvé, le statut de délivrabilité de l’adresse et son fournisseur de messagerie.
L’exemple complet ci-dessous recherche Satya Nadella chez microsoft.com et Reid Hoffman chez greylock.com. Il attend la fin de la tâche exécutée en arrière-plan, puis récupère toutes les pages de résultats. Nous réutiliserons ensuite ces résultats pour préparer en local une liste de contacts vérifiés à contrôler avant le lancement d’une campagne.
📌 Résumé pour les plus pressés
Utilisez une seule fonction Python pour envoyer vos contacts connus à l’API Waterfall Email Finder, attendre la fin de la tâche et récupérer les emails professionnels trouvés. Préparez ensuite les contacts vérifiés pour votre campagne, tout en conservant les contacts non résolus dans votre liste source.
- Entrée : prénom et nom avec le domaine d’une entreprise, nom complet avec le nom d’une entreprise, ou URL publique d’un profil LinkedIn.
- Sortie : un email professionnel accompagné de
emailStatusetmxProvider, puis une liste locale à contrôler contenant uniquement les contacts pour lesquels un email a été trouvé.
💡 Vous préférez une solution no-code ? Utilisez le Waterfall Email Finder de Datablist pour trouver des emails professionnels à partir d’une collection, sans écrire de code.
Configurer Python, Requests et votre clé API
Pour cet exemple Python, nous utilisons le package requests. Créez un fichier nommé find_work_emails.py, puis installez Requests :
python -m pip install requestsCréez une Personal API Key depuis la page API de votre compte Datablist. L’accès à la REST API nécessite le plan Growth. Exportez la clé dans le terminal depuis lequel vous exécuterez le script :
export DATABLIST_API_KEY="your-api-key"Les résultats trouvés par le Waterfall Email Finder consomment également des crédits. La section consacrée aux coûts distingue ces crédits de l’abonnement donnant accès à l’API.
Trouver des emails pro avec une fonction Python
Collez le script complet suivant dans find_work_emails.py :
import json
import os
import time
import uuid
import requests
def find_emails(people, api_key, settings):
"""Submit one email-finder task, wait, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-email-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": people,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
},
{
"inputId": "contact-reid-hoffman",
"data": {
"firstName": "Reid",
"lastName": "Hoffman",
"companyNameOrDomain": "greylock.com",
},
},
]
lookup_results = find_emails(people, api_key, settings)
for result in lookup_results:
print(json.dumps(result, indent=2))Exécutez-le depuis le même terminal :
python find_work_emails.pyVous pouvez aussi télécharger l’exemple Requests maintenu. Une fois la version bloquante bien comprise, le repository propose une alternative asynchrone avec HTTPX.
La fonction effectue successivement trois types d’appels.
D’abord, elle soumet la tâche. Chaque inputId est l’identifiant stable de votre contact. L’objet data imbriqué contient les champs utilisés pour la recherche. La requête POST renvoie 202 Accepted avec @id, l’identifiant de tâche utilisé par les appels suivants. Le code affiche uniqueId avant l’envoi afin que vous disposiez d’une valeur de récupération si la réponse se perd.
Ensuite, elle interroge le statut de la tâche. Datablist traite la tâche en arrière-plan. Ce client Requests attend et vérifie son statut toutes les trois secondes, jusqu’à ce qu’il passe à completed, failed ou stopped. Requests bloque pendant cette attente, mais la tâche API elle-même reste asynchrone.
Enfin, elle récupère les résultats. Une tâche peut comporter plusieurs pages de résultats. La boucle continue à charger les pages jusqu’à ce que nextCursor vaille null. Utilisez inputId, et non l’ordre des réponses, pour associer chaque résultat à son contact source.
Choisir le bon format pour vos données de contact
Une tâche utilise un seul mode d’entrée. Conservez la même fonction find_emails() et remplacez les valeurs de settings et people par celles correspondant à vos données source.
Choisissez un inputId unique dans la tâche et, si possible, déjà associé au contact source. L’identifiant d’une fiche CRM ou tout autre identifiant de Lead durable convient parfaitement. Datablist renvoie cette valeur avec le résultat : vous pouvez ainsi rapprocher les fiches sans comparer les noms ni supposer que les réponses suivent l’ordre des entrées.
Si vous disposez de champs de nom séparés et du domaine de l’entreprise, utilisez sourceKind: "name_company". Un domaine connu est l’identifiant d’entreprise le plus fiable :
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
}
]
lookup_results = find_emails(people, api_key, settings)Si votre source comporte un seul champ pour le nom et le nom de l’entreprise, activez useFullName :
settings = {"sourceKind": "name_company", "useFullName": True}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"fullName": "Satya Nadella",
"companyNameOrDomain": "Microsoft",
},
}
]
lookup_results = find_emails(people, api_key, settings)Si vous disposez de l’URL publique du profil d’une personne, utilisez le mode LinkedIn :
settings = {"sourceKind": "linkedin"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"linkedInProfile": "https://www.linkedin.com/in/satyanadella/"
},
}
]
lookup_results = find_emails(people, api_key, settings)Ce mode accepte une URL publique de profil au format linkedin.com/in/... comme contexte pour rechercher l’email de la personne. Les URL de profils Sales Navigator ne sont pas acceptées.
Si vous devez choisir les clés des providers et définir leur ordre, consultez le guide du waterfall personnalisé. Le waterfall géré utilisé ici ne nécessite aucune configuration propre à chaque provider.
Comment le waterfall géré trouve un email
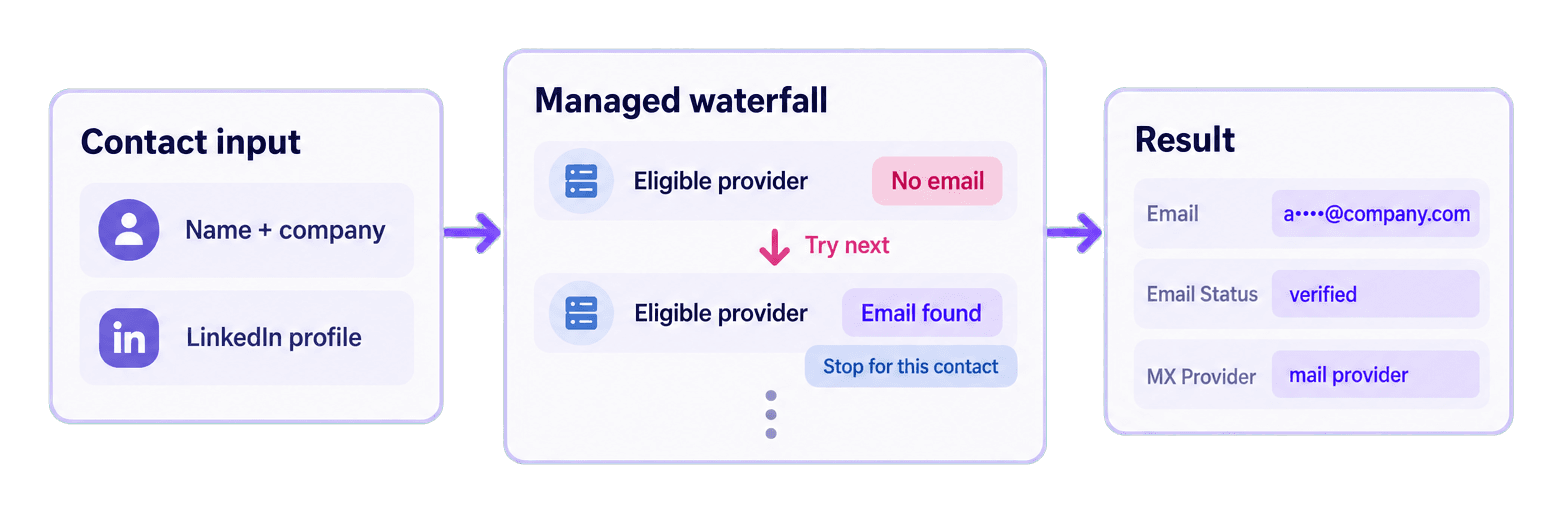
Pour une recherche basée sur le nom et l’entreprise, l’API utilise directement le domaine fourni. Si vous indiquez le nom d’une entreprise, elle tente d’abord de le convertir en un domaine exploitable. Pour une recherche LinkedIn, elle nettoie l’URL du profil public et transforme les informations disponibles sur la personne et son entreprise en un contexte utilisable par les providers d’emails éligibles.
Le waterfall géré transmet un contact non résolu à un provider éligible. Si aucun email exploitable n’est renvoyé, un autre provider éligible peut tenter de traiter le même contact. La séquence s’arrête pour ce contact dès qu’un email professionnel est accepté. La réponse par défaut n’indique pas le finder utilisé.
Pourquoi un waterfall améliore la prospection internationale
Les providers d’emails professionnels s’appuient sur des jeux de données différents. Leur couverture varie donc selon les pays et les marchés. Un provider peut ne trouver aucun résultat pour un contact dans une région, alors qu’un autre possède les données nécessaires pour identifier son adresse.
Pour une équipe sales ou growth, le waterfall offre à chaque contact non résolu de nouvelles chances d’être trouvé avant son exclusion de la liste de prospection. Il permet ainsi de récupérer des contacts qu’un workflow reposant sur un seul provider aurait manqués, tout en conservant un processus technique homogène pour l’équipe.
Datablist gère la séquence des providers éligibles derrière une seule intégration API. Vous envoyez le contact une fois et recevez un format de résultat unique, au lieu de développer et maintenir une intégration distincte pour chaque provider, puis de fusionner vous-même leurs réponses.
Lire l’intégralité des résultats
La tâche de l’exemple a renvoyé deux résultats valides. Les adresses email sont masquées ci-dessous.
{
  "taskId": "2286103ce43748828e27ce71b9cc526b",
  "results": [
    {
      "inputId": "contact-satya-nadella",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "microsoft",
        "emailFound": "s*******@microsoft.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "contact-reid-hoffman",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "mimecast",
        "emailFound": "r*******@greylock.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
emailFound correspond à l’email professionnel renvoyé. emailStatus indique sa délivrabilité au moment de la recherche, tandis que mxProvider identifie, lorsqu’il est disponible, le fournisseur qui héberge la messagerie. Les deux fiches sont verified et ont utilisé 25 crédits chacune.
Le code de campagne ci-dessous place les résultats verified dans campaign_contacts et conserve les autres adresses trouvées dans needs_verification. La valeur creditsUsed fait foi pour connaître le coût de chaque résultat.
Le résultat géré par défaut ne contient pas finderProvider. Ce champ est une sortie conditionnelle réservée à un workflow valide utilisant des clés personnalisées et une recherche par nom et entreprise. Le script ne doit donc pas le déduire de mxProvider.
Préparer les emails trouvés pour votre campagne
Une fois la recherche directe opérationnelle, ajoutez ce bloc à la fin du script, après le retour de lookup_results. Il prépare en local les contacts à contrôler avant la campagne à partir de la recherche déjà effectuée.
results_by_id = {result["inputId"]: result for result in lookup_results}
campaign_contacts = []
needs_verification = []
for person in people:
result = results_by_id.get(person["inputId"])
if result is None:
continue
if result["status"] != "success":
continue
if not result["outputs"].get("emailFound"):
continue
contact = person.copy()
contact["result"] = result
if result["outputs"].get("emailStatus") == "verified":
campaign_contacts.append(contact)
else:
needs_verification.append(contact)
print(json.dumps({
"campaign_contacts": campaign_contacts,
"needs_verification": needs_verification,
}, indent=2))Grâce à results_by_id, l’ordre des réponses n’a aucune importance. Pour Satya, la boucle lit contact-satya-nadella dans la liste people d’origine, trouve le résultat portant le même inputId, copie la fiche source et rattache l’objet API complet sous result. Comme l’adresse est présente et que son statut est verified, le contact est ajouté à campaign_contacts. Reid suit le même parcours, même si son résultat API arrive en premier.
Les trois conditions rendent la décision facile à comprendre. La première ignore un contact si aucun résultat correspondant n’a été renvoyé. La deuxième écarte les erreurs au niveau de la ligne et les autres statuts différents de success. La troisième exige une valeur emailFound. Le rattachement de l’objet result complet conserve le statut, les sorties, les crédits consommés et le champ d’erreur pour un contrôle ultérieur.
Un email trouvé avec un autre statut de délivrabilité est ajouté à needs_verification. Un résultat absent, une erreur sur la ligne ou un résultat sans emailFound n’intègre aucune des deux listes préparées. La liste people d’origine reste disponible pour apporter des corrections ou effectuer des recherches complémentaires.
Estimer le coût de l’API Waterfall Email Finder
Le waterfall géré par défaut utilise 25 crédits par email professionnel trouvé. Une recherche par défaut sans résultat consomme 0 crédit. Consultez creditsUsed dans chaque résultat au lieu de multiplier le nombre total de contacts envoyés.
Un email trouvé avec le statut unverified consomme tout de même 25 crédits, même si le code local de la campagne le place dans needs_verification plutôt que dans campaign_contacts.
Les deux emails trouvés dans cet exemple ont utilisé 50 crédits. Pour établir votre budget :
- 100 emails professionnels trouvés utilisent 2 500 crédits.
- 1 000 emails professionnels trouvés utilisent 25 000 crédits.
- Une liste d’entrée plus importante peut utiliser moins de crédits que
contacts × 25, car les recherches sans résultat ne sont pas facturées.
L’accès à la REST API nécessite le plan Growth. Au tarif actuel des recharges en USD, 20 $ permettent d’acheter 20 000 crédits, soit 0,001 $ par crédit. À ce tarif, 25 000 crédits représentent une valeur de 25 $. L’abonnement est facturé séparément de ces crédits. Consultez la page des tarifs Datablist pour connaître les offres et packs actuellement disponibles.
Corriger les erreurs courantes et récupérer une tâche
La clé API est absente. Le script génère l’erreur Set DATABLIST_API_KEY before running this script. avant toute requête. Exportez la variable dans le terminal actuel, puis relancez le fichier.
L’API renvoie une erreur d’authentification. raise_for_status() signale l’échec HTTP. Copiez une Personal API Key valide, vérifiez que le header X-API-Key l’utilise bien, puis relancez le script après avoir corrigé les identifiants.
Le compte ne dispose pas de suffisamment de crédits. Vérifiez le solde du compte. Ajoutez des crédits ou attendez la prochaine allocation incluse dans votre plan avant d’envoyer de nouvelles tâches.
Les champs d’entrée ne correspondent pas au mode sélectionné. Utilisez des champs de nom séparés ou fullName avec name_company, ou linkedInProfile avec linkedin. Corrigez le contact et envoyez-le avec un mode unique et cohérent.
La tâche est failed ou stopped. Le script génère une RuntimeError contenant l’identifiant de la tâche, son statut final et l’éventuelle erreur disponible. Examinez cette tâche et tous les résultats accessibles avant de décider quels contacts doivent faire l’objet d’une nouvelle recherche.
La réponse POST a été perdue. Copiez le uniqueId affiché avant l’envoi. Listez vos tâches avec la même clé :
curl "https://api.datablist.com/v1/enrichments/tasks" \
-H "X-API-Key: $DATABLIST_API_KEY"Repérez la tâche portant le uniqueId affiché, copiez son @id, puis poursuivez avec l’URL de statut ou de résultats de la tâche. Vous récupérez ainsi la tâche existante sans renvoyer automatiquement les contacts. La documentation de l’API des tâches décrit leur cycle de vie et les endpoints de résultats.
Prochaines étapes
Vous disposez maintenant d’une fonction Python Requests bloquante compatible avec les trois modes d’entrée, ainsi que d’un filtre local qui prépare les emails trouvés et vérifiés pour le contrôle de votre campagne.
Remplacez les deux contacts d’exemple par un petit échantillon des contacts issus de vos recherches. Choisissez le mode d’entrée adapté à vos données, lancez la recherche et contrôlez emailStatus avant d’utiliser une adresse. Pour traiter des listes plus larges, découvrez comment trouver des emails à grande échelle. Le repository GitHub maintenu contient les exemples Python bloquant et asynchrone à télécharger.