
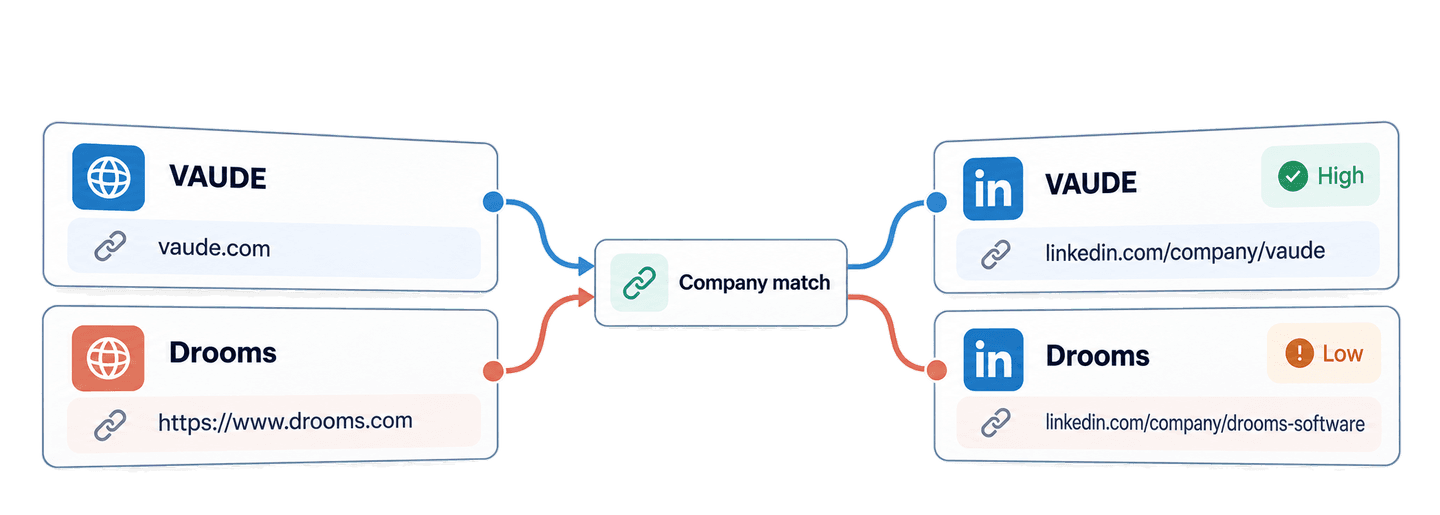
Usa la Company to LinkedIn API di Datablist per trovare la pagina LinkedIn di un'azienda a partire dal suo sito web con Python. Puoi inviare un dominio semplice o l'URL completo del sito, attendere il completamento del task di matching e ricevere il nome dell'azienda, il sito web, l'URL della pagina LinkedIn aziendale e un indicatore di confidence.
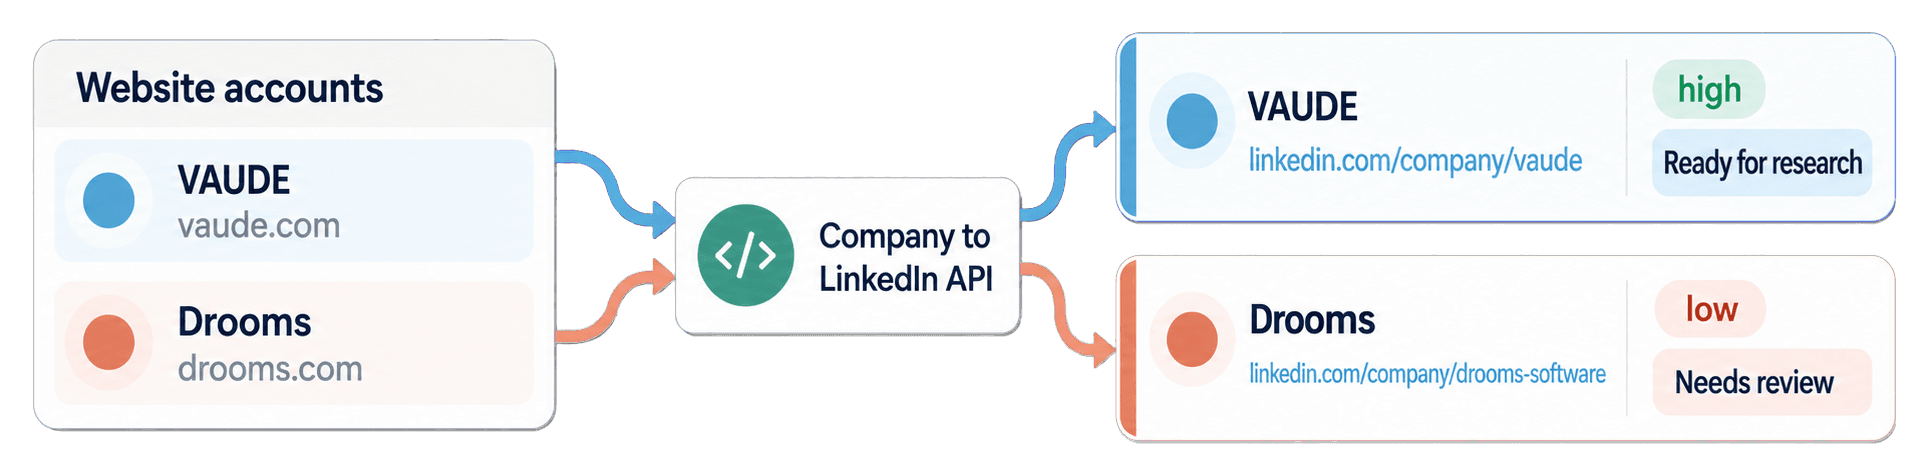
In questa guida uso Python e la libreria Requests per trovare le corrispondenze di cinque siti aziendali. L'elenco comprende note software company, oltre a VAUDE, un'azienda di attrezzature outdoor, e Drooms, una società specializzata in virtual data room. Infine, organizzo i risultati in due code locali: le corrispondenze pronte per la ricerca aziendale e quelle da verificare manualmente.
🔑 Riepilogo per chi ha poco tempo
Invia i siti web della tua lista di account alla Company to LinkedIn API di Datablist. L'API restituisce gli URL delle pagine LinkedIn aziendali e indicatori di confidence che ti aiutano a decidere quali corrispondenze usare e quali verificare.
- Input: domini semplici e URL completi dei siti aziendali.
- Output: nomi delle aziende, siti web associati, URL delle pagine LinkedIn aziendali e confidence
higholow, suddivisi nelle codeReady for researcheNeeds review.
💡 Preferisci una soluzione no-code? Usa LinkedIn Company Pages & Domain Lookup di Datablist per associare siti aziendali e pagine LinkedIn senza scrivere codice.
Configurare Python e la chiave API Datablist
Per questo esempio uso il package requests. L'API funziona tramite HTTP, quindi in seguito potrai adattare la stessa sequenza di richieste a un altro linguaggio.
Ti serve un account Datablist con accesso alla REST API, disponibile con il piano Growth. Anche le ricerche completate con successo consumano crediti di enrichment. Più avanti nella guida trovi il calcolo esatto dei crediti.
Crea una directory di lavoro e un file chiamato find_linkedin_company_pages.py, quindi crea un ambiente virtuale e installa Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyCrea una Personal API Key dal tuo account Datablist, quindi esportala come variabile d'ambiente:
export DATABLIST_API_KEY="your-api-key"Lo script legge questo valore e lo invia nell'header X-API-Key.
Trovare pagine LinkedIn aziendali con una funzione Python
L'esempio usa questi cinque account di origine:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
Ogni account_id diventa l'inputId dell'API. È importante perché i risultati non vengono necessariamente restituiti nello stesso ordine degli input. Un ID stabile permette di collegare ogni risultato all'account di origine corretto.
Incolla lo script completo seguente in find_linkedin_company_pages.py:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))Eseguilo con:
python find_linkedin_company_pages.pyLa funzione effettua tre tipi di chiamate, in quest'ordine.
Per prima cosa, la richiesta POST invia i cinque siti web con matchingDirection impostato su domain_to_linkedin. L'API risponde con 202 Accepted e un task ID, perché il matching viene eseguito in background. Lo script basato su Requests mantiene comunque un flusso sequenziale, poiché attende prima di passare allo step successivo.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]In secondo luogo, la richiesta di stato controlla il task finché non diventa completed, failed o stopped. La pausa di tre secondi evita che lo script invii richieste di stato senza interruzione.
Infine, la richiesta dei risultati legge pagine contenenti fino a 100 risultati. Se nextCursor contiene un valore, il loop lo invia come cursor nella richiesta successiva. Si interrompe soltanto quando nextCursor è null.
Leggere le corrispondenze e scegliere cosa verificare
Ecco l'elenco completo dei risultati per i cinque input:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
Leggi status e confidence separatamente. L'API restituisce un oggetto risultato per ogni input, inclusi quelli senza esito positivo. Lo stato success indica che è stata trovata una possibile pagina aziendale. Il valore outputs.confidence segnala se la corrispondenza con il sito web è stata convalidata. inputId collega l'oggetto all'account di origine, mentre creditsUsed registra il costo di quella riga ed error contiene un errore strutturato, quando presente.
Conserva nella tua applicazione l'intero oggetto outputs, anche se nella prima schermata ti servono soltanto l'URL LinkedIn e la confidence. companyName e companyWebsite velocizzano la verifica manuale, soprattutto quando il nome restituito usa maiuscole e minuscole diverse o quando l'input era un URL completo. Forniscono inoltre un contesto utile senza richiedere un'altra chiamata API.
Il processo di matching inizia normalizzando il sito inviato e cercando nei dataset aziendali una relazione nota tra sito web e LinkedIn. Poi confronta il dominio di input con il sito pubblicato nella possibile pagina LinkedIn aziendale. La corrispondenza del dominio registrato produce una confidence high.
Quando i dataset non contengono un URL LinkedIn, la ricerca può eseguire una query mirata su Google per individuare possibili pagine aziendali. Un risultato che non può essere convalidato rispetto a un sito pubblicato può essere restituito con confidence low. Una discrepanza nota tra i siti non viene accettata.
Considera la confidence come un'indicazione per la verifica. VAUDE ha restituito https://www.linkedin.com/company/vaude con confidence high, quindi può entrare nella coda di ricerca. Drooms ha restituito https://www.linkedin.com/company/drooms-software con confidence low. Apri il sito di Drooms e la pagina LinkedIn prima di fare affidamento su questa corrispondenza.
Anche Datablist, PostHog e n8n hanno restituito corrispondenze con confidence elevata. Questa API individua la relazione tra il sito web e la pagina aziendale. Se, dopo aver verificato l'URL, ti servono dimensioni dell'azienda, settore o altri dati della pagina, consulta la guida alla LinkedIn company scraper API come step successivo.
Preparare una coda per la ricerca sugli account
Ora riutilizza match_results per preparare una coda locale destinata alla ricerca manuale sulle aziende. Questo blocco non chiama nuovamente l'API. Indicizza i risultati per inputId, quindi scorre la lista originale degli account: in questo modo ogni account di origine rimane visibile anche se in futuro dovesse mancare un risultato.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))Il dizionario dei risultati rende il collegamento indipendente dall'ordine della risposta. account-vaude associa il record originale vaude.com alla pagina VAUDE acquisita ed entra in ready_for_research. account-drooms conserva l'URL completo di input e l'intero risultato dell'API, ma entra in needs_review perché la confidence è bassa, anche se lo stato del risultato è success.
La stessa logica mantiene nella coda di verifica anche una riga mancante, con stato no_result o con un errore. Le due liste stampate offrono al team un punto di partenza chiaro per la ricerca manuale sulle aziende.
Puoi anche scaricare l'esempio sincrono con Requests, mantenuto e aggiornato. Il repository include un esempio asincrono con HTTPX per le applicazioni che richiedono HTTP non bloccante, ma la versione bloccante riportata sopra è più semplice da seguire per una prima integrazione.
Dalla pagina LinkedIn aziendale al sito web
La stessa funzione accetta pagine LinkedIn aziendali quando cambi la direzione del matching. È utile se la lista di origine contiene gli URL delle pagine aziendali e ti servono i siti web prima di un enrichment compatibile relativo all'azienda o alle email di lavoro.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)Una ricerca standard da pagina LinkedIn aziendale usa la normale tariffa di matching. Gli ID aziendali numerici e gli URL aziendali di Sales Navigator possono consumare 10 crediti, perché seguono un percorso di reverse lookup diverso. Per una versione no-code di questa procedura, scopri come ottenere gli URL dei siti dalle pagine LinkedIn aziendali.
Stimare i crediti per trovare LinkedIn da un sito
Una normale ricerca da sito web a LinkedIn completata con successo usa 1,5 crediti. Le cinque corrispondenze mostrate hanno quindi consumato 7,5 crediti. Alla stessa tariffa, 1.000 corrispondenze riuscite richiedono 1.500 crediti. Gli input non validi e le righe senza risultati possono consumare zero crediti: controlla il valore creditsUsed di ogni risultato per conoscere l'utilizzo effettivo.
L'accesso alla REST API è incluso nel piano Growth e l'abbonamento mensile è separato dai crediti top-up. Un top-up da 20 $ offre 20.000 crediti, quindi un credito costa 0,001 $. Con 1,5 crediti per ogni corrispondenza riuscita, 1.000 corrispondenze consumano 1.500 crediti, pari a 1,50 $. Consulta i prezzi di Datablist per conoscere piani e pacchetti aggiornati.
Risolvere i problemi di input, task e risultati
- Manca
DATABLIST_API_KEY: lo script si interrompe prima di inviare una richiesta. Esporta la variabile d'ambiente ed esegui nuovamente il comando. - L'API rifiuta la chiave: verifica di aver copiato una Personal API Key e che la richiesta la invii esclusivamente in
X-API-Key. - L'input non è supportato: per
domain_to_linkedin, usa il sito o il dominio di un'azienda. Per la direzione inversa, usa l'URL supportato di una pagina aziendale, non un profilo personale o un valore vuoto. - I crediti non sono sufficienti: controlla il saldo, quindi usa i crediti inclusi o aggiungi un top-up prima di creare un altro task.
- Il task è
failedostopped: esamina lo stato del task, l'errore, i risultati già disponibili e l'utilizzo dei crediti prima di decidere se inviarlo di nuovo. - Un risultato ha confidence bassa, è
no_resulto contiene un errore: conserva il sito web di origine e il risultato completo inneeds_review. Apri la pagina candidata, se presente, e non fare supposizioni sul motivo per cui manca un risultato.
Se la connessione si interrompe durante la creazione del task, usa il uniqueId stampato prima della richiesta POST. Elenca i tuoi task e cerca quel valore prima di crearne un altro:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"La lista dei task non può essere filtrata per uniqueId, quindi esamina ogni task restituito e segui nextCursor, se necessario. Una volta trovato il valore corrispondente, usa il relativo @id con gli stessi URL di stato e dei risultati usati dallo script.
Un singolo task può contenere fino a 10.000 input. Per conoscere tutti i limiti relativi a richieste, conservazione dei task e paginazione, consulta la documentazione della Company to LinkedIn API.
Prossimi passi
Ora hai una funzione Python Requests riutilizzabile che trasforma i siti aziendali in possibili pagine LinkedIn. La coda locale mantiene le corrispondenze con confidence elevata pronte per la ricerca e lascia visibili i record incerti o senza esito per la verifica.
Sostituisci i cinque esempi con una piccola lista di account, verifica ogni risultato con confidence bassa e usa gli URL approvati per la ricerca manuale sulle aziende o come input della LinkedIn company scraper API. Se la tua lista di origine contiene nomi di aziende anziché siti web, parti dalla guida alla company website finder API.