
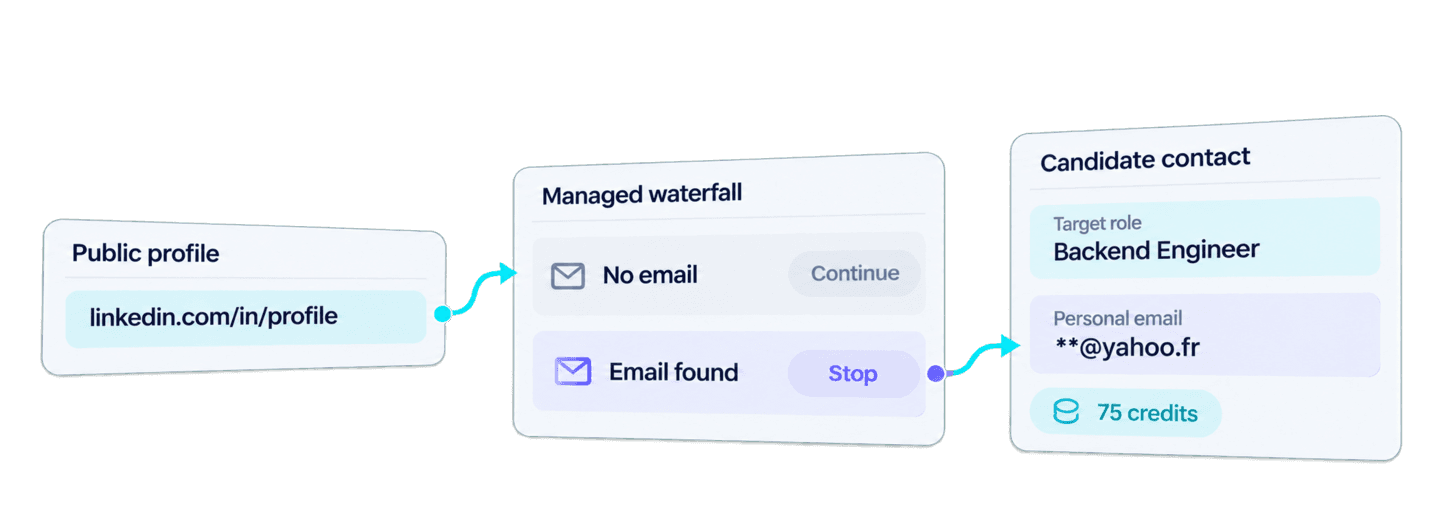
Puoi trovare email personali da LinkedIn con Python inviando gli URL pubblici dei profili linkedin.com/in/... alla Waterfall Personal Email Finder API di Datablist. L’API esegue una sequenza gestita di provider email idonei e restituisce un indirizzo personale non appena uno di essi trova un risultato.
L’esempio completo con Requests qui sotto invia un task in background, ne attende il completamento e recupera tutte le pagine dei risultati. Una volta verificato il funzionamento della ricerca, riutilizzerai gli oggetti restituiti per preparare record di contatto per il recruiting, mantenendo nome del candidato, URL LinkedIn e ruolo target accanto all’email trovata.
Questo workflow cerca un indirizzo email personale indipendente dall’attuale datore di lavoro del candidato. Se invece ti serve un indirizzo collegato alla sua azienda, consulta la guida dedicata per trovare un’email di lavoro da un profilo LinkedIn.
🔑 Riepilogo per chi va di fretta
Fornisci nomi dei candidati, URL pubblici dei profili LinkedIn e ruoli target. Il workflow Python trova le email personali disponibili e associa ogni indirizzo ai dati di recruiting di partenza.
- Input: nomi dei candidati, URL pubblici dei profili
linkedin.com/in/...e ruoli target.- Output: email personali trovate e associate ai dati del candidato corrispondente.
💡 Preferisci una soluzione no-code? Usa il Waterfall Personal Email Finder di Datablist per trovare email personali senza scrivere codice.
Se i dati di partenza contengono i nomi ma non gli URL dei profili, prima trova i profili LinkedIn pubblici con Python, quindi passa gli URL a questa API.
Configurare Python, Requests e la chiave API Datablist
Per questo esempio uso Python con il package requests. Crea un file chiamato find_personal_emails.py, quindi installa Requests:
python -m pip install requestsCrea una Personal API Key nel tuo account Datablist ed esportala come variabile d’ambiente:
export DATABLIST_API_KEY='your-api-key'L’accesso alla REST API è disponibile con il piano Growth. Ogni email personale trovata consuma inoltre dei crediti, che calcoleremo nella sezione dedicata ai costi.
Trovare un’email personale con una funzione Python
La lista modificabile candidates di questo script contiene un record di recruiting. target_role è un valore di esempio proveniente dalla fonte e rimane nel workflow locale. Nel payload dell’API vengono inclusi solo candidate_id e linkedin_url.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Invia un task, ne attende il completamento e restituisce tutti i risultati."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"UniqueId per il recupero: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Imposta DATABLIST_API_KEY prima di eseguire lo script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))Esegui il file dallo stesso terminale:
python find_personal_emails.pyPuoi anche scaricare l’esempio sincrono con Requests, mantenuto e aggiornato. Lo script qui sopra conserva la stessa sequenza di invio, polling e paginazione, utilizzando gli ID dei candidati presenti nei record di origine.
Inviare la ricerca
La funzione trasforma ogni candidato in un input per l’API. inputId riceve l’ID stabile del candidato, mentre data.profileUrl riceve l’URL pubblico del suo profilo LinkedIn. È necessario un URL standard nel formato linkedin.com/in/.... Gli URL di Sales Navigator, le pagine aziendali, i valori vuoti e i nomi senza URL del profilo non sono input validi per questo enrichment.
La richiesta usa waterfall-personal-email-finder come enrichmentId e un oggetto settings vuoto, come illustrato nella documentazione della Waterfall Personal Email Finder API. Prima dell’invio, lo script mostra il uniqueId generato. Conservalo: ti permetterà di identificare un task esistente se la connessione si interrompe dopo che l’API ha accettato la richiesta.
Ecco il body completo della richiesta per l’esempio con un solo profilo:
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
Se l’invio va a buon fine, l’API restituisce HTTP 202 Accepted con l’ID del task nel campo @id. Dopo questa risposta, l’elaborazione prosegue sui server di Datablist.
Attendere il task in background
Lo script Requests resta in attesa in locale mentre il server esegue il task in background. Controlla il task ogni tre secondi e continua finché lo stato è queued o running. Quando il task risulta completed, passa al recupero dei risultati. Se lo stato è failed o stopped, genera un errore con l’ID del task e l’eventuale messaggio disponibile.
Recuperare tutte le pagine dei risultati
L’endpoint dei risultati restituisce per ogni riga l’ID di origine, lo stato, gli output, i crediti e l’errore. La prima richiesta recupera fino a 100 risultati. Lo script continua a scaricare le pagine successive finché nextCursor non è null.
I risultati del task mantengono l’ordine degli input. Il campo inputId continua a collegare esplicitamente ogni risultato al relativo record del candidato, anche quando i risultati occupano più pagine.
Quando adatti l’esempio a un numero maggiore di record, mantieni stabile ogni candidate_id proveniente dal sistema di origine. Questo valore rende prevedibile il join anche quando il task produce più pagine di risultati.
Come il waterfall trova un’email personale
Datablist pulisce l’URL pubblico del profilo LinkedIn inviato e passa i profili ancora senza risultato attraverso una sequenza di provider di email personali idonei. Se un provider non restituisce un indirizzo utilizzabile, il profilo può passare al provider successivo. Quando viene trovata un’email valida, la sequenza si interrompe per quel profilo e l’indirizzo viene restituito come outputs.emailFound.
I provider idonei sono gestiti da Datablist, quindi la tua integrazione non richiede richieste specifiche per ciascun provider né codice di fallback. Il risultato pubblico comunica l’esito della ricerca dell’email, senza esporre un ordine fisso dei provider o la cronologia dei tentativi.
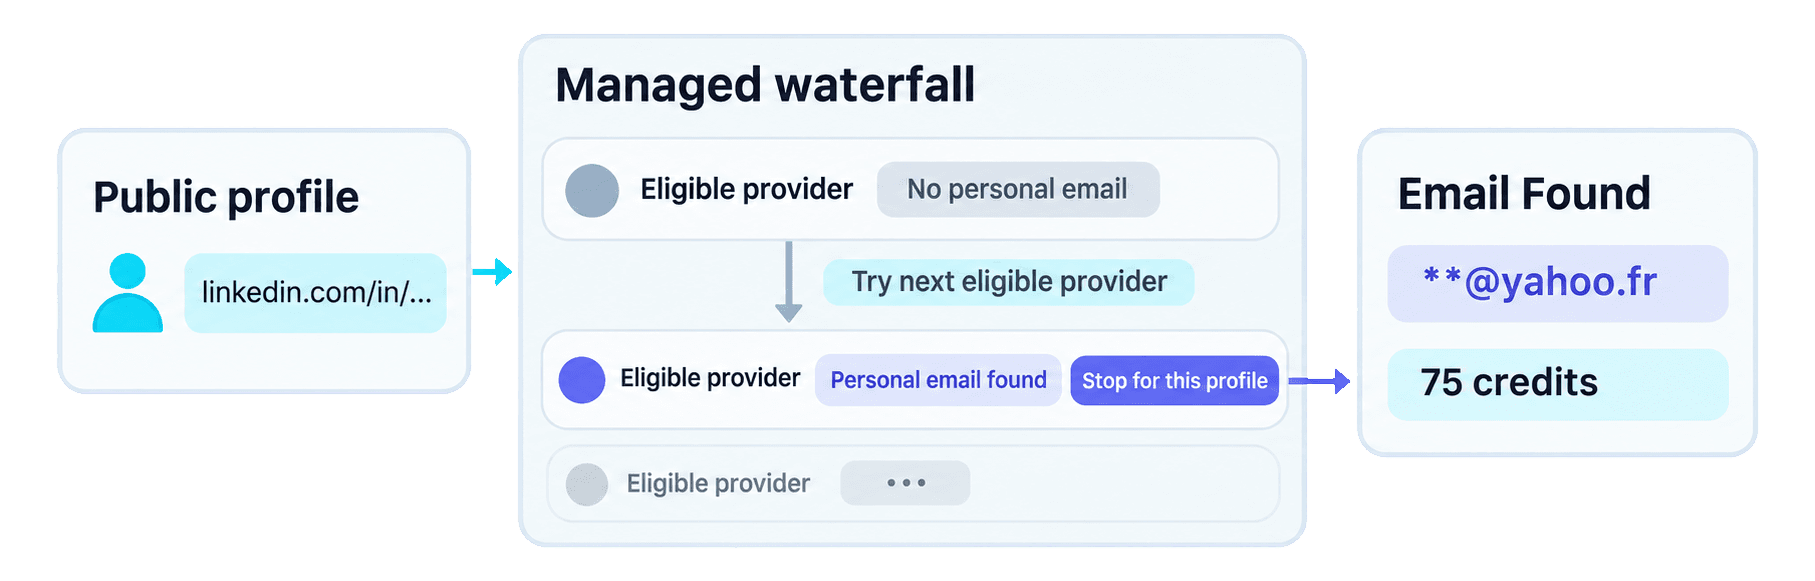
Il waterfall è il metodo di ricerca. Il polling svolge un compito diverso: consente al client Python di attendere il completamento dell’elaborazione in background.
Perché il waterfall aiuta i team di recruiting internazionali
I provider di email personali usano dataset differenti, quindi la loro efficacia varia in base al Paese e al mercato. Se il primo provider non trova l’email di un candidato, un altro provider del waterfall potrebbe riuscirci.
I team di recruiting attivi in più Paesi ottengono una copertura più ampia attraverso un’unica integrazione API. Datablist gestisce la sequenza, consentendo al team di recuperare contatti che una ricerca basata su un solo provider potrebbe non trovare, senza dover collegare e mantenere diverse API.
Leggere il risultato completo
📘 Email mascherata: nell’esempio qui sotto, la parte locale dell’indirizzo è sostituita da
**. Il risultato della tua API contiene il valore completo.
Ecco la pagina completa dei risultati per il candidato inserito:
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
inputId è la chiave di join con il candidato di origine. outputs.emailFound contiene l’indirizzo personale. creditsUsed indica il costo effettivo e definitivo della riga, mentre error: null significa che l’API non ha restituito errori a livello di riga. Il cursore nullo conferma che non esistono altre pagine di risultati.
Considera l’indirizzo come un’opzione di contatto associata al profilo inviato e verificalo prima di utilizzarlo nel recruiting.
Preparare i contatti dei candidati per la revisione
Una volta ottenuti i risultati, puoi preparare in locale una lista da sottoporre ai recruiter, senza effettuare un’altra richiesta API. Il blocco seguente riutilizza le variabili candidates e personal_email_results già esistenti:
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))Per candidate-florian-poullin, la ricerca nel dizionario individua il risultato con lo stesso inputId. Il record copiato conserva il nome di Florian Poullin, l’URL LinkedIn e il ruolo target di esempio Backend Engineer. Aggiunge poi l’oggetto completo restituito dall’API nel campo result, dal quale il recruiter può leggere result.outputs.emailFound.
Il loop parte dalla lista originale dei candidati. In futuro, un risultato mancante, un errore di riga, una ricerca senza esito o un campo emailFound vuoto lasceranno invariata la lista di origine e non verranno aggiunti a prepared_contacts.
Per un processo di revisione più ampio e altri canali di contatto, consulta la guida su come trovare l’indirizzo email di un candidato per il recruiting.
Stimare i costi della Personal Email Finder API
Ogni email personale trovata utilizza 75 crediti. Una ricerca senza risultati utilizza 0 crediti. Per conoscere la spesa effettiva, leggi creditsUsed in ciascun risultato invece di moltiplicare il numero totale di profili inviati.
La formula per la stima è:
email personali trovate × 75 crediti
Ad esempio, se invii 100 profili e 20 restituiscono un’email personale, il task utilizza 20 × 75 = 1.500 crediti. Si tratta di un semplice calcolo di pianificazione, non di un tasso di successo previsto. Per volumi maggiori, 100 email trovate utilizzano 7.500 crediti e 1.000 email trovate ne utilizzano 75.000.
Con l’attuale tariffa base di ricarica in USD, $20 / 20.000 crediti = $0,001 per credito. Un’email trovata consuma quindi crediti per un valore di $0,075, mentre 100 email trovate corrispondono a $7,50. Questa stima valorizza i crediti utilizzati. L’abbonamento Growth necessario per accedere alla REST API è separato. Consulta i prezzi di Datablist per verificare i piani e i pacchetti di crediti disponibili.
Risolvere gli errori e recuperare un task esistente
La maggior parte dei problemi si verifica prima dell’invio, durante la richiesta HTTP o in un singolo risultato. Individua dove si verifica l’errore per scegliere l’azione successiva:
DATABLIST_API_KEYmancante: lo script si interrompe in locale prima di effettuare una richiesta. Esporta la variabile d’ambiente, quindi esegui nuovamente il file.- Errore di autenticazione HTTP: verifica la Personal API Key in
DATABLIST_API_KEY. La funzione la invia nell’headerX-API-Key. Correggi le credenziali prima di effettuare un nuovo invio. - URL del profilo non supportato: sostituisci un URL di Sales Navigator, una pagina aziendale, un valore vuoto o un URL non valido con un profilo personale pubblico nel formato
linkedin.com/in/.... - Crediti insufficienti: controlla il saldo dell’account e i crediti disponibili prima di inviare altri task.
- Il task è
failedostopped: esamina l’errore del task, i risultati disponibili e i crediti utilizzati prima di decidere quali elementi devono ancora essere elaborati. - Una riga non ha risultati o contiene un errore: conserva il candidato originale per la revisione o per un altro canale di contatto. Una ricerca senza esito non spiega perché l’indirizzo non fosse disponibile.
Se la risposta POST va persa, elenca i tuoi task prima di crearne uno nuovo. Cerca nella risposta il uniqueId mostrato dallo script, quindi copia il campo @id del task corrispondente:
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"Se il task corrispondente non compare nella prima risposta della cronologia, segui il cursore di paginazione restituito e controlla la pagina successiva. Continua a monitorare il task recuperato o scarica i risultati disponibili, invece di creare automaticamente un altro task a pagamento. La documentazione sui task descrive il ciclo di vita, la paginazione e i tempi di conservazione dei risultati.
Prossimi passi
Ora disponi di una funzione Python Requests riutilizzabile per gli URL pubblici dei profili LinkedIn e di un merge basato su ID stabili, che associa le email personali trovate al contesto originale di ciascun candidato.
Sostituisci la shortlist di esempio con un piccolo gruppo di candidati, mantieni un ID stabile e un ruolo target per ciascuno, quindi verifica ogni contatto preparato prima di utilizzarlo nel processo di recruiting. Quando la tua applicazione richiederà concorrenza non bloccante, usa l’esempio asincrono con HTTPX, mantenuto e aggiornato, come passo successivo dell’implementazione.