
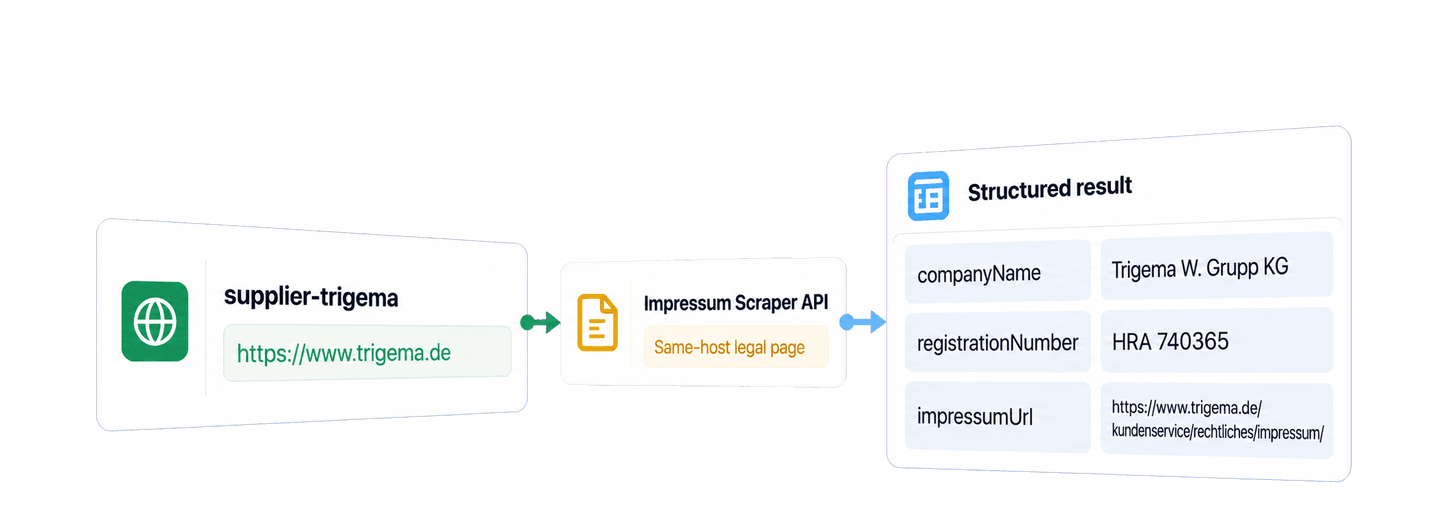
커스텀 크롤러를 직접 구축하지 않고 Python으로 Impressum 데이터를 스크래핑하려면 Requests 라이브러리와 Datablist의 Impressum Scraper API를 사용하세요. 회사 웹사이트 URL을 전달하면 API가 각 사이트의 Impressum 페이지를 찾아 회사 및 연락처 정보를 구조화된 형태로 추출합니다.
레코드에 회사명만 있고 웹사이트 URL이 없다면 먼저 Python으로 회사 웹사이트 찾기를 이용하세요. 반환된 사이트가 찾으려는 회사의 공식 웹사이트인지 확인한 후 Impressum scraper에 전달해야 합니다.
이 예시에서는 독일의 대표적인 두 브랜드인 의류 제조업체 Trigema와 아웃도어 브랜드 VAUDE를 사용합니다. 바로 실행할 수 있는 간단한 Python 예제로 조회를 수행한 뒤, 추출한 정보와 원본 Impressum URL을 각 공급업체 레코드에 함께 저장합니다.
📌 바쁜 분을 위한 요약
Datablist의 Impressum Scraper API를 사용하면 독일 기업 웹사이트를 구조화된 회사 및 연락처 데이터로 변환할 수 있습니다. Python 예제는 두 웹사이트를 제출하고 백그라운드 작업이 끝날 때까지 기다린 다음, 모든 결과 페이지를 가져와 각 레코드에 확인된 법적 고지 페이지 URL을 저장합니다.
- Input: 독일 기업 웹사이트 URL
- Output: 회사 및 연락처 정보와 원본 Impressum 링크
💡 노코드 방식이 더 편하신가요? 코드를 작성하지 않고 회사 정보를 추출하려면 Datablist의 **Impressum Scraper**를 사용하세요.
API 키와 Python 환경 설정
Datablist 계정을 만든 다음 Personal API Key를 생성하세요. REST API는 Growth 플랜에서 이용할 수 있습니다. 키 형식은 다음과 같습니다.
exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2🔑 이미 API 키가 있나요? 이전 키는
auth0|<userId>:<accountId>:<secret>:1형식이며 계속 지원됩니다. 생성된 키를 그대로 사용하세요. 교체하거나 형식을 바꿀 필요가 없습니다.
본인의 키를 DATABLIST_API_KEY로 export합니다.
export DATABLIST_API_KEY="your-personal-api-key"이 Python 예제에서는 requests 패키지를 사용합니다. scrape_impressum.py라는 파일을 만들고 패키지를 설치하세요.
python -m pip install requests제출한 웹사이트 하나당 10 credits가 사용됩니다. 아래 예제에서 두 입력이 모두 처리되면 총 20 credits가 차감됩니다.
scrape_impressums() 함수 만들기
아래 전체 스크립트를 scrape_impressum.py에 붙여 넣으세요.
import json
import os
import time
import uuid
import requests
def scrape_impressums(suppliers, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]
payload = {
"enrichmentId": "impressum-scraper",
"uniqueId": str(uuid.uuid4()),
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
suppliers = [
{
"id": "supplier-trigema",
"label": "Trigema",
"website_url": "https://www.trigema.de",
},
{
"id": "supplier-vaude",
"label": "VAUDE",
"website_url": "https://www.vaude.com",
},
]
impressum_results = scrape_impressums(suppliers, api_key)
for result in impressum_results:
print(json.dumps(result, ensure_ascii=False))다음 명령어로 전체 스크립트를 실행합니다.
python scrape_impressum.py이 함수는 세 단계로 API를 처리합니다. 웹사이트 입력을 제출하고, 작업이 끝날 때까지 기다린 다음, 모든 결과 페이지를 가져옵니다.
웹사이트 입력 제출
스크립트는 각 공급업체를 다음과 같은 API input으로 변환합니다.
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]inputId는 사용자가 지정하는 고유하고 안정적인 식별자입니다. data.websiteUrl은 scraper가 확인할 회사 홈페이지입니다. 디렉터리나 소셜 프로필이 아니라 해당 기업의 공식 웹사이트를 사용하세요. Payload는 공개 impressum-scraper enrichment를 선택합니다. 이 API에는 별도의 공개 설정이 필요하지 않으므로 빈 settings 객체를 사용합니다.
POST 요청은 백그라운드 작업을 생성합니다. Datablist가 요청을 접수하면 해당 실행을 식별하는 @id가 포함된 task 객체를 반환합니다. 함수는 이 ID로 상태 및 결과 URL을 만듭니다.
축약한 생성 응답은 다음과 같습니다.
{
  "@id": "task-id",
  "enrichmentId": "impressum-scraper",
  "status": "queued",
  "links": {
    "self": "https://api.datablist.com/v1/enrichments/tasks/task-id",
    "results": "https://api.datablist.com/v1/enrichments/tasks/task-id/results"
  }
}queued는 요청이 접수되었다는 뜻이며, 결과가 준비되었다는 의미는 아닙니다. 스크립트가 반환된 @id를 다음 두 단계에 전달하므로 task URL을 직접 복사할 필요가 없습니다. 또한 각 응답을 읽기 전에 raise_for_status()를 호출합니다. 따라서 인증 또는 유효성 검사 오류가 발생하면 완료된 조회로 잘못 처리되지 않고, 실패한 HTTP 요청 단계에서 즉시 중단됩니다.
백그라운드 작업 완료 대기
Datablist는 task를 백그라운드에서 처리합니다. 예제는 상태가 completed, failed, stopped 중 하나가 될 때까지 3초마다 확인합니다. Requests는 blocking 방식의 Python 라이브러리이므로 API task 자체는 백그라운드에서 실행되지만, 이 호출 중에는 로컬 스크립트가 대기합니다.
Task가 failed 또는 stopped로 끝나면 함수는 task ID와 최종 상태가 포함된 오류를 발생시킵니다. 같은 유료 작업을 곧바로 다시 제출하지 말고, 해당 ID를 보관해 기존 task를 조사하세요.
모든 결과 페이지 가져오기
Task가 완료되면 스크립트는 한 번에 최대 100개의 결과를 요청합니다. 페이지네이션 규칙은 간단합니다. nextCursor가 null이 될 때까지 다음 페이지를 가져오면 됩니다. Cursor에 값이 있으면 스크립트가 다음 요청에 그 값을 전달합니다.
반환된 레코드를 목록의 위치를 기준으로 애플리케이션 데이터와 결합하지 마세요. 결과 순서는 제출한 input 순서와 다를 수 있습니다. inputId를 join key로 사용해야 합니다.
API가 Impressum 페이지를 찾는 방식
홈페이지는 탐색의 시작점일 뿐, API가 데이터를 추출할 것으로 예상하는 페이지는 아닙니다. Impressum Scraper는 AI로 전달받은 호스트의 내부 링크를 확인하고 Impressum 또는 이에 해당하는 법적 고지·연락처 페이지를 식별합니다. 링크가 /impressum 경로가 아니라 Rechtliches, Kontakt, Legal 같은 레이블 아래에 있을 수 있기 때문에 이 과정이 중요합니다.
AI가 적절한 내부 링크를 찾지 못하면 scraper는 동일한 호스트의 일반적인 /impressum 및 /imprint 경로를 시도합니다. 원본 페이지에 도달하면 AI가 법인, 주소, 연락처, 등록 정보, VAT 번호, 출처 필드를 추출해 하나의 결과로 만듭니다. 검색 엔진을 이용하거나 외부 디렉터리로 이동하지는 않습니다.
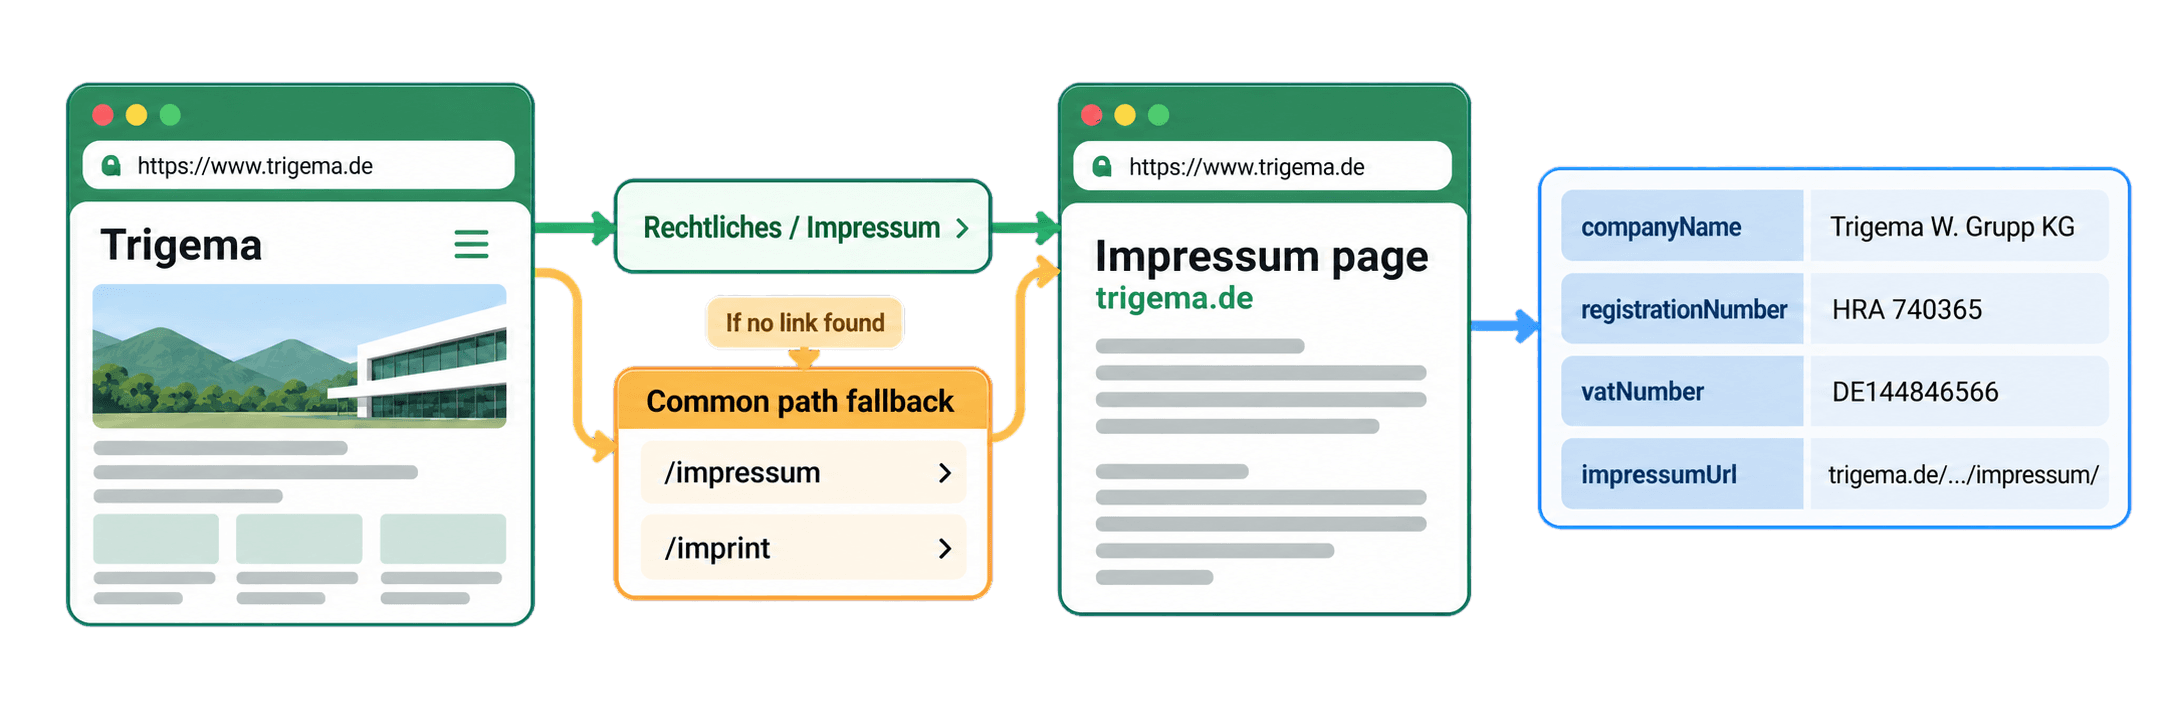
두 결과를 보면 실제로 경로가 어떻게 달라지는지 알 수 있습니다. Trigema에서는 /kundenservice/rechtliches/impressum/이 반환되었고, VAUDE에서는 /de/de/impressum.html이 반환되었습니다. impressumUrl은 추출한 필드의 정확한 원본 페이지를 기록하므로 각 결과와 함께 보관하세요.
Trigema와 VAUDE 결과 확인
다음은 두 예제 결과를 간추린 내용입니다.
📘 이메일 주소 예시: 아래에서는 이메일 일부를
**로 가렸습니다. API는 전체 주소를 반환합니다.
[
  {
    "inputId": "supplier-trigema",
    "status": "success",
    "outputs": {
      "firstName": "Wolfgang",
      "lastName": "Grupp",
      "companyName": "Trigema W. Grupp KG",
      "postalAddress": "Josef-Mayer-Str. 31-35, D-72393 Burladingen",
      "emailAddress": "b**@trigema.de",
      "registrationNumber": "HRA 740365",
      "vatNumber": "DE144846566",
      "impressumUrl": "https://www.trigema.de/kundenservice/rechtliches/impressum/",
      "agentConfidenceScore": 90
    },
    "creditsUsed": "10",
    "error": null
  },
  {
    "inputId": "supplier-vaude",
    "status": "success",
    "outputs": {
      "firstName": "Antje",
      "lastName": "von Dewitz",
      "companyName": "VAUDE Sport GmbH & Co. KG",
      "postalAddress": "Vaude Straße 2, 88069 Tettnang",
      "emailAddress": "s**@service.vaude.com",
      "registrationNumber": "HRA 631071",
      "vatNumber": "DE203894755",
      "impressumUrl": "https://www.vaude.com/de/de/impressum.html",
      "agentConfidenceScore": 95
    },
    "creditsUsed": "10",
    "error": null
  }
]
먼저 이름부터 살펴보겠습니다. Trigema는 Python input에 입력한 공급업체 레이블이고, Trigema W. Grupp KG는 Impressum에서 추출한 법인명입니다. VAUDE에서도 같은 차이를 확인할 수 있습니다. Input 레이블은 VAUDE이고, 반환된 회사명은 VAUDE Sport GmbH & Co. KG입니다. 두 값을 모두 보관하면 팀에서 사용하는 익숙한 이름을 유지하면서 회사 공식 웹사이트에 표시된 법인 정보를 추가할 수 있습니다. 공급업체 레코드를 청구서나 계약서 또는 더 긴 법인명을 사용하는 다른 회사 데이터셋과 대조할 때 특히 유용합니다.
반환되는 각 필드는 서로 다른 리서치 질문에 답합니다.
firstName과lastName에는 페이지에서 확인된 대표이사 또는 창업자의 이름이 들어갑니다. 이 예시에서는 Wolfgang Grupp와 Antje von Dewitz입니다.postalAddress에는 법적 고지 페이지에서 추출한 사업장 주소가, 이메일과 전화번호 필드에는 해당 페이지에 공개된 연락처 정보가 들어갑니다.registrationNumber와vatNumber에는 페이지에 기재된 식별자가 그대로 저장됩니다. Trigema의 값은HRA 740365와DE144846566이고, VAUDE의 값은HRA 631071과DE203894755입니다. 이 값을 공급업체 데이터에 이미 저장된 식별자와 구체적으로 대조할 수 있습니다.impressumUrl은 데이터 추출에 사용된 페이지를 나타냅니다. 제출한 홈페이지는 조사를 시작한 기업을 기록하고, 이 URL은 법인 정보의 출처를 기록하므로 두 필드는 서로 구분됩니다.
두 레코드 모두 status: success이며 각각 10 credits를 사용했습니다. agentConfidenceScore는 검토 우선순위를 정하는 데 도움이 되는 0~100 범위의 신호이며 정확도 백분율은 아닙니다. 페이지에 값이 없거나 추출할 수 없는 경우 output 필드가 비어 있을 수 있습니다. 따라서 item status를 보관하고, 다음 단계에 중요한 정보라면 반환된 Impressum URL을 직접 확인하세요.
문서화된 output에는 성별, 전화번호 및 기타 연락처 정보도 포함될 수 있습니다. 최신 schema는 Impressum Scraper API 문서에서 확인하세요.
Output을 공급업체 리서치 레코드로 변환
직접 API를 호출하는 코드는 이미 완성되었습니다. 이제 이를 공급업체 리서치 업무에 적용해 보겠습니다. 공급업체 발굴이나 온보딩 과정에서는 일반적으로 고유 ID, 팀에서 사용하는 짧은 이름, 홈페이지를 확보하게 됩니다. Impressum 결과에는 해당 웹사이트를 운영하는 법인과 공개된 식별자 및 연락처 정보, 그리고 그 값이 게시된 출처 페이지가 추가됩니다.
다음 snippet은 inputId로 결과를 index한 뒤 로컬 회사 리서치 레코드를 만듭니다. 전체 스크립트의 scrape_impressums() 호출 다음에 추가하세요.
results_by_id = {
result["inputId"]: result for result in impressum_results
}
company_research = []
for supplier in suppliers:
result = results_by_id[supplier["id"]]
company_research.append(
{
"supplier_id": supplier["id"],
"supplier_label": supplier["label"],
"website_url": supplier["website_url"],
"status": result["status"],
"outputs": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
print(json.dumps(company_research, indent=2, ensure_ascii=False))Trigema 레코드에는 supplier-trigema, 표시 레이블 Trigema, https://www.trigema.de가 그대로 보존됩니다. 중첩된 outputs 객체에는 Trigema W. Grupp KG, 주소와 식별자, 반환된 Wolfgang Grupp의 이름, 원본 Impressum URL이 추가됩니다. VAUDE 레코드도 VAUDE 레이블과 홈페이지에서 VAUDE Sport GmbH & Co. KG 및 해당 원본 페이지로 이어지는 같은 구조를 따릅니다. 이제 리서치를 시작할 때 사용한 공급업체 식별 정보를 잃지 않으면서 법인 기준으로 레코드를 비교하거나 그룹화할 수 있습니다.
이 레코드에는 반환된 세부 정보, 성공한 API status, 10-credit 사용량, 공개 error 값이 공급업체 ID, 레이블, 웹사이트와 함께 저장됩니다.
핵심적인 merge 규칙은 공급업체 ID를 이용한 dictionary lookup입니다. API가 Trigema보다 VAUDE를 먼저 반환하더라도 올바른 결과를 연결할 수 있습니다. 또한 이 snippet은 status로 필터링하지 않으므로 실패한 item 결과도 company_research에 보관합니다. no_result 또는 error item 역시 사라지지 않고 해당 ID 및 오류와 함께 검토 대기열에 남습니다.
이 코드는 로컬 리서치 레코드를 준비합니다. API를 다시 호출하지 않고도 목록을 serialize하거나 자체 downstream 코드로 전달할 수 있습니다.
API 비용 계산
Impressum Scraper는 제출한 웹사이트 하나당 10 credits를 고정으로 사용합니다. 예제의 웹사이트 두 개에는 총 20 credits가 사용되었습니다. 같은 요율로 계산하면 웹사이트 1,000개에는 10,000 credits가 필요합니다.
Growth 플랜은 REST API와 구독 credits를 제공합니다. Credits가 더 필요하면 별도의 top-up을 구매할 수 있습니다. 플랜 이용 권한, 포함된 credits, top-up 구매 비용은 각각 별도로 계산되므로 대규모 실행을 계획하기 전에 Datablist 최신 요금제를 확인하세요.
유료 작업을 반복하지 않고 문제 해결하기
요청 전에 스크립트가 중단되는 경우
DATABLIST_API_KEY가 없으면 스크립트에서 Set DATABLIST_API_KEY before running this script. 오류가 발생합니다. 같은 terminal에서 환경 변수를 export한 뒤 파일을 다시 실행하세요.
export DATABLIST_API_KEY="your-personal-api-key"
python scrape_impressum.pyAPI가 요청을 거부하는 경우
response.raise_for_status()는 HTTP 오류가 발생하면 실행을 중단합니다. 유효한 Personal API Key를 입력했는지, 계정에 REST API 이용 권한이 있는지 확인하세요. 이는 환경 변수가 누락된 경우와 다릅니다. 잘못된 값은 API까지 전달된 후 HTTP 응답을 받습니다.
Task가 실패하거나 중단되는 경우
발생한 오류에는 task ID와 status가 포함됩니다. 새 task를 만들기 전에 기존 task와 그 결과 및 credit 필드를 확인하세요. 실패하거나 중단된 task에도 결과와 credit 사용 내역이 남을 수 있으므로 즉시 반복하면 같은 유료 작업을 중복으로 실행할 수 있습니다.
일부 결과가 불완전한 경우
완료된 task에도 item 단위의 no_result, error 또는 불완전한 output이 포함될 수 있습니다. 레코드의 inputId, status, 값이 있다면 impressumUrl, 그리고 공개 error를 보관하세요. Input이 해당 기업의 공식 홈페이지 또는 root domain인지 확인한 다음, 재조회가 유용할지 결정하기 전에 사이트를 직접 살펴보세요.
Task 문서에서 status, 결과 페이지네이션, task 이력, 제한 및 보존 정책을 더 자세히 확인할 수 있습니다.
다음 단계
이제 독일 기업 웹사이트를 제출하고 Impressum Scraper task가 끝날 때까지 기다린 뒤, 모든 결과 페이지를 가져와 구조화된 회사 정보와 원본 URL을 로컬 공급업체 리서치 레코드에 저장하는 실행 가능한 Python Requests integration을 갖추게 되었습니다.
예제의 공급업체 두 곳을 자체 고유 ID와 웹사이트 URL로 교체하세요. 그런 다음 추출된 필드를 downstream process에 사용하기 전에 반환된 각 impressumUrl을 검토하세요. 관리되는 동기식 Requests 예제를 내려받거나, non-blocking concurrency가 필요할 때 repository의 비동기 HTTPX 예제로 전환할 수 있습니다.